Il Nuovo Standard ISO/IEC 27002 e il suo Impatto sulle Organizzazioni

La trasformazione digitale accelerata che le organizzazioni hanno subito negli ultimi anni ha avuto un impatto estremamente significativo sullo scenario di rischio che devono gestire, con una crescita significativa del cyber risk con sempre nuovi vettori di attacco volti sia a compromettere il patrimonio informativo, sia ad avere un vantaggio economico (es. attacchi ransomware).

Questo contesto ha fatto sì che, ai fini della protezione del patrimonio informativo, sia le misure di sicurezza informatica sia quelle di tipo tecnico organizzativo, abbiano assunto un peso significativamente maggiore.

ISO/IEC 27001, è lo standard di riferimento mondiale per la gestione della sicurezza di organizzazioni di tutti i tipi, indipendentemente dalle dimensioni o dal settore, a cui è strettamente legato lo standard ISO/IEC 27002 che è la linea guida su supporta le organizzazioni nell’implementare i controlli raccomandati a mitigazione dei rischi, facendo riferimento ai controlli nell’allegato A della ISO/IEC 27001.

ISO/IEC 27002 è una base di riferimento dettagliata per l’implementazione di questi controlli, ma non ha dei requisiti mandatori per la certificazione del Sistema di Gestione per la Sicurezza delle Informazioni.

Entrambi i principi attuali proposti dalle norme hanno l’ultima data di pubblicazione nel 2013, sebbene abbiano continuato ad essere rivisti periodicamente, mantenendo invariato il principio iniziale.

Tuttavia, la ISO/IEC 27002 è stata a lungo percepita come stagnante e molto spesso ridondante nei suoi controlli e non adattata al nuovo scenario affrontato dalle organizzazioni. Per tale ragione all’interno dei gruppi ISO sono state sviluppate una serie di norme che integravano per specifici settori i controlli previsti all’interno del citato standard (es. ISO/IEC 27017 per il cloud, ISO/IEC 2019 per le energy industries, ecc..)

Al fine di rendere maggiormente aderenti i controlli al mutato panorama internazionale di cybersecurity,  una nuova versione della ISO/IEC 27002 è prevista all’inizio del 2022.

Nel corso degli anni, molte organizzazioni hanno ampliato per anni il proprio framework di controllo od aggiunto altri standard (es. Cobit, ITIL, CSF, NIST  …) per migliorare gli aspetti della sicurezza delle informazioni che l’allegato A della ISO/IEC 27001 e ISO/IEC 27002 non ha affrontato in modo chiaro o diretto. Questo è un elemento importante della ISO/IEC 27001, che ha sempre consentito di ampliare la base dei controlli stabilita dall’allegato A, che è un elenco di base da considerare, ma sempre espandibile alla realtà e al contesto di ciascuna organizzazione (cfr ISO/IEC 27001 – La lista di obiettivi di controllo e di controlli riportati nell’Allegato A non è esaustiva, e ulteriori obiettivi di controllo e controlli potrebbero essere necessari.) .

Pertanto, questa nuova versione della ISO/IEC 27002 è pertinente e benvenuta, porterà naturalmente in un primo momento ad una revisione “minore” della ISO/IEC 27001 con la modifica dei soli controlli dell’allegato A senza modificare le clausole normative e verrà denominata –  “ISO/IEC 27001:2013/DAMD 1 INFORMATION TECHNOLOGY — SECURITY TECHNIQUES — INFORMATION SECURITY MANAGEMENT SYSTEMS — REQUIREMENTS — AMENDMENT 1”. Anche questo aggiornamento è atteso per i primi mesi del 2022.

Poiché ISO/IEC 27002 e ISO/IEC 27001 sono stati gli standard di riferimento per numerose normative e standard a livello internazionale, è naturale aspettarsi che nei prossimi anni verranno avviati diversi aggiornamenti al riguardo.

Un aspetto importante è evidenziato dal nuovo titolo della ISO/IEC 27002 che da “Tecnologie Informatiche – Tecniche di sicurezza – Codice di pratica per la gestione della sicurezza delle informazioni” diventa “Sicurezza delle informazioni, sicurezza informatica e protezione della privacy — Controlli sulla sicurezza delle informazioni” ampliando così a nuovi aspetti (cybersecurity, sicurezza del cloud e data protection …).

Cosa cambia nella nuova ISO/IEC 27002?

La principale differenza della nuova versione della norma e la versione 2013 è la struttura dell’insieme dei controlli. La maggior parte dei controlli ISO 27002 rimangono invariati, in alcuni casi compattati viste alcune ridondanze presenti nella precedente versione. I controlli sono stati raggruppati dai 14 domini precedenti a 4 “Argomenti” principali, a seconda di ciò a cui si riferisce il controllo.

La ISO/IEC  27002 nella nuova versione 2022 riassume l’insieme aggiornato di 93 misure di controllo della sicurezza (rispetto alle 114 previste nella versione precedente).

Non tutte le misure di controllo dettagliate nella nuova ISO/IEC 27002 sono rilevanti per ogni organizzazione, ma quando lo sono (quali misure di mitigazione del rischio), devono essere messe in atto affinché un’organizzazione sia conforme alla ISO/IEC 27001.

Struttura della norma

Invece delle 14 sezioni della versione precedente, ISO 27002 ora ha solo quattro sezioni e due allegati:

  • Controlli organizzativi (clausola 5): questa sezione contiene tutti i controlli relativi a varie questioni organizzative, comprendenti 37 controlli.
  • Controlli sulle persone (clausola 6): questa sezione si concentra sui controlli relativi alla sicurezza delle risorse umane, che comprendono 8 controlli.
  • Controlli fisici (clausola 7): questa sezione si concentra sui controlli relativi all’ambiente fisico, comprendente 14 controlli.
  • Controlli tecnologici (clausola 8): questa sezione si concentra sui controlli relativi alle soluzioni tecnologiche, comprendenti 34 controlli.
  • Allegato A – Utilizzo degli attributi: questo allegato fornisce una matrice di tutti i nuovi controlli, ne confronta gli attributi e fornisce suggerimenti su come i controlli potrebbero essere utilizzati in base ai loro attributi.
  • Allegato B – Corrispondenza con ISO/IEC 27002:2013: questo allegato fornisce una mappatura tra i controlli di questa versione ei controlli della precedente edizione 2013.

Il numero ridotto di sezioni e l’aggiunta di un allegato con indicazioni su come utilizzare i controlli facilitano la comprensione dell’applicabilità dei controlli e della designazione delle responsabilità.

Numero di controlli

Questa nuova versione ha ridotto il numero dei controlli da 114 a 93. I progressi tecnologici e un miglioramento nella comprensione di come applicare le pratiche di sicurezza, sono le ragioni del cambiamento nel numero dei controlli.

I controlli modificati sono elencati ulteriormente in questo white paper.

Elementi di ogni controllo

Ogni controllo nella nuova versione della ISO 27002 ha due nuovi elementi nella sua struttura:

  • Tabella degli attributi: una tabella che presenta l’insieme di attributi associati al controllo (vedere la sezione successiva per la spiegazione).
  • Scopo: motivazione per l’applicazione del controllo, cioè perché un controllo deve essere implementato (ad esempio, per garantire l’integrità, per definire i ruoli, ecc.).
  • Questi elementi aggiunti rendono più facile per coloro che scelgono o analizzano i controlli trovare informazioni per capire meglio come ordinare e giustificare l’uso di un controllo. Ad esempio, dalla tabella degli attributi, un’organizzazione può identificare tutti i controlli di natura preventiva (es. 5.1 Politiche per la sicurezza delle informazioni e 8.25 Ciclo di vita dello sviluppo sicuro) e lavorare con loro in modo integrato. Attraverso Scopo è possibile spiegare meglio agli altri la necessità di attuare un controllo, nonché valutarne l’adeguatezza a trattare rischi specifici.
  • Gli elementi che già esistevano nella vecchia ISO 27002 e restano in questa nuova revisione della norma sono:
    • Titolo del controllo: il nome del controllo.
    • Controllo: una descrizione di ciò che deve essere realizzato per essere conforme al controllo.
    • Guida: suggerimenti su come implementare il controllo.
    • Altre informazioni: informazioni complementari per comprendere il controllo e riferimenti ad altri documenti per la consultazione.

Attributi dei controlli

Dal nostro punto di vista, questa è la modifica che apporta il maggior valore a questa nuova versione dello standard, perché fornisce un modo standardizzato per ordinare e filtrare i controlli in base a criteri diversi.

Gli attributi per ciascun controllo sono i seguenti:

  • Tipi di controllo: Preventivo, Detective e Correttivo.
  • Proprietà di sicurezza delle informazioni: Riservatezza, Integrità e Disponibilità.
  • Concetti di sicurezza informatica: identificare, proteggere, rilevare, rispondere e recuperare.
  • Funzionalità operative: governance, gestione delle risorse, protezione delle informazioni, sicurezza delle risorse umane, sicurezza fisica, sicurezza del sistema e della rete, sicurezza delle applicazioni, configurazione sicura, gestione dell’identità e degli accessi, gestione delle minacce e delle vulnerabilità, continuità, sicurezza delle relazioni con i fornitori, legale e conformità, Gestione degli eventi di sicurezza delle informazioni e garanzia della sicurezza delle informazioni.
  • Ambiti di sicurezza: governance ed ecosistema, protezione, difesa e resilienza.

Questi attributi renderanno più facile capire quali controlli sono applicabili in base a criteri rilevanti per l’azienda (cioè, non relativi solo alla sicurezza delle informazioni), così come l’integrazione dei controlli ISO 27002 ad altri framework di sicurezza simili, come NIST Risk Management Struttura.

Il cambiamento in numeri:

  • 11 controlli completamente nuovi
  • 23 controlli è stato cambiato il nome per una più facile comprensione; tuttavia, la loro essenza è rimasta la stessa del vecchio standard
  • 57 controlli sono stati fusi in 24 nuovi controlli
  • 35 controlli sono rimasti gli stessi, cambiando solo il loro numero di controllo

Le modifiche aiuteranno a mantenere l’attenzione sugli aspetti di sicurezza delle informazioni dei processi e delle attività, riducendo lo sforzo per l’implementazione e il mantenimento del sistema di gestione della sicurezza delle informazioni.

Le fusioni di alcuni controlli sono state prese in considerazione perché i controlli correlati sono passaggi naturali di un processo più ampio o perché è possibile ottenere una sicurezza più efficiente considerandoli in un unico controllo.

C’è solo un controllo che è stato suddiviso, 18.2.3 La revisione della conformità tecnica è stata suddivisa in:

  • 5.36 Conformità a politiche, regole e standard per la sicurezza delle informazioni e
  • 8.8 Gestione delle vulnerabilità tecniche.

Ed ecco i controlli suddivisi nei quattro capitoli:

Controlli organizzativi con 37 misure di controllo

  • Politiche per la sicurezza delle informazioni (5.1)
  • Ruoli e responsabilità della sicurezza delle informazioni (5.2)
  • Segregazione dei compiti (5.3)
  • Responsabilità di gestione (5.4)
  • Contatto con le autorità (5.5)
  • Contatto con gruppi di interesse speciale (5.6)
  • Intelligence sulle minacce (5.7)
  • Sicurezza delle informazioni nella gestione dei progetti (5.8)
  • Inventario di informazioni e altri beni associati (5.9)
  • Uso accettabile delle informazioni e di altre risorse associate (5.10)
  • Restituzione dei beni (5.11)
  • Classificazione delle informazioni (5.12)
  • Etichettatura delle informazioni (5.13)
  • Trasferimento di informazioni (5.14)
  • Controllo accessi (5.15)
  • Gestione delle identità (5.16)
  • Informazioni di autenticazione (5.17)
  • Diritti di accesso (5.18)
  • Sicurezza delle informazioni nei rapporti con i fornitori (5.19)
  • Affrontare la sicurezza delle informazioni negli accordi con i fornitori (5.20)
  • Gestire la sicurezza delle informazioni nella filiera ICT (5.21)
  • Monitoraggio, revisione e gestione del cambiamento dei servizi dei fornitori (5.22)
  • Sicurezza delle informazioni per l’utilizzo dei servizi cloud (5.23)
  • Pianificazione e preparazione della gestione degli incidenti di sicurezza delle informazioni (5.24)
  • Valutazione e decisione sugli eventi di sicurezza delle informazioni (5.25)
  • Risposta agli incidenti di sicurezza delle informazioni (5.26)
  • Imparare dagli incidenti di sicurezza delle informazioni (5.27)
  • Raccolta delle prove (5.28)
  • Sicurezza delle informazioni durante l’interruzione (5.29)
  • Prontezza ICT per la continuità aziendale (5.30)
  • Individuazione dei requisiti legali, statutari, regolamentari e contrattuali (5.31)
  • Diritti di proprietà intellettuale (5.32)
  • Protezione delle registrazioni (5.33)
  • Privacy e protezione delle informazioni di identificazione personale (PII) (5.34)
  • Revisione indipendente della sicurezza delle informazioni (5.35)
  • Conformità alle politiche e agli standard per la sicurezza delle informazioni (5.36)
  • Procedure operative documentate (5.37)

Controlli delle Persone con 8 misure di controllo

  • Selezione del personale – Screening (6.1)
  • Termini e condizioni di lavoro (6.2)
  • Consapevolezza, istruzione e formazione in materia di sicurezza delle informazioni (6.3)
  • Processo disciplinare (6.4)
  • Responsabilità dopo la cessazione o il cambio di rapporto di lavoro (6.5)
  • Riservatezza o accordi di riservatezza (6.6)
  • Lavoro a distanza (6.7)
  • Segnalazione di eventi di sicurezza delle informazioni (6.8)

Controlli Fisici con 14 misure di controllo

  • Perimetro di sicurezza fisica (7.1)
  • Controlli fisici all’ingresso (7.2)
  • Messa in sicurezza di uffici, locali e strutture (7.3)
  • Monitoraggio della sicurezza fisica (7.4)
  • Protezione contro le minacce fisiche e ambientali (7.5)
  • Lavorare in aree sicure (7.6)
  • Scrivania e schermo puliti (7.7) Politica di schermo e scrivania puliti
  • Localizzazione e protezione delle apparecchiature (7.8)
  • Sicurezza degli asset fuori sede (7.9)
  • Supporti di memorizzazione (7.10)
  • Utilità di supporto (7.11)
  • Sicurezza del cablaggio (7.12)
  • Manutenzione attrezzature (7.13)
  • Smaltimento o riutilizzo sicuro delle apparecchiature (7.14)

Controlli tecnologici con 34 misure di controllo

  • Dispositivi utente endpoint (8.1)
  • Diritti di accesso privilegiati (8.2)
  • Limitazione dell’accesso alle informazioni (8.3)
  • Accesso al codice sorgente (8.4)
  • Autenticazione sicura (8.5)
  • Gestione della capacità (8.6)
  • Protezione contro il malware (8.7)
  • Gestione delle vulnerabilità tecniche (8.8)
  • Gestione della configurazione (8.9)
  • Cancellazione delle informazioni (8.10)
  • Mascheramento dei dati (8.11)
  • Prevenzione della fuga di dati (8.12)
  • Backup delle informazioni (8.13)
  • Ridondanza delle strutture di elaborazione delle informazioni (8.14)
  • Registrazione / Logging (8.15)
  • Attività di monitoraggio (8.16)
  • Sincronizzazione orologio (8.17)
  • Utilizzo di programmi di utilità privilegiati (8.18)
  • Installazione di software su sistemi operativi (8.19)
  • Controlli di rete (8.20)
  • Sicurezza dei servizi di rete (8.21)
  • Filtraggio Web (8.22)
  • Segregazione nelle reti (8.23)
  • Uso della crittografia (8.24)
  • Ciclo di vita di sviluppo sicuro (8.25)
  • Requisiti di sicurezza dell’applicazione (8.26)
  • Architettura di sistema sicura e principi ingegneristici (8.27)
  • Sviluppo sicuro (8.28)
  • Test di sicurezza in fase di sviluppo e accettazione (8.29)
  • Sviluppo in outsourcing (8.30)
  • Separazione degli ambienti di sviluppo, test e produzione (8.31)
  • Gestione del cambiamento (8.32)
  • Informazioni sul test (8.33)
  • Protezione dei sistemi informativi durante audit e test (8.34)

In che modo influisce la nuova ISO/IEC 27002 sulle organizzazioni che hanno già la certificazione ISO/IEC 27001?

Attualmente non vi è alcun impatto sulle organizzazioni che già mantengono un Sistema di Gestione per la Sicurezza delle Informazioni certificato fino all’approvazione della nuova ISO/IEC 27002 ed all’aggiornamento dell’allegato A, in una nuova versione della ISO/IEC 27001.

In generale, le organizzazioni avranno un periodo di transizione nel quale sono tenuti ad adottare lo standard ISO/IEC 27001 una volta che lo standard rivisto sarà pubblicato (es. revisione dell’annex A).

Per le organizzazioni che cercano e stanno per certificare il proprio Sistema per la Gestione della Sicurezza delle Informazioni, questo non dovrebbe essere un ostacolo. Le organizzazioni dovrebbero familiarizzare con la nuova serie di controlli e, con l’aiuto della mappatura alla versione 2013 presente all’interno della tabella B2 presente all’interno della nuova 27002, prepararsi ad aggiornare il proprio sistema di gestione.

Altro importante impatto riguarderà quelle organizzazioni che hanno adottato ed ottenuto attestazioni di conformità delle norme definite 270XX in particolare ISO/IEC 27017 e ISO/IEC 27018 che si basano sulla ISO/IEC 27002:2013 ed oltretutto richieste, almeno in Italia, per poter adempiere a specifiche richieste di AgID.

Si precisa che il presente documento è stato predisposto utilizzando prevalentemente le informazioni tratte dalla versione FDIS della ISO/IEC 27002 non essendo, alla data di stesura, ancora disponibile la pubblicazione ufficiale della nuova norma.

Articolo a cura di Attilio Rampazzo e Paolo Sferlazza 


Informazioni sull’Autore

CISA, CRISC, CDPSE
Information Systems Consultant, Trainer & Auditor
European Data Protection Expert
Auditor RGVI QMS ISMS ITSMS BCMS (Registri AICQ SICEV)
Data Protection Officer – Data Protection Auditor (Registri AICQ SICEV)
Referente Registri AICQ SICEV Auditor Sicurezza delle Informazioni & IT Service Management
Referente Registro AICQ SICEV Professionisti ICT (UNI 11506)
Referente Registro AICQ SICEV Professionisti Trattamento e Protezione Dati Personali (UNI 11697)

Informazioni sull’Autore

Advisor, Auditor and Trainer
PCI QSA, CISM, CISA, CRISC, LA27001,
LA 22301, CBCI, MBCI, CDPSE, OPST,
COBIT 5, ITIL, LA20000, LA9001, ISFS,
CMMI, Scrum Master

Condividi sui Social Network:

https://www.ictsecuritymagazine.com/articoli/il-nuovo-standard-iso-iec-27002-e-il-suo-impatto-sulle-organizzazioni/


La CyberSecurity per i droni – Privacy

Introduzione

Quando si parla di droni, qualunque sia lo scopo del loro utilizzo, occorre tenere presente che non si ha a che fare soltanto con le regole tecniche per tutelare l’incolumità fisica, ma anche con quelle a tutela della privacy delle persone fisiche diverse dal pilota e che si trovano nell’area interessata. Infatti, occorre tenere in considerazione che si tratta di strumenti dotati di videocamera e di memoria interna, che possono quindi raccogliere e conservare dati.

CyberSecurity e Privacy: best practice per rispettare la privacy se si usa un drone a fini ricreativi (Garante Privacy)

La grande varietà di dati che possono essere acquisiti utilizzando i droni ha portato il Garante per la Protezione dei Dati Personali a emanare un vademecum sul corretto utilizzo dei droni a fini ricreativi, nel rispetto del GDPR e del Regolamento ENAC. Il trattamento dei dati personali acquisiti mediante l’utilizzo di droni deve essere effettuato secondo specifica base giuridica ai sensi dell’art. 6 del GDPR (es. contratto scritto, legittimo interesse del titolare, ecc.).

Il Garante Privacy ha stilato delle best practice per rispettare la privacy se si utilizza un drone per scopi ricreativi.

Di seguito una lista delle best practice:

  • seguire sempre le regole;
  • fare attenzione alle riprese;
  • rispettare gli altri;
  • non diventare un “orecchio indiscreto”
  • a prova di privacy;
  • come tutelare la tua privacy.

Seguire sempre le regole

Usare i droni per scopi ricreativi è lecito e divertente, ma occorre sempre rispettare la privacy degli altri e informarsi bene sulle regole previste dall’ENAC per far volare i Sistemi Aeromobili a Pilotaggio Remoto (www.enac.gov.it).

Fare attenzione alle riprese

Se si fa volare a fini ricreativi un drone munito di fotocamera in un luogo pubblico (parchi, strade, spiagge) è meglio evitare di invadere gli spazi personali e l’intimità delle persone. La diffusione di riprese realizzate con il drone (sul web, sui social media, in chat) può avvenire solo con il consenso dei soggetti ripresi, fatti salvi particolari usi connessi alla libera manifestazione del pensiero, come quelli a fini giornalistici. Negli altri casi, quando è eccessivamente difficile raccogliere il consenso degli interessati, è possibile diffondere le immagini solo se i soggetti ripresi non sono riconoscibili, o perché ripresi da lontano, o perché si sono utilizzati appositi software per oscurare i loro volti. Occorre poi evitare di riprendere e diffondere immagini che contengono dati personali come targhe di macchine, indirizzi di casa, ecc. Le riprese che violano gli spazi privati altrui (casa, giardino domestico) sono invece sempre da evitare, anche perché si potrebbero violare norme penali.

Rispettare gli altri

La presenza di un drone che effettua riprese nelle vicinanze può dare la sensazione di essere osservati, inducendo disagio e influenzando il normale comportamento delle persone. È quindi buona regola usare questi strumenti senza invadere la sfera personale degli altri, magari anche comunicando preventivamente le proprie intenzioni. Ad esempio, se si vuole far volare un drone per riprendere una festa nel proprio giardino di casa, sarebbe bene prima avvisare i vicini, che hanno il diritto di chiedere di non essere, anche solo inavvertitamente, ripresi nel loro privato. Un’altra buona pratica da seguire è quella di fare in modo che il pilota del drone sia sempre ben visibile, così da non suscitare sospetti o allarme negli altri.

Non diventare un “orecchio indiscreto”

Non si possono usare droni per captare volontariamente conversazioni altrui. Eventuali frammenti di conversazione registrati in modo accidentale possono essere utilizzati (ad esempio, per pubblicare un video online) solo se non rendono riconoscibile il contesto, cioè il contenuto dei discorsi e le persone coinvolte.

A prova di privacy

In base a quanto previsto dal nuovo Regolamento europeo in materia di protezione dei dati personali (Regolamento UE 2016/679), i droni, come tutti i dispositivi elettronici, devono rispettare i principi di privacy by design e privacy by default. Cioè devono essere costruiti e configurati per raccogliere meno dati possibile.

Come tutelare la tua privacy

Se è possibile individuare il pilota del drone, si possono chiedere a lui informazioni su come intende utilizzare le riprese ed eventualmente negare il consenso al trattamento dei dati raccolti, specie se sono previste forme di diffusione delle immagini. E nel caso si ritenesse di essere stati vittime di violazioni della propria privacy, ci si può rivolgere al Garante per la protezione dei dati personali o, in alternativa, all’Autorità giudiziaria.

Conclusioni

Concludendo, in base a quanto previsto dal Regolamento europeo in materia di protezione dei dati personali, i droni, come tutti i dispositivi elettronici, devono rispettare i principi di privacy by design e privacy by default: ovvero tutte quelle misure tecnico-organizzative finalizzate ad assicurare che il trattamento dei dati sia limitato solo a quelli necessari per raggiungere le finalità.

Articolo a cura di Domenico Raguseo, Rosita Galiandro, Giuseppe Marullo e Antonio De Chirico


Informazioni sull’Autore

Domenico Raguseo è Responsabile della Unit di CyberSecurity del gruppo Exprivia|Italtel. Precedentemente ha ricoperto il ruolo di CTO della divisione IBM Security nel Sud Europa. Ha una decennale esperienza manageriale e nel campo della cybersecurity in diverse aree. Domenico collabora con diverse università nell’insegnamento su tematiche relative alla cybersecurity sia come Professore a contratto che invitato come lettore per seminari. Domenico è stato IBM Master inventor grazie a una moltitudine di brevetti e pubblicazioni in diverse discipline (Business Processes, GLI AUTORI © Clusit 2020 249 ROI, Messages and Collaborations, Networking). Infine, è apprezzato speaker, autore e blogger in eventi nazionali ed internazionali. In particolare, da diversi anni collabora con il Clusit come autore

Informazioni sull’Autore

Rosita Galiandro ha conseguito la laurea Magistrale in Sicurezza Informatica presso l’Università di Bari.
Attualmente ricopre il ruolo di Responsabile Osservatorio CyberSecurity presso Exprivia.
Contribuisce alle attività di prevendita, ha partecipato a progetti di risk assessment e GDPR compliance e collabora in piani di insegnamento con diverse università nell’ambito CyberSecurity e nel progetto CyberChallenge.IT. Fa parte della community Women For Security.

Informazioni sull’Autore

Giuseppe Marullo è responsabile dei Servizi di OT security di Exprivia. Precedentemente è stato presales in Blue Coat e Symantec per clienti enterprise in ambito network and cloud security. Ha fatto parte dello WW SWAT team e di X-Force in IBM, come SME di network security e computer forensics.

Informazioni sull’Autore

Responsabile del Security Operation Center di Exprivia. Ha lavorato nella Polizia di stato per oltre 27 anni, di cui 15 operando all’interno della Polizia Postale e delle Comunicazioni nelle attività investigative e di contrasto al Cybercrime ed alla pedopornografia online. Ha operato come CTU per diverse Procure e negli ultimi anni coordinava il team di specialisti del Centro Unico di Backup della Polizia di Stato.

Condividi sui Social Network:

https://www.ictsecuritymagazine.com/articoli/la-cybersecurity-per-i-droni-privacy/


GDPR: conservazione e pseudonimizzazione

L’articolo 32 del Regolamento (UE) 2016/679 del Parlamento Europeo e del Consiglio, più comunemente noto con l’acronimo GDPR, indica misure di sicurezza tecnico e organizzative che titolari e responsabili del trattamento, tenendo conto dello stato dell’arte e dei costi di attuazione, nonché della natura, dell’oggetto, del contesto e delle finalità del trattamento, del rischio per i diritti e le libertà delle persone fisiche, se del caso, mettono in atto per garantire un livello di sicurezza adeguato al rischio cui è esposto il trattamento dei dati personali.

L’indicazione non è prescrittiva e dev’essere valutata, coerentemente con il sopra citato articolo, in considerazione delle specifiche attività di trattamento. Nell’analisi delle richiamate misure tecniche emerge la complessità dovuta dall’adozione di meccanismi di pseudonimizzazione o de-identificazione, i quali non possono essere assoluti e devono considerare lo specifico contesto operativo delle attività di trattamento. L’utilizzo delle suddette misure tecniche, infatti, implica anche l’introduzione di ulteriori complessi meccanismi da attivarsi qualora l’informazione protetta debba successivamente essere ulteriormente trattata.

Risulta necessario ricercare e sviluppare soluzioni tecnologiche che non banalizzino l’applicazione di norme e regolamenti cogenti, finalizzati, come nel caso del GDPR, alla tutela delle persone fisiche con riguardo ai loro dati personali.

Dal punto di vista normativo, a livello ISO, sono in corso attività di normazione tese alla pubblicazione di un “Privacy enhancing data de-identification framework”. La de-identificazione è un mezzo per facilitare l’uso dei dati personali, come definiti dall’articolo 4 del GDPR, in modo che non si possa identificare un individuo, o un gruppo di individui, o compromettere i suoi diritti e libertà con riguardo ai suoi dati personali. L’uso appropriato di tecniche di de-identificazione può sostenere la conformità con i requisiti normativi e i principi di “protezione dei dati”.

La de-identificazione richiede, almeno, una valutazione delle informazioni aggiuntive a disposizione di un individuo, o di un gruppo, che può venire a conoscenza di dati personali in modo inappropriato, e come queste possono essere combinate per rivelare o scoprire dati personali.

Al fine di sapere quali informazioni aggiuntive saranno disponibili a un generico attaccante e conoscere dunque la possibilità di attacchi e motivazioni per la reidentificazione, la de-identificazione richiede sia una valutazione del contesto e delle circostanze in cui i dati personali saranno resi disponibili ai destinatari, sia una valutazione dei dati stessi al fine di determinare come le informazioni aggiuntive disponibili a un generico avversario possono essere utilizzate per rivelare o scoprire i dati personali.

Le norme in corso di definizione hanno lo scopo di fornire indicazioni per governare l’uso appropriato delle tecniche di de-identificazione dei dati descritte nella ISO/IEC 20889[1] che migliora la terminologia di de-identificazione dei dati e la classificazione delle tecniche. Questo quadro di de-identificazione può essere applicato in qualsiasi punto del ciclo di vita dei dati: dalla progettazione dei mezzi di raccolta dei dati, al riutilizzo interno, alla messa a disposizione dei dati a partner esterni oppure, anche, l’archiviazione. I destinatari dei dati possono quindi essere interni o esterni al custode dei dati che sta implementando procedure e pratiche di de-identificazione. In generale si possono identificare tre scenari operativi:

  • l’utilizzo, ed il riuso, di dati personali, implica che il custode mantenga la supervisione sui dati de-identificati mentre li rende disponibili a un dipartimento interno o a un gruppo funzionale;
  • la condivisione esterna implica che il custode mantenga la supervisione sui dati de-identificati mentre li rende disponibili a un destinatario di dati esterno (ad esempio, attraverso un portale web o un’applicazione in cloud);
  • il rilascio esterno implica che il custode trasferisca la supervisione sui dati de-identificati a un destinatario di dati esterno.

In ognuno di questi tre scenari, il processo di de-identificazione stesso può essere trasferito a una terza parte, separata dal custode o dal destinatario.

Nel seguito sono investigate due possibili soluzioni tecnologiche di pseudonimizzazione compatibili con le “Linee Guida sulla formazione, gestione e conservazione dei documenti informatici” emesse da AgID il 9 settembre 2020 ed attuative dal 1° gennaio 2022, data a partire dalla quale è abrogato il previgente DPCM 3 dicembre 2013 di pari argomento.

La trasmissione del documento informatico ai fini della sua conservazione è affiancata dalla generazione dei c.d. metadati di conservazione, che caratterizzano il documento informatico anche da un punto di vista archivistico, andando a descrivere un insieme di proprietà che permettono la corretta tenuta del documento informatico nel tempo.

Del documento informatico, oltre a informazioni, come ad esempio la sua impronta digitale, o hash, che consente di verificare nel tempo l’integrità del documento stesso, i citati metadati si arricchiscono, in questa nuova definizione, di ulteriori dati come le informazioni relative agli stakeholder del documento quali l’autore, il mittente, il destinatario, l’assegnatario, l’operatore o altri ancora, definiti dal nodo Soggetti.
Questi ruoli possono contenere dati personali, come definiti all’art. 4 del GDPR, che, per loro natura, non possono essere sottoposti a mascheramento senza vanificare il loro inserimento fra i metadati stessi. Queste informazioni sono esemplificazione di criticità a cui le organizzazioni, impegnate nella conservazione dei documenti informatici, devono far fronte con soluzioni tecnologiche sempre più evolute.
La creazione del Pacchetto di Versamento, la sua successiva trasformazione in pacchetto di Archiviazione e, infine, Pacchetto di Distribuzione, deve quindi considerare sia il rispetto dei vincoli normativi sia l’esigenza di garantire l’esecuzione dei diritti riconosciuti agli interessati, previsti negli artt.li dal 15 al 21 del GDPR, come il Diritto di accesso dell’Interessato (Art.15) o il Diritto alla cancellazione (Art. 17).
All’interno di ogni fase del processo di conservazione, tutti i dati personali, in transito o a riposo, devono essere opportunamente protetti giungendo anche al mascherato e alla loro de-identificazione al fine di garantirne la riservatezza, in un processo end-to-end.

Tale processo deve, dunque, mantenere la caratteristica di piena reversibilità, affinchè sia sempre possibile risalire al dato originale, ma rispettare i vincoli definiti dallo schema illustrato nell’Allegato 5 “I Metadati”. Dal momento che i campi destinati a ricevere dati personali sono definiti come di tipo string (alfanumerico), il loro valore è potenzialmente di indefinita lunghezza almeno fino a quando non dev’essere memorizzato all’interno di basi dati o supporti tecnologici vincolati da restrizioni dimensionali.

Due sono le tecnologie di pseudonimizzazione applicabili a questo contesto:

  • il Format-Preserving Encryption, e
  • l’adozione di algoritmi crittografici a chiave asimmetrica.

Il Format-Preserving Encryption (FPE), è un algoritmo basato sull’implementazione dell’algoritmo AES a chiave simmetrica e di una funzione di permutazione pseudo-casuale atta a mantenere inalterato il formato del dato.

Nella sua applicazione è prevista la definizione preliminare di un dizionario descrittivo del dominio dei caratteri del testo da cifrare, il cui output è l’applicazione della funzione di permutazione pseudo-casuale che, attingendo dallo stesso dizionario, produce un testo cifrato della medesima lunghezza.
Questo accorgimento permette di integrarsi all’interno di servizi preesistenti o laddove il dato sia sottoposto a validazioni che limitano l’utilizzo dei caratteri a sottoinsiemi predefiniti come il formato delle carte di credito, i numeri telefonici, generalità, importi etc. La principale vulnerabilità di tale algoritmo risiede nella lunghezza del dato da trattare: più questo è di lunghezza minima, più risulta facile individuare la chiave di cifratura.

L’adozione di algoritmi crittografici a chiave asimmetrica, come ad esempio RSA o ECC, già ampiamente implementati nei comuni linguaggi di programmazione, che tuttavia generano un output di dimensioni più elevate rispetto all’input fornito. Questa tecnica è quindi da utilizzarsi in contesti in cui il dato cifrato non sia soggetto a validazioni restrittive o laddove l’informazione non sia memorizzata all’interno di campi limitati eccessivamente in lunghezza.

In entrambe le soluzioni non dev’essere trascurato l’effort computazionale di decifratura a run-time laddove il dato debba essere ricercato all’interno di una base dati: processo che può complicarsi laddove si vogliano applicare filtri di ricerca più complessi come il “contiene”, “inizia/finisce con…” eccetera.

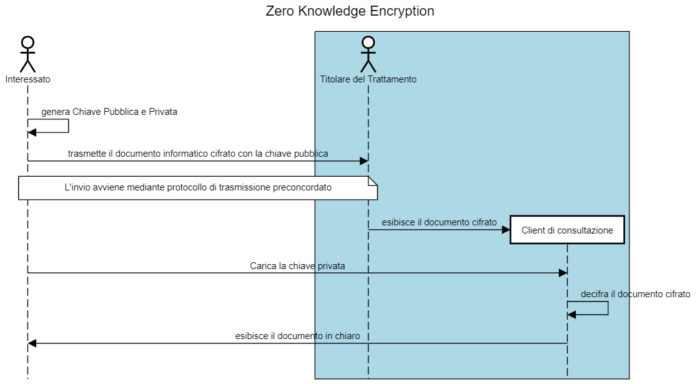
Quando l’aggiunta di un ulteriore strato di sicurezza non costituisca ostacolo implementativo, può essere adoperata una tecnica ancora più robusta e votata al totale controllo sui dati da parte dell’Interessato, nota come zero-knowledge encryption. In base a questa tipologia di soluzione, adoperata già da alcuni provider di posta elettronica, l’Interessato è l’unico detentore della chiave privata per decifrare il dato, mentre la cifratura dei dati avviene prima che l’informazione sia trasmessa al Titolare (o Responsabile) del trattamento.
Una volta che l’informazione è stata mascherata, solo l’Interessato può applicare l’operazione di decifratura, a patto che la chiave privata sia custodita correttamente e mai persa.

Va da sé che il punto di forza dell’approccio zero-knowledge è anche quello di sua massima debolezza: laddove l’Interessato perdesse la chiave privata o la passphrase per recuperarla, nessuno sarebbe potrebbe risalire ai dati cifrati, paradossalmente rischiando di andare a violare il principio di integrità e disponibilità dei dati personali, normato dallo stesso GDPR e da altre norme come, ad esempio, la ISO/IEC 27001.

La scelta di una delle soluzioni precedentemente descritte comporta inevitabilmente da parte degli attori coinvolti l’utilizzo di accorgimenti tecnologici per la gestione e la generazione delle chiavi di cifratura/decifratura.
L’utilizzo della tecnica di mascheramento FPE ha come principale vulnerabilità la presenza di una singola chiave per la cifratura e decifratura dei dati, poiché si basa sulla condivisione di un “segreto”; il suo trattamento deve tenere conto quindi della possibilità da parte di chiunque in possesso di tale quantità di sicurezza di applicare la funzione di decifratura per risalire al dato in originale.

La tecnica a chiave asimmetrica, invece, introduce per progettazione, l’utilizzo di due chiavi, una pubblica ed una privata, responsabili rispettivamente della cifratura e decifratura dei dati: un procedimento computazionalmente più sicuro e che sacrifica l’aspetto funzionale nell’integrazione in processi legacy.

Un approccio zero-knowledge encryption (ZKE), certamente più articolato nella sua strutturazione ed implementazione, pone l’interessato al centro di un più ampio processo di sicurezza, tanto da diventarne elemento imprescindibile. La sua implementazione permette di raggiungere traguardi di sicurezza per nulla banali e scontati, andando oltre la ormai, quasi, scontata cifratura del dato a riposo e riducendo notevolmente anche le conseguenze derivanti da un indesiderato cyberattack al repository dei dati. In questa tipologia di eventi, infatti, l’attaccante spesso guadagnato accesso a tutta la struttura informatica del suo bersaglio, vanificando dunque, ogni meccanismo di protezione. Con un processo ZKE ben congeniato, l’attaccante non avrebbe alcun vantaggio nel minacciare la diffusione di dati che nessuno al di fuori dell’interessato, soggetto diverso dal custode dei dati, è in grado di decifrare, oppure la cifratura di un dato già cifrato, poiché anche la chiave di decifrazione non sta nelle disponibilità del gestore del repository dei dati.

Note

[1] ISO/IEC 20889:2018 – Privacy enhancing data de-identification terminology and classification of techniques

Articolo a cura di Davide Leonardi e Luciano Quartarone

Luciano Quartarone, in oltre 20 anni nel mondo dell’ICT, ha sviluppato significative esperienze in diversi settori del mondo ICT, concentrandosi su PKI, firme elettroniche e sistemi di conservazione. Ha curato diversi importanti progetti di system integration, specializzandosi sui temi della sicurezza delle informazioni, dell’analisi del rischio e della conformità a norme nazionali e internazionali. È auditor ISO/IEC 27001, di cui è anche trainer certificato presso il PECB e Senior Lead Implementer presso lo stesso ente. Membro del consiglio direttivo UNINFO, partecipa alla Commissione UNINFO UNI/CT 510 – Sicurezza e Commissione UNINFO UNI/CT 522 – eBusiness e Servizi Finanziari. Ha collaborato alla redazione di diverse norme nazionali in ambito sicurezza delle informazioni, long-term data preservation, distruzione dei supporti dati, definizione di profili professionali in ambito sicurezza delle informazioni e protezione dei dati personali. Da dicembre 2018 è CISO e Data Protection Director per il gruppo Archiva

https://www.ictsecuritymagazine.com/articoli/gdpr-conservazione-e-pseudonimizzazione/


Innovazione Tecnologica e Cybersecurity nel Sistema Finanziario

Dott. BORIS GIANNETTO – BANCA D’ITALIA

Atti di conferenza – Speech @ Cyber Security Virtual Conference 2021

Il video completo dell’intervento disponibile a fondo pagina.

Bentrovati.

Sono Boris Giannetto, mi occupo di cybersecurity, threat intelligence e cyber resilience nel Servizio Supervisione Mercati e Sistemi di Pagamento della Banca d’Italia.

Ringrazio molto gli organizzatori per la cordiale ospitalità e saluto calorosamente, ancorché a distanza, tutti i partecipanti.

Nel mio intervento tratterò il tema dell’innovazione tecnologica nel sistema finanziario, con particolare attenzione agli aspetti di cybersecurity.

Nuovi modelli di sicurezza (e di resilienza) per nuovi ecosistemi finanziari e tecnologici

Un riferimento preliminare all’emergenza pandemica. La pandemia, fenomeno ampiamente prevedibile e previsto in diversi rapporti antecedenti alla crisi, ha indubbi impatti su tutti gli elementi della nostra trattazione.

Tuttavia, cercheremo qui di seguire un approccio ristretto alla materia, concentrandoci su aspetti peculiari, intrinseci e di lungo periodo riguardanti l’innovazione e la sicurezza nel comparto finanziario.

Un unico cenno all’impulso dato dalla pandemia alla già crescente digitalizzazione, che sarà verosimilmente resa ancora più energica dalla implementazione di piani nazionali e transregionali, volti a promuovere la ripresa economica e la resilienza.

Il fil rouge del mio intervento lega l’innovazione tecnologica al sistema finanziario su due piani, distinti per ordine logico e teorico, ma interrelati nella pratica: sicurezza cibernetica e sicurezza tout court. Questi due piani si compenetrano e si condizionano vicendevolmente.

Lo sviluppo incessante di nuove tecnologie, è sempre più accompagnato dalla crescita di nuovi prodotti e servizi finanziari. Le nuove tecnologie sono via via più collegate al mondo della finanza.

Il ricorso a nuove tecnologie applicate ai servizi finanziari crea un ecosistema nuovo, fluido e in costante mutamento, che vede spesso la disintermediazione delle entità finanziarie classiche. La digitalizzazione amplifica l’accesso ai servizi finanziari e bancari da remoto. Tutti questi aspetti hanno una indubbia rilevanza nel rapporto tra tecnologie, finanza e sicurezza.

La sicurezza non è più un aspetto ancillare; essa diviene un asset intrinseco alle infrastrutture e ai servizi, una sorta di commodity. Occorre sviluppare nuovi modelli di sicurezza (e di resilienza) per tenere il passo a nuovi ecosistemi finanziari e tecnologici.

Aspetti definitori. Esempi di applicazione di nuove tecnologie a infrastrutture, prodotti e servizi finanziari

Per comprendere le interconnessioni tra fenomeno tecnologico, sicurezza e sistema finanziario, dobbiamo innanzitutto partire da alcuni aspetti concettuali e definitori.

Con riguardo al tema dell’innovazione tecnologica, spesso vi è una commistione semantica tra le tecnologie in senso stretto da una parte – intese come strumenti o mezzi di connessione e computazione – e dall’altra le tecniche, le discipline e i metodi che poggiano su questi strumenti. Qui intendiamo entrambi gli aspetti. Fenomeni anticipati decenni fa, come quello della convergenza tecnologica, si sono nel frattempo pienamente sviluppati.

Quanto al cyber, spazio globale interconnesso di tecnologie, Internet e reti, calcolatori e dispositivi etc., è ormai dominio trasversale, crocevia di molteplici azioni e interessi. Entreremo tra poco nel merito della materia.

La sicurezza indica etimologicamente una condizione ideale di assenza di preoccupazioni e pericoli; va però concretamente vista come condizione ottimale di prevenzione e reazione.

Il sistema finanziario è tecnicamente da intendersi come un sistema complesso, ovvero caratterizzato da una grande quantità e varietà di interdipendenze non lineari tra i singoli elementi che lo compongono; piccoli eventi e minime perturbazioni possono provocare grandi impatti e ricadute di tipo sistemico, con problemi ad esempio di accesso alla liquidità o di esecuzione di pagamenti. La trasmissione di tali eventi tra i nodi della rete è peraltro caotica, nell’accezione scientifica del termine.

Il sistema finanziario è costituito da un insieme articolato e interconnesso di attori e di elementi. Vi sono datori di fondi e prenditori di fondi (es. famiglie e imprese); intermediari finanziari (es. banche, assicurazioni,

società di gestione del risparmio, società di intermediazione mobiliare etc.); mercati (monetario, finanziario, dei cambi); infrastrutture, piattaforme e sistemi di pagamento; strumenti e prodotti scambiati sui mercati; Autorità di vigilanza, supervisione e sorveglianza (es. Banca d’Italia, CONSOB, IVASS, AGCM).

Parlando di innovazione tecnologica in campo finanziario occorre certamente partire dalla Fintech. In sintesi, nuove tecnologie applicate alla finanza. In un senso più generale, ci si riferisce a prodotti e servizi finanziari che prevedono l’impiego di avanzate tecnologie dell’informazione e della comunicazione.

Breve parentesi. La Banca d’Italia è molto attiva nel campo dell’innovazione finanziaria e in materia di Fintech: c’è il Milano Hub sull’innovazione, un Canale Fintech, una Divisione Fintech. Su questi temi l’istituto opera anche in seno al Comitato sulla Stabilità Finanziaria, al Comitato di Basilea, alla Banca Centrale Europea (BCE), all’Autorità Bancaria Europea (EBA) e all’Autorità Europea degli Strumenti Finanziari e dei Mercati (ESMA).

Le aree maggiormente interessate dal fenomeno Fintech sono: i pagamenti, la gestione degli assets, la gestione del risparmio e del credito, il trading, l’insurtech (in campo assicurativo), il regtech (per la parte regulatory), il suptech (per la parte supervision), il crowdfunding.

Le principali tecnologie impiegate in campo Fintech, vanno dall’artificial intelligence (AI) alla big data analysis, dalla robotic process automation (RPA) al distributed ledger technology (DLT) e alla blockchain (la dottrina distingue la seconda come sotto-insieme del primo), dal machine learning (ML) alla realtà aumentata (AR), dalle reti neurali (NN) fino agli algoritmi HFT (high frequency trading).

Molte Istituzioni finanziarie hanno da tempo avviato iniziative e progetti concreti in campo Fintech (oltre a Banca d’Italia, ad esempio anche la CONSOB). Il mercato europeo su questo fronte è ora in una fase di recupero rispetto a Stati Uniti d’America e Asia (in queste aree, la forte espansione è data anche dal maggiore utilizzo di app e dispositivi mobili per i pagamenti, in luogo di contante e carte). L’interesse verso questo comparto è stato manifestato anche da parte delle cosiddette Big Techs (con iniziative concrete, progetti di lending, piattaforme di pagamento, carte etc.).

Sul fronte banche, assicurazioni, organizzazioni finanziarie in genere, si assiste a fenomeni di partnership sul fronte Fintech, con avvio di collaborazioni ex novo o in itinere con società specializzate. Si pensi ad esempio alle partnership tra grandi gruppi attivi nel comparto dei pagamenti digitali, con gestori di piattaforme di criptovaluta. L’elemento che emerge è che le entità finanziarie classiche – anche a fronte di incertezza circa la effettiva solidità e gli sviluppi futuri del comparto – investono e diversificano rispetto alle attività ordinarie.

Diverse proiezioni prevedono per i prossimi anni ingenti investimenti in tecnologie blockchain in America, Europa e Asia, sia nel pubblico sia nel privato.

Ma le tecnologie avanzate non vengono applicate soltanto a prodotti e servizi. Esse interessano anche le infrastrutture sulle quali poggiano i prodotti e i servizi finanziari.

A questo riguardo, tecnologie offerte da terze parti per la gestione di piattaforme sono ampiamente impiegate in campo finanziario. Se da un lato alcune di queste tecnologie vengono specificatamente sviluppate per alcuni servizi e strumenti finanziari, dall’altro alcune di esse hanno una gestazione autonoma; soltanto in seguito vengono applicate alla finanza. Si va da ambienti cloud a piattaforme di threat intelligence.

Alcune tecnologie sono poi ancora in fase di sviluppo o consolidamento, e potranno – verosimilmente in un prossimo futuro – arrecare benefici (o anche minacce) al comparto finanziario, sia direttamente sia indirettamente.

Pensiamo ai supercomputer, ai computer quantistici e alle quantum networks, alle connessioni spaziali laser o ad altre tecnologie collegate allo sfruttamento delle risorse dello spazio extra-atmosferico.

Vi sono poi frontiere nuove o ancora non completamente esplorate. Pensiamo al cognitive computing, ad alcuni sistemi cyber-fisici, alle neuro-tecnologie, che per loro natura si potrebbero prestare a un impiego in campo finanziario, soprattutto in ragione della velocità e duttilità di utilizzo. Le interfacce e gli impianti di ingegneria neurale, ad esempio, attraverso i comandi e le interazioni simbiotiche uomo-macchina potrebbero avere un ruolo sia nella parte di analisi, sia nel trading.

Qui, come vedremo, possono sorgere diverse questioni, di varia natura. Questo ci porta ad introdurre il tema della sicurezza.

Sicurezza cibernetica: considerazioni sui trend

L’evoluzione degli ecosistemi tecnologici e finanziari implica la necessità di sviluppare nuovi modelli di cybersecurity e di cyber resilience. Il contesto nel quale operiamo è peraltro sempre più complesso: vi è concomitanza e interconnessione di minacce. Aumentano le minacce cosiddette ibride.

La componente cyber è sempre più interrelata a elementi di finanza, economia, tecnologia, geopolitica, intelligence. Per far fronte a tutto questo occorre mettere in campo analisi sistemiche di scenario (SSA).

Le operazioni cibernetiche “below the threshold” (sotto soglia), non sempre sono agevolmente rilevabili. Spesso non sono affatto rilevate (o vengono scoperte soltanto molto tempo dopo). Vi è un problema di detection. Si corre ai ripari spesso tardi e gli impatti sono a volte seri. Problema della remediation.

Tali operazioni comunque, anche se rilevate, non sono quasi mai attribuibili oltre il mero livello di plausibilità. Problema dell’attribution. Il reperimento di smoking guns (prove certe) non è sempre agevole nel dominio cyber, se non con attività di SIGINT e HUMINT, prerogative delle agenzie di intelligence. L’offuscamento e l’anonimizzazione delle azioni cyber è invece piuttosto semplice e diffuso. Le false flags sono all’ordine del giorno. Tutto questo rende profittevole fare ricorso allo strumento cyber per azioni malevole.

Un nodo da sciogliere è quello dell’impiego di persone con competenze multidisciplinari in campo cyber, dotate di esperienza sul campo e soprattutto di doti quali intuito, capacità di analisi e investigativa.

Mantenendo la narrazione su due piani, parliamo qui di implicazioni di sicurezza cibernetica.

In tema di cybersecurity, nelle sue varie declinazioni, l’obiettivo di alto livello rimane la difesa del perimetro costituito da patrimonio, compiti e reputazione.

Tale difesa ruota attorno a due pilastri, prevenzione e reazione. Due tra gli strumenti principali che ci vengono in aiuto in questo frangente sono sicuramente la threat intelligence e la cyber resilience.

Senza poter entrare qui nel merito di queste discipline, pare utile sottolineare che i lodevoli tentativi di ordinare questa materia con standardizzazioni e framework, vanno costantemente accompagnati da previsioni ed interventi ad hoc, mirati per ciascuna organizzazione.

Un altro elemento da tenere presente, in un contesto complesso e in continua evoluzione, è l’adozione di un approccio “zero trust” in materia di cybersecurity, partendo dal presupposto che vulnerabilità e intrusioni all’interno del perimetro da difendere possono sempre essere presenti. Tale impostazione è stata promossa anche di recente dalla NSA (national security agency) statunitense.

Vediamo ora nel dettaglio alcune implicazioni di cybersecurity derivanti dall’introduzione di specifiche tecnologie nel comparto finanziario.

Sfide di cybersecurity derivanti da Distributed Ledger Technologies (DLTs)

Innanzitutto le sfide di cybersecurity derivanti da Distributed Ledger Technology (DLT).

Breve inciso. In soldoni e semplificando, con “DLT” ci riferiamo a un protocollo che consente il funzionamento di un database digitale decentralizzato, basato su transazioni crittografate.

In materia di DLT rilevano sia temi di cybersecurity generale, sia aspetti peculiari.

Tra i temi di cybersecurity ordinaria da tenere presenti vi è sicuramente l’identification and access management (IAM): quello della identificazione e della gestione degli accessi è un punto fondamentale; occorre prevedere ed implementare sistemi di autenticazione forte, a più fattori e possibilmente ibridi, con impiego di diversi metodi e tecnologie.

Questo tema si lega a quello della crittografia; si pensi alla obsolescenza delle funzioni crittografiche di hash; allo sviluppo di nuova capacità di computazione in grado di scardinare gli attuali schemi di fattorizzazione (si parlerà più avanti di supercomputer e quantum computers).

Sempre sul fronte cybersecurity classica, rilevano gli aspetti di sicurezza legati alla privacy, con riguardo al mantenimento della riservatezza, alla possibilità di risalire agli IP sorgente etc; ma sono anche da rilevare i problemi derivanti da una eccessiva anonimizzazione, per via di possibili traffici illeciti, riciclaggio etc. (anche questo punto, lo vedremo tra poco).

Altro tema classico è quello del data integrity: ancorché in tali ambienti questa componente è maggiormente tutelata rispetto ad altri. Conviene a tal proposito sempre considerare unitamente, anche in questo caso, i tre parametri CIA, confidentiality, integrity, availability.

Sul fronte business continuity classica, la struttura decentralizzata del DLT – si pensi ad esempio a blockchain pubbliche – consente una solida e intrinseca ridondanza, con migliaia di nodi di rete disponibili. Per le blockchain private, è utile fare ricorso a una segmentazione geografica e a una ridondanza su ambienti sicuri separati (tipo VPN).

Questo ci porta ad altri aspetti di sicurezza specifici per DLT: si pensi ai “consensus attacks” (“consensus”, insieme di regole di convalida che forniscono a partecipanti indipendenti la capacità di verificare la validità e l’integrità delle registrazioni delle transazioni su un libro mastro). Alcuni esempi ne sono il “consensus hijacking” tramite ad esempio il “51% attack” con controllo della maggioranza dei validatori su reti permissionless pubbliche o il regulator’s exploitation attack su reti permissioned private. Gli attacchi contro gli algoritmi che governano il consensus possono comunque agire su diversi entry points come reti, nodi, utenti e codice.

I meccanismi di manipolazione del consensus possono portare a trasferimenti non autorizzati di risorse digitali, censura non autorizzata delle transazioni, doppia spesa o interruzione operativa della convalida della transazione etc.

Altri aspetti specifici per DLT. Vi può essere DDoS tramite spam transactions – transazioni fittizie che inondano e saturano la rete.

Può essere compromessa la sicurezza del codice degli smart contracts, con attacchi al chaincode (come presidio, in ambito smart contracts sono ormai da tempo sviluppati tools per l’analisi e lo scanning del protocollo connesso al contratto).

Un altro elemento da tenere in considerazione, è l’interoperabilità dei protocolli di diverse DLT; DLT scarsamente interoperabili o totalmente non interoperabili arrecano diversi problemi di usabilty ma anche di security.

Altro tema è quello dei cryptojacking malwares, finalizzati all’estrazione di criptomoneta da parte di miners. Qui il problema sta nel rilevare l’abuso di risorse computazionali sui devices.

Altro fenomeno rilevante è il furto di criptomoneta dai wallets (vi sono diversi malwares con impiego di codice malevolo che utilizzano zero-day exploits; in ascesa i python-based trojans). Per contro, vanno sempre più prendendo piede efficaci algoritmi di machine learning che aiutano nella fase di detection per entrambi i tipi di attacco, anche a fronte di sofisticate tecniche di evasione e offuscamento.

Un ultimo aspetto al quale si è fatto cenno, è quello della tracciabilità. Ancorché le attività illecite (di diversa natura) siano di per sé tracciabili, esse non sempre sono intercettabili sul nascere. Le singole investigazioni o operazioni più ampie di AML (Anti-Money Laundering) risultano essere time critical.

In considerazione di questi aspetti, in materia di DLT, temi che rimangono aperti e che vanno potenziati, sono:

  • il rafforzamento di misure riguardanti l’identificazione, l’autenticazione e l’accesso;
  • il miglioramento nella conservazione delle informazioni e dell’integrità dei dati;
  • lo sviluppo di standards per rimuovere i dati dai ledgers;
  • lo sviluppo di tecnologia per rendere più tempestivo il monitoraggio delle attività illegali;
  • interoperabilità tra diversi protocolli di ledger;
  • crittografia (anche post-quantistica);
  • rafforzamento dei vincoli di privacy negli smart contracts;
  • parametri legali e di governance per i ledgers;
  • irrobustimento dei meccanismi per l’integrità del consensus;
  • gestione dei wallets con chiavi multiple;
  • sicurezza della rete e degli endpoints.

ENISA, qualche anno fa ha trattato in uno studio molte di queste questioni, che rimangono ancora attuali, anche se in parte sono state affrontate.

Sfide di cybersecurity derivanti dal cloud e da piattaforme di terze parti

Cloud. Qui, considerando le molteplici e variegate declinazioni possibili per gli ambienti cloud (pubblico, privato, ibrido con edge computing etc.), vi sono sfumature differenti in merito alla sicurezza, ma alcune questioni sono valide in generale.

Questioni specifiche. La sicurezza ruota spesso attorno ai poli provider e cliente. Un possibile problema nella esternalizzazione di servizi in cloud, specie in campo finanziario è la possibilità di controllo effettivo ed esclusivo – sottolineo controllo effettivo ed esclusivo – su tutti i processi e i dati in cloud (con preservazione di tutti i parametri CIA – confidentiality, integrity, availability). Un altro aspetto specifico è quello delle possibili errate configurazioni nell’ambiente cloud, che possono portare a vulnerabilità e a incidenti di sicurezza. Altro problema, arrivato alla ribalta per episodi di cronaca, la sicurezza fisica degli ambienti cloud e le possibili ripercussioni. Una questione di tipo gestionale, è la difficoltà di uscire da fenomeni di lock-in specie per servizi infungibili. Ultimo elemento, i dati strategici, sensibili o segreti: qui vi è ampio dibattito sull’approntamento di cloud interamente nazionali (strada non sempre semplice a livello tecnico, si veda l’esperimento di alcuni Stati).

Molti analisti propongono comunque diverse soluzioni per la risoluzione della maggior parte delle questioni indicate e ritengono il cloud una risorsa valida anche sotto il profilo della sicurezza.

Per la parte piattaforme di terze parti, ad esempio su threat intelligence e TIP, oltre ai classici aspetti di cybersecurity, occorre ben ponderare le possibili interferenze di tipo geopolitico sui feeds di terze parti e il possibile data poisoning sui dati grezzi e sulle informazioni fornite.

Sfide di cybersecurity derivanti da artificial intelligence (AI)

Tra le sfide derivanti dall’AI, il tema del rapporto uomo-macchina è centrale, così come lo sono le questioni etiche e quelle relative alla privacy. Le misure proposte recentemente dalla commissione europea sembrano confermare questa centralità. Al riguardo, è opportuno che l’impiego di sistemi di intelligenza artificiale e annessi tenga conto di vincoli e paletti sul fronte libertà e diritti individuali, evitando scenari distopici di orwelliana sorveglianza di massa, con eventuale acquisizione preventiva e inconsapevole di dati biometrici e riconoscimento facciale; riconoscimento facciale considerato possibile anche in Europa, ma con diversi limiti. Su tali limiti, si vedano le recenti proposte della commissione europea (comunicazione, piano e regolamento), che rilevano una serie di rischi per la sicurezza e per i diritti fondamentali degli individui (e a contrario, si veda la lista di casi nei quali è considerata possibile l’identificazione biometrica da remoto).

A questi rischi di sicurezza – che attengono alla sicurezza degli individui che utilizzano o interagiscono con sistemi di intelligenza artificiale – se ne aggiungono altri.

Alcuni aspetti umani, quali coscienza, ingegno, intuito, inventiva, capacità investigativa, stima emozionale del contesto, valutazione etica nella fase decisionale o di analisi et cetera. Sono caratteristiche difficilmente replicabili. E se in parte replicabili, possono rivelarsi critiche. Il dibattito, anche scientifico, sui limiti dell’artificial intelligence è aperto (invero lo è già dai tempi del test di Turing).

In campo finanziario l’utilizzo degli algoritmi di intelligenza artificiale può riguardare ad esempio ispezioni, analisi di big data (si pensi alla profilazione), trading (si pensi all’algo-trading), transazioni finanziarie (si pensi ai robo-advisors), pagamenti in genere, controlli su piattaforme finanziarie, questionari al personale, test sui sistemi, shock test e test sugli algoritmi eccetera.

Anche in tema di AI, sul fronte sicurezza cibernetica valgono sia i classici presìdi invalsi a livello internazionale, sia valutazioni specifiche; occorre in primo luogo considerare e vagliare le possibili criticità derivanti dalla porzione di autonomia della macchina; in sintesi occorre ponderare i meccanismi endogeni di auto-controllo ed esogeni di controllo; potenziali problemi: possibilità di alterare gli algoritmi alla base della sua intelligenza (soprattutto nella fase decisionale); effetti di imponderabilità delle decisioni prese (scarso controllo e previsione sulla fase decisionale); problemi di privacy e di utilizzo per i dati personali e sensibili acquisiti dalla macchina; rischi per interazione uomo-macchina (riconoscimento facciale, manipolazione del comportamento umano, restrizione del libero arbitrio et alia).

Sfide di cybersecurity derivanti da machine learning (ML) e reti neurali (NN)

Machine learning e reti neurali. Su questo fronte, le implicazioni di sicurezza sono già all’ordine del giorno. Attacchi contro gli algoritmi di auto- apprendimento (ad esempio di un SIEM – security information and event management – di un sistema XDR – extended detection & response – o di una TIP – threat intelligence platform) sono non soltanto possibili, ma anche estremamente pericolosi; si pensi al data poisoning su machine learning con manipolazione degli algoritmi di apprendimento e manipolazione di informazioni

– tecnica peraltro già impiegata; gli effetti che questa può avere in campo finanziario sono potenzialmente devastanti (con conseguenze finanche maggiori rispetto alla esfiltrazione di dati e informazioni).

In materia di reti neurali, ammesso che si possa arrivare a modelli che mimino lontanamente la complessità delle reti neurali biologiche, si assiste anche qui a possibili problemi di sicurezza derivanti in sostanza da manipolazione di informazioni, nel caso di specie adversarial examples, che mirano a confondere

i pattern della rete neurale. Si pensi ai possibili danni derivanti dall’uso di questi attacchi contro neural networks impiegate in modelli stocastici per le previsioni finanziarie. Anche l’hackeraggio mirato della rete neurale e l’inserimento in essa di backdoor sono pratiche possibili.

Sfide di cybersecurity derivanti da supercomputer (SC), quantum computers (QC), quantum techs (QT), tecnologie spaziali e altre tecnologie

Parliamo in questa sezione di deep techs. Tecnologie chiave per il presente e per il futuro. Dal punto di vista strategico ci riferiamo a disruptive technologies.

I super computer sono impiegati ormai da tempo da governi, istituti di ricerca e grosse aziende. Il loro impiego è questione corrente. I quantum computers continuano a dare risultati promettenti in diverse aree del globo. Non bisogna dimenticare i fronti delle quantum networks o del quantum Internet. Quindi è bene parlare in genere di quantum techs.

Quali sono qui le principali implicazioni di cybersecurity?

Crittografia, possibilità di elevatissime capacità computazionali, possibile crisi di sistemi classici basati su fattorizzazione di numeri primi a 200 cifre (tipo RSA).

Rimedi: sviluppo di tecniche di post-quantum cryptography e di distribuzione quantistica delle chiavi. Non dico qui nulla di nuovo. Il tema è però fondamentale.

Su tecnologie e connessioni spaziali. Spesso queste tecnologie sono serventi. Il loro ruolo è sovente di supporto alle altre tecnologie “terrestri”. Si pensi alle telecomunicazioni. In molti casi, le tecnologie sviluppate per specifici usi in ambito spazio hanno un successivo riutilizzo e ricadute commerciali, in ambito terrestre. Questo ruolo è già ora importante, sarà via via più centrale nel futuro.

Gli impatti sul sistema finanziario sono per ora mediati, indiretti. Ma queste tecnologie saranno in futuro fondamentali, anche per specifici servizi.

Su questo fronte, vi sono implicazioni di controllo dello spazio e di geopolitica dello spazio – lo sfruttamento delle risorse dello spazio extra- atmosferico, andrà ben al di là delle connessioni radio, delle comunicazioni al laser, delle reti di satelliti. E sarà un fronte cruciale. La sicurezza fisica e logica delle infrastrutture spaziali incrocia elementi di sicurezza generale (che vedremo tra poco). I piani statuali e interstatuali sullo spazio vedono una rimodulazione di scelte strategiche che hanno caratterizzato gli ultimi decenni. Anche in connessione ad iniziative private. Siamo agli albori di una nuova fase.

Correre su alcuni fronti – computazione, intelligenza artificiale, telecomunicazioni e spazio – può dare la possibilità a Paesi che sono più indietro di colmare il gap accumulato su altri fronti: prevalere sul più forte, partendo da una posizione di inferiorità.

Tutte le tecnologie elencate vanno inquadrate in un’ottica di transizione ecologica. Una delle sfide fondamentali per gli anni a venire. Altro tema trasversale rispetto a tutte le tecnologie esposte, è quello dei dati: la conservazione e la gestione sicura dei dati, specie quelli finanziari, è un aspetto centrale.

Altro fronte. Chip, semiconduttori e superconduttori. Qui, la partita è aperta e a tutto campo. Gli Stati che non sono davanti in termini di know-how cercano strade alternative. In questo frangente, hanno un ruolo importante anche le catene di approvvigionamento, le supply chain (ne parleremo più avanti); altra questione è quella di alcune materie prime (si pensi alle terre rare). Per i chip emergono sempre più questioni di sovranità tecnologica.

Anche in materia di telecomunicazioni, oltre alle classiche questioni di cybersecurity, valgono primariamente considerazioni di primato tecnologico e indipendenza tecnologica (vedremo tutti questi aspetti tra poco), specialmente per le reti di ultima generazione (e con questo ci riferiamo non soltanto a quelle in via di attuale commercializzazione, ma anche quelle il cui lancio è previsto tra circa un decennio; le “G” di generations, si susseguono velocemente).

Anche per queste tecnologie, ovviamente l’impatto sul comparto finanziario e è più mediato, indiretto, ma rilevante; la cybersecurity ha comunque ricadute trasversali su tutti i settori.

Per il presente, un filone molto interessante è quello dei sistemi cyber-fisici (cyber phsysical systems – CPS), quindi sistemi informatici che interagiscono con il mondo fisico, in una stretta relazione tra computazione e connessione. Qui l’elemento interattivo è fondamentale. Così come è cruciale, sotto il profilo della sicurezza, l’adozione di un approccio sinottico, che ricongiunga sfere spesso separate come security e safety. Questi sistemi hanno e possono avere un vasto impiego in campo finanziario; anche per contrastare fenomeni specifici (si pensi agli attacchi black-box contro gli ATM).

Un altro filone, già fiorente, è la branca della fotonica. Questa si interconnette ad altre tecnologie, sia per la computazione, sia per le telecomunicazioni. Ciò che interessa sotto il profilo della sicurezza è sia la componente infrastrutturale (si pensi alle telecomunicazioni di nuova generazione), sia quella relativa a dispositivi e Internet of Things (IoT): ad esempio, dispositivi di olografia, congegni ottici, apparati indossabili; oppure, si pensi ai sensori in campo safety e al tema delle smart cities. Tutti elementi validi in generale, ma anche per lo specifico impiego in campo finanziario.

Riguardo a possibili scenari futuri, abbiamo fatto cenno alle neuro-tecnologie, anche per i possibili futuri utilizzi in ambito finanziario. Un loro possibile sviluppo ed impiego investe questioni etiche, scientifiche, mediche e giuridiche. Ma anche questioni di sicurezza: più che di cybersecurity si dovrebbe qui parlare, seriamente e non per facezia, di cyborg-security.

Questo diverrebbe un fronte molto delicato. Al netto di scenari da hackeraggio del cervello, occorrerebbe affrontare comunque il tema in modo multidisciplinare.

Sempre nell’ambito di possibili sviluppi futuri, un filone che potrebbe ricomprendere intelligenza artificiale, reti neurali e machine learning è quello del cognitive computing (cc). Qui si prevede lo sviluppo di nuovo hardware e software per mimare pattern del cervello umano, ben oltre le attuali realizzazioni, in particolare nelle sue facoltà di ragionamento, risposta, stimolo, decisione, emozione, adattamento, evoluzione. Qui, sotto il profilo della sicurezza, rilevano sicuramente le componenti di interpretazione e di impredicibilità del comportamento della macchina.

Tematiche di sicurezza latu sensu, conseguenti all’impiego di nuove tecnologie nel comparto finanziario

Nella parte conclusiva, passiamo in rassegna alcune tematiche di sicurezza latu sensu legate all’impiego di nuove tecnologie nel comparto finanziario. Queste tematiche sono spesso strettamente correlate a quelle di cybersecurity.

La sicurezza nazionale è prerogativa delle agenzie nazionali di intelligence e degli organi di law enforcement. Tale appannaggio non è peraltro intaccato nemmeno dalle previsioni del Trattato sul Funzionamento dell’Unione Europea.

L’interconnessione di minacce di varia natura, il carattere ibrido delle minacce, operazioni di ingerenza sotto-soglia, cyber network operations (CNOs), information warfare, rendono tuttavia il quadro complesso. La componente cyber si intreccia ad altri fattori, geopolitici, economici, finanziari.

Il sistema finanziario è tra i gangli vitali e strategici di un Paese: le informazioni, i sistemi e i processi gestiti dalle istituzioni finanziarie sono particolarmente appetibili per uno Stato estero. Il tema della sicurezza nazionale, ancorché indirettamente, interessa quindi anche le istituzioni finanziarie.

Una stretta cooperazione tra queste istituzioni e le agenzie sopra citate è auspicabile. Così come è auspicabile una maggiore regolamentazione delle attività assimilabili a quelle di intelligence (sempre che possano tecnicamente inquadrarsi come tali), svolte al di fuori delle agenzie. Non è questo un fenomeno di per sé negativo. Ma è bene ricordare che aziende private e altre Istituzioni (anche finanziarie) hanno fini, poteri e mezzi diversi dalle agenzie di sicurezza nazionale.

In campo tecnologico, problemi per la sicurezza e la stabilità finanziaria di un Paese possono derivare non soltanto dagli attacchi cibernetici, condotti da attori statuali, organizzazioni, individui.

Per la sicurezza di un Paese, alcuni fenomeni tecnologici possono rivelarsi anche più insidiosi degli attacchi (che comunque costituiscono una parte rilevante delle minacce). Per converso, gli stessi fenomeni, se opportunamente governati, possono generare effetti sistemici positivi, nel lungo periodo.

Tratteremo qui brevemente di alcuni temi, quali finanza decentralizzata, monete digitali nazionali, central bank digital currencies (CBDC), autonomia strategica, supremazia tecnologica e sovranità cibernetica. Con alcuni focus specifici.

Disintermediazione e DeFi (Decentralized Finance)

La disintermediazione degli istituti di credito, delle Banche Centrali e in genere delle entità finanziarie (ma su questo punto, vedremo tra poco che molto si muove), in virtù dell’avvento di nuove tecnologie, è una questione dibattuta da tempo.

Alcune tecnologie creano de facto un ambiente decentralizzato e disintermediato. Su questo non c’è dubbio. Il nocciolo della questione è nella portata futura di tale fenomeno e nella capacità da parte delle entità finanziarie di governarlo, assecondandone la natura, senza rinunciare al ruolo di guida. Il tema DeFi (decentralized finance) può avere un peso crescente negli anni a venire (anche in considerazione degli attuali ritmi di crescita del segmento, che ha incrementi di miliardi di dollari l’anno).

Il fenomeno DeFi può avere impatti su varie funzioni svolte da entità finanziarie classiche (banche, borse, altri intermediari): può riguardare depositi, investimenti, negoziazione.

Le spinte tecnologiche verso la decentralizzazione, assecondano peraltro aneliti di modifica degli attuali assetti di governance nel sistema finanziario. La DeFi può avere ripercussioni anche sul ruolo delle Istituzioni finanziarie.

Le Autorità non stanno a guardare. La promozione di strumenti innovativi avviene talvolta su scala regionale e transnazionale. Le autorità centrali, a fronte del fenomeno incipiente, ricercano nuovi modelli di governo (vedremo tra poco). Alcuni Paesi e le rispettive Autorità finanziarie vanno nella direzione di una apertura, altri mostrano segnali di rigidità, che arrivano talvolta fino al blocco degli IP di exchange che scambiano crypto-assets, spesso per volumi cospicui di transazioni opache (si applica lo schema KYC – know your customer), altre volte anche in presenza di attività regolari.

Breve digressione in tema di cripto-attività. Molte Autorità negli ultimi anni hanno messo in guardia dai rischi collegati agli investimenti in cripto-

attività (nel 2018 EBA, ESMA, EIOPA; più recentemente Banca d’Italia e CONSOB). In una fase nella quale vi è quotazione di società che operano in cripto valuta, le Autorità mettono in guardia da rischi di bolle speculative. A questo proposito, si è assistito ad elevata volatilità e in alcuni casi a vere e proprie drawdowns, con ribassi anche del 10-20% in poche ore (cd. flash crash). Anche per far fronte a questo, sono fiorite diverse stablecoins.

Ma il tema incertezza (e sull’altro versante, fiducia) rimane centrale, anche a causa di ripetuti booms & busts (tutti elementi validi per economia e finanza in generale). Ma forse, più che di incertezza, si dovrebbe parlare di indeterminazione. Rimane il tema della fiducia.

Oltre al tema volatilità, le autorità rilevano anche i rischi derivanti da scarsa disponibilità di informazioni, complessità di tecnologie sottostanti, insufficienti tutele legali e contrattuali, assenza di controlli regolamentati.

A questo proposito, parlando di regolamentazione, qualcosa si muove in materia di crypto-assets, anche a livello europeo, secondo l’approccio “new functionalities, new rules”. In ambito nazionale, sul modello di altri Paesi, si pensi alla previsione della “sandbox” regolamentare.

A tale riguardo, un aspetto particolare in tema di finanza decentralizzata e sicurezza, che richiede particolare attenzione, anche secondo diverse indicazioni della FATF (financial action task force), è il fenomeno del riciclaggio e del finanziamento di attività illecite attraverso nodi di scambio decentralizzato, cripto-valuta e non-fungible tokens (NFT). La proliferazione di cripto-valute (incluse in questo caso anche le stablecoins), può creare minacce nel mondo reale, perché consentono il movimento di grandi somme di denaro su reti decentralizzate, ancorché tracciabili. D’altro canto, il contante e i flussi di denaro sporco sono in qualche modo appunto tracciabili e tracciati (qui il problema che si pone è il fattore tempo; intercettare sul nascere).

Questione ulteriore da tenere in considerazione, in tema di cripto-monete e mining, il digital carbon footprint. Su questo occorrono comunque maggiori riscontri e dati certi.

Digital cryptocurrencies & CBDC. Implicazioni di cybersecurity

La digital currency è una valuta digitale, gestita e scambiata su sistemi informatici e reti come Internet.

Le digital currencies includono cryptocurrencies e central bank digital currencies (CBDC).

A questo riguardo, la creazione di digital currencies ha destato particolare interesse negli ultimi anni da parte di molte Banche Centrali nazionali e transregionali. Di qui la previsione e i progetti di CBDC. Un sondaggio recente della BIS riporta che più dell’80% delle 66 Banche Centrali intervistate, aveva

in cantiere progetti in tal senso. Il fenomeno è di vasta portata e ha varie possibili implicazioni.

Un approfondimento su CBDC. Trattiamo di digital currencies emesse da una banca centrale. Come noto, sono anche chiamate digital fiat currencies o digital base money.

La differenza con le altre virtual currencies e cryptocurrencies, è che qui vi è un intervento di una istituzione finanziaria e, spesso, l’intervento a monte di organi legislativi o governativi. L’utilizzo di DLT o lo scambio su circuiti similari è possibile (non sempre è previsto), ma vi è comunque una forma di centralizzazione e controllo (questo le fa differire dalle altre cripto-valute) da parte di un regolatore.

Per le CBDC, viene spesso prevista la possibilità di deposito diretto presso la banca centrale da parte di utenza finale ed organizzazioni. L’emissione di CBDC con possibilità di deposito diretto, va nella direzione di controllare uno strumento nuovo ed esterno al normale circuito. Il successo di tale iniziativa è un obiettivo sfidante.

Come detto in apertura, le maggiori entità finanziarie del globo stanno affrontando il fenomeno, attraverso studi, consultazioni pubbliche, progetti pilota.

Alcuni Paesi sono più attivi di altri. Tentativi di innovare in questo campo ce ne furono già agli inizi degli anni 90. Ma CBDC propriamente dette sono un fenomeno relativamente nuovo.

Uno degli aspetti critici sembra essere quello della possibile scarsa partecipazione da parte dell’utenza finale (caso dell’Ecuador nel periodo 2014- 2018) e della tenuta nel lungo periodo. Ma siamo ora in una fase nuova e alcune iniziative si fanno più concrete.

Alcune iniziative strutturate sono partite invero già alcuni anni fa.

Già dal 2014, la Banca Centrale della Repubblica Popolare Cinese (PBOC) lavora al progetto di un digital currency electronic payment, con al centro il cosiddetto “digital yuan“, il renminbi digitale. Ad aprile 2020, il digital currency electronic payment è stato testato in 4 metropoli, Shenzhen, Suzhou, Xiong’an e Chengdu. A febbraio 2021 è stata la volta di Pechino. Nel corso del 2021 sono stati previsti diversi piani pilota di sperimentazione per lo yuan digitale, con coinvolgimento di consumatori e utenti (possibili prove di un possibile diffuso utilizzo anche in vista dei prossimi giochi olimpici invernali del 2022). Sono previste diverse collaborazioni pubblico-privato per il lancio sul mercato dell’e-yuan. Il traino nella Repubblica Popolare Cinese può essere costituito dal massiccio ricorso ai pagamenti tramite app e rete mobile da parte di larghe fasce della popolazione.

Nel 2015, anche Bank of England comincia a ragionare di una possibile CBDC, con un sistema basato su blockchain (ricordiamo che non tutte le CBDC prevedono necessariamente l’impiego di questa tecnologia).

Poi è stata la volta della Banca Centrale di Svezia (2016 – il PoC su e-krona è del 2020).

Nel 2017 la Banca Centrale dell’Uruguay lavora ai “digital pesos”. Nel 2019 è la volta della Eastern Caribbean Central Bank.

Il 20 ottobre 2020, la Banca Centrale delle Bahamas ha dato avvio al “sand dollar”.

In ambito Eurozona, a seguito di consultazione pubblica, sono state attivate diverse iniziative tra il 2020 e il 2021; sono al vaglio diverse opzioni per la possibile adozione dell’euro digitale. Alcune decisioni sono prossime.

La Federazione Russa sta lavorando al progetto del rublo digitale da tempo e sono attese iniziative concrete nel breve-medio periodo; recenti linee strategiche vedono una forte connessione con iniziative in materia di pagamenti.

Gli Stati Uniti d’America hanno avviato diversi progetti pilota, sia pubblici sia privati, mirati a raccogliere dati e fare proiezioni circa una possibile adozione di valuta digitale federale.

Altri Paesi hanno in cantiere sperimentazioni (Giappone, Sud Africa, India, Pakistan, Thailandia etc.).

In genere, tra gli aspetti positivi delle CBDC solitamente elencati vi sono: inclusione finanziaria (tutti possono operare direttamente dal proprio dispositivo e wallet; alcune banche centrali prevedono anche schemi senza conto e token-based), crescita economica (maggiori volumi di transazione e pagamenti per facilità d’uso), innovazione tecnologica ed efficienza nelle transazioni (tracciabili e sicure), velocità di utilizzo (in tempo reale e senza intermediazione), effetto antievasione ed effetto anticrimine (emersione del nero e del traffico illecito), possibile leva supplementare per la politica monetaria (con controllo diretto su offerta di moneta e possibile nuovo canale di trasmissione della politica monetaria, con eventuali misure del tipo helicopter money), rilancio di sistemi finanziari in sofferenza.

I risvolti di sicurezza cibernetica sul tema. Sul fronte sicurezza cibernetica, oltre agli indubbi vantaggi per velocità, duttilità e tracciabilità, possono presentarsi i problemi già presentati in ambito DLT. La CBDC presenta gli stessi aspetti trattati per le cripto-valute in genere, ma con qualche distinguo. La mitigazione di alcuni problemi di sicurezza che si riscontrano per le cripto-valute su DLT, può derivare dal maggiore controllo e centralizzazione da parte della banca centrale e dagli avanzati sistemi informatici utilizzati.

Si perdono però in parte gli elementi disintermediazione e decentralizzazione, importanti nel DLT (qualora vi sia utilizzo di tali tecnologie). Questo rileva anche sotto il profilo della centralizzazione dei rischi di cybersecurity (non distribuiti come in ambienti DLT puri; ma sono accentrati dal regolatore). Gli attacchi possono contare così su un macro-target di tipo classico. Problemi di falsificazione della valuta digitale non sono da escludere, sebbene appaiano difficili da mettere in opera.

Sovranità valutaria e finanziaria. Implicazioni geopolitiche e sicurezza tout court

Altre implicazioni. La citata possibilità di deposito diretto presso la Banca Centrale da parte di utenza finale ed organizzazioni (spesso è prevista nei piani). Questo può generare diversi effetti e rimodulazione nelle attuali interazioni del sistema finanziario. Può comportare ad esempio la possibile disintermediazione degli istituti di credito (questo può anche invero alimentare positivamente la concorrenza). Molti di questi gruppi tuttavia hanno piani per offrire direttamente cripto-valuta alla propria clientela (in alcune aree del globo potrebbe essere prevista ex lege una cooperazione pubblico- privato, anche per risollevare istituti di credito in sofferenza). Nella direzione di piani privati in materia di valuta digitale, si muovono anche grossi conglomerati che gestiscono piattaforme di pagamento, i quali promuovono il ricorso alla moneta digitale anche attraverso campagne di fidelizzazione e premi in criptomoneta legati al numero di transazioni. Chi è nel mezzo (es. Le banche), con la CBDC e il possibile deposito diretto presso la Banca Centrale, potrebbe comunque dover riallocare parte delle sue funzioni principali. Ma tutti questi aspetti, possibile disintermediazione ed eventuale riassetto del sistema finanziario, molto dipenderanno da fattori di contesto.

Anche la regolamentazione in materia di pagamenti e e-commerce dovrà inevitabilmente essere adeguata in caso di adozione di digital currencies.

Al momento, è plausibile pensare che vi saranno fasi di armonica (o disarmonica) coesistenza tra moneta fisica e moneta digitale.

Due questioni specifiche. Solidità del comparto e effettivo utilizzo da parte dell’utenza finale. Sull’effettivo utilizzo dipende molto dai modelli di business promossi, dalla struttura dei mercati, dalle abitudini e dalla mentalità degli utenti finali, dal contesto politico e geopolitico, dalla congiuntura sociale ed economica dei Paesi nei quali viene promossa la moneta digitale, dall’impiego nei pagamenti transfrontalieri. E, ultimo ma non per importanza, molto dipende dalla percezione dell’utente circa la propria privacy; valuta digitale centralizzata vuol dire tracciamento e il costume di mantenere invisibile almeno una porzione delle proprie transazioni appare radicato, specie in alcuni Paesi.

La situazione su questo fronte è comunque fluida, lo scenario è in fieri e ci si attende la coesistenza di un sistema ibrido.

Per il futuro, la moneta come la conosciamo, manterrà verosimilmente i suoi fondamentali (mezzo di scambio, unità di conto, riserva di valore), ma potrebbe arricchirsi di nuove sfumature o comunque alcune componenti già note potrebbero prevalere su altre. Il mezzo tecnologico potrebbe mutare intrinsecamente alcuni aspetti della sua natura.

Più che su altri fronti, elementi di cybersecurity si mescolano qui ad aspetti di sovranità monetaria e sicurezza nazionale.

Tra le reali motivazioni alla base di iniziative CBDC vi possono essere: intercettazione di circuiti valutari innovativi, mantenimento del controllo sulla politica monetaria (che potrebbe essere altrimenti depotenziata dal ricorso ad altre CBDC o a cripto-valute), questioni economiche, ricerca del primato valutario (o di egemonia valutaria), istanze di rimodulazione del sistema bancario e finanziario mondiale, allentamento della morsa generata da sanzioni, risanamento del sistema finanziario nazionale, motivi di sicurezza nazionale.

In merito ad alcuni aspetti accennati. Quanto a possibili implicazioni di tipo geopolitico, l’adozione di una valuta digitale crittografata in alcuni Stati potrebbe mirare (vedremo più avanti, con alcuni caveat) a modificare l’assetto monetario internazionale o a sovvertire l’egemonia valutaria di altri Paesi. Un altro aspetto connesso a questo, e già accennato, potrebbe essere su un piano statuale – almeno limitatamente ad alcuni Paesi che possono avere mezzi e motivazioni per farlo – disintermediare il mercato bancario mondiale o modificarne gli equilibri esistenti. Per altri Stati, l’obiettivo di tale politica potrebbe essere invece quello di supportare politiche economiche e commerciali di dimensione globale (si pensi ad iniziative commerciali ad ampio respiro geografico, basate su prestiti e investimenti vincolati concessi ai Paesi di transito ospitanti, in cambio dell’uso di infrastrutture, dell’apertura di hub o di concessioni territoriali); o rivedere schemi obbligazionari e sofferenze creditizie; per altri ancora, rendere inefficaci sanzioni economiche in essere.

La creazione di monete digitali nazionali o regionali, prevede spesso comunque un sistema di coesistenza tra valute digitali nazionali o CBDC e cripto-valute preesistenti.

Per tutto quanto sopra, pare pacifico sostenere che iniziative per il lancio di nuove cryptocurrencies da parte di gruppi privati – specialmente se di dimensioni rilevanti – ricadano ormai sotto lo scrutinio attento di organi governativi e di sicurezza nazionali. Così come vi può essere – in alcune aree – un controllo diretto o indiretto (attraverso regolamentazione stringente, vincoli antitrust asfittici etc.) Su gruppi Fintech privati dotati di infrastrutture e piattaforme di pagamento evolute, il cui know-how e le cui dotazioni possono peraltro tornare utili, per il lancio e la stabilizzazione di valute digitali statali.

Connesso al precedente tema – ovvero istanze di sovranità valutaria in relazione all’adozione di valuta digitale nazionale o CBDC – è il tema della rimodulazione degli attuali assetti nel comparto del regolamento dei pagamenti internazionali.

Anche il controllo o la rimodulazione degli attuali assetti nel regolamento dei pagamenti internazionali è un fattore strettamente connesso con alcuni piani per l’adozione di valute digitali nazionali. Questo per fini di sovranità finanziaria. Questo aspetto è stato anche palesato in pubbliche esternazioni e intese di pubbliche Autorità o in linee strategiche presentate in rapporti ufficiali di taluni Stati.

Alcuni Paesi potrebbero richiedere o fortemente caldeggiare l’utilizzo di una digital currency nazionale nel regolamento delle transazioni con partner commerciali esteri, sia pubblici sia privati.

Questo, al di là di possibili ripercussioni sul fronte valutario, potrebbe esercitare un certo peso su mercati e pagamenti, nonché in una certa misura su aziende private, anche estere.

L’approntamento di gateway nazionali per il regolamento di pagamenti transnazionali è un altro elemento in quest’ottica; anche questo si collega a istanze di rimodulazione degli assetti valutari e finanziari globali; e a istanze di sovranità (o supremazia) nei pagamenti internazionali. La ricerca di egemonia valutaria è per alcuni aspetti correlata all’utilizzo della valuta nelle transazioni globali. E alle piattaforme in uso per regolare quelle transazioni (ad esempio regolamento tra banche).

Alcuni Paesi stringono accordi volti a ridurre la loro dipendenza da alcune piattaforme per il regolamento dei pagamenti, le quali piattaforme hanno sede principale in alcune aree geografiche del globo (ad es. nei Paesi occidentali).

Tali piattaforme vengono percepite come strumenti di controllo economico- finanziario: vi sono quindi talune iniziative che mirano alla sostituzione con modelli nazionali o comunque a una mitigazione di tale controllo o comunque a una modifica degli assetti correnti.

Al riguardo, un approccio meno confrontational – e che spesso viene portato avanti in contemporanea alle citate iniziative – è l’approntamento di gateway nazionali per la promozione di collaborazioni e sinergie cross-border; qui la piattaforma nazionale, viene vista come ponte tra financial networks, per il regolamento di ingenti volumi di transazioni (per avere un maggiore controllo diretto, anche fisico e geografico, sulle transazioni di propri cittadini e di proprie imprese; ma anche su quelle estere). Si adotta quindi un approccio duplice, concorrente e cooperativo.

In ogni caso, sia i progetti volti ad acquisire un primato nella emissione di valute digitali, sia l’eventuale disintermediazione di piattaforme di regolamento delle transazioni globali, non sono di per sé condizioni sufficienti per ottenere sic et simpliciter egemonia valutaria e rilevanza nel comparto dei pagamenti internazionali. Queste dipendono anche da altri fattori, legati alla cosiddetta finanza reale (si pensi ad eventuali sofferenze nel segmento delle obbligazioni o del credito), all’economia reale (occorre un milieu favorevole agli investimenti), ad aspetti regolatori (serve un giusto trade-off tra libertà e controllo), fiscali (necessità di un contesto flessibile), politici e geopolitici.

Autonomia strategica, indipendenza e supremazia tecnologica. Cyber sovereignty

Il tema della sovranità valutaria e finanziaria (e anche economica, per le conseguenze che ne possono conseguire) coinvolge anche una serie di elementi di natura tecnologica.

Le istanze di indipendenza tecnologica rientrano in più vasti disegni geopolitici di autonomia strategica (questa locuzione è da qualche anno in voga anche in ambito europeo).

Il controllo sugli asset tecnologici e in genere sul dominio cyber, è ormai per i Paesi e per le unioni di Paesi, una priorità: a questo controllo si lega la sicurezza nei vari comparti, compreso quello finanziario.

Tali elementi si fondono ad un fenomeno estremamente rilevante: la cosiddetta cyber sovereignty. Sovranità cibernetica. A sua volta, questa coinvolge aspetti specifici come quello dell’Internet sovereignty e quello dell’indipendenza tecnologica (si pensi al dibattito al quale si è accennato sulle supply chain nazionali in merito a infrastrutture e componenti nelle telecomunicazioni, alla produzione di chip e semiconduttori, alla questione delle terre rare). Qui, per meglio dire, si dovrebbe parlare di supremazia tecnologica. Breve inciso su questo punto dei chip: nell’ultimo decennio i casi di asserito spionaggio – o comunque di potenziale spionaggio – attraverso chip, hanno avuto la ribalta delle cronache (nella forma supply chain seeding attacks ma anche interdiction attacks); vi è stato ricorso al golden power, anche di recente, per proteggere aziende nazionali attive in questo comparto. Al di là dei chip, questo fenomeno riguarda potenzialmente diverse tecnologie di telecomunicazione, di computazione, di videoripresa, di scanning, etc; per chi lavora in questo campo, affrontare il tema del potenziale spionaggio attraverso rootkit o componenti hardware preinstallate, per consentire traffico in uscita ed esfiltrazione di dati, non è certo cosa nuova. Al di là di misure tattiche, occorre potenziare schemi nazionali o transregionali di produzione e certificazione, sotto l’egida di enti o poli ad hoc. Vi sono ora in ambito europeo e nazionale diverse iniziative per consorzi di produzione, alleanze industriali, enti di certificazione, misure di tutela verso sovvenzioni estere distorsive.

Aspetti tecnologici, finanziari e di sicurezza si compenetrano qui ad un livello superiore, di rango statuale. Non parliamo più soltanto di cybersecurity e di sicurezza del singolo prodotto, servizio o infrastruttura finanziaria.

Gli Stati o gruppi di Stati – con l’azione talvolta parallela talvolta divergente di gruppi di interesse privati e transnazionali, i quali interessi non sempre necessariamente collimano con la sicurezza nazionale – adottano diverse misure, per tutelare i propri assets nel dominio cyber (ivi compresi quelli finanziari). Ma la tutela dei singoli assets, è legata al controllo sull’intero dominio.

Per azioni di tutela della cyber sovereignty, si va da azioni di public policy in consessi multilaterali sul tema dell’Internet governance a cyber operations, difensive ed offensive; dall’emanazione di disposizioni nazionali in materia di sicurezza nazionale (ivi compresi, in alcuni casi, obblighi giuridici specifici per aziende private di condividere informazioni con l’intelligence) al citato golden power.

Vi sono poi una serie di misure tecniche – che variano a seconda delle giurisdizioni – come limitazioni all’utilizzo di piattaforme di file sharing e social networks; approntamento di DNS (domain name system), servers e reti nazionali; controllo su cavi sottomarini e transoceanici; verifica su supply chain e infrastrutture tramite centri di valutazione e certificazione nazionali; investimenti nella produzione di componenti e supply chain nazionali; predisposizione di standard tecnici in tema cyber; attività di censura su Internet e geoblocking (blocco geografico, ovvero limitazione dell’accesso ai contenuti Internet in base alla posizione geografica dell’utente).

Tutti questi aspetti attengono alla sfera tecnica, ma incrociano elementi di sicurezza e di governance; su più fronti hanno impatti su infrastrutture, prodotti e servizi del sistema finanziario.

La vera portata della difesa o della promozione di una autonomia strategica in campo tecnologico e cyber, dipende molto dalle effettive capacità economiche, produttive e scientifiche di un’area geografica. Si pensi, per converso, alla dipendenza da talune materie prime non presenti in loco e reperibili soltanto in alcune aree, o al know-how presente soltanto in Paesi esteri, o ancora, ai minori costi nelle catene di approvvigionamento di Stati concorrenti.

Se, come crediamo, è importante mantenere un controllo sui propri assets – siano essi tecnologia o finanza – l’autonomia strategica non deve ridursi ad autarchia tattica. Altrimenti potrebbero insorgere altri problemi di sicurezza, derivanti ad esempio da marginalizzazione. È auspicabile quindi venga adottato un approccio di stabilità flessibile, mantenendo una apertura controllata.

Così come, è sì importante investire in tecnologia, ma questo non deve ridursi a tecnocrazia.

Conclusioni

In conclusione, pare opportuno sottolineare le molteplici connessioni tra elementi di innovazione, sicurezza e finanza. Alcuni di questi elementi hanno dirette implicazioni di cybersecurity, altri possono avere conseguenze sul piano della sicurezza nazionale.

In ottica prospettica, le sfide che si pongono davanti richiedono particolare perizia e competenza su entrambi i fronti; occorre mettere in campo professionalità ibride, poli-competenti (non soltanto specialisti sulla singola materia, la cui cooperazione genera multidisciplinarietà sommatoria), al fine di evitare parcellizzazioni nella conduzione delle analisi. È necessario sviluppare nuovi modelli e nuove strategie di cybersecurity, a fronte di nuovi ecosistemi finanziari e tecnologici.

Piani statuali pluriennali sullo sviluppo di tecnologie di frontiera, con investimenti ingenti, sono in cantiere in America, in Europa e in Asia. Queste iniziative vengono talvolta metaforicamente descritte come una corsa al nuovo oro. È indubbio che chi avrà un vantaggio o il primato, potrà gestire standards, modi e tempi.

In materia di sicurezza cibernetica, pare opportuno rafforzare la cooperazione tra istituzioni finanziarie, settore privato, accademia, ricerca, organismi di prevenzione e contrasto, nell’ambito di un centro unico di coordinamento sulla cybersecurity.

Per affrontare queste sfide e quelle della sicurezza in generale, occorre investire risorse, coltivare talenti e valorizzare sinergie. Questo richiede e richiederà un approccio adattativo ed evolutivo a fronte di un contesto sempre più complesso.

Bene, ho terminato il mio intervento, un caro saluto a tutti.

[embedded content]

Banca d’Italia, Supervisione Mercati e Sistemi di Pagamento. Continuità di servizio del sistema finanziario (CSSF) italiano. Si occupa di analisi strategica e positioning. Ha expertise su threat intelligence, cyber intelligence e cyber resilience. In Banca d’Italia ha ricoperto vari ruoli (es. team europeo su nuove metodologie di testing basate su threat intelligence in CSSF; referente comunicazione su cyber threat intelligence nel CERT; esperto per il rischio operativo in Architettura Informatica). Per un breve periodo è stato impiegato presso l’UIF. Ha lavorato, tra l’altro, alcuni anni per Telecom Italia S.p.A. (TIM) – Public & Regulatory Affairs, strategia regolamentare e public policy. Background in Istituzioni nazionali ed internazionali con focus su temi di sicurezza (es. UNODC, UNICRI). Laurea con Lode in Scienze Politiche Internazionali (La Sapienza) con tesi su regolamentazione e comunicazioni elettroniche. Ha all’attivo diverse pubblicazioni a livello nazionale ed internazionale (es. Banca d’Italia, Rapporto Clusit, Cyber Defense Magazine, Econpapers); ha partecipato come speaker a vari eventi e summit (es. ITASEC, Security Summit, Corso Alta Formazione Germani); parla alcune lingue.

https://www.ictsecuritymagazine.com/articoli/innovazione-tecnologica-e-cybersecurity-nel-sistema-finanziario-2/
Intelligenza Artificiale / Machine Learning: tra Complessità e Sicurezza

Negli ultimi anni Intelligenza Artificiale e Machine Learning sono diventati nomi noti a tutti e usati molto spesso. Ormai moltissime applicazioni informatiche hanno componenti o sono per lo più basate su Intelligenza Artificiale e/o Machine Learning, ma la loro adozione comporta, come sempre, dei rischi anche di sicurezza. In questo articolo verrà proposta una breve e, come si vedrà, incompleta panoramica su alcuni aspetti di Intelligenza Artificiale e Machine Learning che sono o potrebbero diventare rilevanti per la sicurezza, informatica e non. Ma a questo scopo è molto utile fare un passo indietro e partire con un breve riassunto di cosa sono Intelligenza Artificiale e Machine Learning.

Intelligenza Artificiale

Con il nome “Intelligenza Artificiale”, in breve AI (Artificial Intelligence), si intende una branca dell’informatica con lo scopo di sviluppare sistemi informatici con competenze simili a quelle dell’uomo quali quelle:

  1. Dell’apprendimento,
  2. Del ragionamento e
  3. Della soluzione di problemi.

I sistemi AI hanno lo scopo di aiutare l’uomo in tantissimi campi, dal trovare informazioni (i Personal Virtual Assistant come Cortana, Google Assistant, Siri, ecc.), a dimostrare teoremi matematici, alla guida autonoma di automobili, alla realizzazione di Robot (o Automata) che ad esempio possono lavorare in ambienti nocivi per l’uomo, a diagnosticare malattie, gestire il traffico, supportare le vendite, giocare a scacchi o Go, ecc. ecc., e di fare tutto questo molto velocemente, con grande precisione, pochissimi errori e grande affidabilità. AI può quindi interessare quasi tutti i settori della vita umana, dall’educazione alla sanità, ai trasporti, agli ambienti di lavoro, divertimento, commercio, economia, agricoltura, sicurezza ecc.

E’ chiaro quindi che lo sviluppo di AI richiede, oltre all’informatica, conoscenze in molte altre discipline quali ad esempio:

  • Matematica
  • Biologia
  • Psicologia
  • Sociologia
  • Neurologia
  • Statistica.

La storia di AI è molto antica, ad esempio miti di uomini meccanici (Automata) sono già presenti presso gli antichi greci, ma si può far risalire agli anni ’40 l’inizio dello sviluppo moderno di AI, in particolare con il contributo di Alan Turing nel 1950. AI ha vissuto altri due periodi di grande sviluppo: il primo negli anni ’80 con la formulazione dei Sistemi Esperti: algoritmi specifici in grado di analizzare molte informazioni in un determinato ambito per dedurne le decisioni migliori a supporto ed imitazione dei migliori esperti e decision maker. Il secondo periodo è quello attuale, iniziato indicativamente verso la fine degli anni ’90 e dovuto in gran parte sia all’aumento della potenza di calcolo degli elaboratori sia allo sviluppo delle Reti Neurali Artificiali (o Artificial Neural Network, ANN) utilizzate precedentemente quasi esclusivamente nella ricerca ad esempio della fisica dei sistemi elementari. Questo ha portato all’affermarsi del Machine Learning (in breve ML), degli “Agenti Intelligenti” e di tutto quello che oggi consideriamo sotto la sigla AI/ML.

La scienza AI odierna e del prossimo futuro viene indicata come “debole” o “ristretta”, in quanto un sistema AI attuale è in grado di svolgere solo uno o pochi compiti specifici in maniera tipicamente reattiva e con memoria limitata. Non esistono quindi sistemi AI in grado di svolgere funzioni veramente simili a quelle del cervello umano, in particolare di apprendere e ragionare come o meglio di un uomo. In altre parole, non siamo ancora neppure vicini alla realizzazione di veri Androidi (o Robot umanoidi / antropomorfi, o Replicanti) né di elaboratori senzienti (come HAL 9000 nel film “Odissea dello spazio 2001”) basati su sistemi AI con intelligenza e capacità uguali o superiori a quelle del cervello umano (detti sistemi AI Generali e Superiori rispettivamente). Non c’è quindi un pericolo immediato che le macchine prendano il controllo degli umani, come descritto in tantissimi racconti, libri e film di fantascienza; ma alla luce di quanto già succede oggi e che sarà descritto più avanti, è comunque una preoccupazione da tenere in conto sin da subito.

Un’automobile a guida autonoma come esempio

Per comprendere la complessità degli attuali sistemi AI/ML è utile partire da un esempio molto semplice ed ormai noto a tutti: cercheremo di descrivere a livello molto alto l’approccio AI/ML alla realizzazione di un’automobile a guida autonoma (o equivalentemente un Robot adibito a qualche compito specifico). Per potersi muovere un’automobile a guida autonoma ha bisogno di descrivere l’ambiente in cui si trova, è necessario quindi che sia dotata di sensori che le permettono di “vedere” la strada, gli altri veicoli, i cartelli stradali, eventuali pedoni, biciclette, motoveicoli, animali, e quant’altro potrebbe trovarsi su o intorno al suo percorso, ma anche di “sentire” una sirena di un mezzo di soccorso, un clacson di un altro veicolo ecc. Dovrebbe essere ovvio che la tecnologia odierna permette di effettuare tutti questi tipi di rilevazioni ma con sensori diversi (ad esempio anche solo a secondo delle condizioni climatiche: sole, nebbia, pioggia, neve ecc.), ognuno con un diverso algoritmo necessario per identificare gli elementi attesi quali la presenza di un pedone, la lettura di un cartello stradale, la posizione della corsia stradale ecc. Inoltre servono anche altri sensori per monitorare il veicolo stesso: acceleratore, freno, marcia, motore, sterzo e tutti i parametri del veicolo.

Si paragoni questa situazione con quella di un uomo alla guida: per percepire e descrivere l’ambiente bastano solo due sensori, gli occhi e le orecchie; e per monitorare il veicolo anche mani (sul volante) e piedi (sui pedali). Inoltre, l’unità di elaborazione umana è composta da un unico, grande algoritmo: il nostro cervello.

Ma per poter procedere, un’automobile a guida autonoma ha bisogno di valutare tutte le rilevazioni fornite dai sensori e decidere come procedere sulla strada. Anche in questo caso vi sono diversi ragionamenti e tipi di decisione da prendere, tra cui:

  • Identificare il percorso da seguire per raggiungere la destinazione (come i navigatori satellitari che tutti ben conosciamo);
  • Sulla base delle condizioni stradali rilevate, identificare la maniera migliore per percorre i successivi pochi metri di strada;
  • Identificare eventuali situazioni anomale o di pericolo che richiedono azioni di emergenza.

Di nuovo, per svolgere tutte le valutazioni necessarie alla guida autonoma e prendere le relative decisioni sono utilizzati algoritmi di AI/ML distinti e dedicati ad ogni singolo ambito.

Infine, molte decisioni portano all’implementazione di un’azione tramite un attuatore,[1] ovvero un dispositivo che traduce una decisione di un sistema informatico in un’azione fisica. Ovviamente anche gli attuatori necessitano logiche e algoritmi dedicati.

Riprendendo quanto indicato all’inizio, questo esempio ci descrive come un sistema AI/ML:

  1. Apprenda tramite i sensori;
  2. Ragioni tramite algoritmi dedicati valutando le informazioni e prendendo decisioni;
  3. Risolva i problemi implementando delle azioni tramite gli attuatori.

Nella terminologia AI/ML corrente, questo approccio è descritto come quello di un “Agente Intelligente” (o solo “Agente”) le cui caratteristiche principali sono:

  1. Un Agente deve avere la capacità di percepire (osservare) l’ambiente;
  2. Le osservazioni sono utilizzate dall’Agente per prendere delle decisioni;
  3. Una decisione tipicamente porta l’Agente ad eseguire un’azione;
  4. L’azione intrapresa da un Agente deve essere un’azione razionale.

E’ importante sottolineare un aspetto che emerge da questo semplice esempio: a differenza dell’uomo che utilizza il proprio cervello come unità di elaborazione, i 5 sensi come sensori ed il corpo come attuatore, un tipico Agente o sistema AI/ML utilizza una grande numerosità e varietà di sensori, algoritmi e attuatori con caratteristiche spesso molto diverse tra loro.[2]

Pertanto può essere difficile individuare quali approcci, modelli, algoritmi siano i più adatti, efficaci e performanti per sviluppare, implementare o anche solo adottare un sistema AI.  Come esempio, si provi ad esplorare alcune delle decine di librerie esistenti di algoritmi ML [si veda Rif. 1]. In altre parole, l’ampiezza di AI è tale da costituire da sola un aspetto di complessità da non sottovalutare in progetti che includono l’utilizzo di questi sistemi.

Sinora si è fatto cenno al concetto di Agente ma AI, ed in particolare ML, è costituito anche e principalmente da sistemi più semplici, puramente informatici e che non coinvolgono un’interazione con un ambiente esterno. Dal punto di vista IT è un programma con dati in input ed in output; per un Agente sono tutte quelle componenti che implementano la logica che analizza i dati ed elabora le decisioni. Nel rimanente di questo articolo si considererà solo la parte puramente informatica di AI.

Machine Learning

ML può essere definito come una sotto-branca di AI che si occupa di sviluppare sistemi informatici in grado di apprendere dai dati forniti in ingresso in modo tale da poter fornire delle elaborazioni utili ma senza essere programmati in modo esplicito.

Ripensando ai concetti base di programmazione, è ben noto che l’approccio più semplice per scrivere un programma è quello di implementare direttamente nel codice l’algoritmo che esegue l’elaborazione voluta (approccio “procedurale”).

Un approccio a più alto livello adottato anche nei Sistemi Esperti, è quello di implementare nel codice una logica generica (chiamata anche Motore delle Regole o Rules Engine) in grado di analizzare insieme ai dati specifici in ingresso, una Base di Conoscenza (o Knowledge Base, KB) fornita dagli esperti, in modo da ottenere i risultati attesi.

ML compie un ulteriore passo di astrazione in quanto nel codice sono implementate delle strutture logiche molto semplici ed il modello deve imparare dai dati in ingresso anche le regole di elaborazione. L’esempio più immediato è quello di una Rete Neurale che non è altro che una rete con dei nodi di ingresso in cui vengono inseriti i dati da elaborare, nodi interni in cui vengono eseguite le elaborazioni e nodi finali in cui appaiono i risultati (si veda ad esempio Fig. 1). Le elaborazioni svolte dai nodi sono basate su dei coefficienti numerici inizialmente ignoti e scelti in maniera pseudo-casuale. Il modo più semplice per fissare i coefficienti numerici è di fornire in ingresso dei dati per i quali si conosce il risultato dell’elaborazione, e di calcolare i coefficienti numerici in modo da ottenere il risultato corretto.

Fig. 1 Struttura di una rete neurale molto semplice (da Wikipedia)

Quindi all’inizio una rete neurale non ha insita alcuna logica e si comporta in modo casuale nella elaborazione dei dati in ingresso. Nella fase di apprendimento (ovvero determinazione dei coefficienti numerici), i dati forniti alla rete neurale introducono nel programma la logica di elaborazione. Facendo un paragone con i Sistemi Esperti, i dati in ingresso nella fase di apprendimento forniscono alla rete neurale sia il Motore delle Regole che la Base di Conoscenza, entrambi codificati nei coefficienti numerici dei nodi. In altre parole, un modello ML è basato principalmente su due componenti:

  1. Algoritmi statistici e/o predittivi principalmente basati su algebra lineare;
  2. Un insieme di dati (data-set) utilizzato per l’apprendimento da parte del modello.

L’interrelazione tra queste due componenti è la chiave del successo, o del fallimento, di un modello ML. Per gli algoritmi, la principale difficoltà è di identificare quali sono più adatti ad apprendere una determinata logica, ad esempio alcuni algoritmi risultano più efficaci ad identificare il contenuto di un’immagine (ad esempio un Convolutional Neural Network, o CNN) mentre altri a selezionare il percorso ottimale[3] da percorrere (ad esempio un algoritmo ad albero). Invece il problema principale del data-set utilizzato per istruire il modello ML, è quello di dover contenere le informazioni necessarie per l’apprendimento in maniera equilibrata. Questa seconda difficoltà si sta’ dimostrando sempre più complessa essendo la principale causa dei problemi dei modelli ML. Prova ne è che Gartner prevede che fino al 2022, l’85% dei progetti di intelligenza artificiale produrrà risultati errati a causa di errori nei data-set di apprendimento, errori negli algoritmi o errori da parte dei team responsabili della loro gestione [Rif. 2].

Al contempo è importante sottolineare la grande potenzialità ed efficacia già raggiunta dai modelli AI/ML. Innanzitutto bisogna ricordare che questi si basano principalmente su modelli statistici e pertanto non danno quasi mai risposte esatte, come invece nel caso di un approccio “procedurale” ove se si verifica una condizione ne segue un’affermazione unica. Invece i modelli AI/ML tipicamente “apprendono” delle caratteristiche generali (dei pattern) di un insieme di dati e calcolano quanto un altro set di dati è simile a quello di riferimento. I modelli AI/ML forniscono quindi una valutazione statistica di similitudine (probabilità) tra le caratteristiche di interesse dei due set di dati. Questo processo permette ai modelli AI/ML di essere predittivi, ovvero di individuare anche in set di dati molto complessi, caratteristiche simili, non identiche, a quelle di interesse. In altre parole, questi modelli sono in grado di individuare dei pattern anche in set di dati mai analizzati precedentemente, ed essere quindi predittivi. La maggior parte dei modelli AI/ML è quindi basata sulla statistica, apprende dei pattern ed è in grado di essere predittivo.

Debolezze dei modelli AI/ML

I principali rischi connessi all’utilizzo di modelli ML provengono principalmente da due problemi:

  1. Il modello produce risultati errati anche in situazioni ove non ci si aspetterebbe nessun errore; oppure esistono modi molto semplici / facili per ingannare il modello;
  2. Il modello produce, anche volutamente, risultati ingannevoli o risultati falsi difficilmente distinguibili da dati veri.

Vi sono molti casi noti del primo punto, come ad esempio tutti gli esperimenti in cui è stato possibile ingannare un modello ML di riconoscimento delle immagini sottoponendogli delle immagini leggermente deformate, od aggiungendo colori, sticker (anche a cartelli stradali) ecc. (si veda ad esempio Rif, [3]).[4] La problematica in realtà è molto profonda ed include anche quello che usualmente viene chiamato bias[5] del modello. Ad esempio alcuni modelli di riconoscimento facciale riconoscevano con grande precisione maschi bianchi ma con bassa precisione femmine nere, ed analoghi problemi sono stati riscontrati in tanti altri modelli ML come alcuni per il calcolo del rischio per il rimborso di un mutuo a seconda delle condizioni sociali, etniche, economiche, ecc. A prima vista sembrerebbe facile risolvere il problema, dovrebbe bastare ri-eseguire la fase di apprendimento del modello con un data-set più completo ed equilibrato. Ma in pratica questo spesso non riesce in quanto il miglioramento della precisione di una caratteristica del modello porta quasi sempre a peggiorare o almeno non migliorare qualche altra caratteristica o a peggiorare la sua precisione ed efficacia generale. Ad esempio in presenza contemporanea di un bias sul genere e uno sull’etnia delle persone, risulta quasi sempre difficile se non impossibile rimuoverli entrambi [Rif. 4].

Inoltre è stato dimostrato che i modelli attuali di ML [Rif. 5] esibiscono un problema forse ancora più profondo chiamato underspecification. In pratica è stato osservato che il processo di apprendimento di un modello ML è suscettibile a minime, impercettibili variazioni con potenziali serie conseguenze. Come indicato precedentemente, il processo di apprendimento di un modello ML dipende (fortemente) dal data-set utilizzato, ma anche dai valori pseudo-casuali del modello iniziale, dalla procedura di apprendimento stessa e dalla procedura di test della correttezza del modello prodotto. Ripetendo la stessa procedura di apprendimento è possibile generare un modello ottimo come un modello con bias od errori: il problema è che non si ha modo di saperlo sino a quando l’errore o il bias si manifesta. Purtroppo questo tipo di fallimento dei modelli ML avviene spesso quando meno ce lo si aspetta, ad esempio nel caso di due immagini che per l’occhio umano sono quasi identiche ma che il modello ML considera completamente diverse.

La seconda problematica è in realtà costituita da due aspetti che saranno approfonditi più avanti. Un esempio del primo aspetto, che fa parte degli Adversarial Attacks, è l’introduzione di dati “malevoli” (anche abilmente camuffati) nel data-set di apprendimento che porta quindi alla produzione di risultati ingannevoli. La difficoltà di individuazione e gestione di questo attacco è dovuta al fatto che è praticamente impossibile dedurre le logiche apprese da un modello ML se non dai risultati che produce e quindi solo dopo il suo utilizzo. Il secondo aspetto è di utilizzare modelli ML per produrre documenti digitali (testi, immagini, video, suoni) falsi ma difficilmente distinguibili dagli originali sia per gli uomini sia per gli algoritmi ML stessi (Deep Fake).

Altre debolezze dei modelli ML (si veda ad esempio Rif. [6] per un breve riassunto) sono:

  • Eseguire di nuovo il processo di apprendimento su di un modello già preparato per aggiungere ulteriori casi o correggere errori, può introdurre nuovi errori sui dati preesistenti; ad esempio il modello può “dimenticare” pattern che conosceva e quindi non riconoscere più oggetti, situazioni, set di dati ecc. che precedentemente erano riconosciuti;
  • Per costruzione, la maggior parte degli algoritmi ML genera nella fase di apprendimento le logiche che poi utilizza, non è strano quindi che spesso sia difficile se non impossibile capire e spiegare la logica di un certo risultato dell’elaborazione; questo diventa particolarmente significativo quando il risultato non corrisponde a quanto ci si aspetta intuitivamente e si vorrebbe quindi capirne il perché;
  • Tipicamente i modelli ML producono come risultato dei valori di probabilità, ovvero di incertezza del risultato stesso, e spesso è necessario decidere quando un risultato è da considerarsi positivo; ad esempio, in un’applicazione di riconoscimento di volti, bisogna decidere se un match al 80% è sufficiente per essere positivo, e questo è difficile da definire a priori visto quanto descritto al punto precedente;
  • Infine, anche se sembra un paradosso, è molto difficile insegnare la matematica ad un modello ML, e non è chiaro perché un calcolatore da tasca è molto più efficiente e corretto dei più avanzati modelli ML nell’eseguire calcoli numerici e risolvere problemi matematici.

Dalle debolezze dei modelli AI/ML ai rischi di sicurezza

I modelli AI/ML sono oggi pervasivi ed utilizzati in moltissimi ambiti per cui le loro debolezze ed errori possono creare dei rischi di sicurezza in ambiti e con conseguenze molto diverse (si vedano ad esempio Rif. [7,8,9]). Qui di seguito ne indichiamo alcuni di sicuro interesse.

Sicurezza informatica e Cyber-sicurezza

Le capacità di individuare pattern su grandi quantità di dati e di essere predittivi sono molto utili ed ormai ampiamente adottate nelle soluzioni e nei servizi di sicurezza informatica, dagli anti-virus/malware (oggi estesi ai sistemi EPP/EDR/XDR ecc.) al monitoraggio della rete e ai SIEM/SOC. Esempi sono l’individuazione di vulnerabilità e attacchi Zero-day, l’analisi di codice malevole, l’identificazione di un attacco nelle fasi della kill-chain, l’identificazione di campagne di spam/phishing/spear-phishing ed in generale di attacchi basati sul social-engineering. I modelli AI/ML possono anche supportare il disegno di strategie ed il coordinamento di azioni di difesa, ed eseguire analisi per l’identificazione dei responsabili di un attacco.

Al contempo le stesse tecniche possono essere utilizzate da un attaccante per rendere i propri attacchi più difficilmente individuabili, più efficaci e con tempi di evoluzione molto più rapidi. E’ il ciclo (ben noto) di ogni tecnologia che può essere utilizzata sia in difesa che in attacco (si pensi ad esempio alle armi da fuoco) ed è estremamente importante non rimanere indietro.

Nell’utilizzo dei modelli AI/ML per la sicurezza informatica dobbiamo necessariamente tenere conto delle loro debolezze e, come difensore, che un attaccante possa sfruttarle ad esempio per fare in modo che il proprio attacco non venga rilevato. Quindi da una parte è necessario dotarsi di strumenti basati su AI/ML per rimanere al passo con le tecniche di attacco, dall’altro è anche necessario non basarsi esclusivamente su questi, ad esempio sia continuando ad utilizzare approcci più tradizionali sia mantenendo nei processi l’intervento diretto dell’uomo.

Fake News e Deep Fake

Il problema è ben noto a tutti, ed anche in questo caso il ruolo dei modelli ML è duplice. Da una parte i modelli ML possono essere utilizzati per individuare Fake News o comunque informazioni e materiale non lecito o consentito (come sui Social Network), ma ben vediamo che alle volte sono ben poco efficaci o sbagliano nell’individuazione portando al blocco di materiale lecito (si veda come esempio Rif. [10]).

Ma i modelli ML possono essere utilizzati anche per generare informazioni, documenti, immagini, suoni falsi (Deep Fake). L’idea è semplice: si consideri ad esempio un’immagine o una composizione musicale e la si modifichi sino a quando sia all’occhio / orecchio umano sia per gli algoritmi ML questa non risulta praticamente indistinguibile da un originale. Un approccio pratico per creare un falso è quello di utilizzare due modelli ML, uno che genera dei dati ad esempio in un formato di brano musicale ed un secondo che ha appreso a riconoscere i brani musicali di Mozart (questo è un esempio di Generative Adversarial Network, GAN), e di metterli in loop in modo che ad ogni iterazione il primo impari a generare un falso seguendo le indicazioni del secondo. Rimane ancora un problema non del tutto risolto quello di trovare il modo di identificare i Deep Fake così generati.

Frodi e propaganda

Fake News e Deep Fake possono essere utilizzati come componenti di frodi o di campagne di disinformazione orchestrate od anche automatizzate da modelli ML, sfruttando ad esempio le capacità di questi di creare e gestire spam, phishing e attacchi di social-engineering. Come nell’ambito della sicurezza informatica, modelli ML possono essere utilizzati in difesa per identificare frodi (ed ormai sono utilizzati comunemente per individuare frodi nelle transazioni economiche) e campagne di disinformazione, con simili lati positivi e negativi.

Sicurezza delle informazioni nei data-set

Un aspetto interessante riguarda la sicurezza delle informazioni contenute nei data-set utilizzati per l’apprendimento di un modello ML. Si consideri un modello ML utilizzato per identificare informazioni segrete o molto sensibili (in ambito militare o di sicurezza nazionale, sanitario, economico, dei diritti di autore ecc.) ad esempio in qualità o a supporto di un servizio di Data Loss Prevention (DLP). Ora nei data-set utilizzati per l’apprendimento di questo modello ML devono essere presenti sufficienti informazioni segrete o molto sensibili in modo da poterle differenziare da quelle non segrete o sensibili. Il rischio di sicurezza è che studiando il funzionamento del modello, le sue debolezze o utilizzandolo come un oracolo, sia possibile estrarre dal modello stesso delle informazioni sensibili presenti nel data-set di apprendimento (processo chiamato Model Inversion). Al momento questo è ancora un ambito di studio, ma questo rischio di sicurezza deve essere valutato tra le considerazioni da fare sulla sicurezza delle informazioni contenute nei data-set utilizzati per l’apprendimento.

Abuso di sistemi autonomi

Un rischio che deriva da eventuali debolezze di un modello ML è quello di abuso di un sistema autonomo, sia questo un drone, un’automobile o un’applicazione IT che valuta la richiesta di un mutuo casa o che esegue una diagnosi di una malattia ecc. Ad esempio un attaccante a conoscenza di una debolezza di un modello ML di un’automobile a guida autonoma, potrebbe sfruttare questa debolezza per trasformare l’automobile in un’arma all’insaputa del proprietario e dei suoi passeggeri. Il tipico approccio per la mitigazione dei rischi di questo scenario consiste nel ridurre il livello di autonomia del sistema, facendo si che l’uomo possa sempre intervenire in situazioni critiche e per approvare le principali decisioni del sistema.

Ambito militare

L’ambito militare è uno di quelli in cui l’adozione di modelli ML può avere effetti positivi e negativi estremamente profondi. L’adozione è possibile sia in ambito difensivo che offensivo e si estende dagli aspetti strategici, alla raccolta e analisi delle informazioni, alla pianificazione delle azioni ed alla realizzazione autonoma di azioni tramite droni o direttamente in cyberspace, il tutto supportato da velocità di decisione e azione molto superiore a quelle umane. Ma, ovviamente, le conseguenze di errori computi dai modelli di Machine Learning in questo ambito potrebbero essere molto gravi, sino ad arrivare agli scenari apocalittici descritti in libri e film di fantascienza. L’adozione dei modelli ML in questo ambito deve essere quindi sempre accompagnata da opportune contromisure che tengano conto dei rischi inerenti all’utilizzo di una tecnologia ancora così nuova ma al contempo così potente.

In conclusione, ricollegandoci a quanto scritto all’inizio, è vero che la scienza AI odierna e del prossimo futuro è ancora “debole” o “ristretta”, ma le sue capacità e potenzialità unite alle sue attuali debolezze e alla nostra limitata comprensione, richiedono una continua valutazione e rivalutazione dei rischi di adozione e utilizzo, e che l’uomo sia sempre presente per valutare e prendere decisioni nei processi critici in cui AI/ML è coinvolto.

Riferimenti Bibliografici

Rif. 1: Ad esempio: scikit-learn https://scikit-learn.org/stable/index.html, TensorFlow https://www.tensorflow.org/, PyTorch https://pytorch.org/, mlpack https://mlpack.org/, ecc.

Rif. 2: “Gartner Says Nearly Half of CIOs Are Planning to Deploy Artificial Intelligence”, febbraio 2018, https://www.gartner.com/en/newsroom/press-releases/2018-02-13-gartner-says-nearly-half-of-cios-are-planning-to-deploy-artificial-intelligence

Rif. 3: “Psychedelic toasters fool image recognition tech”, BBC News, gennaio 2018, https://www.bbc.com/news/technology-42554735 ; “Adversarial Patch”. Tom B. Brown, Dandelion Mané, Aurko Roy, Martín Abadi, Justin Gilmer, maggio 2018, https://arxiv.org/abs/1712.09665

Rif. 4: “Engineering Bias Out of AI”, IEEE Spectrum, aprile 2021, https://spectrum.ieee.org/engineering-bias-out-of-ai

Rif. 5: “The way we train AI is fundamentally flawed”, MIT Technology Review, novembre 2020, https://www.technologyreview.com/2020/11/18/1012234/training-machine-learning-broken-real-world-heath-nlp-computer-vision/

Rif. 6: “7 Revealing Ways AIs Fail”, IEEE Spectrum, settembre 2021, https://spectrum.ieee.org/ai-failures

Rif. 7: “AI’s 6 Worst-Case Scenarios”, IEEE Spectrum, gennaio 2022, https://spectrum.ieee.org/ai-worst-case-scenarios

Rif. 8: “A National Security Research Agenda for Cybersecurity and Artificial Intelligence”, CSET, maggio 2020, https://cset.georgetown.edu/publication/a-national-security-research-agenda-for-cybersecurity-and-artificial-intelligence/

Rif. 9: “AI-enabled future crime”, M. Caldwell, J. T. A. Andrews, T. Tanay & L. D. Griffin, Crime Science, agosto 2020, https://crimesciencejournal.biomedcentral.com/articles/10.1186/s40163-020-00123-8

Rif. 10: “The innocuous photos banned by Facebook: Social media giant apologises after it blocks art gallery’s images of COWS, the England cricket team and a high-rise office block because they are judged ‘too sexy’”, MailOnline News, febbraio 2021, https://www.dailymail.co.uk/news/article-9249087/Facebook-apologises-blocks-art-gallerys-images-COWS-sexy.html

Note

[1] In Inglese sono utilizzati due termini: Actuator se l’azione ha effetto sul sistema AI stesso ad esempio generando un suo spostamento nello spazio, e Effector se l’azione ha effetto sull’ambiente esterno al sistema AI.

[2] Anche se esistono degli Agenti molto semplici, quale ad esempio un termostato “smart”.

[3] Anche chiamato “Problema del commesso viaggiatore”.

[4] Questo tipo di errore può anche essere sfruttato per un Adversarial Attack.

[5] Si preferisce mantenere il termine tecnico inglese “bias” piuttosto che utilizzare la parola “pregiudizio”.

Articolo a cura di Andrea Pasquinucci

https://www.ictsecuritymagazine.com/articoli/intelligenza-artificiale-machine-learning-tra-complessita-e-sicurezza/


Come costruire e valutare un honeypot per sistemi industriali

I Sistemi di Controllo Industriale o Industrial Control Systems (ICS) sono utilizzati per la gestione dei processi industriali. Questi sistemi gestiscono infrastrutture critiche, come impianti di produzione di energia elettrica, sistemi di trasporto, raffinerie di petrolio, fabbriche chimiche e, in generale, impianti di produzione di vario genere.  Per loro natura, gli ICS sono in genere applicazioni mission-critical a cui si richiede la massima availability, dovendo gestire procedure molto delicate e ad alto rischio. Gli ICS sono spesso gestiti tramite un sistema di controllo di supervisione e acquisizione dati (SCADA), che fornisce un’interfaccia utente grafica per consentire agli operatori di osservare facilmente lo stato di un sistema, ricevere eventuali allarmi che indicano il funzionamento fuori banda o per inserire le regolazioni del sistema per gestire il processo sotto controllo. La maggior parte degli ICS rientra in un sistema di controllo di processi continui, generalmente gestiti tramite un Programming Logic Controller (PLC), o alternativamente di processi discreti (gestiti da un DPC).

Oggi, nell’era dell’Industria 4.0 e dell’Industrial Internet of Things (IIoT) [1], gli ICS possono essere interconnessi alla Intranet aziendale e, volenti o nolenti, anche ad Internet stessa. Questa esigenza di connessione espone inevitabilmente gli ICS a gravi problemi di sicurezza, che per loro natura possono riguardare la sicurezza e la salute dei cittadini di un ampio territorio: pensiamo per esempio alla gestione di una diga idroelettrica. Sono stati per questo motivo inclusi nella definizione di Perimetro Nazionale, così come stabilito dal DPCM 15 giugno 2021 (GU Serie Generale n.198 del 19-08-2021).

LOGistICS, è un sistema di emulazione e monitoraggio per ICS, che abbiamo sviluppato grazie soprattutto ad un lavoro di tesi magistrale del Dott. Emanuele Bosimini, co-supervisionato dal Prof. Stefano Bistarelli. Il cuore di LOGistICS è rappresentato da un honeypot [2] per ICS. Gli honeypot sono componenti hardware/software utilizzati come “esche” per attirare eventuali attaccanti: il loro scopo è quindi quello di esporre solo l’interfaccia vulnerabile di un servizio fittizio (honeypot a bassa interazione), anche se possono essere dotati inoltre di una logica interna (media/alta interazione). Gli honeypot possono quindi essere utilizzati per registrare eventuali attacchi diretti verso di essi e dare così la possibilità di studiare i loro pattern, in modo di comprendere meglio il loro comportamento (attacchi zero-day inclusi).

In LOGistICS ci siamo concentrati su due tipici protocolli ICS, come S7comm (un protocollo proprietario di Siemens) e Modbus (un protocollo aperto) di Schneider Electric, ampiamente utilizzati anche nell’automazione domestica. LOGistICS è composto da i) un honeypot altamente personalizzabile che emula i due suddetti servizi ICS, ii) uno sniffer che registra il traffico e iii) un nodo di monitoraggio, in grado di analizzare e tracciare i dati registrati. Inoltre abbiamo implementato un ulteriore nodo di test localmente distribuito con lo scopo di valutare la capacità dell’honeypot nel registrare efficacemente tali eventi. In Figura 1 viene mostrata l’architettura dei vari nodi che compongono LOGistICS, con i simboli di alcune delle tecnologie utilizzate. Tutto il sistema è a basso impatto energetico, dato che il nodo di monitoraggio utilizza un MiniPC, mentre quello di honeypot viene eseguito su un Raspberry Pi 4.

Figura1

I modelli di PLC emulati sono rappresentati attraverso file csv, ed è quindi possibile aggiungere nuovi modelli a piacimento. Al momento LOGistICS fornisce l’emulazione di 4 PLC che supportano il protocollo Modbus (Schneider, Toshiba, Beckhoff, Panasonic), mentre per quanto riguarda S7comm i PLC emulati sono le versioni S7-300, S7-400 e S7-1200. L’emulazione di S7comm è basata su un’estensione del progetto Snap7.[1] La documentazione Siemens ufficiale a riguardo è infatti molto scarsa, e non esistono API open-source per poter interagire con i PLC menzionati. Emulare questo servizio è stato quindi abbastanza complesso, dovendo in alcuni casi effettuare il reverse-hexdump dei messaggi per comprendere la loro struttura, in particolare i valori dei campi SZL: System-Zustands Listen è infatti la terminologia con cui Siemens fa riferimento agli stati interni del PLC, e quindi alle sue proprietà. Per esempio, l’array di byte SZL W_16_0232 index W_16_0004 contiene informazioni sul livello di protezione della CPU, e i checksum della configurazione hardware e del programma utente. È stato quindi necessario modificare i valori di default presenti in Snap7 allo scopo di renderli più simili a PLC di diverse tipologie.

Fornendo un’elevata personalizzazione dei modelli PLC infatti, il nostro intento è stato quello di ingannare gli strumenti di riconoscimento. Un honeypot deve essere infatti il più difficilmente riconoscibile come tale, in modo da evitare che un attaccante lo individui e se ne allontani. In particolare, il noto strumento di scansione nmap,[2] grazie agli script ausiliari eseguibili dal Nmap Scripting Engine (NSE), è in grado di eseguire una scansione accurata dei servizi Modbus e S7comm. Due script che abbiamo utilizzato sono s7-info.nse e modbus-discover.nse. Tutti i template PLC implementati per entrambi i protocolli sono stati riconosciuti da questi script come effettivamente PLC di quella precisa tipologia. Un simile risultato è stato ottenuto utilizzando strumenti come PLC Scan e Modscan, direttamente disponibili nella distribuzione Moki Linux.

Inoltre, abbiamo anche la sua capacità di camuffamento utilizzando Honeyscore, uno strumento implementato come modulo nella suite di test di penetrazione Metasploit. I parametri richiesti per Honeyscore consistono semplicemente in una API-key di Shodan API (per utilizzare le informazioni fornite appunto da Shodan)[3] e un “target”, che corrisponde all’indirizzo IP da valutare. Come risultato, Questo strumento riporta un valore compreso tra 0 e 1, dove 1 equivale alla certezza che l’IP corrisponda ad un honeypot: in questo caso è importante ottenere un valore inferiore a 0.5, dato che molti tool, come per esempio Shonydanza,[4] utilizzano questa soglia per filtrare automaticamente gli IP identificati come honeypot. Nel nostro caso, abbiamo ottenuto un punteggio di 0 per Modbus e 0.3 per S7comm.

Infine, per valutare la capacità del nostro honeypot di registrare veri attacchi provenienti da tool ben conosciuti, abbiamo utilizzato Metaploit[5] e Industrial Exploitation Framework (ISF)[6], simile al primo ma dedicato interamente a sistemi industriali. Sono stati utilizzate 5 vulnerabilità ben conosciute (tre S7comm e due Modbus), individuate dagli identificativi 19831.rb, 38964.rb, 19833.rb, 42691.rb, quantum_140_plc_control. In tutti gli esperimenti effettuati l’attacco è risultato pienamente riuscito (lato tool di penetration) e registrato (lato honeypot).

L’ultimo passo è stato quello di lasciare LOGistICS in ascolto su Internet, anche se su una rete domestica collegata tramite ISP (non una rete aziendale). Il numero di eventi giornalieri registrati è mostrato in Figura 2. Su questi dati abbiamo poi effettuato un’analisi a posteriori, per eliminare il rumore di fondo provocato da motori di ricerca come Shodan. Nel mese analizzato (Gennaio 2021), abbiamo rilevato 301 attacchi tramite protocollo Modbus, e 6 attacchi al protocollo S7comm. Per un’analisi più approfondita, rimandiamo all’articolo scientifico in cui sono stati pubblicati i risultati ottenuti [3].

Figura 2

L’utilizzo di strumenti di Deception Technology,[7] come gli Honeypot, è fondamentale per poter riconoscere e studiare nuovi attacchi avanzati. In un futuro dove questi diventeranno sempre più sofisticati e impattanti, la messa in sicurezza di sistemi ICS è fondamentale tanto per un’azienda quanto per il Paese, al fine di evitare spionaggio industriale e sabotaggio di strutture vitali.

BIBLIOGRAFIA

[1] Boyes, H., Hallaq, B., Cunningham, J., Watson, T. (2018). “The industrial internet of things (IIoT): An analysis framework”. Computers in Industry. 101: 1–12. doi:10.1016/j.compind.2018.04.015. ISSN 0166-3615.

[2] Nawrocki, M., Wählisch, M., Schmidt, T. C., Keil, C., & Schönfelder, J. (2016). “A survey on honeypot software and data analysis.” arXiv preprint arXiv:1608.06249.

[3] Bistarelli, S., Bosimini E., Santini, F. (2021). A Medium-Interaction Emulation and Monitoring System for Operational Technology. ARES 2021: 118:1-118:7

Note

[1] Snap7: http://snap7.sourceforge.net

[2] Nmap: https://nmap.org

[3] Shodan: https://www.shodan.io

[4] Shonydanza: https://securityonline.info/shonydanza/

[5] Metaploit: https://www.metasploit.com

[6] Industrial Exploitation Framework: https://github.com/dark-lbp/isf

[7] https://it.wikipedia.org/wiki/Deception_technology

Articolo a cura di Francesco Santini

https://www.ictsecuritymagazine.com/articoli/come-costruire-e-valutare-un-honeypot-per-sistemi-industriali/


La CyberSecurity per i droni

Introduzione

La progressiva integrazione dei droni nello spazio aereo civile europeo e l’emergere di numerose applicazioni di questi strumenti (dalle attività ricreative ai servizi, fino ai campi della fotografia, della logistica e della sorveglianza delle infrastrutture) hanno portato alla reale necessità, da un lato, di concentrarsi sulle sfide che il loro utilizzo su larga scala potrebbe comportare per la tutela della privacy, delle libertà civili e politiche di ciascuno e, dall’altro, valutare le misure necessarie per garantire il rispetto dei diritti fondamentali e la protezione dei dati.

Diversi sono, infatti, i rischi per la tutela della privacy che possono derivare dal trattamento di dati (come immagini, suoni e dati di geolocalizzazione relativi a una persona fisica identificata o identificabile) effettuato con i dispositivi a bordo di un drone. Tali rischi possono andare dalla mancanza di trasparenza sui tipi di trattamento, a causa alla difficoltà di vedere i droni da terra, sino alla difficoltà, in ogni caso, di sapere quali siano le apparecchiature a bordo destinate al trattamento di dati, quali siano i fini per cui vengono raccolti i dati personali e da chi. Inoltre, le potenzialità dei droni e la possibilità di interconnetterne più di uno facilita ancor di più la loro capacità di ottenere punti di osservazione unici. Ad esempio, grazie alla possibilità di evitare ostacoli o superare barriere o recinzioni, facilitando la raccolta di un’ampia varietà di informazioni con un alto rischio di raccolta dati in blocco e possibili usi illeciti per molteplici scopi.

Rischi ancora maggiori per i diritti e le libertà delle persone sorgono laddove il trattamento di dati personali mediante droni sia effettuato ai fini di contrasto della criminalità.

Prima di utilizzare un drone è necessario rispettare una serie di obblighi e nello specifico:

  • verificare, ove consentito l’utilizzo di droni, se sia necessaria una specifica autorizzazione da parte delle autorità dell’aviazione civile (AAC);
  • individuare i criteri più idonei di liceità del trattamento;
  • rispettare i principi di limitazione delle finalità, minimizzazione dei dati e proporzionalità (selezionando le tecnologie e le misure più appropriate per evitare la raccolta di dati personali non necessari);
  • soddisfare, nel modo più idoneo alla fattispecie in esame, il principio di trasparenza (informando gli interessati del trattamento effettuato);
  • adottare tutte le opportune misure di sicurezza;
  • garantire l’eliminazione o l’anonimizzazione dei dati personali non strettamente necessari.

È inoltre necessario considerare la possibilità di interconnettere più droni al fine di sorvegliare una vasta area. Sciami di droni con canali di comunicazione in tempo reale che li collegano tra loro e con terze parti comportano rischi ancora maggiori per la protezione dei dati; in quanto potrebbero facilmente consentire una sorveglianza coordinata, ovvero il controllo del movimento di persone o veicoli su vaste aree.

Vi è quindi un alto rischio che il trattamento dei dati personali da parte dei droni diventi segreto e causi significative interferenze nella sfera più privata delle persone. Allo stesso tempo, date le attrezzature messe a bordo potenzialmente sofisticate e la facilità con cui i dati personali raccolti possono essere collegati ad altre informazioni, vi è un maggior rischio di “function creep”; ovvero il rischio di modifica o estensione dell’uso per scopi incompatibili.

Inoltre, il potenziale impatto dell’intrusione nella privacy è aggravato dall’ampia varietà di individui ed entità coinvolti nell’uso dei droni. Anche i produttori di droni, ad esempio, hanno un ruolo da svolgere nella fase di progettazione di tali dispositivi, considerando che le caratteristiche operative possono, in misura minore o maggiore, prestarsi ad applicazioni invadenti per la privacy (ad esempio, nel caso di piccoli o droni di medie dimensioni in grado di volare all’interno di edifici).

Regole di base e regolamenti sui droni

Regolamento europeo

EASA (European Union Aviation Safety Agency)

Il regolamento di base è stato attuato attraverso due regolamenti, di seguito.

Regolamento (UE) 2019/947 e Regolamento (UE) 2019/945

Il Regolamento 2019/947 fornisce regole e procedure incentrate sulle operazioni e basate sul rischio per le operazioni con i droni. Definisce tre categorie di operazioni UAS: Aperte, Specifiche e Certificate sviluppate parallelamente alle categorie JARUS A, B e C.

Categoria aperta (Open Category) – Droni civili

Nella categoria aperta, non esiste un’approvazione operativa ma piuttosto una serie di limitazioni come la Visual Line Of Sight (VLOS), l’altezza massima di 120 metri e la massa massima al decollo inferiore a 25 kg. Il regolamento include “operations over people” (OOP). La categoria aperta è suddivisa in 3 sottocategorie rilevanti per l’OOP indicate di seguito:

  • A1 – consente il sorvolo di persone isolate, con droni con una massa sotto i 250gr nelle classi C0 e 900gr in C1. È richiesta la formazione online. (Sorvolare persone ma non assembramenti di persone);
  • A2 – consente di volare vicino alle persone, per droni con una massa massima di 4kg in classe C2. È richiesta una formazione online più una formazione pratica auto-dichiarata (Volare vicino le persone);
  • A3- consente voli solo lontano dalle persone e dagli aeroporti, per droni con una massa massima di 25kg, classe C3 e C4. È richiesta anche la formazione online. (Volare lontano dalle persone).

Categoria specifica (Specific Category) – Droni civili

La categoria specifica copre tutte le operazioni che non rientrano nelle categorie aperte e certificate. Richiede un’autorizzazione operativa basata sul rischio rilasciata dall’autorità dello Stato membro competente. Gli esempi includono oltre la “Visual Line Of Sight” anche alcune operazioni di delivery dei droni.

Il metodo di compliance accettato utilizzato dagli Stati membri è lo Specific Operation Risk Assesmsment (SORA) sviluppato dalle autorità congiunte per la regolamentazione dei sistemi senza pilota (JARUS). Affronta il rischio terrestre e aereo e combina i due per creare un livello di garanzia e integrità specifico (SAIL) tra I e VI. Un livello di rischio di VII o superiore sposta l’operazione nella categoria certificata superiore. Il SORA definisce anche adeguate misure di mitigazione

Morier, che è stato Presidente della JARUS dal 2017 al 2019, elabora: “Per evitare l’applicazione sistematica di SORA, sono stati definiti scenari standard (operazioni a basso rischio), che consentono di fornire una Dichiarazione di conformità anziché un’autorizzazione formale. Sono state inoltre definite Pre-Determined Risk Assessments (PDRA). Se un’operazione soddisfa questi requisiti, è ancora necessaria un’autorizzazione, ma dovrebbe essere ottenuta più facilmente. Le autorizzazioni nella categoria specifica sono valide in tutti i Paesi dell’UE, ma potrebbe essere necessario verificare le misure di mitigazione legate alla geografia e al tempo”.

BVLOS (Beyond Visual line of Sight) è consentito in categorie specifiche e certificate, a seconda del risk assessment.

Categoria certificata (Certified Category) – Droni civili

Nella categoria certificata, i droni sono certificati, gli operatori ricevono un certificato e il pilota ha una licenza. Questo è molto simile ai voli dell’aviazione con equipaggio. Le operazioni certificate sono state classificate in 3 tipologie:

  • Operazioni di tipo 1– Instrument flight rules (IFR) operazioni per droni che trasportano merci nelle classi di spazio aereo A–C (ICAO airspace classification) e decollano e/o atterrano negli aeroporti che rientrano nel regolamento di base.
  • Operazioni di tipo 2 – droni che decollano e/o atterrano in ambienti congestionati utilizzando rotte predefinite nello spazio aereo U-space. Questi includono le operazioni di aeromobili VTOL (Vertical Take-Off and Landing) senza equipaggio che trasportano passeggeri (ad esempio aerotaxi) o merci (ad esempio servizi di consegna di merci).
  • Operazioni di tipo 3 – come per le operazioni di tipo 2 con velivoli VTOL con pilota a bordo, comprese le operazioni fuori dallo spazio aereo U-Space

Il Regolamento 2019/ 945 stabilisce i requisiti per la progettazione e la fabbricazione di sistemi aeronautici senza equipaggio (UAS) destinati a essere utilizzati secondo le regole e le condizioni definite nel regolamento di esecuzione (UE) 2019/947 e di componenti aggiuntivi per l’identificazione a distanza. Definisce inoltre il tipo di UAS la cui progettazione, produzione e manutenzione sarà oggetto di certificazione. Stabilisce norme sulla messa a disposizione sul mercato di UAS, kit di accessori e componenti aggiuntivi per l’identificazione a distanza e sulla loro libera circolazione nell’Unione.

Il presente regolamento, infine, fissa anche le norme per gli operatori UAS di paesi terzi, quando effettuano un’operazione UAS ai sensi del regolamento di esecuzione (UE) 2019/947 all’interno del single European sky airspace.

Figure 1 – Categoria Open, Specific e Certified

L’immagine mostra chiaramente come vengono identificate le operazioni. Con questo nuovo regolamento, il fatto che si stia pilotando un UAS (Unmanned Aircraft System) per motivi di lavoro o hobby non è più rilevante, conta solo se ciò che stai facendo può essere in qualche modo pericoloso.

JARUS

Le Joint Authority for Rulemaking on Unmanned Systems (JARUS) sono un gruppo di esperti di 60 autorità aeronautiche nazionali mondiali (NAA) e 2 organizzazioni regionali per la sicurezza aerea (EASA ed EUROCONTROL), il cui obiettivo è sviluppare regole armonizzate per gli UAS. Il concetto di regolazione incentrata sulle operazioni con le tre categorie (aperta, specifica e certificata) è stato sviluppato all’interno delle categorie JARUS.

La missione di JARUS è sviluppare requisiti tecnici e operativi per il funzionamento sicuro, protetto ed efficiente degli UAS, per fungere da riferimento comune per l’uso nei rispettivi regolamenti e linee guida dei membri JARUS, facendolo in modo efficace ed efficiente, evita la duplicazione di sforzi con altre organizzazioni aeronautiche internazionali.

JARUS è responsabile dello sviluppo della metodologia per Specific Operations Risk Assessment (SORA). È stato approvato dall’Agenzia europea per la sicurezza aerea (EASA) come mezzo di conformità accettabile (AMC) per soddisfare i requisiti dei regolamenti europei UAS (Basic Regulation, Implementing Act, Delegated Act e Annexes).

EUROCONTROL

Nell’ambito delle proprie attività volte all’integrazione sicura degli UAS, EUROCONTROL ha condotto diversi webinar basati su alcuni temi caldi nel dominio UAS, con la partecipazione delle parti interessate più rilevanti nelle diverse sessioni. L’obiettivo di questi webinar era quello di sviluppare linee guida che non fossero direttamente correlate a un particolare regolamento.

EUROCAE (European Organisation for Civil Aviation Equipment)

EUROCAE è il leader europeo nello sviluppo di standard industriali riconosciuti a livello mondiale per l’aviazione. EUROCAE sviluppa standard per l’industria che:

  • si basano sull’esperienza all’avanguardia dei suoi membri affrontando le slide globali dell’aviazione;
  • sono idonei allo scopo per essere adottati a livello internazionale;
  • supportano i processi operative, di sviluppo e normativi.

Regolamento italiano

Regolamento UAS-IT: integrazione di ENAC al regolamento droni EASA

Il 1° gennaio 2021 è entrato in vigore il Regolamento UAS-IT, che disciplina gli aspetti di competenza dell’Autorità nazionale per le operazioni con droni che non rientrano nelle disposizioni del Regolamento di esecuzione (UE) 2019/497.

Requisiti del pilota

In termini pratici il regolamento UAS-IT, ad una prima lettura, non fa altro che ribadire ciò che è già contenuto nel regolamento europeo in quanto non aggiunge nessun requisito aggiuntivo per il pilota di droni che opera nelle Open Category, per i droni privi di marcatura CE.

Rimangono validi i requisiti relativi ad altezza, distanza da infrastrutture e persone non informate.

Assicurazione

Secondo l’art. 27 dell’UAS-IT non è consentito condurre operazioni con un UAS se un’assicurazione relativa alla responsabilità verso terzi, adeguata allo scopo e con massimali non inferiori ai parametri minimi di cui alla tabella dell’art. 7 del Regolamento (CE) 785/2004.

Registrazione

Secondo quanto previsto dal regolamento di cui all’art. 6, gli operatori UAV sono tenuti a registrarsi sul portale D-Flight, anche ai fini dell’identificazione e imputazione di responsabilità civile e penale, e ad apporre il codice identificativo QR sull’UAV.

Sicurezza

La sicurezza riguarda il contrasto di tutte le azioni dolose intraprese per compiere un attacco deliberato attraverso l’utilizzo di un UAV: un’area in cui ricade il terrorismo, ad esempio. Ma anche spionaggio, aggressione, utilizzo dell’UAV per testare le difese di una struttura per poi compiere atti illeciti come intrusioni, furti, danneggiamenti. È chiaro che le leggi possono fare poco contro le operazioni illecite e criminali, ma il Regolamento ENAC ha alcune disposizioni per complicare l’uso degli UAV per scopi illegali. Il principale è l’articolo 33, che tratta esplicitamente di Sicurezza.

Sicurezza del radio link

Contrastare le minacce alla sicurezza comporta anche obblighi e doveri nei confronti del Pilota e dell’Operatore. A partire dall’obbligo di protezione del radio link, cioè del collegamento tra il drone e la radio, previsto dall’art. 33 comma 1:

“L’operatore deve adottare misure adeguate per proteggere gli UAS per prevenire atti illeciti durante le operazioni anche al fine di prevenire l’interferenza volontaria del radio link“.

Le minacce a cui fa riferimento questo paragrafo sono essenzialmente due: da una parte il cosiddetto “drone Hijack”, il dirottamento del drone, ovvero la possibilità che un malintenzionato si impossessi del nostro UAS per compiere azioni illegali.

Dall’altra parte, invece, l’accesso abusivo ai dati trasmessi a terra dai SAPR: immaginiamo il caso di svolgere un’operazione specializzata per conto di un’azienda che ha segreti industriali da proteggere. Ovviamente avremo firmato stringenti accordi di riservatezza, ma un malintenzionato potrebbe essere in grado di ricevere il video link di ritorno del nostro UAV e quindi rubare informazioni riservate. Per ottemperare alle prescrizioni del comma, l’operatore e il pilota devono proteggere in ogni modo il radio link di controllo e ritorno, installando eventuali patch e aggiornamenti di sicurezza, utilizzando connessioni crittografate ove possibile e proteggendo la chiave per decrittografarle.

Proteggere l’area delle operazioni

Se il primo comma dell’articolo 33 riguarda la protezione del collegamento radio, ovvero dei collegamenti radio, dati e di controllo, tra l’UAV e la stazione di terra, il secondo comma riguarda le intrusioni meno sofisticate e tecnologiche ma non per questo meno pericolose:

“L’operatore deve stabilire procedure per impedire l’accesso di personale non autorizzato all’area operativa, alla stazione di controllo e per lo stivaggio del sistema.”

Il significato è chiaro: non c’è bisogno di hackerare una connessione radio se si può facilmente ottenere la stessa cosa rubando l’hard disk dove abbiamo registrato i dati della missione. E se i malintenzionati possono entrare, possono anche rubare l’UAV e la radio e fare quello che vogliono. Il secondo comma ci invita essenzialmente, anzi ci obbliga, a monitorare e proteggere le nostre apparecchiature, poiché ci sono casi in cui una possibile intrusione non danneggia solo noi, ma potenzialmente l’intera comunità.

Conclusioni

Pur riconoscendo i benefici a livello sociale ed economico dell’uso civile dei droni e il loro potenziale in termini di crescita, è necessario porre l’attenzione sulle minacce e sui rischi per la protezione dei dati e la propria privacy derivanti da un impiego su larga scala della tecnologia dei droni e valutare le misure necessarie per garantire il rispetto di tutti i diritti fondamentali coinvolti.

Concludendo, la continua evoluzione tecnologica ha portato ad una progressiva trasformazione normativa ed è quindi importante informarsi su tutte le novità introdotte nei regolamenti italiani ed europei consentendoci di utilizzare il drone per essere in regola e quindi per agire in sicurezza.

Articolo a cura di Domenico Raguseo, Rosita Galiandro, Giuseppe Marullo e Antonio De Chirico

Rosita Galiandro

Rosita Galiandro ha conseguito la laurea Magistrale in Sicurezza Informatica presso l’Università di Bari.

Attualmente ricopre il ruolo di Responsabile Osservatorio CyberSecurity presso Exprivia.

Contribuisce alle attività di prevendita, ha partecipato a progetti di risk assessment e GDPR compliance e collabora in piani di insegnamento con diverse università nell’ambito CyberSecurity e nel progetto CyberChallenge.IT. Fa parte della community Women For Security.

https://www.ictsecuritymagazine.com/articoli/la-cybersecurity-per-i-droni/


Il trattamento dei dati personali nella lotta all’evasione fiscale: possibilità e tutele

La privacy e il diritto alla protezione dei dati personali sono diritti fondamentali riconosciuti da molteplici norme comunitarie ed internazionali, oltre che da numerose sentenze delle corti sovranazionali. Ciononostante, come ogni altro diritto, si trovano talvolta a dover far fronte all’applicabilità di interessi parimenti meritevoli di tutela e, a seconda degli esiti del bilanciamento, rischiano di essere “sacrificati”. Uno di questi casi è la lotta all’evasione fiscale, la quale risponde ad un interesse pubblico dello Stato.

Privacy e interesse pubblico: il caso specifico dell’applicazione delle norme fiscali

L’interesse pubblico è uno dei concetti giuridici più utilizzati come contrappeso nel bilanciamento tra diversi diritti. Al contempo, però, si caratterizza per essere di difficile definizione anche a causa del fatto che, negli anni, si sono susseguite visioni e orientamenti diversi. Generalmente, viene accettata la definizione secondo la quale l’interesse pubblico rappresenterebbe l’interesse proprio della comunità intesa come collettività dei soggetti che ne fanno parte. Tuttavia, oggi viene rigettata l’ipotesi di una nozione unitaria, in virtù dell’emergere di una pluralità di interessi pubblici “particolari” che col tempo hanno affiancato gli interessi pubblici “generali”.

Il caso specifico della lotta all’evasione non pone però grossi problemi interpretativi, potendo in questo caso parlare di un interesse pubblico dello Stato inteso come “somma” degli interessi della comunità a prevenire e contrastare l’evasione sulla base dell’assunto che ciò rappresenterebbe al contempo la garanzia del diritto dei consociati a non subire le conseguenze delle condotte illecite altrui.

Tutto piuttosto chiaro, senonché la lotta all’evasione presuppone ovviamente l’individuazione degli evasori, ossia coloro che pongono in essere i comportamenti incriminati. Questo può rendere necessario il ricorso a determinate procedure invasive della riservatezza, ed è in questo contesto che l’interesse pubblico in esame si scontra con il diritto alla tutela dei dati personali, con la necessità di diventare oggetto di bilanciamento con lo stesso, onde evitare – quantomeno nelle intenzioni – che la garanzia dell’uno determini un’eccessiva compressione dell’altro.

In tal senso, l’art. 2-ter del Codice della Privacy come novellato  dal D. Lgs n. 101/2018 regola la questione relativa alla “Base giuridica per il trattamento di dati personali effettuato per l’esecuzione di un compito di interesse pubblico o connesso all’esercizio di pubblici poteri”, sfruttando lo spazio di discrezionalità consentito dall’art. 6, comma 2, del Regolamento UE 2016/679 (GDPR) che lascia agli Stati membri la possibilità di mantenere o introdurre disposizioni più specifiche per adeguare l’applicazione delle norme del regolamento con riguardo ai trattamenti compiuti in conformità al paragrafo 1, lettere c) ed e), ossia quelli legittimati – rispettivamente – dall’adempimento ad un obbligo legale e dall’esecuzione di un compito di interesse pubblico o connesso all’esercizio di pubblici poteri.

La materia viene poi ripresa anche dall’art 2-sexies del Codice che detta le condizioni richieste per il “Trattamento di categorie particolari di dati necessario per motivi di interesse pubblico rilevante”. In particolare, suddetto trattamento è ammissibile soltanto laddove sia previsto dal diritto dell’Unione europea o dal diritto nazionale. In quest’ultimo caso, la base giuridica è solo una disposizione di legge o di regolamento che assicuri le condizioni di proporzionalità del trattamento, la salvaguardia del diritto alla protezione dei dati, preveda misure idonee a tutelare gli interessati, e specifichi i tipi di dati che possono essere trattati, le operazioni eseguibili e il motivo di interesse pubblico rilevante. Su quest’ultimo punto, l’articolo 2-sexies elenca quei trattamenti che possono ritenersi effettuati per motivi di rilevante interesse pubblico, includendo al comma 2, lett. i), le attività dei soggetti pubblici dirette all’applicazione – anche tramite loro concessionari – delle disposizioni in materia tributaria e doganale, comprese quelle di prevenzione e contrasto all’evasione fiscale.

Quando la riservatezza “soccombe” alla lotta all’evasione: la sentenza della CEDU e il Decreto Capienze

In tema di bilanciamento tra tutela dei dati personali e della riservatezza e necessità di assicurare l’interesse pubblico della lotta all’evasione, la Corte Europea dei Diritti dell’Uomo (Corte EDU) si è pronunciata con la sentenza sul caso L. B. contro Ungheria del 12 gennaio 2021 la quale però, è necessario precisarlo, non ha potuto tenere conto del GDPR essendo fondata su un ricorso del 2016. Nel caso di specie, l’Amministrazione finanziaria ungherese aveva pubblicato sul proprio sito internet i dati – nello specifico quelli anagrafici e quelli inerenti al debito tributario – dei “grandi” evasori fiscali, in applicazione di una norma nazionale del 2003 che prevedeva proprio la possibilità di pubblicare sul web una lista di quei contribuenti che non avessero versato le imposte dovute sulla base di un accertamento diventato definitivo e per un importo superiore a dieci milioni di fiorini ungheresi entro il termine di 180 giorni. Dopodiché, tale lista consentiva di elaborare una mappa degli evasori volta ad individuarli geograficamente e nominativamente. Ora, nella sentenza la Corte aveva accertato che le informazioni pubblicate rientrassero effettivamente nella definizione di “dati personali” ai sensi della Convenzione 108 sulla protezione dei dati personali del 1981, riconducendo la tutela anche all’art. 8 della CEDU. Ciononostante, ha ritenuto – non senza stupore – che la pubblicazione su internet di una lista di “grandi” evasori fiscali da parte dell’Amministrazione finanziaria ungherese non violasse suddetto articolo, in quanto si tratterebbe di una ingerenza nella vita privata giustificata e proporzionale, anche tenendo conto dell’ampia discrezionalità riconosciuta agli Stati in materia di politica sociale ed economica – ivi compresa quella fiscale – che giustifica la decisione di far prevalere l’interesse pubblico erariale sul diritto alla privacy dei soggetti. Occorre precisare però che la Corte non ha affermato che la pubblicazione dei dati in una lista di evasori non sia un’interferenza nella vita privata, ma ha solo precisato che in questo caso tale ingerenza trova fondamento in una norma di legge che persegue più scopi legittimi, ossia la tutela dell’interesse pubblico al miglioramento della disciplina del pagamento delle imposte e la tutela dell’interesse dei terzi a conoscere la situazione finanziaria degli evasori fiscali onde valutare con chi intraprendere rapporti economici. Quindi, quella che per il ricorrente era una umiliazione pubblica lesiva della sua privacy, per la Corte è invece il semplice prevalere dell’interesse pubblico della collettività sulla protezione dei dati di un singolo, tra l’altro con un solido fondamento normativo.

Nel nostro ordinamento un esempio di bilanciamento tra interesse pubblico e diritto alla tutela dei dati personali che vede la soccombenza di quest’ultimo, è quello che ritroviamo nel D.L. n. 139/2021 – c.d. Decreto Capienze – pubblicato in Gazzetta Ufficiale l’8 ottobre scorso. L’art. 9 comma 1 lett. a) num. 1) prevede che il trattamento dei dati personali da parte di un’amministrazione pubblica, comprese le autorità indipendenti e le amministrazioni inserite nell’elenco Istat (comprese le agenzie fiscali), nonché da parte di una società a controllo pubblico statale o di un organismo di diritto pubblico, è sempre consentito se necessario per l’adempimento di un compito svolto nel pubblico interesse o per l’esercizio di pubblici poteri. Non solo, ma è stato anche interamente abrogato un articolo del Codice della Privacy che, con riguardo ai trattamenti ad alto rischio svolti per l’esecuzione di un compito di interesse pubblico, riconosceva al Garante il potere di prescrivere misure e accorgimenti a garanzia del soggetto interessato. Si tratta quindi un rafforzamento delle procedure di competenza della PA, ivi comprese quelle aventi ad oggetto le indagini fiscali volte all’individuazione degli evasori, con conseguente sacrificio – per tale scopo – del diritto alla privacy.

Conclusioni: quali tutele?

Come si è potuto vedere, il concetto di interesse pubblico rappresenta un elemento caratterizzato da un peso considerevole quando viene messo a confronto con tutti quei diritti che – almeno a primo impatto – riguardano in primo luogo il singolo. Si tratta quindi di situazioni nelle quali incombe la necessità di tutelare la collettività, al punto da giustificare la soccombenza di diritti fondamentali quali, per l’appunto, il diritto alla riservatezza. Di conseguenza, visto che in più occasioni ciò è effettivamente avvenuto sulla base di soluzioni tanto legislative quanto giurisprudenziali, occorre porsi il problema di quali principi e misure possano assumere rilevanza per tutelare il già di per sé sacrificato diritto alla tutela dei dati personali. Un primo spunto in tal senso lo si può rinvenire nella citata sentenza della Corte europea dei diritti dell’uomo, la quale ha ritenuto che il trattamento posto in essere dal fisco ungherese non fosse lesivo della privacy degli evasori. Sta di fatto, però, che un elemento importante al quale fare riferimento per limitare le attività di trattamento finalizzate alla lotta all’evasione è il principio di minimizzazione previsto all’art. 5, par. 1, lett. c) del GDPR, il quale esige che i dati trattati siano adeguati, pertinenti e limitati a quanto necessario rispetto alle finalità.

Alla luce di ciò, ricollegandosi alla sentenza della CEDU, si potrebbe dubitare dell’adeguatezza delle modalità realizzate dal fisco ungherese, e questo per due ragioni: la pubblicazione dell’indirizzo di residenza che viene collegato ai dati identificativi dell’evasore, e l’assenza di una forma di identificazione dei soggetti che potevano accedere a tali dati, visto che questi erano disponibili a chiunque si collegasse al sito in cui erano pubblicati. Ciononostante, l’UE non vieta la pubblicazione di liste di evasori, anzi, la stessa Unione ha un elenco di soggetti che rappresentano una minaccia per la finanza e le istituzioni europee; tuttavia, tale elenco è accessibile solo a queste ultime e non a chiunque.
Quanto invece ad ipotesi diverse concernenti soprattutto l’utilizzo di tecnologie per “scovare” gli evasori, anche qui occorre tenere conto dei principi cardine del diritto della privacy, a partire dal rispetto della condizione essenziale dell’interesse pubblico che non deve diventare un escamotage per forme di sorveglianza incondizionata. Occorre cioè che lo scopo sia effettivamente quello di tutelare l’interesse dello Stato a scongiurare quanto più possibile i danni derivanti dall’elusione dei doveri fiscali, prevedendo al contempo misure idonee per non eccedere nelle attività di trattamento. Dopodiché, qualora questo sfociasse nella pubblicazione di “liste nere” dei contribuenti, è necessario che queste siano – come ormai è chiaro – accessibili con limiti stringenti e chiari ai soli soggetti che esercitano i pubblici poteri. Altro aspetto da monitorare è quello relativo al diritto all’oblio ex art. 17 del GDPR, il quale permette all’interessato di ottenere la cancellazione dei dati qualora divenissero non più necessari rispetto alle finalità o fossero stati trattati illecitamente. Vediamo quindi che se da un lato la direzione intrapresa dalla legge è quella di una forte pressione dell’interesse pubblico erariale sul diritto alla privacy e sulla tutela dei dati personali, ci sono degli accorgimenti che possono regolare le attività dell’Amministrazione finanziaria consentendo comunque di conseguire le finalità perseguite.

Articolo a cura di Marco Martorana

https://www.ictsecuritymagazine.com/articoli/il-trattamento-dei-dati-personali-nella-lotta-allevasione-fiscale-possibilita-e-tutele/


Crittografia si, ma con il giusto Key Mgmt System

In un mondo sempre più interconnesso, le violazioni dei dati catturano sempre più i titoli dei giornali. La sicurezza delle informazioni sensibili è vitale ed i requisiti normativi come il Payment Card Industry Data Security Standard (PCI-DSS), Health Insurance Portability and Accountability Act (HIPAA) e Sarbanes-Oxley (SOX) creano sfide per le aziende che giustamente guardano alla crittografia come mezzo necessario per proteggere le proprie informazioni.

Crittografia che assume un ruolo principale per ogni tipo di organizzazione e con essa diventa ancor più importante un’attenta gestione delle chiavi di crittografia senza cui i nostri dati sarebbero inutilizzabili. Non solo: con l’aumento dell’ impiego della crittografia occorre far fronte ad un numero crescente di chiavi di crittografia richieste dalle applicazioni.

Pertanto una gestione ben organizzata ed efficace di queste chiavi diventa essenziale per garantire sia la disponibilità che la sicurezza delle informazioni crittografate. E’ altresì necessaria una gestione centralizzata delle chiavi e dei certificati per poter eseguire le complesse attività relative alla generazione, al rinnovo, al backup e al ripristino di chiavi e certificati.

Per tutti questi motivi ci si affida spesso ad una soluzione di Key Management capace di gestire efficientemente l’intero ciclo di vita delle chiavi tramite una completa fruibilità e scalabilità tra le differenti tecnologie crittografiche, che sappia interagire con il maggior numero di tipologie di sistemi target e, soprattutto, che sappia operare in un contesto di infrastrutture globali di tipo eterogeneo, quindi anche ambienti Cloud o Hybrid-Cloud.

Ma andiamo con ordine e cominciamo ad esaminare le caratteristiche tecniche principali che deve avere un vero sistema di Key Management.

– Innanzitutto deve essere in grado di controllare dove viene generata la chiave, come viene gestita, conservata, utilizzata e revocata, oltre alla gestione dei metadati collegati alle chiavi. Queste operazioni devono seguire un flusso logico semplice da comprendere ed inequivocabile nell’operare proprio per evitare il più possibile errori umani indotti dall’operatore.

– Poi deve garantire la protezione delle chiavi sia per la loro memorizzazione che per l’archiviazione. L’utilizzo di un unico repository centralizzato consente inoltre di realizzare facilmente il backup includendo il database delle chiavi nelle procedure di backup già presenti nei flussi operativi. Ciò facilita il recupero in caso di smarrimento di chiavi o certificati. Il tutto deve poi rispettare i criteri del NIST per la distribuzione delle chiavi verso le piattaforme target che ne richiedono l’uso.

– Deve conferire caratteristiche prestazionali e di scalabilità per superare eventuali prestazioni di picco, anche in presenza di alti volumi di chiavi utilizzate.

– Deve poter adottare protocolli universali, come KMIP o ANSI X9.24, capaci di cooperare con il più alto numero di target disponibili sul mercato.

Quindi deve fornire supporto multipiattaforma, multisito e multivendor in modo da eseguire tutte le funzioni di gestione di chiavi e certificati su diverse piattaforme, sistemi operativi e posizioni geografiche.

– Monitoraggio. La scadenza del materiale di crittografia deve essere monitorata in modo da generare avvisi in tempo utile per avviare la sostituzione.

– Infine deve assicurare la tracciabilità delle operazioni, in modo da poter effettuare tutte le opportune verifiche attribuendo le rispettive responsabilità, con un controllo degli accessi basato su ruoli

Nella condizione ideale, tutto questo dovrebbe essere gestito e soddisfatto da un’unica entità capace di semplificare operatività, efficienza e fruibilità.

In realtà, osservando la situazione presente nelle infrastrutture IT odierne, soprattutto presso le grandi organizzazioni bancarie e/o finanziarie, notiamo una certa proliferazione di diversi sistemi di gestione delle chiavi, molte volte dedicati o specializzati per ambiente, come ambienti mainframe, ambienti distribuiti su server convenzionali e ultimamente anche ambienti Cloud.

Ed è proprio presso queste realtà che si manifesta l’esigenza di una certa agilità ed automazione tipiche dei moderni processi aziendali, in cui è richiesta una gestione più organizzata e semplificata dell’intero ciclo di vita delle chiavi di crittografia, indipendentemente dalla piattaforma target, in modo da soddisfare tutte le operazioni di crittografia quotidiane eseguite attraverso i vari cloud pubblici, data center e applicazioni on-premise.

La proliferazione di strumenti e software diversi, a volte con funzionalità complementari, proprio per cercare di fornire tutte le funzioni necessarie previste da un KMS (Key Management System) di livello bancario unificato e flessibile, rende più complessa la gestione con conseguenti oneri sia dal punto di vista puramente economico che da quello efficienziale.

Basta pensare, ad esempio, ai processi di importazione delle chiavi che in molti casi avvengono ancora manualmente. Oppure alla necessità di condivisione e trasferimento delle chiavi tra mainframe, server convenzionali e persino servizi basati su cloud. Per non parlare poi della gestione di molteplici repository delle chiavi distribuiti sulle diverse piattaforme.

Ebbene, in questo contesto è interessante considerare soluzioni come quella proposta da IBM con Enterprise Key Management Foundation (EKMF), un sistema che centralizza su IBM zEnterprise la gestione delle chiavi di livello bancario e che fornisce aggiornamenti e distribuzione automatizzati delle stesse ad un’ampia gamma di applicazioni e sistemi, gestendone completamente il loro intero ciclo di vita sia che si tratti di chiavi simmetriche, chiavi asimmetriche e certificati digitali.

Si tratta di una soluzione con delle univocità nel suo genere che la rendono capace di supportare i complessi processi aziendali nel rispetto delle normative di sicurezza aiutando il superamento di qualsiasi tipo di audit interno ed esterno.  La necessità di operare in contesti ibridi dove è fondamentale l’integrazione con i sistemi mainframe z/OS esalta le interessanti funzionalità offerte da EKMF. Funzionalità rese disponibili anche tramite API che consentono alle applicazioni, in esecuzione sia nel cloud che sui mainframe, un facile utilizzo delle chiavi di crittografia.

Nel mondo d’oggi, quando pensiamo alla protezione dei dati mediante l’adozione della crittografia, non bisogna mai sottovalutare l’importanza della scelta contestuale di un buon Key Management System proiettato su scenari evolutivi e sicuri in modo tale da preservare ed esaltare l’investimento, necessario per proteggere oggi e domani i nostri preziosi dati.

Articolo a cura di Luigi Perrone

https://www.ictsecuritymagazine.com/articoli/crittografia-si-ma-con-il-giusto-key-mgmt-system/


La cyber security è anche una questione “domestica”

Introduzione

Internet of things (IoT) & smart device sono sempre più numerosi nella nostra quotidianità. Le nostre abitazioni sono sempre più gestite da home assistant, elettrodomestici intelligenti, smart tv, smartphone e dispositivi vari, tutti collegati al wi-fi domestico e strumentazioni di domotica che si basano sull’Intelligenza artificiale e machine learning. Vere e proprie Smart home che pullulano di dispositivi connessi che, se non adeguatamente protetti, possono essere oggetto di attacchi hacker e violazione della privacy.

Secondo quanto si evince della ricerca dell’Osservatorio Internet of Things della School of Management del Politecnico di Milano, presentata a febbraio scorso durante il convegno online “Stay at home, stay in a Smart Home: la casa intelligente alla prova del Covid” il mercato degli home smart device nel 2020 ammontava a euro 505 milioni. Un mercato – secondo i dati pubblicati da IDC (società mondiale di ricerche di mercato in ambito IT) – cresciuto del 10,3% nel 2021 e che continua a presentare problematiche in termini sia di sicurezza informatica dei dispositivi e dei sistemi smart home sia di privacy e integrità dei dati prodotti e consumati, la maggior parte dei quali, di natura personale e sensibile. La pandemia, provocando l’accelerazione del processo di digitalizzazione ed innovazione, ha acuito enormemente il problema.

Luci ed ombre della smart home

Dobbiamo essere sempre più consapevoli che la smart home e i dispositivi IoT, se da un lato possono essere utili, dall’altro lato, possono presentare vulnerabilità critiche imprevedibili.

La vulnerabilità della cybersecurity delle smart home si evince anche uno studio di Euroconsumers – condotto in Spagna, Portogallo, Belgio ed in Italia tramite Altroconsumo – dal titolo emblematico “Hackable Home”, che esamina quanto i dispositivi intelligenti a cui sono connesse siano tutt’altro che a prova di hacker.

Sono state testate la sicurezza e l’affidabilità di 16 dispositivi “intelligenti” ad uso domestico – tra cui sistemi di allarme, router WiFi, baby monitor, smart tv, etc. – delle principali marche presenti sul mercato dei quattro Paesi europei coinvolti. È risultato che ben 10 dei 16 dispositivi testati non hanno una comunicazione criptata adeguata atta a proteggere la privacy e la sicurezza dei dati degli utenti e tale vulnerabilità è stata classificata come “altamente grave” o “critica”.

Inoltre, lo studio ha evidenziato le seguenti problematiche più diffuse e anche più rischiose:

  • Autenticazione Wi-fi che può essere manipolata da hacker esperti disconnettendo il dispositivo e disattivando, quindi, la rete internet.
  • Possibili violazioni di dati sensibili degli utenti, a causa di problemi strutturali dell’hardware.
  • Impostazioni di fabbrica non sicure principalmente a causa della violabilità delle password preimpostate.

Gli attacchi che rendono vulnerabili i dispositivi IoT che utilizziamo quotidianamente delle nostre case si presentano su una vasta gamma. Basti pensare ai dispositivi intelligenti esterni alle nostre abitazioni (i.e. apriporta, i campanelli wireless, irrigatori intelligenti, telecamere, ecc.) che possono essere facilmente violati da qualche hacker che si trova in prossimità con un computer o un altro trasmettitore Wi-fi. Di fatto, i dispositivi intelligenti all’aperto possono essere utilizzati come punti di ingresso, consentendo agli hacker di accedere all’intera rete domestica intelligente.

Per evitare che uno sconosciuto spii la nostra rete, è importante controllare come questi prodotti memorizzano i nostri dati, ovvero: se il sistema del dispositivo memorizza le nostre informazioni personali ed è connesso alla rete domestica principale, esiste la possibilità che una violazione di un dispositivo sulla rete possa rivelare i nostri dati a un hacker.  Anche le Smart TV possono essere un facile bersaglio di cyber attack: gli hacker potrebbero potenzialmente accedere a un televisore non sicuro e prendere il controllo cambiando canale, regolando i livelli di volume e persino mostrare contenuti inappropriati ai bambini. Inoltre, gli elettrodomestici intelligenti sempre più diffusi nelle nostre cucine e facilmente comandabili dal cellulare o utilizzando l’attivazione vocale, possono anch’essi essere compromessi da abili hacker.

AAA: cybersecurity domestica cercasi

È evidente che più dispositivi connessi abbiamo in casa, maggiori sono le opportunità che i criminali hanno di infiltrarsi nella nostra rete, raggiungere altri dispositivi ricchi di dati, con il rischio di veder compromesse le nostre informazioni private e finanziarie. Pertanto, così come avviene nelle organizzazioni, dobbiamo adottare un approccio cyber resilience -oriented anche per i nostri dispositivi domestici, mettendo in pratica una serie di azioni necessarie per tutelare la nostra sicurezza e privacy. E, precisamente:

  • Protezione della rete Wi-fi – solitamente la maggior parte dei router Wi-fi non sono protetti o utilizzano una password predefinita come “admin”, rendendo più facile per gli hacker accedere ai dispositivi collegati al router: Pertanto, si consiglia di proteggere la rete Wi-fi con una password complessa e di evitare di collegarsi ad essa da reti Wi-fi pubbliche. Ricordarsi di rinominare e riavviare il router regolarmente.
  • Mappatura di tutti i dispositivi domestici smart – Tutti i dispositivi connessi alla rete, dovrebbero essere ben “contabilizzati” in termini di: impostazioni, credenziali, versioni del firmware e patch recenti in modo tale da essere in grado di valutare quali misure di sicurezza adottare e individuare quali dispositivi sostituire o aggiornare.
  • Impostare password complesse ed univoche rif. account di ogni dispositivo – Creare una password lunga almeno 12 caratteri, contenente una combinazione di lettere maiuscole, lettere minuscole, simboli e numeri e che sia univoca per ogni account, in modo che quando un account viene compromesso, gli altri siano al sicuro. E ricordarsi di cambiarla periodicamente. Si consiglia di optare per gestori di password difficili da attaccare e che tracciano la frequenza con cui si modifica la password.
  • Scouting & intelligence preventiva prima di acquistare un dispositivo intelligente – Verificare sempre l’affidabilità e la reputazione del produttore del dispositivo, oltre a prendere nota delle informazioni/dati raccolti dal dispositivo IoT e come essi sono gestiti/utilizzati dal fornitor, verificando altresì che tipo di controllo si ha in termini di privacy e sull’utilizzo delle informazioni (i.e. funzione di rinuncia alla raccolta delle nostre informazioni/dati o di accesso ed eliminazione delle informazioni/dati raccolti.
  • Effettuare (ove possibile) abilitazione dell’autenticazione a più fattori – Contemplare l’autenticazione a due fattori che implica l’inserimento di un codice univoco del sistema a due fattori per verificare la propria identità, in modo tale da impedire agli hacker di utilizzare tattiche di riempimento delle credenziali (i.e., in combinazioni di e-mail e password per compromettere i profili online) per accedere alla rete o all’account.
  • Effettuare periodicamente l’aggiornamento software dei propri dispositivi – Si consiglia altresì di aggiornare le app per dispositivi mobili che si accoppiano con il dispositivo IoT oltre ad abilitare le impostazioni per attivare gli aggiornamenti software automatici, in modo da avere sempre le patch di sicurezza più recenti.
  • Monitorare e proteggere la propria rete – Dato che il router è l’hub centrale che collega tutti i dispositivi di casa, è necessario verificarne il livello di sicurezza. Dopo aver modificato la password e il nome predefiniti del router, assicurarsi che il nome della rete non fornisca il proprio indirizzo, in modo che gli hacker non possano individuarlo. Successivamente, controllare che il router impieghi un metodo di crittografia che garantisca comunicazioni sicure, oltre a considerare di installare un firewall o un software “total protection”.

Inoltre, anche se non molto diffusa come precauzione, sarebbe consigliabile configurare una “rete ospite” per i propri dispositivi IoT. Ovvero, una seconda rete sul router che consente di mantenere i computer e gli smartphone separati dai dispositivi IoT. In questo modo, se un dispositivo è compromesso, un hacker non può accedere a tutte le preziose informazioni salvate sui computer.

Ovviamente, qualora l’utente non fosse in grado di effettuare queste operazioni preventive da solo si affiderà, per il supporto, ad un tecnico di fiducia.

Riflessioni

Indubbiamente le smart home sono una grande opportunità e comodità, ma devono garantire ai consumatori la tutela della propria sicurezza e privacy, soprattutto considerando che la casa è il luogo che, per definizione, deve garantire intimità e protezione. Ne consegue che dobbiamo incorporare anche nella nostra vita quotidiana la cultura della cyber resilience. Solo così potranno venire contenuti i rischi e colti i benefici prospettati da questa evoluzione tecnologica.

Inoltre, per far sì che il futuro dei dispositivi connessi nelle case migliori la nostra vita, dobbiamo abbracciare la tecnologia in modo responsabile ed etico e dobbiamo considerare la sicurezza fin dalla progettazione. Ovvero, i consumatori devono essere tutelati maggiormente e, a tal proposito, le aziende produttrici devono impegnarsi di più in modo tale da assicurare che i dispositivi delle nostre smart home siano “sicuri by design” prima di essere immessi sul mercato, a livello sia hardware sia software. Tale caratteristica deve altresì essere garantita nel tempo con aggiornamenti costanti, tempestivi ed efficaci per far fronte alla rapida evoluzione della tecnologia e dei rischi che comporta.

Articolo a cura di Federica Maria Rita Livelli

Federica Maria Rita Livelli

In possesso della certificazione Business Continuity – AMBCI BCI, UK e Risk Management FERMA Rimap ®, consulente di Business Continuity & Risk Management, svolge attività di diffusione e di sviluppo della cultura della resilienza presso varie istituzioni ed università.

Membro del: Board del BCI Italy Chapter ; Advisory Board di LIUC-ODES Project; Comitato Scientifico di CLUSIT. Socia ANRA, AIPSA, CLUSIT ed UNI.

Membro di diversi Comitati: CLUSIT-Artificial Intelligence, UNI/CT 016/GL 02 “Sistemi di gestione per la qualità” (ISO/TC 176/SC 2), UNI/CT 016/GL 09 “Governance delle organizzazioni” (ISO/TC 309) e UNI/CT 016/GL 89 “Gestione dell’innovazione” (ISO/TC 279) (Commissione Tecnica UNI/CT 016 “Gestione per la qualità e metodi statistici”).

Membro della Community: Women for Cyber Security e Ambassador della Community Donne 4.0

Docente di moduli di introduzione di: ISO 22301 – Business Continuity & Resilience (Università POLIMI–BOCCONI e Università di Verona); ISO 31000 – Risk Management (Università Statale di Milano).

Autrice di numerosi articoli su diverse riviste online, (i.e.: AgendaDigitale, Cybersecurity360, AI4Business, Risk Management360, EnergyUp, Blockchain4Innovation, Internet4Things, Industry4Business, ANRA – RM Magazine, ISPI online, Insurance Review, UNI Magazine online, The BCI Blog).

https://www.ictsecuritymagazine.com/articoli/la-cyber-security-e-anche-una-questione-domestica/