5 modi per rendere il Mainframe “hackerabile”

È incredibile come ancora oggi le più grandi organizzazioni, spaventate dai continui attacchi informatici come ad esempio il Ransomware, stiano ragionando sull’aggiornamento evolutivo di sicurezza della propria infrastruttura IT, senza includere nel perimetro di valutazione la sicurezza del Mainframe, dove molto probabilmente risiedono i dati più preziosi.

Ed è ancora più impressionante notare come le stesse organizzazioni ignorino completamente l’incomparabile qualità di sicurezza offerta dalla piattaforma Z, ricorrendo spesso ad una serie di valutazioni di “replatforming”, tipicamente cloud, con la pura illusione della riduzione dei costi, che andrebbe misurata sul medio-lungo termine, ma soprattutto senza  considerare il concreto aumento dei livelli di rischio a cui ci si espone tralasciando la struttura mainframe-centrica e concentrandosi esclusivamente ad una più distribuita.

E allora, seguendo questa tendenza, ecco cinque punti fondamentali su cui possiamo agire per facilitare maggiormente l’opera dell’insider di turno, rendendo più facile l’hacking sul proprio mainframe:

1) Continuiamo ad utilizzare la Basic-Authentication, senza considerare la possibilità di adottare una più moderna ed efficace autenticazione a più fattori (zMFA)che la stessa piattaforma Z mette a disposizione. Questo perché risulterebbe fastidioso cambiare i propri processi di autenticazione andando ad impattare con le abitudini degli utenti oramai consolidate da tempo. Utilizzando l’autenticazione di base non facciamo altro che aiutare gli hacker a catturare le credenziali degli utenti e ad agire indisturbati nel sistema, specialmente se la password utilizzata risulta di scarsa qualità. L’hacker può essere certo di confidare sulla negligenza dell’utente e attendere il momento propizio per acquisire e utilizzare le credenziali rubate aggirando completamente ogni sistema di sicurezza messo in atto.

2) Non eseguiamo mai un assessment di sicurezza! La conoscenza delle lacune nella sicurezza porta a preoccupazioni inutili che non consentono di svolgere il proprio lavoro in tranquillità. Meglio non conoscere i possibili pericoli e alimentare un giusto senso di incoscienza, lasciando la polvere sotto il tappeto, che tanto ne passa di tempo prima che possa essere scoperta.

3) Non attiviamo alcun monitoraggio e/o alerting in tempo reale. Sul mainframe non serve! Perché già si registrano e si raccolgono moltissime informazioni di quanto accade sul sistema, sufficienti per andare con calma serafica ad effettuare le opportune indagini. Se attiviamo sia il monitoraggio che gli allarmi di sicurezza si è poi obbligati ad essere reperibili e reattivi a fronte di continue segnalazioni relative alle anomalie riscontrate. Meglio aspettare e quando succede qualcosa, se dovesse mai succedere, allora andremo a scoprire cosa è successo.

4) Assegniamo più privilegi allo stesso utente, in particolare se ha compiti amministrativi. In questo modo si riducono le persone e le risorse necessarie per gestire e amministrare l’intero sistema. Una separazione dei compiti produce inutili complicazioni nelle attività ordinaria, creando ostacoli e vincoli che interrompono il workflow operativo.

5) Non applichiamo alcun tipo di crittografia ai dati.  In questo modo è più facile utilizzare tecniche diverse per sniffare importanti dati che viaggiano sulla rete senza il rischio di essere scoperto. Inoltre, utilizzando credenziali improprie posso facilmente intraprendere una escalation di privilegi per poter installare codice malevolo (backdoor) utile poi nell’agevolare un’esfiltrazione di dati sensibili che risultano in chiaro, perché opportunamente non coperti da crittografia.

Molto bene! Fatto questo possiamo stare tranquilli che il nostro Mainframe continua a funzionare senza alcun problema, non avendo fatto mai modiche impattanti sul sistema ed avendo evitato possibili rallentamenti ed interruzioni dei servizi, in un contesto in cui la sicurezza è demandata a componenti esterne perimetrali di cui non si è diretti responsabili. Solo così possiamo essere sicuri di diventare in breve tempo buoni amici degli hacker!

Articolo a cura di Luigi Perrone

https://www.ictsecuritymagazine.com/articoli/5-modi-per-rendere-il-mainframe-hackerabile/


Secondo l’indagine del Computer Emergency Response Team dell’Agenzia per l’Italia Digitale, un server su sette della Pubblica Amministrazione Italiana presenta vulnerabilità di livello alto

L’ultimo report prodotto da CERT-AgID (Computer Emergency Response Team) dell’Agenzia per l’Italia Digitale ha evidenziato che, in media, selezionando casualmente 7 server della Pubblica Amministrazione, uno di essi ha buona probabilità di avere una vulnerabilità High.

Un’indagine approfondita basata sul motore di Shodan che si sofferma a considerare sia la qualità delle vulnerabilità riscontrabili (di livello critico, alto, medio o basso) sia la quantità di sistemi che ne sono affetti evidenziando una situazione “allarmante”.

Il metodo di indagine

Per realizzare l’indagine, il CERT-AgID ha utilizzato il motore di ricerca di Shodan, che raccoglie le informazioni di tutti i dispositivi connessi ad Internet, compresi i server, e li ha incrociati con quelli di IndicePA, in cui sono censiti tutti i siti della Pubblica Amministrazione.

Il portale IndicePA raccoglie solo i siti istituzionali primari e non include quindi i sottodomini (webmail.nomedominio.gov.it, portale.nomedominio.gov.it, bustapaga.nomedominio.gov.it, fornitori32.nomedominio.gov.it, etc).  Per aumentare la portata dell’analisi, il CERT-AgID ha sfruttato alcuni tools in grado di identificare sottodomini basandosi su fonti OSINT (Open Source Intelligence). Questo passaggio ha portato ad individuare 401.532 domini suddivisi fra sanità e assistenza; pubblica amministrazione centrale (PAC); pubblica amministrazione locale (PAL) ed istruzione.

Il motore Shodan analizza i dispositivi connessi ad Internet per mezzo di indirizzi IPv4, per ogni dominio ottenuto è stata fatta un’interrogazione DNS e preso il primo indirizzo IP ritornato: dei 401.532 domini ottenuti sono risultati 62.749 indirizzi IP, quindi in media ogni server ospita 6,4 domini.

L’analisi quantitativa e qualitativa

Le singole vulnerabilità si dividono in base alle categorie (Low, Medium, High, Critical) del loro punteggio CVSS (Common Vulnerability Scoring System) che consente alle organizzazioni di valutare le caratteristiche di una vulnerabilità e la sua gravità mediante un punteggio numerico. CVSS v3.0 ha introdotto 5 livelli di classificazione di una vulnerabilità basata sul suo score: (None: 0.0, Low: 0.1-3.9, Medium: 4.0-6.9, High: 7.0-8.9 e Critical: 9.0-10.0).

È bene precisare che sono categorizzate le vulnerabilità singolarmente riscontrate, quindi per costruzione nell’analisi qualitativa non è possibile avere la categoria “None” (che rappresenta l’assenza di vulnerabilità). In sostanza, il grafico sotto mostra come sono distribuite le vulnerabilità in base alla loro gravità, ma non è significativo riguardo la diffusione di tali vulnerabilità sui server della PA.

L’analisi qualitativa, evidenza che la maggior parte (75%) dei server della Pubblica Amministrazione presenta vulnerabilità di livello medio; il 15% è di livello alto; l’8% di livello basso e il 2% è critico.

Utilizzando i dati aggregati si può risalire al numero di IP che hanno almeno una vulnerabilità Low, Medium, High, Critical e None e ciò consente di passare dall’analisi qualitativa a quella quantitativa, ovvero la misura di quanto sono diffuse le classi di vulnerabilità tra i vari server. In questo caso compare la classe None poiché sono analizzati i singoli IP (i quali possono non avere vulnerabilità rilevate).

L’analisi quantitativa evidenzia che circa quattro server su cinque (79%) non presenta vulnerabilità. Viceversa, significa che il 21% dei server è vulnerabile, prevalentemente con una vulnerabilità di tipo alto (14%).

Si può notare come, esclusi i server senza vulnerabilità (sezione in grigio), in media, prendendo sette server della Pubblica Amministrazione dalla lista di IP, uno di essi ha elevate probabilità di avere una vulnerabilità High” (il 14% pari a 8.784 unità).

Comparando il grafico qualitativo precedente con quello quantitativo, si osserva che sebbene le vulnerabilità di tipo “Medium” siano qualitativamente al 75%, esse tendono ad essere quantitativamente molto concentrate, questo perché riguardano una debolezza crittografica di Apache relativa ad una funzionalità poco usata e che richiede la presenza di macchine clone per essere sfruttata, spiegano i ricercatori.

I rischi associati alle vulnerabilità

Definita la diffusione qualitativa e quantitativa delle vulnerabilità è poi necessario chiedersi quali sono i rischi associati alle vulnerabilità, vale a dire cosa può fare un malintenzionato quando si trova di fronte ad un server vulnerabile. Gli attacchi sono generalmente composti sfruttando una serie di vulnerabilità che, prese singolarmente, appaiono poco gravi e tutte le vulnerabilità possono essere usate in ogni tipo di attacco (inclusi i ransomware).

In media, esaminando i server affetti da almeno una vulnerabilità, ci sono tre vulnerabilità critiche su ogni server; quattro alte; due medie e una bassa. Le vulnerabilità di tipo critico sono state scoperte nel 2008, nel 2010 e nel 2012 e quindi hanno almeno nove anni. Le vulnerabilità di livello medio più vecchie risalgono invece al 2007.

“L’importanza di questa statistica non è mostrare la distribuzione temporale delle CVE (Common Vulnerabilities and Exposures) rilevate bensì focalizzarsi sul problema dell’obsolescenza del software e della sua manutenzione” sottolinea il rapporto. Dai dati si evince che la Pubblica Amministrazione ha un evidente problema di aggiornamento del proprio parco software.

Le Pubbliche Amministrazione utilizzano prevalentemente soluzioni Microsoft (il 65%), mentre una parte minore (34%) Linux. Solo l’1% usa soluzioni Apple. Tale statistica serve, secondo il rapporto, a capire che tipo di corsi formativi e di aggiornamento servono. “Ad esempio, viene fatto notare che i corsi di hardening Linux (vedi SELinux), sebbene molto interessanti, non aiuterebbero che poco più di un terzo della PA”.

Gli esperti ritengono pertanto più utile, “un expertise su Windows che su Linux. In ottica di una facilitazione di passaggio al Cloud della PA è quindi opportuno considerare che il principale sistema operativo usato dalla Pubblica Amministrazione è ad oggi Microsoft Windows.”

Conclusioni

“L’indagine ha evidenziato una situazione preoccupante sullo stato di salute dei sistemi della Pubblica Amministrazione con server e applicativi molto obsoleti.”

“Considerato l’alto numero di server coinvolti, risulta difficile credere che ognuno di essi non sia stato aggiornato solo per questioni tecnologiche.” Il rapporto evidenzia la scarsa attenzione che le Pubbliche Amministrazioni rivolgono alla sicurezza informatica, probabilmente non per scelta ma per mancanza di consapevolezza rispetto alle conseguenze.

Una più attenta considerazione sul tema della sicurezza e dell’aggiornamento dei server porterebbe ad un significativo miglioramento in termini di livelli di affidabilità dei dati gestiti dalla Pubblica Amministrazione, ottenendo anche dei vantaggi nel rapporto tra con cittadini ed imprese.

“Considerando la crescente diffusione del fenomeno dei ransomware in forme sempre più organizzate, bisogna necessariamente adeguarsi a standard di sicurezza più elevati per contrastare meglio questa ed altre piaghe che si presenteranno con maggior frequenza nel futuro prossimo” conclude il rapporto.

Sitografia

https://cert-agid.gov.it/

http://www.shodanhq.com

Articolo a cura di Daniele De Simone

https://www.ictsecuritymagazine.com/articoli/secondo-lindagine-del-computer-emergency-response-team-dellagenzia-per-litalia-digitale-un-server-su-sette-della-pubblica-amministrazione-italiana-presenta-vulnerabilita-di-livello-alto/


GDPR: la figura del Sub-Responsabile e la segmentazione del rapporto contrattuale

Il Legislatore Europeo, tramite l’adozione del Regolamento Generale per la protezione dei dati 2016/679, meglio noto con l’acronimo “GDPR”, si è posto l’obiettivo di armonizzare la normativa concernente la tutela dei dati personali e la libera circolazione dei medesimi, indipendentemente dal fatto che questi siano sul territorio dell’Unione, purché gli interessati si trovino all’interno dell’Unione, in considerazione dell’avvento di nuove tecnologie e della sempre maggior facilità nelle comunicazioni e nello scambio di informazioni.

Con il GDPR la disciplina della protezione dei dati è stata oggetto di una riformulazione sostanziale caratterizzata da un mutamento di approccio, ad oggi dominato dal principio dell’accountability, e richiedente, come necessità imprescindibile, che le aziende si dotino di modelli di gestione dei dati personali in grado di coniugare le esigenze di business con le garanzie richieste dalla disciplina in tema di data protection, onde evitare rischi di trattamento illecito di dati.

La normativa sovranazionale in parola, plasmata con la veste di Regolamento e, conseguentemente, immediatamente applicativa da parte di ciascuno Stato membro dell’Unione, senza necessità di un ulteriore intervento attuativo nazionale, ha rivelato una crescente attenzione a livello europeo per il diffondersi di un mercato di servizi sempre più esternalizzato e realizzato tramite il coinvolgimento di differenti player che possono risultare implicati nella realizzazione del trattamento e quindi del servizio oggetto del contratto.

Un’organizzazione del “processo produttivo” sempre più segmentata, dunque, con conseguente potenziale declinazione del rapporto contrattuale in una pluralità di livelli.

In particolare, il GDPR, all’art. 4, identifica le figure del Titolare e del Responsabile del trattamento definendole come di seguito:

  • “Titolare del trattamento: la persona fisica o giuridica, l’autorità pubblica, il servizio o altro organismo che, singolarmente o insieme ad altri, determina le finalità e i mezzi del trattamento di dati personali.”
  • “Responsabile del trattamento: la persona fisica o giuridica, l’autorità pubblica, il servizio o un altro organismo che tratta dati personali per conto del titolare del trattamento”.

Dal testo della fonte di diritto in oggetto, inoltre, emerge, indirettamente, l’esistenza potenziale anche di un terzo soggetto che può essere coinvolto nella realizzazione del trattamento, il c.d. sub-Responsabile[1].

La normativa de quo, infatti, non ha solamente previsto la possibilità per il Titolare di affidare la realizzazione di un particolare trattamento al Responsabile del Trattamento quale soggetto separato ed autonomo rispetto al proprio complesso aziendale, ma anche la facoltà per il Responsabile, di nominare a sua volta “un altro responsabile”, ed ecco, quindi, l’inedita figura del c.d. Sub-responsabile e lo strutturarsi del rapporto contrattuale su un ulteriore livello.

A ben vedere il Regolamento non si riferisce espressamente alla figura del Sub-responsabile, ma la medesima si ricava implicitamente da quanto disposto all’art. 28, comma 4, secondo cui  “[…]Quando il responsabile del trattamento ricorre ad un altro responsabile del trattamento per l’esecuzione di specifiche attività di trattamento per conto del titolare, su tale altro responsabile del trattamento sono imposti, mediante un contratto o un altro atto giuridico a norma del diritto dell’Unione o degli Stati membri, gli stessi obblighi in materia di protezione dei dati contenuti nel contratto o in altro atto giuridico tra il titolare del trattamento e il responsabile del trattamento di cui al paragrafo 3, prevedendo in particolare garanzie sufficienti per mettere in atto misure tecniche e organizzative adeguate in modo tale che il trattamento soddisfi i requisiti del presente regolamento […]”.

Partendo dal dato normativo si evince che tale “altro responsabile” debba essere legato al Responsabile del trattamento da un ulteriore contratto o atto giuridico che si innesta e, inevitabilmente, si lega al rapporto contrattuale esistente tra Responsabile del trattamento e Titolare del trattamento e questo in quanto, tale “contratto di secondo livello” se così vogliamo definirlo a titolo esemplificativo, dovrà riprodurre il contenuto essenziale del “contratto principale”, poiché l’attività del Sub-responsabile risulta strumentale alla realizzazione del trattamento oggetto del medesimo.

L’esistenza di questa concatenazione tra i diversi soggetti coinvolti nelle attività di trattamento connesse al ciclo produttivo, e quindi anche tra Titolare e Sub-fornitore, emerge dal fatto stesso che quest’ultimo sia tenuto a rispettare gli stessi obblighi in materia di protezione dei dati che sono previsti nel contratto/atto giuridico concluso tra il Titolare e il Responsabile del trattamento. Ciò implica necessariamente che il Sub-Responsabile sia limitato nell’espletamento della sua attività dovendo seguire pedissequamente il perimetro di finalità determinate dal Titolare. In questa stratificazione di diversi contratti e atti giuridici si sostanzia la segmentazione del più ampio rapporto contrattuale fra Titolare e Responsabile del trattamento.

Il Sub-responsabile, quindi, è una figura che da un lato risulta legittimata dalla “investitura” formale operata dal Responsabile ma che, dall’altro, è tenuta ad agire nel rispetto delle direttive impartite dal Titolare nei cui confronti si trova in rapporto di subordinazione.

Il Titolare, dal canto suo, nella valutazione dei rischi determinati dall’affidamento/esternalizzazione, verso il Responsabile, dell’attività di trattamento dovrà tener conto non solo delle modalità di esecuzione e delle misure che questi si impegna ad adottare nell’espletamento di quella porzione di attività a lui facente capo, ma anche che il contenuto dei contratti o degli atti giuridici stipulati tra Responsabile e l’eventuale Sub-responsabile rispondano ai dettami previsti dalla normativa sovranazionale ed, in particolare, dispongano misure tecniche ed organizzative adeguate alla realizzazione degli impegni assunti.

Tant’è che il Regolamento riconosce in capo al Titolare il potere di autorizzare, oppure negare, il ricorso ad un altro responsabile.

Sul punto, l’art. 28 comma 2 appare chiaro “[…]Il responsabile del trattamento non ricorre a un altro responsabile senza previa autorizzazione scritta, specifica o generale, del titolare del trattamento[…]”

Ciò significa che il Responsabile, qualora lo ritenesse necessario per l’espletamento del trattamento oggetto del contratto principale, non potrà, di sua sponte, ricorrere ad altro responsabile senza previo nulla osta del Titolare a meno che quest’ultimo non abbia rilasciato una procura di carattere generale, nel qual caso avrà, eventualmente, facoltà di opporsi alla designazione effettuata autonomamente dal Responsabile.

Allo stesso tempo il Regolamento determina un ulteriore rapporto gerarchico, quello tra Il Responsabile e il Sub-responsabile, in cui il primo si trova in posizione di sovra ordinazione rispetto al secondo. Tale assunto è ricavabile indirettamente dalla responsabilità imposta al Responsabile dall’art. 28 comma 4 secondo cui “[…]Qualora l’altro responsabile del trattamento ometta di adempiere ai propri obblighi in materia di protezione dei dati, il responsabile iniziale conserva nei confronti del titolare del trattamento l’intera responsabilità dell’adempimento degli obblighi dell’altro responsabile”.

Il suddetto assetto determina una sorta di culpa in eligendo e di culpa in vigilando in capo al Responsabile, salvo che quest’ultimo non dimostri che l’inadempimento non sia in alcun modo a lui imputabile.

Una responsabilità siffatta giustifica, di per sé stessa, la possibilità per il Responsabile di impartire delle direttive al Sub-responsabile, purché non esorbitanti rispetto all’alveo delle finalità del trattamento determinate dal Titolare, che permettano di garantire la conformità del Sub-responsabile e della sua organizzazione alla normativa de quo.

È evidente, a questo punto, l’articolarsi del rapporto contrattuale in una pluralità di segmenti e la conseguente difficoltà nella determinazione del contenuto contrattuale in relazione ai diversi livelli del rapporto.

È chiaro che maggiori saranno i “passaggi di mano”, che andranno a caratterizzare la stratificazione del rapporto e la conseguente concatenazione contrattuale, più ampio e articolato sarà il rischio di violazioni della normativa con evidenti ripercussioni sui diritti e le libertà degli interessati.

Vi è da dire poi che, nonostante i contratti in essere tra i vari soggetti debbano sostanziarsi, in linea generale, nei medesimi obblighi in materia di protezione dei dati, non appare semplice ricorrere all’utilizzo di contratti predefiniti date le numerose possibili modalità di esecuzione dei servizi.

Sarebbe, tuttavia, auspicabile una standardizzazione delle clausole contrattuali, tramite una declinazione delle medesime che consenta una validità nel loro contenuto sia per i Responsabili sia per i Sub-Responsabili, di modo da garantire una sorta di preventivo controllo da parte del Titolare su quello che potrà essere il contenuto dell’ipotetico futuro contratto con un Sub-responsabile, essendo nella sostanza riproduttivo del contratto concluso con il Responsabile, e di modo che risultino conformi ai principi di:

  • liceità che può essere intesa come la necessità che il trattamento previsto si fondi sul consenso dell’interessato o su altra base legittima prevista dal Regolamento Europeo o dal diritto dell’Unione o degli stati membri;
  • trasparenza che può essere intesa come la necessità che le informazioni e le comunicazioni relative al trattamento dei dati personali siano accessibili e comprensibili tramite l’impiego di un linguaggio semplice e chiaro;
  • correttezza che può essere intesa come la necessità che il trattamento si svolga in maniera leale ed onesta (sul punto si pensi anche a quanto previsto dalla normativa nazionale italiana che agli artt. 1175 c.c. e 1375 cc. dispone rispettivamente “il debitore e il creditore devono comportarsi secondo le regole della correttezza “,“il contratto deve essere eseguito secondo buona fede”) .

Una siffatta stratificazione dei rapporti contrattuali impone l’adozione di modelli contrattuali omogeni e coerenti con i più alti standard internazionali in ambito di Cybersecurity, con particolare riferimento ai rapporti con i fornitori. Questo tema è indirizzato da ISO/IEC JTC1/ SC27 “Information security, cybersecurity and privacy protection”, sia all’interno della nota ISO/IEC 27001, per il tramite dei controlli di sicurezza descritti nella ISO/IEC 27002, in particolare nella clausola A.15, sia all’interno della ISO/IEC 27036.

Queste due norme internazionali, in particolare, stanno vivendo una fase di rinnovamento che vede la prima, in particolare, in prossima pubblicazione entro il Q1/2022 mentre la seconda dovrà attendere più ampi per terminare il suo iter di revisione. Ciò nonostante, è già possibile rintracciare dei collegamenti fra le attuali versioni delle citate norme e strutturare di conseguenza i processi aziendali che portano alla selezione e gestione dei fornitori, compresi quindi anche i Sub-responsabili, con evidenti vantaggi anche in ambiti ulteriori rispetto la Data Protection.

In linea generale è possibile affermare che la gestione dei rapporti con i fornitori è strutturata secondo un macro-processo, che tipicamente si svolge sotto il coordinamento dell’ufficio acquisti di un’organizzazione, ma con il coinvolgimento di verse funzioni aziendali, articolato nelle seguenti macro-fasi:

  • Formulazione di accordi: le organizzazioni possono avere una molteplicità di rapporti con i fornitori, la cui adeguatezza è raggiunta se almeno i ruoli e le reciproche responsabilità sono esattamente individuate e formalizzate;
  • Definizione di processi organizzativi che abilitano la sub-fornitura e di processi di gestione tecnica: lo scopo di questi processi è definire, mantenere e garantire la disponibilità di politiche, procedure e, se del caso, istruzioni operative che permettano al Sub-responsabile di avere contezza sia degli obiettivi di sicurezza del Responsabile, sia delle strategie per il loro conseguimento, avendo quindi la possibilità di adattare, eventualmente, la propria operatività; In questo ambito rientra anche l’esecuzione di uno specifico risk assessment il cui obiettivo è quello di valutare i rischi nell’adozione di un particolare fornitore;

La sicurezza delle informazioni in un rapporto contrattuale con un Sub-responsabile, o più in generale con un fornitore esterno all’organizzazione, dovrebbe essere organizzato secondo cinque sotto-processi successivi, ognuno dei quali è descrivibile in termini di obiettivi, inputs, attività, outputs:

  1. Processo di pianificazione delle relazioni con i fornitori: il cui scopo è documentare la decisione adottata dalla direzione di ricorrere, per specifiche attività di trattamento, all’approvvigionamento di un servizio erogato da un terzo fornitore, nonché le considerazioni sulla sicurezza delle informazioni relative a tale approvvigionamento;
  2. Processo di selezione dei fornitori: il cui scopo è selezionare un Sub-responsabile che fornisca adeguate garanzie per le attività di trattamento a lui affidate. Allo stesso tempo, il Sub-responsabile ha l’obiettivo di rispondere alla richiesta di offerta, o alla gara indetta dal Responsabile o dal Titolare, considerando i rischi insiti nelle attività di trattamento a lui richieste e i collegati requisiti di sicurezza delle informazioni;
  3. Processo di accordo: il cui scopo è, tanto per il Titolare o Responsabile del trattamento, quanto per il Sub-responsabile, formalizzare in un contratto o altro atto giuridico, la relazione contrattuale, in modo che siano disciplinati almeno i seguenti aspetti:
    1. ruoli e responsabilità in materia di sicurezza delle informazioni per Titolare, Responsabile del trattamento e Sub-responsabile;
    2. controlli di sicurezza richiesti per le attività di trattamento;
    3. processo di transizione quando il servizio è stato precedentemente gestito da una parte diversa dal Sub-responsabile;
    4. gestione delle modifiche alla sicurezza delle informazioni, rilevanti per le attività di trattamento;
    5. gestione degli incidenti di sicurezza delle informazioni e, conseguentemente, delle violazioni dei dati;
    6. monitoraggio e applicazione della conformità;
    7. processo di cessazione delle attività di sub-fornitura.
  4. Processo di gestione delle relazioni con i fornitori: il cui scopo è, tanto per il Titolare o Responsabile del trattamento, quanto per il Sub-responsabile mantenere la sicurezza delle informazioni nelle attività di trattamento durante il periodo di esecuzione del rapporto con il Sub-responsabile e, laddove pertinente, anche successivamente alla cessazione del rapporto;
  5. Processo di risoluzione del rapporto con il Sub-responsabile: nel quale i seguenti obiettivi devono essere raggiunti tanto dal Titolare o Responsabile del trattamento, quanto dal Sub-responsabile, per gestire correttamente la sicurezza delle attività di trattamento anche durante la fase di risoluzione della relazione contrattale informazioni all’interno del processo di risoluzione del rapporto con il fornitore:
    1. proteggere la fornitura delle attività di trattamento durante la sua cessazione per evitare qualsiasi impatto sulla sicurezza delle informazioni che possa evolvere in una violazione dei dati;
    2. portare a conclusione la fornitura delle attività di trattamento in conformità al piano di cessazione precedentemente definito.

In conclusione, è certo che, la potenziale segmentazione contrattuale, eventualmente emergente fra Titolare e Sub-responsabili, impone, come obiettivo essenziale ed ineludibile, a tutte le organizzazioni che svolgono servizi in outsourcing, sia nella veste di Titolari sia nella veste di Responsabili, da un lato di delineare una struttura aziendale, processi operativi e misure tecniche e organizzative conformi e adeguate ai dettami del GDPR e, dall’altro, di delineare disposizioni contrattuali il più possibile standardizzate nel rispetto della normativa pertinente in ambito Protezione del persone fisiche con riguardo ai loro dati personali e, nel loro contenuto, valevoli anche per eventuali ulteriori soggetti , quali i Sub-Responsabili, coinvolti nella catena del trattamento, riducendo di conseguenza l’attività di controllo del Titolare sul contenuto di tali contratti e sulla loro attuazione in concreto nonché i rischi di trattamenti illeciti.

Nel perseguire questo approccio, come spesso accade, l’adozione volontaria di norme internazionali come quelle citate, permette di seguire processi standardizzati con notevoli ed evidenti vantaggi, anche in termini di certificazione dei processi aziendali: elemento questo sempre distintivo rispetto il mercato.

Note

[1] Tale costruzione giuridica era già stata oggetto di un parere n .5/2012 punto 4 fornito dal Gruppo di Lavoro per la tutela dei dati privacy istituito ex art. 29 della Direttiva 95/46 CE in relazione al tema del “cloud computing” ed alle garanzie relative ai subcontraenti. In particolare, nel parere si legge “la diffusione su vasta scala dei servizi di cloud computing comporta una serie di rischi per la protezione dei dati, in particolare una mancanza di controllo sui dati personali, nonché informazioni insufficienti in merito alle modalità, al luogo e all’esecutore del trattamento/sub-trattamento dei dati…qualsiasi contratto tra fornitore e cliente di servizi cloud dovrebbe prevedere delle clausole relative ai subcontraenti. Il contratto dovrebbe specificare che i sub incaricati possono essere autorizzati solo sulla base di un consenso che di norma può essere concesso dal responsabile del trattamento a fronte di un chiaro obbligo dell’incaricato del trattamento di informarlo in merito a eventuali cambiamenti previsti in proposito, mentre il responsabile del trattamento si riserva la possibilità, in qualsiasi momento, di opporsi a tali cambiamenti o di risolvere il contratto. Il contratto dovrebbe chiarire l’obbligo del fornitore cloud di indicare tutti i subcontraenti autorizzati. Inoltre, il fornitore cloud è tenuto a stipulare un contratto con ciascun subcontraente che rispecchi le clausole del contratto stipulato con il cliente cloud; il cliente dovrebbe garantire di essere in grado di avvalersi di possibilità di ricorso in caso di violazioni dei contratti da parte dei subcontraenti del fornitore”.

Articolo a cura di Irene Martinelli e Luciano Quartarone

https://www.ictsecuritymagazine.com/articoli/gdpr-la-figura-del-sub-responsabile-e-la-segmentazione-del-rapporto-contrattuale/


Sicurezza col Mainframe? Una scelta strategica

Siamo nell’era della completa trasformazione, a partire dai cambiamenti climatici alla moneta digitale, senza dimenticare la pandemia che ha indotto un’accelerazione verso il mondo cibernetico, dove non si tocca più nulla di concreto ma sono sufficienti dei click, i riconoscimenti vocali, facciali e comportamentali, vero carburante per la nuova intelligenza artificiale. Nonostante ciò, troviamo ancora i sistemi Mainframe al centro della scena, come a fare eco alla canzone del “Blasco” che ribadisce “Io sono ancora qua, eh …. già”.

Eh già, il tutto è palesemente dimostrato dal fatto che il mainframe continua ad essere la piattaforma capace di macinare grandissime quantità di dati in totale sicurezza in un’epoca dove i dati crescono a dismisura e dove la loro salvaguardia diventa l’obiettivo primario per tutti. Si rimane ancora sbalorditi nel sentire come il nuovo IBM z15 sia capace di gestire ben 19 miliardi di transazioni crittografate al giorno, ad una velocità di circa 220.000 al secondo. Potenze difficili da riscontrare nell’intero panorama dell’Information Technology.

Sono forse questi i motivi per cui i mainframe continuano ad essere costantemente aggiornati e mantenuti da quelle organizzazioni ad alta intensità di informazioni come ad esempio quelle finanziarie?

Per ora non abbiamo una risposta inequivocabile. Ciò che invece risulta evidente in questa trasformazione digitale è la spinta verso una rivalutazione dei propri sistemi mainframe con l’unica prospettiva del contenimento dei costi, a volte ammaliati dalle tecnologie in cloud, spesso perdendo di vista tutti gli altri aspetti che non possono e non devono essere considerati secondari proprio nell’ottica di riduzione della spesa. Uno su tutti? Il pericolo che ci tormenta tutti i giorni relativo al rischio economico e finanziario in caso di una perdita di dati.

Ma allora cosa fare?

Cosa ha più senso sia dal punto di vista economico che per la sicurezza dei dati? Aggiornare il Mainframe ad una versione più recente dell’hardware esistente o, meglio, sostituirlo passando completamente ad una nuova piattaforma? Navigando nel web è facile imbattersi in studi specialistici che denotano come una leggera maggioranza delle organizzazioni mondiali abbia preferito effettuare l’upgrade piuttosto che il replatforming.

Eppure, sembra spontaneo pensare che i costi dell’hardware nel modernizzare il mainframe risultino più onerosi rispetto al replatforming, in quanto il passaggio ad un sistema distribuito debba, per forza di cose, costare meno rispetto all’acquisto dell’ultimo Z system.  E se non fosse proprio così? A far bene i conti, pare che i costi dell’hardware risultino persino equiparabili, almeno nella fascia che va dai 400.000$ ai 2.000.000$. Ma a quanto ammontano i costi del downsizing in termini di software, personale, consulenza e interruzioni varie della disponibilità dei servizi? Il passaggio da una piattaforma all’altra comporta un netto cambiamento di procedure consolidate, funzionali e di routine a favore di uno svecchiamento delle stesse, ma con la grande incognita delle nuove problematiche e conseguenze economiche che questo cambiamento comporta.

E dal punto di vista della sicurezza?

Proviamo a pensare alla semplice installazione di programmi o applicazioni. Un’attività che è all’ordine del giorno per i sistemi distribuiti, persino alla portata di un utente finale se parliamo di sistemi perimetrali. Ed è proprio durante questa attività che molti malware, ransomware compreso, agiscono travestendosi da app legittime ingannando facilmente gli utenti.

Sul mainframe la maggior parte degli utenti non può installare applicazioni in maniera autonoma! Non è altrettanto possibile leggere email o navigare sul web annullando ogni rischio di clic su link insidiosi o apertura di allegati sospetti. Inoltre, se qualche intruso riuscisse comunque a veicolare un malware, quest’ultimo per poter funzionare su z/OS, dovrebbe essere stato sviluppato appositamente per il sistema operativo z/OS, in quanto la maggior parte dei malware che troviamo nel mondo distribuito non funzionano sul mainframe.

Tutta la strategia di prevenzione che viene orchestrata nel mondo distribuito tramite sistemi di logging, monitoring ed alerting, sul mainframe è già a disposizione, tant’è che se accade qualcosa di sospetto risulta difficile mistificarlo. Il mainframe registra automaticamente ogni singola azione di ogni utente, senza possibilità di nascondere una possibile cancellazione di quel record. Ciò significa che se accade qualcosa di anomalo risulta improbabile non accorgersi tempestivamente, sempre che siano state attivate tutte le soluzioni di sicurezza offerte dal sistema, come l’alerting in real-time, magari integrato con un sistema SIEM.

E cosa dire sullo Zero-Trust? Concetto che è già insito nel Security Server (RACF) che regola la sicurezza sul mainframe. A partire da un’autenticazione a più fattori che abbatte ogni tipo di rischio di uso improprio delle credenziali, fino ad arrivare alla concessione di permessi e privilegi minimi indispensabili. La maggior parte degli utenti ha zero autorizzazioni per modificare qualsiasi cosa sul mainframe, se non appositamente concesse e monitorate. L’ereditarietà dei permessi viene inibita da un’azione di revoca delle ridondanze presenti nel sistema. Ed è sempre il RACF che regola l’accesso anche dai servizi esterni. Tutte le applicazioni di terze parti non hanno accesso al sistema se non appositamente concesso e controllato. Ciò elimina uno dei percorsi più comuni per gli hacker, che spesso attaccano i sistemi più deboli per ottenere l’accesso instaurando una backdoor che gli consente di arrivare all’obiettivo più prezioso: il dato.

Ed è proprio nel tutelare i dati che il mainframe mette a disposizione una tecnologia di encryption all’avanguardia, di tipo pervasivo, proprio per proteggere il dato in qualsiasi stadio esso si trovi (at-rest, in-fly, in-use). Tecnologia che non richiede investimenti in nuovi server o software aggiuntivi con l’ulteriore costo di gestione e manutenzione. Insomma, di questi tempi dove i nostri preziosi dati sono in balia di attacchi informatici in continuo aumento e dove le spese devono essere oculate, credo sia un grave errore non prendere in considerazione i benefici che può portare la modernizzazione della piattaforma mainframe anche in un contesto hybrid-cloud. Piattaforma che garantisce la massima affidabilità e la massima sicurezza per le persone ed i dati di ogni azienda, con conseguenti risparmi economici. Proprio come il vecchio Vasco che non passa mai di moda “eh già, io sono ancora qua!”

Articolo a cura di Luigi Perrone

https://www.ictsecuritymagazine.com/articoli/sicurezza-col-mainframe-una-scelta-strategica/


L’AI come arma fondamentale nella guerra ai ransomware

Che i ransomware siano oggi la vera minaccia non è più una novità, eppure il verificarsi di attacchi informatici con conseguente richiesta di riscatto a danno di aziende ed enti pubblici continua a fare notizia. Anche se non sempre si conosce se e quale sia stata la cifra estorta, nel 2020 sono finite nel mirino degli hacker imprese italiane del calibro di Campari, Geox e Luxottica. Ma siamo sicuri che le vittime, anche le più illustri, conoscessero i pericoli e avessero adottato le necessarie misure per proteggersi?

Non sembra che in materia di ransomware ci sia poca consapevolezza, anzi. In base alle ultime ricerche disponibili, il 46% dei Chief Information Security Officer (CISO) lo teme più di qualsiasi altra minaccia e lo pone al vertice delle questioni in tema di cybersecurity. Eppure, gli attacchi con riscatto continuano ad avere successo e a causare danni finanziari e operativi.

Parte del problema è legata all’evoluzione e diversificazione degli attacchi ransomware registrati negli ultimi anni. Gli attaccanti sono passati da tattiche semplici e interamente automatiche, piuttosto facili da intercettare, a strategie più mirate e sofisticate. Allo stesso tempo, molti team di security hanno continuato a usare le stesse tattiche per prevenire gli attacchi, seguendo un approccio ormai superato.

Per tutte le organizzazioni Italiane è tempo di evolvere. È ora di superare un approccio preventivo che cerca di fermare gli attaccanti che hanno fatto breccia nel perimetro aziendale, per concentrarsi piuttosto sulla necessità di armarsi degli strumenti adatti a individuare e stroncare l’attacco sul nascere. Una cosa è certa: nel variegato panorama attuale del mondo IT, l’intelligenza artificiale (AI) giocherà un ruolo decisivo nella battaglia contro i ransomware. I recenti report di Vectra mostrano che la maggior parte delle imprese ha bisogno di analizzare i comportamenti e separare quelli sospetti da quelli malevoli utilizzando strumenti di cybersecurity potenziati dall’AI.

Una minaccia diversificata

Le prime forme di ransomware operavano con il pilota automatico e seguivano un business model semplice: infettare quanti più computer possibili, perché almeno una porzione delle vittime avrebbe sicuramente pagato per recuperare i propri dati. Il cosiddetto ‘commodity’ ransomware si è presto evoluto per cercare e crittografare intere unità di rete: in questo modo è più probabile bloccare file indispensabili per il soggetto colpito. L’evoluzione iniziale ha visto gli attaccanti cominciare a mettere nel mirino le organizzazioni piuttosto che i singoli individui, contando sul fatto che le prime si mostrino più propense a pagare alti riscatti per recuperare i dati critici.

Il commodity ransomware si è poi combinato con il worm, con la conseguenza che oggi è in grado di atterrare su un singolo sistema e infettare rapidamente i sistemi vicini. Ciò ha rappresentato un salto in avanti importante per gli attaccanti: basta che una sola vittima cada nel tranello delle mail di phishing perché la minaccia possa diffondersi rapidamente su migliaia di altre macchine. Sebbene sia in azione già da molti anni, il commodity ransomware rimane una minaccia concreta. Tutti ricordiamo i danni prodotti da WannaCry nel 2017, quando ha bloccato centinaia di migliaia di computer, e soltanto pochi mesi fa, ad agosto, il ransomware Lockbit 2.0 ha messo in ginocchio le prenotazioni dei vaccini anti Covid e gli altri servizi al cittadino erogati dalla Regione Lazio.

I cyber criminali hanno continuato a migliorare il loro gioco e a diversificarsi, sostituendo le tattiche automatizzate con metodi più sofisticati e mirati. Questi attacchi spesso richiedono settimane di pianificazione: dopo aver guadagnato un punto d’appoggio iniziale, gli aggressori adattano manualmente i loro movimenti alle specifiche dell’ambiente in cui hanno fatto irruzione.

Oltre alla diversificazione dell’attacco stesso, il modello di business del ransomware si è anche ramificato in un modello di franchising. L’affiliante fornisce gli strumenti, i manuali di gioco e altre infrastrutture di attacco necessarie, mentre gli affiliati utilizzano i servizi per effettuare gli attacchi, inviando poi una percentuale del riscatto all’affiliante. Il ransomware è diventato un’industria a tutti gli effetti; non sorprende che le sofisticate varianti gestite dall’uomo siano state identificate da Microsoft come “una delle tendenze più impattanti nei cyberattacchi di oggi”.

AI per rinforzare i ranghi

Le varianti ben note di ransomware di base possono generalmente essere bloccate all’ingresso, se i team di sicurezza hanno accesso a indicatori tempestivi di compromissione. Anche i tipi più recenti di commodity ransomware, che riescono a bypassare le misure preventive, sono in genere di portata abbastanza limitata e possono essere superati con un buon processo di backup e ripristino. Contenere le varianti di commodity ransomware che si muovono più velocemente può essere invece più difficile, anche se in questi casi la micro-segmentazione, l’approccio zero-trust, il privilegio minimo e altri controlli fondati su policy specifiche sono un armamentario sufficiente per contenere le epidemie.

Quando si tratta di attacchi ransomware più mirati e gestiti dall’uomo, il successo non dipende più da politiche prescrittive o da configurazioni di sicurezza rafforzate che si concentrano sulla prevenzione. Anche se utili a un certo scopo, un aggressore sufficientemente motivato finirà per superarle. In questo caso, l’attenzione deve spostarsi dal tentativo di prevenire l’inevitabile al rilevamento e all’arresto degli attacchi che hanno avuto successo il prima possibile – ed è qui che entra in gioco l’AI.

Le stime indicano che il tempo medio di permanenza di un attacco ransomware è di 43 giorni. L’AI ricopre un ruolo decisivo all’interno del team di sicurezza per aiutare a stanare la minaccia. Mentre un team di analisti potrebbe aver bisogno di giorni o addirittura settimane, l’AI può rilevare rapidamente – se non immediatamente – quando gli aggressori si stanno muovendo all’interno dei sistemi, prima che il ransomware si propaghi. Questo perché l’AI può contestualizzare e unificare la grande varietà di segnali e marcatori lasciati dagli aggressori mentre si muovono nei sistemi per raggiungere il loro obiettivo. L’AI può riunire tutte queste informazioni disparate in un unico quadro chiaro. Ciò significa che i team di sicurezza possono rispondere in modo efficiente alle minacce più critiche.

Conquistare il campo di battaglia del ransomware

Il ransomware continua a rappresentare una seria minaccia per le organizzazioni e non se ne andrà tanto presto. I team di sicurezza dovrebbero prendere nota dei numerosi incidenti ransomware di alto profilo verificatisi di recente e considerarli come un case study di ciò che può accadere se non si è pronti ad affrontare l’ampia varietà di minacce.

Se si finisce nel mirino di un attacco mirato e non automatizzato, non è realistico aspettarsi che gli analisti di sicurezza siano coperti su tutti i fronti. Poiché gli operatori di ransomware continuano a diversificarsi, le organizzazioni dovrebbero considerare di aggiungere al proprio arsenale mezzi alimentati dall’intelligenza artificiale per rilevare il ransomware, in modo da poter ridurre significativamente il tempo necessario per individuare la minaccia.

Articolo a cura di Massimiliano Galvagna

https://www.ictsecuritymagazine.com/articoli/lai-come-arma-fondamentale-nella-guerra-ai-ransomware/


Come proteggersi dagli attacchi in cloud

In questi giorni è apparsa sui social media professionali una domanda molto importante, ma alquanto provocatoria: “Quanto è sicuro il cloud?”

La ragione principale di questo dubbio risiedeva nella vulnerabilità di un componente software descritta da alcuni ricercatori della società Wiz.

Proviamo quindi ad approfondire cosa è successo per capire rischi e soluzioni.

Microsoft, come parte delle soluzioni cloud che vanno sotto l’ombrello “Azure”, offre una soluzione di database chiamata CosmosDB. Questo è un database di tipo NoSQL, quindi radicalmente differente in struttura e in prestazioni rispetto a un database relazionale come ad esempio SQLServer.

I vantaggi che spingono piccole e grandi aziende ad adottare un database NoSQL in cloud sono essenzialmente tre: archiviazione di grandi quantità di dati non strutturati, velocità di risposta in pochi millisecondi e, non meno importante, scalabilità a livello planetario. Questi vantaggi, uniti alla potenza del cloud, spiegano le ragioni del successo di CosmosDB.

In agosto 2021 la società Wiz, capitanata a livello tecnico da Ami Luttwak che poco tempo fa ricopriva lo stesso ruolo in Microsoft Cloud Security Group, informa Microsoft che il suo team di ricerca ha identificato una vulnerabilità in un componente software utilizzato con CosmosDB che si chiama Jupyter Notebook.

Questa è una piccola applicazione a contorno del motore di database principale, che si definisce Open Document Format. In pratica, è un modo di rappresentare i dati che consente di creare e condividere documenti che contengano dal testo narrativo a equazioni scientifiche, da codice software a dati più complessi. Questi documenti possono poi essere memorizzati nel database, quindi interrogati, ordinati, estratti, e così via.

Jupyter Notebook non nasce con CosmosDB, bensì circa dieci anni fa come parte del linguaggio di programmazione Python. Nel 2015 viene scorporato in un progetto opensource autonomo chiamato per l’appunto Jupyter Project.

Messa nei termini più semplici possibili per capirne il rischio, la vulnerabilità di Jupyter Notebook, se sfruttata con un apposito exploit codificato per l’occasione, permette a un attaccante di interrogare il componente Jupyter Notebook di un database CosmosDB raggiungibile da Internet, ottenendo credenziali valide utili per visualizzare, modificare e cancellare dati nell’utenza di CosmosDB.

Come sempre accade quando si fanno le cose in modo adeguato, i ricercatori hanno dato un nome a questa vulnerabilità chiamandola ChaosDB ed informato Microsoft secondo i dettami della ResponsibleDisclosure.

Microsoft ha reagito prontamente in meno di 48 ore, disabilitando questa opzione software che era presente di default su tutte le istanze CosmosDB, a prescindere dall’utilizzo, e ha avvisato i clienti del rischio in modo che provvedessero a modificare le configurazioni per rimediare al rischio di potenziale compromissione.

In conclusione, dunque, il cloud è sicuro alla stregua di qualsiasi implementazione raggiungibile da chiunque ne sia autorizzato e da ovunque sul pianeta. Ad aumentare il livello di sicurezza, c’è l’attenzione costante e continua di chi su questi servizi genera una parte importante dei propri profitti e ha tutto l’interesse alla costruzione e al mantenimento di un rapporto di fiducia basato sull’integrità e sulla conservazione dei dati.

Alcune, tra le centinaia di migliaia di vulnerabilità, rimangono dormienti per anni fino a quando non vengono rilevate. Partendo dal presupposto che la vulnerabilità di un componente non compromette l’intera piattaforma, Microsoft ha confermato che non risulta nessun accesso illecito ai dati a causa della vulnerabilità di Jupyter Notebook.

È importante altresì ricordare che, per proteggersi dagli attacchi in cloud, occorre avere sempre la massima visibilità sul proprio ambiente digitale, oltre alla conoscenza delle diverse opzioni di configurazione delle istanze che vengono attivate in ambienti cloud. Ad esempio, sebbene vulnerabile a causa di un componente software come Jupyter Notebook, un database CosmosDB diventa compromissibile solo se esposto alla raggiungibilità pubblica via internet.

Nello specifico, per mitigare il rischio della vulnerabilità di Jupyter Notebook, oltre alla guida fornita da Microsoft, la stessa Wiz ha recentemente pubblicato alcune interessanti linee guida in merito, consultabili a questo link.

Sebbene sia compito di Microsoft garantire che il software e le piattaforme offerte come servizio restino il più possibile libere da bug e vulnerabilità, è altresì importante che gli utenti capiscano il concetto di responsabilità condivisa.

Marco Rottigni

Marco is a result driven professional with nearly 30 years’ experience in IT and 20 years in Security space. He is a natural born Evangelist and Sales Engineer who loves the technology he deals with.

He worked for many companies such as Esker, SCO, Stonesoft, McAfee, Fireeye and managed many European teams and projects.

Joining Qualys in 2018 as Chief Technical Security Officer EMEA, Marco’s responsibility is to deliver Qualys technical vision, to pitch Qualys unique advantages and competitive differentiators to strategic customers and partners, while collecting feedback about customers experience with Qualys solutions across the SEMEA region.

www.qualys.com

https://www.ictsecuritymagazine.com/articoli/come-proteggersi-dagli-attacchi-in-cloud/


COVERT CHANNEL – Canali segreti per comunicare in maniera non convenzionale

I covert channel sono un fenomeno in continua espansione che attirano l’interesse di attori diversi, spesso antagonisti: utenti, community, cyber criminali, intelligence governative, aziende e digital lobbies dei big data.

Un covert channel (canale nascosto) è un qualsiasi metodo di comunicazione utilizzato per comunicare e/o trasferire informazioni in modalità occulta e furtiva. Lo scopo primario nell’utilizzare un canale nascosto è quello di superare le politiche di sicurezza di sistemi ed organizzazioni. Esistono molteplici tipologie di cyber minacce che possono riguardare la sicurezza multilivello (MLS) di infrastrutture e sistemi ICT ed aumentano ogni giorno ad un ritmo impressionante. Gli ingegneri e gli amministratori di sistema sono quindi continuamente impegnati nella gestione quotidiana della sicurezza e spesso non prestano sufficiente attenzione sul campo, ignorando ad es. minacce come i canali nascosti. Qualsiasi risorsa condivisa può essere potenzialmente utilizzata come canale nascosto e questo rende tutto più difficile, in altre parole, i canali segreti non sono ovunque ma possono essere ovunque.

I canali nascosti non vanno confusi con i sistemi di anonimato come ad es. TOR, in quanto questi ultimi mirano a proteggere le azioni e l’identità di un utente, mentre i canali nascosti in genere servono per creare flussi nascosti non autorizzati di informazioni, in violazione a politiche di sicurezza (esfiltrazioni di informazioni).

Esistono principalmente tre tipologie di canali nascosti:

  • Covert Channel Timing (Temporizzazione)
  • Covert Channel Storage (Archiviazione)
  • Covert Channel Behavioral (Comportamentali)

le principali tre caratteristiche di un canale nascosto sono:

  • Stealthiness (furtività): cioè la caratteristica intrinseca dei canali nascosti è di aggirare i controlli in maniera nascosta. I canali nascosti sono falle nella sicurezza multilivello di un sistema.
  • Bandwith (capacità di trasmissione): cioè la capacità di trasmissione dati. Nei canali nascosti la capacità di trasmissione è generalmente bassa in termini di dati/tempo (throughput) in quanto utilizzando altre risorse un eccessivo carico di informazioni potrebbe rendere anomalo il funzionamento di quelle risorse o le normali strutture dati. Il throughput è generalmente misurato in b/s (bit al secondo) o kb/s, nei canali nascosti il throughput è generalmente inversamente correlato alla segretezza di un canale, ovvero più dati un canale può trasmettere in un determinato periodo di tempo, maggiore è il rischio che il canale venga scoperto.
  • Indistinguishability (Indistinguibilità) i canali nascosti in genere sfruttano servizi e risorse già presenti quindi non sospette, uno dei maggiori problemi nell’implementazione di un canale nascosto è il “rumore”. Un canale nascosto si dice rumoroso quando per comunicare ad es. sfrutta eccessivamente le risorse alterando e/o danneggiando il corretto funzionamento delle stesse, sollevando così attenzioni da parte degli amministratori di sistema. Riuscire a trasmette attraverso un canale nascosto mantenendo conforme e inalterato il funzionamento della risorsa utilizzata permette di rendersi “indistinguibili” dalla risorsa autorizzata ed invisibili ai sistemi di monitoraggio.

I canali nascosti possono essere progettati sia per un singolo sistema che per una rete. L’incredibile numero di applicazioni e sistemi connessi oggi ad internet, con cui quotidianamente interagiamo, sono diventati un ottimale veicolo per creare canali nascosti: giochi online, app, servizi in cloud, sistemi IoT, lo stesso protocollo TCP/IP, tutti potenziali vettori di cui i canali nascosti sfruttano caratteristiche e difetti. Il livello di attenzione sui canali nascosti negli ultimi anni si è andato sempre più alzando anche in considerazione dell’utilizzo degli stessi da parte della criminalità informatica e in ambito di cyber warfare per quanto riguarda lo spionaggio governativo e le cyber weapon.

Covert Channel Timing (temporizzazione)

I canali nascosti di temporizzazione sono metodi di comunicazione che permettono ad un osservatore (umano o processo) di acquisire informazioni attraverso il cambiamento nel tempo di risposta di una risorsa. In altre parole, è essenzialmente qualsiasi metodo che utilizza un orologio o una misurazione del tempo per segnalare il valore inviato sul canale.

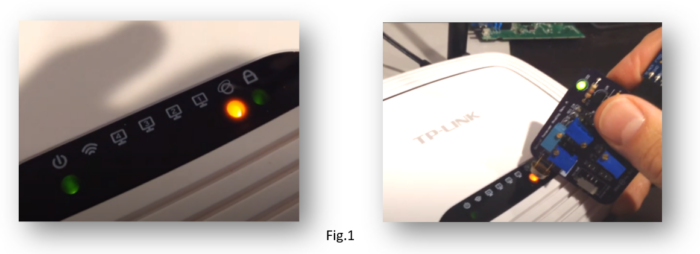
Facciamo qualche esempio, in questo video (fig.1): https://www.youtube.com/watch?v=QIvsmQQ6vu8

l’autore, attraverso un hardware open source, dimostra come esfiltra dati da un router fisicamente non modificato, leggendo il rapido lampeggio (non rilevabile dall’occhio umano) del LED di trasmissione. In questo caso il canale nascosto è addirittura “involontario” cioè non esiste una parte ostile consapevole che trasmette i dati ma solo la parte “osservatrice”.

Covert Channel Storage (Archiviazione)

I canali nascosti di archiviazione sono metodi di comunicazione che “includono tutti i veicoli, che consentirebbero la scrittura diretta o indiretta di una risorsa da parte di un processo, e la lettura diretta o indiretta di esso da parte di un altro. In altre parole, un processo scrive su una risorsa condivisa, mentre un altro processo legge da essa. I canali di archiviazione possono essere utilizzati tra processi all’interno di un singolo computer o tra più computer in una rete. Un esempio di canale di archiviazione è la condivisione di un file. Supponiamo che l’utente A con privilegi di autorizzazione elevati voglia trasmettere in segreto, dati riservati all’utente B con un livello di sicurezza inferiore. Per fare questo, nel nostro esempio, utilizzerà un file word apparentemente contenente informazioni non classificate, dove invece occulterà l’informazione riservata, vediamo come.

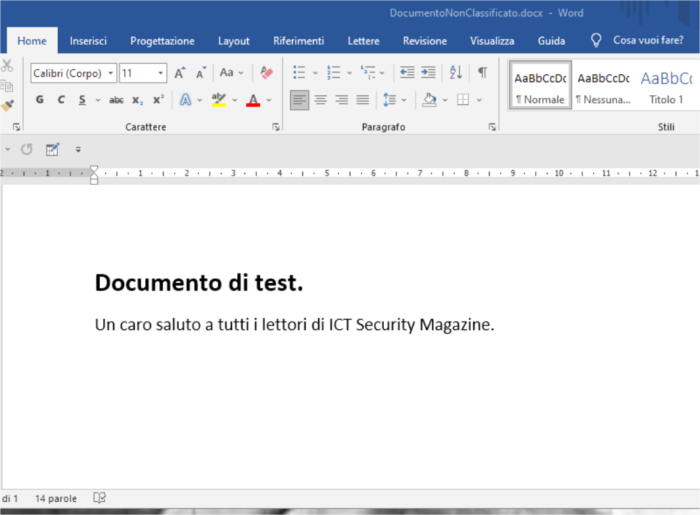
L’utente A crea un file word (DocumentoNonClassificato.docx) con informazioni non classificate (Fig.2):

Fig.2

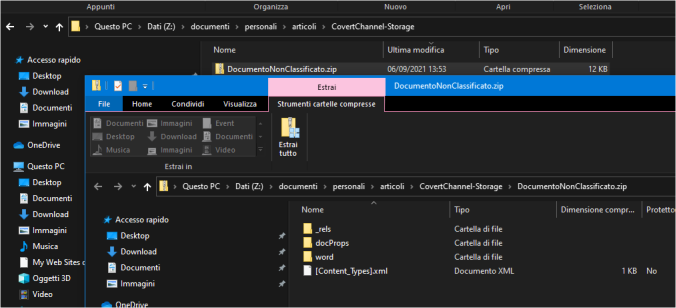
Dopo aver salvato il file cambia la sua estensione da .docx a .zip, in quanto l’attuale formato di Microsoft Word, altro non è che un file zip (Fig.3), facendo quindi doppio click sul file l’utente A potrà vederne la struttura ed il contenuto:

Fig.3

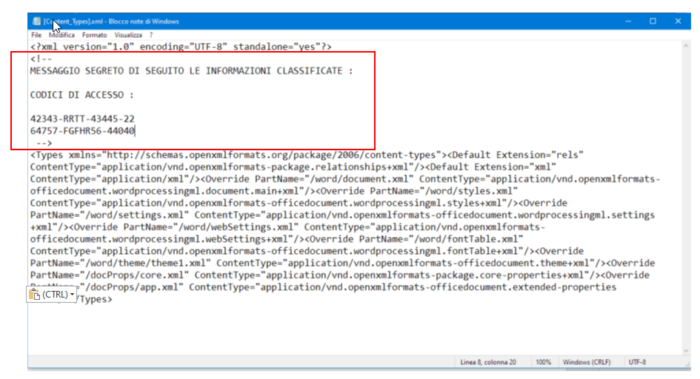
Il file word presenta al suo interno diversi file con estensione .xml e questi file come tali si comportano. Quindi per inserire il messaggio segreto l’utente A non dovrà far altro che inserire un tag di commento (<! — COMMENTO QUI –>) all’interno di uno dei file xml contenuto nel documento di word, e scrivere all’interno del tag l’informazione classificata.

Nell’esempio l’utente A esporta il file [Content_Types].xml ed inserisce l’informazione riservata all’interno del commento (Fig.4) .

Fig.4

A questo punto l’utente A sostituisce il file [Content_Types].xml modificato con quello presente nel file zip, cambia nuovamente l’estensione del file in .docx e prova ad aprire il file per verificare che tutto funzioni correttamente e che l’applicazione Word non rilevi anomalie, quindi invia il file tramite email o lasciandolo condiviso su qualche cartella di rete interna o in cloud, per l’utente B.

In questo esempio notiamo anche la presenza di tecniche di steganografia, frequentemente utilizzata nella creazione stessa dei canali nascosti. Spesso il tema associato all’occultamento delle informazioni, include a pieno titolo la steganografia ma per maggiori approfondimenti sull’argomento vi rimando ad un mio articolo di qualche tempo fa sull’argomento:

https://www.ictsecuritymagazine.com/articoli/steganografia-evoluzione-digitale-dellantica-arte-occultare-le-informazioni-strumento-riservatezza-strumento-offesa-dispositivi-mobili/

Covert Channel Behavioral (Comportamentali)

I canali nascosti comportamentali operano trasmettendo dati in base all’assegnazione di diversi eventi di processi, sistemi e applicazioni, generalmente suddividendo e trasmettendo i dati in pacchetti più piccoli.

Tra i più affascinanti canali nascosti comportamentali, in cui mi sono imbattuto, quello che utilizza il protocollo ICMP (Internet Control Message Protocol), sfrutta appieno caratteristiche quali la rapidità di attivazione, semplicità d’uso e bypassa molte delle policy e standard di sicurezza con estrema nonchalance, manifestando in maniera ottimale le caratteristiche di Stealthiness e Indistinguishability.

L’ICMP è progettato per fornire feedback su problemi di comunicazione di una rete TCP/IP. L’ ICMP si affida al supporto di base dell’IP come parte di protocollo di livello superiore. A causa di questa dipendenza, sia ICMPv4 che ICMPv6 esistono per entrambe le versioni di IP. Applicazioni come ad es. traceroute e ping utilizzano i messaggi ICMP per raccogliere informazioni e diagnosticare eventuali problemi di rete.

I canali nascosti spesso sfruttano per i propri flussi di informazioni, alcune caratteristiche tecniche incorporate nelle reti IEEE 802, caratteristiche che normalmente non vengono “viste” a livello di rete più alto perché considerate di servizio.

L’idea di utilizzare l’ICMP come canale nascosto è quindi quella di sfruttare una comunicazione standard con un protocollo inferiore rispetto a TCP o UDP. Questo avrà un “ingombro” ridotto in tutto il traffico di rete e potrà passare inosservato agli amministratori di rete e agli analizzatori di traffico, in quanto, come detto, normalmente è utilizzato per la diagnostica e manutenzione della rete e degli host connessi, non per il trasporto dati, quindi difficilmente bloccato da policy di sicurezza.

Questo rende il protocollo ICMP un canale nascosto decisamente praticabile, l’uso di campi dati o payload all’interno di determinati messaggi ICMP permette di incorporare il messaggio del canale nascosto facilmente e trasforma paradossalmente l’ICMP stesso in un canale nascosto. Questi semplici fattori consentono all’ICMP di essere di fatto un traffico invisibile, vediamo un esempio.

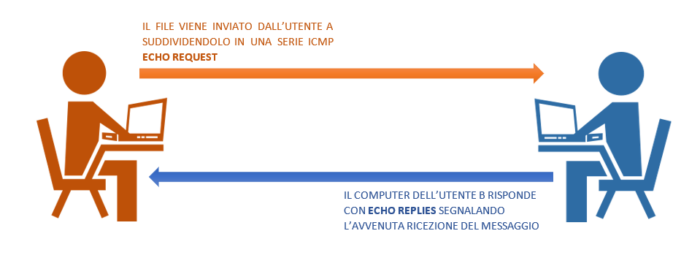
L’utente A vuole trasmettere un file riservato all’utente B. L’utente A utilizzerà il protocollo “ICMP echo request” (con il comando ping) per trasmettere il file all’interno delle richieste icmp suddividendo il documento in piccoli pacchetti (di dimensioni compatibili con la struttura dati del pacchetto icmp) trasmettendoli uno ad uno ad ogni “echo request” (ping) fino al completamento del contenuto del file.

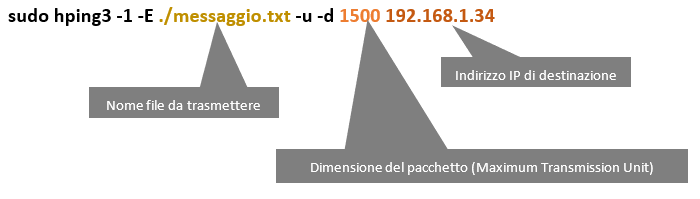
L’utente A per inserire il file riservato nelle trasmissioni “ICMP echo requests”, nell’esempio, utilizza il programma hping3, un generatore e analizzatore di pacchetti per il protocollo TCP/IP, scritto dallo sviluppatore italiano Salvatore Sanfilippo (noto anche come Antirez). Il software si basa sullo stesso concetto del comando Unix ping ma fa anche uso di protocolli diversi dall’ICMP, permettendo di gestire la costruzione a piacere del pacchetto IP, quindi anche l’invio di pacchetti IP semplici, privi al loro interno di un protocollo layer 4 o che possono contenere dati personalizzati, come nel nostro caso.

Per installare il comando sulla sua macchina Linux l’utente A esegue il comando:

sudo apt install hping3

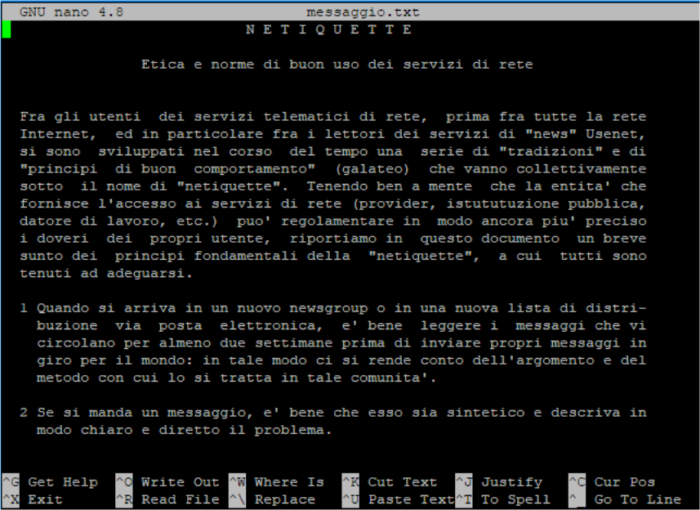
 Il file riservato che l’utente A vuole trasmettere è messaggio.txt (Fig.5)

Fig.5

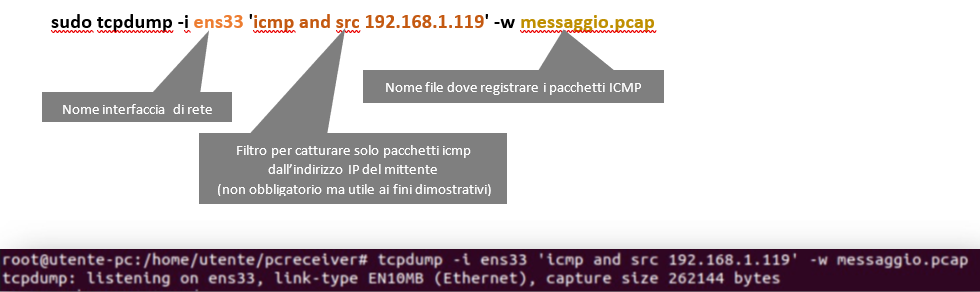
L’utente B per ricevere e catturare i dati deve mettersi in ascolto sulla rete e per fare questo, nel nostro esempio, installa l’applicazione tcpdump:

sudo apt-get install -y tcpdump

tcpdump è un tool per il debug di reti di computer che permette di intercettare i pacchetti che arrivano sulla scheda di rete.

Una volta installato, l’utente B si mette in ascolto, in attesa della trasmissione con il seguente comando:

L’utente A inizia la trasmissione eseguendo il comando :

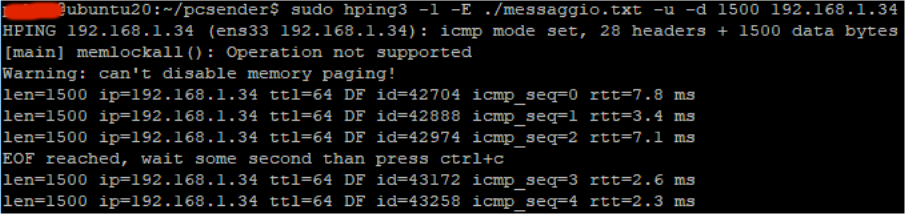
L’utente A comincia a vedere le risposte di ricezione da parte del client remoto agli “echo request” (Fig.6)

Fig.6

Quando hping3 completa la lettura del file lo segnala con la scritta:

EOF reached, wait some second than press ctrl+c

A questo punto l’utente A può terminare la trasmissione.

L’utente B a sua volta termina la cattura dei pacchetti ed analizza i dati ricevuti.

Nel nostro esempio utilizziamo il programma wireshark per l’analisi dei dati e che può essere installato semplicemente con il comando:

sudo apt install wireshark

Installato wireshark l’utente B apre il file direttamente da terminale con il comando:

wireshark messaggio.pcap

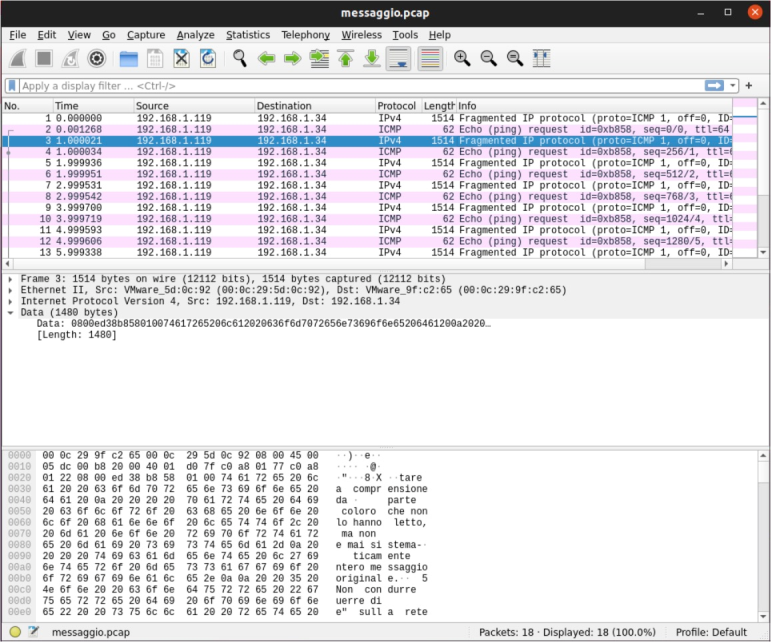
L’interfaccia di wireshark permette all’utente B di vedere i pacchetti acquisiti e capire se i dati sono arrivati (Fig.7).

Fig.7

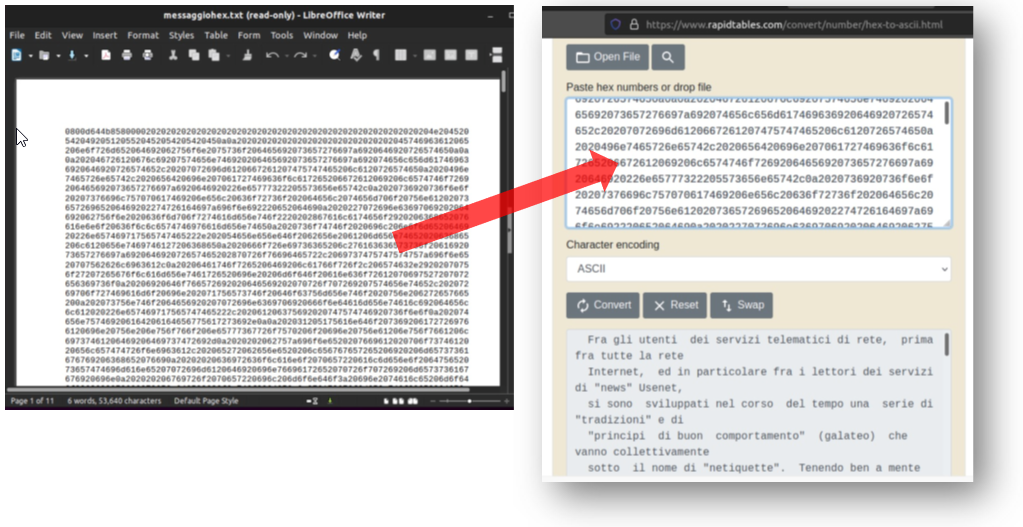
Il passo successivo, per l’utente B, è quello di ricomporre i pacchetti e rendere l’informazione nuovamente leggibile, quindi nel nostro caso, in formato ASCII. L’utente B procede quindi a convertire i dati raw in un formato esadecimale inserendo i caratteri di fine riga per ricostruire la formattazione del testo originale, per questo utilizza il programma tshark (sudo apt install tshark) con il seguente comando:

sudo tshark -n -q -r messaggio.pcap -T fields -e data.data | tr -d “\n” |tr -d “:” > messaggiohex.txt

Generato il file messaggiohex.txt l’utente B converte infine il testo esadecimale ottenuto in ASCII attraverso un sito di conversione di formati online (https://www.rapidtables.com/convert/number/hex-to-ascii.html) (Fig.8)

Fig.8

In questo articolo ho voluto dare una brevissima panoramica su un argomento molto più ampio ed esteso di quanto si possa pensare; infatti, sebbene la maggior parte dei canali nascosti esistenti, sia solitamente utilizzata per scopi dannosi come la diffusione di malware, spionaggio industriale o governativo, esistono molti studi per utilizzarli come alternative nella trasmissione di informazioni sensibili in reti non attendibili, ad es. come una sorta di backup, di connessione di emergenza che sfrutta temporaneamente altre risorse, normalmente progettate e utilizzate per scopi diversi, per poter continuare a comunicare in caso di interruzione del sistema di connessione principale.

I covert channel, i canali nascosti, rappresentano una grande sfida per la cybersecurity, da una parte la minaccia dall’altra una potenziale risorsa da studiare ed utilizzare, entrambe, facce della stessa medaglia.

Articolo a cura di Francesco Arruzzoli

https://www.ictsecuritymagazine.com/articoli/covert-channel-canali-segreti-per-comunicare-in-maniera-non-convenzionale/


La corsa a ostacoli della transizione digitale

Partiamo dal “generale”

Lo sappiamo, la transizione digitale è un punto fermo del Piano Nazionale di Ripresa e Resilienza (PNRR)[i]: se non si compie, arriveranno meno soldi dall’Unione Europea e, questione più grave, l’Italia rimarrà indietro economicamente e socialmente.

Tuttavia, la transizione digitale è un tema che il nostro legislatore ha a cuore da anni. Intanto, già la prima versione del D.Lgs. 82/2005 – Codice dell’Amministrazione Digitale (CAD)[ii], in vigore dal 1 gennaio 2006, prevedeva, all’art. 17, che ogni pubblica amministrazione si dotasse di un centro di competenza che curasse lo sviluppo dei servizi forniti dai sistemi informativi (transizione digitale?). L’art. 17, variamente rimaneggiato negli anni, a partire dal 27 gennaio 2018, cambia la rubrica passando da “Strutture per l’organizzazione, l’innovazione e le tecnologie” a “Responsabile per la transizione digitale e difensore civico digitale”, confermata anche nell’attuale formulazione. Nasce, dunque, un soggetto, appunto il Responsabile per la Transizione Digitale (RTD), che ha il compito, abbastanza articolato, di governare il traghettamento della pubblica amministrazione in cui opera verso “lidi digitali”. E come può farlo? Ispirandosi ad un altro articolo del CAD ovvero il 14‑bis, inserito a valere dal 14 settembre 2016, istitutivo dell’Agenzia per l’Italia Digitale (AGID) alla quale assegna, tra le tante funzioni, la redazione (e verifica) del “Piano triennale per l’informatica nella Pubblica Amministrazione”. In verità, l’idea del piano triennale non è nuova giacché l’art. 7 del (soppresso) D.Lgs. 39/1993 prevedeva che l’allora Autorità per l’Informatica nella Pubblica Amministrazione (AIPA poi diventata CNIPA) redigesse un piano contenente “i progetti e i principali interventi di sviluppo e gestione dei sistemi informativi automatizzati delle amministrazioni”.

Quindi, già da quasi trent’anni, l’Italia, almeno nel comparto pubblico (da sempre vero volano di qualsiasi iniziativa di sviluppo, anche non tecnologico), ha posto le basi per la transizione al digitale cioè per cambiare prospettiva nel fornire servizi alla comunità. Certo, senza voler ripercorrere la storia dell’informatica pubblica italiana, i primi piani adottati puntavano soprattutto all’introduzione di nuove tecnologie nei polverosi uffici ministeriali o comunali (i primi personal computer, le prime LAN, i primi collegamenti remoti, ecc.).

Oggi, il piano si fonda su paradigmi, sistemi e strumenti che, tra l’altro, sono ampiamente nell’uso comune dei cittadini: il web, l’email, le app per dispositivi mobili, il cloud e così via.

L’ultima versione del piano è stata formalizzata con il DPCM del 17 luglio 2020[iii]: è la versione 2020‑2022[iv] che contiene molti suggerimenti per il RTD ma anche molti “ostacoli”, nel senso di step da superare o requisiti da soddisfare per avviare, per esempio, un nuovo servizio digitale. Infatti, basta fermarsi al paragrafo Princìpi guida per capire che possono esserci enormi difficoltà a realizzare, a far realizzare o a trovare sul mercato servizi applicativi che offrano una perfetta rispondenza agli undici princìpi esposti. Naturalmente, le amministrazioni pubbliche possono tranquillamente procedere con un approccio graduale, soprattutto nei casi in cui partono da zero o quasi. I piccoli comuni, per esempio, raramente hanno inserito al primo posto, in passato, programmi di transizione digitale dei loro servizi per due ragioni molto semplici:

  • non sentivano l’urgenza della digitalizzazione perché il rapporto ravvicinato con l’istituzione facilita l’erogazione dei servizi; per esempio, l’ottenimento di un certificato poteva (e forse può) ben essere soddisfatto con la classica richiesta verbale allo sportello;
  • non avevano le risorse per avviare seri programmi di transizione; mancavano le risorse umane per pianificare e condurre i progetti oltre che per sostenerne i risultati a regime; e, per tornare all’esempio precedente, tutto questo, forse, costa più del classico servizio allo sportello.

È chiaro che la pandemia (ma anche la velocità del mondo) ha reso indifferibile una rapida convergenza al digitale.

Dunque, rimuoviamo gli ostacoli:

  • troviamo le risorse; quelle finanziarie dovrebbero arrivare dal PNRR mentre le risorse umane sarà più facile reperirle con la recente riforma Brunetta sulle assunzioni nella P.A.[v];
  • pianifichiamo i servizi da digitalizzare; si tratta di formare una scala di priorità perché, si sa, non è possibile fare tutto insieme ed anche la più semplice amministrazione pubblica offre, come minimo, una mezza dozzina di servizi alla propria comunità di riferimento; nella definizione dei criteri di priorità occorre stabilire il giusto equilibrio tra il contesto interno della pubblica amministrazione e le esigenze della comunità di riferimento; alcune delle domande sono “Quanto questo servizio è necessario alla nostra comunità?”, “Qual è la frequenza con cui viene richiesto?”, “Chi sono i soggetti destinatari del servizio?”, “La struttura organizzativa è pronta ad offrire il servizio in modalità digitale?”;
  • troviamo la soluzione giusta; si tratta di (ri)progettare il servizio ed individuare le soluzioni tecnologiche che meglio possono soddisfare i princìpi presenti nel piano triennale; non è una cosa facile, anche se, com’è noto, AGID ha messo a disposizione il Cloud Marketplace (e già si è a buon punto perché almeno il principio cloud first viene soddisfatto); purtroppo, però, il marketplace non risulta proprio amichevole nell’uso perché, ad esempio, quando si filtra su una determinata categoria SaaS (p.e. servizi scolastici), spesso, i fornitori che il sistema seleziona offrono prodotti che appartengono a tutt’altra categoria;
  • gestiamo la transizione; forse, è la fase più difficile perché la “messa in moto” richiede impegni di natura tecnica (gestione delle utenze, configurazione del DBMS, ecc.) ma anche organizzativa (formazione del personale, comunicazione del servizio all’utenza, ecc.) sia quando si trasforma un servizio tradizionale in un servizio digitale sia quando si sostituisce un servizio che è già digitale (magari cambiando fornitore);
  • portiamo il servizio a regime; alimentiamo il funzionamento del servizio, valutiamone l’efficacia e l’efficienza, modifichiamolo sulla base dei feedback, sosteniamolo nel tempo.

La “specialità” degli operatori di servizi essenziali

Sin qui, ci siamo limitati a delineare i passi salienti, provocatoriamente enfatizzati come “ostacoli”, che, in via generale, le pubbliche amministrazioni devono apprestarsi a condurre per concretizzare la transizione digitale. Tuttavia, ci sono pubbliche amministrazioni speciali. Il riferimento è a quei soggetti, definiti “operatori di servizi essenziali”, che rientrano nell’ambito applicativo del D.Lgs. 65/2018[vi] (detto decreto NIS) ovvero a quei soggetti che soddisfano i seguenti criteri:

  1. forniscono un servizio che è essenziale per il mantenimento di attività sociali e/o economiche fondamentali;
  2. la fornitura di tale servizio dipende dalla rete e dai sistemi informativi;
  3. un incidente avrebbe effetti negativi rilevanti sulla fornitura di tale servizio.

Tra questi soggetti, per esempio, rientrano gli ospedali, i gestori di servizi ferroviari, i gestori degli acquedotti, ecc. sottoposti ad uno specifico obbligo che ne traina tanti altri: devono notificare allo CSIRT[vii] senza ingiustificato ritardo, gli incidenti aventi un impatto rilevante sulla continuità dei servizi essenziali forniti. Questo significa che devono mettere in piedi un’infrastruttura tecnica ed organizzativa che si ispiri agli standard di sicurezza delle informazioni comunemente utilizzati (ISO/IEC 27001) o al classico framework NIST[viii]: Identify, Protect, Detect, Respond and Recover.

Per questi soggetti non è sufficiente attenersi genericamente al principio, previsto dal Piano Triennale, di “sicurezza e privacy by design” ma è necessario attrezzarsi per un atteggiamento proattivo che identifichi esattamente quello che succede nei propri sistemi informativi per far scattare i meccanismi di prevenzione e di protezione adeguati.

Quindi, un ulteriore e pesante requisito da assicurare nella transizione digitale che, ricordiamo, può essere anche una transizione da “vecchio” digitale a “nuovo” digitale (rinnovo della piattaforma, cambio di fornitore, cambio di paradigma di servizio, ecc.).

L’“ultra‑specialità” del perimetro di sicurezza nazionale cibernetica

Il decreto NIS è l’applicazione nell’ordinamento italiano della direttiva europea 2016/1148 e, quindi, in qualche modo, una strada obbligata. Tuttavia, il legislatore italiano ha inteso rafforzare ulteriormente il quadro di regole per la cybersecurity identificando, nell’ambito degli operatori di servizi essenziali, un ulteriore sottoinsieme di soggetti che dovranno rispondere a requisiti ancora più stringenti. Lo ha fatto con il D.L. 105/2019 convertito con la Legge 133/2019 che definisce il perimetro di sicurezza nazionale cibernetica (d’ora in poi solo “perimetro”) composto da

tutte le amministrazioni pubbliche, gli enti e gli operatori pubblici e privati aventi una sede nel territorio nazionale, da cui dipende l’esercizio di una funzione essenziale dello Stato, ovvero la prestazione di un servizio essenziale per il mantenimento di attività civili, sociali o economiche fondamentali per gli interessi dello Stato e dal cui malfunzionamento, interruzioni, anche parziali, ovvero utilizzo improprio, possa derivare un pregiudizio per la sicurezza nazionale

I soggetti che rientrano nel perimetro sono identificati, e periodicamente aggiornati ma non resi pubblici[ix], con un atto amministrativo del Presidente del Consiglio dei Ministri (o di un Ministro appositamente delegato) così come previsto dal DPCM 131 del 30 luglio 2020 (Regolamento in materia di perimetro di sicurezza nazionale cibernetica)[x]. Appena un soggetto riceve la comunicazione di essere all’interno del perimetro è obbligato ad osservare misure stringenti sia nella progettazione, acquisizione, testing ed esercizio delle infrastrutture informatiche sia nella notifica di eventi da cui possa derivare un pregiudizio per la sicurezza nazionale[xi]. L’inosservanza di tali obblighi, peraltro, è punita dal D.L. 105 con pesanti sanzioni pecuniarie amministrative che possono arrivare a sfiorare i 2.000.000 di euro.

Il corpus normativo previsto dal D.L. 105 si è recentemente arricchito proprio del provvedimento che individua le categorie di beni, sistemi e servizi ICT destinati ad essere impiegati nel perimetro di sicurezza nazionale cibernetica ovvero il DPCM del 15 giugno 2021 (pubblicato nella G.U. 198 del 19/8/2021): quando i soggetti che rientrano nel perimetro intendono acquistarli devono preventivamente farne comunicazione al Centro di Valutazione e Certificazione Nazionale accludendo anche una valutazione del rischio nel contesto di impiego.

Si aggiunge, quindi, per i soggetti che rientrano nel perimetro, un ulteriore requisito da osservare nell’evoluzione dei propri sistemi informativi e, quindi, nella transizione digitale.

Senza dimenticare il GDPR

Ma il terreno più scivoloso e, forse, più insidioso dal punto di vista sanzionatorio è il Reg. UE 2016/679 (GDPR)[xii]. È più scivoloso per un paio di ragioni principali:

  • le organizzazioni, pubbliche e private, sono, a volte anche inconsapevolmente, voraci di dati personali e, spesso, trascurano il principio di “minimizzazione dei dati” (art. 5, par. 1, lettera c);
  • i partner/fornitori che trattano dati personali (responsabili del trattamento ai sensi dell’art. 28 del GDPR) sono scelti senza particolare cura e, spesso, con criteri di risparmio di costi.

Su quest’ultimo elemento occorre riflettere tenendo conto del recente rapporto “Threat Landscape for Supply Chain Attacks”[xiii] pubblicato dell’Agenzia Europea per la Sicurezza Cibernetica (ENISA) che, tra gli altri risultati, ha fatto emergere che:

  • il 62% degli attacchi ai clienti sono avvantaggiati dalla fiducia nei fornitori;
  • il 58% degli attacchi provenienti dalla catena della fornitura è finalizzata a conquistare dati personali o segreti industriali.

Quindi, un ulteriore elemento di attenzione: bisogna scegliere i partner secondo requisiti che riducano il rischio per i dati personali. Anche, in questo caso, per superare questo “ulteriore ostacolo” della transizione digitale è opportuno studiare, calibrare ed applicare le clausole contrattuali tipo approvate di recente dalla Commissione Europea[xiv].

Conclusioni

Nell’atletica leggera, per vincere la corsa ad ostacoli, ci vogliono forza, agilità e ritmo. Nella transizione digitale bisogna aggiungere qualcosa in più: studio, pazienza e tenacia.

Note

[i] https://www.governo.it/sites/governo.it/files/PNRR.pdf

[ii] Si consiglia di consultare le varie versioni della norma, anche articolo per articolo, attraverso la Documentazione Economica e Finanziaria (https://def.finanze.it/DocTribFrontend/RS2_HomePage.jsp)

[iii] https://pianotriennale-ict.italia.it/assets/pdf/2020-2022/DPCM_17_luglio_2020_pdf_testo.pdf

[iv] https://www.agid.gov.it/sites/default/files/repository_files/piano_triennale_per_l_informatica_nella_pa_2020_2022.pdf

[v] http://www.funzionepubblica.gov.it/sites/funzionepubblica.gov.it/files/legge113_6_agosto_2021_conv_DL_80_2021.pdf

[vi] https://www.sicurezzanazionale.gov.it/sisr.nsf/wp-content/uploads/2018/06/Dlgs-65_2018-NIS.pdf

[vii] https://csirt.gov.it/

[viii] https://www.nist.gov/cyberframework

[ix] https://www.governo.it/it/articolo/cyber-aggiornato-l-elenco-dei-soggetti-del-perimetro-di-sicurezza-cibernetica-nazionale

[x] https://www.gazzettaufficiale.it/eli/id/2020/10/21/20G00150/sg

[xi] Pregiudizio per la sicurezza nazionale: danno o pericolo di danno all’indipendenza, all’integrità o alla sicurezza della Repubblica e delle istituzioni democratiche poste dalla Costituzione a suo fondamento, ovvero agli interessi politici, militari, economici, scientifici e industriali dell’Italia, conseguente all’interruzione o alla compromissione di una funzione essenziale dello Stato o di un servizio essenziale

[xii] https://www.garanteprivacy.it/documents/10160/0/Regolamento+UE+2016+679.+Arricchito+con+riferimenti+ai+Considerando+Aggiornato+alle+rettifiche+pubblicate+sulla+Gazzetta+Ufficiale++dell%27Unione+europea+127+del+23+maggio+2018.pdf/1bd9bde0-d074-4ca8-b37d-82a3478fd5d3?version=1.9

[xiii] https://www.enisa.europa.eu/publications/threat-landscape-for-supply-chain-attacks/at_download/fullReport

[xiv] https://www.ictsecuritymagazine.com/articoli/arrivano-le-clausole-contrattuali-tipo-dalla-commissione-europea/

Articolo a cura di Francesco Maldera

Francesco Maldera è Data Protection Officer e Data Scientist.

Il suo percorso professionale lo ha chiamato a responsabilità direzionali nell’ambito dei sistemi informativi, della safety&security, della privacy e dell’auditing svolgendo diversi incarichi dirigenziali nella Pubblica Amministrazione e in aziende private.

Attualmente, accompagna l’attività consulenziale a quella di sensibilizzazione delle persone tramite il sito www.prontoprivacy.it

https://www.ictsecuritymagazine.com/articoli/la-corsa-a-ostacoli-della-transizione-digitale/


Sicurezza, Hardware e Confidential Computing – Parte 2

Nella prima parte di questo articolo abbiamo descritto brevemente il ruolo dell’Hardware nel supportare e fornire strumenti di sicurezza informatica, abbiamo mostrato come la catena della fiducia sia cruciale per costruire la sicurezza ed introdotto i concetti di Confidential Computing, Secure Boot e Trusted Execution Environment. Abbiamo poi discusso di come oggi si possono proteggere i dati in transito e a riposo, e visto come la cifratura dei dati in RAM possa proteggere parzialmente le informazioni anche durante “l’uso” dei dati stessi.

In questa seconda parte dell’articolo descriviamo ulteriori modalità per garantire la confidenzialità dei dati “ in uso” approfondendo cosa si intende oggi per Confidential Computing.

Confidenzialità dei dati “In Uso” – Enclavi Sicure

Cifrare i dati in RAM mette in sicurezza un solo scenario di attacco (lettura dei dati in RAM da parte di un utente privilegiato) e non risolve la problematica generale di eseguire elaborazioni di dati sensibili in sicurezza anche su sistemi terzi come gli ambienti Cloud.

Il passo successivo, che ci porta al Hardware-Based Trusted Execution Environment (HW-TEE), è quello della realizzazione all’interno della CPU di una “Enclave Sicura”, di cui l’esempio più noto sono le Software Guard Extensions (SGX) di Intel [Rif. 10] [1].

Piuttosto che cercare di descrivere una tecnologia specifica o l’approccio tecnologico che è in costante e rapida evoluzione, cercheremo di descrivere ad alto livello le finalità di queste ricerche e sviluppi, e quello che ci possiamo aspettare diventi realtà nel prossimo futuro.

L’idea di base, e la nostra descrizione è per forza approssimativa, è di creare all’interno della CPU una zona Hardware, appunto una “Enclave Sicura”, nella quale possano essere elaborati in maniera sicura dati sensibili anche su sistemi di terzi. Alla base di tutto è il fatto che questa elaborazione sicura è protetta dall’Hardware, ovvero utilizza specifiche caratteristiche dell’Hardware per proteggere i dati; per la nostra discussione non è importante che quanto sia protetto sia una macchina virtuale, un container o direttamente un’applicazione, né come la protezione sia implementata in Hardware.

Indicativamente una Enclave Sicura dovrebbe offrire:

  • la creazione e la gestione di chiavi crittografiche
  • la cifratura/decifrazione di dati con le chiavi prodotte internamente o ricevute dall’esterno
  • l’esecuzione di programmi caricati nell’enclave, anche se non tutte le istruzioni macchina della CPU possono essere disponibili
  • che nessun altro programma esterno all’enclave, incluso il sistema operativo, possa accedere ai dati o alle istruzioni eseguite all’interno dell’enclave stessa
  • istruzioni macchina che permettono la creazione / utilizzo di un’enclave e lo scambio di dati e istruzioni con l’enclave da parte di un processo utilizzatore dell’enclave stessa.

Una modalità semplificata, e vedremo che è già ben complessa, di utilizzare questo scenario potrebbe essere la seguente. Si assuma di avere a disposizione un sistema presso un fornitore Cloud che mette a disposizione una Enclave Sicura di cui ovviamente ci si fida. Sul sistema in Cloud sono caricati dal sistema on-premises alcuni dati cifrati, vedremo più avanti come, ad esempio in un Database. Sul sistema in Cloud è anche presente un’applicazione che è in grado di elaborare normalmente i dati non cifrati presenti nel database, ma non è in grado di elaborare i dati cifrati. Quando è necessario elaborare dei dati cifrati, l’applicazione è in grado di inviarli all’Enclave Sicura e di caricare nell’Enclave Sicura anche una piccola componente applicativa scritta appositamente per essere eseguita nell’Enclave Sicura e che può elaborare i dati una volta decifrati.

Una descrizione come sempre approssimata ed ad alto livello di questo processo, è la seguente:

  • i sistemi del cliente e l’Enclave Sicura sul sistema Cloud si scambiano le relative chiavi crittografiche pubbliche o dei certificati digitali che le contengono; in questo modo i sistemi del cliente possono cifrare dei dati che possono essere decifrati solo all’interno dell’Enclave Sicura, e viceversa l’Enclave può cifrare dei dati che possono essere decifrati solo sui sistemi del cliente;
  • l’applicazione in esecuzione sul sistema Cloud è in grado di comunicare con l’Enclave Sicura sia scambiando dati cifrati, sia inviando in esecuzione del codice con una firma digitale riconosciuta dall’enclave sicura;
  • quando l’applicazione in esecuzione sul sistema Cloud deve elaborare dei dati sensibili e cifrati, invia all’Enclave Sicura il codice (firmato) necessario per l’elaborazione ed i dati cifrati;
  • l’Enclave Sicura esegue l’elaborazione come segue:
    • verifica la firma sul codice da eseguire;
    • decifra i dati con la propria chiave privata; [2]
    • esegue l’elaborazione;
    • cifra i dati risultato dell’elaborazione con la chiave pubblica del cliente;
    • invia i dati cifrati all’applicazione in esecuzione sul sistema Cloud.

Sin da questa prima descrizione, è chiaro che questo non è un processo molto semplice, in primo luogo perché richiede che le applicazioni siano adattate a poter eseguire proprie componenti (che devono essere scritte appositamente) all’interno di una Enclave Sicura quando devono agire su dati sensibili e cifrati per l’Enclave stessa. In secondo luogo è necessario gestire le chiavi crittografiche e la cifratura dei dati tra i sistemi del cliente e l’ambiente Cloud.

Tutto questo però ci riporta a considerare il concetto di “fiducia”.

La catena della fiducia distribuita

Come appena descritto, oltre al necessario sviluppo applicativo che permette alle applicazioni in esecuzione su sistemi con Enclave Sicura di comunicare ed eseguire elaborazione in essi, è necessario gestire le chiavi crittografiche con cui identificare sia i sistemi del cliente che l’Enclave Sicura e cifrare i dati. Questo risulta, di nuovo, abbastanza complesso.

Consideriamo il provider Cloud: sinora abbiamo ragionato come se l’applicazione in Cloud fosse eseguita sempre e solo su di un specifico server hardware la cui CPU ha una Enclave Sicura, ma questo al giorno d’oggi sicuramente non è vero. La situazione più comune è che l’applicazione è eseguita in una o più macchine virtuali che possono migrare tra macchine fisiche anche in sale macchine e località diverse.

Come facciamo a gestire le relative chiavi crittografiche o anche solo ad essere sicuri che l’applicazione sia in esecuzione su una CPU con una Enclave Sicura reale e non una versione virtuale che permette ad un attaccante di intercettare tutti i dati del cliente?

Per rispondere a questa domanda dobbiamo ripartire dalla catena della fiducia: per prima cosa il cliente si deve fidare del fornitore Cloud che deve assicurare di avere un gruppo di server fisici ognuno con la propria Enclave Sicura. Nel caso di una Enclave Sicura SGX è richiesto che [Rif. 15]:

  1. L’Enclave è in esecuzione su un vero processore Intel;
  2. La piattaforma è aggiornata al livello di sicurezza più recente;
  3. L’identità dell’Enclave è quella asserita;
  4. L’Enclave non è stata manomessa.

Per soddisfare queste richieste è necessario che il Secure Boot (si veda la prima parte di questo articolo) garantisca l’autenticità ed integrità del sistema Hardware e Software, e fornisca anche le relative versioni di Hardware e Software. Per gestire tutto ciò è necessario che il provider Cloud abbia un servizio di Remote Attestation [Rif. 2, 3] in grado di raccogliere le attestazioni di Secure Boot di ogni server (firmate digitalmente) contenenti anche l’indicazione delle versioni di Firmware, sistema operativo ecc.

Tramite il servizio di Remote Attestation del provider Cloud, un cliente può quindi identificare i server e le CPU le cui caratteristiche Hardware e Software soddisfano i requisiti di sicurezza di cui necessita.

A questo punto è necessario fare una osservazione che riguarda le macchine virtuali: la configurazione standard dei sistemi di virtualizzazione rende disponibile alle macchine virtuali solo Hardware virtuale e non permette l’accesso all’Hardware reale. Diversamente i Container accedono all’Hardware reale (non virtuale) anche se il sistema operativo limita fortemente le loro possibilità di accesso. Quindi se si usano macchine virtuali è necessario accertarsi che queste possano accedere a Enclavi Sicure fisiche e non virtualizzate (almeno per quanto si discute in questo articolo), mentre questo problema non si pone per i Container.

Ritorniamo ora al problema dell’Attestazione delle Enclavi Sicure considerando come esempio il caso di Container. L’Orchestratore che gestisce i Container (ad esempio Kubernetes o OpenStack) deve pertanto essere a conoscenza dell’Attestazione di ogni server e deve poter gestire una classificazione di ogni Container secondo i requisiti di sicurezza richiesti dal cliente, che permette di selezionare i server e le CPU sui quali il Container può essere eseguito in sicurezza ed in presenza di un Enclave Sicura “attestata”. Ovviamente il provider Cloud può raggruppare i propri server in classi di sicurezza che tengono conto di vari parametri, dall’Attestazione Hardware e Software alla località o regione in cui il server è situato.

Questo sistema permette quindi al cliente di selezionare i server con Enclave Sicura sui quali può essere eseguito il proprio applicativo capace di utilizzarla.

Il successivo passo è quello di scambiare le chiavi crittografiche necessarie a cifrare e decifrare i dati. Ovviamente anche questa procedura deve essere automatizzata, ma deve avere anch’essa una propria radice della catena della fiducia (o Root of Trust) sia presso il provider Cloud che presso il cliente.

Per fare questo dobbiamo ricordarci che ogni Enclave Sicura ha le proprie chiavi crittografiche, e che è necessario gestire anche le chiavi crittografiche pubbliche (o certificati digitali) del cliente. Per questo è in pratica necessario utilizzare un Key Manager, ovvero un’applicazione dedicata alla gestione delle chiavi crittografiche e che può quindi raccogliere e rendere disponibili le chiavi crittografiche necessarie. Un Key Manager di norma utilizza un Hardware Security Module (HSM) come Root of Trust, ovvero la chiave privata che identifica il Key Manager è creata e gestita unicamente all’interno dell’HSM, protetta in Hardware. Se anche il cliente utilizza un Key Manager, basta che ogni Key Manager riconosca la chiave crittografica Root of Trust dell’altro per stabilire la fiducia relativa tra i due ambienti. Il processo è simile idealmente a quello delle Certification Authorities (CA) per la navigazione Web: una volta riconosciuta ed accettata la CA superiore (in questo caso la chiave crittografica Root of Trust dell’altro Key Manager), tutti i certificati digitali e le chiavi crittografiche firmate da questa, anche in cascata, sono accettati.

Infine la comunicazione ed il trasferimento di chiavi crittografiche tra Key Manager, HSM e server è possibile ad esempio utilizzando il “Key Management Interoperability Protocol” (KMIP) [Rif. 16, 17], protocollo sviluppato apposta da OASIS a questo scopo. [3]

In Figura 1 abbiamo provato a riassumere i principali componenti di questa architettura.
Fig, 1  Principali componenti di una architettura di Confidential Computing

E’ opportuno notare che il processo appena descritto di gestione delle chiavi crittografiche del cliente da parte di un provider Cloud, si sta diffondendo e molte aziende lo hanno o stanno adottando sotto il nome di Bring Your Own Key (BYOK). L’idea è che una applicazione o servizio del provider Cloud o presso il provider Cloud, sia essa uno Storage, un Database o dei dati cifrati a livello applicativo, per cifrare e decifrare i dati utilizza delle chiavi crittografiche non create, gestite e archiviate nei sistemi del provider Cloud stesso, ma nei sistemi del cliente. Le chiavi crittografiche sono fornite all’applicazione o servizio solo quando sono necessarie per la  cifratura/decifrazione dei dati e direttamente dai sistemi del cliente tramite i Key Manager e protocolli quali KMIP. Le chiavi crittografiche non sono mai archiviate o salvate sui sistemi del provider Cloud ma mantenute in memoria sicura solo per il tempo strettamente necessario alla cifratura/decifrazione dei dati.

Tornando al Confidential Computing, dovrebbe ormai essere chiaro che la sua implementazione è abbastanza complessa sia a livello tecnico che di gestione. Per raggiungere e garantire la confidenzialità (e integrità) completa della elaborazione di informazioni su di una piattaforma di terzi, dobbiamo comunque partire dalla fiducia di base nell’Hardware e Firmware stesso dei sistemi utilizzati dalla terza parte e dobbiamo dotarci di applicazioni e servizi che permettano di:

  • identificare e verificare l’identità e integrità dei sistemi sui cui eseguire le elaborazioni in sicurezza (Attestazione Remota);
  • gestire le chiavi di cifratura e la cifratura dei dati in modo che i dati siano disponibili in chiaro solo per le elaborazioni nelle Enclavi Sicure sui sistemi Hardware scelti;
  • adattare le applicazioni in esecuzione sulla piattaforma del Provider in modo che possano comunicare ed eseguire le componenti di codice necessarie nelle Enclavi Sicure.

Sicurezza e HW-TEE

L’architettura che abbiamo appena descritta molto velocemente ed ad alto livello, dovrebbe permettere l’elaborazione di dati sensibili su sistemi di terze parti garantendo la massima confidenzialità ed integrità dei dati. Infatti non vi dovrebbe essere alcun modo in cui la terza parte sui cui sistemi avvengono le elaborazioni, abbia la possibilità di accedere ai dati in chiaro.

La domanda che sorge spontanea è quanto sia sicura in se stessa questa architettura. Vi sono vari aspetti da considerare:

  • la complessità dell’architettura stessa ed il coinvolgimento di diversi protocolli può esporre a vulnerabilità nei protocolli stessi o dovute all’interazione tra i protocolli;
  • come sempre, è possibile che vi siano vulnerabilità di sicurezza nel codice di Firmware, sistemi operativi ed applicazioni, ad esempio anche quelle utilizzate per la gestione delle chiavi crittografiche;
  • similmente è possibile che l’implementazione in Software degli algoritmi crittografici abbia una vulnerabilità mentre, a meno dell’arrivo di un elaboratore quantistico, gli algoritmi crittografici in uso sono oggi considerati sicuri;
  • infine non va sottovalutato l’aspetto di possibili vulnerabilità dell’Hardware stesso.

E’ opportuno in particolare approfondire l’ultimo punto. Tutta l’architettura che abbiamo descritto si basa sulla presenza di una Enclave Sicura in Hardware. Come ben sappiamo anche solo dalla recente esperienza con le vulnerabilità Hardware delle CPU quali Meltdown e Spectre, la reale soluzione di vulnerabilità Hardware richiede la sostituzione dell’Hardware stesso, anche se in alcuni casi è possibile mitigare i rischi introducendo specifici controlli nel Firmware.

Quindi una vulnerabilità nell’Hardware di una Enclave Sicura minerebbe alla base la sicurezza delle informazioni gestite con il Confidential Computing e HW-TEE. Purtroppo le prime generazioni di HW-TEE non sono immuni da vulnerabilità di sicurezza in Hardware (si veda [Rif. 9] per un elenco esemplificativo) anche se alcune di queste sono state mitigate con appositi controlli Firmware.

E’ importante notare che le Enclavi Sicure Hardware, quali Intel SGX, disponibili al momento sul mercato, sono state progettate senza considerare come scenario di sicurezza gli attacchi di inferenza “Side Channel”, quali gli appena citati Meltdown e Spectre. Pertanto sono stati dimostrati, in condizioni di laboratorio, alcuni attacchi Side Channel in grado di estrarre dati sensibili da Enclavi Sicure Hardware. Ovviamente future generazioni di Enclavi Sicure risolveranno queste vulnerabilità, ma la soluzione sarà più costosa e complessa rispetto ad un aggiornamento software.

Questo rende ancora più importante il processo di Attestazione Remota dei sistemi, in questo caso per l’Hardware, per cui un cliente potrebbe individuare i singoli modelli di HW-TEE del fornitore su cui eseguire le proprie elaborazioni basandosi sulle vulnerabilità Hardware note ed i possibili rischi alle proprie informazioni che ne potrebbero derivare.

Infine va citato un aspetto, per certi versi controverso, degli HW-TEE, ovvero la possibilità di un loro abuso od uso per fini non leciti. I dati elaborati in un HW-TEE non sono accessibili a nessuno se non il legittimo proprietario, per cui ad esempio anche applicazioni quali anti-virus/malware ecc. non possono verificare la presenza di codice maligno in esecuzione in un HW-TEE (ma potrebbero essere identificati gli effetti sui sistemi esterni all’HW-TEE), e non è possibile verificare che non vengano eseguite transazioni all’interno di HW-TEE non lecite per motivi legali o contrattuali. Comunque al momento non è del tutto chiaro quanto questi possano essere dei rischi reali.

Crittografia Omomorfica

Un approccio complementare o alternativo al Confidential Computing è quello di utilizzare la Crittografia Omomorfica [Rif. 11]. Sin dal 1978 nel contesto dello studio degli algoritmi crittografici asimmetrici quali RSA, Rivest,  Adleman e Dertouzos proposero il concetto di Crittografia Omomorfica, ovvero di algoritmi crittografici in qualche modo commutativi rispetto alle operazioni matematiche. Si può descrivere questo concetto con il seguente esempio: dati due numeri M e N ed una operazione O[ , ] tra di loro (somma, prodotto ecc.), un algoritmo crittografico omomorfico C( ) permette di cifrare i dati in C(M) e C(N) ed ha una operazione P[ , ] sui dati cifrati tale che

P[ C(M), C(N) ] = C( O[M,N] )

Ad esempio supponendo che O sia la somma e che P sia il prodotto[4]:

C(M) * C(N) = C( M + N )

In altre parole, se si cifrano i due numeri, si moltiplicano i due numeri cifrati e infine di decifra il risultato del prodotto, si ottiene la somma dei due numeri originali:

M + N= C-1( C(M) * C(N) )

Assumiamo quindi che il nostro fornitore Cloud offra sistemi che supportano il calcolo omomorfico   di questo tipo, possiamo quindi cifrare on-premises tutti i dati numerici prima di inviarli all’applicazione Cloud, far eseguire il prodotto dei numeri cifrati dall’applicazione Cloud, scaricare dall’applicazione Cloud il risultato del prodotto dei numeri e decifrarlo on-premises ottenendo la somma dei numeri originali. In tutto ciò il sistema Cloud gestisce solo dati cifrati e nessuna chiave di cifratura/decifrazione, e quindi non ha nessuna possibilità di accedere ai dati in chiaro.
Fig. 2 Flusso logico di un calcolo omomorfico

La crittografia omomorfica è da sempre considerata come la soluzione definitiva per la confidenzialità dei dati in quanto permette al proprietario dei dati di mantenere la confidenzialità degli stessi (solo il proprietario può decifrarli) ed al contempo permette ad altri di elaborare i dati per contro del proprietario senza però venire a conoscenza delle informazioni rappresentate dai dati stessi.

Purtroppo, come al solito, non tutto è così semplice come si desidererebbe (altrimenti utilizzeremmo già da decenni la crittografia omomorfica). Prima di tutto, dall’enunciazione dell’idea di crittografia omomorfica (1978) sino al primo modello teorico reale sono passati ben 31 anni, ovvero sino alla tesi di dottorato del 2009 di Craig Gentry [Rif. 12]. Da allora sono stati identificati ben 4 tipi di “homomorphic encryption scheme” (HE o FHE) [5], ed i lavori dei crittografi continuano.  Non solo, nel frattempo si è anche aggiunta la richiesta di sicurezza di produrre algoritmi resistenti ad eventuali futuri arrivi dei Computer Quantistici [Rif. 13] che richiede ulteriori valutazioni e, in parte, lo sviluppo di nuovi algoritmi.

Ad oggi sono già disponibili librerie sperimentali che permettono di utilizzare la crittografia omomorfica ed il consorzio in [Rif. 11] ha proprio lo scopo di definire degli standard in modo che soprattutto i fornitori di servizi Cloud la possano offrire ai propri clienti.

I problemi principali sono dovuti alla lentezza e dimensione degli algoritmi e dei dati, ed alle reali garanzie di sicurezza. Benché gli ultimi algoritmi siano ordini di grandezza più veloci e leggeri dei primi proposti, sono ancora molto lenti rispetto al calcolo svolto sui dati in chiaro e la procedura di cifratura rende i dati molto più grandi, occupando più spazio a riposo, in transito ed in uso.

Gli aspetti di sicurezza riguardano da una parte la sicurezza intrinseca degli algoritmi e dei protocolli stessi, che è ovviamente in corso di valutazione, e dall’altra le modalità di uso e applicative anche per evitare attacchi di inferenza e “side channel”.

Uno dei principali problemi degli attuali algoritmi omomorfici è che di norma permettono di effettuare solo alcune operazioni aritmetiche, ad esempio solo la somma e la moltiplicazione. Questo rende difficile, se non impossibile, utilizzarli con applicazioni complesse che gestiscono molti dati, come un DataWareHouse od un modello di Machine Learning. Ovviamente si spera che queste siano solo difficoltà tecniche che in futuro possano essere superate.

Inoltre, finché ci si limita a effettuare somme e prodotti di numeri è difficile immaginare attacchi di inferenza sui dati, ovvero dedurre delle informazioni direttamente dai dati cifrati. Supponiamo invece come semplice esempio, di avere una tabella con gli stipendi dei dipendenti cifrata con crittografia omomorfica e che sia possibile effettuare un test logico su due dati cifrati che ha come risultato di sapere se il primo dato reale è maggiore del secondo (questo è lo stesso che introdurre un meccanismo per ordinare i dati reali). Visto che i dati sono cifrati, guardando questa operazione da sola (atomicamente) non ne otteniamo quasi alcuna informazione sui dati reali. Ma se prendiamo un gruppo di dati, possiamo incominciare ad estrarne delle informazioni: per prima cosa il loro ordinamento reale; inoltre se due dati (cifrati) hanno lo stesso numero di dati più grandi di loro, vuol dire che i dati reali sono uguali. Quindi la possibilità di ordinare i dati cifrati secondo l’ordinamento numerico dei dati reali (ignoti a chi esegue l’ordinamento) permette di ottenere alcune informazioni sui dati reali stessi.

Questo è ovviamente un esempio banale, ma ci deve far riflettere se e come la crittografia omomorfica sarà da sola in grado di garantire la confidenzialità delle informazioni anche durante l’elaborazione in un ambiente potenzialmente ostile, o se più probabilmente sarà un altro strumento a nostra disposizione per la protezione delle nostre informazioni da utilizzare insieme agli altri, a partire dal Confidential Computing.

Riferimenti Bibliografici

Rif. 1: Confidential Computing Consortium, https://confidentialcomputing.io/

Rif. 2: NIST “Hardware-Enabled Security for Server Platforms: Enabling a Layered Approach to Platform Security for Cloud and Edge Computing Use Cases”, Draft 28 aprile 2020, https://doi.org/10.6028/NIST.CSWP.04282020-draft

Rif. 3: NIST “Hardware-Enabled Security: Container Platform Security Prototype”, Draft dicembre 2020, https://doi.org/10.6028/NIST.IR.8320A-draft

Rif. 4: Confidential Computing Consortium “Confidential Computing Deep Dive v1.0”, ottobre 2020, https://confidentialcomputing.io/wp-content/uploads/sites/85/2020/10/Confidential-Computing-Deep-Dive-white-paper.pdf

Rif. 5: Confidential Computing Consortium “Hardware-Based Trusted Execution for Applications and Data”, luglio 2020, https://confidentialcomputing.io/wp-content/uploads/sites/85/2021/01/confidentialcomputing_outreach_whitepaper-8-5×11-1.pdf

Rif. 6: si vedano ad esempio i seguenti recenti articoli: The Register “Microsoft brings Trusted Platform Module functionality directly to CPUs under securo-silicon architecture Pluton”, https://www.theregister.com/2020/11/17/microsoft_pluton_cpu_hardware_security/ ; The Hacker News “Intel Adds Hardware-Enabled Ransomware Detection to 11th Gen vPro Chips”, https://thehackernews.com/2021/01/intel-adds-hardware-enabled-ransomware.html

Rif. 7: “AMD Memory Encryption white paper”, aprile 2016, https://developer.amd.com/wordpress/media/2013/12/AMD_Memory_Encryption_Whitepaper_v7-Public.pdf ; AMD Memory Guard white paper”, marzo 2020, https://www.amd.com/system/files/documents/amd-memory-guard-white-paper.pdf

Rif. 8: ArsTecnica “Intel promises Full Memory Encryption in upcoming CPUs”, https://arstechnica.com/gadgets/2020/02/intel-promises-full-memory-encryption-in-upcoming-cpus/

Rif. 9: si vedano ad esempio i seguenti recenti articoli:

Rif. 10: per Intel SGX si veda ad esempio https://www.intel.com/content/www/us/en/architecture-and-technology/software-guard-extensions.html

Rif. 11: per riferimenti si veda ad esempio consorzio “Homomorphic Encryption Standardization”, https://homomorphicencryption.org/

Rif. 12: Craig Gentry “Fully Homomorphic Encryption Using Ideal Lattices”. In the 41st ACM Symposium on Theory of Computing (STOC), 2009, http://portal.acm.org/citation.cfm?id=1536414.1536440

Rif. 13: si veda ad esempio lo standard NIST in sviluppo “Post-Quantum Cryptography”, https://csrc.nist.gov/Projects/Post-Quantum-Cryptography

Rif. 14:

Rif. 15: Intel Corporation “Strengthen Enclave Trust with Attestation”, 2020,

https://software.intel.com/en-us/sgx/attestation-services

Rif. 16: “OASIS Key Management Interoperability Protocol (KMIP)”, https://www.oasis-open.org/committees/tc_home.php?wg_abbrev=kmip

Rif. 17: NIST Special Publication 800-57 1.rev5 “Recommendation for Key Management”, https://doi.org/10.6028/NIST.SP.800-57pt1r5

Note

[1]     Alcune implementazioni di enclavi sono riportate in [Rif. 14].

[2]     Tipicamente con la chiave asimmetrica (componente pubblica), viene cifrata una chiave simmetrica (ad esempio per AES) utilizzata per cifrare i dati; le chiavi asimmetriche non vengono normalmente utilizzate per cifrare i dati direttamente.

[3]     Oltre a KMIP vi sono altri protocolli / Programming Interface / API (alcuni proprietari) quali MS-CAPI, MS-EKM, PKCS#11 ecc., che permettono il trasferimento di chiavi crittografiche.

[4]     Esistono algoritmi omomorfici che implementano esattamente questa proprietà; invece RSA ha la caratteristica di essere commutativo rispetto alla moltiplicazione, ovvero nel nostro esempio sia O che P sono la moltiplicazione.

[5]     Le quattro generazioni di “Homomorphic Encryption Scheme” sono:

  1. Partially Homomorphic Encryption: schemi di cifratura che permettono l’esecuzione di un solo tipo di operazione, ad esempio solo la somma o il prodotto
  2. Somewhat Homomorphic Encryption: schemi di cifratura che permettono l’esecuzione di due tipi di operazioni, ad esempio somma e prodotto, ma solo per un numero limitato di composizioni tra le operazioni (detto anche “sottoinsieme di circuiti”)
  3. Leveled Fully Homomorphic: schemi di cifratura che permettono l’esecuzione di molti tipi di operazioni, ad esempio somma, prodotto ecc., ma solo per un numero limitato di iterazioni (detto anche “circuiti a profondità limitati”) senza limitazioni sul numero di composizioni
  4. Fully Homomorphic: schemi di cifratura che permettono l’esecuzione di molti tipi di operazioni senza limitazioni sul numero di iterazioni né di composizioni.

Articolo a cura di Andrea Pasquinucci

https://www.ictsecuritymagazine.com/articoli/sicurezza-hardware-e-confidential-computing-parte-2/
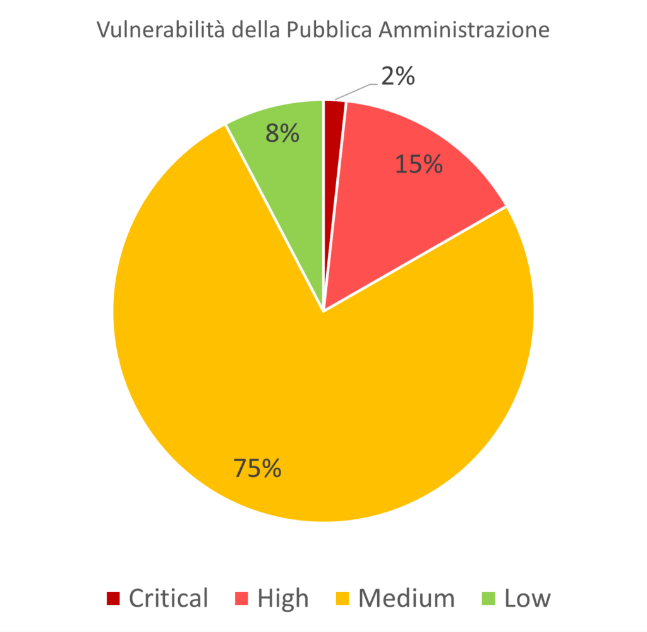
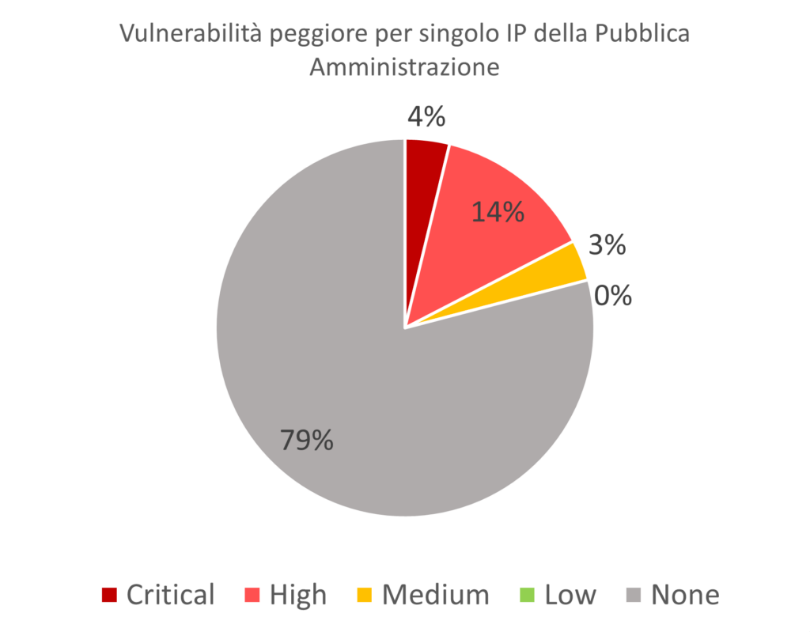
Il consenso informato e l’algoritmo reputazionale

L’orientamento

La sez. I della Corte di Cassazione, con ordinanza 25 maggio 2021, n. 14381, interviene sulla corretta manifestazione del “consenso informato” per il giusto trattamento dei dati personali, il quale presuppone la conoscenza dell’algoritmo utilizzato per determinare il rating reputazionale.

Il caso

La questione involge l’applicazione di un provvedimento inibitorio del Garante per la protezione dei dati personali, riferito al divieto di qualunque operazione di trattamento dei dati personali (presente e futura) effettuata da un’associazione in connessione ai servizi offerti tramite una piattaforma web (con annesso archivio informatico), con la quale l’utente manifestava il proprio “gradimento” su determinati soggetti.

Il sistema consentiva (era nelle intenzioni) di valutare in maniera imparziale il c.d. “rating reputazionale” (analogo al c.d. “rating d’impresa”, di cui all’art. 83, comma 10 del d.lgs. n. 50/2016) finalizzato alla verifica della credibilità dei soggetti individuati (un indicatore a cui fa corrispondere determinati benefici a determinate condizioni)[1], e di conseguenza suscettibile di incidere pesantemente sulla rappresentazione economica e sociale di un’ampia categoria di soggetti.

Base giuridica

Il Garante lamentava l’assenza di una base giuridica di riferimento per il trattamento di dati personali, nonché la mancata conoscenza delle modalità con le quali si definiva il punteggio attribuito dall’algoritmo utilizzato, aspetti che si riverberavano sulla manifestazione dell’autonomia decisionale del privato nel dare il consenso informato.

In effetti, si evidenziava che la mancata conoscenza dell’algoritmo comportava la mancanza del necessario requisito di trasparenza del sistema automatizzato, funzionale a rendere consapevole il consenso prestato dell’interessato in violazione:

  • dell’art. 8, Protezione dei dati di carattere personale, della Carta dei diritti fondamentali della UE, dove si celebra il diritto di ogni individuo «alla protezione dei dati di carattere personale che lo riguardano», disponendo quale precetto diretto che i «dati devono essere trattati secondo il principio di lealtà, per finalità determinate e in base al consenso della persona interessata o a un altro fondamento legittimo previsto dalla legge», con il correlato «diritto di accedere ai dati raccolti che lo riguardano e di ottenerne la rettifica»;
  • degli artt. 13 (Informativa)[2], 23 (Consenso) e 26 (Garanzie per i dati sensibili)[3] del d.lgs. n. 196 del 2003 (articoli abrogati dal D.L. 13 maggio 2011, n. 70, Semestre Europeo – Prime disposizioni urgenti per l’economia e dal Lgs. 10 agosto 2018 n. 101, Disposizioni per l’adeguamento della normativa nazionale alle disposizioni del regolamento (UE) 2016/679 del Parlamento europeo e del Consiglio, del 27 aprile 2016, relativo alla protezione delle persone fisiche con riguardo al trattamento dei dati personali, nonché alla libera circolazione di tali dati e che abroga la direttiva 95/46/CE (regolamento generale sulla protezione dei dati);
  • dell’art. 7, Condizioni per il consenso, del Regolamento (UE) 2016/679 del Parlamento europeo e del Consiglio (GDPR), ove si prevede al comma 1, ai fini della liceità del trattamento (cfr. art. 6, Liceità del trattamento), che «qualora il trattamento sia basato sul consenso, il titolare del trattamento deve essere in grado di dimostrare che l’interessato ha prestato il proprio consenso al trattamento dei propri dati personali», con pieno diritto «di revocare il proprio consenso in qualsiasi momento», precisando al comma 4 che «nel valutare se il consenso sia stato liberamente prestato, si tiene nella massima considerazione l’eventualità, tra le altre, che l’esecuzione di un contratto, compresa la prestazione di un servizio, sia condizionata alla prestazione del consenso al trattamento di dati personali non necessario all’esecuzione di tale contratto»;
  • dell’art. 1346 cod. civ. dove tra i Requisiti del contratto si stabilisce che «l’oggetto del contratto deve essere possibile, lecito, determinato o determinabile», ovvero le prestazioni negoziali devono essere definite.

Il consenso informato

La mancata conoscenza delle modalità valutative dell’algoritmo usato per l’elaborazione dei dati, e relativo trattamento, inciderebbe in modo determinante sulla rilevanza del consenso prestato: una violazione alle regole di trasparenza connesse all’informativa, espugnando, altresì, il correlato principio di liceità e correttezza richiesti dalla legge.

In termini divulgativi, è necessario spiegare da una parte, le ragioni per le quali si richiede il consenso, dall’altra parte, che cosa implica il trattamento in termini di modalità ed effetti (ad es. che i dati sarebbero stati utilizzati seguendo un percorso motivazionale prestabilito, ovvero, per incrociare riferimenti specifici, oppure, non solo per la fornitura del servizio, ma anche per l’invio di comunicazioni promozionali, nonché di informazioni commerciali da parte di terzi): l’informativa pone le regole generali per il trattamento dei dati nel senso che il consenso è condizione della liceità del trattamento.

Il principio definisce il consenso come «qualsiasi manifestazione di volontà libera, specifica, informata e inequivocabile dell’interessato, con la quale lo stesso manifesta il proprio assenso, mediante dichiarazione o azione positiva inequivocabile, che i dati personali che lo riguardano siano oggetto di trattamento» (punto 11), comma 1, dell’art. 4, Definizioni, del GDPR), rilevando che sia da escludere che il consenso considerato dalla disciplina complessiva del cit. Regolamento UE 679/2016 sia semplicemente il medesimo consenso in generale richiesto a fini negoziali.

Invero, si tratta di un consenso rafforzato atteso che siamo in presenza di un trattamento dei dati personali che costituiscono beni attinenti alla persona e la manifestazione non può limitarsi ad una generica espressione di volontà, ma richiede un quid superiore, ovvero la consapevolezza piena di ogni condizione/scopo riferita al trattamento ex se, specie in considerazione della condizione “debole” dell’interessato a fronte di una “asimmetria informativa” relativa alle pratiche commerciali e dei rischi dei trattamenti massivi dei dati personali: il «consenso informato», specie in ambito sanitario, è proprio volto all’esigenza di tutelare la pienezza del consenso, in vista dell’esplicazione del diritto di autodeterminazione dell’interessato[4].

Il pronunciamento

La Corte osserva, in primis, che la liceità del trattamento dei dati si basa non solo sul consenso, ma anche che il consenso sia validamente prestato secondo le indicazioni della fonte di riferimento[5], ove il quadro di regole e principi postula che deve essere “chiaramente individuato”, presupponendo che «il consenso debba essere previamente informato in relazione a un trattamento ben definito nei suoi elementi essenziali, per modo da potersi dire che sia stato espresso, in quella prospettiva, liberamente e specificamente»: un onere probatorio in capo al “titolare del trattamento” tale da dimostrare che l’accesso e il trattamento siano riconducibili alle finalità per le quali sia stato validamente richiesto – e validamente ottenuto – un consenso idoneo.

Si comprende che solo attraverso la conoscenza dell’algoritmo reputazionale si possa validamente, seriamente, consapevolmente esprimere il consenso, e dunque la liceità del trattamento; conoscenza essenziale ai fini di comprendere il calcolo del rating.

Di riflesso, annota la Corte, «non può logicamente affermarsi che l’adesione a una piattaforma da parte dei consociati comprenda anche l’accettazione di un sistema automatizzato, che si avvale di un algoritmo, per la valutazione oggettiva di dati personali, laddove non siano resi conoscibili lo schema esecutivo in cui l’algoritmo si esprime e gli elementi all’uopo considerati».

La massima di diritto

Alla luce del quadro esegetico, la Corte indica il principio di diritto «in tema di trattamento di dati personali, il consenso è validamente prestato solo se espresso liberamente e specificamente in riferimento a un trattamento chiaramente individuato; ne segue che nel caso di una piattaforma web (con annesso archivio informatico) preordinata all’elaborazione di profili reputazionali di singole persone fisiche o giuridiche, incentrata su un sistema di calcolo con alla base un algoritmo finalizzato a stabilire i punteggi di affidabilità, il requisito di consapevolezza non può considerarsi soddisfatto ove lo schema esecutivo dell’algoritmo e gli elementi di cui si compone restino ignoti o non conoscibili da parte degli interessati».

Riflessioni prospettiche

Il pronunciamento, nella sua limpidezza espressiva, non da nulla per scontato, ove nel mondo on line si esprime il proprio consenso con un semplice ed immediato “click”, dovendo, invece, dimostrare che l’espressione del “consenso informato” richiede un processo valutativo dell’interessato non limitato a flaggare un “accetto”, quanto semmai a dare prova di aver compreso l’intero processo del sistema di raccolta dei dati personali, nonché dei risultati di tale raccolta, avendo cura di spiegare le modalità concrete del servizio prestato in relazione allo scopo del trattamento.

Questa metodologia potrebbe richiedere una maggiore quantità di tempo, qualche istante in più dello scorrere del cursore a video, si dovrebbe valorizzare una maggior attitudine a leggere le indicazioni fornite dall’operatore economico/gestore della piattaforma (che generalmente sono presenti e in quantità elevata), ma quando questa richiesta di una maggiore esaustività dell’informativa viene formulata il Titolare/Responsabile del trattamento non può sottrarsi dal fornire le informazioni richieste.

In modo similare, come citato nella sentenza in ambito sanitario, il “consenso” al trattamento richiede che sia dato “libero e informato”, a tutela del diritto alla vita, alla salute, alla dignità e all’auto-determinazione della persona, sicché l’interessato deve comprendere tutte quelle informazioni utili alla cura, compresi gli effetti[6].

Note

[1]Vedi, CARDONE, Il rating di impresa: disciplina, criticità e prospettive di un istituto mai applicato, federalismi.it. 30 dicembre 2020, ove si evidenza che il rating costituisce uno «strumento la cui finalità consiste nell’aumentare il tasso di efficienza del mercato dei contratti, instaurare un sistema di selezione delle imprese a garanzia dell’interesse alla corretta gestione dei contratti pubblici, tenendo conto, nella fase di aggiudicazione, non solo dei requisiti economici validi e conformi all’oggetto del contratto ma anche della “reputazione” dell’impresa, in base ai precedenti appalti eseguiti».

[2] Cfr. l’art. 13, Informazioni da fornire qualora i dati personali siano raccolti presso l’interessato, del GDPR.

[3] Cfr. l’art. 9, Trattamento di categorie particolari di dati personali, del GDPR.

[4] Cass. civ., sez. I, 2 luglio 2018, n. 17278.

[5] Vedi, Cass. civ., sez. I, 22 marzo – 21 giugno 2018, n. 16358.

[6] Vedi, LUCCA, Gli obblighi abnormi di mascheramento e confinamento vaccinale: dal green pass all’uomo nuovo digitale, comedonchisciotte.org, 25 agosto 2021, ove si analizza in “consenso informato” in materia sanitaria.

Articolo a cura di Maurizio Lucca

https://www.ictsecuritymagazine.com/articoli/il-consenso-informato-e-lalgoritmo-reputazionale/