Protezione del dato: stop agli errori più comuni

La protezione dei dati, oggi, continua ad essere un tema prioritario per la sicurezza, e con forti probabilità lo sarà anche per il prossimo futuro. La motivazione è data semplicemente dal numero di violazioni dei dati che risulta in continua crescita.

Tra gli elementi facilitatori di questi rischi vi è certamente l’espansione della superficie di attacco soprattutto quando ci troviamo in ambienti IT complessi di tipo enterprise. Ma anche l’adozione sempre più diffusa di servizi in cloud contribuisce all’aumento del rischio per i dati, così come le tecniche sempre più evolute e sofisticate utilizzate dai cyber-criminal.

Eppure vi sono numerose evidenze di come la maggior parte di queste violazioni siano in realtà prevedibili, in quanto dovute ad errori che molte organizzazioni commettono quando iniziano ad affrontare il tema della sicurezza dei dati, sottovalutando aspetti spesso identificati come “pratica comune” ma che poi in realtà si rivelano la causa di possibili violazioni. Pertanto non bisogna cadere nell’errore di non dare la giusta importanza alla sicurezza dei dati, soprattutto quelli sensibili, anzi, è fondamentale allocare adeguate risorse per implementare e diffondere una solida strategia di protezione dei dati. Strategia che di base deve prevedere tutte le attività di monitoraggio necessarie per affrontare adeguatamente requisiti e rischi di sicurezza. Questa attività spesso implica l’adozione di un approccio graduale in modo tale che, nel tempo, conferisca sviluppo e scalabilità delle best practice per tutta l’infrastruttura aziendale. Ed è per questo che bisogna coinvolgere fin da subito le principali parti aziendali interessate al processo di protezione dei dati, in modo da stabilire e comprendere bene gli obiettivi di breve e di lungo termine.

A tal proposito, in rete possiamo trovare documentazione esaustiva che evidenzia la difficoltà delle aziende nella gestione della sicurezza soprattutto nei nuovi ambienti multi-cloud e hybrid-cloud, spesso dovuto alla crescente complessità delle soluzioni di sicurezza che richiede anche ordine a livello organizzativo. Complessità che rappresenta una vera sfida per molte realtà e che spesso ostacola la governance dei dati con un’applicazione corretta delle policy di sicurezza.

Ma quali sono i principali ed i più comuni errori che, se non controllati, potrebbero costituire la causa di una probabile prossima violazione dei dati?

Conformità: condizione necessaria ma non sufficiente

Quante volte ci è capitato di sentire o di leggere che la conformità non è sicurezza? Sicuramente la maggior parte dei professionisti della sicurezza sarebbe d’accordo con questa affermazione. Tuttavia, le organizzazioni spesso concentrano le loro risorse di sicurezza sul raggiungimento della conformità e, una volta ottenute tutte le certificazioni del caso, diventano compiacenti. Se ne deduce che, molte delle più grandi violazioni dei dati degli ultimi anni si sono verificate in ambienti che potrebbero essere stati pienamente conformi sulla carta, senza per questo essere sicuri e privi di vulnerabilità. Ciò significa che occorre prevedere un piano di sicurezza a lungo termine, che sia continuamente sottoposto a revisioni periodiche ricevendo così una taratura sempre più sofisticata e capace di debellare tutte quelle “sviste” di sicurezza, veri embrioni di possibili criticità.

Centralizzazione della sicurezza dei dati

La conformità ha certamente il pregio di fornire consapevolezza sulla necessità di sicurezza dei dati, ma potrebbe risultare insufficiente se non sorretta da mandati più ampi capaci di includere una strategia per la data-privacy e per la data-protection, in quanto si correrebbe il rischio che una volta superata la conformità si perda la continua concentrazione sulla sicurezza dei dati in coerenza con le policy aziendali. Ad esempio, sono diverse le organizzazioni che dispongono di un ambiente hybrid-cloud, spesso in continua evoluzione tecnologica. E proprio in questi ambienti aumentano le probabilità di trovarci a lavorare con nuovi tipi di database, nuovi archivi di dati generati di giorno in giorno o su cadenza settimanale, favorendo la diffusione se non addirittura una dispersione di dati sensibili.

Assegnazione delle responsabilità

Nonostante tutto, una consapevolezza diffusa della necessità di una politica di protezione dei dati esiste. Eppure si riscontrano spesso situazioni dove non vi è un ruolo specifico di responsabile della protezione dei dati sensibili. Una situazione simile può portare ad un ritardato intervento in caso di incidente di sicurezza e magari proprio in quei momenti in cui l’intera azienda è già sotto forte pressione proprio per scoprire cosa sia accaduto, come sia potuto succedere senza però riuscire a trovare un responsabile che abbia la sufficiente conoscenza della situazione.

Favorire la reattività

Spesso le violazioni di alto profilo nelle aziende sono dovute a vulnerabilità già note ma non corrette anche dopo il rilascio delle patch, posticipandone la loro applicazione. La mancata correzione rapida delle vulnerabilità è sicuramente un punto a sfavore della sicurezza in quanto mette a rischio i dati di ogni organizzazione pigra e non reattiva, proprio perché i criminali informatici non aspettano altro che sfruttare attivamente questi ritardi visti come facili punti di accesso.

Monitoraggio continuo delle attività sui dati

Indipendentemente dalla strategia di sicurezza dei dati messa in campo, il monitoraggio dell’accesso e dell’utilizzo dei dati costituisce una parte fondamentale che consente di avere una percezione sempre più precisa del livello di protezione dei dati contribuendo ad affinare le policy di protezione in atto. E’ essenziale che i responsabili dei dati di ogni organizzazione siano nella condizione di rilevare in ogni momento chi, come e quando i dati critici vengono acceduti. Questo monitoraggio è volto a far comprendere se l’accesso è consono alle richieste dell’utente con un’immediata valutazione dei possibili rischi associati, rafforzando quindi l’intero sistema di controllo della sicurezza dei dati.

Articolo a cura di Luigi Perrone

https://www.ictsecuritymagazine.com/articoli/protezione-del-dato-stop-agli-errori-piu-comuni/


Il Sistema Pubblico di Identità Digitale (SPID) in prospettiva europea: un esempio di “disruptive innovation” decisiva per il rapporto Stato-cittadini

Le tecnologie digitali offrono continuamente nuovi modi per apprendere, intrattenere, lavorare, esplorare e soddisfare le proprie ambizioni. Portano anche nuove libertà e diritti e offrono ai cittadini dell’UE l’opportunità di andare oltre le comunità fisiche, le posizioni geografiche e le posizioni sociali.

Tuttavia, ci sono ancora molte sfide associate al passaggio a un mondo digitale che devono essere affrontate, come peraltro evidenziato anche dalla pandemia Covid-19. L’UE deve aumentare la sua autonomia strategica nella tecnologia e deve sviluppare nuove regole e tecnologie per proteggere i cittadini da prodotti contraffatti, furti informatici e disinformazione: in sintesi, l’UE deve affrontare il divario digitale. Pertanto, nel prossimo decennio, la visione dell’UE è per un mondo digitale che dia potere alle persone e alle imprese e che sia modellato attorno a un approccio incentrato sull’uomo, sostenibile e più prospero. La “bussola digitale” utilizza i quattro punti cardinali per identificare i principali obiettivi da raggiungere nel prossimo decennio:
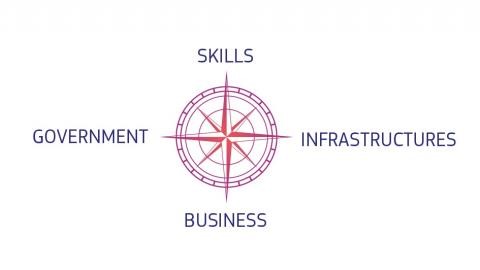
(Fonte: ec.europa.eu/info/strategy/priorities-2019-2024)

e cioè:

  1. una popolazione digitalmente qualificata e professionisti digitali altamente qualificati;
  2. infrastrutture digitali sicure e sostanziali;
  3. trasformazione digitale delle imprese;
  4. digitalizzazione dei settori pubblici.

Le aree chiave per garantire il raggiungimento di questi obiettivi includono il cloud computing, l’intelligenza artificiale, le identità digitali, i dati e la connettività[1].

Nel nostro Paese, il Sistema Pubblico di Identità Digitale – SPID è il sistema unico per accedere tramite identità digitale ai servizi online erogati dalla P.A. e dai privati aderenti al sistema stesso: cittadini e imprese possono accedervi da qualsiasi dispositivo con un’identità digitale unica.

Si tratta di un sistema semplice per l’utente finale, normalizzato a livello nazionale[2], non esclusivo ma inclusivo, integrabile al sistema europeo, come vedremo infra.

L’identità SPID si ottiene facendone richiesta a uno degli identity provider (gestori di identità digitale), che è possibile scegliere liberamente fra quelli autorizzati dall’ Agenzia per l’Italia Digitale – AgID[3].

Il numero delle amministrazioni che hanno adottato SPID progressivamente (alla data indicata) arriva a 7.653 al 28 giugno 2021, come evidenziato nel seguente grafico:
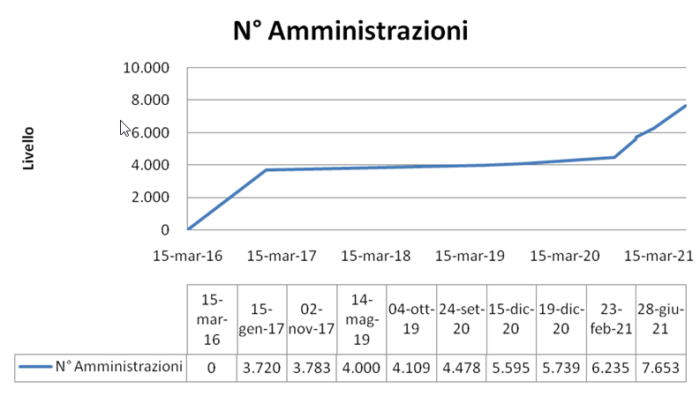
Il nuovo trend ascendente a partire da marzo 2021 è visibilmente iniziato dopo che il cd. “Decreto Semplificazioni”[4] ha stabilito che entro il 28 febbraio 2021 le PA dovevano integrare SPID e Carta d’Identità Elettronica (CIE) come uniche credenziali da utilizzare per accedere ai servizi digitali delle PA centrali e locali italiane.

Il sistema SPID è costituito come insieme aperto di soggetti pubblici e privati che, previo accreditamento AgID, gestiscono i servizi di registrazione web e di messa a disposizione delle credenziali e degli strumenti di accesso in Rete nei riguardi di cittadini e imprese per conto delle pubbliche amministrazioni.

Si distinguono tre diversi ruoli:

  1. gestore delle identità (Identity Provider, IdP), che fornisce le credenziali di accesso al sistema (identità digitali) e gestisce i processi di autenticazione degli utenti;
  2. fornitore di servizi (Service Provider, SP), che gestisce l’autorizzazione tramite il login ed eroga il servizio.
  3. gestore di attributi qualificati (Attribute Authority, AA), che fornisce attributi che qualificano gli utenti (stati, ruoli, titoli, cariche), finalizzati alla fruizione dei servizi. E’ inserito nell’apposito registro AGID e consente di rilevare il possesso di particolari requisiti ai fornitori di servizi.

AgID gestisce le procedure di accreditamento dei gestori di identità digitale e svolge attività di vigilanza sull’operato degli identity provider. D’intesa con il l’Autorità Garante per la privacy, ha definito le regole tecniche per l’adozione del sistema SPID[5]: i Service Provider possono infatti richiedere solo le informazioni minime necessarie all’erogazione del servizio e tali dati sono mantenuti solo per il tempo necessario alla verifica, secondo il GDPR.

L’identità SPID è costituita da credenziali con caratteristiche differenti in base al livello di sicurezza richiesto per l’accesso[6]. Esistono tre livelli di sicurezza:

  1. il primo permette di accedere ai servizi online attraverso un nome utente e una password scelti dall’utente;
  2. a nome utente e password si aggiunge un codice temporaneo di accesso (one-time password[7]), fornito tramite SMS o app;
  3. al terzo livello, oltre al nome utente e la password, si richiede un supporto fisico per l’identificazione, ad esempio una smart card [8].

Attualmente i SP sono i seguenti:

Service provider Servizio Spid
Aruba PEC S.p.A. Aruba ID
InfoCert S.p.A. InfoCert ID
In.Te.S.A. S.p.A. intesaID
Lepida S.c.p.A. Lepida ID
Namirial S.p.A. Namirial ID
Poste Italiane S.p.A. PosteID
Sielte S.p.A. SielteID
Register S.p.A. SpidItalia
TI Trust Technologies S.r.l. TIM id

Si noti che solo i SP Aruba, Poste e Sielte forniscono il terzo livello di sicurezza.

SPID supporta (solo per il primo livello attualmente) l’autenticazione unica Single Sign-On (SSO)[9]: in pratica, dopo aver fatto l’accesso per un servizio non è necessario ripetere l’autenticazione se accedo ad altri servizi.

Lo SPID si basa su una ‘federazione SAML 2.0’: SAML è un framework basato su XML e consente a diverse organizzazioni (con diversi domini di sicurezza) di scambiare in modo sicuro informazioni di autenticazione e autorizzazione[10].

Utilizzando SAML, un’organizzazione può fornire informazioni sulle identità degli utenti e sui privilegi di accesso a un fornitore di servizi in modo sicuro, protetto e standardizzato. Ciò può includere applicazioni Business to Business (B2B) e Applicazioni Business to Consumer (B2C).

Ci sono tre ruoli principali in questa comunicazione:

  1. Utente finale
  2. Provider di identità (IdP)
  3. Fornitore di servizi (SP)

I provider di identità (IdP) forniscono risorse online per fornire l’autenticazione agli utenti finali sulla rete. A volte questi sono anche chiamati provider di servizi di identità o provider di asserzioni di identità. I provider di servizi (SP) forniscono risorse a un utente finale per Single Sign On (SSO).

Ecco due esempi di flussi SSO[11]:

  • Flusso SSO avviato dal fornitore di servizi SAML

l’utente finale avvia il processo di accesso al SP, che reindirizza l’utente all’IdP con una richiesta SAML (AuthnRequest). La richiesta SAML conterrà le informazioni necessarie affinché l’IdP possa autenticare l’utente finale e rispondere all’SP con la corretta Asserzione SAML (SAMLResponse).

  • Flusso SSO avviato dal provider di identità SAML

l’utente finale avvia il processo di accesso presso l’IdP. L’IdP deve essere configurato con le informazioni sui metadati SAML dell’SP, come URL consumatore asserzione, emittente e pubblico. L’IdP invierà un’asserzione SAML (SAMLResponse) all’SP che quest’ultimo convaliderà in base ai requisiti configurati.

Gli standard SAML forniscono una richiesta/risposta per lo scambio di messaggi XML tra questi ruoli. Lo standard specifica le seguenti quattro componenti principali: profili, asserzioni, protocollo e associazione.
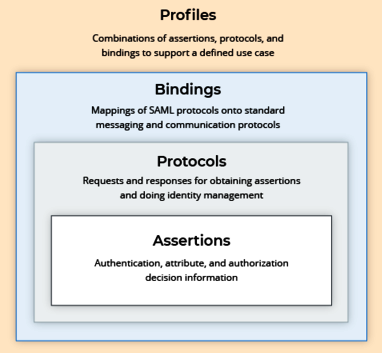
  • Il profilo SAML descrive in dettaglio come le asserzioni, i protocolli e le associazioni SAML si combinano per supportare un caso d’uso definito.
  • SAML Bindingè una mappatura di un messaggio di protocollo SAML su formati di messaggistica standard e/o protocolli di comunicazione.
  • I protocolli SAML descrivono come vengono impacchettati gli elementi SAML.
  • Le asserzioni SAML contengono un pacchetto di informazioni sulla sicurezza o informazioni sulle decisioni.

E così l’aggiunta di un nuovo Service Provider alla rete SPID avviene tramite lo scambio di metadati con l’ Identity Provider con il quale si vuole accoppiare. La federazione permette quindi al Service Provider di estendere la platea dei suoi utenti a quelli attualmente iscritti all’ Identity Provider di aggancio. Purtroppo ad oggi, non risulta una federazione tra i vari Identity Provider per cui è necessario, al momento del login, selezionare l’ Identity Provider in cui l’utente risultato accreditato.

Un punto fermo sin dall’inizio è che per l’utente sia le credenziali sia l’uso dei servizi non devono imporre vincoli come ad es.  l’uso di uno specifico hardware.

Tornando al livello sovranazionale, le tecniche e i protocolli su cui si basa SPID sono già stati sperimentati a livello europeo e adottate dai progetti sperimentali Stork e Stork II (Secure idenTity acrOss boRders linKed)[12].

In quest’ottica – ai fini del mutuo riconoscimento dei mezzi di identificazione elettronica adottati tra Stati membri – l’Agenzia per l’Italia Digitale ha completato nel mese di luglio 2018 il processo di prenotifica alla Commissione Europea del sistema SPID iniziato nel dicembre 2017, come previsto dall’art.9 del Regolamento e successiva Decisione Esecutiva EU 2015/1984 del 3 novembre 2015[13] che definisce le circostanze, i formati e le procedure delle notifiche. Il processo di notifica è stato ultimato e lo SPID è stato pubblicato nella Gazzetta Ufficiale dell’Unione Europea  C318 del 10 settembre 2018.

La notifica comporta che dopo un anno, quindi dal 10 settembre 2019, l’identità digitale SPID deve poter essere usata per l’accesso ai servizi in rete delle pubbliche Amministrazioni dell’Unione che richiedono credenziali di livello 2 o 3.

Lo SPID diviene quindi uno strumento unico per la nostra identità digitale in tutta l’Unione europea[14].

Le pubbliche amministrazioni possono adempiere agli obblighi aderendo al Nodo eiDAS italiano gestito da Agid[15] ai massimi livelli di:

  • Interoperabilità
    Il nodo eIDAS consente a persone e imprese di utilizzare i propri eID nazionali per accedere a servizi pubblici in altri paesi dell’UE con un codice univoco.
  • Sicurezza
    Gli elevati livelli di sicurezza dei sistemi eID con login eIDAS riducono il rischio di furto di identità e l’uso inappropriato delle informazioni personali la tua privacy è garantita.
  • Fiducia
    Il login eIDAS conferisce validità giuridica alle transazioni transfrontaliere e lo stesso status giuridico dei tradizionali processi cartacei; ovunque tu sia e da qualsiasi dispositivo.

Inoltre, a completamento della strategia “disruptive”, anche le PA devono adottare il sistema PagoPA per il pagamento digitale dei servizi (la scadenza era entro fine febbraio 2021). Sinergicamente, le funzionalità dell’ app IO[16] verranno progressivamente ampliate per consentire agli utenti di effettuare autocertificazioni o inoltrare richieste e dichiarazioni direttamente dal proprio smartphone.

Prima di concludere, è utile far riferimento a due importanti esempi di implementazione del sistema SPID nella vita di tutti i giorni.

Nel primo caso, nell’ottica di “favorire al meglio la transizione ecologica e digitale e rispondere all’esigenza di garantire soluzioni più adeguate alle mutate condizioni economiche e di contesto del Paese, il GSE ha deciso di adottare SPID, garantendo così più rapidità e sicurezza agli oltre 700mila accessi al mese all’Area Clienti, la piattaforma attraverso la quale è possibile richiedere i servizi al Gestore, oltre ad essere il principale punto di accesso per dialogare con l’azienda. (..) L’adozione del sistema SPID rappresenta un primo importante obiettivo raggiunto lungo questo percorso di digitalizzazione e ammodernamento delle funzioni disponibili. (..) La transizione digitale consentirà al GSE di erogare servizi in modo più semplice e sicuro e l’attivazione di SPID garantirà in futuro di individuare i servizi che potranno essere forniti ai cittadini, alle imprese e alla Pubbliche Amministrazioni interamente in modalità digitale”[17].

Il secondo caso riguarda l’applicazione mobile LepidaID di Lepida, già presente sugli Store di Google e di Apple, che è stata rinnovata per gli utenti possessori di identità LepidaID utilizzatori dei servizi online aderenti a Spid. “Con la nuova versione della App, l’utente accede a un servizio e subito dopo avere scelto LepidaID nella lista dei gestori di credenziali Spid può decidere di autenticarsi più velocemente senza dovere inserire username e password, ma semplicemente inquadrando con la App LepidaID il QR Code che sarà mostrato nella pagina web di login del servizio scelto. Per utilizzare la App è necessario effettuare un’operazione di associazione dell’App all’identità LepidaID”[18].

Infine, dal punto di vista degli utenti, al 30 aprile scorso essi hanno superato i 20 milioni, “quasi 14 milioni in più rispetto allo scorso aprile. Quest’anno il tasso di crescita settimanale di identità rilasciate è quasi triplicato, annuncia il ministero per l’innovazione tecnologica e la transizione digitale: da 70mila alle oltre 200mila attuali, sostenuto anche dall’intenso lavoro dei gestori di identità, responsabili dell’attivazione e dell’accesso con Spid per i cittadini”[19].

Un trend incoraggiante, seppur influenzato dalle circostanze affatto ‘particolari’ del periodo, ma che comunque va nel segno delle menzionate strategie europee.

“Con l’identità digitale europea potremo fare in qualsiasi Stato membro quello che facciamo nel nostro paese senza costi aggiuntivi e con minori ostacoli, ad esempio affittare un appartamento o aprire un conto bancario all’estero, e tutto questo in modo sicuro e trasparente- spiega la commissaria al Digitale Margrethe Vestager – Così saremo noi a decidere quante informazioni desideriamo condividere su noi stessi, con chi e per quale finalità. Si tratta di un’opportunità unica che ci permetterà di sperimentare ancora di più che cosa significhi vivere in Europa ed essere europei”[20].

Note

[1]  Un’efficace sintesi grafica e rinvii alle analisi di dettaglio delle strategie europee sui temi sono disponibili in https://ec.europa.eu/info/strategy/priorities-2019-2024/europe-fit-digital-age/europes -digital-decade-digital-targets-2030_it

[2] Il primo provvedimento è stato il Decreto del Presidente del Consiglio dei Ministri 24 ottobre 2014, Definizione delle caratteristiche del sistema pubblico per la gestione dell’identita’ digitale di cittadini e imprese (SPID), nonche’ dei tempi e delle modalita’ di adozione del sistema SPID da parte delle pubbliche amministrazioni e delle imprese. (14A09376) (GU Serie Generale n.285 del 09-12-2014) in https://www.gazzettaufficiale.it/eli/id/2014/12/09/14A09376/sg.

Il 28 luglio 2015, con la Determinazione n. 44/2015, sono stati emanati da AgID i quattro regolamenti (accreditamento gestori, utilizzo identità pregresse, modalità attuative, regole tecniche) previsti dall’articolo 4, commi 2, 3 e 4, del DPCM 24 ottobre 2014 con cui il sistema SPID è divenuto operativo.

Il regolamento che disciplina le modalità di accreditamento dei gestori di identità digitale è entrato in vigore il 15 settembre 2015, data dalla quale i soggetti interessati hanno potuto presentare domanda all’Agenzia per l’Italia Digitale.

Il 19 dicembre 2015, nel rispetto delle procedure previste dalle norme, AgID ha accreditato i primi tre gestori di Identità SPID: InfoCert S.p.A., Poste Italiane S.p.A. e Tim (attraverso la società Trust Technologies del gruppo Telecom Italia). Il 15 settembre 2016 sono stati accreditati Aruba Pec S.p.A. e Sielte S.p.A, il 12 maggio 2017 Namirial S.p.A. e Register.it S.p.A.

Dal 15 marzo 2016 i primi tre gestori di identità digitale hanno incominciato a rilasciare le prime identità SPID a cittadini e imprese richiedenti. Entro il mese di giugno 2016 era prevista l’adesione a SPID di 14 amministrazioni pilota: Agenzia delle entrate, Equitalia, INPS, INAIL, Comune di Firenze, Comune di Venezia, Comune di Lecce, Comune di Genova, Regione Toscana, Regione Liguria, Regione Emilia-Romagna, Regione Friuli-Venezia Giulia, Regione Lazio, Regione Piemonte e Regione Umbria.

[3] L’Agenzia per l’Italia Digitale è “l’agenzia tecnica della Presidenza del Consiglio che ha il compito di garantire la realizzazione degli obiettivi dell’Agenda digitale italiana e contribuire alla diffusione dell’utilizzo delle tecnologie dell’informazione e della comunicazione, favorendo l’innovazione e la crescita economica. AgID ha il compito di coordinare le amministrazioni nel percorso di attuazione del Piano Triennale per l’informatica della Pubblica amministrazione, favorendo la trasformazione digitale del Paese. AgID sostiene l’innovazione digitale e promuove la diffusione delle competenze digitali anche in collaborazione con le istituzioni e gli organismi internazionali, nazionali e locali”, come si legge al sito https://www.agid.gov.it/it/agenzia/chi-siamo.

[4] Si tratta del Decreto Semplificazione e Innovazione digitale (DL n. 76/2020), che, al Titolo III, contiene le previsioni normative per velocizzare il processo di trasformazione digitale del Paese.

Con la pubblicazione in Gazzetta ufficiale della legge di conversione (Legge n. 120/2020), è diventato operativo l’insieme di norme che ha il fine di ridisegnare la governance del digitale, accelerare la digitalizzazione dei servizi pubblici e semplificare i rapporti tra cittadini e pubblica amministrazione anche in ottica di diffusione della cultura dell’innovazione e superamento del divario digitale, con un’attenzione anche all’accesso agli strumenti informatici delle persone con disabilità. Dal 28 febbraio 2021 le amministrazioni non potranno più rilasciare o rinnovare le vecchie credenziali. Potranno essere utilizzate le credenziali rilasciate in precedenza fino alla loro naturale scadenza e non oltre il 30 settembre 2021.

L’identificazione digitale è equiparata all’esibizione di un documento d’identità ed è estesa per l’accesso ai servizi dei concessionari pubblici e delle società a partecipazione pubblica.

Il testo del decreto-legge 16 luglio 2020, n. 76 (in S.O. n. 24/L alla Gazzetta Ufficiale – Serie generale – n. 178 del 16 luglio 2020), coordinato con la legge di conversione 11 settembre 2020, n. 120 (nello stesso S.O.), recante: «Misure urgenti per la semplificazione e l’innovazione digitale.». (20A04921) (GU Serie Generale n.228 del 14-09-2020 – Suppl. Ordinario n. 33) è disponibile in https://www.gazzettaufficiale.it/eli/id/2020/09/14/20A04921/sg.

[5]  Da ultimo si veda il provvedimento n. 163 del 17 settembre 2020 con il quale il Garante della Privacy ha ammesso, ritenendola conforme alla normativa privacy, la nuova modalità di attivazione dello SPID da remoto. La procedura è stata rafforzata da specifiche misure di sicurezza e verifiche incrociate. In sintesi, per ottenere l’identità digitale da remoto è necessario:

  • registrarsi sul sito di uno dei gestori di identità digitale accreditati da AgID (Identity Provider), tra i quali possiamo citare: Aruba, Infocert, Poste Italiane, Register.it. Alcuni di questi offrono anche il servizio a soggetti residenti all’estero;
  • Eseguire una registrazione video on-line nella quale si deve esibire uno dei documenti di riconoscimento citati in precedenza, ciò al fine di evitare tentativi di furti di identità. Durante il video si deve anche citare un codice ricevuto via sms o tramite apposita app installata sul dispositivo personale;
  • Effettuare un bonifico, da un proprio conto corrente italiano, indicando nella causale un codice specifico inviato dall’Identity Provider. Il bonifico è considerato ulteriore elemento di verifica dell’identità.
  • Come elementi di garanzia aggiuntivi, il Garante privacy ha richiesto:
  • che la registrazione audio-video e tutti i dati acquisiti siano sottoposti a verifica da parte dell’operatore deputato al rilascio dello SPID;
  • ulteriori e incrociati controlli “a campione” delle richieste pervenute, da parte di un secondo operatore;
  • che trascorso un periodo di test di sei mesi dall’adozione della nuova procedura, l’AgID al fine di valutare l’efficacia del controllo effettuato dal secondo operatore, trasmetta un report con l’esito di queste verifiche;
  • l’invio di report settimanali (redatti dagli Identity Provider) relativi alle richieste di rilascio respinte in ragione di profili critici configurabili come “tentativi fraudolenti”.

Tali riscontri potranno essere utili al Garante per valutare la necessità di individuare ulteriori misure tecniche e organizzative per rafforzare il procedimento di identificazione da remoto.

Il Parere all’Agid sulla bozza di determina che modifica il regolamento recante le modalità attuative per la realizzazione dello SPID e sulla bozza di determina volta a disciplinare una nuova modalità di verifica dell’identità da remoto con l’ausilio di un bonifico bancario, Registro dei provvedimenti del Garante per la Protezione dei Dati Personali, n. 163 del 17 settembre 2020 è disponibile in https://www.garanteprivacy.it/home/docweb/-/docweb-display/docweb/9461061.

[6]Cfr. ad es. Alessandro Mastromatteo e Benedetto Santacroce, Identità digitale: tre livelli di sicurezza per lo Spid , IL SOLE 24 ORE, 13 settembre 2018 in https://www.ilsole24ore.com/ art/identita-digitale-tre-livelli-sicurezza-lo-spid-AE9fGoiF.

[7] “Una one-time password è una password che può essere utilizzata un’unica volta e che, dopo l’utilizzo, perde validità. La password ‘usa e getta’ è generalmente costituita da un codice OTP alfanumerico (lettere e numeri) e viene generata ex novo ogni volta che si esegue una procedura di accesso. Dopo che l’utente ha eseguito l’accesso con una one-time password, questa perde la propria validità e non può più essere utilizzata all’accesso successivo.

Le password usa e getta vengono spesso utilizzate nell’ambito della cd. autenticazione a due fattori, ad esempio nell’online banking.  Questo passaggio aggiuntivo permette di innalzare in modo significativo il livello di sicurezza: anche se, durante la procedura di accesso, un soggetto non autorizzato riuscisse ad accedere alla password normale, gli mancherà comunque la password usa e getta dinamica, poiché questa viene generata solo all’occorrenza. Per questo sempre più servizi online stanno passando all’utilizzo dell’autenticazione a due fattori, in particolare se in gioco ci sono dati sensibili”. (..) Le password usa e getta generate dinamicamente rappresentano oggi il metodo più utilizzato. Molto diffusi sono ad esempio i generatori di password hardware sotto forma di piccoli dispositivi denominati anche token OTP. Ciò che li accomuna è la presenza di un display e la capacità di generare password usa e getta a ogni nuova procedura di accesso semplicemente premendo un pulsante. Per generare una password usa e getta dinamica viene utilizzato uno speciale algoritmo e in base al metodo di generazione, la password può essere di tre tipi:

  • basata sul tempo: il generatore di password (client) e il server generano password abbinate utilizzando lo stesso algoritmo. Questo tipo di password, detta Time-based One Time Password (TOTP) è pertanto nota sul lato client e sul lato server ed è valida per un determinato lasso di tempo, solitamente da uno a quindici minuti.
  • basata su evento: generata attraverso l’esecuzione di una determinata azione, ad esempio premendo un tasto sul generatore token. Come nel processo basato sul tempo, anche in questo caso sul lato server e sul lato client lavora lo stesso algoritmo. La password viene calcolata sulla base dell’ultima password valida e può così essere sincronizzata con il server.
  • generata su richiesta del server (meccanismo challenge-response): il server invia una richiesta (challenge) alla quale il client deve rispondere (response). Il client riceve un determinato valore dal server e, con questo, calcola la password usa e getta. Poiché il server conosce l’algoritmo e il valore prestabilito, è in grado di verificare la password generata”, come si legge al sito https://www.ionos.it/digitalguide/ server/sicurezza/cose-una-one-time-password-otp/.

[8] “Una smart card è un microchip sicuro che consente l’autenticazione dell’utente mediante la generazione, l’archiviazione e l’utilizzo di chiavi crittografiche. Le smart card sono una forte forma di autenticazione con segreti e chiavi crittografiche che è protetta logicamente e fisicamente, rendendone difficile la compromissione. L’autenticazione con smart card è un processo di accesso in due fasi: la card memorizza le credenziali della chiave pubblica di un utente e un numero di identificazione personale (PIN), che funge da chiave segreta per autenticare l’utente sulla smart card. Una smart card migliora la sicurezza: non puoi raccogliere i dettagli dell’utente (come un PIN) manomettendo queste carte.

Vantaggi dell’autenticazione tramite smart card:

Le smart card offrono una maggiore sicurezza rispetto alle carte a banda magnetica. Possono contenere microprocessori in grado di elaborare i dati direttamente senza connessioni remote. Inoltre, le informazioni memorizzate in una smart card non possono essere facilmente eliminate, modificate o recuperate. Anche se una smart card cade in mani malintenzionate, è altamente improbabile che una persona possa creare una copia duplicata e violare la sicurezza.

  • Flessibilità

I dettagli della smart card possono essere aggiornati da remoto senza emettere una nuova card. Tali carte non possono essere duplicate, poiché sono crittografate e hanno un ID univoco. Utilizzando una smart card, un utente può accedere a più servizi, non è necessario portare con sé più carte separate.

  • Produzione

Le smart card sono realizzate in plastica, oltre al microprocessore incorporato a basso costo. Questo le rende meno costose dei token digitali e di altre piattaforme di autenticazione. Inoltre, sono facilmente conformi agli standard di imballaggio dell’Organizzazione internazionale per la standardizzazione (ISO) e della Commissione elettrotecnica internazionale (IEC).

  • Potenza di elaborazione

Le smart card sfruttano una piccola CPU che può svolgere anche altre funzioni, oltre alla semplice memorizzazione dei dati. Ad esempio, la CPU può contare il numero di volte in cui un utente inserisce il PIN in modo errato e blocca automaticamente quell’utente per un periodo specificato”, come si legge in https://www.parallels.com/blogs/ras/smart-card-authentication/.

[9]  Cfr. “il Single Sign-On (SSO) è un processo di autenticazione che consente ad un utente, effettuando il login una sola volta, di ottenere l’accesso a diverse applicazioni senza la necessità di immettere nuovamente le credenziali di accesso in ogni applicazione. L’autenticazione SSO, quindi, facilita l’utilizzo delle risorse di rete senza soluzione di continuità. (..) Idealmente, il Single Sign-On viene utilizzato con altre tecniche di autenticazione, ad esempio smart card e token con password monouso”, come si legge in Bruno Marafini, Single Sign-On, accesso facilitato alle risorse di rete: ecco come funziona, Cybersecurity 360.it, 08 Lug 2019 in https://www.cybersecurity360.it/nuove-minacce/single-sign-on-accesso-facilitato-alle-risorse-di-rete-ecco-come-funziona/.

[10] Il Security Assertion Markup Language, SAML è uno standard che facilita lo scambio di informazioni sulla sicurezza, sviluppato da OASIS (Organization for the Advancement of Structured Information Standards). A causa del numero crescente di applicazioni SaaS (Software as a Service) fornite a dipendenti e consumatori, è cresciuta la necessità di standard nel Single Sign On (SSO) sottostante e nella federazione delle identità, come SAML e OpenID. SAML ha preso piede rapidamente con i provider basati su cloud, come ad es. Google, Salesforce.com e WebEx.

[11] Gli esempi e la figura sono tratti da https://www.secureauth.com/blog/an-introduction-to-saml-security-assertion-markup-language/.

[12] STORK 2.0, il progetto paneuropeo che promuove la mobilità dei cittadini e delle imprese in Europa attraverso l’autenticazione e l’identificazione transfrontaliera (eID) si è concluso a settembre 2015. Il progetto è iniziato nel 2012 e ha coinvolto 55 organizzazioni, pubbliche e private, in 19 paesi europei. Ha ulteriormente sviluppato il quadro STORK per l’identificazione e l’autenticazione elettroniche transfrontaliere (eID) di cittadini e imprese nell’UE e nei paesi associati. STORK 2.0 consente ai cittadini di identificarsi a livello transfrontaliero utilizzando dati relativi all’identità provenienti da fonti autentiche e affidabili (fornitori di attributi) o di rappresentare altre persone fisiche o giuridiche, nel contesto di diversi ambiti di attività, come si legge in https://digital-strategy.ec.europa.eu/en/news/end-stork-20-major-achievements-making-access-mobility-eu-smarter.

[13] E’ la DECISIONE DI ESECUZIONE (UE) 2015/1984 DELLA COMMISSIONE del 3 novembre 2015 che definisce le circostanze, i formati e le procedure della notifica di cui all’articolo 9, paragrafo 5, del regolamento (UE) n. 910/2014 del Parlamento europeo e del Consiglio in materia di identificazione elettronica e servizi fiduciari per le transazioni elettroniche nel mercato interno [notificata con il numero C(2015) 7369] in https://eur-lex.europa.eu/legal-content/IT/TXT/HTML/?uri=CELEX:32015D1984&from=IT.

[14] Cfr. SPID – il Sistema Pubblico per la gestione dell’identità digitale, è stato disegnato in conformità al Regolamento eIDAS, e rappresenta una delle iniziative trasversali della Strategia per la Crescita Digitale 2014-2020, alla pagina web https://www.agid.gov.it /it/piattaforme/eidas/spid-verso-eidas.

[15] Il regolamento eIDAS è la base legislativa per le interazioni elettroniche tra imprese, cittadini e autorità pubbliche, migliorando la sicurezza e l’efficienza dei servizi online e delle transazioni di e-business nell’Unione Europea. Con il pulsante Accedi con eIDAS, il nodo italiano abilita l’interoperabilità transfrontaliera delle identità digitali (eID) e la sua implementazione consentirà la circolarità degli eID italiani tra gli stati membri dell’UE, come si legge in https://eid.gov.it/.  Maggiori dettagli tecnici in https://eid.gov.it/assets/download/avviso_eidas/Avviso_eIDAS_01-2018.pdf e in https://eid.gov.it/assets/download/avviso_eidas/Avviso_eIDAS_02-2018.pdf.

[16] Cfr. ”Regolata dall’articolo 64 del nuovo Codice dell’Amministrazione Digitale (Cad), l’App IO funziona come unico punto di accesso online ai servizi pubblici. Il Cad prevede che le amministrazioni debbano rendere fruibili i propri servizi in rete attraverso l’app IO, “salvo impedimenti di natura tecnologica attestati da PagoPA S.p.A”. Al contempo, prevede la possibilità di presentare istanze, dichiarazioni e autocertificazioni mediante l’App IO. A tale fine, le amministrazioni devono avviare i progetti di trasformazione digitale entro il 28 febbraio 2021. IO funziona dunque come un canale che qualsiasi PA può utilizzare per inviare comunicazioni ai propri utenti: fornire aggiornamenti, ricordare scadenze o richiedere pagamenti relativi a un determinato servizio.      Grazie all’app le amministrazioni potranno interagire con i cittadini in maniera più efficace, grazie a uno strumento in grado di:

  • offrire servizi ai cittadini in modo sicuro, grazie al sistema di autenticazione che utilizza Spid o la Carta d’identità elettronica;
  • proporre un’esperienza semplice e intuitiva, allineata con la qualità offerta da altre app con cui il cittadino è abituato a interagire (come ad esempio quelle per i trasporti e la mobilità urbana o per i pagamenti via smartphone).

L’App IO è, quindi, lo strumento pensato per abilitare concretamente la Cittadinanza Digitale, fornendo al cittadino un collegamento diretto (attraverso lo smartphone) con i servizi e le comunicazioni della PA, un punto di accesso unico per l’erogazione e la fruizione dei servizi pubblici”, come si legge in Federica Meta, App IO, ecco cos’è e come funziona l’applicazione dei servizi pubblici, CorCom, 25 Mag 2021 in  https://www.corrierecomunicazioni.it/guide/app-io-ecco-cose-e-come-funziona-lapplicazione-dei-servizi-pubblici/.

[17] Come si legge in GSE (Gestore dei Servizi Energetici), Transizione Ecologia e Digitale: il GSE introduce SPID per il portale dei servizi, 16/03/2021 in https://www.gse.it/ media/comunicati/transizione-ecologica-e-digitale-il-gse-introduce-spid-per-il-portale-dei-servizi.

[18] Cfr. “nasceva come App semplice ed essenziale per la generazione del codice di sicurezza temporaneo (Otp – One-Time Password) necessario per l’accesso con la propria identità digitale Spid LepidaID ai servizi che richiedono l’identificazione a due fattori, in alternativa alla ricezione via sms dell’Otp. Infatti, la maggior parte dei servizi accessibili con Spid richiede un’autenticazione di Livello 2 Spid che prevede una doppia verifica (password e Otp).

L’utente in fase di autenticazione, dopo avere inserito username e password sceglieva se ricevere la Otp via sms oppure generarla con la App LepidaID. (..) In questa fase, l’utente viene invitato ad attivare lo sblocco tramite riconoscimento biometrico (se disponibile sul dispositivo), che potrà permettergli di evitare l’inserimento del Pin durante l’uso della funzione “Accesso con QR Code”. Successivamente, a ogni accesso ai servizi online sarà possibile utilizzare la modalità di ricezione della Otp, generata dal sistema LepidaID tramite sms, oppure generare il codice temporaneo tramite la App installata sul proprio smartphone oppure utilizzare la lettura del QR Code sempre attraverso la App. In caso di cambio di dispositivo, è possibile procedere con la disassociazione della App LepidaID, operazione che si può scegliere di effettuare o direttamente sulla App (tramite apposita voce del menù) oppure nella propria area personale a cui si accede da id.lepida.it. Si ricorda che l’applicazione mobile funziona anche in assenza di copertura cellulare e quindi anche quando l’sms non è ricevibile, riuscendo a rispondere alle problematiche espresse da alcune utenze che operano con connettività Internet, ma in aree ove per motivi orografici o ambientali non è presente la copertura cellulare”, come si legge in Corriere Comunicazioni, Spid, l’app di Lepida si evolve: autenticazione anche tramite QR code, 03 Mag 2021 in https://www.corrierecomunicazioni.it/pa-digitale/spid-lapp-di-lepida-si-evolve-autenticazione-anche-tramite-qr-code/.

[19] Cfr. Corriere Comunicazioni, Spid: gli utenti italiani a quota 20 milioni, triplicati in un anno, 30 Apr 2021 in https://www.corrierecomunicazioni.it/pa-digitale/spid-gli-utenti-italiani-a-quota-20-milioni-triplicati-in-un-anno/.

[20] Cfr. Federica Meta, Spid europeo, la Ue accelera. Vestager: “Opportunità unica per i cittadini” Corriere Comunicazioni.it, 03 Giu 2021 in https://www.corrierecomunicazioni.it/ pa-digitale/spid-europeo-la-ue-accelera-vestager-opportunita-unica-per-i-cittadini/.

Articolo a cura di Sergio Guida

Da economista aziendale, ha maturato esperienze direzionali in gruppi industriali diversi per settori, dimensioni e caratteristiche. Specializzato in pianificazione strategica e controllo di gestione, finanza, risk e project management, sistemi di gestione e rendicontazione integrativi (sociale, ambientale e intangible assets), è stato relatore in convegni e seminari e pubblica articoli di economia, finanza, digital transformation, data governance, public health, compliance & regulatory affairs.

Ha seguito percorsi multidisciplinari su Design Thinking, Human-Computer Interaction, Data protection & Privacy, Digital Health & Therapeutics. Business angel, segue con attenzione il mondo delle Startup.

https://www.ictsecuritymagazine.com/articoli/il-sistema-pubblico-di-identita-digitale-spid-in-prospettiva-europea-un-esempio-di-disruptive-innovation-decisiva-per-il-rapporto-stato-cittadini/
Sicurezza, Hardware e Confidential Computing – Parte 1

Negli ultimi anni si è posta molta attenzione agli aspetti di sicurezza informatica basati su componenti Hardware: progetti sono in corso, consorzi sono stati creati (si veda ad esempio [Rif. 1]), annunci e nuovi prodotti sono stati presentati. In questo articolo proviamo a fare una rapida panoramica di alcuni aspetti della sicurezza informatica strettamente basati su componenti Hardware che potrebbero portare ad interessanti sviluppi nel prossimo futuro. Per fare questo però, è utile partire ricordando alcuni dei principali concetti del ruolo dell’Hardware nella sicurezza informatica.

Sicurezza e fiducia (o Trust)

Dobbiamo sempre ricordarci che la sicurezza informatica si basa comunque sempre su una catena di fiducia (o all’Inglese, Chain of Trust) che ci coinvolge tutti in vari modi.

Quando utilizziamo un software, dai Sistemi Operativi ad applicazioni grandi e piccole, è ovvio, o dovrebbe esserlo, che esplicitamente o implicitamente ognuno di noi si fida del produttore del software, anche se non sempre allo stesso modo. Per questo anche se ci fidiamo, utilizziamo anti-virus, verifichiamo (o dovremmo verificare) le notizie pubbliche su eventuali incidenti di sicurezza delle applicazioni, facciamo eseguire (o dovremmo fa eseguire) Vulnerability Assessment, Penetration Test, Source Code Analysis, Black Box Test ecc. per verificare l’assenza di lacune di sicurezza dai prodotti. Nessuno di noi dovrebbe procedere ad installare un prodotto software per il quale non si ha nessuna fiducia sulla sicurezza, sia basata su evidenze tecniche sia sulla storia ed il buon nome del produttore.

In genere ci fidiamo di più dell’Hardware, ed a ragione, tipicamente perché vi sono meno incidenti di sicurezza informatica dovuti a problemi Hardware, ma anche perché spesso siamo meno consapevoli del suo ruolo cruciale nella sicurezza informatica.

Ma dove comincia la catena della fiducia? Il primo punto di vista è che ci dobbiamo fidare di tutti i produttori, sia Software che Hardware. Il secondo punto di vista è di guardare a come la sicurezza è implementata nei sistemi informatici, ed in questo caso dovrebbe essere ovvio che si parte dall’Hardware e dal suo Firmware.

Protezione Hardware di base e catena della fiducia

Che l’Hardware sia il punto di partenza (o Root of Trust) della catena della fiducia della sicurezza operativa è fatto ben noto e risale agli albori dell’informatica. L’approccio attuale alla sicurezza Hardware ebbe le prime implementazioni negli anni ’60 e storicamente si fa riferimento a Multics (1964), il papà di Unix. All’interno delle CPU ogni programma è eseguito a un livello di protezione[1] (Protection Ring) controllato dall’Hardware e che ha un set predefinito di privilegi, ovvero nel quale i programmi possono eseguire solo un certo insieme di istruzioni macchina. Tipicamente i programmi sono eseguiti nel livello meno privilegiato nel quale non hanno accesso diretto ad alcuna risorsa, dai file alle periferiche ecc. Nel livello più privilegiato è eseguito invece il Kernel del Sistema Operativo. Ad esempio, quando un programma deve leggere o scrivere dei dati, prepara i dati da leggere o scrivere in apposite locazioni di memoria e poi attiva un particolare bit Hardware (detto Hardware Gate) tramite una chiamata detta System Call. La CPU a questo punto interrompe l’esecuzione del programma ed attiva il Kernel del Sistema Operativo che legge la richiesta del programma, verifica che sia lecita, ovvero ad esempio che non voglia leggere o scrivere dati di altri utenti o su dispositivi ove l’utente o il programma non ha il permesso di accesso, e procede a leggere o scrivere i dati per conto del programma.

Qualsiasi funzionalità di sicurezza informatica nell’esecuzione degli eseguibili è basata su questa architettura Hardware che fa si che solo il Kernel del Sistema Operativo abbia diretto accesso alle periferiche e all’Hardware in generale. Il Kernel del Sistema Operativo ha quindi il compito di implementare le politiche di sicurezza operative.

Il Kernel di un Sistema Operativo è caricato nella CPU all’avvio del sistema e tipicamente non dovrebbe essere modificato durante l’esecuzione [2]. Ma come possiamo essere sicuri che il Sistema Operativo non sia stato manomesso al momento dell’avvio del sistema o durante la sua esecuzione? Entrambi gli scenari sono possibili: il primo ad esempio tramite un aggiornamento fraudolento del Sistema Operativo anche tramite un accesso fisico alla macchina, il secondo ad esempio sfruttando una vulnerabilità del Sistema Operativo stesso durante la sua esecuzione.

Per garantire l’integrità del Sistema Operativo è necessario risalire al momento dell’avviamento del sistema quando viene eseguito il Firmware presente in Hardware e poi i programmi BIOS/UEFI necessari all’avvio del Sistema Operativo. La catena della fiducia deve quindi risalire all’Hardware al momento dell’avvio del sistema: ci fidiamo del produttore dell’Hardware che a sua volta si fida del Firmware, del BIOS/UEFI, del Sistema Operativo e così via. Ad ogni passo è necessario verificare che il componente successivo sia autentico, ovvero di un produttore di cui ci si fida, e integro, ovvero non modificato. E le verifiche devono essere fatte periodicamente per individuare eventuali modifiche non autorizzate a run-time. Il processo è implementato utilizzando tecniche crittografiche calcolando il Hash degli eseguibili (integrità) e apponendo firme digitali (autenticità) tramite moduli crittografici Hardware dedicati o inclusi nelle CPU. Questo processo è tipicamente chiamato Secure Boot ed è ormai implementato nella maggior parte dei dispositivi informatici e supportato da quasi tutti i Sistemi Operativi.

Integrità, Autenticità e Confidenzialità

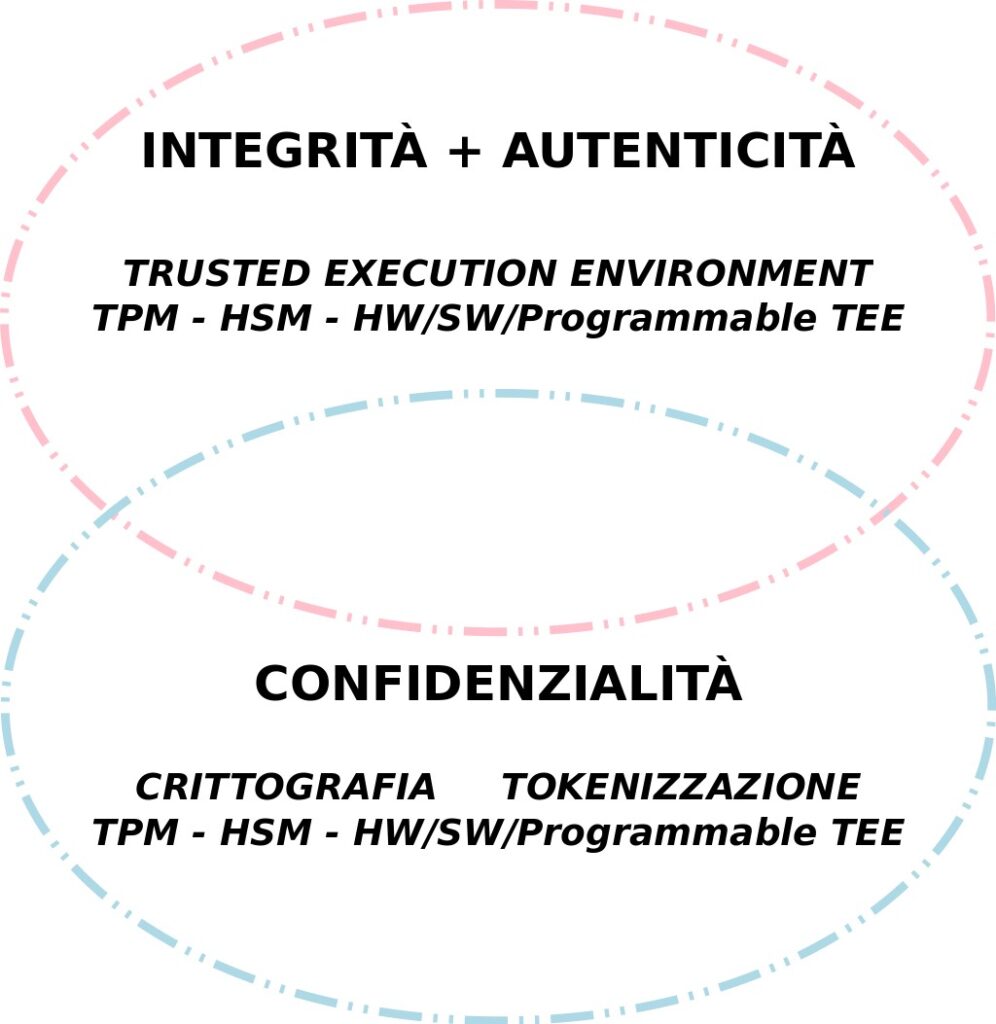
Prima di procedere è necessario distinguere due problematiche che nella pratica sono interconnesse ma hanno scopi e finalità ben diversi, come riassunto in Fig. 1.

Fig. 1 Approcci e alcuni esempi di tecnologie di sicurezza delle elaborazioni

La prima, quella appena descritta, ha come scopo di garantire che gli strumenti Hardware e Software che utilizziamo per le elaborazioni informatiche siano quelli in cui riponiamo la nostra fiducia e che vogliamo utilizzare. Inoltre vogliamo essere immediatamente informati nel caso questi siano modificati in maniera non autorizzata ad esempio da qualche malware. In generale le soluzioni a questi requisiti vanno sotto il nome di Trusted Execution Environment (TEE). Ovviamente in questo caso le proprietà che ci interessano sono l’Integrità e l’Autenticità di Hardware e Software.

La seconda, che di recente sta assumendo sempre maggior interesse, ha come scopo di garantire la Confidenzialità delle elaborazioni anche nei confronti degli amministratori del sistema e del Sistema Operativo stesso e non solo degli altri utenti non amministrativi. Questa esigenza nasce anche dall’utilizzo da parte di più utenti, completamente estranei, dello stesso sistema Hardware/Software in particolare negli ambienti Cloud.

Questo aspetto è usualmente chiamato Confidential Computing (Rif. [1-5]). Prima però di discutere le relazioni tra Confidential Computing, Secure Boot e Trusted Execution Environment, è necessario approfondire le principali tematiche del Confidential Computing.

Confidential Computing

Consideriamo subito il caso più complicato ma sicuramente di maggior interesse: l’utilizzo di servizi Cloud erogati in modalità SaaS, PaaS o IaaS. Lo scenario ben noto è quello di una piattaforma Hardware e Software gestita dal fornitore ed utilizzata in maniera condivisa e self-service dai clienti. I clienti condividono le risorse Hardware e Software, inclusi Sistemi Operativi, Middleware e applicazioni. D’altra parte ogni cliente richiede la confidenzialità dei propri dati, sicuramente rispetto agli altri clienti e in molti casi anche rispetto al fornitore Cloud stesso.

La confidenzialità può essere ottenuta principalmente utilizzando due approcci:

  1. sostituendo i dati sensibili con dati non significativi tramite processi quali la Tokenizzazione, il Data Masking o la pseudo-anonimizzazione;
  2. cifrando tutti i dati o soli i dati sensibili.

In entrambi i casi, se solo parte dei dati sono protetti, si pone il problema di garantire che non sia possibile estrarre informazioni sensibili, via inferenza, dai dati non protetti. Il problema dell’inferenza e dei canali paralleli (side channel) è un problema reale e spesso di difficile soluzione, se non quella di ridurre al massimo la quantità di dati non protetti e rendere assolutamente inintelligibili tutti gli altri.

I processi di mascheramento o sostituzione dei dati sensibili sono particolarmente esposti ai problemi d’inferenza e analisi. Inoltre sono di norma completamente in carico all’utente, che deve preparare correttamente i dati prima d’inviarli al fornitore Cloud. Infine non è possibile adottare queste soluzioni ad esempio quando le elaborazioni devono essere fatte proprio e direttamente sui dati sensibili.

Sembrerebbe quindi che la cifratura di tutti i dati possa essere l’approccio vincente e più semplice per garantire la loro confidenzialità, ma vanno considerati i tre possibili stati dei dati (si veda anche la Tabella 1):

  1. la cifratura dei dati in transito, ovvero quando trasmessi sulle reti di telecomunicazione
  2. la cifratura dei dati a riposo, ovvero quando archiviati su un Filesystem, Storage, Database ecc.
  3. La cifratura dei dati in uso, ovvero durante l’elaborazione.
In transito Cifratura comunicazioni
A riposo Cifratura disco / FileSystem per furto HW o accesso fisico Cifratura dati (es. Tabella / Colonna in DB) con chiave dell’utente,

Confidential Computing

Tokenizzazione, Data Masking,  Pseudonimizzazione
In uso Confidential Computing Crittografia omomorfa Tokenizzazione,

Data Masking, Pseudonimizzazione

Tabella 1: alcune tecniche per la confidenzialità nei tre possibili stati dei dati

La cifratura di tutti i dati in transito è ormai la norma e non dovrebbe costituire un problema per nessuno.

La cifratura dei dati a riposo è ormai abbastanza comune ma è necessario fare alcune precisazioni. La cifratura di interi dischi o FileSystem garantisce la confidenzialità dei dati sicuramente rispetto a scenari quali l’accesso fisico od il furto del supporto Hardware, ma non è utile per garantire la confidenzialità rispetto gli accessi degli amministratori di sistema o quando l’applicazione è condivisa da più utenti e utilizza lo stesso Storage per tutti gli utenti. Al giorno d’oggi questa però è la situazione più comune.

Per garantire la confidenzialità dei dati a riposo anche rispetto agli amministratori dei sistemi Cloud ed agli altri utenti della stessa applicazione, è necessario che i dati siano cifrati con chiavi crittografiche gestite e note solo all’utente. Un caso ormai comune è fornito dai servizi di Storage Web in Cloud, ovvero i servizi di tipo “Cloud Drive” accessibili tipicamente tramite Browser Web e App dedicata. In questi servizi, i dati sono cifrati dal Browser dell’utente sul proprio dispositivo informatico prima dell’invio al servizio di Storage in maniera trasparente all’utente. Lo stesso avviene per servizi Cloud di backup e di puro Storage, ove i dati sono cifrati / decifrati da una applicazione sui sistemi interni dell’utente. Questo da un lato garantisce la confidenzialità dei dati ma dall’altro rende impossibile qualunque elaborazione dei dati sui sistemi in Cloud visto che la chiave di cifratura è loro ignota.

Ma come poter garantire al contempo la confidenzialità dei dati a riposo, ovvero sullo Storage dei servizi Cloud, e la possibilità per le applicazioni Cloud di elaborare i dati?

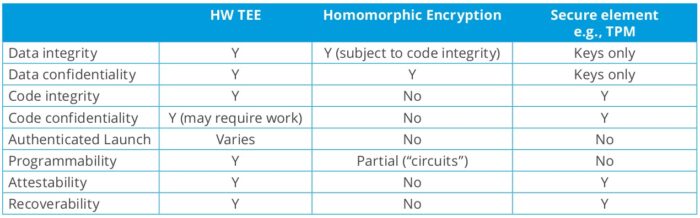
Questo è il principale problema che il Confidential Computing si propone di risolvere. La soluzione è basata sull’utilizzo di moduli Hardware crittografici da affiancare od integrare in tutti i processori (si veda ad esempio [Rif. 6]), che permettano solo all’utente padrone dei dati di cifrarli e decifrarli sui server Cloud. Questi moduli sono chiamati Hardware-Based Trusted Execution Environment (o HW-TEE). Proveremo più avanti a dare una descrizione ad alto livello di come questo possa funzionare, il punto principale è che le chiavi segrete e le elaborazioni sensibili, quali la de-cifratura, sono svolte esclusivamente in Hardware dedicato e non accessibile, in modo da impedire a  chiunque non autorizzato, inclusi gli amministratori dei sistemi, di accedervi. Da questo punto di vista gli HW-TEE sono da considerare come un’evoluzione degli Hardware Security Module (HSM) e dei Trusted Platform Module (TPM): i primi sono sistemi HW per gestire in sicurezza le chiavi e le operazioni crittografiche, i secondi sono micro-chip presenti ormai su quasi tutti i computer anche personali, che gestiscono in sicurezza chiavi crittografiche (si veda anche la Fig. 2).

Fig. 2  Caratteristiche dei tre principali approcci crittografici per la confidenzialità [Sorgente Rif. 4]

Un esempio semplice in ambito Cloud IaaS può essere utile a chiarire questo scenario. Si supponga di creare in un ambiente Cloud una macchina virtuale con un suo storage virtuale dedicato. Si cifra però lo storage con una chiave di cifratura nota solo all’utente che utilizza la macchina virtuale. La maniera tradizionale e poco funzionale di fare ciò, è di inserire manualmente la chiave di cifratura dello storage al momento in cui il relativo FileSystem viene montato sulla macchina virtuale. Questo ovviamente richiede una gestione manuale delle chiavi, e la presenza di una persona che deve digitarle al momento dell’avvio (e riavvio) della macchina virtuale. L’approccio corrente è invece totalmente automatizzato: alla macchina virtuale sono associate delle chiavi crittografiche che permettono di identificarla esattamente e, tramite queste chiavi, solo la macchina virtuale può accedere alla chiave di cifratura del FileSystem. Le chiavi crittografiche possono essere gestite in sistemi Hardware (TPM, HSM, HW-TEE) ma più comunemente sono gestite tramite applicazioni dedicate di Key Management, sistemi sui cui torneremo più avanti in questo articolo quando descriveremo brevemente un altro approccio detto comunemente Bring Your Own Key (BYOK). Il risultato finale è che solo gli utenti della macchina virtuale possono accedere ai dati presenti sullo Storage virtuale ad essa collegato, gli utenti delle altre macchine virtuali e gli amministratori del servizio Cloud non hanno alcun accesso in chiaro ai dati sullo storage.

Riassumendo, rispetto alle due situazioni descritte inizialmente, è possibile creare una configurazione intermedia in cui i dati non sono cifrati dallo Storage stesso né dall’utente sui propri sistemi remoti, ma a livello utente sui sistemi o applicazioni in Cloud con chiavi legate all’utente o all’istanza dell’applicazione (o macchina virtuale). In questo modo la cifratura dei dati garantisce la confidenzialità degli stessi a riposo a livello utente, ma permette di decifrarli e poterli elaborare anche sui sistemi remoti.

Questo approccio può essere ripetuto (anche se non ancora in tutti i casi) per la protezione dei dati a riposo in database o direttamente in istanze di applicazioni.

Confidenzialità dei dati “In Uso” – Cifratura RAM

Purtroppo la cifratura dei dati a riposo è il problema semplice e la cui soluzione sta diventando sempre più standard anche nei servizi Cloud. Il problema difficile e non ancora risolto è quello di proteggere i dati “in uso”.

Prima di tutto dobbiamo chiarire cosa si intende per dati “in uso”: secondo l’accezione generale sono i dati quando non in trasferimento su reti dati e non archiviati in memorie permanenti. I due principali punti di “uso” dei dati sono ovviamente la CPU, che li elabora, e la RAM, che li memorizza temporaneamente. I dati “in uso” sono presenti poi in tutti i registri, cache, bus eccetera che compongono l’architettura hardware degli elaboratori, ed in particolare della scheda madre.

Nella CPU e nei circuiti Hardware che ne formano l’architettura, i dati devono essere in chiaro, ovvero non cifrati, altrimenti nessun tipo di elaborazione è possibile a meno di utilizzare la Crittografia Omomorfica che sarà brevemente considerata più avanti. Inoltre, a meno di attacchi di inferenza (“side channel”) quali ad esempio Spectre e Meltdown o vulnerabilità Hardware, la CPU ed i circuiti Hardware sono i punti ove i dati sono a minor pericolo per la confidenzialità in quanto protetti dall’Hardware stesso. Analogo discorso non vale per la RAM in quanto un utente o programma con privilegi di amministratore di sistema (o amministratore di Host per i sistemi virtualizzati), può leggere tutti i dati in essa contenuti.

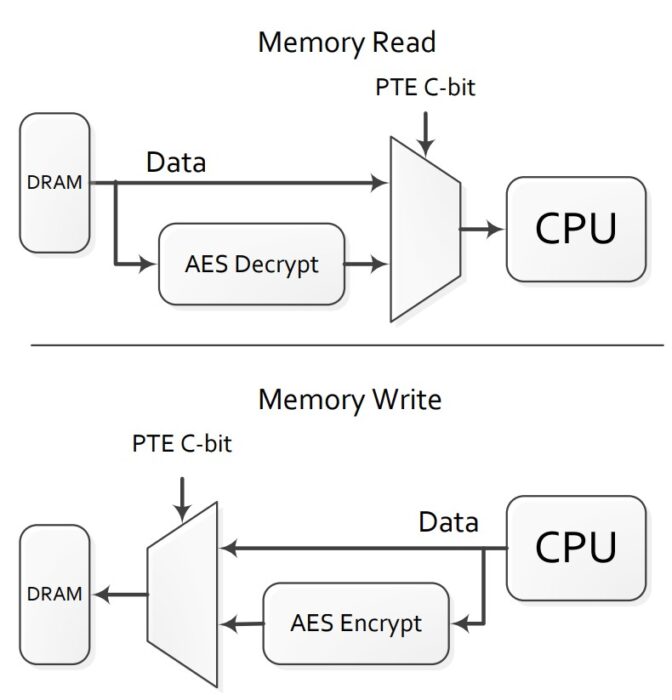
AMD propose nel 2016 [Rif. 7] la realizzazione di moduli RAM nei quali i dati sono cifrati. Questa tecnologia è ormai disponibile da parte di AMD con il nome di “AMD Memory Guard” (inizialmente si chiamava “Secure Memory Encryption”) e Intel ha annunciato una simile soluzione con il nome “Total Memory Encryption” (TME) [Rif. 8]. L’implementazione della cifratura dei dati in RAM è, da un punto di vista logico, abbastanza semplice, come riassunto in Figura 3.

Fig. 3  Schema logico di AMD “Secure Memory Encryption” [Sorgente Rif. 7]

L’idea di base è di inserire dei circuiti dedicati tra la CPU e la RAM che cifrano i dati con AES (128bit) quando questi sono scritti in memoria dalla CPU, e li decifrano quando sono trasferiti dalla memoria alla CPU. In questo modo i dati sono sempre cifrati nella RAM e sempre in chiaro nella CPU. Nella tabella “Page Table Entry” (PTE) che indirizza i dati nella memoria, un bit (“C-bit”) è dedicato a indicare se nella locazione di memoria i dati sono cifrati o in chiaro. Quindi a seconda del valore del “C-bit” nel trasferimento tra CPU e RAM i dati vengono (de-) cifrati o meno. Le chiavi di cifratura sono generate da un generatore di numeri pseudo-casuali Hardware e mantenute in registri Hardware dedicati, temporanei e non accessibili se non al Chip di cifratura. Le chiavi di cifratura sono tipicamente create ad ogni avvio del sistema. AMD-SME permette di cifrare con una singola chiave segreta tutta la RAM o solo i dati gestiti da un particolare processo, ad esempio l’Hypervisor e quindi tutte le macchine virtuali. In questo secondo caso, l’amministratore di sistema dell’Host di virtualizzazione non ha accesso ai dati delle macchine virtuali in RAM. Inoltre in modalità “Secure Encrypted Virtualization” (AMD-SEV) viene creata una chiave di cifratura dedicata per ogni macchina virtuale. Questo permette di proteggere i dati in RAM di una macchina virtuale non solo rispetto all’Host ma anche rispetto a tutte le altre macchine virtuali.

Nella seconda parte di questo articolo proseguiremo la presentazione di soluzioni per la confidenzialità dei dati in “uso”, per arrivare ai Trusted Execution Environment, ai  Key Management System e concludere brevemente con un accenno alla crittografia omomorfica.

Riferimenti Bibliografici

Rif. 1: Confidential Computing Consortium, https://confidentialcomputing.io/

Rif. 2: NIST “Hardware-Enabled Security for Server Platforms: Enabling a Layered Approach to Platform Security for Cloud and Edge Computing Use Cases”, Draft 28 aprile 2020, https://doi.org/10.6028/NIST.CSWP.04282020-draft

Rif. 3: NIST “Hardware-Enabled Security: Container Platform Security Prototype”, Draft dicembre 2020, https://doi.org/10.6028/NIST.IR.8320A-draft

Rif. 4: Confidential Computing Consortium “Confidential Computing Deep Dive v1.0”, ottobre 2020, https://confidentialcomputing.io/wp-content/uploads/sites/85/2020/10/Confidential-Computing-Deep-Dive-white-paper.pdf

Rif. 5: Confidential Computing Consortium “Hardware-Based Trusted Execution for Applications and Data”, luglio 2020, https://confidentialcomputing.io/wp-content/uploads/sites/85/2021/01/confidentialcomputing_outreach_whitepaper-8-5×11-1.pdf

Rif. 6: si vedano ad esempio i seguenti recenti articoli: The Register “Microsoft brings Trusted Platform Module functionality directly to CPUs under securo-silicon architecture Pluton”, https://www.theregister.com/2020/11/17/microsoft_pluton_cpu_hardware_security/ ; The Hacker News “Intel Adds Hardware-Enabled Ransomware Detection to 11th Gen vPro Chips”, https://thehackernews.com/2021/01/intel-adds-hardware-enabled-ransomware.html

Rif. 7: “AMD Memory Encryption white paper”, aprile 2016, https://developer.amd.com/wordpress/media/2013/12/AMD_Memory_Encryption_Whitepaper_v7-Public.pdf ; AMD Memory Guard white paper”, marzo 2020, https://www.amd.com/system/files/documents/amd-memory-guard-white-paper.pdf

Rif. 8: ArsTecnica “Intel promises Full Memory Encryption in upcoming CPUs”, https://arstechnica.com/gadgets/2020/02/intel-promises-full-memory-encryption-in-upcoming-cpus/

Note

[1]     Le CPU attuali hanno usualmente 4 o 5 livelli, anche se tipicamente ne sono usati solo 2, o 3 nel caso di supporto Hardware per gli Hypervisor di macchine virtuali; Multics aveva ben 8 livelli.

[2]     Per limitarne le dimensioni, i Kernel sono tipicamente modulari ed i moduli sono caricati ed eseguiti a run-time solo al momento del reale utilizzo.

Articolo a cura di Andrea Pasquinucci

https://www.ictsecuritymagazine.com/articoli/sicurezza-hardware-e-confidential-computing-parte-1/


Quantum Computing: gli effetti collaterali per la sicurezza

Sempre più spesso ricorre la tematica riguardante la nuova generazione di computer, i “Quantum Computer” che di giorno in giorno comincia a suscitare sempre più interesse vista la direzione presa dal mondo digitale dove la protezione del dato è in cima alla lista delle priorità. Protezione che oggi viene assicurata dalla crittografia mediante i protocolli di firma, di cifratura e di scambio delle chiavi. Già, ma questa stessa crittografia pare non essere resistente ad un eventuale attacco perpetrato tramite un computer quantistico e questo allarma non poco tutto l’intero mondo dell’Information Technology.

Ma allo stesso tempo è proprio il continuo sviluppo della tecnologia quantum computing a trainare la ricerca verso una nuova crittografia, una crittografia del futuro denominata “Post-Quantistica” capace di reggere ad ogni tipo di attacco portato dai computer quantistici, assicurando così tutte quelle modalità e tecnologie di protezione fondate sulla crittografia e di cui Internet ne è il massimo fruitore.

E’ IBM a trainare la tecnologia Quantum, ma sia Microsoft che Google non stanno certo a guardare, visto i cospicui investimenti stanziati per realizzare un quantum computer alla portata di tutti comparabile al computer odierno di tipo binario. La spinta trainante arriva da quei settori ingegneristici dello studio dei materiali ma anche dal settore chimico e da quello farmaceutico che sono alla costante ricerca di soluzioni computazionali che allo stato attuale risultano ancora impossibili attraverso l’utilizzo della tecnologia offerta dai computer di oggi.

Accanto a questa spinta si manifestano gli effetti collaterali che potrebbero scatenarsi a fronte della risoluzione degli enigmi matematici basati sulle più diffuse primitive di crittografia. La potenza di calcolo sprigionata dai computer quantistici è tale da far saltare gli attuali sistemi crittografici mettendo a serio rischio tutti i nostri preziosi dati. Infatti, questi algoritmi crittografici utilizzati da moltissime applicazioni forniscono una robustezza rassicurante per i computer binari di oggi che, per decifrare e risolvere una cifratura del dato, necessitano di uno spazio temporale calcolato nell’ordine di migliaia di anni. Ma cosa accadrebbe se avessimo a disposizione un Quantum Computer? Semplice, in solo poche ore potremmo “sventrare” ogni tipo di crittografia attuata nel contesto odierno.

Ecco perché cresce l’interesse e la preoccupazione verso questa nuova generazione di computer che, è bene dirlo, per ora sono stati costruiti solo per scopi di laboratorio, quindi non ancora pronti su vasta scala. Ma sono gli stessi esperti sviluppatori del Quantum Computer a considerare il 2031 come l’anno di svolta in cui la presenza dei computer quantistici sarà così importante da poter essere in grado di violare uno degli algoritmi più utilizzati fino ad ora, l’algoritmo RSA-2048. Basta ricordare quanto questo algoritmo venga largamente utilizzato con i protocolli di sicurezza SSL e TLS che assicurano la protezione delle comunicazioni sulle reti, Internet compresa. Ad esempio, proviamo a pensare a tutte quelle transazioni economiche realizzate oggi online tramite carte bancarie di ogni tipo e protette con RSA. Ebbene se avessimo a portata un Quantum Computer basta un attimo a mettere a soqquadro l’intero sistema con un conseguente ed inestimabile danno economico.

Cosa fare quindi? Per fortuna c’è già chi si è posto il problema sviluppando la futura crittografia “post-quantistica” capace di utilizzare delle primitive crittografiche in grado di risolvere problemi matematici molto più complessi rispetto a quelli determinati dal Quantum Computer, quindi resistenti per altrettante migliaia di anni di calcolo prima di poter essere risolte anche dai computer quantistici. Questo consente di ripristinare una certa gerarchia computazionale che vede i computer di qualsiasi natura, sempre un passo indietro rispetto alla complessità delle operazioni matematiche utilizzate per la sicurezza crittografica.

E come sempre, in campo crittografico, è il NIST a mettere ordine ad un possibile utilizzo di queste nuove primitive post-quantistiche, mediante la formulazione di nuovi standard che verranno rilasciati entro il 2024 e che saranno capaci di determinare e classificare gli algoritmi di firma e di cifratura con chiave pubblica o asimmetrica, dove viene usata la coppia di chiavi (pubblica + privata), la prima per cifrare e verificare la veridicità della firma digitale, mentre la seconda viene utilizzata per decifrare il dato o per firmarlo.

Abbiamo parlato di chiavi, e sono proprio loro a creare una seconda problematica non certo meno importante della prima, in quanto queste chiavi devono essere scambiate o distribuite tra le controparti che necessitano di comunicare. Ma anche qui c’è già chi se ne sta prendendo cura: la Quantum Key Distribution

Con la Quantum Key Distribution sia il mittente che il destinatario del messaggio possono generare e scambiare contestualmente una stringa randomica fatta di 0 e 1 evitando che un possibile attacco esterno possa individuare il contenuto della stringa mentre questa viene scambiata. Si tratta del concetto basilare con cui lavora la sicurezza crittografica, e cioè della capacità di generare le chiavi in maniera random, in modo che i digit componenti della stringa binaria (0 e 1) da cui si estrae poi la chiave risultino uniformemente distribuiti tra loro. Ed è su questo concetto che si sviluppano gli eventi quantistici, randomici per loro natura, ed utilizzati dalla Quantum Key Distribution per la generazione e distribuzione delle chiavi private. Si tratta di un metodo alternativo, non computazionale, dove sicurezza e veridicità della stringa generata in modalità randomica sono determinate proprio dalla fisica quantistica.

Ma attenzione a non commettere l’errore di contrapporre la soluzione di scambio delle chiavi della Quantum Key Distribution con le soluzioni adottate con la crittografia classica. Si tratta di soluzioni differenti adottabili a seconda del tipo di applicazione. Ad esempio, mentre la crittografia classica può continuare ad essere utilizzata per lo scambio delle chiavi da utilizzare per le applicazioni più comuni, la Quantum Key Distribution può essere adottata per tutte quelle applicazioni che richiedono un elevato livello di sicurezza protratto nel lungo termine, come le comunicazioni strategiche militari o servizi segreti, che non possono certo essere compromesse dai mutamenti tecnologici nè tantomeno dipendere dal potere computazionale di elaboratori di nuova generazione.

Ad ogni modo…ci siamo! Siamo proprio sulla soglia di un cambiamento radicale del mondo digitale, guidato dallo sviluppo del computer quantistico che spinge fortemente sull’acceleratore del progresso, obbligando esperti di crittografia e fisici quantistici a sviluppare nuovi protocolli per la firma, la cifratura e lo scambio delle chiavi, ad alta immunità, capaci di resistere a tutti i tentativi di attacco portati dal futuro Quantum Computer.

Articolo a cura di Luigi Perrone

https://www.ictsecuritymagazine.com/articoli/quantum-computing-gli-effetti-collaterali-per-la-sicurezza/


GDPR e D.Lgs. 101/2018: I diritti sul trattamento dei dati personali riguardanti le persone decedute

Il Nuovo Regolamento europeo 679/2016 (di seguito “GDPR”) riconosce in capo ai soggetti interessati, ai sensi e per gli effetti di cui agli artt. da 15 a 22, una pluralità di diritti che vengono annoverati nell’alveo di quel più ampio diritto all’autodeterminazione informativa che esprime il potere di governare il flusso delle proprie informazioni e che costituisce e rappresenta un elemento primario della materia de qua [1]. Presupposto imprescindibile per l’affermarsi di tali diritti, secondo anche la definizione del termine “dato personale” riportata all’art.  4, punto 1), del GDPR, risulta essere la qualifica di interessato che viene meno ogniqualvolta si verifichi il decesso di una persona fisica. In tal senso il Considerando 27 del GDPR sancisce in primo luogo l’esclusione dell’applicazione della normativa europea ai dati personali delle persone decedute. Preme a tal proposito evidenziare come la formulazione propria del GDPR sia in linea con quanto asserito a suo tempo dal Gruppo di lavoro per la protezione dei dati personali dell’Unione europea che, in un apposito parere del 2007 “sul concetto di dati personali”, sottolineò come le informazioni relative alle persone decedute non potessero considerarsi, in linea di principio, dati personali soggetti alle norme della Direttiva 95/46/CE (oggi del GDPR) poiché, per il diritto civile, i defunti non sono più persone fisiche. Tuttavia, il medesimo parere riconobbe la facoltà a ciascun Stato membro di estendere, in forza di un interesse legittimo, le disposizioni delle leggi nazionali, in materia di tutela della privacy, ad alcuni aspetti attinenti al trattamento dei dati dei defunti garantendo in tal modo una protezione indiretta ai dati di tali soggetti. Recependo tale impostazione, il Considerando sopraccitato ha introdotto una clausola di salvaguardia mediante la quale i singoli Stati membri posseggono un proprio margine di manovra nel prevedere l’adozione di norme interne disciplinanti e riguardanti i dati e le informazioni personali dei defunti. È in questa cornice che si colloca il recente intervento del legislatore italiano, che al primo comma dell’art. 2- terdecies, di cui al novellato Codice della privacy ex D.Lgs. 101/2018, prevede che “i diritti di cui agli articoli da 15 a 22 del GDPR riferiti ai dati personali concernenti persone decedute possono essere esercitati da chi ha un interesse proprio, o agisce a tutela dell’interessato, in qualità di suo mandatario, o per ragioni familiari meritevoli di protezione”.

Siffatto comma, a ben vedere, è del tutto coincidente con l’ormai abrogato art. 9, comma 3, del Codice privacy, ad esclusione dell’inserzione della qualifica del mandatario dell’interessato quale possibile presupposto di legittimazione per l’esercizio dei diritti di cui sopra. Viceversa presentano rilevanti profili di novità i successivi commi dell’art. 2- terdecies che verranno messi in luce nel prosieguo della trattazione al fine di evidenziare l’ambito operativo e giuridico degli stessi. Al riguardo il secondo comma precisa che l’esercizio dei diritti non sia ammesso nei casi previsti dalla legge o quando, limitatamente all’offerta diretta di servizi della società dell’informazione, l’interessato lo abbia espressamente vietato con dichiarazione scritta presentata al titolare del trattamento o comunque a quest’ultimo comunicata. La disposizione in esame prescrive inoltre che la suddetta volontà (revocabile e modificabile, in qualsiasi momento, ad nutum) debba necessariamente risultare in modo non equivoco e debba essere specifica, libera ed altresì informata. Il richiamo alle peculiari modalità di espressione della volontà impongono certamente un particolare onere informativo cui è soggetto il titolare del trattamento che offre servizi della società dell’informazione.

Con norma di chiusura, il comma 5 dell’art. 2- terdecies sottolinea che, in ogni caso, il divieto summenzionato non può produrre effetti pregiudizievoli per l’esercizio da parte di terzi dei diritti patrimoniali che derivano dalla morte dell’interessato nonché del diritto di difendere in giudizio i propri interessi. Si osservi che tale comma, seppure, ai fini della sua diretta applicabilità, richiede una consequenzialità tra l’evento della morte dell’interessato e i diritti che derivano dalla stessa, si caratterizza per un’eccessiva vaghezza che darà adito a conflitti in merito alla verifica dei soggetti che, dal punto di vista giuridico, sono abilitati a inibire le richieste di divieti di esercizio dei diritti in relazione a un proprio interesse (se originato dalla morte del de cuius) [2].

Stante tali incertezze interpretative, che permangono allo stato attuale, occorre mettere in evidenza che il Garante per la privacy ha più volte, in passato, avuto modo ed occasione di pronunziarsi sulla portata e sulla natura “dell’interesse proprio” specie in riferimento al diritto di accesso. In materia si riporta brevemente il contenuto di un provvedimento con il quale il Garante stesso ha concesso alla madre naturale di conoscere i dati clinici della figlia non riconosciuta al momento della nascita e deceduta pochi giorni dopo il parto a causa di gravi malformazioni [3]. L’autorità, richiamando la nozione dell’interesse proprio, di cui all’art. 9, comma 3, del Codice (oggi art. 2- terdecies) ha ritenuto che la ricorrente, nella fattispecie in esame, in qualità di madre, anche solo naturale, della neonata possa legittimamente esercitare il diritto di accesso al fine di disporre di informazioni indispensabili all’accertamento e alle modalità di trasmissione della patologia genetica di cui potrebbe essere portatrice e poter così valutare il rischio procreativo e affrontare una scelta riproduttiva consapevole ed informata.

Delineato il quadro giuridico attinente ai diritti sul trattamento dei dati personali riguardanti le persone decedute, rimane da esaminare la delicata questione dell’impatto che l’esercizio dei diritti, in luogo del defunto, può dispiegare sulle aspettative di riservatezza maturate dal deceduto e dai soggetti terzi che hanno con questo intrattenuto rapporti e comunicazioni di natura privata e confidenziale. Al riguardo è doveroso menzionare una nota ordinanza, adottata dal Tribunale di Milano, che ha concesso ai genitori del figlio defunto di ottenere, dalla società Apple Italia Srl, le credenziali di accesso all’ID Apple, per poter accedere ai contenuti (immagini, registrazioni, video) presenti nello smartphone, archiviati su iCloud [4]. Senza entrare nel merito della vicenda, ciò che giova rilevare in codesta sede è che il Tribunale di Milano ha ritenuto legittimo l’accesso alle informazioni personali del figlio deceduto da parte dei suoi genitori, sia per la finalità di recuperare le immagini anche in vista della creazione di un progetto in memoria del figlio, sia in virtù del legame esistente tra genitori e figli, considerato di per sé idoneo ad integrare le “ragioni familiari meritevoli di protezione” previste espressamente dall’art. 2 terdecies. In aggiunta il giudice ha preso atto che non vi era alcuna dichiarazione rilasciata dal de cuius volta a evitare e/o limitare l’esercizio dei diritti connessi ai dati personali post mortem [5]. Allo stesso modo non sono state attuate ed accolte le osservazioni mosse da Apple circa la necessità della qualifica del richiedente quale amministratore o rappresentante legale del defunto e la sussistenza di una autorizzazione e/o di un consenso legittimo, secondo le definizioni riportate nell’Electronic Communications Privacy Act. In questi termini il Tribunale ha pertanto declarato illegittima la prassi e la pretesa di Apple di vincolare e di subordinare l’esercizio di un diritto riconosciuto dall’ordinamento italiano alla previsione di requisiti previsti da norme americane. Tenuto conto del contesto brevemente illustrato sulla base della decisione poc’anzi menzionata pare emergere che il giudice abbia attribuito un valore primario e assoluto all’interesse degli istanti senza tuttavia effettuare un corretto bilanciamento con gli ulteriori interessi in gioco rappresentati dalle legittime aspettative di riservatezza dei soggetti terzi i cui dati personali (costituiti dalle foto, video e conversazioni) erano presenti e conservati sull’account ICloud. Alla luce di ciò si auspica un celere intervento da parte del Garante per la privacy che possa offrire un precedente e un chiaro quadro di riferimento per le autorità giudiziarie nell’effettuare il più possibile una idonea e ponderata attività di valutazione circa gli interessi contrapposti delle parti ricorrenti.

Bibliografia

[1] In questi termini STEFANO RODOTÁ in GPDP, Discorso di presentazione della Relazione per l’anno 2000.

[2] A. CICCIA MESSINA, Guida al Codice privacy. Come cambia dopo il GDPR e il DLgs. N. 101/2018, Wolters Kluwer, 2018.

[3] Provvedimento del Garante per la privacy n. 556 del 5 dicembre 2013 (doc. web n. 2865660).

[4] Ordinanza del Tribunale di Milano, sez. I civ., 10 febbraio 2021.

[5] FRANCESCO LAVIOLA, Il tribunale di Milano concede i dati in cloud di defunto: la persona elettronica sopravvive alla morte?, in www.e-lex.it, 2021.

Articolo a cura di Ginevra Scalcione

https://www.ictsecuritymagazine.com/articoli/gdpr-e-d-lgs-101-2018-i-diritti-sul-trattamento-dei-dati-personali-riguardanti-le-persone-decedute/


Cybersecurity per la Blockchain e la Blockchain per la cybersecurity (3/3)

Introduzione

La blockchain rappresenta un approccio innovativo alla cyber security perché è una tecnologia che permette di progettare sistemi rispettando il principio security by design.

La sicurezza della tecnologia Blockchain si basa principalmente su tre elementi fondamentali:

  • Riservatezza: la Blockchain offre funzionalità estese per garantire l’anonimato dell’utente. Le chiavi utente sono l’unico collegamento tra un utente e i suoi dati. Tuttavia, queste chiavi sono facili da rendere anonime.
  • Integrità dei dati: le blockchain sono progettate come libri mastri (ledge) in cui ogni blocco è collegato a blocchi vicini utilizzando funzioni hash crittografiche. Pertanto, una volta che una transazione è stata registrata sulla blockchain, non può essere modificata o eliminata. Eventuali modifiche apportate ai dati già registrati vengono elaborate come nuove transazioni.
  • Disponibilità: avere un numero elevato di nodi garantisce la resilienza della blockchain anche quando alcuni nodi non sono disponibili. E poiché ogni nodo della rete ha una copia del registro distribuito, la blockchain corretta rimane accessibile ad altri peer anche nel caso di un nodo compromesso.

Blockchain e CyberSecurity: vantaggi

Le soluzioni basate su Blockchain si stanno rilevando particolarmente efficaci e promettenti al fine di aumentare la sicurezza informatica e prevenire attacchi informatici. In particolare, applicare la Blockchain alla CyberSecurity permette di avere i seguenti vantaggi:

  • Blockchain decentralizza i dati sensibili. L’informazione che circola oggi sul web ha un valore enorme; per questo motivo è spesso oggetto di attacchi informatici.
    • Pertanto, anziché utilizzare l’archiviazione centralizzata, le soluzioni basate su Blockchain archiviano i dati su molti nodi. Ciò complica notevolmente la vita dei criminali informatici, che non possono più accedere a interi database da un unico punto di accesso.
  • Un altro modo in cui la Blockchain trasformerà la CyberSecurity sarà attraverso i dispositivi IoT “più intelligenti”
    • I sistemi e i dispositivi in un impianto possono prendere decisioni sulla sicurezza in modo indipendente, senza l’esigenza di un’autorità centrale;
      Ad esempio, possono formare un consenso condiviso su eventi normali all’interno di una rete e bloccare i nodi che si comportano in modo diverso e quindi sospetto. Ciò renderebbe più difficile per gli hacker sfruttare le vulnerabilità dei dispositivi periferici per penetrare in una rete.
  • Blockchain consente di prevenire attacchi DNS.
    • Il DNS è per lo più centralizzato; è più facile interrompere la connessione tra il nome del sito Web e l’indirizzo IP.In effetti, gli hacker sfruttano questa debolezza per rendere i siti inutilizzabili o reindirizzare le persone a siti truffa. In un sistema basato su Blockchain, il decentramento consentirebbe di archiviare le informazioni sul dominio su un ledger distribuito.
      L’implementazione della tecnologia Blockchain decentralizzerebbe completamente il DNS, distribuendo i contenuti a un numero maggiore di nodi rendendo così quasi impossibile l’hackeraggio per i cyber-attaccanti.
  • Riservatezza
    • L’utilizzo della Blockchain deve garantire l’accesso ai dati corretti solo alle parti interessate e autorizzate. Proteggere l’accesso alla rete Blockchain è importante per garantire l’accesso ai dati, soprattutto per la Blockchain privata.
      La riservatezza dei partecipanti alla rete blockchain è elevata a causa della crittografia a chiave pubblica che autentica gli utenti.
  • Criptovaluta
    • È il tipo più popolare di tecnologia Blockchain. Molte organizzazioni utilizzano le criptovalute per importanti transazioni finanziarie. Alcuni professionisti legali possono persino consentire ai clienti di pagare per servizi con criptovaluta.

Conclusione

Blockchain sta guadagnando terreno nel campo del calcolo distribuito e della garanzia dei dati per implementare infrastrutture condivise di dati affidabili e sicure. La blockchain fornisce quindi vantaggi nella cybersecurity, pertanto questa tecnologia rappresenta un’opportunità per migliorare le recenti sfide e limitazioni alla cybersecurity. Infatti, tra i possibili casi d’uso della blockchain per la cybersecurity si ritrovano, ad esempio, il settore finance, in cui il valore più grande di una blockchain risiede nell‘immutabilità dei dati e nella trasparenza delle transazioni, e il settore healthcare, in cui le organizzazioni sanitarie possono trarre grandi vantaggi dall’utilizzo di blockchain per l’archiviazione sicura e il trasferimento rapido dei dati medici.

In conclusione, la blockchain offre grandi opportunità per mantenere un alto livello di security dei dati grazie a meccanismi affidabili di crittografia degli stessi, integrità dei dati, resilienza della rete e scalabilità.

Articolo a cura di Rosita Galiandro

Rosita Galiandro

Rosita Galiandro ha conseguito la laurea Magistrale in Sicurezza Informatica presso l’Università di Bari.

Attualmente ricopre il ruolo di Responsabile Osservatorio CyberSecurity presso Exprivia.

Contribuisce alle attività di prevendita, ha partecipato a progetti di risk assessment e GDPR compliance e collabora in piani di insegnamento con diverse università nell’ambito CyberSecurity e nel progetto CyberChallenge.IT. Fa parte della community Women For Security.

https://www.ictsecuritymagazine.com/articoli/cybersecurity-per-la-blockchain-e-la-blockchain-per-la-cybersecurity-3-3/


Arrivano le clausole contrattuali tipo dalla Commissione Europea

L’importanza dei partner

Quando si sceglie un partner bisogna stare attenti: il rapporto deve basarsi sulla fiducia. Di solito, nei nostri rapporti personali, scegliamo il partner dopo una lunga frequentazione e gli affidiamo una parte dei nostri segreti, dei nostri sogni, della nostra vita solo quando abbiamo la certezza che sia ridotto al minimo il rischio che ci maltratti. Queste scelte, di solito, hanno quattro caratteristiche:

  • le facciamo in modo poco consapevole, diremmo quasi “naturale”, “istintivo”;
  • non esiste un “regolamento” del rapporto; tra amici o tra fidanzati la relazione si evolve spontaneamente senza formalizzazioni (o formalismi) che specifichino gli obblighi reciproci;
  • esistono momenti di “alti” e “bassi” ovvero situazioni in cui possiamo avere l’impressione che il partner non si comporti come dovrebbe;
  • non si stabiliscono a priori le condizioni (di tempo, di spazio o di altro genere) al cui verificarsi il rapporto si interromperà.

L’importanza della scelta del partner, invece, nella vita professionale risponde a criteri molto diversi. Occorre che

  • la scelta sia consapevole e ragionata;
  • il rapporto sia formalizzato e disciplinato nelle rispettive “obbligazioni”;
  • il rapporto si mantenga su livelli “accettabili” lungo l’intera durata senza che ci siano “cadute” che possano danneggiare l’uno o l’altro dei soggetti coinvolti;
  • siano sempre (o quasi) stabilite condizioni che portano alla “interruzione” del rapporto (durata del contratto, clausole risolutive, ecc.).

Queste caratteristiche diventano essenziali quando il partner professionale è un soggetto al quale vengono affidate una o più operazioni di trattamento di dati personali (tutti i dati personali, non solo quelli sensibili…). Com’è noto, questo soggetto assume, secondo il Reg. UE 2016/679[i] (d’ora in poi GDPR), il ruolo di Responsabile del Trattamento ai sensi dell’art. 28 che, al suo primo paragrafo, prevede che

Qualora un trattamento debba essere effettuato per conto del titolare del trattamento, quest’ultimo ricorre unicamente a responsabili del trattamento che presentino garanzie sufficienti per mettere in atto misure tecniche e organizzative adeguate in modo tale che il trattamento soddisfi i requisiti del presente regolamento e garantisca la tutela dei diritti dell’interessato

Già il primo paragrafo obbliga il titolare a scegliere oculatamente il responsabile del trattamento solo tra quelli che possono assicurargli che i dati personali non siano maltrattati cioè che non siano trattati in modo difforme da quanto previsto dal GDPR.

L’attenzione del Garante per la Protezione dei Dati Personali

Il richiamo, dunque, è forte ma, al contempo, molto sottovalutato. Lo dimostrano i frequenti provvedimenti sanzionatori diretti a soggetti pubblici che, nella loro qualità di titolari del trattamento, non scelgono adeguatamente il responsabile[ii][iii] o, addirittura, non sono nemmeno consapevoli che il proprio partner assumerà quel ruolo[iv] e, con questo, tutto ciò che il GDPR prevede.

In proposito, dunque, occorre ricordare sempre che

  • dato personale è definito come “qualsiasi informazione riguardante una persona fisica identificata o identificabile” e che i dati personali vanno tutti protetti;
  • trattamento è definito come “qualsiasi operazione o insieme di operazioni, compiute con o senza l’ausilio di processi automatizzati e applicate a dati personali o insiemi di dati personali”.

Quindi, proprio per evitare spiacevoli inconvenienti, queste definizioni, apparentemente scontate, devono accompagnare sempre i momenti precedenti l’approvvigionamento ovvero la scelta del partner da parte del titolare. Bisogna domandarsi:

  • il mio partner avrà a che fare con dati personali di cui sono titolare?
  • Il mio partner effettuerà operazioni di trattamento sui dati personali (ricordando che il GDPR cita come operazione di trattamento anche la sola “consultazione”)?

Se la risposta è “si” ad entrambe le domande, il partner assumerà il ruolo di responsabile del trattamento ed è necessario avviare un percorso strutturato per poterlo scegliere.

L’attenzione del Comitato Europeo per la Protezione dei Dati Personali

Un primo percorso strutturato per la scelta del responsabile del trattamento è indicato nelle “Guidelines 07/2020 on the concepts of controller and processor in the GDPR”[v] adottate dal Comitato Europeo per la Protezione dei Dati Personali (EDPB) il 2 settembre 2020.

Gli assi principali indicati dall’EDPB sui quali è opportuno basare la scelta del responsabile sono:

  • l’esperienza precedente nel trattamento dei dati che il titolare intende affidargli;
  • l’affidabilità del soggetto correlata ai comportamenti assunti in precedenti trattamenti analoghi;
  • la solidità del soggetto in termini di risorse di cui dispone per il trattamento.

Questi elementi, ovviamente, vanno declinati in requisiti oggettivi e concretamente misurabili, soprattutto quando il titolare è un soggetto pubblico e, quindi, vincolato a specifiche disposizioni normative in materia di approvvigionamento[vi].

Il ciclo dell’approvvigionamento in ambito pubblico

Infatti, i soggetti pubblici sono vincolati ad approvvigionarsi secondo le previsioni del D.Lgs. 50/2016 (Codice dei contratti pubblici) che, in termini schematici, prevede una rigida attuazione delle seguenti fasi:

  • delibera a contrarre;
  • scelta del contraente;
  • formalizzazione del contratto;
  • esecuzione del contratto.

In realtà, la formalizzazione del contratto è, spesso, una semplice ricaduta dei contenuti e dei risultati delle prime due fasi. Per intenderci, tutto ciò che è scritto nei cosiddetti “atti di gara” (fase di scelta del contraente) verrà ripreso integralmente nel contratto finale. Questo vuol dire che, già nelle prime fasi dell’approvvigionamento, il titolare deve:

  • fare scelte ragionate e consapevoli, con particolare riguardo ai rischi per i dati personali, e, quindi, definire i requisiti opportuni ed i criteri di valutazione adeguati rispetto ad esperienza precedente, affidabilità e solidità;
  • disciplinare le obbligazioni reciproche rispetto al trattamento;
  • specificare le conseguenze per livelli di servizio “non accettabili” rispetto al trattamento dei dati personali (p.e. penali specifiche per comportamenti difformi dal GDPR o da istruzioni sui dati personali e che si aggiungono alle penali ordinariamente previste per le violazioni delle prestazioni oggetto del contratto);
  • individuare le condizioni che possono causare l’interruzione della partnership.

Naturalmente, se questi sono gli elementi essenziali da considerare, sarà opportuno che il titolare tenga a mente, sin dalle fasi di avvio dell’approvvigionamento, l’intero art. 28 del GDPR e, in particolare, i contenuti dei paragrafi 3 e 4.

Le clausole contrattuali tipo

Considerata l’importanza della questione e l’impegno che viene richiesto al titolare, lo stesso art. 28, al paragrafo 7, prevede che la Commissione Europea stabilisca clausole contrattuali tipo (Standard Contractual Clauses – SCCs) che forniscano la traccia su cui basare gli accordi con il responsabile del trattamento.

La Commissione ha assunto la conseguente decisione 2021/915[vii] lo scorso 4 giugno dopo aver acquisito il parere congiunto del Comitato Europeo per la Protezione dei Dati Personali e del Garante Europeo per la Protezione dei Dati Personali (EDPS)[viii]. La decisione assume vigenza a partire dal 27 giugno 2021 visto che è stata pubblicata nella Gazzetta Ufficiale Europea il 7 giugno.

Le clausole contenute nella decisione 915 sono dieci cui si aggiungono quattro allegati (e non più sette come previsto nella prima bozza sottoposta al parere congiunto EDPB‑EDPS); coprendo tutti gli obblighi previsti dall’art. 28, il titolare dovrebbe trovare il modo di inserirle, insieme ai suoi allegati opportunamente personalizzati e completati, nel contratto che andrà a stipulare con il responsabile del trattamento.

Come già detto, tuttavia, la rigidità delle procedure cui è obbligato il soggetto pubblico lo costringerà, anche in ossequio ai princìpi di correttezza e buona fede, a rendere noto ai candidati, sin dall’avvio della gara, l’intenzione di ricorrere alle SCCs al momento di stipulare il contratto. Inoltre, al fine di facilitare la definizione di requisiti misurabili per la scelta del contraente, sarà utile integrare, nella griglia di valutazione ordinariamente utilizzata nelle procedure basate sull’offerta economicamente più vantaggiosa, gli elementi riportati nell’Allegato 2 che presenta una sorta di check‑list rispetto alle possibili “misure tecniche e organizzative, comprese misure tecniche e organizzative per garantire la sicurezza dei dati”.

Infine, nella stesura dei documenti, una particolare attenzione va riservata:

  • alla clausola n. 1 allorché prevede che la sottoscrizione delle clausole non sottrae il titolare agli obblighi previsti dal GDPR; questo significa che il titolare non può disinteressarsi del trattamento effettuato per suo conto dal responsabile per il solo fatto di aver sottoscritto le SCCs;
  • alla clausola n. 2 allorché prevede che eventuali altre previsioni presenti nel contratto non devono contraddire quanto previsto dalle SCCs;
  • alla clausola n. 3 allorché prevede che l’interpretazione delle clausole deve essere effettuata alla luce del GDPR e, quindi, anche dei documenti che, nel tempo, saranno prodotti dall’EDPB o dall’autorità di controllo nazionale (per l’Italia, il Garante per la Protezione dei Dati Personali);
  • alla clausola n. 4 che prevede che le SCCs che titolare e responsabili stanno sottoscrivendo prevalgono, in caso di contrasto, su qualsiasi altro “patto contrattuale” eventualmente precedentemente stipulato.

Conclusioni

Le clausole tipo costituiscono, quindi, un notevole ausilio per i titolari ma occorre, comunque, molta consapevolezza nella stesura personalizzata delle SCCs nell’ambito degli accordi per evitare gli effetti negativi del copia&incolla che vanificherebbero tutti i princìpi stabiliti dal GDPR.

Note

[i] 1bd9bde0-d074-4ca8-b37d-82a3478fd5d3 (garanteprivacy.it)

[ii] Ordinanza di ingiunzione nei confronti di Roma Capitale – 11 febbraio 2021… – Garante Privacy

[iii] Provvedimento del 17 settembre 2020 [9461168] – Garante Privacy

[iv] Provvedimento del 14 gennaio 2021 [9542136] – Garante Privacy

[v] edpb_guidelines_202007_controllerprocessor_en.pdf (europa.eu)

[vi] Le centrali di committenza e il GDPR – ICT Security Magazine

[vii] EUR-Lex – 32021D0915 – EN – EUR-Lex (europa.eu)

[viii] EDPB-EDPS Joint Opinion 1/2021 on standard contractual clauses between controllers and processors | European Data Protection Board (europa.eu)

Articolo a cura di Francesco Maldera

Francesco Maldera è Data Protection Officer e Data Scientist.

Il suo percorso professionale lo ha chiamato a responsabilità direzionali nell’ambito dei sistemi informativi, della safety&security, della privacy e dell’auditing svolgendo diversi incarichi dirigenziali nella Pubblica Amministrazione e in aziende private.

Attualmente, accompagna l’attività consulenziale a quella di sensibilizzazione delle persone tramite il sito www.prontoprivacy.it

https://www.ictsecuritymagazine.com/articoli/arrivano-le-clausole-contrattuali-tipo-dalla-commissione-europea/


Ransomware: che fare?

Ransomware. Ciò che sappiamo

Nell’ultimo anno abbiamo assistito ad una crescita esponenziale degli attacchi di tipo ransomware che hanno provocato, tra gli altri, un aumento di circa tre volte dei riscatti pagati per ottenere le chiavi di cifratura ed un altrettanto pesante aumento dei costi per cyber insurance. Si stima che uno solo dei gruppi criminali attivi nel settore abbia incassato nell’ultimo anno riscatti per circa 90 milioni di dollari. Il rischio generato dal ransomware è talmente elevato che alcune compagnie di assicurazione hanno abbandonato il settore della cyber security.

La situazione in realtà potrebbe essere ancora più pesante di quanto sappiamo, perchè spesso le vittime non condividono informazioni sull’attacco che hanno subito. Oltre ad evitare danni di immagine, questo oscuramento sugli attacchi subiti vuole spesso evitare accuse di collaborazione con il crimine organizzato. La possibilità di accusare di questo crimine chi paga un riscatto è stata evidenziata da recenti prese di posizioni e dichiarazioni del governo USA.

Un altro problema fortemente correlato agli attacchi di tipo ransomware è il furto dei dati. Spesso gli attaccanti non si limitano a criptare le informazioni ma le esfiltrano sui propri sistemi e usano la minaccia di renderle pubbliche per accelerare le trattative sul riscatto o per un ulteriore riscatto se e quando il sistema target è tornato al normale funzionamento. Ciò fa sorgere interessanti correlazioni tra attacco ransomware, rispetto del GDPR ed obblighi di notifica ai proprietari dei dati esfiltrati. In generale, comunque, la necessità di poter riutilizzare il proprio sistema è un motivo più che sufficiente perchè il proprietario del sistema attaccato paghi velocemente il riscatto. Ad esempio gli ospedali che sono state tra le recenti vittime del ransomware non hanno molte alternative al pagamento se vogliono salvaguardare i loro pazienti. Una delle innovazioni più significative degli attacchi ransomware rispetto a quelli tradizionali è che non servono IOC o simili per scoprire un attacco, il mancato funzionamento del sistema è di per se uno IOC più che sufficiente.

Vale anche la pena di notare che per ora non vi sono evidenze di una qualche attacco di tipo ransomware che abbia avuto successo contro impianti di controllo industriale. Anche l’attacco che viene indicato come attacco all’oleodotto Colonial in realtà è stato un attacco al sistema informatico di Colonial che poi ha fermato il proprio oleodotto per paura di non essere in grado di fatturare quanto veniva distribuito ai vari clienti.

Ultima caratteristica recentemente emersa sugli attacchi ransomware è il piccolo numero di gruppi criminali che sono dietro a questi attacchi. Questa deduzione è stata possibile grazie all’analisi dei flussi di pagamenti mediante criptovalute, il metodo di pagamento tipico per i riscatti. L’analisi dei flussi di pagamento memorizzati sulle blockchain ha evidenziato come il numero dei destinatari finali sia molto basso. Questi effetti sono evidenti anche se il numero dei flussi di valuta legati al ransomware è una minima parte dei fussi di criptovalute. La esistenza di pochi gruppi è anche provata da una analisi degli strain di malware usati contemporaneamente. Il numero di strain di malware diversi risulta sempre basso e spesso all’aumentare della frequenza di un certo strain di malware corrisponde la contemporanea diminuzione della frequenza di un altro strain.

Ransomware: che fare?

Uno degli aspetti che ritengo più interessanti della recente impennata degli attacchi ransomware sono le strategie di difesa che si propone di usare. In particolare, pochissimi propongono di migliorare la robustezza e la resilienza, r&r, dei sistemi informativi e quasi tutti puntano su strategie basate su “deterrence and disruption”, d&d.

Tipiche strategie r&r sono basate su defence in depth, hardening dei sistemi, autenticazione a più fattori, patching mirato dei sistemi in base al rischio associato. Le strategie di tipo deterrence prevedono invece di aumentare la collaborazione ed i trattati internazionali per impedire il riciclaggio dei riscatti, perseguire i gruppi criminali che lanciano gli attacchi e scoraggiare alcuni stati a favorire questi gruppi in modo da poterli usare anche come APT quando utile. La deterrence comprende anche l’introduzione di nuove leggi per le criptovalute per tener conto del fatto che, come qualcuno dice, il ransomware non è altro che un problema generato da bitcoin e levato bitcoin sparisce anche il problema. Infine, un vantaggio della deterrence è che si può usare anche contro i propri utenti per evitare che, nonostante gli avvisi e la formazione ricevuta, continuino a cliccare su link in email di phishing o a rivelare le password al telefono.

Le strategie di tipo disruption prevedono invece ritorsioni informatiche contro le infrastrutture di command and control da cui provengono gli attacchi. Ciò avrebbe l’indubbio risultato di rallentare l’attività di questi gruppi ma come dice la pubblicità di Hydra, un darkweb marketplace, tagliata una testa all’idra ne ricrescono almeno altre due. Il rischio del sorgere di altre teste è dovuto ai modelli di business basati sostanzialmente su ransomware as a service. In questo modello, pochi gruppi producono il malware che implementa l’attacco e poi lo rivendono a molti gruppi che implementano l’attacco in cambio di parte dei profitti. Ciò diminuisce l’efficacia di attacchi contro i gruppi che eseguono gli attacchi mentre sarebbe opportuno concentrarsi sulle origini della supply chain ovvero quei, pochi, gruppi che forniscono il malware che gli attaccanti utilizzano.

I veri punti critici delle strategie d&d sono i tempi che richiedono e la volontà internazionale di arrivare a trattati che permettano di perseguire questi reati informatici anche in altri stati. E’ lecito dubitare della disponibilità di alcuni stati in particolare a fornire quelle informazioni che possono facilitare l’attribuzione degli attacchi. Sappiamo che la condivisione di alcune delle informazioni utili fornisce anche indicazioni sulle capacità informatiche di chi condivide le informazioni e sulla sua presenza e persistenza in reti avversarie. Una volta ammesso che i tempi per le strategie di d&d sono non banali, sparisce anche quello che molti invocano come il loro principale vantaggio rispetto a strategie r&r ovvero i tempi ridotti di applicazione.

La deduzione più importante permessa dal fatto che si punti unicamente su strategie d&d è che l’unica difesa contro il ransomware è quella che impedisce l’esecuzione di attacchi di questo tipo vista l’incapacità di prevederli e sconfiggerli se e quando vengono eseguiti. In pratica, invocare strategie di d&d o equiparare il ransomware al terrorismo equivale all’ammissione di un pesante fallimento nel modo in cui la tecnologia ICT è stata progettata, sviluppata ed utilizzata. E’ interessante che per molti il focus siano le strategie migliori di d&d e non il fallimento nell’uso della tecnologia esse ammettono.

Ransomware: cosa stiamo facendo?

L’ammissione del fallimento della tecnologia ICT è l’ultimo frutto di un modello di adozione delle tecnologie ICT utilizzato fino ad ora ed, in particolare, della strategia di difesa utilizzata. Questa strategia di difesa è sostanzialmente passiva perchè è basata non sulla prevenzione dell’attacco aumentando la resilienza del sistema ma sulla scoperta e gestione a posteriori degli attacchi informatici. Vi sono molte conferme della popolarità della strategia passiva. Si consideri ad esempio l’adozione di tecnologie di IA per la scoperta di anomalie nel comportamento degli utenti o dei componenti in seguito ad un attacco. Soluzioni di questo tipo sono molto più popolari di altre che l’IA permetterebbe ad esempio l’automazione della scoperta di vulnerabilità o di percorsi di attacco in un sistema. Ed è quasi commovente, ma molto rivelatore, vedere l’entusiasmo di molti per avere finalmente un modo di scoprire se sono stati attaccati. Purtroppo, questo modo di utilizzare l’IA non li aiuta a capire cosa fare dopo la scoperta dell’attacco per evitare la fatica di Sisifo di scacciare un attaccante per essere attaccati da un altro, o dallo stesso se è persistente.

L’amore per la strategia passiva è difficile da capire perchè, fortunatamente, sono state definite molte soluzioni r&r di tipo proattivo che vanno dall’applicazione rigorosa del privilegio minimo, la segmentazione delle reti in modo da applicare la defence -in-depth. A fianco di queste soluzioni, ben note da anni, ne sono state sviluppate altre fondate, ad esempio, sulla adversary emulation per capire le strategie ed i comportamenti degli attaccanti e per valutare e migliorare la robustezza dei sistemi tenendo conto di questi comportamenti. La possibilità di integrare queste tecniche con informazioni di threat intelligence permette di anticipare in modo accurato i comportamenti degli attaccanti e di riconoscere e predisporre le difese opportune.

La disponibilità di strategie r&r ha portato ad alcuni importanti ripensamenti. Ad esempio, l’esecutivo USA ha annunciato la creazione di un Cyber Safety Review Board (CSRB) nel Department of Homeland Security per investigare gli incidenti ed anche le vulnerabilità che li hanno permessi, i controlli che si possono applicare e simili. Il board dovrà soprattutto investigare gli incidenti per fornire raccomandazioni su come difendersi ed impedirli. Lo scopo finale dovrebbe essere quello di analizzare i sistemi per rimediare alle loro vulnerabilità e debolezze. Ottima notizia ma, come evidenziato da S.Bellovin e A.Shostak, l’importante è eseguire una analisi approfondita degli incidenti usando ad esempio la metodologia dei “5 perchè” in sequenza in modo da scoprire la root cause dei problemi incontrati. L’analisi deve ovviamente evitare facili risposte, estremamente generiche e quindi utilizzabili per un qualsiasi evento di sicurezza, quali “Tutto dipende dalla stupidità degli utenti” oppure “Tutto dipende dalla incredibile abilità degli attaccanti”. Se è vero che molto spesso i comportamenti degli utenti offrono un contributo fondamentale del successo degli attaccanti, altrettanto vero è che un sistema messo in crisi dai comportamenti degli utenti è strutturalmente debole perchè non è stato progettato per compensare questi comportamenti degli utenti, noti da tempo. Quasi tutte le strategie r&r citate in precedenza possono essere usate per compensare, ad esempio, i comportamenti degli utenti. La soluzione che viene cosi costruita è molto più robusta di quella permessa della semplice educazione degli utenti. Soluzione nota ma poco efficace se già circa 20 anni M.Ranum ci aveva avvertito che educare gli utenti non è una idea intelligente. Ci aveva anche detto che basare la sicurezza su una strategia “patch all” non aveva mai funzionato e non funzionerà mai. Oggi dopo un po di anni possiamo verificare quanto le profezie fossero accurate. Per quanto riguarda la risposta “Tutto dipende dalla incredibile abilità degli attaccanti” basterà ricordare la password solarwind1234, oppure il componente vpn che nessuno sapeva fosse attivo ed utilizzato per l’attacco a Colonial ed anche la scelta di JBS, il fornitore di carne bloccato per due settimane, che non riteneva la sicurezza informatica una priorità aziendale.

Nel pensare una strategia contro gli attacchi ransomware è bene evitare gli errori generati da un approccio passivo e basato su penetrate and patch e non inventare strategie per il ranking delle vulnerabilità indipendenti dal sistema ed metodi qualitativi per la gestione del rischio. Le strategie per il ranking indipendenti dal sistema si sono già rivelate non efficaci o poco economiche. Forse molto dipende dal fatto che molti dei metodi qualitativi per l’analisi del rischio su cui si basano sono inconsistenti. E’ anche opportuno non limitarci a delle best practices per i sistemi più critici perchè le vicende di Solarwinds ci hanno fatto toccare con mano come mettere in sicurezza un sistema critico sia difficile se i fornitori dei componenti del sistema non ci offrono qualche garanzia sullo sviluppo dei loro componenti. Infine, decidiamo una volta per tutte che “meglio fare qualcosa che nulla” non è vero. Ci sono delle strategie che dovrebbero aumentare la sicurezza ma che invece danneggiano i sistemi riducendone la già scarsa sicurezza: Ad esempio, non sempre l’acquisto di un nuovo componente aiuta ad aumentare la sicurezza. L’unica cosa che il nuovo componente aumenta sicuramente è la superficie d’attacco. Di contro, l’hardening di un sistema garantisce comunque di non aumentare tale superficie.

Risolvere tutti i vari problemi descritti è indubbiamente complicato e challenging ma la buona notizia è che molte delle tecnologie r&r descritte hanno ottime prestazioni e possono essere applicate. Di conseguenza, è fondamentale smettere di pensare che la soluzione ottima sia quella di mettersi in un framework d&d ed attaccare coloro che sfruttano le nostre debolezze invece che rimediare alle debolezze setesse. Indubbiamente, molti non saranno convinti di quanto ho detto e preferiranno continuare a sperare che le forze di polizia riescano, come è appena accaduto, a recuperare alcuni dei riscatti pagati. Focalizzarsi unicamente sul riscatto, le modalità di pagamento et simili trascura che il problema di interesse non è ridurre gli esborsi economici ma di come una tecnologia è stata e viene utilizzata. Invito chi non è ancora convinto della inutilità di d&d e di approcci post hoc a rileggere il già citato contributo di M.Ranum che evidenzia quanta poca strada sia stata fatta da quando è stato scritto e quanto tempo abbiamo perso, e stiamo perdendo, applicando strategie come Hacking is cool, Action is better than inaction o Penetrate and patch. Queste strategie non sono mai state efficaci e continueranno a non esserlo.

Riferimenti

  1. ChainAnalysis, The 2021 Crypto Crime Report, February 2021
  2. Bellovin, A.Shostack, Finally! A Cybersecurity Safety Review Board, Lawfare, June 2021, https://www.lawfareblog.com/finally-cybersecurity-safety-review-board
  3. Dempsey, Regulatory Alchemy: Turning Cybersecurity Guidelines Into Rules, Lawfare, June 2021, https://www.lawfareblog.com/regulatory-alchemy-turning-cybersecurity-guidelines-rules
  4. Crowdstrike blog, Under Attack: Protecting Against Conti, DarkSide, REvil and Other Ransomware, https://www.crowdstrike.com/blog/how-to-defend-against-conti-darkside-revil-and-other-ransomware/
  5. Jenkins, M.Olney, Intelligence-driven disruption of ransomware campaigns, https://blog.talosintelligence.com/2021/06/intelligence-driven-disruption.html
  6. Ranum, The Six Dumbiest Ideas in Computer Security, http://www.ranum.com/security/computer_security/editorials/dumb/, 2005

Articolo a cura di Fabrizio Baiardi

Laureato in Scienze dell’Informazione all’Università di Pisa.

E’ attualmente è professore ordinario di Informatica presso l’Università di Pisa dove coordina il gruppo di ricerca sy ICT risk assessment and management. La sua attività di ricerca è focalizzata su strumenti e metodi formali l’automazione dell’analisi e la gestione del rischio.

Ha partecipato a numerosi assessment di sistemi ICT con particolare interesse per quelli con componenti SCADA.

Attualmente è responsabile scientifico del progetto Haruspex che ha prodotto una suite integrata di strumenti per analisi e gestione del rischio.

Una lista aggiornata delle pubblicazioni scientifiche sul progetto Haruspex e dei premi ricevuti si può trovare alla pagina http://www.di.unipi.it/~tonelli/securityteam/publications.php

F. Baiardi è stato presidente della laurea in Informatica Applicata e della laurea magistrale in Sicurezza Informatica dell’Università di Pisa.

E’ stato coinvolto in vari progetti nazionali ed europei sulla valutazione della qualità dei corsi di studio e di formazione superiore. Inoltre è valutatore di progetti di innovazione tecnologica per enti pubblici e fondazioni private nazionali ed europei.

https://www.ictsecuritymagazine.com/articoli/ransomware-che-fare/


Zero Trust per tutti, Mainframe incluso

Abstract:

La sicurezza moderna impone scelte architetturali che possano reggere agli attacchi più persistenti e sofisticati. Zero-Trust è diventata la parola d’ordine soprattutto quando si opera su sistemi aperti ed eterogenei dove i confini operativi diventano sempre meno nitidi mettendo a dura prova i reparti di sicurezza sia logica che fisica di ogni infrastruttura IT. Una parola d’ordine che si trasforma in una strategia che deve essere applicata in ogni contesto, incluso quei mondi tradizionali dove il mainframe agisce da cuore pulsante per il proprio business

E Cloud fù!

Già, pare proprio che tutto il mondo digitale guardi con un certo interesse alle continue evoluzioni in quest’area. E pensare che l’idea del cloud risale a quando il mainframe IBM ha cominciato a fare la voce grossa sul mercato dell’Information Technology. Parliamo degli anni ’60 quando l’informatico statunitense John McCarthy introdusse il concetto di “utilità pubblica” dell’IT, primo vero embrione del cloud. La stessa IBM in quegli anni (nel 1964 circa) sfornava il suo scintillante System/360 che dava il via ad un percorso importante per tutte quelle aziende che si attrezzavano di informatica, fino ad arrivare al giorno d’oggi dove il mainframe è diventato System Z e continua a viaggiare a “testa alta” in mezzo alle “nuvole”.

Ricordo come gli uffici aziendali traboccavano di terminali 3270 con cui si instaurava un rapporto di fiducia, come fossero veri e propri compagni della giornata lavorativa. Ora non è più così. Il mondo è cambiato ma nonostante tutto il mainframe è ancora lì al centro di molte realtà aziendali. Non a caso le più importanti aziende mondiali custodiscono i loro dati su questa piattaforma che conferisce i più alti livelli di sicurezza, affidabilità e resilienza ancor oggi ineguagliati. Ma anche il vecchio e caro mainframe ha dovuto cambiare, ha dovuto modernizzarsi riposizionandosi sul mercato e cercando di ricoprire ancora il ruolo di attore principale per quel nuovo mondo definito come Hybrid-Cloud.

Un nuovo mondo dove gli utenti accedono al mainframe tramite laptop, tablet o via smartphone. Si accede spesso da remoto, con connessioni private (VPN) oppure utilizzando direttamente delle API (Application Program Interface) veicolo fondamentale per ogni architettura Hybrid-Cloud. Basta fare l’esempio del gateway IBM z/OS Connect, che indirizza buona parte della trasformazione digitale in ottica Hybrid-Cloud.

E per quanto riguarda la sicurezza?

Generalmente l’immagine fossilizzata negli occhi di molti riporta al concetto del castello accerchiato da mura invalicabili. Il mainframe era posizionato lì, costituiva il centro del castello, dove le aziende custodivano e proteggevano tutte le loro preziose risorse. Un castello fondato su un disegno progettuale che ancora oggi regge agli urti tecnologici, adeguandosi e modellandosi alla continua trasformazione a cui tutti noi siamo sottoposti.

Ma fuori dalle mura del castello vi erano numerose richieste di accesso per poter usufruire dei servizi messi a disposizione dalla piattaforma. I flussi in ingresso venivano regolamentati con protocolli di comunicazione, inizialmente proprietari (SNA) per poi aprirsi al tcp/ip, che conferivano certezza e sicurezza in quanto consentivano di identificare e verificare la presenza di malintenzionati che cercavano di entrare nel castello, mentre in fase di uscita occorreva controllare che nessun oggetto prezioso fosse sottratto dal castello. Tutto questo aveva certamente un senso dal momento che si riteneva che “i cattivi” si trovassero solo all’esterno.

Nel mentre, però, il mondo cambiava e tutto ciò evidenziava forti limitazioni soprattutto per ciò che riguarda la fruibilità della merce più preziosa: il dato. La necessità di superare questa limitazione ha fatto si che i muri fossero abbattuti, o perlomeno abbassati, e che i confini diventassero sempre meno definiti e gradualmente sostituiti dal concetto di perimetro in cui però le minacce diventavano sempre più numerose rispetto al passato.

Basta guardare oggi nel Dark Web dove è presente un volume impressionante di dati personali di cui, la maggior parte, è stata sottratta proprio dall’interno di questo perimetro. E subito viene in mente uno dei pericoli più temuti, l’attacco ransomware che ha l’obiettivo di esfiltrare i dati, corrompendo i loro backup e poi crittografandoli per richiederne riscatto. Ma anche il phishing continua a fare la sua parte. Le aziende sono ben consapevoli che il personale, indipendentemente dalla formazione ricevuta, possa fare click su link sospetti oppure inserire dati personali in “forms” inopportuni.

Questo per dire come, all’interno del perimetro o delle vecchia mura del castello, esista il pericolo costituito dal personale a volte deluso e scontento, a volte non considerato e che potrebbe sottrarre o corrompere dati importanti. A volte succede per errore o per negligenza, come il caso in cui si pensa di avere diritto a una copia dei dati di cui si è stati artefici della creazione. Sembrerebbe naturale chiedersi che cosa ci sia di sbagliato se quei dati dovessero risultare utili per un prossimo impiego. Se vogliamo, è un pò come portarsi con sè il proprio portfolio di clienti affezionati quando si cambia azienda di lavoro.

Ma accanto a questi casi si verificano sempre più forme intenzionali di sottrazione di dati. Indice che le mura del castello o che il perimetro disegnato non risulta più efficiente o perlomeno non è più significativo, in quanto quasi la metà dei cattivi, si trova già al suo interno.  E’ infatti abbastanza comune, navigando in internet, imbattersi in tabelle e grafici che mostrano studi di “Cost of a Data Breach” dove si rileva che circa il 52% delle violazioni è originato dall’esterno, ma il 48% è perpetrato dall’interno!

In che modo ? Il metodo più efficace di tutti risulta sempre l’attacco alle identità. Ad esempio, ancora oggi in molte aziende si fa uso della semplice autenticazione basata sulla sola password, e carpire una password con le tecnologie odierne non è più così difficile come lo poteva essere negli anni passati. Quindi, riassumendo, abbiamo personale con ruoli di fiducia che risulta demotivato, scontento e che lavora anche da remoto utilizzando diversi dispositivi per l’accesso ai dati. Ora, in queste condizioni, c’è realmente da fidarsi ? La risposta la danno i massimi esperti del settore: no, non bisogna fidarsi di nessuno,

Zero-Trust

Secondo Gartner, non dobbiamo fidarci di nessuno che tenti di accedere ai sistemi e ai dati, né di alcun dispositivo che può essere utilizzato per il loro accesso, né di alcuna applicazione. Sono le basi per un’architettura “Zero Trust”.

Come reazione assistiamo ad una corsa affannosa verso la crittografia dei dati, memorizzati su supporti fisici (At-Rest), oltre a tutti i dati inviati sulla rete (In-Fly) che devono essere crittografati per fermare possibili attacchi come il famoso Man-in-the-Middle.

Secondo l’architettura “Zero-Trust”, le persone devono eseguire sempre la propria autenticazione per superare i controlli di accesso, con una valutazione continua della fiducia, che si basa su chi sei, dove sei e cosa stai facendo e con l’eventuale identificazione di ogni anomalia comportamentale. Fino ad arrivare ai controlli adattivi, cioè quei controlli sensibili al contesto in cui si agisce, in modo da tarare il livello di fiducia contro ogni possibile rischio.

Il NIST (National Institute of Standards and Technology), fornisce l’indicazione di come l’accesso adattivo risulti una forma di controllo caratterizzata da una politica di autorizzazione che tiene conto delle necessità operative, del rischio e dell’euristica.

Ed è sempre il NIST che traccia le linee guida per una “Zero Trust Architecture”. La sua pubblicazione documenta la storia di Zero Trust, le sue basi, i componenti logici e gli scenari di implementazione con casi utente.

Seguendo questa strategia la tecnologia interviene in aiuto fornendo l’autenticazione a più fattori (MFA), soluzione subito adottata da diverse organizzazioni ed aziende per l’accesso sicuro ai sistemi, dispositivi e dati presenti sulle piattaforme più comuni.

Già, ma al buon vecchio mainframe non ci pensa più nessuno ?

Con una imponente gestione di dati memorizzati e così tante transazioni in esecuzione su di esso al minuto, per non pensare alle sue integrazioni con dispositivi mobili ed interazioni con i mondi cloud, è lecito chiedersi se abbia senso adoperarsi per renderlo davvero il più sicuro possibile, oppure no.

Magari ingenuamente pensiamo che attuando la MFA a livello perimetrale o dipartimentale risulti sufficiente per assicurare l’accesso ai dati che risiedono sul mainframe. E tutto ciò che abbiamo detto sugli attacchi interni ? Forse vale la pena riconsiderare la situazione. Ancora oggi sono molte le aziende che non considerano l’attuazione della multi-factor-authentication sui sistemi mainframe, spesso “core” del loro business, eppure zMFA esiste da tempo e funziona egregiamente proprio secondo la logica “Zero-Trust”.

Una logica pronta per essere applicata nell’architettura del mainframe che risulta già ben posizionato secondo i più noti modelli di accesso RBAC (Role Based Access Control)  e MAC (Mandatory Access Control). Ora, con Zero-Trust, è possibile fare in modo che gli utenti autorizzati possano accedere ad una risorsa o applicazione mediante i privilegi sufficienti per svolgere il proprio lavoro, niente di più.  Tutto ciò deve avvenire senza alcun rischio che le persone abbiano un livello di privilegio troppo elevato vista anche la possibilità di essere associati a diversi ruoli operativi.

Allora si che risulterebbe possibile rendere la vita difficile ad ogni hacker di questo tempo. Occorre una scelta forte e decisa come “Zero Trust”, scelta da considerare seriamente se si vuol rendere il nostro castello, il mainframe, ancora il posto più sicuro per i propri dati.

Articolo a cura di Luigi Perrone

https://www.ictsecuritymagazine.com/articoli/zero-trust-per-tutti-mainframe-incluso/


Cybersecurity per la Blockchain e la Blockchain per la cybersecurity (2/3)

Introduzione

La Blockchain è particolarmente attraente per gli attaccanti perché le transazioni fraudolente non possono essere annullate come spesso possono essere nel sistema finanziario tradizionale. Oltre a ciò, sappiamo da tempo che proprio come la Blockchain ha caratteristiche di sicurezza uniche, ha anche vulnerabilità uniche.

La Blockchain non è mai stata hackerata?

Iniziamo a ragionare su quale tipo di minaccia dovrebbe preoccuparci. Analizziamone alcune:

  • Indisponibilità del servizio
    • Che renderebbe inutilizzabili i servizi basati su Blockchain
  • Indisponibilità di internet
    • Ad esempio, se un’applicazione su Blockchain lancia un attacco DDoS
  • Controllo fraudolento della Blockchain
    • Furto dei wallet digitali

Attacco Sybil

Un attacco Sybil è un tentativo di controllare una rete peer creando più identità false, in cui una persona cerca di assumere il controllo del network creando diversi account, nodi o computer.

Agli osservatori esterni, queste identità false sembrano essere utenti unici. Tuttavia, dietro le quinte, una singola entità controlla molte identità contemporaneamente. Di conseguenza, quell’entità può influenzare la rete attraverso un potere di voto aggiuntivo in una rete democratica o tramite messaggi echo chamber in un social network.

Molto simile a quello che “potrebbe” accadere in occasione di elezioni con i social network. Account e bot falsi non hanno hackerato Facebook o Twitter, ma hanno comunque utilizzato più identità per influenzare l’intera rete. Poiché gli attacchi Sybil sono così sovversivi e facili da nascondere, può essere difficile capire quando una singola entità controlla molti account. In effetti, Facebook non può rendersi conto dell’estensione degli account falsi sulla sua piattaforma fino a quando le indagini interne non iniziano mesi dopo che gran parte del danno è già stato fatto.

Naturalmente, questa è pura teoria, riferita alle elezioni.

Prevenzione

Le Blockchain e le reti peer in generale hanno varie opzioni quando si tratta di prevenire gli attacchi Sybil. Ogni opzione ha i suoi vantaggi e svantaggi. Gli approcci ibridi alla prevenzione Sybil, che incorporano ciascuno dei tre elementi chiave (costo per creare un’identità, catena di fiducia e reputazione ineguale), sono i più comuni per affrontare i problemi.

Costo per creare un’identità

Il primo modo per mitigare un attacco Sybil è aumentare il costo della creazione di una nuova identità. La sfida qui, tuttavia, è che ci sono molte ragioni legittime per cui si potrebbe voler utilizzare più identità. Ridondanza, condivisione delle risorse, affidabilità e anonimato sono tutti buoni motivi per creare identità multiple su una rete peer.

Rimani informato

Il costo ideale della creazione dell’identità non dovrebbe impedire alle persone di unirsi alla rete o persino di creare una manciata di identità. Invece, dovrebbe essere appena sufficiente per rendere irrealizzabile la creazione di molte identità in un breve periodo di tempo.

Le Blockchain utilizzano il costo di creazione come funzione di protezione Sybil attraverso il mining. Negli algoritmi di proof of work, per creare una nuova identità sulla rete di mining, è necessario dotarsi di un altro computer con potenza di elaborazione per contribuire. Questi attacchi rappresentano un costo significativo per l’aggiunta di centinaia o migliaia di nodi pseudonimi che potrebbero essere in grado di influenzare l’adozione di un fork o di un altro voto blockchain.

Lo stesso vale per la prova della posta in gioco, in cui la potenza di calcolo d’acquisto è sostituita dalla posta in gioco. C’è un costo per entrare a far parte della rete e votare. Questo requisito di risorse limita il numero di account che un cattivo attore può creare.

Catena di fiducia (Chain of Trust)

Un secondo modo per combattere gli attacchi Sybil è richiedere un certo tipo di fiducia prima di consentire a una nuova identità di unirsi alla rete. Questo di solito assume la forma di un sistema di reputazione, in cui solo utenti consolidati a lungo termine possono invitare o concedere nuovi ingressi alla rete. Altre variazioni si basano su un sistema di prova in cui sono possibili nuovi account, ma devono rimanere attivi e unici per un certo periodo prima di ricevere i privilegi di voto.

La catena di fiducia si estende anche alla vera e propria verifica dell’identità. Alcune reti peer richiedono di inviare l’identificazione prima di aderire. Altri consentono di rispondere a un codice di sicurezza autenticato a due fattori. Altri ancora limitano la creazione di account in base all’indirizzo IP.

Tutti questi richiedono un certo livello di verifica dell’identità o creazione di fiducia prima che un account riceva privilegi di voto, rendendo più difficile la creazione di pseudonimi.

Reputazione ineguale

L’ultimo modo per mitigare la minaccia degli attacchi Sybil è ponderare il potere degli utenti in base alla reputazione. Gli utenti che sono stati attivi da più tempo e si sono dimostrati esperti ricevono più potere di voto sulle decisioni comuni. Questo rende il sistema meritocratico e abbassa il potere dei nuovi utenti. Di conseguenza, molti account nuovi o meno attivi non garantiscono alcun vantaggio a un utente malintenzionato Sybil contro account più vecchi e più attivi e quindi affidabili.

Attacco di routing

Un attacco di routing è un attacco reso possibile dalla compromissione o dalla cooperazione di un provider di servizi Internet (ISP). Sebbene sia tecnicamente possibile eseguire nodi in qualsiasi parte del mondo, la realtà attuale è che i nodi sono relativamente centralizzati.

Ad esempio, secondo una ricerca condotta da ETHZurich, 13 provider di servizi Internet ospitano il 30% della rete Bitcoin. Questo è un grave punto di vulnerabilità se un provider di servizi Internet può essere compromesso o danneggiato.

Un attacco di routing funziona intercettando il traffico Internet inviato tra sistemi autonomi. In CyberSecurity esistono diverse tecniche utilizzate come attacchi di reindirizzamento.

Utilizzando questo metodo, una rete di criptovaluta potrebbe essere partizionata in due o più reti separate, esponendo entrambi i lati della partizione ad attacchi a double-spending perché non possono comunicare con l’intera rete per convalidare le transazioni. Una volta che le monete sono state spese su un lato della rete ricevendo in cambio beni o servizi, la partizione potrebbe essere rimossa e il lato della rete con la catena più corta sarebbe rifiutato dalla rete nel suo insieme e quelle transazioni sarebbero cancellate.

Per quanto ne sappiamo, questo tipo di attacco non si è verificato e ci sono misure difensive che possono essere attuate per rendere le monete immuni a questo comportamento.

DDoS (Distributed Denial of Service)

DDoS è un tentativo di attacco che può essere eseguito inondando un server con elevati volumi di traffico. Questo è uno degli attacchi più comuni visti in natura.

Nel caso di un sito web, un attacco DDoS è rappresentato da un enorme volume di richieste al server che vengono inviate continuamente per un periodo di tempo, impedendo alle richieste legittime di ricevere le risorse di cui hanno bisogno. Nel caso di un nodo Bitcoin, sembra che vengano inviati enormi volumi in transazioni piccole o non valide nel tentativo di inondare la rete e impedire l’elaborazione di transazioni legittime.

Le principali reti come Bitcoin sono costantemente sotto attacco da tentativi DDoS, ma le decisioni di progettazione prese nello sviluppo della rete Bitcoin agiscono per mitigare il rischio di attacchi DDoS. Nel caso in cui l’attacco sia riuscito, non vi è alcuna minaccia di furto di fondi o compromissione della sicurezza, ma semplicemente un’interruzione dell’attività di rete.

Bitcoin Backlog Blues

Prevede l’invio di migliaia di transazioni sulla rete, il risultato è che il servizio diventa non disponibile.

Infatti, è stato effettuato uno “stress test” in cui l’aumento incrementale del numero di transazioni verificate, approvate e archiviate ha dimostrato la semplicità di un attacco di spam su larga scala alla rete.

51%

Un attacco del 51% si verifica quando una persona o un gruppo controlla il 51% della potenza di calcolo della rete.

La sicurezza di una Blockchain è direttamente collegata alla potenza del computer che costruisce la catena, e, infatti, è possibile che un aggressore ottenga il controllo sulla maggior parte della potenza hash presente sulla rete. Ciò consentirebbe all’attaccante di minare blocchi più velocemente rispetto al resto della rete combinato, aprendo la porta a “double-spending”.

Double-spending è un metodo per frodare una criptovaluta che comporta l’invio di transazioni alla catena, la ricezione del bene o del servizio per cui la transazione paga e, in seguito, l’utilizzo della maggior parte degli hashpower per eseguire il fork della Blockchain in un punto precedente alla transazione. Ciò cancella in pratica tale transazione dalla cronologia della catena, consentendo all’attaccante di effettuare transazioni con quelle stesse monete una seconda volta. Certo, riferito alle transazioni, ma valido in generale.

Ottenere la maggior parte dell’hashpower non consentirebbe a un utente malintenzionato di creare monete. L’effetto più grande di un tale attacco potrebbe essere la perdita di fiducia nella rete che viene attaccata e un conseguente effetto sul prezzo delle risorse di qualsiasi token sulla rete.

Conclusione

Nessun sistema è perfetto. Conoscere la natura fallibile dei framework tecnologici può fornire agli utenti la possibilità di individuare gli errori ed essere vigili.

Articolo a cura di Rosita Galiandro

Rosita Galiandro

Rosita Galiandro ha conseguito la laurea Magistrale in Sicurezza Informatica presso l’Università di Bari.

Attualmente ricopre il ruolo di Responsabile Osservatorio CyberSecurity presso Exprivia.

Contribuisce alle attività di prevendita, ha partecipato a progetti di risk assessment e GDPR compliance e collabora in piani di insegnamento con diverse università nell’ambito CyberSecurity e nel progetto CyberChallenge.IT. Fa parte della community Women For Security.

https://www.ictsecuritymagazine.com/articoli/cybersecurity-per-la-blockchain-e-la-blockchain-per-la-cybersecurity-2-3/