Evoluzione e confusione nella famiglia delle norme ISO/IEC 27xxx

L’evoluzione delle normative ISO è sempre in fermento e il ciclo di revisione delle varie norme prosegue sempre coi vari tavoli tecnici.

È notizia delle ultime settimane la prossima uscita della nuova ISO/IEC 27002 entro la fine dell’anno o a inizio 2022 (ad oggi in versione DIS già disponibile sullo store di iso.org[1]).

Questa notizia ha provocato in molte aziende preoccupazione e soprattutto tanta confusione. La ISO/IEC 27002 è infatti la “Code of practice for information security controls” che fornisce una linea guida sulle modalità di applicazione dei controlli presenti all’interno dell’allegato A dello standard ISO/IEC 27001. Proprio questo forte legame tra le due norme sta generando confusione generale. È allo studio del gruppo ISO/IEC pertinente (l’ISO/IEC JTC 1 SC 27 WG 1) un aggiornamento “parziale” della ISO/IEC 27001 per adeguare i controlli dell’Annex A con quanto previsto dalla nuova ISO/IEC 27002. Si tratterebbe di un “amendment” e quindi non verrà nemmeno cambiato l’anno di riferimento dalla normativa mantenendo l’attuale 2013. Questo aspetto, insieme ad altri che vedremo in seguito, lascia piuttosto perplessi, in quanto l’anno di una norma è la sua caratterizzazione univoca, una sorta di “cognome” della norma. Per cui se quanto ad oggi solo previsto si concretizzasse avremmo la stessa versione della norma ma con due allegati A diversi… da lì ci sarà da chiedersi…quale usare? Sicuramente usciranno circolari e altre linee guida puntuali, ma per i non addetti ai lavori la confusione sarà certa (considerando che nel 2017 in una esperienza di audit mi sono ritrovato una organizzazione che usava la versione 2005 ormai ritirata da 2 anni con 2 norme dallo stesso nome con parte dei contenuti diversi ci sarà sicuramente da ridere).

Ma è davvero necessario questo cambiamento “parziale” e sono stati valutati realmente bene tutti i risvolti che tale cambiamento avrebbe all’interno delle aziende?

La questione relativa ai controlli dell’Annex A è sempre spinosa e nella maggior parte dei casi si perde il senso dello stesso così come previsto all’interno della norma ISO/IEC 27001. Proviamo quindi a fare un’analisi puntuale dei requisiti richiesti dallo standard ISO/IEC 27001. Il classico approccio “errato” nell’istaurazione di un Sistema di Gestione per la Sicurezza delle Informazioni visto in tanti anni di consulenza e audit è quello di partire analizzando i 114 controlli non tenendo conto che tali controlli dovrebbero essere “solo” un aiuto per le organizzazioni in fase di creazione del piano di trattamento del rischio “cfr ISO/IEC 27001 – 6.1.3.c confrontare i controlli determinati per attuare le opzioni selezionate per il trattamento del rischio relativo alla sicurezza delle informazioni per  con quelli nell’Allegato A e verificare che non siano stati omessi controlli necessari”.  Inoltre la nota 2 ci dice che “La lista di obiettivi di controllo e di controlli riportati nell’Allegato A non è esaustiva, e ulteriori obiettivi di controllo e controlli potrebbero essere necessari.” Proprio questa nota mi rende estremamente dubbioso sulla necessità / opportunità di fare un aggiornamento “parziale” dello standard ISO/IEC 27001.

Proprio analizzando quanto presente all’interno della nota viene da chiedersi. Ma è davvero così necessario aggiornare la ISO/IEC 27001?

Se le due norme non fossero all’interno di un ecosistema molto più complesso e vasto la risposta sarebbe sicuramente SI. L’aggiornamento rientrerebbe nel normale ciclo di vita e sarebbe solo opinabile l’anno di revisione della norma per quanto detto prima.

Purtroppo però le implicazioni nella modifica di quanto previsto dall’Annex A della ISO/IEC 27001 ha dei risvolti estremamente più ampi a causa del “proliferare” delle linee guida 27xxx che nel corso degli ultimi anni hanno avuto un’esplosione piuttosto pesante. Basti pensare ad esempio che i Cloud Service Provider hanno dovuto adeguarsi estendendo la loro certificazione anche alle norme ISO/IEC 27017 e ISO/IEC 27018[2] o che alcune organizzazioni hanno iniziato/completato un percorso ci conformità allo standard ISO/IEC 27701:2019 che estende i requisiti della 27001 per l’implementazione di un sistema di gestione per la sicurezza dei dati personali.

Il problema delle 27017, 27018 e di molte altre norme che contengono linee guida, come ad esempio la 27019 specifica per le energy industry, è che lo schema base è costruito sulla struttura dell’allegato A della ISO/IEC 27001 (mente la 27701 riprende nel capitolo 6 tutti i controlli estendendoli alle informazioni personali). Essendo ormai la maggior parte delle norme utilizzabili per l’estensione del certificato ISO/IEC 27001[3] questo potenziale disallineamento porterebbe ulteriore confusione.

Va detto che il ISO/IEC JTC 1 SC 27 WG 1 ha pianificato un aggiornamento anche di alcune di queste norme, le varie tabelle di correlazione potranno aiutare gli utilizzatori e che, comunque, le difficoltà ci saranno ad ogni cambiamento della ISO/IEC 27001: avremo sempre un momento di disallineamento tra la norma “madre” – la ISO/IEC 27001 – e le sue estensioni (con le implicazioni del caso relative a mantenimento delle certificazioni e audit periodici).

Va comunque osservato che i controlli estesi sono di due tipi:

  • quelli già previsti dalla 27002, ma per i quali è ampliata la sola guida per l’implementazione (e non il “controllo”) e che pertanto non influenzano il SOA;
  • quelli aggiuntivi, che possono essere comunque aggiunti senza problemi in coda a quelli della ISO/IEC 27001, come già oggi succede.

Per ora non possiamo fare altre che plaudire alla prossima versione della ISO/IEC 27002 che rivoluzionerà in modo pesante la sua organizzazione sconvolgendo quello che è il modello attuale ed era stato il modello della versione precedente.

Infatti i 14 gruppi di controllo attualmente in essere andranno a sparire a favore di soli 4 gruppi:

  • Controlli organizzativi;
  • Controlli relativi alle persone;
  • Controlli di tipo fisico;
  • Controlli di tipo tecnologico.

Nella nuova norma saranno tolte alcune ridondanze e il numero di controlli passerà da 114 a 93 (e soprattutto sarà sostituito il tanto discusso tra auditor e consulenti “Teleworking” con il più attuale “Remote working” e si parlerà di “Information security during disruption” creando meno ambiguità e confusione con lo standard ISO 22301).

Tra qualche mese sicuramente avremo le idee più chiare e soprattutto certezze sulle nuove norme con l’auspicio che si tenga conto delle implicazioni che cambiamenti così significativi possono avere sulle organizzazioni che hanno in essere un Sistema di Gestione per la Sicurezza delle Informazioni.

Note

[1] https://www.iso.org/obp/ui/#iso:std:iso-iec:27002:dis:ed-3:v1:en

[2] https://www.agid.gov.it/sites/default/files/repository_files/guida_qualificazione_servizi_cloud_11pt_id2_0.pdf

[3] https://www.accredia.it/documento/circolare-tecnica-dc-n-02-2018-accreditamento-per-lo-schema-di-certificazione-iso-iec-270012013-con-integrazione-delle-linee-guida-iso-iec-270xx20yy/

Articolo a cura di Paolo Sferlazza

Socio fondatore di Gerico Security Srl lavora come advisor, auditor e trainer nel campo della sicurezza delle informazioni, continuità operativa, gestione dei servizi IT e sicurezza delle carte di pagamento.

Ha accompagnato primarie aziende e infrastrutture critiche italiane nell’ottenimento della certificazione ISO/IEC 27001, ISO 22301 e ISO/IEC 20000.

È un Qualified Security Assessor riconosciuto dal PCI Council per la certificazione dei sistemi di pagamento PCI DSS. Ha conseguito la certificazione CISA, CISM, CRISC di ISACA, ed è auditor qualificato e tiene docenze sugli schemi ISO/IEC 27001, ISO 22301, ISO/IEC 27001 e ISO 9001 ed è iscritto ai registri AICQ SICEV quale auditor sulla sicurezza delle informazioni e continuità operativa. Ha inoltre ottenuto altre certificazioni nel campo della sicurezza delle informazioni e dell’IT governance tra cui OPST, COBIT e ITIL. Ha progettato ed erogato docenze, anche in ambito militare, su tematiche di Information Risk Management, ITIL.  Ha effettuato audit interno, assessment e consulenza in merito all’accreditamento dei laboratori VA rispetto alla 17025. Si occupa si sicurezza delle informazioni nel mondo specifico dell’automotive in conformità con lo standard di settore TISAX ed è Responsabile Tecnico del primo organismo di Ispezione di CyberSecurity in conformità alla ISO/IEC 17020

Collabora con primari enti di certificazione come auditor di terza parte.

https://www.ictsecuritymagazine.com/articoli/evoluzione-e-confusione-nella-famiglia-delle-norme-iso-iec-27xxx/


Breve commento alla proposta di Regolamento UE sull’AI

La proposta di Regolamento da parte della UE sull’Intelligenza Artificiale del 21 aprile 2021, introduce in maniera molto forte i concetti di sistema e di governance.

Già dalle prime righe del documento si evince come l’argomento AI debba essere trattato in maniera trasversale e multi disciplinare.

Il sistema AI è quindi considerato attraverso un approccio olistico ed integrato.

Un approccio generale alla governance ed al suo controllo della AI ed ai rischi che questa comporta è già stato affrontato negli articoli: https://www.ictsecuritymagazine.com/articoli/modello-di-autovalutazione-relativo-a-un-sistema-di-intelligenza-artificiale/; https://www.ictsecuritymagazine.com/articoli/un-approccio-alla-governance-della-ai/; https://www.ictsecuritymagazine.com/articoli/ancora-sulla-governance-della-ai/ ai quali rimandiamo per completezza e correttezza.

In particolare si vuole evidenziare come i legislatori abbiano inteso la bozza di regolamento, ispirandosi probabilmente anche al GDPR, come documento relativo proprio ad un sistema di gestione.

In effetti, riportando solo alcuni degli 85 articoli presenti, l’art. 9 e l’art 17, che vengono anche richiamati negli allegati precisamente negli allegati VI e VII si introduce in maniera chiara il concetto di sistema e del suo controllo.

L’art. 9 pone il focus su un sistema di gestione dei rischi, in particolare riportando l’attenzione sugli incidenti (art- 62). Tale sistema di gestione richiama sia modelli che metodologie note, che contemplano il concetto di sistema, e che possono in qualche modo essere d’aiuto integrandosi con altri framework sono ad esempio: la ISO 31000, il CSF NIST e il NIST 800-53, la ISO 27005.

La gestione dei rischi diventa quindi una forzante per guidare il sistema AI, attraverso metodologie e prassi consolidate.

L’art. 12 richiama alcuni concetti fondamentali della ISO 27001 e del CSF NIST cioè la registrazione e la gestione degli eventi (log) che permettono il monitoraggio, la gestione del loro ciclo di vita dei rischi e la gestione della tracciabilità.

L’art. 15 tratta gli argomenti tipici della cybersecurity, della security by design comprese ad esempio: le metriche, la resilienza, la gestione dei back up.

L’art 17, invece richiama proprio il concetto di Sistema di Gestione della Qualità. In quest’ottica la norma ISO 9001 integrata con la norma ISO 27001, che rispettano entrambe la struttura HLS (Hight Level Structure) cioè la suddivisione nei capitoli: 4 Contesto, 5 Leadership, 6 Pianificazione, 7 supporto, 8 Attività Operative, 9 Monitoraggio e 10 Miglioramento (attraverso il concetto di Azioni Correttive dell’art. 21) , permettono il soddisfacimento dei requisiti elencati nell’art. 17, quali ad esempio: la redazione e diffusione delle Policy, delle procedure la realizzazione di test e di assessment, la gestione degli incidenti, la gestione delle risorse, la gestione della comunicazione, il ciclo di vita dei dati.

Non solo proprio collegandosi agli allegati, è fondamentale introdurre il concetto di controllo e misura (assessment) richiamato dalla norma ISO 19011 e dal controllo di conformità della ISO 37301 (artt. 19 e 43).

Un breve riassunto è riportato nella figura sottostante.

L’implementazione di standard internazionali riferiti a sistemi di gestione ed al loro monitoraggio e controllo integrati con una corretta analisi dei rischi ed altri requisiti (GDPR) permettono di gestire i progetti AI e la governance dei dati in maniera conforme e trasparente ed adeguata rispettando le regole e garantendone l’accountability.

Dunque i sistemi di AI ci hanno abituato alla possibilità di utilizzo nei più disparati ambiti e settori, evidenziando tanto le potenzialità, quanto le ricadute in termini di discriminazione, opacità, rischio, danno e responsabilità. In tal senso, la strategia europea (ma per molti versi estesa anche a livello mondiale) sta tentando di approcciare all’intricata materia tenendo in debito conto gli innumerevoli profili di esposizione, richiedendo – in primis – che tali sistemi presentino necessariamente sette requisiti fondamentali, quali: supervisione umana; robustezza tecnica e sicurezza; privacy, controllo e gestione dei dati; trasparenza; diversità, correttezza, assenza di discriminazione; benessere sociale e ambientale; responsabilità.

A ciò si somma la proposta di Regolamento che, prendendo le mosse dal GDPR, sembra presentarsi come un upgrade della normativa in tema di protezione dei dati personali, andando a richiamare alcuni concetti ormai consolidatisi (come le definizioni, il dovere di informativa, l’approccio risk based che fonda le radici nel principio di accountability, la documentazione dettagliata, i principi di sicurezza e accuratezza, il risk assessment, la DPIA, la notifica delle violazioni), ma introducendo anche profili di innovazione. Questi ultimi parrebbero maggiormente concentrati sulla tracciabilità dei risultati, sulla supervisione umana, sui concetti di fiducia ed eccellenza, sull’eliminazione dei bias (i dataset non potranno incorporare alcun pregiudizio intenzionale o non intenzionale), sull’individuazione dei sistemi cd. “ad alto rischio” (quelli ritenuti a rischio inaccettabile saranno vietati[1]) e sul concetto di robustezza.

Quest’ultimo profilo, a dirla tutta, desta non poche preoccupazioni poiché sembrerebbe non essere declinato a seconda della tipologia di AI e dell’ambito di applicazione, ma identificato come requisito imprescindibile di alto livello da rispettarsi tout court.

Anche in punto di sanzioni la Proposta si discosta leggermente dal GDPR, introducendo sanzioni maggiori con un tetto massimo di 30 milioni di € o del 6% del fatturato globale annuo.

Per la dimostrazione della compliance al Regolamento si è pensato, inoltre, ad una dichiarazione di conformità mediante marchio europeo di qualità dell’AI, rilasciato dall’Autorità competente designata dal singolo Stato membro.

Sul punto, vi è da specificare che le AI verranno classificate – in base alla “pericolosità” – in 4 gruppi: 1) a rischio inaccettabile; 2) ad alto rischio; 3) a rischio limitato; 4) a rischio minimo.

Per determinare l’appartenenza al 2° gruppo, sarà necessario che il sistema sia un prodotto, o sia destinato a essere utilizzato come componente di sicurezza di un prodotto, disciplinato dalla normativa di armonizzazione dell’Unione (Allegato II); e che il prodotto in questione sia sottoposto a una valutazione di conformità da parte di terzi.

Le AI ad alto rischio potranno comunque essere immesse sul mercato, ma solo ove presentino determinati requisiti, quali:

  • Istituzione di un sistema di gestione del rischio
  • data governance (formazione, validazione e test di dataset)
  • Documentazione tecnica
  • Registrazione degli eventi,
  • Trasparenza
  • Supervisione umana
  • Robustezza, precisione e sicurezza.

Appare, comunque, evidente come l’uso dell’intelligenza artificiale venga letto come foriero di vantaggi competitivi per le aziende, in ottica di raggiungimento di risultati sociali e ambientali vantaggiosi (Considerando 1), e pertanto la Proposta punta a definire standard di sicurezza, affidabilità, accuratezza e qualità condivisi in grado di gettare le basi per un “mercato” europeo di fiducia ed eccellenza dei sistemi di AI.

Note

[1] Ad esempio: AI che utilizzino tecniche subliminali che vanno oltre la coscienza di una persona, al fine di distorcerne materialmente il comportamento in un modo tale da causare o da rendere probabile causare a tale persona o ad un’altra persona un danno fisico o psicologico, oppure sistemi che sfruttino una qualsiasi delle vulnerabilità di un gruppo specifico di persone a causa della loro età, disabilità fisica o mentale.

Articolo a cura di Stefano Gorla e Anna Capoluongo

Stefano Gorla è nato a Milano, si è laureato in fisica nucleare presso l’Università di Padova. Ha insegnato per qualche anno Matematica e Fisica presso alcuni licei.

Da anni si occupa di privacy e sicurezza dei dati attraverso un approccio sistemico e olistico.
Consulente e formatore in ambito sicurezza e tutela dei dati e delle informazioni e relatore in numerosi convegni.

Auditor ISO 27001, DPO Certificato FAC Certifica, NIST Specialist Certificato Fac Certifica, Certificato COBIT5 ISACA, Master EQFM.
Ha maturato notevoli esperienze come Referente Privacy (DPO) e consulente in tali ambiti.
È autore di varie pubblicazioni sul tema.

Avvocato, esperta in Diritto delle Nuove Tecnologie, Privacy&Data Protection, Contrattualistica e Diritto civile. Partner presso lo Studio Capoluongo, DPO per Aziende in ambito sanitario, universitario e tecnologie dell’informatica, Docente a contratto Sigmund Freud University – campus di Milano e 24Ore Business School, Vicepresidente “Istituto di Ricerca per gli Studi Giuridici, Economici e Sociali”, si occupa prevalentemente di consulenza societaria sia nazionale che internazionale ed è specializzata in new tech law, privacy&data protection, videosorveglianza, contrattualistica e responsabilità medica.

https://www.ictsecuritymagazine.com/articoli/breve-commento-alla-proposta-di-regolamento-ue-sullai/


La disponibilità e la continuità dei servizi nell’amministrazione pubblica: un preciso impegno istituzionale nei confronti della collettività

L’emergenza sanitaria da Covid-19, tutt’ora in corso, ha evidenziato il ruolo chiave della pubblica amministrazione, anche ai fini della gestione dell’emergenza stessa. Questo contesto di profondo e repentino cambiamento ha ribadito e rafforzato l’importanza di poter fruire online dei servizi pubblici. Ne consegue un preciso impegno istituzionale, nel rispetto di normative e linee guida di settore, volto a garantire la disponibilità e la continuità dei servizi offerti.

Il confronto tra ambito privato e settore pubblico

Nell’ambito privato, in un mercato estremamente concorrenziale, l’esigenza di offrire servizi continui e tempestivi rappresenta, senza dubbio, un vantaggio competitivo. Infatti ad oggi, indipendentemente dalla qualità dei beni o dei servizi offerti, un’azienda che non è in grado di garantire ai clienti la continuità del servizio pone a repentaglio il proprio livello reputazionale, mettendo a rischio il suo intero processo di business.

Ciò premesso, nel settore pubblico la disponibilità e continuità dei servizi assume lo stesso valore, se non ancor più significativo, dal momento che il “cliente” del servizio pubblico è l’intera cittadinanza e, pertanto, la garanzia del servizio rappresenta una responsabilità sociale, piuttosto che un fattore competitivo.

Il contesto normativo

Il più importante richiamo normativo di regolamentazione della continuità operativa nella pubblica amministrazione è contenuto nell’art. 51 del Codice dell’Amministrazione Digitale (CAD), il quale dispone che “Con le Linee guida sono individuate le soluzioni tecniche idonee a garantire la protezione, la disponibilità, l’accessibilità, l’integrità e la riservatezza dei dati e la continuità operativa dei sistemi e delle infrastrutture” e ribadisce che “I documenti informativi delle pubbliche amministrazioni devono essere custoditi e controllati con modalità tali da ridurre al minimo i rischi di distruzione, perdita, accesso non autorizzato o non consentito o non conforme alle finalità della raccolta”.

Vi sono anche altre disposizioni normative da rispettare in tema di continuità operativa, dalle misure tecniche ed organizzative previste dall’art. 32 del Regolamento generale per la protezione dei dati (GDPR), alla necessità di redigere un piano di sicurezza (allegato al manuale di gestione documentale, ai sensi delle regole tecniche sul protocollo informatico e la conservazione). Tutte queste disposizioni esigono adempimenti che, il più delle volte, si ripetono. Ragion per cui diventa importante coordinare le attività, in modo da non replicare i processi finalizzati a garantire la continuità operativa.

La chiave di tutto è la gestione organica e strutturata del processo e, nel contesto delle pubbliche amministrazioni, particolare importanza assumono in materia le Linee guida e le circolari messe a disposizione dall’Agenzia per l’Italia Digitale (Agid). Tali documenti forniscono raccomandazioni a supporto dell’individuazione delle soluzioni e dei servizi minimi essenziali per l’adozione di un piano di continuità operativa, in linea con il CAD.

Il piano di continuità operativa è un documento strategico che guida l’amministrazione nella gestione dei rischi cui è soggetta. Il piano definisce ed elenca le azioni da intraprendere prima, durante e dopo un’emergenza, per assicurare la continuità del servizio e massimizzare l’efficacia della risposta. Nello stesso vengono pianificati e specificati tutti gli interventi necessari, assegnate le responsabilità e identificati i percorsi da seguire (definizioni: “chi deve fare”, “che cosa”, e “quando”).

Ciò premesso, l’attuale quadro normativo non obbliga le pubbliche amministrazioni all’adozione di un piano di continuità operativa. Tuttavia, è evidente la necessità di predisporre ugualmente tale piano, al fine di adottare le misure atte a garantire la continua disponibilità dei servizi pubblici ed essere conformi ad altri precetti legislativi, quali ad esempio quelli previsti dalla normativa vigente in materia di protezione dei dati personali (privacy by design).

Il contesto tecnologico

Nella pubblica amministrazione, la continuità operativa è essenzialmente il risultato di un processo organizzativo che comprende tecnologie informatiche rispondenti a precise caratteristiche di robustezza, non diverse da quelle normalmente utilizzate nel contesto privato.

Le Linee guida di Agid in materia di continuità operativa non prevedono misure tecniche predefinite, rimettendo alle amministrazioni la scelta ottimale delle soluzioni da adottare sulla base delle esigenze di continuità in termini di risorse da proteggere e di livelli di servizio attesi.

La raccomandazione principale contenuta in tali Linee guida è quella che invita alla predisposizione di una struttura secondaria in grado di mettere a disposizione risorse alternative a quelle non disponibili. Tra i sistemi da adottare, rivestono particolare importanza le tecnologie per le repliche remote dei dati e le reti di comunicazione tra i siti principali e quelli di backup. Dalla loro capacità e disponibilità, infatti, dipende la possibilità di prevedere meccanismi più o meno efficaci per la salvaguardia dei dati.

Indubbiamente, la struttura secondaria non deve essere situata nell’area metropolitana nella quale è presente la struttura di produzione, ma la distanza minima dipende da scelte e valutazioni effettuate dall’amministrazione. La stessa Agid, a riguardo, non fornisce indicazioni standard sulla distanza necessaria tra i due siti, rimettendo tale scelta all’esito di una valutazione basata sulle peculiarità locali in termini di sismicità del territorio ed assetto idrogeologico dell’area.

Inoltre, il numero di risorse da destinare alla realizzazione di una struttura secondaria potrebbe variare in relazione alle dimensioni e alla disponibilità finanziaria di ciascuna amministrazione. Anche gli enti di minori dimensioni devono assicurare ai propri utenti un livello minimo di continuità dei servizi. In questo caso, Agid raccomanda accordi di mutuo soccorso o forme associative tra enti che consentono di condividere le risorse per l’emergenza.

Anche la diffusione del cloud computing, pur presentando aspetti che vanno attentamente valutati nel contesto delle pubbliche amministrazioni, rappresenta ad oggi un’opportunità da considerare nella scelta delle soluzioni tecnologiche.

Il contesto organizzativo

In qualsiasi organizzazione, la realizzazione della continuità operativa si articola in un processo che coniuga aspetti di natura tecnica ed economica, i quali convergono nel contesto organizzativo. Solo il più alto livello manageriale può dare avvio a questo processo.

A conferma dell’importanza della continuità operativa per gli enti pubblici, Agid ha recentemente emanato le “Linee guida per la qualità delle competenze digitali nelle professionalità ICT” che introducono, nel contesto organizzativo della struttura pubblica, la figura del “Responsabile della continuità operativa (ICT)”.

Il compito principale del Responsabile della continuità operativa consiste nel sensibilizzare sull’argomento i vertici dell’amministrazione, mettendo a loro disposizione uno studio di contesto per l’identificazione delle esigenze di continuità, utile ai fini della scelta delle soluzioni tecniche più adeguate da adottare.

Lo studio di contesto si compone di due processi: il risk assessment, che determina i rischi a cui è soggetta l’organizzazione, analizza le vulnerabilità e identifica le possibili salvaguardie; la business impact analysis, che ha lo scopo di determinare le conseguenze derivanti dal verificarsi di ciascun evento critico e di valutare l’impatto sull’operatività dell’organizzazione.

Il costo organizzativo della continuità operativa nella pubblica amministrazione non è facilmente valutabile, poiché varia in base ai servizi offerti e alle soluzioni tecniche da adottare.  Ciò premesso, Agid stima che nel 2020 le amministrazioni hanno destinato una spesa annua per l’ICT pari al 12% dei loro investimenti.

I dati di spesa forniti da Agid evidenziano la necessità di potenziare gli investimenti in ambito ICT. Relativamente alla continuità operativa, tale necessità è ancor più evidente in considerazione del fatto che, ad oggi, le soluzioni adottate sono in molti casi distanti dall’attuale evoluzione tecnologica. Si pensi, ad esempio, al cloud, il cui utilizzo, sebbene molto diffuso nell’ambito privato, appare ancora poco orientato ad offrire un supporto concreto ed efficace nelle attività degli enti pubblici.

Conclusione

La crescente importanza dell’offerta di servizi online, in particolare da parte delle amministrazioni, comporta l’esigenza di una maggiore disponibilità dell’informazione, da intendersi sia come semplicità e rapidità nella fruizione, sia come garanzia di robustezza delle strutture che contengono l’informazione stessa.

L’attuazione, dunque, delle linee guida in materia di continuità operativa è un corollario del diritto all’uso delle tecnologie e condizione imprescindibile per un’amministrazione digitale e come tale, deve continuamente evolversi al passo con l’innovazione tecnologica.

Sitografia

[https://www.agid.gov.it/]

[https://docs.italia.it/italia/piano-triennale-ict]

[http://www.funzionepubblica.gov.it]

Articolo a cura di Daniele De Simone

https://www.ictsecuritymagazine.com/articoli/la-disponibilita-e-la-continuita-dei-servizi-nellamministrazione-pubblica-un-preciso-impegno-istituzionale-nei-confronti-della-collettivita/


Economia illegale e Crime as a Service

I significativi progressi della tecnologia hanno permesso non solo a cittadini, organizzazioni e governi rispettosi della legge di crescere e prosperare, ma anche ai criminali che ne hanno sfruttato i vantaggi per crescere e prosperare nella loro attività illegale.

Questi individui e/o organizzazioni criminali possono sfruttare le nuove capacità tecnologiche con maggiore facilità e velocità poiché non operano all’interno di confini e di vincoli come accade per i cittadini e le organizzazioni rispettosi della legge. Non sono regolamentati o governati, ma spesso sono ben finanziati e ben coordinati. Questa è la sfida contro cui le organizzazioni, i governi e i loro team di sicurezza combattono quotidianamente.

Il collegamento: economia illegale e crimine finanziario

L’economia illegale, nota anche come economia sommersa, shadow economy o economia informale, si riferisce al commercio illegale di beni e servizi, come traffico di esseri umani, racket, contrabbando di specie in via di estinzione, vendita di droghe illegali, prostituzione illegale, schiavitù infantile e praticamente qualsiasi altra attività che generi transazioni finanziarie ritenute illegali. Questo può variare da giurisdizione a giurisdizione a seconda delle leggi e dei regolamenti all’interno di uno Stato o territorio.

Il termine “crimini finanziari” come definito dall’Australian Criminal Investment Commission (Financial Crimes, 2019) include attività che vanno dalla frode alla manipolazione attiva del mercato azionario o al riciclaggio dei proventi del crimine.

Lo sfruttamento del sistema finanziario consente ai criminali e a gruppi organizzati di riciclare i fondi ricevuti attraverso attività illegali e di mascherare l’attività criminale stessa. Come in qualsiasi organizzazione o entità, i criminali cercano di trarre vantaggio da nuovi modi di lavorare al fine di rendere il loro commercio più efficace ed efficiente, con il risultato che queste entità sfruttano la tecnologia per realizzare la loro mission e aumentare le opportunità di crimini finanziari.

Ciò vale anche per la criminalità informatica e l’agevolazione dei crimini finanziari attraverso mezzi digitali. Sebbene alcune entità stiano cercando di trarre vantaggio dalla tecnologia per promuovere le loro attività illecite, non sempre hanno le competenze tecniche per poterlo fare. Ciò ha dato origine al Crime-as-a-Service (CaaS), grazie al quale criminali informatici esperti e qualificati costruiscono e sviluppano strumenti, piattaforme e capacità sofisticati e poi li vendono o li affittano ad altri criminali (e attori delle minacce) che non hanno le conoscenze tecniche per crearseli da soli.

Il modello è quello di qualsiasi altro modello di business di sviluppo tecnologico. L’entità tecnica (i criminali informatici) sviluppa la tecnologia che può quindi essere venduta o affittata a più clienti e i clienti (altri criminali) traggono vantaggio dall’uso di questa tecnologia per gestire la propria attività, come farebbe qualsiasi altra attività legittima. Questo è uno dei fattori che determina il volume e la sofisticazione degli attacchi a cui assistiamo oggi: gli attori delle minacce non richiedono più la profonda conoscenza tecnica che avevano una volta e la barriera all’ingresso nel crimine informatico e nell’economia illegale si sta abbassando.

Servizi CaaS in vendita sul web

Di seguito, sono elencati alcuni servizi che possono essere facilmente reperiti come CaaS.

Kit/Piattaforme di Phishing

Il phishing continua a essere uno dei principali vettori di attacco utilizzati per compromettere le organizzazioni, quindi non c’è da stupirsi che la mercificazione di queste funzionalità sia notevolmente aumentata. I kit di phishing, così come le piattaforme di phishing, sono prontamente disponibili sul Dark Web a partire da $ 2- $ 10 per agevolare l’attacco a un’organizzazione. Inoltre, questi kit e piattaforme sono personalizzabili anche da parte di chi ha poche conoscenze o capacità e hanno vari livelli di automazione che li rendono molto attraenti per i criminali.

Kit Exploit

Si tratta di kit che includono lo sviluppo di codice di exploit e strumenti per sfruttare le vulnerabilità note. Uno dei kit più popolari, RIG, costa solo $ 150 a settimana e può diffondere ransomware, trojan e altre forme di malware. Tuttavia, a causa dell’aumento degli aggiornamenti automatici nei browser e della riduzione dell’utilizzo di Flash, gli exploit kit sono diventati meno diffusi.

Servizi DDoS

Un gruppo criminale non ha più bisogno di creare una botnet per lanciare un attacco su un bersaglio. Oggi si possono affittare questi servizi su richiesta. Il tempo necessario per lanciare un attacco è minimo e l’infrastruttura può essere avviata e ridotta in modo rapido ed efficiente, rendendo più difficile tracciare e mitigare gli attacchi. I servizi DDoS sono anche economici e accessibili con molti provider che offrono piani di abbonamento sul Dark Web. Si può trovare il più economico a $ 5 al mese per 1 attacco simultaneo con un tempo di attacco di 300 secondi, fino al più costoso per $ 60 al mese che prevede un attacco simultaneo con tempo di attacco di 10800 secondi. Altri fornitori offrono attacchi DDoS su server o siti Web per circa $ 400 al giorno, con alcuni che offrono addirittura attacchi a risorse governative mirate. Tutto ciò rende i servizi DDoS particolarmente pericolosi per la facilità con cui possono essere eseguiti e per i profitti che possono creare per i criminali.

Ransomware as a Service

Analogamente ai servizi DDoS, i criminali informatici possono sfruttare servizi ransomware appositamente creati per prendere di mira una vittima, superando la necessità di elevate conoscenze tecniche. Questi servizi forniscono le competenze e tutte le informazioni necessarie per eseguire un attacco. In alcuni casi, forniscono anche una dashboard e un report sullo stato dell’attacco. Il ransomware as a service ha una quantità variabile di prezzi e modelli di pagamento, alcuni sono basati su abbonamento, altri prevedono tariffa fissa, altri ancora una partecipazione agli utili. Gli importi possono partire da $ 40 e oscillare verso l’alto fino a migliaia per obiettivi di grandi dimensioni (fonte: Ransomware as a Service (RaaS) | The Business of Ransomware, 2020).

Research as a Service

Si intende la raccolta legale o illegale di informazioni su vittime mirate, nonché la rivendita di dati personali rubati, come le credenziali compromesse. Può anche includere la vendita di informazioni su potenziali exploit all’interno di software o sistemi.

Valuta digitale

Le criptovalute sono un metodo ampiamente utilizzato dai criminali informatici per trasferire e raccogliere fondi grazie all’anominato che garantiscono, alla facilità d’uso e alla mancanza di confini e restrizioni internazionali. Gli account di criptovaluta generalmente non richiedono all’utente di fornire alcuna informazione personale né la posizione e consentono anche l’utilizzo di più account contemporaneamente.

Bitcoin è la valuta preferita dei criminali informatici: negli attacchi ransomware, le richieste di riscatto sono spesso in Bitcoin. Gli indirizzi bitcoin registrati nella blockchain non sono associati a determinati individui, solo il titolare dell’account del portafoglio bitcoin che sta ricevendo la transazione può vedere queste informazioni. Ciò significa che le autorità fanno fatica a rintracciare connessioni e percorsi dei criminali. Incassare può essere più rischioso, tuttavia, i servizi di miscelazione di bitcoin possono aiutare a oscurare l’origine dei fondi, nascondendo il legame del criminale con il crimine. Attualmente, organizzazioni legittime, come banche e società di servizi finanziari, trovano difficoltà nell’usare i bitcoin poiché non possono soddisfare gli standard di conformità KYC (Know Your Client) e AML (Anti Money Laundering) per una serie di motivi, inclusi set di dati in silos, valutazioni del rischio o modelli inadeguati, sistemi IT complessi e processi correlati, sfide in termini di risorse e aspettative normative in continua evoluzione. Questi ostacoli, insieme alla complessità e all’anonimato associati alla criptovaluta, rende l’uso della criptovaluta una sfida ancora più difficile per queste organizzazioni.

L’industria della sicurezza come può venire in aiuto?

Con l’accelerazione dettata dalla digital transformation e attività condotte sempre più in digitale, la sicurezza informatica gioca un ruolo sempre più decisivo nella lotta alla criminalità finanziaria e allo smantellamento dell’economia illegale. Questo scenario ha portato i team di sicurezza informatica a lavorare più a stretto contatto con i team che si occupano di frodi e crimini finanziari, soprattutto nel settore bancario. Alcune delle principali banche britanniche ed europee operano con una struttura organizzativa in cui i team di criminalità finanziaria e di cybersecurity fanno parte della stessa business unit da oltre 10 anni, spinti dalla naturale sinergia tra queste funzioni.

Con la convergenza dei team addetti alla criminalità informatica e finanziaria, si è visto  l’emergere di Cyber Fusion Center, una sorta di versione avanzata del modello di gestione del Security Operations Center (SOC) che unifica diversi team all’interno di un’organizzazione, come i team di frode, criminalità finanziaria, informatica, sicurezza fisica e intelligence. Riunendo questi team, le organizzazioni possono condividere più facilmente analisi e informazioni sulle minacce, aumentare la capacità attrattiva per nuovi talenti e disporre di un quadro standard per le procedure. La lotta alla criminalità informatica e l’interruzione dell’economia illegale possono quindi essere realizzate in modo più efficace grazie a una gestione più trasparente, stabilendo un modello operativo end-to-end e consentendo una collaborazione e un consolidamento più semplici su minacce e azioni pertinenti.

Una sfida di questo modello, tuttavia, è l’implementazione iniziale in quanto potrebbe richiedere molto tempo, pianificazione e impegno per essere eseguito. A parte ciò, stabilire questo modello operativo, sia attraverso ruoli e responsabilità concordati, sia attraverso una ristrutturazione organizzativa, si rivelerà estremamente impattante per l’organizzazione e per i clienti.

Alla base di questo modello operativo c’è un modello di dati che consentirà attività e processi decisionali basati sull’intelligence e sui dati. Mettendo insieme quelli che sarebbero normalmente set di dati disparati e l’esecuzione di analisi avanzate, comprese le tecniche di intelligenza artificiale e ML, si possono generare intuizioni che diversamente non si avrebbero. Utilizzando questi approcci, tra cui l’analisi dei cluster e l’analisi della rete neurale, un’organizzazione può identificare le anomalie che possono portare all’identificazione di economia illegale, consentendo quindi all’organizzazione di agire, anche con l’interruzione di questa attività.

Inoltre, l’industria informatica deve essere consapevole di quali fornitori di criptovaluta sono disponibili, quali sono le loro caratteristiche e come le organizzazioni criminali utilizzeranno tali servizi. È inoltre necessario considerare il modo in cui le autorità stanno monitorando queste transazioni e come intendono farlo man mano che le criptovalute diventano più anonime e arrivano persino offline. Bithumb, Upbit, Corbit e Coinone, quattro delle società di criptovaluta della Corea del Sud, hanno deciso di unire le forze per condividere i dati del portafoglio in tempo reale al fine di mitigare schemi piramidali e fondi di phishing inviati attraverso i loro servizi.

Ci sono alcuni esempi in cui l’industria privata e il governo hanno collaborato per interrompere il crimine informatico. Negli Stati Uniti, le grandi banche e il governo degli Stati Uniti hanno formato, sotto il Financial Services Information Sharing and Analysis Center (FS-ISAC), il Financial Services Analysis & Resiliency Center (FS-ARC), per combattere gli attacchi informatici e la criminalità finanziaria che attraversa il settore finanziario.

Anche la Financial Action Task Force (FATF) sta tentando di regolamentare le organizzazioni di criptovaluta costringendole a includere i dettagli dei mittenti o dei destinatari nelle transazioni. In Canada, il Canadian Cyber ​​Threat Exchange (CCTX) (Home – Canadian Cyber ​​Threat Exchange – CCTX – Informing Canadian Business, 2020) è un altro esempio del genere. E in Australia, è stata creata un’iniziativa guidata dalla National Australia Bank (NAB) in cui le principali banche, in collaborazione con le forze dell’ordine e le agenzie di intelligence del governo australiano, sono unite con uno scopo simile, quello di combattere la criminalità informatica.

Conclusioni

Il panorama delle minacce informatiche sta crescendo in velocità e volume a un ritmo senza precedenti. Uno dei fattori chiave è la maturazione del modello di business che si è evoluto a sostegno della criminalità informatica per facilitare l’economia illegale. Dove c’è denaro da fare, anche illegalmente, c’è chi approfitterà delle opportunità che si aprono. Con i progressi della tecnologia e le barriere all’ingresso di nuovi cyber criminali che si abbassano, il rischio per i cittadini, le industrie e le imprese continua a crescere.

Proprio come i criminali informatici continuano a condividere informazioni, coordinarsi ed evolvere le loro capacità, così devono fare l’industria privata e il governo per contrastare la criminalità. Governo e industria devono avere relazioni più profonde, continuare a crescere ed evolversi con il supporto e i progressi della sicurezza informatica e della tecnologia. Non c’è momento migliore di oggi per accelerare questa collaborazione.

A cura di David Fairman, chief security officer, APAC – Netskope

https://www.ictsecuritymagazine.com/articoli/economia-illegale-e-crime-as-a-service/


L’incidente OVH: la lesson learned e gli impatti sul business

A distanza di quasi 10 anni dall’incendio di Aruba (29 aprile 2011), che è stato classificato da diversi analisti come il più grande incidente del digitale italiano, riscontriamo nell’evento che ha colpito OVH alcuni parallelismi.

Nella notte del 10 marzo 2021, alle ore 00.47, un incendio ha devastato uno dei quattro datacenter della compagnia, il SBG2, danneggiando parzialmente un secondo datacenter, il SBG1.
Fortunatamente, non vengono coinvolti i datacenter SBG3 e SBG4, i quali vengono tuttavia spenti quale misura emergenziale e precauzionale.

L’impatto dell’indisponibilità del servizio di Cloud Service Provider è stato elevato, con molti siti irraggiungibili, tra i quali si annoverano anche quelli appartenenti ad istituzioni e amministrazioni pubbliche italiane.

Un disastro che si poteva evitare?

Non si conoscono ancora, ad oggi, le cause dell’incendio, e soprattutto se tali cause siano riconducibili ad eventi di natura dolosa, colposa o indiretta.
Dalle prime ricostruzioni, tuttavia, il sospetto è che ad innescarlo siano stati due UPS (Uninterruptible Power Supply o Gruppo di Continuità), di cui uno sottoposto a manutenzione.
Se confermata tale ipotesi, si potrebbe trattare pertanto di un incendio di origine elettrica, evento che senza alcun dubbio costituisce la principale fonte di pericolo di un Datacenter moderno.

Pericoli di questo tipo sono presi in considerazione dai progettisti di Datacenter, sebbene le soluzioni per fronteggiare tale eventualità si dividano in due diverse scuole di pensiero: tra chi predilige operare in ottica di “minimizzazione degli impatti” e chi invece predilige operare in ottica di “minimizzazione della probabilità”.

Nel primo filone di pensiero, troviamo datacenter progettati con elevati livelli di ridondanza geografica, che accettano il rischio della perdita di un singolo sito (single point of failure) potendo contare su una distribuzione ampia a livello territoriale. Spesso, in tali datacenter troviamo sistemi di estinzione ad acqua, strumento senza dubbio efficace dal punto di vista estinguente, ma altrettanto impattante poiché l’utilizzo dell’acqua su apparecchiature elettriche comporta un elevato livello di danneggiamento e di perdita dei dati. Minori investimenti di sicurezza a livello di “sito”, compensati da maggior ridondanza delle infrastrutture. Tradotto in una logica risk-based: maggiore probabilità di accadimento, minori impatti.

Nel secondo filone di pensiero, troviamo datacenter che magari risultano essere meno ridondati a livello geografico, ma maggiormente resilienti in loco: strutture in cemento armato REI 120, sistemi estinguenti ad utilizzo di gas inerti (maggiormente tutelanti nei confronti sia delle persone che delle infrastrutture informatiche), sistemi di rilevazione e monitoraggio real time. Economicamente più costosi sia in termini progettuali che manutentivi, ma capaci di dare maggiori garanzie di resilienza a livello di singolo sito. E’ questo il caso di molti datacenter italiani. Tradotto in una logica risk-based: minore probabilità di accadimento mediante adozione di efficaci misure di tipo preventivo, spesso accompagnate però da una minor distribuzione geografica.

Tali argomentazioni, anche richiamate dalla società OVH a seguito dell’incidente, a poco afferiscono alla Direttiva Seveso (Direttiva 2012/18/UE, anche nota come “Seveso III”), il cui perimetro di applicazione riguarda quegli stabilimenti produttivi che possono di fatto costituire pericolo per l’ambiente circostante. La non applicabilità di tale Direttiva comporta infatti la non classificazione del sito quale “sito a rischio incidente rilevante”, laddove tale rischio è legato alla possibilità del verificarsi di un incidente all’interno di uno stabilimento che può determinare un pericolo, immediato o differito nel tempo, dovuto all’emissione nell’ambiente di sostanze pericolose.
La non applicabilità di tale Direttiva rileva ai fini della sicurezza territoriale e ambientale e non determina un maggior o minor grado di resilienza rispetto alla sicurezza delle informazioni o delle misure adottate per prevenire incidenti disastrosi.

Giovano invece, parlando di resilienza, l’adozione di misure di sicurezza preventiva e contenitiva volte ad evitare il “single point of failure” o, per i servizi maggiormente critici, il “double point of failure”.
A tal riguardo, l’adozione di un sistema di gestione ISO 22301:2019 (Societal security – Business continuity management systems) e ISO 27001:2017 (Information technology – Security techniques – Information security management systems) possono costituire elementi di valutazione idonei a fornire una certa garanzia di affidabilità nei servizi di Datacenter.

Si tratta dunque di scelte strategiche del Cloud Service Provider, di cui necessariamente il cliente deve tenere conto per una corretta e puntuale valutazione dei rischi connessi ai servizi ospitati.

Come tutelare il proprio business?

Secondo quanto sopra premesso, è opportuno fare alcune considerazioni preventive finalizzate ad una corretta valutazione del rischio.
Perché tale valutazione possa essere realmente compiuta, le imprese dovrebbero porsi alcune domande:

– Il servizio ospitato, per quanto tempo può restare indisponibile?
A tale fine, giova effettuare una valutazione degli impatti dell’indisponibilità del servizio sul business (la c.d. Business Impact Analysis o BIA).

– Qual è il rischio che tale evento di “disruption” possa accadere?
Valutato l’impatto sul business, si tratta di valutare la probabilità di accadimento, contemplando tutte le variabili di rischio (incidenti di natura dolosa, colposa, accidentale, indiretta).

– Valutato il rischio nel suo complesso, qual è il livello di resilienza atteso?
Questa variabile rientra nelle “strategie di continuità operativa” ed è fondamentale. Ho necessità di un servizio ad alta affidabilità active-active (disaster recovery “hot”)? Ho necessità di un servizio che mi dia garanzie di ripartenza nell’arco di poche ore (disaster recovery “warm”)? Ho necessità di un servizio che mi dia garanzie di ripartenza in giorni o settimane? (disaster recovery “cold”)?

L’importanza di una scelta focalizzata sulle strategie di resilienza

L’errore più comune è dare per scontata la continuità operativa.
Infatti, una maggiore o minore resilienza del servizio ospitato è una preoccupazione che deve sin dalla progettazione accompagnare le valutazioni strategiche dell’azienda (business continuity by design).

Quale contratto di hosting devo sottoscrivere?
Molto spesso, i provider offrono diversi pacchetti ai propri clienti, i quali sono capaci di dare garanzie diverse (dal backup manuale a quello automatico, dal disaster recovery a freddo ad un sistema active-active personalizzato). È fondamentale capire il livello di affidabilità offerto da ciascun pacchetto e scegliere quello maggiormente rispondente alle mie necessità, sulla base delle tre variabili sopra enunciate (tempo di indisponibilità, accettazione del rischio, grado di affidabilità atteso).
Un secondo tipo di valutazione può riguardare il possesso, da parte del provider, di adeguate certificazioni che sono sinonimo di garanzia: la compliance alla ISO 22301 e alla ISO 27001 costituisce un punto di indubbia attenzione nella scelta del Datacenter ospitante.

La continuità operativa come cultura aziendale

Non soltanto la scelta del servizio più affidabile secondo le proprie esigenze, ma è anche necessario anche adottare un adeguato piano di continuità operativa (Business Continuity Plan) e di un piano di Disaster Recovery (Disaster Recovery Plan).
Tali piani dovranno essere adottati, condivisi dal personale aziendale e continuamente testati (arrivando anche ad eseguire delle esercitazioni in “effettivo”, ossia spegnendo l’infrastruttura primaria per testare la sua corretta ripartenza sul sito secondario). Il personale dovrà inoltre essere organizzato, formato e addestrato, andando a costituire una vera e propria task force di risposta all’incident di continuità, che in gergo viene definita “Incident Response Structure”.

Gli impatti dell’incidente per GDPR e responsabilità contrattuali

Da un punto di vista privacy, la perdita di dati personali costituirebbe violazione dell’art. 32 GDPR, norma che impone a titolari e responsabili del trattamento l’adozione di «misure tecniche ed organizzative adeguate per garantire un di sicurezza adeguate per garantire un livello di sicurezza adeguato al rischio». Di conseguenza OVH – e i titolari del trattamento che hanno affidato i dati al provider – potrebbero essere soggetti a sanzioni amministrative pecuniarie fino a 10.000.000 di euro o fino al 2% del fatturato mondiale totale annuo dell’esercizio precedente, a norma dell’art. 82 GDPR.

Sempre in relazione alla possibile perdita di dati, un’altra questione estremamente rilevante potrebbe essere se sussista o meno un obbligo per OVH di garantire ai propri clienti il ripristino. Come si diceva poc’anzi, la previsione o meno di un servizio di disaster recovery dipende dagli specifici accordi contrattuali e, dunque, dal “pacchetto” acquistato. Nel caso, infatti, di un accordo contrattuale che preveda anche il servizio di ripristino, il cliente del provider potrebbe senz’altro pretenderlo e, in mancanza, chiedere un congruo risarcimento per inadempimento contrattuale; non vi sarebbe, invece, tutela nel caso in cui non si fosse acquistato anche il servizio di ripristino.

Lo stesso discorso deve essere fatto relativamente al rispetto dei tempi per la risoluzione dell’incidente, verificando nel contratto sottoscritto le limitazioni di responsabilità e la validità legale di quelle specifiche clausole.

Si tratta di aspetti estremamente importanti, poiché si ripercuotono sul cliente, ma, a cascata, anche sui clienti finali e sui rapporti contrattuali con questi ultimi.

Nella scelta di un fornitore di servizi cloud e di una specifica offerta, è dunque fondamentale capire quali servizi siano essenziali per il proprio business e valutarne attentamente la presenza nel “pacchetto” acquistato.

Articolo a cura di Maria Elena Iafolla e Federico Lucia

Avvocato del Foro di Milano e titolare dello Studio Legale Iafolla, si occupa di diritto dell’informatica e delle nuove tecnologie, innovazione, trattamento dei dati e cyber-security.

Laureata presso l’Università Cattolica del Sacro Cuore di Milano, autrice e formatrice sui temi del diritto dell’informatica e privacy/GDPR.

Vice Presidente dell’associazione DFA – Digital Forensics Alumni.

Federico Lucia

Giurista-Informatico specializzato in diritto dell’informatica e digital forensics, si occupa di business continuity, risk management, formazione e sicurezza.

Laureato all’Università del Piemonte Orientale, è Lead Auditor dei sistemi di gestione ISO 27001, ISO 22301 e ISO 45001 ed opera presso il CSI Piemonte come Business Continuity Manager e Corporate Safety and Security Manager. Collabora inoltre con l’Università di Modena e Reggio Emilia come docente nei corsi di alta formazione.

Consigliere Direttivo di ANGIF (Associazione Nazionale Giuristi e Informatici Forensi) e Responsabile Ricerca & Sviluppo dell’ispettorato Piemonte e Valle d’Aosta dell’Associazione Nazionale Carabinieri, è inoltre autore in materia di sicurezza, privacy e continuità operativa.

https://www.ictsecuritymagazine.com/articoli/lincidente-ovh-la-lesson-learned-e-gli-impatti-sul-business/


Ransomware: il protagonista del 2021

Gli attacchi di cybersecurity hanno registrato un’impennata eccezionale nel primo semestre 2020 – 850 attacchi – il 7% in più rispetto allo stesso periodo dell’anno precedente.

Sfortunatamente la tendenza in aumento sembra confermata anche per il 2021.

Si prevede, infatti, che i costi globali conseguenti agli attacchi da ransomware raggiungeranno i 20 miliardi di dollari (USD) e che tale tipologia di attacco colpirà un’azienda ogni 11 secondi entro la fine dell’anno. Da sottolineare che il suddetto dato economico non include gli attacchi verso i singoli individui che si verificano più frequentemente rispetto agli attacchi verso le aziende.

Analizziamo di seguito l’impatto devastante dell’attacco ransomware sulle aziende, soffermandoci sulle modalità da adottare per eliminare o ridurre i danni.

Con il termine ransomware si intente un malware che prima rende inaccessibili i dati dei computer infettati e successivamente chiede il pagamento di un riscatto, in inglese ransom, per ripristinarli.

Una volta infettato un pc, il malware si può diffondere all’intera rete aziendale.

Un rapporto del 2017 di Cybersecurity Ventures identificava nel ransomware il tipo di attacco informatico in più rapida crescita. Lo studio prevedeva che i danni per il 2018 avrebbero raggiunto gli 8 miliardi di dollari e gli 11,5 miliardi di dollari nel 2019. Tali previsioni ad oggi sono state confermate dagli esperti del settore.

Da sottolineare che quando si parla di costi riferiti ad attacchi ransomware si fa spesso riferimento solo al pagamento del riscatto; in realtà il costo globale di un attacco di questo tipo è molto più alto e complesso da quantificare.

Nella quantificazione del costo complessivo si devono includere, tra gli altri, i danni derivanti dalla perdita e/o danneggiamento di dati, dall’interruzione del normale svolgimento dell’attività e conseguente perdita di produttività, dal tempo impiegato in indagini forensi, nonché i danni legati alla reputazione aziendale.

Dal momento che si tratta di un’azione criminale relativamente facile da implementare e i rendimenti, come possiamo facilmente dedurre, sono eccezionali, il ransomware si è trasformato nel principale e temuto avversario da fronteggiare per i team di cybersecurity.

Considerato che il principale vettore dell’infezione è l’e-mail e considerato che la gestione della pandemia COVID-19 ha comportato, tra le altre cose, la necessità di implementare il lavoro a distanza possiamo affermare che oggi il rischio è allarmante.

Una volta infettato il sistema, il recupero completo dei dati è spesso impossibile e non vi è garanzia che vengano restituiti anche se il riscatto è stato pagato.

Nella maggior parte dei casi l’azienda paga il riscatto, il cui importo aumenta ogni anno, ma i dati spesso non possono essere recuperati perché distrutti.

Secondo un’indagine Sophos condotta nel 2020 in 26 paesi tra 5000 IT Manager, le aziende che pagano il riscatto spendono fino al doppio in più per ripristinare l’attività aziendale.

A tutto questo si aggiunge il danno di immagine se i dati aziendali sono resi pubblici.

Contromisure efficaci contro il ransomware devono essere adottate in tempi brevissimi da tutte le aziende investendo e lavorando su un duplice approccio: formazione del personale e strumenti tecnici innovativi.

La formazione del personale è fondamentale in quanto, come già rilevato, il vettore dell’infezione da ransomware è solitamente l’e-mail. La formazione continua sottintende un’attenzione sempre alta sul tema e sulle conseguenze, diffondendo strumenti e suggerimenti per identificare le e-mail dannose (attenzione agli allegati o ai link malevoli).

Dal punto di vista tecnico è necessario installare strumenti software di sicurezza volti ad indentificare e mitigare le conseguenze dell’attacco. Importante è anche definire una soluzione in grado di eseguire il backup dei dati in modo sicuro in caso di emergenza.

La difesa informatica deve oltrepassare i confini dei dipartimenti IT in modo che ogni lavoratore capisca esattamente cos’è il ransomware, come infetta le organizzazioni e come si combatte.

Oggi non è possibile eliminare il rischio di attacco ma è doveroso fronteggiarlo e alzare il livello di allerta. In questo senso la formazione del personale rappresenta la più grande speranza per combattere gli attacchi ransomware.

Articolo a cura di Lisa Da Re

https://www.ictsecuritymagazine.com/articoli/ransomware-il-protagonista-del-2021/


QUIC: un nuovo protocollo Internet e la sicurezza IT

E’ possibile che tra non molto cambi buona parte del traffico Internet, a partire da quella generata dai Browser Web. Questo è dovuto al futuro arrivo di un nuovo protocollo di comunicazione chiamato QUIC (inizialmente era l’acronimo di “Quick UDP Internet Connections”, ma ora è solo un nome, si vedano Rif. 1 e 2) che sarà inizialmente utilizzato dalla terza versione di HTTP, HTTP/3 (Rif. 1).

In questo breve articolo si cerca di descrivere ancor più brevemente QUIC, la sua collocazione tra i protocolli di rete, i principali motivi che hanno portato alla sua creazione, le principali novità che introduce e le ripercussioni che potrebbe avere per la sicurezza delle comunicazioni.

HTTPS e lo stack di rete

Per chiarire dove si colloca QUIC e quale è il suo scopo, è meglio partire da un breve ripasso di come è organizzata una connessione HTTPS secondo la pila ISO/OSI [1]:

Livello Protocollo Note
7. Application HTTP L’applicazione Web che utilizza HTTP spesso stabilisce una sessione ad esempio a seguito di un accesso e utilizzando Cookies
6. Presentation TLS Viene stabilita una sessione
4. Transport TCP Viene stabilita una sessione
3. Network IP

Tabella 1: HTTPS nella pila ISO/OSI

Una vista forse più interessante è quella che considera il processo di incapsulamento dei dati quando passano dall’applicazione sino al livello fisico di trasmissione come descritto sommariamente in Fig. 1:
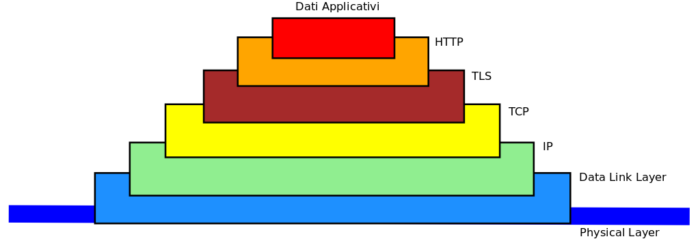
Figura 1. Incapsulamento dei dati per HTTPS.

L’incapsulamento nei vari protocolli ai differenti livelli è sicuramente il motivo della fantastica duttilità delle comunicazioni IT ove ad ogni livello, eccetto al più al livello di Network IP, può essere utilizzato un protocollo diverso a seconda dell’applicazione, del tipo di comunicazione o di rete fisica. Ad esempio, in Fig.1 si è riportato il caso di HTTPS, ma un diagramma simile per HTTP è identico a parte l’esclusione di TLS.

Da HTTP/1.1 a QUIC

Non è detto però che l’incapsulamento, a cui non si vuole e non si può rinunciare, costituisca sempre la soluzione più efficace, efficiente e semplice da implementare. Questo è maggiormente possibile quando sono utilizzati dei protocolli generici, ovvero non orientati e adattati specificatamente all’applicazione che li utilizza.

Già in Tabella 1 è riportato un primo segnale di inefficienza: una comunicazione Web verso un’applicazione tipicamente richiede la gestione di sessioni, ovvero la gestione dello stato della comunicazione, a livello Applicativo, TLS e TCP. Visto che la sessione applicativa deve essere gestita direttamente dall’applicazione, una possibile idea per semplificare la comunicazione potrebbe essere di unificare la gestione delle sessioni TLS e TCP.

In realtà il problema pratico che forse ha contribuito di più alla nascita di QUIC nel 2012 da parte Jim Roskind (Google) è quello chiamato tecnicamente come “multiplexing without head-of-line blocking”, ovvero un problema di Disponibilità.

Una descrizione semplificata del problema è la seguente. Una pagina Web tipicamente contiene molti elementi, ad esempio immagini, codice Javascript, Frame HTML ecc. ognuno dei quali ha un proprio indirizzo (URL). La soluzione più semplice è di far richiedere dal Client Web e far inviare dall’applicazione i componenti in serie, uno dopo l’altro, utilizzando la stessa sessione TCP (e TLS). Questo però sicuramente non è efficiente. Si possono stabilire sessioni TCP (e TLS) parallele per scaricare i componenti della pagina, ma queste comportano un ulteriore carico sui server Web, che anzi si vorrebbero alleggerire.

In HTTP/1.1 è possibile utilizzare il metodo Pipelining, ovvero l’invio dal client di molteplici richieste GET in sequenza senza attendere i dati di risposta di ognuna. L’uso di questo metodo dovrebbe velocizzare la trasmissione dei dati ma in pratica l’implementazione nei Browser è risultata problematica e poco efficiente per cui la quasi totalità dei Browser non lo utilizza.

HTTP/2 ha introdotto la possibilità di gestire molteplici Stream di richieste e di trasferimenti dati all’interno della stessa connessione TCP (e TLS) utilizzando Multiplexing ed altre ottimizzazioni quali la compressione degli Header con HPACK (Rif. 5) [2]. HTTP/2 permette quindi che si instaurino tra server e client sullo stesso canale di comunicazione molteplici e concorrenti sessioni di comunicazione [3]. Tipicamente l’utilizzo di HTTP/2 permette di velocizzare il caricamento di una pagina Web dal 10% al 50%.

Perché QUIC

HTTP/2 non risolve però il problema del “head-of-line blocking” o più precisamente del “TCP head-of-line blocking”. Come indicato, HTTP/2 utilizza una sola connessione TCP e nel caso si perda un pacchetto TCP durante la trasmissione, tutti gli Stream HTTP/2 sono bloccati e devono essere ritrasmessi almeno in parte. La resilienza di TCP e la capacità di recuperare una sessione interrotta, in questo caso generano un problema di efficienza.

QUIC si prefigge i seguenti cinque obiettivi principali:

  1. Implementare il “multiplexing without head-of-line blocking”;
  2. Minimizzare i tempi di creazione di una connessione e di trasporto dei dati per qualunque applicazione, prendendo HTTP come applicazione d’esempio;
  3. Potersi implementare solo a livello applicativo, ovvero senza cambiare protocolli di rete e sistemi operativi;
  4. Permettere la comunicazione con percorsi diversi su rete (es. il cambio dinamico di indirizzi IP del client) e la gestione degli errori di comunicazione;
  5. Garantire sempre la sicurezza delle comunicazioni, per Confidenzialità e Integrità, tramite l’adozione ed inclusione di TLS (specificatamente al momento TLS-1.3).

QUIC non è una nuova versione di HTTP, e la sua collocazione nella pila dei protocolli di rete è descritta sommariamente in Fig. 2:
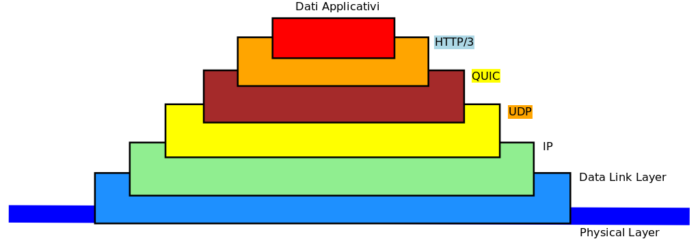
Figura 2: Posizionamento di QUIC nella pila di incapsulamento.

QUIC è posizionato a livello “6. Presentation” al posto di TLS, utilizza UDP a livello “4. Transport” ed in questo esempio è richiamato da HTTP/3 a livello “7. Application”. HTTP/3 è l’evoluzione di HTTP/2 in grado di utilizzare tutte le funzionalità di QUIC: in particolare alcune funzionalità di HTTP/2 sono ora implementate da QUIC. HTTP/3 sarà solo il primo, e probabilmente il più importante, protocollo ad utilizzare QUIC, ma altri protocolli o applicazioni potranno implementarlo e utilizzarlo.

Infatti, la prima osservazione è che QUIC, come dal terzo requisito, è implementabile a livello applicativo, anche tramite librerie dedicate. Anzi ci si aspetta che librerie che oggi forniscono TLS (es. Openssl) implementino anche QUIC con TLS (oggi TLS-1.3).

La seconda osservazione è che QUIC utilizza UDP e non TCP, quindi un protocollo di trasporto che non gestisce la connessione, ogni pacchetto è inviato e non viene tracciato il suo stato, ovvero se è ricevuto correttamente ed in quale ordine. La gestione della connessione è fatta da QUIC che integra la gestione di TLS e della sicurezza del trasferimento dei dati con la gestione di Stream concomitanti (come in HTTP/2).

La struttura di QUIC

La struttura di un pacchetto dati trasferito da QUIC è abbastanza complessa:

  • 1 Datagramma UDP contiene 1 o più QUIC Packet;
  • Ogni QUIC Packet contiene 1 o più Frame;
  • Ogni Frame contiene dati di 1 Stream;
  • Ogni Connessione ha 1 o più Stream.

Tutti i dati sono protetti con TLS, i dati applicativi sono sempre cifrati mentre i dati necessari per la comunicazione sono verificati solo per l’Autenticità e l’Integrità [4]. La Figura 3 cerca di descrivere questa organizzazione dei dati di QUIC:
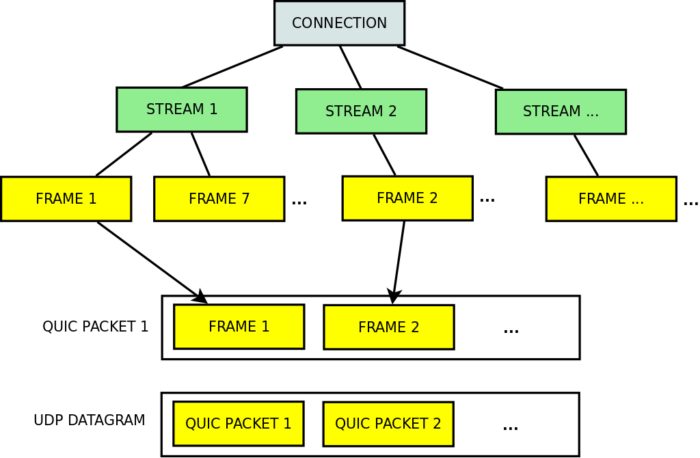
Figura 3: organizzazione dei dati in un pacchetto di rete secondo il protocollo QUIC

QUIC suggerisce che le applicazioni inseriscano in un Datagramma UDP sono QUIC Packet contenenti Frame che appartengono allo stesso Stream, questo per risolvere il problema del “multiplexing with head-of-line blocking”. QUIC lascia però la possibilità a chi utilizza il protocollo di mischiare Frame e QUIC Packet di Stream diversi (vedi Fig. 3) nel caso in cui sia ben chiaro allo sviluppatore che se si perde il pacchetto UDP due o più Stream saranno impattati e dovranno inviare di nuovo i dati. Vi possono essere casi, soprattutto se i Frame sono piccoli, in cui può risultare più conveniente inviare un solo Datagramma UDP con dati di diversi Stream piuttosto che molteplici piccoli Datagrammi UDP ognuno con i dati di un solo Stream.

Ovviamente la macchina a stati di QUIC mantiene lo stato di invio di ogni Frame di ogni Stream implementando un proprio meccanismo di conferma della ricevuta dei dati (ACK o acknowledgment) ed eventuale re-invio, visto che UDP a differenza di TCP non gestisce le connessioni.

La sicurezza dei dati, garantita da TLS (oggi TLS-1.3), è integrata in QUIC in modo che non interferisca con le caratteristiche di Disponibilità ed efficienza nella gestione delle connessioni. Ad esempio, ogni QUIC Packet è cifrato indipendentemente in modo da garantire che ogni Datagramma UDP possa essere decifrato indipendentemente. Questa garanzia non c’è per HTTPS/1.1 e HTTPS/2 perché TLS e TCP agiscono a livelli diversi ed indipendentemente.

Oltre a Multiplexing, per velocizzare il trasferimento di dati, QUIC, come già HTTP/2, offre anche la possibilità per l’applicazione (server) di fare Push dei dati verso il Browser (client). Il caso della navigazione Web è molto semplice da descrivere. Come già indicato, un Browser richiede ad un server Web una pagina, ma questa è composta da molti elementi, ad esempio immagini e codice Javascript, ognuno dei quali ha un proprio indirizzo (URL). L’applicazione sa che per rendere la pagina, il Browser avrà bisogno non solo del codice HTML richiesto ma anche di tutti questi ulteriori elementi. Per velocizzare il trasferimento, l’applicazione può inviare al Browser tutti gli elementi necessari senza che il Browser li richieda esplicitamente, riducendo quindi il tempo necessario a trasferire tutti i dati.

La complessità di QUIC

Come abbiamo brevemente descritto, QUIC deve fare molte cose contemporaneamente. Ed è proprio il fare tutte queste cose contemporaneamente che gli permetterà di rendere più veloce e, da un certo punto di vista, più semplice, trasferire i dati tra applicazione e dispositivo utente. Un breve riassunto (molto incompleto) delle attività contemporanee di QUIC è:

  1. Garantire sempre la sicurezza delle comunicazioni, per Confidenzialità, Integrità e Autenticità, tramite la protezione di tutto il traffico con TLS (TLS-1.3);
  1. Gestire un’unica sessione tra client e server di tutti gli Stream paralleli attivi (ad eccezione di eventuali sessioni applicative a seguito di autenticazione e accesso dell’utente al servizio); questo include la gestione degli errori, la ritrasmissione dei dati persi e l’integrazione di TLS;
  2. Permettere la comunicazione con percorsi diversi su rete tracciando e gestendo eventuali cambi di indirizzo IP del client (cambio di NAT, cambio di cella telefonica per uno smartphone ecc.) e ri-autenticando automaticamente e molto velocemente il client con il supporto di TLS [5];
  3. Gestire la congestione delle comunicazioni (Congestion Control): la perdita di molti pacchetti UDP è di norma dovuta ad una linea lenta e congestionata; QUIC quindi, soprattutto lato server, può rallentare l’invio di dati per diminuire la perdita di pacchetti;
  4. Gestire tutte le componenti di trasmissione dati che possono essere impattate dall’adozione di QUIC, ad esempio Proxy Web e Load Balancer in caso di cambio dinamico di indirizzi IP del client.

In pratica questo richiede di re-implementare parte di HTTP/2, tutto TLS e buona parte di TCP in un unico standard.

Questa complessità si riflette direttamente nel lavoro del QUIC Working Group IETF (Rif. 1) che sta preparando ben nove standard e l’ultima versione, al momento di scrivere queste note, numero 34, consiste di 510 pagine in totale.

Vista la complessità, lo sviluppo dei protocolli va di pari passo con l’implementazione ed i test da parte di un consorzio che comprende praticamente tutti i grandi produttori di Browser e HTTP Server (o, più precisamente, delle librerie utilizzate da Browser e HTTP Server). Vengono verificati sia i protocolli sia l’interoperabilità delle implementazioni (Rif. 2). Lo sviluppo dei protocolli è quindi incrementale con un approccio che si può definire “Agile” e che ha lo scopo di produrre alla fine un protocollo efficace, efficiente e corretto insieme alle relative implementazioni.

Il lavoro del QUIC Working Group IETF è incominciato nel 2016, dopo i primi sviluppi di Google a partire dal 2012, e si prevede che termini tra la fine del 2021 e l’inizio del 2022. Quindi, a 10 anni dalla prima proposta, è possibile che questo protocollo diventi standard e cominci ad essere utilizzato quotidianamente da tutti noi. E’ probabile che i tempi di adozione saranno molto veloci visto che sia i Browser che i Server Web già lo implementano e lo utilizzano nelle versioni di sviluppo e produzione (ma non abilitato per default).

Implementazioni e prestazioni

Come già indicato, QUIC viene al momento utilizzato per le connessioni Web, ovvero HTTP. Browser e Server Web saranno però per un lungo periodo retro-compatibili con HTTP/1.1 e HTTP/2. Il motivo più semplice è che QUIC utilizza la porta UDP/443 mentre HTTP/1.1 e HTTP/2 utilizzano TCP/80 e TCP/443. Nel caso la porta UDP/443 sia chiusa, o vi sia un disallineamento tra client e server, o uno dei due non supporti QUIC, Browser e Server Web ritornano ad utilizzare i protocolli esistenti. Questo è anche il motivo per cui facendo oggi delle prove, come descritto di seguito, si vede che spesso componenti di pagine Web sono scaricati con QUIC, altri con HTTP/1.1 o HTTP/2.

Per quanto riguarda le prestazioni, una rapida ricerca in Internet riporta risultati molto contraddittori. In alcuni casi sono state riscontrate prestazioni nettamente migliori, ad esempio Rif. 6 riporta prestazioni migliori di circa 10% di QUIC rispetto a HTTP/2 e Rif. 7 prestazioni migliori dal 10% al 30% di QUIC rispetto a HTTP/1.1 (mentre in questo caso HTTP/2 si comporta peggio di entrambi). Google, Rif. 8, riporta un miglioramento rispetto a HTTP/1.1 del 2% in Google Search, 9% in Youtube, 3% sui Client Desktop e 7% sui Client Mobile. In altri casi sono stati rilevate prestazioni praticamente uguali o leggermente peggiori di QUIC rispetto a HTTP/1.1 o HTTP/2.

Vi sono vari motivi per queste discrepanze, innanzitutto ci sono molte diverse versioni di sviluppo di QUIC, sia quelle standard IETF sia quelle Google, ed essendo appunto versioni di sviluppo contengono funzionalità diverse o implementate diversamente proprio per verificarne le prestazioni ed il comportamento. Inoltre lo standard non è ancora completato e uno dei principali scopi dei lavori in corso è proprio quello di eliminare le inefficienze degli algoritmi e protocolli. Infine l’aspettativa è che QUIC sia molto più performante dei protocolli attuali non in tutte le situazioni ma in quelle più critiche e problematiche; che riesca come prima cosa a ridurre il carico dei Server Web e di conseguenza possa migliorare anche le prestazioni dei Browser sui Client. Va però segnalato che in condizioni di utilizzo normali l’utente non noterà praticamente alcuna differenza essendo il guadagno troppo piccolo per potersi notare. Quello che dovrebbe invece succedere è che, in situazioni non ottimali di connessione, la navigazione sarà più fluida, con meno blocchi o rallentamenti.

QUIC e Sicurezza IT

Vi sono almeno quattro aspetti da considerare dal punto di vista della sicurezza IT per QUIC:

  1. La sicurezza del protocollo;
  2. La sicurezza delle implementazioni;
  3. La sicurezza nelle interazioni con gli altri componenti della rete IT;
  4. La sicurezza fornita nelle comunicazioni IT.

Molti studi sono stati fatti anche di recente (si vedano ad esempio Rif. 9 e 10) sulla sicurezza del protocollo e della sua implementazione di TLS, questo a garanzia delle caratteristiche di Confidenzialità, Integrità e Autenticità dei dati. Si può dire che almeno a livello teorico, il protocollo è nato ed è stato sviluppato mantenendo la sicurezza come uno dei principali requisiti. Ci si aspetta quindi che non vi saranno problemi di sicurezza dovuti al protocollo stesso.

Diverso è il problema delle implementazioni. Come abbiamo descritto il protocollo è molto ampio e complesso, comprendendo allo stesso tempo parte di HTTP/2, tutto TLS e buona parte di TCP. Tenendo conto che tutti gli aspetti di sicurezza delle comunicazioni sono gestite da QUIC, quanti e quali saranno i fraintendimenti o gli errori di implementazione che avranno ricadute dirette sulla sicurezza? Speriamo nessuno, ma la storia dello stack TCP/IP, nato 47 anni fa, e le vulnerabilità che appaiono ancora, per fortuna raramente, non ci induce ad essere del tutto ottimisti (si vedano ad esempio le recenti vulnerabilità descritte in Rif. 11). D’altra parte visto che QUIC è implementato in librerie applicative o direttamente nelle applicazioni e non nei sistemi operativi, fa sperare che il processo di patching e update possa essere semplice e veloce. Purtroppo vi saranno molte implementazioni diverse, il che aumenta il rischio che qualcuna possa avere delle vulnerabilità che impattano anche pochi sistemi, e che in alcuni casi il processo di patching e update possa essere complesso o lento o non applicato. Come ben noto, il problema principale di patching e update di sicurezza non sono le applicazioni Server, i Browser Web o le applicazioni Desktop, ma gli infiniti sistemi IoT che sono difficilmente se non impossibili da aggiornare.

QUIC è un nuovo protocollo di rete, e quindi deve essere recepito in tutti i dispositivi di rete che interagiscono dal livello 4 “Transport” in su. La prima osservazione è che QUIC utilizza UDP/443 mentre HTTP ha sempre utilizzato TCP/80 e TCP/443. Quindi i Firewall dovranno essere configurati per permettere il traffico sulla porta UDP/443. Questo fornisce anche un modo semplice per bloccare QUIC, basta bloccare la porta UDP/443 (facendo però attenzione a che non sia utilizzata da altre applicazioni, come ad esempio OpenVPN).

In generale comunque tutti i dispositivi di rete che agiscono sul traffico dal livello 4 “Transport” in su, come Firewall, IPS, ProxyWeb, WAF, Bilanciatori ecc., dovranno essere aggiornati in modo da riconoscere il traffico QUIC e gestirlo di conseguenza. Ovviamente questa è una problematica solo transitoria e che se la porta UDP/443 è chiusa, non porterà alcun cambiamento, cioè nessun utilizzo di QUIC, sino all’aggiornamento e riconfigurazione dei sistemi di rete.

Infine ci si aspetta che adottando QUIC ci sarà anche un qualche impatto positivo sulla sicurezza delle comunicazioni IT rispetto alla situazione attuale. L’utilizzo sempre di TLS garantisce che tutte le comunicazioni siano sempre protette per Confidenzialità, Integrità ed Autenticità mentre il protocollo stesso è stato disegnato per migliorare le caratteristiche di Disponibilità delle comunicazioni soprattutto in situazioni non ottimali o critiche. Inoltre QUIC potrà essere utilizzato da qualunque applicazione, non solamente per il traffico Web e HTTP, possibilmente ampliando il numero di applicazioni e i tipi di informazione che saranno protetti.

Parafrasando una nota affermazione, possiamo dire che QUIC mira a implementare la sicurezza nelle comunicazioni IT “by design and by default”. D’altra parte va anche evidenziato che rispetto ad un attuale corretto uso di HTTP+TLS+TCP, i benefici saranno ottenuti più dai fornitori di servizi IT che dagli utenti.

Provare QUIC

Per concludere, è possibile già oggi utilizzare QUIC in via sperimentale. Tutti i grandi fornitori di servizi Web hanno già abilitato in via sperimentale QUIC sui propri servizi. Anche i principali Browser Web supportano QUIC, ma non è abilitato per default.

Ad esempio rifacendosi a Google, che comunque è sempre il padre del progetto, si può procedere come segue:

  • accertarsi che la porta UDP/443 sia aperta dal proprio dispositivo verso Internet
  • aprire il browser Chrome (o Chromium)
  • aprire la pagina “chrome://flags/”, cercare “QUIC” e metterlo “Enabled” (il “Default” è “Disabled”)
  • dal menu aprire i “Developer Tools” (o CTRL-SHIFT-I), selezionare “Network” ed assicurarsi che la colonna “Protocol” sia presente nel frame in basso (altrimenti cliccare con il tasto destro sul nome di una delle colonne presenti ed aggiungerla)
  • infine visitare una pagina di Google, come nell’esempio in Fig. 4 in cui la colonna “Protocol” riporta l’indicazione h3-Q50 che secondo Rif. 8 vuol dire che è stato utilizzato HTTP/3 su Google-QUIC-50 (una versione sperimentale di QUIC di Google).

Una procedura simile può essere utilizzata con un altro Browser e su altri siti già abilitati a QUIC.
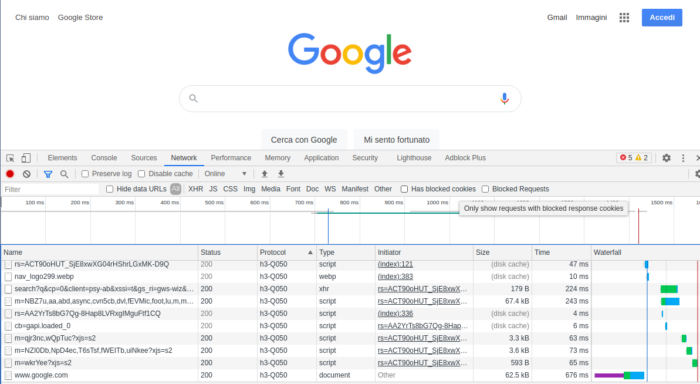
Fig. 4 Esempio di navigazione Web con QUIC sulla pagina di Google Search

Riferimenti Bibliografici

Rif. 1: IETF QUIC Working Group, https://quicwg.org/ e https://datatracker.ietf.org/wg/quic/about/

Rif. 2: Implementazioni di QUIC disponibili a https://github.com/quicwg/base-drafts/wiki/Implementations , l’interoperabilità è descritta in https://interop.seemann.io/

Rif. 3: HTTP/2 RFC 7540, https://tools.ietf.org/html/rfc7540 (ed anche https://en.wikipedia.org/wiki/HTTP/2 )

Rif. 4: per ISO/OSI si veda anche https://en.wikipedia.org/wiki/OSI_model e https://en.wikipedia.org/wiki/List_of_network_protocols_(OSI_model)

Rif. 5:  HPACK RFC 7541, https://tools.ietf.org/html/rfc7541

Rif. 6: Cloudflare “Comparing HTTP/3 vs. HTTP/2 Performance”, https://blog.cloudflare.com/http-3-vs-http-2/

Rif. 7: Uber Engineering “Employing QUIC Protocol to Optimize Uber’s App Performance”, https://eng.uber.com/employing-quic-protocol/

Rif. 8: Chromium Blog “Chrome is deploying HTTP/3 and IETF QUIC”. https://blog.chromium.org/2020/10/chrome-is-deploying-http3-and-ietf-quic.html

Rif. 9: Samuel Jero “QUIC: Performance and Security at the Transport Layer”, https://www.ietfjournal.org/quic-performance-and-security-at-the-transport-layer/

Rif. 10: QUIC Privacy and Security Workshop 2020, https://www.ndss-symposium.org/ndss2020/quic-privacy-and-security-workshop/

Rif. 11: Forescout “Number Jack – Weak ISN Generation in Embedded TCP/IP Stacks”, https://www.forescout.com/company/resources/numberjack-weak-isn-generation-in-embedded-tcpip-stacks/

Note

[1]     Il livello “5. Session” non è utilizzato in questa descrizione di HTTPS, si veda anche Rif. 4., e non sono indicati esplicitamente i livelli inferiori “1. Physical” e “2. Data Link”.

[2]     L’implementazione di HPACK in QUIC è chiamata QPACK ed è uno degli standard RFC QUIC.

[3]     HTTP/2 non richiede l’utilizzo di TLS, ma la pratica comune dei Browser è di utilizzarlo solo insieme a TLS.

[4]     I dati nei pacchetti sono cifrati utilizzando il protocollo “Authenticated Encryption with Associated Data” (AEAD) che protegge non solo i dati trasportati ma anche gli Header dei pacchetti.

[5]     QUIC utilizza un protocollo di rinegoziazione molto veloce chiamato 0-RTT.

Articolo a cura di Andrea Pasquinucci

https://www.ictsecuritymagazine.com/articoli/quic-un-nuovo-protocollo-internet-e-la-sicurezza-it/

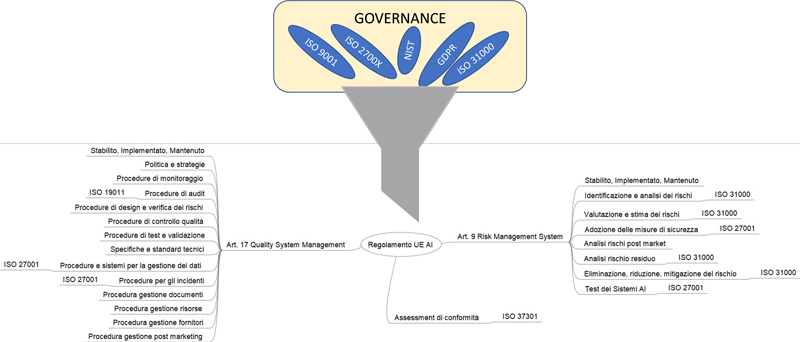


Intervento del Garante Privacy e chiarimenti sulle modalità di inserimento dati nel Fascicolo sanitario elettronico

Come noto, il Fascicolo Sanitario Elettronico (FSE)[1] “ha come obiettivo il fornire ai medici, e più in generale ai clinici, una visione globale e unificata dello stato di salute dei singoli cittadini e rappresenta il punto di aggregazione e di condivisione delle informazioni e dei documenti clinici afferenti al cittadino, generati dai vari attori del Sistema Sanitario. Esso contiene eventi sanitari e documenti di sintesi, organizzati secondo una struttura gerarchica paziente-centrica, che permette la navigazione fra i documenti clinici in modalità differenti a seconda del tipo di indagine”[2]. In pratica, è lo strumento attraverso il quale “il cittadino può tracciare e consultare tutta la storia della propria vita sanitaria, condividendola con i professionisti sanitari per garantire un servizio più efficace ed efficiente. Le informazioni presenti nel Fascicolo del cittadino vengono fornite e gestite dalle singole regioni”[3].

Fonte: Salute.gov.it

Si tratta con tutta evidenza di temi di grande portata e complessità, sicché talvolta le comunicazioni da parte delle stesse istituzioni regionali possono addirittura essere tali da ingenerare perplessità, dubbi e incertezze nei cittadini interessati, come andiamo ad esaminare.

L’art. 11 del decreto-legge n.34/2020 recante “Misure urgenti in materia di salute e di sostegno al lavoro e all’economia” (cd. decreto “Rilancio”)[4] ha abrogato il comma 3-bis dell’art 12 DL 179/12, che prevedeva che “Il FSE potesse essere alimentato esclusivamente sulla base del consenso libero e informato da parte dell’assistito, il quale può decidere se e quali dati relativi alla propria salute non devono essere inseriti nel fascicolo medesimo”.  “L’abrogazione dell’art 3-bis ha scatenato le polemiche: il rischio paventato è quello di non avere più la possibilità di controllare l’accesso a un documento digitale, il FSE, che racchiude tutta la nostra storia clinica (esami effettuati, cure, ricoveri..)”[5].

Anche secondo altri commentatori “il Decreto Rilancio prevede l’estensione delle tipologie di dati sanitari che possono essere inseriti all’interno del FSE, tra cui quelli relativi alle prestazioni fuori dal Servizio Sanitario Nazionale, permettendo, quindi, ai cittadini e ai medici curanti di poter accedere con maggior facilità alle informazioni tramite piattaforma. Inoltre, l’abrogazione del comma 3-bis dell’articolo 11 del DL 179/12 permette il caricamento dei dati anche da parte delle strutture private e delle strutture fuori della propria regione in assenza del consenso dell’assistito, grazie all’interoperabilità tanto ambita nelle P.A.”[6].

Allora “i dubbi su tale abrogazione sono sorti in virtù della possibilità di alimentare il fascicolo personale anche in assenza del consenso. Ne consegue infatti che il Fascicolo Sanitario Elettronico dall’entrata in vigore della normativa viene alimentato in modo automatico, con la possibilità che i dati sanitari siano visibili o meno dal personale sanitario. Questo perché la consultazione rimane sotto il controllo volontario dell’interessato, anche dopo questa recente modifica normativa”[7].

Per qualcuno “sarebbe diventato possibile per tutti gli esercenti le prestazioni sanitarie avere accesso al Fascicolo Sanitario senza più bisogno del nostro consenso, con una enorme violazione della privacy, e di conseguenza è scattata una corsa contro il tempo per opporsi a questo provvedimento. Si è arrivati addirittura a individuare queste modifiche come il primo passo verso l’instaurazione di una “dittatura sanitaria”, che permetterebbe al Governo di schedarci e di tenerci sotto controllo anche dal punto di vista vaccinale, tema particolarmente sensibile in questo periodo data la riluttanza di una discreta percentuale della nostra popolazione a sottoporsi alla vaccinazione contro il coronavirus”[8].

In realtà lo stesso attento commentatore poi ha chiarito che il “decreto Rilancio” è intervenuto sul Fascicolo Sanitario Elettronico modificandone le modalità di alimentazione, ma senza incidere sui soggetti che possono avere accesso ai dati in esso contenuti. In particolare, “la semplificazione apportata dal decreto mira a facilitare l’alimentazione dell’FSE, che in precedenza era ‘limitata’ dalla necessità del consenso, permettendo che in esso confluiscano direttamente i documenti sanitari appartenenti all’interessato, anche se generati da strutture sanitarie private o situate al di fuori della regione di appartenenza, sfruttando il sistema tessera sanitaria. Quanto appena riportato mira a garantire una maggiore completezza del FSE ma non incide in alcun modo sulla nostra privacy (l’accesso all’FSE deve essere sempre autorizzato dall’interessato)[9].

Pochi giorni fa, però, la confusione è stata re-innescata da alcune comunicazioni di autorità regionali, come sopra accennato.

Un primo episodio aveva riguardato il sito della Regione Lombardia, sul quale “è stato pubblicato l’avviso: “in caso di revoca del consenso alla consultazione, il FSE continuerà ad essere alimentato e consultato solo per fini di governo e ricerca”. Quali fini governativi e di ricerca non è dato sapere”[10].

Nello stesso periodo anche il sito della Regione Liguria, indicava “che come previsto dalla Legge 17 luglio 2020, n. 77 di conversione del D.L. n. 34 del 19.05.2020, cosiddetto Decreto Rilancio e a seguito dei chiarimenti forniti dall’Autorità Garante per la protezione dei dati personali, per istituire il Fascicolo Sanitario Elettronico non è più necessario un apposito consenso alla Regione. È stata indicata, altresì, una data (11 gennaio 2021) non definita da alcuna norma. Tutto questo ha contribuito ad alimentare una incredibile confusione in materia”[11].

Pertanto si è reso necessario l’intervento diretto del Garante per fare chiarezza, come avvenuto con l’apposito comunicato stampa[12], in cui si sancisce che “è priva di qualsiasi fondamento normativo la presunta scadenza per manifestare l’opposizione all’inserimento dei propri dati personali nel Fascicolo sanitario elettronico”[13].

In particolare, “in relazione alle notizie diffuse nei giorni scorsi, riguardo ad una presunta scadenza dell’11 gennaio 2021 per manifestare l’eventuale opposizione all’inserimento dei propri dati personali nel Fascicolo sanitario elettronico (FSE), il Garante per la protezione dei dati personali precisa che tale scadenza non esiste ed è priva di qualsiasi fondamento normativo”.

Anzi, “considerati i dati sensibilissimi coinvolti”, l’ Autorità ha avvertito la necessità di precisare innanzitutto come il citato art. 11 decreto legge  ‘Rilancio’ “prevede che, a decorrere dal maggio 2020, a prescindere da qualsivoglia manifestazione di consenso dei cittadini, i dati di tutte le prestazioni sanitarie fruite vadano a confluire automaticamente nel Fascicolo sanitario elettronico” nelle Regioni che abbiano già attivato il FSE. Al riguardo, il Garante specifica che “comunque, anche a seguito di tale alimentazione automatica del FSE, i dati sanitari dei cittadini non saranno accessibili al personale sanitario in assenza di uno specifico consenso del singolo cittadino”[14].

Nello stesso comunicato, si ricorda poi che “con riguardo all’alimentazione del Fascicolo con tutti i dati delle prestazioni sanitarie effettuate in epoca antecedente al maggio 2020, il Garante, con nota del 15 dicembre 2020, ha precisato al Ministero della Salute che l’ingresso nel Fascicolo sanitario elettronico sarebbe stato possibile solo a tre condizioni:

  1. a) avere proceduto a un’idonea campagna nazionale di informazione;
  2. b) avere puntualmente informato i cittadini delle Regioni interessate sulle novità relative all’alimentazione del Fascicolo;
  3. c) avere riconosciuto a questi ultimi, dal momento in cui sono stati informati, un termine non inferiore a 30 giorni per manifestare la propria eventuale opposizione”.

Allo stato, “non essendosi verificata nessuna di queste condizioni, l’invio di comunicazioni alle singole amministrazioni regionali o al Garante, con le quali si rappresenta l’opposizione al citato popolamento, non risulta necessaria”[15].

In tema di alimentazione del FSE, non posso concludere senza richiamare quanto sia cruciale anche il tema, strettamente connesso, della tracciabilità degli accessi e delle operazioni effettuate, mediante la registrazione automatica in appositi file di log degli accessi e delle operazioni compiute. In particolare, “i file di log devono registrare ogni operazione di accesso al fascicolo effettuata da un incaricato, fornendo le seguenti informazioni:

  • il codice identificativo del soggetto che ha posto in essere l’operazione di accesso;
  • la data e l’ora di esecuzione;
  • il codice della postazione di lavoro utilizzata;
  • l’identificativo del paziente il cui FSE si riferisce, e la tipologia dell’operazione compiuta sui dati.

Il periodo di conservazione dei log di tracciamento delle operazioni è individuato dal titolare, che ne risponde dianzi a colui cui quei dati si riferiscono, sia dell’avvenuto accesso ai propri dati personali, sia delle motivazioni che lo hanno determinato”[16].

Con tutta evidenza, è solo mantenendo tutte queste informazioni disponibili, complete e aggiornate che i sistemi di trattamento dati possano risultare condotti con modalità pienamente rispondenti alle regole di compliance sia legali che tecniche.

Note

[1] L’art. 1 comma 382 della Legge di Bilancio 2017, con un emendamento all’art. 12 DL 179/2012, aveva “previsto un’accelerazione nella realizzazione del Fascicolo sanitario elettronico (FSE), attraverso la realizzazione dell’Infrastruttura nazionale per l’interoperabilità dei Fascicoli Sanitari Elettronici da parte del Ministero dell’economia e delle finanze, utilizzando l’infrastruttura del Sistema Tessera Sanitaria” in https://sistemats1.sanita.finanze.it/portale/fse-fascicolo-sanitario-elettronico1.

[2] Come si legge sul portale del Ministero della Salute, in http://www.salute.gov.it/portale/temi/p2_6.jsp?lingua= italiano&id=2512&area=eHealth&menu=vuoto.

[3] Giusta quanto riportato nel sito web https://www.fascicolosanitario.gov.it/, alla pagina Cos’è il Fascicolo Sanitario Elettronico?

[4] Pubblicato in G.U. n. 128 del 19 maggio 2020, ha introdotto misure urgenti in materia sanitaria, tra cui anche l’adozione del Fascicolo Sanitario Elettronico, consultabile da “tutti gli esercenti delle professioni sanitarie”. Il decreto-legge è stato convertito con la Legge n. 77 del 17 luglio 2020, Conversione in legge, con modificazioni, del decreto-legge 19 maggio 2020, n. 34, recante misure urgenti in materia di salute, sostegno al lavoro e all’economia, nonché di politiche sociali connesse all’emergenza epidemiologica da COVID-19. (20G00095) (GU Serie Generale n.180 del 18-07-2020 – Suppl. Ordinario n. 25). Entrata in vigore del provvedimento: 19/07/2020 in https://www. Gazzetta ufficiale.it/eli/id/2020/07/18/20G00095/sg.

[5] Cfr. Salvatore Bella, Fascicolo sanitario elettronico e polemiche privacy, perché non bisogna preoccuparsi, 12/01/2021 in https://www.agendadigitale.eu/sanita/fascicolo-sanitario-elettronico-e-polemiche-privacy-perche-non-bisogna-preoccuparsi/.

[6] Cfr. Anna Rahinò, Fascicolo sanitario elettronico: il difficile equilibrio tra trasparenza e diritto alla salute, 05/02/2021 in https://www.agendadigitale.eu/sanita/fascicolo-sanitario-elettronico-il-difficile-equilibrio-tra-trasparenza-e-diritto-alla-salute/.

[7] Ibidem.

[8] Cfr. Salvatore Bella, Fascicolo sanitario elettronico e polemiche privacy, perché non bisogna preoccuparsi, 12/01/2021 in https://www.agendadigitale.eu/sanita/fascicolo-sanitario-elettronico-e-polemiche-privacy-perche-non-bisogna-preoccuparsi/, cit..

[9] Ibidem.

[10] Cfr. Anna Rahinò, Fascicolo sanitario elettronico: il difficile equilibrio tra trasparenza e diritto alla salute, 05/02/2021 in https://www.agendadigitale.eu/sanita/fascicolo-sanitario-elettronico-il-difficile-equilibrio-tra-trasparenza-e-diritto-alla-salute/, cit..

[11] Ibidem.

[12] Garante per la protezione dei dati personali, Comunicato stampa – Fascicolo sanitario elettronico: nessuna scadenza per l’inserimento dei dati, Doc-Web 9516732 20/01/21 in https://www.garanteprivacy.it/web/guest/home/docweb/-/docweb-display/docweb/9516732.

[13] Cfr. anche QS, Fascicolo sanitario elettronico. La smentita del Garante della privacy: “Nessuna scadenza per l’inserimento dei dati”, 21/01/21 in https://www.quotidianosanita.it/governo-e-parlamento/articolo.php? articolo_id=91774.

[14] Garante per la protezione dei dati personali, Comunicato stampa – Fascicolo sanitario elettronico: nessuna scadenza per l’inserimento dei dati, Doc-Web 9516732 20/01/21 in https://www.garanteprivacy.it/web/guest/home/docweb/-/docweb-display/docweb/9516732, cit..

[15] Ibidem.

[16] Cfr. Serena Nanni, Fascicolo sanitario elettronico, tutti i profili privacy: ecco come tutelare i dati, 03 Dic 2020 in https://www.agendadigitale.eu/sanita/fascicolo-sanitario-elettronico-tutti-i-profili-privacy-ecco-come-tutelare-i-dati/.

Articolo a cura di Sergio Guida

Da economista aziendale, ha maturato esperienze direzionali in gruppi industriali diversi per settori, dimensioni e caratteristiche. Specializzato in pianificazione strategica e controllo di gestione, finanza, risk e project management, sistemi di gestione e rendicontazione integrativi (sociale, ambientale e intangible assets), è stato relatore in convegni e seminari e pubblica articoli di economia, finanza, digital transformation, data governance, public health, compliance & regulatory affairs.

Ha seguito percorsi multidisciplinari su Design Thinking, Human-Computer Interaction, Data protection & Privacy, Digital Health & Therapeutics. Business angel, segue con attenzione il mondo delle Startup.

https://www.ictsecuritymagazine.com/articoli/intervento-del-garante-privacy-e-chiarimenti-sulle-modalita-di-inserimento-dati-nel-fascicolo-sanitario-elettronico/


La de-anonimizzazione dei dati personali. Il caso del dataset Netflix

“Releasing the data and just removing the names does nothing for privacy. If you know their name and a few records, then you can identify that person in the other (private) database” (Vitaly Shmatikov).

“A ticking privacy time bomb” (Marc Rotenberg, Electronic Privacy Information Center).

Introduzione

Nel 2006 Netflix aveva pubblicato una classifica di 10 milioni di film, da parte di 500.000 clienti, come parte di una sfida rivolta agli sviluppatori e agli appassionati di machine learning di trovare sistemi di raccomandazione migliori di quello che l’azienda stava utilizzando in quel torno di tempo. Come base di dati, su cui applicare gli algoritmi, aveva fornito delle variabili anonimizzate, ovvero aveva rimosso i dati personali e sostituito i nomi con numeri casuali, al fine di proteggere la privacy degli utenti. Ciò era stato attentamente vagliato e nel rilascio dei dati l’azienda affermava testualmente, in una domanda retorica, pubblicata nella FAQ di accompagnamento del rilascio pubblico dei dati: “Is there any customer information in the dataset that should be kept private?”. La risposta che l’azienda dava era la seguente. “No, all customer identifying information has been removed; all that remains are ratings and dates. This follows our privacy policy. […] Even if, for example, you knew all your own ratings and their dates you probably couldn’t identify them reliably in the data because only a small sample was included (less than one-tenth of our complete dataset) and that data was subject to perturbation. Of course, since you know all your own ratings that really isn’t a privacy problem is it?”.

In questo breve testo si illustra come due ricercatori dell’Università del Texas, Arvind Narayanan e Vitaly Shmatikov, siano riusciti a de-anonimizzare i dati di Netflix confrontando classifiche dei film (ratings) e marcatori temporali (timestamp) con informazioni pubblicamente disponibili nell’Internet Movie Database (IMDb). Benché siano passati diversi anni la rilevanza della tematica è tuttora di cogente attualità, a maggior ragione dopo l’approvazione del GDPR comunitario e del crescente interesse che viene attualmente annesso a tale tematica. La loro ricerca illustra alcuni problemi di sicurezza intrinseci con i dati anonimizzati e, a parere di chi scrive, è ancora più rilevante che tale tematica sia stata sollevata nel lontano 2008, più di dieci anni fa. Detto in altri termini, come è stato possibile che con un piccolo numero di dati, relativi a un determinato individuo, nessuno dei quali, presi a sé stante, erano univocamente identificabili, inseriti in un contesto più ampio, si siano trasformati, di fatto, in un vero e proprio identificativo personale?

La de-anonimizzazione del dataset Netflix

La metodologia che hanno seguito i due studiosi non è stata quella di fare un reverse engineering dell’intero dataset quanto piuttosto quello di incrociare i dati rilasciati pubblicamente da Netflix con quegli utenti, scelti in maniera casuale, i quali avevano inserito alcune recensioni di film, con i loro nomi, nell’IMDb. Sebbene i records di IMDb siano pubblici, la scansione del sito per ottenerli è contro i termini di servizio di IMDb, quindi i ricercatori hanno utilizzato solo alcuni campioni degli stessi (un piccolo campione di 50 utenti IMDb) per dimostrare la validità del loro ragionamento e del loro algoritmo.

La domanda di ricerca era dimostrare quante poche informazioni siano veramente necessarie per de-anonimizzare le informazioni presenti nei datasets rilasciati pubblicamente. “We investigate the following question: How much does the adversary need to know about a Netflix subscriber in order to identify her record if it is present in the dataset, and thus learn her complete movie viewing history?” (Narayanan & Shmatikov, 2008:8).

I due ricercatori che hanno lavorano sui dati anonimizzati da Netflix non hanno cercato di capire minuziosamente le identità delle persone – come altri avevano fatto in precedenza, ad esempio, con il database di ricerca di AOL. Essi hanno semplicemente comparato i dati anonimizzati con un sottoinsieme già identificato di dati simili presenti sul sito IMDb: ovvero, una tecnica di data mining standard la quale può essere facilmente replicata. La loro è stata una semplice assunzione di fondo. “We expect that for Netflix subscribers who use IMDb, there is a strong correlation between their private Netflix ratings and their public IMDb ratings. […] In many cases, even a handful of movies that are rated by a subscriber in both services would be sufficient to identify his or her record in the Netflix Prize dataset” (Idem, 2008:12).

La tematica è di interesse generale in quanto, a solo titolo esemplificativo, Alphabet Inc., con il database relativo alle ricerche compiute dagli utenti sul suo motore Google Search, potrebbe facilmente de-anonimizzare una base dati pubblica di acquisti sulla rete oppure concentrarsi su ricerche di termini medici per de-anonimizzare un dataset sparso relativo alle cartelle cliniche personali. I siti di commercio elettronico, i quali mantengono informazioni dettagliate sui clienti e sugli acquisti da loro compiuti in rete, potrebbero utilizzare i propri dati per de-anonimizzare parzialmente i dati di qualsiasi altro database di grandi dimensioni, seppur rilasciati in forma anonima. Ulteriore esempio, potrebbe essere quello di una società che acquista una base di dati da altre società commerciali e potrebbe essere in grado di de-anonimizzare la maggior parte dei records ivi contenuti.

Ciò che i ricercatori dell’Università del Texas sono riusciti a dimostrare è, allora, che questo processo non è così impossibile da replicare e, in diversi casi, non richiede nemmeno una mole elevata di dati. Se si eliminano, difatti, i 100 migliori film che tutti guardano, ovvero i risultati più comuni, il resto dei comportamenti individuali in rete costituisce un’impronta digitale (fingerprint), in molti casi, facilmente riconoscibile. “Let us summarize what our algorithm achieves. Given a user’s public IMDb ratings, which the user posted voluntarily to reveal some of his movie likes and dislikes, we discover all ratings that he entered privately into the Netflix system” (Idem, 2008:13).

E ciò non è solo vero per la visione dei film e delle serie televisive compulsate su Netflix, lo si ribadisce ancora una volta, ma vale anche per le abitudini, spiccatamente idiosincratiche, riguardanti la lettura di libri, gli acquisti su internet, le ricerche svolte sui motori di ricerca, ecc.. Il risultato duraturo della ricerca dei due ricercatori è di aver dimostrato che le tecniche di anonimizzazione applicate a datasets sparsi non rappresentano una reale protezione dei dati degli utenti. “Sanitization techniques from the k- anonymity literature such as generalization and suppression do not provide meaningful privacy guarantees, and in many case fail on high-dimensional data. Furthermore, for most records simply knowing which columns are non-null reveals as much information as knowing the specific values of these columns. Therefore, any technique such as generalization and suppression which leaves sensitive attributes untouched does not help” (Idem, 2008:14).

Gli abiti (habits) digitali hanno né più e né meno la stessa valenza degli abiti tradizionali: rappresentano dei comportamenti stabili dell’essere umano, trasferiti attualmente in un contesto digitale, e perciò essi stessi passibili di accumulazione, aggregazione e incrocio da parte di svariate base di dati. Come è stato autorevolmente affermato dagli stessi autori, “in contexts such as behavioral advertising, scholars argue that the power to influence behavior is deeply problematic even if the data is never linked to a real-world identity” (Narayanan & Shmatikov, 2019).

Le contromisure per questa situazione potrebbero essere, purtroppo, inadeguate. Netflix avrebbe potuto randomizzare il suo set di dati rimuovendo un sottoinsieme di dati, modificando i marcatori temporali (timestamp) oppure aggiungendo errori deliberati nei numeri ID univoci utilizzati per sostituire i nomi. I due ricercatori hanno però dimostrato che tutto ciò serve solo a rendere il problema leggermente più difficile. L’algoritmo di de- anonimizzazione di Narayanan e Shmatikov si è dimostrato, difatti, sorprendentemente robusto e funzionante anche con dati parziali, dati randomizzati ed anche con dati volutamente erronei. “It works even if the published records have been perturbed, if only a subset of the original dataset has been published, and if there are mistakes in the adversary’s background knowledge” (Narayanan & Shmatikov, 2008:2). Con solo otto valutazioni date ai film visionati e con delle date che potrebbero avere un errore fino a due settimane, l’algoritmo è riuscito a identificare in modo univoco il 99% dei records nel set di dati. “Our conclusion is that very little auxiliary information is needed for de-anonymize an average subscriber record from the Netflix Prize dataset. With 8 movie ratings (of which 2 may be completely wrong) and dates that may have a 14-day error, 99% of records can be uniquely identified in the dataset. For 68%, two ratings and dates (with a 3-day error) are sufficient” (Idem, 2008:11).

Dopodiché, tutto ciò di cui hanno avuto bisogno i due ricercatori sono stati un po’ di dati passibili di identificazione: può essere IMDb come qui, nel caso di specie, ma potrebbe essere anche un blog, qualsiasi altro social networks, oppure una base di dati differente. La conclusione è che potrebbe bastare anche un piccolo database ad hoc, il quale contenga dei dati personali, affinché si possa de-anonimizzare un dataset sparso molto più grande.

In precedenza, altre ricerche erano giunte alla medesima conclusione. Utilizzando dati anonimizzati, pubblici, relativi al censimento del 1990, Latanya Sweeney aveva scoperto che l’87% della popolazione negli Stati Uniti, 216 milioni su 248 milioni, potrebbe venire identificata in modo univoco solo grazie al codice postale a cinque cifre, combinato con il sesso e la data di nascita. Circa la metà della popolazione degli Stati Uniti è probabilmente identificabile per sesso, data di nascita e città, paese o comune in cui risiede la persona. Se si volesse espandere l’ambito geografico a un’intera contea la percentuale si ridurrebbe del 18% ma rimarrebbe ancora significativa. In un lavoro che rappresenta la ripetizione di tale esperimento, compiuto nel 2006, sui dati censuari del 2000, Philippe Golle riporta che “our results generally agree with the findings of [Sweeney, 2000], although we find that disclosing one’s gender, ZIP code and full date of birth allows for unique identification of fewer individuals (63% of the US population) than reported in [Sweeney, 2000]”. Dal suo breve studio emerge che già solo la data di nascita è in grado di ordinare le persone in migliaia di strati diversi e che riesce a disambiguare in maniera efficace le persone che hanno effettuato il censimento.

Tutto ciò ha profonde implicazioni per il rilascio pubblico di dati anonimi. Da un lato, i dati anonimizzati costituiscono la base del lavoro quotidiano di migliaia di ricercatori, pubblici e privati. In generale, sarebbe da apprezzare che moltissime società, e persino la pubblica amministrazione rilasci i dati in forme pubblicamente disponibili (open data). Nel caso precedentemente citato, ovvero quello di AOL, il CTO della società avrebbe sì compiuto un’azione non disdicevole nel rilasciare pubblicamente il database di dati anonimizzati per motivi di ricerca, però la conseguenza finale è stata l’esposizione pubblica delle ricerche personali compiute dagli utenti, un danno reputazionale enorme subito da AOL e, finanche, le dimissioni dello stesso CTO, insieme all’intero team di ricerca, dopo la protesta sollevata dal giornalista del New York Times. Solo per fare un altro esempio, i dataset medici anonimizzati sono estremamente preziosi per gli avanzamenti scientifici della società intera, ovvero per studi di farmacologia su larga scala, studi di follow-up a lungo termine e così via ma inevitabilmente espongono i nomi dei partecipanti ad essere de-anonimizzati con una relativa facilità, con le inevitabili implicazioni di privacy che si possono facilmente immaginare. E che l’opinione pubblica attuale mostra di non voler più accettare, nemmeno per ragioni di benessere collettivo, come l’insufficiente diffusione dell’app Immuni dimostra assai bene, anche nel caso italiano.

Conclusioni

Nel lavoro seminale di Sweeney (2002) la de-anonimizzazione era basata sulle variabili demografiche in quanto nei databases di allora erano questi i dati predominanti di cui si voleva preservare l’anonimità. Tuttavia, oggigiorno sono cresciute, a dismisura, le modalità di raccolta dei dati ed essi sono disponibili in formati digitali, sparsi nella variegata geografia dei siti web. Ebbene in questi casi sono possibili tecniche di data mining per de-anonimizzarli grazie alla presenza di alcuni attributi di granularità maggiore come le recensioni dei film su IMDb o la cronologia di navigazione dei browers oppure i luoghi digitali visitati i quali, tutti, possono essere utilizzati a questo fine nonostante il set di dati rilasciato pubblicamente contenga centinaia o migliaia di osservazioni individuali. E ciò si è dimostrato vero per campi quali i social networks, i dati genetici, i dati di geolocalizzazione, i dati relativi alle carte di credito, la cronologia di navigazione dei browsers, lo stile di scrittura, il codice sorgente del software, il codice compilato del software, ecc.. “This line of research has firmly established that high-dimensional data is inherently vulnerable to de-anonymization. This is also supported by theoretical evidence. When we consider the fact that 33 bits of entropy are sufficient to identify an individual uniquely among the world’s population, these research findings should be no surprise” (Narayanan & Shmatikov, 2019). Il contributo duraturo di Narayanan e Shmatikov, nel loro paper del 2008, e di molti altri ricercatori che li hanno seguiti su questo percorso di ricerca, è stato dunque quello di mettere in luce come nonostante, e forse proprio per questo, una grandissima mole di dati (big data) disponibili sulla rete digitale sono inerentemente vulnerabili alla de-anonimizzazione. “A small number of data points about an individual, none of which are uniquely identifying, are collectively equivalent to an identifier” (Idem, 2019).

In conclusione, nell’era del capitalismo della sorveglianza (Zuboff, 2019), in cui tutte le entità, sia statuali sia commerciali, raccolgono dati su tutte le persone e per tutto il tempo nei quali sono in rete, l’anonimizzazione dei dati personali e sensibili può risultare una pratica operativa molto fragile e rischiosa più di quanto si potesse immaginare al tempo in cui essa era stata proposta e conseguentemente ampiamente adottata, sia nel settore governativo e, forse ancor più, in quello privato.

In questa situazione, appare assai opportuno chiedersi il “Che fare?” di leniniana memoria. Un ricercatore come Bruce Schneier sostiene che i sistemi di anonimizzazione non dovrebbero essere resi operativi e divulgati se prima non dimostrano di aver superato una fase preparatoria di tecniche di adversarial attacks. Egli fa un paragone con i sistemi di crittografia, di cui è un esperto, e altre modalità di rilascio del software i quali vengono previamente messi a disposizione della comunità open source per essere testati ai fini di sicurezza. Solo quelle modalità di anonimizzazione che dovessero aver superato questi controlli incrociati dovrebbero essere poi sviluppati, messi in produzione e resi pubblicamente disponibili. Allo stesso modo, così come è opinione comune che è non prudente implementare un sistema crittografico prima che venga rigorosamente attaccato, ebbene, si dovrebbe fare la stessa cosa con l’anonimizzazione dei dati personali. E, come ogni altra modalità nel campo della sicurezza, l’anonimizzazione è sempre un difficile compromesso. Ci sono vantaggi e ci sono rischi corrispondenti all’utilizzo o meno di determinate tecniche e metodologie. Ciò implica, evidentemente, l’emergenza di nuovi paradigmi regolativi, a livello normativo, di cui l’attuale GDPR comunitario può essere forse considerato solo il primo esempio di una lunghissima serie di altri di prossima emanazione.

Referenze bibliografiche

  • Golle P. (2006), Revisiting the Uniqueness of Simple Demographics in the US Population, WPES ‘06,October 30, pp. 4.
  • Narayanan A. & Shmatikov V. (2008), Robust de-anonymization of large sparse datasets, 29th IEEE Symposium on Security and Privacy, pp. 111-125.
  • Narayanan A. & Shmatikov V. (2009), De-anonymizing social networks, 30th IEEE Symposium on Security and Privacy, pp. 173-187.
  • Narayanan A. & Shmatikov V. (2019), Robust de-anonymization of large sparse datasets. A decade later, Manuscript, May 21, pp. 5.
  • Sweeney L. (2000), Uniqueness of Simple Demographics in the U.S. Population, Carnegie Mellon University, Laboratory for International Data Privacy, LIDAP WP4, pp. 34.
  • Sweeney L. (2002), k-anonymity. A model for protecting privacy,  International Journal of Uncertainty, Fuzziness and Knowledge-Based Systems”, v.10, n.5, pp. 557-570.
  • Zuboff S. (2019), The Age of Surveillance Capitalism. The Fight for a Human Future at the New Frontier of Power, PublicAffairs, New York (NY).

Articolo a cura di Achille Pierre Paliotta

Achille Pierre Paliotta

Achille Pierre Paliotta, ricercatore INAPP(ex ISFOL), afferente alla Struttura Lavoro e Professioni. Laureato in Sociologia presso l’Università La Sapienza ha conseguito, nel 2015, il Master in Data Science presso l’Università di Tor Vergata. Sta attualmente frequentando il Master in Sicurezza delle informazioni e informazione strategica presso l’Università La Sapienza. I suoi interessi di ricerca vertono su nuove tecnologie, sicurezza informatica, nuove professioni, contrattazione collettiva, welfare occupazionale, data science, blockchain, open data e deep learning.

Tra le sue ultime pubblicazioni: Le politiche innovative di sicurezza nelle città tra tecnologie di riconoscimento e smart cities (“SINAPPSI”, 2020); Decentralized Bargaining and Measures for Productivity and Occupational Welfare Growth in Italy (“eJICLS”, 2019); Il sistema della salute in transizione. La cartella sanitaria personale tra commodificazione dei dati e blockchain (“Salute e Società”, FrancoAngeli, 2019); Nuevas profesiones y técnicas de web data mining en Argentina: el caso del Data Scientist (“CESCOT”, 2018).

https://www.ictsecuritymagazine.com/articoli/la-de-anonimizzazione-dei-dati-personali-il-caso-del-dataset-netflix/


Sicurezza Web e Web Application Firewall

Lo straordinario successo di Internet è supportato e dovuto ai miliardi di siti e servizi Web accessibili a chiunque. Ovviamente tutti questi siti e servizi Web sono primari obiettivi di attacco e punti cruciali per la sicurezza in Internet.

Sin dalla fine degli anni ’90 con l’avvio dei primi siti di commercio elettronico fu evidente l’esigenza di misure dedicate di sicurezza a loro protezione. Nacquero quindi i primi Web Application Firewall (ad esempio il progetto Open Source ModSecurity iniziò nel 2002 [1]) il cui scopo è introdurre misure di protezione a livello applicativo, non di rete, a partire dal protocollo HTTP sino alle applicazioni ed alle transazioni svolte dagli utenti.

Ancora oggi però, più di vent’anni dopo la loro nascita, i Web Application Firewall, o WAF, non sono diffusi come ci si potrebbe aspettare e la loro efficacia è spesso messa in dubbio. In questo articolo si cercheranno di capire i punti di forza e di debolezza dei WAF, partendo da una breve descrizione di cosa sono e come vengono utilizzati.

Utilizzo di un WAF

E’ utile partire da una descrizione di come utilizzare un WAF. Per fare questo consideriamo un esempio teorico utile a identificare i punti di interesse. Ovviamente si parte dall’avere un servizio che espone un’interfaccia pubblica in Internet, ovvero un’interfaccia che può essere raggiunta da chiunque da Internet. Questo però non vuol dire che chiunque possa accedere a tutti i servizi e dati dell’applicazione in quanto può essere richiesta un’autenticazione per fare ciò. In questa discussione però non è necessario arrivare a considerare queste logiche applicative che sono spesso specifiche per ogni applicazione. Per le valutazioni che verranno fatte non è inoltre necessario considerare se il servizio esposto è un classico sito web o di commercio elettronico, il backend di una Mobile App o sono esposte delle Web API. Il punto importante è che il trasferimento di dati in Internet è effettuato utilizzando il protocollo HTTP e codice in HTML, XML, JSON, Javascript ecc.

Considerando una struttura comune di servizio Web, ovvero basato su protocollo HTTP/HTTPS, esposto in Internet, la prima cosa da considerare è dove collocare il WAF nella catena di servizi che compongono l’applicazione.

On-premises, un’architettura logica abbastanza comune per un servizio Web con WAF è descritta in Fig .1.

Fig. 1: Architettura logica di un servizio Web con WAF

L’architettura descritta in Fig.1 è puramente logica in quanto alcuni elementi possono in realtà sia essere realizzati dallo stesso sistema sia da molteplici sistemi. Inoltre le comunicazioni tra i vari componenti sono tipicamente cifrate e sono presenti ulteriori Firewall, appliance di sicurezza dedicate (e router, bilanciatori ecc.) che separano e proteggono i diversi livelli applicativi. Scopo del diagramma è quello di descrivere il principale percorso di un accesso applicativo proveniente da Internet al servizio Web:

  • esposto dal Frontend Web Server
  • gestito dall’Application Server
  • con dati archiviati nel Database.

L’accesso applicativo da Internet utilizza di norma il protocollo HTTPS/TLS e quindi tutti i dati sono cifrati quando attraversano i servizi di sicurezza perimetrali quali il Firewall/IPS presente in figura.

Per proseguire è necessario pertanto che i dati vengano decifrati in modo che possano essere acceduti dai sistemi seguenti e per questo motivo il primo servizio presente è il terminatore TLS che appunto termina la sessione TLS stabilita con l’end-point dell’utente. Questo però non vuol dire che da questo punto in avanti i dati sono trasferiti in chiaro, ma che i canali sono cifrati punto-punto (“hop-by-hop”) da un sistema al seguente.

Visto che ogni sistema seguente il TLS Terminator può accedere ai dati in chiaro, il primo elemento presente è proprio il Web Application Firewall, che esamina i dati ricevuti (sia in ingresso dall’utente che in uscita verso l’utente) e ne garantisce la sicurezza. Se il WAF non identifica problemi di sicurezza, i dati sono inoltrati al Frontend Web Server che gestisce le logiche del protocollo HTTP, all’Application Server che implementa le logiche applicative, e al Database che archivia i dati.

E’ necessario specificare come il WAF riceve e gestisce i dati della connessione. Come dovrebbe essere chiaro dalla posizione del WAF, questo riceve i dati utilizzando il protocollo HTTP che però viene terminato definitivamente solo sul Frontend Web Server. Quindi la configurazione più semplice per un WAF è quella di Reverse HTTP Proxy[1] in cui il WAF termina la connessione HTTP[2] dell’utente, esamina i dati, e stabilisce una nuova connessione HTTP con il Frontend Web Server. Questa modalità introduce però degli ulteriori carichi e dei ritardi, oltre a mascherare le vere sorgenti degli accessi al Frontend Web Server, per cui di solito si preferisce configurare il WAF come Transparent Reverse HTTP Proxy, modalità in cui il WAF esamina i dati ma non termina le connessioni HTTP, o anche come Transparent Bridge in cui il WAF gestisce i dati a livello 2 Data Link nel modello ISO/OSI (es. Ethernet) e quindi risulta trasparente agli altri componenti del sistema.

Come verrà discusso in seguito, un’altra possibilità è che il WAF riceva solo una copia dei dati e quindi non possa agire sui dati in linea e nel caso direttamente bloccare la connessione, ma solo inviare degli allarmi.

WAF Tradizionale

In linea di principio, i controlli svolti da un WAF sono facilmente classificabili in due gruppi:

  1. verifica dei protocolli utilizzati, a partire da HTTP;
  2. verifica dell’assenza di codice nocivo nei dati trasferiti nei linguaggi adottati dal servizio Web che possono comprendere da HTML a XML, Javascript, JSON ecc., ma anche Java, Php, Python, Ruby ecc., ed infine SQL, no-SQL ecc.

E’ chiaro che se il primo punto è relativamente semplice, il secondo non lo è per nulla.

D’altra parte il paragone e la similarità con un servizio Anti-Virus è d’obbligo: in entrambi i casi si tratta soprattutto di individuare codice nocivo ed evitare che venga trasmesso o che siano sfruttate delle vulnerabilità (note) dell’applicazione. Infatti il cuore dei servizi WAF è basato, come per gli Anti-Virus, su librerie di “firme” di attacchi. Come si vedrà più avanti, questa è comunque solo la base delle funzionalità di un WAF.

Ad esempio si assuma che un’applicazione Web sia scritta in Java con un database SQL e che utilizzi pagine HTML con Javascript. Il WAF deve essere configurato con le librerie di firme per attacchi relativi a Java e SQL (ad esempio per attacchi di SQL-Injection), HTML e Javascript. Come per gli Anti-Virus, queste librerie devono essere aggiornate frequentemente in modo da avere disponibili al più presto le firme degli attacchi in corso e delle vulnerabilità appena scoperte per tutti i linguaggi e componenti che compongono il servizio. Tra le librerie di firme devono essere anche presenti (ed aggiornate) tutte le vulnerabilità dello specifico Frontend Web Server, Application Server e Database.

Questo primo livello di funzionalità di un WAF, da alcuni chiamato “WAF Tradizionale”, permette comunque di proteggere l’applicazione Web da molti tipi di attacchi.

I WAF possono essere molto utili anche come misura compensativa di protezione in presenza di vulnerabilità di un componente del servizio in attesa dell’applicazione della relativa patch (questa funzionalità è anche chiamata “Virtual Patching”).

Ad esempio si consideri un servizio Web con un Application Server in Java per il quale viene resa nota una vulnerabilità grave e che la soluzione di questa vulnerabilità richieda sia l’aggiornamento di Java sui sistemi, sia l’applicazione di una patch per l’Application Server e la modifica di parte del codice applicativo. Ovviamente questo processo richiede del tempo per sviluppare e aggiornare il codice, eseguire tutti i test necessari ed installare in produzione la nuova versione. Nel frattempo l’applicazione sarebbe esposta ad attacchi da Internet che sfruttano questa vulnerabilità e che potrebbe portare alla compromissione completa dell’applicazione. Per evitare ciò è sufficiente che sia presente un WAF a protezione dell’applicazione con le firme di questa vulnerabilità. Ovviamente vi è sempre un intervallo di tempo in cui l’applicazione è indifesa da questa vulnerabilità tra il momento della sua scoperta e quello dell’installazione della firma (periodo indicato usualmente come “zero day”), ma è un intervallo di tempo sicuramente molto inferiore (anche ore rispetto a settimane) a quello necessario per installare il patch completo all’applicazione.

I WAF Tradizionali non sono però solo degli strumenti che verificano ciecamente la presenza o meno delle firme degli attacchi nei dati in transito. Come già indicato, verificano anche la correttezza dell’implementazione dei protocolli e della loro sintassi e possono tipicamente applicare delle logiche basate su regole (“rule-based logic”) che permettono sia di concatenare serie di dati e condizioni sia di applicare verifiche solo a particolari tipi di dati. Ad esempio un costrutto potrebbe essere valido se riferito ad un linguaggio di programmazione ma non valido o maligno se riferito ad un altro linguaggio.

Sino ad ora si è descritta la funzionalità del WAF assumendo che in caso di rilevazione di codice maligno o non valido questi blocchi la connessione. In realtà spesso i WAF sono configurati in modo non attivo ma passivo, ovvero solo come un sistema di rilevamento di attacchi le cui segnalazioni vengono poi integrate nei sistemi SIEM/SOC dell’azienda. Il motivo principale di questa modalità di utilizzo dei WAF è nel rischio di falsi positivi nel rilevamento di attacchi e quindi del blocco di connessioni valide. Per evitare quindi che il WAF blocchi le connessioni ed in pratica effettui un attacco di Denial of Service al servizio Web, si preferisce alle volte utilizzarlo solo in modalità passiva ed intervenire in caso di reale attacco ed intromissione tramite le procedure standard per la gestione degli incidenti di sicurezza informatica. Questo rischio verrà discusso più in dettaglio nel seguito dell’articolo.

Ovviamente, i WAF permettono anche di essere configurati in modalità mista, ovvero sia attiva che passiva, nel qual caso l’amministratore lo configura in modo che certi tipi di rilevazioni siano bloccati mentre altri vengano solo segnalati. Ad esempio una configurazione mista potrebbe prevedere che la connessione sia bloccata in caso di rilevamento di una firma associata ad un attacco o vulnerabilità grave, mentre in caso di vulnerabilità non grave o di violazione della sintassi di un protocollo venga fatta solo una segnalazione al SIEM/SOC. Infatti capita anche che alcune rilevazioni di minore gravità da parte di un WAF siano dovute ad errori di programmazione o configurazione dei servizi applicativi o degli end-point degli utenti che possono ridurre l’efficacia del servizio ma non veramente danneggiarne la confidenzialità, integrità o disponibilità. Risulta pertanto più utile segnalare queste situazioni al gestore dell’applicazione piuttosto che bloccarle direttamente.

IPS e ulteriori funzionalità dei WAF

La descrizione che è stata data finora di un WAF non si discosta molto da quella di un Intrusion Prevention System (IPS). Gli IPS sono nati come evoluzione degli Intrusion Detection System (IDS) che hanno solo capacità passive di tracciamento di pacchetti di rete nocivi, aggiungendo anche la possibilità di blocco del traffico. Gli IPS sono di base dei servizi di sicurezza di rete che esaminano tutto il traffico a partire di solito dal livello 3 Networking nel modello ISO/OSI ma arrivano ad esaminare anche i più alti livelli applicativi (es. livello 7 Application). Anche gli IPS lavorano con “firme” di pacchetti nocivi e possono verificare la sintassi dei protocolli con logiche basate su regole. Quindi se sostituissimo in Fig. 1 il WAF con un IPS dovrebbe essere possibile intercettare e bloccare buona parte degli attacchi noti ed implementare il Virtual Patching.

Lo scopo dei due strumenti è però molto diverso: un IPS è uno strumento di sicurezza principalmente a livello rete e generico, che può proteggere contemporaneamente molti servizi e applicazioni di tipo diverso. Un WAF invece è uno strumento di sicurezza a livello applicativo e specializzato che può essere personalizzato per proteggere una specifica singola applicazione. Non è detto che un IPS sia in grado di implementare regole di protezione che dipendono molto profondamente dal linguaggio di programmazione adottato nell’applicazione come invece è naturale che sia per un WAF.

La specializzazione e personalizzazione è però un’arma a doppio taglio. Come prima cosa ogni applicazione dovrebbe avere il proprio WAF dedicato, od almeno la propria istanza di WAF personalizzata. Questo da solo richiede sia molto lavoro di configurazione e gestione che l’utilizzo di risorse umane e applicative adeguate, il che include risorse di rete, di calcolo, di memoria senza dimenticarsi dei costi delle licenze delle applicazioni, middleware e sistemi operativi (o appliance fisiche o virtuali) necessarie.

Come sempre quando si progetta un sistema di sicurezza, bisogna decidere quale approccio adottare: bloccare solo il traffico che è noto essere nocivo, o permettere solo il traffico che è considerato lecito. Come ben noto le due logiche sono opposte, la prima è riassumibile in “blocca eventi specifici e permetti tutto il resto” (default-permit) la seconda in “permetti eventi specifici e blocca tutto il resto” (default-block). Tipicamente la logica default-block è utilizzata dai firewall mentre gli IPS utilizzano spesso la logica default-permit. Nell’accezione più avanzata, un WAF dovrebbe adottare la logica default-block, ma questo richiederebbe di specificare esattamente tutti i contenuti leciti che possono transitare alla e dall’applicazione.

Due semplicissimi esempi possono dare l’idea di quanto sia complesso questo problema. Si consideri un sito Web teorico con due pagine banali e super semplificate[3], la prima statica con solo testo HTML e qualche immagine, la seconda con un Form HTML, Javascript e la possibilità per l’utente di inviare tramite il Form dei dati costituiti solo da lettere, spazi e numeri. Quando l’utente richiede la prima pagina, il WAF dovrebbe verificare che la richiesta contiene solo il URL esatto senza alcun parametro o dato allegato e che la pagina sia richiesta solo con il metodo GET. Inoltre la risposta dell’applicazione dovrebbe contenere solo testo HTML e immagini, nessun altro tipo di dati quali documenti, codice Javascript o altro. La seconda pagina è più complessa, inizialmente l’utente la richiede in modalità GET come la prima pagina e con controlli simili, riceve però dall’applicazione un Form HTML e codice Javascript: il WAF deve quindi permettere il transito solo di questi tipi di dati. L’utente compila il Form e lo invia all’applicazione con il metodo POST. Il WAF deve permettere l’invio all’applicazione solo dei campi previsti dal Form e solo compilati con dati del tipo previsto: ad esempio se sono presenti caratteri di punteggiatura, la comunicazione deve essere bloccata. Per comodità dell’utente, il codice Javascript può essere utilizzato nell’interfaccia cliente sul Browser per verificare che i dati siano permessi prima dell’invio all’applicazione. La verifica deve comunque essere fatta dal WAF (e dall’applicazione) in quanto l’utente può aggirare il codice Javascript ed inviare campi con qualunque dato voglia. Infine il WAF deve verificare che l’applicazione invii all’utente solo i dati previsti come conclusione della transazione, ad esempio solo testo HTML.

Ovviamente non è pensabile poter creare e gestire manualmente una configurazione WAF con questo livello di dettaglio. Una possibile alternativa e via di mezzo tra i due approcci default-permit e default-block è per primo di bloccare i dati nocivi basandosi sulle “firme” e sulla verifica della sintassi dei protocolli, linguaggi di programmazione, applicazioni e database adottati, poi aggiungere regole abbastanza generiche e ampie che permettono il passaggio di dati ritenuti non nocivi per la specifica applicazione, ed infine bloccare tutto il resto. L’approccio è sempre alla default-block, ma la presenza di regole ampie che permettono il traffico, un po’ come nell’approccio più tradizionale della configurazione dei Firewall, rende questa configurazione meno dettagliata e personalizzata e quindi più facilmente gestibile.

Next Generation WAF

Sinora abbiamo descritto i WAF Tradizionali, i loro principali punti di forza ed alcune delle loro criticità, ma come ormai comune nel linguaggio commerciale, i WAF evolvono continuamente in nuove “generazioni”.

Come abbiamo indicato, la gestione di un WAF non è sempre cosa facile e per questo ormai da tempo sono sorte soluzioni Cloud, ovvero servizi WAF erogati in modalità Software-as-a-Service (SaaS). Le modifiche all’architettura descritta in Fig.1 sono in realtà minime, come si vede in Fig. 2.

Fig.2 Architettura logica di un servizio Web con WAF in ambiente Cloud SaaS

I punti di forza di un servizio WAF SaaS sono molteplici e simili in generale a quelli di altri servizi SaaS:

  • la gestione dell’infrastruttura (network, hardware, software) è in carico al fornitore
  • gli aggiornamenti continui del WAF e la sua manutenzione sono in carico al fornitore che sfrutta notevoli economie di scala garantendo al contempo che l’aggiornamento delle firme e delle configurazioni sia molto più veloce e comprensivo per tutti i clienti
  • tipicamente il fornitore offre modalità di scalabilità delle prestazioni non possibili quando il WAF è on-premises in appliance hardware, e non facilmente replicabili o così velocemente implementabili per appliance software
  • il fornitore ha visibilità diretta del traffico di tutti i clienti e quindi ha la possibilità di valutare se anomalie di traffico sono eventi locali e veramente anomali o se invece sono nuove campagne di attacco che vengono man mano indirizzate a tutti i servizi Web
  • il fornitore è tipicamente in grado anche di offrire servizi anti-Distributed-Denial-of-Service (DDoS) specifici per i servizi Web protetti dai WAF, protezione difficilmente replicabile per i singoli servizi Web con le soluzioni WAF on-premises.

Ovviamente valgono anche i comuni aspetti negativi delle soluzioni Cloud SaaS, a partire dalle a volte limitate possibilità di personalizzazione del servizio.

Una delle principali difficoltà di gran parte delle misure di sicurezza attiva è quella di fronteggiare gli zero-days, ovvero il periodo di tempo tra la scoperta di una vulnerabilità e la disponibilità di una misura per contrastarla, tipicamente aggiornando l’applicazione. Come già descritto, un WAF è utile contro gli zero-days come soluzione di Virtual Patching ma solo se è in grado di individuare gli attacchi che sfruttano la vulnerabilità. Oltre alla velocità nella creazione e distribuzione delle firme, i WAF più recenti adottano alcuni ulteriori approcci.

Il primo consiste nella classificazione del traffico che normalmente viene gestito dall’applicazione e dalla creazione di una policy o di un profilo che lo descrive[4]. In altre parole, osservando il traffico ritenuto “normale” e quindi lecito, il WAF ne crea automaticamente una descrizione che traduce in regole che ne permettono il traffico. Viene bloccato tutto il traffico che non rispetta questa descrizione o che fa scattare una regola che descrive traffico maligno (come descritto nella sezione precedente).

Questo approccio rende automatica la creazione della soluzione descritta nella sezione precedente e che dovrebbe essere ottimale: dovrebbe infatti permettere solo il traffico lecito, desunto dal traffico noto, e bloccare tutto il resto. Il problema è che quasi sempre il traffico noto è un sottoinsieme molto ridotto del traffico lecito, e questo per molteplici motivi tra cui:

  • il modo in cui gli utenti interagiscono con l’applicazione può essere molto vario sia nei contenuti sia nell’ordine delle azioni e nelle modalità
  • gli utenti possono connettersi all’applicazione Web con strumenti software diversi (ad esempio Mobile App, Browser Web su smartphone, tablet e PC, accessi via API o programmatici ecc.) ed anche solo una nuova versione di un Browser Web può introdurre modifiche al comportamento del client rispetto all’applicazione
  • le applicazioni sono in costante evoluzione (si pensi solo ai metodi Agile di sviluppo) ed introducono costantemente e continuamente nuove funzionalità e dati, il che può in breve tempo rendere superata la descrizione del traffico fatta dal WAF.

Conseguenza di tutto ciò è un alto rischio di blocco di traffico lecito (ovvero di falsi positivi). Per alcune, poche, applicazioni di nicchia e ad alti requisiti di sicurezza, il blocco di traffico lecito può anche essere accettato (se in limitate quantità), ma non può essere accettato per nulla nella maggioranza delle applicazioni di business, dal commercio elettronico ai siti finanziari, di informazione ecc. E’ questo il principale motivo per cui i WAF spesso sono utilizzati solo in modalità passiva, ovvero di tracciamento di eventuali attacchi ma non di loro blocco.

Un altro approccio alla configurazione e gestione di un WAF parte dalla creazione di un profilo di rischio dell’applicazione: siti di commercio elettronico, finanziario o di informazione sono soggetti a minacce di tipo diverso e soprattutto a rischi diversi relativi ai differenti dati e transazioni gestite. Questo permette di creare regole diverse a seconda del profilo di rischio, molto strette su un certo tipo di traffico rilevante per l’applicazione e meno strette per tutto il resto. Questo riduce i falsi positivi che nel caso sono maggiormente possibili per transazioni a maggior rischio per le quali il business può essere più disposto ad accettare il danno conseguente al blocco della transazione. D’altra parte questo permette maggior traffico non lecito, e quindi riduce la capacità del sistema di bloccare eventuali zero-day.

Infine, come in tutti i sistemi di sicurezza di rete, sono anche utili gli approcci che integrano nei WAF sistemi di Intelligenza Artificiale, o più precisamente Machine Learning. L’approccio è molto simile a quello appena descritto di creazione di un profilo di traffico lecito, solo che in questo caso si utilizza un modello ad esempio di Deep Learning che viene addestrato utilizzando traffico lecito e non lecito. Il modello poi è in grado di estrapolare i dati che ha analizzato individuandone le caratteristiche principali in modo da poter correttamente classificare anche dati che non gli sono mai stati sottoposti. Questi modelli tipicamente ricevono in ingresso in blocchi il traffico diretto all’applicazione e indicano la probabilità che un blocco sia nocivo. Vengono poi definite delle soglie, ad esempio il 90% di probabilità, che possono dipendere dal tipo di dato o dalla catena di regole che gli si applicano, al superamento delle quali i dati sono classificati come nocivi dal WAF. I modelli di Machine Learning, in combinazione con gli altri approcci utilizzati dai WAF, da una parte permettono sia di ridurre sia i falsi positivi dovuti a traffico lecito ma nuovo, sia i falsi negativi, ovvero dati nocivi non identificati, si potrebbe dire per analogia con i dati noti. Comunque pur migliorando l’efficacia dei WAF, i modelli di Machine Learning non eliminano del tutto falsi positivi e falsi negativi, sia per la loro natura intrinseca probabilistica, sia perché anch’essi dipendono comunque essenzialmente dai dati leciti e nocivi utilizzati per la loro istruzione.

Efficacia reale dei WAF

Quanto efficaci sono i WAF realmente? Uno studio di Ponemon [2] del 2019 indica che poco più della metà degli intervistati non è soddisfatta dell’efficacia dei propri WAF e che alcuni attacchi reali non sono stati identificati dai WAF stessi. Il costo e la complessità di gestione sono anche indicati come fattori negativi. Infine solo 1/5 degli intervistati utilizza i WAF in modalità di blocco, in quanto ritiene che il rischio di falsi positivi sia troppo alto.

D’altro canto, sarebbe interessante avere statistiche su quanti attacchi sono stati bloccati o segnalati correttamente dai WAF, e quindi quanti incidenti o intrusioni siano state evitate. Non c’è dubbio che i WAF non sono strumenti perfetti, come tutti gli strumenti di sicurezza informatica, e che sono difficili e spesso costosi da gestire. E’ pertanto difficile fare un rapporto costo benefici, o meglio tra costi e potenziali danni, per l’utilizzo dei WAF.

I WAF sono comunque uno strumento molto utile per la sicurezza delle applicazioni Web esposte in Internet, ed i continui sviluppi li stanno rendendo sempre più efficaci e più semplici da utilizzare.

Riferimenti Bibliografici

Rif. 1: ModSecurity: https://www.modsecurity.org/

Rif. 2: “The State of Web Application Firewalls” https://ponemonsullivanreport.com/2019/07/the-state-of-web-application-firewalls/

Note

[1]   Per convenzione un HTTP Proxy è posizionato di fronte ai client degli utenti, mentre un Reverse HTTP Proxy di fronte ai server HTTP / applicativi.

[2]   Più precisamente una connessione TCP con protocollo HTTP; per semplicità in questo articolo non vengono considerati HTTP/2 e QUIC+HTTP/3.

[3]   Questa descrizione ignora molti dettagli, a partire dalla presenza di link nelle pagine HTML ecc.

[4]   Questo approccio è anche chiamato “Application Learning”.

Articolo a cura di Andrea Pasquinucci

https://www.ictsecuritymagazine.com/articoli/sicurezza-web-e-web-application-firewall/