Migrare verso il cloud in sicurezza

La scelta di un modello di business e di delivery flessibile e dinamico come quello del cloud è oramai diventata imprescindibile. Il cloud, infatti, rappresenta il modo migliore per poter indirizzare le necessità di scalabilità e ottimizzazione di risorse necessarie per garantire e supportare la crescita delle aziende. Allo stesso tempo però le direttive sulla privacy e il cybercrime suggeriscono che la sicurezza debba essere un elemento di discussione se si decide di migrare i servizi verso il cloud.

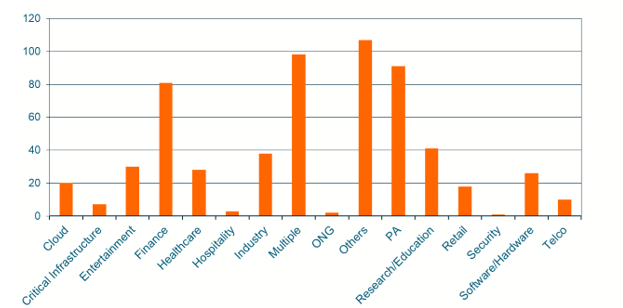
Secondo l’Osservatorio Exprivia di CyberSecurity, sono 20 gli incidenti e attacchi subiti da piattaforme cloud nel corso del 2020 senza contare che molti incidenti classificati su tipi di industria diversi sono comunque assimilabili ad utilizzo di piattaforme cloud.

Pertanto migrare al cloud è necessario, ma è ugualmente necessario fare attenzione alla sicurezza. Ecco alcune semplici raccomandazioni.

Fare attenzione a direttive e regolamentazioni

Migrando dei servizi verso il cloud non è inusuale che dati dapprima processati in una definita e unitaria infrastruttura fisica, possano essere processati, immagazzinati o trasmessi tra diversi cloud che risiedono su diverse infrastrutture fisiche. In diverse nazioni ci sono delle restrizioni su dove i dati di un determinato tipo debbano essere immagazzinati. Senza un contratto specifico che costringa il fornitore ad immagazzinare i dati in una nazione specifica o dia visibilità di dove i dati vengano immagazzinati, l’utilizzatore del servizio non avrà visibilità di dove il dato è stato immagazzinato o da dove il servizio viene erogato. Conoscere le regolamentazioni e direttive è fondamentale, tuttavia non è sufficiente. Infatti, le direttive e regolamentazioni potrebbero cambiare repentinamente. Se si sono fatti diversi investimenti per creare una infrastruttura che si basa su determinate regolamentazioni e direttive, si corre il rischio di dover vanificare gli investimenti a causa di un cambio di direttive e regolamentazioni. La nuova infrastruttura disegnata per il cloud pertanto deve essere sufficientemente flessibile da poter essere adattata in funzione del cambio delle regolamentazioni o direttive.

La segmentazione

Sembra paradossale parlare di segmentazione parlando di migrazione al cloud, ma invece questo tema resta uno dei più critici da prendere in considerazione per due ragioni. La prima è che la migrazione al cloud non riduce la necessità di segmentazione (ad esempio per i motivi legati alle regolamentazioni e direttive). La seconda è più intrinsecamente legata al concetto di migrazione. Infatti, se una applicazione viene sviluppata sul cloud, allora può essere opportunamente segmentata. Se invece la applicazione viene migrata da una infrastruttura fisica on premise, questa è stata sviluppata tenendo conto della segmentazione fisica su cui è stata sviluppata. Tutte le policies di sicurezza fanno spesso riferimento ad elementi infrastrutturali che fanno riferimento alla segmentazione fisica. Portare le policies nel cloud potrebbe comportare la necessità di studiare come reintrodurre le stesse policies in un ambiente in cui i riferimenti alla segmentazione fisica non sono più gli stessi. Questo vuol dire analizzare processi e tecnologie e spesso ridisegnare i controlli di sicurezza.

Microsegmentazione

Una risposta alle necessità di flessibilità e migrazioni di policies di sicurezza verso il cloud è la microsegmentazione (o segmentazione fatta a livello applicativo). Se la segmentazione (e cioè l’insieme di regole che assicurano il controllo di chi sta comunicando con chi) divide la rete in sottoreti, la microsegmentazione fa la stessa cosa ma a livello applicativo aumentando quindi la granularità su cui poter definire le policies e rendendo meno necessario il dover fare affidamento ad elementi che fanno parte della segmentazione fisica.

Non si parla più pertanto di segmenti di reti (normalmente che fanno affidamento sul Livello 4 dello stack OSI), ma di contenitori che possono includere ambienti di test o sviluppo o possono fare riferimento a regolamentazioni, applicazioni ( e quindi oltre il livello 4 dello stack OSI fino al 7).

A parte la migrazione al cloud, gestire le policies di sicurezza facendo affidamento solo alla segmentazione fisica diventa sempre più necessario a causa della crescente complessità delle applicazioni stesse. Pertanto la microsegmentazione, che semplifica la migrazione al cloud indirizzando temi come flessibilità e portabilità delle policies di sicurezza, diventa sempre di più una buona pratica da adottare anche sulle infrastrutture totalmente on premise o ibride.

Ulteriore vantaggio della microsegmentazione è quello che tecniche di attacco che si basano sulla rete (ad esempio IP spoofing o tentativi di esecuzione su porte autorizzate) diventerebbero meni efficaci. Perlomeno l’attaccante avrà la necessità di superare molteplici livelli di sicurezza (sulle applicazioni possono essere create un numero molto elevato di policies).

Articolo a cura di Domenico Raguseo

https://www.ictsecuritymagazine.com/articoli/migrare-verso-il-cloud-in-sicurezza/


Privacy, sicurezza ed etica nell’utilizzo dei Big Data e dell’Intelligenza Artificiale

Presentazione di un quadro d’insieme degli aspetti di particolare rilievo in tema di privacy, sicurezza, ed etica per l’utilizzo di soluzioni basate sui Big Data e sull’Intelligenza Artificiale nella produzione, nella competizione dei mercati, nelle innovazioni di importanti settori pubblici, nella normalità̀ della vita dei cittadini.

Premessa

I Big Data (BD) e l’intelligenza artificiale (IA) sono diventati un fattore strategico nella produzione, nella competizione dei mercati, nelle innovazioni di importanti settori pubblici, nella struttura funzionale delle abitazioni, nella normalità̀ della vita quotidiana. L’enorme vantaggio offerto dai Big Data e dalla loro capacità di estrarre significato da masse di dati anche non strutturati ed il crescente potere di autoapprendimento delle macchine, è destinato a rafforzarsi.

Ma governare questi processi non è certamente un compito semplice; la capacità di estrarre dai dati informazioni che abbiano un significato e siano funzionali, richiede infatti lo sviluppo di sofisticate tecnologie e di competenze interdisciplinari che operino a stretto contatto. Inoltre, l’utilizzo di queste tecnologie e degli scopi con questi perseguiti mettono in discussione molti paradigmi consolidati del diritto ed espongono le persone a nuovi rischi, poiché́ i dati rappresentano la loro proiezione digitale.

Pertanto, l’attenzione alle soluzioni BD&IA non può̀ riguardare soltanto le loro implicazioni scientifiche e tecniche o gli effetti delle innovazioni sull’economia, ma deve concentrarsi anche sugli impatti per le persone fisiche, in quanto, possono creare le condizioni per cui vengono effettuate valutazioni o decisioni con un intervento umano reso via via più marginale, fino ad annullarsi, con effetti dirompenti sul modo di vivere e articolare le esistenze e relazioni, in termini individuali ma anche sociali e politici.

Le Autorità̀ europee in materia di protezione dei dati hanno più volte sottolineato il bisogno di accompagnare questi fenomeni attraverso un più rigoroso approccio etico e di generale responsabilità. In particolare, è necessario che le organizzazioni pubbliche e private adottino misure di garanzia per la trasparenza dei processi basati su tali tecnologie, anche per la progressiva difficoltà a mantenere un effettivo controllo sui dati, derivate dall’opacità delle modalità di raccolta, dai luoghi di conservazione, dai criteri di selezione e di analisi. Inoltre, è necessario che sia effettuata una valutazione del potenziale discriminatorio che deriva dal loro utilizzo, che può nascere per effetto di profilazioni sempre più puntuali ed analitiche, in un modo tale che può portare ad annullare l’unicità̀ della persona, il suo valore, la sua eccezionalità.

Elementi di fiducia

Per analizzare i Big Data, le organizzazioni utilizzano sempre più tecniche di analisi avanzate, predittive e prescrittive, che utilizzano spesso l’intelligenza artificiale e il Machine Learning (ML) in particolare, per comprendere e raccomandare azioni basate sull’analisi di elevati volumi di dati da più fonti, interne o esterne. I casi d’uso tipici includono, ad esempio, l’onboarding dei clienti, il rilevamento delle frodi e l’automazione dei processi di back office, ecc.

Al riguardo, le soluzioni di BD&IA offrono l’opportunità di riutilizzare i dati dall’uso previsto originalmente e di fornire approfondimenti e trovare correlazioni tra set di dati che altrimenti non sarebbero stati previsti. Nuovi canali per la raccolta di dati derivanti da sviluppi tecnologici comportano una costante evoluzione delle fonti di dati e dei metodi per ottenere i dati (ad esempio raccolti, derivati, dedotti e forniti).

Come indicato dalle linee guida etiche per l’IA affidabile del Gruppo di Esperti ad Alto Livello della Commissione europea sull’IA [1], l’affidabilità e fiducia nelle soluzioni IA è essenziale per consentire il massimo beneficio dalle potenziali opportunità offerte e allo stesso tempo garantire l’uso corretto, sicuro e responsabile di tali soluzioni. Un quadro per un uso responsabile e affidabile delle soluzioni BD&IA potrebbe essere basato su una serie di elementi fondamentali, quali:

  • Etica: lo sviluppo, la diffusione e l’uso di qualsiasi soluzione di IA dovrebbe aderire ad alcuni principi etici fondamentali, che possono essere integrati fin dall’inizio in qualsiasi progetto AI, in una sorta di approccio “etico by design“. Ciò significa anche il business case presentato all’inizio di un progetto di IA può includere un’analisi di alto livello della conformità ai principi etici e rifiutare soluzioni non rispondenti.
  • Spiegabilità e interpretabilità: un modello di analisi è spiegabile quando il suo comportamento interno può essere compreso direttamente dall’uomo (interpretabilità) o quando possono essere fornite spiegazioni (giustificazioni) per i principali fattori che hanno portato alla sua produzione.

La Spiegabilità è solo un elemento di trasparenza, che consiste nel rendere disponibili dati, funzionalità, algoritmi e metodi di formazione per eventuali verifiche esterne e costituisce una base per la costruzione di modelli affidabili. La necessità di spiegabilità è maggiore ogni volta che le decisioni hanno un impatto diretto sulle persone e dipendono dal contesto particolare e dal livello di automazione implementato.

Infatti, i modelli IA possono diventare rapidamente “scatole nere”, sistemi opachi per i quali il comportamento interno non può essere facilmente compreso e per i quali, pertanto, non è facile verificare come un modello di analisi abbia raggiunto una certa conclusione o previsione. L’opacità di una soluzione AI può variare a seconda della complessità del modello sottostante e della modalità di apprendimento. Ad esempio, le reti neurali tendono ad essere più opache, a causa della complessità intrinseca dell’algoritmo sottostante, rispetto agli alberi delle decisioni, il cui funzionamento interno può essere più facilmente compreso dagli umani. Questa opacità tecnica è direttamente collegata al concetto opposto di spiegabilità.

  • Equità ed eliminazione di fattori di discriminazione: un altro aspetto importante di un modello IA affidabile è la sua correttezza. Il principio di correttezza richiede che il modello garantisca la protezione dei gruppi di persone contro fattori di discriminazione (diretta o indiretta). La discriminazione può interessare, in particolare, le popolazioni più piccole e i gruppi vulnerabili (ad esempio discriminazione basata sull’età, disabilità, riassegnazione di genere, matrimonio o unione civile, gravidanza o maternità, razza, religione o convinzioni personali, sesso, orientamento sessuale, ecc.). Per garantire l’equità (non discriminazione), il modello dovrebbe essere privo di pregiudizi; generalmente, i dati contengono distorsioni quando non sono rappresentativi della popolazione in questione. Ciò può portare a discriminazioni, ad esempio quando una classe di persone meno rappresentate nel set di dati di training riceve risultati più o meno favorevoli semplicemente perché il sistema ha appreso solo da alcuni esempi e non è in grado di generalizzare correttamente. Tuttavia, la discriminazione può esistere senza pregiudizi o discriminazione diretta; può derivare da attributi sensibili che fungono da variabili di input, indipendentemente dalla distorsione.
  • Tracciabilità e verificabilità: l’uso di soluzioni di tracciabilità aiuta a monitorare tutte le fasi, i criteri e le scelte effettuate durante tutto il processo, che consente la ripetizione dei processi risultanti nelle decisioni prese dal modello e aiuta a garantire la verificabilità del sistema. I passaggi coinvolti in una decisione presa da un modello BD&IA possono essere tracciati dalla raccolta dei dati (anche da fonti di dati di terze parti) al momento in cui viene presa la decisione e anche oltre, poiché le organizzazioni potrebbero ancora essere in dovere di spiegare come sono stati prodotti i risultati e perché sono state prese le decisioni.
  • Protezione dei dati personali: i dati devono essere adeguatamente protetti con un sistema BD&IA affidabile e conforme alla vigente normativa sulla protezione dei dati. Le organizzazioni dovrebbero fondare il trattamento di dati personali con soluzioni BD&IA su una base legale[1] e rispondere agli obblighi previsti dalla normativa comunitaria e nazionale in materia di protezione dei dati. L’organizzazione (o “titolare del trattamento dei dati”) è responsabile del trattamento lecito, equo e trasparente dei dati personali e della garanzia che i dati personali siano stati raccolti per finalità determinate, esplicite e legittime e non ulteriormente trattati in modo incompatibile con tali finalità[2].
  • Sicurezza: l’utilizzo di nuove tecnologiche introducono anche nuove tecniche di attacco che sfruttano le vulnerabilità dei sistemi. È importante mantenere un controllo tecnico sugli ultimi attacchi alla sicurezza delle informazioni e sulle relative tecniche di difesa e garantire che la governance, la supervisione e l’infrastruttura tecnica siano in atto per un’efficace gestione del rischio ICT.
  • Protezione dei consumatori: un sistema BD&IA affidabile dovrebbe rispettare i diritti dei consumatori e proteggere i loro interessi. I consumatori hanno il diritto di presentare un reclamo e ricevere una risposta in un linguaggio chiaro che può essere chiaramente compreso. Il principio di spiegabilità è la chiave per far fronte a questo obbligo.

Protezione dei dati personali

L’utilizzo di sistemi di BD&IA è da considerarsi in crescita grazie al fatto che la tecnologia e il processo decisionale basato sui dati sono considerati fonti di soluzioni sempre più accettate, anche se non esiste ancora una metodologia che consenta di effettuare una valutazione basata su riscontri oggettivi dell’impatto complessivo, ma esistono elementi indicanti che la loro analisi può avere un impatto orizzontale significativo sia sul settore pubblico che su quello privato. Al riguardo, la Commissione europea riconosce il potenziale delle tecnologie e dei servizi basati sui dati, nonché dei Big Data, quali catalizzatori di crescita economica, innovazione e digitalizzazione nell’UE.

E’ da tener conto però che i progressi delle tecnologie di comunicazione e l’uso massiccio di dispositivi elettronici e di monitoraggio, dei social media, delle interazioni e delle reti web, compresi i dispositivi che comunicano informazioni senza intervento umano, hanno portato allo sviluppo di enormi insiemi di dati in costante crescita che, attraverso l’analisi e tecniche avanzate di trattamento, tracciano un quadro senza precedenti del comportamento umano, della vita privata e delle società. La “Risoluzione del Parlamento europeo del 14 marzo 2017 sulle implicazioni dei Big Data per i diritti fondamentali”[2] (di seguito Risoluzione del Parlamento europeo) sottolinea che la conformità con la vigente legislazione in materia di protezione dei dati, unitamente a solide norme scientifiche ed etiche sono fondamentali per creare fiducia nelle soluzioni dei Big Data e considerarle affidabili.

Pertanto, anche in assenza di norme nazionali e internazionali che disciplinino puntualmente la materia dei Big Data, è rintracciabile nel Regolamento UE 2016/679 (di seguito Regolamento) la normativa di riferimento per eccellenza in materia di protezione dei dati. Infatti, molti casi di applicazione di BD&IA riguardano il trattamento di dati personali, che possono riferirsi ad attività di marketing, all’efficientamento dei servizi produttivi, al miglioramento dei servizi ai cittadini, alla prevenzione di attività fraudolente, ecc. Nella fattispecie, il Considerando 91 del Regolamento sancisce l’applicazione delle disposizioni anche ai trattamenti su larga scala, definiti come trattamenti riguardanti una notevole quantità di dati personali a livello regionale, nazionale e sovranazionale che potrebbero incidere su un vasto numero di interessati e presentare potenzialmente un rischio elevato per i diritti delle persone fisiche. I Big Data rientrano, quindi, nella definizione di larga scala e, pertanto, devono essere trattati nel rispetto delle disposizioni previste dal Regolamento.

Il rispetto delle disposizioni previste dal Regolamento pone nuove sfide alle organizzazioni, richiedendo una maggiore attenzione alle strategie di governo dei dati che devono essere attuate. In particolare, il principio di accountability (ex articolo 5, comma 2 del Regolamento) richiede che le organizzazioni siano in grado di garantire e dimostrare il rispetto dei principi relativi al trattamento dei dati personali.

Si tratta, quindi, di regolare ed assicurare l’accountability dei sistemi BD&IA, applicando il principio di trasparenza delle scelte che vengono fatte dagli algoritmi (ad esempio, con appositi diritti come il “right of explanation” citato nel considerando 71 del Regolamento e poi non disciplinato nel testo normativo), l’istituzione di sistemi di tracciatura di ogni scelta effettuata dal sistema, in modo da poter renderlo trasparente, la costruzione di modelli statistici, su cui opera l’intelligenza artificiale, che assumano quale componente fondamentale l’acquisizione del feedback sulle scelte compiute, così da poter effettuare migliori decisioni in futuro.

Oltre al tema della trasparenza del sistema anche quello dei dati che sono trattati dallo stesso assume un’importanza primaria. È noto che in informatica vige il detto “garbage in, garbage out” ed in quest’ottica la qualità e pertinenza del dato su cui un sistema di intelligenza artificiale opera le proprie scelte incide in maniera fondamentale sull’esito delle stesse. È così necessario che tali sistemi, specialmente se utilizzati per assicurare l’ordine pubblico e la sicurezza sociale, evitino di fondare le proprie valutazioni su dati non attinenti alla singola persona e che possano avere conseguenze sulla stessa (come valutazioni in base al luogo di residenza, al comportamento della comunità, etc.).

In aggiunta ai temi sopra citati, molti specialisti di settore ritengono che l’articolo 22 del Regolamento sia particolarmente attinente alle applicazioni IA che elaborano dati personali. L’articolo limita il diritto dei titolari del trattamento dei dati di prendere decisioni su un soggetto “basato esclusivamente sul trattamento automatizzato”, laddove tali decisioni abbiano effetti giuridici o altrettanto significativi sull’individuo. Tale processo decisionale individuale automatizzato include, a titolo esemplificativo, la profilazione, definita dall’articolo 4 del Regolamento come:

“qualsiasi forma di trattamento automatizzato di dati personali consistente nell’utilizzo di tali dati per valutare determinati aspetti personali relativi a una persona fisica, in particolare per analizzare o prevedere aspetti riguardanti il rendimento professionale, la situazione economica, la salute, le preferenze personali, gli interessi, l’affidabilità, il comportamento, l’ubicazione o gli spostamenti di detta persona fisica”

Il Comitato Europeo per la Protezione dei Dati (in precedenza denominato Article 29 Working Party) sta lavorando attivamente, in particolare emettendo pareri e linee guida, per supportare le organizzazioni nell’adempimento degli obblighi previsti dal Regolamento come, ad esempio, il documento “Guidelines on Automated individual decision-making and Profiling” [3] che rappresenta una linea guida essenziale per le organizzazioni che utilizzano o pianificano di utilizzare soluzioni IA.

Sicurezza delle Informazioni

La sicurezza delle informazioni è definita come la protezione delle informazioni e dei sistemi da accesso, uso, divulgazione, interruzione, modifica o distruzione non autorizzati al fine di garantire la riservatezza, l’integrità e la disponibilità. Nel contesto BD&IA, la sicurezza dei dati e la sicurezza dei modelli sono di particolare importanza in quanto entrambi sono aspetti della sicurezza delle informazioni che sono essenziali per il corretto funzionamento degli algoritmi di BD&IA. Mentre la sicurezza dei dati si concentra sulla protezione della riservatezza, integrità e disponibilità dei dati, la sicurezza dei modelli indirizza gli attacchi e le corrispondenti misure di protezione specifiche dei modelli IA.

La rapida espansione dell’intelligenza artificiale in nuovi settori con nuove parti interessate, unita a un panorama delle minacce in evoluzione e all’enorme crescita degli strumenti BD&IA, presenta sfide difficili per la sicurezza delle informazioni.

Alcuni dei principali tipi di attacco che colpiscono, in particolare, le soluzioni IA includono:

  • furto del modello IA;
  • attacchi di avvelenamento (poisoning);
  • attacchi avversari (compresi gli attacchi di evasione).

Gli attacchi di furto / estrazione dei modelli vengono utilizzati per “rubare” i modelli replicandone il funzionamento interno. Questo viene fatto semplicemente sondando il modello target con un elevato numero di query di previsione e utilizzando la risposta ricevuta (la previsione) per addestrare un altro modello. Il modello clonato può raggiungere un alto livello di precisione, anche superiore al 99,9%.

In attacchi di avvelenamento, gli aggressori influenzano deliberatamente i dati di training per manipolare i risultati di un modello predittivo. Questo tipo di attacco è particolarmente valido se il modello è esposto a Internet in modalità online, ovvero il modello viene continuamente aggiornato imparando da nuovi dati.

Un attacco “avversario” consiste nel fornire un campione di dati di input che è stato leggermente alterato per indurre il modello a classificarlo erroneamente. Nella maggior parte dei casi, una perturbazione così piccola (che sostanzialmente rappresenta un “rumore”) può essere così sottile che un essere umano non se ne accorge nemmeno (ad es. Quando il problema riguarda una classificazione dell’immagine e l’immagine in ingresso è stata alterata da un rumore non evidente a l’occhio umano).

Un esempio particolare di un attacco avversario è un attacco di evasione, che consiste nel creare l’input per fare in modo che il modello eviti il rilevamento di un particolare oggetto / elemento.

I ricercatori hanno recentemente sviluppato alcune nuove tecniche di difesa per sconfiggere questi attacchi, ad esempio aggiungendo un de-noiser prima della fase di input. Inoltre, sono in fase di sviluppo librerie open source che offrono tecniche per testare la solidità dei modelli contro questo tipo di attacco.

Pertanto, è importante per le organizzazioni che adottano soluzioni IA mantengano un controllo tecnico sulle vulnerabilità dei sistemi utilizzati e siano regolarmente aggiornate sui progressi degli attacchi alla sicurezza e delle relative tecniche di difesa. In generale, le funzioni aziendali che gestiscono la sicurezza delle informazioni devono avere il compito di individuare e valutare i rischi associati, definire le strategie di gestione del rischio più opportune e garantire che l’azienda abbia le capacità e le risorse necessarie per affrontare e ridurre tali rischi durante tutto il ciclo di vita dei processi IA.  A seguito di ciò, è necessario definire e attuare garanzie adeguate per la sicurezza dei dati, che ricomprendano misure tecniche e organizzative per garantire un livello di sicurezza adeguato al rischio. Tali misure potrebbero essere affrontate nell’ambito di una strategia globale di gestione della sicurezza delle informazioni o, in alternativa, stabilendo ruoli dedicati e un quadro di gestione della sicurezza specifico per la sicurezza dei dati in relazione a soluzioni BD&IA, consentendo all’organizzazione di sviluppare una strategia e procedure per monitorare, rilevare e rispondere agli incidenti di sicurezza dei dati relativi ai sistemi BD&IA, alle loro fonti di dati e ai fornitori di tecnologia di terze parti.

In alcuni casi questa può essere una sfida importante, a causa della scarsa esperienza pregressa relativa alle tecnologie da parte di molte organizzazioni. La politica e l’industria devono perseguire con coerenza e rapidità l’obiettivo di determinare un quadro di riferimento chiaro relativo alla protezione della privacy e della sicurezza dei cittadini, definendo norme e standard di riferimento circa le caratteristiche di protezione dei sistemi BD&IA destinati ad un largo uso.

Al riguardo, è da segnalare il lavoro della ETSI Industry Specification Group on Securing Artificial Intelligence (ISG SAI), che ha un ruolo chiave in Europa per il miglioramento della sicurezza dell’IA attraverso la produzione di standard tecnici. Il gruppo ISG SAI ha l’obiettivo di creare standard per preservare e migliorare la sicurezza delle nuove tecnologie IA. In particolare, L’Istituto Europeo per gli Standard nelle Telecomunicazioni (in inglese European Telecommunications Standards Institute, acronimo ETSI) è un organismo internazionale, indipendente e senza fini di lucro ufficialmente responsabile della definizione e dell’emissione di standard nel campo delle telecomunicazioni in Europa. Il gruppo di ISG SAI sviluppa specifiche tecniche e relazioni per affrontare aspetti importanti per la sicurezza dell’intelligenza artificiale:

  • Proteggere l’IA dagli attacchi: dove l’IA è un componente di un sistema che necessita di protezione;
  • Mitigare gli attacchi che sfruttano l’IA: dove l’intelligenza artificiale viene utilizzata per migliorare i vettori di attacco convenzionali o creare nuovi vettori di attacco;
  • Usare l’IA per migliorare le misure di sicurezza: proteggere i sistemi dagli attacchi laddove l’utilizzo dell’IA fa parte della “soluzione” o viene utilizzato per migliorare le contromisure più convenzionali.

Le parti interessate dall’attività del gruppo ETSI ISG SAI comprendono utenti finali, produttori, operatori e governi. Per maggiori informazioni sul lavoro di ETSI ISG SAI è possibile riferirsi al sito istituzionale al seguente link: https://www.etsi.org/technologies/securing-artificial-intelligence#mytoc3

Un altro istituto di riferimento per la sicurezza delle soluzioni BD&IA è il NIST (National Institute of Standards and Technology), che è un’agenzia del governo degli Stati Uniti d’America con una reputazione consolidata negli anni nello sviluppo di standard per rendere le tecnologie più sicure, utilizzabili, interoperabili e affidabili. La ricerca NIST si concentra su come misurare e migliorare la sicurezza e l’affidabilità dei sistemi IA. Ciò include la partecipazione allo sviluppo di standard internazionali che garantiscono innovazione, fiducia del pubblico e fiducia nei sistemi che utilizzano le tecnologie IA. Inoltre, il NIST sta applicando l’IA ai problemi di misurazione per ottenere una visione più approfondita della ricerca stessa e per comprendere meglio le capacità e i limiti dell’IA.

L’11 febbraio 2019, l’Executive Order on Maintaining American Leadership in Artificial Intelligence ha incaricato il NIST di sviluppare “un piano per l’impegno federale nello sviluppo di standard tecnici e strumenti correlati a sostegno di sistemi affidabili, robusti e affidabili che utilizzano tecnologie di intelligenza artificiale”.

In particolare, il NIST parteciperà allo sviluppo di standard di intelligenza artificiale, insieme al settore privato e al mondo accademico, che affrontano questioni e principi sociali ed etici, governance e politiche e principi sulla privacy. L’impegno relativo agli standard IA include:

  • Supportare e condurre ricerca e sviluppo dell’IA
  • Sviluppare attivamente standard IA
  • Sviluppare e attuare politiche di supporto, comprese le politiche normative ove necessario.

Mentre la comunità dell’intelligenza artificiale ha concordato sul fatto che questi problemi devono tener conto degli standard dell’intelligenza artificiale, molte decisioni devono ancora essere prese sul fatto che vi siano ancora abbastanza basi scientifiche e tecniche per sviluppare tali standard.

Al riguardo, l’ENISA[3] ha pubblicato il 15 Dicembre 2020 il rapporto denominato “AI Threat Landscape”, che sottolinea l’importanza della sicurezza informatica e della protezione dei dati in ogni parte dell’ecosistema IA, al fine di creare tecnologie affidabili per gli utenti. In particolare, lo studio dell’agenzia europea, oltre a presentare le minacce applicabili alle soluzioni IA, pone le basi per le prossime iniziative politiche sulla sicurezza informatica e le relative linee guida tecniche, sottolineando quelle che saranno le sfide rilevanti.

I principali punti trattati nel rapporto possono essere riassunti in:

  • Definizione del campo di applicazione dell’IA nel contesto della sicurezza informatica secondo un approccio basato sul ciclo di vita, delineando l’ecosistema dei sistemi e delle applicazioni dell’IA.
  • Identificazione degli elementi che costituiscono un ecosistema IA, in modo da individuare cosa deve essere protetto e le vulnerabilità che possono essere esposte per la sicurezza dell’ecosistema IA.
  • Classificazione delle minacce per i diversi elementi dell’ecosistema IA durante il suo ciclo di vita.
  • Mappatura delle minacce IA mediante una tassonomia dettagliata, al fine di identificare eventuali scenari di attacco e definire i termini nelle prossime valutazioni dei rischi e dei controlli di sicurezza necessari per mitigarli.

In particolare, il rapporto è diretto ai responsabili delle politiche quando sviluppano linee guida future sulle implementazioni sicure dell’IA, agli esperti tecnici per supportare valutazioni del rischio personalizzate e agli organismi di standardizzazione per supportare i futuri standard di sicurezza dell’IA.

In conclusione, il panorama delle minacce dell’IA dell’ENISA identifica le sfide e le opportunità per implementare sistemi e servizi di IA sicuri in tutta l’Unione, sottolineando la necessità di misure di sicurezza più mirate e proporzionate per mitigare le minacce individuate.

Quadro normativo di riferimento

L’Unione Europea (di seguito UE) ha istituito un quadro giuridico rigoroso, i cui obiettivi sono, tra gli altri, quelli di garantire la tutela dei consumatori, far fronte alle pratiche commerciali sleali e proteggere i dati personali e la privacy dei cittadini. L’acquis comunitario prevede, inoltre, norme settoriali specifiche (ad esempio per il settore dell’assistenza sanitaria o dei trasporti). Tali disposizioni vigenti del diritto dell’UE continueranno ad applicarsi in relazione anche ai processi di BD&IA, ma potrebbero rendersi necessari determinati adeguamenti di tale quadro giuridico per tenere conto della trasformazione digitale e dell’uso delle specifiche tecnologie. Di conseguenza, gli aspetti già trattati dalla legislazione orizzontale o settoriale in vigore (ad esempio per quanto riguarda i dispositivi medici o i sistemi di trasporto) continueranno ad essere disciplinati da tale legislazione.

Esiste un vasto corpus di norme vigenti dell’UE in materia di sicurezza dei prodotti e di responsabilità per danno da prodotti difettosi, comprendente norme settoriali ed integrate dalle legislazioni nazionali; tale corpus di norme è pertinente e potenzialmente applicabile a una serie di applicazioni di BD&IA emergenti.

Per quanto riguarda la protezione dei diritti fondamentali e dei diritti dei consumatori, il quadro legislativo dell’UE comprende atti normativi come la direttiva sull’uguaglianza razziale (Direttiva 2000/43/CE), la direttiva sulla parità di trattamento in materia di occupazione e di condizioni di lavoro (Direttiva 2000/78/CE), le direttive sulla parità di trattamento tra uomini e donne per quanto riguarda l’accesso a beni e servizi e in materia di occupazione (Direttiva 2004/113/CE; Direttiva 2006/54/CE), una serie di norme sulla tutela dei consumatori (es.: Direttiva sulle pratiche commerciali sleali n. 2005/29/CE e Direttiva sui diritti dei consumatori n. 2011/83/CE), sulla protezione dei dati personali e sulla privacy, in particolare il Regolamento generale sulla protezione dei dati (Regolamento UE 2016/679), nonché altre normative settoriali riguardanti la protezione dei dati personali, come la direttiva sulla protezione dei dati nelle attività di polizia e giudiziarie (Direttiva (UE) 2016/680). Inoltre, a partire dal 2025 si applicheranno le norme sui requisiti di accessibilità dei beni e dei servizi previste dall’atto europeo sull’accessibilità (Direttiva (UE) 2019/882).

I diritti fondamentali devono, inoltre, essere rispettati in sede di attuazione di altre normative dell’UE, anche nel settore dei servizi finanziari, della migrazione o della responsabilità degli intermediari online.

Se da un lato la legislazione dell’UE rimane in linea di principio pienamente applicabile, indipendentemente dall’utilizzo di tecnologie BD&IA, dall’altro è importante valutare se tale normativa possa essere adeguatamente applicata per far fronte ai rischi derivanti dall’impiego di tali sistemi o se sia necessario apportare adeguamenti a determinati strumenti giuridici.

Ad esempio, gli operatori economici rimangono pienamente responsabili della conformità dei processi che presuppongono l’utilizzo di tecnologie BD&IA alle norme vigenti a tutela dei consumatori: è vietato utilizzare algoritmi che sfruttano il comportamento dei consumatori in violazione delle norme vigenti, e qualunque infrazione a tale divieto è punita di conseguenza.

Pertanto, è da prevedere nei prossimi anni un’evoluzione del quadro normativo di riferimento, al fine di disciplinare il corretto utilizzo delle tecnologie BD&IA per la tutela dei consumatori e dei diritti fondamentali delle persone.

Norme sull’Intelligenza Artificiale

La definizione del quadro normativo per l’utilizzo di tecnologie AI è rappresentata dallo sviluppo di un percorso teso a realizzare una legislazione europea in materia. Tale percorso è stato iniziato ad aprile 2019, quando la Commissione europea ha pubblicato, in allegato alla sua Comunicazione al Parlamento europeo, al Consiglio, al Comitato economico e sociale europeo e al Comitato delle Regioni dal titolo “Creare fiducia nell’intelligenza artificiale antropocentrica”, le linee guida etiche per un’intelligenza artificiale affidabile redatte da un gruppo di esperti di alto livello da essa istituito [1]. Lo stesso gruppo di esperti fece seguire nel giugno 2019 le sue raccomandazioni politiche e di investimento per un’intelligenza affidabile.

Pochi mesi dopo il suo insediamento, la Presidente della Commissione, Ursula Von der Leyen, fissò tra le sue priorità in ambito legislativo quella di guidare l’Europa attraverso la transizione digitale per rispondere alle sfide relative alle nuove tecnologie. La Presidente ha così dichiarato di voler introdurre al più presto una legislazione specifica sull’intelligenza artificiale, simile al Regolamento sulla protezione dei dati, sulla base dei rapporti realizzati dagli esperti innanzi richiamati.

Nel Febbraio del 2020 è stato realizzato un primo passo verso la realizzazione di una legislazione europea, attraverso la pubblicazione del c.d. Libro Bianco sull’IA [4]. I libri bianchi della Commissione (in inglese white paper) “sono documenti che contengono proposte di azione dell’UE in un settore specifico. Essi costituiscono, talvolta, il prolungamento dei libri verdi, il cui scopo è invece quello di avviare un processo di consultazione a livello dell’UE. Lo scopo dei libri bianchi è di avviare una discussione con il pubblico, le parti interessate, il Parlamento europeo e il Consiglio allo scopo di raggiungere il consenso politico.

Il Libro Bianco ribadisce la necessità di un approccio comune europeo all’IA per raggiungere dimensioni sufficienti ed evitare la frammentazione del mercato unico. L’introduzione di iniziative nazionali rischia di compromettere la certezza del diritto, di indebolire la fiducia dei cittadini e di ostacolare l’emergere di un’industria europea dinamica. La costituzione di un futuro quadro normativo per l’IA in Europa consentirà, pertanto, di creare un “ecosistema di fiducia” unico. A tal fine, dovrà garantire il rispetto delle norme dell’UE, comprese le norme a tutela dei diritti fondamentali e dei diritti dei consumatori, in particolare per i sistemi di IA ad alto rischio gestiti nell’UE. La costruzione di un ecosistema di fiducia è un obiettivo strategico in sé e dovrebbe dare ai cittadini la fiducia di adottare applicazioni di IA e alle imprese e alle organizzazioni la certezza del diritto necessaria per innovare utilizzando l’AI.

La Commissione ritiene che, per stabilire in generale se una determinata applicazione di IA debba essere ritenuta ad alto rischio, occorre valutare gli interessi in gioco e considerare se il settore interessato e l’uso previsto per tale applicazione implichino rischi significativi, in particolare per quanto concerne la protezione della sicurezza, dei diritti dei consumatori e dei diritti fondamentali. Più specificamente, un’applicazione di IA dovrebbe essere considerata ad alto rischio se soddisfa i due criteri cumulativi descritti di seguito:

  • In primo luogo, l’applicazione di IA è utilizzata in un settore in cui i rischi sono generalmente ritenuti più probabili. I settori interessati dovrebbero essere elencati in maniera specifica ed esaustiva nel nuovo quadro normativo. Ad esempio, settori dell’assistenza sanitaria, dei trasporti, dell’energia e parti del settore pubblico. L’elenco dovrebbe essere periodicamente rivisto e modificato, ove necessario, in funzione dei pertinenti sviluppi nella pratica.
  • In secondo luogo, l’applicazione dell’IA nel settore in questione è, inoltre, utilizzata in modo tale da poter generare rischi significativi. Questo secondo criterio riconosce il fatto che non tutti gli usi dell’IA nei settori selezionati comportano necessariamente rischi significativi. La valutazione del livello di rischio derivante da un determinato uso potrebbe basarsi sull’impatto per i soggetti interessati. Ad esempio, usi delle applicazioni di IA che producono effetti giuridici, o effetti altrettanto rilevanti, sui diritti di una persona o di una società̀; usi che presentano il rischio danni materiali o immateriali significativi; usi che producono effetti non ragionevolmente evitabili dalle persone fisiche o giuridiche.

L’applicazione dei due criteri cumulativi garantirebbe un ambito di applicazione del quadro normativo mirato e atto a garantire la certezza del diritto. Le prescrizioni obbligatorie contenute nel nuovo quadro normativo sull’IA si applicherebbero in linea di principio unicamente a quelle che siano state identificate come applicazioni ad alto rischio utilizzando i due criteri cumulativi sopra descritti.

Fatto salvo quanto precede, possono esistere anche casi eccezionali in cui, a causa dei rischi in gioco, l’uso di applicazioni di IA per determinati scopi deve essere considerato ad alto rischio di per sé, ossia indipendentemente dal settore interessato, per cui si applicherebbero comunque prescrizioni puntuali. A titolo esemplificativo, si possono citare in particolare i seguenti usi:

  • Alla luce dell’importanza che riveste per le persone, e tenendo conto dell’acquis dell’UE sulla parità in materia di occupazione, l’uso delle applicazioni di IA nei processi di selezione del personale e nelle situazioni che incidono sui diritti dei lavoratori sarebbe sempre considerato “ad alto rischio”.
  • L’uso delle applicazioni di IA a fini di identificazione biometrica remota e l’impiego di altre tecnologie di sorveglianza intrusive sarebbero sempre considerati “ad alto rischio”.

In conclusione, gli orientamenti esposti dalla Commissione per un’intelligenza artificiale affidabile si basano su un principio di IA antropocentrica (cfr. “Creare fiducia nell’intelligenza artificiale antropocentrica” [5]) volto a garantire che i valori umani rivestano un ruolo centrale nelle modalità di sviluppo, distribuzione, utilizzo e monitoraggio dei sistemi di IA, garantendo il rispetto dei diritti fondamentali, tra cui quelli sanciti nei trattati dell’Unione europea e nella Carta dei diritti fondamentali dell’Unione europea, accomunati dal riferimento a un fondamento condiviso radicato nel rispetto della dignità umana, nei quali l’essere umano gode di uno status morale unico e inalienabile.

Le linee guida tracciate dalla Commissione per la definizione di un quadro normativo comune nell’UE si prefiggono di garantire una costante sorveglianza umana dei sistemi IA, la robustezza tecnica e la sicurezza degli algoritmi, la riservatezza dei dati nonché il rispetto del principio di accountability stabilito dal Regolamento UE 2016/679, la trasparenza e il rispetto della diversità, la non-discriminazione e l’equità.

Norme sui Big Data

I Big Data, secondo la “Risoluzione del Parlamento europeo del 14 marzo 2017 sulle implicazioni dei Big Data per i diritti fondamentali” [2] (di seguito Risoluzione del Parlamento europeo), si riferiscono alla raccolta, all’analisi e all’accumulo ricorrente di ingenti quantità di dati, compresi i dati personali, provenienti da una serie di fonti diverse, che sono oggetto di un trattamento automatizzato mediante algoritmi informatici e tecniche avanzate di trattamento dei dati, che usano sia informazioni memorizzate sia in streaming, al fine di individuare determinate correlazioni, tendenze e modelli (analisi dei Big Data).

L’enorme disponibilità di ogni sorta di informazione è una prospettiva allettante e apre innumerevoli scenari di ricerca; ad esempio, il progetto 4cE, descritto dal direttore generale dell’Oms Tedros Adhanom, può spiegare come i big data e le soluzioni IA possano trasformate i dati informatici al fine di salvare la vita ai malati Covid. In particolare, il progetto ha coinvolto 350 ospedali di 6 nazioni e riguardato più di 35mila ricoverati, dei quali sono state digitalizzate e confrontate le cartelle cliniche in una prima pubblicazione nell’aprile scorso. Grazie all’utilizzo dell’IA, che ha elaborato questi parametri nelle cartelle cliniche esaminate, è stato possibile definire come e quando intervenire sui malati gravi per evitare che peggiorino sino alla morte.

Pur avendo benefici incontestabili, però, si presenta la possibilità di risalire alle fonti di questa conoscenza e ai dati delle persone fisiche, minacciando i loro diritti sulla protezione dei dati che li riguardano. Infatti, è molto comune che un data set includa, nella sua forma originale, informazioni che sono riconducibili a specifici individui – un nome, una data di nascita, un indirizzo IP. Ciò diventa potenzialmente pericoloso nel momento in cui si dispone di una chiave per collegare dati su uno stesso individuo provenienti da fonti diverse – informazioni sanitarie, preferenze e opinioni espresse sui social network, dati collegati alle spese online e ai metodi di pagamento.

Pertanto, il rispetto degli obblighi previsti dal Regolamento UE 2016/679 in materia di protezione dei dati risulta come logica conseguenza. Ciò nonostante, sono molte le difficoltà di applicazione delle disposizioni del Regolamento a questa tipologia di trattamento. Alcune di esse fanno riferimento all’oggetto della tutela. Secondo l’art. 2 del Regolamento, l’ambito di applicazione materiale riguarda il trattamento di dati personali, che permettano l’identificazione dell’interessato. Nei Big Data il trattamento riguarda dati personali e anche dati non personali. Tuttavia, a causa dell’ingente quantità e della varietà di algoritmi che possono essere ad essi applicati, in alcuni casi, distinguere i dati personali da quelli non personali diventa estremamente difficile. La natura dei dati da analizzare, in effetti, sarà definibile solo a seguito dell’elaborazione, per cui un dato non personale potrà condurre ad un dato personale, ed un dato anonimo, invece, potrà, a seguito dell’analisi, condurre all’identificazione dell’interessato. La natura propria dei Big Data e questa difficoltà di distinzione dei dati personali dai dati non personali, in essi connaturata, genera ulteriori criticità, rendendo ardua l’applicazione di alcuni principi previsti nel Regolamento eppure ritenuti essenziali per il raggiungimento dell’accountability del titolare del trattamento.

In primis, la varietà e la quantità dei dati analizzati impediscono di verificare sin dall’origine l’esattezza degli stessi (principio di esattezza). In secondo luogo, l’impossibilità di stabilire dall’inizio le finalità della raccolta e dell’analisi delle informazioni a causa da un lato delle potenzialità intrinseche del dato e, dall’altro, dalla varietà delle elaborazioni che possono condurre a nuovi dati (principio di minimizzazione dei dati e di principio di limitazione delle finalità).

L’apparente inesauribilità dei dati, trattabili per qualsiasi finalità, fa sorgere criticità anche per il principio di limitazione della conservazione. Infine, merita attenzione anche il consenso dell’interessato. Nei Big Data non sempre vi è un consenso informato dell’interessato per le ulteriori finalità perseguite. Ciò deriva proprio dal gap strutturale e conoscitivo tra l’utente ed il titolare del trattamento. L’interessato-utente non sempre ha tutte le informazioni per poter esprimere un consenso informato, ed inoltre, anche nel caso in cui le avesse, non potrebbe comprenderle, poiché si fondano su algoritmi e software basati su un linguaggio complesso ai più incomprensibile.

Le considerazioni fin qui esposte mostrano come il ruolo assunto dai Big Data nel “funzionamento dei mercati, nel benessere dei consumatori, ma anche sotto il profilo sociale e democratico” è destinato a diventare sempre più rilevante e centrale. Tuttavia, la rilevanza e la centralità del fenomeno evidenziano, come sopra descritto, l’inadeguatezza del quadro normativo attuale, rendendo assolutamente necessario un intervento del legislatore. Anche l’Autorità Garante per la protezione dei dati (Garante Privacy), di concerto con l’Autorità Garante delle Comunicazioni (AGCOM) e l’Autorità Garante della Concorrenza e del Mercato (AGCM), si è fatta portatrice di questa esigenza.

Con il provvedimento del 10 luglio 2019, in effetti, è stata annunciata la fine dell’indagine conoscitiva ed interdisciplinare avviata nel maggio 2017 congiuntamente dalle tre Autorità con l’obiettivo di comprendere le implicazioni – per la privacy, la regolazione, la tutela della concorrenza e del consumatore – dello sviluppo di un’economia digitale fondata sulla raccolta e analisi di una mole sempre più ingente di dati.

Nel corso dell’indagine sono state svolte, da parte delle tre Autorità, circa quaranta audizioni, nell’ambito delle quali sono stati interpellati i principali operatori dell’economia dei dati, delle telecomunicazioni, dei settori finanziari e dell’editoria, nonché esperti e accademici. Sono state inviate richieste di informazioni ai grandi operatori digitali e sono pervenuti numerosi contributi. Il risultato dell’indagine conoscitiva ha portato alla costituzione delle Linee e Raccomandazioni di Policy [6] condivise relative al tema dei Big Data. Ciò che rende il documento interessante è il fatto che le Autorità hanno ritenuto opportuno anticipare, almeno in parte, le conclusioni delle analisi svolte, con la pubblicazione di un documento che identificasse delle raccomandazioni destinate non tanto (e non solo) agli operatori economici coinvolti, quanto ai legislatori, al fine di indirizzare le future, necessarie regolamentazioni.

Entrando nel merito delle Linee Guida, queste si sviluppano attraverso raccomandazioni (“Raccomandazioni”) rivolte, come detto, eminentemente a legislatori e regolatori, e solo di riflesso (anche) agli operatori di mercato. In quest’ottica, particolare rilevanza assume la Raccomandazione 1, di carattere “programmatico”, rivolta a Governo e Parlamento nell’ottica della promozione di “un appropriato quadro normativo che affronti la questione della piena ed effettiva trasparenza nell’uso delle informazioni personali (nei confronti dei singoli e della collettività)”. Nel dettaglio, vengono brevemente considerate le disposizioni normative rilevanti in ambito privacy, concorrenza e comunicazioni, giungendo alla conclusione che sarebbe necessario un intervento di natura sostanziale soprattutto in materia di pluralismo informativo, considerato che la normativa è ancora oggi diretta a regolamentare un quadro più tradizionale, che non tiene in considerazione le peculiarità (e le possibili distorsioni) dell’economia digitale.

La Raccomandazione 5 è rilevante, invece, oltre che dal punto di vista contenutistico, anche sotto il profilo metodologico. Nel merito, è specificamente improntata su aspetti privacy, ed esprime due esigenze: da un lato, è necessario accertarsi della natura personale o non personale dei dati trattati (al fine di comprendere le disposizioni normative applicabili), dall’altro gli operatori dell’economia digitale dovrebbero essere chiamati a valutare se una persona fisica possa essere “ragionevolmente identificata” mediante l’utilizzo (e l’incrocio) di una molteplicità di dati anonimi. Sotto l’aspetto metodologico, la Raccomandazione in commento è rilevante dal momento che per la prima volta nel documento ci si rivolge non solo a legislatori e regolatori, ma anche agli operatori del mercato.

Al riguardo, se è possibile individuare la norma che disciplina il trattamento di dati personali nel Regolamento UE 2016/679, quella relativa ai dati non personali risulta essere il Regolamento UE 2018/1807. Quest’ultimo si propone di eliminare le barriere che attualmente impediscono la libera circolazione transfrontaliera all’interno della UE dei dati che non riguardano persone fisiche identificate o identificabili. Le disposizioni contenute nel Regolamento UE 2018/1807 integrano quelle che prevedono la libera circolazione e la portabilità dei dati personali all’interno della UE contenute nel Regolamento UE 2016/679, ed assieme a queste ultime, nell’intenzione del legislatore europeo, contribuiscono alla creazione di quello “spazio comune europeo dei dati” auspicato più volte dalla stessa Commissione europea.

Nel Febbraio del 2020, è stato pubblicato il rapporto finale dell’indagine conoscitiva sui Big Data [7], che partendo da tre prospettive diverse e complementari, ha individuato le principali sfide per il loro utilizzo, tra cui:

  • la centralità del dato, anche come bene economico e l’importanza della sua tutela come diritto fondamentale della persona;
  • l’impatto della profilazione algoritmica e delle piattaforme on-line sul grado di concorrenza in vecchi e in nuovi mercati rilevanti;
  • l’effetto del programmatic advertising sulla qualità dell’informazione e sulle modalità di diffusione e acquisizione della stessa;
  • la tutela e la promozione del pluralismo on-line in un contesto informativo esposto a strategie di disinformazione e di hate speech;
  • la necessità di garantire trasparenza e scelte effettive al consumatore, con particolare attenzione alla tutela dei minori, in relazione al consenso circa l’uso del proprio dato;
  • la protezione del dato personale anche in ambiti non attualmente coperti dal Regolamento UE 2016/679;
  • la definizione di politiche di educazione in relazione all’uso del dato.

Riferimenti bibliografici

  1. Ethics Guidelines for Trustworthy Artificial Intelligence, by High-Level Expert Group on Artificial Intelligence, published on 8 April 2019.
  2. Risoluzione del Parlamento europeo del 14 marzo 2017 sulle implicazioni dei Big Data per i diritti fondamentali: privacy, protezione dei dati, non discriminazione, sicurezza e attività di contrasto.
  3. Guidelines on Automated individual decision-making and Profiling for the purposes of Regulation 2016/679, adopted on 3 October 2017 and revised on 6 February 2018 by Article 29 Working party
  4. Libro Bianco sull’intelligenza artificiale -Un approccio europeo all’eccellenza e alla fiducia – pubblicato dalla Commissione Europea il 02 Febbraio 2020.
  5. Comunicazione della Commissione al Parlamento Europeo, al Consiglio, al Comitato Economico e Sociale Europeo e al Comitato delle Regioni del 8 Aprile 2019.
  6. Big Data. Linee guida e raccomandazioni di policy – Indagine conoscitiva congiunta di Agcom, Agcm e Garante privacy di Luglio 2019.
  7. Indagine conoscitiva sui Big Data (rapporto finale) del 10 Febbraio 2020.

Note

[1] Articolo 6 del Regolamento UE 2016/679

[2] Articolo 5, comma 2 del Regolamento UE 2016/679

[3] ENISA – European Union Agency for Network and Information Security  è un centro di ricerca sulla cyber security, che contribuisce al mantenimento di elevati standard di sicurezza delle reti all’interno dell’Unione europea. Il lavoro dell’Agenzia si svolge in stretta connessione con i Paesi membri e con il settore privato.

Articolo a cura di Ivano Pattelli

Ivano Pattelli è Associate Manager presso Business Integration Partners S.p.A. e si occupa di sviluppo business e di servizi di consulenza in ambito cyber security e protezione dei dati personali, per clienti di grandi dimensioni nei diversi settori di appartenenza (pubblica amministrazione, sanità, telco, finance, luxury, ecc.). In precedenza, ha maturato un esperienza pluriennale in importanti società di consulenza ed in multinazionali del settore ICT (Ernst & Young, TTP, HPE), occupandosi principalmente di attività nell’ambito dell’IT Security Governance, Risk & Compliance, con particolare focus sugli aspetti di conformità normativa in materia di protezione dei dati personali. Nel corso degli anni ha conseguito diverse certificazioni, quali ISO/IEC 27001:2013 Lead Auditor, CISSP, CISA, CRISC, “Privacy Officer e Consulente della Privacy” di TUV Italia, European Privacy Auditor ISDP©10003:2015 e Lean 6 Sigma Green Belt.

https://www.ictsecuritymagazine.com/articoli/privacy-sicurezza-ed-etica-nellutilizzo-dei-big-data-e-dellintelligenza-artificiale/
WhatsApp Web Forensics

E’ trascorso ormai del tempo dal mio ultimo articolo inerente WhatsApp Messenger– WhatsApp Forensics – ICT Security Magazine –, l’applicazione di messaggistica istantanea più popolare al mondo. Mi ripropongo, in questo nuovo articolo, di analizzare le ulteriori modalità di utilizzo della classica app evidenziandone le ulteriori attività utili alle indagini digitali forensi.

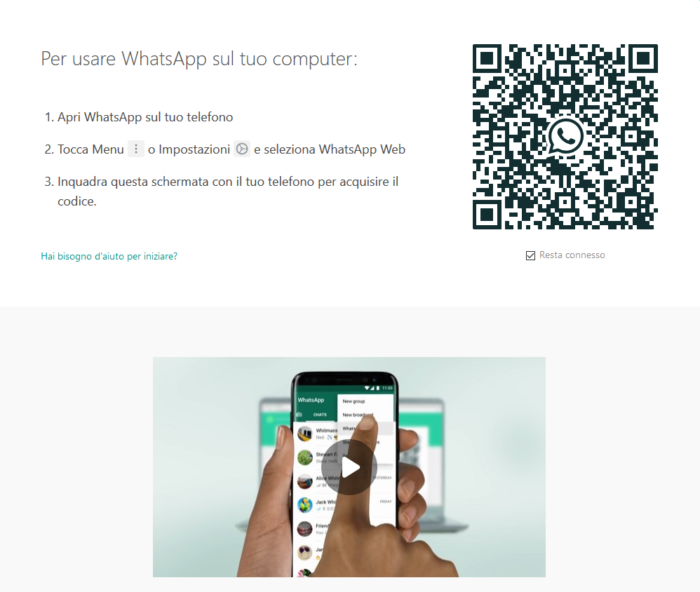
Nel gennaio 2015 fu introdotto il client web WhatsApp, accessibile dai principali browser utilizzati (Google Chrome, Mozilla Firefox, Opera, Safari, Microsoft Edge) e, nel maggio 2016, l’applicazione desktop WhatsApp (Mac o Windows); queste due modalità sono oggi di usuale utilizzo. Per utilizzare il client web WhatsApp è necessario digitare l’indirizzo web https://web.whatsapp.com su uno qualsiasi dei browser supportati e scansionare, dall’app installata sul dispositivo mobile nella sezione Impostazioni – WhatsApp Web/Desktop (esempio per iOS) –, il codice QR;

da quel momento, il client web potrà gestire i contenuti dell’app installata sul mobile, comportandosi come un’estensione della stessa sempre, e soltanto se, il dispositivo che abbia autorizzato l’accesso sia coperto dalla rete; in caso contrario sarà impossibile gestire l’invio o la ricezione dei messaggi sul client desktop, indipendentemente dalla piattaforma.

Questa architettura consente ad una persona, anche non autorizzata ma in grado di avvalersi del dispositivo per connetterlo al client web oppure di utilizzarne una connessione già in essere, la completa gestione delle chat del dispositivo stesso che, a tal punto, possono essere intercettate, visualizzate e scaricate.

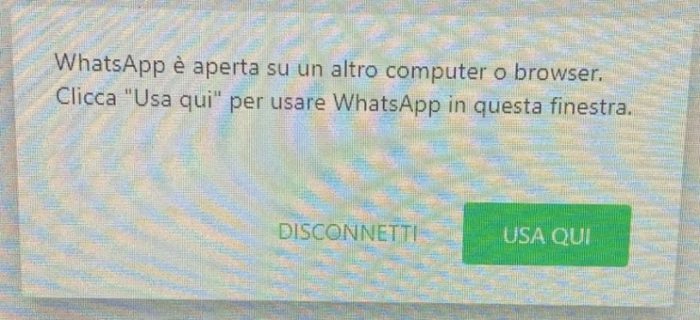
Qualora una nuova sessione di WhatsApp Web venga creata dalla stessa applicazione mobile utilizzando un altro browser o un altro computer, WhatsApp si scollegherà dal client precedente visualizzando un messaggio pop-up “WhatsApp è aperta su un altro computer o browser. Clicca su “Usa qui” per utilizzare WhatsApp in questa finestra” (fig. 1), connettendosi al nuovo client.

Fig.1

Quando dal nuovo computer o dal nuovo browser si effettuerà la disconnessione da WhatsApp Web, la precedente connessione verrà nuovamente ristabilita.

Ritengo fondamentale per la conduzione di una corretta analisi delle evidenze, la comprensione del funzionamento di quanto ci si accinge ad analizzare e quindi la necessità di porsi delle domande atte a meglio comprendere l’oggetto da analizzare.

E’ indubbio che la ricerca nel campo della mobile forensics, con specifico riferimento all’applicativo Whatsapp, si è concentrata principalmente, sino ad oggi, sulle evidenze estraibili dall’applicazione installata sui dispositivi mobile tralasciando il web client o l’applicazione desktop di WhatsApp. Non vi sono, infatti, studi inerenti l’applicazione desktop di WhatsApp e appena un paio su WhatsApp web.

In questo articolo proverò quindi ad evidenziare trattare tutte le possibili informazioni digitali forensi estraibili da WhatsApp Desktop/Web e la relativa rilevanza nella visione d’insieme del quadro investigativo.

Prenderemo in considerazione, per ora, i browser Firefox, Chrome e Microsoft Edge, solo per sistemi Windows e la relativa applicazione desktop.

Per le prove effettuate ci si è avvalso di un laptop con le seguenti caratteristiche:

  • Processore: Intel(R) Core(TM) i7-10875H CPU @ 2.30GHz 30 GHz;
  • RAM: 16,0 GB;
  • Tipo S.O.: Sistema operativo a 64 bit, processore basato su x64;
  • O.: Windows 10 Pro vers. 20H2, build 19042.685.

La maggior parte delle evidenze di interesse investigativo sono state reperite nei percorsi indicati in fig. 2, all’interno dei file con estensione log e nei file di cache.

I file di log di WhatsApp vengono costantemente aggiornati in base alle iterazioni dell’utente con l’applicativo client WhatsApp. Le informazioni precedentemente salvate su detti file di log potrebbero anche essere sovrascritte da nuovi dati e quindi potrebbe non contenere l’intera cronologia delle azioni dell’utente. Nei file di log non viene memorizzato alcun messaggio scambiato, ma le informazioni presenti possono essere di fondamentale importanza nel corso delle indagini. Si potrebbe risalire, ad esempio, ad un dispositivo mobile totalmente diverso da quello in possesso degli inquirenti, oppure con un S.O. più aggiornato, il tutto utilizzabile dagli investigatori forensi per indirizzare l’A.G.[1] verso una ricerca più mirata che coinvolga eventuali altri dispositivi e, nel contempo, operare una scelta più oculata di strumenti idonei allo scenario che si prospetta.

Client di WhatsApp Percorsi contenenti le evidenze
Applicazione Desktop File di Log

%USERPROFILE%\AppData\Roaming\WhatsApp\IndexedDB\file__0.indexeddb.leveldb\******.log

Directory di installazione

%USERPROFILE%\AppData\Local\WhatsApp

Chiavi di registro

HKEY_CLASSES_ROOT\Local Settings\Software\Microsoft\Windows\Shell\MuiCache

HKEY_CLASSES_ROOT\whatsapp\shell\open\command

HKEY_CURRENT_USER\SOFTWARE\Classes\Local Settings\Software\Microsoft\Windows\Shell\MuiCache

HKEY_CURRENT_USER\SOFTWARE\Classes\whatsapp\shell\open\command

HKEY_CURRENT_USER\SOFTWARE\Microsoft\Windows\CurrentVersion\ContentDeliveryManager\SuggestedApps

HKEY_CURRENT_USER\SOFTWARE\Microsoft\Windows\CurrentVersion\Explorer\FeatureUsage\AppBadgeUpdated

HKEY_CURRENT_USER\SOFTWARE\Microsoft\Windows\CurrentVersion\Explorer\FeatureUsage\AppSwitched

HKEY_CURRENT_USER\SOFTWARE\Microsoft\Windows\CurrentVersion\Notifications\Settings\com.squirrel.WhatsApp.WhatsApp

HKEY_CURRENT_USER\SOFTWARE\Microsoft\Windows\CurrentVersion\PushNotifications\Backup\com.squirrel.WhatsApp.WhatsApp

HKEY_CURRENT_USER\SOFTWARE\Microsoft\Windows\CurrentVersion\Uninstall\WhatsApp

HKEY_CURRENT_USER\SOFTWARE\Microsoft\Windows NT\CurrentVersion\AppCompatFlags\Compatibility Assistant\Store

HKEY_LOCAL_MACHINE\SOFTWARE\Microsoft\RADAR\HeapLeakDetection\DiagnosedApplications\WhatsApp.exe

HKEY_LOCAL_MACHINE\SOFTWARE\Nahimic\NahimicAPO4\NahimicSettings\Applications\WhatsApp.exe

Directory del profilo

%USERPROFILE%\AppData\Roaming\WhatsApp

Prefetch

Windows\Prefetch\WHATSAPP.EXE-118A19ED.pf[2]

Collegamenti Windows

%USERPROFILE%\AppData\Local\WhatsApp\WhatsApp.exe

%USERPROFILE%\DeskTop\WhatsApp.lnk

Cache immagini del profilo

%USERPROFILE%\AppData\Roaming\WhatsApp\Cache

Chrome File di log

%USERPROFILE%\AppData\Local\Google\Chrome\User Data\Default\IndexedDB\https_web.whatsapp.com_0.indexeddb.leveldb\*****.log

History

%USERPROFILE%\AppData\Local\Google\Chrome\User Data\Default\History

Prefetch

Windows\Prefetch\CHROME.EXE-039F1FD1.pf

Collegamenti Windows

Utenti\Public\Desktop\Google Chrome.lnk”

%USERPROFILE%\Desktop\Google Chrome.lnk

%USERPROFILE%\AppData\Roaming\Microsoft\Internet Explorer\Quick Launch\Google Chrome.lnk

Cache immagini del profilo

%USERPROFILE%\AppData\Local\Google\Chrome\User Data\Default\Cache

Firefox File d log

%USERPROFILE%\AppData\Roaming\Mozilla\Firefox\Profiles\XXXXXXXX.default-1557048742432\storage\default\https+++web.whatsapp.com\idb\********wcaw.sqlite

History

%USERPROFILE%\AppData\Roaming\Mozilla\Firefox\Profiles\xqimcopc.default\places.sqlite

Prefetch

Windows\Prefetch\FIREFOX.EXE-25FC0A66.pf

Collegamenti Windows

%USERPROFILE%\AppData\Roaming\Microsoft\Windows\Start Menu\Programs\Firefox.lnk

%USERPROFILE%\AppData\Desktop\Firefox.lnk

Cache immagini del profilo

%USERPROFILE%\AppData\Local\Mozilla\Firefox\Profiles\xqimcopc.default\cache2\entries

Edge File di log

%USERPROFILE%\AppData\Local\Microsoft\Edge\User Data\Default\File System

%USERPROFILE%\AppData\Local\Microsoft\Edge\User Data\Default\IndexedDB\https_web.whatsapp.com_0.indexeddb.leveldb

History

%USERPROFILE%\AppData\Local\Microsoft\Edge\User Data\Default\History

Cookie

%USERPROFILE%\AppData\Local\Microsoft\Edge\User Data\Default\Cookies

Prefetch

Windows\Prefetch\ MSEDGE.EXE-37D25F9C.pf

Cache immagini del profilo

%USERPROFILE%\AppData\Local\Microsoft\Edge\User Data\Default\Cache

Percorsi e file ulteriori

%USERPROFILE%\AppData\Local\Microsoft\Edge\User Data

%USERPROFILE%\AppData\Local\Microsoft\Edge\User Data\Default\Local Storage\leveldb

%USERPROFILE%\AppData\Local\Microsoft\Edge\User Data\Default\Service Worker\Database

%USERPROFILE%\AppData\Local\Microsoft\Windows\WebCache\

%USERPROFILE%\AppData\Local\Microsoft\Edge\User Data\Default\QuotaManager

%USERPROFILE%\AppData\Local\Microsoft\Edge\User Data\Default\Shortcuts

Fig.2

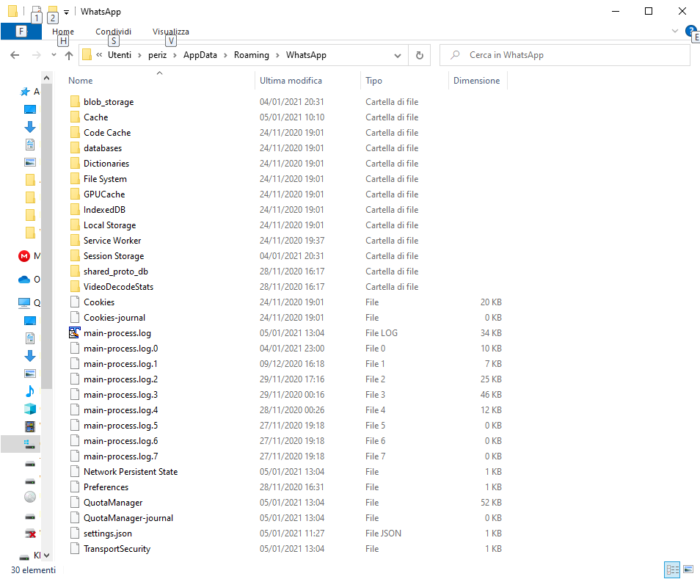
In calce il contenuto tipico della cartella del profilo WhatsApp Desktop – cfr. fig.3 -:

Fig.3

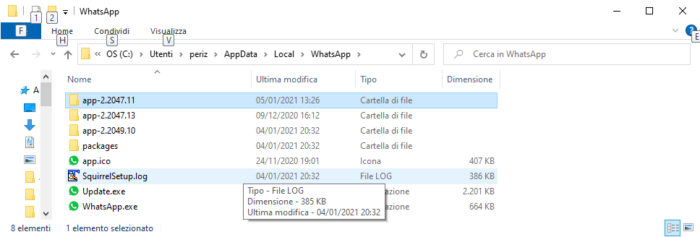
In fig.4, il contenuto tipico della directory di installazione:

Fig.4

Le evidenze significative rinvenute – la tabella non è certamente esaustiva – provengono dai valori delle azioni identificate all’interno dei file di log, a cui si è attribuito il significato descritto:

Tipologia Comandi Opzioni Descrizione dell’azione
action,presence, (available/unavailable) Stato dell’utente
action,chatstate, (composing/paused/

recording)

Attività dell’utente:composizione di un messaggio, ascolto di un audio,, etc.
action,message, (image/video/chat/vcard/document/ptt/sticker) Inviodel messaggi da parte dell’utente; non viene specificato il destinatario. L’opzione Vcardrappresenta un’informazione di contatto, mentre l’opzioneptt è sinonimo di push-to-talk (registrazionediunmessaggio audio).
action,msgs,delete Cancellazione di un messaggio da parte dell’utente
action,battery,80, (True/False) Stato di carica della batteria in un determinato istante.
Timestamps

/Actions

action,chat,read,{“fromMe”: false,”remote”: 393518193636@c.us…} Phone Number @c.us or @g.us Lettura di un messaggio da parte dell’utente e/o all’interno di un gruppo
action,status,read,{“fromMe”:false,”remote”: “status@broadcast Id, Partecipant, Visualizzazione dello Stato aggiornato di un utente
Media:sendToChat chat 393518193636@c.us Phone Number @c.us or @g.us Invio file multimediali da parte dell’utente attraverso chat individuale e/o di gruppo
action,msg,relay,…393292094446-1390410687@ g.us,393474497649@c.us (chat,image,video,stickers) Ricezione di un messaggio, e/o di un’immagine, e/o di un video, e/o di uno sticker.

Fig.5

In calce, alcuni estratti con evidenziati i comandi in tabella di fig. 5, relativi al file di log prodotto dall’app, situato nella cartella indicata in tabella 2 alla voce “file di log”, quale esempio:

lineI®” log”S#T*. 2020-12-12 21:42:20.889:sending: 1607805740.–101, action,presence,unavailable” timestampN .–

‹ewB{ 2­ÿÿÿÿÿÿõ

lineIò” log”N#T*. 2020-12-12 21:42:00.301:sending: 1607805720.–99, action,chatstate,paused” timestampNqK™‹ewB{ 2¦ÿÿÿÿÿÿõ

o” lineIô “ log”f#T*. 2020-12-12 21:42:00.301: send: 3EB05ED8549191C0A709, action,message,chat,,3EB05ED8549191C0A709″ timestampN L™‹ewB{ 2¦ÿÿÿÿÿÿð

o” lineI²” log”L#T*. 2020-12-12 21:58:03.203:bin-recv: 1607804037-127,action,battery,80,true”  timestampN\!¤ð‹ewB{ 2Üÿÿÿÿÿÿë

o” lineIœ” log”®#T*. 2020-12-12 21:58:01.637: send: 796.–106, action,chat,read,{“fromMe”:false,”remote”:”393292094446-1390410687@g.us”,”id”:”DA93D149790E43314E9C7557FAB6A62D”,”participant”:”393518193636@c.us”,”_serialized”:”false_393292094446-1390410687@g.us_DA93D149790E43314E9C7557FAB6A62D_393518193636@c.us”},13″ timestampNá¼Lð‹ewB{ 2Úÿÿÿÿÿÿá

” log”ž#T*. 2020-12-12 21:24:17.266: send: 985.–67, action,status,read,{“fromMe”:false,”remote”:”status@broadcast“,”id”:”82603420D13984BDD68E6B3F33598FD8″,”participant”:”393473863418@c.us”,”

_serialized”:”false_status@broadcast_82603420D13984BDD68E6B3F33598FD8_393473863418@c.us”},undefined”    timestampNtŠewB{ 2Þ ÿÿÿÿÿÿë

o” lineI¬” log”â#T*. 2020-12-12 21:16:37.341:bin-recv: 1607804037-17,action,msg,relay,video,393292094446-1390410687@g.us,393474497649@c.us,false_393292094446-1390410687@g.us_C0329DF75DED117BB83319C9EB2BB064_393382437657@c.us,393382437657@c.us”   timestampNÍÜÊ‘‰ewB{ 2£ ÿÿÿÿÿÿÜ


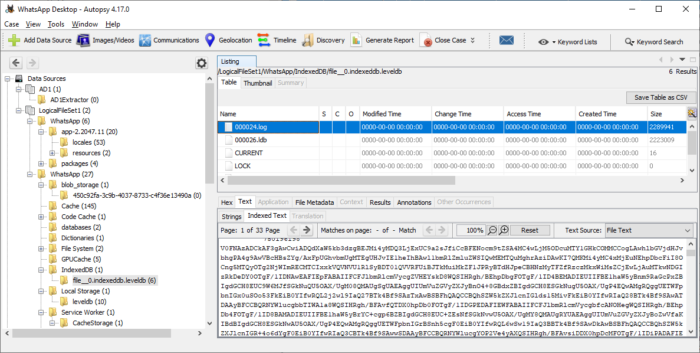
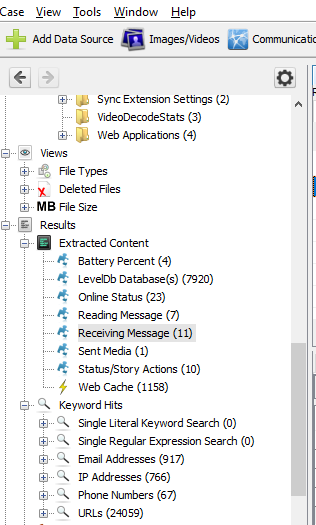
Con l’ausilio di Autopsy rel. 4.17 si è analizzato il contenuto delle cartelle inerenti la app Desktop e indicate in fig.2, ottenendo il risultato in calce:

Fig.6

Fig.7

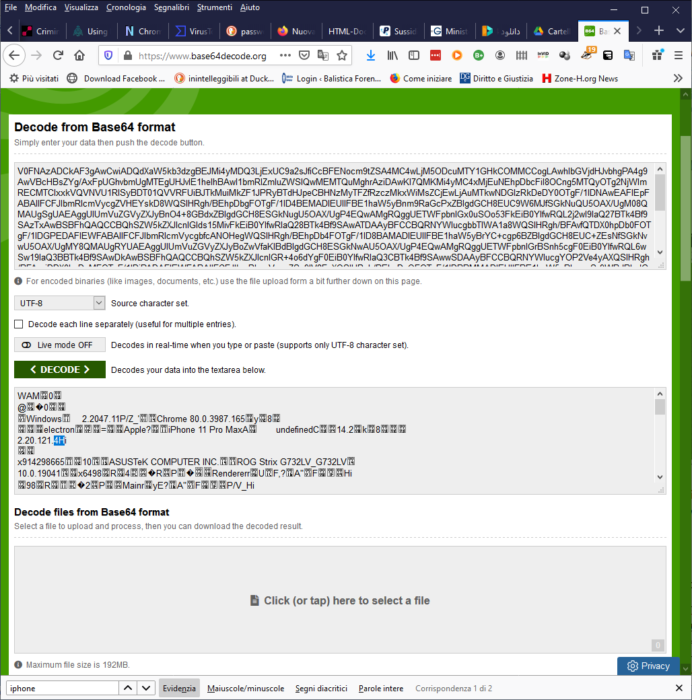
Decodificando il contenuto espresso inBase64[3] del file 000024.log – evidenziato in fig.6 -, è possibile rinvenire il contenuto di alcune variabili insite nel codice di WhatsApp, e non solo:

webcPhoneDeviceManufacturer: Apple
webcPhoneDeviceModel: iPhone 11 Pro Max
webcPhoneOsBuildNumber:undefined
webcPhoneOsVersion: 14.2
webcPhoneAppVersion: 2.20.121

E’ possibile quindi estrarre, oltre il contenuto delle variabili ut supra, anche altri dati interessanti quali: la tipologia dell’ambiente operativo in cui è installata l’app – nel caso di specie Windows -, la versione utilizzata della stessa – 2.20.121 -, il computer utilizzato con marca e modello – ASUSTeK COMPUTER INC, ROG Strix G732LV – la versione di Windows installata sul computer utilizzato – 10.0.19041 x64– e altri ancora oggetto di studio.

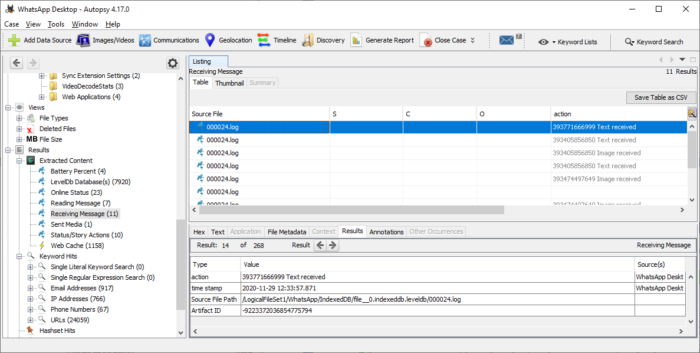
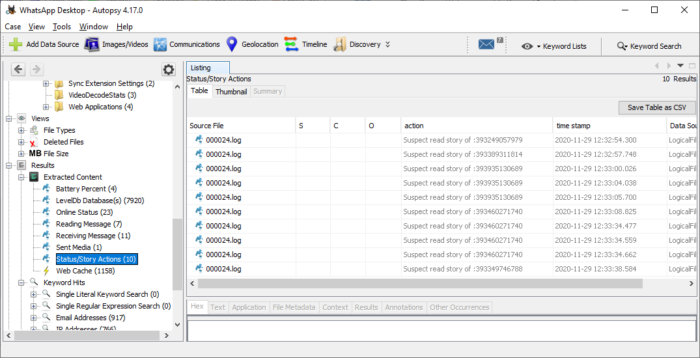
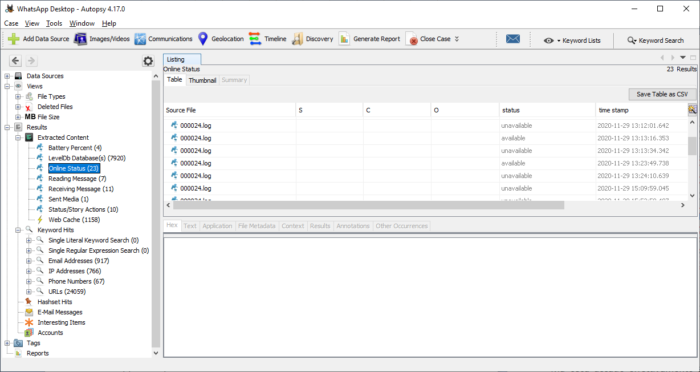
Un ottimo plugin, realizzato per la release 4.11 di Autopsy ma valido anche per le release successive, liberamente scaricabile all’indirizzo https://github.com/sathwikv143/Autopsy-Whatsapp-Plugin, consente il parsing[4] del file di log creato dall’app desktop di WhatsApp, estraendo dati di indubbia utilità nel corso delle indagini investigative.

Le figg.8-9 evidenziano, nei risultati di Autopsy, tutte le evidenze estratte.

Fig.8

Fig.9

E’ possibile, tra l’altro, attribuire la data e ora di visualizzazione di una storia pubblicata da un altro utente, identificata dal numero telefonico dell’utente visualizzato (cfr. fig. 8).

Fig.8

Non solo: si può determinare anche lo stato online dell’utente (available/unavailable) corredato dal relativo timestamp – cfr. fig. 9 -.

Fig.9

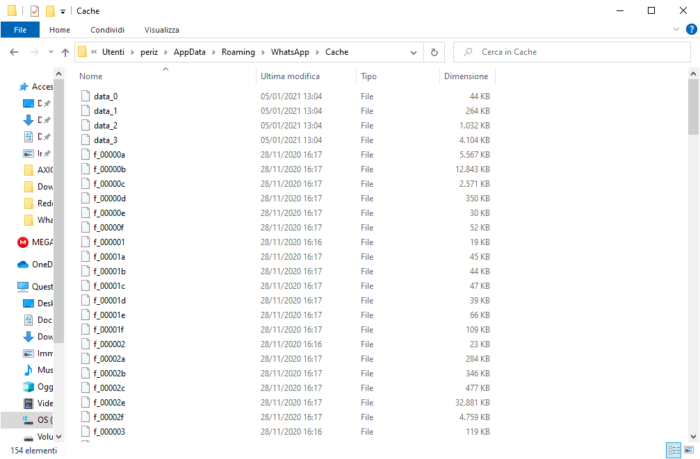
Di particolare interesse dal punto di vista forense è il contenuto della directory Cache evidenziato in fig.10:

Fig.10

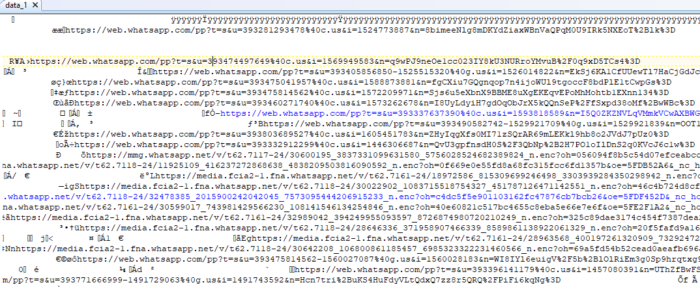
Si tratta di file denominati f_******* (dove * è un numero da 0 a 9) a contenuto multimediale, cifrati. Alcuni di essi, tuttavia, possono essere non cifrati e quindi facilmente visualizzabili. I file più interessanti sono data_0, data_1, data_2 e data_3, che si trovano nella stessa subdirectory. Questi file contengono, al loro interno, i collegamenti a file e documenti multimediali cifrati trasferiti dall’utente.

In calce un esempio del contenuto del file denominato data_1:

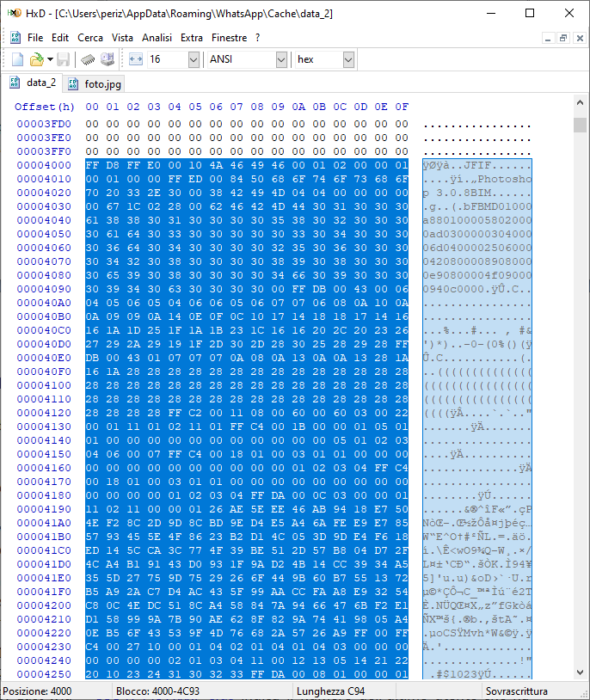
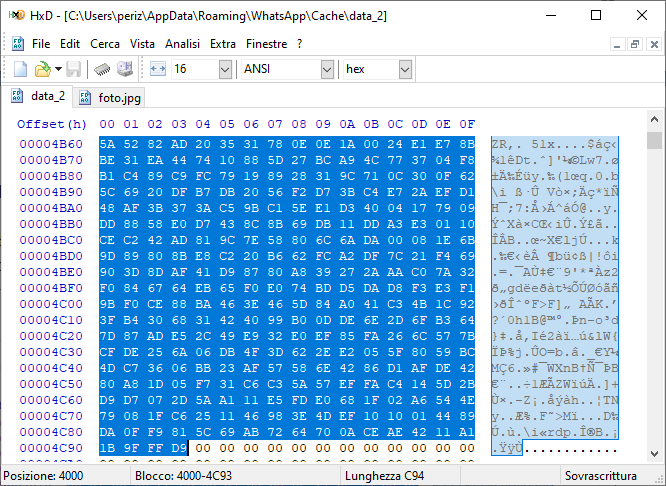
Il file data_2 contiene avatars e foto inerenti i profili dell’utente e devono essere ricercati utilizzando gli header propri dei file grafici. Ad esempio, nello stralcio evidenziato in calce, selezionando il blocco da offset 4000h a offset 4c90h è possibile estrarre la foto del profilo evidenziata in fig. 11:

Fig.11

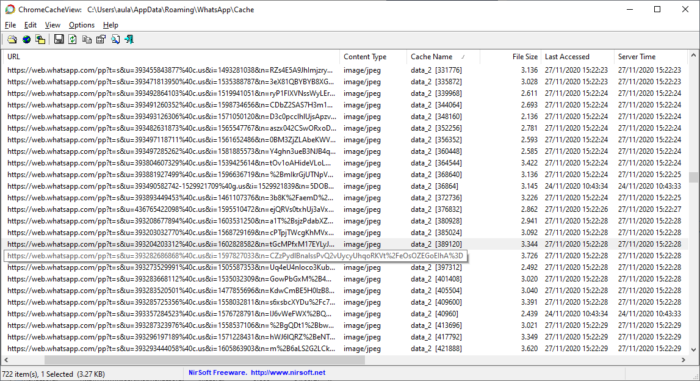
Adoperando il tool fornito da Nirsoft[5], denominato ChromeCacheView,è pensabile di esaminare le evidenze contenute in detta directory allo scopo di trarne maggiori e più dettagliate informazioni ed evitando la ricerca degli header dei file; il tool consentirà la visualizzazione dell’elenco degli stessi corredata da: url, tipologia del contenuto, dimensioni del file, ora di accesso, nome del server e risposta eventuale dello stesso e tanto altro ancora.

In calce uno stralcio del risultato ottenuto dal software:

Selezionando una delle righe con contenuto “image/type” e premendo il tasto F7,è ottenibile l’immagine del profilo relativa:

t=s&u=39320420xxxx[6]%40c.us&i=1602828582&n=tGcMPfxM17EYLyJ%2BMXg.jpg

t=s&u=39349421xxxx[7]%40c.us&i=1605448195&n=T6V0sGDHyMzGmaiFxLJNi.jpg

Dopo questo breve excursus inerente l’applicazione Desktop di WhatsApp e nella speranza di aver fatto cosa gradita, continuo illustrandovi l’alternativa fornita da WhatsApp Web.

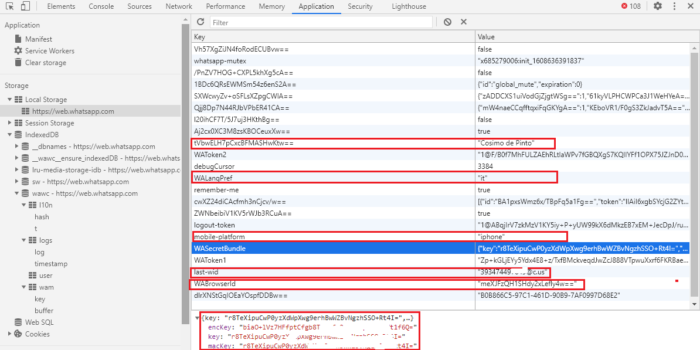
WhatsApp Web possiede anche una comoda interfaccia API[8]. È accessibile direttamente dal browser avviandone la relativa console di sviluppo – Google Chrome Developer Console, ad esempio – , dopo aver avuto accesso al client web di WhatsApp. Un esempio delle evidenze estratte e di facile comprensione a cui è possibile accedere, viene evidenziato in rosso e riportato in Fig.12.

I campi suddetti consentono di ottenere informazioni utili ai fini delle indagini – si possono notare campi non intelligibili e opportunamente cifrati; tutto ciò non verrà trattato in questo articolo – quali ad esempio:

  1. WaLangPref = “it” indica la lingua preferita dall’utente;
  2. Mobile-platform=”iphone” indica il dispositivo connesso all’applicativo web;
  3. Last-wid = 393474497xxx@c.us indica il numero dell’ultimo utente che ha scritto un messaggio; il formato del numero riportato è così ripartito:
  • “39” identificativo internazionale = Italia;
  • 3474497xxx numero dell’utente;
  • @c.us identificativo del singolo utente distinto dal gruppo che invece riporta la sigla @g.us;

Fig.12

Risulta quindi di palmare evidenza che, per quanto concerne le estrazioni inerenti WhatsApp Web, verranno adoperati tool forensi in grado di gestire le informazioni memorizzate dai vari browser, quali la cronologia, i termini di ricerca, la cache, le sessioni web, i tempi di utilizzo e i contenuti dei vari db utilizzati, incluso lo storageIndexedDB.

Poiché Internet e il World Wide Web si sono rapidamente evoluti rivoluzionando le modalità di fruizione delle applicazioni nella vita di tutti i giorni, l’investigatore forense è costantemente impegnato a tenere il passo con le tecnologie emergenti per le analisi forensi. Le indagini sulle attività prodotte mediante l’utilizzo dei browser web, – la cosiddetta web browser forensics –, è ormai divenuta parte significativa della digital forensics, data la grande mole di informazioni reperibili dalla navigazione sul web dell’indagato. Difatti, la memorizzazione in locale delle strutture dati e delle sessioni di navigazione, ha consentito la gestione di evidenze digitali dapprima inimmaginabili.

Di conseguenza, le soluzioni strutturate di database sono state inevitabili.

IndexedDB è una di queste. Si tratta di una tecnologia di “storage”web che consente la memorizzazione, lato client, di grosse moli di dati.

La sua popolarità, quale tecnologia di archiviazione nelle applicazioni web più diffuse, ha richiesto un studio dettagliato onde permettere l’analisi della stessa da parte dell’investigatore forense.

Una breve panoramica inerente lo storage IndexedDB[9] pare d’obbligo, e consente di poter comprendere al meglio quanto trattato più avanti.

IndexedDB è un sistema di database transazionale NoSQL (Non solo SQL) di relativa nuova concezione, orientato agli oggetti e che consente un rapido accesso ai dati persistenti attraverso gli oggetti JSON (Java Script Object Notation). Viene gestito da codice Java Script che lo rende altamente utilizzabile per i browser web. Il grande vantaggio di IndexedDB risiede nella sua capacità di storage: la sua offerta fornisce un minimo di 50MB di spazio per ogni origine dati, rispetto alla concorrenza che si limita a massimo 5 MB.

Ciò ha permesso a IndexedDB di aumentare drasticamente il suo utilizzo nell’ambito dei siti web degli ultimi anni e nei browser per la gestione dei propri dati. Proprio per questo suo diffuso utilizzo, inizia a divenire un’ottima fonte di supporto alle indagini digitali tradizionali. Per chi volesse approfondire la tematica inerente IndexedDB, potrà trovare quanto necessario consultando il link: https://www.geeksforgeeks.org/indexeddb-introduction/.

Dove trovare, quindi, gli artefatti di WhatsApp Web relativi a IndexedDB? Come analizzarli ? Quali evidenze è possibile estrarre ? Quali strumenti adoperare ?

Nella tabella 2 vengono forniti i relativi percorsi in cui ricercare le evidenze utili al fine delle indagini.

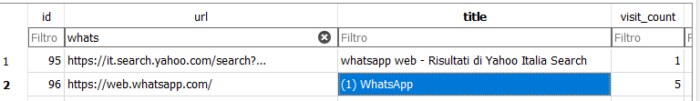
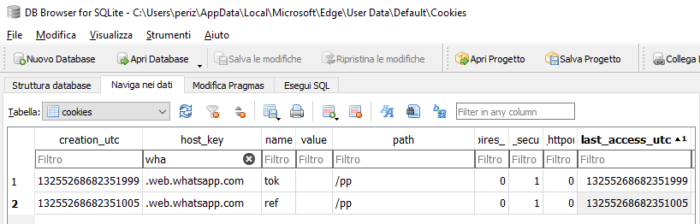
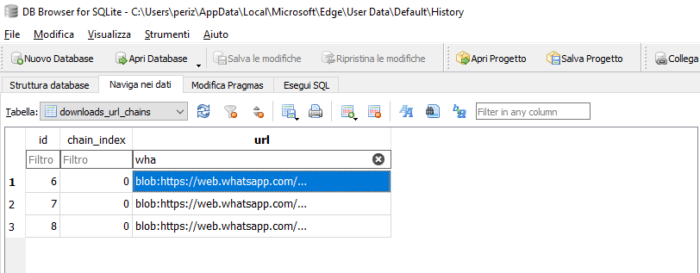
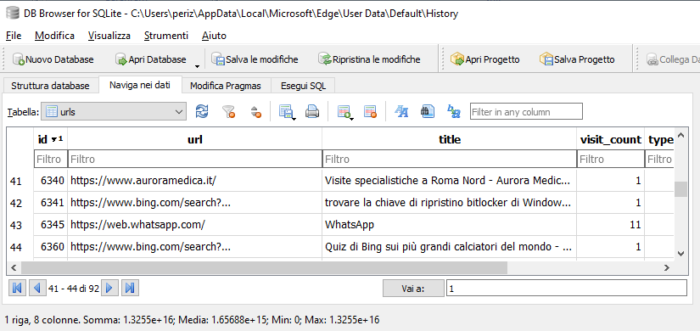
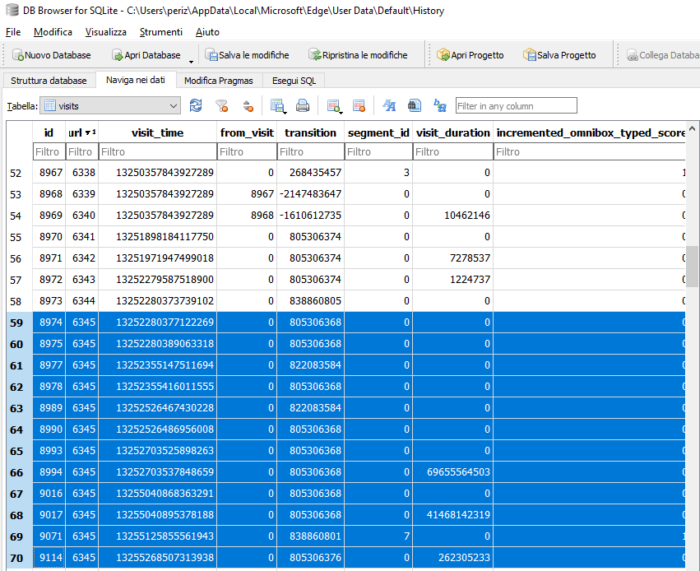
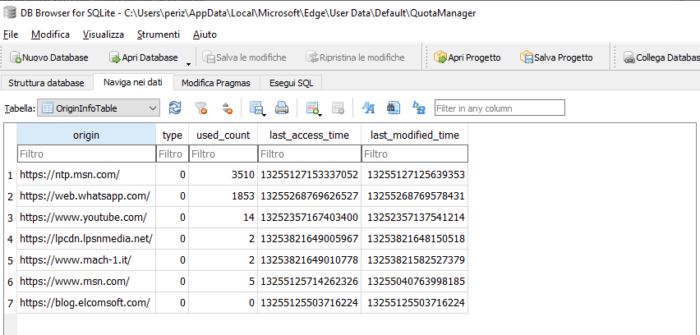
Nei file di log si troveranno le principali evidenze; nelle directory cache le immagini dei vari profili; nelle tabelle dei db in formato sqlite il conteggio delle visite agli url/data e ora; il numero delle esecuzioni con i timestamp di creazione e modifica, etc, etc.

In generale, nei weblog di Chrome, Firefox e Microsoft Edge si troveranno il maggior numero di informazioni.

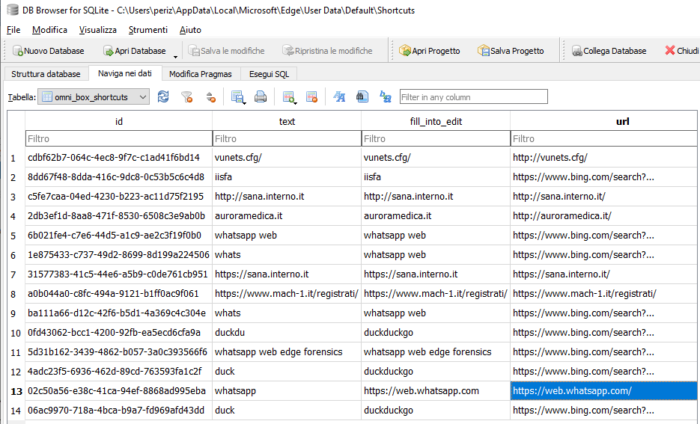
Alcuni esempi di tabelle contenenti dati utili sono esemplificati nelle figure in calce e riguardano il browser Microsoft Edge – i timestamp evidenziati nei campi sono nel formato utilizzato dai browser web come Apple Safari (WebKit), Google Chrome e Opera (Chromium/Blink). È un valore a 64 bit che rappresenta il numero di intervalli di 100 nanosecondi trascorsi dal 1 gennaio 1601 00:00 UTC -.

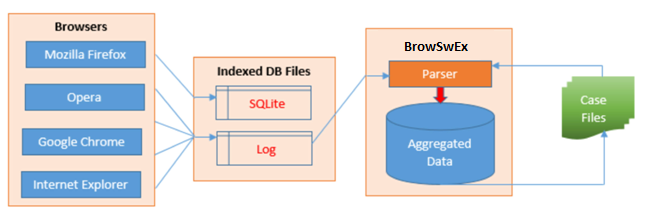
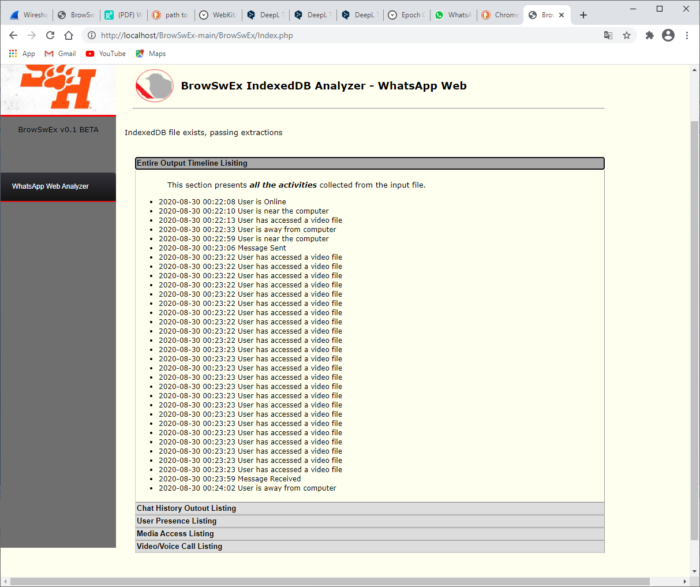
Al fine di rendere le indagini forensi uniformi nell’estrazione delle evidenze dalle piattaforme web in cui è consentito l’utilizzo di WhatsApp, è possibile utilizzare uno strumento denominato BrowSwtEx (Browser Software Extractor), utile all’aggregazione degli artefatti di IndexedDB di ausilio alle indagini di Digital Forensics. E’ altresì evidente che, al giorno d’oggi, onde procedere all’archiviazione di dati sempre più complessi inerenti la navigazione web, è necessario conservare localmente i dati in strutture di database.

IndexedDb è la tecnologia di storage attualmente utilizzata dai cinque principali browser web (Chrome, Internet Explorer, Firefox, Opera, e Safari).

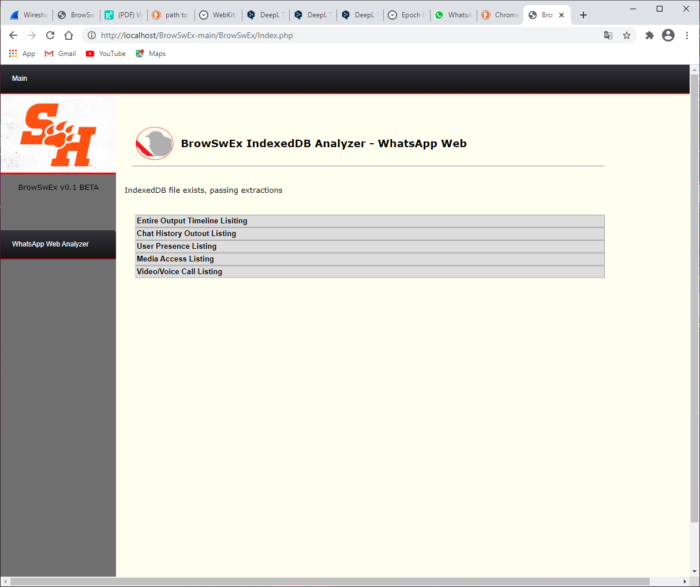
Di seguito viene schematizzato il funzionamento di BrowSwEx e in fig.13 il tool in esecuzione:

Fig.13

A seguito dell’elaborazione del file .log, i risultati ottenuti vengono utilizzati nelle differenti funzioni previste per la presentazione dei risultati.

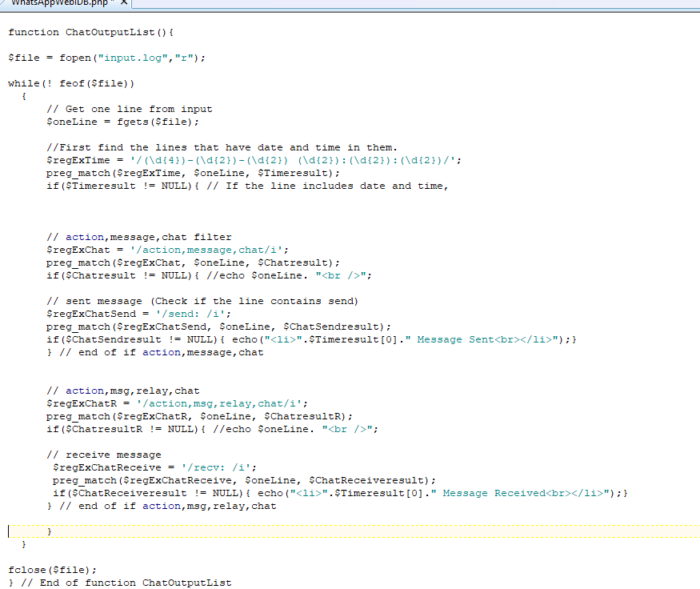
Lo strumento utilizza la funzione preg_match e cinque funzioni speciali: EntireOutputList(), ChatOutputList(), PresenceOutputList(), MediaAccessOutputList() e VideoCallOutputList() per estrarre e presentare le informazioni rinvenute nelle varie sezioni previste dalla pagina principale dell’applicativo.

In calce, il codice della funzione ChatOutputList():

In calce si evidenzia la sezione del software che racchiude tutte le operazioni riscontrate all’interno del file log esaminato, ripartite poi nelle sezioni successive.

Siamo arrivati alla conclusione: abbiamo rivelato, a seguito di detta analisi, quali artefatti possono essere estratti dai client WhatsApp, artefatti che possono rivelarsi molto utili agli investigatori.

Abbiamo descritto la principale fonte di dette evidenze, i file di log, presenti in tutte le versioni dei client di WhatsApp, da dove è possibile estrarre i timestamp delle attività degli utenti, le informazioni sui dispositivi utilizzati, lo user agent dei browser adoperati e le foto dei profili dei recenti contatti, comprese le chat di gruppo con cui l’utente ha interagito. Nel complesso, Chrome, Firefox ed Edge sono i browser che conservano la maggior parte delle informazioni utili rispetto ad altri client su cui è possibile utilizzare WhatsApp.

Stay tuned!

Note

[1] Acronimo utilizzato per Autorità Giudiziaria

[2] I file di prefetch contengono informazioni circa il numero delle esecuzioni del programma e la data/ora dell’esecuzione

[3] https://it.wikipedia.org/wiki/Base64

[4] https://it.wikipedia.org/wiki/Parsing

[5] ChromeCacheView – Cache viewer for Google Chrome Web browser (nirsoft.net)

[6] Numero telefonico dell’utente corrispondente alla foto del profilo

[7] Numero telefonico dell’utente corrispondente alla foto del profilo

[8] https://it.wikipedia.org/wiki/Application_programming_interface

[9] https://developer.mozilla.org/en-US/docs/Web/API/IndexedDB_API/Using_IndexedDB

Articolo a cura di Cosimo De Pinto

Informatico Forense, socio IISFA, socio ONIF, certificato CIFI, è Perito e Consulente Tecnico presso il Tribunale Ordinario di Roma. Laureato in Beni Culturali, è stato un pioniere della Digital Forensics, espletando il suo primo incarico come ausiliario di P.G. presso la Procura di Bari nel lontano 1990.Titolare di uno studio professionale, presta la propria consulenza a studi legali, aziende, Procure e FF.OO., in materia di Digital Forensics e CyberCrime.

https://www.ictsecuritymagazine.com/articoli/whatsapp-web-forensics/


Cybersecurity: testare la responsiveness del team di incident management con i Full Spectrum Vulnerability Assessment

Il Cefriel ha elaborato, una nuova modalità di testing della sicurezza informatica. La metodologia si va ad affiancare alle altre attività di testing dei sistemi informatici (i normali vulnerability assessment tecnologici) e delle persone (test di social engineering simulato, che chiamiamo Social Driven Vulnerability Assessment – SDVA). In questo caso l’obiettivo del test sono i team di security incident management.

La metodologia elaborata prende in nome di Full Spectrum Vulnerability Assessment (FSVA): una simulazione di un attacco “completo”, seppure simulato, che agendo nei modi e metodi dei veri attacchi informatici, ha lo scopo di testare la “responsiveness” del team che gestisce la sicurezza informatica in un’azienda. Ciò che viene stimolato pertanto, non è la risposta a un problema specifico, ma la capacità di adattarsi e pensare in modo autonomo quando accade il peggio.

La trasformazione digitale forzata di questi ultimi mesi, avvenuta su entrambi i fronti del cybercrime e della cybersecurity, a seguito del COVID, comporta che anche la sicurezza debba trasformarsi. Ben prima della attuale pandemia, l’addestramento dei team di risposta agli incidenti è stato tendenzialmente affrontato in condizioni di relativa tranquillità rispetto al reale panorama degli attacchi informatici: le esercitazioni e i corsi spesso non sono allineati con i trend realmente usati negli attacchi informatici o comunque avvengono in condizioni di gioco simulato (e.s., i cyber range).

In altre parole, rispetto alla figura sotto, l’esercitazione avviene al di fuori del “period of intensity”. In generale gli incident response plan sono una parte complicata di una azienda, che viene usata e testata, scoprendo se è efficiente, solo di fronte ad un attacco vero.

Recenti statistiche riportano che, nonostante il ritmo vertiginoso delle violazioni, circa un terzo delle organizzazioni lascia passare un anno o più tra le esercitazioni per la gestione delle crisi informatiche.

La proposta Cefriel va nella direzione di fornire un metodo per aumentare la frequenza della formazione e allo stesso tempo renderla meno onerosa per le persone, coinvolgendo una gamma più ampia di stakeholder in azienda. Questo comporta esercitazioni realistiche, più frequenti che possano essere comprese da tutti, dalle pubbliche relazioni e dai team legal all’HR.

La simulazione di un attacco in questo modo, noto anche come micro-drilling, aiuta i membri del team a costruire la memoria «muscolare» vitale o l’agilità cognitiva, che insegnerà loro gli istinti necessari (il ciclo Observe, Orient, Decide, and Act -OODA-) per rispondere quando accadrà il peggio (figura sotto).

Figura 1 – Incident Response Life Cycle moderno (fonte [1])

Come si vede dalla successiva figura invece, gli FSVA sono uno strumento di testing particolare perché si pone a metà fra il tecnico e l’organizzativo, indirizzando l’elemento umano sia come mezzo di offesa che di difesa, permettendo di verificare i KPI delle organizzazioni e definire delle strategie di miglioramento, a vali livelli.

Figura 2 – Copertura di un FSVA in termini di risposte per il team di security incident management

Come si mappa un FSVA rispetto agli altri tipi di Assessment.

Come reso evidente dalla figura precedente, per molti aspetti, un FSVA copre attività che solitamente vengono svolte da Black, Red, Purple o Gold Team Assessment. Un FSVA differisce da queste tipologie di test per tre macro-elementi.

  • Innanzi tutto, l’obiettivo, come detto prima, non è testare la corretta configurazione tecnologica delle difese, ma comprendere la preparazione del team di IT security e in generale stimolare la sua “memoria muscolare” (o la agilità cognitiva) in situazioni di stress, percepite come un vero e proprio attacco.
  • Secondo, la capacità che ha un FSVA di collegare i KPI aziendali con i risultati del test.
  • Terzo, un FSVA è pensato per testare una procedura di sicurezza composta tipicamente da quattro elementi: policy, tool, procedure e persone.

La figura sotto riporta una mappatura dei vari tipi di Assessment rispetto alle domande già elencate e dove concettualmente si posiziona un FSVA.

Figura 3 – Confronto fra FSVA ed altri tipi di Assessment

Gli FSVA sono un particolare tipo di test che si configura in modo unico, rispetto ad altri tipi di Assessment, proprio in virtù dei risultati che vuole ottenere.

Con riferimento alla figura sopra, si evidenzia che un FSVA si differenzia, rispetto ad un Purple Team Assessment, per il fatto che testa sia i processi che le persone. Rispetto ad un Gold Team Assessment invece un FSVA ha una dimensione tecnica che permette di creare test molto più realistici. Rispetto ad un Black Team Assessment la principale differenza è l’assenza di una fase di reconnaissance, che trascende gli scopi di un FSVA, senza contare che spesso è una attività decisamente time consuming. Infine, un FSVA si differenzia anche rispetto un Red Team Assessment (il cui scopo è testare la sicurezza dei sistemi agendo, ovviamente su autorizzazione, come un hacker malevolo): un FSVA si concentra più sull’elemento umano della difesa e la combinazione di procedure, processi e persone, e meno sugli aspetti puramente tecnologici e di configurazione.

I fondamenti teorici di un FSVA, le security ceremonies

Il fondamento teorico di un FSVA rientra nel campo delle security ceremonies (introdotti per la prima volta da Ellison [2]). Il termine è usato per descrivere l’insieme di sistemi informatici, protocolli ed esseri umani che interagiscono per uno scopo specifico.

Figura 4 – Martina, J. E. et al. “An adaptive threat model for security ceremonies.” International Journal of Information Security 14 (2014): 103–121.

Una security ceremony può essere descritta come un protocollo nel suo contesto d’uso, fatto di macchine, protocolli, applicativi ed umani.

Molti protocolli (ad esempio, organizzativi o di governance) che si sono dimostrati sicuri in teoria, sono insicuri nella pratica, quando vengono impiegati nel mondo reale. I test di sicurezza spesso testano i protocolli in modo isolato, non considerano la vasta gamma di attacchi possibili quando si allarga il perimetro di indagine, includendo l’ingegneria sociale, le interfacce / interferenze con altri protocolli e l’ambiente.

Le security ceremonies sono un superset dei normali protocolli di sicurezza, un’estensione che include operazioni che normalmente non sono considerate o sono date per scontate (es. la reazione psicologica degli operatori ad uno stimolo esterno). Ad esempio, chi ha progettato un protocollo di intervento di un SOC, a fronte di una minaccia informatica aveva in mente un operatore con caratteristiche di reattività e competenze specifiche?

L’inclusione dell’interazione umana, e di conseguenza del comportamento e dei processi cognitivi, è una caratteristica delle cerimonie, che normalmente è difficile considerare perche è fuori dai limiti dei sistemi attuali di modellazione dei protocolli operativi.

Gli FSVA sono una soluzione che il Cefriel ha pensato per testare la sicurezza di un particolare tipo di security ceremonies, quelle legate agli incident management response team.

I fondamenti teorici degli FSVA, la differenza fra awareness, training e learning.

In termini generali ricorrono nella cybersecurity tre termini spesso usati in sovrapposizione ma che hanno significati differenti: awareness, traning e learning. Sebbene tutti è tre contribuiscano alla definizione sia delle capacità delle persone che alle tecniche di difesa di una organizzazione, è bene capire la differenza.

Il termine awareness è il più semplice e si riferisce alla conoscenza sommaria di un fenomeno senza la necessità della sua completa compresione. Awareness è ad esempio una campagna di formazione sul phishing. Il training viceversa è la fornitura di informazioni e conoscenze, attraverso il discorso, la parola scritta o altri metodi di dimostrazione in modo da istruire il tirocinante in maniera statica. Il learning è la questione più complessa dei tre casi in quanto è il processo di assorbimento delle informazioni al fine di aumentare le competenze e le abilità e farne così uso in una varietà di contesti [3].

Da questa definizione risulta che il training è qualcosa che nasce dall’esterno preparando una persona a rispondere ad operazioni predeterminate, (di solito la formazione per un compito/attività/argomento specifico); mentre il learning avviene all’interno (nella mente), e prepara una persona a nuove e inattese situazioni.

In letteratura è stato più volte sottolineata la necessità nel contesto della cybersecurity, di compiere la transizione dal training al learning [4].

In questo senso si può dire che un FSVA sia un metodo di learning e non di training. In particolare un metodo di learn-by-doing, ma in un contesto off-guard. Il punto di forza di un FSVA è la simulazione realistica di un attacco, più o meno complesso a seconda delle specifiche, ma comunque eseguito al di fuori di una simulazione, con procedure, mind-set e dinamiche del tutto simili alla realtà.

Benefici attesi

Figura 5 – Come posso stimolare il senso di ragno dei team di gestione degli incidenti?

  • Migliorare la resistenza di una organizzazione ad un attacco operato in modi spesso non ancora incontrati.
  • Addestrare il gruppo di gestione degli incidenti in azienda nella gestione di attacchi avanzati e persistenti.
  • Effettuare Benchmarking delle prestazioni delle operazioni di sicurezza, ad esempio rispetto a KPI o policy aziendali
  • Comprendere e acquisire fiducia nella resilienza dell’organizzazione.
  • Pianificare mitigazioni sia organizzative, di governance, che tecniche.

Conclusioni

Tramite un FSVA si compie una simulazione mirata, usando parametri di valutazione specifici, misurando la reale efficacia di una organizzazione nella gestione delle minacce alla sicurezza informatica. Utilizzando un approccio attivo, un FSVA espone le vulnerabilità critiche dei processi aziendali interni, simulando attacchi cyber multi-vettore. Un FSVA simula un attacco realistico, impersonando hacker, altri agenti malevoli o persino gli addetti ai lavori (insiders), in modo proattivo, cioè prima che un attacco vero e proprio colpisca. Tutto questo senza alcun impatto su utenti o infrastrutture. Con un FSVA un’organizzazione può testare in modo proattivo la propria postura di sicurezza informatica contro i cyberattack.

In sintesi, il focus di un FSVA è su processi, governance, KPI gestionali e crescita delle capacità operative del personale, ma allo stesso tempo permette di avere un’indicazione chiara di come un attacco analogo a quello simulato avrebbe agito su persone e macchine.

Note

[1] https://www.immersivelabs.com/resources/blog/the-psychology-of-cyber-how-to-build-cognitive-agility-with-micro-drilling/

[2] Ellison, C.: Ceremony design and analysis. Cryptology ePrint Archive, Report 2007/399 (2007), http://eprint.iacr.org/

[3] B. Olaniran, ―Culture, learning styles, and Web 2.0,‖ Interactive Learning Environments, 2009

[4] C. Di Gregorio, “Law enforcement training and learning: a comprehensive “capacity building” approach,” European Law Enforcement Research Bulletin, vol. 3, pp. 31–44, 2017.

Articolo a cura di Enrico Frumento

https://www.ictsecuritymagazine.com/articoli/cybersecurity-testare-la-responsiveness-del-team-di-incident-management-con-i-full-spectrum-vulnerability-assessment/


Normativa sui Cookie: l’Italia adegua le linee guida e in Europa sanzioni da 100 milioni di euro a Google e 35 milioni per Amazon

La normativa sui cookie può presentare sotto alcuni aspetti alcune complessità applicative anche in riferimento alla varietà delle norme applicabili, in quanto a seguito dei recenti pronunciamenti della Corte di Giustizia dell’Unione Europea (CGUE) 1 e delle Linee guida sul consenso adottate il 4 maggio 2020 dall’ EDPB2 si è reso necessario un nuovo intervento del Garante per la protezione dei dati personali allo scopo di integrare i propri precedenti interventi del 2014 e 2015. Per il questo il Garante ha avviato una consultazione pubblica sull’utilizzo dei cookie3 e di altri strumenti di tracciamento pubblicata in Gazzetta Ufficiale l’11 dicembre 2020.

La CGUE e l’EDPB, con le loro decisioni hanno mostrato un cambiamento verso il rafforzamento della protezione dei dati personali per i cookie e di altre tecnologie di tracciamento, evidenziando la necessità di un quadro rafforzato di tutele maggiormente orientate a favorire e a rendere effettivo il controllo sulle informazioni personali oggetto di trattamento e, in sostanza, della capacità di autodeterminazione del singolo.

In attesa dell’emanazione del nuovo Regolamento e-Privacy che dovrà abrogare la direttiva attuale, introducendo così un nuovo set di norme europee comuni a tutti gli stati membri dell’unione, ad oggi, in tema cookie le normative di riferimento sono sia di tipo europeo e nazionale. Il GDPR in quanto regolamento europeo è direttamente applicabile dagli stati membri, mentre la direttiva e-privacy è stata recepita dagli stati membri con leggi nazionali. Possiamo quindi considerare come applicabili gli artt. 7 e 8 della Carta dei diritti fondamentali dell’UE (Carta di Nizza), direttiva 2002/58/Ce (Direttiva ePrivacy) e successive modifiche, art. 122 del d.lgs. 30 giugno 2003, n. 196 (Codice Privacy italiano) che recepisce le indicazioni della direttiva ePrivacy. Il Regolamento (UE) 2016/679, per la nozione di consenso di cui agli artt. 4, punto 11) e 7 e al considerando 32, come da ultimo interpretati dalle “Linee guida 5/2020 sul consenso ai sensi del regolamento (UE) 2016/679” versione 1.1 adottate il 4 maggio 2020 dall’ EDPB.
Appare quindi opportuno applicare il Regolamento a tutti gli aspetti relativi alla tutela dei diritti e delle libertà fondamentali anche a tutti quei trattamenti di dati personali che non rientrano in obblighi specifici aventi lo stesso obiettivo di altre direttive compresa la direttiva ePrivacy, come da considerando 173 e art. 95 GDPR.

Molte attività di trattamento devono essere quindi ricondotte all’ambito di applicazione tanto della direttiva quanto del Regolamento come infatti la Corte di Giustizia si è espressa con alcune sentenze. Si tratta della sentenza Fashion ID (C-40/17 del 29 luglio 2019) e Planet49 (c-673/17), dalle quali è emerso che un inserzionista (amministratore di Fan Page Facebook) o il titolare di un sito web possono ricoprire il ruolo di contitolari del trattamento limitatamente all’operazione o all’insieme di operazioni di trattamento per le quali entrambi i soggetti determinano congiuntamente le finalità e i mezzi. Ne consegue che a norma dell’art.26 del GDPR risulta obbligatori la definizione di un accordo interno, in cui si devono definire chiaramente le rispettive responsabilità in merito all’osservanza degli obblighi derivanti dal Regolamento, con particolare riguardo all’esercizio dei diritti dell’interessato, e le rispettive funzioni di comunicazione delle informazioni di cui agli articoli 13 e 14.

Nella sentenza Fashion ID la Corte ha indicato che la contitolarità del trattamento può sorgere quando funzionalità o plug-in di terze parti sono inserite in un sito Web. Nel caso Planet49 (caso c-673/17) la Corte ha rivalutato lo standard per il la richiesta del consenso per l’utilizzo dei cookie che deve avvenire secondo le condizioni previste dal GDPR e come precisate nelle linee guida dell’EDPB sul consenso.

In queste circostanze, fornitore di social network, inserzionista e gestore del sito o di Fan Page, si dovrebbero sempre considerare titolari o contitolari del trattamento, limitatamente all’operazione o all’insieme di operazioni di trattamento per le quali entrambi i soggetti determinano congiuntamente le finalità e i mezzi; ma non dovrebbero essere considerati contitolari per tutto ciò che è avvenuto prima e che avverrà dopo in modo autonomo sulle parti di trattamento di loro esclusiva competenza.  Inoltre, l’EDPB ha evidenziato che in questi casi la titolarità ovvero la contitolarità si potrebbero configurare anche senza avere accesso ai dati personali.

La legge nazionale italiana che ha recepito la direttiva ePrivacy al’art.122 dice in sostanza che i cookie (e qualsiasi altro sistema di tracciamento) è generalmente vietata (art.122 2-bis) e consentita solo a precise e tipizzate condizioni.

Codice della privacy, (D.lgs. 30 giugno 2003, n. 196 Aggiornato al 30/10/2020)
Articolo 122 – Informazioni raccolte nei riguardi dell’contraente o dell’utente.
2-bis. “Salvo quanto previsto dal comma 1, è vietato l’uso di una rete di comunicazione elettronica per accedere a informazioni archiviate nell’apparecchio terminale di un contraente o di un utente, per archiviare informazioni o per monitorare le operazioni dell’utente.”

La scrittura o lettura di cookie (e di qualsiasi altra informazione o elemento di tracciamento) nell’apparecchio terminale (da intendersi nel senso più ampio del termine computer, tablet, smartphone, console di gioco, IoT, smat meeters o contatori intelligenti, ecc.) di un contraente o di un utente dovrebbe avvenire solo con il suo consenso e dopo aver fornito un’informativa.

Articolo 122 – Informazioni raccolte nei riguardi dell’contraente o dell’utente.
  1. L’archiviazione delle informazioni nell’apparecchio terminale di un contraente o di un utente o l’accesso a informazioni già archiviate sono consentiti unicamente a condizione che il contraente o l’utente abbia espresso il proprio consenso dopo essere stato informato con modalità semplificate.
    …

Unica deroga al consenso, sempre prevista dall’art.122 del Codice, è la possibilità di effettuare l’archiviazione tecnica o l’accesso a informazioni già archiviate nel dispositivo, ma solo nella misura in cui queste siano unicamente necessarie al funzionamento della comunicazione o se strettamente necessaria al fornitore di un servizio online per erogare un servizio che è stato espressamente richiesto dall’abbonato o dall’’utente.

Articolo 122 – Informazioni raccolte nei riguardi dell’contraente o dell’utente.

…

Ciò non vieta l’eventuale archiviazione tecnica o l’accesso alle informazioni già archiviate se finalizzati unicamente ad effettuare la trasmissione di una comunicazione su una rete di comunicazione elettronica, o nella misura strettamente necessaria al fornitore di un servizio della società dell’informazione esplicitamente richiesto dal contraente o dall’utente a erogare tale servizio.
…

Queste norme si riferiscono quindi a tutte le operazioni di lettura e scrittura tramite cookie e altri tracciatori o sistemi di tracciamento che utilizzano informazioni memorizzate o accessibili in apparecchiature terminali, indipendentemente dal fatto che si tratti o meno di dati personali.

Per i cookie non tecnici è sempre necessario il consenso nelle modalità previste dal Regolamento. Per i cookie tecnici, che hanno il solo scopo di consentire o facilitare la comunicazione elettronica, non è richiesto il consenso, ma solo se indispensabili all’erogazione del servizio di connessione o di contratto richiesto dall’utente. In questo caso la base legale per il trattamento non dovrebbe essere ricondotta ai casi previsti dalle lette a) e f) dell’articolo 6 del Regolamento (consenso e legittimo interesse).

In ogni caso, qualsiasi cookie tecnico, che di per sé non richiederebbe il consenso, se è utilizzato anche per altre ulteriori finalità, comprese quelle di tracciamento per finalità di marketing e la profilazione, se utilizzato per altre finalità ovvero se incrociato con qualsiasi altro dato per finalità ulteriori, tali ulteriori trattamenti devono considerarsi illeciti a norma art. 122 del Codice se per ciascuno di essi non è stato raccolto un libero, specifico, esplicito, informato e inequivocabile consenso.

Tenere traccia del comportamento degli utenti, elaborare preferenze di consumo e fornire pubblicità personalizzata è sempre un tracciamento da ritenersi rigorosamente regolato dalle ‘Cookie Law’ dell’UE (articolo 5, paragrafo 3, della direttiva e-Privacy) e dell’art.122 del Codice Privacy e richiede il consenso informato e inequivocabile degli utenti. In assenza di consenso si deve sempre supporre il rifiuto dell’utente e qualsiasi tipo di tracciante non può essere depositato e/o letto sul terminale dell’utente.

Qualsiasi forma di elusione del consenso attraverso il ricorso al legittimo interesse o altra forma, comunque la si voglia chiamare (es. Gestione Partner; Fornitori ecc.), dove spesso compare un elenco di diverse decine se non centinaia di voci con le caselle preselezionate (a volte senza nemmeno la possibilità di rifiutarli tutti in blocco) deve essere considerata non in linea con i principi di liceità, correttezza e trasparenza e ed è in violazione delle norme sul consenso.

Per i cookie tecnici che hanno il solo scopo di consentire o facilitare la comunicazione elettronica, non è richiesto il consenso, nella misura in cui l’archiviazione tecnica o l’accesso alle informazioni già archiviate se finalizzati unicamente ad effettuare la trasmissione di una comunicazione su una rete di comunicazione elettronica, o nella misura strettamente necessaria al fornitore di un servizio della società dell’informazione esplicitamente richiesto dal contraente o dall’utente a erogare tale servizio come previsto art 122 del codice. Mentre per i cookie non tecnici, se non strettamente funzionali alla fornitura del servizio, è generalmente necessario il consenso nelle modalità previste dal Regolamento e come previsto dall’ art. 122 del Codice, come visto sopra.  Ne deriva quindi che qualsiasi cookie tecnico, che di per sé non richiede il consenso, se utilizzato anche per altre ulteriori finalità, comprese quelle di tracciamento per finalità di marketing compresa la profilazione ovvero se incrociato con qualsiasi altro dato per finalità ulteriori, tali ulteriori trattamenti devono considerarsi illeciti a norma art. 122 del Codice se per ciascuno di essi non è stato prestato un libero, specifico, informato, esplicito ed inequivocabile consenso. Apparirebbe quindi essere gergalmente non lecito il ricorso al legittimo interesse, ormai diffusamente utilizzato come mezzo per eludere l’obbligatorietà del consenso in quanto non conforme alle previsioni del Codice privacy art. 122. Il ricorso al legittimo interesse per finalità di marketing potrebbe considerarsi lecito solo nella misura in cui ricorrano le condizioni, da documentare e comprovare, che il caso sia riconducibile al caso del così detto soft spam.

Il 7 dicembre 2020, l’autorità francese CNIL ha sanzionato le società GOOGLE LLC e GOOGLE IRELAND LIMITED per un totale di 100 milioni di euro per aver inserito cookie pubblicitari sui computer degli utenti attraverso il motore di ricerca google.fr, senza ottenere il consenso preventivo e senza fornire informazioni adeguate. Sempre il 7 dicembre la CNIL ha sanzionato anche la società AMAZON EUROPE CORE per 35 milioni di euro per aver inserito cookie pubblicitari sui computer degli utenti, dalla pagina amazon.fr, senza ottenere il consenso preventivo e senza fornire informazioni adeguate.

I due casi presentano ambiti di particolare interesse come il fatto che il meccanismo di cooperazione previsto dal GDPR (“meccanismo one-stop shop”) non era applicabile in quanto le operazioni relative all’uso dei cookie rientrano nella direttiva “ePrivacy”, recepita nell’articolo 82 della legge francese sulla protezione dei dati e di essere territorialmente competente perché l’uso dei cookie viene effettuato nell’ambito delle “attività” della società GOOGLE FRANCE, che è lo “stabilimento” delle società GOOGLE LLC e GOOGLE IRELAND LIMITED sul territorio francese e che promuove i loro prodotti e servizi. Stesse motivazioni per Amazon Europe Core è una società di diritto lussemburghese, che fa parte del gruppo Amazon ed è responsabile dei siti web europei “Amazon”, il cui sito Web Internet è Amzon.fr.

La CNIL ritenuto inoltre che nel caso Google le società GOOGLE LLC e GOOGLE IRELAND LIMITED siano contitolari del trattamento ai sensi degli articoli 4, paragrafo 7 e 26, paragrafo 1, del GDPR in quanto determinano entrambe le finalità e i mezzi relativi all’uso dei cookie.

Se l’Italia in Europa e l’Europa nel mondo potranno assumere un ruolo trainante, sarà principalmente per la leadership culturale che riusciranno a promuovere, mettendo la tecnica al servizio dell’uomo; facendo percepire a tutti che la data protection non deve essere vista come ostacolo al business o vincolo burocratico, ma come sintesi di incontro tra tutela della persona ed economia digitale. In questo, anche le nuove linee guida del Garante italiano per la protezione dei dati, relative al corretto utilizzo dei cookies, risultano centrali per ribadire anche l’importanza di creare un clima diffuso di fiducia nei sistemi digitali che consentirà di favorire lo sviluppo dell’economia digitale in tutto il mercato interno (c.7 GDPR), in caso contrario le persone potrebbero essere tentate ad allontanarsene.

Note

  1. Corte di Giustizia dell’Unione Europea (CGUE) – Istituita nel 1952 con sede in Lussemburgo, ha il ruolo di garantire che il diritto dell’UE venga interpretato e applicato allo stesso modo in ogni paese europeo, garantire che i paesi e le istituzioni dell’Unione rispettino la normativa dell’UE.
  2. Il Comitato europeo per la protezione dei dati, istituito dal GDPR, ha sede a Bruxelles ed è un organo europeo indipendente, che contribuisce all’applicazione coerente delle norme sulla protezione dei dati in tutta l’Unione europea e promuove la cooperazione tra le autorità competenti per la protezione dei dati dell’UE. È composto da rappresentanti delle autorità nazionali per la protezione dei dati e dal Garante europeo della protezione dei dati (GEPD); ne fanno altresì parte le autorità di controllo degli Stati EFTA/SEE senza diritto di voto.
  3. “Cookie: il Garante privacy avvia una consultazione pubblica sulle regole per il loro uso” https://www.garanteprivacy.it/home/docweb/-/docweb-display/docweb/9501006, ultima consultazione 07.01.2021

Articolo a cura di Stefano Luca Tresoldi

Data protection advisor, esperto nell'implementazione del GDPR in contesti operativi complessi anche in ambiti internazionali.

Ha maturando una significativa esperienza nella progettazione e nello sviluppo di Metodologie DPIA ad hoc per importanti gruppi internazionali. Ha ricoperto il ruolo di DPO ad interim per importanti gruppi industriali.

Dal 2017 collabora con il Team Privacy di Unione Industriale Torino.

Dal 2011 al 2015 consulente su progetti legati al PCT (Processo Civile Telematico).

Socio del Centro Studi di Informatica Giuridica Ivrea-Torino, relatore a seminari e corsi su tematiche GDPR.

Laureato al dipartimento di Giurisprudenza di UNITO in Scienze dell'amministrazione, perfezionato in diritto della protezione dei dati personali presso l'Università degli Studi di Torino; perfezionato in DATA PROTECTION E DATA GOVERNANCE. LA GESTIONE DEI DATI PERSONALI NELLA PUBBLICA AMMINISTRAZIONE E NELLA SANITÀ presso Università degli Studi di Milano.

https://www.linkedin.com/in/stefanotresoldi/

https://www.ictsecuritymagazine.com/articoli/normativa-sui-cookie-litalia-adegua-le-linee-guida-e-in-europa-sanzioni-da-100-milioni-di-euro-a-google-e-35-milioni-per-amazon/


Backup dei dati aziendali, anche se effettuato dal socio può integrare accesso abusivo a sistema informatico

Integra il reato di accesso abusivo a sistema informatico la condotta di chi si introduca nel sistema informatico aziendale, avendo a disposizione le necessarie password, e copi i dati in esso contenuti per finalità estranee agli scopi sociali o associativi.

Lo ha di recente affermato la Corte di Cassazione, Sez. V Penale, con sentenza del 2 dicembre 2020, n. 34296.

Il caso

Nel caso all’esame della Corte, l’imputato, socio di uno studio e una società, era stato condannato in primo e in secondo grado ai sensi dell’art. 615 ter cod. pen. per aver effettuato copie di backup dei dati contenuti nei sistemi informatici di tali enti. Ciò perché tale condotta risultava posta in essere per ragioni estranee alla propria carica e, in particolare, per l’apertura di una nuova ed autonoma attività professionale.

Secondo il ricorso per cassazione, l’accesso al sistema non poteva considerarsi abusivo, essendo egli socio e, come tale, in possesso delle relative credenziali d’accesso; parallelamente, non esisteva alcuna regola, neppure interna, che vietasse di effettuare copie di backup o ne limitasse in qualche modo la possibilità.

La Corte ha ritenuto il motivo non fondato e rigettato il ricorso.

L’accesso abusivo a sistema informatico

L’art. 615 ter cod. pen. sanziona con la reclusione fino a tre anni il comportamento di chiunque «abusivamente si introduce in un sistema informatico o telematico protetto da misure di sicurezza ovvero vi si mantiene contro la volontà espressa o tacita di chi ha il diritto di escluderlo». La pena è aggravata se il fatto è commesso da un pubblico ufficiale o un incaricato di un pubblico servizio con abuso dei poteri o violazione dei doveri inerenti alla funzione o al servizio o, ancora, se è commesso da chi esercita la professione di investigatore privato o con abuso della qualità di operatore del sistema.

Particolarmente interessante è la questione relativa alla condotta posta in essere da un soggetto che sia autorizzato ad accedere ad un sistema e sia dotato, quindi, delle relative credenziali d’accesso, ma vi si introduca per scopi o finalità estranei a quelli per cui la facoltà di accesso gli era stata attribuita

Le Sezioni Unite della Corte di Cassazione hanno affrontato la questione già nel 2011[1], affermando la rilevanza ai sensi dell’art. 615 ter cod. pen. sia quando l’agente violi i limiti di accesso impartiti dal titolare del sistema (ad esempio, con regolamenti interni, prassi e policy aziendali o clausole di contratti individuali di lavoro), sia quando ponga in essere operazioni di natura “ontologicamente diversa” da quelle per le quali l’accesso è a lui consentito[2].

Si ha accesso abusivo, in sintesi, sia quando l’accesso sia espressamente vietato, sia quando ci si introduca per finalità diverse da quelle consentite e autorizzate.

Più di recente, le Sezioni Unite sono tornate sul tema[3], con specifico riferimento all’operato dei pubblici dipendenti, ribadendo l’illiceità ed abusività di qualsiasi comportamento che si ponga in contrasto con i principi generali dell’amministrazione pubblica. Ci si riferisce, in particolare, all’art. 1 della legge n. 241 del 1990, per il quale «l’attività amministrativa persegue fini determinati dalla legge ed è retta da criteri di economicità, efficacia, imparzialità, pubblicità, trasparenza, secondo le modalità previste dalla presente legge e dalle disposizioni che disciplinano singoli procedimenti, nonché dai principi dell’ordinamento comunitario». L’accesso a sistema informatico per uno scopo estraneo alle finalità per cui è permesso manifesta, perciò, una “ontologica incompatibilità” con i principi fondanti l’attività amministrativa stessa.

Conclusioni

Decisiva per giudicare la liceità dell’accesso a sistema informatico di chi sia abilitato ad entrarvi è, per la giurisprudenza, la finalità perseguita dall’agente, che deve corrispondere alla ratio per la quale il potere è stato attribuito e, dunque, alle regole interne dettate dal titolare o dall’amministratore del sistema.

Principio, questo, che vale tanto per i pubblici dipendenti quanto per i privati, laddove in questo secondo caso la limitazione deriva, ovviamente, non da norme pubblicistiche, che non esistono, ma dal rapporto privatistico (sociale o associativo) volto al perseguimento dello scopo comune, che impone l’utilizzo di tutto gli strumenti e le utilità in conformità a tale scopo.

Anche l’accesso ai sistemi informatici posti a servizio dell’attività comune deve avvenire, quindi, in conformità alla ratio attributiva del potere e alle finalità concretamente perseguite, configurandosi come abusivo, ex art. 615 ter cod. pen., ogni accesso che risulti incompatibile con tali dette finalità.

Note

[1] Sentenza n. 4694 del 27/10/2011, rv 251270-01.

[2] Conforme a tale orientamento anche la successiva Cass. Pen., Sez. V, sentenza n. 565 dell’8 gennaio 2019.

[3] Sentenza n. 41210 del 18/5/2017, rv 271061-01.

Articolo a cura di Maria Elena Iafolla

Avvocato del Foro di Milano e titolare dello Studio Legale Iafolla, si occupa di diritto dell’informatica e delle nuove tecnologie, innovazione, trattamento dei dati e cyber-security.

Laureata presso l’Università Cattolica del Sacro Cuore di Milano, autrice e formatrice sui temi del diritto dell’informatica e privacy/GDPR.

Vice Presidente dell’associazione DFA – Digital Forensics Alumni.

https://www.ictsecuritymagazine.com/articoli/backup-dei-dati-aziendali-anche-se-effettuato-dal-socio-puo-integrare-accesso-abusivo-a-sistema-informatico/


Certificazioni per il cloud: in arrivo le indicazioni europee

Perché i servizi cloud sono così importanti

Oggi parliamo di servizi cloud (e non genericamente di cloud, rimandando ai paragrafi successivi il motivo di questa precisazione) perché sono entrati nella vita delle persone e delle organizzazioni con una forza ed una rapidità senza precedenti nella storia tecnologica recente. Hanno sfondato più rapidamente dei personal computer (anni ‘80), del web e dell’email (anni ‘90) ma, spesso, si è badato solo ai vantaggi senza la dovuta attenzione alle conseguenze che possono derivare dall’uso della nuvola.

Le conseguenze possono essere molto serie sia per gli utenti domestici sia per gli utenti professionali (persone fisiche o organizzazioni complesse). Per i primi esistono rischi di violazione di dati riguardanti l’intimità della vita personale e familiare (foto, video, messaggi, ecc.) anche se tali dati sono esclusi dall’applicazione del Regolamento UE 2016/679 (GDPR) perché di uso “domestico”; per i secondi, invece, le eventuali violazioni ricadono nelle fattispecie previste dagli articoli 33 e 34 del GDPR: si rischia di ledere pesantemente i diritti e le libertà delle persone fisiche di cui si trattano i dati personali. Per esempio, molti medici, approfittando della gratuità, depositano dati riguardanti la salute dei propri pazienti su servizi cloud di memorizzazione; pochi di loro hanno la consapevolezza di essere titolari del trattamento e, quindi, di dover scegliere il responsabile del trattamento (ovvero il Cloud Service Provider, CSP) “che presenti[no] garanzie sufficienti per mettere in atto misure tecniche e organizzative adeguate in modo tale che il trattamento soddisfi i requisiti del presente regolamento [GDPR n.d.r.] e garantisca la tutela dei diritti dell’interessato”.

Peraltro, da qualche anno, la strategia tecnologica italiana sta cercando di indurre la Pubblica Amministrazione (soprattutto quella locale) a migrare verso servizi cloud. Naturalmente, questa è una scelta condivisibile da molti punti di vista e che farà giustizia delle tante debolezze infrastrutturali che caratterizzano le centinaia di CED locali. In proposito, l’ultima iniziativa legislativa è contenuta nel comma 1‑bis (introdotto dal cosiddetto decreto semplificazioni) dell’articolo 33‑septies del Decreto Legge 179/2012 che dispone quanto segue

Le amministrazioni locali individuate ai sensi dell’ articolo 1, comma 3, della legge 31 dicembre 2009, n.196, nel rispetto dei principi di efficienza, efficacia ed economicità dell’azione amministrativa, migrano i loro Centri per l’elaborazione delle informazioni (CED) e i relativi sistemi informatici, privi dei requisiti fissati dal regolamento di cui al comma 4, verso l’infrastruttura di cui al comma 1 o verso altra infrastruttura già esistente in possesso dei requisiti fissati dallo stesso regolamento di cui al comma 4. Le amministrazioni locali, in alternativa, possono migrare i propri servizi verso soluzioni cloud nel rispetto di quanto previsto dal regolamento di cui al comma 4.

L’ultimo periodo, quindi, induce alla scelta delle soluzioni cloud (sarebbe stato meglio parlare di servizi cloud) come futura configurazione dei servizi digitali verso i clienti esterni (cittadini, imprese, altre PP.AA., ecc.) e verso i clienti interni (uffici, settori, aree, ecc.).

Sui servizi cloud e sulla loro qualità, quindi, si gioca molta parte del futuro dei dati e, quindi, delle persone.

Le indicazioni del Comitato Europeo per la Protezione dei Dati Personali

La scelta dei servizi cloud, come abbiamo già detto, implica una serie di premesse per la salvaguardia dei soggetti di cui si trattano i dati personali; in particolare, occorre scegliere il CSP che in maniera tale che funga da responsabile del trattamento sufficientemente affidabile. E non si tratta solo di avere un CSP che offra misure tecniche adeguate: occorre che sia capace di applicare misure organizzative volte a rispettare i princìpi fissati dall’art. 5 GDPR e che il quadro normativo del paese in cui opera offra le stesse tutele del GDPR.

A questo proposito, occorre richiamare due importanti documenti che di recente sono stati pubblicati dal Comitato Europeo per la Protezione dei Dati Personali:

Entrambi i documenti, sebbene non propriamente focalizzati sui servizi cloud, aiutano ad orientarsi negli aspetti giuridici di tutela degli interessati e, quindi, a regolare le dinamiche contrattuali con i responsabili del trattamento.

Le Guidelines, come emerge dal titolo, sono focalizzate sulle caratteristiche del responsabile del trattamento e, quindi, anche sulle qualità che il cliente deve richiedere al CSP. L’EDPB riconosce che alcuni soggetti che intendono fornire un servizio digitale e, quindi, assumere il ruolo di responsabile del trattamento hanno una forza contrattuale superiore al titolare; perciò, tendono ad imporre le loro condizioni contrattuali che, di solito, corrispondono a soluzioni standard. In questa categoria possiamo certamente annoverare i fornitori dei servizi cloud più diffusi: Google, Microsoft, ecc. Il capoverso 82 delle Guidelines, tuttavia, ribadisce che il titolare rimane colui che deve stabilire se accettare o meno le modalità di trattamento suggerite dal candidato responsabile senza nascondersi dietro la presunta imposizione. Il concetto, peraltro, è ribadito dall’esempio successivo al capoverso citato che riporta proprio il caso di un Comune che vorrebbe affidarsi ad un CSP per l’erogazione dei servizi scolastici ed educativi (lezioni a distanza, messaggistica, calendarizzazione delle lezioni, ecc.): il Comune, in quanto titolare del trattamento, deve assicurarsi che le sue eventuali istruzioni specifiche (periodo di conservazione, cancellazione dei dati, ecc.) siano rispettate dal CSP a prescindere dal contratto standard che, eventualmente, lo stesso CSP è abituato ad offrire.

Le Recommendations, invece, traggono origine dalla sentenza della Corte di Giustizia Europea sul cosiddetto caso “Schrems II” (C-311/18) che, di fatto ha considerato non soddisfacente il Privacy Shield ovvero l’accordo tra UE ed USA per consentire più agevolmente il trasferimento di dati personali da un soggetto europeo ad un soggetto statunitense che avesse, appunto, aderito ai requisiti previsti dal Privacy Shield. Questa sentenza incide notevolmente proprio sulle dinamiche dei più grandi CSP che, in via diretta o indiretta, mantengono i dati personali presso data center con sede negli Stati Uniti. Peraltro, le motivazioni della sentenza sono tutte di natura giuridica ed hanno poco a che vedere con le capacità tecniche dei CSP di proteggere i dati personali. Infatti, la CGUE ha ritenuto che il quadro normativo statunitense non fornisse agli interessati (cioè coloro ai quali i dati si riferiscono) garanzie sufficienti a tutelare i loro diritti e le loro libertà; in particolare, il quadro normativo USA consente alle autorità pubbliche (p.e. alle diverse agenzie che si occupano di prevenzione e repressione dei reati) di accedere a tutti i dati personali trattati da chiunque (quindi anche dai CSP) senza bilanciare questa possibilità con le dovute salvaguardie giuridiche per gli interessati.

Le Reccommendations sollecitano, quindi, a rivedere gli eventuali contratti con responsabili del trattamento (e, quindi, anche con i CSP) con sede nei paesi extra‑UE o che, comunque, trasferiscano dati personali presso infrastrutture con sede fuori dai confini UE.

Il codice di condotta europeo

La matassa, quindi, già abbastanza difficile da sbrogliare, si è ulteriormente complicata per i CSP con la sentenza “Schrems II”. Se ne sono accorti anche i promotori dell’EU Cloud Code of Conduct che, a fine settembre, hanno emesso un comunicato stampa che prendeva atto della necessità di rivedere il Codice di Condotta Europeo per i CSP arrivato, a marzo 2020, alla versione 2.6 ma che:

  • non teneva conto della sentenza “Schrems II” (emessa il 16 luglio 2020);
  • era ancora in corso di esame da parte dell’EDPB ai sensi dell’art. 40 del GDPR e, pertanto, non poteva ancora essere impiegato come “garanzia adeguata” per il trasferimento extra‑UE ai sensi della lettera e, par. 2 dell’art. 46 del GDPR.

Tutto da rifare, dunque? Certamente, tutto questo cambia di parecchio la prospettiva di molti OTT che forniscono servizi cloud.

L’intervento dell’ENISA

Sul fronte squisitamente tecnico, invece, c’è da registrare il recente intervento dell’Agenzia dell’Unione Europea per la Cibersicurezza (ENISA) che, lo scorso 22 dicembre ha pubblicato, per la consultazione pubblica, l’EUCS – Cloud Services Scheme cioè un quadro di prescrizioni che i Cloud Service Provider devono rispettare per ottenere la certificazione che la Commissione ha richiesto ai sensi del par. 2, art. 48 del Regolamento UE 2019/881 (il regolamento che riforma l’ENISA).

Lo schema proposto appare molto impegnativo per i CSP perché allarga di parecchio i controlli in materia di sicurezza delle informazioni già previsti dallo standard ISO/IEC 27001:2018 che, peraltro, costituiva la base di garanzie tecniche previste dall’EU Cloud Code of Conduct.

D’altra parte, lo schema non si limita a disciplinare il cloud come categoria tecnologica indistinta né a suddividerla nei soliti paradigmi SaaS, PaaS, Iaas, ecc.; punta, invece, sul Cloud capabilities type ovvero sulle concrete funzionalità che un servizio cloud fornisce al cliente, basandole sulle risorse utilizzate e calibra l’incisività dei controlli che il CSP deve attuare su tre livelli di garanzia (assurance):

  • base (basic); a questo livello viene certificato un servizio cloud che è realizzato e reso operativo con procedure e meccanismi tali per cui i requisiti di sicurezza assicurano garanzie nei confronti di rischi di attacchi ed incidenti noti;
  • rilevante (substantial); a questo livello viene certificato un servizio cloud che è realizzato e reso operativo con procedure e meccanismi tali per cui i requisiti di sicurezza assicurano garanzie nei confronti di rischi di attacchi ed incidenti noti ma anche per attacchi condotti da soggetti con competenze e risorse limitate;
  • alto (high); a questo livello viene certificato un servizio cloud che è realizzato e reso operativo con procedure e meccanismi tali per cui i requisiti di sicurezza assicurano garanzie nei confronti di rischi di attacchi ed incidenti rispetto allo stato dell’arte (quindi, anche potenziali ma non ancora comunemente noti) ma anche per attacchi condotti da soggetti con competenze e risorse significative.

L’ENISA spiega anche a quali servizi si adatta i tre livelli di garanzia:

  • il livello base si adatta ai servizi cloud progettati per assicurare i requisiti sufficienti a dati e sistemi non critici; per esempio, servizi di memorizzazione remota ad uso personale senza contenuti di carattere intimo;
  • il livello rilevante si adatta ai servizi cloud progettati per assicurare i requisiti sufficienti a dati e sistemi critici per il business; per esempio, per servizi di memorizzazione remota di fascicoli medici;
  • il livello alto si adatta ai servizi cloud progettati per assicurare i requisiti sufficienti a dati e sistemi impiegati in missioni critiche; per esempio, per servizi applicativi per compagnie aeree.

In questo quadro, ENISA calibra i requisiti di sicurezza ai diversi livelli di garanzia che, quindi, gli organismi di certificazione devono verificare.

Una specifica attenzione è rivolta alla sicurezza della supply chain (DEV-02 dell’allegato A dello schema) che richiede ai CSP che volessero certificare un loro servizio al livello alto l’esecuzione di un risk assessment per ogni prodotto utilizzato nella fornitura del servizio stesso. Questa caratteristica dello schema appare particolarmente rilevante perché, nel mondo del trattamento di dati personali, sembra spianare la strada ad uno degli aspetti più critici del rapporto tra titolare (cliente del servizio cloud), responsabile (CSP) e sub‑responsabili (fornitori del CSP). Infatti, oggi, per il titolare è sempre difficile ottenere dal responsabile del trattamento una lampante assicurazione delle garanzie offerte dal sub‑responsabile; la certificazione del rispetto di questo requisito fornirebbe al titolare la tranquillità di una seria scelta di partner da parte del responsabile del trattamento.

Articolo a cura di Francesco Maldera

Francesco Maldera è Data Protection Officer e Data Scientist.

Il suo percorso professionale lo ha chiamato a responsabilità direzionali nell’ambito dei sistemi informativi, della safety&security, della privacy e dell’auditing svolgendo diversi incarichi dirigenziali nella Pubblica Amministrazione e in aziende private.

Attualmente, accompagna l’attività consulenziale a quella di sensibilizzazione delle persone tramite il sito www.prontoprivacy.it

https://www.ictsecuritymagazine.com/articoli/certificazioni-per-il-cloud-in-arrivo-le-indicazioni-europee/


Chi ha paura dell’AI?

Molte volte sentire parlare di AI ci spaventa, ci vengono in mente immagini fantascientifiche, macchine che si sostituiscono all’uomo o complotti internazionali.

Ma dobbiamo comprendere che tutti questi scenari sono solo riportati per il mondo della letteratura e dello spettacolo. Analizzeremo alcune questioni che ci permetteranno di affrontare questi argomenti con serenità e senza panico. L’AI è e sarà sempre molto utile aiutando l’essere umano a svolgere compiti e prendere decisioni ma difficilmente si sostituirà ad esso.

L’AI è molto lontana da questi aspetti. Esistono vari tipi di AI che spaziano dalla robotica al machine learning, all’analisi dei dati, e questi si dividono ancora in sistemi deboli (utilizzando tecniche di problem solving, elaborando casi simili, confrontandoli ed elaborando una serie di soluzioni scegliendo quella più razionale) e forti (cioè i “sistemi esperti”, software che riproducono prestazioni e conoscenze di persone esperte in un determinato ambito).

Alla natura sono occorsi milioni di anni per potersi evolvere e all’uomo migliaia di anni per arrivare alle conoscenze odierne.

La natura, l’uomo durante il suo percorso evolutivo, è riuscito ad utilizzare molti elementi della tavola periodica combinandoli in molecole e strutture che gli permettono la vita.

Anche i segnali che noi decodifichiamo dall’esterno utilizzano le basi della biologia (con una varietà elevata di molecole e combinazioni delle stesse) traducendoli in segnali elettrici, nel campo dell’AI invece i sensori che traduco le informazioni in impulsi elettrici sono formati da un numero relativamente basso di elementi. Questo comporta un’enorme diversità nella percezione e nella codifica delle informazioni mantenendo l’uomo sempre al vertice.

Tavola periodica degli elementi

Inoltre proprio per le caratteristiche biologiche, l’uomo possiede delle potenzialità infinite come ad esempio l’intuizione o la percezione delle sensazioni.

Nel caso dei Big Data, l’AI è in grado di elaborare velocemente grandi quantità di informazioni strutturate e non, che conducono a dei risultati importanti ma sempre confinati dentro format o framework costruiti. L’AI non possiede il concetto di intuizione, si pensi ad esempio al tenente colonnello dell’Armata Rossa Stanislav Petrov che, il 26 settembre 1983, identificò un falso allarme missilistico derivante da un malfunzionamento del sistema di controllo satellitare sovietico prendendo difficili decisioni al limite dei regolamenti preposti, evitando così lo scoppio di un conflitto nucleare mondiale.

Oppure si pensi a due persone che guardandosi intensamente negli occhi scoprono mondi infiniti fino a innamorarsi l’uno dell’altra, ma dei sensori installati nelle macchine non potranno mai rilevare e rivelare quello che succede se non creando un’immagine di quello che vedono.

L’AI possiamo dire che traduce bene il mondo fisico, permette di analizzare quantità infinite di dati velocemente ma ad essa sfugge l’aspetto metafisico. Ad esempio se la temperatura esterna è di – 20 °C, una corretta analisi mi indica che devo coprirmi e vestirmi adeguatamente, ma magari io ho molto caldo e sto sudando perché devo recarmi ad un colloquio e sono molto emozionato, gli aspetti “soft” non sempre vengono considerati.

Consideriamo anche la capacità dell’AI di immagazzinare una enorme quantità di informazioni sia strutturate che non, da queste svolgere delle azioni e prendere decisioni, sicuramente molto più velocemente dell’essere umano, ma che dire delle sensazioni che ci portano i ricordi? Anche l’essere umano immagazzina informazioni ma queste sono anche collegate con altri aspetti, altre informazioni particolari: un profumo, una visione, un sentimento. Tutto questo l’AI non può farlo.

Dobbiamo anche non confondere il raggiungimento di un obiettivo da parte dell’AI, attraverso vari metodi ed interazioni, con la “testardaggine” umana nel raggiungere uno scopo.

L’intelligenza artificiale non è l’intelligenza umana, ci aiuta ma non ci sostituisce. All’AI mancano alcuni aspetti tipici dell’essere umano quali: il relazionarsi con gli altri, scoprire cose nuove, comprendere, avere atti di fede, vedere le cose da altri punti di vista, provare emozioni. L’AI accetta un input di dati, li traduce, li analizza trova il modello (sviluppato da un essere umano) e restituisce l’output.

Questa breve e sintetica riflessione vuole solo essere solo un punto di partenza per non farci trarre in inganno da tutto il mondo che circonda l’AI; l’AI è molto utile: apre nuovi scenari, supporta l’uomo in molteplici aspetti e attività, gestisce enormi quantità di dati, risolve problemi. Manteniamo, se vogliamo, questo aspetto “fiabesco” raccontato dai media e dai film ma ricordiamoci che non potrà mai sostituirsi all’uomo e alla sua umanità come persona (nel bene e nel male), quindi non spaventiamoci ma utilizziamola al meglio.

Articolo a cura di Stefano Gorla

Stefano Gorla è nato a Milano, si è laureato in fisica nucleare presso l’Università di Padova. Ha insegnato per qualche anno Matematica e Fisica presso alcuni licei.

Da anni si occupa di privacy e sicurezza dei dati attraverso un approccio sistemico e olistico.
Consulente e formatore in ambito sicurezza e tutela dei dati e delle informazioni e relatore in numerosi convegni.

Auditor ISO 27001, DPO Certificato FAC Certifica, NIST Specialist Certificato Fac Certifica, Certificato COBIT5 ISACA, Master EQFM.
Ha maturato notevoli esperienze come Referente Privacy (DPO) e consulente in tali ambiti.
È autore di varie pubblicazioni sul tema.

https://www.ictsecuritymagazine.com/articoli/chi-ha-paura-dell-ai/


Perché l’autenticazione a due fattori è diventata una misura necessaria

Perché è così importante

Oggi l’autenticazione a due o più fattori non può più essere considerata un’opzione da utilizzare solo nei nostri account bancari (dove peraltro è obbligatoria) ma è diventata una necessaria misura di sicurezza da adottare per tutti i nostri account più importanti.

Non basta impostare password forti ed univoche: come abbiamo spiegato in un nostro precedente articolo, qualunque password potrebbe essere rubata e quindi compromessa.

Magari non per causa nostra, ma a seguito della compromissione del sito dove è stata registrata. Sono frequenti i casi di violazione di siti (data breach) con il furto massivo di migliaia o milioni di password: in questi casi le nostre password finiscono nel mercato nero del web e qualcuno potrebbe usarle per realizzare un Account Takeover (acquisizione dell’account).

Un’autenticazione basata solo su password è dunque intrinsecamente debole, anche se la password impostata è robusta, perché la sicurezza dell’account dipende da un solo fattore, appunto la password.

Per questo ci viene in aiuto la Strong Authentication o autenticazione forte a due o più fattori, definita anche 2FA o MFA (Multi-Factor Authentication). Essa rappresenta la misura di sicurezza più importante per proteggere l’accesso ai nostri account.

In ambito bancario è utilizzata ormai da anni ed è definita Strong Customer Authentication (SCA): la sua applicazione è stata ulteriormente rafforzata e resa obbligatoria per le operazioni bancarie online a seguito dell’entrata in vigore della Direttiva (UE) 2015/2366 nota come PSD2 (Payment Services Directive 2).

La SCA viene definita in modo molto preciso nella PSD2 all’art.4 comma 30 come:

«autenticazione forte del cliente»: un’autenticazione basata sull’uso di due o più elementi, classificati nelle categorie della conoscenza (qualcosa che solo l’utente conosce), del possesso (qualcosa che solo l’utente possiede) e dell’ine­renza (qualcosa che caratterizza l’utente), che sono indipendenti, in quanto la violazione di uno non compromette l’affidabilità degli altri, e che è concepita in modo tale da tutelare la riservatezza dei dati di autenticazione”.

La medesima Direttiva indica i casi in cui è obbligatorio utilizzarla, cioè quando il pagatore:

  1. a)  accede al suo conto di pagamento on line;
  2. b)  dispone un’operazione di pagamento elettronico;
  3. c)  effettua qualsiasi azione, tramite un canale a distanza, che può comportare un rischio di frode nei pagamenti o altri abusi.

Questa direttiva dell’Unione Europea è stata recepita dall’Italia con il D.Lgs. 15 dicembre 2017, n. 218 ed è in vigore in Italia dal 14 settembre 2019.

Molti utenti avranno notato, dopo questa data, che la loro banca ha reso più stringenti (e spesso anche più complicate!) le modalità di accesso ai servizi di internet banking.

Ormai tutti i siti importanti rendono disponibile l’autenticazione a due fattori, ma in forma facoltativa. Quindi sarà l’utente a doverla attivare come opzione aggiuntiva.

A darci la misura di questo determinante incremento di sicurezza è – per esempio – quanto esposto da Microsoft nel corso della RSA Conference 2020, svoltasi a San Francisco nel febbraio 2020. Nel corso di questo evento Microsoft ha evidenziato lo studio su oltre 1,2 milioni di account violati nel gennaio 2020: oltre il 99,9% di tali account violati non aveva la MFA (come evidenziato in figura).

Cosa è la 2FA/MFA

Quando eseguiamo l’autenticazione in qualunque servizio informatico (un sito, un account aziendale, ecc.), dopo aver inserito il nostro username dobbiamo autenticarci (dare dimostrazione non equivoca della nostra identità).

L’autenticazione può esser eseguita con modalità diverse che tipicamente sono le seguenti tre:

  1. CONOSCENZA: ”Una cosa che sai”, per esempio una password o il PIN.
  2. POSSESSO: ”Una cosa che hai”, come uno smartphone, una smartcard o un token di sicurezza.
  3. INERENZA: ”Una cosa che sei”, cioè un dato biometrico, quale l’impronta digitale, il timbro vocale, il viso, l’iride.

Nella maggioranza dei casi l’autenticazione avviene con la sola password: si definisce quindi “autenticazione ad un fattore”.

Si parla invece di 2FA se si usano almeno due dei tre fattori sopra elencati.

Ma affinché si possa definire propriamente “autenticazione a due fattori” è necessario che i due fattori utilizzati siano generati attraverso due modalità differenti tra le tre possibili. Non è corretto quindi parlare di 2FA se l’autenticazione è fatta con due password (perché due fattori della stessa natura).

È possibile – anche se molto meno diffusa – anche l’autenticazione a tre fattori (3FA), ovviamente se vengono richiesti insieme tutti i tre fattori.

Viene impiegata nello SPID (il Sistema Pubblico di Identità Digitale) di Poste Italiane, che offre appunto i tre diversi livelli di autenticazione:

  • SPID 1: solo con la password associata allo UserID.
  • SPID 2: con password più l’App PosteID, oppure un OTP (codice “one time password”) ricevuto via SMS. È la versione più utilizzata.
  • SPID 3: oltre a password e App PosteID, richiede un terzo livello, che può essere una smart card o un dispositivo per la firma digitale remota (HSM).

Anche Aruba offre lo SPID di livello 3.

Come utilizzare la 2FA e come attivarla

Utilizzare la 2FA non è difficile e – come abbiamo detto – tutti i siti e servizi più importanti la prevedono, ma come opzione da attivare facoltativamente.

In questo utile sito è possibile consultare quali sono i servizi che la prevedono (e sono tanti!)  e con quali opzioni alternative.

Quindi non abbiamo alcun motivo per non adottarla.

Dovremo accedere al servizio, facendo il login, poi entrare nella sezione del sito delle “Impostazioni di Sicurezza” (il nome può anche essere leggermente diverso, ma si tratta sempre della sezione dove andiamo, per esempio, a modificare la password).

Qui troveremo il menù dedicato all’autenticazione a due fattori, definita in alcuni casi “autenticazione forte”.

Una volta selezionata l’opzione “autenticazione a due fattori”, ci verrà chiesto la modalità con la quale vogliamo utilizzarla: in genere le soluzioni disponibili sono più di una, ma non tutte – come vediamo ora – ugualmente sicure.

Quasi sempre il primo fattore è comunque la password, mentre il secondo fattore potrebbe essere un codice numerico che, a differenza della password, viene generato in maniera pseudocasuale secondo uno specifico algoritmo (come spiegato in seguito) ed ha una durata molto limitata nel tempo (solitamente 30 secondi). Per questo motivo, lo si definisce anche OTP: “one time password”.

A differenza della password, che rimane invariata, questo secondo codice è di fatto inattaccabile, perché generato in maniera pseudocasuale e variato ogni 30÷60 secondi.

Il codice OTP può arrivare attraverso un SMS (meno frequentemente via email), oppure può essere generato mediante apposite applicazioni installate sul nostro smartphone. Siamo quindi nella modalità ”Una cosa che hai”.

Il codice OTP potrebbe anche essere generato da un Token hardware: una oggetto simile ad una chiavetta USB che fornisce il codice a tempo a seguito della pressione di un pulsante. In passato erano forniti dalle banche per accedere ai loro servizi di home bank,  ma sono ormai abbandonati, in quanto non conformi alle nuove disposizioni della PSD2.

Sono considerati non sicuri, perché possono essere attivati senza alcun codice di sicurezza. Quindi in caso di furto o smarrimento, chiunque potrebbe utilizzarli.

Sono invece ammessi dalla PSD2 i codici OTP generati dalle app su smartphone.

Il motivo è spiegato chiaramente nella NIST SP 800-63B “Digital Identity Guidelines – Authentication and Lifecycle Management” (https://csrc.nist.gov/publications/detail/sp/800-63b/final): quando si usa una combinazione di due fattori di autenticazione, il secondo autenticatore deve essere basato sul possesso (cioè “qualcosa che hai”) e deve soddisfare il requisito di  “garantire una resistenza all’impersonificazione”; in altre parole: impedire che qualcuno li possa usare al nostro posto. Questo è reso possibile perché lo smartphone richiede una procedura di sblocco per essere attivato.

Il secondo fattore può essere – in alternativa – di tipo biometrico (”una cosa che sei”). Ne abbiamo un esempio nelle applicazioni per smartphone che ci forniscono le banche: per aprire l’app ed anche per eseguire operazioni dispositive (p.es. fare un bonifico), ci viene richiesta la seconda autenticazione con l’impronta digitale o con il riconoscimento facciale.

Vediamo più in dettaglio quali sono le possibili alternative per il secondo fattore di autenticazione, presupponendo che il primo sia comunque la password. Per ciascuno esamineremo anche i vantaggi e gli svantaggi.

  1. SMS che ci viene inviato sullo smartphone che abbiamo indicato come attendibile: questo ci obbliga a fornire un numero di telefono, la qual cosa potrebbe essere sconsigliata per ragioni di privacy. Inoltre per funzionare richiede che lo smartphone sia connesso alla rete cellulare. È la modalità più diffusa, ma indiscutibilmente la meno sicura. Ciò a causa della ormai nota vulnerabilità del protocollo Signalling System No 7 (SS7): tale protocollo è piuttosto datato (fu sviluppato addirittura nel 1975) e le vulnerabilità di cui è affetto potrebbero consentire ad un attaccante l’intercettazione del messaggio con il codice OTP.
    Ma il rischio più grave – e più frequente, soprattutto nel caso di account di home banking – è quello della SIM Swap Fraud: un malintenzionato che sia già riuscito ad avere le credenziali di accesso all’account bancario (per esempio con tecniche di phishing), potrebbe poi ottenere una SIM card con il nostro numero di telefono. Sebbene questo possa apparire un’eventualità poco probabile e complicata, in realtà si sono verificati numerosi casi in cui la SIM swap è stata perpetrata. Questo può accadere tramite tecniche di social engineering, così da indurre gli operatori di telefonia mobile a emettere una nuova SIM card, oppure con la complicità di un operatore del provider, o anche con la presentazione di un documento falso (ma talvolta l’utente riesce ad ottenere una nuova SIM senza che neppure gli venga richiesto un documento di identità).
    La SIM swap permette di ottenere il completo accesso al numero di telefono del legittimo (e ignaro) proprietario di tale numero e quindi ricevere l’SMS con i codici di autenticazione a due fattori, ovviamente per realizzare operazioni bancarie. Il proprietario dello smartphone si troverà con il dispositivo muto e disconnesso dalla rete. Quando si sarà reso conto che la sua SIM non è più attiva potrebbe essere troppo tardi e i soldi già scomparsi dal suo conto corrente.
    Per questo motivo, la 2FA con SMS è deprecata dal NIST nella già citata SP 800-63B, al capitolo 5.1.3 Out-of-Band Devices.
    Quindi, potendo scegliere, consiglio di evitare sempre l’opzione SMS ed optare per le scelte seguenti.
  2. Soft Token: sono applicazioni dedicate, che non richiedono la copertura telefonica e sono più sicure, perché legate non al numero di telefono, ma al dispositivo su sui sono installate. Restituiscono un OTP a 6 cifre, della durata in genere di 30 secondi, generato da un apposito algoritmo basato sul tempo ed associato allo specifico account.
    Esistono numerose applicazioni del genere: le più note – tutte gratuite – sono Authy, Google Authenticator, Microsoft Authenticator. Anche i migliori password manager (di cui abbiamo parlato in questo articolo) offrono questa funzionalità: 1Password la implementa nel password manager stesso, mentre LastPass ha un’applicazione aggiuntiva dedicata (LastPass Authenticator).
    Come utilizzare queste app: l’abbinamento va fatto (una volta sola quando si attiva la 2FA) attraverso la lettura di un QRcode che compare sullo schermo del computer e che dovremo inquadrare con la camera dello smartphone, nel quale abbiamo preventivamente aperto l’applicazione.
    In questo modo viene eseguito l’Enrollment (registrazione) con lo scambio della chiave crittografica tra l’app sul dispositivo ed il sito. L’operazione permetterà di abbinare in futuro la specifica sessione del browser con la corrispondente istanza dell’app e generare una TOTP (Time-based One Time Password). Tale corrispondenza si basa sul timestamp T utilizzando un hash H (SHA-1) nella seguente funzione:
    TOTP = HOTP(K, T)
    ove:
    T = (Current Unix time – T0)/X
    X rappresenta la fase di tempo in secondi (predefinito X=30 sec.)
    Questo algoritmo di generazione TOTP è codificato da due standard di riferimento emessi da IETF (Internet Engineering Task Force):
    RFC-4226 (HOTP) (2005)
    RFC-6238 (TOTP) (2011).
    Nella fase di attivazione dell’autenticazione a due fattori è possibile (ma non sempre accade) che dal sito ci venga fornita anche una chiave di recupero, molto complessa e da conservare a parte. Tale chiave di recupero è da utilizzare solo in caso di password dimenticata o dispositivo smarrito o rubato.
    Nella categoria dei Soft Token possiamo annoverare anche le app bancarie, che hanno la possibilità sia di generare un codice OTP, sia di fornire l’accesso con una seconda autenticazione di tipo biometrico.
    Analogo funzionamento si trova nell’app PosteID, utilizzata per l’autenticazione SPID 2.
    Ovviamente sia PosteID che le app delle banche sono dedicate ad un unico servizio. Viceversa le app precedentemente citate (quali Authy, Google Authenticator, Microsoft Authenticator) possono memorizzare differenti account ed essere utilizzate per qualsiasi servizio che supporti questa modalità di 2FA.
  3. Token hardware: trascuriamo quelli che venivano in passato forniti dalle banche, che sono in via di dismissione, perché considerati non sicuri (per i motivi che abbiamo già spiegato e per effetto della PSD2).
    Sono invece nati nuovi tipi di token, secondo lo standard FIDO U2F Security Key. Trattasi di uno standard di autenticazione open source, creato inizialmente da Google e da Yubico e successivamente confluito nella FIDO (Fast IDentity Online) Alliance.
    Ne esistono numerosi modelli: i più semplici richiedono l’inserimento in una porta USB, quelli più avanzati (per esempio YubiKey) operano anche con NFC (Near Field Communication) o via Bluetooth come i Titan Security Key di Google (quindi possono essere utilizzati anche con gli smartphone che non hanno la porta USB).
    I costi partono dai 20 dollari fino a 50-60 dollari ed oltre. Non è certamente il sistema più economico.
    Ma il limite maggiore è dovuto al fatto che si tratta di una tecnologia recente, quindi con una diffusione ancora limitata. Solo alcuni browser la supportano, tra questi Chrome, Firefox ed Opera. Diventerà comunque lo standard del prossimo futuro, anche perché garantisce la conformità alla direttiva PSD2 per quanto riguarda la Strong Customer Authentication (SCA).

Quanto è complicato utilizzare la 2FA?

Nella pratica l’onere supplementare che ci viene richiesto è piuttosto modesto ed ampiamente ripagato dal notevole incremento in termini di sicurezza degli account.

L’attivazione della 2FA andrà fatta una volta sola.

Ai successivi login, dopo username e password, dovremo inserire il codice OTP a 6 cifre visualizzato dall’applicazione (o ricevuto via SMS) e che ogni 30 secondi verrà rigenerato.

Su molti siti è disponibile una comoda opzione chiamata in genere: “considera questo dispositivo attendibile” (o qualcosa di simile). Se la attiviamo (una tantum), nei login successivi – solo se eseguiti da quel dispositivo – non verrà più richiesto il codice OTP.

Questo non elimina la 2FA (che rimane attiva), né la rende meno sicura: poiché l’autenticazione a due fattori è finalizzata ad evitare accessi da computer o dispositivi diversi dai nostri, potremo fare in modo che il sito riconosca che stiamo facendo il login dal nostro “abituale” dispositivo e non ci richieda più il secondo fattore di autenticazione.

Continuerà a richiederlo, viceversa, se il login viene tentato da un dispositivo non riconosciuto come affidabile.

Articolo a cura di Giorgio Sbaraglia

Giorgio Sbaraglia, ingegnere, è Information & Cyber Security Advisor e svolge attività di consulenza e formazione per la sicurezza informatica, Risk Management e per il GDPR.

Tiene corsi su questi temi per molte importanti società italiane di formazione, tra le quali 24Ore Business School e ABIFormazione.

È membro del CLUSIT (Associazione Italiana per la Sicurezza Informatica) e certificato “Innovation Manager” da RINA.

Ricopre l’incarico di DPO (Data Protection Officer) per alcune aziende italiane.

È autore dei libri:

  • “GDPR kit di sopravvivenza” (Editore GoWare);
  • “Cybersecurity kit di sopravvivenza. Il web è un luogo pericoloso. Dobbiamo difenderci!” (Editore GoWare);
  • “iPhone, come usarlo al meglio” (Editore GoWare).

www.giorgiosbaraglia.it

https://www.ictsecuritymagazine.com/articoli/perche-lautenticazione-a-due-fattori-e-diventata-una-misura-necessaria/


La resilienza delle supply chain

Introduzione

Le “supply chain” o filiere di fornitura si sono ritagliate un ruolo sempre più importante nella gestione aziendale. Queste sono un pilastro fondamentale dell’economia globale, dal momento che mettono spesso in contatto organizzazioni in diverse parti del mondo, da diversi settori e di diversa grandezza. Esistono tantissime variabili che interessano una corretta gestione delle supply chain, che possono riguardare il personale, i processi o i dati di diverse aziende. Basti pensare ad attori che operano in due aree geografiche con diverse legislazioni in tema di privacy o a fornitori basati in regioni afflitte da forti eventi atmosferici.

Il 2020 è stato indubbiamente un anno con molte difficoltà e sfide per le filiere, con un evento avverso dominante – la pandemia legata al Covid-19 – e molti effetti domino che hanno richiesto uno sforzo inusuale, creando un vero e proprio “Worst Case Scenario”. Ad ogni modo, nonostante possa sembrare un cliché, è non solo possibile ma d’obbligo cambiare radicalmente la visione della gestione aziendale e delle supply chain in relazione agli eventi accaduti. Mentre molti vedono come obiettivo principale il ritorno alla normalità, vecchia o nuova che sia, sarebbe invece importante accettare l’incertezza del contesto aziendale.

Saper cambiare per essere resilienti

Secondo un’indagine del Business Continuity Institute, tre supply chain su quattro subiscono almeno un incidente all’anno (questo succedeva già prima della pandemia). Il parco minacce include tipologie di incidenti estremamente diverse, come gli attacchi cyber, incidenti IT, mancanza di personale qualificato, cambiamenti politici, nuove legislazioni ed eventi atmosferici[1], in aggiunta ai vari cambiamenti della domanda e delle esigenze di mercato. Al momento esistono inoltre infrastrutture critiche per i trasporti completamente digitalizzate che sfruttano l’esistenza di una intera copia digitale di tutti i propri impianti, qualcosa di impensabile solo all’inizio di questa decade[2]. Alla luce di tutto ciò viene decisamente da chiedersi se il concetto stesso di normalità sia poi così affidabile e utile.

Lo stato dell’arte per quanto riguarda lo studio della resilienza delle supply chain include diverse componenti, come la visibilità dei rischi della filiera, la capacità di reazione nel minor tempo possibile e, soprattutto, la flessibilità[3]. Avere la capacità di riconfigurare la propria supply chain durante un periodo interessato da profondi cambiamenti o shock è infatti una qualità imprescindibile per una rete di fornitori. Questo si è rivelato evidente durante la prima ondata della pandemia, dove grazie alla reattività di alcune supply chain è stato possibile trovare soluzioni alternative per la produzione di materiale sanitario, come ad esempio le mascherine prodotte tramite stampanti 3D. Ad ogni modo, tale dinamica può essere riscontrata anche in casi passati, con aziende capaci di riconfigurare le proprie filiere tramite sistemi di back-up, diversificazione e stretta collaborazione anche con alcuni clienti.

È questo, ad esempio, il caso di Boeing, che durante gli allagamenti del 2011 nel sudest asiatico fu in grado di mantenere attiva la produzione facendo leva sullo stretto rapporto tra l’azienda focale e i fornitori, garantendo una efficace alternanza di soluzioni all’interno della filiera. Notevoli capacità di riconfigurazione furono dimostrate anche da Dell Inc., capace di arginare (a differenza dei suoi competitor) una serie di scioperi del personale portuale negli Stati Uniti nel 2002 utilizzando il trasporto aereo, rendendo così la continuità operativa un vantaggio competitivo[4].

Nonostante si possa pensare che la flessibilità e la pianificazione siano agli opposti, non è questo il caso. La flessibilità della supply chain viene creata pianificando diverse alternative ai processi di produzione utilizzati, in maniera tale che la capacità di reazione ad un cambiamento o uno shock nel mercato venga massimizzata. Negli anni si sono sviluppati dei sistemi di gestione che si pongono proprio l’obiettivo di aiutare le aziende – e le loro supply chain – a navigare attraverso i mercati di oggi, dove ricercare la normalità può diventare uno sforzo inutile.

Questo è il caso del Business Continuity Management, che tramite una serie di processi, suddivisi in più fasi, supporta le filiere in diversi modi:

  • Fornisce un’analisi delle minacce e dei cambiamenti tramite tecniche di horizon scanning;
  • Aiuta l’azienda ad individuare i propri fornitori critici grazie all’analisi di impatto aziendale;
  • Forma il personale e lo sensibilizza verso tali problematiche con sessioni di awareness;
  • Punta a coinvolgere il top management nei programmi riguardanti la resilienza e la continuità operativa;
  • Fornisce una mappatura dei singoli punti di cedimento e dei dipartimenti da proteggere da possibili shock o cambiamenti.

Il beneficio portato da sistemi di BCM non è solo teoria. In una recente indagine sulle sinergie tra BCM e sostenibilità, è emerso che la business continuity aiuta ad avere anche una maggiore visibilità dei rischi di tipo Environmental, Social and Governance (ESG), che al giorno d’oggi interessano le filiere come non mai per questioni di salute e sicurezza, compliance e reputazione. Tale indagine ha anche rivelato che le aziende dotate di sistemi di BCM hanno subito meno l’impatto degli effetti della pandemia. Ovviamente, questo si applica soprattutto a chi segue in maniera più rigorosa le buone pratiche descritte negli standard internazionali[5].

Gli standard internazionali: il punto di Gianna Detoni, Project Leader della nuova ISO/TS 22318 sulla resilienza delle supply chain.

Le discipline di continuità e resilienza sono praticate da più di 30 anni. Tuttavia, solo recentemente hanno riscosso maggior interesse da parte delle organizzazioni che hanno realizzato, anche grazie a lezioni apprese da gravi interruzioni subite, che non possono fare a meno di queste importanti metodologie di tutela di tutti gli asset organizzativi.

Nel 2012 sono state emesse le prime ISO per la certificazione delle organizzazioni (ISO 22301 e ISO 22313). Entrambe sono già passate attraverso una revisione della Commissione Tecnica e sono state riemesse nel 2019 e nel 2020. A seguire, si è sentita l’esigenza di emettere le Specifiche tecniche relative ad aree della continuità e resilienza. Quindi, nel 2015 sono state emesse le ISO/TS 22317 (relativa alla Business Impact Analysis) e la ISO/TS 22318 (relativa alla Supply Chain Continuity). Entrambe queste technical specification sono oggetto di revisione quest’anno e la data stimata di emissione sarà nel luglio 2021. Molte altre negli anni sono state emesse per le esercitazioni, le strategie e le soluzioni di continuità, per la continuità delle persone. Ulteriori informazioni si possono trovare al link: https://www.iso.org/committee/5259148.html).

Avendo l’onore e il privilegio di rappresentare l’UNI e l’Italia nelle commissioni tecniche relative alle discipline di Continuità e Resilienza, ho partecipato e partecipo con PANTA RAY a tutti i lavori di emissione e revisione degli standard internazionali. Inoltre, quest’anno mi hanno nominato Project Leader della revisione della ISO 22318. La continuità della supply chain era un tema molto sentito già prima del 2020. Molte organizzazioni nel passato avevano infatti riportato gravi conseguenze proprio per interruzioni nella propria catena di fornitura. Quindi, si era sentita l’esigenza, e presa la decisione di revisionare la ISO/TS 22318 già a settembre 2019. È indubbio che il periodo storico che stiamo vivendo quest’anno ha portato il tema della continuità della supply chain sui tavoli del top management e sicuramente tutti i cambiamenti effettuati nello standard internazionale saranno molto utili agli stakeholder – ai team di business continuity, al procurement, ai titolari dei processi di supporto e di business e al top management – per applicare una metodologia che assisterà in questo complesso controllo indiretto che tutte le organizzazioni devono esercitare per tutelare il proprio business e i propri clienti in caso di interruzioni della catena di fornitura. Nella nuova ISO/TS 22318 ci siamo molto concentrati sia sulla parte upstream che downstream della supply chain, tenendo presente non solo il primo livello (tier 1), ma gli altri livelli (tier 2, 3 ecc.) per eventuali interruzioni dei fornitori dei nostri fornitori. Abbiamo anche migliorato la metodologia, semplificando il processo di presupposti e di azioni da compiere. Abbiamo applicato l’esperienza acquisita in questi anni (inclusa la pandemia) e inserito delle appendici con esempi pratici relativi, ad esempio, ai questionari da inviare ai fornitori, alle azioni da eseguire durante una crisi, alle possibili esercitazioni da eseguire con i fornitori.

Il controllo della continuità dei fornitori non è semplice e sono fermamente convinta che senza una metodologia le organizzazioni saranno in difficoltà in caso di crisi e interruzioni nella supply chain.

Note

[1] BCI Supply Chain resilience Report 2019. The BCI. 2019.

[2] https://www.start4-0.it/

[3] Christopher and Peck, 2004.

[4] Resilience Strategies for Complex Supply Chains. PANTA RAY. 2019

[5] Business Continuity and Sustainability Report 2020. PANTA RAY. 2020.

Articolo a cura di Gianna detoni e Gianluca Riglietti

Gianna Detoni, Presidente PANTA RAY e BCI Global Industry Personality 2017

Con un passato nella gestione della Risk Resilience in JPMorgan Chase, Gianna Detoni è Presidente e Fondatrice di PANTA RAY, società leader nella consulenza e formazione in ambito continuità e resilienza.

È considerata uno dei massimi esperti internazionali in queste materie. Per questa ragione il Business Continuity Institute (BCI) l’ha eletta ‘Global Continuity & Resilience Industry Personality of the Year 2017’.

Nel ruolo di BCI Approved Instructor, ha dato un importante contributo alla realizzazione dell’attuale edizione delle Good Practice Guidelines del BCI, il testo di riferimento per i professionisti di continuità e resilienza.

Inoltre, Gianna è spesso ospite di importanti conferenze e tavole rotonde internazionali come esperta nelle tematiche di sua competenza.

https://www.ictsecuritymagazine.com/articoli/la-resilienza-delle-supply-chain/