Scoperte diverse vulnerabilità nello stack TCP/IP utilizzato da milioni di dispositivi IoT

I ricercatori dei Forescout Research Labs hanno scoperto 33 vulnerabilità che interessano quattro dei principali TCP/IP stack open source utilizzati in milioni di dispositivi connessi in tutto il mondo.

Questo gruppo di vulnerabilità denominato “Amnesia: 33”, perchè colpisce prevalentemente lo stato di memoria dei dispositivi, può consentire agli aggressori di:

  • compromettere il corretto funzionamento dei dispositivi da remoto,
  • far eseguire del codice malevolo o dannoso al dispositivo,
  • compiere attacchi del tipo denial-of-service,
  • esfiltrare le informazioni sensibili,
  • iniettare record DNS modificati per far puntare il dispositivo ad un domain controller gestito dall’attaccante.

Criticità

Lo stack TCP/IP embedded fornisce le funzionalità di comunicazione in rete, essenziali per i dispositivi IoT, a molti dei sistemi operativi utilizzati nei dispositivi integrati che desiderano sfruttare i protocolli basati sul TCP/IP. Questi software sono sfruttati anche nelle più recenti tecnologie come l’Edge Computing.

I ricercatori hanno individuato le 33 vulnerabilità nelle seguenti implementazioni:

Le vulnerabilità interessano sette diversi componenti dello stack: DNS, IPv6, IPv4, TCP, ICMP, LLMNR e mDNS e possono essere trovate in prodotti che vanno dai componenti embedded (come i Systems on a Chip – SoC, i moduli di connettività e le schede OEM) all’IoT consumer (come le prese e i termostati intelligenti), dal networking alle apparecchiature d’ufficio (come stampanti, switch e software dei server) per finire con i dispositivi OT (come i dispositivi utilizzati per il controllo dell’accesso, le telecamere IP, i Remote Terminal Unit (RTU) e i sistemi di condizionamento (HVAC)).

Le vulnerabilità e le loro possibili conseguenze sono state dettagliate nel Report dei Forescout Research Labs (1). Tuttavia, va sottolineato, l’impatto finale dipende dallo specifico dispositivo che utilizza lo stack vulnerabile e dal contesto in cui è inserito. Per esempio, una vulnerabilità della classe DoS non è generalmente considerata critica, ma potrebbe esserlo se il target è un dispositivo OT in ambiente critico dove la disponibilità rappresenta indubbiamente un requisito indispensabile.

È possibile, inoltre, sfruttare la vulnerabilità offerta dal Remote Code Execution dei dispositivi attaccabili per commettere frodi ad un contatore smart, violare le reti aziendali tramite la building automation e i router, le VPN, i firewall o gateway o tentare di causare danni fisici ad un safety controller.

Poiché i bugs interessano diverse implementazioni dello stack TCP/IP open source, è difficile individuare in maniera puntuale tutti i dispositivi interessati. Inoltre, a causa delle molteplici fork, branch e versioni dello stack non supportate (ancora disponibili), sarà difficile applicare le patch e spesso questo non avverrà mai.

Un ulteriore difficoltà è rappresentata dalla circostanza che questi componenti software possono essere integrati nei S.O. dei dispositivi IoT in diverse modalità: possono essere compilati direttamente nel codice sorgente, modificati, integrati e collegati come librerie dinamiche o statiche e, conseguentemente, fornire un’ampia varietà di implementazioni. La molteplicità di opzioni e la mancata visibilità della catena di approvvigionamento rende molto difficile e complessa la valutazione precisa del loro impatto e, soprattutto, la potenziale sfruttabilità di queste vulnerabilità.

In generale, la maggior parte di questi bugs causa errori nella gestione della memoria. L’impatto può variare significativamente da un dispositivo ad un altro simile a causa delle molteplici combinazioni di build e runtime personalizzate incluse nei dispositivi IoT.

In sintesi, un utente malintenzionato, remoto e non autenticato, potrebbe essere in grado di utilizzare dei pacchetti di rete appositamente predisposti per far sì che il dispositivo vulnerabile si comporti in maniera imprevista, oppure generare un errore, con la conseguenza che ciò possa causare il diniego ad un determinato servizio e, perfino, divulgare informazioni private o eseguire del codice arbitrario.

Soluzione

Questa fattispecie di problematiche connesse all’implementazione dei software può essere affrontata con due approcci distinti.

Il primo approccio, che ha un obiettivo a breve termine, si concentra sui dispositivi in produzione e si concretizza in una serie di azioni a carico del settore IT o dell’utente finale per tentare di applicare tutti gli aggiornamenti di sicurezza rilasciati e rimuovere le vulnerabilità note.

Se questi componenti software sono stati forniti da un provider, occorrerebbe contattarlo per ottenere gli aggiornamenti appropriati che dovranno essere integrati nel software in uso. Mentre gli utenti finali di dispositivi IoT embedded, che implementano questi software vulnerabili, devono contattare il proprio fornitore o il rivenditore per ottenere gli aggiornamenti opportuni.

Il secondo approccio ha una visione a medio e lungo termine e si attua attraverso una serie di best practices che è opportuno seguire prima di connettere un nuovo dispositivo IoT alla propria rete:

  • Evitare di esporre il dispositivo IoT direttamente sulla rete Internet e, se disponibile, utilizzare una zona di rete segmentata,
  • Abilitare la funzionalità di debugging per effettuare un’analisi approfondita dei pacchetti di rete e rilevare le anomalie del firewall, se presente, per proteggere i dispositivi embedded e IoT,
  • Garantire l’adozione delle impostazioni predefinite sicure e disabilitare le funzioni e i servizi inutilizzati,
  • Aggiornare regolarmente il firmware all’ultima versione stabile fornita dal fornitore per garantire che il dispositivo sia sempre aggiornato.

Conclusioni

Non è la prima volta che gli stack TCP/IP risultano vulnerabili agli attacchi. Alla fine del 2019, i ricercatori di Armis hanno rivelato 11 vulnerabilità in IPnet, uno stack TCP/IP utilizzato in Wind River VxWorks, un sistema operativo utilizzato da oltre due miliardi di dispositivi in ambienti industriali, medici e aziendali (3).

Quindi, nel giugno 2020, i ricercatori di JSOF hanno individuato 20 vulnerabilità nella libreria Treck TCP/IP, utilizzata in centinaia di milioni di dispositivi IoT e OT (4).

Queste criticità rappresentano indubbiamente una grande sfida per la mitigazione del rischio cyber a carico delle organizzazioni che sfruttano le tecnologie basate sull’IoT nei loro cicli produttivi.

L’analisi ha consentito di evidenziare un’altra importante debolezza: molto spesso questi dispositivi non sono accompagnati da schede tecniche dettagliate che aiutano a comprendere i componenti, hardware e software, utilizzati per produrli e, di conseguenza, diventa particolarmente complesso, se non impossibile, ottenere queste informazioni utili agli addetti alla sicurezza per l’applicazione del patching adeguato.

L’ecosistema IoT è altamente competitivo e, di conseguenza, è divenuto un settore dell’ICT fortemente esposto all’utilizzo di software difettoso a causa di catene di approvvigionamento complesse che propagano facilmente le vulnerabilità.

A riguardo si sottolinea l’importanza della sicurezza nella supply chain del software e dei dispositivi IoT.

A tal proposito è utile ricordare le recenti “Guidelines for Securing the Internet of Things” (5) emanate il 9 novembre 2002 dall’ European Union Agency for Cybersecurity (ENISA) e incentrate sulla sicurezza della supply chain per l’IoT. L’Italia ha già avviato da anni un percorso virtuoso di validazione con l’istituzione dell’OCSI (Organismo di Certificazione della Sicurezza Informatica) a cui è stata delegata la gestione dello Schema nazionale per la valutazione e la certificazione della sicurezza di sistemi e prodotti nel settore della tecnologia dell’informazione ai sensi del DPCM del 30 ottobre 2003 (G.U. n.98 del 27 aprile 2004). Pertanto, al momento di scegliere un prodotto IoT o OT è fortemente consigliato verificare il percorso di certificazione effettuato.

Fonti:

  1. Report del Forescout Research Labs: https://www.forescout.com/company/resources/amnesia33-how-tcp-ip-stacks-breed-critical-vulnerabilities-in-iot-ot-and-it-devices/
  2. Vulnerability Note VU#815128 del Cert Coordination Center: https://kb.cert.org/vuls/id/815128
  3. URGENT/11 affects additional RTOSs – Highlights Risks on Medical Devices https://www.armis.com/urgent11/
  4. Ripple20 – 19 Zero-Day Vulnerabilities Amplified by the Supply Chain: https://www.jsof-tech.com/ripple20/
  5. Guidelines for Securing the Internet of Things dell’Enisa: https://www.enisa.europa.eu/publications/guidelines-for-securing-the-internet-of-things

Articolo a cura di Vincenzo Calabrò

È laureato in Ingegneria Informatica ed in Sicurezza Informatica presso le Università di Roma La Sapienza e di Milano. Ha, altresì, indirizzato la sua formazione nei settori della Cyber Security e Digital Forensics conseguendo i Masters in Data Protection e Data Governance, IT Risk Management  e Sicurezza Informatica ed Investigazioni Digitali, oltre al CERT Certification in Digital Forensics rilasciato da Carnegie Mellon University, all’European Certificate on Cybercrime and E-Evidence (ECCE) rilasciato dall’European Commission’s Directorate General Justice, Freedom and Security.

Dal 1992 ricopre, nei ruoli del Ministero dell’Interno, gli incarichi di Referente Informatico e di Funzionario alla Sicurezza CIS. In tale veste si occupa della gestione di diversi sistemi informativi, assicura la funzionalità delle connessioni telematiche esterne e contribuisce alla definizione e implementazione delle misure di sicurezza informatica. Ha, inoltre, partecipato alla progettazione e realizzazione di diverse banche dati relazionali, di applicativi gestionali, di sistemi collaborativi, di portali web e di alcune reti Lan e Wan.

Dal 2004 opera nel campo della Sicurezza Informatica dal punto di vista tecnico e giuridico. In particolare, realizza l’analisi dei sistemi e la progettazione degli interventi, la valutazione dei rischi per la riduzione delle minacce, il penetration test, la redazione dei piani di sicurezza e di protezione dei dati, lo sviluppo delle policy di sicurezza, la definizione di procedure per la gestione e la manutenzione dei sistemi, l’intervento in caso di emergenza per il contenimento dei danni.

Dal 2005 esercita, su incarico di Privati o della Procura, l’attività di Consulente Tecnico in procedimenti civile e penali, a fini legali e per utilizzo in Tribunale o in sede stragiudiziale, sui temi dell’Informatica Forense e delle Investigazioni Digitali che includono l’uso dell’ICT con particolare riferimento ai reati informatici e telematici, o comunque attuabili attraverso l’uso delle tecnologie dell’informazione, computer, smartphone e rete internet, ed alle violazioni del diritto alla riservatezza ed alla protezione dei dati personali ed al diritto d’autore. Ha prestato la propria consulenza in casi che riguardavano i seguenti ambiti: l’alibi informatico, le truffe digitali, lo stalking, la sostituzione di persona, la pedopornografica, l’accesso abusivo ai sistemi informatici, la diffamazione online, la tracciabilità tramite tabulati e rilevazioni gps, l’acquisizione e valutazione di prove digitali quali: memorie di massa, dispositivi mobili, pagine web e e-mail e chat.

Dal 2017 è Professore a contratto del corso di Tecnologie per la Sicurezza Informatica, afferente al Corso di Laurea Magistrale in Ingegneria Informatica e dei sistemi per le Telecomunicazioni dell’Università degli Studi Mediterranea di Reggio Calabria, ove sviluppa le tematiche del penetration testing, dell’analisi dei rischi, dell’information security assessment, dell’incident response e della digital forensics. È Relatore per Tesi di Laurea di Studenti su argomenti legati alla Sicurezza Informatica, Cybercrime e Digital Forensics.

È stato, inoltre, relatore in diversi corsi di formazione e seminari di aggiornamento professionale presso Enti della P.A., Associazioni Professionali ed Università.

Infine, è autore di alcuni articoli e saggi in tema di Sicurezza Informatica e Investigazioni Digitali.

https://www.ictsecuritymagazine.com/articoli/scoperte-diverse-vulnerabilita-nello-stack-tcp-ip-utilizzato-da-milioni-di-dispositivi-iot/


Stuxnet (Iran, 2009) – Il case study per disarticolare la Cyber War

La variabile che identifica l’ “ora della morte di Stuxnet” è quella definita nel rettangolo rosso: “00 c0 45 4c 9c 51 cd 01” si traduce al 24 giugno 2012 nel formato standard di data e ora di Windows a 64 bit.

In linea con un mondo che continua ad essere sempre più̀ interconnesso e dipendente dall’efficace funzionamento e dalla resilienza di reti, sistemi e dispositivi informatici – che conferiscono natura ubiquitaria ai contenuti da essi trasportati, elaborati e conservati – l’architettura nazionale cyber ha conosciuto, nel 2017, interventi di modifica miranti a razionalizzare e potenziare ulteriormente le capacità di difesa cibernetica del sistema – Paese. Tale riorganizzazione, in Italia, è stata formalmente declinata nel “Piano nazionale per la protezione cibernetica e la sicurezza informatica”, che ha individuato, nell’annesso Piano d’Azione, le misure ritenute più urgenti per rafforzare gli assetti cibernetici del nostro Paese.

Numerosi, però, sono stati gli episodi di guerra cibernetica che si sono fatti spazio ben anche prima del 2017 sulla quarta dimensione, notoriamente indicata come “spazio cibernetico”, ed intesa come nuova arena della rivalità multinazionale. Nel campo della guerra militare, la storia indicizza, almeno per quanto riguarda il primo millennio, una serie di episodi in cui si è fatto principalmente uso delle armi convenzionali. Con l’affacciarsi ad un mondo del tutto nuovo, dall’introduzione dell’uso di Internet ad oggi, si è progressivamente abbandonato il vecchio sistema per approdare ad uno scenario di guerra non convenzionale, che si avrà modo di disarticolare più avanti.

Dall’analisi di un professionista qual è Umberto Gori, professore Emerito di Relazioni Internazionali all’Università̀ di Firenze, apprendiamo che il primo vero caso di “cyber war” e quindi di guerra cibernetica vera e propria, – che non va per ciò solo confusa con “info war”, la cui traduzione è “guerra informatica” – è rappresentato dall’attacco sferrato attraverso Stuxnet: questo è il nome del virus letale iniettato negli impianti della nota centrale di Natanz (Iran, 2009).

Questa valutazione prende vita dal contesto strategico situazionale e parte dall’individuazione di alcuni fattori principali scaturiti dall’attacco subito dagli iraniani:

  1. Il target scelto per l’attacco, elemento fondamentale per la realizzazione dell’attacco.
  2. Il tipo di azione e gli effetti commisurati ai danni prodotti.
  3. Occorre poi una motivazione importante. Sarà questa, insieme all’analisi della complessità dell’azione, che consentirà alla polizia giudiziaria, coadiuvata da un team di periti ed esperti, di pervenire anche ad una prima ipotesi di attribuzione. Saranno dunque le indagini di un Pubblico Ministero che permetteranno di giungere ad un capo d’imputazione. Non sono sempre alte le percentuali con cui viene annunziata una vittoria delle Autorità, ma quasi sempre si punta ad individuare, dopo una serie di accertamenti, l’autore del reato.

Osserviamo meglio quali elementi mette a disposizione l’analisi del caso Stuxnet.

La centrale nucleare è stata classificata dagli iraniani, con una certa facilità, quale target prescelto, cioè quale obiettivo materiale della spedizione militare.

L’azione è stata subito accertata, in quanto ha prodotto evidenti effetti e gravi danni a cose; nel caso di specie la distruzione materiale delle centrifughe della centrale, anche se resta non accertata la presenza di eventuali vittime. La complessità̀ per la pianificazione e l’esecuzione dell’azione hanno permesso di stabilire un enorme dispendio di risorse economiche e di intelligence, di conseguenza si ravvisa la partecipazione – anche se non dichiarata – di un’entità̀ statale capace di supportarne i costi. Si comincia già da questo dettaglio a ventilare un’ipotesi di “attribuzione”.

La motivazione politica è evidente, come si avrà modo di spiegare.

A questo punto, appare altrettanto evidente il valore fondamentale dell’analisi situazionale del contesto strategico nel quale avviene l’attacco cibernetico. La valutazione oggettiva del contesto serve a classificare un atto cibernetico nel suo sviluppo reale e nelle sue finalità. Vediamone alcuni casi, a mero titolo di esempio.

Se l’intento principale di un attacco informatico è la ricerca del guadagno finanziario tramite l’uso di mezzi criminali (come possono essere gli strumenti di phishing o le azioni di furto di identità̀ e dati informatici), il fine ultimo è talmente chiaro che permette di classificare tale condotta come un atto di “cyber crime” o di “cyber espionage”.

Se, invece, l’intento dell’attacco è esclusivamente la volontà̀ di arrecare un danno significativo a una Nazione o ai suoi cittadini, l’intrusione informatica subita da infrastrutture civili e/o militari ricadrebbe invece con ogni probabilità nell’alveo di un classico “atto di guerra” disciplinato dallo jus ad bellum[1]. Quest’ultima fattispecie, quindi, non risponde alla voce “atti di cyber crime”, ma ricade nel più ampio novero di episodi di “cyber war”.

Il software dannoso, sviluppato dagli Stati Uniti presumibilmente nel 2010, in collaborazione con lo Stato di Israele, ha seguito uno schema inquadrabile in alcuni passaggi definiti ed imprescindibili alla realizzazione del suo scopo ultimo.

Stuxnet, una volta iniettato attraverso un dispositivo USB all’interno di un device direttamente collegato alla centrale, rallentò ed accelerò di nascosto i motori delle centrifughe iraniane che venivano utilizzate per arricchire l’uranio, nonché le valvole che a loro volta collegavano sei cascate di centrifughe.

La dinamica è certamente ben più complessa di così e richiederebbe di essere meglio trattata in altra sede, ma fonti iraniane ci riferiscono che, alla fine, i motori si separarono e l’Iran dovette sostituire 1.000 macchine danneggiate. Un ulteriore passaggio risulta, ai nostri occhi, oltremodo fondamentale: mentre stava producendo il danno, Stuxnet, ha fornito un feedback falso agli operatori in modo che non avessero idea di cosa stesse succedendo: l’obiettivo era rendere i cambiamenti così impercettibili che gli iraniani potessero pensare che la distruzione derivasse da parti del meccanismo guaste, ingegneria difettosa, incompetenza, o tutte e tre le cose. Ralph Langner, che è esperto in sicurezza informatica, è anche fra i primi analisti ad aver decodificato i bit di Stuxnet. Ha stimato che il 50% dei costi di sviluppo del malware sono stati impiegati per nascondere l’attacco.

Un funzionario del governo americano ha dichiarato al New York Times che Stuxnet mirava a “confondere le migliori menti scientifiche iraniane”: sebbene gli iraniani avessero ammesso alcune infezioni nei loro sistemi informatici, l’effetto strategico ultimo del malware sul loro programma nucleare è rimasto tutt’oggi poco chiaro. Non di poco momento sono stati, infatti, gli orientamenti della dottrina sulle conseguenze dell’incidente.

Alcuni funzionari del governo degli Stati Uniti hanno affermato di aver rallentato il programma nucleare iraniano di un periodo compreso tra diciotto mesi e due anni. Altri esperti americani hanno detto che l’attacco non ha contribuito a ritardare gli sforzi iraniani, ed in effetti potrebbe averli accelerati; gli scienziati iraniani hanno infatti lavorato per far funzionare correttamente le centrifughe, migliorandone le prestazioni ed il design, aumentandone la produzione. Il tempo guadagnato dagli attacchi potrebbe dunque essere stato un fattore importante per riportare l’Iran al tavolo dei negoziati e raggiungere un accordo sul suo programma nucleare previsto a luglio 2015.

Il ritardo, anche se pari a ben due anni, ha dato alle sanzioni economiche sul paese più tempo per realizzare un impatto notevole sotto diversi punti di vista.

Ed ecco che giungiamo, ora con una certa agilità, alla motivazione politica. A quanto pare la realizzazione del codice velenoso è stato anche un compromesso per convincere Israele a non condurre attacchi aerei contro le strutture iraniane. Nel 2008, Israele avrebbe chiesto all’amministrazione americana, durante il secondo mandato della presidenza di George W. Bush, di preparare bombe in grado di distruggere bunker, sperando di poterle usare nei siti di produzione e di ricerca nascosti nei fianchi delle montagne. Nel respingere la richiesta, il presidente Bush aveva placato gli israeliani dicendo loro che avrebbe autorizzato la missione “Giochi Olimpici” al fine di sabotare l’infrastruttura nucleare iraniana.

La giornalista statunitense Kim Zetter, nel suo libro “Countdown to Zero Day”, pubblicato nel novembre 2013, ha analizzato alcuni aspetti dell’attacco ancora poco conosciuti al grande pubblico, riferendosi soprattutto alle interazioni che hanno scatenato una serie d’infezioni tra il 2009 e il 2010. Riprodurre l’infezione, nel caso di Stuxnet, era piuttosto semplice per via di una caratteristica del malware, ovvero la sua capacità di mantenere un resoconto dei dispositivi compromessi, compresi nome, nome di dominio e indirizzo IP.

Grazie alla particolarità̀ di questi dati di poter essere continuamente aggiornati, è possibile risalire all’originale.

Successivamente, Symantec, leader globale della sicurezza informatica di nuova generazione, nel febbraio 2011 ha pubblicato il dossier “W32 Stuxnet”, nel quale è arrivata alla conclusione che la diffusione del malware sia partita da cinque aziende (due sono state attaccate due volte, rispettivamente nel 2009 e nel 2010). Alla fine Kaspersky Lab, fra le più grandi società private di sicurezza informatica, se non prima in assoluto in Russia, è riuscita a risalire a queste aziende grazie all’analisi di 2.000 file in un arco di tempo di due anni.

La prima iterazione di Stuxnet 2009, chiamata anche “Stuxnet.a”, venne creata il 22 giugno dello stesso anno. Poche ore dopo la compilazione, il malware aveva già infettato un PC del dominio ISIE. È improbabile quindi, secondo Zetter, che i cyber offensori avessero utilizzato un dispositivo Usb e, soprattutto, sarebbe stato molto difficile, in un lasso di tempo così breve, introdurre il malware nell’azienda colpita.

Sebbene fosse difficile pervenire ad un’identificazione, sospetti concreti suggerivano che si sarebbe potuto trattare di Foolad Technic Engineering Co (FIECO), azienda iraniana produttrice di sistemi automatizzati per l’industria pesante. Stuxnet era caratterizzato da un modulo spyware, per questo Fieco poteva essere un buon obiettivo. Probabilmente i cyber offensori avevano immaginato che potesse essere una scorciatoia per arrivare al vero obiettivo (il sabotaggio della centrale nucleare di Natanz) e dal quale si sarebbero compromessi dati importanti che riguardavano l’industria nucleare iraniana. Nel 2010, l’azienda è stata attaccata nuovamente dalla terza iterazione di Stuxnet.

La seconda vittima è stata attaccata per ben tre volte: a giugno 2009, poi a marzo, infine a maggio 2010.

Il secondo attacco ha scatenato l’epidemia globale Stuxnet 2010, anche nota come “Stuxnet.b”.

Il dominio “Bepajooh” ha permesso di identificare immediatamente la vittima: si trattava dell’azienda “Behpajooh Co. Elec & Comp. Engineering”. Coinvolta anche nell’automazione industriale, era per questo collegata a molte altre aziende. Il 24 aprile 2010, Stuxnet è passato dal dominio Behpajooh al dominio Mscco. La candidata più probabile era l’azienda metallurgica iraniana Mabarakeh Steel Company (Msc). L’azienda utilizzava numerosi PC e ha tutt’oggi connessioni con molte aziende di tutto il mondo. Stuxnet, con tante opportunità a disposizione, è stata in grado di scatenare una vera e propria epidemia globale: nell’estate del 2010, il worm ha raggiunto anche aziende in Russia e Bielorussia.

Il 7 luglio 2009, Stuxnet ha infettato il PC “appserver” del dominio Neda. In questo caso, non vi sono stati problemi a identificare la vittima: si trattava di Neda Industrial Group, dal 2008 nella lista nera del Ministero della Giustizia statunitense, poiché accusata di esportazione illegale di sostanze proibite in Iran. Oltre a Neda, un’altra organizzazione è stata infettata, la Control- Gostar Jahed Company, anch’essa con sede in Iran. Qui si è fermata la diffusione del malware, nonostante l’azienda avesse un buon portafoglio clienti ed una vasta portata.

L’ultima “vittima zero” va considerata per il grande numero di dispositivi infettati: l’11 maggio 2010, Stuxnet è uscita a entrare in tre computer del dominio “Kala”. Si tratta di Kala Electric o anche Kalaye Electric Co. L’azienda è considerata la maggiore produttrice di centrifughe per l’arricchimento di uranio IR-1B nonchè uno dei pilastri del programma nucleare iraniano.

In definitiva, di Stuxnet si può dire che si sia trattato di un malware incredibilmente produttivo: i suoi creatori hanno eseguito la più grande operazione offensiva a livello mondiale, inaugurando una nuova era nel campo delle armi cibernetiche. Prima di esso, infatti, nessuno aveva pensato di mettere al sicuro le infrastrutture industriali. È risaputo che un metodo efficace è isolare completamente le apparecchiature dalle reti globali. Con la manomissione di dispositivi non connessi, i creatori del worm hanno dischiuso nuovi orizzonti all’Information Security, tanto che l’importanza di Stuxnet può essere comparata solo a quella di Great Worm, conosciuto anche come “Worm Morris”, il primo malware della storia ad essersi guadagnato l’attenzione dei media e che risale al lontano 1988. Qualunque fosse stato l’impatto sul programma nucleare iraniano, Stuxnet è stato notevole su due fronti.

In primo luogo, era estremamente sofisticato, o, per citare una rivista tecnica, “senza precedenti, magistrale e malevolo”. Il malware ha fatto uso di cinque “zero days”, ovvero vulnerabilità software sconosciute che consentono a un utente malintenzionato di accedere a un computer, un router o un server; non avendo mai rilevato prima questi difetti, gli sviluppatori avevano “zero giorni” per correggerli.

I giorni zero sono preziosi sia per gli attaccanti che per i difensori: si possono ottenere prezzi a sei cifre pur acquistandoli sul mercato nero e quindi anche un solo attacco particolarmente avanzato, ordinato da uno Stato – Nazione, può rivelarsi molto efficace. Inoltre, i computer che controllavano le centrifughe non erano collegati a Internet. Stuxnet ha dovuto saltare questo “vuoto d’aria” ed essere consegnato nel sistema, probabilmente tramite una pen – drive o un altro dispositivo portatile.

Il worm è stato anche configurato per funzionare su un sistema specifico: sebbene si diffondesse ampiamente – dati rilevano che il numero di infezioni avesse superato la cifra totale di 300 mila in più di cento paesi tra cui Australia, Brasile, Brunei, Cina, India, Indonesia, Paesi Bassi e persino Stati Uniti – si attivava solo quando “vedeva” una configurazione di una linea di controllori logici programmabili Siemens, e avrebbe perciò distrutto le centrifughe solo dopo averne constatato l’impianto computer a Natanz, il principale impianto di arricchimento dell’Iran.

Stuxnet era solo uno degli strumenti più sofisticati a disposizione degli Stati Uniti e di Israele: altri due programmi, Flame e Duqu, progettati per raccogliere informazioni sulle reti di computer in Iran e in altri paesi del Medio Oriente, sembrano aver fatto anch’essi parte dell’Operazione Giochi Olimpici. Tuttavia, la complessità di Stuxnet va ben oltre la portata dei singoli hackers, in quanto ha indicato il coinvolgimento di interi Stato – Nazione che intendevano danneggiare fisicamente un obiettivo. La parentela con gli altri programmi è la seconda caratteristica degna di nota di Stuxnet e rappresenta un cambiamento epocale strategico.

Prima di Stuxnet, il codice informatico era servito principalmente a rubare o distruggere dati su altri computer; ora, causava il malfunzionamento dell’apparecchiatura. Stava creando risultati fisici prorompenti.

Tuttavia, a differenza di quanto capitava con le armi convenzionali o con quelle nucleari, gli effetti e le regole delle armi cibernetiche erano in gran parte sconosciuti. Non c’era alcuna comprensione delle conseguenze che Stuxnet avrebbe potuto scatenare, anche se c’era il timore che lo stesso tipo di armi avesse potuto, eventualmente, bersagliare gli Stati Uniti.

I dati e le informazioni riportate in questo elaborato dimostrano come la distruzione della centrale nucleare di Natanz abbia rappresentato, per l’Iran in primo luogo, e subito dopo per l’intero asset mondiale, un esempio fortissimo di nuova rivalità: ad aggravare il controllo di un sistema minacciato da un’arma estremamente sofisticata, le cui dinamiche operative sono ad oggi per alcuni aspetti ancora ignote, ha fatto da supporto un autore invisibile, che opera completamente nell’anonimato. Ciò non solo contribuisce ad aumentare la vulnerabilità della parte soccombente nella singola ipotesi, ma alimenta un clima di incertezza che si dovrebbe in qualsiasi modo evitare. L’obiettivo principe del cyber offensore è infatti quello di realizzare un contesto del genere: incerto, instabile e dove, di conseguenza, può muoversi con una certa disinvoltura.

Note:

[1] Nel diritto internazionale con il termine Jus ad bellum si fa riferimento all’uso legittimo della forza da parte degli Stati; mentre con Jus in bello si rinvia alle modalità con le quali tale uso della forza deve essere messo in atto; lo scontro, seppur legittimo, non deve mai contrastare con i diritti umani che determinano la condotta delle ostilità.

Bibliografia:

  • GORI U. e GERMANI L. S., “Information Warfare. Le nuove minacce provenienti dal cyber spazio alla sicurezza nazionale italiana”, Franco Angeli, Milano, 2011
  • GUASTELLA G., Il dominio geopolitico dello spazio cibernetico, Edizioni Ex Libris, Palermo, 2020
  • KAPLAN F., “Dark Territory, The secret history of cyber war”, Simon e Schuster, 2016
  • KISSINGER H., “Ordine Mondiale”, Mondadori, Milano, 2014;
  • SANGER E. D., “Confront and Conceal”, Broadway Paperbacks, New York, 2013;
  • SEGAL A., “The Hacked World Order”, Public Affairs, New York

Sitografia:

  • Sistema di informazione per la sicurezza della Repubblica, Documento di Sicurezza Nazionale, Roma, 2017
  • Presidenza del Consiglio dei Ministri, Il linguaggio degli organismi informativi. Glossario intelligence, Sistema di informazione per la sicurezza della repubblica, Quaderni di Intelligence Gnosis (2012)
  • Presidenza del Consiglio dei Ministri, Quadro strategico nazionale per la sicurezza dello spazio cibernetico (2013)
  • Presidenza del Consiglio dei Ministri, Piano nazionale per la protezione cibernetica e la sicurezza informatica (2017)
  • DPCM 2013 – Decreto del Presidente del Consiglio dei Ministri (24 gennaio 2013), “Direttiva recante indirizzi per la protezione cibernetica e la sicurezza informatica nazionale”
  • DPCM 2017 – Decreto del Presidente del Consiglio dei ministri (17 febbraio 2017), “Direttiva recante indirizzi per la protezione cibernetica e la sicurezza informatica nazionali”

Articolo a cura di Giulia Guastella

Giulia Guastella

Giulia Guastella è dottoressa in Relazioni Internazionali. Nel Luglio 2018 si specializza alla Luiss Guido Carli (Roma) con una tesi sperimentale in Studi Strategici, nella quale si approccia per la prima volta allo studio dell’ambiente digitale, tuttavia dando al suo lavoro un taglio internazionalistico che le permette di ricollegarsi al suo percorso universitario. Questo passo le fa da apripista a quello che, di lì a poco, sarebbe stato il suo vivo interesse per la cyber sicurezza e per i rami ad essa affini, muovendosi così tra le Relazioni Internazionali, il Diritto Penale e quello Privato nella tutela della privacy.

Da sempre affascinata dagli studi interdisciplinari, insieme ad un team di colleghi dà vita ad IMESI, un’associazione, nata a scopo benefico, che oggi funge da hub per la ricerca e la formazione post-universitaria. Giulia si interessa anche di Antimafia ed è impegnata nella causa del contrasto alla criminalità organizzata, ragione che l’ha spinta al prosieguo dei suoi studi presso la Facoltà di Giurisprudenza.

https://www.ictsecuritymagazine.com/articoli/stuxnet-iran-2009-il-case-study-per-disarticolare-la-cyber-war/


Sicurezza informatica: buoni propositi e sfide culturali per il 2021

Ci apprestiamo a chiudere l’anno 2020 che ha visto le organizzazioni costrette ad operare in condizioni di emergenza determinata dal manifestarsi dello scenario pandemico.

L’esperienza maturata e l’attenzione agli errori passati dovranno generare nel 2021 proposte per superare alcuni vecchi comportamenti in tema di gestione della sicurezza informatica.

Il cambiamento richiede importanti sfide culturali, alcune delle quali andremo di seguito ad analizzare.

Gestione di un problema VERSUS Rinvio dell’intervento fino alla crisi

Troppo spesso le organizzazioni rinviano la gestione di problematiche manifeste fino all’inevitabile aggravarsi del fatto rilevato che può comportare, ad esempio, un attacco cyber o un disservizio al cliente.

Esempi classici di mancate azioni riguardano il rifiuto a spegnere un server per una corretta applicazione di patch, piuttosto che la scelta di continuare a lavorare utilizzando hardware e software obsoleti per risparmiare budget.

Questo atteggiamento operativo e culturale comporta una operatività malata con conseguenze negative per l’immagine dell’organizzazione.

È necessario, quindi, che i rischi derivanti dal rinvio degli interventi e le possibili conseguenze siano condivisi con il Top Management in modo tale da supportarlo nel processo decisionale.

Sicurezza come supporto al Business VERSUS Sicurezza come limite al Business

Da sempre la sicurezza è vista come il principale freno all’innovazione e alle attività di business. Tale visione deve cambiare.

La sicurezza oggi gioca un ruolo fondamentale nel business; essa è la chiave del vantaggio competitivo, conquistando la fiducia dei clienti e proteggendo il nome dell’azienda.

Il Chief Information Security Officer (CISO) di oggi non deve solo essere esperto di tecnologia ma deve sostenere l’Head of Business per una sicurezza allineata e di supporto alle necessità del mercato.

La sicurezza non deve rappresentare solo una difesa dell’organizzazione da attacchi ed imprevisti ma deve essere sempre più un elemento facilitatore di decisioni che bilanciano la necessità di protezione ed una efficiente gestione delle attività.

A sua volta, il responsabile del business deve rispondere anche del livello di sicurezza dei servizi offerti sul mercato.

Investimenti VERSUS Contenimento di risorse

La pandemia ha visto molte aziende investire in sistemi IT, ad esempio fornendo computer portali per favorire lo smart working ai dipendenti o potenziando la network per garantire a tutto il personale il lavoro da remoto.

L’aumento degli attacchi informatici, specie durante la pandemia, ha evidenziato che la sicurezza non va mai in vacanza. Sono stati identificate lacune e punti di miglioramento che devono essere affrontati e risolti principalmente aumentando gli investimenti in modo da fronteggiare scenari di attacchi sempre più sofisticati.

Assunzione di rischio VERSUS Ignorare il rischio

Gestire la sicurezza non significa solo adottare le azioni necessarie per l’eliminazione di tutti i rischi.

Il processo di governance prevede l’identificazione dei rischi e la loro analisi con relativa misurazione. Nel caso non sia possibile implementare le azioni necessarie alla loro cancellazione o nel caso tal azioni siano possibili solo nel medio o lungo termine allora la soluzione da adottare è una mitigazione ed accettazione del rischio.

Fondamentale, infatti, è la conoscenza del rischio e delle possibili conseguenze da parte del top management. Al management si richiede, quindi, non di ignorare i rischi ma di comprenderli e di assumersi la relativa responsabilità.

L’accettazione del rischio deve ovviamente prevedere una data di scadenza ed un piano di mitigazione e/o eliminazione del rischio entro il termine stabilito.

Awareness continua VERSUS Formazione una tantum

Come ormai è noto con sicurezza informatica si intende una materia molto ampia ed in continua evoluzione. L’ultimo buon proposito sta nel riconoscere che la cybersecurity è in continua evoluzione e per questo necessita che il personale sia continuamente formato e sensibilizzato.

Non solo le aziende devono pianificare budget per investimenti hardware, software, di network o infrastrutturali ma anche di training ed awareness.

Naturalmente tutto il personale riveste un ruolo fondamentale per quanto concerne la sicurezza dell’organizzazione in quanto coinvolto direttamente nell’uso di strumenti informatici e piattaforme che interagiscono fra loro.

Un attacco informatico banale spesso si insinua nella posta elettronica utilizzata da tutto il personale. Per questo motivo, è importante fornire a tutto il personale gli strumenti per affrontare le minacce derivanti dalla loro attività, riconoscerle e se possibile evitarle.

In conclusione, molte saranno le sfide che le organizzazioni dovranno affrontare nel corso del 2021 ma sicuramente investire su dipendenti formati e sensibilizzati sulle vulnerabilità delle organizzazioni sarà il presupposto necessario per la crescita futura delle stesse.

Articolo a cura di Lisa Da Re

https://www.ictsecuritymagazine.com/articoli/sicurezza-informatica-buoni-propositi-e-sfide-culturali-per-il-2021/


Metodi Formali per la rilevazione di collusioni in ambiente Android

Introduzione

L’internet of things è ormai una realtà. Sul mercato si possono trovare centinaia di dispositivi intelligenti diversi, e le nostre case sono piene di elettrodomestici e sensori intelligenti.

Gli smartphone hanno fatto da apripista in questa rivoluzione delle connessioni, e tuttora mantengono la maggior parte di share del mercato per quanto riguarda i dispositivi elettronici. In questo contesto, da diversi anni, Android si è affermato come il sistema operativo più utilizzato al mondo con quasi il 39% del mercato [1], che supera addirittura il 70% se si considera solo l’ambiente mobile. Di conseguenza, Android risulta essere il sistema operativo più minacciato da malware.

I nostri smartphone sono assistenti di tantissime attività quotidiane, dal leggere le mail, navigare sul web e parlare con altre persone, fino al monitorare i nostri allenamenti, il traffico sulle strade che percorriamo e gli acquisti della spesa. La quantità di informazioni e dati che passano tramite i nostri smartphone è una risorsa di grande valore, ambita dalle grandi aziende informatiche, dai governi ma anche dai criminali.

La maggior parte di antimalware attuali fanno uso di tecniche ‘signature-based’ per il rilevamento di minacce, ossia comparano l’applicazione in analisi con un database di minacce conosciute. Chiaramente, questo tipo di approccio risulta inefficace nel rilevare nuove minacce non presenti nei database. Inoltre, gli sviluppatori di malware fanno largo uso di tecniche di offuscamento del codice per modificare parzialmente il malware mantenendo intatta la sua azione malevola ma rendendolo “nuovo” e quindi non rilevato dagli antimalware [2]. Per mantenere alto il livello di sicurezza dei dispositivi mobili c’è un continuo bisogno di sviluppo di tecniche di rilevamento di applicazioni malevole sempre più’ efficaci ed efficienti.

In questo contesto, gli scrittori di malware stanno sviluppando attacchi sempre più complessi per evadere i sistemi di rilevamento del malware, uno di questi recentemente apparso è il cosiddetto colluding attack (attacco tramite collusione): l’azione dannosa è suddivisa in più applicazioni che comunicano tra loro quando l’utente esegue una determinata azione o al verificarsi di uno specifico evento all’interno del sistema. In questo modo gli attuali antimalware, che analizzano un’applicazione alla volta, non sono in grado di identificare il payload dannoso in quanto suddiviso tra diverse applicazioni. Pertanto, negli attacchi tramite collusione, un payload dannoso viene suddiviso in parti più piccole e distribuito in più applicazioni. In questo tipo di attacco le applicazioni non destano sospetti per gli antimalware, perché richiedono i permessi minimi necessari per eseguire l’azione dannosa. Ad esempio, quando due applicazioni implementano questo tipo di attacco, la prima applicazione potrebbe avere il permesso di leggere dati sensibili e trasmetterli alla seconda applicazione, che col permesso di connessione ad una rete li trasmette al mondo esterno. In questo modo la prima non richiede il permesso per utilizzare la connessione Internet, ma solo il permesso per leggere i dati, eludendo così i controlli, poiché reputata innocua; dall’altra parte la seconda applicazione richiedendo solo il permesso di connessione ad Internet, non risulta essere sospetta se non può accedere direttamente a informazioni di tipo sensibile. A tal proposito si può affermare che se analizzate singolarmente, le applicazioni sono considerate benigne poiché non esiste un percorso diretto dai dati sensibili alla loro trasmissione.

Metodologia

Partendo dalla problematica dell’attacco tramite collusione in ambiente mobile, abbiamo sviluppato una metodologia basata sull’utilizzo di tecniche di model checking e su una nuova funzione euristica, il cui scopo è quello di ridurre il numero di applicazioni analizzate. La funzione è stata definita sulla base della Logica Temporale Mu-Calculus e del model checking [3].

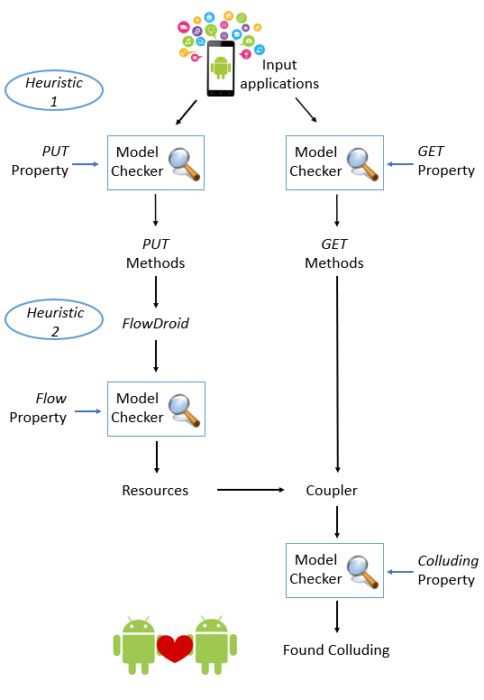
Figura 1. Schema del metodo proposto

La metodologia lavora sulle risorse condivise di tipo stringa, andando a sfruttare le SharedPreferences di Android, usate per salvare i settaggi delle impostazioni nelle applicazioni. Il nostro metodo, mostrato in Figura 1, prevede in input un insieme di applicazioni, che viene ridotto grazie ad una prima euristica, ottenendo così un sottoinsieme di candidati all’analisi. La prima euristica inoltre divide le applicazioni in base al diverso utilizzo delle shared resource, infatti in figura possiamo notare uno split tra le applicazioni che verificano la proprietà di GET (se leggono i dati) e quelle che verificano le proprietà di PUT (se scrivono dati). La seconda euristica entra in azione dopo la verifica della proprietà di PUT, visto che le applicazioni di questo tipo sono quelle che permettono una modifica attiva; e serve a ridurre ulteriormente lo spazio di ricerca tra le applicazioni colludenti andando ad analizzare l’esecuzione del flusso e quindi il tipo di informazione che viene inviata, per fare ciò si utilizza FlowDroid. Dopo ciò, con il model checker CWB-NC si verifica se tra le applicazioni è presente una proprietà di collusione che soddisfa la formula in mu-calculus [4].

Conclusioni

In conclusione, possiamo dire che l’attacco tramite collusione è una minaccia emergente in ambiente mobile che si basa sulla comunicazione tra due o più applicazioni. Per mitigare gli effetti dannosi di questa nuova minaccia in ambiente Android, proponiamo l’utilizzo di un metodo basato sul model checking. Il metodo proposto ottiene una accuracy pari a 0.99 nella valutazione di applicazioni che effettuano diversi tipi di attacchi tramite collusione, applicazioni malevole che non effettuano collusione ed applicazioni considerate legittime.

Referenze

[1] Statcounter Global Stats website. “Operating System Market Share Worldwide.” URL: https://gs.statcounter.com/os-market-share ACCESSED: 02/12/20

[2] Canfora, Gerardo, et al. “Obfuscation techniques against signature-based detection: a case study.” 2015 Mobile Systems Technologies Workshop (MST). IEEE, 2015.

[3] Iadarola, Giacomo, et al. “Call Graph and Model Checking for Fine-Grained Android Malicious Behaviour Detection.” Applied Sciences 10.22 (2020): 7975

[4] Casolare, Rosangela, et al. “Malicious Collusion Detection in Mobile Environment by means of Model Checking.” 2020 International Joint Conference on Neural Networks (IJCNN). IEEE, 2020

Articolo a cura di Giacomo Iadarola, Rosangela Casolare, Fabio Martinelli, Francesco Mercaldo, Antonella Santone 

Rosangela Casolare

Rosangela Casolare è una dottoranda presso l’Università degli Studi del Molise. È risultata vincitrice di una borsa di dottorato cofinanziata dall’Istituto di Informatica e Telematica del Consiglio Nazionale delle Ricerche (CNR) di Pisa.

Il 21 Febbraio 2019 ha conseguito la Laurea Magistrale in Sicurezza dei Sistemi Software presso la stessa università.

Le sue attività di ricerca rientrano nell’ambito della sicurezza dei sistemi mobili, con particolare enfasi sullo sviluppo di metodologie per la rilevazione di applicazioni colludenti attraverso tecniche di verifica formale in ambiente Android.

https://www.ictsecuritymagazine.com/articoli/metodi-formali-per-la-rilevazione-di-collusioni-in-ambiente-android/


Ancora sulla Governance dell’AI

Come è stato già più volte rimarcato anche da fonti autorevoli la governance dell’AI si basa su una visione e un approccio Olistico al problema. E’ opportuno considerare tutte le variabili in gioco e gli aspetti che impattano sull’organizzazione, sui processi e sui progetti. In particolare l’utilizzo della metodologia G.R.C: Governance, Risk e Compliance può aiutare e migliorarne la gestione.

In particolare i rischi relativi all’AI possono essere così definiti:

R1: Perdita di autonomia personale

Lo sviluppo di assistenti intelligenti può aiutare a gestire le attività amministrative e comuni di tutti i giorni, ma potrebbe comportare una diminuzione dell’intelligenza e dell’autonomia dell’utente. Tale fenomeno viene descritto dagli esperti come: demenza digitale cioè una possibile conseguenza dell’uso improprio della tecnologia digitale, che potrebbe portare al deterioramento o alla rottura delle capacità cognitive. A causa della crescente dipendenza dall’assistenza digitale, le capacità umane potrebbero andare perdute.

R2: Responsabilità per i danni causati dai sistemi di IA

I sistemi di intelligenza artificiale sono sempre di più utilizzati in sostituzione dell’attività svolta dagli esseri umani. Questo solleva il problema dell’attribuzione delle responsabilità il che solleva la questione di chi dovrebbe essere nel caso di potenziali danni causati dal loro funzionamento.

Il problema, anche dal punto di vista etico è se un essere umano è responsabile dei danni causati da un sistema di IA che ha preso una decisione autonoma e ha causato danni alla vita, alla salute o alla proprietà di un essere umano, questo aspetto crescerà come criticità aumentando la capacità di prendere sempre più decisioni autonome da parte di sistemi di intelligenza artificiale. L’aspetto giuridico non è assolutamente da sottovalutare, considerando magari il concetto di responsabilità in caso di un prodotto difettoso. E’ quindi opportuno definire correttamente i ruoli e le responsabilità.

R3: Rischio di errori e manipolazione dell’IA

Utilizzare e implementare l’intelligenza artificiale significa utilizzare e implementare software e sistemi informatici. E’ possibile che questi sistemi, per natura intrinseca dell’informatica, possano non funzionare correttamente o che si possano verificare diversi alcuni errori.

Le decisioni e i risultati dell’IA si basano su algoritmi che utilizzano modelli statistici che analizzano determinate quantità e qualità di dati, infatti l’uso di modelli statistici può generare decisioni e risultati errati, sia perché i dati analizzati non riflettono le singole circostanze del rispettivo scenario o campione, sia perché i dati analizzati sono parziali o errati, sia perché il modello statistico è   incompleto o incorretto.

I sistemi AI possono inoltre essere manipolati e possono contenere vulnerabilità o carenze dei sistemi di sicurezza.

R4: Manipolazione, sorveglianza e comportamento illecito

Infine, il rischio per manipolazione, sorveglianza o altri scopi illegali è elevato. Ad esempio, le tecniche biometriche e di sorveglianza potrebbero essere abusate per controllare i cittadini, le organizzazioni potrebbero utilizzare algoritmi di estrema profilazione sia dei consumatori che dei dipendenti, oppure effettuare un controllo massimo della popolazione.

R5: Perdita della privacy

Solo attraverso una accurata raccolta ed elaborazione dei dati i sistemi di AI possono prendere decisioni.

L’accesso ai dati è di fondamentale importanza per lo sviluppo delle tecnologie digitali in generale, e dell’IA.

Una delle principali preoccupazioni è quella di garantire che la privacy dei dati sia garantita, protetta e mantenuta.

Il GDPR, regolamento generale sulla protezione dei dati, introduce degli articoli che permettono una accurata tutela dei dati personali, in particolare gli articoli 25 (Privacy by Design/Default), 32 (Misure di Sicurezza) e 35 (Valutazione d’Impatto).

R6: Mancanza di trasparenza dell’IA

I sistemi di intelligenza artificiale hanno subito innumerevoli critiche a causa della loro mancanza di trasparenza.

La trasparenza è necessaria per costruire la fiducia nell’uso di un sistema di intelligenza artificiale, inoltre per    comprendere cosa farà un sistema di intelligenza artificiale in diverse circostanze.

R7: Perdita degli aspetti umani nelle relazioni sociali e mancanza di protezione della vita umana e della dignità umana

L’IA riesce a creare cambiamenti fondamentali sia alle attività che all’umanità in generale.

Una maggiore automazione decisionale e dipendenza dall’IA nella nostra vita quotidiana può portare ad una diminuzione dei contatti sociali.

Le applicazioni di intelligenza artificiale, come i robot sanitari, quelli di servizio per anziani o quelli utilizzati nel campo del turismo o addirittura i giocattoli, possono comportare un aumento dell’interazione uomo-machina importante. I nuovi sviluppi tecnologici relativi all’attuazione e all’uso dell’IA, compresa l’analisi dei Big Data, porranno questioni su cosa sia la vita umana, l’etica, la dignità e le relazioni che devono incorrere tra uomo e macchina.

R8: Restrizione della pluralità delle opinioni e della concorrenza

Un altro rischio è che le applicazioni di AI riflettono il contesto e la distorsione della fonte che le ha programmate.

L’uso crescente degli algoritmi può ridurre la pluralità delle opinioni livellando i risultati o creando/alimentando dei pregiudizi, influenzando le decisioni o distorcendo le varie opinioni.

Ad esempio strategie di comunicazione potrebbero avere un’ingerenza sulle elezioni e su altre procedure decisionali democratiche, causando in tal modo notevoli problemi.

 R9: Perdita dei posti di lavoro

Il cambiamento tecnologico è stato generalmente accompagnato da cambiamenti sociali spesso con implicazioni in campo lavorativo. Questo solleva preoccupazioni ed incertezze con la paura che la AI possa sostituire il lavoro umano sia da un punto di vista dell’analisi che da un punto di vista operativo.

I rischi sopra riportati sono solo un esempio delle criticità alle quali si va incontro implementando un sistema di AI. Un’analisi dei rischi, attraverso una metodologia consolidata (definendo la probabilità, la gravità e di conseguenza il rischio con le relative soglie), dovrebbe permettere alle organizzazioni di individuare i rischi, analizzarli e definire i relativi piani d’azione per la riduzione degli stessi considerando anche l’eventuale rischio residuo.

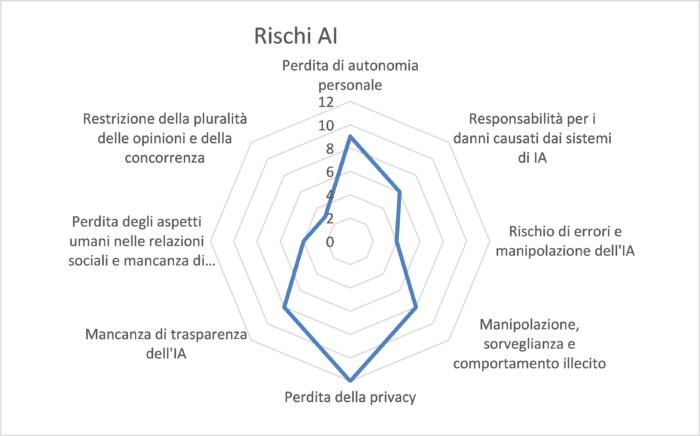
Effettuando un’autovalutazione sui rischi elencati sopra, si potrebbe ottenere un grafico come quello della figura sottostante (ad esempio), dove la scala per la probabilità P e la gravita G è da 1 a 4, conseguentemente il rischio R va da 1 a 16.

Dal grafico emergono immediatamente le aree forti e le aree deboli dove è necessario definire e attuare al più presto dei piani d’azione.

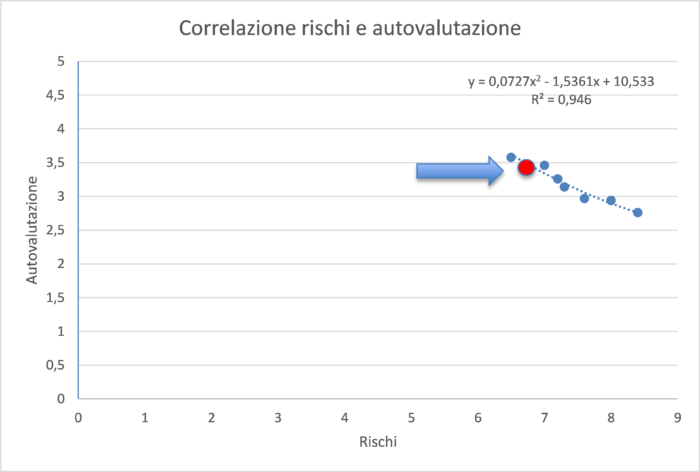
Il risultato si potrebbe integrare con il risultato ottenuto dal tool di autovalutazione proposto nell’articolo “Modello di autovalutazione relativo a un sistema di Intelligenza Artificiale” pubblicato su ICT Security Magazine ottenendo un posizionamento aziendale come illustrato nel grafico seguente.

Dal grafico si può notare come la curva riporta che, come un aumento dei valori dell’autovalutazione corrisponda una diminuzione dei rischi. Si nota inoltre un andamento quadratico della curva rappresentata.

Per una corretta governance è quindi indispensabile approcciare in modo olistico il quale contempli tutti gli aspetti del G.R.C. integrandoli nei processi e nei progetti relativi. Il supporto dell’autovalutazione permette di effettuare una radiografia dell’organizzazione implementando i relativi piani d’azione. Solo attraverso una metodologia rigorosa che analizzi tutte le problematiche e i rischi relativi all’AI possiamo fornire fiducia e sicurezza alle applicazioni e all’utilizzatore.

Articolo a cura di Stefano Gorla

Stefano Gorla è nato a Milano, si è laureato in fisica nucleare presso l’Università di Padova. Ha insegnato per qualche anno Matematica e Fisica presso alcuni licei.

Da anni si occupa di privacy e sicurezza dei dati attraverso un approccio sistemico e olistico.
Consulente e formatore in ambito sicurezza e tutela dei dati e delle informazioni e relatore in numerosi convegni.

Auditor ISO 27001, DPO Certificato FAC Certifica, NIST Specialist Certificato Fac Certifica, Certificato COBIT5 ISACA, Master EQFM.
Ha maturato notevoli esperienze come Referente Privacy (DPO) e consulente in tali ambiti.
È autore di varie pubblicazioni sul tema.

https://www.ictsecuritymagazine.com/articoli/ancora-sulla-governance-della-ai/


I migliori scanner di vulnerabilità per valutare la sicurezza di un’applicazione Web?

Nel Rapporto Clusit 2020 [1], redatto dagli esperti aderenti all’Associazione Italiana per la Sicurezza Informatica, si evidenzia che nel 2019+2020 (primo semestre) gli attacchi informatici gravi in Italia sono stati 1.670 (2019), più 850 nel primo semestre del 2020, con un aumento rispetto al 2018 del 7%. Se si prende in considerazione il lasso di tempo tra il 2014 e il 2019, gli attacchi sono aumentati del 91.2%. Gli attacchi gravi registrati nel primo semestre 2020 (850) sono quasi pari al numero di attacchi registrati in tutto il 2014. La media degli attacchi gravi nel 2019 è 139 al mese, rispetto ad una media di 107 al mese dal 2014. Nel 2020 questa media sale a 142 al mese. Purtroppo il rapporto Clusit non valuta gli attacchi ad applicazioni Web, oggetto di questo articolo, come una classe ben precisa, . Le classi utilizzate nel rapporto sono per esempio DDoS, 0-day, SQL Injection ed altre, che sicuramente comprendono anche attacchi Web. Siamo certi che l’impatto di questi attacchi non sia marginale sul totale, e ancor di più per quanto riguarda la loro pericolosità, visto anche l’utilizzo più intenso del Web in stato di pandemia.

Un Penetration Test, o più brevemente pentest, è un processo di valutazione della sicurezza e dei rischi di un’infrastruttura di rete, o di un sistema informatico, atto a mettere in risalto potenziali vulnerabilità. Esso simula un vero e proprio attacco secondo le regole di ingaggio concordate dal professionista di cybersecurity con l’organizzazione sottoposta al test. Dato la gravità descritta nel primo paragrafo, ogni azienda che si propone sul Web e che offra servizi o informazioni può essere colpita anche in modo grave, con perdita o compromissione di dati o servizi (e relative conseguenze, anche in termini di immagine). Diventa quindi necessario valutare la sicurezza delle proprie interfacce verso il Web, in modo da mettere in sicurezza i propri asset e clienti attraverso le vulnerabilità riscontrate.

Le vulnerabilità delle applicazioni Web, come il Cross-Site Scripting (XSS), Injection (SQL injection, Code Injection), Broken Authentication, Sensitive Data Exposure, XML External Entities (XXE), Broken Access control, Security misconfigurations, e Cross Site Scripting (XSS), sono oggi uno dei problemi di sicurezza più urgenti su Internet.  Per un’iniziale descrizione di queste classi di attacco, rimandiamo il lettore alla lettura di [2]. Le vulnerabilità delle applicazioni Web sono molto diffuse e rappresentano la maggior parte delle vulnerabilità segnalate nel Common Vulnerabilities and Exposures database (CVE) [3]: una semplice ricerca “Web application” restituisce 2293 vulnerabilità su CVE, mentre su National Vulnerability Database del NIST (NVD) [4], possiamo recuperare 926 vulnerabilità solamente negli ultimi 3 anni, di cui 416 con una severità classificata come medium, 338 come high, e ben 105 come critical.

Di seguito descriviamo un esperimento volto a valutare sette differenti tool (o scanner) black-box di pentesting, sia proprietari, sia open source e free, su un insieme di 216 differenti vulnerabilità reperite collezionando quattro note macchine vulnerabili e assemblate come laboratorio di test, più una sviluppata appositamente per l’esperimento. In un pentest black-box, il pentester viene posto nel ruolo dell’hacker medio, senza quindi alcuna conoscenza interna del sistema di destinazione. I tester non vengono forniti di diagrammi dell’architettura o codice sorgente non disponibile pubblicamente. I test black-box (che si estendono a gray e white a seconda della disponibilità di informazione) si basano sull’analisi dinamica dei programmi e dei sistemi in produzione all’interno della rete di destinazione. Le conoscenze limitate rendono i test di penetrazione black-box più rapidi e semplici da eseguire, soprattutto attraverso strumenti di scansione automatica. Di contro, eventuali vulnerabilità interne alla rete target non possono venire rilevate in caso non si riesca a guadagnare l’accesso ad essa.

I risultati presentati in questo articolo sono frutto del lavoro svolto per la tesi triennale in Informatica (Università degli Studi di Perugia) dal Dott. Alessio Amatucci, i cui relatori, oltre al sottoscritto, sono stati il Prof. Stefano Bistarelli (UniPG), il Dott. Pietro Minniti, e il Dott. Cristiano Regni (entrambi Cybertech, gruppo Engineering). Ad Amatucci si deve la produzione di tutte le immagini e tabelle prodotte in questo articolo, oltre che la maggior parte del merito e dello sforzo speso nell’esperimento.

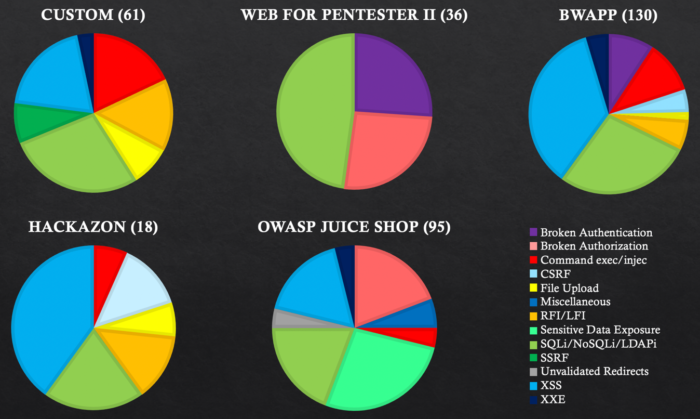
Il laboratorio di applicativi Web vulnerabili è composto dalle seguenti macchine virtuali: una macchina Custom personalmente assemblata, Web for Pentester II, bWAPP, Hackazon, e OWASP Juice Shop. In Figura 1 vediamo la distribuzione degli attacchi per ogni macchina, suddivisi per tipologia. Tra parentesi dopo il nome, il numero totale di attacchi per ciascuna di esse, per un totale di 340.

Figura 1

Gli scanner black-box testati includono 3 software proprietari (P) e 4 open-source (O). Questi tool sono Acunetix 360 (P), AppScan (P), BurpSuite (P), Arachni (O), Vega (O), Wapiti (O), w3af (O). La macchina OWASP Juice Shop è sicuramente quella più all’avanguardia e più interessante da testare al momento, essendo un applicativo Web basato su l’uso esclusivo di Javascript. Per questo motivo, tutti gli scanner open-source non sono riusciti a rilevare alcuna vulnerabilità. Neanche gli scanner commerciali si sono mostrati però molto performanti, trovando solamente una manciata di vulnerabilità in questo ambito.

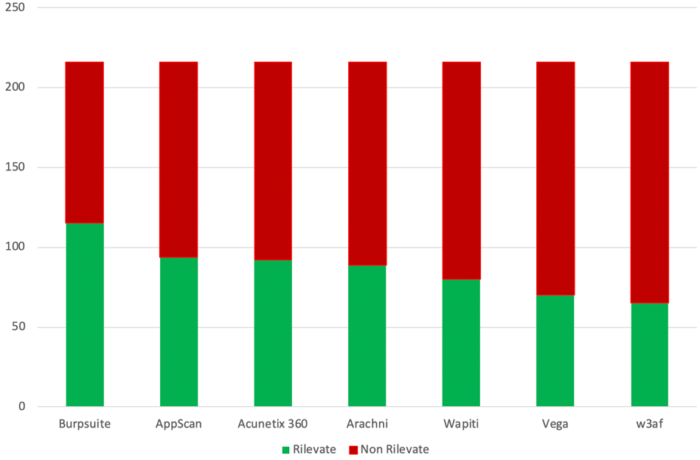
Dalle iniziali 340, abbiamo stilato una classifica tra gli scanner utilizzando 216 vulnerabilità. Le rimanenti 124 vulnerabilità sono al di fuori delle capacità di tutti gli scanner trattati: per esempio riguardavano aspetti criptografici. In Figura 2 possiamo osservare i risultati, seguendo una graduatoria discendente da sinistra verso destra.

Figura 2

Alcuni degli scanner testati non possiedono alcuni moduli per poter individuare attacchi ben precisi: per esempio Wapiti non ha un modulo per LDAP injection. Abbiamo ritenuto questi attacchi come “non-rilevabili” da parte di un tool. In Tabella 1, il dettaglio delle vulnerabilità trovate sul totale (/), e tra parentesi le vulnerabilità non rilevabili da parte di quello scanner per via di moduli mancanti. Lo sfondo più scuro evidenzia i vincitori per ogni macchina. È interessante notare che, senza considerare il fattore non-rilevabili, lo scanner Burp Suite sia predominante in quasi tutti gli scenari. Se si considera invece il rapporto trovati / rilevabili la situazione cambia: gli scanner open-source riescono a spodestare nelle macchine Custom e Web for Pentester II la prima posizione di Burp Suite. Nella classifica generale inoltre, Burp Suite mantiene la prima posizione, ma Wapiti e Arachni arrivano in seconda e terza rispettivamente.

Tabella 1

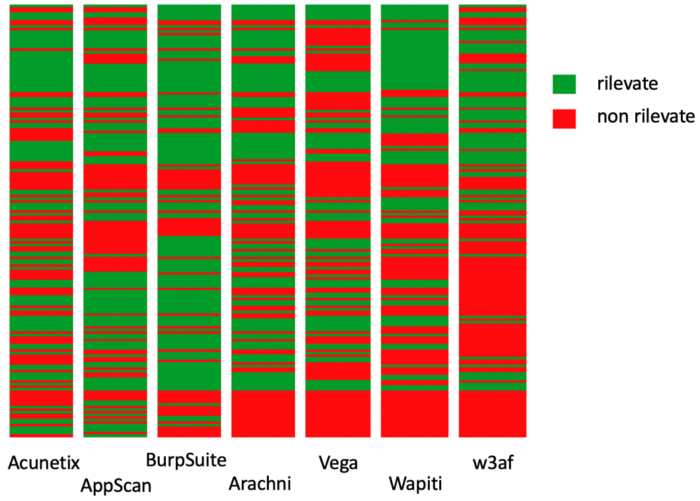
La Figura 3 visualizza il riassunto delle differenti vulnerabilità trovate per ciascuno scanner/macchina (stessa riga, stessa vulnerabilità). Nelle “non rilevate” includiamo anche le “non-rilevabili”.

Sebbene le tecniche per rilevare determinati tipi di vulnerabilità siano ben consolidate e funzionino in modo affidabile, abbiamo constatato che esistono intere classi di vulnerabilità su cui gli scanner si sono rilevati deboli. Per esempio, abbiamo scoperto che 6 vulnerabilità su 28, riguardanti l’autenticazione e l’autorizzazione, sono state rilevate da solo 3 scanner (Acunetix, AppScan e w3af).

Figura 3

Una prima classe di problemi che abbiamo riscontrato consiste nella difficoltà, da parte degli scanner, di comprendere la differenza tra sessioni di autenticazione diverse. La seconda classe di problemi che ha ostacolato la scansione è correlata alla progettazione di applicazioni Web che fan- no pesante uso di JavaScript. Abbiamo rilevato che applicazioni con moduli complessi e un controllo aggressivo dei valori di input possono bloccare efficacemente uno scanner, impedendogli di eseguire la scansione delle pagine in profondità nella struttura del sito Web. Gli scanner attuali non riescono a rilevare efficacemente le vulnerabilità logiche (e.g., Broken Authentication/Authorization); solo w3af ed Acunetix sono riusciti in minima parte. Sono sempre più diffuse le applicazioni che prevedono un modulo di autenticazione e questo tipo di vulnerabilità può potenzialmente rimanere tra i più diffusi.

Un consiglio finale che ci sentiamo di dare è quello di utilizzare più di un tool solo durante un pentest approfondito, in modo da coprire il più possibile le debolezze scoperte: per esempio, su attacchi di tipo Command Injection Wapiti risulta scoprire più vulnerabilità di Burp Suite.

Lungi dall’essere strumenti punta e clicca utilizzabili da chiunque, gli scanner di sicurezza black-box per applicazioni Web richiedono una conoscenza sofisticata dell’applicazione sotto test e dei limiti dello strumento. Ovviamente se l’obiettivo è un’analisi approfondita, come dovrebbe sempre essere.

Note

[1] Clusit Associazione Italiana per la Sicurezza Informatica. Rapporto clusit 2020: https://clusit-webcast.1rnd.com/presentazione-rapporto-2020/.

[2] Open Web Application Security Project OWASP. Top 10 web application security risks, 2017. https://owasp.org/www-project-top-ten/.

[3] Common Vulnerability Exposure. https://cve.mitre.org

[4] National Vulnerability Database. https://nvd.nist.gov

Articolo a cura di Francesco Santini

https://www.ictsecuritymagazine.com/articoli/i-migliori-scanner-di-vulnerabilita-per-valutare-la-sicurezza-di-unapplicazione-web/


Cybersecurity: l’anno che sta finendo e l’anno che verrà

Ci avviciniamo alla fine di un anno molto difficile, che ha stravolto radicalmente sia le abitudini personali che il modo di lavorare di milioni di persone. Tanto per citare numeri notissimi, nel periodo del primo lockdown abbiamo assistito ad un incremento radicale del lavoro da remoto: ad aprile di quest’anno i lavoratori che si sono trovati in questa condizione erano 4 milioni con un incremento quasi di circa 3 milioni rispetto all’anno precedente. In pratica, si tratta del 18,5% della forza lavoro con un potenziale di crescita fino al 35,7% pari ad 8,2 milioni di lavoratori[1]. È perfino superfluo sottolineare che tipo di impatto possa avere questa nuova condizione di vita e di lavoro su tutti noi: è una discussione rimbalza in ogni momento su tutti i media, da quelli tradizionali a quelli digitali.

Oltre al lavoro da remoto, abbiamo acquistato online molto di più di prima (quasi il doppio rispetto al corrispondente periodo dell’anno precedente) e siamo ricorsi ad Internet anche per servizi “sensibili” come i servizi sanitari. Di conseguenza, si è di molto ampliata la superficie esposta al cybercrime che ha intensificato le sue attività attraverso il veicolo principe, ovvero, le e-mail di phishing che in molti casi – per far leva sulla preoccupazione del momento – sono state subdolamente predisposte con contenuti legati al Covid-19.

La nuova condizione generata dalla crisi pandemica ha, quindi, un impatto significativo anche su chi si occupa di cybersecurity, che dall’inizio della crisi è stato impegnato a cercare di mantenere in piedi controlli di sicurezza disegnati per un mondo che all’improvviso è cambiato radicalmente. Si tratta, quindi, di capire quanto le tecnologie utilizzate per realizzare questi controlli si siano rivelate adatte a supportare l’evoluzione che si è resa necessaria nello scenario di crisi pandemica.

Vediamo con ordine. Sicuramente, per le aziende questa nuova situazione ha comportato la necessità di adeguare le proprie infrastrutture di accesso e di collaborazione sia in termini di capacità che (spesso) in termini di funzionalità. Possiamo dire chi aveva già adottato soluzioni cloud per la gestione del lavoro d’ufficio (documenti, posta, chat, videoconferenza) è riuscito ad essere pronto più velocemente di chi, invece, alla data aveva queste infrastrutture realizzate on-premise. Le aziende cloud-based non hanno avuto problemi di scalabilità e, inoltre, hanno potuto abilitare ulteriori controlli di sicurezza con semplici configurazioni. Possibili esempi di ulteriori controlli sono: aggiungere elementi di irrobustimento delle procedure di accesso (come, ad esempio, aggiunta di un secondo fattore di autenticazione), oppure, usufruire di strumenti come le sandbox o i sistemi di URL filtering utili a rendere più sicure le e-mail che – come abbiamo visto – sono il principale veicolo di attacco.

In questo frangente, quindi, il cloud ha dimostrato di poter fornire vantaggi in termini di scalabilità, semplicità e velocità troppo rilevanti per essere ignorati, anche dal punto di vista della sicurezza.

Facciamo un esempio: nella prima settimana di settembre tante aziende sono state interessate da una campagna di phishing generata a partire da mail «reali» scambiate in precedenza dai destinatari di tale campagna con clienti o fornitori, probabilmente derivate da breach dei medesimi. La campagna aveva l’obiettivo di diffondere il malware Emotet, testa di ponte per il ransomware Ryuk o per il banking trojan Trickbot. La particolarità di questa campagna è stata quella di usare tecniche di social engineering piuttosto evolute, in quanto le mail di phishing apparivano come reply a mail effettivamente inviate dal mittente ad una sua controparte. Questo caso testimonia l’aumento della complessità delle campagne di attacco che tentano di sfruttare l’aumento esponenziale della superficie digitale nel periodo Covid. Di fronte a campagne di questo tipo è indispensabile: a) avere controlli di sicurezza adeguati e facilmente configurabili; b) avere il giusto livello di visibilità sugli end-point e sulla rete; c) addestrare le persone a riconoscere le e-mail di phishing attraverso le quali arrivano i tentativi di propagazione di queste minacce. Viceversa, il rischio di dover sopportare impatti rilevanti dovuti – ad esempio – alla propagazione di un ransomware è veramente elevato; ma questa, nel 2020, è una storia vista più di una volta.

Il secondo punto cruciale su cui sono stati impegnati gli specialisti di cybersecurity è stato quello relativo all’accesso da remoto. Più o meno tutte le aziende si sono riversate ad aumentare la loro capacità di accesso dall’esterno che prima era dedicata ad una quota tutto sommato limitata di dipendenti. Quindi, creazione di nuovi collegamenti VPN o aggiunta di capacità alle VPN esistenti che implica, a seconda dei casi, un’attività realizzativa piuttosto intensa (ad esempio, distribuzione di client VPN e di certificati digitali e configurazione del secondo fattore di autenticazione via OTP) che è commisurata anche al numero di collegamenti da creare che, per alcune aziende, ha raggiunto le decine di migliaia di unità. Insomma, un problema anche in termini di mantenimento e gestione.

In tanti casi, poi, l’apertura verso l’esterno è avvenuta in situazioni in cui e aziende non erano pronte, ovvero, non avevano attuato all’interno le corrette pratiche di segregazione in termini di raggiungibilità sia di reti che di applicazioni, altro controllo fondamentale che in molti casi si è dovuto realizzare ex-novo. Se poi aggiungiamo il fatto che le tecnologie che realizzano le VPN non sono esenti da pecche (nel recente passato molte di queste hanno manifestato vulnerabilità critiche), allora, si delinea completamente quello che è successo. Tante aziende hanno aperto all’esterno in fretta, gestendo complessità tecnologica e organizzativa e non avendo filtrato a monte quello che deve essere esposto alla singola utenza che si connette. Quindi, una situazione preoccupante, specialmente quando le credenziali di accesso alla VPN – nella logica del SSO – sono anche quelle che danno accesso al PC ed ai servizi aziendali. Insomma, le VPN sono punti di criticità da controllare per bene.

Che cosa succederà il prossimo anno? Probabilmente nulla di diverso da quanto abbiamo già visto. Molti dei trend di cui abbiamo discusso si consolideranno e diventeranno permanenti. La superficie esposta non diminuirà e l’accesso da remoto alle infrastrutture aziendali rimarrà un punto critico.

Di seguito le mie previsioni: ma è un gioco, o forse no.

Ci sarà un incremento dell’adozione di servizi Cloud sia in ambito interno che di business; questa tendenza darà molti vantaggi in termini di semplicità e agilità ma richiederà un’attenta gestione da parte degli uomini che si occupano di cybersecurity. Un proliferare disordinato di presenza in cloud è di per sé una criticità.

Le VPN saranno progressivamente sostituite da servizi cloud SASE (Secure Access Service Edge) che offrono sia il servizio di accesso sicuro senza richiedere l’installazione di client sul PC, che servizi di configurazione che consentono di restringere l’accesso alle risorse aziendali per gruppi di utenti o per singoli utenti.

Spariranno le password, sostituite da modalità di accesso biometrico eventualmente supportate da app su mobile.

Proseguirà l’adozione di tecnologie AIML (Artificial Intelligence & Machine Learning) applicate all’analisi di Big Data; e speriamo che questo approccio in ambito cybersecurity inizi a mantenere le promesse fatte già da qualche anno.

Note

[1] Fonte “Rapporto annuale ISTAT – capitolo 3”

Articolo a cura di Marcello Fausti

Il Dott. Marcello Fausti è attualmente responsabile della CyberSecurity del Gruppo Italiaonline.

Nei 10 anni precedenti, è stato responsabile della IT Security di TIM con responsabilità della protezione delle infrastrutture critiche; dello sviluppo e gestione dei sistemi a supporto dell’Autorità Giudiziaria; della gestione del Security Operation Center, della gestione del processo di ICT Risk Management e dello sviluppo delle contromisure di sicurezza per la gestione operativa dei piani di sicurezza. È stato, inoltre, responsabile del Security Lab di TIM. In precedenza ha lavorato nel gruppo Olivetti come direttore marketing e business development di una società di system integration attiva sul mercato dei large account e come marketing manager della divisione PA della capogruppo.

È certificato CISM, PMP, COBIT, ITIL, ISO20000.

https://www.ictsecuritymagazine.com/articoli/cybersecurity-lanno-che-sta-finendo-e-lanno-che-verra/


Multa di oltre 9,5 milioni Euro per violazioni al GDPR inflitta dal Garante tedesco ad un fornitore di servizi di telecomunicazioni ridotta del 90% in sede contenziosa

Non c’è dubbio che il Regolamento generale sulla protezione dei dati (GDPR) sia stato un enorme passo avanti verso un panorama giuridico armonizzato per la data privacy nell’Unione europea (UE) e nello Spazio economico europeo (SEE). Tuttavia, due anni e mezzo dopo l’introduzione del GDPR, le Autorità garanti negli Stati membri dell’UE stanno ancora dibattendo alcuni dei suoi aspetti per i quali non hanno adottato un approccio uniforme. Ciò è particolarmente vero per le sanzioni imposte ai titolari del trattamento per mancata conformità alle leggi sulla privacy dei dati.

In linea generale, il legislatore comunitario ha previsto, per tutti i casi di danno prodotto, all’interessato o a terzi, nello svolgimento delle attività connesse al trattamento, un principio di responsabilità civile ripartita tra titolare e responsabile del trattamento dei dati. In particolare, dall’art. 83 del Regolamento emerge il principio di proporzionalità della pena alla violazione, in considerazione della gravità del fatto commesso e della natura dolosa o colposa della trasgressione, nonché di eventuali reiterazioni del comportamento illecito e di collaborazione con l’organo competente a comminare le sanzioni.

Ogni Autorità Garante per la Protezione dei Dati Personali pertanto valuta le singole violazioni tenendo in conto, così come indicato al considerando 148 del Regolamento, affinché le sanzioni siano sempre effettive, proporzionate e dissuasive, la natura, la gravità, la durata della violazione, il carattere doloso o colposo della stessa e le categorie di dati personali interessate dalla violazione.

Come noto, l’art. 83 Gdpr distingue due gruppi di sanzioni amministrative, come schematizzato di seguito:

fino a 10 milioni di euro

per le imprese:

fino al 2% del fatturato mondiale totale annuo dell’esercizio precedente, se superiore

Violazioni di minore gravità commesse dai seguenti soggetti:

– il titolare ed il responsabile del trattamento (artt. 8, 11, da 25 a 39, 42 e 43 Gdpr);

– l’organismo di certificazione (Accredia);

– l’organismo di controllo dei codici di condotta (art. 41 Gdpr).

fino a 20 milioni di euro

per le imprese:

fino al 4% del fatturato mondiale totale annuo dell’esercizio precedente, se superiore

Violazioni di maggiore gravità:

– dei principi di base del trattamento, comprese le condizioni relative al consenso, a norma degli articoli 5, 6, 7 e 9;

– dei diritti degli interessati a norma degli articoli da 12 a 22;

– i trasferimenti di dati personali a un destinatario in un paese terzo o un’organizzazione internazionale a norma degli articoli da 44 a 49;

– qualsiasi obbligo ai sensi delle legislazioni degli Stati membri adottate a norma del capo IX;

– l’inosservanza di un ordine, di una limitazione provvisoria o definitiva di trattamento o di un ordine di sospensione dei flussi di dati dell’autorità di controllo ai sensi dell’articolo 58, paragrafo 2, o il negato accesso in violazione dell’articolo 58, paragrafo 1 Gdpr.

Nel marzo 2019 l’autorità olandese per la protezione dei dati era stata la prima nell’UE a elaborare una struttura documentata su come calcolare le sanzioni previste dal GDPR per futuri casi di trattamento illegale dei dati e violazioni degli obblighi di riservatezza dei dati, creando quattro diverse categorie di non conformità al GDPR. Sebbene abbia stabilito multe predefinite per le violazioni in ciascuna categoria, aveva anche impostato un intervallo da applicare a seconda delle caratteristiche specifiche di una violazione.

La prima categoria è riservata a violazioni “semplici” come l’insufficiente registrazione delle responsabilità dei responsabili o contitolari del trattamento e la mancata pubblicazione dei dati di contatto del Responsabile della protezione dei dati (DPO).

La seconda categoria è riservata al mancato rispetto di determinati requisiti per il trattamento, come la mancata conclusione di accordi sul trattamento dei dati con i responsabili del trattamento, la protezione insufficiente dei dati personali, la mancata conduzione di valutazioni d’impatto o non garantire l’indipendenza del DPO.

Esempi della terza categoria includono violazioni del requisito di trasparenza, mancata notifica di data breaches e mancata collaborazione con la DPA olandese.

La quarta categoria è riservata al trattamento illecito di categorie speciali di dati (compreso il numero di identificazione nazionale), profilazione illecita e non conforme a specifici ordini della DPA olandese.

È interessante notare che le categorie I e II non corrispondono a violazioni punibili con la sanzione GDPR inferiore (10 milioni di euro), né le categorie III e IV corrispondono esclusivamente a violazioni punibili con la sanzione GDPR di 20 milioni di euro.

Il Garante olandese si discosta dall’importo predefinito elencato se vi sono circostanze attenuanti o aggravanti, come la natura, la gravità e la durata della violazione, il numero delle persone interessate e l’entità dei danni. Ancora più importante, se l’importo è ritenuto non adeguato, l’autorità olandese per la protezione dei dati può ancora imporre la multa massima di 20 milioni di euro o il 4% dei ricavi.

Nell’ottobre 2019 la Conferenza delle Autorità tedesche per la protezione dei dati (Datenschutzkonferenz) ha introdotto una diversa struttura in cinque fasi[1], che sostanzialmente parte anch’essa dalle dimensioni dell’azienda e fatturato medio annuo, prima di prendere in considerazione la gravità dell’infrazione, inclusi eventuali fattori attenuanti.

In particolare,

  1. l’impresa viene inizialmente assegnata a una categoria di dimensioni, successivamente
  2. verrà determinato il fatturato medio annuo della rispettiva sottocategoria della categoria di dimensioni, quindi
  3. viene calcolato un valore di base economico,
  4. questo valore di base verrà moltiplicato per un fattore che dipende dalla gravità dell’atto e
  5. il valore determinato al punto 4.sarà successivamente adeguato in base alle circostanze relative al trasgressore e ad altre, non ancora incluse.

Questo metodo garantisce una forma di commisurazione delle sanzioni comprensibile, trasparente ed equa per il singolo caso.

Sulla base di questo concept, le DPA tedesche hanno imposto alcune ammende notevoli ai titolari del trattamento dei dati.

Una di queste sanzioni è stata recentemente soggetta a revisione presso il Tribunale regionale di Bonn, con una riduzione dell’ammenda di circa il 90%.

In questo caso, il Commissario federale per la protezione dei Dati e la libertà di Informazione (BfDI) aveva inflitto un’ammenda di EUR 9.550.000 al fornitore di servizi di telecomunicazioni ‘1 & 1 Telecom GmbH’, poiché l’azienda non aveva predisposto misure tecniche e organizzative (art 32 GDPR) adeguate per impedire a persone non autorizzate di ottenere informazioni sui clienti tramite i suoi call center della hotline del servizio di assistenza clienti[2].

A questo proposito, il commissario federale Ulrich Kelber aveva affermato: “La protezione dei dati è la protezione dei diritti fondamentali. Le ammende inflitte sono un chiaro segno che rafforzeremo questa protezione dei diritti fondamentali. Il regolamento generale europeo sulla protezione dei dati (GDPR) ci offre l’opportunità di punire in modo decisivo una protezione insufficiente dei dati personali. Applichiamo questi poteri tenendo conto della proporzionalità richiesta”[3].

Nel caso di ‘1 & 1 Telecom GmbH’, la BfDI aveva appurato che le persone che chiamavano la hotline del servizio clienti della società potevano ottenere ampie informazioni su dati personali con facilità: nella fattispecie, un operatore del call center aveva rilasciato informazioni personali (numero di cellulare) a una persona che aveva chiamato affermando falsamente di essere la moglie di uno dei clienti e in seguito aveva utilizzato il numero di cellulare per assoggettare il cliente a stalking. Gli unici fattori di autenticazione richiesti dall’operatore del call center erano stati il nome e la data di nascita del cliente ‘1 & 1’ in questione.

La BfDI aveva ritenuto che questa procedura di autenticazione fosse in violazione dell’articolo 32 del GDPR che obbliga l’azienda ad adottare misure tecniche e organizzative adeguate per proteggere sistematicamente il trattamento dei dati personali.

Dopo che la BfDI aveva criticato l’insufficiente protezione dei dati, ‘1 & 1 Telecom GmbH’ si era dimostrata comprensiva e altamente collaborativa. Come primo passo, la procedura di autenticazione era stata rafforzata richiedendo ulteriori informazioni, poi, a seguito della consultazione con la BfDI, la società aveva provveduto a introdurre una nuova procedura di autenticazione che era stata notevolmente migliorata in termini di tecnologia e protezione dei dati[4].

“Nonostante tali misure, era necessario infliggere un’ammenda. Tra le altre cose, l’infrazione non era limitata a un numero limitato di clienti, ma rappresentava un rischio per l’intera base di clienti. Tuttavia, il BfDI era rimasto nella fascia più bassa delle possibili ammende poiché ‘1 & 1 Telecom GmbH’ si era dimostrata molto collaborativa durante l’intera procedura”[5].

Nella vicenda si è verificata una chiara violazione della protezione dei dati perché il fornitore di servizi di telecomunicazione non aveva protetto i dati dei propri clienti nell’ambito della comunicazione tramite il cosiddetto call center con una procedura di autenticazione sufficientemente sicura. In questo modo, i chiamanti non autorizzati sono stati in grado di utilizzare dati facilmente reperibili (nome e data di nascita) per accedere ad altri dati del cliente, come ad es. il nuovo numero di telefono.

Il tribunale regionale di Bonn, pur confermando il parere del commissario federale secondo cui il trattamento dei dati personali era illegale, ha stabilito una riduzione significativa dell’importo della sanzione riducendolo a 0,9 milioni di euro, ovvero una riduzione di ben il 90 per cento[6].

La Corte ha tenuto in considerazione che il trattamento illecito (rilascio del numero di cellulare) era relativo a un singolo evento, che non riguardava dati sensibili o un volume elevato di dati. La colpa del fornitore di servizi di telecomunicazione è stata valutata come bassa. “Per quanto riguarda la pratica di autenticazione praticata negli anni, che non era stata contestata fino all’emissione della sanzione, è mancata la consapevolezza del problema. Inoltre, si dovrebbe tenere conto del fatto che si tratta solo di una violazione minore della protezione dei dati. Ciò non avrebbe potuto portare al rilascio massiccio di dati a persone non autorizzate”[7].

È interessante notare che in pratica la Corte ha stabilito che le determinazioni delle sanzioni previste dal GDPR basate esclusivamente sul fatturato annuale di un’impresa non sono appropriate. Tuttavia, la Corte ha anche rilevato che la responsabilità di un’impresa per le violazioni del GDPR non richiede che uno specifico rappresentante o responsabile di tale impresa abbia commesso la violazione del GDPR. In tal modo, la Corte ha lasciato prevalere le regole del GDPR e ha deciso di non applicare i principi di base della legge tedesca sui reati amministrativi, come sottolineato nello stesso comunicato.

Sebbene il testo completo della sentenza della Corte non sia ancora disponibile ed entrambe le parti, cioè sia il Commissario federale che il fornitore di servizi di telecomunicazioni, possano ancora presentare ricorso contro la sentenza, questo caso mostra che la materia delle sanzioni per violazioni al GDPR

  1. è ben lontana dall’essere consolidata e
  2. non è stato ancora raggiunto un approccio paneuropeo.

In definitiva, per le Law Firm, la sentenza dimostra che, in caso di appello contro le ammende inflitte dalle DPA, in generale potrebbero sussistere non poche probabilità di successo.

D’altronde, non va dimenticato che il principio di proporzionalità trae origine proprio dalla giurisprudenza costituzionale e amministrativa tedesca[8] e successivamente è stato fatto proprio dalla Corte di Giustizia UE soprattutto in materia di sanzioni, di aiuti di Stato, di deroghe alle regole della concorrenza, assurgendo così a principio generale dell’ordinamento comunitario.

Note

[1] Cfr.il “Concept of the independent data protection authorities of the Federation and the Länder for the admeasurement of fines in proceedings against undertakings” pubblicato dalla Conference of the independent data protection authorities of the Federation and the Länder il 14 ottobre 2019, in https://www.datenschutzkonferenz-online.de/media/dskb/20191126_dsk_fining_concept_en.pdf.

[2] Cfr. EDPB News, “BfDI imposes Fines on Telecommunications Service Providers” – Wednesday, 18 December, 2019 in https://edpb.europa.eu/news/national-news/2019/bfdi-imposes-fines-telecommunications-service-providers_it.

[3] Ibidem.

[4] Ibidem.

[5] Ibidem.

[6] Cfr. Comunicato stampa – Bonn, 11/11/2020 – Sentenza nel procedimento di ammenda contro un fornitore di servizi di telecomunicazioni (Urteil im Bußgeldverfahren gegen einen Telekommunikationsdienstleister) in https://www.lg-bonn.nrw.de/behoerde/presse/zt_aktuell_020/Aktuelle-Pressemitteilung/index.php.

[7] Ibidem.

[8] Si veda ad es. Francesco Nicotra, “Una misura dell’esercizio del potere amministrativo: il principio di proporzionalità dell’azione amministrativa. Nota a Consiglio di Stato, IV Sezione, 26 febbraio 2015, n. 964”, 18 Settembre 2015 in https://www.filodiritto.com/una-misura-dellesercizio-del-potere-amministrativo-il-principio-di-proporzionalita-dellazione-amministrativa.

Articolo a cura di Sergio Guida

Da economista aziendale, ha maturato esperienze direzionali in gruppi industriali diversi per settori, dimensioni e caratteristiche. Specializzato in pianificazione strategica e controllo di gestione, finanza, risk e project management, sistemi di gestione e rendicontazione integrativi (sociale, ambientale e intangible assets), è stato relatore in convegni e seminari e pubblica articoli di economia, finanza, digital transformation, data governance, public health, compliance & regulatory affairs.

Ha seguito percorsi multidisciplinari su Design Thinking, Human-Computer Interaction, Data protection & Privacy, Digital Health & Therapeutics. Business angel, segue con attenzione il mondo delle Startup.

https://www.ictsecuritymagazine.com/articoli/multa-di-oltre-95-milioni-euro-per-violazioni-al-gdpr-inflitta-dal-garante-tedesco-ad-un-fornitore-di-servizi-di-telecomunicazioni-ridotta-del-90-in-sede-contenziosa/


Trasferimento dei dati all’estero: quali soluzioni?

Introduzione

Come sarà ormai noto a tutti, qualunque trasferimento di dati personali verso un paese terzo o un’organizzazione internazionale può avvenire esclusivamente alle condizioni descritte al capo V del Regolamento generale sulla protezione dei dati, che hanno il fine di assicurare che il livello di protezione delle persone fisiche garantito dal GDPR non sia pregiudicato (cfr at. 44 RGPD).

Nel capo in commento vengono indicate le misure di salvaguardia che possono consentire un trasferimento lecito “extra UE” (o meglio, al di fuori dallo Spazio Economico Europeo), e tra queste vi sono le decisioni di adeguatezza (art. 45 GDPR), che vengono prese dalla Commissione Europea all’esito di peculiari valutazioni, e, in mancanza di decisioni di adeguatezza, altri sistemi meno immediati, come le clausole contrattuali standard – o clausole contrattuali tipo (articolo 46).

Anche le clausole contrattuali standard, in realtà, in prima battuta sono adottate con decisione della Commissione Europea, che ne determina forma e sostanza. Le imprese che per effettuare trasferimenti extra SEE decidono di ricorrere alle clausole contrattuali standard devono necessariamente usare il modello corrispondente alle loro necessità (le clausole variano a seconda che il trasferimento verso l’importatore di dati debba avvenire tra titolare e responsabile del trattamento, o tra titolari).

Le multinazionali possono avvalersi di un ulteriore strumento, le norme vincolanti d’impresa, che hanno però una procedura relativamente lunga e complessa. Non risultano ancora implementati gli ulteriori sistemi previsti dall’articolo in commento (certificazioni e codici di condotta)

Gli interventi della Corte di Giustizia

Quando la Corte di Giustizia con la sentenza nota come Schrems I (dal nome dell’attivista che le diede impulso) travolse il Safe Harbor – una decisione di adeguatezza che presidiava la maggior parte dei trasferimenti di dati personali verso gli USA- buona parte dei maggiori provider e buona parte delle imprese che operavano in più Paesi, decisero di adottare come strumento di trasferimento le clausole contrattuali standard (molti provider, ad esempio, le resero accessibili nelle aree riservate, in modo che i titolari del trattamento potessero aderirle).

Con l’avvento del Privacy Shield- una decisione di adeguatezza volta a colmare il vuoto lasciato dal Safe Harbor- molti titolari decisero di mantenere il doppio binario di trasferimento (nulla vieta, infatti, di poggiare il trattamento all’estero su due diverse misure di salvaguardia) così da non restare scoperti nel caso in cui anche il Privacy Shield per qualche ragione fosse venuto meno.

Cosa che infatti è puntualmente avvenuta, con la sentenza Schrems II: questo primo effetto, ampiamente atteso, non ha causato un terremoto, perchè molti si aspettavano che il Privacy Shield, un ponteggio allestito in fretta e furia, esposto a continua erosione sia per le critiche mosse dal Comitato dei Garanti (EDPB) sia per quelle di esperti e attivisti, crollasse miseramente da un momento all’altro.

Molti però confidavano che sarebbe rimasto in piedi l’altro strumento di transito, cioè le clausole contrattuali standard: la sentenza Schrems II, invece, ha minato completamente anche questo terreno, trasformando in via impervia quello che prima appariva come un corridoio di transito collaudato e sicuro. Come ha fatto la Corte di Giustizia ad ottenere un tale effetto?

Nella sentenza Schrems II la Corte di Giustizia ha invalidato direttamente il Privacy Shield, ma non ha direttamente invalidato le clausole contrattuali standard.

La Corte di Giustizia, però, ha aggiunto alcuni elementi molto importanti:

ha dichiarato, infatti, che in caso di trasferimenti verso un paese terzo occorre garantire agli interessati un livello di protezione sostanzialmente equivalente a quello garantito all’interno dell’Unione dal GDPR, letto alla luce della Carta dei diritti fondamentali dell’Unione europea.

Chi intende trasferire dati con le clausole contrattuali standard, pertanto, dovrà valutare non solo il contenuto delle clausole contrattuali standard medesime, ma anche “per quel che riguarda un eventuale accesso delle autorità pubbliche di tale paese terzo ai dati personali così trasferiti, gli elementi rilevanti del sistema giuridico di quest’ultimo (…)”.

Per quanto riguarda la valutazione della normativa statunitense, la Corte di giustizia offre parametri piuttosto precisi circa i trattamenti che possono essere effettuati a fini di sicurezza pubblica, di difesa e sicurezza dello Stato. Sono gli stessi parametri che hanno condotto la Corte alla invalidazione del privacy shield.  Difficilmente potrà giungersi a diverse conclusioni ove analoghe valutazioni venissero applicate a diversi sistemi di trasferimento dei dati “verso” gli USA (il virgolettato si impone, perché, come vedremo, non sempre è necessario che i dati siano fisicamente allocati negli USA -o in altro Paese Terzo).

Se non si riesce a garantire il livello di protezione sostanzialmente equivalente a quello garantito all’interno dell’Unione Europea dal GDPR, il Titolare dovrà interrompere il trasferimento, o, in mancanza, dovrà farlo L’Autorità di protezione dei dati nazionale.

La Sentenza della Corte di Giustizia pone principi che non valgono solo per le clausole contrattuali standard, ma anche per le norme vincolanti d’impresa, compromettendo l’applicazione dell’intero articolo 46 del Regolamento.

L’intervento dell’EDPB

E’ ovvio che un tema importante come quello sollevato dalla sentenza Schrems II non poteva cadere nel vuoto, e gli interventi degli organismi chiamati a coordinare l’applicazione del Regolamento generale sulla protezione dei dati nei vari Paesi Europei non si sono fatti attendere.

Il primo intervento del Comitato Europeo per la protezione dei dati (l’organo che raccoglie le Autorità per la protezione dei dati nazionali più il Garante europeo, di seguito anche EDPB dall’acronimo con cui è conosciuto universalmente) si è avuto con le FAQ relative alla sentenza Schrems II.

Il Comitato ha chiarito che, “in generale, per i paesi terzi, la soglia fissata dalla Corte si applica anche a tutte le garanzie adeguate di cui all’articolo 46 del RGPD, utilizzate per il trasferimento dei dati dal SEE a qualsiasi paese terzo. La normativa statunitense richiamata dalla Corte [l’articolo 702 del Foreign Intelligence Surveillance Act (FISA) e l’Executive Order (EO) 12333] si applica a qualsiasi trasferimento verso gli Stati Uniti eseguito con mezzi elettronici che rientri nell’ambito di applicazione della suddetta normativa, a prescindere dallo strumento utilizzato per il trasferimento”.

Qualunque strumento si stia utilizzando, pertanto, occorrerà effettuare una valutazione della normativa del Paese Terzo, considerando anche le norme che regolano gli accessi ai dati per fini di sicurezza pubblica, di difesa e sicurezza dello Stato.

Occorrerà quindi valutare il livello di garanzia apportato dalle clausole contrattuali standard, alla luce della stima operata sulla normativa del Paese terzo.

Occorrerà poi individuare misure tecniche e organizzative (ma anche contrattuali) supplementari, che possano garantire un livello di protezione sostanzialmente equivalente a quello offerto dal GDPR nello Spazio Economico Europeo.

Come precisa L’EDPB “La possibilità di trasferire dati personali sulla base delle clausole contrattuali tipo dipenderà dall’esito della valutazione condotta; tenendo conto delle circostanze dei trasferimenti e delle misure supplementari eventualmente attuabili.

Le misure supplementari unitamente alle clausole contrattuali tipo, previa analisi caso per caso delle circostanze del trasferimento, dovrebbero assicurare che la normativa statunitense non interferisca con il livello di protezione adeguato dalle stesse garantito.

Qualora si giunga alla conclusione che, tenuto conto delle circostanze del trasferimento e delle possibili misure supplementari, non sarebbero assicurate garanzie adeguate, vi è l’obbligo di sospendere o cessare il trasferimento dei dati personali. Se si intende tuttavia proseguire col trasferimento dei dati malgrado la suddetta conclusione, è obbligatorio informarne l’autorità di controllo competente”.

La soluzione suggerita dall’EDPB passo passo

Al fine di chiarire ulteriormente gli adempimenti che dovrebbero condurre il Titolare nelle sue valutazioni, il Comitato Europeo per la Protezione dei dati – ha pubblicato innanzi tutto le “Recommendations 02/2020 on the European Essential Guarantees for surveillance measures

Adopted on 10 November 2020” che si pongono l’obiettivo di offrire un catalogo dei parametri da rispettare nella valutazione della normativa del Paese terzo in materia di sicurezza nazionale qualora le misure di sorveglianza del Paese terzo consentano l’accesso ai dati personali ad Autorità pubbliche, in modo da comprendere se tali interferenze possano essere giustificabili o meno. Esse però non esauriscono di per sé la valutazione che il Titolare è chiamato a compiere.

Quindi al fine di fornire uno strumento più concreto e ampio sono state pubblicate anche le “Recommendations 01/2020 on measures that supplement transfer tools to ensure compliance with the EU level of protection of personal data” che resteranno in consultazione pubblica fino al 21 dicembre 2020.

Queste ultime si pongono l’ambizioso obiettivo di coadiuvare coloro che trasferiscano dati all’estero nella complessa valutazione che sono chiamati ad operare sulla normativa del Paese terzo e nell’individuazione delle misure supplementari che si rendessero necessarie. Le raccomandazioni si compongono di una serie di step che coloro che esportano dati personali dovrebbero seguire, suggerimenti sulle possibili fonti di informazioni e alcuni esempi di misure supplementari che potrebbero essere adottate.

I primi step

Il primo passo suggerito dal Comitato, condivisibile, è come sempre quello di conoscere quello che si fa, quindi: mappare i trasferimenti. Il CEPD riconosce che una simile mappatura potrebbe non essere una operazione facile: essa tuttavia appare imprescindibile per garantire un livello di protezione essenzialmente equivalente a quello offerto dal GDPR nel SEE.

La mappatura consentirà di valutare se i trasferimenti siano adeguati, pertinenti e limitati a quanto strettamente necessario in relazione alla finalità perseguita.

Il secondo step sarà quello di verificare lo strumento di trasferimento, se, cioè si stia utilizzando una decisione di adeguatezza o se invece ci si fondi su uno degli altri meccanismi previsti dall’articolo 46 GDPR.

Se i trasferimenti sono poggiati esclusivamente su decisioni di adeguatezza, allora la valutazione potrà arrestarsi qui (almeno fino a quando permarrà la decisione di adeguatezza…)

A questo punto, per meglio comprendere la portata della mappatura, chi scrive farà alcune considerazioni, partendo da una osservazione lapalissiana, e cioè che la definizione di dato personale è amplissima: gli indirizzi IP sono dati personali, per esempio. In linea generale, i dati pseudonimizzati sono dati personali. E non solo: quando parliamo di trasferimento extra UE, dimentichiamo spesso di considerare che anche l’accesso da remoto potrebbe essere un trasferimento: come precisa il CEPD alla nota 22: “Please note that remote access by an entity from a third country to data located in the EEA is also considered a transfer”: insomma se è possibile per un governo straniero accedere a dati allocati nello Spazio Economico Europeo (lo stesso ambito di applicazione del GDPR), allora si avrà un trasferimento di dati personali per cui sarà necessario seguire tutti gli Step indicati.

Non importa pertanto che i dati risiedano fisicamente su server che si trovano nello Spazio Economico Europeo: quando l’impresa che li tratta è sotto la giurisdizione di un Paese terzo non adeguato ed è previsto dalle norme del medesimo Paese terzo che le sue autorità possano accedere ai dati sul server in UE, allora siamo in presenza di un trasferimento di dati per cui è necessario procedere alla valutazione e alla applicazione, oltre che degli strumenti previsti dall’articolo 46, anche delle misure supplementari.

Tanto chiarito sia in ordine alla definizione di dato personale, sia in ordine alla estensione della nozione di “trasferimento”, pensiamo a quanti servizi possono essere interessati dal trasferimento dei dati all’estero, seppure i dati siano trattati in Europa: social network, servizi email, gestionali, servizi di condivisione o hosting di documenti, servizi di sicurezza dei siti web che trattano esclusivamente indirizzi IP, strumenti di analisi, quasi tutti i servizi di marketing, per citare i più diffusi.

Il Comitato europeo per la protezione dei dati ha anche ribadito che in assenza di una decisione di adeguatezza, occorrerà che il trasferimento sia assistito da uno degli strumenti previsti dall’articolo 46 GDPR, se i trasferimenti sono regolari e ripetitivi, e solo in caso di trasferimento di dati personali occasionali e non ripetitivi, si potrebbero quindi utilizzare gli strumenti previsti invece dall’articolo 49 GDPR, se ne sussistono tutte le condizioni. Su questo punto sarebbero auspicabili maggiori chiarimenti, dato che diversi esperti prefigurano un ricorso massivo ai mezzi previsti dall’articolo 49 GDPR in conseguenza della paralisi in cui versa, almeno per alcune tipologie di trattamento, l’articolo 46 del Regolamento, impostazione che al momento non parrebbe però avallata dal laconico rinvio operato dal Comitato alle proprie pregresse posizioni (cfr Linee guida 2/2018 sulle deroghe di cui all’articolo 49 del regolamento 2016/679).

Il terzo step consiste nello stimare se vi siano elementi nella normativa o nella prassi del Paese terzo che possano impattare sulla effettiva protezione della salvaguardia adottata per il trasferimento, nel contesto dello specifico trasferimento effettuato.

La valutazione deve prima indagare la normativa del Paese terzo (che sia rilevante rispetto al trasferimento effettuato e la misura di trasferimento adottata ai sensi dell’articolo 46) che potrebbe compromettere il livello di protezione, poi la prassi.

La valutazione sulla normativa va operata alla stregua delle “Recommendations 02/2020 on the European Essential Guarantees for surveillance measures Adopted on 10 November 2020”. Occorrerà prestare particolare attenzione soprattutto qualora le norme che regolano l’accesso ai dati da parte di Autorità pubbliche del Paese Terzo non siano chiare o disponibili al pubblico.

Anche in assenza di norme di tal fatta, prima di procedere al trattamento occorrerà valutare altri fattori, definiti dal CEPD “rilevanti e obiettivi” e non basarsi su fattori soggettivi come la probabilità che le Autorità del Paese terzo accedano ai dati in maniera non conforme agli standard dell’Unione Europea.

Chi scrive avrebbe voluto riferire quanto riportato nelle raccomandazioni senza annotazioni, ma qui un rilievo si impone. Dato che il GDPR è un sistema basato sulla valutazione del rischio, ci si aspetta che l’ulteriore valutazione che si viene chiamati a compiere dal CEPD si basi su criteri probabilistici, come è di regola nel risk assessment. Invece no: la valutazione della probabilità che i dati che ci prefiggiamo di trasferire costituiscano l’obiettivo di un organismo governativo che effettua sorveglianza per ragioni di sicurezza nazionale, viene liquidato come parametro meramente soggettivo. Occorrerà quindi mettere in piedi una procedura di due diligence documentata, cercando informazioni da altre fonti come: precedenti, risorse organizzative e tecniche dello Stato terzo, ecc. Chi scrive vuole richiamare due punti importanti per comprendere pienamente la portata di questa valutazione. Nel nostro Paese abbiamo una costellazione di PMI e professionisti che trasferiscono dati in Paesi extra SEE, che non possono effettuare l’assessment richiesto dall’EDPB: non ne hanno i mezzi. Peraltro, quando parliamo di Paesi terzi non ci riferiamo ai soli Stati Uniti, ma a qualunque Paese non abbia ricevuto una decisione di adeguatezza: pensiamo cosa significhi effettuare una simile indagine su un Paese come la Cina, ove anche la lingua costituirà un ostacolo non banale.

Vedremo se questa impostazione verrà confermata dopo la consultazione pubblica, ma certamente il criterio della probabilità dell’accesso da parte del governo straniero potrebbe rivelarsi cruciale per gli operatori e chi scrive si auspica sul punto una maggiore apertura.

Gli step finali

Il quarto step in apparenza restituisce qualche blanda speranza: identificare le misure

supplementari per innalzare il livello di protezione di dati personali agli standard europei.

Questo step, precisa il Comitato Europeo per la protezione dei dati, è necessario solo qualora, all’esito dell’indagine, si evidenziasse che la normativa del Paese Terzo, impatti sulla effettività delle misure di salvaguardia ex art. 46 GDPR. Ma appare difficile a chi scrive immaginare che l’esito della complessa indagine condotta sia diverso. Come potrebbero strumenti di natura pattizia arginare il potere dello Stato in materia di sicurezza nazionale?

Ci torneremo tra poco.

Il quinto step esprime la necessità di adottare formalmente le misure supplementari individuate.

Il sesto prevede un meccanismo di revisione periodica, che imporrà quindi una nuova analisi della normativa (e non solo, come si è visto sopra) del Paese terzo.

Tornando quindi al quarto step, c’è un intero allegato (“annex 2”) che contiene una lista esemplificativa e non esaustiva di misure che possono essere adottate.

L’EDPB precisa che talune potrebbero essere efficaci in alcuni Paesi e non in altri.

Colui che decide di trasferire i dati, pertanto, resterà l’unico responsabile della valutazione operata e della efficacia delle misure supplementari adottate, nel contesto del trattamento effettuato, alla luce della normativa (e delle prassi!) del Paese terzo, degli strumenti di salvaguardia adottati ai sensi dell’articolo 46, e delle misure supplementari cui decidesse di ricorrere.

Il tutto dovrà essere documentato e si potrebbe anche rendere necessario combinare più misure supplementari. Ove comunque all’esito del “personal data transfer impact assessment” non si riuscisse ad ottenere un livello di protezione sostanzialmente equivalente a quello offerto dall’UE, il trasferimento dovrà essere interrotto, sospeso o evitato, per non compromettere il livello di protezione dei dati personali dell’interessato.

In ordine al rapporto tra misure contrattuali, organizzative e tecniche, le prime (cioè le misure organizzative e contrattuali) appaiono il più delle volte strettamente connesse con le misure tecniche alle quali forniscono una sponda, ma difficilmente le misure contrattuali e organizzative potranno essere “autoportanti”.

Quali misure supplementari preferire? La lettura degli scenari immaginati dal CEPD offre molti spunti. Uno strumento aggiuntivo di protezione dei dati suggerito da più parti già alla prima lettura della sentenza Schrems II è la crittografia. Ed in effetti essa viene indicata più volte tra le misure tecniche.

Non si creda tuttavia che sia sufficiente applicare la crittografia all’esito della complessa valutazione operata per superare gli stretti limiti posti dall’EDPB: come detto, vi è una lunga serie di esempi che vengono portati a corredo delle considerazioni sopra brevemente riassunte, e appaiono notevoli gli scenari indicati sub “Scenarios in which no effective measures could be found” e in particolare quelli indicati al punto 88 “Use Case 6: Transfer to cloud services providers or other processors which require access to data in the clear” e 90 “Use Case 7: Remote access to data for business purposes”: si tratta di configurazioni che riguardano la maggior parte dei cloud saas (e non solo), che appaiono, prima facie, impossibili da regolarizzare.

Infine anche le misure contrattuali suggerite appaiono foriere di gravami e costi per l’importatore di dati, che può trovarsi a dover fornire informazioni che esulano dalla sua area di attività, come ad esempio informazioni sulla legislazione, o addirittura ad assumersi l’obbligo, in determinate condizioni, di opporsi alle richieste governative: si tratta di pattuizioni non banali, pertanto, che potrebbero avere serie ripercussioni sui costi del servizio soprattutto ove i servizi siano offerti da aziende che non hanno le spalle larghe dei giganti della Silicon Valley.

Le clausole contrattuali standard

In questo contesto piuttosto complesso si inscrive l’intervento della Commissione Europea, che ha pubblicato la bozza dei nuovi testi delle clausole contrattuali standard, anch’essi sottoposti a consultazione pubblica.

La prima nota positiva è che finalmente vengono introdotti i trasferimenti da responsabile a subresponsabile (“processor to processor”), che ancora non avevano un testo ad hoc.

La seconda annotazione è che paiono riferirsi solo a parte dei trasferimenti presi in considerazione dall’EDPB: e anche le misure indicate non appaiono perfettamente allineate a quelle suggerite dal Comitato.

Non è questa la sede per una disamina della bozza delle clausole contrattuali standard, che meriterebbe uno spazio a sé, tuttavia non si può tralasciare un dato importante, che riguarda l’ambito di applicazione: nella bozza “COMMISSION IMPLEMENTING DECISION (EU) …/… of XXX on standard contractual clauses for the transfer of personal data to third countries pursuant to Regulation (EU) 2016/679 of the European Parliament and of the Council” (Ref. Ares (2020)6654686 – 12/11/2020) all’articolo 1 si legge: “The standard contractual clauses set out in the Annex are considered to provide appropriate safeguards within the meaning of Article 46(1) and (2)(c) of Regulation (EU) 2016/679 for the transfer of personal data from a controller or processor subject to Regulation (EU) 2016/679 (data exporter) to a controller or (sub-) processor not subject to Regulation (EU) 2016/679 (data importer).”

Significa che le clausole contrattuali standard, qualunque esse siano, si applicheranno solo ove l’esportatore di dati personali sia soggetto alla applicazione del Regolamento, mentre l’importatore non lo sia.

L’ambito di applicazione del RGPD prescinde dal criterio prettamente geografico della allocazione dei dati o della sede (o stabilimento dell’impresa), come è noto, e il GDPR si applica anche “al trattamento dei dati personali di interessati che si trovano nell’Unione, effettuato da un titolare del trattamento o da un responsabile del trattamento che non è stabilito nell’Unione, quando le attività di trattamento riguardano:

  1. a) l’offerta di beni o la prestazione di servizi ai suddetti interessati nell’Unione, indipendentemente dall’obbligatorietà di un pagamento dell’interessato; oppure
  2. b) il monitoraggio del loro comportamento nella misura in cui tale comportamento ha luogo all’interno dell’Unione.”
Pertanto l’ambito di applicazione delle clausole contrattuali standard appare agganciato all’ambito del trattamento delineato dall’articolo 3 del Regolamento generale sulla protezione dei dati e non appare coincidere con quello tratteggiato dall’EDPB, che invece non chiarisce il rapporto tra l’articolo 3 e il capo V del Regolamento generale sulla protezione dei dati, e come abbiamo visto sopra, richiama criteri molto ampi per individuare i trasferimenti all’estero (che però sono in linea con la sentenza Schrems II). Ciò significa che potremmo avere dei trasferimenti extra SEE non coperti dalle clausole contrattuali standard.

La mancanza della definizione del trattamento dei dati all’estero nel testo del Regolamento si fa sentire in tutta la sua potenza. Vedremo se all’esito della consultazione pubblica i testi troveranno una miglior coordinazione.

Quali soluzioni per i trasferimenti extra UE?

Dalla lettura della casistica individuata dall’EDPB si evince facilmente che non esiste una soluzione unica, ma molteplici soluzioni a seconda delle diverse tipologie di trattamento.

Un primo dato che possiamo trarre è che la soluzione di cercare più meccanismi di trasferimento per garantire un trattamento contro cambi di rotta repentini, non è più praticabile per le piccole imprese (ad esempio: appoggiarsi al doppio binario costituito da decisione di adeguatezza e clausole contrattuali standard). O meglio, è praticabile al costo di dover effettuare una valutazione di impatto sul trasferimento: abbiamo visto grazie a Schrems quanto possano essere precarie le decisioni di adeguatezza, ma non è detto che riusciremo ancora ad appoggiare i trasferimenti coperti da decisioni di adeguatezza anche alle clausole contrattuali standard, almeno fino a quando non avremo il nuovo testo (e sempre che sia possibile utilizzarle in relazione al concreto trasferimento posto in essere).

La maggiori problematiche, al momento, sono rinvenibili nel fatto che la sentenza Schrems II produce già ora i suoi effetti e come precisa l’EDPB il periodo di consultazione pubblica non va interpretato come un periodo di grazia.

A diverse conclusioni non giunge la Commissione Europea, che ritiene che per un periodo di un anno a far data dalla entrata in vigore della nuova decisione sulle SCC, i trasferimenti potranno basarsi sulle pregresse clausole contrattuali aggiornate con le necessarie misure di salvaguardia.

Cosa bisogna fare dunque? Non vi è molta scelta, occorrerà procedere alla mappatura dei trasferimenti, alla valutazione di impatto del trasferimento con analisi della normativa e delle prassi del Paese terzo (con tutte le difficoltà che ciò può comportare) ed infine individuare le misure supplementari.

Non è scontato che l’esito dell’esame sia favorevole al trasferimento, anzi: alcuni dei servizi più utilizzati potrebbero non trovare appigli in adeguate misure tecniche, quanto alle misure contrattuali occorre realisticamente tenere conto dello squilibrio di forza contrattuale tra le PMI e i maggiori provider di servizi, per cui, in assenza di iniziative che partano dai fornitori, difficilmente si troveranno soluzioni praticabili.

L’elefante nella stanza

In effetti a parere (non solo) di chi scrive è possibile che gli effetti della sentenza Schrems II abbiano finito col disattivare, in un certo senso, buona parte degli strumenti di trasferimento dei dati più utilizzati dalle imprese e, addirittura, finiscano col paralizzare completamente la possibilità di effettuare alcuni tipi di trasferimenti.

Gli effetti sono tali perché nonostante gli sforzi che possiamo fare, come è già stato autorevolmente rilevato, l’unica vera soluzione ha una portata internazionale: se il problema è il conflitto tra due o più ordinamenti non saranno né i privati né gli organismi di un solo ordinamento a poterlo risolvere.

La necessità impellente di un accordo internazionale è l’elefante nella stanza, ed è impossibile giunti a questo punto continuare ad ignorarlo: Europa ed USA, per restare ai contendenti più noti, giocano la partita spingendo quanto più possibile le loro norme oltre i confini territoriali: in questo modo però arriviamo al paradosso per cui un’impresa, soggetta alla giurisdizione  di un Paese non adeguato, che tratta dati su suolo europeo (nel SEE!) non offre sufficienti garanzie per i parametri fissati dalla stessa UE, anche ove le si applichi il GDPR (ai sensi dell’articolo 3 del GDPR medesimo). E’ evidente che in un quadro simile (impresa che applica il GDPR, si trova in UE,  ma non offre garanzie sufficienti perché accessibile da parte di Agenzie Governative del Paese terzo) il problema travalica ogni valutazione di impatto che si possa compiere (per non parlare dei casi che riguardano i gruppi di imprese) ed è ormai del pari evidente che il problema non potrà essere nascosto sotto gli arabeschi di un tappeto di adempimenti più o meno burocratizzati, buoni nella migliore delle ipotesi a guadagnare tempo prima della prossima sentenza tranciante della Corte di Giustizia, nella peggiore sino al prossimo whistleblower che ne palesi l’inconsistenza. In assenza di un accordo internazionale solido come una casa di mattoni, continueremo a proteggere i trasferimenti di dati personali con capanne di paglia e legno, come i porcellini della nota fiaba, ben sapendo che saranno soffiate via dal primo lupo che passa.

Riferimenti

  1. Regolamento (UE) 2016/679 del Parlamento europeo e del Consiglio, del 27 aprile 2016, relativo alla protezione delle persone fisiche con riguardo al trattamento dei dati personali, nonché alla libera circolazione di tali dati e che abroga la direttiva 95/46/CE (regolamento generale sulla protezione dei dati) (Testo rilevante ai fini del SEE) LINK: https://eur-lex.europa.eu/legal-content/IT/TXT/?uri=celex%3A32016R0679
  2. Sentenza Schrems I – SENTENZA DELLA CORTE (Grande Sezione) 6 ottobre 2015 Nella causa C‑362/14 http://curia.europa.eu/juris/document/document.jsf?text=&docid=169195&pageIndex=0&doclang=it&mode=lst&dir=&occ=first&part=1&cid=388
  3. Sentenza Schrems II SENTENZA DELLA CORTE (Grande Sezione) 16 luglio 2020 Nella causa C‑311/18 http://curia.europa.eu/juris/document/document.jsf?docid=228677&doclang=IT
  4. Domande più frequenti in merito alla sentenza della Corte di giustizia dell’Unione europea nella causa C-311/18 – Data Protection Commissioner contro Facebook Ireland Ltd e Maximillian Schrems https://edpb.europa.eu/our-work-tools/our-documents/ohrajn/frequently-asked-questions-judgment-court-justice-european-union_en
  5. Recommendations 02/2020 on the European Essential Guarantees for surveillance measures https://edpb.europa.eu/our-work-tools/our-documents/recommendations/edpb-recommendations-022020-european-essential_en
  6. Recommendations 01/2020 on measures that supplement transfer tools to ensure compliance with the EU level of protection of personal data – version for public consultation https://edpb.europa.eu/our-work-tools/public-consultations-art-704/2020/recommendations-012020-measures-supplement-transfer_en
  7. Tene, Omer (Vice President, Chief Knowledge Officer at IAPP – International Association of Privacy Professionals): “Quick Reaction to EDPB Schrems II Guidance” https://www.linkedin.com/pulse/quick-reaction-edpb-schrems-ii-guidance-omer-tene/
  8. Data protection – standard contractual clauses for transferring personal data to non-EU countries (implementing act) https://ec.europa.eu/info/law/better-regulation/have-your-say/initiatives/12741-Commission-Implementing-Decision-on-standard-contractual-clauses-for-the-transfer-of-personal-data-to-third-countries
  9. Scorza, Guido (Autorità Garante Privacy) “Trasferimento dati extra-Ue, Scorza (Garante Privacy): Abbiamo un problema, anzi tre” https://www.agendadigitale.eu/sicurezza/privacy/trasferimento-dati-extra-ue-abbiamo-un-problema-anzi-tre-e-non-riguarda-solo-gli-usa/

Articolo a cura di Cristina Vicarelli

https://www.ictsecuritymagazine.com/articoli/trasferimento-dei-dati-allestero-quali-soluzioni/


Attacco alle credenziali degli utenti della LAN. LLMNR e NBT-NS Poisoning con Responder e MultiRelay.

Tra le diverse attività che può eseguire un criminale all’interno di una rete informatica aziendale, così come può fare un dipendente infedele o un attaccante esterno che controlla una macchina compromessa tramite botnet, c’è sicuramente lo sniffing delle credenziali degli utenti.

Se la cosa può sembrare di difficile attuazione o complessa, e per taluni attacchi lo è davvero, grazie alla presenza di due protocolli insicuri abilitati di default da Windows, si dimostra invece molto semplice e realizzabile ancora in molte, troppe, realtà aziendali. Se è vero che si è scritto di questo attacco già dal 2001 o forse prima, per lo più solo in lingua inglese, è altresì vero che sono ancora molte le aziende e i responsabili IT che ne hanno scarsa consapevolezza. Sto infatti riscontrando una buona riuscita di questo attacco in tutte le realtà in cui eseguo attività di Penetration Testing interno in qualità di Red Teamer di 3C N-SOC, azienda per cui lavoro. Credo, per tale motivo, che sia importare far conoscere questa minaccia e mettere in guardia gli amministratori di rete e le aziende che ancora la ignorano, consigliando al contempo le opportune azioni per prevenirla.

LLMNR e NTB-NS

I protocolli LLMNR (Local-Link Multicast Name Resolution) e NBT-NS (NetBIOS Name Service) sono due protocolli abilitati di default sui sistemi Windows e il loro scopo, apparentemente innocuo, è quello di intervenire in supporto del Sistema Operativo quando non è in grado di risolvere un nome Host tramite il servizio DNS o tramite il suo file Host locale. LLMNR, introdotto con Windows Vista è il successore di NBT-NS e si basa sul formato DNS (Domain Name System) che consente agli Host presenti sulla stessa rete locale di eseguire la risoluzione dei nomi per altri Host. NBT-NS, invece, identifica i sistemi tramite il loro nome NetBIOS.

Sappiamo che la ricerca del nome Host può fallire, ad esempio, se i server DNS non sono raggiungibili, spenti o mal configurati, ma anche se l’utente digita il nome Host in modo errato. In quest’ultimo caso, infatti, pur essendo disponibile un server DNS, questo non sarà comunque in grado di dare una risposta al sistema richiedente.

Inoltre i sistemi Windows configurati per rilevare automaticamente i proxy Web (protocollo Web Proxy Auto Discovery – WPAD), in un ambiente senza un proxy Web tenteranno di risolvere il nome Host “wpad” senza riuscirci. Anche i browser utilizzano il protocollo WPAD e Internet Explorer ce l’ha abilitato di default.

Ci sono poi diverse applicazioni che tentano di risolvere nomi Host inesistenti. Il browser Google Chrome, ad esempio, tenterà di risolvere tre nomi di dominio casuali ogni volta che viene caricato come parte di una routine di auto-configurazione e ottimizzazione

Ecco che allora, in tutti i casi in cui il sistema non riuscirà tramite il DNS a individuare gli Host, si attiveranno i protocolli LLMNR e NBT-NS, i quali invieranno in broadcast richieste UDP a tutti i dispositivi della rete affinché qualcuno di essi possa dare informazioni della risorsa cercata. Si tratta di comunicazioni non autenticate, non cifrate e che chiunque nella rete potrà intercettare.

Nell’immagine sopra vediamo lo sniffer di rete Wireshark in ascolto mentre su Windows10 un utente cerca la risorsa (inesistente) “ftp://PIOPPO”. Le prime due righe in alto rappresentano il protocollo NTB-NS e quello LLMNR (che supporta anche IPv6) inviati in broadcast. Nel dettaglio dei pacchetti, invece, vediamo come NBT-NS, a destra, invia il pacchetto sulla porta di destinazione 137/udp (e in basso vediamo anche la query di ricerca di “PIOPPO”) e LLMNR, a sinistra, sulla porta 5355/udp.

La Vulnerabilità

A questo punto, se tra i vari sistemi presenti nella rete ci fosse anche quello di un criminale in ascolto sulle porte 137/udp e 5355/udp, ricevendo la richiesta mandata in broadcast potrebbe rispondere fingendo di essere l’Host cercato (spoofing). Il sistema richiedente, quindi, credendo di aver individuato finalmente la risorsa voluta, tenterà di autenticarsi ad essa inviando l’HASH NTLMv1/v2 o LMv2 dell’utente attivo in quel momento sul sistema. HASH che ovviamente verrebbe catturato dall’attaccante.

E cosa se ne può fare l’attaccante dell’HASH delle credenziali Windows di un utente? Potrebbe, in primis, cercare di craccarlo offline per ottenere le credenziali in chiaro e quindi usarle successivamente per altri attacchi, ma qualora questo fosse invece inviolabile a causa della complessità della password, e l’utente fosse di tipo Amministrativo, potrebbe addirittura usare l’HASH per compromettere e prendere il controllo di un altro sistema della rete che condivida le stesse credenziali.

Dimostrazione – Responder.py

Esistono diversi strumenti per sfruttare questa vulnerabilità.

NBNSpoof, ad esempio, inventato nel 2007 da Wesley McGrew, crea automaticamente risposte alle query NetBIOS, mentre Metasploit ha vari moduli sia per creare risposte NetBIOS

(auxiliary/spoof/nbns/nbns_response) sia LLMNR (auxiliary/spoof/llmnr/llmnr_response).

Quello di cui vi parlerò però è Responder.py di Laurent Gaffie (https://github.com/lgandx/Responder), un tool Python capace di restare in ascolto nella rete e rispondere alle richieste LLMNR e NBT-NS (utilizzando falsi server di autenticazione HTTP, SMB, MSSQL, FTP, LDAP, POP3, …) spacciandosi per il server legittimo e carpendo, in questo modo, le credenziali dell’utente (in formato HASH NTLMv2 mentre per i protocolli insicuri come l’FTP o l’HTTP, invece, in chiaro). Nel momento in cui sto scrivendo la pagina di github di Responder viene segnalata da firefox come sito che potrebbe contenere software dannoso, capiremo andando avanti, il perché 😊

È possibile scaricare Responder da GitHub con il comando GIT

$ sudo git clone https://github.com/lgandx/Responder.git

Una volta fatto il download troveremo una cartella chiamata “Responder”, all’interno della quale ci sarà il tool “Responder.py”, il file di configurazione “Responder.conf”, la cartella “logs” con all’interno i file degli HASH catturati, e la cartella “tools” all’interno della quale si trovano altri strumenti come “MultiRelay.py” e “RunFinger.Py” che vedremo più avanti.

Supponiamo ora di essere in una rete composta da quattro sistemi, due Windows 7 Professional SP1, un Windows 10 Professional e una macchina attaccante (ad esempio di un dipendente infedele) con sistema operativo Kali Linux (versione 2020.4). Sui sistemi Kali Linux i tool sono già presenti, ma purtroppo siccome quello chiamato MultiRelay.py non funziona correttamente è consigliabile in ogni caso scaricarli da GitHub. La versione Python utilizzata sul sistema attaccante per eseguire i tool è la 2.7.18. Si tratta di macchine in gruppo di Lavoro “Workgroup” ma tutto quello che vedremo funziona allo stesso modo in un ambiente di dominio.

  1. L’attaccante (10.10.10.102) guarda le opzioni di Responder con il parametro (-h). Quindi lo avvia in modo che si metta in ascolto sulla rete 10.10.10.0/24 e sull’interfaccia di rete eth0 (-I) in attesa di richieste LLMNR o NBT-NS, come si vede nella foto in basso.
    Responder è stato avviato con il comando:
    $ sudo ./Responder.py -I eth0
  2. L’utente (Administrator) della macchina Windows 10 (10.10.10.105) tenta di accedere alla risorsa “\\share223” ma invece digita “\\share23”. Siccome il Server DNS non sa dire al sistema chi è “\\share23”, quest’ultimo invia richieste LLMNR e NBT-NS a tutta la rete per cercarla.
  3. Il sistema attaccante intercetta le richieste e fingendo di essere la risorsa “\\share23” risponde alla macchina richiedente. Questa, allora, credendo di parlare con la risorsa giusta, invia l’HASH NTLMv2 dell’utente attivo sul sistema (Administrator) affinché questo possa autenticarsi… Ecco che l’attaccante, in questo momento, entra in possesso dell’HASH delle sue credenziali, come vediamo nell’immagine in basso. Responder, inoltre, tramite il suo server fake SMB, restituirà un errore all’utente il quale crederà semplicemente di aver digitato male il nome di condivisione (foto in alto).
  4. Nel frattempo l’utente del sistema Windows 7 (10.10.10.103) cerca di raggiungere via browser la risorsa “ftp:\\share14”, inesistente. Responder.py che continua ad essere in esecuzione sul sistema dell’attaccante risponde ad esso con una finta maschera di login. L’utente ingenuamente (senza sapere di aver sbagliato a digitare l’indirizzo (share14 invece di share114) inserisce delle credenziali per autenticarsi. Credenziali che in questo caso saranno raccolte dall’attaccante in chiaro, trattandosi di FTP. È interessante vedere, nella foto in basso, che oltre alle credenziali FTP in chiaro, Responder abbia registrato in precedenza la richiesta del protocollo WPAD (Web Proxy Auto Discover) effettuata dal sistema operativo Windows 7 e quella del sito “www.bing.com” avvenuta con l’apertura di Internet Explorer (in questa rete mancando un server DNS tutte le richieste vanno su LLMNR e NTB-NS).Se l’attaccante avesse utilizzato Responder con l’opzione (-F), in caso di richieste WPAD da parte del browser, avrebbe forzato quest’ultimo ad autenticarsi fornendo le credenziali dell’utente, che nel caso di Internet Explorer avrebbe passato automaticamente. Utilizzando invece l’opzione (-A) avrebbe usato Responder in modalità di solo ascolto. Vuol dire che avrebbe potuto analizzare le richieste senza rispondere a nessuna. Ciò può essere utile per capire quanto una rete sia loquace senza interagire con alcun Host.
  5. Dopo un po’ di tempo nella cartella “/Responder/logs” si saranno raccolti vari file di testo all’interno dei quali ci sono gli HASH e le password in chiaro raccolte da Responder mentre era in ascolto. Quelli interessanti per l’attaccante sono ovviamente quelli che cominciano con “FTP-..”, “HTTP-NTLMv2-“, “SMB-NTLMv2-“… Nella foto in basso vediamo l’elenco dei file di log, l’apertura del file “SMB-NTLMv2-SSP-10.10.10.105” che corrisponde alla prima richiesta fatta dall’utente Administrator su Windows 10. Vediamo l’HASH della sua password. Vediamo anche il contenuto di altri due file, il primo contenente l’HASH della password di un utente Michele per una richiesta HTTP e il secondo contenente le credenziali in chiaro inserite sulla richiesta FTP. Essendoci diversi utenti per lo stesso computer 10.10.10.103, probabilmente il computer è di Michele ma per accedere ad alcune risorse serve l’utente Antonio (che forse è un Amministratore). O più semplicemente il dispositivo potrebbe essere utilizzato da diversi utenti.
  6. Ecco che, infine, utilizzando il tool di cracking “Jhon The Ripper”, con la sua wordlist di default, in zero secondi l’attaccante riesce a craccare l’HASH della password dell’Administrator che come si vede nella foto in basso è “batman”. Capiamo benissimo come gli HASH di password semplici vengano individuate in pochissimo tempo. E quindi quanto importante sia disporre di password robuste.

HASH inviolabili – MultiRelay-py

E se l’HASH ottenuto non fosse così facilmente violabile? Se l’azienda target usasse password lunghe 18 caratteri sarebbe davvero arduo decifrarne l’HASH. L’attaccante allora si dovrà arrendere? No! Perché gli HASH NTLM possono essere usati direttamente, anche senza ottenere la password in chiaro, in quelli che vengono definiti attacchi di tipo “Pass-the-Hash” utilizzando vari strumenti. Tra questi, uno è presente nella stessa suite di Responder, e si chiama “MultiRelay.py” il quale, proprio utilizzando gli HASH NTLM cercherà di autenticarsi, attraverso il protocollo SMB, su un sistema che condivida lo stesso utente e le stesse credenziali. È importante però sapere che:

  • L’HASH da utilizzare dovrà essere di un utente che abbia privilegi di Amministratore sul sistema da violare.
  • MultiRelay non potrà inoltrare l’autenticazione NTLMv1/2 alla stessa macchina da cui proviene l’HASH (e questo a seguito della correzione, da parte di Microsoft, della vulnerabilità MS08-068);
  • MultiRelay non potrà utilizzare gli HASH raccolti e archiviati durante l’attività di Responder, ma dovrà inoltrare solo richieste di autenticazione NTLM in tempo reale. Significa che MultiRelay dovrà essere utilizzato in contemporanea a Responder. Per tale motivo bisogna apportare una modifica al file di configurazione di questo, nel file che si chiama conf. e che si trova nella stessa directory di Responder.py. Occorre disabilitare i protocolli HTTP e SMB come si vede nell’immagine in basso. Questo perché vorranno entrambi utilizzare le porte 80/tcp e 445/tcp e invece vogliamo che sia MultiRelay ad utilizzarle ora. Nel file di configurazione si vede anche qual è il database del tool, ovvero il file Responder.db, contenuto nella stessa cartella.
    Poiché Responder non indica più a video gli HASH degli utenti che ha già raccolto basterà cancellare proprio questo file database affinché il programma riprenda a farci vedere l’HASH dell’utente mentre lo raccoglie creando un nuovo file Responder.db.
  • Prima di poter eseguire l’attacco il criminale deve accertarsi che i dispositivi che vuole attaccare non abbiano abilitata la funzione di sicurezza del protocollo SMB chiamata “SMB Signing”. Non devono cioè richiedere la firma SMB. Di default tale funzione di sicurezza è disabilitata nei client mentre è obbligatoria per i Controller di Dominio. Garantisce al destinatario l’autenticità del mittente dei pacchetti. È una sorta di firma digitale del pacchetto. Ecco che in presenza di tale meccanismo attacchi di tipo Man In The Middle, come quelli di cui stiamo parlando, non potrebbero avvenire.
    L’attaccante per verificare la presenza o meno di questo meccanismo lancia su tutta la rete un altro strumento presente nella cartella “/Responder/tools”, chiamato RunFinger.py. Non ha intenzione di sprecare tempo con obiettivi che hanno SMB Signing abilitato ma solo con quelli che hanno SMB signing impostato a “False”. Ecco che individua la macchina 10.10.10.106 (W7) che fortunatamente ha la funzione disabilitata! Qualunque dispositivo, e quindi anche quello dell’attaccante, potrà autenticarsi via SMB con tale sistema, passando le credenziali (o l’HASH) giusto! Invece la 10.10.10.103 (W7) ha il SMB signing a “True” e quindi non andrebbe bene, mentre la 10.10.10.105 (W10) non compare.

L’attacco – SMB Relay

Al criminale non rimane altra che avviare sia Responder che MultiRelay indicando, a quest’ultimo, che la macchina da compromettere è la 10.10.10.106 come vediamo nella foto in basso. Quello che avverrà è che gli HASH NTLMv2 raccolti da Responder, verranno passati direttamente a MultiRelay il quale li utilizzerà per autenticarsi alla macchina target attraverso un attacco definito SMB Relay.

N.B. Nelle versioni più datate di Kali Linux (di sicuro nella 2019.2) MultiRelay funziona. Nelle versioni recenti di Kali (2020.4) il tool non funziona per mancanza della libreria “Crypto” che dal repository ufficiale di Kali non si riesce a scaricare. Una soluzione funzionante (ma non ne ho provate altre) è quella di scaricare dal servizio ftp di debian.org, ed installare, il pacchetto “python-crypto_2.6.1.9…deb” più appropriato per il proprio sistema.

Il parametro (-t) indica a MultiRelay il target e il (-u ALL) che stiamo inoltrando tutte le richieste di autenticazione NTLMv1/v2 di tutti gli utenti. Potrebbe pertanto capitare un utente che non hai i privilegi elevati sul sistema e quindi l’attacco non riuscirebbe. In questo caso il tool impedirà ulteriori tentativi da parte dello stesso utente, in modo da evitare il blocco. Senza alcun altro parametro MultiRelay, in caso di attacco riuscito, farà ottenere una shell sulla macchina target, come nell’esempio che seguirà. È però, questa, la funzione più intrusiva e non è detto che sia sempre quella voluta dall’attaccante. Aggiungendo ad esempio il parametro (-d), invece, MultiRelay farà solo il dump degli HASH delle password locali, che rappresenta al contrario l’opzione meno intrusiva.

Dopo un po’ di tempo, Responder intercetta le credenziali dell’Administrator, e le passa a MultiRelay, il quale consente all’attaccante di autenticarsi sulla macchina target. A questo punto il criminale si trova nel file system del sistema 10.10.10.106 come Amministratore locale e potrà pertanto disporre completamente di esso.

Potrà fare il dump degli hash delle password locali, eseguire il pivot (saltare) su altri dispositivi della rete, installare malware, cifrare i dati, utilizzare il comando “reg save” per tentare di recuperare le eventuali password di dominio salvate in cache, e molto altro. Come vediamo nell’immagine in basso, ottenuta la shell il criminale digita i comandi hostname e poi ipconfig (magari scopriva una seconda scheda di rete).

Nel marzo del 2017 sono state integrate a MultiRelay le funzionalità di Mimikatz, l’eccezionale e potente tool opensource per il recupero delle credenziali di Windows e molte altre informazioni sulle stesse. Da una shell ottenuta con MultiRelay possiamo richiamare Mimikatz con il semplice comando “mimi” o “mimi32” se Host a 32 bit. Nella foto che segue vediamo uno dei Tweet sull’account ufficiale di Responder che informano dell’integrazione.

Altre utili funzionalità che sono state integrate in MultiRelay includono uno scanner SMB molto veloce che può essere utilizzato una volta che si ha una shell sull’Host compromesso, per trovare altri potenziali bersagli all’interno della rete e la possibilità di generare ed utilizzare la shell privilegiata preferita da criminali e pentester, ovvero Meterpreter.

PREVENIRE QUESTO ATTACCO

Abbiamo visto come abusando di alcuni servizi di Windows e con un paio di strumenti gratuiti disponibili online un eventuale attaccante, presente in una rete aziendale, potrebbe sniffare con semplicità le credenziali degli utenti. E come potrebbe utilizzarle per prendere il controllo di eventuali computer o passare da utente senza alcun privilegio ad Amministratore di Dominio in pochi minuti. Come possiamo prevenire tutto ciò?

Prevenire l’attacco LLMNR NBT-NS è abbastanza semplice. In primis è fondamentale capire ed accertarsi di avere la vulnerabilità e quanto questa sia estesa con regolari attività di penetration testing. In secondo luogo occorre disabilitare sia LLMNR sia NetBIOS Name Service. Disabilitando solo LLMNR windows eseguirà il failover su NetBIOS per la risoluzione dei nomi. Inoltre occorre impostare la sicurezza del protocollo SMB. Quanto seguirà è a livello generale, ma attenzione alle specificità di ogni rete, non per tutte le reti possono andar bene tali consigli. È sempre bene considerare vantaggi e potenziali svantaggi che derivano dal cambio di impostazioni sui sistemi e sui protocolli.

Disabilitare il protocollo LLMNR

È possibile disabilitare il protocollo LLMNR attraverso le Group Policy (GPO).

Aprendo “l’Editor Criteri di Gruppo Locali (gpedit.msc)” -> “Local Computer Policy” -> “Computer Configuration” -> “Administrative Templates” -> “Network” -> “DNS Client” e impostando a “Enabled” le impostazioni “Turn off Multicast Name Resolution”, come nell’immagine in basso.

Disabilitare il protocollo NTB-NS

N.B: Se nella rete esistono computer che eseguono sistemi operativi precedenti a Windows 2000, il protocollo NBT-NS non dovrebbe essere disabilitato in quanto in tali sistemi i nomi NetBIOS erano necessari per individuare le risorse di rete non supportando completamente il Domain Name System (DNS), supportato invece da Windows 2000 in poi. (https://technet.microsoft.com/en-us/library/cc728457(v=ws.10).aspx) .

In ogni caso disporre di sistemi antecedenti a Windows 2000 espone a ben altri gravi rischi.

  • Vediamo un primo procedimento per disabilitare NetBIOS su uno specifico Host.
    “Control Panel” -> “Network Connection / Network and Sharing Center” -> “Network Connection properties” -> “Internet Protocol Version 4 (TCP/IPv4)” -> “Properties” -> “Advanced” -> “WINS” -> selezionare “Disable NetBIOS over TCP”.

  • È possibile poi disabilitare NetBIOS sui client di dominio che ottengono indirizzi IP da un server DHCP
    Aprire “dhcpmgmt.msc”, connettersi al server DHCP e selezionare “Scope Option zone settings” (o “server – Server Options”) quindi selezionare “Advanced” poi “Microsoft Windows 2000 Options” dal menu a tendina Vendor Class:” e infine abilitare “001 Microsoft Disable Netbios Option” impostando il valore 0x2.
    Per dettagli è possibile consultare il documento Microsoft.
  • Attraverso le GPO non c’è un sistema per disabilitare NetBIOS.
    Però è possibile utilizzare le GPO per fare il deploy sui client di uno script Powershell che lo faccia all’avvio delle macchine.
    Creare il seguente script Powershell chiamandolo, ad esempio “NoNTBNS.ps1”
    $regkey = “HKLM:SYSTEM\CurrentControlSet\services\NetBT\Parameters\Interfaces”
    Get-ChildItem $regkey |foreach { Set-ItemProperty -Path “$regkey\$($_.pschildname)” -Name NetbiosOptions -Value 2 -Verbose}Quindi aprire l’editor dei Criteri di Gruppo (gpedit.msc) e mettere lo script NoNTBNS.ps1 in “Computer Configuration” -> “Windows Settings” -> “Scripts (Startup/Shutdown)” -> “Startup”.

Abilitare “SMB Signing”

Con la configurazione che di seguito illustrerò si forzeranno tutte le connessioni dei sistemi ad utilizzare la firma SMB indipendentemente dal fatto che stiano agendo come server o come client.

Va però considerato che se la firma fosse abilitata e richiesta su un server e disabilitata sul client, o viceversa, la connessione fallirà e le macchine non saranno in grado di comunicare tramite SMB.

Pertanto se si applicheranno tali impostazioni è importante farlo in modo uniforme tramite GPO su tutte le macchine della propria rete, senza dimenticare però quelle fuori dominio che vanno configurate manualmente. Inoltre alcune stampanti non supportano la firma SMB, determinando l’impossibilità di stampare.

Tengo a sottolineare che i Vulnerability Scanner evidenziano la mancata firma SMB come vulnerabilità. E del resto come abbiamo visto è una situazione molto pericolosa, che se da un lato può sfuggire agli Amministratori di Rete., viene invece monitorata da eventuali criminali. Voglio ricordare che Microsoft ha introdotto questo meccanismo di protezione da Windows 98! Però come sappiamo, è abilitato di default solo sui controller di dominio. Vediamo come abilitare “SMB Signing” attraverso le Group Policy anche ai sistemi che non sono controller di dominio.

gpedit.msc -> “Computer Configuration” -> “Windows Settings” -> “Security Settings” -> “Local Policies”  -> “Security Options” e quindi abilitare “Microsoft network client: Digitally sign communications (always)” e “Microsoft network server: Digitally sign communications (always)” come nell’immagine che segue. Notiamo l’alert che compare all’abilitazione della protezione (Q823659). Se non applichiamo queste impostazioni a tutti i sistemi potremmo non riuscire a comunicare.

E i sistemi Linux e Apple? – Multicast DNS (mDNS)

Desidero chiudere facendo un cenno ai sistemi che non sono Windows.

Questi, soffrono della stessa vulnerabilità? Certo!

I client Apple e Linux utilizzano un protocollo simile a LLMNR e NTB-NS chiamato “multicast DNS o mDNS” sorto nei primi anni 2000 e regolato dalla RFC6762. Quando un client mDNS deve risolvere un nome Host, invia un messaggio di query multicast IP sulla porta di destinazione 5353/tcp che chiede all’Host che ha quel nome di identificarsi. La macchina di destinazione invia quindi un messaggio multicast che include il suo indirizzo IP. Tutte le macchine in quella sottorete possono quindi utilizzare tali informazioni per aggiornare le proprie cache mDNS. mDNS è implementato da Apple Bonjour e dai pacchetti software open source Avahi, inclusi nella maggior parte delle distribuzioni Linux.

Per il protocollo mDNS possono esistere due client con lo stesso nome. Pertanto a fronte di una query multicast di ricerca di una risorsa, vincerà il primo che invierà la risposta dicendo di essere la risorsa cercata. Ma il funzionamento sarebbe lo stesso se la risorsa proprio non esistesse, vincerebbe chi si presenta come tale, mancando qualsiasi forma di autenticazione. Quindi, ad esempio, se un’applicazione deve stampare sulla stampante epson.local, un attaccante potrebbe inviare una risposta alla query DNS con una risposta contraffatta che indica di stampare su un indirizzo IP diverso. Ma ovviamente si può far redirigere qualsiasi cosa, e pertanto anche le credenziali degli utenti.

La cosa interessante? Che Responder supporta anche il protocollo mDNS!

Si parla di Multicast DNS, però, per lo più per attacchi subiti su servizi mDNS esposti ad internet. Interrogando tale servizio in modo appropriato un criminale può ottenere il MAC Address della macchina ma anche la lista dei servizi in esecuzione. Inoltre, siccome mDNS si basa su query UDP, è possibile per un attaccante creare un attacco DoS/DDoS verso un obiettivo se cambia (spoofing) il suo indirizzo IP di destinazione dei pacchetti (Alert US-Cert TA14-017A).

Articolo a cura di Antonio Sagliocca

Red Team Manager, certificato “Ethical Hacker Master” e “Penetration Tester Professional”, ha una grande passione ed esperienza nella Sicurezza Informatica e la fortuna di lavorare in tale ambito.

Socio CLUSIT scrive su alcune riviste online ed è relatore a eventi pubblici di sensibilizzazione sulla sicurezza in Internet oltre a formatore nelle aziende. Dal 2016 collabora con le Cattedre di “Informatica Giuridica” e “Informatica Giuridica Avanzata” dell’Università degli Studi di Milano.

Per la rivista Internazionale “Ciberspazio e Diritto” vol. 18 n.57 (1-2017) edito da STEM Mucchi Editore, ha scritto la pubblicazione “Open Source Intelligence e Deep Web: scenari moderni delle Investigazioni Digitali”.

Ha scritto i capitoli “Le minacce più comuni: difendersi da malware e da altri attacchi” e “La protezione dalle frodi, dal phishing e dalle estorsioni online” di alcuni volumi per studenti universitari a cura di Giovanni Ziccardi e Pierluigi Perri pubblicati nel 2017 e 2019 ed editi da Giuffrè Editore.

https://www.ictsecuritymagazine.com/articoli/attacco-alle-credenziali-degli-utenti-della-lan-llmnr-e-nbt-ns-poisoning-con-responder-e-multirelay/