Social Media Intelligence e tracciamento individuale – quando gli smartphone offline “sparlano” di te

Lo straordinario e drammatico periodo che stiamo vivendo – e nel quale mi accingo a scrivere questo articolo – è dominato da un indiscusso sentimento di incertezza, che spazia dalla paura per la malattia provocata dal COVID-19 a quella economica provocata dai lockdown. Eppure rimangono evidenti, soprattutto su internet, paure di altra natura, spesso frutto di sospetti infondati dovuti alla non conoscenza dell’argomento o del quadro generale delle cose e che comunemente chiamiamo complotti; tra questi c’è né uno che periodicamente ritorna più o meno incalzante, quello del “grande fratello”. Negli ultimi mesi lo spettro del “grande fratello” ha preso la forma delle app anti pandemia, per il tracciamento della prossimità fra le persone, sospettate di tracciare le nostre relazioni e le nostre attività quotidiane; e così ad un tratto il contact tracing sembra diventato lo strumento principe per il controllo delle masse.

In realtà ogni giorno i nostri dispositivi mobili, come gli smartphone, ci espongono a innumerevoli potenziali minacce per la privacy che per alcuni versi, oltre ad essere minacce reali, possono addirittura considerarsi più pericolosi del complottistico contact tracing.

Ne è un esempio il problema del Wi-Fi Location Tracking di cui negli ultimi anni si è spesso parlato, ovvero del tracciamento della posizione di un dispositivo tramite le reti WiFi. Quando ci connettiamo a reti WiFi con il nostro dispositivo attraverso un access point, uno dei parametri principali che viene comunicato alla rete WiFi è il MAC (Media Access Control) Address, un codice univoco di 48 bit che identifica la scheda di rete wireless del nostro dispositivo. Tramite questo codice è possibile rintracciare un dispositivo nei vari spostamenti che compie all’interno dell’area coperta dalla rete WiFi.

Se ad esempio immaginiamo di connettere il nostro smartphone alla rete WiFi free di un centro commerciale, una volta connessi, quando ci spostiamo all’interno del complesso il nostro smartphone si aggancerà di volta in volta ai vari access point presenti all’interno del perimetro, necessari per garantire una uniforme e adeguata copertura della rete WiFi in tutto il complesso. Conoscendo l’ubicazione dei vari access point è possibile quindi sapere con buona approssimazione in che punto del centro commerciale il nostro dispositivo è presente, riscostruire il percorso che abbiamo effettuato all’interno del complesso e quanto tempo siamo rimasti fermi in un determinato posto. Se poi il gestore di quella rete WiFi controlla altre reti di altri centri commerciali potremmo essere tracciati anche successivamente in altri complessi e la correlazione tra questi dati potrebbe essere utilizzata per statistiche di marketing, ad esempio, quanto tempo siamo rimasti davanti la vetrina di un particolare negozio. Se a questo aggiungete il fatto che generalmente la prima volta che si accede ad una rete WiFi free viene richiesta una registrazione dove nel migliore dei casi si deve inserire un indirizzo email, allora capite che si viene a configurare l’ipotesi di profilazione dell’utente.

Quindi nei casi in cui non si desidera esporsi al rischio di un tracciamento di questo tipo è sufficiente non collegarsi a reti WiFi free; fortunatamente le offerte degli operatori telefonici oggigiorno sono sempre più ricche di giga, e per le normali attività di comunicazioni via instant messaging e social non è più necessario connettersi a questo tipo di reti WiFi quando si è fuori… quindi, tutto risolto? Non proprio.

Quando un dispositivo mobile (smartphone, tablet, etc.) ha la scheda WiFi attiva ma non è connesso a una rete wireless (anche se dispone di una connessione dati tramite SIM telefonica), tenta periodicamente di connettersi alla più vicina rete WiFi. In questa ricerca il dispositivo mobile invia delle richieste di connessione (Probe Requests) e all’interno della richiesta è presente il MAC Address della sua scheda di rete wireless. Un access point WiFi potrebbe, a questo punto, registrare tali chiamate e anche senza attivare nessuna connessione di rete sarebbe in grado di rilevare la posizione di quel dispositivo.

Questa possibilità di tracciamento, che di fatto crea un serio problema di privacy, ha indotto i principali leader di mercato – Apple con il suo sistema operativo iOS, Google con Android e infine Microsoft con Windows – a inserire una contromisura per rendere la richiesta di connessione più anonima possibile, attraverso una tecnica denominata MAC Address Randomization.

La Mac Address Randomization permette al dispositivo di utilizzare indirizzi MAC casuali durante la ricerca di nuove reti, quando ancora non è associato ad una di esse. La randomizzazione dei MAC Address impedisce quindi ad eventuali ascoltatori di utilizzare gli indirizzi MAC per creare una cronologia dell’attività del dispositivo. Nelle ultimissime versioni dei sistemi operativi (iOS 14, Android 10+, etc.) la randomizzazione dei MAC avverrà non solo durante la fase di scoperta della rete, ma anche durante la fase associativa e sarà implementata su qualsiasi tipo di connessione.
Questo, per inciso, se da una parte aumenta il livello di privacy, dall’altra può creare problemi di sicurezza negli accessi alle reti: ad esempio annulla qualsiasi attuale controllo di autenticazione alle reti attraverso il riconoscimento del MAC Address.

È possibile identificare gli indirizzi MAC casuali, generati con questa tecnica, analizzando un bit che viene impostato nel MAC Address e che indica appunto che quel MAC è randomizzato. Molto semplicemente, senza entrare nei dettagli tecnici, basta guardare il secondo carattere di un indirizzo MAC: se è un 2, 6, A o E, è un indirizzo casuale (Fig.1).
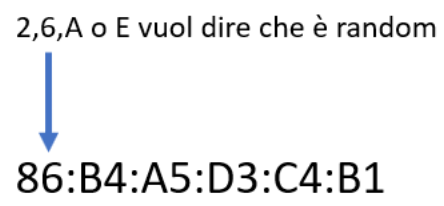
Fig.1

Sicuramente questo è un metodo efficace per risolvere il problema dell’identificazione univoca del dispositivo tramite MAC, ma possiamo considerare definitivamente chiuso l’argomento dei dispositivi mobili “chiacchieroni” anche se non connessi? Decisamente no.

Esiste un’altra forma di Wi-Fi Location Tracking che parte da un principio diverso, basato sulla “memoria” che il dispositivo mobile ha delle reti WiFi familiari a cui cioè è stato connesso e a cui, in caso di assenza di connessione, cerca di ricollegarsi.

In questo particolare stato – che in gergo viene definito “orfano” – il dispositivo, oltre a effettuare scansioni periodiche per trovare nuove reti WiFi, effettua delle chiamate a reti già note nella speranza di potersi riconnettere; ma mentre quando il dispositivo cerca nuove reti WiFi effettua delle chiamate broadcast generiche, quando ricerca reti note, familiari, inserisce nelle chiamate il nome SSID della rete conosciuta.

La sigla inglese SSID sta per Service Set IDentifier e altro non è che il nome della rete WiFi, quello che ci appare generalmente visualizzato nella lista delle reti wireless disponibili sul nostro dispositivo mobile. Il risultato è che un ascoltatore potrebbe ottenere una lista completa di tutti i nomi delle WiFi a cui quel dispositivo si è collegato in passato. Questo vero e proprio Data Leak di SSID, fatto dai dispositivi mobili, potrebbe essere utilizzato da un cracker ostile per effettuare un attacco man‐in‐the‐middle (MITM), predisponendo ad es. un access point in grado impersonare reti con i nomi SSID acquisiti e fingersi una di esse, in modo da interporsi tra il dispositivo mobile e internet, catturando così il traffico passante (Fig. 2 ), come già spiegato in un mio precedente articolo.
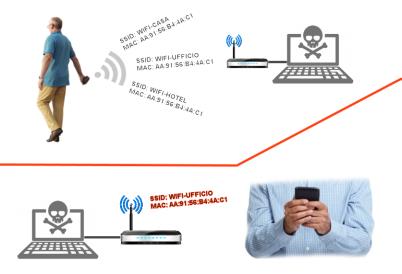
Fig. 2

Questo attacco però prevede che il dispositivo-vittima rimanga nel raggio del falso access point per diverso tempo; inoltre, se l’utente utilizza poi il dispositivo mentre è connesso alla falsa rete, non dovrebbe sospettare nulla, il che potrebbe essere complicato in quanto il nome dell’SSID utilizzato potrebbe appartenere alla rete di casa dell’utente e questi – trovandosi magari in un parco – mangerebbe la foglia.

Se invece il nostro ostile volesse utilizzare gli SSID catturati per effettuare un’attività investigativa di social media intelligence nei confronti della sua vittima, allora la cosa risulterebbe più facile dal punto di vista operativo e forse anche più produttiva dal punto di vista dei risultati. L’ostile potrebbe infatti utilizzare sempre una scheda di rete WiFi configurata in modo promiscuo, cioè in grado di catturare qualsiasi pacchetto trasmesso da dispositivi wireless della sua categoria, connessa a un microcomputer alimentato da una batteria, rendendolo così facilmente trasportabile e invisibile.

I risvolti di questa tipologia di attività possono essere davvero molti e i risultati che si possono ottenere, per alcuni aspetti, veramente inquietanti. Ma per descrivere meglio il funzionamento di questa tecnica e quali risultati si possono ottenere, non rimane che fare un esempio reale, simulando un ostile che la utilizza per effettuare attività di intelligence.

Premesso che spiare le trasmissioni dei dispositivi altrui è vietato dalla legge, va ricordato che questa dimostrazione ha scopo didattico e se volete replicare l’esperimento fatelo solamente con dispositivi di vostra proprietà.

Per questa dimostrazione utilizzeremo una scheda di rete WiFi che possa essere configurata in modalità “promiscua”: ne esistono vari modelli e tipologie, in questo caso ho scelto un modello USB della Alfa Network a lungo raggio (Fig. 3)
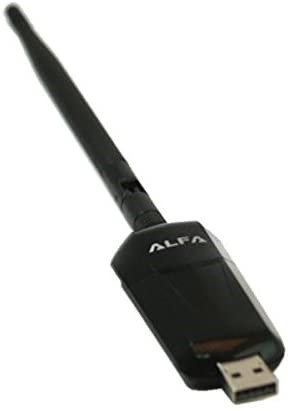
Fig. 3

Come microcomputer a cui collegare la scheda per la dimostrazione, ho scelto un dispositivo pensato per sviluppare prototipi IoT con un consumo energetico basso e con dimensioni estremamente ridotte, in modo che possa essere più facilmente trasportato, un Orange PI Zero (Fig. 4), dotato di un processore Arm, porta USB, scheda di rete WiFi integrata (che non utilizzeremo), porta ethernet e come sistema operativo una versione personalizzata di Linux Debian (Armbian).
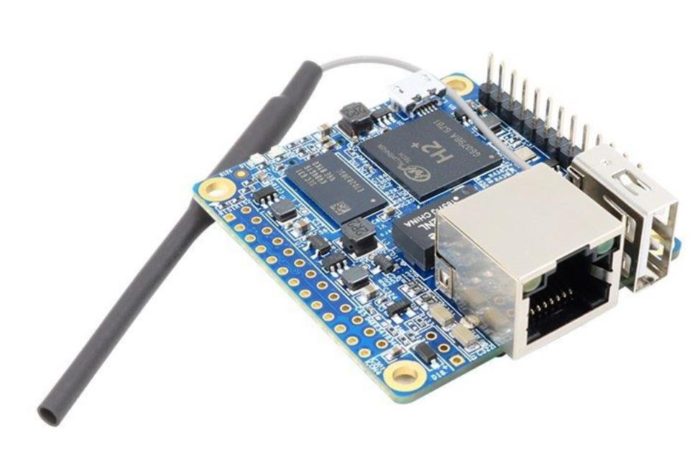
Fig. 4

Installato il sistema operativo e configurata la scheda WiFi usb, è possibile collegare il tutto a un alimentatore portatile, come ad es. una power bank, per renderlo trasportabile e poco ingombrante.
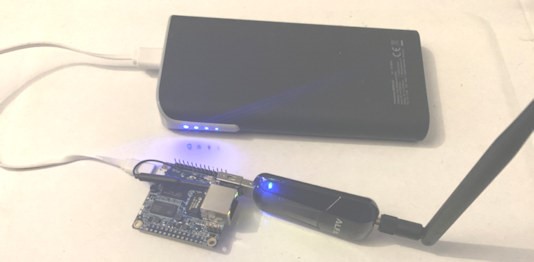
Fig. 5

Per collegarci al dispositivo e configurare il tutto utilizzeremo la porta ethernet e ci collegheremo in console attraverso il servizio SSH, attivo di default su questa versione di sistema operativo.

Una volta connessi e verificato che il PI Zero vede correttamente la scheda WiFi USB, installeremo il programma wireshark, uno sniffer di rete e lo utilizzeremo nella sua versione da terminale: tshark..
Il comando per l’installazione è:

apt install tshark

Digiteremo poi i seguenti comandi, per configurare le corrette autorizzazioni al programma:

usermod -a -G wireshark ${USER:-root}
dpkg-reconfigure wireshark-common
newgrp wireshark

Terminata la configurazione, siamo pronti per la “caccia”.
Dal terminale digiteremo il comando tshark con i parametri necessari per leggere solo i pacchetti di Probe Request.
Di seguito la descrizione dei parametri principali (Fig.6):
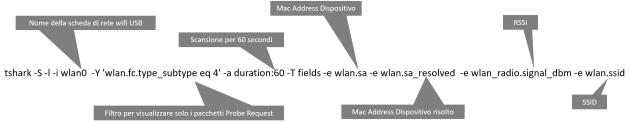
Fig. 6

Una volta eseguito il comando, lo sniffer inizierà a catturare i pacchetti (Fig. 7):
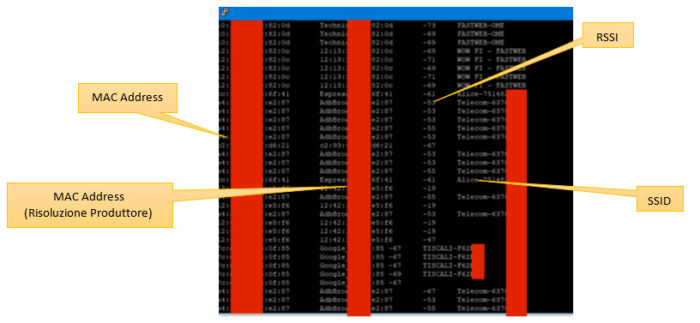
Fig. 7

Tra i dati da catturare oltre al MAC Address ed al nome SSID abbiamo inserito un altro campo interessante: l’RSSI. L’RSSI è l’acronimo di “Received Signal Strength Indicator” (indicatore della potenza del segnale ricevuto) ed è una misura stimata della qualità di ricezione del segnale di un dispositivo remoto da parte di un punto di accesso, come ad esempio un access point. L’RSSI aiuta a determinare se un segnale è sufficiente per stabilire una connessione wireless, maggiore è il suo valore, più vicino si trova il dispositivo che trasmette. Questo parametro ci permette quindi di effettuare un’analisi approssimativa della distanza dal dispositivo-vittima (Fig.8).
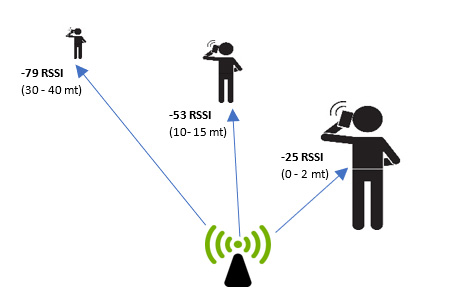
Fig. 8

Siccome la misurazione dell’RSSI è stimata e può variare da antenna ad antenna, per avere una conversione della potenza del segnale in distanza approssimativa è necessario fare prima dei test di taratura.

Il campo wlan.sa_resolved invece ci indicherà il nome del produttore del dispositivo (dove possibile e dove non sia attivo un algoritmo di mac-address randomization), attraverso la decodifica dell’indirizzo MAC, dove i primi tre ottetti identificano l’organizzazione o comunque l’azienda che ha realizzato l’interfaccia di comunicazione.

Esaminando i risultati del nostro test (Fig.9) osserviamo 5 dispositivi:

  • un Dispositivo Apple connesso alla rete WiFi con SSID Telecom-6370***** con un RSSI costante di -65;
  • un Dispositivo “orfano” Samsung che trasmette delle Probe Request (nessun SSID) con un RSSI costante di -23;
  • un Dispositivo “orfano” Google che trasmette delle Probe Request (nessun SSID) con un RSSI costante di -50;
  • un Dispositivo AirgoNet connesso alla rete WiFi con SSID Alice-7514**** con un RSSI costante di -79;
  • un Dispositivo “orfano” che utilizza il mac address anonimization (12:42:17:a8:e5:f6) con un RSSI costante di -42.
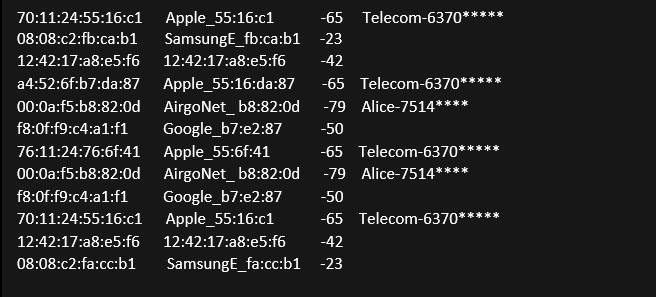
Fig. 9

Il valore costante dell’RSSI dimostra che i dispositivi non sono in movimento; nel caso specifico l’ostile è interessato al dispositivo Samsung e cerca di avvicinarsi il più possibile al dispositivo (e alla sua vittima) fino a che dal valore dell’RSSI non risulti quello più vicino a lui e, poiché il dispositivo è in modalità orfano, rimane in attesa di acquisire eventuali Probe Request a reti familiari.

Dopo qualche minuto il dispositivo trasmette una sequenza di Probe Request delle reti conosciute (Fig.10)
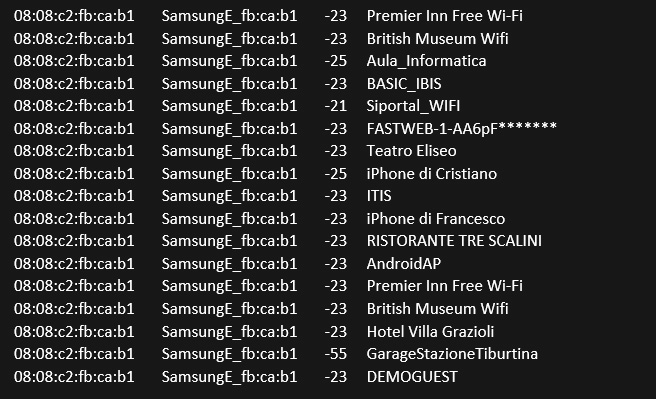
Fig.10

Una volta ottenuta la lista delle reti, l’ostile si concentra nell’individuare SSID con “nomi parlanti”, cioè con nomi non troppo generici che possono identificare in maniera abbastanza precisa luoghi e posti in cui la vittima possa essersi collegata.

Dall’analisi vengono individuate 5 SSID:

  • British Museum WiFi
  • Teatro Eliseo
  • RISTORANTE TRE SCALINI
  • Hotel Villa Grazioli
  • GarageStazioneTiburtina
  • FASTWEB-1-AA6pF*******

A questo punto l’ostile deve verificare l’ubicazione delle reti WiFi associate all’SSID. Per questo esiste un sito (www.wigle.net), frutto di un progetto open source, che archivia le informazioni delle varie reti WiFi visibili in tutto il mondo grazie al contributo degli utenti. Attraverso un’app (attualmente disponibile solo sullo store Android) permette a chiunque di alimentare l’archivio di questo sito in maniera semplice e automatica: in pratica ogni utente, con il suo smartphone, diventa uno sniffer mobile che in base al luogo in cui si trova registra la presenza delle reti WiFi visibili e invia al sito wigle.net una serie di informazioni come ad es. nome SSID, tipo di cifratura della WiFi, indirizzo della localizzazione, etc.

Grazie a questo sito è quindi possibile effettuare delle ricerche testuali con il suo motore di ricerca per individuare l’ubicazione delle reti WiFi di cui conosciamo l’SSID. L’accesso al sito è molto semplice: una volta connessi a www.wiglet.it è sufficiente registrarsi e andare nel menu View selezionando una modalità di ricerca. Nel nostro caso selezioniamo la modalità avanzata ed effettuiamo la ricerca inserendo il nome della prima SSID: British Museum WiFi (Fig.11)
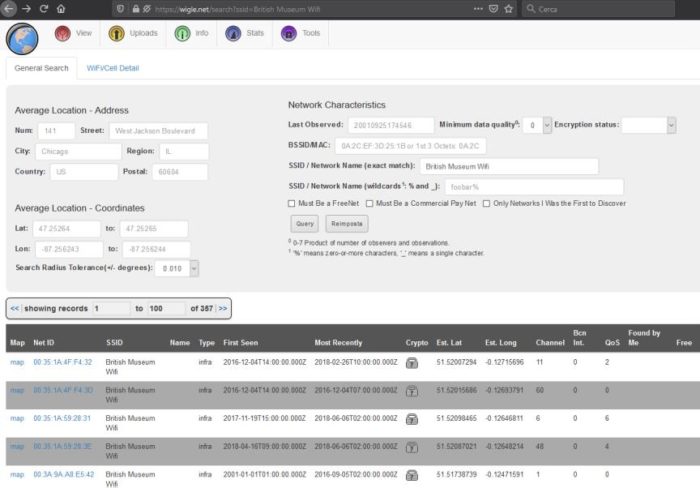
Fig. 11

Il risultato della ricerca è il nome SSID associato a moltissimi access point con diversi MAC Address e questo è corretto, in questo caso, considerando che parliamo del British Museum, il museo più grande del mondo, con una superficie di circa 92 mila metri quadrati e che quindi, per la copertura WiFi, necessita dell’utilizzo di centinaia di access point. Per ogni record di risultato possiamo poi visualizzare la mappa e il luogo dove l’SSID è stato rilevato (Fig.12).
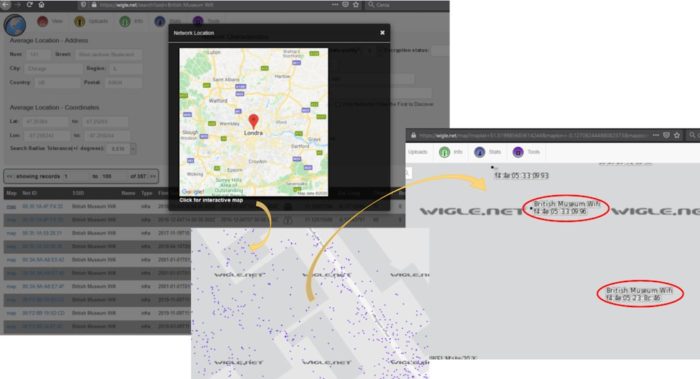
Fig. 12

Effettuando la ricerca sulle altre SSID otteniamo la mappa di tutte le posizioni dove quel dispositivo si è connesso Fig.13 .
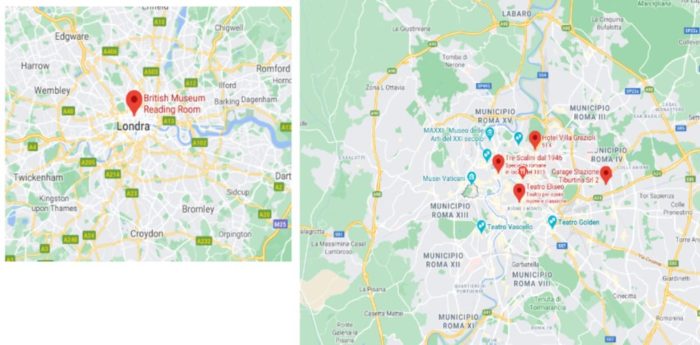
Fig.13

Questa prima attività di intelligence rileva che il dispositivo ha una forte correlazione con la città di Roma e che le SSID di hotel, garage, teatri e ristoranti, permettono già di creare ipotesi sugli spostamenti e sui possibili comportamenti (ad es. è ipotizzabile che l’utente potrebbe essere andato a Roma per vedere uno spettacolo teatrale, aver soggiornato in hotel, pranzato al ristorante e lasciato l’automobile nel parcheggio custodito).

Ma si può andare oltre: se correliamo le ricerche fatte finora con ricerche svolte sui social network, possiamo addirittura provare a identificare il proprietario del dispositivo. Effettuando su Facebook la ricerca dei posti individuati, possiamo verificare se esistono utenti comuni che si sono registrati in quei luoghi o hanno lasciato commenti sulle loro pagine. Nel nostro esempio la ricerca ha rilevato la presenza di 3 correlazioni su 4, nelle pagine Facebook, dei luoghi individuati con un particolare utente (Fig.14) che nell’arco di 24 ore ha lasciato commenti e registrazioni (Fig.14), proprio su quelle pagine.
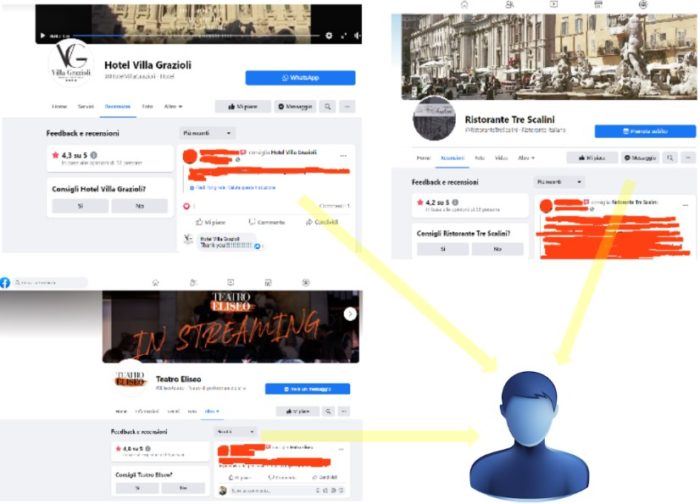
Fig.14

Ulteriori correlazioni vengono poi riscontrate sulle recensioni, in un diverso periodo temporale, relative al British Museum e considerando l’ultima SSID: FASTWEB-1-AA6pF******* tipico nome di una connessione privata di casa. Effettuando una ricerca su wigle.net si riesce a scoprire, con buona approssimazione, anche in quale zona probabilmente abita la vittima e che provider telefonico utilizza; ed ecco che ad un tratto senza neanche sfiorare il dispositivo della vittima l’ostile può acquisire, attraverso un’attività di intelligence su fonti OSINT (Open Source Intelligence) e SIGINT (SIGnals INTelligence) moltissime informazioni sulla vita e il comportamento della vittima.

In conclusione, non dobbiamo mai dimenticare che dispositivi mobili come i nostri smartphone sono diventati una nostra appendice e custodiscono oggi più informazioni personali e riservate su di noi che qualsiasi altro oggetto ci circondi. Conoscere bene questa “protesi” cibernetica non è così semplice come sembra ma può fare la differenza tra controllare la propria riservatezza o renderla disponibile al primo (cracker) che passa. Proprio per la loro natura così “simbiotica” con tutte le informazioni che ci riguardano, spesso gli smartphone involontariamente possono “sparlare” di noi anche quando pensiamo che siano offline; per cui, se avete timore di questo tipo di tracciamento individuale e avete un buon contratto di telefonia mobile con tanti “Giga”, allora vi conviene spegnere la scheda WiFi quando siete in giro.

Articolo a cura di Francesco Arruzzoli

Download PDF

https://www.ictsecuritymagazine.com/articoli/social-media-intelligence-e-tracciamento-individuale-quando-gli-smartphone-offline-sparlano-di-te/

Accesso, sicurezza informatica, tutela dei dati personali (e responsabilità)

La base giuridica

La disciplina comunitaria (Regolamento UE 679/2016, apparato normativo self executing) e quella nazionale (d.lgs. n. 196/2003) si curano di garantire la tutela dei dati personali, sotto una molteplicità di profili; per coloro che operano all’interno della Pubblica Amministrazione, particolare attenzione viene richiesta sin dal momento di stesura dell’atto (c.d. privacy by design) al fine di evitare una diffusione illecita, dovendo redigere i testi omettendo di inserire dati personali eccedenti o non pertinenti, in riferimento allo scopo[1], rispettando al contempo di accertare la base giuridica che legittima il trattamento, ex art. 6, par. 3, lettera b), del GDPR (General Data Protection Regulation), costituita esclusivamente da una norma primaria, ex art. 2 ter, comma 1 del Codice in materia di protezione dei dati personali.

I dati “particolari” e la loro diffusione

A rafforzare la tutela l’art. 7 bis, «Riutilizzo dei dati pubblicati», del d.lgs. n. 33/2013, dispone che gli obblighi di pubblicazione dei dati personali diversi dai dati “sensibili” e dai dati “giudiziari” (quelli previsti del 9 «Trattamento di categorie particolari di dati personali» e 10 «Trattamento dei dati personali relativi a condanne penali e reati» del GDPR), comportano la possibilità di una diffusione dei dati medesimi attraverso siti istituzionali[2], nonché il loro trattamento secondo modalità che ne consentono la indicizzazione e la rintracciabilità tramite i motori di ricerca web ed il loro riutilizzo, ai sensi dell’articolo 7, nel rispetto dei principi sul trattamento dei dati personali.

Su questo aspetto di “trasparenza”, secondo il modello FOIA (Freedom of Information Act) dei siti istituzionali, l’ANAC[3] se da una parte, ha rammentato che l’utilizzo di filtri o soluzioni similari che impediscono la ricercabilità e il riutilizzo delle informazioni, è contrario al perseguimento degli obiettivi generali della trasparenza amministrativa, invitando gli Organismi Indipendenti di Valutazione, in quanto soggetti competenti ad attestare l’avvenuta pubblicazione dei dati, al puntuale rispetto della normativa anche in materia di apertura dei dati e di indicizzazione delle pagine contenute nella sezione “Amministrazione trasparente”, dall’altra, ha segnalato, con un ragionamento a contrario, che gli obblighi di pubblicazione dei dati personali “sensibili e giudiziari” (ora definiti “particolari”) non possono essere diffusi indistintamente attraverso siti istituzionali, seguendo un trattamento ne impedisce la indicizzazione e la rintracciabilità tramite i motori di ricerca web e il loro riutilizzo.

Inoltre, al terzo comma del cit. art. 7 bis, viene precisato che la P.A. possa disporre la pubblicazione nel proprio sito istituzionale di dati, informazioni e documenti che non ha l’obbligo di pubblicare o sulla base di specifica previsione di legge o regolamento, nel rispetto dei limiti indicati dall’articolo 5 bis, «Esclusioni e limiti all’accesso civico» del decreto Trasparenza, «procedendo alla indicazione in forma anonima dei dati personali eventualmente presenti».

A completare il quadro normativo sull’accessibilità, nei termini sia del c.d. accesso “civico semplice” (ex art. 5, comma 1 del d.lgs. n. 33/2013, pubblicazioni obbligatorie) che “civico generalizzato” (ex art. 5, comma 2, del d.lgs. n. 33/2013, pubblicazioni ulteriori, ovvero dove non vi è un obbligo giuridico di pubblicare) il comma quattro dell’art. 7 bis impone a tutte le P.A. – nei casi di pubblicazioni obbligatorie – di «rendere non intelligibili i dati personali non pertinenti o, se sensibili o giudiziari, non indispensabili rispetto alle specifiche finalità di trasparenza della pubblicazione», confermando un obbligo di ridurre all’essenziale i dati da pubblicare.

I divieti di diffusione

Il divieto di pubblicazione (ostensibilità), presente nei successivi commi, se non nei casi previsti dalla legge, si estende:

  • alle «notizie concernenti la natura delle infermità e degli impedimenti personali o familiari che causino l’astensione dal lavoro, nonché le componenti della valutazione o le notizie concernenti il rapporto di lavoro tra il predetto dipendente e l’amministrazione, idonee a rivelare» i dati particolari (ex sensibili);
  • quelli previsti dall’articolo 24, «Esclusione dal diritto di accesso», commi 1 e 6, della legge 7 agosto 1990, n. 241;
  • i dati di cui all’articolo 9, «Disposizioni per la tutela del segreto statistico», del decreto legislativo 6 settembre 1989, n. 322;
  • quelli previsti dalla normativa europea in materia di tutela del segreto statistico;
  • quelli che siano espressamente qualificati come riservati dalla normativa nazionale ed europea in materia statistica;
  • quelli relativi alla diffusione dei dati idonei a rivelare lo stato di salute e la vita sessuale[4].

Il quadro di riferimento involge una serie di attività che vanno, in primis, dall’esigenza cogente di assumere una serie di misure sulla sicurezza dei dati, individuando le modalità di pubblicazione e i responsabili delle pubblicazioni, onere già previsto nel PNA 2019[5]; dall’altro (e non secondariamente) di apprestare delle soluzioni ICT (Information and Communication Technology) in grado di scongiurare la diffusione accidentale o illecita, la distruzione, la perdita, la modifica, la divulgazione non autorizzata o l’accesso ai dati personali trasmessi, conservati o comunque trattati (c.d. data breach), nonché accertare che le pubblicazioni (alias diffusione on line dei dati) permangano il tempo strettamente necessario definito dalla legge (c.d. diritto all’oblio)[6].

Giova rilevare che il danneggiato che lamenti la lesione dell’interesse non patrimoniale all’illecito trattamento dei dati personali può limitarsi a dimostrare l’esistenza del danno e del nesso di causalità rispetto al trattamento illecito, mentre spetta al danneggiante (titolare del trattamento), eventualmente in solido con il responsabile, dimostrare di aver adottato tutte le misure idonee per evitare il danno.

Tale schema è parzialmente confermato dall’art. 82 comma 3, del Regolamento UE 679/2016 che, sulla base del principio di responsabilizzazione (accountability) addossa al titolare del trattamento dei dati – eventualmente in solido con il responsabile – il rischio tipico d’impresa (ex art. 2050 c.c.): il pregiudizio non patrimoniale non è in re ipsa, ma deve essere allegato e provato da parte dell’attore, a pena di uno snaturamento delle funzioni della responsabilità aquiliana.

La posizione attorea è, tuttavia, agevolata dal regime più favorevole dell’onere della prova, descritto all’art. 2050 c.c., rispetto alla regola generale del danno aquiliano, nonché dalla possibilità di dimostrare il danno anche solo tramite presunzioni semplici e dal risarcimento secondo equità[7].

Il titolare del trattamento, per non incorrere in responsabilità, deve dimostrare che l’evento dannoso non gli è in alcun modo imputabile e non può limitarsi alla prova negativa di non aver violato le norme (e, quindi, di essersi conformato ai precetti), ma occorre la prova positiva di aver valutato autonomamente il rischio, purché tipico – cioè prevedibile – e attuato misure organizzative e di sicurezza tali da eliminare o ridurre il rischio connesso alla sua attività: l’accertamento del danno non patrimoniale è un accertamento di fatto, rimesso al giudice di merito e resta ancorato alla concretezza della vicenda materiale portata alla cognizione giudiziale e al suo essere maturata in un dato contesto temporale e sociale[8].

Serve, in parole diverse, dimostrare di aver adottato tutte le misure di sicurezza che la tecnica e “le regole d’arte” consentono, in relazione all’avanzamento dello sviluppo dell’ICT, dando concreta dimostrazione del costante monitoraggio delle più recenti misure.

I termini di pubblicazione

In questo senso, giova rammentare che la pubblicazione di dati personali oltre il tempo previsto dalla legge se può definirsi lecita per la durata ex lege, non può ritenersi consentita per un tempo eccedente i termini imposti dalla disposizione, in quanto gli eventuali dati personali (anche afferenti la vita privata, ad es. lo stato di famiglia o una domanda di rateizzazione) non possono ricondursi alle esigenze di trasparenza amministrativa con la permanenza on line, costituendo un illecito trattamento sanzionabile.

La scadenza dei termini di pubblicazione impone la rimozione degli atti (compresa l’indicizzazione) quando è presente un dato personale e vige una disciplina specifica sulla visibilità on line, differenziando le funzioni della trasparenza del d.lgs. n. 33/2013 rispetto agli altri provvedimenti oggetto di pubblicazione obbligatoria.

Il diritto all’obblio e la deindicizzazione comporta che “perdurante reperibilità” sul web di contenuti non corretti e inesatti presenta un impatto “sproporzionatamente negativo” sulla sfera privata del titolare del dato, in palese violazione con la disciplina di riferimento, specie in particolare proprio nel trattamento dei dati sulla “salute”[9] che è uno dei criteri principali da tenere in considerazione per un corretto bilanciamento tra diritto all’oblio e diritto/dovere all’informazione a causa del suo maggiore impatto sulla vita privata, rispetto ai dati personali “comuni”[10].

I dati riferiti alla salute non possono essere oggetto di diffusione e la loro ostensione mediante l’accesso civico generalizzato è esclusa, come ad es. la richiesta di conoscere i dati di distribuzione dei casi di COVID-19 registrati da una regione, suddivisi «per comune, sesso, età, esito (guariti, deceduti, casi attivi), domicilio (al proprio domicilio oppure casa di riposo/microcomunità/RSA), data delle diagnosi di infezione, numero ed esiti dei tamponi eseguiti per paziente», nonché concernenti «numero, distribuzione per comune e data dei contatti telefonici della Centrale a ciò deputata con le persone prese in carico per infezione da COVID-19»: i dati aggregati sono ammissibili mentre i dati personali puntuali suddivisi «per ogni comune» presentano un elevato potenziale di pregiudizio che «il disvelamento di alcune delle informazioni richieste (ad esempio, il domicilio o la data di insorgenza della malattia) potrebbe arrecare alla protezione dei dati personali, appartenenti, per loro natura, alla categoria dei dati particolari, in ragione dell’esiguità demografica che caratterizza molti Comuni…, tale da consentire la verosimile identificazione dei soggetti colpiti dal virus», donde, ne è preclusa la diffusione[11].

In generale, si può anche affermare che la diffusione di dati personali – in presenza di una popolazione o campione limitato – ben può, mediante il loro incrocio con informazioni verbali facilmente acquisibili, almeno in taluni casi, far risalire all’identità dei soggetti coinvolti e, conseguentemente, al loro stato di salute (anche le iniziali dei nomi sono insufficienti per garantire l’anonimato)[12].

L’omessa rimozione dei dati oltre i termini leciti di pubblicazione

In termini diversi, l’omessa rimozione dall’albo pretorio on line, ma anche dalla home page di un sito istituzionale, dei dati personali oltre i termini previsti da una norma di legge (c.d. base giuridica) costituisce una violazione alla disciplina sulla tutela dei dati personali che non è ammissibile, non potendo giustificare tale inadempimento dall’assenza di professionalità interne, né all’inerzia del tecnico esterno incaricato di configurare il sito internet dell’Amministrazione, ovvero dalla mancanza di adeguate misure di sicurezza informatica (software), atteso che il titolare del trattamento è la persona giuridica, non il legale rappresentante o l’amministratore, visto che la disciplina deroga al principio della imputabilità personale della sanzione, di cui alla legge n. 689/1981, configurando, nello specifico regime sanzionatorio ivi dettato, un’autonoma responsabilità della persona giuridica (la quale dovrà a sua volta verificare le singole responsabilità).

La responsabilità per la violazione delle norme di sicurezza dei dati

La responsabilità non può ritenersi oggettiva ma, analogamente a quanto previsto dal d.lgs. n. 231/2000 in tema di responsabilità da reato degli enti, va configurata come “colpa di organizzazione”, da intendersi, in senso normativo, come rimprovero derivante dall’inottemperanza da parte dell’Amministrazione dell’obbligo di adottare le cautele, organizzative e gestionali, necessarie a prevenire la commissione degli illeciti, peraltro attinente alle misure specifiche di sicurezza informatica (comprese di prevenzione della corruzione) per evitare tale genere di rischio[13].

La permanenza nel web di dati personali contenuti nei provvedimenti oltre il termine previsti dalla legge (ad es. art. 124 del d.lgs. n. 267/2000) configura una violazione degli obblighi di pubblicazione laddove non esista un diverso parametro legislativo o regolamentare che preveda la relativa diffusione.

Non può invocarsi efficacia esimente alla circostanza che il ritardo nella rimozione dal sito web dei dati personali possa dipendere da fattori esterni o imprevedibili, ovvero dipesa da una disfunzione degli applicativi informatici gestiti esternamente, visto che tale rischio (probabile e, quindi, prevenibile) risulta pienamente riconducibile alla sfera di signoria dell’Ente e del suo apparato amministrativo/tecnico: sarà indispensabile approntare un corretto ed esaustivo registro dei rischi (misure di sicurezza e DPIA, valutazione impatto dei rischi sulla protezione dei dati) in linea con il Piano Triennale per l’informatica della Pubblica Amministrazione e con le indicazioni AGID che, in tale ambito del Piano, definisce la “sicurezza informatica” di importanza fondamentale per garantire la disponibilità, l’integrità e la riservatezza delle informazioni proprie del Sistema informativo della Pubblica Amministrazione, direttamente collegata ai principi di privacy previsti dall’ordinamento giuridico.

Accesso ai curricula

Il Garante privacy[14], con riferimento a un diniego di accesso civico generalizzato alla copia «dei curricula dei 13 partecipanti alla selezione, mediante proposta di candidatura (avviso pubblico…) per la nomina dell’amministratore unico della società in house del Comune», nonché – ove esistenti – anche la copia, in presenza di un diniego parziale da parte degli interessati, premette che:

  • la disciplina stabilisce «chiunque ha diritto di accedere ai dati e ai documenti detenuti dalle pubbliche amministrazioni, ulteriori rispetto a quelli oggetto di pubblicazione ai sensi del presente decreto, nel rispetto dei limiti relativi alla tutela di interessi giuridicamente rilevanti secondo quanto previsto dall’articolo 5 bis» (ex 5, comma 2, d.lgs. n. 33/2013);
  • l’art. 5 bis del d.lgs. n. 33/2013 prevede che l’accesso civico debba essere rifiutato, fra l’altro, «se il diniego è necessario per evitare un pregiudizio concreto alla tutela [della] protezione dei dati personali, in conformità con la disciplina legislativa in materia»;
  • per dato personale si intende «qualsiasi informazione riguardante una persona fisica identificata o identificabile («interessato»)» e si considera “identificabile” «la persona fisica che può essere identificata, direttamente o indirettamente, con particolare riferimento a un identificativo come il nome, un numero di identificazione, dati relativi all’ubicazione, un identificativo online o a uno o più elementi caratteristici della sua identità fisica, fisiologica, genetica, psichica, economica, culturale o sociale» (ex 4, par. 1, n. 1, RGPD).
  • trattasi di ostensione, tramite l’istituto dell’accesso civico generalizzato, di tutti curricula ove non tutti i soggetti controinteressati si sono opposti all’accesso.

Ciò posto, distingue le valutazioni da effettuare in ordine alla possibile ostensione di dati personali (o documenti che li contengono) tramite l’istituto dell’accesso civico rispetto all’accesso documentale, ai sensi della legge n. 241 del 7 agosto 1990, evidenziando che mediante l’accesso civico chiunque ha diritto «di conoscerli, di fruirne gratuitamente, e di utilizzarli e riutilizzarli ai sensi dell’articolo 7», sebbene il loro ulteriore trattamento vada in ogni caso effettuato nel rispetto dei limiti derivanti dalla normativa in materia di protezione dei dati personali (ex art. 3, comma 1, del d.lgs. n. 33/2013).

Di conseguenza, dovrà essere vagliato il regime di pubblicità con l’eventuale esistenza di un possibile pregiudizio concreto alla protezione dei dati personali dei soggetti controinteressati (i titolari dei curricula), in base al quale decidere se rifiutare o meno l’accesso ai dati, informazioni o documenti richiesti, rispettando, in ogni caso, i principi del GDPR di «limitazione della finalità» e di «minimizzazione dei dati», in base ai quali i dati personali devono essere «raccolti per finalità determinate, esplicite e legittime, e successivamente trattati in modo che non sia incompatibile con tali finalità», nonché «adeguati, pertinenti e limitati a quanto necessario rispetto alle finalità per le quali sono trattati» (ex art. 5, par. 1, lett. b e c).

Se coloro che vengono nominati, ai sensi 14, commi 1, lett. b, e 1 bis, del d.lgs. n. 33/2013, vedono obbligatoriamente pubblicato il loro curriculum vitae, diversa questione è con riferimento ai partecipanti all’avviso non nominati (ossia, coloro che hanno solo presentato la candidatura, ma non sono stati selezionati per l’incarico societario).

Quest’ultimi possono ricevere un pregiudizio (ex art. 5 bis, comma 2, lett. a), del d.lgs. n. 33/2013) dai dati personali contenuti (ad es. esperienze e competenze professionali, istruzione e formazione, competenze personali, competenze comunicative, competenze organizzative e gestionali, pubblicazioni, presentazioni, progetti, conferenze, seminari, riconoscimenti e premi, appartenenza a gruppi/associazioni, referenze, menzioni, corsi, certificazioni, ecc.) atteso che non sempre si desidera portare a conoscenza di soggetti estranei in relazione ai casi e al contesto in cui possono essere utilizzati da terzi: l’accesso civico generalizzato non opera per coloro che hanno presentato la candidatura ad amministratore unico di una società in house ma non sono stati scelti per l’incarico.

In termini diversi, la diffusione mediante l’accesso ai curricula «potrebbe determinare un’interferenza ingiustificata e sproporzionata nei diritti e libertà dei soggetti controinteressati, arrecando a questi ultimi proprio quel pregiudizio concreto alla tutela della protezione dei dati personali previsto dall’art. 5 bis, comma 2, lett. a), del d. lgs. n. 33/2013 (art. 5, par. 1, lett. b e c, del RGPD)»: tali operano per tutti, anche per coloro che non hanno presentato opposizione all’accesso civico[15].

Sanzionata la diffusione di dati personali

Il Garante per la protezione dei dati personali[16] interviene censurando una P.A. (nello specifico un’Azienda Ospedaliera) con la sanzione amministrativa pecuniaria di euro 80.000,00 (ottantamila) a seguito di una segnalazione con la quale si lamentava la diffusione incontrollata di dati personali di candidati a un concorso pubblico (c.d. data breach): in particolare: «è stato rappresentato che accedendo all’URL http://… era possibile visualizzare un elenco di codici alfanumerici, corrispondenti al “codice iscrizione” dei candidati a uno specifico concorso (XX). A ciascuno di tali codici era associato un collegamento ipertestuale che permetteva l’accesso a un’area del portale nella quale erano contenuti alcuni documenti presentati dai candidati a integrazione della domanda di partecipazione al concorso. Digitando i codici nelle caselle di inserimento dei dati presenti nella pagina accessibile all’URL http://…, era consentito l’accesso a una maschera nella quale erano riportati i dati inseriti dai candidati con la possibilità di modificarli (cfr., segnalazione e relazione di servizio del XX). Attraverso l’URL http://…, era possibile visualizzare, inoltre, ulteriori documenti allegati dagli stessi candidati, contenenti anche dati relativi alla salute (es. titoli di preferenza e certificazione medica)».

In sede istruttoria, si giunge ad acclarare che:

  • la piattaforma gestionale utilizzata per l’attuazione dei concorsi apparteneva ad una società affidataria (mediante MEPA) del servizio di gestione della procedura concorsuale on line;
  • l’affidataria non aveva fornito alcuna attestazione di conformità relativamente ai dati e ai documenti forniti (mancava un’adeguata sicurezza del processo, «privo di precauzioni di protezione e al cui interno i file erano “conservati in cartelle, denominate con nome e cognome del candidato e il codice assegnato dalla procedura. I file sono resi disponibili in formato PDF non firmato”»);
  • la P.A. sarebbe venuta a conoscenza dell’evento segnalato solo in occasione della nota di richiesta di elementi da parte del Garante privacy;
  • viene rilevato che il trattamento dei dati personali degli interessati, nelle modalità assunte, è stato effettuato dalla P.A. in violazione del principio di liceità, correttezza e trasparenza (ex 5, par. 1, lett. a) del Regolamento UE 679/2016) e dell’art. 13 del Regolamento UE 678/2016 (mancava un’adeguata “informativa”)[17];
  • in violazione dell’art. 28 del GDPR, in quanto la P.A. aveva omesso di regolamentare il rapporto con l’affidataria società mediante un contratto o altro atto giuridico che disciplinasse il trattamento effettuato per suo conto;
  • risulta l’assenza di un idoneo presupposto di liceità e in violazione del divieto di diffusione dei dati sulla salute (ex 6 par. 1, lett. c) ed e) del GDPR e artt. 2 ter e 2 septies, comma 8 del Codice in materia di protezione dei dati);
  • violazione dell’art. 32 del Regolamento UE 679/2016, per mancata adozione di adeguate misure tecniche e organizzative volte a garantire la riservatezza e l’integrità dei dati personali trattati.

Dall’analisi del provvedimento emerge che:

  • «per cause legate all’imperizia nel trattamento dei dati da parte del fornitore del servizio di cui si è avvalsa l’Azienda ospedaliera per la gestione della procedura, si è verificata una diffusione di dati personali dei candidati al concorso in assenza di idoneo presupposto di liceità», specie ove si consideri la diffusione ha avuto ad oggetto anche dati relativi alla salute, rispetto ai quali la disciplina in materia di protezione dei dati personali, in ragione della particolare delicatezza di tale categoria di dati, prevede espressamente che “non possono essere diffusi” (ex 2 septies, comma 8 del Codice in materia di protezione dei dati);
  • il trattamento, di cui è titolare la P.A., risulta essere stato effettuato «in violazione degli articoli 5, lett. a), 6 par. 1, lett. c) ed e) del Regolamento e degli artt. 2-ter e 2 septies, par. 8 del Codice»;
  • sono mancate le adeguate misure di sicurezza dei dati personali, compresa la protezione, mediante misure tecniche e organizzative adeguate, da trattamenti non autorizzati o illeciti e dalla perdita, dalla distruzione o dal danno accidentali (ex 5, par. 1, lett. f), del Regolamento UE 679/2016);
  • dalla consultazione della sezione “Amministrazione trasparente” della P.A. è emerso che sono stati pubblicati numerosi atti e documenti (es. graduatorie, ricorsi amministrativi, deliberazioni) relativi alla medesima procedura concorsuale e contenenti dati personali, anche relativi a categorie particolari e alla salute, dei partecipati al concorso (che sarà oggetto di autonomo rilievo).

La vicenda, esemplare dell’importanza di una valida rete informatica studiata sin dall’origine (in ossequio ai principi di privacy by design e by default) per evitare una diffusione dei dati personali non autorizzata, amplifica l’esigenza di garantire la protezione dei dati personali, determinando un elevato livello di precisione e perizia:

  • sia nel definire i rapporti con il soggetto gestore, con la sottoscrizione di un contratto nel quale sono definiti gli obblighi e responsabilità in materia, compreso la titolarità del trattamento che la puntuale sicurezza dei dati (c.d. “accountability”);
  • sia nello stabilire concretamente delle misure di sicurezza interne capaci di vigilare sull’attività e monitorare costantemente tutte quelle operazioni di trattamento che possano causare la “diffusione” di dati personali, al di fuori dei casi ammessi;
  • in presenza di dati riferiti alla salute le garanzie devono essere maggiori, e di conseguenza la struttura tecnologica non può presentare tali carenze (come nel caso di specie).

Proiezioni

La tutela dei dati personali non potrà avvenire se non attraverso una rete internet adeguata e sicura, con l’utilizzo degli strumenti di Information and Communication Technology capaci di contenere e anticipare l’evoluzione della tecnica, adeguandosi costantemente alla società digitale e al cyberspazio, aumentando le professionalità specifiche nella P.A., senza lasciare alcuna libertà all’improvvisazione (o alla c.d. buona volontà del singolo) ma strutturando le reti con investimenti adeguati e formazione continua.

La diffusione dei servizi della società dell’informazione, l’identità digitale (SPID), l’ingresso massiccio dei social nelle istituzioni (vedi, le dirette di Facebook del Governo in epoca COVID-19)[18] impongono sicuramente la “transizione digitale” della P.A. e lo smart working, come forma ordinaria della prestazione da remoto, cambiando i modi di rapportarsi tra cittadino ed istituzioni, compresi i meccanismi decisionali non in presenza.

Si potrebbe affermare che l’on line diviene pervasivo di ogni relazione umana: solo con una rete sicura e con delle misure di sicurezza adeguate si potrà garantire la tutela dei dati personali, limitare ogni traccia digitale, cautelando una “soglia minima” di libertà di essere disconnessi, assecondando quella parte di “riservatezza” («to be let alone», nella sua originaria definizione di diritto a “a essere lasciato solo”) che ancora è pur sempre possibile.

Note

[1] Cfr. Corte Giustizia Unione Europea, sez. III, 16 gennaio 2019, n. 496/17, ove si stabilisce che ogni trattamento di dati personali deve, da un lato, essere conforme ai principi relativi alla qualità dei dati enunciati all’articolo 6 della direttiva n. 95/46 o all’articolo 5 del Regolamento UE 2016/679 e, dall’altro, rispondere a uno dei principi legittimanti un trattamento dati enumerati all’articolo 7 di detta direttiva o all’articolo 6 di detto regolamento. Più in particolare, i dati personali devono essere raccolti per finalità determinate, esplicite e legittime e risultare adeguati, pertinenti e limitati a quanto è necessario rispetto a tali finalità, mentre il loro trattamento è lecito, secondo l’articolo 7, lettera c), della stessa direttiva o l’articolo 6, paragrafo 1, lettera c), dello stesso Regolamento, se è necessario per adempiere un obbligo legale al quale è soggetto il titolare del trattamento.

[2] Per diffusione s’intende che i dati personali vengano comunicati a più soggetti indeterminati, in qualunque forma, Cass. pen., sez. III, 9 giugno 2006, n. 22059, di converso il reato di trattamento illecito di dati personali non è integrato se il trattamento dei dati avvenga per fini esclusivamente personali, senza una loro diffusione o destinazione a una comunicazione sistematica, Cass. pen., sez. V, 22 ottobre 2008, n. 46454.

[3] ANAC, Comunicato del Presidente, «Indicazioni in merito alla indicizzazione delle pagine della sezione ‘Amministrazione trasparente’», 1° luglio 2020.

[4] Per i “dati relativi alla salute” è previsto un espresso divieto di diffusione, ex art. 2 septies, comma 8, del d.lgs. n. 196/2003, dove opera anche l’art. 7 bis, comma 6, del d.lgs. n. 33/2013, che al riguardo prevede, analogamente, come «Restano fermi i limiti… alla diffusione dei dati idonei a rivelare lo stato di salute», Garante per la protezione dei dati personali, «Parere su una istanza di accesso civico», doc. web n. 9084520, Registro provvedimento n. 2 del 10 gennaio 2019.

[5] ANAC, Delibera n. 1064 del 13 novembre 2019, «Approvazione in via definitiva del Piano Nazionale Anticorruzione 2019», dove si prescrive che nei singoli PTPCT (Piani triennali di prevenzione della corruzione e della trasparenza), per regolare il flusso delle informazioni sulla sez. “Amministrazione Trasparente”, sia essenziale l’indicazione dei nominativi dei soggetti responsabili della trasmissione dei dati, degli uffici tenuti alla individuazione e/o alla elaborazione dei dati, di quelli cui spetta la pubblicazione; nella sez. del PTPCT per ciascun obbligo, sono espressamente indicati i nominativi dei soggetti e gli uffici responsabili di ognuna delle citate attività, in mancanza è ritenuto responsabile il RPCT (Responsabile della prevenzione della corruzione e della trasparenza).

[6] La pubblicazione di un’informazione concernente una persona determinata, a distanza di tempo da fatti e avvenimenti che la riguardano, non può che integrare la violazione del fondamentale diritto all’oblio, Cass., sez. I, 20 marzo 2018, n. 6919.

[7] Cass. civ., sez. I, 8 gennaio 2019, n. 207; 25 gennaio 2017, n. 1931 e 23 maggio 2016, n. 10638.

[8] Cass. civ., sez. I, Ord., 17 settembre 2020, n. 19328.

[9] Sono i dati attinenti alla salute fisica o mentale di una persona fisica, compresa la prestazione di servizi di assistenza sanitaria, che rivelano informazioni relative al suo stato di salute, ex art. 4, par. 1, n. 15; considerando n. 35 del Regolamento UE 679/2016.

[10] Garante per la protezione dei dati personali, «Diritto all’oblio: cittadini italiani tutelati anche al di fuori dei confini europei. Google dovrà cancellare gli url anche dai risultati di ricerca nelle versioni extraeuropee», Newsletter n. 437 del 26 gennaio 2018.

[11] Garante per la protezione dei dati personali, «Parere su istanza di accesso civico – 3 settembre 2020», Registro dei provvedimenti n. 155 del 3 settembre 2020, doc. web n. 9461036.

[12] Garante per la protezione dei dati personali, «Linee guida in materia di trattamento di dati personali, contenuti anche in atti e documenti amministrativi, effettuato per finalità di pubblicità e trasparenza sul web da soggetti pubblici e da altri enti obbligati», Registro dei provvedimenti n. 243 del 15 maggio 2014, doc. web n. 3134436, dove si evidenzia che «la prassi seguita da alcune amministrazioni di sostituire il nome e cognome dell’interessato con le sole iniziali è di per sé insufficiente ad anonimizzare i dati personali contenuti negli atti e documenti pubblicati online. Inoltre, il rischio di identificare l’interessato è tanto più probabile quando, fra l’altro, accanto alle iniziali del nome e cognome permangono ulteriori informazioni di contesto che rendono comunque identificabile l’interessato (si pensi, ad esempio, alle informazioni relative alla residenza oppure quando si possiede un doppio nome e/o un doppio cognome)».

[13] Cass. civ., sez. II, ord. 3 settembre 2020, n. 18292.

[14] Garante per la protezione dei dati personali, «Parere su istanza di accesso civico – 17 settembre 2020», registro dei provvedimenti n. 156 del 17 settembre 2020.

[15] Cfr. ANAC, delibera n. 1309 del 28 dicembre 2016, «Linee guida recanti indicazioni operative ai fini della definizione delle esclusioni e dei limiti all’accesso civico di cui all’art. 5 co. 2 del d.lgs. 33/2013. Art. 5- bis, comma 6, del d.lgs. n. 33 del 14/03/2013 recante «Riordino della disciplina riguardante il diritto di accesso civico e gli obblighi di pubblicità, trasparenza e diffusione di informazioni da parte delle pubbliche amministrazioni», nello specifico punto 8.1. «I limiti derivanti dalla protezione dei dati personali».

[16] Garante per la protezione dei dati personali, «Provvedimento del 17 settembre 2020», Registro dei provvedimenti n. 160 del 17 settembre 2020, doc. web n. 9461168.

[17] Cfr. Corte Europea dei Diritti dell’Uomo del 5 settembre 2017, Ricorso n. 61496/08 – Causa Barbulescu c. Romania, spec. n. 140 e Parere 2/2017 sul trattamento dei dati sul posto di lavoro, adottato dal «Gruppo di lavoro art. 29 per la protezione dei dati», l’8 giugno 2017.

[18] Vedi LUCCA, L’arido latrato del nuovo dpcm: la “di(e)ttatura” COVID-19. Riflessioni minime sul senso della misura, mauriziolucca.com, 17 ottobre 2020.

Articolo a cura di Maurizio Lucca

Download PDF

https://www.ictsecuritymagazine.com/articoli/accesso-sicurezza-informatica-tutela-dei-dati-personali-e-responsabilita/


Qualificazione AGID e sicurezza applicativa per le PPAA: un efficace ambito d’intervento per infrastrutture e servizi in-Cloud più robusti

Nell’ambito del Piano Triennale per l’Informatica nella Pubblica Amministrazione 2019-2021, con l’obiettivo di qualificare servizi e infrastrutture cloud secondo specifici parametri di sicurezza, affidabilità strutturale ed elevato QoS, stanno assumendo sempre maggior rilievo le procedure operative che devono portare Analisti e Sviluppatori software – così come i Service Providers – a elaborare prodotti e servizi nel rispetto dei principali standard definiti a livello internazionale, omogenei e universalmente riconosciuti. Le modalità di soddisfacimento di tali requisiti sono state definite nei dettagli da AGID all’interno di un percorso di qualificazione, rivolto a soggetti fornitori di software e servizi in ambito pubblico.

Lo scenario

Il modello Cloud per le PPPA prevede servizi e infrastrutture qualificate di tipo public, private e community parallelamente all’introduzione del principio cloud first, in base al quale le amministrazioni sono tenute a valutare l’adozione di servizi digitali disponibili in-cloud prima di qualsiasi altra soluzione tradizionale. Si tratta di un tassello fondamentale all’interno di un disegno più ampio declinato nel noto Piano Triennale per l’informatica nella PA 2019-2021, i cui obiettivi dichiarati sono quelli di favorire la transizione a modelli di gestione digitale più facilmente scalabili verso architetture che, in ambito privato, risultano invece già piuttosto diffuse.

Gli obiettivi del percorso di qualificazione

Il percorso si rivolge a servizi qualificati identificabili sia all’interno della categoria di CSP (Cloud Service Provider) e sia tra i fornitori di applicativi ascrivibili alla tipologia di Software as a service (Saas), in modo tale da garantire il rispetto di elevati canoni di affidabilità̀ e sicurezza, considerati necessari per i servizi digitali pubblici.

La qualificazione CSP prevede che il Fornitore qualifichi la propria infrastruttura Cloud e si suddivide in 3 tipologie, in funzione dello specifico scopo:

  1. CSP – Tipo A: Il fornitore vuole qualificare sia la sua Infrastruttura, sia servizi Infrastructure as a Service (IAAS) e/o Platform as a Service (PAAS) per poterli vendere. Questo tipo non prevede la vendita di servizi Software as a Service (SAAS) da parte del fornitore.
  2. CSP – Tipo B: Il fornitore vuole qualificare sia la sua infrastruttura, sia servizi SAAS per poterli vendere. Non si prevede la vendita di servizi IAAS e/o PAAS da parte del fornitore.
  3. CSP – Tipo C: Il fornitore vuole qualificare sia la sua Infrastruttura, sia servizi IAASe/o PAAS, sia servizi SAAS per poterli vendere.

Per il più ampio contesto di Saas, i macro obiettivi imposti da Agid al fine di ottenere la qualificazione consistono in vari punti, suddivisi in base alla natura tecnologico-semantica dei contesti:

  • la sicurezza applicativa;
  • la disponibilità di un adeguato supporto tecnico per il cliente;
  • la trasparenza e la disponibilità di informazioni dettagliate e aggiornate sulle modalità di erogazione del servizio e di esportazione dei dati;
  • la disponibilità di incident report, statistiche e strumenti di monitoraggio;
  • un insieme minimo di livelli di servizio garantiti obbligatori;
  • la protezione dei dati e la portabilità in tutte le fasi di avanzamento della fornitura;
  • l’interoperabilità mediante opportune API;
  • l’esportabilità dei propri dati in un formato interoperabile verso un’altra piattaforma, per ridurre il rischio di dipendenza esclusiva della PA dal fornitore (lock in).

Un esempio concreto di adeguamento tecnico fattivo

Con particolare riferimento agli aspetti del percorso di qualificazione AGID rivolti ai fornitori Software as-a-service (Saas) della PA, presupponendo quindi che l’ipotetico software considerato si avvalga di architetture CSP qualificate, consideriamo qui un esempio reale di tematiche da affrontare: qualora ci si trovasse nella situazione di dover reingegnerizzare un modulo applicativo, mantenendo determinati standard di compliance Agid stilati in precedenza, lo sviluppatore e il fornitore dovrebbero impostare una fase analitica idonea a considerare ogni elemento di rischio dell’attività intrapresa.

La porzione di software qui ipotizzata è parte integrante di un applicativo fornito in modalità Saas e posizionato – by design – su un’architettura cloud a VPS; lo schema di assessment complessivo lo ha etichettato a “rischio elevato” per quanto concerne aspetti di load balancing delle risorse e relativa disponibilità delle informazioni. In particolare, essa è dedicata a un accesso condiviso a un insieme di risorse persistenti collocate su uno schema relazionale a RDBMS fornito da service provider di terze parti.

Si evidenziano i seguenti 3 facts, scaturiti a seguito dall’analisi preliminare di contesto:

a) il modulo applicativo destinato alla gestione della persistenza è inserito all’interno di una logica complessiva multithreading, per cui esso debba servire una moltitudine di request/response parallele provenienti dall’esterno (servitizzazione via application server). Gli aspetti correlati all’isolamento informativo e alla sicurezza dedicata a ogni istanza sono fondamentali e derivano da una corretta implementazione (e test) del parallelismo applicativo secondo casi d’uso e di carico previsti già in fase di progettazione;

b) la struttura di persistenza a RDBMS di cui fruisce è collocata a sua volta su un’infrastruttura cloud-based, esterna alla rete fisica su cui è posizionato il modulo applicativo;

c) sussistono dei limiti prestazionali correlati alla banda massima messa a disposizione dal service provider che fornisce il servizio di RDBMS, per cui il modulo applicativo debba implementare logiche algoritmiche di load balancing che evitino di saturare il valore di banda disponibile con un margine dell’80% di occupazione.

I tre punti evidenziano reali vincoli tecnologici da analizzare, in quanto essi vanno a impattare sostanzialmente sulle scelte architetturali operate dagli analisti per il modulo software stesso, dettate dalla presenza di una infrastruttura cloud-based distribuita – nell’esempio di fattispecie – su due livelli differenti.
Lo stack tecnologico complessivo deve dunque tenere conto della sussistenza di fattori abilitanti alla capacità dei vari componenti funzionali di interagire e garantire risultati solidi dal punto di vista del flusso di dati e informazioni coinvolto. Gli standard di sicurezza raggiunti con la versione in produzione, devono essere mantenuti e, ove possibile, potenziati.

Riferendosi direttamente all’infrastruttura complessiva su cui sussiste il software Saas a cui appartiene il modulo DAO, è evidente che il version number dell’application server (es. Apache Tomcat) sia direttamente correlato al numero di revisione del RDBMS: tale key point – che in semantica Agid-compliant, all’interno di un doc di assessment complessivo, potremmo definire univocamente “ID01_revv” – va inquadrato all’interno di precise logiche prescritte dal percorso di qualificazione, tra cui si citano:

  • dipendenza dall’hardware fisico (o virtuale, nel caso di VPS). In che misura la nuova revisione dell’application server implementata va a impattare su aspetti hardware della macchina su cui sussiste, in termini di risorse necessarie (es. occupazione heap)?
  • Misure di sicurezza. L’architettura precedente, intesa come application server (soggetto a revisione) e RDBMS, è stata soggetta a un risk assessment relativo a minacce e vulnerabilità mappate in documentazione di dettaglio create ad hoc. Il cambio di revisione conferma la validata di tale analisi precedente o richiede la reingegnerizzazione delle fasi di test?
  • Modificabilità del codice sorgente. Qualora la migrazione portasse a ratificare la necessità di intervenire su aspetti funzionali correlati al modulo oggetto dell’esempio (o ad altri correlati), qual è il livello di intervento possibile sul codice sorgente? Un’eventuale modificabilità nulla o parziale potrebbe costituire elemento bloccante alla revisione → Disponibilità di documentazione tecnica: disponibilità della documentazione tecnica che spiega il funzionamento interno dell’applicativo e delle sue componenti per intervenire in modo mirato e controllato.
  • Livello di test necessario. Lo scenario ipotizzato considera la presenza di vari moduli funzionali, tra cui quello DAO va a interagire con un RDBMS posizionato in cloud. La modifica dell’environment su cui sussiste l’applicativo, ed è ciò che avviene nel caso di modifica di revisione di un application server, chiama procedure di component e assembly test che devono precedere successive fasi di product test. Poiché di fatto un cambio di revisione di un componente funzionale indispensabile può essere equiparata a una attività di micro-migrazione, in tale scenario è importante eseguire un test di completezza a più livelli, ove vengano identificate varie Unità di Migrazione (Unit of Migration o UoM), con un approccio top-down a partire dallo strato business (gli aspetti di view appaiono qui non coinvolti), funzionali a capire quali porzioni di codice rivelino un comportamento anomalo a seguito della modifica di environment.

 È evidente, per concludere, che il percorso di qualificazione AgID dei servizi SaaS rappresenti il volano per lo sviluppo dell’intero comparto, anche grazie alla corretta implementazione tecnologica dei principi “by default” e “by design”  previsti dalla nuova normativa a protezione dei dati personali (si veda in proposito il contributo Compliance al GDPR dei servizi cloud SaaS).

Articolo a cura di Igor Serraino

Igor Serraino, Ingegnere dell’Informazione, opera nel settore della consulenza ICT e da progettista sviluppatore software in ambienti Java.

È attivo nel contesto Impresa 4.0 in qualità di Technology Expert per una importante società di settore, consolidando quotidianamente le proprie expertises in ambiti aziendali eterogenei e complessi.

Il suo portfolio professionale si consolida tecnicamente attraverso una pluriennale esperienza da analista e sviluppatore freelance, in ambienti Java based – full stack, con particolare riferimento ad applicativi finanziari orientati alla commercializzazione per la Pubblica Amministrazione.

Completano il profilo costanti collaborazioni in ambiti legal-tech, Cyber security, Blockchain (CBSA), e numerose partecipazioni da relatore nelle edizioni SMAU nazionali.

Sito web: www.serraino.it

Linkedin: www.linkedin.com/in/igorserraino

Download PDF

https://www.ictsecuritymagazine.com/articoli/qualificazione-agid-e-sicurezza-applicativa-per-le-ppaa-un-efficace-ambito-dintervento-per-infrastrutture-e-servizi-in-cloud-piu-robusti/


La sfida del COVID-19: dalla crisi pandemica alle opportunità di Business Continuity

Sono trascorsi diversi mesi dal manifestarsi della pandemia da COVID-19, vissuta e subita da molte organizzazioni come evento traumatico e fortemente impattante che ha evidenziato importanti lacune, in particolare nel campo della sicurezza informatica e della continuità operativa.

Con il tempo, molte aziende hanno trasformato questi campanelli di allarme in opportunità rappresentate da maggiori investimenti in termini di budget e/o di tempo da dedicare a tematiche di sicurezza, per colmare e dare risposta alle lacune emerse durante l’emergenza e gestire con prontezza una pluralità di rischi in costante e continua evoluzione.

Ricordiamo in particolare la sicurezza del lavoro da remoto, visto il numero sempre crescente di persone che lavorano a distanza; fino alla gestione delle problematiche relative alla resilienza per sostenere le operazioni aziendali.

Oggi, alla luce di quanto accaduto, possiamo sicuramente affermare che un piano di Continuità Operativa aziendale ben consolidato consente alle aziende di fronteggiare crisi determinate da scenari in precedenza non prevedibili e di operare in una condizione ottimale, cioè il più possibile vicina alla normalità.

Analizziamo, di seguito, alcune proposte di attività aziendali che daranno luogo ad azioni e interventi di miglioramento della continuità operativa aziendale.

1. Identificare le lacune esistenti e definire un piano di miglioramento aziendale

È necessario effettuare una analisi AS-IS legata ai processi, alle tecnologie, alle applicazioni in essere per identificare le lacune di sicurezza e i relativi punti di miglioramento su cui concentrare gli sforzi.

Tale analisi può riguardare i seguenti ambiti:

  • Policy: esistono un piano e una strategia di Business Continuity? Sono state definite le policy di Business Continuity?
  • Processi: sono analizzati annualmente attraverso la Business Impact Analysis? Sono stati identificati i processi, le risorse, le applicazioni considerate critiche? Ci sono processi che non possono essere svolti da remoto?
  • Infrastruttura: l’infrastruttura per l’accesso remoto necessita di aggiornamenti?
  • Applicazioni: è possibile per gli utenti scaricare autonomamente applicazioni o viene permesso solo dopo un confronto con l’IT? Sono state comunicate le applicazioni consigliate per i meeting online? Si è analizzato se vi siano applicazioni considerate shadow IT?
  • Software: sono state installate tutte le patch disponibili?
  • Network: sono possibili eventuali ulteriori interventi? È possibile potenziare il traffico necessario per il lavoro da remoto?

2. Formare il personale circa l’importanza della sicurezza e dei possibili impatti del loro operato sull’organizzazione

Spesso si pensa che la sicurezza aziendale sia una responsabilità dei soli dipartimenti IT.

In una visione unitaria aziendale tutto il personale – compresi i collaboratori esterni – deve invece interagire e considerarsi parte attiva dell’organizzazione anche per quanto concerne la responsabilità in materia di sicurezza aziendale.

I mesi di pandemia hanno evidenziato che l’utilizzo consistente del lavoro da remoto ha determinato un aumento dei rischi in materia di sicurezza, compresi i tranelli ben studiati dagli hacker con conseguenze spesso devastanti per l’organizzazione.

I corsi di formazione e le iniziative di awareness diventano fondamentali per coinvolgere tutto il personale nella conoscenza e gestione dei nuovi servizi adottati dall’organizzazione, per confrontarsi su dubbi e conoscenze circa gli strumenti disponibili e le azioni da adottare per evitare o ridurre i rischi informatici.

Ottobre è stato il Cyber Security Month 2020, un’occasione per sostenere e implementare l’attenzione che tutto il personale deve rivolgere all’ambito informatico nei suoi molteplici aspetti: dal sapere riconoscere un’email di phishing, a come scegliere una password sicura, fino alle modalità sicure per gestire dati, documenti e informazioni sensibili lavorando da postazioni remote.

Non perdiamo l’opportunità di rinnovare l’awareness il prossimo 30 novembre, in occasione del Cyber Monday 2020.

3. Verificare la preparazione dei fornitori

La preparazione dei fornitori in tema di sicurezza e continuità operativa viene spesso trascurata nelle analisi aziendali. Con l’outsourcing di un servizio, le aziende tendono a sottovalutare i molteplici rischi e le conseguenze negative di un comportamento inadeguato dei fornitori.

Una soluzione può essere quella di condividere un questionario di self-assessment volto a verificare la maturità dei fornitori sui temi di cyber security e di Business Continuity.

Infine, è importante analizzare la strategia e il piano di Business Continuity dei fornitori, oltre a richiedere le evidenze degli annuali test di Business Continuity da loro effettuati.

Oggi, a distanza di diversi mesi dall’inizio della pandemia che ha colto impreparato un importante numero di organizzazioni, abbiamo maturato esperienza e perfezionato nuovi strumenti di gestione per affrontare emergenze non prevedibili, siano esse pandemie o scenari di rischio ancora diversi (minacce terroristiche, attacchi cyber, disastri naturali etc.).

Articolo a cura di Lisa Da Re

Download PDF

https://www.ictsecuritymagazine.com/articoli/la-sfida-del-covid-19-dalla-crisi-pandemica-alle-opportunita-di-business-continuity/


Criminalità informatica, Covid-19 e tutela del correntista

La criminalità informatica – come è noto – si evolve di continuo, studiando nuove tattiche e strategie per realizzare i propri obiettivi illegali.

La crisi economica costituisce un’occasione per arruolare nuove leve e la crisi pandemica, purtroppo, pure. Pertanto, durante questa pandemia, i criminali esperti di informatica si sono organizzati per sfruttare nuove e vecchie debolezze dei sistemi informatici a danno delle loro vittime quali consumatori e organizzazioni piccole, medie o complesse. In tale contesto i clienti degli istituti di credito sono stati tra i più bersagliati, subendo le frodi più svariate.

Dal tradizionale Phishing, noto fenomeno illecito diffusosi da almeno due decenni in tutto il mondo, nel quale il malintenzionato invia una e-mail di phishing (sinonimo di abboccamento) alla vittima chiedendole di inserire informazioni riservate (p.e. password) e il malcapitato, senza verificare la provenienza della e-mail, inserisce incautamente i dati riservati fornendo gli stessi a terzi non autorizzati; alle forme leggermente più evolute dello Smishing, nel quale i malintenzionati per truffare la vittima utilizzano non più l’e-mail ma un SMS. Il contenuto di tale SMS è piuttosto facile da scrivere, solitamente riporta un semplice link. Per maggiore chiarezza, di seguito si riporto di seguito un testo di Smishing piuttosto ricorrente: “nome dell’Istituto di credito: la sua carta è stata bloccata per mancata sicurezza web, per informazioni per proseguire tramite il portale indicato (link al portale dell’istituto di credito)”. Il testo scritto in italiano piuttosto stentato dovrebbe far sorgere qualche dubbio ma d’altra parte un SMS, essendo uno short message, è per sua natura molto sintetico; pertanto il destinatario, per evitare di cliccare sul link, dovrebbe solo riflettere sulla circostanza che un istituto non invia mai sms ai propri clienti. Purtroppo, si tratta di un’affermazione ripetuta e riportata su molti siti web degli istituti di credito. Tuttavia, vi sono evidenze per asserire il contrario atteso che diversi clienti ricevono comunicazioni in tale modalità.

Altro fenomeno di criminalità informatica che colpisce il correntista è il Vishing, ovvero una forma di Phishing che sfrutta i sistemi Voip (Voice Over Internet). Almeno in passato, alcuni istituti di credito utilizzavano un account Skype per facilitare la comunicazione con i clienti; tuttavia, sembra allo stato attuale che tale scelta sia stata ritenuta rischiosa comportando la disattivazione di questi canali di comunicazione. Per alcuni il Vishing ha acquisito anche un diverso significato, assimilabile al Voice Phishing[1], ma questo fenomeno – a parere di chi scrive – è diverso e dovrebbe essere tenuto distinto.
Infatti il Voice Phishing è una tecnica truffaldina, molto diffusa anche in Italia, che avviene tramite il camuffamento del numero di telefono: in tal senso anche la Federal Trade Commission (FTC) e la Federal Communications Commission (FCC) definiscono tale tecnica come Caller ID spoofing[2], dove il malintenzionato si presenta come operatore dell’istituto di credito, per esempio camuffando il numero verde dell’istituto di credito.

Altra tecnica che merita di essere menzionato è lo Spear Phishing, che consiste in una variante più insidiosa del Phishing tradizionale. Si tratta di un’azione mirata commessa da parte di malintenzionati nella quale gli stessi sfruttano informazioni relative alla vittima come, per esempio, il ruolo professionale o la qualifica aziendale, al fine di carpire illecitamente ulteriori informazioni riservate.

Con riguardo invece alle organizzazione professionali e aziendali, si sta diffondendo negli ultimi anni la “Truffa del CEO” (Chief Executive Officer). Si tratta di una frode che può essere considerata una variante dello Spear Phishing, in quanto il criminale informatico si presenta nelle vesti di un apparente Amministratore delegato o, comunque, di una figura apicale dell’organizzazione; l’impostore (apparente CEO) chiede di effettuare un bonifico motivato con una causale attinente alle normali operazioni contabili dell’organizzazione, o un’altra operazione economica apparentemente connessa alle attività professionali o aziendali. L’IBAN del beneficiario, tuttavia, si riferisce a un conto corrente nella disponibilità di terzi non autorizzati.
Questa frode oggi sfrutta, in particolare, il periodo della pandemia di Covid-19, ove l’aumento dello smart working facilita la realizzazione di tecniche di ingegneria sociale che ingannano l’amministrazione o l’ufficio di contabilità delle organizzazioni.

Il Pharming è invece il fenomeno informatico che prevede un dirottamento dell’utente – o, meglio, del traffico di rete dello stesso – da un URL (Uniform Resource Locator) a un altro sito fraudolento (o fake site), all’interno del quale l’utente ingannato inserisce dati riservati, facendo così in modo che i terzi non autorizzati possano carpire informazioni private.

Peraltro, vi sono altre azioni criminali ancora più insidiose, come il Man in the Middle (MITM); si tratta, in questo caso, di un attacco informatico nel quale un malintenzionato si inserisce nella comunicazione tra due soggetti. Tale tipo di attacco può essere particolarmente efficace anche nel settore bancario, potendo essere effettuato per manipolare o carpire informazioni tra l’istituto di credito e l’utente nell’ambito delle comunicazioni che avvengono nel servizio di internet banking. Il Man in the Browser può essere visto come una variante del MITM e si verifica quando viene inoculato un malware tramite il browser, consentendo al malintenzionato di carpire illecitamente informazioni riservate; anche questo attacco può essere realizzato nell’ambito di sistemi di internet banking, come evidenziato in pronunce giudiziarie ed arbitrali.

Infine, una frode diffusasi nell’ultimo decennio è la Sim Swap Fraud: si tratta di una frode informatica tra le più insidiose che si conoscano e colpisce in particolare i sistemi di autenticazione a due fattori (qualcosa che conosco e qualcosa che possiedo), tramite la disattivazione della sim card telefonica (c.d hijacking). Tale operazione consente ai malintenzionati di carpire le comunicazioni che avvengono tramite sms, si tratta di una frode particolarmente diffusa nell’ambito dei sistemi di internet banking nella quale il malintenzionato si presenta al dealer telefonico, con documenti di riconoscimento e talvolta con una denuncia contraffatta, chiedendo il duplicato della SIM.

Si tratta di una frode di una certa complessità tramite la quale il malintenzionato acquisisce, prima, i dati riservati della vittima e, successivamente, riesce a introdursi nel sistema internet banking grazie al possesso delle SIM presso la quale viene comunicata la password “usa e getta”, mentre la vittima rimane ignara dell’azione programmata dai criminali. Rivolgendosi all’operatore telefonico per denunciare il malfunzionamento della SIM, il correntista purtroppo si accorge solo successivamente (in genere dopo alcuni giorni, quando cerca senza successo di accedere al sistema di internet banking) delle operazioni avvenute sul proprio conto corrente.

Purtroppo, in tale contesto, il correntista vittima di frode si trova sfornito di tutele immediate: l’esperienza delle vittime mostra che il riaccredito immediato delle somme illegalmente sottratte viene infatti addebitato sul conto corrente, con grande stupore del correntista, mentre immediatamente dopo il disconoscimento dell’operazione di bonifico si trova di nuovo la somma accreditata da parte dell’istituto di credo con la clausola “salvo buon fine”.

Infatti, le modifiche apportate dalla riforma sui servizi di pagamento prevedono che, qualora il correntista disconosca l’operazione, l’istituto sia tenuto ad un accredito immediato. Tuttavia, al correntista – in via quasi ordinaria – viene comunicato che, dopo aver effettuato le verifiche e non aver riscontrato anomalie in ordine all’autenticazione alla regolare contabilizzazione delle stesse, vi sarà un riaddebito delle somme sottratte. Tale addebito è da intendersi di fatto, purtroppo, nell’ottica dell’istituto di credito, come riscontro di colpa grave del cliente che avrebbe in qualche modo concorso alla realizzazione della frode consentendo ai terzi di accedere incautamente alle proprie credenziali di autenticazione.

Tale interpretazione, accolta da numerosi istituti di credito, si ritiene non conforme alla recente riforma normativa in materia dei servizi di pagamento. Infatti, le modifiche normative apportate dal decreto legislativo n. 11/2010 prevedono per contro che sia l’istituto di credito (ovvero il prestatore del servizio di pagamento), a dover dimostrare la colpa grava o il dolo e quindi l’intenzionalità di porre essere la frode ai danni dell’istituto di credito.

A tale proposito, appare doveroso ricordare la pronuncia leading case: si tratta della sentenza n. 16221 del 31 agosto 2016, nella quale il Tribunale capitolino ha sancito il primo risarcimento del danno da Sim Swap Fraud ed è questo, in effetti, il primo caso giudiziario in Italia relativo a tale frode complessa.

Come mostrato nel leading case sopra richiamato, che successivamente ha trovato conferma in altre pronunce di giurisprudenza successive, le vittime di frodi spesso devono ricorrere alle vie legali per recuperare il denaro loro sottratto illegalmente, tutela che trova fondamento principale in due normative di settore con particolare riguardo alla normativa sui servizi di pagamento, recentemente riformata in recepimento della Direttiva UE 2015/2366 (c.d. PSD2) e del Regolamento UE 2018/389 (c.d. RTS), divenuta applicabile per gli aspetti di sicurezza lo scorso 14 settembre 2019, e il Regolamento UE 2016/679 (c.d. GDPR) divenuto invece applicabile a partire dal 25 maggio 2018. Si tratta di normative che considerano l’interessato o il consumatore come parte contrattuale debole e – salvo che sussista una determinante condotta negligente del correntista – stabiliscono che a farsi carico dei costi economici-sociali, ovvero dei danni subiti dalla vittima, volti a prevenire gli accessi non autorizzati al sistema informatico deve essere l’istituto di credito, da intendersi come titolare del trattamento in ambito protezione dei dati personali oppure come prestatore del servizio di pagamento.

In conclusione, si ritiene, infatti, che un’interpretazione coerente e letterale delle disposizioni normative sopra richiamate dovrebbe necessariamente portare a concludere che, qualora non vi fosse dimostrazione evidente di colpa grave o dolo del correntista (colpa grave da intendersi come un comportamento abnorme del correntista), l’istituto di credito dovrebbe provvedere immediatamente e stabilmente al riaccredito delle somme disconosciute, così tutelando i propri clienti. Il semplice controllo interno della banca successivo al riaccredito delle somme disconosciute non appare in alcun modo coerente con il dato normativo e con l’interpretazione maggioritaria in giurisprudenza: come sopra accennato, il riaddebito delle somme sottratte al correntista lascia lo stesso sfornito di tutela immediata.

L’istituto di credito, infatti, nei casi sopra descritti in tale modo si pone su una posizione non giustificata asserendo che il comportamento del correntista sia necessariamente doloso o colposo. A parere di chi scrive, secondo l’attuale normativa, la parte contrattualmente forte dovrebbe invece farsi immediatamente carico del danno subito e solo a seguito di un giudizio arbitrale, come ad esempio la decisione emessa dall’ABF (Arbitro Bancario Finanziario)[3] o a seguito della sentenza dalla giudice ordinario che accerta le eventuali responsabilità esclusive del correntista, potrebbe provvedere al riaddebito delle somme illegalmente sottratte alla parte più debole.

Note

[1] https://en.wikipedia.org/wiki/Voice_phishing: nella nota enciclopedia del web si conferma che la definizione di Vishing solo da alcuni viene assimilata Voice Phishing, quando invece si riferiscono a due tecniche diverse.

[2] https://www.consumer.ftc.gov/articles/caller-id-spoofing-infographic; https://www.fcc.gov/consumers/guides/spoofing-and-caller-id.

[3] https://www.arbitrobancariofinanziario.it/.

Articolo a cura di Fabio Di Resta e Giovanni Grassucci

Fabio Di Resta

Fabio Di Resta. Esercita come avvocato principalmente nei fori di Roma, Milano e Latina. Dopo la specializzazione in Gran Bretagna in diritto dell’informatica in ambito comunitario, inizia l’attività di consulenza legale per società di primaria importanza in ambito nazionale ed internazionale riguardo la protezione dei dati personali e il diritto delle nuove tecnologie.  In tale contesto ha maturato oltre 17 anni di esperienza sia per la consulenza legale che per la gestione dei contenziosi, ricopre attualmente la posizione di Responsabile della protezione dei dati personali (Data Protection Officer) prevalentemente per primari gruppo ospedalieri privati, nel settore trasporti, nei servizi tecnologici avanzati. In ambito contenzioso lo studio Di Resta Lawyers, di cui l’avvocato è titolare, può vantare importanti esperienze in ambito bancario, in particolare, gestendo con successo casi complessi di risarcimento del danno relativo all’internet banking a favore dei correntisti ( www.direstalawyers.eu ). Attualmente è docente universitario a contratto nel Master di II livello in “Competenze digitali per la protezione dei dati, la cybersecurity e la privacy” istituito presso il Dipartimento di management e diritto dell’Università Tor Vergata di Roma. Ricopre, infine, il ruolo di Presidente dal Centro europeo per la Privacy – EPCE associazione che coinvolge avvocati e tecnici specializzati di privacy e diritto delle nuove tecnologie www.europeanprivacycentre.eu.

Download PDF

https://www.ictsecuritymagazine.com/articoli/criminalita-informatica-covid-19-e-tutela-del-correntista/


L’hacking è un percorso, non una destinazione

La parola Hacking deriva dal verbo inglese “to hack”, che significa “intaccare”.

La storia dell’hacking inizia da molto lontano, nei sotterranei dell’edificio 26 del MIT (Massachusetts Institute of Technology), precisamente nel 1958 presso il Tech Model Railroad Club, da appassionati di modellismo ferroviario.

Il club gestiva una sofisticatissima ferrovia in miniatura, ed era drasticamente diviso in due fazioni:

  • la prima fazione era denominata “knife-and-paintbrush” letteralmente “coltello e pennello”. Passavano la maggior parte del loro tempo a ricreare modelli di vagoni ferroviari da anni scomparsi oppure costruzioni e paesaggi, oltre a leggere riviste e a viaggiare lunego le vecchie linee ferroviarie;
  • la seconda fazione si chiamava “Signal-and-Power” ovvero “segnali e corrente”. Questa fazione era più interessata a quello che succedeva sotto il complesso layout, quindi studiavano le tecnologie per la costruzione della rete elettrica che governava gli scambi dei trenini, che chiamavano “the system”.

Il sistema era costantemente migliorato, rinnovato, perfezionato e talvolta -nel gergo tecnico del club –“gronked”, che voleva dire rovinato. Tale gergo gettò le basi per quello che, qualche anno dopo, divenne il famoso Jargon File, quella miniera di storia, usanze e termini della cultura Hacker dove (a parte le tante parole conosciute) troviamo raffinate collezioni del famoso umorismo fatalista hacker, altamente saporito, che colpisce sempre nel segno di giovani, vecchi e bambini.

Le matricole collaboravano con i membri anziani e tutte erano persone brillanti, intelligenti, i “primi della classe”, rigorosamente vestiti con camicia a maniche corte a scacchi, pantaloni color kaki e una bottiglia di coca cola tra le mani.

Ma la cosa più importante era lavorare assieme o in prima persona su un progetto, sbagliare per poi riprovare e apprendere costantemente dai propri errori.

Questo, a loro pensiero, era l’unico modo per progredire nella conoscenza e guardate oltre, sempre avanti. Ma non si trattava di un gruppo di svitati.

Pensate che, quando parlavano tra di loro, gli altri non riuscivano minimamente a comprendere quello che dicevano… erano ragazzi che persero la testa prima per i trenini e, poi, per l’informatica.

C’erano anche dei membri particolari: c’era un certo Morton, che piombava di colpo in stato catatonico. I suoi pugni si chiudevano improvvisamente, il suo corpo si irrigidiva e la sua attività fisica si riduceva a quella di un vegetale.

Ma i rapporti di fratellanza erano così sviluppati nel club che non solo il comportamento di Morton veniva tranquillamente tollerato, ma qualcuno trovò anche un’efficace terapia. Morton era un grandioso giocatore di scacchi, cosa frequente tra gli hacker come la sindrome di Asperger, e stava lavorando a un programma per far giocare a scacchi il computer.

Quando piombava nel suo stato catatonico era sufficiente pronunciare la frase “Morton, che ne dici di una bella partita a scacchi?” e Morton meccanicamente si sedeva al tavolo e iniziava una silenziosa partita a scacchi che lo riportava finalmente sulla Terra.

È da qui, da questo posto che prese forma il motto del club e di molti libri successivi sulla programmazione informatica, “mettici le mani sopra” (in inglese “hands on”), per evidenziare l’importanza di procedere empiricamente, oltre che teoricamente, nello studio di una disciplina.

Ma tutto questo cosa c’entra con l’informatica e la cultura hacking?

La parola Hacker prese forma dalla fazione che si occupava di Signal and Power.
Infatti il plastico era governato inizialmente da un mainframe IBM 704, per poi passare al TIX-0 e successivi elaboratori quali il famoso PDP-1, dove presero forma il linguaggio LISP (dalla mente del mitico Prof. John McCarthy) oltre che il primo videogioco munito di gamepad collegato, creato da Steve Russel per il PDP-1, ovvero Spacewar!

Nel Tech Model Railroad Club non si giocava solo con i trenini. Si parlava anche di computer militari, o dei primi programmi per creare e diffondere musica. Qui nacque l’etica hacker, ovvero una sorta di “manifesto programmatico”, che avrebbe fatto una grande “presa” sull’humus libertario degli anni Sessanta.

Perché, ieri come oggi, l’hacking è esplorazione, manipolazione, comprendere le cose come sono fatte dentro per poi migliorarle, vederle sotto altre angolazioni, vedere oltre attraverso intuizione, genio e arte.

Quindi essere un Hacker non è riferito solo alla sicurezza informatica, ma può abbracciare tutte le discipline.

E allora, nel tuo lavoro, sei un hacker anche tu?

[embedded content]

Articolo a cura di Massimiliano Brolli

Download PDF

https://www.ictsecuritymagazine.com/articoli/lhacking-e-un-percorso-non-una-destinazione/


Framework dell’analisi digitale forense – parte II

Segue dalla prima parte

Identificazione

Il processo di identificazione (da non confondere con la fase di identificazione, che solitamente si svolge in fase di perquisizione e sequestro) deve essere messo in atto per ogni elemento contenuto nell’elenco dei dati estratti.

In primo luogo, si determina la natura dell’elemento attenzionato. Se non è rilevante per rispondere ai quesiti posti, si contrassegna semplicemente come elaborato o processato e si va avanti. Proprio come in una ricerca fisica, se ci si imbatte in un elemento potenzialmente incriminante, ma al di fuori dell’ambito del mandato di ricerca originale, è consigliabile interrompere immediatamente tutte le attività, notificare l’evento ai soggetti appropriati (fatto salvo nei casi previsti dall’ordinamento o in caso di investigazione difensiva c.p.p. art. 334-bis), incluso il richiedente, e attendere ulteriori istruzioni.
Ad esempio, le forze dell’ordine potrebbero sequestrare un computer alla ricerca di prove per frode fiscale, ma ci si imbatte poi in un’immagine pedopornografica. L’approccio più prudente, nel caso in cui si rinvengono prove fuori dell’ambito di un mandato, è quello di fermare la ricerca e cercare di ampliare l’autorità di quel mandato o di ottenere un secondo mandato. Se un elemento, invece, è rilevante e pertinente ai fini dell’indagine viene documentato e inserito in un terzo elenco, l’elenco dei dati pertinenti (“Relevant Data List”). Questo elenco è una raccolta di dati rilevanti utili per rispondere al quesito o ai quesiti posti.

Figura 1 – Identificazione

In un caso di furto di identità, i dati rilevanti potrebbero includere tra le altre cose numeri di codice fiscale, numero di CI o patente, false immagini di identificazione o e-mail in cui si discute di furto di identità. È anche possibile che un elemento generi un altro oggetto (“lead”) che induca una nuova ricerca (“Data Search Leads”). Un’e-mail potrebbe rivelare che un target, oggetto di indagine, stava usando un altro nickname. Questo porterebbe a una nuova parola chiave da ricercare, ovvero quel nuovo nickname. Si può aggiungere questo nuovo elemento nella Lista di Elementi da ricercare (“Data Search Lead List”) in modo che ci si ricordi di indagare approfonditamente su di esso in seguito.

Un elemento può anche condurre a una nuova potenziale fonte di dati utili (“New Source of Data”) e che precedentemente non era stata considerata.
Ad esempio, si potrebbe trovare un nuovo account di posta elettronica utilizzato dal target. Si potrebbero anche trovare prove che indicano l’esistenza di file memorizzati su un’unità USB rimovibile e che le forze dell’ordine non hanno trovato al momento della perquisizione. In queste circostanze, le forze dell’ordine possono prendere in considerazione la possibilità di richiedere un nuovo mandato di perquisizione per cercare l’unità USB. Un’accurata elaborazione forense dei dati può portare alla luce molti tipi diversi di nuove prove. Tra questi si possono considerare i registri di sistema, i file di log, la creazione di registri di accesso o di eventi, recent files, lnk files, metadati, ecc. e cronologie di diversa natura, come ad esempio navigazione web e molti altri ancora.

Si documenta, quindi, tutto ciò e li si inserisce in un quarto elenco, la Lista di nuove fonti di dati (“New Source of Data list”). Dopo aver esaminato ed esaurito l’elenco dei dati estratti (“Prepared/Extracted Data List”), si esaminano tutti i nuovi lead sviluppati. Per tutti i nuovi lead di ricerca dei dati, può rendersi utile tornare alla fase di Estrazione lavorando sull’immagine forense. Questo nell’eventualità in cui i dati a cui fanno riferimento i nuovi processi di ricerca non siano immediatamente disponibili, già estratti. Allo stesso modo, per qualsiasi nuova fonte di dati che potrebbe portare a nuove prove, sarà necessario tornare fino al processo di acquisizione e imaging dei nuovi dati forensi. Questo è il caso in cui, ad esempio, venisse rinvenuto un nuovo supporto di memorizzazione come l’unità USB di cui si parlava prima.

A questo punto delle indagini – e a seconda dei casi -, potrebbe essere consigliabile informare il richiedente dei risultati ottenuti. I dati pertinenti estratti e identificati possono già fornire informazioni sufficienti per portare avanti il caso. La conseguenza sarebbe non aver bisogno di effettuare ulteriori lavori. Infatti, in un caso di pedopornografia, se si recuperano un numero sufficiente e schiacciante di immagini pedopornografiche organizzate in directory create dall’utente e sussistono ulteriori condizioni necessarie anche di natura tecnica che permettano di accertare i fatti, un pubblico ministero potrebbe essere in grado di ottenere una sentenza di colpevolezza senza ulteriori analisi forensi.

Se invece i dati estratti e identificati “semplici” non sono sufficienti, la fase successiva è l’analisi.

Analisi

Nella fase di analisi bisogna cercare di collegare tutti i punti e dipingere un quadro completo del caso.

Per ogni elemento dell’elenco dei dati pertinenti, è appropriato rispondere a domande come chi, cosa, quando, dove e come. Bisogna cercare di spiegare quale utente o applicazione ha creato, modificato, ricevuto o inviato ogni elemento e come esso ha avuto origine. È importante spiegare e documentare anche dove vengono trovati questi elementi. Ancora più importante, spiegare perché tutte queste informazioni sono significative e cosa significano per il caso in esame.

Spesso gli esperti possono rendere l’analisi più preziosa e meticolosa osservando tecnicamente quando sono avvenute le cose e producendo una linea temporale (timeline) che racconti una storia coerente. Per ogni elemento pertinente, si illustra quando è stato creato, acceduto, modificato, ricevuto, inviato, visualizzato, eliminato e avviato. Si osservano e spiegano sequenze di eventi, mettendo in evidenza e in relazione quali eventi sono accaduti nello stesso momento o periodo temporale.

Figura 2 – Analisi

Si deve documentare adeguatamente tutte le analisi svolte e altre informazioni rilevanti per la richiesta forense da soddisfare e aggiungere tutto in un quinto e ultimo elenco, l’“Elenco dei risultati dell’analisi” (“Analysis results list”). Questo è un elenco di tutti i dati significativi che rispondono a chi, cosa, quando, dove, come e altre domande. Le informazioni contenute in questo elenco devono soddisfare la richiesta e i questi sottoposti all’analista forense dal richiedente. Anche in questa fase avanzata del processo, qualcosa potrebbe generare nuovi lead di ricerca dei dati o anche una nuova fonte di dati: in questo caso, questi verranno aggiunti agli elenchi appropriati per poi valutare la possibilità di tornare indietro per esaminarli approfonditamente.

Infine, dopo avere effettuato questi passaggi un numero sufficiente di volte e quando si è certi dei risultati ottenuti, si può rispondere compiutamente alla richiesta formulata dal richiedente, redigendo la necessaria relazione tecnica. A questa fa seguito la preparazione di una adeguata presentazione. Questo è il passaggio in cui bisogna documentare con adeguato registro i risultati, in modo che il richiedente o autorità giudiziaria possa comprenderli e utilizzarli nel procedimento.

La relazione finale è il modo migliore per comunicare i risultati al richiedente. La presentazione, ancor di più, è importante perché l’intero processo forense diventa valido e utilizzabile, nelle opportune sedi, in funzione della capacità di trasmettere correttamente tutte le informazioni al richiedente, qualsiasi esso sia. Dopo la presentazione, il richiedente esegue un’analisi a livello di caso in cui egli (eventualmente con gli esperti) interpreta i risultati nel contesto dell’intero caso giudiziario.

Conclusioni

Mentre esperti e richiedenti si destreggiano attraverso questo tutto questo processo, è doveroso pensare al ritorno economico dell’investimento profuso in termini di tempo, competenze e risorse. Vi è anche un tema molto dibattuto sulla proporzionalità delle vacazioni e il corretto riconoscimento delle competenze in questo settore. Oltretutto, durante un’azione investigativa, le fasi del processo possono essere ripetute più volte determinando ulteriore dispendio. Tutti coloro che sono coinvolti nel caso devono determinare quando possa essere utile fermarsi. Una volta ottenute le prove, il valore dell’identificazione e dell’analisi aggiuntive tende inevitabilmente a diminuire.

Si spera che questo articolo possa essere un’utile introduzione alla informatica forense e alla metodologia di analisi digitale forense; il diagramma di flusso può servire come strumento utile per guidare le analisi.

Riferimenti

https://www.altalex.com/documents/news/2013/12/18/notizia-di-reato

https://www.sicurezzaegiustizia.com/giustizia-ed-informatica-forense-particolarita-ed-eccezioni/

Articolo a cura di Francesco Costanzo

Ho conseguito la laurea in Ingegneria Informatica presso l’Università della Calabria.

Mi sono specializzato in digital forensics e investigazioni digitali attraverso un master in digital forensics e cyber security presso l’ISF College Corporate University (Milano). In seguito perfezionato in Criminalità Informatica e Investigazioni Digitali presso l’Università Statale di Milano.

Sono membro dell’Associazione Nazionale Criminologi e Criminalisti (Elenco del Ministero dello Sviluppo Economico, legge 14 gennaio 2013, n. 4). Iscritto al n. 00148/2020/PRO Sett. B Criminalisti in qualità di Criminalista esperto.

In possesso dell’Attestato di Qualità e Qualificazione Professionale dei Servizi prestati ai sensi degli artt. 4, 7 e 8 della legge 14 gennaio 2013, n. 4 (Attestato approvato Ministero dello Sviluppo Economico) rilasciato dall’Associazione Nazionale Criminologi e Criminalisti.

Presso l’Istituto di Scienze Forensi ricopro la figura di Investigatore tecnico forense.

Sono docente titolare degli insegnamenti di “Digital e computer forensics” presso l’ISF College Corporate University di Corsico (MI).

Download PDF

https://www.ictsecuritymagazine.com/articoli/framework-dellanalisi-digitale-forense-parte-ii/


Modello di autovalutazione relativo a un sistema di Intelligenza Artificiale

Introduzione

L’intelligenza artificiale – o meglio, i devices che posseggono una qualche forma di intelligenza artificiale – sono ormai numerosi. Sono innumerevoli le applicazioni che utilizzano la AI per analizzare, confrontare i dati e produrre risultati. L’intelligenza artificiale (IA), la robotica, i dati e il machine learning entrano quotidianamente nelle nostre case, nei luoghi di lavoro e nell’ecosistema sociale.

È opportuno anche definire cosa si intenda per Intelligenza Artificiale. Quando si parla di AI si pensa subito ai robot, a tecnologie di avanguardia, a un mondo futuristico con sistemi complessi utilizzati in moltissimi settori. Si tratta però anche di sistemi meno invasivi e meno visibili: si pensi al machine learning, ai big data o alle reti neurali.

In pratica l’Intelligenza Artificiale è un ramo dell’informatica che permette la programmazione e la progettazione di sistemi sia hardware che software, conformando le macchine a determinate caratteristiche tipicamente umane (il tatto, le percezioni visive, le percezioni spazio-temporali, le prese decisionali).

I dati sono i mattoni dell’IA; a volte sono semplici algoritmi, ma spesso sono esponenzialmente più complessi.

L’aumento delle tecnologie digitali, insieme all’enorme quantità di dati prodotti ogni giorno da ognuno di noi, ha dato all’intelligenza artificiale una dimensione interamente nuova e importante: il machine learning, un’applicazione dell’IA che offre ai sistemi la capacità di imparare automaticamente e migliorare dall’esperienza senza essere esplicitamente programmati.

Il machine learning si concentra sullo sviluppo dei software per computer che possono accedere ai dati e usarli per imparare in autonomia.
Si considera, quindi, non solo l’intelligenza intesa come capacità di calcolo o conoscenza di dati astratti, ma anche di forme di intelligenza riconosciute dalla teoria di Gardner e che possono considerare l’intelligenza spaziale, sociale, cinestetica o introspettiva. Un sistema intelligente viene realizzato cercando di ricreare una o più di queste differenti forme che, anche se considerate come semplicemente umane, possono essere ricondotte a particolari comportamenti riproducibili da alcune macchine.

Immagine del report: “Una definizione di IA: principali capacità e discipline scientifiche Gruppo di esperti ad alto livello sull’intelligenza artificiale della Commissione Europea (aprile 2019), Figura 2: quadro semplificato delle sottodiscipline dell’IA e delle correlazioni esistenti tra di esse”

Per un efficace sistema di gestione dell’AI è necessario definire alcuni principi, sia dal punto di vista etico sia dal punto di vista della sicurezza e dell’impatto sull’utente.

I principi – dignità e supervisione umana; robustezza e sicurezza; privacy e governance dei dati; trasparenza; diversità, non discriminazione ed equità; benessere sociale e ambientale; accountability – vanno poi declinati in ulteriori controlli.

Fonte: Research Publication No. 2020 -1 January 15, 2020 Principled Artificial Intelligence: Mapping Consensus in Ethical and Rights-based Approaches to Principles for AI

Risulta quindi fondamentale avere un approccio olistico di governance, che va oltre la componente tecnologica per abbracciare varie discipline tra loro correlate (tecniche, giuridiche, tecnologiche, di GRC [governance, risk, compliance]) affrontando l’argomento in termini di metodologia.

Metodologia

Il sistema di autovalutazione illustrato è stato mutuato dal framework del CSF e CSFP del NIST, nonché dalla linea guida Assessment List for Trustworthy AI (ALTAI) del luglio 2020.

Il tool utilizza le sette categorie dell’AI e utilizzando un modello simile ai framework riportandole nelle funzioni del modello; vengono poi individuate delle categorie dedicate e delle sotto categorie che corrispondono alle domande dell’autovalutazione.

Viene introdotta anche una scala di maturità (1, 3 e 5) come punteggio da assegnare alle singole risposte delle sotto categorie. La scala riporta il valore di completezza delle risposte.

Il modello produce poi dei grafici riassuntivi della fotografia dell’organizzazione. Riportiamo un esempio del modello.

È opportuno anche porsi alcune rapide domande in merito alla sicurezza e ai rischi relativi all’implementazione di un sistema AI, che ci permettono di comprendere meglio cosa e come fare e rendere più efficace l’autovalutazione:

  • determinare il contesto di sicurezza nazionale;
  • identificare il tipo di applicazione AI utilizzata;
  • identificare i potenziali rischi e i problemi associati all’applicazione;
  • determinare le metriche più importanti che potrebbero aiutare a indicare che il sistema “lavora” in modo affidabile, accurato, appropriato;
  • scegliere un tipo di standard e adattalo alle metriche precedentemente identificate;
  • identificare le considerazioni, le limitazioni e i presupposti chiave.

Nel quadro dell’approccio olistico sopra delineato, va sempre tenuto a mente che l’impatto delle intelligenze artificiali nella dimensione reale passa attraverso due principali macro-argomenti: l’etica e la responsabilità.

Da una parte, dunque, è bene riferirsi alle Linee Guida Etiche sull’intelligenza artificiale[1] della Commissione Europea, caratterizzate da un approccio umano-centrico, e che rivolgono il focus su alcuni principi etici e argomenti quali la sicurezza, la riservatezza e la privacy dei dati e del materiale informatico in questo particolare ambito.

Per essere eticamente corretta l’AI deve essere sostanzialmente affidabile, il che si traduce concretamente in conformità alle leggi, rispetto dei principi etici e solidità, ossia principi capaci di assicurare la centralità della dignità e delle libertà umane.

Inoltre – ci ricordano le Linee Guida – va tenuto in buon conto che 7 sono i requisiti individuati, come anche riportato sopra e qui integrati, affinchè un’intelligenza artificiale possa dirsi anche etica, ossia è necessario che vi siano:

  1. supervisione umana e dunque che i sistemi di IA siano sorvegliati da personale umano, a garanzia del rispetto dei diritti fondamentali e del benessere dell’utente;
  2. robustezza e sicurezza, intese come sicurezza ed affidabilità degli algoritmi e come tenuta dei sistemi di controllo in caso di ipotetiche operazioni illecite;
  3. privacy, controllo e gestione dei dati;
  4. trasparenza a garanzia della tracciabilità dei sistemi e a dimostrazione delle operazioni compiute dell’algoritmo;
  5. diversità, correttezza, assenza di discriminazione: i sistemi di intelligenza artificiale dovrebbero tenere conto delle diverse e distinte abilità e capacità umane, garantendo al tempo stesso a tutti il libero accesso a tali strumenti;
  6. benessere sociale e ambientale, ossia avere sempre riguardo all’impatto sull’ambiente e sull’assetto sociale, promuovendo l’utilizzo dell’IA solo laddove il suo utilizzo possa garantire uno sviluppo sostenibile;
  7. responsabilità, ovvero verifica continua dei sistemi, sia internamente che esternamente.

Riprendendo l’ancor attualissimo pensiero del Prof. Rodotà, insomma, “proprio perché i problemi più acuti nascono dalla disponibilità di un arsenale tecnologico sempre più imponente, qui come altrove bisogna chiedersi se tutto quel che è tecnicamente possibile sia pure eticamente lecito, politicamente e socialmente accettabile, giuridicamente ammissibile. L’avvenire democratico si gioca sempre di più intorno alla capacità sociale e politica di trasformare le tecnologie dell’informazione e della comunicazione in tecnologie della libertà, e non del controllo”.

Altro aspetto che va debitamente soppesato in una valutazione a tutto tondo è quello inerente i profili di responsabilità che potrebbero derivare in caso di errore durante l’utilizzo dell’intelligenza artificiale (e quindi il problema dell’attribuzione della responsabilità) e di risarcimento dell’eventuale danno.

Oltre ai rischi prettamente materiali, sono da valutare anche quelli informatici, legati al software, all’algoritmo (e alla mancanza di trasparenza dello stesso), ai comandi a distanza, alla cybersicurezza e ai cyber-attacchi, alla manutenzione, alla messa in sicurezza dei dati personali e delle informazioni, così come le ricadute in ambito di danni e di titolarità delle responsabilità.

Ecco che, quindi, ancora una volta bisognerà seguire il principio del Risk Based Approach, adottando modelli di “security by design” e “by default” che permettano di improntare i processi al rispetto dei principi in materia di privacy e sicurezza, come del controllo, aggiornamento e adeguamento periodico e sistematico di dati e informazioni.

Sul punto, un profilo particolarmente dibattuto da ultimo è quello relativo alla possibilità di aprire la strada a una responsabilità civile per danno da algoritmo (forse anche mediante la creazione di una personalità giuridica ad hoc per l’AI), quanto meno nei casi di algoritmi generati da machine learning o deep learning, caratterizzati – oltre che dai tre elementi tipici dell’AI (interattività, autonomia, adattabilità) – anche dall’imprevedibilità[2].

In tal senso, essendo l’AI costituita da sistemi complessi, bisognerebbe capire se incardinare la responsabilità sulla figura del solo produttore dell’AI – ad esempio –, o se configurarla in capo a ulteriori e diversi responsabili, partendo da chi ne abbia realizzato una singola parte sino ad arrivare – in via potenziale – direttamente all’algoritmo di base del sistema.

Ulteriore punto discusso è quello relativo ai casi di danni prodotti direttamente dall’AI in qualità di soggetto agente: in questa evenienza secondo alcuni si potrebbe tranquillamente riconoscere una responsabilità anche penale in capo all’AI, mentre secondo la tesi avversaria, non potendo essere rintracciati gli elementi di base di una vera e propria responsabilità, l’AI non potrebbe rispondere di alcunchè e – ovviamente – neppure essere sanzionata.

Di certo, come si legge nel White Paper del 19 febbraio 2020 della Commissione Europea[3], “gli attori economici rimangono pienamente responsabili di garantire che l’IA sia conforme alle attuali norme sulla protezione dei consumatori. Qualsiasi sfruttamento algoritmico del comportamento del consumatore in violazione delle disposizioni esistenti è proibito e le violazioni saranno sanzionate di conseguenza”.

Ecco che quindi, attraverso un’azione legislativa comune, l’Unione Europea (e l’Italia nel suo piccolo) avrebbero tutto il potenziale necessario per diventare un modello di riferimento e riuscire a trovare la risposta ad alcune domande che naturalmente scaturiscono dall’utilizzo dell’intelligenza artificiale.

In quest’ottica, dunque, è bene non dimenticare di guardare anche agli ultimi lavori in tema condotti dal Servizio di Ricerca del Parlamento Europeo (European framework on ethical aspects of artificial intelligence, robotics and related technologies[4]) e dal MISE (Strategia Nazionale per l’Intelligenza Artificiale[5]).

L’EPRS ci ricorda, infatti, che dall’uso dell’intelligenza artificiale possono derivare grandi vantaggi per i cittadini, le imprese e i pubblici servizi (ad es. migliore assistenza sanitaria, automobili e altri sistemi di trasporto più sicuri e anche prodotti e servizi su misura, più economici e più resistenti), ma anche rischi rilevanti (abuso e sottoutilizzo, responsabilità civile, minacce ai diritti fondamentali e alla democrazia, scomparsa di posti di lavoro).

Nello specifico e sugli aspetti di responsabilità per danni causati da un dispositivo o servizio azionato dall’intelligenza artificiale, nella Relazione ci si interroga su chi sarebbe tenuto a pagare i danni in caso di incidente con un’auto a guida autonoma: il proprietario, il costruttore o il programmatore?

Se il produttore fosse privo di responsabilità potrebbero non esserci incentivi sufficienti a fornire un prodotto sicuro ed efficiente e il pubblico potrebbe finire per avere meno fiducia nella tecnologia. Ma, allo stesso tempo, anche norme troppo severe potrebbero soffocare i tentativi di innovazione.

La strategia italiana sull’intelligenza artificiale sembra allinearsi a quella europea, nell’ottica di un’AI “affidabile”, che sappia conquistare la fiducia dei cittadini grazie a caratteristiche come trasparenza, robustezza, resilienza, antropocentrismo e miglioramento della vita delle persone.

“L’IA deve essere al servizio delle persone, garantendo una supervisione umana, prevenendo i rischi di inasprimento degli squilibri sociali e territoriali potenzialmente derivanti da un suo utilizzo inconsapevole o inappropriato. L’IA deve essere progettata e realizzata in modo affidabile e trasparente, per una sua accettabilità consapevole e una intrinseca robustezza affinché sia adottabile in ogni ambito produttivo e capace di rispondere alle sfide sociali del nostro Paese. L’IA deve generare opportunità di crescita e di benessere per tutti gli individui, in linea con i principi contenuti nell’articolo 3 della Costituzione italiana e gli Obiettivi di Sviluppo Sostenibile delle Nazioni Unite (ONU). Deve essere essa stessa una tecnologia sostenibile e fornire strumento per la sostenibilità ambientale, economica e sociale”.

E ancora, “I dati sono il carburante delle tecnologie IA. E sono i dati ad aver ‘cambiato le carte’ in tavola. È stata, infatti, la disponibilità di informazioni in formato digitale, più ancora che l’aumentata capacità di calcolo, a spiegare lo sviluppo dell’IA nell’ultimo decennio. Dati strutturati e non, attività su Internet, sensori che rilevano dati in qualsiasi ambiente: dalla strada all’industria. Se è qui il fulcro dello sviluppo dell’IA, dobbiamo continuare a focalizzare la nostra attenzione su questo aspetto, gestendolo anziché lasciare che altri lo facciano per noi.
In questo senso l’impegno italiano è definire una policy dei dati”.

Cruciale, quindi, è la sicurezza dei dati. In questo senso l’attuazione della direttiva NIS è stato il primo passo; il secondo sarà l’attuazione della legge sul perimetro di sicurezza nazionale cibernetica.

C’è da augurarsi che sarà il più importante cambio di paradigma tecnologico dei nostri tempi.

Note

[1] https://www.europarl.europa.eu/RegData/etudes/BRIE/2019/640163/EPRS_BRI(2019)640163_EN.pdf

[2] Sul punto si vedano anche: M. D’Agostino Panebianco, “Legal aspects and liability of Algorithm, in the light of the White Paper on AI of European Commission”, https://www.federalismi.it/nv14/articolo-documento.cfm?Artid=44090&content=Legal%2Baspects%2Band%2Bliability%2Bof%2BAlgorithm%2C%2Bin%2Bthe%2Blight%2Bof%2Bthe%2BWhite%2BPaper%2Bon%2BAI%2Bof%2BEuropean%2BCommission&content_author=%3Cb%3EManlio%2Bd%27Agostino%2BPanebianco%3C%2Fb%3E e Anna Capoluongo, “AI, la giurisprudenza guarda al danno da algoritmo”, https://www.ai4business.it/intelligenza-artificiale/ai-la-giurisprudenza-guarda-al-danno-da-algoritmo/#post-5361-footnote-5

[3] https://ec.europa.eu/info/publications/white-paper-artificial-intelligence-european-approach-excellence-and-trust_en

[4] https://www.europarl.europa.eu/RegData/etudes/STUD/2020/654179/EPRS_STU(2020)654179_EN.pdf

[5] https://www.mise.gov.it/images/stories/documenti/Strategia_Nazionale_AI_2020.pdf

Articolo a cura di Stefano Gorla, Anna Capoluongo e Augusto Bernardi

Stefano Gorla è nato a Milano, si è laureato in fisica nucleare presso l’Università di Padova. Ha insegnato per qualche anno Matematica e Fisica presso alcuni licei.

Da anni si occupa di privacy e sicurezza dei dati attraverso un approccio sistemico e olistico.
Consulente e formatore in ambito sicurezza e tutela dei dati e delle informazioni e relatore in numerosi convegni.

Auditor ISO 27001, DPO Certificato FAC Certifica, NIST Specialist Certificato Fac Certifica, Certificato COBIT5 ISACA, Master EQFM.
Ha maturato notevoli esperienze come Referente Privacy (DPO) e consulente in tali ambiti.
È autore di varie pubblicazioni sul tema.

Avvocato, esperta in Diritto delle Nuove Tecnologie, Privacy&Data Protection, Contrattualistica e Diritto civile. Partner presso lo Studio Capoluongo, DPO per Aziende in ambito sanitario, universitario e tecnologie dell’informatica, Docente a contratto Sigmund Freud University – campus di Milano e 24Ore Business School, Vicepresidente “Istituto di Ricerca per gli Studi Giuridici, Economici e Sociali”, si occupa prevalentemente di consulenza societaria sia nazionale che internazionale ed è specializzata in new tech law, privacy&data protection, videosorveglianza, contrattualistica e responsabilità medica.

Augusto Bernardi, nato a Bressanone (BZ), ha seguito un ciclo di studi in giurisprudenza e diritto internazionale presso l’Università di Innsbruck (A). Dopo un’esperienza nel modo assicurativo e finanziario si è dedicato alla consulenza normativa, giuridica e di protezione dei dati delle cooperative di distribuzione elettrica e centrali di teleriscaldamento della Provincia di Bolzano.

Negli ultimi anni si è dedicato all’approfondimento delle conoscenze della nuova regolamentazione europea in materia di protezione dei dati e opera come consulente privacy e responsabile per la protezione dei dati per numerose aziende dell’Alto Adige.

Formatore e relatore in ambito sicurezza e tutela dei dati per le aziende e organizzazioni pubbliche, è DPO Certificato UNI 11697 da FAC Certifica.

Download PDF

https://www.ictsecuritymagazine.com/articoli/modello-di-autovalutazione-relativo-a-un-sistema-di-intelligenza-artificiale/


Le centrali di committenza e il GDPR

L’esperienza nella definitiva applicazione del Reg. UE 2016/679 (GDPR) ci ha portato ad affrontare molti casi concreti, superandoli anche con l’aiuto delle linee guida dell’European Data Protection Board (EDPB)[1] e del Garante per la Protezione dei Dati Personali[2]. Tra i documenti più recenti dell’EDPB, ancora nella fase di consultazione, ci sono le Guidelines 07/2020 on the concepts of controller and processor in the GDPR[3] che chiariscono la dinamica del rapporto tra titolare e responsabile del trattamento, con particolare attenzione alle previsioni dell’art. 28 del GDPR. Purtroppo, le linee guida n. 7 non hanno aiutato a chiarire alcuni aspetti che caratterizzano tale dinamica quando, in ambito di scelta del contraente nella pubblica amministrazione, interviene un soggetto terzo che funge da centrale di committenza secondo la definizione contenuta nell’art. 3, comma 1, lett. i) del D.Lgs. 50/2016 (Codice dei contratti pubblici)[4].

Cercheremo, dunque, di approfondire gli aspetti problematici di questa fattispecie e di esprimere alcuni elementi che possono aiutare a superarli.

Le “garanzie sufficienti”

L’art. 28 del GDPR prevede che:

“Qualora un trattamento debba essere effettuato per conto del titolare del trattamento, quest’ultimo ricorre unicamente a responsabili del trattamento che presentino garanzie sufficienti per mettere in atto misure tecniche e organizzative adeguate in modo tale che il trattamento soddisfi i requisiti del presente regolamento e garantisca la tutela dei diritti dell’interessato”.

Questo vuol dire che, quando una pubblica amministrazione vuole scegliere un partner esterno al quale affidare una parte o l’intero processo di trattamento di dati personali, deve:

  • attenersi alle previsioni del Codice dei contratti pubblici e, quindi, avviare una procedura pubblica di scelta del contraente per l’affidamento;
  • definire, fin dall’avvio della procedura di scelta del contraente, quali garanzie richiedere al contraente per proteggere i dati personali; questo vale sia quando si tratta di una vera e propria “gara” (così come comunemente sono chiamate le procedure che prevedono la candidatura di più soggetti) sia quando si procede all’affidamento diretto.

Il combinato disposto di questi due obblighi deve indurre l’amministrazione aggiudicatrice a:

  1. predisporre una valutazione dei rischi (se è necessario nelle forme e nei contenuti della valutazione d’impatto sulla protezione dei dati personali prevista dall’art. 35 del GDPR);
  2. formalizzare preventivamente, in un apposito documento, misure di garanzia adeguate a minimizzare il rischio precedentemente valutato, che il contraente deve assicurare durante il trattamento effettuato per conto del titolare (cioè della stessa amministrazione aggiudicatrice); il documento può assumere la forma di requisiti specifici obbligatori o di criteri di valutazione dell’offerta tecnica nell’ambito di un capitolato oppure di un apposito allegato ad una richiesta di preventivo; in ogni caso, le misure di garanzia devono essere portate a conoscenza del “candidato contraente” (potenziale responsabile del trattamento) prima di giungere alla conclusione del contratto affinché tali misure siano parte integrante del contratto stesso e, quindi, figurino tra le obbligazioni del contraente;
  3. definire, nell’ambito del contratto, apposite penali in caso di inadempimento rispetto alle misure di garanzia previste oltre che, nei casi più gravi, clausole risolutive.

Le linee guida dell’EDPB

Le linee guida n. 7/2020 dell’EDPB dedicano un apposito paragrafo alla scelta del responsabile del trattamento e alle garanzie sufficienti.
L’elemento chiave sul quale punta l’EDPB è la definizione caso-per-caso delle garanzie che l’amministrazione deve effettuare tenendo conto della natura, del perimetro, del contesto e degli scopi del trattamento (in pratica effettuando una preventiva valutazione dei rischi) pur suggerendo alcuni elementi che possono essere impiegati per caratterizzare i candidati contraenti, cioè:

  • privacy policy;
  • adeguati termini del servizio;
  • registrazione delle operazioni di trattamento;
  • sistema di gestione della sicurezza delle informazioni (p.e., ISO-IEC 27001);
  • resoconti periodici di audit esterni;
  • precedenti esperienze di trattamento in ambiti analoghi;
  • risorse disponibili per il trattamento;
  • adesione a codici di condotta;
  • meccanismi di certificazione.

Tuttavia, questi costituiscono elementi generali che, sebbene ragionevoli, non tengono conto della specificità del singolo trattamento adottato dall’amministrazione aggiudicatrice.

Le centrali di committenza

A questa circostanza si aggiunge un ulteriore elemento problematico. In alcuni casi, non infrequenti, le procedure di scelta del contraente si sviluppano con l’aiuto di un intermediario: la centrale di committenza. Il Codice dei contratti pubblici, infatti, all’art. 37, comma 1 prevede che:

“Le stazioni appaltanti, fermi restando gli obblighi di utilizzo di strumenti di acquisto e di negoziazione, anche telematici, previsti dalle vigenti disposizioni in materia di contenimento della spesa, possono procedere direttamente e autonomamente all’acquisizione di forniture e servizi di importo inferiore a 40.000 euro e di lavori di importo inferiore a 150.000 euro, nonché attraverso l’effettuazione di ordini a valere su strumenti di acquisto messi a disposizione dalle centrali di committenza e dai soggetti aggregatori”.

Con la seguente specificazione, al successivo comma 7:
“Le centrali di committenza possono:
a) aggiudicare appalti, stipulare ed eseguire i contratti per conto delle amministrazioni aggiudicatrici e degli enti aggiudicatori;
b)
stipulare accordi quadro ai quali le stazioni appaltanti qualificate possono ricorrere per l’aggiudicazione dei propri appalti;
c)
gestire sistemi dinamici di acquisizione e mercati”.

Accade, quindi, che le centrali di committenza (o qualsiasi altro soggetto aggregatore) fungano da intermediari per una pluralità di singole amministrazioni. Questo accade molto spesso per piccoli comuni, carenti di professionalità adeguate a gestire le gare, o anche per aziende sanitarie pubbliche, obbligate dalla normativa regionale, e significa che la centrale di committenza arriva a definire in modo completo il quadro delle obbligazioni al quale è vincolato il contraente. Quando l’oggetto del contratto coinvolge, in tutto o in parte, il trattamento dei dati personali, il contraente assume il ruolo di responsabile del trattamento per la singola amministrazione che, quindi, si trova:

  • ad assumere il ruolo di titolare senza essere il soggetto che ha effettuato la scelta e, quindi, senza aver avuto la possibilità concreta di definire le “garanzie sufficienti” adeguate al proprio contesto;
  • a non poter integrare gli obblighi contrattuali per il contraente-responsabile che, ovviamente, non sarebbe disposto a sopportare eventuali costi aggiuntivi non preventivati.

Qualche ipotesi risolutiva

Per superare questo aspetto problematico, con riferimento all’ipotesi in cui il contraente assumerà il ruolo di responsabile del trattamento per conto delle singole amministrazioni, possono essere utili le seguenti indicazioni pratiche.

Indagare preventivamente le esigenze delle singole amministrazioni: la centrale di committenza, nel raccogliere le esigenze funzionali delle singole amministrazioni aggiudicatrici, deve porre particolare attenzione alla valutazione dei rischi nel trattamento dei dati personali; la valutazione dei rischi e la conseguente griglia delle misure di garanzia da chiedere ai candidati dovrebbero essere sottoposte alle singole amministrazioni aggregate affinché possano preventivamente condividerle.

Lasciare un margine di libertà nell’ambito delle singole dinamiche contrattuali: la centrale di committenza, ferma restando la necessità di obbligare il contraente ad offrire garanzie minime legate allo specifico trattamento di dati personali connesso all’oggetto del contratto, potrebbe prevedere, nell’ambito degli accordi con lo stesso contraente, un margine decisionale alle singole amministrazioni affinché possano autonomamente completare il quadro di protezione che sono obbligate ad offrire agendo quali titolari del trattamento.

Note

[1] https://edpb.europa.eu/edpb_it

[2] https://www.garanteprivacy.it/

[3] https://edpb.europa.eu/sites/edpb/files/consultation/edpb_guidelines_202007_controllerprocessor_en.pdf

[4] «Centrale di committenza»: un’amministrazione aggiudicatrice o un ente aggiudicatore che forniscono attività di centralizzazione delle committenze e, se del caso, attività di committenza ausiliarie.

Articolo a cura di Francesco Maldera

Francesco Maldera è Data Protection Officer e Data Scientist.

Il suo percorso professionale lo ha chiamato a responsabilità direzionali nell’ambito dei sistemi informativi, della safety&security, della privacy e dell’auditing svolgendo diversi incarichi dirigenziali nella Pubblica Amministrazione e in aziende private.

Attualmente, accompagna l’attività consulenziale a quella di sensibilizzazione delle persone tramite il sito www.prontoprivacy.it

Download PDF

https://www.ictsecuritymagazine.com/articoli/le-centrali-di-committenza-e-il-gdpr/


Framework dell’analisi digitale forense

Introduzione

Emersa a partire dai primi nei anni 80, quando i personal computer cominciavano ad essere più accessibili ai consumatori accrescendone però l’utilizzo in attività criminali, il campo dell’informatica forense è relativamente giovane rispetto ad altre scienze forensi.

Nonostante intervenga oramai in moltissimi procedimenti giudiziari come uno dei principali mezzi di investigazione legato a diversi crimini, di natura puramente informatica e non, non sempre si riesce a capire pienamente ciò che significa il termine informatica forense e quali siano le tecniche convolte. In particolare, sovente, vi è una mancanza di chiarezza per quanto riguarda la distinzione tra l’estrazione dei dati e l’analisi dei dati.

Il Cybercrime Lab in the Computer Crime and Intellectual Property Section (CCIPS) ha sviluppato un interessante flow chart che descrive nel dettaglio la metodologia di analisi forense digitale, disponibile sul sito web https://www.justice.gov/sites/default/files/criminal-ccips/legacy/2015/03/26/forensics_chart.pdf. Tale flow chart è frutto della collaborazione di numerosi computer forenser expert operanti in diverse agenzie federali americane. Questo lo rende una valida guida durante le fasi dell’investigazione e aiuta a chiarire meglio le varie fasi del processo di analisi forense.

In questo articolo, sfruttando le caratteristiche di questo diagramma di flusso, si analizzerà e spiegherà la metodologia e i passi coinvolti in tale processo di analisi.

Panoramica della metodologia di analisi digitale forense

La definizione completa di informatica forense può essere espressa come: “L’uso di metodi collaudati e scientifici per la raccolta, conservazione, validazione, identificazione, analisi, interpretazione, documentazione e presentazione di prove digitali provenienti da fonti digitali allo scopo di facilitare o promuovere la ricostruzione di eventi ritenuti criminosi o per aiutare ad identificare preventivamente azioni non autorizzate che si potrebbero dimostrare lesive o distruttive”.

La scienza dell’informatica forense si snoda in diversi settori della tecnologia al fine di permettere al perito informatico di acquisire e analizzare diverse tipologie di dispositivi e di dati.

Molti discutono se l’informatica forense sia una scienza o un’arte. Dati i numerosi modi in cui le informazioni vengono memorizzate su un dispositivo digitale, in maniera consapevole ed esplicita ad opera dell’utente o in maniera inconsapevole e nascosta ad opera dei sistemi e degli applicativi, la ricerca di tali dati può essere tanto un’arte quanto una scienza. La questione, tuttavia, non deve necessariamente porsi.

Gli strumenti e i metodi utilizzati sono scientifici e sono verificabili scientificamente. Il loro uso, però, richiede necessariamente il possesso, da parte di chi li utilizza, di competente specialistiche fortemente caratterizzanti ovvero abilità, giudizio e capacità di interpretazione. È proprio l’esercizio di tali competenze, la cui cognizione, specie da parte dei giuristi, è conquista degli ultimi anni, ad indurre gli osservatori a far trascendere il concetto di scienza o di metodo scientifico a favore del concetto di arte.

Ecco perché la parola “tecnica”, in tutta la sua accezione, è spesso e volentieri usata per evitare l’annosa e improduttiva controversia tra scienza e arte in questo campo.

Alcuni elementi chiave dell’informatica forense sono elencati di seguito:

  • uso di metodi scientifici;
  • uso di best practices;
  • collezione (o acquisizione) e conservazione;
  • validazione;
  • identificazione;
  • analisi e interpretazione;
  • documentazione e presentazione.

Il flow chart del Laboratorio di Cybercrime propone uno schema del processo investigativo molto intuitivo e confortevole, si veda la Figura 1.

Figura 1

I tre passi, la preparazione/estrazione dei dati (1), l’identificazione (2) e l’analisi (3), sono i più importanti dell’intero processo di analisi.

Lo schema è potenzialmente iterativo, quindi si può anche decidere quante volte ripetere i passi. Infatti è di fondamentale importanza che si comprenda se un caso richiede l’esperimento di ogni singola fase o solamente la preparazione, l’estrazione e l’identificazione. Questo perché, ad esempio, lo scopo di un’analisi forense può variare dal recupero di semplici informazioni alla ricostruzione di una serie di eventi.

Il punto di partenza è l’ottenimento di tutto il necessario per procedere, ovvero le immagini forensi dai dati da sottoporre alle analisi e una richiesta formale da parte dell’autorità giudiziaria o del privato. È proprio in questa prima fase che si effettua un’analisi preliminare del caso, si analizzano i quesiti, si stende un verbale e si predispone una catena di custodia. Essere meticolosi e precisi è particolarmente importante e il rispetto delle best practices lo è ancora di più. Ogni singola azione del processo investigativo che interviene nella metodologia forense adottata deve essere spiegata nel dettaglio.

Si procede, quindi, al vero e proprio accertamento tecnico che consiste nei tre passi evidenziati. Ognuno di questi tre passi, come si nota dallo schema, rappresenta un ipotetico nuovo punto di partenza. Questo perché potrebbe rendersi utile ripetere l’intero processo al fine di trovare ulteriori elementi ed evidenze digitali da studiare. Difatti potrebbero emergere elementi del tutto nuovi o che vadano ad agire come sussidiari alle prime rinvenute.

Preparazione ed Estrazione dei dati

Si inizia chiedendosi se vi sono sufficienti informazioni per procedere. Ci si assicura di avere una richiesta chiara e non equivoca in mano, sotto forma di quesiti, e che vi siano sufficienti dati per riuscire a rispondere in modo esaustivo. Se manca qualcosa, ci si confronta e coordina con il richiedente per determinare come proseguire.

In caso contrario, ovvero se gli elementi a disposizione risultano sufficienti, si continua a portare avanti il processo. Si veda la figura 2.

Figura 2

Il primo passo, di natura tecnica, in qualsiasi processo forense è la convalida di tutto l’hardware e il software, per garantire che funzionino correttamente. Potrebbe rendersi necessario aggiornare i firmware, verificare che non sia state rinvenuti falle o più semplicemente che gli strumenti a disposizione non siano danneggiati o compromessi da usi incauti. Anche in questo caso una approfondita analisi a livello del “caso” è quanto mai consigliata. Non sempre gli strumenti validi per un caso lo sono anche per quello in esame, e non sempre gli strumenti utilizzati producono i risultati attesi. Flessibilità, adattabilità e apertura mentale sono altri requisiti fondamentali. Non sono pochi i casi risolti usando semplicemente dei piccoli tool gratuiti od open source. L’affidabilità di quest’ultimi è se non altro garantita, senza difficolta alcuna, dal codice aperto e dalla comunità dei peer reviewer. Tutti gli strumenti dovrebbe essere ritestati anche dopo ogni aggiornamento o riconfigurazione.

Quando la workstation forense è pronta, si duplicano i dati forensi forniti e se ne verifica l’integrità.

Questa attività presuppone che si siano già ottenuti i dati attraverso un processo legale e metodico che abbia condotto a creare un’immagine forense. Un’immagine forense è una copia bit-a-bit dei dati che sono memorizzati sul supporto originale, senza aggiunte o eliminazioni o in definitiva modificazioni. Si presuppone inoltre che l’esaminatore forense abbia ricevuto una copia di lavoro dei dati, ovvero una copia dell’immagine forense originale. Se gli esaminatori ottengono, invece, direttamente le prove originali, hanno bisogno di fare una copia di lavoro e custodire l’originale con una opportuna catena di custodia. Bisogna assicurarsi che la copia in possesso sia intatta e inalterata.

A tal fine, si procede verificando l’hash, o impronta digitale, delle prove. Se sono presenti problemi, incongruenze o atro ci si consulta con il richiedente per determinare come si intendere procedere. Registrare tutto su verbale è il minimo.

Dopo aver verificato l’integrità dei dati da analizzare, viene sviluppato un piano per estrarre i dati di interesse. Si organizza, quindi, e raffina la comprensione della richiesta del cliente in relazione ai quesiti posti per determinare come pervenire alla risposta attesa.

Vengono individuati gli strumenti che consentono di rispondere a questi quesiti. Già dalle prime battute, in genere, si hanno delle idee di massima su cosa cercare, sulla base della richiesta. A questi elementi si aggiunge poi una “Search Lead List”, ovvero una lista di ricerche specifiche da condurre che funge da guida per indirizzare l’attenzione dell’esaminatore sul caso in esame.

Ad esempio, la richiesta potrebbe vertere su provvedere indizi utili per dimostrare una “ricerca di materiale pedopornografico.” La lista li guiderà in maniera specifica a concentrare le ricerche su elementi attinenti alla richiesta. Man mano che emergono nuovi indizi vengono aggiunti alla lista come elementi di approfondimento. Mentre viene elaborata ogni singola ricerca, questi sono segnati come “processato” o “fatto” realizzando di fatto una vera e propria “to do list”.

Per ogni ricerca condotta, si estraggono i dati pertinenti e si contrassegnano anch’essi come processati. Tutti questi vanno a comporre un secondo elenco chiamato “Elenco dei dati estratti”.

La fase successiva è l’identificazione.

Riferimenti

https://www.justice.gov/criminal-ccips
https://it.wikipedia.org/wiki/Informatica_forense
A Road Map for Digital Forensic Research, Report from the First Digital Forensic Research Workshop (DFRWS), available at http://www.dfrws.org/sites/default/files/session-files/a_road_map_for_digital_forensic_research.pdf.

The Need for Digital Forensic Investigative Framework, at https://www.researchgate.net/publication/266794518_THE_NEED_FOR_DIGITAL_FORENSIC_INVESTIGATIE_FRAMEWORK

Articolo a cura di Francesco Costanzo

Ho conseguito la laurea in Ingegneria Informatica presso l’Università della Calabria.

Mi sono specializzato in digital forensics e investigazioni digitali attraverso un master in digital forensics e cyber security presso l’ISF College Corporate University (Milano). In seguito perfezionato in Criminalità Informatica e Investigazioni Digitali presso l’Università Statale di Milano.

Sono membro dell’Associazione Nazionale Criminologi e Criminalisti (Elenco del Ministero dello Sviluppo Economico, legge 14 gennaio 2013, n. 4). Iscritto al n. 00148/2020/PRO Sett. B Criminalisti in qualità di Criminalista esperto.

In possesso dell’Attestato di Qualità e Qualificazione Professionale dei Servizi prestati ai sensi degli artt. 4, 7 e 8 della legge 14 gennaio 2013, n. 4 (Attestato approvato Ministero dello Sviluppo Economico) rilasciato dall’Associazione Nazionale Criminologi e Criminalisti.

Presso l’Istituto di Scienze Forensi ricopro la figura di Investigatore tecnico forense.

Sono docente titolare degli insegnamenti di “Digital e computer forensics” presso l’ISF College Corporate University di Corsico (MI).

Download PDF

https://www.ictsecuritymagazine.com/articoli/framework-dellanalisi-digitale-forense/