NOYB vs. Google LLC/Google Ireland Limited: il reclamo sul funzionamento dell’AAID – Android Advertising ID

Premessa – Chi è NOYB

NOYB – Centro europeo per i diritti digitali (www.noyb.eu), è un’organizzazione senza scopo di lucro con sede a Vienna, in Austria, fondata nel 2017.
Co-fondatore di NOYB è l’avvocato austriaco Max Schrems, attivista per la privacy diventato noto nel 2013 per avere avviato campagne contro Facebook Ireland per violazioni delle leggi europee sulla privacy; nello specifico, Schrems contestava alla sede europea del social in blu come il livello di protezione dei dati dei cittadini europei nell’ambito del trasferimento verso il quartier generale di Menlo Park non potesse essere considerato sufficiente a garantire un’adeguata tutela della vita privata da intromissioni generalizzate e indiscriminate, in particolare alla luce delle rivelazioni di Edward Snowden sull’esistenza dei programmi di sorveglianza di massa PRISM e Upstream.

L’AAID oggetto del reclamo promosso da NOYB

Oggetto del reclamo promosso da NOYB è l’attivazione su tutti i sistemi Android, da parte di “Big G” (ovvero Google LLC e la sua sede europea Google Ireland Limited), dell’AAID – Android Advertising ID, che consiste in una stringa di caratteri alfanumerici il cui scopo è quello di rendere esattamente identificabile il device dell’utente, al fine di utilizzarlo come tracciatore delle abitudini di quest’ultimo e, così, di permetterne il riconoscimento univoco nel c.d. eco-sistema di advertising a favore di sviluppatori di App, e di un indefinito numero di terze parti.

Come riportato nell’esempio citato nel reclamo, “…se il reclamante utilizza un’app e mostra un particolare interesse per un evento, tale preferenza è associata al suo AAID e viene utilizzata per pubblicare annunci pertinenti su un’altra app o anche su pagine Web non correlate”.

In sostanza, allorquando attiviamo per la prima volta un sistema Android (cellulare o tablet, per esempio) e attiviamo i servizi offerti da Google, viene generato un codice identificativo univoco (c.d. “unique identifier”) che, senza richiedere uno specifico consenso all’utente, viene generalmente condiviso mediante tracker incorporati nelle App (come ad es. gli SDK), per consentire alle terze parti destinatarie di tracciare e profilare gli utenti attraverso applicazioni e servizi.

Questo codice viene, poi, trasmesso e condiviso all’interno di tutto l’ecosistema pubblicitario tra una miriade di soggetti e terze parti, che spesso generano anch’essi identificativi di tracciamento persistenti; questo sistema permette così ai soggetti operanti nel circuito pubblicitario di raccogliere molti dati dell’utente da un alto numero di fonti diverse, per poi ricondurli ad un minimo comun denominatore (l’AAID appunto).

L’oggetto del reclamo di NOYB verte proprio sul sistema di attivazione e funzionamento dell’AAID: si tratterebbe, infatti, di una forma di tracciamento non autorizzata dall’utente e senza alcuna valida base giuridica, sulla quale gli utenti, una volta attivato il cellulare o il tablet, non hanno alcun controllo e contro cui possono fare ben poco, con grave violazione dei principi e delle norme previste dal Regolamento generale per la protezione dei dati personali (UE) 2016/679, posto che – come affermato da Google medesima – non è possibile la cancellazione dell’AAID generato di default dal sistema attivato, ma solo la generazione di un codice ex novo in sostituzione dell’originale, funzione che pare in ogni caso inefficace per limitare le capacità di tracciamento; infatti, se è vero che l’AAID rigenerato viene sincronizzato con altri identificativi dell’utente, le terze parti destinatarie possono semplicemente aggiungere il nuovo codice al precedente, e riprendere in tal modo la profilazione dell’utente aggregando i nuovi dati con quelli precedentemente acquisiti.

Il reclamo di NOYB avanti l’Autorità di Controllo austriaca

La tesi di NOYB parte della convinzione che l’AAID, per un verso, sia da considerare dato personale (ex art. 4, par. 1, del GDPR) che viene continuamente recuperato, utilizzato, collegato e condiviso tra Google e le terze parti, al fine di (1) tracciare le azioni degli utenti, (2) elaborare le preferenze di consumo e, infine, (3) fornire pubblicità pertinente su dispositivi Android, e, per altro verso, sia oggetto di trattamento secondo quanto previsto dall’art. 4, par. 2, del GDPR.

In sostanza, contesta NOYB, l’AAID non sarebbe nient’altro che un codice identificativo che “marchia” univocamente e “per sempre” l’utilizzatore (consumatore) del sistema Android, senza che vi sia stata una scelta consapevole e volontaria dell’utente al momento dell’attivazione del sistema e, inoltre, senza che sia addirittura prevista una possibilità di opt-out, cioè di cancellazione dell’AAID, o quantomeno di dissociazione definitiva dal dispositivo utilizzato, e quindi dall’identità dell’utilizzatore – impedendo, così, il c.d. single-out (cfr. WP 29, Opinion 16/2011, Opinion 2/2013 e Opinion 5/2014).

E ancora, NOYB ha altresì fatto oggetto di reclamo il fatto che Google, al momento dell’attivazione della contestata stringa ID, non abbia fornito al reclamante, che ne aveva assoluto diritto, informazioni specifiche, complete e aggiornate sul trattamento effettuato dall’AAID, sui destinatari, sulle fonti, sulla base giuridica utilizzata o sul periodo di conservazione, facendo riferimento e genericamente richiamando le proprie politiche sulla privacy.

Le contestazioni di NOYB

NOYB, a mezzo del proprio reclamo, ha contestato:

  1. la violazione dell’art. 6, par. 1, del GDPR, in quanto, pur nell’impossibilità di stabilire una valida base giuridica sottostante al trattamento condotto a mezzo AAID, in ogni caso il trattamento sarebbe illecito, se è vero che (a) nel caso in cui la base giuridica ipotizzata fosse il consenso ex art. 6, par. 1, lett. a), questo non sarebbe stato informato, specifico, fornito liberamente, e quindi non sarebbe in ogni caso valido (a tacere dell’assenza di qualsiasi funzione effettiva di opt-in); (b) nel caso in cui la base giuridica fosse, invece, il legittimo interesse ex art. 6, par 1, lett. f), sarebbe ancor qui invalida posto che l’interesse di Google e delle terze parti per il tracciamento delle abitudini di acquisto dell’interessato non sarebbe, comunque, prevalente sugli interessi o i diritti e le libertà del medesimo;
  2. la violazione degli articoli 7, par. 3, e 21 del GDPR, posto che, indipendentemente dalla base giuridica adottata, l’AAID, avendo il reclamante correttamente esercitato i propri diritti, avrebbe dovuto essere “cancellato” definitivamente da parte di Google, il quale, però, lungi dall’aver provveduto a disattivarlo, ha rigettato la richiesta, asserendo, in modo apodittico e generico, di non avere i mezzi tecnici “per verificare l’identità delle persone interessate da un Advertising ID” e, quindi, di non essere in grado di adottare le misure specifiche di disattivazione richieste.

L’alternativa proposta da Google

Vista i motivi di asserita incapacità tecnica dichiarata dal motore di ricerca di far fronte alle richieste avanzate dall’utente/reclamante, Google ha proposto a quest’ultimo una soluzione alternativa, ovvero, resettare l’originario AAID, con la conseguente riassegnazione di un nuovo codice identificativo.

Sulla base dei rapporti contrattuali in corso tra Google e terze parti, sostiene “Big G”, non sarebbe infatti più possibile utilizzare il vecchio codice, ma – al netto del paradosso per cui parrebbe che per ottenere l’interruzione del trattamento illecito l’unica opzione sarebbe di acconsentirne uno nuovo con le stesse modalità – è stato in ogni caso dimostrato da recenti studi ed analisi (cfr. report Out of Control del Norwegian Consumer Council) come l’Advertising Id – che a tutti gli effetti è da considerarsi dato personale al pari degli altri codici identificativi infornatici – possa essere “…condiviso e, se necessario, collegato a vecchi valori tramite innumerevoli altri identificatori come indirizzi Ip, codici Imei e coordinate GPS, username di social media, indirizzi email o numero di telefono, di fatto permettendo un tracciamento persistente degli utenti Android”.

Sembra – così conclude NOYB – che il fatto stesso che sia Google a dover richiedere alle terze parti di interrompere il tracciamento dell’AAID originario, sia la prova stessa che la soluzione proposta da Google di fatto non consenta di interrompere il tracciamento continuo dell’AAID dell’utente, e che, quindi, Google abbia creato un sistema che strutturalmente non consente la disattivazione del tracciamento delle abitudini dell’interessato.

Le richieste conclusive di NOYB

NOYB, in conclusione, ha richiesto all’Autorità di Controllo austriaca di avviare un’indagine su quanto oggetto del reclamo promosso e di ordinare a Google: (1) di eliminare definitivamente l’AAID, interrompendo, quindi il trattamento dei dati associati ad esso, e (2) di consentire al reclamante il diritto di accesso ai dati richiesti oggetto del trattamento, applicando a Google, in forza degli artt. 58, par. 2, e 83, par. 4, lett. a) del GDPR, una sanzione effettiva, proporzionata e dissuasiva per tutte le violazioni contestate.

Articolo a cura di Jacopo Giunta e Matteo Chiavassa

Download PDF

https://www.ictsecuritymagazine.com/articoli/noyb-vs-google-llc-google-ireland-limited-il-reclamo-sul-funzionamento-dellaaid-android-advertising-id/



Cybersecurity vs Internet delle cose. Quale scenario ci attende?

Mai come in questo momento storico c’è stata una trasformazione digitale così capillare. Lo chiamano Internet delle cose, ma forse sarebbe più coretto chiamarla Internet della vita. Sì, perché ogni oggetto, azione e pensiero presto sarà gestito e veicolato attraverso la rete Internet. Alcuni esempi? All’interno di un’abitazione ormai molte persone hanno il proprio termostato collegato a un’app e, dunque, raggiungibile dal proprio smarthphone. Tutti (o quasi tutti) abbiamo un’app che permette di collegarci ed effettuare movimenti attraverso il proprio conto corrente bancario.
Presto – anzi molto presto – questo proliferare di interconnessioni aumenterà vertiginosamente, arrivando a connettere praticamente tutto quello che ci circonda.

Ma l’internet della vita non si ferma solo nel quotidiano. Va molto oltre e riguarda, o riguarderà a breve, una serie di dispositivi “salva-vita” applicati in medicina come pacemaker, sonde, siringhe intelligenti, che saranno interconnesse via Internet. Per non parlare di tutta una serie di asset strategici tipici di tutte le nazioni quali porti, aeroporti, dighe o centrali energetiche (comprese quelle nucleari), che saranno sempre più interconnesse in una sola rete, ovvero la rete Internet.

Lo scenario è indubbiamente positivo, perché l’interconnessione di tutto quello che ci circonda permette un utilizzo più rapido, semplice ed efficiente, miglioramento quindi sensibilmente la qualità della nostra vita. Tutto molto bello se non fosse per il problema della sicurezza, o per meglio dire della Cybersecurity: perché se tutto questo presto sarà così capillarmente interconnesso, saranno invitabili scenari di grande incertezza per quanto riguarda la sicurezza delle informazioni e dei dati coinvolti. È necessario, quindi, sviluppare piani adeguati e risolutivi per prevenire e gestire gli accessi non autorizzati.

Basti pensare alle possibilità nefaste che un accesso non autorizzato presso una qualsiasi infrastruttura informatica potrebbe generare: parliamo ad esempio di server dati di tribunali o ospedali. E perché non ricordare che, già sei anni or sono (settembre 2014), la multinazionale FCA, guidata dal manager di origini abruzzesi Sergio Marchionne, fu costretta a richiamare un milione e quattrocentomila veicoli a causa di una falla informatica nelle centraline delle automobili, potenzialmente accessibile dall’esterno da persone non autorizzate e mentre l’auto fosse stata in marcia?

Bene, lo scenario futuro è ormai chiaro. Ma come ci proteggeremo dai possibili attacchi informatici e quali saranno i protocolli da adottare?

Internet non è un luogo sicuro

C’è un problema di fondo da non sottovalutare, anzi probabilmente è il problema più rilevante: la rete più famosa e utilizzata oggi nel mondo, ovvero la rete Internet, non è stata ideata per comunicare fra persone che non si fidano e non si conoscono. Questo non è un dettaglio da poco, anzi! La reteInternet infatti nasce per permettere la comunicazione fra alcune università americane; comunicazioni cioè fra soggetti che si conoscevano e che condividevano informazioni sicure, ovvero prive di software malevolo. Su questa stessa rete, oggi, seppur con protocolli di sicurezza e gestioni diverse, stiamo implementando l’interconnessione di tutti i nostri oggetti e servizi, anche i più i delicati come poc’anzi elencato. Volendo utilizzare un paragone, è come voler pretendere di entrare all’interno di un laboratorio pieno di agenti chimici estremamente pericolosi, farlo senza indossare alcuna protezione e ipotizzare che tutto andrà bene. Ovviamente, non andrà tutto bene. A meno che non vengano adottate opportune precauzioni.

Internet delle cose e cybersecurity, come difendersi?

Volendo evitare di entrare in trattazioni troppo tecniche, è chiaro che sarà necessario per evitare conseguenze disastrose causate dall’utilizzo dell’internet delle cose, procedere all’attuazione di processi e protocolli per garantire un utilizzo sicuro dei nostri servizi e dei nostri oggetti interconnessi. È un lavoro che dovrà essere svolto su più livelli e da tutti gli attori protagonisti. In particolare:

  • gli Stati dovranno definire le linee guida di attuazione, ovvero le regole di sicurezza che tutti i produttori di servizi dovranno rispettare con estrema attenzione. Qui sorge evidentemente la necessità di implementare un organo internazionale indipendente e autorevole di gestione e controllo, esattamente come oggi avviene per la gestione della sanità tramite l’OMS. È impensabile che ci possano essere protocolli e indicazioni diverse da paese a paese: tutti nel mondo dovranno rispettare gli stessi protocolli, la forma spinta di globalizzazione oggi presente nel mondo non lascia altra via d’uscita;
  • i produttori di beni e servizi interconnessi dovranno rispettare con attenzione tutte le prescrizioni fornite dagli organi competenti, fornendo quindi certificazioni sulla sicurezza in rete dei propri prodotti e servizi e fornendo, inoltre, la possibilità alle autorità competenti di accedere al proprio codice sorgente in un qualsiasi momento;
  • l’interconnessione e lo scambio dei dati dovrà avvenire con protocolli sicuri e cifrati, anche qui nel pieno rispetto di prescrizioni forniti dagli organi competenti;
  • le aziende di ogni dimensione dovranno attuare precise procedure di sicurezza informatica specifiche per lo scambio di informazioni in rete, con il supporto anche di specialisti esterni qualora all’interno non vi fossero le opportune competenze necessarie;
  • i registri delle operazioni di interconnessione (log) dovranno essere riclassati come asset di carattere strategico da parte delle nazioni, in quanto ogni processo di interconnessione dovrà fornire opportune tracce, limitando e combattendo la possibilità di connessioni bridge anonime su server “di rimbalzo”.

Naturalmente, anche l’utilizzatore finale potrà adottare una serie di precauzioni per limitare la possibilità di accessi abusivi. Ma qualsiasi buon comportamento è da ritenersi del tutto inefficace se il sistema di interconnessione (rete Internet) non verrà resa realmente sicura e affidabile. È da qui che si inizia a combattere la battaglia sulla sicurezza informatica dei prossimi 20 anni.

Articolo a cura di Raffaele Bisegna 

Raffaele Bisegna è un amministratore di azienda, fondatore e C.E.O. della società Eccellenza Medica che opera nel campo medico-sanitario in Italia, Regno Unito e Svizzera. Esperienze lavorative con società Italiane ed Americane. E’ esperto di management aziendale.

Formazione: MBA presso l’università Tor Vergata di Roma. Laureato in tecnologie informatiche e CyberSecurity presso l’università La Sapienza di Roma (tesi sviluppata in collaborazione con il Raggruppamento Operativo Speciale R.O.S. dell’arma dei Carabinieri e con il Prof. Stefano Aterno, esperto in materia di Privacy).

È stato, presso il Senato della Repubblica, progettista e responsabile CyberSecurity di alcuni server dati ed email; per la società Techmind s.r.l. è stato consulente per l’elaborazione e lo sviluppo di brevetti nell’ambito dell’ High tech; è stato inoltre supervisore ai sistemi di controllo informatici quali UPS-Sap-Merc, gestore rete Man e Lan interna presso la multinazionale Micron Technology con sede a Boise, Idaho(USA).

Svolge regolarmente consulenze in tema di sicurezza informatica, analisi forensi e privacy digitale. Svolge lezioni in tema di reati informatici e indagini informatiche presso alcune università pubbliche.

https://www.eccellenzamedica.it/team/raffaele-bisegna

Download PDF

https://www.ictsecuritymagazine.com/articoli/cybersecurity-vs-internet-delle-cose-quale-scenario-ci-attende/


Information Security, Data Protection e Privacy

Information Security, Data Protection e Privacy: questi tre termini vengono spesso usati come sinonimi, ignorando le caratteristiche che ne sostanziano le differenze. È così che, soprattutto in contesti colloquiali, si parla indistintamente di Information Security, Cybersecurity o anche Sicurezza, Privacy e protezione dei dati. Allo stesso modo ci si riferisce al “Garante Privacy” o alla “normativa sulla privacy”, intendendo invece il Garante per la protezione dei dati personali; la normativa sulla protezione dei dati, d’altronde, viene indicata anche come normativa sulla “sicurezza”.

Mantenere una chiara distinzione terminologica non è un puro esercizio accademico o una questione di stile: i concetti di Information Security, Data Protection e di privacy sono sorretti da sostanziali distinzioni concettuali con implicazioni pratiche, nelle attività operative di ogni azienda e organizzazione, che trovano fondamento nella storia dell’uomo, del diritto e dell’evoluzione tecnologica e normativa.

Con il termine Information Security, non si intende solamente la protezione delle informazioni da accessi non autorizzati. Chiamiamo “informazioni” tutti gli insiemi di dati che vengono elaborati, strutturati e presentati in relazione ad uno specifico contesto, all’interno del quale assumo un significato altrimenti non rinvenibile. I dati, al contrario, rappresentano un fatto grezzo, non organizzato, che deve essere elaborato per renderlo significativo. I dati devono quindi essere sempre interpretati, da un essere umano o da una macchina, per derivarne il significato. I dati, decontestualizzati, non hanno un proprio significato intrinseco. I dati, possiamo dire, hanno bisogno di essere raffinati, come il petrolio, prima di acquisire valore spendibile ed essere utilizzati.

ISO[1] definisce nella norma internazionale ISO/IEC 27000:2018[2] il termine Information Security come “preservation of confidentiality, integrity and availability of information”[3]. L’Information Security, si occupa dunque della protezione della riservatezza, integrità e disponibilità di qualsiasi tipologia di informazione, all’interno di qualsiasi organizzazione e si concretizza nella pratica di prevenire l’accesso, l’uso, la divulgazione, l’interruzione, la modifica, l’ispezione, la registrazione o la distruzione non autorizzata delle informazioni.

Il termine Data Protection non deve far pensare, in contrapposizione a quanto detto in precedenza, alla protezione dei dati. Il significato di Data Protection diventa chiaro, richiamando le differenze con il termine Privacy. A questo fine è bene ricordare come il termine Privacy abbia origine nord-americana. Gli studiosi fanno risalire l’origine del termine Privacy, al 1890 quando Samuel D. Warren e Louis D. Brandeis, due giuristi di Boston, pubblicarono sull’Harvard Law Review[4] un articolo dal titolo “The right to Privacy”.  In questa pubblicazione la privacy è vista come la necessità di salvaguardia della sfera più “intima” dell’essere umano: la necessità di non vedere invaso il proprio spazio abitativo, le relazioni familiari e tutto ciò che si svolge al suo interno. Questa necessità non è certo diversa e distante dai bisogni fondamentali dell’uomo teorizzati da Abraham Maslow nel 1954, il quale ha evidenziato come i bisogni di sicurezza, appartenenza, stima e autorealizzazione, ciascuno con le proprie specificità e ognuno declinabile in ulteriori fabbisogni specifici, siano alla base dell’agire umano: fin dalle sue origini.

Il bisogno “primordiale” della salvaguardia della privacy è, quindi, alla base del pragmatismo umano.

La Data Protection, più strettamente legata al contesto culturale e storico europeo, si è significativamente sviluppata anche in conseguenza delle guerre che hanno interessato (non solo) il nostro continente nel corso del secolo scorso, quando i dati relativi a persone fisiche potevano essere usati – e venivano usati – per controllare e discriminare le persone. È stato così con le attività condotte su larga scala da vari governi in differenti nazioni, a proposito di anziani, ammalati, omosessuali, partiti politici e professioni religiose. La cultura della Data Protection nasce quindi dalla necessità di proteggere le persone fisiche, prima ancora del dato o dell’informazione in quanto tale, dal controllo invasivo operato da governi e nazioni e dall’utilizzo automatizzato e indiscriminato dei dati personali.

Dagli anni ’80 del secolo scorso si sono susseguite diverse attività normative a livello europeo culminate nel Regolamento (UE) 2016/679, noto come GDPR (o RGPD in italiano), il cui obiettivo è proprio la protezione delle persone fisiche per quanto attiene al trattamento dei loro dati personali, dal cui scorretto uso possono derivare gravi lesioni delle libertà e dei diritti degli individui. Il diritto alla protezione dei dati personali, è bene ricordare, “non è una prerogativa assoluta, ma va considerato alla luce della sua funzione sociale e va contemperato con altri diritti fondamentali, in ossequio al principio di proporzionalità”[5]. Inoltre, l’articolo 12 della Dichiarazione universale dei diritti umani, recita: “Nessun individuo potrà essere sottoposto ad interferenze arbitrarie nella sua vita privata, nella sua famiglia, nella sua casa, nella sua corrispondenza, né a lesione del suo onore e della sua reputazione. Ogni individuo ha diritto ad essere tutelato dalla legge contro tali interferenze o lesioni”. È curioso osservare quanto spesso anche il GDPR, e la sua implementazione, venga con troppa leggerezza criticato, accusando costrizioni e limitazioni di presunte libertà prive di qualsiasi fondamento.

La Data Protection si occupa, quindi, della protezione delle persone fisiche; la privacy è più legata alla sfera “intima” dell’essere umano; l’information security si occupa di qualsiasi tipo di informazione. Anche per questo motivo, ad esempio, non tutti gli incidenti di sicurezza delle informazioni rappresentano anche un data breach, mentre quest’ultimo implica certamente una violazione nella sicurezza delle informazioni.

Possiamo quindi pensare al dominio di competenza di Information Security, Data protection e Privacy come tre cerchi concentrici, con la prospettiva più ampia secondo la quale l’Information Security ingloba la Data protection e la privacy. Queste ultime due, pur condividendo “il dato”, hanno prospettive diverse: la prima si occupa della protezione delle persone fisiche, mentre la seconda è più concentrata sulla protezione di informazioni di persone fisiche.

È dunque chiaro come mai risulti scorretto e approssimativo l’indifferente utilizzo dei termini Information Security, Data Protection e Privacy.

Note

[1] International Organization for Standardization

[2] Information technology — Security techniques — Information security management systems — Overview and vocabulary

[3] ISO/IEC 27000:2018(en), § 3.28: information security: preservation of confidentiality (3.10), integrity (3.36) and availability (3.7) of information.
Note 1 to entry: In addition, other properties, such as authenticity (3.6), accountability, non-repudiation (3.48), and reliability (3.55) can also be involved

[4] Warren, Samuel D., and Brandeis, Louis D., The Right to Privacy, Harvard Law Review, vol. 4, no. 5, 1890, pp. 193–220. JSTOR, www.jstor.org/stable/1321160.

[5] Regolamento (UE) 2016/679, Considerando 4.

Articolo a cura di Luciano Quartarone

Download PDF

https://www.ictsecuritymagazine.com/articoli/information-security-data-protection-e-privacy/


La Weaponization dell’Intelligenza Artificiale

La diffusione di sistemi di intelligenza artificiale sempre più economici ed efficaci sta avendo, e avrà in grado sempre maggiore, effetti distruttivi su numerosi ambiti della vita umana. L’ambito militare è sicuramente uno di questi. L’intelligenza artificiale sta progressivamente diventando il centro focale della competizione internazionale per la leadership tecnologica, e non stupisce che tale competizione si manifesti anche nello sviluppo e accumulazione di armi autonome – così dette Autonomous Weapons System.

La peculiarità di queste armi risiede nella loro potenziale capacità di comprendere le caratteristiche dell’ambiente circostante e definire in modo autonomo le strategie più efficaci per raggiungere un dato obbiettivo. Sistemi di intelligenza artificiale stanno venendo attualmente integrati in tecnologie militari quali sistemi di difesa missilistica, veicoli aerei senza equipaggio (UAVs) o sottomarini senza equipaggio (UUVs). Il drone Harpy utilizzato dall’esercito israeliano è, ad esempio, a giudicare dalla sue caratteristiche tecniche, un’arma completamente autonoma[1]. Oltre che all’integrazione dell’intelligenza artificiale in sistemi e piattaforme nei quattro domini – terra, aria, mare e spazio – la weaponization (letteralmente, “trasformazione in arma”) dell’intelligenza artificiale si riferisce anche al suo utilizzo indipendente per compromettere o distruggere i network nemici attraverso attacchi nello spazio cibernetico – il quinto dominio.
Questa rivoluzione in campo militare avrà plausibilmente effetti dirompenti sugli equilibri di potere internazionali, e comporterà notevoli cambiamenti dottrinali circa il modo di condurre una guerra.

Da un lato, l’applicazione di queste tecnologie in operazioni militari permette, dal punto di vista tattico, una migliore e più facile analisi in tempo reale del campo di battaglia e una migliore consapevolezza delle condizioni esterne da parte del battaglione. Fornisce poi alle truppe sul campo strumenti intelligenti che possano migliorare il loro processo decisionale. Migliora inoltre la precisione delle operazioni militari e dei loro effetti, potenzialmente riducendo il numero di vittime collaterali o civili. Fornisce aiuti logistici alle truppe, riducendo e ottimizzando i costi legati alle operazioni e permette, infine, di portare a termine i compiti militari più faticosi, noiosi, pericolosi o moralmente complessi[2].

D’alto lato, il processo di weaponization comporta però numerosi rischi. In primo luogo, la proliferazione di queste tecnologie e la prospettiva di una corsa agli armamenti aumenta inevitabilmente l’instabilità del sistema internazionale, specialmente se si considera che l’adozione queste tecnologie favorisce un considerevole rafforzamento militare di nuovi attori quali attori non-statali o “Stati paria”. Il rischio legato a tali tecnologie è inoltre amplificato dalla ridotta capacità di controllare e limitare le conseguenze indesiderate quando queste vengono utilizzate.[3] Estremamente problematico è inoltre l’aspetto legato all’attribuzione di responsabilità. La possibilità di negare plausibilmente la responsabilità per un attacco (plausible deniablity), caratteristica anche di più convenzionali attacchi cyber, è definita come l’abilità di un attore A di lanciare un attacco contro un attore B in modo che la sua responsabilità sia difficilmente comprovabile[4]. Questo implica che un attore in possesso di armi autonome può ritenere di poter lanciare un attacco con relativa impunità, fattore  che contribuisce anch’esso all’aumento dell’instabilità del sistema internazionale. A tal riguardo, il 14 settembre 2019 un drone ha attaccato alla raffineria Saudi Aramco, in Arabia Saudita, causando una perdita del 5% della produzione petrolifera globale: quasi un anno dopo, rimane ancora poco chiaro chi sia stato il mandante di questo attacco[5].

In aggiunta a tali problematicità, occorre poi menzionare rischi più specificatamente legati all’intelligenza artificiale. Primo fra tutti, quale che sia l’ambito di applicazione, è stato largamente evidenziato come i sistemi di intelligenza artificiale presentino importanti problemi di estrinsecazione di pregiudizi nel loro processo decisionale. Se tali pregiudizi vengono incorporati in sistemi utilizzati nel campo militare, o a fronte di una intenzionale manipolazione dei dati da parte del nemico o di problemi dell’algoritmo o del dataset utilizzato, questi sistemi falliranno nel produrre gli effetti desiderati con disproporzionali effetti negativi a danno dei soggetti del pregiudizio.

Un altro rischio specifico di questi sistemi è quello connesso alla facilità con cui questi possano essere attaccati. A tal proposito Comiter afferma che la manipolazione dell’intelligenza artificiale è legata a delle “limitazioni fondamentali sottostanti questi sistemi”[6]. In altre parole, esistono dei fattori matematici che caratterizzano sia l’algoritmo che i dataset utilizzati tali per cui i sistemi di intelligenza artificiale risulteranno inevitabilmente vulnerabili. In questo senso, tali vulnerabilità sono sostanzialmente diverse da quelle che vengono sfruttate in un attacco cyber classico, poiché non sono causate da un errore umano nella scrittura del codice ma sono connaturate all’intelligenza artificiale stessa.

Lasciare che scelte di vita o morte vengano potenzialmente assunte, in modo arbitrario, da armi autonome pone infine un fondamentale quesito etico circa la deresponsabilizzazione dell’essere umano nel compiere queste scelte. A livello di società, è necessario che ci si interroghi se questa è la direzione verso cui desideriamo andare.

La tensione esistente tra potenzialità e problematicità legate alla weaponization dell’intelligenza artificiale ha portato le Nazioni Unite ad instituire, già nel 2013, un gruppo di esperti per deliberare circa la possibilità di bandire internazionalmente i sistemi di armi autonome. Ad oggi le negoziazioni non sembrano tuttavia avallare tale proposta. Esemplificativa in tal senso è la posizione degli Stati Uniti i quali, nel 2018, dichiaravano la necessità di sviluppare “una comprensione internazionalmente condivisa circa i rischi e benefici di questa tecnologia prima di decidere una specifica risposta di policy” dichiarandosi convinti che fosse prematuro intraprendere negoziazioni su qualunque strumento legale o politico[7].

In generale, sembra che gli Stati stiano comprendendo il potenziale di queste armi, la loro potenza ed efficacia, e che siano pertanto restii a limitarne lo sviluppo; bisognerebbe nondimeno chiedersi a quale costo societario si stia intraprendendo tale strada.

Note

[1] Harpy NG. (n.d.). Retrieved from http://www.iai.co.il/2013/36694-16153-en/Business_Areas_Land.aspx

[2] Joe Burton and Simona R. Soare, Understanding the Strategic Implications of the Weaponization of Artificial Intelligence, 2019 11th International Conference on Cyber Conflict: Silent Battle, NATO CCD COE Publications, 2019.

[3] Ibid.

[4] Adam P. Liff, 2019, Cyberwar: A New “Absolute Weapon”? The Proliferation of Cyberwarfare Capabilities and Interstate War, Journal of Strategic Studies, Vol. 35, No.3, p. 412

[5]  https://www.nytimes.com/2019/09/14/world/middleeast/saudi-arabia-refineries-drone-attack.html?login=email&auth=login-email

[6] Marcus Comiter, Attacking Artificial Intelligence: AI’s Security Vulnerability and What Policymakers Can Do About It , Belfer Center for Science and International Affairs, Harvard Kennedy School, 2019

[7] https://futureoflife.org/2019/05/09/state-of-ai/?cn-reloaded=1

Articolo a cura di Carolina Polito

Download PDF

https://www.ictsecuritymagazine.com/articoli/la-weaponization-dellintelligenza-artificiale/


Principi di sicurezza e Machine Learning

Parlando di sicurezza, nel mondo digitale, è ben noto il concetto che proteggersi da ogni tipo di attacco informatico sia pressoché impossibile. L’ingegneria della sicurezza può essere considerata dunque come una sorta di esercizio nella gestione delle strategie del rischio.

Un approccio che funziona molto bene è quello di fare uso di una serie di principi o linee guida come punto di riferimento nelle fasi di progettazione e costruzione delle infrastrutture tecnologiche. D’altronde anche l’articolo 25 del nuovo Regolamento europeo per la protezione dei dati personali (GDPR) introduce i principi di privacy by design e privacy by default, secondo un approccio concettuale innovativo che impone alle aziende l’obbligo di avviare un progetto prevedendo, fin da subito, gli strumenti e le corrette impostazioni a tutela della sicurezza dei dati personali.

Questi principi generali, quando correttamente applicati e contestualizzati, tendono a migliorare le prospettive di sicurezza anche rispetto a condizioni di rischio sconosciute e possibili attacchi futuri.

In questo articolo verranno esposti i due dei principi per la sicurezza che impattano anche sulle nuove tecnologie dei sistemi intelligenti (in breve AI) e di apprendimento automatico o Machine Learning (in breve ML), trattati dal Building Secure Software, il cui obiettivo è quello di identificare e mettere in evidenza gli aspetti più importanti della sicurezza da prendere in seria considerazione quando si progetta e costruisce un sistema tecnologico di nuova generazione.

Come accennato, per un approccio consapevole nella gestione del rischio, l’applicazione di questi principi dev’essere sensibile al contesto nel quale si applicano e sul quale andrà fatta un’analisi preventiva di assessment per comprendere al meglio i criteri adeguati di implementazione e di messa a processo.

Vediamo quindi più in dettaglio gli aspetti di questi principi, trattati dal Berryville Institute of Machine Learning.

Proteggere l’anello più debole

I responsabili della sicurezza IT ribadiscono il noto concetto che la sicurezza sia come una catena: forte quanto l’anello più debole.

In relazione a questo, anche un sistema tecnologico è da ritenersi sicuro tanto quanto il suo componente più debole.

Vuoi conoscere in anticipo dove potranno attaccarti?
Bene, allora pensa all’anello più debole della tua infrastruttura tecnologica e conoscerai la risposta: questo ambiente della tua infrastruttura tecnologica sarà, presumibilmente, la superficie sensibile ad un possibile attacco. Maggiore sarà l’estensione di questa superfice, maggiore sarà la possibilità che l’attacco possa andare a buon fine e creare i maggiori danni.

Nei sistemi intelligenti (AI) e di apprendimento automatico (ML) occorre prestare maggiore attenzione nelle fasi di addestramento degli stessi. Durante queste fasi, i sistemi necessitano di grandissime quantità di dati che rappresentano degli esempi in grado di insegnare loro come comportarsi rispetto a ciascuno di questi.

Questo rappresenta un limite in quanto ci sono situazioni in cui di esempi non ce ne sono tanti, vedi ad esempio problemi nuovi o situazioni in cui non vi è la possibilità di avere così tanti dati a disposizione in grado di fiduciare delle azioni coerenti. C’è bisogno quindi di aiutare questa intelligenza artificiale a poter imparare a risolvere problemi anche quando non ci sono esempi a disposizione dai quali poter apprendere.

Altro limite di questi sistemi è la capacità di capire e inferire concetti generali mentre impara a risolvere un problema specifico. Per ora è in grado di risolvere specifici problemi, ma quando si passa a dover risolvere un altro problema, magari simile al precedente, occorre riiniziare tutto l’iter di apprendimento da capo.

Questi esempi dunque rappresentano una grossa mole di informazioni in input da “masticare” e “comprendere” per poter successivamente fornire delle risposte coerenti alle richieste dell’utente.

“Alexa, qual è il mio colore preferito?”
“OK Google, conosci Alexa?”
“Ehi Siri, consigliami una ricetta per il pranzo”…

Queste sono alcune frasi con le quali comunichiamo con dei noti sistemi di intelligenza artificiale, ormai alla portata di tutti e che ci danno uno spaccato di quanto stiano evolvendo queste nuove tecnologie. Ma se da un lato ci divertono e ci aiutano, dall’altro non si ha ancora una chiara consapevolezza dei meccanismi legati alle dinamiche di gestione dei dati che li educano e che man mano vengono incamerati e trattati in un cyber spazio completamente ignoto all’utente finale ma che, allo stesso tempo, ne fa un uso largo e a tratti inconsapevole.

Se ad esempio si considera un “luogo pubblico” come la sorgente di questi dati di addestramento e, per sua natura, soggetto a una scarsa qualità di controlli, il modo più semplice per condurre un attacco potrebbe essere quello di manipolare i dati a monte, ancor pima che arrivino al sistema di elaborazione. In questo caso, l’obiettivo dell’attaccante è quello di arrivare al sistema, prima che lo stesso inizi ad apprendere. Una volta che i dati sono all’interno sarà dunque più facile alterare il processo di apprendimento e modificarne di conseguenza il suo comportamento in relazione a differenti e malevole esigenze.

Un sistema “intelligente” impara a fare ciò che fa grazie ai dati che gli vengono iniettati, ma se un utente malintenzionato riesce a manipolarli in modo adeguato, l’intero sistema potrebbe esserne compromesso. Per tale motivo questo genere di attacchi (avvelenamento dei dati) richiede un’attenzione particolare. In quanto esistono diverse fonti di dati, sensibili a questo genere di attacchi e dove dati “grezzi” e set di dati vengono assemblati ad hoc per addestrare, testare e convalidare i processi di apprendimento.

Non è difficile capire la logica che porta a voler attaccare questi sistemi intelligenti: monetizzare il valore dei dati. Volendo fare una similitudine che troviamo nel mondo reale, sappiamo bene che una banca ha moti più soldi di un piccolo market, ma tra i due, chi ha più possibilità di subire un attacco? La risposta è alquanto scontata e di facile intuizione; l’attaccante viene certamente attratto dalla quantità di denaro presente all’interno di una banca ma altrettanto dissuaso dai suoi molteplici sistemi di sicurezza.

Proprio questo elemento di maggior costo e rischio per l’attaccante lo porta a cercare un target meno “ricco” ma sicuramente più facile da colpire e con una probabilità più alta di successo: meno ma più probabile, piuttosto che molto ma meno probabile o molto difficile.

I sistemi di ML hanno un altro strano fattore che vale la pena considerare: la maggior parte del codice sorgente utilizzato è open source e, come tale, di dominio pubblico. Pertanto, alcune domande sorgono spontanee:

“Dovresti fidarti dell’algoritmo che hai scaricato da Github? “
“Come funziona?”
“E se l’algoritmo stesso fosse subdolamente compromesso? “

Quesiti che rappresentano sono alcuni dei potenziali “anelli deboli” da considerare nel contesto di una buona analisi dei rischi. Quando si parla di una buona analisi dei rischi, occorre valutare, in primis, il rischio più grave in relazione a quel particolare contesto, anziché un rischio di minore entità e più facile da mitigare. Di conseguenza, le risorse destinate alla sicurezza dovrebbero essere distribuite in base al risultato di questa analisi e attribuendo un livello di alta priorità per tutte le criticità evidenziate.

Altro elemento fondamentale è quello attribuire delle priorità in relazione agli aspetti più critici per poi passare a quelli che in ordine di gravità presentano un livello di rischio inferiore. Lo scopo finale è quello di giungere a una soglia di rischio accettabile e sulla base della quale verranno stabilite eventualmente nuove strategie di mitigazione.

Come già detto, nel mondo digitale la sicurezza non è perseguibile in valore assoluto e anche quando tutti gli elementi di rischio, emersi dalla nostra buona analisi, siano rientrati nella una soglia di un rischio accettabile, non bisogna mai abbassare la guardia e considerare questi aspetti in un contesto di insieme e secondo un ciclo di vita continuo e perfettamente integrato nell’infrastruttura tecnologica.

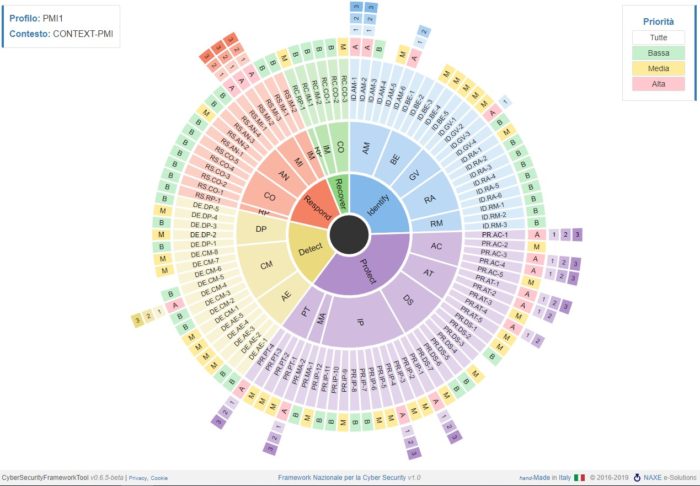
Il Framework Nazionale per la Cybersecurity e la Data Protection ne è un esempio e nasce per supportare le organizzazioni che necessitano di strategie e processi volti alla protezione dei dati personali e alla sicurezza cyber.

Framework Nazionale per la Cybersecurity

A parte tutte le nostre analogie, le buone pratiche di sicurezza impongono sempre un approccio di tipo olistico dove la protezione dei componenti nel loro insieme, della catena tecnologica, risulta di gran lunga maggiore della protezione offerta da ogni singolo elemento o singolo anello della stessa.

Gli elementi più deboli saranno comunque sempre presenti in una infrastruttura tecnologica, per quanto evoluta, ma considerando la sicurezza come un processo e non come un prodotto, si potranno subito identificare e rafforzare fino al raggiungimento di un livello accettabile del rischio.

La nozione di accettabilità dipende poi dal contesto in cui si opera e da quelle che saranno le scelte strategiche dell’alta direzione.

Stratificare le difese

L’idea alla base di questo principio, di una difesa efficace e profonda rispetto a eventi di rischio, è quella di stratificare le strategie di difesa in modo tale che, se la prima linea dovesse fallire, subentrino subito dopo le altre linee di difesa messe in campo. Torniamo quindi al nostro esempio di sicurezza della banca:

“perché la nostra banca è più sicura di un piccolo market?”
Poiché esistono molte misure di sicurezza ridondanti a tutela di un contesto che lo richiede.

Una banca ha per sua natura un prodotto molto ambito, quale il denaro e questo contesto necessita certamente di un’attenzione particolare, che non si limita a un solo elemento di difesa ma si esplica in più misure (strati) a salvaguardia del patrimonio aziendale. Più di questi strati saranno presenti e più saranno le garanzie a tutela della sicurezza. Pertanto, al fianco delle telecamere di sicurezza ci sarà magari un congegno di rilevazione delle presenze, delle procedure di controllo agli ingressi, una guardia che vigila all’esterno e così via.

Come si può facilmente capire, in questo contesto, la superfice di attacco risulta alquanto limitata da tutta una serie di misure di prevenzione che portano a dissuadere gli attaccanti o comunque, far loro capire quali potrebbero essere i rischi e le scarse probabilità di successo anche riuscendo a bypassare le prime linee di difesa. Per esempio, superare l’ingresso o addirittura arrivare agli uffici, non servirebbe a compromettere quello che è il vero patrimonio della banca che invece si troverà dietro l’ultima linea di difesa, all’interno di un più sicuro caveau.

Detto questo, comunque, anche avere tutte le misure di sicurezza del caso non garantisce alla banca l’immunità da qualsiasi attacco e che non venga mai derubata o compromessa. Certo è che lo sforzo da mettere in campo, da parte di un attaccante, risulterebbe alquanto difficile e scoraggiante rispetto ad altre realtà (come il piccolo market) dove lo sforzo richiesto sarebbe decisamente a minor costo e con più alte probabilità di successo.

Il principio della difesa in profondità o difesa stratificata può sembrare in qualche modo contraddittorio con il principio “metti in sicurezza l’anello più debole” perché stiamo essenzialmente dicendo che le difese degli elementi nel loro insieme possono essere più forti dell’elemento più debole.

Come mai invece, non c’è contraddizione?

Il principio del proteggere l’anello più debole si applica quando i componenti hanno un livello di sicurezza e funzionalità che non si sovrappongono. Ma quando si tratta di misure di sicurezza ridondanti, la protezione offerta dalla somma delle stesse è di gran lunga maggiore di quella offerta da ogni singolo componente.

I sistemi di ML sono per loro natura costruiti con numerosi componenti e – come più volte evidenziato – i dati, dei quali si nutrono, rappresentano l’elemento più importante da tutelare dal punto di vista della sicurezza.

Ciascuna di queste componenti presenta un certo fattore di rischio e, come tale, potenzialmente sfruttabile da attori malintenzionati. In un tale scenario, la vulnerabilità di un singolo componente dovrebbe essere colta da un altro componente, secondo una logica di gioco di squadra. In realtà, nei sistemi complessi, come quelli di AI e ML, non è cosi semplice fare in modo che “tutto” venga gestito e controllato secondo queste logiche di squadra e un mancato controllo a monte potrebbe determinare un problema a valle.

Pensiamo a come la difesa stratificata influisce sull’obiettivo di proteggere i dati di autoapprendimento in un sistema di ML e AI.
Un primo livello di sicurezza tenterà di proteggere i dati di formazione sensibili attraverso qualche tipo di autenticazione e autorizzazione, per poi consentire all’utente o al componente così identificato di operare solo dopo che il processo di riscontro dell’identità sia andato a buon fine. Questa potrebbe essere una buona pratica a garanzia della sicurezza ma non di certo sufficiente a garantire che nessuna informazione “sensibile” possa essere divulgata a causa di uso o abuso, dannoso per l’intero sistema. Un elemento di criticità, che non riguarda solamente i sistemi di ML e AI, è certamente dato da un’inadeguata assegnazione dei privilegi a utenti od oggetti che accedono alle informazioni.

Pertanto, un altro aspetto importante da considerare nelle strategie di difesa stratificata e soprattutto su sistemi di ML e AI, riguarda l’applicazione del principio del privilegio minimo. Tale pratica consente agli utenti e, in particolare, a coloro che operano con privilegi amministrativi, di poter operare solo ed esclusivamente su determinati ambienti, con determinati strumenti e in relazione a specifici privilegi.

Fuori da questi confini si dovrebbe determinare un’anomalia da notificare ai responsabili della sicurezza per valutarne in tempi rapidi dinamiche e tipologia dell’evento. In questo modo risulta molto più agevole identificare e prevenire gli exploit di sicurezza quando ogni componente limita l’accesso solo alle risorse effettivamente necessarie.

Identificare e compartimentare i vari componenti di un progetto IT può essere certamente d’aiuto, poiché su ciascuno di questi elementi diventa possibile implementare specifici controlli e politiche di sicurezza secondo quella logica che vede ciascun componente lavorare di concerto con gli altri in un contesto di insieme.

Conclusioni

L’approccio alla sicurezza IT richiede certamente grande consapevolezza da parte di tutti, a partire da coloro che progettano le tecnologie per arrivare a tutti coloro che in qualche modo risultano coinvolti nella filiera tecnologica. È auspicabile che le aziende, con atteggiamento proattivo, mettano in campo strategie e investimenti in grado di mitigare il rischio sulla sicurezza delle informazioni digitali, ma altrettanta attenzione e proattività è richiesta ai governi e alle istituzioni di ogni ordine e grado.

Occorre prendere coscienza che la tutela della sicurezza richiede interventi e regolamentazioni a livello di sistemi paese in grado di fornire garanzie adeguate in termini di fiducia del mercato, privacy dei cittadini e interessi nazionali.

Riferimenti bibliografici

Articolo a cura di Alessandro Bonu

Systems Infrastructure Engineer at Engineering D.HUB

IT Security Specialist – Digital Forensics Expert

Docente a contratto Università di Cagliari

Download PDF

https://www.ictsecuritymagazine.com/articoli/principi-di-sicurezza-e-machine-learning/


L’Italia tra dominio cibernetico e geopolitica ibrida

Quando si parla di sicurezza, il pensiero va subito alla protezione delle nostre case, famiglie, attività, comunità. Su questo fronte le forze dell’ordine, tutte, sono impegnate quotidianamente. Tuttavia è necessario aumentare risorse e strumenti in mano alle autorità, occorre un piano di formazione che preveda anche la creazione di corpi specializzati che si occupino direttamente di prevenzione e difesa.

Alle strategie per tutelare il cittadino sul piano della sicurezza fisica si devono affiancare misure efficaci sul piano cibernetico, non meno pericoloso e insidioso; come cittadini, rappresentanti del mondo imprenditoriale e Pubblica Amministrazione dobbiamo essere pronti a monitorare e proteggere il nostro mondo digitale, che durante la pandemia ha visto sicuramente una forte capacità di adattamento e trasformazione, ma serve un piano, una strategia seria e ragionata.

Nel passato abbiamo avuto idee che non potevamo immaginare, né realizzare a causa della mancanza degli strumenti tecnologici; oggi la potenza di calcolo e il basso costo rendono tali strumenti estremamente più accessibili e questo riscriverà il concetto di crittografia e altro, aprendo il mondo a nuove sfide connesse al calcolo quantistico.

Le contromisure da intraprendere devono essere pensate in ottica stratificata (“layered defence”): solo l’adozione coordinata di misure comportamentali (i.e. cambio frequente di password complesse, backup regolare dei dati, aggiornamento sistematico degli strumenti di sicurezza, consapevolezza nei confronti del phishing e delle tecniche di Social Engineering, utilizzo consapevole dei social, …) e tecnologiche (i.e. utilizzo di firewall, antivirus, VPN…) può condurre a una corretta postura di sicurezza.

Questa la strategia che ognuno di noi può perseguire per far fronte a minacce sempre più crescenti e complesse: in un futuro che è gia qui, l’utilizzo di nuovi vettori di attacco quali il cyberspazio, le tecnologie avanzate di droni, canali organizzati di disinformazione costituiranno sempre più una minaccia al sistema paese e alle sue principali componenti: infrastrutture critiche, tessuto produttivo, sistemi elettorali.

Lo sviluppo e la crescente adozione di tecnologie IoT e AI aumenteranno sensibilmente la superficie d’attacco e getteranno le basi di una nuova generazione di malware adattivi e di tecniche avanzate di spoofing d’identità; gli attacchi ransomware saranno sempre più sofisticati e mirati, le accresciute capacità e disponibilità di algoritmi di AI saranno strumento nelle mani di organizzazioni criminali per lo sviluppo e l’esecuzione di sofisticati attacchi di Aocial Engineering e, in sinergia con le recenti tecnologie Big Data, per l’elaborazione e commercializzazione sul mercato nero di informazioni riservate e sensibili come segreti di stato, brevetti e dati di natura sanitaria e socio politica dei cittadini.

La difesa ed il presidio del cyberspazio devono entrare nel nostro modo di vivere, esattamente come l’avvento delle automobili ha reso naturale guardare a destra e a sinistra prima di attraversare una strada trafficata.

Tenere sotto controllo i nostri dispositivi, aggiornarne i software, conoscere le nostre eventuali vulnerabilità, sono azioni che devono far parte di un processo continuo di gestione del rischio informatico. E ancora, se si allarga l’orizzonte, pensare a un cambiamento culturale profondo che parta dalle fondamenta: educazione – dunque scuola – e coinvolgimento di giovani imprese nello strutturarsi sempre di più come cyberguardian del prossimo futuro, perché la trattazione di questo argomento non può prescindere dal coinvolgimento attivo delle Istituzioni: solo attraverso una seria campagna di sensibilizzazione e consapevolezza mirata a tutte le fasce sociali, si possono gettare le fondamenta di quel substrato necessario a motivare e invogliare le nuove generazioni a intraprendere un percorso di studi legato al mondo della cybersecurity.

Un importante passo in tal senso è stato fatto con l’attuazione della Direttiva europea NIS, come con il DL Cyber che definisce un perimetro di sicurezza nazionale cibernetica; siamo sulla buona strada ma non possiamo fermarci, la sicurezza informatica è dinamica – non statica – e il processo amministrativo burocratico non sostiene un rapido adeguamento, rischiando di lasciare “aree scoperte” o scelte rinviate per troppo tempo.

Solo un forte sinergia tra mondo pubblico e privato, con il puntuale coinvolgimento degli atenei, può colmare un tema cruciale, ovvero quello di affrontare l’elevato skill shortage per far fronte alle crescenti richieste e quindi alla necessità di avere figure professionali qualificate.

Ma non solo formazione; risulta a mio avviso aumentare la presenza, in seno ai consigli di amministrazione di società che operano in settori rilevanti, di membri che abbiano la capacità di comprendere meglio la posizione dell’organizzazione sullo stato della sicurezza informatica, in quanto essa è uno dei temi su cui si concentra l’attenzione dei top manager e quindi trasferire tematiche complesse all’intero board per prendere le scelte migliori volte a garantire la sicurezza in primis dell’azienda, dei clienti, dei piccoli e grandi investitori. Tema che negli Stati Uniti è affrontato con molta enfasi.

Il cyberspazio è diventato uno degli aspetti più importanti di una società, di uno stato e di una vita individuale a seguito di rapidi sviluppi e dell’applicazione della tecnologia dell’informazione in modo estensivo. Presenta un elevato numero di potenziali sfide e rischi, oltre alla sua convenienza. Molti paesi che hanno fatto progressi nella tecnologia dell’informazione e della comunicazione hanno escogitato strategie e politiche per il cyberspazio, come la creazione di corpi militari specializzati e l’istituzione di unità e dipartimenti specifici, finanche alla creazione di specifici ministeri (UK, Australia, Giappone etc).

La geopolitica, in special modo in questo contesto, è un fattore cruciale per comprendere, spiegare e prevedere la condotta internazionale dei paesi. Dal punto di vista del cyberspazio, occorre comprendere le influenze geopolitiche per fronteggiare e in taluni casi prevedere le gravi minacce che corrono in rete. Un’analisi delle operazioni informatiche negli ultimi dieci anni mostra una chiara connessione tra motivazioni geopolitiche e campagne informatiche sponsorizzate da Stati il cui obiettivo era duplice: sabotare e acquisire conoscenza. La geopolitica moderna deve essere combinata con la tradizionale raccolta di informazioni sulle minacce per aiutare le aziende e stati a determinare come, dove e quando rischiano di ottenere attacchi da parti esterne, coniugando quindi gli aspetti digitali ad aprendo alla geopolitica ibrida.

Su di noi grava la grande responsabilità di decodificare la realtà di oggi, coglierne le opportunità e lavorare seriamente per impostare una strategia di crescita sostenibile, economica, sociale ed etica; le scelte che prendiamo e che dovranno essere prese nell’immediato futuro, detteranno le condizioni di vita di quella che sarà l’Italia di domani, quella che non vediamo e che dobbiamo necessariamente tutelare.

L’Italia ha tutte le carte per avere un ruolo centrale nelle sfide “connesse” al dominio cibernetico: dobbiamo puntare a essere leader e non follower.

Articolo a cura di Andrea Chiappetta

Download PDF

https://www.ictsecuritymagazine.com/articoli/litalia-tra-dominio-cibernetico-e-geopolitica-ibrida/


Guida per lo svolgimento della valutazione d’impatto sulla protezione dei dati (DPIA) – Parte V

Segue dalla quarta parte.

4.5 FASE 5: identificazione delle misure di mitigazione del rischio per dimostrare la conformità

Nella FASE 5 è necessario da parte del Titolare, sulla base dei risultati ottenuti nella valutazione del rischio effettuata nella fase precedente, decidere se e come introdurre nuove misure di mitigazione del rischio.

Se dai risultati della valutazione emerge che non esistono scenari a “rischio elevato” allora questa FASE 5 può essere saltata completamente a meno che il Titolare non voglia comunque svolgere azione di mitigazione dei rischi di natura media o bassa analizzati.

Se, invece, tra i risultati esistono scenari a “rischio elevato”, allora è necessaria una integrazione delle misure di riduzione del rischio, riavviando per gli scenari individuati una ulteriore fase di analisi.

Gli elementi, tra i molteplici, che potrebbe essere utile tenere in considerazione sono i seguenti:

  • decidere di non raccogliere determinati tipi di dati;
  • ridurre l’ambito di applicazione;
  • ridurre i periodi di conservazione;
  • introdurre ulteriori misure di sicurezza tecnologica/fisica/organizzativa;
  • formare in modo efficace il personale per garantire che i rischi siano anticipati e gestiti;
  • dati anonimizzati o pseudonimizzati, ove possibile/necessario;
  • scrivere delle procedure interne più puntuali per ridurre i rischi;
  • aggiungere una valutazione con intelligenza umana per rivedere le decisioni automatizzate e legate all’intelligenza artificiale;
  • utilizzare una tecnologia diversa da quella adottata fino ad ora;
  • migliorare gli accordi di condivisione dei dati;
  • apportare modifiche alle informative sulla privacy;
  • offrire alle persone la possibilità di rinunciare al trattamento ove opportuno;
  • introdurre nuovi sistemi per facilitare alle persone l’esercitare dei loro diritti.

Si sottolinea come questo elenco non sia esaustivo e come possano essere individuate ulteriori misure/azioni utili a contribuire alla riduzione del rischio. In ogni caso, per questo genere di attività è importante chiedere sempre un contributo al DPO che può fornire utili consigli sulle azioni da intraprendere.

Anche l’analisi svolta in questa FASE 5 va comunque descritta formalmente attraverso una scheda sintetica, proposta in Appendice F, che specifichi come la misura/misure individuate ridurrebbero il rischio e analizzi anche i costi/benefici di ogni misura ulteriore introdotta, al fine di poter svolgere una scelta consapevole sull’impatto per le risorse necessarie all’implementazione.

4.6 FASE 6: redazione e presa in carico della documentazione di valutazione

Tutto il materiale che è stato prodotto attraverso le schede di analisi, dalla FASE 0 fino alla FASE 5 (vedi Appendici di questo documento da A a F) del metodo costituisce la documentazione della DPIA, documentazione che va conservata a cura del Titolare del trattamento per le attività di revisione periodica previste dalla norma e per le eventuali visite ispettive del Garante nazionale.

Nella FASE 6 della DPIA si deve compilare una ulteriore scheda (Appendice G) che riassume la presa in carico dei risultati di valutazione e le diverse osservazioni dei principali attori. In questa scheda si anticipa anche il nominativo di chi, all’interno dell’organizzazione del Titolare, sarà incaricato delle attività periodiche di revisione della DPIA.

4.7 FASE 7: monitoraggio e riesame periodico della DPIA ai fini del mantenimento nel tempo della protezione dei dati

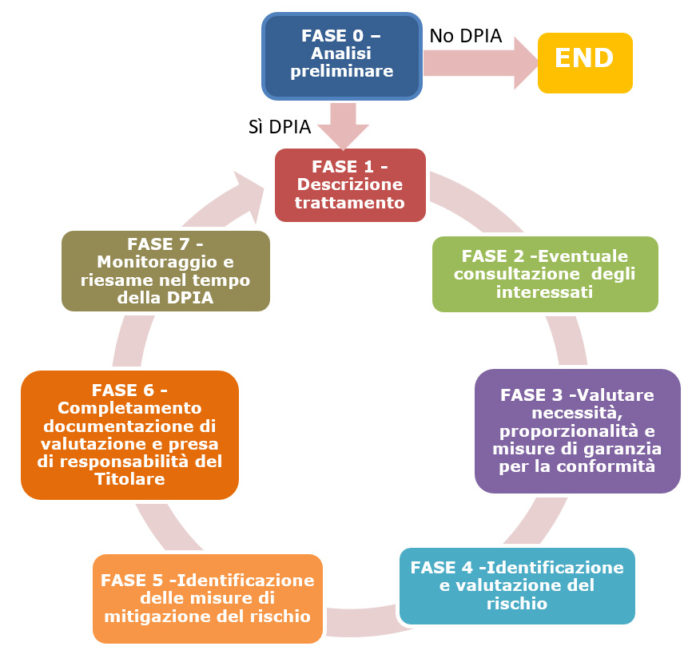
Il Titolare identifica un incaricato all’interno della sua organizzazione che svolge e pone all’attenzione del Titolare stesso tutte le azioni di revisione/integrazione della DPIA al fine di mantenere la validità e l’aggiornamento del tempo della valutazione condotta e dei suoi risultati. Le attività di mantenimento vengono svolte conformemente al ciclo descritto in fig.2.1 di questo documento, tenendo in conto di tutte le fasi e le indicazioni qui fornite. Tutte le decisioni relative a modifiche/integrazioni della DPIA debbono essere autorizzate e prese in carico dal Titolare che resta il responsabile del trattamento dei dati analizzato nella valutazione.

5. Appendice A – FASE 0: questionario di screening

ATTENZIONE: per le declaratorie delle caratteristiche del trattamento sintetizzate nelle sezioni del Questionario, si consiglia di far riferimento – prima di rispondere – alla versione integrale discussa nel par.2.8 della Guida per la DPIA.

Codice ID trattamento _____________________      Nome Trattamento _______________________

Dip. ________________________   Ufficio _______________  Servizio _________________________

Note _______________________________________________________________________________

____________________________________________________________________________________

____________________________________________________________________________________

Sezione A – DOMANDE GENERALI (Art.35 punto 3 del Regolamento GDPR)

ll trattamento considerato presenta queste caratteristiche*?

ID Caratteristica Sì No
G1 Valutazione sistematica automatizzata dei dati (anche con profilazione) con effetti significativi sulle persone
G2 Uso su larga scala di dati delle categorie particolari
G3 Sorveglianza sistematica pubblica su larga scala

Sezione B – DOMANDE SPECIFICHE tratte dalla letteratura nazionale e internazionale

ll trattamento considerato presenta queste caratteristiche*?

ID Caratteristica Sì No
S1 Trattamenti valutativi o di scoring su larga scala o trattamenti che comportano la profilazione degli interessati relativi ad aspetti riguardanti il rendimento professionale, la situazione economica, la salute, le preferenze o gli interessi personali, l’affidabilità o il comportamento, l’ubicazione o gli spostamenti
S2 Trattamenti automatizzati finalizzati ad assumere decisioni che producono “effetti giuridici” oppure che incidono “in modo analogo significativamente” sull’interessato
S3 Trattamenti che prevedono un utilizzo sistematico di dati per l’osservazione, il monitoraggio o il controllo degli interessati
S4 Trattamenti su larga scala di dati aventi carattere estremamente personale
S5 Trattamenti effettuati nell’ambito del rapporto di lavoro mediante sistemi tecnologici
S6 Trattamenti non occasionali di dati relativi a soggetti vulnerabili
S7 Trattamenti effettuati attraverso l’uso di tecnologie innovative
S8 Trattamenti che comportano lo scambio tra diversi Titolari di dati su larga scala con modalità telematiche
S9 Trattamenti di dati personali effettuati mediante interconnessione, combinazione o raffronto di informazioni
S10 Trattamenti sistematici di dati biometrici (per identificare univocamente persone) o genetici
S11 Trattamenti di categorie particolari di dati (diversi da S10)
S12 Trattamenti che possono comportare un impedimento di esercizio di un diritto o di un servizio e/o contratto
S13 Trattamenti che possono comportare rischio di danni fisici

* Per un aiuto alla comprensione dettagliata delle caratteristiche del trattamento riferirsi ai Cap.2 e 3 della Guida per la DPIA.

Luogo e data della compilazione  ______________________________

Firma dei Compilatori                                                    Firma del Titolare

________________

________________                                                              _________________

________________

6. Appendice B – FASE 1: descrizione del trattamento

Codice ID trattamento _____________________      Nome Trattamento _______________________

Descrivere sinteticamente la finalità del trattamento – Quali sono le finalità del trattamento? Quali sono gli eventuali interessi legittimi e le basi legali connesse al trattamento? Che vantaggio/benefici traggono gli individui coinvolti nel trattamento? Quali benefici induce il trattamento sull’organizzazione? Quali benefici induce il trattamento sulla società?


Descrivere sinteticamente la natura del trattamento – Come sono raccolti i dati? Come vengono gestiti? Come vengono conservati? Come vengono usati i dati? Chi ha accesso ai dati? Con chi vengono, eventualmente, condivisi i dati? Qual è il periodo di conservazione dal dato? Come si chiude il ciclo di vita del dato a termine del periodo di conservazione? Si prevede l’intervento della figura del Responsabile del trattamento? Quali sono le misure di sicurezza organizzativa/procedurale messe in atto? Quali sono le misure di sicurezza tecniche messe in atto? Si utilizzano nuove tecnologie per il trattamento? Si utilizzano nuovi metodi di trattamento del dato? Quali criteri di screening sono stati adottati nell’analisi preliminare (FASE 0)?


Descrivere sinteticamente l’ambito di applicazione del trattamento – Che tipo di dati personali vengono raccolti nel trattamento? Si trattano anche dati appartenenti dalla Categorie Particolari (Art.9)? Quali? A quanto ammonta il numero delle persone gestite nel trattamento? Il trattamento è allargato anche a bambini e categorie vulnerabili? Qual è la frequenza di trattamento del dato? Quanto dura un processo ordinario di accesso al dato? Quale area geografica è coperta? Dove sono conservati fisicamente i dati?


Descrivere sinteticamente il contesto del trattamento – Qual è la relazione tra il Titolare e le persone soggette al trattamento? Quali sono le responsabilità connesse al trattamento? Qual è il grado di controllo che le persone possono esercitare suoi propri dati personali? Ci sono esperienze pregresse di questo stesso tipo di trattamento? Il trattamento fa riferimento a codici di condotta approvati e/o è soggetto a certificazione di terza parte? Che uso della tecnologia si fa nel trattamento? Quanti e quali risorse tecnologiche vengono impiegate? Quante sono le risorse umane impiegate nel trattamento? Che caratteristiche professionali hanno tali risorse umane?


7 Appendice C – FASE 2: Consultazione degli interessati

Codice ID trattamento _____________________      Nome Trattamento _______________________

Descrivere le consultazioni – Come si sono o si intendono consultare gli interessati o i loro rappresentanti? Su cosa sarà basata la consultazione? Se si decide di non consultare, quali sono le ragioni a giustificazione di tale scelta? E’ stato coinnvolto il DPO nell’analisi? Sono state coinvolte altre figure professionali specifiche nella valutazione? Se sì quali e che contributo hanno fornito?


8 Appendice D – FASE 3: Valutare necessità, proporzionalità e misure di garanzia per la conformità

Codice ID trattamento _____________________      Nome Trattamento _______________________

Descrivere gli aspetti di necessità, proporzionalità e le misure di garanzia adottate – Gli scopi del trattamento sono specifici, espliciti e legittimi? Quali sono le basi legali che rendono lecito il trattamento? I dati raccolti sono adeguati, pertinenti e limitati a quanto necessario in relazione alla finalità per cui sono trattati (minimizzazione dei dati)? I dati sono esatti e aggiornati? Il periodo di conservazione del dato è verificato con periodicità e sono applicate le procedure previste per il ‘fine vita’ del dato? Come sono informati del trattamento gli interessati? Come si ottiene il consenso degli interessati, quando necessario? Come fanno gli interessati ad esercitare i loro diritti di accesso e di portabilità dei dati? Come fanno gli interessati ad esercitare i loro diritti di rettifica e cancellazione (diritto all’oblio)? Come fanno gli interessati ad esercitare i loro diritti di limitazione e opposizione? Gli obblighi di eventuali Responsabili del trattamento sono disciplinati con chiarezza da un contratto? In caso di trasferimento di dati fuori dall’UE, i dati stessi godono di una protezione equivalente?


9 Appendice E – FASE 4: identificazione e valutazione del rischio

Codice ID trattamento _____________________      Nome Trattamento _______________________

PRIMA AZIONE

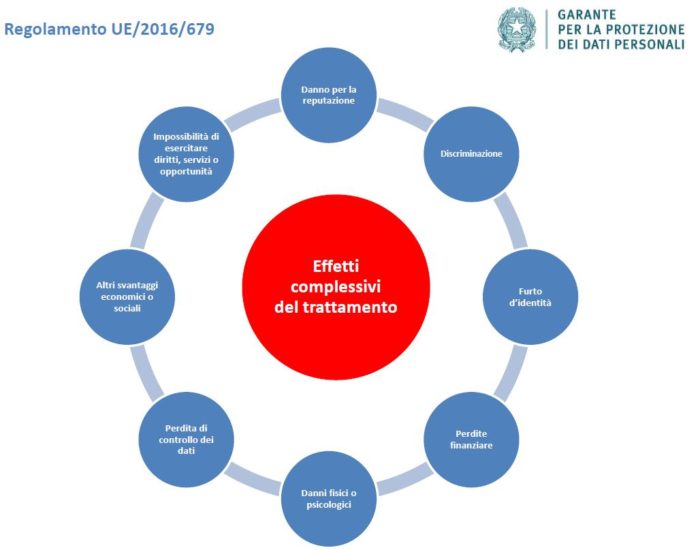
Identificare i danni specifici potenziali connessi al trattamento
  • danno per la reputazione
  • discriminazione
  • furto d’identità e frodi
  • perdite finanziarie
  • danni fisici
  • danni psicologici
  • perdita del controllo dei dati personali
  • perdita di riservatezza di dati personali protetti da segreto professionale
  • decifratura non autorizzata della pseudonimizzazione
  • impossibilità di esercitare diritti
  • impossibilità di accedere a servizi e opportunità
  • rivelazione non autorizzata dell’origine razziale o etnica
  • rivelazione non autorizzata delle opinioni politiche
  • rivelazione non autorizzata delle convinzioni religiose o filosofiche
  • rivelazione non autorizzata dell’appartenenza sindacale
  • rivelazione non autorizzata di dati relativi alla salute
  • rivelazione non autorizzata di dati relativi alla vita sessuale
  • rivelazione non autorizzata di condanne penali, reati e relative misure di sicurezza
  • rivelazione non autorizzata di dati relativi al rendimento professionale
  • rivelazione non autorizzata di dati relativi alla situazione economica
  • rivelazione non autorizzata di dati relativi all’affidabilità e al comportamento
  • rivelazione non autorizzata di dati relativi all’ubicazione e agli spostamenti
  • rivelazione non autorizzata di dati relativi a persone fisiche vulnerabili
  • altri svantaggi economici e sociali qui non elencati

SECONDA AZIONE – Parte 1 di 4

Sistema utilizzato per l’archiviazione
  • Archivio cartaceo
  • Cartella condivisa centralizzata
  • Cartella condivisa locale
  • Cartella personale
  • Database centralizzato
  • Altro (specificare) ______________________________________________

SECONDA AZIONE – Parte 2 di 4

Misure procedurali/organizzative di sicurezza adottate
  • Accesso controllato aree fisiche
  • Accesso fisico ai dati (es. armadi chiusi)
  • Accesso digitale ai dati (es. autenticazione e autorizzazione)
  • Formazione
  • Istruzioni per il trattamento
  • Nomina per iscritto personale
  • Nomina Amministratore di sistema
  • Nomina per iscritto responsabili esterni
  • Policy aziendali (specificare)
  • Policy aziendali utilizzo posta elettronica (specificare)
  • Procedura Data Breach
  • Procedura gestione dati (variazione, cancellazione)
  • Procedure (Altre procedure, specificare)
  • Altro (specificare) ______________________________________________

SECONDA AZIONE – Parte 3 di 4

Misure tecniche di sicurezza adottate – Misure Digitali
  • Antivirus/AntiSpam
  • Autenticazione
  • Autorizzazione
  • Business continuity
  • Data Inventory & Classification
  • Disaster recovery
  • DLP (Data Loss Prevention)
  • FIM (File Integrity Monitorig/Controllo integrità)
  • Firewall/WAF (Web Application Firewall)
  • Intrusion Detection/Intrusion Prevention
  • Monitoraggio/Log Management
  • Log Amministratori di sistema
  • Separazione (VLAN, Virtual Local Area Network)
  • Trattamento Dati -> Anonimizzazione
  • Trattamento Dati -> Cifratura dei dati
  • Trattamento Dati -> Pseudonimizzazione
  • Trattamento Dati -> Tokenizzazione
  • Back Up periodici
  • Altro (specificare) ______________________________________________

SECONDA AZIONE – Parte 4 di 4

Misure tecniche di sicurezza adottate – Misure Fisiche
  • Armadi/cassettiere chiusi a chiave
  • Autorizzazione di accesso – Badge – Sistema Biometrico
  • Guardiania/Presidio fisico locali
  • Sistemi di rilevamento accessi (es: sensori di accesso)
  • Sistemi di registrazione (es: telecamere)
  • Altro (specificare) ______________________________________________

TERZA AZIONE – Valutazione del rischio           Scheda n.___________

(NB Questa è una scheda multipla) Come prima azione selezionare uno Scenario e un Sistema di archiviazione (tra quelli indicati in precedenza) da analizzare nella scheda. L’analisi va svolta su tutti gli scenari indicati, compilando una scheda completa per ogni combinazione Scenario/Sistema di archiviazione precedentemente indicato.

Ad esempio:

– se il Sistema di archiviazione indicato è uno soltanto, le schede da compilare sono quattro;

– se i Sistemi di archiviazione indicati sono due, le schede complessive da compilare sono otto; e così via.

SCENARI MINIMI

  • Scenario A) accesso illegittimo
  • Scenario B) divulgazione non autorizzata
  • Scenario C) modifica non autorizzata
  • Scenario D) perdita dei dati
SISTEMA DI ARCHIVIAZIONE

  • Archivio cartaceo
  • Cartella condivisa centralizzata
  • Cartella condivisa locale
  • Cartella personale
  • Database centralizzato
  • Altro (specificare) __________________


1) Quali possibili minacce, per lo scenario e il sistema di archiviazione considerati, possono consentire il concretizzarsi del rischio?
2) Quali dei danni già indicati in precedenza si possono in questo scenario concretizzare per gli interessati, tenendo conto del sistema di archiviazione analizzato?
3) Quali sono le misure di mitigazione che, per lo scenario e per il sistema di archiviazione considerati, risultano già applicate? (tra le misure indicate nella SECONDA AZIONE selezionare quelle che risultano utili alla riduzione del rischio in questo scenario)
4) Quali sono gli eventuali nuovi elementi di vulnerabilità/debolezza del processo di trattamento che si individuano, per lo scenario considerato, a questo stadio dell’analisi?
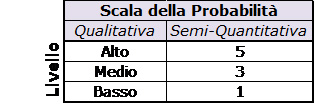
5) Su una scala a tre valori (Alto, Medio, Basso) a che valore si pone la Probabilità che questo scenario si presenti nella realtà?
Probabilità dell’evento nello scenario considerato:

œ  Alto (5)            œ  Medio (3)            œ  Basso (1)

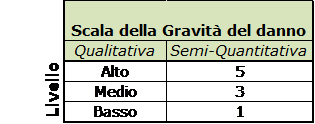
6) Su una scala a tre valori (Alto, Medio, Basso) a che valore si pone la Gravità del danno che sarebbe prodotto dal realizzarsi di questo scenario nella realtà?
Gravità del danno generato nello scenario considerato:

œ  Alto (5)            œ  Medio (3)            œ  Basso (1)

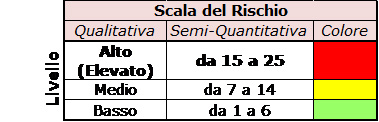
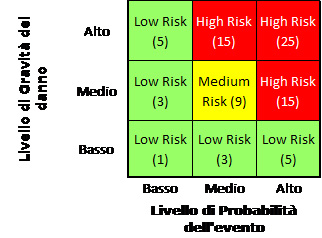
7) Quantificazione Rischio:  Rischio= Probabilità x Gravità del danno (punti 6 e 7 precedenti)
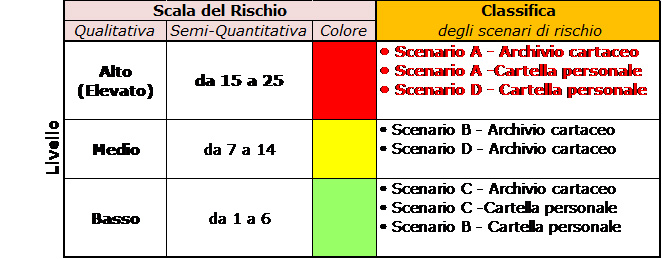
Rischio        œ  Alto (Elevato) (da 15 a 25)            œ  Medio (da 7 a 14)            œ  Basso (da 1 a 6)

10 Appendice F – FASE 5: misure di mitigazione del rischio

Codice ID trattamento _____________________      Nome Trattamento _______________________

Dip. ________________________   Ufficio _______________  Servizio _________________________

Note _______________________________________________________________________________

____________________________________________________________________________________

____________________________________________________________________________________

MISURA INTEGRATIVA n. __

Tipo di rischio  


Descrizione della azione/misura per la riduzione/eliminazione del rischio  
Effetto della misura sul rischio esistente

(ridotto, eliminato, accettato)

 
Rischio residuo

(Alto, Medio, Basso)

 
Analisi costi benefici  
Approvazione

(sì/no)


MISURA INTEGRATIVA n. __

Tipo di rischio  


Descrizione della azione/misura per la riduzione/eliminazione del rischio  
Effetto della misura sul rischio esistente

(ridotto, eliminato, accettato)

 
Rischio residuo

(Alto, Medio, Basso)

 
Analisi costi benefici  
Approvazione

(sì/no)


11 Appendice G – FASE 6: completamento documentazione e presa di responsabilità

Codice ID trattamento _____________________      Nome Trattamento _______________________

Dip. ________________________   Ufficio _______________  Servizio _________________________

Note _______________________________________________________________________________

____________________________________________________________________________________

____________________________________________________________________

Presa di Responsabilità al termine della valutazione

Sezione del DPO  
Indicazioni del DPO sulla DPIA svolta  


Nome Cognome DPO  
Luogo e data  
Firma DPO  
Sezione del Titolare  
Indicazioni del DPO accettate o non accettate?  
Eventuali osservazioni del Titolare sulle indicazioni espresse  dal DPO sulla valutazione svolta  
Nominativo dell’incaricato delle attività di revisione periodica della DPIA  


Eventuali note ulteriori  


Nome Cognome del Titolare  
Luogo e data  
Firma del Titolare  


Acronimi e glossario

CNIL = Commission Nationale de l’Informatique et des Libertés = Garante francese

Data Controller = Titolare del trattamento

Data Processor = Responsabile del trattamento

DPIA = Data Protection Impact Assessment (valutazione d’impatto sulla protezione dei dati)

DPO = Data Protection Officer = RPD

EDPB = European Data Perotection Board = Comitato Europeo per la Protezione dei Dati

Garante nazionale = Garante Privacy italiano = Autorità di Controllo nazionale

ICO = Information Commissioner’s Officer = Garante del Regno Unito

IoT = Internet of Things

Regolamento = Regolamento UE 679/16, GDPR

RPD = Responsabile della Protezione dei Dati = DPO

Titolare del trattamento = Data Controller

WP29 = UE-Article 29 Data Protection Working Party

Riferimenti

[Bil1]     Bilan M. Ayyub, “Risk Analysis in Engineering and Economics”, University of Maryland, Chapman & Hall/CRC, New York 2003, pp.35-38

[Car1]   M. Carbonelli, “Terrorist attacks and natural/anthropic disasters: risk analysis methodologies for supporting security decision-making actors”, International CBRNe Book Series, Aracne editrice, 2019, pp.66-70, pp. 110-123

[Gar1]   Garante per la protezione dei dati, Valutazione d’impatto sulla protezione dei dati, https://www.garanteprivacy.it/regolamentoue/DPIA

[Gar2]   Garante per la protezione dei dati, Allegato 1 al provvedimento n. 467 dell’11 ottobre 2018 [doc. web n. 9058979] ‘Elenco delle tipologie di trattamenti, soggetti al meccanismo di coerenza, da sottoporre a valutazione d’impatto’

[ICO1]   Information Commissioner’s Office -UK, ‘GDPR DPIA guidance’, aprile 2018

[UE1]    UE-Article 29 Data Protection Working Party, ‘Linee guida in materia di valutazione d’impatto sulla protezione dei dati e determinazione della possibilità che il trattamento “possa presentare un rischio elevato” ai fini del regolamento (UE) 2016/679’, WP248 rev.1, 4 ottobre 2017

[UE2]    EDPB, Opinion 12/2018 on the draft list of the competent supervisory authority of Italy regarding the processing operations subject to the requirement of a data protection impact assessment (Article 35.4 GDPR), 25 settembre 2018

[UE3]    https://edpb.europa.eu/search/site/dpia_en

[UE4]    UE-Article 29 Data Protection Working Party, ‘Linee guida per i responsabili della protezione dei dati’, WP 243 rev. 01, aprile 2017

[GDP1]  Regolamento (UE) 2016/679 del Parlamento europeo e del Consiglio del 27 aprile 2016 “Regolamento generale sulla protezione dei dati”

[T4D1]  T4Data, “The DPO Handbook: Guidance for data protection officers in the public and quasi‐public sectors on how to ensure compliance with the European Union General Data Protection Regulation”, Elaborated for the EU‐funded “T4DATA” programme (Grant Agreement number: 769100 — T4DATA — REC‐DATA‐2016/REC‐DATA‐2016‐01), luglio 2019

[CNI1]   Homepage:https://www.cnil.fr/en/home, DPIA: https://www.cnil.fr/en/privacy-impact-assessment-pia

Articolo a cura di Marco Carbonelli

Marco Carbonelli si è laureato in Ingegneria elettronica presso l’Università di Roma Sapienza, diplomato presso la Scuola Superiore di Specializzazione post-laurea in TLC del Ministero delle Comunicazioni ed è in possesso del titolo di Master internazionale di II livello (Università di Roma Tor Vergata) in “Protection against CBRNe events”.

È, inoltre, qualificato esperto NBC presso la Scuola Interforze NBC di Rieti, esperto di Risk Management, ICT security, protezione delle infrastrutture critiche, gestione delle crisi e delle emergenze di protezione civile. Ha svolto per vent’anni l’attività di ricercatore nel settore delle TLC e poi dell’ICT; opera dal 2006 nella Pubblica Amministrazione centrale, dal 2012 ricopre nell’Organo Centrale di Sicurezza della PCM il ruolo di funzionario alla Sicurezza CIS (Communication and Information System), con ulteriori incarichi anche nei settori dell’anticorruzione e della protezione dei dati personali della PCM. Ha pubblicato oltre 150 articoli tecnici in ambito nazionale e internazionale ed è docente, presso l’Università di Tor Vergata di Roma, nei Master Internazionali di I e II livello “Protection against CBRNe events” di Ingegneria Industriale e nel Master AntiCorruzione del Dipartimento di Economia e Finanza.

Download PDF

https://www.ictsecuritymagazine.com/articoli/guida-per-lo-svolgimento-della-valutazione-dimpatto-sulla-protezione-dei-dati-dpia-parte-v/


Guida per lo svolgimento della valutazione d’impatto sulla protezione dei dati (DPIA) – Parte IV

Segue dalla terza parte.

4.3 FASE 3: valutazione della necessità e proporzionalità del trattamento, e delle misure di garanzia per la conformità

Nella FASE 3 è necessario valutare come il Titolare abbia intenzione di risultare conforme alla norma in relazione alla necessità e proporzionalità del trattamento. Inoltre, deve descrivere come vengano gestite le misure di garanzia a tutela dei diritti degli interessati.

In particolare, il Titolare deve argomentare perché sia necessario svolgere il trattamento nel modo immaginato (o realizzato) e come non sia possibile individuare un altro approccio che eviti la gestione dei dati personali per la specifica finalità.

In Appendice D è proposta una Scheda DPIA relativa alla FASE 3. I temi da trattare sono nel seguito descritti attraverso una serie di possibili domande.

a) Gli scopi del trattamento sono specifici, espliciti e legittimi?
b) Quali sono le basi legali che rendono lecito il trattamento?
c) I dati raccolti sono adeguati, pertinenti e limitati a quanto necessario in relazione alla finalità per cui sono trattati (minimizzazione dei dati)?
d) I dati sono esatti e aggiornati?
e) Il periodo di conservazione del dato è verificato con periodicità e sono applicate le procedure previste per il “fine vita” del dato?
f) Come sono informati del trattamento gli interessati?
g) Come si ottiene il consenso degli interessati, quando necessario?
h) Come fanno gli interessati ad esercitare i loro diritti di accesso e di portabilità dei dati?
i) Come fanno gli interessati ad esercitare i loro diritti di rettifica e cancellazione (diritto all’oblio)?
j) Come fanno gli interessati ad esercitare i loro diritti di limitazione e opposizione?
k) Gli obblighi di eventuali Responsabili del trattamento sono disciplinati con chiarezza da un contratto?
l) In caso di trasferimento di dati fuori dall’UE, i dati stessi godono di una protezione equivalente?

Riferimenti al Regolamento per approfondimenti

Art.5 (punto 1 b, c, e), Art. 6, Artt. da 12 a 21, Art.35 (punto 7 b, d, ), Art. 36 e Considerando 90

4.4 FASE 4: identificazione e valutazione del rischio

Nella FASE 4 è necessario da parte del Titolare identificare e valutare il rischio.

Nel par.2.6 precedente è stato preliminarmente affrontato il tema della definizione del rischio per la valutazione della DPIA. In sintesi possiamo dire che nella DPIA ci si deve concentrare sui “rischi per i diritti e le libertà delle persone fisiche“. Il Considerando 75, collega il rischio al concetto di danno materiale o immateriale, declinato nella forma di danno fisico, danno economico e danno sociale, e inoltre, introduce una casistica dettagliata che meglio identifica, con esemplificazioni di varia natura, tale rischio. Il Garante nazionale ha riassunto questa esemplificazione con il grafico di fig. 4.1.

Fig.4.1 – Esemplificazione grafica dei danni specifici che possono essere potenzialmente indotti dal trattamento inadeguato di dati personali

Come prima azione della FASE 4 il Titolare si dovrà domandare se, per il trattamento che sta valutando, possono essere identificate una o più voci di questo elenco di danni specifici potenziali:

  • danno per la reputazione
  • discriminazione
  • furto d’identità e frodi
  • perdite finanziarie
  • danni fisici
  • danni psicologici
  • perdita del controllo dei dati personali
  • perdita di riservatezza di dati personali protetti da segreto professionale
  • decifratura non autorizzata della pseudonimizzazione
  • impossibilità di esercitare diritti
  • impossibilità di accedere a servizi e opportunità
  • rivelazione non autorizzata dell’origine razziale o etnica
  • rivelazione non autorizzata delle opinioni politiche
  • rivelazione non autorizzata delle convinzioni religiose o filosofiche
  • rivelazione non autorizzata dell’appartenenza sindacale
  • rivelazione non autorizzata di dati relativi alla salute
  • rivelazione non autorizzata di dati relativi alla vita sessuale
  • rivelazione non autorizzata di condanne penali, reati e relative misure di sicurezza
  • rivelazione non autorizzata di dati relativi al rendimento professionale
  • rivelazione non autorizzata di dati relativi alla situazione economica
  • rivelazione non autorizzata di dati relativi all’affidabilità e al comportamento
  • rivelazione non autorizzata di dati relativi all’ubicazione e agli spostamenti
  • rivelazione non autorizzata di dati relativi a persone fisiche vulnerabili
  • altri svantaggi economici e sociali qui non elencati.

Dopo aver identificato i possibili danni specifici connessi al trattamento, si passerà alla seconda azione della FASE 4 che corrisponde all’elencazione dettagliata delle misure procedurali/organizzative e tecniche (digitali e fisiche) messe in atto nella gestione del trattamento.

Per condurre questa parte di attività si potrà operare tenendo conto del sistema utilizzato per l’archiviazione e dell’elenco di possibili misure. Le misure indicate dovranno essere quelle realmente implementate ed operative nel processo di trattamento analizzato.

Sistema utilizzato per l’archiviazione dei dati

a) Archivio cartaceo
b) Cartella condivisa centralizzata
c) Cartella condivisa locale
d) Cartella personale
e) Database centralizzato
f) Altro (specificare)

Misure procedurali/organizzative di sicurezza adottate

a) Accesso controllato aree fisiche
b) Accesso fisico ai dati (es. armadi chiusi)
c) Accesso digitale ai dati (es. autenticazione e autorizzazione)
d) Formazione
e) Istruzioni per il trattamento
f) Nomina per iscritto personale
g) Nomina Amministratore di sistema
h) Nomina per iscritto responsabili esterni
i) Policy aziendali (specificare)
j) Policy aziendali utilizzo posta elettronica (specificare)
k) Procedura Data Breach
l) Procedura gestione dati (variazione, cancellazione)
m) Procedure (Altre procedure, specificare)
n) Altro (specificare)

Misure tecniche di sicurezza adottate – Misure Digitali

a) Antivirus/AntiSpam
b) Autenticazione
c) Autorizzazione
d) Business continuity
e) Data Inventory & Classification
f) Disaster recovery
g) DLP (Data Loss Prevention)
h) FIM (File Integrity Monitorig/Controllo integrità)
i) Firewall/WAF (Web Application Firewall)
j) Intrusion Detection/Intrusion Prevention
k) Monitoraggio/Log Management
l) Log Amministratori di sistema
m) Separazione (VLAN, Virtual Local Area Network)
n) Trattamento Dati -> Anonimizzazione
o) Trattamento Dati -> Cifratura dei dati
p) Trattamento Dati -> Pseudonimizzazione
q) Trattamento Dati -> Tokenizzazione
r) Back Up periodici
s) Altro (specificare)

Misure tecniche di sicurezza adottate – Misure Fisiche

a) Armadi/cassettiere chiusi a chiave
b) Autorizzazione di accesso – Badge – Sistema Biometrico
c) Guardiania/Presidio fisico locali
d) Sistemi di rilevamento accessi (es: sensori di accesso)
e) Sistemi di registrazione (es: telecamere)
f) Altro (specificare)

Dopo aver identificato i possibili danni e le misure di sicurezza adottate ed operative, si potrà affronterà la terza azione di questa FASE 4 di valutazione del rischio, assumendo che:

1) un “rischio” è uno scenario che descrive un evento e le sue conseguenze, stimato in termini di gravità (severity) e di probabilità (likelihood). [UE1]

2) la valutazione del rischio deve essere condotta analizzando la probabilità (likelihood) di accadimento dell’evento e la gravità (severity) del danno (o impatto) potenziale che ne consegue; (derivato da Art.24 punto 1, Art.32 punto 1)

Nella valutazione verranno considerati, come minimo, i seguenti quattro scenari di rischio desunti dal Regolamento (Art.4 comma 12; Art.5 comma f, Art.32 comma 2):

Scenari di Rischio

A) accesso illegittimo ai dati;
B) divulgazione non autorizzata dei dati;
C) modifica non autorizzata dei dati;
D) perdita dei dati.

Per ognuno degli scenari sopra indicati (quindi al minimo 4) si svolge l’analisi, considerando ciascuno dei sistemi di archiviazione indicati all’azione precedente (cartaceo, cartella condivisa, database centralizzato …), rispondendo ai seguenti quesiti:

  1. Quali possibili minacce, per lo scenario e il sistema di archiviazione considerati, possono consentire il concretizzarsi del rischio?
  2. Quali dei danni già indicati in precedenza si possono in questo scenario concretizzare per gli interessati, tenendo conto del sistema di archiviazione analizzato?
  3. Quali sono le misure di mitigazione che, per lo scenario e il sistema di archiviazione considerati, sono già applicate?
  4. Quali sono gli eventuali nuovi elementi di vulnerabilità/debolezza del processo di trattamento che si individuano, per lo scenario considerato, a questo stadio dell’analisi?
  5. Su una scala a tre valori (Alto, Medio, Basso) a che valore si pone la probabilità che questo scenario si realizzi nella realtà?
  6. Su una scala a tre valori (Alto, Medio, Basso) a che valore si pone la gravità del danno che sarebbe prodotto dal realizzarsi di questo scenario nella realtà?

La Scala di Probabilità dell’evento utilizzata nel metodo qui proposto (ispirata a quella indicata in [ICO1]) è di seguito riportata: nella scala (fig.4.2) si associano ai livelli qualitativi dei valori quantitativi per rendere più spedita l’analisi che seguirà.

Fig.4.2 – Scala della Probabilità a tre livelli

La Scala di Gravità del danno (o impatto) utilizzata nel metodo qui proposto è quella di seguito riportata: nella scala (fig.4.3) si associano ai livelli qualitativi dei valori quantitativi per rendere più spedita l’analisi che seguirà.

Fig.4.3 – Scala della Gravità del danno a tre livelli

La Scala del Rischio utilizzata nell’analisi è quella di seguito riportata in fig.4.4. Il livello di Rischio si ottiene, utilizzando i valori quantitativi delle scale introdotte per la Probabilità e la Gravità, applicando la formula [Bil1] [Car1]:

(1)     Rischio = Probabilità x Gravità del danno

Anche nella Scala del Rischio (fig.4.4) si associano ai livelli qualitativi dei valori quantitativi per rendere più spedita l’analisi.

Fig.4.4 – Scala del Rischio a tre livelli qualitativi espressa anche con scala di colore

Si osservi che nel seguito il livello Alto della Scala del Rischio sarà indicato, in modo del tutto equivalente, anche come Elevato, in conformità alla traduzione adottata dal Garante nazionale dell’inglese ‘high risk = rischio elevato’.

Infine, è possibile rappresentare, come proposto anche dall’Autorità di Controllo UK [ICO1], il Rischio attraverso una matrice, come mostrato nella fig.4.5 che segue. La figura evidenzia, in modo totalmente congruente alla Scala del Rischio di fig.4.4, le combinazioni di Probabilità e Gravità da considerare per la dichiarazione di “High Risk”, cioè “Rischio Elevato” in un determinato scenario. Nella matrice sono riportati, in parentesi tonde, i valori numerici assunti dal livello di Rischio.

Fig.4.5 – Matrice di rischio del tipo Probabilità/Gravità, con scala di colore

Resta ora la quarta azione di questa fase di valutazione del rischio. Tale azione consiste nel prendere visione della situazione complessiva di rischio dei vari scenari analizzati, verificando se in alcuni casi il rischio risulti di livello elevato e, quindi, non sia sufficiente la mitigazione prodotta dalle misure adottate fino a questo momento. La rappresentazione del rischio deriva dal semplice calcolo proposto con la formula (1) al termine della terza azione. Il sistema di rappresentazione può facilmente essere reso automatico da un punto di vista informatico e si possono immaginare delle rappresentazioni di sintesi, a vettore o a matrice. Qui di seguito si riporta, a titolo esemplificativo, la rappresentazione a vettore della classifica degli scenari di rischio in cui, nel caso rappresentato, si presentano tre scenari che ricadono nella valutazione di color rosso di ‘rischio elevato’. Analoga rappresentazione si potrebbe adottare applicando il modello a matrice di fig.4.5.

Fig.4.5 – Esempio di rappresentazione a vettore della classifica degli scenari di rischio

In Appendice E è proposta una Scheda DPIA relativa alla FASE 4. La scheda è articolata in diverse AZIONI, coerenti alla descrizione precedente.

Come prima attività sulla scheda selezionare uno Scenario e un Sistema di archiviazione. L’analisi va svolta su tutti gli scenari indicati, compilando una scheda completa per ogni combinazione Scenario/Sistema di archiviazione precedentemente indicato.

Ad esempio:

– se il Sistema di archiviazione indicato è uno soltanto, le schede da compilare sono quattro;
– se i Sistemi di archiviazione indicati sono due, le schede complessive da compilare sono otto; e così via.

Articolo a cura di Marco Carbonelli

Marco Carbonelli si è laureato in Ingegneria elettronica presso l’Università di Roma Sapienza, diplomato presso la Scuola Superiore di Specializzazione post-laurea in TLC del Ministero delle Comunicazioni ed è in possesso del titolo di Master internazionale di II livello (Università di Roma Tor Vergata) in “Protection against CBRNe events”.

È, inoltre, qualificato esperto NBC presso la Scuola Interforze NBC di Rieti, esperto di Risk Management, ICT security, protezione delle infrastrutture critiche, gestione delle crisi e delle emergenze di protezione civile. Ha svolto per vent’anni l’attività di ricercatore nel settore delle TLC e poi dell’ICT; opera dal 2006 nella Pubblica Amministrazione centrale, dal 2012 ricopre nell’Organo Centrale di Sicurezza della PCM il ruolo di funzionario alla Sicurezza CIS (Communication and Information System), con ulteriori incarichi anche nei settori dell’anticorruzione e della protezione dei dati personali della PCM. Ha pubblicato oltre 150 articoli tecnici in ambito nazionale e internazionale ed è docente, presso l’Università di Tor Vergata di Roma, nei Master Internazionali di I e II livello “Protection against CBRNe events” di Ingegneria Industriale e nel Master AntiCorruzione del Dipartimento di Economia e Finanza.

Download PDF

https://www.ictsecuritymagazine.com/articoli/guida-per-lo-svolgimento-della-valutazione-dimpatto-sulla-protezione-dei-dati-dpia-parte-iv/


Guida per lo svolgimento della valutazione d’impatto sulla protezione dei dati (DPIA) – Parte III

Segue dalla seconda parte

3. Come valutare la necessità dello svolgimento della DPIA: la FASE 0

La prima fase operativa, indicata nel seguito come Fase 0 del processo della DPIA, è rappresentata dalla decisione che il Titolare deve assumere a riguardo della necessità, o meno, di svolgere una DPIA per un trattamento specifico.

3.1 Fase 0 della DPIA

Nella fig.3.1 è mostrato lo schema del flusso logico proposto dal Garante nazionale sullo svolgimento della DPIA. La FASE 0 indicata nella fig.2.1 precedente coincide con le prime due domande proposte nel flusso logico di fig.3.1 riguardo – per la prima domanda – alla possibilità di rischio elevato per il trattamento e – per la seconda domanda – alle eccezioni per l’esclusione della DPIA.

Fig.3.1 – Flusso logico proposto dal Garante nazionale per lo svolgimento della DPIA

Le due domande poste all’inizio del flusso logico sono tra loro indipendenti ed è dunque possibile scegliere liberamente l’ordine in cui affrontarle, pur mantenendo la loro stretta consecutività.

Immaginando che il trattamento considerato non faccia parte delle ‘eccezioni’ (vedi par.2.10 precedente) resta da dirimere unicamente se (seconda domanda in questo caso) il trattamento ‘può comportare un rischio elevato’.

Come dettagliato in par.2.7, utilizzeremo per questa pre-analisi un questionario di screening, in modo da decidere con un approccio sufficientemente analitico ma al contempo rapido, se sia necessaria o meno la DPIA completa per quel trattamento.

Sulla base dell’analisi condotta nel par.2.8, in cui si sono stati elencati e descritti assieme alle prime tre tipologie estremamente generali indicate dalla norma anche quelle individuate dal Garante Italiano [Gar2], dal Gruppo di Lavoro europeo Art.29 [UI1] e dal Garante UK ICO [ICO1], si è predisposto il questionario di screening proposto in Appendice A di questo documento.

Basterà, per il Titolare e per gli esperti da lui indicati per la valutazione della DPIA, rispondere alle domande del questionario relativamente ad ogni trattamento effettuato.

Nel caso in cui:

e) per la Sezione A del questionario di screening si raccolga almeno una risposta ‘Sì’, indipendentemente dalle risposte della Sezione B, viene raccomandato di svolgere la DPIA nella sua completezza;
f) non siano raccolte risposte ‘Sì’ nella Sezione A del questionario di screening ma si raccolgano almeno due risposte ‘Sì’ nella Sezione B, viene raccomandato di svolgere la DPIA nella sua completezza;
g) non siano raccolte risposte ‘Sì’ nella Sezione A del questionario di screening ma si raccolga una sola risposta ‘Sì’ nella Sezione B, viene raccomandato di valutare assieme al DPO la necessità di svolgere la DPIA nella sua completezza.

Nel caso  in cui le risposte al questionario siano state tutte ‘No’ si può ragionevole concludere che il trattamento pre-analizzato non è caratterizzato da “rischio elevato” per i diritti e le libertà delle persone fisiche e quindi può essere conclusa la Fase 0 dell’analisi senza ulteriori valutazioni relative alla DPIA.

Importante – Resta comunque valida l’affermazione generale riportata in varie sedi nazionali ed internazionali che, in caso di dubbio da parte del Titolare sul livello di rischio da assegnare in fase di analisi preliminare, venga deciso di svolgere comunque la DPIA nella sua interezza.

4. Come condurre una DPIA

In questo Cap.4 si descrive in dettaglio come svolgere la DPIA una volta accertato nella FASE 0 di trovarsi di fronte ad un trattamento che ‘può presentare un rischio elevato’.

La descrizione segue le FASI in cui è stata strutturata la DPIA (fig.2.1), a partire dalla FASE 1 fino a completare il ciclo con la descrizione della FASE 7.

4.1 FASE 1: descrizione del trattamento

Nella FASE 1 (Regolamento, Art.35, punto 7, comma a) è necessario descrivere come e perché il Titolare utilizzerà i dati personali relativi al Trattamento.

La descrizione si deve soffermare su: “la natura, l’ambito di applicazione, il contesto e le finalità del trattamento” (Considerando 90).

In Appendice B è proposta una Scheda DPIA relativa a questa FASE. I temi da trattare sono nel seguito descritti attraverso una serie di possibili domande.

Descrizione del trattamento

Per le finalità del trattamento rispondere sinteticamente, tipicamente, a queste domande:

  1. Quali sono le finalità del trattamento?
  2. Quali sono gli eventuali interessi legittimi e le basi legali connesse al trattamento?
  3. Che vantaggio/benefici traggono gli individui coinvolti nel trattamento?
  4. Quali benefici induce il trattamento sull’organizzazione?
  5. Quali benefici induce il trattamento sulla società? 

Per la natura del trattamento rispondere, tipicamente, a queste domande:

  1. Come sono raccolti i dati?
  2. Come vengono gestiti?
  3. Come vengono conservati?
  4. Come vengono usati i dati?
  5. Chi ha accesso ai dati?
  6. Con chi vengono, eventualmente, condivisi i dati?
  7. Qual è il periodo di conservazione dal dato?
  8. Come si chiude il ciclo di vita del dato a termine del periodo di conservazione?
  9. Si prevede l’intervento della figura del Responsabile del trattamento?
  10. Quali sono le misure di sicurezza organizzativa/procedurale messe in atto?
  11. Quali sono le misure di sicurezza tecniche messe in atto?
  12. Si utilizzano nuove tecnologie per il trattamento?
  13. Si utilizzano nuovi metodi di trattamento del dato?
  14. Quali criteri di screening sono stati adottati nell’analisi preliminare (FASE 0)?

Per l’ambito di applicazione del trattamento rispondere, tipicamente, a queste domande:

  1. Che tipo di dati personali vengono raccolti nel trattamento?
  2. Si trattano anche dati appartenenti dalla Categorie Particolari (Art.9)? Quali?
  3. A quanto ammonta il numero delle persone gestite nel trattamento?
  4. Il trattamento è allargato anche a bambini e categorie vulnerabili?
  5. Qual è la frequenza di trattamento del dato?
  6. Quanto dura un processo ordinario di accesso al dato?
  7. Quale area geografica è coperta?
  8. Dove sono conservati fisicamente i dati?

Per il contesto del trattamento rispondere, tipicamente, a queste domande:

  1. Qual è la relazione tra il Titolare e le persone soggette al trattamento?
  2. Quali sono le responsabilità connesse al trattamento?
  3. Qual è il grado di controllo che le persone possono esercitare suoi propri dati personali?
  4. Ci sono esperienze pregresse di questo stesso tipo di trattamento?
  5. Il trattamento fa riferimento a codici di condotta approvati e/o è soggetto a certificazione di terza parte?
  6. Che uso della tecnologia si fa nel trattamento?
  7. Quanti e quali risorse tecnologiche vengono impiegate?
  8. Quante sono le risorse umane impiegate nel trattamento? Che caratteristiche professionali hanno tali risorse umane?
Riferimenti al Regolamento per approfondimenti

Art.35 (punto 7, a) e Considerando 84, 90, 94

4.2 FASE 2: consultazione degli interessati al trattamento

In questa FASE (Regolamento Art.35, punto 2 e 9) è necessario descrivere come il Titolare abbia coinvolto o abbia intenzione di coinvolgere con consultazioni gli interessati al trattamento (o i loro rappresentanti) e altre figure chiave della valutazione quali il DPO, il Responsabile della Sicurezza Informatica, il Responsabile dell’IT, esperti in vari settori, …

Se il Titolare decide di non ricorrere alla consultazione degli interessati deve motivare in questa parte dell’analisi la scelta, mostrando come tale scelta possa, ad esempio, condizionare la sicurezza dell’ente o comprometterne la mission, oppure come essa risulti sproporzionata o impraticabile.

In Appendice C è proposta una Scheda DPIA relativa alla FASE 2. L’analisi va svolta in questa fase tenendo in conto le seguenti considerazioni:

  1. se la DPIA riguarda il trattamento dei dati personali di contatti esistenti (per esempio i dipendenti esistenti), è necessario realizzare una consultazione sul trattamento effettuato per cercare di raccogliere il punto di vista di queste persone o dei loro rappresentanti;
  2. se la DPIA si concentra su un trattamento di dati personali di individui che non sono ancora stati identificati, potrebbe essere necessario effettuare un processo pubblico di consultazione o ricerca mirata. Questo potrebbe assumere la forma di una indagine su una certa fascia demografica oppure la forma di una campagna su gruppi specifici di individui che hanno qualche affinità, per esempio per aspetti professionali, con la tipologia di individui da trattare;
  3. se la decisione sulla DPIA assunte dal Titolare risultassero in contrasto con le opinioni raccolte nella consultazione, sarà necessario documentare i motivi che hanno indotto ad ignorare le opinioni raccolte;
  4. è certamente utile poter consultare, oltre al DPO, tutte le parti interessate interne dell’organizzazione che hanno responsabilità particolari che possono ricadere nella protezione dei dati: ad esempio il Responsabile della Sicurezza Informatica, il Responsabile dell’IT, esperti in vari settori;
  5. in alcuni casi particolarmente complessi potrà essere necessario consultare anche il Garante Privacy nazionale al fine di completare la DPIA. In questa azione, il Titolare sarà supportato dal DPO.
Riferimenti al Regolamento per approfondimenti

Art.35 (punti 2 e 9)

Articolo a cura di Marco Carbonelli

Marco Carbonelli si è laureato in Ingegneria elettronica presso l’Università di Roma Sapienza, diplomato presso la Scuola Superiore di Specializzazione post-laurea in TLC del Ministero delle Comunicazioni ed è in possesso del titolo di Master internazionale di II livello (Università di Roma Tor Vergata) in “Protection against CBRNe events”.

È, inoltre, qualificato esperto NBC presso la Scuola Interforze NBC di Rieti, esperto di Risk Management, ICT security, protezione delle infrastrutture critiche, gestione delle crisi e delle emergenze di protezione civile. Ha svolto per vent’anni l’attività di ricercatore nel settore delle TLC e poi dell’ICT; opera dal 2006 nella Pubblica Amministrazione centrale, dal 2012 ricopre nell’Organo Centrale di Sicurezza della PCM il ruolo di funzionario alla Sicurezza CIS (Communication and Information System), con ulteriori incarichi anche nei settori dell’anticorruzione e della protezione dei dati personali della PCM. Ha pubblicato oltre 150 articoli tecnici in ambito nazionale e internazionale ed è docente, presso l’Università di Tor Vergata di Roma, nei Master Internazionali di I e II livello “Protection against CBRNe events” di Ingegneria Industriale e nel Master AntiCorruzione del Dipartimento di Economia e Finanza.

Download PDF

https://www.ictsecuritymagazine.com/articoli/guida-per-lo-svolgimento-della-valutazione-dimpatto-sulla-protezione-dei-dati-dpia-parte-iii/


Guida per lo svolgimento della valutazione d’impatto sulla protezione dei dati (DPIA) – Parte II

Segue dalla prima parte

2.8 In quali trattamenti è necessaria la DPIA?

L’Art.35 punto 3 evidenzia, in particolare, tre prime tipologie di trattamento in cui è sempre richiesto lo svolgimento della DPIA:

Valutazione sistematica automatizzata dei dati (anche con profilazione) con effetti significativi sulle persone

Una valutazione sistematica e globale di aspetti personali relativi a persone fisiche, basata su un trattamento automatizzato, compresa la profilazione, e sulla quale si fondano decisioni che hanno effetti giuridici o incidono in modo analogo significativamente su dette persone fisiche;

Uso su larga scala di dati delle categorie particolari

Il trattamento, su larga scala, di categorie particolari di dati personali di cui all’articolo 9, paragrafo 1 del Regolamento UE GDPR 679/16, o di dati relativi a condanne penali e a reati di cui all’articolo 10 del Regolamento;

Sorveglianza sistematica pubblica su larga scala

La sorveglianza sistematica su larga scala di una zona accessibile al pubblico.

Assieme a queste prime tre tipologie estremamente generali si deve, in prima istanza, certamente prendere in considerazione le tipologie più specifiche indicate dal Garante nazionale [Gar2] nel 2018, come anche tenere conto di quanto indicato, a livello Europeo, dal Working Party Art.29 [UE1]. Ai fini di assumere un atteggiamento prudenziale nell’analisi e di mirare ad una maggior ampiezza nella casistica descrittiva nella fase di screening, è qui proposto di integrare anche alcuni aspetti indicati dal Garante UK ICO [ICO1], fornendo questo secondo elenco più ampio e dettagliato.
Tale secondo elenco può considerarsi, alla luce degli approfondimenti nazionali e internazionali disponibili allo stato dell’arte, un riferimento adeguato per la fase di screening:

Trattamenti valutativi o di scoring su larga scala, nonché trattamenti che comportano la profilazione degli interessati nonché lo svolgimento di attività predittive effettuate anche on-line o attraverso app, relativi ad “aspetti riguardanti il rendimento professionale, la situazione economica, la salute, le preferenze o gli interessi personali, l’affidabilità o il comportamento, l’ubicazione o gli spostamenti dell’interessato”. [Gar2]

Trattamenti automatizzati finalizzati ad assumere decisioni che producono “effetti giuridici” oppure che incidono “in modo analogo significativamente” sull’interessato, comprese le decisioni che impediscono di esercitare un diritto o di avvalersi di un bene o di un servizio o di continuare ad esser parte di un contratto in essere (ad es. screening dei clienti di una banca attraverso l’utilizzo di dati registrati in una centrale rischi). [Gar2]

Trattamenti che prevedono un utilizzo sistematico di dati per l’osservazione, il monitoraggio o il controllo degli interessati, compresa la raccolta di dati attraverso reti, effettuati anche on-line o attraverso app, nonché il trattamento di identificativi univoci in grado di identificare gli utenti di servizi della società dell’informazione inclusi servizi web, tv interattiva, ecc. rispetto alle abitudini d’uso e ai dati di visione per periodi prolungati. Rientrano in tale previsione anche i trattamenti di metadati ad es. in ambito telecomunicazioni, banche, ecc. effettuati non soltanto per profilazione, ma più in generale per ragioni organizzative, di previsioni di budget, di upgrade tecnologico, miglioramento reti, offerta di servizi antifrode, antispam, sicurezza etc. [Gar2]

Trattamenti su larga scala di dati aventi carattere estremamente personale [UE1]): si fa riferimento, fra gli altri, ai dati connessi alla vita familiare o privata (quali i dati relativi alle comunicazioni elettroniche dei quali occorre tutelare la riservatezza), o che incidono sull’esercizio di un diritto fondamentale (quali i dati sull’ubicazione, la cui raccolta mette in gioco la libertà di circolazione) oppure la cui violazione comporta un grave impatto sulla vita quotidiana dell’interessato (quali i dati finanziari che potrebbero essere utilizzati per commettere frodi in materia di pagamenti). [Gar2]

Trattamenti effettuati nell’ambito del rapporto di lavoro mediante sistemi tecnologici (anche con riguardo ai sistemi di videosorveglianza e di geolocalizzazione) dai quali derivi la possibilità di effettuare un controllo a distanza dell’attività dei dipendenti. [Gar2] [UE1] [UE2]

Trattamenti non occasionali di dati relativi a soggetti vulnerabili (minori, disabili, anziani, infermi di mente, pazienti, richiedenti asilo). [Gar2]

Trattamenti effettuati attraverso l’uso di tecnologie innovative, anche con particolari misure di carattere organizzativo (es. IoT; sistemi di intelligenza artificiale; utilizzo di assistenti vocali on-line attraverso lo scanning vocale e testuale; monitoraggi effettuati da dispositivi indossabili (wearable); tracciamenti di prossimità come ad es. il wi-fi tracking). [UE1] [Gar2]

Trattamenti che comportano lo scambio tra diversi Titolari di dati su larga scala con modalità telematiche. [Gar2]

Trattamenti di dati personali effettuati mediante interconnessione, combinazione o raffronto di informazioni, compresi i trattamenti che prevedono l’incrocio dei dati di consumo di beni digitali con dati di pagamento (es. mobile payment). [Gar2]

Trattamenti sistematici di dati biometrici (trattati per identificare univocamente una persona fisica) e/o genetici, tenendo conto, in particolare, del volume dei dati, della durata, ovvero della persistenza, dell’attività di trattamento. [UE1] [Gar2]

Trattamenti di categorie particolari di dati ai sensi dell’Art. 9 oppure di dati relativi a condanne penali e a reati di cui all’Art. 10 interconnessi con altri dati personali raccolti per finalità diverse. [Gar2]

Trattamenti che possono comportare un impedimento di esercizio di un diritto o di un servizio e/o contratto, cioè quando il trattamento in sé “impedisce agli interessati di esercitare un diritto o di avvalersi di un servizio o di un contratto” (Art. 22 e Considerando 91). Ciò include i trattamenti che mirano a consentire, modificare o rifiutare l’accesso degli interessati a un servizio oppure la stipula di un contratto. Un esempio di ciò è rappresentato dal caso in cui una banca esamina i suoi clienti rispetto a una banca dati di riferimento per il credito al fine di decidere se offrire loro un prestito o meno. [UE1]

Trattamenti che possono comportare rischio di danni fisici, quando, cioè, il trattamento è di natura tale che una violazione dei dati personali potrebbe compromettere la salute fisica o la sicurezza fisica (safety) degli individui. [ICO1]

È opportuno sottolineare come, in ordine ai trattamenti di cui al precedente elenco, è stata svolta di recente dal Comitato Europeo per la Protezione dei Dati (EDPB = European Data Protection Board) in applicazione del meccanismo di coerenza previsto nel Regolamento, una intensa attività con le diverse Autorità di Controllo nazionali (come verificabile sul sito dell’EDPB [UE3]). Il lavoro svolto a livello EDPB ha condotto, ad esempio per l’Italia, alle osservazioni formali evidenziate in [UE2] che mostrano come a livello UE si propenda in questa fase ad una interpretazione meno restrittiva dell’obbligo della DPIA rispetto agli indirizzi assunti in prima istanza dal Garante nazionale, ma più in generale, anche dalle altre Autorità di Controllo nazionali. Tale dibattito resta sostanzialmente aperto tra il Comitato Europeo per la protezione dei dati e le Autorità di Controllo nazionali sull’interpretazione finale della norma e non è da escludere che le considerazioni qui svolte non debbano essere integrare e modificate in un futuro anche prossimo.

Ciò nonostante si ritiene utile, in questa fase ancora di sostanziale rodaggio di applicazione del Regolamento, preferire prudenzialmente un approccio più conservativo, che allarghi, come detto in precedenza, la casistica disponibile nella fase di screening.

Riferimenti al Regolamento per approfondimenti

Art.35 (punti 3 e 4) e Considerando n. 89, 90 e 91

2.9 Cosa significano per il Regolamento le parole chiave: nuove tecnologie, sistematico ed estensivo, effetto significativo, larga scala?

Le definizioni che seguono fanno riferimento agli studi internazionali svolti su questa materia e, come si osserverà, a volte si intersecano sovrapponendosi. Si ritiene comunque utile dare queste indicazioni e definizioni di massima affinché i Titolari del trattamento che operano nelle strutture pubbliche e private possano avere una linea di azione a cui fare, se del caso, riferimento.

Nuove tecnologie

Il Regolamento non definisce la nozione di nuove tecnologie, tuttavia oltre alla interpretazione letterale che si può immaginare come di tecnologie precedentemente non disponibili per conoscenza e industrializzazione (e quindi con conseguente mancanza di esempi già esistenti di applicazione nel trattamento di dati personali), il WP Art.29 suggerisce anche [UE1, UE4] l’interpretazione legata all’innovativa applicazione al trattamento dei dati personali di tecnologie già esistenti, quindi intendendo nuove modalità di utilizzo e di scopo delle stesse tecnologie.

Sistematico ed estensivo

Anche in questo caso il Regolamento non definisce in modo puntuale la nozione di sistematico ed estensivo. Ci può aiutare in questa definizione la Linea Guida Europea per i DPO [UE4] e il recente testo sempre derivato da progetti dell’UE [T4D1] sul trattamento dei dati personali, in cui si specifica che per trattamento sistematico si intende che:

  • avviene in accordo ad un sistema, cioè con un approccio sistematizzato;
  • è organizzato in modo metodico e dettagliato;
  • è inserito in un piano più generale di raccolta dei dati;
  • è condotto come parte di una strategia.

Il termine estensivo, invece, implica che il trattamento:

  • ricopre un’ampia area geografica;
  • coinvolge un ampio insieme di dati;
  • comporta conseguenze su un gran numero di persone.

Effetto significativo

Il Regolamento non definisce la nozione di effetto significativo, tuttavia il WP Art.29 nei suoi documenti [UE1, UE4] indica come questa nozione si traduca in un impatto notevole sulle persone, potendo influenzare il loro status, il loro comportamento e le loro scelte ultime in modo rilevante.

Ad esempio si ha un effetto significativo di un trattamento quando questo, con i suoi effetti, può influenzare lo stato finanziario, la salute, la reputazione o altre caratteristiche economiche e/o sociali delle persone.

Larga scala

Anche in quest’ultimo caso il Regolamento non definisce la nozione di ‘su larga scala’, tuttavia fornisce un orientamento di merito nel Considerando 91 dove si specifica, dopo la locuzione trattamenti su larga scala, come questi mirino a gestire “una notevole quantità di dati personali a livello regionale, nazionale o sovranazionale… che potrebbero incidere su un vasto numero di interessati”.

Inoltre, il WP Art.29 raccomanda [UE1] di tenere conto, in particolare, dei seguenti fattori al fine di stabilire se un trattamento sia effettuato su larga scala:

  • numero di soggetti interessati dal trattamento, in termini assoluti oppure espressi in percentuale della popolazione di riferimento;
  • volume dei dati e/o le diverse tipologie di dati oggetto di trattamento;
  • durata, ovvero la persistenza, dell’attività di trattamento;
  • portata geografica dell’attività di trattamento.

2.10 In quali casi esistono “eccezioni’”e si è esentati dallo svolgimento della DPIA?

Secondo le indicazioni fornite dal Gruppo Art. 29 [UE1], la DPIA non risulta necessaria, oltre che per trattamenti che non presentano rischio elevato per diritti e libertà delle persone fisiche, anche per trattamenti che:

  • hanno natura, ambito, contesto e finalità molto simili a quelli di un trattamento per cui è già stata condotta una DPIA;
  • sono stati già sottoposti a verifica da parte di un’Autorità di controllo nazionale prima del maggio 2018 e le cui condizioni (es: oggetto, finalità, ecc.) non hanno subito modifiche;
  • sono compresi nell’elenco facoltativo dei trattamenti eventualmente indicato dall’Autorità di controllo nazionale per i quali non è necessario procedere alla DPIA;
  • fanno riferimento a norme e regolamenti, Ue o di uno stato membro, per la cui definizione è stata condotta una DPIA.

Alla luce delle disposizioni attuali disponibili anche a livello nazionale, nel seguito si considereranno questi quattro punti come le “eccezioni” operative da analizzare (vedi capitolo successivo).

2.11 Che ruolo svolge il Data Protection Officer nella conduzione della DPIA?

Il DPO supporta il Titolare nello svolgimento della DPIA. In termini generali, il DPO dovrebbe fornire consiglio e parere [T4D1, UE4] su:

  • la necessarietà di eseguire una DPIA per uno specifico trattamento;
  • la modalità di svolgimento della DPIA;
  • quali misure di salvaguardia si possono adottare per mitigare gli eventuali rischi;
  • l’esito finale della DPIA.

È opportuno che i consigli e le indicazioni fornite dal DPO sulla DPIA al Titolare vengano tracciate e documentate. Se il Titolare decidesse di operare in modo contrastante a quanto indicato dal DPO è necessario documentare nella DPIA le ragioni che inducono a tale decisione e assicurarsi di poter giustificare coerentemente scelte non condivise dal DPO.

Il DPO, inoltre, ha il compito di svolgere un’azione di monitoraggio nel tempo sulla DPIA e sulle azioni di mitigazione del rischio decise nella DPIA.

Riferimenti al Regolamento per approfondimenti

Art.35 (punto 2) e Art.39 (punto 1 a,c)

Ulteriori approfondimenti sul ruolo del DPO sono descritti in WP29 Guidelines on Data Protection Officers

2.12 Come è strutturata la DPIA proposta in questa Guida?

La modalità di svolgimento della DPIA descritta in questa Guida è graficamente rappresentabile con la fig.2.1 che segue.

Tale modalità recepisce – oltre ai dettami del Regolamento – tutti le indicazioni del Garante nazionale al momento disponibili, integrandole con i suggerimenti forniti dal WP Art.29 a livello europeo e con l’esperienza internazionale proposta, in particolare, dall’ICO (Autorità di Controllo del Regno Unito) e dal CNIL (Autorità di Controllo francese).

Fig. 2.1 – Rappresentazione grafica della strutturazione in 8 FASI della DPIA proposta nella Guida

La rappresentazione grafica presentata in Fig.2.1 è ripartita in fasi disgiunte che, partendo da una fase preliminare indicata come Fase 0, guidano il Titolare nella valutazione facendogli percorrere tutte le tappe logiche (corrispondenti a 7 ulteriori fasi) necessarie per svolgere una DPIA secondo i dettami delle norma e dello stato dell’arte nella materia.

Nei prossimi articoli, ognuna delle otto fasi qui rappresentate verrà discussa in dettaglio per fornire una guida, il più possibile chiara e esaustiva, nella valutazione.

Articolo a cura di Marco Carbonelli

Download PDF

https://www.ictsecuritymagazine.com/articoli/guida-per-lo-svolgimento-della-valutazione-dimpatto-sulla-protezione-dei-dati-dpia-parte-ii/