Smart Working e Cybersecurity: le problematicità di Zoom e delle piattaforme di videoconferenza

A causa della pandemia di COVID-19 è avvenuta un’imponente riconversione nel mondo del lavoro. Al fine di garantire allo stesso tempo la continuità delle funzioni di aziende e pubbliche amministrazioni e il rispetto delle nuove norme di distanziamento sociale, molte entità si sono adoperate per permettere ai propri dipendenti di lavorare in modalità di smart working. Uno dei risultati di tale riconversione è stato l’incremento esponenziale dell’utilizzo di piattaforme di videoconferenza. Tra le piattaforme più popolari attraverso le quali enti pubblici e privati stanno conducendo i propri meeting online si contano Zoom, Cisco Webex, Skype for Business, Microsoft Teams e Google Classroom. Oltre a facilitare la riconversione del mondo del lavoro, l’aumento di traffico su queste piattaforme ha tuttavia inevitabilmente stimolato l’attenzione di hacker e attori malevoli intenzionati a trarre il maggior vantaggio possibile da questo nuovo contesto d’azione.

Nei giorni scorsi la piattaforma Zoom è stata presa ad esempio di questa dualità. Fin da prima dello scoppio della pandemia di COVID-19 la facilità di utilizzo dell’interfaccia della piattaforma aveva notevolmente contribuito al suo diffuso successo. Come molte altre start-up digitali, Zoom ha avuto il merito di mutuare la strategia commerciale introdotta agli inizi degli 2000 da Google: offrire un servizio straordinariamente semplice in grado di comprendere cosa voglia un utente e di fornirglielo immediatamente. Non stupisce quindi che nello scorso trimestre Zoom avesse già registrato una crescita dell’85% del suo fatturato annuo e un allargamento del 67% della sua base di utenti durante lo stesso trimestre[1].

A seguito dell’avanzare della pandemia, la pagina preposta al download del sistema di videoconferenza ha poi visto, nel solo mese di marzo, un incremento del suo traffico giornaliero del 535%[2]. Il potenziale valore della compagnia ha inoltre attirato investimenti sempre crescenti. La notizia circolata a fine marzo circa la sospensione messa in atto dall’ente statunitense preposto alla vigilanza della borsa valori, la U.S. Security and Exchange Commission, del trading di azioni della Zoom Technologies Inc. (ticker: ZOOM) è misura della crescente attrazione di nuovi investimenti da parte della piattaforma. Le vendite azionarie dell’azienda avevano infatti subito un incremento inusuale a causa di un errore degli investitori, intenzionati ad acquistare in realtà le azioni della piattaforma di videoconferenza Zoom Video Communications Inc. (ticker: ZM)[3].

Oltre a un cospicuo numero di investitori, il servizio di videoconferenza ha tuttavia attirato a sé anche l’attenzione di vari attori malevoli. Nello stesso mese di marzo è stato registrato un incremento del 2.000% di file dannosi contenenti “zoom” nel nome. Secondo una ricerca condotta dalla compagnia di cyber security Cyiax, dall’inizio della pandemia sarebbero circa 3.300 i nomi dominio registrati all’interno dei quali era presente la parola “zoom.” Di questi, 2.000 sono stati identificati come domini finalizzati al phishing[4]. Nello specifico, la creazione di tali nomi dominio è legata a campagne di ingegneria sociale attraverso le quali, tramite l’invio di messaggi mail targhettizzati, attori malevoli cercano di sottrarre informazioni personali, in genere di natura finanziaria, fingendosi degli interlocutori credibili. La stessa Cyiax ha inoltre scoperto la creazione di uno strumento, chiamato zWarDial, utilizzato da tali attori, che avrebbe permesso loro di individuare meeting non protetti da password.

Lo zoombooming, nuovo termine coniato da alcuni analisti di sicurezza informatica, è un ulteriore tipo di attacco cibernetico legato alla piattaforma e consiste nell’intrusione di hacker in meeting privati, o comunque di utenti estranei a una conversazione, i quali “bombardano” i partecipanti di messaggi di insulti, immagini pornografiche o altri contenuti indesiderati.

Le problematiche di Zoom non sono tuttavia legate esclusivamente all’ambito della sicurezza. Diverse obiezioni sono state sollevate relativamente al trattamento dei dati personali e alla salvaguardia della privacy messe in atto dalla piattaforma. A tal riguardo, tra le polemiche che hanno più infiammato il dibattito pubblico in queste settimane si conta quella della condivisione di dati con Facebook senza il consenso informato degli utenti, pratica oggi bloccata dalla piattaforma. I dati condivisi da Zoom comprendevano il tipo di dispositivo utilizzato dagli utenti, il sistema operativo, le dimensioni dello schermo e l’operatore mobile, nonché un identificatore univoco che le aziende avrebbero utilizzato per proporre annunci pubblicitari targettizzati.

In aggiunta, il Washington Post ha pubblicato negli scorsi giorni un’inchiesta secondo la quale migliaia di registrazioni di videoconferenze sarebbero state diffuse online, rendendo pubblicamente accessibili dati personali e strettamente confidenziali. Di fatto, alcune videoconferenze registrate tramite l’applicazione sono state posizionate in un archivio cloud, per accedere al quale non veniva richiesta alcuna password, che archiviava tutte le registrazioni sotto il medesimo nome identificativo, permettendo a chiunque cercasse tale identificativo online di accedere a una lista di circa 15.000 registrazioni omonime[5].

Ulteriori problematiche legate al trattamento dei dati da parte di Zoom sono insorte a seguito della pubblicazione di una ricerca dell’Università di Toronto che ha evidenziato come il sito di videoconferenza abbia fatto passare dati dei suoi utenti attraverso due suoi server localizzati in Cina, esponendo le riunioni coinvolte al rischio dello spionaggio da parte di Pechino[6]. Anche in questo caso, Zoom ha annunciato di aver risolto il problema e che l’utilizzo di server in Cina per la gestione delle conversazioni ha coinvolto un numero molto limitato di casi, quantunque l’apprensione circa il rischio di azioni di intelligence straniera a danno dell’azienda sia rimasta alta.

La piattaforma si è vista infine coinvolta in un’inchiesta condotta dal magazine The Intercept circa il mancato utilizzo di cifratura end-to-end, problema anch’esso risolto attraverso un aggiornamento delle policy dell’azienda. In questo contesto, al fine di rassicurare i propri utenti e investitori Zoom ha annunciato una serie di misure tra le quali la creazione dell’opzione “security”, che un host può selezionare in caso di intrusione in una videoconferenza privata di ospiti non riconosciuti; la rimozione del Meeting ID dalla barra degli strumenti dell’applicazione; e l’assunzione del ex CSO di Facebook Alex Stamos come consulente per la sicurezza[7].

Il tortuoso succedersi di notizie che ha visto coinvolto Zoom e la dinamica di rincorsa tra scandali e politiche correttive dimostra come le risorse preposte alla sicurezza cibernetica e al controllo della salvaguardia della privacy degli utenti siano ad oggi ancora largamente insufficienti. In aggiunta, il fatto che nelle ultime settimane la piattaforma sia stata così duramente attaccata lascia intendere non tanto che queste problematiche riguardino solo Zoom, quanto che queste siano insorte perché il sito è diventato un soggetto particolarmente sotto scrutinio. È anzi realistico pensare che, proprio alla luce dei vari scandali che l’hanno vista coinvolta, la piattaforma stia prendendo maggiori misure al fine di salvaguardare sicurezza e privacy di quanto non stiano facendo i suoi competitor.

Più che una caccia all’ “untore” di cattive pratiche, la vicenda che ha visto coinvolta la piattaforma Zoom dovrebbe quindi servire come monito riguardo alle vulnerabilità a cui sono esposti questi sistemi, e alla prontezza e ferocia con cui diversi attori sono disposti a servirsene. Risposte mirate a problemi mirati sono necessarie, ma non sufficienti: una maggiore cyber hygene degli utenti, nonché una risposta concertata a livello internazionale, appaiono dunque più che mai necessarie.

Note

[1] Jon Quast, Can Zoom Stay Focused on Happiness While It Grows Like Gangbusters?, The Motley Fool, 8 gennaio 2020. https://www.fool.com/investing/2020/01/08/can-zoom-stay-focused-on-happiness-while-it-grows.aspx

[2] Davey Winder, Zoom Isn’t Malware But Hackers Are Feeding That Narrative, And How: Zoom-Related Threats Up 2,000%, Forbes, 12 aprile 2020. https://www.forbes.com/sites/daveywinder/2020/04/12/zoom-isnt-malware-but-hackers-are-feeding-that-narrative-and-how-zoom-related-threats-up-2000/#3bce55af1ae5

[3] Jen Wieczner, ‘ZOOM’ stock halted after investors confuse it with Zoom Video stock, Fortune, 26 Marzo 2020. https://fortune.com/2020/03/26/zoom-stock-halt-zm-ticker/

[4] CYJAX INSIGHTS AND RESEARCH. https://www.cyjax.com/category/blog/

[5] Drew Harwell, Thousands of Zoom video calls left exposed on open Web, Washington Post, 3 aprile 2020. https://www.washingtonpost.com/technology/2020/04/03/thousands-zoom-video-calls-left-exposed-open-web/

[6] Patrizia Licata, Zoom fa mea culpa: “Dati degli utenti inviati per errore in Cina”, CorCom, 6 aprile 2020. https://www.corrierecomunicazioni.it/privacy/zoom-fa-mea-culpa-dati-degli-utenti-spediti-per-errore-in-cina/

[7] Kate O’Flaherty, Zoom Security: Here’s What Zoom Is Doing To Make Its Service Safer, Forbes, 10 aprile 2020. https://www.forbes.com/sites/kateoflahertyuk/2020/04/10/zoom-security-heres-what-zoom-is-doing-to-make-its-service-safer/#720332bc30fc

Articolo a cura di Carolina Polito

Download PDF

https://www.ictsecuritymagazine.com/articoli/smart-working-e-cybersecurity-le-problematicita-di-zoom-e-delle-piattaforme-di-videoconferenza/


Declinazioni applicative del progetto europeo sull’Intelligenza Artificiale secondo il Libro Bianco della Commissione UE

[unable to retrieve full-text content]https://www.ictsecuritymagazine.com/articoli/declinazioni-applicative-del-progetto-europeo-sullintelligenza-artificiale-secondo-il-libro-bianco-della-commissione-ue/


Lo Smart Working al tempo del COVID-19 e il paradigma delle Virtual Private Network (VPN)

In questo particolare momento di emergenza dovuto alla pandemia da Covid-19 la tecnologia delle Virtual Private Network (VPN) rappresenta lo strumento più semplice e il più immediato per consentire ai dipendenti di un’organizzazione di accedere ai loro desktop remoti senza dover apportare notevoli modifiche alla propria infrastruttura IT.

Di seguito sarà sinteticamente descritta l’architettura e l’implementazione di una VPN fornendo al lettore, se pur in modo sintetico, le conoscenze tecnico-informatiche di base necessarie a comprendere l’efficacia dei collegamenti di rete virtuali per la sicurezza delle informazioni trasferite.

Il paradigma delle Virtual Private Network (VPN)

Il meccanismo di base di una VPN è quello di implementare un canale “privato” mediante un insieme di regole di sicurezza e riservatezza formalmente descritte, i c.d. protocolli, dove tutti i pacchetti di dati seguono lo stesso percorso dalla sorgente alla destinazione. Pertanto, quando si fa riferimento ad una VPN ci si riferisce a determinati protocolli informatici ed alla loro implementazione e abbinamento.

Funzioni e tipologie di VPN

Una VPN può essere distinta sia per la tecnologia sia per l’impiego che se ne fa.

In base alla tecnologia avremo VPN definite Trusted dove non è prevista una procedura di tunneling su un mezzo di comunicazione pubblico ma si utilizzano uno o più circuiti virtuali noleggiati da un fornitore di telecomunicazioni e ogni circuito (di livello 2 o 3 della pila ISO/OSI) si comporta come il singolo cavo di una ipotetica rete LAN controllata dall’utente; avremo invece VPN definite Secure che utilizzano reti pubbliche e condivise come Internet e le piattaforme cloud, garantendo la riservatezza di quanto trasportato mediante l’uso di crittografia e specifiche procedure di sicurezza con connessione autenticata. Infine avremo VPN di tipo Hybrid VPN che coniugano i vantaggi delle Trusted VPN e delle Secure VPN.

In base all’uso che se ne fa, invece, avremo VPN di tipo Remote access quando ad accedere alle risorse dell’organizzazione è un utente remoto attraverso apposito applicativo o browser; Site-to-site nel caso di connessione di sedi distaccate, di dipartimenti interni o di società con le quali si ha un rapporto di collaborazione.

Di fatto, per la realizzazione di una VPN non esiste un unico protocollo ma esistono differenti tipologie di protocolli per l’implementazione di metodi e modelli di codifica e sicurezza.

Tra i protocolli più comunemente utilizzati, per la sua robustezza, è il protocollo IPSec (IP Security – opera a Livello 3 della Pila ISO/OSI). Di particolare interesse è il protocollo SSL (Secure Socket Layer – opera tra il livello di trasporto e il livello di applicazione. In realtà racchiude il traffico di livello Application nella crittografia durante il trasporto) che rappresenta il più utilizzato per le comunicazioni sicure sulla rete Internet nella sua versione TLS (Transport Layer Security). E’ il protocollo utilizzato per le comunicazioni sicure sul web nella versione HTTPS (HyperText Transfer Protocol over Secure Socket Layer).

A titolo esemplificativo si riportano di seguito alcune caratteristiche del protocollo IPSec al fine di una più chiara comprensione di come sono implementati i diversi metodi di codifica e sicurezza dell’architettura IPSec per la realizzazione di una VPN.

È in grado di operare sia in modalità tunnel mode che come semplice trasporto dei dati end-to-end in modalità transport mode. La prima modalità incapsula un intero datagramma IP al suo interno, rendendola ideale per l’uso con le VPN o per trasportare traffico IP privato all’interno di reti IP pubbliche. La seconda modalità invece incapsula solamente il protocollo TCP o UDP, rendendo sicura la sola comunicazione applicativa tra due nodi della rete, ad esempio la comunicazione tra un web server e un database server.

I tre principali protocolli di cui fa uso la soluzione di sicurezza IPSec sono:

– Authentication Header (AH) che fornisce servizi di autenticazione e integrità;
– Encapsulation Header (ESP) che fornisce servizi di riservatezza, autenticazione e integrità;
– Internet Key Exchange (IKE) che gestisce lo scambio delle chiavi.

ESP e AH non si preoccupano dello scambio delle chiavi presumendo che i due interlocutori si siano già accordati tra loro con una Security Association (SA)[1] mediante opportuni meccanismi di sicurezza di scambio delle chiavi e autenticazione. Il compito di negoziare e gestire le Security Association, secondo opportune e predefinite politiche, è affidato a IKE. Le quattro metodologie più usate per l’autenticazione e lo scambio di chiavi attraverso IKE sono:

– Shared Secret: questa metodologia prevede che i sistemi conoscano una password comune;
– Public/Private Key: questa metodologia prevede l’uso di chiavi asimmetriche pubbliche e private;
– Digital Certificates: è simile a Public/Private Key ma con chiavi aderenti allo standard X.509 ovvero esiste una verifica dell’utente o del sistema remoto tramite una Certification Authority (CA);
– XAUT: si tratta di una metodologia proprietaria. Alcuni vendor come ad esempio Cisco, includono questa funzionalità per autenticare un utente attraverso Username e Password. Questa modalità differisce dalla Shared Secret perchè legata a un utente e non a un sistema.

Tuttavia, la robustezza di IPSec comporta procedure di installazione non di immediata realizzazione e, in molti casi, per sfruttarne pienamente la sua robustezza necessita di un hardware dedicato e software dedicato.

Una soluzione molto apprezzata per creare una connessione VPN sicura e affidabile in modo agevole è rappresentata dal pacchetto software open source con licenza GPL denominato OpenVPN[2].

La soluzione, basata sul protocollo e le librerie crittografiche SSL/TLS, è molto intuitiva e semplice da installare[3]. Per i sistemi Windows dispone anche di un’interfaccia grafica (GUI) che guida l’utente nell’installazione di tutte le componenti necessarie per l’attivazione. Tra le diverse impostazioni è possibile attivare l’abilitazione automatica del “tunneling” dei dati oppure lasciare all’utente decidere quando attivarla.

Conclusioni

In definitiva una soluzione VPN rappresenta un framework di sicurezza all’interno del quale due o più utenti possono scambiarsi dati su un’infrastruttura condivisa. Va comunque osservato che a determinare effettivamente un livello di sicurezza elevato è l’utilizzatore finale, ovvero la persona che utilizza la tecnologia di sicurezza implementata, sia fisica che logica. Ogni apparente sistema blindato può essere vanificato da utilizzatori poco convinti della sua efficacia o non addestrati al suo corretto utilizzo.

Note

[1] SA è un agreement o contratto tra due IPSec endpoints.

[2]  http://openvpn.net/index.php/open-source/345-openvpn-project.html

[3] OpenVPN utilizza openssl per poter effettuare tutte le operazioni crittografiche.

Articolo a cura di Onofrio Signorile

Download PDF

https://www.ictsecuritymagazine.com/articoli/lo-smart-working-al-tempo-del-covid-19-e-il-paradigma-delle-virtual-private-network-vpn/


Le ultime Linee Guida EDPB sul trattamento dati nel contesto di veicoli e applicazioni connessi alla mobilità: principi di base e prospettive

L’industria automobilistica ha subito un cambiamento di paradigma verso automobili sempre più connesse e autonome. Le auto intelligenti (smart cars) disponibili oggi sono veicoli dotati di sistemi che offrono funzionalità connesse e a valore aggiunto al fine di migliorare l’esperienza-utente (UX) e migliorare la sicurezza delle auto. Entro i prossimi anni, si prevede che la connettività delle auto intelligenti si espanderà e le auto intelligenti saranno connesse ad altri veicoli, pedoni e la loro infrastruttura circostante attraverso scambi di informazioni continui (connected vehicles), fino ad auto semi-autonome e autonome (ovvero i livelli 4 e 5 di autonomia definiti in SAE J30163), che faranno uso di tecniche avanzate di Machine Learning e Intelligenza Artificiale.

Mentre secondo le previsioni ottimistiche i veicoli completamente automatizzati potrebbero essere ampiamente utilizzati entro il 2030, gli esperti scientifici sono più cauti e sottolineano che sono ancora necessarie ulteriori ricerche per costruire un veicolo completamente autonomo, principalmente nei settori dell’IA e della sicurezza informatica. Molto, moltissimo dipenderà anche dai tempi di implementazione generalizzata della tecnologia 5G, oggi candidata a diventare il principale standard a livello mondiale per l’iperconnettività delle auto.

Nel precedente articolo, relativo proprio allo studio ENISA che definisce le buone pratiche per la sicurezza delle smart car, accennavo alle “Linee guida 1/2020 sul trattamento dei dati personali nel contesto dei veicoli connessi e delle applicazioni connesse alla mobilità” che l’EDPB (European Data Protection Board – Comitato Europeo per la Protezione dei Dati) ha adottato per pubblica consultazione a fine gennaio 2020.

Entrando nel merito delle Linee Guida, in ogni caso in cui l’elaborazione dei dati nel contesto di veicoli connessi comporti il trattamento dei dati personali di individui, il pertinente quadro giuridico dell’UE è il GDPR, Regolamento Generale sulla Protezione dei Dati 2016/679. In aggiunta al GDPR, la direttiva “ePrivacy” (2002/58/CE, modificata dalla direttiva 2009/136/CE) stabilisce uno standard specifico per tutti i soggetti che intendano archiviare o accedere alle informazioni archiviate nell’apparecchiatura terminale di un abbonato o utente nello Spazio economico europeo (SEE).

In effetti, la direttiva ePrivacy è una disposizione generale, non si applica solo ai servizi di comunicazione elettronica, ma anche a tutti i soggetti che collocano o leggono informazioni da un’apparecchiatura terminale: il veicolo collegato e tutti i dispositivi a esso collegati devono essere considerati come “apparecchiature terminali” (proprio come un computer, uno smartphone o una smart TV,) e la direttiva ePrivacy deve essere applicata ove pertinente. La definizione precisa parla di a) apparecchiature collegate direttamente o indirettamente all’interfaccia di una rete pubblica di telecomunicazioni per inviare, elaborare o ricevere informazioni oppure b) apparecchiature per stazioni terrestri satellitari.

Come sottolineato dall’EDPB nel suo parere 5/2019 sull’interazione tra la direttiva ePrivacy e il GDPR, la direttiva prevede che, di norma, sia richiesto il consenso preventivo per la memorizzazione di informazioni o per l’accesso a informazioni già memorizzate nell’apparecchiatura terminale di un abbonato o di un utente. Qualsiasi operazione di trattamento di dati personali a seguito delle suddette operazioni di trattamento deve inoltre avere una base giuridica ai sensi dell’art. 6 GDPR per essere lecita.

Dal momento che il titolare del trattamento dovrà informare l’interessato in merito a tutte le finalità del trattamento, quando si richiede il consenso per la memorizzazione o l’accesso alle informazioni ai sensi dell’art. 5(3) Direttiva ePrivacy, il consenso coprirà normalmente anche tali operazioni di trattamento. Il consenso costituirà probabilmente la base giuridica ex GDPR sia per la memorizzazione e l’ottenimento dell’accesso alle informazioni già memorizzate sia per il trattamento dei dati personali a seguito delle suddette operazioni di elaborazione.

L’ambito di applicazione delle Linee Guida si concentra in particolare sul trattamento dei dati personali in relazione all’uso non professionale dei veicoli connessi da parte degli interessati: ad esempio conducenti, passeggeri, proprietari di veicoli, noleggiatori, ecc. Più specificamente, si occupano del dati personali (i) elaborati all’interno del veicolo, (ii) scambiati tra il veicolo e i dispositivi personali a esso collegati (ad es. smartphone dell’utente) o (iii) raccolti all’interno del veicolo ed esportati verso entità esterne (ad es. produttori di veicoli, infrastrutture, compagnie assicurative, riparatori di automobili) per ulteriori elaborazioni.

La definizione del veicolo connesso deve essere qui intesa come un concetto ampio: può essere definito tale un veicolo dotato di molte centraline elettroniche (ECU) collegate tra loro tramite una rete di bordo (in-vehicle) e strutture di connettività che le consentono di condividere informazioni con altri dispositivi sia all’interno che all’esterno del veicolo. Pertanto, i dati possono essere scambiati tra il veicolo e i dispositivi personali ad esso collegati, ad esempio consentendo il mirroring delle applicazioni mobili sull’unità in-dash dell’auto di informazione e intrattenimento. Inoltre, lo sviluppo di applicazioni mobili autonome, ovvero indipendenti dal veicolo (ad esempio, basandosi sull’uso esclusivo dello smartphone) per aiutare i conducenti, è incluso nell’ambito di questo documento poiché esse contribuiscono alle capacità di connettività del veicolo.

Le applicazioni per i veicoli connessi sono molteplici e diverse e possono includere:

  • Gestione della mobilità: funzioni che consentono ai conducenti di raggiungere una destinazione rapidamente e in modo economico, fornendo informazioni tempestive sulla navigazione GPS, condizioni ambientali potenzialmente pericolose (ad esempio strade ghiacciate), congestione del traffico o lavori di costruzione di strade, assistenza per trovare parcheggio o garage, consumo di carburante ottimizzato o tariffe stradali.
  • Gestione del veicolo: funzioni che dovrebbero aiutare i conducenti a ridurre i costi operativi e migliorare la facilità d’uso, come la notifica delle condizioni del veicolo e i promemoria di servizio, il trasferimento dei dati di utilizzo (ad esempio, per i servizi di riparazione del veicolo), assicurazione personalizzata tipo “Paghi come guidi”, operazioni a distanza (ad es. Sistema di riscaldamento) o configurazioni del profilo (ad es. posizione del sedile).
  • Sicurezza stradale: funzioni che avvisano il conducente di pericoli esterni e risposte interne, come protezione da collisioni, avvisi di pericolo, avvisi di abbandono di corsia, rilevamento di sonnolenza del conducente, chiamata di emergenza (eCall) o “scatole nere” (registratori di dati/modalità di guida).
  • Intrattenimento: funzioni che forniscono informazioni e implicano l’intrattenimento di guidatore e passeggeri, come interfacce per smartphone (chiamate in vivavoce, messaggi di testo generati dalla voce), hot spot WLAN, musica, video, Internet, social media.
  • Assistenza alla guida: funzioni che implicano la guida parzialmente o completamente automatizzata, come l’assistenza operativa o il pilota automatico in situazioni di traffico intenso, parcheggi o autostrade.
  • Benessere: funzioni che monitorano il comfort, la capacità e l’idoneità del guidatore a guidare come il rilevamento della fatica o l’assistenza medica.

I veicoli possono essere collegati in modo nativo o meno e i dati personali possono essere raccolti attraverso diversi mezzi, tra cui: (i) sensori del veicolo, (ii) box telematici o (iii) applicazioni mobili (ad esempio accessibili da un dispositivo appartenente al conducente). Per rientrare nell’ambito di questo documento, le applicazioni mobili devono essere correlate all’ambiente di guida. Ad esempio, le applicazioni di navigazione GPS rientrano assolutamente nell’ambito di applicazione, mentre le applicazioni che suggeriscono all’utente luoghi di suo interesse (ristoranti, monumenti storici, ecc.) non saranno coperte da questo documento.

Gran parte dei dati generati da un veicolo connesso si riferiscono a una persona fisica identificata o identificabile e pertanto costituiscono dati personali. I dati includono dati identificabili direttamente (ad esempio, l’identità completa del conducente), nonché dati identificabili indirettamente come i dettagli dei viaggi effettuati, i dati di utilizzo del veicolo (ad esempio, i dati relativi allo stile di guida o alla distanza percorsa), oppure i dati tecnici del veicolo (ad es. dati relativi all’usura delle parti del veicolo) che, facendo riferimento a altri file e in particolare al numero di identificazione del veicolo (VIN), possono essere correlati a una persona fisica. I dati personali nei veicoli connessi possono anche includere metadati, come lo stato di manutenzione del veicolo.

Alcuni dati generati da veicoli connessi possono anche meritare un’attenzione particolare, data la loro “sensibilità” e/o potenziale impatto sui diritti degli interessati. Allo stato attuale, l’EDPB ha identificato tre categorie di dati personali che meritano particolare attenzione da parte dei produttori di veicoli e attrezzature, fornitori di servizi e altri titolari del trattamento dei dati (e specifiche prescrizioni): dati sulla posizione, dati biometrici (e qualsiasi categoria speciale di dati come definita nell’articolo 9 GDPR) e dati che potrebbero rivelare reati o violazioni del traffico.

In altre parole, tutti i dati che possono essere associati a una persona fisica rientrano pertanto nell’ambito di queste Linee Guida.

Tenendo conto del volume e della diversità dei dati personali prodotti dai veicoli connessi veicoli connessi, l’EDPB rileva che i titolari del trattamento dei dati sono tenuti a garantire che le tecnologie impiegate nel contesto dei veicoli connessi siano configurate per rispettare la privacy delle persone applicando gli obblighi di protezione dei dati by design and by default come richiesto dall’art. 25 GDPR. Le tecnologie dovrebbero essere progettate per ridurre al minimo la raccolta di dati personali, fornire impostazioni predefinite di protezione della privacy e garantire che gli interessati siano ben informati e abbiano la possibilità di modificare facilmente le configurazioni associate ai loro dati personali.

Una guida specifica su come i produttori e i fornitori di servizi possano conformarsi alla protezione dei dati by design and by default potrebbe essere vantaggiosa per il settore.  Alcune pratiche generali, descritte di seguito, possono già contribuire a mitigare i rischi per i diritti e le libertà delle persone fisiche associate ai veicoli connessi.

In generale, i produttori di veicoli e attrezzature, i fornitori di servizi e altri titolari del trattamento dei dati dovrebbero, ove possibile, utilizzare processi che non comportino dati personali o il trasferimento di dati personali al di fuori del veicolo (vale a dire, i dati vengano elaborati internamente).

Questo scenario offre il vantaggio di garantire all’utente il controllo esclusivo e completo dei propri dati personali e, in quanto tale, presenta – “by design” – minori rischi per la privacy, in particolare vietando qualsiasi trattamento di dati da parte delle parti interessate all’insaputa dell’interessato. Consente inoltre il trattamento di dati particolari (‘sensibili’) come dati biometrici o relativi a reati o altre infrazioni, nonché dati dettagliati sulla posizione che altrimenti sarebbero soggetti a regole più rigorose. Allo stesso modo, presenta meno rischi per la cybersecurity e comporta poca latenza (ecco che torna la rilevanza del 5G!), il che lo rende particolarmente adatto alle funzioni di assistenza alla guida automatica.

L’elaborazione locale dei dati (in car) dovrebbe essere presa in considerazione dalle case automobilistiche e dai fornitori di servizi ogni qualvolta possibile per mitigare i potenziali rischi dell’elaborazione in cloud, come sottolineato nel parere sul cloud computing rilasciato dal gruppo di lavoro Articolo 29 (Article 29 Working Party, ora EDPB).

Questo, da un lato, migliorerà lo sviluppo di servizi incentrati sull’utente e, dall’altro, faciliterà e garantirà in futuro ulteriori usi che potrebbero rientrare nell’ambito del GDPR. Più specificamente, l’EDPB raccomanda di sviluppare una piattaforma applicativa in-car sicura, divisa fisicamente dalle funzioni della macchina rilevanti per la sicurezza, in modo che l’accesso ai dati delle auto non dipenda da funzionalità cloud esterne non necessarie.

In generale, gli utenti dovrebbero essere in grado di controllare il modo in cui i loro dati vengono raccolti ed elaborati nel veicolo:

  • le informazioni relative al trattamento devono essere fornite nella lingua del conducente (manuale, impostazioni, ecc.);
  • l’EDPB raccomanda che vengano trattati di default solo i dati strettamente necessari per il funzionamento del veicolo. Gli interessati dovrebbero avere la possibilità di attivare o disattivare il trattamento dei dati per ogni altro scopo e titolare/responsabile del trattamento e avere la possibilità di eliminare i dati in questione;
  • i dati non devono essere trasmessi a terzi (ovvero, l’utente ha accesso esclusivo ai dati);
  • i dati devono essere conservati solo per il tempo necessario alla fornitura del servizio o altrimenti richiesto dalla normativa dell’Unione o degli Stati membri;
  • gli interessati dovrebbero essere in grado di eliminare definitivamente tutti i dati personali prima che i veicoli siano messi in vendita;
  • ove possibile, gli interessati dovrebbero avere accesso diretto ai dati generati da tali applicazioni.

Infine, sebbene possa non essere sempre possibile ricorrere all’elaborazione dei dati locali per ogni caso d’uso, è spesso possibile mettere in atto un “trattamento ibrido”. Ad esempio, nel contesto dell’assicurazione basata sull’utilizzo, i dati personali relativi al comportamento alla guida (come la forza esercitata sul pedale del freno, il chilometraggio, ecc.) potrebbero essere elaborati all’interno del veicolo o dal fornitore di servizi telematici per conto della compagnia di assicurazione (il titolare del trattamento dei dati) per generare punteggi numerici che vengono trasferiti alla compagnia di assicurazione su una base definita (ad esempio base mensile). In questo modo, la compagnia assicurativa non ottiene l’accesso ai dati comportamentali grezzi ma solo al punteggio aggregato che è il risultato del trattamento. Ciò garantisce che i principi di minimizzazione dei dati siano soddisfatti by design. Ciò significa anche che gli utenti devono avere la possibilità di esercitare i propri diritti quando i dati sono archiviati da altre parti: ad esempio, un utente dovrebbe avere la possibilità di eliminare i dati memorizzati nei sistemi di un’officina di manutenzione o di una concessionaria.

Se proprio i dati devono lasciare il veicolo, è necessario considerare la possibilità di anonimizzarli prima di essere trasmessi. L’EDPB ricorda che i principi di protezione dei dati non si applicano alle informazioni anonime, vale a dire informazioni che non si riferiscono a una persona fisica identificata o identificabile o ai dati personali resi anonimi in modo tale che l’interessato non sia o non sia più identificabile. Una volta che un set di dati è veramente anonimo e le persone non sono più identificabili, la legge europea sulla protezione dei dati non si applica più. Di conseguenza, l’anonimizzazione, ove pertinente, può essere una buona strategia per mantenere i benefici e mitigare i rischi in relazione ai veicoli connessi.

I costruttori di veicoli e apparecchiature, i fornitori di servizi e altri titolari del trattamento dei dati devono, poi, adottare misure che garantiscano la sicurezza e la riservatezza dei dati trattati e tutte le precauzioni necessarie. In particolare, va considerata l’adozione delle seguenti misure:

  • crittografia dei canali di comunicazione mediante un algoritmo all’avanguardia;
  • mettere in atto un sistema di gestione delle chiavi di crittografia unico per ciascun veicolo, non per ciascun modello;
  • se archiviati in remoto, crittografando i dati mediante algoritmi all’avanguardia;
  • rinnovare regolarmente le chiavi di crittografia;
  • proteggere le chiavi di crittografia da qualsiasi divulgazione;
  • autenticazione dei dispositivi di ricezione dei dati;
  • assicurare l’integrità dei dati (ad es. tramite hashing);
  • subordinare l’accesso ai dati personali a tecniche di autenticazione dell’utente affidabili (password, certificato elettronico, ecc.).

Infine, queste raccomandazioni generali devono essere completate da requisiti specifici che tengano conto delle caratteristiche e delle finalità di ciascun trattamento di dati.

Articolo a cura di Sergio Guida

Da economista aziendale ha maturato esperienze in gruppi industriali diversi per settori, dimensioni e caratteristiche. Specializzato in pianificazione e controllo di gestione, finanza, risk e project management, sistemi di rendicontazione integrativi (sociale, ambientale e intangible assets), è stato relatore in convegni e seminari e ha pubblicato articoli di economia, finanza, strategie e compliance.

Forti interessi verso complessità, multidisciplinarietà, innovazione tecnologica, concentrati ora su digital economy, interazione uomo-macchina (aspetti etici, cognitivi ed epistemologici), data protection & privacy regulations.

Download PDF

https://www.ictsecuritymagazine.com/articoli/le-ultime-linee-guida-edpb-sul-trattamento-dati-nel-contesto-di-veicoli-e-applicazioni-connessi-alla-mobilita-principi-di-base-e-prospettive/


Le nostre reti IoT casalinghe sono sicure?

Con l’incremento sempre più importante della domotica nelle nostre case [1], il numero dei piccoli – e non così piccoli – dispositivi connessi in rete all’interno delle nostre abitazioni sta crescendo sempre di più. Il loro scopo è, attraverso l’utilizzo di tecnologie per lo più wireless, quello di migliorare la qualità della vita, ottimizzare le spese (in bolletta energetica per esempio), e in generale rendere più comoda la vita di tutti i giorni.

Alcuni esempi pratici riguardano sistemi di sorveglianza interna, magari connessi all’impianto di allarme generale (Webcam interne/esterne, sensori di movimento/incendio/gas, baby-monitor), impianti di illuminazione intelligenti (smart lighting interfacciati con App), termostati che comandano interruttori e ricevono informazioni da sensori, sistemi di entertainment, di citofonia (rispondono anche quando non ci siamo), controllo degli accessi, elettrodomestici avanzati e altro. Mentre alcuni sistemi più integrati possono essere previsti durante la costruzione o la ristrutturazione di un appartamento e sono cablati tra loro l’interno di opere murarie, la maggior parte dei device di oggi si appoggia invece alla connessione wireless di casa. Essi sono dispositivi IoT (“Internet of Things” [2]) che possono esser aggiunti man mano senza stravolgere l’ambiente interno. Queste “cose” dialogano spesso tra loro con un hub di controllo attraverso lo stack TCP/IP, ed in generale comunicano con App che si possono connettere dall’esterno quando siamo fuori a lavoro, per esempio.

Ma cosa può intrufolarsi dentro le nostre case, a parte dei leciti comandi che accendono per esempio il riscaldamento due ore prima che torniamo da un lungo viaggio in inverno?

Con uno studio svolto in collaborazione con il Dott. Emanuele Bosimini, iniziato con la sua tesi di laurea triennale e poi proseguito con un articolo scientifico [3], ci siamo occupati di monitorare la quantità e qualità degli attacchi informatici verso protocolli tipici del mondo IoT. Essi possono impattare sul funzionamento delle nostre abitazioni in molteplici scenari: la porta o le finestre esterne possono essere aperte per commettere furti, le nostre abitudini giornaliere possono essere profilate, i nostri dati sensibili possono essere rubati, o semplicemente le risorse computazionali a disposizione della casa possono essere utilizzate per gli scopi dell’attaccante.

Per monitorare questo ambiente abbiamo utilizzato degli honeypot (in Italiano, “vasi di miele”). Essi sono strumenti hardware/software utilizzati come “esche” per attirare eventuali attaccanti: il loro scopo è quello di esporre solamente l’interfaccia vulnerabile di un servizio o dispositivo completo, senza implementarne tutta la loro logica e funzionalità. Gli honeypot possono essere quindi utilizzati per attirare e registrare attacchi identificando “pattern” ricorrenti e nuovi. In questo modo è possibile quindi adottare le dovute contromisure istruendo attraverso opportune regole dei sistemi di controllo SIEM (Security Information Event Management). Un vantaggio caratteristico degli honeypot è quello che essi registrano attività solamente in caso si interagisca direttamente con loro, diminuendo così la quantità di dati da analizzare e minimizzando i falsi positivi. Per questo motivo, essi sono in grado di registrare efficacemente anche attacchi di tipo zero-day.

Torniamo adesso all’esperimento che abbiamo effettuato per testare la sicurezza delle reti IoT nelle nostre case. Abbiamo lasciato per due mesi (dicembre 2019 e gennaio 2020) tre differenti honeypot, ciascuno installato attraverso tecniche di virtualizzazione (Docker) all’interno di un Raspberry Pi. Questi honeypot sono Cowrie [4], Dionaea [5], e Whaler [6]. Ben tre perché non esiste al momento una soluzione unica in grado di tracciare tutti i protocolli che ci interessavano. L’utilizzo dell’architettura Raspberry è dovuto alla minimizzazione del costo energetico, vista la lunga durata dell’esperimento; questi dispostivi si avvicinano inoltre alle “cose’’ IoT, anche se sono sicuramente tra le più performanti tra esse (anche 4Gbyte di RAM, e svariate porte di connessione con l’esterno).

Gli attacchi sono stati monitorati sui protocolli 1) Cowrie: 22 (ssh), 23 (telnet), 2)Dionaea 21 (ftp), 42 (wins), 135 (msrpc), 443 (https), 445 (samba) 1433 (ms-sql), 1723 (pptp), 1883 (mqtt), 1900 (upnp), 3306 (mysql) 5060 (sip), 5061 (sip-tls), 8081 (http), 11211 (memcache), 69 (tftp), 3) Whaler 2375 (Docker Unencrypted Socket).

Al fine di concentrarci su device IoT, ci siamo rivolti maggiormente ai protocolli UPnP (Universal Plug and Play), MQTT (Message Queue Telemetry Transport) e XMPP (Extensible Message Passing Protocol). UPnP deriva da “universal plug-and-play” e permette a diversi terminali come smart-tv, stampanti, videocamere, console di gioco, di connettersi l’uno all’altro semplicemente. MQTT è un protocollo di messaggistica leggero di tipo “publish-subscribe”, utile in caso di banda limitata. XMPP è un protocollo aperto per la comunicazione  in tempo reale (in forma di video, voce, testo) che utilizza XML (Extensible Markup Language) come linguaggio base per scambiare le informazioni. Infine, il monitoraggio dell’ambiente Docker potrebbe risultare al di fuori delle funzionalità di una rete IoT. Tutt’altro. L’eterogeneità delle configurazioni tipiche dei dispositivi IoT è spesso un ostacolo: le medesime applicazioni per questi device devono essere configurate per ogni differente ambiente (sistema operativo + hardware), se installate direttamente. Per questo motivo, servizi IoT racchiusi in container stanno diventando molto popolari: un esempio è Eclipse-Mosquitto (ovvero un broker MQTT dockerizzato), che  ha raggiunto oltre dieci milioni di download [7].

Quello che abbiamo potuto rilevare dal nostro esperimento è stato molto interessante. Per esempio, in due mesi sono stati caricati sui nostri honeypot più di 3Gigabyte di malware: analizzando più in dettaglio, ai primi tre posti troviamo Mirai, Nyadrop, e Ircbot, quindi malware per creare botnet IoT. Inoltre, la seconda password più spesso tentata (in telnet per esempio) è stata “xc3511”, utilizzata di default da videocamere IP di produzione cinese (la password di gran lunga più usata è stata “admin”).

Passando ai tre protocolli tipici di servizi IoT, XMPP non ha ricevuto nessun attacco nei due mesi considerati, MQTT circa 4300 (quasi completamente provenienti dagli USA), mentre UPnP circa 85000 (in stragrande maggioranza dal Brasile). In aggiunta, abbiamo rilevato circa 43400 attacchi sulla porta Telnet (USA al primo posto) e 50800 su SSH (UK al primo posto). Chiaramente anche questi ultimi protocolli permettono di connettersi ai dispostivi IoT e impartire comandi. Le restanti porte hanno sollevato solamente una manciata di allarmi.

Per quanto riguarda il monitoraggio Docker, abbiamo registrato 50 indirizzi IP differenti che hanno installato un container sull’honeypot Whaler, molti di questi contenenti applicazioni di mining di criptovalute come Bytecoin e Monero, al fine quindi di utilizzare risorse computazionali altrui per i propri scopi. In Figura 1 possiamo vedere la geolocalizzazione di questi attacchi, in maggior parte provenienti da Europa e Stati Uniti (almeno nel periodo temporale considerato).

Figura 1: Geolocalizzazione degli attacchi verso la piattaforma Docker

Che dire, quindi? La risposta al titolo del nostro articolo è ovviamente negativa se non prendiamo precauzioni. Dobbiamo essere molto attenti quando installiamo nuovi dispositivi IoT all’interno delle nostre case. Le password di default vanno cambiate, i servizi inutili vanno disabilitati, e l’accesso alla rete di casa dall’esterno deve essere protetto. Difendersi solamente controllando il traffico attraverso il gateway verso il mondo esterno può non bastare: la nostra rete e i nostri dispositivi rimangono comunque direttamente accessibili dai vicini, come dagli ospiti che portino con sé un cellulare, un tablet o un portatile.

Bibliografia

[1] Smart home: nel 2018 mercato in crescita del 52% – https://www.ilfattoquotidiano.it/2019/03/19/smart-home-nel-2018-mercato-in-crescita-del-52/5048220/

[2] Simone Cirani, Gianluigi Ferrari, Marco Picone, Luca Veltri – Internet of Things: Architectures, Protocols and Standards, ISBN: 978-1-119-35967-8 November 2018 408 Pages, Wiley

[3] Stefano Bistarelli, Emanuele Bosimini, Francesco Santini – A Report on the Security of Home Connections with IoT and Docker Honeypots, Italian Conference on Cybersecurity, Ita

[4] Cowrie: https://github.com/cowrie/cowrie

[5] Dionaea: https://github.com/DinoTools/dionaea

[6] Whaler: https://github.com/oncyberblog/whaler

[7] https://hub.docker.com/_/eclipse-mosquitto

Articolo a cura di Francesco Santini

Download PDF

https://www.ictsecuritymagazine.com/articoli/le-nostre-reti-iot-casalinghe-sono-sicure/


Dallo Zeroday al sistema di Intelligence

Molto spesso parliamo di ZeroDay, del loro valore, del fatto che possono essere rivenduti a prezzi esorbitanti.

Come spesso abbiamo detto, la privacy in questo periodo è oggetto della massima attenzione. Se ne parla al telegiornale, se ne parlava a scuola, se ne parlava al bar (perdonatemi il passato, visto il regime di lockdown), ma di fatto la privacy inizia e finisce con l’avvento dei Social Network e con tutto quello che ruota attorno; e dopo il Datagate, Vault7 e Crypto-Ag, abbiamo abbondanti motivi per parlarne.

Gli Stati nazionali, sulla base delle loro costituzioni, acquistano strumenti di Intelligence per “controllare il crimine, per investigare sul terrorismo e salvare centinaia di vite umane”, così si legge sulle home-page dei siti delle aziende che vendono questo genere di sistemi.

Ma è possibile che tutto questo avvenga alla luce del sole?

Di recente Facebook ha fatto notizia denunciando la Israeliana NSO Group, la quale vendette a enti governativi il sistema Pegasus (armato da un potente Zeroday per Whatsapp) che ha consentito di violare circa 1400 utenti tra i quali personaggi politici, attivisti, ecc.

Ma per capire tutto questo e come funziona, dobbiamo seguire un filo logico.

Oggi negli smartphone abbiamo tutto: dall’accesso alla nostra banca alle chat con i nostri amici, colleghi, conoscenti. Abbiamo l’accesso all’email dell’ufficio e a quelle personali; abbiamo le nostre foto, le coordinate di dove andiamo e dove siamo stati, le nostre perversioni, insomma tutta la nostra vita. 

Immaginate se fossimo dei criminali e le forze di polizia accedessero a questo “ecosistema” di preziose informazioni, saremmo pressoché rovinati (e che “colpo grosso” sarebbe per le polizie di stato, vero?).

Ma accedere a un terminale di un individuo lo si può fare in diversi modi.

  1. Il primo modo, se se ne è il legittimo proprietario;
  2. il secondo, qualora lo smartphone venga perduto;
  3. il terzo, Attraverso backdoor progettate per scopi di spionaggio (appannaggio dei governi e delle agenzie di Intelligence, come ad esempio NSA, CIA, GCHQ, IDF, ecc… parlando di software americano);
  4. il quarto – il più ghiotto – sfruttando degli errori di scrittura del software, dei “bug” sconosciuti che fanno eseguire codice con i massimi privilegi su un software specifico o su terminale remoto.

Ecco appunto i famosi zeroday no-click RCE su sistemi quali IoS, Whatsapp, Android, che vengono acquisiti nel clear-web o nelle darknet a prezzi stratosferici da “Broker zero-day” con picchi di ricompense tra i 2 e i 3 milioni di dollari.

Quindi, se noi fossimo una agenzia che produce tool di spionaggio (ma chiamiamoli, in modo più mite e pacato, di Intelligence), quale sarebbe il nostro canale di approvvigionamento?

  1. Il ricercatore scopre una vulnerabilità zero-day che consente l’esecuzione di codice arbitrario su un WhatsApp senza l’interazione dell’utente;
  2. il ricercatore divulga privatamente a un Broker zero-day la vulnerabilità che gli riconosce 2.5 milioni di dollari per la scoperta, pagando di fatto il suo silenzio;
  3. il broker rivende ad aziende che sviluppano tool di Intelligence lo zero-day, magari attraverso un’asta privata. L’azienda che sviluppa sistemi di Intelligence si aggiudica lo zero-day a 4 milioni di dollari;
  4. su quello zero-day l‘azienda sviluppa un sistema (ovviamente per i soli enti governativi), che consente l’accesso completo ai dati di uno smartphone di ipotetica vittima (ad es. inviandogli un SMS o una chiamata WhatsApp senza avere interazione con l’utente), magari fornendo anche strumenti di controllo remoto e di dashboard.
  5. L’azienda rivende questo tool a 10 governi alla cifra di 2 milioni di dollari (passatemi il termine) a licenza.
  6. le revenue è presto fatta.

Ecco quindi che i governi possono beneficiare di questi strumenti per “prevenire il crimine e il terrorismo, e poter vegliare sulle nazioni con un grande occhio vigile”.

Ma dove è il confine tra legalità e illegalità?
Ogni fine giustifica un mezzo?
Rispetto alle possibili risposte esistono molte scale di grigio e non è facile rispondere.

Sicuramente, però, questa non è fantascienza.Parliamo di sistemi quali Karma, Pegasus e tanti altri ancora, creati in continuazione sfruttando questo sistema, fino a quando queste falle non verranno rese pubbliche da un ricercatore eticamente corretto o da una “spifferata”, in seguito a un eventuale ricatto, verso le stesse aziende che producono spyware.

Ma ricordiamoci di Eternalblue che ci insegna come passarono 5 lunghi anni prima che The Shadow Broket rubasse l’exploit dai server della NSA; e se così non fosse stato, i nostri sistemi Windows starebbero ancora ballando la Samba! (Perdonatemi la battuta… ma ci stava bene).

Questa è la realtà di oggi: la racconto nella convinzione sia importante che tutti la conoscano bene.

Articolo a cura di Massimiliano Brolli

Download PDF

https://www.ictsecuritymagazine.com/articoli/dallo-zeroday-al-sistema-di-intelligence/


Rischio Cyber e Covid-19

Introduzione

Stiamo vivendo dei momenti drammatici. Tutti noi stiamo combattendo contro un nemico invisibile che ha mietuto un numero incredibile di vittime, mettendoci in una situazione fuori da ogni possibile immaginazione. Un evento pandemico di queste dimensioni era imprevisto e largamente sottostimato anche da autorevoli fonti come il World Economic Forum che, nel suo Global Risk Report 2020[1], inserisce il rischio di infezione pandemica solo al decimo posto nella classifica dei dieci principali rischi a livello globale e addirittura fuori da questa classifica in termini di probabilità.

Paradossalmente (e alla luce dei fatti si può ben dire), tutti i rischi che riguardano il mondo delle tecnologie interconnesse tramite Internet (Information Infrastructure Breakdown, Data Fraud or Theft e Cyberattacks) nella medesima classifica sono posizionati ben più in alto sia in termini di probabilità di accadimento che di impatto potenziale.

Come a dire, ci siamo concentrati sui virus informatici e siamo stati messi alle corde da un virus che appartiene al mondo reale.

Questa situazione ci insegna anche che c’è una differenza tra rischio percepito e rischio reale e che questa differenza può essere marcata. In alcuni casi il rischio percepito sovrastima il rischio reale, in altri casi lo sottostima, come ad esempio nel caso del rischio di infezione pandemica. Come mai? Di solito, quando in relazione a un dato rischio si materializza un evento avverso inatteso, il rischio percepito cresce verticalmente. E nel caso del rischio Cyber negli ultimi dieci anni abbiamo assistito a un susseguirsi di eventi con fattore di scala medio-grande, che hanno impressionato l’opinione pubblica e creato preoccupazione in relazione alla tenuta di un sistema economico che si basa largamente su una serie di sottosistemi interconnessi tramite le reti di comunicazione.

A volte, invece, rischi diversi hanno dei punti di contatto; infatti il nuovo stile di vita che il COVID-19 ci ha imposto e lo stato di apprensione in cui ci ha precipitato offre ai cybercriminali una grande opportunità di mettere a segno i loro odiosi colpi. Vediamo perché.

Contesto

Il momento che stiamo vivendo ci pone in uno stato d’animo che è facilmente sfruttabile dai cybercriminali.

Siamo preoccupati per la diffusione del virus, poniamo grande attenzione a tutte le notizie che riguardano questo tema, ci sentiamo molto coinvolti dal punto di vista emotivo in tutte le storie che suscitano in noi preoccupazione, compassione o anche orgoglio per come la nostra comunità sta affrontando questa battaglia.

Siamo confinati nelle nostre case; lavoriamo, studiamo, facciamo acquisti in buona parte utilizzando Internet e i suoi strumenti. La posta elettronica ci tiene in contatto con l’ufficio ma consente anche ai nostri figli di mantenere il rapporto con i propri professori. Per evitare di uscire, usiamo i siti di eCommerce per fare la spesa o acquistare i beni che ci sono necessari. Per pagare l’affitto di casa, le bollette delle utenze domestiche, la rata del mutuo, utilizziamo i servizi di home banking della nostra banca. Insomma, si sta allargando in modo considerevole la fascia di popolazione che usa Internet per assolvere ai piccoli/grandi compiti della vita di tutti i giorni.

Rischi

Nulla di nuovo, solo che la base di utenza di questi servizi è aumentata vertiginosamente[2] e con essa il rischio di furti, truffe, ricatti e di tutte le altre odiose azioni che i cybercriminali mettono costantemente in atto. Ora, quali sono i principali rischi[3] che solitamente corriamo e che in una situazione come quella attuale risultano amplificati?

  • Per primo considererei il rischio che qualche malintenzionato riesca a sottrarci informazioni per noi importanti; come ci può riuscire e cosa fare per difendersi lo vedremo più avanti. Potrebbe trattarsi delle informazioni relative alla nostra carta di credito o peggio ancora delle credenziali di accesso al nostro sito di remote banking. Da notare però, che in quest’ultimo caso, la normativa europea ha imposto alle banche (e di conseguenza agli utenti) l’adozione di un metodo di autenticazione a due fattori per l’accesso ai siti di home banking che ha notevolmente migliorato la situazione (anche questo punto lo approfondiremo più avanti);
  • poi, c’è il rischio che un cybercriminale riesca in qualche modo a crittografare i dati del nostro hard disk rendendoli illeggibili e ci chieda poi un riscatto (in genere in bitcoin[4]) per renderci disponibile la chiave che ci permetterebbe di decifrarli e rendere le nostre foto e i nostri documenti di nuovo leggibili;
  • proseguendo, prenderei in considerazione il rischio che i cybercriminali riescano a sottrarci le credenziali della nostra posta elettronica o dei social network a cui siamo iscritti. Perché dovrebbe farlo? Per inviare spam[5] o per trollare[6] (a nostra insaputa), in altre parole per sottrarci la nostra identità digitale;
  • e ancora, considererei il rischio che un cybercriminale installi un software sul nostro computer per assoldarlo all’interno di una botnet[7] allo scopo di effettuare attacchi informatici contro qualche altro obiettivo in Italia o all’estero. Il cybercriminale sarebbe, quindi, in grado di utilizzare il nostro computer a nostra insaputa per scopi illeciti; insomma, il nostro computer diventerebbe uno zombie;
  • infine, esaminerei il rischio certamente ad impatto più elevato anche se, per fortuna, con probabilità non elevatissime. Si tratta del rischio che un minore sia adescato online da malintenzionati a scopi che tremo anche solo a pronunciare. In questo caso non si riesce a ragionare in termini statistici, anche un solo caso è di una gravità estrema.

Cosa fare per difendersi?

Per perpetrare questi crimini, i cybercriminali devono installare del software sul nostro computer o sul nostro smartphone. Come fanno di solito? Tramite una e-mail di phishing[8]. Le e-mail di phishing sono il principale veicolo di malware[9], ovvero del software che i cybercriminali utilizzano per raggiungere tutti gli obiettivi descritti in precedenza. È molto importante capire che non esistono programmi in grado di filtrare completamente le e-mail di phishing ma che siamo noi a dover fare una parte del lavoro ponendo la giusta attenzione nel riconoscerle. Ecco, quindi, i suggerimenti più importanti:

  • non aprite mai le e-mail provenienti da mittenti sconosciuti o sospetti;
  • se anche avete aperto un’e-mail sospetta, non aprite mai gli allegati e non cliccate mai sui link contenuti nel corpo dell’e-mail;
  • attenzione ai link che vi vengono proposti sui social network; cliccate solo se siete sicuri del profilo che ha postato il link e, comunque, state attenti;
  • dotate il vostro personal computer di un software antivirus che deve essere costantemente aggiornato;
  • attenzione alle e-mail che riguardano il tema della pandemia COVID-19: raccolte fondi, avvisi urgenti, app dedicate al monitoraggio della diffusione del virus sono veicoli perfetti per la diffusione di malware;
  • sul vostro smartphone, non cliccate mai su link che vi inducono a scaricare APP da store non ufficiali (quelli ufficiali più noti sono Apple Store e Google Play);
  • ove previsto dal servizio Internet che state utilizzando (es. webmail, social, e-commerce), attivate l’autenticazione a due fattori basata sul vostro numero di telefono cellulare;
  • aggiornate costantemente la versione del sistema operativo del vostro PC e del vostro smartphone e tutte le applicazioni o APP che utilizzate più di frequente;
  • non rispondete mai alle e-mail di spam;
  • non fidatevi mai delle e-mail che propongono sconti eccezionali o che promettono qualcosa in regalo;
  • non lasciate mai soli per troppo tempo i più piccoli davanti al PC o allo smartphone; in questo momento anche gli adescamenti online sono in aumento.

Ora procediamo con ordine.

E-mail e social

Come si fa a riconoscere un mittente “sospetto”? Bisogna fare molta attenzione. Alcune e-mail sono semplici da individuare, altre sono molto sofisticate, praticamente indistinguibili dalle e-mail originali. Facciamo un esempio: un indirizzo di posta elettronica di questo tipo nome.cognome@gestore.it, se non si fa molta attenzione, è indistinguibile rispetto all’indirizzo nome.cognome@gestore.lt (.elleti), solo che il secondo indirizzo non è di un gestore italiano ma di un gestore lituano, e la cosa è in effetti sospetta! Quando si leggono le e-mail molto velocemente e con una dimensione di carattere piccola (ad esempio nel caso di uno smartphone), è probabile che la differenza non si colga. Quindi, ci vuole molta attenzione. Bisogna, però, fare attenzione anche se il nome del mittente corrisponde ad una persona effettivamente nota, potrebbe essere una trappola. Nel mondo di Internet in generale e dunque anche nei sistemi di posta elettronica, è molto semplice fare spoofing[10], ovvero, fare in modo che nella e-mail il nome del mittente sia diverso e non corrispondente all’indirizzo di e-mail del mittente. Quindi, potremmo ricevere e-mail da “nome. cognome” (persona a noi nota e conosciuta) che però non sono realmente inviate da un indirizzo presumibilmente lecito come nome.cognome@gestore.it, ma da un altro indirizzo non correlato all’identità mostrata nel nome utente. Come si fa a controllare l’indirizzo e-mail sottostante ad un nome utente? È semplice: basta passare il mouse sopra il nome utente e vedrete comparire il reale indirizzo mittente. Se l’indirizzo mittente vi sembra non correlato al nome utente, non fidatevi e cestinate l’e-mail. Le e-mail di phishing possono essere molto sofisticate, scritte in modo indistinguibile rispetto a un’e-mail “vera” e dal punto di vista grafico indistinguibile rispetto alle e-mail originali.

Se per caso avete aperto l’e-mail, non affrettatevi a cliccare sui link in essa contenuti; concedetevi una seconda opportunità di controllo. Se all’interno dell’e-mail vedete dei link del tipo “Clicca qui”, non lo fate! Prima passate il mouse sul link e controllate l’indirizzo web che si attiverebbe in caso di click. Controllatelo con la stessa attenzione con cui avreste dovuto controllare l’indirizzo e-mail nascosto sotto il nome utente. Se c’è qualcosa che non vi torna e che non corrisponde tra nome utente, indirizzo e-mail reale e indirizzo web dei link contenuti nell’e-mail, allora chiudete l’e-mail e cancellatela. In ogni caso, non aprite mai nessun allegato a meno che non siate assolutamente sicuri che l’e-mail sia lecita e proveniente da una persona da voi effettivamente conosciuta.

Gli stessi criteri vanno utilizzati se, invece di un’e-mail, state consultando un post[11] pubblicato su di un social network: attenzione all’autenticità del profilo e occhio ai link sui quali cliccate.

Come abbiamo visto in precedenza, uno dei business più importanti dei cybercriminali è quello relativo allo spam. Ovvero acquistare sui mercati illegali stock di indirizzi e-mail a cui inviare informazioni commerciali non richieste. Nella buona parte dei casi, si tratta di e-mail fastidiose ma innocue; in altri casi queste e-mail (come abbiamo visto in precedenza) nascondono vere e proprie attività di phishing. È importante sapere che non bisogna mai rispondere ad una e-mail di spam. Una nostra risposta equivale a comunicare al mittente: “io ci sono e posso ricevere e-mail di spam” e questi si affretterà ad aumentare il volume di e-mail indesiderate destinate a noi o, peggio ancora, a rivendere il nostro indirizzo e-mail ad altri spammer[12]. In ogni caso c’è una correlazione diretta: se si risponde aumenta il volume delle e-mail che riceviamo. Attenzione anche ad un aspetto ancor più subdolo. A volte le e-mail di spam espongono un link per cancellare l’iscrizione dalla mailing list, potrebbe essere un trucco per indurci a scaricare un malware. Gli spammer, infatti, non sono interessati ad offrire meccanismi leciti per non ricevere più e-mail di spam da quel mittente.

Ovviamente, i principi di cui abbiamo appena discusso valgono se utilizziamo un personal computer ma anche se consultiamo le e-mail da uno smartphone. In questo caso, uno degli obiettivi dei cybercriminali è indurvi a scaricare APP da link che non riportano ad uno store ufficiale (quelli ufficiali più noti sono Apple Store per iOS e Google Play per Android). Questa è un’indicazione semplice: non scaricate mai APP da uno store non ufficiale! È una condizione necessaria ma non sufficiente; a volte, i cybercriminali riescono a superare i filtri di sicurezza che i gestori degli store impongono a chi vuole pubblicare APP disponibili pubblicamente al download.

Autenticazione a due fattori

Come dicevamo, uno degli obiettivi più importanti dei cybercriminali è il furto di credenziali, le credenziali di posta elettronica, le credenziali del sito di e-commerce, le credenziali del servizio Cloud[13] su cui archiviamo le nostre foto e i nostri documenti, le credenziali per l’accesso alla nostra azienda.

In questo caso il suggerimento è semplice: ove possibile, attivate la modalità di autenticazione a due fattori[14]. L’idea alla base di questa modalità è semplice: visto che il furto di credenziali (nome utente e password) è un fenomeno che cresce costantemente, ci dobbiamo proteggere richiedendo l’accesso ad un sito tramite un fattore di autenticazione ulteriore rispetto a nome utente e password, che consiste in un codice numerico inviato sul nostro cellulare. In questo modo, l’autenticazione è possibile conoscendo le credenziali (qualcosa che sai) ed essendo in possesso del proprio smartphone (qualcosa che hai). Un cybercriminale per accedere al posto vostro ad un servizio web dovrebbe possedere sia le credenziali di autenticazione (possibile ma – se stiamo attenti – poco probabile) che il secondo fattore di autenticazione (molto più difficile e dunque meno probabile). Può essere un fastidio, ma dal punto di vista della sicurezza è sicuramente un passo in avanti.

La cyber hygiene

È anche possibile che i cybercriminali riescano ad installare un malware sul vostro PC senza bisogno di utilizzare una e-mail di phishing; in questo caso sfruttando vulnerabilità[15] del sistema operativo o di uno dei software applicativi che utilizzate sul vostro PC o delle APP che utilizzate sul vostro smartphone.

Anche se non è un metodo del tutto infallibile, è bene che il vostro PC sia dotato di un software antivirus[16] costantemente aggiornato. Se il sistema operativo del vostro PC non è dotato di un antivirus, è possibile reperirne uno in rete dove si trovano software free molto affidabili. L’importante è che l’antivirus sia configurato per effettuare controlli periodici e per aggiornare periodicamente l’elenco dei nuovi virus da cercare.

In questi giorni ci stanno chiedendo di rimanere a casa e di lavarci spesso le mani; nel mondo digitale vale la stessa cosa: attenzione a dove andiamo, a chi visitiamo e prendiamoci cura dell’igiene dei nostri dispositivi digitali. Si chiama, infatti, Cyber Hygiene[17].

E-commerce

In questo triste periodo, per ovvi motivi, aumenta il ricorso ai siti di eCommerce. Anche in questo caso possiamo dare qualche semplice raccomandazione:

  • non affidatevi mai a siti di eCommerce sconosciuti o solo perché fanno promesse poco realistiche;
  • quando utilizzate un sito di eCommerce controllate sempre che il sito utilizzi il protocollo https[18] che indica che la comunicazione tra PC e sito di eCommerce è protetta con tecniche di crittografia. Capire se il sito che stiamo utilizzando è protetto da https è semplice, basta guardare nella barra degli indirizzi e verificare la presenza del simbolo di un lucchetto chiuso seguito dalla stringa https://;
  • adottate sempre l’autenticazione a due fattori.

Il rischio per i minori

Come ultimo tema vorrei parlare del fatto che la forzata permanenza a casa costringe i nostri figli a utilizzare smartphone e PC per rimanere in contatto con i propri insegnanti. Non solo gli studenti universitari o delle medie superiori, ma anche quelli delle medie inferiori e – addirittura – delle elementari. Ci troviamo in una situazione in cui ogni componente della famiglia avrebbe bisogno di un proprio PC e, specialmente per i più piccoli, aumenta esponenzialmente l’esposizione online. Anche per questa tipologia di casi d’uso valgono tutte le raccomandazioni fatte in precedenza più, come risulta dal report di Europol[19], una fondamentale per pericolosità: i tentativi di adescamento online sono in aumento. A questo proposito non ci sono raccomandazioni semplici da dare, ma è meglio fare riferimento a quanto già magnificamente fatto dalla Polizia Postale[20].

Note

[1] https://www.weforum.org/reports/the-global-risks-report-2020

[2] https://www.engage.it/tecnologia/comportamenti-online-mapp-223888/223888
https://www.engage.it/agenzie/triboo-vendite-ecommerce-coronavirus/221392
https://www.merlinwizard.com/ll-covid-19-ha-contagiato-anche-lecommerce.htm
https://www.ilsole24ore.com/art/triboo-il-coronavirus-balzo-volumi-e-commerce-AD2BvFC

[3] Rischi: vengono classificati in base alla probabilità di accadimento e all’impatto potenziale (R=PxI). Esistono rischi con impatto potenziale molto elevato ma (per fortuna) probabilità di accadimento remota e rischi che si concretizzeranno con elevata probabilità ma che (sempre per fortuna) ha un impatto piuttosto limitato. Nel mezzo c’è un’ampia gamma di rischi che devono essere singolarmente valutati e gestiti.

[4] Bitcoin: è una criptovaluta, ovvero un sistema di pagamento elettronico basato su Internet e su protocolli sicuri. I bitcoin diversamente dalle monete non sono mediati da un ente centrale (sistema bancario) ma sono convertibili in moneta tradizionale (è possibile acquistarli e venderli).

[5] Spam: invio non richiesto di pubblicità e offerte commerciali. Usato anche per indicare una quantità eccessiva di messaggi sui social o su chat.

[6] Trollare: il comportamento di chi provoca, insulta, aggredisce qualcuno online pubblicando commenti negativi nei confronti di altri utenti della comunità virtuale.

[7] Botnet: è una rete di robot (robot-net, da cui il termine botnet), cioè di dispositivi informatici che una volta infettati da malware, passano sotto il controllo di una entità centrale chiamata centro di comando e controllo. Lo scopo è utilizzare tali dispositivi per realizzare attacchi informatici distribuiti, propagare virus e malware, sottrarre dati personali, inviare spam, ecc.

[8] Phishing: è una frode informatica finalizzata all’acquisizione, con l’inganno, di dati riservati del cliente (ad esempio username e password) attraverso l’invio di e-mail contraffatte che presentano grafica e loghi ufficiali di aziende ed istituzioni conosciute (es. banche).

[9] Malware: software malevolo creato per danneggiare un computer o un terminale mobile (smartphone o tablet) collegato in rete.

[10] Spoofing: camuffarsi, mascherarsi allo scopo di assumere le sembianze di qualcun altro falsificando l’indirizzo sorgente di una comunicazione. Ad esempio, è possibile fare spoofing di un indirizzo di e-mail impostando il nome utente (quello che in prima battuta viene visualizzato nella e-mail) con un nome conosciuto dal destinatario, mentre il reale indirizzo ne rivela la provenienza sconosciuta e inaffidabile. Si usa il termine spoofing (in questo caso IP spoofing o address spoofing) quando si crea un pacchetto IP nel quale viene falsificato l’indirizzo IP del mittente.

[11] Post: è un messaggio che può contenere testo, immagini, video, link a siti web o ad altri post pubblicato su un social netwok.

[12] Spammer: colui che invia e-mail di spam.

[13] Servizio Cloud: servizio che permette di accedere a risorse hardware e software disponibili su server ubicati altrove, attraverso dispositivi collegati alla rete fissa o alla rete mobile. Il termine “nuvola” lascia intendere che la localizzazione fisica delle risorse assume un’importanza minore rispetto alla possibilità di accedervi ovunque e dovunque il cliente si trovi.

[14] Autenticazione a due fattori: il sito web dopo la digitazione di user-id e password invia sul numero di cellulare dell’utente registrato un codice numerico che deve essere inserito sul sito web per completare l’autenticazione. Il codice numerico può essere ricevuto dall’utente via SMS o generato tramite un’APP Authenticator opportunamente configurata per generare codici per lo specifico sito web.

[15] Vulnerabilità: è l’assenza, la presenza in misura ridotta o la compromissione delle misure di sicurezza di un sistema (quale esso sia); una vulnerabilità rappresenta un punto debole che consente a un eventuale aggressore (la minaccia) di compromettere il livello di sicurezza dell’intero sistema.

[16] Antivirus: software che serve a prevenire, rilevare e/o rendere inoffensivi codici dannosi: i virus.

[17] Cyber Hygiene: si tratta di tutte le misure di prevenzione che è necessario applicare ai sistemi e dispositivi digitali per ridurre la cosiddetta “superficie esposta” agli attaccanti, ovvero, il numero di vulnerabilità che possono essere sfruttare dalle minacce. Il puntuale aggiornamento delle versioni di sistema operativo e dei software applicativi (patching) è la principale misura di Cyber Hygiene.

[18] https: HyperText Transfer Protocol su Secure Socket Layer (HTTPS) è un protocollo per la comunicazione sicura attraverso una rete di computer utilizzato su Internet.

[19] https://www.europol.europa.eu/publications-documents/pandemic-profiteering-how-criminals-exploit-covid-19-crisis

[20] https://www.commissariatodips.it/index.html, sezioni “Da Sapere: Per i Genitori / Per i bambini / Per i Cittadini e i Ragazzi”

Articolo a cura di Marcello Fausti

Il Dott. Marcello Fausti è attualmente responsabile della CyberSecurity del Gruppo Italiaonline.

Nei 10 anni precedenti, è stato responsabile della IT Security di TIM con responsabilità della protezione delle infrastrutture critiche; dello sviluppo e gestione dei sistemi a supporto dell’Autorità Giudiziaria; della gestione del Security Operation Center, della gestione del processo di ICT Risk Management e dello sviluppo delle contromisure di sicurezza per la gestione operativa dei piani di sicurezza. È stato, inoltre, responsabile del Security Lab di TIM. In precedenza ha lavorato nel gruppo Olivetti come direttore marketing e business development di una società di system integration attiva sul mercato dei large account e come marketing manager della divisione PA della capogruppo.

È certificato CISM, PMP, COBIT, ITIL, ISO20000.

Download PDF

https://www.ictsecuritymagazine.com/articoli/rischio-cyber-e-covid-19/


Protezione del software: limiti e potenzialità

In cybersecurity siamo abituati a confinare le informazioni all’interno di perimetri, o zone di sicurezza. All’interno della zona di sicurezza, considerata un ambiente attendibile, è possibile accedere alle informazioni e utilizzarle in una forma condivisa comune, in modo sicuro e aperto. Al di fuori della zona, le informazioni non dovrebbero essere accessibili senza autorizzazione. Il problema che stiamo affrontando al giorno d’oggi è che, una volta che qualcuno penetra nella zona di sicurezza, nulla può fermare l’accesso e l’uso non autorizzati delle informazioni.

È possibile costruire una zona di sicurezza attorno al SW – ovvero tale per cui la logica e le strutture dati, cioè il know-how che ha reso possibile la sua realizzazione – siano protette?

Ci sono alcune caratteristiche intrinseche del Software (SW) che lo rendono un prodotto altamente vulnerabile sotto quest’aspetto. Innanzitutto il fatto che esso incorpora e rende per certi versi esplicito il know-how che ha reso possibile la sua creazione. Tutto è esplicitato in modo chiaro nelle istruzioni e nelle strutture dati che compongono un dato programma o una data architettura SW. Pertanto, quanto più il know-how di una azienda è concentrato sul prodotto SW, tanto più questo è a disposizione di chiunque ne faccia una copia, lecita o illecita che sia!
Inoltre, il SW per essere eseguito (o interpretato) deve essere esplicitato in un linguaggio (es. C, C++. .Net. Java, binario x86 etc). Pertanto, non possiamo immaginare di criptare le istruzioni e aspettarci che il programma così reso illeggibile, sia eseguibile da un interprete (sia esso in PC o altro) senza che questo, a un certo punto, non decripti le istruzioni rendendole in questo modo leggibili [1].

Un attacco MATE (Man-At-The-End) significa la possibilità, assolutamente concreta, che un attaccante abbia a disposizione un dato sistema SW, che possa analizzarlo – ad esempio in un debugger o mediante emulazione – possa disassemblarlo e decompilarlo, nel caso di SW distribuito come file eseguibili, estraendo la struttura logica che lo caratterizza, e possa fare reverse engineering delle strutture dati e quindi del know-how che ha respo possibile la sua realizzazione [4]. Attacchi MATE sono frequenti, se non la norma, sia nel mercato legale che nel mercato illegale.
Tipici attacchi MATE sono: individuazione ed eventuale riutilizzo di funzionalità ritenute strategiche, identificazione di falle o contesti di utilizzo che possono essere sfruttati per compromettere le funzionalità del SW, o pirateria e compromissione del’IP (Intellectual Property).

Se pensiamo al SW come a un asset fondamentale del nostro business, non possiamo prescindere da considerare nel suo sviluppo anche metodi e tecnologie di protezione. Sono necessarie tecnologie che combinino crittografia, trasformazione di programmi e ingegneria del software al fine di permettere una sicurezza incentrata sull’applicazione, dove la sicurezza di un’applicazione non è supportata solo dalle funzionalità di sicurezza provenienti dall’ambiente in cui l’applicazione è in esecuzione, ma è anche integrata nel suo stesso codice, utilizzando tecnologie di protezione appositamente progettate per il software.

Un risultato teorico fondamentale – apparso in versione preliminare nel 2001 e in versione estesa e dettagliata nel 2012 [2] (si veda [1] per una introduzione) – dimostra che è teoricamente impossibile trasformare un dato programma P mediante un compilatore T in modo che il programma compilato T(P) mantenga sostanzialmente le performance di P e sia tale che tutto ciò che un attacco MATE a T(P) può imparare è solo la relazione input/output di T(P), detto virtual black-box (VBB). Più semplicemente, questo risultato dimostra che non è possibile costruire un compilatore (che chiameremo offuscatore) che renda il nostro programma (asset) P completamente oscuro, ovvero per il quale tutta la logica, la dinamica delle strutture dati sia nascosta e sia visibile solo ciò che P calcola.

Nella scienza è ben noto che i risultati negativi sono spesso fonte dei più importanti sviluppi, anche tecnologici. L’impossibilità di avere un offuscatore VBB chiaramente pone dei limiti alla possibilità di proteggere il nostro SW. Ad esempio non possiamo immaginare di nascondere in modo indefinito un segreto (ad esempio una chiave criptografica) in un programma e assumere che questa non sia determinabile da un attacco MATE.
Bisogna quindi pensare alla protezione del SW non come un processo definitivo, ovvero dato in modo definitivo da un magico compilatore offuscante VBB T per un qualsiasi attacco MATE, come è nel caso della criptografia per ciò che concerne la comunicazione sicura tra parti rispetto ad attacchi Man-In-The-Middle. Dobbiamo pensare in modo differente, sfruttando le intrinseche proprietà del SW, che in questo caso ci possono venire in aiuto:

  1. i programmi sono probabilmente tra gli oggetti più complessi mai costruiti dall’uomo. Anche comprendere un programma di poche righe può essere estremamente difficile;
  2. per comprendere un programma abbiamo bisogno di strumenti che, a causa del punto 1), sono anch’essi programmi: disassemblatori per ricostruire il codice simbolico da un dato eseguibile, decompilatori per ricostruire il sorgente da un codice simbolico eseguibile [2], analizzatori statici e dinamici, debugger, emulatori, slicer per ridurre la struttura etc.

In quest’ottica, proteggere il SW significa sviluppare metodi e tecnologie per rendere il SW oltremodo complicato e per far sì che gli strumenti dell’attaccante siano inefficaci a ridurre la complessità del problema del reverse engineering, rendendo questo processo estremamente dispendioso e più lungo nel tempo. Quindi significa pensare la protezione in un arco temporale: prima o poi l’attaccante MATE avrà la meglio.

Questo è il campo di studio e ricerca del code obfuscation, ovvero dei metodi e delle tecnologie per rendere parzialmente possibile il nascondimento di informazioni nel programma. Si tratta spesso di una combinazione di tecniche che uniscono al mero nascondimento alcune funzionalità aggiuntive. Ad esempio, offuscamento e versionamento frequente possono essere strategie vincenti per ingaggiare l’attaccante in una rincorsa continua a tutto svantaggio di chi insegue, in questo caso l’attaccante!

Sul piano tecnologico, le tecnologie impiegate sono principalmente una combinazione di trasformazioni di programmi, ovvero manipolazioni che mantengono sostanzialmente inalterato le funzionalità dei programmi trasformati, agendo quindi sulla struttura del codice. Un’antologia di queste tecniche si può trovare in [3].

L’introduzione di funzionalità anti manipolazione (anti-tampering) che permettano al codice di ispezionare e verificare a run-time la propria consistenza contrastando in questo modo sia riutilizzazioni non autorizzate che attacchi MATE svolti mediante debugger; l’iniezione di SW watermark, ovvero di particolari sequenze che identificano in modo univoco un dato programma e che pertanto possono essere utilizzate per tracciarne l’eventuale riutilizzo, sono esempi di tecnologie che richiedono offuscamento. Offuscamento di parti del programma, dal layout (offuscamento banale riguardante nomi ad esempio di variabili e strutture dati) passando per la logica di esecuzione (offuscamento più complesso spesso ottenibile mediante un processo di virtualizzazione controllata su architetture costruite ad hoc per essere complesse e non standard) fino alle strutture dati (offuscamento dei dati mediante trasformazioni omomorfe).

Queste tecnologie devono essere pensate e adattate al particolare contesto e spesso progettate ad hoc, onde evitare che per ogni tecnologia di protezione disponibile sul mercato esista una tecnologia simmetrica che ne vanifichi le funzionalità.

Note

[1] Su questo aspetto studi recenti cercano di estendere tecniche di homomorphic encryption [1], ovvero la possibilità di operare su dati criptati senza una fase di decriptazione, alla esecuzione di programmi. Risultati preliminari rendono possibile idealmente l’esecuzione di istruzioni criptate su macchine a stati finiti di potenza limitata. L’estendibilità di questa tecnologia a set di istruzioni più ampie, o a veri e propri linguaggi di programmazione, è oggetto di studio e comunque fuori dalla portata dell’odierna ingegneria del SW.

[2] Chiunque pensasse che distribuire l’eseguibile sia una forma di protezione del SW è chiaramente ingenuo. Ogni eseguibile se non opportunamente manipolato (offuscato) è decompilabile.

Riferimenti

[1] B. Barak. Hopes, fears, and software obfuscation. Communications of the ACM, 2016 vol. 59(3), pp. 88-96.

[2] B. Barak, O. Goldreich, R. Impagliazzo, S. Rudich, A. Sahai, S.P. Vadhan, and K. Yang. On the (im)possibility of obfuscating programs. J. ACM, 59(2):6, 2012.

[3] C. Collberg. Surreptitious Software: Obfuscation, Watermarking, and Tamperproofing for Software Protection. Addison-Wesley, 2010.

[4] C. Collberg, J. Davidson, R. Giacobazzi, Y. Gu, A. Herzberg, and F. Wang. Towards Digital Asset Protection. IEEE Intelligent Systems. 26(6):8-13, 2011.

Articolo a cura di Roberto Giacobazzi

Download PDF

https://www.ictsecuritymagazine.com/articoli/protezione-del-software-limiti-e-potenzialita/


Le nuove linee guida AgID e il sistema di conservazione

Introduzione

In questo articolo approfondiremo le novità relative al sistema di conservazione, introdotte dalle nuove Linee Guida AgID [1] sul documento informatico. Come già evidenziato in un precedente articolo [2] gli approfondimenti proposti fanno riferimento alla bozza delle Linee Guida AgID sul documento informatico, così come pubblicate nella fase di consultazione pubblica che ha avuto luogo tra il 17 ottobre e il 16 novembre del 2019. Si ricorda che queste linee guida assumono carattere giuridicamente vincolante in quanto si configurano come linee guida contenenti le Regole tecniche di cui all’articolo 71 della novellata versione del Codice dell’Amministrazione Digitale (CAD)[1] [3].

La normativa vigente prevede che l’adozione delle Linee guida da parte di AgID possa avvenire solo previa consultazione pubblica, “sentiti le amministrazioni competenti e il Garante per la protezione dei dati personali nelle materie di competenza, nonché acquisito il parere della Conferenza unificata”[2] [3]. Inoltre, anche alla luce del fatto che “le regole tecniche di cui al […] codice sono dettate in conformità […] alle discipline risultanti dal processo di standardizzazione tecnologica a livello internazionale ed alle normative dell’Unione europea”[3] [3], la loro bozza “deve essere trasmessa alla Commissione europea per eventuali osservazioni sul testo, qualora il contenuto dovesse avere un impatto sul mercato interno dell’Unione europea ai sensi del Regolamento UE n. 1025/2012” [4]. A seguito di quest’ultimo passaggio, l’Agenzia per l’Italia Digitale “ha recentemente ricevuto dalla Commissione europea alcune osservazioni e prontamente ha provveduto a rispondere” [4], pertanto al momento è in attesa di “conoscere l’ultimo, definitivo parere della Commissione europea, senza il quale non può procedere alla pubblicazione delle Linee guida” [4].

Un nuovo punto di vista

Le nuove linee guida [1] introducono alcune interessanti novità sotto il profilo della sicurezza dei sistemi di conservazione, rispetto a quanto previsto dalle vigenti regole tecniche [5]. Si tratta di aspetti già rilevabili da un punto di vista definitorio, dato che ora il sistema di conservazione viene indicato come “l’insieme di regole, procedure e tecnologie che assicurano la conservazione dei documenti informatici in attuazione a quanto previsto dall’art. 44, comma 1, del CAD”[4] [1]. Si tratta di una definizione che evidenzia meglio la sua caratterizzazione come sistema informativo e non come mero sistema informatico.

Infatti la nuova definizione di conservazione, dopo aver richiamato (così come avveniva nelle Regole tecniche [5]) la formulazione di “insieme delle attività finalizzate a definire ed attuare le politiche complessive del sistema di conservazione e a governarne la gestione in relazione al modello organizzativo adottato”[5] [1], aggiunge la specificazione che ciò dovrà avvenire “garantendo nel tempo le caratteristiche di autenticità, integrità, leggibilità, reperibilità dei documenti”[6] [1]. Si tratta di una precisazione importante[7], in quanto crea un riferimento diretto con quanto sancito dall’articolo 44, comma 1-ter, del D.lgs. 82/2005, laddove si afferma che “il sistema di conservazione dei documenti informatici assicura, per quanto in esso conservato, caratteristiche di autenticità, integrità, affidabilità, leggibilità, reperibilità, secondo le modalità indicate nelle Linee guida”[8] [3].

I ruoli operanti nel processo di conservazione

Le nuove linee guida [1] introducono un’espansione dei ruoli interagenti all’interno del processo di conservazione, rispetto a quanto contenuto nelle vigenti regole tecniche [5]. I ruoli ora previsti sono cinque: due coincidenti funzionalmente con quelli esistenti (ovvero il produttore dei pacchetti di versamento e l’utente abilitato) seppur leggermente variati nella denominazione, due completamente nuovi e uno (il responsabile della conservazione) modificato nella sua definizione. Più in dettaglio, nella nuova definizione di responsabile della conservazione si vuole evidenziare sia la sua piena autonomia, sia la sua piena responsabilità nell’ambito della definizione e nell’attuazione delle politiche globali del sistema. Infatti, esso è quel “soggetto che definisce e attua le politiche complessive del sistema di conservazione e ne governa la gestione con piena responsabilità e autonomia”[9] [1].

Per quanto concerne i nuovi ruoli, il primo è quello del titolare dell’oggetto di conservazione, qui definito come il “soggetto produttore degli oggetti di conservazione”[10] [1]; mentre il secondo è quello del conservatore, inteso come il “soggetto pubblico o privato che svolge attività di conservazione dei documenti informatici”[11] [1].

In merito alla nozione di oggetto di conservazione, si evidenzia come nelle nuove Linee Guida [1] questo sia definito come un “oggetto digitale versato in un sistema di conservazione”[12] [1]. A sua volta l’oggetto digitale è descritto come un “oggetto informativo digitale, che può assumere varie forme tra le quali quelle di documento informatico, fascicolo informatico, aggregazione documentale informatica o archivio informatico”[13] [1]. Si tratta di una definizione chiara e coerente con quella di pacchetto informativo, inteso come un “contenitore logico che racchiude uno o più oggetti di conservazione con i relativi metadati, oppure anche i soli metadati riferiti agli oggetti di conservazione”[14] [1] e che pertanto è utilizzato nel sistema di conservazione per la trattazione proprio degli oggetti di conservazione. Per quanto riguarda la nozione di pacchetto informativo, questa fa sempre riferimento ai tre tipi classici, ovvero al pacchetto di versamento (PdV), al pacchetto di archiviazione (PdA) e al pacchetto di distribuzione (PdD).

Complessivamente, in relazione a queste nuove aggiunte nell’ambito dei ruoli e delle responsabilità delle entità coinvolte, è necessario evidenziare che si tratta di soggetti già operanti all’interno del processo di conservazione, pur non essendo esplicitamente citati tra i ruoli di interesse per il sistema di conservazione. Tutto ciò a testimonianza del fatto che nelle linee guida si realizzi non tanto un ampliamento dei ruoli di riferimento, quanto un’espansione della prospettiva con la quale si vuole approcciare il fenomeno conservazione, indagandolo non più solo dal lato del sistema informatico, ma soprattutto dal lato del sistema informativo. Insomma è corretto affermare che in tal senso la prospettiva di analisi cessa di essere incentrata sul sistema di conservazione per spostarsi verso il processo di conservazione.

A tal riguardo si ritiene necessario evidenziare alcune perplessità sollevate dal Garante per la protezione dei dati personali nell’ambito della definizione dei ruoli e delle responsabilità dei soggetti coinvolti nel trattamento dei dati. Si tratta di aspetti fondamentali, atteso che “una chiara attribuzione dei compiti è il presupposto necessario per garantire anche una corretta ripartizione delle responsabilità, in relazione al trattamento dei dati personali” [6]. Dunque, rilevata la necessità di modificare lo schema preliminare delle nuove Linee guida al fine di “rendere evidente che il dovere di adottare e mettere in atto tutte le misure di sicurezza adeguate, ricade, in primo luogo, in capo al titolare del trattamento[15]” [6], il Garante ha espresso l’opportunità di specificare meglio le attività affidate al Responsabile della conservazione. Più in dettaglio, con riferimento alla previsione che lo stesso “adotta le misure necessarie per la sicurezza fisica e logica del sistema di conservazione come previsto dal par. 4.11”[16], il Garante evidenzia la necessità di “chiarire che l’adozione delle misure è in capo al titolare o, in caso di trattamento effettuato per suo conto, al responsabile del trattamento e non al responsabile del sistema di gestione” [6].

I nuovi requisiti infrastrutturali del sistema di conservazione e il GDPR

Nelle nuove Linee guida [1] viene poi dato ampio spazio all’indicazione di alcuni requisiti di tipo infrastrutturale che devono essere soddisfatti, sia dai sistemi di conservazione delle Pubbliche Amministrazioni, sia da quelli dei conservatori accreditati.

Nello specifico, questi sistemi “prevedono la materiale conservazione dei dati e delle copie di sicurezza sul territorio nazionale e garantiscono un accesso ai dati presso la sede del Titolare dell’oggetto di conservazione e misure di sicurezza conformi a quelle stabilite dalle presenti linee guida”[17] [1]. Si tratta evidentemente di indicazioni finalizzate a consentire lo svolgimento delle attività di vigilanza da parte dell’Agenzia per l’Italia Digitale[18].

Parimenti, le nuove Linee guida [1] prevedono che “le componenti tecnologiche hardware e software utilizzate dai sistemi di conservazione delle Pubbliche Amministrazioni e dei conservatori accreditati sono segregate fisicamente e logicamente per i servizi di cui all’art. 29 del CAD”[19] [1], ovvero per i servizi fiduciari qualificati, per i servizi di conservazione dei documenti informatici, per i servizi di posta elettronica certificata, nonché per quelli relativi alla gestione dell’identità digitale. Particolarmente importante e chiarificatrice è l’indicazione secondo la quale, “qualora i servizi vengano erogati in modalità cloud, il servizio deve essere qualificato come previsto dalla Circolare Agid n. 3 del 9 aprile 2019 e, conseguentemente, essere presente nel «Catalogo dei servizi Cloud per la PA qualificati» [7]”[20] [1].

Va evidenziato che in merito ad alcune previsioni relative alla sicurezza delle infrastrutture del sistema di conservazione, così come delineate nelle nuove Linee guida [1] permangono delle profonde perplessità, che sono tra l’altro state in parte ben evidenziate dal Garante per la protezione dei dati personali. Infatti, l’autorità di controllo italiana ha rilevato che, nell’ambito della definizione dei requisiti di sicurezza a cui dovranno attenersi tutti i soggetti a vario titolo coinvolti nel trattamento, non sia possibile limitarsi a un mero richiamo delle Linee guida AgID in materia di misure minime di sicurezza ICT per le pubbliche amministrazioni. Invero, tale rimando “non è di per sé sufficiente ad assicurare l’adozione di misure di sicurezza del trattamento adeguate, in conformità al Regolamento, a norma del quale, occorre invece valutare, in concreto, i rischi che possono derivare, in particolare, dalla distruzione, dalla perdita, dalla modifica, dalla divulgazione non autorizzata o dall’accesso, in modo accidentale o illegale, a dati personali trasmessi, conservati o comunque trattati” [6]. Del resto già in precedenza, seppur con riferimento allo schema di Linee guida in merito alla sicurezza nel procurement ICT, il Garante aveva evidenziato che “il mero riferimento alle linee guida AgID in materia di misure minime di sicurezza nell’ambito dei requisiti di sicurezza […], non è di per sé sufficiente a garantire la sicurezza del trattamento in conformità al Regolamento [(UE) 2016/679]” [8], specificando che “le misure tecniche ed organizzative che il titolare e il responsabile del trattamento sono tenuti ad adottare, devono essere tali da garantire un livello di sicurezza adeguato al rischio, che presenta il trattamento” [8]. Inoltre ciò deve essere implementato, “tenendo conto dello stato dell’arte e dei costi di attuazione, nonché della natura, dell’oggetto, del contesto e delle finalità del trattamento, come anche del rischio di varia probabilità e gravità per i diritti e le libertà delle persone fisiche”[21] [9].

Anche in merito all’utilizzo dei sistemi di conservazione in cloud, il Garante raccomanda un’integrazione dello schema delle nuove Linee guida [1], “al fine di richiamare i titolari al rispetto del principio di integrità e riservatezza, nonché dei principi di protezione fin dalla progettazione e per impostazione predefinita, e dei conseguenti adempimenti previsti dal Regolamento (art. 25 e 32 del Regolamento)” [6]. Inoltre, i sistemi di autenticazione informatica utilizzati per riconoscere i soggetti autorizzati ad accedere agli oggetti digitali conservati, dovranno “garantire modalità di accesso diverse, in funzione delle tipologie di dati personali trattati, nonché delle operazioni di trattamento consentite” [6].

Per quanto riguarda i soggetti privati che agiscono in qualità di conservatori accreditati, il Garante evidenzia la necessità di integrare lo schema delle nuove Linee guida [1] per prevedervi “l’obbligo di individuare tali soggetti esterni quali responsabili del trattamento” [6]. Inoltre, sempre nel citato schema delle nuove Linee guida andrà altresì esplicitamente indicato che i servizi di conservazione esternalizzati dovranno essere “sempre organizzati nel rispetto dei principi e dei requisiti previsti in materia di sicurezza dei dati e dei sistemi dal Regolamento (artt.  32 – 34), avuto riguardo anche alla notifica delle violazioni dei dati personali di cui all’art. 33 del Regolamento stesso” [6].

Il piano della sicurezza del sistema di conservazione e il GDPR

Per quanto riguarda la sicurezza del sistema di conservazione, permane la dicotomia tra le previsioni che si applicano alle Pubbliche Amministrazioni e quelle riferibili solo ai soggetti privati. Per le PA, nelle Linee guida [1] permane la previsione, già contenuta nelle Regole tecniche [5], che venga disposto, nell’ambito del piano generale della sicurezza, il piano della sicurezza del sistema di conservazione. Anche il regime definitorio è identico considerando che per piano generale della sicurezza si intende quel “documento che pianifica le attività volte alla realizzazione del sistema di protezione e di tutte le possibili azioni indicate dalla gestione del rischio nell’ambito dell’organizzazione di appartenenza”[22] [1], mentre con piano della sicurezza del sistema di conservazione ci si riferisce al “documento che, nel contesto del piano generale di sicurezza, descrive e pianifica le attività volte a proteggere il sistema di conservazione dei documenti informatici da possibili rischi nell’ambito dell’organizzazione di appartenenza”[23] [1]. A tal riguardo vorrei evidenziare le perplessità sollevate dal Garante per la protezione dei dati personali, il quale ha proposto che dalle suddette definizioni venga rimosso l’inciso che fa riferimento all’organizzazione di appartenenza, “per evitare fraintendimenti per i quali potrebbero essere presi in esame esclusivamente rischi interni all’organizzazione e non anche quelli che potrebbero verificarsi presso eventuali fornitori esterni” [6].

Come già previsto precedentemente, tale redazione sarà a cura del responsabile della conservazione, il quale dovrà operare di concerto con il responsabile della sicurezza e con il responsabile della transizione digitale, ma solo dopo aver acquisito il parere del responsabile della protezione dei dati. Di fatto è questa la vera novità, con cui si riconoscono le funzioni e i compiti che il Regolamento (UE) 2016/679 attribuisce al RPD[24]. La predisposizione del succitato piano avviene “mettendo in atto opportune misure tecniche e organizzative per garantire un livello di sicurezza adeguato al rischio in materia di protezione dei dati personali, ai sensi dell’art. 32 del Regolamento (UE) 2016/679, e in aderenza alle linee guida emanate dall’Agenzia per l’Italia digitale con riferimento alle misure minime di sicurezza in ambito ICT «Misure minime di sicurezza ICT per le pubbliche amministrazioni»”[25] [1]. Senza voler entrare nei dettagli per brevità espositiva, si segnala che il citato articolo 32 del GDPR fa riferimento alla messa in atto di misure tecniche e organizzative, non minime (e uguali per tutti i titolari del trattamento), bensì adeguata a garantire un livello di sicurezza adeguato al rischio rilevato (e quindi specifiche per il particolare titolare del trattamento). Non a caso, viene richiesto che tali misure adeguate siano individuate “tenendo conto dello stato dell’arte e dei costi di attuazione, nonché della natura, dell’oggetto, del contesto e delle finalità del trattamento, come anche del rischio di varia probabilità e gravità per i diritti e le libertà delle persone fisiche”[26] [9].

Per i soggetti privati ci sono due possibilità. Nell’eventualità in cui tali soggetti appartengano a organizzazioni che già adottano particolari regole di settore per la sicurezza dei sistemi informativi, gli stessi dovranno adeguare il sistema di conservazione a tali regole. Invece, nelle altre eventualità, tali “soggetti possono adottare quale modello di riferimento le regole di sicurezza indicate dall’articolo 51[27] del CAD e dalle suddette linee guida emanate dall’Agenzia per l’Italia digitale in merito alle misure minime di sicurezza in ambito ICT”[28] [1].

Il Garante per la protezione dei dati personali ha evidenziato alcune criticità in merito alle disposizioni di carattere generale in materia di sicurezza contenute nello schema delle nuove Linee guida. Oggetto di attenzione devono essere le misure tecniche e organizzative descritte nel manuale di conservazione adottato dal Responsabile della conservazione, in cui dovrebbero essere considerate tutte le “implicazioni connesse al trattamento dei dati personali contenuti nei documenti informatici, tra i quali potrebbero essere compresi anche quelli riferibili alle categorie particolari di cui all’art. 9 e 10 del Regolamento” [6]. In tal senso, il Garante raccomanda un’integrazione dello schema delle Linee guida in modo che vi siano contemplati anche “accorgimenti e misure che prevedano un incremento del livello di sicurezza, anche in funzione delle tipologie di dati verosimilmente trattati, nell’ambito dei predetti sistemi informatici” [6].

Il “rinnovato” manuale di conservazione

Per quanto concerne il manuale di conservazione si segnala, tra l’altro, la rinnovata definizione contenuta nelle Linee guida [1], in cui si evidenzia sia la sua natura di documento informatico, sia la sua peculiarità di descrivere non solo il sistema di conservazione, ma anche il processo di conservazione. In realtà, si tratta di elementi rilevabili già altrove nel testo delle Linee guida [1], ma che è comunque utile ritrovare sinteticamente espressi nel glossario.
Dunque, il manuale di conservazione è il “documento informatico che descrive il sistema di conservazione e illustra dettagliatamente l’organizzazione, i soggetti coinvolti e i ruoli svolti dagli stessi, il modello di funzionamento, la descrizione del processo, la descrizione delle architetture e delle infrastrutture”[29] [1].

Da un punto di vista della gestione del processo sicurezza, evidenzio che sempre nel manuale di conservazione dovranno confluire sia la descrizione delle citate misure di sicurezza adeguate, sia quella delle procedure di notifica di una violazione dei dati personali all’autorità di controllo e di comunicazione di una violazione dei dati personali all’interessato. Le ultime due sono procedure da adottarsi in caso di violazione dei dati personali, ai sensi degli articoli 33 e 34 del Regolamento (UE) 2016/679 [9].

Invece, nel caso in cui il servizio di conservazione dovesse essere affidato all’esterno, coerentemente con la visione adottata, le “misure di sicurezza sono descritte nel manuale del conservatore”[30] [1]. A proposito di quest’ultima affermazione trovo opportuno riportare l’osservazione del Garante per la protezione dei dati personali secondo cui si tratta di un inciso da rivedere, poiché “sembrerebbe sollevare il titolare del trattamento dall’onere di indicare/descrivere le misure di sicurezza, aggiuntive e richieste al conservatore esterno” [6]. Tra l’altro questa formulazione è palesemente in contrasto con le previsioni presenti nel paragrafo 4.10 delle Linee guida [1] laddove, in merito alla descrizione delle modalità di esibizione dei documenti, si specifica che “nel caso di affidamento esterno del servizio di conservazione tali modalità sono concordate tra le parti e indicate nei rispettivi manuali”[31] [1].
Si tratta dunque di una porzione dello schema delle nuove Linee guida che dovrà necessariamente essere oggetto di future integrazioni prima della sua pubblicazione definitiva.

Note

[1] Il D.lgs. 82/2005 ha subito moltissime modifiche e integrazioni, tra le quali (in ordine cronologico) le ultime sono state quelle apportate: dal D.lgs. 26 agosto 2016, n. 179, dal D.lgs. 13 dicembre 2017, n. 217, dal D.L. 28 settembre 2018, n. 109, convertito con modificazioni dalla L. 16 novembre 2018, n. 130, dal D.L. 14 dicembre 2018, n. 135, convertito con modificazioni dalla L. 11 febbraio 2019, n. 12, dalla Legge 30 dicembre 2018, n. 145 e dal D.L. 26 ottobre 2019, n. 124.

[2] D.lgs. 82/2005, articolo 71, comma 1.

[3] D.lgs. 82/2005, articolo 71, comma 1-ter.

[4] Allegato 1 “Glossario dei termini e degli acronimi” al documento “Linee guida sulla formazione, gestione e conservazione dei documenti informatici (Release bozza) – Paragrafo 1.2 “Glossario dei termini”.

[5] Idem nota 4.

[6] Idem nota 4.

[7] Precisazione che, comunque, non introduce elementi di novità rispetto al contenuto delle Regole tecniche, essendo già presenti tali requisiti anche nel D.P.C.M. 3 dicembre 2013, articolo 3, comma 1.

[8] D.lgs. 82/2005, articolo 44, comma 1-ter.

[9] Idem nota 4.

[10] Idem nota 4.

[11] Idem nota 4.

[12] Idem nota 4.

[13] Idem nota 4.

[14] Idem nota 4.

[15] Ai sensi dell’articolo 24 del Regolamento (UE) 2016/679.

[16] Linee guida sulla formazione, gestione e conservazione dei documenti informatici (Release bozza) – Paragrafo 4.6 “Responsabile della conservazione”.

[17] Linee guida sulla formazione, gestione e conservazione dei documenti informatici (Release bozza) – Paragrafo 4.9 “Infrastrutture”.

[18] Va evidenziato che, in ogni caso, sono fatte salve le previsioni contenute nel Codice dei beni culturali.

[19] Idem nota 17.

[20] Idem nota 17.

[21] Regolamento (UE) 2016/679, articolo 32(1).

[22] Idem nota 4.

[23] Idem nota 4.

[24] Laddove RPD è un acronimo per indicare il Responsabile della protezione dati.

[25] Linee guida sulla formazione, gestione e conservazione dei documenti informatici (Release bozza) – Paragrafo 4.11 “Sicurezza del sistema di conservazione”.

[26] Regolamento (UE) 2016/679, articolo 32, paragrafo 1.

[27] A tal proposito si consideri che l’articolo 51, comma 2, del d.lgs. 82/2005, prevede che “i documenti informatici delle pubbliche amministrazioni devono essere custoditi e controllati con modalità tali da ridurre al minimo i rischi di distruzione, perdita, accesso non autorizzato o non consentito o non conforme alle finalità della raccolta” [3].

[28] Linee guida sulla formazione, gestione e conservazione dei documenti informatici (Release bozza) – Paragrafo 4.11 “Sicurezza del sistema di conservazione”.

[29] Idem nota 4.

[30] Idem nota 28.

[31] Linee guida sulla formazione, gestione e conservazione dei documenti informatici (Release bozza) – Paragrafo 4.10 “Modalità di esibizione”.

Bibliografia

[1] Agenzia per l’Italia Digitale, “Linee guida sulla formazione, gestione e conservazione dei documenti informatici Release bozza AGID”, Roma, pp. 1–39, 2019.

[2] F. Ciclosi, Le nuove linee guida AgID sul documento informatico, ICT Security Magazine, 2020. [Online]. Available: https://www.ictsecuritymagazine.com/articoli/le-nuove-linee-guida-agid-sul-documento-informatico/ [Accessed: 11-Apr-2020].

[3] DECRETO LEGISLATIVO 7 marzo 2005, n. 82 (Così come modificato dal Decreto legislativo 13 dicembre 2017, n. 217, in G.U. 12/01/2018, n.9), GU n.112 del 16-5-2005-Suppl. Ordinario n. 93, 2005.

[4] Agenzia per l’Italia Digitale, “Precisazioni sulla pubblicazione delle nuove linee guida sulla formazione, gestione e conservazione dei documenti informatici”, 2020. [Online]. Available: https://www.agid.gov.it/it/agenzia/stampa-e-comunicazione/notizie/2020/04/01/precisazioni-sulla-pubblicazione-nuove-linee-guida-sulla-formazione-gestione. [Accessed: 11-Apr-2020].

[5] Decreto del Presidente del Consiglio dei Ministri 3 dicembre 2013 – “Regole tecniche in materia di sistema di conservazione ai sensi degli articoli 20, commi 3 e 5-bis, 23-ter, comma 4, 43, commi 1 e 3, 44 , 44-bis e 71, comma 1, del Codice dell’amministr. Italia: Gazzetta Ufficiale della Repubblica Italiana, 2013, pp. 1–44.

[6] Garante per la protezione dei dati personali, “Parere sullo schema di ‘Linee Guida sulla formazione, gestione e conservazione dei documenti informatici’ (n. 32 del 13 febbraio 2020) [doc. web. 9283921]”, Roma, 2020.

[7] Agenzia per l’Italia Digitale, “Catalogo dei servizi Cloud per la PA qualificati” [Online]. Available: https://cloud.italia.it/marketplace/supplier/market/index.html. [Accessed: 20-Nov-2019].

[8] Garante per la protezione dei dati personali, “Parere sullo schema di ‘Linee guida – La Sicurezza nel procurement ICT’ predisposto da AgID – del 30 gennaio 2020 [doc. web 9283857]”, Roma, 2020.

[9] REGOLAMENTO (UE) 2016/679 DEL PARLAMENTO EUROPEO E DEL CONSIGLIO.

Articolo a cura di Francesco Ciclosi

Download PDF

https://www.ictsecuritymagazine.com/articoli/le-nuove-linee-guida-agid-e-il-sistema-di-conservazione/

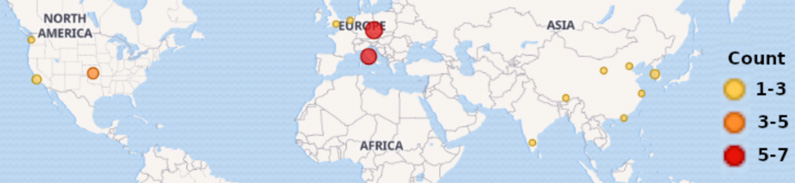
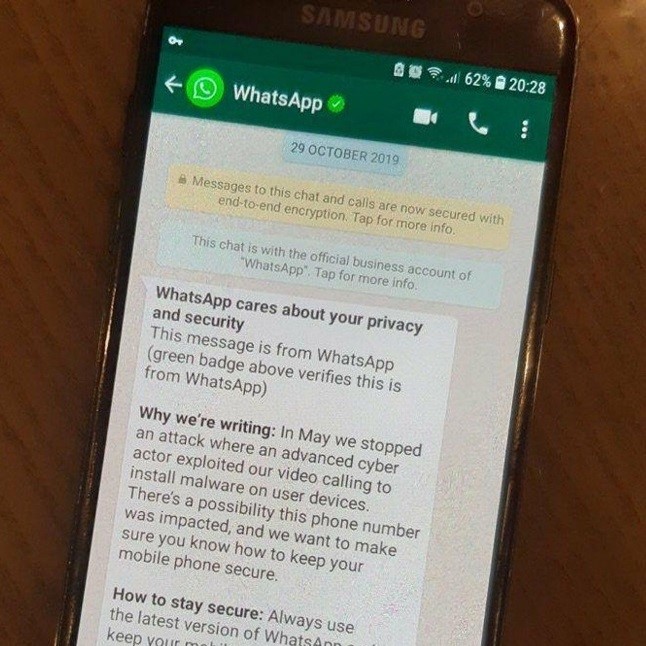
Bug Hunting: tra responsabilità, etica e collaborazione

Quando scoprite una vulnerabilità non documentata – un cosiddetto zeroday – oppure siete un’azienda che produce software e vi viene segnalato un bug, cosa fate?

Siete responsabili?
Siete etici?

Il mercato dei bug sta diventando sempre più complesso, connesso a fortissimi interessi economici e caratterizzato da diverse scale di grigio. Seppur esistono delle prassi internazionali (anche in ambito ENISA) che regolano la Coordinated Vulnerability Disclosure, chiamata anche CVD, non sempre la collaborazione tra fornitore e ricercatore di sicurezza porta a un corretto riconoscimento dei bug e, quindi, a un miglioramento generale.

In una situazione di non sempre corretta adozione della CVD, il buonsenso e l’etica diventano allora la strada da seguire, cercando di essere responsabili nelle cose che si fanno, adottando sempre trasparenza e collaborazione.

In questo senso, i termini Responsabilità ed Etica si riferiscono non solo ai ricercatori di bug, ma anche ai fornitori di prodotti hardware e software in quanto una “stretta collaborazione” consente e rinforza la volontà di entrambi di ridurre il rischio per tutte le parti interessate, oltre che per tutti gli utilizzatori di quel prodotto specifico.

Premesso che ancora oggi si discute se sia corretto divulgare le vulnerabilità pubblicamente, oppure tenerle segrete fino alla realizzazione della fix, c’è da dire che spesso si è davanti a mancate risposte dei vendor di prodotto ai ricercatori di bug, cosa che in regime di buon senso è paradossale oltre che controproducente per tutti.

Ecco quindi che il vendor (anche se non ha un programma di Responsible Disclosure o di bug bounty), dovrebbe essere riconoscente al singolo ricercatore che lo informa di una vulnerabilità che lui stesso non ha rilevato sul suo prodotto, cosa che alle volte non accade e che in alcuni casi finisce sui giornali o in cause legali, cosa che abbiamo visto accadere anche a big player quali Google, Apple e Microsoft.

Ma comprendo che il contesto è complicato.

Avere sul National Vulnerability Database (CVN) dei CVE del proprio prodotto può dare fastidio a tutti i produttori, in quanto sta a significare che le cose non siano state fatte “a regola d’arte”.

Ma è anche vero che se quelle vulnerabilità non fossero pubbliche – e se, magari, la weaponization abbia avuto luogo in maniera efficace per poi armare Virus, Rat e Malware di altra natura – la cosa potrebbe finire molto, ma molto peggio.

Occorre quindi sviluppare software sicuro, attivando tutti i corretti programmi di sicurezza; ma siamo grati ai ricercatori che scoprono i bug, perché rendono le nostre applicazioni più sicure e ci aiutano a vedere oltre, arrivando anche dove noi non eravamo riusciti a farlo.

Articolo a cura di Massimiliano Brolli

Download PDF

https://www.ictsecuritymagazine.com/articoli/bug-hunting-tra-responsabilita-etica-e-collaborazione/