Il grande data breach

Cos’è la protezione dei dati personali

Proteggere i dati personali significa garantirne riservatezza, disponibilità e integrità. Lo ripetiamo perché questo periodo di grande paura per la COVID‑19 sembra corrispondere a una vorticosa circolazione di dati personali, più o meno consapevole e più o meno controllata.

La paura e la costrizione dovuta alle misure di contenimento hanno fatto aumentare il numero di tweet, messaggi Whatsapp, post Facebook che, in molti casi, contengono dati personali di persone contagiate e, quindi, dati appartenenti alle particolari categorie (quelli sulla salute).

Le possibili misure di prevenzione del contagio nei luoghi di lavoro hanno disturbato i sonni di amministratori delegati e di amministratori pubblici che, senza mai essersi occupati seriamente né di safety né di protezione di dati personali, si sono inventati le più disparate soluzioni investigative (peraltro, non troppo gradite al Garante per la Protezione dei Dati Personali) che, spesso, vanno ben oltre il Protocollo Governo-Parti sociali siglato lo scorso 14 marzo 2020[1].

Inoltre vale la pena di indagare, coerentemente (ma senza alcun possibile paragone valoriale) con il saggio metodo investigativo del giudice Falcone, per capire dove vanno a finire, prevalentemente, i soldi in questo momento e, con essi, anche molti dati personali: aziende di sanificazione, supermercati e piattaforme che offrono servizi di collaboration online.

In questa situazione, milioni di dati personali stanno circolando confusamente in un grande data breach di cui, probabilmente, non avremo mai contezza e di cui ci accorgeremo solo quando tutto tornerà, gradualmente, alla normalità (sempre che la privacy sopravviva ai recenti emendamenti al decreto Cura Italia che intendono sospendere l’applicazione del GDPR[2]).

Non eravamo pronti all’emergenza sanitaria. Ma non eravamo pronti nemmeno a reggere questa circolazione incontrollata di dati personali. Non erano pronte le istituzioni pubbliche, che:

  • non hanno predisposto, nel tempo, sistemi strutturati e sicuri per interagire con i cittadini;
  • credono che la protezione dei dati personali corrisponda soltanto alla tutela della riservatezza e che, quindi, si possa effettuare qualsiasi trattamento e che basti “mettere tutto sotto chiave” (ammesso che siano in grado di farlo).

E non erano pronte le persone che, ancora oggi:

  • non hanno alcuna percezione dell’importanza dei loro dati personali;
  • non riescono a fare a meno di riempire i loro smartphone di inutili app.

Qualche esempio di questa bulimìa potrà essere utile a comprendere le dimensioni del problema e, quindi, anche a suggerire le eventuali misure per la riduzione del danno.

Dove sono i soldi

I soggetti che in questo momento, più di altri e per motivi diversi tra loro, stanno vedendo ampliare la domanda per i loro prodotti/servizi sono:

  • le aziende di sanificazione;
  • i supermercati e, in generale, le attività commerciali autorizzate a operare, da ultimo, dal decreto legge n. 19 del 25 marzo 2020[3];
  • le piattaforme che offrono servizi di collaboration.

Cerchiamo di chiarire quali effetti questa dinamica commerciale può avere sul trattamento dei dati personali.

L’attività di sanificazione su commissione delle ASL avviene, spesso, all’interno delle abitazioni private e, quindi, le aziende incaricate vengono in possesso, direttamente o indirettamente, di una mole enorme di dati personali che riguardano la salute (ma non solo) dei soggetti contagiati e dei loro familiari. È presumibile che il trattamento di questi dati, anche considerate l’impreparazione delle aziende a queste circostanze eccezionali e la rapidità con la quale devono intervenire, non avvenga con le tutele previste dal GDPR (misure di sicurezza, addestramento dei dipendenti, ecc.).
Oltre alla riservatezza, quindi, possono essere messe a rischio:

  • l’integrità; per esempio, qualche malintenzionato può manomettere l’elenco dei soggetti per i quali si è intervenuto nella sanificazione e, successivamente, pubblicarlo su un social network per danneggiare qualche ignaro soggetto;
  • la disponibilità; per esempio, può smarrirsi lo stesso elenco e, quindi, non aversi certezza che la sanificazione sia stata effettuata.

Le attività commerciali che sono rimaste operative si sono attrezzate, in molti casi, per la consegna a domicilio oppure con app per controllare le file. In entrambi i casi l’acquisizione e il successivo trattamento di dati personali (soprattutto per la consegna a domicilio) sta avvenendo senza le dovute garanzie per gli interessati. La consegna a domicilio, per esempio, richiede il trattamento (spesso eseguito con l’ausilio di supporti elementari e poco sicuri) dell’indirizzo, del numero di telefono e delle fasce orarie di disponibilità dell’acquirente; invece le app, spesso, tendono a essere sviluppate da soggetti terzi non ben attrezzati per proteggere i dati personali e, di solito, articolano il loro funzionamento chiedendo l’accesso a dati presenti nel dispositivo, in palese violazione del principio di privacy by default previsto dal GDPR. Si tratta, quindi, di milioni di dati personali, anche appartenenti alle particolari categorie, che, prima della diffusione della COVID‑19, non venivano trattati e per i quali è ipotizzabile un trattamento non particolarmente aderente al GDPR.

L’hashtag #iorestoacasa ha dato una scossa alla modalità agile di effettuare riunioni di lavoro, realizzare incontri a distanza e impostare lezioni e formazione da remoto. Fatta eccezione per molte istituzioni universitarie e qualche grande soggetto privato, poche organizzazioni avevano messo in piedi organicamente un servizio di comunicazione/collaborazione a distanza; sono state, quindi, imbastite infrastrutture volanti che hanno costretto i soggetti partecipanti (alle lezioni, alle riunioni, ecc.) a creare degli account presso la piattaforma prescelta che, di solito, è resa disponibile – in maniera apparentemente gratuita – da soggetti con forti interessi commerciali[4]. In qualche caso, nella spasmodica ricerca di una soluzione idonea, le organizzazioni hanno provato varie piattaforme prima di trovare quella che poteva fare al caso loro; in ogni  prova i poveri interlocutori hanno dovuto creare account e fornire, tutte le volte, i dati personali richiesti. Com’è noto, tuttavia, la creazione di account è una procedura che, conformemente al GDPR, deve seguire regole precise e, prima di tutto, deve essere corretta e trasparente ovvero deve chiarire all’interessato le finalità del trattamento e cosa succede se non fornisce i dati che vengono richiesti. In molti casi, anche quando l’accesso al servizio è strutturato secondo canoni di correttezza e trasparenza, il furore di veder “funzionare le cose” induce gli utenti ad accettare ciecamente tutti i passaggi cruciali nei quali si accettano condizioni e si forniscono consensi.

Siamo di fronte, quindi, al trattamento di milioni di dati personali che, a causa della situazione emergenziale e della fretta con la quale sono raccolti/conferiti (secondo il punto di vista), nasce con i seguenti (possibili) peccati originali:

  • carenza di applicazione dei principi di correttezza e trasparenza;
  • ambiguità delle finalità, anche perché, di solito, l’offerta gratuita dell’uso della piattaforma ha, come contropartita, proprio il successivo utilizzo dei dati personali degli utenti;
  • difficoltà nell’esercizio effettivo dei diritti previsti come, ad esempio, il diritto alla revoca del consenso.

Sicurezza dei lavoratori e privacy

Oltre a questi esempi di trattamento che la situazione di emergenza ha generato, prevalentemente legati ad attività commerciali, sono germogliati altri trattamenti, anch’essi effettuati con finalità e modalità più o meno disinvolte, ideati da amministratori pubblici o manager aziendali per tutelare la salute dei propri lavoratori.

I vertici delle amministrazioni pubbliche e delle organizzazioni private, nell’ordinarietà della loro attività, sono raramente impegnati nelle vicende che riguardano la salute dei lavoratori e la protezione dei dati personali: insomma, ne sanno poco, dell’una e dell’altra materia. Tuttavia, la diffusione del COVID‑19 li ha rapidamente catapultati in una realtà che doveva coniugarle. Ci sono state, quindi, escalation che, man mano che montava la gravità del contagio, hanno condotto a:

  • chiedere ai lavoratori di autocertificare di non provenire da zone a rischio;
  • chiedere ai lavoratori di segnalare situazioni di rischio riguardanti i propri familiari;
  • misurare la temperatura dei lavoratori;
  • chiedere ai lavoratori di elencare, giornalmente, le persone (soggetti esterni e colleghi) con i quali si è avuto contatto diretto (anche oltre la fatidica distanza di sicurezza).

Naturalmente queste misure, spesso, non hanno rispettato il principio di proporzionalità e hanno generato la raccolta e il trattamento di migliaia di dati personali (spesso contenuti su supporto cartaceo) di cui non si sa quali potranno essere gli esiti futuri.

L’ultima iniziativa simile, in ordine di tempo, ha riguardato un gruppo di sindaci che, per attrezzare specificatamente gli operatori ecologici che eseguono la raccolta differenziata nel proprio territorio e tutelarne la salute, hanno chiesto alla ASL di competenza i nominativi dei soggetti affetti da COVID‑19. Purtroppo, anche in questo caso, la semplice lettura sistematica del D.Lgs. 81/2008 e del GDPR avrebbe portato alle seguenti conclusioni:

  • la valutazione del rischio per i lavoratori spetta al datore di lavoro;
  • in caso di epidemia (cioè nella situazione attuale), conoscere i nominativi dei soggetti contagiati non incide sulla valutazione del rischio giacché la minaccia (come si dice in gergo) è potenzialmente diffusa anche oltre i contagiati già riconosciuti;
  • le misure di riduzione del rischio, quindi, devono essere applicate a tutti gli operatori ecologici prescindendo dal fatto che il ritiro dei rifiuti riguardi o meno soggetti contagiati;

e, quindi, alla sostanziale inutilità di ottenere i dati personali dei contagiati.

Tracking e tracing

A tutti questi trattamenti di dati personali che la COVID‑19 ha innescato, con la prospettiva di tante mini‑violazioni che si possono tradurre in un gigantesco data breach diffuso, potrebbe aggiungersi quello governativo che sembra oscillare tra tracking (corrispondente al tracciamento continuo) e tracing (corrispondente al rintracciamento a posteriori) ma che, si spera, sarà avviato nel rispetto dei consigli[5] del Comitato Europeo per la Protezione dei Dati Personali e solo a fronte di una solida base normativa e organizzativa (magari sottoposta preventivamente al parere del Garante per la Protezione dei Dati Personali).

Note

[1] http://www.salute.gov.it/portale/nuovocoronavirus/dettaglioNotizieNuovoCoronavirus.jsp?lingua=italiano&menu=notizie&p=dalministero&id=4237

[2] http://www.senato.it/leg/18/BGT/Schede/Ddliter/testi/52873_testi.htm

[3] http://www.regioni.it/download/news/608221/

[4] https://www.federprivacy.org/?option=com_k2&view=item&id=1373:migliaia-di-videochiamate-su-zoom-finite-su-internet-ad-insaputa-degli-utenti&Itemid=540

[5] https://edpb.europa.eu/sites/edpb/files/files/file1/edpb_statement_2020_processingpersonaldataandcovid-19_en.pdf

Articolo a cura di Francesco Maldera
Francesco Maldera è Data Protection Officer e Data Scientist.

Il suo percorso professionale lo ha chiamato a responsabilità direzionali nell’ambito dei sistemi informativi, della safety&security, della privacy e dell’auditing svolgendo diversi incarichi dirigenziali nella Pubblica Amministrazione e in aziende private.

Attualmente, accompagna l’attività consulenziale a quella di sensibilizzazione delle persone tramite il sito www.prontoprivacy.it

Download PDF

https://www.ictsecuritymagazine.com/articoli/il-grande-data-breach/


A case history: CTF Necromancer – Parte 1

You can create art and beauty on a computer

C’è stato un tempo in cui questa frase, nell’underground dell’hacking, faceva parte di una filosofia culturale. Rappresentava un valore morale umanamente condivisibile, simile a una forma d’arte dove creta o argilla, marmo o gesso, prendevano forma per divenire qualcosa di più. Così 0 e 1 rappresentavano l’espressione di una filosofia di libertà, condivisione e pari diritti. Ora che il termine hacker viene associato a criminali che sfruttano una pandemia per rubare soldi o attaccare il sistema sanitario in un momento di crisi, criptando device e strumenti che stanno salvando la vita a diverse centinaia di persone, il caos che gli stessi mass media hanno contribuito a fomentare imperversa celando l’essenziale differenza che separa le due facce della stessa medaglia.

I Capture The Flag (CTF) sono giochi, a volte competizioni, in cui singoli o team di hacking tentano di “catturare la bandiera”, ricercando una vulnerabilità in un dato sistema o in un software messo a disposizione dagli organizzatori. Il primo che colleziona tutte le flag nascoste sul sistema bersaglio, vince la competizione. Ne esistono di vari tipi: Attacco e Difesa, Jeopardy e Boot2Root (per approfondimenti: https://cyberdivision.net/2020/03/13/universita-perugia-ctf/).

In collaborazione con l’Università di Perugia e DiGiOne, nello specifico con i Proff. Stefano Bistarelli e Francesco Santini, in occasione dell’evento di Cyber Challenge [1], ho avuto il piacere di svolgere in un’aula (virtuale, dati i tempi) una delle CTF che preferisco: The Necromancer, ideata da @xerubus[2]. La mia preferenza nasce sia dal fatto che essa offre l’opportunità di discutere e spaziare fra molti argomenti, sia dall’affascinante ambientazione narrativa. È composta da 11 flag da scovare, in un contesto narrativo “fantasy”. La missione finale? Semplice… distruggere il Necromante!
Quindi, senza indugiare oltre, direi di preparare l’inventario e partire.

FLAG – 01. Intro

“Le prime sparizioni ebbero luogo nelle plumbee giornate di novembre, dove gli astri allineati presagivano orribili e indicibili rituali sulle montagne più a nord del villaggio.

Nessuno osava pronunciare il nome dell’antico Re che una volta sedeva sul trono ma che ora asserviva terribili orrori nascosti fra le viscere di quei monti.

Ti guardi alle spalle mentre lasci il villaggio ormai quasi abbandonato, dirigendoti verso il sentiero acciottolato che conduce alle montagne. La tua missione: distruggere il Necromante.”

L’ambiente virtuale creato per l’evento era composto da una macchina attaccante e dalla nostra macchina “target”, Necromancer. La macchina attaccante era una versione dell’ormai celebre Kali Linux e Oracle Virtual Box, l’ambiente di virtualizzazione scelto.

Figura 1

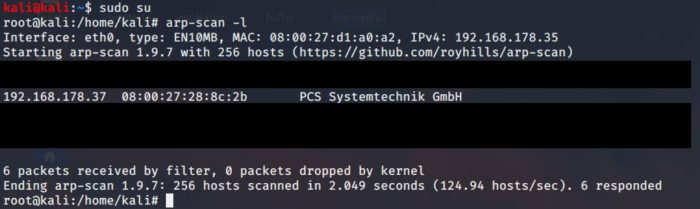
La prima cosa che feci fu utilizzare il comando arp-scan –l (Fig. 1) al fine di identificare i miei dispositivi sulla rete:

Figura 2

Il protocollo Address Resolution Protocl (ARP) opera al secondo livello del modello ISO/OSI, Data Link (sotto di esso c’è solo il layer fisico). Qualsiasi host che all’interno di una rete voglia conoscere l’indirizzo fisico di un altro host (il MAC Address), invia una “richiesta ARP” in broadcast sulla rete (ad ogni device). In questo modo, tutti i device all’interno della rete ricevono una richiesta con il MAC della macchina da cui essa è stata originata e l’indirizzo IP della macchina del destinatario. L’host che riconosce il proprio IP, risponderà con un “ARP Reply” contenente il proprio MAC, inviandolo direttamente al mittente.

Sostanzialmente, equivale ad urlare in una stanza affollata: «Chi è il proprietario della macchina targata 192.168.178.37?» Riposta: «La macchina è mia! Mi chiamo 08:00:27:28:8c:2b». Se la richiesta venisse eseguita per tutte le auto nel parcheggio, sapremmo a chi appartiene ogni singola macchina.

Analogamente, il comando arp-scan –l faceva proprio questo, aiutandomi ad identificare il mio “Necromante” all’interno della rete: 192.168.178.37.

Nota: lo stesso risultato avrei potuto ottenerlo, ad esempio, con il comando netdiscover.

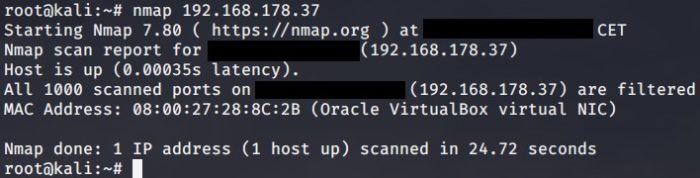
Una volta identificato il mio obbiettivo, potei cominciare ad “aggirarmici attorno”, studiandolo con nmap (Figura 3).

Figura 3

La mia fu una ricognizione veloce. Non diedi nessun’altra opzione al comando e il mio port scanning diede esito negativo. Nmap assolve prevalentemente questa funzione: individuare, su un dato dispositivo bersaglio, quali sono le porte aperte e quali servizi di rete ad esse associate sono disponibili. Il comando permette anche di eseguire determinati script, test di vulnerabilità e molto altro. Per il momento, mi limitai a dare una fugace occhiata al nascondiglio del Necromante.

Nessuna porta aperta, almeno apparentemente… nessun ingresso.

A questo punto, non potendo contare sulla “vista”, decisi di ricorrere all’“udito”, ascoltando le strane voci che sibilavano nell’aria.

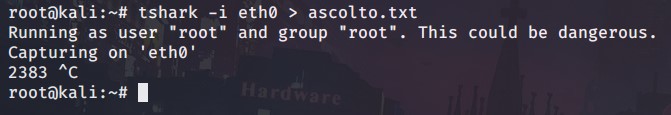
Wireshark[3] poteva fare al caso mio, e utilizzai la versione da command line (Fig. 4).

Figura 4

Scelsi la mia interfaccia di rete ed effettuai la cattura del traffico dei pacchetti. Tutti i dati che attraversavano la mia rete da un punto di origine ad una destinazione, sarebbero stati catturati e analizzati.

  • tshark : mi permetteva di mettermi in ascolto;
  • -i : identificava l’interfaccia con cui volevo effettuare il “packet captures”;
  • eth0 : il nome dell’interfaccia;
  • > ascolto.txt : l’intero output del comando veniva ridirezionato su un file di testo chiamato ascolto.txt.

Infine, una volta che il contatore arrivò a segnare un numero di pacchetti catturati che ritenni sufficiente, effettuai con control+C la terminazione del processo.

Per fare un paragone, l’operazione equivaleva a mettersi in ascolto in un’area affollata di gente e sentire che cosa veniva detto, di cosa si parlava…

Figura 5

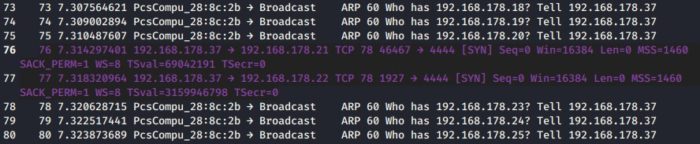
Analizzando il file ascolto.txt (Figura 5) tutto pareva alquanto normale (“i soliti rumori di sottofondo”, “il vento che ulula”, “il frascheggiare delle fronde dei rami”) tranne che per un messaggio di broadcast inviato a tutte le macchine della rete, sulla porta 4444, proveniente dal Necromante.

Non mi rimaneva che seguire quella voce e scoprire che cosa dicesse.

Figura 6

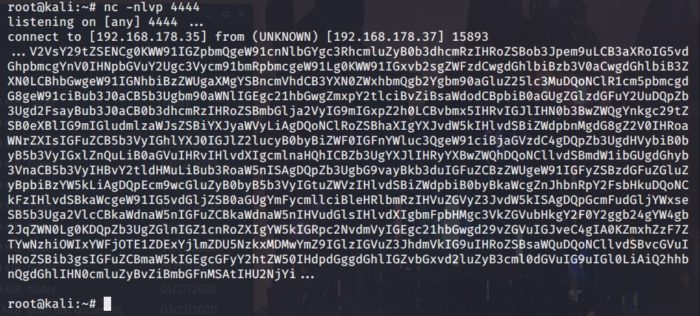
Così feci, mettendomi in ascolto sulla porta 4444 (Fig. 6). Per farlo utilizzai netcut: conosciuto come il “coltellino svizzero” nelle reti di calcolatori, esso permette di stabilire una comunicazione remota sia attraverso il protocollo TCP, che UDP.
Quindi esplicitai il mio intento con le opzioni –nlvp:

  • -n : esclusivamente da indirizzi IP e non da DNS;
  • l : in modalità listening (ascolto);
  • v : fornisce dettagli aggiuntivi nell’output del comando;
  • p: porta da utilizzare;
  • 4444 : la porta da cui volevamo “ascoltare”, da cui giungevano i messaggi.

Il messaggio (Fig. 6) era codificato base64, un sistema di codifica che consente la traduzione di dati binari in stringhe di testo nell’American Standard Code for Information Interchange (ASCII)[4]. Viene usato principalmente nella codifica di dati binari nelle e-mail, per convertire dati nel suddetto formato.

Figura 7

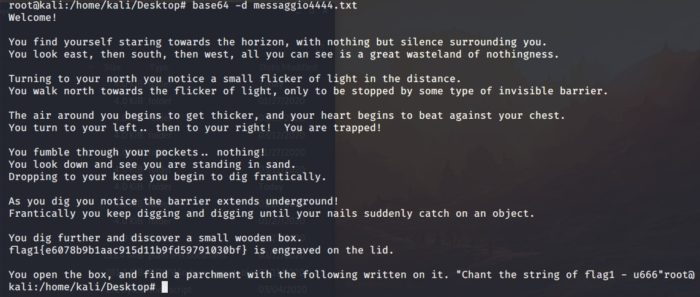
Decodificai il messaggio utilizzando il comando base64 –d (Figura 7), seguito dal file di testo: messaggio4444.txt dove avevo copiato ed incollato il testo codificato (Figura 6).

La decodifica ebbe successo e apparve la mia prima Flag! Con lei, alcuni indizi.

“Benvenuto!

Ti ritrovi a fissare l’orizzonte, con nient’altro che silenzio attorno.

Guardi ad est, poi a sud, poi ad ovest, tutto ciò che puoi vedere è una grande terra desolata.

Girandoti verso nord, noti uno sfarfallio di luce in lontananza.

Ti dirigi verso lo sfarfallio, solo per essere fermato da un qualche tipo di barriera invisibile.

L’aria intorno a te inizia a diventare più densa e il tuo cuore inizia a battere contro il petto.

Ti giri a sinistra…poi a destra! Sei intrappolato!

Armeggi nelle tasche…niente!

Abbassi lo sguardo e vedi che sei in piedi nella sabbia.

Cadendo in ginocchio inizi a scavare freneticamente.

Mentre scavi, noti che la barriera si estende sotto terra!

Continui freneticamente a scavare e scavare, fino a quando le tue unghie non si impigliano improvvisamente su un oggetto.

Scavi ulteriormente e scopri una piccola scatola di legno.

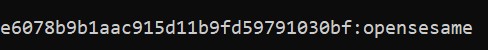
flag1 {e6078b9b1aac915d11b9fd59791030bf} è inciso sul coperchio.

Apri la scatola e trovi una pergamena con la scritta seguente. “Invoca la stringa: flag1 – u666”

FLAG – 02

A quanto pare eravamo finiti in trappola…

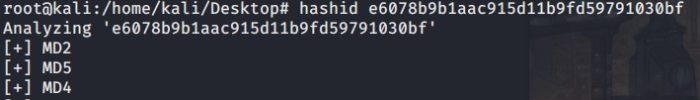
La Flag 1 recava con sé un hash di qualche tipo: flag1 {e6078b9b1aac915d11b9fd59791030bf} .
Quindi, la prima cosa che feci fu identificare di che tipo di hash si potesse trattare (Fig.8).

Figura 8

Gli algoritmi di hash mappano una stringa di lunghezza arbitraria in una stringa di lunghezza predefinita. A differenza della codifica e della cifratura, sono processi irreversibili. Ad esempio, nel nostro caso, la funzione crittografica di hash prende in input una stringa di lunghezza arbitraria e ne produce un’altra in output a 128 bit. L’output è noto anche come “MD5 Checksum o MD5 Hash”.

Ad esempio la codifica MD5 della frase:  “mi ritrovai per una selva oscura, ché la diritta via era smarrita” è:  cecd668227b837e56f326beffea802a3

Qualsiasi modifica alla frase (sia essa anche di un solo spazio o di una virgola) produrrebbe un hash completamente differente.

In teoria, se volessimo risalire da un hash alla password, potremmo ipotizzare di prendere un elenco di parole (wordlist) che potrebbero rappresentare la mia password, tradurlo nel corrispondente hash e qualora l’hash della mia password fosse uguale a uno degli hash della mia wordlist, allora avremmo trovato la password.

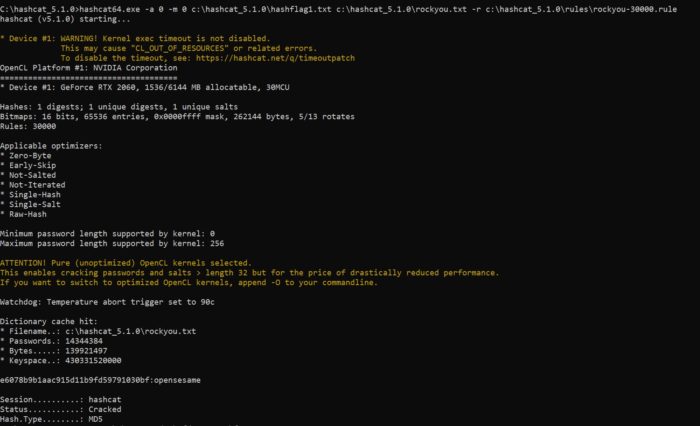
Per fare ciò utilizzai hashcat, scaricabile all’indirizzo: https://hashcat.net/hashcat/ (Fig. 9).

Figura 9

hashcat64.exe -a 0 -m 0 c:\hashcat_5.1.0\hashflag1.txt c:\hashcat_5.1.0\rockyou.txt -r c:\hashcat_5.1.0\rules\rockyou-30000.rule 
  • exe : è il comando per lanciare hashcat;
  • -a 0 : indica la modalità con cui voglio procedere nell’attacco dell’hash, nel mio caso tramite una wordlist, una lista di parole;
  • -m 0 : identifica il tipo di hash che voglio craccare. In accordo con le opzioni di hashcat il formato MD5 è identificato come “0”;
  • c:\hashcat_5.1.0\hashflag1.txt : il file .txt che contiene il mio hash (Fig. 8);
  • c:\hashcat_5.1.0\rockyou.txt : la lista di parole con cui voglio effettuare il cracking (le mie possibili password);
  • -r : identifica che sarà specificato un elenco di regole5, utilizzate come criteri di matching per la mia wordlist, in modo da incrementare le mie possibilità di successo;
  • c:\hashcat_5.1.0\rules\rockyou-30000.rule : il file delle regole.

In pochi secondi la password fu craccata (Figura 9 – 10) e il verdetto fu:

Figura 10

Bene, non mi rimaneva che utilizzare il secondo indizio (Figura 7): “Invoca la stringa: flag1 – u666”.

U666 molto probabilmente indicava: “U” stava per User Datagram Protocol (UDP) e 666 era il numero della porta.

Il protocollo UDP consente il trasporto di pacchetti di dati da un Host A ad un Host B ed è utilizzato principalmente per stabilire connessioni a bassa latenza, “tolleranti” alla perdita di pacchetti. Ad esempio, nei giochi online i comandi inviati ad un personaggio per fargli compiere determinate azioni, come quella di muoversi, prescindono dalla ricezione del dato, nel senso che potremmo vedere il nostro alter ego saltare da una zona all’altra senza continuità, perché molti pacchetti UDP inviati sono andati persi.

Figura 11

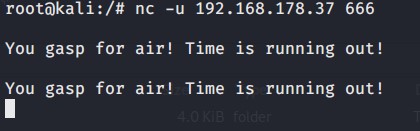
Ancora una volta mi venne in soccorso netcut, ma questa volta lo utilizzai per connettermi alla posta UDP (Fig. 11):

  • -u : connessione ad una porta UDP;
  • 168.178.37 : L’IP della macchina a cui desideravo connettermi, quella del Necromante (la mia CTF);
  • 666 : Infine, la porta che avevo trovato nell’indizio.

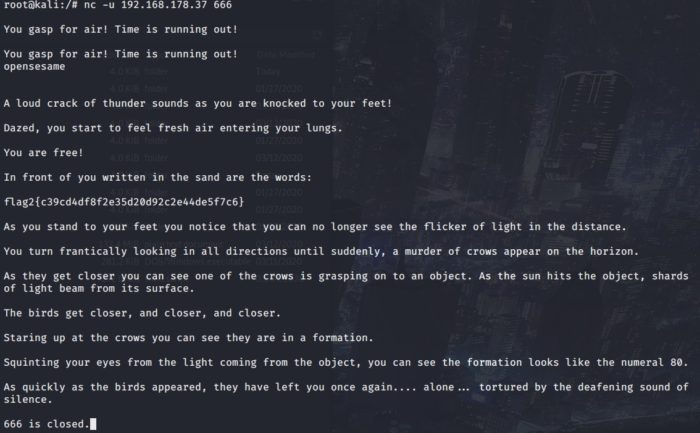
“You gasp for air! Time is running out!” Così, mentre mi affannavo alla ricerca dell’aria, digitai la password che avevo appena craccato: “opensesame” (Fig. 12).

Figura 12

Un forte rombo di tuono echeggia mentre sei in piedi!

Stordito, inizi a sentire aria fresca entrare nei tuoi polmoni.

Sei libero!

Di fronte a te, scritte sulla sabbia, ci sono le parole:

flag2 {} c39cd4df8f2e35d20d92c2e44de5f7c6

Mentre ti alzi in piedi, noti che non riesci più a vedere lo sfarfallio della luce in lontananza.

Ti giri freneticamente guardando in tutte le direzioni fino a quando, all’improvviso, uno stormo di corvi appare all’orizzonte.

Man mano che si avvicinano, puoi vedere uno dei corvi afferrare un oggetto. Nel riverbero del suo riflesso, frammenti di luce si irradiano dalla sua superficie.

Lo stormo si avvicina sempre più.

Osservando lo stormo di corvi noti la loro particolare formazione.

Accecato dalla luce dell’oggetto, strizzi gli occhi, riesci ad identificare la formazione come il numero 80.

Appena gli uccelli scompaiono, sei ancora una volta…solo…torturato dal suono assordante del silenzio.

666 è chiusa.

Scampata per un pelo! Ma ne era valsa la pena, avevo appena conquistato la seconda flag2!

FLAG – 03

Avevo adesso a disposizione un altro hash, simile al precedente, e un numero: 80.

Il numero 80 identifica una celebre porta che utilizziamo di consueto: HTTP – HyperText Transfer Protocol (WWW).

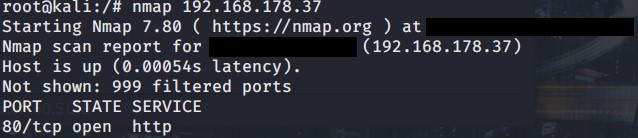
Un altro nmap sulla macchina mi confermò la direzione (Fig. 13):

Figura 13

A differenza della prima volta in cui avevo eseguito l’nmap sul “Necromante” (Figura 3), il risultato fu diverso. La porta 80 risultava “open”.

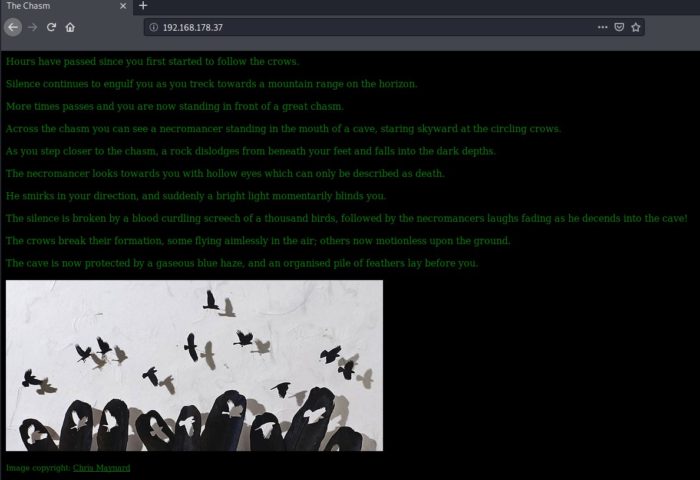
Senza indugiare oltre, aprii il mio browser e digitai sulla barra degli indirizzi 192.168.178.37 (Figura 14):

Figura 14

Sono passate ore da quando hai iniziato a seguire i corvi.

Il silenzio continua ad avvolgerti mentre cammini verso una catena montuosa all’orizzonte.

Il tempo passa e ora ti ritrovi di fronte ad un grande abisso.

Dall’altra parte del baratro puoi vedere un Necromante in piedi nella bocca di una grotta, che fissa verso il cielo i corvi in ​​cerchio.

Mentre ti avvicini all’abisso, una roccia si sposta da sotto i tuoi piedi e cade nelle profondità oscure.

Il Necromante ti guarda con occhi vuoti che possono essere descritti solo come morte.

Lui sorride nella tua direzione e improvvisamente una luce intensa ti acceca momentaneamente.

Il silenzio è interrotto da uno stridio agghiacciante di mille uccelli, seguito dalle risate del Necromante che svaniscono mentre scende nella caverna!

I corvi interrompono la loro formazione, alcuni volano senza meta nell’ aria; altri ora sono immobili sul terreno.

La grotta è ora protetta da una foschia blu gassosa ed un mucchio organizzato di piume giace davanti a te.

Fu così che mi trovai dinanzi a un altro enigma…

To be continued…

Riferimenti

  1. https://cyberchallenge.it/
  2. https://twitter.com/xerubus
  3. https://it.wikipedia.org/wiki/Wireshark
  4. https://it.wikipedia.org/wiki/ASCII
  5. https://hashcat.net/wiki/doku.php?id=rule_based_attack

Articolo a cura di Vincenzo Digilio

Ha lavorato come Network System Administrator, Security Auditor, System Integrator, Penetration Tester per importanti client, enti governativi ed agenzie spaziali. Seguendo progetti come calcolo distribuito, security resource implementation in aree nuclearizzate, adeguamenti di security policy e Security Engineering per la selezione d’importanti fornitori al fine d’implementare sistemi di sicurezza per diverse Multinazionali. Ha tenuto corsi di tecniche Hacking, studiando in contemporanea per il corso di Laurea in Sicurezza delle reti Informatiche. È attualmente impiegato in progetti classificitati in ambito spaziale di Cyber Sicurezza; nella ricerca di vulnerabilità, sviluppo di exploit e whitebox / black box Penetration Testing. Coordina, inoltre il RedTeam della società’ Cyber Division di cui e’ uno dei fondatori. È consulente in materia di Global Security Policy Statement, Risk management e Data Breach Investigation. È intervenuto in diversi casi di compromissione dati, analisi forensi, system breach e attacchi hacking al fine di mitigare la situazione. Crede nella libertà d’informazione e nel diritto alla privacy.

Download PDF

https://www.ictsecuritymagazine.com/articoli/a-case-history-ctf-necromancer-parte-1/


PA e digitalizzazione – la Strategia MID 2025 per l’Italia che verrà

Premessa

Stiamo vivendo il periodo a più alto tasso d’innovazione della storia dell’umanità, in un contesto dove tecnologia e progressi scientifici, frutto dell’attuale IV° rivoluzione industriale, offrono opportunità mai viste prima.

La nostra epoca è altamente sfidante ma anche estremamente complessa.

Proprio le nuove tecnologie, associate a nuovi scenari internazionali e trend geopolitici, alla globalizzazione e alla diffusa velocità di processo, invadono infatti prepotentemente ogni settore della nostra vita (istruzione, politica, produzione, previdenza sociale, sfera professionale e privata) imponendo capacità di adeguamento molto rapide.

Per cogliere le sfide futuribili della società contemporanea il MID – Ministero dell’Innovazione Digitale propone quindi un intervento guida (i.e. “Strategia 2025 per l’innovazione tecnologica e la digitalizzazione del paese” [1]) che, poggiando su una visione comune, preannuncia azioni volte a una profonda trasformazione digitale del Paese, organizzando processi in modo interconnesso; per un cambiamento strutturale ad ampio raggio.

Nei prossimi 5 anni assisteremo cioè a un progresso socio-economico accelerato sul piano digitale, senza precedenti, che richiederà nuova formazione per nuovi lavori e nuove competenze.

Il programma del MID è articolato su tre macro temi, cui corrispondono collegati obiettivi ed azioni; poggia sul coinvolgimento attivo e collaborativo di tutti i principali stakeholdes della società contemporanea: Istituzioni, Aziende private, Pubbliche Amministrazioni (PA) e cittadinanza; e si articolerà per stati di avanzamento.

1. Presupposti di fattibilità del piano di sviluppo digitale

La Strategia MID 2025 origina dagli obiettivi di sviluppo sostenibile delle Nazioni Unite ed è volta a cogliere 3 sfide principali:

  1. digitalizzazione della società;
  2. innovazione del Paese;
  3. sviluppo etico e sostenibile.

A ciascuna sfida sono associati tre obiettivi specifici, oltre a 21 azioni previste per realizzarli, all’interno di un unico ampio piano operativo, la cui fattibilità poggia:

a) sulla previsione di aggiornamento periodico della strategia (di norma ogni 4 mesi);
b) sul fatto che la strategia sia “partecipativa” (sarà inserita sulla piattaforma “PARTECIPA” della PA per dare a chiunque la possibilità di contribuire con un progetto/ una iniziativa);
c) sull’utilizzabilità di specifici fondi (i.e. fondi per l’innovazione da manovra di bilancio; fondi non ancora impegnati, da programmi nazionali e UE es. PON, PON gov, Fondi di coesione; fondi già disponibili o di nuova programmazione per il tramite del Dipartimento della funzione pubblica).

La visione sottesa alla strategia MID 2025 è presto detta: innovazione e digitalizzazione come parte di una riforma strutturale dello Stato, che promuova più democrazia, uguaglianza, etica, giustizia ed inclusione, generando al contempo una crescita sostenibile nel rispetto dell’essere umano e del pianeta.

2. Le 3 sfide al 2025

2.1.  SFIDA 1: Società digitale

Cittadini e imprese devono poter fruire a livello capillare di servizi pubblici digitali efficienti, in modo semplice e sistemico. Il tutto anche a fini di impulso per la trasformazione digitale del settore privato.

Si punterà quindi sulla radicale digitalizzazione del settore pubblico, mediante la realizzazione di migliori infrastrutture digitali, la valorizzazione dei dati e la creazione delle competenze digitali necessarie, nel rispetto dei seguenti step:

I) accelerazione digitale e ridisegno dei processi di gestione ed erogazione dei servizi pubblici;
II) aumento delle competenze della PA e collaborazione con PMI e start up innovative;
III) dismissione di tecnologie non ancora mature e/o diversamente superate;
IV) monitoraggio dei risultati.

I 3 OBIETTIVI ASSOCIATI ALLA SFIDA 1
Cittadini e imprese accedono on line ai servizi della PA

Occorreranno piattaforme abilitanti, nuove infrastrutture e risorse (cloud), promozione di modelli virtuosi ed introduzione di nuovi servizi digitali.

PA volano della digitalizzazione del privato

Occorreranno una efficace integrazione dei servizi pubblici con quelli privati, il miglioramento del    procurement e l’attuazione di politiche di open innovation.

Patrimonio informativo pubblico; utilizzo e condivisione dei dati incentivati da parte di PA e privati

Occorrerà valorizzare il patrimonio di open data della PA per permettere efficienza e trasparenza nei servizi attuali, svilupparne di nuovi ed attrarre nuove realtà   imprenditoriali.

2.2. SFIDA 2: Paese innovativo

Occorrono cambiamenti strutturali per sviluppare l’innovazione del Paese con progettazione ed applicazione di nuove tecnologie nel tessuto produttivo italiano e crescita di prioritari settori merceologici (robotica; mobilità del futuro; IA; cyber security).

I principi guida sottesi alla strategia 2 sono:

I) collaborare con le diverse realtà locali, territoriali, nazionali e internazionali rispettando le caratteristiche peculiari del territorio;
II) organizzare azioni di innovazione in modo interconnesso;
III) diminuire la polarizzazione tra aziende e attori che utilizzano il digitale e attori che non hanno ancora iniziato la trasformazione.

I 3 OBIETTIVI ASSOCIATI ALLA SFIDA 2
Cambiamenti strutturali per agevolare ed accelerare l’innovazione dell’ecosistema nei settori verticali del made in Italy (manifatturiero, food, turismo, moda, design, sociale, digital humanities), dell’industria tech (IA, cybersecurity, robotica, mobilità del futuro), dei processi c.d. di “cross fertilization” (settori diversi la cui sinergia aumenta l’innovazione)

Occorreranno la possibilità di sperimentare in deroga, l’accesso ad assets innovativi, la nascita ed il sostegno a servizi utili alla crescita e sviluppo dell’innovazione, incentivi alla creazione di ecosistemi di innovazione che aiutino la contaminazione (hub), la formazione ad hoc per start up e società di venture capital.

Città e territori con potenziale innovativo aumentato

Occorrerà un supporto mirato alle PA locali e dei piccoli borghi per permettere di aumentare il potenziale innovativo ed applicare le nuove tecnologie alle esigenze di comunità e territori.

Italia con infrastrutture tecnologiche capillari, affidabili, innovative e green

Occorrerà realizzare una infrastruttura fisica affidabile, sicura e capillare fatta di fibra, strumenti cloud, tecnologie innovative (5G), anche con reingegnerizzazione delle infrastrutture digitali, uso di data center centralizzati, drastica riduzione del consumo energetico, utilizzo di fonti energetiche alternative.

2.3. SFIDA 3: Sviluppo inclusivo e sostenibile

La sfida industriale presuppone e dipende anche dalla sfida umana.

Richiede di lavorare per l’innovazione etica, inclusiva, trasparente e sostenibile, per il benessere aumentato della società.

I principi si cui si fonda la strategia 3 sono:

I) pari opportunità, nella partecipazione attiva alla società digitale e tecnologica;
II) garanzia di trasparenza, etica e positivo impatto sociale del processo digital;
III) tutela della sostenibilità economica ambientale e sociale di ogni innovazione.

I 3 OBIETTIVI ASSOCIATI ALLA SFIDA 3
Capacità digitali rafforzate delle persone

Occorrerà un aumento delle capacità digitali dei cittadini, così che si possano sfruttare al meglio nuovi servizi digitali pubblici e privati; favorendo la partecipazione attiva del singolo alla creazione di una società digitale e democratica.

Garanzia di sviluppo tecnologico etico, responsabile e non discriminatorio

 Compete allo Stato di governare l’uso delle tecnologie e di promuoverne la diffusione; massimizzando i benefici collettivi e minimizzando impatti negativi, tramite la ricerca di eticità, responsabilità e non discriminatorietà delle soluzioni tecnologiche (in particolare quanto all’IA).

Cittadini formati per accedere a lavori del futuro

Occorrerà implementare la formazione continua trasformando il mondo del lavoro con competenze innovative degli studenti e futuri  lavoratori ed anche mediante reskilling dei lavoratori attuali.

3. Il Quadro delle azioni del Piano strategico

Per trasformare il Paese occorrono strategia, obiettivi e collegate azioni.

Strategia MID 2025 ne contempla come detto 21, o meglio 20, lasciando aperta, a chiunque lo desideri, la possibilità di fornire il proprio contributo partecipativo, formulando proposte per la ventunesima azione da mettere a Piano.

Di seguito il quadro di sintesi di “cosa e come” il MID si propone di fare.

Il quadro delle azioni coordinate
Governance centrale per l’innovazione digitale
COSA: Occorre un coordinamento delle idee tra Stakeholdes pubblici e privati, fare gioco di squadra, unire forze e risorse. COME: Il MID istituirà e presiederà una cabina di regia per la digitalizzazione della PA e l’innovazione del Paese, con partecipazione di tutti i Ministeri ed invito quali osservatori, di rappresentanti di enti ed amministrazioni pubbliche.

Sarà altresì istituito uno specifico Comitato tematico, cui potranno partecipare i rappresentati delle associazioni di categoria degli Stakeholders privati (settore ITC e altri più rappresentativi).

Si costituirà un Tavolo di lavoro con Regioni e città.

Identità digitale (reloaded)
COSA: Ogni cittadino deve disporre di una identità digitale; unica, gratuita e user friendly. Che gli permetta di identificarsi in modo sicuro e di accedere a tutti i servizi digitali pubblici e privati, in Italia e nell’UE. COME: Sarà modificata la disciplina vigente, per permettere il rilascio delle identità digitali direttamente allo Stato (con coordinamento pubblico di  tale identità con quella della carta di identità elettronica per realizzare una unica identità digitale ed analogica, per finalità diverse) e gestione ad una rete di soggetti dotati di elevati standard di affidabilità organizzativa e tecnologica.
Domicilio digitale per tutti
COSA:Il domicilio digitale che sostituirà nell’operatività quello fisico, consentirà ad ogni cittadino di ricevere corrispondenza con valore legale, in digitale e – in prospettiva- di consultarla tramite “IO”, l’app dei servizi pubblici. COME: Verrà istituito il “Registro dei domicili digitali dei cittadini” di Infocamere, con la gestione della Presidenza del Consiglio dei Ministri ed il tramite dell’Agenzia per l’Ttalia Digitale. Nelle comunicazioni tra cittadini e tra cittadini ed imprese, tutti potranno eleggere il proprio domicilio digitale presso un indirizzo di recapito certificato della corrispondenza.
“IO” – Servizi pubblici mediante app
COSA: A livello capillare nazionale sarà resa fruibile una app che consentirà di realizzare servizi e di interagire con la PA in modo digitalizzato. COME: Si trasformerà il rapporto cittadino – PA.

Con una unica interfaccia si accederà a tutti i servizi pubblici da smartphone, dopo essersi identificati digitalmente. Tramite l’app tutti potranno accedere a procedimenti personali di interesse, ivi compresi quelli riguardanti le proprie aziende.

In prospettiva, si accederà anche a servizi di pubblica utilità forniti da privati.

Ristrutturazione digitale
COSA: “Designers Italia” offrirà alle PA strumenti e linee guida per progettare siti e servizi on line in modo efficace sulla base delle reali esigenze dei cittadini. COME: “Ristrutturazione digitale” sarà il programma a cui aderiranno soggetti privati “sponsor” di iniziative di rifacimento di siti e di servizi digitali sul (il tutto sul modello di programmi già adottati per rinnovare edifici e monumenti storici, in cambio di visibilità).
PA – Open innovation 
COSA: Il “Progetto PA – Porte Aperte all’innovazione” intende promuovere l’open innovation  dell’amministrazione italiana, anche con coinvolgimento di start up innovative. COME: Ogni anno saranno selezionati 10 servizi pubblici di interesse nazionale, con invito delle PA centrali e locali a candidarsi (con idee di progetto di digitalizzazione o trasformazione di un servizio in modalità open innovation, secondo requisiti predefiniti) nello sviluppo di uno di questi, con modalità open.

Il tutto con il coinvolgimento di team ministeriali specializzati nella gestione e nel coordinamento di progetto open e con un contributo pari al 50% del budget di progetto.

Procurement semplificato
COSA: Si dovrà riformare il settore degli appalti pubblici di servizi, in chiave moderna. COME: Verrà introdotto un meccanismo di deroga al vigente Codice degli appalti per i servizi digitali, per dare la possibilità alla PA di acquisire in modo più semplice e veloce soluzioni tecnologiche e prodotti e servizi digitali.
IA al servizio dello Stato
COSA: IA e Big data applicati a procedimenti amministrativi ed alla giustizia devono poter guidare i Decision Makers pubblici in modo più efficace e meno discrezionale; ciò nel rispetto della moderna applicazione dei principi costituzionali che vogliono una PA efficiente ed un processo giusto, trasparente e breve. COME: Verrà promosso l’utilizzo dell’ IA nella gestione dei procedimenti amministrativi dei servizi e nel mondo giustizia.

Con i Ministeri competenti le soluzioni di IA saranno supportate da principi etici e giuridici di cui allo “Statuto etico e giuridico dell’IA” predisposto dall’AI Ethical Lab- el”.

Dati per le città del futuro
COSA: Migliaia di fornitori di servizi pubblici diversi operano nelle città e raccolgono quantità enormi di dati eterogenei e preziosi che costituiscono un patrimonio di inestimabile valore per i Decision Makers pubblici chiamati a sviluppare nuovi servizi, attività imprenditoriali, soluzioni innovative. Occorre gestire ed avere accesso a questi numerosi dati. COME: Sarà istituito un accordo quadro per la condivisione dei dati diversi da quelli personali generali e raccolti in occasione della fornitura di servizi pubblici in regime di concessione o analoghi, da parte dei fornitori pubblici e privati; così da arrivare a creare un vero e proprio “patrimonio informativo pubblico” centralizzato.
Borghi del futuro
COSA: E’ necessario portare l’innovazione anche in piccoli centri. L’idea è di trasformare 10 borghi italiani in 3 anni in autentici “borghi del futuro”, in cui concentrare tutte le tecnologie emergenti disponibili, facendone luoghi da mettere in mostra e valutare l’impatto dell’innovazione sulla società; al contempo amplificandone il potenzialità di attrattività turistica. COME: Occorrerà innanzitutto progettare “Il borgo del futuro”.

I Ministeri coinvolti dovranno definire requisiti comuni a tutti i borghi e requisiti specifici così da contraddistinguere un borgo dall’altro. Molta attenzione verrà data alla sostenibilità ambientale ed alla ciclular economy.

Mediante appositi bandi, verranno selezionati i borghi per partecipare al progetto digitale.

Innovazione bene comune
COSA:  Occorre mettere a fattor comune sia all’interno nel Paese sia verso altri Paesi gli assets strategici dell’innovazione digitale. COME: Sarà istituita una piattaforma negoziale e tecnologica per garantire la circolazione delle informazioni concernenti l’esistenza e la disponibilità di grandi assets innovativi italiani ed esteri e facilitarne la condivisione e fruizione.
Diritto ad innovare
COSA: La sperimentazione di iniziative imprenditoriali innovative è impedita o rallentata da norme, divieti o processi burocratici complessi (l’indice 2019 della BANCA MONDIALE colloca l’ITALIA al 51° posto tra i Paesi dove e più facile fare impresa); occorrerà consentire la sperimentazione di innovazione di frontiera, disapplicando temporaneamente – in presenza di requisiti predefiniti – le norme vigenti ove necessario. COME: Una nuova disposizione di legge riconoscerà a start up ed imprese con idee innovative, il diritto ad innovare, derogando a regole che imbrigliano il futuro, in scelte tecnologiche o modelli di business del passato.

Il Ministero per l’innovazione – sentite le altre amministrazioni – valuterà innovatività, fattibilità, finalità, risultati attesi, condizioni per il successo, sostenibilità dell’impatto su società/mercati, ed eventualmente accorderà il diritto ad innovare in deroga.

Made.it – idea dell’impresa innovativa
COSA: Aiutare gli innovatori a trasformare le idee in imprese è anche compito dello Stato.

“Made.it” sarà il progetto di accompagnamento e comunicazione per start up tecnologiche nazionali nei campi IA, cybersecurity, robotica, mobilità autonoma.

COME: Una collaborazione inter ministeriale porterà ad un programma strutturale e ad un brand aggregante tutte le misure esistenti e nuove per lo sviluppo delle tecnologie innovative in Italia (verrà lanciato il brand del settore tech made in Italy “Made.it”, in uno con il programma “Eccellenze del Made.it”; per la selezione annuale di 30 idee innovative da trasformare in altrettante imprese di successo.
Cross – Tech hub Italia
COSA: E’ necessario creare in Italia come in altri Paesi ambienti ad alto potenziale tecnologico ed innovativo. COME: Attraverso partnership del settore pubblico con quello privato ed in coordinamento con Ministeri competenti, Università e centri di ricerca interessati a dare origine ad autentiche eccellenze territoriali, si creeranno hub tecnologici cross industries (per i settori IA, cybersecurity, robotica, mobilità autonoma e sostenibile e altri settori del made in Italy – manifatturiero, turismo, food, moda, design, sociale, digital humanity), nel rispetto  delle eccellenze dei territori e partendo dalle eccellenze già esistenti nel nostro Paese.
Moontransfer Found & Missione Formare
COSA: Occorre invertire l’attuale dato che vede l’Italia impegnata in investimenti in ricerca e sviluppo per solo l’1,3% del PIL (ossia per meno della metà rispetto a quanto fanno i Paesi più innovativi e lontano dall’obiettivo del 3.0% dell’UE).

Il focus sarà puntare su: mobilità, robotica, AI, cybersecurity.

COME: Nei settori di interesse, il Ministero dello Sviluppo Economico istituirà un Fondo di investimento dedicato (60 Milioni di Euro) incardinato in ENEA (Agenzia Nazionale per le Nuove Tecnologie, l’Energia e lo Sviluppo Sostenibile) che raccoglierà risorse da grandi investitori istituzionali – anche UE-, dal Governo e da grandi imprese. Moontransfer sarà un fondo che mescolerà strumenti di finanza innovativa che vanno dal grant alla equity, al sostegno, alla brevettazione in forma di grant d’onore; quota parte del fondo sarà dedicata all’alta formazione di grandi talenti che guideranno il Paese di domani.
Infrastrutture digitali condivise, sicure, affidabili, green
COSA: Occorre sviluppare le infrastrutture digitali (reti e server su cui viaggiano i servizi) per garantire all’Italia ed all’UE, l’autonomia tecnologica necessaria al controllo dei nostri dati. COME: L’azione si articolerà per step in collaborazione con settore privato e Paesi UE. Si tratterà di: i) favorire l’adozione e lo sviluppo delle tecnologie cloud computing; ii) garantire l’ accesso ad Internet su tutto il territorio nazionale; iii)  promuovere lo sviluppo di infrastrutture digitali del Paese in collaborazione con le iniziative UE e realizzando data center sicuri ed affidabili sul territorio in cui consolidare le infrastrutture digitali per abbattere lo spreco di risorse ed aumentare la sostenibilità ambientale e la sicurezza.
AI ethical LAB –EL
COSA: L’Italia al centro di un vero e proprio “Umanesimo dell’IA”, per un “rinascimento digitale” che vede il Paese protagonista in Europa. Questo il progetto; che si basa anche sulla scelta di mettere l’uomo al centro, impegnandosi per la promozione dell’IA sostenibile sul piano sociale, culturale e democratico. COME: Verrà creata una “Alleanza per l’IA sostenibile”, gestita da apposito Comitato cui saranno invitati a partecipare soggetti pubblici e privati con il compito di elaborare uno “Statuto etico – giuridico dell’IA”, fissando un minimo di principi guida e di regole per la qualificazione di soluzioni di IA destinate al settore pubblico e privato. Si tratterà di una sorta di “certificazione di sostenibilità etico –giuridica” della soluzione innovativa di IA.

Sarà anche resa disponibile in forma gratuita e partecipativa, una piattaforma e –learning , di educazione base all’IA.

Il sabato del futuro
COSA: I giovani sono i lavoratori di domani. Non si può innovare senza prevedere il coinvolgimento delle scuole. COME: Nell’ambito del progetto “Repubblica digitale” con il Ministero per l’Università, la Ricerca Scientifica e Partner privati sarà attivato il programma “Il sabato del futuro”; 10 sabati all’anno saranno dedicati all’aggiornamento di studenti delle superiori nazionali e di loro insegnanti (con coinvolgimento di ricercatori, scienziati delle Università, Enti di ricerca e Aziende tecnologiche) per formarli sui settori emergenti di tecnologia ed innovazione del futuro.
Anziani, tablet e inclusione digitale
COSA: In Italia gli “over 65 “sono quasi 14 milioni (pari al 22% della popolazione).

Di questi circa 1,2 milioni si definiscono isolati, privi di amicizie e reti fuori dalla famiglia (fonte ISTAT); occorre porre rimedio al rischio che gli anziani restino esclusi dalla trasformazione digitale in atto, attraverso un programma di “inclusione digitale” che miri a fornire a questa parte della popolazione – in particolare dei piccoli centri – strumenti, informazioni e competenze del nuovo ecosistema digitale.

COME: Gli anziani che vivono nei Comuni a più alto rischio di digital devide riceveranno un tablet personalizzato con una serie di app forniti da soggetti pubblici e privati per varie utilieities (leggere il giornale, fare la spese, ordinare farmaci, fare chiamate di soccorso, comunicare con la famiglia).

Si creerà un vero e proprio “servizio civile digitale”, con scopi formativi ed educativi mirati sugli anziani.

Repubblica digitale
COSA: I servizi pubblici digitali dovranno essere accessibili a tutti i cittadini. Questo impegno, richiederà di combattere ogni forma di divario digitale, a cominciare da quelli culturali. COME: “Repubblica Digitale” è il progetto che si prefigge di combattere i digital devide e di educare sulle tecnologie del futuro.

Si basa sulla convinzione che azioni di carattere divulgativo, educativo e formativo, siano un “dovere civico” di Stato, imprese e singoli cittadini.

L’obiettivo è di avviare percorsi innovativi di formazione digital su temi specifici (cultura digitale, etica – non discriminazione, tecnologie del futuro nell’aerospaziale, robotica, 5G, IA e cybersecurity) e per fasce diverse della popolazione (cittadini, giovani, studenti).

Note

[1] Per la visione estesa della Strategia si rimanda al sito del MID www.innovazionegov.it

Articolo a cura di Giovanna Raffaella Stumpo

Giovanna Raffaella Stumpo, Avvocato del Foro di Milano, Giornalista pubblicista, collabora con primarie Case editrici e Quotidiani per l’attività redazione specialistica e per discipline strumentali all’esercizio della professione.  Formatore accreditato, in collaborazione con Università, CNF, Consigli dell’Ordine, Scuole di formazione, Associazioni ed Enti per svolge con continuità attività di docenza e di progettazione di corsi nell’ambito della formazione e dell’aggiornamento professionale continuo. Auditor 231/2001 e Valutatore SGQ ISO 9001, è Consulente per il settore dei servizi alle imprese: nella progettazione e sviluppo di SGQ – Sistema Gestione Qualità ISO 9001, SGI – Sistemi Gestione Integrati (Privacy, Qualità, Ambiente e Sicurezza), MOG – Modello Organizzativo Gestionale ex Dl. 231/2001, Reti d’impresa e/o collaborative; nel coaching alle PMI per progetti con finanziamento europeo (www.giovannastumpo.it)

Download PDF

https://www.ictsecuritymagazine.com/articoli/pa-e-digitalizzazione-la-strategia-mid-2025-per-litalia-che-verra/


Le nuove linee guida AgID sul documento informatico

La novellata versione del Codice dell’Amministrazione Digitale (CAD)[1] ha previsto che l’Agenzia per l’Italia Digitale (AgID), “previa consultazione pubblica da svolgersi entro il termine di trenta giorni […] adotta Linee guida contenenti le regole tecniche e di indirizzo per l’attuazione del […] Codice”[2] (1). Tali linee guida “divengono efficaci dopo la loro pubblicazione[3] nell’apposita area del sito Internet istituzionale dell’AgID”[4], (1).

Il 16 novembre 2019 si è conclusa la fase di consultazione pubblica della bozza delle Linee Guida AgID sul documento informatico, precedentemente avviata il 17 ottobre dello stesso anno. Al momento siamo in attesa di pubblicazione[5] sul sito istituzionale di AgID della versione definitiva delle linee guida. A partire dal giorno successivo alla loro pubblicazione le linee guida entreranno in vigore, e quindi si applicheranno successivamente “a partire dal centottantesimo giorno successivo alla loro entrata in vigore”[6],(2).

Il contesto di riferimento

Lo scopo delle linee guida è sicuramente quello di aggiornare le attuali regole tecniche concernenti la formazione, protocollazione, gestione e conservazione dei documenti informatici, in base alle disposizioni di cui all’articolo 71 del Codice dell’amministrazione digitale. Esiste comunque anche un’altra e ben più importante finalità che è quella di “incorporare in un’unica linea guida le regole tecniche e le circolari in materia, addivenendo a un «unicum» normativo che disciplini gli ambiti materiali sopracitati, nel rispetto della disciplina in materia di Beni culturali”[7], (2).

L’ambito di applicazione delle linee guida è duplice, essendo sia soggettivo che oggettivo. Per quanto concerne l’ambito soggettivo, le linee guida si applicano[8] alle pubbliche amministrazioni, ai gestori di servizi pubblici, alle società a controllo pubblico, nonché, per specifiche disposizioni, anche ai privati, ove non diversamente previsto. Invece, per quanto riguarda l’ambito oggettivo di applicazione, le linee guida contengono le regole tecniche sugli ambiti materiali disciplinati da alcune disposizioni del CAD[9].

In pratica le nuove Linee Guida “costituiscono la nuova versione aggiornata delle regole tecniche in materia di formazione, protocollazione, gestione e conservazione del documento, già precedentemente regolate nei DPCM del 2013 e 2014”[10] (2). Con esse, il legislatore ha voluto fornire una gestione complessiva e semplificata del documento informatico, che ora si esprime “attraverso una visione d’insieme che aggrega in un «corpo unico» materie prima disciplinate separatamente”[11] (2).

Si tratta di un approccio metodologico di tipo olistico, finalizzato “a mettere in evidenza e a rappresentare le interdipendenze funzionali tra le varie fasi della gestione documentale dal momento della formazione fino alla selezione per lo scarto o la conservazione permanente”[12](2).

La natura vincolante delle linee guida

Il parere del Consiglio di Stato – numero 02122/2017, del 10/10/2017 – fornisce interessanti interpretazioni in merito alla vincolatività delle nuove linee guida adottate da AgID, che sostituiranno le regole tecniche in precedenza previste dall’art. 71 del CAD. Nello specifico, la Commissione ha rilevato “come la scelta di introdurre nella normativa di settore uno strumento di regolazione più flessibile rispetto alle regole tecniche appaia sostanzialmente in linea con il criterio direttivo[13][…] della legge di delega (3)”. Tale conformità si concretizza nell’esigenza “che le disposizioni del Codice siano connotate da «neutralità tecnologica», al fine di evitare il rischio che le previsioni del CAD comportino la necessità di ricorrere a soluzioni e servizi tecnologici non in linea con lo sviluppo, di certo rapido, del settore” (4).

In particolar modo, “la Commissione ritiene che le citate linee guida, per poter consentire al Codice di trovare una applicazione uniforme su tutto il territorio nazionale e nei confronti dell’intera collettività, non possono che assumere una valenza erga omnes e un carattere di vincolatività” (4). Dunque, per quanto concerne il profilo della gerarchia delle fonti, queste dovrebbero essere inquadrate “come un atto di regolazione seppur di natura tecnica, con la conseguenza che le medesime dovrebbero ritenersi pienamente giustiziabili dinanzi al giudice amministrativo” (4).

Il Consiglio di Stato evidenzia anche che il “procedimento di approvazione e di pubblicazione […] previsto dal novellato art. 71 del CAD” [4], è in linea con le osservazioni contenute nel parere n. 855 del 2016 (5), laddove si evidenziava che nel caso di linee guida di natura vincolante, fosse necessaria la presenza di garanzie procedimentali al fine di “compensare la maggiore flessibilità del «principio di legalità sostanziale» con un più forte rispetto di criteri di «legalità procedimentale»” (5).

Le novità delle linee guida

Le nuove linee guida introducono delle significative novità rispetto alle vigenti regole tecniche, sia relativamente al sistema di conservazione, sia per quanto concerne la formazione e la gestione dei documenti informatici. Nel prosieguo dell’articolo ci concentreremo su alcune riflessioni in merito al ruolo delle norme ISO, così come presentate dalle linee guida, per rimandare a due successivi articoli di approfondimento gli altri aspetti citati.

Le linee guida e le norme ISO/IEC

In conclusione vorrei evidenziare alcune affermazioni, contenute nelle linee guida, che potrebbero essere fuorvianti rispetto l’utilizzo corretto e consapevole delle norme ISO/IEC, nonché dei processi di certificazione connessi con alcune di loro.

Infatti, nelle linee guida si afferma che “le certificazioni di sistema ISO 9001 e 27001 rappresentano […] – lato organizzazione – una ragionevole garanzia di qualità a fronte delle variabili tecnologiche individuate”[14] (2). Personalmente credo che si tratti di un’affermazione pericolosa, nonché collegata a una visione semplicistica di sistemi complessi. Pur senza voler negare i vantaggi che tali certificazioni di processo potrebbero portare in organizzazioni che decidessero di implementarle modificando la cultura aziendale nell’ottica di recepire lo spirito delle norme stesse, è evidente che la letteratura scientifica ha più volte sottolineato che tali certificazioni di processo non sono effettivamente in grado di assicurare nulla sull’effettiva qualità dei prodotti realizzati, nonché sul grado di sicurezza effettivamente conseguito, dovendosi necessariamente limitarsi a rilevare che, dall’analisi dei processi in essere sia presumibile che questi risultati possano essere raggiunti.

Se a titolo esemplificativo si prende come termine di paragone la norma ISO/IEC 27001:2013, questa “non si occupa direttamente di cosa ci sia all’interno della policy in questione; dunque, non si occupa della qualità intrinseca della policy, né tantomeno della qualità dello strumento […] che da tale policy è governato” (6); infatti il suo “focus è tutto sulla presenza dello strumento di gestione e sul fatto che in esso siano presi in considerazione gli obiettivi del controllo ivi indicati” (6).

Nella sua formulazione lo standard ISO/IEC 27001:2013 si occupa essenzialmente della qualità dei processi in essere in un sistema di gestione della sicurezza delle informazioni, ma si disinteressa della qualità delle soluzioni che sono implementate nel sistema stesso.

Non a caso la declinazione pratica della norma, quella che poi è oggetto di certificazione, si appoggia nei fatti su altre norme (come la ISO/IEC 27002:2013) che nascono come “riferimento per la scelta dei controlli nel processo di attuazione di un Sistema di gestione della sicurezza delle informazioni basato sulla ISO/IEC 27001:2013” (6). Non a caso nel certificato, che viene rilasciato all’organizzazione da parte di un organismo di certificazione, si indica che si è proceduto a verificare “la corretta applicazione dei controlli contenuti nella norma a uno specifico ambito di certificazione” (6).

Per dare concretezza ai ragionamenti testé effettuati è possibile fare riferimento al recente Provvedimento d’urgenza[15], (7) del Garante per la protezione dei dati personali, con cui l’autorità di controllo è intervenuta nei confronti di un noto gestore di servizi fiduciari, nonché del servizio di posta elettronica certificata[16]. Tale azione è avvenuta a seguito della rilevazione di numerose vulnerabilità emerse durante un accertamento ispettivo in merito alla gestione del servizio PEC.

A titolo esemplificativo il Garante ha evidenziato che “circa 560.000 utenti utilizzavano ancora, per l’accesso alla propria casella pec, la password iniziale, scelta per loro da uno degli 8.900 partner della società […] senza che fosse imposto, come avrebbe dovuto, l’obbligo di modifica al primo accesso” (8). Ma anche che “le password tecniche di gestione di alcuni servizi informatici erano riportate in chiaro nei log di tracciamento delle operazioni” (8). Inoltre, era possibile “consultare ed esportare, da rete internet, i log dei messaggi scambiati da oltre 6 milioni di caselle pec” (8), anche attraverso l’utilizzo di “un’utenza, con elevati privilegi di amministrazione (superadmin), utilizzata da più persone, in violazione dei più elementari principi di sicurezza del trattamento”.

Ai fini della nostra trattazione è d’interesse il fatto che il gestore in questione fosse in possesso di numerose certificazioni in materia di sicurezza ivi incluse la ISO/IEC 27001:2013. Malgrado ciò, le vulnerabilità rilevate erano proprio insite nelle procedure informatiche adottate e la valutazione di alcuni rischi connessi era risultata carente (8).

Da qui, la critica alle affermazioni riportate all’interno delle Linee guida, nella quali sembra che il possesso della certificazione ISO/IEC 27001 sia sufficiente a garantire con ragionevolezza la qualità del processo, mentre questa, limitandosi a verificare la coerenza tra i controlli implementati e gli obiettivi di sicurezza dichiarati e auto-prefissatesi dall’organizzazione, “andrebbe vista come una sorta di norma base, la cui implementazione conforme non possa prescindere dalla consultazione e dal rispetto di altre norme” (6).

In tal senso, interessante è anche il parere[17] emesso dal Garante sullo schema delle linee guida, nel quale si evidenzia come sia “opportuno ribadire che i titolari del trattamento devono mettere in atto, ed essere in grado di comprovare, al fine di soddisfare i requisiti del Regolamento e tutelare i diritti degli interessati, l’adozione di misure tecniche ed organizzative adeguate avendo riguardo anche ai principi della protezione dei dati fin dalla progettazione e della protezione dei dati per impostazione predefinita (artt. 5, 24 e 25 del Regolamento)” (9).

Note

[1] Il D.lgs. 82/2005 ha subito moltissime modifiche e integrazioni, tra le quali (in ordine cronologico) le ultime sono state quelle apportate: dal D.lgs. 26 agosto 2016, n. 179, dal D.lgs. 13 dicembre 2017, n. 217, dal D.L. 28 settembre 2018, n. 109, convertito con modificazioni dalla L. 16 novembre 2018, n. 130, dal D.L. 14 dicembre 2018, n. 135, convertito con modificazioni dalla L. 11 febbraio 2019, n. 12, dalla Legge 30 dicembre 2018, n. 145 e  dal D.L. 26 ottobre 2019, n. 124.

[2] D.lgs. 82/2005, articolo 71, comma 1.

[3] Di tale circostanza ne è poi data notizia nella Gazzetta Ufficiale della Repubblica italiana.

[4] Idem 2.

[5] Fonti ufficiose sembrerebbero confermare l’uscita della versione definitiva delle linee guide entro il mese di marzo dell’anno 2000.

[6] Linee guida sulla formazione, gestione e conservazione dei documenti informatici (Release bozza) – Paragrafo 1.4 “Abrogazioni e norme transitorie”.

[7] Linee guida sulla formazione, gestione e conservazione dei documenti informatici (Release bozza) – Paragrafo 1.1 “Scopo del documento”.

[8] Ovvero si applicano ai soggetti indicati nell’articolo 2, commi 2 e 3 del CAD.

[9] Nello specifico il riferimento è alle disposizioni di cui agli articoli 20, 21, 22, 23, 23-bis, 23-ter, 23-quater, 34, 40, 40-bis, 41, 42, 43, 44, 45, 46, 47, 49, 50, 51, 64-bis e 65.

[10] Linee guida sulla formazione, gestione e conservazione dei documenti informatici (Release bozza) – Paragrafo 1.9 “Premessa metodologica”.

[11] Ibidem.

[12] Ibidem.

[13] Il riferimento è al criterio direttivo recato dall’articolo 1, comma 1, lettera m) della legge di delega (ovvero la legge 7 agosto 2015, n. 124). In tale provvedimento si fa riferimento, tra l’altro, alla necessità di rispettare il criterio direttivo di “semplificare le modalità di adozione delle regole tecniche e assicurare la neutralità tecnologica delle disposizioni del CAD, semplificando allo stesso tempo il CAD medesimo in modo che contenga esclusivamente principi di carattere generale” [3].

[14] Allegato 3 “Certificazione di processo” al documento “Linee guida sulla formazione, gestione e conservazione dei documenti informatici (Release bozza) – Paragrafo 2.3 “Ciclo di dematerializzazione: requisiti, fasi e controlli”.

[15] Il riferimento è al Provvedimento n. 228 del 18 dicembre 2019.

[16] Si evidenzia la criticità delle fattispecie, dato che il gestore in questione ha in carico oltre sei milioni di caselle utilizzate da vari soggetti, sia pubblici che privati.

[17] Il riferimento è al Provvedimento del Garante n. 32 del 13 febbraio 2020.

Bibliografia

  1. Decreto legislativo 7 marzo 2005, n. 82 (come modificato dal Decreto legislativo 13 dicembre 2017, n. 217 (in G.U. 12/01/2018, n.9), GU n.112 del 16-5-2005-Suppl. Ordinario n. 93, 2005.
  2. Agenzia per l’Italia Digitale, “Linee guida sulla formazione, gestione e conservazione dei documenti informatici Release bozza AGID”. Roma, pp. 1–39,
  3. Legge 7 agosto 2015, n. 124 – “Deleghe al Governo in materia di riorganizzazione delle amministrazioni pubbliche”. Gazzetta della Repubblica Italiana, 2015, pp. 5–53.
  4. Consiglio di Stato, “Parere del Consiglio di Stato, n. 02122/2017, del 10/10/2017, sullo schema di decreto legislativo recante disposizioni integrative e correttive al decreto legislativo 26 agosto 2016, n. 179”, 2017.
  5. Consiglio di Stato, “Parere del Consiglio di Stato, n. 855/2016, del 1/4/2016, sullo schema di decreto legislativo recante “Codice degi appalti pubblici e dei contratti di concessione.”
  6. Ciclosi, La protezione dei dati e la gestione del rischio nella pubblica amministrazione. Un approccio unificato nel contesto del GDPR e del framework europeo di sicurezza cibernetica. Santarcangelo di Romagna (RN): Maggioli Editore, 2019.
  7. Garante per la Protezione dei dati personali, “Provvedimento correttivo d’urgenza nei confronti di Aruba Posta Elettronica Certificata S.p.a. (n. 228 del 18 dicembre 2019) [doc. we.9283040]”, Roma, 2019.
  8. Garante per la protezione dei dati personali, “Newsletter 06/03/2020 – Prescritte ad un gestore misure urgenti per la sicurezza del servizio pec – Sanità: più tutele privacy nei bandi di gara – Scuola, graduatorie docenti: no alla pubblicazione di dati sulla salute o non necessari – Privacy: luci e om,” 2019. [Online]. Available: https://garanteprivacy.it/web/guest/home/docweb/-/docweb-display/docweb/9283047#1. [Accessed: 08-Mar-2020].
  9. Garante per la protezione dei dati personali, “Parere sullo schema di ‘Linee Guida sulla formazione, gestione e conservazione dei documenti informatici’ (n. 32 del 13 febbraio 2020) [doc. web. 9283921]”, Roma, 2020.

Articolo a cura di Francesco Ciclosi

Download PDF

https://www.ictsecuritymagazine.com/articoli/le-nuove-linee-guida-agid-sul-documento-informatico/


Il regolamento ePrivacy e l’emergenza sanitaria: un’occasione persa

Lo stato dell’arte della privacy nelle comunicazioni

Qualche mese fa ci siamo occupati del regolamento ePrivacy[1] raccontando, forse con troppo ottimismo, come questa norma avrebbe potuto (e dovuto) integrare il quadro della protezione dei dati personali spingendosi nell’oceano di informazioni che vengono trattate dai soggetti che operano nel campo delle comunicazioni elettroniche.

L’ottimismo, e quindi l’urgenza di completare il quadro normativo, era giustificato da una frase contenuta nella relazione accompagnatoria della proposta (rimasta tale) di regolamento[2]:

“I consumatori e le imprese si sono affidati sempre più ai nuovi servizi basati su internet intesi a consentire le comunicazioni interpersonali, quali il voice-over-IP, la messaggistica istantanea e i servizi di posta elettronica basati sulla rete anziché fruire dei servizi di comunicazione tradizionali. Questi servizi di comunicazione over-the-top (“OTT”) non sono di norma soggetti all’attuale quadro di riferimento dell’Unione per le comunicazioni elettroniche, compresa la direttiva sulla vita privata elettronica. Ne consegue che la direttiva non è al passo con gli sviluppi tecnologici, il che si traduce in una lacuna nella tutela delle comunicazioni effettuate mediante i nuovi servizi.”

La Commissione Europea, dunque, sembrava abbastanza consapevole che andassero regolati alcuni aspetti essenziali riguardanti:

  • l’accesso ai nuovi servizi (per la verità non più tanto “nuovi”) offerti dalla websfera e le rispettive modalità di conferimento di dati personali;
  • la facilità con la quale i nuovi servizi sono resi disponibili attraverso dispositivi alla portata di chiunque (smartphone, tablet, assistenti vocali, ecc.);
  • i dati personali di contenuto delle comunicazioni elettroniche (ormai non più solo testuali ma multimediali);
  • i dati personali di supporto alle comunicazioni elettroniche (data, luogo, durata, ecc. denominati metadati).

Per comprendere esattamente la portata di questi elementi critici, la cui disciplina sembrava essere affidata al regolamento ePrivacy, occorre far riferimento alle definizioni contenute nella Direttiva EU 2018/1972 che istituisce il Codice Europeo delle Comunicazioni Elettroniche[3] e riprese, appunto, dalla proposta – non ancora definitiva – del regolamento ePrivacy:

  • servizio di comunicazione interpersonale: un servizio di norma a pagamento che consente lo scambio diretto interpersonale e interattivo di informazioni tramite reti di comunicazione elettronica tra un numero limitato di persone, mediante il quale le persone che avviano la comunicazione o che vi partecipano ne stabiliscono il destinatario o i destinatari e non comprende i servizi che consentono le comunicazioni interpersonali e interattive esclusivamente come elemento accessorio meno importante e intrinsecamente collegato a un altro servizio;
  • servizio di comunicazione interpersonale basato sul numero: un servizio di comunicazione interpersonale che si connette a risorse di numerazione assegnate pubblicamente — ossia uno o più numeri che figurano in un piano di numerazione nazionale o internazionale — o consente la comunicazione con uno o più numeri che figurano in un piano di numerazione nazionale o internazionale;
  • servizio di comunicazione interpersonale indipendente dal numero: un servizio di comunicazione interpersonale che non si connette a risorse di numerazione assegnate pubblicamente — ossia uno o più numeri che figurano in un piano di numerazione nazionale o internazionale — o che non consente la comunicazione con uno o più numeri che figurano in un piano di numerazione nazionale o internazionale;

Queste definizioni rivestono una particolare importanza perché includono tutti i servizi forniti dagli Over the Top (ma anche da altri soggetti); sono i servizi che si traducono in forme di comunicazione che vanno oltre il classico formato audio (le telefonate) o testuale (la posta elettronica), includendo i formati più vari (p.e. foto e video) e che, potenzialmente, contengono molti più dati personali provenienti da più mittenti.

La differenza con la pregressa normativa è notevole. Infatti, la Direttiva 2002/21/CE (direttiva quadro per le comunicazioni elettroniche superata dalla Direttiva EU 2018/1972) che ha fornito la base definitoria alla Direttiva 2002/58/CE (ancora in vigore) trasposta in Italia nel Dlgs. 196/2003 (il Codice privacy, in particolare nel Titolo X – Comunicazioni elettroniche, articoli dal 121 al 132‑quater) espone solo la seguente definizione:

  • servizio di comunicazione elettronica: i servizi forniti di norma a pagamento consistenti esclusivamente o prevalentemente nella trasmissione di segnali su reti di comunicazioni elettroniche, compresi i servizi di telecomunicazioni e i servizi di trasmissione nelle reti utilizzate per la diffusione circolare radiotelevisiva, ma ad esclusione dei servizi che forniscono contenuti trasmessi utilizzando reti e servizi di comunicazione elettronica o che esercitano un controllo editoriale su tali contenuti; sono inoltre esclusi i servizi della società dell’informazione di cui all’articolo 1 della direttiva 98/34/CE non consistenti interamente o prevalentemente nella trasmissione di segnali su reti di comunicazione elettronica,

che, mutuata integralmente nell’ambito del Codice privacy, non fa alcun cenno a un’interazione tra più persone.

Il regolamento ePrivacy, quindi, avrebbe dovuto:

  • allineare concetti più aderenti agli strumenti moderni, che la normativa europea sulle comunicazioni elettroniche ha già introdotto, alla disciplina della protezione dei dati personali;
  • garantire, a causa della pervasività di tali strumenti, una regolamentazione più stringente rispetto al trattamento dei dati personali (comunicazione ad altri soggetti, periodi di conservazione, ecc.);

integrando opportunamente il Regolamento UE 2016/679 (GDPR).

Sembra, invece, che l’arrivo del COVID‑19, oltre a creare immensi danni alla salute delle persone, stia penetrando anche nelle larghe maglie normative dell’ePrivacy con rischi molto elevati per i diritti e le libertà delle persone. Per questo appare opportuno, sempre considerando lo stato di emergenza che stiamo vivendo, riflettere su alcune scelte che coinvolgono molti soggetti titolari del trattamento, pubblici e privati, e molti fornitori di servizi di comunicazione interpersonale.

Le scuole

Le scuole italiane non erano pronte a fronteggiare una chiusura così lunga e, quindi, ad utilizzare sistemi alternativi (tipicamente telematici) per garantire l’attività didattica. Così molti istituti hanno dovuto improvvisare soluzioni basate su servizi apparentemente gratuiti forniti dagli Over the Top; per esempio, sono state massicciamente impiegate le piattaforme messe a disposizione da Google: Google Classroom e Google Meet.

Secondo il GDPR, l’unica (debole per questo ambito) fonte normativa attualmente disponibile insieme al Codice privacy, le scuole, in qualità di titolari del trattamento dati (immagini dei docenti, elaborati degli studenti, ecc.) avrebbero dovuto designare Google quale responsabile del trattamento conformemente all’art. 28 oltre a fornirgli adeguate istruzioni; avrebbero dovuto, solo per citare uno degli elementi più significativi, fornire adeguate istruzioni sulla durata della conservazione del contenuto delle comunicazioni (per esempio, della lezione effettuata dal docente in diretta con gli alunni). Quanti istituti scolastici l’hanno fatto? Se fosse entrato in vigore il regolamento ePrivacy non sarebbe stato necessario dare questa istruzione, giacché l’art. 7 della proposta prevede che:
“Fatto salvo quanto disposto all’articolo 6, paragrafo 1, lettera b) e all’articolo 6, paragrafo 3, lettere a) e b), il fornitore del servizio di comunicazioni elettroniche cancella il contenuto delle comunicazioni elettroniche o anonimizza tali dati dopo che il o i destinatari previsti hanno ricevuto il contenuto della comunicazione elettronica. Tali dati possono essere registrati o conservati dagli utenti finali o da un terzo da essi incaricato di registrare, conservare o trattare altrimenti tali dati, a norma del regolamento (UE) 2016/679″.

Inoltre, c’è da chiedersi: come sono state attivate le utenze su piattaforme pubbliche come quelle offerte da Google (ma non solo)? Bisogna tener conto che molti alunni, nelle scuole, sono minori e che molti di loro hanno un’età inferiore a 14 anni. Quindi, nel delicato momento di creazione dell’utenza (per esempio, su Google Meet), quanta attenzione c’è stata alla verifica del soggetto che ha fornito i diversi consensi al trattamento (ricordiamo che le app per smartphone chiedono consensi ad accedere e trattare vari dati personali contenuti nel dispositivo)?

Anche in questo caso sarebbe stato utile l’art. 9 della proposta del regolamento ePrivacy che prevede, al terzo paragrafo, che:
“Gli utenti finali che hanno acconsentito al trattamento dei dati delle comunicazioni elettroniche a norma dell’articolo 6, paragrafo 2, lettera c), e dell’articolo 6, paragrafo 3, lettere a) e b), dispongono della facoltà di revocare tale consenso in qualsiasi momento, conformemente a quanto disposto all’articolo 7, paragrafo 3, del regolamento (UE) 2016/679, e ogni sei mesi viene loro rammentata tale possibilità, finché prosegue il trattamento”.

Le riunioni di lavoro

Anche i datori di lavoro sono stati presi alla sprovvista e, senza voler considerare la superficialità con la quale hanno avviato lo smart‑working da un giorno all’altro affidandosi a piattaforme più o meno sicure, è opportuno riflettere sulle riunioni basate su strumenti molto utili per le comunicazioni personali tra due soggetti privati ma poco idonei a garantire i dati personali dei lavoratori. Per esempio, l’utilizzo esteso di Skype, con l’impiego di account o di numeri di telefono personali del lavoratore, può risultare molto invasivo della privacy dei dipendenti oltre che, in qualche caso, potenzialmente in contrasto  con l’art. 4 dello Statuto dei Lavoratori (L. 300/1970).

Anche il questo caso, avrebbe potuto aiutare l’art. 7 della proposta del regolamento ePrivacy.

La psicoterapia

Un’altra fattispecie significativa si è diffusa nelle pratiche di terapia psicologica, sia da parte di strutture pubbliche sia di professionisti privati. La terapia psicologica ha due caratteristiche fondamentali:

  • non può essere interrotta improvvisamente se non al prezzo di gravi danni per il paziente;
  • richiede la fitta interazione tra il paziente e lo psicoterapeuta, che avviene tramite comunicazione verbale e non verbale.

Purtroppo, gli obblighi di isolamento imposti dalle autorità in questo periodo di emergenza sanitaria rischiano di incidere su entrambe le caratteristiche della psicoterapia. Quindi, per non interrompere il contatto con i pazienti, molti psicologi hanno fatto ricorso alle sedute telematiche basate su strumenti gratuiti (da Whatsapp a Skype) che, purtroppo, con la normativa attuale, possono presentare rischi elevati per i diritti e le libertà degli interessati. Non dimentichiamo, infatti, che la conversazione su Whatsapp tra paziente e psicoterapeuta ha, come contenuto, dati appartenenti alle particolari categorie di dati personali (i dati sulla salute): un’eventuale Man In The Middle malintenzionato potrebbe violare la riservatezza della comunicazione.

Siamo, quindi, di fronte ad un altro caso in cui l’introduzione del regolamento ePrivacy avrebbe aiutato a rafforzare le garanzie per gli interessati.

Conclusioni

Il legislatore europeo ha temporeggiato a lungo – forse consapevole degli enormi interessi in gioco – per regolare la privacy nell’immenso mondo dei servizi di comunicazione elettronica. Le recenti circostanze emergenziali, tuttavia, hanno messo a nudo questi vuoti normativi che, come emerge dagli esempi riportati, rischiano di incidere sui soggetti considerati, per consolidato orientamento, tra quelli meritevoli delle più elevate garanzie.

Note

[1] https://www.ictsecuritymagazine.com/articoli/eprivacy-lintegrazione-del-gdpr/

[2] https://eur-lex.europa.eu/legal-content/IT/TXT/PDF/?uri=CELEX:52017PC0010&from=IT

[3] https://eur-lex.europa.eu/legal-content/IT/TXT/PDF/?uri=CELEX:32018L1972&from=EN

Articolo a cura di Francesco Maldera

Francesco Maldera è Data Protection Officer e Data Scientist.

Il suo percorso professionale lo ha chiamato a responsabilità direzionali nell’ambito dei sistemi informativi, della safety&security, della privacy e dell’auditing svolgendo diversi incarichi dirigenziali nella Pubblica Amministrazione e in aziende private.

Attualmente, accompagna l’attività consulenziale a quella di sensibilizzazione delle persone tramite il sito www.prontoprivacy.it

Download PDF

https://www.ictsecuritymagazine.com/articoli/il-regolamento-eprivacy-e-lemergenza-sanitaria-unoccasione-persa/


Una nuova frontiera nelle certificazioni di sicurezza cyber: Il CMMC

Da fine gennaio 2020, il Department of Defence americano (DoD) ha rilasciato la versione 1.0 di un nuovo standard di certificazione, il CyberSecurity Maturity Model Certification (CMMC), certificazione obbligatoria per tutti coloro che risponderanno a una RFQ dal prossimo autunno. E con oltre 300.000 (sì, trecentomila) fornitori, la platea interessata è impressionante.

Le modalità di certificazione non sono ancora note; infatti in questo momento il CMMC Accreditation Body è al lavoro per definire le modalità più idonee a garantire le necessità del DoD e adeguati livelli di imparzialità. Inoltre, l’amministrazione ha tenuto a precisare che i costi di certificazione terranno conto delle possibilità dell’intera filiera, che vede in prima fila i colossi delle forniture militari ma anche piccole e piccolissime imprese al termine della catena di fornitura.

Lo schema gerarchico di responsabilità per la certificazione è comunque chiaro: al primo livello troviamo il CMMC Accreditation Body, che ha il compito di definire tutte le regole per la certificazione e di accreditare le C3PAO (Certified 3rd Party Assessment Organization), ovvero gli enti di certificazione che poi rilasceranno i certificati.
Le C3PAO si avvalleranno degli Assessors (ovvero Auditors) per effettuare le attività di verifica di conformità allo standard.

Nulla di nuovo sotto il sole, ma al momento – a parte il CMMI Institute che ha supportato il DoD nella realizzazione della norma -, non si hanno notizie (bensì soltanto voci) su altri enti che abbiano chiesto l’accreditamento.

A giugno dovrebbe essere tutto più chiaro, visto che è prevista la prima tornata di training e corsi per gli Assessors. Tuttavia, si deve considerare che per le verifiche più complesse (relative al Livello 5) è previsto che gli Assessors possano essere nominati dal DoD o, comunque, di sua fiducia.

Ma perché una nuova certificazione? A chi non doveva operare su informazioni classificate, ove insistono altre norme e regole, per lavorare con il DoD bastava effettuare un self-assessment e autocertificare la propria “cyber-posture”; il DoD ha scoperto (tutto mondo è Paese!) che oltre il 90% delle dichiarazioni non erano esattamente vere!

Il CMMC prevede cinque livelli di certificazione.

Il Livello 1 stabilisce le misure minime atte a garantire che non vengano esposte all’esterno le FCI -Federal Contract Information, ovvero le informazioni non destinate al pubblico dominio che definiremmo in termini aziendali “ad uso interno” o riservate a chi le deve conoscere in base al principio del Need to Know.  Dal Livello 2 in poi si tratta di proteggere le CUI – Controlled Unclassified Information, ovvero tutte quelle informazioni che definiremmo in termini aziendali “Confidenziali” ma non classificate secondo l’Executive Order 13526 o l’Atomic Energy Act; tra queste abbiamo le “NATO restricted” e “NATO Unclassified” e, per la Difesa, tutte le “Controlled Technical Information”[1][2].

Il Level 1 di certificazione è obbligatorio per tutti i fornitori; poi, in base al tipo di commessa o di dato scambiato e gestito con l’Amministrazione, si sale di Livello sino al Level 5.

Dalle spiegazioni fornite dal DoD si può dedurre che in realtà il Level 2 sia solo un passo transitorio al Level 3, mentre i Level 4 e 5 riguardano prevalentemente i Prime contractors. Probabilmente avremo quindi requisiti di Gara che prevedono i Livelli 1 (come standard minimo), poi Level 3 e per i Prime Level 4 o Level 5 in base alla criticità del progetto/programma. Questo vuol dire che a parte i “Big” della Difesa a cui toccheranno i Level 4 e 5, i fornitori di parti “pregiate”, dovranno presumibilmente certificarsi per il Level 3.

Come per la ISO27001 è presumibile che non necessariamente tutta la società dovrà essere certificata: basterà invece il perimetro ove si svolgono le attività relative alla Gara, i relativi processi e infrastrutture, quello che nella ISO sono nel “Campo di Applicazione”. Per le aziende più grandi, questo potrebbe significare il dover avere più certificati per ambiti produttivi diversi.

Dato il numero di aziende coinvolte – non solo negli USA ma nel mondo intero – questo processo avverrà per gradi, partendo proprio dai “Big” per poi coinvolgere, a scendere, tutti gli altri.

CMMC: Il nuovo Standard basato sul Maturity Model

Volendo avere diversi livelli di requisiti di sicurezza in base alle informazioni da trattare, il Cybersecurity Maturity Model Certification è disegnato a livelli crescenti di misure di sicurezza, appunto dal Level 1 al Level 5; ogni livello si appoggia e migliora quello sottostante.

Vengono identificati 17 Capability Domains, ognuno delle quali prevede un insieme di Practices (misure di sicurezza), che si accrescono per ogni Livello di certificazione. Il CMMC, come la ISO27001, è orientato sia agli aspetti tecnologici sia alla gestione delle persone e di come sono implementati i processi; possiamo quindi vedere i Capability Domains come i Controls Objective della ISO27001 e le Practices come i Controls ISO27001, anche se rispetto alla ISO le norme americane entrano maggiormente nel dettaglio delle misure da implementare, facendo sostanzialmente riferimento a tutto il framework normativo NIST e FIPS pertinente.

Le misure di sicurezza sono state definite avendo a riferimento le principali norme già utilizzate in ambito Federale: in particolare chi approccerà il Level 3 avrà come riferimento tutti i controlli della NIST SP800-171r1 più un altro set di 20 controlli per un totale di 130 Practices, mentre per i Level 4 e 5 vi sono, tra le altre cose, ulteriori controlli ereditati dalla NIST SP800-171B arrivando a 171 Practices.

Il CMMC richiede inoltre di garantire adeguati livelli di maturità dei processi che guidano tali Practices. Valutare i processi per mezzo di un Maturity Model lo abbiamo già visto, ad esempio con il Cobit 5; il CMMC richiede di valutare contestualmente la maturità dei Capability Domains applicabili. Si raggiunge un determinato Level di certificazione se contemporaneamente si garantiscono, oltre alle Practices richieste, l’opportuno livello di maturità del processo afferente quelle Practices. Ad esempio, se si deve raggiungere il Level 3, dovranno essere implementate le 130 Practices caratteristiche di quel livello e i processi a loro afferenti dovranno essere tutti a livello “Managed”; la mancanza di uno dei requisiti porta a certificarsi al livello inferiore.

Anche se non si fa mai riferimento a un sistema di gestione, le misure nel loro complesso portano a un risultato equivalente. Infatti, se si vanno a leggere con attenzione le Practices, già al Level 2 abbiamo da “Sviluppare, documentare e periodicamente aggiornare i System Security plans” e periodicamente “Verificare i Security Controls nel sistema organizzativo al fine di verificare se siano efficaci nella loro applicazione nel tempo” e al Level 3 si devono definire misure per il monitoraggio continuo che faciliti la consapevolezza di minacce e vulnerabilità emergenti avendo sotto controllo lo stato complessivo della Sicurezza delle Informazioni nel perimetro in certificazione.

Il CMMC sembra destinato a diventare il nuovo standard per tutta l’amministrazione federale e statale statunitense, e probabilmente anche per il B2B americano. Potrà avere l’onda lunga in Europa e soppiantare la ISO27001? Diciamo che anche le future certificazioni ENISA, inevitabilmente, strizzeranno l’occhio al CMMC.

*Le figure presenti nel testo, ad eccezione della prima, sono tratte dalla documentazione ufficiale del CMMC V1.0.

Note

[1] “Controlled Technical Information means technical information with military or space application that is subject to controls on the access, use, reproduction, modification, performance, display, release, disclosure, or dissemination. Controlled technical information is to be marked with one of the distribution statements B through F, in accordance with Department of Defense Instruction 5230.24”, Distribution Statements of Technical Documents.

[2] “Technical Information” means technical data or computer software, as those terms are defined in Defense Federal Acquisition Regulation Supplement clause 252.227-7013, “Rights in Technical Data – Noncommercial Items” (48 CFR 252.227-7013). Examples of technical information include research and engineering data, engineering drawings, and associated lists, specifications, standards, process sheets, manuals, technical reports, technical orders, catalog-item identifications, data sets, studies and analyses and related information, and computer software executable code and source code.

Articolo a cura di Giustino Fumagalli e Paolo Sferlazza

Socio fondatore di Gerico Security Srl opera come Chief Information Security Officer “As a service” e garantisce consulenze direzionali nel campo della sicurezza delle informazioni e continuità operativa.

Con un importante passato nella progettazione di software real-time e project management per sistemi spaziali e telecomunicazioni, ha partecipato a progetti civili e militari internazionali, anche di protezione civile e protezione delle infrastrutture critiche. Supporta le aziende nella gestione dei rischi, nella realizzazione di programmi di information security, continuità operativa e supply chain security, eventualmente accompagnandole nell’ottenimento della certificazione ISO/IEC 27001 e ISO 22301.

È certificato Senior Security Manager UNI10459:2017, in accordo al Decreto del Ministero dell’Interno n.269/2010 e al disciplinare del 24 febbraio 2015 del Capo della Polizia. È inoltre certificato PMP per il Project Management, CISM, CRISC di ISACA per l’information security, CBCP in materia di Business Continuity, Lead Risk manager ISO31000, è infine qualificato Lead Auditor ISO27001 e Lead Auditor ISO22301.

Socio fondatore di Gerico Security Srl lavora come advisor, auditor e trainer nel campo della sicurezza delle informazioni, continuità operativa, gestione dei servizi IT e sicurezza delle carte di pagamento.

Ha accompagnato primarie aziende e infrastrutture critiche italiane nell’ottenimento della certificazione ISO/IEC 27001, ISO 22301 e ISO/IEC 20000.

È un Qualified Security Assessor riconosciuto dal PCI Council per la certificazione dei sistemi di pagamento PCI DSS. Ha conseguito la certificazione CISA, CISM, CRISC di ISACA, ed è auditor qualificato e tiene docenze sugli schemi ISO/IEC 27001, ISO 22301, ISO/IEC 27001 e ISO 9001 ed è iscritto ai registri AICQ SICEV quale auditor sulla sicurezza delle informazioni e continuità operativa. Ha inoltre ottenuto altre certificazioni nel campo della sicurezza delle informazioni e dell’IT governance tra cui OPST, COBIT e ITIL. Ha progettato ed erogato docenze, anche in ambito militare, su tematiche di Information Risk Management, ITIL.  Ha effettuato audit interno, assessment e consulenza in merito all’accreditamento dei laboratori VA rispetto alla 17025. Si occupa si sicurezza delle informazioni nel mondo specifico dell’automotive in conformità con lo standard di settore TISAX.

Collabora con primari enti di certificazione come auditor di terza parte.

Download PDF

https://www.ictsecuritymagazine.com/articoli/una-nuova-frontiera-nelle-certificazioni-di-sicurezza-cyber-il-cmmc/


Smart Working ed emergenza: rischi, minacce e raccomandazioni

Pandemia e rischio cyber

COVID-19 è una malattia respiratoria causata da un nuovo coronavirus, identificato per la prima volta alla fine del 2019[1]. L’attuale pandemia determina impatti dirompenti su ogni aspetto della nostra vita quotidiana, mettendo in discussione quelli che fino a ieri erano considerati pilastri fondamentali dal punto di vista economico, sociale, politico e di salute pubblica.

Uno dei capisaldi della strategia di contrasto e contenimento del contagio è il cosiddetto distanziamento sociale[2], ovvero un insieme di misure– peraltro adottate da un numero sempre crescente di nazioni in tutto il mondo – finalizzate a ridurre drasticamente la probabilità di contatto tra le persone. L’applicazione sempre più stringente di questa politica di controllo dell’infezione ha determinato, ormai da diverse settimane, una condizione di lockdown progressivo dei luoghi fisici tradizionalmente e naturalmente deputati alla socialità: scuole, luoghi di lavoro legati ad attività considerate non essenziali, negozi, centri commerciali, spazi adibiti a ospitare eventi di massa quali cinema, teatri e stadi. I voli sono quasi tutti cancellati e le città sono vuote. Altre misure adottate comprendono la quarantena, l’autoisolamento e il cordone sanitario. Ad oggi (fine marzo 2020) si stima che oltre 2 miliardi di persone in tutto il pianeta siano costrette a vivere in un regime di distanziamento sociale, isolate all’interno delle proprie abitazioni e private, quanto più possibile, di contatti fisici con altre persone.

Appare evidente che, nonostante la riduzione ai minimi termini del campo di azione individuale nel dominio fisico della realtà, i bisogni umani non possano essere similmente compressi: ne consegue che la nostra dipendenza dalla tecnologia digitale aumenta esponenzialmente. Le infrastrutture digitali e Internet (in senso lato) diventano l’elemento principale che abilita l’interazione umana nelle modalità in cui comunichiamo, ci aiutiamo, studiamo o lavoriamo. Il bisogno che i servizi essenziali continuino a funzionare senza interruzioni non è mai stato più urgente: la situazione globale è senza precedenti e, di fatto, ci si trova in una condizione di verifica sul campo dei limiti e delle capacità di comunicare, capire il contesto e reagire in modo appropriato. Proprio durante una crisi di queste dimensioni e portata è fondamentale garantire il corretto funzionamento dell’infrastruttura digitale nel suo complesso[3].

In un contesto come quello attuale, senza precedenti e caratterizzato dai tratti della totale emergenza, un attacco cyber in grado di privare le organizzazioni pubbliche e private e le famiglie dell’accesso ai propri dispositivi, ai propri dati o all’infrastruttura digitale sarebbe devastante. Nello scenario peggiore, attacchi cyber di grande portata potrebbero disconnettere intere comunità o città, interrompendo, per esempio, la normale operatività dei servizi erogati dal sistema sanitario o da altri operatori essenziali. Una dipendenza maggiore dall’infrastruttura digitale aumenta anche il costo complessivo di un suo eventuale malfunzionamento e la pandemia in corso ha già ottenuto l’effetto di veder aumentare gli attacchi cyber: le campagne di phishing sono in preoccupante aumento[4], applicazioni malevole promettono di tracciare le dinamiche di diffusione del virus (in realtà sono trojan[5]), i social media sono oggetto di attacchi differenziati (fake news e attività di Social Engineering[6] finalizzate a manipolare consensi, influenzare opinioni o destabilizzare le comunicazioni) e gli ospedali e le infrastrutture sanitare sono attaccate in vari modi (ransomware, attacchi DDoS).

Nel presente articolo il focus è relativo agli aspetti di sicurezza logica delle infrastrutture e delle tecnologie digitali coinvolte nell’applicazione dei comuni scenari di Smart Working. Gli elementi attinenti al fattore umano e alla sfera comportamentale (Security Awareness[7], Social Engineering, le buone pratiche di Cyber Hygiene[8], etc) sono disseminati e distribuiti all’interno delle misure consigliate sotto forma di Raccomandazioni.

Smart Working

Il lavoro da casa – più in generale, da remoto – è una delle caratteristiche intrinseche all’infrastruttura digitale: finora è stato utilizzato da un numero ristretto di organizzazioni all’interno delle quali, tipicamente, tale opzione veniva offerta a una quota della popolazione aziendale. La realtà che stiamo vivendo ha accelerato drammaticamente questa dinamica, estendendo la platea del lavoro da remoto a una parte significativa della forza lavoro globale. Di fatto si tratta di un test di proporzioni giganti dettato dalle condizioni di emergenza e di incertezza, non da una pianificazione articolate secondo passaggi graduali.

Il cambiamento così repentino, ex abrupto, di una consuetudine plurisecolare (i luoghi di lavoro sono da sempre un contesto materiale di socialità e relazioni interpersonali) potrà essere valutato in futuro nella sua portata e nei relativi impatti (ad esempio di natura psicologica, economica o sociale), ma nell’immediato pone concretamente determinati rischi cyber che richiedono misure tecniche e organizzative adeguate unitamente a comportamenti corretti.

Nel contesto del quadro normativo di riferimento italiano il “lavoro agile (o Smart Working) è una modalità di esecuzione del rapporto di lavoro subordinato caratterizzato dall’assenza di vincoli orari o spaziali e un’organizzazione per fasi, cicli e obiettivi, stabilita mediante accordo tra dipendente e datore di lavoro; una modalità che aiuta il lavoratore a conciliare i tempi di vita e lavoro e, al contempo, favorire la crescita della sua produttività. Come indicato nel DPCM dell’11 marzo 2020, si raccomanda venga attuato il massimo utilizzo, da parte delle imprese, di modalità di lavoro agile per le attività che possono essere svolte al proprio domicilio o in modalità a distanza[9]”.

Problematiche comuni

Esistono diverse problematiche di sicurezza connesse allo Smart Working[10]:

  • le persone operano da remoto – in questo caso da casa propria, sia tramite dotazioni aziendali sia tramite dispositivi di loro proprietà. Si tratta di sistemi che potrebbero essere datati, privi di patch di sicurezza e di protezione. Sono maggiormente esposti alle vulnerabilità semplicemente perché sono meno sicuri;
  • i dati sensibili dell’organizzazione potrebbero muoversi al di fuori della rete. I dipendenti che lavorano da casa potranno salvare i dati sui propri dispositivi, dove non sono poste in essere le misure tecniche di protezione tipiche dell’organizzazione. Questa condizione espone i dati a essere oggetto di furto e hacking;
  • le persone potrebbero accedere alle reti aziendali in maniera poco sicura. Alcune aziende predispongono accessi remoti VPN per i quali è opportuno l’utilizzo di un apposito software client di connessione. Anche se può essere faticoso far installare tale client su un dispositivo proprio da parte di una persona con poca competenza tecnico informatica, è molto peggio non prevedere l’utilizzo di una VPN;
  • le persone potrebbero essere costrette a utilizzare strumenti di lavoro e videoconferenza relativamente nuovi e poco familiare come Zoom[11] (per esempio) al fine di sostituire gli incontri faccia a faccia. A volte il set up frettoloso di questi sistemi può creare problematiche di sicurezza;
  • il caos generale derivato dal dover agire improvvisamente in modo diverso è di per se una condizione di potenziale attacco. Azioni quali il Business Email Compromise[12], quando cioè si riceve un’e-mail fasulla da una figura apicale della propria organizzazione che ci chiede di effettuare un trasferimento di denaro, tenderà ad avere maggior successo nel momento stesso in cui non abbiamo più la possibilità di verificare fisicamente la validità stessa del messaggio – magari andando a parlare di persona con il presunto mittente. Quando si agisce in uno stato di distrazione diffusa e generalizzata il livello di attenzione e di difesa tende ad abbassarsi e molte cose rischiano di essere fatte in maniera diversa da solito.

Obiettivi di sicurezza

Gli obiettivi di sicurezza per lo Smart Working sono:

  • Riservatezza: assicurare che le comunicazioni tramite accesso remoto e i dati degli utenti interessati non possano essere acceduti da entità non autorizzate;
  • Integrità: rilevare qualsiasi cambiamento intenzionale o non intenzionale alle comunicazioni che avvengono durante il transito dei dati;
  • Disponibilità: assicurare che gli utenti possano accedere alle risorse tramite accesso remoto ogni volta che ne hanno bisogno.

Al fine di raggiungere tali obiettivi è necessario che tutte le componenti tecnologiche coinvolte all’interno della filiera (dispositivi client, server di accesso remoto, server interni all’organizzazione acceduti tramite l’accesso remoto) siano opportunamente messe in sicurezza contro un insieme di minacce cyber. Uno dei problemi principali è dovuto al fatto che le tecnologie di accesso remoto sono per propria natura maggiormente esposte a minacce esterne nei confronti delle tecnologie che vengono normalmente accedute e utilizzate dall’interno dell’organizzazione: è per questo che è necessario, già in fase di progettazione e design, modellizzare opportunamente le minacce cyber che sarà inevitabile affrontare.

Al fine di mitigare i rischi derivanti da tali minacce, sarà necessario identificare le risorse di interesse, le minacce più probabili, le vulnerabilità e i controlli di sicurezza applicabili a tali risorse, quindi quantificare la probabilità di buon esito di un attacco con i relativi impatti analizzando, infine, l’informazione per determinare dove i controlli di sicurezza devono essere migliorati o creati ex novo.

La modellizzazione delle minacce permette di definire i requisiti di sicurezza e progettare di conseguenza le soluzioni tecnologiche in grado di incorporare i controlli di sicurezza capaci di soddisfare tali requisiti.

Modelli di minaccia

Mancanza di controlli della sicurezza fisica

I dispositivi tramite cui il dipendente può connettersi alle risorse dell’organizzazione sono utilizzati in una estrema varietà di luoghi tutti al di fuori del perimetro di controllo dell’organizzazione: casa propria, hotel, etc. La natura mobile di questi dispositivi ne rende più semplice il furto e lo smarrimento, aumentando proporzionalmente il rischio di compromissione dei dati ospitati all’interno di tali dispositivi.

Il modello di minaccia deve assumere che l’appropriazione indebita del dispositivo, sia per cercare di estrarne dati aziendali sia per cercare di usarlo come strumento di accesso alla rete aziendale, si verificherà.

Reti insicure

Normalmente non è possibile effettuare alcun controllo sul livello di sicurezza della rete da cui il dipendente si connette quando opera in Smart Working. I sistemi di comunicazione utilizzabili comprendono reti a banda larga, ADSL e meccanismi wireless quali Wi-Fi e reti cellulari. Si tratta di sistemi di comunicazione suscettibili ad attacchi di tipo eavesdropping[13] che mettono a rischio di compromissione informazioni sensibili nel corso del loro transito. È anche possibile subire attacchi di tipo Man In The Middle[14] (MITM) finalizzati a intercettare e modificare i contenuti delle comunicazioni.

È necessario assumere che le reti esistenti tra il dispositivo usato dal dipendente per operare in Smart Working e l’organizzazione non possono essere considerate affidabili (trusted).

Dispositivi infetti

I dispositivi – particolarmente BYOD[15] e portatili controllati da terze parti – sono spesso utilizzati all’interno di reti estranee all’organizzazione. Un attaccante che ha accesso fisico a uno di questi dispositivi può installarvi a bordo codice malevolo per raccogliere dati da esso e dalle reti e dai sistemi con cui interagisce. Se un dispositivo client è infetto da malware, tale malware potrebbe diffondersi all’interno dell’organizzazione non appena il dispositivo client si connetta alla rete dell’organizzazione.

Le organizzazioni devono assumere che i dispositivi client prima o poi si infetteranno e devono pianificare conseguentemente i propri controlli di sicurezza.

Accessi esterni a risorse interne

L’accesso remoto fornisce a entità esterne un accesso diretto a risorse interne e protette, ad esempio server o applicativi aziendali. Rendere tali risorse disponibili ad accessi esterni le espone a nuove minacce cyber aumentando sensibilmente la probabilità di essere compromesse. Ogni forma di accesso remoto a risorse interne ne aumenta intrinsecamente il rischio di compromissione.

Le aziende dovrebbero bilanciare molto attentamente i benefici correlati all’accesso remoto con il potenziale impatto derivante dalla compromissione di tali risorse: ogni risorsa interna che potrà essere acceduta da remoto dovrà essere sottoposta ad attività di hardening[16] e di applicazione di configurazioni di sicurezza, limitandone l’accesso allo stretto necessario attraverso meccanismi di controllo degli accessi e filtraggio del traffico di rete (Next Generation Firewall, Web Application Firewall, etc).

Raccomandazioni

Per tutelare la riservatezza, l’integrità e la disponibilità dei dati aziendali tutte le componenti di rete e delle soluzioni di accesso remoto (dispositivi client, server di accesso remoto e server acceduti da remoto) devono essere messe in sicurezza e al riparo da una varietà di minacce.

Prima di progettare e successivamente realizzare una soluzione di Smart Working ogni azienda deve sviluppare un sistema che modelli le minacce cyber che insistono sulle componenti infrastrutturali di accesso remoto e sulle risorse che sono accedute tramite l’accesso remoto.

Quando si pianificano le policy e i controlli di sicurezza relativi allo Smart Working, ogni azienda deve assumere che i dispositivi client remoti saranno compromessi da agenti ostili che cercheranno di appropriarsi dei dati in essi contenuti oppure cercheranno di usare i dispositivi compromessi per ottenere accessi apparentemente legittimi alla rete aziendale.

Le organizzazioni devono:

  • pianificare la sicurezza del proprio accesso remoto dando per assodato che le reti attraversate dal dispositivo client del dipendente in Smart Working e la rete dell’organizzazione stessa non possono essere fidate;
  • dare per scontato che i dispositivi client dei dipendenti in Smart Working siano infettati da malware, predisponendo di conseguenza i relativi controlli di sicurezza;
  • cercare di posizionare le infrastrutture di accesso remoto sul perimetro della propria rete, tenendo in considerazione fattori quali le prestazioni richieste, la capacità di analisi del traffico e la gestione del NAT;
  • implementare meccanismi di autenticazione forte per validare l’identità del lavoratore remoto. Se possibile, sarebbe opportuno implementare meccanismi di mutua autenticazione;
  • pianificare con attenzione le modalità di gestione e manutenzione dei client software per l’accesso remoto, ponendo attenzione che queste attività operative avvengano in maniera sicura, cifrando le comunicazioni di rete e applicando la mutua autenticazione tra gli endpoint;
  • trarre vantaggio dalla capacità di gestione centralizzata ove applicabile. In ogni caso molti dispositivi potrebbero dover essere messi in sicurezza tramite configurazioni manuali ed è opportuno fornire guide tecniche agli amministratori dei dispositivi responsabili della sicurezza degli stessi;
  • proteggere la riservatezza e l’integrità di qualsiasi informazione sensibile che possa attraversare reti non trusted tramite l’utilizzo della crittografia;
  • mettere in sicurezza i dispositivi client devono mantenendo nel tempo un adeguato livello di protezione. Se possibile, i dispositivi client dei lavoratori remoti dovrebbero avere lo stesso livello di sicurezza dei dispositivi client aziendali. Se l’utilizzo di particolari meccanismi di controllo non fosse applicabile, è opportuno predisporre tecnologie VDI o VMI per realizzare un ambiente sicuro oppure adottare soluzioni MDM per aumentare il livello di sicurezza dei dispositivi mobili;
  • avere una policy per gestire informazioni sensibili, come certi tipi di proprietà intellettuale o dati classificati, e fare uso di tecnologie appropriate (crittografia, DLP, Information Right Management);
  • definire una policy di sicurezza per lo Smart Working che individui quali sono le forme di accesso remoto consentite, quali tipologie di dispositivi sono permessie per usare le varie tipologie di accesso remoto, il tipo di accesso garantito a ogni lavoratore e come deve essere gestito il provisioning degli account e delle utenze sui sistemi;
  • prendere le proprie decisioni basate sul rischio rispetto ai livelli di accesso remoto che intende concedere ai vari tipi di dispositivi client dei lavoratori remoti;
  • periodicamente riesaminare le proprie policy considerando eventuali cambiamenti nei livelli di accesso e dei dispositivi remoti di connessione.

Si suggerisce l’adozione dell’insieme dei controlli applicabili contenuti all’interno del Cyber Security Framework del NIST[17] e della NIST Special Pubblication 800-53 “Security and Privacy Controls for Federal Information Systems and Organizations[18]” così come suggeriti all’interno della NIST Special Pubblication 800-46 “Guide to Enterprise Telework, Remote Access, and Bring Your Own Device (BYOD) Security[19]”:

Controllo

NIST SP 800-53

NIST Cyber Security Framework Subcategory Descrizione
AC-2, Account Management

IA-2, Identification and Authentication (Organizational Users)

PR.AC-1: Identities and credentials are managed for authorized devices and users Il controllo riguarda la gestione di autenticazione a un fattore o multi fattore degli utenti che fanno accesso remoto, quali password, certificati digitali e/o token hardware e software di autenticazione.
AC-17, Remote Access PR.AC-3: Remote access is managed Il controllo è dedicato alla documentazione dei requisiti di accesso remoto.
AC-19, Access Control for Mobile Devices PR.AC-3: Remote access is managed Il controllo include requisiti di sicurezza e di controllo accessi dei dispositivi mobile con le relative autorizzazioni.
AC-20, Use of External Information Systems ID.GV-1: Organizational information security policy is established Il controllo coinvolge l’utilizzo di sistemi esterni quali dispositivi di proprietà personale (BYOD) e dispositivi controllati da terze parti che potrebbero processare, conservare o trasmettere i dati controllati dall’organizzazione per suo conto.
CA-9, Internal System Connections ID.GV-1: Organizational information security policy is established Il controllo riguarda le connessioni tra un sistema e le sue componenti, inclusi dispositivi mobili e laptop.
CP-9, Information System Backup PR.IP-4: Backups of information are conducted, maintained, and tested periodically I dispositivi dei lavoratori remoti devono avere i propri dati protetti da backup locali o remoti.
IA-3, Device Identification and Authentication PR.AC-1: Identities and credentials are managed for authorized devices and users La mutua autenticazione è raccomandata ove fattibile per verificare la legittimità di un server di accesso remoto prima di fornirgli le credenziali di autenticazione.
IA-11, Re-Authentication PR.AC-1: Identities and credentials are managed for authorized devices and users Il controllo richiede ai lavoratori remoti di autenticarsi periodicamente durante le sessioni di connessioni, ad esempio dopo 30 minuti di inattività.
RA-3, Risk Assessment ID.RA-5: Threats, vulnerabilities, likelihoods, and impacts are used to determine risk Il controllo richiede l’effettuazione di un risk assessment per poter selezionare il miglior metodo di accesso remoto.
SC-7, Boundary Protection PR.AC-5: Network integrity is protected, incorporating network segregation where appropriate Il controllo riguarda la segmentazione di una rete per mantenere i componenti pubblicamente accessibili separati dalle reti interne, monitorando e controllando le comunicazioni nei punti chiave e di confine.
SC-8, Transmission Confidentiality and Integrity PR.DS-2: Data-in-transit is protected I vari metodi di accesso remoto proteggono la riservatezza e l’integrità delle trasmissioni tramite l’utilizzo della crittografia.

Note

[1] http://www.salute.gov.it/nuovocoronavirus

[2] https://en.wikipedia.org/wiki/Social_distancing

[3] https://www.weforum.org/agenda/2020/03/coronavirus-pandemic-cybersecurity/

[4] https://www.us-cert.gov/ncas/current-activity/2020/03/06/defending-against-covid-19-cyber-scams

[5] https://blog.lookout.com/commercial-surveillanceware-operators-latest-to-take-advantage-of-covid-19

[6] https://en.wikipedia.org/wiki/Social_engineering_(security)

[7] https://en.wikipedia.org/wiki/Security_awareness

[8] https://www.ictsecuritymagazine.com/articoli/cyber-hygiene-gli-ingredienti-di-base-per-un-programma-di-cyber-protection/

[9] https://www.lavoro.gov.it/strumenti-e-servizi/smart-working/Pagine/default.aspx

[10] https://www.schneier.com/blog/archives/2020/03/work-from-home_.html

[11] https://en.wikipedia.org/wiki/Zoom_Video_Communications

[12] https://en.wikipedia.org/wiki/Business_email_compromise

[13] https://en.wikipedia.org/wiki/Eavesdropping

[14] https://en.wikipedia.org/wiki/Man-in-the-middle_attack

[15] https://en.wikipedia.org/wiki/Bring_your_own_device

[16] https://en.wikipedia.org/wiki/Hardening_(computing)

[17] https://www.nist.gov/cyberframework

[18] https://csrc.nist.gov/publications/detail/sp/800-53/rev-5/draft

[19] https://csrc.nist.gov/publications/detail/sp/800-46/rev-2/final

Articolo a cura di Andrea Boggio

Andrea Boggio è Security Solutions Sales Manager in Vodafone Business, la divisione Vodafone dedicata ai servizi per le imprese, e si occupa di attività di vendita, prevendita e progettazione di soluzioni e servizi di Cyber e ICT Security. In precedenza ha lavorato presso aziende focalizzate sulla sicurezza informatica (HP, NTT Data) e di telecomunicazione (Fastweb).
Andrea lavora da oltre 15 anni nell’Information Security Arena e si occupa di diverse aree tematiche quali: Governance, Risk & Compliance, SIEM e SOC, Mobile Protection, Threat e Vulnerability Management, Network Security e Cyber Security.
Andrea detiene le certificazioni professionali ISO/IEC 27001:2013 Lead Auditor, CISA, CISM, CGEIT, CRISC, ITIL e diverse altre legate a specifici vendor di sicurezza, è membro del capitolo italiano di ISACA e ha partecipato al Cloud Security and Resilience Expert Group di ENISA.

Download PDF

https://www.ictsecuritymagazine.com/articoli/smart-working-ed-emergenza-rischi-minacce-e-raccomandazioni/


Il mercato della security in Italia: in quali aree investono le aziende?

Nel corso del 2019 l’information security è diventata una delle maggiori priorità di investimento nel digitale per le aziende nell’agenda dei Chief Innovation Officer. Basta tale dato a testimoniare come l’attenzione verso questo ambito sia cresciuta in maniera esponenziale anche agli occhi di chi non si occupa, nello specifico, della materia. Parallelamente, è maturata la consapevolezza che si tratti ormai di un tema strategico e imprescindibile per le organizzazioni e non più un ostacolo allo sviluppo del business.

In questo scenario si è mosso l’Osservatorio Information Security & Privacy del Politecnico di Milano, che ha condotto durante l’anno appena trascorso un’indagine volta a monitorare il mercato dell’information security in Italia con l’obiettivo di fotografarne le principali dinamiche di sviluppo.

Nello specifico, la Ricerca 2019 dell’Osservatorio ha proposto una survey di rilevazione che ha coinvolto 698 CISO, CSO, CIO, Compliance Manager, Risk Manager, Chief Risk Officer e DPO di imprese italiane. In particolare sono state coinvolte 180 organizzazioni grandi (>249 addetti) e 501 PMI (tra 10 e 249 addetti).

L’evoluzione del mercato dell’information security e la sua scomposizione

Il mercato dell’information security in Italia ha raggiunto nell’anno appena concluso un valore di 1,3 miliardi di euro, in crescita rispetto ai 12 mesi precedenti. Il 2019 ha registrato pertanto un trend positivo in continuità con gli ultimi anni, con un aumento della spesa di poco inferiore all’11% (Figura 1).

Figura 1: Il mercato dell’information security in Italia nel 2019 – Fonte: Osservatorio Information Security & Privacy, School of Management Politecnico di Milano

Ma quali sono le aree su cui le aziende investono maggiormente? Per meglio comprendere le dinamiche all’interno del mercato, l’Osservatorio ha approfondito due viste di dettaglio, una focalizzata sulla tipologia di sicurezza e l’altra sulle componenti di spesa.

In merito alla tipologia di sicurezza sono state identificate sei categorie principali, in relazione al target da proteggere. Secondo questa categorizzazione, la quota principale della spesa, ossia il 36%, è catalizzata dalla voce “Network & Wireless Security”, termine con cui si intende la protezione della rete fisica e logica. Al secondo posto, con il 20%, si trova la sicurezza degli endpoint, siano essi postazioni fisse o devices mobili funzionali allo smart working. Una porzione rilevante, pari al 19%, è invece ascrivibile agli strumenti di supporto alla sicurezza a livello di applicazioni: in questa categoria si trovano le logiche di gestione delle implicazioni della security in fase di sviluppo (by design), così come le misure di protezione attive una volta che il servizio è operativo.

La crescente diffusione dei servizi Cloud richiede strumenti all’avanguardia dal punto di vista della protezione delle informazioni: non stupisce quindi che il 13% della spesa sia dedicata a questa categoria che rappresenta peraltro l’area in cui il maggior numero di organizzazioni dichiara una crescita di spesa. Altro tema di interesse, per un 5%, è rappresentato dai dispositivi connessi dell’Internet of Things, ormai diffusi in svariati ambiti che spaziano dalla casa, alla città o ai veicoli, solo per citare gli esempi più rilevanti.
Infine vi è un’ulteriore categoria residuale, non indagata esplicitamente, in cui rientrano svariate voci, relative prevalentemente ad aspetti di governance, che occupa il restante 7% (Figura 2).

Figura 2: La scomposizione della spesa in information security per tipologia di sicurezza – Fonte: Osservatorio Information Security & Privacy, School of Management Politecnico di Milano

La seconda classificazione, come anticipato, riguarda le componenti di spesa, a loro volta suddivise, a un primo livello, in soluzioni, per il 52% della spesa totale, e in servizi, per il restante 48%.

Tale vista è stata scomposta ulteriormente: in particolare, per quanto riguarda le soluzioni sono state approfondite otto categorie riferibili alla tipologia di prodotto offerto (Figura 3).

A catalizzare le quote maggiori di spesa sono innanzitutto le soluzioni di Identity and Access Management, che permettono la gestione e il monitoraggio degli accessi degli utenti a infrastrutture, applicazioni e dati critici, seguite dai prodotti di Vulnerability Management/Penetration Testing, volti a individuare e misurare il grado di gravità delle vulnerabilità e testare la sicurezza di sistemi, applicazioni o reti, anche attraverso la simulazione di attacchi da parte di soggetti malintenzionati e dalle soluzioni appartenenti alla categoria Risk and Compliance Management, volte ad analizzare il livello di esposizione al rischio cyber dei sistemi informatici aziendali e garantire la conformità a standard, framework e normative in materia di sicurezza delle informazioni e protezione dei dati.

Leggermente più in basso dal punto di vista dell’incidenza sul budget si trovano le soluzioni di Intrusion Detection System (IDS)/Intrusion Prevention System (IPS), che monitorano il traffico di rete per identificare e bloccare gli accessi non autorizzati a un determinato sistema o dispositivo e quelle di Security Information and Event Management (SIEM), in grado di raccogliere e analizzare dati provenienti da vari fonti e segnalare in tempo reale eventuali anomalie e criticità al personale che si occupa di security; quest’ultima componente, peraltro, rappresenta la principale voce su cui le organizzazioni dichiarano di voler aumentare i propri investimenti.

Le altre tipologie di soluzioni indagate appartengono alla categoria Unified Threat Management (UTM), in cui rientrano prodotti per una gestione integrata delle minacce di sicurezza che includono normalmente funzionalità come antivirus, anti-spyware, anti-spam, firewall di rete, rilevamento e prevenzione delle intrusioni, filtraggio dei contenuti e protezione dalle perdite di dati, e alla categoria OSS Risk Prevention (CVE): quest’ultima voce, più di “nicchia”, racchiude soluzioni volte a mitigare i rischi per la sicurezza attraverso la valutazione dei gap e delle vulnerabilità note presenti nelle componenti software open source.

Figura 3: La scomposizione della spesa in soluzioni di information security – Fonte: Osservatorio Information Security & Privacy, School of Management Politecnico di Milano

Anche la componente di spesa relativa ai servizi è stata ulteriormente suddivisa: la quota relativa ai professional services, ossia i servizi offerti da provider esterni all’organizzazione per il compimento di uno specifico progetto, vale il 54% del totale, mentre la quota relativa ai managed services, voce con cui si intendono i servizi offerti in maniera continuativa da provider esterni all’organizzazione per garantire il supporto e la manutenzione dei sistemi informativi aziendali, vale il restante 46%.

In conclusione, la dinamica del mercato pare confermare la maggiore attenzione da parte delle organizzazioni al tema della security, con un bilanciamento della spesa che interessa in misura crescente componenti innovative, legate alla gestione degli endpoint, al design delle applicazioni, al Cloud e ai dispositivi connessi.
In tale contesto di diffusa crescita, si evidenzia inoltre la tendenza a ricorrere sempre di più a servizi professionali e servizi gestiti, in grado di fornire il supporto necessario per garantire un’adeguata ed efficace tutela delle informazioni aziendali.

Bibliografia

Security-enabled transformation: la resa dei conti – Osservatorio Information Security & Privacy, School of Management Politecnico di Milano

Articolo a cura di Alessandro Piva

Download PDF

https://www.ictsecuritymagazine.com/articoli/il-mercato-della-security-in-italia-in-quali-aree-investono-le-aziende/


Adversarial Learning e sue applicazioni nella Cyber Security

1. Security e Machine Learning

Le tecnologie di Machine Learning sono state spesso applicate nel contesto della sicurezza informatica, con numerose aree di applicazione specifica che comprendono il riconoscimento di malware, il rilevamento di intrusioni, i filtri anti-spam, l’autenticazione utente (one-shot e continua), e i sistemi di password checking.

In generale, l’idea è quella di vedere l’incidente di sicurezza come anomalia rispetto al funzionamento atteso di un sistema, le cui caratteristiche posso essere apprese da esempi passati. Siamo quindi nel campo della “anomaly detection”. Quando il classificatore, ottenuto attraverso tecniche adattive, segnala un’anomalia, scattano azioni correttive o controlli aggiuntivi, quali la generazione di allarmi in un SIEM, il blocco di traffico di rete sospetto, o la richiesta di un ulteriore e più forte livello di autenticazione.

2. Adversarial Learning

Dobbiamo tuttavia considerare un fatto molto importante: è possibile che un avversario sia a conoscenza dei nostri metodi di difesa e della nostra strategia adattativa, e provi quindi a evitarla o a interferire. Per esempio potrebbe modificare i dati che vediamo e impedirci di apprendere un classificatore, o indurci ad acquisirne uno errato. In altri casi, sarà interessato a conoscere l’output del nostro sistema di Machine Learning, in modo da preparare attacchi che non siano classificati come anomalie. Sulla base di queste osservazioni, negli ultimi anni ha ottenuto sempre maggiore attenzione un settore di ricerca e di applicazione noto come “Adversarial Machine Learning” [1].

Secondo Marco Barreno (Università di Berkeley e ora Google, Inc.), è possibile classificare in tre macrocategorie gli attacchi di tipo “adversarial” a un sistema di sicurezza adattativo [2].

  • Causativo/Esplorativo. Un attacco causativo inserisce data manipolati, come esempi classificati erroneamente, o cambierà la frequenza con cui particolari tipologie di dati si presentano. Un attacco esplorativo cercherà soltanto di scoprire informazioni. Tipicamente sarà finalizzato a predire la descrizione di “anomalia” che risulterà come output del sistema di Machine Learning;
  • Mirato/Indiscriminato. In un attacco mirato l’avversario sarà interessato al successo di uno specifico attacco, che gli sarà sufficiente per compromettere is sistemi target. In un attacco indiscriminato l’avversario si accontenterà di un qualsiasi successo, con il solo scopo di superare le barriere difensive del sistema;
  • Integrità/Disponibilità. Un avversario che vuole mettere in pericolo l’integrità del sistema difensivo metterà in atto attacchi che non posso essere rilevati. Se invece ha come obiettivo la disponibilità del sistema, cercherà di renderlo instabile o non utilizzabile in pratica. Per esempio, causerà la generazione di un numero molto elevato di allarmi casuali, o realizzerà attacchi DoS per limitare il numero di esempi disponibili.

Nelle applicazioni di Cyber Security, in particolare nell’ambito della Anomaly Detection, il contesto è spesso [1] esplorativo, [2] mirato e [3] interessato all’integrità del sistema. Questo perché il nostro avversario cercherà normalmente di simulare il sistema di Machine Learning, e predire il suo output, con l’obiettivo di attuare specifici attacchi che non possano essere riconosciuti.

Per difendersi da questo tipo di attacchi “adversarial”, un sistema di anomaly detection deve mantenere segrete alcune delle sue componenti.
Questo viene fatto nascondendo alcuni parametri del processo di Machine Learning:

Figura 1: Anomaly detection con randomizzazione

[2, 3]. Per evitare però il rischio di un approccio del tipo security through obscurity (STO), sono stati proposti meccanismi di randomizzazione [4] e l’utilizzo di chiavi segrete [5, 6]. Un sistema di anomaly detection che sia “adversarial-aware”, può essere rappresentato come in Fig. 1.

L’introduzione di dati random, non predicibili per l’avversario, rende impossibile per quest’ultimo la replicazione esatta del procedimento di Machine Learning, rendendo il suo attacco di tipo esplorativo molto meno efficace. In particolare l’avversario, nel momento in cui dovrà mettere in pratica un nuovo attacco, non potrà sapere con esattezza se sarà classificato come anomalia, e quindi rilevato dai sistemi difensivi (ad esempio all’interno di un SOC, e con l’ausilio di software SIEM e intrusion detection/prevention che implementino questi principi).

3. Generative Adversarial Networks (GAN)

Consideriamo un sistema di Machine Learning supervisionato, nell’ambito della classificazione, ovvero dove gli esempi disponibili sono correttamente associati a una classe. Ad esempio abbiamo degli esempi di malware e di applicazioni benigne, e per ognuno di questi esempi sappiamo appunto qual è la loro natura.

Figura 2: Generative Adversarial Network (GAN)

Il sistema di Machine Learning produrrà un classificatore capace di etichettare esempi futuri, nell’esempio quindi con la conseguente possibilità di rilevare la presenza di malware.

Una “Generative Adversarial Network” (GAN) è un sistema capace di utilizzare il classificatore appreso come black box e di generare esempi che rispecchiano la distribuzione e la natura degli esempi utilizzati in fase di Machine Learning. Le GAN sono state proposte in [7] da Ian Goodfellow (ora alla Apple).
Il funzionamento può essere sintetizzato come in Fig. 2:

  1. il generatore inizialmente non sa nulla e genera esempi partendo da dati random;
  2. il classificatore invece, utilizzando Machine Learning su dati reali, è in grado di distinguere i dati “fake” generati da quelli reali;
  3. la decisione del classificatore però ritorna come feedback al generatore, il quale comincia ad apprendere come generare dati più credibili;
  4. dopo un sufficiente numero di interazioni i dati generati saranno di fatto indistinguibili da quelli veri.

Per una descrizione dei principi matematici e degli algoritmi utilizzati in una GAN si faccia riferimento alla pubblicazione originaria di Goodfellow [7].

Secondo Yann LeCun, professore alla New York University e Chief Scientist per l’Intelligenza Artificiale di Facebook, i GAN sono “la più interessante idea nell’ambito del Machine Learning negli ultimi 10 anni” [8]. In effetti le GAN hanno avuto straordinario successo nelle applicazioni di image processing, e sono in grado di generare immagini artificiali perfettamente realistiche, compresa la controversa possibilità di generare situazioni e immagini false di persone conosciute o che si vogliano utilizzare come target.

Più recentemente è cresciuto l’interesse per l’utilizzo delle GAN nell’ambito della Cyber Security. Il collegamento è ovvio: se posso generare dati falsi, che però sembrano veri, potrò facilmente ottenere la cosiddetta “evasion” di un sistema di sicurezza, evitando la generazione di allarmi e riuscendo a battere i sistemi di autenticazione biometrica.

4. Applicazioni nella Cyber Security

Le tecnologie “adversarial” sono in primo luogo un pericolo per i sistemi difensivi, in quanto permettono di aggirare allarmi e strumenti di controllo di accesso che sono stati appresi in base ai dati disponibili.
Di conseguenza esse diventano anche uno strumento difensivo, nel senso che servono a progettare sistemi di anomaly detection e di autenticazione che siano più robusti rispetto a questo tipo di attacchi. In particolare, le possibili aree di applicazione comprendono gli ambiti descritti sotto.

Network Intrusion Detection

Un avversario può aggirare un sistema di intrusion detection (evasion) se riesce a ottenere un classificatore simile a quello del sistema IDS. A quel punto potrà attuare intrusioni che sa non essere rilevabili. Per difendersi da questa situazione sono stati realizzati sistemi di intrusion detection “adversarial”, basati su chiavi segrete [5].

Autenticazione biometrica

Le GAN rappresentano un gigantesco problema per i sistemi di autenticazione biometrica. Ad esempio uno dei migliori sistemi di Face Recognition, il Deepface di Facebook, con un’accuratezza dichiarata del 97,35%, può essere facilmente ingannato con una GAN. Allo stesso modo i sistemi di riconoscimento utente basati ad esempio su impronta digitale, keystroke dynamics o riconoscimento della voce non possono prescindere dall’utilizzo di tecniche adversarial, e devono impedire l’utilizzo del classificatore come black box, perché potrebbe essere utilizzato in modo malevolo per allenare il generatore di una GAN.

Rilevamento di Defacement

Siccome il rilevamento di Web e Web Application Defacement è soggetto ad “evasion” mediante tecniche adversarial, sono stati proposti metodi per ridurre l’efficacia di questi attacchi, utilizzando randomization e chiavi segrete [3, 6].

Riconoscimento di Malware

Il sistema MalGAN [9] descrive una GAN che è in grado di generare malware non rilevabile da un classificatore reso disponibile anche come black box. Di nuovo, anche in questo ambito, i sistemi di malware detection devono introdurre randomization o informazioni segrete nella fase di Machine Learning, in modo da evitare l’uso adversarial dei classificatori appresi.

Proactive password checking

La verifica di password scelte dall’utente può essere basata su semplici regole, o, meglio, sull’appartenenza ad un dizionario di password. Ancor meglio, la password deve essere rifiutata se è “simile” a parole presenti in un dizionario dato [10]. Questo perché, ad esempio attraverso una GAN, è possibile generare un gran numero di password a partire da un dizionario, come dimostrato dal sistema PassGAN [11]. PassGAN, allenandosi sul dizionario “rockyou”, ha dimostrato di poter riconoscere il 24,2% del password leak di Linkedin, che non ha relazione con il dataset di partenza.

Riferimenti bibliografici

  1. Huang, A. D. Joseph, B. Nelson, B. Rubinstein and J. D. Tygar, Adversarial Machine Learning, ACM W. on AI and Security, 2011.
  2. Barreno, B. Nelson, R. Sears, A. D. Joseph, J. D. Tygar. Can Machine Learning be Secure?, Proc. ACM Symp. on Information, Computer and Communications Security (AsiaCCS), 2006.
  3. Davanzo, E. Medvet and A. Bartoli, Anomaly detection techniques for a web defacement monitoring service, Expert Systems with Applications, vol. 38, number 10, 2011.
  4. Rota Bulò, B. Biggio, I. Pillai, M. Pelillo, F. Roli, Randomized Pre- diction Games for Adversarial Machine Learning, IEEE Transactions on Neural Networks and Learning Systems, vol. 28, no. 11, 2017.
  5. E. Tapiador, A. Orfila, A. Ribagorda, and B. Ramos, Key-Recovery Attacks on KIDS, a Keyed Anomaly Detection System, IEEE Trans. On Dependable and Secure Computing, vol. 12, no. 3, 2015.
  6. Bergadano, F. Carretto, F. Cogno, D. Ragno, Defacement Detection with Passive Adversaries, Algorithms, 12:8, n. 150, 2019.
  7. J. Goodfellow, J. Pouget-Abadie, M. Mirza, B. Xu, D. Warde-Farley, Ozair, A. C. Courville, Y. Bengio, Generative Adversarial Networks, ArXiv, abs/1406.2661, 2014
  8. LeCun, Recent and potentially upcoming breakthroughs in deep learning, https://www.quora.com/What-are-some-recent-and-potentially-upcoming-breakthroughs-in-deep-learning, 2016.
  9. Hu, Y. Tan, Generating Adversarial Malware Examples for Black- Box Attacks Based on GAN, arXiv:1702.05983, 2017.
  10. Bergadano, B Crispo, G Ruffo, High dictionary compression for proactive password checking, ACM Trans. Inf. and System Security, 1998.
  11. Hitaj, P. Gasti, G. Ateniese, F. Perez-Cruz, PassGAN: A Deep Learning Approach for Password Guessing, arXiv:1709.00440, 2017.

Articolo a cura di Francesco Bergadano

Francesco Bergadano ha ottenuto il Ph.D. in informatica dal consorzio delle Università di Milano e Torino nel 1991. E’ professore ordinario di informatica e insegna sicurezza informatica e identity management presso l’Università di Torino.

E’ stato consulente di numerose organizzazioni pubbliche e private, e principal inverstigator di diversi progetti di ricerca finanziati dall’Unione Europea. Recentemente, è stato valutatore di progetti Horizon 2020, per conto della Commission Europea. Nel 2003 ha fondato Certimeter s.r.l., prima spin-off dell’Università di Torino, sulla base di attività di ricerca e sviluppo nel settore della sicurezza informatica. Oggi la società conta 140 dipendenti. Fa parte della commissione brevetti dell’Università di Torino.

E’ autore di più di 120 pubblicazioni in riviste scientifiche e atti di congressi internazionali, 2 libri e 3 brevetti internazionali. I suoi interessi sono nell’area della Cyber Security, e in particolare anomaly detection adattativa, autenticazione biometrica, security analytics e sicurezza delle applicazioni mobile.

Download PDF

https://www.ictsecuritymagazine.com/articoli/adversarial-learning-e-sue-applicazioni-nella-cyber-security/


L’approvvigionamento ICT di un ospedale: le questioni da affrontare

“Dottore, stia attento…”

Aiutare le grandi strutture sanitarie (pubbliche o private) a effettuare un percorso finalizzato a ridurre i rischi per i dati personali è un mestiere difficile. Di solito esiste un committment forte da parte del vertice aziendale che, tuttavia, si infrange, spesso, su uno scoglio che è abbastanza noto in letteratura (illuminante il saggio di Koppel, Smith,Blythe, Kothari)[1] e che suona, più o meno, così “You want my password or a dead patient?”.

Infatti il punto di vista dei clinici, cioè dei professionisti (medici e non) che si occupano della salute dei pazienti, è che loro trattano dati, appunto, clinici e non si preoccupano del fatto che i dati clinici sono dati personali (secondo il GDPR, appartenenti alle particolari categorie di dati personali) e che, pertanto, devono essere tutelati. Il loro obiettivo è migliorare la salute del paziente: costi quel che costi. Le regole di sicurezza informatica e di protezione dei dati personali sembrano assurde, inutili e faticose da applicare.

Inoltre, un’ulteriore fatica è quella di far percepire loro che, ormai, in (quasi) tutti i dispositivi medici che funzionino con l’aiuto dell’elettricità ci sono dati personali e che, quindi, è necessario applicare alcune misure di sicurezza: che sia il saturimetro oppure l’acceleratore lineare, ognuno, nel suo “piccolo” o “grande”, contiene un minimo dispositivo “interno” (la sua memoria) che trattiene dati riguardanti la salute del paziente.

E molta memoria c’è negli strumenti di comunicazione che i clinici, sempre in buona fede e sempre per convergere verso la buona salute del paziente, utilizzano disinvoltamente scambiandosi immagini radiologiche su Whatsapp oppure inviando email con esami clinici senza curarsi se li mandano dalla propria casella ad uso personale (tipicamente poco protetta) o da quella istituzionale fornita dall’organizzazione (che si suppone sia stata costruita più professionalmente e, quindi, meno vulnerabile).

“Dottore, stia attento…” è l’esortazione più frequente. Ma pochi ci credono.

L’importanza di cominciare bene

Consapevole delle enormi difficoltà che, spesso, si incontrano nel settore sanitario quando si parla di cybersecurity o privacy, l’European Union Agency for Cybersecurity[2] (ENISA) ha voluto cominciare a sciogliere la matassa cominciando dalla fase cruciale per tutta la filiera della cura ed assistenza clinica: l’approvvigionamento di prodotti e servizi di una struttura sanitaria. Ha, quindi, pubblicato le “Procurement Guidelines for Cybersecurity in Hospitals”[3] (le Linee Guida per la Sicurezza Informatica nell’Approvvigionamento degli Ospedali) che offrono utili consigli per l’acquisizione di beni e servizi che, già in partenza, dovrebbero poter ridurre al minimo i rischi informatici e sui dati personali.

Il documento parte da alcuni dati significativi:

  • è stato calcolato che, negli ospedali statunitensi, funzionano, in media, 10 dispositivi connessi per ciascun paziente ricoverato;
  • è emerso che, la maggior parte di questi dispositivi, sono manutenuti da soggetti (la stessa ditta produttrice o altri soggetti) che si collegano tramite connessioni remote.

Questi due elementi, se vogliamo apparentemente banali, fanno scorgere, con una certa immediatezza, la punta dell’iceberg delle vulnerabilità che possono essere presenti nei sistemi informativi ospedalieri (HIS).

Anche il Garante per la Protezione dei Dati Personali ha sentito la necessità, conformemente a quanto prevede l’art. 57 par. 1 lettera d) (“promuove la consapevolezza dei titolari del trattamento e dei responsabili del trattamento riguardo agli obblighi imposti loro dal presente regolamento”), di incidere sulla corretta acquisizione dei dispositivi medici annunciando una collaborazione con CONSIP per inserire idonee misure a tutela dei dati trattati, come ad esempio l’impossibilità per il fornitore, che esegue un’attività di manutenzione a distanza dell’apparecchio, di accedere direttamente ai dati anagrafici dei pazienti presenti nelle immagini diagnostiche[iv]. Il Garante è stato mosso dalla approfondita conoscenza di casi in cui i manutentori hanno approfittatto della propria posizione privilegiata ed hanno utilizzato illecitamente dei dati personali presenti nei dispositivi medici[v].

Il ciclo dell’approvvigionamento

L’ENISA, nel sollecitare la sensibilizzazione delle strutture ospedaliere, definisce le fasi standard del ciclo dell’approvvigionamento: pianificazione, acquisizione ed esercizio e gestione. In ciascuna di queste fasi è necessario assumere specifici comportamenti finalizzati a garantire la sicurezza delle informazioni oltre che la tutela dei dati personali.

Tuttavia, l’ENISA suggerisce comportamenti comuni a ciascuna fase che, spesso, vengono trascurati:

  • coinvolgimento della struttura che gestisce i sistemi informativi aziendali; gli attori che, di solito, partecipano alla definizione dei requisiti dei dispositivi medici appartengono alla struttura dell’ingegneria clinica e alla specifica struttura sanitaria dove il dispositivo andrà ad operare; come è noto, tuttavia, l’integrazione dei dispositivi nel sistema informativo ospedaliero richiede una profonda conoscenza delle infrastrutture di comunicazione e di elaborazione esistenti e, quindi, il coinvolgimento di chi le gestisce ovvero del servizio ICT ospedaliero; senza questo coinvolgimento si rischia di introdurre pesanti vulnerabilità nell’intero sistema oppure, come di solito accade, di creare isole integrabili al prezzo di considerevoli inefficienze;
  • gestione delle vulnerabilità; in ogni momento dell’approvvigionamento è necessario che ci sia una specifica attenzione alle vulnerabilità sia da parte dell’organizzazione cliente (in questo caso l’ospedale) sia da parte del fornitore che, periodicamente, deve farsi parte diligente nella segnalazione delle vulnerabilità che emergono nel corso della fornitura (scoperte magari in altri contesti);
  • definizione di una politica degli aggiornamenti hardware e software; non è possibile pensare di mantenere in esercizio sistemi che scontano la naturale obsolescenza; questo vale sia per le componenti hardware (che spesso non reggono gli aggiornamenti software) sia per i software di base ed applicativi; occorre, quindi, stabilire intervalli certi per effettuare verifiche e, se necessario, procedere agli aggiornamenti;
  • difesa delle comunicazioni senza fili; i sistemi di comunicazione senza fili costituiscono un elemento di flessibilità molto diffuso soprattutto in luoghi dove il cablaggio è difficile o impossibile ma, al tempo stesso, possono diventare gli anelli deboli dell’intero sistema informativo ospedaliero; diventa, quindi, determinante stabilirne le modalità di esercizio e le relative misure di riduzione del rischio;
  • definizione di politiche di test; le fasi che precedono l’avvio in esercizio dei dispositivi medici sono cruciali per comprendere a fondo gli effetti dell’interazione con i sistemi esistenti oltre che la loro effettiva funzionalità nel contesto operativo; spesso queste fasi sono trascurate nella definizione di quelle che l’ENISA chiama Request for Proposal (RfP) e che, nel contesto italiano, sono i capitolati speciali di gara;
  • definizione dei piani per assicurare la continuità; nelle strutture sanitarie, soprattutto in quelle ospedaliere, la continuità del servizio è un elemento essenziale che è necessario valutare in fase di pianificazione, implementare rigorosamente in fase di avvio in esercizio e verificare periodicamente durante le gestione corrente; naturalmente, anche questo è un aspetto che bisogna definire con precisione insieme al partner che fornirà il prodotto/servizio (tipicamente già nella RfP);
  • definizione di programmi di audit e di specifiche di logging; la storia d’uso di una risorsa (sia essa un dispositivo medico oppure un servizio acquisito all’esterno) è un elemento fondamentale per consentire di comprendere il reale livello di rischio ad essa associato; quindi, diventa fondamentale poter condurre attività di auditing (sull’uso ordinario ma anche sugli interventi manutentivi) supportata adeguatamente dal logging delle operazioni svolte;
  • uso della cifratura; è opportuno precisare che la cifratura non è, in sé, una misura di riduzione del rischio; in qualche caso, se maneggiata con superficialità, può diventare un elemento che aumenta il rischio (per esempio di indisponibilità di dati personali); è, invece, uno degli strumento attraverso il quale è possibile introdurre misure di sicurezza che possono consistere nella pseudonimizzazione ovvero nella anonimizzazione.

Difficile ma non impossibile

I consigli dell’ENISA, per chi si occupa professionalmente di questa materia, sembrano ovvi e quasi banali. Esistono, tuttavia, due ostacoli che si presentano spesso nelle strutture sanitarie:

  • i clinici, oltre a quello che è stato già detto nell’introduzione, pensano che i meccanismi richiesti dalla cybersecurity (verifica periodica dei piani di continuità, attività di auditing, ecc.), da eseguire con la loro concreta collaborazione, sottraggano risorse preziose alla cura dei pazienti (in particolare il tempo);
  • clinici e informatici parlano lingue diverse; un famoso saggio del 2013[6] tipizza questa divergenza che può avere effetti devastanti sulla sicurezza dei sistemi informativi ospedalieri.

È molto importante, dunque, cercare di coinvolgere i clinici, anche con l’aiuto degli ingegneri clinici, in un assessment a raggio più ampio degli aspetti tipicamente diagnostici o terapeutici: sfida difficile, ma non impossibile.

Note

[1] https://pdfs.semanticscholar.org/c74b/d5c43fcb11094dee5ce616d8df61ebce14dd.pdf?_ga=2.267335054.1452898703.1582882795-1984855386.1582882795

[2] https://www.enisa.europa.eu/

[3] https://www.enisa.europa.eu/publications/good-practices-for-the-security-of-healthcare-services/at_download/fullReport

[4] https://www.gpdp.it/web/guest/home/docweb/-/docweb-display/docweb/9283047#2

[5] https://www.gpdp.it/web/guest/home/docweb/-/docweb-display/docweb/9144941#3

[6] https://www.researchgate.net/profile/Ross_Koppel/publication/242016935_Healthcare_information_technology’s_relativity_problems_A_typology_of_how_patients’_physical_reality_clinicians’_mental_models_and_healthcare_information_technology_differ/links/568fb62f08aef987e56b5ff0/Healthcare-information-technologys-relativity-problems-A-typology-of-how-patients-physical-reality-clinicians-mental-models-and-healthcare-information-technology-differ.pdf

Articolo a cura di Francesco Maldera

Francesco Maldera è Data Protection Officer e Data Scientist.

Il suo percorso professionale lo ha chiamato a responsabilità direzionali nell’ambito dei sistemi informativi, della safety&security, della privacy e dell’auditing svolgendo diversi incarichi dirigenziali nella Pubblica Amministrazione e in aziende private.

Attualmente, accompagna l’attività consulenziale a quella di sensibilizzazione delle persone tramite il sito www.prontoprivacy.it

Download PDF

https://www.ictsecuritymagazine.com/articoli/lapprovvigionamento-ict-di-un-ospedale-le-questioni-da-affrontare/