Aspetti di sicurezza di BGP e Routing in Internet – parte II

Nella prima parte di questo articolo è stata fatta una breve rassegna dei principali aspetti di sicurezza relativi al Routing BGP in Internet. In questa seconda parte sono descritte in maggior dettaglio le problematiche di sicurezza di BGP-4 e le misure di sicurezza adottate e in corso di valutazione.

Modalità di attacco a BGP-4

Il modo più semplice per effettuare un attacco al Routing BGP-4 o “BGP Hijacking”, è quello di accedere ad un router BGP di un Internet Provider o Carrier, attraverso credenziali rubate o vulnerabilità di sistemi. Una volta avuto accesso ad un router BGP, si possono modificare gli annunci BGP inviati ai Peer in modo da bloccare o dirottare il traffico di interesse. Il protocollo BGP-4 non prevede meccanismi espliciti di controllo o sicurezza: in linea di principio ogni router ripone completa fiducia negli annunci che riceve dai propri Peer. Quindi, se un router BGP invia annunci errati o malevoli, questi possono essere accettati senza alcun controllo dagli altri router BGP.

Un altro modo per modificare le tabelle di Routing è quello di intercettare e modificare il traffico dati tra due router BGP e quindi gli annunci che i due router si scambiano. Di base il traffico tra due router BGP è costituito da sessioni TCP non autenticate e non protette da cifratura o altre misure di sicurezza, sono verificati solo gli indirizzi IP dei due router. In alcune situazioni è pertanto possibile, anche se non del tutto facile, inserire o modificare i dati scambiati tra due router BGP.

È anche possibile inserire volontariamente (o per errore) nei propri router BGP degli “annunci” allo scopo di deviare o bloccare il traffico verso alcuni Prefissi. Gli effetti di questi annunci malevoli sono tipicamente locali, ma in alcuni casi particolari possono estendersi a livello globale (come già visto per alcuni incidenti descritti nella prima parte di questo articolo).

Infine, come indicato ad esempio dalla frode “3ve” precedentemente descritta, è possibile attaccare i processi formali e burocratici di assegnazione di AS e Prefissi alle organizzazioni per ottenerne un uso formalmente valido. Ad esempio, “3ve” utilizzò, tra gli altri, gli indirizzi IP del Prefisso 192.73.128.0/18 assegnato ma non utilizzato dall’Aeronautica Militare Americana (United States Air Force); questo annuncio BGP fu accettato globalmente sino a quando non fu mostrato che l’Aeronautica Militare Americana non aveva autorizzato ad utilizzare i propri indirizzi IP una sconosciuta azienda Ucraina sospettata di gestire reti e servizi criminali.

Prime misure di sicurezza

La prima misura di sicurezza pratica applicabile agli annunci BGP consiste nell’applicare dei filtri (Rif. 1). Il primo tipo di filtri è quello che va genericamente sotto il nome di “Bogon Filtering”[1] ovvero filtri di rotte invalide. La comunità degli operatori mantiene delle liste basate principalmente sui documenti ufficiali di IANA e delle RIR di AS e Prefissi non allocati e che quindi non devono comparire in alcun annuncio BGP (Rif. 2). Sta però a chi configura e mantiene i router BGP applicare filtri agli annunci sia ricevuti che inviati ai Peer per impedire che questi AS e Prefissi compaiano nella tavola di Routing dei propri router e che vengano inviati ai Peer. Configurando in questo modo i propri router BGP, un AS impedisce che annunci e traffico invalido possano transitare sulle proprie reti.

Il secondo tipo di filtri su AS e Prefissi è invece specifico per ogni Peer. Infatti a seconda del tipo di accordo contrattuale in essere con un Peer, è norma di sicurezza, anche per il rispetto delle clausole contrattuali, configurare dei filtri che accettino e inviino solo gli annunci previsti dagli accordi. Ad esempio si consideri il caso di un’organizzazione con proprio AS che ha come Peer alcuni Internet Provider e Carrier che le forniscono accesso ad Internet. L’organizzazione configura sui propri router BGP dei filtri sugli annunci inviati ai fornitori che permettono l’invio solo del proprio AS e dei propri Prefissi. In questo modo l’organizzazione impedisce di diventare un nodo di transito del traffico tra i fornitori. L’organizzazione può poi mettere dei filtri sugli annunci che riceve in modo ad esempio di utilizzare un fornitore solo per il traffico in uscita verso una particolare regione geografica, e comunque sempre in accordo con gli accordi contrattuali. Specularmente i Peer dell’organizzazione configurano dei filtri BGP in modo da accettare solo gli annunci dell’AS e dei Prefissi dell’organizzazione. Questo impedisce ad esempio che anche solo per errore, l’organizzazione invii annunci di AS e Prefissi non propri e che diventi un nodo di transito di traffico verso altre AS. Infine i Peer possono configurare filtri sugli annunci che inviano all’organizzazione basati sugli accordi contrattuali in essere.[2]

Un altro tipo di filtro, da applicare non agli annunci BGP ma al traffico stesso, è quello sugli indirizzi IP sorgenti di ogni pacchetto IP. Il routing BGP considera solo gli indirizzi di destinazione ed il problema di consegnare al corretto destinatario i pacchetti IP. Molti attacchi in rete, in particolare di Denial of Service, sfruttano però la possibilità di inviare un pacchetto IP indicando un indirizzo sorgente diverso da quello reale. L’effetto è che chi riceve il pacchetto IP non  sa chi è il vero mittente e nel caso invia il pacchetto IP di risposta ad un altro sistema. Questo meccanismo è stato spesso utilizzato per attacchi di Distributed (Reflected and Amplified) Denial of Service, in cui moltissimi sistemi attaccanti inviano contemporaneamente richieste a servizi quali DNS o NTP indicando come sorgente lo stesso indirizzo IP, che viene quindi subissato dalle risposte. Per contrastare questo attacco, si può applicare sui router il “Ingress Filtering” (Rif. 3) ma solo quando si conoscono esattamente i Prefissi IP da cui proviene il traffico. Tipicamente questo è il caso descritto precedentemente di un’organizzazione che si connette a Internet tramite alcuni Peer: visto che i Peer ricevono da una certa connessione solo il traffico originato dall’organizzazione, possono inserire filtri sugli indirizzi IP sorgenti per limitarli a quelli dei Prefissi annunciati dall’organizzazione. In generale però, quando un AS od un Peering è di transito, ovvero scambia qualunque traffico IP, non è possibile filtrare gli indirizzi IP sorgenti, se non eliminando i Prefissi Bogon, che comunque non sono raggiungibili. È importante notare che nel routing BGP il percorso di andata di un pacchetto può essere diverso dal percorso di ritorno, pertanto anche i filtri su “reverse-path”, ovvero che il pacchetto di ritorno segua la stessa strada di quello d’andata, vanno applicati con cura e solo ove possibile.

I filtri appena descritti, se implementati da tutti ed in maniera completa, avrebbero impedito molti degli incidenti descritti precedentemente.

È anche possibile mettere in sicurezza la comunicazione BGP tra due Peer. Benché il protocollo BGP originale non lo prevedesse, un’estensione di BGP-4 permette di garantire l’integrità dei pacchetti scambiati tra i due Peer aggiungendo ad ognuno di essi un HMAC (“Hash-based Message Authentication Code”), ovvero un codice d’impronta del pacchetto BGP basato su di una chiave segreta condivisa tra i due router (Rif. 4).

Un’altra soluzione è quella di stabilire un tunnel IPSEC tra i due router BGP e instradare il traffico BGP attraverso questo tunnel. Visto che le informazioni scambiate sono comunque pubbliche, non è tipicamente necessario che siano cifrate a protezione della confidenzialità, quindi possono essere utilizzati tunnel IPSEC AH invece di IPSEC ESP. Questa soluzione è ormai disponibile nella maggior parte dei router in quanto IPSEC vi è in buona parte implementato in Hardware con circuiti dedicati. Al contempo però va valutato se la presenza di un tunnel IPSEC può comportare maggiori rischi di instabilità degli annunci. Infatti in caso di caduta del tunnel IPSEC tutti gli annunci ricevuti dal Peer vengono cancellati ed il traffico con il Peer bloccato, anche se il problema sia da addebitare al tunnel IPSEC e non alla linea tra i due router.
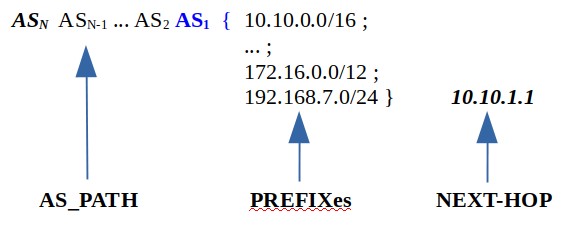
Fig. 1. Principali informazioni presenti in un annuncio BGP

Ulteriori problemi di sicurezza di BGP-4

Le misure di sicurezza appena descritte aiutano, ma non risolvono i problemi di sicurezza di BGP-4.
Sempre facendo riferimento alla Fig. 1, è possibile identificare le seguenti due principali problematiche di sicurezza:

  1. garantire e dare la possibilità di verifica che AS1 sia autorizzato ad annunciare i Prefissi indicati;
  2. garantire e dare la possibilità di verifica che la AS_PATH non sia stata manipolata.

Il primo è principalmente un problema di autenticazione chiamato anche Origin Authentication (“OA”), mentre il secondo si può accostare a un problema di integrità, anche se non completamente.

Sin dagli anni ’90 sono state proposte e studiate molte possibili soluzioni per queste problematiche di sicurezza di BGP-4. Queste proposte possono essere organizzate in tre categorie:

a) nuovi protocolli di Routing che sostituiscono completamente BGP-4;
b) nuove versioni di BGP che estendono il protocollo includendo anche le necessarie misure di sicurezza;
c) protocolli paralleli ma indipendenti da BGP-4 e che possono essere facilmente integrati con questo;

per una rassegna, si veda ad esempio Rif. 5, in particolare la tabella II.

La quasi totalità delle soluzioni proposte prevede l’utilizzo di algoritmi crittografici principalmente per firmare gli annunci e/o i dati relativi agli annunci BGP.  Ben poche però di queste proposte hanno avuto anche un minimo successo. Negli ultimi anni, due proposte sono state sviluppate ed ora sono in fase di valutazione e possibile adozione: BGPSec (Rif. 6) e RPKI (Rif. 7).

BGPSec e RPKI

BGPSec è una nuova versione di BGP-4 che si propone di affrontare il problema dell’integrità di AS_PATH. L’idea di base del protocollo è quella di firmare digitalmente ogni “annuncio” sostituendo la AS_PATH con una BGPSEC_PATH che contiene sia i dati dell’AS_PATH ma anche il numero di AS a cui l’annuncio è inviato e la firma digitale dell’annuncio. In questo modo non solo l’annuncio è firmato, ma ogni annuncio è specifico tra due Peer. Un router BGP che riceve un annuncio firmato deve recuperare usando RPKI, discusso di seguito, le chiavi pubbliche di tutti i router delle AS presenti in un BGPSEC_PATH e verificare tutte le firme presenti. Allo stesso tempo, un router BGP che invia annunci BGPSec deve firmare singolarmente ogni annuncio inviato ad ogni Peer. E’ chiaro che BGPSec richiede molte più risorse di BGP-4 ma non è chiaro quanto questo sia compatibile con l’hardware attuale dei router BGP. Inoltre l’utilizzo di BGPSec è opzionale rispetto a BGP-4, per cui se un router BGP nella rotta non supporta BGPSec, da quel punto in avanti non saranno più presenti le firme digitali ma solo la AS_PATH tradizionale.

Si può porre la situazione di ricevere da due Peer distinti per lo stesso Prefisso una AS_PATH BGP-4 e una BGPSEC_PATH, come deve procedere il router BGP nella scelta dell’annuncio? Deve scegliere BGPSEC_PATH solo perché firmato digitalmente anche se la rotta non sarebbe conveniente rispetto a tutti gli altri parametri di scelta ed alla propria  “Politica di Routing”? Va anche considerato che la firma digitale degli annunci, anche se fosse implementata da tutti i router BGP, non coprirebbe tutti gli scenari di attacco discussi: ad esempio annunci dovuti ad errori involontari di configurazione o ad intrusioni nei router BGP e perfino ad azioni volontarie, sarebbero comunque firmati digitalmente. Non è chiaro quindi se e come il fatto di firmare digitalmente a catena gli annunci BGP possa fornire il livello di integrità e “assurance” in grado di contrastare efficacemente le problematiche di sicurezza relative alla gestione delle AS_PATH. Vi sono parecchie voci discordi sull’adozione di BGPSec, e nel prossimo futuro vedremo se avrà fortuna o farà parte delle tante soluzioni proposte ma non adottate.

Nel frattempo in assenza di BGPSec, si può monitorare, anche attraverso servizi pubblici quali BGP Route Servers e Looking Glass Servers, lo stato degli “annunci” e delle AS_PATH ed implementare tecniche di baselining, analytics e visualizzazione per identificare modifiche e possibili anomalie sulle quali poi nel caso intervenire anche manualmente.

Se BGPSec è una proposta formalmente del 2017 anche se basata su idee già avanzate anche 20 anni prima, RPKI, ovvero “Resource Public Key Infrastructure” ha una storia ancora più lunga e culminata nella sua formalizzazione nel 2012/2013.

Prima di RPKI è necessario partire da quello che comunemente è chiamato WHOIS. La necessità di creare una base dati di assegnatari di AS e Prefissi, nomi ed indirizzi, risale ai primi anni ’70 in ARPANET, prima ancora di Internet, ed una delle prime formalizzazioni è in Rif. 8. Sono stati creati quindi degli archivi che permettono di raccogliere in modo più o meno strutturato, tra l’altro, le informazioni sull’assegnazione di AS, Prefissi, nomi a dominio ecc. Queste basi dati sono oggi chiamate “Internet Routing Registries” (IRR), sono gestite da varie organizzazioni e le principali sono in carico alle RIR (e LIR), mentre una famosa base dati che risale ai primi anni ’90 è Merit RADb (https://www.radb.net/). È procedura comune di molti Internet Provider e Carrier di permettere un Peering BGP solo se i corrispondenti dati di AS e Prefissi sono presenti nelle basi dati IRR / Whois. Ma oltre ai problemi di Privacy e conformità al GDPR, che non sono qui discussi, molte di queste basi dati contengono informazioni non aggiornate ed in alcuni casi del tutto errate. In generale queste basi dati sono di difficile manutenzione in quanto spesso la responsabilità di gestione è destrutturata e assegnata diversamente a seconda della nazione in cui opera chi mantiene la base dati. È opinione comune che queste basi dati siano sì utili ma solo a livello informativo, più o meno come un elenco telefonico non troppo aggiornato di cui ci si può fidare sino ad un certo punto. Ad esempio, nel 2014 il “Expert Working Group on gTLD Directory Services” di ICANN (Rif. 9) ha caldamente suggerito di rimuovere del tutto i servizi IRR / Whois perché ritenuti inaffidabili, e di sostituirli completamente con nuovi servizi di registrazione. Malgrado ciò, ancora oggi le informazioni presenti nelle basi dati IRR / Whois sono utilizzate quotidianamente anche per validare gli annunci BGP-4.

Nel frattempo però, a partire dal 2013, è stata introdotta la  “Resource Public Key Infrastructure” (RPKI). Questa è una forma di PKI simile a quella a cui siamo ben abituati dalle Certification Authorities (CA) e dai certificati della navigazione Web. Invece di CA, la RPKI è basata su Trust Anchors (TA) che sono state individuate nelle cinque RIR. Ogni RIR genera i propri certificati X.509 “Trust” (ovvero “root”) con i quali firma altri certificati, inclusi in caso quelli delle LIR, e le “Route Origination Authorizations” (ROAs). Un ROA è un documento firmato digitalmente che attesta che un AS è autorizzato ad annunciare un Prefisso con una massima lunghezza in bit: ad esempio AS1 può annunciare 10.1.0.0/16 con lunghezza massima /22. Quindi AS1 può annunciare 10.1.0.0/16 o 10.1.64.0/18 ma non 10.1.9.0/24. Ogni certificato ed ogni ROA ha una definita validità temporale, entro il quale deve essere nel caso rinnovato.

Le RIR hanno anche implementato delle basi dati pubbliche che contengono tutti i certificati pubblici necessari per verificare le firme, e tutti i ROA di competenza di quella RIR. Per verificare che gli annunci dei Prefissi siano corretti e autorizzati, un operatore BGP tipicamente allestisce dei server RPKI che interrogano le basi dati dei RIR, scaricano i certificati ed i ROA e verificano le firme svolgendo così la parte più onerosa dei calcoli. Le versioni più recenti dei router BGP di tutti i vendor permettono di interrogare server RPKI per verificare l’autorizzazione di un AS ad annunciare un prefisso. Il protocollo RPKI prevede solo tre possibili risposte alla domanda “AS1 è autorizzato ad annunciare il Prefisso X ?”:

  1. valido: è stato trovato un ROA con firma valida che autorizza AS1 all’annuncio del Prefisso;
  2. non valido: è stato trovato un ROA per il Prefisso con firma valida ma per un altro AS, oppure l’AS è corretto ma la lunghezza del Prefisso supera il massimo previsto nel ROA;
  3. sconosciuto: tutti gli altri casi, in particolare quando per il Prefisso non è stato trovato alcun ROA valido.

Si noti che vi è almeno un caso di difficile gestione: ritornando all’esempio precedente si supponga che AS1 annunci 10.1.0.0/16, con risultato Valido, e AS2 annunci 10.1.9.0/24, con risultato Sconosciuto in quanto non c’è un ROA valido per 10.1.9.0/24. Il router BGP deve accettare l’annuncio 10.1.9.0/24? In realtà no, in quanto il ROA di 10.1.0.0/16 ha lunghezza massima /22 ed assumendo che non vi siano altri ROA per 10.1.0.0/16 con altre AS, questo annuncio non dovrebbe essere accettato. Questo però è lasciato alla “Politica di Routing” decisa dall’operatore ed alle relative configurazioni dei router BGP.

Sinora abbiamo silentemente assunto che un Prefisso possa essere annunciato solo da un AS. In realtà questo non è vero in quanto più AS possono annunciare lo stesso prefisso e questo capita in particolare per grandi fornitori di connettività e servizi Internet (si veda ad esempio Rif. 10 per alcune statistiche sui Prefissi annunciati da più AS). L’esempio precedente, anche se come caso limite, può essere pertanto riformulato in maniera più generale: come bisogna comportarsi se un Prefisso ed un suo sotto-Prefisso sono annunciati da due AS uno con RPKI Valido e uno con RPKI Sconosciuto? Come prima, la risposta è lasciata alla “Politica di Routing” decisa dall’operatore.

La fig. 2 mostra il livello di adozione attuale di RPKI, quasi il 20% di Prefissi è autorizzato tramite un ROA mentre l’80% circa dei Prefissi non è descritto da alcun ROA. L’adozione di RPKI comunque prosegue, ad esempio nel corso del 2019 il numero di Prefissi descritti da ROA è aumentato di almeno il 50%.
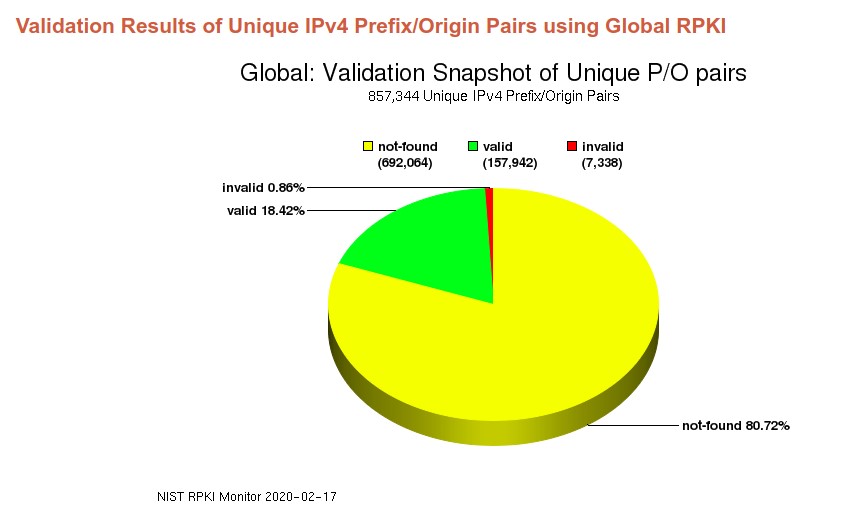
Fig. 2 Statistica sull’adozione di RPKI IPv4 al 17 febbraio 2020 [sorgente NIST https://rpki-monitor.antd.nist.gov/]

Se le recenti statistiche saranno confermate, sembra quindi che RPKI sarà adottato nel prossimo futuro da un numero sufficiente di operatori BGP da poter coprire la grande maggioranza di Prefissi. Questo porterà sicuramente a migliorare l’autenticità degli annunci dei Prefissi, riducendo di molto le possibilità di attacchi di BGP Hijacking.

Note

[1] Anche chiamato “Martian Filtering” ovvero filtri di rotte al più valide su Marte, denominazione valida sinché l’uomo non arriverà su Marte.

[2] Tipicamente un fornitore di traffico Internet, in assenza di specifici accordi contrattuali, invia tutti gli annunci BGP al cliente finale in modo che questi possa bilanciare il proprio traffico tra i vari fornitori.

Riferimenti bibliografici

Rif. 1: RFC-7454 “BGP Operations and Security”

Rif. 2: si veda ad esempio https://www.team-cymru.com/bogon-reference.html

Rif. 3: RFC-2827 “Network Ingress Filtering: Defeating Denial of Service Attacks which employ IP Source Address Spoofing”

Rif. 4: RFC-5925 “The TCP Authentication Option”

Rif. 5: K.Butler, T.Farley, P.McDaniel, and J.Rexford “A Survey of BGP Security Issues and Solutions”, 2008, https://www.cs.princeton.edu/~jrex/papers/bgp-security08.pdf

Rif. 6: RFC-8205 “BGPsec Protocol Specification”, 2017/09

Rif. 7: RFC-6480 “An Infrastructure to Support Secure Internet Routing” 2012/02

Rif. 8: RFC-920 “NAME/FINGER”

Rif. 9: ICANN “Final Report from the Expert Working Group on gTLD Directory Services: A Next-Generation Registration Directory Service (RDS)”, https://www.icann.org/en/system/files/files/final-report-06jun14-en.pdf , 6 June 2014

Rif. 10: Hurricane Electrics “Multi Origin Route Report” https://bgp.he.net/report/multi-origin-routes

Articolo a cura di Andrea Pasquinucci 

Download PDF

https://www.ictsecuritymagazine.com/articoli/aspetti-di-sicurezza-di-bgp-e-routing-in-internet-parte-ii/

Aspetti di sicurezza di BGP e Routing in Internet – parte I

Lo straordinario successo di Internet, ovvero della rete globale di comunicazione che ormai viene usata dalla maggioranza degli abitanti del nostro pianeta Terra, è dovuto ed è possibile fondamentalmente grazie a due protocolli che permettono all’infrastruttura di telecomunicazioni di funzionare egregiamente: il “Domain Name System (DNS)”, di cui abbiamo scritto nel maggio 2019, e il “Border Gateway Protocol (BGP)” ovvero il protocollo di Routing dei pacchetti IP.

Entrambi i protocolli risalgono agli anni ’80 (Rif. 1), sono evoluti nel tempo e hanno dimostrato una incredibile resilienza, scalabilità e capacità di supportare la disponibilità del servizio. D’altra parte funzionalità specifiche per garantire l’integrità e l’autenticità dei dati[1] non sono state previste inizialmente e col tempo è risultato difficile includerle. Se per DNS è in corso l’implementazione di DNSSEC (si vedano gli articoli di maggio 2019), in questo articolo si considerano gli aspetti di sicurezza del Routing in Internet, ovvero del protocollo BGP-4 (Rif. 3) attualmente in uso.

Routing in Internet

Prima di descrivere minacce, vulnerabilità e rischi, è necessario un breve ripasso di cosa sia Routing IP in Internet. Il protocollo IP (Internet Protocol, Rif. 2) assegna a ogni dispositivo connesso alla rete Internet un indirizzo numerico IPv4[2], di 32 bit tipicamente scritto con 4 ottetti come 192.168.222.1, o IPv6, di 64 bit. Per semplicità in questo articolo si considerano solo gli indirizzi IPv4 ma quanto discusso si applica in generale anche agli indirizzi IPv6, seppur nel caso con qualche modifica.

Scopo primario del protocollo IP è di permettere a un pacchetto di dati inviato da un elaboratore di raggiungere un altro elaboratore di cui sia noto l’indirizzo IP. Visto che la rete IP si estende su tutta la superficie terreste[3], il problema che il Routing, in questo caso BGP-4, risolve è quello di individuare il percorso nelle reti di trasporto di dati digitali per raggiungere l’indirizzo di destinazione. Figuratamente la situazione è simile a quella di una rete autostradale (i cavi di trasporto dati) sulla quale transitano vetture (i pacchetti dati) e gli svincoli tra due o più autostrade (i router). Come agli svincoli autostradali sono presenti i cartelli di segnalazione per indicare su quale autostrada proseguire per raggiungere una destinazione, nei router è presente una “tabella di Routing” che indica su quale cavo/rete inviare un pacchetto perché giunga a destinazione. Il protocollo BGP-4 ha come compito quello di gestire la “tabella di Routing” di ogni router IP in Internet[4].

Si incontrano immediatamente due difficoltà pratiche:

  • il numero di Prefissi, ovvero di “cartelli stradali”, che ogni ruoter IP che ha una tabella di Routing completa deve mantenere, oggi supera 800.000;
  • le tabelle di Routing sono molto dinamiche, gli aggiornamenti sono continui e molto frequenti, tipicamente nell’ordine dei minuti.

Questo si comprende facilmente visto che una tabella completa di Routing contiene le indicazioni su come raggiungere ogni indirizzo IP pubblico, in qualunque parte della Terra. Le modifiche della tabella sono dovute non solo all’attivazione o rimozione di indirizzi IP, ma anche al cambio di percorso per l’attivazione o spegnimento di percorsi dati, ad esempio cavi sottomarini, collegamenti satellitari o anche solo collegamenti tra due Internet Provider.

Indirizzi IP e Routing

È necessario approfondire un poco la gestione degli indirizzi IP e il funzionamento del Routing BGP-4 anche per quanto sarà discusso più avanti.

Gli indirizzi IP sono gestiti a livello globale dalla IANA (Internet Assigned Numbers Authority) che assegna blocchi di indirizzi IP alle cinque RIR (Regional Internet Registries): APNIC, LACNIC, ARIN, AFRINIC, RIPE. Ognuna delle cinque RIR ha competenza solo su di una zona geografica (Rif. 4), ad esempio il RIPE su Europa e Asia del Nord e Ovest. Le RIR a loro volta assegnano blocchi di indirizzi IP ai LIR (Local Internet Register) che tipicamente sono Internet Provider, Carrier ma anche grandi organizzazioni e università. A loro volta le LIR allocano blocchi di indirizzi IP ai propri clienti finali. Un’organizzazione che vuole connettersi a Internet con indirizzi IP esplicitamente a lei assegnati, deve per prima cosa ottenere dalla propria LIR uno (o più per organizzazioni molto grandi o distribuite a livello mondiale) numero di AS (Autonomous System). Gli indirizzi IP possono essere assegnati solo ad un AS che è stato assegnato a sua volta a un’organizzazione.

Gli indirizzi IP sono assegnati in blocchi ed ogni blocco è descritto dal proprio Prefisso. Il Prefisso sono le cifre più significative (a sinistra) comuni a tutti gli indirizzi IP del blocco. Ogni Prefisso ha una lunghezza indicata con /nn ove nn è la lunghezza in bit del Prefisso. Ad esempio il blocco di indirizzi IP con inizio [5] 10.10.0.0 e fine 10.10.255.255 ha Prefisso 10.10.0.0/16.

Visto che gli indirizzi IP sono assegnati solo a AS e solo in blocchi identificati da Prefissi, è logico che una tabella BGP contenga Prefissi e AS.

BGP-4 prevede la presenza, almeno logica, di tre tipi di tabelle: per comodità in questo articolo sarà chiamata  “tabella BGP” (o “Adj-RIB-In”) una tabella logica in cui un router raccoglie tutti i dati di Routing BGP che ha ricevuto e che possono essere utili; con “tabella di Routing” (o Loc-RIB, Local-Routing-Information-Base) è indicata la tabella con solo le informazioni utilizzate dal router stesso per il Routing dei pachetti IP in ogni istante; e infine con tabella “Update BGP” (o “Adj-RIB-Out”) una tabella logica con le informazioni di routing da inviare ai propri Peer.
La procedura di compilazione di queste tabelle è in linea di principio non troppo difficile anche se richiede alcuni passaggi.

  1. Accordi tra organizzazioni

Potrà sembrare strano, ma il primo passo è un accordo, tipicamente commerciale, tra organizzazioni che intendono scambiarsi traffico dati su Internet tramite il protocollo IP. Questo accordo disciplina eventuali costi, tipo e quantità di traffico e anche quali router BGP dell’AS di una organizzazione scambiano “annunci”, ovvero i dati necessari a compilare le tabelle BGP, di Routing e di Update, con quali router BGP dell’altra organizzazione.

  1. “Peering” BGP

Una volta definito l’accordo tra le organizzazioni, è possibile configurare un collegamento dati detto “Peering” tra i router BPG delle due AS allo scopo di scambiare “annunci” BGP ed i loro aggiornamenti (modifiche, cancellazioni ecc.). Un annuncio BGP contiene molte informazioni, ma per gli scopi di questo articolo ci limitiamo solo a quelle principali descritte in Fig. 1.

Fig. 1. Principali informazioni presenti in un annuncio BGP

Quando un AS (AS1) invia i propri indirizzi IP ad un’altra AS con cui ha un peering BGP, invia i Prefissi (vedi Fig.1), prepende (anche più di una volta) il proprio numero di AS (AS1) e postpone l’indirizzo IP (Next-Hop) verso il quale il Peer deve inviare il traffico per raggiungere i Prefissi. Il router BGP dell’AS ricevente deve validare il numero di AS da cui ha ricevuto i dati e la raggiungibilità del Netx-Hop. In generale ogni volta che un router BGP riceve un annuncio da un’altra AS, verifica che all’annuncio sia stato preposto il numero dell’AS da cui lo ha ricevuto. In questo modo, mentre l’annuncio transita da AS ad AS, si forma la AS_PATH, ovvero il cammino tra le AS che l’annuncio ha fatto per arrivare al router BGP in cui è presente. Si noti che i Prefissi appartengono alla prima AS in AS_PATH (AS1 nel caso di Fig.1).

L’indirizzo IP del Next-Hop, ovvero del primo router a cui inviare i dati per raggiungere quei Prefissi, è invece un’informazione locale, può essere l’indirizzo del router BGP che gli ha inviato l’annuncio od un altro indirizzo IP dell’AS (ASN) da cui è arrivato l’annuncio e concordato tra le due AS in Peering.

Tutti gli annunci ricevuti da un router BGP dai propri Peer vengono inseriti e tenuti aggiornati nella “tabella BGP”. Si noti come i dati contenuti nella “tabella BGP” sono sempre una vista locale condivisa con i propri Peer.

  1. La “tabella di Routing”

È importante notare che nella “tabella BGP” lo stesso Prefisso può essere presente più volte, annunciato da AS diverse con AS_PATH diverse ma sempre terminanti in AS1 (ma nel caso di grandi organizzazioni con più AS, lo stesso prefisso può anche essere annunciato inizialmente da AS diverse, come sarà discusso più avanti). Un router BGP deve quindi decidere a quale dei propri Peer inviare il traffico per ognuno dei Prefissi conosciuti. I criteri di scelta sono molti, a partire dai requisiti stipulati negli accordi con i propri Peer: alcune rotte devono essere escluse (filtrate), altre  privilegiate ecc. In generale ogni AS deve decidere la propria “Politica di Routing” ed in base a questa vengono configurati i router BGP in modo da selezionare le rotte appropriate. La rotta scelta, viene quindi inserita nella “tabella di Routing” (o Loc-RIB, Local-Routing-Information-Base) ove le uniche informazioni necessarie sono il Prefisso di destinazione del pacchetto e l’indirizzo IP a cui inviarlo, ovvero il Next-Hop.

La “tabella di Routing” è però molto dinamica, si consideri il seguente esempio: il router BGP di una AS in mezzo all’AS_PATH scelta si guasta ed un aggiornamento dell’annuncio pertanto cancella la rotta dalle tabelle. Il router BGP che utilizzava quella rotta, deve scegliere una rotta alternativa per raggiungere quel Prefisso. Alla riattivazione del router BGP guasto, viene re-inserita la rotta precedente, e così via.

  1. La “tabella di Update”

Infine il router BGP invia ai propri Peer gli annunci BGP che contengono solo rotte (Prefissi) presenti nella “tabella di Routing” (altrimenti i Prefissi non sarebbero raggiungibili tramite il router BGP che invia l’annuncio) con l’AS_PATH e gli altri dati BGP presenti nella “tabella di Update”. Si noti che un router BGP non è obbligato ad inviare la propria intera “tabella di Routing” ma solo quei Prefissi concordati con il Peer negli accordi formali.

Minacce, rischi e attacchi al Routing BGP

La principale minaccia al Routing BGP è usualmente chiamata “BGP Hijacking” e consiste nella manipolazione (modifica, cancellazione, inserimento ecc.) delle informazioni (annunci) utilizzate per costruire le tabelle BGP e di Routing, o la modifica diretta delle tabelle.

Le possibili conseguenze di un attacco di BGP Hijacking possono essere raggruppate in due classi:

Denial of Service: se un Prefisso è rimosso dalla tabella di Routing od il traffico è inviato su di una rotta che non è in grado di consegnarlo al destinatario (fenomeno anche chiamato “blackholing”), effettivamente viene rimosso da Internet qualunque sistema e servizio che utilizza gli indirizzi IP in quel Prefisso. Questo è spesso accaduto per errore, ma vi sono stati alcuni casi di attacchi volontari. Tra gli episodi più famosi di questo tipo si possono citare:

  • 24 dicembre 2004: l’Internet Provider TTNet in Turchia per errore fa convergere tutto il traffico Internet verso la propria rete;
  • 7 maggio 2005: per un errore di configurazione di un Internet Provider, Google scompare da Internet per poco meno di 1 ora;
  • 24 febbraio 2008: nel tentativo di bloccare l’accesso a YouTube, il Pakistan lo rimuove completamente da Internet;
  • 5 gennaio 2017: nel tentativo di bloccare l’accesso ad alcuni siti solo per adulti, l’Iran blocca l’accesso a questi siti in tutto Internet;
  • 12 novembre 2018: per un errore di configurazione di un Internet Provider, Google scompare da Internet per poco meno di un’ora.

Ovviamente per un sito web commerciale di grande traffico lo scomparire da Internet anche per poco tempo può provocare dei danni economici ingenti.

Man in the Middle: in questo caso la manipolazione delle tabelle di Routing ha lo scopo di deviare il traffico e farlo passare attraverso reti anche nemiche. Il traffico può essere solamente letto oppure indirizzato verso siti o servizi civetta che imitano il servizio originale. Molti di questi attacchi sono stati perpetrati allo scopo di rubare monete digitali (ad esempio Bitcoin) o di attaccare siti di banche e istituti finanziari, tra questi si possono citare:

  • febbraio 2013: il traffico diretto ad alcuni siti di banche e grandi aziende di diverse nazioni è stato instradato per piccoli periodi di tempo, una vittima alla volta, attraverso una rete in Bielorussa;
  • agosto 2013: il traffico verso alcuni Prefissi principalmente americani è diretto attraverso un Internet Provider Islandese;
  • 24 aprile 2018: diversione del traffico diretto ad alcune reti Amazon allo scopo di rubare monete digitali da alcuni servizi su AWS;
  • 30 luglio 2018: il traffico mondiale dell’App Telegram viene fatto transitare attraverso l’Iran;
  • 2016-2017: forse il più famoso caso di ridirezione del traffico Internet è quello relativo al dirottamento del traffico attraverso la Cina, per lunghi periodi di tempo, anche mesi, tra gli Stati Uniti ed alcuni Prefissi in altre nazioni tra cui Italia, Canada, Corea, Giappone, Scandinavia ecc. (Rif. 5).

Se un attaccante riesce a dirottare il traffico di suo interesse attraverso una rete che controlla, oltre a leggere il contenuto dei dati scambiati (se non cifrati), può modificarli o impersonare il destinatario

Un altro interessante esempio di BGP Hijacking è stata la frode “3ve” (Rif. 6) che nel 2017 arrivò a controllare 1,5 milioni di indirizzi IP e defraudò alcune aziende di pubblicità online di circa 29 milioni di US dollari. Fornendo spesso documenti falsi, questa organizzazione criminale riuscì a far assegnare a proprie società di comodo, alcuni AS in realtà assegnati ad aziende chiuse o fallite, e Prefissi assegnati ad altre organizzazioni ma non utilizzati, ovvero non “annunciati”. Sfruttando la mancanza di controlli e di interesse dei veri assegnatari delle AS e dei Prefissi, “3ve” utilizzò questi indirizzi IP per creare traffico realistico ma falso[6] su propri siti web nei quali erano presenti le pubblicità delle aziende da frodare. Nell’arco di circa un anno, vi fu un enorme numero di visualizzazioni delle pubblicità su questi siti web che da una parte fruttò all’organizzazione criminale lauti guadagni, ma al contempo suscitò l’interesse delle aziende di pubblicità online che avviarono una investigazione che portò all’individuazione ed all’arresto di alcuni dei criminali.

Route flapping e BGP route flap damping

Uno dei problemi che può creare gravi difficoltà alla gestione delle rotte BGP, è quello dell’instabilità negli annunci. Vi possono essere molti motivi, dalla non convergenza dell’algoritmo di scelta del miglior annuncio per un certo Prefisso, al troppo traffico sul canale di comunicazione con un Peer (si ricordi che il traffico BGP è inline, non utilizza connessioni dedicate), per i quali un annuncio può essere inserito nella Tabella di Routing e poco dopo rimosso. L’alternarsi, o “flapping”, dell’annuncio di alcune rotte può rallentare il router BGP impiegando troppe risorse nel calcolo del miglior annuncio, nella modifica delle rotte, e nell’invio delle modifiche ai Peer. E la distribuzione di un “flapping” può causare nei Peer ulteriori “flapping” in una reazione a catena.

La soluzione prevista da BGP-4 è quella del “route flap damping” (Rif. 7): nel caso in cui un annuncio vari troppo frequentemente, il router deve sospenderlo (quindi non inserirlo nella propria tabella di Routing ne inviarlo ai Peer) per un certo periodo di tempo in attesa che l’instabilità si risolva. Più è instabile la rotta e più il periodo di sospensione è lungo, sino ad un massimo di tempo dopo il quale il router prova comunque a ri-annunciare la rotta. Ma l’utilizzo stesso del “route flap damping” può in alcune situazioni causare più danni di quanti ne risolva (si vedano ad esempio le due posizioni del RIPE riportate in Rif. 8) e va quindi adottato con cautela.

Nella seconda parte di questo articolo saranno descritte in maggior dettaglio le problematiche di sicurezza di BGP-4 e le misure di sicurezza adottate e in corso di valutazione.

Note

[1] Essendo tutti dati pubblici, non si pongono problemi riguardo la riservatezza dei dati se non per quanto riguarda eventuali aspetti di Privacy, che però non sono considerati in questo articolo.

[2] Si noti che tra il 2011 e il 2019 si è esaurita l’assegnazione di indirizzi IPv4, oggi si possono richiedere nuovi indirizzi IPv6 o attendere che vengano resi liberi degli indirizzi IPv4 in uso.

[3] In realtà dal 2010 anche gli astronauti sulla Stazione Spaziale possono accedere a Internet ma indirettamente, tramite un elaboratore a terra.

[4] Questo è tecnicamente indicato con E-BGP, External BGP, mentre I-BGP, Internal BGP, descrive l’applicazione del protocollo a reti interne a un’organizzazione, o più precisamente a una AS, come viene descritto di seguito.

[5] Gli indirizzi IP mostrati in questo articolo sono del tutto casuali e tipicamente non validi in Internet ma solo come indirizzi privati locali.

[6] Gli indirizzi IP erano assegnati a server sui quali erano eseguiti dei Bot che visitavano i siti web e cliccavano sulle pubblicità.

Riferimenti bibliografici

Rif. 1: i protocolli originali sono specificati in RFC-882 e RFC-883 per DNS e RFC-1105 per BGP.

Rif. 2: RFC-791 “Internet Protocol”.

Rif. 3: RFC-4271 “A Border Gateway Protocol 4 (BGP-4)”

Rif. 4: si veda ad esempio https://en.wikipedia.org/wiki/Regional_Internet_registry per cartine e maggiori dettagli.

Rif. 5: C.C. Demchak, Y. Shavitt “China’s Maxim – Leave No Access Point Unexploited: The Hidden Story of China Telecom’s BGP Hijacking”, Military Cyber Affairs: Vol. 3, Iss. 1, Article 7, https://scholarcommons.usf.edu/mca/vol3/iss1/7/

Rif 6: Google and White Ops “The Hunt for 3ve”, https://services.google.com/fh/files/blogs/3ve_google_whiteops_whitepaper_final_nov_2018.pdf , si veda anche A. Pasquinucci “Like a Movie Plot: the 3ve Defrauding Scheme”, https://blog.ucci.it/2019/01/02/like-a-movie-plot-the-3ve-defrauding-scheme/ , e ArsTechnica “How 3ve’s BGP hijackers eluded the Internet—and made $29M”, https://arstechnica.com/information-technology/2018/12/how-3ves-bgp-hijackers-eluded-the-internet-and-made-29m/

Rif. 7: RFC-2439 “BGP Route Flap Damping”

Rif. 8: “RIPE Routing Working Group Recommendations On Route-flap Damping” https://www.ripe.net/publications/docs/ripe-378 e https://www.ripe.net/publications/docs/ripe-580

Articolo a cura di Andrea Pasquinucci 

Download PDF

https://www.ictsecuritymagazine.com/articoli/aspetti-di-sicurezza-di-bgp-e-routing-in-internet-parte-i/


I risvolti penalistici delle criptovalute

Molto si è detto in tema di criptovalute e soprattutto di blockchain: dal suo funzionamento all’utilizzo in campi quali sicurezza e cybercrime ma anche privacy, copyright e democrazia.

Nella presente sede, invece, ci si concentrerà sui rischi di reato che possono correre vari soggetti che, a diverso titolo, si interfacciano con i Bitcoin o con altre forme di cryptocurrency (basate sulla blockchain o meno).

Il mondo del fintech – la tecnologia applicata alla finanza – sta difatti ponendo sempre più attenzione al fenomeno delle criptovalute e, conseguentemente, cresce il rischio di criminalizzazione e di commissione di condotte illecite che possono portare alla responsabilità degli operatori.

Innanzitutto, è opportuno accennare alle definizioni di valuta virtuale che sono state recepite nel nostro ordinamento. La Banca d’Italia, con comunicazione del 30 gennaio 2015, ha definito le criptovalute come “rappresentazioni digitali di valore non emesse da una banca centrale o da un’autorità pubblica. Esse non sono necessariamente collegate a una valuta avente corso legale, ma sono utilizzate come mezzo di scambio o detenute a scopo di investimento e possono essere trasferite, archiviate e negoziate elettronicamente.. Le VV non sono moneta legale e non devono essere confuse con la moneta elettronica” (https://www.bancaditalia.it/pubblicazioni/bollettino-vigilanza/2015-01/20150130_II15.pdf).[1]

Il D.Lgs. 125/2019, attuativo della V Direttiva UE Antiriciclaggio, ha invece dettato una prima definizione legislativa di valuta virtuale, intesa come “la rappresentazione digitale di valore, non emessa né garantita da una banca centrale o da un’autorità pubblica, non necessariamente collegata a una valuta avente corso legale, utilizzata come mezzo di scambio per l’acquisto di beni e servizi o per finalità di investimento e trasferita, archiviata e negoziata elettronicamente”; non viene, però, considerata alla stregua di una “moneta”: essendo priva del potere liberatorio, un creditore potrà sempre rifiutare di ricevere un pagamento in criptovalute.

Venendo ai rischi, in ragione della caratteristica di “pseudo anonimato” dei Bitcoin e dei suoi consimili (che sostanzialmente impedisce l’identificazione dei soggetti e la tracciabilità delle operazioni sottostanti), si è posta innanzitutto l’attenzione sulle possibili attività di riciclaggio[2], autoriciclaggio[3] e impiego di denaro, beni o altre utilità di provenienza illecita[4].

Trattasi di reati, previsti dal nostro codice penale, che aggrediscono le condotte successive alla commissione di un reato e che sono commesse da coloro che intendono reinvestirne i profitti in attività lecite (portando così a una distorsione del mercato).

Non è certo questa la sede per trattare le distinzioni tra le tre fattispecie delittuose, ma quello che qui rileva è il possibile utilizzo di virtual currencies nell’attività di reimpiego di capitali frutto di reato.

Più in generale, bisogna accennare al concetto di cyberlaundering, fenomeno più ampio rispetto al riciclaggio compiuto attraverso le criptovalute e consistente nell’insieme di attività illecite poste in essere col fine di “ripulire” i proventi delittuosi, ricorrendo a sistemi “cibernetici”. Nell’ambito di tale manifestazione criminosa si può, a questo punto, tratteggiare la differenza tra “riciclaggio digitale strumentale” e “riciclaggio digitale integrale”. Mentre nel primo caso la rete viene utilizzata per porre in essere le operazioni di laundering, che si svolgono secondo il classico schema, nel secondo, invece, tutte le fasi di riciclaggio avvengono attraverso transazioni online in forma anonima e fuori da un penetrante controllo delle autorità statali.

Al fine di scongiurare, o quantomeno ridurre, i sopracitati rischi, con la IV e la V Direttiva UE Antiriciclaggio, recepite rispettivamente con il D.Lgs. 90/2017 e con il già citato D.Lgs. 125/2019, sono stati previsti specifici obblighi nei confronti dell’exchanger (cambiavalute di Bitcoin et similia, definiti come “ogni persona fisica o giuridica che fornisce a terzi, a titolo professionale, anche online, servizi funzionali all’utilizzo, allo scambio, alla conservazione di valuta virtuale e alla loro conversione da, ovvero in, valute aventi corso legale o in rappresentazioni digitali di valore, ivi comprese quelle convertibili in altre valute virtuali nonché i servizi di emissione, offerta, trasferimento e compensazione e ogni altro servizio funzionale all’acquisizione, alla negoziazione o all’intermediazione nello scambio delle medesime valute”, art. 1, c.2, lett. ff, D.Lgs. 231/2007) e del wallet provider (gestori di portafogli virtuali, definiti come “ogni persona fisica o giuridica che fornisce, a terzi, a titolo professionale, anche online, servizi di salvaguardia di chiavi crittografiche private per conto dei propri clienti, al fine di detenere, memorizzare e trasferire valute virtuali”, art. 1, c.2, lett. ff-bis), entrambi inseriti nella categoria “altri operatori non finanziari”.

Tali soggetti, pertanto, sono oggi tenuti all’adempimento degli obblighi di adeguata verifica della clientela, tra i quali l’identificazione del cliente e del titolare effettivo (artt. 17 ss. D.Lgs. 231/2007), alla conservazione dei documenti, dei dati e delle informazioni raccolte (artt. 31 ss.), nonché alla segnalazione di operazione sospetta alla Unità di Informazione Finanziaria per l’Italia (UIF).

A prescindere da un effettivo concorso nelle attività di riciclaggio, pertanto, exchanger e wallet provider incomberanno in una specifica responsabilità penale anche solo in caso di violazione dei predetti obblighi (art. 55) senza considerare il rischio di integrare le fattispecie di abusivismo bancario e finanziario, per omissione degli adempimenti di comunicazione e iscrizione (anche se non è ancora stato emesso il decreto del MEF che dovrà istituire la sezione speciale del registro dei cambiavalute virtuali).

In conclusione, bisogna evidenziare come vi sia la possibilità – seppur più marginale rispetto alle ipotesi di riciclaggio lato sensu – di commettere altre tipologie di condotte illecite mediante l’utilizzo delle criptovalute, quali estorsioni (art. 629 c.p.) tramite ransomware (con pagamento del riscatto in Bitcoin), danneggiamento o accesso abusivo al sistema informatico (rispettivamente artt. 635 bis e 615 ter c.p.), nonché alcuni reati tributari (per esempio dichiarazione infedele od omessa dichiarazione dei redditi ex artt. 4 e 5 D.Lgs. 74/2000).

A parte l’estorsione, inoltre, tutte le condotte illecite che possono essere poste in essere con le cryptocurrencies, costituiscono anche reati presupposto della responsabilità delle persone giuridiche. Ciò significa che, oltre all’autore del delitto, anche la società che ne ha tratto un profitto o un vantaggio sarà sottoposta a invasive sanzioni (pecuniarie, interdittive…), salvo che non abbia adottato ed efficacemente attuato un adeguato modello di organizzazione e di gestione.

Note

[1] Si segnala anche che lo scorso 2 gennaio Consob ha pubblicato un interessante documento sul tema, intitolato “Le offerte iniziali e gli scambi di cripto-attività“: http://www.consob.it/documents/46180/46181/doc_disc_20190319.pdf/12117302-78b0-4e6e-80c4-d3af7db0fdae

[2] Art. 648 bis c.p. “Fuori dei casi di concorso nel reato, chiunque sostituisce o trasferisce denaro, beni o altre utilità provenienti da delitto non colposo, ovvero compie in relazione ad essi altre operazioni, in modo da ostacolare l’identificazione della loro provenienza delittuosa, è punito con la reclusione da quattro a dodici anni e con la multa da euro 5.000 a euro 25.000 (…)”.

[3] Art. 648 ter.1 c.p. “Si applica la pena della reclusione da due a otto anni e della multa da euro 5.000 a euro 25.000 a chiunque, avendo commesso o concorso a commettere un delitto non colposo, impiega, sostituisce, trasferisce, in attività economiche, finanziarie, imprenditoriali o speculative, il denaro, i beni o le altre utilità provenienti dalla commissione di tale delitto, in modo da ostacolare concretamente l’identificazione della loro provenienza delittuosa (…)”.

[4] Art. 648 ter c.p. “Chiunque, fuori dei casi di concorso nel reato e dei casi previsti dagli articoli 648 e 648bis, impiega in attività economiche o finanziarie denaro, beni o altre utilità provenienti da delitto, è punito con la reclusione da quattro a dodici anni e con la multa da euro 5.000 a euro 25.000 (…)”.

Suggerimenti bibliografici

  • AMATO M.-FANTACCI L., Per un pugno di bitcoin, Milano, 2016;
  • ESPOSITO E., Antiriciclaggio e Criptovalute, 2019;
  • LUCEV R.-BONCOMPAGNI F., Criptovalute e profili di rischio penale nella attività degli exchanger, in Giurisprudenza Penale Web, 2018, 3 (http://www.giurisprudenzapenale.com/2018/03/01/criptovalute-profili-rischio-penale-nella-attivita-degli-exchanger/);
  • PICOTTI L., Profili penali del cyberlaundering: le nuove tecniche di riciclaggio, in trim. dir. pen. econ., n. 3-4, 2018
  • SIMONCINI E., Il cyberlaundering: la nuova frontiera del riciclaggio, in Riv. trim. dir. pen. econ., n. 4, 2015.

Articolo a cura di Lorenzo Nicolò Meazza

Lorenzo Nicolò Meazza è Avvocato penalista, titolare dell’omonimo studio legale a Milano. L’area di attività prevalente è il diritto penale d’impresa, con attenzione a criminalità informatica, diritto penale delle nuove tecnologie e digital forensics.

Laureato con il massimo dei voti all’Università degli Studi di Pavia, si è distinto tra i migliori cinque studenti del Master in Diritto Penale dell’Impresa presso l’Università Cattolica di Milano.

È stato selezionato dall’Ordine forense di Milano e dal Pool Reati Informatici della Procura milanese tra gli avvocati esperti in diritto dell’informatica e fa parte dei legali con specifica competenza nella trattazione dei reati informatici che costituiscono uno specifico sportello.

Presidente di un Organismo di Vigilanza ex D.Lgs. 231/2001, redattore di AODV231, è stato membro della Commissione Nazionale in materia, istituita dall’Unione Camere Penali Italiane. È membro della Commissione Giustizia Penale dell’Ordine di Milano, Cultore di materie penalistiche presso l’Università Statale di Milano, Responsabile della sede milanese della Scuola Nazionale di Alta Formazione dell’Avvocato Penalista e Direttore Responsabile della rivista giuridica Giurisprudenza Penale.

Website: www.studiolegalemeazza.com

Download PDF

https://www.ictsecuritymagazine.com/articoli/i-risvolti-penalistici-delle-criptovalute/


A Case History: Exit Through the Tor

Ultimamente mi è capitato di leggere diversi slogan propagandistici di aziende (le cosiddette “mission aziendali”), cioè dichiarazioni di intenti riassunti a mo’ di slogan in due o tre righe. Questo mi ha spinto a domandarmi: quale dovrebbe essere la mission di una società di cyber sicurezza, quali le sue responsabilità?

Partiamo dal presupposto che, in una società utopica, la cyber sicurezza non avrebbe ragione d’esistere. Ciò che esisterebbe invece, è la difesa della propria individualità in quanto esseri viventi differenti gli uni dagli altri, indubbiamente alla pari sul piano di valori e diritti, ma intimamente unici. Ed è proprio questa unicità che va difesa. La nostra forza come umanità è infatti rappresentata dall’unione delle nostre diversità.
Questo concetto si scontra con l’omologazione di massa, che tende ad annientare gli aspetti di unicità del nostro essere, preferendoci individui fagocitati da una sola mente pensante. Un esempio è il cyber bullismo, un sopruso lampante di male fine a sé stesso, che tende a reprimere ciò che è diverso dal gruppo. Ed è questo, a mio modo di vedere le cose, che la cyber sicurezza dovrebbe fare: proteggere la nostra “intimità”, valorizzandola. Ma come per tutto, è l’utilizzo che si fa di un dato strumento a determinarne la sua natura buona o cattiva.

Erano circa le 19 ed ero appena sopravvissuto a una lunga riunione. Fuori dalla sala meeting due miei colleghi, assieme a un altro signore sulla cinquantina vestito elegantemente e dallo sguardo cupo, mi stavano attendendo. Il mio collega del reparto forensic1 sembrava piuttosto agitato mentre giocherellava con le chiavi dell’auto aziendale, ed il fatto che le avesse con sé già non era un buon presagio.

«Ah eccoti!» esordì il secondo collega, dedicandosi poi alle presentazioni.
Scoprii così che la persona di mezza età era un funzionario di un’agenzia governativa. Pensai che per scomodarsi a quell’ora fosse successo qualcosa di grave.
«Dovremmo andare» tagliò corto l’altro collega, indicando l’uscita.
«Andare dove?» chiesi con aria circospetta.
I miei colleghi guardarono il funzionario, attendendo che fosse lui a svelare l’arcano, ma la risposta fu solo: «Non abbiamo molto tempo».

Viaggiammo in macchina per circa un’oretta, attraversando la città in direzione di uno dei quartieri di periferia. L’alto funzionario raccontò una storia riguardo ad alcune tracce che stavano seguendo, con l’intento di smascherare una fitta rete di traffico di materiale pedopornografico, e parlò di un internet-point che numerosi soggetti tenuti sotto osservazione sembravano frequentare di recente. Certo, potevano irrompere nell’internet-point con distintivo alla mano, sequestrando ed arrestando. Ma loro volevano scavare più nel profondo, con l’obiettivo di arrivare direttamente ai server che ospitavano quel tipo di materiale. Il problema (non da poco) era che lo scambio di informazioni, almeno in parte, avveniva tramite nodi di rete Tor; la restante quantità di scambi era riservata a reti peer to peer il cui accesso avveniva esclusivamente tramite “invito”.
«E io come posso aiutarvi?» domandai.
La risposta alla mia domanda fu una tuta nera incellofanata: «Indossi questa, prego».
«È uno scherzo?»
«Nessuno scherzo, ci stiamo dirigendo all’internet-point sospetto, il proprietario è già lì. Abbiamo simulato una fuga di gas nell’edificio vicino, quindi entreremo come vigili del fuoco incaricati di fare delle verifiche in stato emergenziale. Lei avrà dai sessanta agli ottanta minuti circa, per eseguire delle analisi e recuperare più informazioni possibili. Non abbiamo avuto molto tempo per avvisarla prima, ci spiace».

Spiaceva più a me, ve lo assicuro.

PARTE I – The Onion Router: Tor

Il progetto Tor nacque nel 1997 allo scopo di proteggere le comunicazioni dei servizi segreti degli Stati Uniti. Fu portato avanti dalla DARPA e infine sdoganato al grande pubblico attraverso l’associazione no profit “The Tor Project”. Attualmente, il principale sponsor del progetto è l’organizzazione internazionale per la tutela dei diritti digitali e la libertà di parola.

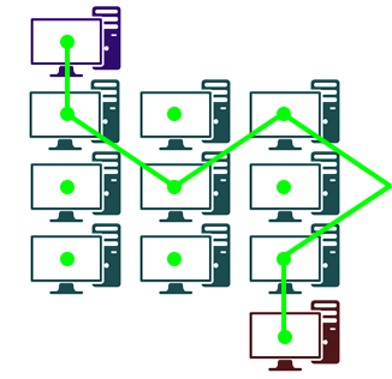
L’effettivo scopo di Tor è quello di salvaguardare l’anonimato degli utenti, preservando i dati del traffico internet da una possibile analisi. La casualità della distribuzione dei pacchetti attraverso un percorso sconosciuto, passando da router a router, stabilisce di volta in volta una comunicazione criptata e cancella le tracce ad ogni passaggio, rendendo attacchi come il man-in-the-middle  quasi impossibili.

Figura 1

La figura 1 mostra uno schema semplificato del funzionamento della rete Tor: l’informazione parte dal nostro computer –> Entra in quello che viene chiamato Entry Guard –> Attraversa successivamente n. Middle Relay(s) in maniera pseudo casuale –> Infine giunge ad un Exit Relay –> da cui il traffico esce in maniera non criptata verso il server di destinazione.

Durante il percorso all’interno della rete Tor, il traffico è completamente criptato. L’Entry Guard (o Entry Relay) conosce l’IP sorgente dell’informazione da trasmettere, ma non conosce che cosa state trasmettendo. L’Exit Relay può esclusivamente leggere il traffico in chiaro (se non è opportunamente criptato), ma non conosce chi lo ha trasmesso.

PARTE II – The Exit Node

Forse qualcuno avrà già intuito che il punto debole di questa rete è il nodo di uscita: se controllassimo l’Exit Node (Relay) potremmo leggere tutto il traffico in chiaro, se non opportunamente criptato.

La lista di “Exit Node” di Tor è in parte pubblica ed è possibile consultarla all’indirizzo:

https://check.torproject.org/cgi-bin/TorBulkExitList.py?ip=1.1.1.1

La pagina HTML che si presenta sui nodi di uscita è solitamente la seguente:

https://gitweb.torproject.org/tor.git/plain/contrib/operator-tools/tor-exit-notice.html

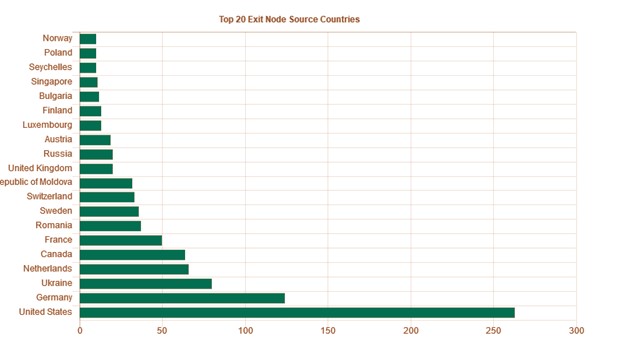
Diviene quindi possibile geolocalizzare i server d’uscita:

Figura 2

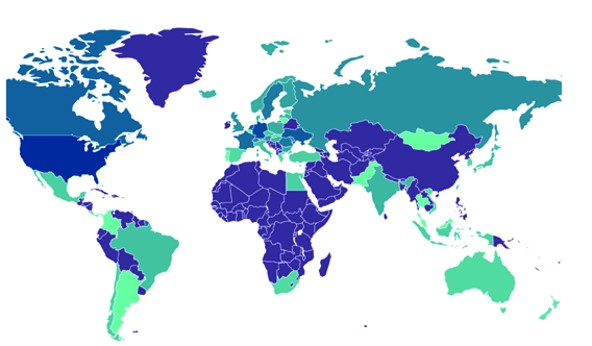
I server sono così distribuiti attraverso i continenti:

Figura 3

Lascio a voi le considerazioni derivanti dalla localizzazione della densità dei nodi.

PARTE III – Malicious Router: Install an Exit Node

Fu abbastanza semplice, una volta all’interno dell’internet-point, avere accesso ai PC. Con una versione di Windows 7 discretamente aggiornata, per resettare la password ci vollero pochi minuti[1].

Farò un esempio di ciò che successe quella notte.

Se ipotizzassimo di riuscire a controllare un nodo di uscita delle comunicazioni Tor, in teoria riusciremmo a sniffarne tutto il traffico. Quindi, la prima cosa da fare è creare un nostro Exit Node.
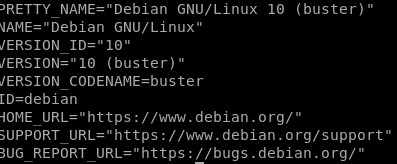
La versione di Debian che ho scelto di utilizzare per il nostro esempio è la seguente:

Potete verificare la vostra utilizzando il comando:

cat /etc/os-release

Come prima cosa è necessario installare l’ultima versione di Tor.
Non essendo supportata di default, è necessario installare l’HTTPS utilizzando il comando:

apt install apt-transport-https

Successivamente nel file sources.list (o in un nuovo file in sources.list.d) vanno aggiunti i seguenti repository:

Adesso, è necessario aggiungere la nostra “gpg key” come firma dei nostri pacchetti, utilizzando il comando:

curl https://deb.torproject.org/torproject.org/A3C4F0F979CAA22CDBA8F512EE8CBC9E886DDD89.asc | gpg --import
gpg --export A3C4F0F979CAA22CDBA8F512EE8CBC9E886DDD89 | apt-key add -

Se il comando curl non viene eseguito è necessario installarlo con un

sudo apt install curl

Non resta che aggiornare il nostro repository e la nostra key utilizzando:

apt update
apt install tor deb.torproject.org-keyring

Ultimata l’installazione possiamo procedere alla configurazione del nostro Exit node, editando il file torrc all’interno della directory /etc/tor

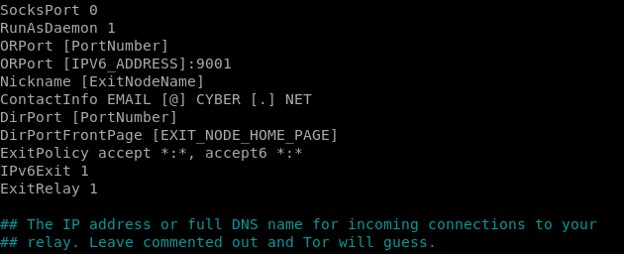
Procediamo inserendo i seguenti campi:

[PortNumber] Specifica la porta Desiderata es. 9001 / 80

[IPV6_ADDRESS] L’indirizzo IPv6

[ExitNodeName] Il nome del nostro nodo di uscita.

Sotto la voce ContactInfo potremmo specificare la nostra mail.

Come spiegavo, [EXIT_NODE_HOME_PAGE] serve per mettere la nostra pagina HTML, che segnala che questo è un nodo di Uscita.

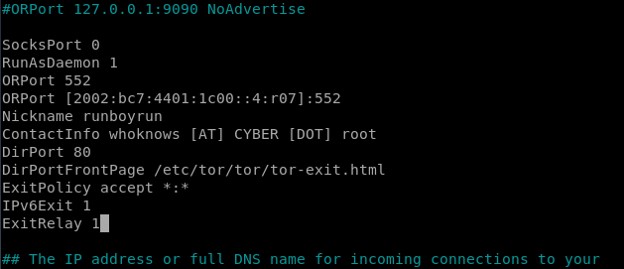
Nel caso non volessimo associare un IPv6, è necessario rimuovere i parametri IPv6, l’ ”ORPort” relativo e l’opzione “ accept6 *:*

Ad esempio:

A questo punto aggiungiamo anche l’auto start nel momento del boot della macchina:

systemctl enable tor

Lanciando il servizio:

systemctl start tor

Se l’operazione va a buon fine, il nostro Exit Node sarà visualizzabile dopo 8/24 ore a questo indirizzo: https://metrics.torproject.org/rs.html

PARTE IV – Tor Code

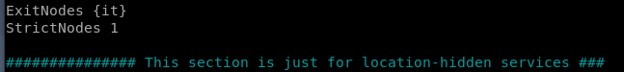
Mettiamo di voler selezionare un country specifico di uscita per il nostro browser Tor e di voler indirizzare tutto il traffico verso quell’uscita. Dovremmo procedere ancora una volta editando il torrc configuration file, ma questa volta facendolo dai client, specificando l’opzione

ExitNodes {NomedelCountry}

Quindi, se volessimo far uscire tutto il traffico Tor di un determinato client dagli Exit Node italiani ci basterebbe editare il file aggiungendo:

Oppure potremmo specificare il fingerprint di un determinato Exit Node, cercandolo attraverso:
https://metrics.torproject.org/rs.html.

ExitNodes 25.123.XX.XX

ExitNodes $fingerprint

ExitNodes 1ADBDL8C371D17190F0185D7CDA42F30A617B6A7F

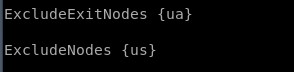
Se volessimo, potremmo anche escludere un Exit Node o tutti i nodi di un Continente, utilizzando il comando:

PARTE V – WAITING

Contestualizzando al nostro caso, potremmo dedurre che se un dato gruppo di Exit Node fosse monitorato costantemente, si riuscirebbe a sniffare buona parte del traffico in maniera relativamente semplice.

Così, quella notte, gran parte del traffico dell’Internet-Point fu forzato a convergere verso degli Exit Node fasulli. In questi nodi l’attività di rete fu monitorata ininterrottamente per circa due settimane. Questo diede alle forze dell’ordine la possibilità di accumulare le prove necessarie per il sequestro dei server e l’arresto delle differenti persone coinvolte, colpevoli di crimini contro minori.

Note

[1] Per chi fosse interessato vi rimando ad un mio articolo dove ho fatto già spiegato l’utilizzo di questa tecnica: https://www.ictsecuritymagazine.com/articoli/a-case-history-come-ho-risolto-un-sabotaggio-interno/.

[2] Fonte di esempio figure 2 & 3: Hacker-Target.

Articolo a cura di Vincenzo Digilio

Ha lavorato come Network System Administrator, Security Auditor, System Integrator, Penetration Tester per importanti client, enti governativi ed agenzie spaziali. Seguendo progetti come calcolo distribuito, security resource implementation in aree nuclearizzate, adeguamenti di security policy e Security Engineering per la selezione d’importanti fornitori al fine d’implementare sistemi di sicurezza per diverse Multinazionali. Ha tenuto corsi di tecniche Hacking, studiando in contemporanea per il corso di Laurea in Sicurezza delle reti Informatiche. È attualmente impiegato in progetti classificitati in ambito spaziale di Cyber Sicurezza; nella ricerca di vulnerabilità, sviluppo di exploit e whitebox / black box Penetration Testing. Coordina, inoltre il RedTeam della società’ Cyber Division di cui e’ uno dei fondatori. È consulente in materia di Global Security Policy Statement, Risk management e Data Breach Investigation. È intervenuto in diversi casi di compromissione dati, analisi forensi, system breach e attacchi hacking al fine di mitigare la situazione. Crede nella libertà d’informazione e nel diritto alla privacy.

Download PDF

https://www.ictsecuritymagazine.com/articoli/a-case-history-exit-through-the-tor/


Il rischio Cyber è un rischio di sistema?

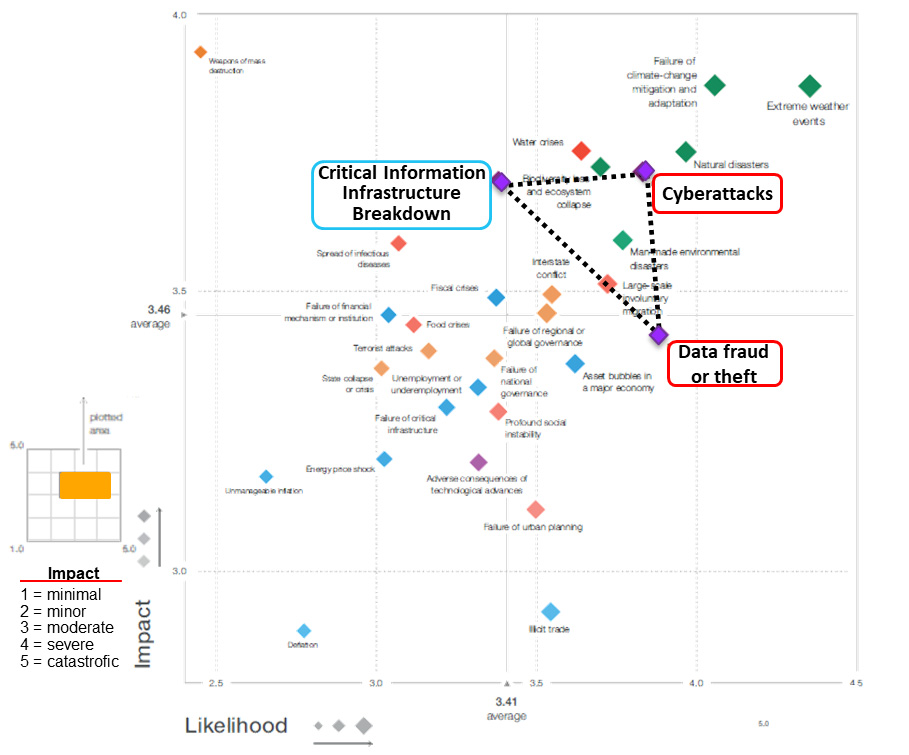
Partiamo dal solito punto, il Global Risk Landscape 2019 pubblicato dal World Economic Forum nel suo annuale Global Risk Report1. Da diversi anni, la triade dei rischi riconducibili al Cyber Risk (Critical Information Infrastructure Breakdown, Cyberattacks e Data Fraud or Theft) staziona nel quadrante in altro a destra e forse questa cosa non è del tutto sorprendente.

Quello che, invece almeno per me è sorprendente è che il percepito dei membri del panel, le cui valutazioni finiscono nel GRL, sia che i cyberattack comportino un rischio (probabilità x impatto) più elevato rispetto agli attacchi terroristici, alle crisi alimentari, alla disoccupazione e a tutta una serie di altri rischi che riempiono in ogni istante i notiziari radiotelevisivi e i social.

Vediamo perché. Il ragionamento che sta alla base di una valutazione apparentemente così starata rispetto alla comune percezione è il seguente:

  • il funzionamento delle moderne economie è sempre di più basato sulle tecnologie digitali;
  • l’interdipendenza delle Infrastrutture critiche aumenta costantemente;
  • di conseguenza, aumenta il rischio che un danno prodotto in un nodo del sistema si ripercuota sui nodi circostanti con effetti a catena potenzialmente catastrofici.

D’altra parte, anche la Direttiva NIS (dlgs 18 maggio 2018 n.65) classifica accuratamente gli attori della piattaforma digitale su cui si realizzano la gran parte delle attività economiche. Si tratta di un nucleo “centrale” di «servizi essenziali» e «servizi digitali» a cui si interconnettono una serie di HUB di servizi digitali che hanno il compito di aggregare, semplificare, vestire con funzionalità aggiuntive i servizi digitali per determinate categorie di cittadini o profili di aziende (in particolare per le microimprese e le PMI). In questa vasta rete, si stabiliscono interdipendenze: operative, logiche o anche solo geografiche di cui bisogna tenere conto quando si valuta il rischio Cyber.

Tra i “servizi essenziali”, la NIS include: Telecomunicazioni, Energia, Acqua, Banche, Finanza, Sanità, Trasporti, Infrastrutture digitali (DNS, MIX…) mentre nei “servizi digitali” ricadono i provider di Search Engine, di eCommerce e di servizi Cloud. Rimane fuori da questa classificazione la Digital Factory, una realtà emergente che chiama in causa direttamente il governo dell’altrettanto emergente realtà IoT.

L’idea che sottende alla direttiva NIS è “secure us to secure me”. Purtroppo, però, non possiamo fidarci del fatto che per garantire la sicurezza dell’intero sistema sia sufficiente che ciascun attore lavori al proprio interno per garantire la sicurezza e la resilienza delle proprie infrastrutture. La resilienza del sistema non deriva (solo) dall’adozione di regole di buon senso sul perimetro interno ma dalle caratteristiche di progettazione del sistema. Dobbiamo evitare che si creino nodi in cui la concentrazione di rischio è troppo elevata (single point of failure); ciò avviene quando elementi (che magari hanno al proprio interno un livello di ridondanza elevatissimo) non hanno un’alternativa funzionale e non possono, quindi, essere sostituiti in caso di fault/attacco.

Siamo sicuri che il rischio Cyber sia un rischio di sistema nel senso spiegato prima? Vediamo2.

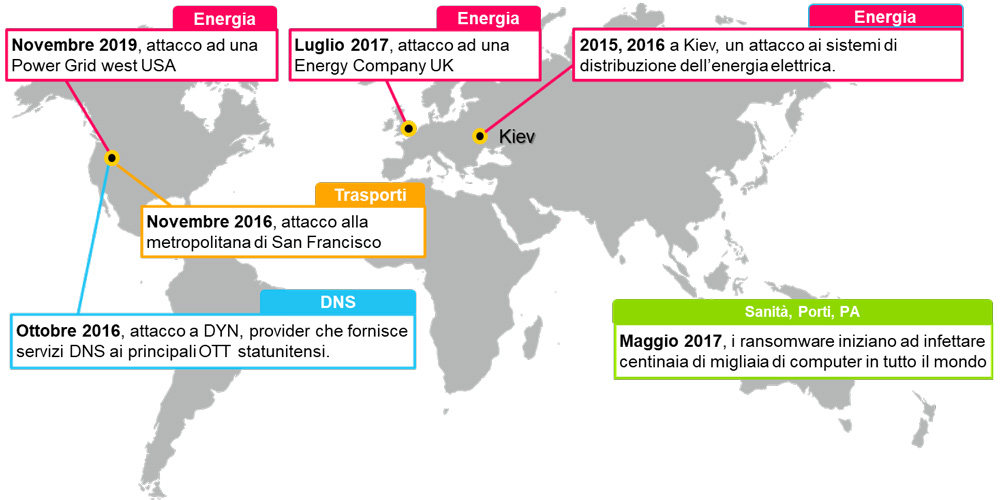
Già nel 2015 e poi il 17 dicembre 2016, a Kiev, un attacco ai sistemi di distribuzione dell’energia elettrica realizzato utilizzando un malware poi denominato “Industroyer” causa un black out che si è protratto per 75 minuti.

Il 21 ottobre 2016, un attacco DDoS (Distributed Denial of Service) a DYN (provider di servizi DNS) ha generato per 6 ore seri impatti sulla disponibilità dei servizi dei principali over-the-top statunitensi. La botnet utilizzata per l’attacco era composta da circa 10 milioni di indirizzi IP, per la maggior parte videoregistratori e videocamere “intelligenti”.  Nei fatti, si è trattato del primo significativo black out di Internet negli USA!

Il 12 maggio 2017, il virus informatico WannaCry ha infettato centinaia di migliaia di sistemi Microsoft Windows in tutto il mondo, mettendo in seria difficoltà più di 105 Paesi. Si è trattato di una vera e propria epidemia su vasta scala che ha colpito più di duecentomila computer, paralizzando aziende e organizzazioni, dal Servizio Sanitario Nazionale inglese alla compagnia telefonica spagnola Telco, passando per FedEx, Renault, Deutsche Bahn, una parte del porto di Rotterdam (Maersk) e il Ministero degli Interni russo. Tra i paesi più colpiti troviamo Spagna, UK, Olanda, Usa, Cina, Portogallo, Vietnam, Russia e Ucraina.

E ancora, nel 2017 si registrano attacchi a una Energy Company in UK e nel 2019 a una Power Grid nell’Ovest degli USA.

Ora, visto che le evidenze sembrano inconfutabili, cerchiamo di capire meglio cos’è un rischio sistemico e come si definisce3.

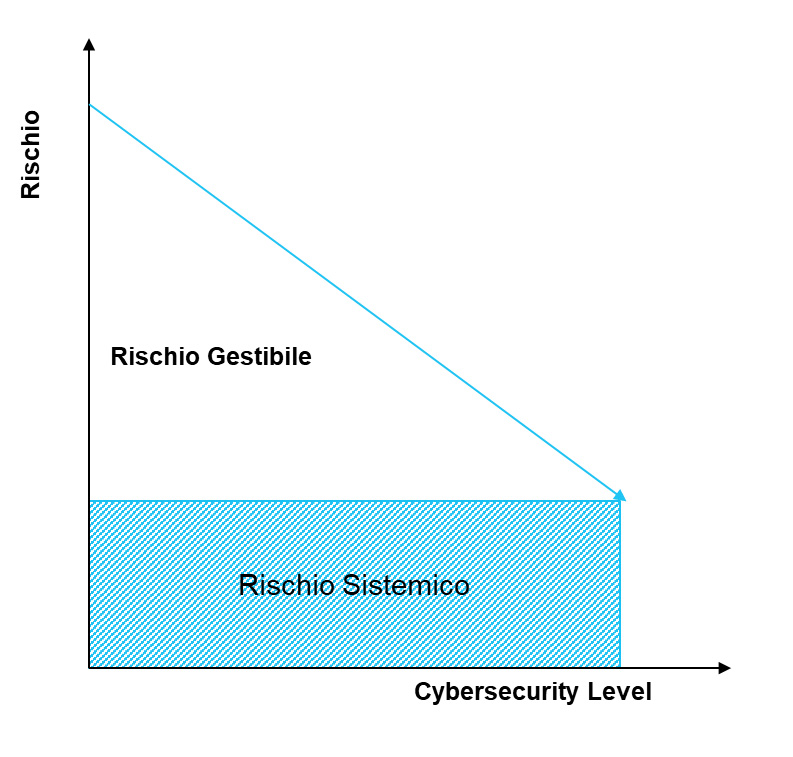
Secondo il WEF, il cyber-risk non impatta solo la singola impresa ma ha anche una importante componente sistemica che è «il rischio che un attacco (o altri eventi avversi) in un singolo componente di un ecosistema infrastrutturale critico, causi ritardi significativi, diniego, guasto, interruzione o perdita, tali da influire sui servizi non solo nella componente originaria, ma anche nelle componenti dell’ecosistema (logicamente e / o geograficamente correlate), causando significativi effetti negativi sulla salute pubblica o sulla sicurezza, sulla sicurezza economica o sulla sicurezza nazionale».

Dal punto di vista dell’impresa o istituzione, il rischio sistemico è lo stock di rischio non direttamente gestibile all’interno del proprio perimetro che deriva dal fatto di essere «immersi» in una rete di componenti (sistemi) digitali che sono fuori dal controllo del singolo nodo. Questo tipo di rischio si manifesta quando si verifica un’alta concentrazione di rischio (single Point of Failure) in un nodo della rete, un livello di correlazione tra nodi molto elevato (e spesso non conosciuto) e un’amplificazione dovuta ad un fattore esterno (shock esterno).

Per affrontare un rischio sistemico, quindi, è necessario prendere in considerazione categorie di rischio differenti e – di conseguenza – adottare strategie di gestione differenti. Fare assessment del proprio stock di rischio sistemico non ha nulla che vedere con il risk assessment che si può eseguire in relazione alla propria infrastruttura IT interna.

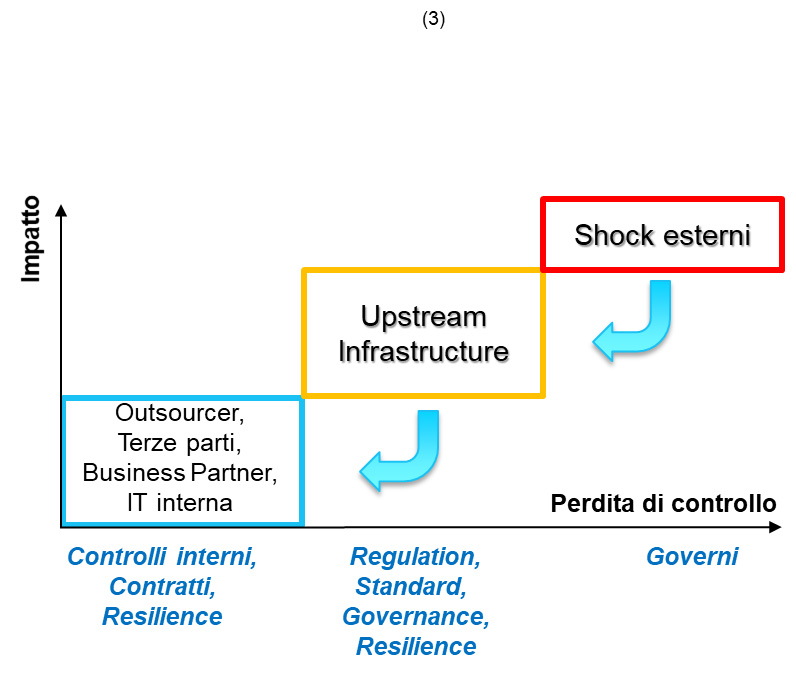
Affrontare il rischio sistemico vuol dire lavorare su tre livelli: quello interno e dell’ecosistema dei principali stakeholder dell’azienda; quello degli upstream provider e quello degli eventi esterni imprevisti.

Oggi si inizia (con non poche difficoltà) a considerare anche il rischio derivante dai rapporti con le terze parti, i business partner e gli outsourcer mentre non vengono ancora considerati a sufficienza gli scenari di rischio legati agli upstream provider (telco, energia e finanza) e agli shock esterni imprevisti, come catastrofi naturali o conflitti armati, che richiedono l’intervento dei governi.

Se sul livello interno e dell’ecosistema aziendale si può lavorare con gli assessment basati sulle best practice e sui controlli da esse suggeriti, sugli altri due livelli si può lavorare solo con l’analisi di scenario, un modo relativamente semplice per incorporare il rischio di sistema nel proprio risk assessment.

Se il rischio cyber è un rischio di sistema, allora anche la risposta deve essere di sistema. E in effetti negli ultimi anni, sia a livello nazionale che a livello comunitario, sono stati adottati una serie di provvedimenti che sono ora attesi alla sfida di “funzionare come un sistema” e non come una raccolta di provvedimenti difficili da integrare tra di loro. Essi sono:

  • Direttiva NIS (dlgs 18 maggio 2018 n.65);
  • GDPR (dlgs 10 agosto 2018 n.101);
  • Cybersecurity Act (Reg. UE2019/881 del 17 aprile 2019);
  • Golden Power (dl 11 luglio 2019 n.64);
  • Perimetro Sicurezza Nazionale Cibernetica (dl 21 settembre 2019 n.105);
  • Disposizioni sull’organizzazione e il funzionamento del CSIRT Italiano (dpcm 8 agosto 2019).

Si tratta di regole, indicazioni operative, elementi di organizzazione delle istituzioni e definizione di punti di contatto che hanno come obiettivo il governo della complessità che deriva dai seguenti macro-driver:

  • la superficie digitale aumenta costantemente;
  • cresce la velocità della trasformazione digitale;
  • realizzare attacchi è semplice e poco costoso;
  • aumenta la complessità delle minacce.

Forse, bisogna fare ancora un passo in più. Le istituzioni dovrebbero un’idea di resilienza basata sui criteri di progettazione di servizi e/o business resilienti; che è cosa ben diversa dal progettare un’infrastruttura tecnologica resiliente.


Riferimenti

  1. World Economic Forum (WEF), “Global Risk Report 2019”, https://www.weforum.org/reports/the-global-risks-report-2019
  2. CSIS Center for Strategic International Studies «Significant Cyber Incidents Since 2006», https://www.csis.org/programs/technology-policy-program/significant-cyber-incidents
  3. Emanuel Kopp-Lincoln Kaffenberger, “Cyber Risk Scenarios, the Financial System, and Systemic Risk Assessment ”, Cyber Policy Initiative Working Paper Series | “Cybersecurity and the Financial System” #4, September 2019, https://carnegieendowment.org/files/Kaffenberger_Cyber_Risk_Scenarios_final1.pdf
  4. World Economic Forum (WEF), “Understanding Systemic Cyber Risk”, Global Agenda Council on Risk & Resilience, White Paper, October 2016, http://www3.weforum.org/docs/White_Paper_GAC_Cyber_Resilience_VERSION_2.pdf
  5. Atlantic Council, “Beyond Data Breaches: Global Interconnections of Cyber Risk” Zurich Insurance Group, Risk Nexus, April 2014, https://www.atlanticcouncil.org/wp-content/uploads/2014/04/Zurich_Cyber_Risk_April_2014.pdf
  6. International Telecommunication Union (ITU), “Global Cybersecurity Index (GCI) 2017,” 2017, p. 9-11,
    https://www.itu.int/dms_pub/itu-d/opb/str/D-STR-GCI.01-2017-PDF-E.pdf

Articolo a cura di Marcello Fausti

Il Dott. Marcello Fausti è attualmente responsabile della CyberSecurity del Gruppo Italiaonline.

Nei 10 anni precedenti, è stato responsabile della IT Security di TIM con responsabilità della protezione delle infrastrutture critiche; dello sviluppo e gestione dei sistemi a supporto dell’Autorità Giudiziaria; della gestione del Security Operation Center, della gestione del processo di ICT Risk Management e dello sviluppo delle contromisure di sicurezza per la gestione operativa dei piani di sicurezza. È stato, inoltre, responsabile del Security Lab di TIM. In precedenza ha lavorato nel gruppo Olivetti come direttore marketing e business development di una società di system integration attiva sul mercato dei large account e come marketing manager della divisione PA della capogruppo.

È certificato CISM, PMP, COBIT, ITIL, ISO20000.

Download PDF

https://www.ictsecuritymagazine.com/articoli/il-rischio-cyber-e-un-rischio-di-sistema/


Globalizzazione e privacy: una difficile convivenza all’interno dei siti internet, soprattutto nella gestione dei cookie

I principali provvedimenti UE del 2019 in tema di cookie e siti internet

Nel corso di quest’anno sono state molte le questioni e gli aspetti oggetto di chiarificazione sul Regolamento UE 2016/679 (GDPR) da parte delle autorità comunitarie, dei Garanti nazionali e della Corte di Giustizia.

Come garantire il corretto trattamento dati e il rispetto del GDPR nei siti internet soprattutto se collegati a pagine social e piattaforme? La corretta gestione dei cookie è uno dei principali problemi della gestione del dato nei siti web. L’origine del problema è che la tematica è disciplinata dalla direttiva e-privacy (direttiva comunitaria 2009/136/CE, che ha modificato la direttiva 2002/58/CE) che va però oggi armonizzata da quanto previsto nel GDPR, in attesa di un conseguente aggiornamento del testo legislativo[1].

Molte le pronunce sul tema siti web e cookie, sia sanzionatorie sia interpretative di una difficile materia.

Ecco, quindi, di seguito sintetizzate i principali provvedimenti emanati nel corso dell’anno, da cui risulta che il problema di validità del consenso e quello di stabilire la titolarità del trattamento sono i punti più delicati su cui occorre prestare molta attenzione.

Provvedimento del Garante Olandese 7 marzo 2019, Guida sull’utilizzo dei cookie nei siti web [2]

Il Garante Olandese si esprime nella guida in maniera netta rispetto ai “cookie wall”, cioè di quei banner che informano l’utente dell’utilizzo dei cookie che consentono di accedere al contenuto del sito solo a seguito dell’accettazione in toto degli stessi.

Per il Garante, sono illegittimi: l’unico modo che hanno i fruitori del sito stesso per accedere ai contenuti della pagina web è quello di accettare i cookie in questione.

L’Autorità olandese ha motivato la propria posizione ritenendo che il cookie wall non permette di ottenere validamente il consenso degli utenti. Infatti, ai sensi dell’articolo 4, n. 11) del Regolamento (UE) 2016/679, il consenso dell’interessato si definisce come “qualsiasi manifestazione di volontà libera, specifica, informata e inequivocabile dell’interessato, con la quale lo stesso manifesta il proprio assenso, mediante dichiarazione o azione positiva inequivocabile, che i dati personali che lo riguardano siano oggetto di trattamento”.

Secondo l’Autorità il problema è il requisito della “libertà del consenso”, che sarebbe pregiudicato nel caso in cui all’interessato non fosse data la possibilità di rifiutare l’installazione dei cookie, in particolare quelli di profilazione, quantomeno senza incorrere in conseguenze negative, quali l’impossibilità di utilizzare il sito.

In altri termini: il gestore del sito, nel proporre il banner, deve effettuare una distinzione tra i cookie tecnici e quelli di profilazione, dando la possibilità di accedere ai contenuti anche a coloro che dovessero rifiutare i secondi.

La posizione del Garante Olandese, peraltro è in linea con l’approccio già adottato dall’Autorità per la protezione dei dati personali austriaca (decisione del 30 novembre 2018) dove è stato sanzionata la modalità di acquisizione del consenso al “cookie di marketing” che non era realmente volontario in conformità con i principi del GDPR[3]. Lo stesso approccio si ritrova nella sentenza del Consiglio di Stato francese il 6 giugno 2018[4], il quale ha ulteriormente precisato che i cookie che hanno finalità pubblicitaria non possono essere ritenuti “strettamente necessari”, e quindi sono soggetti a consenso preventivo.

Sentenza della CGUE del 29 luglio 2019 (causa C-40/17) – Caso Fashion ID [5]

Il caso

L’associazione tedesca a tutela degli interessi dei consumatori, ha intentato causa contro Fashion ID, per avere quest’ultimo incorporato nel proprio sito web il plug-in “Mi piace” del social network Facebook, con conseguente trasmissione al server di Facebook di alcuni dati personali dei visitatori, a prescindere dalla loro interazione con tale plug-in. Per l’associazione ciò comportava una violazione della normativa sulla protezione dei dati.

In particolare, l’associazione dei consumatori ha contestato al gestore dell’e-commerce di agire quale titolare del trattamento nella raccolta e trasmissione di tali dati personali alla piattaforma social, senza fornire al visitatore preventiva idonea informativa e senza raccoglierne il consenso.

Dopo il primo grado è seguito il ricorso della Fashion ID durante il quale il Giudice Tedesco ha chiesto alla Corte di giustizia d’interpretare varie disposizioni della precedente direttiva del 1995 sulla protezione dei dati, applicabile alla causa nonostante l’entrata in vigore del GDPR.

 Il Giudizio della Corte UE

Secondo la Corte il proprietario di un sito web che incorpori un plug-in social, mantiene la titolarità del trattamento rispetto ad alcune delle operazioni effettuate tramite plug-in: la raccolta e la trasmissione dei dati personali dei visitatori al social network, ciò anche in mancanza di un effettivo accesso ai dati trasmessi.

Infatti, unicamente in relazione a tali trattamenti (e non rispetto alle operazioni successive effettuate dal social network) si individuano in capo alla società autonome finalità di trattamento, in particolare, ad esempio, la scelta di utilizzare il plug-in, ottimizzare la pubblicità dei suoi prodotti rendendoli più visibili sul social e beneficiare del vantaggio commerciale che consiste nell’aumentare la pubblicità dei suoi beni.

Interessanti sono le considerazioni della Corte in relazione alla base giuridica.

Per quanto riguarda il caso in cui la persona interessata abbia manifestato il proprio consenso, la Corte decide che il gestore di un sito Internet come la Fashion ID è tenuto a ottenere tale consenso preventivamente (soltanto) per le operazioni di cui è (cor)responsabile, vale a dire la raccolta e la trasmissione.

Per quanto riguarda i casi in cui il trattamento dei dati sia necessario alla realizzazione di un interesse legittimo (art. 6 GDPR), la Corte decide che ciascuno dei cor(responsabili) del trattamento, vale a dire il gestore del sito Internet e il fornitore del plug-in social, deve perseguire, con la raccolta e la trasmissione dei dati personali, un interesse legittimo affinché tali operazioni siano giustificate per quanto lo riguarda, il tutto conforme a quanto

Sentenza della CGUE del 1 ottobre 2019 (causa C‑673/17) – Caso Planet49 [6]

Il caso

La società Planet49 ha organizzato un gioco a premi sul sito Internet www.dein-macbook.de. Gli utenti di Internet che desideravano partecipare a detto gioco dovevano fornire il loro codice postale, il che li rinviava ad una pagina web in cui dovevano inserire il loro nome e il loro indirizzo. Al di sotto dei campi da riempire per l’indirizzo si trovavano due didascalie accompagnate da caselle di spunta. La prima didascalia, la cui rispettiva casella (in prosieguo: la «prima casella di spunta») non era preselezionata, recitava come segue:

«Acconsento a ricevere informazioni per posta, per telefono, per posta elettronica o via SMS da sponsor e partner sulle offerte del loro rispettivo settore commerciale. È mia facoltà stabilire qui autonomamente i soggetti legittimati ad inviarmi dette offerte, in caso contrario la scelta spetta all’organizzatore. Posso revocare il consenso in qualsiasi momento. Ulteriori informazioni al riguardo si trovano qui».

La seconda didascalia, la cui rispettiva casella (in prosieguo: «la seconda casella di spunta») era preselezionata, recitava come segue:

«Acconsento a sottopormi al servizio di analisi web Remintrex. Di conseguenza, l’organizzatore del gioco a premi, [la Planet49], a seguito dell’approvazione della mia registrazione al gioco, installa cookie al fine di analizzare tramite Remintrex le mie navigazioni sul web e le mie visite ai siti Internet dei partner commerciali e di inviarmi pubblicità centrata sui miei interessi. Posso cancellare i cookie in ogni momento. Per ulteriori dettagli si legga qui».

Era possibile partecipare al gioco a premi solo dopo aver selezionato quanto meno la prima casella di spunta.

Il caso viene esaminato dalla Corte federale di giustizia tedesca (Bundesgerichtshof) che sottopone alla Corte di giustizia europea di chiarire se, alla luce del diritto UE, il consenso all’istallazione di cookie possa essere validamente ottenuto nei modi sopra descritti, e quali informazioni debbano essere fornite all’utente riguardo all’uso dei cookie affinché si possa ritenere che il consenso espresso sia “informato”.

Il giudizio della Corte UE

La definizione di “consenso” attualmente fornita dall’articolo 4(11) del GDPR specifica che, oltre a dover essere libero, specifico ed informato, il consenso debba tradursi in una manifestazione di volontà “inequivocabile” dell’interessato, con la quale lo stesso manifesta il proprio assenso a che i dati personali che lo riguardano siano oggetto di trattamento.

Tali definizioni di consenso si applicano anche ai fini della Direttiva ePrivacy.

Secondo la Corte Ue, in particolare il consenso dev’essere manifestato in maniera attiva.

A tal proposito, non è da considerarsi valido un consenso espresso mediante una dichiarazione preformulata che richieda all’utente di opporsi attivamente qualora non acconsentisse al trattamento dei dati.

Inoltre, la Corte ritiene che, al momento in cui gli viene richiesto di prestare il proprio consenso all’uso di cookie, l’utente debba essere informato, tra le altre cose, sulla durata dei cookie, nonché sul fatto che taluni terzi abbiano accesso o meno ai cookie stessi.

Le ultime recenti pronunce sui cookie dell’Agencia Española de Protección de Datos

La Agencia Española de Protección de Datos (di seguito, “AEPD”) ha emesso due provvedimenti sanzionatori in materia di Cookie.

  1. Il Caso Vueling[7] con una multa pari a 30.000 euro (riducibile a 18.000 euro in caso di pagamento immediato in un’unica soluzione) per non aver dato agli utenti del proprio sito web la possibilità di gestire le proprie preferenze sulle tipologie di cookie installati, ovvero di opporsi al relativo utilizzo. In particolare, il banner cookie sanzionato specifica che l’utente può accettare l’utilizzo dei cookie tecnici e di profilazione acconsentendovi espressamente, ovvero continuando nella navigazione. Sul lato destro del banner un unico button con il quale viene fornita all’utente la sola opzione di accettare i cookie, mentre non vi è alcuna menzione circa la possibilità di opporsi.
    Tale banner, uguale a quello della maggior parte dei siti italiani, non va bene.
    Il Garante privacy spagnolo, in particolare, ha rilevato che la compagnia aerea dovrebbe dotarsi di un sistema di gestione o un pannello di configurazione dei cookie che permetta all’utente non solo di accettarne/rifiutarne l’utilizzo, bensì anche di scegliere la tipologia di cookie che desidera vengano installati sul proprio dispositivo, manifestando in tal modo un consenso “granulare”, finalizzato alla gestione delle proprie preferenze.
  2. Recentemente, infine, l’Agenzia Spagnola ha imposto una sanzione di 10.000 euro a Ikea Spagna per violazioni sui cookie. Infatti, in seguito a un reclamo, l’Autorità ha scoperto che ogni volta che un utente accedeva al sito, venivano scaricati in automatico 23 cookie, per i quali non veniva richiesto il consenso dell’utente[8].

Note

[1] Sul tema interessante è quanto previsto da “Opinion 5/2019 on the interplay between the ePrivacy Directive and the GDPR, in particular regarding the competence, tasks and powers of data protection authorities” dell’European Data Protection Board https://edpb.europa.eu/our-work-tools/our-documents/stanovisko-vyboru-cl-64/opinion-52019-interplay-between-eprivacy_it. L’Opinione – stimolata da una richiesta dell’Autorità belga – cerca di stabilire quando un trattamento di dati ricada sia sotto l’ambito applicativo del GDPR sia sotto quello della Direttiva ePrivacy.
L’EDPB ritiene che le autorità sono competenti per far rispettare il GDPR. Il semplice fatto che un sottoinsieme del trattamento rientri nell’ambito della direttiva ePrivacy, non limita la competenza delle autorità di protezione dei dati ai sensi del GDPR.
Una violazione del GDPR può allo stesso tempo costituire una violazione delle regole nazionali di ePrivacy e le autorità nazionali possono tenerne conto nell’applicare il GDPR (ad esempio, quando valutano la conformità ai principi di legalità o correttezza).

[2] https://autoriteitpersoonsgegevens.nl/nl/nieuws/websites-moeten-toegankelijk-blijven-bij-weigeren-tracking-cookies

[3] https://www.ris.bka.gv.at/Dokumente/Dsk/DSBT_20181130_DSB_D122_931_0003_DSB_2018_00/DSBT_20181130_DSB_D122_931_0003_DSB_2018_00.html

[4] http://www.conseil-etat.fr/fr/arianeweb/CE/decision/2018-06-06/412589

[5] http://curia.europa.eu/juris/document/document.jsf?text=&docid=216555&pageIndex=0&doclang=it&mode=lst&dir=&occ=first&part=1&cid=7768314

[6] http://curia.europa.eu/juris/document/document.jsf?text&docid=218462&pageIndex=0&doclang=IT&mode=req&dir&occ=first&part=1&cid=1996312

[7] https://www.aepd.es/resoluciones/PS-00300-2019_ORI.pdf?utm_source=POLITICO.EU&utm_campaign=fc1f5e664f-EMAIL_CAMPAIGN_2019_10_17_04_52&utm_medium=email&utm_term=0_10959edeb5-fc1f5e664f-190359285

[8] https://www.aepd.es/resoluciones/PS-00127-2019_ORI.pdf?fbclid=IwAR2mblxGgPuevoeVPD598tpwjSgR9Gc9CPocpeoaj4w-bRGWm0ROs9EpwyM

Articolo a cura di Alessandra Delli Ponti

L’Avvocato Alessandra Delli Ponti (www.avvocatodelliponti.it ) è Of counsel dello Studio Legale Stefanelli&Stefanelli (www.studiolegalestefanelli.it), con cui collabora dal 1999.

Ha maturato esperienza pluriennale in materia di privacy e diritto delle nuove tecnologie e lavora principalmente con imprese e professionisti.

Nel 2016 ha conseguito il diploma di Data Protection officer ottenendo la Certificazione del Personale Schema CDP – Privacy Officer e Consulente della Privacy, presso TÜV Italia srl.

Ha competenza nell’implementazione di sistemi di gestione e, in particolare, costruzione di Modelli Organizzativi di prevenzione e gestione dei rischi reato ai sensi del D.L.gs. 231/2001.

E’ membro di diversi Organismi di Vigilanza (Odv) e possiede la qualifica per l’iscrizione con Audiotor 231 all’Albo SICEV.

Download PDF

https://www.ictsecuritymagazine.com/articoli/globalizzazione-e-privacy-una-difficile-convivenza-allinterno-dei-siti-internet-soprattutto-nella-gestione-dei-cookie/


Juice Jacking: facciamo il punto sugli attacchi agli smartphone via USB

Ognuno di noi può avere l’esigenza di ricaricare il proprio smartphone, in particolar modo quando si è in viaggio o fuori casa. L’attacco informatico denominato Juice Jacking consiste nella possibilità, da parte di un attaccante, d’iniettare sul dispositivo un malware o di carpire i dati in esso memorizzati tramite i servizi di ricarica USB pubblici sempre più diffusi in stazioni, aeroporti o hotel.

Questa tipologia di attacco – non molto conosciuta e tanto meno percepita come una potenziale minaccia – è tornata a far notizia nell’ultimo periodo a seguito di un comunicato in merito, rilasciato dal procuratore distrettuale di Los Angeles [1].

Tuttavia, c’è da precisare che non siamo di fronte a una novità. Già in passato in occasione delle conferenze DEF CON 2011 [2] e Black Hat 2013 [3] sono state presentate delle dimostrazioni di fattibilità.

Di cosa si tratta

Una caratteristica accomuna tutti gli smartphone (Android, iPhone): il cavo utilizzato per ricaricare la batteria del proprio telefonino è lo stesso che si usa per trasferire e sincronizzare i dati. È proprio questo dualismo (dati/alimentazione) può essere sfruttato come vettore per ottenere l’accesso durante un processo di ricarica. Anche se il juice jacking è una minaccia in gran parte teorica, e le probabilità che le porte di ricarica di una stazione USB possano essere compromesse con relativa facilità sono molto basse, questo non deve assolutamente fare abbassare la guardia ma, piuttosto, ogni volta che colleghiamo il nostro smartphone o tablet con un device sconosciuto dobbiamo essere consapevoli dei potenziali rischi di sicurezza. Ricordiamoci che il connettore USB in dotazione al caricabatterie di ogni cellulare non è un semplice cavo di corrente ma dispone solitamente di 4 pin, due usati per la ricarica (1, 4) e due per trasferire solo dati (2,3).

Possibili scenari

Qualora la stazione di ricarica che si sta adoperando sia realmente compromessa, esistono due possibili scenari una volta collegato il nostro dispositivo: un furto di dati o l’iniezione di malware. Gli smartphone sono dei veri propri archivi di informazioni sensibili e private e il movente che può spingere un cyber criminale ad attuare uno di questi scenari d’evento è, molto probabilmente, vendere i dati sul darkweb oppure riutilizzarli in successive campagne di phishing.

L’attacco può avvenire in modo automatizzato se lo stesso pc del chiosco, adoperato solitamente per l’elaborazione delle statistiche d’uso, è stato violato con il rilascio di applicazioni malevole per la sincronizzazione verso un altro dispositivo mobile. E questa eventualità non è per niente trascurabile se si pensa che i sistemi di queste stazioni potrebbero non essere aggiornati e a causa di vulnerabilità non risolte rappresentare essi stessi dei potenziali vettori d’infezioni.

Esistono diverse tipologie di malware che i criminali informatici potrebbero installare per questi scopi:

  • Il cryptominer allo scopo di sfruttare il processore di un telefono cellulare per generare criptovaluta inficiando le prestazioni delle batterie;
  • il ransomware allo scopo di prendere in ostaggio i dispositivi crittografandone i file per il riscatto;
  • lo spyware [4] allo scopo di monitorare a lungo termine ed in background conversazioni, messaggi e quant’altro;
  • il Trojan allo scopo di ottenere gli accessi per l’installazione di altri malware.

Come difendersi

Il principio alla base del juice jacking è sfruttare disattenzione, fretta, bisogno e scarsa consapevolezza. Va comunque notato che questa tecnica, utilizzata non solo tramite le prese elettriche USB ma anche con la compromissione degli stessi jack usb [5] o delle connessioni HDMI (mirroring dello schermo su altro dispositivo [6]), a fronte delle poche segnalazioni registrate, non sembra essere particolarmente diffusa anche se praticamente fattibile. Dal 2011, anno in cui si è parlato per la prima volta di questa minaccia alla sicurezza, fino ad oggi i principali produttori di sistemi operativi per smartphone hanno sanato le principali vulnerabilità, mitigando di fatto il rischio oggettivo. Ciò non toglie, però, che tale rischio possa essere ulteriormente calmierato seguendo delle best practices.

Le buone regole andrebbero applicate sempre e con qualsiasi dispositivo. È ormai assodato che ogni nostro spostamento e comportamento possa essere, a vario titolo, monitorato, analizzato e usato in rete; figuriamoci allora cosa possiamo aspettarci a opera di malintenzionati, anche con l’ausilio del juice jacking.

Ecco allora alcuni consigli utili da seguire:

  • evitare di caricare il telefono usando un sistema di terze parti;
  • portare sempre con sé il caricabatterie in dotazione o una power bank;
  • evitare di collegare a un chiosco USB il proprio smartphone anche se preventivamente bloccato o spento, perché questi tipi di accorgimenti possono funzionare solo per alcuni modelli di telefonini, soprattutto adesso che le batterie sono integrate con il device e non possono essere rimosse, lasciando di fatto il circuito USB sempre alimentato;
  • considerare l’utilizzo di soluzioni di protezione hardware aggiuntive:
    – un USB Data Blocker, adattatore USB che inibisce il traffico dati;
    – cavi USB di sola ricarica, privi dei pin per la trasmissione dati.

Note

[1] http://da.lacounty.gov/about/inside-LADA/juice-jacking-criminals-use-public-usb-chargers-steal-data-ff

[2] https://krebsonsecurity.com/2011/08/beware-of-juice-jacking/

[3] https://www.youtube.com/watch?v=EWTo8cg0wQM, Mactans: Injecting Malware into iOS Devices via Malicious Chargers

[4] https://www.cybersecurity360.it/nuove-minacce/spyware-cosa-sono-come-si-diffondono-e-come-eliminarli/

[5] https://mg.lol/blog/omg-cable/

[6] https://youtu.be/PiZkBH8KjEo, iPhone Video Jacking

Sitografia

Articolo a cura di Salvatore Lombardo

Salvatore Lombardo è laureato in Ingegneria Elettronica orientamento Telematico. Ha frequentato un Master in Information and Communication Technologies – Internet Software Engineering.

Da oltre dieci anni svolge l’attività di funzionario informatico presso la Pubblica Amministrazione, curando in particolare la sicurezza informatica e l’amministrazione di rete.

In qualità di esperto ICT, iscritto all’albo dei docenti della ex Scuola Superiore dell’Amministrazione dell’Interno, ha tenuto vari corsi di formazione e aggiornamento per il personale.

È autore del libro La Gestione della Cyber Security nella Pubblica Amministrazione.

Download PDF

https://www.ictsecuritymagazine.com/articoli/juice-jacking-facciamo-il-punto-sugli-attacchi-agli-smartphone-via-usb/


Anche la stampa nella privacy by design

Partiamo dagli eventi sfavorevoli

Esistono eventi sfavorevoli difficili da intercettare. Low and slow è un tipico esempio di approccio d’attacco che amano i malintenzionati più furbi: “ti rubo denaro poco alla volta (low) e una volta ogni sei mesi (slow), così tu non te ne accorgi”. Oppure quando qualcuno se ne accorge, è passato troppo tempo e la violazione, ormai, ha colpito centinaia di migliaia di persone e ha causato molti danni.

Esistono, tuttavia, eventi ancora più subdoli che, peraltro, non sono neanche legati ad attacchi di malintenzionati. Parliamo di malfunzionamenti del software che producono in stampa[1] un documento dai contenuti diversi da quelli presenti nel sistema informativo e, comunque, differenti da quelle che erano le intenzioni del soggetto che detiene e tratta i dati personali (sia esso titolare o responsabile).

L’esempio più classico è la polizza assicurativa che, in Italia, viene fornita insieme alla Carta Internazionale di Assicurazione Veicoli a Motore (la cosiddetta Carta Verde): questo è il documento che garantisce all’estero la copertura assicurativa. Supponiamo che, per un errore di stampa, nel punto dove deve essere indicata la targa, venga riportato un carattere sbagliato; per esempio, venga riportato uno spazio bianco al posto della prima lettera. Nessun utente se ne accorgerebbe anche perché nessun utente controlla la propria Carta Verde! Tuttavia, questo errore potrebbe, in caso di controllo da parte delle forze di polizia all’estero o di sinistro, creare molte difficoltà al conducente e, in qualche caso, anche gravi compressioni dei diritti e delle libertà della persona.

Dal punto di vista del Regolamento UE 2016/679 (GDPR) questo “evento negativo” è una violazione di integrità ovvero è avvenuta (seppur in stampa) una modifica non autorizzata di un dato personale. Non è detto che sia un data breach ai sensi dell’art. 33 del GDPR: per capirlo, conviene affidarsi alle linee guida del WP 29 n. 250rev.01 riviste ed adottate il 6/2/2018[ii]. In ogni caso, è un evento negativo che, spesso, passa inosservato perché collegato a “nuove versioni” di software che “ha sempre funzionato bene”.

Insomma, la sicurezza informatica e la protezione dei dati personali deve occuparsi anche degli eventi più inattesi e, forse, più banali ma, potenzialmente, molto dannosi: le nuove release del software e le relative assicurazioni di compatibilità con l’ambiente nel quale devono operare.

La privacy by design del GDPR

Come già osservato, anche un errore nella stampa può costituire un data breach ai sensi dell’art. 33 del GDPR: deve esserci un rischio per i diritti e le libertà degli interessati. E se un referto sanitario è stampato senza un termine che il medico aveva, invece, inserito nel suo sistema di gestione delle diagnosi? Se il medico aveva scritto la frase “Senza tracce di lesioni dell’arteria…” e la stampa viene prodotta con la frase “tracce di lesioni dell’arteria…”, che succede? Quali sono le possibili conseguenze? È un data breach? Probabilmente sì: certamente c’è una violazione di integrità del dato personale ed è anche possibile che ci siano conseguenze piuttosto serie per il paziente (nel lessico del GDPR l’”interessato”). Intanto, il referto è formalmente “normale” nel senso che non presenta elementi che possano apparire strani e, quindi, generare la reazione di chi lo legge: è una frase sensata rispetto alla fattispecie refertata e, quindi, non è suscettibile di una specifica richiesta di chiarimenti.
Quindi, per esempio, a fronte di quel referto, il medico di famiglia (o un altro sanitario che dovesse leggerlo successivamente) potrebbe prescrivere un ulteriore esame invasivo (una coronografia o una risonanza) che, sulla base del “vero” contenuto del referto, non sarebbe stato necessario.

Per difendersi dai comportamenti improvvisamente “strani” del software, il GDPR mette in campo un principio determinante: la privacy by design. Ricordiamo che il primo paragrafo dell’articolo 25 prevede che:

“Tenendo conto dello stato dell’arte e dei costi di attuazione, nonché della natura, dell’ambito di applicazione, del contesto e delle finalità del trattamento, come anche dei rischi aventi probabilità e gravità diverse per i diritti e le libertà delle persone fisiche costituiti dal trattamento, sia al momento di determinare i mezzi del trattamento sia all’atto del trattamento stesso il titolare del trattamento mette in atto misure tecniche e organizzative adeguate, quali la pseudonimizzazione, volte ad attuare in modo efficace i principi di protezione dei dati, quali la minimizzazione, e a integrare nel trattamento le necessarie garanzie al fine di soddisfare i requisiti del presente regolamento e tutelare i diritti degli interessati”.

Il titolare (o il suo responsabile del trattamento), quindi, deve prevedere, preliminarmente (al momento di determinare i mezzi del trattamento) e correntemente (all’atto del trattamento stesso) meccanismi tecnici e organizzativi che riducano al massimo i rischi per gli interessati. E un meccanismo che ha caratteristiche sia tecniche sia organizzative è il test del software.
In particolare, i meccanismi correnti di testing devono garantire che le nuove release del software:

  • funzionino correttamente cioè svolgano le attività per le quali sono state progettate e realizzate;
  • non presentino vulnerabilità che possano essere sfruttate da minacce note.

A questo, sia per la versione iniziale sia per le nuove versioni del software, il produttore – che normalmente è diverso dal titolare – deve aggiungere la chiara esplicitazione degli ambienti (sistemi operativi, browser, librerie di corredo, ecc.) nell’ambito dei quali è stato testato affinché chi lo utilizza (ovvero lo stesso titolare) possa adeguare i propri apparati ai requisiti corretti.

Anche quest’ultima misura, soprattutto quando il titolare è una grande organizzazione che non ha adottato alcun meccanismo simile a un Configuration Management Database, può non essere sufficiente e richiede un’ulteriore fase di test sul campo. Pensiamo a un ospedale nel quale sono presenti decine di postazioni di lavoro che, nel tempo, possono aver assunto, per varie ragioni, configurazioni del software di base (soprattutto librerie) differenti: occorre verificare direttamente sul campo che la stampa non subisca alterazioni così lievi da non essere notate ma potenzialmente molto dannose come quelle descritte in precedenza.

E se si applicasse ITIL v3 2011?

Abbiamo accennato al Configuration Management Database (CMDB) che è uno degli elementi fondanti del framework ITIL v3 2011 (talvolta impropriamente denominato ITIL v4) e, in particolare, delle linee guida sulla Service Transition ovvero di quella fase che prepara all’introduzione in esercizio di nuovi servizi o nuove release di servizi già in uso. L’implementazione di un CMDB potrebbe essere un buon punto di partenza nell’applicare il principio di privacy by design anche se, ad essere corretti, sarebbe necessario percorrere tutti i processi previsti dalla Service Transition e, in particolare, i processi di Release and deployment management e Service testing and validation.

Questo consentirebbe di dormire sonni un po’ più tranquilli anche su possibili violazioni subdole come quelle che possono verificarsi in fase di stampa di un documento che viene consegnato all’interessato.

Oppure ISO 27001?

L’alternativa metodologica, non meno impegnativa di ITIL, per garantire una privacy fin dalla progettazione potrebbe essere quella di dotarsi di un Information Security Management System (ISMS) conforme allo standard ISO‑IEC 27001. Certamente, i puristi direbbero che non possiamo far coincidere la sicurezza informatica con la protezione dei dati personali: hanno ragione, ma la privacy ha molto da imparare dai princìpi dell’information security.

E, quindi, per introdurre qualche misura che riduca il rischio di essere colti da un data breach da “stampa tagliata”, è possibile ispirarsi ad alcuni dei controlli, tra i più sottovalutati, presenti nell’Allegato A dello standard ISO 27001:

  • A.12.1.2 Change management: ogni cambiamento nell’organizzazione riguardante i processi, i sistemi e le infrastrutture deve essere controllato;
  • A.14.2.7 Outsourced development: l’organizzazione deve supervisionare e monitorare le attività di sviluppo dei sistemi in outsourcing;
  • A.14.2.8 System security testing: durante lo sviluppo devono essere condotte specifiche attività di test riguardanti la sicurezza;
  • A.14.2.9 System acceptance testing: piani di test ed i relativi criteri di accettazione devono essere stabiliti per nuovi sistemi, upgrade e nuove versioni.

Conclusioni

Ogni realtà potrà decidere di programmare il percorso più utile e, in fondo, più proficuo rispetto ai propri obiettivi. Basta non dimenticarsi di due cose:

  • il data breach (in condominio con il diavolo) si nasconde nei dettagli;
  • non serve inventarsi nulla, è quasi già tutto scritto nei framework e negli standard internazionali.

Note

[1] Quando si parla di stampa, si intendono i formati elettronici PDF o le stampe cartacee.

[2] https://ec.europa.eu/newsroom/article29/document.cfm?action=display&doc_id=49827.

Articolo a cura di Francesco Maldera

Francesco Maldera è Data Protection Officer e Data Scientist.

Il suo percorso professionale lo ha chiamato a responsabilità direzionali nell’ambito dei sistemi informativi, della safety&security, della privacy e dell’auditing svolgendo diversi incarichi dirigenziali nella Pubblica Amministrazione e in aziende private.

Attualmente, accompagna l’attività consulenziale a quella di sensibilizzazione delle persone tramite il sito www.prontoprivacy.it

Download PDF

https://www.ictsecuritymagazine.com/articoli/anche-la-stampa-nella-privacy-by-design/


IpFire RouterFirewall-IPS

La distro Gnu/Linux Ipfire fork del progetto ipcop è una soluzione orientata per soluzioni router/firewall con una intuitiva interfaccia grafica da remoto tramite https per la gestione, l’abilitazione di servizi da attivare e da aggiungere tramite plug-in installabili.

La sicurezza informatica è la priorità centrale dietro al progetto che, migliorato da un processo di harding interno al sistema, impedisce gli attacchi mirati al suo interno. Progetto OpenSource sviluppato sotto licenza GPL, ha alle spalle un’attivissima comunità di utenti e sviluppatori che hanno creato, dietro alla distro, la soluzione alle richieste più frequenti per uso sistemistico. IpFire è un software gratuito sviluppato da una vasta comunità aperta, esso è considerato affidabile da moltissimi utenti considerata la filosofia Opensource in cui ogni persona del comparto IT può visionare il codice sorgente, integrarlo e migliorarlo per rendere il progetto più innovativo.

Rilevante è la cura per il kernel con la protezione grsec e – nelle recenti versioni – la minimizzazione dagli attacchi Meltdown e Spectre legati ai processori intel. Il sito web (ipfire.org) contiene forum e blog a servizio della comunità. IpFire applicato ad un PC con due schede di rete e una wifi può funzionare da routerFirewall, routerwifi o access point con funzioni di proxy e sistema IDS/IPS tramite l’uso di snort per bloccare attacchi mirati alla rete LAN da parte della WAN. Dal terminale del pc è possibile usare il gestore di pacchetti pakfire per installare e rimuovere software o monitorare con tools come htop, iotop o tshark.

L’installazione viene guidata da un susseguirsi di step per il settaggio della macchina dove, al termine, sarà possibile amministrare sia da riga di comando tramite root sia tramite interfaccia web https. La varietà dei menù permette il monitoraggio del traffico in uscita e entrata e le connessioni con possibilità di storage di log e intuitivi grafici a torta. Ipfire non è una soluzione solo per uso firewall ma anche come BackupPc, client torrent e server multimediale interno per lo streaming.

Il punto di riferimento della comunità è all’indirizzo web (community.ipfire.org) dove discussioni raggruppate per tool e argomento permettono di ottimizzare e rendere questo progetto OpenSource sempre più famoso. Vi è un portale italiano di appassionati per solo utenti italiani (ipfireitalia.it) dove chiedere aiuto per chi è alle prime armi nella questioni di protocolli TCP/IP.

Apprezzatissimi sono gli aggiornamenti frequenti che mantengono forte IPFire contro vulnerabilità di sicurezza e nuovi vettori di attacco. Funzionalità quali QoS, proxy web e VPN permette il filtraggio dei contenuti web consentendo solo ad alcuni utenti la navigazione, resa più veloce tramite la memorizzazione cache delle pagine web. Clamav, associato al proxy, permette di eseguire la scansione trasparente dei virus e bloccarli prima che infetti i pc windows/Macosx della lan.

Le funzioni associabili al proxy web permettono anche il controllo degli accessi e la registrazione.

L’uso della crittografia più recente per OpenVPN, IPsec e https permette di garantire connessioni sicure, sia su internet che alla postazione ipfire. Nella sezione download (ipfire.org/download/ipfire-2.23-core138) si possono scaricare le iso e flash image per le architetture più utilizzate.

Per un aiuto professionale per consulenze specifiche c’è la lightning wire labs che prevede l’assistenza per un uso business; per i restanti nerd c’è l’apposito wiki (wiki.ipfire.org).

Nella ultima release (core138) in cui scrivo questo articolo, IpFire si affretta a risolve e mitigare le vulnerabilità recentemente annunciate nei processori Intel.

Per chi volesse contribuire al progetto TOR, la comunità mette a disposizione il pacchetto installabile tramite pakfire per realizzare un punto di entrata al deepweb o anonimato per la rete lan o contribuire alla rete globale tor avviando un server Tor relay. La varietà degli strumenti messi a disposizione dalla distro permette di alzare le difese di una rete lan e utilità per il sistemista IT.

La funzione proxy cache offline associato alle blacklist (anche classificate in base alla nazione) permette di ottimizzare e risparmiare il traffico dati passante. Per chi volesse contribuire nello sviluppo del codice a questo link (wiki.ipfire.org/devel) è possibile trovare tutti i riferimenti necessari. Essendo un progetto OpenSource si sostiene con donazioni a sostegno da parte della comunità, un progetto che fin dagli inizi ha riscosso molti consensi positivi da parte di amministratori di rete ed esperti di pentest. Linux come sempre è il sistema operativo principale per chi ha sposato la filosofia opensource e free. La filosofia linux permette la modellazione del sistema operativo per gli usi più svariati, dai microcomputer ai supercomputer.

Il supporto Hardware associato al kernel linux sempre in aumento, la ricerca e sviluppo del software, la sicurezza by design e la privacy by default del progetto rende questo progetto un ottimo punto di riferimento, in ogni tipo di scenario, per proteggere da eventi di data breach.

Articolo a cura di Fabio Carletti aka Ryuw

Fabio Carletti aka Ryuw è un White Hat del gruppo (SoldierX Hacker team).

Noto ai più per questioni legate alla Sicurezza Informatica ha ottenuto importanti apprezzamenti in attività investigative per conto di Carabinieri e Polizia Postale. Dal 98 si
occupa del mondo gnu/linux come security IT evangelist. Collabora come membro nel Tor Project team e nella Linux Foundation.

Ospite di rilevanti eventi italiani riguardanti la privacy, linux/unix, hacker camp e software open source dedica le sue energie alla ricerca nella sicurezza informatica.

Download PDF

https://www.ictsecuritymagazine.com/articoli/ipfire-routerfirewall-ips/


Protezione dei dati personali: i tre aspetti critici più diffusi

L’esperienza da DPO

In questi anni di prima applicazione del Regolamento Europeo 2016/679 (GDPR) abbiamo incontrato tante realtà, analizzato tanti processi di trattamento e parlato con qualche responsabile dei sistemi informativi, quando abbiamo avuto la fortuna di collaborare con organizzazioni che ne avevano uno.

Il nostro lavoro da Responsabili della Protezione dei Dati Personali (DPO) o da consulenti di supporto al DPO interno ci ha portati a suggerire, a mente dell’art. 32 del GDPR, “misure tecniche ed organizzative adeguate per garantire un livello di sicurezza” congruo con il rischio.

Ma in che modo si individua il rischio? Come si valuta? Come si tratta? Per tutte queste attività viene in soccorso la norma ISO‑IEC 27001:2017 e, naturalmente, il primo passo, ovvero l’individuazione dei rischi, è quello che determina il successo (o l’insuccesso) delle attività successive.

L’individuazione del rischio

Nel dizionario ISO‑IEC 27000 l’identificazione del rischio è definita come il processo di “ricerca, riconoscimento e descrizione del rischio”: detto così, sembra facile! Ma, per molti aspetti, questa definizione è fin troppo generica: ci vorrebbe un metodo. Per fortuna, la definizione si arricchisce di due note:

Nota 1
“L’identificazione del rischio richiede l’individuazione delle fonti di rischio, gli eventi (accadimento o cambiamenti di un insieme di circostanze particolari), le loro cause e le loro conseguenze”.

Nota 2
“L’identificazione del rischio può richiedere dati storici, analisi teoriche, opinioni di esperti e di persone informate, richieste degli stakeholder”.

Le note, quindi, forniscono un metodo. Quello che, successivamente, lo standard 27001 spiega meglio, rispetto alla Nota 1, è che bisogna analizzare bene gli asset e comprenderne le vulnerabilità perché un’altra definizione (più circostanziata) di rischio è “la probabilità che una minaccia sfrutti una vulnerabilità per generare conseguenze negative”.

L’analisi degli asset, quindi, aiuta ad individuare le vulnerabilità e ad avviare tutto il ciclo di assessment dei rischi. Nell’analizzare le vulnerabilità conviene sempre partire da quelle più macroscopiche che, di solito, sono quelle che più facilmente possono essere sfruttate da malintenzionati o da tentativi di attacco “a strascico”. Vogliamo, quindi, focalizzare la nostra attenzione sulle vulnerabilità che si incontrano più di frequente nelle realtà italiane, pubbliche e private.

I sistemi operativi

Come sappiamo, il sistema operativo più diffuso nel mondo è Microsoft Windows (nelle sue varie versioni): la sua diffusione sfiora il 90% dell’installato. Lo è anche in Italia con una larga diffusione della versione 7 e con una residua presenza di Windows XP. Questa circostanza costituisce una delle vulnerabilità più diffuse nelle organizzazioni pubbliche e private italiane. Infatti, il supporto di Microsoft a Windows XP è terminato l’8 aprile 2014[1] (ben 5 anni fa) mentre il supporto a Windows 7 terminerà il prossimo 14 gennaio 2020[2]; volutamente trascuriamo le versioni “intermedie” di Windows ovvero Windows Vista e Windows 8.1 perchè hanno una diffusione molto meno intensa.

Per quanto riguarda Windows XP la presenza residua riguarda, perlopiù, personal computer non collegati alla rete (né interna né esterna) sui quali operano vecchi software di gestione di apparati tipicamente meccanici (apparati di controllo di sistemi frenanti nelle officine meccaniche) o di gestione di aspetti amministrativi non integrati (bollette di consegna, gestione di magazzino, ecc.). Tuttavia, non sono rari i casi nei quali i personal computer equipaggiati con XP sono collegati alla rete e, quindi, costituiscono un varco che può essere sfruttato per prendere il controllo di altri sistemi.

Più seria è la situazione che riguarda MS‑Windows 7. Intanto, esiste ancora un parco di installato importante: le ultime statistiche parlano di poco meno del 30% di personal computer che in Italia montano ancora questo sistema operativo. Nella nostra esperienza, peraltro, esistono organizzazioni, soprattutto pubbliche, che hanno una percentuale di installato anche più elevata dovuta al fatto che, di solito, gli approvvigionamenti hanno la caratteristica di essere “massivi” e, quindi, concentrati in un determinato periodo storico (quello, appunto, nel quale Windows 7 era l’ultima generazione di sistemi operativi commerciali).

Questa circostanza, associata ad una scarsa pianificazione finalizzata ad ricambio graduale in vista della deadline, porterà certamente a sforare il 14 gennaio prossimo ed a prestare il fianco ad eventuali eventi sfavorevoli che possono compromettere il funzionamento dell’intera organizzazione.

Le virtual machine

In tutte le organizzazioni, piccole o grandi, pubbliche o private, ormai la virtualizzazione dei server è una realtà molto diffusa. Esistono due circostanze che rendono questo paradigma una vulnerabilità:

  • la proliferazione delle virtual machine;
  • la scarsa attenzione a meccanismi di difesa puntati sulle singole virtual machine.

Nella maggior parte delle organizzazioni medio‑grandi le virtual machine nascono su richiesta dei fornitori esterni di software o di servizi; tuttavia, quando cambia il fornitore di un software o di un servizio (circostanza molto frequente soprattutto nelle organizzazioni pubbliche) esiste un periodo transitorio che, di solito, viene utilizzato per la migrazione dei dati. Vengono, quindi, mantenute operative una o più vecchie virtual machine – di solito almeno due, una di produzione/test, l’altra di (non-)esercizio – dedicate al vecchio software/servizio e una o più nuove virtual machine concesse al nuovo fornitore. Purtroppo, questo periodo transitorio, spesso, si prolunga a tal punto da avere come conseguenza la perdita di controllo da parte della struttura interna che si occupa di gestione del sistema informativo aziendale. Abbiamo trovato organizzazioni pubbliche medio‑grandi che ci hanno detto di avere in esercizio più di duecento virtual machine ma che stavano ancora cercando di comprendere quali di queste fossero veramente essenziali alla loro attività.

Inoltre, quando si affidano virtual machine a fornitori esterni capita che la gestione infrastrutturale (compresa la sicurezza della singola virtual machine) sia affidata ai fornitori stessi che, tuttavia, sono più interessati affinché tutto funzioni e l’utenza possa operare piuttosto che a garantire che tutti gli anelli della catena siano difesi in maniera opportuna. Quindi, esiste la possibilità che qualche virtual machine mal gestita possa costituire il buco attraverso il quale può introdursi un malintenzionato.

E a poco vale l’alibi di avere solidi sistemi di sicurezza sulla macchina ospite: la letteratura in materia è piena di descrizioni di attacchi che si propagano tra virtual machine entrando, per esempio, da ingressi principali deliberatamente consentiti dai firewall o dagli IDS/IPS posti a difesa della macchina ospite.

La gestione delle credenziali

Poche organizzazioni hanno reali meccanismi per gestire le credenziali amministrative. Questa circostanza riguarda, peraltro, vari livelli di gestione:

  • personal computer; in molte organizzazioni vengono mantenute credenziali amministrative locali con password perpetue e, di solito, convenzionali; inoltre, il relativo elenco, nelle mani della struttura di gestione del sistema informativo, non è conservato con i dovuti meccanismi di sicurezza;
  • virtual machine e DBMS; non vengono create utenze amministrative assegnate a specifici operatori (la maggior parte dei quali, come si diceva prima, dipendenti da fornitori esterni) e, quando vengono create, sono gestite senza i dovuti controlli periodici circa la perdurante necessità di mantenerle;
  • sistema operativo delle macchine ospiti o dell’hypervisor; sono credenziali, di solito, nella disponibilità del personale interno deputato alla gestione del sistema informativo aziendale ma, comunemente, non assegnate ai singoli soggetti.

Manca, in definitiva, una visione organica (e, possibilmente, sostenuta da un software sufficientemente solido) di gestione delle credenziali.

Conclusioni

Queste sono le vulnerabilità più diffuse e, se vogliamo, più facilmente identificabili anche perché già presenti nei documenti di riferimento che, per esempio, l’Agenzia per l’Italia Digitale ha divulgato ormai da qualche anno[3].

Note

[1] https://support.microsoft.com/it-it/help/14223/windows-xp-end-of-support

[2] https://support.microsoft.com/it-it/help/4057281/windows-7-support-will-end-on-january-14-2020

[3] https://www.agid.gov.it/it/sicurezza/misure-minime-sicurezza-ict

Articolo a cura di Francesco Maldera

Francesco Maldera è Data Protection Officer e Data Scientist.

Il suo percorso professionale lo ha chiamato a responsabilità direzionali nell’ambito dei sistemi informativi, della safety&security, della privacy e dell’auditing svolgendo diversi incarichi dirigenziali nella Pubblica Amministrazione e in aziende private.

Attualmente, accompagna l’attività consulenziale a quella di sensibilizzazione delle persone tramite il sito www.prontoprivacy.it

Download PDF

https://www.ictsecuritymagazine.com/articoli/protezione-dei-dati-personali-i-tre-aspetti-critici-piu-diffusi/