Una volta che la privacy è invasa, la privacy è perduta

Nell’era dei big data e dell’analisi predittiva la tutela dei dati personali – e dei dati in genere – è anche un interesse generale della società contro le capacità manipolative dei processi algoritmici e le nuove forme di sorveglianza basate sui dati.

Sempre più nuove e sofisticate forme di profilazione massiva dei comportamenti dei singoli e delle collettività, eseguite su larga scala, aventi ad oggetto non solo o non tanto i dati personali ma piuttosto i metadati e i dati inferiti1, riescono ad influenzare e ad incidere, in modo a volte occulto o subliminale, sui bisogni reali o percepiti dei singoli, dei gruppi e della società. Si potrebbe quindi ritenere che le attuali legislazioni per la tutela dei dati personali e della privacy non risultino sempre adeguate a garantire la tutela del diritto delle persone all’autodeterminazione.
Tenendo conto di tutto questo nonché del fatto che il GDPR è stato il miglior compromesso legislativo che in quel particolare momento si poteva ottenere, e che ancora non ha visto la luce il nuovo Regolamento Europeo e-Privacy, si deve ritenere di dover considerare la necessità di individuare ulteriori quadri di protezione relativi ai dati, che vadano oltre le attuali nozioni di protezione dei dati personali e della privacy, arrivando ad affrontare in modo più ampio e organico gli impatti significativi dell’uso mirato dei dati sulle società e sull’effettivo esercizio dei diritti umani2. Questo emerge anche dalla dichiarazione adottata dal Comitato dei Ministri del Consiglio di Europa sulle capacità manipolative dei processi algoritmici, in cui il Comitato richiama l’attenzione sul crescente rischio di utilizzare processi algoritmici per manipolare anche il comportamento sociale e politico.

Le discussioni in corso sull’applicazione e il rafforzamento delle leggi sulla protezione dei dati dovrebbero considerare i rischi e gli interessi particolari di tutti quei soggetti che potrebbero essere inconsapevoli dei pericoli derivanti dallo sfruttamento dei dati. Il riferimento non è rivolto solo a soggetti vulnerabili quali minori, anziani e minoranze in genere, ma deve soprattutto includere coloro che, a causa della loro ‘impronta digitale’ particolarmente ampia, sono specificatamente esposti a nuove forme di sorveglianza basate sui dati.

Sembrerebbe quindi che le normative oggi vigenti sulla protezione dei dati non risultino pienamente adeguate a poter garantire il rispetto e la tutela dei diritti fondamentali della persona e della società a causa dell’uso di tecnologie digitali avanzate. Questo con particolare riferimento al rispetto del diritto all’autodeterminazione quale sintesi del concetto di privacy3, che racchiude in sé tutti i diritti fondamentali della persona e sulla quale si concretizza la libertà della persona concepibile come lo spazio fisico e digitale nel quale ogni persona ha la facoltà di sviluppare ed esprimere la propria personalità.

Le problematiche sulla privacy legate all’autodeterminazione dell’individuo non sono questioni solo di oggi, ma le possiamo già ritrovare nelle dichiarazioni fatte nel 1952 da un giudice della Corte Suprema degli USA e rileggendole oggi, tenuto conto delle ovvie differenze tecnologiche e culturali, si può notare come tali parole possano essere ritenute attuali anche nei contesti dei giorni nostri.

Si trattava del caso 343 U.S. 451 (1952) Public Utilities Commission of District of Columbia v. Pollak e Martin4, riguardante il ricorso alla Corte Suprema di due pendolari contro la una società di trasporto pubblico per violazione della privacy a causa della diffusione di messaggi promozionali sui mezzi di trasporto pubblico.

I due pendolari persero il ricorso4 ma il giudice Douglas, che fu a favore dei ricorrenti, nella sua opinione dissenziente sostenne che:

Il caso ricade nel significato della “libertà” come intesa nel Quinto emendamento. Il ‘right to be let alone’ è infatti l’inizio di ogni libertà.
La privacy che un uomo gode nella propria casa (Quarto emendamento) viene in parte persa in luogo pubblico.  Ma anche nelle sue attività al di fuori della casa gode ancora di alcune tutele che riconducono comunque al concetto di Privacy.

Quando costringiamo le persone ad ascoltare le idee di un’altra, stiamo dando al propagandista un’arma potente.

Oggi è un’impresa commerciale che trasmette un programma radiofonico con il benestare del governo. Domani potrebbe essere un gruppo politico o religioso dominante. Oggi lo scopo è benigno e non ci sono fini nascosti.

Ma il vizio è intrinseco al sistema. Una volta che la privacy è invasa, la privacy è perduta. Una volta che un uomo è costretto a sottomettersi ad un tipo di programma radiofonico, può essere costretto a sottomettersi ad un altro. Ma potrebbe anche essere breve il passo per passare da un programma culturale a un programma politico.

La forza del nostro sistema -e dei sistemi democratici- risiede nella fiducia verso la capacità degli individui di fare la scelta più saggia. Il diritto alla privacy, oggi violato, è un potente deterrente per chiunque voglia controllare le menti degli uomini (William O. Douglas, 1952).

Le parole del giudice Douglas, riviste nell’era dei Big Data, della Data Driven Society, dell’AI e del machine learning devono portare a comprendere l’enorme importanza della tutela della data protection e della privacy. Privacy intesa come diritto all’autodeterminazione dell’individuo, quale presupposto di tutti gli altri diritti, che viene ristretto nel momento in cui, contro la propria volontà, si viene esposti a messaggi pubblicitari come nel caso Pollak.

Ma la caratteristica sostanziale della pubblicità di cui parla Douglas e della pubblicità commerciale degli anni ’80 che ha profondamente influenzato e cambiato la società di allora, è che si trattava di pubblicità riconoscibili in quanto tali. Invece gli strumenti di machine learning contemporanei hanno la crescente capacità non solo di prevedere le scelte delle persone ma anche di influenzare emozioni e pensieri e alterare un corso d’azione previsto, a volte subliminalmente. Inoltre, per le attuali società democratiche, i pericoli derivano dalla possibilità di utilizzare tali capacità per manipolare e controllare non solo le scelte economiche ma anche i comportamenti sociali e politici.

Le tecnologie basate sui dati sono una presenza sempre crescente nella vita quotidiana delle persone, ma rimane diffusamente limitata la consapevolezza della misura in cui i dispositivi tecnologici di uso quotidiano raccolgono e generano enormi quantità di dati. Questi dati vengono poi utilizzati anche per addestrare le tecnologie di apprendimento automatico per varie finalità come prevedere e modellare le preferenze personali, modificare i flussi di informazioni e, tal volta, sottoporre gli individui a sperimentazione comportamentale.

La raccolta e l’analisi di grandi quantità di dati per identificare i modelli di comportamento, ricostruire e prevedere i desideri dei singoli, dei gruppi, delle collettività e anche di interi paesi, viene poi utilizzato e veicolato in forme e modi pervasivi e non riconoscibili, che espongono gli individui ad una significativa limitazione del diritto all’autodeterminazione.

Oggi si restringe la libertà di autodeterminazione dei singoli non con i dati personali ma attraverso i metadati e l’utilizzo aggregato dei dati.

L’utilizzo di grandi analisi sui dati supera i confini della dimensione individuale e assume una dimensione collettiva della privacy e della data protection.

Il rischio è quello di orientare lo sviluppo di una coscienza sociale senza che chi viene orientato se ne renda conto: per questo è necessario arrivare a normare e definire dove poter tracciare il confine tra forme di persuasione ammissibile e manipolazione inaccettabile.

Note

  1. Dati ricavati, derivati o tratti da altri dati; un’informazione aggiunta ad altri dati o che descrive un set di dati.
  2. Dalla dichiarazione sulle capacità manipolative dei processi algoritmici adottata dal Comitato dei Ministri del Consiglio di Europa il 13 febbraio 2019, URL: https://search.coe.int/cm/pages/result_details.aspx?ObjectId=090000168092dd4b , ultima consultazione 30/10/2019
  3. Il termine Privacy è spesso impropriamente utilizzato per riferissi al diritto alla protezione dei dati personali. Il termine Privacy indica il diritto alla riservatezza che negli USA avviene per via giurisprudenziale con l’affermazione del Right to Privacy. Diritto di escludere gli altri dalla propria sfera più intima siano essi privati o pubblici poteri. Diritto di essere lasciati soli.
    In Europa si parla di protezione dei dati personali ed è un processo che avviene attraverso un riconoscimento normativo. Il diritto alla riservatezza è declinato, in alcuni Stati europei, a partire dagli anni settanta, come diritto alla tutela dei propri dati personali.
    È diventato ormai di uso comune utilizzare il termine Privacy per indicare, a seconda dei casi, sia il diritto di escludere gli altri dalla propria sfera più intima, sia come diritto alla protezione dei dati personali.
  4. 343 U.S. 451 (1952) Public Utilities Commission of District of Columbia v. Pollak e Martin, URL: https://supreme.justia.com/cases/federal/us/343/451/, ultima consultazione 30/10/2019
  5. Solo nel 1964 avviene il primo riconoscimento costituzionale del diritto alla privacy negli Stati Uniti. Sentenza Kats della Corte Suprema US; il caso riguardava la registrazione ambientale avvenuta in una cabina telefonica pubblica.

Bibliografia

De Montjoye – Yves-Alexandre, Computational Privacy: Towards Privacy-Conscientious Uses of Metadata, (2015),  URL: https://dspace.mit.edu/handle/1721.1/101850, ultima consultazione 30/10/2019

Council of Europe, Declaration by the Committee of Ministers on the manipulative capabilities of algorithmic processes (Adopted on 13 February 2019 at the 1337th meeting of the Ministers’ Deputies), URL: https://search.coe.int/cm/pages/result_details.aspx?ObjectId=090000168092dd4b, ultima consultazione 30/10/2019

Articolo a cura di Stefano Luca Tresoldi
Consulente GDPR con oltre quindici anni di esperienza professionale nel settore ICT, perfezionato in ‘Diritto della protezione dati personale per la formazione del data protection officer’ presso Dipartimento di Giurisprudenza dell’ Università degli Studi di Torino, laureato in Scienze dell’amministrazione presso UNITO.

Dal 2011 al 2015 consulente su progetti legati al PCT (Processo Civile Telematico).

Attualmente impegnato in qualità di consulente su progetti di adeguamento al GDPR.

https://www.linkedin.com/in/stefanotresoldi/

Download PDF

https://www.ictsecuritymagazine.com/articoli/una-volta-che-la-privacy-e-invasa-la-privacy-e-perduta/

La conoscenza è la soluzione alle sfide attuali della Cyber Security

Al giorno d’oggi i professionisti della cyber security devono affrontare una quantità di sfide senza precedenti e, allo stesso tempo, di opportunità. Tra queste ultime devono essere annoverate le informazioni sulle potenziali minacce e vulnerabilità che, all’interno dei sistemi di sicurezza, possono aiutare i professionisti a svolgere il proprio lavoro in maniera più efficace.

Le informazioni di sicurezza, come quelle provenienti dai Cyber Threat Hunter, permettono alle organizzazioni di prevenire e di ridurre al minimo i danni derivanti dalle violazioni ai loro sistemi?

Ogni giorno i team di sicurezza (SOC) ricevono un’enorme quantità di avvisi non correlati alle reali minacce a cui sono esposti. Da ciò consegue una serie di effetti negativi, quali: l’aumento dei costi di gestione, la perdita di produttività e la riduzione dei livelli di sicurezza.

Alcune recenti soluzioni tecnologiche riescono a fornire un valido supporto alla risoluzione di queste problematiche, perché sfruttano le potenzialità offerte dal Machine Learning e dal Data Analytics.

Come ci dimostrano le recenti statistiche sui Cyber Security Incident, questo approccio non è ancora pervenuto ai risultati attesi. L’analisi degli eventi avversi ha messo in risalto, in molti casi, una scarsa compliance tra gli elementi caratterizzanti l’organizzazione e le soluzioni di sicurezza adottate.

Per risolvere queste problematiche occorre adottare una strategia operativa, coerente con l’organizzazione, e un’infrastruttura tecnologica che siano in grado di dare un significato a tutti i dati e, di conseguenza, semplificarne l’analisi.

Pertanto i sistemi di Cyber Threat Intelligence, su cui si fondano i moderni sistemi di Cyber Security, non devono eseguire le loro analisi basandosi solo sui dati provenienti dai sistemi di apprendimento interni ed esterni – quali gli Alerts, i Behavior o i Security Feed – ma devono comprendere ed esaminare anche gli indicatori che rappresentano il contesto in cui operano.

Apprendere il contesto organizzativo

Il concetto chiave può essere sintetizzato in un solo termine: la conoscenza (o knowledge).

L’esame approfondito dei Cyber Security Incident ha evidenziato numerose organizzazioni criminali, dotate di un’elevata capacità di attacco, in grado di intraprendere una serie di azioni complesse e sofisticate per il raggiungimento dell’obiettivo, a cui corrispondete una crescente intensità degli effetti negativi.

Le minacce di Cyber Security più nefaste attaccano i target su più fronti e agiscono sfruttando tattiche complesse e strumenti eterogenei. Di conseguenza l’azione di contrasto deve, necessariamente, prevedere una capacità di Detection e Response che prenda in considerazione tutti i fattori rappresentavi dell’organizzazione stessa.

I principali componenti, che da un lato aiutano a comprendere le criticità di un’organizzazione e, dall’altro, contribuiscono ad alimentare un efficace sistema di Cyber Threat Intelligence, possono essere individuati come segue:

  • le persone: la classificazione degli attori, la descrizione dei ruoli e delle responsabilità, la consapevolezza del Cyber Risk;
  • i processi: la descrizione delle attività e delle procedure adottate, i comportamenti degli attori, le interazioni interne ed esterne, la governance;
  • la tecnologia: le caratteristiche e la mappatura delle reti e dei sistemi informatici, degli strumenti di sicurezza e degli altri apparati intelligenti;
  • le informazioni: il dizionario delle informazioni gestite, la distinzione tra dati sensibili, classificati e non, le informazioni per la gestione della sicurezza;
  • la valutazione dei rischi: l’analisi dei rischi e delle vulnerabilità, l’accettazione del rischio residuo, il risk assessment;
  • i sistemi di controllo: le policy di sicurezza, i permessi di accesso, i sistemi di autovalutazione e di audit, ecc.

Attuando un processo di Data Fusion, le predette informazioni devono essere integrate a quelle pertinenti la Cyber Security (già citate) e produrre una base informativa più coerente, accurata e utile al processo di difesa.

Adottare soluzioni basate sull’Intelligence

Le soluzioni di difesa Intelligence Driven aiutano i team ad affrontare efficacemente le nuove sfide. Queste tecnologie, che sfruttano il Machine Learning e la capacità di analisi dei Big Data, possono notevolmente favorire e velocizzare il processo di identificazione e analisi dei trend più importanti migliorando così la protezione dalle minacce reali.

Per gestire e risolvere gli attuali problemi di sicurezza le organizzazioni hanno bisogno di nuove tecnologie, come l’apprendimento automatico (ML) e l’intelligenza artificiale (AI), perché i processi di sicurezza convenzionali non possono essere ridimensionati e non sono idonei a gestire le attuali esigenze di Cyber Security.

Il Machine Learning e l’Intelligenza Artificiale facilitano le attività di:

  • analisi di tutte le informazioni che arrivano,
  • identificazione dei posti giusti in cui cercare le anomalie,
  • risposta di cui le organizzazione hanno bisogno per trovare le minacce in pochi minuti o giorni (e non settimane o mesi).

Le capacità computazionali e analitiche di un framework di Cyber Threat Intelligence permettono di identificare segnali come gli utenti più rischiosi all’interno di un’organizzazione e le potenziali minacce che questi rappresentano.

Ad esempio, sono in grado di rilevare un attacco completo ad un’organizzazione attraverso la disamina di una combinazione di dati provenienti dall’Active Directory, dal Repository degli IP Log, dai Proxy Web e dai dati dai DLP, e, di conseguenza, i team possono rapidamente visualizzare e comprendere lo stato degli utenti, dei repository, degli endpoint e del traffico di rete.

Tutto ciò consente di ottimizzare tempo, risorse e budget spesi per la fase di detection; riduce il tempo dedicato alla raccolta dei dati e concede più tempo alla comprensione di un attacco. Il team può valutare, in tempo reale, l’indice di rischio di un’entità come un utente, un file, un dispositivo client, un server, un indirizzo IP o un altro componente IT.

Se tutte queste informazioni potessero essere rappresentate in una dashboard intuitiva e interattiva, gli operatori sarebbero messi nelle condizioni di analizzare direttamente i dettagli delle caratteristiche, dei patterns di utilizzo e dei comportamenti di un’entità considerata a rischio più elevato rispetto ad altri. Il sistema d’Intelligence offre, inoltre, la possibilità di apprendere in modo dinamico i modelli di comportamento e di contesto per ciascuna entità e il modo in cui tali entità interagiscono tra loro. Il Machine Learning Analytics è in grado di distinguere facilmente le attività normali da quelle anomale. Ciò comporta una valutazione del rischio di altissima qualità e riduce i falsi positivi caratteristici di altri modelli di valutazione del rischio.

È importante sottolineare che un livello di sicurezza ottimale non dipende solo dalla distribuzione degli strumenti e dalla loro operatività. Gli operatori alla sicurezza devono lavorare a stretto contatto gli altri colleghi, per comprendere i dati e il contesto di riferimento.

Occorre, inoltre, tenere presente che ciò che rende una soluzione così efficace sono i dati. Più dati sono disponibili e meglio funziona la logica. Migliore è il funzionamento della logica e più velocemente i team possono rilevare una minaccia reale. E, infine, più velocemente sono in grado di rilevare una minaccia, più velocemente possono rispondere. Pertanto, se si utilizzassero le tecnologie basate sul Machine Learning, l’aggiunta di dati da più fonti eterogenee favorirebbe la rilevazione delle minacce.

Conclusioni

I vettori di attacco stanno diventando sempre più celati e variegati, permettendo agli utenti malevoli – come gli hacker o i criminali informatici – di non essere rilevati tramite gli strumenti tradizionali. Per comprendere realmente l’impatto di una minaccia, i team devono adottare un approccio olistico che sia in grado di valutare le informazioni da diversi punti di vista.

Gli strumenti di difesa basati su Machine Learning e Data Analytics consentono di accedere direttamente a un elenco di segnali di compromissione di ottima qualità, in modo da poter identificare rapidamente le minacce. Poiché nessun addetto alla sicurezza è in grado di superare la velocità computazionale con cui un sistema informatico può elaborare e correlare grandi quantità di dati provenienti da più fonti, questa soluzione offre una capacità di analisi con un livello di efficienza e produttività senza precedenti.

Articolo a cura di Vincenzo Calabrò

Si è laureato in Ingegneria Informatica ed in Sicurezza Informatica presso le Università di Roma La Sapienza e di Milano. Ha, altresì, conseguito i seguenti Master in Diritto, Economia e Tecnologie Informatiche, in Sicurezza Informatica ed Investigazioni Digitali, in Management & E-Governance per la Pubblica Amministrazione, in Information & Communication Technology e in Cybersecurity.

Dal 1992 ricopre, nei ruoli del Ministero dell’Interno, gli incarichi di Referente Informatico e di Funzionario alla Sicurezza CIS. In tale veste si occupa della gestione di diversi sistemi informativi, assicura la funzionalità delle connessioni telematiche esterne e contribuisce alla definizione e implementazione delle misure di sicurezza informatica. Ha, inoltre, partecipato alla progettazione e realizzazione di diverse banche dati relazionali, di applicativi gestionali, di sistemi collaborativi, di portali web e di alcune reti Lan e Wan.

Dal 2004 opera nel campo della Sicurezza Informatica dal punto di vista tecnico e giuridico. In particolare, realizza l’analisi dei sistemi e la progettazione degli interventi, la valutazione dei rischi per la riduzione delle minacce, il penetration test, la redazione dei piani di sicurezza e di protezione dei dati, lo sviluppo delle policy di sicurezza, la definizione di procedure per la gestione e la manutenzione dei sistemi, l’intervento in caso di emergenza per il contenimento dei danni.

Dal 2005 esercita, su incarico di Privati o della Procura, l’attività di Consulente Tecnico in procedimenti civile e penali, a fini legali e per utilizzo in Tribunale o in sede stragiudiziale, sui temi dell’Informatica Forense e delle Investigazioni Digitali che includono l’uso dell’ICT con particolare riferimento ai reati informatici e telematici.

Dal 2017 è Professore a contratto del corso di Tecnologie per la Sicurezza Informatica afferente al Corso di Laurea Magistrale in Ingegneria Informatica e dei sistemi per le Telecomunicazioni dell’Università degli Studi Mediterranea di Reggio Calabria.

È relatore in diversi corsi di formazione e seminari di aggiornamento professionale presso Enti della P.A., Associazioni Professionali ed Università.

È autore di alcuni articoli e saggi in tema di sicurezza informatica e investigazioni digitali.

Download PDF

https://www.ictsecuritymagazine.com/articoli/la-conoscenza-e-la-soluzione-alle-sfide-attuali-della-cyber-security/


Bitcoin, Blockchain e il ginepraio delle fonti (in)attendibili

Se c’è una cosa difficile da fare in un contesto informativo che brulica di opinioni e documenti ufficiali, è rimettere ordine e stabilire, nella gerarchia delle fonti, quali di esse possano essere considerate attendibili e quali invece non possano essere connotate come tali.

Questo assunto non può non essere valido anche – e soprattutto – rispetto a un argomento innovativo e rivoluzionario che solo in parte sembra mettere tutti d’accordo, come quello che riguarda bitcoin e la classe di protocolli Blockchain.

Guardando alla dimensione giuridica interna e d’oltralpe si evince un’esposizione concettuale piuttosto variegata, dove il fenomeno viene dipinto con contorni talvolta vaghi e altre volte fin troppo definiti.

La stessa semantica utilizzata per trattare la questione appare piuttosto variopinta: si parla di Distributed Ledger Technology (DLT) invece di Blockchain e di criptoasset piuttosto che bitcoin, quasi fossero sinonimi. Eppure, non ogni DLT è una Blockchain e non ogni criptoasset è un bitcoin. Se i gelati e i semifreddi fossero la stessa cosa, non avremmo bisogno di due termini diversi per distinguerli. La terminologia conta!

La disamina del contesto europeo, inoltre, registra alcune prese di posizione della BCE, condivise da altri Paesi nel mondo, secondo le quali bitcoin è pericoloso e andrebbe trattato come un virus da incubare e tenere sotto controllo, al contrario della Blockchain che invece è considerata portatrice sana di importanti utilità.

Ne deriva che fuorvianti convinzioni collettive indicano bitcoin e Blockchain come due entità perfettamente separabili. Ma è davvero così? No. Non esiste bitcoin senza Blockchain, e viceversa. Al massimo, quel che tecnicamente si può fare è rendere la criptovaluta trascurabile rispetto alla considerazione generale del registro distribuito.

Eppure, questo stile dicotomico risulta assai diffuso. In più – e cosa ancora più grave – Francoforte, Londra, Washington, Pechino, Emirati Arabi, Italia e molti altri governi identificano la criptovaluta più famosa al mondo come la più grande minaccia per la politica monetaria e finanziaria di tutti i tempi. Nel tempo si è evinto che l’impossibilità di gestire questo sistema genera più panico di quanto non sia stato ufficialmente dichiarato dai governi. Ma questo equivale (quasi) a dire che tutto ciò che non è governabile è nocivo e privo di senso.

Altra convinzione interessante: bitcoin è pericoloso, perché è anonimo! Quanto è grave questa affermazione agli occhi di chi studia, approfondisce, conosce ed è in grado di sostenere degnamente l’argomento? Molto. Eppure fioccano testi, articoli, documenti ufficiali, governativi e non, dove si asserisce che bitcoin è anonimo.

A scanso di equivoci, è doveroso precisare che bitcoin è pseudonimo e che tutte le transazioni che vengono validate e iscritte all’interno della Blockchain vi rimangono in eterno e sono perfettamente trasparenti. Ad oggi, risulta impossibile manometterle, falsificarle o celarne la presenza. Chiunque opera in bitcoin, pertanto, lascia una perpetua traccia di sé all’interno del libro mastro. Altro che anonimato!

Altra chicca, criptovalute come se piovesse!: se si potesse dare un titolo ad alcune (ritenute) super notizie del momento potremmo usare questo. La Libra di Facebook, ad esempio, in questo scenario è solo uno dei tanti fenomeni emulativi di bitcoin considerati geniali e degni di nota. Ci sono stati innumerevoli aperture di testate giornalistiche a menzionarla, connotandola come la nuova crittovaluta globale.

Ma la domanda è: Libra è davvero una criptovaluta?

Tradizionalmente le criptovalute sono strumenti monetari supportati dalla crittografia, indipendenti, decentralizzati, privi di alcuna terza parte fiduciaria, incontrollabili, resistenti ad attacchi esterni, utilizzabili da tutti, ovunque, h24, senza nessuna limitazione governativa o regolatoria.

Libra corrisponde a questa descrizione? No. Sebbene venga descritta come asset digitale similare, non ha nessuna di queste caratteristiche. Si tratta di un progetto che sintetizza una moneta regolamentata, supportata sì dalla crittografia, ma censurabile e perfettamente controllabile come qualsiasi altro strumento di pagamento digitale ufficialmente riconosciuto, come Visa, PayPal, etc.. Libra è, dunque, l’opposto di una criptovaluta, oppure potremmo considerarla tale a patto da considerare anche una comune carta di credito una criptovaluta. Eppure, quasi nessuna delle fonti che ha citato Libra ne ha parlato come un progetto di un asset digitale che ricalca pienamente il modello delle valute di Stato tradizionali regolamentate.

Qual’è la convinzione sottesa a questo taglio demonizzante della maggior parte delle opinioni?

Il riciclaggio di denaro e la sovvenzione ai gruppi terroristici che bitcoin renderebbe possibili. Perchè il tema della sicurezza mette tutti d’accordo e tutto ciò che la minaccia fa audience. Questa è la risposta più comune!

E non v’è dubbio che, in linea teorica, il riciclaggio di denaro e il finanziamento del terrorismo siano fenomeni certamente realizzabili con l’ausilio di criptovalute, ma quel che viene trascurato è il fatto che non vi sono prove in tal senso. E, anzi, quel che preoccupa di più è che vi sono prove per l’esatto contrario. Facciamo parlare le fonti, quelle utili.

Il report ufficiale dell’Europol di quest’anno, “European Union Terrorism Situation and Trend Report 2019”, identifica nel sistema Hawala il più importante strumento di finanziamento del terrorismo. Hawala: antico come il diritto romano, lontano dalle fattezze da conio moderno, è uno strumento di cambio di transazioni tra broker basato sull’onore che non richiede un necessario riconoscimento giuridico per funzionare. I fondi entrano nel sistema nella forma della valuta del Paese d’origine ed escono dallo stesso nella forma della valuta del Paese destinatario, e in entrambe le circostanze si ha a che fare con monete aventi corso legale negli stati di riferimento, non con criptovalute. Nello stesso documento il riferimento a bitcoin viene fatto in via del tutto presuntiva, senza alcuna attribuzione di certezza in merito all’utilizzo di questa, o altre monete crittografate, per la raccolta di fondi online.

Da qui, si apre uno spunto riflessivo notevole volto a voler inquadrare con esattezza e precisione un fenomeno mondiale che ha cambiato le vesti finanziarie delle nostre generazioni e che impone un cambiamento culturale che non richiede un grande sforzo, al contrario di ciò che si pensa, perché connaturato nella natura evolutiva dell’uomo.

In conclusione, bisogna badare bene al contenuto di ciò che si legge sull’argomento e ascoltare in totale condizione d’apertura tutte le voci interessate al tema, imparando ad isolare quei pochissimi, rari e preziosi autori di notizie fondate, reali e concettualmente corrette, che stanno facendo un lavoro monumentale per portare bitcoin nella mente e nel cuore di chi ha voglia di conoscerlo davvero.
Infine, senza una profonda conoscenza tecnologica, il giurista rischia di impaludarsi in ragionamenti costruiti sulla sabbia.

Suggerimenti bibliografici

Pagano M., Blockchain cyberwar e strumenti di Intelligence, Stampa Alternativa, ottobre 2017
Capaccioli S., Criptovalute e bitcoin: un’analisi giuridica, Giuffrè Editore, 2015
https://www.europol.europa.eu/activities-services/main-reports/terrorism-situation-and-trend-report-2019-te-sat
https://www.econopoly.ilsole24ore.com/2018/09/28/blockchain-con-cognizione/

Articolo a cura di Marilù Pagano

Nata a Giarre il 22 Maggio del 1980, Marilù Pagano  ha conseguito la Maturità classica ed ha proseguito gli studi in Giurisprudenza presso l’Università di Catania. Tesista in Diritto Internazionale Umanitario ha sviluppato interesse per le missioni militari aeree e i problemi di sicurezza ad esse correlate.

Attualmente, è copywriter e appassionata di informatica e diritto delle nuove tecnologie. Da Marzo 2016 è entrata a far parte del BEN Italia, acronimo di Blockchain Education Network, e l’anno successivo ne è diventata Rappresentante per la Regione Sicilia.

Sognatrice e avanguardista è alle prese con il suo primo romanzo.

Download PDF

https://www.ictsecuritymagazine.com/articoli/bitcoin-blockchain-e-il-ginepraio-delle-fonti-inattendibili/


Come funziona l’autenticazione forte del cliente (Strong Customer Authentication) introdotta dalla Direttiva PSD2

La direttiva europea PSD2 (2015/2366/UE) ha recentemente introdotto il tema dell’autenticazione forte del cliente, in inglese Strong Customer Authentication o semplicemente SCA.

La Strong Customer Authentication impone che tutte le operazioni di pagamento elettronico, e alcune altre operazioni a distanza che comportino un rischio di frode, vengano confermate e autorizzate combinando due o più fattori di autenticazione, scelti tra qualcosa che solo chi effettua l’operazione conosce (ad esempio un PIN o una password), qualcosa che solo chi effettua l’operazione possiede (un’app su un dispositivo mobile o una chiave che genera codici OTP), oppure un elemento di inerenza, cioè qualcosa che contraddistingue univocamente l’utente (l’impronta digitale, la geometria del volto, o un’altra caratteristica biometrica).

I fattori scelti devono essere mutuamente indipendenti, in modo che la violazione di uno dei fattori non comprometta l’affidabilità degli altri.

Questo al fine di garantire servizi di pagamento elettronici basati su tecnologie in grado di garantire l’autenticazione sicura dell’utente e ridurre il rischio di frode

Questo articolo esamina tutti i più diffusi metodi di autenticazione, e la loro accettabilità con i requisiti della SCA, secondo le precisazioni della European Banking Authority (EBA).

Elementi di conoscenza

Un elemento di conoscenza, secondo la PSD2, contraddistingue qualcosa che solo l’utente conosce. La conoscenza è un elemento statico che deve già esistere prima della transazione elettronica.

Un PIN, una password o passphrase, oppure la risposta a una domanda di sicurezza sono elementi di conoscenza ai quali siamo già abituati, e certamente validi nel contesto della autenticazione forte del cliente. Anche un pattern disegnato sullo schermo, come il codice di sblocco del cellulare, costituisce un elemento di conoscenza, anche se decisamente poco robusto in quanto visibile da una persona vicina, e facilmente replicabile.

Elementi a cui altri possono, anche occasionalmente, avere accesso non rappresentano un valido elemento di conoscenza per la PSD2. Un chiaro esempio sono i dettagli stampati su una carta di pagamento (numero, data di scadenza, codice di sicurezza CVV) in quanto leggibili del commerciante a cui affidiamo la carta per effettuare il pagamento in un negozio. Per contrasto, un numero di carta di credito che cambia dinamicamente, ad esempio generato prima di ogni acquisto, è un valido elemento di conoscenza.

Elementi di possesso

La PSD2 definisce il possesso come qualcosa che solo l’utente possiede.

Il possesso va oltre il mero possesso fisico di un oggetto e si estende anche al possesso di qualcosa di immateriale, come un’app su uno smartphone, oppure una sessione Internet. L’app sul dispositivo mobile necessita tuttavia di una operazione preliminare di registrazione del dispositivo, detta enrollment, e che serve a creare un collegamento univoco tra il servizio remoto, il dispositivo mobile e l’utente che lo possiede. Nel caso della sessione Internet, la scansione di un QR code presentato a schermo tramite un dispositivo mobile consente di associare univocamente la sessione all’utente presente davanti al computer.

All’atto pratico, nella fase di enrollment, viene scambiata una chiave univoca che permetterà di contraddistinguere in futuro questa istanza dell’app oppure la specifica sessione del browser. Un’app installata sullo smartphone che non sia stata sottoposta ad enrollment non soddisfa invece i requisiti di Strong Customer Authentication.

Una chiave che genera token OTP è ancora un valido elemento di autenticazione secondo la PSD2, ma questo approccio diventa sempre meno diffuso in favore di app per smartphone che generano codici OTP, e che consentono di portare a termine una transazione utilizzando un solo dispositivo.

Elementi di inerenza

La PSD2 definisce l’inerenza come qualcosa che l’utente è, e si riferisce sia alle caratteristiche fisiche che comportamentali che contraddistinguono l’utente che effettua il pagamento. Per caratteristiche fisiche intendiamo caratteristiche che non cambiano nel tempo, come ad esempio l’impronta digitale, le caratteristiche geometriche del volto o della mano lette da una telecamera, e negli approcci più sofisticati la scansione della retina o dell’iride. Esempi di caratteristiche comportamentali sono invece elementi come l’andatura durante una camminata, l’inclinazione con cui teniamo lo smartphone, oppure la velocità di movimento su una tastiera, o il battito cardiaco.

Il riconoscimento biometrico è indubbiamente il settore più innovativo e con lo sviluppo più veloce. Tra le aree di frontiera rientra anche l’autenticazione continua, permessa dai dispositivi wearable (ad esempio gli smart watch o gli occhiali per visione aumentata) e rimangono a contatto con il corpo per un periodo di tempo prolungato. Dopo una prima fase di autenticazione complessa, il dispositivo può rimanere autenticato fintanto che rimane fisicamente a contatto con il corpo.

Su quest’area si continueranno a vedere progressi nel prossimo futuro. Il nuovo protocollo 3-D Secure v2.0, usato per autorizzare transazioni remote con carte di pagamento, almeno nelle implementazioni attualmente sul mercato, non permette la trasmissione di caratteristiche biometriche.

Un’opportunità per il commercio online

Il volume transato con carte di credito in Italia nel 2018 ha superato gli 80 miliardi di euro, con circa 15 milioni di carte di credito attive.

Secondo i dati più recenti disponibili, nel corso del solo 2016 il valore totale delle transazioni fraudolente condotte utilizzando carte di pagamento emesse all’interno dell’area SEPA ha toccato gli 1,8 miliardi, e in termini percentuali ha rappresentato lo 0.041% del valore totale delle transazioni.

Il 73% delle frodi in valore, per un totale di 1,32 miliardi di euro è avvenuto sui pagamenti da remoto di tipo card-not-present (CNP), ad esempio tramite Internet o telefono, dove i dettagli della carta vengono comunicati in remoto, e la carta non viene fisicamente inserita o avvicinata al lettore al momento del pagamento. Per questo tipo di transazione il rischio di frode è chiaramente più alto, in quanto non c’è incontro fisico tra titolare e commerciante, e su queste transazioni l’autenticazione forte del cliente porterà i maggiori benefici [6]. Le frodi al terminale POS rappresentano circa il 19% del totale, mentre quelle su prelievo di contante su macchine ATM ammontano a circa l’8% del valore. Il 47% di queste due ultime categorie è avvenuto con carte smarrite o rubate.

I numeri indicano un continuo spostamento nel corso degli ultimi anni dalle frodi card-present (CP) a quelle di tipo card-not-present (CNP). Tuttavia il mercato sta sviluppando proprio per questa modalità, una moltitudine di soluzioni anti-frode (protocollo 3-D Secure, risk-based authentication).

Tra le pieghe della Strong Customer Authentication si cela una pratica che, più di altre, potrebbe imprimere al mercato una spinta virtuosa. Uno scenario di esenzione dalla SCA è relativo ai pagamenti elettronici gestiti da fornitori che dimostrano un tasso di frode particolarmente basso. L’importo della transazione esente dipende in maniera diretta dal tasso di frode del fornitore, e raggiunge fino a €500 nel caso di pagamenti elettronici il cui fornitore di servizi di pagamento mantenga un tasso di frode inferiore allo 0,01%, un obiettivo ambizioso e decisamente inferiore all’attuale tasso di frode medio nell’area SEPA.

Questo spingerà tutti gli attori del sistema dei pagamenti a migliorare costantemente il proprio tasso di frode, potendo così offrire soglie di esenzione crescenti e attraendo di conseguenza un numero sempre maggiore di clienti.

Riferimenti

[1] Pier Luigi Rotondo, Multifactor Authentication Delivers the Convenience and Security Online Shoppers Demand, SecurityIntelligence.com, January 2019

[2] Directive (EU) 2015/2366 of the European Parliament and of the Council, Official Journal of the European Union, November 2015

[3] Fifth report on card fraud, European Central Bank – Eurosystem, September 2018

[4] Pier Luigi Rotondo, How Will Strong Customer Authentication Impact the Security of Electronic Payments?, SecurityIntelligence.com, September 2019

Articolo a cura di Pier Luigi Rotondo

Pier Luigi Rotondo (Twitter @PGRotondo) lavora per il team di Technical Enablement IBM, su temi di Identity e Access Management. In oltre 20 anni di esperienza nella sicurezza delle informazioni ha contribuito a molti progetti internazionali su soluzioni di sicurezza per l’Identity e l’Access Management, il Single Sign-on e la Security Intelligence.

Con una la laurea in Scienze dell’Informazione da Sapienza – Università di Roma, Pier Luigi è coinvolto in attività accademiche sui temi di Sicurezza delle Informazioni in Corsi di Laurea e Master presso Sapienza – Università di Roma e l’Università di Perugia. E’ inoltre istruttore per i team che partecipano alla CyberChallenge italiana, il primo programma italiano di addestramento alla cybersecurity per giovani di talento delle scuole superiori e delle università, sin dalla sua prima edizione.

Pier Luigi Rotondo è autore per il Clusit, e contribuisce permanentemente dal 2015 al Rapporto Clusit sulla Sicurezza ICT in Italia su temi di malware per frodi finanziarie in Europa.

Download PDF

https://www.ictsecuritymagazine.com/articoli/come-funziona-lautenticazione-forte-del-cliente-strong-customer-authentication-introdotta-dalla-direttiva-psd2/


Fare intelligence nel cyber spazio: Big Data e Virtual Humint, dal deep state all’uso personale

La parola intelligence ha sempre evocato uno strumento utilizzato esclusivamente in ambito governativo e militare, un “deep state” che – indipendentemente dalle maggioranze politiche – opera per poter fornire ai governanti tutte le informazioni utili per far prendere loro le decisioni e supportarli quando non sono in grado di farlo. Prevenire i pericoli per la propria nazione e garantire la sicurezza dei propri cittadini sono gli obiettivi primari che l’intelligence di uno stato persegue.

I rapidi progressi tecnologici e l’evoluzione socio-economica delle nazioni hanno permesso all’intelligence di disporre di nuovi strumenti in grado di raccogliere una quantità di dati prima inimmaginabile, tali e tanti da non poter essere analizzati e correlati tutti contemporaneamente e correttamente.
La tecnologia ha sovralimentato lo spionaggio attraverso discipline come il Signals Intelligence (SIGINT), l’Electronic Intelligence (ELINT), il Communications Intelligence (COMINT) che si occupano di raccogliere informazioni mediante l’intercettazione e l’analisi dei segnali e delle comunicazioni (Radio, reti dati, telefonia, etc.), l’imagery intelligence (IMINT),che raccoglie informazioni mediante l’analisi delle immagini (ad es. fotografie aere, satellitari, etc..) e tante altre discipline con altrettante sigle, non utili ai fini di questo articolo.

Anche le operazioni di HUMINT (Human Intelligence) basate sull’eterna e inevitabile interazione interpersonale, fondamento storico dell’intelligence che rimarranno sempre un elemento di primaria importanza nella raccolta di informazioni, sono state potenziate dal progresso tecnologico che le ha integrate nel cyber spazio, creando il VIRTUAL HUMINT, cioè l’unione delle capacità “umane” dello HUMINT con quelle “virtuali” del SOCMINT (Social Media Intelligence). La VIRTUAL HUMINT rappresenta un approccio metodologico estremamente interessante perché coniuga mondi apparentemente opposti e riporta al centro dell’analisi delle informazioni la figura umana e non quella tecnologica, completando e integrando le lacune dei grandi sistemi automatizzati di raccolta ed elaborazione. È una disciplina specializzata nella creazione ed utilizzo di identità virtuali in rete e in particolare nei social network.

Il risultato di tutto questo “potenziamento” tecnologico è stata la nascita di due scuole di pensiero: quella dei big data e quella dell’Analyst Human Centric.

La prima è un’analisi quantitativa delle informazioni, si basa sull’utilizzo di software di analisi evoluti, estremamente potenti ma standardizzati, che non tengono conto di quegli elementi di dettaglio che possono indirizzare a nuove piste investigative; questi software hanno un elevato TCO (total cost of ownership) in termini di costo di acquisto, gestione, tempo di formazione del personale e limiti nella personalizzazione delle interfacce di analisi.

La seconda è un’analisi qualitativa di porzioni di informazioni, pone al centro del processo l’analista e non i software, secondari rispetto all’implementazione di strategie di ricerca ed analisi basate sulle capacità personali e professionali dell’analista. L’approccio qualitativo richiede analisti dotati di una elevata conoscenza informatica, di una eccellente cultura generale, di ottime conoscenze umanistiche e soprattutto di una spiccata predisposizione investigativa, prerogative indispensabili nella disciplina del Virtual Humint.

Un classico esempio di utilizzo delle due scuole di pensiero è la loro applicazione nella lotta al terrorismo. Le analisi dei Big Data permettono di fornire una visione complessiva e statistica degli eventi, ad es. fare una comparazione delle tipologie di attacco, una statistica dei paesi maggiormente colpiti, degli eventi precedenti e successivi correlati ad un attacco, identificare e filtrare la disinformazione, valorizzando le informazioni utili, etc.

Le analisi incentrate sul Virtual Humint operano in maniera verticale, in profondità su una specifica porzione di informazioni presenti nel cyber spazio e tentano di individuare non solo le correlazioni esistenti ma ne cercano di nuove. Sono ormai  diventati famosi i lavori svolti dal sito di giornalismo britannico Bellingcat che attraverso i suoi giornalisti/analisti, utilizzando strumenti gratuiti e open source, ha individuato e profilato l’infiltrazione di gruppi terroristici dell’ISIS provenienti dal  confine turco, membri e attività di un reparto speciale dell’ISIS denominato Katibat al-Battar, l’identità dei due agenti russi accusati di avere avvelenato Sergei Skripal e geolocalizzato i sicari dei narcos nello stato messicano di Chihuahua.

Nel caso specifico del terrorismo inoltre è importante notare che l’ISIS, pur continuando a perdere terreno sui campi di battaglia reali, sta sempre più continuando guadagnare terreno virtuale sui social, arruolando continuamente nuovi adepti in tutto il mondo con il loro Cyber-califfato e grazie alla propaganda CyberJihad delle loro parole ed idee. Ambito questo dove la disciplina del Virtual Humint può fare la differenza perché permette di costruire relazioni, contatti e acquisire nuove informazioni nel cyber spazio esattamente come un’agenzia di intelligence tradizionale fa nel mondo reale.

L’attività di intelligence quindi si trova oggi a raccogliere, catalogare, analizzare e filtrare una mole di informazioni enorme che ogni giorno aumenta in quantità e complessità.

Questo ha anche creato il paradosso che tanti dati non fanno necessariamente un’informazione: una eccessiva quantità di dati che non si è in grado di gestire, analizzare e filtrare rischia di trasformarsi in catastrofici cortocircuiti informativi, dalle gravissime conseguenze, come quelli accaduti l’11 settembre 2001 nel tremendo attentato alle due torri di New York o il 7 gennaio 2015 nel tragico attentato in Francia al Charlie Hebdo. Entrambe queste date rappresentano oltre ad immani tragedie il fallimento dell’intelligence, che non è stata capace di filtrare le false notizie da quelle attendibili sottovalutandole.

Ma come possono discipline di intelligence come l’analisi dei Big Data o il Virtual Humint essere utilizzate nel nostro quotidiano?

Tutti noi facciamo nel nostro piccolo, ogni giorno, attività di intelligence, ad es. quando chiediamo ad amici e conoscenti consigli di vario genere su ristoranti, alberghi, visite mediche, oppure utilizziamo i motori di ricerca o le app sul nostro smartphone per cercare risposte; e sempre più spesso, se non troviamo subito l’informazione che cerchiamo, sarà l’informazione stessa a venire da noi, ci appare sotto forma di banner pubblicitario o mail o messaggi da app varie, già personalizzata e pronta per i nostri bisogni.  Se quando vi capita questo pensate che qualcuno vi stia spiando dal microfono del vostro smartphone, vi sbagliate: sono solo gli algoritmi di profilazione dei motori di ricerca e dei social network che funzionano bene.

Questo enorme flusso di dati (testo, audio, video, etc..) che noi stessi mettiamo in rete (inconsapevolmente) durante le nostre ricerche su internet o (consapevolmente) attraverso i nostri profili social fornisce informazioni pregiate a chi ha interesse in noi, ad es. aziende che vogliono vendervi qualcosa, multinazionali finanziarie, farmaceutiche, enti governativi, semplici curiosi o peggio criminali. Per questo motivo possiamo applicare alcune tecniche di intelligence alla nostra sfera privata e pubblica per verificare e meglio tutelare la riservatezza delle nostre informazioni.

Il valore di queste informazioni è inestimabile, perché i costi necessari per acquisire dati così dettagliati e spontaneamente inviati da un così enorme numero di fonti (si pensi solo a Facebook, che oggi conta oltre 2 miliardi di iscritti) è complessivamente irrisorio; e poco importa se le informazioni possono essere “taroccate” perché a qualcuno piace apparire quello che non è, magari mettendo foto non sue, “photoshoppate” o post di viaggi mai fatti, etc.; non è un problema, gli algoritmi di profilazione riescono, a trovare tra i tanti post quelli “reali” e a classificarli, anche grazie a nuovi algoritmi di intelligenza artificiale, specializzati nel profilare gli aspetti più intimi delle nostre personalità (come ad esempio il narcisismo che ci spinge a postare foto in ogni luogo e momento per renderci più interessanti agli occhi dei nostri amici e degli sconosciuti).

L’importanza di questo input spontaneo, massivo e il conseguente utilizzo “tracciante” di strumenti che lo agevolano come i social network non sono certo sfuggiti all’attenzione delle organizzazioni di intelligence.

E non è complottismo (come ho spesso ribadito fin dal 2009, quando il fenomeno FB esplose in Italia) dire che proprio l’intelligence americana ha investito per prima su Facebook quando ne ha capito le potenzialità. Prima di Facebook c’era stato un solo un importante tentativo da parte dell’FBI di sfruttare la rete per acquisire informazioni spontanee; era il progetto INFRAGARD (https://www.infragard.org/) ancora oggi attivo, nato per permettere a chiunque di poter fare segnalazioni su su persone, attività sospette o pericolose per la sicurezza nazionale. Ma INFRAGARD non è mai decollato perché era soggetto a una continua attività di disinformazione e controspionaggio da parte di diverse intelligence straniere e quindi lo sforzo per vagliare la veridicità delle informazioni e l’affidabilità delle fonti era un lavoro estremamente oneroso.

Poi la società privata In-Q-Tel pagata dalla CIA per cercare nuove tecnologie e soluzioni da applicare nel campo dell’Intelligence scopre l’idea di FB nel 2004 e la finanzia più volte nella sua fase di start-up fino a quando non si quota in borsa nel 2012.

Facebook ha realizzato un modo nuovo di acquisire informazioni per l’intelligence, per tre motivi fondamentali:

  1. permette a chiunque nel mondo di connettersi e inserire i suoi dati personali, foto, video, spontaneamente creando lo schema delle sue relazioni con altri utenti e organizzazioni;
  2. ottiene spontaneamente dagli utenti anche informazioni sensibili come quelle politiche, religiose, sessuali e comportamentali analizzando i dati e profilando i post che l’utente scrive;
  3. può interagire a sua discrezione e in maniera subliminale (attraverso i suoi algoritmi) con l’utente, pilotandone le scelte con alcune determinate informazioni sotto forma di pubblicità, post, consigli, etc. che rientrano negli interessi identificati dalla profilazione e che quindi l’utente sicuramente guarderà.

Accedere in maniera indiscriminata a queste informazioni non è solo il sogno di ogni Intelligence ma di tantissime altre organizzazioni, come ci insegna il caso di Cambridge Analytica.

Avere la possibilità di analizzare i Big Data che compongono gli aspetti comportamentali dell’universo digitale della popolazione mondiale vuol dire per l’intelligence avere in mano la possibilità di prevedere e controllare il futuro.

Ma l’aspetto interessante da considerare è che questo progresso tecnologico e sociale ha reso disponibile la stragrande maggioranza di queste informazioni alla portata di chiunque possieda un computer e una connessione a Internet; non solo, ha anche messo a disposizione potenti strumenti per cercarle ed analizzarle facilmente.

Questo ha fatto fare un salto evolutivo epocale all’intelligence, se prima era utilizzata esclusivamente in ambiti ristretti e quasi “esoterici” oggi può essere utilizzata da chiunque, dalle istituzioni, dalle aziende e da noi privati cittadini.

L’Open Source Intelligence (OSINT) rappresenta appunto l’insieme di informazioni di libero accesso presenti in internet (siti web, blog, social network, etc..) e anche di molte altre informazioni riservate che non dovrebbero esserci.

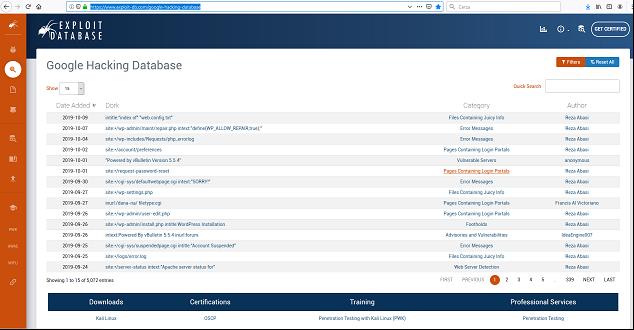
Uno degli strumenti più potenti di intelligence che abbiamo tutti a disposizione oggi e che usiamo quotidianamente è il motore di ricerca Google. Google è un motore che lavora sui Big Data e dispone di operatori semantici avanzati per effettuare query mirate e dettagliate che normalmente non utilizziamo nelle nostre ricerche quotidiane. Se ben impostati questi operatori possono dare risultati incredibili, tramite specifiche query possiamo verificare l’eventuale presenza di informazioni che dovrebbero essere riservate e che invece sono di dominio pubblico. Un esempio di quanto possano essere versatili e accurate le ricerche attraverso questi operatori ce lo dà il Google Hacking Database (GHDB; https://www.exploit-db.com/google-hacking-database), un sito dove gli utenti postano le query più particolari effettuate su Google tramite operatori con specifiche chiavi di ricerca.

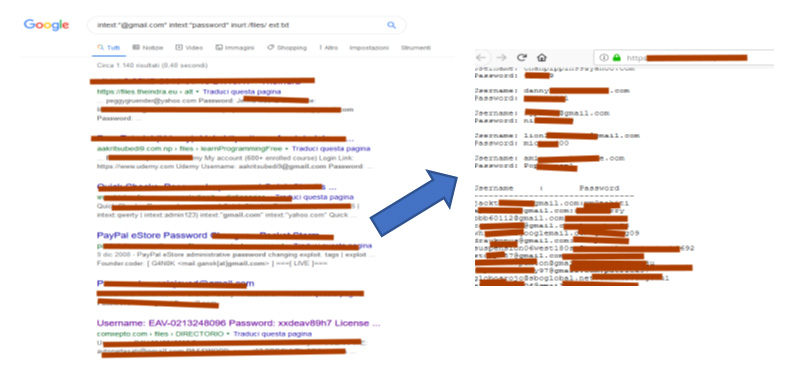
Per fare un test ho utilizzato una delle query presenti nel GHDB:

intext:“@gmail.com” intext:“password” inurl:/files/ ext:txt

questa semplice riga inserita nel motore di ricerca mostra tutti i contenuti indicizzati da Google con le seguenti caratteristiche:

  • il parametro intext: richiede che all’interno del contenuto indicizzato da Google siano presenti le stringhe: @gmail.com e password
  • il parametro inurl: che nell’url analizzato siano presenti i caratteri : /files/
  • il parametro ext: seleziona solo i nomi dei file indicizzati con estensione txt

Il risultato è effettivamente “imbarazzante”, Google ha rilevato molte informazioni su credenziali di diversi utenti che dovevano essere riservate:

Ho personalizzato la medesima query aggiungendo ulteriori parametri per verificare se il mio sito personale poteva essere stato esposto ad indicizzazione di informazioni sensibili da parte di Google. Aggiungendo quindi il parametro site:dominio.sito, dove dominio.sito indica il nome del dominio si restringe la ricerca esclusivamente al dominio web indicato.

Ancora oggi, nonostante tutte le campagne di sensibilizzazione e sanzionatorie sulla privacy, solamente inserendo semplici stringhe per effettuare filtri nella ricerca Google si possono estrarre password, dati personali e sensibili nascosti nei meandri dei Big Data indicizzati dal famigerato motore di ricerca. Effettuare periodicamente un’attività di intelligence preventiva su Google relativamente alla presenza dei propri dati personali in rete è fortemente consigliato.

Questa attività di intelligence, utilizzando esclusivamente Google, dimostra quante informazioni possono essere presenti sul web e la potenza degli strumenti a disposizione per cercarle. Ma se da una parte possiamo facilmente interagire attraverso programmi come Google per svolgere le nostre personali attività di intelligence, dall’altra – essendo sempre più interconnessi e interattivi – ci troviamo sempre più spesso di fronte a forme di rappresentazione virtuale di persone che possono apparire non veritiere, come nel caso dei profili falsi (fake) sui social. Quando ci troviamo nel cyber spazio, di fronte a situazioni non del tutto chiare che meritano approfondimento e richiedono la nostra interazione con estranei, non dobbiamo correre il rischio di esporre subito le informazioni non pubbliche sulla nostra identità.

Prima di proseguire però va chiaramente detto che è fortemente sconsigliato creare profili falsi anche se per giuste cause. Di per sé, in alcuni ambiti aprire un profilo falso non è reato a meno che non si assumano i connotati di persone reali: rubare l’identità ad una persona realmente esistente prendendone le generalità e magari usando le foto del suo profilo è un reato punito dall’art. 494 del Codice Penale, come è reato utilizzare un falso profilo per molestare altre persone, adescare minorenni, etc. Il regolamento Facebook vieta ad es. di fornire informazioni personali false e creare più di un account personale (pratica tuttavia frequente) ma dal punto di vista giuridico il doppio profilo non è di per sé sanzionabile, se non utilizzato per compiere attività illecite.

Detto questo, se vi trovate in una delle situazioni sopra elencate l’unica soluzione è quella di rivolgersi alla Polizia Postale, mentre in tutti quei casi in cui non ci sentiamo completamente sicuri e vogliamo cercare di capire meglio, possiamo utilizzare alcune tecniche e metodologie del Virtual Humint applicandole però al contrario, cioè cercando di capire se quel profilo su cui abbiamo dei dubbi mostra delle evidenze ricollegabili a tipiche attività di mascheramento.

In termini generali un profilo falso (fake) segue le stesse regole di creazione delle false identità denominate “sock puppet”, generate nelle operazioni di Virtual Humint; solo che il fake è normalmente più grezzo perché chi lo gestisce di solito non deve infiltrarsi, ad es., in un gruppo social di cellule terroristiche, quindi spesso è meno accorto ai dettagli e quindi più facilmente smascherabile.

Un falso profilo per essere credibile deve innanzitutto essere coerente e avere personalità: l’assenza di foto personali, del volto o di momenti della sua vita con altre persone non depongono a suo favore.

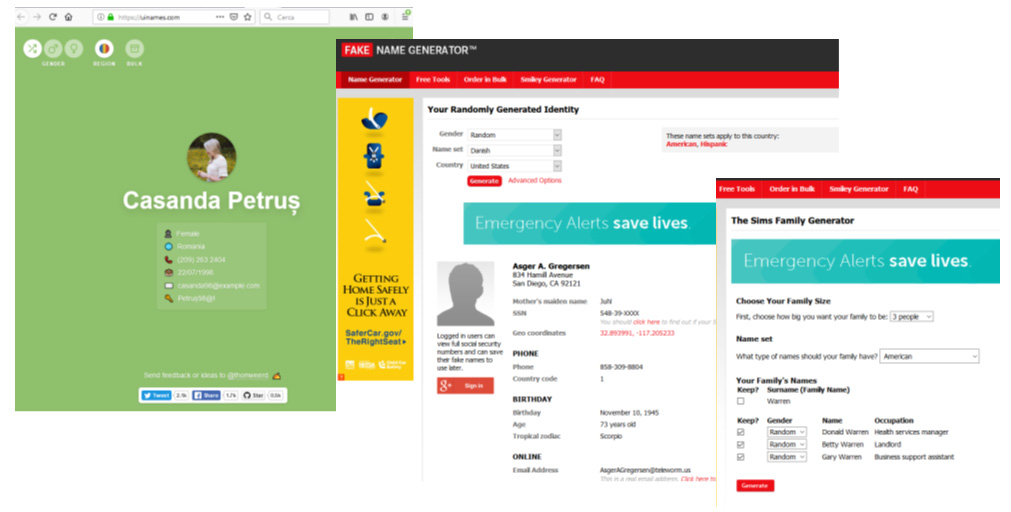
Sui dati personali postati potrebbe essere più complicato; esistono moltissimi siti che offrono un servizio di creazione di profili random con alcune informazioni di base coerenti con il fake generato.

Ad esempio https://uinames.com  e https://www.fakenamegenerator.com sono alcuni di questi.

È sufficiente scegliere la nazione di appartenenza del falso profilo e il sito lo genererà. Volendo, è possibile creare anche intere famiglie fake con profili correlati. Quindi le informazioni che potrebbe esporre il falso profilo potrebbero trarci in inganno perché ben strutturate e coerenti.

Verificate i follower e i like dei suoi post, l’assenza o un numero minimo (sotto i 3) di like e follower non è normale; non è indice di una vita sociale reale.

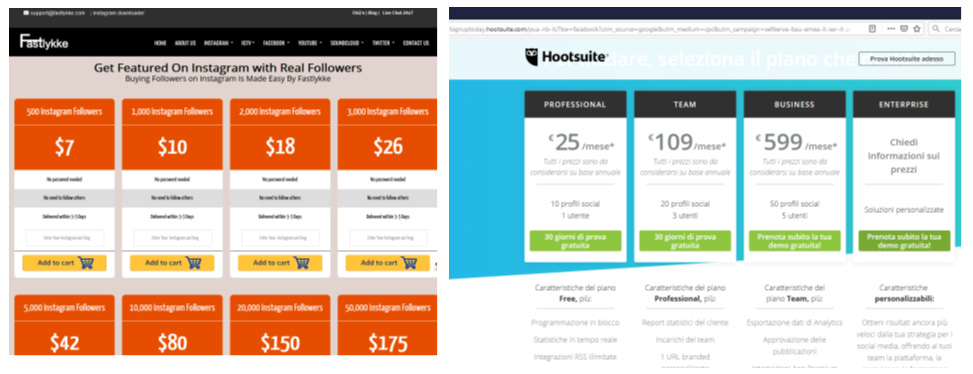
Nelle operazioni di Virtual Humint il falso profilo (sock puppet) viene spesso alimentato da like e follower acquistati su specifici servizi online, come ad esempio: https://www.fastlykke.com.

Ciò serve a dare credibilità al falso profilo.

Anche la frequenza dei post va verificata: un profilo che posta con continuità in orari plausibili e diversi da quelli di lavoro e sonno è più coerente.

Nelle operazioni di Virtual Humint spesso vengono creati decine di sock puppet e per renderli credibili e “vivi” si utilizzano dei servizi per la pubblicazione programmata e automatica di post come ad esempio http://hootsuite.com.

Anche la qualità dei post è importante: se sono solamente condivisi non commentati, sporadici e soprattutto non aggiornati, la cosa è sospetta.

A volte l’interazione con profili dubbi richiede la ricezione o l’invio di mail. In questi casi – se non volete utilizzare la vostra mail o crearne una nuova – potete utilizzare dei servizi di mail temporanea come quello di https://www.guerrillamail.com, che vi permette di avere subito una mail temporanea in grado di inviare,  ricevere e rimanere anonimi.

Infine, anche nel caso fosse necessario dover dare un numero di cellulare per  ricevere un SMS da un profilo o un servizio su cui si ha qualche dubbio, esistono servizi con numeri telefonici temporanei di varie parti del mondo che possono essere utilizzati gratuitamente per ricevere messaggi, come ad esempio: https://receive-smss.com.

Che voi facciate intelligence “casalinga” o intelligence governativa, la regola finale rimane sempre la stessa: non si deve mai perdere la concentrazione su quello che si sta facendo. Dall’omissione di un’informazione alla creazione di bugie il passo è breve: si deve sempre avere il controllo operativo ed etico dell’operazione, sia nel modo in cui si cerca l’informazione di interesse sia nel modo in cui l’informazione è appositamente “deviata” per tutelare la nostra riservatezza. Perdere il controllo su questo significa perdere i riferimenti sulla validità delle informazioni ed essere costretti ad analizzarle tutte indistintamente e, come scrive Harari nel suo libro Homo Deus, «Nei tempi antichi deteneva il potere chi aveva accesso alle informazioni. Oggi avere potere significa sapere cosa ignorare».

Articolo a cura di Francesco Arruzzoli

Download PDF

https://www.ictsecuritymagazine.com/articoli/fare-intelligence-nel-cyber-spazio-big-data-e-virtual-humint-dal-deep-state-alluso-personale/


I rischi di cyber attacchi in vetta alla classifica dei rischi aziendali più temuti sia in Europa che in Italia

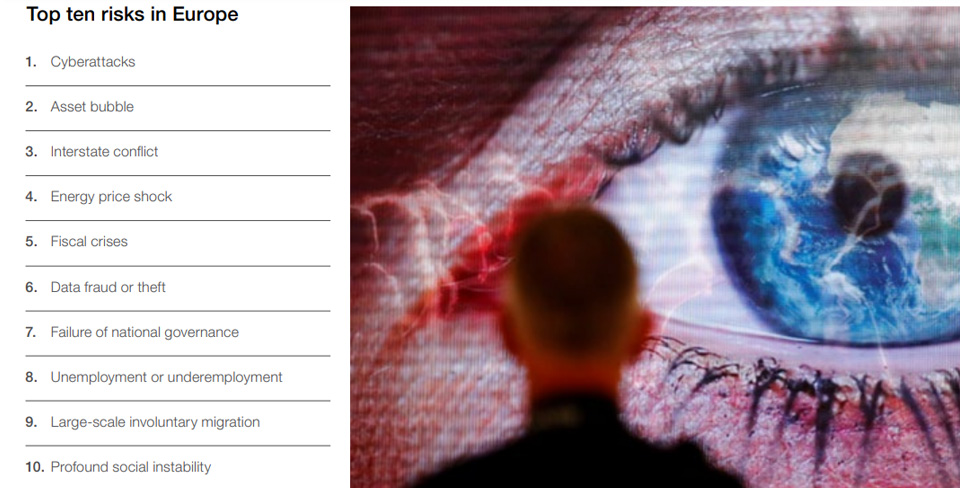
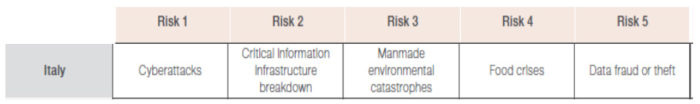
Dal Regional Risks for Doing Business Report 2019, realizzato dal World Economic Forum in collaborazione con i colossi assicurativi internazionali Zurich e Marsch, emerge come il cyber risk sia la prima preoccupazione delle imprese italiane.

Il mondo nel 2019 è più intrecciato e più complesso che mai. Ma mentre le interconnessioni hanno portato un certo grado di stabilità negli ultimi decenni, attraverso relazioni commerciali affidabili, i sistemi strettamente collegati stanno diventando più vulnerabili e in molti ambiti si intravedono fili sfilacciati nel tessuto che avvolge la società. Il lavoro sui rischi globali del World Economic Forum serve a segnalare quali fili, se tirati, potrebbero portare a un disfacimento di interi sistemi. Per questo motivo, dal 2018 il World Economic Forum sviluppa il rapporto annuale sui rischi regionali per le imprese in collaborazione con Marsh&McLennan Companies (MMC) e Zurich Insurance Group, rivolto a oltre 13.000 business leader in 130 Paesi nel mondo con lo scopo di classificare i principali timori legati allo svolgimento della loro attività nei prossimi 10 anni.

Gli attacchi informatici si evolvono e si diversificano

Nei sondaggi del World Economic Forum rispettivamente sulle Executive Opinion e sulla Global Risks Perception vengono tracciate cinque categorie di rischio: economico, ambientale, geopolitico, sociale e tecnologico. Quella relativa ai rischi tecnologici costituisce l’unica categoria classificata nelle cinque preoccupazioni più urgenti da entrambe le serie di intervistati. “Attacchi informatici” e “frode o furto di dati” sono il secondo e il settimo rischio globale che probabilmente aumenteranno entro i prossimi 10 anni nella visione del settore privato mondiale e sono stati percepiti come il quarto e il quinto rischio più grande dalla più ampia rete di multi-stakeholder intervistati per il Global Risks Report 2019.

Il fatto che le minacce informatiche preoccupino la comunità imprenditoriale tanto quanto il mondo accademico, la società civile, i governi e altri leader di pensiero mostra quanto sia dirompente questo rischio per tutti gli aspetti della vita.
Mentre le economie e le società continuano a essere digitalizzate, gli attacchi informatici diventano infatti sia più redditizi per gli aggressori che più pericolosi per le vittime.

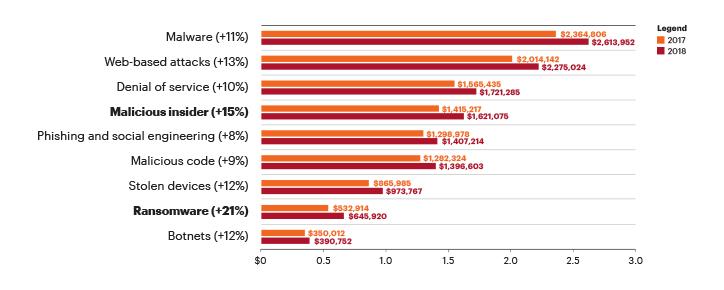
Secondo lo studio del costo annuale del crimine informatico di quest’anno, condotto dal Ponemon Institute in collaborazione con Accenture, i crimini informatici sono costati alle aziende in media il 12% in più tra il 2017 e il 2018 e stanno cambiando a causa di:

  • obiettivi in ​​evoluzione: il furto di informazioni è la conseguenza più costosa e in più rapida ascesa del crimine informatico. Ma i dati non sono l’unico obiettivo. I sistemi di base, come i controlli industriali, vengono violati in una pericolosa tendenza a interrompere e/o distruggere;
  • impatto in evoluzione: mentre i dati rimangono un obiettivo, il furto non è sempre il risultato. Una nuova ondata di attacchi informatici vede i dati non più semplicemente essere copiati ma distrutti, o addirittura modificati nel tentativo di generare sfiducia. Attaccare l’integrità dei dati è la prossima frontiera;
  • tecniche in evoluzione: i criminali informatici stanno adattando i loro metodi di attacco. Stanno prendendo di mira il livello umano – l’anello più debole nella difesa informatica – attraverso un aumento del ransomware e attacchi di phishing e ingegneria sociale come percorso di accesso. Può addirittura verificarsi che Stati o gruppi di attacco associati usino questo tipo di tecniche per attaccare imprese commerciali. Si tenta di classificare gli attacchi da queste fonti come “atti di guerra” nel tentativo di limitare i risarcimenti assicurativi in casi di violazioni della sicurezza informatica.

Come mostrato dalla seguente figura, gli attacchi basati sulle persone sono aumentati in misura maggiore.

Tre passaggi per sbloccare il valore nella sicurezza informatica

  1. Dare priorità alla protezione dagli attacchi basati sulle persone: contrastare le minacce interne è ancora una delle maggiori sfide con un aumento degli attacchi di phishing e ransomware, nonché degli insider malintenzionati.
  2. Investire per limitare la perdita di informazioni e l’interruzione dell’attività: quella che era già era la conseguenza più costosa degli attacchi informatici, ora comporta una preoccupazione crescente in ragione dele nuove normative sulla privacy come GDPR e CCPA.
  3. Mirare alle tecnologie che riducono i costi in aumento: utilizzare l’automazione, l’analisi avanzata e l’intelligence sulla sicurezza per gestire l’aumento dei costi necessari per scoprire gli attacchi, che sono la principale componente della spesa.

Dal canto suo, anche Symantec ha avvertito nel suo Rapporto sulle minacce alla sicurezza di Internet come siano emerse nuove forme di minacce informatiche – ad es. il formjacking, un codice malevolo che ruba i moduli di acquisto dai siti Web di e-commerce – mentre le aziende e le persone continuano a rimanere esposte a forme più onnipresenti di ransomware e cryptojacking.
Ecco perché rilevare, difendere e scoraggiare nuovi crimini informatici è importante quanto la gestione delle minacce note.

Infattim secondo il WEF, le preoccupazioni relative agli “attacchi informatici” sono al top tra i leader delle quattro maggiori economie dell’Unione europea – Germania, Francia, Italia e Regno Unito – e al primo posto in altri sei Paesi in tutto il continente. Alla fine del 2018 e per tutto il 2019, diversi Paesi europei hanno subito attacchi informatici e attacchi con furto di dati ad agenzie statali e grandi imprese: la Germania ha visto attacchi su account di posta elettronica di parlamentari, militari e diverse ambasciate nel novembre 2018, mentre vari tipi di attività dannose sono stati riscontrati nella fase culminante delle elezioni europee di maggio. Attacchi simili si sono verificati prima delle elezioni finlandesi in aprile e contro le istituzioni pubbliche in Croazia e Repubblica ceca in aprile e agosto, rispettivamente. Inoltre, dal 2018 sono aumentati gli incidenti informatici rivolti al settore imprenditoriale europeo: il 61% delle imprese ha riferito di incidenti informatici, rispetto al 45% dell’anno precedente.

Per mitigare queste minacce, aziende e autorità stanno rispondendo con centri di formazione informatica specificamente designati. A livello regolamentare, l’UE ha adottato nel marzo 2019 il Law Enforcement Emergency Response Protocol – un protocollo di risposta alle emergenze di cyber security  pensato al fine di contrastare gli attacchi su larga scala – e nel maggio 2019 ha implementato un nuovo quadro sanzionatorio al fine di utilizzare strumenti più efficaci per scoraggiare gli attaccanti.

In Italia, il cyber risk occupa il primo posto della classifica:

“La Survey Regional Risks for doing Business 2019 mostra dati che ritroviamo perfettamente nel comportamento delle imprese nostre clienti” ha dichiarato Elena Rasa, Chief Underwriting Officer di Zurich Italia. “Rispetto a qualche anno fa, stiamo assistendo a una crescente richiesta di protezione e tutela assicurativa sul fronte cyber, a dimostrazione di quanto il tema della sicurezza informatica sia divenuto ormai cruciale per la pianificazione e la gestione del proprio business. Attacchi informatici, furti di dati personali, falle e intrusioni tecnologiche possono generare, infatti, crisi reputazionali difficili da sanare”.

Sulla stessa lunghezza d’onda Andrea Bono, AD di Marsh Italy, per il quale “i risultati della survey mostrano chiaramente un cambio di percezione in merito al rischio cyber da parte dei business leader italiani ed europei che lo pongono ora al vertice della classifica dei rischi. Tale percezione (…) è un segnale importante e spetta a noi continuare a supportare le aziende per favorire una crescente cultura di mitigazione di questo rischio e una maggiore consapevolezza dell’importanza del tutelarsi contro eventuali attacchi.”

In effetti, sebbene la Direttiva europea NIS in tema di cyber security abbia definito le misure necessarie a conseguire un elevato livello di sicurezza delle reti e dei sistemi informativi e il decreto attuativo nazionale si applichi agli Operatori di Servizi Essenziali (OSE) e ai Fornitori di Servizi Digitali (FSD), nel nostro Paese un’azione diffusa di valutazione del cyber risk risulta ancor più necessaria in considerazione della peculiare struttura del sistema economico-aziendale, la cui ossatura vede una forte prevalenza delle piccole e medie imprese: vale a dire soggetti maggiormente esposti, in termini sia di preparazione e comprensione del rischio che di capacità di affrontarlo.

Articolo a cura di Sergio Guida

Da economista aziendale ha maturato esperienze in gruppi industriali diversi per settori, dimensioni e caratteristiche. Specializzato in pianificazione e controllo di gestione, finanza, risk e project management, sistemi di rendicontazione integrativi (sociale, ambientale e intangible assets), è stato relatore in convegni e seminari e ha pubblicato articoli di economia, finanza, strategie e compliance.

Forti interessi verso complessità, multidisciplinarietà, innovazione tecnologica, concentrati ora su digital economy, interazione uomo-macchina (aspetti etici, cognitivi ed epistemologici), data protection & privacy regulations.

Download PDF

https://www.ictsecuritymagazine.com/articoli/i-rischi-di-cyber-attacchi-in-vetta-alla-classifica-dei-rischi-aziendali-piu-temuti-sia-in-europa-che-in-italia/


Il professionista dell’inganno: l’ingegnere sociale

L’attività di un ingegnere sociale fonda le proprie basi essenzialmente sull’inganno. Indurre la vittima designata a intraprendere azioni inconsuete a proprio beneficio (per ottenere informazioni riservate e sensibili), magari sfruttando ed enfatizzando l’uso dell’autorità, dell’urgenza e della pressione psicologica, sono solo alcuni tra gli escamotages adottati.

Le azioni criminali basate sull’ingegneria sociale, di cui abbiamo notizie fin dalla notte dei tempi, possono concretizzarsi con o senza l’ausilio di tecnologia. Purtroppo è un dato di fatto che l’ingegneria sociale si è evoluta nel tempo da una tecnica di attacco che puntava esclusivamente sul carisma e l’abilità dell’attaccante verso una strategia ibrida, ancora più incisiva e subdola che sfrutta sia le abilità cognitive che quelle informatiche. Questo è stato reso possibile negli ultimi anni grazie alla crescita della digitalizzazione della comunicazione con la diffusione dei social (fucina inesauribile di informazioni) e dei vari servizi di messagistica. L’ingegnere sociale sfrutta, per l’appunto, la percezione distorta che l’utente medio ha di questi strumenti, ritenendoli puramente virtuali, privi di insidie e scollegati dal mondo reale.

Anatomia di un attacco

Qualunque sia il modus operandi adottato, è possibile suddividere l’anatomia di un attacco in quattro fasi principali:

Fase 1. Footprinting. Raccogliere quanto più informazioni sulla vittima è il primo passo fondamentale e propedeutico. Ogni dato anche apparentemente insignificante è indispensabile per focalizzare il contesto da colpire. È in questa fase che si definiscono le modalità di attacco da intraprendere. Lo scopo è acquisire familiarità con il target e definire l’obiettivo criminale, modalità e strategie;

Fase 2. Instaurare una relazione. Il passo successivo consiste nel guadagnare fiducia e complicità con la vittima, stabilendo una relazione in modo diretto o attraverso una catena di conoscenze e relazioni di terze parti;

Fase 3. Manipolazione psicologica. È questo il momento di allestire un inganno verosimile. Grazie alle informazioni reperite e alla relazione instaurata, si procede all’abbattimento delle difese per sferrare l’attacco definitivo;

Fase 4. Esecuzione. In quest’ultima fase, che dipenderà dall’abilità dell’ingegnere sociale nell’eliminare ogni rischio o traccia, si consolida il risultato ottenuto.

Tecniche di ingegneria sociale

Alla luce di quanto detto, oggettivamente risulta più semplice e meno dispendioso sfruttare un bug umano piuttosto che spendere del tempo alla ricerca di una falla in un sistema informatico. Volendo colpire un’infrastruttura, la domanda che potrebbe balenare a un criminale è: “perché cercare di forzare i sistemi di sicurezza più o meno complessi, se è possibile sfruttare le vulnerabilità intrinseche dell’elemento umano?”

In questo modo è la stessa vittima prescelta a rappresentare – inconsapevolmente – il vettore per l’adempimento dell’azione fraudolenta, magari allestita con la commistione di malware, persuasione umana ed empatia, tutti gli ingredienti (fondamentali e interscambiabili tra loro) preferiti dall’ingegnere sociale.

Di seguito si elencano alcune delle tecniche più comuni, tecnologiche e non.

Intercettazione delle comunicazioni

Ascoltare telefonate personali, conversazioni tra addetti ai lavori o intercettare chat o messagistica istantanea, rappresentano tutti un buon punto di partenza per il progetto preliminare dell’ingegnere sociale.

Shoulder Surfing

È una tecnica non invasiva che consiste, ad esempio, nello spiare la digitazione di credenziali d’accesso, o semplicemente nello sbirciare estremi o documenti quando si è in coda agli sportelli, oppure seduti in luoghi o mezzi di trasporto pubblici. 

Dumpster Diving

È un’azione che consiste nel cercare nella spazzatura dell’azienda o del target informazioni riservate e utili per l’allestimento dell’inganno. Si pensi a cosa usualmente si può gettare nell’immondizia (estratti conti, ricevute fiscali, solo per citarne alcuni!)

Tailgating

Con questo termine si classificano le modalità di attacco che consentono all’ingegnere sociale:

  • di accedere a un luogo fisico protetto, fingendo di aver dimenticato la chiave di sicurezza oppure chiedendo una cortesia a un utente autorizzato, o ancora fingendosi un tecnico (telefonico, elettricista…) per operare indisturbato sulla rete aziendale;
  • di sfruttare il rapporto di fiducia instaurato con la vittima per chiedere in prestito un dispositivo elettronico e approfittare del tempo a disposizione per violare dati sensibili o installare software dannosi.

Baiting

Con questa tecnica si utilizza come esca, opportunamente armata con un malware, un supporto informatico quale una chiavetta USB, un hard disk, un CD lasciato volutamente incustodito, come se fosse stato smarrito e contare sulla curiosità della vittima di volerne conoscere il contenuto, per eseguire il codice malevolo nascosto.

Pretexting

Il criminale induce l’utente a commettere determinate azioni, creando un falso contesto, cercando di entrare in empatia con la vittima, di interpretare un ruolo di autorità credibile oppure di intimare delle gravi ripercussioni: la truffa del falso CEO [1] e le campagne sextortion [2] ne sono tipici esempi.

Phishing

Il phishing, di cui ho ampiamente parlato in un precedente articolo [3], è una tecnica fraudolenta caratterizzata dall’abilità di ottenere informazioni confidenziali con pretesti fuorvianti attraverso l’uso combinato di strumenti tecnologici/digitali e maestria ingannevole. Solitamente l’attaccante invia alla vittima una mail oppure un SMS (in tal caso si parla di Smishing) impersonando, anche con loghi contraffatti un ente, un istituto di credito o azienda legittima, con l’invito a cliccare su di un link (che porta verso un sito “farlocco”) o a scaricare degli allegati (contenenti un payload malevolo).
È comunque ancora in voga anche una versione telefonica della tecnica di phishing (Vishing), in cui l’ingegnere sociale, con la scusa di offrire un servizio o prestare un intervento tecnico, cerca di ottenere indirettamente delle informazioni riservate inducendo il malcapitato a eseguire delle operazioni mirate alla realizzazione della truffa stessa.

Conclusioni

Dall’ultima edizione del rapporto Clusit emerge che il 63% degli attacchi totali, nel primo semestre 2019, è stato messo a segno attraverso tecniche semplici e a basso costo, tra le quali primeggia quella adoperata dal professionista dell’inganno: l’ingegneria sociale (con un aumento del +104% rispetto al medesimo periodo del 2018).

Per riconoscerla in tempo ed evitarla occorre, soprattutto, averne consapevolezza.

A tal proposito, ecco alcune best practices valide sia per privati che aziende:

  • è buona norma diffidare dall’installazione di app di cui non possiamo verificare con certezza la fonte e in ogni caso valutare sempre quali permessi concedere;
  • prestare attenzione agli URL dei siti;
  • dubitare sempre delle mail che richiedono dati riservati o che promettono offerte imperdibili;
  • seguire le procedure di sicurezza secondo le politiche aziendali, evitando di intraprendere procedure inusuali;
  • richiedere sempre un riconoscimento ufficiale prima di ogni consenso;
  • utilizzare in modo consapevole e responsabile i social network, senza condividere in rete informazioni personali o riservate;
  • evitare l’uso di servizi di messaggi in risposta automatica in caso di assenza da lavoro;
  • evitare connessioni wifi aperte e pubbliche.

Non meno importanti e trascurabili, le regole di buona pratica non tecnologiche:

  • adottare una metodologia di distruzione documenti (aziendali/privati) in modo da evitare un eventuale riassemblaggio se prelevati dai rifiuti;
  • adottare una più attenta politica di sicurezza fisica degli accessi, che consenta l’accertamento della legittimità degli ingressi;
  • evitare di diffondere informazioni private e riservate, di trascrivere password su appunti o biglietti volanti;
  • evitare d’installare dispostivi di dubbia provenienza (trovati/non autorizzati) sui propri pc di lavoro o privati.

Note

[1] https://www.cybersecurity360.it/nuove-minacce/la-truffa-del-falso-ceo-cose-come-funziona-come-difendersi/

[2] https://www.ictsecuritymagazine.com/articoli/sextortion-analisi-di-una-mail-del-ricatto/

[3] https://www.ictsecuritymagazine.com/articoli/phishing-consigli-utili-per-attenuare-il-rischio-di-adescamento/

Riferimenti

Articolo a cura di Salvatore Lombardo

Salvatore Lombardo è laureato in Ingegneria Elettronica orientamento Telematico. Ha frequentato un Master in Information and Communication Technologies – Internet Software Engineering.

Da oltre dieci anni svolge l’attività di funzionario informatico presso la Pubblica Amministrazione, curando in particolare la sicurezza informatica e l’amministrazione di rete.

In qualità di esperto ICT, iscritto all’albo dei docenti della ex Scuola Superiore dell’Amministrazione dell’Interno, ha tenuto vari corsi di formazione e aggiornamento per il personale.

È autore del libro La Gestione della Cyber Security nella Pubblica Amministrazione.

Download PDF

https://www.ictsecuritymagazine.com/articoli/il-professionista-dellinganno-lingegnere-sociale/


Attacchi informatici all’azienda, responsabilità ex D.Lgs. 231/2001 e ruolo dell’organismo di vigilanza

In un sistema basato sostanzialmente sui rischi e sulla loro prevenzione, come quello della responsabilità da reato degli enti (prevista dal D.Lgs. 231/2001), oggi il settore informatico è sicuramente uno degli ambiti che destano maggiore attenzione nelle società.

Già nel 2014, solo per fornire alcuni esempi della sempre crescente sensibilità sul tema, l’United Nations Interregional Crime and Justice Research Institute (UNICRI) ha pubblicato le “Linee guida per la sicurezza informatica per le PMI”, mentre di recente l’“ECB Banking Supervision: Risk Assessment for 2019”, un documento ufficiale della Banca Centrale Europea, ha individuato proprio l’informatica come uno dei settori con i più alti fattori di rischio per probabilità e impatto nelle grandi organizzazioni.

A chiudere il cerchio abbiamo un’aggressione dello Stato, nei confronti dei nostri sistemi telematici, via via più stringente. Da un lato, si registra l’ormai sdoganato utilizzo come mezzi di captazione dei Trojan Horse; tali strumenti, nati per combattere la criminalità organizzata e il terrorismo, oggi, con l’emanazione della Legge n.3/2019, la c.d. “Spazzacorrotti”, sono adoperati anche per un numero di reati sempre più nutrito, compresi i delitti contro la Pubblica Amministrazione.
D’altro canto, sono sempre più estesi dalla giurisprudenza potere e perimetro del sequestro di tutti quei dispositivi (pc, tablet, pen drive…) che, in fase di indagine, si ritiene possano essere stati utilizzati per commettere dei crimini o che comunque possano fornire la prova della commissione degli stessi (Cass. pen. sez. V, 17 settembre 2019 n. 38456).

La tecnologia, sostanzialmente, ha travolto non solo il Codice Penale (che reca la data del 19 ottobre 1930), ma anche il più recente Codice di Procedura Penale (22 settembre 1988). Con riferimento agli aspetti procedurali, soprattutto sotto il profilo di accertamento dei fatti, molteplici sono le risposte che il processo penale deve ancora dare rispetto all’evoluzione informatica. Analogamente, bisogna considerare che tutti i reati (o quasi) con le nuove tecnologie possono essere commessi molto più facilmente. Tanto che è stata coniata appositamente l’espressione di “computer facilitated crimes” per indicare quei delitti comuni dopati dall’informatica (si pensi al riciclaggio di denaro e alle sue molteplici sfaccettature che può assumere con il reimpiego di somme derivante da un illecito in criptovalute).

I beni aziendali che possono essere aggrediti dagli attacchi informatici, inoltre, sono davvero molteplici: riservatezza informatica, integrità dei dati, patrimonio e onorabilità della stessa società e dei suoi membri.

Più nel dettaglio, dal punto di vista dell’azienda, destano preoccupazione due diverse e opposte condotte. Innanzitutto devono essere segnalati gli attacchi informatici commessi da terzi nei confronti della società. Si pensi all’ipotesi delle “Fake CEO Mail”, ossia delle comunicazioni di posta elettronica inviate da un soggetto che si finge l’amministratore e ordina pagamenti ai propri sottoposti da una casella mail che magari si differenzia di un solo carattere da quella ufficiale.

Vi sono, d’altro lato, reati commessi da un soggetto intraneo all’ente e che possono, seppur “di rimbalzo” (o “par ricochet”, secondo il sistema di imputazione delle persone giuridiche in Francia), portare a un danno per l’azienda. Si pensi al caso di una fattispecie illecita portatrice di un interesse (quindi di un’utilità valutata ex ante) o di un vantaggio (utilità magari anche non effettivamente voluta, ma comunque maturata ex post) per l’impresa, come stabilito dall’art. 5 del D.Lgs. 231/2001, il testo normativo disciplinante la responsabilità da reato degli enti, che così dispone: “1. L’ente è responsabile per i reati commessi nel suo interesse o a suo vantaggio(…). 2. L’ente non risponde se le persone indicate nel comma 1 hanno agito nell’interesse esclusivo proprio o di terzi”. Nel caso in cui, ad esempio, un dipendente di una società ponesse in essere un accesso abusivo a un sistema informatico (art. 615 ter c.p.) utilizzando un computer aziendale finalizzato a carpire segreti industriali di una concorrente, anche l’impresa sarebbe suscettibile di sanzioni, perché beneficerebbe di un interesse o un vantaggio. Qualora lo stesso dipendente commettesse invece una frode informatica (art. 640 ter c.p.) volta a farsi accreditare sul proprio conto una somma di danaro, sarebbe più evidente la sussistenza di un interesse esclusivo dell’autore del reato, tale da escludere il coinvolgimento dell’ente.

Bisogna a questo punto soffermarsi sul ruolo dell’Organismo di Vigilanza in materia.
L’art. 6 del D.Lgs. 231/2001, difatti, tra gli elementi necessari affinché un ente possa non rispondere di un reato commesso da un soggetto in posizione apicale, annovera il seguente requisito: “il compito di vigilare sul funzionamento e l’osservanza dei modelli di curare il loro aggiornamento è stato affidato a un organismo dell’ente dotato di autonomi poteri di iniziativa e di controllo”. Il compito proattivo del c.d. OdV consiste, quindi, nell’effettuare una sorta di stress test di procedure e protocolli interni (che assieme costituiscono il Modello di organizzazione, gestione e controllo), volti a prevenire la commissione di reati all’interno dell’azienda.
 

In relazione a degli attacchi informatici, pertanto, l’organismo sarà tenuto a vigilare che il sistema di compliance interno sia adeguato a una prevenzione più ampia possibile (il rischio zero, purtroppo, non esiste), in modo da evitare in primis il verificarsi delle stesse condotte illecite o, quantomeno, escludere un coinvolgimento di responsabilità da parte dell’azienda stessa.

Utile, da questo punto di vista, il ricorso a internal investigations o specifici audit tesi a verificare l’effettiva vulnerabilità della rete e – allo stesso tempo – l’affidabilità del personale dell’ente. Non di rado vengono effettuati da parte dei responsabili Information e Technology, in accordo con amministratori o dirigenti, invii di false mail di phishing, tese a verificare se e chi nell’azienda potrebbe essere più esposto a un attacco.

Importante è, in ogni caso, che l’azione dispiegata dall’Organismo di Vigilanza nella lotta al cybercrime sia frutto di risoluzioni assolutamente coscienti e consapevoli. A titolo esemplificativo, un’investigazione interna, non disposta con le forme previste dal codice di procedura penale, potrebbe condurre a risultati paradossali. Gli esiti delle indagini societarie, finalizzate a fornire elementi a favore, potrebbero al contrario costituire una prova a carico dell’ente, già predisposta dallo stesso e impacchettata per la Procura.

Articolo a cura di Lorenzo Nicolò Meazza 

Lorenzo Nicolò Meazza è Avvocato penalista, titolare dell’omonimo studio legale a Milano. L’area di attività prevalente è il diritto penale d’impresa, con attenzione a criminalità informatica, diritto penale delle nuove tecnologie e digital forensics.

Laureato con il massimo dei voti all’Università degli Studi di Pavia, si è distinto tra i migliori cinque studenti del Master in Diritto Penale dell’Impresa presso l’Università Cattolica di Milano.

È stato selezionato dall’Ordine forense di Milano e dal Pool Reati Informatici della Procura milanese tra gli avvocati esperti in diritto dell’informatica e fa parte dei legali con specifica competenza nella trattazione dei reati informatici che costituiscono uno specifico sportello.

Presidente di un Organismo di Vigilanza ex D.Lgs. 231/2001, redattore di AODV231, è stato membro della Commissione Nazionale in materia, istituita dall’Unione Camere Penali Italiane. È membro della Commissione Giustizia Penale dell’Ordine di Milano, Cultore di materie penalistiche presso l’Università Statale di Milano, Responsabile della sede milanese della Scuola Nazionale di Alta Formazione dell’Avvocato Penalista e Direttore Responsabile della rivista giuridica Giurisprudenza Penale.

Website: www.studiolegalemeazza.com

Download PDF

https://www.ictsecuritymagazine.com/articoli/attacchi-informatici-allazienda-responsabilita-ex-d-lgs-231-2001-e-ruolo-dellorganismo-di-vigilanza/


Divenire-software delle reti e Cyber Security

Il software si è mangiato il mondo

Nel 2011 Mark Andreessen, imprenditore informatico statunitense e co-fondatore, tra le varie cose, di Netscape, scrisse un famoso articolo per il Wall Street Journal dal titolo “Why Software Is Eating The World”. All’alba degli anni 10 del terzo millennio, Andreessen evidenziava che in quello specifico momento storico era in atto un cambiamento epocale dal punto di vista tecnologico ed economico, con le software company in procinto di conquistare enormi quote di mercato.

La previsione era che, nell’arco di un decennio, moltissimi settori dell’industria sarebbero stati scompaginati dal software per due ragioni fondamentali:

  • tutta la tecnologia software necessaria a trasformare radicalmente i processi di produzione e distribuzione di beni e servizi era finalmente funzionante e disponibile su scala globale;
  • il software si era già insinuato nella catena del valore di industrie che erano sempre e solo state percepite come facenti parte del mondo fisico.

Per esemplificare la portata del cambiamento in atto, Andreessen faceva una serie di contrapposizioni tra software company e aziende tradizionali che sarebbero diventate, nel corso degli anni successivi, veri e propri topos: Amazon VS le maggiori catene di librerie, Netflix VS Blockbuster, iTunes, Spotify e Pandora VS le tradizionali etichette musicali, Pixar VS case di produzione cinematografica, Snapfish e Flickr VS Polaroid, Skype VS le compagnie telefoniche tradizionali. Non solo: anche i settori finanziario, sanitario ed energetico, nonché colossi quali FedEx e Wal-Mart, avevano già “riversato” interamente all’interno del software alcuni processi strategici produttivi, distributivi e logistici.

A distanza di quasi 10 anni dall’articolo di Andreessen la dinamica descritta si è ulteriormente accentuata: oggi le maggiori software company hanno differenziato le proprie attività aggredendo nuovi business. Amazon sfida Wal-Mart nel commercio al dettaglio, Google investe nei settori dei servizi alle imprese, del trasporto, della salute e dell’energia, Facebook punta ai servizi finanziari lanciando addirittura Libra, la propria criptovaluta.

Il processo attraverso cui il software “si mangia il mondo”, che preferisco generalizzare con l’espressione divenire-software, rientra nella più ampia dinamica di Digital Transformation che investe ormai da diversi anni il pianeta determinando notevoli cambiamenti a livello sociale, culturale, organizzativo e politico.

Dinamiche di sviluppo delle reti

Nel contesto generale appena descritto, l’universo delle tecnologie dell’informazione e della comunicazione (ICT) rappresenta simultaneamente il motore dell’innovazione e il campo di sperimentazione e applicazione naturale della trasformazione digitale.

Le infrastrutture di comunicazione che abilitano i servizi digitali sono la spina dorsale – il backbone – che permette alla società globale di attuare lo spostamento nella sfera immateriale di relazioni, beni e servizi finora esclusivamente radicati nel dominio del mondo fisico. Ne consegue che le dimensioni classiche della sicurezza dell’informazione – la disponibilità, la riservatezza e l’integrità – diventano elementi di necessaria garanzia nella generale prospettiva di resilienza, affidabilità e prosperità della nostra società.

Gli operatori di comunicazione, con particolare riferimento a coloro che offrono servizi di comunicazione elettronica, rivestono un ruolo fondamentale nell’erogazione di servizi essenziali alla comunità, come sancito anche dal quadro normativo a livello nazionale e internazionale: proprio alla luce del loro ruolo e della loro intrinseca sensibilità, per tali operatori sono previste specifiche misure di cyber security e obblighi formali verso le istituzioni.

Come noto, la grande narrazione che oggi viene promulgata a vari livelli sotto il nome generico di 5G comporterà nuovi modelli di business, nuovi scenari di utilizzo e impatti la cui portata complessiva è ancora difficile da prevedere con precisione, come ho avuto modo di illustrare in un precedente articolo. La visione 5G non può essere soddisfatta attraverso gli approcci di progettazione di rete convenzionali: entra in gioco una quantità di innovazione mai vista prima e gli operatori di comunicazione dovranno utilizzare nuove tecnologie per consegnare servizi 5G sicuri e senza soluzione di continuità attraverso confini di rete multipli. Per ottenere l’interoperabilità, le reti 5G dovranno interconnettersi con soluzioni di rete legacy e diverse tecnologie di accesso.

Per raggiungere gli obiettivi tecnici le reti 5G devono essere altamente flessibili, scalabili e programmabili. Il trend tecnologico che abiliterà a breve questa rivoluzione è profondamente segnato dal divenire-software delle reti di comunicazione e si può riassumere in alcuni elementi fondamentali:

  • virtualizzazione delle architetture di rete attraverso Software Defined Network (SDN). La SDN permette di programmare dinamicamente la rete disaccoppiando il processo di forwarding dei pacchetti (Data Plane) da quello di routing (Control Plane) tramite elementi di controllo centralizzati, intelligenti e residenti nel Cloud;
  • virtualizzazione delle funzioni di rete, meglio conosciuta come Network Function Virtualization (NFV). NFV permette configurazioni di rete multiple tra cui, per esempio, l’allocazione dinamica di indirizzi IP, il firewalling e la scalabilità della rete in tempo reale;
  • diffusione delle architetture distribuite quali, ad esempio, il Multi-access Edge Computing (MEC). MEC porta i dati vicino all’utente finale, spostando le funzioni di calcolo e storage ai bordi (edge) della rete. Questo scenario riduce notevolmente i tempi di latenza e il volume dei dati gestiti dagli elementi centrali della rete (core e backbone), apportando benefici in termini di aumento delle prestazioni;
  • Distributed Core Network, ovvero l’abilità di spostare le funzioni di rete core laddove è maggiore la richiesta di utilizzo. La distribuzione delle funzioni (quali, ad esempio, l’autenticazione) introduce vantaggi prestazionali abbassando i tempi di latenza e permettendo le comunicazioni a latenza ultra-bassa;
  • Network Slicing, ovvero la capacità di eseguire reti virtuali multiple su una singola infrastruttura di rete condivisa. Lo Slicing della rete abbraccia diversi livelli della pila ISO/OSI: interfacce radio, VLAN Layer 2 e routing/forwarding virtuale Layer 3;
  • introduzione dei modelli architetturali basati su container e micro-servizi;
  • adozione massiccia di interfacce Open.

Sicurezza del software: croce e delizia

È evidente che il divenire-software è una dinamica inarrestabile e pervasiva che nella propria traiettoria disegna un percorso ormai irreversibile in cui il mondo fisico e quello virtuale, ibridandosi, tendono a confondersi. I contorni si fanno sempre più sfumati e liquidi, il volume dei dati assume dimensioni abnormi (Big Data) e il software stesso necessita di evoluzioni continue (Intelligenza Artificiale).

Tutte le mirabilia rese possibili dalla Digital Transformation si fondano sul software: peccato che, ad oggi, non c’è modo di scrivere software intrinsecamente sicuro.

Come giustamente sostiene Bruce Schneier, il software è spesso scritto male (poorly written) perché, a parte poche eccezioni, il mercato non premia il software di buona qualità: “economico” e “veloce sul mercato” sono attributi più importanti della qualità e, del resto, per la maggior parte di noi il software scritto male è in ogni caso di qualità sufficiente e accettabile.

Questa filosofia ha permeato l’industria a tutti i livelli: le aziende non premiano la qualità del software allo stesso modo in cui premiano la capacità di consegnare un manufatto nel rispetto dei costi e dei tempi previsti. Le università si focalizzano più su un codice funzionante che su un codice affidabile. La maggior parte dei consumatori non intende pagare il sovrapprezzo determinato dal miglioramento della qualità del software.

Il software moderno è costellato di miriadi di bug. Alcuni sono inerenti alla complessità del codice stesso, ma altri sono errori di programmazione. Molti bug non sono corretti durante il processo di sviluppo e rimangono nel prodotto finito anche dopo che questo viene completato e immesso sul mercato. Alcuni bug sono anche vulnerabilità di sicurezza e alcune di queste possono essere sfruttate da attaccanti e malintenzionati.

Chiaramente non tutti i processi di sviluppo sono uguali: Microsoft ha impiegato risorse enormi per migliorare nel tempo il proprio processo di sviluppo al fine di minimizzare il numero di vulnerabilità di sicurezza presenti nei propri prodotti, che non sono perfetti – in quanto la perfezione va oltre le capacità tecnologiche attualmente disponibili – ma sono superiori alla media. Apple è famosa per la qualità del proprio software, lo stesso vale per Google. Alcuni piccoli pezzi di codice sono di qualità estremamente elevata, ad esempio il software dell’avionica dei velivoli.

Internet of Things (IoT) significa anche la proliferazione di oggetti e dispositivi più o meno intelligenti dotati di specifico software (miliardi di oggetti): più linee di codice, più bug, più vulnerabilità di sicurezza. Il costo di tali dispositivi tende a essere contenuto al massimo e ciò significa utilizzare programmatori poco esperti, processi di sviluppo software spesso superficiali e fare ampio riutilizzo di codice, con il concreto rischio di effetti domino incontrollabili (una singola vulnerabilità presente nello stesso frammento di codice utilizzato in prodotti diversi ne determina la replica immediata su scala maggiore).

Il software da cui dipendiamo – quello che gira sui nostri computer e telefoni, nelle nostre automobili e nei dispositivi medicali, su Internet, nei sistemi di controllo delle nostre infrastrutture critiche, sulle reti di nuova generazione (5G) – è insicuro in molteplici modi. Il problema non è solo trovare tutte le vulnerabilità e correggerle: ce ne sono troppe e la maggior parte di esse non viene nemmeno mai scoperta. È un problema di correzione, nel tempo, delle vulnerabilità note attraverso opportuni processi di patching.

Un veloce excursus sulla storia delle vulnerabilità software ci porta dalla nascita della responsible disclosure fino agli attuali programmi di bug bounty, con il naturale approdo al patching come possibile soluzione – ex post – dei problemi di insicurezza del codice. Peccato che, anche in questo caso, sempre secondo Schneier, il patching come paradigma di sicurezza stia fallendo:

  • molte volte il rilascio delle patch di sicurezza non è tempestivo. Nel caso, ad esempio, di smartphone con sistema operativo Android questo significa che l’esposizione delle vulnerabilità non corrette sui dispositivi può rimanere tale diversi mesi;
  • nel caso di sistemi particolarmente datati, le patch non sono più rilasciate e i sistemi rimangono vulnerabili nel tempo;
  • a volte le patch che correggono vulnerabilità software compromettono la stabilità dei sistemi in cui sono installate, con conseguenti rollback (nei casi migliori) o brick degli stessi (nei casi peggiori);
  • nei dispositivi a basso costo e sistemi embedded (tanti router Internet domestici, dispositivi IoT, webcam, etc) le patch devono essere scaricate e installate manualmente dagli utenti in assenza di un processo remoto e automatico. Tale mancanza di automatismo genera, normalmente, assenza di consapevolezza e delle conseguenti azioni di rimedio da parte dell’utente medio.

Gli attuali sistemi di patching saranno sempre meno adeguati in un mondo caratterizzato dal divenire-software, in cui i computer e il software vengono incorporati in qualsiasi cosa. Secondo Schneier una strada possibile è l’integrazione dei due principali paradigmi adottati dall’industria dello sviluppo software: Waterfall e Agile. Nel tradizionale modello Waterfall l’iter naturale dello sviluppo del codice prevede la definizione dei requisiti, delle specifiche, la progettazione, l’implementazione, la verifica e la manutenzione. Il modello Agile, più recente, funziona diversamente: come prima cosa si costruisce un prototipo per soddisfare le esigenze basilari del cliente, si osservano gli errori e i fallimenti, si ripara velocemente, si aggiornano i requisiti e le specifiche e si ripete tutto il processo più volte nel tempo. Non riusciamo a ingegnerizzare la sicurezza al 100% sin dall’inizio, quindi non abbiamo altra scelta che rilasciare e applicare le patch velocemente. A causa dell’intrinseca complessità di Internet e dei dispositivi a essa connessi, abbiamo bisogno sia della stabilità a lungo termine del modello Waterfall sia della capacità reattiva del modello Agile.

Conclusioni

Le reti di quinta generazione hanno ottime caratteristiche di resilienza, disponibilità e affidabilità. La flessibilità di questo modello è rappresentata dalla possibilità, per i servizi, di condividere dinamicamente molteplici funzioni di rete, che a loro volta condividono dinamicamente diversi micro-servizi di base. Le componenti a maggiore criticità sono relative al core della rete, all’interfacciamento tra le reti e ai sistemi di gestione e supporto: ancora una volta si tratta di elementi software.

Il cambio di paradigma introdotto dal divenire-software delle reti di nuova generazione è senz’altro positivo in termini di:

  • gestione (maggiore visibilità determinata da un modello di controllo centralizzato);
  • possibilità di applicare la Security by Design: le reti di nuova generazione includono funzioni e capability di sicurezza native che possono essere progettate e implementate sin da subito e non, come storicamente accaduto, ex post (prima i router, poi i firewall);
  • protezione avanzata: essendo i tempi di provisioning e remediation estremamente ridotti, la risposta agli attacchi può essere parzialmente automatizzata e variare dinamicamente anche durante un evento di sicurezza. Inoltre, gli aggiornamenti e le patch di sicurezza possono essere facilmente programmati ed eseguiti;
  • Defense in Depth: i dati possono essere efficacemente protetti tramite l’integrazione delle diverse funzioni di sicurezza disponibili ad ogni livello;
  • aumento complessivo delle capacità di risposta agli incidenti;
  • maggiore resilienza agli attacchi DDoS;
  • Zero Trust: possibilità di eliminare il trust debole segmentando l’accesso alla rete e autorizzando, ispezionando e cifrando tutto il traffico in modalità end-to-end.

Non esistono risposte semplici alla domanda di sicurezza generata da uno scenario di tale complessità, ma è opportuno, almeno, cercare di imparare le lezioni del passato facendone tesoro:

  • il processo di Secure Software Developement Lifce Cycle deve essere opportunamente integrato sia nel paradigma Waterfall sia in quello Agile, focalizzando gli sforzi sia sulle fasi ex-ante (definizione dei requisiti di sicurezza, progettazione delle interfacce, Static Application Security Testing, etc) sia su quelle ex-post (Vulnerability Assessment, Penetration Test, Dynamic Application Security Testing, Patching, etc);
  • per mitigare il rischio di compromissione della Supply Chain, è necessario implementare processi di selezione dei propri fornitori con particolare attenzione ai requisiti di sicurezza di questi ultimi. È opportuno richiedere l’utilizzo di standard e best practice, unitamente al possesso delle opportune certificazioni di qualità e sicurezza con le relative evidenze. I fornitori sono coloro che, materialmente, scrivono il codice su cui si basano le reti di nuova generazione degli operatori di comunicazione;
  • per mitigare i rischi derivanti dalle vulnerabilità di determinati protocolli di comunicazione e segnalazione, è necessario attuare misure tecniche di sicurezza che prevedano il monitoraggio continuo e la protezione attiva dei punti di interconnessione verso le reti di terze parti. Le reti di nuova generazione dispongono di capability adeguate a gestire tempestivamente situazioni di emergenza di questo tipo.

Il divenire-software delle reti si innesta all’interno di un’ampia trasformazione digitale della società operante a vari livelli ed eredita le caratteristiche tipiche del software. Al netto delle capability di modularità, scalabilità e programmabilità delle funzioni, un punto di attenzione è rappresentato dalla storica difficoltà di garantire un adeguato livello di sicurezza del software.

Nota

Ho utilizzato per la prima volta la locuzione Divenire-software durante un evento organizzato da AFCEA dal titolo “Hybrid Landscape: strategie e sistemi per la difesa e sicurezza delle reti”.
Slide: https://www.afcearoma.it/images/icagenda/files/Presentazioni_Eventi/Anno2019/19_giugno_2019/Convegno_AFCEA_Andrea_Boggio.pdf
Video: https://youtu.be/pNZSsDlPyqQ

Articolo a cura di Andrea Boggio

Andrea Boggio è Security Solutions Sales Manager in Vodafone Business, la divisione Vodafone dedicata ai servizi per le imprese, e si occupa di attività di vendita, prevendita e progettazione di soluzioni e servizi di Cyber e ICT Security. In precedenza ha lavorato presso aziende focalizzate sulla sicurezza informatica (HP, NTT Data) e di telecomunicazione (Fastweb).
Andrea lavora da oltre 15 anni nell’Information Security Arena e si occupa di diverse aree tematiche quali: Governance, Risk & Compliance, SIEM e SOC, Mobile Protection, Threat e Vulnerability Management, Network Security e Cyber Security.
Andrea detiene le certificazioni professionali ISO/IEC 27001:2013 Lead Auditor, CISA, CISM, CGEIT, CRISC, ITIL e diverse altre legate a specifici vendor di sicurezza, è membro del capitolo italiano di ISACA e ha partecipato al Cloud Security and Resilience Expert Group di ENISA.

Download PDF

https://www.ictsecuritymagazine.com/articoli/divenire-software-delle-reti-e-cyber-security/


A Case History: the OSINT

Avete mai pensato a cosa muove un Hacker?
È semplicemente un reflusso di ormoni adolescenziali oppure vi è qualcosa dietro, qualcosa di più profondo? Come l’esigenza e la necessità di reagire ad un sopruso o di liberarsi dalle sbarre dorate di questa società? Due testi su questo argomento la dicono lunga: il primo è “La Coscienza di un Hacker”1; il secondo “The Fallen Dreams: Diario di un Hacker”, reperibile facilmente per una decina di euro.
Entrare nella mente di un Hacker è uno degli aspetti fondamentali per prevenire un attacco, soprattutto perché spesso, quando si tenta di intervenire a posteriori, si rivela essere già troppo tardi.

Ora la domanda è: esistono davvero queste “sbarre dorate”? Vi è realmente una guerra silente in atto che prende piede, giorno dopo giorno, sullo sfondo delle nostre vite?
Analizziamo alcuni fatti.
Lo Xinjiang è una regione autonoma della Cina nord-occidantale, che ha più o meno gli stessi abitanti di Pechino. La Cina sta usando questi abitanti come cavie per sperimentare nuove forme di controllo della tecnologia, investendo massicciamente nello sviluppo di IA e Software. I cittadini sono obbligati a scaricare sui loro dispositivi diverse app in grado di analizzare flussi di dati in ingresso e in uscita dai loro smartphone. Tali dati vengono successivamente trasmessi a un server centralizzato, in grado di stabilire un insieme di comportamenti dell’individuo e creare una categoria di azioni ritenute “standard”. Ora, se il comportamento di un cittadino dovesse discostarsi da quello “standard”, il server avvertirebbe subito dell’anomalia. Oltre a questo, numerose startup cinesi di cyber sicurezza hanno ricevuto ingenti finanziamenti per lo sviluppo di sistemi di riconoscimento facciale, che in Cina si affermano come realtà più che consolidata e risultano ormai un affare globale. Se, a tutto questo, aggiungiamo droni dal peso di 200 grammi dotati di fotocamera ad alta definizione che simulano la reale aerodinamica degli uccelli, capiamo l’urgenza di proteggere la nostra libertà.

Similmente, nel nostro Paese, vi è una profanazione costante della privacy: veniamo profilati in maniera sistematica quando navighiamo su internet, quando facciamo la spesa, quando dormiamo, quando guardiamo una pubblicità; viene persino analizzata la nostra risposta facciale a un determinato stimolo al fine di capire se ci piaccia o meno quel determinato oggetto, oppure se quello che stiamo leggendo è o non è nelle nostre corde.

Le tracce che quotidianamente lasciamo sulla rete sono innumerevoli, tra dati testuali, video, audio… non solamente i privati, ma anche molte aziende sottovalutano il potere dello “Spionaggio da Fonti Libere”.
L’OSINT, acronimo di Open Source INTelligence, si occupa proprio della “raccolta d’informazioni mediante la consultazione di fonti di pubblico accesso”2.

Recentemente, un’agenzia investigativa ci ha chiesto di collaborare per un caso di diffamazione, riguardante un personaggio molto in vista. Vi confesso che non amo particolarmente far da balia a un paio di damerini quindi, quando il nostro collega mi propose il lavoro, la risposta fu ben più colorita della seguente:

«Se lui non riesce a tenersi stretto il suo profilo, noi non possiamo farci molto».
«Non è solo questo, pare che siano stati coinvolti anche i suoi figli di dodici e sedici anni» replicò il mio socio. Poi, dopo una breve pausa, aggiunse «Le foto dei minori sono apparse anche su alcuni siti anonimi… inoltre, pare che sia presente in rete un elenco con diversi numeri di telefono associati ad altri personaggi».
«Traduci: “anonimi”. Tor? L2P? Freenet?3» domandai.
Il mio socio scosse la testa: «Internet».
«Cioè, sono sul “Surface Web”? (Il cosiddetto web di superficie, dove quotidianamente navighiamo)» dissi fra lo stupito e l’incredulo.
«Lo accettiamo questo lavoro oppure no?» replicò lui con un sorrisetto sornione.

Ormai aveva stuzzicato la mia curiosità, quindi non rimaneva che approfondire…

PARTE I: THE REVERSE BRUTE FORCE

Solitamente, chi è avvezzo a questo genere di cose (un cyber criminale, o un cracker) non utilizza il web di superficie per uplodare contenuti, a meno che non si tratti di un atto di hacktivismo o deliberatamente volto a far emergere fatti o dati all’”opinione pubblica”. Anche se la vittima avrebbe potuto potenzialmente rappresentare un bersaglio per gli Hacker, le modalità utilizzate ed il coinvolgimento di minori, li scagionava. Almeno in linea teorica.

Decisi come prima cosa di dare un’occhiata al dominio imputato, attualmente sotto sequestro. Per ovvie ragioni, non potrò parlare direttamente del caso in questione, ma farò un esempio parallelo ad esso:

La prima cosa che feci, fu un whois del sito utilizzando la famosa distro: Kali Linux4.

whois example.net –verbose

Per chi non fosse pratico, whois è un protocollo di rete che consente di interrogare il server database, per stabilire a quale provider internet appartenga un determinato IP o DNS. Ciò che attirò la mia attenzione furono le informazioni successive mostrate dal comando, in particolare l’intestatario e la data di registrazione.

(L’immagine è estratta dall’output del comando a puro scopo esemplificativo)

L’opzione verbose mi consentiva di collezionare eventuali informazioni aggiuntive sullo stato dell’output.

Ciò che mi colpì fu il dominio, intestato a una vecchia società (che chiameremo “Example S.p.A”). Feci qualche ricerca su internet e trovai diversi articoli che parlavano della chiusura di diverse holding, assorbite da un grosso gruppo finanziario. Un dominio morto, quindi, apparentemente.

Utilizzai il comando: host example.net, per assicurarmi dell’IP.

(L’immagine è estratta dall’output del comando a puro scopo esemplificativo)

La domanda che mi posi successivamente fu: esistono altri IP registrati da “Example S.p.A”? Per scoprirlo decisi di fare un Reverse Brute Force degli IP. Mi spiego meglio: avevo ottenuto l’indirizzo del sito internet grazie al comando “host: 194.168.244.97 dominio example.net”. Ora, non mi restava che scoprire se ci fossero altri IP dell’insieme hosts 192.168.244.1-254 registrati a nome della holding “Example S.p.A”… e se sì, quali?

Improvvisai un semplice script in bash5, del tipo:

#!/bin/bash
for ip in $(cat listadegliIP.txt);
# per ogni “ip” contenuto nel file di testo denominato: “listadegliIP.txt”
do whois $ip | grep "Example S.p.A";
#esegui il commando “whois” dell’IP e stampa a video (tramite il comando grep) solo le stringhe che contengono la dicitura “Example S.p.A”
echo $ip;
#mostrami l’IP associato
Done
#fine

Sorpresa! Altri 3 IP risultavano ancora registrati a nome di questa vecchia holding. Effettuai un altro whois esteso per ogni indirizzo IP, ma le informazioni ottenute non differivano dall’originale.

PARTE II: Google Hacking

A questo punto, decisi di utilizzare un’altra tecnica: il Dorking (conosciuta anche come Google Hacking). Essa consiste in interrogazioni mirate del web, sfruttando Google. Esiste un database di riferimento con cui sbizzarrirsi: https://www.exploit-db.com/google-hacking-database.

Quindi aprii il browser e utilizzando la barra di ricerca di Google digitai:

  • site:example.net  ext:xml | ext:conf | ext:cnf | ext:reg | ext:inf | ext:rdp | ext:cfg | ext:txt | ext:ora | ext:ini

Dove “site” è il sito target ed “ext” sta per “estensione”. Ergo, avrei cercato nei tre siti registrati a nome della holding Example S.p.A eventuali file di configurazione esposti. Eseguii una decina di Dork, fra cui “site:example.net inurl:login”, al fine di cercare le pagine di Login in correlazione con il target.

Ma la query che aggiunse un tassello al nostro puzzle fu:

  • site:example.net ext:doc | ext:docx | ext:odt | ext:pdf | ext:rtf | ext:sxw | ext:psw | ext:ppt | ext:pptx | ext:pps | ext:csv

In questo caso, cercai tutti i documenti esposti pubblicamente nei siti target Example S.p.A.

Nel terzo sito, ben annidati nel ginepraio dei sotto URL del dominio, apparvero due pdf, ignaramente esposti sulla rete. Non posso citare cosa contenevano, ma posso dirvi che menzionavano un’altra holding estera, ritenuta responsabile del crollo della società (che chiameremo con molta fantasia “Example2 S.p.A”).

PARTE III: RESURRECT

Dalle semplici ricerche su Google della società, non apparve nulla. Molte portavano a vicoli ciechi o pagine rimosse e non più reperibili. Decisi di avvalermi di un’estensione del browser nota come “Resurrect Pages”6, che permette di raccogliere informazioni da vari aggregatori come Achive.is, Google Cache, WebCite, Google, etc…

A questo punto, tornai su alcune di quelle pagine che mi avevano restituito un errore di Google “404” ed eseguii il “Resurrect”, tramite l’estensione del browser che avevo appena scaricato. Mi apparvero a video alcune vecchie pagine di Example2 S.p.A, incomplete. Bastò poi un’analisi superficiale con un banale F127 per rivelare il dominio a cui faceva riferimento la società: example2.eu.

(L’immagine è estratta dall’output del comando a puro scopo esemplificativo)

PARTE IV: FORWARD LOOKUP BRUTE FORCE

Decisi che questo dominio appena trovato meritava un’analisi più approfondita, così eseguii quello che in gergo viene chiamato “Forward LookUp BruteForce”. L’idea alla base è quella di fare un guessing (tirare ad indovinare) i nomi dei server validi (appartenenti al dato dominio), tendando ogni volta di risolverli.

Quindi produssi un file .txt con un centinaio di hostname più comuni.

(L’immagine è a puro scopo esemplificativo)

E scrissi il semplice script:

#!/bin/bash
for ip in $(cat hostname.txt);  // per ogni nome contenuto nella lista che avevo creato
do host $ip.example2.eu |grep -v "not found"; // esegui il commando “host” (esegue un DNS lookup) del nome presente nella mia lista, unito al dominio target (example2.eu). –v scarta le stringhe di output che contengono “not found”.
done
//fine

Il risultato fu che, fra gli n server che trovai, vi era un webmail.example2.eu ancora attivo. Navigando sull’indirizzo IP associato, venivo reindirizzato automaticamente ad un vecchio server di posta8 ancora attivo.

PARTE V: SMTP

Decisi di fare una ricognizione non invasiva su webmail.example2.eu utilizzando nmap9:

nmap -sS –p25 192.168.X.

– sS: permette di effettuare la scansione delle porte in modo “relativamente” nascosto e poco invasivo, non completando del tutto la connessione TCP;

– p: specifica esplicitamente la porta sul quale effettuare la scansione. Non sapendo chi c’era dall’altra parte, decisi di procedere con prudenza, specificando solo la porta che mi interessava. Nel mio caso il protocollo SMTP, porta 25, utilizzato come standard per la trasmissione di e-mail;

– 143 192.168.X.X: era l’IP del mio target: webmail.example2.eu.

 Il risultato del comando diede come esito: “SERVICE: smtp STATE: open”.

 A questo punto, con la porta 25 in “state open”, avrei potuto utilizzare diversi script per l’enumerazione degli utenti (ad esempio: smtp-user-enum) con wordlist specifiche, ma avevo scarse informazioni sui potenziali utenti di quel server. Quindi decisi di fare un tentativo con alcune credenziali di default.

Utilizzai ancora il mio terminale e digitai:

telnet 192.168.X.X 25

Per chi non lo sapesse, telnet è un protocollo “generalizzato” che viene utilizzato solitamente per aprire sessioni di login10.

La sessione mi restituì “Connected to webmail.example2.eu” e quello che in gergo viene chiamato “Banner” (contenente molte volte diverse informazioni sensibili). Il mio primo comando fu un banale HELO che dava inizio alle comunicazioni fra il mio client telnet e il server SMTP.

Utilizzai quindi il comando VRFY seguito da administrator poi root e successivamente sys. Ma non accadde nulla: le risposte furono tutte negative.

A questo punto, decisi di chiudere la connessione e non tentare ulteriori accessi, per il momento. Avevo bisogno di maggiori informazioni.

PARTE VI: THEHARVESTER

Mi venne in soccorso un programma in grado di estrarre dati da un dato sitoweb e di recuperare informazioni sul target consultando numerose fonti: THEHARVESTER.

Dalla mia Kali, digitai:

theharvester –d example2.eu –b all

– d specificava il dominio target;

– l’opzione –b indicava le sorgenti di dati a cui volevo attingere. Ad esempio: yahoo, twitter, linkedin, etc…Nel mio caso “all”, cioè cercai in tutte le sorgenti disponibili.

Il risultato furono una quindicina di indirizzi email. Rimossi quelli delle mailing list11 (ad esempio amministrazione, paghe, contabilità, etc.), ne rimasero otto. Tutti erano del tipo classico: nome.cognome@example2.com.

La cosa si faceva interessante, ma mi mancavano le password. Avrei potuto tentare un brute force12 classico a questo punto, ma temevo che il server andasse giù o, peggio, che qualcuno si accorgesse dell’attacco. Decisi quindi di seguire ancora la strada dell’OSINT.

Nota di Approfondimento: un attacco di tipologia brute force porta il server vittima al limite in termini di risorse hardware (anche se esistono diverse tecniche per mitigare l’ “overload” generato), il risultato potrebbe essere un crash del sistema. La possibilità che l’evento avvenga è potenzialmente maggiore su macchine datate.

PARTE VII: DATA BREACH

Avevo diverse possibilità. Fra queste, ad esempio, avrei potuto impiegare tool come Maltego per la ricerca di fingerprint13. Decisi invece di verificare se gli indirizzi mail fossero stati esposti ad un Data Breach14, utilizzando siti come: https://haveibeenpwned.com/.

Quando vidi comparire la scritta “Oh no — pwned!” Scaricai le collection15 contenenti tutti i Breach, e quindi le password delle mail compromesse. Ovviamente nei file non erano presenti password in chiaro, bensì gli Hash16 delle password stesse. A questo punto era giunto il momento di tentare il brute force in locale sulla mia lista di hash, appena scaricata.

Per farlo utilizzai hashcat https://hashcat.net/hashcat/ su Kali.

Vi faccio un esempio:

hashcat -m 0 -a 0 -o cracked.txt target.lst txt/wordlistExample2_eu.txt

– m: identifica il format dell’hash da craccare (MD5 in questo caso);

– a 0: un attacco dizionario;

– o: l’output con le password;

– target.lst: lista degli hash;

– la word list che avevo preparato per l’occasione.

Il lasso di tempo, avendo anche a disposizione l’hardware dedicato, fu notevole. La mia speranza era questa: che il tassello che mancava fosse la correlazione fra la password e il mio username.

Avevo preparato una word list utilizzando un crunch17 (se siete interessati, vi rimando a un mio precedente articolo: A case history – Worst Case Scenario) con molteplici combinazioni di password contenente i nomi che avevo a disposizione della holding e dei vari ex impiegati. Il cracking sulle password sarebbe andato a buon fine solo se il match – fra la mia word list e le password contenute nella collection deldata breach – avesse trovato una correlazione 1:1. Un tentativo al limite, ma decisi comunque di tentare.

Saltarono fuori due password. Una era composta da tre lettere del nome, tutto il cognome con una maiuscola finale e un punto esclamativo. L’associazione del cognome fu scontata. La seconda era un classico: tutto il cognome, con la prima lettera in maiuscolo, e un punto interrogativo finale. Le associazioni furono pressoché immediate.
Incrociai le dita e tornai sul server Exchange: webmail.example2.eu, digitandovi user e password.

Fu così che dalle email successivamente rinvenute e analizzate dagli investigatori venne fuori un caso di vendetta. L’ex amministratore delegato della holding ritenuta responsabile (Example2 S.p.A.) era finito sotto inchiesta, per volere del nostro “personaggio noto”. Aveva quindi ingaggiato un gruppo di cyber-criminali al fine di estorcere dati sensibili alla vittima e diffonderli sul web, per diffamarlo pubblicamente. La polizia postale, che eseguì il forensic sui dispositivi, confermò che erano stati hackerati e che la rubrica con tutti i numeri della vittima era stata data in pasto alla rete, comprese le foto dei due figli.

Referenze:

  1. https://gist.github.com/FiloSottile/3787073
  2. https://it.wikipedia.org/wiki/Open_Source_Intelligence
  3. https://it.wikipedia.org/wiki/Dark_web
  4. https://it.wikipedia.org/wiki/Kali_Linux
  5. https://it.wikipedia.org/wiki/Bash
  6. https://addons.mozilla.org/it/firefox/addon/resurrect-pages/
  7. https://www.html.it/pag/45642/gli-strumenti-f12-il-debug-con-ie11/
  8. https://it.wikipedia.org/wiki/Microsoft_Exchange
  9. https://it.wikipedia.org/wiki/Nmap
  10. https://it.wikipedia.org/wiki/Mailing_list
  11. https://it.wikipedia.org/wiki/Telnet
  12. https://it.wikipedia.org/wiki/Metodo_forza_bruta
  13. https://en.wikipedia.org/wiki/Maltego
  14. https://en.wikipedia.org/wiki/Data_breach
  15. https://en.wikipedia.org/wiki/Collection_No._1
  16. https://it.wikipedia.org/wiki/Funzione_crittografica_di_hash
  17. https://www.ictsecuritymagazine.com/articoli/a-case-history-worst-case-scenario/

Articolo a cura di Vincenzo Digilio

Ha lavorato come Network System Administrator, Security Auditor, System Integrator per importanti client ed enti governativi, seguendo progetti come calcolo distribuito, security resource implementation in aree nuclearizzate, adeguamenti di security policy e Security Engineering per la selezione d’importanti fornitori al fine d’implementare sistemi di sicurezza per diverse Multinazionali. Ha tenuto corsi di tecniche Hacking, studiando in contemporanea per il corso di Laurea in Sicurezza delle reti Informatiche. È attualmente impiegato nella ricerca di vulnerabilità, sviluppo di exploit e whitebox / black box Penetration Testing. Coordina, inoltre il RedTeam della società’ Cyber Division di cui e’ uno dei fondatori. È consulente in materia di Global Security Policy Statement, Risk management e Data Breach Investigation. È intervenuto in diversi casi di compromissione dati, analisi forensi, system breach e attacchi hacking al fine di mitigare la situazione. Crede nella libertà d’informazione e nel diritto alla privacy.

Download PDF

https://www.ictsecuritymagazine.com/articoli/a-case-history-the-osint/