WeChat Forensics – parte II

Nel precedente articolo mi sono occupato dell’analisi forense di WeChat iOS. Questa seconda parte riguarderà Android.

Con la versione 7.0.4 – ultima release attualmente scaricabile da Play Store alla data di stesura dell’articolo – arrivano: le “Capsule del tempo”, un design tutto nuovo con interfaccia più semplice e intuitiva e il “Fai una bolla” che consente di far conoscere a un amico l’apertura di una “Capsula del tempo”; chi volesse approfondire può farlo qui.

Le caratteristiche dell’applicazione sono state già descritte nell’articolo su iOS; darò quindi dei cenni qualora vi siano delle evidenti discrepanze.

Allo stato attuale, molti prodotti commerciali a supporto della mobile forensics quali Cellebrite, XRY, Oxygen e Belkasoft supportano le estrazioni dei dati inerenti le applicazioni di terze parti per Android – tra cui WeChat – ma solo in presenza di una determinata condizione: il rooting[1] dei dispositivi, che  può essere anche effettuato dall’applicazione forense stessa durante l’estrazione.

Una sostanziale differenza tra WeChat iOS e WeChat Android risiede nella modalità di gestione del database; in iOS – come abbiamo avuto modo di verificare nel precedente articolo – il database non è cifrato, mentre lo è in Android.

Quindi, per proteggere la privacy degli utenti, WeChat for Android cifra il database contenente i messaggi di chat avvalendosi di SQLCipher[2]; questa è la prima sostanziale differenza rispetto a iOS.

Ma vi è di più: mentre in iOS è possibile estrarre i dati dell’app con iTunes, dalla versione 6.0 di WeChat non è più possibile estrarre i contenuti tramite la funzionalità di backup insita in Android su dispositivi non rootati; ciò si traduce in una ulteriore difficoltà per l’analista forense.

Come già detto, vi sono molti tool forensi in grado di estrapolare le evidenze di WeChat: per questo articolo adopereremo Oxygen Forensic Detective[3].

Oxygen Forensic Detective supporta l’estrazione e l’analisi della messaggistica WeChat sia da dispositivi Android che da dispositivi iOS.

Verrà utilizzata, in questo contesto, l’acquisizione fisica effettuata di un dispositivo Samsung Edge S6 + mediante l’utilizzo di Oxygen Detective. Essendo fondamentale assicurare l’integrità delle prove acquisite, l’acquisizione deve essere condotta necessariamente in ambiente forense mediante collegamento del dispositivo a una stazione di lavoro opportunamente predisposta.

In Android, i dati di interesse investigativo di WeChat sono archiviati nella cartella /data/data/com.tencent.mm, che contiene quanto riportato in fig. 1.
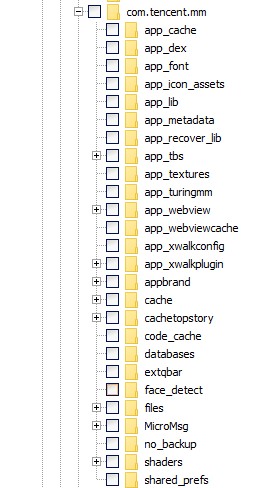
fig 1

Le cartelle che contengono i file di particolare interesse sono:

  1. files/host;
  2. MicroMsg;
  3. shared_prefs;
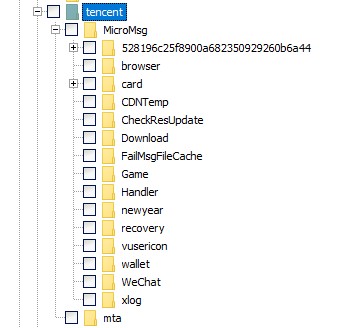
  4. /sdcard/tencent/MicroMsg.

fig 2

I file di maggiore interesse contenuti nelle cartelle descritte, sono così suddivisi:

  1. /files/host/*.getdns2
  2. MicroMsg
  • db
  • db
  • SnsMicroMsg
  • cfg
  1. /shared_prefs/
  • tencent.mm_preferences.xml
  • xml
  1. /sdcard/tencent/MicroMsg
  • WeChat
  • image2
  • video
  • voice2

I file con estensione getdns2 – fig. 4 – che si trovano nella cartella /files/host possono essere tranquillamente aperti con un editor di testo o esadecimale. All’interno è possibile trovare la sezione [clientip] – fig. 5 – che mostra gli indirizzi IP dai quali l’utente si è connesso e la data della connessione in formato “Epoch Linux”; il formato può essere facilmente convertito in data e ora intellegibile  anche a mezzo di siti web quali, ad esempio, https://epochconverter.com.

fig 4
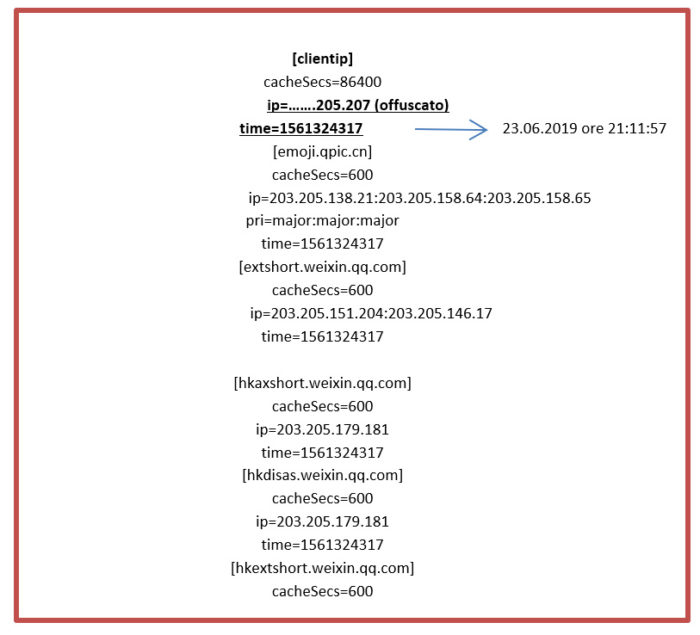
fig 5

La cartella MicroMsg è così composta:
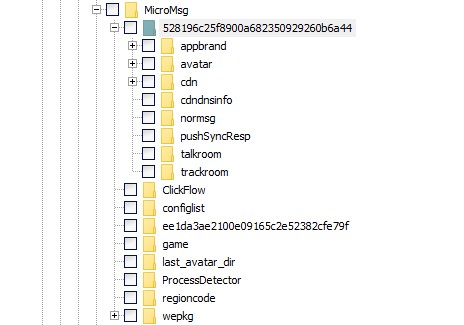
Viene posta in evidenza la cartella denominata 528196c25f8900a682350929260b6a44 – determinata dal risultato di MD5 (‘mm’ + uin) – che contiene, tra l’altro, due file di database cifrati: quello contenente le chat dell’utente, EnMicroMsg.db e enFavourite.db.

Entrambi sono cifrati tramite l’estensione di crittografia opensource per SQLite denominata SQLCipher [14]. SQLCipher fornisce un’interfaccia trasparente a SQLite; il file è diviso in piccoli blocchi di 4Kb e il testo cifrato viene calcolato utilizzando l’algoritmo AES[4] 256-bit. La decifrazione viene eseguita utilizzando la chiave di decrittografia – calcolata con il metodo esposto in seguito – e convertendo il testo cifrato in testo semplice.

In calce, figg. 7 e 8,  il contenuto della cartella 528196c25f8900a682350929260b6a44:
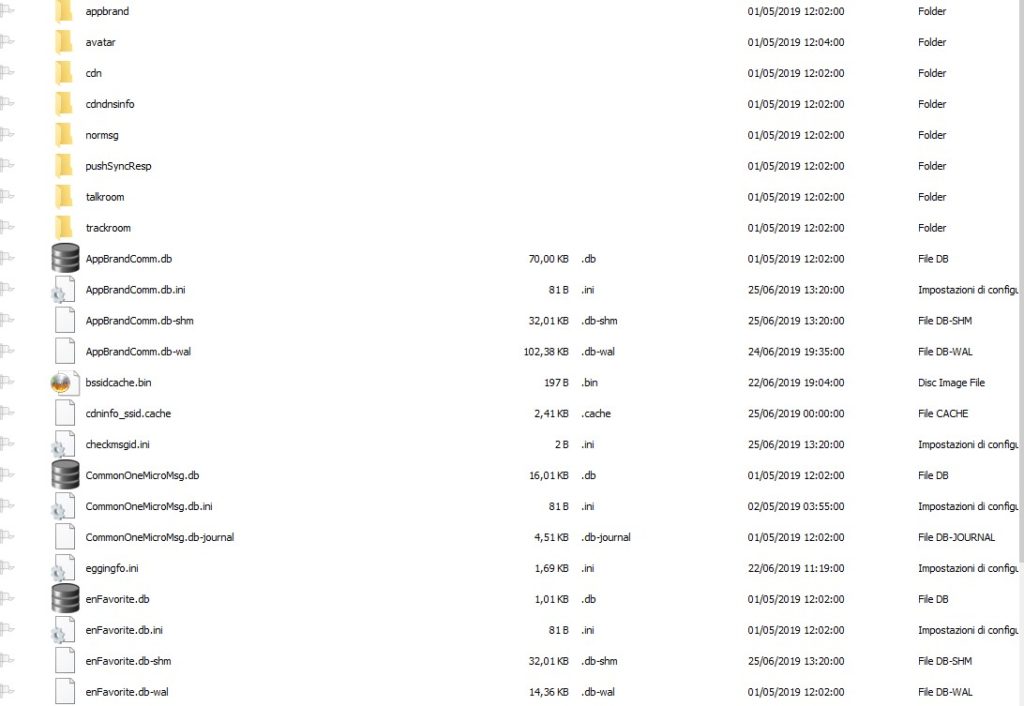
fig 7
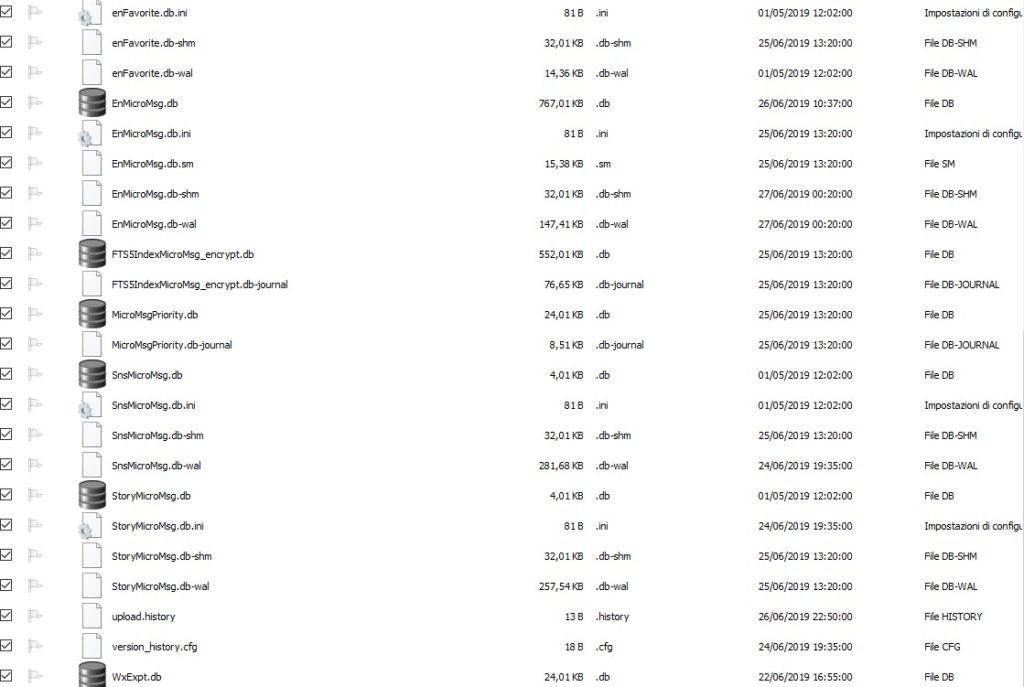
fig 8

Per decifrare i database menzionati – enFavourite.db e EnMicroMsg.db – è necessario utilizzare un codice di decifrazione che, nel caso di WeChat, è composto dal codice IMEI (International Mobile Equipment Identity) – estraibile dal file CompatibleInfo.cfg, fig.9 – e l’id univoco del profilo utente di WeChat, rinvenibile dal file /shared_prefs/system_config_prefs.xml, come indicato in fig. 10:
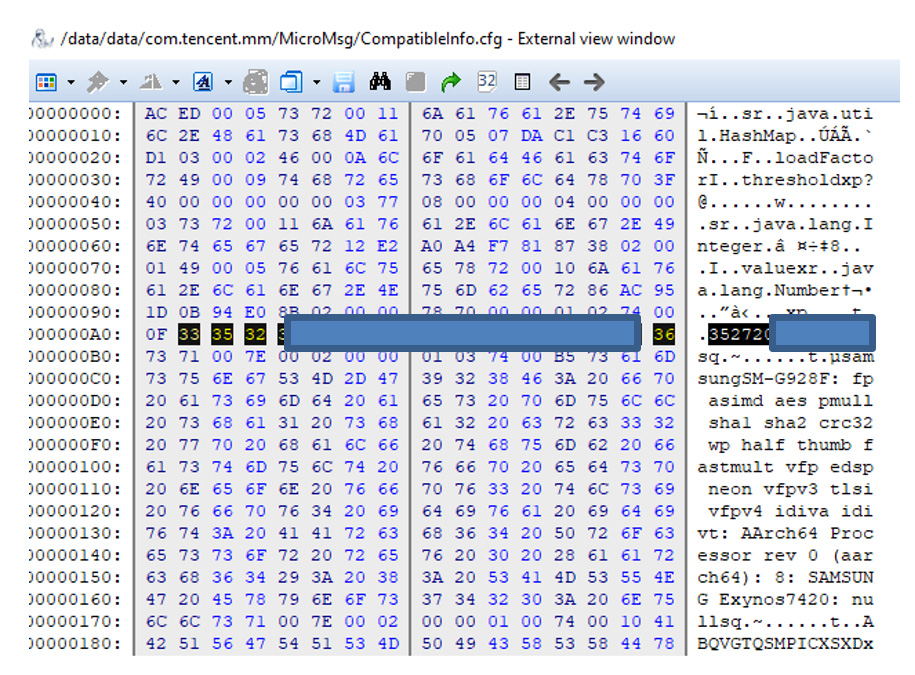
fig 9
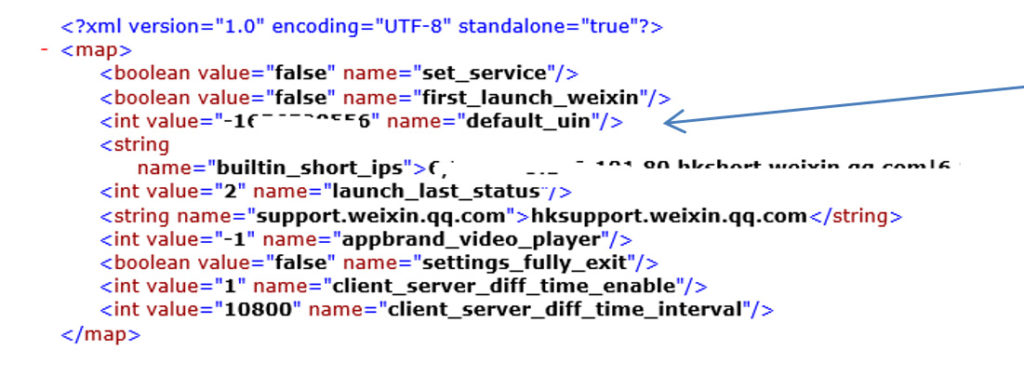
fig 10

La chiave per decifrare i db è composta dai primi sette (7) caratteri risultanti dalla seguente espressione: Md5 (IMEI + default_uni).

Utilizzando una semplice applicazione, denominata sqlcipher (e liberamente scaricabile dal seguente indirizzo web: https://raw.githubusercontent.com/xiejiangzhao/Wechat_database_decrypt/master/sqlcipher.exe) è possibile, fornendo all’applicazione la chiave ricavata in precedenza – fig.11 – , avere accesso alle numerose tabelle – ben 173 evidenziate in parte in fig. 12 –, che compongono il database EnMicroMsg.db:
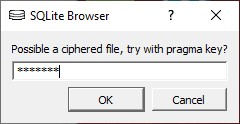
fig 11
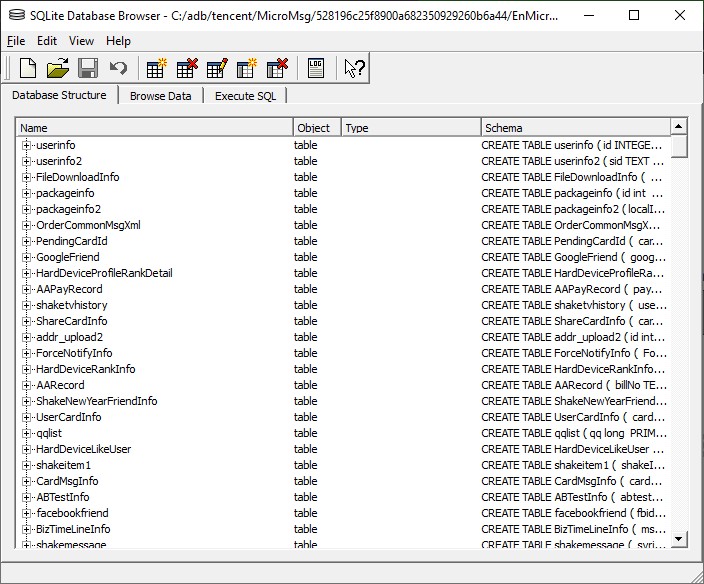
fig 12

Analogo metodo è adoperabile per l’accesso al database enFavourite.db dato che la chiave di decifrazione è la stessa utilizzata per EnMicroMsg.db:
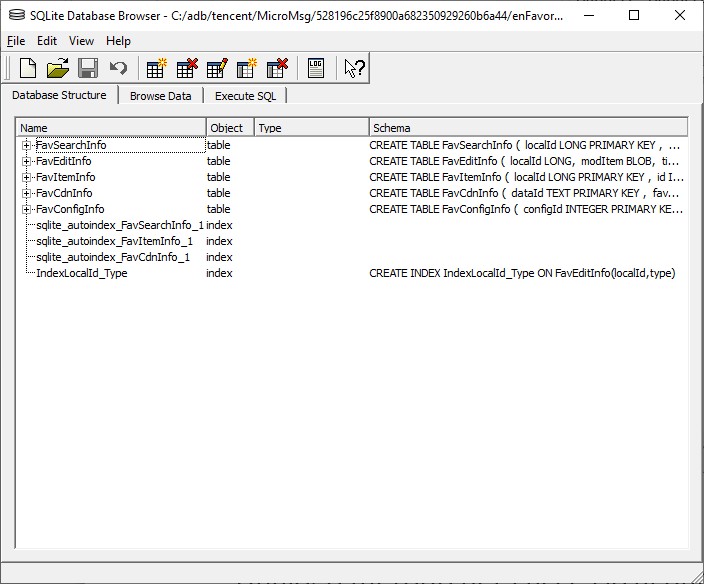
fig 13

I dati chiave sono principalmente concentrati nelle tabelle FavSearchInfo e FavItemInfo e l’analisi corrispondente consente di ottenere, tra l’altro, l’ID locale, il contenuto, l’etichetta, la data e ora, il mittente e il destinatario che sono tutti dati inerenti il contenuto preferito memorizzato:
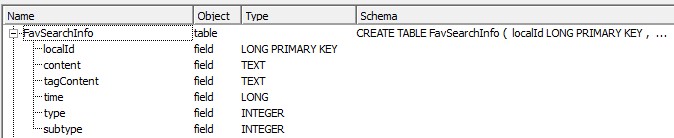
fig 14
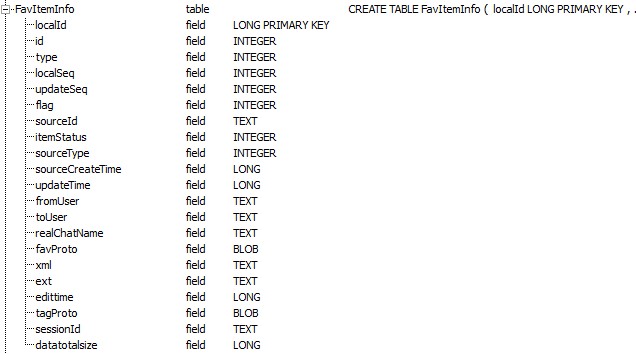
fig 15

Certamente, i dati più significativi risiedono nel database EnMicroMsg.db.
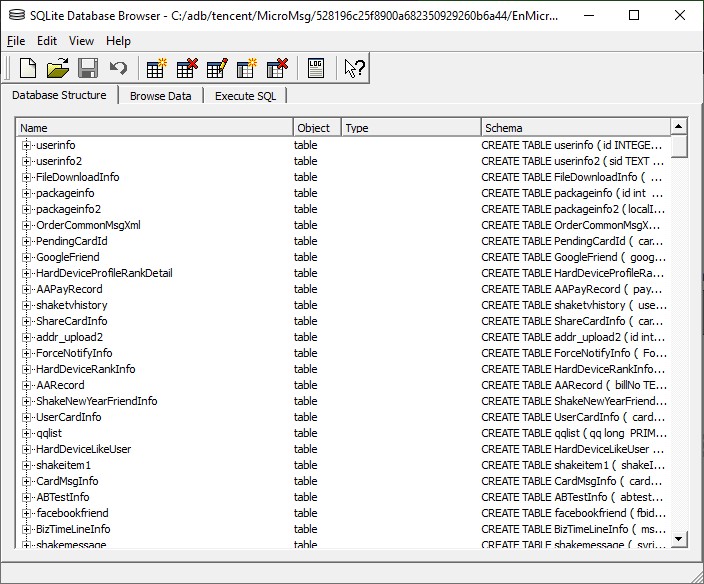
fig 16

Analizzaremo solo le tabelle che potrebbero contenere le informazioni utili all’analista forense.

1. userinfo, atta a contenere le informazioni di base dell’utente, come specificato in calce:
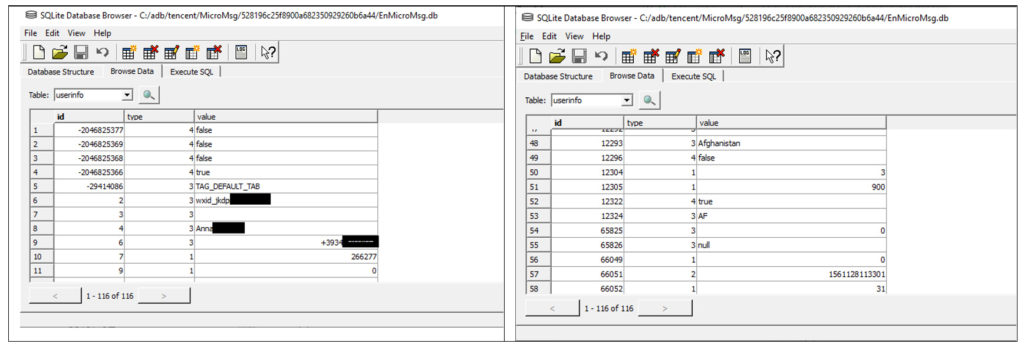
fig 17

  • Il campo id con valore 2 contiene l’identificativo dell’utente WeChat;
  • Il campo id con valore 3 contiene l’eventuale soprannome;
  • Il campo id con valore 4 contiene il nominativo dell’utente;
  • Il campo id con valore 6 contiene il numero del cellulare dell’utente;
  • Il campo id con valore 12293 contiene le informazioni sul paese dell’utente.

2. userinfo2 – fig. 18 – contiene le altre informazioni legate all’utente:

  • USERINFO_INSTALL_FIRST_TIME_LONG: contiene le Informazioni inerenti la data di prima installazione dell’app;
  • USERINFO_INSTALL_FIRST_CLIENT_VERSION_INT: il numero della prima versione installata;
  • USERINFO_HEAVY_USER_REPORT_TYPE_FAV_DB_SIZE_LONG: dimensione del database;
  • USERINFO_HEAVY_USER_REPORT_TYPE_DB_CHATROOM_LONG: il numero dei gruppi;
  • USERINFO_HEAVY_USER_REPORT_TYPE_DB_MESSAGE_LONG: numero dei messaggi;
  • USERINFO_HEAVY_USER_REPORT_TYPE_DB_CONTACT_LONG: numero dei contatti;
  • USERINFO_HEAVY_USER_REPORT_TYPE_DB_CONVERSATION_LONG: numero di sessioni complessive;
  • USERINFO_UPDATE_UPDATE_TIME_LONG: data e ora dell’ultimo aggiornamento;
  • USERINFO_UPDATE_UPDATE_VERION_LONG: versione aggiornata;
  • USERINFO_LAST_LOGIN_AVATAR_PATH_STRING: il percorso più recente relativo all’avatar dell’utente;
  • USERINFO_WALLET_RELEAY_NAME_BALANCE_CONTENT_STRING: posizione utilizzata di recente.
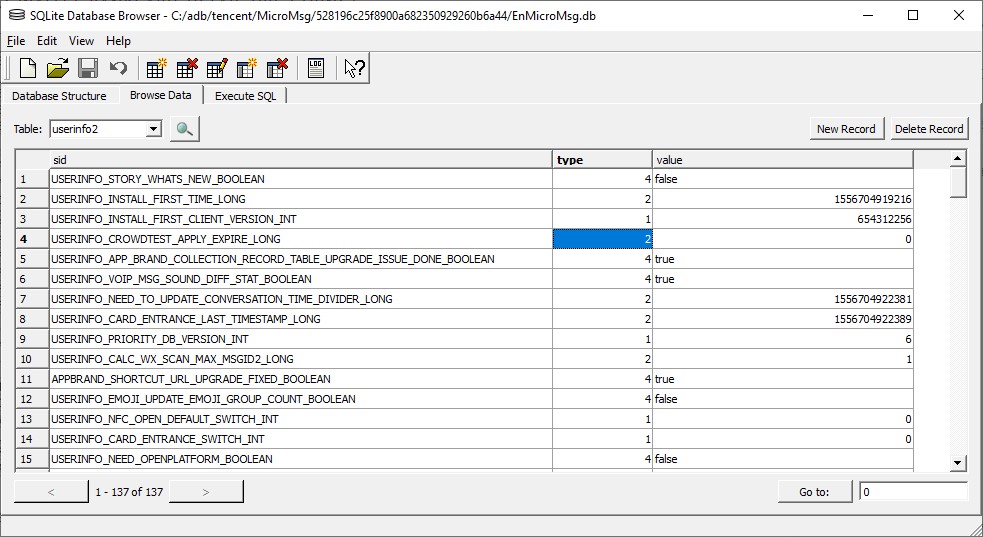
fig 18

3. MediaDuplication – fig. 19 – contiene le informazioni sui file multimediali, inclusi il valore MD5, le dimensioni, il percorso e il timestamp relativo alla creazione del file (nel caso di studio, non erano presenti file multimediali).
fig 19

4. Voiceinfo – fig. 20 – contiene le informazioni vocali, inclusi l’id dell’utente, il nome del file vocale, la dimensione, la durata dell’audio, la data e ora di creazione, etc.
fig 20

5. ImgInfo2 – fig.21 – contiene le informazioni sull’immagine, inclusi ID del messaggio, lunghezza, percorsi dell’immagine e della sua miniatura, data di creazione, immagine originale MD5, etc.
fig 21

6. Videoinfo2 – fig.22 – contiene le informazioni sul video, inclusi il nome del file, le dimensioni, la durata, ID del messaggio, l’attributo ora, ID dell’utente corrispondente (individuo o gruppo), etc.
fig 22

7. Rconversation – fig. 23 – contiene informazioni sulla sessione – gruppo di messaggi inerenti lo stesso oggetto della chat -, incluso il numero di messaggi, l’ID oggetto (incluso l’ID gruppo), il numero di messaggi non letti, il timestamp, il contenuto e altro.
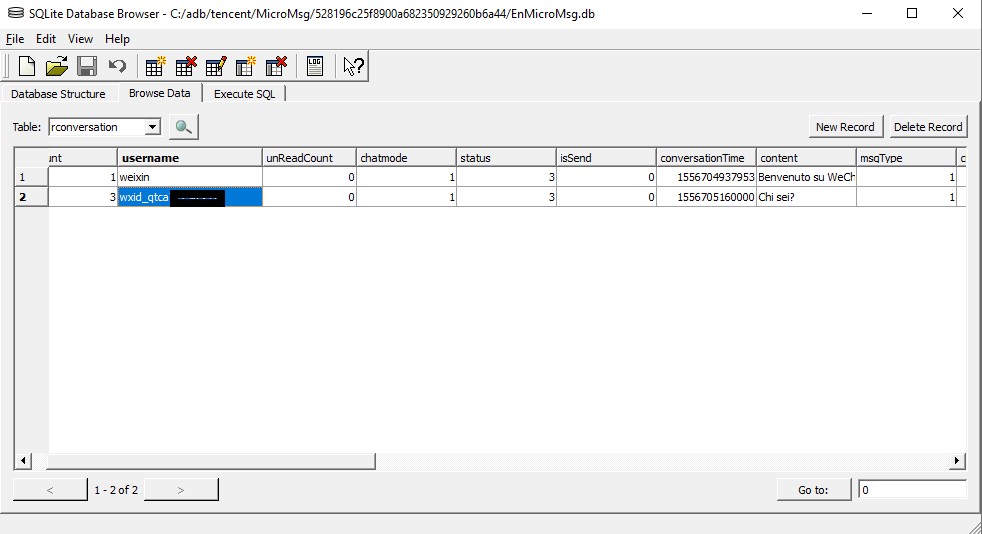
fig 23

8. message – fig. 24 – contiene le conversazioni scambiate, inclusi i messaggi peer-to-peer (mittente, contenuto del messaggio, timestamp) e i messaggi di gruppo (ID gruppo, contenuto del messaggio, timestamp), i percorsi di archiviazione dei file multimediali e così via.

I messaggi offline QQ sono memorizzati separatamente nella tabella qmessage.
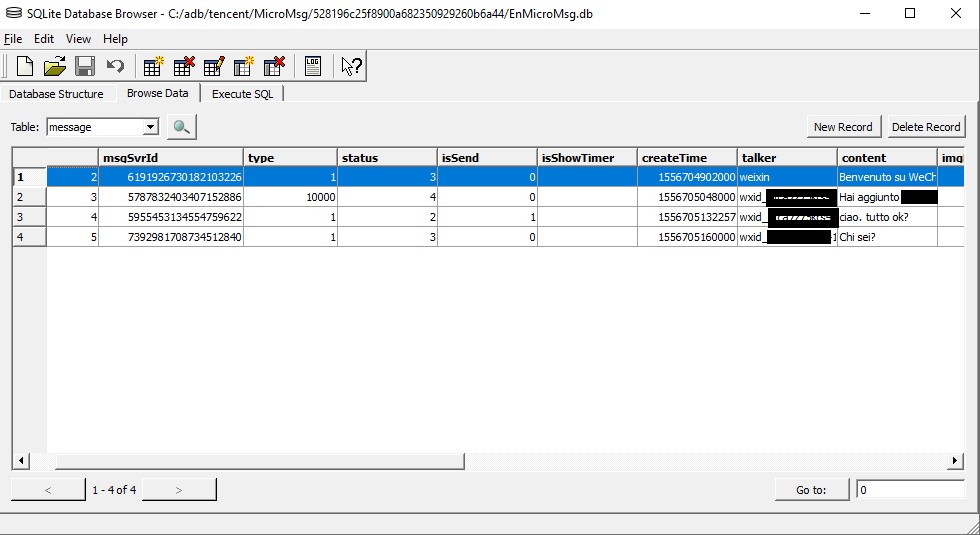
fig 24

I campi di ciascun record che potrebbero rivestire particolare interesse per l’analista forense sono: “talker“, “createTime“, “type“, “content“, “imgPath” e “isSend“. Il campo “talker”  memorizza l’account WeChat con cui l’utente sta comunicando; le sue informazioni dettagliate sono invece memorizzate nel tabelle “userinfo” – fig.17 – e “rcontact” – fig. 25 -.
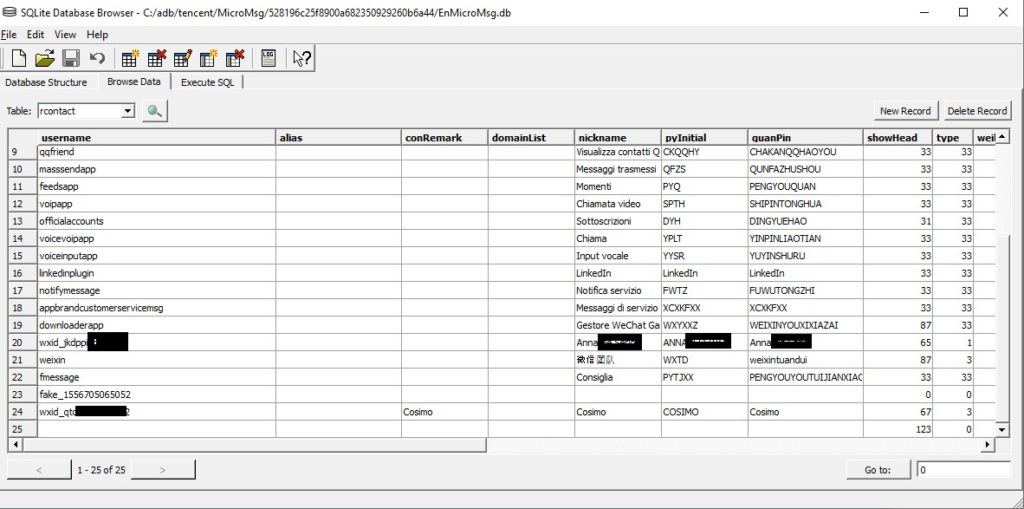
fig 25

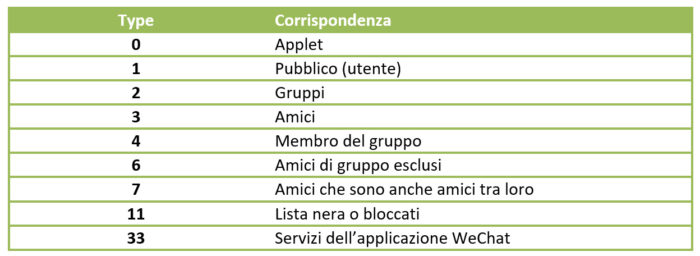
Nella fig.25, che evidenzia la tabella rcontact, il campo type viene utilizzato per distinguere il tipo di oggetto, il cui significato è esplicitato nella tabella in calce:
Conclusa la panoramica sui due database cifrati – anche se non sono i soli – è interessante soffermarsi ad esaminare, se pur velocemente, anche il database SnsMicroMsg.db.

Esso  contiene i dati relativi ai “momenti” della propria vita che gli utenti condividono con gli amici, in cui sono presenti anche contenuti multimediali. Questo database non è cifrato ed è costituito da 9 tabelle.

I dati di interesse possono essere rinvenuti nelle tabelle “SnsInfo” e “SnsComment”.

La tabella “SnsInfo” memorizza i messaggi Moments, inclusi i testi e il collegamento dei file multimediali (immagini o video). La tabella “SnsComment” contiene  invece i commenti associati al messaggio condiviso.

Di interesse nella tabella “SnsInfo” vi sono i campi  “userName“, “createTime” e “content“. Il campo “userName” contiene l’identificativo del mittente del messaggio, il campo “content” i dati del messaggio memorizzati in formato (BLOB) e il campo “createTime” il timestamp relativo.

Per concludere, è utile dettagliare alcuni dei contenuti presenti nel percorso /sdcard/tencent/MicroMsg, utilizzato per archiviare le risorse multimediali come immagini ricevute, file audio, etc.

Ogni utente ha una sua cartella privata – nel caso in esame 528196c25f8900a682350929260b6a44, la stessa di cui abbiamo già parlato che contiene, tra l’altro, alcune cartelle interessanti:

  • image2, le immagini relative ai messaggi;
  • voice2, i file audio delle conversazioni vocali;
  • video, i file video relativi ai messaggi.

Ritengo conclusa la trattazione dell’app WeChat per i sistemi Android.

Come sempre,
Stay Tuned.

Note

[1] https://it.wikipedia.org/wiki/Rooting

[2] https://www.zetetic.net/sqlcipher/open-source/

[3] https://www.oxygen-forensic.com/en/products/oxygen-forensic-detective

[4] https://en.wikipedia.org/wiki/Advanced_Encryption_Standard

Articolo a cura di Cosimo De Pinto

Download PDF

https://www.ictsecuritymagazine.com/articoli/wechat-forensics-parte-ii/


ISO/IEC 27701, la norma internazionale per certificare la protezione dei dati personali

Durante il mese di agosto 2019 ha finalmente visto la luce una norma molto attesa, i cui lavori erano iniziati già nel lontano 2016 e che, dopo diversi cambi di titolo e anche di numerazione, è infine risultata essere la:

“ISO/IEC 27701 Security techniques — Extension to ISO/IEC 27001 and ISO/IEC 27002 for privacy information management — Requirements and guidelines”.

La forte attesa per questa norma è motivata da più elementi, il primo dei quali è l’argomento, che la colloca in un segmento di mercato in forte evoluzione quale quello delle certificazioni secondo l’art.42 del Regolamento UE 679/2016 per la protezione dei dati personali (d’ora innanzi GDPR). Il secondo motivo è il comitato che l’ha pubblicata, ISO/IEC JTC 1 SC 27 (WG 5), recentemente rinominato “Information Security, Cybersecurity and Privacy Protection”. Questo comitato, essendo lo stesso che ha creato e manutiene la ISO/IEC 27001, la ISO/IEC 15408 e 200 altre norme tecniche massimamente rilevanti in questo ambito a livello internazionale dal lontano 1989, è certamente una delle fonti autorevoli più importanti al mondo e lo stesso fatto che abbia deciso di intraprendere dei lavori in questo senso la dice lunga sulla loro prevista strategicità.

La nuova ISO/IEC 27701 – identificata, fino a pochi giorni prima della pubblicazione, con il numero 27552 e poi passata a un numero da “testa di serie” per i sistemi di gestione – è impostata secondo quanto prescritto dalla ISO/IEC 27009 come una norma “sector specific” che va quindi a contestualizzare le prescrizioni generali della ISO/IEC 27001 nell’ambito specifico della protezione dei dati personali, aggiungendovi sia dei requisiti sia delle linee guida.

Questo approccio da una parte rende più facile l’adozione della ISO/IEC 27701 laddove già esista un sistema di gestione per la sicurezza delle informazioni conforme alla ISO/IEC 27001 mentre, dall’altro, richiede lo sforzo di implementare ex novo tale sistema qualora non sia già esistente, cosa che tipicamente comporta costi e tempi non trascurabili.

Il testo della ISO/IEC 27701, tolti i primi capitoli introduttivi, è articolato in quattro capitoli principali (5, 6, 7, 8), rispettivamente relativi a:

  • requisiti specifici per il sistema di gestione per la protezione dei dati personali collegati alla ISO/IEC 27001;
  • linee guida per il sistema di gestione per la protezione dei dati personali collegate alla ISO/IEC 27002;
  • linee guida aggiuntive alla ISO/IEC 27002 per i titolari;
  • linee guida aggiuntive alla ISO/IEC 27002 per i responsabili.

In sostanza la norma aggiunge una serie di requisiti alla ISO/IEC 27001 nel capitolo 5 per estendere il sistema di gestione dalla sola sicurezza delle informazioni a tutto l’ambito della protezione dei dati personali, richiedendo ad esempio di considerare esplicitamente i trattamenti ed i ruoli in essi legalmente coperti dall’organizzazione e di valutarne i rischi non solo relativamente a disponibilità, integrità e riservatezza delle informazioni ma anche al rispetto dei diritti e delle libertà degli interessati. Questa sezione è l’unica che specifica requisiti: quindi l’unica da rispettare in ogni caso per poter dichiarare la conformità alla ISO/IEC 27701.

Nel capitolo 6 sono invece riportate, per ogni controllo della ISO/IEC 27002, delle linee guida aggiuntive per l’attuazione del controllo stesso inerenti alla protezione dei dati personali. Per il controllo 5.1.1 relativo alle politiche per la sicurezza delle informazioni, ad esempio, viene suggerito di inserire, in una politica esistente o in una dedicata, l’impegno a mantenere la conformità con i requisiti legali e contrattuali in materia di protezione dei dati personali. Vale la pena di segnalare che non tutti i controlli godono di questa estensione.

I capitoli 7 e 8, invece, riportano i principi enunciati all’interno della ISO/IEC 29100 come controlli aggiuntivi contestualizzati a un’applicazione da parte dei titolari (capitolo 7) e dei responsabili (capitolo 8) del trattamento di dati personali.

L’impiego dei contenuti dei capitoli 6, 7 e 8 è, come si evince dai loro titoli, interamente opzionale. Si tratta infatti di aggiunte ai controlli della ISO/IEC 27002 che possono quindi essere o non essere attuati sulla base dei risultati della valutazione e del successivo trattamento del rischio, che in questo caso è assolutamente importante che non sia solo relativo alla sicurezza delle informazioni ma anche alla tutela dei diritti e delle libertà degli interessati.

Vi sono infine ben 6 appendici che forniscono dei comodi schemi di riferimento per i capitoli 7 e 8 o vanno a mappare la ISO/IEC 29100, il GDPR, la ISO/IEC 27018, la ISO/IEC 29151 e a fornire linee guida su come utilizzare la norma stessa.

Vale la pena notare che la norma non può essere utilizzata indipendentemente ma è necessario fare uso congiunto di una copia della ISO/IEC 27001 e di una copia della ISO/IEC 27002, in quanto si è deciso in fase di produzione della stessa di non ripetere il testo di queste ultime ma di includere nel testo solo le modifiche differenziali alle stesse.

La ISO/IEC 27701, considerando anche i validissimi editor messi in campo tra cui lo stesso della fortunata BS 10012, è senza dubbio uno strumento sofisticato, ben integrato con il parco normativo internazionale esistente e di potenziale interesse per tutte le organizzazioni dotate di un sistema di gestione per la sicurezza delle informazioni già solo per il fatto che molte di queste tratteranno inevitabilmente dei dati personali interni o di clienti. La sua stessa sofisticazione, d’altro canto, la rende un oggetto utilizzabile correttamente solo da una piccola porzione del mercato potenzialmente interessato da una certificazione secondo l’articolo 42 del GDPR, proprio per la limitata diffusione dei sistemi di gestione per la sicurezza delle informazioni (da fonti ISTAT e Accredia, circa 1 su 4500 in Italia), con particolare riferimento alle PMI. Un altro ostacolo in questo senso è costituito dallo schema di accreditamento utilizzato, coincidente con la ISO/IEC 17021 della ISO/IEC 27001 e diverso dalla più estesa ISO/IEC 17065 prescritta dall’articolo 43 del GDPR che, oltre ai sistemi di gestione e ai servizi forniti tramite gli stessi, include anche i prodotti. A questo proposito SC 27 ha appena varato un periodo di studio per valutare eventuali azioni correttive in materia ma queste ultime, quali che siano, difficilmente saranno messe in pista prima di un anno.

Superato questo passaggio, per quanto quasi certamente la ISO/IEC 27701 sarà sottoposta all’EDPB per valutazione rispetto ad uno schema di certificazione Europeo, rimarrà molto probabilmente spazio per altri schemi, quali ad esempio l’italiana – e liberamente scaricabile – UNI PdR 43.2:2018 (http://store.uni.com/catalogo/index.php/uni-pdr-43-2-2018.html), purché siano più semplici, autoconsistenti e direttamente applicabili, soprattutto nel vastissimo mercato delle PMI.

Articolo a cura di Fabio Guasconi

Laureato in Informatica, opera dal 2003 nella consulenza su sicurezza delle informazioni e protezione dei dati personali, con focus sui temi di analisi del rischio, di governance e di conformità a norme internazionali, cui contribuisce direttamente. Certificato CISA, CISM, PRINCE2, ITIL e ISFS, è auditor ISO 9001 e ISO/IEC 27001, di cui è anche lead implementer.

Coautore del quaderno CLUSIT sulle certificazioni professionali e sullo standard PCI-DSS, è un PCI QSA / QPA attivo e partecipa regolarmente ad eventi e pubblicazioni sulla sicurezza. Ha coordinato la stesura delle norme UNI 11621, 11679 e PdR 43.2 sui profili professionali per la sicurezza delle informazioni e per la protezione dei dati personali.

Presiede il comitato italiano mirror di ISO/IEC JTC 1 SC 27 in UNINFO dal 2008 ed è membro del direttivo dell’associazione italiana per la sicurezza informatica CLUSIT dal 2012. Partecipa attivamente alle attività di SBS e della European Digital SME Alliance per lo sviluppo nel settore delle PMI.

È co-fondatore e presidente dell’azienda di consulenza BL4CKSWAN S.r.l.

Download PDF

https://www.ictsecuritymagazine.com/articoli/iso-iec-27701-la-norma-internazionale-per-certificare-la-protezione-dei-dati-personali/


Bitcoin e Libra a confronto: affinità, differenze e (s)vantaggi

Lo scorso 18 giugno Facebook ha rilasciato al pubblico una serie di White Paper che descrivono la nuova piattaforma di gestione di smart contract basata su tecnologie blockchain, denominata “Libra”. La notizia ha ricevuto l’attenzione dei media di tutto il mondo per diverse ragioni. Libra infatti nasce da un consorzio ben assortito di player dell’industria informatica (Facebook in primis), dei sistemi di pagamento (VISA) e dei servizi (Uber e Vodafone). Un raggruppamento di aziende che, complessivamente, dispone di un potere di penetrazione nel mercato dei sistemi di pagamento dirompente: basti pensare che le App per smartphone gestite dalla sola Facebook raggiungono ormai più di due miliardi di persone.

E lo scopo che si prefigge il consorzio è quello di rendere i pagamenti effettuati dai propri utenti una vera e propria commodity presente nelle proprie applicazioni. Ecco che, quindi, si potranno effettuare pagamenti tramite Libra verso una molteplicità di merchant, ad esempio pagando tramite Libra una corsa Uber o la propria bolletta Vodafone. Gli utenti potranno inoltre effettuare liberamente scambi di denaro tra di loro, il tutto senza appoggiarsi ad alcun intermediario specifico. Nell’attuale panorama dei pagamenti istantanei e peer-2-peer, questa caratteristica rende Libra unico nel suo genere. Sebbene altre piattaforme di pagamenti istantanei e peer-2-peer esistano ormai da tempo, l’interoperabilità appare ancora una chimera. Due individui che volessero scambiare tra loro denaro dovrebbero infatti essere utenti della stessa piattaforma. Oltretutto, le garanzie che gli utenti hanno verso questo tipo di sistemi è meramente formale: in Libra tali garanzie sono invece costruite su una solida base crittografica che limita drasticamente scenari di compromissione dell’integrità, caratteristica fondamentale di questo tipo di sistemi.

Libra, inoltre, si differenzia in modo sostanziale da altre piattaforme crittovalutarie, come Bitcoin. In questo articolo in particolare tenteremo di effettuare un confronto tra Libra e Bitcoin/Ethereum per capire dove siano le differenze, in modo da comprendere punti di forza e svantaggi di entrambe.

Libra è una piattaforma di gestione di smart contract

Libra non è soltanto uno strumento di pagamento. Infatti, è una vera e propria piattaforma di esecuzione di smart contract per la gestione di asset digitali, molto simile ad Ethereum. Come in quest’ultima, infatti, l’utente può definire a piacimento smart contract, i quali poi vengono eseguiti dalla piattaforma in base allo stato assunto in quel momento dallo specifico smart contract. Come in Ethereum, Libra offre piena flessibilità nello sviluppo, proponendo un linguaggio per la scrittura di smart contract che è Turing-completo e che quindi consente la definizione di qualsiasi tipologia di programma. Ed esattamente come Ethereum, al fine di evitare situazioni in cui il contratto possa entrare in un ciclo infinito, Libra implementa un meccanismo di limitazione dell’esecuzione basato sul paradigma del “gas”. D’altro canto “Libra Coin”, la moneta scambiata nelle transazioni degli utenti, non è nient’altro che uno smart contract costruito per gestire questo specifico asset digitale. Libra, al momento, non consente la definizione di custom smart contract  definiti dagli utenti, ma tale feature verrà aggiunta in un secondo momento.

Libra Coin è una stable coin

A differenza di Bitcoin ed Ethereum, Libra Coin non dovrebbe soffrire della grande volatilità che caratterizza queste crittovalute. Infatti, ogni Libra Coin rappresenta una quota definita di un portafoglio di strumenti finanziari ad elevata liquidità e stabilità. Ogni volta che si acquista un Libra Coin attraverso un Exchange, il valore della gamba in valuta fiat (ad es. Euro) della transazione viene investito in questo portafoglio. Al contrario, ogni volta che si vende un Libra Coin, la quota di portafoglio corrispondente viene venduta sui mercati finanziari e il valore relativo restituito al venditore. Tale portafoglio è fattivamente gestito dalla Libra Foundation, con sede in Svizzera. Come detto, il benchmark è rappresentato da titoli molto liquidi e poco volatili. Tutto ciò fa sì che Libra Coin abbia un valore intrinseco, anziché speculativo, causa quest’ultima dell’estrema volatilità di Bitcoin ed Ethereum. In realtà, l’idea di una stable coin agganciata a uno strumento finanziario non è nuova e l’esempio più famoso è rappresentato da Tether, il cui valore è agganciato a un deposito monetario denominato in Dollari statunitensi. La stabilità di Libra Coin la rende adatta ad applicazioni come i prestiti a lungo termine, per i quali Bitcoin o Ethereum non sono invece adatti proprio perché non esistono certezze sul mantenimento del valore futuro.

Libra è una piattaforma permissioned

Un’altra grande differenza tra le crittovalute come Bitcoin e Libra riguarda la comunità di validazione delle transazioni. In Bitcoin, tale comunità è rappresentata dai miners, il cui compito è quello di validare e ordinare le transazioni inviate dai client della piattaforma. In Bitcoin – come in Ethereum – tale comunità è aperta e chiunque può entrare o uscire senza particolari vincoli. Per evitare abusi e in particolare attacchi di tipo Sybil, Bitcoin utilizza un sistema chiamato Proof-of-Work per evitare la proliferazione di identità fittizie nella comunità dei miners. In Libra Coin, invece, la comunità dei validatori è chiusa: ogni entità che partecipa al processo di validazione deve essere identificata e l’accesso con il proprio nodo di validazione deve essere, di conseguenza, autorizzato. Per entrare nella comunità dei validatori, l’entità deve rispettare alcuni requisiti di onorabilità ed essere in possesso di una certa quantità di Libra Investment Token, ovvero uno share della Libra Foundation. In tal senso, Libra è stata una vera e propria ICO non pubblica che ha raccolto, in totale, 1 miliardo di dollari di capitale. Poiché l’insieme dei validatori è chiuso, lo stato del registro delle transazioni non è direttamente visibile dai client, come invece avviene in Bitcoin. Tuttavia i client possono interrogare i validatori circa lo stato di uno smart contract e la storia delle transazioni. Meccanismi crittografici avanzati consentono ai client di verificare le risposte a queste interrogazioni in termini di correttezza rispetto al ledger condiviso. Infine, va osservato che nel white paper di Libra si adombra la possibilità che in futuro tale piattaforma possa diventare permissionless (quindi come Bitcoin ed Ethereum).

Libra garantisce la finalità delle transazioni

In Bitcoin e in Ethereum viene impiegato un protocollo per la definizione dell’ordine delle transazioni denominato “Nakamoto Consensus”. Tale protocollo prevede che i miners eseguano una complessa coreografia al fine di raggiungere il consenso circa la sequenza dei blocchi. Tuttavia, in Bitcoin, tale sequenza non si finalizza mai in quanto esiste sempre una probabilità, tipicamente marginale, che un miner malevolo possa cambiare la sequenza dei blocchi (anche senza possedere il 50%+1 della potenza di calcolo), riscrivendo di fatto la storia delle transazioni e potendo spendere due volte gli stessi Bitcoin. Tale attacco è noto come “riorganizzazione della catena” ed è stato già osservato nel mondo reale.

Libra utilizza invece un protocollo completamente diverso per raggiungere il consenso da parte di validatori, denominato “LibraBFT”, che garantisce la finalità delle transazioni in un tempo finito. In sostanza i validatori, al momento di validare un blocco, entrano in una fase in cui votano circa l’ordine delle transazioni. Quando il numero di voti a favore di un blocco proposto raggiunge almeno il 66%+1 dei validatori, il blocco viene finalizzato e la fase si conclude con la creazione di una prova crittografica del raggiungimento di tale consenso, denominato “Quorum Certificate”. Tale prova non è in alcun modo falsificabile ed essendo basata su firme digitali (con uno schema molto avanzato, denominato BLS), non è ripudiabile dai validatori. Ecco quindi che si raggiunge la finalità delle transazioni, la quale avviene però al costo di un innalzamento della soglia di validatori onesti rispetto a Bitcoin, che passa dal 50%+1 al 66%+1. Tuttavia, i vantaggi sono innegabili. Anche da un punto di vista prestazionale, gli esperimenti su Libra parlano di circa 1000 transazioni al secondo, contro le 15 di Bitcoin. Inoltre, la finalità viene raggiunta nel giro di pochi secondi, mentre in Bitcoin si raggiunge dopo circa un’ora: immaginate cosa significa acquistare un caffé al bar pagando in Bitcoin e dover aspettare un’ora affinché la transazione si consolidi. Infine, LibraBFT è efficiente da un punto di vista dell’utilizzo delle risorse, in quanto la configurazione permissioned dell’insieme dei validatori non pone problemi di attacchi Sybil. In Bitcoin, è noto che il meccanismo del Proof-of-Work è invece estremamente inefficiente, con quantitativi ingenti di energia “sprecata” per risolvere problemi matematici, di fatto, inutili. Se e quando Libra diventerà una piattaforma permissionless, verranno sperimentati protocolli Proof-of-Stake simili a quelli allo studio da parte di Ethereum per la prossima generazione di questa Blockchain.

Libra è gestito attraverso una governance definita

La configurazione permissioned della piattaforma e il fatto che le entità che posseggono i nodi di validazione siano legate alla Libra Foundation attraverso accordi legali rende la governance della piattaforma molto più semplice rispetto a Bitcoin o Ethereum. L’evoluzione della piattaforma infatti viene decisa di autorità attraverso processi ben definiti e normati da clausole contrattuali. Parimenti, la gestione dei problemi può essere gestita in modo del tutto autoritario. Tale differenza è cruciale rispetto a piattaforme come Bitcoin o Ethereum, in cui la governance viene invece esercitata attraverso l’autorevolezza dei membri delle rispettive fondazioni di riferimento. In una Blockchain aperta, infatti, il potere di cambiare “le regole del gioco” (ovvero, in termini tecnici, di rendere un “hard fork” effettivo) risiede nella potenza di calcolo dei miners, che quindi devono essere “convinti” a installare una versione diversa del software di un nodo di una Blockchain. Libra quindi non sarà piagata da versioni alternative, come avviene ad es. con Bitcoin, di cui esistono versioni minori come Bitcoin Cash o Bitcoin Unlimited. Oppure incidenti come il DAO, avvenuto su Ethereum, non determineranno in Libra la creazione di monete alternative come Ethereum Classic. Andrà, tuttavia, capito come garantire questa stabilità della governance anche quando la piattaforma transiterà verso una configurazione di tipo permissionless.

Questo conclude il nostro viaggio su Libra. Come il lettore avrà capito, la piattaforma non appare rivoluzionaria da un punto di vista tecnologico e, in alcuni casi, sembra invece retrocedere rispetto a Blockchain come Bitcoin o Ethereum. Rappresenta invece un evento dirompente nel mondo dei pagamenti istantanei peer-2-peer, proprio per via della enorme base di utenti posseduta dalle applicazioni dei vari membri del consorzio. Infine va osservato che, nei white paper che descrivono Libra, non si parla mai della privacy delle transazioni, che rimangono quindi totalmente visibili ad aziende come VISA o la stessa Facebook, peraltro aspramente criticata proprio per le problematiche di privacy evidenziate nel caso Cambridge Analytica.

Articolo a cura di Cristiano Paris

Download PDF

https://www.ictsecuritymagazine.com/articoli/bitcoin-e-libra-a-confronto-affinita-differenze-e-svantaggi/


Cloud first nella PA

Il principio cloud first

Il piano Triennale per l’Informatica nella Pubblica Amministrazione 2019-2021[1] è basato su quattro principi cardine:

  • digital by default – la Pubblica Amministrazione deve impegnarsi a ideare, progettare e realizzare servizi digitali come prima (e, se possibile, unica) modalità di erogazione;
  • once only – la Pubblica Amministrazione non deve chiedere al cittadino informazioni di cui è già in possesso in una delle proprie articolazioni;
  • digital identity only – la Pubblica Amministrazione deve basare le modalità di riconoscimento del cittadino su elementi digitali (per la PA italiana il sistema di identificazione è SPID);
  • cloud first – la Pubblica Amministrazione deve progressivamente abbandonare le infrastrutture IT proprietarie per convertirsi alla tecnologia cloud.

Viene, quindi, ribadito l’orientamento alla diffusione della tecnologia cloud nella Pubblica Amministrazione perché è stato facile constatare che:

  • i data center delle pubbliche amministrazioni italiane non garantiscono un sufficiente livello di sicurezza;
  • le disponibilità di spesa per gli investimenti ICT sono andate, negli anni, riducendosi generando una progressiva obsolescenza delle infrastrutture;
  • i costi di esercizio sono direttamente proporzionali alla vetustà delle apparecchiature;
  • le figure professionali per garantire l’esercizio delle infrastrutture ICT scontano carenze quantitative e qualitative, considerando il blocco del turn‑over e la progressiva riduzione di capacità di spesa per la formazione come conseguenza dei tagli lineari che hanno subito le Pubbliche Amministrazioni.

L’approccio di AGID

L’AGID, come organismo di coordinamento della strategia della trasformazione digitale della Pubblica Amministrazione, ha ritenuto di basare l’approccio all’applicazione del principio del cloud first su tre direttrici che le pubbliche amministrazioni possono praticare rispetto alle infrastrutture verso le quali transitare:

  • infrastrutture messe a disposizione da Cloud Service Provider (CSP) privati opportunamente qualificati dalla stessa AGID che pubblica un apposito registro[2] contenente i soggetti fornitori e la relativa scheda che riepiloga le caratteristiche tecniche ed i prezzi dei servizi;
  • infrastrutture di Community Cloud contrattualizzate tramite CONSIP con la gara SPC Cloud – Lotto 1[3] al cui contratto quadro le Pubbliche Amministrazioni possono aderire;
  • infrastrutture messe a disposizione dal Polo Strategico Nazionale (PSN) ovvero dal “Soggetto titolare dell’insieme di infrastrutture IT (centralizzate o distribuite), ad alta disponibilità, di proprietà pubblica e qualificato da AGID ad erogare ad altre amministrazioni, in maniera continuativa e sistematica, servizi infrastrutturali on-demand, servizi di disaster recovery e business continuity, servizi di gestione della sicurezza IT e assistenza ai fruitori dei servizi erogati”.

Le prime due opzioni sono già disponibili mentre la terza è in via di definizione perché ha richiesto un percorso più articolato che vedrà, nel corso dei prossimi mesi, il traguardo finale.

La ricognizione dei data center pubblici

Il percorso per l’individuazione dei soggetti pubblici che comporranno il PSN nasce con la circolare AGID n. 5 del 30 novembre 2017[4] con la quale le pubbliche amministrazioni sono state invitate a compilare un “Questionario di rilevazione del Patrimonio ICT della PA” al fine di collocarle in tre diverse classi rispetto alle caratteristiche dell’infrastruttura IT in esercizio:

  • candidati ad essere integrati nel Polo Strategico Nazionale;
  • Gruppo “A”, corrispondenti a data center di qualità ma non idonei a candidarsi come PSN oppure con carenze strutturali o organizzative minori;
  • Gruppo “B”, corrispondenti a data center che non garantiscono i requisiti minimi di affidabilità e sicurezza dal punto di vista infrastrutturale o organizzativo.

Il censimento si è focalizzato su quattro caratteristiche cruciali per la determinazione del gruppo di appartenenza:

  • caratteristiche organizzativo‑gestionali, tipicamente improntate al rispetto di standard internazionali (ISO 20000‑1, ISO 22301, ISO 27001);
  • caratteristiche infrastrutturali, volte a identificare quali elementi fisici di contesto (edifici ospitanti, sistemi antincendio, ecc.) e specifici (tasso di disponibilità su base annua, continuità dell’alimentazione, ecc.) che caratterizzano il data center;
  • caratteristiche tecnologiche, tese a delineare il livello di tecnologia impiegato nel data center;
  • caratteristiche economico‑finanziarie, indirizzate a definire la solidità del soggetto pubblico in termini di sostenibilità dell’impegno di spesa connesso all’esercizio del data center.

La circolare n. 5/2017 è stata sostituita dalla circolare 1/2019[5], pubblicata l’1 luglio scorso sul n. 152 della Gazzetta Ufficiale[6] che, tra l’altro, dice che alla rilevazione hanno partecipato 778 amministrazioni delle quali 625 hanno dichiarato di possedere un data center mentre le restanti 153 hanno dichiarato di affidarsi a servizi forniti da altri soggetti. La data di pubblicazione non è indifferente, giacché la stessa circolare prevede che:

  • entro 30 giorni dal primo luglio le amministrazioni che hanno partecipato al censimento riceveranno una comunicazione sulla classificazione delle loro infrastrutture IT; potranno, nei successivi 45 giorni, aggiornare i propri dati se ritengono di dover modificare la classe di appartenenza;
  • l’AGID invii una PEC alle amministrazioni che non hanno partecipato al primo censimento affinché producano le informazioni richieste e possano essere debitamente classificate; le amministrazioni che non dovessero rispondere al questionario saranno classificate nel “Gruppo B” e, quindi, come prevede l’art. 7 della stessa circolare, “dovranno procedere alla dismissione dei propri Data Center per migrare senza indugio al Cloud della PA”.

Il percorso per realizzare il PSN

A conclusione della seconda fase del censimento, l’AGID chiederà formalmente ai soggetti pubblici titolari dei data center candidabili ad integrarsi nel PSN la loro disponibilità ad aderire.

Chi intenderà aderire dovrà sottoporsi ad una valutazione d’idoneità la cui procedura è stata pubblicata il 5 luglio scorso[7]. Si tratta di una verifica on‑site che sarà condotta da appositi Gruppi di Verifica (GdV) secondo i principi della norma UNI EN ISO 19011:2018 (ovvero le linee guida per gli audit di sistemi di gestione).

La procedura di verifica contiene due allegati che i GdV dovranno seguire:

  • l’Allegato A, una sorta di check‑list utile a verificare che le caratteristiche infrastrutturali e tecnologiche dichiarate in sede di censimento siano effettivamente operative; si tratta di verificare 76 condizioni operative, di cui 11 preferibili ma non obbligatorie, tese a garantire l’affidabilità e la sicurezza dei sistemi; i controlli spaziano dalla verifica della possibilità di manutenzione a caldo del sistema di distribuzione elettrica al controllo della presenza di sistemi antiallagamento con presenza di apparati attivi;
  • l’Allegato B, che contiene l’elenco dei controlli rispetto alla gestione del servizio che ogni candidato intende mettere a disposizione del PSN (e, quindi, di altre amminisrazioni); si tratta di controlli di conformità rispetto alle norme ISO 20000 (standard per la gestione dei servizi IT), ISO 22301 (standard per la continuità operativa), ISO 27001 (standard per i sistemi di gestione per la sicurezza delle informazioni); in presenza delle rispettive certificazioni, il Gruppo di Verifica non effettuerà alcun controllo.

Considerando le caratteristiche da verificare, è ipotizzabile che il Polo Strategico Nazionale potrà cominciare a comporsi verso la fine del 2019.

Conclusioni

Sarà raggiunto, così, un traguardo importante perché quest’ultimo tassello potrà risultare determinante per superare lo scetticismo di alcune pubbliche amministrazione nell’affidare la gestione delle proprie informazioni a Cloud Service Provider privati e, quindi, avviarsi verso una stagione di maggior affidabilità, sicurezza, efficacia ed efficienza delle infrastrutture IT pubbliche.

Note

[1] https://www.agid.gov.it/sites/default/files/repository_files/piano_triennale_per_linformatica_nella_pubblica_amministrazione_2019_-_2021_allegati20190327.pdf

[2] https://cloud.italia.it/marketplace/supplier/market/index.html

[3] https://www.cloudspc.it/

[4] https://www.google.com/url?sa=t&rct=j&q=&esrc=s&source=web&cd=2&ved=2ahUKEwiC4ffblr7jAhXF66QKHZzlAMYQFjABegQIAhAC&url=https%3A%2F%2Ftrasparenza.agid.gov.it%2Fmoduli%2FdownloadFile.php%3Ffile%3Doggetto_allegati%2F173371816170O__O05%2B-%2BAGID%2BCIRC%2Bn.%2B05%2B-%2B30%2Bnov%2B2017.pdf&usg=AOvVaw3FhkF1CwlGQNDi3jXxHncq

[5] https://trasparenza.agid.gov.it/archivio19_regolamenti_0_5379.html

[6] https://www.gazzettaufficiale.it/atto/serie_generale/caricaDettaglioAtto/originario?atto.dataPubblicazioneGazzetta=2019-07-01&atto.codiceRedazionale=19A04222&elenco30giorni=true

[7] https://www.agid.gov.it/sites/default/files/repository_files/procedura_verifica_idoneita_infrastruttura_per_utilizzo_da_psn-agid.pdf

Articolo a cura di Francesco Maldera

Francesco Maldera è Data Protection Officer e Data Scientist.

Il suo percorso professionale lo ha chiamato a responsabilità direzionali nell’ambito dei sistemi informativi, della safety&security, della privacy e dell’auditing svolgendo diversi incarichi dirigenziali nella Pubblica Amministrazione e in aziende private.

Attualmente, accompagna l’attività consulenziale a quella di sensibilizzazione delle persone tramite il sito www.prontoprivacy.it

Download PDF

https://www.ictsecuritymagazine.com/articoli/cloud-first-nella-pa/


Sistemi di controllo industriale: il primo rischio sono le persone

Le persone rappresentano il maggior rischio per la compromissione di sistemi OT/ICS: l’elemento umano è quasi sempre al centro di incidenti e violazioni di cybersecurity.

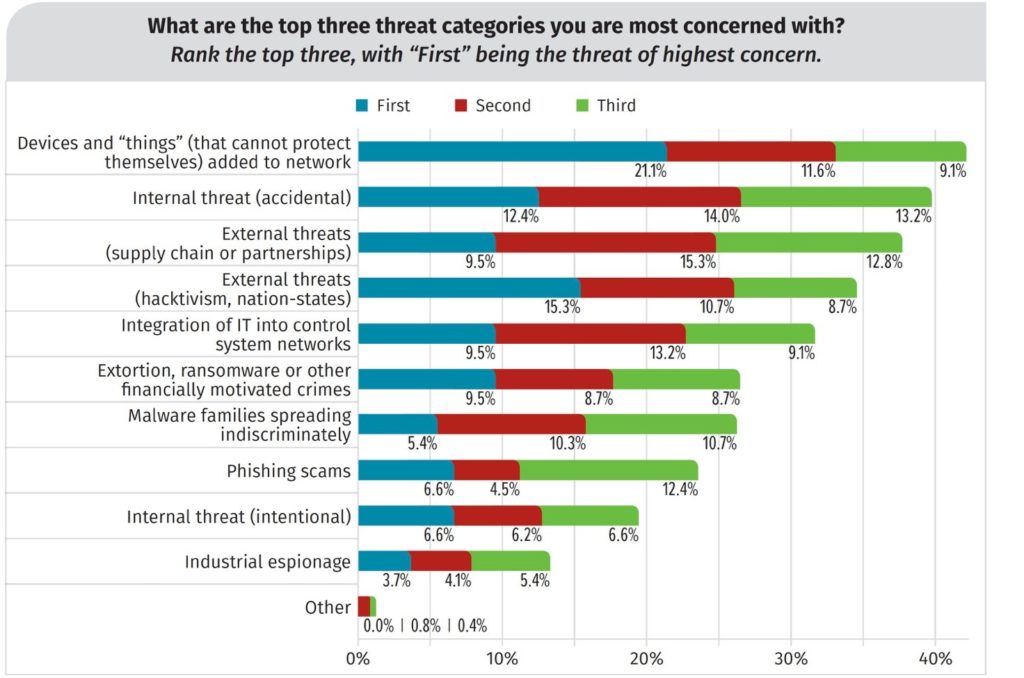
Nella nuova edizione del SANS 2019 State of OT/ICS Cybersecurity Survey, pubblicato a giugno 2019 e curato da Barbara Filkins, si possono trovare interessanti spunti sulla percezione del rischio OT/ ICS Cyber nelle aziende, su come vengono fissati i confini tra sistemi OT, IT e sistemi esterni, su come sono adottate le contromisure di Sicurezza OT/ICS e su dove si posiziona la Cybersecurity per la convergenza OT/IT.

Aziende più mature, ma il rischio resta alto

Tra i 338 intervistati a livello globale, oltre il 50% ha valutato il livello di rischio cyber OT/ICS della propria azienda come critico o alto. È un dato in calo rispetto al 69% dell’ultimo sondaggio, condotto nel 2017: questo potrebbe sembrare un po’ sorprendente, visto l’aumento di attacchi informatici e violazioni dei dati (come anche segnalato dalle analisi di Clusit).

Questi numeri indicano che le aziende sono più coinvolte; che, sul tema della cybersecurity in ambito OT/ICS, stanno diventando più mature e che il livello di rischio è valutato come inferiore rispetto al passato.

Allo stesso tempo, tuttavia, la sfida per proteggere i sistemi OT/ICS si sta allargando quanto le dimensioni della superficie di attacco: i confini di reti e sistemi OT/ICS sono sempre più ampi in quanto “…connessi e interdipendenti, e si scambiano anche dati e informazioni con una miriade di altri sistemi e processi”.

Il rapporto sottolinea che alcune applicazioni mobili stanno sostituendo le applicazioni di workstation di ingegneria, quindi la relativa gestione del rischio dovrebbe essere trattata a un livello più alto.

Inoltre, l’uso di dispositivi mobili e del wireless è sempre più diffuso per trasferire i dati dai sensori a reti e operatori di impianto: ciò aumenta ulteriormente la superficie di attacco ed espone a gravi conseguenze se compromessa.

Il rischio più grosso? Sempre le persone!

Il rischio, ovviamente, guida l’approccio delle organizzazioni alla sicurezza dei sistemi OT/ICS: circa il 50% degli intervistati giudica il livello del rischio cyber OT/ICS come alto/critico se riferito al profilo di rischio complessivo della propria azienda.

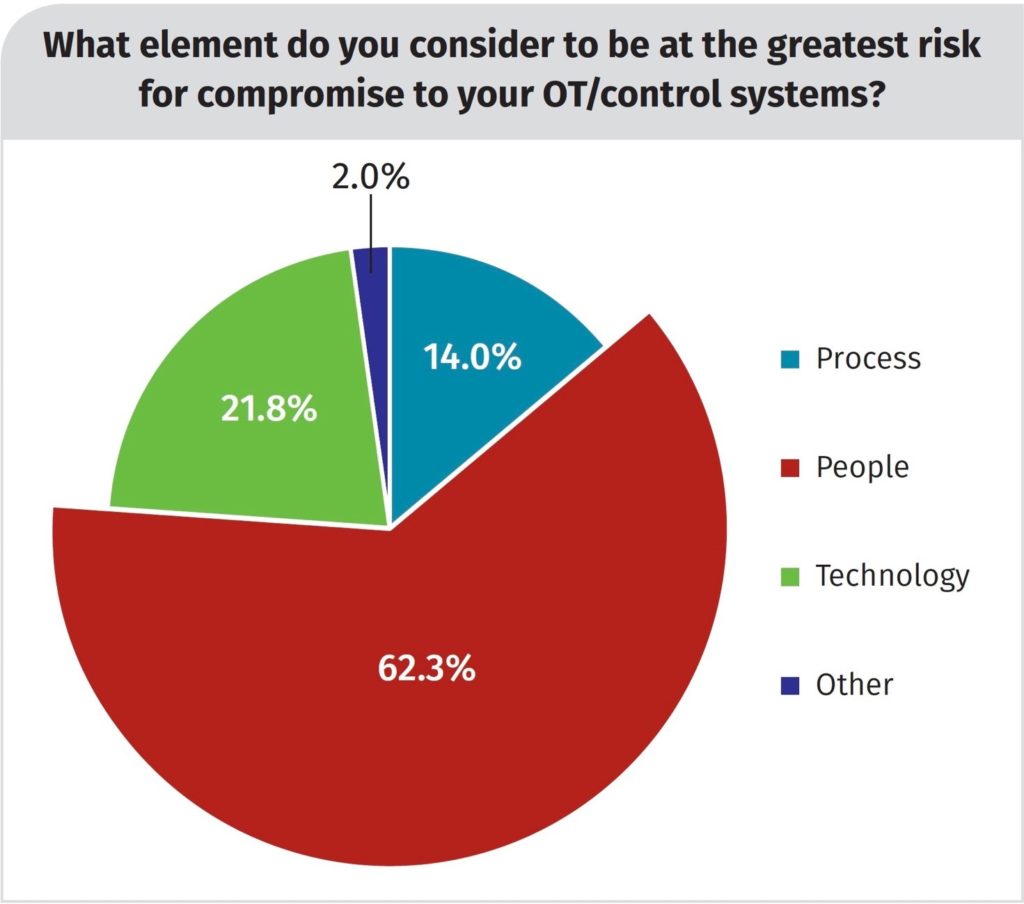
Le persone rappresentano il maggior rischio (62%) per la compromissione di sistemi OT/ICS; questo non sorprende, perché l’elemento umano è quasi sempre al centro di incidenti e delle violazioni alla cybersecurity. Troviamo poi, a una certa distanza, la tecnologia (22%) e il processo (14%).

Il report solleva un’interessante domanda sul perché il processo come categoria di rischio non sia superiore, possibilmente superiore alla tecnologia. La progettazione e l’implementazione del processo industriale rappresentano elementi chiave nelle scelte e implementazioni delle architetture OT/ICS e delle tecnologie da utilizzare.

Le persone rappresentano un’ampia categoria di rischio, che comprende esterni e attori interni, con azioni intenzionali (danneggiamenti e sabotaggi) e non intenzionali (incidenti, errori e incuria).

OT/ICS Security by Visibility

Avere una chiara visibilità di ciò che avviene nella rete di fabbrica e sui dispositivi OT/ICS è un elemento fondamentale in un robusto programma di cybersecurity. Inoltre, la necessità di definire e proteggere il confine tra IT e OT include la necessità di visualizzare e monitorare le risorse di sistema all’interno del perimetro.

Il report SANS 2019 State of OT/ICS Cybersecurity Survey indica una crescente richiesta per una maggiore visibilità di asset cyber dei sistemi di controllo: questa è una tendenza per i prossimi 12-18 mesi.

In effetti, la necessità di identificare le risorse all’interno di una rete di controllo industriale è un fattore chiave per molte aziende industriali e utility.

Per esperienza abbiamo visto che non è insolito, per il team, chiedere ed effettuare un Proof of Concept (PoC) per fare “Asset Discovery” e “Vulnerability Assessment”: al primo incontro i responsabili indicano che sulla propria rete di fabbrica hanno connesso – diciamo – 200/300 dispositivi.

Poi, quando il tool di individuazione degli asset viene installato, si identificano rapidamente oltre 5-600 dispositivi (a volte anche molti di più!).

E dopo diverse installazioni, è quindi normale scoprire una grande discrepanza tra il numero di dispositivi connessi percepiti rispetto al numero reale.

Sfida delle persone e convergenza IT/OT

Il report citato mette in luce le sfide per le persone coinvolte e il miglioramento della cybersecurity OT/ICS: è interessante notare che le organizzazioni stanno aumentando lo staff di personale interno per i loro programmi di cybersecurity. È un altro indicatore della maturazione dei processi che circondano la cybersecurity industriale.

La cybersecurity interna OT richiede che IT e OT lavorino insieme, anche se allineare le priorità e assicurare la cooperazione e la comunicazione tra i team non è, tuttavia, semplice.

Secondo i risultati del sondaggio SANS, l’IT assume un ruolo guida nella gestione della politica di sicurezza aziendale e nell’attuazione dei controlli necessari, anche nel dominio dell’OT, mentre OT spesso controlla il budget per la salvaguardia dei sistemi OT/ICS stessi.

Gli obiettivi di questi due domini non sono ben allineati: la governance IT e la gestione dei rischi si concentrano sulla continuità, sulla protezione delle informazioni e della reputazione (privacy e GDPR), mentre l’OT si concentra sulla Safety e affidabilità dei processi cyber-fisici in produzione.

Per garantire la collaborazione e ridurre i rischi per l’organizzazione, è necessaria una comprensione comune di questi concetti chiave.

I budget di spesa per la cyber security IT e OT/ICS

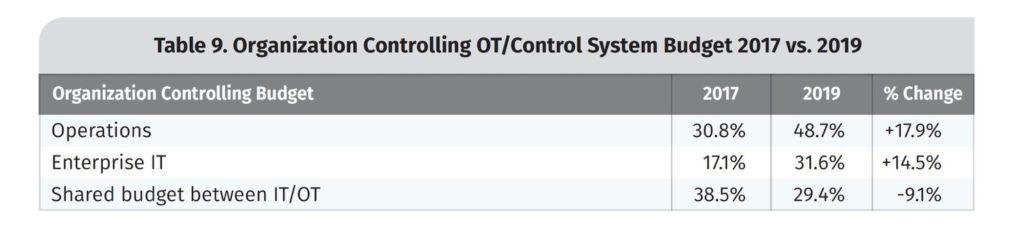
Dal 2017, i budget per la sicurezza di OT/ICS sono cambiati dall’essere principalmente condivisi tra IT e OT, ad oggi dove:

  • Il 48,7% degli intervistati ha dichiarato che il proprio budget è controllato da OT, con un aumento del 18% dal 2017;
  • Il 31,6% degli intervistati ha dichiarato che il budget è controllato dall’IT, con un aumento del 14,5% rispetto al 2017;
  • Il 29,4% degli intervistati ha dichiarato che il controllo del budget è ancora condiviso tra IT / OT, ​​in calo del 9,1% dal 2017.

Quando il budget è detenuto da uno o dall’altro, è essenziale che i gruppi lavorino insieme per dare priorità alle persone, ai processi e alle misure tecnologiche che saranno al centro di un piano annuale di miglioramento della cybersecurity.

Quali le prime scelte per la protezione di reti e sistemi OT/ICS?

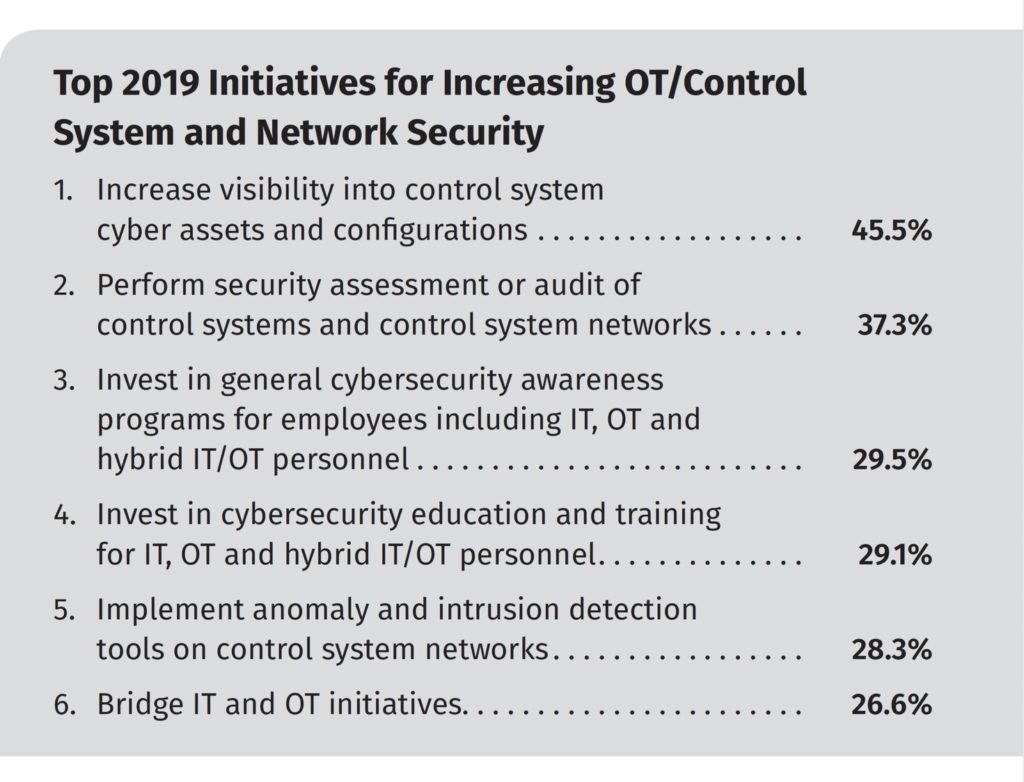
Ecco alcune indicazioni sui trend (dal campione della Survey) per le scelte fatte e da fare per il 2019 per migliorare la sicurezza dei sistemi OT/ICS:

  • al primo posto, i tool per aumentare la visibilità su asset e configurazioni di sistemi OT/ICS (45,5%);
  • fare security assessment e/o audit su sistemi e reti OT/ICS (37,3%);
  • investire in programmi di cybersecurity awareness/training che includano OT/ICS (29,5% e 29,1%);
  • installare tool per anomaly/intrusion detection su reti e sistemi OT/ICS (28,3%).

Come si vede, un mix di attività da fare e tool da implementare per rafforzare in modo consistente la protezione dal rischio cyber di reti e sistemi di fabbrica e impianto, sia nell’industria che nelle utility.

Quali gli standard e le best practices più utilizzati per proteggere OT/ICS?

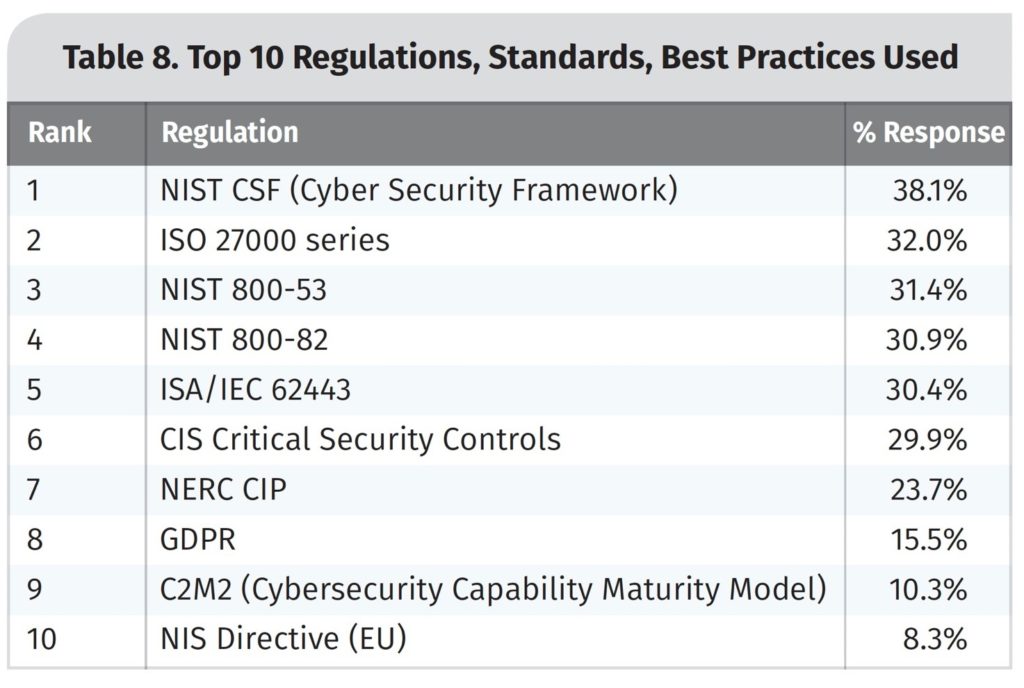
Riguardo a framework e regolamentazioni di riferimento per la OT/ICS cyber security abbiamo la conferma, come prima scelta, del NIST CSF (Cyber Security Framework) menzionato dal 38,1% degli intervistati.

Abbiamo poi menzionati tra i più utilizzati le ISO2700x, NIST SP800-53, NIST SP800-82m ed ISA/IEC62443. Interessante il “debutto nell’elenco della Direttiva NIS europea con un 8,3%.

IT e OT/ICS, come lavorare insieme

Il report SANS 2019 State of OT/ICS Cybersecurity Survey è un documento prezioso per tutti quelli che si occupano di sicurezza OT/ICS e, probabilmente, può aiutare a chiedere e ottenere impegno e budget più forti da parte del management delle aziende: con le sue analisi, infatti, ci indica dove si trovano le difficoltà, ricordandoci che la nostra azienda non è l’unica organizzazione alle prese con la sfida di migliorare la resilienza informatica operativa e la cybersecurity OT/ICS.

Articolo a cura di Enzo Maria Tieghi

Enzo Maria Tieghi, imprenditore, informatico, milanese, da oltre 30 anni si occupa di software per automazione e controllo di impianti, di security e compliance a standard e normative dei diversi settori industriali, utility e delle infrastrutture in cui opera.

Tieghi è A.D. di ServiTecno (Milano), che dal 1985 distribuisce e supporta software di GE Digital per sistemi ICT industriale, SCADA, Industrial Internet, IIoT, Plant Intelligence e tool per protezione di reti e sistemi nell’industria ed utility.

Socio in CSA Italy, ove coordina l’ Area di Ricerca Internet of Things, tiene lezioni e partecipa come speaker ad eventi specialistici sia in Italia che all’estero, oltre a contribuire con articoli e memorie a riviste specializzate e conferenze internazionali.

Download PDF

https://www.ictsecuritymagazine.com/articoli/sistemi-di-controllo-industriale-il-primo-rischio-sono-le-persone/


Blockchain e distributed ledger: di cosa stiamo parlando?

Blockchain sta diventando sempre più un termine in grado di scatenare amori folli e altrettanti odî sconfinati. Raramente una tecnologia informatica ha generato reazioni così forti. Ma innanzitutto dobbiamo capire quale sia l’oggetto di amore o di odio.

Quindi dobbiamo distinguere nettamente tra distributed ledger, che è una tecnologia, e blockchain, che è una particolare base di dati fondata sulla tecnologia. La distributed ledger è tecnologia che genera tutta una classe di basi di dati che possono resistere a malfunzionamenti dovuti a guasti o a comportamenti maliziosi.

Le proprietà interessanti delle basi di dati basate su distributed ledger, in breve, sono:

a) possono essere estese con nuovi dati ma, grazie a meccanismi crittografici, non permettono di modificare i dati già inseriti. Ad esempio, si inserisce in ogni elemento del ledger il codice hash di quelli precedenti. Questo equivale a inserire nell’elemento la versione estremamente compressa della base di dati precedente;

b) sono replicate tra più gestori, ognuno dei quali può proporre nuovi elementi da inserire. L’elemento da inserire viene scelto tra quelli proposti dai vari gestori;

c) la scelta dell’elemento da inserire si basa su un meccanismo di consenso che garantisce che tutti i gestori ben funzionanti scelgano lo stesso elemento e quindi modifichino nello stesso modo la base di dati.

Di conseguenza, la base di dati può solo crescere in un ciclo ripetuto all’infinito in cui vengono proposti degli elementi dai vari gestori, uno di essi viene scelto, tutti i gestori ben funzionanti lo inseriscono nella loro copia del ledger. I gestori malfunzionanti faranno a piacer loro, ma questo non invalida quanto fatto dagli altri. Il termine “malfunzionanti” va inteso sia in senso di safety che di security, quindi un gestore può non funzionare correttamente a causa di un guasto o di un attacco informatico di cui è stato bersaglio. Il distributed ledger fallisce sempre e comunque quando il numero di gestori malfunzionanti o maliziosi supera una soglia che dipende dalle specifiche soluzioni utilizzate.

La lettura della base di dati avviene interrogando un certo numero di copie – cioè di gestori – e poi scegliendo la risposta restituita dalla maggioranza dei gestori. Il numero dei gestori da interrogare dipende dalla soglia sul numero di gestori che possono essere malfunzionanti.

Se non interessa costruire un sistema in grado di tollerare guasti o attacchi informatici, sicuramente la tecnologia distributed ledger non interessa, perché esistono soluzioni più semplici ed efficienti per gestire una base di dati replicata. Queste soluzioni non possono però in molti casi tollerare guasti e attacchi. La resilienza rispetto ad attacchi e guasti è quindi discriminante ed è più influente delle prestazioni possibili. Trascurare questa resilienza vuol dire lasciare fuori dal dibattito mezzo problema e questo non permette di raggiungere conclusioni ben fondate.

Ovviamente anche qui vale il teorema “No Free Lunch” e quindi la resilienza ha necessariamente un costo, che aumenta con la soglia sul numero di gestori guasti che si intende tollerare. Un vantaggio dei distributed ledger su cui riflettere è che impediscono la strategia, purtroppo molto popolare, che rinvia la sicurezza e la resilienza “alla prossima versione”. In un contesto in cui minacce ibride e dottrina Gerasimov non ci aiutano a capire se viviamo in pace o in conflitti non dichiarati, una soluzione informatica che abbia intrinseche proprietà di resilienza dovrebbe essere vista come un vantaggio, non come un problema. In altre parole, i distributed ledger non sono una tecnologia in cerca di un problema, perché tutto manca meno i problemi a cui applicare la tecnologia.

Prima di parlare di bitcoin dobbiamo ancora distinguere tra versioni permissioned e not permissioned dei ledger. Un distributed ledger è permissioned quando i gestori sono noti e decisi a priori. Ad esempio, alcune università stanno creando un distributed ledger con i diplomi che ognuna ha concesso. In questo caso, ogni università ha il ruolo di gestore e, ovviamente, organizzazioni pubbliche o private diverse dalle università non possono essere gestori in quanto non coinvolti nel processo di rilascio dei titoli di studio. Un distributed ledger è not permissioned quando chiunque può assumere il ruolo di gestore. In questo caso, il numero di gestori cambia dinamicamente e dipende da ragioni economiche o di altro tipo. Anche se il caso not permissioned è più attraente per anarchici e spiriti liberi, raramente organizzazioni con vincoli economici e sociali lo accetteranno: non è ad esempio molto credibile che uno Stato sovrano decida di appaltare il ledger con il risultato delle sue elezioni a un insieme di gestori sconosciuti e stabiliti in altri Paesi.

La blockchain di bitcoin è un distributed ledger di tipo not permissioned, in cui il meccanismo di consenso è basato sul lavoro e chiunque può diventare gestore. Il primo gestore che dimostra di aver eseguito un certo lavoro è quello che ha il diritto di scegliere il nuovo elemento da inserire nella blockchain. In bitcoin il lavoro è un calcolo complesso che richiede un tempo non banale. Se n gestori eseguono in parallelo un calcolo per ottenere il diritto di inserire un elemento è chiaro che n-1 di questi calcoli saranno inutili e sarà sprecata l’energia utilizzata. Sicuramente questa soluzione non è ecologica ed è anche lenta.

Questo dimostra solamente che la blockchain di bitcoin non rispetta i principi della buona ingegneria. Come ricorda Steven Bellovin “Bitcoin was deployed by enthusiasts who in essence let experimental code escape from a lab to the world, without thinking about the engineering issues — and now they’re stuck with it. Perhaps another, better cryptocurrency can displace it, but it’s always much harder to displace something that exists than to fill a vacuum”.

Ma la blockchain di Bitcoin è solo uno dei distributed ledger possibili e il suo algoritmo di consenso è solo uno degli algoritmi possibili. Altri algoritmi sono più “ecologici” e richiedono tempi di elaborazione minori. Un possibile esempio è un algoritmo di tipo byzantine fault tolerance che permette di tollerare comportamenti anomali in al più un terzo dei gestori. Altri algoritmi di consenso utilizzano una votazione in cui ogni gestore riceve i voti di un sottoinsieme di altri gestori. La votazione continua fino al raggiungimento di una maggioranza. Di nuovo, il numero di votazioni dipende dal numero di gestori guasti che si intende tollerare. Tutte queste soluzioni hanno prestazioni e consumi energetici diversi da quelle della blockchain. Quindi usare la blockchain come modello del consumo energetico della tecnologia dei distributed ledger è solo un esempio di strawman fallacy.

Un’altra obiezione che viene avanzata è l’impossibilità di modificare una informazione erronea se inserita in un distributed ledger. Il problema esiste, anche se ovviamente il fatto che l’informazione inserita sia erronea non dipende da dove venga inserita ma da chi la raccolga.

Comunque, dal punto di vista puramente informatico, il problema di aggiornare informazioni in una struttura dati che non può essere aggiornata è già stata affrontato. Consideriamo, ad esempio, un certificato di chiave pubblica: il fatto che debba essere aggiornato viene affrontato mediante strumenti come le liste di revoca o simili. Nel caso del distributed ledger possiamo inserire un nuovo elemento collegato a quello da aggiornare e prevedere che il software di accesso al ledger controlli se esistano modifiche in elementi successivi. Se un documento viene inserito in un ledger e poi si decide di modificarlo – si pensi a uno stato di famiglia o a un certificato di residenza – se ne inserirà una nuova versione in un elemento successivo. Possiamo anche inserire in una informazione nel ledger una data di scadenza, come per il latte.

Riassumendo, se il problema prevede la cooperazione tra più organizzazioni, se una organizzazione può essere fraudolenta o soggetta a guasti, se si vuole privilegiare la capacità di resistere ai guasti e agli attacchi rispetto alla velocità di inserzione di nuovi elementi, se è necessario dover ricostruire la storia delle operazioni eseguite allora la tecnologia dei distributed ledger diventa fondamentale e, spesso, senza alternative.

Non è casuale che uno dei primi campi di utilizzo sia quello delle supply chain per ricostruire la storia di un certo pezzo di ricambio o di un alimento. In una supply chain cooperano fornitori diversi, sono necessarie garanzie di sicurezza e tolleranza ai guasti per resistere a fornitori maliziosi o a furti di materiale. Un altro campo di applicazione estremamente interessante è la costruzione di inventari intelligenti di sistemi o infrastrutture informatiche complesse. La costruzione di questi inventari è spesso il primo passo di un’organizzazione per garantirsi il controllo del proprio sistema informativo, problema di non facile soluzione.

Ma vi sono interessanti applicazioni anche nella sanità pubblica, perchè l’esistenza di un database replicato che garantisca sicurezza e che sia resistente rispetto a guasti e attacchi è indubbiamente fondamentale, molto più importante del tempo necessario per inserire un health-record, che rimane comunque accettabile. Inoltre, l’uso di un singolo database che permetta a ospedali diversi di accedere a informazioni sullo stesso paziente minimizza la probabilità di errori in diagnosi o cure. I problemi di compatibilità tra database diversi gestiti da più ospedali restano ancora molto seri. Ad esempio, pochi giorni fa un giornale USA ricordava questi problemi con il significativo titolo di “Death by a thousand clicks” dove le migliaia di click sono quelle di chi tenta di accedere, senza successo, alle informazioni.

Se la preoccupazione è invece quella della privacy, ricordiamo che in questo caso deve essere utilizzato un permissioned distributed ledger, le cui informazioni possono essere cifrate e che può anche conservare informazioni su chi ha avuto accesso a cosa. Il fatto che l’informazione sugli accessi sia, per definizione, non modificabile dovrebbe essere visto come un vantaggio.

Infine, l’uso di un ledger nella pubblica amministrazione può semplificare molte pratiche e ridurre lo scambio di informazioni, nel rispetto delle norme sulla protezione dei dati personali. Infatti, una amministrazione non ha ragione di richiedere un documento che può agevolmente ritrovare nel proprio ledger o in un ledger di una diversa amministrazione. Inoltre, il ledger può fornire in maniera nativa informazioni sulla storia di una pratica, su chi ha elaborato dei documenti, li ha emessi e via dicendo. Queste informazioni sono fondamentali per analizzare e ricostruire i processi della P.A., verificarne l’efficacia e l’efficienza. Può essere vero che la digitalizzazione di molte P.A. sia ancora lontana da una situazione che permetta l’adozione di distributed ledger ma non è nemmeno detto che i processi di digitalizzazione della P.A. debbano necessariamente ripercorrere tutto lo sviluppo tecnologico.

È possibile, forse auspicabile, che si facciano dei salti, evitando tecnologie che in altri settori sono già state superate.

Articolo a cura di Fabrizio Baiardi e Cosimo Comella

Laureato in Scienze dell’Informazione all’Università di Pisa.

E’ attualmente è professore ordinario di Informatica presso l’Università di Pisa dove coordina il gruppo di ricerca sy ICT risk assessment and management. La sua attività di ricerca è focalizzata su strumenti e metodi formali l’automazione dell’analisi e la gestione del rischio.

Ha partecipato a numerosi assessment di sistemi ICT con particolare interesse per quelli con componenti SCADA.

Attualmente è responsabile scientifico del progetto Haruspex che ha prodotto una suite integrata di strumenti per analisi e gestione del rischio.

Una lista aggiornata delle pubblicazioni scientifiche sul progetto Haruspex e dei premi ricevuti si può trovare alla pagina http://www.di.unipi.it/~tonelli/securityteam/publications.php

F. Baiardi è stato presidente della laurea in Informatica Applicata e della laurea magistrale in Sicurezza Informatica dell’Università di Pisa.

E’ stato coinvolto in vari progetti nazionali ed europei sulla valutazione della qualità dei corsi di studio e di formazione superiore. Inoltre è valutatore di progetti di innovazione tecnologica per enti pubblici e fondazioni private nazionali ed europei.

Download PDF

https://www.ictsecuritymagazine.com/articoli/blockchain-e-distributed-ledger-di-cosa-stiamo-parlando/


Peculiarità delle perquisizioni dirette alla ricerca di evidenze informatiche: l’ago nel pagliaio

Non posso negare di avere già trattato l’argomento: tuttavia ritengo il “tema” (come si dice dalle mie parti…) talmente “strategico” per le sorti del lavoro rimesso a coloro che quotidianamente – nella veste di consulenti, ausiliari di P.G. o polizia giudiziaria – si ritrovano “esecutori” di una perquisizione/ispezione informatica delegata dall’Autorità Giudiziaria, da volerlo nuovamente affrontare. Pertanto, scusandomi per le eventuali ripetizioni di alcuni concetti “fondamentali”, invito comunque a un’attenta lettura che, al di là dell’ovvia considerazione “sono cose che si sanno!”, aiuterà ciascuno di quegli operatori nel duro lavoro quotidiano che ogni giorno risulta sempre più complicato.

Ricordo ancora mia nonna che, quando dovevo cercare qualcosa a suo dire impossibile, mi diceva: “è come cercare un ago nel pagliaio”. La metafora spesso abusata rende comunque l’idea e quando mi veniva citata, al di là dell’effetto “demoralizzante” (era meglio lasciar perdere!), era riconducibile a un’“era” (così la definiscono le mie figlie) in cui la media dello storage informatico arrivava a… lasciamo perdere; per gli archeologi dell’informatica, avevo un Commodore 64 con un’unità Commodore 1581 per floppy da 3,5… altri tempi.

Ma torniamo a noi, all’oggetto di questo mio articolo.

Volevo introdurre il problema che, da capacità di storage che oggi appaiono “ridicole”, siamo passati in pochi decenni a dischi con capacità di diversi TB che oggi ogni utente cd. “medio” può vantare di custodire nella propria abitazione.

Sono sicuro che, se facessi un sondaggio tra i miei lettori, più della metà confermerebbe di avere a casa un HD da qualche TB se non un bel NAS di capacità anche maggiori: del resto i filmini dei compleanni, delle comunioni e cresime, uniti a quelli di matrimoni e viaggi di nozze (soprattutto se in 4K) occupano un certo spazio, e perderli equivale a subire il “processo di Norimberga” con conseguenti condanne degne delle piazze di Parigi nel luglio 1789.

Ecco che allora siamo tutti concordi nel ritenere che oggi lo storage medio/personale (tralascio, per ovvietà, quello professionale e aziendale) sia notevolmente incrementato, a cagione di un ormai inarrestabile progresso tecnologico-informatico che fa sì che oggi la nostra vita sia di fatto pervasa non solo di strumenti tecnologici che ci aiutano in diverse occupazioni ma anche di un impressionante mole di “dati” (spesso ridondanti) che siamo chiamati a conservare e custodire.

Capita allora sempre più spesso che, nel corso di una perquisizione e/o ispezione informatica presso un’abitazione – non certo di qualche “smanettone” o “guru” informatico ma di un semplice e ordinario “user” – ci si imbatta in capacità di storage di alcuni TB. Del resto basti pensare che un desktop medio ormai è accompagnato da dischi di uno o più terabyte, per non parlare degli smartphone che ormai accompagnano non gli adolescenti ma i fanciulli con capacità di 128/256 GB… capacità che all’epoca del mio Commodore 64 erano pura “fantascienza”.

Volutamente poi, in quanto ci arriverò poco a poco nel corso dei miei “viaggi” nell’informatica “operativa”, tralascio al momento “l’universo” (mai definizione fu più esatta) CLOUD, per il quale non basterà certo qualche articolo, ma serviranno un bel po’ di lavori e considerazioni tra tutti i soggetti: esperti, giuristi, polizia giudiziaria e tutti gli altri a vario titolo anche solo “incidentalmente” coinvolti. Qui mi permetto solo di stuzzicare gli appetiti richiedendovi una breve ma doverosa riflessione su quali siano i confini (geografici) del CLOUD e come questi debbano essere considerati rispetto a quei confini geografici che invece regolano la “giurisdizione” di ciascun Paese (su dai che avete capito, ma ci torneremo…).

Torniamo al nostro utente medio, ormai corredato di diversi TB e, tralasciando il CLOUD, caliamoci nella semplicità (è un eufemismo) di una perquisizione informatica che richieda di affrontare solo le problematiche legate allo storage fisico presente, ovvero a quei dispositivi dotati di spazio di storage che vengono rinvenuti nel corso dell’incombente. Pur apparendo più un caso di “scuola” ormai appartenente a un passato prossimo, vorrei evidenziare come anche tale “caso” già complichi non poco la vita del Digital Forensics Expert.

Tra gli addetti ai lavori si sente spesso rispondere che la soluzione al nostro “caso” sta nella copia bit to bit di tutti i dispositivi digitali rinvenuti, riservando poi successivamente un esame analitico dei dati. Per quanto la soluzione appaia la più conveniente, efficace e sulla quale concordo, come ho già avuto modo di far notare[1], non sempre risulta realizzabile e scevra di problematiche, in quanto:

a) nel nostro ordinamento giuridico esiste un complesso di norme e tutele giurisdizionali che fanno sì che il cd. “superamento del sequestro” incomba sull’attività della polizia giudiziaria e possa costituire oggetto di “censura” da parte degli organi giurisdizionali deputati al cd. “riesame”. Pertanto, quand’anche fosse realizzabile la copia bit to bit di tutti i dispositivi rinvenuti (vedi anche il punto successivo), ci si confronterebbe poi con problematiche di natura più squisitamente “giuridica” che potrebbero “cassare” l’acquisizione effettuata. In merito ricordo che le eventuali tesi del tipo “è solo una copia dei dati!” non trovano sempre conforto… nel riportare uno stralcio della sentenza in nota[2], esorto il lettore a una lettura completa della stessa, che ritengo alquanto utile ed interessante per ogni operatore : “”le Sezioni Unite hanno concluso che la legittimità dell’intrusione nella sfera patrimoniale privata e la legalità dell’acquisizione espletabile nel procedimento incidentale non possano ritenersi soddisfatte mediante la mera reintegrazione del rapporto fisico, materiale, fra il titolare e l’oggetto dell’ablazione (id est della restituzione del “contenitore” con l’intero “contenuto”), ma presuppongano necessariamente la protezione del rapporto di disponibilità esclusiva dell’informazione acquisita, facente capo all’avente diritto. Sintetizzando quanto affermato dalle Sezioni Unite Andreucci, i dati informatici acquisiti mediante l’integrale riproduzione di quelli presenti sulla memoria del computer rimangono sotto sequestro anche se il supporto fisico di memorizzazione sia restituito, in quanto permane, sul piano del diritto sostanziale, una perdita autonomamente valutabile per il titolare del dato, che perde la disponibilità esclusiva del “patrimonio informativo” che rientra nella sfera personale dell’individuo. Da tale assunto discende, quale naturale corollario, che non solo la persistenza dell’interesse a ricorrere, ma anche l’osservanza o meno dei principi di pertinenza e di proporzionalità del vincolo reale, debba essere valutata con riferimento non al “contenitore” (computer e supporti informatici) in ipotesi restituito, bensì al “contenuto” (dati informatici in essi memorizzati), costituente “patrimonio informativo” ancora assoggettato ad ablazione”.

b) È ancora “credibile”, “realizzabile”, “possibile” ritenere (nel caso delineato dell’utente medio corredato di alcuni TB e decine di dispositivi digitali) di aver fatto una copia bit to bit di “tutti” i dispositivi adibiti, anche indirettamente, a storage di dati? Oggi esistono ormai dispositivi “intelligenti” che sono tali in quanto dotati di tecnologie che, se da un lato permettono a questi di essere “collegati alla rete”, contestualmente permettono anche, quasi sempre, lo storage di quantità variabili di dati. Ho di recente acquistato una smart TV con 4GB di storage (ridicolo no?) ma in quei 4GB potrei facilmente occultare (senza essere un Guru dell’informatica) molti dati. Orbene in risposta al principio bit to bit ci ritroveremo a fare i dump del frigo, della lavastoviglie, dello smart toy, dello smart watch, della mia smart-TV e anche dell’autovettura che uso per spostarmi quotidianamente da casa al lavoro (forensic Veichle!)? In sintesi, l’osservazione ci porta a considerare che oggi e sempre più in futuro (vi ricordo il Cloud) sarà sempre più improbabile per l’operatore essere sicuro o meglio tranquillo di aver provveduto alla copia bit to bit di tutti i potenziali dispositivi digitali coinvolti. Oggi ancor più di ieri è richiesto all’operatore di “pronosticare” dove possano trovarsi i dati di interesse per il prosieguo delle indagini, atteso che soluzioni del tipo “prendo tutto e poi lo guardo” sono ormai retaggio del passato e tendono a essere una “chimera” sia sul piano pratico che su quello giuridico (si veda il punto a) che precede).

c) Non vanno poi sottovalutati, in queste ovvie considerazioni, tutti i casi (che ho citato più volte ma che si palesano sempre con maggior frequenza) di “sistemi” che di fatto non possono essere per vari motivi sottoposti a copia bit to bit, sia per difficoltà legate alla loro operatività (sistemi di controllo militari, sanitari, di sicurezza etc., ovvero impossibilità di interrompere la loro operatività anche solo momentaneamente) sia per difficoltà legate all’impossibilità, anche a sistema in funzione, di procedere a copia bit to bit per problematiche legate alla loro dimensione (si pensi ai sistemi di alcune grandi aziende che si avvalgono ormai di storage misurati in Petabyte o Exabyte).

Quindi, per sintetizzare, sarebbe sempre bello fare copie bit to bit di tutto lo storage rinvenuto ma le difficoltà sono tante e spesso non superabili, soprattutto in sede di perquisizione; l’operatore, poi, ha quella “spada di Damocle” sulla testa costituita dall’affermazione: “se da un lato mi si contesta di aver copiato tutto indiscriminatamente, dall’altro potrei essere censurato proprio per non aver copiato tutto ed essermi lasciato sfuggire qualcosa”.

Sulla seconda censura, venendo da trent’anni di attività, mi sento di poter affermare che anche nelle perquisizioni informatiche pretendere di aver perquisito “tutto” rimane una “chimera”: la storia giudiziaria del nostro Paese è piena di casi in cui quello che si cercava non è stato trovato, perché ben nascosto o non era dove lo si cercava. Del resto, volendo fare un parallelo, perquisire un’intera casa non è perquisire una stanza e una stanza che ci appare con quattro pareti potrebbe celarne altre; o ancora, basta farsi un giro su YouTube per comprendere come i sistemi di “occultamento” superino la normale fantasia e come sia veramente complicato e difficile per l’operatore scoprirli[3] (esempio dei colleghi di Lisbona!). Ma torniamo a noi: il concetto evidente è che “perquisire” tutto spesso è impossibile e, anche quando ci si riesce, molto può sfuggire anche all’occhio più attento. Ecco forse perché le censure relative a quella parte: “dall’altro potrei essere censurato proprio per non aver copiato tutto ed essermi lasciato sfuggire qualcosa”, siano alquanto rare e per lo più legate a casi di “omissione” veri e propri.

Diverse le valutazioni per la prima parte: “se da un lato mi si contesta di aver “copiato” tutto indiscriminatamente”. Qui occorre prendere in considerazione anche la legge 48/2008 la quale, da molti, fu considerata la norma che “finalmente” avrebbe fatto cessare i sequestri indiscriminati di PC e di tutto ciò che vi era attaccato (stampanti comprese). Di fatto la norma che ha introdotto la possibilità di procedere a “perquisizione” e “ispezione” di un sistema prima di procedere alla copia bit to bit dello stesso (qualora contenga elementi di interesse) o al sequestro del dispositivo (qualora sia impossibile procedere sul posto alla copia o all’estrazione dei dati utili), non sembra “aiutare” oltremodo nella soluzione e superamento delle problematiche prima evidenziate che permangono ed incombono (mai termine fu più esatto) sull’operatore.

In questo quadro, tutt’altro che roseo e ricordando ancora le parole della nonna, mi accingo allora a esporre una serie finale e conclusiva di considerazioni, sperando che queste possano costituire un sano e costruttivo dibattito tra tutti gli operatori coinvolti.

Certo che ognuno ha le proprie tecniche e stratagemmi per trovare l’ago (il nonno mi consigliava: con la calamita!); orbene, volendo proprio cercarlo, partirei (ormai è un mio cavallo di battaglia!) dalla cd. “analisi di contesto”, che qui potremo paragonare al cercare di capire dove sia caduto l’ago. Senza un’adeguata e corretta analisi di contesto si rischia di cadere nel paradosso del “tutto tutto/niente niente”, ovvero nel rischio (per quel che ci riguarda più da vicino) di prendere migliaia di dati inutili da dispositivi inutili tralasciando i pochi dati di interesse sul dispositivo “target” utilizzato per la perpetrazione del reato. L’analisi di contesto, al pari di un “profiling” qui inteso nel suo doppio significato di:

  • ambito psicologico: metodo di valutazione qualitativa della personalità, delle attitudini comportamentali e delle specifiche abilità di un individuo e anche la descrizione del profilo psicologico e comportamentale dell’autore di un crimine;
  • ambito informatico: tracciatura;

non potrà che aiutare l’operatore nell’individuare i potenziali “target” tra i molteplici rinvenuti e ancora lo aiuterà a selezionare tra i molti, sondando le specifiche caratteristiche del reato e individuo responsabile, quali siano le abitudini di quest’ultimo ovvero se possa più facilmente rinvenirsi la traccia del reato in procedimento o il corpo del reato.

Quanto all’Intelligenza Artificiale (IA), se potrà venirci in soccorso in un ormai prossimo futuro non è dato sapere: tuttavia nulla mi impedisce di augurarmi che, di pari passo a evoluti e più veloci sistemi di triage, si possa giungere con l’aiuto della IA a risolvere parte delle problematiche evidenziate.

Tuttavia, sul tema mi sia permesso di esprimere alcune perplessità in ordine all’affidare solo all’ IA il difficile compito dell’analisi di contesto e profiling: spero che l’intelligenza umana sia ancora lungi dall’essere superata e che l’investigatore 4.0 sia colui che si avvale, certo, di strumenti e potenzialità fino a qualche anno fa impensabili ma che ancora ci mette il suo fiuto e l’esperienza della “vecchia scuola”.

Mi ricollego a un esempio pratico: ho assistito nel tempo a decine di workshop et similia di presentazione di prodotti innovativi, strabilianti e capaci di fare con un click quello che fino a qualche anno fa realizzavo in lunghe giornate di lavoro e mal di testa. Tuttavia, ciascuno dei prodotti richiede sempre di essere “instradato” sulla “pista giusta”, risolvendosi viceversa in un mero per quanto utilissimo “ordinatore di dati” che, senza l’analisi dell’investigatore, rimangono vuoti di significato.

In conclusione, l’ago nel pagliaio non lo si trova facilmente: tuttavia è evidente come un lavoro di équipe a più teste e competenze professionali possa aiutare non poco nell’individuare, quantomeno, la balla di fieno sotto il quale è nascosto. Di qui il consiglio che ormai è un mantra: non affidare mai al solo Digital Forensics (quand’anche Expert) il compito di cercare quell’ago, perché spesso, presi dallo sconforto, non si potrebbe giungere al target. Solo un lavoro di squadra tra tutti i soggetti coinvolti potrà portare a qualche risultato; e se non troveremo l’ago avremo almeno individuato dove potrebbe trovarsi, e usare poi la “calamita” senza portarci diretro l’intero pagliaio.

Buona estate!

Note

[1] https://www.ictsecuritymagazine.com/articoli/bit-stream-image-dellintero-supporto-digitale-ieri-oggi-domani/.

[2] http://www.ricercagiuridica.com/sentenze/sentenza.php?num=4727.

[3] https://www.youtube.com/watch?v=i3R6FXg1lv4.

Articolo a cura di Pier Luca Toselli

Download PDF

https://www.ictsecuritymagazine.com/articoli/peculiarita-delle-perquisizioni-dirette-alla-ricerca-di-evidenze-informatiche-lago-nel-pagliaio/


Il trade-off sullo stato di attuazione del Gdpr in Italia e le prospettive dei temi strategici legati alla dominanza digitale

L’accountability è prima di tutto volta alla ricerca del corretto bilanciamento tra diritti, libertà e altri beni giuridici primari, che si inviluppano un una dialettica continua e richiedono l’applicazione del principio di proporzionalità.
Lo testimoniano le esperienze di questi ultimi anni che rendono sempre più urgente affrontare temi quali la democrazia nella società digitale e gli effetti distorsivi della profilazione e del
nudging, sia sul piano commerciale che su quelli delle relazioni sociali e pubbliche.

Il nostro Garante nazionale persegue l’obiettivo di rispondere alle sfide poste dai nuovi modelli economici fondati in maniera sempre più invasiva sullo sfruttamento dei dati e, specularmente, alle accresciute esigenze di tutela dei diritti fondamentali delle persone, onde assicurare un’adeguata protezione dei loro dati.

D’altronde, il 2018 ha rappresentato una tappa di grande importanza con l’entrata nella sua piena applicazione del GDPR che ha irrobustito la tutela dei diritti per gli individui (natural person) e dilatato le responsabilità per i soggetti che trattino i dati.

Come emerge dalla Relazione sull’attività recentemente pubblicata, gli interventi sono stati polarizzati sulle rilevanti novità normative e sulle grandi questioni legate alla tutela dei diritti e delle libertà delle persone nel mondo digitale: si pensi ad es. alle implicazioni etiche della tecnologia alle grandi piattaforme; ai big data; agli algoritmi ad uso sociale; alla pervasività nella raccolta dei dati, nella profilazione online, talvolta anche pensando alle possibilità di orientare la pubblica opinione; alla cybersecurity; all’Internet delle cose.

Proprio nel 2018 si sono verificati fatti clamorosi che hanno messo a rischio la sicurezza informatica di milioni di persone in tutto il mondo, tanto che sotto il profilo dei possibili utilizzi illeciti dei dati personali sulle piattaforme social, sono emersi due casi paradigmatici: il primo è stato il caso Cambridge Analytica, sul quale l’Autorità è intervenuta non solo per accertare le responsabilità ma soprattutto per aumentare la consapevolezza sui rischi che forme distorte di influenza possono rappresentare per la libertà delle persone. Nel secondo, a Facebook il Garante ha vietato l’ulteriore trattamento dei dati degli utenti italiani, riservandosi di valutare l’iter verso un eventuale procedimento sanzionatorio.

In tema di tutele per i minori per le attività online, il lavoro si è concentrato sui possibili rischi insiti negli smart toys e, per combattere il fenomeno del cyberbullismo, il Garante ha potuto, alla luce dei nuovi compiti, prescrivere misure e procedure per la rimozione dei contenuti offensivi, siglando inoltre un protocollo di intesa con la Polizia postale e con alcuni Co.Re.Com. onde realizzare una vera e propria rete per la protezione delle giovani vittime che possa effettivamente agire in maniera coordinata e tempestiva.

Non sono mancate indicazioni sull’uso dei droni a scopo ricreativo e su come difendersi dai software dannosi, in particolare dal ransomware, software malevoli diffusi per bloccare un dispositivo elettronico (pc, tablet, smartphone, smart tv), o criptare i dati in esso contenuti (foto, video, file) allo scopo di ottenere un riscatto per sbloccarlo.

Nel mondo del lavoro sono state indicate le garanzie per la raccolta delle impronte digitali per i dipendenti pubblici a fini di lotta all’assenteismo; fissate regole per la geolocalizzazione dei lavoratori e vietati i controlli massivi su email e smartphone dei dipendenti, così come prassi di valutazione lesive della dignità del lavoratore.

Sul fronte cybersecurity, l’attività di vigilanza e intervento è stata molto intensa, procedendo d’ufficio o a seguito di specifiche segnalazioni relative a violazioni di dati personali (data breach), alcune gravi; fornendo prescrizioni dettagliate per la messa in sicurezza di una piattaforma di partecipazione politica; rafforzando la cooperazione con l’intelligence in ordine ai trattamenti di dati per fini di sicurezza nazionale e alle garanzie da assicurare ai cittadini; prescrivendo i criteri per l’esercizio del diritto all’oblio e per la sua tutela al di là dei confini UE.

Sulle delicate questioni di trasparenza online della P.A., le amministrazioni sono state richiamate a rispettare canoni di proporzionalità e di scrupoloso bilanciamento fra obblighi di pubblicità degli atti e dignità delle persone. Inoltre è stata bloccata la diffusione online, su siti di amministrazioni pubbliche, di dati sensibili delle persone; sono state fissate precise regole per l’esercizio del diritto di accesso civico; sono state chieste garanzie riguardo al nuovo censimento permanente, che prevede l’integrazione di banche dati e l’uso massivo dei dati dell’intera popolazione; sono state intraprese azioni per aumentare il livello di sicurezza della P.A. digitale e per rafforzare le garanzie per i cittadini nell’attuazione dello Spid.

Per quanto riguarda il sistema fiscale, il Garante ha individuato i presupposti e le condizioni necessari affinchè l’Agenzia delle entrate avviasse il nuovo obbligo della fatturazione elettronica, in particolare sulle tutele per evitare trattamenti sproporzionati dei dati personali dei contribuenti; ha prescritto misure tecniche relative all’accesso alla dichiarazione dei redditi precompilata da parte di contribuenti, Caf e soggetti autorizzati, nonchè alla messa in sicurezza delle grandi banche dati pubbliche, in primis quella dell’Anagrafe tributaria.

Per la tutela dei consumatori sono state dettate regole per il trattamento dei dati effettuato attraverso i totem pubblicitari nelle stazioni ferroviarie, proseguendo il contrasto al telemarketing aggressivo con l’applicazione di pesanti sanzioni agli operatori che utilizzano i dati degli abbonati senza il loro consenso; accertando rilevanti illeciti da parte di società di telefonia; svolgendo ispezioni presso diversi call center e suggerendo l’opportunità di modifiche normative per rafforzare le garanzie dei cittadini.

Naturalmente è stata costante l’azione di supporto a imprese e pubbliche amministrazioni e di formazione in vista della definitiva applicazione del GDPR.

Nel periodo 2012-2018 sono state riscosse sanzioni per l’importo complessivo di 31.322.754 Euro.
Nel solo 2018 sono stati adottati 517 provvedimenti collegiali.

Sono stati riscontrati oltre 5.600 quesiti, reclami e segnalazioni in diversi settori: marketing telefonico e cartaceo; centrali rischi; credito al consumo; videosorveglianza; concessionari di pubblico servizio; recupero crediti; settore bancario e finanziario; assicurazioni; lavoro; enti locali; sanità e servizi di assistenza sociale.

I 130 ricorsi, decisi fino all’applicazione del Regolamento UE, hanno riguardato soprattutto editori; datori di lavoro pubblici e privati; banche e società finanziarie; P.A. e concessionari di pubblici servizi; fornitori telefonici e telematici.

Sono stati resi 28 pareri al Governo e al Parlamento (di cui 5 su norme di rango primario) e hanno riguardato, inter alia, l’attività di polizia e sicurezza nazionale; il casellario giudiziale; i trattamenti di dati a fini di polizia; le misure antiassenteismo e la raccolta delle impronte digitali dei dipendenti pubblici; il Programma statistico nazionale; il “bonus cultura”; il Fascicolo sanitario elettronico; la carta di identità elettronica; il Registro tumori; l’Archivio dei rapporti finanziari; l’Anagrafe nazionale dei vaccini; il fisco.

Le comunicazioni di notizie di reato all’autorità giudiziaria sono state 27, in particolare per mancata adozione di misure minime di sicurezza a protezione dei dati e illecito controllo a distanza dei lavoratori.

Sono state contestate 707 violazioni amministrative, quasi tutte per trattamento illecito di dati; mancata adozione di misure di sicurezza; violazioni di banche dati; omessa o inadeguata informativa agli utenti sul trattamento dei loro dati personali; omessa esibizione di documenti, mentre sono state riscosse sanzioni amministrative per oltre 8 milioni 160 mila euro (+115% in più rispetto al 2017).

Le 150 ispezioni, effettuate anche con il contributo del Nucleo speciale tutela privacy e frodi tecnologiche, hanno riguardato numerosi e delicati settori:

  • nell’ambito privato: trattamenti effettuati da istituti di credito; da società per attività di rating sul rischio e sulla solvibilità delle imprese; dalle aziende sanitarie locali e poi trasferiti a terzi per il loro utilizzo a fini di ricerca; da società che svolgono attività di telemarketing; da società di “money transfer”. Particolare attenzione è stata rivolta ai trattamenti di dati svolti da società assicuratrici attraverso l’installazione di “scatole nere” a bordo degli autoveicoli e da società che offrono servizi medico-sanitari tramite app;
  • nel settore pubblico: enti pubblici, soprattutto Comuni e Regioni, che svolgono trattamenti di dati personali mediante app per smartphone e tablet (con particolare attenzione all’eventuale profilazione e geolocalizzazione degli utenti); sulle grandi banche dati; sul sistema della fiscalità, con speciale riguardo alle misure di sicurezza e al sistema degli audit; sul sistema informativo dell’Istat e sullo Spid.

Per quanto riguarda l’attività di relazione con il pubblico, sono stati riscontrati quasi 23.000 quesiti, relativi agli adempimenti legati all’applicazione del Regolamento Ue, seguiti dalle questioni legate alle telefonate, mail, fax e sms promozionali indesiderati; a Internet; alla videosorveglianza; al rapporto di lavoro; ai dati bancari.

A livello internazionale, la nostra Authority ha svolto un ruolo rilevante nel contesto che a livello Ue è stato caratterizzato soprattutto dalla definitiva applicazione del nuovo Regolamento in materia di protezione dei dati (GDPR), il 25 maggio 2018.

Con esso l’Advisory Board, che riuniva le Autorità dei 28 Paesi Ue, è stato sostituito dal “Comitato europeo per la protezione dei dati”, che ha acquisito un ruolo non solo consultivo, ma anche decisionale e il Garante italiano ha continuato a fornire i propri contributi riguardo all’elaborazione di importanti Linee guida sull’interpretazione e l’applicazione delle disposizioni del GDPR, tra le quali quelle sul consenso; sulla trasparenza; sui registri dei trattamenti; sulla profilazione e le decisioni automatizzate; sull’adeguatezza del Paese terzo in caso di trasferimenti di dati extra Ue; sui data breach.

La nostra Authority partecipa ai meccanismi di cooperazione (“sportello unico”) e coerenza previsti dal Regolamento, attraverso scambi quotidiani di informazioni e documentazione: in particolare, dal 25 maggio 2018, è operativa la sezione GDPR della Piattaforma IMI (Internal Market Information System), utilizzata da tutte le autorità di controllo per garantire una coerente tutela dei dati personali all’interno dell’Unione europea. Inoltre, del 24-25 settembre 2018 il Comitato europeo per la protezione dei dati ha assegnato all’IMI help desk una funzione non solo di supporto tecnico ma anche di complessivo monitoraggio del sistema.

Così, attraverso IMI, le autorità possono ora contare su uno strumento trasparente, flessibile e sicuro per diverse finalità, quali ad esempio identificare l’autorità capofila nel caso di trattamenti transfrontalieri per poi contribuire all’elaborazione di un progetto di decisione condiviso fra l’autorità capofila e le autorità interessate (cd. meccanismo dello sportello unico o one stop shop) oppure assicurare assistenza reciproca attraverso lo scambio di informazioni o condurre indagini e misure di contrasto congiunte.

Infine, allo scopo di favorire un’applicazione coerente del GDPR in tutta l’Unione, la piattaforma verrà utilizzata per consentire alle autorità di controllo di consultare il Comitato europeo per la protezione dei dati al fine di raccoglierne un parere, ad esempio per questioni di applicazione generale o che producono effetti in più di un Paese membro oppure per ottenere una decisione vincolante del Comitato che componga eventuali conflitti fra le stesse autorità di controllo.

Il Garante ha continuato la collaborazione con le altre Authority europee in ordine all’istituzione di meccanismi per la certificazione della protezione dei dati personali. I lavori hanno riguardato in particolare la stesura dei documenti concernenti, rispettivamente, l’identificazione di criteri comuni per accreditare gli organismi di certificazione e i requisiti aggiuntivi per l’accreditamento, ai sensi dell’art. 43, par. 1, lett. b), del GDPR, e quelli aventi ad oggetto l’identificazione di criteri comuni per la certificazione dei trattamenti, che hanno portato all’elaborazione delle Guidelines 4/2018 e 1/2018. Il decreto legislativo n. 101/2018 ha poi individuato in Accredia l’organismo nazionale di accreditamento deputato all’accreditamento degli organismi di certificazione.

Altre rilevanti attività sovranazionali del Garante italiano sono state espletate per il Consiglio d’Europa, che – attraverso il Comitato presieduto da una rappresentante del Garante italiano – ha portato a termine i lavori tesi alla “modernizzazione” della Convenzione 108 del 1981 sulla protezione dei dati, nonché nell’ambito di gruppi internazionali (quali la Global Privacy Enforcement Network, GPEN) preposti a interventi congiunti e mirati di verifica del rispetto della normativa in materia di protezione dei dati.

Looking ahead, dal cospicuo “bilancio” presentato si può trarre la misura di come la nostra Autorità Garante rappresenti ormai il fulcro al centro del framework teso alla modernizzazione del Paese attraverso il potenziamento delle sue infrastrutture digitali, affinché possa effettivamente aver luogo nel rispetto dei diritti individuali e delle libertà fondamentali dei cittadini.

Articolo a cura di Sergio Guida

Da economista aziendale ha maturato esperienze in gruppi industriali diversi per settori, dimensioni e caratteristiche. Specializzato in pianificazione e controllo di gestione, finanza, risk e project management, sistemi di rendicontazione integrativi (sociale, ambientale e intangible assets), è stato relatore in convegni e seminari e ha pubblicato articoli di economia, finanza, strategie e compliance.

Forti interessi verso complessità, multidisciplinarietà, innovazione tecnologica, concentrati ora su digital economy, interazione uomo-macchina (aspetti etici, cognitivi ed epistemologici), data protection & privacy regulations.

Download PDF

https://www.ictsecuritymagazine.com/articoli/il-trade-off-sullo-stato-di-attuazione-del-gdpr-in-italia-e-le-prospettive-dei-temi-strategici-legati-alla-dominanza-digitale/


Attacco RAMBleed

La continua miniaturizzazione delle componenti elettroniche ha contribuito ad incrementare sensibilmente le prestazioni dei dispositivi: componenti di ridottissime dimensioni che riescono a lavorare con latenze ridottissime a frequenze altissime.

A volte però, portare all’esasperazione tali componenti all’interno dei chip può portare alla manifestazione di fenomeni fisici inaspettati: è il caso del “memory bit flip”, ovvero l’inversione dei bit di memoria all’interno dei banchi DRAM.

Tale fenomeno in verità è sempre esistito, ma fino a qualche anno fa poteva manifestarsi solo in maniera sporadica[1]. Era quindi possibile avere alcuni incidenti di inversione dei bit di memoria durante la durata pluriennale di un computer medio: in tali casi, o venivano rilevati e corretti dal sistema, o si otteneva un danneggiamento silenzioso del dato.

Nei casi più fortunati, gli errori si manifestavano nelle porzioni di RAM inutilizzata, senza comportare alcun sintomo; viceversa, l’inversione avrebbe potuto incidere sul codice in esecuzione – causando arresti anomali e/o malfunzionamenti – o sui dati, portando alla corruzione di caratteri nei documenti (o a cause peggiori).

La miniaturizzazione dei chip ha alzato notevolmente la percentuale di accadimento spontaneo di questa fenomenologia; è altresì vero che i progettisti stanno continuando a studiare delle valide contromisure per ovviare a questo fenomeno.

Non a caso, in ambito server/mainframe, vengono utilizzati tipi di RAM differenti: le RAM con ECC[2]. Queste ultime sono una tipologia di memoria che formula particolari informazioni aggiuntive (ridondanti) che la CPU utilizza per rilevare e riparare eventuali “bit-flip”. Un banale esempio consiste nell’utilizzo del codice di Hamming[3].

Di fatto, per quanto detto in precedenza, le memorie di tipo ECC sono state originariamente sviluppate per far fronte ai bit-flip dovuti a raggi cosmici o a situazioni di simili: eventi occasionali che tipicamente comportano la rotazione di un singolo bit.

Analizzeremo di seguito come, tuttavia, esistano tecniche in grado di bypassare gli attuali controlli, permettendo l’ottenimento dei dati sensibili presenti all’interno della memoria di un qualsivoglia elaboratore.

ROW HAMMER – Descrizione

Nel 2014 alcuni ricercatori[4] hanno documentato una bizzarra vulnerabilità presente nei chip di memoria DRAM, soprannominata “Rowhammer”: quando molte letture o scritture accedono a una particolare posizione di memoria, potrebbe verificarsi un’inversione di bit in una locazione adiacente.

Nella letteratura questo tipo comportamento è definito “martellare” una posizione di memoria, con l’intento di capovolgere un bit in un’altra locazione.

Inizialmente tale fenomeno fu considerato come un comportamento curioso, più che come qualcosa di cui preoccuparsi. La comunità di ricerca ha però rapidamente imparato ad armare i bit-flip per compromettere una moltitudine di dispositivi: PC, smartphone, VM nel cloud, ecc.[5].

Poiché il bug è presente in molti tipi di chip DRAM e le patch non sono possibili per i difetti dell’hardware, Rowhammer è diventato un problema soprattutto per i dispositivi consumer.

ROW HAMMER – Come funziona

Come accennato, le memorie ECC aggiungono comunemente una ridondanza sufficiente a correggere (riparare) i bit-flip singoli in una parola di – diciamo – 64 bit. Nel caso “sfortunato” in cui si verifichino più inversioni, l’algoritmo insito in ECC può rilevarne fino a un massimo di due per parola. A seguito della rilevazione, il programma di gestione della memoria si blocca, poiché non ha modo di eseguire la riparazione del dato.

Ciò significa per un singolo bit-flip in Rowhammer non causerà alcun danno; due bit-flip verranno rilevati, ma bloccheranno il sistema, quindi l’attacco. Pertanto, solo se si avranno tre o più inversioni di bit al posto giusto, si avrà la possibilità di bypassare la protezione ECC.

La condizione potrebbe sembrare alquanto improbabile: tentare di ottenere contemporaneamente tre inversioni, senza accidentalmente ottenerne due innescando un arresto anomalo, è molto arduo. Per questo motivo, ECC è sempre stato considerato una buona difesa contro Rowhammer, permettendo al massimo attacchi di tipo denial-of-service, ma non una completa compromissione. In realtà si è poi dimostrato che l’algoritmo ECC è in grado di rallentare un attacco Rowhammer, ma non è sufficiente a fermarlo completamente.

L’idea basilare di un attacco consiste nel modificare un determinato bit in memoria che garantisce la sicurezza del sistema: ad esempio, se si riesce a modificare il bit che indica che un settore di memoria è riservato, qualunque processo potrà accedere a quei dati precedentemente inaccessibili.

Quindi, modificando opportunamente determinati bit in memoria, è possibile accedere a dati riservati al kernel, ad altri utenti, a processi, all’anello 0 (kernel mode), senza passare tramite le System Call del SO.

Potenzialmente, gli attacchi di tipo RowHammer possono aggirare completamente qualunque misura di sicurezza e permettere all’attaccante qualsivoglia azione sul sistema. Le conseguenze di tale attacco includono: l’accesso amministrativo a un SO, l’accesso a chiavi crittografiche, a dati riservati, a dati presenti su macchine virtuali, a dati su macchine remote ecc.[6].

RAM Bleed – Descrizione

Gli attacchi di tipo Rowhammer prevedono la modifica della memoria per l’ottenimento di dati riservati, e sono quindi potenzialmente rilevabili.

Alcuni ricercatori[7] hanno di recente scoperto una nuova vulnerabilità che influisce sulla riservatezza dei dati archiviati nella RAM, senza però modificare in alcun modo la celle di memoria originali. Tramite il nuovo sistema, soprannominato “RamBleed”, è stato possibile estrarre una chiave di firma digitale da un server OpenSSH usando i normali privilegi utente.

Questo tipo di attacco si basa sempre su RowHammer, ma affronta la problematica da un punto di vista differente. Gli attacchi funzionano a causa dell’elevata miniaturizzazione che caratterizza le DDR3/DDR4: considerando che i condensatori delle celle di memoria sono estremamente vicini, questi ultimi tendono a perdere molto facilmente le cariche elettriche che immagazzinano i bit, se sovrastimolati.

Quindi RAMBleed porta Rowhammer in una nuova direzione. Anziché utilizzare i bit-flip per modificare i dati sensibili, la nuova tecnica sfrutta l’errore hardware per estrarre i dati sensibili memorizzati nelle regioni di memoria che sono off-limits per l’attaccante.

Gli attacchi richiedono solo che l’exploit “martelli” le posizioni di memoria per le quali il codice exploit ha già i permessi di accesso. Inoltre, l’estrazione dei dati funziona anche quando la DRAM è protetta da ECC!

RAM BLEED – Come funziona

L’estrazione delle chiavi richiede l’individuazione preventiva di una regione contenente una buona quantità di bit flipppabili. Questa fase può richiedere molto tempo: nel dettaglio, 34 ore per localizzare gli 8400 bit-flip necessari per estrarre la chiave SSH. L’investimento – non banale – di tempo e risorse richiesto è comunque compensato dal fatto che può essere eseguito in anticipo, con le sole autorizzazioni utente e senza alcuna interazione con SSH.

Dopo che i ricercatori hanno filtrato dal totale i bit inutili per l’esecuzione dell’attacco, sono state collezionate le locazioni di memoria valide, per un totale di circa 4.200 bit.

RAMBleed utilizza quindi una speciale tecnica di memorizzazione per far in modo che il sistema memorizzi la chiave SSH in locazioni di memoria prestabilite: l’obiettivo è quello di ottenere un layout simile a quello mostrato nella figura, che corrisponde alle pagine da 8 KiB necessarie per poter attuare le due varianti di attacco.

La prima utilizza un tipo di accesso fronte-retro; la seconda solo fronte.

Sebbene RAMBleed funzioni meglio nel primo caso, a causa del rumore proveniente dalle altre attività del sistema i risultati dell’attacco a volte risultano essere migliori nel secondo caso.

Il dettaglio dell’attacco è riassunto esaustivamente nell’immagine seguente: l’attaccante, possedendo i 4200bit di memoria flippabile, crea la condizione per il caricamento dei dai al di sopra ed al di sotto di una determinata pagina di memoria (A1)[8].

Detenendo il controllo delle due pagine di attivazione adiacenti al “segreto”, può “martellarle” ripetutamente per influenzare la riga centrale. Se il bit nel segreto è 0, il martellamento farà invertire il bit nella pagina di campionamento in 1; viceversa, il bit ricavato sarà 1.

Eseguendo ripetutamente il processo su diversi offset di memoria flippabili, sarà possibile rilevare tutti i bit dei dati segreti.

“Qui notiamo che né la vittima né l’attaccante accedono al segreto in alcun modo, ma accedendo alle pagine di attivazione delle righe controllate dagli aggressori l’attaccante usa i dati della vittima per influenzare le immagini di bit indotte da Rowhammer nelle proprie pagine private. L’attaccante controlla direttamente la pagina di campionamento per i bit flip, deducendo in tal modo i bit della vittima” – spiegano i ricercatori.

L’attacco ha dimostrato di poter leggere una chiave RSA-2048 da un server con OpenSSH 7.9. Il test ha misurato una velocità di 0,3 bit al secondo e una precisione dell’82%. Quindi, per ottenere il set dati completo, i ricercatori hanno utilizzato una variante dell’algoritmo di Heninger-Shacham[9] in grado di ricostruire interamente le chiavi RSA da informazioni parziali.

CONCLUSIONI – Possibili contromisure

“RAMBleed può rompere la riservatezza della memoria ECC, anche se tutti i bit flip venissero corretti con successo dal meccanismo ECC” – affermano i ricercatori.

Ovviare un attacco RAMBleed è possibile, ma solo sui sistemi in cui la crittografia della memoria RAM è attiva. Deve quindi essere disponibile ed abilitata sul processore la funzionalità di “esecuzione in ambiente trusted” (TEE)[10].

I TEE in commercio come: Software Guard Extensions (SGX) di Intel, Secure Encrypted Virtualization (SEV) di AMD, TrustZone di ARM (non implementata da tutti i vendor di smartphone, e non utilizzabile dai produttori di app di terze parti[11]), Secure Enclave dal processore Apple A7 in poi, applicano la crittografia sulla memoria con cui lavorano.

Un altro metodo per ridurre il rischio verso questo tipo di attacco è quello di eliminare le chiavi di crittografia dalla memoria immediatamente dopo il loro utilizzo. Questo riduce le possibilità di apprendere i dati segreti perché RAMBleed ha bisogno che il dato rimanga in memoria per almeno un intervallo di aggiornamento, che è 64 ms per impostazione predefinita.

Tale metodo è stato migliorato e automatizzato dallo standard di memoria LPDDR4 pubblicato da JEDEC, che include il supporto hardware opzionale per il cosiddetto “target row refresh” (TRR), che rallenta notevolmente l’effetto Rowhammer a livello fisico, senza influire negativamente sulle prestazioni o sul consumo energetico.

Note

[1] DRAM badness: https://www.blackhat.com/docs/us-15/materials/us-15-Seaborn-Exploiting-The-DRAM-Rowhammer-Bug-To-Gain-Kernel-Privileges.pdf.

[2] RAM ECC, acronimo di Error Correction Code.

[3] Codice di Hamming: https://it.wikipedia.org/wiki/Codice_di_Hamming.

[4] Flipping Bits in Memory Without Accessing Them: https://users.ece.cmu.edu/~yoonguk/papers/kim-isca14.pdf.

[5] Alcuni tipi di attacchi risultato essere possibili anche tramite l’esecuzione di codice Javascript, o tramite l’iniezione di codice su server collegati in desktop remoto.

[6] Rowhammer: https://www.ictsecuritymagazine.com/articoli/lhardware-e-la-sicurezza-it-parte-2-attacchi-side-channel-row-hammer-ed-attacchi-alla-cache/.

[7] RamBleed: https://rambleed.com/docs/20190603-rambleed-web.pdf.

[8] I ricercatori hanno sviluppato un particolare metodo, denominato Frame Feng Shui, che consente loro di posizionare le pagine contenenti i dati desiderati in una specifica posizione all’interno del frame di memoria flippabile predeterminato.

[9] Heninger-Shacham Algorithm: https://eprint.iacr.org/2008/510.pdf.

[10] Trusted Execution Environment: https://en.wikipedia.org/wiki/Trusted_execution_environment.

[11] Android Trusted Zone: https://medium.com/@nimronagy/arm-trustzone-on-android-975bfe7497d2.

Articolo a cura di Daniele Rigitano

Download PDF

https://www.ictsecuritymagazine.com/articoli/attacco-rambleed/


Le TLC europee e le aree di miglioramento

Come di consueto, l’Agenzia dell’Unione Europea per la Sicurezza delle Reti e delle Informazioni (ENISA)[1] ha pubblicato, lo scorso 5 giugno, il Rapporto Annuale sugli Incidenti di Sicurezza nelle Telecomunicazioni riferito all’anno 2018 (Annual Report Telecom Security Incidents 2018)[2].

Rispetto allo scorso anno[3], il rapporto è caratterizzato da alcune conferme e da qualche elemento di novità. Le conferme sono collegate al numero di incidenti segnalati, tramite le Autorità di Regolazione nazionali: nel 2018 sono stati segnalati 157 incidenti significativi che, ancorché in lieve diminuzione, risultano in linea rispetto ai 169 segnalati nel corso del 2017.

Invece, un primo elemento di novità riguarda il numero di ore d’uso perse dagli utenti a causa degli incidenti segnalati: nel 2018 sono state perse 960 milioni di ore a fronte dei 1.942 milioni del 2017. Quindi, rispetto a un numero di incidenti calato di una percentuale inferiore al 10%, le ore perse sono meno della metà dell’anno precedente; questo è un segnale davvero positivo ed è talmente marcato che non può essere considerato casuale. Siamo senz’altro di fronte a un miglioramento della capacità di reazione da parte dei fornitori di servizi di comunicazione elettronica che, evidentemente, si sono dotati di sistemi di fault detection e di business continuity più efficaci.

Un altro elemento di novità riguarda il numero di autorità nazionali che hanno segnalato incidenti significativi: nel 2018 sono state solo 19 rispetto alle 22 del 2017. L’auspicio è che questo calo non sia il segnale di un progressivo disimpegno degli Stati rispetto al tema degli incidenti nelle telecomunicazioni. In realtà, l’Unione Europea, rispetto al passato, ha varato uno strumento in più per incidere sul monitoraggio degli incidenti. Infatti, come già anticipato lo scorso anno, nella Gazzetta Ufficiale Europea del 17 dicembre 2018 è stata pubblicata la direttiva 2018/1972[4] (nota come Codice Europeo delle Comunicazioni Elettroniche) che, all’art. 40, precisa, meglio di quanto facesse il precedente art. 13 bis della direttiva 2002/21/EC[5], le caratteristiche degli incidenti significativi nonché il flusso delle segnalazioni.

L’articolo 40 del nuovo codice, che dovrà essere recepito dagli ordinamenti nazionali, specifica, inoltre, che la Commissione Europea potrà essere ancora più esplicita adottando atti di esecuzione “che descrivano dettagliatamente le misure tecniche e  organizzative di cui al paragrafo 1 [misure che dovranno adottare i provider di telecomunicazioni, ndr] nonché le circostanze, il formato e  le procedure che si applicano agli obblighi di notifica ai sensi del paragrafo 2 [modalità di notifica degli incidenti, ndr]”.

Al rapporto di quest’anno, inoltre, l’ENISA ha aggiunto il perfezionamento di uno strumento visuale[6] per l’analisi degli incidenti e destinato a chiunque volesse approfondire l’argomento nella sua evoluzione pluriennale. Proprio grazie a questo strumento, sono emersi alcuni elementi interessanti che meritano di essere affrontati.

Le cause prime

Come di consueto, l’ENISA offre un’analisi degli incidenti rispetto a quattro cause prime:

  • malfunzionamento dei sistemi;
  • errori umani;
  • fenomeni naturali;
  • azioni di malintenzionati.

Analizzando il numero di incidenti rispetto alla loro causa prima, non ci sono novità di rilievo: il malfunzionamento dei sistemi è sempre quello che primeggia, superando il 60% del totale, rispetto alle altre cause che si mantengono tutte al di sotto del 20%.

Le cose cambiano, anche rispetto agli anni precedenti, se si analizza il numero di ore perse rispetto alla rispettiva causa prima: il 2018 è il primo anno in cui si incrociano le linee dei fenomeni naturali e dei malfunzionamenti di sistema. Infatti, il numero di ore perse dagli utenti per fenomeni naturali è pari al 50% del totale rispetto al 39% dovuto ai malfunzionamenti di sistema; nel 2017 le proporzioni erano pari al 60% per i malfunzionamenti di sistema a fronte del 20% circa dovuto a fenomeni naturali.

È curioso notare che, nel 2018, gli incidenti dovuti ad azioni di malintenzionati sono pari solo al 4% del totale, ancorché in lieve aumento rispetto al 2017 (2%), e che questa causa prima è quella con la percentuale più bassa tra le quattro analizzate dall’ENISA.

Il tool visuale dell’ENISA offre un’analisi ancora più granulare delle cause prime (cause specifiche) che fa emergere alcune considerazioni di una certa rilevanza:

  • la mancanza di corrente elettrica incideva, nel 2017, con una frequenza del 22%; nel 2018 gli incidenti dovuti a questa causa specifica si abbassa al 15%;
  • aumenta, invece, il numero di incidenti dovuto alla manutenzione/aggiornamento del software passando dal 13% del 2017 al 19% del 2018;
  • risulta ancora troppo alta la percentuale di incidenti dovuta al taglio di cavi che si attesta al 12% nel 2018 ed al 10% nel 2017.

L’impatto sui servizi

Con riguardo ai servizi, l’analisi dell’ENISA fornisce una visione rispetto a:

  • connessioni dati fisse;
  • connessioni di fonia fisse;
  • connessioni dati mobili;
  • connessioni di fonia mobili;
  • altri servizi.

Nel 2017, le percentuali di incidenti con riflessi su fonia mobile e su dati mobili erano molto vicine: 51% e 49%; nel 2018, invece, aumenta la percentuale di incidenti che compromettono la fonia mobile (52%) mentre diminuisce quella degli incidenti che colpiscono le connessioni dati mobili (45%).

Le connessioni fisse risultano, invece, meno colpite e la percentuale di incidenti che ne influenza il corretto funzionamento è sempre al di sotto del 40%, sia per la fonia che per i dati.

Gli asset coinvolti

Andando ad approfondire quali asset siano stati colpiti dagli incidenti, emerge che c’è una inversione di tendenza: nel 2018 al primo posto ci sono gli switch e i router (12%) e al secondo posto sono collocate le stazioni base per la fonia mobile (7%). Nel 2017 la situazione era inversa: risultavano più colpite le stazioni base per la fonia mobile (9%) rispetto a switch e router (8%).

Per i router e gli switch esistono forti differenze nelle cause specifiche (anche concorrenti) degli incidenti. Per il 2018, le cause specifiche rispetto a questi apparati sono, in ordine decrescente, il malfunzionamento hardware (55%), i difetti di manutenzione/aggiornamento del software (25%) e i tagli di cavo (15%); nel 2017, invece, le cause specifiche risultano essere i difetti di manutenzione/aggiornamento del software (42%), il sovraccarico (35%) e la mancanza di corrente elettrica (35%).

Per le stazioni base di fonia mobile, invece, la causa specifica più rilevante rimane sempre la mancanza di corrente elettrica anche se, percentualmente, con una forte flessione nel 2018 (41%) rispetto al 2017 (68%). Le differenze sostanziali sono nelle due posizioni che seguono: nel 2018 abbiamo i malfunzionamenti hardware (33%) ed il forte vento (33%) mentre nel 2017 si riscontrano il ghiaccio e la neve (50%) e i malfunzionamenti hardware (31%).

Considerando l’importanza che ha, nelle cause specifiche, la mancanza di corrente elettrica, appare interessante approfondire gli incidenti, spesso trascurati, che incidono sui gruppi di continuità. Nel 2018 tutti gli incidenti che hanno colpito i gruppi di continuità sono dovuti alla mancanza di corrente elettrica: vuol dire che il gruppo di continuità, sostanzialmente, non è mai stato testato e, concretamente, non tratteneva energia (probabilmente per motivi dovuti alla batteria esausta o alle componenti elettroniche malfunzionanti). Questa tendenza era già emersa nel 2017 anche se ha riguardato solo il 55% degli incidenti sui gruppi di continuità.

Conclusioni

La versalità e la ricchezza del tool interattivo messo a disposizione dall’ENISA, di cui sono stati sintetizzati solo alcuni aspetti che hanno differenziato i trend negli ultimi due anni, sembrano, quindi, caratteristiche determinanti per avviare un’analisi più accurata – sia da parte delle autorità nazionali di controllo che da parte degli operatori del mercato – delle aree di miglioramento nei sistemi di telecomunicazione.

Note

[1] https://www.enisa.europa.eu/.

[2] https://www.enisa.europa.eu/publications/annual-report-telecom-security-incidents-2018/at_download/fullReport.

[3] https://www.ictsecuritymagazine.com/articoli/la-risposta-agli-incidenti-una-questione-aperta/.

[4] https://eur-lex.europa.eu/legal-content/IT/TXT/PDF/?uri=CELEX:32018L1972&from=EN.

[5] https://eur-lex.europa.eu/LexUriServ/LexUriServ.do?uri=OJ%3AL%3A2009%3A337%3A0037%3A0069%3AEN%3APDF.

[6] https://www.enisa.europa.eu/topics/incident-reporting/for-telcos/visual-tool.

Articolo a cura di Francesco Maldera

Francesco Maldera è Data Protection Officer e Data Scientist.

Il suo percorso professionale lo ha chiamato a responsabilità direzionali nell’ambito dei sistemi informativi, della safety&security, della privacy e dell’auditing svolgendo diversi incarichi dirigenziali nella Pubblica Amministrazione e in aziende private.

Attualmente, accompagna l’attività consulenziale a quella di sensibilizzazione delle persone tramite il sito www.prontoprivacy.it

Download PDF

https://www.ictsecuritymagazine.com/articoli/le-tlc-europee-e-le-aree-di-miglioramento/