SCADA (In)Security: un’analisi approfondita sulla superficie di attacco del noto sistema di controllo industriale

Il termine SCADA, acronimo di Supervisory Control And Data Acquisition, si riferisce a un sistema informatico, in genere un’architettura distribuita con gestione centralizzata, utilizzato per il monitoraggio e il controllo elettronico dei sistemi industriali.

Un sistema SCADA è un software che consente all’operatore di interfacciarsi con i processi tramite sistemi di controllo. Più in generale, qualsiasi applicazione che riceve dati dal funzionamento di un sistema di controllo per controllarla e ottimizzarla è un’applicazione SCADA. L’applicazione può riguardare un processo di distillazione petrolchimica, un sistema di filtrazione dell’acqua, un compressore del condotto o qualsiasi altro elemento.

I sistemi SCADA hanno due obiettivi principali:

  1. monitoraggio del sistema fisico, è possibile controllare e gestire a distanza le varie macchine e tutti i processi in esecuzione;
  2. acquisizione dei dati, utile per verificare il corretto funzionamento del sistema e per identificare più facilmente guasti o possibili problemi.

L’interconnessione dei sistemi SCADA è, da un lato, una grande opportunità e un vantaggio per molte applicazioni industriali, consentendo una maggiore accessibilità; dall’altra, espone le debolezze e le vulnerabilità dei sistemi a un rischio molto più elevato. Per questo motivo è necessaria un’analisi globale della sicurezza dell’intero sistema, verificando ogni interconnessione o componente e identificando le rispettive vulnerabilità e l’impatto relativo che queste possono avere sui processi di produzione.

I rischi di un attacco ai sistemi industriali sono concreti e reali: si tratta di obiettivi molto sensibili data l’importanza dei processi che governano e dell’impatto che un disservizio può causare sulla comunità.

Con l’attacco malware noto come “Stuxnet”, i problemi di sicurezza di SCADA sono diventati di primaria importanza. È diventato evidente che gli attaccanti erano disposti ad accedere ai sistemi SCADA / PLC per danneggiare l’impianto industriale. Data la difficile natura dell’attuazione di controlli robusti in ambienti industriali, varie autorità nazionali come NIST e CPNI hanno prodotto standard e guide di sicurezza per i sistemi in tempo reale. Con l’abbondanza di apparecchiature ICS / SCADA scarsamente protette, poiché non prevedevano alcun controllo di sicurezza, gli organismi nazionali e internazionali hanno compiuto uno sforzo significativo per definire gli standard per la sicurezza dell’infrastruttura CNI.

Esempi di standard sviluppati sono:

  • Guide di sicurezza CPNI del Regno Unito;
  • USA NIST 800-82;
  • ISA 99;
  • IEC62443.

La sfida principale è proteggere le apparecchiature legacy esposte alla rete per evitare possibili intrusioni all’interno del sistema. Tuttavia, l’uso di queste norme pone solo le basi per la sicurezza e potrebbe non essere sufficiente. Al fine di comprendere meglio le vulnerabilità dei sistemi SCADA e su quali attacchi erano basati, lo studio è proseguito con l’analisi dello stato dell’arte dei malware ICS / SCADA.

ICS/SCADA Malware

L’esposizione dei sistemi SCADA a Internet ha introdotto molti rischi per la sicurezza. Ciò è particolarmente vero perché i protocolli di sicurezza e autenticazione in SCADA sono stati ritenuti non necessari fino agli anni ’90. Queste implementazioni legacy erano basate sull’oscurità/anonimato di protocolli specializzati con interfacce proprietarie e isolamento fisico del sistema. Collegando il sistema alla rete, la proprietà dell’oscurità degli strumenti utilizzati nell’ambiente è venuta meno. Gli attacchi ai sistemi ICS / SCADA sono diventati molto sofisticati nel corso degli anni – vedi Stuxnet – mentre allo stesso tempo sono stati abbassati il livello di abilità e il tempo necessario per lanciare un attacco. Altri problemi, come l’aumento della complessità e l’interdipendenza delle infrastrutture critiche, comprendono i rischi derivanti dalla perdita del servizio (ad esempio elettricità, traffico o controllo dei processi), danni alle proprietà, all’ambiente e potenzialmente alla vita umana. Tra i malware più noti ed emergenti che colpiscono i sistemi ICS / SCADA ci sono:

Malware CVE
Stuxnet CVE-2010-2729
CVE-2010-2568
CVE-2008-4250
Triton N/A
Industroyer CVE-2015-5374
Havex (RAT) CVE-2014-1761
CVE-2013-5671
CVE-2013-1756
IronGate N/A
BlackEnergy CVE-2014-4114
CVE-2014-0751

Security design

Gli ambienti SCADA sono nati come sistemi isolati e quindi gli hacker potrebbero difficilmente accedere al sistema. Collegandosi ad altre reti, il sistema è esposto a tutte le possibili minacce relative alla rete. Tutto ciò ha introdotto nuove vulnerabilità nei sistemi SCADA. Inoltre, il problema dell’utilizzo di standard aperti per i protocolli di comunicazione interna ha sollevato ulteriori vulnerabilità da affrontare. Il motivo principale per cui sono stati utilizzati gli standard aperti è principalmente legato al costo: ma questi sono aperti, sono accessibili a tutti e quindi un possibile utente malintenzionato che studia i protocolli può identificare le possibili lacune da sfruttare per un attacco. Queste scelte hanno inevitabilmente influito sulla sicurezza del sistema. Tutto ciò ha consentito agli aggressori un maggiore accesso alle informazioni nei sistemi SCADA. La robustezza dei sistemi SCADA / ICS di fronte a un attacco cibernetico diretto è molto inefficiente perché, come precedentemente affermato, non erano destinati a essere connessi a reti esterne. I sistemi dovrebbero essere progettati in modo tale che ci siano controlli di sicurezza come:

  • firewall,
  • Data-diode,
  • IDS e IPS,
  • sistemi di gestione delle identità e degli accessi.

Lo stato attuale di sicurezza dei sistemi SCADA / ICS è considerato molto basso. Gli approcci di codifica sicuri sono rari e molti sistemi sono così fragili da non poter resistere alle scansioni di sicurezza.

Esistono account amministrativi con backdoor e, in alcuni casi, credenziali di autenticazione con “hardcoded” che, se note, garantiscono l’accesso a potenziali aggressori. Il “flicker” di base di SCADA / ICS può causare arresti anomali e problemi relativi all’overflow del buffer. In alcuni casi non ci sono sistemi di sicurezza basati sul “timeout della password” e tutto ciò espone il sistema ai tentativi di accesso basati sulla “forza bruta”. Attraverso l’uso di framework come Metasploit e Nessus, gli hacker sono in grado di ottenere informazioni di sistema e accedervi in tempo reale.

Gli attacchi informatici su SCADA / ICS sono rari ma in aumento. La tentazione iniziale delle aziende era di respingere il problema; tuttavia, una presentazione di “Blackhat” nel 2013 ha mostrato che se un honeypot è presente sulla rete simulando un sistema in tempo reale, le parti che erano connesse potevano cambiare le impostazioni nei livelli creando un potenziale pericolo. Questo era solo un honeypot virtuale, non un vero sistema SCADA, ma il risultato di attaccanti esterni che si collegavano ai sistemi reali cambiando le impostazioni poteva avere serie implicazioni. Se possibile, dovrebbero essere usati prodotti robusti SCADA / ICS, con sistemi di sicurezza elevati. È essenziale separare il sistema dalle reti ad alto rischio – come Internet – e non consentire l’accesso diretto agli indirizzi IP SCADA/ICS.

ICS/SCADA Vulnerabilities Taxonomy

Come citato in nota[1], i sistemi SCADA presentano diverse vulnerabilità di sicurezza:

  • vulnerabilità hardware: I componenti SCADA (master SCADA, RTU, IED) presentano vulnerabilità che possono essere sfruttate dagli attacker. Ad esempio, le RTU hanno una bassa capacità di elaborazione e poca memoria, quindi possono essere soggette ad attacchi legati all’overflow del buffer;
  • vulnerabilità del software: le vulnerabilità più comuni riguardano l’interruzione, l’intercettazione del traffico di dati e la modifica. Il software potrebbe essere rimosso da un utente malintenzionato per causare un errore potenzialmente grave. Altre vulnerabilità sono legate al sistema operativo e alla sicurezza basata su firewall. Il problema si verifica perché molti nodi su sistemi SCADA eseguono sistemi operativi in tempo reale (RTOS). Questi sistemi sono più suscettibili agli attacchi DoS (Denial of Service) perché le piccole disfunzioni della messaggistica possono portare a una significativa perdita di disponibilità delle informazioni. Inoltre, ci sono problemi legati alla mancanza di meccanismi di autenticazione nei vecchi protocolli utilizzati in questi sistemi (Modbus o, ad esempio, InterControl Center Communications Protocol [ICCP]). I protocolli più semplici sono spesso preferiti su meccanismi più complessi per migliorare l’affidabilità, la manutenibilità e le prestazioni, ma questo potrebbe esporre il sistema a possibili aggressori;
  • vulnerabilità legate ai collegamenti di comunicazione: i sistemi di comunicazione possono essere utilizzati come mezzi di connessione al mondo esterno, poiché non sono presenti funzionalità di sicurezza;
  • vulnerabilità in merito all’autorizzazione: l’accesso non autorizzato alle apparecchiature può impedire l’accesso legittimo alle richieste degli utenti o di altre risorse, causando problemi nel sistema in quanto potrebbero non essere disponibili o funzionare in modo Con l’accesso non autorizzato è inoltre possibile modificare le logiche di controllo e/o caricare un codice di controllo per distruggere o danneggiare il sistema.

Le misure di controllo della sicurezza includono: tecniche crittografiche, parole chiave, firewall, sistemi di rilevamento delle intrusioni, VPN, antivirus, controllo degli accessi, ecc. Altre misure sono state proposte per i sistemi SCADA, tra cui utilizzare gli standard IEEE / ISO e NIST Guidelines e, in secondo luogo, migliorare i protocolli SCADA inserendo crittografia e decrittografia per la comunicazione a ogni estremità, senza apportare modifiche ai protocolli che utilizzano crittografia e sistemi di sicurezza esterni (SSL / TLS, IPSec) o che cambiano fondamentalmente i protocolli.

Una sfida significativa, tuttavia, riguarda la decisione su quale di queste misure sia la più appropriata e che consideri rischi, impatto e costi. Tuttavia, queste tecniche non affrontano la quantificazione della probabilità di successo (e impatto) di questi diversi insiemi di minacce alla sicurezza. Da questi limiti nasce la necessità di sviluppare approcci di modellizzazione del rischio e della minaccia. Un modello di minaccia / rischio può aiutare a valutare la probabilità, il danno potenziale, la priorità degli attacchi e quindi contribuire a minimizzare o sradicare le minacce. Tutto ciò è necessario per formalizzare il rischio percepito.

Risk and Impact Analysis

Per effettuare un’analisi di rischio e impatto, la tabella 1 è stata definita con tutti i possibili attacchi, attualmente noti, su un sistema SCADA / ICS. Le informazioni mostrate sono:

Attacks Description Probabili ty Impact
Malware (Virus, Trojan, Worms ecc.) Programmi software progettati per eseguire azioni indesiderate e non autorizzate su un sistema senza il consenso dell’utente, con conseguenti danni, corruzione o furto di informazioni. Il suo impatto può essere grave e si è osservato che il malware può essere comune o personalizzato. Questo tipo di attacchi, in particolare i worm, riguardano un’ampia gamma di risorse, dai sistemi SCADA ai sistemi standard. Very high High
Exploit Kits and rootkits Un exploit è un codice appositamente predisposto per sfruttare una vulnerabilità al fine di ottenere l’accesso a un sistema. È una delle minacce più importanti alle reti ICS / SCADA, in quanto può essere utilizzata anche da malintenzionati poco esperti e sono difficili da rilevare. Medium High
Advanced Persistent Threats (APTs) Attacchi progettati per un obiettivo specifico che si verificano per un lungo periodo di tempo e di solito vengono effettuati in più fasi. L’obiettivo principale è rimanere nascosti e ottenere quante più informazioni, dati sensibili o controlli per raggiungere l’obiettivo dell’attacco. Mentre la probabilità di questo attacco è bassa, è importante tener conto della difficoltà di individuarli, che di solito richiede molto tempo. Sono progettati per molti scenari, come il furto di informazioni riservate o proprietarie o l’interruzione delle operazioni. Low High
Insider Threat (Internal employee incidents) Un dipendente, un appaltatore o una terza parte che ha accesso a sistemi interni limitati si avvale di questo vantaggio per rubare, modificare o accedere senza autorizzazione a questi sistemi o ad altri che possono essere accessibili attraverso di essi. Low Crucial
Eavesdropping, (MitM, SCADA

communication hijacking)

Intercettazione in tempo reale non autorizzata di una comunicazione privata, ad esempio una telefonata, una sessione di messaggistica istantanea, videoconferenze o comunicazioni e-mail. In questo ambiente, può anche includere l’intercettazione di comunicazioni SCADA, ad es. comandi di controllo e anche la loro modifica per scopi non autorizzati. Low High/Crucial
Communication Systems network outage Un’interruzione o un guasto nella fornitura di rete, intenzionale o accidentale. A seconda del segmento di rete interessato e del tempo necessario per ripristinare le comunicazioni, l’importanza di questa minaccia può variare da alta a critica. Low High/Crucial
(Distributed) Denial of Service Questo attacco consiste in più sistemi che “attaccano” un singolo bersaglio per saturarlo e farlo schiantare. Questo può essere fatto semplicemente cercando di fare troppe connessioni, inondando un canale di comunicazione o ripetendo ripetutamente le stesse comunicazioni. È di grande importanza se i dispositivi SCADA sono interessati da questo attacco e possono causare la cessazione delle operazioni. Low Medium/High
Data/Sensitive information leakage I dati sensibili vengono rivelati, intenzionalmente o meno, a soggetti non autorizzati. L’importanza di questa minaccia può variare notevolmente a seconda del tipo di dati trapelati:

•  Medio: dati operativi standard, procedure interne.

•  Alto:  dati  aziendali,  dati  utente  privati  o proprietà industriale.

Low Medium/High
  • tipo di attacco,
  • descrizione dell’attacco,
  • probabilità di accadimento,
  • impatto sul

Caratterizzazione di vulnerabilità delle componenti di un sistema SCADA

Componenti coinvolti

Partendo dalle basi di attacco e dall’analisi del malware descritto è stato possibile identificare una serie di componenti per i quali è necessario fornire un robusto sistema di sicurezza. Questi componenti includono:

  • Unità terminale remota (RTU);
  • Controllore logico programmabile (PLC);
  • Master Terminal Unit (MTU);
  • Sistema operativo (SO);
  • Server I / O (IOS);
  • Database server (DBS);
  • Comunicazione (C).

Ognuno di questi componenti può essere colpito da una serie di minacce che, se riuscite, possono portare il sistema a non funzionare. Tra le principali minacce[1] che possono influenzare i componenti identificati, vi sono:

  • accesso non autorizzato (UA);
  • malware (MW);
  • denial of service (DoS);
  • vulnerabilità del sistema operativo (OSV);
  • autenticazione (A);
  • vulnerabilità del software (SV);
  • attacchi umani (HA);
  • vulnerabilità hardware (HV);
  • vulnerabilità nelle comunicazioni (CV).
Impact Matrix UA MW DoS OSV A SV HA HV CV No Threats
RTU 0 0 0.2 0.14 0 0.01 10−3 0.02 0.02 0.349
PLC 0 0 0.2 0.14 0 0.01 10−3 0.02 0.2 0.349
OS 0 0.01 0.2 0.1 10−3 0.2 0 0 0 0.669
MTU 0.3 0.3 0.2 0.1 10−3 0.2 0 0.02 0.02 0.399
IOS 0.3 0.02 0.2 0.02 10−3 0.2 0 0.02 0.02 0.399
DBS 0.3 0.02 0.2 0.02 10−3 0.2 0 0.02 0.02 0.399
C 0 0.01 0.2 0.01 0 0.01 0 0 0.5 0.450
No Failure 0.1 0.64 0.86 0.07 0.996 0.17 0.999 0.9 0.04 1

Tabella 2: Impact Matrix per sistemi SCADA

All’interno di ciascuna cella viene stimata la probabilità che il componente venga compromesso, data la possibile minaccia. Ovviamente queste probabilità possono variare in base alla metodologia di attacco e alle strategie e tattiche dell’attaccante.

Analisi e identificazione degli exploits

Per identificare ulteriori possibili componenti e minacce, è stata condotta un’analisi degli exploit noti sui sistemi SCADA, il tutto con l’aiuto di “Metasploit”. Questa è una struttura che consente lo sviluppo di exploit il cui scopo è quello di prendere il controllo totale della macchina remota e oltre. È uno strumento creato per testare la sicurezza di un sistema, questi infatti offrono strumenti anti-rilevamento ed evitamento. Non avendo un obiettivo specifico, la ricerca di exploit è rivolta principalmente ai software e ai componenti più diffusi utilizzati all’interno di un sistema SCADA. Pertanto, sono state condotte ricerche volte a identificare questi exploit. Dalla ricerca sono stati identificati circa sessanta exploit e trentuno software/componenti SCADA, tra cui:

  1. mySCADA – myPro Zscada
  2. Rockwell Scada system GE Proficy Cimplicity
  3. KingScada Certec EDV
  4. 7-Technologies IGSS IniNet SpiderControl
  5. Advantech webaccess ClearScada
  6. AzoTech DaqFactory Soitec SmartEnergy
  7. CADA 3S CoDeSys Novus Electronics WS10
  8. DataC RealWin ABB MicroScada SYS600
  9. Procyon Iconics Genesis32
  10. ScadaTec & ScadaPhone Siemens FactoryLink
  11. CitecScada Sunway Force control
  12. Winlog ITS SCADA
  13. Modbus Intellicom Netbiter webSCADA
  14. BroadWin TwinCat
  15. KingView OPC Client
  16. Moxa Device manager
  17. Zscada
  18. GE Proficy Cimplicity
  19. Certec EDV
  20. IniNet SpiderControl
  21. ClearScada
  22. Soitec SmartEnergy
  23. Novus Electronics WS10
  24. ABB MicroScada SYS600
  25. Iconics Genesis32
  26. Siemens FactoryLink
  27. Sunway Force control
  28. ITS SCADA
  29. Intellicom Netbiter webSCADA
  30. TwinCat
  31. OPC Client.

Per ciascuno dei componenti software/hardware “Metasploit” ha fornito molteplici exploit, che forniscono informazioni su:

  • versione software;
  • vulnerabilità sfruttabile;
  • fonte dell’analisi approfondita (percorso).
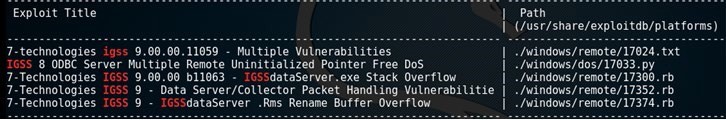
Utilizzando il percorso consigliato da Metasploit, che in genere ci ha indirizzato a database noti come ExploitDB, è stato possibile estrapolare ulteriori informazioni, tra cui:

  1. tipo di attacco, locale o remoto,
  2. conseguenza dell’attacco, impatto
  3. CVE, se esistente,
  4. presenza del codice sorgente,
  5. verifica della fattibilità,
  6. sistema operativo coinvolto,
  7. data in cui era nota la vulnerabilità,
  8. collegamenti di riferimento.

Esistono standard di settore, come il NIST, in cui è definito un punteggio di vulnerabilità. NIST ha un database CVE (Common Vulnerability Enumeration) che ci ha fornito un elemento aggiuntivo per classificare l’attacco. Ogni CVE è associato a un sistema di punteggio di vulnerabilità comune (CVSS) che definisce il livello di rischio di tale vulnerabilità. Il CVE identifica effettivamente una vulnerabilità. Ogni CVE ha uno o più enumerazioni di piattaforma comune (CPE) ad esso associate, che identificano univocamente un prodotto software. Parliamo invece di CWE (Common Weakness Enumeration) usato per descrivere le classi di vulnerabilità. Ogni CVE può appartenere a più CWE.

L’analisi, a questo punto, ha mirato ad approfondire il livello di dettaglio partendo dal CVE e risalendo al CVSS corrispondente, ove presente. Da questi, ulteriori informazioni sull’attacco potrebbero essere ottenute sul sistema, tra cui:

  • autenticazione, se richiesta o meno;
  • complessità dell’attacco;
  • punteggio di impatto (da 0 a 10);
  • punteggio di sfruttabilità (che definisce quante fonti dobbiamo supportare l’attacco).

Ulteriori informazioni relative alle metriche CVSS, ovvero: punteggio base, metriche ambientali e temporali. A questo punto è stato possibile classificare gli altri componenti interessati e le vulnerabilità tipicamente sfruttate, oltre a quelle identificate nel paragrafo 3.1, tutto ciò che è possibile osservare nella seguente tabella:

Affected Components Exploitable vulnerabilities
Executables (file) Buffer overflow
Webserver Path/Directory trasversal
Webapp Cross-site scripting
HMI Sql Injection
ActiveX Port attack
Specific ports (tipicamente protocolli tcp/udp) Privileage escalation
libraries “.DLL” Overwrite information

Tabella. Componenti e vulnerabilità SCADA

A questo punto è stato possibile capire, sulla base dell’attacco, quali potrebbero essere le possibili conseguenze a cui un sistema ICS / SCADA potrebbe rispondere, tra cui:

  • esecuzione di codice arbitrario da parte di un utente malintenzionat;
  • configurazione del cambio di servizio, generazione di comportamenti indesiderati;
  • un utente malintenzionato potrebbe accedere alle informazioni in registri, memoria, ecc.;
  • smettere di funzionare, causando di fatto un Denial of service (DoS);
  • modifica delle informazioni da parte di un utente.

Per definire il costo di ciascun exploit identificato, è stata definita una funzione di costo per ciascun exploit e una funzione di impatto per gli exploit senza CVE, in modo da poter calcolare la funzione di costo. Ogni elemento interessato, vulnerabilità, impatto e tipo di attacco (remoto o locale) avrà un punteggio basato sulle possibili conseguenze che può generare.
I punteggi proposti sono i seguenti:

Vulnerabilità (Vn) Score 0-10
Buffer overflow 8
Hard coded credential 10
Cross site scripting 8
Web access 8
sql injection 10
Multi-vulnerability 10
Port attack 8
Privilage escalation 10
Overwrite information 10
Consequences (Cs) Score 0.1-0.7
Esecuzione di codice arbitrario 0,7
Service change config. 0,7
Denial of service (DoS) 0,7
Overwrite information 0,7
Accesso a info (registri ecc.) 0,7
Elementi colpiti (Ec) Score 0-10
File (.exe/activeX) 8
WebServer/webapp 8
Gateway Server 8
Sw platform(plc/sensori/rtu) 10
Port udp/tcp 8
Modbus 10
HMI 10
Type (T) Score
Remote 0.5
Local 0.1
CVE Score
si 0,5
no 0,2

Essendo un sistema critico, i punteggi assegnati risultano inevitabilmente molto alti. La funzione di impatto (punteggio 0-10) proposta è la seguente:

I = (Vn * Cs) + (Ec * T)

A questo punto è stata definita una funzione di costo per ogni exploit:

((Vn * I) + (Ec * T)) * CVE

La funzione di costo è stata normalizzata e definita con una percentuale.

Infine, nella tabella seguente, verranno mostrate le analisi effettuate in dettaglio e quali sono i componenti software e hardware interessati dalle vulnerabilità e informazioni relative precedentemente descritte.

Component Version Date Type of vulnerability Local/ Remote
mySCADA –

myPRO

7 20/05/2018 Hard-Coded Credentials FTP User&Password Remote
Rockwell Scada System_MicroLogi x 27.011 e precedenti 16/05/2018 Cross-site scripting (XSS) nel web server Remote
LAquis Scada 4.1.0.3237 27/09/2017 Path Traversal, consente accesso a file Remote
KingScada Precedenti alla 3.1.2.13 14/09/2017 Stack-based buffer overflow Remote
Zscada Modbus 2.0 13/09/2017 Buffer overflow Remote
GE Proficy CIMPLICITY 8.2 07/07/2016 SERVICE_CHANG E_CONFIG

Privilege Escalation

Local
Certec EDV 2.5.9 09/05/2016 Path issue – Fornisce privilegi ad utente non autorizzato Local
SpiderControl 2.02.0000 08/12/2015 Elevazione di privilegi Remote
ClearSCADA 2010
R1.0, 2009,
2007,
2005.
SCX 67
R4.5 e 68 R3.9
28/01/2015 Remote Authentication Bypass Remote
Soitec SmartEnergy 1.4 e 1.3 15/12/2014 SQL Injection Remote
WS10 1.83 24/09/2014 Overflow (PoC) Remote
KingScada precedente a 3.1.2 11/02/2014 Consente di caricare una “.dll” malevola tramite url specifico Remote
ABB

MicroSCADA

4.1, 4.2,

8.4.5 e da9.0 a 9.3

03/12/2013 Remote Code Execution Remote
IGSS 9.00.00.11

059 e

precedenti

22/10/2013 Remote command injection. Directory traversal in “dc.exe” Remote
Advantech Webaccess 7.1

2013.05.3

0 e precedenti

08/01/2013 Cross-Site Scripting Remote
7-Technologies IGSS 9.00.00.11

063 e

precedenti

09/06/2011 Multiple stack-based buffer overflows in “IGSSdataServer.ex e” Remote
7-Technologies IGSS 10 e precedenti 30/05/2011 Stack-based buffer overflow in Schneider Electric igss. Esegue codice arbitrario inviando sulla porta TCP – 12397 Remote
7-Technologies IGSS 9.00.00 b11063 16/05/2011 Multiple stack-based buffer overflows in “IGSSdataServer.ex e” Remote
7-Technologies IGSS 9.00.00.11

059

22/03/2011 Multiple Vulnerabilities Remote
DaqFactory 5.85 build 1853 e precedenti 18/09/2011 Stack-based buffer overflow Remote
DaqFactory 5.85 build 1842 24/06/2011 Dos Remote
CADA 3S

CoDeSys

2.3.9.27 e precedenti 02/02/2013 Directory traversal su “Gateway- Server” Remote
CoDeSys SCADA 3.4 SP4 Patch 2 e precedenti 13/12/2011 Stack-based buffer overflow sulla componente “CmpWebServer” Remote
CoDeSys 3.4 SP4 Patch 2 30/11/2011 Null Pointer Invalid HTTP Request Parsing Remote Denial of Service Remote
Iconics GENESIS32 9.21.201.0

1

17/07/2011 Integer Overflow Remote
mySCADAPro 7 29/07/2016 Local Privilege Escalation Local
Measuresoft ScadaPro 4.0.0 e precedenti 16/09/2011 Multiple stack-based buffer overflows in “service.exe” Remote
DATAC RealWin SCADA Server 2.1 Build 6.0.10.10 e precedenti 22/06/2011 Stack buffer overflow Remote
DATAC RealWin SCADA Server 2.1 e precedenti 20/06/2011 Stack-based buffer overflow Remote
DATAC RealWin SCADA Server 2.0 (Build 6.1.8.10) 30/11/2010 Multiple stack-based buffer overflows Remote
Procyon Core Server 1.13 e precedenti 12/09/2011 Stack-based buffer overflow & Dos Remote
ScadaTEC ModbusTagServer

& ScadaPhone

4.1.1.81 e precedenti 12/09/2011 Buffer overflow Local
ScadaPhone 5.3.11.123

0 e precedenti

13/09/2011 Stack-Buffer overflow Local
CitectSCADA/Cite ctFacilities ODBC 5, 6 e 7 14/11/2010 Stack-based buffer overflow Remote
CitectSCADA ODBC Server 5.1.2600.

6, 7

05/09/2008 Stack-based buffer overflow Remote
Sielco Sistemi Winlog 2.07.16 e precedenti 13/09/2017 Remote Buffer Overflow Remote
Winlog Lite SCADA 2.06.17 29/08/2012 SEH overwrite Remote
Sielco Sistemi Winlog 2.07.16 27/06/2012 Vulnerabilità multiple Remote
Sielco Sistemi Winlog 2.07.18 08/06/2012 Remote Buffer Overflow, application presente Remote
Sielco Sistemi Winlog 2.07.00 e precedenti 21/06/2011 Stack based Buffer Overflow Remote
Siemens FactoryLink 8 25/06/2011 Buffer Overflow Remote
FactoryLink 7.5, 7.5

SP2, 8.0.1.703

21/06/2011 Stack buffer overflow Remote
Siemens tecnomatix factorylink  

8.0.1.1473

e precedenti

22/03/2011 Vulnerabilità multiple Remote
Modbus/TCP OPC Server 3 25/01/2011 Heap-based buffer overflow. Remote Heap Corruption (PoC) Remote
Advantech Studio 7.0 Build Number 0501.1111 04/12/2012 Path traversal in “NTWebServer.exe” Remote
.0402.000

0

, SCADA/HMI

Directory Traversal

Winlog Lite SCADA HMI

system

2.06.17 29/08/2012 Overwrite (SEH) Remote
CoDeSys SCADA 3.4 SP4 Patch 2 e precedenti 13/12/2011 Stack-based buffer overflow Remote
BroadWin 7.0 e precedenti 31/10/2011 WebAccess consente di causare da remoto un DoS Remote
Measuresoft ScadaPro 4.0.0 e precedenti 16/09/2011 Multiple stack-based buffer overflows in “service.exe” Remote
ScadaTEC ScadaPhone 5.3.11.123

0 e precedenti

13/09/2011 Buffer overflow Local
Sunway Force Control 6.1 26/08/2011 Remote Overflow in “httpsrv.exe” Remote
Advantech/BroadW in SCADA 7.0 23/03/2011 esecuzione di codice arbibrario sulla porta TCP – 4592 in

“webvrpcs.exe”

Remote
KingView 6.53 e 6.52 07/03/2011 Stack-based buffer overflow Remote
KingView 6.53 09/01/2011 Heap-based buffer overflow Remote
ITS SCADA Non presente 04/10/2010 SQL-injection Remote
Intellicom Netbiter webSCADA Products WS100, WS200,

altre versioni potrebbero essere colpite

01/10/2010 Vulnerabilità multiple tra cui: directory-traversal, information- disclosure e arbitrary-file-upload Remote

SCADA Enumeration

Shodan è un motore di ricerca che identifica all’interno della rete i dispositivi che lo compongono e che attraverso di esso sono collegati tra loro. I risultati restituiti da questo motore di ricerca sono relativi a server, computer, router, stampanti di rete, webcam e persino semafori, centrali elettriche, impianti di condizionamento industriale e turbine eoliche. Shodan è in grado di analizzare e passare attraverso tutti i nodi che compongono Internet e che consentono di interagire anche a migliaia di chilometri di distanza. Ogni mese il motore di ricerca “scheda” circa 500 milioni di nuovi dispositivi, creando un enorme database di computer, server, router e webcam collegati a Internet.
La registrazione su Shodan ti consentirà di utilizzare filtri specifici, tra cui:

  • città: cerca i dispositivi in una città specifica;
  • Paese: cerca i dispositivi nel paese indicato;
  • geo: consente di passare le coordinate geografiche;
  • hostname: cerca gli host che corrispondono alla stringa di testo specificata;
  • net: esegue una ricerca basata su IP o CIDR;
  • os: ricerca basata sul sistema operativo;
  • porto: cercare una porta aperta;
  • prima / dopo: cerca i risultati in una particolare finestra temporale;
  • prodotto: per cercare un prodotto specifico.

È possibile utilizzare l’API per effettuare ricerche basate su:

  • CVE;
  • Vuln: vulnerabilità specifiche;
  • metodo di ricerca;
  • ricerca su richiesta di scansione;
  • avvisi di rete.

L’analisi condotta attraverso l’uso di Shodan è stata fatta sulla base delle seguenti domande:

  • Query: https://www.shodan.io/search?query=NomeSW/Numero versione – CVE;
  • Vuln: CVE-NumeroCVE;
  • Server Scada;
  • Protocolli e porte di comunicazione, principalmente porta modbus: 502;
  • Usa il codice https:
    “200 ok” fornirà tutti quei sistemi il cui accesso non richiede autenticazione,
    “401” viceversa fornirà sistemi a cui è possibile accedere solo tramite autenticazione.

Nella figura qui sotto è possibile osservare una dashboard a cui potremmo accedere ed eseguire qualsiasi azione dannosa praticamente senza costi e sforzi.
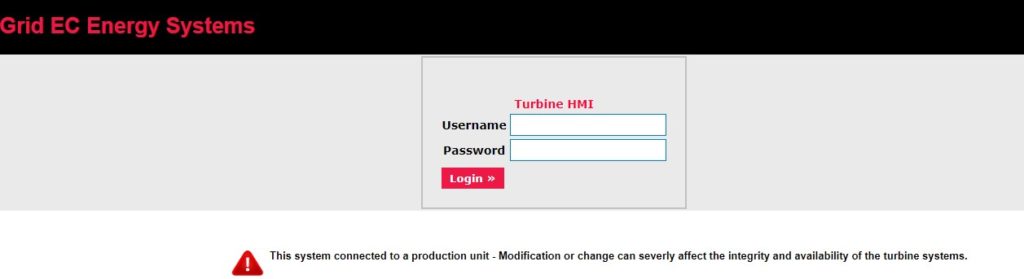
Tra i problemi più importanti segnaliamo che esistono diversi sistemi a cui è possibile accedere senza autenticazione e che eseguono un controllo remoto del sistema, ad esempio: gestione delle valvole, disattivazione degli allarmi, ecc. A tale proposito, si consiglia di tali sistemi richiedere l’autenticazione o meno remoto per prendere le necessarie precauzioni per evitare che un possibile aggressore possa causare danni al sistema. Tra i server e i servizi più utilizzati vogliamo segnalare:

  • CirCarLife Scada;
  • Servizio BAS Scada;
  • VTScada;
  • SCADA ISC;
  • Web scada;
  • Soluzioni software HMI / Scada;
  • Cloud Scada;
  • Server OPC InView.

Inoltre, utilizzando l’immagine Shodan e inserendo la seguente query:

  • screenshot.label: “ics / SCADA”,

è possibile osservare un’intera serie di HMI a cui è possibile accedere, ad esempio tramite strumenti come vcn viewer, che sarà sufficiente per fornire l’indirizzo e la porta di utilizzo (che sono spesso chiari) in modo da accedere al sistema e fare una qualsiasi azione malevola per compromettere il sistema. È possibile osservarne un esempio nella figura qui sotto:
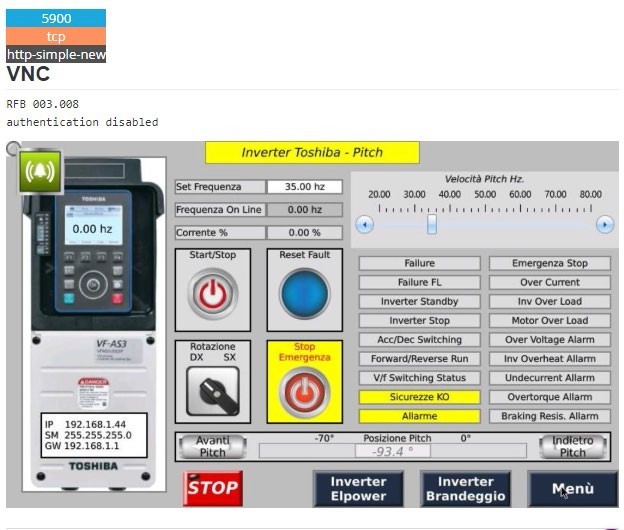
In effetti, molti di questi sistemi risultano avere l’autenticazione disabilitata e quindi, inserendola nel sistema IP e nel numero di porta, è possibile accedervi e manipolarla, oltre a spiare l’utente che la sta usando. Quindi dall’analisi di Shodan è chiaro che l’accesso a un sistema ICS / SCADA generico non richiede quasi nessuno sforzo e quasi nessun costo da parte di un aggressore, ma può creare enormi danni al sistema. A tale riguardo, i vari amministratori di sistema SCADA sono invitati a effettuare i controlli necessari relativi all’autenticazione e a fornire adeguati sistemi di sicurezza.

A questo punto dell’analisi sono state definite le reali tassonomie di attacco che possono influenzare un sistema SCADA e le ulteriori contromisure da utilizzare.

Attack Taxonomy

Le minacce e le vulnerabilità elencate potrebbero essere utilizzate dagli attacker per causare diversi livelli di danno con relativi effetti a cascata nelle infrastrutture. Nella tabella sono stati definiti i principali scenari di attacco, ognuno dei quali con il relativo impatto. L’impatto varierà tra “Basso”, “Medio”, “Alto” e “Cruciale”.

Attack scenarios Impact
Contro I sistemi di amministrazione Crucial
Contro gli attuatori High/Crucial
Contro il collegamento di rete tra sensori/attuatori e HMI High
Contro i sensori Medium/Crucial
Contro le informazioni che transitano sulla rete Medium/Crucial
Compromissione di componenti ICT Medium/High
Vulnerabilità dei protocolli, exploit High/Crucial
Contro lo storico dei dati di controllo Medium

Standard for the security of SCADA systems

Esistono molti standard applicabili a diversi settori industriali con una parte di essi che affronta già, almeno parzialmente, gli aspetti della sicurezza IT che dovrebbero essere affrontati nei sistemi e nelle reti ICS / SCADA.

Inoltre, i governi stanno anche iniziando a definire regolamenti obbligatori, come il Regolamento europeo sulla protezione dei dati (GDPR), per “forzare” le organizzazioni a raggiungere, almeno, un livello base di sicurezza delle informazioni sui loro sistemi, promuovendo in alcuni casi il uso di questi standard.

Tra gli standard più noti e consigliati da seguire vi sono i seguenti:

  • AGA 12 Parte 1 (Protezione crittografica delle comunicazioni SCADA): il suo obiettivo principale ruota intorno a una proposta di progettazione di sistema completa per ottimizzare i sistemi Ciò consente di ridurre i requisiti per l’esecuzione dei processi di manutenzione e gestione;
  • IEC 61968/61970 (Common Information Model [CIM] – Distribution / Energy management): definisce un “Common Information Model” che può essere utilizzato per le interazioni tra applicazione e applicazione tra i sistemi nel centro;
  • IEC 62351 (Sicurezza nei sistemi di gestione dell’energia): fornisce raccomandazioni di sicurezza per molti protocolli alcuni dei quali sono principalmente utilizzati nel settore energetico (include IEC 60870-5, DNP3, IEC 60870-5-101 e IEC 60870-5-104);
  • IEEE P1711 (Standard per un protocollo crittografico per la sicurezza informatica dei collegamenti seriali delle sottostazioni): definisce un protocollo crittografico che fornisce integrità e riservatezza opzionali, per la sicurezza informatica dei collegamenti;
  • ANSI / ISA 99 (Sicurezza dei sistemi di automazione e controllo industriale): definisce una linea guida per la sicurezza dei sistemi di automazione industriale e di Lo sviluppo di questo standard è stato interrotto quando è stato avviato ISA IEC 62443, che si rivela essere la sua evoluzione, il cui intento è quello di espanderlo e completarlo;
  • NIST SP 800-82 (Guida ai sistemi di controllo industriale): definisce la topologia tipica dei sistemi SCADA, identificando le minacce e le vulnerabilità del sistema fornendo raccomandazioni e contromisure per mitigare i rischi;
  • ISO 27000 (sistemi di gestione della sicurezza delle informazioni): uno standard per scopi generali che fornisce buone pratiche e raccomandazioni per la gestione della sicurezza delle informazioni e viene normalmente utilizzato per l’implementazione o la “gestione dei sistemi di gestione della sicurezza delle informazioni” (ISMS).

Note

[1] Sulla base delle minacce e dei componenti identificati finora, una matrice di impatto è stata definita da Chen, Qian, Abercrombie e Sheldon, Risk assessment for industrial control systems quantifying availability using mean failure cost (MFC), Journal of Artificial Intelligence and Soft Computing Research 5.3 (2015), 205-220.

Articolo a cura di Antonio Pirozzi e Corrado Aaron Visaggio

Corrado Aaron Visaggio è nato a Molfetta (BA) nel 1977. E’ professore associato di Sicurezza Informatica al Dipartimento di Ingegneria dell’Università degli Studi del Sannio. Ha conseguito la laurea in Ingegneria Elettronica (2001) presso il Politecnico di Bari e il dottorato (2005) presso l’Università degli Studi del Sannio. E’ docente di master universitari, quali quello di Roma Tor Vergata, Link University e Università degli Studi di Bari. E’ docente della Scuola Internazionale di Alta Formazione per la Prevenzione ed il Contrasto del Crimine Organizzato, del Ministero della Difesa ed è stato istruttore persso il Dipartimento di Sicurezza delle Informazioni del Ministero degli Interni. E’ il direttore del nodo Unisannio per il Laboratorio Nazionale CINI di Cybersecurity. E’ il responsabile scientifico di numerosi progetti di ricerca finanziati in Cybersecurity, che riguardano sicurezza delle reti, malware analysis e protezione dei dati. E’ nell’editorial board di numerose riviste scientifiche e conferenze internazionali di settorie (MALWARE, ISSRE, ARES, SECRYPT, SEKE, ITASec, FORSE, DATA, WETSOM). E’ autore di circa cento articoli scientifici su riviste e atti di convegni internazionali di settore. E’ co-fondatare della Spin-off accademica SER&P. Gli interessi di ricerca sono: malware analysis, data privacy and protection, software security, empirical software engineering.

Download PDF

https://www.ictsecuritymagazine.com/articoli/scada-insecurity-unanalisi-approfondita-sulla-superficie-di-attacco-del-noto-sistema-di-controllo-industriale/
Cyber Deception Technology, nuova frontiera nell’arte della guerra

Il concetto è semplice: l’espressione “inganno militare” si riferisce alla possibilità di ingannare i nemici durante una guerra o una rappresaglia. Ciò si ottiene normalmente alterando i fenomeni di contorno come le informazioni, la comunicazione e la percezione psicologica ad uso di un più ampio scopo strategico.

Kevin Mitnick (nome in codice “condor”, famoso hacker americano ispiratore di tantissimi film sull’hacking, oltre ad essere stato l’inventore dello “spoofing ip”), nel suo libro The Art of Deception riportava:

«La mente umana è un’invenzione meravigliosa. È interessante notare quanto riesca a essere creativa la gente quando si tratta di inventare modi subdoli per ottenere quanto le pare o per togliersi da una situazione spinosa. Dovete usare la medesima creatività e immaginazione per proteggere i sistemi informatici e di informazione nei settori pubblici e privati. Perciò, gente, quando pensate alle politiche di sicurezza delle vostre aziende… siate creativi e pensate fuori dal sentiero tracciato».

La cyberwar è del tutto simile alle guerre reali, ne abbiamo già parlato nell’articolo Stati e Guerre senza confini geografici pubblicato su Safety & Security Magazine; ma ad oggi come possiamo sfruttare “l’arte dell’inganno” nella cybersecurity per aumentare la sicurezza delle infrastrutture informatiche, proprio come Kevin Mitnick ci incitava a fare?

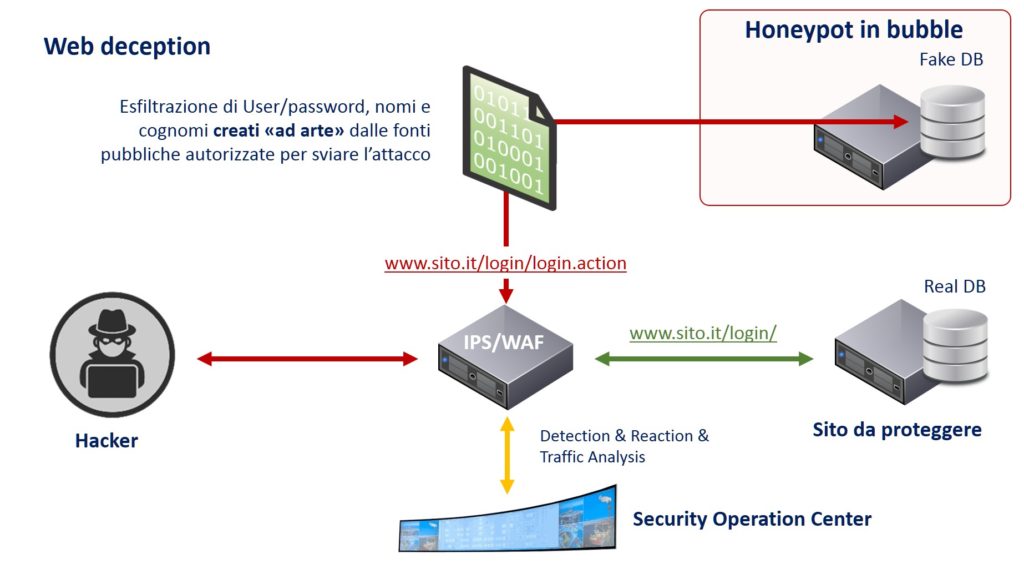
Come sappiamo, il concetto di honeypot è presente da tempo, ma si tratta di un ecosistema bersaglio auto-consistente che funge da “trappola” per eventuali intrusioni informatiche.

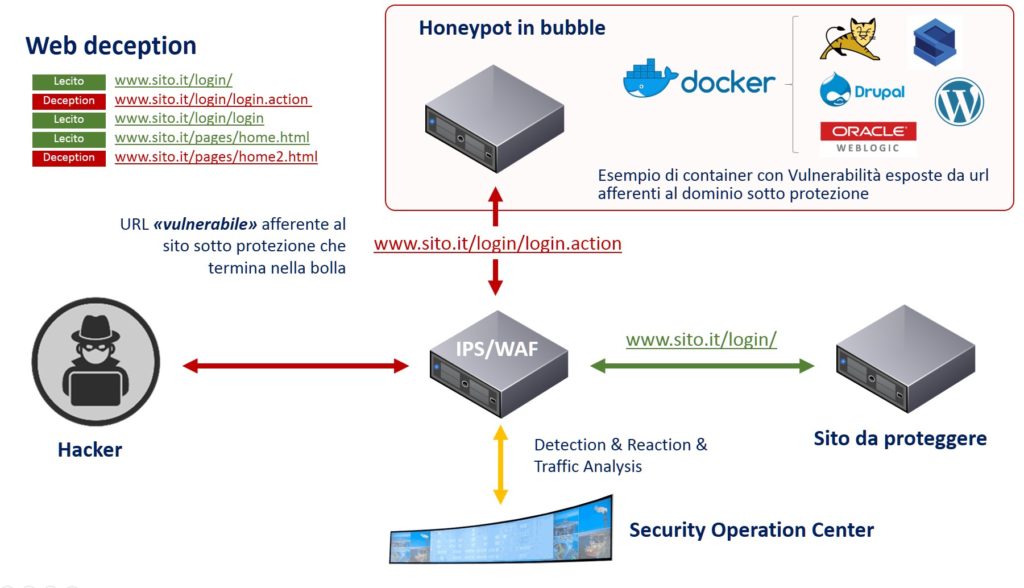
Lo step successivo è quello di creare delle trappole in-line alle applicazioni, che risultino esposte come parte integrante dell’applicazione stessa, in maniera customizzabile e gestibile, che portino l’attaccante in una bolla creata ad arte per simulare vulnerabilità finalizzate a depistarlo dal bersaglio reale, anche esponendo dati simili a quelli dall’applicazione da proteggere.

Ad esempio, un utilizzo della cyber-deception sulle web-application, può essere implementata simulando la presenza di url (esposte sullo stesso dominio che si vuole proteggere, magari come pagine di backup o altro), affette da note vulnerabilità come ad esempio sql-injection, XSS o Remote Code Execution che consentono di ingannare i potenziali aggressori e condurli su percorsi di attacco creati per loro, monitorandone gli avanzamenti attraverso il Security Operation Center pronto ad agire una volta raccolte tutte le tracce essenziali per poter impugnare un’analisi forense.

Tali applicazioni “parallele”, di fatto, non saranno altro che delle honeypot “multi layer” esposte in “bolle” completamente separate dalle reti aziendali (ad es. utilizzando hypervisor o virtualizzatori vari) che conterranno vulnerabilità note in modalità “inline” alle applicazioni da proteggere, magari riutilizzando e customizzando applicazioni già presenti negli hub-container pubblici per la creazione di sandbox.

Ovviamente la customizzazione risulterà fondamentale, in particolar modo per rendere le pagine simili al portale da proteggere e, quindi, non far accorgere i potenziali aggressori di essere atterrati su qualcosa di noto, magari da loro utilizzato per precedenti esercitazioni di attacco.

A questo punto il criminale informatico, qualora sia riuscito a completare l’attacco sul sito “fake”, potrebbe:

  1. ritirarsi e immagazzinare i dati “fake” pensando che questi siano corretti;
  2. in caso di attivismo, pubblicare i dati su repository pubblici (ad es. pastebin), oppure effettuare deface del sito “fake”, ovviamente non l’applicazione principale (il dominio da proteggere);
  3. incorrere in potenziali azioni legali, dovute alle tracce lasciate sui sistemi e acquisite dal Security Operation Center di competenza.

Nel secondo caso occorre prestare attenzione, in quanto potrebbero esserci implicazioni sul brand e nella web reputation dell’impresa: l’inganno non deve influenzare gli scenari del mondo reale.

Come difendere brand & web reputation dopo una deception

In un contesto così labile tra difensore e attaccante, che pubblica in rete informazioni “fake” provenienti da un nostro sito, rispetto all’opinione pubblica, come occorre comportarci?

Sicuramente l’aspetto più importante sta nel rendere inviolabile il “miele” contenuto all’interno delle applicazioni da proteggere e, su questo fronte, tutte le tecniche di guerra risultano lecite.

Applicando tutto questo, occorrerà attraverso la comunicazione (che vedevamo all’inizio essere uno tra i principali attori nell’arte dell’inganno), proteggere il brand da eventuali attacchi sulle fonti pubbliche. Questo forse in molte aziende potrebbe essere oggi ancora difficile da sostenere, per una mancanza di specifiche competenze o reattività nell”attraversamento dei processi aziendali di Cyber Security.

Conclusioni

L’arte della deception è stata avviata nel lontano 1999 con le honeypot che hanno trainato il mercato di quel periodo. Dopo molto entusiasmo si è avuto negli anni successivi un forte arresto, tanto che si parlò di “inganno dell’inganno” che si concluse nel 2014 quando tali concetti cominciano a riprendere forma, anche se in modo differente.

Probabilmente questa sarà una nuova branca di sviluppo nella cybersecurity nel prossimo futuro. Gartner, all’inizio del 2019, parla di “Cyber Deception Technology” (o CDT) e stima che nel 2019 solamente il 10% delle aziende introdurrà strumenti o poc – e, soprattutto, sarà organizzato per gestire una corretta comunicazione – su questo nuovo fronte. Un problema è legato anche a una carenza di listino di questo genere di strumenti, che risultano oggi limitati se non completamente assenti.

Nelle guerre, come sappiamo, non esistono limiti nella sperimentazione tecnologica: ce lo insegna Mitnick ma anche gli eventi e anche questa branca di “guerra cibernetica” non è da meno. Il tempo ci farà comprendere se questa nuova visione dell’inganno consentirà di fornire supporto alle grandi aziende oppure se si tratti, come in molti casi, di architetture inutili acquistate e poi non più utilizzate, collezionate in rack spenti nei datacenter.

Articolo a cura di Massimiliano Brolli

Download PDF

https://www.ictsecuritymagazine.com/articoli/cyber-deception-technology-nuova-frontiera-nellarte-della-guerra/


GDPR e cifratura: concetti base e approcci pratici

La definizione delle misure di sicurezza da applicare al proprio sistema di gestione dei dati personali rappresenta una delle sfide principali, se non la più importante, posta ai titolari del trattamento dal Regolamento UE sulla protezione dei dati – General Data Protection Regulation, comunemente noto come GDPR.

A complicare il panorama, l’abrogazione dell’ex Allegato B al Codice Privacy (D.Lgs. 196/2003) che conteneva un elenco dettagliato di misure minime di sicurezza, unanimemente considerato esaustivo.

L’attuale quadro normativo, invece, affida al titolare il compito e la responsabilità di decidere quali misure di sicurezza possano essere considerate idonee al fine di garantire un’adeguata protezione ai dati personali trattati. Tale libertà di scelta ha portato, nel corso dell’ultimo anno – il primo da quando il GDPR è divenuto pienamente applicabile – a considerare la cifratura quale misura “regina” atta a garantire riservatezza, integrità e disponibilità dei sistemi e dei servizi di trattamento.

All’interno del testo del Regolamento UE, il concetto di cifratura viene citato a più riprese.

Si parte dal Considerando 83 ove è previsto che i titolari o i responsabili del trattamento dovrebbero valutare i rischi delle loro varie attività di trattamento dei dati e attuare misure per mitigare tali rischi, come la cifratura, in modo da:

  • mantenere la sicurezza;
  • impedire trattamenti non conformi al GDPR[1].

Pertanto, tale valutazione dovrebbe partire dall’individuazione dei tipi di dati personali coinvolti per arrivare all’effettivo danno che potrebbe essere causato agli interessati in assenza di idonee misure di sicurezza.

L’art. 32, poi, annovera la cifratura tra le misure tecniche e organizzative a disposizione del titolare, per garantire un livello di sicurezza adeguato al rischio. Ancora, l’art. 34, focalizzato sulla comunicazione di un’eventuale violazione di dati ai soggetti interessati, menziona nuovamente la cifratura come esimente per il titolare che abbia implementato misure adeguate a rendere i dati, oggetto della violazione, incomprensibili a chiunque non sia autorizzato ad accedervi.

L’esplicito riferimento alla cifratura nel GDPR ha però causato confusione circa la sua configurazione quale requisito essenziale. L’impiego di tecniche di cifratura, oltre ad essere impegnativo, può risultare talvolta inefficace poiché non necessario o sproporzionato rispetto alle tipologie di trattamenti effettuati e di dati trattati.

In linea generale, possiamo dunque considerare questo come uno strumento certamente utile ma, di certo, non l’unico da implementare. Va ricordato, infatti, che le modalità di compromissione dei dati sono molteplici e la crittografia blocca solo alcune di queste.

Pur non essendo una misura “obbligata”, rimane comunque “caldamente consigliata” per limitare i rischi impattanti sui dati personali. Il ricorso alla cifratura viene dunque rimesso all’iniziativa dei titolari del trattamento, in forza di quel principio di accountability che sta alla base del nuovo approccio promosso dalla normativa.

Appurata quindi la necessità di introdurre – all’interno dei propri processi – meccanismi di crittografia, è conveniente partire dai concetti base e dare le opportune definizioni.

Crittografia: maneggiare con cura

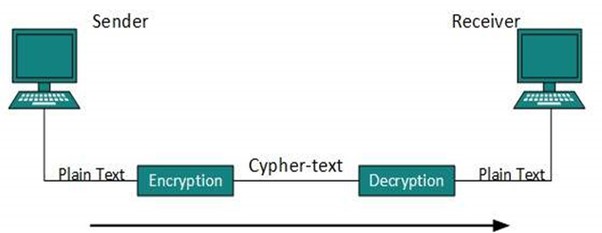
La cifratura è essenzialmente quel processo che rende un determinato dato incomprensibile, al fine di garantire la sua confidenzialità. I concetti alla base di questo processo sono l’informazione da proteggere, l’algoritmo di cifratura, il crittogramma (cypher-text) e un valore segreto definito chiave (key). La crittografia dovrebbe garantire che, senza conoscere la chiave, non si possa mai avere la possibilità di ottenere il messaggio in chiaro da cui proviene il crittogramma.

Il lettore attento avrà notato che è stato utilizzato il condizionale dovrebbe, in quanto l’utilizzo della crittografia ad oggi è in un certo senso idealizzato. La crittografia in teoria è un meccanismo forte e affidabile, soprattutto perché è basato su teorie e concetti matematici dimostrabili e dimostrati. In pratica, invece, è potenzialmente affetta da tutti i problemi che affliggono le implementazioni di tutti gli altri sistemi di sicurezza. Questo è ancora più evidente quando i sistemi di cifratura vengono, in qualche modo, ideati o concepiti da persone non esperte che, in un impeto di creatività – e forse anche egocentrismo – immaginano di aver inventato l’algoritmo di crittografia perfetto.

Appurato quindi che la creazione di algoritmi di cifratura dovrebbe essere sempre dominio di professionisti esperti, cosa significa in realtà avere una cifratura sicura? In maniera molto intuitiva, dato un crittogramma generato da un certo algoritmo di cifratura, il sistema non permette, in un determinato intervallo di tempo, di risalire al testo in chiaro se non conoscendo la relativa chiave di cifratura utilizzata.

Crittografia: tante tipologie, un unico scopo

Come abbiamo già accennato, il fine ultimo della crittografia è proteggere un’informazione. Permettere a questa informazione di essere condivisa solo tra i soggetti interessati e proteggerla da occhi indiscreti. Che sia un’informazione di guerra, un’informazione elettorale, dati personali o anche una lettera d’amore, il fine rimane lo stesso: che sia garantita la sua confidenzialità. A questo fine si può arrivare in modi diversi, ci limiteremo a presentare quelli più noti ed utilizzati.

Crittografia simmetrica

Questo tipo di crittografia è quella classica, quella che intuitivamente possiamo immaginare ed utilizzare nella vita di tutti i giorni. Facciamo un esempio:

Mario e Anastasia hanno un’informazione da scambiare; un’informazione che reputano così importante da non poter rischiare che qualcun altro possa conoscerla. Mettiamo che tale informazione sia un documento testuale che Mario deve inviare ad Anastasia in modo che possa revisionarlo prima di inviarlo a un cliente.

Il concetto alla base della crittografia simmetrica è che la chiave usata per cifrare il documento è la stessa utilizzata per decifrarlo. Quindi, Mario non dovrà fare altro che scegliere una chiave di cifratura, magari di un certo livello di complessità, cifrare il documento utilizzando un software adeguato e inviarlo ad Anastasia. Quest’ultima, con un software compatibile (non per forza lo stesso) decifrerà il documento, fornendo la chiave di cifratura utilizzata da Mario e potrà quindi leggere il documento in chiaro. La confidenzialità dell’informazione è quindi garantita in quanto, se anche un utente malintenzionato fosse in grado di rubare e/o copiare l’informazione, non avrebbe modo di decifrarla senza conoscere la chiave. A prima vista tutto sembra funzionare correttamente, ma resta un problema: in che modo Mario e Anastasia hanno condiviso la chiave di cifratura utilizzata? Di certo non possono condividerla tramite lo stesso canale che utilizzano per scambiarsi l’informazione. A tal fine, potrebbero incontrarsi o telefonarsi e scambiarla a voce, inviarla via sms o utilizzare un altro sistema di messaggistica. In questi casi, diciamo che i due hanno scambiato la chiave in modalità OOB (Out Of Band): hanno utilizzato quindi un canale diverso da quello in cui viaggia l’informazione da proteggere, in modo da rendere più complicata la vita al malintenzionato. Attenzione: diciamo più complicata, non impossibile. Le motivazioni risiedono tutte nell’importanza dell’informazione da proteggere. Se questa ha un’elevata importanza, diciamo di sicurezza nazionale, è probabile che sia Mario, sia Anastasia, possano essere tenuti sotto controllo e spiati. Non si può quindi considerare sicuro il canale che hanno utilizzato per scambiare la chiave. Il problema da risolvere è quello di proteggere il modo in cui i due attori si scambiano la chiave di cifratura.

Un esempio pratico di crittografia simmetrica è quello che utilizza, come algoritmo di cifratura, il DES (Data Encryption Standard). Nel mondo finanziario, la cifratura DES è stata utilizzata per anni per proteggere la sicurezza delle transazioni, come quelle relative alle nostre carte di credito. Tuttavia, negli ultimi decenni è stato dimostrato che tale algoritmo ha delle debolezze matematiche che possono essere sfruttate per decifrare l’informazione che esso protegge, anche non conoscendo la chiave di cifratura utilizzata. Si parla, in questo caso, di attacchi basati sulla crittoanalisi e cioè lo studio dei metodi per ottenere il significato di informazioni cifrate senza avere accesso all’informazione segreta che è di solito richiesta per effettuare l’operazione[2]. Al DES è seguita poi una sua versione più complessa, il 3DES (Triple Data Encryption Standard) e cioè l’applicazione del DES per tre volte. Oggigiorno, è praticamente l’algoritmo di cifratura più utilizzato nel mondo finanziario, bancario e assicurativo.

Crittografia asimmetrica

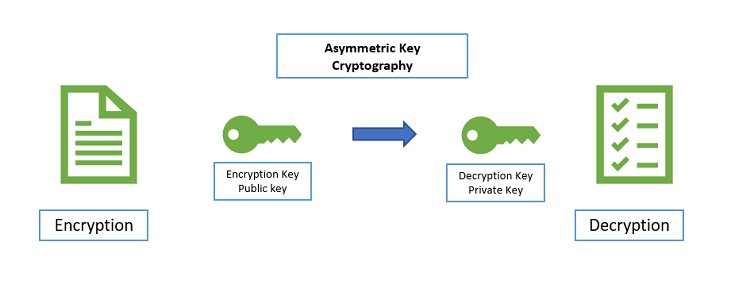
Il problema della condivisione della chiave di cifratura è stato risolto, in maniera davvero elegante, dalla crittografia definita asimmetrica. Proprio nel termine asimmetrica risiede la vera novità di questo nuovo tipo di crittografia: si usano due chiavi diverse per cifrare e decifrare l’informazione. Ogni attore ha quindi due chiavi: una per cifrare, definita chiave pubblica o pubkey, una per decifrare, definita chiave privata. Quindi, tornando ai due attori di prima, Mario userà la chiave pubblica di Anastasia per cifrare il messaggio; Anastasia userà la sua chiave privata per decifrarlo. Non c’è più il problema della condivisione della chiave di cifratura perché, per definizione, questa è pubblica: tutti possono vederla. Ma per decifrare, bisognerà utilizzare la chiave privata, quella che ognuno dovrà gelosamente custodire e che non dovrà mai condividere con nessuno.

Ma cosa garantisce questo legame tra chiave pubblica e chiave privata? Sempre la matematica! Noi comuni mortali non siamo tanto interessati a capire il funzionamento intimo degli algoritmi e teoremi matematici che garantiscono l’affidabilità di questo sistema, ci basti pensare che funziona, che è sicuro e che la nostra chiave privata è, per definizione, personale: non va condivisa con nessuno al mondo. Mai. In nessun caso.

Il primo sistema basato sulla crittografia asimmetrica a chiave pubblica vede la luce alla fine degli anni ’70 nei laboratori del MIT, grazie al lavoro di un geniale gruppo di ricerca formato da R. Rivest, A. Shamir e L. Adleman che ideano il famoso algoritmo RSA. Alla base del funzionamento di questo algoritmo c’è un concetto molto semplice, presente in bibliografia sin dai tempi dei matematici greci: i numeri primi. Semplificando veramente di molto, possiamo pensare che è computazionalmente molto facile moltiplicare due numeri primi di grandezza arbitraria, mentre è molto difficile (e computazionalmente molto oneroso) risalire ai due numeri primi che, moltiplicati tra loro, danno il numero in questione. In questo contesto, possiamo identificare la chiave privata come la coppia di numeri primi, mentre la chiave pubblica come il loro prodotto.

Tale algoritmo protegge la nostra vita di tutti i giorni: dalle applicazioni presenti nei chip delle nostre carte di credito, ai famosi certificati SSL che assicurano la riservatezza dei nostri dati di navigazione.

Quindi la crittografia asimmetrica ha risolto tutti i problemi della confidenzialità nello scambio delle informazioni? Effettivamente ne risolve tanti, ma non proprio tutti. Per sua stessa natura, è molto lenta e dunque poco utilizzabile all’interno di processi che richiedono prestazioni real-time, quali quelli autorizzativi nei pagamenti elettronici. Cosa che non capita con la cifratura simmetrica, che invece è semplice e, quindi, veloce. Ecco perché il connubio tra le due è la soluzione scelta unanimemente: si può utilizzare la crittografia a chiave pubblica per trasmettere la chiave di cifratura per poi proseguire con la crittografia simmetrica.

Approcci pratici

Tornando ai titolari del trattamento, cosa dovranno fare quindi questi poveri malcapitati che si troveranno a dover gestire in modo pratico e reale il problema crittografia? Ecco alcuni consigli basati sulla nostra personale esperienza:

  • affidarsi a prodotti basati su algoritmi standard di mercato e non cadere nell’errore di adottare soluzioni raffazzonate e fatte in casa da sconosciuti, benché auto conclamati geni e professori emeriti di crittografia, inventori del sistema di cifratura perfetto (…);
  • non sempre i prodotti commerciali sono la scelta migliore in ogni contesto: il mondo Open Source è costellato di eccellenti soluzioni che possono essere adottate anche in particolari ambienti dove è richiesto il supporto del fornitore;
  • studiare e definire bene l’architettura del sistema di cifratura utilizzato: una scelta approssimativa prima si trasformerà certamente in un problema enorme, e costoso, da gestire in seguito;
  • non sottovalutare mai la gestione delle chiavi crittografiche: il loro ciclo di vita, il loro backup, la loro gestione e la loro manutenzione. Definire, prima di adottare qualunque soluzione di cifratura, come si andranno a gestire le chiavi;
  • non applicare la crittografia subito su tutto: partire da pochi processi, coinvolgere pochi dipartimenti alla volta, capire il contesto in cui impatterà l’introduzione della crittografia;
  • utilizzare un approccio basato sul rischio, come sempre;
  • formare i collaboratori: importantissimo spiegare i veri motivi del perché un’informazione deve essere protetta.

Non sempre la soluzione più complessa e costosa è quella giusta: ad esempio, in determinati semplici contesti, anche l’utilizzo di archivi compressi protetti da password può risolvere in maniera veloce il problema, abbassando il rischio di data breach a livelli accettabili. D’altronde, il cambio di approccio del legislatore è stato proprio in questa direzione: non dettare regole precise, ma lasciare ai singoli la scelta del migliore sistema di protezione dei dati, compatibilmente con il proprio contesto.

Questi pochi semplici accorgimenti, che possono sembrare banali e normali, purtroppo raramente appaiono ben applicati nelle realtà organizzative. Si commette spesso l’errore di affidarsi a entità esterne che, condotte dalle buone intenzioni di introdurre in azienda un software di ultima generazione, provocano un abbattimento drastico della produttività, cosa che oggi poche aziende possono permettersi.

Note

[1] Regolamento (UE) 2016/679 del Parlamento europeo e del Consiglio del 27 aprile 2016 relativo alla protezione delle persone fisiche con riguardo al trattamento dei dati personali, nonché alla libera circolazione di tali dati (Regolamento generale sulla protezione dei dati).

[2] https://it.wikipedia.org/wiki/Crittoanalisi.

Articolo a cura di Anastasia Ambesi e Mario Ciccarelli

Download PDF

https://www.ictsecuritymagazine.com/articoli/gdpr-e-cifratura-concetti-base-e-approcci-pratici/


Smart manufacturing e cybersecurity

Il contesto di riferimento

La parola sicurezza corrisponde, nella lingua inglese, a due termini che esprimono significati molto diversi: safety e security. Il primo corrisponde a quello che – in italiano – è espresso dalla parola salubrità, connessa alle azioni per ridurre il rischio per il benessere fisico e psicologico delle persone. Il secondo si riferisce, invece, alle azioni che intendono prevenire o ridurre danni al patrimonio delle persone, delle organizzazioni e della società in generale.

Questi concetti, pur rimanendo distinti, sono stati oggetto di un approfondimento dell’Agenzia dell’Unione Europea per la Sicurezza delle Reti e delle Informazioni (ENISA)[1] nel documento “Good Practices for Security of Internet of Things in the context of Smart Manufacturing”[2] orientato a focalizzare l’attenzione sulla security for safety nelle aziende manifatturiere moderne.

L’impegno dell’ENISA è partito dalla considerazione che negli apparati produttivi delle aziende manifatturiere operano molti attuatori che agiscono sul mondo reale e, potenzialmente, sulle persone. Tradizionalmente, questi elementi sono stati dotati di meccanismi di prevenzione finalizzati a ridurre la probabilità che la loro azione possa incidere sulla salute (safety) delle persone; si pensi, per esempio, a un braccio di verniciatura di una fabbrica automobilistica: il suo angolo d’azione è configurato a monte affinché non sconfini in un’area dove possono essere presenti gli operai.

Tuttavia, nell’industria 4.0 e, in particolare, nella cosiddetta Industrial Internet of Things (IIOT) gli oggetti che compongono la fabbrica hanno una caratteristica in più: sono connessi attraverso protocolli aperti (appunto quelli del mondo Internet) diversamente da quelli tradizionali che comunicavano, spesso in maniera molto elementare, attraverso protocolli proprietari. Questo, certamente, li rende flessibili perché sono raggiungibili, configurabili e impiegabili “quando serve”e “da dove serve”; d’altra parte, la connessione attraverso protocolli ben noti aggiunge una vulnerabilità cui è necessario far fronte affinché siano ridotte le probabilità che una minaccia possa sfruttarla per fare danni (a persone e a cose).

ENISA, nell’affrontare questo problema, ha ritenuto di indicare le prossime sfide connesse a questo tema e di fornire alcune raccomandazioni per i soggetti interessati. Il documento, molto snello, pubblicato il 20 maggio 2019 con il titolo “Industry 4.0 – Cybersecurity Challenges and Recommendations”[3], riepiloga le azioni che dovrebbero caratterizzare il mondo della Smart Manufacturing con riguardo alle tre componenti essenziali delle realtà produttive moderne: le persone, l’organizzazione e la tecnologia.

Le persone

La prima sfida riguardante le persone è la necessità di stimolare e allineare la competenza e la consapevolezza tra la sicurezza operativa (OT) e la sicurezza informatica (IT). La maggior parte delle persone che lavorano negli ambienti manifatturieri sono abituate a maneggiare la strumentazione pensando soprattutto a evitare comportamenti che possano comprometterne l’operatività immediata, trascurando che esistono aspetti IT che possono causare danni molto più gravi. Per esempio, per l’accesso al pannello di configurazione di un robot, utilizzare una password facile da ricordare e messa in comune tra tutti gli operatori ha il vantaggio di garantire, in modo semplice, la continuità di governo e funzionamento; ma, al tempo stesso, potrebbe costituire un elemento di debolezza che aumenta il rischio per l’intero sistema produttivo e per la stessa sicurezza delle persone (ancora, safety).

L’ENISA, quindi, raccomanda di curare questo aspetto promuovendo una conoscenza trasversale tra sicurezza OT e sicurezza IT, sia attraverso interventi formativi specifici per gli operatori già impiegati in azienda sia attraverso la diffusione della sicurezza IT nei curricula accademici rivolti agli studenti.

La seconda sfida riguarda le persone che, in azienda, ricoprono incarichi di alta responsabilità. In molti casi, il top management ha scarsa sensibilità verso la sicurezza IT: la considera un costo aggiuntivo sia per gli investimenti necessari sia perché credono che i meccanismi di sicurezza informatica rallentino i ritmi produttivi. Molte aziende manifatturiere, per esempio, si sono affidate a soluzioni cloud pubbliche per i loro impianti facendo prevalere l’immediata riduzione dei costi e non tenendo conto dei rischi che sono connessi a questo tipo di tecnologia.

L’ENISA ritiene che l’avvio di specifiche campagne di incentivazione all’investimento in cybersecurity da parte degli organismi governativi possano convincere molti top manager a pianificare interventi in questo ambito.

L’organizzazione

Dal punto di vista dell’organizzazione dell’intero sistema Industry 4.0, l’ENISA vede uno specifico problema nella scarsa attenzione degli operatori a identificare le responsabilità, contrattuali e di altro tipo, nel corretto funzionamento della strumentazione, anche rispetto ad eventuali minacce IT. Nello smart manufacturing, infatti, ogni elemento è frutto della cooperazione di molti attori: chi produce le componenti hardware, chi le assembla, chi realizza il software, chi lo vende, chi fa manutenzione, ecc. Ma quali di questi è responsabile per eventuali vulnerabilità che dovessero essere sfruttate da una minaccia?

L’appello dell’ENISA, per questa sfida, è ai soggetti governativi, nazionali ed internazionali: occorre stabilire un quadro normativo che indichi chiaramente quali sono le responsabilità di ciascun attore in caso di eventi sfavorevoli che possano incidere sulle persone o sul patrimonio dell’azienda utilizzatrice dei dispositivi smart.

ENISA prende atto, inoltre, che esistono standard di sicurezza IT molto frammentati nel mondo dell’industria 4.0. È necessario un impegno internazionale per uniformare i comportamenti che sono attesi dalla strumentazione intelligente con riguardo alla loro capacità di reazione a tentativi di attacchi informatici o a situazioni di possibili alert.

La tecnologia

In realtà, la standardizzazione appare come una questione di confine tra gli aspetti organizzativi e gli aspetti tecnologici. E lo riconosce anche l’ENISA che, tra le sfide tecnologiche, inserisce quella della necessità di rendere interoperabili le singole componenti dei sistemi industriali smart. È noto, infatti, che per garantire la sicurezza di un sistema non basta che sia ridotto al minimo il rischio per ciascun componente, ma è necessario che ciascun componente possa validamente interagire con gli altri per evitare il propagarsi della minaccia.

Anche in questo caso, è raccomandabile che siano definiti appositi criteri e protocolli di interoperabilità, anche attraverso la classica impostazione a livelli che incapsuli adeguatamente i comportamenti dei sistemi legacy operanti nelle realtà manifatturiere.

Un reale problema di natura strettamente tecnologica, invece, risiede nei limiti – economici e costruttivi – che alcune componenti devono avere: dimensione, peso, costi di manutenzione, ecc. Questi limiti incidono indubitabilmente sulla possibilità di integrare funzionalità di sicurezza IT evolute e anche sulla possibilità di rimuovere vulnerabilità che vengono alla luce nel tempo. È chiaro che, in questo caso, non ci sono raccomandazioni valide per tutte le fattispecie applicative e, quindi, ENISA indica, per ogni operatore economico, la strada di un approccio sistematico all’analisi del rischio e alla conseguente valutazione costi‑benefici per comprendere quale assetto tecnologico convenga adottare a supporto del proprio modello di business.

Quali soggetti responsabilizzare

ENISA, nel fornire le raccomandazioni per ciascuna delle sfide esplorate, individua i soggetti che hanno l’onere di applicarle, così come sintetizzati nella tabella sottostante.

Soggetto interessato Esperti di industria 4.0 Operatori economici di Industria 4.0 Organi regolatori Comunità di standardizzazione Centri di ricerca e sviluppo
Raccomandazione
Promozione della consapevolezza trasversale OT/IT security SI SI – – SI
Incentivazione degli investimenti in sicurezza IT – SI SI – –
Definizione delle responsabilità tra gli attori di Industry 4.0 – SI SI – –
Armonizzare gli standard di Industry 4.0 – – SI SI –
Stabilire le basi di interoperabilità con criteri di sicurezza SI SI SI SI SI
Bilanciare i limiti fisici delle componenti smart con le vulnerabilità conseguenti SI SI – – –

Questo ci dice che, per lo smart manfacturing, occorre uno sforzo globale: difficile e complesso ma, almeno nel medio periodo, non impossibile.

Note

[1] https://www.enisa.europa.eu/.

[2] https://www.enisa.europa.eu/publications/good-practices-for-security-of-iot/at_download/fullReport.

[3] https://www.enisa.europa.eu/publications/industry-4-0-cybersecurity-challenges-and-recommendations.

Articolo a cura di Francesco Maldera

Francesco Maldera è Data Protection Officer e Data Scientist.

Il suo percorso professionale lo ha chiamato a responsabilità direzionali nell’ambito dei sistemi informativi, della safety&security, della privacy e dell’auditing svolgendo diversi incarichi dirigenziali nella Pubblica Amministrazione e in aziende private.

Attualmente, accompagna l’attività consulenziale a quella di sensibilizzazione delle persone tramite il sito www.prontoprivacy.it

Download PDF

https://www.ictsecuritymagazine.com/articoli/smart-manufacturing-e-cybersecurity/


Il valore di un framework integrato per un ambiente collaborativo sicuro

Estratto dalla relazione di Martina Casiraghi tenutasi al 10° Cyber Crime Conference 2019

Berlino, gennaio 2019, attacco hacker in Germania. I dati personali di centinaia di politici, inclusi quelli della cancelliera tedesca Angela Merkel, sono stati pubblicati su un account Twitter a seguito di un attacco hacker. Il ministro della giustizia tedesco è intervenuto sulla questione definendo l’hackeraggio un grave attacco alla democrazia.

Amsterdam, febbraio 2019, studenti e tirocinanti presso una delle principali cliniche sanitarie della città, per anni hanno avuto libero accesso ai dati personali e record medici di centinaia di pazienti. Scandalo non solo per la capitale olandese, ma anche per l’intero mondo della sanità.

Oslo, marzo 2019, attacco hacker contro Norsk Hydro, gigante mondiale nella filiera del metallo. A seguito dell’attacco, Norsk Hydro ha dovuto interrompere la produzione in molteplici impianti in tutto il mondo. In generale, l’industria del metallo e mineraria risultano essere le più vulnerabili: il 97% delle società del settore ammette di avere tutt’ora difese inadeguate.

Roma, aprile 2019, chi sarà il prossimo?

Di fronte ad uno scenario così allarmante, l’unica arma è la prevenzione Buongiorno a tutti, io sono Martina Casiraghi, International Marketing Executive per Boole Server. Quest’oggi intraprenderemo insieme un viaggio nel mondo della Cyber Security e cercheremo soprattutto di comprendere il valore di un framework integrato per un ambiente collaborativo sicuro.

Dunque, iniziamo il nostro viaggio con una domanda: perché tutta questa necessità di intervento e di prevenzione?

Perché i dati che abbiamo sotto gli occhi sono allarmanti: il 41% delle aziende detiene più di 1000 file con contenuto altamente confidenziale, tra cui i dati delle carte di credito o informazioni personali sui propri dipendenti, lasciati completamente in chiaro. Un file su 5 risulta non protetto, quindi potenzialmente accessibile a qualsiasi utente non autorizzato, e meno di un terzo delle aziende può contare su un piano strategico di Cyber Security. Uno scenario di estrema fragilità.

Chi si approfitta di questa vulnerabilità?

In primis, il cybercrime che sta raggiungendo livelli di sofisticatezza senza precedenti. Pensate che, a livello globale, si verifica in media un attacco informatico ogni 39 secondi.
Questo vuol dire che, per esempio, da quando io ho iniziato a parlarvi questa mattina, nel mondo si sono verificati almeno 4 casi di attacchi.
Nel quadriennio 2014-2018 c’è stato un incremento del 77,8% del numero di attacchi gravi.
Passando all’Italia, lo scenario non è di certo più confortante: il 55% delle aziende ammette di aver subito almeno un attacco informatico.

Quali sono i settori più colpiti?
In primis la sanità, seguono la pubblica amministrazione, l’istruzione e il settore finanziario.
Seconda criticità è l’errore umano.
Analisti ed esperti di sicurezza, infatti, concordano nell’affermare che la maggior parte degli incidenti di sicurezza sia legato all’errore umano: tra l’80% e il 90% dei casi.

Cosa si intende quando si parla di errore umano?
Intendiamo anche la semplice negligenza. Pensate che il 97% degli utenti abitudinari di internet non è in grado di riconoscere una e-mail di phishing.
La leggerezza nel pubblicare informazioni strettamente personali sul web, la scarsa consapevolezza delle policy e delle procedure aziendali in tema di security, l’uso di password banali e spesso ripetute su più account, o ancora, anche la semplice distrazione, per esempio quando ci si dimentica di effettuare il logout prima di lasciare il proprio dispositivo, quindi lasciandolo potenzialmente in preda di qualsiasi sguardo indiscreto.

Terza criticità, lo scenario contemporaneo.
Ricco, certo, di nuovi trend e nuove potenzialità, ma al tempo stesso incubatore di nuovi e potenziali rischi.

Pensiamo anche solo ai nuovi trend dell’Industria 4.0, a partire da algoritmi e tecniche dell’intelligenza artificiale, passando per il machine learning, la realtà aumentata, blockchain, così come la progressiva decentralizzazione delle architetture logiche e tecnologiche e l’avvento di soluzioni in Cloud. O ancora il boom dei dispositivi, quindi l’accesso dei dati via mobile.

Chi di noi, infatti, questa mattina non ha guardato, per esempio, le proprie e-mail personali o di lavoro almeno una volta dallo smartphone?
Quindi, la vera domanda sembra essere: “chi e cosa rimane effettivamente all’interno dei confini aziendali? Ha ancora senso parlare di utenti interni e utenti esterni, dati all’interno del perimetro aziendale e dati all’esterno del perimetro aziendale?”.
Quello che è certo è che i confini si sono fatti sempre più labili. E proprio per questo motivo, al crescere della complessità degli ambienti IT, anche le esigenze di gestione e quindi di sicurezza aumentano.

Perché bisogna intervenire fin da subito?
Perché l’impatto sul business in caso di Data Loss sarebbe catastrofico.
L’azienda andrebbe incontro innanzitutto a una perdita finanziaria diretta, subirebbe un forte rallentamento delle attività, perderebbe in termini di competitività, subirebbe pesantissimi danni all’immagine, così come una perdita di credibilità.
Dovrebbe affrontare tutta una serie di pesantissime sanzioni di carattere normativo e, infine, sobbarcarsi tutta una serie di costi di ripristino.
Quindi diventa prerogativa dotarsi di un piano strategico di Cyber Security.
Perché? Perché, ricordiamocelo, servono 20 anni per costruirsi una reputazione, bastano 20 secondi per rovinarsela.
Cosa possiamo dedurre da quello che abbiamo visto velocemente finora?
Che è necessario un cambio di paradigma.
In particolar modo, passare da un approccio classico basato sul Risk Management a una gestione preventiva della minaccia.
Come?
Tramite un approccio olistico che tenga in considerazione diversi aspetti.
Certo la sicurezza delle piattaforme dei sistemi usati, ma anche il fatto di avere a disposizione un corpus di policy sempre aggiornato, così come puntare alla formazione del personale, oppure si rende necessario un commitment trasversale tra tutte quelle che sono le principali funzioni aziendali.
Solo in questo modo è possibile creare un vero e proprio ecosistema di protezione dati, che non può che avere effetti positivi sulla mia azienda.
In primo luogo, l’aumento della capacità di prevenzione da qualsiasi potenziale minaccia; in secondo luogo, l’aumento della sicurezza di sistemi, piattaforme, impianti utilizzati; in terzo luogo, un aumento della stabilità aziendale nel suo complesso.

E arriviamo così al concetto di resilienza, cosa vuol dire?
Significa che, in caso anche di evento avverso, la mia azienda è in grado di reagire in maniera attiva e proattiva. Ho quindi raggiunto il mio goal ultimo, quello di diventare Cyber-resilient.

Continua a leggere…

Scarica gratuitamente gli atti del 10° Cyber Crime Conference 2019

Download PDF

https://www.ictsecuritymagazine.com/articoli/il-valore-di-un-framework-integrato-per-un-ambiente-collaborativo-sicuro/


Cryptocurrency, Blockchain and Cyber Crime

Estratto dalla relazione di Stefano Bistarelli tenutasi al 10° Cyber Crime Conference 2019

Oggi non parlerò di Blockchain in termini di numeri: d’altronde, tutte le informazioni relative ai numeri si trovano facilmente in internet.
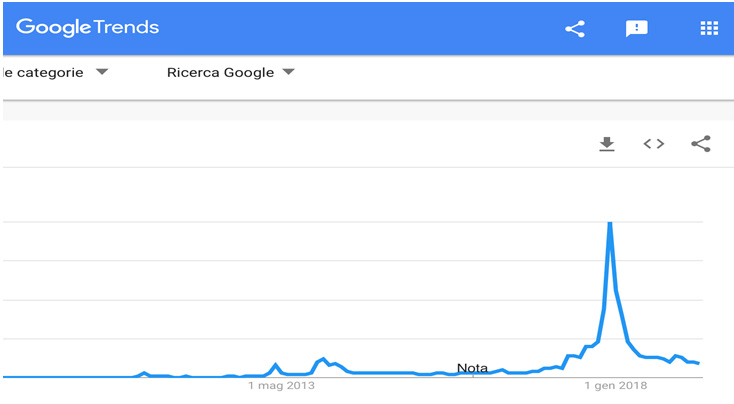
Parlerò essenzialmente di cyber security collegata alla Bitcoin Blockchain, un fenomeno disruptive di cui ormai tutti parlano – nel 2018 questo era il trend delle ricerche su internet dei termini Bitcoin blockchain – e che sicuramente dovremmo tutti affrontare nel corso del 2019. In realtà, avrei sperato che questo trend di ricerca fosse dovuto alla blockchain, la nuova tecnologia che dovremmo utilizzare; invece, come potete immaginare, il termine di ricerca usato più spesso era Bitcoin.

Sono due cose strettamente collegate; qualcuno dice che Bitcoin sia il motore della blockchain, altri che ne sia solo un’applicazione. Esistono vari punti di vista, ma quel che è certo è che l’interesse scaturito dal Bitcoin sia stato anche un punto di avvio per attività tecnologiche intorno alla blockchain. In realtà, si tratta di due realtà che dovremo affrontare in stretta correlazione: da una parte vediamo la blockchain come una tecnologia che può offrire innumerevoli benefici, un amico da proteggere, un friend; dall’altra parte, spesso si storce la bocca perché sono stati molti gli attacchi di tipo ransomware che hanno avuto pagamenti in Bitcoin e, così, qualcuno vede nel Bitcoin “un foe”. Proveremo a considerare entrambe le sfaccettature: sia la parte di blockchain come “amico da proteggere” – esaminandone il funzionamento e le problematiche da affrontare – sia gli aspetti di sicurezza collegati ai ransomware e perché vedano il frequente utilizzo di Bitcoin come strumento di pagamento.

Cos’è questo Bitcoin? Se ne sente parlare tanto e, quando si parla di Blockchain, si deve inevitabilmente parlare di Bitcoin perché è la criptovaluta che, a partire dal 2009, ha diffuso questa tecnologia. Potrei usare molte parole difficili, parlare di “problema bizantino”, CAP theorem, crittografia… ma non è la sede giusta: la scelta della pillola rossa o blu – chi conosce il film Matrix capirà il significato – oggi cade sulla pillola blu. Prima di parlare di aspetti tecnici, qualche aneddoto divertente a tema Bitcoin: una storiella che circola su Internet parla di uno studente norvegese che è diventato milionario perché nel 2009 si era divertito ad acquistare dei Bitcoin (che non valevano nulla) per poi ritrovarsi, nel 2013, con un portafoglio veramente consistente. Sarà vero? Penso di sì, perché una cosa del genere è successa anche a me: nel 2010 un mio studente, a cui avevo assegnato uno studio sui Bitcoin, in realtà ne aveva anche acquistati per conto suo. Qualche anno fa scrisse un’email per ringraziarmi: pensavo fosse perché gli avevo insegnato qualcosa, invece mi ringraziava perché a quel tempo aveva comprato dei Bitcoin ed era diventato milionario.

Chiunque abbia sentito parlare di Bitcoin conosce anche questo fantastico nome – Satoshi Nakamoto – collegato alla criptovaluta e sa che, nel 2008, è stato sviluppato (e diffuso in una mailing list crittografica) un documento che ne descrive il funzionamento.

Ma chi è questo Satoshi Nakamoto? Si tratta di un mistero che in tanti provano a risolvere. Qualcuno dice che sia Dorian Satoshi Nakamoto ma cosi’ non è. Lui era così stanco di queste richieste da pubblicare un post in cui diceva “Non sono Satoshi Nakamoto, non chiedetemelo più”. Qualcun altro ha pensato fosse un dipendente della NSA che lavora in ambiente crittografico; potrebbe essere, ma in realtà non è neanche lui. In ogni caso, chi sia in realtà è ancora un mistero e penso rimarrà tale per molto tempo.

Dopo questi aneddoti, passiamo agli aspetti più complessi dell’universo Bitcoin:

Tale universo è composto da nodi distribuiti che mantengono traccia delle transazioni digitali effettuate per trasferire cryptocurrencies, ovvero denaro virtuale. La transazione, quindi, è l’attore principale che dobbiamo considerare per capire quali siano le problematiche di questo ambiente distribuito.

Tutti noi compiamo transazioni nel mondo reale: ma in quel caso il trasferimento del bene – per esempio del caffè – avviene contestualmente al pagamento del bene stesso. Questo garantisce sia il compratore che il venditore, garantendo un alto livello di fiducia; è difficile che il barista mi dia il caffè se io non gli do la moneta e io non gli do la moneta se non mi dà il caffè. Nel mondo digitale non è così: il trasferimento di denaro avviene in un momento separato rispetto al trasferimento del bene, specie se si tratta di un acquisto online.

Questa non è una problematica esclusiva del Bitcoin, ma riguarda ogni tipo di acquisto digitale. Se avvengono transazioni in momenti diversi del trasferimento del bene, sorge il primo dubbio: come posso fidarmi di un acquisto di questo tipo? Chi mi vieta di copiare, con un “magico” control C+control V, la mia moneta elettronica e spenderla un’altra volta? Questo è il principale problema che Satoshi Nakamoto ha dovuto risolvere nel documento citato. Sembrerebbe, infatti, possibile effettuare doppi acquisti: compro un caffè in un bar, poi spendo la stessa moneta (crittografica) in un altro bar. In realtà il protocollo prova a risolvere questo problema: quando Alice vuole fare una transazione verso il coniglio, invia questa transazione in broadcast a tutti i nodi di questa rete che appartengono al protocollo Bitcoin. E cosa fanno i nodi? Non si comportano come una banca che, quando avviene una transazione, la memorizza sul proprio database centralizzato: in questo la banca sarebbe stata la famosa “terza parte fidata” (Alice ha pagato Bob e ve lo dimostro con la transazione “scritta” nel database). Con Bitcoin le transazioni non sono mantenute da una terza parte fidata ma, in maniera distribuita, da tutti gli appartenenti alla rete. Questa è una grande garanzia: primo, non dovete fidarvi dell’unico attore che mantiene l’informazione; secondo, le informazioni sono replicate ed è difficile, per un utente, modificare la propria copia della transazione senza che gli altri se ne accorgano, così com’è facilmente verificabile se qualcuno prova a “barare”. Quindi siamo abbastanza sicuri che, se la transazione verrà inserita all’interno di uno di questi database distribuiti, esisterà una copia con cui dimostrare che quella transazione sia avvenuta.

Continua a leggere…

Scarica gratuitamente gli atti del 10° Cyber Crime Conference 2019

Download PDF

https://www.ictsecuritymagazine.com/articoli/cryptocurrency-blockchain-and-cyber-crime/


Le sanzioni amministrative pecuniarie nel GDPR: l’art. 83 alla luce della “Fining policy” dell’Autorità olandese per la protezione dei dati personali

Le sanzioni amministrative pecuniarie previste dal GDPR

Una delle ragioni alla base dell’interesse di massa sviluppatosi intorno al Reg. UE 2016/679[1] (di seguito GDPR) è sicuramente rinvenibile nello stringente sistema sanzionatorio che tale fonte normativa europea, nel suo art. 83, ha introdotto.

Il GDPR prevede infatti due tipologie di sanzioni amministrative pecuniarie particolarmente stringenti:

A. fino a 10.000.000 EUR, o per le imprese, fino al 2% del fatturato mondiale totale annuo dell’esercizio precedente, se superiore;
B. fino a 20.000.000 EUR, o per le imprese, fino al 4% del fatturato mondiale totale annuo dell’esercizio precedente, se superiore.

Al diverso ammontare della potenziale sanzione pecuniaria si accompagnano violazioni di differenti norme:

  • nel caso delle sanzioni appartenenti alla tipologia A, le norme violate si riferiscono a: obblighi del titolare del trattamento e del responsabile del trattamento (artt. 8, 11, da 25 a 39, 42 e 43), obblighi dell’organismo di certificazione (art. 42 e 43) nonché agli obblighi dell’organismo di controllo (art. 41 par.4);
  • nel caso delle sanzioni appartenenti alla tipologia B, invece, le norme violate riguardano: principi di base del trattamento (art. 5, 6, 7 e 9), diritti degli interessati (artt. da 12 a 22), trasferimenti di dati personali a un destinatario in un paese terzo o un’organizzazione internazionale (artt. da 44 a 49), obblighi previsti dalle legislazioni degli Stati membri adottate a norma del capo IX, l’inosservanza di un ordine, di una limitazione provvisoria o definitiva di trattamento o di un ordine di sospensione dei flussi di dati dell’autorità di controllo o il negato accesso in violazione (art. 58).

L’elevato ammontare delle sanzioni pecuniarie previste dal Regolamento europeo ha costituito – e costituisce tuttora – cagione di evidente preoccupazione per i Titolari e i Responsabili del trattamento, intimoriti dalle possibili ripercussioni che sanzioni siffatte, unitamente ai probabili danni reputazionali collegati, potrebbero avere sulle proprie aziende o sul proprio business.

In realtà, è lo stesso GDPR a porre un argine alla discrezionalità delle Autorità garanti per i dati personali nel determinare l’ammontare della sanzione pecuniaria da comminare.

L’art. 83, paragrafo 2, prevede infatti una serie di criteri in base ai quali l’eventuale sanzione dovrà essere parametrata:

a) la natura, la gravità e la durata della violazione tenendo in considerazione la natura, l’oggetto o a finalità del trattamento in questione nonché il numero di interessati lesi dal danno e il livello del danno da essi subito;
b) il carattere doloso o colposo della violazione;
c) le misure adottate dal titolare del trattamento o dal responsabile del trattamento per attenuare il danno subito dagli interessati
d) il grado di responsabilità del titolare del trattamento o del responsabile del trattamento tenendo conto delle misure tecniche e organizzative da essi messe in atto ai sensi degli articoli 25 e 32;
e) eventuali precedenti violazioni pertinenti commesse dal titolare del trattamento o dal responsabile del trattamento;
f) il grado di cooperazione con l’autorità di controllo al fine di porre rimedio alla violazione e attenuarne i possibili effetti negativi;
g) le categorie di dati personali interessate dalla violazione;
h) la maniera in cui l’autorità di controllo ha preso conoscenza della violazione, in particolare se e in che misura il titolare del trattamento o il responsabile del trattamento ha notificato la violazione;
i) qualora siano stati precedentemente disposti provvedimenti di cui all’articolo 58, paragrafo 2, nei confronti del titolare del trattamento o del responsabile del trattamento in questione relativamente allo stesso oggetto, il rispetto di tali provvedimenti;
j) l’adesione ai codici di condotta approvati ai sensi dell’articolo 40 o ai meccanismi di certificazione approvati ai sensi dell’articolo 42; e
k) eventuali altri fattori aggravanti o attenuanti applicabili alle circostanze del caso, ad esempio i benefici finanziari conseguiti o le perdite evitate, direttamente o indirettamente, quale conseguenza della violazione.

Nonostante tali criteri possano, in un certo senso, guidare l’interprete, amplissimi spazi di incertezza permangono in merito all’effettiva portata della sanzione economica cui il Titolare o il Responsabile andrebbero incontro in caso di inadempimento dei precetti normativi del GDPR. Tale indeterminatezza riverbera i propri effetti anche sui professionisti chiamati a coadiuvare le aziende nel processo di adeguamento alla normativa europea, i quali sono costretti a sforzi di astrazione per tentare di quantificare ai propri assistiti, nel modo migliore possibile, il plausibile costo di un disallineamento della condotta aziendale rispetto a quanto imposto o suggerito dal GDPR.

Il tutto va a pesare altresì sul già rilevante bilancio di incertezza dovuto all’adeguamento a una normativa di recente introduzione, basata sul criterio – di matrice anglosassone – dell’accountability, ossia della responsabilizzazione del titolare del trattamento, in forza del quale quest’ultimo sarà tenuto, proattivamente, a dimostrare di aver attuato misure adeguate per garantire che il trattamento dei dati personali effettuato sia conforme allo stesso Regolamento.

La “Fining policy” dell’Autorità olandese per la protezione dei dati personali

Nel quadro così tratteggiato, il primo e (sinora) unico tentativo di portare maggiore trasparenza del processo di determinazione della sanzione pecuniaria è stato effettuato dall’Autorità garante per la protezione dei dati personali olandese.

L’Autoriteit Persoonsgegevens[2] ha infatti recentemente pubblicato una vera e propria “Fining policy” relativa al processo di determinazione delle sanzioni dovute alla violazione degli obblighi imposti dal GDPR.

La policy olandese introduce un sistema basato su quattro categorie di sanzioni pecuniarie ricollegate alla violazione di norme specifiche del GDPR (indicate analiticamente negli allegati 1 e 2 delle “Norme sulle norme dell’Autorità per i dati personali del 19 febbraio 2019 per quanto riguarda la determinazione del livello delle ammende amministrative”[3]).

Le categorie in esame possono essere in tal modo schematizzate:

Categoria Sanzione minima Sanzione massima Sanzione base
I € 0 € 200.000,00 € 100.000,00
II € 120.000,00 € 500.000,00 € 310.000,00
III € 300.000,00 € 750.000,00 € 525.000,00
IV € 450.000,00 € 1.000.000,00 € 725.000,00

In base alla policy dell’Autoriteit Persoonsgegevens, la Categoria I includerà violazioni minori, ad esempio l’inosservanza del diritto di rettifica o cancellazione o la mancata pubblicazione dei dati di contatto del DPO. Le categorie II e III copriranno la maggior parte delle possibili violazioni del GDPR, quali l’inosservanza dei principi relativi al trattamento di dati personali (violazione dell’articolo 5) o dell’obbligo relativo alla liceità del trattamento (violazione dell’articolo 6). Naturalmente la Categoria IV si presterà a violazioni più gravi, come violazioni che implicano l’elaborazione di categorie di dati personali particolari, decisioni automatizzate o profilazione e qualsiasi trattamento illecito di dati giudiziari (per un’analisi più approfondita sulle singole violazioni rientranti nelle quattro categorie sopracitate si rimanda alle tabelle di dettaglio in calce all’articolo).

L’ammontare effettivo della sanzione sarà poi determinato a partire dalla sanzione base e aumentando o diminuendo tale importo sulla base dei molteplici criteri disciplinati nell’art. 7 della “Fining policy”, quali: a) la natura, la gravità e la durata dell’infrazione, tenendo conto della natura, o della finalità del trattamento in questione, nonché del numero di persone interessate e dell’entità del danno da esse subito; b) della natura dolosa o colposa della violazione; c) le misure che il titolare del trattamento o responsabile del trattamento hanno adottato per limitare il danno subito dagli interessati; d) il grado di responsabilità del titolare o del responsabile del trattamento sulla base delle misure tecniche e organizzative attuate conformemente agli articoli 25 e 32 del Regolamento generale sulla protezione dei dati; e) precedenti violazioni rilevanti; f) il grado di cooperazione con l’autorità di controllo per sanare l’infrazione e limitare le possibili conseguenze negative; g) le categorie di dati personali interessati dall’infrazione; h) il modo in cui l’autorità di vigilanza è venuta a conoscenza dell’infrazione, etc.

Meritevoli di specifico approfondimento sono altresì alcune norme di chiusura, dalle quali traspare la meritoria opera di adeguamento dell’Autorità olandese a quanto sancito dal paragrafo 9 dell’art. 83 GDPR, ai sensi del quale “le sanzioni pecuniarie irrogate sono effettive, proporzionate e dissuasive”:

  • nell’art. 8 è disciplinata la possibilità di irrogare sanzioni amministrative superiori ai massimali di cui alle quattro categorie prima citate (sempre nel rispetto dei limiti previsti dal GDPR), nel caso in cui l’ammontare della sanzione non sia tale da costituire un’adeguata reazione alla violazione perpetrata dal Titolare o dal Responsabile del trattamento;
  • l’art. 9 prevede esplicitamente che la situazione economica del soggetto sanzionato venga presa in considerazione come elemento di parametrizzazione della sanzione; ciò comporta che l’Autorità olandese ben potrebbe decidere di comminare una sanzione “più lieve” nel caso in cui l’applicazione tassativa della “Fining policy” risultasse essere eccessivamente punitiva per il Titolare o Responsabile del trattamento.

Considerazioni finali

Anche nella consapevolezza dell’ambito di applicazione della policy (limitato naturalmente all’attività dell’Autorità garante olandese) e dei pur ampi margini di discrezionalità che la caratterizzano[4], non si può ignorare la portata innovativa del provvedimento dell’Autorità garante olandese.

Nonostante infatti la normativa europea non imponga agli Stati membri di dotarsi di una politica di dettaglio in relazione all’applicazione dell’art. 83, la policy olandese potrebbe fungere da apripista per l’emissione di simili provvedimenti anche da parte delle altre Autorità garanti europee che volessero emulare i colleghi dell’Autoriteit Persoonsgegevens nell’emissione di provvedimenti atti a chiarire e precisare la portata applicativa dell’art. 83 GDPR.

La categorizzazione delle violazioni e delle relative sanzioni potrebbe altresì rappresentare uno strumento in più a disposizione di Titolari e Responsabili del trattamento per poter valutare, con un maggiore grado di precisione, le conseguenze patrimoniali di una violazione o di un mancato adeguamento alle norme previste dal GDPR.

Tabella di dettaglio relativa agli allegati 1 e 2 della “Fining policy” olandese

Articolo GDPR Rubrica della norma Categoria

Allegato 1

8 Condizioni applicabili al consenso dei minori in relazione ai servizi della società dell’informazione II
11 Trattamento che non richiede l’identificazione I
25 Protezione dei dati fin dalla progettazione e protezione dei dati per impostazione predefinita II
26 Contitolari del trattamento I
27 (fatto salvo il III par.) Rappresentanti di titolari del trattamento o dei responsabili del trattamento non stabiliti nell’Unione III
27 (III par.) Rappresentanti di titolari del trattamento o dei responsabili del trattamento non stabiliti nell’Unione II
28 (fatto salvo il IX par.) Responsabile del trattamento II
28 (IX par.) Responsabile del trattamento I
29 Trattamento sotto l’autorità del titolare del trattamento o del responsabile del trattamento I: se il sanzionato è una persona fisica;
II: se il sanzionato è una persona giuridica;
30 (fatto salvo il III par.) Registri delle attività di trattamento II
30 (III par.) Registri delle attività di trattamento I
31 Cooperazione con l’autorità di controllo III
32 Sicurezza del trattamento II
33 (fatto salvo il III par.) Notifica di una violazione dei dati personali all’autorità di controllo III
33 (III par.) Notifica di una violazione dei dati personali all’autorità di controllo II
34 (fatto salvo il II par.) Comunicazione di una violazione dei dati personali all’interessato III
34 (II par.) Comunicazione di una violazione dei dati personali all’interessato II
35 (fatto salvo il IX par.) Valutazione d’impatto sulla protezione dei dati II
35 (IX par.) Valutazione d’impatto sulla protezione dei dati I
36 Consultazione preventiva II
37  (fatto salvo il VII par.) Designazione del responsabile della protezione dei dati II
37 (VII par.) Designazione del responsabile della protezione dei dati I
38 (fatti salvi il II e il VI par.) Posizione del responsabile della protezione dei dati II
38 (II e VI par.) Posizione del responsabile della protezione dei dati I
39 Compiti del responsabile della protezione dei dati II
41 (IV par.) Controllo dei codici di condotta approvati I
 42 (fatti salvi il III e il VI par.) Certificazione II
42 (III par.) Certificazione I
42 (III par.) Certificazione III
43 (VI par.) Organismi di certificazione I

Allegato 2

5, I par. esclusa la lettera a) Principi applicabili al trattamento di dati personali III
5, I par. lettera a) e II par. Principi applicabili al trattamento di dati personali I,II,III,IV a seconda della violazione accertata
6 Liceità del trattamento III
7 Condizioni per il consenso III
9 Trattamento di categorie particolari di dati personali IV
12 (fatti salvi il III, IV e V par.) Informazioni, comunicazioni e modalità trasparenti per l’esercizio dei diritti dell’interessato III
12 (III, IV e V par.) Informazioni, comunicazioni e modalità trasparenti per l’esercizio dei diritti dell’interessato II
13 Informazioni da fornire qualora i dati personali siano raccolti presso l’interessato III
14 Informazioni da fornire qualora i dati personali non siano stati ottenuti presso l’interessato III
15 Diritto di accesso dell’interessato III
16 Diritto di rettifica III
17 Diritto alla cancellazione («diritto all’oblio») III
18 (fatto salvo il III par.) Diritto di limitazione di trattamento III
18 (III par.) Diritto di limitazione di trattamento II
19 Obbligo di notifica in caso di rettifica o cancellazione dei dati personali o limitazione del trattamento II
20 Diritto alla portabilità dei dati III
21 (fatto salvo il IV par.) Diritto di opposizione III
21 (IV par.) Diritto di opposizione II
22 Processo decisionale automatizzato relativo alle persone fisiche, compresa la profilazione IV
44 Principio generale per il trasferimento III
45 Trasferimento sulla base di una decisione di adeguatezza III
46 Trasferimento soggetto a garanzie adeguate III
47 Norme vincolanti d’impresa III
48 Trasferimento o comunicazione non autorizzati dal diritto dell’Unione III
49 Deroghe in specifiche situazioni III
Tutti gli obblighi previsti dagli stati membri ai sensi del Capo IX GDPR Disposizioni relative a specifiche situazioni di trattamento I,II,III,IV a seconda della violazione accertata
58 Poteri IV

Note

[1] https://www.garanteprivacy.it/regolamentoue.

[2] https://autoriteitpersoonsgegevens.nl/.

[3] https://autoriteitpersoonsgegevens.nl/sites/default/files/atoms/files/stcrt-2019-14586.pdf.

[4] Aspetto evidenziato anche da importanti esponenti del panorama forense olandese: https://globaldatareview.com/article/1188985/dutch-watchdog-releases-gdpr-fining-policy.

Articolo a cura di Mauro Formato

Laureato in giurisprudenza nel 2015 con tesi in diritto processuale dell’Unione Europea presso l’Università degli Studi del Sannio.

Dal 2015 al 2017 collaboratore presso diversi studi legali e tirocinante presso la sezione Lavoro e Previdenza del Tribunale di Benevento.

Ha frequentato un corso intensivo di specializzazione in privacy & data protection conseguendo la qualifica di Data Protection Specialist. Ha conseguito il diploma di perfezionamento in Diritto dell’Unione Europea al termine del “Jean Monnet Progamme”.

Attualmente collabora con NSR S.r.l. in qualità di Legal Consultant, prestando la propria opera prevalentemente in ambito Privacy & Data Protection.

Download PDF

https://www.ictsecuritymagazine.com/articoli/le-sanzioni-amministrative-pecuniarie-nel-gdpr-lart-83-alla-luce-della-fining-policy-dellautorita-olandese-per-la-protezione-dei-dati-personali/


Informazione e computazione quantistica: quali conseguenze?

Estratto dalla relazione di Alessandro Luongo tenutasi al 10° Cyber Crime Conference 2019

Mi piacerebbe fare un po’ di divulgazione scientifica per capire quali siano le conseguenze della comunicazione della computazione quantistica nel campo della Cyber Security. Vorrei spiegare – con pochissima matematica – cosa vuol dire usare la meccanica quantistica per fare dei calcoli (e per questo voglio anche portarvi l’esempio di alcune applicazioni sviluppate nel nostro laboratorio) ovvero come utilizzare dei computer quantistici per fare formal software verification e malware detection.

Vedremo poi, dal lato dell’attaccante, cosa si può fare avendo a disposizione un computer quantistico – probabilmente lo sapete già, si può riuscire a scomporre un numero in fattori primi e rompere la crittografia a chiave pubblica; vedremo cosa questo comporti nell’ambito delle cryptocurrencies – e poi faremo un’overview generale su cosa si possa fare utilizzando della comunicazione quantistica.

Ecco due o tre slide con un po’ di matematica: se noi volessimo descrivere matematicamente l’evoluzione di un sistema fisico classico, come per esempio la palla lanciata da questo ragazzo, abbiamo a disposizione le leggi che descrivono il moto e quindi possiamo determinare, per ogni intervallo di tempo, la posizione della palla all’interno del nostro sistema: una cosa molto facile, che abbiamo studiato alle superiori (e che probabilmente abbiamo dimenticato). Se anche avessimo necessità di descrivere due di questi sistemi fisici classici, non è un grosso problema;

Ma nel caso in cui abbiamo a disposizione un Qubit – la più piccola unità che usiamo per salvare le informazioni all’interno del sistema quantistico – incorriamo in un piccolo problema perché, se vogliamo descrivere due Qubit assieme, la lunghezza del vettore necessario per salvare questa informazione raddoppia ogni volta che aggiungiamo un Qubit. La conseguenza è in questa formula:

la particolarità è che la dimensione del vettore necessario a salvare tutti questi numeri che descrivono lo stato del sistema quantistico cresce esponenzialmente con il numero di Qubit e, quindi, con un computer classico non riusciamo a simulare in maniera efficiente più di 50 Qubit. Crediamo che, grazie al computer quantistico, riusciamo a fare dei calcoli che prima non riuscivamo a fare, o a svolgerli in maniera più efficiente.

Dal lato della programmazione, programmazione ed evoluzione di un computer vengono descritte da dalle matrici. Qui vedete il caso più semplice, una matrice che rappresenta una sorta di not logico: è facile vedere come mandi un Qubit, che è in coda allo stato zero, nel Qubit che in coda al valore dello stato uno. Possiamo visualizzare un software quantistico semplicemente come un grosso circuito, molto simile a un circuito elettrico; l’evoluzione del tempo è sull’asse orizzontale e sull’asse verticale abbiamo il numero di Qubit ovvero, in qualche modo, quanto sia potente il nostro computer. Giusto per dare un’idea pratica di cosa voglia dire programmare un computer quantistico, ora questa cosa la stiamo facendo in Python: ci sono dei linguaggi Open Source che permettono di “giocare” con dei computer quantistici piuttosto piccoli (fino a 16 Qubit circa).

Potete pensare al computer quantistico come ad un coprocessore, quasi come una GPU, al quale inviate dei calcoli molto specifici da fare. A livello di interfaccia utente, vedete un oggetto che chiamiamo Quantum Circuit, una grossa lista di istruzioni che andiamo a riempire con il nostro codice.

Questa, per esempio, è una funzione che serve semplicemente a fare la somma tra due numeri. Non serve capire bene cosa faccia nel dettaglio – ci vorrebbero ore e ore per spiegarlo – ma, alla fine, potete vedere che il software genera questo circuito: le linee verticali sono i Qubit, qui vedete i gates che fanno la somma tra due numeri.

Sappiamo benissimo che, grazie all’algoritmo di Shor, riusciamo a “rompere” quasi tutta la crittografia a chiave pubblica che abbiamo oggi a disposizione, – curve ellittiche, logaritmo discreto, il problema del factoring… – con un computer quantistico, riuscire a scomporre in fattori primi un numero del genere potrebbe richiedere una settimana o qualche giorno, dipende dallo sviluppo della tecnologia che implementa effettivamente questi strumenti; non è un processo istantanea, siamo ancora relativamente lontani da avere computer quantistici grandi abbastanza da riuscire a rompere la crittografia di RSA a 2048 bit.

Continua a leggere…

Scarica gratuitamente gli atti del 10° Cyber Crime Conference 2019

Download PDF

https://www.ictsecuritymagazine.com/articoli/informazione-e-computazione-quantistica-quali-conseguenze/


Decisioni automatizzate su algoritmi: il quadro giuridico

Estratto dalla relazione di Enrico Pelino tenutasi al 10° Cyber Crime Conference 2019

Entriamo subito nel vivo della materia: si può essere condannati da un software?
La risposta è sì e non stiamo parlando del futuro, ma di qualcosa che già esiste.
Negli Stati Uniti c’è stato un caso eclatante: Eric Loomis, fermato dalla polizia del Wisconsin per due imputazioni minori (che, a quanto apprendiamo, nel sistema statunitense non avrebbero determinato la pena della reclusione) è stato poi condannato a 6 anni di carcere.

Com’è potuto accadere?

Perché è stato utilizzato un software predittivo chiamato COMPAS, che, analizzando una serie di input riguardanti la storia penale di Loomis ma anche vari altri aspetti della sua vita, l’ha indicato come un soggetto ad alto rischio di commettere, in futuro, ulteriori reati; quindi parliamo di un soggetto che non è stato condannato soltanto per cose fatte in passato – recidiva “classica” – ma anche per quello che potrebbe fare nel suo futuro. Una cosa sconvolgente, che ci porta alla mente film distopici come Minority Report.

Come può succedere tutto questo?

Per contestualizzare è necessario fare un passo indietro. Negli Stati Uniti, fin dagli anni Venti vengono svolte analisi predittive soprattutto per quanto riguarda la liberazione condizionale, quindi allo scopo di capire se un soggetto rappresenti un pericolo una volta rientrato nella società. Poi, negli anni ’70, questi studi vengono condotti in maniera più sofisticata: la ricerca, frequentemente citata, di Wolfgang, Figlio e Sellin è considerata un lavoro seminale in questa materia. Questi tre ricercatori scoprono, esaminando un campione di reati, che oltre il 50% di essi viene commesso da un piccolo numero di persone; il 6-7% commette più del 50% dei reati.

Di conseguenza, ipotizzano che se si riuscisse a “bloccare” questi soggetti si avrebbe un’incidenza di reati molto minore in quel determinato contesto. Invece di avere carceri sovraffollate, teorizzano di tenervi questi soggetti per più tempo e detenere, invece, per meno tempo (o non detenere affatto) chi presenti un profilo di rischio molto basso, in quanto è improbabile che commetta altri reati. Le risorse risparmiate potrebbero essere utilizzate, ad esempio, per riabilitare i soggetti ad alto rischio.

Quindi c’è qui un brillante obiettivo di politica criminale: abbattere della metà l’incidenza dei reati in un certo settore. Il problema, a parte le agghiaccianti implicazioni – come condannare qualcuno o fargli scontare un periodo di detenzione maggiore perché si “prevede” che possa commettere nell’immediato futuro altri reati – è: come facciamo a profilare questi soggetti, a capire chi sono? La teoria della selective incapacitation è infatti completamente fallita negli anni ‘80 perché dava luogo a molti falsi positivi e molti falsi negativi.

Oggi abbiamo, però, strumenti di gran lunga più sofisticati: possiamo accedere a set statistici molto più ricchi (che implicano una maggiore qualità del risultato) e abbiamo strumenti di machine learning. Ma quindi possiamo (davvero) premere un bottone e sapere se il signor Loomis presenti un alto rischio di commettere reati in futuro? Questo, ovviamente, ci spaventa.

Un altro punto correlato è che, se io faccio degli investimenti per realizzare algoritmi predittivi, voglio che questi investimenti siano protetti. Nel caso Loomis la difesa ha cercato in tutti i modi – anche rendendosi disponibile a sottoscrivere un non disclosure agreement – di avere accesso alla logica del sistema COMPAS per capire quale peso venisse dato a certi input rispetto ad altri: non è stato possibile perché si tratta di un sistema proprietario, di una black box.

Questo è un primo tema. Il secondo è più generale: quando costruiamo un processo facciamo una scelta, cioè selezioniamo alcune cose che riteniamo importanti e ne scartiamo altre. Chiaramente, questa scelta ha delle conseguenze nel processo. E inoltre, spesso, questa scelta riguarda dei proxy: uso cioè degli elementi che ne rappresentano altri, però, in questo modo, mi sto allontanando dalla realtà. Sto compiendo un’astrazione. Applico una logica, incrocio dei dati; quindi posso essere anche molto sofisticato, ma lavoro comunque su un piano astratto e lo scarto tra questo piano e la realtà può determinare un bias, ossia un pregiudizio. Paradossalmente, cercando di correggere il pregiudizio umano – lo human bias – potrei determinare il pregiudizio chiamato machine bias, cioè quello prodotto dall’utilizzo di un algoritmo.

Questa è una slide che a cui tengo tengo molto

racconta di una ricerca fatta dall’associazione ProPublica proprio sul sistema COMPAS, quello utilizzato nella condanna Loomis. Dato che il sistema è una black box, ProPublica ha cercato di lavorare sugli output, mettendo a confronto una serie di casi con delle caratteristiche comuni e paragonando un soggetto di pelle bianca a un soggetto di pelle nera. Curiosamente, ne è emerso che il sistema COMPAS attribuiva quasi costantemente al soggetto di pelle nera un rischio di commissione di nuovi reati particolarmente più alto rispetto al soggetto di pelle bianca. Qui c’è uno schema che riassume il dossier.

Questo indica un Machine Bias su base razziale: non stiamo dicendo che chi ha programmato quel sistema lo abbia fatto con questa intenzione – molto probabilmente è stato utilizzato un set di dati che già incorporava un bias – però la questione, dal punto di vista giuridico, diventa interessantissima. Possiamo aprire questa black box, sì o no? E un ipotetico “caso Loomis” potrebbe verificarsi anche da noi? Abbiamo strumenti che ci mettono al riparo? Questa slide è interessante perché affronta proprio il punto chiave, che è il seguente: la Corte Suprema del Wisconsin – tra le altre cose – ha rilevato come il sistema COMPAS non sia stato decisivo ai fini della condanna. Ha cioè fornito delle indicazioni al giudice, ma poi il giudice ha fatto le sue valutazioni. Ora, il fatto che non sia stato decisivo ci porta esattamente nel nostro perimetro, perché – vedete – noi pensiamo al GDPR come a uno “scudo” universale.

Continua a leggere…

Scarica gratuitamente gli atti del 10° Cyber Crime Conference 2019

Download PDF

https://www.ictsecuritymagazine.com/articoli/decisioni-automatizzate-su-algoritmi-il-quadro-giuridico/


Perché il deep fake preoccupa l’intelligence? Disinformazione e attacchi psicologici con l’uso illecito dell’IA

“We’re entering an era in which our enemies can make anyone say anything at any point in time”, ovvero “stiamo entrando in un’era nella quale i nostri nemici possono far dire qualsiasi cosa, a chiunque, in qualsiasi momento”, è il sottotitolo di un video presente su Youtube:

In tale video l’ex presidente degli Stati Uniti Barack Obama mette in guardia su possibili manipolazioni dell’informazione: l’unico problema è che Obama non hai mai detto quelle parole, né ha mai fatto quello specifico video… ma per potervi spiegare il perché i deep fake preoccupino tanto le intelligence di mezzo mondo, dobbiamo fare un passo indietro e cominciare dall’inizio.

Nei primi mesi del 2017 un utente di Reddit (social network e sito di notizie in cui i membri registrati possono pubblicare contenuti di tutti i tipi, come post o link diretti), soprannominato “Deepfakes”, comincia a pubblicare video di alcuni spezzoni di film dove i volti di attori vengono sovrapposti agli attori originali, realizzando così dei video fake, tutto sommato divertenti e molto realistici. Nel giro di poche settimane si passa, però, da divertenti e innocui video a spezzoni di video hard dove il volto dei pornoattori viene sostituito con quello di celebrità del mondo dello spettacolo, come ad es. il caso di Taylor Swift, in cui la faccia della cantante è stata inserita in diversi video fake a contenuto pornografico.

I video di Deepfakes diventano virali; l’accuratezza e la qualità dei fake prodotti è notevole, prima su Reddit, subito dopo su altri social network e, infine, su tutte le più importanti piattaforme pornografiche online. Il successo è tale che Deepfakes crea una “subreddit” – una specifica categoria all’interno di reddit – dove i post sono organizzati in categorie e argomenti, seguita da migliaia di utenti. Il successo dei post di Deepfakes non è solo virale per il “prodotto finale” che pubblica ma soprattutto perché, oltre ai video, alcuni utenti cominciano a postare link ad applicazioni che permettono a tutti di poter creare i propri video senza nessuna conoscenza di computer grafica e di intelligenza artificiale: già, perché la componente tecnologica alla base della produzione di queste tipologie di video si basa proprio sull’intelligenza artificiale.

Di per sé la manipolazione video dei volti denominata “face-swap” non è una novità, in quanto è una tecnologia utilizzata da tempo nell’ambito del mondo cinematografico dove a volte, a causa dell’impossibilita di poter girare delle scene con specifici attori (ad esempio, perché deceduti) il loro volto viene sovrapposto a quello di altri attori,  come accaduto all’attore Peter Cushing, morto nel 1994 e redivivo nei panni del comandante della Morte Nera nell’episodio Rouge One di Star Wars del 2016, grazie all’elaborazione grafica del volto dell’attore Guy Henry.

Prima di Deepfakes, quindi, la possibilità di eseguire dei video credibili di face-swap rimaneva appannaggio esclusivo di professionisti della computer grafica che avessero a disposizione strumenti e software potenti e costosi. I deep fakes rappresentano un primo salto evolutivo del “face-swap” perché permettono a utenti senza alcuna esperienza in computer grafica e intelligenza artificiale (ma con una buona scheda video e un po’ di tempo a disposizione) di utilizzare applicativi in grado di realizzare video fake di ottima qualità: ed è così che la parola “deep fake” diventa sinonimo di video falsi prodotti con l’intelligenza artificiale.

La star delle applicazioni di deep fakes diviene Fakeapp, gratuita e scaricata più di 150.000 volte, in grado di ottenere un face swapping accurato, privo di elementi di manipolazione. Uno dei suoi primi “elaborati” pubblicati è stato un video fake che ritraeva Michelle Obama mentre faceva uno striptease.

A dicembre del 2017 il caso deep fakes esplode: un articolo del magazine online Motherboard mette in luce l’uso della tecnologia, i rischi relativi alla manipolazione dell’informazione e i rischi di potenziali attacchi anche di natura politica; l’account dell’utente Deepfakes viene bannato da Reddit.

Il 2018 è stato caratterizzato da una grande attenzione da parte dei giornalisti al fenomeno deep fakes e ai suoi potenziali pericoli, in particolare la preoccupazione che potessero essere prodotti video fake costruiti ad hoc, veicolo di specifici messaggi, in grado di influenzare persone con ideologie radicalizzate e farle cadere in “trappola” come avviene con i bias cognitivi (pregiudizi).

A distanza di due anni dalle apparizioni dei primi video fake su Reddit la minaccia, però, non si è ancora materializzata. Twitter e Facebook nel frattempo hanno smascherato migliaia di account falsi di troll e haters creati per condurre campagne di vario tipo, ma non è mai stato prodotto un solo video deep fake specificatamente progettato per manipolare un determinato tema politico; altresì l’eccesiva attenzione dei giornalisti sul tema dei video deep fakes ha finito per ingenerare un alone sinistro sui sistemi di intelligenza artificiale.

La tecnologia alla base del deep fake

La prima tecnica utilizzata nei video deep fake, come dicevamo, sfrutta il face-swap: celebri i video falsi con il volto dell’attore Nicolas Cage sovrapposto a quello di altri personaggi.

https://youtu.be/dh-QM54RuAs
https://youtu.be/DIZf7eRlD4w
https://youtu.be/v0zFR0ElRd4

La tecnica face-swap richiede una base dati di centinaia o migliaia di immagini di entrambi i soggetti che oggi, grazie a internet, non è così difficile da reperire. Una volta popolata la base dati le immagini vengono codificate tramite un “encoder”, un codificatore che elabora tutte le immagini utilizzando una rete neurale convoluzionale CNN (ConvNet – convolutional neural network). Lo scopo dell’encoder è individuare le peculiarità dei volti – deve cioè estrarre le caratteristiche più significative per ricreare l’input originale, nelle varie espressioni e angolazioni – non memorizzare tutte le immagini acquisite. Per decodificare le caratteristiche viene poi utilizzato un “decoder” o, più specificatamente, un decoder per ogni persona.

Una volta impostati dati, codificatore e decodificatori si deve avviare una procedura di addestramento della rete neurale utilizzando l’algoritmo di backpropagation, che confronta il valore in uscita dal sistema con il valore desiderato (obiettivo). Ho provato sia l’applicazione Fakeapp sia un’applicazione simile denominata DeepFacelab (che consiglio a chi si volesse cimentare nei test), nel mio caso l’addestramento è durato circa 4 giorni (con un PC dotato di una buona scheda grafica con GPU), durante i quali la rete neurale ha effettuato più di 10 milioni di elaborazioni.

Completato l’allenamento, si procede alla sovrapposizione del volto del soggetto A con quello del soggetto B. Il video viene elaborato fotogramma per fotogramma: il volto del soggetto A viene inserito nell’encoder che però, invece di alimentare il decodificatore 1 del soggetto A, alimenta il decodificatore 2 del soggetto B per ricostruire l’immagine finale.

Per quanto riguarda il mio esperimento, l’effetto finale è stato ottimale solo con il primo piano del volto; la vista prospettica non era perfetta, probabilmente a causa di una base dati iniziale non completa e soddisfacente. È infatti necessario preparare migliaia di immagini di ottima qualità, in diverse pose per entrambe le persone, e numerose riprese video per poter ottenere un video realistico.

L’evoluzione, il salto della specie e il reale pericolo

Nell’ultimo anno, però, il deep fake ha fatto un notevole balzo in avanti nella sua evoluzione, impiegando sempre meglio l’utilizzo dell’intelligenza artificiale e applicando nuove metodologie di elaborazione delle immagini. Il video di Obama all’inizio di questo articolo è stato realizzato dal regista Jordan Peele, ed è uno dei più difficili da identificare come falso. La tecnica utilizzata in questo caso è diversa da quella che ha reso famosi i primi video deep fake. Qui le sorgenti dati non appartengono a soggetti diversi ma allo stesso soggetto: se si analizza nel dettaglio il video, il labbro inferiore di Obama è più sfocato rispetto alle altre parti del viso. Invece di scambiare il volto, in questo caso viene sovrapposta sempre la bocca di Obama, rielaborata in sincronia labiale con un audio falso.

La creazione di un falso audio che imita la voce del soggetto target oggi è possibile in maniera rapida, veloce ed economica anche grazie ad aziende come Lyrebird, che ha sviluppato l’omonima applicazione in grado di imitare – con un grado di accuratezza stupefacente – la voce di qualunque persona. La tecnologia della Lyrebird, insieme a quella sviluppata all’Università di Washington (UW), permette quindi di sincronizzare il movimento labiale con un audio e di elaborare un video in cui il soggetto “parla” con un audio ri-elaborato e mai veramente pronunciato. 

Sorgente audio:

Sorgente video:

encoding, ri-elaborazione, sincronizzazione delle labbra e output finale:

Un ulteriore salto di qualità nei deep fake si ha quando nuove classi di algoritmi di intelligenza artificiale usate per l’apprendimento automatico non supervisionato, dette reti antagoniste generative (generative adversarial networks – GAN), vengono utilizzate per creare immagini sempre più realistiche. Le GAN introducono un deep discriminator di rete (un classificatore CNN) per distinguere se le immagini facciali siano originali o create dal computer. Fornendo immagini reali al discriminatore, il sistema impara a riconoscere meglio le immagini. Il discriminatore a sua volta addestra gli encoder a catturare le peculiarità sempre più realistiche delle immagini e i decoder a generare, oltre alle immagini, anche delle maschere. Le maschere che vengono costruite con i dati di allenamento mascherano meglio l’immagine, creando una transizione più fluida del volto di destinazione. Questa continua analisi, ripetuta milioni di volte, genera alla fine immagini così realistiche che non sono più distinguibili da quelle reali.  Questa evoluzione della tecnica porta a controllare anche altre parti del volto: non più solo le labbra ma anche occhi ed espressioni facciali. Uno degli esempi più esplicativi è il video realizzato da un team di studenti di un’università tedesca, che sono riusciti a far sorridere anche Putin…

Ma quello che più stupisce e inquieta è l’interazione in tempo reale con il video: le espressioni del loro volto vengono “imitate” dal clone riprodotto artificialmente e questo vuol dire, ad esempio, che in un’ipotetica intervista in videoconferenza con dei giornalisti, il clone del presidente Trump potrebbe rispondere in tempo reale (con la sua voce) alle domande ma con le parole e l’espressione di un’altra persona, oppure un redivivo Bin Laden  potrebbe apparire in video e parlare cordialmente con George Bush, entrambi fake controllati come  burattini virtuali, dichiarando che l’11 settembre era tutto un complotto. Il tutto fatto prendendo video e foto da internet, senza particolari tecnologie né strumenti costosi e, soprattutto, senza nessuna particolare capacità tecnica… un incubo vero e proprio per chi combatte la disinformazione.

Ed è a questo punto che l’attenzione delle intelligence di tutto il mondo si è focalizzata con particolare attenzione sulla problematica dei deep fake.  Provate a immaginare il seguente scenario: un gruppo di cyber terroristi trasmette un video dove il leader della Corea del Nord Kim Jong-un, in collegamento diretto con alcune TV nazionali, dichiara che nell’arco di un’ora scatenerà un attacco nucleare contro la Corea del Sud. Il video verrebbe trasmesso contemporaneamente in diretta sui social network e ripreso dai principali mainstream. Sarebbe il caos: l’intero network mondiale dell’informazione lo diffonderebbe e lo amplificherebbe esponenzialmente ed eventuali immediate smentite non farebbero altro che aumentare dubbi e paure. Probabilmente la Corea del Sud non si difenderebbe attaccando per prima ma la notizia getterebbe comunque la popolazione di entrambi gli stati nel panico più totale, paralizzandoli per giorni.

La prima struttura di intelligence a muoversi formalmente per contrastare attacchi basati sul deep fake è stata il DARPA (l’agenzia nordamericana di ricerca per la difesa) che, per trovare soluzioni in grado di mitigare il gli attacchi a “effetto sorpresa”, ha impiegato un primo investimento di 68 milioni di dollari per lo sviluppo di tecniche in grado di identificare automaticamente i video manipolati, nonché un programma denominato DARPA’s Media Forensics (MediFor) che coinvolge diversi centri di ricerca e università nel mondo per lo studio di soluzioni anti-deep fake e fake news.

Nel 2018, menzione d’onore all’Italia: l’Università Federico Secondo di Napoli, che studia il fenomeno dei deep fake, si è rivelata la più “prolifica” nelle pubblicazioni di studi e approfondimenti in merito alla problematica. L’esecutivo statunitense si è formalmente mosso attraverso il senatore Ben Sasse che ha firmato, a dicembre 2018, il “Malicious Deep Fake Prohibition Act”, disciplinando implicazioni giudiziarie e responsabilità connesse alla creazione e distribuzione di contenuti fraudolenti. Anche nei meandri di internet le agenzie per la sicurezza si stanno muovendo informalmente, eseguendo una vera e propria “epurazione” dei codici software pubblicati dagli utenti per generare deep fake e disinformazione. Sappiamo per esperienza che nel dominio cibernetico gli attacchi dell’avversario sono comunque destinati, prima o poi, ad avere successo: quindi uno degli obiettivi da perseguire è anche quello di complicare almeno la vita ai potenziali attaccanti.

Uno studio della DEEPTRACE sul fenomeno – effettuato a fine 2018 – mostrava l’andamento della pubblicazione di applicazioni e codici per realizzare deep fake inizialmente in crescita esponenziale, poi stabilizzatosi negli ultimi mesi del 2018 per iniziare, successivamente, una decrescita nel primo semestre del 2019. Molte applicazioni e codici pubblicati non sono più disponibili, altri sono disponibili  solo nelle prime versioni spesso altamente instabili (ad esempio la versione 2.2 dell’applicazione FakeApp è molto difficile da trovare, mentre la versione 1.1 è presente su diversi siti di download), altre ancora sono state infettate e quindi, oltre a non funzionare, sono pericolose da utilizzare.

Fonte: DEEPTRACE Report – 2018

Al momento non esiste un software in grado di identificare in maniera certa un deep fake: sono state però implementate delle tecniche che sfruttano alcune “mancanze” temporanee di informazione, come il fatto che gli esseri umani sbattono gli occhi ogni 2-10 secondi, ogni battito di ciglia richiede tra uno e quattro decimi di secondo e in rete non si trovano facilmente foto di persone a occhi chiusi. Così le reti neurali dei video deep fake hanno poco materiale a cui attingere e, di conseguenza, raramente nei video deep fake il protagonista sbatte le palpebre. Facendo analizzare il video ad altre applicazioni, anch’esse basate su I.A. e specializzate nell’individuare il “battito di ciglia”, si riesce attualmente – nel 95% dei casi – a individuare video deep fake: ma questa, come si può immaginare, è solo una vittoria temporanea.

Nonostante l’azione di epurazione in atto su codici e applicazioni deep fake, esiste una quantità incredibile di pubblicazioni e materiale sull’argomento.
Ho voluto provare a realizzare un semplice editore di deep fake partendo da zero e utilizzando delle librerie neurali in cloud già pronte e a disposizione sulla piattaforma Azure di Microsoft per manipolare video. In questo caso l’algoritmo utilizzato suddivide il video sorgente in tante piccole sequenze separandole in base alle espressioni o al movimento del viso, che vengono poi associate al movimento di un utente ripreso da una telecamera: il risultato è un video collage di frame che l’I.A. utilizza per imitare i movimenti del volto dell’utente, senza modificare il movimento labiale ma solo cercando i frame più “simili” alla sincronizzazione dell’audio.

Per la fonte audio ho utilizzato il sito https://clash.me, che applica una tecnica molto semplice simile a quella utilizzata per il video: isola le parole in un audio e poi permette di creare nuove frasi con la voce originale del soggetto.

L’audio che ho realizzato lo trovate a questo link:

https://clash.me/MZSW4VI

Il mio video deep fake finale, il soggetto del video (il presidente Trump) che fa i complimenti alla nostra mitica rivista:

[embedded content]

Un esperimento rozzo ma divertente che rende l’idea delle potenzialità coinvolte. L’intelligenza artificiale è una componente fondamentale nel processo dei deep fake e nei prossimi anni lo sarà sempre di più: in questo e in moltissimi altri ambiti, è difficile a dirsi ma estremamente probabile come ciò possa concretizzare minacce in Internet. Tra i possibili rischi veicolati da un uso illecito dell’IA (Malicious Use of Artificial Intelligence – MUAI) vi è appunto la destabilizzazione psicologica attraverso la disinformazione manipolata dall’I.A., in grado di operare a livelli di complessità e velocità di esecuzione che la mente umana non è in grado di comprendere: questo potrebbe condurre facilmente anche a conflitti di ordine mondiale.

Per certi versi, i deep fake hanno evidenziato ancora una volta che viviamo un’epoca in cui i contenuti multimediali e l’informazione non controllata possono avere un impatto devastante sul comportamento delle persone, accentuando in modo particolare quanto sia sempre più vicino il momento in cui avverrà il sorpasso della macchina nei confronti dell’essere umano. Per ora l’I.A., con i deep fakes, è arrivata a confutare anche Eraclito, che affermava: “Gli occhi sono testimoni più precisi delle orecchie”.

Note

  1. https://www.govinfo.gov/content/pkg/BILLS-115s3805is/pdf/BILLS-115s3805is.pdf
  2. https://s3.eu-west-2.amazonaws.com/rep2018/2018-the-state-of-deepfakes.pdf
  3. https://arxiv.org/pdf/1803.09179.pdf
  4. https://github.com/deepfakes/faceswap
  5. https://github.com/iperov/DeepFaceLab

Articolo a cura di Francesco Arruzzoli

Download PDF

https://www.ictsecuritymagazine.com/articoli/perche-il-deep-fake-preoccupa-lintelligence-disinformazione-e-attacchi-psicologici-con-luso-illecito-dellia/