Vulnerabilità a 360° – Casi reali e l’importanza dell’analisi del rischio

Estratto dalla relazione di Daniele Rigitano tenutasi al 10° Cyber Crime Conference 2019

Siamo circondati da vulnerabilità. È un dato di fatto.

Malgrado questa sia un’asserzione forte, dovrebbe essere vista come una presa di coscienza, piuttosto che come qualcosa di negativo.

Per avvalorare quanto detto, invito il lettore a riflettere sui seguenti punti:

  • Quale versione del SO è equipaggiata sul proprio dispositivo mobile?
  • Si ha contezza delle patch di sicurezza installate?
  • L’utente aggiorna abitualmente il SO del proprio PC?
  • L’utente cifra abitualmente la partizione dati del proprio PC?
  • L’utente aggiorna costantemente le applicazioni che installa?

La trattazione relativa a tali domande sarà ripresa nel corpo dell’articolo.

Cyber security

Nell’ultima decade vi è stata un’accelerazione nel comprendere il concetto di “sicurezza”. Infatti nel recente passato i dirigenti aziendali con il termine “sicurezza” hanno sempre inteso la sicurezza fisica dei locali, oppure la normativa relativa alla sicurezza sul lavoro.

Fortunatamente gli americani hanno forgiato il termine CYBERSECURITY, che ha permesso all’esperto di essere compreso riguardo al nuovo contesto cyber.

Si sono quindi sviluppati nel contempo tutta una serie di prodotti specifici, volti ad aumentare il livello di sicurezza delle infrastrutture IT.

Tuttavia, la sicurezza TOTALE non esiste.

Il famosissimo hacker statunitense Kevin Mitnick ci conferma in un suo libro che:

[…] L’unico computer sicuro è un computer spento; tuttavia un abile ingegnere sociale troverà sempre qualche persona disponibile che glielo accende! […]”.

Deduciamo da tale affermazione che è possibile far tendere la PROBABILITÀ di accadimento di un evento malevolo più vicina allo zero possibile; ma rimarrà sempre la componente umana l’ultimo baluardo di difesa dei sistemi IT di una qualsiasi organizzazione.

Un utente inesperto potrebbe essere quindi un serio problema per la sicurezza di un’organizzazione.

Vulnerabilità

Ma cosa sono le vulnerabilità? Sostanzialmente sono errori o di progettazione o di scrittura del codice, che permettono ad un attaccante di essere sfruttate per accedere in maniera non autorizzata ad un dispositivo.

Dalle più classiche:

  • SO;
  • smartphone;
  • applicazioni;

a quelle che richiedono maggior impegno da parte dell’attaccante:

  • ingegneria sociale;
  • fakelogin;

infine, quelle più gravi che compromettono infrastrutture o intere organizzazioni:

  • cytrix, 6 TB di esfiltrazione;
  • centrali nucleari, malware Triton à verso macchinari della francese Schneider Electric;
  • reti mobili 4G/5G.

Saranno dunque mostrate una carrellata di vulnerabilità partendo da quelle che riguardano da lontano un utente finale, fino ad interessarlo direttamente.

Cytrix – 6 Tb di Esfiltrazione

Cytrix è il colosso della virtualizzazione per eccellenza (SaaS, IaaS, PaaS, HaaS) con clienti sparsi in tutto il globo. I benefici di implementazioni di questo tipo sono evidenti:

  • manutenzione gestita da altri;
  • infrastruttura logistica gestita da altri;
  • obsolescenza gestita da altri (flessibilità e scalabilità);
  • sicurezza gestita da altri.

Appunto: la sicurezza. Questa debacle non ha pubblicizzato in maniera ottimale una società come Cytrix! Inoltre è da aggiungere che tutto questo “CLOUDIFY” ha un po’ stancato: di fatto, molte società soprattutto americane stanno tornando all’ “on-premise”, cercando di riportare entro i confini aziendali il proprio know-how.

Password Sprayng

La metodologia di attacco iniziale, utilizzata per impersonificare un dipendente della società e proseguire l’infiltrazione, è denominata “password spraying”, una variante del comune attacco a forza bruta.

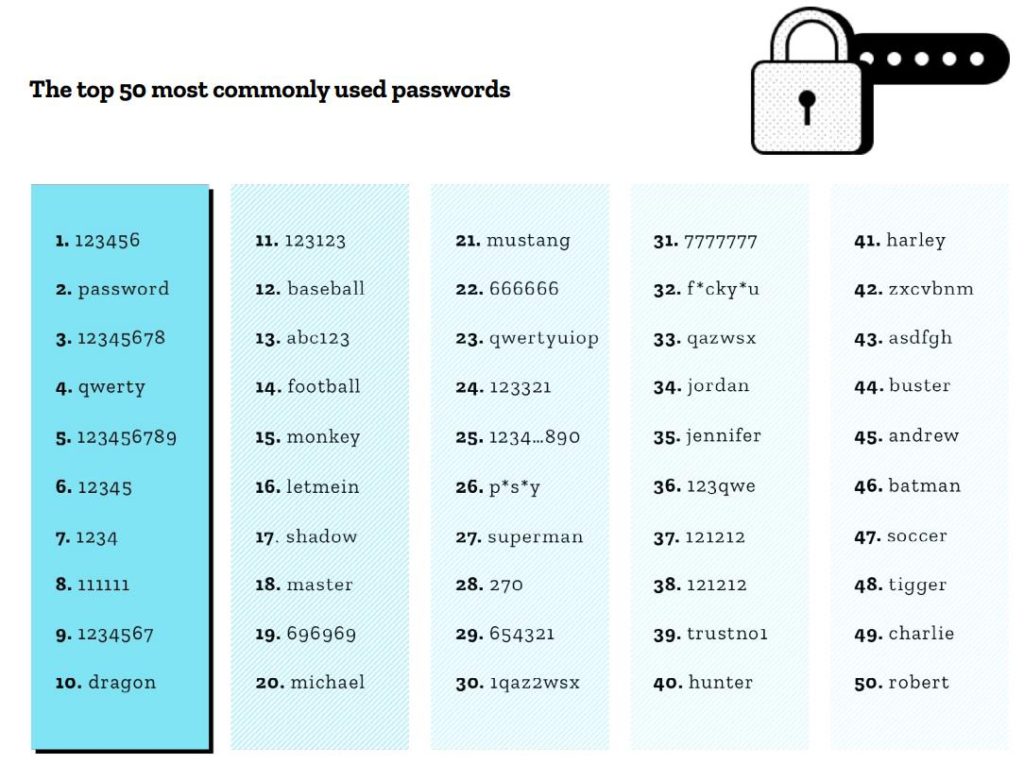
Secondo l’INTERNET HEALTH REPORT 2018, le password + comuni rappresentano l’1,6% del totale.

Vuol dire che su 100 persone, circa una ha quasi sicuramente utilizzato una delle password in figura.

In base a questa statistica, analizzando la struttura che si intende attaccare, studiando la naming convention relativa agli utenti, è possibile ricostruire un dizionario dei dipendenti. Ciclando quindi sul nome utente, utilizzando progressivamente le password comuni, è possibile evitare il ban per reiterati errori di inserimento password.

Ad attacco ultimato, impersonato un dipendente, è bastata un po’ di ingegneria sociale e di analisi del contesto per riuscire ad ottenere dati sensibili.

Quello che ci chiediamo è: “Ma da qualche parte un allarmino non sarebbe dovuto scattare…?”

Continua a leggere…

Scarica gratuitamente gli atti del 10° Cyber Crime Conference 2019

Download PDF

https://www.ictsecuritymagazine.com/articoli/vulnerabilita-a-360-casi-reali-e-limportanza-dellanalisi-del-rischio/


ITIL 4 Foundation

Axelos (la società che mantiene ITIL) ha pubblicato il volume ITIL 4 Foundation e messo a disposizione l’esame.

Breve storia di ITIL

ITIL nacque negli anni Ottanta del secolo scorso per fornire indicazioni in merito alla gestione dell’infrastruttura informatica. Nel 2000 fu consolidato quanto pubblicato fino a quel momento in due volumi dedicati al Service support e al Service delivery, noti come ITILv2.

Nel 2007 fu pubblicata ITILv3, in 5 volumi. Esso rispondeva all’esigenza di spostare sempre più l’attenzione verso la gestione dei servizi informatici e non della sola infrastruttura. Nel 2011 fu pubblicato un ulteriore aggiornamento, visto soprattutto come correttivo del precedente.

Nel 2019 è stato pubblicato il volume ITIL 4 Foundation. Al momento, quindi, non è stato pubblicato ITIL 4 nella sua completezza, ma solo il manuale per sostenere l’esame ITIL4 Foundation (disponibile dal 28 febbraio 2019).

I contenuti

Il manuale mette a disposizione le informazioni di base del modello ITIL, senza doverle estrarre da volumi più ampi.

Ora, il modello ruota intorno a tre elementi chiave: le attività del SVS (Service value system), le pratiche e i principi.

I contenuti nuovi rispetto alla precedente edizione sono molti e per questo molti suggeriscono, anche a chi abbia già ottenuto la certificazione ITILv3 o ITIL 2011 Foundation, di seguire il corso completo.

Il Service value system (SVS)

Le attività del SVS sono sei:

  • pianificazione;
  • miglioramento;
  • coinvolgimento (engage);
  • progettazione (design) e transizione;
  • acquisizione e realizzazione;
  • consegna e supporto.

In precedenza, ITIL si basava sulle cinque fasi di strategia, progettazione, transizione, esercizio, miglioramento continuo (corrispondenti ai cinque libri che componevano ITILv3 e ITIL 2011). Il SVS può essere visto come un’evoluzione del precedente modello.

Per una corretta realizzazione di quanto necessario, vanno sempre considerate quattro dimensioni:

  • organizzazione e persone;
  • informazioni e tecnologia;
  • partner e fornitori;
  • flussi di valore e processi.

In precedenza, ITIL richiamava l’importanza delle 4 P: persone, prodotti, partner e processi. Ancora una volta, ITIL 4 rinnova concetti già espressi in precedenza e ne propone un’evoluzione.

Da aggiungere che, rispetto alle edizioni precedenti, è stata data importanza ai servizi cloud.

Le pratiche

Le “pratiche” di ITIL 4 corrispondono ai “processi” delle precedenti versioni. Sono 34, divise in generali, di servizio e tecniche. Non sono diminuite rispetto alla precedente edizione. L’idea è però quella di fornire indicazioni in merito agli aspetti della gestione dei servizi, non di presentare un modello unitario e coerente di queste pratiche.

Forse proprio il numero eccessivo di processi e l’impossibilità di presentarne un modello unitario (ossia di correlare i processi tra loro) ha condotto gli autori di ITIL 4 a rinunciare all’idea di “processi” e ad abbracciare quella di “pratiche”. È possibile dire che la riduzione delle “pratiche” è un’occasione mancata, visto che alcune sovrapposizioni (per esempio tra “service design” e “change control” e tra “release management” e “deployement management“) non sono spiegate o vengono affrontate superficialmente.

In merito alle pratiche, alcune considerazioni:

  • è usata l’espressione “forza lavoro e talenti” (workforce and talent) al posto di “risorse umane”;
  • nell’ambito del Configuration management, è sottolineato che il CMS (Configuration management system) è importante, ma non deve necessariamente raccogliere troppi dettagli né deve essere unico;
  • nell’ambito del Change control è specificato che i processi di controllo dei change possono essere distinti per ambienti distinti (in molti pensavano ad un unico Change manager per tutti i change);
  • sempre nell’ambito del Change control (per lo meno a livello di foundation) non si parla più di change manager e CAB (Change advisory board), ma solo della necessità di prevedere diversi livelli di autorizzazione per i change;
  • l’importanza della pratica di “change control” è ridotta rispetto alle precedenti versioni (per esempio, viene citata solo una volta nei quattro esempi forniti in Appendice A);
  • è usato il termine “continuity” per eventi di elevato impatto, contrariamente ad altri (per esempio il BCI) che lo usano, invece, anche per incidenti di impatto minore.

Per ogni pratica sono indicati gli impatti sulle sei attività del SVS. Alcune scelte sono discutibili. Si tratta di un tentativo di correlare il modello SVS con le 34 pratiche, ma, come spesso succede, i tentativi di correlare modelli diversi risultano difficili e il risultato non è ottimale.

I principi guida

I principi sono otto:

  • concentrarsi sul valore;
  • iniziare da dove si è (ossia essere consapevoli del proprio stato prima di iniziare attività di miglioramento: questo include, finalmente, una critica alle misurazioni e un richiamo all’importanza del monitoraggio);
  • progredire con iterazioni e riscontri (con questo principio, ITIL promuove l’approccio Agile, criticando, in qualche modo, chi ha cercato di adottare ITIL con un approccio di reingegnerizzazione dei processi; si ritorna, insomma, al Kaizen promosso nell’ambito della qualità);
  • collaborare e promuovere visibilità;
  • pensare e lavorare in modo olistico;
  • mantenere semplicità e praticità (principio spesso dimenticato da manager, consulenti e auditor: una frase interessante è “Simplicity is the ultimate sophistication”);
  • ottimizzare e automatizzare.

Articolo a cura di Cesare Gallotti

Lavora dal 1999 nel campo della sicurezza delle informazioni, della qualità e della gestione dei servizi IT.

Ha condotto progetti di consulenza per la pubblica amministrazione e per il settore privato. Opera, sia in Italia che all’estero, come Lead Auditor ISO/IEC 27001, ISO 9001, ISO/IEC 200000 e ISO 22301. Ha progettato ed erogato corsi di Quality Assurance e di certificazione Lead Auditor ISO/IEC 27001 e ITIL Foundation.

Tra gli attestati si segnalano: le certificazioni AICQ SICEV Lead Auditor ISO/IEC 27001, IRCA Lead Auditor 9001, CISA, ITIL Expert e CBCI, la qualifica come Lead Auditor ISO/IEC 20000 e il perfezionamento postlaurea in “Computer Forensics e investigazioni digitali”.

E’ capodelegazione del WG1 del comitato italiano ISO/IEC SC27 in UNINFO.

Ha pubblicato il libro, aggiornato nel 2017, “Sicurezza delle informazioni: valutazione del rischio; i sistemi di gestione; la norma ISO/IEC 27001:2013”.

Cura la pubblicazione, dal 2008, della newsletter “IT Service management news” (http://www.cesaregallotti.it/Newsletter.html).

Web: www.cesaregallotti.it; Blog: blog.cesaregallotti.it

Download PDF

https://www.ictsecuritymagazine.com/articoli/itil-4-foundation/


Vulnerabilità di Injection e Remote Code Execution: la principale causa di Data Breach e furto di dati

Estratto dalla relazione di Massimiliano Brolli tenutasi al 10° Cyber Crime Conference 2019

Vorrei partire dalla nota frase di un grandissimo inventore greco – Archimede da Siracusa – del quale si narra che, dopo aver avuto l’intuizione della leva, disse: “Datemi una leva e vi solleverò il mondo”. Qual è il nesso con la Cyber Crime Conference? Partiamo con un po’ di storia.

Sia la grande, sia la piccola e media impresa hanno, nel tempo spostato il loro business su Internet: sono 15-20 anni che assistiamo – abbiamo terminato da poco – al trasferimento dei servizi sul web e, quindi, tutte le applicazioni (e i database) che in precedenza giravano nelle Intranet aziendali sono state in qualche maniera rivisti e portati, attraverso Web Application e app mobile, nel web.

Ma il mondo web, lo sappiamo, è un ecosistema complesso, pieno di minacce e che viene costantemente scansionato per indicizzare tutto quanto il contenuto in esso presente e pubblicizzarlo all’interno di repository accessibili a chiunque (ad esempio Shodan, zoomeye, ecc…) che possono essere utilizzati come vettori d’attacco per consentire ai cybercriminali l’esfiltrazione di dati dalle nostre aziende.

Mettendo a paragone i cyberspace Intranet e Internet, possiamo dire che molto spesso ci siamo focalizzati sul tentativo di analizzare ciò che era all’interno della nostra Intranet, per prevenire possibili frodi e fenomeni di esfiltrazione dati per diverse finalità (ad esempio, nel caso di dipendenti infedeli). Ma Internet cos’è? Secondo le ultime stime si parla di 4 miliardi di utenti singoli e 24 miliardi di devices: in questa stima sono comprese applicazioni web ma anche app mobile, ecosistemi IoT e via discorrendo. Quindi, se tenendo in considerazione una Intranet di 10 mila utenze – stiamo già parlando di un’Intranet di grandi dimensioni, per non dire di una Big Company a livello internazionale – per ogni potenziale aggressore possiamo dire che, da rete Internet, possono essercene ben 400mila.

Sappiamo che le informazioni saranno il petrolio del nuovo millennio; quindi, ricollegandomi alla citazione d’apertura, ci saranno nuove “leve” che consentiranno di esfiltrare dai sistemi i nostri dati e i nostri “gioielli della corona”, che pensiamo di aver messo in sicurezza ma, probabilmente, questo non sempre è stato fatto nella maniera dovuta.

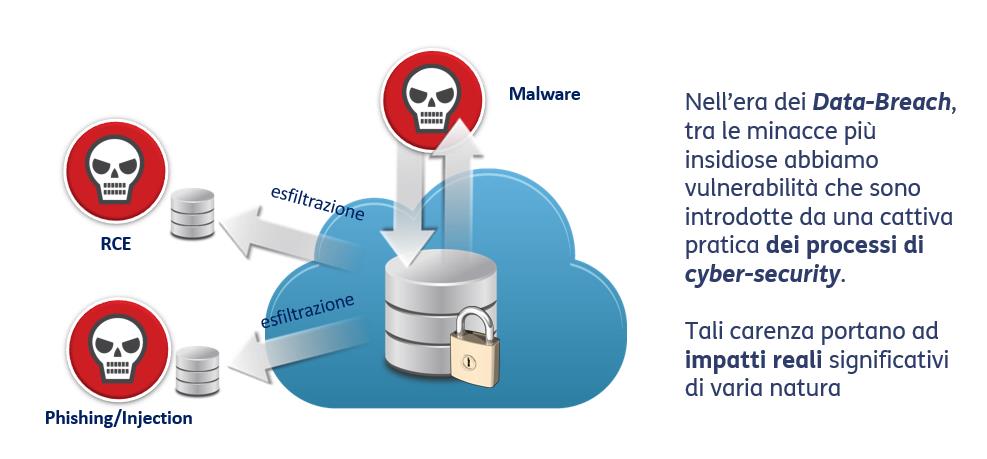
ne cito alcuni: il fenomeno del phishing, dell’SQL injection, Remote Code Execution, i malware in generale. Dobbiamo però partire dal concetto che, purtroppo, oggi tutti i sistemi risultano violabili, dipendentemente dal tempo e soprattutto dall’interesse che hanno i cybercriminali nel produrre attacchi verso le nostre aziende. Nell’era dei data breach, questo non può essere più sostenibile; per fortuna si può evitarlo con l’adozione di processi di cybersecurity in grado di risolvere tutte queste carenze. Ma questo richiede costanza e precisione, una precisione di livello militare: stiamo parlando del processo del patching, quindi condurre un’efficace attività di discovery delle minacce e patching delle applicazioni non appena vengono ufficializzate, da parte dei vendor, le vulnerabilità rilevate sulle nostre applicazioni; stiamo parlando del fenomeno dell’hardening – sappiamo tutti che, per sostituire un kit che non funziona bene in una notte burrascosa, i nostri sistemisti le provano tutte fino, magari, a creare all’interno del sistema delle misconfigurations che poi non vengono ripristinate (password di default, servizi che prima non c’erano e poi compaiono, magari anche portando nuove vulnerabilità) – e quindi bisogna presidiare il tema dell’hardening loss.

Un altro vettore importante – qui mi ricongiungo all’altra “leva” prima citata, quindi phishing e SQL injection – è lo sviluppo sicuro del codice. Siamo tutti convinti che avendo buoni strumenti di scansione statica e dinamica, di metterci al riparo da tutte le vulnerabilità di sicurezza presenti sulle nostre Web application. Purtroppo questo non è vero, perché un best in class di questi prodotti può rilevare all’incirca 4 su 10 (parlando sempre di Top 10 owasp, che più o meno conosciamo) vulnerabilità di sicurezza che, generalmente, sono vulnerabilità di depurazione dell’input: tutte le restanti vulnerabilità presenti sui nostri sistemi sono demandate allo sviluppo. E non è detto che un bravo sviluppatore sia un buon sviluppatore di codice sicuro, quindi dobbiamo fare formazione: in particolar modo chi produce software nelle sue factory deve insegnare a produrre codice di qualità.

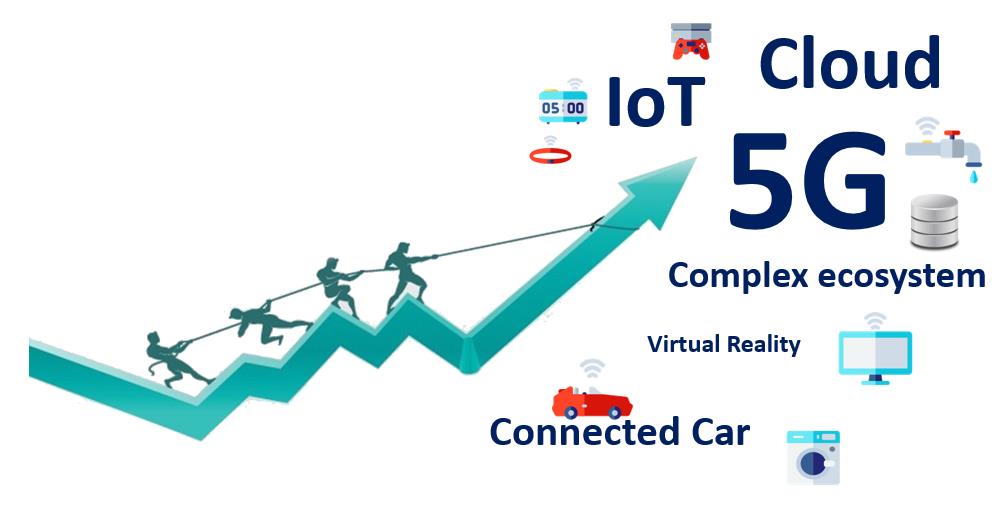
Oltretutto abbiamo assistito, nell’ultimo periodo, al completamento del paradosso della sicurezza informatica: se in precedenza, tra un client e il server passava un flusso in chiaro e noi potevamo tranquillamente verificare quello che transitava, riuscendo così a vedere (e bloccare) i payload dannosi, in seguito – poiché, ovviamente, all’interno di questo flusso in chiaro transitavano anche user e password – per garantire una corretta gestione della privacy dell’utente abbiamo implementato i flussi di cifratura. Ovviamente, avendo distribuito tutti questi canali di protocolli cifrati, ci siamo trovati a un certo punto a non “vedere” più nulla. Allora ci siamo rivolti agli ingegneri di sicurezza, che come soluzione ci hanno proposto di mettere in mezzo uno “scatolotto” (che possiamo chiamare Web Application Firewall) cifrando da entrambi i lati, lasciando al centro la possibilità di avere visibilità del traffico in chiaro; quindi, con meccanismi di Machine Learning, intelligenza artificiale, correlazione, SSL inspection e chi più ne ha più ne metta, possiamo far passare le non-vulnerabilità – quindi tutte le richieste lecite che arrivano al sistema- e bloccare tutto quello che rientra all’interno dei pattern di policy implementati dentro lo “scatolotto”. Come gestire, invece, tutto ciò che risulta “grigio”, quindi i falsi positivi? Mandiamo tutte le richieste border all’interno di un SIEM dove gli analisti del Security Operation Center analizzano questi flussi, generano nuove regole e le re-implementano all’interno dello “scatolotto”. Quindi, di fatto, generiamo un meccanismo di self-improvement che consente di automatizzare questo processo; il che rende gestibile anche la migrazione sul cloud, ma comporta una vertiginosa crescita della complessità. Inoltre, con l’aumento dell’esposizione su internet avremo ulteriori difficoltà; perché il 5G sarà un fenomeno abilitante di nuove tecnologie e nuovi ecosistemi che proietteranno su Internet una quantità industriale di devices e di applicazioni

Anche se penso che siamo tutti al corrente di questo fenomeno.

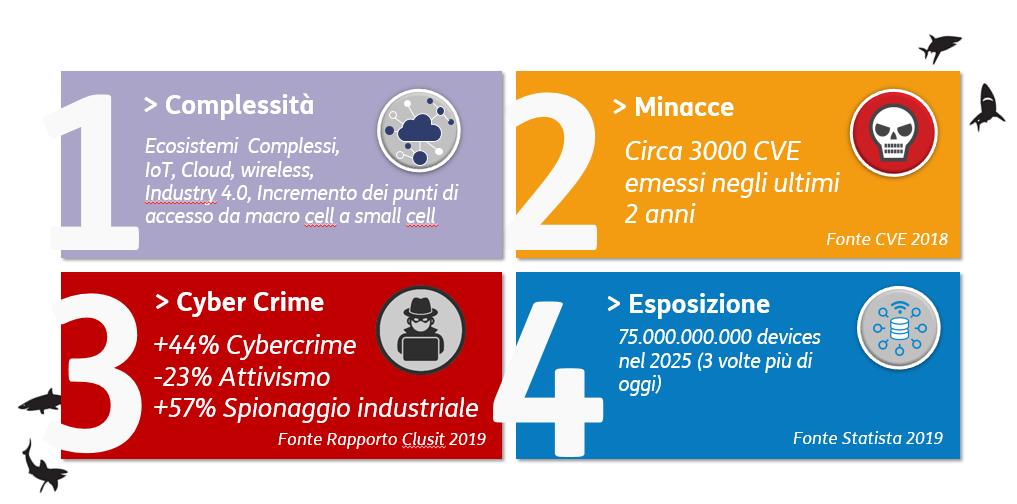
Noi esperti di sicurezza informatica ci troviamo di fronte a una grande sfida nei prossimi anni, perché abbiamo in mano quattro carte che non vanno molto d’accordo con gli obiettivi di cybersecurity: in primis la complessità, quindi ecosistemi complessi, cloud, protocolli wireless (perché di fenomeni di attacco verso le reti wi-fi ce ne sono, eccome), industry 4.0 in generale e anche il cambiamento da macro cell a small cell portato dal 5G, che a sua volta genera ulteriore complessità.

In secondo luogo le minacce, che negli ultimi due anni si sono assestate su circa 3000 CVE annuali critici (senza parlare del fenomeno degli Zero Day, del cyberspionaggio, il cui mercato sta sviluppando una complessità a tale da poter cominciare a suscitare preoccupazioni).

Continua a leggere…

Scarica gratuitamente gli atti del 10° Cyber Crime Conference 2019

Download PDF

https://www.ictsecuritymagazine.com/articoli/vulnerabilita-di-injection-e-remote-code-execution-la-principale-causa-di-data-breach-e-furto-di-dati/


Sicurezza Informatica: una responsabilità condivisa

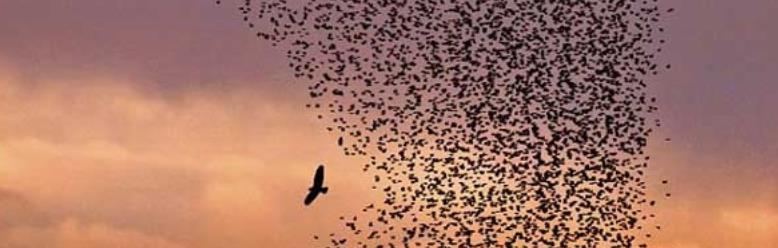
Moltissimi sono gli esempi del regno animale che ci insegnano che per risolvere un problema complesso dove il “singolo” non riuscirebbe, la collaborazione tra gli individui, consente di superarlo. Ad esempio lo Storno Comune (Stormus Vulgaris), piccolo uccello originario dell’Eurasia introdotto in tutti i continenti tranne America Meridionale e Antartide (sinonimo che la specie sa essere resiliente in situazioni critiche) utilizza, nei suoi spostamenti, la logica dello “stormo” per impersonare un essere di più grandi dimensioni, “collaborando” assieme per il primo scopo:

La sopravvivenza

Infatti un falco pellegrino, contro un singolo, avrebbe avuto una vittoria scontata.

Ma tanti storni in movimento coordinato riescono a far allontanare il falco e non farlo concentrare su un’unica preda. Questa ci insegna l’intelligenza “primordiale” del mondo animale: che la collaborazione, in situazioni di crisi, risulta sempre la via per il successo.

Le guerre si sono sempre vinte con grandi strategie, idee, armi oltre alle “persone”; e la logica della “collaborazione”, o più in generale “di squadra”, ha sempre fatto la differenza nei percorsi critici (oltre a far appassionare tifosi e radunare folle in grandi stadi da moltissimi anni). I crimini informatici stanno sempre più prendendo i connotati di una “cyber-war” dove singoli, grandi potenze, organizzazioni e divisioni di intelligence stanno dotando le proprie forze armate di armi cibernetiche, anche se abbiamo già approfondito il tema nello scorso articolo Stati e Guerre senza confini geografici.

Mi limito in questo caso solo a dire che, se una volta le guerre venivano vinte dagli eserciti, questa nuova guerra si potrà vincere solo se tutti (anche i singoli) saranno disposti a fare la loro parte con la propria “sensibilità” e “consapevolezza” mirando ad un secondo scopo:

Proteggere le informazioni

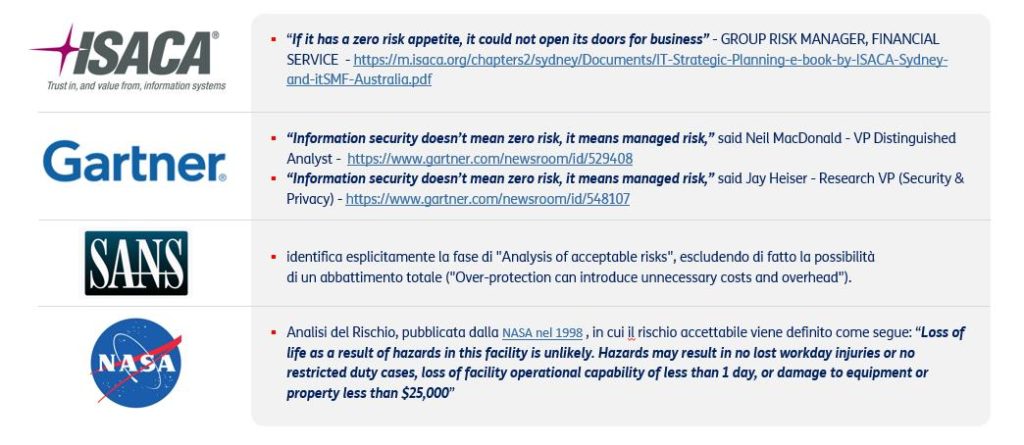
La parola “sicuro” non vuol dire “inviolabile”, perché il “Rischio zero” non esiste e, anche se tutti siamo coscienti di questo semplice principio, non riusciamo ad accettarlo.

Fonti internazionali che trattano il “rischio” come materia del proprio business hanno riportato, in saggi ed articoli accademici, messaggi puntuali e chiari su come tale concetto non sia perseguibile, spiegando che ogni rischio risulta “quantificabile”, “gestibile”, ma non completamente “eludibile”.

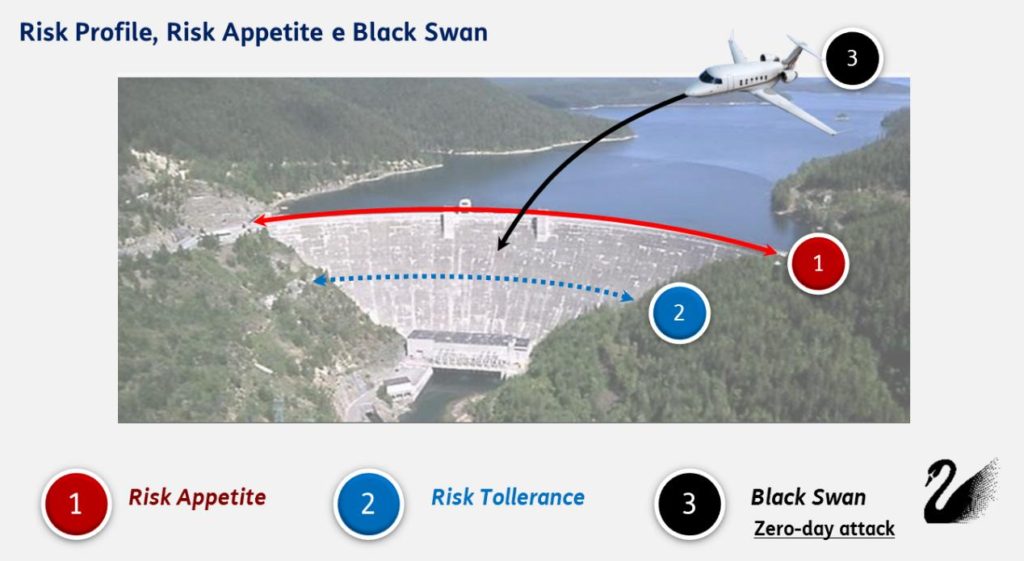
L’incidente dell’11 settembre del 2001 alle Torri Gemelle ci ha introdotto nell’era del “black swan”. Dopo l’incidente, infatti, si sono analizzati i progetti e ripercorse le analisi del rischio svolte in precedenza, che, seppur ipotizzavano un impatto di un aereo, non prevedevano una serie di situazioni di contorno completamente ignote, imprevedibili e concomitanti (almeno con gli strumenti dell’epoca) che ne hanno provocato il crollo.

Il vero problema è che su questi aspetti oggi siamo “antropologicamente refrattari” e poco strutturati ad accettare i rischi, oltre a non comprendere con precisione il reale danno che può essere generato da un abuso informatico – in termini di “brand-reputation” e “web-reputation” – se non correlando il tutto a una diretta perdita di denaro.

Nel prossimo futuro verremo chiamati più volte in causa, in quanto siamo solo all’inizio di questa “Big Challenge” che coinvolgerà tutti, pena una “De-Digitalization” massiva che riporterà l’uomo agli inizi del ‘900.

Presagio o verità? Lo scopriremo solo vivendo.

Sicuramente la materia è complessa, ma dobbiamo cominciare a pensare che la sicurezza informatica viene fatta da ognuno di noi e coinvolge le vite di ognuno ed è arrivato il momento di elevarci dall’essere focalizzati solo sul business, perché il business, dopo un data breach ben fatto, potrebbe non esserci più oppure riportare danni economici insostenibili. Per evitare tutto questo, in una complessità in continuo aumento, c’è solo una strada.

Una responsabilità condivisa

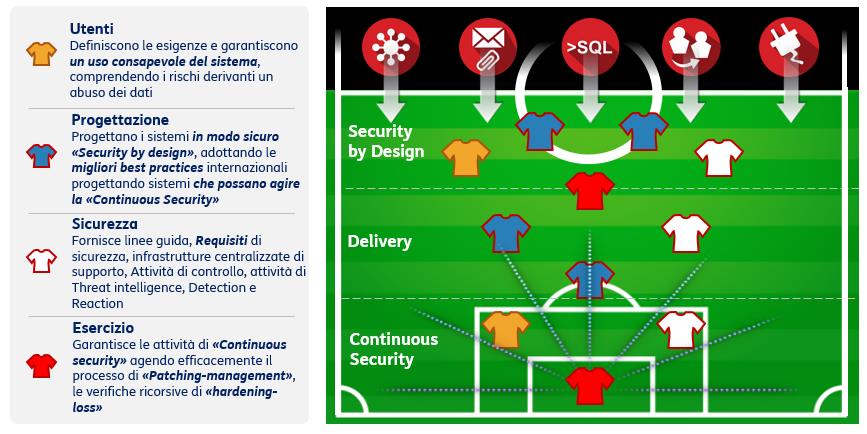
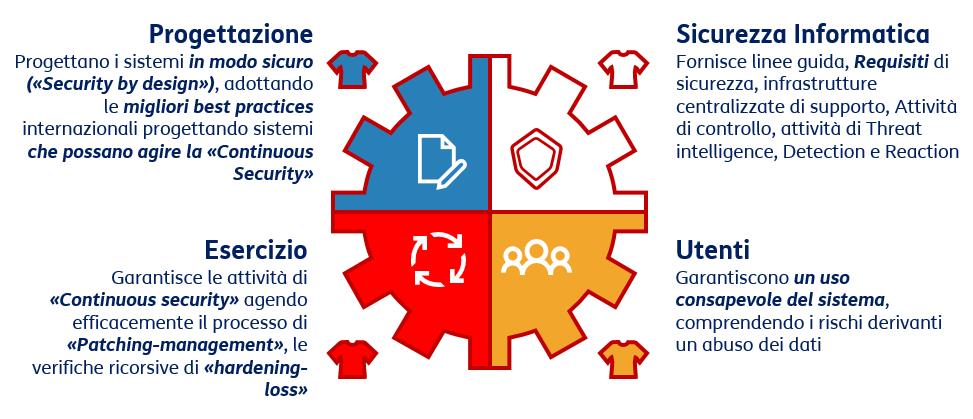
La sicurezza informatica è infatti una responsabilità condivisa tra chi progetta i sistemi, chi fornisce i requisiti di sicurezza da implementare, chi ne esercisce le funzionalità e chi utilizza i sistemi, cioè gli utenti finali.

Come una squadra di calcio protegge l’inviolabilità della propria porta da eventuali azioni di attacco, le persone coinvolte nella “squadra”, ognuna con il proprio “ruolo” e la propria “responsabilità”, garantiranno l’inviolabilità del sistema.

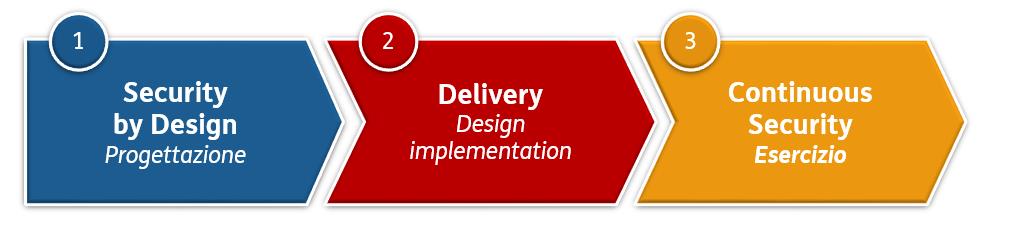
Se dovessimo dividere in fasi il ciclo di vita di un sistema, ci troveremo di fronte a tre macro-blocchi distinti e separati, in ognuno dei quali prenderanno parte attori differenti, che dovranno “collaborare” per progettare il sistema e, successivamente, esercirlo in modo sicuro.

La fase più delicata è la Security by Design, ovvero l’ideazione del sistema, dove vengono effettuate le scelte “strategiche” per rendere il tutto sicuro “sulla carta”, oltre a garantire nel futuro una efficace fase di Continuous Security (ovvero di sicurezza a lungo termine) dove dovranno essere agiti i processi industriali di Patching-Management e di Hardening-Loss.

La fase di Delivery, invece, sarà una fase prettamente “operativa”, di messa in atto di tutto quello che è stato pensato “sulla carta” nella fase di progettazione del sistema: come ad esempio la scrittura del codice, l’installazione dei prodotti e delle infrastrutture fisiche di supporto.

Conclusioni

La Sicurezza informatica è una materia complessa, connessa alle nostre vite che giorno dopo giorno sono sempre più bramose di “software” – e lo saranno ancor più inell’immediato prossimo futuro.

Tutti i sistemi sono violabili, questo è un dato di fatto: sappiamo anche che il successo di una violazione informatica è direttamente proporzionale al tempo di attacco e all’appetibilità dei dati contenuti in un sistema.

Occorre quindi mettere in atto tutte le migliori strategie per consentire che un eventuale attacco venga meno, o almeno provare (e riuscire) a farlo.

Ogni membro della squadra dovrà conoscere bene gli avversari e le loro strategie, i compagni della propria squadra, il campo di gioco, le proprie strategie di difesa e agire in modo competente e appropriato per garantire l’inviolabilità della propria porta.

Ecco perché la sicurezza informatica è una responsabilità condivisa, dove il risultato finale potrà essere raggiunto solo tramite la collaborazione. Purtroppo ci scontriamo sempre con i soliti problemi: materia complessa e conoscenza relativa, carenza nella gestione dei “dettagli”, inadeguatezza di skill per poter agire correttamente una Security by Design che si rispetti.

Ed ecco la grande sfida: elevare la cultura della Cyber Security su tutte le filiere di produzione dei sistemi, perché – d’altra parte – i sistemi li fanno i progettisti, le fabbriche e gli esercizi, oltre agli utilizzatori dei sistemi informatici stessi.

Articolo a cura di Massimiliano Brolli

Download PDF

https://www.ictsecuritymagazine.com/articoli/sicurezza-informatica-una-responsabilita-condivisa/


WeChat Forensics – parte I

In questo articolo continuo la carrellata iniziata con WhatsApp, seguita poi da Telegram IOS e Android, occupandomi di WeChat. La prima parte sarà dedicata a iOS.

WeChat (in cinese pinyin: a proposito di questo suono Wēixìn significa, letteralmente, “micro-messaggio”)[1] è un servizio di messaggistica disponibile su tutte le maggiori piattaforme mobile nonchè su computer tramite un’interfaccia Web accessibile da qualsiasi browser. È totalmente gratuito e offre una vasta gamma di funzioni che lo rendono estremamente interessante.

WeChat offre tre servizi principali: chat, wallet e servizi di terze parti. I suoi servizi di chat sono integrati in messaggistica, voice messaging e videochiamate. WeChat Wallet consente agli utenti di pagare le bollette, ricaricare cellulari, effettuare acquisti online, trasferire denaro ad altri utenti e effettuare pagamenti tramite codice QR presso i negozi commerciali.

I servizi di terze parti di WeChat comprendono abbonamenti, acquisti online, consegna di cibo, prenotazione taxi, viaggi, etc.

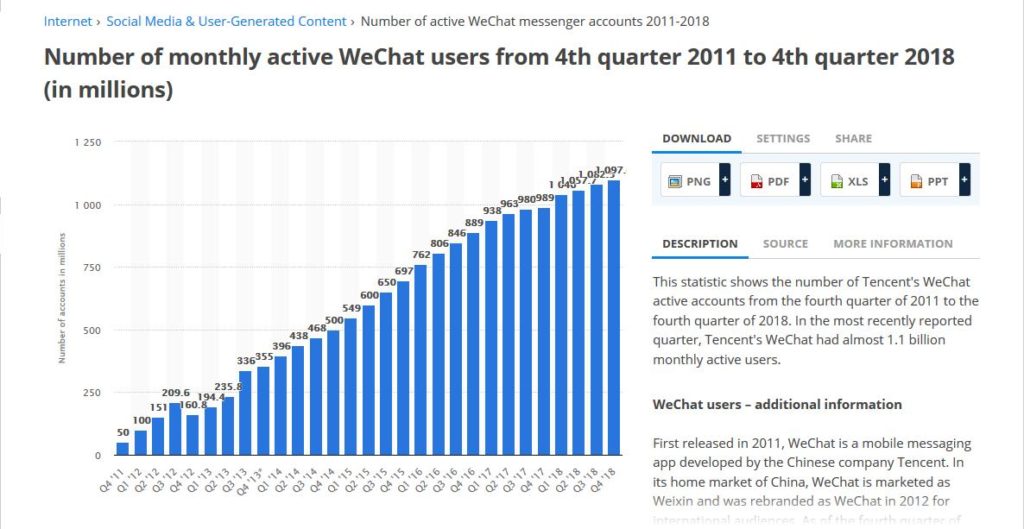
WeChat, sviluppata da Tencent[2] nel 2011, è una delle prime cinque applicazioni di messaggistica istantanea a livello globale. Nel 2018, ha aumentato i suoi utenti attivi mensili a 1,08 miliardi (un miliardo di utenti attivi ogni giorno). Oltre alla Cina, è l’app di messaggistica più popolare in Bhutan.

Alla data di stesura dell’articolo, l’ultima release rilasciata – il 22.01.2019 – risulta essere la 7.0.3; con detta release arrivano le “capsule del tempo” adoperate per raccontare le proprie storie attraverso la fotocamera, un design decisamente nuovo con interfaccia chiara e intuitiva, la creazione e l’invio di uno sticker selfie, solo per citarne alcune[3].

A WeChat viene comunemente attribuita la denominazione di “super-app“, dato il numero di utenti WeChat in tutto il mondo, che è incredibilmente elevato. Tuttavia, l’apprezzata etichetta di super-app fornita a WeChat è probabilmente attribuita alla combinazione tra il numero di utenti della stessa e le numerose funzionalità user friendly offerte.

In calce la statistica prodotta dal sito statista.com e raggiungibile al link https://www.statista.com/statistics/255778/number-of-active-wechat-messenger-accounts/, che evidenzia il numero degli account WeChat nel periodo 2011-18:

WeChat ha tanti utenti, prevalentemente asiatici e in particolare di origine cinese, in quanto la Cina è soggetta ad un regime che impedisce il libero flusso di informazioni e, in special modo, quello scambiato online.

La sicurezza è assicurata dalla cifratura dei dati trasmessi anche se, nelle comunicazioni di WeChat, i dati vengono cifrati e inviati ai server, situati in Cina, e solo successivamente all’utente finale. Questa raccolta intermedia di dati non è comune in altre app di comunicazione come Facebook Messenger, Whatsapp o iMessage, le quali inviano i  dati cifrati direttamente tra gli utenti.

Se diamo uno sguardo più da vicino a questa nuova versione, potremo notare che vi sono stati apportati alcuni cambiamenti nei file di WeChat.

Queste modifiche influiscono direttamente sull’estrazione e il recupero dei dati dall’applicazione stessa.

Vi sono molti tool forensi in grado di estrapolare le evidenze di WeChat: uno di questi è Belkasoft Evidence Center[4].

Belkasoft Evidence Center (BEC) supporta l’estrazione e l’analisi della cronologia di WeChat sia da dispositivi Android che da dispositivi iOS; in mancanza di strumenti forensi idonei, pur non essendo stato progettato per l’acquisizione forense, è possibile utilizzare l’opzione iTunes.

iTunes è un’applicazione di gestione e sincronizzazione disponibile sul sito ufficiale Apple[5].
È adoperato per la creazione di backup o per l’ottenimento di immagini logiche dai dispositivi Apple, trasferirendoli sul computer.

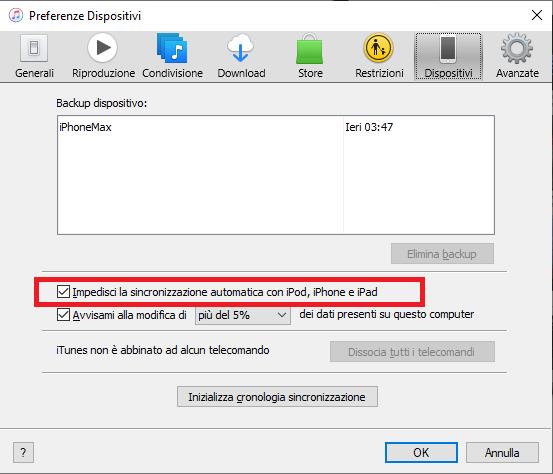
Per questo articolo utilizzeremo un’acquisizione logica dei dati effettuata su di un iPhone Xs Max mediante l’utilizzo di iTunes. Essendo fondamentale assicurare l’integrità delle prove acquisite, l’acquisizione deve essere condotta necessariamente in ambiente forense mediante collegamento del dispositivo a una stazione di lavoro opportunamente predisposta e impedire la sincronizzazione automatica del dispositivo stesso, come evidenziato dalla figura in calce:

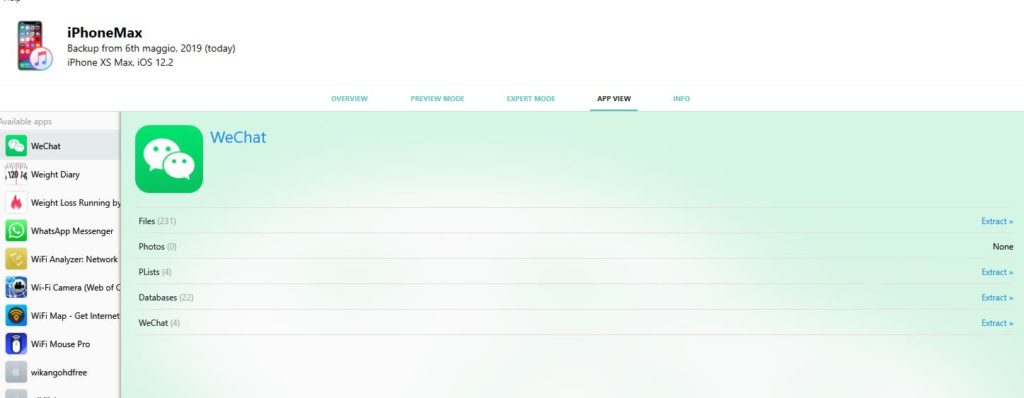
Al termine dell’acquisizione verrà utilizzato Iphone Backup Extractor[6] prodotto da Reincubate per visualizzare, nel dettaglio, il backup estratto.

I file di interesse per l’analisi forense si trovano nel seguente percorso:

Applications\com.tencent.xin[7]

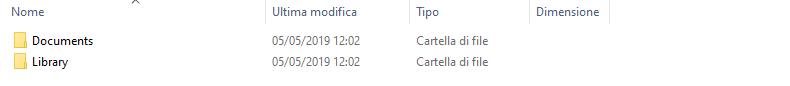
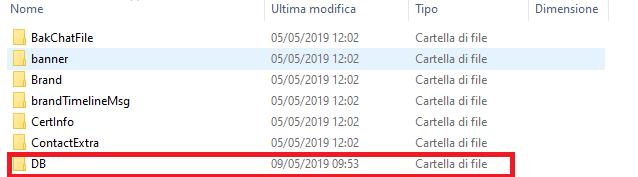
Esplorando la directory Applications\com.tencent.xin\Documents, viene rinvenuto quanto visualizzato in fig. 1:

Fig.1

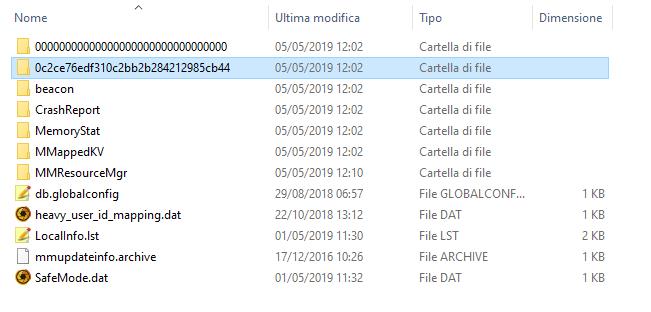
La directory di maggiore interesse da esaminare al fine di estrarre evidenze utili è quella denominata 0c2ce76edf310c2bb2b284212985cb44 – che corrisponde al valore MD5[8] dell’ID WeChat, wxid_qtca7z75krs412, nel caso di specie -, la quale  presenta la seguente struttura:

Fig.2

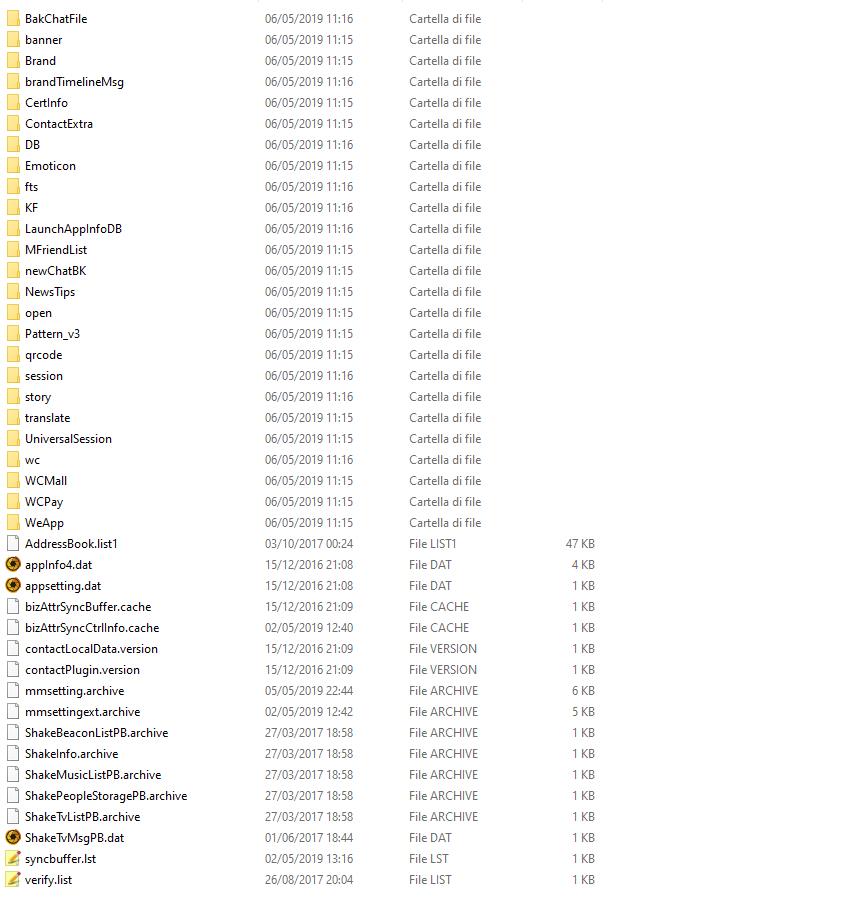
Non essendo stati rinvenuti, nel caso in esame, audio, video e foto, le directory relative non sono presenti.

Fig. 3

Possono essere utili, per compredere alcuni dati fondamentali dell’app WeChat, i contenuti di alcuni file plist:

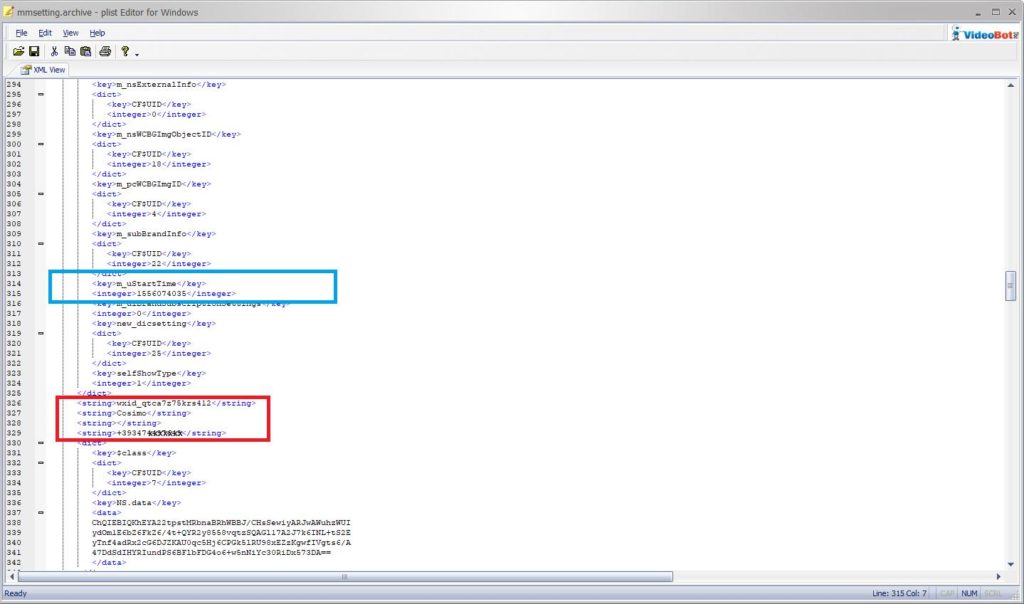
mmsetting.archive situato all’interno della directory 0c2ce76edf310c2bb2b284212985cb44 e localinfo.lst rinvenibile in Applications\com.tencent.xin\Documents.

Fig. 4

La fig. 4 ne mostra alcune informazioni: il timestamp relativo all’ultimo avvio dell’applicazione – nel riquadro in blu, 1556074035 che, opportunamente convertito, evidenzia la data del 24 Aprile 2019 ore 04:47:15  – , l’Id assegnato dall’applicazione stessa – riquadro in rosso wxid_xxxxxxxxxx -, il nome dell’utilizzatore e il suo numero telefonico, +39347xxxxxxx.

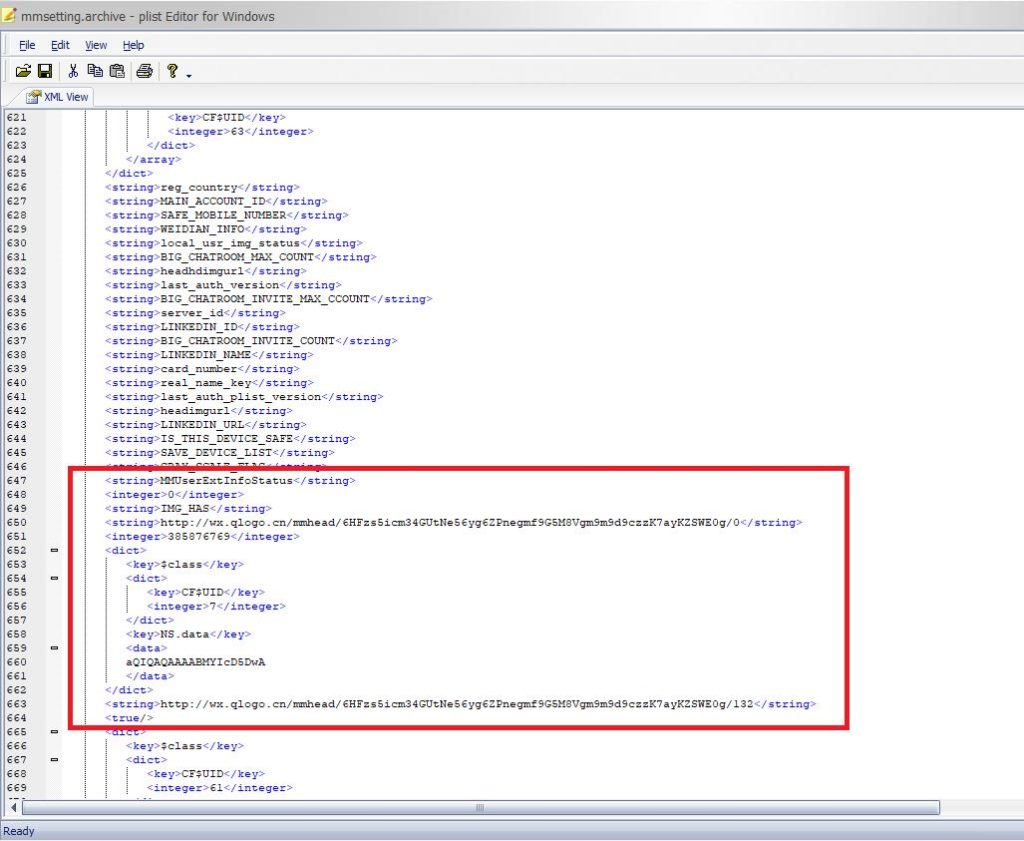
Dallo stesso file è possibile estrarre la foto del profilo e la relativa miniatura, come evidenziato nel riquadro in rosso di fig. 5:

Fig.5

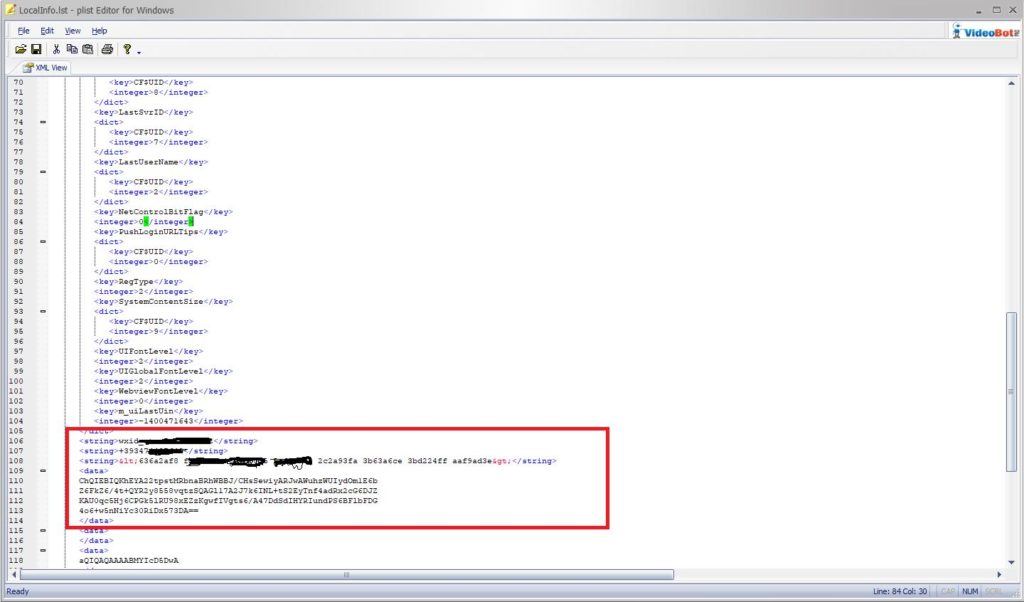
Per avere contezza, invece,  dei dati relativi all’utente connesso, è necessario verificare quanto riportato nel file localinfo.lst; vi sono le informazioni – id, numero telefonico e altri dati appartenenti all’interfaccia ClocalInfo – idonee a disvelare quanto necessario:

@interface CLocalInfo: NSObject { Unsigned int m_uiLastUin; NSString * m_nsCurUsrName; NSString * m_nsLastUserName; NSString * m_nsLastLoginName; NSString * m_nsLastNickName; NSString * m_nsLastPhoneNumber; }

Fig. 6

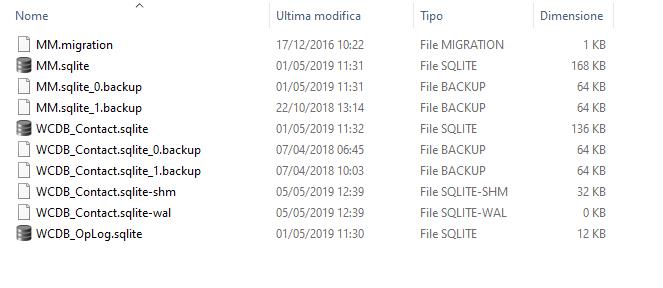
Per quanto concerne lo studio e l’estrazione dei dati relativi ai contatti e alle chat, la subdirectory più interessante è certamente DB, ove è possibile rinvenire i database contenenti tutte le informazioni utili: WCDB_Contact.sqlite e MM.sqlite (fig.7):

Fig.7

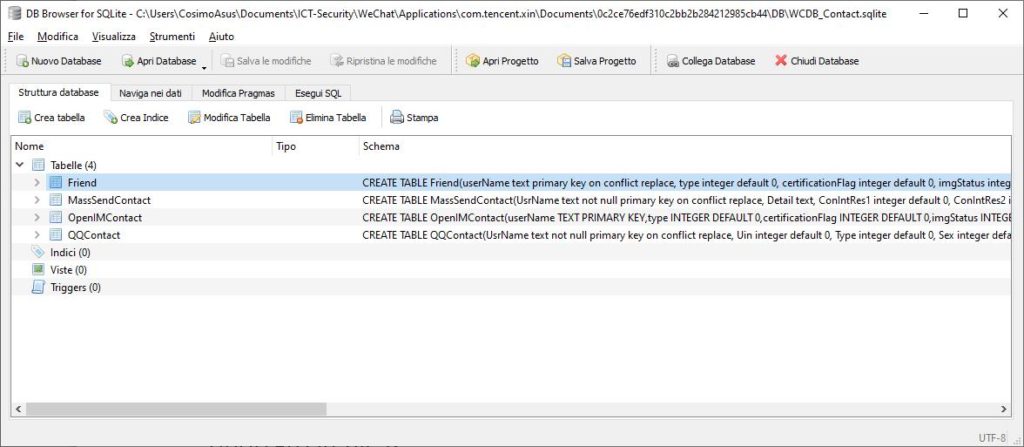
Il database WCDB_Contact.sqlite consta di 4 tabelle, così come riportato in fig. 8:

Fig.8

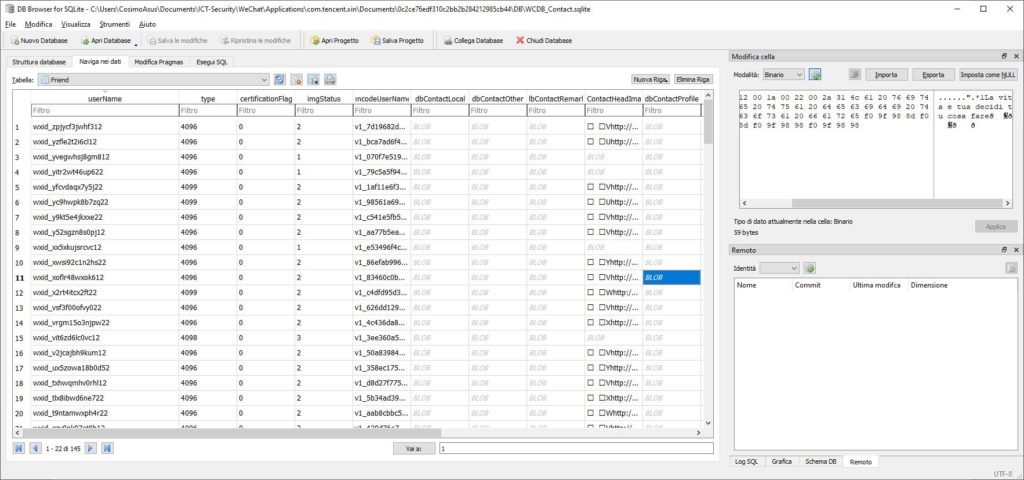
La tabella “Friend” è quella di maggiore interesse dato il suo contenuto inerente i dati di tutti gli “amici”:

Fig. 9

Come è facile verificare, la maggior parte dei campi contiene dei valori BLOB[9], in formato binario e, a prima vista, poco interpretabili.

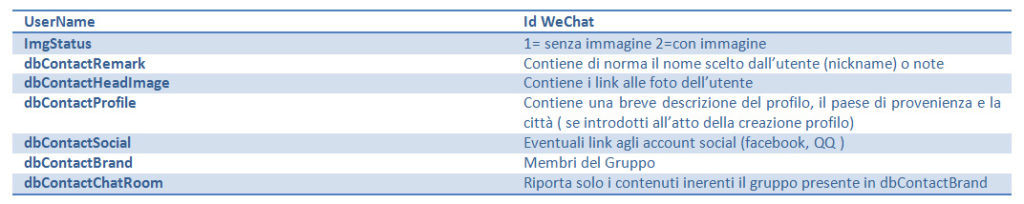
Il campo “dbContactProfile”, ad esempio, – in blu – evidenzia una breve descrizione immessa dall’utente che meglio descrive il suo profilo.

La tabella si compone di altri campi utili per la ricostruzione della lista “amici”:

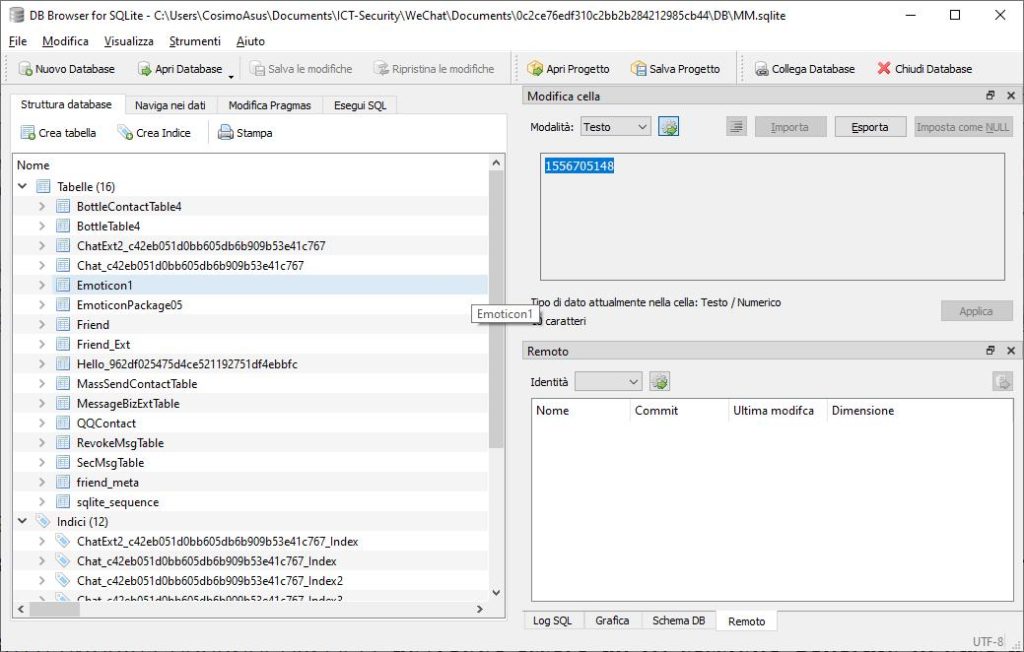
Nel database MM.sqlite, dove è possibile rinvenire le chat, consta di 16 tabelle, così come riportato in fig. 10:

Fig. 10

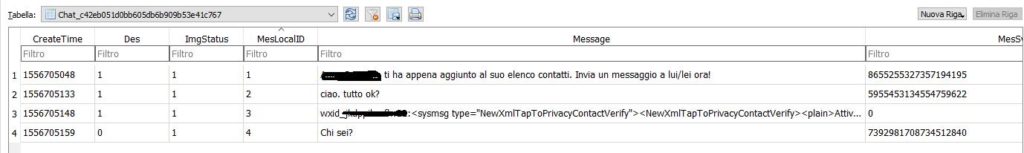
La tabella di interesse investigativo, corrispondente alle conversazioni effettuate, è: Chat_c42eb051d0bb605db6b909b53e41c767.

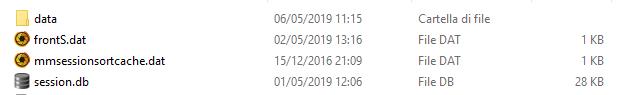
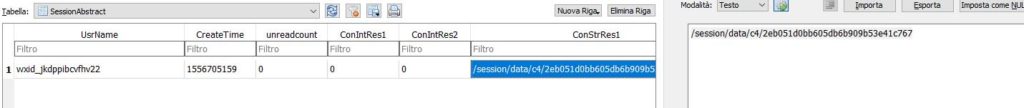
Nella tabella compare un ID univoco di sessione che è possibile ritrovare nel database session.db, tabella SessionAbstract, situato nella subdirectory 0c2ce76edf310c2bb2b284212985cb44\session:

Osservando la tabella è possibile risalire all’interlocutore della chat (UsrName) e al timestamp della conversazione (CreateTime):

Con una semplice query tra le tabelle WCDB_Contact.sqlite->Friend e session.db->SessionAbstract è possibile risalire all’identità dell’interlocutore stesso.

Nella tabella Chat_c42eb051d0bb605db6b909b53e41c767 è possibile ritrovare la conversazione vera e propria (Message) con i relativi timestamp (CreateTime) tra l’utente in esame e il suo interlocutore:

Bene, siamo giunti al termine anche di questa trattazione.

Tornerò ad occuparmi a breve di WeChat, questa volta per i sistemi Android.

Stay tuned.

Note

[1] https://en.wikipedia.org/wiki/WeChat.

[2] http://www.tencent.com/en-us/index.html.

[3] https://blog.wechat.com/.

[4] https://belkasoft.com/ec.

[5] https://www.apple.com/it/itunes/.

[6] https://reincubate.com/about/.

[7] https://www.iphonebackupextractor.com/it/blog/ios-data-recovery-apps-data-iphone-backups/.

[8] https://it.wikipedia.org/wiki/MD5.

[9] https://it.wikipedia.org/wiki/Binary_large_object.

Articolo a cura di Cosimo De Pinto

Download PDF

https://www.ictsecuritymagazine.com/articoli/wechat-forensics-parte-i/


La privacy oltreoceano

Il framework statunitense

L’Unione Europea è considerata il soggetto che, più di ogni altro a livello internazionale, si è interessato di protezione di dati personali e che, tradizionalmente, ha avviato un percorso di tutela normativa d’avanguardia. Ma siamo proprio sicuri che sia così? L’occasione per rispondere a questa domanda è data dall’avvio in consultazione pubblica, da parte del National Institute of Standards and Technology (NIST)[1], del “NIST privacy framework: an enterprise risk management tool”[2] (d’ora in poi, Framework).

Il NIST è un autorevole istituto federale statunitense, dipendente dal Dipartimento del Commercio, che ha la missione di promuovere la competitività, il miglioramento della qualità della vita e il potenziamento della sicurezza economica attraverso la definizione di standard scientifici e tecnologici.

Il Framework è un documento che ha l’obiettivo di fornire alle imprese un riferimento metodologico per assicurare che i dati personali siano adeguatamente protetti. Il documento è il frutto del consueto stile pragmatico di matrice anglosassone e, in particolare, statunitense; perché, se è vero che le norme americane non sono così giuridicamente protettive come le norme europee, l’approccio al risultato che contraddistingue gli yankee è molto più intenso rispetto a quello che caratterizza il Vecchio Continente.

Peraltro, il Framework è uno spin‑off di un complesso percorso di studi che il NIST ha condotto, prevalentemente, per fornire indicazioni metodologiche agli Enti Federali americani (uno per tutti: “An Introduction to Privacy Engineering and Risk Management in Federal Information Systems”[3], d’ora in poi PERM). D’altra parte, proprio il trattamento dei dati personali da parte di specifici enti governativi statunitensi (soprattutto a scopi di difesa e sicurezza nazionale) è stato oggetto di specifici approfondimenti nel rapporto dell’European Data Protection Board sul secondo incontro congiunto per la verifica dell’U.S. Privacy Shield, pubblicato lo scorso gennaio[4].

In ogni caso, le caratteristiche distintive del percorso tecnico scientifico del NIST sono due:

  • viene introdotto il concetto di privacy engineering;
  • è molto orientato ai sistemi informativi ancorché non vengano affatto trascurati gli aspetti organizzativi.

Privacy engineering vs privacy by design/privacy by default

Il PREM definisce l’ingegneria della privacy (la privacy engineering) come una:

“specialità della più generale ingegneria dei sistemi (la systems engineering) volta a ridurre le condizioni che possono creare problemi per gli individui con conseguenze inaccettabili che derivano da come il sistema tratta i dati personali”.

Sembra una definizione che, nella sua vaghezza, la accomuna alle definizioni di privacy by design (privacy fin dalla progettazione):

“tenendo conto dello stato dell’arte e dei costi di attuazione, nonché della natura, dell’ambito di applicazione, del contesto e delle finalità del trattamento, come anche dei rischi aventi probabilità e gravità diverse per i diritti e le libertà delle persone fisiche costituiti dal trattamento, sia al momento di determinare i mezzi del trattamento sia all’atto del trattamento stesso il titolare del trattamento mette in atto misure tecniche e organizzative adeguate, quali la pseudonimizzazione, volte ad attuare in modo efficace i principi di protezione dei dati, quali la minimizzazione, e a integrare nel trattamento le necessarie garanzie al fine di soddisfare i requisiti del presente regolamento e tutelare i diritti degli interessati”;

e privacy by default (privacy per impostazione definita):

“il titolare del trattamento mette in atto misure tecniche e organizzative adeguate per garantire che siano trattati, per impostazione predefinita, solo i dati personali necessari per ogni specifica finalità del trattamento. Tale obbligo vale per la quantità dei dati personali raccolti, la portata del trattamento, il periodo di conservazione e l’accessibilità. In particolare, dette misure garantiscono che, per impostazione predefinita, non siano resi accessibili dati personali a un numero indefinito di persone fisiche senza l’intervento della persona fisica”,

contenute nel nostro GDPR. Tuttavia, il PERM riconosce che i classici Fair Information Practice Principles (FIPPs, molto simili ai principi contenuti nell’art. 5 del GDPR) ovvero trasparenza, specificità della finalità, limitazione della conservazione, ecc., non sono misurabili. E, quindi, il NIST va alla ricerca di obiettivi di privacy che possano essere misurabili e che possano assicurare, fin dalla progettazione, un’efficace applicazione dei principi della privacy.

Gli obiettivi di privacy, definiti nel PERM e ripresi dal Framework, costituiscono gli elementi i cui indicatori quantitativi devono essere posti a base della progettazione dei processi di trattamento e dei sistemi di supporto. Per due motivi essenziali:

  • per definire parametri che possano diventare pratiche comuni in contesti differenti;
  • per garantire l’accountability misurando i progressi nel tempo.

Per queste ragioni, il NIST stabilisce tre obiettivi di privacy:

  • prevedibilità (predictability) ovvero l’obiettivo di misurare, sin dalla progettazione, l’uso che viene fatto del dato personale; è possibile misurare questo obiettivo in vari modi: numero di moduli software che richiamano il dato personale, numero di moduli software che (direttamente o indirettamente) espongono il dato personale a estrazioni massive, ecc.;
  • gestibilità (manageability) ovvero l’obiettivo di calibrare la granularità di gestione del dato personale rispetto a tutte le fasi del trattamento anche per rendere effettiva la possibilità dell’interessato (cioè della persona alla quale i dati si riferiscono) di scegliere, nel tempo, i dati per i quali permettere il trattamento; questo obiettivo può essere misurato, per esempio, attraverso l’inverso del numero di data set in cui ogni attributo personale (nome, cognome, indirizzo email, post ricevuti, post inviati, ecc.) è contenuto. Più è basso questo rapporto meno gestibile sarà il singolo attributo;
  • disassociabilità (disassociability) ovvero l’obiettivo di rendere difficile, se non impossibile, l’associazione dei dati al singolo soggetto; anche in questo caso, è possibile misurare l’obiettivo, per esempio, attraverso il rapporto tra numero di data set crittografati e numero totale di data set.

I dettagli del framework

Inoltre il pragmatismo statunitense completa il suo percorso, all’interno della proposta di Framework, nella definizione di una serie di funzioni che devono essere presidiate per garantire un approccio ingegneristico alla privacy. Ogni funzione, tra l’altro, è specificata in categorie di interventi molto dettagliati che rispondono a specifiche azioni da condurre.

Le funzioni sono cinque, riepilogate attraverso verbi coniugati all’infinito: identificare, proteggere, controllare, informare e rispondere.

Prima di scendere nel dettaglio delle singole funzioni appare significativo che la funzione di informare sia preceduta, logicamente e forse anche cronologicamente, dalle funzioni identificare, proteggere, controllare. Significa che per poter informare correttamente l’interessato è opportuno aver svolto preventivamente le attività di analisi del processo di trattamento dei dati personali e di aver messo in campo i presidi del rischio scaturiti dall’analisi. Non possiamo nascondere che in Italia, nella maggior parte dei casi, i consulenti privacy partono, invece, dalla produzione delle informative per adempiere agli articoli 13 e 14 del GDPR.

La funzione di identificazione parte dall’inventariazione dei processi di trattamento, e dei rispettivi strumenti di supporto, per concludersi con la valutazione del rischio, comprendendo i rischi connessi alla catena del valore intesa come l’insieme dei legami che ogni organizzazione ha con il mondo esterno.

La funzione di protezione è quella nella quale vengono definite le misure di riduzione del rischio, in termini tecnici e organizzativi. È opportuno che quest’ultimo aspetto sia approfondito compiutamente: non si tratta solo di definire puntualmente i singoli processi di trattamento dei dati personali (p.e. il modo nel quale le analisi cliniche dei lavoratori debbano essere fatte pervenire dal laboratorio che le effettua al medico competente); si tratta di definire anche i processi che, apparentemente, possono non essere strettamente connessi ai dati personali (p.e. l’uso di appositi distruggi‑documenti da installare presso le stampanti di rete multifunzione per evitare la dispersione di dati contenuti nelle stampe malriuscite).

La funzione di controllo serve a definire le modalità con le quali si tengono costantemente aggiornate le misure di riduzione del rischio oltre che gli stessi dati personali. In questo ambito, per esempio, rientrano le attività di controllo di qualità dei dati personali che possono basarsi sulle diverse strategie disponibili: confronto con le controparti (ovvero con gli interessati), database bashing, ecc.

La funzione di informazione è la tipica funzione che assicura il principio di trasparenza e si basa sulla definizione, anche in co‑ideazione e co‑progettazione con gli interessati, degli elementi che consentono alla platea dei soggetti di cui si trattano dati personali di averne un controllo effettivo.

La funzione di risposta determina i processi di reazione a eventi sfavorevoli che possono, nel peggiore dei casi, culminare in un data breach ovvero in conseguenze che, per riprendere la definizione statunitense, “creano problemi per gli individui con conseguenze inaccettabili” (nel GDPR si parla di “rischio elevato per i diritti e le libertà delle persone fisiche”).

Conclusioni

Siamo di fronte, quindi, a un’elaborazione di metodologie e strumenti che, seppur nati in un contesto molto diverso da quello europeo, possono offrire molti spunti di riflessione nei percorsi di compliance che le organizzazioni del Vecchio Continente stanno faticosamente articolando.

Note

[1] https://www.nist.gov/

[2] https://www.nist.gov/privacy-framework/working-drafts

[3] https://www.nist.gov/publications/introduction-privacy-engineering-and-risk-management-federal-information-systems

[4] https://edpb.europa.eu/sites/edpb/files/files/file1/20190122edpb_2ndprivacyshieldreviewreport_final_en.pdf

Articolo a cura di Francesco Maldera

Francesco Maldera è Data Protection Officer e Data Scientist.

Il suo percorso professionale lo ha chiamato a responsabilità direzionali nell’ambito dei sistemi informativi, della safety&security, della privacy e dell’auditing svolgendo diversi incarichi dirigenziali nella Pubblica Amministrazione e in aziende private.

Attualmente, accompagna l’attività consulenziale a quella di sensibilizzazione delle persone tramite il sito www.prontoprivacy.it

Download PDF

https://www.ictsecuritymagazine.com/articoli/la-privacy-oltreoceano/


Gli Spyware: cosa sono e come difendersi

Una storia molto istruttiva: “The Million Dollar Dissident”

Per introdurre gli spyware e per comprenderne meglio l’importanza e la pericolosità, cominciamo raccontando una vicenda accaduta nel 2016: l’incredibile storia di Ahmed Mansoor, il “dissidente da 1 milione di dollari”, preso di mira dai software spia di tre diverse società.

Ahmed Mansoor è un ingegnere e blogger degli Emirati Arabi Uniti, noto difensore dei diritti umani, critico verso le politiche del governo degli Emirati. Per questo è stato perseguitato dal suo paese e arrestato per alcuni mesi nel 2011, malgrado avesse ricevuto da Amnesty International un premio come difensore dei diritti umani.
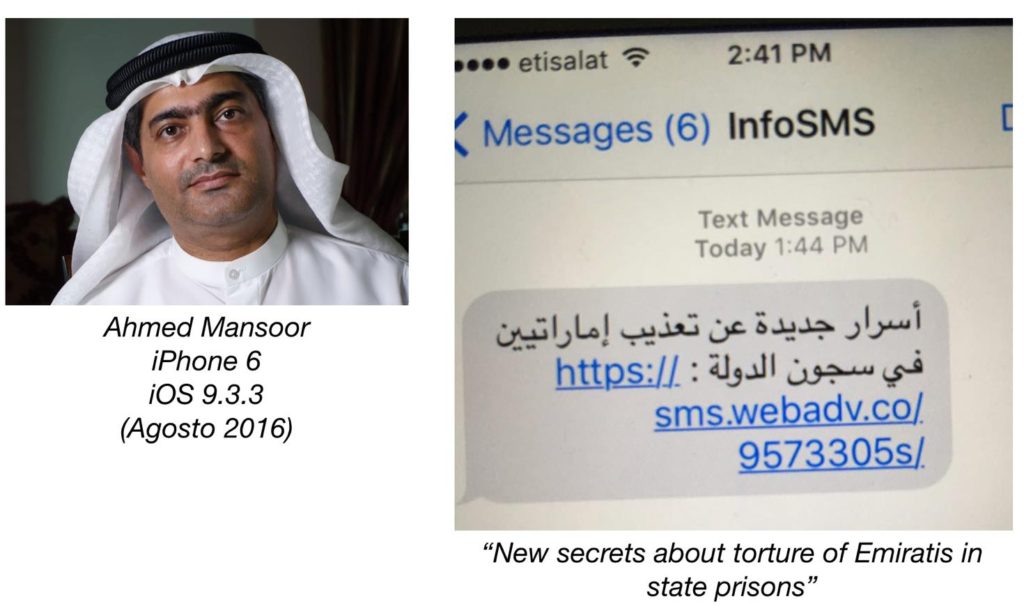
Il 10 e 11 agosto 2016 Mansoor riceve sul suo iPhone 6 due SMS (vedi figura) che promettono rivelazioni sulle torture nelle carceri degli Emirati. Gli SMS contengono un link. Anche stavolta si punta sul social engineering per convincere la vittima ad abboccare al phishing. Ma Mansoor, sapendo di essere nel mirino, si insospettisce e invia gli SMS a Citizen Lab[1], un laboratorio di cybersecurity dell’università di Toronto. Qui i messaggi vengono analizzati – in collaborazione con un’altra società di cybersicurezza, Lookout Security[2] – scoprendo che il link avrebbe attivato “Pegasus”: un micidiale malware per iOS che sfruttava tre gravi vulnerabilità zero-day (Trident iOS Exploit Chain).

I ricercatori hanno quindi avvisato Apple, che si è mossa velocemente e ha chiuso le tre vulnerabilità con un importante e urgente aggiornamento di sicurezza iOS 9.3.5, rilasciato a fine agosto 2016. Vulnerabilità come queste sul mercato degli attacchi informatici erano valutate intorno a 1÷1,5 milioni di dollari.

Il malware Pegasus (realizzato dagli israeliani di NSO Group, che lo commercializza a Stati e polizie a prezzi di centinaia di migliaia di dollari) era uno SPYWARE: un software malevolo, in grado di violare un iPhone da remoto, senza che su questo fosse stato fatto precedentemente un jailbreak. Lo scopo dello spyware è sorvegliare l’attività della vittima, dalle telefonate, a WhatsApp e SMS, alle chat, dall’uso silente del microfono e della videocamera del dispositivo alla sua geolocalizzazione.

Il coinvolgimento di NSO Group che venderebbe solo a Stati e il tipo di vittima fanno concludere ai ricercatori di Citizen Lab che dietro l’azione ci possa essere il governo degli Emirati Arabi Uniti.

Anche perché Mansoor aveva già subito in precedenza altri due attacchi analoghi, portati da società simili a NSO Group: nel 2011 da FinFisher e nel 2012 dall’italiana Hacking Team.

Lo spyware italiano: il caso Exodus

Se la vicenda di Mansoor rappresenta un caso di spyware mirato, di alto livello e con finalità politiche, dobbiamo essere consapevoli che gli spyware possono colpire anche le persone comuni.

Nello scorso mese di aprile è apparsa la notizia di circa 25 applicazioni[3] presenti nel Play Store di Google (per Android) infettate da uno spyware chiamato “Exodus”, che sarebbe finito negli smartphone di diverse centinaia di cittadini italiani, forse un migliaio, che non avevano nulla a che fare con inchieste e procedimenti penali.

Nel tentativo di indurre le potenziali vittime a installarle con l’inganno, le applicazioni contenenti lo spyware erano progettate per assomigliare a innocue app per ricevere promozioni e offerte di marketing da operatori telefonici italiani, o per migliorare le performance del dispositivo.

Le applicazioni sarebbero state sviluppate da una società italiana chiamata eSurv, di Catanzaro, che opera principalmente nel settore della videosorveglianza e che sembra essere fornitrice di questi prodotti anche alla Polizia di Stato italiana.

La scoperta dello spyware è stata fatta dai ricercatori di Security Without Borders[4], un’organizzazione non-profit che investiga sulle minacce contro i dissidenti e attivisti per i diritti umani, e dall’azienda di sicurezza ESET.

Questi ricercatori hanno scoperto che il malware Exodus scaricava un file ZIP per installare il vero malware, in grado di hackerare lo smartphone e di rubarne i dati.

Ottenendo in questo modo il controllo del dispositivo, il malware ha accesso ai dati più sensibili presenti sul telefono infettato, quali le chiamate telefoniche, la cronologia dei browser, le informazioni del calendario, la geolocalizzazione, i log di Facebook Messenger, le chat di WhatsApp e i messaggi. Inoltre era anche in grado di fare eseguire dei comandi al telefono spiato grazie a una shell e a una porta dati che veniva aperta (una cosiddetta “backdoor”).

Non è ancora chiaro quali siano i motivi per i quali queste applicazioni infette siano state diffuse tra comuni cittadini: la Procura di Napoli ha avviato un’indagine “finalizzata all’accertamento di gravi reati collegati alla gestione di software utilizzati per l’intercettazione di comunicazioni telematiche con captatore informatico”. Nell’ambito dell’inchiesta la Procura di Napoli ha iscritto nel registro degli indagati quattro persone. Il Gip ha adottato lo scorso 20 febbraio il decreto di sequestro preventivo dell’infrastruttura delle aziende di E-Surv, ideatrice delle applicazioni, e Stm, che si occupava della commercializzazione.

Cosa ci insegnano queste due vicende, diverse eppure con alcune similitudini?

  • Gli Spyware possono essere molto pericolosi, anche se in genere – ma non solo – colpiscono obbiettivi mirati;
  • qualsiasi smartphone, anche un iPhone (nonostante sia ritenuto più sicuro) può essere vulnerabile, soprattutto se non viene mantenuto aggiornato;
  • da un messaggio (SMS o WhatsApp che sia) possono arrivare minacce importanti;
  • questi malware possono essere introdotti anche attraverso applicazioni che nascondono al loro interno lo spyware;
  • come sempre il fattore umano fa la differenza: se Mansoor fosse stato meno attento (o meno consapevole dei rischi) l’attacco avrebbe avuto successo e per lui sarebbero stati grossi guai.

Cosa sono gli Spyware

Oggi i nostri smartphone contengono tante informazioni e vengono usati in modo continuo, quindi per il cybercrime (ma non solo!) può essere più utile spiare il dispositivo piuttosto che rubarlo. Questo può essere realizzato utilizzando un particolare tipo di malware che, come abbiamo spiegato, viene definito “Spyware”.

Lo spyware è un’applicazione di monitoraggio (spionaggio) che viene introdotta in uno smartphone all’insaputa del proprietario. Può essere installata:

1) con accesso diretto al dispositivo. Per questo motivo è importante fare sempre attenzione a non lasciare lo smartphone incustodito senza un codice di blocco. Vedremo successivamente come questi software malevoli siano facilmente reperibili sul mercato e anche una persona non particolarmente esperta potrebbe installarlo nello smartphone di un altro (magari un collega o un familiare…);

2) da remoto: le tecniche per riuscire a installare l’applicazione (con tutti i permessi necessari) passano ancora una volta attraverso il phishing, il social engineering e la navigazione Web (le modalità d’intrusione sono sempre le stesse). Questo è il caso accaduto ad Ahmed Mansoor. Oppure possono essere nascosti all’interno di applicazioni o giochi gratuiti, come nella citata vicenda di Exodus.

Una volta installato, lo spyware può inviare all’esterno i dati contenuti nello smartphone – telefonate, messaggi, e-mail, foto – e attivare funzioni all’insaputa dell’utente, come fotocamera e microfono.

Il mondo degli spyware è molto variegato: si va da quelli “artigianali” reperibili nel web a poco prezzo, fino a prodotti altamente sofisticati, realizzati da aziende specializzate (come NSO Group), che li vendono alle polizie e agli enti governativi.

Un rapporto pubblicato dal già citato Citizen Lab ha rivelato che lo spyware Pegasus di NSO Group è stato utilizzato contro obiettivi in 45 Paesi del mondo.

Pegasus (utilizzato contro Mansoor) è – come detto – un malware di spionaggio che può infettare sia gli iPhone che i dispositivi Android ed è – o dovrebbe essere – venduto esclusivamente ai governi e alle forze dell’ordine.

Citizen Lab ha rilevato che lo spyware NSO è stato utilizzato in attacchi contro 175 obiettivi in tutto il mondo. Questi attacchi si sono realizzati soprattutto contro individui in Qatar o in Arabia Saudita, dove il software di sorveglianza israeliano sta diventando molto popolare, con evidenti e serie implicazioni sui diritti umani delle persone. Si sospetta che fosse presente anche nell’iPhone del giornalista saudita Jamal Khashoggi, ucciso lo scorso ottobre nel consolato dell’Arabia Saudita a Istanbul.

Quando questi programmi vengono impiegati dalle polizie a scopo di spionaggio, si parla di “captatori informatici”, utilizzati a fine di indagine per l’intercettazione di comunicazioni o conversazioni in dispositivi elettronici portatili.

Questi strumenti, per quanto utili a fini investigativi, rischiano, se utilizzati in assenza delle necessarie garanzie, di determinare inaccettabili violazioni della libertà dei cittadini, fino ad arrivare a scenari da “sorveglianza di massa” e, conseguentemente, a potenziali indebite pratiche di spionaggio.

Su questo delicato tema è stato approvato a fine 2017 un decreto che tratta le disposizioni in materia di intercettazioni (D.Lgs. 29 dicembre 2017, n.216[3], c.d. Decreto Orlando, dal nome dell’allora ministro della Giustizia) allo scopo di regolamentarne l’utilizzo e impedire gli abusi.

Il governo Conte ha successivamente disposto la proroga, dal 26 luglio 2018 al 31 marzo 2019, dell’entrata in vigore del D.lgs n. 216.

Non esistono solo prodotti di alto livello, come quelli venduti (a centinaia di migliaia di dollari!) da NSO Group. Come ho scritto, si possono trovare nel web degli spyware meno raffinati e a buon mercato. Non occorre cercarli nel Darkweb, perché sono distribuiti come applicazioni “legali” (0 che vorrebbero far credere di esserlo).

Molte di queste applicazioni vengono vendute infatti con lo scopo ufficiale e dichiarato di “controllare lo smartphone dei propri figli”. In realtà si tratta di programmi la cui installazione nel dispositivo di un terzo (senza la sua autorizzazione) rappresenta un vero e proprio reato.

Ne cito qui alcuni (senza riportare i link dove trovarli), che tutti possono acquistare e utilizzare per spiare qualcun altro (la moglie, il marito, il collega, ecc.):

SpyFone: commercializzato come “the world’s number one parental monitoring software”. L’azienda californiana che lo vende dichiara che ci vogliono appena 15 minuti per installare lo spyware sul dispositivo di destinazione e non vi è alcuna indicazione, per coloro che vengono spiati, che “qualcosa non vada” nei loro telefoni. Spyfone è in grado di monitorare l’attività degli smartphone, compresi i messaggi SMS inviati, registrare le chiamate e le informazioni provenienti da applicazioni come Skype e Whatsapp. Alcuni ricercatori hanno scoperto che SpyFone, oltre a compiere un’attività illegale, lascia i dati e le registrazioni esposte online, a causa di errori di configurazione dell’applicazione e delle API.

mSpy: è uno dei prodotti più noti, per iPhone e Android. Anche in questo caso il disclaimer dell’applicazione recita: “mSpy è progettato per monitorare i vostri figli, dipendenti o altri su uno smartphone o un dispositivo mobile di vostra proprietà o che avete il consenso a monitorare. L’utente è tenuto a notificare agli utenti del dispositivo che sono stati monitorati”. Ma anche per mSpy le finalità reali sono ben altre e ovviamente illegali. L’accesso fisico diretto al dispositivo è necessario per installare mSpy (in circa 20 minuti). Ma – come successo per SpyFone – anche i dati spiati da mSpy sono stati violati ed esposti al pubblico dominio.

La violazione è stata segnalata dall’esperto di cyber sicurezza Brian Krebs che ha scoperto milioni di record sensibili pubblicati online, “tra cui password, registri delle chiamate, messaggi di testo, contatti, note e dati di localizzazione raccolti in segreto da telefoni che eseguono lo spyware”.

Altri spyware facilmente reperibili in rete e di dubbia reputazione sono: Retina-X, FlexiSpy, Mobistealth, Spy Master Pro, SpyHuma, TheTruthSpy, Family Orbit, Copy9, Xnore.

Sembra incredibile, ma quasi tutte queste aziende che promettono di fornire servizi per i genitori per mantenere i figli al sicuro, monitorare i dipendenti, o spiare i coniugi, sono state violate negli ultimi due anni o hanno lasciato i dati esposti online.

Un motivo in più per non avere la tentazione di utilizzarle… oltre ai reati nei quali si incorrerebbe.

I sintomi degli Spyware

Non è facile capire se uno smartphone sia stato infettato da uno spyware.

Per i prodotti più sofisticati (come quelli realizzati da NSO Group), potrebbe non bastare neppure il reset del telefono alle condizioni di fabbrica, perché sono progettati per non essere visibili sullo smartphone della vittima e – nei casi più evoluti – per annidarsi nel Bootloader (il software che, all’accensione del dispositivo, ha l’incarico di caricare il sistema operativo installato).

Quelli meno evoluti (precedentemente elencati), pur riuscendo a non essere visibili, possono in genere essere eliminati con un reset del dispositivo. In altri casi – se si sospetta uno spyware – potrebbe essere necessario far esaminare il dispositivo da aziende specializzate, ma in questa eventualità i costi sono paragonabili a quelli per acquistare un nuovo smartphone…

Comunque l’esistenza dello spyware può essere quantomeno sospettata in presenza di sintomi quali:

  • riduzione della durata della batteria: lo spyware è sempre attivo e consuma batteria anche se noi non stiamo usando il telefono;
  • aumento anomalo del traffico dati: lo spyware deve inviare all’esterno i dati raccolti;
  • conseguente aumento dei costi non motivato;
  • prestazioni rallentate e più in generale comportamento anomalo del cellulare.

Le buone regole difendersi dagli spyware sui dispositivi mobile

Come detto gli spyware vengono sempre utilizzati contro obbiettivi mirati: un avversario politico, ma anche un concorrente, un collega o – molto spesso – un coniuge.

Riassumiamo qui le “best practices” per difendersi dagli spyware, che come sempre riguardano il fattore umano (che è più che mai l’anello debole nella catena della sicurezza):

  1. installare applicazioni scaricate solo da fonti attendibili, quali Google Play Store (anche se il controllo su questo store si è rivelato spesso debole), Apple App Store. Evitare (per Android) le applicazioni provenienti da repository di dubbia reputazione. Controllare feedback e recensioni degli utenti. Non fidarsi di link presenti in e-mail o sms che ci consigliano di installare un’applicazione;
  2. non cliccare su link o allegati in e-mail o messaggi testuali (il caso di Ahmed Mansoor insegna);
  3. mantenere il sistema operativo sempre aggiornato. Gli aggiornamenti sono finalizzati a risolvere le vulnerabilità presenti nel sistema operativo: uno smartphone aggiornato risulterà quindi meno attaccabile dai malware;
  4. proteggere i dispositivi con una password forte. Impostare una password sicura (consiglio che non sia di sole quattro cifre numeriche, ma alfanumerica e di almeno otto caratteri) è diventata una necessità, per evitare che qualcuno possa accedere al nostro smartphone, spiarlo e soprattutto installarvi un’applicazione malevola. Purtroppo, ancora oggi molte persone – per pigrizia e disattenzione – non impostano una password di blocco, sebbene l’utilizzo dei sistemi biometrici (touch-ID, Face-ID) renda questa opzione estremamente comoda: la password di sblocco dovrà essere digitata solo raramente, per esempio all’accensione dello smartphone.

Bibliografia

Giorgio Sbaraglia, “Cybersecurity kit di sopravvivenza. Il web è un luogo pericoloso. Dobbiamo difenderci!”, GoWare, 2018.

Note

[1] https://citizenlab.ca/2016/08/million-dollar-dissident-iphone-zero-day-nso-group-uae/.

[2] https://blog.lookout.com/trident-pegasus.

[3] https://www.dday.it/redazione/30379/exodus-indagata-esurv-spyware-play-store.

[4] https://securitywithoutborders.org/blog.html.

[5] https://www.agendadigitale.eu/sicurezza/intercettazioni-con-captatori-informatici-trojan-tutto-cio-che-bisogna-sapere/.

Articolo a cura di Giorgio Sbaraglia

Giorgio Sbaraglia, ingegnere, è Information & Cyber Security Advisor e svolge attività di consulenza e formazione per la sicurezza informatica, Risk Management e per il GDPR.

Tiene corsi su questi temi per molte importanti società italiane di formazione, tra le quali la Business School de Il Sole 24 Ore.

È membro del CLUSIT (Associazione Italiana per la Sicurezza Informatica) e certificato “Innovation Manager” da RINA.

Ricopre l’incarico di DPO (Data Protection Officer) per alcune aziende italiane.

È autore dei libri:

“GDPR kit di sopravvivenza” (Editore GoWare) e “Cybersecurity kit di sopravvivenza. Il web è un luogo pericoloso. Dobbiamo difenderci!” (Editore GoWare)

www.giorgiosbaraglia.it

Download PDF

https://www.ictsecuritymagazine.com/articoli/gli-spyware-cosa-sono-e-come-difendersi/


Domain Name System (DNS) e Security Extensions (DNSSEC): alcuni aspetti di Privacy e Sicurezza – Parte 2

Nella prima parte di questo articolo è stato descritto brevemente il protocollo DNS e sono state indicate le principali debolezze di sicurezza che lo affliggono. In questa seconda parte dell’articolo presenteremo il protocollo DNSSEC, che si propone di risolvere buona parte di queste debolezze.

DNS Security Extensions (DNSSEC)

Il processo di studio, implementazione e valutazione di una nuova versione del protocollo DNS che garantisca autenticità e integrità dei dati è incominciato almeno 20 anni fa e non si è ancora concluso. Già solo questo intervallo temporale indica la difficoltà di introdurre delle nuove misure di sicurezza nel protocollo senza stravolgerlo e garantendo l’interoperabilità con quanto in essere.

Vi sono state molte proposte diverse, ma quella ad uno stadio avanzato di implementazione si chiama DNSSEC. L’idea di base è molto semplice: firmare digitalmente tutti i record DNS. L’implementazione si è mostrata invece molto ardua. La seguente è una descrizione a livello molto alto del protocollo (per i dettagli, si vedano tra gli altri gli RFC 4033, 4034, 4035).

Scopo principale di DNSSEC è quello di apporre una firma digitale all’insieme di dati detto Resource Record Set (RRSet) che forniscono la risoluzione di nome nei relativi indirizzi IP con i parametri associati. Quindi nel server DNS d’autorità per un certo nome a dominio, oltre ai dati DNS, ovvero il RRSet, sono presenti anche un record RRSIG che contiene la firma digitale sul RRSet, e un record di tipo DNSKEY che contiene la chiave pubblica necessaria per la verifica della firma digitale RRSIG e corrispondente alla chiave privata utilizzata per creare la firma digitale. Queste coppie di chiavi pubbliche-private sono chiamate Zone Signing Key pair (ZSK). Si noti che una DNSKEY che contiene la chiave pubblica di una ZSK è identificata dal flag 256.

Ovviamente la firma digitale è effettuata in un ambiente sicuro, tipicamente off-line e la chiave privata di firma è, ove possibile, tenuta in un modulo hardware apposito.

Con la firma digitale sui RRSet viene assicurata l’integrità dei dati, ma per il momento non è risolto il problema dell’autenticità perché un attaccante potrebbe sostituire la tripletta RRSet, RRSIG(RRSet) e DNSKEY(ZSK) con i propri dati, ad esempio tramite attacchi di tipo “DNS spoofing” e “cache poisoning” descritti precedentemente.

Il problema è, quindi, garantire l’autenticità delle chiavi ZSK, ovvero che queste siano proprio quelle create e gestite dal titolare del dominio DNS sul server DNS d’autorità.

Si potrebbe pensare di introdurre un repository centrale per queste chiavi alla PGP, oppure adottare l’approccio delle Certification Authorities come per i certificati utilizzati per i siti web. Questi e altri approcci simili, però, avrebbero notevoli conseguenze sul protocollo DNS originario e non sarebbero facilmente integrabili in esso.

DNSSEC, invece, segue l’approccio del protocollo DNS originario che, come descritto precedentemente, è basato sulla presenza dei 13 root server di cui sono noti pubblicamente a priori gli indirizzi IP, e della catena di fiducia (trust) a partire da questi. Vi sono quindi due punti da risolvere: come gestire l’origine dell’albero delle firme digitali e come passare da un ramo al successivo mantenendo la fiducia. DNSSEC risolve questi punti introducendo un nuovo tipo di chiavi[1] chiamate Key Signing Key (KSK), la cui parte pubblica è disponibile sempre in record di tipo DNSKEY. Si noti che le KSK sono chiavi “self-signed” e che una DNSKEY che contiene la chiave pubblica di una KSK è identificata dal flag 257.

Tutto l’albero di fiducia è attestato su di una chiave, la KSK(ROOT), si veda la Fig. 5.

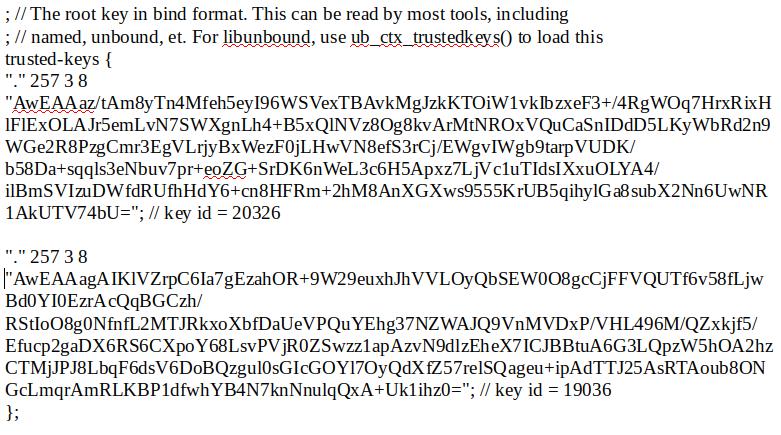
Fig. 5 La chiave pubblica KSK(ROOT) all’origine dell’albero di autenticità DNSSEC

In realtà in Fig. 5 sono presenti due chiavi ma, come indicato in https://data.iana.org/root-anchors/root-anchors.xml, la chiave con id=19036 è scaduta il 2019-01-11 e rimane solo per retro compatibilità.

Questo ci porta ad affrontare le modalità di gestione delle chiavi KSK(ROOT). Vista l’enorme importanza di questa chiave, la procedura di creazione e la sua gestione sono soggette a misure di sicurezza estremamente complesse ed estese. Ad esempio la procedura di creazione della chiave KSK(ROOT) include una cerimonia con la presenza fisica di autorità delegate a questo e la produzione di evidenze conservate fisicamente in luoghi separati, si veda https://www.iana.org/dnssec/files per ulteriori informazioni. La chiave KSK(ROOT) è usata raramente e la procedura di sostituzione è lunga e complessa, anche perché questa chiave deve essere distribuita manualmente a tutti i server e resolver DNS, insieme agli indirizzi IP dei 13 root server. Inoltre si deve tenere conto dei TTL che indicano i tempi di permanenza dei dati nelle cache DNS in tutto il mondo. Pertanto la chiave KSK(ROOT) deve durare a lungo: la prima chiave è stata introdotta nel 2010 e, come visto, sostituita solo all’inizio del 2019 dalla seconda chiave che è stata generata nel 2016 (si veda ancora https://www.iana.org/dnssec/files).

La chiave KSK(ROOT) viene utilizzata solo per firmare le chiavi ZSK dei root server, generate e sostituite più frequentemente e utilizzate per firmare gli RRSet presenti nei 13 (identici) root server. Per verificare l’autenticità delle ZSK, bisogna scaricare da un root server la ZSK e la RRSIG(ZSK) – ovvero la chiave pubblica ZSK e la sua firma digitale RRSIG – e verificare la firma digitale RRSIG con la chiave pubblica KSK(ROOT) ottenuta direttamente da fonte fidata.

Ogni autorità DNS genera le proprie chiavi KSK con le quali firma unicamente le proprie chiavi ZKS. Inoltre ogni autorità DNS genera un figerprint (o “hash”) della propria chiave pubblica KSK e la invia in un record chiamato Delegation Signer (DS) alla zona genitore (ovvero il ramo dell’albero superiore) in modo che questa sia associata agli indirizzi IP e agli altri dati dei propri server DNS, e ovviamente sia firmata con la ZSK della zona genitore.

La procedura è sicuramente complessa e rispetto al protocollo originale DNS richiede molti più passaggi, molti più dati e molte più risorse computazionali. Ma DNSSEC è in grado di garantire sia l’integrità che l’autenticità della risoluzione DNS a un costo, ad oggi, sicuramente affrontabile.

Per descrivere ad alto livello come tutto questo funzioni, utilizziamo come esempio di risoluzione il nome a dominio di prova DNSSEC sigok.verteiltesysteme.net:

  1. il punto di partenza del nostro resolver DNSSEC è la conoscenza dei 13 indirizzi IP dei root server e della chiave pubblica KSK(ROOT);
  2. la prima richiesta a un root server è di fornire la ZSK e la sua RRSIG;
  3. utilizzando KSK(ROOT) il resolver verifica la firma RRSIG sulla ZSK; ora la ZSK è integra e autentica;
  4. il resolver chiede al server root di risolvere sigok.verteiltesysteme.net, il server root risponde di non conoscere la risoluzione ma invia i dati del server DNS della zona .net in un RRSet firmato con la ZSK;
  5. il resolver verifica la firma della ZSK sul RRSet che quindi è integro e autentico; si noti che all’interno del RRSet c’è la fingerprint della KSK della zona .net (record DS);
  6. il resolver si collega al server DNS della zona .net indicato dal server root e richiede la chiave pubblica KSK della zona, la chiave ZSK e la firma RRSIG;
  7. il resolver verifica che la fingerprint della chiave KSK sia identica a quella presente nel RRSet ricevuto dal root server; ora la chiave KSK della zona .net è integra e autentica;
  8. Con la chiave KSK della zona .net, il revolver verifica la firma RRSIG della chiave ZSK; ora la ZSK della zona .net è integra e autentica;
  9. il processo continua ripetendo i passaggi da 4 a 8 con i server DNS delle zone delegate scendendo nell’albero DNS sino a che un server risponde inviando un RRSet contente gli indirizzi IP e gli altri dati di sigok.verteiltesysteme.net; a questo punto il resolver verifica con la chiave pubblica dell’ultima ZSK la firma su questo RRSet e si conclude la risoluzione DNSSEC.

Alcuni tool online, quale ad esempio https://www.dnslookup.org/, permettono di visualizzare i principali passaggi di questa procedura e in particolare la verifica delle firme digitali sugli RRSet e  sulle DNSKEY.

Un’ultima osservazione sulle chiavi KSK e ZSK: a differenza degli altri dati delle zone la cui validità temporale è soggetta a un TTL ovvero un intervallo di tempo relativo, queste sono valide sino a una data assoluta. Quindi ogni server e resolver DNS deve avere un orologio allineato all’ora esatta. Prima di DNSSEC questo non era un requisito essenziale: ora lo diviene e apre la possibilità, anche se remota, di attacchi basati sulla retro-datazione dell’ora nei server DNS.

DNSSEC e la cache

Come indicato precedentemente, l’efficienza della risoluzione DNS è basata sull’uso delle cache e dei resolver ricorsivi. Anche i dati DNSSEC possono essere mantenuti in cache secondo le logiche dei TTL. I resolver ricorsivi DNSSEC inviano le loro richieste con il flag “DNSSEC OK” (DO) attivo, il che richiede che il server DNS risponda con tutti i dati DNSSEC, o informando il resolver che DNSSEC non è disponibile per le informazioni richieste. Si noti che il flag “DO” fa parte delle estensioni EDNS, in ogni caso necessarie per poter gestire tutti i dati DNSSEC.

Ovviamente la cache di un resolver ricorsivo DNSSEC è molto più grande della corrispondente cache DNS originale, in quanto devono essere gestite anche tutte le firme e le chiavi pubbliche necessarie per la loro verifica.

Si noti anche la completa interoperabilità di DNSSEC con DNS, in quanto se un server DNS risponde negativamente alla richiesta del flag “DO”, la risoluzione procede esattamente come prima. Altrimenti i dati DNSSEC sono dati in più rispetto al protocollo originale.

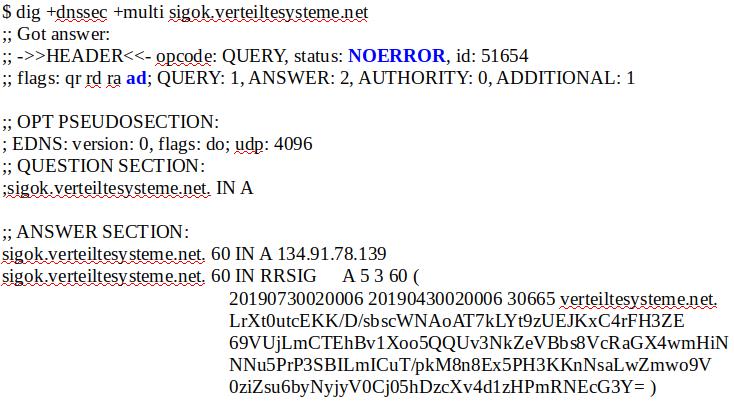
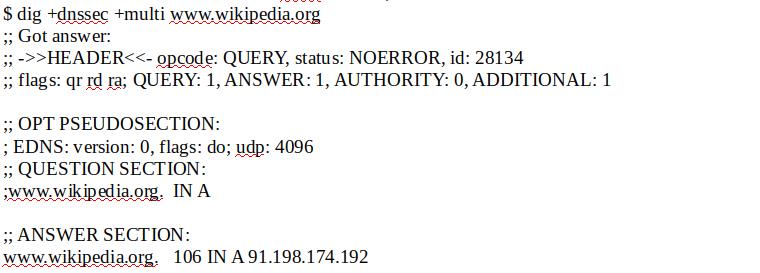
Più complessa è la situazione degli stub resolver, ovvero dei resolver presenti sui dispositivi client. Uno stub resolver potrebbe verificare indipendentemente tutte le firme digitali e tutti i dati che riceve, ma questo imporrebbe sia un elevato carico di lavoro sui client che un enorme carico sui server DNS, particolare sui server root e TLD. La configurazione tipica di un stub resolver è invece quella di essere “non validating”. In questo caso lo stub resolver si fida della risoluzione e delle verifiche fatte dal resolver ricorsivo a cui si connette. Se il resolver ricorsivo risponde con il flag Authenticated Data (AD) vuol dire che DNSSEC è valido e la risoluzione è integra e autentica, si veda la Fig. 6.

Fig. 6 Esempio di risoluzione DNSSEC valida

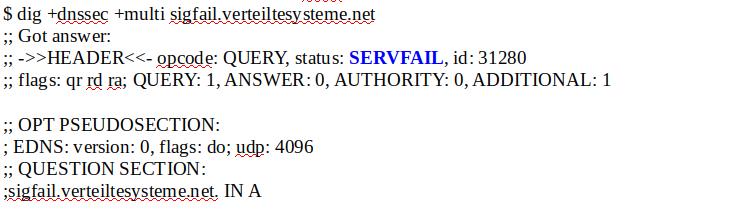
Se invece il processo di verifica delle firme digitali fallisce, la risoluzione non va a buon fine (l’indirizzo IP, in questo caso 134.91.78.139, non viene fornito anche se presente nei dati ricevuti dal server DNS) e viene riportato un messaggio di errore con codice SERVFAIL e senza il flag AD, come in Fig. 7.

Fig. 7 Esempio di risoluzione DNSSEC con errore di verifica delle firme digitali

Nel caso invece la zona DNS non sia gestita con DNSSEC, il processo di validazione DNSSEC si interrompe quando non viene trovato un record DS che permette di scendere nell’albero di risoluzione e si prosegue con il processo DNS originario come in Fig. 8.

Fig. 8 risoluzione DNS in zone senza DNSSEC

Infine, un problema di non semplice soluzione riguarda la dimostrabilità dell’assenza di un nome a dominio. In questo caso il protocollo DNS originale fornisce una risposta vuota, ma questa è facilmente gestibile da parte di un attaccante che può rimuovere tutti i dati presenti in cache od in transito verso un resolver. DNSSEC fornisce invece una risposta autentica che dimostra l’assenza di un nome a dominio utilizzando i record detti Next Secure Record (NSEC o NSEC3). NSEC3 fornisce la prova che, nella lista ordinata di nomi del dominio, non vi sia quello richiesto, utilizzando tecniche crittografiche di Hash in modo da non permettere la numerazione dei domini presenti. La risposta DNSSEC alla richiesta di risoluzione di un nome non esistente genera un errore NXDOMAIN e riporta i record NSEC3 firmati, come in Fig. 9.

Fig. 9 esempio di risposta NXDOMAIN NSEC3 alla richiesta di risoluzione di un dominio inesistente in DNSSEC

Usare oggi DNSSEC

L’utilizzo di DNSSEC è ancora molto limitato. Solamente i livelli superiori dell’albero DNS hanno adottato consistentemente DNSSEC, mentre l’adozione per i nomi completi che usiamo tutti i giorni è ancora molto “a macchia di leopardo”. Ad esempio registro.it riporta che ad aprile 2019, su un totale di 1.225 Registrar accreditati per registrare nomi a dominio nella zona .it, solo 19 permettono di registrare zone con DNSSEC. Inoltre, https://stats.dnssec-tools.org/ mostra che ai primi di maggio 2019 nella zona .it sono presenti solo circa 4.400 nomi a dominio DNSSEC su un totale di circa 3.200.000.

Questo vuol anche dire che molti dei resolver DNS ricorsivi che utilizziamo ogni giorno non hanno ancora implementato DNSSEC.

In realtà non è molto complesso adottare un resolver locale DNSSEC. I punti principali da considerare sono tre:

  1. identificare un resolver ricorsivo DNSSEC di fiducia soprattutto per quanto riguarda gli aspetti di Privacy discussi precedentemente;
  2. configurare una connessione sicura tra il proprio stub resolver ed il resolver ricorsivo DNSSEC (questo sia per motivi di privacy che per impedire attacchi ai dati trasmessi visto che lo stub resolver tipicamente è “non validating”);
  3. utilizzare localmente uno stub resolver DNSSEC.

Per la sicurezza della connessione dello stub resolver al resolver ricorsivo è stato introdotto il protocollo DNS-over-TLS (RFC 7858) che permette di trasportare il protocollo DNS all’interno di un canale cifrato con TLS sulla porta TCP/853. Oppure è possibile adottare “DNS queries over HTTPS” (DoH, RFC 8484) a cui si è già accennato precedentemente, o infine DNSCrypt (https://dnscrypt.info/), una soluzione alternativa che permette di stabilire una connessione cifrata anche sulla porta TCP/443 tra uno stub resolver ed un resolver ricorsivo che supporti questo protocollo.

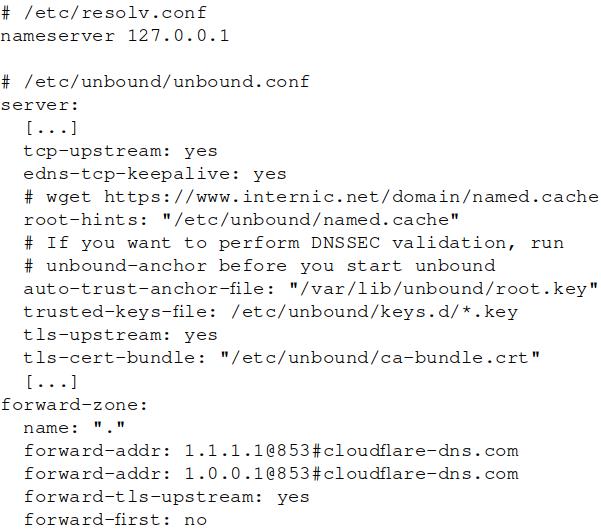
Come esempio, su un client linux è possibile implementare una soluzione locale di stub resolver DNSSEC installando il server DNS unbound (https://www.unbound.net/) con DNS-over-TLS e adottando una configurazione simile a quella brevemente descritta in Fig. 10.

Fig. 10 Esempio di configurazione di unbound come stub resolver con i server Cloudflare come resolver ricorsivi DNSSEC

Sicurezza attuale di DNS e DNSSEC

Come abbiamo visto, il protocollo DNSSEC è sicuramente complesso da adottare e, malgrado sia stato proposto ormai da molti anni, non è ancora diffuso a sufficienza per poter fornire tutte le garanzie di sicurezza di cui avremmo bisogno. Inoltre DNSSEC non fornisce una sicurezza end-to-end, ovvero sino allo stub-resolver locale, né offre misure per garantire la privacy dell’accesso a internet.

Più in generale, la gestione gerarchica del DNS – e in particolare quella di ICANN dei principali TLD – ha da sempre sollevato critiche, sia sulla possibilità di censura sia su possibili influenze commerciali a danno della circolazione delle idee e della libertà di accesso alle informazioni e ai servizi in internet.

A questo proposito si noti che i protocolli DNS e DNSSEC permettono anche la presenza di più alberi paralleli, ovvero di utilizzare più origini fidate contemporaneamente per la risoluzione di nomi in alberi diversi. Questa possibilità è stata sfruttata ad esempio da OpenNIC, Open Root Server Network (ORSN) e New Nations. Questi servizi DNS sono compatibili con quello principale gestito da ICANN ed aggiungono anche la risoluzione di domini in ulteriori TLD quali ad esempio .ko (Kosovo) e .libre.

Un approccio alternativo alla risoluzione dei nomi in indirizzi IP è quello utilizzato per primo da Tor con la risoluzione del TLD .onion gestita all’interno dello stesso protocollo di anonimizzazione. Con l’avvento delle monete virtuali, a partire dal bitcoin, e dell’uso della blockchain, altri servizi alternativi di risoluzione dei nomi sono stati introdotti quali Blockchain-DNS, Emercoin, Namecoin eccetera. Questi servizi si basano tipicamente su protocolli decentralizzati quali la blockchain e permettono la risoluzione di un nome in un indirizzo IP tramite un plugin da installare sul browser web che contatta direttamente questi servizi. Sia per Tor che per Blockchain-dns ecc., la risoluzione del nome in indirizzo IP avviene solo utilizzando l’apposita applicazione o plugin e non è un servizio offerto dal sistema operativo e disponibile generalmente a tutte le applicazioni presenti in un dispositivo informatico.

Vi sono opinioni contrastanti sul fatto che sia utile e salutare per Internet la presenza concomitante di servizi paralleli – e anche in concorrenza – per la risoluzione dei nomi in indirizzi IP. Da una parte vi sono logiche di libertà di mercato, di libera scelta e anche di alta affidabilità dei servizi, dall’altra una parcellizzazione del servizio può renderlo più fragile, ad esempio rispetto ad attacchi DdoS o di oscuramento di alcune zone, meno omogeneo e di più difficile accesso.

La risoluzione dei nomi in indirizzi IP è una di quelle attività poco conosciute ma senza la quale non esisterebbe Internet. Malgrado la grandissima efficienza del protocollo che è stato in grado di supportare la crescita esponenziale di Internet degli ultimi 20 anni, rimangono serie problematiche di sicurezza relative all’autenticità, all’integrità e alla privacy dell’accesso a Internet. La lenta adozione di DNSSEC sicuramente risolve alcune di queste criticità, ma rimane ancora tanto da fare perché la risoluzione dei nomi in indirizzi IP sia un servizio non solo efficiente ma anche “sicuro”.

Note:

[1] Si noti che gli RFC DNSSEC non richiedono espressamente di utilizzare due chiavi diverse per KSK e ZSK.

Articolo a cura di Andrea Pasquinucci

Download PDF

https://www.ictsecuritymagazine.com/articoli/domain-name-system-dns-e-security-extensions-dnssec-alcuni-aspetti-di-privacy-e-sicurezza-parte-2/


Internet of Things: profili di rischio in termini di privacy e sicurezza dei dati

Negli ultimi anni si è assistito a una vera e propria rivoluzione tecnologica grazie all’avvento dell’Internet of Things e degli smart objects: la natura degli oggetti evolve grazie alla possibilità, mediante il collegamento in rete, di comunicare dati su se stessi e di usufruire di informazioni esterne.

L’oramai enorme diffusione di tali dispositivi ha da ultimo portato all’apertura di un dibattito rispetto al loro utilizzo. Essi infatti hanno un forte impatto nella vita quotidiana degli utenti, essendo in grado di estrapolare una serie di dati (riguardanti consumi, abitudini, geolocalizzazione, etc.) che consentono alle aziende di tracciare un preciso profilo dei propri clienti, e di utilizzarlo a livello commerciale.

Nel 2017 il mercato Internet of Things (IoT) in Italia è arrivato a toccare i 3,7 miliardi di euro, con una crescita del 32% rispetto al 2016 spinta sia dalle applicazioni più consolidate che sfruttano la “tradizionale” connettività cellulare (2,2 miliardi di euro, +29%), sia da quelle che utilizzano altre tecnologie di comunicazione (1,5 miliardi di euro, +36%) [fonte: Osservatorio IoT Polimi].

Riportiamo alcune immagini tratte dal rapporto Buon compleanno IoT del Polimi.

A fronte di ciò, si è avvertita la necessità di una regolamentazione specifica del rapporto tra Internet of Things e Privacy.

In particolare negli ultimi mesi abbiamo assistito a un boom degli assistenti vocali, integrati in gran parte di computer, tablet e smartphone, a cui è sufficiente dare un preciso ordine vocale per ottenere una risposta rapida e puntuale. Oggi li conosciamo come Siri, Alexa, Cortana e Google Assistant, ognuno sviluppato da una diversa casa produttrice: Apple, Amazon, Microsoft e Google.  Il loro utilizzo risulta particolarmente semplice e intuitivo: tuttavia la loro crescente diffusione, unita alla nascita degli smart speaker (dispositivi molto simili a casse Bluetooth, ma che integrano anche le funzioni degli assistenti vocali), ha scatenato molte polemiche, legate in particolare alla privacy e alla protezione dei dati personali, che molti utenti temono possano essere violati.

Per poter funzionare correttamente, uno smart assistant necessita di una connessione a Internet e di un microfono funzionante. Quando pronunciamo un comando vocale, infatti, il nostro assistente personale deve essere in grado di registrare quanto pronunciato e collegarsi a un server tramite il quale decodificare gli ordini impartiti. È proprio tale costante connessione a server appartenenti a grandi colossi dell’industria digitale che desta preoccupazione in molti utenti. Tutto si basa su algoritmi, machine learning e sistemi di riconoscimento che raccolgono continuamente un’enorme quantità di dati.

Gli assistenti vocali, quindi, ascoltano, apprendono, si adattano alle esigenze dell’utente, personalizzando l’esperienza e offrono le risposte più adatte a quel tipo di profilo.

Provando ad analizzare alcune tra le principali finalità comuni alla grandissima maggioranza dei dispositivi in grado di supportare uno smart assistant può senz’altro citarsi la possibilità di eseguire ricerche online. Tale funzione permette di trovare una risposta veloce a moltissime e diverse domande. Uno smart assistant permette insomma di sfruttare tutte le possibilità offerte dai motori di ricerca moderni e dalle enciclopedie senza la necessità di uno schermo e di una tastiera.

Altra funzione – utilizzata soprattutto dai giovani, data l’integrazione con applicazioni ormai molto popolari come Spotify – è la possibilità di riprodurre musica, controllando la riproduzione delle proprie playlist e dei propri brani preferiti.

Sarà possibile anche gestire il calendario e quindi chiedere al proprio assistente vocale di ricordare un appuntamento o una riunione.

Tra le novità più apprezzate dagli utenti vi è poi il controllo dei devices in una smart home: un servizio che permette di connettere tutti i propri dispositivi smart e controllarli con la propria voce. Sarà per esempio possibile ordinare di accendere la TV, abbassare il termostato o programmare lo spegnimento delle luci.

Vi sono infine alcuni ambiti, più delicati e non ancora diffusi in tutti i Paesi, in cui gli smart assistant sono utilizzati. Ad esempio, da pochi mesi è disponibile il servizio che permette di effettuare telefonate gratis via Internet senza bisogno di schede SIM oppure quello relativo ai pagamenti online: la possibilità di gestire l’online banking semplicemente con dei comandi vocali è però ancora limitata.

Si possono, dunque, ben comprendere le preoccupazioni legate all’utilizzo sempre più diffuso degli assistenti vocali. I dispositivi in cui questi sono integrati ci seguono tutto il giorno, tengono traccia dei nostri gusti, delle nostre preferenze e abitudini, sfruttando in parte queste informazioni per offrire suggerimenti personalizzati sempre più precisi, soprattutto a fini pubblicitari e commerciali.

Inoltre parliamo di dispositivi che restano in ascolto, in attesa di un comando o di una richiesta. Per cui, nonostante le aziende garantiscano la massima riservatezza dei dati raccolti, l’anonimizzazione delle registrazioni e la privacy degli utilizzatori, non sono mancati casi in cui le registrazioni delle conversazioni tra utenti e assistenti vocali siano state spedite per errore via mail ad utenti sconosciuti o siano state pubblicate sui social network, o casi relativi a comportamenti anomali degli stessi dispositivi, che si attivavano senza richiesta o fornivano informazioni su discussioni effettuate in casa in momenti in cui non sarebbero dovuti essere in ascolto attivo.

Di fronte a un siffatto scenario diverse sono le implicazioni che l’uso di tali dispositivi comporta in materia di privacy e di protezione dei dati personali.

Il Regolamento generale sulla protezione dati (GDPR) 2016/679 offre importanti garanzie su tali fronti, intervenendo su alcuni punti chiave riguardanti la disciplina dell’IoT. In termini generali, il GDPR dispone che i dati vengano trattati in quanto “adeguati, pertinenti e limitati” rispetto a ciò che è necessario per le finalità perseguite (principio, appunto, della minimizzazione).

Nel caso specifico dell’IoT, viene richiesta l’elaborazione di un sistema di gestione della privacy che venga sviluppato fin dalla fase di progettazione del prodotto: non qualcosa di posteriore, quindi, ma di integrato all’oggetto stesso.

Come ha osservato proprio il Presidente dell’Autorità garante per la protezione di dati personali, Antonello Soro: “Il GDPR prevede l’incorporazione delle misure di protezione dati negli stessi sistemi e dispositivi, in modo che essi siano progettati e configurati in maniera da minimizzare l’uso di dati personali e proteggerli adeguatamente.
Queste misure compensano quel deficit di consapevolezza nell’utilizzo di dispositivi intelligenti di uso quotidiano, la cui apparente innocuità ci induce a sottovalutarne la potenziale esposizione ad attacchi informatici o comunque la capacità di rivelare, tramite i dati raccolti, stili e tenore di vita, persino patologie o dipendenze. Inoltre, rispetto alla profilazione e al microtargeting che questi dispositivi possono incentivare, risultano determinanti il diritto di opposizione e quello di contestare la decisione automatizzata, nonché di ottenere l’intervento umano nel processo decisionale”.

L’art. 21 GDPR, a protezione dell’interessato, prevede il diritto di quest’ultimo di opporsi, in qualsiasi momento, per motivi connessi alla sua posizione, al trattamento dei dati personali che lo riguardano, ai sensi dell’art. 6, par.1, lett.e) o f), compresa la profilazione sulla base di tali disposizioni. In tal caso il titolare del trattamento si asterrà dal trattare i dati personali salvo egli dimostri la presenza di motivi legittimi cogenti che prevalgono sugli interessi, sui diritti e sulle libertà dell’interessato, oppure nel caso di accertamento, esercizio o difesa di un diritto in sede giudiziaria.

L’art. 22 GDPR sancisce inoltre il diritto dell’interessato di non essere sottoposto a una decisione basata unicamente sul trattamento automatizzato, compresa la profilazione, che produca effetti giuridici che lo riguardano o che incida in modo analogo sulla sua persona in modo significativo. Un’eccezione a tale disposizione è prevista nel caso in cui la decisione sia autorizzata dal diritto dell’Unione o dello Stato membro cui è soggetto il titolare del trattamento, nel caso in cui la decisione sia necessaria per la conclusione o l’esecuzione di un contratto tra l’interessato e un titolare del trattamento e infine nel caso in cui si basi sul consenso esplicito dell’interessato. In tali ultimi due casi il titolare del trattamento dovrà porre in essere misure appropriate per tutelare i diritti, le libertà e i legittimi interessi dell’interessato, quale ad esempio il diritto di ottenere l’intervento umano da parte del titolare del trattamento, di esprimere la propria opinione e di contestare la decisione.

Il considerando n. 90, inoltre, stabilisce l’obbligo per il titolare del trattamento di effettuare una valutazione d’impatto antecedente al trattamento, per valutare la particolare probabilità e gravità del rischio, tenuto conto della natura, dell’ambito di applicazione, del contesto e delle finalità di trattamento e delle fonti di rischio, soprattutto in caso di trattamenti su larga scala (cioè sui prodotti il cui utilizzo coinvolgerebbe un vasto numero di interessati).

Più precisamente, gli articoli 35 e 36 della normativa impongono, a questo proposito, una tutela rafforzata in caso di rischio elevato: sarà necessario, in quel caso, interpellare l’autorità di controllo (il Garante per la protezione dei dati personali) la quale, entro otto settimane dalla richiesta, dovrà fornire il proprio parere positivo o, in caso contrario, intervenire ammonendo e addirittura inibendo i produttori.

Tutto ciò premesso, non bisogna dimenticare la sicurezza dei dati e delle informazioni che noi forniamo. Sono oramai su tutte le cronache gli attacchi che molti dispositivi stanno subendo, con furto di dati o richieste di riscatto.

Dal rapporto 2019 del Clusit si evidenzia come gli attaccanti non risparmino nessuno.

La sensibilità su questi temi è ancora molto ridotta. Non bisogna pensare che nell’IoT rientrino solo i devices vocali, poiché di tale mondo fanno parte integrante anche gli smart watch, gli antifurti, i comandi robotici, la domotica, i dispositivi bio medici, le app mediche, le autovetture, i giocattoli, le smart city e le smart home, etc.

Tutto ciò che è connesso è facilmente attaccabile. È quindi necessario elevare la nostra consapevolezza dei pericoli connaturati negli oggetti connessi. Per innalzare l’asticella della sicurezza è opportuno avvalersi di metodologie che ci possano supportare durante il percorso.

Il primo passo da compiere è quello dell’analisi dei rischi che l’implementazione di queste tecnologie comporta. A seguito dell’analisi dei rischi – sia a livello dei diritti e libertà dell’interessato, sia a livello aziendale – è necessario verificare e/o implementare le misure di sicurezza più adatte. In ottica GDPR si potrebbe effettuare una DPIA e una Privacy by design; in ottica di scurezza aziendale è necessario verificare la sicurezza logica dei sistemi coinvolti.

Anche in questo caso è necessario un approccio olistico al problema. Il processo deve essere analizzato nel suo complesso dall’inizio alla fine, andando a cercare gli anelli deboli e magari effettuando test e verifiche periodiche.

Articolo a cura di Federica Maria Calì e Stefano Gorla

Download PDF

https://www.ictsecuritymagazine.com/articoli/internet-of-things-profili-di-rischio-in-termini-di-privacy-e-sicurezza-dei-dati/
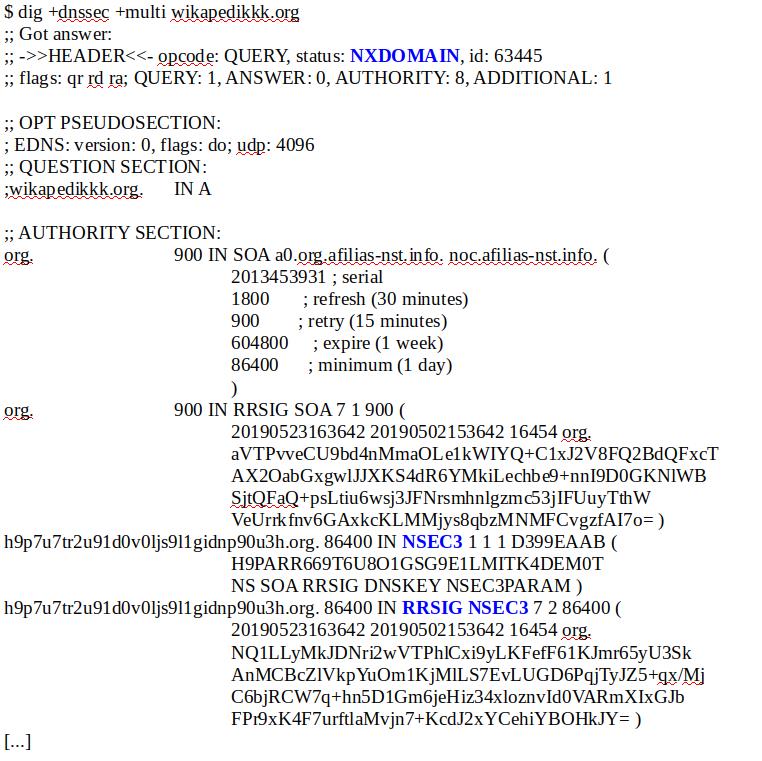


Differenze di approccio tra tecnologie Open Source e tecnologie commerciali nella Cyber Threat Intelligence

Sempre di più  i CISO (Chief Infomation Security Officer) e i direttori dell’area Risk&Compliance valutano le funzionalità e le caratteristiche offerte dai servizi di CTI (Cyber Threat Intelligence) inserendoli nei programmi di sicurezza delle loro aziende.

Entro il 2022, il 20% delle grandi imprese utilizzerà i servizi CTI per definire le proprie strategie di Cybersecurity, il che rappresenta un aumento almeno del 10%[1] rispetto allo scorso anno.

Ad oggi i maggiori fruitori dei servizi di CTI commerciali sono i servizi governativi e finanziari ma si intravede un aumento di altri settori, causato da una maggiore maturità dei programmi di sicurezza, piuttosto che da una specifica tendenza del settore industriale o area geografica.

Anche altri settori – come il trasporto aereo, le assicurazioni sanitarie, oil & gas, energia,  servizi di pubblica utilità e vendita al dettaglio – iniziano ad affacciarsi all’utilizzo dei servizi di  CTI. Questo fenomeno è maggiormente evidente per le grandi imprese che hanno maggior esposizione del proprio brand e presentano strutture organizzative e programmi di sicurezza più maturi.

La CTI è una caratteristica importante e fondamentale di un programma di Cybersecurity, ed è spesso un elemento di differenziazione verso altri mercati, in particolare per le aziende che lavorano nel mercato digitale.

Esistono diversi fornitori nel mercato globale che promuovono molteplici servizi informativi (FEED), usati principalmente per arricchire i dati interni o raccogliere dati da altre fonti a cui è stata applicata un’analisi specialistica (PORTALI di CTI).

Altri fornitori, invece, sono più focalizzati sulla condivisione delle informazioni di Cyber Intelligence e sulle piattaforme di analisi (TIP – Threat Intelligence Platform), che aggregano i dati di altre fonti aggiungendo metadati e/o arricchendo l’accesso verso terze parti, in cui il valore è rappresentato dalla fusione dei dati interni ed esterni (data fusion) per fornire un risultato actionable (Strategic Report, Operational Report o Technical Report).

Ad alto livello, i servizi di CTI possono essere utilizzati in due modalità:

  • fornire informazioni solo alle macchine o ai sistemi di elaborazione automatica, vale a dire MRTI -Machine-Readable Threat Intelligence;
  • fornire informazioni prodotti da un team di specialisti, al TOP Management.

Informazioni leggibili da una macchina/sistema di sicurezza

Sono informazioni principalmente di monitoraggio e/o notifica in tempo reale (IoC – indicator of compromise), ricavati per lo più da fonti esterne e utilizzati per arricchire i sistemi di sicurezza interna. Spesso includono anche informazioni sull’attività operativa che si sta verificando (fonti esterne) o si è già verificata (fonti interne) ma con approcci e obiettivi puramente tecnici.

Informazioni prodotto da un team di specialisti

Sono informazioni acquisite da diverse fonti (Commerciali o Open Source), contenenti elementi come TTP, Threat Actor o report prodotti da analisti umani. Queste informazioni includono generalmente un’analisi su misura per il cliente, con dettagli delle azioni di rimedio da effettuare.

Tutte queste informazioni sono generate utilizzando standard di mercato come STIX, JSON, etc. ed elaborate da piattaforme commerciali come TIP[2] (commerciali) od Open Source come MISP[3] (open source) utilizzate per effettuare una corretta Cyber Threat Information Sharing e, in particolare, per svolgere un’attività di Cyber Threat Hunting[4] [5].

Il mercato si divide tra tecnologie/piattaforme di Cyber Threat Intelligence commerciali e open source. Entrambe le tecnologie/piattaforme sono usate per la gestione delle Cyber Threat, ma applicate in modi diversi.

Esistono diversi elementi da considerare per effettuare un confronto tra le diverse tecnologie da adottare nel mondo della CTI. In particolare possiamo distinguere 5 principali elementi caratterizzanti, che sono:

  • gestione dei feed e fusione di diverse fonti;
  • capacità di arricchimento, analisi e discovery dei dati;
  • taggatura dei dati e delle fonti e information sharing;
  • gestione degli utenti e collaborazione tra i team;
  • scalabilità e supporto.

La figura seguente illustra le principali differenze in merito alle maggiori tecnologie/piattaforme commerciali e open source disponibili sul mercato rispetto alle diverse categorie di elementi (category) e caratteristiche tecniche per ogni singola categoria (features) su cui poi è stato applicato un confronto.

Figura 1 – Differenze tra piattaforme commerciali e open source

Si può notare facilmente che le soluzioni commerciali offrono caratteristiche tecniche maggiori rispetto a soluzioni open source, spesso legate alla possibilità di generazione di report ad hoc (Category: Feed e Features: Report) e alla possibilità di effettuare un’opportuna taggatura delle fonti FEED attraverso gli elementi cardine della CTI come Half Life, maliciousness [6] (Category: Int. Management and Automation e Features: Half Life, maliciousness).

Gli altri elementi distintivi delle soluzioni commerciali rispetto alle soluzioni open source sono:

  • il non pieno utilizzo dello standard STIX/TAXII da parte di tecnologie open source;
  • necessità di aggregare più soluzioni open source per avere gli stessi benefici di una soluzione commerciale integrata.

Ultimo elemento da non sottovalutare è rappresentato da supporto e maintenance, elemento cardine di soluzioni commerciali ma completamente assente per soluzioni open source (Category: Scalability and Support e Features: Maintenance and support).

Pertanto uno dei vantaggi di utilizzare servizi e tecnologie di  CTI, siano esse commerciali od open source, è rappresentato dalla possibilità di migliorare il processo decisionale aziendale, in modo da rendere giustificabile la necessità di risorse aggiuntive e/o delineare al meglio la strategia  da adottare.

I CISO sono spesso tenuti a rispondere a domande come:

  • Perché viene implementato un particolare cambiamento di policy?
  • Le minacce diffuse dai media esistono anche al mio interno ? Qual è la loro rilevanza per l’azienda?
  • Quali potrebbero essere le minacce nel prossimo futuro?
  • Quali sono i KPI che posso definire per effettuare un corretto monitoraggio del mio livello di sicurezza?

Per concludere, ad avviso di chi scrive, entrambe le tecnologie/piattaforme possono essere utilizzate come strumenti di analisi delle Cyber Threat, ma la TIP risulta essere una piattaforma più completa per la gestione integrata di un processo di Cyber Threat Intelligence, a differenza di tecnologie puramente Open Source.

La figura seguente mostra una possibile integrazione delle due tecnologie.

Figura 2 – Possibile modello d’integrazione tra tecnologie commerciali e open source

Al momento, il consiglio più importante resta quello di non limitarsi agli aspetti puramente tecnologici ma vedere i servizi di CTI come un processo integrante di una strategia di Cybersecurity aziendale, incrementando gli investimenti sul tema e prevedendo una maggiore integrazione tra le due tecnologie/piattaforma (commerciali e open source), al fine di migliorare il processo d’indagine di una Cyber Threat e di identificazione dei “Bad Actor”, delle campagne di attacco e così via, per ogni specifico settore di mercato.

Note:

[1] Gartner, Market Guide for Security Threat Intelligence Products and Services – 19 Febbraio 2019.

[2] Threat Intelligence Platform.

[3] MISP ovvero Malware Information Sharing Platform, http://www.misp-project.org/.

[4] WP2017 O.3.1.2u3 – Limits of TISPs, https://www.enisa.europa.eu/publications/exploring-the-opportunities-and-limitations-of-current-threat-intelligence-platforms/at_download/fullReport.

[5] La Cyber Threat Information Sharing: differenze di approccio tra MISP e TIP, https://www.ictsecuritymagazine.com/articoli/la-cyber-threat-information-sharing-differenze-di-approccio-tra-misp-e-tip/.

[6] L’attività di taggatura della fonte risulta essere uno step fondamentale per effettuare una corretta analisi dei dati in fase di hunting.

Articolo a cura di Mattia Siciliano 

Download PDF

https://www.ictsecuritymagazine.com/articoli/differenze-di-approccio-tra-tecnologie-open-source-e-tecnologie-commerciali-nella-cyber-threat-intelligence/