Analisi di un Cyber Attacco sofisticato

Questo articolo vuole essere un modo per avvicinare il lettore a comprendere la complessità degli attacchi cyber. Di seguito verrà trattato un modus operandi molto particolare con un focus specifico sulla grafica, sulle operazioni bit a bit[1] (AND, NOT, OR, XOR) e, quindi, con un pizzico di matematica.

Le operazioni bit a bit sono operazioni primitive e veloci, tant’è che spesso sono implementate nei processori a basse prestazioni perché più veloci da svolgere rispetto alle classiche operazioni aritmetiche (divisione, moltiplicazione, somma).

Partiremo dall’articolo pubblicato dalla società “360 Enterprise Security Group” e nello specifico dal suo team d’intelligence “360 Threat Intelligence Center” riguardante la vulnerabilità di WinRar (CVE-2018-20250)[2], resa nota il 2 febbraio di quest’anno, per poi vedere l’uso della stessa in attacchi cyber strutturati. In fine il lettore verrà condotto passo passo in un’analisi della Backdoor “Fileless[3]” che rappresenta, a mio parere, la parte più interessante per comprendere meglio la complessità degli attacchi cyber strutturati.

L’articolo, intitolato Warning! Upgrades in WinRAR Exploit with Social Engineering and Encryption[4] riassume gli attacchi e le tecniche di social engineering orbitanti intorno a tale vulnerabilità. Questo riporta, come vettore iniziale di attacco, email di phishing che usano come pretesto opportunità lavorative in Arabia Saudita con l’obiettivo di convincere l’utente ad estrarre il file compresso e quindi avviare la compromissione.

Immagine dell’archivio rar

A tale scopo, all’interno del file compresso è stato inserito un file PDF con una proposta di lavoro fittizia associata alla società “YASREF” – Yanbu Aramco Sinopec Refining, una una joint venture tra Saudi Aramco e China Petrochemical Corporation (Sinopec)[5].

Immagine del PDF contenuto all’interno dell’archivio Rar

Il primo fatto degno di nota è che il PDF in sé non contiene nessun componente malevolo: la vulnerabilità di WinRar provvede all’infezione della macchina appena l’archivio viene decompresso.

Tralasciando tutti i tecnicismi di come viene sfruttata tale vulnerabilità e di come, quindi, l’infezione sia avvenuta (per questi dettagli si rimanda all’articolo originale), è utile per il lettore notare che alla fine della prima fase del processo di compromissione verrà “letta” una specifica immagine remota.

La parola “letta” è posta appositamente tra apici per far notare al lettore che l’immagine non viene scaricata ma, come già detto, letta da remoto (attacco fileless).

Arrivati a questo punto siamo nella parte più interessante dell’attacco. L’immagine in questione, sotto riportata, è un semplice paesaggio montano, in formato PNG, con una dimensione di 300×300 pixel.

Da notare che l’immagine di per sé, senza uno specifico script che ne interpreti il contenuto, non rappresenta una componente malevola.

Immagine usata per nascondere il codice malevolo

A questo punto sorgerà spontanea, nel lettore, la curiosità di capire come sia possibile che la successiva fase della compromissione abbia come fonte questa immagine.

L’attaccante è stato molto abile e astuto in questo attacco. Partendo dall’immagine e sfruttando solamente i primi 3000 pixel (anche se, in realtà, i pixel usati sono stati per la precisione 2864), ha “giocato” con i colori variandone la gradazione in modo da poter estrarre da ogni pixel un carattere. Quanto detto è stato fatto usando una specifica formula che vedremo successivamente.

Per essere più chiari nell’illustrare la tecnica utilizzata, bisogna innanzitutto dire che un pixel è formato dai 3 colori base (Rosso, Verde, Blu) più il colore Alpha, che indica l’opacità/trasparenza. Ogni colore può avere una gradazione che va da 0 a 255, interpolando i valori dei tre colori principali il pixel assume uno specifico colore. Nell’immagine sottostante possiamo vedere come questi valori vengono interpretati dai computer e per maggiore chiarezza utilizziamo come esempio i valori del colore “GreenYellow”.

Immagine che illustra come il computer interpreta i colori

L’attaccante pertanto ha modificato leggermente la gradazione dei primi 3.000 pixel (una matrice di 10 righe per 300 colonne) e nello specifico la gradazione del colore Blu e il verde, molto predominanti in quell’area dell’immagine (racchiusa nel rettangolo rosso) rendendo, pertanto, quasi impossibile percepire la modifica a occhio nudo.

Immagine che illustra l’area dove è nascosto il codice malevolo da estrarre

Grazie ad approfondite conoscenze di grafica, all’attaccante è bastato mettere a punto una specifica formula logico/matematica per riuscire a estrarre il carattere desiderato da ogni pixel e quindi costruire lo script da eseguire (tecnica stenografica).

La formula usata è la seguente:

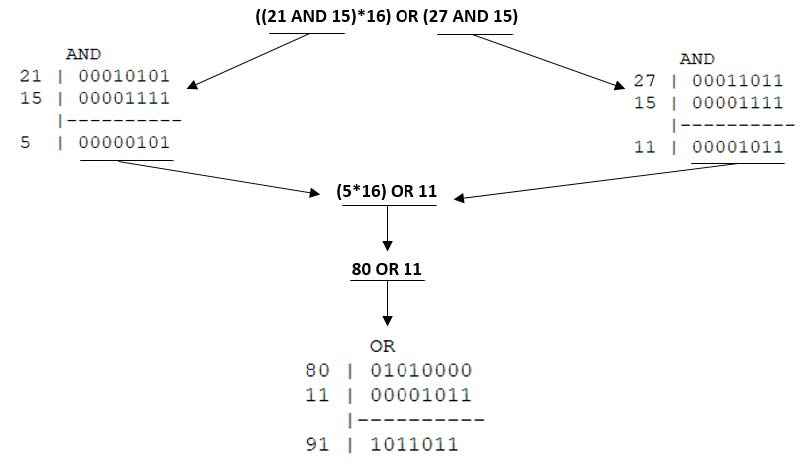
((Valore_Colore_Pixel _Blue AND 15)*16) OR (Valore_Colore_Pixel_Verde AND 15) 

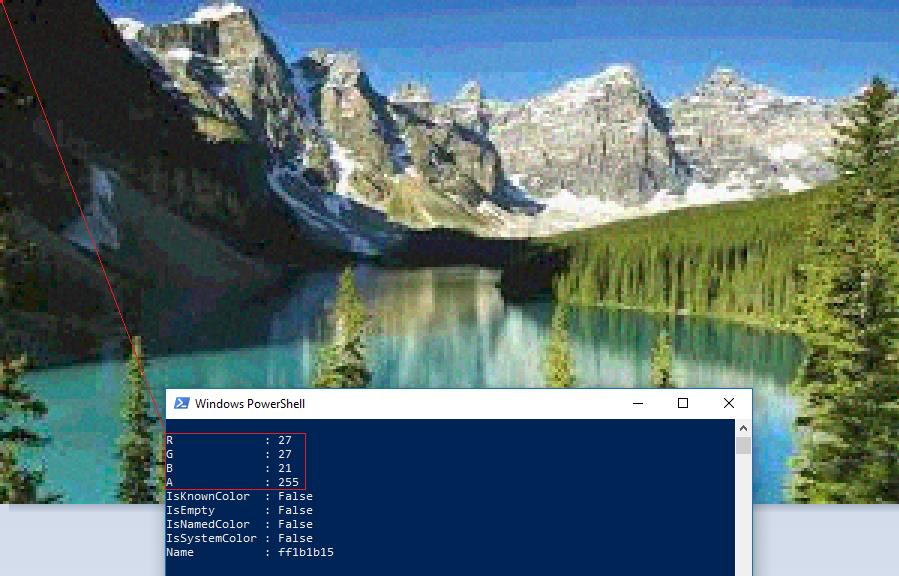
Data l’immagine e i valori del primo pixel (Blu:21, Verde:27, Rosso:27, Alpha:255), tenendo in considerazione il valore del colore blue e del colore verde, la formula si trasforma come segue:

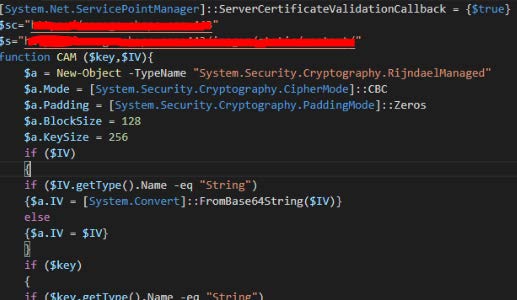
Infine, il numero 91 (risultato di tutta l’operazione) viene trasformato in un carattere ASCII[6], in questo caso otteniamo il carattere di parentesi quadra aperta “[”. Di seguito un estratto dello script nascosto dentro l’immagine.

Come è facile intuire, si tratta di un attacco molto strutturato che fa leva su diverse componenti:

  • tecniche di Social Engineering (opportunità lavorative e nomi di società importanti nel settore energetico e oil & gas);
  • malware di tipo Fileless;
  • nuove vulnerabilità, in questo caso scoperta pochi giorni prima;
  • tecniche di stenografia per nascondere informazioni all’interno delle immagini.

Quanto appreso da questo articolo deve costituire un monito per il lettore a non sottovalutare le minacce nel mondo cyber. Un modo per intuire che anche un’immagine banale, o all’apparenza tale, può nascondere al suo interno una minaccia ben più critica di quando si possa immaginare. Specialmente gli attori strutturati e con elevate capacità, spesso sponsorizzati da uno Stato, hanno strumenti molto sofisticati che possono essere impiegati nelle diverse fasi di un attacco, per non parlare delle avanzate tecniche che sono in grado di mettere in atto durante ogni fase della compromissione

Note:

[1] https://it.wikipedia.org/wiki/Operazione_bit_a_bit

[2] https://nvd.nist.gov/vuln/detail/CVE-2018-20250

[3] https://en.wikipedia.org/wiki/Fileless_malware

[4] https://ti.360.net/blog/articles/upgrades-in-winrar-exploit-with-social-engineering-and-encryption/

[5] https://www.yasref.com/en-us/Pages/About.aspx

[6] https://it.wikipedia.org/wiki/ASCII

Articolo a cura di Giuseppe Brando

Dottore in Ingegneria Informatica, ha trasformato la passione per la sicurezza informatica nella sua attività professionale.

Durante il periodo universitario ha costruito forti competenze nello sviluppo software. Ha ampliato la sua conoscenza e le sue competenze lavorando in aziende di primaria importanza e svolgendo attività di Incident Response, sistemista in ambito Security, Penetration Test, Source Code Review, Malware Analysis e Code Reverse Engineering.

Esperto in attività di Open Source Intelligence (OSINT), attualmente si occupa di Cyber Threat Intelligence con l’obbiettivo di individuare preventivamente le minacce, studiare le tattiche, le tecniche e le procedure (TTP) usate durante gli attacchi e il modus operandi dei Cyber criminali.

Collabora a programmi di Bug Bounty tramite i quali ha ricevuto diversi riconoscimenti per le vulnerabilità individuate e conduce inoltre attività di formazione sulle tematiche legate alla Cyber Security e investigazione su eventi Cyber.

Download PDF

https://www.ictsecuritymagazine.com/articoli/analisi-di-un-cyber-attacco-sofisticato/


I codici di condotta: un’occasione da cogliere

L’inquadramento normativo

Ci siamo già occupati, almeno in parte, dei codici di condotta[i] previsti dall’art. 40 del Reg. UE 2016/679 (GDPR) e li abbiamo collocati nella normativa secondaria che i titolari ed i responsabili del trattamento dei dati personali saranno chiamati a rispettare.

Sinora nessun codice di condotta è stato varato a livello nazionale ed europeo, perché il Comitato Europeo dei Garanti per la Protezione dei Dati Personali (EDPB) non aveva prodotto le relative linee guida per l’uniforme applicazione dell’istituto in tutta l’Unione Europea. Le Linee guida sui Codici di Condotta e sugli Organismi di Monitoraggio[ii] (d’ora in poi “linee guida”) sono state avviate alla consultazione pubblica nella settima riunione plenaria, tenutasi il 13 febbraio 2019: ciascuno ha potuto esprimere le proprie considerazioni su questo documento dal 19 febbraio al 2 aprile 2019.

Una volta consolidate le linee guida, potranno essere avviati ad approvazione i codici di condotta. In questo momento, almeno in Italia, la normativa che detta il percorso per renderli operativi è contenuta nell’art. 20 del D.Lgs. 101/2018 che ha modificato e integrato il D.Lgs. 196/2003 (Codice privacy). Il punto di partenza sono i codici di deontologia e buona condotta (previsti dal vecchio Codice privacy e ad esso allegati): questi documenti non esistono più, almeno in questa denominazione. Sono stati sostituiti dalle regole deontologiche pubblicate sulle Gazzette Ufficiali del 3 gennaio 2019 (quelle relative all’attività giornalistica), del 14 gennaio 2019 (quelle relative alla ricerca scientifica e statistica) e del 15 gennaio 2019 (quelle riguardanti le attività investigative e l’archiviazione ai fini storici). Tuttavia, le regole deontologiche (non previste dal GDPR) costituiscono solo un ponte verso i più omogenei (a livello europeo) codici di condotta. Infatti, lo stesso art. 20 prevedeva (e prevede) che, entro il 19 marzo 2019, le associazioni e gli altri organismi rappresentanti le categorie interessate avrebbero dovuto presentare all’attenzione del Garante italiano i rispetti codici di condotta e che la loro procedura di approvazione sarebbe durata, al massimo, ulteriori sei mesi.

Purtroppo, il termine del 19 marzo non si è potuto rispettare visto che, come si diceva, l’EDPB non ha concluso per tempo la necessaria divulgazione delle relative linee guida finalizzate a definire criteri uniformi per la redazione e l’approvazione dei codici di condotta.

Cosa sono i codici di condotta

I codici di condotta costituiscono uno strumento messo in campo dal legislatore europeo per indurre le associazioni di titolari (o responsabili) del trattamento a definire un quadro di comportamenti omogenei, diretti alla corretta applicazione del GDPR per specifici trattamenti di dati personali. L’esempio più classico, peraltro non nuovo nel contesto italiano, riguarda la nozione di dato aggregato (quindi anonimo e fuori dal campo di applicazione del GDPR) nell’ambito di ricerca statistica: quando un insieme di valori assunti da variabili statistiche può definirsi aggregato? La risposta (presente nelle regole deontologiche tutt’ora in vigore) è che viene considerato aggregato l’insieme di valori che conta, al minimo, tre unità statistiche; al di sotto di questa soglia l’insieme di valori assunti dalle variabili può condurre alla identificazione dei soggetti e, quindi, a potenziali rischi per i relativi dati personali. Questo è un esempio di elementi di interesse da inserire nei codici di condotta (nello specifico riguarda la ricerca statistica).

Un altro esempio di raggio d’azione dei codici di condotta potrà essere la definizione, in via generale, dell’applicazione del legittimo interesse come base giuridica di specifici trattamenti. Com’è noto, l’impiego di questa base giuridica richiede un test di bilanciamento che potrebbe essere utile eseguire una volta per tutte con l’approvazione del Garante.

Quindi, si tratta di un’autoregolamentazione sorvegliata (perché approvata dall’autorità di controllo) da parte delle associazioni qualificate di titolari (o di responsabili): l’adesione ai codici di condotta e la relativa applicazione dimostrano che il titolare ha adeguato il proprio comportamento ai fini della protezione dei dati personali.

Chi prende l’iniziativa

L’iniziativa per l’elaborazione di un codice di condotta viene assunta da associazioni o organismi che rappresentano un insieme qualificato di soggetti omogenei (p.e. organismi rappresentanti delle imprese edili, associazioni delle società di igiene ambientale, ecc.). Le linee guida specificano che chi elabora il codice di condotta deve essere qualificato, cioè deve dimostrare la rappresentatività (che l’autorità di controllo verificherà) attraverso alcuni indicatori: la percentuale di membri aderenti rispetto al totale dei soggetti che rientrano nella categoria e la durata dell’esperienza nel settore che si vuole rappresentare.

Per rafforzare la significatività del codice di condotta, l’associazione deve dimostrare di averlo preliminarmente sottoposto ad esame (consultazione) da parte di tutti i portatori di interesse. In particolare, il codice deve accogliere integrazioni e modifiche proposte sia dagli associati (che svolgeranno il ruolo di titolari o responsabili del trattamento) sia dai soggetti di cui si tratteranno i dati personali (interessati).

Ogni codice di condotta, inoltre, deve avere una struttura minima rilevabile dal paragrafo 2 dell’art. 40 del GDPR, definendo:

a) il trattamento corretto e trasparente dei dati;
b) i legittimi interessi perseguiti dal responsabile del trattamento in contesti specifici;
c) la raccolta dei dati personali;
d) la pseudonimizzazione dei dati personali;
e) l’informazione fornita al pubblico e agli interessati;
f) l’esercizio dei diritti degli interessati;
g) l’informazione fornita e la protezione del minore e le modalità con cui è ottenuto il consenso dei titolari della responsabilità genitoriale sul minore;
h) le misure e le procedure di cui agli articoli 24 e 25 e le misure volte a garantire la sicurezza del trattamento di cui all’articolo 32;
i) la notifica di una violazione dei dati personali alle autorità di controllo e la comunicazione di tali violazioni dei dati personali all’interessato;
j) il trasferimento di dati personali verso paesi terzi o organizzazioni internazionali; o
k) le procedure stragiudiziali e di altro tipo per comporre le controversie tra titolari del trattamento e interessati in materia di trattamento, fatti salvi i diritti degli interessati ai sensi degli articoli 77 e 79.

In ogni caso, le linee guida, nell’Allegato 3, presentano una check‑list per arrivare ad una elaborazione corretta del codice e ad avviare un corretto iter di approvazione.

Chi decide sul codice di condotta

L’associazione che predispone la bozza di codice di condotta potrà essere nazionale o internazionale (comprendendo associati presenti in più Paesi membri dell’UE). Nel primo caso il codice opererà, qualora approvato, solo nell’ambito di un Paese mentre, nel secondo caso, avrà valore transnazionale. Questa differenza incide molto sull’iter di approvazione e, quindi, su chi concretamente decide sul codice.

Quando il codice di condotta intende operare solo a livello nazionale, l’iter di approvazione riguarda solo l’autorità di controllo del singolo paese (detta CompSA che, sul territorio italiano, è il Garante per la Protezione dei Dati Personali).

Se il codice di condotta intende operare a livello transnazionale, l’associazione lo presenta in bozza all’autorità di controllo competente per la nazione dove ha sede legale (CompSA). Tuttavia, la CompSA non decide da sola ma deve coinvolgere, in prima battuta, tutte le altre autorità competenti dei Paesi nei quali il codice intende operare affinché possa avviarsi una cooperazione volta a verificare che il codice non confligga con specifiche disposizioni normative nazionali. L’ultima parola, in ogni caso, spetta al Comitato Europeo per la Protezione dei Dati (EDPB) che esprime un’opinione formale rispetto alla bozza di codice e determina l’eventuale approvazione o la modifica da parte della CompSA. In caso di approvazione di un codice transnazionale la Commissione Europea fornirà la corrispondente decisione dandone opportuna pubblicità legale nell’ambito della Gazzetta Ufficiale Europea.

Chi controlla l’applicazione del codice di condotta

All’interno della bozza del codice di condotta le associazioni proponenti devono specificare chi è l’organismo che ne verificherà l’applicazione nell’ambito degli associati. Tale organismo, disciplinato dall’art. 41 del GDPR, deve essere preventivamente accreditato dall’autorità di controllo competente. Le linee guida dedicano a questo aspetto un apposito capitolo che è utile soprattutto alle autorità di controllo per procedere al preventivo accreditamento di questi soggetti. Ai soggetti che si proporranno per l’accreditamento e per il successivo controllo dell’applicazione dei codici di condotta vengono richieste:

  • indipendenza e assenza di conflitti di interesse;
  • esperienza nell’attività di verifica dell’efficacia delle misure tecniche e organizzative adottate;
  • organizzazione significativa e strutturata in grado di adempiere allo scopo (soprattutto quando il codice di condotta è transnazionale);
  • capacità di risolvere eventuali situazioni di conflitto derivanti dall’applicazione dei codici di condotta, anche attraverso un proficuo rapporto con l’autorità di controllo.

Come si evolve il codice di condotta

Il GDPR è una normativa che induce titolare e responsabile all’applicazione del classico ciclo di Deming: Plan‑Do‑Check‑Act. Questo vuol dire che la compliance alla normativa non è raggiunta una volta per tutte ma che è necessario prevedere procedure che consentano l’adeguamento dei comportamenti al mutare del contesto del trattamento.

Per questo, anche i codici di condotta devono prevedere specifici meccanismi per la loro revisione che coinvolgano gli associati, gli interessati e l’organismo accreditato che ne sorveglia l’applicazione. Senza la definizione di queste specifiche procedure, il codice di condotta non ha alcuna speranza di poter essere approvato.

Conclusioni

I codici di condotta, quindi, costituiscono un’occasione da cogliere per dare all’applicazione del GDPR una concretezza che molti operatori economici, soprattutto quelli più piccoli, cercano da tempo. Le linee guida dell’EDPB costituiscono un passo importante rispetto all’obiettivo di fare chiarezza nei percorsi di adeguamento e, soprattutto, di diffusione della cultura della protezione dei dati personali.

Note:

[i] https://www.ictsecuritymagazine.com/articoli/la-privacy-e-la-regolazione-multilivello/

[ii] https://edpb.europa.eu/sites/edpb/files/files/file1/edpb-20190219_guidelines_coc_public_consultation_version_en.pdf

Articolo a cura di Francesco Maldera

Francesco Maldera è Data Protection Officer e Data Scientist.

Il suo percorso professionale lo ha chiamato a responsabilità direzionali nell’ambito dei sistemi informativi, della safety&security, della privacy e dell’auditing svolgendo diversi incarichi dirigenziali nella Pubblica Amministrazione e in aziende private.

Attualmente, accompagna l’attività consulenziale a quella di sensibilizzazione delle persone tramite il sito www.prontoprivacy.it

Download PDF

https://www.ictsecuritymagazine.com/articoli/i-codici-di-condotta-unoccasione-da-cogliere/


I confini del digitale. Nuovi scenari delineati dal Garante per la privacy dopo la Giornata Europea della protezione dei dati personali

Riflessioni a tutto campo su temi particolarmente rilevanti nella società attuale e futura: l’impatto delle tecnologie digitali sulle libertà degli individui e sugli stessi modelli di democrazia; il confronto tra Europa e Cina sul concetto di sovranità digitale e le nuove forme di controllo sociale; il ruolo che in questi nuovi scenari può giocare la protezione dei dati personali.

La Giornata Europea della protezione dei dati personali, promossa dal Consiglio d’Europa con il sostegno della Commissione europea e di tutte le Autorità europee per la privacy, viene celebrata a partire dal 2007 con l’obiettivo di sensibilizzare i cittadini sui diritti legati alla tutela della vita privata e delle libertà fondamentali.

In occasione della Giornata, l’Autorità Garante ha organizzato un convegno intitolato “I confini del digitale. Nuovi scenari per la protezione dei dati”.

Le innovazioni connesse alle tecnologie digitali influenzano sempre più pesantemente le coordinate stesse del diritto: a partire dal principio di territorialità e dalla nozione di sovranità, fino alla stessa soggettività giuridica, in un contesto in cui si discute della possibilità di considerare la responsabilità dei robot.

D’altronde, ogni tecnologia riflette e a un tempo determina anche la propria cornice giuridica, così la tecnologia digitale concorre alla definizione di criteri valoriali e orienta sempre più le decisioni private e pubbliche.

La rete, come ogni sistema relazionale, rischia però di determinare in forme nuove quelle asimmetrie – anzitutto di potere – da cui aveva promesso di liberarci; e il digitale, per sua stessa natura privo di confini, diviene esso stesso confine del nostro essere persone, segnando il limite che separa la libertà dal determinismo.

Rileva in questo senso, soprattutto, l’intelligenza artificiale applicata alla vita individuale e collettiva, la cui progressiva diffusione ha segnato quella che è stata definita “quarta rivoluzione industriale”, con il passaggio all’economia della condivisione, al “pianeta connesso”, all’ IoT (Internet of Things).

Il tutto con straordinarie possibilità, impensabili anche solo pochi anni fa, ma anche con rischi che vanno prevenuti per porre davvero la tecnica al servizio dell’uomo, come recita il Regolamento europeo sulla protezione dati.

Ad esempio il progetto “Smart Nation” a Singapore da un lato ha sperimentato droni-postino e taxi a guida autonoma, dall’altro ha legittimato, tra le deroghe ampie alla disciplina di protezione dati che pure ha introdotto, un incisivo controllo pubblico sulle persone, basato persino sul monitoraggio dei post pubblicati sui social, con tecniche di sentiment analysis.

Va ancora oltre il modello cinese, caratterizzato da soluzioni avveniristiche e dall’investimento nelle tecnologie digitali delle sue grandi risorse umane e finanziarie. Più di un quarto delle oltre duemila compagnie di intelligenza artificiale del mondo si trovano in Cina, che in questo campo possiede una carta vincente: la demografia, assieme all’assenza di norme efficaci a tutela della privacy, costituisce un fattore di enorme vantaggio competitivo, in un contesto economico fondato sull’intelligenza artificiale che si alimenta di quantità crescenti di dati, così come accadeva per l’industria del petrolio nel Novecento.

E infatti la Cina compete per il primato nello sviluppo del computer quantistico e partecipa alla grande sfida per la costruzione delle maggiori reti 5G nel mondo. D’altra parte, in Cina l’innesto così profondo della tecnologia nella vita privata e pubblica si accompagna a un’altrettanto pervasiva ingerenza dello Stato nell’esistenza individuale, in un contesto di sostanziale osmosi tra i grandi provider e il Governo, legittimato ad ottenere dai primi, per generiche ragioni di sicurezza, i dati personali di chiunque. È senz’altro una peculiare espressione del patto sociale, fondato sulla promozione del benessere a fronte della limitazione di molti diritti civili e politici.

Le tecnologie di riconoscimento facciale sono utilizzate, sia nelle aziende che in qualsiasi spazio pubblico, come sistema di controllo sociale e prevenzione del crimine.  Ai cittadini viene dunque assegnato un “punteggio” (Social Credit System) fondato sulla valutazione delle abitudini di acquisto, delle frequentazioni più o meno esibite, dei contenuti pubblicati in rete, penalizzando quelli socialmente o politicamente indesiderabili, con inevitabili effetti di normalizzazione.

La “vita a punti” dei cinesi è quindi qualcosa di più e di diverso dalla mera digitalizzazione dell’azione pubblica, ma appare rivolta all’uso della tecnologia per un controllo ubiquitario sul cittadino, nel nome del totem della sicurezza.

Torna dunque la tentazione e la pretesa di espropriazione di quella sfera essenziale di diritti e libertà, della stessa autodeterminazione individuale, la cui affermazione di inviolabilità si deve invece proprio al diritto alla privacy. Un diritto sancito a livello internazionale, nella forma dell’immunità da interferenze arbitrarie nella vita privata, nel secondo dopoguerra, come reazione alle profonde ingerenze realizzate dai regimi totalitari.

Eppure, in un contesto di progressiva erosione del confine e della sua idea, le ostilità si manifestano a livello globale in maniera più sottile, alimentate da strumenti e controlli meno percettibili e più sfuggenti alle garanzie tradizionali: le relazioni ostili tra gli Stati si svolgono prevalentemente in rete e sin dall’attacco informatico all’Estonia nel lontano 2007 si è discusso se in questi casi possa invocarsi un intervento della Nato, estendendo così al digitale gli strumenti tradizionali pensati per la difesa dell’equilibrio internazionale.

Ancora una volta, “contro ogni rischio di espropriazione del diritto da parte della tecnica”, è proprio la proiezione nella dimensione digitale dello Stato e della sua stessa sovranità a dimostrare come la protezione dati possa divenire presupposto di sicurezza, promuovendo quella resilienza indispensabile per la difesa della democrazia nel rispetto dell’identità.

Anzi è proprio questa circolarità tra protezione dati e democrazia a spiegare perché l’Unione europea abbia voluto affermare la propria sovranità digitale in senso diverso da quella reclamata dalla Cina e, cioè, verso la garanzia dei diritti della persona rispetto a chiunque ne gestisca, con i suoi dati, l’identità stessa.

Il modello europeo costituisce allora non soltanto un punto di riferimento cui si stanno progressivamente ispirando un numero crescente di ordinamenti – e il GDPR si avvia ad essere un esempio felice in tale direzione – ma anche uno dei pochi campi nei quali l’Unione mantiene una posizione comune, destinata a dimostrarsi vincente nella governance della società digitale.

Il nesso profondo che lega protezione dati e sovranità nazionale è emerso con veemenza anche negli Stati Uniti d’America in occasione della vicenda Cambridge Analytica, nella quale si è visto come molte delle comunicazioni personalizzate con inserzioni occulte, rese possibili da una disciplina della privacy nei fatti lacunosa, fossero riconducibili a potenze straniere, interessate ad influenzare attraverso il web il consenso elettorale.

L’antidoto non può che risiedere nell’affermazione progressiva della protezione dati come diritto universalmente tutelato, per restituire alla persona quella centralità che sembrava aver perso.

Ecco il ruolo più significativo che l’Europa potrà giocare in un contesto geopolitico in cui domina il potere dell’algoritmo: ridisegnare, proprio a partire dalla protezione dei dati, i confini del tecnicamente possibile alla luce di ciò che è giuridicamente ed eticamente accettabile.

Tornano in mente le parole – che potrebbero oggi apparire persino  profetiche – di Arnold Gehlen, quando affermava che “uno dei risultati principali di tutta la storia della civiltà umana è, senza dubbio, la tendenza, constatabile nello sviluppo della tecnica, a soppiantare l’elemento organico mediante materie ed energie inorganiche […]  e ciò ha la sua ragione nel fatto che la sfera della natura inorganica è la più accessibile ad una conoscenza metodica, razionale e rigorosamente analitica, ed alla corrispondente prassi sperimentale”.

I confini del digitale, appunto. In fondo sarebbe una singolarità davvero notevole se la hybris umana venisse soppiantata da quella, in prospettiva forse ancor più letale, del prodotto più sofisticato dell’umana techne, l’intelligenza artificiale.

Articolo a cura di Sergio Guida

Da economista aziendale ha maturato esperienze in gruppi industriali diversi per settori, dimensioni e caratteristiche. Specializzato in pianificazione e controllo di gestione, finanza, risk e project management, sistemi di rendicontazione integrativi (sociale, ambientale e intangible assets), è stato relatore in convegni e seminari e ha pubblicato articoli di economia, finanza, strategie e compliance.

Forti interessi verso complessità, multidisciplinarietà, innovazione tecnologica, concentrati ora su digital economy, interazione uomo-macchina (aspetti etici, cognitivi ed epistemologici), data protection & privacy regulations.

Download PDF

https://www.ictsecuritymagazine.com/articoli/i-confini-del-digitale-nuovi-scenari-delineati-dal-garante-per-la-privacy-dopo-la-giornata-europea-della-protezione-dei-dati-personali/


Gestione del rischio: quale processo adottare per la protezione dei dati personali

La gestione del rischio ed il concetto di accountability sono due principi fondamentali del Regolamento (UE) 2016/679 (di seguito Regolamento) e fra le principali innovazioni da questi introdotte. Infatti, la gestione del rischio diventa lo strumento atto a dimostrare l’adeguatezza delle misure implementate a tutela dei dati trattati. Soprattutto per le aziende italiane, questa è una grande novità in termini di approccio, in quanto, abituate a leggi prescrittive predeterminate, hanno basato in passato la loro azione sulla rigorosa valutazione ed applicazione delle misure indicate, c.d. checklist, come, ad esempio, l’Allegato B (Misure Minime di Sicurezza) del Decreto Legislativo 30 Giugno 2003, n. 196. Il Regolamento, invece, non prescrive misure tecniche ed organizzative puntuali per proteggere i dati, ma chiede al titolare di essere in grado di dimostrare di averle protette in modo adeguato, rispetto ai rischi che presentano i trattamenti ed alla natura dei dati personali da proteggere.

Diventa a questo punto molto utile, se non indispensabile, al fine di dimostrare il rispetto del principio di accountability, seguire e documentare un percorso logico in grado di individuare e valutare il rischio inerente al trattamento e, quindi, ponderare e mettere in atto misure adeguate a limitare la portata di tale rischio sui diritti e le libertà degli interessati. Con tale valutazione, quindi, si determina il grado di responsabilità del titolare o del responsabile del trattamento nella gestione del rischio inerente al trattamento, attraverso la valutazione delle misure messe in atto per prevenire eventuali limitazioni dei diritti e libertà degli Interessati, per consentire a questi di mantenere un controllo sui dati che li riguardano, nonché per garantire un livello di protezione adeguato dei dati da minacce che possono pregiudicare la loro riservatezza, integrità e disponibilità ed essere la causa di un danno, materiale o immateriale, per le persone fisiche.

Definizione del rischio per la protezione dei dati

Il primo punto da chiarire per poter attuare un processo di gestione del rischio coerente e conforme ai requisiti del Regolamento, è la definizione stessa di rischio. Al riguardo, l’Autorità di Controllo nazionale (di seguito Garante), ai sensi dell’Art. 2-bis del Decreto Legislativo 30 Giugno 2003, n. 196 e s.m.i., fornisce nella guida “La Valutazione di Impatto – Individuazione e gestione del Rischio” una definizione del rischio, quale: “scenario che descrive un evento e le sue conseguenze, stimati in termini di gravità e probabilità”.

A sua volta, il Considerando 83 del Regolamento precisa:

“[…] Nella valutazione del rischio per la sicurezza dei dati è opportuno tenere in considerazione i rischi presentati dal trattamento dei dati personali, come la distruzione accidentale o illegale, la perdita, la modifica, la rivelazione o l’accesso non autorizzati a dati personali trasmessi, conservati o comunque elaborati”.

Tale definizione di rischi può essere assimilabile anche alla definizione di “eventi temuti” (in inglese feared event) fornita dalle Linee Guida “Privacy Impact Assessment (PIA)” del CNIL, oppure “privacy risk” come indicati dalla standard internazionale ISO/IEC 29134. In entrambi i casi, i rischi che può presentare il trattamento possono essere riassunti in: accesso illegittimo, modifica indesiderata e perdita dei dati.

L’evento e le relative conseguenze, comunque, sono esplicitamente riferiti dal Regolamento per l’interessato o la persona a cui i dati personali fanno riferimento. La valutazione del rischio deve, quindi, focalizzarsi sui risvolti in termini di possibile violazione della protezione dei dati che riguardano gli interessati, escludendo altri aspetti riferibili al titolare o al responsabile del trattamento.

Nell’ambito dell’applicazione del Regolamento, il rischio per i diritti e le libertà delle persone fisiche, aventi probabilità e gravità diverse, sono da intendersi, quindi, come eventi che possono generare effetti negativi, o impatti, sugli Interessati, come un danno fisico, materiale o immateriale. Il Considerando 75 del Regolamento ci aiuta ad individuare le tipologie di rischi che possono derivare dal trattamento o dalla natura dei dati trattati, e che possono a loro volta essere classificati come:

  • Rischi per la sicurezza del trattamento e per i dati trattati, in termini di riservatezza, integrità e disponibilità (di seguito RID), che possono comportare per gli Interessati, ad esempio, discriminazione, furto o usurpazione d’identità, perdite finanziarie, pregiudizio alla reputazione, ecc. Dove la violazione delle dimensioni di sicurezza dei dati (RID) e degli strumenti utilizzati (ad esempio sistemi informatici o mezzi cartacei) possono essere la causa degli effetti negativi sugli interessati, è necessario identificare le minacce che potrebbero causare l’evento dannoso e portare ad accessi illegittimi, modifiche indesiderate e perdita dei dati (Allegato 2 – Linee Guida per la DPIA del Working Party article 29, n. wp248 rev1.0). Tali rischi possono essere ricondotti, pertanto, alla definizione più generale di “violazione dei dati personali”, c.d. data breach, che, se non affrontata in modo adeguato e tempestivo, può provocare danni fisici, materiali o immateriali alle persone fisiche (Considerando 85).
  • Rischi che possono derivare da un trattamento non conforme ai principi generali del Regolamento e limitare i diritti e le libertà degli interessati, come ad esempio:
    • un trattamento di dati effettuato per finalità diverse rispetto a quelle dichiarate e legittime (principio di “limitazioni delle finalità”);
    • un trattamento dei dati effettuato in assenza di una base giuridica legittima, come il consenso espresso dall’Interessato (principio di “liceità del trattamento”);
    • un trattamento di dati eccedente rispetto alle finalità perseguite (principio di “minimizzazione dei dati”);
    • un trattamento di dati non esatti o aggiornati (principio di “esattezza”);
    • una conservazione dei dati, o anche non cancellazione, per un periodo superiore a quello consentito per il conseguimento delle finalità legittime (principio di “limitazione della conservazione”).
  • Rischi che possono impedire agli Interessati l’esercizio dei loro diritti ed il controllo sui dati personali che li riguardano, come ad esempio:
    • informazioni fornite agli Interessati non complete o chiare circa i termini del trattamento di dati personali che li riguardano (articoli 12, 13 e 14 del Regolamento)
    • Modalità e meccanismi non in grado di consentire l’accesso e la portabilità dei dati in base ad una richiesta effettuata dall’Interessato (articoli 15 e 20 del Regolamento);
    • Modalità e meccanismi non in grado di consentire la rettifica, la cancellazione, l’opposizione e la limitazione del trattamento da parte dell’Interessato (articoli da 16 a 19 e 21 del Regolamento);
    • Impossibilità per l’Interessato di esprimere la propria opinione o contestare una decisione basata unicamente sul trattamento automatizzato, compresa la profilazione, che produca effetti giuridici che lo riguardano o che incida in modo analogo significativamente sulla sua persona (articoli da 22 del Regolamento).

Requisiti normativi per la valutazione del rischio

Il principio di accountability rappresenta uno dei pilastri su cui si fonda l’impianto normativo del Regolamento e, anche se nella traduzione del termine anglosassone viene tradotto impropriamente in “responsabilità”, la sua traduzione più corretta, anche se poco pratica, potrebbe essere quella di “rendicontazione”. Infatti, l’articolo 24 del Regolamento dispone:

“Tenuto conto della natura, dell’ambito di applicazione, del contesto e delle finalità del trattamento, nonché dei rischi aventi probabilità e gravità diverse per i diritti e le libertà delle persone fisiche, il titolare del trattamento mette in atto misure tecniche e organizzative adeguate a garantire, ed essere in grado di dimostrare, che il trattamento è effettuato conformemente al presente regolamento”.

Inoltre, se ciò è proporzionato rispetto alle attività di trattamento, le predette misure includono l’attuazione di politiche adeguate in materia di protezione dei dati da parte del titolare del trattamento.

L’accountability è oggi considerata come un approccio pratico al trattamento dei dati personali, avendo l’obiettivo di individuare le attività e sviluppare gli strumenti che possano consentire alle organizzazioni di valutare ed individuare le misure in grado di raggiungere la conformità al Regolamento e renderne conto alle Autorità di Controllo competenti. Fondamentale tra le tali attività da prevedere per rispondere al principio di accountability è, quindi, la gestione del rischio per la protezione dei dati personali. Quest’ultimo è da intendersi come rischio che può generare impatti negativi sulle libertà e i diritti degli interessati (Considerando 75 e 77), che devono essere analizzati attraverso un apposito processo di valutazione (Articoli 32 e 35), tenuto conto dei rischi noti o evidenziabili e delle misure tecniche e organizzative, anche di sicurezza, che il titolare ritiene di dover adottare per mitigarli. E’ da sottolineare che il processo di valutazione del rischio può essere sviluppato in momenti differenti: prima di iniziare le operazioni di trattamento dei dati personali e all’atto del trattamento stesso, prevedendo un riesame e aggiornamento periodico tenuto conto dei possibili cambiamenti che possono avvenire in riferimento ai termini del trattamento (ad esempio, finalità, destinatari, trasferimenti dei dati, ecc.), alle responsabilità organizzative, all’introduzione di nuove tecnologie ed, in particolar modo, all’evoluzione delle minacce informatiche che possono incombere sulla protezione dei dati.

Il Regolamento richiede alle organizzazioni, in particolare, di effettuare una valutazione oggettiva mediante cui si stabilisce se i trattamenti di dati comportano un rischio o un rischio elevato “inerente” per i diritti e le libertà delle persone fisiche, in relazione alla loro natura, ambito di applicazione, contesto e finalità. È utile però precisare che vi sono due tipologie di valutazione del rischio previste dal Regolamento, distinte e complementari.

La prima, denominata Data Protection Impact Assessment (DPIA), prevede ai sensi dell’articolo 35 una valutazione degli impatti per la protezione dei dati prima di procedere con un nuovo trattamento, quando questi possa presentare un rischio elevato intrinseco, come ad esempio:

  • “se sono trattati dati personali che rivelano l’origine razziale o etnica, le opinioni politiche, le convinzioni religiose o filosofiche, l’appartenenza sindacale, nonché dati genetici, dati relativi alla salute o i dati relativi alla vita sessuale o a condanne penali e a reati o alle relative misure di sicurezza;
  • in caso di valutazione di aspetti personali, in particolare mediante l’analisi o la previsione di aspetti riguardanti il rendimento professionale, la situazione economica, la salute, le preferenze o gli interessi personali, l’affidabilità o il comportamento, l’ubicazione o gli spostamenti, al fine di creare o utilizzare profili personali;
  • se sono trattati dati personali di persone fisiche vulnerabili, in particolare minori;
  • se il trattamento riguarda una notevole quantità di dati personali e un vasto numero di interessati.
  • di sorveglianza di zone accessibili al pubblico su larga scala”.

Il Working Party article 29 (di seguito WP29) prima con le Linee Guida per la DPIA, n. wp248 rev1.0, e successivamente il Garante con l’Allegato 1 al Provvedimento n. 467 dell’11 Ottobre 2018 [doc. web n. 905897], hanno indicato le tipologie di trattamenti che presentano un rischio elevato intrinseco e devono essere oggetto di una DPIA.

Per comprendere se i trattamenti effettuati dal titolare del trattamento presentino un rischio elevato intrinseco, è necessario che l’Organizzazione definisca una procedura che valuti la necessità di effettuare la DPIA nella fase di progettazione o, comunque, prima di procedere alla realizzazione di un nuovo servizio, processo o applicazione che comporti il trattamento di dati personali. Comunque, vista la sua utilità per facilitare il processo decisionale relativo al trattamento, il WP29 suggerisce di valutarne l’impiego per tutti i trattamenti, e non solo nei casi in cui il Regolamento o l’Autorità di Controllo la prescrive come obbligatoria.

La DPIA è un onere posto direttamente a carico del titolare del trattamento e rappresenta uno strumento importante in termini di accountability, in quanto, è in grado di attestare l’adozione di misure adeguate a garantire il rispetto delle prescrizioni del Regolamento. Il suo obiettivo è quello di determinare, in particolare, l’origine, la natura, la particolarità e la gravità dei rischi sulla protezione dei dati personali per quei trattamenti che presentano intrinsecamente un rischio elevato per i diritti e le libertà delle persone fisiche, al fine di adottare tutte le opportune misure per dimostrare che il trattamento dei dati personali rispetta le disposizioni del Regolamento (Considerando 84). È da sottolineare che l’esecuzione della DPIA nella fase di progettazione di un nuovo trattamento rappresenta uno strumento efficace per rispondere anche ai principi di “data protection by default and by design” (articolo 25 del Regolamento), ossia alla necessità di configurare il trattamento prevedendo fin dall´inizio le garanzie indispensabili “in grado di soddisfare i requisiti” del Regolamento e tutelare i diritti degli interessati, tenendo conto del contesto complessivo ove il trattamento si colloca e dei rischi per i diritti e le libertà degli interessati.

La DPIA è forse uno degli argomenti più complessi del Regolamento e pone molti dubbi che la sola lettura dell’articolo 35 non riesce a dipanare. Infatti, il Regolamento non impone una metodologia o specifica le operazioni da effettuare per la valutazione del rischio per la protezione dei dati e indubbiamente le Linee Guida n. wp248 rev1.0 del WP29 hanno portato un importante contributo nel fare chiarezza e fornire indicazioni utili di lavoro. A tal riguardo, l’Allegato 2 – “Criteri per una DPIA adeguata” delle Linee Guida n. wp248 rev1.0 del WP29 fornisco i criteri che i titolari possono utilizzare per valutare se il modello di DPIA utilizzato è sufficientemente completo per conformarsi alle prescrizioni del Regolamento, prevedendo:

  1. una descrizione sistematica del trattamento (articolo 35, comma 7, lett. a)), al fine di individuare e determinare:
    • la natura, la portata, il contesto e le finalità del trattamento (Considerando 90);
    • i dati personali trattati e il loro periodo di conservazione;
    • i destinatari a cui possono essere comunicati i dati;
    • una descrizione funzionale del trattamento, che comprenda, ad esempio, il servizio o il processo per cui vengono raccolti ed elaborati i dati;
    • le risorse utilizzate per il trattamento dei dati personali (hardware, software, reti di comunicazione elettronica, persone, mezzi cartacei);
  2. una valutazione di necessità e proporzionalità del trattamento (articolo 35, comma 7, lett. b)), tenuto conto delle:
    • misure che contribuiscono al rispetto dei principi generali del trattamento, la cui mancanza o inefficacia possono comportare un rischio per i diritti e delle libertà degli Interessati riguardo ai dati trattati che li riguardano:
      • determinazione e documentazione di finalità specifiche, esplicite e legittime (articolo 5, comma 1, lett. b));
      • determinazione e documentazione della/e condizioni di liceità del trattamento (articolo 6);
      • meccanismi e procedure per garantire l’adeguatezza, la pertinenza e limitazione dei dati a quanto necessario (articolo 5, comma 1, lett. c));
      • meccanismi e procedure per garantire la limitazione della durata di conservazione dei dati (articolo 5, comma 1, lett. e));
    • misure che contribuiscono all’esercizio dei diritti delle persone interessate, la cui mancanza o inefficacia possono comportare un rischio per il controllo sui dati:
      • mezzi e completezza delle informazioni fornite alle persone interessate riguardo il trattamento di dati personali che li riguardano (articoli 12, 13 e 14);
      • meccanismi e procedure per garantire l’accesso e la portabilità dei dati (articoli 15 e 20);
      • meccanismi e procedure per garantire la rettifica e la cancellazione dei dati, oppure l’opposizione e limitazione del trattamento (articolo da 16 a 19 e 21);
      • completezza delle informazioni fornite sui destinatari a cui possono essere comunicati i dati;
      • informazioni fornite sui responsabili, che eseguono per conto del titolare operazioni di trattamento di dati personali, ad esempio, nell’ambito di contratti di fornitura (articolo 28);
      • misure di tutela adottate in caso di trasferimento dei dati a soggetti stabili al di fuori dell’Unione Europea (Capitolo V).
  1. una gestione dei rischi per i diritti e le libertà delle persone (articolo 35, comma 7 lett. c), che possono derivare da un accesso illegittimo, modifica indesiderata e perdita dei dati e causare un danno fisico, materiale o immateriale, agli interessati, attraverso:
    • l’analisi dell’origine, della natura, della probabilità e gravità dei rischi per la protezione dei dati (Considerando 84), tenendo conto di:
      • fonti o origine di rischio (considerando 90);
      • minacce che potrebbero portare all’accesso illegittimo, alla modifica indesiderata e alla perdita dei dati;
      • impatti, o danni, potenziali per i diritti e le libertà delle persone in caso di accesso illegittimo, modifica indesiderata e perdita dei dati;
      • probabilità e la gravità di ciascun rischio individuato (Considerando 90);
      • misure previste per il trattamento di tali rischi (articolo 35 comma 7, lett. d), e il considerando 90).

Quest’ultimo punto rappresenta la seconda tipologia di valutazione del rischio, riconducibile principalmente all’articolo 32 del Regolamento, che ha lo scopo di valutare il livello di sicurezza del trattamento e dei dati trattati, in funzione dei rischi che possono derivare, in particolar modo, dalla distruzione, dalla perdita, dalla modifica, dalla divulgazione non autorizzata o dall’accesso, in modo accidentale o illegale, a dati personali trasmessi, conservati o comunque trattati (articolo 32, comma 2 del Regolamento). Questa seconda analisi è parte complementare della DPIA, ma è dovuta in generale per tutti i trattamenti effettuati sia dal titolare che dal responsabile del trattamento. Si tratta di uno dei criteri principali previsti dal Regolamento, che prevede appunto l’obbligo di effettuare una valutazione del rischio del trattamento, al fine di adottare le misure di sicurezza tecniche od organizzative “adeguate” a garantire un livello di sicurezza adeguato al rischio a cui può essere esposto il trattamento e i dati personali trattati.

Partendo dalle indicazioni fornite dalle Linee Guida n. wp248 rev1.0 del WP29, è possibile strutturare il processo generale di valutazione del rischio di sicurezza come segue:

  1. Identificare le fonti di rischio
    • Chi e cosa potrebbe essere la causa degli eventi che potrebbero creare un danno ai dati personali?

Esempio:

  • Amministratori di Sistema
  • Utenti o esterni all’organizzazione
  • Attacchi informatici
  • Virus e Malware
  • Competitor
  • Eventi climatici
  • Acqua, fuoco ed esplosioni
  1. Identificare le potenziali minacce
    • Quali possono essere le minacce agli strumenti informatici e non (ad esempio, applicazioni, hardware, networking, hard disk esterni, archivi cartacei, ecc.) utilizzati per il trattamento e che possono avere conseguenze per la protezione dei dati personali da questi elaborati o archiviati?

Esempio:

  • Errori utente: utilizzo in modo inappropriato degli asset, mancato rispetto delle politiche e procedure di sicurezza
  • Denial of service: Attacchi di rete di tipo DDoS, attacchi di tipo SQL injection, saturazione della capacità elaborativa delle componenti del sistema informativo.
  • Abuso di privilegi: escalation illecita dei privilegi di accesso ai programmi informatici per la lettura e modifica illecita dei dati, accesso a programmi di posta elettronica per l’invio di posta indesiderata o non autorizzato.
  • Malware: perdita di riservatezza o disponibilità dei dati in seguito all’installazione accidentale di codice malevolo, virus e software vulnerabile.
  • Furto: furto di dispositivi in cui sono archiviati, come computer portatili, smartphone, unità di memorizzazione elettronica.
  • Spionaggio: analisi del traffico di rete, acquisizione di dati attraverso strumenti di geolocalizzazione di hardware.
  • Sovraccarico: attacchi DDOS o overload dei supporti di memorizzazione
  1. Individuare i potenziali effetti sui diritti e le libertà delle persone interessate:
    • Quali conseguenze per i dati personali degli Interessati nel caso che una o più minacce si concretizzino?

Esempio:

  • Accesso non autorizzato ai dati personali: discriminazione, problemi di natura psicologica, ricezione di comunicazioni indesiderate.
  • Modifica indesiderata dei dati: negazione dell’accesso a servizi, pagamenti imprevisti, perdita di tempo per la ripetizione di formalità.
  • Indisponibilità temporanea o definitiva dei dati: perdita finanziaria, mancanza di cure adeguate, perdita di opportunità uniche e non ricorrenti.
  1. Valutare alla probabilità e la gravità dei rischi:
    • Quali possibilità esistono che una minaccia possa concretizzarsi ed eventualmente che livello di danno può produrre sugli strumenti utilizzati (informatici e cartacei) e, quindi, sui dati personali trattati?
      • Probabilità: stima della possibilità di accadimento di una minaccia rispetto agli strumenti utilizzati per il trattamento.
      • Gravità: stima del livello di compromissione, o anche di danno, che una minaccia può causare sugli strumenti utilizzati e sui dati stessi.
  1. Identificare ed implementare le misure di sicurezza:
    • quali misure di sicurezza è necessario adottare per proteggere gli strumenti utilizzati e i dati trattati, in modo da limitare la probabilità di accadimento e gli effettivi negativi che possono essere generati dal concretizzarsi di una o più minacce?

Esempio:

  • Controllo degli accessi a sistemi e ai dati.
  • Analisi degli eventi di sistema.
  • Backup e Disaster Recovery.
  • Crittografia, anonimizzazione e pseudonimizzazione.

In conclusione, la valutazione degli impatti (DPIA) e quella per la sicurezza del trattamento e protezione dei dati pare evidente siano differenti e complementari, dove, in caso contrario, avremmo avuto esplicite indicazioni della DPIA anche negli articoli 24, 25 e 32 del Regolamento. È da considerare che le normative e gli standard non sempre presentano una coerenza interna, in quanto, l’elaborazione del testo può essere il prodotto di più gruppi di lavoro o il frutto di compromessi, come l’aggiunta di alcuni passaggi in momenti diversi. Data la premessa, è ragionevole pensare che gli articoli relativi alla DPIA siano stati introdotti non considerando appieno le relazioni con gli articoli relativi alla sicurezza del trattamento e dei dati (articolo 32). Infatti, non è possibile immaginare di valutare gli impatti per la protezione dei dati in relazione al rischio elevato inerente al trattamento per i diritti e le libertà delle persone fisiche, senza effettuare una valutazione del rischio per la sicurezza del trattamento e dei dati da proteggere. Al contempo, non è possibile valutare soltanto il rischio per la sicurezza del trattamento, trascurando i rischi inerenti che possono derivare da un trattamento non conforme ai principi generali del Regolamento o che possono impedire l’esercizio dei diritti degli agli Interessati (vedi anche principio di “necessità e proporzionalità del trattamento” dell’Allegato 2 alle Linee Guida n. wp248 rev.1.0 del WP29). In questo caso, il Regolamento non richiede di effettuare una valutazione “necessità e proporzionalità” se il trattamento non presenti un rischio elevato o, comunque, non rappresenti un nuovo trattamento, ma è sottinteso che il titolare abbia adottato e sappia dimostrare l’adeguatezza delle misure necessarie perché il trattamento sia conforme ai principi generali (Capo II del Regolamento) e sia consentito l’esercizio dei diritti degli Interessati (Capo III del Regolamento).

Definizione del processo di gestione del rischio

I rischi per la protezione dei dati personali non possono essere decontestualizzati dal più ampio processo della “Gestione dei rischi aziendali”, c.d. Enterprise Risk Management (ERM), in una visione aziendale generale che dovrebbe essere basata sul rischio. Il processo di gestione del rischio per la protezione dei dati personali, pertanto, dovrebbe anch’esso considerare preliminarmente il settore in cui opera l’organizzazione, i suoi particolari obiettivi di business, le principali attività svolte in termini di servizi e prodotti offerti, la sua struttura, i processi organizzativi adottati, i sistemi informatici utilizzati, le sedi, i relativi portatori d’interesse (utenti, dipendenti, clienti, pazienti, ecc.) e la diversità dei criteri di identificazione e valutazione del rischio. Tutti elementi che contribuiscono a rivelare e valutare la natura e la complessità dei rischi specifici connessi al trattamento dei dati personali.

Il processo di gestione del rischio per la protezione dei dati personali, essendo applicabile a tutti i settori economici, dovrebbe fa riferimento in generale alla norma di ISO 31000 che ha, tra i suoi scopi, anche quello di armonizzare i processi della gestione del rischio di una organizzazione alle norme attuali e future. Al riguardo, diverse norme, che definiscono i criteri e le linee guida per i sistemi di gestione aziendale basati sul rischio, fanno riferimento alla ISO 31000, al fine di determinare i criteri per lo sviluppo di un processo di gestione del rischio adeguato agli obiettivi dell’organizzazione.

La definizione generale che può essere fornita per il processo di gestione del rischio (o anche Risk Management) è relativa allo sviluppo di un processo complessivo di identificazione, analisi e ponderazione e trattamento del rischio, dove quest’ultimo rappresenta l’adozione delle misure necessarie a mitigare i rischi residui. In altre parole, la gestione del rischio è un insieme di attività volte ad identificare i rischi, calcolarne il livello di gravità, decidere se sono accettabili o da ridurre e, se del caso, agire in modo da prevenirne o limitarne gli effetti. Pertanto, il processo di valutazione del rischio risulta essere parte del processo generale di gestione del rischio, come rappresentato nella figura seguente:
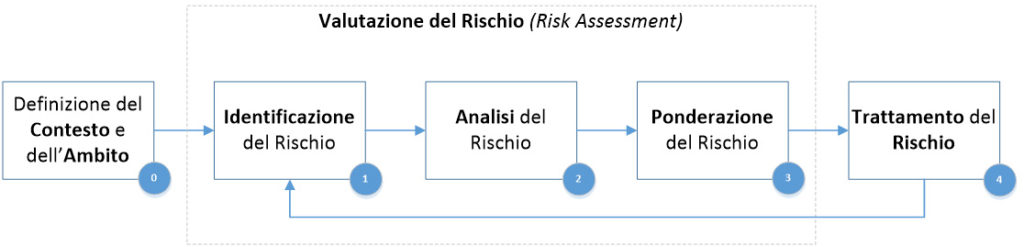
Figura 1: processo di Gestione del Rischio

Le fasi che costituiscono il processo possono essere descritte come segue:

  1. Identificazione del Rischio: il processo di valutazione del rischio del trattamento deve prevedere una prima valutazione che stabilisca quali siano i rischi per i diritti e le libertà delle persone fisiche a cui l’organizzazione è potenzialmente esposta. L’obiettivo di tale fase è quello di generare un elenco completo dei rischi, basato sull’individuazione di quegli eventi che possono generare un accesso illegittimo, una modifica indesiderata o una perdita dei dati, coerenti con il contesto, con i termini del trattamento e gli strumenti utilizzati. L’identificazione globale è un’attività critica, poiché un rischio non identificato in questa fase non viene considerato nelle fasi successive. Oltre ad identificare i rischi per i diritti e le libertà degli Interessati, è necessario considerare gli effetti negativi che possono essere generati (valutazione degli impatti) come, ad esempio, un danno per la reputazione, discriminazione, furto d’identità, perdite finanziarie, danni fisici o psicologici, perdita di controllo dei dati, ecc. Al riguardo, l’Organizzazione dovrebbe applicare metodologie e strumenti per l’identificazione dei rischi adatti per la natura, l’ambito di applicazione, il contesto e le finalità del trattamento. Nella fase d’identificazione dei rischi è importante avere disponibili informazioni pertinenti ed aggiornate, come check-list e appropriate informazioni derivanti dal riesame dei dati storici (IEC 31010 par. 5.2 Risk identification). L’elemento principale in cui consiste il processo di identificazione dei rischi è la mappatura dei rischi al trattamento, anche se le metodologie di mappatura possono variare in base al contesto e ai principi generali applicati nella gestione dei rischi derivanti dal trattamento dei dati. L’identificazione dei rischi e la conseguente mappatura è preliminare alla fase successiva di analisi dei rischi del trattamento di dati personali e andrebbe effettuata su più livelli, tenendo conto che un rischio può incombere su uno o più trattamenti o su parti di esso.
  2. Analisi del rischio: questa fase implica lo sviluppo di una conoscenza specifica degli stessi, fornisce i dati per effettuare la ponderazione dei rischi e per prendere decisioni sulla necessità di gestione o meno di ogni singolo rischio identificato, risultando oltremodo di supporto alle strategie ed ai metodi di trattamento dei rischi (par. 5.4.3 UNI ISO 31000). L’analisi del rischio richiede una valutazione sull’origine, la natura, la gravità per la protezione dei dati personali, la loro probabilità di accadimento e l’impatto sui diritti e le libertà degli interessati. Il rischio è analizzato mediante la determinazione della gravità per la protezione dei dati e la probabilità che tale rischio si concretizzi. L’analisi del rischio può essere intrapresa con vari livelli di dettaglio, in funzione del rischio, dello scopo dell’analisi e delle informazioni, dei dati e delle risorse disponibili, ma è importante che sia coerente con la metodologia e la relativa procedura definita dall’Organizzazione. L’elemento importante che deriva dal Considerando 76 del Regolamento è la differenziazione tra “rischio” e “rischio elevato”, dove quest’ultimo dovesse presentare un rischio elevato per i diritti e le libertà delle persone fisiche, si dovrebbe applicare, prima di procedere, una valutazione dell’impatto per la protezione dei dati personali (DPIA). Come visto in precedenza, la DPIA deve valutare, oltre i rischi per la sicurezza del trattamento (ai sensi dell’art.32), la necessità e proporzionalità del trattamento.
  3. Ponderazione del Rischio: l’obiettivo di questa fase è di agevolare, sulla base degli esiti dell’analisi del rischio, i processi decisionali riguardo quali rischi necessitano un trattamento e le relative priorità di attuazione, considerando gli obiettivi dell’organizzazione ed il contesto in cui la stessa organizzazione opera, nonché l’equilibrio tra costi e benefici nel trattare i rischi stessi. La ponderazione del rischio implica il confronto tra il livello di rischio identificato durante il processo di analisi ed i criteri di rischio stabiliti per la rappresentazione della sua significatività (ad esempio, Alto, Medio, Basso). La necessità di trattamento, o anche di adottare misure tecniche ed organizzative adeguate a ridurre il livello di rischio determinato, può essere considerata sulla base di questo confronto. Con la ponderazione del rischio si perviene alla conclusione della fase di “Valutazione del rischio” producendo risultati tesi a massimizzare l’efficacia e l’efficienza delle misure di trattamento dei rischi assunti; ma si perviene, soprattutto, ad effettuare misurazioni nel continuo dei rischi, al fine di verificare l’emergere di rischi prima ritenuti poco significativi per l’organizzazione.
  4. Trattamento del Rischio: Il trattamento del rischio implica la selezione di una o più opzioni per modificare il livello dei rischi individuati e l’attuazione di tali opzioni. Le opzioni di trattamento del rischio non sono necessariamente incompatibili tra loro o adatte a tutte le circostanze e possono comprendere:
    a) evitare il rischio decidendo di non avviare o continuare l’attività che comporta l’insorgere del rischio;
    b) assumere o aumentare il rischio al fine di perseguire una opportunità;
    c) rimuovere l’origine del rischio;
    d) modificare la probabilità;
    e) modificare la gravità per la protezione dei dati;
    f) condividere il rischio con altra parte o parti (ad esempio forme assicurative, contratti di fornitura, ecc.); e
    g) ritenere il rischio con una decisione informata.

La scelta dell’opzione di trattamento del rischio più appropriata implica l’individuazione delle misure tecniche ed organizzative adeguate a gestire il livello di rischio identificato, tenendo conto del bilanciamento dei costi e degli sforzi di attuazione a fronte dei benefici derivanti, dei requisiti cogenti e dei diritti e delle libertà degli Interessati. È da notare che il rispetto delle disposizioni del Regolamento dovrebbero imporre all’Organizzazione una propensione a ridurre sempre il livello di rischio identificato, adottando misure tecniche ed organizzative adeguate definite dal piano di trattamento.

Il piano di trattamento dovrebbe identificare chiaramente l’ordine di priorità in cui i singoli trattamenti del rischio dovrebbero essere attuati. Poiché, il trattamento stesso del rischio può introdurre rischi come, ad esempio, il fallimento o l’inefficacia delle misure di trattamento individuate, è necessario che il monitoraggio sia una parte integrante del piano in modo da assicurare che le misure siano e rimangano efficaci. Le informazioni fornite nei piani di trattamento dovrebbero comprendere:

  • le motivazioni per la scelta delle opzioni di trattamento, compresi i benefici attesi;
  • i soggetti che devono rendere conto dell’approvazione del piano e quelli responsabili della loro attuazione;
  • le misure tecniche ed organizzative proposte;
  • le risorse necessarie per l’attuazione delle misure tecniche ed organizzative proposte;
  • la tempistica e la programmazione.

I piani di trattamento dovrebbero essere integrati con il processo di gestione del trattamento e discussi con i responsabili delle strutture organizzative deputate all’attuazione della politica per la protezione dei dati personali.

Questa definizione generale del processo può essere applicata alla protezione dei dati personali, come anche all’analisi dei rischi strategici di un’organizzazione, di quelli finanziari, di quelli sulla sicurezza dei lavoratori, ecc.

Per poter sviluppare un processo coerente e adeguato, è possibile riferirsi ad alcuni standard e linee guida che utilizzano un approccio basato sul rischio per l’implementazione del relativo sistema di gestione aziendale (ad esempio, ISO 9001, ISO 27001, UNI/PdR 43.1:2018, ecc.), oppure che definiscono in particolare il processo di gestione del rischio per la protezione dei dati personali.

Il primo standard internazionale che è opportuno considerare è la ISO/IEC 29134, dal titolo “Guidelines for privacy impact assessment”, che integra le norme della famiglia ISO per la gestione dei dati personali (ISO 29100, ISO 29151, ISO 27018) e specifica il processo e le linee guida per effettuare una privacy impact assessment (PIA), la cui denominazione è possibile considerarla sinonimo della DPIA del Regolamento. Lo standard non concentra la sua attenzione sui trattamenti, anche se sarebbe possibile interpretarlo in quest’ottica, ma sugli elementi, o asset, che concorrono all’elaborazione ed archiviazione dei dati (principalmente programmi, sistemi informatici, processi, ecc.). Di particolare interesse, oltre a definire i criteri per una gestione del rischio adeguata, risulta essere l’Allegato B, dove viene fornito un catalogo di minacce generiche per la protezione dei dati, tenendo conto della tipologia di asset a cui si applicano (hardware, software, reti di comunicazione elettronica, persone e documenti cartacei) e delle possibili azioni che possono essere condotte dalle minacce (ad esempio, attacchi informatici, virus e malware, errori utente, eventi climatici, ecc.). Il processo di valutazione del rischio presenta, quindi, un livello di dettaglio più ampio se riferito al trattamento di dati personali nel suo insieme, andando ad analizzare le vulnerabilità delle sue componenti che possono essere sfruttate dalle minacce. A titolo esemplificativo, possiamo riferirci alle vulnerabilità del software che possono essere sfruttate da hacker per portare i loro attacchi al sistema informativo dell’organizzazione; oppure, carenze da parte di quest’ultima per le attività di formazione e sensibilizzazione del personale riguardo la sicurezza dei sistemi informatici utilizzati, che possono causare un’involontaria installazione sui computer in dotazione di codice malevolo.

La ISO/IEC 29134 per diversi aspetti ricorda molto la metodologia e le linee guida pubblicate dal CNIL (Commission nationale de l’informatique et des libertés), l’Autorità di Controllo francese per la protezione dei dati personali. Creata nel 1978, il CNIL è un’autorità amministrativa indipendente che esercita le sue funzioni in conformità con il French Data Protection Act del 6 Gennaio 1978, modificata dalla legge del 20 giugno 2018 in accordo con le disposizioni del Regolamento (UE) 2016/679. L’ordinamento nazionale francese prevedeva, già prima dell’entrata in vigore del Regolamento nel maggio del 2016, lo strumento della valutazione di impatto per la protezione dei dati, denominato anch’esso Privacy Impact Assessment (PIA). Nel corso degli anni ha sviluppato ed aggiornato la metodologia e gli strumenti per poterla effettuare conformemente al Regolamento, arrivando a pubblicare nel febbraio del 2018 l’ultima versione, recependo i criteri contenuti nell’Allegato 2 delle Linee Guida n. wp248 rev1.0 del WP29 e dichiarando la sua compatibilità con gli standard internazionali sulla gestione del rischio ([ISO 31000).

L’approccio sviluppato dal CNIL per l’esecuzione di una PIA conforme al Regolamento, riprende i punti evidenziati nell’Allegato 2 delle Linee Guida n. wp248 rev1.0 del WP29 e possono essere riassunti in:

  1. definizione e descrizione del contesto del trattamento dei dati personali in esame;
  2. analisi dei controlli che garantiscono il rispetto dei principi fondamentali del Regolamento: la proporzionalità e la necessità del trattamento (articolo 5) e la protezione dei diritti delle persone interessate (Capo III);
  3. valutazione dei rischi per la privacy associati alla sicurezza dei dati e garantire che siano trattati correttamente;
  4. documentazione ed accettazione formale della PIA.

Per quanto riguarda la valutazione dei rischi di sicurezza dei dati, riprende quanto già indicato nella ISO 29134, fornendo la definizione di rischio come: “uno scenario ipotetico che descrive un evento temuto e tutte le minacce che permetterebbero che ciò accadesse”, indicando più specificamente:

  • le fonti di rischio (ad esempio, un dipendente corrotto da un concorrente)
  • le vulnerabilità delle risorse di supporto che potrebbero essere sfruttate (ad esempio, il sistema di gestione dei file che consente la manipolazione dei dati)
  • il contesto di minacce (ad esempio, un uso improprio di e-mail)
  • gli eventi temuti che potrebbero verificarsi (ad es. un accesso illegittimo ai dati personali)
  • la natura dei dati personali soggetti al rischio (ad esempio: file cliente)
  • gli impatti sulla privacy degli interessati (ad esempio, sollecitazioni indesiderate, sentimenti di violazione della privacy, problemi personali o professionali).

Al documento che descrive la metodologia, il CNIL ha accompagnato anche un modello “tipo” di PIA e, soprattutto, un documento (denominato Knowledge base) che descrive in dettaglio gli elementi e i criteri del processo PIA da considerare. Per comprendere al meglio il processo di valutazione dei rischi per la sicurezza dei dati, risulta molto utile l’elenco degli esempi di minacce che possono incombere sulle categorie di asset che concorrono ai trattamenti, suddivisi per le possibili conseguenze che potrebbero ricadere sulla loro protezione (accesso illegittimo, modifiche indesiderate e perdita). Pur considerando punto centrale il trattamento per valutare tramite la PIA la conformità alla disposizione del Regolamento, il CNIL non prescinde dalla valutazione del rischio per i diritti e le libertà degli Interessati dall’analisi degli asset utilizzati per il trattamento (hardware, software, reti, persone, mezzi cartacei) e delle potenziali minacce a cui possono essere esposti, come già visto nella ISO29134.

Il CNIL ha, inoltro, pubblicato un software per la conduzione di una PIA, che rappresenta in realtà un modello di documento che indica quali argomenti trattare in ciascun capitolo del rapporto di PIA, seguendo la metodologia e le linee guida di cui sopra.

Un’altra metodologia interessante per la gestione del rischio è quella pubblicata dall’ENISA (Agenzia europea per la sicurezza delle reti e delle informazioni), per aiutare le PMI ad effettuare la valutazione dei rischi per la sicurezza dei trattamenti ed adottare conseguentemente le contromisure necessarie per la protezione dei dati personali. Su questa base e come parte del suo continuo supporto sull’implementazione delle politiche di sicurezza della UE, ENISA ha pubblicato nel 2016 una serie di linee guida per le PMI che agiscono come Titolare o come Responsabile del trattamento. Nel corso del 2017 l’Agenzia ha continuato la sua attività e si è concentrata sulla fornitura di ulteriori indicazioni circa l’applicazione delle sopradescritte linee guida, attraverso lo sviluppo di casi di utilizzo specifici e criteri interpretativi, in stretta collaborazione con gli esperti delle autorità nazionali per la protezione dei dati, rendendo tali linee guida utili in tutti i casi in cui è prevista la valutazione del rischio ai sensi del Regolamento (vedi DPIA e sicurezza del trattamento). E’ da sottolineare che la norma UNI/PdR 43.1:2018 ritiene la pubblicazione dell’ENISA una best practice di mercato riconosciuta ed affidabile anche per organizzazioni diverse dal settore PMI, in grado di assicurare l’esaustività delle misure di sicurezza da valutare ed adottare nel processo di gestione del rischio, rendendo disponibile un elenco di controlli divisi in funzione del livello di rischio a cui è esposto il trattamento e sulla base dei controlli di sicurezza previsti dalle norme internazionali ISO/IEC 27001 e ISO/IEC 27002.

Il documento non nomina quasi mai la PIA, ma presenta un metodo molto semplice e pragmatico per la valutazione del rischio dei trattamenti, mantenendo il punto di vista del trattamento piuttosto degli asset che vengono utilizzati per l’elaborazione ed archiviazione dei dati, come già visto nella ISO 29134 e nelle Linee Guida del CNIL.

La pubblicazione dell’ENISA, in particolare, si fonda su un processo semplificato di valutazione del rischio, suddiviso in 4 fasi:

  1. Definizione dell’operazione di trattamento e del relativo contesto: questa fase è da considerarsi come il punto di partenza della valutazione del rischio e risulta fondamentale per definire i termini del trattamento dei dati oggetto di valutazione (ad esempio, finalità perseguite, natura dei dati trattati, strumenti utilizzati, destinatari dei dati, ecc.).
  2. Comprensione e valutazione dell’impatto per i diritti e le libertà degli interessati: questa fase ha l’obiettivo di valutare l’impatto sui diritti e sulle libertà degli Interessati, derivanti dall’eventuale perdita di sicurezza dei dati, utilizzando metodologie qualitative e una scala di valori (Basso/Medio/Alto/Molto Alto). Per supportare la fase di valutazione, vengono proposte una serie di domande volte ad identificare il livello di impatto in termini di perdita di riservatezza, integrità e disponibilità dei dati, come ad esempio:
    a) Quale potrebbe essere l’impatto per l’Interessato in caso di divulgazione non autorizzata (perdita di riservatezza) dei dati che lo riguardano?
    b) Quale potrebbe essere l’impatto per l’Interessato in caso di un’alterazione non autorizzata (perdita di integrità) dei dati che lo riguardano?
    c) Quale potrebbe essere l’impatto per l’Interessato in caso di distruzione o perdita non autorizzata (perdita di disponibilità) dei dati che lo riguardano?

Per ciascun valore considerato valore di impatto considerato (Basso/Medio/Alto/Molto Alto), vengono forniti degli esempi di danni materiali o immateriali in cui le persone fisiche possono incorrere, in modo da agevolare la selezione del livello di rischio inerente al trattamento, avendo il punto di vista degli Interessati.

  1. Definizione delle possibili minacce e la valutazione della loro probabilità: questa fase ha lo scopo di comprendere le minacce correlate al contesto complessivo del trattamento dei dati personali (esterno o interno) e valutare la loro probabilità (probabilità di accadimento della minaccia). Per semplificare il processo, è stato realizzato un questionario di 20 domande, suddiviso in 4 aree rilevanti, che mira a sensibilizzare l’organizzazione sugli elementi del trattamento e su quei fattori che possono consentire alle minacce di violare la sicurezza dei dati personali. In tale prospettiva, le domande sono relative a quattro diverse aree di valutazione che interessano gli ambienti di elaborazione e trattamento dei dati, vale a dire:
    a) Risorse di rete e tecniche (hardware e software);
    b) Processi/procedure relativi all’operazione di trattamento dei dati;
    c) Parti/persone coinvolte nel trattamento di dati personali;
    d) Settore di operatività e scala del trattamento.

Ciascuna domanda rappresenta una minaccia inerente del trattamento a cui viene richiesto all’Organizzazione di valutare il livello probabilità di occorrenza, utilizzando una scala di valori (Basso/Medio/Alto).

  1. Valutazione del rischio, combinando la probabilità di accadimento della minaccia e il relativo impatto: questa fase ha l’obiettivo di effettuare la valutazione finale del rischio, dopo aver valutato l’impatto dell’operazione di trattamento dei dati personali e la probabilità di accadimento della minaccia rilavante, utilizzando una griglia di valori 3×3, al fine di ottenere la stima del livello di rischio in una scala Basso/Medio/Alto.

Al termine della valutazione, l’Organizzazione è in grado di procedere con la selezione delle misure di sicurezza appropriate al livello di rischio calcolato per la protezione dei dati personali. Le misure sono, peraltro, perfettamente coerenti con quelle proposte dalla norma ISO 27001:2013 (norma cardine sulla sicurezza delle informazioni).

Conclusioni

In conclusione, alle norme e linee guida sopra citate, è possibile aggiungere numerosi altri documenti pubblicati per fornire un aiuto nelle realizzazione di un processo di gestione del rischio per la protezione dei dati, ma ciascuna della metodologia o del processo utilizzato dall’Organizzazione dovrà prevedere alcune fasi preliminari per dimostrare il rispetto del principio di accountability e altre fasi successive essenziali per gestire correttamente le risultanze, in modo da rendere l’intero processo adattabile e aggiornabile al mutare delle condizioni e delle esigenze organizzative. A tal fine, è possibile riassumere le macro-fasi del processo di gestione del rischio nell’ambito dei trattamenti effettuati dall’Organizzazione:

  1. Mappatura dei processi e dei servizi che sottintendono gli scopi per cui vengono trattati i dati personali, tenendo conto delle finalità perseguite, della natura dei dati, delle categorie di interessati, di eventuali destinatari o trasferimenti dati a un paese terzo, nonché degli strumenti, o asset, utilizzati per la loro raccolta ed elaborazione;
  2. Esecuzione della DPIA, qualora il trattamento presenti un rischio elevato intrinseco per i diritti e le libertà degli interessati, ovvero ricada nelle fattispecie indicate, dall’articolo 35, comma 3 del Regolamento, dal Garante o dal WP29.
  3. Valutazione del rischio per la sicurezza del trattamento e dei dati trattati, sia nel caso sia parte integrante della DPIA, sia per tutti i tutti i trattamenti in essere e che devo rispondere all’obbligo di cui all’articolo 32 del Regolamento;
  4. Ponderazione del rischio valutato in funzione dei criteri di accettazione stabiliti dall’Organizzazione, in modo da individuare le opzioni di trattamento del rischio coerenti (evitare, modificare, condividere, ecc.) e le relative misure tecniche ed organizzative da adottare, che costituiscono i Piani di trattamento del rischio.
  5. Richiesta di consultazione preventiva all’autorità di controllo, prima di procedere al trattamento, qualora la DPIA indichi che il trattamento presenta un rischio elevato in assenza di misure o di misure sufficientemente efficaci che l’Organizzazione può adottare per mitigare tale rischio.
  6. Costituzione ed aggiornamento del Registro dei rischi per la protezione dei dati, al fine di mantenere un elenco aggiornato e periodicamente adattabile delle valutazioni effettuate, incluse le DPIA.

Il Regolamento, come precedentemente trattato, non specifica una metodologia specifica da seguire per effettuare la valutazione del rischio per i diritti e le libertà degli Interessati, salvo fornire alcune indicazioni nei Considerando 83 e 85, che chiariscono quanto disposto all’articolo 32 del Regolamento. Pertanto, anche se il processo complessivo di gestione del rischio che può adottare l’Organizzazione può essere diverso ed ispirato a standard e linee guida differenti, è utile far riferimento alla norma ISO 31000, in quanto, in grado di porre ogni organizzazione nelle condizioni di individuare, analizzare e gestire tutti i rischi incombenti nell’ambito della propria attività, attraverso un approccio strutturato.

Per quanto riguarda, invece, le modalità e le operazioni da seguire per la valutazione del rischio, è da registrare che le norme prese in esame propongono un livello di dettaglio differente, in funzione che l’oggetto dell’analisi sia il trattamento nel suo insieme, oppure siano considerati gli asset che lo costituiscono. Pertanto, il livello di dettaglio prodotto dalla valutazione del rischio sarà sicuramente diverso in funzione che l’oggetto sia il trattamento, piuttosto che gli asset che lo costituiscono. Per definire e realizzare un corretto processo di valutazione del rischio è necessario avere chiare gli obiettivi e la disponibilità delle informazioni necessarie, in modo da individuare i metodi più adeguati.

Al riguardo, è possibile utilizzare la piramide di Robert Anthony per comprendere quale approccio adottare per il processo di valutazione del rischio, in funzione degli obiettivi gestionali o operativi di diversa lunghezza temporale che si vuole. Rappresenta, in particolare, un modello gerarchico di comportamento organizzativo, articolato su tre livelli di decrescente importanza e che può essere mutuato, pertanto, anche per definire l’approccio del processo di valutazione del rischio:

  1. A livello strategico sono richiesti dati stimati e approssimati, utili per dare indirizzi con prospettive a lungo termine (qualche anno) e per individuare i rischi principali, in modo da definire un programma di implementazione di misure tecniche ed organizzative adeguato, che possono essere comuni anche a più trattamenti. Questo può essere il caso, ad esempio, di un’Organizzazione che deve predisporre il Registro dei trattamenti ed effettuare la valutazione del rischio ex novo per tutti i trattamenti censiti, richiedendo un approccio semplificato e rapido per rispondere nei tempi agli obbiettivi prefissati. Di conseguenza, la valutazione del rischio potrà avere come oggetto il trattamento, piuttosto, che i singoli asset che lo compongono, in modo da ottenere più velocemente informazioni utili su eventuali impatti che possono derivare dal trattamento sui diritti e le libertà degli Interessati e adottare, conseguentemente, le misure di sicurezza che possono conseguire efficaci risultati di protezione dei dati a lungo termine (ad esempio, pseudonimizzazione e cifratura dei dati personali, politiche di sicurezza, back up dei dati e dei sistemi, controllo degli accessi ai dati e ai sistemi, ecc.), definendo, al contempo, le basi per lo sviluppo di un sistema di gestione della protezione dei dati adeguato.
  2. A livello tattico sono richiesti dati consuntivi, arrotondati e abbastanza tempestivi, utili per avere indicazioni sull’andamento delle attività operative e prendere decisioni con prospettive a medio termine (qualche mese). Questo tipo di approccio del processo di valutazione del rischio può essere indicato, ad esempio, successivamente alla prima ricognizione, soprattutto per ottenere un dettaglio maggiore dei rischi specifici di ciascun trattamento censito dall’Organizzazione. Tale approccio richiede, quindi, l’individuazione dell’origine, natura, gravità, probabilità ed impatto sui diritti e le libertà degli interessati, tenuto conto degli strumenti utilizzati (hardware, software, reti di comunicazione elettronica, persone, mezzi cartacei) e di un modello di controlli esaustivo per valutare le vulnerabilità del sistema di protezione dei dati ed adottare misure di sicurezza adeguate al rischio (ad esempio, ISO 27002, ISO 29151, ecc.). Tale approccio è particolarmente indicato per verificare periodicamente l’efficacia delle misure di sicurezza tecniche e organizzative adottate, anche in funzione dei possibili cambiamenti che possono avvenire in riferimento ai termini del trattamento, alle responsabilità organizzative, all’introduzione di nuove tecnologie e, in special modo, all’evoluzione delle minacce informatiche.
  3. A livello operativo i dati devono essere esatti e in tempo reale, poiché servono ad effettuare e tenere sotto controllo le attività in corso. Il processo di valutazione del rischio in questo caso deve essere supportato da adeguati strumenti e risorse, in grado di individuare e contrastare le minacce per la protezione dei dati in tempo reale (ad esempio, Intrusion Prevention System) o di determinare tempestivamente se è avvenuta una violazione dei dati personali (ad esempio, SIEM), al fine di ottemperare agli obblighi di notifica previsti dal Regolamento.

Concludendo, qualsiasi metodologia utilizzata, punto di vista adottato o processo definito, la valutazione del rischio per la sicurezza del trattamento e dei dati trattati non può prescindere da considerare la sua “origine, natura, gravità, probabilità e impatto sui diritti e le libertà degli interessati” (cfr. Garante per la protezione dei dati).

Articolo a cura di Ivano Pattelli

Ivano Pattelli è Associate Manager presso Business Integration Partners S.p.A. e si occupa di sviluppo business e di servizi di consulenza in ambito cyber security e protezione dei dati personali, per clienti di grandi dimensioni nei diversi settori di appartenenza (pubblica amministrazione, sanità, telco, finance, luxury, ecc.). In precedenza, ha maturato un esperienza pluriennale in importanti società di consulenza ed in multinazionali del settore ICT (Ernst & Young, TTP, HPE), occupandosi principalmente di attività nell’ambito dell’IT Security Governance, Risk & Compliance, con particolare focus sugli aspetti di conformità normativa in materia di protezione dei dati personali. Nel corso degli anni ha conseguito diverse certificazioni, quali ISO/IEC 27001:2013 Lead Auditor, CISSP, CISA, CRISC, “Privacy Officer e Consulente della Privacy” di TUV Italia, European Privacy Auditor ISDP©10003:2015 e Lean 6 Sigma Green Belt.

Download PDF

https://www.ictsecuritymagazine.com/articoli/gestione-del-rischio-quale-processo-adottare-per-la-protezione-dei-dati-personali/
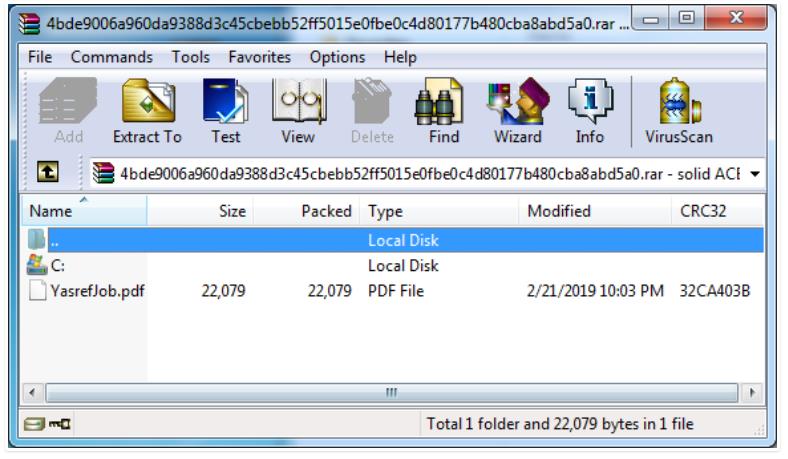
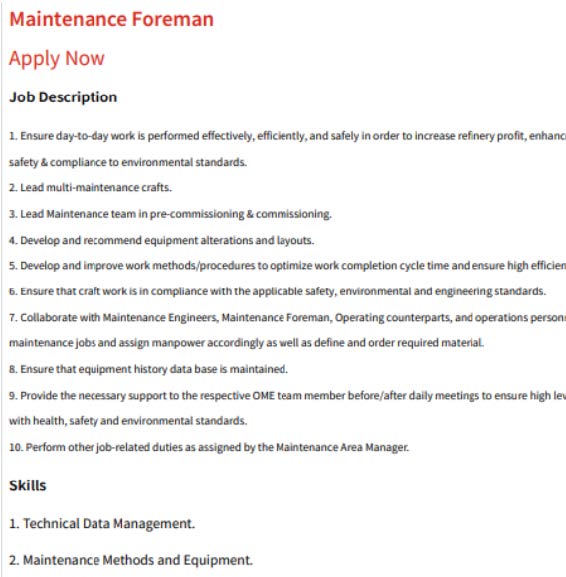
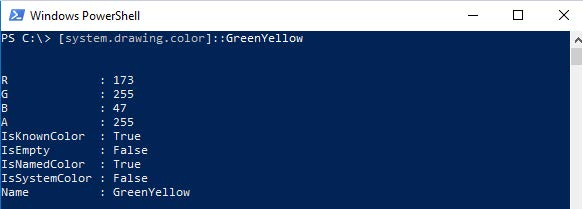
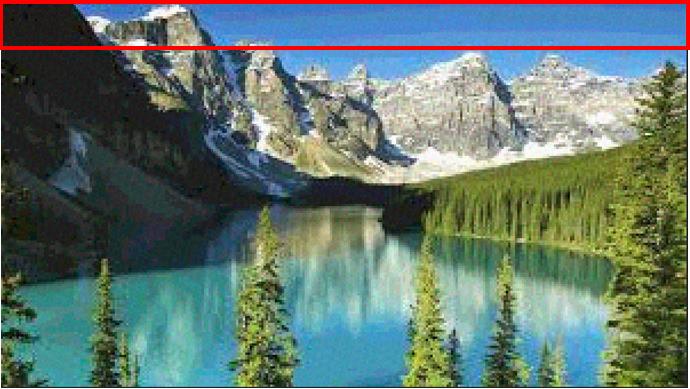
Sistemi di sorveglianza e sicurezza

Il 7 febbraio 2019 è uscito sul Corriere della sera un articolo di Massimo Gaggi dal titolo “Usa, il business sicurezza nelle scuole”.

Dopo le stragi compiute da ragazzini nelle proprie scuole (la più famosa è quella della Columbine High School del 1999 con 15 morti; la più recente è quella di Parkland, con 17 morti), le contromisure non hanno portato alla riduzione delle armi da fuoco, ma all’aumento dei sistemi di videosorveglianza nelle scuole, con migliaia e migliaia di telecamere.

Con le dovute cautele, è possibile vedere alcuni parallelismi tra questa vicenda e alcune tendenze nell’ambito della sicurezza delle informazioni.

Prevenzione e rilevazione

Chiunque si occupa di sicurezza sa che le misure di rilevazione sono importanti, ma meno efficaci di quelle di prevenzione. Eppure le misure di rilevazione (telecamere, IDS, SIEM, vulnerability assessment e penetration test, processi di gestione degli incidenti) sono oggetto da sempre di maggiore interesse da parte dei venditori e degli utilizzatori delle misure di sicurezza.

Consideriamo solo due esempi. Il primo riguarda il NIST Cybersecurity framework, un insieme di 108 controlli di sicurezza pubblicati dal National Institute of Standards and Technology degli USA e adottati, tra gli altri, dalla BCE e dal “Framework Nazionale per la Cybersecurity e la Data Protection”. I controlli dedicati alla rilevazione e al trattamento degli incidenti e delle vulnerabilità (controlli di rilevazione e di recupero) sono più di 40 (più del 30%). Ad essi vanno aggiunti altri controlli come quelli di verifica dell’integrità (PR.DS-6 e PR.DS-8). I controlli relativi alla configurazione sicura dei sistemi sono invece… uno (il PR.IP-1). Da questo punto di vista, sembra sicuramente meglio bilanciata la ISO/IEC 27001, che dedica 7 controlli su 114 alla gestione degli incidenti.

Il secondo esempio riguarda controlli di rilevazione come i vulnerability assessment e i penetration test, più pubblicizzati rispetto a quelli preventivi di configurazione sicura dei sistemi e di programmazione dei software da parte anche di persone qualificate. Tre casi tra gli altri:

  • AgID e Accredia, per la qualifica dei servizi di conservazione, hanno promosso uno schema di certificazione delle società che vendono servizi di vulnerability assessment e penetration test, senza però promuovere schemi di certificazione delle competenze dei sistemisti, degli addetti alle reti e degli sviluppatori dei software;
  • oggi lo schema di certificazione delle competenze degli “esperti di sicurezza” più riconosciuto è quello da Lead auditor ISO/IEC 27001, nonostante sia rivolto a persone addette alla verifica e non alla pianificazione e attuazione di un sistema di gestione per la sicurezza delle informazioni;
  • relativamente alla sicurezza applicativa, il punto di riferimento più significativo è The OWASP™ Foundation (owasp.org); nella sua home page, i Flagship Projects (ossia i progetti ritenuti più significativi) sono 16 e più della metà di essi riguardano strumenti per identificare vulnerabilità, non per prevenirle.

Il caso della celebre OWASP Top ten è significativo: sebbene raccolga misure di prevenzione, è presentata inizialmente come strumento di identificazione delle vulnerabilità.

Come parlare (ma non usare) l’analisi del rischio

Nei supermercati è presente un gruppo ridotto di guardie addette alla prevenzione dei furti. Sicuramente i furti sono numerosi, ma non sufficienti per mettere in discussione il modello economico e organizzativo, per cui è evidentemente più conveniente la riduzione dei costi del personale rispetto alle perdite dovute ai furti. Nei supermercati sono comunque numerosi i dispositivi di videosorveglianza, necessari anche a dissuadere alcuni ladri.

Nel caso dei supermercati, l’analisi del rischio indica che il costo di ciascun evento è basso, anche se la probabilità è elevata. Questo giustifica l’uso delle misure di rilevazione (telecamere) e non di prevenzione (personale di vigilanza).

Nel caso delle stragi nelle scuole, l’analisi del rischio dovrebbe indicare che la probabilità di accadimento è bassa, ma le conseguenze sono altissime e questo dovrebbe portare a scegliere misure di sicurezza diverse rispetto a quelle da prevedere per probabilità alte e impatti bassi (per inciso, nel campo della sicurezza delle informazioni, nel caso di probabilità basse e impatti elevati, si preferiscono misure di recupero, come per esempio i backup e i siti di Disaster recovery; quando però sono in gioco vite umane è evidente che non si parla più di “sicurezza delle informazioni” e non è utilizzabile lo stesso schema; questo dimostra, ancora una volta, che ogni materia richiede una sensibilità diversa da quella richiesta da altre materie, anche se apparentemente simili).

I manager e il controllo

Chi prende le decisioni di spesa è un manager. E per un manager, per svolgere il proprio mestiere, il controllo è importantissimo. Lo dimostrano, tra le altre, le teorie dedicate al controllo di gestione, la diffusione del “Management-by-objective” trasformato in “Management-by-measures” e la richiesta ossessiva di report da parte di tanti manager (questo, tra gli altri, ha portato all’introduzione di software gestionali molto complessi, ma anche molto problematici, in quanto l’obiettivo era quello di avere report senza pensare agli impatti sui processi).

Qui non si sta proponendo una critica alle pratiche di gestione delle organizzazioni; si sta solo richiamando l’attenzione su un atteggiamento tipico delle persone che hanno responsabilità all’interno di un’organizzazione. Questo atteggiamento è una delle componenti necessarie al loro ruolo: se non dovessero controllare alcunché, non sarebbero necessarie.

L’orientamento al controllo ha come effetto che i manager, dovendo scegliere, potrebbero preferire misure di rilevazione rispetto a quelle di prevenzione, anche se sono meno efficaci (non si spiegherebbe altrimenti l’introduzione, in alcune organizzazioni, degli inefficaci e inefficienti sistemi di Data loss prevention, che sono soprattutto sistemi di rilevazione).

Sfiducia nel prossimo e fiducia nei venditori

La vicenda del “controllo” delle armi nelle scuole mette in evidenza due atteggiamenti contrapposti ma presenti: il primo è la sfiducia completa nei confronti del prossimo, per cui è necessario armarsi di armi reali o di forme di controllo sempre più sofisticate, il secondo è la fiducia totale nei confronti dei venditori delle tecnologie, nonostante abbiano già dimostrato di potersene approfittare (si veda il caso di Cambridge Analytica).

I venditori di tecnologie hanno un vantaggio: vendono “soluzioni”. Magari non sono efficaci, ma sono sempre “soluzioni”. Un tempo era caratteristica degli informatici rispondere, ad ogni problema di sicurezza informatica, “ho un tool”; oggi sembra la risposta comune. Ancora più apprezzati sono i fornitori che propongono un “servizio chiavi in mano” (installazione della “soluzione”, sua manutenzione ed esercizio).

Conclusione

La tendenza è quindi sempre più quella di rifugiarsi in tecnologie di controllo sempre più sofisticate, complesse da mantenere e che lasciano sempre più spazio di manovra ai fornitori. Invece spesso basterebbe risparmiare su qualche gadget o consulente e investire di più in misure preventive, negli stipendi del personale che c’è già, nella sua formazione e nella sua crescita numerica. Questo permetterebbe anche di ridurre lo stress delle persone spesso costrette ad orari più lunghi del previsto e quindi gli errori. Dovrebbero però essere ridotti anche i super-fornitori, i super-consulenti e le super-tecnologie specializzate nella sorveglianza.

Riferimenti

L’articolo citato è disponibile online al seguente URL: https://www.corriere.it/editoriali/19_febbraio_07/usa-business-sicurezza-scuole-667de962-2afb-11e9-8bb3-2eff97dced46.shtml.

Il sito di OWASP è stato visitato il 12 marzo 2019.

Articolo a cura di Cesare Gallotti

Lavora dal 1999 nel campo della sicurezza delle informazioni, della qualità e della gestione dei servizi IT.

Ha condotto progetti di consulenza per la pubblica amministrazione e per il settore privato. Opera, sia in Italia che all’estero, come Lead Auditor ISO/IEC 27001, ISO 9001, ISO/IEC 200000 e ISO 22301. Ha progettato ed erogato corsi di Quality Assurance e di certificazione Lead Auditor ISO/IEC 27001 e ITIL Foundation.

Tra gli attestati si segnalano: le certificazioni AICQ SICEV Lead Auditor ISO/IEC 27001, IRCA Lead Auditor 9001, CISA, ITIL Expert e CBCI, la qualifica come Lead Auditor ISO/IEC 20000 e il perfezionamento postlaurea in “Computer Forensics e investigazioni digitali”.

E’ capodelegazione del WG1 del comitato italiano ISO/IEC SC27 in UNINFO.

Ha pubblicato il libro, aggiornato nel 2017, “Sicurezza delle informazioni: valutazione del rischio; i sistemi di gestione; la norma ISO/IEC 27001:2013”.

Cura la pubblicazione, dal 2008, della newsletter “IT Service management news” (http://www.cesaregallotti.it/Newsletter.html).

Web: www.cesaregallotti.it; Blog: blog.cesaregallotti.it

Download PDF

https://www.ictsecuritymagazine.com/articoli/sistemi-di-sorveglianza-e-sicurezza/


L’email non è uno strumento sicuro: dalla Business Email Compromise allo Spoofing

1.1  La Business E-mail Compromise (BEC): che cos’è e quanti danni sta causando nelle aziende

Oggi la maggior parte delle truffe informatiche sono realizzate utilizzando l’e-mail, uno strumento diffuso ma con quale risulta estremamente facile (e poco costoso) applicare le tecniche del Social Engineering e il phishing.

Tra le truffe veicolate attraverso l’e-mail, quella che oggi sta mietendo più vittime (soprattutto in termini economici!) è la Business Email Compromise (BEC). Introduciamo l’argomento raccontando un caso reale, accaduto a settembre 2017 e finito su tutti i giornali.

Il direttore della delegazione della Confindustria presso l’Unione Europea a Bruxelles riceve un’e-mail dalla sua superiore:

“Caro G., dovresti eseguire un bonifico di mezzo milione di euro (in realtà la cifra era leggermente inferiore, ndr) su questo conto corrente. Non mi chiamare perché sono in giro con il presidente e non posso parlare”. Mittente: M. P.

BEC Confindustria

Figura 1. Dal sito di Repubblica.it (30/09/2017), http://www.repubblica.it/cronaca/2017/09/30/news/beffa_a_bruxelles_mister_confindustria_truffato_e_licenziato-176906111/.

Il funzionario della Confindustria a Bruxelles ha eseguito il bonifico – che non avrebbe dovuto fare – e circa cinquecentomila euro sono passati da un conto della Confindustria a un conto estero di cui non si conosce l’intestatario. Soldi evaporati, scomparsi per sempre.

Come è stato possibile? Tutto è cominciato da una mail che era falsa, ma alla quale il funzionario ha purtroppo dato credito. E per questo è stato licenziato.

Il lettore potrebbe pensare: “è stato uno sprovveduto, come si può cascare in una truffa del genere?”

E invece, anche se sembra incredibile, in tantissimi ci cascano…

È successo in Confindustria ma sono centinaia le aziende quotidianamente colpite da frodi finanziarie e addirittura milioni le mail contraffatte (“mail spoofing”, appunto) da cui partono ordini per spostare denaro in ogni parte del mondo.

È accaduto anche alla società calcistica S.S. Lazio, che a marzo 2018 ha pagato l’ultima rata per il giocatore De Vrij su un conto bancario diverso da quello indicato dal club olandese del Feyenoord di Rotterdam. E così, due milioni di euro sono andati in fumo…

Un importante rapporto redatto dal Federal Bureau of Investigation[1] (la ben nota FBI) del 4 maggio 2017 ci mostra i danni generati dalla BEC nel mondo.

BEC Rapporto FBIFigura 2. Il Rapporto FBI del 4 maggio 2017
Secondo l’FBI, le truffe BEC sono state segnalate in oltre cento Paesi e hanno fatto registrare un notevole aumento, pari al 2.370%, delle perdite rilevate tra gennaio 2015 e dicembre 2016.

L’ultimo aggiornamento del Rapporto FBI sulla BEC è uscito il 12 luglio 2018[1]: il totale delle perdite è salito all’astronomica cifra di 12.536.948.299 USD (nel periodo tra ottobre 2013 e maggio 2018). Confrontando i due rapporti scopriamo che in meno di un anno e mezzo (da dicembre 2016 a maggio 2018) sono stati persi per la BEC altri 7,2 miliardi di dollari, con un aumento del 2.200% tra il 2015 ed il 2017 e un picco massimo nel settembre 2017, con oltre 18 milioni di dollari persi in un solo mese.

Quindi, riassumendo, l’e-mail spoofing può servire per veicolare malware (tra i cui i famigerati ransomware), ma anche per la truffa nota come Business E-mail Compromise (BEC) e di cui il caso raccontato (verificatosi in Confindustria) rappresenta solo una delle possibili varianti, quella definita come “CEO Fraud” (la frode del CEO).

Ogni giorno, circa 400 organizzazioni sono vittime di attacchi tramite BEC, che rappresentano un enorme fattore di rischio per le aziende. E nella maggior parte dei casi vengono presi di mira addetti all’interno dello staff finanziario dell’azienda.

Il funzionamento ha le caratteristiche di una truffa classica, dove la tecnologia è soltanto un mezzo nuovo per portare a termine raggiri vecchi.

In genere, i cyber attacchi che sfruttano le e-mail come vettore di minacce cibernetiche al loro interno contengono allegati con malware. Con le CEO Fraud e le BEC, invece, non ci sono allegati, ma solo il corpo normale di un messaggio, nel quale l’attaccante cerca solo di rendersi credibile, “clonando” al meglio il mittente.

L’obiettivo è che la vittima riconosca il messaggio come veritiero, proveniente da una fonte certificata e autorevole. A quel punto, l’aggressore chiederà al suo bersaglio di compiere un gesto specifico, che sia un trasferimento di denaro o fornire l’accesso a informazioni riservate. Quest’ultimo non si insospettirà, perché il messaggio non contiene allegati (considerati pericolosi). Quindi probabilmente eseguirà la richiesta, soprattutto se operazioni simili (bonifici, ecc.) avvengono già in azienda e con le stesse modalità.

1.1.1 La truffa “The Man in the Mail”

Un’altra delle varianti della BEC è la truffa definita “The Man in the Mail”.

I delinquenti intercettano la posta elettronica di un’azienda e fanno in modo che i pagamenti finiscano sui loro conti correnti. Colpisce soprattutto aziende che fanno import/export, in quanto il conto su cui viene dirottato il pagamento si trova all’estero (preferibilmente in paesi molto lontani e generalmente extra-europei).

Ma non solo: ultimamente ho conosciuto molti casi nei quali il conto utilizzato per la truffa era localizzato in Italia (e intestato a un ignaro prestanome). È l’evidenza di un fenomeno in forte crescita e di cyber criminali sempre più intraprendenti.

Come funziona la truffa “The Man in the Mail”?

Il malvivente viola la casella di posta, quella del mittente oppure quella del destinatario, mediante tecniche diverse ma ugualmente efficaci: phishing, social engineering, furto delle credenziali o attacco “brute force”.

Studia quindi le comunicazioni dell’azienda, la carta intestata, le firme dei responsabili, lo stile della corrispondenza. Scopre i ruoli aziendali, individuando – per esempio – chi è preposto ad eseguire i pagamenti ai fornitori.

Poi si inserisce in conversazioni già in corso comunicando, alla persona giusta dell’azienda, coordinate bancarie diverse (le sue!) su cui eseguire i pagamenti. Per fare questo usa appunto lo “spoofing”, falsificando il mittente, oppure usando un indirizzo e-mail appena diverso, o – ancora – accedendo direttamente all’email violata.

In alcuni casi, avendo avuto accesso alla corrispondenza tra cliente e fornitore, riesce anche a richiamare numeri d’ordine o importi relativi a forniture realmente eseguite.

Il risultato è che l’azienda cliente (quella che deve pagare) si vede arrivare un messaggio credibile o addirittura contenente una fattura confezionata con la grafica uguale a quella vera (che l’hacker ha copiato), che indica di eseguire il pagamento su un conto diverso (non quello solito). E probabilmente lo eseguirà senza farsi troppe domande…

I numeri riportati nel citato Rapporto FBI ci fanno capire che questa truffa – se ben organizzata – ha ottime probabilità di successo.

1.1.2 Le varianti della Business Email Compromise

Questa frode si sviluppa in svariate modalità: sono classificate nel citato Rapporto FBI, che indica cinque differenti scenari (ove i primi due sono i più diffusi):

  1. Business tra cliente e fornitore: richiesta di pagamento con e-mail falsificata. Viene definita – come sopra spiegato – “The Man in the Mail” e anche “Bogus Invoice Scheme” “Supplier Swindle” o “Invoice Modification Scheme”.
  2. “CEO Fraud” o “Business Executive Scam”: una richiesta di bonifico bancario viene inviata dall’account compromesso di un dirigente aziendale di alto livello (CEO o Chief Financial Officer) a un dipendente all’interno dell’azienda, che è in genere responsabile dell’elaborazione di tali richieste. È la variante di phishing definita anche “whaling”, perché punta al “pesce grosso”.
  3. Business Contacts through Compromised E-mail: un dipendente di un’azienda ha la sua e-mail personale violata. Questa e-mail personale può essere utilizzata per comunicazioni personali e aziendali. Le richieste di pagamenti di fatture a conti bancari controllati da frodi vengono inviate dall’e-mail personale di questo dipendente a più fornitori, identificati dall’elenco dei contatti di questo dipendente.
  4. Business Executive and Attorney Impersonation: le vittime vengono contattate da truffatori che di solito si identificano come avvocati o rappresentanti di studi legali e sostengono di trattare questioni riservate o urgenti. Le vittime possono essere spinte dal truffatore ad agire rapidamente o segretamente nella gestione del trasferimento di fondi. Questo tipo di truffa BEC può verificarsi alla fine della giornata o della settimana lavorativa ed essere programmata per coincidere con la chiusura delle attività delle istituzioni finanziarie internazionali.
  5. Data Theft (furto di dati): le richieste fraudolente vengono inviate utilizzando l’e-mail compromessa di un dirigente. I destinatari della richiesta sono figure dell’organizzazione aziendale che conoscono dati importanti, come risorse umane, contabilità o auditing. Queste richieste, in genere, si verificano prima di una richiesta fraudolenta di bonifico bancario.

1.1.3 Come difendersi dalla Business E-mail Compromise

Esaminiamo ora come proteggerci da queste frequenti e temibili truffe.

Come sempre è importante avere la consapevolezza (“awareness”) del rischio e non sottovalutarlo. Vediamo quindi quali sono gli accorgimenti da adottare in azienda:

  • Usare credenziali di accesso alle mail robuste e sicure, quindi impostare una corretta gestione delle password.
  • Non utilizzare in azienda indirizzi e-mail basati su webmail, perché sono più facilmente accessibili ed attaccabili.
  • Leggere le mail con attenzione, soprattutto quelle che si riferiscono a pagamenti. Nel dubbio, fare verifiche con mezzi diversi. È cioè molto importante non chiedere la conferma usando lo stesso indirizzo, perché ci risponderebbe il truffatore. Usare piuttosto il telefono, o contattare direttamente il mittente utilizzando l’indirizzo presente nella rubrica aziendale oppure un altro indirizzo e-mail, della cui credibilità siamo certi.
  • Controllare bene il mittente delle e-mail: un dettaglio (anche solo una lettera!) potrebbe fare la differenza. Alcuni esempi di come è facile indurre in inganno con un indirizzo e-mail modificato ad arte: l’e-mail reale info@pippodomus.com potrebbe essere trasformata dal truffatore in: info@pippodornus.com. La sostituzione della lettera “m” con “rn” è difficilmente distinguibile a colpo d’occhio (e chi legge l’e-mail va sempre di fretta…). Oppure potrebbe essere modificata in info@pipp0domus.com sostituendo la lettera “o” con il numero “0”, pressoché identico. O anche: info@pippo-domus.com (un segno meno che passerà facilmente inosservato). E molte altre: l’inventiva degli attaccanti è illimitata…
  • E soprattutto: evitare di pensare “figurati se una cosa del genere può succedere a me”. Può succedere a chiunque, se non si è attenti e consapevoli.

In altre parole: come sempre, è il fattore umano che può fare la differenza.

1.2 Come funziona la posta elettronica e perché è insicura

La BEC, come abbiamo illustrato, è resa possibile grazie al basso livello di sicurezza della posta elettronica.

L’email non è che una delle molte modalità di utilizzo di Internet. È stata una delle prime, creata alla nascita di Internet, e proprio in questo risiede la sua intrinseca debolezza.

La sua invenzione risale infatti al 1971, quando Ray Tomlinson installò su ARPAnet un sistema in grado di scambiare messaggi fra alcune università americane e inviò la prima e-mail. Cosa c’era scritto in quella e-mail? Ray Tomlinson disse di non ricordarlo, ma che probabilmente era una semplice scritta: “QWERTYUIOP” o qualcosa di simile.

Un’altra curiosità: fu proprio Tomlinson a scegliere il simbolo @ per collegare username e dominio e-mail.

Successivamente, nel 1982, fu creato il protocollo SMTP (Simple Mail Transfer Protocol), ancora oggi universalmente utilizzato: tutte le e-mail spedite su Internet vengono trasferite usando questo protocollo in uscita.

protocollo SMTP per emailFigura 3. Come funziona la posta elettronica

SMTP rappresenta l’esempio più evidente di come uno strumento creato quasi per gioco, quindi senza particolare attenzione alla sicurezza, oggi gestisce e controlla tutte le attività della nostra società.

Infatti, quando fu inventata l’email, questa fu pensata come “strumento collaborativo”.
La sicurezza non era un requisito ritenuto importante, quindi le caratteristiche dell’e-mail erano:

  • Nessuna autenticazione del mittente;
  • Nessuna riservatezza del contenuto;
  • Nessuna verifica di integrità lungo il percorso;
  • Nessuna protezione contro messaggi indesiderati.

Per questo, oggi tutti noi usiamo l’e-mail, senza pensare che si tratta di uno degli strumenti più antiquati e vulnerabili della rete.

Il protocollo SMTP è quindi uno dei più vecchi di Internet ed è volutamente mantenuto semplice, visto che un server SMTP deve poter gestire decine di connessioni al secondo. Questa semplicità si traduce in vulnerabilità, perché le due informazioni identificative che il server mittente passa al destinatario (il nome del mittente e l’indirizzo e-mail a cui il messaggio è diretto) non vengono verificate e possono essere quindi facilmente falsificate.

L’e-mail può essere intercettata e letta da un malintenzionato: il cosiddetto “Man in the middle” che si frappone tra mittente e destinatario. Infatti, nella maggior parte dei casi, le e-mail vengono trasmesse non criptate, come se fossero state scritte su una cartolina (che tutti possono leggere!).

Abbiamo detto che tra le molte limitazioni del protocollo SMTP c’è quella che non è in grado di gestire l’autenticazione del mittente. Questo è probabilmente la vulnerabilità più grave, perché viene sfruttata da chi usa l’e-mail come strumento di attacco per fare phishing.

È infatti possibile – e anche abbastanza facile! – inviare e-mail falsificando il mittente.

In altre parole: si può spedire un’e-mail facendo apparire come mittente l’indirizzo corrispondente ad un altro account. Questo anche senza avere accesso all’account falsificato, cioè senza conoscere le credenziali della casella di posta che si usa.

Questa tecnica si chiama spoofing ed è estremamente pericolosa, realizzabile senza grandi competenze informatiche e – ahimè – estremamente efficace.

1.3 Cos’è lo Spoofing?

È una tecnica di attacco utilizzata per falsificare diverse informazioni, come ad esempio l’identità di un host (computer o server connesso in rete) o il mittente di un messaggio. Una volta che un attaccante riesce ad impersonare qualcun altro all’interno di una rete, gli è possibile intercettare informazioni riservate, diffondere informazioni false e tendenziose o effettuare qualsiasi tipo di attacco. Risulta particolarmente efficace combinata a tecniche di social engineering per ottenere l’accesso a informazioni “riservate” e credenziali degli utenti. Social media scammers (truffatori) o phishers possono usare questa tecnica, ad esempio, per convincere un utente a connettersi a un server malevolo intercettando così le sue credenziali, o ad eseguire azioni dannose.

Nonostante lo spam e lo spoofing siano ancor oggi una grave vulnerabilità della posta elettronica, non si ritiene praticabile una revisione radicale del protocollo SMTP, per via del gran numero di implementazioni di questo protocollo e, soprattutto, per la complessità e il costo che comporterbbe una tale modifica.

La tecnica dello spoofing è molto efficace per realizzare attacchi di phishing e soprattutto di spear phishing, che sono diventati gli strumenti di attacco più diffusi, sia a livello privato che aziendale.

Proviamo a pensare cosa potrebbe succedere se ricevessimo un’e-mail proveniente (in apparenza!) da un collega, da un superiore o da un amico. Se questa e-mail è ben confezionata e resa credibile con riferimenti personali o aziendali, sarà abbastanza probabile che il destinatario (la “vittima” dell’attacco) cada nel tranello e apra l’allegato, clicchi sul link o esegua l’indicazione riportata nel messaggio. E, molto probabilmente, non sarà neppure stata bloccata dall’antispam, proprio perché costruita con cura.

PRECISAZIONE: nel caso in cui l’attaccante sia riuscito a ottenere la password della casella di posta, le e-mail di phishing vengono inviate dalla casella originale che è stata violata e non da un indirizzo fittizio. In questo caso si tratta di Violazione della casella e non di E-mail Spoofing.

Questo caso è ancora più grave, perché significa che qualcuno sta usando la nostra casella a nostro nome e che, addirittura, potrebbe cambiare la password e impedirci di accedere alla nostra casella. Siamo già nel caso – ancor più grave – del “furto di identità”.

1.4 Gli strumenti informatici per proteggersi dallo spoofing

Gli attacchi di phishing, soprattutto se mirati (spear phishing) sono difficili da prevenire e rilevare. Manca l’oggetto della minaccia cibernetica: un link malevolo, un malware, ecc… quei segnali che i normali programmi antispam o antivirus sono in genere in grado di rilevare.

Inoltre, a causa della citata debolezza del protocollo SMTP e al fatto che i principali client di posta elettronica mostrano solitamente solo il nome del mittente, è complicato per chi riceve i messaggi capire che si tratta di un inganno.

In realtà, le e-mail di spoofing lasciano sempre qualche traccia, ma per vedere l’indirizzo reale del mittente (o quanto meno il server da cui è partita) bisogna compiere alcune azioni, che l’utente medio non conosce e che solo chi ha una certa esperienza di informatica riesce a mettere in pratica.

Quando si sospetta la ricezione di messaggi contraffatti, il modo migliore di verificarne la reale identità del mittente sarebbe quello di leggere le informazioni contenute nell’header dell’e-mail ricevuta.

1.4.1 Leggere l’HEADER di un messaggio di posta

L’header contiene le intestazioni del messaggio stesso e ha al suo interno le informazioni relative a tutta la storia dell’e-mail, dal momento in cui viene inviata all’accettazione da parte del server destinatario, oltre alle informazioni che riguardano l’autore del messaggio stesso.

Tutti i client che usiamo per la posta elettronica (es. Outlook o Thunderbird) hanno l’opzione per visualizzare l’header di un’e-mail ricevuta. Il comando in genere si chiama “Mostra intestazioni”, o qualcosa di simile. Attivando il comando, potremo accedere alla parte “nascosta” dell’e-mail e visualizzarne molti dettagli.

Per esempio: il campo “Received From” indica il server mittente, da cui è partito il messaggio (questa informazione potrebbe svelarci lo spoofing).

In realtà, saper leggere l’header di un’e-mail non è facile e non si può pretendere che lo faccia un normale utente, senza specifiche competenze IT.

1.4.2 Una Email sicura: come ottenerla?

Rendere più sicuro un sistema progettato nativamente in modo totalmente insicuro, qual è SMTP, non è semplice.

Sono stati creati – a posteriori – metodi di controllo per prevenire lo spoofing e validare i messaggi di posta. Si tratta di:

  • Sender Policy Framework (SPF): consente di verificare che una e-mail inviata da un dato dominio arrivi effettivamente da uno degli host abilitati dai gestori del dominio stesso.
  • DomainKeys Identified Mail (DKIM): permette ai gestori di un dominio di aggiungere una firma digitale tramite chiave privata ai messaggi di posta elettronica. DKIM aggiunge quindi un ulteriore strumento per verificare la corrispondenza tra mittente e relativo dominio di appartenenza. DKIM e SPF non sono due tecniche alternative ma piuttosto complementari.
  • Domain-based Message Authentication, Reporting and Conformance (DMARC): è un sistema di validazione dei messaggi di posta elettronica. Le caratteristiche di DMARC sono state definite nella RFC 7489 del marzo 2015.

Questi sistemi di controllo sono implementati nei software antispam più avanzati e moderni, che quindi possono eseguire in automatico quelle verifiche che l’utente medio – come detto – non sarebbe in grado di fare da solo.

Non basta, tuttavia, installare antispam dotati di questi sistemi: occorre anche configurare SPF, DKIM e DMARC nel modo corretto. In caso contrario si rischia che siano inefficaci o che – viceversa – blocchino anche le e-mail lecite. Aggiungiamo, in conclusione, che affinché la loro efficacia sia massima, dovrebbero essere implementate sia dal mittente che dal destinatario.

Note

[1] https://www.ic3.gov/media/2017/170504.aspx.

[2] https://www.ic3.gov/media/2018/180712.aspx.

Bibliografia e sitografia

Giorgio Sbaraglia: “Cybersecurity kit di sopravvivenza. Il web è un luogo pericoloso. Dobbiamo difenderci!”, GoWare, 2018.

Articolo a cura di Giorgio Sbaraglia

Giorgio Sbaraglia, ingegnere, è Information & Cyber Security Advisor e svolge attività di consulenza e formazione per la sicurezza informatica, Risk Management e per il GDPR.

Tiene corsi su questi temi per molte importanti società italiane di formazione, tra le quali la Business School de Il Sole 24 Ore.

È membro del CLUSIT (Associazione Italiana per la Sicurezza Informatica) e certificato “Innovation Manager” da RINA.

Ricopre l’incarico di DPO (Data Protection Officer) per alcune aziende italiane.

È autore dei libri:

“GDPR kit di sopravvivenza” (Editore GoWare) e “Cybersecurity kit di sopravvivenza. Il web è un luogo pericoloso. Dobbiamo difenderci!” (Editore GoWare)

www.giorgiosbaraglia.it

Download PDF

https://www.ictsecuritymagazine.com/articoli/lemail-non-e-uno-strumento-sicuro-dalla-business-email-compromise-allo-spoofing/


Il Vulnerability Management a Processo

Creare un processo di Vulnerability Management senza supportarlo equivale a non averlo affatto.
Usare un tool che non considera il processo può illudere di essere sicuri.

Le ragioni che possono spingere le aziende a prendere in seria considerazione la tematica del Vulnerability Management sono molteplici: dagli obblighi contrattuali (v. dominio #6 dello standard PCI DSS “Develop and maintain secure systems and application”) alle policy dettate dalla propria parent company, senza dimenticare la necessità di ridurre il rischio di data breach, per contenere eventuali danni d’immagine e possibili sanzioni dovute al GDPR. Non bisogna infine trascurare il fattore psicologico: in questo senso possono giocare un ruolo rilevante gli attacchi, tentati o riusciti, nei confronti della propria azienda o di realtà dello stesso settore, così come un’accresciuta consapevolezza del rischio, reale o anche solo percepito, in merito a un possibile attacco.

Indipendentemente dalle motivazioni alla base, le aziende che necessitano di gestire le vulnerabilità IT possono andare incontro a numerose difficoltà, diverse tra loro solo in apparenza, e a risultati spesso non soddisfacenti.

Nella maggior parte dei casi, il fattore debilitante è la mancanza di cultura aziendale in termini di Information Security che, in combinazione con uno scarso commitment da parte del top management, porta a sottovalutare la tematica e a limitare fortemente il budget a disposizione, l’avvio dei progetti e, di conseguenza, i risultati ottenibili. L’efficacia delle attività già in corso può essere minacciata da conflitti di competenza tra sicurezza e reparti IT, che vogliono evitare impatti sulla normale operatività.

In altre situazioni, invece, si notano aziende sprovviste di reparti dedicati alla sicurezza, ma che dispongono di reparti IT discretamente predisposti e sensibili ad alcuni temi di Information Security. In questi casi vi sono tentativi di aggiornare i sistemi e gli apparati, di intervenire sulle configurazioni, di gestire l’obsolescenza e altre attività che molto spesso si traducono in semplici azioni destrutturate e poco organizzate, quasi di “volontariato”, per correre al riparo da potenziali attacchi (dimenticando o ignorando, tra le altre cose, la parte di Application Security). Una prassi comune in questo tipo di scenario consiste nel lanciare una scansione generica, con un tool già a disposizione, su un perimetro parziale o non ben definito, per poi intervenire tecnicamente secondo tempistiche fortemente legate alle urgenze di business e alla casualità. Nemmeno questo è un approccio corretto, in quanto rischia di essere poco continuativo e stabile.

In entrambi i casi, i problemi alla radice sono simili: mancanza di un approccio basato sul rischio, di analisi preventive (si dovrebbe parlare anche di threat modelling), di gestione degli asset, ma soprattutto l’incapacità di trovare soluzioni che soddisfino le reali esigenze e di individuare corrette strategie di gestione. Il risultato? Una confusione diffusa che genera senso di smarrimento e distoglie l’attenzione dai problemi reali.

Una volta conseguita la consapevolezza sul tema del Vulnerability Management, è fondamentale che questa si traduca nel commitment necessario per proseguire con le fasi successive. In questo senso, la consapevolezza del rischio è, al pari di un budget adeguato, assolutamente propedeutica alle azioni da intraprendere – in primo luogo, la scelta di professionisti accreditati e con comprovata esperienza sul campo.

A valle di un primo assessment sullo stato dell’arte, si dovrebbe quindi procedere con la creazione, formalizzazione e messa in opera di un processo che, benché spesso venga visto soltanto come un adempimento normativo, un documento “da avere da qualche parte” atto a definire “chi fa cosa” o, peggio, una vera e propria scocciatura, è in realtà la giusta base di partenza per organizzarsi adeguatamente e giustificare le relative necessità di staffing, definendo ruoli e responsabilità, attività, tempistiche e flussi di comunicazione. In realtà, la definizione del processo può essere relativamente semplice, mentre la sua applicazione risulta essere la parte più complessa; basti pensare alla predisposizione di un ambiente di test in cui verificare le patch prima della messa in produzione, così come a garantire che il processo stesso tenga sempre conto del rapporto costi/benefici.

Essendo questo processo verosimilmente scritto a più mani, il risultato può essere scadente a prescindere da altri fattori. Uno dei problemi più gravi che si possono riscontrare nel neonato processo di Vulnerability Management è la carenza di armonia con i processi già esistenti, come il processo di Patch Management (con il quale ha diversi punti di contatto) e quello di Incident Management. Per far sì che questo non accada, occorre miscelare le best practice di settore, le competenze specialistiche e il contesto aziendale, non solo dal punto di vista organizzativo, ma anche considerando le possibilità economiche. Questo garantisce un processo formale, completo e su misura.

Una volta creato (o corretto) il processo di Vulnerability Management, è tuttavia necessario applicarlo e supportarlo con risorse adeguate. Affinché funzioni, occorre verificare la predisposizione ad interventi tempestivi mediante l’allocazione di figure tecniche di Security a presidio degli asset tecnologici. Occorrono anche figure gestionali in grado di facilitare il processo, interfacciandosi ad esempio con le altre funzioni aziendali per contrastare ritardi e segnalare criticità, sulla falsa riga di quanto avviene quotidianamente nell’ambito di un classico project management. In certi contesti, questo tipo di figura può coincidere con il profilo del Vulnerability Analyst, che, in estrema sintesi, è uno specialista che si occupa di analizzare e segnalare le vulnerabilità, per poi produrre la reportistica per i Security Manager di riferimento. Non può mancare ovviamente un incaricato al monitoraggio dell’intero processo che, in ambienti strutturati, è spesso collocato nella funzione del CISO.

Sono altrettanto necessari strumenti avanzati di Vulnerability Management a supporto dell’omonimo processo che, se dotati delle giuste caratteristiche, possono fare la differenza nel passaggio da semplici attività passive di Vulnerability Scanning (anch’esse da identificare, valutare, programmare ed eseguire secondo regole specifiche) al più efficace, efficiente e proattivo Vulnerability Management, di cui le scansioni rappresentano solo una fase. In realtà strutturate, infatti, non è più sufficiente l’utilizzo di un semplice scanner, ma è consigliabile l’utilizzo di uno strumento che sia compatibile con i principali scanner (di rete ed applicativi), centralizzando la gestione degli output che ne derivano per ottenere un totale controllo del perimetro e per un monitoraggio più efficace dei progressi.

Supportare il Vulnerability Management dal punto di vista del tool significa anche facilitare – o persino automatizzare – certi tipi di valutazioni del rischio associato ad ogni istanza di vulnerabilità, tenendo traccia in maniera strutturata di tutte le informazioni relative a remediation, mitigation e accettazione del rischio. Sarebbe auspicabile avere a disposizione anche feature che consentano la gestione delle priorità, la pianificazione di tutte le attività e la produzione di reportistica di sintesi. I principali benefici ottenibili con questo approccio sono l’ottimizzazione dell’operatività e il supporto alle decisioni, che portano ad un notevole risparmio in termini di risorse e ad una maggiore efficacia del processo. Non può nemmeno essere trascurata la necessità dei clienti di adattare il modello prestabilito alle proprie logiche di gestione, senza che queste generino conflitti o loop inaspettati una volta a regime.

Bl4ckswan lavora da anni a supporto di aziende di primaria importanza per inserire e mettere in opera tutte queste caratteristiche in J4rvis, una piattaforma che si propone come soluzione “vendor neutral” a supporto del processo di Vulnerability Management.

Articolo a cura di Mattia Fierro

Download PDF

https://www.ictsecuritymagazine.com/articoli/il-vulnerability-management-a-processo/


BRAVE + BAT: navigare in internet in modo veloce, privato, sicuro e ricompensato

Cos’è BRAVE?

Brave è un browser open-source, realizzato e presentato da Brendan Eich (inventore di Java Script e co-fondatore di Mozilla) basato sul progetto Chromium e sul motore di rendering Blink.

Brave è graficamente molto simile a Chrome ed è in media circa 5 volte più veloce di Chrome e Safari su dispositivi mobili IOS/Android, 2 volte più veloce sui desktop Linux/Windows/Mac.

Figura 1 https://brave.com/

Nato nel 2016, ha fatto passi in avanti importanti nel 2018 introducendo, oltre a blocchi automatici e nativi per malware e pubblicità, anche un piano per la funzione di sostituzione degli annunci e un programma di compartecipazione agli introiti integrandosi con il token BAT.

Di recente, ha aggiunto sul browser desktop – oltre ad una modalità di navigazione privata standard (che in realtà, come vedremo, non è mai del tutto anonima) – anche una modalità di navigazione privata avanzata via TOR (The Onion Router) in modo da oscurare il più possibile la propria esperienza, anche sfruttando un motore di ricerca come DuckDuckGO che non registra le ricerche effettuate come fanno solitamente gli altri.

Il classico Private browsing, chiamato anche navigazione in incognito, è una funzionalità di molti browser Web che nasconde alcune delle attività online da altre persone che utilizzano lo stesso computer. La navigazione privata salvaguarda alcuni aspetti della tua privacy online ma non è sicura. Se si è in rete, o si utilizza un server proxy per accedere a Internet, l’attività di navigazione passerà attraverso altri server e potrà essere archiviata o tracciata da altri, come l’amministratore di sistema sulla rete aziendale. Alcune informazioni relative alla tua attività di navigazione sono memorizzate sul tuo computer locale e possono essere comunque monitorate e tracciate.

  • Protezione: la navigazione privata protegge la tua privacy nella maggior parte delle normali situazioni di navigazione sul Web, ad esempio quando utilizzi il tuo computer privato a casa e desideri nascondere i tuoi acquisti per i regali di Natale online alla tua famiglia. La maggior parte degli utenti di computer medi non può tracciare la tua attività di navigazione privata. La sessione di navigazione privata viene eseguita come sessione isolata, quindi è possibile accedere a più account contemporaneamente, ad esempio gli account di posta elettronica e social network.
  • Vulnerabilità: la navigazione privata non è sicura, né è completamente privata. È una funzionalità del tuo browser Web, il che significa che altre applicazioni possono ancora accedere alla tua attività online. Se sul tuo computer è installato un keylogger o uno spyware, qualcuno può utilizzare questi programmi per tracciare la tua attività di navigazione privata. Possono anche utilizzare il software di controllo parentale per vedere quali siti hai visitato. Se si è su una rete aziendale, l’amministratore di sistema può registrare e tenere traccia delle attività online anche se si utilizza la navigazione privata e il provider di servizi Internet può registrare l’attività se si utilizza la macchina su una rete domestica.
Figura 2 Private browsing avanzato in Brave (ip oscurato con Tor e ricerche non memorizzate con DuckDuckGo)

Privacy by design

Brave ci offre un’esperienza di navigazione abbracciando la privacy by design e by default, sollecitando addirittura – con una lettera aperta indirizzata ai governi Europei scritta assieme ad altre 38 compagnie (WeTransfer, Tresorit, etc…) impegnate in questa tematica – l’adozione di regolamentazioni tali da proteggere gli utenti dai data breach.

La sfida è molto seria poiché bloccare determinati script significa anche compromettere la completa fruibilità del sito che si sta visitando.
Proteggere gli utenti da pubblicità e trackers rende la navigazione più veloce, diminuendo i tempi di caricamento, e maggiormente discreta: prendiamo ad esempio facebook.com.

Mentre capiamo benissimo cosa sono gli annunci pubblicitari, dobbiamo entrare nell’ottica di cos’è e di come funziona un tracker per il monitoraggio web.

Il monitoraggio Web è l’attività (e abilità) di un sito Web di tenere sotto controllo, utilizzando speciali strumenti software, i propri visitatori.

Ci si aspetterebbe che il monitoraggio Web abbia lo scopo di migliorare l’esperienza online, nello stesso modo in cui gli spot televisivi sono destinati a migliorare la vita (non solo l’esperienza di visione televisiva) quando guardiamo la TV.

Ma quanti di noi amano gli spot televisivi? Ci piacerebbe sapere che quelle pubblicità stanno, senza il nostro permesso, tenendo traccia di cosa stiamo guardando e su quali canali? Di quando abbiamo cambiato programma, quando abbiamo comprato qualcosa o quando abbiamo chiamato un numero di telefono perché lo spot ci ha detto di “chiamare ora”?

Questo è più o meno quello che fanno i web tracker. Tengono sotto controllo l’attività su Internet. Possono conoscere il tuo nome (se hai aperto un account online) oppure semplicemente “conoscere” i tuoi interessi.

Ma la cosa ancora più “inquietante” è che molti di questi siti web specializzati nel monitoraggio possono condividere le informazioni con altri servizi web, al fine di creare un profilo più completo o più accurato su di te, signor Consumatore.

Senza entrare in una grande quantità di ulteriori dettagli e possibilità, questo è quanto dobbiamo sapere.

Figura 3 monitoraggio web

Ma come siamo rintracciati?

Gli script incorporati nei siti Web riportano all’amministratore quando si è visualizzata una pagina. Molti siti utilizzano “cookie” per raccogliere statistiche sulla cronologia di navigazione, e anche i tuoi social network preferiti potrebbero svolgere un ruolo determinante nel monitorarti.

Sappiamo degli scandali di Google e Facebook: figuriamoci se possiamo fidarci di siti che non hanno tutta quella visibilità o che non rientrano nel rispetto delle attuali regolamentazioni in questa materia.

Tutto accade senza che tu sappia nulla: succede dietro le quinte e senza approvazione.

Tra tutti i siti web preferiti, tra migliaia di inserzionisti e aziende di monitoraggio online, ce ne saranno sicuramente una manciata che vogliono sapere cosa stai facendo.

Il browser Web Firefox, ad esempio, ha rilasciato una nuova funzionalità chiamata Lightbeam che dà un’idea di chi ti sta tracciando quando sei online.

Ti consente di seguire l’attività di tracciamento per il tuo comportamento online e ti darà una chiara idea visiva di ciò che sta accadendo mente navighi e aprirà gli occhi su ciò che accade ogni volta che si va online.

Brave invece non ha bisogno di plugin aggiuntivi: è nato proprio per proteggere la tua esperienza e, se per te questa è la cosa più importante, pazienza se qualche bottone “like” incorporato dai social su un sito web non funzionerà a dovere.

Il sistema di pubblicità attuale online è diventato invasivo e inutilizzabile. Gli utenti si sono rivolti agli ad blockers per reclamare la propria privacy a causa di annunci che li monitorano e, a volte, addirittura li infettano. Abbiamo preso ad esempio pubblicità il cui scopo non è truffarci deliberatamente, ma non è detto che i siti non vengano compromessi o che, tramite link malevoli, non veniamo rimandati a navigare siti in mano a degli scammer.

Cos’è BAT?

Brave può essere scaricato liberamente dal sito ufficiale oppure può essere “consigliato” da qualcuno tramite un link per scaricare il browser e verrà remunerato in BAT dalla società Brave stessa.

Acronimo di Basic Attention Token, BAT è un utility token basato sulla tecnologia blockchain Ethereum che ha come scopo fondamentale quello di dare un valore all’attenzione di un utente che naviga in internet misurandola in modo anonimo e sicuro, a differenza di quanto succede oggi con le tecnologie attuali (Explorer, Chrome, Mozilla, Firefox, Safari etc..), evitando la poca chiarezza e le frodi in cui i consumatori cadono leggendo attualmente gli annunci digitali (advertising) sui social e sui motori di ricerca.

Chi crea un’inserzione (advertiser) paga in BAT l’autore di contenuti web (publisher) che catturano l’attenzione degli utenti.

È un “mènage à trois” in cui l’utente (user) viene pagato a sua volta per gli annunci che vede e può decidere di pagare il publisher dimostrando apprezzamento per i contenuti trovati anche grazie a una inserzione (advertise).

Il BAT quindi diventa un token utile a dare valore a questo processo inserzionistico tra le tre entità coinvolte ed un modo per incentivare in modo sicuro e trasparente, tramite blockchain, l’utilizzo di Brave.

Figura 4 https://basicattentiontoken.org/
USER: i dati privati dell’utente sono legati ad device da cui naviga e non lo lasciano mai, in questo modo l’attenzione dell’utente è monitorata localmente e privatamente direttamente dentro al browser installato. L’utente viene ricompensato in BAT per la sua attenzione.

PUBLISHER: colui che pubblica contenuti web viene ricompensato in base all’attenzione ricevuta dagli utenti (banalmente quanto si sono soffermati sul sito, etc..) e in base all’efficienza del sito stesso, che se ad esempio è lento e inefficiente (magari si vede male su dispositivi mobili) fatica a catturare attenzione e, quindi, a guadagnare BAT.

ADVERTISER: l’inserzionista è colui che è interessato a pagare per avere un servizio migliore, in un ecosistema con ridottissimo rischio di frodi, una migliore targetizzazione e un ROI (ritorno di investimento) più elevato.

Alla fine, quindi, ci si potrebbe domandare: ma allora anche su Brave ci sono le pubblicità che ci tracciano?

Gli editori trovano sempre più difficile guadagnare con entrate pubblicitarie per sostenere contenuti di qualità a causa di intermediari che riscuotono enormi commissioni (pensiamo a Google o Facebook ads). Brave Ads mette al centro la sicurezza e la privacy dell’utente bloccando a priori ads e trackers e non fa uscire i dati personali dal proprio dispositivo poiché, a differenza dei tradizionali annunci digitali, la corrispondenza degli annunci avviene direttamente sul dispositivo dell’utente, quindi i suoi dati non vengono mai inviati a nessuno, inclusa Brave stessa.

La promessa è che l’accesso all’attenzione dell’utente non comporterà più la raccolta di dati privati su larga scala.


Articolo a cura di Marco Giuricin

Nato a Roma nel novembre del 1976 è un Senior System Administrator con esperienza ventennale nel mondo dell’Information Technology, lavorando da  consulente o dipendente presso importanti realtà come Tele Sistemi Ferroviari spa, Alitalia spa, Poste Italiane spa, Corte di Cassazione, Ministero di Grazia e Giustizia, Sir 2001 srl, Arianna 2001 spa, focalizzando la propria attività sulla progettazione, la gestione, la protezione ed il monitoraggio di ambienti sistemistici fisici e virtuali e loro implicazioni su tematiche come fiducia, privacy e sicurezza.

Sviluppatore di siti web di varia natura ed autore del blog sistemistico https://vmgmt.wordpress.com/ incentrato nel fornire piccole soluzioni e suggerimenti su tematiche di protezione dei dati e di disaster & recovery, virtualizzazione, database, blockchain, storage, architetture linux, microsoft, vmware, citrix, netapp, sicurezza logica e privacy anche legate alle tematiche del regolamento UE 2016/679 del garante della privacy (GDPR).

Download PDF

https://www.ictsecuritymagazine.com/articoli/brave-bat-navigare-in-internet-in-modo-veloce-privato-sicuro-e-ricompensato/


Riflessioni sulla “indipendenza dal software” nei sistemi di e-voting (parte seconda)

Riprendiamo l’analisi critica del concetto di Sistema Indipendente dal Software proposto da Rivest [1] iniziato nell’articolo precedente andando a vedere come questa idea, che approfondisce il problema della fiducia dell’elettore sulla qualità del software che ne gestisce e registra il voto, abbia già diverse incarnazioni pratiche esistenti.

Esempi di sistemi indipendenti dal software

Rivest non si esime dal chiarire con degli esempi concreti il tema di “come” realizzare sistemi indipendenti dal software anzi riporta esempi di soluzioni esistenti che rientrano nella definizione.

Seppur sottolineando la vastità delle possibili soluzioni esistenti, Rivest si sofferma principalmente su due categorie principali: sistemi basati su un approccio VVPR (Voter-Verifiable Paper Record) – ovvero sistemi che consentono tramite un riconteggio la possibilità di rilevare e ricorreggere gli errori dovuti al software – e sistemi basati su crittografia.

L’esempio più importante di VVPR è il sistema di voto a scansione ottica utilizzato dalla maggior parte degli elettori nelle elezioni americane del 2006.

Il voto cartaceo è verificabile immediatamente dal votante perché l’elettore può attestare la precisione del voto prima di essere inserito nello scanner ottico; la scheda elettorale serve quindi come traccia di controllo e può essere utilizzata negli audit post-elettorali. Un sistema elettronico di marcatura delle schede (EBM) può essere usato per registrare elettronicamente le scelte dell’elettore con un’interfaccia touch-screen che quindi stamperà una scheda elettorale certificabile da inserire nello scanner ottico. Una variante a questo sistema è il VVPAT (Voter-Verifiable Paper Record Audit Trail) simile a un DRE ma con una stampante e una logica aggiuntiva. Produce due registrazioni delle scelte dell’elettore, uno sul display touch-screen e uno su carta e l’elettore deve verificare che entrambi i record siano corretti prima di inviare il voto.

La categoria di sistemi basati su crittografia può fornire meccanismi di rilevamento per errori causati da modifiche del voto o errori del software [2]. L’approccio crittografico consente agli elettori di rilevare quando il loro voto è stato rappresentato in modo improprio e poter quindi richiedere una ri-votazione. Inoltre questi sistemi possono anche consentire a chiunque di rilevare quando i voti sono stati persi o cambiati, o quando il conteggio ufficiale è stato calcolato in modo errato e offrendo così un metodo per il recupero del voto. Rivest sottolinea nella sua analisi come la maggior parte dei sistemi di votazione crittografica proposti sono fortemente indipendenti dal software.

Problematiche dell’indipendenza dal software

La definizione di sistema indipendente dal software apre nuove problematiche tecniche a cui Rivest ci introduce:

  • quali aspetti del sistema di voto lo rendono “indipendente dal software”?
  • è solo l’hardware e il software, o include anche le procedure circostanti?
  • un sistema di votazione è ancora indipendente dal software se non vengono eseguiti audit post-elettorali?

Come si evince dai temi elencati da Rivest, il tema non è specificatamente di natura informatica ma mostra ancora una volta come sia fondamentale che le questioni tecnologiche e legislative debbano oggi essere trattate simbioticamente allo scopo di garantire un’evoluzione che preservi la concretezza dei principi giuridici.

La risposta che Rivest ci da è che un sistema di votazione è indipendente dal software se, dopo aver preso in considerazione il suo software e il suo hardware, consenta l’uso di una qualsiasi procedura di verifica necessaria per determinare se il risultato elettorale sia accurato senza doversi fidare del fatto che il software del sistema di voto sia effettivamente del tutto corretto. Questo implica che il legislatore dovrebbe includere nelle procedure elettorali quelle azioni svolte dagli elettori, o nel caso di scansione ottica e VVPAT, dovrebbero includere procedure ufficiali di audit post-elettorali. Ci preme sottolineare che il legislatore dovrebbe assumere con serenità il fatto che il software non debba essere perfetto ma debba solo funzionare con una probabilità sufficientemente alta, in un ambiente ideale e dare la possibilità di verificare e individuare le anomalie.

Ad esempio, si consideri l’EBM che stampa un foglio di scansione ottica compilato. Alcuni votanti potrebbero non riesaminare il voto stampato. Eppure l’EBM sarebbe ancora un sistema indipendente dal software, poiché esiste una probabilità significativa che venga rilevato un comportamento scorretto del software da parte dell’EBM.

In questa nuova prospettiva un ruolo importante lo riveste l’elettore che, si assume, sia sufficientemente attento da rilevare i comportamenti scorretti. Questo comportamento virtuoso non può essere dato per scontato come anche Rivest sottolinea: potrebbe essere necessario un aumento della formazione e della sensibilizzazione degli elettori.

Per chiarire ulteriormente la differenze tra un sistema indipendente dal software e uno dipendente dal software possiamo portare ad esempio i sistemi di voto tipo sondaggio (polling). Questi sistemi sono i più semplici da realizzare e primi che vengono in mente parlando di e-voting. I sistemi di e-polling purtroppo sono esempi di sistemi DRE (descritti inizialmente) e non sono quindi indipendenti dal software per costruzione, difatti non è possibile fare un audit per determinare la correttezza della registrazione del voto in modo indipendente dal software stesso. La loro dipendenza dal software porta gli eventi elettorali relativi immancabilmente al centro di polemiche ricorrenti poiché l’elettorato non attribuisce in modo uniforme la propria fiducia ai sistemi software.

Esempi in questo senso in Italia si possono trovare dell’esperimento del 2017 fatto in occasione del referendum regionale sull’indipendenza amministrativa della Lombardia o più recentemente sulle votazioni sulla piattaforma Rousseau interne al Movimento 5 Stelle. In entrambi i casi, l’utilizzo di sistemi non indipendenti dal software e le relative complessità tecniche hanno compromesso il valore percepito da parte dell’elettorato. L’applicazione del concetto di Indipendenza del Software potrebbe in questi scenari preservare il valore culturale e politico di iniziative simili di e-democracy evitando ai cittadini la necessità di atteggiamenti fideistici e garantire il valore democratico delle consultazioni evitando ai rappresentanti politici che scelgono la via dell’innovazione per avvicinare la democrazia diretta e quella rappresentativa, un’impossibile difesa del risultato ottenuto.

Conclusione

La riflessione con cui vogliamo chiudere questa revisione critica all’articolo di Rivest è che, sebbene l’articolo originale sia 2008 (nel mondo dell’informatica, un’era fa) il suo contenuto resta fortemente attuale. Rivest dimostra che fin dal 2008 la tecnologia per una corretta implementazione dell’e-voting esiste e che ci sono i presupposti per poter analizzare, studiare e risolvere il problema. Tuttavia è necessario avvalersi di professionisti seri che sappiano di cosa si parli, che abbiano competenze trasversali nel campo dell’informatica e del diritto, che lavorino gomito a gomito in team di esperti di cyber security, di blockchain, di software, di application security e di ingegneria del software per la progettazione dei migliori modelli.

Tutto questo merita una riflessione a diversi livelli e sarà nostra cura tornare a stimolare il dibattito sul tema, magari in articoli successivi.

Note:

[1] Ronald L Rivest, On the notion of ‘software independence’ in voting systems. Published: 06 August 2008 – https://doi.org/10.1098/rsta.2008.0149.

[2] Adida 2006, Chaum 2004, Chaum et al. 2004, Karloff et al., 2005, Neff 2004, Ryan & Peacock 2005, Ryan & Schneider 2006.

Articolo a cura di Michelangelo De Bonis e Matteo De Simone

Download PDF

https://www.ictsecuritymagazine.com/articoli/riflessioni-sulla-indipendenza-dal-software-nei-sistemi-di-e-voting-parte-seconda/


Procedure di gara o istanze telematiche alla P.A.: problemi informatici o di malfunzionamento delle piattaforme online. Che fare e chi risponde?

L’utilizzo di una piattaforma informatica per la partecipazione ad un procedimento di gara pubblica o, più in generale, per la formulazione di una richiesta alla P.A. mediante una specifica procedura on line, deve garantire e assolvere, da una parte, la sicurezza della trasmissione/trattamento dei dati, delle procedure e l’individuazione certa dell’offerente/richiedente; dall’altra, le eventuali anomalie del sistema (ad es. blocchi di linea) o i suoi limiti strutturali (o di programma software) sono a carico del titolare/concessionario del servizio pubblico o dell’Autorità pubblica procedente.

La sez. IV del T.A.R. Lombardia, Milano, con la sentenza 9 gennaio 2019, n. 40, conferma che gli eventuali problemi di linea e/o di upload, che ritardano il processo e i tempi di partecipazione alla procedura di affidamento di un servizio non possono gravare sul concorrente, con l’inevitabile esigenza di riaprire i termini di presentazione delle offerte.

Si può sostenere, in linea generale, che in presenza di procedure informatiche on line mediante piattaforme per l’individuazione del contraente, il procedimento amministrativo non può incontrare limitazioni di sorta, non essendo concepibile che, per problematiche di tipo tecnico (malfunzionamento del sistema), sia ostacolato l’ordinato svolgimento dei rapporti fra operatore economico e Pubblica Amministrazione.

Il mondo digitale – e l’informatica applicata all’attività della P.A. – porta inevitabilmente un onere cogente per le stazioni appaltanti di doversi accollare il rischio dei malfunzionamenti e degli esiti anomali dei sistemi informatici di cui la stessa si avvale, essendo evidente che l’agevolazione che deriva alla P.A. stessa, sul fronte organizzativo interno, dalla gestione digitale dei flussi documentali, deve essere controbilanciata dalla capacità di rimediare alle occasionali possibili disfunzioni che possano verificarsi, con l’approntamento di misure tese ad assicurare favor partecipationis, garantendo i necessari provvedimenti al fine di assicurare la regolarità della procedura, alias la riapertura dei termini.

Del resto, ad avallare l’orientamento, non sembra potervi essere dubbio che la modalità elettronica non solo di formazione del documento di gara, ma anche di trasmissione, risponde alla necessità di una semplificazione generale delle procedure, interesse pubblico certamente rilevante, che richiede l’approntamento di un funzionale sistema informatico, in grado di assolvere efficacemente i meccanismi di presentazione delle offerte: prescrizioni cogenti di redazione e trasmissione elettronica ricavabile dal combinato disposto delle norme degli art. 85 «Documento di gara unico europeo» e 40 «Obbligo di uso dei mezzi di comunicazione elettronici nello svolgimento di procedure di aggiudicazione» del D.Lgs. n. 50/216.

Giova, altresì, rammentare che il “documento informatico”, secondo il D.Lgs. n. 82/2015 (c.d. CAD), è il documento elettronico che contiene la rappresentazione informatica di atti, fatti o dati giuridicamente rilevanti, osservando che il “duplicato informatico” risulta essere un documento informatico ottenuto mediante la memorizzazione, sullo stesso dispositivo o su dispositivi diversi, della medesima sequenza di valori binari del documento originario, con la conseguenza «i duplicati informatici hanno il medesimo valore giuridico, ad ogni effetto di legge, del documento informatico da cui sono tratti, se prodotti in conformità alle linee giuda»: dal punto di vista tecnico il duplicato è, pertanto, identico ed indistinguibile dall’originale e si ottiene replicando il file originale stesso, evitando di applicare sulla copia l’imposta di bollo[1].

La semplificazione (le finalità del DGUE)[2] e l’accelerazione procedimentale (le comunicazioni elettroniche)[3] riducono gli oneri amministrativi che gravano sulle Amministrazioni aggiudicatrici, sugli Enti aggiudicatori e sugli operatori economici, il tutto attraverso l’adozione di un modello gestionale (la piattaforma on line) capace di garantire la funzionalità del software e la connessa regolarità del procedimento, senza pretendere di addebitare al concorrente i rischi di malfunzionamento del sistema[4].

Un operatore economico impugna la determinazione di aggiudicazione dell’affidamento in concessione della gestione di impianti sportivi comunali, e della relativa riapertura dei termini per la presentazione delle offerte.

Successivamente alla riapertura dei termini (a fronte di un’unica offerta presentata), un’Associazione sportiva partecipava e si aggiudicava la concessione.

La ricorrente lamentava che:

  • la proroga dei termini di presentazione delle offerte è stata disposta dopo la scadenza del termine;
  • non si è verificato alcun malfunzionamento della piattaforma sulla quale dovevano essere caricate le offerte;
  • l’unico rallentamento è durato complessivamente non più di trenta minuti.

Il giudice di prime cure, nel ritenere in ricorso infondato, fornisce le motivazioni nel merito:

  • è stato dimostrato un rallentamento della piattaforma telematica su cui dovevano essere caricate le offerte in prossimità della scadenza del termine di presentazione delle offerte stesse;
  • il rallentamento risulta una circostanza idonea a giustificare la decisione della stazione appaltante di riaprire il termine di presentazione delle offerte, in applicazione del disposto dell’articolo 79, comma 5 bis, D.Lgs. n. 50/2016;
  • il comma 5 bis dell’art. 79 cit., puntualmente prevede nel dato testuale «Nel caso di presentazione delle offerte attraverso mezzi di comunicazione elettronici messi a disposizione dalla stazione appaltante, ivi incluse le piattaforme telematiche di negoziazione, qualora si verifichi un mancato funzionamento o un malfunzionamento di tali mezzi tale da impedire la corretta presentazione delle offerte, la stazione appaltante adotta i necessari provvedimenti al fine di assicurare la regolarità della procedura, anche disponendo la sospensione del termine per la ricezione delle offerte per il periodo di tempo necessario a ripristinare il normale funzionamento dei mezzi e la proroga dello stesso per una durata proporzionale alla gravità del mancato funzionamento».

Il pronunciamento, allineandosi ai precedenti[5], stabilisce che in una procedura ad evidenza pubblica in cui vi è un’unica modalità di presentazione dell’offerta, predeterminata dalla stazione appaltante, o prescritta dalla legge, senza margine di scelta per il concorrente, e il cui controllo è sottratto al concorrente stesso, il malfunzionamento del sistema di presentazione dell’offerta non può andare a danno dell’offerente.

L’utilizzo di una piattaforma informatica per le procedure di gara impone che le sopraggiunte circostanze di malfunzionamento del sistema informatico, di interruzione del servizio o di un suo rallentamento (con obbligo comunicazione all’AgID), costituiscano un oggettivo impedimento alla funzionalità di ricezione delle offerte: è ragionevole aspettarsi dalla stazione appaltante, da una parte, di informare i potenziali concorrenti mediante appositi avvisi dei fatti accaduti, dall’altra parte, di prorogare (riaprire) i termini di presentazione delle offerte.

A rafforzare tale orientamento si richiamano i principi di leale collaborazione che informano i rapporti tra Amministrazione e amministrato:

  • il concorrente deve farsi parte diligente nel presentare correttamente e tempestivamente la propria offerta, salvo una causa di forza maggiore che renderebbe scusabile il ritardo[6];
  • la stazione appaltante deve mettere l’operatore economico in condizione di partecipare alla gara.

Ne consegue la massima che, accertato un malfunzionamento del sistema telematico di gestione della gara, tale da aver realmente interferito sull’intervallo di presentazione dell’offerta stabilito dalla disciplina di gara, la Stazione appaltante è tenuta, nelle forme più adeguate alla fattispecie, a ripristinare tale intervallo, compromesso dal malfunzionamento, in modo da dare la possibilità all’operatore economico di presentare la propria offerta, così da garantire la par condicio competitorum.

Peraltro, si annota che è del tutto irrilevante, e non può andare a discapito dell’operatore economico, il fatto che la stazione appaltante non si avveda tempestivamente del malfunzionamento del sistema, e operi la riapertura del termine originario dopo la scadenza, adottando un provvedimento con finalità sovrapponibili a quelle della proroga[7].

A margine dell’orientamento giurisprudenziale della stessa sez. IV[8], non può rientrare nella diligenza del concorrente avviare le procedure di caricamento a sistema dell’offerta con “congruo” anticipo rispetto alla scadenza, al fine di minimizzare i rischi di un malfunzionamento della piattaforma; ciò renderebbe privo di significato lo stesso termine finale, che fino alla sua scadenza, rende possibile l’attivarsi, consentendo al concorrente di presentare un’offerta ponderata[9].

È, infatti, palese come la valutazione di “congruità” del termine di presentazione delle offerte presenti, almeno di norma, un grado di insuperabile indeterminatezza, tale che si giungerebbe ad una dequotazione del termine perentorio, con una perdita di certezza delle regole della competizione: il rispetto del canone della diligenza professionale finirebbe, infatti, per variare caso per caso, in relazione a valutazioni non predeterminabili a priori dall’operatore economico, che non saprebbe quale sia la condotta in concreto da esso esigibile e quando incorra in negligenza.

Inoltre, va detto che quando la procedura di gara (rectius, modalità di presentazione delle offerte) risulta pienamente nella sfera di disponibilità della Pubblica Amministrazione e, solo per una anomalia tecnica non altrimenti identificata, il concorrente non perfezioni l’invio telematico, il rischio inerente alle modalità di trasmissione non può far carico che alla Stazione appaltante che unilateralmente aveva scelto il relativo sistema e ne aveva imposto l’utilizzo ai partecipanti: se rimane impossibile stabilire se vi sia stato un errore da parte del trasmittente, o piuttosto la trasmissione sia stata danneggiata per un vizio del sistema, il pregiudizio ricade sull’ente che ha bandito, organizzato e gestito la gara[10].

Va aggiunto che in una procedura di gara telematica la sottoscrizione in calce alla domanda di partecipazione e ai relativi allegati in forma “scansionata” (quindi, non in “originale”), non determini la nullità – o a fortiori l’inesistenza – dei documenti (caso di specie di un contratto di avvalimento), con conseguenti effetti espulsivi, venendo in rilievo una scrittura privata per la cui validità è necessaria e sufficiente la forma scritta e non essendo rilevante la concreta attribuzione della paternità del documento contrattuale all’impresa ausiliaria, consentendo la partecipazione al procedimento selettivo[11].

A suffragare la tesi descritta, giunge in soccorso l’ulteriore orientamento[12], secondo il quale non è ammissibile l’esclusione di un candidato ad una procedura concorsuale per la mancanza di firma della domanda, quando il bando stabilisce che la partecipazione al concorso sia formulata in un apposito modulo da trasmettere on line e firmato in calce, nell’ipotesi che tutta la documentazione venga trasmessa in tale modalità e che la domanda – pur priva di sottoscrizione – presentava tutti i requisiti di identificazione, compresa l’allegazione del documento di riconoscimento (identità, poi, accertata in sede di prova concorsuale).

L’utilizzo di tale modalità informatica di partecipazione, con relativa ricevuta identificativa dell’istanza, rende comunque certa la provenienza e il suo autore (apparente), essendo proprio la modalità on line quella di semplificare e garantire l’iter amministrativo in relazione alle peculiari modalità procedimentali afferenti alla fase di ammissibilità formale e sostanziale dell’aspirante candidato al concorso: l’esibizione della ricevuta della domanda completa del numero identificativo, copia della domanda corredata dal documento di riconoscimento devono ritenere senz’altro elementi idonee a supplire in modo adeguato alla mancanza di sottoscrizione in calce alla domanda di partecipazione al concorso stesso.

Il quadro descrittivo risalta per le correlazioni del procedimento digitale rispetto a quello squisitamente analogico, giacché attraverso un apposito software (c.d. piattaforma informatica) si stabilisce ex ante le modalità di confronto partecipativo, e le regole di selezione, senza margini di discrezionalità visto che sono affidate al sistema tecnologico scelto, con l’evidente precipitato pratico che la stazione appaltante deve da una parte, predeterminare i criteri di partecipazione (da rendere trasparenti con il manuale applicativo, di necessaria osservanza, mettendosi altrimenti a repentaglio lo stesso funzionamento della procedura), dall’altra, assicurare che il sistema informatico funzioni assumendone tutta la responsabilità in caso di malfunzionamento.

Di converso, la violazione delle procedure informatiche di partecipazione ad una gara on line comporta l’esclusione dalla gara del concorrente, rilevando che l’inesatto o erroneo utilizzo rimane a rischio del partecipante che si deve attrezzare dal seguire le modalità di inserimento e compilazione dei documenti previsti nel portale (integrative della disciplina di gara e sono poste a garanzia di tutti i partecipanti): risulta, pertanto, legittima l’esclusione dell’offerta quando il concorrente presenta documenti o compila moduli in una modalità diversa rispetto a quella prevista dal sistema informatico[13].

Alla luce delle considerazioni che precedono, risulta evidente l’utilizzo sempre più pervasivo delle tecnologie informatiche, al punto da essere, in un prossimo futuro se non già ora, l’unico sistema per comunicare tra P.A. e cittadino, in funzione di un’esigenza di semplificazione, efficientamento e rapidità di risposta, impone e postula un serio apparato di sicurezza, finalizzato a garantire sicuramente lo scambio di relazioni, ma contestualmente i diritti alla riservatezza che sono intimamente connessi alla tutela del trattamento dei dati.

Si fronteggia nel nuovo mondo digitale un’esigenza di connessione continua ma, allo stesso tempo, questa continua trasmissione/profilazione di dati (personali) può essere posta in pericolo dalla indiscriminata/irresponsabile, in assenza di una soglia minima di misure di sicurezza, circolazione di informazioni/dati/documenti.

Rileva, pertanto, che la più ampia circolazione dei dati se può meglio consentire a ciascuno di informarsi e comunicare, di partecipare ai processi pubblici (di gara o di trasparenza), può minare la convivenza sociale, i processi democratici di rappresentanza, l’economica ex se, rilevando che il possesso di dati personali (anche quelli che non sono necessari, o a seguito di un malfunzionamento/dispersione dati immessi in rete) può essere un valido ausilio per orientare il mercato, definire le scelte, incidere sul processo decisionale, in definitiva sulle libertà: «in un tempo rapidissimo si è costituito un nuovo equilibrio nei rapporti di forza a livello globale, con una concentrazione di poteri in capo a poche società che non ha precedenti nella storia dell’umanità. Poche aziende nel mondo hanno acquisito tutti i potenziali competitori creando un regime di oligopolio e fondando l’economia dei dati»[14].

Note

[1] Per i duplicati informatici di documenti informatici, di cui all’articolo 23 bis, comma 1, del CAD, non essendo prevista alcuna dichiarazione di conformità all’originale, non realizza il presupposto dell’imposta di bollo previsto dal citato articolo 1 della tariffa, parte prima, allegata al D.P.R. n. 642 del 1972, Agenzia delle Entrate, Risposta n. 45 del 2019, «Imposta di bollo sul duplicato informatico di un documento amministrativo informatico prodotto in conformità alle disposizioni del Codice dell’Amministrazione Digitale».

[2] È noto che il 18 ottobre 2018 è la data di entrata in vigore dell’obbligo delle comunicazioni elettroniche, ex art. 40, comma 2, del Codice dei contratti pubblici, osservando che i requisiti di integrità, autenticità e non ripudio del DGUE elettronico devono essere garantiti secondo quanto prescritto dal Codice dell’Amministrazione digitale, di cui al Decreto Legislativo 7 marzo 2005, n. 82, in conformità alle regole tecniche che saranno emanate da AgID, ai sensi dell’art. 58, comma 10 del D.Lgs. n. 50/2016.

[3] Cfr. T.A.R. Sicilia, Catania, sez. I, 8 gennaio 2019, n. 12.

[4] Sotto altro profilo e in funzione della convenienza dell’utilizzo dell’informatica, la considerazione che le notificazioni mediante l’invio di un file, al di là del formato, sono comunque valide, considerato che l’irritualità della notificazione di un atto a mezzo di posta elettronica certificata non ne comporta la nullità se la consegna telematica – nella specie, in “estensione.doc”, anziché “formato.pdf” – ha comunque prodotto il risultato della conoscenza dell’atto e determinato così il raggiungimento dello scopo legale, Cass. Civ., sez. VI, ordinanza 14 febbraio 2019, n. 4505.

[5] T.A.R. Lombardia, Milano, sez. IV, 5 dicembre 2018, n. 2737.

[6] Vedi, T.A.R. Campania, Napoli, sez. V, 2 dicembre 2014, n. 6296.

[7] Cons. Stato, sez. V, sentenza n. 4135/2017.

[8] T.A.R. Lombardia, Milano, sez. IV, 19 settembre 2018, n. 2109.

[9] T.A.R. Puglia, Lecce, sez. III, 13 novembre 2012, n. 1878.

[10] T.A.R. Puglia, Bari, sez. I, 28 luglio 2015, n. 1094, idem Cons. Stato, sez. III, 25 gennaio 2013, n. 481.

[11] T.A.R. Calabria, Catanzaro, sez. I, 22 febbraio 2019, n. 388 e sez. II, 29 giugno 2018, n. 1291.

[12] T.A.R. Lazio, Roma, sez. I quater, 6 marzo 2019, n. 2947.

[13] Cfr. LUCCA, Gara telematica e modalità di upload, segretaricomunalivighenzi.it, 2 gennaio 2019, dove si analizza l’esclusione di un concorrente o in quanto ha “tentato” di inserire nel sistema MEPA il file contenente l’offerta tecnica ma in un formato non ricevibile dalla piattaforma non riuscendoci.

[14] C. COSSU, Proteggiamo i dati, sono la nostra vita, intervista ad A. SORO, Presidente del Garante per la protezione dei dati personali, L’Unione Sarda, 6 giugno 2018.

Articolo a cura di Maurizio Lucca

Download PDF

https://www.ictsecuritymagazine.com/articoli/procedure-di-gara-o-istanze-telematiche-alla-p-a-problemi-informatici-o-di-malfunzionamento-delle-piattaforme-online-che-fare-e-chi-risponde/