Bitcoin e resistenza agli attacchi

La tecnologia blockchain, proprio per la sua natura, offre nuovi metodi per rendere sicuri ed immutabili i dati degli utenti che la utilizzano, rispetto ai sistemi tradizionali. Ogni nuovo blocco di dati è matematicamente legato e dipendente dal blocco che lo precede. Si viene così a creare una struttura univocamente riconosciuta dai partecipanti alla rete, che non può essere soggetta a modifiche non desiderate senza che queste possano esser rilevate e rese invalide. Reti come Bitcoin ed Ethereum sono decentralizzate nel modo in cui vengono gestite, ma sono in un certo senso centralizzate per quanto riguarda i dati che i blocchi contengono: un’unica catena di blocchi viene univocamente riconosciuta come valida e funge da riferimento per tutti i nodi partecipanti alla rete, che ne detengono una copia (completa o soltanto parziale).

Per questi motivi, la tecnologia blockchain è per natura resistente ad attacchi di tipo DDoS (Distributed Denial of Service) e ad attacchi di “tampering”. Per quanto riguarda Bitcoin, che utilizza il Proof Of Work come metodo di consenso delle transazioni, il principale rischio di compromissione resta legato all’attacco del 51%.

Attacco 51%

La sicurezza di Bitcoin è garantita dalla distribuzione del grosso lavoro computazionale (“mining”) messo a disposizione della rete da alcuni dei nodi partecipanti: i miners. Essi sono chiamati a competere tra loro per risolvere in un determinato arco temporale dei complessi algoritmi matematici, a seguito dei quali gli è permesso aggiungere nuovi blocchi di transazioni al registro distribuito della rete di Bitcoin, in cambio di ricompense economiche, andando a definire lo storico delle transazioni effettuate sulla blockchain. Questi miners vengono selezionati per aggiungere nuovi blocchi in modo proporzionale alla potenza di calcolo (hash power) che riescono a mettere a disposizione della rete.

Possiamo affermare che più è alto e uniformemente distribuito il numero di partecipanti a queste operazioni di mining, più sicura la rete di Bitcoin può essere considerata. Proprio questo aspetto rappresenta uno dei principali rischi descritti nel White Paper originale di Bitcoin [2]. Nel caso in cui un individuo, o un gruppo di individui, dovesse essere in grado di ottenere il 51% del totale dell’hash power facente parte della rete bitcoin, sarebbe in grado di compromettere la sicurezza garantita dalla rete.

Per spiegare questo attacco, bisogna partire da uno dei concetti chiave su cui si basa il funzionamento di Bitcoin, ossia che la catena più lunga di blocchi è considerata la catena di Bitcoin valida.

Qualora uno o un gruppo di miners riesca a detenere il controllo del 51% dell’hash power totale, potrebbe essere in grado di selezionare un blocco della catena già pubblicato e di estendere una nuova catena di blocchi “parallela” che cresca più velocemente di quanto non riescano a fare il resto dei miners attivi con la catena di blocchi originale, creando di fatto uno storico di blocchi e transazioni diverso da quello precedente.

Questo fenomeno, chiamato “chain reorganization”, permetterebbe ad un attaccante di:

  • Eseguire operazioni di “double-spending”: l’attaccante potrebbe inviare delle coin verso un exchange con una transazione T ed utilizzarle per acquistare delle altre tipologie di criptovalute e, contemporaneamente, minare blocchi “in segreto” più velocemente di quanto fatto dal resto del network, NON includendo questa transazione T nella sua catena. Nello stesso tempo potrebbe eseguire una seconda operazione T2, stavolta inserita nella sua catena di blocchi, dello stesso importo di coin, verso un altro destinatario X. Una volta effettuata la transazione, l’attaccante può rendere pubblica la sua catena di blocchi che, avendo uno storico più lungo della precedente (minata dai restanti partecipanti), non includerà la transazione T precedentemente effettuata, rendendola di fatto invalida (mai eseguita);
  • Annullare o modificare le conferme per delle transazioni precedentemente occorse durante il tempo in cui è rimasto in controllo del network;
  • Prevenire la conferma di nuove transazioni;
  • Prevenire che altri miners riescano a creare nuovi blocchi.

In ogni caso l’attaccante, pur controllando il 51% dell’hash power del network, non potrebbe:

  • Annullare o modificare le transazioni di altri, se non con la loro cooperazione;
  • Prevenire l’invio di nuove transazioni (anche se potrebbero rimanere non confermate);
  • Cambiare il numero di coin generate all’interno del blocco e/o creare dal nulla nuove coin;
  • Effettuare transazioni con coin che non gli appartengono.

Ma quanto può risultare complicato portare a termine un attacco di questo tipo?
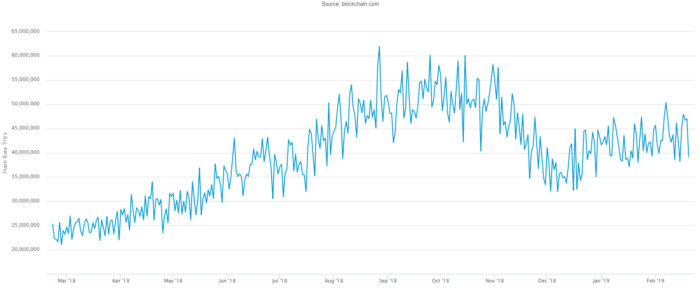
Al momento della stesura di questo articolo, l’hash power totale della rete Bitcoin è di circa 40.000.000 TH/s.

Volendo simulare lo scenario in cui un attaccante voglia ottenere il 51% dell’hash power totale della rete, partendo da zero e con disponibilità illimitata da parte dei costruttori di hardware, egli dovrebbe affrontare i costi di seguito descritti. Al momento uno degli hardware ad hoc (ASIC) considerato tra i più performanti sul mercato è chiamato “AntMiner S9”.

Il suo costo di mercato è di circa 2400$, produce 14 TH/s con un consumo medio di circa 1375W. Dovendo raggiungere un target di circa 41.000.000 TH/s e stimando una media di 0,05$ per KWh, dovrebbe affrontare una spesa di circa 7 BLN di $ per l’acquisto dell’hardware (circa 2,8MLN di dispositivi ASIC), più circa 5 MLN di $ al giorno per il consumo di elettricità. Il tutto per un ricavo di 918 BTC al giorno che, al cambio attuale, si aggirerebbe intorno ai 3,7 MLN di $.

Tutto ciò supponendo che, a fronte dell’evidenza di un tentativo di attacco del genere, la rete non adotti delle contromisure, andando a “rinforzare” la capacità di calcolo “onesta” del network.

Questo causerebbe, di fatto, ad una “hash war” che porterebbe alla perdita di svariati milioni di dollari, come peraltro già successo, nonostante i numeri di partenza decisamente meno rilevanti, nella recente vicenda relativa al fork di Bitcoin Cash [2].

In ogni caso, si tratta di cifre decisamente importanti e proibitive per – quasi – chiunque.

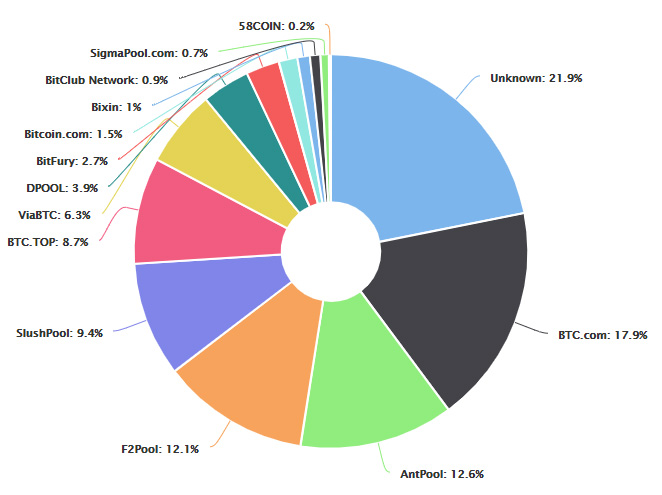
Ovviamente, questo non rappresenta l’intera fotografia della situazione attuale. Nel seguente grafico è riportata la attuale distribuzione dell’hash power delle principali pool già esistenti.

Come si può notare, nessuna delle pool riportate supera il 20% del totale dell’hash power impiegato per la rete BTC. Questo sembrerebbe garantire un importante fattore di decentralizzazione del mining.

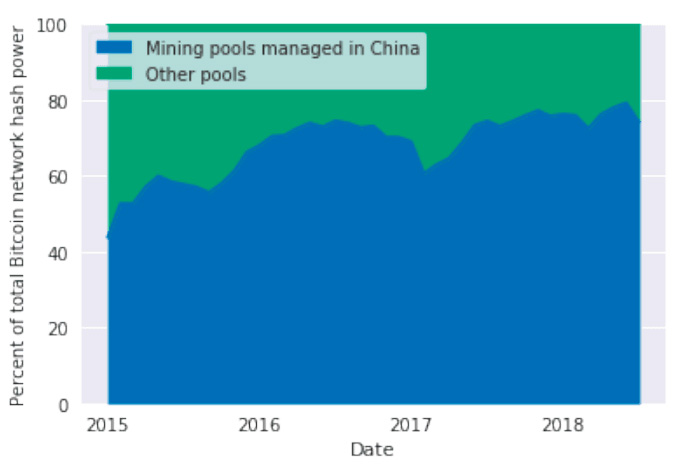
In realtà, un recente studio [3] pubblicato da Princeton University of Florida, ha evidenziato come la Cina sia potenzialmente in grado di centralizzare molto di questo hash power all’interno di una singola entità, e quindi diventare capace di poter controllare per lunghi periodi di tempo, e quindi potenzialmente di distruggere, la rete BTC.

Lo studio ha evidenziato, infatti, come circa l’80% delle operazioni di mining (NB: Si tratta di una cifra stimata e non ufficialmente confermabile) sia effettuato da un totale di sole 6 pool principali, ben 5 delle quali sono gestite, più o meno direttamente, da aziende sul territorio cinese.

Questo potrebbe potenzialmente consentire al Governo cinese di prendere il controllo della rete, effettuare attacchi, oppure applicare azioni di censura o di de-anonimizzazione delle informazioni presenti sulla blockchain di Bitcoin.

Ma non è tutto: lo studio sottolinea anche come, per qualche motivo, queste pool cinesi abbiano causato nel corso del tempo, e stanno continuando a farlo, una diminuzione dell’efficienza della rete Bitcoin. Questo perché, per come è strutturata la rete, essa permette la creazione di blocchi vuoti (ossia non contenenti transazioni prese dalla mempool, in attesa di essere verificate) concedendo comunque la ricompensa dovuta per l’attivitià di mining eseguita.

Si è calcolato che storicamente circa il 7% dei blocchi minati da pool cinesi siano rimasti vuoti. La media per le restanti pool si attesta intorno al 2-3%. I ricercatori dell’Università di Princeton avrebbero individuato, come causa di questa percentuale elevata, la presenza di un collo di bottiglia per quanto riguarda l’utilizzo di banda di rete, causato dal “Great Firewall” cinese.

Altri presunti problemi di sicurezza

Oltre a quanto descritto, si riporta di seguito un elenco (non esaustivo) dei possibili problemi di sicurezza o delle debolezze di Bitcoin e più in generale delle criptovalute, ai diversi livelli “logici”. Verranno trattate in seguito in dettaglio anche altre possibili vulnerabilità ed attacchi conosciuti sulle principali blockchain esistenti, soprattutto in riferimento ad Ethereum e all’utilizzo degli smart contract.

  • Vulnerabilità e bug di sicurezza nel software;
  • Tracciamento dell’history e de-anonimizzazione delle transazioni;
  • Sybil Attack;
  • Packet Sniffing;
  • Attacchi DoS;
  • Presenza di contenuti illegali all’interno dei blocchi;
  • Furto da Wallet vulnerabili;
  • Attacchi di tipo social engineering verso gli utenti (detentori delle chiavi private del proprio wallet);
  • Attacchi e data breach verso Exchange ed aziende che offrono servizi di conversione di criptovalute.

Gli scenari di attacco al network di Bitcoin descritti in precedenza, al momento, possono sembrare abbastanza remoti. Di fatto, nei primi 10 anni di vita, Bitcoin ha resistito a qualunque tipo di attacco su scala globale e, man mano che si evolverà, la speranza è che anche il suo livello di sicurezza risulterà sempre maggiore e comunque adeguato. Discorso a parte va fatto per quanto riguarda la sicurezza offerta dal software (talvolta contenente bug clamorosi) utilizzato, e, soprattutto, particolare attenzione va posta ai rischi ai quali gli utenti utilizzatori delle criptovalute vengono esposti, dovendo nella maggior parte dei casi detenere in prima persona le proprie chiavi private di accesso ai wallet.

BIBLIOGRAFIA

[1] “Bitcoin: A Peer-to-Peer Electronic Cash System” Satoshi Nakamoto – https://bitcoin.org/bitcoin.pdf.

[2] “The Bitcoin Cash Hash War is Over. It Also Ended the BTC/BCH War.” coinjournal.net  – https://coinjournal.net/the-bitcoin-cash-hash-war-is-over-it-also-ended-the-btc-bch-war/.

[3] “The Looming Threat of China: An Analysis of Chinese Influence on Bitcoin” – Ben Kaiser 1 , Mireya Jurado 2 , and Alex Ledger 1 Princeton University, Princeton – Florida International University, Miami – https://arxiv.org/pdf/1810.02466.pdf.

Articolo a cura di Luca Dinardo

Luca Dinardo, si occupa di tematiche di Cyber Security in contesti SOC e CERT da più di 10 anni, con specifico focus su Cyber Threat Intelligence, Malware & Threat Analysis, Incident Response e Cyber Deception.

Svolge attività di ricerca e sviluppo mirate all’analisi ed al contrasto di fenomeni legati al Cyber Crime.

Grande appassionato di tecnologia ed, in specifici ambiti, convinto sostenitore del mondo blockchain e criptovalute.

Download PDF

https://www.ictsecuritymagazine.com/articoli/bitcoin-e-resistenza-agli-attacchi/


Steganografia digitale: come nascondere l’esistenza di un payload in un’immagine

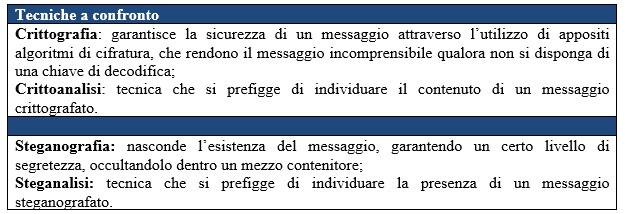
Nell’era della comunicazione digitale la necessità di mantenere la segretezza e la sicurezza delle informazioni è divenuta di fondamentale importanza. A tale scopo negli anni sono stati implementati algoritmi basati su tecniche ben note fin dall’antichità:

  • la crittografia, che ha lo scopo di rendere sicuro il contenuto di un messaggio (garanzia della sicurezza);
  • la steganografia, che ha lo scopo di rendere segreta l’esistenza stessa del messaggio (garanzia della segretezza).

Questi metodi basati sui principi di segretezza e sicurezza, purtroppo, possono essere usati anche per la realizzazione e la diffusione di malware di tipo criptolocker e trojan horse.

In questo articolo tratterò della steganografia digitale applicata sulle immagini, descrivendone i concetti base e fornendo degli spunti di riflessione sui possibili usi illeciti.

L’utilizzo di una tecnica steganografica presuppone l’esistenza di due oggetti:

  • un messaggio segreto;
  • un messaggio contenitore.

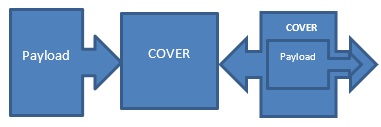
Indicando come payload l’oggetto che vogliamo steganografare e cover il suo contenitore possiamo rappresentare graficamente la funzione steganografica in questo modo:

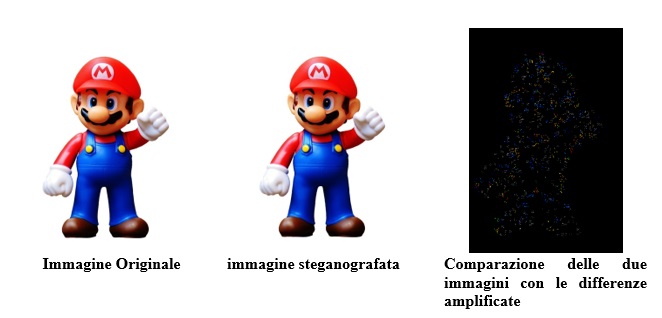
Nel caso in cui il nostro contenitore sia un’immagine, la tecnica consente di rendere praticamente indistinguibile l’immagine che custodisce il payload da quella originale.

Steganografia sostitutiva su immagini bitmap (.bmp)

Quella che vi presento è un tipo di steganografia sostituiva che per la conservazione del messaggio da nascondere usa un’immagine.

Bisogna fare però una piccola premessa riguardo al modello più comune di rappresentazione del colore: Il modello RGB. Un’immagine è composta da tanti piccoli elementi, i pixel, ciascuno dei quali fornisce la tonalità del colore come somma di tre colori primari: i canali Rosso (R), Verde (V) e Blu (B). Ogni pixel è rappresentato da una sequenza di bit che determina la specifica gradazione di tono (24 bit per un’immagine a colori).

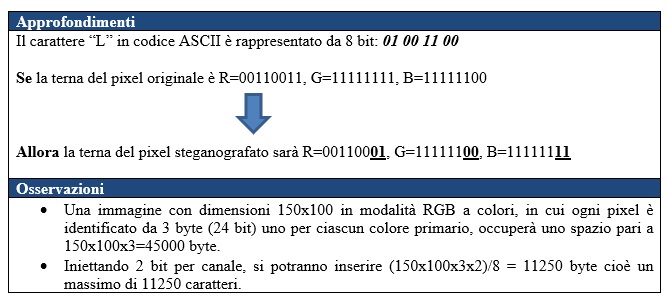
La tecnica impiegata è concettualmente molto semplice e consiste nel sostituire i bit meno significativi – LSB (Least Significant Bit) – di uno o più canali del colore con i bit che costituiscono il messaggio nascosto. Viene sfruttato il fatto che il peso dei bit meno significativi influenza solo le piccole variazioni di colore, senza alterare la percezione complessiva dell’immagine ad occhio nudo.

In figura si può notare come cambiando il bit meno significativo del blu (da 0 a 1) la percezione complessiva del colore non cambia!

Esempio pratico

Testo da steganografare: Alea iacta est

Testo in codice ASCII: 010000010 11011000 11001010 11000010 01000000 11010010 1100001 01100011 01110100 01100001 00100000 01100101 01110011 01110100

Numero caratteri spazi inclusi: 14

Numero bit Ascii: 14×8 = 112

Numero Pixel necessari per la steganografia su tre canali: 112/3= 37

Per l’esempio pratico ho utilizzato il programma steghide [1] ed un’immagine a colori con un numero di pixel compatibile a contenere 112 bit (un’immagine di 100×150 pixel è più che sufficiente!). Di seguito riporto i risultati a confronto.

“Stegosploit” con immagini jpeg (.jpg)

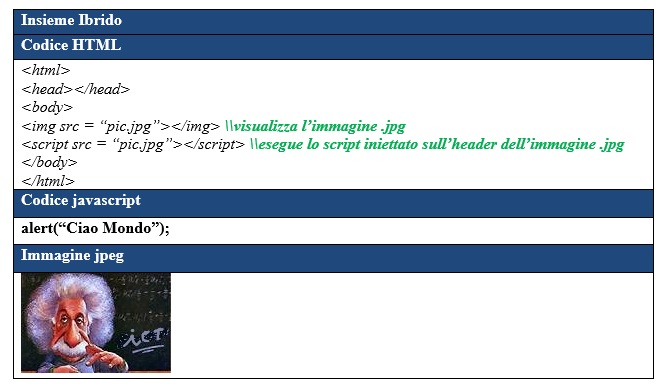
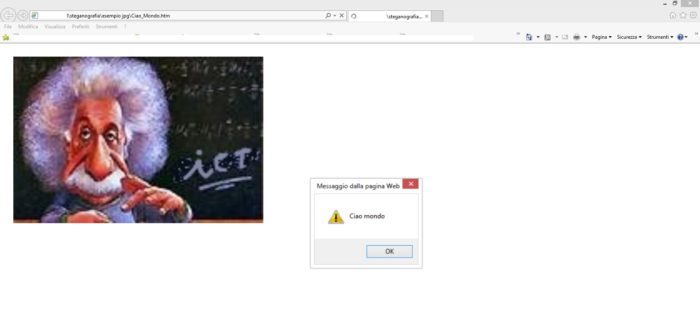
Con il termine “Stegosploit” [2] che nasce dalla composizione dei due termini “Steganography” e “Exploit”, si indica una tipologia di attacco informatico che utilizza per l’appunto un exploit basato sulla steganografia delle immagini: L’insieme ibrido risultante costituito da un’immagine e da pezzi di codice HTML/javascript, appare come un’immagine ma viene riconosciuto come codice javascript valido quando caricato da un comune browser (sull’argomento invito a guardare la presentazione del 2015 di Saumil Shah [3]). Con l’esempio che segue inietterò il codice javascript alert(“Ciao Mondo”) sull’header jpeg tramite un editor esadecimale e successivamente con una pagina html, appositamente allestita, farò visualizzare l’immagine ed eseguire lo script in essa nascosto.

Lo stesso esempio può essere ripetuto anche con immagini in formato bitmap, .gif e .png, ma in questi casi il codice andrà rispettivamente inserito alla fine della codifica binaria nei formati bitmap e .gif e iniettato nel tEXT chunk delle informazioni testuali nei formati .png.

Esempio pratico

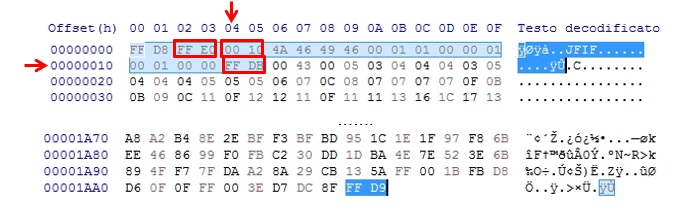
I file JPG sono costituiti da un certo numero di segmenti. Ogni file inizia con un marcatore che ha sempre lo stesso valore esadecimale 0xFFD8 e termina con il marcatore esadecimale 0xFFD9. Con il termine JFIF (in codice esadecimale 0x 4A46 4946), si indica il formato standard previsto per le immagini fotografiche usate su Internet.

Ogni marcatore è formato da 2 byte, il primo sempre con valore FF ed il secondo con un valore che specifica il tipo di marcatore:

  • se il segmento contiene dei dati i 2 byte che seguono il marcatore indicano la grandezza dei dati;
  • se, invece, il segmento non contiene dati dopo il marcatore comincia subito il segmento successivo.

In figura il primo marcatore dopo quello iniziale (0xFFD8) è 0xFFE0 che identifica il segmento applicazione APP0. Questo segmento che ha inizio all’indirizzo di offset 0x0004 è un header con dati, pertanto i successivi 2 byte (0x0010) indicheranno la lunghezza del segmento stesso (0x0010 equivale a 16 in decimale, ovvero il segmento APP0 ha una lunghezza di 16 byte). Il successivo segmento inizierà a partire dal marcatore 0xFFDB che si trova all’indirizzo di offset 0x0004+0x0010=0x0014.

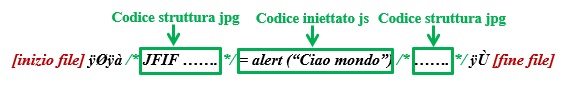
L’obiettivo consiste, come già detto, nell’iniettare il codice js alert(“Ciao mondo”) all’interno del segmento APP0 di lunghezza 16 byte, compreso tra i marcatori 0xFFE0 e 0xFFDB, facendo attenzione a mantenere sempre valida l’integrità della struttura del file, sia come immagine .jpeg sia come codice javascript!

Per iniettare il codice ho utilizzato il programma HxD Hex Editor [4]. Per evitare errori nell’interpretazione del codice da parte del browser ho dovuto racchiudere tra i simboli /* (0x2F2A) e */ (0x2A2F), che rappresentano la sequenza di caratteri utilizzata in javascript per i commenti multi riga, il resto della codifica esadecimale strettamente collegata alla struttura jpeg che sta prima e dopo il codice iniettato:

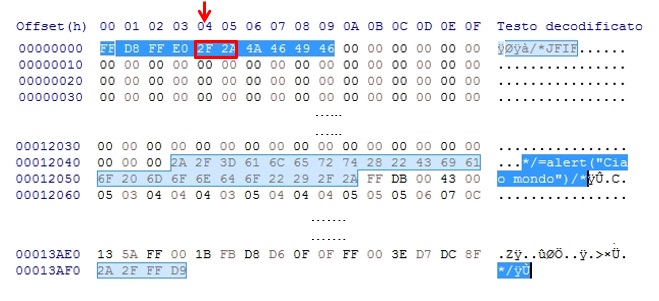
Lo screenshot finale della codifica esadecimale del file .jpeg è il seguente:

Occorre fare un’ulteriore precisazione. Il segno di commento (/*) dopo l’inizio del file che in esadecimale equivale a 0x2F2A, ha sostituito in posizione di offset (h) 0x0004 il valore originale 0x0010, modificando di fatto l’informazione relativa alla lunghezza del segmento APP0. La dimensione pertanto ha assunto il valore decimale di 0x2F2A, ovvero 12074 bytes. Per compensare questa differenza rispetto alla lunghezza originale di 16 byte e aumentare la dimensione del segmento stesso, ho inserito un certo numero di byte nulli.

Infine, aprendo la pagina html allestita, il risultato è stato il seguente: la pagina visualizza l’immagine ed esegue lo script nascosto.

Conclusioni

Gli impieghi possibili della steganografia digitale sono limitati solamente dalla fantasia. Ne è un esempio l’ondata di infezione del trojan bancario Ursnif che ha interessato l’Italia, e che ha sfruttato per la propagazione esattamente una tecnica di questo genere.

In particolare, uno degli stadi di propagazione prevedeva l’esecuzione di codice Powershell attraverso il download di un’immagine .png apparentemente innocua, ma che in realtà nascondeva nei propri pixel i byte di uno script. L’immagine è stata opportunamente armata tramite l’utilizzo del progetto software Invoke-PSImage [5].

Dopotutto anche l’immagine di copertina di questo articolo potrebbe celare chissà quale messaggio! [6]

Note

[1] http://steghide.sourceforge.net/.

[2] https://www.opswat.com/blog/hacking-pictures-stegosploit-and-how-stop-it.

[3] https://www.youtube.com/watch?v=np0mPy-EHII.

[4] https://mh-nexus.de/en/hxd/.

[5] https://github.com/peewpw/Invoke-PSImage.

[6] https://futureboy.us/stegano/decinput.html.

Riferimenti sitografici

https://www.researchgate.net/publication/301110877_TECNICHE_DI_STEGANOGRAFIA_SU_IMMAGINI_DIGITALI

http://www.orkspace.net/docs/jpg.htm

https://medium.com/@codedbrain/hiding-js-in-a-jpeg-header-454386f9e20

http://www.file-recovery.com/jpg-signature-format.htm

https://www.opswat.com/blog/hacking-pictures-stegosploit-and-how-stop-it

https://www.difesaesicurezza.com/en/cyber-en/cybercrime-attacks-italy-with-super-mario-to-disguise-the-ursnif-malware/

https://blog.yoroi.company/research/ursnif-long-live-the-steganography/

Articolo a cura di Salvatore Lombardo

Salvatore Lombardo è laureato in Ingegneria Elettronica orientamento Telematico. Ha frequentato un Master in Information and Communication Technologies – Internet Software Engineering.

Da oltre dieci anni svolge l’attività di funzionario informatico presso la Pubblica Amministrazione, curando in particolare la sicurezza informatica e l’amministrazione di rete.

In qualità di esperto ICT, iscritto all’albo dei docenti della ex Scuola Superiore dell’Amministrazione dell’Interno, ha tenuto vari corsi di formazione e aggiornamento per il personale.

È autore del libro La Gestione della Cyber Security nella Pubblica Amministrazione.

Download PDF

https://www.ictsecuritymagazine.com/articoli/steganografia-digitale-come-nascondere-lesistenza-di-un-payload-in-unimmagine/


Reti 4G/5G: profili di vulnerabilità e possibili contromisure

Le reti mobili stanno evolvendo velocemente nell’ultimo periodo.

Dall’entrata in funzione del 4G, si sono potuti toccare con mano i benefici della banda larga anche nelle connessioni in mobilità. A distanza di qualche anno, il 4G Plus ha permesso un incremento di prestazioni sostanziale rispetto alla tecnologia di base. Con l’arrivo del 5G, previsto nel 2020, saremo di fronte ad una vera e propria rivoluzione, che prevede la proliferazione dei dispositivi IoT e un incremento di velocità di banda nell’ordine dei Gbit/s.

Come appreso dal recente passato, ogni miglioria tecnologica porta con sé l’introduzione di nuove vulnerabilità di progettazione, potenzialmente sfruttabili da utenti malevoli. È quindi facilmente ipotizzabile che, come per le connessioni Bluetooth e WiFi, anche le connessioni mobili soffrano di potenziali errori di progettazione.

Difatti, nell’ultimo periodo sono emersi numerosi studi nei quali alcuni ricercatori evidenziano le vulnerabilità dello standard 4G. La cosa ben più grave è che alcune di esse impattano anche sul nuovo standard 5G di imminente introduzione.

Analizziamo, quindi, di seguito le falle più gravi e verifichiamo se vi sono contromisure applicabili.

AUTHENTICATION RELAY ATTACK (4G)

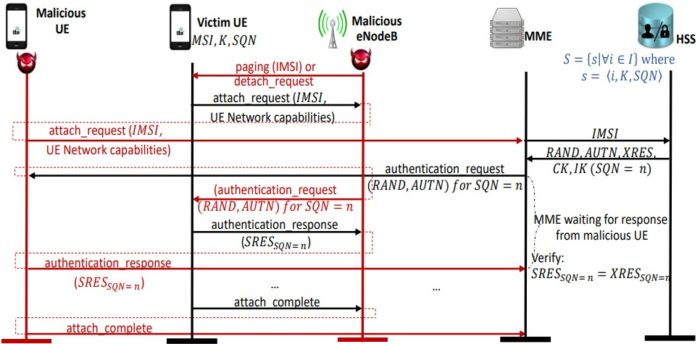
Questo tipo di attacco potrebbe non solo consentire a un attaccante di compromettere la rete cellulare per leggere i messaggi – in entrata e in uscita – delle vittime, ma anche di impersonificare qualcun altro per l’esecuzione di un qualsiasi atto delinquenziale.

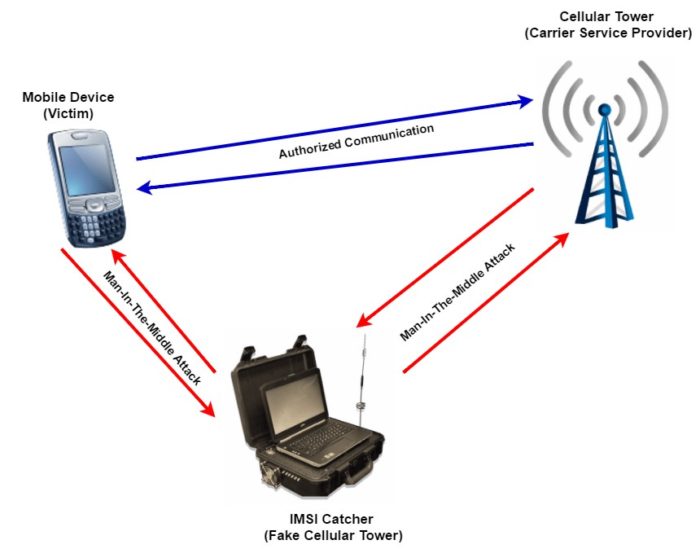
Come è banalmente intuibile analizzando la figura precedente, disponendo di una cella e di un dispositivo effimeri, è possibile:

  1. forzare la disconnessione del dispositivo vittima da una cella valida[1];
  2. forzare la connessione di quest’ultimo alla cella effimera;
  3. reindirizzare la richiesta di autenticazione fornita dal dispositivo vittima al fornitore del servizio;
  4. tramite la cella effimera, far decodificare i messaggi di autenticazione al dispositivo vittima;
  5. completare l’autenticazione, al posto del dispositivo vittima, con dispositivo effimero.

A seguito dell’autenticazione, l’attaccante possiede una copia speculare (agli occhi della rete) del dispositivo della vittima.

aLTEr (4G/5G?)

Gli standard 4G/5G prevedono diversi meccanismi di sicurezza. Quando un dispositivo si collega alla rete, stabilisce un’autenticazione reciproca[2] con il fornitore del servizio, ottenendo una chiave di crittografia condivisa per la trasmissione sicura dei dati.

Tale chiave è utilizzata per crittografare anche il traffico di “controllo”. Quest’ultimo è protetto da meccanismi di controllo dell’integrità, il che significa che l’utente malintenzionato non è in grado di manipolare il traffico durante la trasmissione.

Scendendo nel dettaglio, aLTEr interviene sfruttando un errore di progettazione relativo alla gestione del “livello 2” dello stack di rete. Nello stack del protocollo TCP/IP, il layer 2 è quello che corrisponde al Data Link, posto gerarchicamente al di sotto dei livelli TCP ed IP, nei quali è implementato il meccanismo di sicurezza precedentemente illustrato.

Brevemente: i dati utente, a livello 2 – Data Link, vengono crittografati in modalità contatore (AES-CTR), in cui l’algoritmo genera un keystream (caratteri pseudorandomici). Il testo cifrato viene quindi calcolato dallo XORing del keystream con il testo in chiaro.

Non essendo stati previsti negli standard dei controlli di integrità a questo livello, e conoscendo il testo in chiaro originale della richiesta[3], è facile modificare il contenuto di un pacchetto DNS anche se crittografato, reindirizzando la richiesta a un server DNS sotto il controllo dell’avversario.

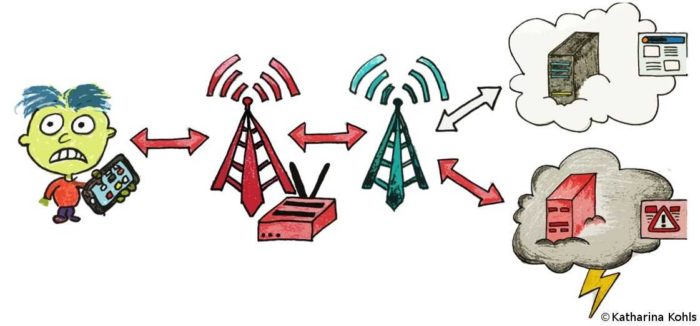
Riassumendo: un utente malintenzionato può creare una cella LTE effimera, alla quale il dispositivo della vittima si collegherà in automatico, poiché il segnale di quest’ultima sarà più potente per prossimità rispetto a una qualsiasi cella reale limitrofa. A questo punto il traffico e le relative richieste effettuate dal dispositivo mobile della vittima verranno tutte filtrate dalla cella effimera, per essere poi inoltrate alla cella reale, ignara di eventuali manipolazioni avvenute precedentemente.

La dimostrazione dell’attacco è visionabile tramite il video https://www.youtube.com/watch?v=3d6lzSRBHU8.

ToRPEDO (4G/5G)

Acronimo di TRacking via Paging mEssage DistributiOn, sfrutta una debolezza nel protocollo di paging utilizzato dagli ISP per segnalare ad un dispositivo in stato di inattività una notifica, prima dell’effettivo arrivo di una comunicazione in entrata.

Se un dispositivo non stabilisce, per un certo periodo, una comunicazione attiva con la rete cellulare, entra in una sorta di modalità di risparmio della batteria. In questo contesto la rete cellulare, prima che una chiamata o un messaggio di testo raggiungano il dispositivo, invia a quest’ultimo un messaggio di paging per anticipare, tramite una notifica, una chiamata o un messaggio in arrivo. Il messaggio di paging incorpora in sé l’identificativo temporaneo del dispositivo – TMSI (Temporary Mobile Subscriber Identity)[4] – che viene aggiornato, a seguito dell’aggancio ad una cella, solo in rari casi.

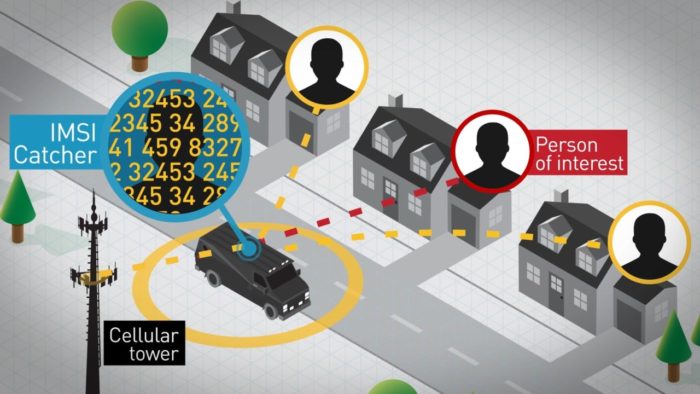
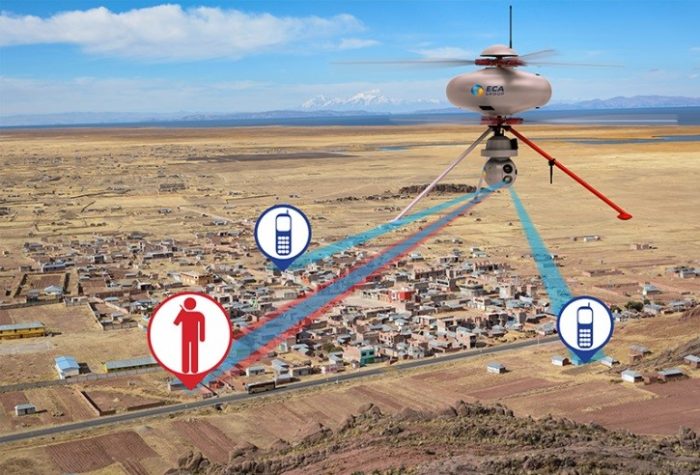
I ricercatori hanno scoperto che, effettuando e annullando un gran numero di chiamate in un breve lasso di tempo, avviene, da parte del fornitore del servizio, l’aggiornamento del valore TMSI nel proprio database più frequentemente del solito. Quanto detto si compie unicamente sulla stazione mobile, senza generare un tipo di avviso nel dispositivo vittima. A seguito di quanto descritto, utilizzando un IMSI Catcher[5], un malintenzionato può verificare se la vittima si trova in un raggio di distanza entro il quale è possibile intercettare eventuali comunicazioni.

Quindi, conoscendo il Paging Occasion (PO)[6], l’attaccante potrebbe:

  • tracciare il dispositivo vittima;
  • dirottare il canale di paging iniettando o negando i messaggi di paging di controllo;
  • effettuare lo spoofing delle comunicazioni;
  • lanciare attacchi DoS, saturando le risorse del dispositivo vittima, fino al punto da mandarlo in blocco.

PIERCER ⮕ IMSI-Cracking attack (4G/5G)

I ricercatori hanno ulteriormente precisato che Torpedo può fungere da apripista per altri due tipi di attacco.

Il primo, denominato Piercer (Persistent Information ExposuRe by the CorE netwoRk), consente all’attaccante di determinare l’IMSI (International Mobile Subscriber Identity) della vittima sulla rete 4G/5G, ed associarlo al proprio dispositivo.

I numeri IMSI sono crittografati nelle reti 4G e 5G, in modo da poterli proteggere da eventuali attacchi; tuttavia i ricercatori hanno nuovamente riscontrato che tali protezioni sono inadeguate.

Il problema sta nell’implementazione del vettore, denominato per l’appunto Piercer, che espone i numeri IMSI sull’attuale rete 4G e sulla futura rete 5G. Alcuni fornitori di servizi utilizzano l’identificativo IMSI al posto del TMSI nei messaggi di paging per identificare i dispositivi con servizi “eccezionali”, o per verificare servizi rimasti in stato “pending”. I test effettuati hanno rivelato che è possibile dare l’impressione, al fornitore di servizi, che si stia verificando uno di questi casi eccezionali, in modo da costringere il dispositivo a rivelare il proprio IMSI.

Il secondo attacco, detto IMSI-Cracking attack, utilizza un attacco a forza bruta per individuare il codice IMSI su rete 4G o 5G.

Con il numero IMSI a disposizione, gli aggressori possono inscenare attacchi di vario genere: potrebbero spiare la lista delle chiamate della vittima, registrare le conversazioni audio, leggere gli SMS in arrivo, individuare l’esatta posizione del dispositivo, quindi gli spostamenti della vittima durante l’arco della giornata. E molto altro ancora…

Considerazioni

I requisiti hardware per effettuare questo tipo di attacchi bisogna trovarsi abbastanza vicini al terminale che si vuole hackerare. Va premesso inoltre che per attuare questo tipo di attacco serve dell’attrezzatura abbastanza costosa, per le tasche dell’utente comune: circa 4.000$[7].

Tuttavia, se prendiamo ad esempio contesti come lo spionaggio industriale o, peggio ancora, quello politico, ci rendiamo conto l’eventuale costo dell’attrezzatura è assolutamente trascurabile.

Possibili contromisure

Per l’Autentication Relay Attack non vi sono contromisure. Fonti attendibili confermano che tale metodologia è spesso sfruttata dagli organismi investigativi statunitensi, per perseguire eventuali azioni delinquenziali.

Per quanto riguarda aLTEr, l’utente non ha modo di difendersi, se non quello di consultare esclusivamente siti web che utilizzano HSTS (HTTP Strict Transport Security), cosa ben diversa dal protocollo HTTPS (HTTP secure).

Sta agli Internet Service Provider, quindi ai gestori telefonici, utilizzare protocolli di autenticazione del tipo AES-GCM o ChaChat20-Poly1305. Come evidenziato anche dai ricercatori, però, una modifica dell’attuale infrastruttura comporterebbe un elevato sforzo finanziario e organizzativo. Perciò, la maggior parte dei gestori potrebbe decidere di non fixare la vulnerabilità, dal momento che non è obbligatorio farlo.

Altra contromisura potrebbe consistere nell’adozione del protocollo DNS over TLS or DTLS, che permetterebbe di proteggere i dispositivi provvedendo alla cifratura del traffico DNS, garantendo la di fatto l’integrità dello stesso.

Ad ogni modo, allo stato dell’arte, ne deriva che anche il 5G potrebbe essere potenzialmente insicuro a questo tipo di attacco. Essendo la crittografia autenticata una funzione ad implementazione facoltativa, molti ISP potrebbero decidere di non adottarla nelle nuove reti 5G che stanno implementando.

Per quanto riguarda ToRPEDO, PIERCER ed IMSI-Cracking, vengono sfruttate debolezze intrinseche nei protocolli LTE 4G e 5G, che riguardano le prime fasi dell’interazione con i terminali mobili ed al mutuo riconoscimento con la rete in previsione di trasferimento di messaggi e chiamate.

Conclusioni

Le dinamiche di autenticazione ed identificazione reciproca dovrebbero essere rese più sicure sin dalla fase di progettazione. Sarebbe opportuno evitare l’applicazione di metodi di autenticazione antiquati volti a garantire vecchie esigenze, dipendenti da reti e terminali meno performanti, o a metodi di comunicazione di base (ad esempio la retro-compatibilità) in cui non si è tenuto conto del concetto di “security by design”.

Come si comporteranno i vari fornitori? Probabilmente non prenderanno alcun provvedimento. Secondo gli stessi ricercatori è difatti molto probabile che queste vulnerabilità siano troppo onerose da correggere (sia tecnicamente che economicamente), e che sia necessario aspettare una radicale modifica del protocollo per una reale risoluzione del problema.

Nel contempo sarà meglio tener presente che gli input digitali che ci giungono, potrebbero non provenire dal reale mittente della comunicazione e/o potrebbero essere intercettati da chiunque sia a portata di tiro.

Benvenuti nell’Era della paranoia…

Note

[1] Stealthy kicking-off Attack.

[2] Autenticazione reciproca significa che la rete e il telefono possono verificare rispettivamente le loro identità.

[3] Ipotizzando i siti più visitati dalla vittima, tramite Website Fingerprinting.

[4] Un numero univoco che lo smartphone utilizza per interfacciarsi con la rete GSM. Serve a garantire la riservatezza degli utenti, evitando di mandare il codice IMSI: https://it.wikipedia.org/wiki/IMSI.

[5] Ad esempio Stingrays and DRTBox.

[6] http://www.techtrained.com/paging-procedure-lte/.

[7] Secondo gli stessi ricercatori che hanno messo in atto i vari scenari di attacco.

Articolo a cura di Daniele Rigitano

Download PDF

https://www.ictsecuritymagazine.com/articoli/reti-4g-5g-profili-di-vulnerabilita-e-possibili-contromisure/


L’autenticazione che si evolve: dalla password ai token U2F – Parte 2

Nell’articolo precedente sono state brevemente riassunte le principali caratteristiche del processo di autenticazione tramite password, biometria e chiavi pubbliche+private. La problematica principale è però non tanto definire delle tecniche di autenticazione teoricamente sicure, quanto trovare dei processi di autenticazione che siano facilmente adottabili e che garantiscano un livello di sicurezza adeguato ai rischi dei relativi servizi informatici.

Autenticazione a Fattori Multipli (MFA)

La possibilità di utilizzare tipi di autenticazione diversi (qualcosa che si ha, si sa, si è), unita alle criticità dell’utilizzo della password e della necessità per alcuni servizi di aumentare il livello di sicurezza del processo, porta a considerare l’utilizzo di più tipi di autenticazione per la stessa richiesta di accesso. Nella pratica si presentano principalmente due tipologie di MFA:

  1. vengono richiesti in serie due (molto raramente tre) fattori di autenticazione al momento del primo accesso al servizio o sistema: ad esempio prima una richiesta di username+password e, se questa ha successo, la richiesta di autenticazione biometrica o di autenticazione tramite un token che si ha, ad esempio, tramite una smartcard; se entrambe le autenticazioni hanno successo, viene stabilita una sessione e si ha accesso senza restrizioni al servizio;
  2. al momento del primo accesso al servizio o sistema viene richiesto un fattore di autenticazione, ad esempio username con password o autenticazione biometrica; se l’autenticazione ha successo, viene stabilita una sessione e si ha accesso al servizio ma limitatamente a funzioni con un livello di rischio basso, ad esempio solo in lettura; per poter eseguire delle attività a maggior rischio (scrittura, modifica dei dati o attività dispositive) viene richiesta un’ulteriore autenticazione al momento stesso dell’attività e per ogni esecuzione di attività a rischio elevato.

Ovviamente queste sono solo due tipologie di base di MFA e, in pratica, sono spesso adottate molteplici varianti.

Un concetto importante da sottolineare è la necessità per attività che comportano un livello di rischio non basso, di autenticare la singola transazione e non basarsi unicamente sull’autenticazione dell’intera sessione. Per capire la necessità di autenticare la singola transazione è necessario descrivere brevemente alcuni tipi di attacchi.

Attacchi di Session Hijacking, Replay, Man in the Middle (MitM) e Phishing

Quando ci si autentica presso un servizio viene usualmente creata una sessione, ovvero all’utente vengono assegnati dei codici temporanei che lo identificano per la durata della sessione in modo da non dover ripetere il login ad ogni transazione. Nel caso di navigazione Web questo è tipicamente realizzato con dei Cookie (SessionID) contenenti del materiale crittografico creato dal Server, inviati e archiviati temporaneamente nel Browser. Ad ogni richiesta al Server, il Browser allega i Cookie di sessione in modo che il Server identifichi e autentichi la richiesta senza dover ripetere il processo di login. Ma diversi tipi di Malware sul dispositivo dell’utente possono intercettare i Cookie e, in assenza di altre misure di sicurezza, utilizzare i dati di sessione per accedere al servizio al posto dell’utente, in pratica una sottrazione e appropriazione della sessione utente (“hijacking”).

Un altro tipo di attacco, ormai raramente efficace, consiste nell’intercettare i dati o il traffico di autenticazione dell’utente, anche se cifrato, e riutilizzarlo (attacco “replay”). Per evitare questo tipo di attacco tipicamente si allega del materiale unico per ogni autenticazione, che non può essere riutilizzato.

Per evitare questi tipi di attacchi bisogna quindi non solo autenticare con materiale unico ogni sessione, ma anche autenticare indipendentemente – meglio se con un diverso tipo di autenticazione – ogni singola transazione con livello di rischio non trascurabile. L’autenticazione di una sessione deve permettere l’accesso per un periodo di tempo esteso (ma non illimitato) che può andare dai pochi minuti a giorni o anche mesi a secondo del livello di rischio dell’applicazione, mentre l’autenticazione di una singola transazione deve essere molto limitata nel tempo e non riutilizzabile.

Infine, l’attacco più pericoloso e difficile da sconfiggere consiste nell’impersonare il servizio (“Phishing”) o riuscire a intercettare la connessione al servizio inserendosi al suo interno (“Man in the Middle”)[1]. In entrambi i casi, l’effetto è che l’attaccante vede passare (in chiaro) le informazioni di autenticazione, ovvero lo username+password, i cookie e qualunque altro dato, e può utilizzarli a suo piacimento.

Autenticazione e codici One Time (OTP)

L’evoluzione degli attacchi e delle contromisure di sicurezza ha portato a una specie di gara di velocità (“race condition”). Visto che username+password sono a relativamente alto rischio di essere intercettate e riutilizzate anche a distanza di giorni, mesi o anni, per transazioni a rischio non basso è necessario autenticare ogni singola transazione con un codice valido solo per quella transazione (OTP) e per un limitato periodo di tempo. Il primo metodo adottato a questo scopo è quello delle chiavette (Token) che generano codici pseudo-casuali, ormai abbastanza comuni per gli accessi ai servizi online bancari, anche se recentemente in via di dismissione.

L’idea di base è abbastanza semplice: il Token mantiene in hardware un numero segreto (“seed”) a partire dal quale un algoritmo crittografico, tipicamente di Hash, periodicamente (ad esempio ogni 30 o 60 secondi) genera un numero pseudo-casuale di cui mostra all’utente una parte (usualmente 6 cifre). Un’elaborazione parallela viene eseguita dall’Hardware collegato al Server che eroga il servizio di accesso. Quando è necessario autenticare una transazione, l’applicazione richiede all’utente l’inserimento del codice prodotto in quel momento dal Token, che viene verificato con il corrispondente codice prodotto sul Server. Il Token fornisce un secondo tipo di autenticazione (“qualche cosa che si ha”) rispetto alla password (“qualche cosa che si sa”), è valido solo per quella transazione e la sua validità è limitata nel tempo.

Questa soluzione sembrerebbe a prima vista garantire ottimi livelli di sicurezza. Purtroppo presenta due debolezze: i costi dell’Hardware e di gestione, e una “race condition”. È facile immaginare i costi di questa soluzione pensando a un servizio, ad esempio bancario, con milioni di clienti disseminati geograficamente: anche se il costo di ogni Token fosse di pochi euro, con milioni di clienti il solo costo dei Token ammonterebbe a milioni di euro, a cui aggiungere i sistemi server e la gestione del supporto ai clienti. Non è detto, quindi, che questa sia la soluzione di sicurezza più efficace dal punto di vista della gestione dei rischi e dei costi/benefici.

Un’alternativa meno costosa è quella di inviare un codice OTP a tempo al telefono cellulare dell’utente via SMS. In questo caso è il telefono cellulare che ha il ruolo di “qualche cosa che si ha”, anche se il codice è generato sul server e inviato al telefono su un canale diverso da quello utilizzato per l’accesso al servizio. Ovviamente molto meno costosa, questa soluzione è anche meno sicura[2] in quanto il protocollo SMS non garantisce né la consegna del messaggio né la sua confidenzialità. Infatti vi sono stati casi di attacchi alle infrastrutture telefoniche per intercettare gli SMS con codici di autenticazione OTP [1]. Come sempre, il rapporto costi/benefici di sicurezza è l’argomento principale per scegliere una qualunque soluzione.

Abbiamo visto che il codice OTP può essere utilizzato una volta sola e dura un limitato periodo di tempo, ma gli attaccanti, a costo di spese maggiori, possono aggirare questa difficoltà: è sufficiente fare hijacking della sessione ed intercettare il codice OTP inviato dall’utente utilizzandolo nella propria sessione. Il tutto richiede tempi ben precisi, per transazioni su siti di banche online nell’ordine della decina di secondi, ma possibili.

Si noti come per l’OTP via SMS un punto di debolezza sia già l’invio del codice al telefono cellulare, mentre per la soluzione a Token la debolezza è nella possibile intercettazione del codice o direttamente sul Browser dell’utente oppure tramite siti di Phishing [2,3].

La rinascita della biometria

Negli ultimi anni l’evoluzione dei processi di autenticazione ha avuto principalmente due obiettivi:

  1. semplificare i processi di autenticazione per gli utenti
  2. ridurre i costi.

È sicuramente un problema per tutti ricordare una gran quantità di codici, PIN, username+password eccetera. Siamo tutti invece molto soddisfatti dell’utilizzo delle smartcard contactless, che ci permettono di fare acquisti per piccole cifre avvicinando la carta di credito al lettore, e null’altro. In questo caso ci si autentica unicamente con “qualche cosa che si ha” e il rischio principale è la perdita o furto della carta di credito. Nel caso di furto, questo particolare rischio economico per l’utente e per l’emittente della carta di credito è però basso e ampiamente compensato dall’aumento delle transazioni[3].

Al contempo, lo sviluppo negli ultimi anni dei lettori di caratteristiche biometriche ha permesso la produzione di dispositivi a basso costo e relativa buona efficienza che sono stati integrati nei prodotti per i consumatori. Ormai non solo i PC portatili di alta gamma ma anche moltissimi smartphone sono dotati di un lettore delle impronte digitali o delle caratteristiche del viso. Invece di ricordarci un username+password o un PIN, basta appoggiare il dito al lettore biometrico dello smartphone per aver accesso al telefono e alle App che sfruttano questa funzionalità, prime di tutte le App bancarie ma anche molte altre [5]. Le problematiche di Privacy sono per lo più risolte dal fatto che i dati biometrici sono raccolti e mantenuti da apposite componenti hardware sul dispositivo dell’utente, e non sono gestite da un sistema centrale.

Un possibile approccio è quindi quello di utilizzare username+password come metodo di autenticazione di riserva, che si può mantenere in busta chiusa in caso di difficoltà, ma utilizzare quotidianamente l’autenticazione biometrica per accedere a questi dispositivi e alle relative applicazioni.

Ovviamente non stiamo facendo autenticazione a più fattori, ma sostituendo l’utilizzo di un fattore scomodo con uno più funzionale. È importante notare anche che quanto appena descritto riguarda l’accesso al dispositivo, lo smartphone, non l’accesso a servizi remoti come quelli descritti nella sezione precedente. Accedere ad uno smartphone con l’impronta digitale non risolve direttamente il problema di autenticare le transazioni economiche sul sito della banca.

Autenticazione mutua

Il vero problema dell’autenticazione delle transazioni online risiede nella reale autenticazione reciproca tra client e server: ovvero l’applicazione deve essere sicura di chi sia l’utente che la contatta e viceversa l’utente deve essere sicuro di comunicare direttamente con l’applicazione, senza alcuna interferenza.

Il protocollo SSL/TLS prevede a questo scopo l’utilizzo di certificati client, similmente ai certificati server che ben conosciamo, ma la complessità della loro gestione – ad esempio tramite smartcard – non ne ha favorito l’adozione.

Un recente approccio alternativo è quello di utilizzare lo smartphone come oggetto di seconda autenticazione tramite un App Authenticator, quali quelle di Google, Microsoft, eccetera o della propria banca. L’idea è quella di sostituire il Token o l’SMS descritto precedentemente con lo smartphone sul quale è installata una App di autenticazione. Questa App associa lo specifico smartphone, con il proprio numero di telefono, ad un utente del servizio. Inoltre questa App si autentica mutualmente con il servizio online. Quando l’utente esegue tramite PC una transazione sul servizio online, il servizio online richiede alla specifica App associata all’utente la conferma della transazione. Grazie alla mutua autenticazione, il servizio online è sicuro di comunicare con l’App sullo smartphone dell’utente. L’utente non deve far altro che avere a disposizione lo smartphone e confermare la richiesta di autorizzazione inserendo il PIN di accesso all’App, oppure l’impronta digitale o il riconoscimento facciale. Facendo in questo modo si può anche raggiungere un’autenticazione a tre fattori: unsername+password per l’accesso al servizio online (“qualcosa che si sa”), lo smartphone (“qualcosa che si ha”) e l’autenticazione biometrica (“qualcosa che si è”) per accedere allo smartphone.

Le Authenticator App, seppur molto più sicure dell’invio di un SMS, hanno però anch’esse alcune limitazioni: a parte la possibilità di smarrimento, furto o anche solo scaricamento della batteria dello smartphone, il sistema operativo e le applicazioni per smartphone non sono esenti da vulnerabilità, malware ecc. Ad esempio in caso di rooting, jailbreaking o unlocking, un’App malevola potrebbe interferire con l’esecuzione dell’App di autenticazione portando comunque alla esecuzione di frodi.

Ma forse la principale vulnerabilità degli smartphone è quella di sostituire, in molti casi, il PC e diventare l’unico dispositivo di accesso ai servizi online: in questo caso sia la transazione che tutte le autenticazioni sono svolte sullo stesso dispositivo. Accedendo ad esempio con l’impronta digitale, abbiamo un solo tipo di autenticazione (“qualcosa che si è”) eseguita localmente dal dispositivo e non dal servizio online, che deve basarsi solo sull’associazione del dispositivo all’utente fatta al momento di installazione dell’App. In caso di furto, cloning o presenza di malware a questo punto è teoricamente sempre possibile interferire con il processo di autenticazione.

Ovviamente l’adozione di una Authenticator App ha dei costi, in particolare per lo sviluppo e la gestione del software, dei vantaggi, svantaggi e rischi sia per il fornitore di servizi che per gli utenti. È comunque da notare che l’utilizzo dello smartphone dell’utente, a la BYOD, rende il fornitore di servizi dipendente da qualche cosa – lo smartphone scelto dall’utente – che non può gestire né realmente controllare, introducendo un ulteriore fattore di rischio.

Security Keys e FIDO2/U2F

La FIDO Alliance ha proposto un approccio all’autenticazione sicura online alternativo o complementare al Single Sign On (SSO) Federato gestito da un Identity Provider (come discusso nell’articolo precedente), puntando alla realizzazione di un sistema diffuso, non centralizzato, e garante della Privacy dell’utente. La soluzione proposta dalla FIDO Alliance [6], che va sotto il nome di FIDO2, comprende un gruppo di standard tra cui U2F (CTAP1), UAF, CTAP2 e W3C WebAuthn, ed è basata su molte delle tecnologie di cui abbiamo trattato, dalle smartcard ai Token fisici, ponendosi come obiettivo l’autenticazione mutua utente-servizio.

Il processo di autenticazione è basato su di una Security Key fisica con delle caratteristiche interne simili a quelle di una smartcard, ma che può comunicare a seconda del modello sia tramite USB, sia NFC (come le carte di credito contactless) che Bluetooth Low Energy (BLE). Lo scopo delle Security Key è molteplice [7,8]: sostituire i Token OTP descritti precedentemente, ridurne i costi di gestione, semplificare e automatizzare la gestione per l’utente, aumentare il livello di sicurezza implementando anche l’autenticazione mutua.

Per l’utente l’utilizzo di una Security Key comporta molti benefici: la stessa Security Key può essere utilizzata per autenticarsi a molti diversi servizi online e in qualunque momento può essere svolta la registrazione di un nuovo servizio; può essere utilizzata indifferentemente con PC desktop, portatili, tablet e smartphone senza necessità di particolari dispositivi di collegamento. Svolge quindi le funzioni di una molteplice chiave fisica per il mondo digitale. Inoltre tipicamente una Security Key presenta un bottone, o un lettore di impronte digitali, e agisce solo se attivata da questo.

Ad alto livello il protocollo FIDO2 è abbastanza semplice [7], le principali funzioni sono due: registrazione e autenticazione. Lo scenario è quello di un utente che si collega a un servizio online Web ed effettua prima la registrazione poi, successivamente, utilizza il servizio. Consideriamo il caso più semplice: quello di un servizio che utilizza la Security Key come secondo fattore di autenticazione per transazioni a rischio non basso (Universal Second Factor, U2F).

L’utente crea inizialmente la sua utenza con username+password e poi procede ad aggiungere il secondo fattore di autenticazione. Per far questo è in possesso di una Security Key che connette al dispositivo che sta usando per accedere al servizio online. L’utente attiva nel servizio online la registrazione della propria Security Key. Le principali attività che seguono sono queste (Fig. 1):
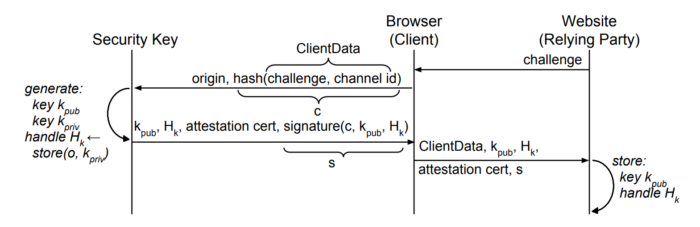
Fig. 1: Registrazione di una Security Key [7]
  • il servizio online invia al Browser (o App) dell’utente una stringa pseudo-casuale (“challenge”) e l’istruzione di registrare la Security Key;
  • Il Browser (o App) identifica la Security Key connessa al dispositivo, le invia i dati ricevuti dal servizio online e delle informazioni sul servizio quali il suo indirizzo (“origin”), e richiede la creazione di una nuova chiave pubblica+privata;
  • La Security Key, dopo la pressione del bottone, crea una chiave pubblica+privata con un identificativo (“handle”), con la chiave privata firma i dati ricevuti e invia la chiave pubblica e i dati firmati al Browser (o App);
  • Il Browser (o App) inoltra i dati ricevuti dalla Security Key al servizio online;
  • Il servizio online, verificato con la chiave pubblica ricevuta che la firma effettuata dalla Security Key sui dati (ed in particolare sul challenge) sia corretta, archivia la chiave pubblica con il suo identificativo associandoli all’utenza.

D’ora in avanti il servizio online può utilizzare la chiave pubblica ed il suo identificativo per richiedere una seconda autenticazione all’utente. Questo procede in maniera simile, come segue (Fig. 2):
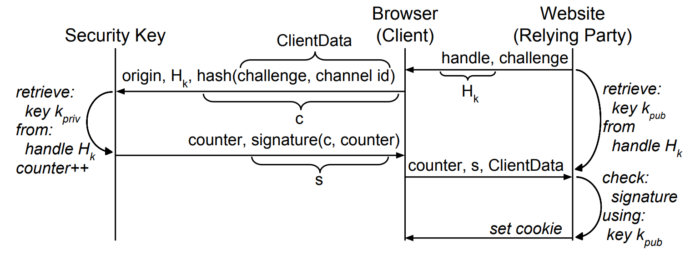
Fig. 2: Autenticazione tramite Security Key [7]
  • il servizio online invia al Browser (o App) dell’utente una stringa pseudo-casuale (“challenge”) e l’identificativo (“handle”) della chiave pubblica associata all’utente che vuole autenticare;
  • Il Browser (o App) identifica la Security Key connessa al dispositivo, le invia i dati ricevuti dal servizio online e delle informazioni sul servizio quali il suo indirizzo (“origin”), e richiede l’autenticazione;
  • La Security Key, dopo la pressione del bottone, verifica che l’identificativo corrisponda a una propria chiave, che corrisponda ai dati del servizio per cui l’ha creata, firma i dati ricevuti con la chiave privata e invia i dati firmati al Browser (o App);
  • Il Browser (o App) inoltra i dati ricevuti dalla Security Key al servizio online;
  • Il servizio online verifica con la chiave pubblica dell’utente che la firma effettuata dalla Security Key sui dati sia corretta, e quindi procede con l’esecuzione della transazione.

Si noti come in questo processo il servizio online si fidi solo della firma della Security Key, ovvero dell’attestazione della presenza della chiave privata nella Security Key. D’altra parte, la Security Key verifica sia i dati inviati direttamente dal servizio online che quelli forniti dal Browser: la Security Key esegue la firma solo se tutti i dati ricevuti sono consistenti. In questa maniera abbiamo due attori che in maniera automatica verificano reciprocamente la propria identità: il servizio online e la Security Key. Questo indipendentemente da chi possa cercare di intercettare o modificare la comunicazione.

Ovviamente questa soluzione non riesce a coprire tutti i possibili scenari di attacco: la fase più delicata è sicuramente quella della registrazione iniziale, ove un attaccante potrebbe cercare di immedesimare il servizio online. Si noti anche che, quando l’utente autorizza la firma della Security Key premendo il suo bottone (o verificando l’impronta digitale), non ha la possibilità di verificare il contenuto dei dati firmati su di un display sicuro; un attaccante potrebbe quindi cercare di modificare i dati della transazione, ad esempio cambiandone il destinatario, prima della firma.

Rimane da chiarire un aspetto comunque importante: come revocare le chiavi generate da una Security Key in caso, ad esempio, di furto o smarrimento della Security Key stessa, o per rimuovere una chiave generata dalla Security Key ma che non si vuole più utilizzare. Il protocollo al momento non prevede la possibilità di cancellare chiavi dalla Security Key né di notificare la perdita (o il ritiro) di una Security Key. Per garantire la Privacy degli utenti, non vi è un identificativo univoco di ogni singola Security Key che altrimenti permetterebbe di tracciare le attività dell’utente. Lo scenario più critico è sicuramente quello del furto di una Security Key e, al momento, il protocollo lascia al gestore di ogni servizio online decidere come gestire questo evento.

Un’ultima osservazione su questo protocollo: le Security Key permettono di gestire un numero arbitrario di servizi online, si pone pertanto il problema della conservazione delle chiavi private sul piccolo dispositivo poiché potrebbero occupare parecchio spazio all’interno del processore sicuro. Lo standard non impone una soluzione ma offre un approccio: mantenere nel processore sicuro una (o due) master key private ed esportare in maniera sicura le altre chiavi private. In questo caso, tutte le chiavi private delle coppie pubblico+privato generate dalla Security Key sono cifrate e decifrate con la master key privata solo all’interno del processore sicuro e possono essere esportate solo se cifrate. Le chiavi private cifrate possono quindi essere archiviate o in un’area di memoria apposita sulla stessa Security Key, o inviate al servizio online che le archivia insieme alla chiave pubblica. La sicurezza è fornita dal fatto che solo la master key privata all’interno della Security Key può decifrare ed utilizzare queste chiavi.

L’adozione delle Security Key da parte di Google Inc. [7,8] e di molte altre aziende sta dando risultati soddisfacenti sia per la semplicità d’uso che per i livelli di sicurezza raggiunti. Il fatto di essere una “chiave” che possiamo aggiungere al nostro portachiavi, utilizzabile con molteplici nostri dispositivi e diversi servizi online, sicuramente può semplificarci la vita oltre ad aumentare la sicurezza dell’accesso ai servizi.

È però troppo presto per dichiarare che abbiamo finalmente individuato la strada per abbandonare definitivamente le nostre vecchie e care password.

Note:

[1] Alcuni Malware (ad esempio bancari) si inseriscono tra il frontend del Browser e il sistema operativo sul dispositivo dell’utente per accedere, e anche modificare, i dati della connessione al servizio remoto.

[2] Per il momento non consideriamo il caso di accesso al servizio tramite App sullo stesso smartphone.

[3] Per pagamenti di cifre superiori, sono in corso sperimentazioni di carte di credito contactless con autenticazione biometrica delle impronte digitali, si veda ad esempio [4], invece della richiesta del PIN.

Riferimenti Bibliografici

[1] Per un recente caso si vedano:

[2] B. Schneier, “Hacking Two-Factor Authentication”, https://www.schneier.com/blog/archives/2009/09/hacking_two-fac.html.

[3] Si vedano, ad esempio:

  • Ars Technica, “Iranian phishers bypass 2fa protections offered by Yahoo Mail and Gmail”, https://arstechnica.com/information-technology/2018/12/iranian-phishers-bypass-2fa-protections-offered-by-yahoo-mail-and-gmail/.
  • The Hacker News ,“WARNING – New Phishing Attack That Even Most Vigilant Users Could Fall For”, https://thehackernews.com/2019/02/advance-phishing-login-page.html.

[4] “Intesa Sanpaolo and Mastercard introducing the first contactless biometric payment card in Italy”, https://www.world.intesasanpaolo.com/hp-news/intesa-sanpaolo-mastercard-introducing-first-contactless-biometric-payment-card-italy/.

[5] Si veda ad esempio “WhatsApp can now be locked using Face ID or Touch ID”, http://www.theverge.com/2019/2/4/18210197/whatsapp-touch-id-face-id-security.

[6] https://fidoalliance.org/ , https://www.w3.org/TR/webauthn/.

[7] J. Lang et al., “Security Keys: Practical Cryptographic Second Factors for the Modern Web”, Google Inc., http://fc16.ifca.ai/preproceedings/25_Lang.pdf.

[8] Ars Technica, “This low-cost device may be the world’s best hope against account takeovers”, https://arstechnica.com/information-technology/2016/12/this-low-cost-device-may-be-the-worlds-best-hope-against-account-takeovers/.

Articolo a cura di Andrea Pasquinucci

Download PDF

https://www.ictsecuritymagazine.com/articoli/lautenticazione-che-si-evolve-dalla-password-ai-token-u2f-parte-2/
La sicurezza delle Blockchain e gli impatti sulla professione dell’IT Auditor

Dopo l’introduzione di Bitcoin nel 2006, le tecnologie legate alla Blockchain sono oggi impiegate in molti settori industriali diversi dagli strumenti di pagamento o di moneta elettronica. Peraltro, le implementazioni di applicazioni basate su Blockchain possono essere molto diversificate, sia rispetto ai suoi elementi costitutivi – come l’impiego di uno specifico algoritmo di consenso – sia per quanto concerne gli aspetti di contesto, come la struttura organizzativa in cui l’applicazione dovrà essere collocata. In un simile panorama, caratterizzato da un’estrema eterogeneità (oltre che da un’inerente immaturità delle soluzioni disponibili), si inseriscono tematiche orizzontali come la governance, gli aspetti normativi e regolamentari, la gestione dei rischi e la sicurezza delle informazioni.

Quest’ultimo aspetto appare senz’altro uno dei più critici per via della natura delle applicazioni sviluppate, che spesso presentano connessioni dirette con gli aspetti finanziari di un’organizzazione. Immaginiamo infatti il caso classico di un token gestito attraverso uno smart contract, sviluppato nell’ambito di una Initial Coin Offer (ICO) e rilasciato su una Blockchain pubblica come Ethereum. Qualora lo smart contract dovesse presentare delle vulnerabilità, l’effetto di un eventuale attacco potrebbe determinare impatti finanziari diretti, ad esempio tramite lo spostamento non autorizzato di token verso i conti dell’attaccante.

Un’eventualità tutt’altro che peregrina. In tal senso, il caso del cosiddetto “DAO incident” è in qualche modo paradigmatico degli effetti spesso drammatici che un problema di sicurezza può determinare in un simile contesto. In questo specifico incidente, una vulnerabilità nello smart contract su cui era basato il progetto Distributed Autonomous Organization (DAO) ha consentito a un attaccante esterno di sottrarre illecitamente ingenti somme dai fondi costituiti per il progetto, riuscendo a inserire, direttamente all’interno della Blockchain di Ethereum, transazioni fraudolente per centinaia di milioni di dollari.

In un simile scenario, i tempi a disposizione per una reazione efficace all’incidente sono compressi quasi fino ad annullarsi. Inoltre, le tipiche garanzie di forte integrità che caratterizzano la Blockchain possono rivelarsi controproducenti quando si tratta di correggere il comportamento di uno smart contract, il quale, una volta rilasciato e inizializzato, è sostanzialmente immutabile, precludendo qualsiasi possibilità di fixing ex-post della vulnerabilità sfruttata dall’attaccante. Nel caso del DAO incident, tale dilemma è stato risolto in un modo unico e, ormai, irripetibile: attraverso un hard-fork del codice dei nodi Ethereum, lo stato dei conti dello smart contract del DAO è stato alterato per sterilizzare gli effetti dell’attacco. In un certo senso, le attività di patching tipiche in una procedura di incident management in questo caso sono state applicate all’infrastruttura sottostante (la Blockchain) anziché all’oggetto dell’attacco (lo smart contract).
Tale modus operandi viola in modo palese il principio di segregazione tra le componenti di un sistema informatico, intervenendo su un componente corretto per ripararne uno vulnerabile. Oltre ad essere del tutto insoddisfacente, come dicevamo, tale approccio risulterebbe oggi irripetibile. Infatti, applicare un hard-fork in una Blockchain pubblica come Ethereum equivale a convincere l’intera comunità dei miner ad applicare la relativa patch ai propri nodi. Il termine “convincere” è particolarmente appropriato, non esistendo alcuna leva, tecnologica od organizzativa, che possa imporre tale correzione a un miner. Nei fatti, l’applicazione di una procedura così estrema ed eterodossa ha determinato una spaccatura della comunità di Ethereum, conducendo alla creazione di una blockchain parallela nota come “Ethereum Classic”. Le due fazioni, infatti, si sono polarizzate intorno a due diverse opinioni rispetto al principio noto come “code is law”. In particolare la fazione più rigida sosteneva che, poiché il codice era pubblicamente disponibile agli utilizzatori dello smart contract, questi erano consapevoli dei possibili percorsi di esecuzione, inclusi quelli potenzialmente malevoli, e ne accettavano tutte le conseguenze. Gli smart contract infatti non sono ambigui, in quanto le modalità di esecuzione del codice sono note a priori e del tutto deterministiche.

Dal DAO incident scaturiscono considerazioni molto importanti:

  • i processi tipici di gestione della sicurezza, come l’incident management, devono essere adattati e, a causa delle caratteristiche strutturali della Blockchain, il sistema dei controlli deve essere focalizzato nelle fasi di prevenzione e di rilevamento.
  • La governance della Blockchain presenta problematiche specifiche a causa della totale decentralizzazione dell’algoritmo di consenso. Nelle blockchain pubbliche e non permissioned, in particolare, non esiste alcun controllo a livello accentrato che consenta di prevenire possibili situazioni di rischio per un’applicazione dovute a cambiamenti delle regole di funzionamento introdotti tramite hard fork. La comunità, in particolare, potrebbe spaccarsi ovvero la blockchain essere indotta al collasso.
  • La dualità tra un accordo legale e il relativo smart contract che lo implementa (almeno in parte) potrebbe presentare rischi non facilmente identificabili in fase di progettazione dell’applicazione. Uno smart contract potrebbe infatti essere indotto in uno stato non previsto – o contrario – rispetto alle previsioni contrattuali dell’accordo legale.

Rispetto a queste considerazioni, possiamo cercare di capire se e come cambia il lavoro dell’IT auditor sotto il punto di vista dell’approccio metodologico e della cassetta degli attrezzi di cui dispone. In effetti, come peraltro abbiamo già accennato, possiamo considerare un’applicazione basata su Blockchain come un qualsiasi altro componente informatico che fa parte dell’universo di audit su cui l’auditor è chiamato a dare assurance. Tale applicazione sarà infatti composta da componenti IT che fanno tradizionalmente parte del bagaglio esperienziale di un auditor: certamente avremo un’interfaccia di front-end (ad es. un’app per smartphone o un sito web), uno o più componenti di middleware (come ad es. un message broker) e un sistema di memorizzazione (il tipico database relazionale). L’applicazione sarà poi inserita in un contesto IT in cui saranno presenti altre componenti infrastrutturali comuni come un sistema di autenticazione, un accentratore di log, proxy di frontiera ecc.

Ecco che quindi l’assessment portato a termine dall’auditor per tali componenti IT non prevede peculiarità specifiche rispetto alle attività business as usual. Rimane quindi da comprendere come affrontare l’analisi della componente “blockchain”. Sebbene l’approccio di analisi della blockchain stessa si differenzi in modo sostanziale qualora ci si trovi in presenza di una blockchain pubblica o privata, da un punto di vista applicativo, le primitive esposte da questa componente tecnologica non risultano molto diverse da quelle di un normale sistema di memorizzazione tradizionale: attraverso l’uso di transazioni, dalla blockchain è possibile leggere (in modo sincrono) o modificare (in modo asincrono) lo stato di un smart contract. Se rimaniamo a questo livello di astrazione, possiamo senz’altro applicare tutti gli strumenti metodologici utilizzati dall’auditor per condurre il proprio assessment sotto i profili tipici di efficacia, efficienza e sicurezza. Risultano quindi utilizzabili, seppure con qualche adattamento, framework come COBIT, ISO, COSO, NIST, ITIL ecc.

Attraverso questi strumenti, in sede di audit, è possibile analizzare taluni aspetti tipici di un’applicazione IT:

  • Quali controlli sono stati previsti per assicurare che l’applicazione rispetti tutti i requisiti normativi e regolamentari cogenti? Per le blockchain pubbliche, il tema della privacy appare particolarmente significativo, per via delle previsioni del GDPR. Nel caso di strumenti di pagamento, i requisiti della PSD2 vanno soddisfatti.
  • Contratti e accordi. Com’è possibile tutelare l’organizzazione proprietaria dell’applicazione rispetto a eventuali scenari di rischio legale? Ad esempio, se un’applicazione gestisce quantità di tipo finanziario, in caso di abuso da parte di soggetti interni o esterni, come vengono gestite eventuali richieste di risarcimento?
  • Processi IT. Come vengono gestiti aspetti del ciclo di vita tipici di un servizio informatico, come ad es. il change management o l’incident handling? In particolare, l’evoluzione di uno smart contract è senz’altro rilevante per via dell’immutabilità della Blockchain. L’auditor quindi dovrà capire quali controlli, prevalentemente di tipo tecnologico, consentono a uno smart contract di subire cambiamenti in modo controllato. Dalla prospettiva del forensics invece la situazione appare più rosea, in quanto l’intera storia delle transazioni di una blockchain è dispoinibile pubblicamente.
  • IT General Controls. Come qualsiasi componente informatica, anche la blockchain deve essere protetta da scenari di rischio tipico, come l’accesso non autorizzato a quantità di sicurezza come le chiavi crittografiche.
  • Costi e ritorni. Anche per la blockchain andranno valutati aspetti finanziari ed economici tipici, come i costi di progetto, il ritorno sull’investimento, il raggiungimento del break-even.
  • Infine, andrà capito l’allineamento dell’applicazione della blockchain rispetto agli obiettivi di business dell’organizzazione.

Oltre a questi ausilii metodologici, l’auditor può disporre infine di strumenti che consentono di analizzare, in modo più o meno automatico, le applicazioni basate sulla blockchain per quanto riguarda aspetti più squisitamente tecnologici. Seppure in fase ancora embrionale, nella comunità delle blockchain cominciano ad apparire tool che consentono di effettuare veri e propri vulnerability scanning di smart contract. Un esempio molto importante è rappresentato dal progetto Mythril di ConsenSys per smart contract su rete Ethereum. Altri strumenti utili riguardano senz’altro lo sviluppo di checklist e compendi di best practices che consentono di guidare l’auditor nell’assessment di un’implementazione di uno smart contract – o di un’intera blockchain privata. Per il futuro assumeranno sicuramente un peso preponderante gli strumenti di analisi formale degli smart contract, che consentiranno di fornire assurance sull’aderenza del codice sviluppato rispetto alle clausole contrattuali dell’accordo legale a esso associato.

In conclusione, si può senza dubbio affermare che l’avvento della Blockchain determinerà un cambiamento significativo nelle attività di IT audit sebbene, da un punto di visto strettamente metodologico, gli strumenti e gli approcci correntemente utilizzati dall’auditor risultino senz’altro ancora validi e pertinenti. Da un punto di vista tecnologico, i tool a disposizione sono ancora primitivi ma la direzione verso cui questi si stanno muovendo è senz’altro quella corretta. Certamente, la sfida più rilevante che attende la comunità degli IT auditor sarà quella di sviluppare un bagaglio di esperienze che consentirà di individuare e comprendere gli scenari di rischio tipici di un’applicazione basata sulla Blockchain.

Articolo a cura di Cristiano Paris

Download PDF

https://www.ictsecuritymagazine.com/articoli/la-sicurezza-delle-blockchain-e-gli-impatti-sulla-professione-dellit-auditor/


Riflessioni sulla “indipendenza dal software” nei sistemi di e-voting (parte prima)

Introduzione

Il presente articolo vuole essere un punto di ripresa della discussione sulla tematica dell’e-voting che molto tiene banco in questi tempi. Per questo motivo proponiamo una rilettura liberamente basata sulle considerazioni basilari raccolte in un articolo scritto da Ronald L. Rivest[1], uno dei più importanti crittografi statunitensi e che riteniamo particolarmente attuale. Il lavoro più noto di Rivest è il sistema di crittografia asimmetrica, progettato insieme a L. Adleman e A. Shamir, che prende il nome crittografia RSA nel 1978. La sua attività di ricerca non è limitata all’ambito accademico: infatti Rivest ha avuto un ruolo significativo nel dibattito politico-sociale fra le opposte esigenze del diritto alla tutela dei dati personali (privacy) da parte del cittadino e l’esigenza del controllo della sicurezza da parte dello Stato. L’articolo da cui prende spunto il nostro intervento è un punto importante che Rivest ha messo nella discussione sull’e-voting, offrendo una visione che possa chiarire se esiste una possibilità di realizzare sistemi elettronici per il voto che garantiscano l’anonimato, la sicurezza e l’integrità del voto stesso.

Iniziamo subito dall’analisi delle considerazioni finali dell’articolo per cui la capacità di dimostrare la correttezza del software che gestisce il voto elettronico diminuisce rapidamente mentre il software diventa più complesso. È impossibile verificare adeguatamente che i sistemi di voto siano totalmente privi di difetti o assicurare l’assenza da eventuali bug che permettano frodi. Su questi sistemi rimane quindi sempre l’alone del sospetto di una loro incapacità di supportare elezioni sicure e accurate. Altresì sembra impossibile garantire l’effettiva indipendenza del voto dal software usato per registrarlo. Nel voto tradizionale è sempre possibile verificare la congruenza tra il voto espresso (sulla scheda) e quello registrato (durante lo spoglio) mentre nell’e-voting l’atto di acquisizione del voto e la sua registrazione si basano su meccanismi invisibili e complessi e quindi sulla fiducia che si ripone nel software stesso, dato che verificare e assicurarsi che i voti siano registrati con precisione è difficile e costoso. Il problema principale è fornire garanzia di sicurezza, integrità, riservatezza e anonimato del voto espresso: il software potrebbe essere corretto ma convincersene – o convincere tutti gli elettori – è certamente compito arduo.

I software nei sistemi di votazione sono complessi

I sistemi di votazione elettronica sono complessi e continuano a crescere nella loro complessità. I requisiti per la privacy dell’elettore, per la sicurezza del voto contro un attacco informatico o contro il fallimento del voto stesso e, non in ultimo, l’accuratezza del conteggio finale sono tutti requisiti totalmente in conflitto tra di loro. Questi requisiti, complessi e conflittuali, conducono a una crescente difficoltà di verifica dell’affidabilità.

Un esempio riportato da Rivest riguarda i sistemi di votazione Direct-Recording Electronic (DRE), che generalmente forniscono solamente l’interfaccia utente touch-screen per effettuare la selezione del voto e che memorizzano i record di voto sia in memoria interna che su memoria rimovibile. Un DRE può visualizzare una varietà essenzialmente infinita di diversi tipologie di voto e può includere complesse caratteristiche di accessibilità per i non vedenti (ad esempio, l’uso di cuffie per essere guidato ad effettuare la scelta). Nonostante questa grande varietà di funzionalità un DRE non è in grado di offrire una verifica, direttamente osservabile dall’elettore o verificabile in fase di spoglio, che il voto sia stato correttamente memorizzato: bisogna fidarsi della tecnologia.

Il cuore della riflessione di Rivest è appunto qui: come fornire garanzie, a dispetto della complessità del software, che il sistema di voto registrerà accuratamente le intenzioni dell’elettore?

La necessità di un punto di vista diverso

È pacifico per chi si occupa di sviluppo software che la complessità sia nemica della sicurezza e dell’accuratezza: è molto difficile valutare un sistema complesso. Un errore molto piccolo (pensate a un errore di battitura nel nome di una variabile o la sua mancata inizializzazione) in un sistema complesso di grandi dimensioni può causare risultati imprevisti, in momenti imprevedibili. Oppure, può mostrare il fianco inserendo una vulnerabilità che può essere sfruttata da un avversario politico per avvantaggiarsi.

L’individuazione di tutti gli errori in un sistema di grandi dimensioni è generalmente ritenuta impossibile o estremamente costosa. “La capacità di sviluppare software complessi supera di gran lunga la capacità di dimostrarne la correttezza o di testarla in modo soddisfacente entro limiti economici ragionevoli”, afferma Rivest. Un sistema di voto per il quale l’integrità dei risultati elettorali dipende intrinsecamente dalla correttezza del suo software sarà sempre ritenuto per lo meno sospettabile.

L’idea introdotta da Rivest per affrontare questo problema fondamentale è quello di cambiare ottica e seguire una metodologia indipendente dal software: “Verificare i risultati delle elezioni, non il sistema di voto.”

Con l’approccio DRE, si è costretti ad assumere che il software sia totalmente corretto. Se sorgono domande a posteriori sull’accuratezza dei risultati elettorali (ad esempio è richiesto un nuovo conteggio), non c’è altra strada che quella di presumere che il sistema di voto abbia effettivamente registrato i voti in modo accurato. È chiaro, quindi, che sarebbero da preferire sistemi di voto in cui l’integrità del risultato elettorale non dipenda dalla fiducia nella correttezza del software. Non ci dovrebbe essere nessun motivo di preoccupazione che il risultato elettorale sia stato influenzato o determinato da qualche bug del software o peggio, ad esempio, da un codice malevolo esterno.

L’indipendenza dal software

Rivest definisce quindi un nuovo concetto, quello di “indipendenza dal software”, che coglie la caratteristica necessaria di fornire risultati elettorali che siano verificabili, senza dover dipendere dal presupposto che il software sia corretto.

“Un sistema di votazione è indipendente dal software se una modifica o un errore non rilevato nel suo software non può causare una modifica o un errore non rilevabile in un risultato elettorale”.

Per contrasto, quindi, si può definire un sistema di votazione dipendente dal software come vulnerabile a errori di programmazione non rilevati, codice dannoso o manipolazione del software, in modo tale che la correttezza dei risultati delle elezioni dipenda dalla correttezza stessa del software.

Per illustrare la logica dell’indipendenza dal software, Rivest propone degli  “esperimenti mentali” riprendendo la tradizione iniziata da Einstein. “Immedesimiamoci nei panni di un avversario politico” scrive Rivest “e immaginiamo di avere il potere di sostituire segretamente qualsiasi software esistente utilizzato dai sistemi di votazione elettronico con una loro versione appositamente modificata. Con questa precisa capacità, si può (come avversario politico) cambiare un risultato elettorale o indirizzare un’elezione senza paura di essere scoperti?”

Se la risposta è affermativa. allora per Rivest il sistema è dipendente dal software; in caso contrario, il sistema è indipendente dal software ovvero il sistema di votazione nel suo insieme (compresi i componenti non software) ha una ridondanza e un controllo incrociato per cui un suo comportamento incoerente può essere rilevato. L’individuazione potrebbe avvenire da parte dell’elettore (che verifica il voto con un sistema incrociato), da un funzionario elettorale o da un tecnico, da un audit post-elettorale, da un osservatore esterno (in realtà va bene qualsiasi persona o ente, tranne l’avversario stesso).

Messa in questi termini il pensiero va subito a un contesto di cyber security e a interventi di hacker blackhat. Ma lo stesso Rivest, correttamente, astrae il contesto specificando che si può considerare un “avversario” lo stesso processo di sviluppo e test del software. Questo avversario astratto sarebbe rappresentato da tutti gli errori del software presenti fin dall’inizio e che siano sfuggiti ai processi di controllo e certificazione.

Dato che i software complessi sono difficili da scrivere e da testare, è molto probabile che conterranno numerosi “bug” non intenzionali e che a volte possano far sì che riportino risultati errati nelle elezioni. Non è ragionevole sperare di realizzare software privi di bug, a causa principalmente dei costi proibitivi che una tale operazione sottintenderebbe.

Nella seconda parte di questo articolo andremo ad approfondire come in concreto la definizione offerta da Rivest può darci una soluzione a garanzia dei processi di e-voting.

Note:

[1] Ronald L Rivest, On the notion of ‘software independence’ in voting systems. Published: 06 August 2008 – https://doi.org/10.1098/rsta.2008.0149.

Articolo a cura di Michelangelo De Bonis e Matteo De Simone

Download PDF

https://www.ictsecuritymagazine.com/articoli/riflessioni-sulla-indipendenza-dal-software-nei-sistemi-di-e-voting-parte-prima/


Analisi forense di Tor Browser Bundle su sistemi Windows

In questo nuovo articolo illustrerò i vari aspetti legati all’analisi forense[1] del browser Tor, acronimo di The onion routing, – https://www.torproject.org – ovvero di uno dei browser più utilizzati per accedere alla rete Tor, evidenziando gli artefatti che potrebbero rappresentare una fonte attendibile di informazioni utili ai fini investigativi.

Il browser Tor è in realtà Mozilla Firefox, opportunamente modificato in modo da potersi connettere alla rete Tor. Pertanto, se si ha già esperienza di analisi forense del browser Mozilla Firefox, si potranno notare, nel corso delle operazioni descritte, evidenti similitudini.

Il Tor Browser può essere utilizzato su svariati sistemi operativi tra cui Windows, Mac e Linux e può essere eseguito sia da computer che da Pen Drive o Hard Disk esterno.

In fig. 1 la tipica struttura su disco dopo l’installazione della versione 8.0.6:

Prima di addentrarsi nel processo di analisi dal punto di vista forense, è necessaria una premessa almeno introduttiva del contesto in cui browser come Tor si trovano ad operare.

The Tor Project venne originariamente sviluppato, negli anni ’90, dal Naval Research Laboratory negli Stati Uniti, in collaborazione con il matematico Paul Syverson e gli informatici Michael Reed e David Goldschlag; lo scopo del progetto era la creazione di uno strumento atto a proteggere le comunicazioni sensibili dell’intelligence. Fu il periodo dell’affermazione del principio cardine del routing di Tor-onion e della tecnica che protegge, ancora oggi, l’anonimato degli utenti online attraverso una serie di livelli crittografati.

Ci sarebbero voluti ancora anni prima che la versione originale di Tor diventasse disponibile: la versione alfa di The Onion Router o TOR venne rilasciata solo nel 2002.

Quindi, l’utilizzo dei principi di routing onion sviluppato negli anni ’90 aveva consentito lo sviluppo  di uno strumento veramente sicuro e anonimo per navigare in Internet.

Sarebbero comunque passati altri due anni prima del rilascio del codice sorgente del progetto da parte del Naval Research Laboratory, con una licenza free.

Fu proprio in quel momento che la Electronic Frontier Foundation (EFF) iniziò a finanziare lo sviluppo di Tor; nel 2006 nacque l’attuale organizzazione senza scopo di lucro dedita alla gestione e manutenzione del progetto, denominata Tor Project, che rese sempre più popolare l’utilizzo del browser Tor per chiunque stesse cercando uno strumento atto a mantenere la propria identità al sicuro durante la navigazione Web.

Oggi, The Tor Project ha sede in Massachusetts e opera nell’ambito della ricerca continuando a mantenere sia il Browser Tor che l’intricato sistema di ritrasmissione globale in grado di fornire i necessari strati di anonimato indispensabili alla navigazione in sicurezza; il tutto in un’epoca in cui, la sorveglianza da parte di agenzie governative – e non solo -, desta non poche preoccupazioni nei frequentatori della rete Internet.

Ma cos’è esattamente Tor ?

Nella sua accezione più semplice, The Tor Project è composto da due parti:

  1. un browser lato client che consente agli utenti di connettersi alla rete Tor;
  2. un sistema globale di trasmissione che, basandosi su punti di ingresso della rete apparentemente casuali, hop[2] di instradamento e punti di uscita, rende ostica l’identificazione, attraverso l’analisi dello stesso o il monitoraggio della rete, del percorso end-to-end relativo al flusso di traffico.

Quando si utilizza un browser Web convenzionale, la maggior parte delle richieste Internet sono facilmente intercettate. È relativamente semplice comprendere la posizione di un determinato utente sulla base dell’indirizzo IP (Internet Protocol) – anche se nella realtà potrebbe non essere così scontato.

L’utilizzo di Tor fornisce un modo sicuro per navigare in Internet senza trasmettere l’indirizzo IP del dispositivo o alcuna delle informazioni visualizzate durante la sessione. Il sistema sembra funzionare talmente bene che, la National Security Agency (NSA) ha più volte affermato come Tor sia “il re dell’anonimato di Internet ad alta sicurezza e bassa latenza“.

Tor rende dunque anonimo l’indirizzo IP, ma vi sono altri dettagli che potrebbero comunque rivelarne l’identità: i font installati, il tipo di browser e la grandezza delle finestre di navigazione.

Tra i vari suggerimenti che lo stesso browser evidenzia, uno di questi  è rappresentato dalla buona norma di non tenere la finestra di navigazione a schermo intero, come da figura in calce, per motivi che potrebbero anche non essere di immediata comprensione.

Fig. 2

Bene, dopo questa breve e necessaria panoramica poco “tecnica” – gli addetti ai lavori mi perdoneranno –, risulta di palmare evidenza la sfida che un informatico forense si trova ad affrontare.

Risulta altresì evidente come l’utilizzo di strumenti come Tor possa rientrare nella definizione di Anti-Forensic (AF), quale tentativo di ridurre la qualità e la quantità degli artefatti digitali per garantire che le evidenze digitali ritrovate da un investigatore forense non siano utilizzabili o non rappresentino la reale situazione in essere, non agevolando il lavoro di chi dovrebbe estrarle per contribuire alla verità processuale.

Come approcciare l’analisi ?

Per prima cosa è necessario trovare la cartella di installazione di Tor che potrebbe essere ovunque su di un dispositivo, essendo un’applicazione portatile. Chi cerca di nascondere il browser Tor potrebbe aver rinominato l’eseguibile o averlo installato in una directory di sistema, dove non ci si aspetterebbe di trovarlo.

È ovvio che il metodo più accurato e veloce per scovarlo è utilizzare i valori di hash corrispondenti in aggiunta alla ricerca di “Tor”.

Poiché il browser Tor viene costantemente aggiornato, nel dispositivo potrebbero risiedere varie versioni di Tor. Creare un proprio set di hash univoco delle versioni di Tor con cui effettuare le ricerche successive è semplice: il Tor Project archivia tutte le versioni precedenti al seguente indirizzo web: https://archive.torproject.org/tor-package-archive/torbrowser, come evidenziato in fig. 3.

Uno degli scopi della ricerca di versioni più datate di Tor è quello di avere contezza circa il periodo di tempo in cui l’utente potrebbe aver utilizzato Tor come strumento di navigazione e di comunicazione anonima, indizio che, se verificato, avrebbe una sua rilevanza.

Infatti, un utente abituale di Tor aggiorna il proprio browser con regolarità onde evitare la compromissione a seguito di “debolezze” insite nelle versioni precedenti.Fig. 3

Quindi, dove cercare ? Cosa analizzare ? Quali artefatti tenere in considerazione ?

L’analisi forense del browser Tor può essere davvero ardua e rappresentare, come già evidenziato, una grande sfida per un esperto di Digital Forensics.
Il tempo è il fattore più determinante in caso di analisi live: per recuperare la cronologia di navigazione di Tor, è necessario un dump di memoria della macchina; sfortunatamente gli artefatti di Tor rimangono in memoria solo per pochi minuti dopo l’uso. Se il browser Tor è stato eseguito e successivamente terminato, i dati in memoria scompaiono quasi istantaneamente. Tuttavia, se è ancora in esecuzione, è possibile, sebbene la disponibilità sia di pochi minuti, recuperare le tracce  relative alle url utilizzate. Quindi è necessario, qualora ci si trovi con un dispositivo e Tor in esecuzione, catturare il contenuto della memoria; ogni secondo è prezioso.

Vi sono pochi altri artefatti di Tor utili alle indagini che forniscono, principalmente, alcune indicazioni sul suo utilizzo, ma poco o nulla sul contenuto effettivo delle comunicazioni o sulla cronologia di navigazione. Il file di paging di Windows (pagefile.sys) potrebbe contenere il nome del file per il browser Tor e si potrebbero rinvenire tracce del browser Tor in file di cache – entreremo nel dettaglio in seguito.

# This file was generated by Tor; if you edit it, comments will not be preserved

# The old torrc file was renamed to torrc.orig.1 or similar, and Tor will ignore it

DataDirectory C:\Users\cosimo\Desktop\Tor Browser\Browser\TorBrowser\Data\Tor

GeoIPFile C:\Users\cosimo\Desktop\Tor Browser\Browser\TorBrowser\Data\Tor\geoip

GeoIPv6File C:\Users\cosimo\Desktop\Tor Browser\Browser\TorBrowser\Data\Tor\geoip6 

Condurre una ricerca per la parola chiave “HTTP-memory-only-PB” all’interno di pagefile.sys può comportare il recupero dei siti web visitati con il browser Tor, ma il recupero della cronologia di Internet non sarà mai soddisfacente come per la cronologia di comuni browser.

La ricerca di qualsiasi parola chiave correlata a “Tor” come “torproject” su tutta l’immagine del dispositivo potrebbe rivelare informazioni sull’uso di Tor nelle e-mail o nella cronologia di Internet recuperabile.

Le cartelle più interessanti per la ricerca delle evidenze sono localizzate in “\Tor Browser\Browser\TorBrowser”:

Fig. 4

Analizziamo i contenuti dei file evidenziati in rosso.

Il file state conterrà la data di ultima esecuzione del browser:

Il file torrc conterrà le informazioni di esecuzione del browser corredato del percorso completo utilizzato:

[Compatibility]

LastVersion=60.5.1_20190204060201/20190204060201

LastTorBrowserVersion=8.0.6

LastOSABI=WINNT_x86-gcc3

LastPlatformDir=C:\Users\cosimo\Desktop\Tor Browser\Browser

LastAppDir=C:\Users\cosimo\Desktop\Tor Browser\Browser\browser

Il file compatibility.ini  conterrà il percorso completo di ultima esecuzione del browser:

{“version”:2,”commands”:{},”prefs”:{},”url_overrides”:{},”default_search”:{“defaultSearch”:{“initialValue”:”DuckDuckGo”,

“precedenceList”:[{“id”:”jid1-ZAdIEUB7XOzOJw@jetpack”,”installDate”:1551203318966,”value”:”DuckDuckGo”,”enabled”:true}]}}}


Il file extension-settings.json  conterrà, tra l’altro, il valore della data di installazione del browser

che, oppurtunamente convertita, consentirà la visualizzazione della stessa in formato “umano” – 26 febbraio 2019 ore 17:48:38 – :

# Tor state file last generated on 2019-03-02 17:36:41 local time

# Other times below are in UTC

# You *do not* need to edit this file.

TorVersion Tor 0.3.5.7 (git-9beb085c10562a25)

LastWritten 2019-03-02 17:36:41

Fig.5

Le evidenze di ausilio all’investigatore forense possono ritrovarsi anche nei file di prefetch, nel file di registro NTUSER.DAT nella chiave UserAssist, nella cache delle Thumbnail, nel file di registro USRCLASS.DAT, in Pagefile.sys e Hiberfil.sys mediante una semplice ricerca per parole chiave determinanti quali “torrc, geoip, tor, torproject, onion”, nonchè nel db sqlite “places.sqlite”.

 Si dovranno quindi ad analizzare i file di prefetch rinvenuti mediante l’ausilio del tool peCMD “PECmd.exe -d “C:\Windows\Prefetch” –csv “C:\Users\Admin\Desktop\” , filtrando i risultati utili; e ottendendo quanto riportato nella fig. 6:

Fig. 6

Noteremo le date di creazione, di modifica e di accesso delle singole applicazioni, i nomi degli eseguibili, il numero di esecuzioni – campo RunCount – e le date di ultimo utilizzo.

Continueremo la nostra analisi con il file di registro NTUSER.DAT avvalendoci di RegRipper per esplorare il contenuto della chiave UserAssist al fine di identificare:

  1. la data di ultima esecuzione dell’applicazione – in rosso;
  2. il numero di esecuzioni – in verde;
  3. il percorso di esecuzione – in blu.
Software\Microsoft\Windows\CurrentVersion\Explorer\UserAssist

LastWrite Time Sun Jun 24 10:17:32 2018 (UTC)

{CEBFF5CD-ACE2-4F4F-9178-9926F41749EA}

Wed Feb 27 16:26:23 2019 Z

C:\Users\cosimo\Desktop\Tor Browser\Browser\firefox.exe (2)

Wed Feb 27 15:41:53 2019 Z

{CEBFF5CD-ACE2-4F4F-9178-9926F41749EA}

Tue Feb 26 16:20:41 2019 Z

C:\Users\cosimo\Downloads\torbrowser-install-8.0.6_it.exe (1)

{F4E57C4B-2036-45F0-A9AB-443BCFE33D9F}

Wed Feb 27 16:26:23 2019 Z

C:\Users\cosimo\Desktop\Start Tor Browser.lnk (2)

Fig.7

Esamineremo successivamente i file contenenti le icone.

Ancora oggi, sin dal lancio sul mercato di Windows 95, tutto ciò che è visibile dall’utente è associato ad un’icona. Difatti, ogni qualvolta la shell deve visualizzare una cartella con dei file, ha necessità di reperire le icone che associa a ciascuno degli elementi e che recupera in una cache di memoria denominata “Shell Icon Cache”. Il database IconCache è un file di sistema nascosto memorizzato in posizioni diverse, a seconda della versione del sistema operativo Windows.

L’analisi di detti file potrà confortare ulteriormente i risultati. Di seguito si indicano i percorsi contenenti i file da attenzionare:

[%HomeDrive%\Users\ProfiloUtente]\AppData\Local\Microsoft\Windows\Explorer\thumbcache_32.db

[%HomeDrive%\Users\ProfiloUtente]\AppData\Local\Microsoft\Windows\Explorer\thumbcache_32.db

[%HomeDrive%\Users\ProfiloUtente]\AppData\Local\Microsoft\Windows\Explorer\thumbcache_96.db

[%HomeDrive%\Users\ProfiloUtente]\AppData\Local\Microsoft\Windows\Explorer\thumbcache_256.db

[%HomeDrive%\Users\ProfiloUtente]\AppData\Local\Microsoft\Windows\Explorer\thumbcache_ thumbcache_1024.db

[%HomeDrive%\Users\ProfiloUtente]\AppData\Local\Microsoft\Windows\Explorer\thumbcache_sr.db

[%HomeDrive%\Users\ProfiloUtente]\AppData\Local\Microsoft\Windows\Explorer\thumbcache_idx.db

[%HomeDrive%\Users\ProfiloUtente]\AppData\Local\Microsoft\Windows\Explorer\IconCache.db

Con l’utilizzo di un semplice strumento di visualizzazione e armandosi di pazienza, potremmo esplorare i file menzionati contenenti le icone alla ricerca di quelle distintive del browser Tor:

Determinante potrà risultare la ricerca testuale con parole chiavi pertinenti quali “torrc, geoip, tor, torproject, onion”  effettuata sia sull’immagine forense che sui file pagefile.sys, hiberfil.sys e swapfile.sys.
Si evidenziano in calce, per il caso in esame, alcuni risultati estratti.

Interessante potrà essere il contenuto del database “places.sqlite che è possibile reperire in “ \Tor Browser\ Browser\TorBrowser\Data\Browser\profile.default”.

Nella tabella “moz_places” si potrebbe rinvenire l’elenco dei siti visitati senza alcun riferimento temporale,  come illustrato nella figura in calce:

Bene, spero che la disquisizione su detta analisi abbia dissipato alcuni dei tanti dubbi insiti in chi si trova ad affrontare giornalmente un’analisi su strumenti di questo tipo.

Di certo l’analisi presentata in questo articolo non esaurisce tutte le concrete possibilità che possono essere poste in atto attraverso un dump della memoria; ad esempio l’utilizzo del tools Volatility[3] e dei plug Pslist, Psscan, Netscan e Procmemdump consentirebbero un’analisi approfondita e una raccolta di informazioni sulle porte in uso, i processi in esecuzione e la posizione degli eseguibili, ma questa è un’altra storia.

Quindi, possiamo riepilogare i luoghi e le informazioni da cercare nella seguente tabella:

File di Prefetch Data di primo utilizzo, Data di Ultimo utilizzo, Numero di esecuzioni.
Registro NTUSER\UserAssist Percorso di esecuzione, Data di ultimo utilizzo, Numero di esecuzioni.
Altre Informazioni Thumbnail Cache, Registro USRCLASS.DAT, Windows Search Database.
 
Pagefile.sys (Ricerca per parola chiave) HTTP-memory-only-PB,Torproject, Tor, Torrc, Geoip, Onion, Torbutton, Tor-Luncher
Hiberfil.sys Conversione in un dump di RAM, Analizzare tramite Volatility e ricerca per keyword.

Stay Tuned.

Note:

[1] Chiaramente l’analisi dovrà essere effettuata su una copia di lavoro dell’immagine forense del dispositivo in  esame.

[2] https://it.wikipedia.org/wiki/Tabella_di_routing.

[3] https://github.com/volatilityfoundation/volatility/wiki/Command-Reference.

Articolo a cura di Cosimo De Pinto

Download PDF

https://www.ictsecuritymagazine.com/articoli/analisi-forense-di-tor-browser-bundle-su-sistemi-windows/


La Apple contrasta con un brevetto i cell-site simulator stingray. Una forma di Trusted Computing?

Si parla sempre più frequentemente di caselle stingray, un prestito linguistico inglese ben diverso dall’interpretazione letterale del “pesce razza”. Il termine descrive, nelle comunicazioni cellulari, uno o più  falsi ponti ripetitori che, simulando le tradizionali antenne BTS, si insinuano tra device e ponte di aggancio con un attacco man in the middle, acquisendo in modo silente copia del traffico prodotto in chiaro (cioè della fonia nel corso della telefonata sulla rete cellulare – e non di quella generata attraverso protocolli VoIP – nonché dei relativi  metadati riconducibili all’IMSI/IMEI catturato).

Un attacco che, letto nel contesto dell’architettura delle reti di comunicazione GSM, avviene al livello più elementare di interconnessione, cioè tra la Stazione Mobile (o Mobile Station – MS, che corrisponde all’apparato telefonico cellulare dell’utente) e la Stazione Radio Base (o Base Transceiver Station – BTS, che identifica l’apparato radio ricetrasmittente presente in ogni cella).

Si tratta di una tecnica di snitch dinamica, che “insegue” il target frapponendosi tra questo e la BTS, una struttura, quest’ultima, che nella consuetudine delle telecomunicazioni viene rilevata dall’utente automaticamente secondo una prassi “fiduciaria” consolidata, una sorta di rapporto  privilegiato, detto di trust, in analogia al termine usato nell’ambito giuridico per inquadrare un “affido”.

Il presupposto di “trust” viene, allora, ingannato attraverso pratiche infide di Treacherous Computing generate dai cell-site simulator o C.S.S., simulatori di ripetitori meglio noti con il termine tecnico IMSI Catcher.

Tecnologie dual use di intercettazione tattica, in passato in grado di procedere alla scansione della microzona d’interesse rilevando tutti segnali GSM presenti e, da qui, accoppiando IMSI ed IMEI di ogni utente presente sulla rete, riuscendo ad acquisirne i metadati di base.

Strumenti sempre più evoluti ed insidiosi, ormai da diversi anni in grado di “presentarsi sulla rete” come una fake BTS – in taluni casi robotizzate su sofisticati droni intelligenti – da qui duplicando, in modalità anonima, il flusso di informazioni trasmesse dal device ed effettuando la captazione dinamica dell’apparato in movimento, se del caso disturbando i protocolli di comunicazione più avanzati che viaggiano attraverso la c.d. voice over long term evolution (VoLTE), degradandone il segnale verso uno standard GSM.

Ecco, allora, la nuova trovata di Cupertino: si tratterebbe di un brevetto in grado realizzare una crittografia end to end tra la rete (quindi con il “trust” rappresentato dalla BTS) e l’ID univoco di un iPhone, quindi, si suppone, una forma di privilegiato trusted computing.

Attesa la scarna consistenza delle indiscrezioni trapelate è difficile, allo stato dell’arte, comprendere quale sia la portata dello strumento anti intercettazione che – è bene evidenziarlo – riguarderà comunque le intrusioni M.I.T.M. e non le intercettazioni giudiziarie tradizionali che, nella maggior parte dei casi, avvengono attraverso la predisposizione di un sistema di gateways (L.I.G.) sulle dorsali parametriche di comunicazione (L.I.N.), a cura dei gestori telefonici.

La Apple, nelle sue evoluzioni del software iOS, si è sempre distinta, rispetto alle tecnologie concorrenti, in relazione alla sicurezza informatica ed alla tutela della privacy verso i suoi consumatori, in primo luogo attraverso una propria piattaforma di acquisti delle applicazioni, con uno store sempre monitorato e catalogato, per evitare spiacevoli intrusioni spia.

Una accortezza filtrata “blindando” gli apparati nei vari aggiornamenti, così da aggirare, nel caso di operazioni brutali di jailbreak, tentativi di amministrazione del sistema operativo e, conseguentemente, della possibilità di inoculazione di spyware o, come indicato dal legislatore nel codice di procedura penale, di “captatori informatici”.

Un’attenzione, ormai da anni, sempre più raffinata, considerato che il sistema iOS da molto tempo ha introdotto la tecnologia di messaggistica proprietaria end to end c.d. iMessage (per un certo tempo contrastata soltanto da un analogo sistema, detto pin to pin, presente sulle piattaforme BlackBerry) e quella di video call nota con il termine FaceTime.

Un’accuratezza che, considerata l’eventualità di acquisizione di un iPhone da parte di soggetti terzi che non hanno il privilegio di amministratore, prevede da tempo opzioni di autodistruzione del contenuto dell’apparato dopo un certo numero di accessi andati a vuoto, adottando perdipiù, già dal modello 5S, l’identificazione biometrica attraverso l’impronta digitale, ormai divenuta obsoleta con le nuove procedure di autenticazione con tecnologie di imagery intelligence, attraverso l’identificazione facciale.

Si tratta di applicativi di nicchia che anche i moderni strumenti di analisi forense e di autopsia digitale fanno spesso fatica a contrastare.

Rimane però il quesito di base che, già in passato, ha investito il colosso della mela e quello delle comunicazioni VoIP o della cripto-messaggistica multimediale veicolate dai vari applicativi social media: l’esigenza, nel rispetto della privacy, di mettere a disposizione delle autorità governative, per esigenze di giustizia e di sicurezza interna, delle tecnologie di comunicazione utilizzate dai gestori.

Espressione, quella attinente i “gestori telefonici”, che non può più essere intesa, strictu sensu, quale onere delle compagnie che gestiscono il traffico ed amministrano le reti, oggi impossibilitate a qualsivoglia forma di controllo sulle comunicazioni digitali protette da autenticazioni HyperText Transfer Protocol over Secure Socket Layer (HTTPS), o crittografate da procolli end to end e, in alcuni casi, peer to peer, sulle innumerevoli piattaforme social.

Si tratta di un’esigenza, quantomeno in ambito comunitario, a cautela di quella ossidata, quanto indispensabile, Risoluzione adottata il 17 gennaio 1995 dal Consiglio Europeo in materia di intercettazioni legali delle comunicazioni, recepita in Italia soltanto nel 2003 con il Decreto Legislativo 1 agosto 2003, n. 259 che ha disciplinato, per la prima volta, il Codice delle comunicazioni elettroniche nell’ordinamento interno.

Articolo a cura di Michelangelo Di Stefano

Dottore in Giurisprudenza,  in Comunicazione Internazionale,  specialista in Scienze delle Pubbliche Amministrazioni ed esperto in Criminologia, è un appartenente ai ruoli della Polizia di Stato.

Si interessa da oltre venti anni di tecnologie avanzate nelle intercettazioni audio video e localizzazioni, con approfondite ricerche nel settore della comunicazione in ambito investigativo e forense.

E’ esperto di balistica a tiro curvo, di topografia e cartografia militare, di analisi e profiling, con specializzazioni in campo nautico, subacqueo e nel settore delle operazioni investigative speciali sotto copertura.

Ha maturato esperienza trentennale nella P.A. presso i Ministeri della Difesa, del Tesoro ed Interno, è stato formatore e componente di comitati scientifici di  alcuni atenei,  scuole internazionali di management e di riviste di informazione e formazione giuridica, nel settore delle scienze criminologiche applicate alle investigazioni, all’intelligence ed al contrasto al terrorismo.

Autore di più lavori originali e pubblicazioni scientifiche ex art. 67 DPR 3.5.1957 n. 686,   collabora con diverse riviste giuridiche e periodici d’informazione.

Vincitore nel 2012 dell’ XI concorso internazionale “Domenico Aliquò” per la sezione saggistica-giornalistica.

Ha ricevuto nell’ anno 2013 il premio internazionale “Professionisti di Calabria per la letteratura“.

Download PDF

https://www.ictsecuritymagazine.com/articoli/la-apple-contrasta-con-un-brevetto-i-cell-site-simulator-stingray-una-forma-di-trusted-computing/


L’importanza dell’eliminazione sicura dei dati secondo il GDPR

La sicurezza dei dati è diventata ormai un aspetto imprescindibile dell’attività di un’organizzazione. La sicurezza dei dati deve intendersi come un processo generale che considera la gestione dei dati in tutti i suoi flussi e i suoi percorsi. La Data protection e la Security by design devono essere parte integrante delle organizzazioni. I dati devono essere gestiti in ottica sistemica: dalla culla alla tomba.

Molte organizzazioni si concentrano nella gestione interna dei dati ma perdono di vista sia la gestione esterna sia il fine vita degli stessi, con eventuali gravi conseguenze in termini di potenziali Data Breach.

I modelli di gestione della sicurezza dei dati riportano punti di controllo proprio su tali aspetti, infatti:

  • CSF CORE NIST

PR.IP-6: I dati sono distrutti in conformità con le policy;

  • NIST SP 800-53 Rev. 4

MP-6 MEDIA SANITIZATION;

  • ISO 27001:2014

A.8.2.3 Trattamento degli asset

A.8.3.2 Dismissione dei supporti

A.11.2.7 Dismissione sicura o riutilizzo delle apparecchiature;

BAI09.03 Manage the asset life cycle.

La gestione a fine vita dei dati non deve considerarsi solo per i dati di natura informatica ma anche per tutti i dati cartacei che sono custoditi, gestiti, archiviati presso le organizzazioni.

Non ultimo, la gestione dei dati ed il loro fine vita vengono ribaditi dal Regolamento 2016/679.

L’entrata in vigore del Regolamento Generale sulla Protezione dei Dati (GDPR) definisce nel dettaglio i compiti che il Titolare del Trattamento dei dati (Data Controller) dovrà ottemperare al fine di garantire al meglio la conformità dell’intero processo di acquisizione, trattamento, conservazione ed eliminazione dei dati personali dei clienti.

L’eliminazione sicura dei dati è un’attività già da molti anni consolidata nel resto del mondo e che, ad oggi, si rende necessaria al fine di evitare – e quindi prevenire – una qualsiasi “violazione del dato”.

Nel GDPR, infatti, per “dato” si intende qualsiasi informazione riguardante una persona fisica identificata o identificabile («interessato»); si considera identificabile la persona fisica che può essere identificata, direttamente o indirettamente, con particolare riferimento a un identificativo come il nome, un numero di identificazione, dati relativi all’ubicazione, un identificativo online o a uno o più elementi caratteristici della sua identità fisica, fisiologica, genetica, psichica, economica, culturale o sociale; mentre per “violazione del dato” si intende la violazione di sicurezza che comporta, accidentalmente o in modo illecito, la distruzione, la perdita, la modifica, la divulgazione non autorizzata o l’accesso ai dati personali trasmessi, conservati o comunque trattati.

L’eliminazione dei dati può avvenire sia tramite la distruzione fisica dei supporti sia tramite la cancellazione dei dati contenuti nei supporti; l’importante è che l’attività sia svolta da un provider certificato e che vi sia un report che attesti il lavoro svolto.

L’obbligo del titolare del trattamento dei dati a cancellare i dati dell’interessato è chiaramente espresso nell’articolo 17 del GDPR, “Diritto alla cancellazione (Diritto all’oblio)” che recita così:

  1. L’interessato ha diritto di ottenere dal titolare del trattamento la cancellazione dei dati personali che lo riguardano senza ingiustificato ritardo e il titolare del trattamento ha l’obbligo di cancellare senza ingiustificato ritardo i dati personali, se sussiste uno dei motivi seguenti:
    a)
    i dati personali non sono più necessari rispetto alle finalità per le quali sono stati raccolti o altrimenti trattati;
  2. Il titolare del trattamento, se ha reso pubblici dati personali ed è obbligato, ai sensi del paragrafo 1, a cancellarli, tenendo conto della tecnologia disponibile e dei costi di attuazione adotta le misure ragionevoli, anche tecniche, per informare i titolari del trattamento che stanno trattando i dati personali della richiesta dell’interessato di cancellare qualsiasi link, copia o riproduzione dei suoi dati personali.

Terminato il tempo utile di ritenzione, il titolare del trattamento è obbligato a cancellare i dati senza alcun tipo di procrastinazione temporale. Il tempo di conservazione dei dati dovrebbe essere limitato al minimo necessario e il titolare del trattamento dovrebbe stabilire un termine per la cancellazione di ogni dato. Inoltre, la cancellazione deve essere effettuata utilizzando tecnologie che garantiscano la conformità al regolamento e la sicurezza dell’intero processo, come la distruzione certificata dei documenti cartacei o la cancellazione (wiping) certificata dei dati digitali.

La distruzione e/o cancellazione dei dati dai supporti (attività contenute nel trattamento dei dati) deve essere svolta sotto il diretto controllo del Titolare del Trattamento dei Dati come descritto nell’articolo 24, “Responsabilità del titolare del trattamento”:

  1. Tenuto conto della natura, dell’ambito di applicazione, del contesto e delle finalità del trattamento, nonché dei rischi aventi probabilità e gravità diverse per i diritti e le libertà delle persone fisiche, il titolare del trattamento mette in atto misure tecniche e organizzative adeguate per garantire, ed essere in grado di dimostrare, che il trattamento è effettuato conformemente al presente regolamento. Dette misure sono riesaminate e aggiornate qualora necessario.

È compito del titolare del trattamento scegliere il giusto provider per l’eliminazione dei dati. Infatti, nel caso in cui vi sia una violazione a seguito di un trattamento svolto in maniera difforme al regolamento, la responsabilità ricadrebbe, oltre che sul provider, anche sul titolare del trattamento per aver messo a rischio i dati dei propri clienti scegliendo un servizio di distruzione/cancellazione non certificato e non conforme al regolamento.

È, quindi, estremamente importante selezionare un provider che assicuri una distruzione/cancellazione dei dati completamente certificata, che si avvalga di personale professionale, qualificato e specificatamente formato, che utilizzi strumenti e mezzi conformi, che rispetti elevati standard di qualità e che garantisca la sicurezza delle informazioni in ogni fase del servizio che svolge.

A volte scegliere un provider certificato non è l’opzione più conveniente in quanto un servizio di eccellenza è sicuramente più gravoso ma assicura più sicurezza, maggiori garanzie e una completa conformità alle normative.

Inoltre, ogni attività di distruzione o di cancellazione dei dati deve essere certificata da un documento, come esposto nel Decreto Legislativo n° 51 del 18 maggio 2018 sulla protezione dei dati personali in ambito penale, entrato in vigore subito dopo il GDPR.

L’articolo 21, “Registrazione”, recita così:

  1. Le operazioni di raccolta, modifica, consultazione, comunicazione, trasferimento, interconnessione e cancellazione di dati, eseguite in sistemi di trattamento automatizzati, sono registrate in appositi file di log, da conservare per la durata stabilita con il decreto di cui all’articolo 5, comma 2.
  2. Le registrazioni delle operazioni di cui al comma 1 debbono consentire di conoscere i motivi, la data e l’ora di tali operazioni e, se possibile, di identificare la persona che ha eseguito le operazioni e i destinatari.

Soprattutto in ambito digitale, ogni cancellazione dei dati deve essere registrata in appositi file di log che contengano data e ora, nome di chi effettua la cancellazione e tutte le informazioni dei dispositivi cancellati.

Sul mercato italiano sono presenti aziende che effettuano la distruzione dei supporti cartacei e digitali direttamente presso il cliente e che vendono software che eliminano i dati digitali in maniera certificata, rilasciando un report al termine del lavoro.

Le aziende che svolgono i servizi di distruzione certificata si recano presso il cliente con l’unità mobile di triturazione e, come prima operazione, inseriscono tutta la documentazione in sacchi anti-taglio che vengono chiusi con sigilli di sicurezza codificati. Successivamente, i sacchi vengono trasportati sull’unità mobile e, dopo aver scansionato ogni sigillo, tutta la documentazione viene inserita all’interno del trituratore situato a bordo del mezzo per la sua distruzione.  La distruzione avviene in poco tempo assicurando la completa inintelligibilità dei dati e delle informazioni contenute, che non potranno essere recuperate in nessun modo. I trituratori a bordo delle unità mobili possono arrivare ad effettuare una distruzione pari al livello 7 della norma DIN 66399. Tutte le operazioni sono svolte sotto la supervisione diretta del cliente, che può assistere anche alla distruzione. Al termine delle attività di distruzione, il triturato viene avviato al recupero in modo da garantire la salvaguardia ambientale.

Per quanto riguarda l’attività di eliminazione dei dati digitali, nel caso in cui debba essere svolta per grandi aziende, vengono utilizzate soluzioni che permettono di collegare più di un dispositivo o hard disk all’apparecchio e operare una cancellazione simultanea rilasciando, al termine, un certificato di cancellazione. Per le piccole aziende o per i professionisti sono in commercio, invece, delle chiavette USB che, inserite nel PC, permettono di cancellare in modo semplice e veloce qualsiasi dato presente rilasciando, al termine, un report che permette di dimostrare l’avvenuta cancellazione dei file in linea con le leggi italiane ed europee sulla Privacy e la sicurezza dei dati. Nessun tipo di informazione potrà essere recuperata, neanche tramite analisi forense.

Chi è nominato Titolare del trattamento dovrebbe rivolgersi a questo tipo di aziende e utilizzare questi prodotti al fine di tutelare i dati dei propri clienti.

Il Regolamento Generale sulla Protezione dei Dati, quindi, ha risvegliato la sensibilità delle aziende sull’importanza di trattare i dati personali in maniera corretta in tutte le sue sfaccettature, dalla loro creazione alla loro eliminazione, che deve essere svolta seguendo determinati standard di sicurezza.

Articolo a cura di Stefano Gorla e Giorgia Tursini

Download PDF

https://www.ictsecuritymagazine.com/articoli/limportanza-delleliminazione-sicura-dei-dati-secondo-il-gdpr/


WinRAR – un’esposizione lunga 19 anni

In questo articolo riportiamo nel dettaglio il modo in cui i ricercatori di CheckPoint sono venuti a conoscenza di una vulnerabilità, presente nelle dll utilizzate da WinRAR, che permette di ottenere il controllo completo di un dispositivo[1].

WinRAR è un’utilità di archiviazione di file “trialware”, che può manipolare archivi RAR/ZIP e decomprimere numerose altre tipologie di archivi.

Secondo lo stesso produttore di WinRAR, oltre 500mln di utenti rendono WinRAR lo strumento di compressione oggi più popolare al mondo.

L’exploit, attivato tramite la semplice estrazione di un archivio, mette in grave pericolo l’intera clientela che utilizza questa utilità. Tale vulnerabilità, vecchia di oltre 19 anni, ha obbligato gli sviluppatori di WinRAR a prendere in tempi brevi una decisione drastica per porre rimedio al problema.

SCENARIO DI ANALISI

CheckPoint ha creato di recente un laboratorio di analisi volto ad analizzare la sicurezza dei software di terze parti. Tale laboratorio usa tecniche innovative tra le quali il “binary fuzzing”, ovvero una tipologia di attacco brute-force al codice binario che, “bombardando” un software con input formati da dati casuali, permette di individuare la presenza di vulnerabilità all’interno del codice.

Lo strumento utilizzato per questo tipo di attività è una particolare versione di WinAFL, una fork di
AFL[2] – American Fuzzy Lop, creata da GoogleProjectZERO.

L’analisi è stata incentrata verso le dll ritenute obsolete, ma ancora gestite dell’applicazione.

Come è facile immaginare, già dai primi test il fuzzer ha prodotto risultati che hanno evidenziato comportamenti “anomali” da parte di una dll. Tali anomalie hanno poi confermato la presenza di un bug logico denominato “Absolute Path Traversal”[3].

FASI PRELIMINARI DEL PROCESSO DI FUZZING

Prima partire con le analisi, sono richieste alcune operazioni preliminari volte ad ottimizzare l’esecuzione del fuzzer, tra le quali:

1. il patching dell’eseguibile WinRAR per:

a) processare qualsiasi tipo di archivio, senza dover ricorrere a test-case specifici per ogni formato;

b) disabilitare la GUI, evitando qualsiasi interazione umana;

2. reperire in rete della documentazione sulle utilità di archiviazione, come la ricerca condotta nel 2005 dall’Università di Oulu.

3. integrare WinAFL con le opzioni da riga di comando di WinRAR.

Fatto ciò è stato possibile procedere con il fuzzing dell’eseguibile.

I PRIMI TEST

I primi tentativi evidenziato delle vulnerabilità di tipo Memory Corruption – Writes Out-of-Bounds per gli archivi:

  • RAR
  • LZH
  • ACE

Purtroppo sfruttare queste vulnerabilità è risultato da subito infruttuoso, poiché le primitive di estrazione offrono controlli limitati verso la manipolazione di buffer sovrascritti.

Malgrado ciò, un crash relativo al parsing del formato ACE ha attirato l’attenzione dei ricercatori.

WinRAR utilizza una dll chiamata unacev2.dll per manipolare questo tipo di archivi. Si tratta di una vecchia libreria, compilata nel 2006, senza alcun meccanismo di protezione. Ed è proprio questa libreria l’input della seguente analisi.

COSTRUIRE UN TEST-CASE SPECIFICO

Per analizzare la libreria è necessario capire come quest’ultima viene usata. Il reverse enginering del codice che invoca degli archivi ACE, ha evidenziato due funzioni chiave:

Le intestazioni dettagliate delle strutture dati in firma sono state ricavate da un progetto open source chiamato FarManager[4]. Tali informazioni hanno permesso l’affinamento dei vari test-case, per una migliore integrazione con il fuzzer.
COMPRENDERE IL FORMATO ACE

Non esiste un RFC per questo formato, ma vi sono numerose informazioni su internet a tal proposito:

  • la creazione di un archivio ACE è protetta da un brevetto;
  • l’unico software che è autorizzato a creare un archivio ACE è WinACE;
  • l’ultima versione di questo programma è datata novembre 2007;
  • il sito Web dell’azienda non è raggiungibile dell’agosto 2017;
  • l’estrazione di un archivio ACE non è protetta da un brevetto.

Per comprendere a pieno il formato del file ACE è stato creato un archivio, col “vecchio” WinACE, contenente un semplice file “.TXT”. Successivamente è stata utilizzata l’utility acefile per analizzare l’header di tale archivio.

I campi importanti sono:

hdr_crc (contrassegnato in rosa):

  • campo di controllo integrità: se il CRC non corrisponde ai dati, l’estrazione viene interrotta.

filename (evidenziato in verde):

  • contiene il percorso relativo al file. Tutte le directory specificate nel percorso relativo vengono create durante il processo di estrazione (incluso il file).

Poiché il campo filename contiene il percorso relativo al file, si possono sicuramente effettuare dei tentativi per verificare se l’algoritmo è vulnerabile al “Path Traversal”.

Va sottolineato che, per quanto accennato in precedenza, per ogni tentativo di attacco vi è la necessità di generare un valore CRC valido da inserire nell’intestazione del file, per permettere l’estrazione dell’archivio.

RILEVAZIONE DEL BUG PATH TRAVERSAL

Eseguendo vari tentativi con il fuzzer, i ricercatori hanno immediatamente rilevato un comportamento anomalo: l’output di ogni analisi dovrebbe finire all’interno della cartella “output_folders”: ad esempio R:\ACE_FUZZER\<output_folders>\<analisys_number>\.

È stata invece riscontrata una nuova cartella denominata sourbe nella root. All’interno di essa, è stato trovato un file denominato “RED VERSION_¶” con il seguente contenuto:

Analizzando l’header con acefile, si ottiene quanto segue:
Se ne deduce che il fuzzer ha scatenato la copia di parti del campo “advert” in altri campi, nel dettaglio:
  • il file è un archivio ACE;
  • il contenuto dell’archivio è “SIO”, e fa parte della stringa di annuncio “*UNREGISTERED VERSION*”;
  • il campo filename contiene la stringa “RED VERSION*” che fa parte della stringa di “*UNREGISTE RED VERSION*”;
  • il percorso nel campo filename è stato utilizzato, nel processo di estrazione, come path di destinazione, sebbene faccia riferimento al path relativo della cartella di destinazione;
  • il nome del file estratto, “RED VERSION_¶”, presuppone che:
    • gli asterischi nel campo filename siano convertiti nel carattere “_”;
    • il valore \ x14\ (0x14 HEX) sia il carattere di fine linea “¶”.

È quindi il momento di evidenziare quali siano stati i vincoli che hanno indotto l’algoritmo ad utilizzare il campo filename come path di destinazione per l’estrazione.

VALIDAZIONE DELL’OUTPUT

Vi sono alcune regole che l’algoritmo di estrazione applica per la validazione del path nel quale saranno estratti i file dell’archivio.

In figura, “SourceFileName” rappresenta il path relativo di estrazione.
Il validatore esegue i seguenti controlli:

  1. il primo carattere non deve essere “\” o “/”.
  2. il nome del file non deve iniziare con i pattern “..\” o “../”.
  3. non vi siano, all’interno della stringa, i seguenti pattern: “\..\” – “\../” – “/../” – “/..\”.

In caso contrario, l’estrazione viene interrotta.

ALLA RICERCA DEL BUG PRINCIPALE

Rimane ancora da capire perché la cartella di destinazione reale viene ignorata a favore del path relativo (campo filename).

Decompilando il codice binario, ed analizzando con IDA il flusso di esecuzione e le varie chiamate a funzione, si evince quanto segue:

L’exploit creato dal fuzzer non attraversa il blocco contrassegnato in blu, ma esegue il blocco di codice opposto (freccia rossa).

Di fatto, il codice all’interno della cornice verde sostituisce la cartella di destinazione con “” (stringa vuota); mentre la chiamata successiva alla funzione sprintf concatena la cartella di destinazione con il path relativo del file da estrarre.

Il flusso del codice è influenzato dalla chiamata alla funzione denominata GetDevicePathLen: se il risultato della chiamata è 0, sprintf apparirà come questo:altrimenti:

È questa la porzione di codice che effettivamente attiva la vulnerabilità Path Traversal.

Analizziamo nel dettaglio la funzione GetDevicePathLen per ottenere una migliore visione del bug:

Il path relativo del file da estrarre viene passato a GetDevicePathLen.
Quest’ultima controlla che il nome del dispositivo o la lettera dell’unità siano presenti nel path, restituendo in output la lunghezza di tale sottostringa:

  • 3 per C:\some_folder\some_file.ext
  • 1 per \some_folder\some_file.ext
  • 15 per \\LOCALHOST\C$\some_folder\some_file.ext
  • 21 per \\?\Harddisk0Volume1\some_folder\some_file.ext
  • 0 per some_folder\some_file.ext

Se il valore restituito da GetDevicePathLen è >0, il path relativo del file estratto verrà considerato come path di destinazione, poiché la cartella di destinazione viene sostituita da una stringa vuota durante la chiamata a sprintf.

Tuttavia, è prevista una funzione che “pulisce” il path relativo da eventuali tentativi di Path Traversal, omettendo qualsiasi sequenza non consentita prima nella chiamata GetDevicePathLen.

Questo è uno pseudo-codice della funzione “CleanPath”:

Tale funzione omette la sequenza “..\”, se si trova all’inizio del percorso, e le occorrenze relative alle unità: “C:\” – “C:” – “C:\C:”[5].

METTIAMO TUTTO INSIEME

L’obiettivo finale è creare un file exploit che faccia sì che WinRAR estragga un file su un percorso scelto arbitrariamente dall’attaccante. La destinazione ideale consiste nella cartella di Esecuzione Automatica, che esegue quanto al suo interno ad ogni avvio del SO.

Iniziamo col sostituire l’estensione “.ACE” in “.RAR”, tanto WinRAR rileva il formato del file dal contenuto dell’header, non dall’estensione.

Sappiamo poi che ci sono almeno due cartelle di Esecuzione Automatica nei seguenti percorsi di Windows:

C:\ProgramData\Microsoft\Windows\Start Menu\Programs\StartUp

C:\Users\<user name>\AppData\Roaming\Microsoft\Windows\Start Menu\Programs\Startup

Il primo percorso richiede privilegi elevati/livello di integrità elevato (nel caso di UAC attivo). WinRAR viene eseguito di default con un livello di integrità medio, quindi tale soluzione non è percorribile.

Il secondo percorso richiederebbe di conoscere l’account utente.

Esiste però un vettore d’attacco migliore, che non richiede di conoscere lo <user name>.

Considerando che:

  • il validatore di WinRAR e la CleanPath non ammettono i pattern:
    • \..\
    • \../
    • /../
    • /..\
    • C:\
    • C:
    • C:\C:
  • la CleanPath non ammette che ad inizio stringa vi siano:
    • \
    • /
    • ..\
    • ../
  • la GetDevicePathLen deve ritornare un valore >0;

utilizzando la seguente stringa nel campo filename nell’header dell’archivio ACE:

C:\C:C:../AppData\Roaming\Microsoft\Windows\Start Menu\Programs\Startup\some_file.exe

otterremo il seguente risultato finale:

C:../AppData\Roaming\Microsoft\Windows\Start Menu\Programs\Startup\some_file.exe

che permette di aggirare la convalida della stringa, poiché:

  • la GetDevicePathLen restituirà 2, quindi il path di destinazione reale verrà scartato in favore del campo filename;
  • Cleanpath rimuove “C:\C:”
  • non vi sono pattern che rimuovono “C:../”, ne “../” è presente ad inizio stringa.

Va inoltre sottolineato che in Windows la sequenza “C:” referenzia la “directory corrente” del processo in esecuzione. Nel nostro caso la directory di default di WinRAR, tipicamente in C:\Program Files\WinRAR.

Tuttavia, interagendo con l’archivio tramite doppio clic, o facendo clic con il pulsante destro del mouse -> “Estrai”, la “directory corrente” sarà il path in cui risiede l’archivio, per l’appunto:

  • C:\Users\<user name>\Downloads
  • C:\Users\<user name>\Desktop

Quindi per arrivare alla cartella di Esecuzione Automatica, è bastato semplicemente salire di un livello ( ../) raggiungendo la cartella utente, senza saperne il nome, e concatenare il segmento di percorso che porta ad essa.

CONSIDERAZIONI FINALI

L’installazione di un eseguibile malevolo tramite questo exploit va a buon fine sia errori di progettazione delle librerie, sia per una serie di comportamenti imputabili all’utilizzo tipico effettuato dall’utenza.

Innanzitutto le funzioni di validazione del path non agiscono in maniera ricorsiva. Se così fosse, la sequenza “C:\C:C:../” sarebbe stata suddivisa in “C:\C:”, “C:” e “../”, impendendo di fatto il raggiungimento della cartella desiderata.

Inoltre, l’attaccante fa leva sulle modalità di utilizzo tipico dell’utente medio. In caso di estrazione di quest’ultimo al di fuori delle principali sottocartelle della cartella utente, tale exploit è totalmente inoffensivo.

Senza contare il fatto che l’utente predilige l’utilizzo della funzione “tasto dx -> estrai”, piuttosto che aprire l’archivio ed estrarre i file tramite GUI. In questo caso ci si renderebbe immediatamente conto che all’interno dell’archivio, oltre a file innocui, è presente un file eseguibile. E ci si renderebbe anche conto che, estratto tale archivio nelle modalità abituali, il file eseguibile non risulterebbe presente nella cartella di destinazione, evidenziando quantomeno un comportamento anomalo.

Note

[1] https://research.checkpoint.com/extracting-code-execution-from-winrar/.

[2] https://en.wikipedia.org/wiki/American_fuzzy_lop_(fuzzer).

[3] https://it.wikipedia.org/wiki/Directory_traversal_attack.

[4] È inoltre curioso che il creatore di tale progetto sia anche il creatore di WinRAR stesso.

[5] Si noti che non interessa la lettera dell’unità. I pattern sono validi per qualsiasi lettera.

Articolo a cura di Daniele Rigitano

Download PDF

https://www.ictsecuritymagazine.com/articoli/winrar-unesposizione-lunga-19-anni/