(Im)mortalità digitale

Ricordo che un paio di anni fa mi venne chiesto un parere sul caso di Dama, quel ragazzo minorenne precocemente scomparso il cui padre richiedeva l’accesso all’iPhone per visualizzzare le immagini degli ultimi istanti di vita del figlio. Eravamo reduci dal due di picche di Tim Cook che vietava la creazione di una backdoor nel cellulare dell’attentatore di San Bernardino e l’ipotesi che qualcuno potesse toccare i nostri dispositivi allo scoccare del rigor mortis già allora aveva dato adito a riflessioni personali non solo sui profili di diritto, quanto piuttosto sulle questioni etiche della vicenda e sulla tutela dell’identità digitale post mortem.

Un anno dopo Dama il capitolo si è riaperto in Germania, dove una decisione della Corte federale di giustizia di Karlsruhe ha stabilito il diritto dei genitori di gestire il profilo della figlia, deceduta a seguito di un incidente ferroviario nel 2012. I genitori della ragazza avevano fatto richiesta di poter accedere all’account Facebook della minorenne, ma la richiesta era stata respinta in appello e l’account della ragazza era stato bloccato. Tuttavia, nel luglio del 2018 la Corte federale ha sancito il diritto per i genitori di accedere all’account della figlia scomparsa, reputandolo come parte dell’eredità della quindicenne.

La vicenda mi è tornata in mente perché è di questi giorni il parere su un’istanza per l’accesso civico adottato dal Garante privacy [1], che ha ridestato l’interesse per la questione dell’eredità digitale, soprattutto alla luce del D. Lgs. 101/2018.

Il Garante ha infatti rilevato che il Regolamento europeo sulla protezione dati (GDPR), pur escludendo l’applicazione della normativa ai dati delle persone decedute (cfr. Considerando 27), stabilisce, la cd. “clausola di salvaguardia”, che permette agli Stati membri di prevedere norme che riguardano il trattamento dei dati personali dei defunti. E in effetti il legislatore italiano, con il d. lgs. n.101/2018, ha sancito proprio che «I diritti di cui agli articoli da 15 a 22 del Regolamento», laddove «riferiti ai dati personali concernenti persone decedute possono essere esercitati da chi ha un interesse proprio, o agisce a tutela dell’interessato, in qualità di suo mandatario, o per ragioni familiari meritevoli di protezione» (art. 2-terdecies, comma 1, del Codice, introdotto dall’art. 2, comma 1, lett. f, del d. lgs. n. 101/2018). Da tale riconoscimento derivano quindi due conseguenze:

– Da un lato, ai dati delle persone decedute continuano ad applicarsi i diritti di cui agli articoli da 15 a 22 del Regolamento – fra cui il diritto di accesso ai dati personali, i diritti di rettifica e cancellazione dei dati, il diritto alla limitazione del trattamento, il diritto di opposizione al trattamento, il diritto di non essere sottoposto a una decisione basata unicamente sul trattamento automatizzato;

– Dall’altro, i summenzionati diritti e il loro esercizio prescindono dalla configurazione in capo all’interessato all’esercizio dei diritti della nozione tecnica di erede, così come individuato nel Provvedimento del Garante n. 268 del 3 maggio 2018.

Così, se da un lato vengono stabilite dal d. lgs. n. 101/2018 le condizioni per le quali i terzi possono esercitare i diritti dell’interessato con riferimento ai dati delle persone defunte, dall’altro bisogna sottolineare che la stessa disciplina stabilisce la facoltà di opporsi preventivamente a tale esercizio.

In particolare, l’esercizio dei diritti da parte di «chi ha un interesse proprio, o agisce a tutela dell’interessato, in qualità di suo mandatario, o per ragioni familiari meritevoli di protezione» è precluso laddove una norma di legge vieti espressamente a terzi di esercitare i diritti relativi ai dati personali del defunto, come ad esempio il caso esaminato dal Garante, che ha precluso l’accesso civico alla documentazione richiesta poiché tale accesso comporterebbe la conoscenza di “dati relativi alla salute”, per i quali è previsto un espresso divieto di diffusione ex art. 7-bis, comma 6, del d. lgs. n. 33/2013.

In secondo luogo, limitatamente all’offerta diretta di servizi della società di informazione, è precluso l’esercizio di diritti da parte di «chi ha un interesse proprio, o agisce a tutela dell’interessato, in qualità di suo mandatario, o per ragioni familiari meritevoli di protezione» laddove l’interessato abbia vietato espressamente l’esercizio dei diritti relativi ai propri dati personali da parte di terzi che potrebbero averne titolo. Tale volontà, al pari di un consenso prestato ex art. 7, GDPR deve essere espressa mediante dichiarazione scritta presentata al titolare del trattamento e deve essere specifica, non equivoca, libera e informata. Ovviamente, l’interessato ha in ogni momento il diritto di revocare o modificare il divieto espresso nelle modalità di cui sopra.

Così, ad esempio, Google [2] e Facebook [3], con una funzione che in realtà in pochi conoscono, hanno entrambi previsto la possibilità di stabilire un piano di gestione del proprio account in caso di decesso: nominare una persona che eredita l’account al posto del defunto o eliminare l’account dopo un periodo di inattività, una sorta di oblìo post mortem. Nella vicenda svoltasi in Germania, cui si faceva riferimento, Facebook aveva negato ai genitori ogni accesso anche perché la ragazza non aveva potuto impostare alcun “contatto erede”, non essendo ancora disponibile questa opzione. Eppure, per i giudici federali tedeschi, il profilo social della ragazza è da ritenere ereditabile, al pari delle lettere cartacee e dei diari, con la conseguenza che i genitori siano a tutti gli effetti “eredi” dei contenuti condivisi, scritti, postati o commentati dalla ragazza.

E qui subentra un ulteriore aspetto da valutare. Si tratta del bilanciamento tra il diritto di accesso ai dati personali del defunto e l’accesso ai dati personali non riferiti al defunto. L’esempio più semplice nel mondo offline è quello relativo ai dati dei terzi beneficiari di assicurazioni sulla vita per cui, in effetti, la Cassazione aveva già adottato il seguente orientamento: «in tema di trattamento dei dati personali, tra i dati concernenti persone decedute, ai quali hanno diritto di accesso gli eredi non rientrano quelli identificativi di terze persone, quali, ad esempio, sono i beneficiari della polizza sulla vita stipulata dal de cuius (defunto), ma soltanto quelli riconducibili alla sfera personale di quest’ultimo» (Cass. civ., n. 17790/2015).

Eppure, quando si parla di social network è piuttosto complesso definire in che termini l’accesso al profilo del defunto possa essere scevro dall’accesso anche a dati riferibili a terzi con cui il defunto era in contatto. Per questa ragione, nel caso di Facebook è esplicitamente escluso l’accesso ai messaggi dell’account della persona defunta, il cui profilo diviene meramente commemorativo. Più critico, da questo punto di vista, l’approccio di Google che demanda al titolare dell’account la possibilità di conferire all’erede un link con i dati scaricabili relativi all’indirizzo Gmail, compresa la posta elettronica. Si tratta senz’altro di un accesso parziale alle informazioni che esclude l’utilizzo diretto dell’account, tuttavia non appare di facile gestione la tutela dei soggetti terzi che hanno avuto contatti con il titolare defunto.

Comunque, ciò che appare evidente è la portata innovativa del d. lgs. 101/2018 che permette a ciascun soggetto di disporre post mortem dell’utilizzo dei propri dati digitali nei servizi della società dell’informazione, riconoscendo a livello normativo la rilevanza dei dati digitali come un bene di cui ogni interessato, cui i dati si riferiscono, può liberamente disporre secondo le proprie volontà.

Chiaramente, il divieto posto dall’interessato non potrà produrre effetti pregiudizievoli per l’esercizio da parte di terzi dei diritti patrimoniali che derivano dalla morte dello stesso, tantomeno del diritto di difendere in giudizio i propri interessi. Ciò significa che il titolare del trattamento, anche nei servizi della società dell’informazione, non potrà rifiutare al terzo l’accesso ai dati del defunto qualora questi agisca a tutela dei suoi diritti patrimoniali o per far valere in giudizio i suoi interessi.

Diciamo che dalla vicenda di Dama sono stati fatti molti passi avanti. La normativa attuale ha reintrodotto il tema, già da tempo ‘chiacchierato’, dell’eredità digitale anche se sono ancora numerose le questioni irrisolte. Saranno il Garante per la privacy e i Tribunali nazionali a spiegarci come gestire l’immortalità digitale e una sfera privata sempre più social e meno propensa all’oblio.

Note

[1] https://www.garanteprivacy.it/web/guest/home/docweb/-/docweb-display/docweb/9084520.

[2] https://myaccount.google.com/u/0/inactive?pli=1.

[3] https://www.facebook.com/help/991335594313139/?helpref=hc_fnav.

Articolo a cura di Camilla Bistolfi

Specializzata cum laude in Scienze di governo e della comunicazione pubblica alla LUISS Guido Carli. Attualmente ricopre la posizione di Associate nel dipartimento TMT presso lo studio legale Hogan Lovells ed è Privacy Officer e Consulente della Privacy certificato dal TÜV.

Dopo un tirocinio presso il Garante Privacy (Dipartimento attivià ispettive e sanzioni), ha ottenuto nel 2014 l’incarico di Research Fellow dell’Istituto Italiano per la Privacy e la Valorizzazione dei Dati – di cui è diventata nel 2017 componente del Consiglio di Amministrazione – e per il quale ha seguito progetti di advocacy nazionali ed europei nonché quelli di ricerca e innovazione Horizon2020, finanziati dalla Commissione Europea.

Camilla ha fondato e diretto il Centro Nazionale Anti-Cyberbullismo (CNAC) sino a dicembre 2018 e continua a occuparsi delle tematiche relative a minori e genitorialità digitale.

È coautrice nella raccolta “Privacy Technologies and Policies” (Springer, 2016) di uno studio in tema di IoT e 3D privacy e di una pubblicazione su pseudonimizzazione, privacy e Big Data sulla Computer Law & Security Review. Ha scritto, in questi anni, anche di social network, minori e abusi online, digital parenting, identità digitali e portabilità dei dati.

È autrice con Luca Bolognini ed Enrico Pelino del volume “Il Regolamento Privacy Europeo”, il primo commentario italiano sulla materia pubblicato nel 2016 da Giuffrè.

Download PDF

https://www.ictsecuritymagazine.com/articoli/immortalita-digitale/


Le fork sulla blockchain: un equilibrio fra opportunità e rischi di una governance decentralizzata

Sulle blockchain di tipo permissionless [1] nelle quali la governance è decentralizzata e il modello di gestione è off-chain [2] (ad esempio la Blockchain [3] dei Bitcoin), non esistendo un unico decisore centralizzato in grado di determinare risoluzioni, quando si vogliono cambiare le regole è necessario che la rete stessa – rappresentata da programmatori e validatori – sia d’accordo. A tale situazione, spesso di compromesso, si perviene grazie al coordinamento fra la comunità degli sviluppatori, mediante la sottomissione di proposte di modifica (nel caso dei Bitcoin si chiamano BIP – Bitcoin Improvements Proposal) che saranno votate. Nel solco di tali determinazioni, all’esito delle votazioni, è possibile inserire l’avvicendarsi di particolari “momenti” nella vita di una blockchain chiamati “fork”. Il termine inglese richiama l’immagine di una biforcazione e, nei fatti, ciò che avviene è proprio uno sdoppiamento della catena di blocchi che, in alcune circostanze, può dar luogo alla creazione di nuove criptovalute.

In questo articolo analizziamo le diverse tipologie di fork e le motivazioni che possono indurle, spiegando alcune tra le più famose avvenute sulla Blockchain dei Bitcoin e i rischi che occorrono durante il verificarsi delle medesime.

Le tipologie di fork

Le fork si possono suddividere in due macro-categorie: “Soft fork” e “Hard fork”.

Le Soft fork si realizzano e si attuano dando vita a una versione aggiornata del protocollo compatibile con le versioni precedenti. Tali tipi di fork mettono in atto un cambiamento reversibile che consente la partecipazione alla blockchain anche a tutti quei nodi che, per ragioni diverse, decidono di non effettuare l’aggiornamento del software.

Le Hard fork prevedono invece un cambiamento irreversibile e impongono ai nodi di effettuare obbligatoriamente l’aggiornamento. Con le Hard fork vengono create nuove criptovalute come, ad esempio, nei casi di Bitcoin Cash.

Analizzando nel dettaglio le Hard fork, scopriamo che possono essere di tipo “Planned”, ovvero pianificate e programmate, o di tipo “Contentious”, ovvero che non riescono a trovare il consenso della comunità. In questa seconda tipologia di Hard fork il cambiamento proposto al protocollo non trova un accordo all’interno della comunità e si arriva, pertanto, a una forma di scissione della Blockchain.
Nel caso di Hard fork “Planned” il cambiamento del protocollo è pianificato e il passaggio viene approvato dai partecipanti ove sia raggiunto un quorum definito in fase di proposta dei cambiamenti delle regole.
Le Hard fork “Planned” non conducono allo sdoppiamento della catena e le regole vengono aggiornate in continuità.

Scalabilità, costi e rischio di concentrazione

Passiamo ora a condividere alcune riflessioni su talune caratteristiche basilari delle blockchain permissionless, volendo con ciò portare l’attenzione del lettore sui diversi rischi che devono essere opportunamente ponderati, laddove si vogliano progettare soluzioni basate sull’impiego di tali architetture.

Prenderemo come riferimento la Blockchain permissionless per antonomasia, ossia quella dei Bitcoin, premettendo tuttavia che le considerazioni in esame possono (rectius, devono) ritenersi altrettanto valide per tutte le blockchain di tale tipo e, cosa assai più importante, per qualsiasi impiego che delle stesse si voglia fare. Si osserva infatti che una siffatta ponderazione dei rischi deve potersi considerare anche quando l’impiego di una blockchain permissionless vuole essere impiegata – ad esempio – a supporto di servizi di marcatura temporale o finalizzata all’esecuzione di smart contract [4].

Sulla Blockchain dei Bitcoin durante il processo di validazione dei blocchi (il c.d. “mining”) vengono “coniate” nuove unità di criptovaluta come sistema di remunerazione che ripaga – almeno in parte – il costo sostenuto dai nodi validatori (risorse di calcolo, energetiche ecc.). Il modello d’incentivazione basato sulle Proof-of-Work (PoW), il sistema con cui si perviene a un “consenso distribuito” [5], assicura che questi ultimi vengano premiati per il loro lavoro di approvazione solo laddove il compito sia stato svolto correttamente, rendendo antieconomico qualsiasi tentativo di alterazione surrettizia dei blocchi precedentemente validati.
Cionondimeno, esiste un ulteriore modello di incentivazione basato sulle commissioni (o “mance”) che permette ai validatori di essere ulteriormente ricompensati, in aggiunta alla ricompensa prevista per chi presenta per primo la PoW.

I nodi validatori, soprattutto nei periodi di intenso traffico transazionale, tendono a scegliere i blocchi che contengono mance più significative, creando una disparità di trattamento per quegli utenti che, non volendo spendere in commissioni esorbitanti, sono costretti ad attendere ben più di un’ora per vedersi confermate le proprie transazioni. La dimensione di un blocco della Blockchain (dei Bitcoin) non può superare 1 MB e pertanto i miner sceglieranno di inserire nei blocchi che si accingono a minare le transazioni con commissioni più alte, soprattutto nei periodi in cui sul network viene propagato un numero di transazioni particolarmente elevato; ne consegue che transazioni meno “redditizie” possono attendere ore prima che un miner scelga di inserirle nel proprio blocco.

Nel seguito vediamo quali sono stati alcuni fra i maggiori interventi che hanno animato la comunità dei principali miner sulla Blockchain dei Bitcoin, volti a trovare una sorta di ottimo paretiano tra le necessità di: rendere (più) scalabile la Blockchain, abbassare il costo delle commissioni, evitare il ricrearsi di “concentrazioni di fatto”.

Come preannunciato, è opinione di chi scrive che sia utile spiegare l’avvicendarsi di tali interventi, poiché essi rappresentano un potenziale vulnus che deve essere noto e gestito, soprattutto laddove si pensa di impiegare una blockchain per finalità che vadano oltre il concetto di mero scambio di criptovaluta. Tali criticità minano, nella sostanza, il principio di governance tipica della Blockchain dei Bitcoin e, in generale, qualsiasi principio di governance decentralizzata tipica di una blockchain permissionless.

SegWit2X

Al fine di migliorare l’utilizzo e la scalabilità dell’infrastruttura decentralizzata che gestisce gli scambi di bitcoin proprio laddove, in particolare nei periodi di utilizzo intensivo, il calo prestazionale è avvertito maggiormente, un gruppo di miner ha proposto nel corso del 2017 una serie di modifiche strutturali alla Blockchain, suddivise in due fasi: la prima, chiamata “Segregated Witness”, prevedeva di efficientare il protocollo riducendo la dimensione delle transazioni, mediante la segregazione di alcuni metadati che accompagnano le transazioni.

Tali metadati avrebbero potuto essere gestiti off-chain, ossia al di fuori della catena. In tal modo, mantenendo la stessa dimensione del blocco originaria, ci sarebbero state più transazioni validate nell’arco di 10 minuti, il tempo mediamente necessario per generare un nuovo blocco e aggiungerlo alla catena, per cui, in pratica, la gestione delle transazioni in Bitcoin sulla Blockchain è limitata a 6 o 7 al secondo.

Il secondo step (attivabile ove si fosse raggiunto il consenso richiesto) avrebbe dovuto condurre all’aumento della dimensione massima dei blocchi. Tecnicamente quanto avvenuto è stato non riuscire ad attivare la seconda parte di SegWit2x (ossia quella su cui maggiormente la comunità si era divisa), che avrebbe dovuto raddoppiare la dimensione dei blocchi portandoli a 2 MB, volendo con ciò incrementare l’efficienza del protocollo e, almeno in teoria, portare a una diminuzione delle commissioni richieste dai miner per validare più velocemente le transazioni.

I Bitcoin Cash

SegWit, la prima parte, con cui si era iniziato ai primi di agosto 2017, è avvenuta al netto di un compromesso che ha prodotto l’Hard fork dei Bitcoin Cash, una nuova catena dalla quale si è originata un’altra criptovaluta (il BCH), separata dalla quella core e irreversibile, dove i blocchi hanno la dimensione massima di 8 MB. Per questa nuova blockchain, i sostenitori hanno sempre dichiarato che avrebbe potuto costituire un buon mezzo per effettuare pagamenti P2P, attese le prestazioni decisamente superiori rispetto alla Blockchain parent.

I rischi che comportano le Hard Fork

Ora che abbiamo spiegato cosa sono le fork, le ragioni per cui si generano e narrato delle principali avvenute negli ultimi due anni, è il momento di descrivere quali possono essere gli effetti che le stesse ingenerano.

Nei casi di Hard fork o, meglio, durante il propagarsi degli effetti sulla rete delle Hard fork, emergono alcuni rischi che pongono in pericolo l’affidabilità e, soprattutto, l’immutabilità delle transazioni avvenute.
Ciò che infatti può accadere è il manifestarsi dei cosiddetti “replay attack”, dove soggetti malintenzionati replicano le transazioni sulla nuova catena appena effettuate sulla catena di origine. Tale situazione si verifica per via del fatto che le due criptovalute (quella legacy e quella della forked chain), nel periodo in cui si sta consumando la scissione, possono essere “sbloccati”[6] con la stessa chiave privata, esponendo quindi le transazioni al rischio di essere duplicate.

Guardando oltre il mero impiego di una blockchain permissionless per gli scambi di criptovaluta, riteniamo sia sufficientemente chiaro a tutti (evitando con ciò di addentrarci oltre) quali possano essere i rischi nel caso di un “replay attack”, allorché si voglia impiegare una blockchain permissionless, ad esempio, quale strumento a supporto della validazione temporale elettronica.

Le contromisure a mitigazione dei rischi di “replay attack”

Mitigare i rischi causati dai “replay attack” è possibile adottando alcuni sistemi, fra cui i più noti sono conosciuti con il nome di “Strong replay protection” e “Opt-in replay protection”.
Nel primo caso viene aggiunto uno speciale marcatore alla nuova catena a posteriori dell’Hard fork, al fine di evitare che le transazioni eseguite siano (ancora) valide nella catena originaria (legacy chain) e non viceversa. Se la “Strong replay protection” è una procedura che viene eseguita in automatico al verificarsi dell’Hard fork, la “Opt-in replay protection” richiede invece un intervento manuale di “manutenzione” sulle transazioni per assicurare la loro irripetibilità.

In alternativa (o in aggiunta) alle contromisure spiegate da attuare per fronteggiare i rischi evidenziati, è possibile prevedere l’interruzione di qualsiasi trasferimento/transazione fino a quando la nuova catena di blocchi non abbia raggiunto una certa altezza [7]. Ciò implica, ovviamente, un intervento “ai morsetti” della blockchain (ossia off-chain), con tutte le conseguenze che esso comporta.

I vulnus della e-democracy

Concludiamo questo articolo con una riflessione più ampia che, all’avviso di chi scrive, appare utile non foss’altro come monito teso ad allertare chi, pur in buona fede, corre il rischio di subire la fascinazione delle blockchain quale panacea di ogni male.

Alcune vulnerabilità tipiche delle blockchain pubbliche, ossia quelle il cui accesso segue una logica permissionless, emergono durante il propagarsi sul network delle Hard fork. I casi di Hard fork che producono scissioni irreversibili della catena, con la conseguente nascita di nuove criptovalute, non sono in sé deprecabili, poiché rappresentano un metodo per esprimere miglioramenti (almeno così si auspica) in cui le comunità di sviluppatori e di validatori credono.

La presenza di un modello di governance decentralizzata (o, se si preferisce, l’assenza di un modello di governo centrale) può rappresentare l’espressione democratica di un sistema decisionale, dove una pluralità di soggetti può esprimere il proprio voto per il conseguimento di obiettivi condivisi: una sorta di e-democracy [8]. Tuttavia, l’esercizio stesso di tale democrazia impone la necessità di prevedere, in molti casi, scissioni interne al sistema; è proprio in queste circostanze che, come nella vita materiale organizzata da una politica intesa quale espressione di una sovranità popolare, si indeboliscono le difese e si sguarnisce il fianco, esponendo l’intera comunità a rischi che devono sapersi mitigare, agendo preventivamente laddove possibile.

Note

[1] Una piattaforma blockchain è di tipo permissionless (da non confondere con le blockchain permissioned), quando soddisfa almeno i seguenti requisiti: è aperta al pubblico, ognuno può accedere e vedere il relativo codice (software), tutti possono leggere qualsiasi transazione riportata sul registro, chiunque può effettuare transazioni e candidarsi, a propria volta, ad eseguirne la validazione.

[2] Per le blockchain permissionless esistono almeno due tipologie di governance tecnologica: 1) “off-chain”, dove è necessario raggiungere un consenso più ampio per attuare le modifiche del protocollo e dove quando ciò non avviene si verificano le Hard fork descritte in questo articolo, 2) “on-chain”, dove il potere di voto è determinato dall’entità di quota (espressa in token) da ciascun attore-votante detenuta.

[3] Con il termine “Blockchain” (quando l’iniziale è maiuscola) ci si riferisce alla tecnologia che supporta i Bitcoin, mentre con il termine “blockchain” (con l’iniziale minuscola) si intende l’architettura tecnologica posta alla base di altri sistemi dove la criptovaluta non è necessariamente il Bitcoin.

[4] Il riferimento (non casuale) è al decreto-legge 14 dicembre 2018, n. 135 con cui il legislatore Italiano, correttamente non discernendo la tipologia di blockchain (permissionless o permissioned), ha provveduto ad attribuire il requisito della forma scritta – previa identificazione informatica delle parti interessate – agli smart contract, nonché ha disposto che la memorizzazione di un documento informatico mediante l’uso di tecnologie basate su registri distribuiti produca gli effetti giuridici della validazione temporale elettronica ex art. 41 del regolamento (UE) n. 910/2014 (c.d. “Regolamento eIDAS”).

[5] Possiamo definire come “consenso distribuito” l’accordo tra i nodi sulla validità di una transazione e sull’esistenza di un insieme coerente nonché di un ordine garantito delle transazioni da memorizzare nel registro distribuito, cui si perviene in un sistema decentralizzato dove la governance è distribuita tra i partecipanti.

[6] Lo script di sblocco è solitamente una firma digitale che dimostra la proprietà dell’Address inserito nello script di blocco del precedente Output.

[7] Nella Blockchain dei Bitcoin con altezza ci si riferisce alla posizione del blocco nella catena.

[8] Con e-democracy si intende l’utilizzo delle tecnologie dell’informazione e della comunicazione atto a favorire la partecipazione dei cittadini alla vita democratica. In questo contesto, si è ritenuto utile riferirsi a tale termine per rappresentare l’espressione democratica del sistema decisionale tipico della Blockchain.

Articolo a cura di Roberto Garavaglia

Roberto Garavaglia è un consulente strategico nel settore dei sistemi di pagamento digitali, da oltre venticinque anni specializzato nell’ideazione di nuovi modelli di business e prodotti innovativi.

Nel 2014 è fra i primi in Italia ad occuparsi di progetti Blockchain in ambito finance. Accanto agli impegni di strategic advisor svolge attività di divulgazione scientifica e di docenza presso imprese e università.

Dal 2008 collabora con il Politecnico di Milano – Osservatori Digital Innovation, contribuendo con la propria esperienza all’analisi delle strategie in ambito New Digital Payments e tenendo corsi su Blockchain e gli scenari di mercato che possono orientarne uno sviluppo cross-industry.

Ha al suo attivo innumerevoli pubblicazioni scientifiche sviluppate nell’ambito degli Osservatori del Politecnico di Milano, su temi che concernono l’innovazione e la regolamentazione dei sistemi di pagamento innovativi. Nell’aprile 2018 pubblica per Hoepli il libro “Tutto su Blockchain”.

Download PDF

https://www.ictsecuritymagazine.com/articoli/le-fork-sulla-blockchain-un-equilibrio-fra-opportunita-e-rischi-di-una-governance-decentralizzata/


Criptovalute e algoritmi di consenso – parte 1

Da qualche anno a questa parte siamo costantemente bombardati di informazioni relative all’andamento economico delle principali criptovalute, tramite qualunque mezzo di comunicazione a disposizione dell’essere umano. Al contrario di quanto si è spesso portati a pensare, in modo superficiale ed errato, le criptovalute non rappresentano soltanto un mezzo per “guadagnare soldi facili” (affermazione che di per sé risulta già molto discutibile).

Sono importanti perché sono diventate, di fatto, un elemento fondamentale nel processo di evoluzione del nostro mondo digitale. E quello che spesso si dimentica è che l’aspetto tecnologico è il fattore principale che guida questa rivoluzione.

Le criptovalute sono uno strumento utilizzabile dagli utenti di tutto il mondo per lo scambio di “valore” in maniera istantanea, tramite un’infrastruttura decentralizzata che, sfruttando la rete internet (ma non solo), permette di non avere più delle singole entità centralizzate (ad esempio banche o governi) come autorità di controllo e gestione delle transazioni.

Ma questo, sul piano tecnologico, come è possibile? Com’è possibile che milioni di utenti possano coesistere in questo spazio virtuale e utilizzare le criptovalute per effettuare transazioni senza necessità di affidarsi a un’entità centrale?

Alla base di tutto, ciò che rende davvero una criptovaluta decentralizzata è l’algoritmo di consenso utilizzato per gestire e validare le transazioni: gli utenti si “accordano” secondo dei criteri di equità e seguono regole ben definite che consentono l’esecuzione, tramite l’utilizzo della tecnologia blockchain, di transazioni immutabili, definitive e impossibili da contraffare, “premiando” economicamente coloro che facciano un corretto utilizzo del network e penalizzando eventuali tentativi di abuso.

Algoritmi di consenso e Byzantine Fault Tolerance (BFT)

Un algoritmo di consenso deve poter risolvere quello che, in letteratura, è definito il problema dei generali bizantini [1]: deve esser possibile raggiungere un consenso “globale” in situazioni in cui è possibile la presenza di errori (siano essi in buona o in cattiva fede) da parte delle entità coinvolte nella decisione. Il problema consiste nel trovare un accordo tra entità diverse, nel caso in cui siano presenti informazioni discordanti, allo scopo di mantenere intatta l’integrità, l’operatività e la consistenza della rete distribuita.

Proof Of Work, Proof Of Stake e gli altri algoritmi di consenso

Senza voler entrare, almeno per ora, troppo nel dettaglio tecnico, vengono di seguito descritti alcuni dei principali algoritmi di consenso utilizzati dalle più note criptovalute. Ad oggi, il più adottato è il cosiddetto “Proof Of Work”, su cui Bitcoin prima, Ethereum e molte altre criptovalute dopo, sono basati.

Il concetto di Proof Of Work viene reso pubblico dapprima nel 1993 da Cynthia Dwork e Moni Naor e poi, nel 1999, da Markus Jakobsson. Nel White Paper originale di Bitcoin [2], pubblicato da un utente rimasto anonimo sotto lo pseudonimo di Satoshi Nakamoto, viene descritto il funzionamento dell’algoritmo di consenso e del network di Bitcoin. Nel documento si descrive la modalità di esecuzione e di approvazione delle transazioni effettuate all’interno della rete peer-to-peer, che avvengono senza la necessità di fare affidamento a un’entità centrale. Semplificando, il network di bitcoin si basa sul lavoro computazionale effettuato da alcuni nodi della rete che, per pubblicare nuovi blocchi di informazioni all’interno di un registro distribuito e verificare/validare le transazioni effettuate dai vari nodi del network, competono per risolvere un problema matematico con difficoltà sempre crescente, a fronte di una ricompensa economica. La combinazione di questi fattori porta all’assunto che il network sia intrinsecamente resistente a operazioni di “double-spending” da parte di nodi appartenenti alla rete, fintanto che questi non riescano a controllare almeno il 51% del totale dell’hash power impiegato da tutti i nodi partecipanti.

Ad oggi è possibile constatare come, nel corso dei primi 10 anni di vita di Bitcoin, nessuno sia mai riuscito a comprometterne realmente la sicurezza in questo modo.

L’alternativa più nota al Proof Of Work è rappresentata dal Proof Of Stake, al quale Ethereum sta pianificando di passare in futuro, con l’applicazione dell’update denominato Casper [3].

Lo scopo primario, anche in questo caso, è validare le transazioni e raggiungere il consenso all’interno della rete ma, in questo caso, tale processo non viene effettuato tramite la risoluzione di problemi matematici e la generazione di nuove monete, assegnate come ricompensa ai miners. Con il PoS, il nodo preposto per la creazione del nuovo blocco di transazioni da pubblicare sul registro distribuito, viene scelto in modo deterministico sulla base dello stake (quantità di coins) “bloccato” e messo a disposizione per tale scopo.

Per fare un esempio concreto, se un nodo detiene e “blocca” 10 coins e un altro nodo ne blocca 100, quest’ultimo avrà 10x le possibilità di essere “eletto” dal network come creatore del successivo blocco di transazioni. La sua ricompensa sarà esclusivamente legata alle fee generate dalle transazioni effettuate sul network. Come detto, infatti, non vi è alcuna nuova creazione di coins, che sono già tutte distribuite in origine, durante la fase di lancio del progetto e della criptovaluta.

Questo meccanismo di consenso risulta esser decisamente più economico rispetto al Proof Of Work, in quanto permette di risparmiare sui costi dell’hardware e dell’elettricità necessaria per alimentare la rete. In compenso però, in determinate condizioni, tale meccanismo potrebbe finire per favorire coloro che posseggono già grossi capitali, aumentandone le possibilità di vincere le varie assegnazioni con stake sempre più grossi e quindi, alla lunga, potenzialmente creare un fattore di centralizzazione del network su un numero ristretto di entità. Costringere i nodi a mantenere bloccate le coin (come definito nelle versioni più recenti di PoS), d’altra parte, permette di avere una garanzia sul rispetto delle regole dei vari nodi ed evita attacchi di tipo “nothing at stake” [4]. Come deterrente per comportamenti scorretti, da protocollo, è definito che i nodi possano veder perso l’intero stake messo a disposizione, qualora venga accertato abbiano intrapreso attività non lecite.

Diversi altri algoritmi ibridi e con logiche diverse sono nati nel corso del tempo. Alcuni progetti di criptovalute hanno optato per l’utilizzo di algoritmi di consenso PoW ASIC-based, altri GPU-based, altri hanno preferito optare per il Delegated Proof Of Stake (un numero limitato di nodi scelti in base allo stake a disposizione ed al “comportamento” tenuto nel corso del tempo) o altri meccanismi ibridi PoW-PoS, etc. Sono anche nati progetti che stanno provando ad utilizzare meccanismi di consenso completamente diversi, come il Proof Of Authority (PoA) , Proof Of Weight (PoWeight) , i Directed Acyclic Graphs (DAGs)  etc.

Nessuna di queste soluzioni è perfetta – ci sono pregi e difetti in ognuna di esse – ma, sintetizzando, possiamo affermare che, per essere considerato un buon meccanismo di consenso, questo deve poter garantire a una criptovaluta le seguenti caratteristiche:

  • Decentralizzazione: per evitare attacchi di 51% (o simili) e per garantire l’assenza di entità centrali che possano controllare le transazioni.
  • Sicurezza: l’algoritmo deve essere resistente a eventuali attacchi di varia natura che possano essere intrapresi contro la rete.
  • Fault Tolerance: in qualunque caso di fault di uno o più nodi, la rete deve continuare ad essere in grado di funzionare correttamente.
  • Incentivi alla partecipazione: devono esser presenti degli incentivi (economici) forti che spingano gli utenti a comportarsi in maniera corretta piuttosto che in maniera illecita.

Riferimenti bibliografici

[1] “The Byzantine Generals Problem” LESLIE LAMPORT, ROBERT SHOSTAK, and MARSHALL PEASE SRI International – https://people.eecs.berkeley.edu/~luca/cs174/byzantine.pdf.

[2] “Bitcoin: A Peer-to-Peer Electronic Cash System” Satoshi Nakamoto – https://bitcoin.org/bitcoin.pdf.

[3] “Casper: What Will the Upgrade Bring to the Ethereum’s Network?” – https://cointelegraph.com/news/casper-what-is-known-about-the-new-ethereums-network-upgrade.

[4] “Understanding Proof of Stake: The Nothing at Stake Theory” – Julian Martinez https://medium.com/coinmonks/understanding-proof-of-stake-the-nothing-at-stake-theory-1f0d71bc027.

Articolo a cura di Luca Dinardo

Luca Dinardo, si occupa di tematiche di Cyber Security in contesti SOC e CERT da più di 10 anni, con specifico focus su Cyber Threat Intelligence, Malware & Threat Analysis, Incident Response e Cyber Deception.

Svolge attività di ricerca e sviluppo mirate all’analisi ed al contrasto di fenomeni legati al Cyber Crime.

Grande appassionato di tecnologia ed, in specifici ambiti, convinto sostenitore del mondo blockchain e criptovalute.

Download PDF

https://www.ictsecuritymagazine.com/articoli/criptovalute-e-algoritmi-di-consenso-parte-1/


Blockchain Security, un paradigma multilayer

Security technologies and products may be improving, but they’re not improving quickly enough. We’re forced to run the Red Queen’s race, where it takes all the running you can do just to stay in one place. As a result, today computer security is at a crossroads. It’s failing, regularly, and with increasingly serious results[1].
Bruce Schneier

È opinione comune che in ambito di Computer Security i problemi si dividano in due grandi categorie: quelli relativi a dispositivi e programmi e quelli che sono situati sopra la tastiera. I sistemi basati su blockchain non fanno eccezione alla regola: il modello prescelto deve essere sicuro sia sotto l’aspetto tecnico sia nell’uso che ne viene fatto dall’utente.

Generazione delle credenziali

L’educazione degli utenti è la prima tessera del puzzle. Per quanto possa apparire improbabile, a volte anche gli utenti esperti dimenticano le regole di base. È il caso, ad esempio, delle indagini condotte nel 2016 su alcuni venditori del black–market AlphaBay, un sito (chiuso dalle autorità nel 2017) dove merci illecite venivano scambiate per un controvalore in bitcoin. Uno dei dealer si era presentato con due diverse identità, AREA51 e DARKAPOLLO, attivate con protezione PGP. Per individuarlo, gli investigatori non sono dovuti ricorrere a tecniche di analisi della blockchain ma hanno potuto utilizzare la chiave pubblica PGP, che include l’indirizzo mail fornito dall’utente. Entrambi i profili facevano, infatti, riferimento a un indirizzo unico che era stato attivato con dati anagrafici reali [2].

Dove ho messo le chiavi?

Un tipico problema lato utente è, da sempre, quello della conservazione di username, password e P.I.N. I sistemi di blockchain sono messi in sicurezza crittografica ma la conservazione delle chiavi spetta agli utenti. Hal Finney conservava i bitcoin di cui aveva fatto mining in un DVD [3], riprodotto in copia di back up (e chiuso in cassaforte quando il loro valore è divenuto ingente). Nel tempo si sono susseguiti diversi scandali relativi al furto di bitcoin. Già nel 2016, in occasione di un’intervista rilasciata a Cointelegraph su chat Twitter, Andreas Antonopulos ha cercato di sensibilizzare gli utenti alla gestione personale delle chiavi crittografiche, lanciando lo slogan “your keys your bitcoins” [4]. È un dato di fatto che questa soluzione non è praticabile da chi sia privo di conoscenze informatiche approfondite. In questo caso, la second best option applicabile è quella di scegliere un gestore di capacità e serietà riconosciute. Resta comunque ferma la necessità di gestire il portafoglio in sicurezza lato utente, attuando le misure necessarie a mantenere riservate credenziali e chiavi crittografiche. È fondamentale adottare un atteggiamento cauto, prestando attenzione alle trappole informatiche come phishing, farming e free download che contengono spesso anche del malware; ma bisogna anche tenere le macchine in condizione di sicurezza, adottando gli strumenti informatici idonei come firewall e antivirus.

Supporto tecnico e strumenti di sicurezza

La sicurezza di hardware e software sconta, anch’essa, un problema situato sopra la tastiera: la brutta abitudine di considerare l’informatica roba da smanettoni, con largo affidamento su fai da te e soluzioni on the shelves. È opportuno tenere sempre presente che l’informatica è un ramo applicato della matematica e che prodotti con costi sensibilmente differenti hanno, normalmente, una resa diversa. Quindi: no ai lavori affidati al figlio del cugino del vicino del lattaio (“cosa vuole signora, non ha mica mai studiato, ma con quelle robe lì è tanto bravo…”), no ai dispositivi usati in maniera impropria e no a soluzioni apparentemente vantaggiose ma mal progettate e messe in opera ancora peggio (quante volte abbiamo sentito frasi come “guardi, mi hanno detto che se uso un NAS al posto del server risparmio un bel po’ di soldini…”)

La “sicurezza della blockchain”

Ciò premesso, va necessariamente detto che parlare di “sicurezza della blockchain” in quanto tale, come purtroppo spesso si sente dire, non ha senso perché la blockchain è una struttura dati, cioè uno strumento di rappresentazione delle informazioni. Sarebbe come disquisire della “sicurezza dei numeri interi” o della “sicurezza delle liste concatenate”. La blockchain in sé non garantisce né aumenta la sicurezza di un sistema o di una applicazione. La sicurezza è un attributo dei sistemi nel loro complesso e, in informatica, viene rapportata al paradigma C.I.A.: Confidenzialità, Integrità e Disponibilità (Availability in inglese). La blockchain è una struttura dati che in presenza di determinate condizioni (come accade ad esempio in Bitcoin, il modello di riferimento di molti sistemi) garantisce la certificazione del dato in essa conservato: pertanto la sua funzione c.d. notarile (cioè di rendere notorio e certo un fatto) la esenta dal vincolo di Confidenzialità; saranno eventualmente i sistemi che la usano a dover prevedere delle funzioni di controllo degli accessi ai dati ivi conservati, implementando la Confidenzialità a livello esterno. Anche l’Integrità è una proprietà che deve essere garantita attraverso specifiche di implementazione: nel caso Bitcoin, di cui stiamo facendo esempio, questo avviene subordinando la validità degli hash dei blocchi all’avveramento di determinate condizioni. Infine, la Disponibilità è una proprietà che sancisce che il dato debba essere consultabile quando necessario, quindi è una proprietà dinamica che richiede di garantire la raggiungibilità dello stesso tramite ridondanze e copie di riserva (nel caso di Bitcoin è ottenuta con la replica della catena in tutti i full nodes).

Turing completeness e velocità di sistema

Quindi, per i sistemi basati su blockchain le questioni di sicurezza da prendere in considerazione sono più di una. Bitcoin, ad esempio, è stato volutamente disegnato con un linguaggio di programmazione non Turing complete. Questo significa che molte funzioni, come lo smart contracting, non sono sviluppabili direttamente su questa piattaforma, ma significa anche che la sicurezza del sistema rispetto ad attacchi che si prefiggano di sfruttarne la programmazione interna è maggiore. Per dirla con Bruce Schneier, è la complessità che rende il sistema vulnerabile [5]. Nei sistemi di blockchain anche la velocità di esecuzione delle operazioni complica la questione della sicurezza in maniera direttamente proporzionale. Infatti, più aumenta questa velocità più diventa probabile che i nodi lavorino ognuno sulla propria copia del registro, aprendo la porta a una serie di fork che possono facilitare l’azione a eventuali double spender. Il problema viene risolto alla radice da molti sistemi introducendo l’irreversibilità delle transazioni, che impedisce di utilizzare nuovamente somme già trasferite in precedenza.

Attacco ai nodi

Nei sistemi pubblici, ogni full node gestisce in maniera autonoma una copia del registro delle transazioni che resterà dunque al sicuro anche in caso di attacco a singoli end point. Ai fini di una valutazione di affidabilità del sistema, risulta così molto importante il numero dei nodi operativi che è direttamente proporzionale alla stabilità del sistema medesimo. Infatti, non tutti i nodi lavorano all’unisono, come nel caso di progetti nati da fork in cui i miners si dedicano selettivamente all’attività che in quel momento risulta maggiormente redditizia.

Nel caso delle mining pool, diviene fondamentale il tipo di architettura adottato, che deve consentire la convergenza degli sforzi di calcolo di macchine autonome e indipendenti fra loro. L’Integrità dei dati dipende, qui, anche dalla sicurezza dei protocolli di calcolo distribuito implementati.

Nei sistemi privati, o a gestione ristretta, la sicurezza dipende anche dal grado di indipendenza dei nodi. Le credenziali di accesso vengono qui autorizzate a livello centrale. In questo caso ha rilevanza anche il sistema di autenticazione che non deve concedere privilegi amministrativi passe-partout né consentire l’accesso indiscriminato a superuser la cui attività sfuggirebbe, così, a ogni controllo.

Gli esempi che precedono sono riconducibili a minacce all’integrità delle informazioni rappresentate. Peraltro, negli attacchi a gruppi di nodi, l’alterazione della maggioranza di potenza computazionale potrebbe essere finalizzata non solo alla manipolazione della struttura dati, ma anche al blocco del sistema, facendone venire meno la Disponibilità.

Tracciabilità delle transazioni

La tracciabilità delle transazioni, infine, costituisce una sensibilità assolutamente personale degli utenti. Bisogna comunque ricordare che nei sistemi pubblici il registro delle transazioni è liberamente consultabile. Ci sono casi in cui la privacy assume connotazioni particolari, come nel caso dei trial clinici, dove diventa fondamentale occultare l’identità dei pazienti che partecipano alla sperimentazione. Per questo genere di esigenze si rivelano particolarmente utili i sistemi basati su algoritmi che agiscono da tumbler, aggregando gli utenti in gruppi e impedendo di rintracciare l’effettiva provenienza della transazione. Nel caso si tratti di operazioni economiche, bisogna sempre tenere in conto che le transazioni in entrata saranno comunque dirette a un indirizzo specifico e che per mantenere questo indirizzo anonimo bisogna che esso sia stato creato allo scopo e utilizzato solo in maniera oscurata. Come evidenziato da Husam Basil Al Jawaheri [6], esiste infatti la possibilità di mettere in relazione alcuni degli indirizzi Bitcoin utilizzati in TOR con identità e indirizzi pubblicati su varie pagine in chiaro, correlandoli poi a transazioni e wallet.

Ancora una volta, un problema di sicurezza situato sopra la tastiera…

Note

[1] Bruce Schneier, Secrets and Lies: Digital Security in a Networked World, 15th Anniversary Edition, 2015, ed. John Wiley & Sons, Inc., ISBN: 9781119092438.

[2] Paolo Dal Checco, Arresti nel dark web grazie (anche) alle chiavi PGP, 2016: “Durante la generazione della chiave pubblica, per comodità dell’utilizzatore più che altro, viene richiesto l’indirizzo email al quale tale chiave sarà associata e tale indirizzo email verrà inserito all’interno della chiave pubblica PGP, quindi pubblicamente visibile da chiunque abbia la chiave. […] La “leggerezza” dei due venditori di AlphaBay AREA51 e DARKAPOLLO è stata quella di inserire nella loro chiave pubblica l’indirizzo di posta elettronica, Adashc31@g___l.com, che ha permesso agli investigatori di risalire ai loro profili Facebook, Twitter e Instagram anche tramite l’utilizzo del nick “Adashc31”. Ci è voluto poco, quindi, a richiedere a Facebook i dati di registrazione e accesso al profilo e scoprire che i due venditori erano in realtà la stessa persona residente a Brooklyn, New York”, http://www.bitcoinforensics.it/2016/08/arresti-dark-web-chiave-pgp/.

[3] Hal Finney, Bitcoin and me (Hal Finney), 2013, https://bitcointalk.org/index.php?topic=155054.0.

[4] Olusegun Ogundeji, Antonopoulos: Your Keys, Your Bitcoin. Not Your Keys, Not Your Bitcoin, 2016: “My primary goal is to ensure that none of the simple users who just need to exchange currencies are using custodial exchanges and leaving money there,” Andreas Antonopoulos says in a Twitter chat with Cointelegraph. “It is risky, it is unnecessary and they are the least aware or capable of understanding and managing that risk. Hence the slogan: your keys, your Bitcoin. Not your keys, not your Bitcoin”, https://cointelegraph.com/news/antonopoulos-your-keys-your-bitcoin-not-your-keys-not-your-bitcoin.

[5] Bruce Schneier, Secrets and Lies: Digital Security in a Networked World, 15th Anniversary Edition, 2015, ed. John Wiley & Sons, Inc., ISBN: 9781119092438: “Complex systems are inherently more vulnerable than simple ones, and the Internet is the most complex machine mankind has ever built. It’s simply easier to attack our modern computer systems than it is to defend them, and this is likely to remain true for the foreseeable future. It’s not that defense is futile, it’s that attack has the upper hand”.

[6] Husam Basil Al Jawaheri, Deanonimizing TOR hidden service users through bitcoin transaction analysis, 2018, https://qspace.qu.edu.qa/handle/10576/5797.

Bibliografia

Articolo a cura di Maria Letizia Perugini e Marco Carlo Spada

Download PDF

https://www.ictsecuritymagazine.com/articoli/blockchain-security-un-paradigma-multilayer/


Blockchain: la cassaforte di cristallo

Una delle prime caratteristiche che vengono tipicamente associate alla blockchain è la sicurezza. Questo non dovrebbe sorprendere, data la dimostrazione pratica che questa tecnologia ci sta dando ogni giorno in ormai 10 anni di diffusione. Vediamo infatti che, per la prima volta, una tecnologia informatica ci permette di avere dati che vengono resi praticamente immutabili una volta scritti, protetti in modo esemplare da funzioni crittografiche di comprovata affidabilità.

È proprio grazie a queste sue esclusive peculiarità che la blockchain è in grado di gestire addirittura una moneta elettronica ad alto valore, come bitcoin e molte altre. Va ricordato che la blockchain di fatto è nata per rendere possibile il bitcoin, il cui nome compare fin dal titolo del famoso paper di Satoshi Nakamoto, mentre il termine blockchain arriverà solo successivamente, come contrazione di “chain of blocks”, man mano che la criptomoneta si diffondeva.

La blockchain non solo permette di gestire e spostare bitcoin, ma soprattutto è il suo habitat. Non bisogna farsi trarre in inganno su questo punto: i bitcoin “nascono” nella blockchain e non escono mai da essa: esistono solo al suo interno, sotto forma di transazioni. I wallet non contengono bitcoin, ma solo le chiavi crittografiche che permettono di muoverli e disporne.

Ma se la blockchain è la “casa” dei bitcoin, quanto è sicura? Non è facile dare una risposta a questa domanda dato che non esiste un’unità di misura o paragone, ma possiamo dare un’idea della sua sicurezza attraverso un’immagine.
La blockchain è come una cassaforte di cristallo: da una parte è completamente trasparente, dato che chiunque ha la possibilità di averne una copia, studiarla, esaminarla e conoscere ogni spostamento, da indirizzo a indirizzo, di ogni frazione di bitcoin in essa contenuto. Dall’altra, le strutture scelte per immagazzinare i dati, le modalità utilizzate per legare tra loro transazioni e blocchi, e la crittografia asimmetrica usata per autorizzare le operazioni fanno sì che nessuno abbia modo di interferire col funzionamento di questa cassaforte, asportare il valore in essa contenuto o impossessarsene.

Non solo; il codice sorgente della blockchain è completamente aperto, chiunque lo può studiare per trovare falle o bug. Chiunque può realizzare, con poca spesa, un nodo di questa rete ed entrare a farne parte, eventualmente provare a interferire, senza dover chiedere alcuna autorizzazione. Chiunque può scrivere programmi per interfacciarsi alla blockchain e – potenzialmente – mandare transazioni errate o malevole, ma senza sortire effetto. Infatti, tentativi di questo tipo vengono fatti costantemente e ininterrottamente. Eppure la blockchain non ha mai perso un solo satoshi (la centomilionesima parte di un bitcoin) e ha continuamente dimostrato, nei 10 anni passati, la sua totale sicurezza e affidabilità.

Inoltre, la Blockchain è sostenuta da una rete di nodi diffusi sul pianeta, interconnessi tra loro in una modalità nota come “peer-to-peer” (da pari a pari) per cui, anche in caso di pesanti menomazioni di questa rete (c’è chi si spinge a dire anche in caso di disastro nucleare), essa non ne soffrirebbe in alcun modo.

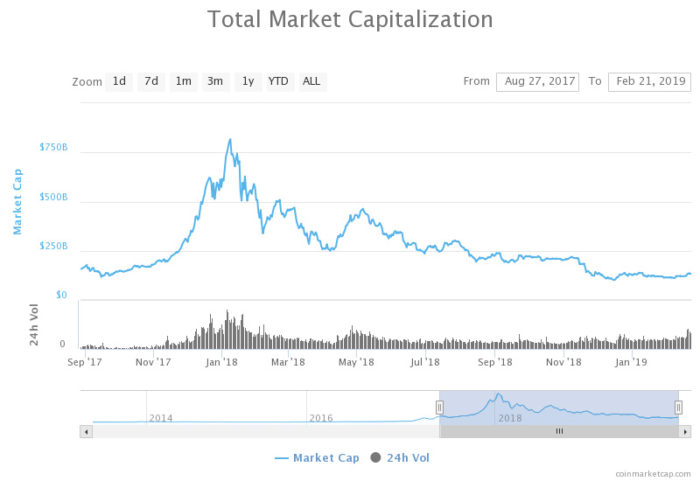
Quindi, per rispondere alla nostra domanda, potremmo dire che la blockchain è stata finora in grado di resistere ad ogni attacco di cui sia stata oggetto mantenendo in totale sicurezza al suo interno un controvalore che ora ammonta a 133 miliardi di dollari (market cap a marzo 2019, mentre a dicembre 2017 ammontava a 813 miliardi). Un bottino di tutto rispetto, di certo più che sufficiente a motivare molti hacker a fare del loro meglio per impossessarsene, ma senza successo. Non sono molti i sistemi in grado di reggere un confronto e di fornire altrettante garanzie all’utente.

Ma come è possibile tutto questo? Innanzitutto va precisato che quando si parla di “blockchain” si intende il modello pubblico, aperto, decentralizzato, trustless e permissionless che possiamo trovare in molte blockchain, quali quelle di bitcoin, ethereum e molte altre. Sono solo queste, infatti, le blockchain che possono fornire livelli superiori di sicurezza in grado di proteggere i dati anche in condizioni di totale apertura ed esposizione. Per tutti gli altri modelli permissioned, privati, trust based, contrariamente a quanto si potrebbe pensare, non si possono né si devono fare le stesse considerazioni, né dare per scontato di avere le stesse garanzie, dal momento che questi funzionano sotto assunti diversi e in differenti condizioni.

Le blockchain pubbliche traggono la loro sicurezza dal proprio protocollo, che è sicuro “by design” in quanto concepito per dare delle forti garanzie in tal senso, tenendo conto che ogni singola operazione sarà certamente oggetto di un attacco. Non solo: il protocollo tiene conto del fatto che più attori all’interno della blockchain potranno avere comportamenti scorretti e, quindi, l’intero sistema di regole dovrà essere affidabile sia in presenza di nemici interni al sistema sia di nemici esterni.

Il concetto di base di questo protocollo è che tutte le informazioni che veicola possono e devono essere controllate in modo autonomo da ogni nodo della rete che le riceve. Si fa leva sulla trasparenza e sulla verifica costante e distribuita. Su questo si innesta un articolato sistema di pesi e contrappesi basato sulla teoria dei giochi: le regole infatti incoraggiano ogni partecipante ad applicare le regole su sé stesso e sugli altri, essendo questa la condotta che gli darà i risultati migliori sia a breve che a lungo termine. Barare non conviene mai: è molto difficile, si viene facilmente scoperti, ci si trova a competere contro tutti gli altri nodi onesti e costa moltissimo lavoro che, se fosse impiegato in modo consono alle regole, avrebbe una resa molto più promettente.

Il sistema degli indirizzi si basa sulla crittografia a chiave pubblica. Le criptovalute di quella blockchain sono associate a un indirizzo (concettualmente simile a un IBAN). Questo indirizzo deriva dalla chiave di cifratura pubblica dell’utente. Solo dimostrando di possedere la chiave privata corrispondente, con lo stesso meccanismo alla base della firma digitale, si può disporre un movimento delle monete associate a quell’indirizzo. Va ricordato che stiamo parlando di un tipo di crittografia tra le più sicure al mondo.

I dati sono resi immutabili da un complesso sistema di validazione distribuita chiamato mining. I blocchi che contengono le informazioni devono prima essere validati controllando la validità di ogni informazione, e successivamente “chiusi”. La chiusura, nota anche col termine “Proof of Work”, richiede che il blocco presenti delle caratteristiche ben precise. Questa operazione richiede moltissimi calcoli e l’utilizzo di moltissima energia. Successivamente, una volta che il blocco è chiuso, chiunque avrà la possibilità di verificare autonomamente la correttezza e la validità dello stesso in tempi infinitesimali. Questa complessa procedura, tra le altre cose, rende i dati contenuti nella blockchain virtualmente immodificabili: riscrivere un blocco richiederebbe di ripetere tutto il lavoro di chiusura e validazione spendendo di nuovo tutta l’energia, mentre il resto della catena di blocchi continua a crescere avendo quindi una situazione in cui, una volta tanto, è la tartaruga ad inseguire (senza possibilità alcuna) Achille.

Su questa caratteristica di “immutabilità pratica” si innesta il concetto di data certa. Questa caratteristica, accoppiata alla data inserita nel blocco che contiene le informazioni, consente di legare indissolubilmente l’esistenza di quelle informazioni a quella data.

Ma questa non è l’unica trovata all’interno del protocollo delle blockchain: vi sono molti altri dettagli che rivelano tratti di genialità. Ad esempio, uno dei grossi limiti di tutte le altre monete digitali antecedenti la blockchain è stata la possibilità di inflazionare la moneta a piacere, facendo un semplice copia-incolla della moneta virtuale. Bitcoin ha trasformato questo punto debole in un punto di forza utilizzando un approccio diverso, per cui non viene digitalizzata la moneta, ma il suo spostamento. Le transazioni infatti non registrano l’informazione “+10€” e neppure che “Mario ha 10€” ma che “Luigi ha dato 10€ a Mario”. Questa informazione non è alterabile in quanto richiede l’utilizzo della chiave privata di Luigi, e solo lui può fare questa operazione. Contemporaneamente, se duplichiamo più volte questa informazione, non facciamo che renderla più sicura. Inoltre, restiamo sempre in grado di conoscere il saldo di Luigi e Mario ripercorrendo la storia di tutte le transazioni. Stesso risultato, massima sicurezza.

Dal punto di vista accademico, va poi ricordato che la blockchain concepita da Nakamoto è “Bizantine Fault Tollerant” (BFT) ovvero è in grado di risolvere il cosiddetto “dilemma dei generali bizantini”: un problema sottostante alle reti distribuite in cui si cerca un modo sicuro per raggiungere il consesso, ovvero fare sì che tutti i nodi della rete distribuita, comunicando fra loro, possano raggiungere l’accordo su una data informazione, anche in presenza di nodi che potrebbero non funzionare o alterare volutamente la sincronizzazione.

A questo protocollo lavorano alcuni tra i migliori crittografi e programmatori al mondo. Il tutto è costantemente sottoposto a review, ad analisi, ad adversarial thinking, ed è sottoposto ad un costante lavoro di correzione e miglioramento. Basta pensare che spesso, contrariamente a quanto succede con molti software proprietari, nelle blockchain le correzioni agli errori sono pubblicate e applicate prima che queste vengano scoperte e sfruttate per scopi fraudolenti.

Un capitolo a parte andrebbe dedicato agli smart contract. Contrariamente a quanto suggerisce il nome, questi sono programmi che nulla hanno a che vedere col concetto legale di contratto e hanno molteplici ambiti di applicazione che non hanno alcuna attinenza con i contratti. Questi software, sviluppati in proprio da privati e aziende, sono stati spesso messi in crisi da errori nel codice che hanno portato alla perdita di ingenti somme di denaro. Per questo motivo, molto lavoro viene fatto proprio sul versante della sicurezza del codice, spingendo verso l’adozione di librerie, standard implementativi e revisione del codice da parte di enti terzi. Ma tutte le volte che uno smart contract ben scritto viene messo in azione, abbiamo la garanzia di un programma che verrà eseguito all’unisono da centinaia di nodi, che dovranno pervenire deterministicamente allo stesso risultato. Avremo cioè un codice inarrestabile.

Tuttavia, nonostante la sicurezza implicita nella blockchain, esistono dei rischi per l’utenza dovuti agli errori che si possono commettere o all’inesperienza. La blockchain non perdona: l’utente infatti è responsabile della corretta conservazione delle proprie chiavi crittografiche e di come dispone le transazioni. Molti furti di bitcoin sono stati fatti agendo su vulnerabilità dei wallet, rubando le chiavi o agendo in diversi modi sull’elemento più fragile: l’utente. Ma va ribadito che mai si è stati in grado di scalfire la sicurezza della blockchain stessa.

Esiste un’unica possibilità, nota e costantemente monitorata, di sovvertire il funzionamento di una blockchain, che consiste nel possedere e controllare almeno il 51% dei nodi che la compongono, imponendo a tutti questi di comportarsi in modo sleale e barare. Tuttavia questo rischio, legato alla centralizzazione delle risorse, è fortemente tenuto sotto controllo dalla comunità. Al momento attacchi di questo tipo si sono dimostrati possibili solo sulle blockchain di più piccole dimensioni e a costi molto alti.

Tutte queste caratteristiche fanno sì che, ad oggi, la blockchain sia uno dei sistemi più sicuri mai esistiti, in grado di dare totale controllo all’utente degli asset in suo possesso, garantendo una “pseudo-privacy”, rendendo impossibili intromissioni, espropri o ingerenze esterne. Molti dei sistemi che usiamo tutti i giorni e di cui ci fidiamo non danno le stesse garanzie. Diversamente la blockchain è trustless by design, ovvero non richiede fiducia: al suo interno tutto viene verificato, controllato e dimostrato. Uno dei motti della sua community è infatti “don’t trust, verify”.

La sicurezza della blockchain, accoppiata da tutte le caratteristiche che abbiamo visto fin qui, ha giustamente stimolato in molti la volontà di utilizzare la blockchain per scopi diversi dal trasferimento di valore. Sono da qui nate le ricerche relative alla notarizzazione dei documenti, supply chain management, tokenizzazione degli asset e molte altre. Tutte queste applicazioni distribuite (DApp) godono immediatamente di livelli di sicurezza molto alti. Per questo, c’è da aspettarsi che nel prossimo futuro sempre più applicazioni che necessitano di alte garanzie dal punto di vista della sicurezza saranno sviluppate sulle blockchain pubbliche, decentralizzate e permissionless.

Bibliografia:

Articolo a cura di Marco Crotta

Diventa informatico a 12 anni imparando a programmare da autodidatta il suo C=64, fino a laurearsi all’Università di Milano Bicocca, dove poi rimane come ricercatore per quasi un anno.

Già durante gli studi segue diversi progetti come consulente, successivamente entra nel mondo reti, telecomunicazioni e sicurezza, dove ha partecipato allo sviluppo di progetti di sicurezza per Magistratura e Forze dell’Ordine.

Attivo da alcuni anni nel settore delle cryptovalute, nel 2017 diventa divulgatore col suo canale YouTube “Blockchain Caffè”. Istruttore per corsi privati ed aziendali, consulente ed Advisor per startups ed ICO in progetti relativi all’applicazione della Blockchain in diversi settori. Nel 2019 apre la società di consulenza e formazione “Bcademy Milano srl”.

www.blockchaincaffe.it

Download PDF

https://www.ictsecuritymagazine.com/articoli/blockchain-la-cassaforte-di-cristallo/


DMARC: un record dns per proteggere noi stessi e i nostri clienti dall’email SCAM

Cos’è lo SCAM?

SCAM è un tentativo pianificato di truffa con metodi di ingegneria sociale, come ad esempio fingere di essere qualcun altro, o qualcos’altro, a scopo fraudolento.

Questo può essere fatto di persona, per telefono, tramite profili social, siti web e anche tramite email, sfruttando ulteriori tecniche malevole come spam e phishing.

Un tipico esempio di Scam è la “truffa alla nigeriana”, in cui viene inviata un’email nella quale si parla di grosse somme di denaro che dovrebbero essere trasferite (o recuperate) da una banca estera che chiede alcune garanzie come la cittadinanza, un conto corrente, un deposito cauzionale. Lo scammer perciò chiede aiuto sia per trasferire il denaro tramite il conto di chi legge, sia per anticipare il deposito cauzionale; come ricompensa si promette una percentuale del denaro recuperato, che non arriverà mai.

Altri classici esempi di Scam sono email che condizionano una vincita a una qualsiasi lotteria al versamento di una certa tassa: ovviamente, non esiste nessuna vincita e la tassa pagata viene rubata.

Un moderno esempio di Scam via chat telegram è il giveaway di cryptovalute in cui, se si versano un tot di token in un wallet a scopo di “verifica del mittente”, ne ritorneranno 10 volte tanti al wallet mittente dal wallet destinatario… ma ovviamente non succederà mai.

Nell’era del marketing, l’email è ancora uno strumento utilizzatissimo ma – essendo datato e non nato sicuro “by design” – è ancora molto appetibile per i malintenzionati.

Figura 1 (blog.prisync.com)

Quando qualche nostro cliente è vittima di scam tramite email e qualcuno si sta fingendo un dipendente o una mailing list della nostra azienda, si entra in una situazione antipatica, con implicazioni giuridiche (vedi GDPR) in cui è certamente meglio dimostrare di aver fatto di tutto per proteggere noi stessi e gli altri da questo fenomeno.

Quello che certamente dobbiamo evitare che accada è che qualcuno sia in grado di inviare una email dal dominio di posta della nostra compagnia: un discorso è se lo scammer “finge” di essere un mittente accreditato, un altro discorso è se riesce ad “esserlo” veramente.

Infatti, volendo fare un esempio recente, è relativamente semplice per chi ha dimestichezza con le email capire se il mittente ci scrive da PosteItaliane.it o se si è vittime della truffa postepay e bancoposta semplicemente andando ad espandere i dettagli del mittente della email per vedere se arriva dal dominio @posteitaliane.it: l’indirizzo sarà pincopallino@posteitaliane.it e non weioru9932923@2387ss.ru, a prescindere dal nome visualizzato nella email; a meno che qualcuno sia riuscito a rubare le credenziali di accesso di un account valido, implementando il DMARC in modo sufficientemente restrittivo non sarebbe possibile ricevere una email da @posteitaliane.it se non fosse stata inviata – ed autenticata – da quel dominio.

Questo sarebbe valido se le cassette di posta riceventi facessero parte di server mailbox abbastanza evoluti da implementare i metodi di autenticazione per filtrare i messaggi di posta “sospetti” compatibili con il DMARC, che al giorno d’oggi sono tutti i principali (google, facebook, microsoft, yahoo, etc…).

Cos’è il DMARC?

Acronimo di “Message-based Domain Authentication, Reporting & Conformance”, è una specifica tecnica creata da un gruppo di organizzazioni per ridurre il rischio di abusi via email grazie all’utilizzo di una coppia di protocolli di autenticazione.

È un metodo di protezione nativo del server di posta che implementa il mittente e, quindi, del tutto diverso da filtri antispam e tecniche simili, che solitamente sono configurate dai riceventi utilizzando server ed applicazioni aggiuntive.

L’implementazione del DMARC si basa su due procedure di autenticazione ben precise: SPF e DKIM.

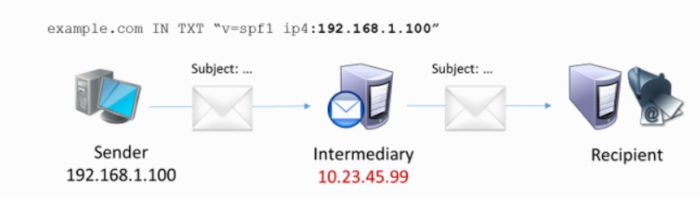
  1. SPF (Sender Policy Framework) prevede l’inserimento di un record nel DNS del dominio di posta mittente che consente a determinati IP di mandare e-mail tramite quel dominio. Durante la verifica degli indirizzi IP verranno dunque identificati eventuali indirizzi email non autorizzati. La lista degli indirizzi IP certificati a cui si fa riferimento è quella presente nel “Return Path” della email. Detto in altri termini, la procedura SPF consente di riconoscere se chi invia l’email da un determinato indirizzo email è realmente autorizzato a farlo.
    Come vantaggio l’SPF è facile da configurare e non implica particolare overhead computazionale sui sistemi che inviano e ricevono posta elettronica.
  2. DKIM (DomainKeys Identified Mail) fa sì che l’email in uscita venga contrassegnata con una firma digitale che il server di posta ricevente confronterà con la chiave pubblica inserita nel DNS del dominio mittente. Se la firma corrisponde alla chiave pubblica significa che il mittente è verificato e che l’email ricevuta è stata inviata, senza essere stata sottoposta a successive modifiche, dal mittente indicato nella mail che stiamo leggendo.
    Come vantaggio, Dkim non controlla gli ip dei mittenti ma richiede un minimo di overhead in invio e ricezione per elaborare la firma digitale allegata al messaggio.
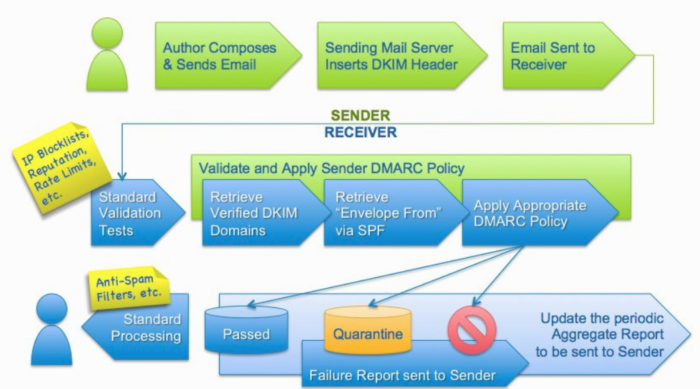
Figura 2 Flusso di posta (dmarc.org)

In sostanza, i due metodi si completano a vicenda ed è fortemente consigliato utilizzarli entrambi, soprattutto se la nostra posta passa per email forwarders che richiedono molta attenzione nel configurare il record SPF (i server di inoltro della posta potrebbero non essere presenti nella whitelist degli ip mittenti).

Figura 3 Email Forwarding SPF fail (dmarc.org)

Come funziona il DMARC

In effetti implementare il record DMARC è molto semplice, poiché si tratta solo di aggiungere un record DNS nello stesso dominio dns del proprio server di posta elettronica (dove esiste il record MX).

Il DMARC è una protezione in uscita: sono gli amministratori del dominio di posta mittente che decidono di comunicare ai riceventi come filtrare le email.

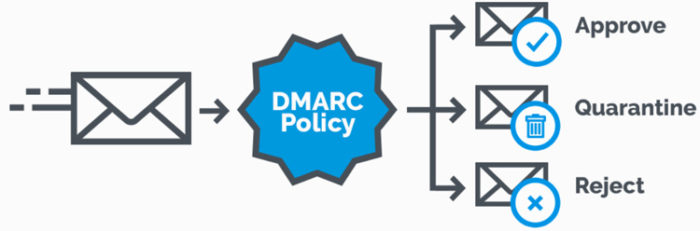
Le email considerate illecite dal server di posta ricevente (su indicazione dei record dns del mittente) potrebbero essere ricevute se la policy del mittente è approve, non andranno nella cassetta spam degli utenti ma verranno ignorate se la policy è reject oppure andranno in “junk” se la policy è quarantine.

Figura 4 Policy Dmarc (www.dmarcanalyzer.com)

È possibile indicare nel record DMARC indirizzi di posta a cui inoltrare report xml e forensi delle email scartate (illegittime) per un’analisi del flusso di posta che sia anche compliant con il GDPR.

Quando per la prima volta si introduce il record DMARC è consigliabile avere un approccio “soft”, istruendo i destinatari ad accettare tutte le email (approve) ma notificarci quali sarebbero state scartate se avessimo impostato una policy più restrittiva: in questa fase potremmo anche non avere alcun metodo di autenticazione SPF e/o DKIM impostato.

Tramite strumenti di analisi adeguati esistenti sul mercato, possiamo andare ad affinare e correggere i nostri record DNS affinche tutte quelle newsletter inviate, ad esempio, da terzi per nostro conto siano incluse nei mittenti attendibili; fino ad arrivare al punto di applicare policy sempre più restrittive senza creare disservizi per il business della nostra azienda e, allo stesso tempo, proteggere lei ed i clienti dallo SCAM.

Figura 5 Analisi forense (vitolavecchia.altervista.org)

Questi strumenti, relativamente economici ma di grande aiuto, permettono anche di inviarci report periodici da esaminare, effettuare controlli e mandarci avvisi sulla compliance, sulla correttezza dei nostri record e – soprattutto – ci offrono la possibilità di esaminare gli headers dei feedback ricevuti dai server destinatari e gli headers delle email illegittime, utili nelle attività di indagine forense.


Articolo a cura di Marco Giuricin

Nato a Roma nel novembre del 1976 è un Senior System Administrator con esperienza ventennale nel mondo dell’Information Technology, lavorando da  consulente o dipendente presso importanti realtà come Tele Sistemi Ferroviari spa, Alitalia spa, Poste Italiane spa, Corte di Cassazione, Ministero di Grazia e Giustizia, Sir 2001 srl, Arianna 2001 spa, focalizzando la propria attività sulla progettazione, la gestione, la protezione ed il monitoraggio di ambienti sistemistici fisici e virtuali e loro implicazioni su tematiche come fiducia, privacy e sicurezza.

Sviluppatore di siti web di varia natura ed autore del blog sistemistico https://vmgmt.wordpress.com/ incentrato nel fornire piccole soluzioni e suggerimenti su tematiche di protezione dei dati e di disaster & recovery, virtualizzazione, database, blockchain, storage, architetture linux, microsoft, vmware, citrix, netapp, sicurezza logica e privacy anche legate alle tematiche del regolamento UE 2016/679 del garante della privacy (GDPR).

Download PDF

https://www.ictsecuritymagazine.com/articoli/dmarc-un-record-dns-per-proteggere-noi-stessi-e-i-nostri-clienti-dallemail-scam/


Distributed Ledger: una tecnologia abilitante per la resilienza ICT

Dopo aver discusso alcune funzioni per aumentare la resilienza di un sistema ICT, consideriamo lo scambio di informazioni fra i moduli che implementano queste funzioni. I moduli possono operare correttamente solo se possono scambiare informazioni corrette e consistenti. Proponiamo di implementare queste comunicazioni attraverso un ledger distribuito. Il meccanismo del consenso alla base di un ledger può garantire una corretta trasmissione di informazioni anche se alcuni nodi sono maliziosi o guasti. Dopo aver descritto la soluzione proposta, presentiamo una prima analisi delle prestazioni.

1. Introduzione

La diffusione crescente di sistemi ICT nella nostra società sottolinea l’importanza di come essi debbano poter tollerare e reagire all’occorrenza di minacce che riducono le loro funzionalità e i servizi che offrono [1], [2], [3]. In principio, esistono diverse prospettive per analizzare il problema, in base al tipo di evento, per esempio se naturale o malizioso, la quantità di informazioni che sono disponibili sull’evento prima del suo avvenimento e le conseguenze attese. Ad esempio, le analisi di safety e di security si concentrano, rispettivamente, su eventi naturali e sul comportamento malizioso di qualche attaccante. Un framework sulla resilienza fonde le due prospettive per coprire più sorgenti di attacco.

Esistono definizioni alternative di resilienza. Ad esempio, “La resilienza è l’abilità di una architettura di supportare le funzioni necessarie per il successo della missione a dispetto di azioni ostili o condizioni avverse. Un’architettura è più resiliente se può fornire queste funzioni con più alta probabilità, periodi più brevi di capacità ridotta, e attraverso una più ampia gamma di scenari, condizioni e minacce”[4]. Più in generale, la resilienza si riferisce all’abilità di prepararsi e adattarsi a condizioni mutevoli e resistere e recuperare rapidamente dai disturbi di tipi di attacchi deliberati, eventi accidentali, minacce naturali o incidenti. Nel caso di infrastrutture informatiche, la cyber resilienza indica la capacità di un sistema di recuperare o di rigenerare le sue prestazioni dopo un degrado dovuto a guasti o ad attacchi.

In un articolo precedente abbiamo visto che la resilienza di un sistema può essere ottenuta integrando ridondanza, monitoraggio e riconfigurazione. In maggior dettaglio, possiamo ottenere la cyber resilienza integrando cinque funzioni:

  • Anticipazione: scoprire e mitigare le vulnerabilità,
  • Rilevamento: scoprire attacchi in corso, crash e fallimenti,
  • Confinamento: cambiare la superficie d’attacco corrente per minimizzare la probabilità di successo di attacchi in corso o isolare i moduli che l’attaccante controlla,
  • Ripristino: ripristinare le funzionalità originali del sistema quando l’attacco termina o parziali durante l’attacco,
  • Miglioramento: aggiornare il sistema per migliorare la resilienza.

Questo articolo discute lo scambio di informazioni tra queste funzioni. In particolare, discute come le componenti che implementano il rilevamento possano interagire in modo sicuro con quelle di confinamento o di ripristino. Queste interazioni sono altamente critiche perché determinano le azioni di confinamento e di ripristino per ripristinare alcune funzionalità del sistema, ad esempio alcuni dei servizi offerti. Quindi, la trasmissione di false informazioni sugli attacchi in corso o sullo stato di alcune componenti risulterà in un comportamento inconsistente dei moduli che realizzano il confinamento o il ripristino. Questo è il motivo per cui proponiamo di implementare lo scambio di informazioni fra il task di rilevamento e quelli di confinamento e ripristino attraverso un ledger distribuito [5], [6], [7], una struttura dati che può superare i fallimenti bizantini [8], [9], [10] dei moduli che aggiornano il ledger.

Il cap. 2 di quest’articolo richiama brevemente i task principali che un sistema deve implementare per ottenere la resilienza. In seguito, il cap. 3 descrive come un ledger distribuito possa offrire un canale di comunicazione sicuro ed affidabile che può tollerare errori ed attacchi. Il cap. 4 mostra come i moduli che monitorano un sistema possano usare questo canale per trasmettere informazioni a quelli che riconfigurano il sistema. Il cap. 5, infine, discute una possibile implementazione e una prima valutazione delle prestazioni.

2. Funzioni per la cyber resilienza

Oltre ai servizi normali, un cyber-resiliente [11], [12] deve eseguire cinque funzioni: anticipazione, rilevamento, riconfigurazione, ripristino e miglioramento. I moduli che realizzano ognuna delle funzioni e quelli che si occupano delle attività normali lavorano concorrentemente, cioè alcuni moduli possono essere coinvolti in attività normali ed altri in una riconfigurazione. Come discusso di seguito, ogni funzione può essere implementata in parallelo da moduli distinti con un certo grado di ridondanza. Introduciamo brevemente le cinque funzioni.

La funzione di anticipazione scopre le vulnerabilità correnti nelle componenti del sistema e le mitiga prima che un evento malizioso o naturale le sfrutti. Questa funzione comprende, tra gli altri, il vulnerability scanning e l’installazione di patch o di una nuova versione di un modulo.

La funzione di rilevamento monitora continuamente il sistema per scoprire e correlare gli attacchi in corso e il loro obiettivo. Le tecnologie a supporto includono il rilevamento signature-based e anomaly-based [13]. La funzione si occupa sia di guasti che di incidenti da attacchi maliziosi. Un guasto è un evento singolo che è solitamente rilevato usando il time out così come implementato nel timer watchdog; un attacco malizioso è formato da una catena di attacchi mirati a incrementare i privilegi dell’attaccante. Ogni attacco nella catena aumenta i privilegi. Proprio perché deve fronteggiare una catena di attacco, il sistema può rilevare e reagire alla catena prima che un attaccante la esegua completamente. Di seguito, quando si discute di un attaccante intelligente, usiamo il termine attacco per denotare un’intera catena di attacco mentre denotiamo come attacco elementare un elemento della catena. Il rilevamento correla l’attacco elementare corrente con quelli già rilevati per scoprire l’intera catena e predirne l’obiettivo finale Inoltre, esso deve definire lo stato, e.g. attaccato, integro o guasto, dei moduli del sistema. Questa informazione è fondamentale per riconfigurare il sistema e continuare ad offrire dei servizi.

Il confinamento opera a partire dai risultati del rilevamento. Usando le informazioni sulle catene di attacco e la previsione degli obiettivi finali, il confinamento decide se e come riconfigurare il sistema per resistere meglio agli attaccanti e continuare ad offrire dei servizi. Un sistema resiliente può sospendere alcuni servizi quando o non può implementarli in modo affidabile, o potrebbero essere il prossimo passo nella catena perché appartengono all’attuale superficie d’attacco. Questa superficie dipende dai privilegi che l’attaccante ha acquisito attraverso gli attacchi precedenti. Un modulo può essere sospeso spegnendolo, o riconfigurando la topologia del sistema in modo tale che non possa più essere raggiunto.

Il ripristino riporta il sistema ad uno stato normale, o almeno ad uno in cui alcuni servizi sono disponibili. Ha inizio dopo un intervallo di tempo predefinito dall’ultimo attacco di un attaccante malizioso o dopo un evento naturale. Opera a partire dallo stato aggiornato dei moduli del sistema che riceve dal rilevamento e riattiva alcune componenti e/o riconfigura le interconnessioni fra componenti. Se gli attacchi hanno un impatto fisico sulle componenti del sistema, un sistema completamente funzionale può essere ripristinato solo se il sistema presenta una qualche ridondanza fisica. Di seguito, assumiamo che la riconfigurazione possa anche avvenire attraverso alcuni piani pre-calcolati. Questo implica che confinamento e riconfigurazione richiedono solo la scoperta dei i moduli affetti da guasti o attacchi.

Le prime quattro funzioni gestiscono un crash e/o un fallimento finché non è risolto o l’attaccante è sconfitto. Il miglioramento deve ottimizzare i vari parametri e le soglie che guidano il comportamento delle altre funzioni per minimizzare la perdita di prestazioni. Non usiamo il termine apprendimento perché questa funzione può non adottare metodologie di apprendimento standard.

L’obiettivo complessivo delle varie funzioni è che il sistema sopravviva agli attacchi, offra dei servizi nonostante l’attacco e ritorni alle sue piene funzionalità il prima possibile. Di seguito discutiamo come garantire la consistenza e l’integrità delle comunicazioni fra rilevamento, confinamento e ripristino. Questi attributi sono importanti perché le funzioni possono essere efficaci solo se dispongono di informazioni accurate e consistenti sullo stato del sistema.

Comunicazioni resilienti attraverso un distributed ledger

Dopo aver presentato brevemente un distributed ledger, discutiamo di come questa struttura possa supportare alcune comunicazioni in un sistema resiliente.

2.1  Distributed Ledger

Un distributed ledger [14], [15] [16] è un database di asset che può essere condiviso su una rete di più siti, geografie o istituzioni. Tutti i partecipanti all’interno di una rete possono avere la loro copia identica del ledger perché tutti i cambiamenti al ledger vengono riflessi in tutte le copie. Le imprese usano questa tecnologia per processare, validare o autenticare transazioni o altri tipi di scambio dati. Tipicamente, questi record sono salvati nel ledger solo quando è stato raggiunto il consenso fra tutte le parti coinvolte. A ogni record nel ledger vengono associati un timestamp e una firma crittografica univoca. La tecnologia fornisce una storia verificabile ed ispezionabile di tutte le informazioni nel dataset che un ledger memorizza e tutti i partecipanti nella rete possono vedere tutta la storia.

L’aggiornamento di un ledger distribuito adotta un algoritmo di consenso per determinare l’informazione da inserire per estenderlo. Alcuni algoritmi sono basati su una proof of work, cioè il modulo che può inserire un record è il primo che risolve un problema che richiede un pesante lavoro computazionale. In questo caso, non abbiamo nessun consenso a priori ma solo un meccanismo di arbitraggio tra le varie richieste. Esiste un meccanismo di consenso a posteriori perché, se un modulo malizioso inserisce un record con informazioni false nella catena, quelli corretti la trascureranno e continueranno la catena dal record precedente. In un ledger, questa fork può produrre una situazione in cui due o più record hanno la stessa altezza, cioè un record ha più di un successore. La fork viene risolta quando i moduli corretti aggiungono altri record ed una delle catene diventa più lunga rispetto alle alternative. I moduli corretti abbandonano i record al di fuori della catena più lunga e che diventano record orfani.

Altre soluzioni raggiungono il consenso a priori attraverso alcuni round di voto finché una percentuale predefinita dei partecipanti della rete si accorda sullo stesso record. Di seguito, consideriamo un problema in cui tutti i moduli che possono accedere ed aggiornare il ledger distribuito sono noti in anticipo. Questo aumenta il numero dei possibili algoritmi di consenso.

2.2  Un distributed ledger come canale

Consideriamo un’applicazione del ledger distribuito diversa dalle tradizionali perché nella maggior parte dei sistemi un ledger sostituisce un database centralizzato o distribuito [17], [18], [19], [20]. Ad esempio, un sistema per una supply chain memorizza la provenienza di ogni componente usato. In questo caso si sostituisce un sistema di database centralizzato con un distributed ledger in cui ogni fornitore gestisce una copia del ledger. Il distributed ledger opera come sorgente sincronizzata dei dati che sono successivamente distribuiti alle altre copie. In questo modo, ogni fornitore non gestisce un solo nodo della rete ma replica, valida e gestisce un ledger. Ogni nodo della rete propone aggiornamenti e determina quelli da eseguire sulle copie del ledger. In questa soluzione, il ledger coordina i sistemi ICT dell’organizzazione nella rete.

La soluzione proposta utilizza un ledger distribuito come canale di comunicazione fra moduli di un sistema. Anche se le proprietà teoriche non dipendono dimensioni del ledger, ci sono alcune differenze. Ad esempio, la frequenza di inserimento è molto più elevata in una struttura dati.

La comunicazione mediante ledger può resistere sia a guasti sia ad attacchi maliziosi ai moduli che aggiornano e accedono il ledger. Consideriamo, ad esempio, un problema produttore/consumatore con molti produttori e molti consumatori. I produttori calcolano delle informazioni, mentre i moduli consumatori utilizzano le informazioni prodotte. Consumatori distinti possono consumare la stessa informazione. I produttori salvano le informazioni che calcolano in un ledger distribuito da cui ogni consumatore preleva i suoi input. Per semplicità, assumiamo che ogni produttore possieda una copia locale del ledger e che tutti i produttori decidano le informazioni da inserire nel record successivo del ledger mediante un algoritmo di consenso. Assumiamo anche che il ledger consista di una catena di record e che ognuno ricordi lo stato dei moduli di interesse a un certo istante. L’intero ledger memorizza la storia dei moduli di interesse. I produttori corretti, quelli non guasti e non controllati dell’attaccante, calcolano un nuovo record solo dopo aver aggiunto il precedente al ledger. Questa sincronizzazione è garantita dall’algoritmo di consenso che permette ai produttori di calcolare l’informazione nell’i+1-esimo record del ledger solo dopo aver raggiunto il consenso sull’i-esimo.

Alcuni dei produttori possono essere maliziosi e/o guasti e quindi tentano di inserire informazioni false nel ledger con l’obiettivo di provocare decisioni inconsistenti nel consumatore. Nonostante questi moduli, le informazioni nel ledger sono affidabili perché l’algoritmo del consenso garantisce che le informazioni che vengono salvate nel ledger dipendano solo dai produttori corretti. Questo può essere garantito ogni volta che il numero di produttori maliziosi è inferiore a una data percentuale del numero totale di produttori. Ad esempio, alcuni ledger adottano un algoritmo del consenso “pratical byzantine fault tolerant” [21], [22], [23] che garantisce che i consumatori corretti raggiungano il consenso sul valore corretto purchè il numero n di produttori e quello f di produttori guasti o maliziosi soddisfino n > 5f + 1. Questo implica anche che almeno f + 1 produttori calcolino lo stato di ogni nodo. Sotto questa condizione, possiamo assumere che le informazioni nel ledger di un produttore non guasto o malizioso sia sempre consistente.

L’algoritmo di consenso garantisce che il ledger memorizzi solo informazioni affidabili purché esista un’intersezione fra gli output di produttori diversi, cioè più produttori calcolino lo stesso output. Di conseguenza, l’output di un produttore permette di controllare la consistenza di quello di altri produttori. Supponiamo, ad esempio, che le informazioni di interesse descrivano lo stato attaccato/sicuro di ognuno di un insieme di moduli. In questo caso, ogni produttore calcola e salva nel ledger lo stato di alcuni moduli e più produttori calcolano e salvano lo stato di ogni modulo. L’informazione ridondante su ogni modulo permette di controllare la consistenza dell’output di ogni produttore. Assumiamo anche che il ledger consista di una catena di record e che ognuno ricordi lo stato dei moduli di interesse a un certo istante. L’intero ledger memorizza la storia dei moduli di interesse. I produttori corretti, cioè quelli che non sono guasti e non sotto il controllo dell’attaccante, sono sincronizzati in modo da calcolare un nuovo record solo dopo aver aggiunto il precedente al ledger. Questo vincolo è soddisfatto dal meccanismo del consenso che permette ai produttori di calcolare l’informazione nel record i+1-esimo del ledger solo dopo aver raggiunto il consenso sull’i-esimo.

I consumatori recuperano le informazioni di interesse accedendo al ledger. Ad esempio, possono leggere il numero di nodi guasti o attaccati e azionare alcune azioni per riconfigurare il sistema. La lettura delle informazioni nel ledger deve considerare che un produttore malizioso può trascurare l’algoritmo di consenso ed aggiornare la sua copia del ledger usando informazione falsa. Quindi, un consumatore deve confrontare più copie del ledger e può fidarsi delle informazioni nel ledger solo se almeno f + 1 copie distinte del ledger concordano sullo stesso valore. Ad esempio, un consumatore è certo che un modulo è stato attaccato se almeno f+1 copie del ledger memorizzano questo stato del modulo. Di seguito, denotiamo come validati, i dati salvati in almeno f+1 ledger distinti. Il meccanismo di validazione richiede semplicemente di leggere le stesse informazioni in più copie del ledger.

3. Attivare una riconfigurazione

Nella progettazione di un sistema resiliente, il problema produttore/consumatore più interessante sorge fra i monitor e i manager, i moduli che implementano, rispettivamente, il rilevamento e confinamento e la riconfigurazione.

Consideriamo per primi i produttori, cioè i monitor. Questi moduli valutano, mediante opportuni test, lo stato degli altri moduli per rilevare se ciascuno è sicuro, è guasto o è stato attaccato con successo. La relazione fra questi produttori e i moduli del sistema è molti-a-molti perché monitor diversi controllano lo stesso modulo mentre lo stesso monito controlla molti moduli. Come già detto, se al più f monitor possono essere guasti o maliziosi, almeno f+1 monitor dovrebbero controllare ogni modulo per garantire che almeno uno di loro non sia guasto.

In un sistema resiliente, i consumatori sono i manager che aggiornano la configurazione di sistema per confinare i moduli guasti o attaccati con successo. I manager possono migrare i moduli fra i nodi del sistema per ripristinare alcuni servizi. La tecnologia principale sottostante la riconfigurazione e il confinamento è la virtualizzazione [24], una tecnologia chiave per la resilienza perché disaccoppia completamente l’implementazione di un ambiente dalle risorse hardware. Una macchina virtuale è un ambiente di programmazione autonomo, auto contenuto con sistema operativo, applicazioni e server. È mappata su un nodo fisico e può migrare su un nodo diverso in modo completamente trasparente per le sue applicazioni e i suoi utenti. Inoltre, il sistema può facilmente duplicare una macchina virtuale per motivi di ridondanza o per creare un backup economico con tutti i dati e il codice della macchina. La memorizzazione del backup su un nodo diverso è il meccanismo di base di riconfigurazione e ripristino di un servizio quando quello originale è guasto o è stato attaccato.

La migrazione di una macchina virtuale è anche un meccanismo di difesa poiché offusca il nodo fisico da attaccare per raggiungere una certa macchina virtuale. Ad esempio, l’anticipazione può implementare strategie di inganno attive che migrano ogni macchina su un nodo selezionato casualmente con una frequenza predefinita. Questo incrementa fortemente la complessità di attacchi che eseguono del software sullo stesso nodo della macchina virtuale di interesse. Un esempio sono gli attacchi side-channel, che rubano informazioni da una macchina sfruttando il monitoraggio dell’uso delle risorse. La virtualizzazione semplifica anche l’implementazione di honeynet altamente interattive che non solo rallentano un attaccante ma collezionano anche informazioni sul suo conto. Infine, la virtualizzazione supporta l’introspezione di macchine virtuali, una tecnica potente per la scoperta di malware mediante analisi della memoria.

Nella soluzione proposta, i manager recuperano in un ledger distribuito, quello dello stato, l’informazione per determinare le macchine virtuali da ripristinare. I manager possono anche aggiornare la tabella di routing dei messaggi nei nodi del sistema per isolare un modulo.

Una questione critica è come evitare che un manager guasto o sotto il controllo dell’attaccante invalidi i due task. Anche in questo caso, implementiamo con un ledger distribuito, quello dell’azione, la comunicazione fra i monitor e i supervisori del nodo, i moduli che implementano la riconfigurazione in ciascun nodo. Nel problema considerato, ogni monitor produce le informazioni nel ledger mentre ogni supervisore del nodo le consuma. Anche in questo caso, un supervisore aggiorna la configurazione del proprio nodo, cioè le macchine virtuali e la tabella di routing, solo dopo aver validato l’informazione sullo stato. Il meccanismo di consenso e quello di validazione garantiscono la consistenza dell’input di ogni supervisore.

Si noti che sia i ledger di stato che quelli di azione – che implementano la comunicazione fra, rispettivamente, i monitor e i manager e i manager e i supervisori dei nodi – sono una catena di record. L’ultimo record nel ledger di stato memorizza informazioni riguardo allo stato attuale dei moduli del sistema, mentre l’ultimo record in quello di azione codifica l’azione da eseguire per ripristinare le prestazioni del sistema.

Possiamo evitare i manager e il ledger che supporta la comunicazione tra manager e supervisori solo se le azioni di ogni supervisore dipendono unicamente dallo stato degli altri moduli. Ad esempio, il comportamento del supervisore del nodo c può essere guidato dalla regola:

       Se i nodi a e b sono down, allora ferma le macchine virtuali Va, Vb e Vc e riattiva Vx e Vy.

Nell’esempio, Vx e Vy possono essere copie di macchine in esecuzione sul nodo a o sul nodo b. Questa policy di riconfigurazione è statica e quindi più efficiente ma può ridurre la resilienza globale, perché decide in anticipo le possibili reazioni.

Le fig. 1-3 riportano alcune prestazioni di un distributed ledger in cui alcuni nodi sono maliziosi. Il punto interessante è la forte correlazione delle prestazioni con la frequenza di transazioni maliziose, indipendentemente dal numero di nodi maliziosi.
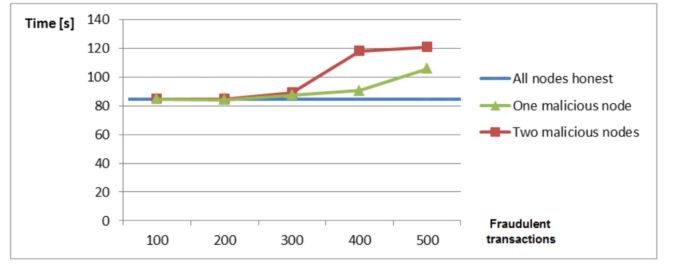
 Fig. 1: Degradazioni delle Prestazioni con un Nodo Malizioso, quorum al 60%
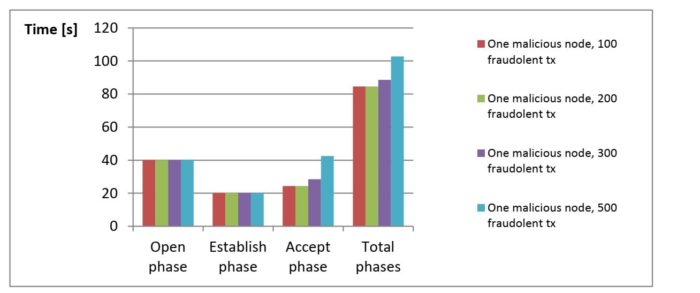
Fig. 2: Degradazione delle Prestazioni con un Nodo Malizioso, quorum all’ 80%
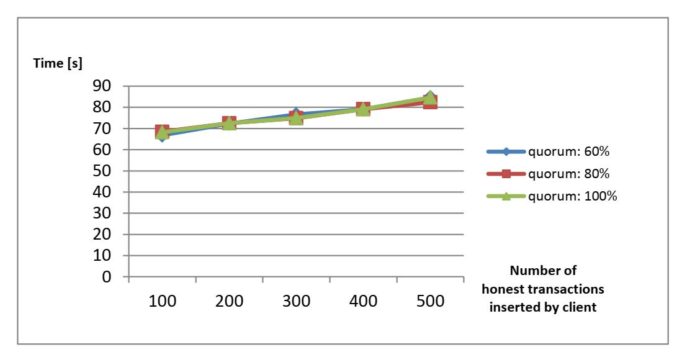
Fig. 3: Degradazione delle Prestazioni per valori diversi del quorum

Note

[1] D J. Bodeau, D. Graubart, J. Picciotto, R. McQuaid, Cyber Resiliency Engineering Framework, Technical rep. R110237, Sept. 2011, MITRE Corporation.

[2] B. Donnet and T. Friedman, Internet topology discovery: a survey, IEEE Communications Surveys & Tutorials, vol. 9, no. 4, Fourth Quarter 2007, pp. 56-69.

[3] NIAC, A Framework for Establishing Critical Infrastructure Resilience Goals: Final Report and Recommendations by the Council, NIAC, October 19, 2010.

[4] NIAC, A Framework for Establishing Critical Infrastructure Resilience Goals: Final Report and Recommendations by the Council, NIAC, October 19, 2010.

[5] Gov. Office for Science, Uk, Distributed Ledger Technology: beyond block chain: A report by the UK Government Chief Scientific Adviser, 2016.

[6] K. Wüst and A. Gervais, Do you Need a Blockchain?, 2018 Crypto Valley Conference on Blockchain Technology (CVCBT), Zug, 2018, pp. 45-54. doi: 10.1109/CVCBT.2018.00011

[7] Z. Zheng, et al. Blockchain challenges and opportunities: A survey, International Journal of Web and Grid Services 14.4 (2018): 352-375.

[8] M. J. Fischer, N. A. Lynch and M.S. Paterson, Impossibility of Distributed Consensus with One Faulty Process, J. ACM, vol. 32, 1985, pp. 374-382.

[9] Y. Gilad, R. Hemo, S. Micali, G. Vlachos and N. Zeldovich, Algorand: Scaling Byzantine Agreements for Cryptocurrencies, IACR Cryptology ePrint Archive, 2017.

[10] S. Joao, A. Bessani, and M. Vukolic, A byzantine fault-tolerant ordering service for the hyperledger fabric blockchain Platform, 2018 48th Annual IEEE/IFIP International Conference on Dependable Systems and Networks (DSN). IEEE, 2018.

[11] D J. Bodeau, D. Graubart, J. Picciotto, R. McQuaid, Cyber Resiliency Engineering Framework, Technical rep. R110237, Sept. 2011, MITRE Corporation.

[12] S. Nakamoto, Bitcoin: a Peer-to-Peer Electronic Cash System, 2008.

[13] S. Joao, A. Bessani and M. Vukolic, A byzantine fault-tolerant ordering service for the hyperledger fabric blockchain platform, 2018 48th Annual IEEE/IFIP International Conference on Dependable Systems and Networks (DSN). IEEE, 2018.

[14] Gov. Office for Science, Uk, Distributed Ledger Technology: beyond block chain: A report by the UK Government Chief Scientific Adviser, 2016.

[15] K. Wüst and A. Gervais, Do you Need a Blockchain?, 2018 Crypto Valley Conference on Blockchain Technology (CVCBT), Zug, 2018, pp. 45-54. doi: 10.1109/CVCBT.2018.00011.

[16] Z. Zheng, et al. Blockchain challenges and opportunities: A survey, International Journal of Web and Grid Services 14.4 (2018): 352-375.

[17] Gov. Office for Science, Uk, Distributed Ledger Technology: beyond block chain: A report by the UK Government Chief Scientific Adviser, 2016.

[18] S. Joao, A. Bessani, and M. Vukolic. “A byzantine fault-tolerant ordering service for the hyperledger fabric blockchain platform”, 2018 48th Annual IEEE/IFIP International Conference on Dependable Systems and Networks (DSN). IEEE, 2018.

[19] S. Joao, A. Bessani, and M. Vukolic, A byzantine fault-tolerant ordering service for the hyperledger fabric blockchain platform, 2018 48th Annual IEEE/IFIP International Conference on Dependable Systems and Networks (DSN). IEEE, 2018.

[20] K. Wüst and A. Gervais, Do you Need a Blockchain?, 2018 Crypto Valley Conference on Blockchain Technology (CVCBT), Zug, 2018, pp. 45-54. doi: 10.1109/CVCBT.2018.00011.

[21] B. Chase and E. MacBrough, Analysis of the XRP Ledger Consensus Protocol, 2018.

[22] Y. Gilad, R. Hemo, S. Micali, G. Vlachos and N. Zeldovich, Algorand: Scaling Byzantine Agreements for Cryptocurrencies, IACR Cryptology ePrint Archive, 2017.

[23] NIAC, A Framework for Establishing Critical Infrastructure Resilience Goals: Final Report and Recommendations by the Council, NIAC, October 19, 2010.

[24] A. Wang, M. Iyer, R. Dutta, G.N. Rouskas, G. N., and I. Baldine, Network virtualization: Technologies, perspectives, and frontiers, Journal of Lightwave Technology, 31(4), 2013, 523-537.

Articolo a cura di Fabrizio Baiardi e Francesco Balzano, Università di Pisa

Laureato in Scienze dell’Informazione all’Università di Pisa.

E’ attualmente è professore ordinario di Informatica presso l’Università di Pisa dove coordina il gruppo di ricerca sy ICT risk assessment and management. La sua attività di ricerca è focalizzata su strumenti e metodi formali l’automazione dell’analisi e la gestione del rischio.

Ha partecipato a numerosi assessment di sistemi ICT con particolare interesse per quelli con componenti SCADA.

Attualmente è responsabile scientifico del progetto Haruspex che ha prodotto una suite integrata di strumenti per analisi e gestione del rischio.

Una lista aggiornata delle pubblicazioni scientifiche sul progetto Haruspex e dei premi ricevuti si può trovare alla pagina http://www.di.unipi.it/~tonelli/securityteam/publications.php

F. Baiardi è stato presidente della laurea in Informatica Applicata e della laurea magistrale in Sicurezza Informatica dell’Università di Pisa.

E’ stato coinvolto in vari progetti nazionali ed europei sulla valutazione della qualità dei corsi di studio e di formazione superiore. Inoltre è valutatore di progetti di innovazione tecnologica per enti pubblici e fondazioni private nazionali ed europei.

Download PDF

https://www.ictsecuritymagazine.com/articoli/distributed-ledger-una-tecnologia-abilitante-per-la-resilienza-ict/
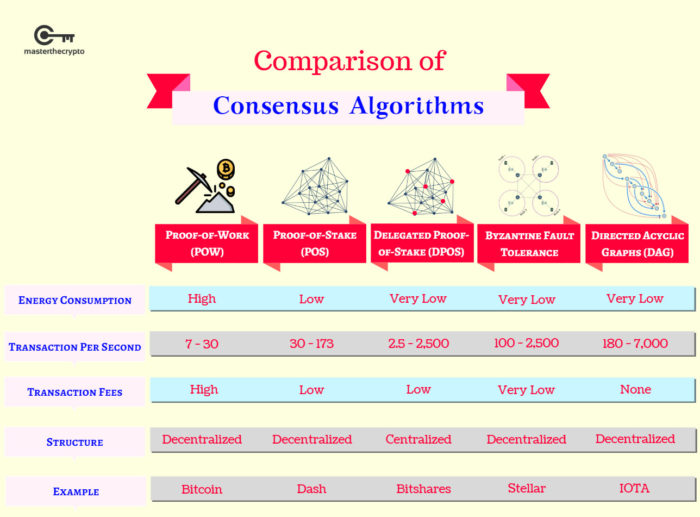

PhotoMiner – FTP e SMB ancora a rischio

Durante una ricerca su Shodan, mi sono imbattuto in alcuni file eseguibili con estensione *.exe e  *.scr, presenti in delle directory FTP senza autenticazione (o con account Guest).

I file erano presenti non solo nella root, ma anche in tutte le sottocartelle contenenti immagini e video.

Analizzandoli su Virustotal e su altre sandbox, ho notato subito che erano conosciuti già da diverso tempo.

Ho voluto vederci chiaro anche perché, da un’analisi più approfondita, ho notato che erano presenti su altri FTP pubblici con la stessa persistenza e metodologia.

Da una veloce ricerca su Google con gli MD5, sono risalito a un articolo di un paio di anni fa, dove era presente un’analisi su un nuovo malware adibito a minare criptovaluta infettando NAS e server FTP denominato “PhotoMiner[1]”.

Fig.1 – Esempio di directory FTP compromessa dal malware.

I file analizzati sono:

https://www.virustotal.com/#/file/807126cbae47c03c99590d081b82d5761e0b9c57a92736fc8516cf41bc564a7d/detection

https://www.hybrid-analysis.com/sample/807126cbae47c03c99590d081b82d5761e0b9c57a92736fc8516cf41bc564a7d?environmentId=120

https://www.joesandbox.com/analysis/94216/0/html

  • IMG001.scr

https://www.virustotal.com/#/file/d9901b16a93aad709947524379d572a7a7bf8e2741e27a1112c95977d4a6ea8c/detection

https://www.joesandbox.com/index.php/analysis/50558/0/html

  • Info.zip (IMG001.exe \ information.vbe)

– IMG001.exe

https://www.virustotal.com/#/file/52389828c44846fa863a6b308fad05315c13176e94c989511c2629fef0847d51/detection

– Information.vbe

https://www.virustotal.com/#/file/30daba44a4a25ff5750508613f897057a55337458f19b562e2ed1172c77e626b/detection

Fig.2 – File contenuti nell’archivio denominato Info.zip\info2.zip (a seconda della variante).
A questo punto la situazione è stata molto più chiara, dato che ho potuto intuire che il meccanismo di propagazione dei malware sfrutta proprio l’assenza di autenticazione su NAS e server FTP, permettendo al worm di propagarsi e replicarsi senza ostacoli.

La situazione al febbraio 2019 appare abbastanza complessa dato che, negli ultimi 3 anni, la botnet ha continuato a estendersi.

Effettuando una rapida ricerca con Shodan, possiamo vedere che i server FTP senza autenticazione sono circa 304.000; affinando la ricerca, in Italia, ne abbiamo circa 5.000.

 Query per i servizi FTP:

“230 user logged in”

 Fig.3 – Servizi FTP senza autenticazione nel mondo

Servizi FTP in Italia
“230 user logged in” country:”IT”

Fig.4 – Servizi FTP senza autenticazione in Italia

La situazione per il protocollo SMB è ancora più disastrosa: nel mondo abbiamo circa 545.000 servizi esposti e circa 35.000 nel territorio italiano.

Query per i servizi SMB:

SMB “Authentication: disabled”

Fig.5 – Servizi SMB senza autenticazione nel mondo
Servizi SMB in Italia:

SMB “Authentication: disabled” country:”IT”

Fig.6 – Servizi SMB senza autenticazione nel territorio italiano

Ho ripercorso l’evoluzione del malware per capire se la minaccia è ancora attiva o se è circoscritta a pochi server.

La sua prima comparsa ha destato molta curiosità, sia per la tipologia di diffusione – che non si avvaleva di nessun exploit specifico – sia perché offriva un meccanismo di infezione unico per propagarsi su NAS (con protocolli SMB e FTP) e su server FTP, allo scopo di estrarre Monero.

DESCRIZIONE DELL’ATTACCO

Fig.7 – Schema d’attacco di PhotoMiner [2]
La prima variante, che includeva il core e le abilità di propagazione di base, è stata compilata il 9 dicembre 2015.

La seconda variante, rilasciata il 3 febbraio 2016, è rapidamente diventata la versione dominante ed è tuttora la più diffusa.

In questo lasso di tempo PhotoMiner ha aggiunto nuove funzionalità, tra cui un esclusivo meccanismo di infezione multistadio.

Sono stati in primo luogo compromessi i server FTP senza autenticazione o con autenticazione di default.

Esempi di autenticazione di default:

Usernames: anonymous, www-data, administrator, ftp, user, user123

Passwords: password, pass1234, 123456, 1234567, 12345678, 123456789, 1234567890, qwerty, 000000, 111111, 123123, abc123, admin123, derok010101, windows, 123qwe, 000000

Con essi anche i siti Web ospitati sono diventati vettori di infezione e di conseguenza, a causa della tipologia di minaccia, anche gli stessi visitatori infettati sono divenuti vettore d’infezione.

PhotoMiner utilizza principalmente due tipi di attacco.

Il primo prevede la scansione di IP casuali, allo scopo di accedere ai servizi con attacchi a dizionario utente/password, in modo da caricare una copia di se stesso sul server, compromettendo tutti quei file che possono essere sfruttati ai danni di un utente (come HTML, PHP, XML ecc…).

Con l’utilizzo di un Google Dork creato ad hoc, ho potuto constatare come molte pagine web abbiano inserito nel codice sorgente un “iframe” che provvede a generare in automatico il download del malware al caricamento delle stesse.

Ricerca per singolo file:

intitle:’index of’ “photo.scr”

intitle:’index of’ “IMG001.scr”

intitle:’index of’ ” IMG001.exe ”

Ricerca globale:

intitle:’index of’ photo.scr | IMG001.scr | IMG001.exe

Fig.8 – Sorgente della Homepage con l’iframe al suo interno
Successivamente al download e al click sul file eseguibile, il nuovo processo creato provvederà a inviare alla struttura di C&C, l’IP del server, le sue credenziali e l’elenco dei file infetti.
Con queste informazioni gli aggressori possono in seguito accedere ai server FTP compromessi in modo da infettare più file e vittime possibili.

Il secondo metodo si basa sull’attacco di endpoint e server Windows raggiungibili nella rete locale.

PhotoMiner utilizza strumenti di sistema integrati in Windows, tentando di forzare la connessione sul protocollo SMB e  rilasciando copie di se stesso in ogni posizione accessibile.

Alcune varianti aprono di nascosto un punto di accesso Wi-Fi pubblico con SSID “Free_WIFI_abc12345“.

Da analisi approfondite, si evince come il malware sia progettato in modo modulare, creando un eseguibile standalone focalizzato sull’estrazione di Monero e un wrapper complesso che è responsabile del meccanismo di persistenza.

  • La prima variante img001.scr è unica nel suo uso di NSIS (Nullsoft Scriptable Install System), un linguaggio di scripting personalizzato costruito per gli installatori. NSIS è perfetto per la scrittura di semplici programmi di installazione, incluso malware. Il codice è facile da leggere ed eseguire il debug, consentendo agli aggressori di aggiungere funzionalità facilmente.
  • La seconda variante photo.scr è un binario nativo che implementa la funzionalità img001.scr nel codice nativo.

All’esecuzione viene creata la cartella NsMiner in %AppData%, con all’interno i seguenti file e cartelle:

– Un file di testo chiamato pools.txt che contiene un elenco con URL e le porte dei pool di mining Bitcoin;

– Un’altra copia del sample originale chiamato IMG001.exe;

– Una versione a 32 bit di un bitcoin miner chiamato NsCpuCNMiner32.exe;

– Una versione a 64 bit di un bitcoin miner chiamato NsCpuCNMiner64.exe.

Fig.9 – Posizione della cartella “NsMiner” con i file contenuti al suo interno
Il file pool.txt contiene il pool dei domini per il mining dei Monero.

Fig.10 – File pool.txt con domini e porte di comunicazione
Il malware utilizza l’algoritmo CryptoNight per estrarre i bitcoin, come si evidenzia con l’analisi effettuata con il tool Binary Ninja.

Fig.11 – Il malware utilizza l’algoritmo CryptoNight per estrarre i bitcoin
Durante la fase di inizializzazione, PhotoMiner crea il meccanismo di persistenza ed esegue la raccolta dei dati di configurazione per il miner.

Per installare dunque un meccanismo di persistenza, lo si posiziona nell’avvio automatico di Windows, modificando anche le seguenti chiavi di registro:

HKCU\SOFTWARE\Microsoft\Windows\CurrentVersion\Run

%ALLUSERSPROFILE%\Microsoft\Windows\Start Menu\Programs\Startup\

%HOMEPATH%\AppData\Roaming\Microsoft\Windows\Start Menu\Programs\Startup\

Fig.12 – Collegamento creato in C:\Users\\AppData\Roaming\Microsoft\Windows\Start Menu\Programs\Startup
Tutti i dati di configurazione raccolti durante l’attività vengono inviati verso diversi domini predefiniti su protocollo HTTP.

PhotoMiner si connette ai server C&C esclusivamente per comunicare i propri progressi senza includere nessuna funzionalità di accesso remoto.

In conclusione è possibile affermare che tutt’ora la botnet è viva e vegeta.

I file trovati nelle directory risultano aggiornati a 2\3 giorni prima della stesura di quest’articolo.

Buona parte dell’infrastruttura (contenuta nel file pool.txt) risulta ancora attiva e da analisi su Virustotal continua a ricevere traffico relativo a nuove infezioni.

Qualora fossero stati rispettati i requisiti minimi di sicurezza dei servizi FTP e SMB, la botnet non avrebbe avuto modo di svilupparsi a macchia d’olio, poiché ha sfruttato la debolezza delle password di default e la mancanza di autenticazione.

Note

[1] https://kc.mcafee.com/resources/sites/MCAFEE/content/live/PRODUCT_DOCUMENTATION/27000/PD27402/en_US/McAfee_Labs_Threat_Advisory-Photominer.pdf

[2] https://www.guardicore.com/wp-content/uploads/2016/06/drawing-e1465891322649.png

Articolo a cura di Sergio Caruso

Download PDF

https://www.ictsecuritymagazine.com/articoli/photominer-ftp-e-smb-ancora-a-rischio/


Telecamere e sicurezza: connubio possibile?

Il tema della videosorveglianza è sicuramente caro al cittadino del terzo millennio. Il crescente utilizzo della rete internet nell’ambito delle telecomunicazioni, la diffusione della banda larga e i sempre più contenuti costi di implementazione hanno permesso l’affermazione delle telecamere IP, ormai onnipresenti nella vita e nelle abitazioni di ciascuno di noi.

La comodità di questi apparecchi è indiscutibile: con una semplice interrogazione al web server interno è possibile accedere in remoto all’apparecchio, visualizzare dal vivo le immagini e memorizzarle su dispositivi di archiviazione o piattaforme cloud spesso integrate.

Nel nostro Paese si contano all’incirca 2 milioni di telecamere, una ogni 35 abitanti. In Europa è la Gran Bretagna a guidare la classifica con 4 milioni, un apparecchio ogni 14 abitanti.

Cifre sicuramente importanti e che offrono spunti di riflessione circa la concezione della privacy dell’odierna civiltà tecnologica. Eppure non reggono il confronto con la Cina, che entro la fine del 2020 conterà ben 626 milioni di telecamere – una ogni due abitanti – a completamento di una manovra orwelliana e distopica di social rating e controllo delle masse, in cui chi attraversa fuori dalle strisce pedonali, oppure non rispetta la fila, vede comparire il proprio volto sui tanti schermi presenti in città, quasi fosse un ricercato in fuga.

I più curiosi – e coloro che si occupano di sicurezza informatica – si saranno sicuramente trovati a riflettere, volgendo lo sguardo verso l’ennesima telecamera, riguardo l’effettiva sicurezza e discrezione che l’onnisciente apparecchio è in grado di garantire.

Per rendercene conto e avere un quadro più ampio della situazione, dobbiamo presentare Shodan, il motore di ricerca del mondo dell’internet delle cose. Inizialmente sviluppato da John Matherly per finalità di monitoring di prodotti tecnologici al fine di migliorare le strategie di marketing, è in grado di indicizzare i dispositivi connessi a Internet e, con opportune query, filtrare i risultati a seconda della versione del software installato (con relative indicazioni di potenziali vulnerabilità e bollettini CVE), del protocollo che si desidera interrogare, della presenza di credenziali di default o della completa assenza di autenticazione.

Previa registrazione al portale è possibile, seppur con diverse limitazioni circa il numero di risultati visualizzabili, restringere la ricerca per territorio, ottenere informazioni su porte e servizi aperti, versioni di sistemi operativi e così via.

Come è facile intuire, su Shodan troviamo anche un numero enorme di telecamere mal configurate ed esposte incautamente ad internet. Per i nostri scopi, ecco alcune semplici query che è possibile formulare alla ricerca dei più diffusi software per videosorveglianza:

Server: SQ-WEBCAM country:IT
webcamxp country:IT

Come si può vedere, la facilità con cui si accede alle pagine di login delle telecamere è sbalorditiva. In diversi casi l’accesso avviene direttamente al pannello delle impostazioni della telecamera, dunque il web server non è protetto da credenziali.

È bene puntualizzare che l’accesso a queste risorse, nonostante la totale assenza di procedure di autenticazione, può rappresentare comunque una violazione del Codice Penale:

Art. 614 (Violazione di domicilio), art. 615-bis (Interferenze illecite nella vita privata), art. 615-ter (Accesso abusivo ad un sistema informatico o telematico), art. 615-quater (Detenzione e diffusione abusiva di codici di accesso a sistemi informatici o telematici) art. 617-quater (Intercettazione, impedimento o interruzione illecita di comunicazioni informatiche o telematiche), art. 635-bis (Danneggiamento di informazioni, dati e programmi informatici), art. 635-ter (Danneggiamento di informazioni, dati e programmi informatici utilizzati dallo Stato o da altro ente pubblico o comunque di pubblica utilità), art. 635-quater (Danneggiamento di sistemi informatici o telematici),  art. 635-quinquies (Danneggiamento di sistemi informatici o telematici di pubblica utilità).

Dopo aver visto come cercare un dispositivo vulnerabile attraverso internet, sorge spontaneo chiedersi se sia possibile, per l’utente malintenzionato, individuare una telecamera di un dato luogo correttamente configurata ed eventualmente attaccarla al fine di ottenere un accesso abusivo. La risposta a questa domanda è sì, si può tentare.

Vestiamo dunque, per un attimo, i panni di un potenziale attaccante e prepariamo il terreno per definire il campo di azione.

Come prima cosa individuiamo la localizzazione del nostro indirizzo IP: un semplice myip digitato in un browser potrà illuminarci sulla nostra posizione. Dal momento che è ragionevole presumere – seppur entro certi limiti – che lo stesso ISP acquisti un blocco di indirizzi IP da assegnare ad una determinata zona geografica, possiamo tentare di individuare l’indirizzo IP pubblico delle telecamere che presentano un IP contiguo al nostro e che dovrebbero trovarsi, dunque, vicine alla nostra posizione. È bene sapere che la ricerca potrebbe non essere accurata, non potendo conoscere le policy interne con cui ciascun provider internet acquista e assegna gli indirizzi, ma è sicuramente un buon punto di partenza.

Procuriamoci poi una distribuzione Linux dedicata al pentesting e installiamo AngryIP, uno scanner di rete leggero e multipiattaforma, e impostiamo i parametri Ports e Web detect per avere più probabilità di successo (la visibilità degli indirizzi MAC e relativi vendor è opzionale). Specifichiamo poi le well-known ports più utilizzate in ascolto sul web server della telecamera. Naturalmente, se l’amministratore ha saggiamente impostato una porta non comune, il device non rientrerà nella nostra scansione:


Stabiliamo a questo punto un range di indirizzi IP e avviamo la rilevazione. Per un primo test, suggerisco di impostare a /24 oppure a /20 la dimensione della sottorete IP, per arrivare a /16 nel caso non si trovassero device on-line; proseguire oltre risulterebbe poco pratico e allungherebbe significativamente i tempi di attesa. Ad ogni modo, è buona norma avvalersi di un calcolatore di indirizzi IP per meglio definire il numero di host che è possibile passare al vaglio. Per le distribuzioni debian-based, è possibile installarlo rapidamente con il comando:

sudo apt install ipcalc.

Per gli host trovati attivi, il programma consente poi di effettuare rapide ricerche whois oppure di aprire rapidamente con un browser la pagina web dell’interfaccia di login:

La classica combinazione admin/admin è d’obbligo per tentare un primo accesso: vale poi sicuramente la pena rintracciare su internet una lista di credenziali di default per marca/modello da provare rapidamente.

Qualora non avessimo successo, dovremo ricorrere a Hydra, strumento sviluppato da The Hacker Choice dedicato al cracking on-line utilizzabile su svariati protocolli.

Aiutandoci con un proxy interceptor (la scelta, in questo caso, ricade sempre su Burp Suite), identifichiamo il metodo HTTP impiegato dal server della telecamera e specifichiamolo come parametro per Hydra:

Infine, costruiamo il comando per lanciare un attacco di tipo dizionario al web form di accesso della telecamera:

hydra -s http-get 80 -l ​admin -P ​WORDLIST -e nsr -t 20 ​IPPUBBLICOCAMERA

dove:

-s rappresenta il numero di porta e il metodo usato;

-l è l’username da testare (in questo caso admin, ma possiamo indicare un file di username con lo switch -L);

-P è la lista di password da testare;

-e indica di provare password nulle, di usare l’username e il suo inverso come password;

-t rappresenta il numero di thread in parallelo.

CONCLUSIONI

L’installazione di una IP cam è, oggigiorno, un’operazione semplice e alla portata di tutti. Bisogna però tenere presente che – come per qualsiasi altro server esposto ad internet – vanno adottate tutte le cautele per minimizzare le probabilità di successo di un attacco.

Prescindendo da vulnerabilità di cui potrebbe soffrire la piattaforma cloud cui la telecamera potrebbe appoggiarsi per la trasmissione delle immagini, è buona norma assicurarsi di aver impostato una combinazione username/password robusta, da cambiare periodicamente, e una porta di accesso alta per evitare facili scansioni. Nel caso ci si appoggi a servizi DDNS, indicare anche qui nomi complessi e di difficile individuazione. In gioco c’è la nostra privacy e in questi casi essere paranoici paga, eccome. Dopotutto, “la paranoia è solo un calcolo più attivo delle probabilità” (Richard Krause).

BIBLIOGRAFIA

https://www.repubblica.it/esteri/2017/12/29/news/cina_il_grande_fratello_che_controlla_un_miliardo_e_mezzo_di_cittadini-185424301/.

https://www.ilsole24ore.com/art/tecnologie/2018-04-10/cina-quando-sorveglianza-e-globale-sotto-controllo-13-miliardi-persone-084939.shtml?uuid=AEuUQXVE&refresh_ce=1.

Articolo a cura di Milo Caranti

Download PDF

https://www.ictsecuritymagazine.com/articoli/telecamere-e-sicurezza-connubio-possibile/


Il ruolo della pseudonimizzazione nel GDPR

La pseudonimizzazione: questa sconosciuta

Pseudonimizzazione significa, rifacendosi all’etimologia letterale dal greco, assegnare un nome falso a qualcosa. Questa semplice ricostruzione comprende tutta la forza che l’utilizzo di uno pseudonimo può avere nella protezione dei dati personali; d’altra parte, l’utilizzo di uno pseudonimo è una pratica applicata comunemente nella nostra interazione con il web: il nick name è un esempio classico che dovrebbe servire, falsificando la nostra identità, a proteggerci ma che, spesso, è solo un nome di battaglia visto che, nei nostri post, riveliamo molto di più della nostra identità attraverso foto, filmati e così via.

Lo pseudonimo veniva (e viene) usato molto dagli autori e dai giornalisti anche se raramente serviva a proteggerne l’identità. L’ultimo esempio è quello di Elena Ferrante che, a quanto sembra, è lo pseudonimo utilizzato da un misterioso autore di romanzi che qualcuno arriva ad ipotizzare di sesso maschile.

Questo è un tipo di pseudonimo analizzato da uno degli ultimi documenti prodotti dall’European Network and Information Security Agency (ENISA)[i], denominato “Recommendations on shaping technology according to GDPR provisions – An overview on data pseudonymisation”[ii]. Il documento dedica, infatti, un paragrafo ai cosiddetti self‑chosen pseudonyms, concludendo che non possono essere impiegati da titolare o responsabile del trattamento per tutelare i dati personali degli interessati.

A parte questo doveroso inciso, che sgombra il campo da uno dei tanti equivoci che si sono creati da quando è in vigore il Regolamento UE 679/2016 (d’ora in poi GDPR), il documento è una raccolta di elementi utili a comprendere la portata della pseudonimizzazione nella protezione dei dati personali. Come si sa, infatti, la pseudonimizzazione non era presente nel vecchio D.Lgs. 196/2003 (Codice in materia di protezione dei dati personali), nel cui Allegato B – Disciplinare tecnico in materia di misure minime di sicurezza (abrogato dal D.Lgs. 101/2018) si parlava di cifratura dei dati che, come vedremo, è una pratica differente.

La pseudonimizzazione è, quindi, una misura di sicurezza introdotta ufficialmente dal GDPR, che la definisce come:

“Il trattamento dei dati personali in modo tale che i dati personali non possano più essere attribuiti a un interessato specifico senza l’utilizzo di informazioni aggiuntive, a condizione che tali informazioni aggiuntive siano conservate separatamente e soggette a misure tecniche e organizzative intese a garantire che tali dati personali non siano attribuiti a una persona fisica identificata o identificabile”

e che lo stesso GDPR include  tra le misure della privacy by design, inserendole al primo paragrafo dell’art. 25:

“Tenendo conto dello stato dell’arte e dei costi di attuazione, nonché della natura, dell’ambito di applicazione, del contesto e delle finalità del trattamento, come anche dei rischi aventi probabilità e gravità diverse per i diritti e le libertà delle persone fisiche costituiti dal trattamento, sia al momento di determinare i mezzi del trattamento sia all’atto del trattamento stesso il titolare del trattamento mette in atto misure tecniche e organizzative adeguate, quali la pseudonimizzazione, volte ad attuare in modo efficace i principi di protezione dei dati, quali la minimizzazione, e a integrare nel trattamento le necessarie garanzie al fine di soddisfare i requisiti del presente regolamento e tutelare i diritti degli interessati”.

Appare, dunque, utile riprendere i consigli che l’ENISA ha fornito, cercando di osservarli nella prospettiva di una loro applicazione pratica all’interno delle realtà organizzative.

Pseudonimizzazione, anonimizzazione, crittografazione

Pseudonimizzazione, quindi, vuol dire sostituire i dati identificativi veri con dati identificativi falsi in maniera che:

  • i terzi non possano associare i dati personali ad una persona fisica (interessato);
  • il titolare o il responsabile del trattamento possano effettuare la riassociazione quando questo è necessario.

Queste caratteristiche conducono, quindi, a due corollari essenziali:

  • il processo di pseudonimizzazione produce, a fronte di un dataset di partenza, due oggetti: il primo è un dataset che, per ogni interessato, contiene lo pseudonimo ed i dati personali che lo riguardano (ma che in nessun modo possono identificarlo) mentre il secondo è un dataset che contiene, sempre per ogni interessato, lo pseudonimo e i dati che ne permettono l’identificazione;
  • il secondo dataset deve essere mantenuto separato dal primo, deve essere adeguatamente protetto, deve rimanere nella sola disponibilità del titolare o del responsabile del trattamento e deve essere utilizzato solo quando ciò sia strettamente necessario per le finalità previste.

Per fare un esempio, si supponga di avere un registro scolastico implementato tramite un foglio elettronico e che contiene:

  1. nome e cognome dell’alunno;
  2. luogo e data di nascita dell’alunno;
  3. indirizzo dell’alunno;
  4. nome e cognome del padre;
  5. nome e cognome della madre;
  6. numero di fratelli dell’alunno;
  7. ISEE del nucleo familiare;
  8. sport preferito dall’alunno;
  9. voti dell’ultimo trimestre.

Quali sono i dati del registro da pseudonimizzare? È intuitivo che la risposta dipende dal contesto di riferimento, come confermato anche dal documento ENISA. Certamente i dati del punto 1 sono direttamente identificativi ma possono considerarsi indirettamente identificativi anche i dati dei punti 2, 3, 4 e 5 se, per esempio, il titolare del trattamento fosse una scuola di un paese con 10.000 abitanti: in contesti così ristretti, infatti, conoscere il nome e il cognome della madre potrebbe facilmente consentire di identificare anche l’alunno. Questo vuol dire che il processo di pseudonimizzazione deve spezzare il dataset iniziale in due tronconi, che risulteranno così formati:

dataset1

  1. pseudonimo;
  2. numero di fratelli dell’alunno;
  3. ISEE del nucleo familiare;
  4. sport preferito dall’alunno;
  5. voti dell’ultimo trimestre.

dataset2

  1. pseudonimo;
  2. nome e cognome dell’alunno;
  3. luogo e data di nascita dell’alunno;
  4. indirizzo dell’alunno;
  5. nome e cognome del padre;
  6. nome e cognome della madre.

È ovvio che il dataset2, conformemente al GDPR, costituisce l’informazione aggiuntiva per leggere correttamente il dataset1 e che devono essere “conservate separatamente e soggette a misure tecniche e organizzative intese a garantire che tali dati personali non siano attribuiti a una persona fisica identificata o identificabile”. Ovviamente, le misure tecniche ed organizzative per proteggere le informazioni aggiuntive (cioè il dataset2) non potranno più far ricorso alla pseudonimizzazione ma dovranno essere di natura differente.

Per la verità, sempre con riferimento al contesto e per rendere ancora più difficile la questione (peraltro non affrontata nel documento ENISA), i dati contenuti ai punti 7 ed 8 del registro potrebbero essere dati che identificano indirettamente un soggetto se, statisticamente, risultano ampiamente fuori range (tecnicamente outlier). Infatti, sempre nel caso di una scuola di un paese con 10.000 abitanti, il fatto che un alunno abbia 12 fratelli è un elemento fuori range che lo individua univocamente. Pertanto, risulta opportuno che il processo di pseudonimizzazione sia preceduto da un’analisi statistica accurata (sia per i dati quantitativi sia per quelli qualitativi) affinché siano individuati esattamente i dati che possono identificare gli interessati.

Cosa distingue la pseudonimizzazione dall’anonimizzazione? La possibilità di riassociare i dati personali ad un interessato: in caso di pseudonimizzazione questo è possibile (da parte del titolare o del responsabile facendo ricorso alle informazioni aggiuntive) mentre in caso di anonimizzazione questo non è più possibile. Il documento dell’ENISA specifica che i dati anonimizzati non sono più dati personali e non lo saranno mai più (irreversibilità del processo), purché l’anonimizzazione sia effettuata correttamente. Sempre per tornare all’esempio, se si vuole rendere anonimo il registro di partenza occorrerà cancellare qualsiasi dato personale che possa identificare, direttamente o indirettamente, l’interessato (ovvero i dati contenuti ai punti 1, 2, 3, 4, 5). Il documento ENISA, peraltro, specifica che una buona anonimizzazione, oltre alla cancellazione dei dati che identificano direttamente o indirettamente l’interessato, dovrebbe riportare, per quanto possibile, gli altri dati a range generici. Per tornare al caso dell’esempio, il numero di fratelli dovrebbe essere rappresentato non più da un numero esatto ma da una collocazione all’interno di intervalli: da 0 a 2, da 3 a 5, oltre 5.

Il rapporto tra pseudonimizzazione e crittografazione è, invece, un po’ più difficile da spiegare perché, in alcuni casi, la crittografazione diventa funzionale alla prima fase della pseudonimizzazione (che non abbiamo ancora affrontato) ovvero al calcolo dello pseudonimo. Tuttavia, il documento ENISA riporta la crittografazione al processo che:

  • nasconde tutti i dati personali, sia quelli che consentono l’identificazione sia gli altri;
  • prevede, per natura, il processo inverso, ovvero la decrittografazione;
  • si basa su sofisticati algoritmi matematici che trasformano l’insieme di bit contenente i dati originari in un altro insieme di bit utilizzando una chiave (a sua volta, costituita da un insieme di bit). Si tratta, quindi, di un complesso calcolo matematico che, tuttavia, soffre di una vulnerabilità intrinseca: se un attaccante viene a conoscenza della chiave e conosce il tipo di calcolo applicato (di solito sono algoritmi standard a livello internazionale) riesce ad accedere all’intero dataset crittografato.

Questo vuol dire che è opportuno applicare congiuntamente pseudonimizzazione (prima) e crittografazione (dopo, sulle informazioni aggiuntive).

Tante tecniche, risultati diversi

Una volta chiarito il significato di pseudonimizzazione, occorre soffermarsi sul primo passo per poterlo applicare: il calcolo dello pseudonimo. Il punto di partenza sono i dati da nascondere: questo è l’insieme di bit che deve essere falsificato ovvero trasformato in un altro insieme di bit. Il documento ENISA presenta alcune alternative per questo passaggio:

  • l’hashing semplice: si tratta di applicare all’insieme di bit corrispondente ai dati da nascondere (dati che identificano, direttamente o indirettamente, l’interessato) un algoritmo matematico che lo trasforma in un altro insieme di bit che costituisce lo pseudonimo; l’algoritmo di hashing deve essere irreversibile e non dare risultati identici a partire da insiemi di bit differenti; queste caratteristiche sono rispettate da diversi algoritmi noti a livello mondiale – MD5, SHA‑1, SHA‑2 e SHA‑3 – ma ENISA considera solo questi ultimi due sufficientemente solidi;
  • l’hashing con chiave: si tratta di applicare un algoritmo di hashing che tuttavia tiene conto, nel calcolo, di un’ulteriore variabile scelta da chi effettua la pseudonimizzazione (una chiave numerica);
  • l’hashing salato e pepato; si tratta di applicare un algoritmo di hashing semplice all’insieme di bit  corrispondente ai dati da nascondere che, però, è preventivamente mescolato secondo una certa logica scelta da chi effettua la pseudonimizzazione ed applicata a tutte le istanze da pseudonimizzare (per esempio, scambiare il posto di alcuni bit);
  • la crittografazione come pseudonimizzazione: si tratta di applicare algoritmi di crittografazione all’insieme di dati che identificano l’interessato per generare lo pseudonimo; naturalmente esistono varie tecniche di crittografazione, principalmente suddivise in crittografazione simmetrica (con una sola chiave) e asimmetrica (con chiave pubblica e chiave privata);
  • la tokenizzazione, ovvero l’assegnazione di un numero generato casualmente ad ogni istanza da pseudonimizzare, avendo cura di non riassegnare uno stesso numero già assegnato in precedenza.

Conclusioni

Sebbene la pseudonimizzazione sia uno degli elementi chiave per la protezione dei dati personali, il percorso per un’applicazione concreta e sistematica è lungo e difficile perché richiede un profondo ripensamento degli strati software che accedono ai dati.

Come già accennato, la semantica dei dati non è indifferente rispetto all’impiego di questa tecnica e, peraltro, non è indifferente nemmeno il contesto di riferimento. Questo significa che i produttori di software dovranno fornire apposite funzioni che consentano all’utente di configurare, secondo una valutazione dei rischi conforme al GDPR, i dati ai quali applicare la pseudonimizzazione e le modalità con le quali condurla.

Note

[i]  https://www.enisa.europa.eu/.

[ii] https://www.enisa.europa.eu/publications/recommendations-on-shaping-technology-according-to-gdpr-provisions/at_download/fullReport.

Articolo a cura di Giuseppe Diretto e Francesco Maldera 

Giuseppe Diretto è commercialista, revisore contabile, consulente manageriale, docente area amministrazione finanza e controllo di gestione ed esperto modelli D.Lgs. 231/2001, esperto in formazione finanziata tramite fondi interprofessionali.

Coordina i team di consulenza privacy di ISFORM & Consulting Srl per enti pubblici e privati.

È Presidente Nazionale UNAGRACO – Unione Nazionale Commercialisti e degli Esperti Contabili e Vicepresidente dell’Ordine dei dottori commercialisti e degli Esperti Contabili di Bari.

Francesco Maldera è Data Protection Officer e Data Scientist.

Il suo percorso professionale lo ha chiamato a responsabilità direzionali nell’ambito dei sistemi informativi, della safety&security, della privacy e dell’auditing svolgendo diversi incarichi dirigenziali nella Pubblica Amministrazione e in aziende private.

Attualmente, accompagna l’attività consulenziale a quella di sensibilizzazione delle persone tramite il sito www.prontoprivacy.it

Download PDF

https://www.ictsecuritymagazine.com/articoli/il-ruolo-della-pseudonimizzazione-nel-gdpr/