Honeypot – Barattoli di miele per cracker

Per gli addetti ai lavori di IT, con il termine “HoneyPot” si intende una trappola contro gli attacchi di pirati informatici. Il termine deriva dal personaggio dei cartoni Winnie the Pooh, orso goloso di miele. Nel mondo della sicurezza informatica si usano queste esche per identificare intromissioni abusive. Sono utili per trovare, ad esempio, un cracker entrato in una rete LAN, un NAS o un server web interno. Queste risorse sono un’esca allettante da bucare e usare per attacchi su internet o per spionaggio industriale. Queste trappole simulano un bottino interessante per chi è intento a bucare workstation e permettono al responsabile IT di monitorare, tramite allarmi, il comportamento di botnet e attaccanti, analizzando i log dei movimenti fatti. Le trappole sono finte, quindi non si usano pc potenti o server costosi ma vps e vecchi pc ancora funzionanti, contenenti file fasulli e/o insignificanti.

Con l’arrivo di pc lowcost come raspberry e simili, molti usano questi mini-pc che, avendo un basso impatto energetico, sono sempre più utilizzati dalle aziende. Sostanzialmente una macchina HoneyPot è un server che simula un server reale in una rete che attira l’attaccante a entrare attratto da dati riservati, password, account e informazioni per prendere il controllo dei sistemi informatici o ricattare con malware cryptolocker. In ambienti con sotto-reti e grandi realtà si vedono anche HoneyNet in cui termini come prevention/detection/response, DMZ e intranet sono da controllare tutti i giorni da un apposito addetto security ITC specialist.

L’approccio delle HoneyPot fisiche permette di avere macchine reali e un alto livello di interazione, mentre per le esche virtuali – quindi simulando i PC – si può rispondere al traffico verso la trappola e simulare differenti tipologie di HoneyPot. L’amministratore di sistema punta a ottenere dall’esca informazioni su come limitare i rischi dell’organizzazione e ricercare come le attuali botnet scansionano gli IP esposti a internet e agiscono verso di essi.

Esistono appositi servizi offerti da Symantec, kfsensor, honeynets, honeytrap, honeystick, nebula, nepenthes, pehunter, phoneyC e altri vendor che mettono a disposizione software a pagamento o free e, spesso, opensource per questo genere di attività, catturando pacchetti sospetti verso l’esca. Questa attività di monitoraggio ha il vantaggio di richiedere poche risorse, aiuta a controllare i falsi positivi ed è utilizzabile con IPv6.

HoneyWall è un progetto simile, basato su linux, per questo genere di attività, con tool per catturare e analizzare il traffico di rete abilitando ALL nelle regole di traffico verso la HoneyNet. La restrizione del traffico in uscita, strategia orientata ad evitare il rischio di attacco di ulteriori sistemi a partire da un honeypot compromesso, può essere facilmente rilevata attivando un elevato numero di connessioni in uscita e osservando la presenza di una qualche limitazione.

Un progetto molto dinamico, completo e facile da usare è OpenCanary, disponibile su github con utility da configurare per gli alert tramite email e il monitoraggio di vulnerabilità e metodi di attacco. Una risorsa dove trovare link a progetti simili più specifici in settori di esca informatica è presso il sito Honeynet Project (honeynet.org). Il sito è una fonte realizzata da studenti appassionati di sicurezza informatica dove trovare lezioni e info riguardanti honypot/honeynet. Ci sono due livelli di interazione: uno basso, in cui l’esca potrebbe essere scoperta da un attaccante esperto poiché non viene usato un server reale; e un livello alto, in cui c’è il pieno accesso al sistema operativo, una macchina creata per apparire simile alle altre nella rete. Ma questa scelta comporta un maggior rischio di sicurezza e necessita di un constante supervisione, risultando un lavoro complesso e dispendioso.

Un’alta interazione cattura più informazioni – compresi nuovi tool e nuovi tipi di attacco – e pregiudica l’approccio del tecnico, che deve avere skill anche in ambito forensics. Pacchetto disponibile per Debian è Kippo, che emula un servizio ssh protetto da password debole, raccogliendo informazioni sugli attacchi a forza bruta e a dizionario, loggando ogni input dell’attaccante.

Uno strumento spesso usato insieme ad una honeypot/honeynet è Snort, famoso IDS/IPS per proteggere e monitorare, tramite regole assegnate dalla comunità snort, traffico di rete e richieste IP. Snort è rilasciato sotto GNU license – quindi liberamente utilizzabile – e multipiattaforma usando librerie libpcap per analizzare protocolli e controllare i contenuti dei pacchetti. Nelle honeynet la presenza di un honeywall è indispensabile per svolgere un’azione di contenimento degli attacchi che possono sfruttare il sistema compromesso come testa di ponte e, allo stesso tempo, per acquisire maggiore informazioni in maniera trasparente.

L’adozione di particolari misure di sicurezza, come si può capire, può rivelarsi un’arma a doppio taglio in grado di facilitare il lavoro di riconoscimento di un sistema-trappola da parte di un cracker preparato. Un aggressore esperto potrebbe intuire la presenza di un honeywall, costruendo dei pacchetti ad hoc contenenti un payload dannoso che sicuramente comporterebbe la loro eliminazione da parte di SnortInline. Inviando pacchetti “maliziosi” verso un sistema target di cui si ha il controllo, è possibile stabilire se tali pacchetti sono stati alterati in qualche modo o scartati. Questo tool, messo in modalità IPS, previene minacce di port scanner, buffer overflow e IP da bannare.

Gli HoneyPot vanno maneggiati con cura, poiché potrebbero diventare il punto di ingresso alla nostra rete: quindi la scelta deve essere oculata e bisogna, innanzitutto, valutare se occorre realmente. Inutile in piccole realtà, maggiormente utile in grandi contesti dove più persone si occupano della sicurezza della rete con pentest regolari e titolari sensibili a tematiche di sicurezza informatica e disaster recovery.

L’utilità di questi sistemi è che si possono rilevare o impedire attacchi verso macchine reali e spesso la sua efficienza dipende da dove viene collocato. L’attaccante, fino a quando non si rende conto di essere in trappola, perderà tempo per impadronirsi del sistema OS. I network admin più attenti attuano le honeypot per proteggere e monitorare maggiormente la rete lan, così da avere un accertamento in tempo reale dell’utilizzo del traffico da internet.

Nello scorso anno è capitato a un cliente che monitorando una honeypot (una vps con debian GNU/linux) e simulando un webserver con account dei dipendenti, l’admin ha notato che l’attaccante provava account con le email aziendali dei dipendenti – segno evidente che già le possedeva – e cercava, quindi, possibili server di posta interni per mandare email manipolate verso clienti esteri. La vicenda si è conclusa tra i vari accorgimenti con il cambio di tutte le password e indirizzi di email interne e la blacklist di IP sospetti.

Altro caso: un’azienda che ha preparato una HoneyNet tramite una rete wifi “fake/esca”, con ID amministrazione e password WPA2. Monitorando i dispositivi a cui si connettevano, si è studiato il loro modo di agire per organizzare misure di controspionaggio industriale.

Le honeypot sono uno strumento ingegnoso per distogliere l’attenzione, in alcuni casi, dal tesoro dell’azienda. La sicurezza informatica non è un prodotto, ma un processo; e solo la ricerca continua, da parte del tecnico sensibile a queste tematiche, può – attraverso tecniche e tool – proteggere le macchine PC e la rete.

Spesso nella piccola e media azienda non c’è questa figura di riferimento, considerando la sicurezza come un optional e non come punto di riferimento e di necessaria attenzione per la produttività. Il nuovo GDPR sta costringendo le attività commerciali ad alzare il livello di sicurezza informatica e ad adottare password più complicate. Il vero problema è l’utente non attento, che adopera la tecnologia prendendo con leggerezza privacy e  sicurezza informatica così lasciando spesso, inconsapevolmente, vettori di attacco a potenziali cracker.

Articolo a cura di Fabio Carletti aka Ryuw

Fabio Carletti aka Ryuw è un White Hat (Hacker) italiano.

Noto ai più per questioni legate alla Sicurezza Informatica ha ottenuto importanti apprezzamenti in attività investigative per conto di Carabinieri e Polizia Postale.

Dal 98 si occupa del mondo gnu/linux come security ITC evangelist.

Ospite di rilevanti eventi italiani riguardanti la privacy, linux/unix, hacker camp e software open source dedica le sue energie alla ricerca nella sicurezza informatica.

Oltre alla security ITC si occupa anche di Digital Forensics come perito di parte.

Download PDF

https://www.ictsecuritymagazine.com/articoli/honeypot-barattoli-di-miele-per-cracker/


Sequestro di sistema informatico e principio di proporzionalità

È illegittimo, per violazione dei principi di proporzionalità ed adeguatezza, il sequestro a fini probatori di un sistema informatico – quale è un personal computer – che conduca, in difetto di specifiche ragioni, ad una indiscriminata apprensione di tutte le informazioni ivi contenute.

Il principio, già affermato nel 2015 (Cass., n. 24617/2015, Rizzo), è stato di recente espresso dalla Corte di Cassazione con sentenza n. 4857 del 14 novembre 2018 – 30 gennaio 2019 (Pres. Fidelbo – Rel. Bassi), in relazione ad un procedimento per il reato di rivelazione ed utilizzazione di segreti d’ufficio ex art. 326 c.p.

Il detto procedimento traeva origine dall’invio al ricorrente, ad opera di ignoti, di una pen-drive contenente atti processuali relativi ad indagini in corso presso la Procura della Repubblica di Vicenza.

Cose sottoposte a sequestro

Giova, innanzitutto, individuare cosa possa essere assoggettato a sequestro probatorio ai sensi dall’art. 253 c.p.p. e cioè “il corpo di reato e le cose pertinenti al reato, necessarie per l’accertamento dei fatti”. Da un lato, dunque, si trovano “le cose sulle quali o mediante le quali il reato è stato commesso, nonché le cose che ne costituiscono il prodotto, il profitto o il prezzo”; dall’altro lato, si rinvengono, invece, le “cose pertinenti al reato”, intese come tutte quelle cose che sono in rapporto sia pur indiretto con la fattispecie criminosa concreta e risultano strumentali all’accertamento dei fatti. Nell’ambito del necessario bilanciamento tra gli interessi in gioco – tutti, a ben guardare, di rilievo costituzionale – l’assoggettamento a vincolo reale di un bene può, infatti, ritenersi ragionevole, equilibrato e, dunque, legittimo e proporzionato, soltanto quando sia sorretto da un’effettiva esigenza di accertamento di un fatto-reato.

La concreta esigenza probatoria perseguita dall’inquirente deve, perciò, necessariamente emergere dalla motivazione del decreto di sequestro probatorio, a pena di nullità.

Principio di proporzionalità

È evidente, inoltre, che le finalità legittimamente perseguite dall’Autorità inquirente debbano fungere anche da metro di valutazione del provvedimento di ablazione con riferimento ai principi di proporzionalità ed adeguatezza, validi tanto per le misure cautelari personali quanto per i sequestri ex art. 253 c.p.p..

Proporzionalità e adeguatezza rispondono, infatti, senz’altro ad un criterio generale di ragionevolezza immanente al sistema processuale e si declinano sia sul perimetro del sequestro, che sul tempo dello stesso. Nel primo senso, infatti, l’art. 258 c.p.p., comma 4 – nel prevedere il sequestro di documenti che fanno “parte di un volume o di un registro” – esclude che possa, di norma, procedersi a sequestri di masse indistinte di documenti senza una specifica ragione. Dall’altro, nel caso in cui un accertamento non possa essere immediato (richiedendo, ad esempio, un’analisi tecnica da parte di esperti informatici o il vaglio di un’ampia mole di dati), la valutazione della proporzionalità non può prescindere dall’apprezzamento del dato temporale.

L’autorità giudiziaria può senz’altro disporre un sequestro dai contenuti molto estesi per esaminare un’ampia massa di dati, ma non può esimersi dall’immediata restituzione delle cose sottoposte a vincolo, non appena sia decorso il tempo ragionevolmente necessario per gli accertamenti.

Ne consegue che, in caso di mancata tempestiva restituzione, l’interessato potrà presentare la relativa istanza e far valere le proprie ragioni, se necessario, anche mediante i rimedi impugnatori offerti dal sistema.

La restituzione della cosa in sequestro

Tanto premesso, la Corte si spinge oltre, prendendo in considerazione il contenuto del sequestro di un sistema informatico. Come già le Sezioni Unite avevano, infatti, chiarito nella sentenza Andreucci (n. 40963 del 20/07/2017, Rv. 270497), estraendo una copia del dato informativo (back-up) si realizza un “clone” in tutto identico all’originale e da esso indistinguibile: al fine di assicurarne conformità ed immodificabilità, tale dato viene, infatti, riversato in una “copia immagine” che ne preserva l’integrità e l’identità alle condizioni in cui si trovava al momento del prelievo, consentendo così successive verifiche o accertamenti tecnici.

In simili fattispecie, l’interesse alla restituzione della cosa non può essere limitato al supporto informatico che all’origine conteneva i dati, ma riguarda necessariamente il dato “in sé” sicché la mera restituzione del primo non può considerarsi come esaustiva restituzione della cosa in sequestro. Questo perché, atteso che il back-up realizza “cloni” identici e indistinguibili dagli originali, la mera restituzione del “contenitore” con l’intero “contenuto” non può ritenersi sufficiente, essendo necessaria – al fine della legittimità dell’ablazione – la protezione del rapporto di disponibilità esclusiva dell’informazione acquisita facente capo all’avente diritto.

In tal caso, infatti, i dati informatici acquisiti mediante l’integrale riproduzione di quelli presenti sulla memoria del computer rimangono sotto sequestro anche se il supporto fisico di memorizzazione sia restituito, con una perdita autonomamente valutabile per il titolare del dato, relativa all’esclusiva disponibilità delle informazioni, alla privacy e al diritto al segreto violati dal provvedimento ablativo.

La sentenza

Alla luce delle motivazioni in questa sede brevemente riportate, la Corte ha ritenuto di annullare l’ordinanza del Tribunale di Vicenza rinviando per un nuovo esame sulla base dei principi di pertinenza e di proporzionalità del materiale oggetto di ablazione e, dunque, anche dei dati informativi estrapolati dai supporti sequestrati. Tale esame dovrà, secondo il provvedimento, valutare anche la distruzione dei “cloni” dei dati che risultassero non pertinenti al thema probandum e, dunque, non utili ai fini dell’accertamento dei fatti, così da scongiurare una lesione/compressione del diritto alla disponibilità esclusiva del patrimonio informativo “sproporzionata” rispetto alle esigenze d’indagini e, dunque, illegittima.

Note

Sulla nozione di cose pertinenti al reato, Cass., Sez. 4, n. 2622 del 17/11/2010, dep. 2011, Rossini, Rv. 249487 e, in termini più generali, Sez. 3, n. 22058 del 22/04/2009, Bortoli, Rv. 243721).

Il testo della Convenzione di Budapest del Consiglio d’Europa del 23 novembre 2001, ratificata dall’Italia con la L. 18 marzo 2008, n. 48 è disponibile sulla Gazzetta Ufficiale n. 80 del 4 aprile 2008, Serie Generale, rinvenibile al sito: http://www.gazzettaufficiale.it/eli/gu/2008/04/04/80/so/79/sg/pdf.

Per una valorizzazione del fattore tempo come parametro di valutazione della correttezza di un sequestro, a norma dell’art. 1 del Protocollo addizionale n. 1 alla Convenzione E.D.U., cfr. Corte E.D.U., 7 giugno 2007, Smirnov c. Russa, n. 71362/01, ma anche Corte E.D.U., 19 giugno 2014, Draghici c. Portogallo, n. 43620/10.

Sul sequestro di interi archivi informatici contenenti dati potenzialmente rilevanti ai fini della prosecuzione delle indagini cfr. Cass., Sez. 6, n. 53168 del 11/11/2016, Amores, Rv. 268489, relativa ai reati di abuso di ufficio e turbativa d’asta, ipotizzati in relazione ad una procedura di affidamento della gestione del servizio idrico integrato.

Articolo a cura di Maria Elena Iafolla

Download PDF

https://www.ictsecuritymagazine.com/articoli/sequestro-di-sistema-informatico-e-principio-di-proporzionalita/


La consulenza privacy ed il rapporto con il cliente

Fiducia… ma quanta fatica

Dopo qualche mese di attività di consulenza in ambito privacy ai tempi del GDPR, abbiamo pensato di fare un primo bilancio, con l’obiettivo di fornire anche spunti di riflessione a molti colleghi che faticano a trovare il bandolo della matassa nel rapporto con il cliente in questo particolare ambito.

Cominciamo a tracciare alcune differenze tra la consulenza in materia di privacy e gli ambiti consulenziali tradizionali:

  • la protezione dei dati non ha scadenze: non prevede, cioè, la trasmissione della dichiarazione dei redditi telematica (consulente tributario), la produzione delle buste paga (consulente del lavoro) o il progetto del nuovo archivio da presentare al Comando Provinciale dei Vigili del Fuoco (ingegnere); la privacy non si identifica con un prodotto finale, è impalpabile e, in buona parte, difficile da rappresentare concretamente;
  • la protezione dei dati personali, eccettuate alcune prassi di riferimento UNI e le linee guida WP29 ed EDPB, non ha standard metodologici assoluti di riferimento, né ci sono, per il momento, albi professionali. Queste caratteristiche inducono spesso le organizzazioni ad affidare il compito della compliance alla normativa sulla privacy alle figure più disparate: per esempio, al capo del personale (nelle organizzazioni che ne hanno uno) oppure a chi presidia la compliance al Dlgs. 231/2001;
  • i dati personali da proteggere sono ovunque e, quindi, in nessun posto specifico; non sono appannaggio esclusivo di una funzione aziendale o di una persona o di un ruolo, perché la loro presenza permea l’organizzazione.

Queste considerazioni incidono notevolmente sull’approccio che il consulente privacy deve avere con il cliente. Ci siamo convinti, infatti, che molto spesso il rapporto, almeno all’inizio, è molto simile a quello con il nonno riottoso che tossisce tutta la notte, ma non vuole farsi curare. La dinamica, infatti, si sviluppa in quattro passaggi delicati (simili a quelli da praticare con il nonno):

  • convincere;
  • analizzare;
  • consigliare;
  • verificare.

Cercheremo di approfondire le difficoltà che bisogna affrontare in ognuna di queste quattro fasi, anche per capire quali possano essere i comportamenti da adottare per evitare contrapposizioni poco proficue.

Convincere

Innanzitutto, il nonno non vuole andare dal medico. Dice che è inutile, minimizza i sintomi e, poi, un suo amico ha tossito per due settimane di seguito e, alla fine, tutto è passato senza alcuna cura. Il cliente ha un comportamento molto simile: qualche conoscente gli ha detto che “questa storia della privacy” è una moda che, ogni tanto, ritorna ma che, in fondo, non ha nessun effetto pratico. E, poi, nella sua azienda non si trattano “dati sensibili” (la tendenza a minimizzare  prima di aver approfondito l’argomento) e, sentendo alcuni colleghi, nessuno si è mosso.

Qualcuno (come farebbe il nonno) arriva persino a tentare l’automedicazione e, con un giro su Internet,  scarica qualche fac‑simile per l’informativa o per la designazione dei soggetti autorizzati al trattamento.

Qualcun altro, invece, decide che è meglio farsi consigliare. Molti consiglieri ammettono, però, che “stanno per affrontare la questione ma non l’hanno ancora fatto” o, qualche volta, si trasformano in consulenti privacy improvvisati e forniscono i format che, a loro volta, hanno trovato su Internet.

Certo, esistono anche imprenditori o dirigenti pubblici più accorti, sensibili al buon andamento della loro organizzazione. Ma, spesso, il budget disponibile è ridotto oppure si fanno eterodirigere da qualche fornitore (tipicamente i fornitori di servizi ICT). Per esempio, in un avviso pubblico per la manifestazione di interesse di una società medio‑piccola a partecipazione pubblica abbiamo potuto leggere, come requisito di capacità economica e finanziaria, che “il concorrente deve aver realizzato un fatturato globale minimo annuo riferito a ciascuno degli ultimi 3 (tre) esercizi finanziari disponibili di Euro 350.000 (IVA esclusa). Il settore di attività è Produzione di software, consulenza informatica e attività connesse – Gestione di strutture informatizzate”. È come se il nonno accettasse di essere curato solo in una clinica Mességué.

Per convincere i clienti che la protezione dei dati è un primario interesse dell’organizzazione e che conviene farsi guidare da professionisti capaci, non basta neanche l’illustrazione degli aspetti sanzionatori. Quindi, nella nostra esperienza, abbiamo fatto leva su due aspetti: la reputazione e la consapevolezza.

La reputazione è importante, tanto per un albergo quanto per un ente pubblico, come un Comune. Abbiamo fatto l’esempio del turista straniero che ha il potere di danneggiare, con qualche tweet, il brand che un albergo o una città si sono faticosamente costruiti nel tempo per il solo fatto di non aver ricevuto un’informativa (per esempio, dall’albergo) o perché gli sono stati richiesti dati non necessari (per esempio, nel corso di un controllo della Polizia Locale).

La consapevolezza arriva con qualche domanda mirata: “Lo sai che il tuo servizio telefonico di customer care chiede il numero di componenti del nucleo familiare? Perché lo chiede?” Oppure: “Lo sai che l’avviso che i vigili urbani del tuo comune lasciano sotto il tergicristallo corrisponde ad un trattamento che non ha basi giuridiche? E che qualche malintenzionato può approfittarne?”

In questo modo, molti “potenziali clienti” hanno messo a fuoco la questione, anche se il percorso per arrivare in fondo, dopo questa fase, è ancora lungo.

Analizzare

Una volta seduti al tavolo delle riunioni con i clienti, la seconda fase prevede che si debba aiutarli ad individuare ed analizzare i processi di trattamento. Il nostro approccio è semplice: di solito partiamo da un documento aziendale che tutti conoscono (o dovrebbero conoscere): la documentazione di riferimento del sistema di gestione della qualità, il “modello 231”, il “Piano triennale per la prevenzione della corruzione e della trasparenza”, ecc. (è meglio non prendere in considerazione il vecchio Documento Programmatico sulla Sicurezza perché troppo datato e, tradizionalmente, sempre mal digerito o addirittura sconosciuto). Partire da uno o più di questi documenti serve a rompere il ghiaccio con lo stato maggiore dell’organizzazione (dirigenti o funzionari responsabili di uffici) sia essa pubblica o privata. Serve a far capire loro che, nonostante l’analisi necessaria alla protezione dei dati personali sia una cosa diversa, abbiamo elementi di partenza che, in passato, loro stessi sono stati capaci di approfondire. Certo, qualcuno rimane stupito quando chiediamo di avere le copie delle planimetrie dei locali dove opera l’organizzazione: ma l’analisi deve essere condotta fino in fondo e, finalmente, si convincono che la tenuta della catena di protezione dei dati personali si può valutare solo misurando la tenuta dell’anello più debole, che può essere anche una stanza poco protetta.

Abbiamo trovato utile muoverci tra identificazione ed analisi dei processi di trattamento dei dati personali con l’impiego di linguaggi visuali standard (tipicamente il Business Process Model and Notation). Si costruisce, insieme allo stato maggiore aziendale, un diagramma di flusso interfunzionale per ogni ipotetico processo arricchendolo, tra le altre, con le seguenti informazioni:

  • soggetti interni coinvolti nel trattamento;
  • soggetti esterni coinvolti nel trattamento (quelli che diventeranno i responsabili ex art. 28 del GDPR e per i quali bisognerà rivedere attentamente le dinamiche contrattuali);
  • basi giuridiche;
  • dati trattati;
  • strumenti utilizzati (sistemi di archiviazione cartacea, sistemi informativi interni, sistemi informativi esterni).

Modellare un diagramma visuale, tra le altre cose, aiuta a capire se il processo di trattamento è uno o più di uno: spesso nella testa di chi opera quotidianamente, si danno per scontate circostanze che, invece, scontate non sono. Per esempio, ci è capitato di analizzare un processo di raccolta di rifiuti “da incontinenza” su richiesta del cittadino. Dal punto di vista pratico la dinamica operativa è identica: il cittadino segnala che ci sono rifiuti da raccogliere e l’operatore ecologico, periodicamente, li preleva. Dal punto di vista dei dati personali, invece, i processi di trattamento sono due, con basi giuridiche completamente differenti visto che per i pannolini si trattava di acquisire e gestire dati personali comuni riferiti ai neonati mentre per i pannoloni gli interessati, aventi diritto al servizio, erano persone con patologie di incontinenza certificate da un medico. Con questa tecnica si arriva a completare, tenendole su binari paralleli, le fasi di identificazione e di analisi dei processi.

In molti casi, l’analisi effettuata concentrandosi sui dati personali ha indotto il cliente (titolare o responsabile del trattamento) ad estendere la rivisitazione dei processi anche oltre le previsioni del GDPR:

  • con un ridisegno e, quindi, solo con qualche aggiustamento;
  • con una reingegnerizzazione e, quindi, con un totale ripensamento di attività e flussi.

Dopo aver consolidato il diagramma, lo studio prosegue con l’analisi del rischio. Anche in questo caso non è semplice interagire con i clienti che, di solito, tendono a minimizzare i rischi; è un atteggiamento normale, dovuto all’istinto di difendere ciò che hanno costruito, spesso faticosamente, in termini di strumentazione, di prassi organizzative, di cultura aziendale. E, quindi, viene alla luce che:

  • lo switch nel corridoio di un ospedale è il frutto dello sforzo di razionalizzazione fatto per aumentare il numero di posti letto;
  • il dipendente che si occupa dei fascicoli del personale è eccellente, ma è troppo impegnato per tenere separati i documenti contenenti dati comuni dai documenti contenenti le particolari categorie di dati personali;
  • la profilazione del sistema informativo prevede solo due livelli (lettura e lettura/modifica sull’intero patrimonio di dati) ma cambiare software significherebbe disorientare i dipendenti.

Inoltre, quando l’analisi va più in profondità, anche utilizzando specifici strumenti per sondare le misure di sicurezza informatiche, si mette in discussione il lavoro, spesso ingrato e faticoso, di chi si occupa di conduzione e sviluppo ICT all’interno dell’organizzazione: si tratta, di solito, di persone che hanno subìto tagli al budget ma che, in qualche maniera, sono riusciti a far funzionare la ditta.

Consigliare

Dall’analisi all’elaborazione del piano d’azione, con la dovuta indicazione degli interventi prioritari, il passo è breve. È buona norma redigere il piano d’azione in stretta collaborazione con i dirigenti dell’organizzazione. Questo ha alcuni vantaggi: si possono modulare meglio gli interventi sia in termini di efficacia sia con riferimento alla reale tempistica necessaria. Ci sono, però, alcuni svantaggi (apparentemente di segno diverso):

  • l’atteggiamento conservatore che il management, per varie ragioni, può assumere;
  • l’occasione, insperata, da parte di qualche dirigente, di aumentare il budget disponibile per il semestre successivo.

Un approccio alternativo può essere quello di elaborare un piano d’azione senza il contributo del management e, successivamente, contrattarne il contenuto con la dirigenza senza, tuttavia, cedere troppo sull’efficacia finale degli interventi e, piuttosto, pianificando approcci graduali che possono costituire un compromesso tra l’as is ed il to be.

Nei nostri piani d’azione non mancano mai i riferimenti alla formazione dei soggetti autorizzati che, in qualche caso, è un insieme più ampio dei dipendenti (vedi, per esempio, i consiglieri comunali nel caso dei Comuni). D’altra parte le statistiche ci dicono che circa il 70% delle violazioni derivano, direttamente o indirettamente, da comportamenti non corretti da parte di chi opera all’interno delle organizzazioni (rispetto ad email di phishing, attacchi di ingegneria sociale, password ripetute, mancato rispetto del clean desk, ecc.)

Verificare

Anche la fase di verifica del rispetto del GDPR e delle policy interne autodefinite crea qualche problema al cliente. Le organizzazioni già certificate rispetto a standard ISO sono abituate a questo approccio e, quindi, risentono poco dei riscontri che occorre fornire periodicamente; le altre, soprattutto quelle medio‑piccole, vivono l’azione di verifica come un intralcio alle “dinamiche di business quotidiane” piuttosto che come un doveroso pit‑stop per capire se ci sono elementi non sufficientemente integrati o ulteriori margini di miglioramento.

Non dimentichiamo, inoltre, il punto H, comma 3, art. 28 del GDPR: le ispezioni presso i responsabili (esterni) del trattamento. Anche questo è un momento difficile, che costringe il titolare a concordare con il fornitore di servizi (per esempio, la ditta che si occupa dell’archiviazione storica della documentazione cartacea) tempi e modalità di verifica. Bisogna far comprendere al fornitore che non è un segnale di mancanza di fiducia, magari consolidatasi in anni di proficua collaborazione, ma un elemento al quale, in passato, non era stata dedicata l’attenzione necessaria e che, per il futuro, può servire a migliorare il lavoro di tutti.

Le verifiche (o gli audit, come è più corretto chiamarli) non chiudono definitivamente il cerchio: spesso lo riaprono per riprendere l’analisi e, se necessario, agire con ulteriori misure tecniche ed organizzative.

Il faticoso ma affascinante lavoro del consulente privacy non finisce mai.

Articolo a cura di Giuseppe Diretto e Francesco Maldera 

Giuseppe Diretto è commercialista, revisore contabile, consulente manageriale, docente area amministrazione finanza e controllo di gestione ed esperto modelli D.Lgs. 231/2001, esperto in formazione finanziata tramite fondi interprofessionali.

Coordina i team di consulenza privacy di ISFORM & Consulting Srl per enti pubblici e privati.

È Presidente Nazionale UNAGRACO – Unione Nazionale Commercialisti e degli Esperti Contabili e Vicepresidente dell’Ordine dei dottori commercialisti e degli Esperti Contabili di Bari.

Francesco Maldera è Data Protection Officer e Data Scientist.

Il suo percorso professionale lo ha chiamato a responsabilità direzionali nell’ambito dei sistemi informativi, della safety&security, della privacy e dell’auditing svolgendo diversi incarichi dirigenziali nella Pubblica Amministrazione e in aziende private.

Attualmente, accompagna l’attività consulenziale a quella di sensibilizzazione delle persone tramite il sito www.prontoprivacy.it

Download PDF

https://www.ictsecuritymagazine.com/articoli/la-consulenza-privacy-ed-il-rapporto-con-il-cliente/


Differenza tra sicurezza IT e OT

A ottobre 2018, Daniel Ehrenreich, esperto di sicurezza della “tecnologia operativa” (OT), ha pubblicato un breve articolo su LinkedIn con l’immagine che accompagna questo articolo.

In sostanza dice che chi si occupa di sicurezza informatica (orientata alla difesa di riservatezza, integrità e disponibilità) non può riutilizzare gli stessi concetti legati alla sicurezza della tecnologia “operativa”.

Il termine OT (Operational technology) è definito, dal sito Gartner, come “l’insieme di hardware e software che rileva o causa cambiamenti attraverso il monitoraggio o il controllo diretto di dispositivi fisici, processi ed eventi di un’impresa”. È usato per elencare un vasto insieme di strumenti, inclusi quelli ICS (Industrial Control Systems) e SCADA.

Daniel Ehrenreich asserisce che la sicurezza per OT si concentra sulla difesa di sicurezza fisica (safety), affidabilità (reliability) e produttività (productivity), parametri evidentemente diversi da quelli della sicurezza informatica. Per questo la “convergenza di sicurezza IT e OT” non è realizzabile e la promuovono solo consulenti di sicurezza IT che cercano di estendere il proprio mercato senza averne le competenze.

Caratteristiche della sicurezza OT

È necessario ricordare che la sicurezza OT deve includere elementi ignorati da chi si occupa dei sistemi informatici “di ufficio”.

Per esempio, quando si tratta di sistemi OT è necessario considerare elementi come:

  • comportamento del sistema in caso di assenza di alimentazione;
  • comportamento del sistema in fase di avvio o riavvio e in fase di spegnimento;
  • separazione completa dei sistemi di sicurezza fisica dagli altri sistemi;
  • presenza sulla rete di dispositivi obsoleti e non più mantenuti dal produttore;
  • condivisione dei macchinari tra più operatori;
  • necessità di accesso in situazioni di emergenza;
  • protezione dai fattori ambientali (polvere, calore, eccetera).

Al di là della complessità tecnica, è importante riconoscere la differenza di sensibilità necessaria per affrontare le due materie.

Un classico esempio, forse una leggenda metropolitana, è fornito da un esperto di “sicurezza informatica” che voleva fosse impostata una password nel sistema di blocco in emergenza di un macchinario. Inutile specificare perché avesse torto.

Più complesso è comprendere che le tecnologie usate possono essere molto diverse rispetto a quelle IT e così le architetture da realizzare per assicurare la sicurezza ed efficienza dei sistemi OT.

Conclusione

Il post su LinkedIn esprime forse concetti troppo estremi. Infatti, anche la sicurezza OT deve considerare la riservatezza, per esempio delle ricette e dei progetti, che possono essere recuperati dalle macchine.

È innegabile, però, che, per affrontare bene una materia, è necessario capirne la cultura di fondo. Questo vale, per esempio, quando si tratta di sicurezza delle informazioni (orientata alla protezione di un’organizzazione), di sicurezza dei dati personali (orientata alla protezione degli interessati) o di qualità del servizio informatico (orientata alle aspettative del cliente). Ogni materia ha le sue peculiarità e queste vanno capite e apprezzate prima di farle “convergere”.

Nota

L’articolo di Daniel Ehrenreich si trova all’URL https://www.linkedin.com/pulse/itot-cyber-security-experts-daniel-ehrenreich.

L’immagine di copertina è di SCCE – Daniel Ehrenreich.

Articolo a cura di Cesare Gallotti

Lavora dal 1999 nel campo della sicurezza delle informazioni, della qualità e della gestione dei servizi IT.

Ha condotto progetti di consulenza per la pubblica amministrazione e per il settore privato. Opera, sia in Italia che all’estero, come Lead Auditor ISO/IEC 27001, ISO 9001, ISO/IEC 200000 e ISO 22301. Ha progettato ed erogato corsi di Quality Assurance e di certificazione Lead Auditor ISO/IEC 27001 e ITIL Foundation.

Tra gli attestati si segnalano: le certificazioni AICQ SICEV Lead Auditor ISO/IEC 27001, IRCA Lead Auditor 9001, CISA, ITIL Expert e CBCI, la qualifica come Lead Auditor ISO/IEC 20000 e il perfezionamento postlaurea in “Computer Forensics e investigazioni digitali”.

E’ capodelegazione del WG1 del comitato italiano ISO/IEC SC27 in UNINFO.

Ha pubblicato il libro, aggiornato nel 2017, “Sicurezza delle informazioni: valutazione del rischio; i sistemi di gestione; la norma ISO/IEC 27001:2013”.

Cura la pubblicazione, dal 2008, della newsletter “IT Service management news” (http://www.cesaregallotti.it/Newsletter.html).

Web: www.cesaregallotti.it; Blog: blog.cesaregallotti.it

Download PDF

https://www.ictsecuritymagazine.com/articoli/differenza-tra-sicurezza-it-e-ot/


In materia di privacy anche il legislatore nazionale deve sottostare ai principi europei

Il 6 febbraio 2019 si è tenuta alla Camera dei Deputati, davanti alle Commissioni riunite 1ª Affari costituzionali e 11ª Lavoro pubblico e privato, l’audizione informale del Presidente del Garante per la protezione dei dati personali, Antonello Soro, sul disegno di legge n. 1433, già approvato al Senato, recante interventi per la concretezza delle azioni delle pubbliche amministrazioni e la prevenzione dell’assenteismo.

In tale testo, all’art. 2, si rinviene infatti la previsione per ogni pubblica amministrazione di predisporre congiuntamente sistemi di rilevazione biometrica delle presenze, unitamente a sistemi di videosorveglianza.

Si tratta in realtà di un tema complesso, già oggetto di rilevi in occasione dell’audizione presso il Senato, rispetto alla cui versione è stata apportata in sede di prima lettura una limitata modifica alla previsione di cui all’articolo 2.

Questa modifica deve tuttavia essere valutata alla luce del canone di proporzionalità che nel contesto della protezione dei dati si pone come parametro essenziale di legittimità del trattamento sotto un duplice profilo.

Esso infatti da un lato rappresenta un criterio regolativo essenziale nello svolgimento del trattamento da parte del titolare per quanto concerne la scelta sulla portata e sulle modalità del trattamento; dall’altro lato il principio di proporzionalità rappresenta un parametro generale di legittimità delle limitazioni del diritto alla protezione dei dati da osservare in conformità ai canoni di cui all’articolo 52 della Carta di Nizza anche in sede di esercizio del potere legislativo.

La Carta di Nizza prevede infatti una serie di requisiti molto puntuali per le limitazioni all’esercizio dei diritti e delle libertà dalla stessa riconosciuti e tra questi rileva anzitutto il necessario rispetto del contenuto essenziale del diritto e il principio di proporzionalità, che ammette limitazioni dei diritti fondamentali solo se siano necessarie e rispondano effettivamente a finalità di interesse generale riconosciute dall’Unione o all’esigenza di proteggere i diritti e le libertà degli interessati.

I principi di necessità e proporzionalità sono stati declinati in maniera particolarmente puntuale della disciplina della protezione dei dati prima con la direttiva 95/46 e ora con il Regolamento europeo 2016/679.

A tale riguardo va sottolineato che con la famosa sentenza Digital Right, a proposito di Data retention, la Corte di Giustizia europea ha dichiarato invalido un intero atto normativo dell’Unione per violazione del principio di proporzionalità. La Corte in tale occasione ha infatti ritenuto eccessivamente compresso il diritto alla protezione dei dati, nonostante l’indiscutibile merito del fine di contrasto dei reati per effetto di una misura quale la conservazione dei tabulati telefonici e telematici massiva, in quanto indirizzata verso la generalità dei cittadini e non limitata ad esigenze repressive dei soli reati gravi.

Il principio di proporzionalità impone dunque in primo luogo di limitare le misure a vario titolo restrittive del diritto ai soli casi sorretti da esigenze specifiche differenziate, rendendo così generalmente illegittime le misure massive; in secondo luogo i principi di necessità e proporzionalità inducono a ritenere illegittime le misure limitative del diritto ogni qualvolta sia possibile adottare misure parimenti efficaci ma meno invasive.

Per la stessa ragione la Corte di Giustizia europea si è risolta ad annullare per violazione di tali principi un regolamento europeo in materia di pubblicità delle sovvenzioni agricole. Non una norma statale, ma un Regolamento europeo.

In tale occasione la Corte di Giustizia ha avuto modo di affermare che le restrizioni ai diritti fondamentali devono intervenire entro il limite dello stretto necessario. Il regolamento 2016/679 ha valorizzato ulteriormente il canone di proporzionalità, soprattutto in ambito pubblico, riferendolo alla stessa previsione normativa prima ancora che al trattamento in sé, chiedendo quindi al legislatore di contemperare le specifiche esigenze sottese al trattamento con il diritto alla protezione dei dati.

Da ciò consegue logicamente che scrutinio di proporzionalità debba essere ancora più stringente rispetto ai dati ai quali si riconosce una tutela rafforzata in ragione dei rischi inevitabilmente connessi al loro trattamento. Così, per particolari categorie di dati, tra i quali appunto quelli biometrici, il Regolamento sancisce in linea generale un divieto di trattamento superabile solo in presenza di alcuni presupposti, tra i quali, anche in materia lavoristica, non solo la sussistenza della previsione normativa specifica, che in caso di approvazione del disegno di legge di cui oggi si è discusso, sarebbe assicurata, ma anche la necessità del trattamento per la realizzazione dei legittimi fini perseguiti nonché il rispetto di garanzie.

E proprio alla luce di questi parametri va dunque letto l’articolo 2 del disegno di legge che prevede per tutte le amministrazioni pubbliche, eccetto per il personale in regime di diritto pubblico per il lavoro agile, l’introduzione di sistemi di verifica biometrica dell’identità e di videosorveglianza degli accessi in sostituzione dei diversi sistemi di rilevazione automatica attualmente in uso ai fini della verifica dell’osservanza dell’orario di lavoro.

L’introduzione di tali sistemi deve avvenire secondo la previsione introdotta al Senato nel rispetto del principio di proporzionalità, non eccedenza e gradualità ai sensi dell’articolo 5 paragrafo 1, lett c) del Regolamento, mentre le attività attuative della norme sono da adottarsi tramite regolamento da adottarsi previo parere del garante sulle modalità di trattamento dei dati biometrici nel rispetto dell’articolo 9 del GDPR e delle misure di garanzia definite dall’Autorità.

La norma prevede attraverso l’impiego contestuale e non alternativo dei relativi sistemi biometrico e di videosorveglianza, il trattamento sia di dati personali (quali l’immagine della persona) con un utilizzo di strumenti di videosorveglianza, sia dei dati biometrici destinatari come detto di una tutela rafforzata che ne ammette l’utilizzo solo in presenza di specifici requisiti.

Nonostante l’inciso prima richiamato inerente al rispetto dei principi di proporzionalità non eccedenza e gradualità la norma deve ritenersi una mera clausola di stile, incompatibile con tali principi sovraordinati anche ad una legge statale, laddove intenda invece perseverare nel configurare la rilevazione biometrica. unitamente peraltro alle videoriprese, come obbligatoria in ogni pubblica amministrazione. Infatti, per dirla con le parole del Garante, non può ritenersi in alcun modo conforme al canone di proporzionalità l’ipotizzata introduzione sistematica, generalizzata ed indifferenziata per le tutte le pubbliche amministrazioni di sistemi di rilevazione biometrica delle presenze in ragione dei vincoli posti dall’ordinamento europeo per l’invasività di tali forme di verifica.

E per le implicazioni proprie della particolare natura del dato, il requisito dei principi di proporzionalità e minimizzazione introdotti al Senato avrebbero una portata normativa effettiva solo laddove la norma prevedesse da una parte l’alternatività del ricorso alla biometria o alla videosorveglianza, e dall’altra l’ammissibilità della rilevazione biometrica solo in presenza di fattori di rischio specifici per i quali sarebbero vani altri sistemi meno invasisi, vale a dire di particolari presupposti, quali, ad esempio, le dimensioni dell’ente, il numero dei dipendenti coinvolti, la ricorrenza di situazioni di criticità che potrebbero essere anche influenzate dal contesto ambientale.

Ma il dettato normativo di per sé è chiaro nel configurare invece tali sistemi come cumulativi, il che di per sè contrasta con il canone di necessità e proporzionalità; inoltre la previsione di tali nuovi sistemi di rilevazione come obbligatori rendono opportuno modificare il testo.

L’articolazione del dettaglio di tali requisiti potrebbe essere demandata ai regolamenti previsti al comma 1 e 4. Ove invece si confermasse la versione attuale della norma, mirante a sancire l’indiscriminata e astratta obbligatorietà dei nuovi sistemi di rilevazione essa sarebbe difficilmente compatibile con il criterio del principio di necessità e proporzionalità per le ragioni prima richiamate.

Ciò a cui bisogna prestare particolare attenzione è la generalizzazione in assoluto perché essa contrasta con il principio di proporzionalità previsto dall’ordinamento europeo.

Mai come nell’ambito della privacy il diritto europeo è intervenuto in maniera così puntuale e specifica, tanto da limitare anche il potere legislativo dei singoli Stati membri che debbono tenere conto dei principi imposti dall’Europa sia a livello normativo, sia a livello di Corti di giustizia che in tale ambito si sono dimostrate particolarmente severe. La ragione di ciò è da rinvenirsi nell’assioma in base al quale  la protezione del dato è considerato come la tutela di una grande libertà individuale che non è più la privacy del passato, ma un diritto fondamentale dell’uomo la cui scarsa tutela può giungere a mettere a rischio la vita di una persona.

Attualmente nel mondo in questo momento il dato personale è diventato centrale rispetto a dinamiche attorno alle quali non solo l’economia ruota, ma anche la criminalità, il contrasto fra gli Stati e la minaccia per le persone.

Si tratta di una nuova dimensione della protezione del dato dove anche il legislatore italiano, come quello di tutti gli altri Stati membri, è chiamato a tradurre questa nuova sensibilità in un utilizzo della norma che valorizzi la nuova cultura del dato personale che vede al centro la tutela della persona fisica in quanto essere umano.

Articolo a cura di Elena Bassoli

Elena Bassòli, Avvocato in Genova, Professore a contratto di Diritto della comunicazione elettronica (54 h) e di Cyber Security and Data Protection (Master II liv. post lauream Ingegneria), presso l’Università degli Studi di Genova. Si occupa di diritto e nuove tecnologie dal 1995 ed è autore di oltre 200 pubblicazioni in materia, tra monografie, contributi a collettanee, articoli, note e commenti. Membro del Comitato di Redazione della rivista “Sicurezza e Giustizia”, è formatore per Ministero dell’Interno e Ministero di Giustizia, Presidente ANGIF (Associazione Nazionale Giuristi Informatici e Forensi). Coautore del software Verslex in uso al Senato della Repubblica per l’aiuto alla redazione dei testi normativi. È dottore di ricerca in Metodi e tecniche della formazione e valutazione delle leggi, XII ciclo. Coordinatore della Commissione “Privacy” e Consigliere presso CTI-Liguria (Club Tecnologie dell’Informazione); membro ANDIG-Ass. Naz. Docenti Informatica giuridica e ANDIP-Ass. Naz. Difesa Privacy. Delegato al Congresso Nazionale Forense.

Download PDF

https://www.ictsecuritymagazine.com/articoli/in-materia-di-privacy-anche-il-legislatore-nazionale-deve-sottostare-ai-principi-europei/


Rischio Cyber tra incertezza e tecnologia

Introduzione

Il presente articolo sintetizza il Global Risks Report 2019 del World Economic Forum (WEF). La rappresentazione dei rischi globali è, per propria natura, organica e olistica al tempo stesso: le minacce, le probabilità di accadimento e gli impatti degli eventi rischiosi sono parte di un unico ed esteso dominio di analisi. D’altro canto, quando entrano in gioco fattori di rischio tecnologici in generale e cyber in particolare, la natura simultaneamente globale e locale degli stessi li rende automaticamente elementi degni della massima attenzione in ogni parte del mondo. Alcuni concetti generali relativi alla gestione del rischio, ai più comuni bias cognitivi e alla centralità del fattore umano sono stati già affrontati nel mio intervento del 2018 “Cyberspazio: minacce e fattore umano[1]”, cui rimando per eventuali approfondimenti.

Panorama dei Rischi Globali

Come ogni anno il WEF, istituzione internazionale focalizzata sulla collaborazione tra mondo pubblico e privato, ha pubblicato a gennaio il proprio Global Risks Report[2]. Nel corso del 2018, anno analizzato all’interno del report, i rischi macroeconomici sono saliti alla ribalta: la volatilità dei mercati finanziari è infatti aumentata e il tasso di crescita globale sembra aver raggiunto il proprio picco, con conseguente inizio di dinamiche di discesa previste dal Fondo Monetario Internazionale[3]. Le tensioni geo-politiche e geo-economiche tra le maggiori potenze mondiali rappresentano un punto di attenzione, così come le evidenti frizioni tra la globalizzazione dell’economia mondiale e la crescita di nazionalismi e localismi. I rischi ambientali sono percepiti come i maggiori e la tecnologia gioca un ruolo sempre più determinante: è diffuso il timore di frodi sui dati, di attacchi cyber e di un elevato numero di vulnerabilità tecnologiche (preoccupano i rischi associati alle fake news[4] e al furto di identità digitale[5] così come quelli collegati alla perdita di privacy per aziende e governi). Nel 2018 si sono verificate enormi violazioni di dati personali (data breach[6]), sono state scoperte gravi vulnerabilità hardware e la ricerca si è focalizzata sui potenziali utilizzi dell’Intelligenza Artificiale per ingegnerizzare attacchi cyber sempre più efficaci; già nel report del 2018 il WEF aveva sottolineato i rischi che gli attacchi cyber comportano per le infrastrutture critiche.

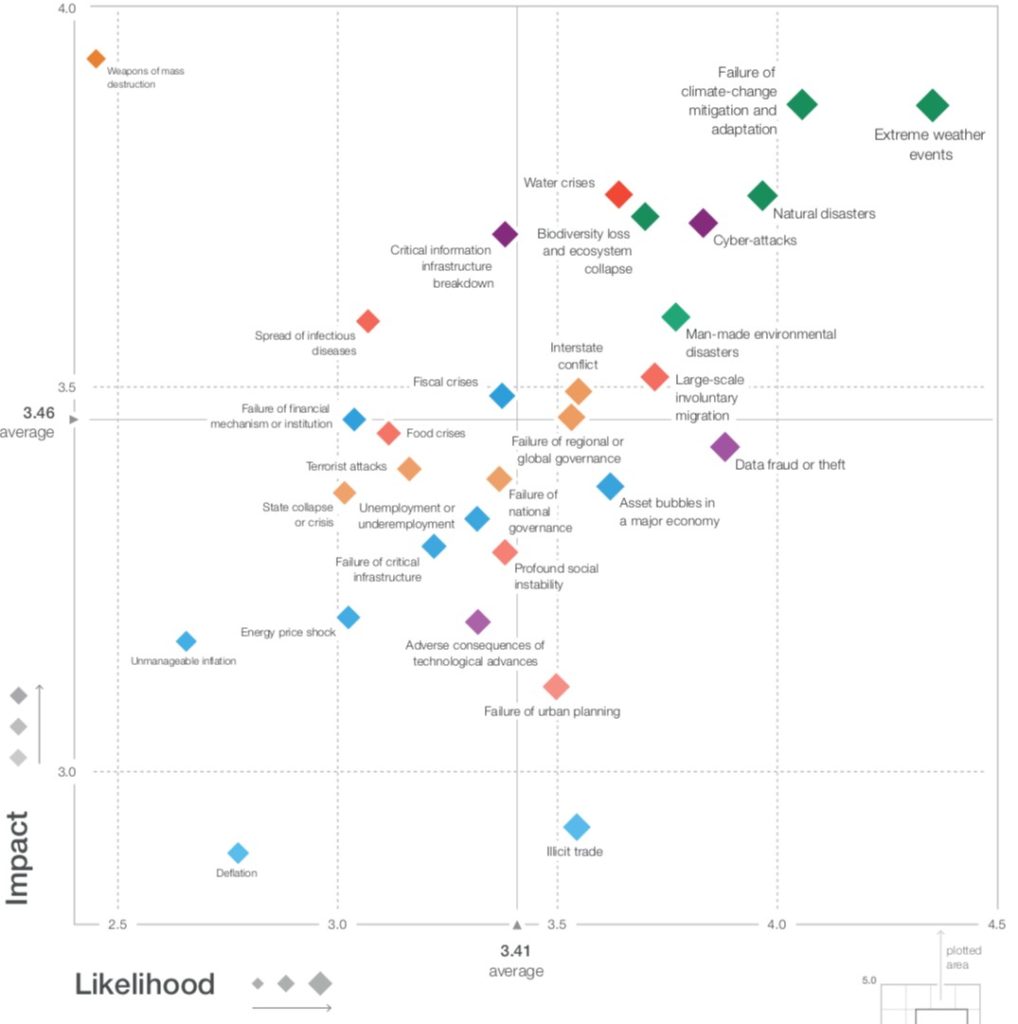
Figura 1 – Global Risks Landscape 2019

Il lato umano dei rischi globali è rappresentato dalla proliferazione diffusa di sentimenti di ansia, infelicità e solitudine (si stima che al mondo ci siano almeno 700 milioni di persone affette da problemi di salute mentale). In particolare, le complesse trasformazioni – siano esse di natura sociale, tecnologica o collegate al lavoro – determinano un profondo impatto sulle esperienze di vita delle persone: un tema comune è quello relativo allo stress psicologico collegato al sentimento di mancanza di controllo di fronte all’incertezza.

Altri rischi rilevanti riguardano le minacce biologiche e l’innalzamento del livello dei mari.

In generale, il report esplora la percezione dei rischi globali nelle loro dimensioni di vulnerabilità economiche, tensioni geopolitiche, sociali e politiche, fragilità ambientali e instabilità tecnologiche.

Rischio tecnologico

La tecnologia continua a giocare un ruolo chiave nel dare forma al panorama dei rischi globali ed è una tendenza che ricalca lo schema registrato anche nel 2018, con i rischi cyber che di fatto consolidano la propria posizione predominante (accanto ai rischi ambientali) in termini di impatto e probabilità nel quadrante del panorama dei rischi globali. Le instabilità tecnologiche sono causate dall’inesorabile e progressiva integrazione delle tecnologie digitali all’interno di ogni aspetto della vita quotidiana, con potenziali effetti dirompenti sulla psicologia e sulle vite delle persone.

Attacchi cyber e protocolli di cybersecurity inefficienti hanno portato a violazioni massive di dati personali nel 2018. Il più grande data breach si è verificato in India, dove il database governativo delle Identità Digitali, Aadhaar[7], ha subito numerosi attacchi e violazioni con la potenziale compromissione di 1.1 miliardi di cittadini registrati. Durante il mese di Gennaio è stato riferito che i cyber criminali stavano vendendo l’accesso temporaneo al database (10 minuti al prezzo di 500 rupie). In altri casi eclatanti, violazioni di dati personali hanno riguardato 150 milioni di utenti dell’app MyFitnessPal[8] e oltre 50 milioni di utenti Facebook[9].

Il 2018 ha registrato anche impatti negativi dovuti ai disservizi cloud: condizioni ambientali particolarmente avverse hanno determinato, per esempio, periodi prolungati caratterizzati da alte temperature (Microsoft)[10], venti e pioggia dei Noreaster[11] di Marzo (AWS, Equinix)[12]e fulmini (Microsoft). Questi eventi sottolineano il collegamento tra le catastrofi naturali e il rischio cyber all’interno dei Data Center.

La minaccia rappresentata dagli attacchi cyber alle infrastrutture critiche implica impatti economici assoluti. Un esempio della magnitudine dei disservizi tali attacchi possono provocare è la campagna ransomware[13] condotta a Marzo contro la città di Atlanta: l’erogazione dei principali servizi ai cittadini si è interrotta dopo che i computer municipali sono stati compromessi[14].

Le vulnerabilità cyber possono arrivare da direzioni inattese, come risulta evidente dalle minacce di Meltdown[15] e Spectre[16], che coinvolgono debolezze hardware e non software. Potenzialmente, si tratta di minacce che riguardano ogni processore Intel prodotto negli ultimi 10 anni. Il 2018 ha ulteriormente evidenziato che gli attacchi cyber sono un rischio per le infrastrutture critiche: nel mese di Luglio il governo degli Stati Uniti ha dichiarato che gli hacker avevano ottenuto accesso alle control room[17] di alcune aziende nazionali fornitrici di servizi di pubblica utilità. La potenziale vulnerabilità dell’infrastruttura tecnologica critica è diventata sempre più un problema di sicurezza nazionale.

L’Intelligenza Artificiale (IA) sta diventando sofisticata e capace di amplificare i rischi esistenti: in particolare, l’Internet of Things (IoT) connette miliardi di dispositivi. IBM ha segnalato un malware basato su Intelligenza Artificiale capace di nascondere una minaccia ben nota – WannaCry[18] – all’interno di un’applicazione di videoconferenza, attivandola solo in caso di riconoscimento del volto degli obiettivi dell’attacco[19]. Innovazioni simili si stanno verificando anche in altri campi (è possibile per un agente di minaccia usare l’IA nella biologia sintetica per creare nuovi micro-organismi patogeni). L’IA può anche riconoscere, rispondere e manipolare le emozioni umane e giocare un ruolo fondamentale nelle camere dell’eco[20] dei social media e delle fake news (una ricerca ha dimostrato che su 126.000 tweet analizzati la maggior parte di essi conteneva fake news e informazioni non vere[21]).

Altro rischio tecnologico è rappresentato, paradossalmente, dall’avanzamento del quantum computing[22], le cui capacità di calcolo monstre rendono obsolete le basi dell’attuale crittografia digitale, in particolare degli algoritmi a chiave pubblica. Un’eventuale debacle della crittografia a chiave pubblica trascinerebbe nel baratro le fondamenta stesse della vita digitale insieme ai propri elementi costitutivi quali autenticazione, riservatezza, integrità, fiducia e identità.

Il lato umano

Il report del WEF dedica una sezione al lato umano dei rischi globali partendo da alcuni dati estremamente interessanti: per molte persone questo è un mondo sempre più ansioso, infelice e solitario. Il sentimento di rabbia cresce e l’empatia sembra essere in declino in ogni area analizzata (sociale, tecnologica e lavorativa). Lo stress psicologico è legato a una sensazione di mancanza di controllo di fronte all’incertezza: i dati dell’Organizzazione Mondiale della Sanità (OMS) suggeriscono che la depressione e i disturbi d’ansia sono aumentati rispettivamente del 54% e del 42% tra il 1990 e il 2013[23]. In uno studio recente[24], la tecnologia è stata citata come una delle principali cause di solitudine e isolamento sociale dal 58% degli intervistati negli Stati Uniti e dal 50% nel Regno Unito. Il cambiamento tecnologico è sempre una fonte di stress, ma l’attuale ondata di trasformazione, cui spesso viene dato il nome di Quarta Rivoluzione Industriale[25], tende a sfumare ulteriormente la linea di demarcazione tra “umano” e “tecnologico”.

L’automazione ha permesso a un enorme numero di lavoratori di risalire la catena del valore e sfuggire a compiti monotoni e pericolosi, ma già nel 1959 l’OMS aveva notato segnali di effetti psicologici allarmanti unitamente alle possibili minacce insite nelle dinamiche stesse dell’automazione[26]. La tecnologia rende più facile per i datori di lavoro l’esercizio di forme di controllo e monitoraggio dei lavoratori: l’aumento notevole delle capability di sorveglianza contribuisce a creare diffidenza e condizioni difficili per lo sviluppo del trust[27] tra Labour e Capital. I cambiamenti più ampi nella struttura del lavoro sono un’ulteriore fonte di potenziale stress: la sicurezza e la stabilità del lavoro sono in declino in molte economie avanzate, con una crescita degli utili lenta o stagnante e un’espansione meno prevedibile della gig economy[28].

Panopticon digitale[29] 

La biometria[30] sta facendo progressi esponenziali: le tecnologie che ieri erano fantascienza plasmano oggi la realtà di miliardi di persone. Riconoscimenti facciali[31], analisi della deambulazione[32], assistenti digitali, affective computing[33], microchip, lettura labiale digitale, sensori di impronte digitali: mentre queste e altre tecnologie proliferano, ci spostiamo in un mondo in cui tutto di noi viene catturato, immagazzinato e sottoposto ad analisi operate da algoritmi di Intelligenza Artificiale. Ciò rende possibili servizi pubblici e privati sempre più individualizzati, ma anche nuove forme di persuasione mirata. Se gli esseri umani sono sempre più sostituiti da macchine in processi decisionali cruciali, il risultato può portare non solo a una maggiore efficienza, ma anche a una maggiore rigidità sociale. La politica globale si espone a rischi di derive autoritarie, facilitate in un mondo caratterizzato da visibilità e tracciabilità totali. Molte società stanno già lottando per bilanciare le minacce alla privacy, alla fiducia e all’autonomia contro le promesse di maggiore sicurezza, efficienza e novità.

Mentre l’intreccio della tecnologia con la vita umana si rafforza, è probabile che l’affective computing – l’uso di algoritmi in grado di leggere le emozioni umane predicendo le nostre risposte emotive – diventi sempre più prevalente. Col tempo, l’avvento di woebot[34] e strumenti simili basati sull’IA potrebbe modificare radicalmente le modalità di erogazione delle terapie psicologiche, in modo similare a quanto sta avvenendo nel mondo dei dispositivi indossabili[35] (monitor cardiaci, contapassi, etc). Eventuali conseguenze negative prodotte da algoritmi emotivamente intelligenti, causate sia accidentalmente sia intenzionalmente, potrebbero essere profonde.

Conclusioni

In generale, il sociologo Charles Perrow[36] ha identificato due aspetti dei sistemi che li rendono vulnerabili ai fallimenti imprevisti: complessità e accoppiamento forte. Un sistema complesso è simile a una rete elaborata con molte parti intimamente connesse a gran parte di ciò che accade, mentre un sistema strettamente accoppiato presenta poco spazio e scarso margine di errore. Quando qualcosa va storto in un sistema complesso, i problemi iniziano a spuntare ovunque ed è difficile capire cosa sta succedendo. Un accoppiamento forte significa che i problemi emergenti si trasformano rapidamente in situazioni fuori controllo e anche piccoli errori possono precipitare in crolli e fallimenti epocali.

Il modello sviluppato da Perrow all’epoca (primi anni 80) era riferito ai pochi sistemi complessi e fortemente accoppiati di quei tempi: centrali nucleari, sistemi di allarme missilistico e missioni di esplorazione spaziale. Da allora, tuttavia, un’enorme quantità di complessità è stata aggiunta al nostro mondo – sempre più dipendente da tecnologie digitali, a volte intrinsecamente fragili, per il proprio funzionamento e per la propria prosperità – e la possibilità che piccoli problemi possano innescare catene di eventi che portano a enormi fallimenti è assolutamente concreta.

La rappresentazione dei rischi globali del WEF non deve essere interpretata come descrizione apocalittica di eventi escatologici che conducono inevitabilmente a scenari di distruzione di massa (anche se, obiettivamente, la definizione di rischio globale del WEF va in questa direzione: “evento o condizione incerta che, nel caso in cui effettivamente si verificasse, potrebbe causare un significativo impatto negativo per diversi paesi o industrie nei 10 anni successivi”). D’altronde, non è possibile gestire il rischio e proteggere un asset (sia esso materiale o immateriale) senza valutare la probabilità e l’impatto delle minacce che lo mettono a repentaglio, esplorando ogni esito in tutte le sue conseguenze, anche le più estreme.

Dal punto di vista della comunità cyber è fondamentale concentrare gli sforzi e le capacità sulla dimensione tecnologica dei rischi globali, in particolare sulla loro caratterizzazione cyber, ma è imprescindibile inquadrarli all’interno di una visione analitica organica e multidimensionale.

Articolo a cura di Andrea Boggio

Andrea Boggio è Business Development Manager in Fastweb dal 2014 ed è coinvolto in attività di prevendita e progettazione di servizi di Cyber e ICT Security, con particolare attenzione al settore della Pubblica Amministrazione. In precedenza ha lavorato presso multinazionali (HP, NTT Data) e presso aziende italiane focalizzate sulla sicurezza informatica.
Andrea lavora da oltre 15 anni nell’Information Security Arena e si occupa di diverse aree tematiche quali: Governance, Risk & Compliance, SIEM e SOC, Mobile Protection, Threat e Vulnerability Management, Network Security e Cyber Security.
Andrea detiene le certificazioni professionali ISO/IEC 27001:2013 Lead Auditor, CISA, CISM, CGEIT, CRISC, ITIL e diverse altre legate a specifici vendor di sicurezza, è membro del capitolo italiano di ISACA e ha partecipato al Cloud Security and Resilience Expert Group di ENISA.

Download PDF

https://www.ictsecuritymagazine.com/articoli/rischio-cyber-tra-incertezza-e-tecnologia/


Un “hacker” come amico

Quante volte abbiamo sentito parlare di “alleanze con il nemico”?

Normalmente ci contorniamo di persone amiche, persone che riteniamo importanti, anche se capita di essere traditi e di comprendere dopo molto tempo che quelle persone alle quali tenevamo così tanto non erano tali. Al contrario degli amici, ci sono persone che vanno contro ogni nostra regola e decisione e lo fanno palesemente, in contrasto su tutto. Conoscere le loro strategie fornisce vantaggi indiscussi perché ci aiuta a comprendere i loro pensieri ed evitare percorsi critici e discussioni su tematiche a rischio. Insomma, capire il ragionamento del “Nemico”, di un antagonista o di un concorrente nel business, ci aiuta nella vita, nel lavoro e non da meno nella sicurezza informatica.

Robert Green riportava, come seconda tra le “48 Leggi del potere”, quanto segue;

Se l’occasione giusta si presenta, chiedi piuttosto il supporto
del nemico di un tempo, dovendo dimostrare la sua lealtà
nei tuoi confronti, sarà più leale di un amico.

Se non hai nemici, createne di nuovi.

Ma anche Friedrich Nietzsche recitava, “Ama i tuoi nemici perché essi tirano fuori il meglio di te” in quanto la sfida e la collaborazione sono opposti che si attraggono e generano sempre miglioramento, introducendo viste completamente “disruptive” e ignote. Tutto questo dà ritorni non immaginabili nel medio e lungo termine, oltre a portare all’attenzione “quel bivio” che prima non era per nulla ipotizzato.

Ma ora caliamoci nel contesto della sicurezza informatica e capiamo cosa c’entra tutto questo. I termini “Security by design” e “Privacy by design” sono slogan da tempo abusati.

Sembrano quegli slogan pubblicitari che tutti conoscono, e spesso li si dice solo perché “genera importanza” (a Roma si direbbe “fa fico”) e fa sembrare di essere attenti a problemi comuni, ma che poi, immancabilmente, non facciamo nostri. Quanti di noi si sono chiesti se questo principio di per sé corretto (e mi riferisco principalmente ai progettisti e agli sviluppatori software) lo stanno veramente mettendo in atto nel modo giusto in ogni fase del progetto?

Di fatto la teoria è molto lontana dalla pratica e su questi temi l’operatività e i dettagli “sono tutto”. Molti nuovi sistemi risultano carenti di minime implementazioni di sicurezza che portano in fase di controllo a rilevare “impatti reali” importanti e potenziali data-breach dirompenti, ma siamo già troppo tardi.

Gli attacchi informatici e i concetti di cybersecurity oggi sono sempre più complessi e di difficile comprensione e il mestiere dell’ingegnere software è totalmente “avulso” e spesso in antitesi a quello dell’ingegnere di sicurezza perché orientato al business e al servizio. Ahimè, sono rari i casi di convivenza di una corretta progettazione con una rigorosa implementazione della sicurezza.

Ci sono poi molte persone che pensano che gli esperti di cybersecurity “di processo” o “high-level” possano garantire un corretto ritorno in termini di esposizione al rischio dei sistemi, risolvendo errori (ma spesso “orrori”) commessi in quella delicata fase che è la progettazione, senza sapere che (facendo un calzante paragone) si stanno facendo operare al cuore da un chirurgo plastico.

Per i progetti importanti, chiamate gli “Hacker”!

Ecco un nuovo slogan. Un sistema per non essere violato deve essere progettato come sicuro, ma questo lo sappiamo. È la fase di progettazione, la fase nella quale fare scelte strategiche, calandole nel contesto del business, quella normalmente più importante in un sistema nuovo; anche questo lo sappiamo.

Ma, operativamente, lo stiamo facendo bene?

Avere a bordo un esperto in materia di “ethical-hacking” che valuti il progetto fin dall’inizio, nei dettagli (e anche nei processi) in termini di scelta dell’architettura, degli algoritmi di cifratura, della rete, delle librerie software, della corretta gestione dello sviluppo sicuro del codice guardandolo dal punto di vista della sicurezza informatica e delle possibili “violazioni”: è questo che fa la differenza.

Perché i “requisiti minimi di sicurezza” devono essere calati in un contesto complesso e vanno fatte scelte tecnologiche, ovvero quanto necessario a “metterli in atto”; chi meglio del “nemico” sa come contrastare le minacce, visto che le conosce con precisione?

Il concetto di “Red” e “Blue” si evolve in quanto i “Red” non sono essenziali solo nella fase di produzione, ma occorre averli “all’interno”, nei progetti. Possiamo quindi immaginare una nuova figura di progetto (e sbizzarriamoci con il nome) ad esempio “Expert on Cyber-Security & Operational Supervisor” oppure “Expert on Cyber-Security Data-Breach Prevention” che possa, stando dentro i progetti, visionare, suggerire, approvare e presidiare le scelte tecnologiche dal punto di vista della Cyber-Security. Di seguito alcuni spunti:

 Fase 1: Progettazione

  • Approvare i disegni architetturali e fornire consigli che consentano una corretta segregazione degli ambienti oltre a introdurre, qualora necessarie, ulteriori componenti architetturali se non presenti negli schemi.
  • Approvare la visibilità in rete dei servizi (sia di erogazione che di amministrazione) in relazione all’esposizione del rischio della piattaforma.
  • Approvare e indirizzare la scelta degli algoritmi di cifratura/hashing dell’intera piattaforma.
  • Consigliare la scelta dei sistemi operativi, anche sulla base dei sistemi di patching management automatizzati e indirizzarne la scelta.
  • Approvare, in collaborazione con il team di sviluppo, il linguaggio di programmazione da utilizzare, gli ambienti, i RAD e la gestione del codice sorgente.
  • Definire un catalogo delle librerie da utilizzare (in particolare modo se open source) per quel progetto, evitando componenti con ricorrenti problematiche di sicurezza su soluzioni make.
  • Definire il corretto livello di Log da implementare e le componenti da tracciare.
  • Verificare che le componenti “embedded” nei software buy (con particolar riferimento all’open source) non abbiano vulnerabilità critiche ricorrenti e che risultino aggiornabili semplicemente (senza riscrittura di codice) in fase di “long-security”.
  • Definire le librerie di depurazione degli input da far utilizzare al team di sviluppo.
  • Definire linee guida di standard di progetto (sia per gli sviluppatori che per i gestori di esercizio) che assicurino e sensibilizzino, una volta che il sistema è in produzione, i livelli di sicurezza attesi.

Fase 2: Delivery

  • Controllare e supervisionare la corretta implementazione delle architetture di rete e di piattaforma con test di verifica sulle configurazioni degli apparati di rete.
  • Controllare che i team di sviluppo adottino le scelte tecnologiche effettuate nella fase di progettazione.
  • Formare i team di sviluppo per evitare vulnerabilità con impatti gravi non rilevabili dagli scanner statici/dinamici, come ad esempio “broken access control” o “broken authentication” e verificare che abbiano compreso il modello implementativo.
  • Verificare in delivery lo stato del patching delle piattaforme e assicurarsi che il patching management venga adottato, sia come processo che allo stato dell’arte.
  • Verificare che le componenti di patching management automatizzato funzionino correttamente, soprattutto sulla superficie internet.

Fase 3: Pre-Produzione

  • Verificare che i requisiti di Hardening, Patching e Sviluppo Sicuro del codice siano stati correttamente implementati e verificare che i processi siano a regime con un’attività di controllo interno.
  • Svolgere scansioni automatizzate, sia infrastrutturali che dinamiche, del codice per verificare la presenza di possibili falle di sicurezza.
  • Svolgere una verifica attraverso tecniche manuali (penetration test) per assicurare che non siano presenti vulnerabilità non rilevabili dagli strumenti automatizzati.
  • Verificare il patching level della piattaforma, anche effettuando scansioni in white-box.

L’ultima fase, ovvero la pre-produzione, è quella che porta un reale vantaggio in quanto l’ethical hacker, essendo stato presente in tutte le fasi di realizzazione del progetto e conoscendo l’infrastruttura, è in possesso di informazioni “privilegiate” ed è a conoscenza di tutti i punti critici dell’applicazione.

Nella fase di avvio della produzione potrà condurre un penetration test con metodologia grey-box per verificare, in modo semplice, la presenza di ulteriori falle fino a quel momento non controllate.

Conclusioni

Le grandi guerre spesso si sono vinte con alleanze strategiche con chi prima era un nemico, beneficiando delle sue strategie, delle sue tecnologie e delle sue armi.

Gli “hacker” conoscono – il fronte – meglio di chiunque altro.
Scovate i migliori “ethical-hacker” tra i vostri fornitori
e portateli nei progetti.

È questo il grande vantaggio e la grande opportunità da cavalcare nella “security by design”, ovvero “aumentare le competenze cyber utilizzando chi sa violare i sistemi” oltre a consentire di progettarli bene, realizzarli, collaudarli per poi gestirli in modo semplice e sicuro nel tempo.

Dobbiamo anche essere consapevoli che, sebbene il nostro “Risk-appetite” sia alto, la nostra “Risk-tollerace” spesso risulta inferiore alle attese e se un data-breach viene fatto alle big-company di oltre oceano, noi siamo più a rischio perché la tecnologia non la facciamo noi, ma la usiamo. Occorre quindi prestare massima attenzione a questi aspetti in un’era in cui basta anche un solo data breach per minare la sopravvivenza di un’intera azienda.

Tutto questo per dire che la differenza nell’applicare bene la sicurezza informatica (a parte l’impalcatura di norme, di requisiti e di gestione del rischio e degli slogan spesso abusati da tutti) la farà sempre più “la gestione e il presidio dei dettagli”, perché un sistema è come un castello di carte al quale basta una piccola folata di vento per farlo completamente collassare su se stesso.

Tutto sta ad evitare che quella piccola folata ci sia.

Articolo a cura di Massimiliano Brolli

Download PDF

https://www.ictsecuritymagazine.com/articoli/un-hacker-come-amico/


Collection#1 vs GDPR: Data Breach e riflessioni sulla Cyber Security

Come riportato dal noto ricercatore di sicurezza Troy Hunt sul suo blog [1], è recentemente apparso sul servizio di condivisione file Mega un archivio da oltre 87 GB contenente qualcosa come 2,7 miliardi di righe. Un forum specializzato in hacking dopo poche ore ne estrae il contenuto, lo riorganizza in directory per una più facile e veloce ricerca e fruizione. Troy Hunt continua così l’analisi dei dati e scopre che, una volta ripulito, l’archivio contiene oltre 700 milioni di indirizzi mail e oltre 21 milioni di password. Molte di queste informazioni sono frutto di vecchi data breach e, forse, sono incluse anche informazioni provenienti da campagne di hacking dirette a singoli individui. Siamo probabilmente davanti ad uno degli archivi più grandi di dati personali mai recuperati, così il ricercatore ne celebra la dimensione e l’importanza battezzando questa grande raccolta di dati Collection#1.

Possiamo, quindi, interrogarci e cercare di fare un’analisi critica di questi dati oramai a disposizione di tutti.

Collection#1: 140 milioni di email e 21 milioni di password

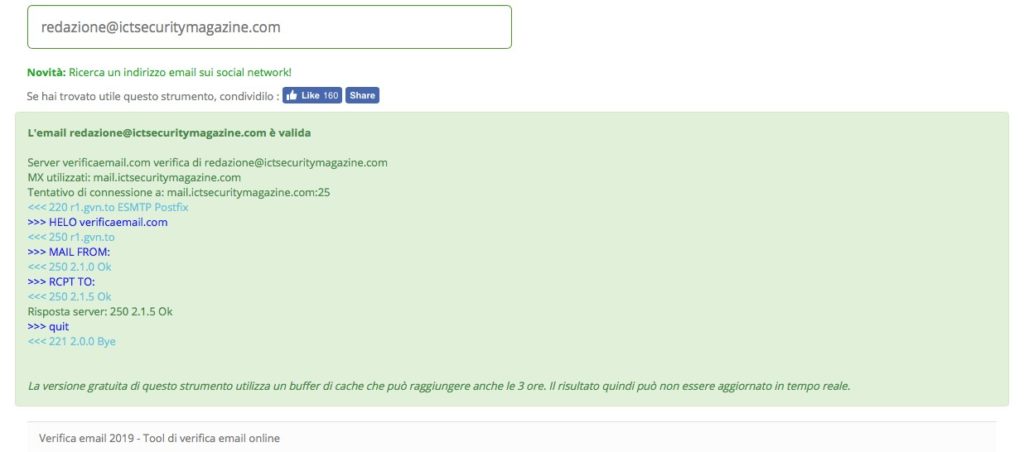
Il numero di indirizzi email contenuti in questo colossale archivio è sicuramente un numero elevato e strabiliante ma, onestamente, l’indirizzo email non è un elemento particolarmente sensibile. Basta pensare a come noi stessi “pubblicizziamo” giornalmente il nostro indirizzo email su biglietti da visita, nei siti professionali come LinkedIn o in altre mille modi. Esistono poi dei servizi online, come il sito www.voilanorbert.com, che permettono la ricerca di indirizzi mail di utenti utilizzando nome, cognome e dominio in cui ricercare, offrono API per l’integrazione del loro servizio in bot leciti o meno. Oppure servizi come www.verificaemail.com che, come mostrato in Figura 1, ricevono uno status OK direttamente dal server del gestore di posta elettronica per la validazione o meno dell’indirizzo stesso.

Figura 1 – Esempio www.verificaemail.com

Il ricercatore Troy Hunt offre un servizio sul suo sito Have I Been Pwned (HIBP)[2], per controllare se un particolare account sia mai stato interessato o coinvolto in una violazione dei dati. Quindi non c’è da sorprendersi se l’80% degli indirizzi di Collection#1 sono risultati già presenti nel database di HIBP magari perché già coinvolti in precedenti data breach. In questo archivio risultano “sconosciuti” solo 140 milioni di indirizzi email.

E l’analisi delle password invece? Degli oltre 21 milioni di password elencate, la metà è risultata nuova al sito HIBN. Analizzando questo numero, l’ottica del “bicchiere mezzo vuoto” ci porterebbe ad affermare che sono state rese pubbliche e violate una mole enorme di password (che dovrebbero essere assolutamente cambiate molto in fretta…). D’altro canto il bicchiere può essere anche visto come mezzo pieno: perché il rapporto numerico tra password e indirizzi email presenti in Collection#1 indica che una buona metà degli utenti a cui è stata rubata la password, non la usava già su altri siti hackerati precedentemente.

Il rischio più immediato è che queste credenziali siano usate per effettuare “crediantial stuffing” cioè l’uso della combinazione email/password su svariati siti nella speranza di poter accedere contando sul fatto che, di solito, l’utente riutilizza la stessa combinazione per comodità.

Non esiste una valida alternativa alle password, questo lo sappiamo, specialmente quando si tratta di proteggere la propria casella di posta elettronica, il conto bancario online e tutti i dispositivi che archiviano i nostri dati personali. Anche nei casi di autenticazioni a due fattori o tramite token generati al volo, c’è sempre una prima combinazione utente/password a “dare il La” alla sequenza. Inoltre, le evidenze portano alla luce che gli utenti non amano sistemi complessi di autenticazione (es. solo il 10% degli utenti Google usano il sistema a due fattori [3]) e che questi sistemi di ridondanze soffrono anche di criticità gravi [4]. Ecco perché è cruciale utilizzare delle combinazioni uniche e affidabili, e non solo per i siti e i servizi più importanti. Il sito specializzato in sicurezza informatica Kaspersky offre uno strumento che permette di verificare e testare la robustezza di una password utilizzabile gratuitamente [5].

Altro strumento utilissimo che segnaliamo dal sito Kaspersky è, invece, di tenore metodologico: una metafora che ci aiuti a cambiare l’atteggiamento verso le nostre password. Gli esperti di sicurezza dell’azienda russa consigliano di pensare alle proprie password come se fossero biancheria intima [6]. Questo inusuale cambio di prospettiva da vita a tre regole fondamentali di gestione delle password:

  1. non sono mostrate a chiunque;
  2. sono cambiate regolarmente;
  3. non sono esposte ben in vista sulla propria scrivania.

Se a questo saggio trittico di regole si aggiunge il buon senso di usare combinazioni lunghe, non direttamente derivabili dalla propria vita, con lettere maiuscole, minuscole, numeri e simboli, le password diventano sempre più affidabili e difficili da hackerare.

Il data breach non è questione di password

Il grosso problema dei data breach però è sostanzialmente un altro: i nostri dati sono esposti in modo totalmente indipendente dalla nostra accortezza e accuratezza. Infatti possiamo essere stati attenti ed efficaci nella scelta delle password, ma se queste sono rubate dal sito in cui sono depositate non possiamo farci nulla!

Tuttavia uno strumento utile a gestire il tema del data breach è stato recentemente introdotto in Europa. Il 25 maggio 2018 è entrato, infatti, in vigore in tutti gli Stati membri il Regolamento Ue 2016/679, noto come GDPR (General Data Protection Regulation)[7]. Tale regolamento è incentrato sulla protezione delle persone fisiche con riguardo al trattamento e alla libera circolazione dei dati personali.

Il regolamento europeo GDPR è uno strumento importante per veicolare una maggiore consapevolezza e cultura sulla cyber security nelle aziende di ogni dimensione. I meriti principali di una corretta applicazione del Regolamento sono:

  • l’obbligo di definire nelle aziende un processo di gestione della sicurezza dei dati
  • chiarire in modo inequivocabile a soggetti piccoli e grandi (dalla multinazionale alla PMI) che la sicurezza informatica è un tema non sacrificabile
  • per “contagio” aumentare la consapevolezza degli utenti sull’importanza dei dati personali e sugli strumenti che si hanno per assicurarsi della loro corretta conservazione

Lo sforzo – e la sfida – per tutti dovrebbe essere volto a combattere la consunzione della norma e la tentazione di incasellare il messaggio culturale e di innovazione di processo della GDPR come l’ennesima vessazione burocratica. La GDPR è l’opportunità per introdurre una nuova forma di mentalità nei comportamenti e nei processi, trasformando il tema della sicurezza in un elemento strutturale, in un cambiamento culturale.

Riferimenti

Articolo a cura di Michelangelo De Bonis e Matteo De Simone

Download PDF

https://www.ictsecuritymagazine.com/articoli/collection1-vs-gdpr-data-breach-e-riflessioni-sulla-cyber-security/


Analisi forense di sistemi Linux

La metodologia di analisi forense di un sistema GNU/Linux segue sostanzialmente gli standard e le best practises in uso nella Digital Forensics ma, per poter applicare correttamente tali metodologie, in particolare nelle fasi di identificazione, acquisizione ed analisi, è necessario conoscere le caratteristiche, le potenzialità e le criticità dello specifico sistema.

L’argomento è molto vasto e non è possibile trattarne i vari aspetti in un articolo; quindi si tenterà un rapido excursus con lo scopo di dare le informazioni essenziali sul sistema – anche un pò di storia che non guasta mai – e le principali problematiche relative all’approccio.

Sicuramente la maggior parte dei lettori avrà dimestichezza con i sistemi Windows e sarà in grado di effettuare un’acquisizione e successiva analisi dei sistemi in cui sono installati i prodotti della famiglia Windows; verrà utilizzata quindi una linea di confronto – per quanto possibile – onde procedere alla comprensione con riferimenti già noti.

Prima di addentrarsi nel processo di analisi dei sistemi Linux dal punto di vista forense, è necessaria ripercorrere la storia di Unix e Linux. All’inizio degli anni ’70, il sistema operativo (OS) Unix – abbreviato da UNICS (UNiplexed Information and Computing Service) – evolve dalle ceneri di un progetto di AT&T Bell Labs atto a fornire all’utente l’accesso simultaneo ai servizi di computer mainframe. Unix crebbe in popolarità e dimostrò sul campo la sua alta affidabilità, iniziando a sostituire i sistemi operativi nativi su alcune comuni piattaforme mainframe. La nuova versione del sistema, riscritta nel linguaggio C, ne migliorò sensibilmente la portabilità e consentì l’emersione sul mercato di diverse versioni di Unix, – comprese quelle per i microcomputer -; nei decenni successivi alcuni derivati di Unix, denominati “Unix-like” presero forma: è il caso di ricordare Mac OS di Apple, Sun Microsystem Solaris, e BSD (Berkeley Software Distribution).

Gli sforzi per creare una versione liberamente disponibile di Unix iniziarono negli anni ’80 con il progetto GNU (“GNU’s Not Unix”) General Public License (GPL), ma non riuscirono a produrre i risultati sperati.

Questo portò il programmatore finlandese Linus Torvalds ad affrontare lo sviluppo di un nuovo kernel Unix (il modulo di controllo centrale di un sistema operativo) come progetto studentesco. Usando il sistema operativo educativo Unix-like Minix, Torvalds codificò con successo un kernel affidabile nel 1991, rendendo il codice sorgente liberamente disponibile per il download pubblico e la manipolazione sotto la GNU GPL.

Il progetto fu poi chiamato Linux (una combinazione del nome di Torvalds, “Linus”, con “Unix”). La flessibilità e l’efficienza di Linux lo hanno conseguentemente portato all’adozione diffusa – da parte di industrie, aziende e singoli utilizzatori in tutti i continenti -; oggi il sistema è presente su smartphone, orologi, auto, negli elettrodomestici, nelle installazioni militari e in svariati altri dispositivi. La maggior parte dei server attualmente presenti nella rete internet[1] (Wikipedia e la Borsa di New York, ad esempio) utilizzano Linux.

IBM lo scelse nel 2011 per realizzare Sequoia[2], il supercomputer che doveva essere il più potente mai creato.

Attualmente il 100%[3] dei supercomputer[4] attualmente esistenti usa GNU-Linux, e un motivo sicuramente ci sarà – esecuzione di carichi di lavoro ad elevata disponibilità all’interno di data center e ambienti cloud; modularità, che consente una gestione più semplice dato che ogni singolo componente del sistema operativo Linux può essere sottoposto ad audit, monitorato e protetto; dotazione di moduli e strumenti integrati, come SELinux, – per citarne uno – che aiutano a bloccare, monitorare, segnalare e rimediare in maniera più completa eventuali problematiche relative alla sicurezza; etc. –

Bene, cominceremo ad addentrarsi nei meandri del kernel, descrivendone la prima differenza con i sistemi operativi Windows: il File System. Windows utilizza File System NTFS, FAT e exFAT o FAT64 che dir si voglia, pensato per le memorie flash; ReFS, (Resilient File System) è l’ultimo sviluppo di Microsoft introdotto con Windows 8 e ora disponibile per Windows 10. L’architettura del File System differisce assolutamente dagli altri File System di Windows ed è principalmente organizzata in una forma di B + -tree.

Un cenno lo merita NTFS, il più adoperato tra i File System Windows: una sola struttura fissa, il boot sector; le altre strutture di controllo non sono predeterminabili essendo rappresentate da file. La principale struttura dati è delineata dalla MFT (Master File Table), anch’essa costituita da file – fisicamente – ma logicamente strutturata come una sequenza lineare ≤ 2^48 record di ampiezza da 1 a 4 Kbyte.[5]

Linux impiega come regola generale il mounting dei dispositivi su directory, generalmente “/mnt” e “/media”. L’organizzazione del filesystem di Linux è gerarchica: la sua struttura è ad albero con il livello più alto espresso dal simbolo “/” e denominato “directory root”.

Non esiste distinzione tra hardware e software (le periferiche hardware in Linux vengono rappresentate come dei file speciali) e qualsiasi parte del sistema è figlia della directory radice. In calce un esempio esplicativo di directory costituenti il File System Linux:
fig. 1

All’interno della directory root (/) è presente un insieme di directory comuni a tutte le distribuzioni Linux. Quello che segue è un elenco delle più comuni presenti nella root (/):

  • /bin: applicazioni per la gestione del sistema;
  • /boot: kernel e file di configurazione necessari al processo di boot;
  • /dev: file dei device (dispositivi);
  • /etc: file di configurazione, script di avvio, etc…;
  • /home: directory home degli utenti locali;
  • /lib: librerie di sistema;
  • /media: dispositivi rimovibili (media) montati (caricati) come CD, fotocamere digitali, etc.;
  • /mnt: Punto di montaggio per media esterni;
  • /opt: contiene applicazioni aggiuntive ed opzionali (Oracle, OpenOffice, Libreoffice, etc.);
  • /proc: contiene un File System virtuale. Non è infatti un File System vero e proprio, in quanto viene creato dal kernel dinamicamente istante per istante, in memoria e non sul disco. Al suo interno sono contenute le informazioni relative al sistema (originariamente erano contenute esclusivamente le informazioni relative ai vari processi in esecuzione, da ciò il nome proc);
  • /root: home directory dell’utente root;
  • /sbin: contiene programmi di sistema eseguibili solo dall’amministratore del sistema come ad esempio fdisk o fsck;
  • /sys: file di sistema;
  • /tmp: file temporanei;
  • /usr: file e applicazioni che sono per la maggior parte disponibili a tutti gli utenti (users) e non indispensabili al sistema;
  • /var: parte variabile dei programmi. Contiene log, mail, database, etc.

Tutti i file in un sistema Linux hanno permessi che abilitano o meno gli utenti alla visualizzazione, modifica o esecuzione. Il super utente “root” ha l’abilità di accedere a ogni file nel sistema. Ogni file possiede delle restrizioni di accesso, restrizioni sull’utente ed è associato con un proprietario/gruppo.

Un ausilio importante per l’analisi di un sistema Linux proviene dalla comprensione del processo di avvio. Infatti, la conoscenza dei file coinvolti in detto processo potrebbe aiutare l’esaminatore forense a determinare, ad esempio, la versione del sistema operativo in esecuzione e la data di installazione.

Inoltre, gli consentirebbe di mirare la ricerca delle evidenze in caso di modifica fraudolenta di alcuni aspetti del processo di avvio che, data la sua natura di sistema aperto, un utente dotato dei privilegi sufficienti, potrebbe aver modificato.

Una trattazione completa del processo di avvio di Linux esula la trattazione di questo articolo, ma è opportuno esporre una breve descrizione dello stesso.

Il primo passo del processo di avvio di Linux è l’esecuzione del boot loader[6], che individua e carica il kernel. Il kernel è il cuore del sistema operativo ed è generalmente presente nella directory “/boot”.

Successivamente viene montato in memoria initrd[7] (Inizial RamDisk).

Il File System temporaneo initrd contiene i driver di dispositivo, i moduli del File System, i moduli del volume logico e altri elementi richiesti per l’avvio ma non presenti nel kernel.

Terminata la cosiddetta fase di bootstrap, il kernel procede ad inizializzare l’hardware del sistema e ad avviare il processo “/sbin/init” che porterà il sistema in uno stato operativo.

Due sono le filosofie che organizzano il funzionamento di init: System V[8] e BSD[9].

Nel metodo System V, il processo init legge il file “/etc/inittab” per determinare l’impostazione predefinita del runlevel. Un runlevel è un numero che identifica il set di script che una macchina eseguirà per un dato stato. Ad esempio, sulla maggior parte delle distribuzioni Linux, runlevel 3 fornirà un pieno ambiente di console multiutente, mentre runlevel 5 produrrà un ambiente grafico. Da notare che ogni voce in una directory di runlevel è in realtà un collegamento software a uno script in “/etc/init.d/”, che verrà avviato o interrotto a seconda del nome del collegamento: il nome che inizia con “S” indica l’ordine di avvio, mentre quelli che iniziano con “K” ne indicano l’ordine di interruzione del servizio.

Nel metodo BSD, invece, a ogni runlevel corrisponde uno script (solitamente chiamato /etc/rc.d/rc.X), che ha il compito di avviare tutti i processi necessari a portare il sistema nel runlevel richiesto.

Conclusa la breve panoramica sul processo di boot, andremo ora ad esaminare le peculiarità del File System di Linux, ovvero il meccanismo con il quale i file vengono immagazzinati ed organizzati su un dispositivo di archiviazione.

Vengono utilizzati principalmente due tipologie: Ext3 e Ext4; Ext3 è retrocompatibile con il File System Ext2 da cui deriva con l’aggiunta del journaling[10] che permette di eseguire modifiche ai file adoperando il concetto di transazione[11], preservando in questo modo l’integrità dei dati.

Genericamente un file in Linux consiste in uno o più blocchi di dati contenenti qualsiasi tipo di informazioni (una directory è un particolare tipo di file). Ad ogni file è associato un inode; inoltre gli inode vengono identificati tramite un numero chiamato inumber; con un inumber è possibile identificare univocamente un file all’interno del File System.

Poiché un inode ha una dimensione limitata e ha lo spazio solo per un piccolo numero di puntatori diretti ai blocchi di dati, i blocchi successivi sono referenziati in modo indiretto.

L’accesso indiretto ai blocchi di dati è realizzato attraverso alcuni puntatori in ogni inode.

Quando la dimensione di un file richiede più blocchi di quelli che possono essere indirizzati dai puntatori diretti, viene allocato un blocco che non fa parte del file, ma viene usato per contenere puntatori diretti ai blocchi successivi del file (indirizzamento indiretto singolo).

Se il file è particolarmente grande, un blocco pieno di puntatori diretti può non bastare, in questo caso sarà necessario usare uno o due livelli di indirizzamento (indirizzamento indiretto doppio o triplo).

Un puntatore indiretto doppio di inode punta a un blocco che contiene puntatori indiretti singoli, ciascuno dei quali punta ai blocchi contenenti puntatori diretti. Così il sistema operativo può seguire una catena fino a 4 di questi puntatori per accedere ai blocchi di un file molto grande.

Vi sono grandi differenze tra File System Ext2 e Ext3; su Ext3 il recupero dei dati è decisamente arduo e, in alcuni casi, addirittura impossibile; per garantire l’integrità dei dati dopo un malfunzionamento, il sistema azzera tutti i puntatori agli inode[12], che vanno irrimediabilmente persi una volta che il file è in stato non allocato.

Il contenuto del file originale sarà ancora presente nei blocchi di dati non allocati del File System, almeno fino a quando tali blocchi non saranno riutilizzati, ma non esiste una “mappa” per ricostruire quei blocchi di dati nel file originale.

I metodi tradizionali per il recupero dei file si basano su strumenti di “file carving” quali Scalpel e Foremost. Questi strumenti, imperniandosi sull’allocazione consecutiva dei blocchi di dati che compongono un file, consentono, adoperando una “signature“[13] – che normalmente identifica un particolare tipo di file -, il recupero della maggior parte o di tutto il file, raccogliendo via via i blocchi successivi. Se il formato del file include anche una “signature” di fine file, lo strumento sarà in grado di interrompere la raccolta dei blocchi appartenenti al file in esame.

Pur tuttavia, vi sono alcuni problemi derivanti dall’utilizzo di detta tecnica durante il recupero dei dati dai sistemi Linux:

  1. Data l’intrinseca struttura del sistema operativo, orientato ampiamente al testo, molti artefatti Linux mancano di “signature” valide.
  2. Ext3, come già evidenziato, utilizza i blocchi indiretti nel mezzo del contenuto del file per memorizzare i metadati. Questi “blocchi indiretti” – che Foremost ignorerà semplicemente sia come blocco che come contenuto – vengono utilizzati per archiviare i puntatori di riferimento ai blocchi di dati quando un file diventa troppo grande e non può più essere rappresentato dal numero relativamente piccolo di puntatori di riferimento all’inode; ciò potrebbe causare il danneggiamento dei file qualora vengano estratti assieme ai blocchi di dati che lo compongono;
  3. Il tentativo di recuperare un file raccogliendo blocchi consecutivi si interromperà quando verrà individuata una frammentazione del file su più aree del disco.

In calce la struttura degli Inode in Ext2/Ext3: gli offset e le lunghezze sono espressi in byte.
fig. 2

In generale, il layout Ext, si basa su blocchi sequenziali di 1024, 2048 o 4096 byte numerati e raggruppati, a loro volta, in gruppi.

Ogni catena di blocchi contiene metadati che documentano la sua struttura interna.

La disposizione generale di tutte le catene di blocchi è illustrata in Fig. 3.

Il superblocco contiene molti metadati essenziali del File System, come ad esempio il numero e la dimensione dei blocchi, il numero di inode e i blocchi riservati. La “group descriptor table” contiene le informazioni per ogni catena di blocchi nel File System e la “block bitmap” memorizza lo stato libero/utilizzato di ciascun blocco. Allo stesso modo, la “inode-bitmap” memorizza lo stato libero/utilizzato di ogni inode nella tabella degli inode. Il resto della catena di blocchi è costituito da dati consecutivi che vengono utilizzati per memorizzare i dati.
fig. 3

In tutti i File System Ext, quasi tutti i metadati di file/directory, come ad esempio timestamp, diritti di accesso, riferimenti a blocchi di dati, sono memorizzati nell’inode del file (i nomi dei file, ad esempio, non lo sono, sebbene non siano sempre considerati come metadati). Gli inode sono numerati, a partire dall’inode numero 1 e memorizzati nella tabella degli inode della rispettiva catena di blocchi.

Con la Ext3, per motivi di compatibilità con le versioni precedenti, sono state implementate solo poche modifiche alla struttura inode. Ad esempio, alcuni degli spazi precedentemente non utilizzati sono stati adoperati per introdurre nuovi attributi, come mostrato nella fig.4 (Per la struttura originale completa degli inode Ext3, si faccia riferimento alla fig.2).
fig. 4

Il layout generale di Ext4 è molto simile a Ext3 anche se ha subito alcune modifiche.

Una caratteristica, ad esempio, introdotta in Ext4 è il concetto dei cosiddetti “Flex Group”. I Flex Group combinano più gruppi di blocchi in un unico gruppo di blocchi logici. Solo il primo gruppo di blocchi contiene le bitmap di blocco e inode, nonché le tabelle di inode di tutti i gruppi di blocchi.

E ancora:

  • Spazio degli indirizzi a 48 bit;
  • Utilizzo di estensioni (Extend) invece di catene di blocchi indiretti;
  • Timestamp a 64 bit con precisione al nanosecondo;
  • Data e ora di creazione del file.

Il recupero dei dati, anche con detta versione del File System, è particolarmente ardua.

Pur utilizzando una tecnologia diversa da Ext3 basata sugli Extent, – cioè un gruppo di blocchi contigui invece del mapping dei blocchi indiretto – non cambia la la gestione dei puntatori che vengono comunque azzerati dopo la cancellazione di un file.

Oltre a ciò vi è un’ulteriore complicazione dovuta all’organizzazione dei File System di Linux in blocchi logici tramite la tecnologia LVM (Logical Volume Manager)[14].

Quindi il sistema oggetto di analisi, non si presenta come una passeggiata, anzi!

La necessaria e propedeutica carrellata degli aspetti tecnici più salienti ci consente di riepilogare brevemente la diversità tra i sistemi Windows e Linux.

Ma cosa c’è di realmente diverso in Linux rispetto a Windows, molto più conosciuto?

  • Non vi è alcun registro;
  • È necessario raccogliere le informazioni da fonti diverse e sparse;
  • La struttura del File System è diversa;
  • Non vi sono date di creazione file alla versione del File System nota come Ext4[15];
  • I metadati importanti vengano azzerati con la cancellazione dei file;
  • I file/dati sono per lo più composti da semplice testo;
  • Ottimo per la ricerca di stringhe e l’interpretazione dei dati;
  • Accesso complesso al File System data la presenza di Encryption, RAID, LVM (Logical Volume Manager)[16];
  • Molteplici partizioni – anche nascoste – da montare.

Linux usa il kernel come un singolo grande processo eseguito interamente in un unico spazio di indirizzamento, rappresentato da un singolo file binario statico. Tutti i servizi del kernel vengono eseguiti nello spazio di indirizzamento dedicato ed è il kernel stesso a richiamare direttamente le sue funzioni.

Windows utilizza invece programmi e sottosistemi in modalità utente e quindi limitati in termini di risorse di sistema a cui si ha accesso, al contrario della modalità kernel che ha, invece, accesso illimitato alla memoria di sistema e ai dispositivi esterni.

Mi si perdonerà la spiegazione forse elementare dell’operatività insita nei due sistemi ma ritengo necessario farne comprendere la differenza senza inutili tecnicismi (kernel monolitico e kernel ibrido).

Quindi, dove cercare? Cosa analizzare? Quali artefatti tenere in considerazione?

L’analisi forense di un sistema GNU/Linux può essere davvero ardua e rappresentare una vera sfida per un esperto di Digital Forensics. Da un lato il sistema fornisce una grande quantità di informazioni rispetto ad un sistema Windows, dall’altro, la sua prerogativa di sistema aperto consente all’utente con privilegi di amministratore, la compilazione del kernel includendo tutte le patch che desidera, trasformando l’analisi in un incubo.

Per meglio comprendere le analogie con Windows, si adopererà una tabella che confronta la posizione di alcuni dei file rilevanti ai fini delle indagini nei due sistemi.
fig. 5

È consigliato quindi, prima di intraprendere l’analisi del sistema, porsi alcune semplici domande:

  1. Quando è stato installato il sistema operativo Linux?
  2. Quale distribuzione Linux è stata installata?
  3. L’orologio e la time zone della macchina erano corretti?
  4. Qual’era l’indirizzo IP della macchina al tempo dell’accadimento?
  5. Chi era connesso alla macchina in corrispondenza della data e ora segnalate?
  6. Sono stati riscontrati accessi al server Web del cliente identificati in base alla data e ora segnalate?
  7. Vi è una cronologia dei comandi digitati?

Va tenuto in debita considerazione che, la fase più importante dell’analisi del caso che viene affidato, è costituita proprio dai dati da acquisire e soprattutto dalla profonda conoscenza delle strutture utili al reperimento delle evidenze rilevanti.

Nel caso di dati volatili, si ha davvero una sola possibilità di acquisirli correttamente; è necessario quindi documentare attentamente tutte le operazioni sin dalla fase di acquisizione forense.

Ma come rispondere correttamente alle domande poste?[17]

Di seguito verranno fornite le risposte seguendo lo stesso ordine delle domande; a riferimento si è adoperata la distribuzione Ubuntu 14.01.1.

  1. La data di installazione del sistema operativo può essere estrapolata dal contenuto del file “/root/install.log” oppure dai file .key contenuti nella directory /etc/ssh;
  2. La versione del sistema operativo e le informazioni sulla release sono identificate dal contenuto del file “/etc/os-release”;
  3. Le informazioni sul fuso orario della macchina sono identificate dal contenuto del file “/etc/localtime”, adoperando l’output del comando zdump. Per ulteriore conferma è possibile ricercare il file nella directory “/usr/share/zoneinfo”;
fig.6

  1. L’indirizzo IP della macchina è identificato dal contenuto del file “/etc/host” per gli indirizzi statici e dal contenuto dei file /etc/dhcp/dhclient.conf, /var/lib/dhclient/dhclient.leases,
    /var/run/dhclient.pid, var/lib/dhclient/dhclient.leases~ per gli indirizzi dinamici (DHCP);
  1. I dettagli delle attività di accesso degli utenti sono identificati dal contenuto dei file “/var/log/wtmp e “/var/log/auth.log”;
  2. I browser normalmente utilizzati sono Firefox e Chrome/Chromium. Gli artefatti di interesse sono identificati nel seguente modo:
  3. Il riepilogo dei dispositivi di archiviazione USB collegati è identificato dal contenuto del file “/var/log/syslog”. Le voci relative ai file recentemente utilizzati sono stati evidenziati dal contenuto di “/home/[username]/.local/share/recently-used.xbel”;
  4. La cronologia dei comandi digitati è rilevata dal contenuto del file “/home/[username]/.bash_history”. Non è possibile rilevarne i timestamp di esecuzione, dato che non è previsto di default. Va comunque tenuto in debito conto che la stessa cronologia può essere modificata o rimossa dall’utente. Nel caso di utilizzo di “sudo”, la cronologia può essere rinvenuta in “/var/log/auth.log” e “/var/log/sudo.log”.

Questi semplici quesiti consentono un iniziale approccio all’analisi forense del sistema Linux, avvalendosi successivamente dei molteplici strumenti a supporto delle indagini.La vera sfida che questi strumenti devono superare riguarda la necessità di non modificare o danneggiare, neanche minimamente o temporaneamente, nessuna delle periferiche che possono contenere dati sensibili.

Le distribuzioni forensi di Linux, quali ad esempio le italiane Caine, DeFT, la nuovissima TSURUGI o le straniere Paladin, Raptor, SIFT, Kali, Parrot e BlackBox consentono un’adeguata analisi e ricerca delle evidenze con ottimi tool automatici di ausilio.

Essi possono essere suddivisi in quattro macro-categorie:

  • Tool di acquisizione: consentono l’acquisizione delle evidenze digitali da una macchina;
  • Tool di analisi: consentono l’analisi delle evidenze ottenute in fase di acquisizione; a loro volta si suddividono in tool di analisi di basso livello e tool di analisi di alto livello; Fra i tool di analisi di alto livello è possibile individuare, inoltre, le seguenti categorie:
    • Tool di cracking: consentono il recupero, a partire da un’evidenza cifrata, dell’evidenza originale e/o la password utilizzata per la cifratura;
    • Tool integrati: supportano il consulente informatico forense nella ricerca, estrazione e stesura degli elaborati peritali, consentendogli il riporto, in modo dettagliato, delle informazioni rilevanti trovate.

Per l’analisi di ciò che è avvenuto sul sistema in esame, sono essenziali e indispensabili due strumenti: The Sleuth Kit basato su “The Coroner’s Toolkit” – https://www.sleuthkit.org – e log2timeline/Plaso – https://github.com/log2timeline/plaso/wiki/Using-log2timeline –

The Sleuth Kit e la sua estensione grafica Autopsy è ormai consolidato da anni e permette di eseguire la timeline del sistema basata sui metadati temporali del File System che, a mezzo dell’opzione “daily summary” consente anche la costruzione di un grafico (istogramma) contenente l’attività rilevata sul sistema durante ogni giorno e ad ogni ora del periodo selezionato. Autopsy ha funzione molto avanzate di gestione dei file, di analisi degli stessi – inclusi i file cancellati -, permettendo la visione degli stessi in diverse modalità, l’estrazione di immagini, l’analisi delle estensioni e del loro cambiamento.

Log2timeline con la nuova versione PLaso è uno strumento che permette l’estensione della timeline generata tramite TSK[18] aggiungendo attività ricavate da metadati o da informazioni interne ai file, quali ad esempio dati exif[19], di registro, eventi di sistema, log di antivirus, journaling NTFS, storia della navigazione internet, etc., consentendo un’agevole analisi degli accadimenti molto più precisa e puntale.

Un tool da non sottovalutare è Bulk Extractor, un software open source sviluppato da Simson L. Garfinkel, professore e ricercatore californiano, autore tra l’altro di altri utili progetti relativi alla computer forensics. Il software consente l’estrazione di mail, artefatti facebook, indirizzi e domini web, numeri di telefono, carte di credito, prefetch, indirizzi ip e molto altro ancora. Tramite accesso sequenziale a livello di settore, Bulk Extractor è in grado di estrarre da dischi, immagini forensi o directory di file, informazioni utili per gli investigatori senza la necessità di dover accedere al File System sottostante. Oltre al rilevamento delle informazioni direttamente disponibili sul disco durante il “parsing”, Bulk Extractor è in grado di rilevare, decomprimere e processare ricorsivamente i dati contenuti all’interno di archivi compressi con svariati algoritmi. Il software consente quindi accesso alle analisi dei contenuti dei vari file zip rar e via dicendo presenti nelle aree allocate e non allocate del sistema. Anche per questo aspetto, se non opportunamente configurati, diversi tool commerciali rischiano di trascurare informazioni rilevanti non parsificando gli archivi.

Il software produce delle “Feature Files”, ovvero dei file suddivisi per tipologia di dati estratti e contenenti le informazioni ritrovate. In fig. 7 è riportato un esempio di contenuto del “Feature File” denominato “domain.txt”:
Fig.7

Infine, per quanto riguarda il recupero di dati cancellati su sistemi Linux, ricordiamo Testdisk/Photorec, Scalpel e Foremost.

Testdisk permette di ricostruire partizioni danneggiate di qualsiasi tipo, indispensabile per la ricostruzione di supporti danneggiati.

Photorec consente il recupero dei file cancellati dalle aree di memoria non allocate. Il recupero utilizza la cosiddetta tecnica di carving, basata sulle firme dei file.

Foremost è il più famoso tool di carving su Linux, in grado di lavorare su file immagine (dd, Ewf, etc.) oppure direttamente sul dispositivo. Gli Header e i footer dei file da ricercare possono essere specificati nei file di configurazione o attraverso parametri della riga di comando. Una volta in esecuzione crea nella directory di output un file denominato “audit.txt” ed una serie di sub directory nominate con il tipo di file ritrovato (doc, jpg, tiff, etc.).

Scalpel è stato riscritto a partire da Foremost onde consentire un miglioramento di performance e riduzione dell’utilizzo di memoria. Nel caso di Scalpel, i file da identificare devono essere specificati nel file di configurazione “/etc/scalpel/scalpel.conf”.

Bene, per ora è tutto. Stay Tuned.

Note

Articolo a cura di Cosimo De Pinto

Download PDF

https://www.ictsecuritymagazine.com/articoli/analisi-forense-di-sistemi-linux/
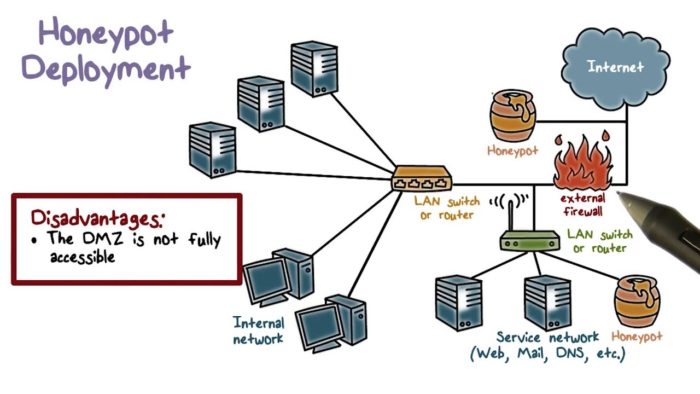


Onionshare, trasferire i file in modo anonimo e sicuro sfruttando la rete TOR

Quanti di noi utilizzano già la rete Tor (The Onion Router), che permette al momento la forma più sicura di anonimato per navigare in Internet, cercando così di salvaguardare la propria privacy? Ebbene, quello di cui vorrei parlavi oggi è un programma che consente di trasferire in modo sicuro e anonimo i file di qualsiasi dimensione utilizzando proprio la rete Tor. Possiamo trasferire un file a una persona remota senza dover utilizzare servizi di terze parti, come Cloud e Mailing che, se anche offrono un traffico cifrato, richiedono spesso la registrazione o comunque cercherebbero di profilarci e impicciarsi dei nostri affari.

RETE TOR E DEEP/DARK WEB

La rete Tor, per chi non la conoscesse, è però anche la rete che permette di navigare nel Deep/Dark Web (non è questa la sede per spiegare qual è la differenza tra i due), proprio grazie alla sua caratteristica di anonimato che consente così a malfattori di ogni tipo di portare avanti attività criminose forti del fatto di non poter essere individuati (ma questo non è sempre vero al 100%). Ma è anche la rete nella quale chi è vittima di censura nel proprio paese può invece esprimere le proprie idee ed aggiornarsi dei fatti che accadono nel mondo in modo critico e libero. Nel Deep Web, da vari anni, sono sbarcati progetti importanti proprio per poter raggiungere anche chi nel web tradizionale (definito Surface web) non può andarci.

ONIONSHARE

Attraverso il programma “OnionShare”, installato sul computer di chi trasferisce il file, viene avviato un Server Web accessibile in internet come servizio Tor Onion, viene quindi generato un link che va condiviso con chi deve scaricare il file e che da questo deve essere aperto attraverso il Tor Browser. A quel punto il destinatario non farà altro che scaricarsi il file, prelevandolo direttamente dal computer del mittente attraverso una connessione peer-to-peer, cifrata end-to-end, della rete Tor. Il destinatario non avrà bisogno di OnionShare, bensì solo del famoso Tor Browser. L’anonimato del Destinatario e quello del mittente sarà protetto da Tor.

OnionShare è un software sviluppato da Micah Lee, un ingegnere informatico, sviluppatore software open source che si occupa di sicurezza e privacy. Si batte per la libertà di internet e delle informazioni, lavora per “The Intercept” l’organizzazione giornalistica pluripremiata nata dopo che gli informatori della NSA, tra cui Edward Snowden, hanno rivelato la sorveglianza di massa perpetrata dalla NSA. È inoltre membro di “Freedom of the Press Foundation” l’organizzazione no-profit che protegge, difende e potenzia il giornalismo di interesse pubblico nel 21° secolo. È conosciuto anche perché ha collaborato direttamente con Snowden nella fabbricazione di “Haven” l’applicazione open source per Android in grado di proteggerci dagli “spioni” (mentre scriviamo si trova sul Play Store con il nome “Haven: Keep Watch (beta)”. Attraverso i sensori dello smartphone, quali microfono, rilevatore di luce e telecamere, che si attivano quando il proprietario si allontana, questa applicazione registra tutto ciò che accade, facendo da sentinella ai propri dati.

L’idea di OnionShare è venuta a Lee nel 2013 quando David Miranda, un giornalista del “The Guardian”, veniva perquisito e detenuto per nove ore all’aeroporto di Heathrow a Londra mentre stava cercando di imbarcarsi su un aereo per tornare a casa a Rio de Janeiro. Stava lavorando a un incarico giornalistico delicato e aveva con se una chiavetta USB cifrata che conteneva documenti governativi classificati. Per Lee doveva esistere un sistema più sicuro per trasferire documenti sensibili in tutto il mondo senza doverlo fare di persona rischiando così sia di perderli sia di farli cadere in mani sbagliate.

E del resto, non è un caso se dal 24 gennaio 2017 OnionShare è incluso nella distribuzione linux live “Tails”, famosa perché ha come slogan “Privacy per tutti dappertutto” permettendo di utilizzare internet in modo anonimo e sicuro e non lasciando tracce (se non espressamente voluto) sul computer che viene utilizzato per navigare. Per chi non ha le conoscenze tecniche per configurare Tor sul proprio computer e non vuole così correre alcun rischio, Tails risulta la soluzione ideale.

Conosciamo finalmente OnionShare, l’importante strumento di trasferimento dei file anonimo, utilizzato quotidianamente da centinaia di organizzazioni e professionisti che si occupano di libertà delle informazioni e da coloro che vogliono trasferire file all’altro capo del mondo in totale tranquillità, nonché utilizzato proprio dallo stesso Lee nella sua attività professionale. E conosciamone le caratteristiche più importanti.

La home page si presenta così …

Premendo il bottone “Download” giungeremo dove si trovano le piattaforme per le quali il programma è progettato. Per MacOS e Windows scaricheremo i binari dell’installazione, per le varie distribuzioni linux, invece, troveremo i comandi da digitare per scaricarlo ed installarlo.

Se invece premessimo “Learn More” verremo trasportati sulla pagina “OnionShare Wiki” dell’autore. Questa pagina GitHub è molto importante in quanto qui possiamo trovare tutte le guide che potranno servirci, le guide di installazione, di configurazione e di utilizzo del programma.

Per poter utilizzare OnionShare è necessario essere collegati alla rete Tor in quanto questa rappresenterà il canale di collegamento. Vedremo che ci saranno vari sistemi che questo strumento mette a disposizione per connettersi alla rete Tor. Quello scelto da noi è tramite il Tor Browser, quindi una volta scaricato e installato OnionShare, dovremo avviare il Tor Browser (supposto di averlo già presente sulla macchina) e lasciarlo aperto in background.

Se ci dimenticassimo di avviare il Tor Browser e provassimo ad aprire subito OnionShare, ci comparirebbe questo alert per ricordarcelo.

OnionShare, all’avvio, si presenterà come nell’immagine seguente (le maschere che si vedranno sono tratte da una installazione su Sistema Operativo Windows 10 e riguardano OnionShare versione 1.3.1).

Almeno la prima volta conviene aprire il pannello delle impostazioni premendo la rotellina in basso a destra in modo da configurare i parametri principali. Il pannello delle impostazioni appare come nell’immagine in basso.

Molte sono le impostazioni da poter regolare per ottimizzare il programma alle nostre esigenze.

Vediamo quali sono.

“Stop Sharing After First Download” Permette il download solo ad un utente, disabilitando la condivisione se un altro utente utilizza lo stesso link per scaricare. Ovviamente se vogliamo condividere il file a più utenti occorre disabilitare questo flag.

“Show Desktop Notifications” Fa comparire pop-up e notifiche sul computer quando un utente inizia, interrompe o completa un download.

“Using the Auto Stop Timer” Abilita una maschera nella finestra principale dell’applicazione dove è possibile impostare l’arresto della condivisione in base a data e ora. Per configurazioni particolari vedere l’OnionShare Wiki.

“Use a Persistent address” Di norma OnionShare fornisce un link da utilizzare per il download che vale solo una volta. Se si volesse riutilizzare il link per condivisioni successive occorre abilitare questo parametro. Questa impostazione è utile qualora si volesse organizzare una condivisione subito ma avviarla in data successiva, oppure se ci fossero problemi di connessione e poter continuare il download successivamente.
Deselezionando questo parametro si perderanno gli indirizzi persistenti eventualmente salvati in precedenza.
L’uso di questa impostazione salva la chiave privata nel file delle impostazioni di OnionShare. Quindi attenzione a non smarrire tale file perché significherebbe permettere ad altri di accedere alla nostra condivisione.

“Create Stealth Onion Services” Questa è una funzione che rende molto più sicuro OnionShare, ma anche molto più complesso il collegamento per chi dovrà ricevere il file. Normalmente, chiunque conosca il nostro indirizzo di condivisione Onion può collegarsi e quindi scaricare quanto stiamo pubblicando. Ovviamente cercheremo di condividere tale indirizzo solo con chi è autorizzato a farlo. Tuttavia, può succedere che nodi malevoli della rete Tor memorizzino il nostro indirizzo e provino a collegarsi ad esso così come un attaccante possa furtivamente venirne a conoscenza. Con la procedura Stealth invece, consigliata quando i file da trasferire sono davvero confidenziali, il ricevente dovrà inserire in un file di configurazione del proprio Tor Browser (nel file torrc) una determinata stringa che gli avremo fornito e in questo modo solo lui potrà scaricare il file anche se il link venisse a conoscenza di altri. Precise informazioni su come configurare questo servizio si possono trovare sulla pagina GitHub Wiki di Lee.

“How Should Onionshare Connect to Tor?” Qui è importante impostare come OnionShare si deve connettere alla rete Tor. Ricordiamo che è fondamentale essere connessi alla rete Tor perché il programma funzioni. Quattro sono le possibili scelte.

  • Utilizzare il servizo Tor che è incluso in OnionShare. Questo è il modo predefinito e più semplice con cui OnionShare si connette a Tor. Aprendo OnionShare verrà avviato un processo Tor in background configurato appositamente per OnionShare. Sarà un processo indipendente da altri processi Tor presenti sul computer.
    Qualora per determinati motivi la connessione Tor non dovesse riuscire ci sarà la possibilità di impostare la modalità Bridges.
  • Se abbiamo Tor Browser installato sul computer e vogliamo utilizzare questo per connetterci alla rete Tor basterà avviare Tor Browser prima di avviare OnionShare.
  • Possiamo anche installare Tor come servizio di sistema e dire a OnionShare di connettersi a questo. Sarebbe anche possibile connettersi al servizio Tor presente su un sistema remoto. Sarà possibile quindi decidere se connettersi al servizio Tor utilizzando una “control port” o un “socket file”. Per le configurazioni approfondite e per capire come installare Tor come servizio, l’OnionShare Wiki anche in questo caso sarà utilissimo.

Una volta che avremo configurato il programma e salvato le impostazioni, ci troveremo nuovamente sulla sua finestra principale e saremo pronti ad utilizzarlo. Nei passaggi seguenti vedremo il trasferimento di un grosso file (circa 3 Gb).

Il primo passo è quello di trascinare il file all’interno della maschera centrale di OnionShare oppure selezionarlo premendo il bottone “Aggiungi”. Nel nostro esempio abbiamo aggiunto il file ISO di Kali Linux 2018.3 come si vede nell’immagine in basso.

Ovviamente, anziché un file solo, avremmo potuto aggiungere più file utilizzando la stessa condivisione. A questo punto premiamo il grosso bottone verde che recita “Inizia la condivisione”. Dopo alcuni secondi, comparirà il link che dovremo fornire a chi dovrà ricevere il nostro file come vediamo nell’immagine seguente.

Il link fornito sarà costituito dal “nome di dominio .onion / slug” (dove slug sembrano essere parole generate automaticamente dalla pagina, leggibili dall’essere umano e che identificano la risorsa che si sta condividendo). Questo è il link che dovremo fornire al destinatario del file facendo attenzione, come è riportato sulla maschera del programma, che chiunque conosca quell’indirizzo potrà fare il download del file. Pertanto sarà necessario comunicare questo indirizzo in modo sicuro. Il destinatario del file quindi si collegherà attraverso il Tor Browser al link che ha ricevuto e visualizzerà quello che vogliamo trasferire.

Il destinatario non farà altro che premere “Download Files” per iniziare il trasferimento. Si tratta, come già detto, di una connessione Peer-to-Peer. Il tempo di trasferimento attraverso la rete Tor sarà ovviamente più lungo rispetto ad un download classico in quanto come sappiamo la rete Tor è costituita da molti nodi sui quali viene dirottato il traffico. Quindi file di grosse dimensioni potrebbero impiegare molto ad essere trasferiti. Nel nostro esempio per trasferire il file da 3 Gb abbiamo impiegato oltre quattro ore. Quando il destinatario premerà il bottone download, l’operazione verrà notificata al mittente il quale visualizzerà nella maschera del programma una barra di avanzamento del trasferimento.

L’icona raffigurante un utente in alto indica il numero 1 perché un utente sta effettivamente scaricando il nostro file, mentre lo 0 sulla destra indica che nessun utente ha ancora completato il trasferimento. Quando il trasferimento sarà completato sulla maschera comparirà il 100% ed il tempo trascorso per scaricarlo tutto, come illustrato nell’immagine che segue.

OnionShare, ora che il trasferimento è terminato (la barra di avanzamento in questa versione non giunge fino alla fine), ha chiuso la condivisione perché nei parametri abbiamo lasciato il check su “Stop Sharing After First Download”. Essendoci stato già un download, il link che il programma ci aveva fornito non è più utilizzabile. Se volessimo trasferire nuovamente questo file dovremmo premere “Inizia la condivisione”, quindi OnionShare ci fornirebbe un nuovo link di condivisione.

Se ci spostiamo dal destinatario noteremo che questo non avrà ricevuto il file così come è stato condiviso (kali-linux-kde-2018.3-amd64.iso) perché, invece, è stato inserito durante il trasferimento in un archivio compresso .zip. Sia che si trasferiscano più file, sia che se ne trasferisca uno solo, il risultato sarà comunque un archivio compresso da OnionShare. Una volta scompattato l’archivio, il destinatario avrà esattamente quello che il mittente ha voluto trasmettergli e tutto è avvenuto in modo cifrato e anonimo.

In un mondo come quello attuale dove gravano su di noi forme diverse di sorveglianza di massa, conoscere un ulteriore strumento di difesa è importante. Ricordandoci però sempre che in internet, non esiste garanzia di anonimato assoluto al 100%. Molti sono i fattori che potrebbero inficiarlo, spesso causati dallo stesso utente.

Articolo a cura di Antonio Sagliocca

Cyber Security Specialist, certificato “Ethical Hacker” e “Penetration Tester Professional”, si occupa di Vulnerability Assessment, Penetration Test e redazione di Alert di sicurezza.

Socio e Docente CLUSIT scrive su alcune riviste online ed è relatore a eventi pubblici di sensibilizzazione sulla sicurezza in Internet. Dal 2016 collabora con le Cattedre di “Informatica Giuridica” e “Informatica Giuridica Avanzata” dell’Università degli Studi di Milano.

Nel Gennaio 2017 per la rivista Internazionale di Informatica Giuridica “Ciberspazio e Diritto” vol. 18 n.57 (1-2017) edito da STEM Mucchi Editore, ha scritto la pubblicazione “Open Source Intelligence e Deep Web: scenari moderni delle Investigazioni Digitali”.

Ha scritto il capitolo VIII “Le minacce più comuni: difendersi da malware e da altri attacchi” del volume per studenti universitari “Tecnologia e Diritto – Fondamenti di informatica per il giurista” a cura di Giovanni Ziccardi e Pierluigi Perri pubblicato nel 2017 ed edito da Giuffrè Editore.

Download PDF

https://www.ictsecuritymagazine.com/articoli/onionshare-trasferire-i-file-in-modo-anonimo-e-sicuro-sfruttando-la-rete-tor/