Le principali novità introdotte dal Decreto n. 101 del 10 Agosto del 2018 rispetto agli obblighi previsti dal GDPR 2016/679 e Dlgs 196/03

In Italia il quadro normativo in materia di tutela dei dati personali è disciplinato dal Regolamento Europeo sulla Privacy e dal Codice Privacy novellato dal Decreto Legislativo 101/2018.

Un impianto normativo, che si può ben affermare, essere regolamentato su 2 livelli:

  • il primo, rappresentato da una norma di fonte superiore, quella “Europea” (il GDPR entrato in vigore il 25 maggio 2018), cui tutti gli Stati Membri dell’Unione devono indistintamente uniformarsi;
  • il secondo, rappresentato dal Codice per la protezione dei dati personali (codice della privacy Dlgs 196/2003) e dal Decreto legislativo n.101/2018 emanato il 10 agosto 2018 ed entrato in vigore il 19 settembre 2018.

L’iter di emanazione del Decreto 101/2018 attuativo del Nuovo Regolamento europeo è stato molto sofferto; prima di giungere all’emanazione sono stati vari i cambi di rotta sul Tavolo dei lavori:

  • nella prima fase la Commissione sembrava infatti più propensa ad abrogare “in toto” il vecchio codice privacy con l’obiettivo di alleggerire e semplificare la disciplina;
  • ad una seconda valutazione, è cambiato totalmente l’orientamento optando per una decretazione “modificatrice ed integrativa”. A tale impostazione si è addivenuti nella considerazione e nella consapevolezza di dover armonizzare ed inserire nuove indicazioni e disposizioni in un contesto caratterizzato ancora da “scarsa cultura della privacy” ed in un ambito normativo già ben stratificato e con non poche complessità pregresse.

La necessità di emanare il Decreto 101/2018 trova dunque il suo fondamento nell’esigenza di contemperare un duplice scopo:

  • il primo “abrogativo”, si procede all’abolizione di alcune disposizioni del vecchio codice: principi, diritti degli interessati, obblighi generali di titolari e responsabili, misure di sicurezza, adempimenti e notifiche nei confronti dell’Autorità;
  • il secondo “innovativo”, con l’inserimento e la modifica di nuove disposizioni perseguendo l’ambizione di completare il quadro della “nuova privacy” adeguando le vecchie disposizioni del Codice privacy rimanenti in vigore in una nuova rilettura tutta “europea” disciplinata dal GDPR.

Le maggiori novità introdotte con il D. Lgs 101/2018 sono notevoli. La loro applicazione risulta non priva di problematiche e complessità riconducibili alla difficoltà di interpretare in chiave più ampia la nuova spinta “innovativa” europea, tenuto conto di una cultura nazionale sulla Privacy, che a differenza dell’impostazione culturale anglosassone (ispiratrice del GDPR), la quale detta i principi cardine ispiratori, lasciando ampio spazio nella scelta delle misure e modalità di attuazione degli stessi, è abituata al contrario a ricevere dal legislatore italiano indicazioni, modalità di attuazione e linee guida il più possibile precise, puntuali, dettagliate “step by step”, che a livello attuativo hanno lasciato sicuramente in passato, un ridotto margine di “interpretazione”. È evidente che di conseguenza nel nuovo scenario “applicativo” così impostato sull’”accountability” professionisti e capi di Imprese facciano fatica ad abbandonare “certezze” del passato per  adattarsi a questo nuova mentalità “libertina” nella quale il rischio di “cadere in scelte errate” si fa più elevato,  esponendo le aziende  a conseguenze di non poco rilievo sotto il profilo sanzionatorio.

Nell’adeguamento al Nuovo Regolamento europeo, il Decreto attuativo 101/2018, se da un lato non introduce novità rilevanti in merito a temi quali l’informativa ed il consenso regolamentati dal GDPR (ad eccezione di alcune disposizioni sui minori, sugli studenti, sul trattamento di dati genetici, biometrici e sanitari), dall’altro, detta ed introduce invece rilevanti modifiche riguardanti le sanzioni, i diritti dell’interessato, l’utilizzabilità dei dati acquisiti in violazione delle disposizioni, l’attribuzione al Garante di poteri più forti e compiti ulteriori, le modalità di attuazione del GDPR per le micro, piccole e medie imprese, i servizi dell’informazione e i minori, i codici deontologici, le regole di condotta, il trattamento di “categorie particolari di dati” per finalità di ricerca scientifica, fini statistici, ricerca storica e di rilevante interesse pubblico.

Di seguito un riepilogo delle principali modifiche attuative apportate:

Principi, consenso e informativa

Consenso dei minori in relazione ai servizi della società dell’informazione (Art.2-quinquies)

L’età minima richiesta al minore per esprimere il consenso è stata abbassata a 14 anni. Sotto tale soglia il consenso per essere ritenuto lecito dovrà essere prestato da chi esercita la potestà genitoriale.

Trattamento dei dati sanitari, genetici e biometrici (Art.2-septies, Art.100, Art. 104, Art. 110)

Non occorre più il consenso per il trattamento dei dati sanitari, genetici e biometrici se tali dati vengono trattati per finalità di diagnosi, cura, ricerca scientifica, biomedica o epidemiologica. Vista la “particolarità” dei dati sarà il Garante a dare indicazione sulle “misure di garanzia” da adottare nel trattamento di tali dati.

Trattamento di dati per fini di rilevante interesse pubblico (Art.2-sexies)

Viene individuato un elenco di trattamenti per categorie “particolari” di dati il cui trattamento trova legittimazione nel presupposto che vengano effettuati per l’esecuzione di un compito di interesse pubblico o connesso all’esercizio di pubblici poteri (accesso a documenti amministrativi e accesso civico, tenuta degli atti e dei registri dello stato civile, delle anagrafi della popolazione residente in Italia e dei cittadini italiani residenti all’estero, delle liste elettorali, rilascio di documenti di riconoscimento o di viaggio o cambiamento delle generalità, tenuta di registri pubblici relativi a beni immobili o mobili, tenuta dell’anagrafe nazionale degli abilitati alla guida e dell’archivio nazionale dei veicoli, cittadinanza, immigrazione, asilo, condizione dello straniero e del profugo, stato di rifugiato etc.)

Informativa ed invio di curriculum (Art.111-bis)

L’informativa privacy secondo le nuove indicazioni, potrà essere resa anche successivamente, ovvero al momento del primo contatto utile con il soggetto che ha proposto la sua candidatura con l’invio spontaneo del proprio curriculum, al fine della instaurazione di un rapporto di lavoro.

Figure intermedie operanti sotto l’autorità del titolare o responsabile (Art.2-quaterdecies)

Viene introdotta la figura del “soggetto designato” o “autorizzato”. Il Titolare ed il Responsabile, infatti, potranno delegare compiti e funzioni specifiche che il soggetto nominato dovrà svolgere sotto la loro diretta autorità e responsabilità.

Sanzioni

Sanzioni Amministrative Pecuniarie (Art. 166)

Sono definiti i criteri di applicabilità delle sanzioni amministrative pecuniarie di cui all’art. 83 GDPR.

Con il Decreto attuativo n. 101/2018 si definiscono i criteri secondo i quali applicare le sanzioni. Dall’applicazione delle sanzioni di minore entità, che possono raggiungere i 10 milioni di euro per i singoli e per le aziende fino al 2% del fatturato globale annuo riguardanti la violazione degli obblighi previsti per i titolari ed i responsabili, a quelle di maggiore entità, che possono arrivare a 20 milioni di euro per i singoli o fino al 4% del fatturato mondiale annuo per le aziende, a prescindere da dove sia la sede principale che può essere anche fuori dall’Europa.

Sanzioni penali (artt.167 e ss.)

Vengono introdotti reati più specifici in relazione al “Trattamento dei dati”. Le sanzioni prevedono misure che vanno da 6 mesi fino ad arrivare ai casi più gravi a 6 anni di reclusione “…Chiunque, al fine di trarre per sé o per altri profitto ovvero di arrecare danno all’interessato, operando in violazione di quanto disposto dal Regolamento arreca nocumento all’interessato, sarà punito” per i reati di:  1) Trattamento illecito di dati (reclusione da 1 a 3 anni);2) Comunicazione e diffusione illecita di dati personali oggetto di trattamento su      larga scala (reclusione da 1 a 6 anni);3) Acquisizione fraudolenta di dati personali oggetto di trattamento su larga scala (reclusione da 1 a 4 anni); 4) Falsità nelle dichiarazioni al Garante e interruzione dell’esecuzione dei compiti o     dell’esercizio dei poteri del Garante (da 6 mesi a 3 anni);5) Inosservanza dei provvedimenti del Garante (da 3 mesi a 2 anni). 

Diritti dell’interessato

Esercizi dei diritti dell’interessato – Limitazioni (artt. 2-undecies e 2-duodecies)

I diritti riconosciuti all’interessato dal Regolamento (GDPR) non possono essere esercitati con richiesta al titolare del trattamento ovvero con reclamo ai sensi dell’articolo 77 del Regolamento qualora dall’esercizio di tali diritti possa derivare un pregiudizio effettivo e concreto su interessi normativamente tutelati (antiriciclaggio, sostegno delle vittime di atti estorsivi, attività delle commissioni parlamentari d’inchiesta, controllo dei mercati finanziari e monetari, esercizio di diritti in sede giudiziaria e per ragioni di giustizia, indipendenza della magistratura). Diritto all’eredità del dato in caso di decesso (Art.2 –terdecies).I diritti riferiti a persone decedute possono essere esercitati da chi ha un interesse proprio o agisce a tutela dell’interessato, in qualità di suo mandatario o per ragioni familiari meritevoli di protezione.

Autorità di controllo (tutela amministrativa e giurisdizionale)

Forma di tutela alternativa per l’interessato (Art.140-bis)

Qualora l’interessato ritenga che i diritti di cui gode in base alla normativa sulla protezione dei dati siano stati violati deve scegliere quale forma di “tutela” attivare. Potrà scegliere di proporre il reclamo dinanzi al Garante o in alternativa il ricorso dinanzi all’Autorità giudiziaria competente. Una forma di tutela esclude l’altra.

Rafforzamento dell’indipendenza dei poteri e dei compiti del Garante (Art.2 quater)

Estensione e rafforzamento dei poteri del Garante (emanazione di provvedimenti specifici in merito al trattamento di dati particolari ; emanazione di provvedimenti che diano indicazione sulle “misure di sicurezza” anche tecniche necessarie a garantire i diritti degli interessati; adozione di provvedimenti riguardanti codici di condotta e regole deontologiche).

Modalità semplificate per le PMI (Micro, piccole e medie imprese) (Art.154-bis)

Il Garante dovrà adottare linee guida di indirizzo riguardanti le misure organizzative e tecniche di attuazione dei principi del Regolamento predisponendo nello specifico, modalità semplificate di adempimento degli obblighi del titolare del trattamento delle micro, piccole e medie imprese.

Legittimazione ad agire in giudizio del Garante (Art. 154-ter)

L’Autorità del Garante può agire in giudizio nei confronti del titolare o del responsabile in caso di violazione delle disposizioni in materia di protezione dei dati personali.

Segnalazione all’Autorità del Garante (Art. 144)

Non solo l’interessato, ma “chiunque può rivolgere una segnalazione che il Garante può valutare anche ai fini dell’emanazione dei provvedimenti di cui all’articolo 58 del Regolamento.”

Fase transitoria agevolata nell’applicazione delle sanzioni amministrative pecuniarie

Attenuazione delle sanzioni per la prima fase di applicazione (Art. 22, comma 13)

“Per i primi otto mesi dalla data di entrata in vigore del presente decreto, il Garante per la protezione dei dati personali tiene conto, ai fini dell’applicazione delle sanzioni amministrative e nei limiti in cui risulti compatibile con le disposizioni del Regolamento (UE) 2016/679, della fase di prima applicazione delle disposizioni sanzionatorie.”

Per i procedimenti ancora pendenti relativi a violazioni del vecchio codice Privacy è prevista una definizione agevolata attraverso l’istituto dell’oblazione (le imprese potranno usufruire di una sanzione in forma ridotta da pagare entro 90 gg dall’entrata in vigore del D.Lgs n.101/2018).

Conclusioni

In questo nuovo contesto di “mutamento”, tutto è demandato all’Autorità Garante di “controllo” per la protezione dei dati; spetterà a tale Organismo armonizzare le nuove disposizioni garantendo un minimo di certezza ad operatori, manager di azienda, professionisti e Pubblica Amministrazione. Sono questi infatti i soggetti che, nell’applicazione e nell’interpretazione delle normative nazionali, si confrontano ormai quotidianamente con le criticità prodotte dai dettami “privacy” dinanzi alle quali, nel dubbio conseguente al “vuoto normativo”, possono per il momento percorrere l’unica “via certa rappresentata dalla vincolatività della norma di fonte superiore: il regolamento europeo 2016/679 (GDPR).

Sitografia:

Articolo a cura di Maria Bolognesi
Laureata in giurisprudenza nel 2004 con tesi in “Iure Civili” presso l’Università degli Studi “La Sapienza” di Roma.

Dal 2004 al 2009 ha collaborato presso diversi studi legali in materia di Diritto penale, Diritto civile, Diritto societario e commerciale.

Attualmente collabora con NSR S.r.l. in qualità di Senior Legal Consultant, prestando la propria opera prevalentemente in ambito Privacy & Data Protection, in particolare come supporto alla funzione di DPO per diverse aziende del settore privato.

Download PDF

https://www.ictsecuritymagazine.com/articoli/le-principali-novita-introdotte-dal-decreto-n-101-del-10-agosto-del-2018-rispetto-agli-obblighi-previsti-dal-gdpr-2016-679-e-dlgs-196-03/


Facebook OSINT: come ricavare informazioni tramite specifiche Query

Le tecniche OSINT permettono di ricavare informazioni da fonti pubbliche come:

  • Mezzi di comunicazione — giornali, riviste, televisione, radio e siti web.
  • Dati pubblici — rapporti dei governi, piani finanziari, dati demografici, dibattiti legislativi, conferenze stampa, discorsi, avvisi aeronautici e marittimi.
  • Motori di ricerca e community

Anche sulle piattaforme Social è possibile ricavare informazioni senza per forza far riferimento a software del settore come Maltego e relativi Transform (es. SocialLinks).

Facebook è una di quelle piattaforme che meglio si presta alla raccolta d’informazioni.

Nell’articolo sarà illustrato un procedimento che potrà poi essere automatizzato in completa autonomia, scrivendo qualche riga di codice o semplicemente creandosi un form in HTML.

Il “Facebook OSINT” si avvale quindi di due grosse macro-categorie:

  • Google Dork (solo tecnica)
  • Manipolazione delle URL

Queste tecniche permettono di scoprire informazioni su persone, gusti, mi piace, recensioni, luoghi visitati e tutte quelle informazioni che non sono reperibili dal profilo dell’utente stesso.

Il primo passo è quello di cercare il codice numerico dell’utente Facebook, per poterlo poi inserire in specifiche posizioni di una URL.

Le URL che utilizzeremo sono così composte:

  1. URL statica
  2. ID Utente
  3. Termine di ricerca

| URL statica | ID utente | Variabile di ricerca |

https://www.facebook.com/search/0000000/photos-liked

Seguendo questo piccolo schema, che sarà sempre identico nella struttura, possiamo utilizzare le variabili di ricerca.

Per ogni variabile di ricerca, ho specificato il corrispondente in italiano e la struttura della URL

  • Places Visited / Luoghi visitati
    https://facebook.com/search/[User ID]/places-visited
  • Recent Places Visited / Luoghi visitati di recente
    https://facebook.com/search/[User ID]/recent-places-visited
  • Places Checked/In / Luoghi in cui ci si è registrati
    https://facebook.com/search/[User ID]/places-checked-in
  • Places Liked / “Mi Piace” ai luoghi
    https://facebook.com/search/[User ID]/places-liked
  • Pages Liked / “Mi Piace” alle pagine
    https://facebook.com/search/[User ID]/pages-liked
  • Photos By User / Foto dell’utente
    https://facebook.com/search/[User ID]/photos-by
  • Photos Liked / “Mi Piace” alle foto
    https://facebook.com/search/[User ID]/photos-liked
  • Photos Of /Tagged / Foto in cui l’utente è stato taggato
    https://facebook.com/search/[User ID]/photos-of
  • Photos Comments / Commenti alle foto
    https://facebook.com/search/[User ID]/photos-commented
  • Photos Interacted / Interazioni con foto
    https://facebook.com/search/[User ID]/photos-interacted
  • Photos Interested / Foto di interessi
    https://facebook.com/search/[User ID]/photos-interested
  • Photos Recommended / Foto raccomandate
    https://facebook.com/search/[User ID]/photos-recommended-for
  • Apps Used / App in uso
    https://facebook.com/search/[User ID]/apps-used
  • Videos / Video
    https://facebook.com/search/[User ID]/videos
  • Videos Of User / Video dell’utente
    https://facebook.com/search/[User ID]/videos-of
  • Videos Tagged / Video con Tag
    https://facebook.com/search/[User ID]/videos-tagged
  • Videos By User / Video per l’utente
    https://facebook.com/search/[User ID]/videos-by
  • Videos Liked / “Mi Piace” ai video
    https://facebook.com/search/[User ID]/videos-liked
  • Video Comments / Commenti ai video
    https://facebook.com/search/[User ID]/videos-commented
  • Future Event Invitations / Inviti agli eventi futuri
    https://facebook.com/search/[User ID]/events
  • Events Year / Eventi per anno (da specificare)
    https://facebook.com/search/str/[User ID]/events/[Year]/date/events/intersect/
  • Events Created Year / Eventi creati dall’utente in un anno specifico (da indicare)
    https://facebook.com/search/str/[User ID]/events-created/[Year]/date/events/intersect/
  • Events Invited Year / Inviti agli venti in un anno specifico (da indicare)
    https://facebook.com/search/str/[User ID]/events-invited/[Year]/date/events/intersect/
  • Events Joined Year / “Partecipo\Mi interessa” agli venti in un anno specifico (da indicare)
    https://facebook.com/search/str/[User ID]/events-joined/[Year]/date/events/intersect/
  • Posts by User / Post dell’utente
    https://facebook.com/search/[User ID]/stories-by
  • Posts by Year / Post dell’utente per anno (da specificare)
    https://facebook.com/search/[User ID]/stories-by/[Year]/date/stories/intersec
  • Posts Tagged / Post con Tag
    https://facebook.com/search/[User ID]/stories-tagged
  • Posts Liked / “Mi Piace” ai Post
    https://facebook.com/search/[User ID]/stories-liked
  • Posts Commented / Commenti ai post
    https://facebook.com/search/[User ID]/stories-commented
  • Employers / Luogo di lavoro\Datore di lavoro\Azienda
    https://facebook.com/search/[User ID]/employers
  • Reviews / Recensioni
    https://facebook.com/[User ID]/reviews
  • Groups / Gruppi
    https://facebook.com/search/str/[User ID]/groups
  • Co/Workers / Colleghi\Collaboratori
    https://facebook.com/search/[User ID]/employees
  • Friends / Amici
    https://facebook.com/search/[User ID]/friends
  • Followers / Followers
    https://facebook.com/search/[User ID]/followers
  • Relatives / Parenti
    https://facebook.com/search/[User ID]/relatives
  • Friends’ Likes / “Mi Piace” degli amici alle pagine
    https://facebook.com/search/[User ID]/friends/pages-liked

C’è da specificare che tutto ciò è normale, non si tratta di un bug o altro, ma è proprio Facebook che è strutturato in questa maniera; le limitazioni alla privacy sono decise da ogni singolo utente che interagisce con la piattaforma.

Un profilo che utilizza tutti gli accorgimenti di privacy possibili, interagendo con un altro utente che non le utilizza, deve “sottostare” alle impostazioni di quest’ultimo.

Riassumendo, nelle interazioni, chi ha il livello di privacy più basso, decide la visibilità o meno delle informazioni.

Di seguito, ho voluto effettuare degli esempi pratici proprio per constatare l’efficacia di una indagine OSINT condotta in questo modo:

Ho preso come esempio il profilo Facebook di Bill Gates (questa tecnica vale sia per i profili che per le pagine):

https://www.facebook.com/BillGates/

Fig1 – Pagina\Profilo di Bill Gates

Adesso occorre ricavare l’ID del profilo.

Per semplificare i passaggi ho utilizzato un tool online molto intuitivo

Find your Facebook ID
https://findmyfbid.com/

Fig2 – Inserimento del link al profilo nel form del servizio “Find your Facebook ID”

Inserendo la URL del profilo, come da immagine, ci viene immediatamente restituito l’ID 216311481960

Fig3 – ID del profilo di Bill Gates

Adesso che abbiamo l’ID, possiamo svolgere tutte le ricerche che desideriamo, l’importante è che nello stesso browser, ci sia una sessione Facebook attiva, dato che la piattaforma blocca qualsiasi richiesta effettuata dall’esterno.

Non occorre essere amici del profilo o seguire la pagina oggetto di studio, può bastare anche un profilo TEST.

Vediamo che foto piacciano a Bill

| URL statica | ID utente | Variabile di ricerca |

https://www.facebook.com/search/216311481960/photos-liked

Fig4 – Dettaglio delle foto dove Bill ha messo un “Mi Piace”

Con lo stesso identico procedimento di prima, possiamo vedere tutti i commenti effettuati sotto le foto

https://www.facebook.com/search/216311481960/photos-commented

Fig5 – Dettaglio delle foto commentate

Fig6 – Il commento inserito sotto una foto

Qui invece abbiamo la lista delle pagine che Bill segue

https://www.facebook.com/search/216311481960/pages-liked

Fig7 – Lista delle pagine seguite

Abbiamo visto che, anche se si tratta di una pagina, lo stesso identico procedimento è possibile effettuarlo con il profilo personale di un utente

Effettuando la stessa prova con la pagina di Mark Zuckerberg, otteniamo altri risultati molto dettagliati

Il primo passo è sempre quello di ricavare l’ID utente partendo dal link del suo profilo:

https://www.facebook.com/zuck

Con lo stesso metodo di prima, utilizziamo il servizio “Find your Facebook ID”

Fig8 – Inserimento del link utente nel form


Fig9 – ID utente restituito dal servizio

 Ricostruendo la URL, abbiamo i seguenti parametri

| URL statica | ID utente |

https://www.facebook.com/search/4/

Analizzando i risultati, riusciamo a trovare i vari commenti lasciati da Mark su varie foto

https://www.facebook.com/search/4/photos-commented

Fig10 – Varie foto commentate da Mark

Fig11 – Dettaglio di un commento

Si è parlato anche delle tecniche di “Dorking”, però possono essere utilizzate per ottenere informazioni a largo spetto.

Infatti, se utilizzassimo la query “Photos commented on by Bill Gates” come nell’esempio precedente, otterremmo dei risultati grossolani.

Se addirittura venisse utilizzata per un nome comune come ad esempio Mario Rossi, i risultati sarebbero numerosi, ma prenderebbe i dati di tutti gli utenti che hanno quel nome e cognome

Fig12 – Query di ricerca in Facebook

Difatti, inserendo la ricerca su Facebook nella relativa casella, otterremo anche una URL non attinente a quella in esame

https://www.facebook.com/search/top/?q=photos%20commented%20on%20by%20bill%20gates&epa=SEARCH_BOX

Per motivi di privacy sulla pubblicazione dell’articolo, ho evitato di analizzare profili personali, ma posso assicurare che le informazioni ottenute con questa tecnica sono molte e sui profili che adottano tutte le impostazioni di privacy al massimo, i risultati sono ottimi.

Articolo a cura di Sergio Caruso

Download PDF

https://www.ictsecuritymagazine.com/articoli/facebook-osint-come-ricavare-le-informazioni-tramite-specifiche-query/


Processo di Governance della Privacy

Introduzione

La tematica della Compliance alle normative in tema di Privacy e del trattamento dei dati individuali ha un peso sempre crescente nella definizione delle strategie aziendali le quali, nel corso del tempo, hanno approcciato a tali tematiche implementando processi e sistemi al fine di adempiere alle prescrizioni declinate dalle normative di riferimento.

In tale contesto, nell’ottica di un’implementazione ed evoluzione continua del processo di Data Protection necessario per le imprese e di compliance rispetto al nuovo regolamento, sarà necessario avviare un processo di analisi e definizione di un modello che le permetta di valutare l’attuale status di conformità dell’organizzazione, di eseguire un assessment e di misurare lo stato di esposizione al rischio.

Al fine da identificare, definire, implementare e gestire nel tempo le evoluzioni organizzative, processive e tecnologiche necessarie alle aziende, in linea con le strategie e le necessità del business, in riferimento alla nuova normativa europea in ambito Privacy, si rende necessario dotarsi di servizi per la realizzazione di una piattaforma di supporto alla Governance della privacy in linea con la normativa “GDPR” in grado di assicurare un adeguato presidio alla gestione del:

  • Registro Dei Trattamenti
  • Registro Dei Data Breach

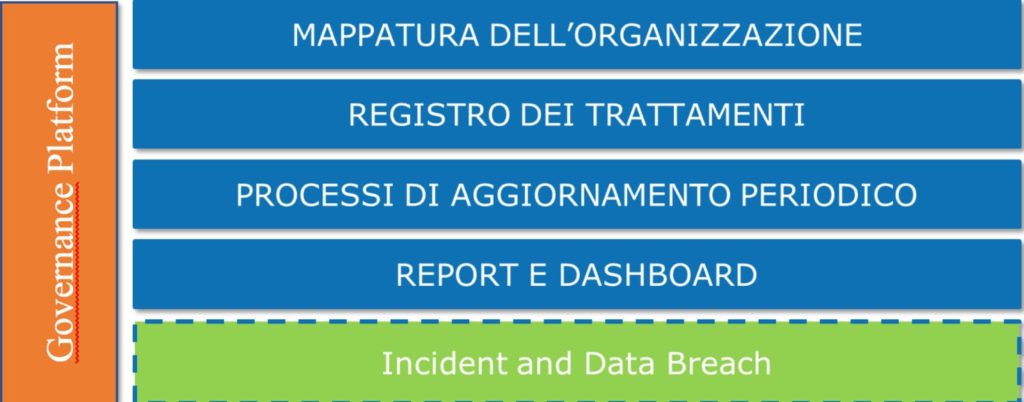
La realizzazione di una piattaforma di supporto alla Governance della privacy in grado di assicurare la gestione delle funzionalità dei Trattamenti” e dei consensi correlati; “Registro Dei Data Breach” in linea con la normativa “GDPR”, consentendo agli attori coinvolti di svolgere le azioni previste sui dati di competenza.

In particolare, la componente “Registro dei Trattamenti”  dovrà consentire la gestione di tutti i trattamenti, il legame con l’organizzazione aziendale, con le banche dati e gli strumenti applicativi nonché tutte le informazioni di dominio che contribuiscono alla caratterizzazione dei singoli trattamenti (finalità, base giuridica, tipologia del consenso/contratto, tipologia dati trattati, categorie di interessati e legame con le misure di sicurezza identificate a valle dell’analisi dei rischi e/o della Data Protection Impact Assessment – DPIA).

La componente “Registro Dei Data Breach”  dovrà consentire la gestione di tutte le violazioni di dati personali verificatesi all’interno del contesto aziendale riportando: la tipologia (tipo e natura) del dato violato – dettagli relativi alla violazione (disponibilità dati violati,  misure di sicurezza) – dettagli sull’incident (data ora, posizionamento dei dati, eventuale causa della violazione, numerosità persone impattate dalla violazione, Remediation Plan) – il livello di gravità della violazione dei dati personali.

Inoltre, dovranno essere gestite su base storica le informazioni che riguardano le comunicazioni con gli interessati dalla violazione e con le autorità di controllo includendo la gestione dei documenti inviati e ricevuti.

Impatti del GDPR

La conformità al GDPR richiede un impegno considerevole, mettere in campo una serie di azioni e tecnologie specifiche finalizzate a tutelare i dati trattati dall’azienda al fine di:

  • proteggere i dati durante la memorizzazione e il transito attraverso la rete;
  • garantire la consapevolezza dei rischi tramite un’analisi dei log costante e monitoraggio di chi sta facendo cosa sui vari filesystem di rete;
  • consentire azioni preventive, correttive in realtime contro le vulnerabilità o incident rilevati che possano rappresentare un pericolo per i dati;
  • fornire strumenti di valutazione per l’efficacia delle policy di sicurezza;
  • implementare meccanismi di recupero dei dati che consentano di ripristinare l’accesso ai dati ed ai sistemi quando un incidente ne pregiudica la disponibilità̀;
  • aumentare la consapevolezza degli utenti relativamente alle minacce in termini di sicurezza informatica che si trovano ad affrontare quotidianamente tramite una formazione/informazione, anche solo basilare ma costante;

Il GDPR declina una serie di obblighi e benefici per quanto riguarda le misure tecniche e organizzative tecniche poste in essere per garantire la sicurezza dei dati trattati ad esempio:

  • Tali obblighi devono essere implementati dal Titolare e dal Responsabile del trattamento dei dati personali (art.24 GDPR);
  • I principi di privacy by design e privacy by default sono inclusi in appropriate misure tecniche e organizzative (art.25 GDPR);
  • Danno efficacia al diritto alla portabilità̀ dei dati personali (articolo 20 GDPR) e al diritto all’oblio (art.17 GDPR);
  • Dimostrano che il Titolare e il Responsabile del trattamento hanno garantito un livello adeguato di protezione dei dati personali;

Misure Tecniche

Le misure tecniche includono i controlli relativi alla pseudo anonimizzazione, (procedimento che comporta la possibile attribuzione di determinate qualità a un interessato specifico solo attraverso l’utilizzo di informazioni aggiuntive, tipicamente l’impiego di chiavi crittografiche, sistemi di autenticazione, politiche per le password, ecc. e deve essere completato per quanto riguarda le Applicazioni IT utilizzate per l’elaborazione dei dati personali. Nella compilazione delle misure tecniche la funzione IT dovrà fare riferimento alle applicazioni IT utilizzate per i trattamenti di dati personali.

Misure Organizzative

Le misure organizzative includono i controlli relativi alle istruzioni operative fornite ai responsabili del trattamento dei dati e agli incaricati, controlli critici che ogni azienda dovrebbe implementare per mettere in sicurezza la propria infrastruttura.

Di seguito uno schema funzionale della Piattaforma di Governance.

Figura 1 – Architettura Funzionale Registro Trattamenti.

Considerazioni

Partendo dal presupposto che il grado di sicurezza di un’azienda sia strettamente legato ai processi organizzativi, dove procedure e sensibilizzazione verso i dipendenti sono gli elementi “core”, le soluzioni tecnologiche finalizzate alla risoluzione di specifiche problematiche dovranno essere individuate analizzando l’ambito secondo reali esigenze e soprattutto garantire un’integrazione completa della preesistente infrastruttura tecnologica al fine da massimizzarne benefici e costi.

La sicurezza è guidata dai processi di business, i quali sono concepiti come attività nelle quali operano: persone, sistemi, infrastrutture, in genere autonomi e interdipendenti, interni ed anche esterni.

La garanzia della corretta operatività e interazione tra i processi e quindi del flusso delle informazioni è data dalla gestione della sicurezza, la quale provvede non solo alla prevenzione di: errori umani e/o procedure, infiltrazioni e attacchi, ma, soprattutto, è arbitro della corretta interazione tra i processi e scambio delle informazioni.

Una soluzione per il monitoraggio della Privacy implica un approccio condiviso, è l’impiego di strumenti omogenei che siano in grado di garantire un framework completo che inizi soprattutto dall’analisi del processo di business fino ad arrivare al processo tecnologico  come ad esempio nell’ambito della protezione dei dati attraverso il processo di cifratura delle informazioni classificate “sensibili” con impiego di soluzioni preconfezionate o sviluppate ad hoc che tengano in considerazione tutto il ciclo di vita del dato (residente o in transito).

Articolo a cura di Cristian Rei

Download PDF

https://www.ictsecuritymagazine.com/articoli/processo-di-governance-della-privacy/


Analisi e SMT (Satisfiability Modulo Theories)

Sicurezza e matematica, ovvero quando la matematica viene in soccorso della sicurezza per renderla più efficiente in termini di tempo e più solida in termini di soluzioni. In particolare in questo articolo vedremo come la security utilizza l’SMT, Satisfiability Modulo Theories (Riquadro 1), in vari campi.

Gli SMT solver non sono uno strumento nuovo, così come non è innovativo il loro utilizzo nell’ambito della sicurezza. Una maggiore capacità dell’hardware e una migliore resa degli algoritmi che stanno dietro ai solver hanno reso le soluzioni che coniugano sicurezza e SMT ampiamente utilizzate e utili a risolvere problemi che fino a qualche tempo fa erano noiosi, quindi soggetti ad errore, o, peggio ancora, non facilmente risolvibili. Inoltre, la complessità delle nuove tecniche di offuscamento, ma anche del software in generale, ha reso necessario un nuovo tipo di tool e un nuovo tipo di operazioni di analisi.

I campi riconducibili alla sicurezza che fanno uso di un SMT solver possono essere ricondotti a tre grandi famiglie:

  • Ricerca di bug
    • Fuzzing
    • Analisi
  • Generazione di exploit
    • Generazione di exploit automatizzata
    • Proof of Concept
    • Generazione di payload automatizzata
  • Malware Analysis
    • Obfuscation
    • Packing
    • Anti-debugging
    • Crittoanalisi

Vediamo in dettaglio come alcune di queste operazioni si avvalgono di un SMT solver.

Riquadro 1: breve introduzione a SMT e SAT

Non vedremo nel dettaglio gli SMT, ma ci basta sapere che questi strumenti funzionano e si basano su solide teorie matematiche.

In matematica una formula booleana (che ritorna i valori vero o falso) si dice soddisfacibile se esiste almeno un valore delle variabili per le quali quella formula è verificata. Per la soluzione sono possibili tre stati:

  • La formula non può essere soddisfatta
  • La formula può essere soddisfatta
  • Risultato ignoto (possibile timeout)

Gli SMT si occupano proprio di questo: data una formula determinano il suo stato e, se esistono, i valori delle variabili che la verificano.

Gli SMT solver utilizzano dei SAT solver come backend: in pratica li possiamo vedere rispettivamente come linguaggio di alto livello e assembly, ovvero, i SAT solver sono molto più efficiente ma anche più complessi da programmare e manutenere.

Ricerca di bug

Symbolic execution e concolic execution

Senza scendere nei dettagli di queste analisi, che vedremo meglio in un prossimo articolo, vediamo ora come gli SMT solver intervengono in tali casi.

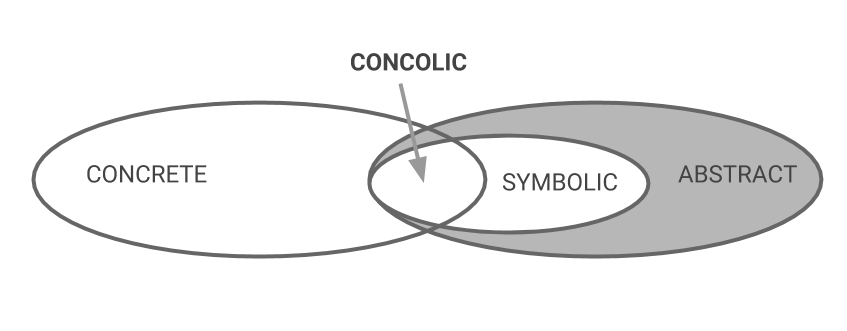
In una esecuzione concreta (figura 2) un’applicazione è eseguita con uno specifico set di input che eseguirà un unico path.

Invece, una symbolic execution, tecnica nata a metà degli anni ’70, consiste nell’analizzare un’applicazione determinando quali valori di ingresso causano l’esecuzione di un determinato percorso. Per fare ciò vengono assunti come input dei valori simbolici invece dei normali input dell’applicazione e viene quindi seguita l’esecuzione del programma.

L’esecuzione simbolica di un’applicazione può generare tutti i possibili percorsi che un programma può raggiungere durante un’esecuzione concreta in corrispondenza di determinati valori di input. Si capisce subito che, anche se dal punto di vista della copertura non c’è nessun problema, un simile approccio non è sostenibile in pratica.

Per ovviare a ciò si fa ricorso alla concolic execution (unione dei termini concrete e symbolic). Un approccio molto diffuso di concolic execution è la dynamic symbolic execution (DSE) dove l’esecuzione concreta è guidata da quella simbolica. In sostanza la concolic execution è una tecnica ibrida che si basa sulla symbolic execution, che è utilizzata insieme ad un automated theorem prover o ad un constraint solver per generare input concreti, allo scopo di massimizzare la copertura del codice.

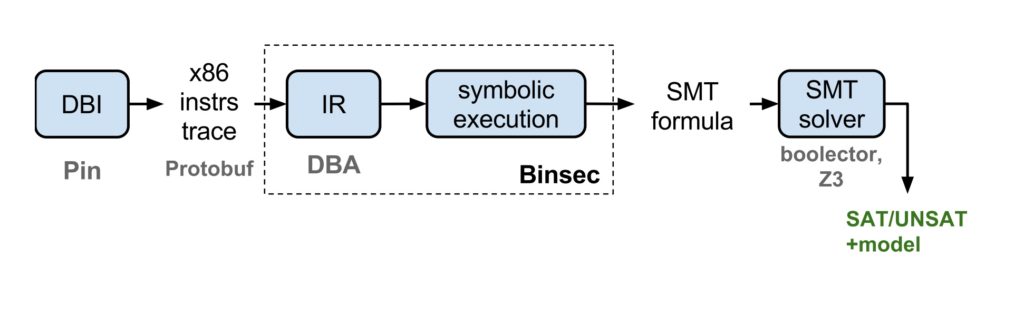
Semplificando, un model checker, basato su un solver SMT, viene utilizzato per verificare se il path definito dal symbolic execution engine è realizzabile; ovvero se esistono dei valori concreti che soddisfano la formula definita dall’engine.

I principali framework che si occupano di esecuzione simbolica fanno largo uso dei solver SMT nelle loro procedure di analisi di un software (figura 3).

Però, come avviene per la symbolic execution, anche la concolic execution ha dei limiti. Nonostante il notevole sviluppo degli SMT solver, un’analisi basata sulla concolic execution di un’applicazione di media grandezza è impraticabile, quindi è possibile analizzare solo parti limitate dell’esecuzione. Inoltre, i solver attuali, anche i più evoluti, non garantiscono buone prestazioni quando si ha a che fare con un certo numero di variabili e condizioni.

Symbolic-Assisted Fuzzing

Si hanno quindi grossi limiti in termini di efficienza. Per poter sopperire a tale deficit si fa in genere uso dei fuzzer, utilizzando strumenti che generano valori casuali di input, in modo da portare l’applicazione esaminata a raggiungere stati inattesi. Anche questi strumenti presentano diversi limiti.

Ricapitolando, entrambe le tecniche utilizzate nella ricerca automatizzata di bug, concolic execution e fuzzing, presentano dei limiti per quanto riguarda la copertura del codice, però fortunatamente sono limiti complementari. Di conseguenza, è sempre più diffuso un processo ibrido che vede l’utilizzo allo stesso tempo di entrambe le tecniche.

Malware analysis

L’SMT ci torna utile quando abbiamo a che fare con l’elaborazione, di una o più variabili, riconducibile ad una formula matematica. Ad esempio, quando ci troviamo di fronte ad un assembly dove ci viene chiesto di determinare una chiave calcolata in vari passi con diverse operazioni e che ha questi vincoli:

  • La chiave è formata da 3 valori interi: a, b e c
  • a è multiplo di 5
  • il risultato dell’or tra a e b è 123
  • a > 0x12345678
  • c è la media di a e b
  • c è minore di 0x76543210

possiamo tradurre tutto in formule e usare un solver SMT per risolvere il problema. Usando il solver Z3, una delle tante implementazioni dell’SMT, (https://github.com/Z3Prover/z3) avremo:

from z3 import *

a = BitVec(‘a’, 32)
b = BitVec(‘b’, 32)
c = BitVec(‘c’, 32)

s = Solver()
s.add(a % 5 == 0)
s.add(((a | b) & 0xFF) == 123)
s.add(a > 0x12345678)
s.add(c == (a + b)/2)
s.add(c < 0x76543210)

if s.check():
print(s.model())

Come risultato avremo dei valori di a, b e c che verificano i vincoli. Ad esempio: [b = 2647883066, a = 556565315, c = 3749707839]

Malware obfuscation

I malware tipicamente fanno largo uso di packer e tecniche di offuscamento, in modo da rendere più ardua l’analisi.

Eseguite singolarmente le analisi statiche, dinamiche e simboliche non sono sufficienti ad analizzare in modo completo un malware del genere. Scopo finale di un’analisi è invertire la trasformazione, oppure, se questo non è possibile, almeno di rendere più agevoli le analisi successive, semplificando il codice: ovvero di fornire del codice disassemblato semanticamente esatto come definito dall’esecuzione simbolica.

In definitiva, l’equivalence checking, effettuato da un SMT solver, consiste nel valutare la correttezza di un’operazione di deoffuscamento; per la serie: è più difficile camuffare la semantica di un’applicazione invece che la sua forma sintattica.

Generazione di exploit

Quando dobbiamo trovare dei gadget utili ad un attacco di tipo ROP (https://www.ictsecuritymagazine.com/articoli/rop-cercare-gadget-nelle-applicazioni-android/), un SMT solver viene in aiuto essenzialmente in due casi: nella ricerca semantica dei gadget e in un compilatore ROP.

Nel primo caso, un solver trova tra tutti i gadget esistenti in un’applicazione quelli che sono funzionalmente equivalenti ad un determinato comportamento. In altre parole, cerca di trovare una equivalenza tra un singolo gadget e un modello definito in precedenza. Ad esempio, per implementare la ricerca semantica dei gadget, Ropper (https://github.com/sashs/Ropper) utilizza pyvex per creare una rappresentazione intermedia del software in esame e z3 come solver SMT:

(ropper)> help semantic
semantic  –  Searchs gadgets
semantic <constraint>[; <constraint>][ !<stable reg>*]

Example:
semantic eax==ebx; ecx==1 !edx !esi

Valid constraints:
reg==reg
reg==number
reg==[reg]
reg<+|-|*|/>=<reg|number|[reg]>

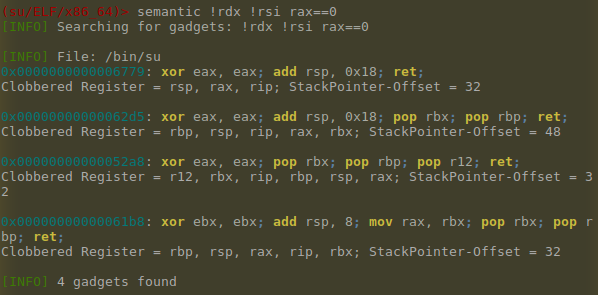
In Figura 4 è riportato un esempio di ricerca semantica: abbiamo cercato gadget che non modificano i registri RDX e RSI ma impostano RAX a zero.

Nel caso invece di un compilatore ROP, ovvero uno strumento capace di generare delle ROP chain, l’SMT aiuta a creare delle sequenze di gadget semanticamente simili ad un modello di payload.

Conclusioni

In questo articolo abbiamo visto solo alcune applicazioni dell’SMT nell’ambito della sicurezza. I campi di applicazione di questa tecnica, ma anche di altre mutuate dalla matematica, sono in continua evoluzione soprattutto nell’ambito del reverse engineering, disciplina legata a filo doppio alla matematica.

Articolo a cura di Gianluigi Spagnuolo

Si interessa di sicurezza informatica, reti di sensori e ingegneria del sotware.

Attualmente si occupa pricipalmente dell’analisi dei dati.

Collabora con diverse riviste del settore scrivendo di programmazione e sicurezza

Download PDF

https://www.ictsecuritymagazine.com/articoli/analisi-e-smt-satisfiability-modulo-theories/


La società globalizzata e il rischio cyber: dinamiche, impatti e soluzioni

Cercare rapporti di causa effetto lineari in un mondo complesso come il nostro è, quasi sempre, una pura illusione. Però, se ci sforziamo di guardare le cose dall’alto, si può affermare con sufficiente tranquillità che le forze che stanno modellando il nostro mondo sono quattro: il progresso tecnologico, i mercati, la questione ecologica e le migrazioni.

Il progresso tecnologico ha generato un cambiamento dirompente ad una velocità elevatissima ed ancora lo farà negli anni a venire. Molti vecchi lavori scompaiono e ne compaiono di nuovi e il passaggio dagli uni agli altri richiede un’elevata capacità di adattamento al nuovo contesto. Proprio questo è il punto centrale: il progresso tecnologico crea un profondo cambiamento che offre grandi vantaggi in termini di aumento della produttività, ma richiede (pretende) una grande capacità di adattamento. Genera quindi come effetto negativo l’esclusione della fascia di popolazione più debole e meno pronta da questo flusso velocissimo che offre i suoi frutti solo a chi è in grado di mantenerne il ritmo. Il problema è, quindi, riuscire a costruire un sistema educativo che consenta a tutte le fasce di popolazione, anche le più deboli, di agganciare la scia del progresso tecnologico.

La forza dei mercati è dirompente al pari di quella del progresso tecnologico. Queste due forze assieme hanno la capacità di modellare oltre che il lavoro, anche la nostra vita quotidiana: le abitudini alimentari, le abitudini di consumo e così via. I mercati, però, sono ancora più forti di quanto appare, sono perfino capaci di incidere nella vita politica e di modellare nuove aggregazioni istituzionali. Basti pensare all’Unione Europea che nasce come spazio economico comune sulla spinta del progressivo accorciamento delle distanze tra gli Stati dovuto sia dal progresso dei mezzi di trasporto che dall’informatizzazione dei mercati. Che ci piaccia o no, i mercati sono globali e negli ultimi 10 anni la tecnologia ci ha reso parte di una comunità globale. Anche se gli esseri umani hanno costantemente bisogno di confermare la propria identità all’interno di un gruppo, il progresso tecnologico e la dinamica dei mercati ampliano i confini della “comunità” abbattendo i rischi di conflitti che spesso nascono dalle dispute “tribali”. “Ampliare i confini della comunità” ha come fine, principalmente, la ricerca della soluzione al problema di come trovare uno spazio più ampio in cui il denaro e le merci possono circolare senza trovare ostacoli; la cosa rivoluzionaria è che nei secoli passati per trovare il “campo più ampio” serviva una guerra e/o la conquista di nuovi territori, ora la globalizzazione richiede la pace, e ciò è possibile solo con la pace! L’evoluzione della tecnologia e delle istituzioni rende possibile tutto questo.

Anche la questione ecologica è centrale. I mutamenti climatici cambiano la geografia del pianeta rendendo alcune zone molto vulnerabili ad eventi climatici estremi e sottraendo costantemente ampie fasce di territorio alla possibilità di essere coltivate e produrre reddito. Solo per fare un esempio, una parte delle migrazioni attualmente in atto in Europa è dovuta alla progressiva desertificazione delle zone intermedie tra Africa Centrale e Nord Africa causata anche dalla dissennata politica ecologica attuata dai paesi più sviluppati. È un paradosso: più i mercati avanzati spingono sull’acceleratore della produzione non ecologicamente sostenibile, più aumenta la desertificazione di vaste zone prima fertili e di conseguenza aumentano le migrazioni che costituiscono oggi la più grande minaccia alla stabilità delle economie avanzate. Meno queste si dimostrano consapevoli degli effetti negativi sul pianeta delle produzioni selvagge, più questi effetti si ritorcono contro di loro generando instabilità politica che tende a spostare l’asse politico globale-locale di nuovo sulla dimensione locale.

Fin qui lo storytelling delle quattro forze che lascia, però, aperti i nodi che conosciamo bene: giustizia, equità sociale, immigrazione e sistema educativo che minano alla base il sogno globalizzante che può funzionare solo se si dimostra in grado di “portare tutti a bordo”, diversamente le tensioni che si generano rischiano di rompere il giocattolo e modellare sempre di più un mondo a due velocità, sbilanciato e non inclusivo quale quello in cui viviamo ora. Le quattro forze, quindi, oltre agli indubbi benefici, producono molte e importanti esternalità negative.

Oltre agli effetti indesiderati, però, bisogna considerare il fatto che tutti i sistemi basati sulla forza dell’innovazione tecnologica sono minati alla base dalla dimensione del rischio cyber che minaccia di abbattersi con forza su costruzioni che assomigliano a castelli di carte. Ciò vale anche per la globalizzazione dei mercati: l’iper-tecnologia su cui essa si basa è – purtroppo – l’anello debole della catena. La relazione di causalità è – in questo caso – molto semplice: più aumenta la superficie digitale, più cresce il rischio cyber che è strutturalmente in grado di generare una crisi di sistema con impatti primari e secondari catastrofici. Con tutto ciò, giustizia, equità sociale, immigrazione, sistema educativo sono giustamente oggetto prioritario delle politiche dei governi, mentre il rischio cyber ancora non lo è, almeno fino a quando anche nel nostro paese sperimenteremo un evento realmente serio in grado di produrre effetti reali sui servizi erogati alle persone e sulla crescita economica del paese.

Intendiamoci, di recente c’è stato un significativo passo avanti sia a livello europeo che a livello nazionale: sul versante europeo GDPR, Direttiva NIS, Regolamento eIDAS e Cybersecurity Act, costituiscono un framework di regole che inizia ad assumere una dimensione organica mentre, sul versante italiano, il DPCM 17 febbraio 2017 ridisegna l’impostazione dell’architettura nazionale per la cybersecurity.

Anche se credo che la regolazione possa essere uno stimolo positivo a far crescere l’attenzione su questi temi, non credo sia la soluzione del problema. Credo che la regolazione sia necessaria e anzi obbligatoria se ci sono in ballo servizi di interesse pubblico essenziale; credo che debba essere semplice, di facile interpretazione, non in sovrapposizione con altre regolazioni che – magari – trattano il tema cyber solo incidentalmente; credo che la regolazione debba essere sufficientemente “alta” e non prescrittiva, ovvero, che non debba indicare in modo esplicito compiti da eseguire su base periodica; credo, infine che la regolazione debba essere seriamente verificabile dal regolatore o da entità da esso delegate. Il punto centrale credo che sia la consapevolezza del problema e della sua importanza che, a quanto vediamo ogni giorno, appare decisamente scarsa.

Negli USA, il presidente Trump ha di recente emanato la nuova strategia nazionale di cybersecurity che si basa su quattro punti fondamentali scritti direttamente dal presidente nella prima pagina del piano:

  1. Difendere la patria proteggendo reti, sistemi, funzioni e dati;
  2. Promuovere la prosperità americana alimentando un’economia digitale sicura e prospera e promuovendo una forte innovazione interna;
  3. Preservare la pace e la sicurezza rafforzando la capacità degli Stati Uniti – di concerto con alleati e partner – di scoraggiare e, se necessario, punire chi usa strumenti informatici per scopi malevoli;
  4. Espansione dell’influenza americana all’estero per estendere i principi chiave di un Internet aperto, interoperabile, affidabile e sicuro.

In sostanza gli obiettivi sono proteggere le infrastrutture critiche e i sistemi governativi, combattere il crimine informatico e migliorare la segnalazione degli attacchi coltivando nuovi talenti nella cybersecurity. Tutto ciò è certamente necessario, forse, potremmo tentare di seguire anche un’altra strada, che punta a cercare di colmare il gap di consapevolezza che c’è in primis nei cittadini ed in particolare nei cosiddetti nativi digitali fin dalle scuole medie inferiori. Ovvero, potremmo affrontare il problema dal punto di vista della crescita culturale del paese con il ripristino di una sorta di insegnamento di educazione civica adattato ai tempi e, quindi, un’educazione civica “digitale”.

La regolazione va bene per proteggere le infrastrutture critiche, ma è una guerra che si combatte in trincea, molto difficile da portare avanti, con costi molto elevati che non tutte le realtà (in verità poche) possono permettersi e con probabilità di successo non certo scontate. La situazione è, peraltro, aggravata dalla diffusa carenza di competenze tecniche tra gli operatori del settore e dalla totale dipendenza da tecnologie estere, con tutti i dubbi e le perplessità che possono emergere.

Puntare sulla crescita culturale del paese, invece, ci consentirebbe di conseguire un miglioramento della nostra postura sul lungo periodo. Considerando che il 90% del nostro tessuto economico è costituito da PMI, credo che questo possa essere l’approccio più idoneo a garantire risultati duraturi. Ovviamente, il tema ha molte sfaccettature e non riguarda solo la sensibilizzazione della base della cittadinanza ma anche lo sviluppo di competenze che – ai vari livelli – aiutino il sistema paese a costruire una valida risposta alla necessità di protezione degli asset aziendali e delle infrastrutture critiche. Lo skill shortage, che è riconosciuto come tema primario da tutte le survey e ricerche di mercato sul tema cyber, è uno dei punti da affrontare in via prioritaria, preferibilmente con una forma di collaborazione tra sfera pubblica e aziende private.

Articolo a cura di Marcello Fausti

Download PDF

https://www.ictsecuritymagazine.com/articoli/la-societa-globalizzata-e-il-rischio-cyber-dinamiche-impatti-e-soluzioni/


Trasmettere il Cyber-Risk attraverso attività di controllo basate sull’Impatto Reale

Quante volte vi siete imbattuti in un controllo di sicurezza che recitava queste parole?

  • Presenza di password predicibili di sistema operativo
  • Account di amministrazione di default
  • Mancato patching delle componenti di middleware

Ma tutto questo, per chi non si occupa di sicurezza, cosa può significare?

Come riusciamo a trasmettere, in modo efficace, la consapevolezza del rischio ai non addetti ai lavori? Ce lo siamo mai chiesto?

La Cyber Security è una materia vasta, costantemente in evoluzione dove spesso si fatica a rincorrere nuovi concetti di difficile comprensione. In questo articolo vorrei provare a raccontare come superare e migliorare l’efficacia della comunicazione nelle attività di offensive-security per consentirne una facile divulgazione del rischio, a tutti i livelli, compreso il management.

Il concetto di Api, Alveare e Miele

Prima di addentrarci su come comunicare, soffermiamo l’attenzione su una piccola metafora che spiega in maniera semplice e intuitiva un concetto chiave, il concetto di Alveare.

  1. L’Alveare: è il sistema da violare che contiene un’infinità di possibili strade, cunicoli e percorsi da affrontare per arrivare al bene più prezioso in esso contenuto.
  2. Il Miele: è il bene più prezioso contenuto nel sistema, ad esempio le carte di credito in applicazioni di e-commerce, i dati di traffico in sistemi telco, le transazioni in sistemi bancari, ecc…
  3. Le Api: sono tutte le soluzioni di sicurezza e le protezioni perimetrali implementate per garantire l’inviolabilità di un sistema che occorre superare per arrivare al miele.

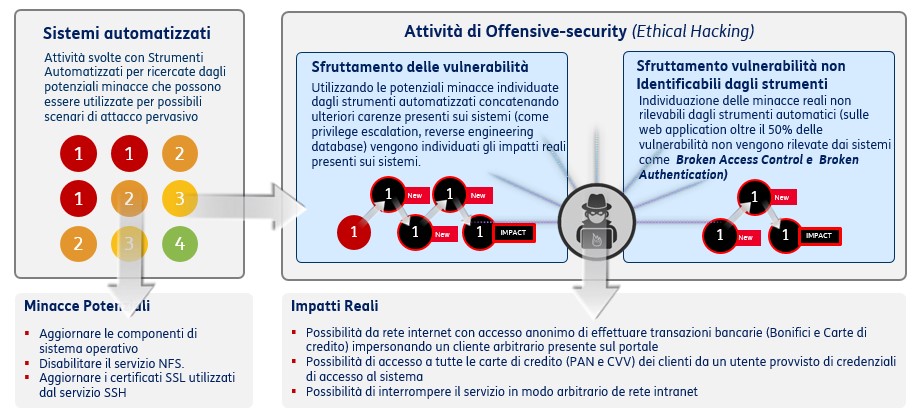
Una attività di controllo di sicurezza non vuol dire solo fornire “mere” vulnerabilità potenziali rilevate in campo ma verificare se risulti possibile entrare nell’alveare indisturbati dalle api che lo circondano e prelevare il bene più prezioso in esso contenuto, cioè il miele.

Pertanto, volendo svolgere attività di controllo finalizzate a rilevare gli “Impatti reali”, dobbiamo sempre tenere in considerazione quanto sopra e porci sempre una importante domanda prima di attivare la nostra Kali Linux, ovvero: quale è il miele custodito nel sistema?

Differenza tra Impatto Reale e Impatto Potenziale

Esiste una sostanziale differenza tra una vulnerabilità di sicurezza con exploit pubblico capace di generare un “impatto reale” di compromissione della RID e una vulnerabilità di sicurezza “potenziale”.

Mettere in sicurezza un sistema ha un costo e sebbene operare in logica “security by design” è sempre la scelta migliore, un sistema ben progettato dall’inizio, con il passare del tempo, tende ad essere insicuro per una serie di motivi come il mancato Patching, il fenomeno di Hardening-loss, l’obsolescenza tecnologica e tutto quello che conosciamo come Cyber-Security-Evolution.

In una logica di “coperta corta”, saper evidenziare gli “impatti reali” ai quali è esposto un sistema (e le relative vulnerabilità sfruttabili) consente di indirizzare e focalizzare al meglio l’effort disponibile evitando di agire in modo indiscriminato su tutte le minacce senza fornire una priorità di intervento.

Costruire una attività di controllo basata sull’Impatto Reale

E’ necessario quindi evolvere il modello di Assessment fino ad oggi basato nel prelevare il più alto numero di vulnerabilità potenziali presenti in campo in un modello basato sulla priorità di intervento e misurazione del rischio attraverso l’impatto reale. La realtà ci insegna che solo alcune vulnerabilità critiche potenziali presenti su un sistema possono essere sfruttate per condurre un attacco pervasivo.

Per far questo non bastano le attività automatiche (ancora oggi gli APT e i data-breach vengono preparati da persone e non da automi). Occorre svolgere attività di ethical-hacking per consentire un controllo profondo, su specifiche direttrici di rischio, mirate a “rubare” quel “miele” di cui parlavamo in precedenza.

Questo perché non esistono ancora strumenti capaci di concatenare vulnerabilità e di portarci, su un piatto d’argento, un “Impatto reale” significativo, paragonabile ad un data-breach. Pensiamo ad esempio alle Top10 Owasp e al Broken Access Control e Broken Authentication in ambito web application. Sono due esempi di falle altamente critiche, di difficile rilevazione (dalla mia esperienza di impossibile rilevazione da parte di uno scanner automatico) che possono condurre ad un data-breach senza precedenti.

Dobbiamo quindi distinguere vulnerabilità critiche, utili a generare un impatto reale, da vulnerabilità critiche (ma di minore priorità) non utili a generare un impatto significativo. Non bisogna per far comprendere quanto è critico un sistema rendere tutto indiscriminatamente “rosso”. Il “rosso” nel nostro caso sarà l’impatto reale che dovrà essere “immediatamente” rimosso dai sistemi, il resto viene dopo in termini di priorità di intervento.

L’attività di controllo cambia forma e aspetto, più orientata ad impersonare un reale “cattivo” che vuole prelevare il “miele” da un sistema per poi trarne un “reale” vantaggio.

Inoltre sarà necessario rappresentare, in un quadro più ampio di analisi, ulteriori grandezze misurate in quel preciso “time-stamp” di Assessment come ad esempio:

  1. Livello di skill necessario per generare l’impatto.
  2. Superfice di esposizione dell’impatto (ad es. Internet in pre-auth o in post-auth, da rete segregata, subnet, dietro firewall, mitigato da waf, ecc…)
  3. Livello di compromissione del sistema attraverso la misurazione della RID; fornire un indice sulla compromissione della Riservatezza, Integrità e Disponibilità dei dati trattati per gli impatti reali analizzati.

Comunicare l’Impatto Reale

Comunicare efficacemente consente di aumentare la consapevolezza del Cyber-Risk ai non addetti ai lavori, per far capire con parole semplici – rigorosamente non tecniche – quali sono i reali rischi misurati su un sistema informatico.

L’approccio top-down aiuterà a disegnare un modello di documentazione, che, partendo dagli impatti Reali, farà addentrare l’utente negli aspetti più tecnici fino alle vulnerabilità di sicurezza rilevate. Nel documento saranno poi riportati i vettori di attacco fino ad arrivare al tecnico-specialistico di dettaglio che potrà essere utile per indirizzare le remediation da parte dei tecnici delle linee di progettazione.

Ma se vi state ancora domandando quale possa essere un reale impatto, ne riporto alcuni che credetemi, valgono più di 1000 altre parole:

  • Possibilità da rete internet, con accesso anonimo, di effettuare transazioni bancarie (utilizzando Bonifici e Carte di credito) impersonando un cliente arbitrario.
  • Possibilità di esfiltrazione di carte di credito (compreso PAN e CVV) dei clienti, da parte di un utente provvisto di credenziali di accesso al sistema.
  • Possibilità di interrompere il servizio da rete internet, in modo arbitrario, in assenza di autenticazione.

D’altra parte, l’headline delle testate giornalistiche ci insegnano come trasmettere in pochi caratteri messaggi “Importanti”. Il recente Data Breach di Facebook veniva rappresentato in questo modo: “Violati 50 milioni di account Facebook, a rischio la nostra privacy” … tutto questo è diverso dall’Impatto Reale?

Conclusioni

La differenza tra “impatto reale” e “minaccia potenziale” anche se sottile, risulta sostanziale nelle attività di Controllo. Se questo concetto risulta semplice da far comprendere a persone fuori dalla Sicurezza, è paradossalmente ostico da far digerire a chi quotidianamente svolge attività tecniche specialistiche di ethical-hacking sempre focalizzato nel comunicare in modo tecnico a volte incomprensibile da chi di sicurezza conosce a malapena il significato.

Il messaggio tecnico e l’executive (ma il potere di sintesi in generale) lo sappiamo tutti, sono punti di vista poco conciliabili. Riuscire ad unirli risulta fondamentale per raggiungere un grado di rappresentazione del rischio comprensibile, a tutti i livelli.

Utilizzare messaggi semplici, fornire le priorità di intervento, far comprendere in modo inequivocabile i rischi ai quali si va in contro (magari citando anche data-breach pubblici similari e successive sanzioni amministrative sostenute dai malcapitati) consente di ottenere la giusta attenzione e quindi avviare una veloce “remediation” con conseguente ripristino della sicurezza in un sistema.

Al contrario, non fornendo un indicatore di priorità, si porta a trattare in maniera “opaca” il rischio e avviare remediation trasversali poco efficaci, magari tralasciando i punti nevralgici del sistema, solo perché, “…era finito il budget!”.

L’impatto Reale risulta la sintesi finale che ci consente di arrivare a trasmettere il reale impatto presente su un sistema fornendo inoltre la giusta priorità di intervento per ogni singola attività di remediation. Questo è necessario perché quando si parla di sicurezza informatica, non sempre è possibile realizzare tutto per differenti motivazioni, non ultima quella dei costi.

Articolo a cura di Massimiliano Brolli

Download PDF

https://www.ictsecuritymagazine.com/articoli/trasmettere-il-cyber-risk-attraverso-attivita-di-controllo-basate-sullimpatto-reale/


Combattere le minacce usando il Cyber Threat Hunting

Le minacce informatiche odierne sono diventate sempre più complesse da individuare a causa della loro continua mutevolezza, asimmetricità e diversificazione degli autori. Secondo i più recenti report[1] le attività di attacco “cyber” si consumano in poche ore e le exfiltration di dati avvengono in pochi giorni, mentre l’identificazione dell’incidente nei 2/3 dei casi rimane inosservata per un periodo che va dagli 80 ai 200 giorni[2]. Il processo di Cyber Threat Intelligence, ovvero la possibilità di avvalersi di una knowledge base costruita su fonti esterne ed interne al fine di aumentare la conoscenza dell’avversario, risulta particolarmente efficace nell’affrontare consapevolmente le minacce e diminuire i tempi di identificazione dell’incidente. In tandem con il processo di Cyber Threat Intelligence troviamo il concetto di Cyber Threat Hunting, ovvero quell’approccio che, sfruttando le fonti di intelligence, mira alla ricerca, all’individuazione e alla comprensione dell’attaccante sfruttando un metodo di generazione/validazione di ipotesi (SANS 2018[3]).

Come descritto nella Threat Survery 2018 della SANS[4] una grossa percentuale delle organizzazioni attaccate reagisce agli attacchi in maniera scomposta e lo fa solo dopo esserne diventata bersaglio, utilizzando poi le informazioni provenienti dall’attacco per la generazione di automatismi di controllo basati su IoC  (Indicatori di Compromissione); questa risposta è una risposta di tipo reattivo, mentre diventa desiderabile, vista la complessità degli attacchi odierni, valutare ulteriori modalità di risposta di tipo preventivo e proattivo.

E’ necessario dunque pensare ad una difesa in cui venga considerata, oltre alla quantità, la qualità degli IoC, possibilmente contestualizzati ed arricchiti ed alla collaborazione tra gli analisti di Cyber Threat Intelligence e le figure preposte al Digital Forensic e Incident Response, al fine di costruire un team che sappia estrapolare dagli indicatori iniziali le tecniche, le tattiche, le procedure ed eventualmente l’identità dell’attaccante.

Fine ultimo è, oltre all’individuazione della minaccia, generare nuova intelligence, sia di tipo strategico che di tipo operativo.

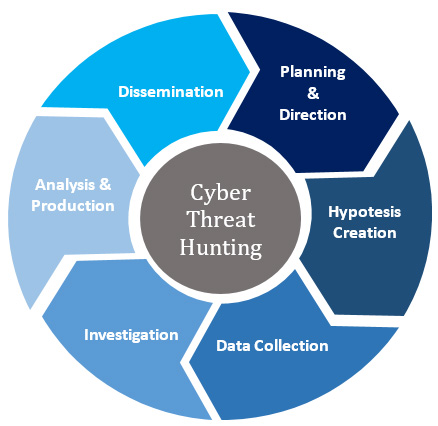
Si vuole dunque proporre un framework di Cyber Threat Hunting che sappia conciliare processi, strumenti e persone e dove il fattore umano posso avere l’importanza che merita, in quanto l’intrusione cyber è sempre perpetrata da un soggetto umano ed è quindi fondamentale interpretarne la sua psicologia per comprendere le intenzioni e rispondere in maniera efficace alla minaccia[5].

Il framework proposto, basato principalmente sul lavoro di sqrll[6][7] e della SANS[8], oltre che sui concetti dell’intelligence classica, è composto da 6 fasi sequenziali, dove le fasi di Hypotesis Creation, Data Collection, Investigation ed Analysis condividono strumenti e talvolta metodologie.

  • Planning & Direction
  • Hypotesis Creation
  • Data Collection
  • Investigation
  • Analysis e production
  • Dissemination

Planning & Direction

Questa è la fase dove viene definita una strategia e vengono scelti i PIR (Priority Intelligence Requirements)[9] e gli obiettivi da raggiungere. Per il successo di questa fase è auspicabile una stretta collaborazione tra l’executive board e gli analisti, oltre all’utilizzo di fonti di intelligence aggiornate utili a definire il contesto in cui si opera.

Hypotesis Creation

La fase di creazione delle ipotesi è il momento più razionale dell’intero ciclo, dove il team di Cyber Threat Intelligence, con la guida dell’executive e la collaborazione dei team di Digital Forensic e Incident Response, valuta minacce, topografia/vulnerabilità dei sistemi ed obiettivi da raggiungere. Il team di Cyber Threat Intelligence, grazie all’esperienza pregressa, all’utilizzo di metodologie strutturate di analisi (ACH, Key Assumptions Check, Brainstorming, volte a diminuire i «bias» cognitivi, ovvero pregiudizi e debolezze che possono inficiare il lavoro dell’analista), metodologie proprio della cybersecurity (cyber killchain) e di strumenti tecnici, formula delle ipotesi (i.e. Siamo oggetto di un attacco? Abbiamo un Exfiltration?).

Data Collection

In questa fase si scelgono i dati sui cui verrà effettuata l’investigation, ovvero la validazione delle ipotesi e la successiva analisi. I dati scelti appartengono sia alla categorie dei logs appartenenti ai vari apparati, sia ad evidenze provenienti dal campo del Digital Forensic ed Incident Response, oltre che a fonti interne ed esterne di intelligence.

Investigation

E’ in questa fase che avviene l’hunt vero e proprio, ovvero la verifica/validazione delle ipotesi generate in precedenza attraverso l’utilizzo di ragionamenti logici[10] (induttivo, deduttivo, abduttivo), strumenti di machine learning[11] e strumenti tecnici, per lo più appartenenti ai processi ed alle metodologie proprie della Digital Forensic e Incident Response. Si spazia dall’utilizzo dei SIEM e/o piattaforme specifiche[12] a piattaforme di Threat Intelligence[13], dalla link/network analisys[14] all’utilizzo di tassonomie operative integrate con strumenti[15][16]. Se consideriamo i dati raccolti come testi, e paragoniamo la Cyber Threat Intelligence all’intelligence classica, possiamo pensare a questo momento ed ai precedenti momenti di creazione delle ipotesi e raccolta di dati, come momenti “ermeneutici”[17], ovvero momenti in cui gli analisti usufruiscono, in termini di esperienza, sia del frutto del lavoro sull’interpretazione del dato, sia dell’esperienza degli altri membri del gruppo di lavoro.

L’operatore di intelligence è soprattutto un ermeneuta perché quando entra in contatto con la notizia scritta, prima ancora di essere un analista, è un interprete e, in quanto, entra in rapporto con un testo che parla di cose, al quale si avvicina non come una tabula rasa, bensì con la sua pre-comprensione (Vorverständnis), cioè con i suoi pregiudizi (Vorurteile), le sue pre-supposizioni e le sue attese[…] ed è qui che l’esperienza deve potersi arricchire grazie al rinnovarsi della feconda reazione tra essa stessa, la creatività e l’intuito” [18]

Il frutto del lavoro svolto in questa fase è intelligence operativa e tecnica che, nella fase successiva di analisi/produzione, verrà trasformata in intelligence tattica e strategica.

Analisi & Production

Come sopra citato in questa fase l’intelligence operativa viene rifinita e contestualizzata attraverso una serie di macro fasi, l’utilizzo di tassonomie[19], di fonti di intelligence pubbliche e private e di metodologie proprie della cybersecurity come la cyber killchain e la diamond analysis.

Fine ultimo è avere una conoscenza quanto più possibile approfondita dell’avversario in termini di tecniche, tattiche, procedure ed identità. Una conoscenza che, insieme all’utilizzo del concetto della Pyramid Of Pain, ovvero che l’attaccante cambia più lentamente le sue tattiche rispetto agli indicatori base come ip e dominio, permette all’organizzazione di assumere una postura proattiva e reagire rallentando l’avversario.

Il sapere «come» opera l’avversario, ed eventualmente la sua identità (soggetto singolo, collettivo, criminale, soggetto istituzionale) e le sue motivazioni (politiche, finanziarie, etc.) aiutano l’azienda a sviluppare nuovi pattern di difesa da affiancare ai tradizionali e a produrre nuova intelligence strategica e tattica da condividere e riutilizzare.

Dissemination

La fase finale del ciclo è il momento di dissemination, ovvero il momento in cui i risultati prodotti dalle fasi precedenti vengono condivisi con l’executive, gli stakeholder, gli altri team e la comunità. Il successo di questa fase dipende dalla forza dei processi di condivisione dell’organizzazione verso la comunità e gli altri apparati, e soprattutto dagli strumenti utilizzati: l’utilizzo di protocolli condivisi e free come taxii e stix[20], che permettono di condividere facilmente IOC, e l’utilizzo di una TIP[21](Threat Intelligence Platform) che permette di creare report per il management e condividere modelli complessi riguardanti tecniche, tattiche, procedure ed analisi di threat, incrementano decisamente la forza di condivisione e sono il primo tassello per la creazione di una comunità di condivisione delle informazioni, veloce ed aggiornata.

In conclusione tutte le organizzazioni sentono l’esigenza di individuare le minacce in anticipo e comprendere chi o cosa li sta attaccando, pertanto l’utilizzo di un framework di Cyber Threat Hunting, grazie alla combinazione di più processi e all’utilizzo di più strumenti, aiuta ad individuare minacce interne, generare nuova intelligence e ad aumentare la propria capacità di difesa passando da una modalità di risposta reattiva ad una risposta articolata e proattiva.

Note

Articolo a cura di Giampaolo Darelli

Laureato in filosofia, lavora come Senior Cyber Security Analyst presso Deep cyber, una newco specializzata in Advanced Cyber Threat Intelligence, Protection e Antifrode.

In precedenza ha lavorato in Italia ed all’estero presso clienti appartenenti ai settori di media, telecomunicazione e finanza.

Giampaolo lavora da 20 anni nell’Information Security e si occupa di diverse aree tematiche quali:Cyber Threat Intelligence e Cyber Threat Hunting, SIEM, Identity and Access Management, oltre che di Network e Cyber Security.

Download PDF

https://www.ictsecuritymagazine.com/articoli/combattere-le-minacce-usando-il-cyber-threat-hunting/


HTTPS è ancora sicuro?

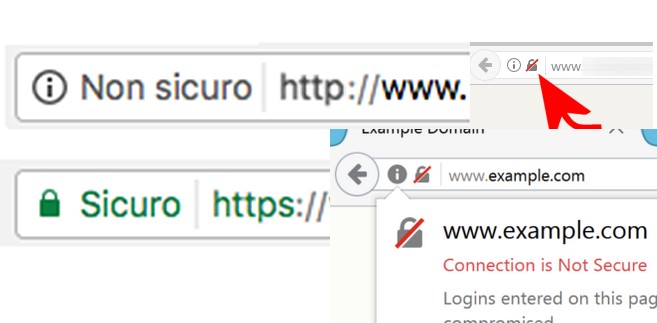
Durante i primi mesi del 2017 gli utenti di internet potevano ritenersi un pizzico più sicuri in seguito all’uscita delle nuove versioni di Chrome e Firefox[1]. Google e Mozilla ebbero l’ottima idea di introdurre una funzionalità in grado di segnalare tutte i siti HTTP che contenessero al loro interno moduli da riempire: le pagine contenenti campi quali username, password, carta di credito o similari, iniziarono ad essere contrassegnate come “non sicure”[2].

In questo modo è stato indirettamente imposto ai creatori di contenuti web l’utilizzo del protocollo HTTPS.

L’HTTPS consente la comunicazione sicura mediante il protocollo HTTP all’interno di una connessione criptata, SSL o TLS. Il principio alla base dell’HTTPS è quello di avere:

  • un’autenticazione del sito web visitato;
  • protezione della privacy;
  • integrità dei dati scambiati tra le parti comunicanti.

Questa misura di sicurezza implica che se un utente ha intenzione di creare un proprio sito internet si trova nella condizione di dover acquistare un certificato SSL[3].

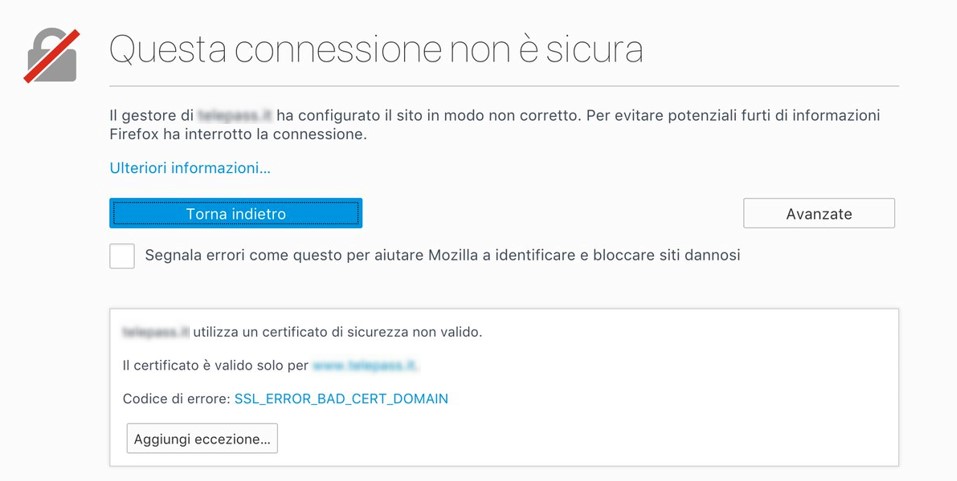
In caso contrario vi è l’opportunità di auto-generare il proprio certificato, ottenendo però uno sgradevole avviso come quello riportato nella figura sottostante, poiché non vi è alcuna Certification Autority (CA) in grado di garantire i punti precedentemente descritti.

Non tutti sanno però che già da prima dell’introduzione di queste restrizioni, è presente sul mercato un servizio totalmente gratuito che consente di generare certificati SSL in pochi semplici passaggi.

I VANTAGGI DI LET’S ENCRYPT

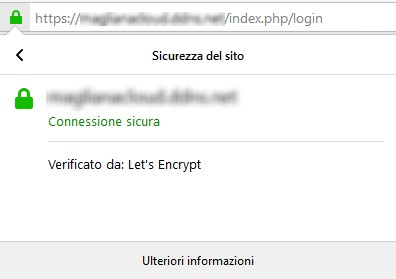
Let’s Encrypt è una Certification Authority che gratuitamente automatizza la creazione, la validazione, il rilascio ed il rinnovo di certificati X.509 per il protocollo TLS.

Il protocollo utilizzato da Let’s Encrypt per l’autenticazione e il rilascio dei certificati si chiama Automated Certificate Management Environment (ACME), ed è un protocollo di tipo challenge-response. Il server (Let’s Encrypt) presenta al client (il web server da certificare) un insieme di challenge che il proprietario del dominio deve risolvere per provare di essere il responsabile del dominio.

Nel 2017, l’organizzazione ha annunciato di aver emesso oltre 100 milioni di certificati di sicurezza, diventando in breve tempo una delle più grandi CA per numero di certificati emessi.

Lo scopo principale del progetto è quello di riuscire a cifrare tutte le comunicazioni sul World Wide Web. Let’s Encrypt si prefigge di raggiungere questo obiettivo azzerando il costo dei certificati ed andando ad automatizzare il processo di configurazione del web server, della verifica tramite email e del rinnovo del certificato. In questo modo la complessità di gestione e manutenzione di una cifratura TLS si riduce drasticamente[4].

LET’S ENCRIPT È SICURO?

Nonostante l’obiettivo prefissato dai creatori di Let’s Encrypt sia quello di migliorare la sicurezza e la privacy per tutti gli utenti, ciò non significa che non vi siano modi per utilizzare i certificati generati in modo improprio. Difatti, nel marzo 2017, l’esperto di crittografia Vincent Lynch ha rivelato che in un periodo di 12 mesi Let’s Encrypt ha emesso circa 15.000 certificati di sicurezza contenenti il ​​termine PayPal riconducibile a siti utilizzati per attività di phishing[5].

Allo stato dell’arte, questo tipo di attacchi si è palesato anche in Italia.

Di seguito è presentato un semplicissimo esempio (reale) di come può essere utilizzato questo servizio per far sembrale lecito un sito che non lo è.

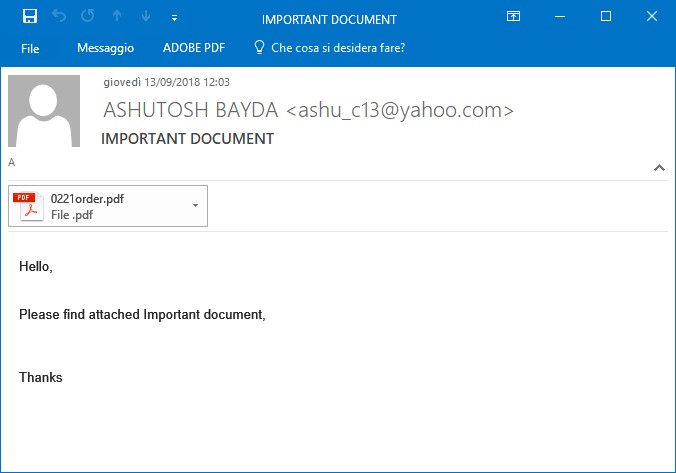
Il vettore iniziale è la solita email di phishing che invita ad aprire un allegato.

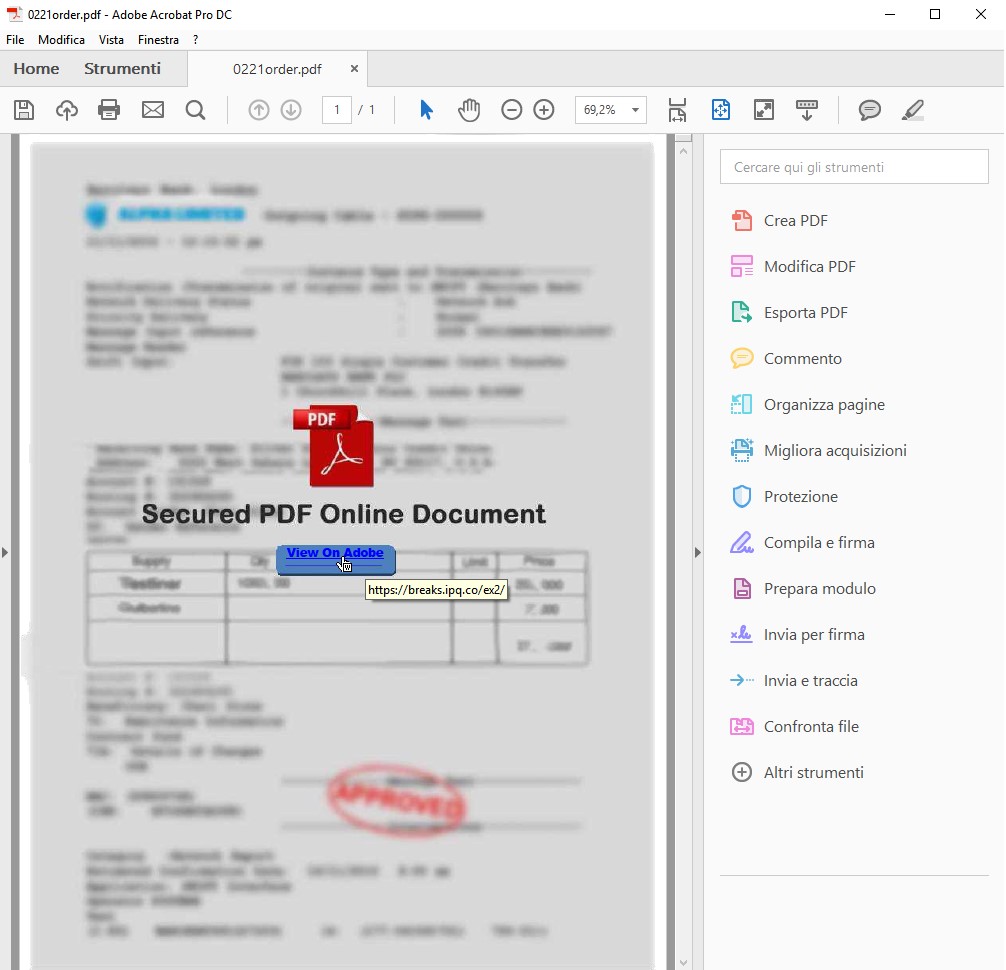
Aprendo l’allegato pdf, non virato, ci troviamo di fronte alla seguente schermata:

Come si può notare, il documento tenta di ingannare l’utente inesperto simulando un documento “secretato”, accessibile cliccando su un bottone posto in evidenza al centro della pagina.

Il bottone in questione non è altro che un link che punta al sito https://breaks.ipq.co/ex2/ (oggi bonificato e non più raggiungibile).

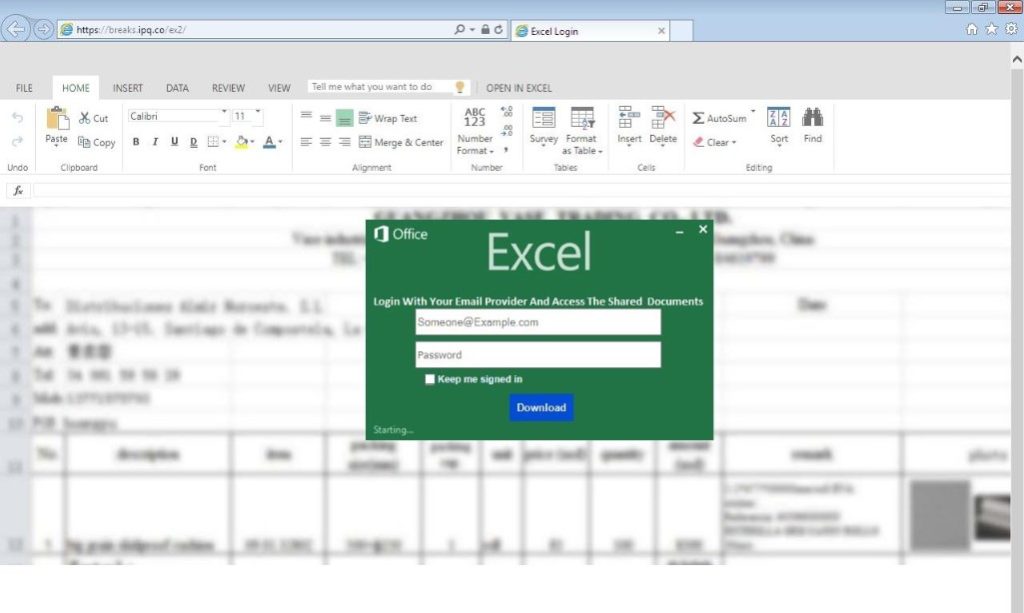
Un click su tale link permetterà l’apertura di una pagina internet che invita l’utente ad autenticarsi, in modo da poter “finalmente” effettuare il download del documento secretato inviatoci dal mittente della email:

Ovviamente lo scopo ultimo dell’attaccante è quello di estorcere malevolmente i dati sensibili dell’utente vittima. Infatti, inserendo anche credenziali a caso e cliccando su download, verrà prelevato un documento pubblico relativo ad un’analisi economica americana, totalmente privo di senso per l’utente vittima.
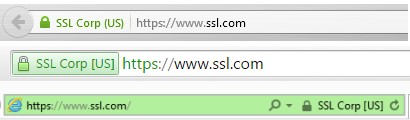
Ad ogni modo, quest’ultimo potrebbe non essersi reso conto di essere stato raggirato, poiché nella sequenza di passaggi effettuata non è stato presentato all’utenza alcun messaggio di allerta.

Questo perché il sito di destinazione è stato certificato dall’attaccante proprio con il servizio messo a disposizione da Let’s Encrypt.

DIFFERENZE TRA LET’S ENCRYPT E GLI ALTRI CERTIFICATI SSL

Nonostante gli svantaggi derivanti da un utilizzo fraudolento di Let’s Encrypt, è da sottolineare che vi sono ben altri motivi per i quali ogni giorno continuano ad essere venduti, dalle CA commerciali, un gran numero di certificati SSL a pagamento.

Quello di maggior interesse in termini di sicurezza, riguarda il fatto che Let’s Encrypt fornisce solo certificati di tipo Domain Validated (DV); non offre certificati Organizazion Validated (OV) né tantomeno Extended Validated (EV).

Nel dettaglio con il DV di Let’s Encrypt è possibile validare esclusivamente la proprietà del dominio, ovvero la CA conferma esclusivamente che il dominio è controllato dalla parte che richiede il certificato, qualunque essa sia (benevola o malevola). Semplificando, chi si connette ad un sito certificato con Let’s Encrypt può star certo che il proprietario del dominio ha il pieno controllo su di esso, e che la trasmissione tra host e server è sicura. Quanto detto è chiaramente un ossimoro: basti pensare a tutti i casi di utilizzo fraudolento simili a quello descritto in precedenza.

Viceversa, un certificato di tipo OV[6], contiene al suo interno il nome dell’organizzazione. Ciò permette di garantire un grado di fiducia superiore verso il sito che si sta visitando e l’azienda che esso rappresenta.

In aggiunta il certificato di tipo EV[7], oltre a garantire gli stessi attributi del, mostra il nome dell’organizzazione direttamente nella barra degli indirizzi.

Infine, ulteriori motivi relativi alle modalità di “amministrazione” del dominio, sono i seguenti: Let’s Encrypt…

  • non offre alcuna garanzia, non c’è quindi alcuna assicurazione di protezione in caso, ad esempio, di data breach o di utilizzo non lecito da parte di terzi del certificato;
  • non offre l’opzione Wildcard, quindi non copre i terzi livelli associati al dominio principale;
  • in caso di problemi o quesiti, non è possibile ricevere assistenza via call center o altro; gli unici riscontri sono ottenibili unicamente accedendo ai pareri forniti dalla community online;
  • scade dopo 90 giorni; occorre quindi attrezzarsi di frequente per rinnovarlo[8].

CONCLUSIONI

Indubbiamente Let’s Encrypt è un prodotto estremamente valido, semplice ed utile a chi vuole pubblicare un proprio sito/servizio (anche per motivi ludici) senza dover forzatamente acquistare un certificato SSL (o doversi sorbire i noiosi avvisi presentati in caso di certificati autogenerati). È altresì vero che tale servizio non è adeguato nel caso in cui si voglia mettere in piedi un servizio di e-commerce, o una vetrina relativa ad un progetto importante.

Si potrebbe, nella pratica, affermare che l’obiettivo iniziale dei creatori di Let’s Encript ha ottenuto i risultati (in termini di incremento della sicurezza del web) diametralmente opposti a quelli attesi. A conti fatti, gli hacker possono agevolmente mascherare siti fittizi e fraudolenti come portali sicuri.

Proprio per questo motivo si può affermare che i creatori di Let’s Encrypt hanno messo un po’ i bastoni tra le ruote sia agli sviluppatori di browser, sia ai tecnici che negli anni hanno ripetutamente esortato l’utente medio nel controllare che all’interno della barra degli indirizzi fosse presente la dicitura “HTTPS”, prima di “fidarsi” della bontà un sito internet.

Di fatto, ad oggi i controlli posti in essere volti ad arginare la navigazione erronea su siti fraudolenti e a salvaguardare l’utenza inesperta, risultano del tutto inefficaci.

L’unico rimedio, come nella maggior parte dei casi, risulta essere l’awarness. Sensibilizzare l’utenza poco esperta è l’unico modo per ovviare al problema.

Le uniche buone pratiche da seguire, per cercare di non incappare in siti malevoli sono, quelle di:

  • verificare puntualmente l’indirizzo presente nella barra di navigazione;
  • controllare nel dettaglio il tipo di certificato relativo ad un sito ogni qualvolta un sito possa risultarci di dubbia validità:
    • preferendo certificati di tipo OV/EV ai DV;
    • verificando la CA emettitrice dello stesso.

Note

  • [1] Rispettivamente versione 56 e 51.
  • [2] Quando apriamo un sito internet che usa il protocollo HTTP, un qualsiasi utente malintenzionato potrebbe facilmente leggere o modificare la pagina da noi visualizzata tramite la tecnica del “man in the middle”.
  • [3] La spesa di un certificato SSL varia dalle decine alle centinaia di Euro l’anno, in base al tipo di certificato richiesto.
  • [4] su un web server su un sistema unix-like sono sufficienti pochi secondi per configurare il supporto ad HTTPS, senza contare la possibilità di impostare job di rinnovo automatici.
  • [5] https://www.thesslstore.com/blog/lets-encrypt-phishing/
  • [6] https://www.ssl.com/faqs/ssl-ov-validation-requirements/
  • [7] https://www.ssl.com/faqs/ssl-ev-validation-requirements/
  • [8] problema facilmente risolvibile tramite meccanismi di rinnovo automatico basato su script, o job, auto eseguibili: uno tra tanti consiste nell’utilizzo del servizio cron sulle distribuzioni linux. In alteranativa, Let’s Encrypt stesso elenca qui i client compatibili per il rinnovo automatico dei suoi certificati.

Articolo a cura di Daniele Rigitano

Download PDF

https://www.ictsecuritymagazine.com/articoli/https-e-ancora-sicuro/


Insider Threat: tipologie di minacce e contromisure

Ormai negli ultimi 5 anni riscontriamo un’evoluzione del mercato della Cybersecurity da parte delle organizzazioni pubbliche e private che sempre più spesso ricorrono ad un adeguamento delle tecnologie e dei programmi legati alla gestione del rischio Cyber.

Solo nel 2018 abbiamo dato seguito all’attuazione di due importanti direttive europee: la Direttiva 2016/679 (GDPR) per la protezione della privacy e la Direttiva (UE) 2016/1148 (NIS – Network and Information Security) per la gestione degli incidenti di sicurezza informatica e relativa comunicazione verso terzi.

Molto spesso però si dimentica che la parte più importante del rischio Cyber è legata e generata dai dipendenti dove gli strumenti attuali non riescono sempre ad essere efficaci; pertanto risulta importante pensare ed attuare un approccio innovativo di gestione del rischio Cyber, che contempli sia gli aspetti tecnologici sia l’“human factor” [1].

L’elemento più ricorrente legato al rischio cyber e che sempre più spesso viene citato da report internazionali come Verizon, è il Data Breach, ovvero la fuga di dati, in cui l’elemento minaccia definito come Insider Threat rappresenta uno dei fattori principali.

In questo ultimo anno, nel mondo si sono registrati oltre 53.000 incidenti e 2.216 data breach confermati di cui circa il 30% sono legati alla minaccia Insider Threat; di questi, il 28% ha coinvolto attori interni alle organizzazioni, mentre il restante 2% ha coinvolto fornitori/partner. Quasi la metà (48%) dei Data Breach è relativa ad attività di hacking di cui le principali motivazioni sono di tipo finanziario (76%); si riscontra altresì un aumento dei Data Breach in ambito Sanitario e PMI[2].

Figura 1 – Summary of findings from DBIR 2018

Le aziende e i responsabili della cybersecurity, stanno quindi iniziando a valutare e prevenire eventuali minacce da Insider.

Ma che cosa si intende per Insider Threat? Insider Threat è una minaccia dannosa per un’organizzazione che proviene da persone interne all’organizzazione, come dipendenti, ex dipendenti, appaltatori o soci in affari, che dispongono di informazioni interne relative alle pratiche di sicurezza dell’organizzazione, ai dati e ai sistemi informatici.

La minaccia può comportare la frode, il furto di informazioni riservate o di valore commerciale, il furto di proprietà intellettuale o il sabotaggio di sistemi informatici[3].

La minaccia di utilizzo e/o vendita di informazioni privilegiate da parte dei propri dipendenti (fornitori e/o venditori) è uno dei maggiori problemi irrisolti in materia di sicurezza informatica. Le aziende sono certamente consapevoli del problema, ma raramente dedicano le risorse o l’attenzione esecutiva necessaria per risolverlo.

La maggior parte dei programmi di prevenzione sono insufficienti e si concentrano esclusivamente sul monitoraggio dei comportamenti senza prendere in considerazione le norme culturali e di privacy[4].

L’ Insider può appartenere a quattro categorie:

  • Pedine (Pawns). Questi sono i dipendenti che vengono manipolati da qualcun altro, di solito un hacker esterno, al fine di farsi aiutare a commettere il crimine. Esempio: un dipendente diventa bersaglio di un attacco di spear phishing e scarica inconsapevolmente un malware sul desktop consentendo all’hacker di infiltrarsi nell’organizzazione.
  • Persona Incompetente (Goofs). Si tratta di dipendenti non intenzionalmente maliziosi o che deliberatamente danneggiano i propri datori di lavoro. Sono spesso soggetti che agiscono per ignoranza o anche per dolo, credendo di poter aggirare le politiche di sicurezza. Esempio: un dipendente ignora le procedure e le soluzioni di sicurezza interne per la trasmissione di informazioni confidenziali (server dedicati, aree cloud aziendali, etc) ed invia le informazioni tramite la posta aziendale non crittografata o peggio ancora su un CD, USD drive. Tali azioni sempre più spesso rappresentano una minaccia per i datori di lavoro. Gartner indica che circa il 90% degli incidenti interni è causato da personale incompetente.
  • Collaboratori (Collaborators). Si tratta di addetti ai lavori che collaborano consapevolmente con un altro soggetto, di solito esterno all’azienda, al fine di perpetrare un crimine contro il proprio datore di lavoro. Sono pienamente consapevoli delle loro azioni e del loro ruolo nel crimine. Spesso vendono attivamente i propri servizi ai criminali che incontrano su forum di social media e sul deep web.
  • Lupi solitari (Lone wolves). Questi attori agiscono da soli, senza alcun collaboratore esterno che li manipoli e sono soggetti che pur avendo bassi privilegi, accedono ad informazioni privilegiate/sensibili. Peccato che le organizzazioni spesso si preoccupino più degli utenti con privilegi elevati come amministratori del database o amministratori di sistema,  che dei lupi solitari.

Rispetto alle categorie di cui sopra, i controlli disponibili e le tecnologie emergenti nel mercato, sono limitate rispetto alle azioni del malintenzionato coinvolto in attività non autorizzata.

La figura seguente mostra come l’uso della tecnologie (in verde) e l’approccio da seguire (in blu) cambia rispetto al tipo di Insider, da cui l’organizzazione deve proteggersi.

Figura 2 – Different types of Insider – Gartner source

I manager di cybersecurity sempre di più devono adottare un approccio innovativo e proattivo sulla base di tre elementi:

  • La microsegmentazione, consente all’organizzazione di identificare le aree ad alto rischio adottando un approccio mirato di monitoraggio e attenuazione delle minacce. In tal senso si identificano i gruppi di dipendenti in grado di provocare un elevato danno all’Azienda e si sviluppano interventi mirati per limitarne il rischio.
  • Il cambiamento culturale, permette di identificare in anticipo eventi di rischio dannosi o azioni negligenti da parte dei dipendenti, ponendo l’azienda in una fase preventiva anziché reattiva. Ciò è possibile se i dipendenti si sentono coinvolti nel processo di “Cyber-Hygiene” di cui i dirigenti aziendali sono i primi promotori e sostenitori.
  • La tecnologia, che consente all’organizzazione di identificare e interrompere le attività da parte degli Insider, molto prima nel ciclo di vita della minaccia stessa.

Tutti gli elementi dipendono molto dalla strategia aziendale, dal livello di consapevolezza dell’azienda rispetto alle minacce Cyber e dalle azioni intraprese delle diverse funzioni aziendali (es. Direzione Generale, CIO, Compliance, CFO, HR, Legale, etc).

Per quanto riguarda la tecnologia, esistono ad oggi 3 soluzioni avanzate di rilevamento delle minacce interne “Insider Threat”, come alternative ai tradizionali sistemi di prevenzione e perdita di dati (DLP –  Data Loss Prevention):

  1. Analisi del comportamento degli utenti e delle entità (UEBA);
  2. Monitoraggio del dipendente (o di qualsiasi utente) – utilizzando un endpoint, un’applicazione di monitoraggio basata su agenti;
  3. Audit e protezione incentrati sui dati (DCAP – Data Centric Audit and Protection).

Le soluzioni UEBA analizzano il comportamento degli utenti, i loro gruppi di appartenenza e le entità coinvolte nella comunicazione tra utenti stessi, utilizzano tecniche analitiche avanzate al fine di rilevare transazioni e comportamenti anomali. La maggior parte di queste soluzioni è in grado di rilevare prontamente accessi anomali e/o comunicazioni anomale, ed applicare i modelli di apprendimento automatico (Machine Learning) grazie anche all’utilizzo di fonti di cyber threat intelligence esterna (Feed).

Invece strumenti di monitoraggio basati su agenti, offrono una visibilità più completa dell’attività dell’utente sulla sua postazione di lavoro rispetto a minacce Cyber o comportamenti dannosi verso l’organizzazione. La maggior parte di queste soluzione è in grado di effettuare una registrazione video di eventi di sicurezza degni di nota, come per esempio un accesso ad un aree riservata o l’avvio di un processo anomalo sulla postazione di lavoro (es. Malware, Trojan, etc).

Infine le soluzioni DCAP, si concentrano tradizionalmente sull’accesso privilegiato ai dati memorizzati nei file, come ad esempio sistemi di gestione di database relazionali (RDBMS), big data, database NoSQL o cloud pubblici. Le tecnologie DCAP sono in grado di rilevare potenziali attività dannose o accidentali prima che ci sia una violazione. Gli Alert e le azioni possono essere prioritizzate in base alla classificazione o alla sensibilità dei set di dati a cui si accede.

Per concludere, ad avviso di chi scrive, questo approccio ha però un limite rappresentato dalla privacy, che dipende principalmente dalla cultura aziendale e dalla presenza dell’azienda in particolari geografie (es. EU, USA, CINA, etc). Alcune cose si possono fare ma è importante stare attenti ai processi ed alla trasparenza e correttezza verso i dipendenti, che devono essere consapevoli sia dei comportamenti non ammessi ma anche delle modalità di controllo e delle tecnologie sottostanti.

Al momento , il consiglio più importante resta quello di adottare, il prima possibile politiche di microsegmentazione e programmi di formazione sui temi Cyber, anche attraverso simulazioni avanzate di attacco o di gestione della crisi, mentre per quanto riguarda gli aspetti tecnologici limitarsi alla verifica di comunicazioni anomale tra entità  (UEBA) e controllo delle postazioni di lavoro attraverso soluzioni di EDP – End Point Protection, limitandosi al monitoraggio di accessi anomali ai dati “sensibili” aziendali (es. patrimonio informativo aziendale, dati di R&D, conti correnti dei clienti, etc) e non ai dati personali dei dipendenti.

Note

  • [1] Il fattore umano nella cybersecurity: Phishing, Social Engineering e Mind Hacking –  Gerardo Costabile e Ilenia Mercuri  Luglio 2018
  • [2] DBIR – Data Breach Investigation Report – Verizon 2018
  • [3] Fonte wikipedia
  • [4] Insider threat: The human element of cyber risk – McKinsey Settembre 2018


Articolo a cura di Mattia Siciliano 

L’articolo Insider Threat: tipologie di minacce e contromisure proviene da ICT Security Magazine.

https://www.ictsecuritymagazine.com/articoli/insider-threat-tipologie-di-minacce-e-contromisure/


Come può un computer fidarsi di un altro computer?

Introduzione

Negli ultimi cinquant’anni gli algoritmi crittografici hanno garantito segretezza e integrità nella trasmissione dell’informazione. Tuttavia la crittografia non può garantire la veridicità sulla natura del dato. Chiariamo il concetto con un esempio: se io cifro il numero dei miei anni (dichiarando di averne 5) con la chiave pubblica del lettore questo potrà correttamente decifrare l’età che ho dichiarato di avere, ma non potrà mai sapere se ho detto la verità.

Invece se il lettore chiedesse la mia età all’ufficio anagrafe del comune in cui risiedo saprebbe con certezza quanti anni ho.

Nel mondo internet “classico”, anche detto internet delle persone, un’informazione è veritiera se la fonte da cui proviene è autorevole. Una fonte è autorevole se la sua identità è garantita sia nel mondo analogico grazie a norme e controlli periodici sia in quello digitale tramite certification authority.

Nel mondo internet “delle cose” (IoT) questo schema non va più bene. Le fonti da cui proviene l’informazione sono troppe per essere tutte garantite sia ‘online’ che ‘offline’. Si parla di decine di bilioni di dispositivi connessi nel prossimo futuro.

A questo punto la domanda che ci facciamo è:

Come posso stabilire se un’informazione è veritiera se non posso fidarmi della fonte da cui proviene essendo questa priva di garanzie?

L’intento dell’articolo sarà quello di rispondere a questa domanda illustrando cos’è una Network of Trust e quali sono le vulnerabilità di cui soffrono queste reti. In seguito verrà brevemente introdotta la subjective logic.

Che temperatura c’è adesso a Honolulu?

Per contestualizzare meglio il funzionamento di una TON (trust overlay network) introduciamo un esempio. Consideriamo un sistema di rilevamento della temperatura secondo il modello di internet ‘classico’. La misura è frutto di numerose certificazioni e adempimenti di leggi: tipicamente l’azienda che offre il servizio meteo ha contratti con un’altra azienda che gestisce i sensori ed entrambe le aziende devono essere accreditate dall’istituto metrologico dello Stato interessato. A livello globale gli istituti metrologici sono accreditati in modo gerarchico dall’istituto metrologico internazionale. Così un’azienda italiana accreditata potrà comprare il dato relativo alla temperatura in America da un’azienda americana, anch’essa a norma, e sapere che il dato ricevuto è veritiero.

Ora immaginiamo un sistema di rilevamento della temperatura globale nel mondo dell’internet delle cose.  Ci saranno decine di migliaia di aziende che offriranno a pagamento (pay-per-data) il servizio di lettura della temperatura per una o più città nel mondo. Accreditare tutte queste aziende a livello globale è praticamente impossibile.

In assenza di un sistema di accreditamento, la misura di temperatura fornita da un’azienda sarà veritiera se l’azienda si comporta in modo onesto, falsa in caso contrario. Il problema è capire di quali aziende ci si può fidare e di quali no.

Un’azienda italiana necessita di sapere la temperatura che c’è ad Honolulu. L’azienda italiana dovrà scegliere una tra le mille aziende che gestiscono i sensori di temperatura ad Honolulu. L’azienda italiana non ha mai avuto rapporti con nessuna delle aziende di Honolulu per cui non sa se la misura che gli verrà fornita sarà veritiera. Per evitare di essere truffata l’azienda italiana chiama una ditta spagnola (di cui si fida) per sapere quali sono le aziende più serie di Honolulu. Per confermare quanto detto da quella spagnola, la società italiana chiama anche un’altra impresa.

Dopo aver confrontato i vari pareri l’azienda italiana seleziona, tra le tante di Honolulu, quella che ritiene più affidabile (e che costa meno fissata la qualità). Dopo aver ottenuto il dato sulla temperatura la società italiana potrà a sua volta giudicare la veridicità della misura e di conseguenza suggerire o meno la ditta di Honolulu ad altre imprese.

Questo semplice meccanismo, automatizzato per ogni nodo della rete e calcolato ad ogni transizione, è alla base di una network of trust.

Le insidie in una Network of Trust

In una network of trust la fiducia di un nodo viene calcolata a priori, basandosi sulla fiducia diretta/indiretta espressa dagli altri nodi della rete e modificata nel tempo valutando la positività delle transazioni fatte da/verso quel nodo.

Non esiste un ente terzo di garanzia, la fiducia viene costruita dagli stessi nodi che fanno parte della rete.

Così i nodi che frodano il sistema, detti nodi selfish in letteratura, vengono penalizzati fino ad essere esclusi dalla rete, mentre quelli onesti vengono premiati garantendo così l’affidabilità delle fonti, quindi la veridicità dell’informazione.

Tutto questo in teoria. In pratica le insidie che si nascondono dietro una network of trust sono molte e verranno discusse in seguito.

Iniziamo considerando il caso di un singolo nodo selfish che agisce in autonomia. Questo tenderà a fornire una misura non corretta della temperatura per cui verrà valutato negativamente dagli altri nodi della rete, individuato ed evitato di conseguenza. Ma le cose non sono così semplici.

Uno degli attacchi più noti in una network of trust è il così detto Sybil Attack. Ogni nuovo nodo che entra a far parte della rete avrà assegnato una reputazione neutra di default. Ci sono casi in cui il frodatore elimina il nodo che ha una cattiva reputazione e ne crea uno nuovo. La reputazione neutra del nuovo nodo è migliore della reputazione cattiva di quello vecchio. Possiamo pensare che lo stesso nodo perda la cattiva reputazione che aveva accumulato e continui a frodare il sistema all’infinito.

Un altro problema si verifica quando nel calcolo numerico della reputazione si perdono informazioni per normalizzare il valore e diminuire la complessità computazionale (migliore performance). Questo avviene ad esempio nell’algoritmo Eigentrust dove l’indice di trust è calcolato come differenza tra le transizioni positive e quelle negative. Un nodo truffaldino che effettua un numero leggermente superiore di transizioni positive rispetto a quelle negative potrebbe apparire come onesto: un nodo che effettui 900 transizioni negative e 100 transizioni positive sarebbe considerato al pari di uno che effettua 10 transizioni positive e zero negative.

Ma il vero problema di una rete di trust nasce quando più nodi orchestrati da uno stesso frodatore si coalizzano per valutare positivamente un nodo selfish.

Questo tipo di attacco è molto difficile da individuare perché questi nodi si comportano in modo onesto ma la rete non sa che sono orchestrati da un unico frodatore. Infatti i nodi realmente onesti danno fiducia a questi perché, di fatto, si comportano rettamente, ma essendo sotto il controllo del frodatore questi nodi mentono e valutano positivamente il nodo selfish. Così per la proprietà transitiva quelli realmente onesti si fidano di quello selfish.

Vero && Vero… è un’opinione!

Nel corso dell’articolo ho parlato di fiducia da un punto di vista qualitativo. In verità una rete TON si basa su algoritmi che attribuiscono alla fiducia un valore quantitativo. Alcuni di questi algoritmi si basano su un tipo di logica probabilistica detta subjective logic.

Nella logica tradizionale una proposizione è vera oppure falsa. Inoltre le proposizioni possono essere combinate secondo le tabelle di verità: AND, OR, XOR…etc.

Nella subjective logic si parla di opinione. Un’opinione è una quadrupla (b,d,u,a) dove:

b è la “belief mass”:  un valore tra 0 e 1 che indica con quale probabilità la proposizione è vera;

d è la “disbelief mass”:  un valore tra 0 e 1 che indica con quale probabilità la proposizione è falsa;

u è la “uncertainty mass” : un valore tra 0 e 1 che indica il grado di incertezza dell’opinione;

a è la “prior probability”; un valore tra 0 e 1 che indica il grado di fiducia in un nodo prima di ogni interazione.

La subjective logic è molto usata nelle reti di trust perché permette di definire delle operazioni con cui è possibile combinare le opinioni. Ad esempio se A ha un’opinione di B e B ha un’opinione di C, allora A calcola la fiducia in C come un’operazione ‘serie’ tra le due opinioni. Allo stesso modo si potrà calcolare l’opinione di un nodo come un’operazione “parallela” tra tutte le opinioni espresse verso quel nodo.

Una volta definito come calcolare la fiducia non resta che implementare l’algoritmo distribuito sui nodi della rete o centralizzato verso un unico nodo logico (tipo SDN).

Conclusione

Nel mondo dell’internet delle cose risulta difficile, se non impossibile, poter autenticare e accreditare ogni fonte di informazione. I frodatori sono sempre in agguato e per garantire la veridicità dell’informazione è necessario trovare meccanismi diversi da quelli usati fino ad oggi. Una rete di fiducia è un sistema che permette ai nodi della rete di collaborare per garantire l’onestà dei nodi e la veridicità delle informazioni. La scelta o la progettazione di una rete di fiducia deve tenere in considerazione le vulnerabilità note.


Articolo a cura di Francesco Ermini

L’articolo Come può un computer fidarsi di un altro computer? proviene da ICT Security Magazine.

https://www.ictsecuritymagazine.com/articoli/come-puo-un-computer-fidarsi-di-un-altro-computer/