Delibera del Garante Privacy e DPIA

Apprendo da una delle tante newsletter fornite dalle banche dati giuridiche alle quali sono abbonato che il Garante ha appena approvato la “Delibera del Garante Privacy dell’11 ottobre 2018, n. 467; in G.U. del 19 novembre 2018, n. 269 – Valutazione d’impatto”

Orbene tale delibera concerne o, meglio, individua, come esplicitamente scritto nella medesima delibera, quali siano i trattamenti e/o le tipologie di trattamenti da sottoporre a preventiva Valutazione di Impatto (ar.35 e 36 GDPR)

Partiamo dall’analisi dell’art.35, riportato nella tabella che segue:

1. Quando un tipo di trattamento, allorché prevede in particolare l’uso di nuove tecnologie, considerati la natura, l’oggetto, il contesto e le finalità del trattamento, può presentare un rischio elevato per i diritti e le libertà delle persone fisiche, il titolare del trattamento effettua, prima di procedere al trattamento, una valutazione dell’impatto dei trattamenti previsti sulla protezione dei dati personali. Una singola valutazione può esaminare un insieme di trattamenti simili che presentano rischi elevati analoghi.
2. Il titolare del trattamento, allorquando svolge una valutazione d’impatto sulla protezione dei dati, si consulta con il responsabile della protezione dei dati, qualora ne sia designato uno.
3. La valutazione d’impatto sulla protezione dei dati di cui al paragrafo 1 è richiesta in particolare nei casi seguenti:
3. a) una valutazione sistematica e globale di aspetti personali relativi a persone fisiche, basata su un trattamento automatizzato, compresa la profilazione, e sulla quale si fondano decisioni che hanno effetti giuridici o incidono in modo analogo significativamente su dette persone fisiche;
3. b) il trattamento, su larga scala, di categorie particolari di dati personali di cui all’articolo 9, paragrafo 1, o di dati relativi a condanne penali e a reati di cui all’articolo 10; o
3. c) la sorveglianza sistematica su larga scala di una zona accessibile al pubblico.
4. L’autorità di controllo redige e rende pubblico un elenco delle tipologie di trattamenti soggetti al requisito di una valutazione d’impatto sulla protezione dei dati ai sensi del paragrafo 1. L’autorità di controllo comunica tali elenchi al comitato di cui all’articolo 68.
5. L’autorità di controllo può inoltre redigere e rendere pubblico un elenco delle tipologie di trattamenti per le quali non è richiesta una valutazione d’impatto sulla protezione dei dati. L’autorità di controllo comunica tali elenchi al comitato.
6. Prima di adottare gli elenchi di cui ai paragrafi 4 e 5, l’autorità di controllo competente applica il meccanismo di coerenza di cui all’articolo 63 se tali elenchi comprendono attività di trattamento finalizzate all’offerta di beni o servizi a interessati o al monitoraggio del loro comportamento in più Stati membri, o attività di trattamento che possono incidere significativamente sulla libera circolazione dei dati personali all’interno dell’Unione.
7. La valutazione contiene almeno:
7. a) una descrizione sistematica dei trattamenti previsti e delle finalità del trattamento, compreso, ove applicabile, l’interesse legittimo perseguito dal titolare del trattamento;
7. b) una valutazione della necessità e proporzionalità dei trattamenti in relazione alle finalità;
7. c)  una valutazione dei rischi per i diritti e le libertà degli interessati di cui al paragrafo 1; e
7. d) le misure previste per affrontare i rischi, includendo le garanzie, le misure di sicurezza e i meccanismi per garantire la protezione dei dati personali e dimostrare la conformità al presente regolamento, tenuto conto dei diritti e degli interessi legittimi degli interessati e delle altre persone in questione.
8. Nel valutare l’impatto del trattamento effettuato dai relativi titolari o responsabili è tenuto in debito conto il rispetto da parte di questi ultimi dei codici di condotta approvati di cui all’articolo 40, in particolare ai fini di una valutazione d’impatto sulla protezione dei dati.
9. Se del caso, il titolare del trattamento raccoglie le opinioni degli interessati o dei loro rappresentanti sul trattamento previsto, fatta salva la tutela degli interessi commerciali o pubblici o la sicurezza dei trattamenti.
10. Qualora il trattamento effettuato ai sensi dell’articolo 6, paragrafo 1, lettere c) o e), trovi nel diritto dell’Unione o nel diritto dello Stato membro cui il titolare del trattamento è soggetto una base giuridica, tale diritto disciplini il trattamento specifico o l’insieme di trattamenti in questione, e sia già stata effettuata una valutazione d’impatto sulla protezione dei dati nell’ambito di una valutazione d’impatto generale nel contesto dell’adozione di tale base giuridica, i paragrafi da 1 a 7 non si applicano, salvo che gli Stati membri ritengano necessario effettuare tale valutazione prima di procedere alle attività di trattamento.
11. Se necessario, il titolare del trattamento procede a un riesame per valutare se il trattamento dei dati personali sia effettuato conformemente alla valutazione d’impatto sulla protezione dei dati almeno quando insorgono variazioni del rischio rappresentato dalle attività relative al trattamento.

Orbene, la delibera in questione specifica:

…omissis…

Tutto cio’ premesso:

  • ai sensi degli articoli 35, paragrafo 4, e 57, paragrafo 1, lettera k), del RGPD fermo restando quanto indicato nel richiamato WP 248, rev. 01, individua l’elenco delle tipologie di trattamenti, soggetti al meccanismo di coerenza, da sottoporre a valutazione d’impatto, riportate nell’allegato 1 facente parte integrante del presente provvedimento, che specificano quanto riportato nel citato WP 248, rev. 01;

…omissis…

Conseguentemente, l’articolo di riferimento è il 35 del GDPR, oltre all’art.57 del GDPR medesimo, che è quello che concerne i compiti in generale dell’Autorità di Controllo, ossia del Garante per il trattamento dei dati personali nel nostro paese.

Poi, però, prima di passare all’analisi pratica della questione, occorre NON DIMENTICARE cosa afferma l’art.36 del GDPR, che concerne la c.d. “consultazione preventiva”, ossia l’obbligo per i soggetti individuati di sottoporre i trattamenti da essi effettuati al previo controllo dell’Autorità Garante:

1 Il titolare del trattamento, prima di procedere al trattamento, consulta l’autorità di controllo qualora la valutazione d’impatto sulla protezione dei dati a norma dell’articolo 35 indichi che il trattamento presenterebbe un rischio elevato in assenza di misure adottate dal titolare del trattamento per attenuare il rischio.
2 Se ritiene che il trattamento previsto di cui al paragrafo 1 violi il presente regolamento, in particolare qualora il titolare del trattamento non abbia identificato o attenuato sufficientemente il rischio, l’autorità di controllo fornisce, entro un termine di otto settimane dal ricevimento della richiesta di consultazione, un parere scritto al titolare del trattamento e, ove applicabile, al responsabile del trattamento e può avvalersi dei poteri di cui all’articolo 58. Tale periodo può essere prorogato di sei settimane, tenendo conto della complessità del trattamento previsto. L’autorità di controllo informa il titolare del trattamento e, ove applicabile, il responsabile del trattamento di tale proroga, unitamente ai motivi del ritardo, entro un mese dal ricevimento della richiesta di consultazione. La decorrenza dei termini può essere sospesa fino all’ottenimento da parte dell’autorità di controllo delle informazioni richieste ai fini della consultazione.
3 Al momento di consultare l’autorità di controllo ai sensi del paragrafo 1, il titolare del trattamento comunica all’autorità di controllo:
3 a) ove applicabile, le rispettive responsabilità del titolare del trattamento, dei contitolari del trattamento e dei responsabili del trattamento, in particolare relativamente al trattamento nell’ambito di un gruppo imprenditoriale;
3 b) le finalità e i mezzi del trattamento previsto;
3 c) le misure e le garanzie previste per proteggere i diritti e le libertà degli interessati a norma del presente regolamento;
3 d) ove applicabile, i dati di contatto del responsabile della protezione dei dati;
3 e) la valutazione d’impatto sulla protezione dei dati di cui all’articolo 35;
3 f) ogni altra informazione richiesta dall’autorità di controllo.
4 Gli Stati membri consultano l’autorità di controllo durante l’elaborazione di una proposta di atto legislativo che deve essere adottato dai parlamenti nazionali o di misura regolamentare basata su detto atto legislativo relativamente al trattamento.
5 Nonostante il paragrafo 1, il diritto degli Stati membri può prescrivere che i titolari del trattamento consultino l’autorità di controllo, e ne ottengano l’autorizzazione preliminare, in relazione al trattamento da parte di un titolare del trattamento per l’esecuzione, da parte di questi, di un compito di interesse pubblico, tra cui il trattamento con riguardo alla protezione sociale e alla sanità pubblica.

Ed infatti in questo senso deve essere intesa la delibera, non nella esenzione per i soggetti NON indicati nella delibera medesima dall’obbligo di valutazione preventiva, e questo  per alcuni semplicissimi motivi:

  • La delibera medesima precisa che …omissis… Rilevato che tale elenco e’ riferito esclusivamente a tipologie di trattamento soggette al meccanismo di coerenza e che non e’ esaustivo, restando fermo quindi l’obbligo di adottare una valutazione d’impatto sulla protezione dei dati laddove ricorrano due o più dei criteri individuati dal WP 248, rev. 01 e che in taluni casi «un titolare del trattamento può ritenere che un trattamento che soddisfa soltanto uno [dei predetti] criteri richieda una valutazione d’impatto sulla protezione dei dati» (cfr. WP 248, rev. 01, pag. 11) …omissis…;
  • Il riferimento nella Delibera all’art.35 e non ad altri articoli dovrebbe togliere ogni dubbio sulla necessità per tutti di effettuare comunque una DPIA, nella maggior parte dei casi anche semplicemente perché se non si effettua una corretta DPIA non si può essere certi che i trattamenti effettuati rientrino o meno nell’elenco collegato alla cennata Delibera del Garante;
  • La delibera medesima, nella propria parte introduttiva, in un certo senso spiega perché venga emanata, e la ragione è quella di individuare specificatamente e direi per dettato normativo le tipologie di trattamenti ed i trattamenti per i quali i titolari (ovvero i responsabili per la parte loro concernente) debbano necessariamente procedere ad una valutazione di impatto preventiva.

Passiamo ora ad esaminare le singole ipotesi previste dalla Delibera, con riserva di una più approfondita analisi nel prosieguo.

TESTO DELIBERA COMMENTO
1. Trattamenti valutativi o di scoring su larga scala, nonche’ trattamenti che comportano la profilazione degli interessati nonche’ lo svolgimento di attività predittive effettuate anche on-line o attraverso app, relativi ad «aspetti riguardanti il rendimento professionale, la situazione economica, la salute, le preferenze o gli interessi personali, l’affidabilità o il comportamento, l’ubicazione o gli spostamenti dell’interessato». La prima obiezione che a mio parere salta subito agli occhi è la mancanza di una definizione normativa del concetto di “larga scala”, peraltro già più volte sollecitata da più parti, in quanto senza che tale concetto sia definito – giusto o sbagliato, ma definito – in qualche modo, l’interprete (ossia il consulente che debba applicare nella realtà la normativa, si trova privo di strumenti stabili e deve necessariamente ricorrere alla propria esperienza e conoscenza, ampliando però il margine di errore.

Per il resto mi sembra chiaro il riferimento alle varie “centrali rischi”, ove confluiscono i nostri dati relativi all’essere o meno “buoni pagatori”.

2. Trattamenti automatizzati finalizzati ad assumere decisioni che producono «effetti giuridici» oppure che incidono «in modo analogo significativamente» sull’interessato, comprese le decisioni che impediscono di esercitare un diritto o di avvalersi di un bene o di un servizio o di continuare ad esser parte di un contratto in essere (ad es. screening dei clienti di una banca attraverso l’utilizzo di dati registrati in una centrale rischi). Anche qui mi sembra chiaro il riferimento alle varie “centrali rischi”, ove confluiscono i nostri dati relativi all’essere o meno “buoni pagatori”.

Ritengo che però tutto l’ambito relativo a questo aspetto dovrebbe, per un principio di correttezza generale, essere integrato anche dalle notizie sulla esistenza di eventuali cause promosse dai c.d. “cattivi pagatori” nei confronti dei soggetti che hanno dato origine a tale “marchio”.

3. Trattamenti che prevedono un utilizzo sistematico di dati per l’osservazione, il monitoraggio o il controllo degli interessati, compresa la raccolta di dati attraverso reti, effettuati anche on-line o attraverso app, nonche’ il trattamento di identificativi univoci in grado di identificare gli utenti di servizi della società dell’informazione inclusi servizi web, tv interattiva, ecc. rispetto alle abitudini d’uso e ai dati di visione per periodi prolungati. Rientrano in tale previsione anche i trattamenti di metadati ad es. in ambito telecomunicazioni, banche, ecc. effettuati non soltanto per profilazione, ma piu’ in generale per ragioni organizzative, di previsioni di budget, di upgrade tecnologico, miglioramento reti, offerta di servizi antifrode, antispam, sicurezza etc. Qual è il significato preciso di “l’osservazione, il monitoraggio o il controllo degli interessati”?

Non mi sembra che gli esempi siano così chiari.

A volere essere pignoli la norma sembra stabilire che sono sottoposti alla Delibera tutti i trattamenti che non sfocino specificatamente nella profilazione, ma anche …omissis… ma piu’ in generale per ragioni organizzative, di previsioni di budget, di upgrade tecnologico, miglioramento reti, offerta di servizi antifrode, antispam, sicurezza …omissis…

Il che lascia ben poco spazio alla fantasia!

4. Trattamenti su larga scala di dati aventi carattere estremamente personale (v. WP 248, rev. 01): si fa riferimento, fra gli altri, ai dati connessi alla vita familiare o privata (quali i dati relativi alle comunicazioni elettroniche dei quali occorre tutelare la riservatezza), o che incidono sull’esercizio di un diritto fondamentale (quali i dati sull’ubicazione, la cui raccolta mette in gioco la libertà di circolazione) oppure la cui violazione comporta un grave impatto sulla vita quotidiana dell’interessato (quali i dati finanziari che potrebbero essere utilizzati per commettere frodi in materia di pagamenti). Quali sono “dati aventi carattere estremamente personale”?

Una cosa sono i dati relativi alla ubicazione, già oggetto della notificazione del trattamento al Garante nel codice previgente, ben altra cosa sono i dati la cui violazione comporta un grave impatto sulla vita quotidiana dell’interessato. Qual sono?

5. Trattamenti effettuati nell’ambito del rapporto di lavoro mediante sistemi tecnologici (anche con riguardo ai sistemi di videosorveglianza e di geolocalizzazione) dai quali derivi la possibilità di effettuare un controllo a distanza dell’attività dei dipendenti (si veda quanto stabilito dal WP 248, rev. 01, in relazione ai criteri numeri 3, 7 e 8). Qui il riferimento è e rimane la legge n.300/1970 art. 4 ed 8, pur con le opportune circoscrizioni effettuate nel corso degli anni dalla giurisprudenza.
6. Trattamenti non occasionali di dati relativi a soggetti vulnerabili (minori, disabili, anziani, infermi di mente, pazienti, richiedenti asilo). In pratica si vuole affermare che qualunque tipo di trattamento che NON SIA OCCASIONALE e che concerna determinate categorie di persone più vulnerabili¸ è soggetto alla applicazione della Delibera.
7. Trattamenti effettuati attraverso l’uso di tecnologie innovative, anche con particolari misure di carattere organizzativo (es. IoT; sistemi di intelligenza artificiale; utilizzo di assistenti vocali on-line attraverso lo scanning vocale e testuale; monitoraggi effettuati da dispositivi wearable; tracciamenti di prossimità come ad es. il wi-fi tracking) ogniqualvolta ricorra anche almeno un altro dei criteri individuati nel WP 248, rev. 01. Qui si fa semplicemente riferimento alla utilizzazione di tecnologie molto avanzate, quasi auto-decidenti.

Per il contenuto del documento,tra gli altri:

https://www.privacy.it/2017/10/04/wp248-rev01/

8. Trattamenti che comportano lo scambio tra diversi titolari di dati su larga scala con modalità telematiche. Anche qui la mancanza di una definizione normativa del concetto di “larga scala”, peraltro già più volte sollecitata da più parti, in quanto senza che tale concetto sia definito – giusto o sbagliato, ma definito – in qualche modo, l’interprete (ossia il consulente che debba applicare nella realtà la normativa, si trova privo di strumenti stabili e deve necessariamente ricorrere alla propria esperienza e conoscenza, ampliando però il margine di errore.
9. Trattamenti di dati personali effettuati mediante interconnessione, combinazione o raffronto di informazioni, compresi i trattamenti che prevedono l’incrocio dei dati di consumo di beni digitali con dati di pagamento (es. mobile payment). In questo caso ritengo che la Delibera colga nel segno, anche perché la realtà ci ha spesso portati a scontrarci con situazioni simili che risultavano di palmare evidenza ma conto le quali non si avevano molte armi
10. Trattamenti di categorie particolari di dati ai sensi dell’art. 9 oppure di dati relativi a condanne penali e a reati di cui all’art. 10 interconnessi con altri dati personali raccolti per finalità diverse. In questo caso ritengo che la Delibera colga nel segno, anche perché la realtà ci ha spesso portati a scontrarci con situazioni simili che risultavano di palmare evidenza ma conto le quali non si avevano molte armi; in pratica si vuol dire che se si trattano dati sensibili o dati giudiziari per finalità che non siano strettamente connesse all’oggetto della prestazione, si ricade nell’ambito di applicazione della Delibera.
11. Trattamenti sistematici di dati biometrici, tenendo conto, in particolare, del volume dei dati, della durata, ovvero della persistenza, dell’attività di trattamento. In questo caso ritengo che la Delibera colga nel segno, proprio in relazione alla grande possibilità di incrociare facilmente (=interconnessione, combinazione o raffronto di informazioni) molti dati e/o metadati
12. Trattamenti sistematici di dati genetici, tenendo conto, in particolare, del volume dei dati, della durata, ovvero della persistenza, dell’attività di trattamento. In questo caso ritengo che la Delibera colga nel segno, proprio in relazione alla grande possibilità di incrociare facilmente (=interconnessione, combinazione o raffronto di informazioni) molti dati e/o metadati

Continuerò questa disamina nei prossimi articoli.


Articolo a cura di Luca-M. de Grazia

L’articolo Delibera del Garante Privacy e DPIA proviene da ICT Security Magazine.

https://www.ictsecuritymagazine.com/articoli/delibera-del-garante-privacy-e-dpia/


L’Hardware e la Sicurezza IT – Parte 3: Meltdown e Spectre

Nei due articoli precedenti, L’Hardware e la Sicurezza IT – Parte 1: un poco di storia e L’Hardware e la Sicurezza IT – Parte 2: Attacchi Side Channel, Row Hammer ed attacchi alla Cache, sono stati riassunti brevemente i principali eventi ed alcune informazioni utili per poter svolgere una breve analisi delle vulnerabilità di sicurezza informatica dovute all’Hardware e chiamate “Meltdown” e “Spectre” [1], divulgate al pubblico il 3 gennaio 2018.

Ma prima di addentrarci in alcuni dettagli di queste vulnerabilità è necessario chiarire un poco il motivo della loro rilevanza e della loro fama. A prima vista infatti Row Hammer, descritto nell’articolo precedente, risulta essere una vulnerabilità di gravità maggiore in quanto permette di modificare dei dati (anche privilegiati) ed in alcuni casi di prendere il controllo totale del sistema. Invece Meltdown e Spectre permettono di accedere in sola lettura ad informazioni riservate presenti sul sistema. Row Hammer è però mitigato da alcuni fattori:

  • si applica solamente alla memoria RAM e non tutte le memorie RAM sono vulnerabili (in linea di principio sarebbe possibile sostituire RAM vulnerabili con RAM non vulnerabili nei sistemi esistenti);
  • gli attacchi Row Hammer sono molto evidenti in quanto vengono eseguite delle azioni non usuali;
  • sono possibili e disponibili varie contromisure sia software che hardware che possono mitigare o impedire gli attacchi.

Meltdown e Spectre sono invece vulnerabilità hardware del disegno delle CPU. Meltdown si applica praticamente a tutti i processori Intel disegnati e prodotti dal 1995 (ad eccezione dei processori Intel Itanium e Intel Atom prima del 2013) ed in parte anche ai processori ARM. Spectre si applica a tutti i recenti processori.

È da notare anche che sia di Meltdown che di Spectre esistono molte varianti che differiscono tipicamente per dettagli tecnici di esecuzione ma che ovviamente possono rendere del tutto inefficace una particolare mitigazione. Infatti sono state prodotte delle patch software sia per i sistemi operativi sia con microcodice di aggiornamento delle CPU, patch che mitigano alcune, ma non tutte, delle molte varianti di Meltdown e Spectre. Tra le varianti vi sono anche:

  • Netspectre [3] che implementa un attacco Spectre via rete in Javascript;
  • Foreshadow [4] che implementa un attacco al Software Guard eXtension (SGX), estensione delle CPU Intel per gestire dati riservati (Trusted Execution Environment), e a qualunque informazione presente nella Cache L1, anche del Kernel del Sistema Operativo, di un Hypervisor o del System Management Mode (SMM) della CPU stessa.

Come vedremo, Meltdown e Spectre si basano sul disegno di funzionalità di base delle CPU moderne. Per questo soluzioni definitive richiedono il ridisegno, la produzione e la sostituzione di tutte le CPU esistenti, nei server, nelle postazioni di lavoro, negli smartphone e anche di quelle integrate nei molti piccoli dispositivi IoT presenti nella nostra vita quotidiana. Se da una parte la gravità di queste vulnerabilità non è potenzialmente grave quanto quella di Row Hammer, l’origine e la diffusione fanno di Meltdown e Spectre due vulnerabilità molto più significative e la cui risoluzione richiederà ancora parecchi anni.

Meltdown

Delle due vulnerabilità, Meltdown è la più semplice da implementare ed al contempo quella per cui, come vedremo, esistono alcune contromisure software.

La caratteristica principale di Meltdown è di violare uno dei principali assunti di sicurezza del disegno delle CPU moderne. Infatti, come abbiamo descritto nel primo articolo, uno degli assunti del disegno delle CPU moderne è la presenza di anelli di privilegi, implementati in hardware, tali per cui i processi non possono accedere a dati ed istruzioni ad un livello di privilegio maggiore rispetto a quello a cui sono eseguiti. In particolare, accede ed è eseguito a livello zero (il più alto) solo il kernel del Sistema Operativo, che controlla e gestisce tutto l’hardware, i dati e l’esecuzione di tutti i processi. La vulnerabilità Meltdown permette di accedere in lettura a tutti i dati gestiti dal kernel del Sistema Operativo da parte di un processo con privilegi bassi, evitando i controlli hardware presenti nella CPU.

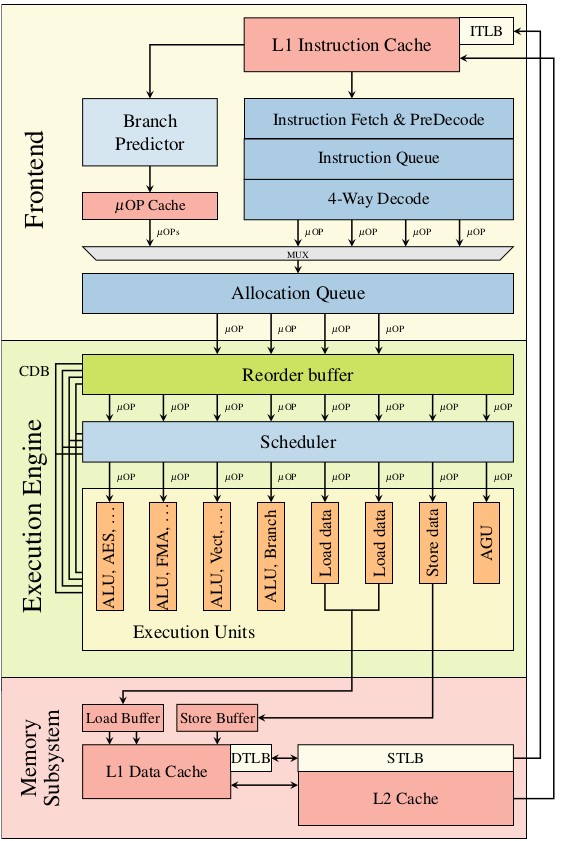
L’osservazione principale su cui si basa Meltdown è che le micro-istruzioni non sono sempre eseguite dalle CPU nell’ordine previsto dal programma. Come abbiamo descritto nel primo articolo, caratteristiche comuni delle CPU moderne, sin dagli anni ’60 e ’70, sono le pipeline di esecuzione e l’esecuzione di istruzioni non in ordine (“out-of-order”). Nel corso degli anni, queste caratteristiche sono state sviluppate ampiamente dai progettisti e le CPU attuali sfruttano ampiamente sia l’esecuzione parallela di istruzioni di tipo diverso, sia l’esecuzione out-of-order che l’esecuzione speculativa (si veda Fig. 1). Il caso più semplice di esecuzione out-of-order è l’esecuzione speculativa in presenza di un branch nel programma: ad esempio l’esito di un test su di un valore di una variabile decide se eseguire alcune istruzioni o delle altre (il tipico IF-THEN-ELSE). In attesa che vengano calcolati i valori che permettono di valutare la condizione (IF), se sono già presenti i valori per calcolare il THEN (o l’ELSE), allora la CPU procede all’esecuzione delle istruzioni nel branch. Quando poi sarà valutata la condizione (IF) la CPU decide se mantenere il branch già calcolato nel caso di scelta corretta, oppure abbandonarlo e calcolare un altro branch. La presenza di un branch non è però l’unica situazione in cui una CPU esegue istruzioni out-of-order, ve ne sono molte altre individuate dai progettisti delle CPU e che permettono delle ottimizzazioni, alle volte anche notevoli, delle prestazioni.

Fig 1. Descrizione schematica della micro-architettura di una CPU Intel Skylake con le principali componenti per l’esecuzione out-of-order delle micro-istruzioni [2]

L’attacco Meltdown si può riassumere come segue:

  1. l’attaccante è un processo utente senza alcun privilegio particolare, per cui non dovrebbe avere accesso diretto in lettura alla memoria del kernel;
  2. per prima cosa viene individuata una linea di esecuzione che garantisce l’esecuzione out-of-order delle istruzioni successive;
  3. tra le istruzioni da eseguire out-of-order ed in anticipo rispetto al flusso delle altre operazioni, viene inserita, come descritto nei passi seguenti,  la lettura di una locazione di memoria del kernel, in linea di principio operazione vietata dall’hardware;
  4. la CPU carica in un proprio registro il contenuto della locazione di memoria del kernel per prepararsi all’istruzione di lettura;
  5. la lettura del registro viene eseguita nel branch out-of-order e sulla base del valore del registro viene scritto un dato nella cache;
  6. in parallelo la CPU verifica se il processo in esecuzione nella branch out-of-order ha privilegi sufficienti per accedere ai dati;
  7. quando la verifica dei privilegi è completata senza successo, la CPU esegue una eccezione che blocca l’esecuzione del programma.

E’ chiaro che tra l’esecuzione del punto 5 e quella del punto 7 c’è una “race condition” (corsa critica), ma è possibile scrivere un flusso di istruzioni tale che 5 venga tipicamente eseguito prima di 7.

L’attacco non è però finito, perché l’informazione è presente solo nella cache della CPU, non è memorizzata dal processo attaccante e non è direttamente leggibile in quanto privilegiata. Per estrarre l’informazione dalla cache prima che la CPU la sovrascriva o la cancelli, si possono sfruttare gli attacchi alla cache descritti nel precedente articolo. In particolare la prima versione di Meltdown utilizza Flush+Reload come Covert Channel per inferire i dati presenti in cache.

Ripetendo la procedura di attacco per tutte le locazioni di memoria del kernel, il processo attaccante può leggere tutti i dati nella memoria del kernel della macchina, violando l’isolamento che dovrebbe essere garantito dalla struttura hardware in anelli del kernel.[1]

Nell’esecuzione di Meltdown c’è un passaggio cruciale: l’attaccante deve già conoscere gli indirizzi in memoria (virtuale) dei dati del kernel. In realtà, nei principali Sistemi Operativi attuali lo spazio di memoria del kernel (kernel space) è mappato anche nello spazio di memoria virtuale di ogni processo (user space). Questo rende molto più veloce e semplice la chiamata al kernel (via System Call) per eseguire azioni anche comuni ma privilegiate e controllate dal Sistema Operativo, quali ad esempio la lettura e scrittura di dati su disco e qualunque altra operazione che interagisca con l’hardware. L’assunto era che non vi fossero rischi di sicurezza, in quanto l’hardware avrebbe protetto l’accesso allo spazio di memoria virtuale riservato al kernel.

Visto che Meltdown viola questo assunto, la più semplice ed efficace contromisura per impedire Meltdown è di non mappare lo spazio di memoria del kernel nello spazio di memoria virtuale di ogni processo. Questa modifica del Sistema Operativo era già stata proposta[2] ed è stata rapidamente adottata dai produttori di Sistemi Operativi. È da notare che questa non è la soluzione definitiva per Meltdown in quanto, ad esempio, nello spazio virtuale di ogni processo devono comunque essere presenti degli indirizzi di memoria privilegiati necessari per eseguire System Call ecc. Un effetto negativo di questa contromisura è che riduce le prestazioni dei sistemi: a seconda del tipo di elaborazione e di come la contromisura è stata implementata, si possono avere rallentamenti minimi o con incrementi sino al 30% del tempo di esecuzione dei programmi.

D’altronde altre soluzioni richiedono modifiche all’hardware, anche tramite microcodice di aggiornamento delle CPU, ad esempio per modificare il flusso di esecuzione delle istruzioni out-of-order o per separare più efficacemente l’area di memoria utilizzata dal kernel da quella utilizzata dagli altri processi.

Spectre

Se Meltdown permette di accedere a tutta la memoria del Sistema Operativo, è relativamente semplice da implementare ma al contempo sono presenti delle misure di mitigazioni efficaci, al contrario Spectre è molto complesso da implementare, non dà accesso a dati privilegiati del Sistema Operativo ma di altri processi e utenti sul sistema. Inoltre Spectre è implementabile su praticamente tutte le CPU moderne ed è difficile introdurre contromisure sia software che hardware senza modificare significativamente l’architettura delle moderne CPU.

Come Meltdown, Spectre si basa sull’abuso dell’esecuzione out-of-order delle istruzioni, ma in questo caso si basa specificatamente sul processo di esecuzione speculativa di alcune istruzioni. Ad alto livello, possiamo descrivere un attacco Spectre come segue:

  1. l’attaccante e la vittima sono due utenti dello stesso sistema in grado di eseguire programmi sulla stessa CPU;
  2. l’attaccante conosce un programma od una libreria utilizzata dalla vittima, ad esempio una libreria che contiene delle procedure crittografiche, e vuole ottenere le chiavi crittografiche segrete utilizzate dalla vittima;
  3. l’attaccante individua nel codice utilizzato dalla vittima un branch che la CPU esegue tipicamente in maniera speculativa, ovvero in anticipo rispetto alla disponibilità dei valori per la valutazione della condizione di scelta; tipicamente la CPU sceglie di eseguire il ramo di codice che di recente è stato eseguito più frequentemente;
  4. l’attaccante scrive un breve programma il cui codice esegue frequentemente le stesse istruzioni macchina del branch della libreria sotto attacco, ma con dati diversi in modo da indurre la CPU a ritenere più probabile l’esecuzione da parte della vittima sul branch errato; contemporaneamente l’attaccante svuota alcune aree della cache in modo che l’esecuzione del branch errato porti al caricamento in cache solo dei dati segreti;
  5. quando la CPU esegue il programma della vittima, basandosi sull’esperienza dell’esecuzione del codice malevolo, segue il branch errato e carica in cache i dati segreti, quali ad esempio delle chiavi crittografiche;
  6. a questo punto l’attaccante utilizza un attacco alla cache quale Flush+Reload o Evict+Reload come Covert Channel per leggere i dati segreti dalla cache.

L’implementazione di un attacco Spectre è molto complessa e difficile, anche se vi sono esempi persino in Javascript eseguiti all’interno di un browser Web da remoto [3].

Non di meno è difficile trovare delle contromisure a questo attacco: l’esecuzione di un branch errato di un processo non dovrebbe portare ad alcuna conseguenza: infatti non vi è alcun effetto per l’esecuzione del processo vittima, i dati calcolati nel branch errato sono scartati nell’esecuzione finale, ma inevitabilmente i dati del calcolo errato compaiono in cache per un breve periodo di tempo. Il problema è come evitare che un attaccante forzi una CPU a seguire un branch errato in modo da poi poter accedere, anche indirettamente, a dati presenti in cache. A differenza di Meltdown, in un attacco Spectre non sono coinvolte aree di memoria privilegiate, per cui la CPU e il Sistema Operativo non hanno informazioni hardware da poter eventualmente sfruttare per impedire l’attacco.

Quindi la soluzione definitiva di Spectre richiede un ridisegno delle logiche hardware di esecuzione out-of-order e speculative nelle CPU di prossime generazioni, anche se per alcune varianti di Spectre sono state identificate delle contromisure sia a livello di microcodice di aggiornamento delle CPU che per i Sistemi Operativi.

L’Hardware e la Sicurezza IT

Come descritto nel primo articolo, il disegno architetturale alla base delle moderne CPU risale agli anni ’60 e negli ultimi anni sono state individuate delle vulnerabilità insite nel disegno stesso che minano alcuni dei principali assunti per la sicurezza nella gestione dell’elaborazione. Come spesso accade in questi casi, non è la singola funzionalità od il singolo blocco del disegno ad essere problematico, ma una combinazione non prevista di attività possono portare alla violazione dei requisiti di sicurezza assunti.

Ad oggi le conseguenze di Row Hammer, degli attacchi alla Cache, di Meltdown e Spectre sono più teoriche che pratiche, in quanto non sono stati realmente rilevati gravi incidenti ove queste vulnerabilità fossero la causa principale della violazione della sicurezza. Ancora oggi lo sfruttamento delle vulnerabilità dei Sistemi Operativi, delle applicazioni e delle configurazioni dei sistemi, è molto più semplice e produttivo per un attaccante.

D’altra parte non possiamo minimizzare il fatto che alcuni degli assunti principali per la sicurezza dei sistemi IT, assunti basati sul disegno e le funzionalità di base dell’Hardware, non possono più essere considerati completamente veritieri. Visto anche che la risoluzione di una vulnerabilità di disegno dell’Hardware richiede tempi lunghi e alti costi (dovendo ridisegnare l’Hardware, produrlo, adattare i Sistemi Operativi al nuovo Hardware e sostituire l’Hardware esistente) è necessario iniziare sin d’ora lo studio di nuovi disegni architetturali per l’Hardware IT o delle modifiche necessarie all’attuale, e di pianificare nell’evoluzione dei sistemi IT non solo gli aspetti di prestazioni, qualità e affidabilità ma anche nuove e più estese misure di sicurezza.

Riferimenti Bibliografici

[1] Alcuni riferimenti su “Spectre and Meltdown”:

[2] M. Lipp et al., “Meltdown”, https://arxiv.org/abs/1801.01207v1

[3] M. Schwarz et al., “Netspectre: Read Arbitrary Memory over Network”, https://gruss.cc/files/netspectre.pdf

[4] “Foreshadow: Breaking the Virtual Memory Abstraction with Transient Out-of-Order Execution”, https://foreshadowattack.eu/

Note

[1] Questo può avere conseguenze particolarmente critiche per sistemi di virtualizzazione a Container o para-virtualizzazione, ove il kernel del Sistema Operativo è comune a tutte le istanze virtuali.

[2] Ad esempio il Linux è chiamata Kernel Page Table Isolation (KPTI) o Kernel Address Isolation to have Side-channels Efficiently Removed (KAISER), ed era stata proposta per sopperire ad alcune limitazione del Kernel Address Space Layout Randomization (KASLR), introdotto a sua volta per impedire lo sfruttamento di alcuni tipi di vulnerabilità del kernel.


Articolo a cura di Andrea Pasquinucci

L’articolo L’Hardware e la Sicurezza IT – Parte 3: Meltdown e Spectre proviene da ICT Security Magazine.

https://www.ictsecuritymagazine.com/articoli/lhardware-e-la-sicurezza-it-parte-3-meltdown-e-spectre/


Sextortion: Analisi di una mail del ricatto

Nel mese di Settembre il CNAIPIC (Centro Nazionale Anticrimine Informatico per la Protezione delle Infrastrutture Critiche) ha diramato una comunicazione riguardante una massiva attività di spamming a scopo estorsivo. Un’email informa che il proprio account di posta elettronica è stato violato e che attraverso un malware installato mentre si visitavano siti web per adulti sono state fatte delle registrazioni video compromettenti. Pertanto per non condividere il materiale con i contatti personali viene fatta una richiesta di denaro in criptovaluta.

Ovviamente trattatasi di una mail allestita ad hoc per indurre la vittima a pagare il riscatto. Ecco di seguito alcune considerazioni al riguardo che ritengo possano essere utili per capire di cosa si tratta.

Cercherò attraverso una trattazione più semplice possibile e senza richiedere al lettore particolari conoscenze tecniche, di fornire degli spunti per valutare l’attendibilità delle mail che si ricevono. Tenendo sempre bene in mente che, in caso di reati telematici, bisogna rivolgersi alle autorità competenti. A tale scopo la Polizia di Stato, per avviare l’iter investigativo, ha reso disponibile un servizio di denuncia via web.

Come funziona la posta elettronica

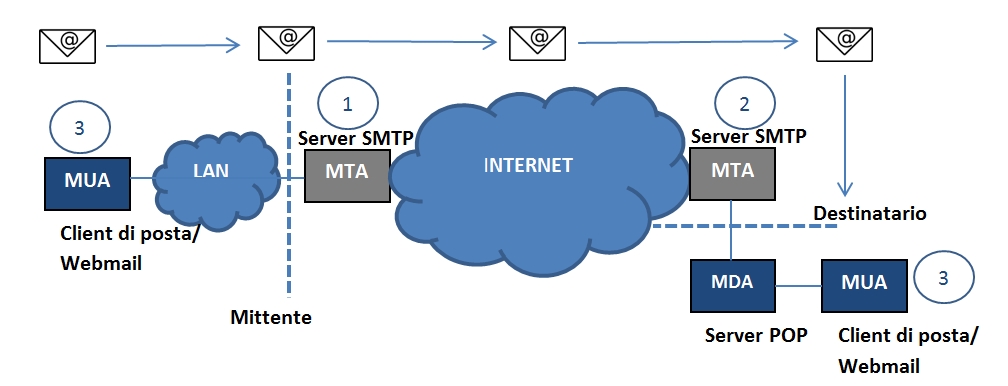
Quando si spedisce una mail da un PC ad un altro attraverso la rete, nella trasmissione vengono coinvolti anche altri computer, i cosiddetti server di posta. Il mittente e il destinatario, dispongono di un client di posta elettronica, ossia un programma in grado di gestire, scaricare e spedire le email.

È opportuno che il client sia opportunamente configurato per dialogare con predeterminati server, demandando a questi il compito di contattare il server destinatario oppure di immagazzinare la posta in attesa di lettura.

Detto questo, vediamo di capire quali siano i passaggi seguiti da un messaggio di posta elettronica dal momento in cui il client del mittente lo spedisce a quello in cui viene consegnato definitivamente al client del destinatario.

  1. Quando si invia una email, il messaggio viene consegnato al server di posta elettronica mittente deputato al suo trasporto, il cosiddetto MTA (Mail Transport Agent) e inoltrato fino al raggiungimento dell’MTA del destinatario. Gli MTA comunicano tra loro attraverso il protocollo SMTP (Simple Mail Transfer Protocol) e vengono per questo chiamati server SMTP.
  2. Il server MTA del destinatario consegna quindi la posta al server di posta elettronica in entrata l’MDA (Mail Delivery Agent), il cui compito è quello di conservare il messaggio in attesa che venga scaricato dal client di posta del proprio utente (ricevente). I protocolli di comunicazione degli MDA sono il POP3 (Post Office Protocol) e l’IMAP (Internet Message Access Protocol).
  3. L’invio ed il ritiro della posta avviene tramite un software detto MUA (Mail User Agent):
  • Se si utilizza un software installato sul proprio sistema, si parla di client di posta (esempio Microsoft Outlook, Eudora Mail, etc.).
  • Se si tratta di un’interfaccia web, si parla di servizio Webmail.

Gli header di una email

Ogni messaggio email è composto da un intestazione e da un corpo:

  • Il corpo comprende il contenuto del messaggio (body).
  • L’intestazione (header) comprende delle indicazioni standard visibili, come il nome mittente, l’oggetto e la data d’invio, e delle altre informazioni nascoste, riguardanti soprattutto il mittente e il percorso fatto dal messaggio, che possono essere visualizzate su richiesta. Per visualizzare le intestazioni complete, sia nel caso si utilizzi un client di posta che un servizio Webmail, occorre cercare tra le proprietà e le opzioni del messaggio una voce di menu del tipo “visualizza intestazioni”, “mostra dettagli” o “leggi header”.

Gli header visibili standard sono:

  1. From/Da: indica l’indirizzo mail del mittente, cioè autore del messaggio.
    Da: nomeMittente  <indirizzoMittente@dominio.xx>
  2. To/A: indica gli indirizzi mail dei destinatari, separati da una virgola.
    A: nomeDestinatario <indirizzoDestinatario@dominio.xx>, nomeDestinatario2 <indirizzoDestinatario2@dominio.xx>, etc.
  3. Cc: indica gli indirizzi mail di uno o più destinatari, separati da una virgola, che devono ricevere una copia dell’email (opzionale).
    NomeDestinatarioInCopia <indirizzoDestinatarioInCopia@dominio.xx>, nomeDestinatarioInCopia2 <indirizzoDestinatarioInCopia2@dominio.xx>
  4. Subject/oggetto: indica una spiegazione sintetica sul contenuto della mail.
    Oggetto: spiegazione del contenuto mail

Gli header nascosti possono essere:

  1. Return-Path: se presente, indica l’opzione di rinvio per il mail server.
    Return-Path: <indirizzoMailRinvio@dominio.xx>
  2. Received: indica il percorso del messaggio di posta, la data e gli indirizzi dei mail server coinvolti. Generalmente sono presenti almeno due di queste righe, rispettivamente per server mittente e destinatario.
    Received: from mta.slv.esempio (mail@mta.slv.esempio [indirzzo IP x.y.z.k])
    by mailserver.dest.it with SMTP
    for <nomeDestinatario@dominio.xx>; Thu, gg m anno ore:min:sec
  3. Message-ID: indica un codice alfanumerico identificativo del messaggio.
    Message-ID: <123456.abcdef@dominio.xx>
  4. Content-Type: indica il tipo e il codice del corpo del testo.
    Content-Type: text/plain; charset=UTF-8

Come risulta evidente gli header più importanti e utili per la ricostruzione del percorso fatto da una email sono le righe Received, le quali aggiunte di volta in volta alla busta da ciascun server coinvolto nella trasmissione, individuano a ritroso il mittente e il destinatario.

Le righe Received, almeno in parte, possono essere ritenute affidabili, anche se eventuali righe di Received possono essere falsificate ed inserite all’inizio dell’header (solitamente le righe Received più in basso). Nel dettaglio “from mta.slv.esempio (mail@mta.slv.esempio [indirzzo IP x.y.z.k])” il campo mta.slv.esempio è il nome con cui il mittente si identifica al destinatario e può essere camuffato, mentre il campo [indirizzo IP x.y.k.z] può verosimilmente indicare il reale indirizzo del mittente.

Analisi di una mail del ricatto

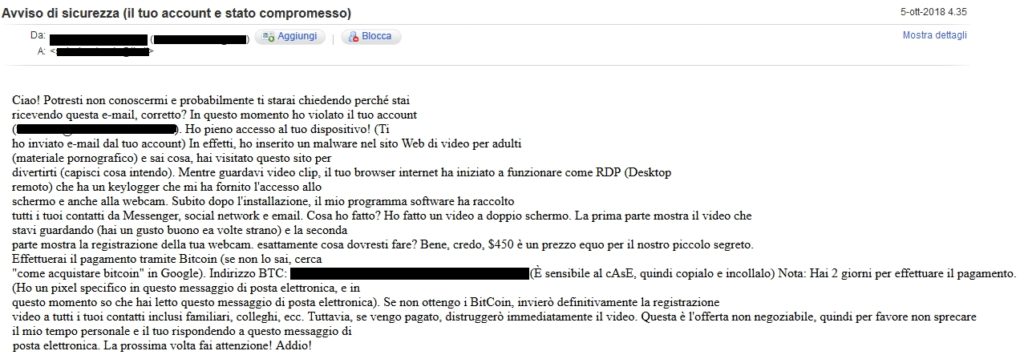
Analizziamo il corpo e il relativo header completo di una mail della campagna estorsiva.

Negli screenshot che seguono alcune parti sono state oscurate.

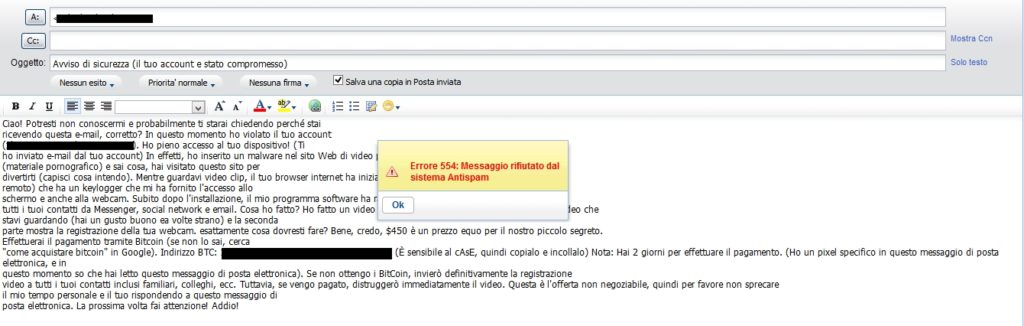
Dopo un saluto confidenziale e diretto, il ricattatore informa il destinatario di aver violato il suo account di posta elettronica “Ti ho inviato una mail dal tuo account” – scrive.

Prosegue affermando che tramite un keylogger installato sul dispositivo, ha proceduto alla registrazione, attraverso la webcam frontale, di ogni azione fatta durante la visione di un video clip a luci rosse, minacciando di inviare tutto il materiale ai suoi contatti. Per mantenere il segreto viene chiesto il versamento di una somma in un conto bitcoin.

L’email si conclude con un monito e un secco saluto: “La prossima volta fai attenzione. Addio”.

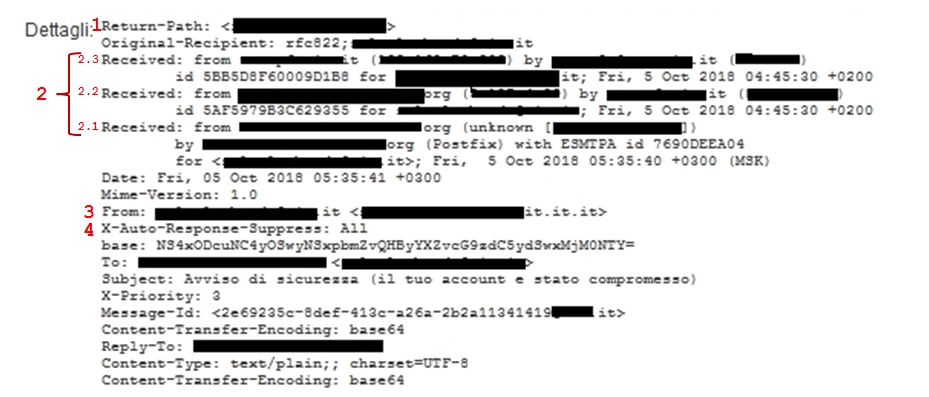
Purtroppo l’indirizzo di posta elettronica del destinatario di tale messaggio è finito nella rete di indirizzi di uno spambot. Non ci resta che esaminare le righe dell’header mail.

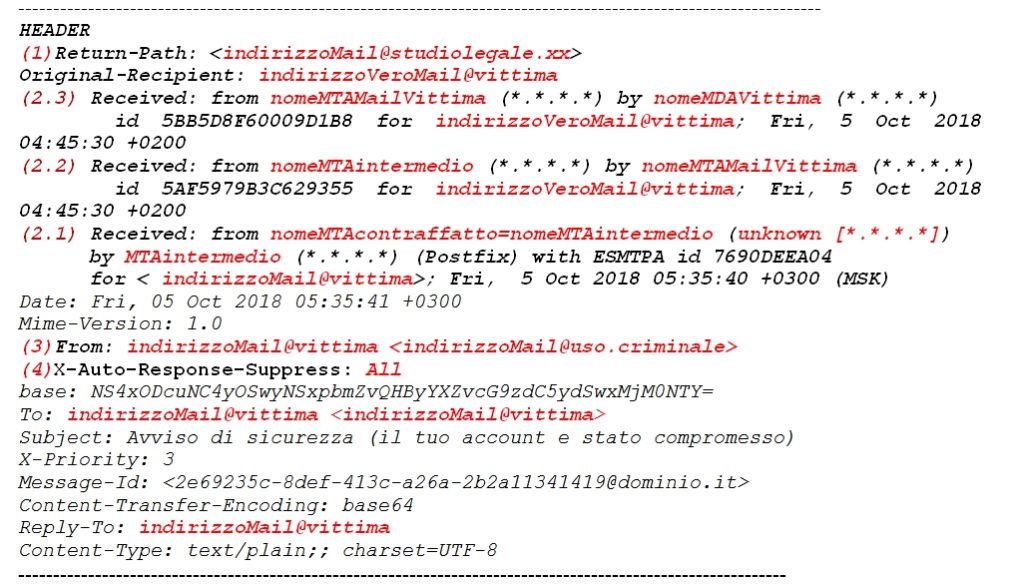
  1. La riga return-path indica un indirizzo email, che non è quello della vittima. Da una semplice ricerca su internet, risulta essere il contatto di uno studio legale (l’autore del messaggio si prende gioco di noi!)
    Return-Path: <indirizzoMail@studiolegale.xx>
  2. Le tre righe Received tracciano, a ritroso, il percorso della mail dal mittente al destinatario:
    (Received 2.1) il messaggio originale è partito da un MTA, con nome identificativo falsificato (spoofing del server SMTP: non c’è corrispondenza tra l’indirizzo IP e l’MTA dichiarato);
    (Received 2.2) il messaggio è stato successivamente inoltrato ad un MTA intermedio e recapitato all’MTA del destinatario;
    (Received 2.3) il messaggio infine è stato consegnato all’MDA della vittima.
  3. Con questa riga, per rendere più verosimile il messaggio, il truffatore fa credere che la mail sia stata inviata dallo stesso account della vittima (spoofing del mittente). L’affermazione “ti ho inviato una e-mail dal tuo account” è falsa.
    From: indirizzoVeroMail@vittima <indirizzoMail@uso.criminale>
  4. Questa riga, per la quale non esiste una standard ed è stata inserita dal client di posta mittente, indica che tutte le tipologie di notifiche e delivery reports sono state disattivate. Pertanto anche l’affermazione della presenza di un pixel specifico per la notifica di lettura e per il conseguente scatto del countdown è falsa.

Senza scendere troppo nei particolari, tramite una geo localizzazione degli indirizzi IP, è stato possibile individuare la posizione geografica dell’MTA che ha preso in carico il messaggio di posta. Dall’IP del mittente si è potuto constatare che l’autore del messaggio ha inviato la mail da un computer collegato ad una rete appartenente ad un provider estero.

Di seguito riporto l’header completo e reinterpretato con i dettagli più significativi evidenziati.


Ulteriore verifica

Se si prova a fare ciò che il criminale dice di aver fatto, inviandoci una copia fedele della mail del ricatto dal nostro stesso account, ecco cosa dovrebbe apparire:

Il server di posta dovrebbe impedire l’invio con un codice blocco errore 554.

Qualora, invece, il filtro antispam dovesse incorrere in un errore di valutazione, generando un falso negativo, consiglio di segnalare l’anomalia al proprio gestore di posta.

Considerazioni finali

Non bisogna assolutamente pagare alcun riscatto, perché il criminale, in questo caso, non dispone di alcun filmato compromettente e di nessuna lista dei nostri contatti. Ciò che invece è necessario ed indispensabile fare è proteggere i nostri account, cambiare periodicamente la propria password, utilizzare quando possibile l’autenticazione multi fattore e non abbassare mai la guardia nei confronti di possibili episodi di phishing. A tal proposito, per verificare se l’account della nostra mail è stato violato, come ulteriore accertamento possiamo consultare il servizio web HIBP.

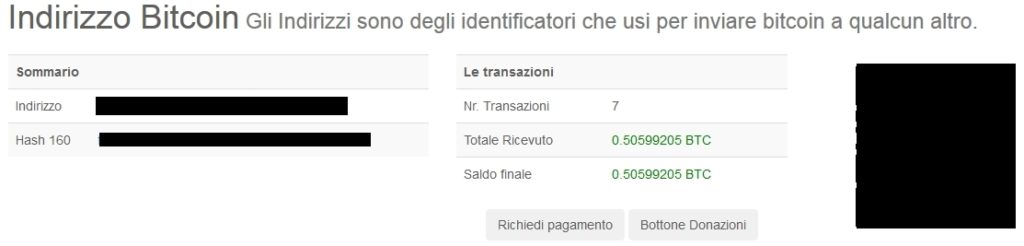
Ad oggi, sul conto bitcoin riportato nel messaggio, il cui saldo risulta ancora attivo e destinato verosimilmente a crescere, sono stati effettuati versamenti per un totale di circa 3.000$ (0,505 BTC). Se si tiene conto dell’entità di tale fenomeno, risulta facile stimare l’indebito guadagno percepito dai truffatori attraverso le diverse campagne in atto.

Ancora una volta, gli attaccanti non sfruttano una vulnerabilità software ma fanno leva sull’elemento umano. L’unico fix possibile, in questi casi, è l’aggiornamento e il miglioramento della CONSAPEVOLEZZA.

Riferimenti Sitografici


Articolo a cura di: Salvatore Lombardo

L’articolo Sextortion: Analisi di una mail del ricatto proviene da ICT Security Magazine.

https://www.ictsecuritymagazine.com/articoli/sextortion-analisi-di-una-mail-del-ricatto/


Sviluppo sicuro del codice… 4 semplici domande a 3 strati di una cipolla

Sempre più spesso, in grandi organizzazioni, si parla di Sviluppo Sicuro del Codice (di seguito SSC) ovvero strumenti automatici a supporto dei programmatori che consentono di analizzare il software prodotto alla ricerca di vulnerabilità (tipicamente Owasp TOP10 o SANS25) da sanare prima del rilascio per rendere un software robusto a prova di intrusione.

Ma questo approccio premia davvero?

Esistono differenti modi di effettuare test di sicurezza applicativi, tutti basati nel rilevare errori di programmazione e di implementazione delle logiche applicative, ma la pratica dello sviluppo sicuro risulta sempre lo strato più delicato ed “insicuro” per produrre applicazioni “rock-solid”.

Occupandomi di verifiche di sicurezza, molto spesso mi sono imbattuto nel rilevare negli assessment impatti derivanti l’abuso di vulnerabilità non sanate nello SSC e molto spesso di tali vulnerabilità non vi era traccia nei report prodotti dagli strumenti di scansione statica. Ma prima di darvi una visione di dettaglio delle mie considerazioni dobbiamo porci una domanda: “che cosa è una scansione statica del codice?” Se per voi la risposta è “un tool che consente di identificare tutte le problematiche di sicurezza applicative che possono mettere a rischio la nostra applicazione”, siete completamente fuori strada.

Infatti gli strumenti di scansione statica (ma come vedremo successivamente anche dinamica, tralasciando quanto dichiarato dai fornitori dei tool) consentono di rilevare, con buona confidenza, vulnerabilità tipiche di depurazione dell’input quali XSS ed *Injection.

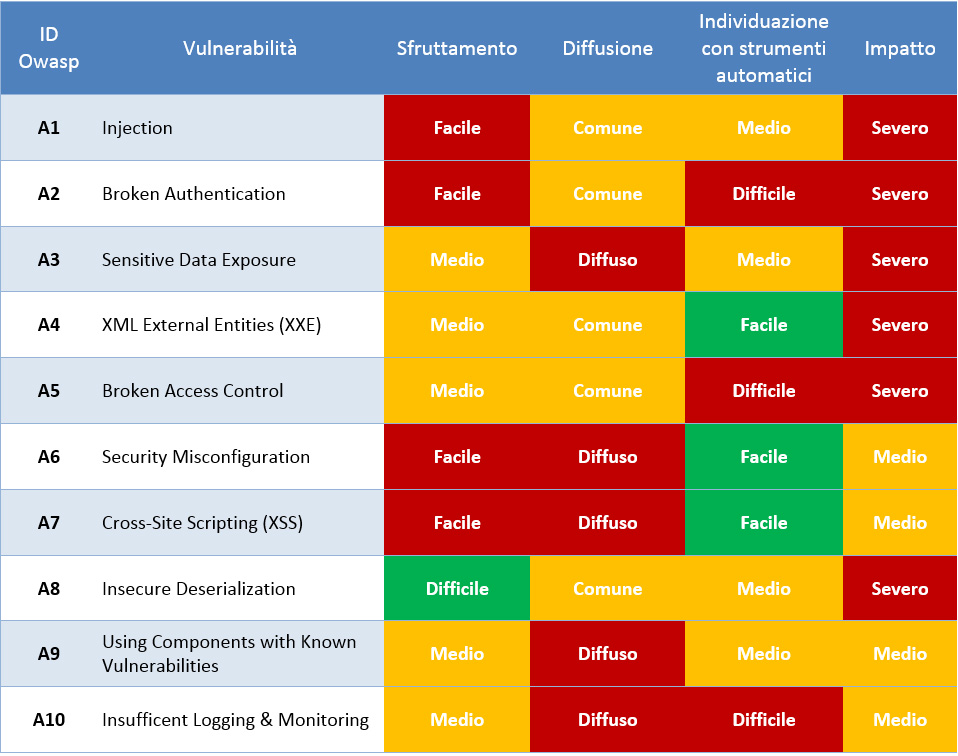
La tabella in calce (Fonte Owasp con qualche arricchimento) pone attenzione su questo problema, ma lascio a voi le dovute considerazioni.

Il problema principale, analizzando nel dettaglio le TOP10 Owasp, è che esistono vulnerabilità con impatti molto severi che non vengono rilevate dagli strumenti automatici e tali vulnerabilità sono comportamenti “applicativi” o errori (spesso orrori) di progettazione che non possono essere rilevati dagli strumenti di oggi.

Ad esempio Broken Authentication e Broken Access Control sono vettori di attacco formidabili che conducono ad impatti molto severi senza pensare ad una SQL Injection difficile da rilevare, quindi la scansione statica porta con se dei limiti in quanto:

  • Non mette al riparo dalla presenza di errori nella logica applicativa, proprio gli ambiti di sfruttamento più critico come ad esempio carenze nello sviluppo della profilazione e nel principio del need to know, ovvero consentire l’accesso ai contenuti sui quali si è autorizzati;
  • Introduce molti Falsi positivi (oltre il 50% delle rilevazioni sono tali) e ancora più rischiosi e fuori controllo sono i Falsi negativi, ovvero vulnerabilità reali non identificate spesso SQL injection;
  • La bontà della scansione risulta dipendente dall’istruzione degli scanner e dell’ambiente di scansione (ad esempio dipendenze tra librerie, dipendenze tra moduli applicativi, framework di terze parti utilizzati e warning di scansione non gestiti).

Ma il “cattivo” non lavora in sviluppo ma in produzione e magari dalla Cina o dalla Russia, quindi potrebbe venire lecita la seconda domanda: “…ma se sposto il controllo in produzione utilizzando scanner dinamici potrei avere maggiori margini di confidenza?” La risposta è la stessa di quando si confronta un uomo e una macchina. Ma al netto della risposta la scansione dinamica (ad esempio gli strumenti di web scanning) sono utili come tutti i Vulnerability Assessment perché spostano il controllo più vicino all’attività illecita ma anche in questo caso sono presenti una serie di limitazioni da considerare:

  • Gli scanner web non mettono al riparo dalla presenza di errori applicativi di sviluppo del software (come visto in precedenza nelle scansioni statiche) anche se hanno un ventaglio maggiore di copertura proprio perché eseguite in campo.
  • Uno Scanner dinamico è molto intrusivo, pertanto è buona pratica farlo in collaudo per salvaguardare l’esercizio, ma facendolo in collaudo si introducono possibili elementi di debolezza come ambienti disomogenei, versioni software differenti, patch differenti, ambienti di collaudi non disponibili, ecc…
  • L’intrusività delle policy è direttamente proporzionale alle vulnerabilità rilevate. È importante avere esperienza in tal senso per ottenere il giusto compromesso.
  • A differenza delle tecnologie e dalle policy definite può introdurre Falsi positivi e i più rischiosi Falsi negativi.

Quindi siamo arrivati alla terza domanda: “… ma allora, forse è meglio lasciare perdere tutto per avviare dei Penetration Test Applicativi?”. Potrebbe essere una soluzione, ma anche in questo caso ci sono dei punti di attenzione da prendere in considerazione in quanto:

  • Un PT web si fa direttamente in esercizio e da un buon grado di confidenza del rischio presente nell’applicazione e risulta poco invasivo in quanto svolto da un tecnico specializzato e l’efficacia è direttamente proporzionale agli skill del personale specializzato;
  • In applicazioni complesse non può essere praticabile su tutte le “foglie” dell’applicazione per i limiti temporali di gestione di un controllo (un PT non è un Ethical-APT a livello temporale);
  • Consente di identificare gli “Impatti reali” ed è efficace nel rilevare carenze dove risulta impossibile l’identificazione con scansioni statiche/dinamiche;
  • Fornisce un quadro completo (anche abbinandolo ad una scansione web) del reale grado di rischio dell’applicazione;
  • Ha dei costi superiori alle consuete attività automatizzate.

Quindi ci posizioniamo sulla quarta domanda …“e allora? … quale è la soluzione migliore da adottare?”, la risposta come al solito è “dipende” in quanto:

  1. Lo Sviluppo Sicuro del Codice è demandato alle fabbriche, serve a “rastrellare” tramite scansione statica le falle di sicurezza più semplici e deve essere fatto. Inoltre l’utilizzo di questi scanner (inteso come tool di sviluppo allo stesso livello di un Eclipse o un VisualStudio) crea valore indiretto introducendo “Consapevolezza” nei Team di sviluppo, molti di questi ancora oggi con grosse lacune in termini di sviluppo sicuro del software;
  2. La scansione dinamica (come tutti i vulnerability assessment) è il “setaccio a grana grossa”, è utile, porta benefici e vulnerabilità spesso reali ma occorre prestare molta attenzione sui rischi in produzione, sull’invasività dei prodotti di scansione scelti, sulle policy utilizzate rispetto a quanto visto in precedenza;
  3. Il Penetration test Applicativo è la soluzione ideale per avere una buona confidenza sui rischi derivanti un abuso della nostra applicazione in quanto riesce a coprire tutte le TOP10 Owasp, ma un PT su una applicazione complessa potrebbe avere costi proibitivi oltre ad essere a livello di tempistiche poco sostenibile.

Concludendo, tutte e tre le tecniche (scansione statica, dinamica e PT Applicativo) sono tecniche che forniscono raramente risultati sovrapponibili, sarà la nostra esperienza metterle a fattor comune per individuare il livello di sovrapposizione e i delta delle vulnerabilità rilevate.

Il rischio Zero non esiste (pensiamo all’incidente del 28/09/2019 di Facebook denominato “view as” che ha portato al reset di 100mln di token) ma esiste il rischio “tollerabile”. Tutte e tre le tecniche dovranno quindi essere misurate per comprendere dove una sia migliore dell’altra, dove dovranno essere scelte tecniche miste, anche in funzione dell’appetibilità dei dati contenuti all’interno delle nostre applicazioni. Su applicazioni con dati critici, personalmente utilizzo tutte e tre le tecniche mentre su applicazioni con dati non critici, anche la sola scansione statica può risultare una scelta sensata.

E’ chiaro che chi sviluppa software non può limitarsi all’utilizzo di uno strumento di scansione ma deve essere guidato dall’esperienza e dall’applicazione delle migliori best practices conosciute in termini di sviluppo sicuro del codice. Per chi usa e abusa di forniture esterne, risulta di focale importanza l’aspetto contrattuale articolato su deliverable differenti a seconda della criticità dei sistemi.

Effettuando un paragone, mi viene da pensare ai guasti difficili da identificare in una macchina di oggi e i meccanici che collegano la centralina al computer e fanno solo quello che lui dice nelle attività di riparazione. Altri meccanici invece che conoscono a fondo tutte le componenti del veicolo comprendono che quanto fornito dallo scanner potrebbe essere una indicazione di un difetto presente in un’altra parte non chiaramente identificata, identificabile univocamente dalla loro esperienza.


Articolo a cura di Massimiliano Brolli

L’articolo Sviluppo sicuro del codice… 4 semplici domande a 3 strati di una cipolla proviene da ICT Security Magazine.

https://www.ictsecuritymagazine.com/articoli/sviluppo-sicuro-del-codice-4-semplici-domande-a-3-strati-di-una-cipolla/


Cybersecurity ai tempi delle Reti OT: come e perché gestire le vulnerabilità di dati e processi nell’interconnessione con reti IT

L’era della Smart Factory 4.0 è entrata pienamente nella fase 2, quella dell’implementazione e dell’entrata in funzione dei nuovi processi di automazione industriale. In tale contesto, il corretto partizionamento tra risorse IT (Information Technology) e risorse OT (Operational Technology) assume particolare rilevanza dal punto di vista semantico, tecnico e giuridico.

Premessa doverosa è definire adeguatamente la differenza tra i due contesti: il dominio IT è accademicamente molto ampio e include l’intero spettro di tecnologie deputate alla gestione dell’informazione, comprensive di software, hardware, infrastrutture di comunicazione e servizi correlati. Si tratta del dominio orientato alla gestione dei dati, ed è per questo “data-centric”.

Il dominio OT è, invece, di sviluppo relativamente recente ed è per definizione orientato agli eventi e al controllo di stato di beni fisici che ad esso appartengono. Nel contesto OT rientrano aspetti quali il monitoraggio di eventi o i cambiamenti di stato delle entità su di esso attestate, nonché il controllo di devices fisici e dei relativi processi/eventi generati.

Il focus negli ultimi due anni si è inevitabilmente spostato sul contesto OT, in considerazione dell’evoluzione tecnologica e normativa che ha portato le imprese a puntare con decisione sull’interconnessione di beni e sistemi industriali, presentando all’infrastruttura del sistema informativo già presente nuovi attori dotati di caratteristiche hardware e software decisamente differenti da tutti gli altri apparati attestati sulla tipica rete IT.

Se nell’ambito IT il tradizionale parametro R-I-D sui dati viene enfatizzato nell’ordine in cui le lettere dell’acronimo sono riportate (Riservatezza-Integrità-Disponibilità), nelle reti di tipo operazionale (OT) l’ordine è esattamente invertito, dando assoluta priorità alla disponibilità dei dati necessari per implementare una gestione degli eventi solida ed efficace, oltre che in tempo reale. Così, il nuovo parametro diventa (C)-D-I-R, con al top il “Controllo”, e presuppone l’esistenza di policies di cybersecurity modellate ad hoc per garantirne il soddisfacimento, e con il giusto grado di priorità.

L’oggetto della tutela in ambito operazionale deve essere il processo: arrivando da scenari in cui il dato rappresenta il focus di ogni analisi sulla sicurezza, si può commettere il grave errore di seguire un approccio “a strati” (layers) anche per la realtà operazionale, strutturando i gradi di difesa azione/reazione su livelli potenzialmente infiniti come l’IT propone. Le applicazioni che operano sulla protezione dei dati, tipicamente coprono singoli contesti di vulnerabilità, e anche ove esse offrano suite applicative più ampie, l’approccio è sempre di tipo settoriale, arrivando a proteggere aree semantiche di rischio ben definite. Sistemi di autenticazione web, ad esempio, vengono resi solidi attraverso tecniche che minimizzino a livello algoritmico la possibilità di intercettare le chiavi di accesso o infiltrare entità software intermedie che possano bypassare il sistema software di verifica credenziali e farne le veci.

Il dinamismo del contesto IT impedisce qualunque altro tipo di approccio che non sia a strati: il numero di variabili da considerare nell’analisi del rischio è potenzialmente infinito.

I sistemi OT vedono attestati sulla propria infrastruttura entità che generano eventi, ben definiti e costituiti da una sequenzialità di operazioni (definite spesso da “ricette” o ordini di produzione), e dalla forte connotazione deterministica. Un’operazione di fresatura effettuata da una macchina interconnessa su una porzione di materia prima, solo per fare un esempio, modifica irreversibilmente la materia prima; se il sistema di controllo del processo è alterato da un attacco operazionale in grado di modificare il controllo numerico della macchina, il danno sarà irreversibile.

La separazione, spesso adottata dalle aziende lungimiranti, tra la porzione IT della rete aziendale e quella OT, deriva dalla necessità di fornire ai potenziali attaccanti un numero minore di punti di ingresso, privilegiando l’isolamento della sezione operazionale e, al contempo, rafforzando gli accessi alla rete esistenti e imprescindibili.

Si consideri l’esempio di applicazioni DCS (Distributed Control Systems) o MES (Manufacturing Execution System): esse, per definizione, devono essere in grado di alterare lo stato dell’impianto attraverso l’inoltro di comandi ben definiti e circoscritti a quelle che sono le reali esigenze di produzione, controllo e monitoraggio dell’azienda, esigenze peraltro spesso amplificate in virtù di aspetti normativi connessi all’Impresa 4.0. La presenza di istruzioni di controllo direttamente interpretabili dalla macchina pone il sistema a rischio di attacco nel momento in cui lo stato macchina sia “ready”, ove una eventuale compromissione porterebbe minacce fisiche agli operatori a bordo macchina (ad esempio surriscaldamento, interruzioni forzate, sovratensioni) e contemporaneamente danni irreversibili al ciclo di produzione.

Gli attacchi contro i sistemi di controllo di supervisione e acquisizione dati (SCADA) hanno subìto incrementi notevoli negli ultimi tre anni, secondo i dati di ricerca redatti dalle più importanti compagnie IT su scala mondiale. La Finlandia è stata l’obiettivo principale di questi attacchi, seguita da strutture nel Regno Unito e negli Stati Uniti, paesi nei quali i sistemi SCADA connessi a Internet sono più diffusi e le policies di separazione tra contesto IT e OT non sono ancora così rigide e definite da costituire un ostacolo concreto alla diffusione di attacchi.

Le statistiche rilevano inoltre una sostanziale differenza di gestione tra le vulnerabilità scoperte in ambito IT e quelle in ambito OT, poiché mentre le società sono tenute a segnalare violazioni dei dati che coinvolgono informazioni personali o di pagamento, gli attacchi SCADA spesso non vengono segnalati, con il risultato di rendere difficoltoso il censimento dei data breaches in tale ambito e ostacolare il rinnovamento tecnologico.

L’età delle apparecchiature è davvero una sfida significativa per quanto riguarda gli hack di tipo operazionale. Sebbene la minimizzazione del rischio per gli attacchi sistemi OT esposti alla rete WAN (internet) sia attività complessa, a causa dell’elevato numero di gateway esistenti, la tecnica suggerisce di verificare entry points su canali non esclusivi del protocollo TCP/IP, come porte USB, porte seriale e dispositivi Bluetooth che, in molti casi, risultano presenti sui macchinari industriali, di fabbrica o come moduli aggiuntivi. Parallelamente, ancorché la segnalazione dei breaches su rete OT non sia ad oggi sistematica, la condivisione degli attacchi e dei relativi dettagli tecnici tra la comunità di sviluppatori e sistemisti industriali potrebbe aiutare a limitare il fenomeno.

Appare infine fondamentale, nel tentativo di trovare una convergenza tra sistema orientato ai dati e sistema operazionale orientato ai processi, l’individuazione di strategie già consolidate in ambito IT replicandole opportunamente, per quanto possibile, anche in contesti OT:

  • Identificazione e autenticazione di tutti i dispositivi e macchine all’interno del sistema, sia all’interno degli impianti di produzione, sia sul campo, per garantire che dispositivi e sistemi approvati siano gli unici autorizzati a comunicare tra loro. Ciò ridurrebbe il rischio di dispositivi non affidabili inseriti da hacker per assumere il controllo del sistema;
  • Crittografia di tutte le comunicazioni tra i dispositivi convergenti IT/OT per garantire la riservatezza dei dati trasmessi;
  • Garantire l’integrità dei dati generati da questi sistemi, attraverso l’applicazione di metodi di analisi intelligente (euristica, predittiva) nell’adozione di Internet industriale, adottando criteri matematico statistici al fine di ottenere precisione assoluta;
  • Supponendo che i prodotti fabbricati contengano software o firmware embedded, consentire la possibilità di eseguire aggiornamenti remoti e garantendo l’integrità di tali aggiornamenti. Non è un caso che tale criterio sia ripreso anche dal Piano Industria 4.0 nell’allegato A dei beni abilitati a iperammortamento (Rif. Circolare ministeriale 4/e del 30 marzo 2017), ove si legge che tra i criteri richiesti vi è il monitoraggio remoto o teleassistenza.

La strada da seguire per soddisfare la crescente esigenza di sicurezza nel contesto dell’impresa altamente interconnessa porta a considerare una sinergia di metodi e di tecniche tra i due scenari IT e OT, valorizzando opportunamente le loro sostanziali differenze, senza aspettarsi che misure consolidate nel primo scenario possano necessariamente funzionare anche nel nuovo contesto operazionale.

Un’ultima notazione.

L’uomo è e resta al centro anche di scenari di “cyber insicurezza”. Per questo motivo occorre preparare la propria azienda non solo dal punto di vista tecnologico e organizzativo, ma anche sotto il profilo delle competenze e della valorizzazione del capitale umano. L’adozione di specifiche policies aziendali e di percorsi di formazione continua potrà incrementare i livelli di sicurezza a protezione dei dati aziendali, sempre più rilevanti e preziosi in contesti di Industria 4.0; ma non solo. L’industria (o l’impresa) altamente interconnessa porta inevitabilmente con sé implicazioni anche lato privacy, con particolare riguardo alla sicurezza dei sistemi e dei processi e, in definitiva, dei dati personali accessibili attraverso di essi. Non va dunque dimenticata l’importanza di adottare e mantenere nel tempo – anche e soprattutto in sistemi OT di supervisione e controllo – quelle misure di sicurezza adeguate al rischio fortemente volute dal GDPR (General Data Protection Regulation) e imposte ad ogni titolare in ossequio al principio di accountability.


Articolo a cura di Igor Serraino e Andrea Maggipinto

L’articolo Cybersecurity ai tempi delle Reti OT: come e perché gestire le vulnerabilità di dati e processi nell’interconnessione con reti IT proviene da ICT Security Magazine.

https://www.ictsecuritymagazine.com/articoli/cybersecurity-ai-tempi-delle-reti-ot-come-e-perche-gestire-le-vulnerabilita-di-dati-e-processi-nellinterconnessione-con-reti-it/


Performance dei sistemi di gestione per la sicurezza delle informazioni

La valutazione delle performance di un Sistema di Gestione per la Sicurezza delle Informazioni (SGSI) è il cuore centrale della fase di Check del noto ciclo PDCA sotteso al SGSI stesso e trova le sue fondamenta nella corretta progettazione del SGSI. Nel seguito viene illustrata la catena logica che porta all’individuazione dell’insieme di attività richieste per il controllo delle performance di un SGSI, comprendendo anche la definizione di alcune metriche di valutazione delle performance del SGSI, partendo dalla sua definizione.

Ogni sistema di gestione per la sicurezza delle informazioni è costituito da un insieme di risorse composto da persone, responsabilità, informazioni e procedure impiegate da un’organizzazione per raggiungere e mantenere gli obiettivi di sicurezza delle informazioni definiti in termini di riservatezza, integrità e disponibilità.

Dal momento che l’informazione è di per sé un asset aziendale, ovvero un bene che aggiunge valore all’organizzazione e considerando che la maggior parte delle informazioni sono custodite su supporti informatici, ogni organizzazione deve essere in grado di garantire la sicurezza dei propri asset informativi, e non solo, in un contesto dove i rischi informatici sono in continuo aumento. La norma ISO/IEC27001[1], come noto, definisce i requisiti per impostare, gestire e mantenere un SGSI, in modo trasversale rispetto il mercato, e richiama aspetti relativi alla sicurezza logica, fisica ed organizzativa.

La sicurezza delle informazioni comporta l’applicazione e la gestione di misure di sicurezza adeguate e proporzionate al contesto di riferimento, che possono implicare la considerazione di una vasta gamma di minacce, con l’obiettivo di garantire il raggiungimento e mantenimento nel tempo degli obiettivi di business e di sicurezza, anche in situazioni avverse, riducendo al minimo l’impatto di eventuali incidenti relativi alla sicurezza delle informazioni.

Tale obiettivo di sicurezza è ottenuto attraverso l’implementazione di una serie di controlli di sicurezza, selezionati per mitigare i rischi evidenziati durante il risk assessment.

Questi controlli devono essere specificati, attuati, monitorati, riesaminati e migliorati, per assicurare che gli specifici obiettivi di sicurezza delle informazioni e di business siano raggiunti. I pertinenti controlli relativi alla sicurezza delle informazioni dovrebbero, quindi, essere perfettamente integrati con i processi di business di un’organizzazione.

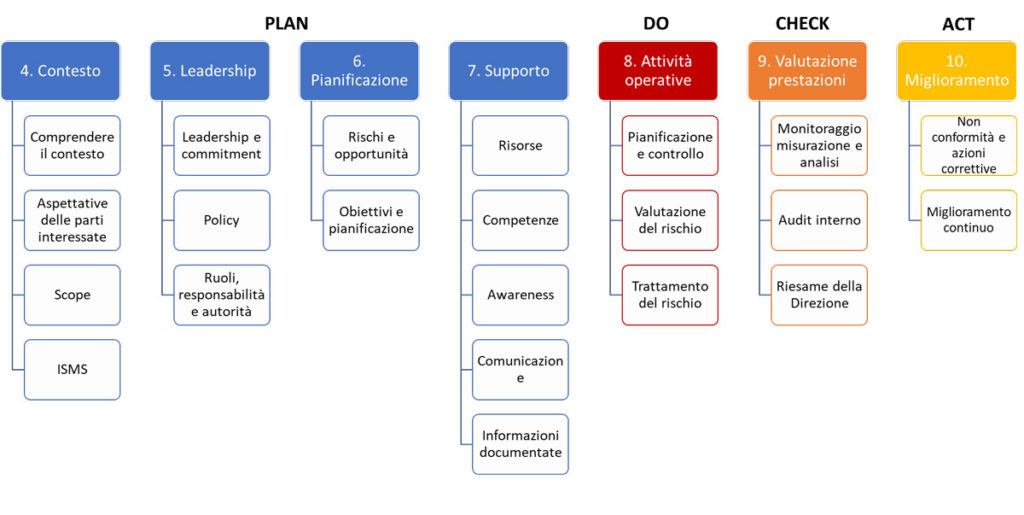
Anche la norma ISO/IEC 27001 è mappabile sul modello di Deming, così come avviene per altre norme (ad esempio la ISO 9001). Questo modello, indicato notoriamente con l’acronimo PDCA, si suddivide in quattro fasi ciclicamente e continuamente ripetute: Plan (pianificare), Do (eseguire), Check (controllare), Act (agire).

Nella fase di Plan, si definisce lo scopo del SGSI e le politiche che lo guidano, sono identificati gli obiettivi ed i mezzi per raggiungerli, è stabilito il processo di analisi del rischio, sono individuate le risorse necessarie.

La fase Do si preoccupa di realizzare il programma che è stato pianificato, viene eseguito il risk assessment e tutti i controlli e le procedure che sono state previste, vengono implementate.

Nella fase di Check, si valutano le performance del SGSI.

La fase Act prevede di intraprendere azioni correttive per indirizzare eventuali non conformità e nell’ottica del miglioramento continuo, migliorare la sostenibilità, l’adeguatezza, l’efficacia del SGSI.

Al fine di valutare la performance del SGSI, occorre approfondire le fasi Check e Act del suddetto Ciclo di Deming.

Relativamente al monitoraggio delle prestazioni e dell’efficacia del SGSI, l’organizzazione deve innanzitutto determinare:

  • cosa è necessario monitorare e misurare, includendo i processi e i controlli relativi alla sicurezza delle informazioni;
  • i metodi per il monitoraggio, la misurazione, l’analisi e la valutazione, per quanto applicabile, per assicurare risultati validi;
  • quando il monitoraggio e la misurazione devono essere effettuati;
  • chi deve monitorare e misurare;
  • quando i risultati del monitoraggio e della misurazione devono essere analizzati e valutati;
  • chi deve analizzare e valutare questi risultati.

Per fare ciò, lo strumento più indicato è costituito da indicatori di performance (Key Performance Indicators -KPI), che permettono di valutare le prestazioni di un determinato target.

Un KPI costituisce un indicatore quantitativo dell’efficacia ed efficienza di un controllo di sicurezza tecnologico, procedurale e/o organizzativo, in relazione agli obiettivi di sicurezza definiti ed al relativo piano per il loro raggiungimento.

Idealmente è possibile considerare un KPI come una variabile controllata in uscita ad un sistema di controllo, il cui valore è quindi determinabile a partire da un certo numero di variabili in ingresso, che coincidono con l’implementazione pratica di misure/verifiche a sostegno dei piani di sicurezza.

Per variabile controllata si intende un indicatore quantitativo sintetico che esprime lo stato di un particolare elemento di un processo di business dal punto di vista della sicurezza.

Le variabili di controllo sono, invece, elementi su cui è possibile agire per modificare nel tempo il valore della variabile controllata. Identificano le aree di intervento possibili nel particolare ambito rappresentato dalla variabile controllata.

La scelta degli indicatori più utili dipende da diversi elementi e può essere guidata da tre dimensioni: ambito, oggetto ed esigenza di misurazione [2].

Nella tabella seguente viene riportato qualche esempio di KPI in ambito di implementazione ISO/IEC 27001:

INDICATORE MODALITA’ DI CALCOLO CAMPIONAMENTO
Etichettatura informazioni Num. informazioni etichettate/num. informazioni etichettabili Annuale
Dismissione dei supporti Num. supporti dismessi/num. supporti non più necessari Annuale
Anti-malware non aggiornati Num. antivirus obsoleti/num. totale di workstation con antivirus aggiornato Settimanale
Disponibilità del servizio Disponibilità totale/Massima disponibilità esclusi i tempi di inattività Mensile/Annuale
Sistemi informativi critici Num. sistemi informativi critici/Num. sistemi informativi Semestrale
Livello di vulnerabilità Num. vulnerabilità per Severity/Sistemi a perimetro Mensile
Information Security Incident Numero di IS incident (pre introduzione SGSI)/numero di IS incident (post introduzione SGSI) Annuale
Rapporti con i fornitori Assessment condotti sui servizi erogati /Num. di servizi erogati Annuale

Figura 2: esempi di indicatori

L’obiettivo principale per lo sviluppo e l’implementazione di processi di misurazione di un SGSI risiede nella creazione di una base informativa che consenta all’organizzazione di acquisire, analizzare e comunicare informazioni relative ai processi definiti nell’ambito del proprio SGSI.

Questi dati, adeguatamente raccolti ed organizzati, forniranno informazioni sullo stato del SGSI, e andranno utilizzati per adottare decisioni inerenti al suo sviluppo ed al miglioramento dell’implementazione.

In questo ambito assume un utile rilievo la norma ISO/IEC 27004 “Information technology — Security techniques — Information security management — Monitoring, measurement, analysis and evaluation”[3] la quale aiuta a valutare le prestazioni di sicurezza delle informazioni e l’efficacia di un sistema di gestione per la sicurezza delle informazioni al fine di soddisfare il requisito 9.1 della ISO/IEC 27001: monitoraggio, misurazione, analisi e valutazione.

I risultati del monitoraggio e della misurazione di un SGSI possono essere di supporto alle decisioni relative alla governance, alla gestione, all’efficacia operativa e al miglioramento continuo del SGSI stesso.

L’organizzazione deve conservare appropriate informazioni documentate quale evidenza dei risultati dei monitoraggi e delle misurazioni effettuate.

Per valutare se il proprio SGSI sia conforme ai requisiti richiesti dallo standard internazionale e sia efficacemente attuato e mantenuto, viene utilizzato lo strumento dell’audit interno.

A tal fine, l’organizzazione:

  • pianifica uno o più programmi di audit;
  • definisce i criteri di audit e il campo di applicazione;
  • seleziona gli auditor e conduce gli audit in modo da assicurare l’obiettività e l’imparzialità del processo di audit;
  • assicura che i risultati degli audit siano riportati ai relativi responsabili;
  • conserva informazioni documentate quale evidenza dell’attuazione del programma di audit e dei risultati.

I principali vantaggi derivanti da monitoraggio, misurazione, analisi e valutazione possono includere:

  • maggiore responsabilità: vi è un aumento di responsabilità per la sicurezza delle informazioni, aiutando a identificare specifici processi o controlli che sono implementati in modo non corretto, non sono implementati o sono inefficaci;
  • miglioramento delle prestazioni di sicurezza delle informazioni e dei processi: si consente alle organizzazioni di quantificare i miglioramenti nella protezione delle informazioni nell’ambito del loro SGSI e dimostrare progressi quantificabili nel raggiungimento dei propri obiettivi di sicurezza delle informazioni;
  • evidenze del rispetto dei requisiti: è possibile fornire prove documentate che dimostrino il rispetto dei requisiti ISO/IEC 27001 (e di altri standard), quali leggi applicabili, norme e regolamenti;
  • supporto al processo decisionale: può essere supportato un processo decisionale basato sul rischio, contribuendo con informazioni quantificabili al processo di gestione del rischio: si può consentire alle organizzazioni di misurare i successi e i fallimenti degli investimenti passati e attuali in materia di sicurezza delle informazioni e fornire dati quantificabili in grado di supportare l’allocazione delle risorse per gli investimenti futuri.

Al fine di assicurarne la continua idoneità, adeguatezza ed efficacia, l’alta Direzione, a intervalli pianificati, riesamina il SGSI implementato.

Il riesame della Direzione include considerazioni su:

  • lo stato delle azioni derivanti dai precedenti riesami di direzione;
  • i cambiamenti dei fattori esterni e interni che hanno attinenza col SGSI;
  • le informazioni di ritorno sulle prestazioni relative alla sicurezza delle informazioni, compresi gli andamenti:
    • delle non conformità e azioni correttive;
    • dei risultati del monitoraggio e della misurazione;
    • dei risultati di audit;
    • del raggiungimento degli obiettivi per la sicurezza delle informazioni;
  • le informazioni di ritorno dalle parti interessate;
  • i risultati della valutazione del rischio e lo stato del piano di trattamento del rischio;
  • le opportunità per il miglioramento continuo.

Gli output derivanti dal riesame della Direzione comprendono, dunque, decisioni relative alle opportunità per il miglioramento continuo e ogni necessità di modifiche al SGSI.

In conclusione, la valutazione delle performance del SGSI è un processo che per sua natura deve essere integrato nei processi operativi aziendali al fine di fornire misurazioni utili a supportare la determinazione di decisioni aziendali. L’insieme di queste valutazioni può confluire in una sorta di cruscotto aziendale, di complessità variabile a seconda del contesto organizzativo, utilizzato dal Management per valutare costantemente e puntualmente il raggiungimento o meno degli obiettivi prefissati. Come ogni processo, anche la valutazione delle performance del SGSI deve essere progettata, pianificata, attuata e misurata, al fine di individuare eventuali scostamenti rispetto gli obiettivi che hanno portato alla sua determinazione. L’introduzione di strumenti software COTS, con set di KPI predeterminati, può rappresentare un valido supporto solo se permette di modellare in modo “sartoriale” le necessità di analisi e reporting dell’organizzazione, evitando quindi ogni elemento non in linea con gli obiettivi e le esigenze dell’organizzazione stessa.

BIBLIOGRAFIA

[1] ISO/IEC 27001 Information technology — Security techniques — Information security management systems — Requirements

[2] Thomas Castagna – Luciano Quartarone, Information Security Performance, https://www.ictsecuritymagazine.com/articoli/information-security-performance/

[3] ISO/IEC 27004 Information technology — Security techniques — Information security management — Monitoring, measurement, analysis and evaluation


Articolo a cura di Anastasia Ambesi

L’articolo Performance dei sistemi di gestione per la sicurezza delle informazioni proviene da ICT Security Magazine.

https://www.ictsecuritymagazine.com/articoli/performance-dei-sistemi-di-gestione-per-la-sicurezza-delle-informazioni/


Analisi forense dei sistemi di videosorveglianza

Ormai i sistemi di videosorveglianza fanno parte già da tempo degli strumenti atti a garantire sicurezza sia alle persone che alle cose. Anche i sistemi di videosorveglianza sono cambiati nel corso del tempo, sia nella tecnologia che nell’approccio. I sistemi di nuova generazione consentono dettagli di immagini impensabili fino a qualche anno fa e l’avvento del digitale ha reso possibile lo sviluppo delle cosiddette “analisi video”,  consentendo – a mezzo software sempre più sofisticati – il riconoscimento automatico delle eventuali criticità e una miriade di diverse applicazioni come, ad esempio: il rilevamento automatico del movimento, il riconoscimento di volti umani e di oggetti in movimento, la ricostruzione dei movimenti in un dato lasso di tempo, di una persona o di un oggetto.

I moderni sistemi di monitoraggio video sono progettati per eseguire più attività contemporaneamente. Solo la semplice presenza di una telecamera di sorveglianza funziona già come elemento preventivo, ma ovviamente offre anche altre funzionalità, come il monitoraggio in tempo reale o la valutazione automatica degli eventi. Dal punto di vista legale, la cosa più importante è riuscire ad estrarre la videoregistrazione che riveli il colpevole e fornisca prove di colpevolezza o che sia almeno di ausilio alle indagini nell’ambito della ricerca della verità processuale.

L’esperienza ha dimostrato che le registrazioni delle telecamere di sicurezza – e non solo -, continuano a rivestire un’importanza sempre maggiore nelle indagini su reati gravi.

Le informazioni visive sono molto importanti indipendentemente dal fatto che riguardino un reato o un’attività criminale. Tuttavia, spesso gli investigatori hanno solo delle registrazioni, prelevate senza alcuna precauzione forense, che sono inutili o rese inutilizzabili.

Ma come è fatto un sistema di videosorveglianza ?

Il sistema si compone normalmente di:

  • telecamere analogiche o IP con possibilità di memorizzazione locale inclusa;
  • sistemi di trasmissione mediante cavo, fibra ottica, wireless, internet;
  • sistemi di registrazione quali videoregistratori digitali ed eventuali software di gestione;
  • sistemi di visualizzazione quali monitor e computer.

Il DVR (Digital Video Recorder) consente la registrazione in simultanea di uno o più segnali analogici video compositi[1] – un modo per trasportare tutte le informazioni di un filmato (luminosità, colore, audio,sincronia, etc. ) attraverso un segnale elettrico variabile –  su di una memoria di massa – ad es. Hard Disk -, tramite schede di acquisizione e compressione video integrate. Non vi sono standard per quanto concerne la modalità di scrittura dei dati su disco – il file system molto spesso non è nemmeno noto – e quindi l’analisi del contenuto potrebbe, in alcuni casi divenire ostica. I sistemi operativi che equipaggiano le apparecchiature possono essere “conosciuti” – ad es. Windows based – o proprietari – normalmente Linux con kernel[2] modificato -.

L’NVR (Network Video Recorder) può essere costituito da un software applicativo in grado di gestire e registrare flusso video provenienti dalla rete su di una memoria di massa, ma potrebbe anche  essere un’apparecchiatura elettronica adatta allo scopo descritto.

In una visione molto semplificata un sistema di videosorveglianza IP potrebbe essere schematizzato come in fig. 1:

Fig. 1 – Schema semplificato di impianto di videosorveglianza con apparecchiatura NVR

Le principali difficoltà che potrebbero insorgere nell’imbattersi in sistemi organizzati con architettura distribuita è intrinseca: la distribuzione può riguardare sia la collocazione geografica sia l’ubicazione di server o apparecchiature dedite alla registrazione. E’ quindi necessario approcciarsi con cautela e applicare con molta attenzione le best practices in materia di Digital Forensics.

Anche le SD – Secure Digital – possono essere utilizzate in modalità distribuita – collocate nelle apparacchiature di ripresa (telecamere IP) o di codifica (encoder[3] IP per segnali analogici) e pur essendo di ridotte capacità di memoria – normalmente da 1 a 256 GB – possono essere utilizzate come contenitori delle videoregistrazioni o come supporti di backup qualora la trasmissione venisse temporaneamente interrotta verso il sistema principale. E’ possibile individuare, non di rado, parti di video non presenti nel sistema di videoregistrazione principale. Anche le SD possono essere formattate in formato proprietario e pertanto è necessario sempre sequestrare anche la telecamera e/o l’encoder e soprattutto non rimuoverle prima di aver effettuato almeno un’acquisizione logica.

Il Cloud oggi è la vera sfida: il Cloud Computing si è ormai diffuso come modello di elaborazione distributa anche nei sistemi di videosorveglianza; è chiaro quindi che i video potrebbero non essere più disponibili nel luogo del sequestro o dove è ubicato l’impianto e  non essere accessibili con le procedure standard. In questi casi ci si trova di fronte ad un’interfaccia applicativa messa a disposizione dal fornitore del servizio e dal funzionamento sconosciuto. La piattaforma esemplificativa del produttore AVTECH ne è un esempio: la fig. 2 mostra la maschera di accesso al servizio denominato EaZy Service[4]:

Fig. 2 – Schermata di accesso EaZy Service

Oltre a tutto ciò, vi sono anche i limiti dovuti alle caratteristiche tecniche delle apparecchiature utilizzate; le più frequenti, per una successiva analisi ed elaborazione, sono:

  • bassa risoluzione e frequenza dell’immagine;
  • angolo di ripresa della telecamera;
  • condizioni di illuminazione inadeguate;
  • riferimenti temporali errati o non sufficientemente documentati.

Fig. 3 – il rettangolo rosso indica l’area dove si svolgerà l’evento criminoso

Le best practices in ambito di acquisizione, oltre a contrastare la fragilità propria di ogni digital evidence – a maggior ragione quando trattasi di immagini e video – forniscono un approccio sistematico al settore della Digital Forensics, denominato Video Forensics.

Le best practices, le linee guida e le raccomandazioni sono tese ad assicurare che vengano utilizzati i metodi migliori per il recupero dei dati presenti sugli apparati e di mantenerne l’integrità. Tra le altre prescrizioni vi è inoltre la necessità, quando possibile, della conservazione nel formato nativo dei video estratti, evitando le conversioni in altri formati che potrebbero deteriorare ulteriormente la qualità delle immagini originali e la perdita dei preziosi metadati.

Tutti gli apparati idonei alla registrazione e conservazione dei filmati utilizzano fattori di compressione atti a consentire, tra l’altro, la riduzione dello spazio di archiviazione. I file prodotti vengono conservati in maniera nativa e necessitano quindi di software e opportuni codec[5] rilasciati da ciascun produttore per poter essere riprodotti ed analizzati assieme a tutti i metadati ( data e orario della registrazione, numero della telecamera, risoluzione, etc. ).

Oltre al recupero dei file video, molti sistemi consentono l’esportazione degli stessi in diversi formati – ad esempio Avi[6] o Mov[7] -; bisogna sempre tenere in considerazione che dette operazioni possono comportare, come già evidenziato, l’ulteriore compressione dei dati e la perdita di informazioni che potrebbero risultare vitali alla ricostruzione degli eventi.

Vediamo in cosa consistono le precauzioni da adottare sul luogo dove è presente il sistema da acquisire:

  • annotare dettagliatamente lo stato delle cose e i metodi utilizzati nelle operazioni;
  • verificare la disponibilità di un manuale operativo del sistema oggetto di acquisizione in cui poter rilevare i parametri tecnici, le procedure di impostazione e i modi per accedere alla configurazione e/o setup;
  • attivare una videoregistrazione esterna utilizzando una videocamera posta in modo da poter documentare visivamente tutte le operazioni compiute;
  • annotare la marca, il modello e il numero di serie del dispositivo;
  • annotare la marca e modello delle telecamere;
  • documentare il numero totale delle telecamere connesse e fotografare l’angolo di ripresa di quelle attive;
  • verificare la presenza di un multiplexer[8] e nel caso annotare marca e modello;
  • verificare l’eventuale dotazione di infrarossi[9] delle telecamere;
  • stabilire se il sistema è basato su di un PC o è un sistema stand-alone[10] embedded[11];
  • stabilire il numero delle eventuali unità supplettive installate (PC, server di archiviazione, telecamere connesse via rete, etc.) idonee o utili alla registrazione degli eventi;
  • verificare l’eventuale connessione in rete del sistema;
  • individuare tutti i dispositivi funzionanti connessi al sistema e dotati di un indirizzo di rete;
  • documentare la data e l’ora visualizzate sul sistema;
  • verificare la data e l’ora correnti attuali – da un orologio di riferimento – e annotarne l’eventuale scostamento;
  • verificare la presenza di un eventuale NTP[12] server di sincronizzazione documentando la corrispondenza degli orari – cfr. fig. 4-;

Fig. 4 esempio di configurazione server NTP

  • documentare la capacità di memorizzazione totale del sistema ( numero e capacità dei supporti magnetici installati) – cfr. fig. 5 -;

Fig. 5 funzione per rilevare la capacità di memorizzazione del sistema

  • lo stato dell’opzione di sovrascrittura delle immagini e del relativo periodo di conservazione dei dati – cfr. fig. 6 -;

Fig. 6 esempio di funzione del limite di conservazione dei dati – 4 nella figura

  • verificare la presenza di eventuali password di sistema;
  • annotare le impostazioni di sistema:
    • qualità dell’immagine (high,medium,low, etc.);
    • frame o immagini al secondo;
    • risoluzione delle immagini ( 352×288 [CIF][13], 720×576 [4CIF], etc.) – cfr. fig. 7 –

      Fig. 7 esempio di impostazioni del sistema in formato ridotto

  • Individuare eventuali altre impostazioni di sistema (ad esempio il registro degli eventi) – cfr. fig. 8 -;

Fig. 8 esempio di registro degli eventi

  • Individuare la presenza di audio e se presente comprendere il numero di canali attivi e la possibilità di poterne esportare i contenuti;
  • rimuovere il cavo di rete, se necessario;
  • determinare la quantità di dati da recuperare;
  • determinare il formato del file proprietario utilizzato dal sistema;
  • determinare il metodo migliore per il recupero.

L’elenco non è certamente esaustivo e ben potrebbe essere integrato dall’esperienza sul campo di ogni buon investigatore, ma ritengo dette basilari operazioni fondamentali per il buon esito dell’acquisizione.

Risulta di palmare evidenza che la fase di accertamento – iniziando con la ricerca dei filmati di interesse investigativo -, dovrebbe avvenire a seguito della conclusione della fase irripetibile del repertamento; nella realtà ciò non è sempre possibile, dato che vi possono essere accertamenti urgenti dettati da particolari accadimenti e circostanze nonchè sistemi di videosorveglianza difficilmente sequestrabili – si pensi, ad esempio a quelli aereoportuali, portuali, ferroviari o a sistemi di sicurezza per il controllo del territorio, solo per citarne alcuni -.

In detti casi è necessario procedere ad un rapido esame del sistema e tale operazione diviene quindi un atto irripetibile. Sarà necessario rilevare i dati in modalità live adoperando determinate precauzioni:

  • annotare minuziosamente tutte le operazioni compiute per la ricerca dei filmati da estrarre;
  • salvare i filmati di interesse tenendo in debita considerazione il mantenimento degli stessi in formato originale, preservando i metadati e tutti i dati correlati;
  • qualora il sistema ne sia dotato, esportare i filmati con un watermark[14];
  • calcolare immediatamente le firme hash dei file salvati;
  • verificare i contenuti di eventuali SD situate nelle telecamere;
  • verificare ed estrarre il file di log del sistema di videosorveglianza: molti sistemi prevedono una funzione di estrazione su supporto esterno.

Eterno dilemma al riguardo dei dispositivi posti in sequestro è lo spegnimento del sistema:

  1. è opportuno spegnerlo fisicamente con una operazione di shutdown[15]?
  2. è oppurtuno spegnerlo rimuovendo l’alimentazione ?

Nel caso 1 si potrebbero attivare procedure automatiche sconosciute all’investigatore che potrebbero portare a distruzione e/o modifica dei dati; nel secondo caso si potrebbero danneggiare i dati contenuti nei supporti in maniera irreparabile.

Non è possibile quindi dare una risposta univoca alle domande poste sopra se non consigliare un’attenta valutazione caso per caso, in relazione alla tipologia dell’impianto in sequestro.

Qualora invece si dovessero riscontrare DVR spenti, è bene non accenderli mai anche se solo per comprenderne l’utilità della loro eventuale acquisizione dato che, non potendo essere a conoscenza del tempo trascorso dal loro spegnimento, potrebbero, al momento dell’accensione, sovrascrivere interamente il contenuto.

E’ bene ricordare che la presenza di un’evidenza video contenuta all’interno di un sistema, anche nel caso che il contenuto apparisse palese, non giustifica in alcun modo il mancato obbligo di assicurarne la sua genuinità.

Infatti quando la struttura del sistema operativo è ben conosciuta la ricerca e il repertamento dei dati risulta certamente più semplice e mette sicuramente nelle condizioni di poter garantire l’autenticità della prova digitale e l’eventuale ripetibilità dell’acquisizione e dell’analisi; di contro si presta a comportamenti fraudolenti per ovvi motivi – antiforensics -.

Quando invece la struttura è nota solo al produttore è chiaro che la falsificazione è ardua e la prova eventualmente estratta è sicuramente autentica; l’acquisizione e l’analisi risulterà più difficoltosa per cui sarà necessario studiare la documentazione tecnica fornita dal produttore – se disponibile – altrimenti si cercherà di recuperare quanti più dati possibile per poterli analizzare e nel contempo, verificare a posteriori la stessa autenticità. Esistono sul mercato vari software commerciali di estrazione e analisi video anche se non tutti sono pienamente affidabili. Tra i più degni di nota nell’ambito identificazione ed estrazione possiamo citare DVRExaminer[16] sviluppato da DME Forensics che consente, specie nel caso di filesystem proprietari come nella maggior parte dei DVR,  l’identificazione del filesystem installato e la conseguente localizzazione dei file video in esso contenuti. Le partizioni dei filesystem proprietari non vengono nemmeno riconosciute dai tool convenzionali di computer forensics, rendendo sicuramente più arduo il lavoro del consulente. Onde verificare le potenzialità di detto software è possibile scaricare dal sito del produttore una demo completamente funzionante per 30 giorni e utilizzarla per verificarne la semplicità d’uso e la versatilità. In calce una schermata riepilogativa di un’estrazione effettuata in un caso reale:

Il software ha giustamente individuato la tipologia di filesystem – nel caso in esame riferito al produttore Dahua[17] – ha eluso le password di amministrazione e operatore e ha correttamente recuperato ed estratto i file di interesse. Premesso che il DVR non sovrascrive i dati video ma modifica un indice per tenere traccia dei blocchi non più in uso, a volte cancellando le voci pertinenti o contrassegnandole in qualche modo, non è affatto semplice recuperare dati cancellati in un filesystem proprietario. Il software è riuscito egregiamente nell’intento, recuperando i dati presenti in questi blocchi e consentendo l’evidenza di parti di video che non erano più presenti. Con dette evidenze gli investigatori hanno potuto dirimere il caso.

Va tenuto in debito conto che i file presenti nel DVR non sono semplici file – l’utilizzo di applicativi carver[18] sarebbero stati più che sufficienti in quel caso – ma file video compressi H264[19] e spesso suddivisi in sezioni contenenti ciascuno un singolo frame, pertanto si deve desumere che il lavoro portato a termine dal software non è stato affatto banale.

Riepilogando:

  • l’analista forense deve sempre accertarsi che i dati provengano dalla fonte nella forma originale;
  • deve sempre verificare la catena di custodia della prova ottenuta, senza la quale non sarà possibile sostenere in dibattimento la validità del proprio lavoro;
  • deve sempre cercare di ottenere i migliori risultati possibili.

E’ certo che la trattazione non può esaurirsi qui; questo è solo un piccolo contributo in un oceano sconfinato; è evidente che il seguito di una corretta acquisizione è il percorso di analisi consistente, tra l’altro, nella selezione di fotogrammi di un certo tipo, nel miglioramento dell’immagine, nella correzione dei disturbi, nella riduzione del rumore, etc.

Il campo, avrete sicuramente compreso, è quello della Video Forensics: ma questa, è un’altra storia.

Note


Articolo a cura di Cosimo De Pinto

L’articolo Analisi forense dei sistemi di videosorveglianza proviene da ICT Security Magazine.

https://www.ictsecuritymagazine.com/articoli/analisi-forense-dei-sistemi-di-videosorveglianza/


Si fa presto a dire backup. Rispettando i principi del GDPR

Il GDPR non parla mai direttamente di backup o di copie di riserva. Eppure, uno dei primi elementi che le organizzazioni verificano (o fanno verificare) nel percorso di adeguamento alla nuova normativa europea sulla protezione dei dati personali è proprio il backup. Le domande che si pongono sono quasi sempre le stesse: si fanno i backup? Con quale frequenza? Con quale politica? Quali supporti si usano? Dove si conservano i supporti?

  • La finalità delle copie di riserva, in realtà, è ben definita dalla lettera c), comma 1 dell’art. 32 del GDPR: ogni organizzazione che tratta dati personali deve avere la capacità di ripristinare tempestivamente la disponibilità e l’accesso dei dati personali in caso di incidente fisico o tecnico.

L’incidente

Ecco, appunto, l’incidente: quando accade, tutti si mobilitano per ripristinare una situazione accettabile ricorrendo alle copie di riserva.

Quali sono i problemi? Il problema principale è che tra il tempo T, dell’incidente, ed il tempo T-ξ, nel quale è stato eseguito l’ultimo backup, le organizzazioni sono andate avanti, i dati sono cambiati e, se si parla di aziende con migliaia di clienti e con sedi in molti punti della Terra, la questione è molto seria. Di solito si agisce su ξ cercando di minimizzarlo, arrivando a parlare, impropriamente da un punto di vista teorico, di sincronizzazione tra copie: la perfetta sincronizzazione non esiste ed un’azione di recupero della storia tra T ξ e T è sempre necessaria.

Quindi, al backup, inteso come insieme di policy, strumenti e procedure per produrre copie di riserva dei propri dati, occorre affiancare policy, strumenti e procedure di ripristino. Inoltre, il GDPR prevede, alla lettera d), comma 1 dell’art. 32, che le misure di sicurezza tecniche ed organizzative, tra le quali il backup ed il ripristino, siano testate (che vuol dire provate), verificate (cioè corrispondenti all’obiettivo e ripetibili) e valutate (cioè esaminate negli eventuali margini di miglioramento) regolarmente nella loro efficacia.

Le conseguenze dell’incidente

Accade, invece, che molte organizzazioni si concentrino sul backup e perdano di vista cosa può succedere dopo un incidente. In particolare, si crede che basti avere il backup da qualche parte e, prima o poi, tutto si risolverà.

A parte gli impatti diretti sul business che il prima o poi può significare, la riflessione che si vuole condurre riguarda le conseguenze che un ripristino affrettato e mal gestito può avere nell’infrangere i principi del GDPR e, quindi, i diritti degli interessati. Non bisogna dimenticare, infatti, che, soprattutto per le piccole e medie imprese, violare i principi del GDPR o incidere sui diritti dell’interessato può essere economicamente molto più gravoso che ritardare la consegna di un ordine o sospendere le funzionalità di consultazione del sito: il rischio è una sanzione amministrativa che può arrivare fino a 20.000.000 di euro.

Quindi, calma e gesso: non conviene prendere il database salvato la settimana precedente e ripristinarlo sui sistemi in esercizio. Prima di procedere, è doveroso porsi le seguenti domande sui principi:

  • i dati personali che si stanno ripristinando sono minimizzati rispetto alla finalità che perseguo “oggi”?
  • i dati personali che si stanno ripristinando sono esatti ed aggiornati?
  • i dati personali che si stanno ripristinando sono in chiaro mentre, normalmente, dovrebbero essere pseudonimizzati?

E, ancora, le seguenti domande sui diritti degli interessati:

  • si rischia di ripristinare un dato personale per il quale era stata chiesta una rettifica?
  • si rischia di ripristinare un dato personale per il quale era stata chiesta una cancellazione?
  • si rischia di ripristinare un dato personale per il quale era stata chiesta una limitazione al trattamento?
  • si rischia di ripristinare un dato personale per il quale era stata manifestata un’opposizione al trattamento?
  • si rischia di ripristinare un dato personale per il quale era stato revocato il consenso?

In pratica tra il tempo T ξ ed il tempo T può essere successa qualsiasi cosa: in particolare, può accadere che qualche interessato abbia effettuato una richiesta di esercizio di un diritto che rende l’operazione di ripristino molto rischiosa. Per esempio, un cliente può aver richiesto l’esercizio del diritto alla cancellazione (art. 17 del GDPR) il giorno dopo l’esecuzione del backup; a fronte di tale richiesta, vengono cancellati definitivamente i dati personali del cliente dal sistema in esercizio. Tuttavia, a seguito di un incidente, può essere necessario ripristinare il backup che, sfortunatamente, contiene ancora i dati personali del cliente. Tra i dati personali, c’è anche l’indirizzo email dello stesso interessato che, quindi, viene raggiunto dalla newsletter periodica inviata a tutta la clientela. È verosimile che il cliente si rivolga al Garante per la Protezione dei Dati Personali e che la sanzione non tardi ad arrivare.

Qualche ipotesi risolutiva

Senza voler entrare nelle sofisticate strategie di backup e di ripristino che le grandi organizzazioni possono permettersi, qualche ipotesi risolutiva può essere suggerita ai soggetti che non possono disporre di risorse (umane e strumentali) tali da evitare gli inconvenienti ipotizzati a seguito di incidenti.

1 – Eseguire le richieste “a blocchi”

Il suggerimento è di non dare immediatamente corso alle richieste di esercizio dei diritti; il GDPR prevede che queste siano eseguite senza ingiustificato ritardo ma, se il backup viene eseguito settimanalmente (o con maggiore frequenza), si possono accumulare tutte le richieste e si possono eseguire poco prima dell’esecuzione del backup. Il ritardo di esecuzione può essere ampiamente giustificato, documentandolo opportunamente, con la garanzia di effettività dell’esercizio dei diritti a favore degli interessati. Tuttavia, chi dovesse optare per questa soluzione ha il dovere di informare immediatamente l’interessato del momento, leggermente differito, nel quale diventerà effettiva la sua richiesta.

2 – Backup incrementale immediato

Si può ipotizzare di configurare il software applicativo per scatenare un backup incrementale immediato (e circoscritto alle sole strutture logiche interessate) al momento dell’esecuzione di una richiesta di esercizio di un diritto da parte dell’interessato. Non è una soluzione semplice e può richiedere una significativa manutenzione evolutiva del software.

3 – Registro per l’esercizio dei diritti

Un registro per l’esercizio dei diritti, manuale o disponibile in formato elettronico su un apparato elaborativo separato dai sistemi core, può essere una soluzione semplice ed immediata. In caso di ripristino di un backup effettuato al tempo T ξ, occorre consultare il registro e verificare quali operazioni sono state eseguite in corrispondenza di richieste di esercizio dei diritti fino al tempo T dell’incidente: basta replicarle senza rischiare di ledere gli interessati.


Articolo a cura di Francesco Maldera

L’articolo Si fa presto a dire backup. Rispettando i principi del GDPR proviene da ICT Security Magazine.

https://www.ictsecuritymagazine.com/articoli/si-fa-presto-a-dire-backup-rispettando-i-principi-del-gdpr/


Ipotesi per la realizzazione di un modello per l’analisi di efficacia di Sistemi di Sicurezza delle Informazioni

La sicurezza dei dati e delle informazioni, sia nel campo del trattamento di dati personali, che negli altri campi aziendali è ormai un requisito fondamentale e strategico per le organizzazioni. I dati sono la linfa delle organizzazioni e le aziende, come noi, sono perennemente e costantemente connesse.

I dati sono un asset importante e la loro gestione, siano essi di progetto, di business, di ricerca, di produzione o personali, permette alle aziende di vivere.

I dati sono un asset strategico, la gestione dei quali consente un vivere quotidiano tranquillo. Questo vale per tutte le fasi della vita aziendale: progettuale, aziendale, Ricerca e Sviluppo, produttiva e personale.

Comunque a fronte di questa importanza, poche aziende, ad oggi, si sono dotate di adeguati strumenti di controllo e gestionali.

Oltretutto il decreto 679/2016 spinge verso questa direzione.

Per meglio comprendere l’impatto della sicurezza (e la sua gestione) sulla struttura organizzativa, abbiamo analizzato il contenuto di tre normative:

  • ISO 27001;
  • Framework NIST;
  • D.P.R.

Per ognuna abbiamo individuato i punti inerenti la sicurezza, Compliance normativo e Sistema di Gestione. I singoli punti ed articoli sono stati conseguentemente assegnati alle classi sopra individuate.

Se la sicurezza dei dati è così importante, poche sono però le aziende che si sono dotate di un sistema di gestione e controllo.

Anche il regolamento 679/2016 spinge verso questi aspetti.

La sicurezza non è un prodotto ma un processo che si basa su aspetti organizzativi e tecnici.

Come si può notare dal grafico riportato sopra, per la parte compliance e sistema, emergono delle differenze caratteristiche di ciascuna norma.

Ad esempio il GDPR copre molto di più la parte compliance rispetto alle altre due, le quali coprono di più l’area di sistema.

Sono poi stati riportati, nei grafici seguenti, le differenze correlando le tre aree.

Come si può notare la parte del leone per sicurezza e sistema la fanno le norme NIST e 27001, mentre il GDPR per la parte compliance.

Sono stati poi pesati i singoli impatti come riportato nei grafici seguenti.

A questo punto abbiamo cercato di creare un modello matematico – statistico (relativamente al GDPR e ISO 27001) collegando il grado di copertura e l’efficacia di un Sistema di gestione della sicurezza dei dati e delle informazioni, con i rischi derivanti da una non copertura.

Per fare questo abbiamo definito lo specifico peso/impatto degli articoli rispetto alla sicurezza dei dati, alla normativa 27001, al GDPR: il tutto evidenziato nel grafico seguente:

Riportiamo, nella tabella seguente, i capitoli della norma e gli articoli del 2016/679 con i relativi pesi. Per la norma 27001 sono stati pesati anche i sottopunti. Il valore riportato e la media dei singoli pesi.

Sono state individuate quattro aree di copertura:

  • Non implementato = 25%
  • Debolmente implementato = 50%
  • Parzialmente implementato = 75%
  • Completamente implementato = 100%

Individuati i punti, essi sono stati correlati con il grado di copertura e di completamento dei singoli articoli applicando la formula sotto riportata

pi = peso del singolo item

γi = copertura del singolo item

ρi = risultato del singolo item

Ρ =Si ρi =Si γi *pi

Con Ρ il risultato totale dei pesi e copertura.

Utilizzando l’analisi dei rischi precedentemente fatta e calcolando il rischio, definito come:

R = P*G

con p = probabilità e g = gravità dell’evento dannoso.

Questo rischio così calcolato, è stato suddiviso in 4 aree:

  • Rischio ambientale
  • Rischio fisico
  • Rischio Informatico
  • Rischio Organizzativo

che riportano la sommatoria per ciascuna area dei rischi di pertinenza.

A questo punto sono stati abbinati ai punti e agli articoli individuati sopra, i rischi relativi ottenendo, anche in questo caso, una sommatoria generale.

Nel grafico viene riportato l’andamento ottenuto.

Conclusioni

Abbiamo cercato di realizzare un modello di analisi matematico-statistico per verificare la copertura e abbinare i rischi relativi in un sistema di gestione della sicurezza dei dati.

Attraverso un’autovalutazione dell’analisi dei rischi e del grado di copertura di implementazione dell’item/articolo di riferimento, si è potuto ottenere il grafico sopra riportato che individua la posizione dell’organizzazione rispetto ai due valori calcolati.


Articolo a cura di Stefano Gorla

L’articolo Ipotesi per la realizzazione di un modello per l’analisi di efficacia di Sistemi di Sicurezza delle Informazioni proviene da ICT Security Magazine.

https://www.ictsecuritymagazine.com/articoli/ipotesi-per-la-realizzazione-di-un-modello-per-lanalisi-di-efficacia-di-sistemi-di-sicurezza-delle-informazioni/


Traffico di rete nella risposta agli incidenti: Implementazioni e Tecnologie

Introduzione

L’analisi del traffico o del flusso di dati è uno dei compiti più importanti da eseguire durante un’indagine interna al fine di confermare o negare l’esistenza di un incidente di sicurezza. Qualora un ambiente abbia preliminarmente previsto una buona infrastruttura preposta alla raccolta e all’analisi del traffico di rete, in caso di incidente il team dedicato alla sua gestione dovrebbe infatti essere in grado di raccogliere rapidamente informazioni quali registri di flusso, endpoint di comunicazione interni, componentistica malevola utilizzata nell’attacco, canali di esfiltrazione e così via

Al fine di sintetizzare quanto questa fonte di informazioni sia di vitale importanza in tale tipologia di indagini, è possibile elencare una serie di situazioni per le quali i dati di rete (oltre la seguente analisi e reportistica) risultano essenziali:

  1. Estrarre indicatori ed eventuali evidenze di compromissione
  2. Confrontare i dati con sorgenti aperte e/o chiuse
  3. Identificare le risorse coinvolte e movimentazioni laterali
  4. Indicare lo scopo dell’intrusione
  5. Costruire una “timeline” degli eventi
  6. Indicare il vettore del’intrusione

Quanto detto risulta ancora più importante se si considera che in molte situazioni potremmo trovarci nella necessità di acquisire dettagli da comunicazioni destinate a servizi interni che potrebbero non essere in grado di mostrare l’intero payload della richiesta (si pensi, ad esempio, ai servizi web nell’uso dei metodi HTTP POST e PUT).

In questo caso, pur avendo a disposizione log locali provenienti da host compromessi, non saremo generalmente in grado di vedere quale sia stato l’intero contenuto della richiesta originale. Questo è solo un esempio di come è essenziale implementare una buona strategia di acquisizione del traffico di rete per supportare il team di gestione degli incidenti.

Al fine di elencare quali potrebbero essere le tecnologie e le attività dedite all’acquisizione ed al monitoraggio di tale flusso di informazioni, è necessario elencare alcune grandi categorie di elementi in cui queste potrebbero ricadere:

  1. Collezionamente basato sul “full packet logging” sulla base di eventi di
  2. Collezionamente basato sul “full packet logging”come condizione
  3. Collezionamento basato sul “full packet logging” in base a criteri specifici (allorchè, per esempio, il flusso vada ad interessare una DMZ o particolari nodi di rete).
  4. Collezionamento basato sul

Ciascuna di queste implementazioni ha i suoi punti di forza e di debolezza, strettamente correlati allo spazio di storage disponibile, alle policy di ritenzione dei dati, oltre che alle fasi antecedenti e successive di un incidente di sicurezza.

Per ragioni legate al main topic di questo elaborato, non verranno approfonditi nel dettaglio tutte le possibili implementazioni di tali tecnologie, ma, in linea generale, esistono due grandi modalità principali che è possibile utilizzare per eseguire una raccolta dei dati di traffico: analisi del flusso (NetFlow) e analisi dei pacchetti .

Sistemi “NetFlow”

Ogni “flusso di dati” risulta caratterizzato da una serie specifica di identificatori.

Di solito questi identificatori sono IP di origine, IP di destinazione, porta di origine, porta di destinazione, protocollo e tutti i metadati che definiscono quelli che vengono comunemente chiamati “canali di traffico“.

Qualora anche solo uno di questi identificatori vada a subire delle modifiche durante una sessione di comunicazione, un nuovo flusso di traffico viene generato. Per una singola connessione client-server, possiamo avere flussi di traffico multipli poiché il client molto spesso va a creare connessioni multiple da una porta sorgente diversa per ogni singola sessione di comunicazione.

I dispositivi di rete moderni come router o switch eventualmente coinvolti nel canale di comunicazione generato da un host interno da/veso internet, possono generare flussi di dati (in genere NetFlow v.5) sulla base delle specifiche del traffico che si trovano a gestire.

E’ bene chiarire che i dati così ricavati ed inviati al collector NetFlow sono dati “statistici” sul traffico in transito e non risultano copie di pacchetti come possiamo osservare per le implementazioni basate su porte di SPAN e in generale nelle tecnologie DPI.

Inoltre, i dati NetFlow sono spesso campionati per ridurre i requisiti di archiviazione. Una ipotetica implementazione di una soluzione di raccolta e analisi dati di tipologia NetFlow può essere rappresentata nella Figura 1:

Figura 1

Analisi del NetFlow nella gestione degli incidenti

Soluzioni dedite all’analisi del NetFlow vengono spesso utilizzate dagli incident responders ed in generale dagli specialisti di sicurezza come risorsa utile al rilevamento di anomalie e di comportamenti classificabili come “anomali” rispetto ad una baseline di utilizzo pre-osservata.

L’analisi delle anomalie, indifferentemente dal fatto che sia focalizzata ad una particolare indagine o che sia eseguita come controllo generico, viene utilizzata al fine di rilevare particolarità nel traffico di rete che vadano a discostarsi dai normali modelli di comportamento previsti.

Sulla base di quanto appena affermato ed in considerazione delle sei fasi della gestione degli incidenti (preparazione, identificazione, contenimento, eradicazione, recupero, apprendimento), l’implementazione e l’analisi del traffico di rete risulta molto utile nella prima e nella seconda di queste.

Tali pratiche infatti possono essere utilizzate come ausilio all’identificazione ed alla categorizzazione di eventi sospetti e potrebbe fornire informazioni molto utili per rintracciare e contenere eventuali azioni dannose oltre che agevolare, in qualche caso, le pratiche di attribuzione.

Nella pratica, risultano inoltre molto utili al fine di provare o smentire azioni mirate all’esfiltrazione di dati durante l’investigazione di incidenti sia accertati che sospetti. La Figura 2 mostra un grafico derivato da una reale attività di risposta ad un incidente con il quale è stato possibile individuare una attività di data exfiltration mediante cover channel:

Figura 2

La linea blu rappresenta la baseline del comportamento per quanto concerne il normale traffico in uscita. La linea rossa è un derivata dall’analisi dei metadati del traffico in uscita dopo l’installazione, in uno dei sistemi interni, di un malware progettato per lo spionaggio industriale non precedentemente rilevato.

Rispetto ad una baseline inferiore a 1 GB di traffico in medio, c’è un picco di quasi 14 GB nel periodo di tempo estratto, a dimostrazione di una sorta di attività anomala.

Riassumendo come l’analisi del flusso di rete tramite NetFlow possa essere utile nel rilevare comportamenti anomali nelle attività  di risposta  agli incidenti, può essere sufficiente pensare alle capacità che questa pratica offre in termini di “visione complessiva” di ciò che è accaduto o che sta accadendo.

I team dediti alla risposta di incidenti informatici infatti, hanno spesso necessità di trovare delle risposte molto rapidamente. Per tale motivo, in molti casi, questi non necessitano, almeno nelle prime fasi del ciclo IR, di una visione troppo dettagliata degli ambienti in cui si trovano ad operare.

Implementare sistemi e tecnologie dedite alla raccolta e all’analisi del traffico NetFlow, risulta nei fatti una soluzione davvero efficace se il nostro scopo risulta quello di possedere una capacità di visione e controllo a “largo spettro” del nostro ambiente.

Sistemi “Full Packets Log“

Le attività di estrazione ed analisi dei flussi di rete basati su tecnologie DPI o più genericamente su tecnologie “full packet log” del flusso dati in transito sono solitamente implementate al fine di arrivare a possedere la capacità di approfondire nel dettaglio singoli eventi occorsi all’interno dell’ambiente in questione.

Un aspetto di estrema importanza di questa pratica è quello di collezionare evidenze riguardo attività ostili in modo da supportare sia le attività di investigazione interne che esterne, essere di ausilio ad eventuali indagini penali da parte degli organi competenti, oltre che di acquisire, in dettaglio, indicatori di compromissione utili a valutare il grado di estensione della minaccia, nonchè eseguire pratiche di “threat hunting” sulla base di quanto osservato nel dettaglio (per esempio diffondendo nella rete agents che vadano alla ricerca di specifici payload malevoli estratti in precedenza).

Tale tipologia di analisi infatti consente di avere un tale dettaglio di informazioni che in molti casi permette di ricomporre ed identificare quelli che sono stati, per esempio, i tool utilizzati nelle prime fasi di intrusione, quali tecniche o componentistiche malevole sono state utilizzate per raggiungere un certo grado di privilegi all’interno dei sistemi colpiti o per archiviare l’esigenza di un accesso continuato al network in esame (c.d. persistenza).

Inoltre, c’è anche da dire che implementare tali tecnologie permette una c.d. analisi retrospettiva di quanto transitato all’interno dell’ambiente, per esempio nel confronto fra un flusso dati non recente con indicatori noti solo all’atto dell’analisi.

In tali casi, per esempio, è possibile avere evidenze di attività ostili occorse in passato per le quali oramai i tool utilizzati sono stati cancellati o per le quali non ci sono evidenze dirette nel presente.

Ovviamente, in considerazione di quanto appena enunciato, l’implementazione di tali tecnologie potrebbe risultare, ad una prima e veloce analisi, sempre la soluzione migliore da possedere al fine di riuscire ad avere buone capacità di risposta ed analisi.

In effetti, sotto l’ottica di un professionista di settore, tali capacità rappresentano il meglio di quanto si possa desiderare. Tuttavia, nelle prime fasi di risposta ad un incidente, un così approfondito livello di dettaglio potrebbe addirittura sovraccaricare il gruppo di analisi di una tale quantità di informazioni tale da dover considerare il rischio di perdersi fra l’esclusione di falsi positivi nonchè nell’esame di eventi totalmente estranei alla specifica missione.

Oltremodo, l’inclusione di metodologie FPC/DPI per la raccolta e l’analisi del traffico non può fare a meno di considerare la sempre parziale capacità di copertura dell’ambiente da controllare nonchè i requisiti di spazio necessari per l’archiviazione.

All’interno di ambienti molto estesi e distribuiti infatti risulta quantomeno difficile posizionare centinaia di sistemi c.d. “packets sniffers” (TAP o periferiche per la cattura dei pacchetti) oltre al fatto che un progetto con tali requisisti potrebbe raggiungere costi davvero gravosi.

Come accennato in precedenza, nel caso di una intrusione sospetta o accertata, agli analisti viene solitamente chiesto di muoversi molto rapidamente al fine di trovare risposte rapide su quanto accaduto, e molto difficilmente avranno il tempo e le capacità (in termini di numero di elementi) per muoversi all’interno di vari terabytes e terabytes di log, oltre al fatto che è impensabile approcciare la missione partendo dall’analisi delle singole sottoreti o sistemi.

La via migliore e maggiormente rapida per capire quanto accaduto, è muoversi avendo a disposizione qualcosa che permetta di avere una visione più ampia della rete, e solo in un secondo momento approfondire nel dettaglio quanto trovato di interesse.

Un caso a metà: “Full Packets Log” su eventi di sicurezza

Come la stessa parola suggerisce, una piattaforma di tipo “full packet log” basata su eventi permette di registrare il completo traffico di sessione relativo ad un probabile (o presunto, in considerazione dei falsi positivi) evento di sicurezza.

Le periferiche di rete che consentono una tale tipologia di approccio nel controllo del traffico sono molto spesso basate su firme (signatures) ed una delle sue maggiori implementazioni nel settore è sicuramente SNORT.

L’approfondimento dello specifico funzionamento delle periferiche di tipo IDS/IPS è fuori lo scopo di questo elaborato, tuttavia, è possibile chiarire che, come anticipato, la loro logica spesso è basata sul riconoscimento di pattern specifici, solitamente mantenuti in costante aggiornamento, che si devono verificare all’interno del flusso dati in esame affinchè un evento possa essere sollevato.

Semplificando molto l’intero ciclo di detection di una eventuale intrusione mediante tali sensori, un evento potrebbe essere classificato come qualcosa di possibile interesse per l’analista.

Tali tecnologie hanno solitamente lo svantaggio di dover essere mantenute in costante aggiornamento. La loro efficacia inoltre si basa sul riconoscimento di qualcosa già classificato come malevolo dalla comunità di sicurezza. Le firme su cui tali apparati basano la loro efficacia infatti, fanno parte di un set di regole per il riconoscimento di payload ostili che potrebbero essere evase e/o illuse (eh già, pensi che sia aria quella che respiri ora? cit. Morpheus).

Infine, il tuning di tali apparati è essenziale. Sensori non ben configurati potrebbero portare alla mancata detection di un reale incidente o sovraccaricare il gruppo di analisti con una tale mole di informazioni da rendere difficile il concentrarsi nella discriminazione di un reale evento di sicurezza.

Tuttavia, questi restano dispositivi molto utili e dalla reale importanza nell’analisi degli incidenti di sicurezza. Un dispositivo ben configurato e mantenuto è in grado, molto spesso, di indirizzare nella giusta via una eventuale analisi e di accorciare di molto i tempi di risposta e contenimento della minaccia.

Solitamente tali sensori sono posizionati all’ingresso di reti sensibili e sono, in genere, in grado  di  riconoscere  molto  efficacemente  minacce  dalla  diffusione  massiva  e generalista. La loro capacità di risposta si abbassa inesorabilmente nel confronto con attacchi mirati, in risposta a minacce persistenti avanzate (APT) o malware particolarmente furtivi.

Poco utile, infine, ricordare che qualora un flusso in transito, seppur realmente malevolo, non venga classificato dal sensore come tale, non ci saranno i dettagli (e dunque il “full packet log“) di quanto accaduto.

Implementazione di un sistema “Full Packet Log“

Allorchè un Security Architect si trovi davanti la necessità di soddisfare dei requisiti (solitamente abbastanza stringenti in termini di bugdet) nell’implementazione di architetture di rete che consentano l’acquisizione dell’interno flusso dati, egli problabilmente dovrà considerare alcune variabili che andranno ad influire sul piano delle capacità operative nell’ottica di soddisfare determinati requisiti di prestazione.

Le maggiori questioni a cui trovare risposta in tali tipologie di progetto sono solitamente legate alle direttive del cliente, alla natura ed alla sensibilità dei sistemi da proteggere, nonchè al già citato budget a disposizione.

Solitamente, esse sono le seguenti:

  • Dove, fisicamente, tale sistema dovrebbe essere posizionato?
  • Quali sono i servizi, le sottoreti ed i sistemi da controllare?
  • Quali sono le aree, i sistemi ed i servizi critici per il business in questione?
  • Quali sono le richieste per la ritenzione dei dati?
  • Quali sono i requisiti di ridondanza dell’infrastruttura?
  • E’ necessario orientare l’applicazione verso sistemi commerciali o open?

Come è facile immaginare, non esiste una risposta omni-comprensiva a tali questioni.

Ovviamente è necessario tener conto delle influenze dell’organizzazione riguardo le sue inclinazioni sull’hardware, sul software, le capacità operative attese etc. etc., ma, in linea generale, un tale sistema di controllo è sempre posizionato fra un servizio / rete “fidato/a”, ed un servizio / rete “non fidato/a”.

Un tale scenario potrebbe essere rappresentato da un segmento di rete interno (LAN) che sarà la nostra “zona fidata“, ed Internet, che rappresenta la zona “non fidata“.

Solitamente, un’ architettura di rete che vada ad implementare un sistema per la raccolta completa del traffico di rete in grado di ben supportare le attività di risposta agli incidenti, è simile a quelle rappresentata nella Figura 3:

Figura 3

Posizionando il sensore prima del NAT di rete permetterà ad un eventuale CERT/SOC di identificare immediatamente eventuali sistemi compromessi all’interno del network in esame e di passare da subito alle fasi di “remediation“.

Al contrario, un posizionamento del sensore dopo il NAT, costringerà gli specialisti ad eseguire analisi approfondite sull’intera sottorete prima di poter identificare con certezza gli host coivolti dall’infezione prima di passare alle successive fasi di contenimento e bonifica.

Una immagine rappresentativa è quella mostrata nella Figura 4:

Figura 4

Parlando in via generale, è bene ricordare che il posizionamento delle sonde nella fase progettuale di tale tipologia di sistemi risulta di estrema importanza. Da questi dipende l’intera capacità ed efficacia dell’infrastruttura di monitoraggio posta in essere

Tale concetto, inoltre, si applica all’interno panorama delle tecnologie per la raccolta di dati e metadati del traffico in transito, siano esse FPC / DPI e/o NetFlow.

Conclusioni

Come visto, l’analisi e le informazioni provenienti da apparati in grado di supportare protocolli e standard per la raccolta del traffico in transito svolgono un ruolo cruciale nelle attività di risposta agli incidenti. Le aziende e le organizzazioni che vogliano implementare un buon ambiente di controllo in grado di supportare efficacemente un processo di indagine interna in risposta ad eventi di sicurezza, dovrebbero necessariamente pensare a tecnologie in grado di fornire sia una visione ad alto livello dell’intera infrastruttura, sia una visione nel dettaglio per quanto di interesse.

Poichè, come analizzato, le soluzioni progettate per la raccolta totale del traffico di rete non si rivelano totalmente appropriate nel lungo periodo in considerazione dei requisiti di calcolo e di conservazione dei dati, il protocollo NetFlow potrebbe essere utilizzato come risorsa utile al rilevamento di eventuali anomalie non previste.

Tecnologie di tipo FPC/DPI di contro, fornendo una visione maggiormente dettagliata di quanto accaduto, potrebbero essere utilizzate, su richiesta, a supporto di analisi specifiche che vadano a considerare un limitato numero di settori, servizi o sottoreti.

In una situazione ottimale, un’organizzazione o un’azienda dovrebbe infatti essere in grado di supportare un team di risposta agli incidenti includendo la capacità potenziale di effettuare una raccolta FPC/DPI (almeno per le aree critiche per il business) all’interno del proprio piano di risposta agli incidenti.

Oltre quanto affermato, una buona progettualità nelle architetture di rete e nel posizionamento di sistemi e tecnologie dedite alla raccolta ed all’analisi del traffico, rimane essenziale per una accurata ricostruzione dei fatti.

Bibliografia

  • Network Security with Netflow and IPFIX: Big Data Analytics for Information Security by Omar Santos – Ciscopress
  • CCNA Cyber Ops SECOPS 210-255 Official Cert Guide by Omar Santos – Ciscopress
  • The Tao of Network Security Monitoring: Beyond Intrusion Detection by Richard Bejtlich – Tenable Network Security
  • Security Monitoring: Proven methods for Incident Detection on Enterprise Networks by Chris Fry, Martin Nystrom – 0’Reilly
  • Crafting the InfoSec Playbook: Security Monitoring and Incident Response Master Plan by Jeff Bollinger – O’Reilly


Articolo a cura di Emanuele De Lucia

L’articolo Traffico di rete nella risposta agli incidenti: Implementazioni e Tecnologie proviene da ICT Security Magazine.

https://www.ictsecuritymagazine.com/articoli/traffico-di-rete-nella-risposta-agli-incidenti-implementazioni-e-tecnologie/