Attacco a reti Air Gap, tra mito e realtà

La protezione di ambienti classificati da attacchi non convenzionali

Air Gap, termine che in italiano significa “vuoto d’aria”, “intercapedine”, è una parola spesso utilizzata in ambito edile per definire un spazio divisorio tra due o più ambienti, uno spazio spesso utilizzato come isolante termico, tra due stanze.

In sicurezza informatica con il termine “Air Gap” si intende una misura di sicurezza che isola fisicamente un’infrastruttura critica (computer, reti private con dati altamente sensibili) da qualsiasi altro collegamento con il mondo esterno, come ad esempio Internet.

Quando si adottano misure di sicurezza di questo tipo, normalmente il livello di riservatezza delle informazioni gestite (all’interno del sistema ICT) è altamente confidenziale e classificato. Nella mia esperienza professionale, l’applicazione di una misura “Air Gap” ad una infrastruttura ICT ha il suo vantaggio nella sicurezza informatica dei governi ed in settori critici quali ad es. reti militari classificate o centrali nucleari, ma soffre anche di svantaggi significativi, come ad esempio: costi di implementazione, manutenzione, limitazione nella produttività e paradossalmente il degrado di alcuni aspetti chiave della sicurezza (ad es. l’aggiornamento tempestivo dei sistemi).

Un “Air Gap” crea barriere, molti servizi e sistemi governativi che hanno lo scopo di interagire direttamente con i cittadini rischiano di essere rallentati e resi più macchinosi dai protocolli di separazione. I vantaggi delle città intelligenti (Smart Cities) e delle nazioni intelligenti rischiano di essere significativamente ridotti se non possono sfruttare tecnologie come il cloud e le Internet of Things. L’isolamento fisico da qualsiasi tipo di contatto umano o tecnologico diminuisce drasticamente le probabilità che i dati protetti possano essere “portati fuori” accidentalmente o trafugati, perché gli attacchi informatici non possono attraversare il “vuoto d’aria” per raggiungere il loro obiettivo. Eppure esiste sempre una remota possibilità che questo accada, un ambiente difficilmente può essere isolato completamente dal mondo esterno, esistono forze elettriche, magnetiche, termiche, acustiche e la natura “fallibile” dell’essere umano che possono creare canali di comunicazione segreta in grado di superare queste barriere fisiche.

Attacchi a sistemi di protezione “Air Gap” sono studiati da anni e nel corso del tempo sono state realizzate varie soluzioni di attacco che sfruttano spesso ambiti e approcci completamente diversi, di seguito vi illustrerò alcune delle tecniche più note anche in considerazione delle loro caratteristiche e limitazioni.

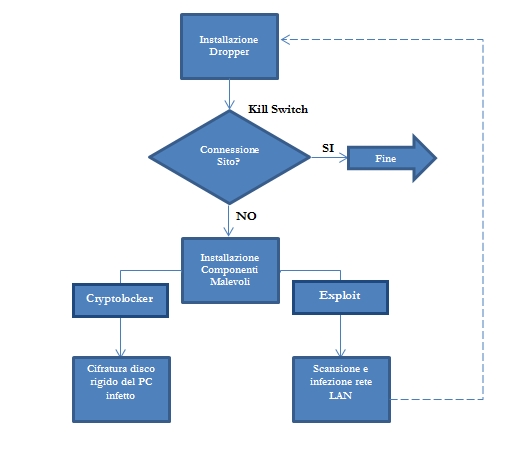
La rilevanza di queste minacce è sempre proporzionale all’interesse dei dati, poi l’evoluzione tecnologica unita alla “creatività” dell’uomo permettono di sviluppare tecniche di attacco più o meno sofisticate e non convenzionali. L’attacco in ogni caso prevede normalmente sempre tre fasi (Fig.1):

Fig.1

Tralasciando per il momento la fase di “infiltration” che vi illustrerò nel mio prossimo articolo, per entrare maggiormente nel “mood” dell’argomento, una tecnica di attacco che è possibile provare anche a casa senza particolari requisiti è quella basata sulle frequenze ad ultrasuoni. Questo attacco prevede la possibilità di creare un canale di comunicazione segreto attraverso la trasmissione con frequenze a ultrasuoni.

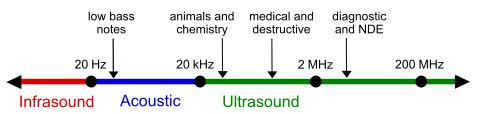
Gli ultrasuoni sono onde sonore con frequenza superiore a 20.000 hz. Il limite superiore di frequenza nell’uomo (circa 20 kHz) è dovuto alle limitazioni dell’orecchio medio (Fig.2). Le onde sono troppo piccole e veloci perché l’orecchio interno trasmetta le vibrazioni. Se il suono è troppo basso o troppo alto, le nostre orecchie non sono in grado di percepirlo.

Fig.2

In queste tipologie di attacco mediamente la distanza max di comunicazione può arrivare mediamente a 4/5 metri che può sembrare poca ma in certi ambiti può essere più che sufficiente.

Un volta attivato, il malware all’interno del computer target, invierà all’attaccante le informazioni richieste attraverso una trasmissione ad ultrasuoni generata con le casse audio ed il microfono del computer target, e se pensiamo a pc portatili e notebook parliamo del 99% di essi.

A scopo didattico un buon esempio pratico per comprendere il “proof of concept” di funzionamento di un canale di comunicazione ad ultrasuoni è il progetto QuietNet (https://github.com/Katee/quietnet), un semplice programma di chat che utilizza frequenze vicine agli ultrasuoni (19100 Hz) per comunicare.

Una volta scaricato da github il file zip contenente il progetto e decompressi i file in una cartella, si troveranno due principali script in python:

  •  send.py
  • listen.py

Il file send.py trasmette il testo digitato mentre il file listen.py riceve il testo. Nella mia prova ho utilizzato due pc portatili ed ho eseguito su uno send.py (trasmettitore) e sull’altro il file listen.py (ricevente).

Usando sistemi Microsoft Windows ho installato su entrambi i pc il linguaggio di programmazione python ver. 2.7.x e successivamente ho installato due librerie (pyaudio e numpy) necessarie al funzionamento di QuietNet attraverso i seguenti comandi:  

python -m pip install pyaudio python -m pip install numpy 

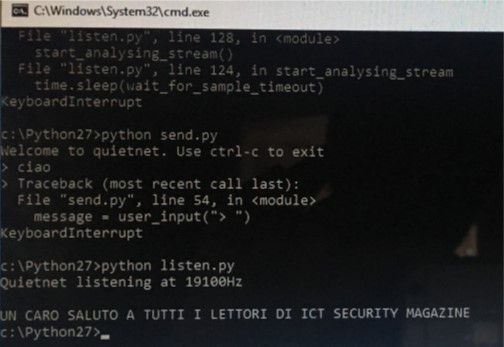
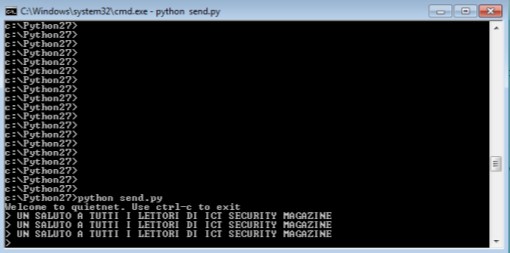
A questo punto ho avviato il file listen.py (Ricevitore Fig.3) sul primo pc e send.py sul secondo pc (Trasmettitore Fig.4).

Dal secondo pc (trasmettitore) ho scritto una frase e con invio ho iniziato la trasmissione (Fig.4).

Sul primo PC (ricevente) dopo alcuni secondi di ritardo è apparso il testo. Prima di riuscire a trasmettere correttamente il testo ho dovuto però effettuare diverse prove, modificare il volume del trasmettitore sotto il 50% e posizionare i due pc ad una distanza di 70 cm tra loro, questo pur essendo un semplice esempio la dice lunga sulla difficoltà nel mettere a punto un attacco che sfrutta questa tecnologia.

Fig.3


Fig.4

AirHopper è un attacco che sfrutta i campi elettromagnetici, si basa sul principio che la corrente elettrica in un conduttore produce un campo elettromagnetico, il campo elettromagnetico dipende quindi dal passaggio di corrente che attraversa il conduttore. Se si controlla la corrente nel conduttore, si controlla l’emissione elettromagnetica (frequenza ed ampiezza). I cavi dello schermo emanano radiazioni elettromagnetiche, dipende dall’immagine trasmessa nel cavo. E’ possibile controllare la radiazione elettromagnetica trasmettendo immagini appositamente predisposte regolando la radiazione elettromagnetica su una frequenza ricevibile da una radio FM (88 Mhz-108 MHz), Il malware utilizza il display video come trasmettitore FM per trasmettere i dati ed il cavo dello schermo come un’antenna.

Maggiori dettagli potete trovarli in questo articolo: https://ieeexplore.ieee.org/document/6999418 mentre ecco un video dimostrativo:

Se AirHopper vi ha stupito, il metodo ODINI lo farà di più. Si basa sullo sfruttamento dei campi magnetici a bassa frequenza generati dalla CPU del computer, la radiazione magnetica a bassa frequenza emessa si propaga attraverso l’aria, riuscendo a penetrare anche schermature metalliche come la gabbia di Faraday. Anche in questo caso il malware installato controlla la frequenza della CPU facendogli eseguire specifici calcoli che convertono i dati da trasmettere in onde magnetiche. L’attaccante dal di fuori con un ricevitore di onde magnetiche riconvertirà le radiazioni in dati.

Per maggiori dettagli potete consultare la seguente documentazione: https://arxiv.org/abs/1802.02700 mentre di seguito un video dimostrativo:

Concludo questo breve viaggio tra le connessioni segrete non convenzionali dette “Air Gap Jumpers” riportandovi due metodologie di attacco che sfruttano le tecnologie ottiche. La prima, LED-it-GO, utilizza i led presenti sui computer e periferiche (hard disk, power, etc…), controllabili via software/firmware, dove il malware codifica i dati tramite “lampeggi” che possono essere intercettati e decodificati da telecamere locali o remote, magari aiutandosi con un drone… tutto vero anche se difficilmente applicabile, come in questo video:

per maggiori info potete consultare:  https://www.springerprofessional.de/led-it-go-leaking-a-lot-of-data-from-air-gapped-computers-via-th/12476142

Sempre basandosi sui led ma questa volta ad infrarossi, aIR-Jumper sfrutta le telecamere di sorveglianza per ricevere o trasmettere dati. Controllando le luci led ad infrarossi (luce invisibile all’occhio umano), normalmente utilizzate dalle telecamere per illuminare gli ambienti bui trasmettono con impulsi lampeggianti informazioni all’attaccante oppure le ricevono analizzando le immagini delle telecamere come lo dimostrano i seguenti video:

per maggiori approfondimenti:  http://arxiv.org/abs/1709.05742

CONSIDERAZIONI FINALI

Le limitazioni di molte delle metodologie descritte restringono il campo di applicazione ad attacchi mirati alla raccolta di piccole quantità di dati (credenziali di accesso, codici, etc…) ma non per questo meno importanti, anzi.

So già che starete pensando al fatto che in ogni caso un sistema protetto da una misura di sicurezza “Air Gap” deve comunque essere prima infettato per poter permettere al malware di utilizzare una o più delle metodologie sopra illustrate, ma come preannunciato questo sarà oggetto del mio prossimo articolo.

Articolo a cura di: Francesco Arruzzoli

L’articolo Attacco a reti Air Gap, tra mito e realtà proviene da ICT Security Magazine.

https://www.ictsecuritymagazine.com/articoli/attacco-a-reti-air-gap-tra-mito-e-realta/


Nuova edizione della ISO/IEC 27005 “Information security risk management”

A luglio 2018 è stata pubblicata una nuova edizione (la terza) della ISO/IEC 27005 dal titolo “Information security risk management”. Si tratta dello standard internazionale di riferimento per la valutazione del rischio relativo alla sicurezza delle informazioni.

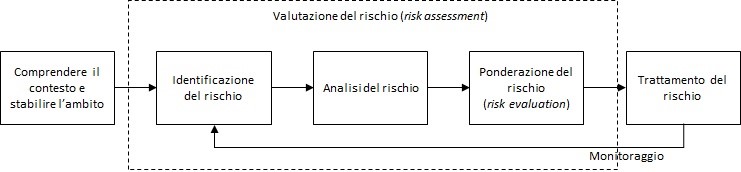
Lo schema della ISO/IEC 27005 è molto noto e si trova sul web impostando la ricerca delle immagini con la parola “ISO/IEC 27005”. Rappresentato in modo leggermente diverso, lo schema è il seguente:

Le modifiche apportate non sono particolarmente significative. Se ne tratta dopo aver presentato la norma stessa e i suoi limiti.

È opportuno ricordare che la ISO/IEC 27005 è una linea guida e non può quindi essere un criterio per valutare e certificare una “metodologia di valutazione del rischio”, anche se alcuni, impropriamente, lo hanno fatto.

La ISO/IEC 27005, trattando di valutazione del rischio relativo alla sicurezza delle informazioni, è applicabile anche alla valutazione del rischio relativo ai dati personali.

Il contenuto della ISO/IEC 27005

Seguendo lo schema, il contenuto della ISO/IEC 27005 è suddiviso in 6 capitoli (quelli dal 7 al 12):

  • stabilire il contesto;
  • valutare il rischio (a sua volta suddiviso nelle tre sezioni relative all’identificazione, analisi e ponderazione del rischio);
  • trattare il rischio;
  • accettare il rischio;
  • comunicare il rischio e consultare le parti interessate;
  • monitorare e riesaminare il rischio.

Molto interessanti sono le appendici. Infatti queste approfondiscono ulteriormente alcuni aspetti della gestione del rischio. Particolarmente utili sono: quella che riporta un esempio di lista di minacce e quella che riporta alcuni esempi per analizzare (ossia per calcolare) il rischio.

I limiti della ISO/IEC 27005

La prima edizione della ISO/IEC 27005 era del 2008. La seconda edizione era del 2011 e si rese necessaria per allinearla alla ISO 31000 dal titolo “Risk management — Principles and guidelines” (all’epoca era disponibile l’edizione del 2009; oggi è vigente la seconda edizione del 2018).

Nel 2013, come noto, fu pubblicata una nuova edizione della ISO/IEC 27001, basata sull’HLS (High level structure) e per questo molto diversa dalla precedente.

L’edizione del 2011 della ISO/IEC 27005 non era quindi più allineata alla nuova edizione della ISO/IEC 27001 e questo la rendeva formalmente scorretta.

La ISO/IEC 27005 promuove un approccio alla valutazione del rischio ritenuto troppo rigido e non sempre consigliabile. Questo approccio è detto “basato sull’identificazione di asset, minacce e vulnerabilità” e in effetti è peculiare della sicurezza delle informazioni ed ha origine, almeno, dalla fine degli anni Ottanta (alcuni metodi basati su questo approccio sono elencati nel documento “Description of automated risk management packages that NIST/NCSC Risk Management Research Laboratory have examined” del 1991), quando la sicurezza delle informazioni era decisamente diversa da quella attuale.

Il gruppo di esperti, a inizio 2014, appena dopo la pubblicazione della nuova ISO/IEC 27001, ha quindi iniziato a discutere di come modificare la ISO/IEC 27005, ma si sono scontrate due scuole di pensiero: una che ritiene ancora valido l’approccio basato sull’identificazione di asset, minacce e vulnerabilità (e infatti ancora oggi si vedono valutazioni del rischio che partono da un “inventario degli asset”), un’altra che promuove altri approcci, denominati “basati sugli eventi” (se ne trova traccia nella ISO/IEC 27003:2017).

Ad onor del vero, già l’ISO/IEC 27005 del 2008 suggeriva di accorpare gli asset, ma promuoveva comunque il miglioramento basato sul raffinamento dell’identificazione degli asset. Dall’altra parte, l’approccio “basato sugli eventi” non può non considerare gli asset che possono essere impattati dagli eventi stessi.

Come spesso succede, però, le due scuole di pensiero non hanno trovato in tempi ragionevoli il modo per comporre i propri punti di vista in uno standard comune, sebbene da un punto di vista formale la ISO/IEC 27005:2011 fosse scorretta e richiedesse una correzione. Per le regole dell’ISO, superato un certo tempo non è più possibile pubblicare “correzioni” alle norme (come è stato fatto recentemente, per esempio, per la ISO/IEC 27001 e la ISO/IEC 29100) ma è necessario pubblicarne una nuova edizione.

Le modifiche apportate alla ISO/IEC 27005

Per il normale lettore della norma, le modifiche sono quasi invisibili. Per questo non è necessario specificarle nel dettaglio.

La prefazione della norma stessa fornisce l’elenco delle modifiche più significative:

  • tolti tutti i riferimenti ai paragrafi della ISO/IEC 27001;
  • specificato più chiaramente che la ISO/IEC 27005 non è una guida per l’attuazione dei requisiti relativi alla valutazione del rischio specificati dalla ISO/IEC 27001 (la questione è posta ambiguamente, ma ha l’obiettivo di ricordare che possono essere adottati metodi di valutazione del rischio coerenti con i requisiti della ISO/IEC 27001 e non con quelli della ISO/IEC 27005);
  • la ISO/IEC 27001 non è più un riferimento normativo per la ISO/IEC 27005 (ma è comunque nella bibliografia).

L’introduzione ribadisce che la ISO/IEC 27005 si concentra su un approccio basato su asset, minacce e vulnerabilità e che altri approcci possono essere considerati.

Conclusioni

In questi anni ho avuto modo di vedere molti metodi di valutazione del rischio che richiedono un elevato dispendio di risorse per censire e valutare asset, minacce e vulnerabilità, purtroppo compensati da una scarsa significatività dei risultati (questo è facilmente dimostrato quando si vedono attivi progetti per “migliorare” la sicurezza delle informazioni senza però essere associati a rischi “inaccettabili” evidenziati dalla valutazione del rischio). L’approccio basato su asset, minacce e vulnerabilità può essere di difficile applicazione per le piccole o medie imprese.

Negli anni ho mantenuto aggiornato un metodo misto basato su un foglio di calcolo, denominato VERA (Very easy risk assessment). Esso è arrivato alla versione 4.0 nel 2018.

Altri, negli anni, hanno adottato metodi più simili a quello “basato sugli eventi”, adattando, per esempio, metodi di calcolo mutuati dalla FMECA o applicando i semplici principi promossi con la sigla STRIDE.

Per questo la ISO/IEC 27005 può essere considerata come obsoleta ed è un peccato che gli esperti non siano riusciti a trovare un accordo per una nuova versione, più adatta ai tempi.


Articolo a cura di Cesare Gallotti

L’articolo Nuova edizione della ISO/IEC 27005 “Information security risk management” proviene da ICT Security Magazine.

https://www.ictsecuritymagazine.com/articoli/nuova-edizione-della-iso-iec-27005-information-security-risk-management/


Sicurezza nell’era dei container

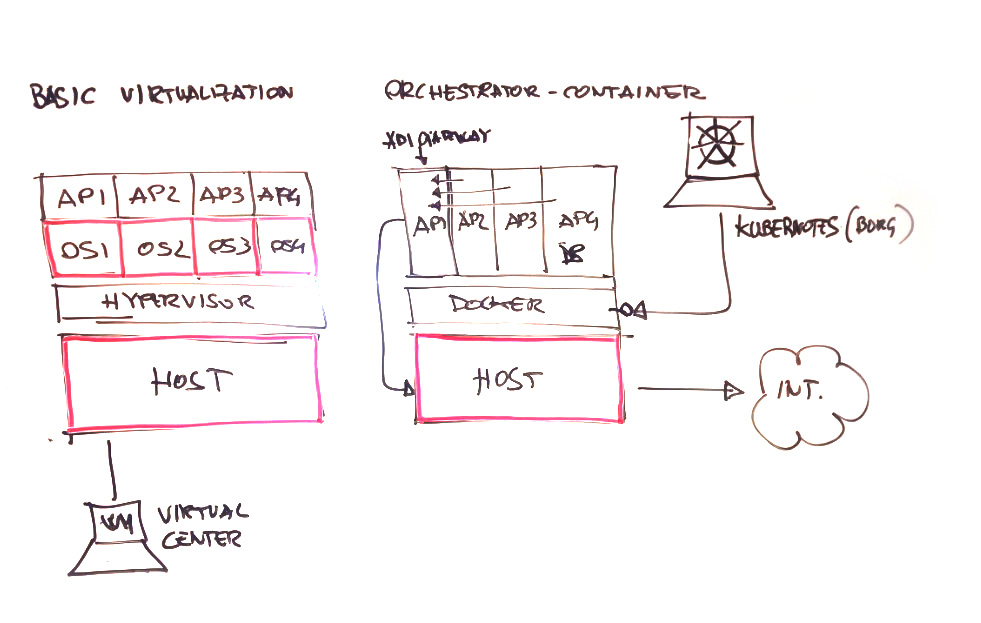
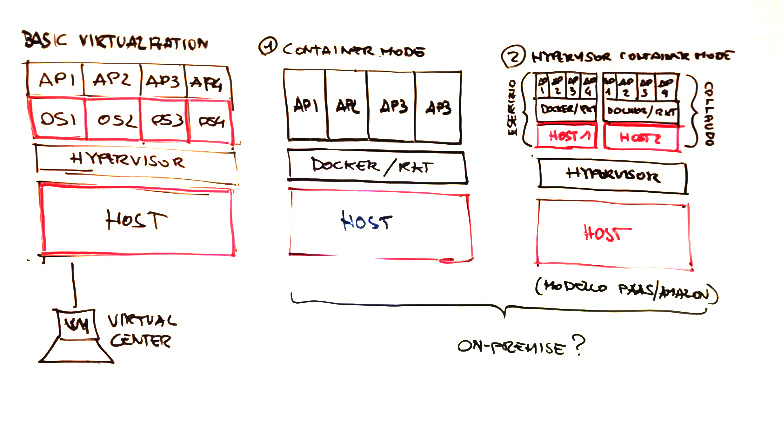
La sicurezza nell’era della Digital Trasformation e devOps subisce forti cambiamenti e “potenziali” semplificazioni evolvendo la logica di basic-virtualization verso una stagione di virtualizzazione applicativa basata sul modello a container. Ma come sempre, dietro all’evoluzione tecnologica si nascondono nuove minacce che cercheremo in questo articolo di “intravedere”.

L’utilizzo di strumenti quali Docker, Rkt, *, che non sono altro che una semplificazione ed evoluzione del concetto di LXC già integrato in ambiente linux (primitive cgroup, scritte dagli ingegneri Google nel 2006 e rilasciati dal kernel 2.6.24 unite ai Namespace che implementano i concetti di isolamento e a chroot) garantiscono un aumento dell’isolamento delle componenti applicative riducendo in maniera drastica la presenza di Hypervisor e – teoricamente – anche della superfice di esposizione al rischio delle piattaforme.

Al netto delle problematiche di questa nuova tecnologia che risulta ad oggi ancora in evoluzione in termini di flessibilità e dvOps su architetture enterprise (soprattutto in ambito di operation), analizziamo i vantaggi promessi dalla filosofia a “container”:

  • Minori risorse occupate rispetto alla Basic-Virtualization
  • Disaccoppiamento applicativo, versioning e portabilità.
  • Vantaggi in operation (ad es. orchestration, riavvio, spegnimento, provisioning, cloning, routing, *)
  • Completamento dell’implementazione del concetto di PaaS.

Ma esistono anche dei vantaggi tangibili in termini di sicurezza?

Dipende dalle scelte architetturali e applicative che verranno fatte, dalla corretta gestione dello sviluppo sicuro, dalla scelta del cloud da utilizzare e degli hypervisor di mediation, ma senza addentrarci troppo analizziamo la logica “basic” dell’approccio a container. Essendo ogni container tecnicamente isolato, non avendo accesso ai processi degli altri container e al sistema Host che li gestisce, cominciamo ad intravedere dei benefici in termini di sicurezza:

  1. Patching & Hardening: in assenza di hypervisor, sicuramente si riduce il numero di Host e Guest da gestire. In una logica on-premise a container ridurremo di molto il numero di macchine virtuali e probabilmente riusciremo ad implementare finalmente una corretta gestione degli interventi di patching riducendo i volumi ma aumentando la qualità percepita. Ovviamente al netto dei benefici in termini di sicurezza, dovrà risultare tangibile la riduzione dei costi sull’hardware, licenze, energia e opex in generale.
  2. Sviluppo sicuro del Codice: essendo i container isolati a livello applicativo vulnerabilità quali XSS, Injection, Path Traversal, * saranno pressoché difficili da ottenere per aver accesso alla macchina Host. Ad esempio i famosi path Traversal per l’accesso in lettura del password o dello shadow dei server saranno degli exploit forse da ricordare?
  3. Database: i database noSQL in logica a micro-servizio (qualora dalle analisi applicative possibile) devono essere utilizzati e possono essere un ottimo spunto per migliorare la sicurezza in quanto i container avranno al loro interno sia la componente applicativa (ad esempio apache-tomcat) che la componente dati (ad esempio mongo db, Redis, Cassandra, *) per la sola quota parte in gestione del micro-servizio stesso. In questa ottica il micro-servizio accederà solo ai dati presenti nel DB noSQL all’interno del proprio container pertanto eventuali violazioni di accesso non potranno violare l’intera base dati utilizzata e condivisa da tutti gli altri container.

E ovviamente, quando ci sono dei benefici devono essere previsti dei livelli di attenzione su specifici temi, di seguito alcuni esempi:

  1. Kernel exploit & Kernel Panic: Attenzione agli attacchi su base Kernel. Circa il 45% delle vulnerabilità sul kernel Linux sono di DOS. Violando da un container il kernel (o anche violando le primitive di isolamento LXC), visto che tale kernel risulta condiviso tra tutti i container presenti nell’host, tale azione comprometterà tutti i container e l’host stesso utilizzato dal container engine. Pertanto maggiori sono le applicazioni presenti sull’host, maggiori sono i rischi in termini di negazione del servizio. Attivare un controllo del level patching del kernel avendolo sempre aggiornato è una cosa da implementare nei processi di patching management anche perché, su molti Unix/Like, le patch cadenzate non sempre comprendono le patch del Kernel del sistema ma potrebbero essere patch separate.
  2. Sicurezza dei contenitori: Attenzione a dove si scaricano, producono, archiviano e versionano i container. Sono già presenti su DockerHub molti container archiviati dagli utenti ma di fatto fallati, contenenti una pila software con vulnerabilità note e malware generico. Il Patching management dei Middlware presenti nei container dovrà essere gestita con cadenza e non cambia rispetto alla basic-virtualization, se un container contiene uno stack “fallato”, tali vulnerabilità potranno essere utilizzate per violare il sistema.
  3. Patching del Container Engine: sicuramente questo potrebbe essere un reale problema. Essendo l’engine un middleware del sistema Host, effettuando il patching di questa componente potrebbero esserci problematiche di blocco applicativo che dovranno essere gestite mentre tali exploit potranno essere utilizzati per violazioni delle applicazioni stesse per passare a livello Host. Oggi questi prodotti sono acerbi e poco conosciuti, cominciando ad essere più popolari l’incremento dei CVE/exploit sarà maggiore e quindi dovrà essere valutato il patching a caldo dei container engine per evitare disservizi applicativi oppure prevedere hypervisor di mediation per consentire lo switch dell’applicativo da una VM ad un’altra per evitare il fermo applicativo.
  4. Resource Locking: i contenitori condividono risorse, qualora l’accesso a tale risorse viene compromesso con un qualche exploit (ad esempio l’impostazione di un file System in Read-Only-Mode oppure CPU Reservation, ecc…) tutti gli altri container non potranno più svolgere il loro lavoro compromettendo l’intera applicazione.
  5. Compromissione delle password: Come sempre, le chiavi di accesso alle risorse condivise (ad esempio alla base dati) e l’host stesso devono essere sicure, cifrate e mai in chiaro. Questo aspetto ricade nella logica dello sviluppo sicuro del software già discussa nel precedente articolo. Ad esempio utilizzando Database SQL ovviamente condivisi da più container, una stringa di connessione in chiaro e un Database mal configurato comprometterà tutti i dati presenti nel db stesso, ma questa è storia già conosciuta nelle applicazioni monolitiche.

…e come spesso accade, partendo da una semplice architettura potremmo complicarci le cose per implementare un più complesso modello PaaS e quindi combinare hypervisor e Container engine o addirittura utilizzare OpenStack per massimizzarne i benefici, ma direi di aspettare e non pensarci ancora e di farci prima le ossa su quello che adesso risulta disponibile, perché un conto è lo stack di sviluppo (facile e flessibile e massivamente utilizzato oggi) e un conto è montarci una applicazione enterprise che concentra il business-core della nostra azienda.

Quindi Docker, RkT e container-engine sì ma con la giusta attenzione. Facciamoci le ossa in laboratorio, esploriamo il comportamento applicativo di questi nuovi prodotti e cominciamo a svilupparci sopra piccole applicazioni per poi “bucarle” e comprendere se queste nuove tecnologie in termini di sicurezza realizzano i benefici attesi e solo dopo portare queste nuove tecnologie negli ambienti di produzione prima su piccoli sistemi e dopo su sistemi enterprise.

L’informatica è fatta di stagioni, siamo passati dalla Platform-1 alla 3 passando dall’era del client-server e oggi ai container, ma quando penso ai container non so perché rivedo in piccolo il concetto più allargato di isolamento delle subaree in architettura mainframe e il tutto risulta coerente con quanto diceva un mio vecchio responsabile che l’ingegneria del software e l’informatica in generale è fatta da un input, un programma e un output.


Articolo a cura di Massimiliano Brolli

L’articolo Sicurezza nell’era dei container proviene da ICT Security Magazine.

https://www.ictsecuritymagazine.com/articoli/sicurezza-nellera-dei-container/


Sicurezza dei Sistemi (id)IoT

Il fenomeno della domotica “fai da te” ultimamente sta prendendo sempre più piede. Ormai è alquanto facile trovare elettrodomestici o piccoli dispositivi di uso comune che permettono la connessione alla rete interna della propria abitazione in modo da poter svolgere alcuni compiti “da remoto”.

Siamo partiti dalle Smart TV e dalle Smart Cam. Passando per le Smart Plug e le Smart Light, siamo giunti agli Smart Fridge, agli Smart Cooling, alle Smart Washing Machine.

Tutto questo “smart” e tutti questi inglesismi stando rendendo l’automazione, la domotica, uno status simbol del quale vantarsi.

Il solito reiterato errore che si fa al momento dell’acquisto di un qualsiasi dispositivo sta nel concentrarsi unicamente sul tipo di esperienza che questo è in grado di fornirci, o basare la nostra scelta in base al marchio di produzione perché lo prediligiamo ostinatamente rispetto alla concorrenza.

Si tende quindi a tralasciare del tutto la valutazione della qualità del supporto/assistenza che è in grado di fornire il produttore.

Ultimo ulteriore sbaglio che si compie con i dispositivi IoT è che una volta installati spesso ci si dimentica della loro esistenza (vedasi le smart cam di sorveglianza).

Il problema quindi sta sempre nel sottovalutare i problemi di sicurezza che possono scaturire a causa di un erroneo acquisto, installazione e configurazione di un dispositivo di rete IoT.

INTERESSE ALL’ATTACCO

Analizziamo le criticità dal punto di vista software: è estremamente raro che un utente medio si preoccupi di aggiornare periodicamente il software/firmware dei sistemi IoT installati nella propria abitazione.

È altresì vero che spesso i dispositivi messi in commercio con una data versione di firmware, vengano poi velocemente abbandonati dal produttore senza ricevere mai alcun aggiornamento di sicurezza.

C’è da sottolineare anche che per dispositivi poco conosciuti, è realisticamente raro che un utente malintenzionato perda tempo nello sviluppo di exploit in grado di colpire una manciata di vittime.

Naturalmente quanto detto non garantisce una protezione de facto: tali dispositivi garantiscono un’esposizione ad agenti malevoli pressoché totale, lasciando l’utenza esposta ad eventuali attacchi mirati.

Di contro, munirsi di dispositivi largamente utilizzati espone l’utenza ad altri pericoli e pensare che l’installazione delle patch di sicurezza garantisca una copertura totale da agenti malevoli è quantomeno ingenuo.

Basti considerare dispositivi perfettamente aggiornati, ma con errate impostazioni di configurazione/manutenzione. I danni risultanti da un eventuale attacco potrebbero essere catastrofici su scala mondiale.

LE NON VULNERABILITÀ

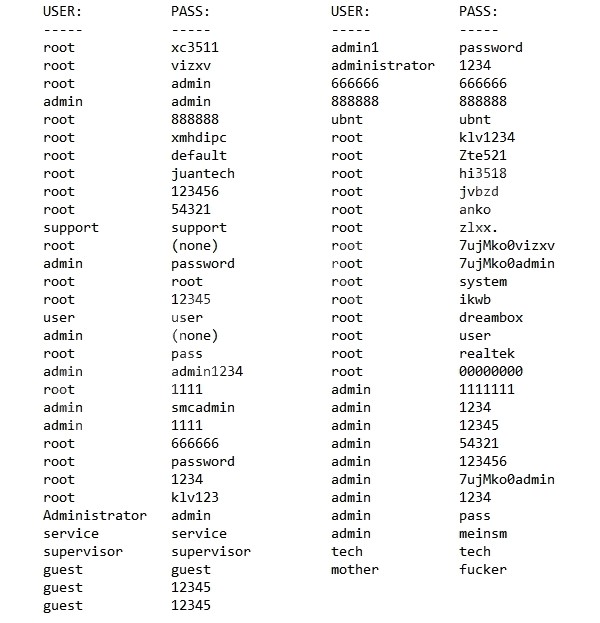
Quando si parla di IoT, la più grande ingenuità si compie nel momento in cui si mantiene la password di default del dispositivo. L’esempio lampante della gravità di tale azione è quanto avvenuto con la famosissima la BotNet Mirai.

Per compromettere i dispositivi IoT, la versione iniziale di Mirai faceva affidamento esclusivamente su un set fisso di 64 combinazioni predefinite di login/password note, comunemente utilizzate dai produttori di dispositivi IoT.

Come si può facilmente intendere, questo attacco molto poco tecnologico, si è rivelato estremamente efficace e ha portato alla compromissione di oltre 600.000 dispositivi in poco tempo.

Col tempo le tecniche di iniezione del codice Mirai si sono evolute. Una delle più ingegnose sfrutta una falla nella gestione dei protocolli di gestione remota TR-064 (obsoleto) e TR-069, serviti entrambi erroneamente tramite la porta 7547, aperta di default.

L’attacco prevede iniezione di codice arbitrario verso il protocollo TR-064 senza alcuna autenticazione, poiché in origine non era stato pensato per funzionare nella WAN. L’esecuzione di codice arbitrario ha portato a vari scenari, tra i quali:

  • invio di specifici comandi che portano il dispositivo ad aprire la porta 80 per l’accesso alla console web di amministrazione. L’utenza e la password per l’accesso sono ottenute sempre tramite specifici comandi TR-064;
  • nel caso il precedente metodo non andasse a buon fine, vi è il modo di forzare tramite crash di sistema il reset del dispositivo alle impostazioni di fabbrica, in modo da vedersi reimpostata l’utenza/password di default nota;

A questo punto diventa facile per l’hacker impadronirsi del dispositivo attaccato.

Un altro possibile Point of Failure che riguarda i dispositivi IoT diffusi su larga scala consiste nel rischio derivante dagli aggiornamenti automatici: il patching automatico può portare ad eventi molto rari, ma estremamente catastrofici.

Quando gli hacker compromettono il sito di un fornitore, hanno la possibilità di distribuire patch di sicurezza virate generate ad-hoc. È il caso di notPetya, l’evento più catastrofico mai visto su Internet, lanciato sovvertendo una patch automatizzata di software di contabilità.

Analizzando però più attentamente i fatti, Mirai non è conseguenza di bug accidentali, ma di errate decisioni prese consapevolmente. Stessa cosa vale per NotPetya: dopo la sua iniziale manifestazione, si è propagato sfruttando una vulnerabilità derivata da un’inopportuna configurazione della rete di Windows.

In altre parole, né Mirai, né NotPetya in realtà hanno sfruttato vulnerabilità imputabili ai dispositivi commercializzati, ma configurazioni errate definite dall’utente utilizzatore.

VITTIME PREFERITE

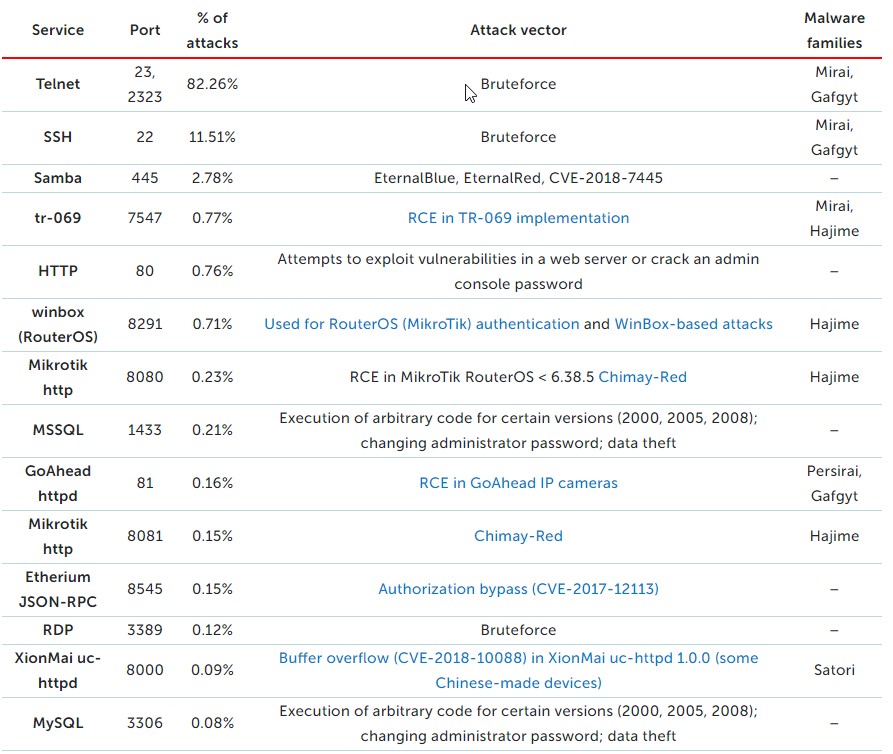
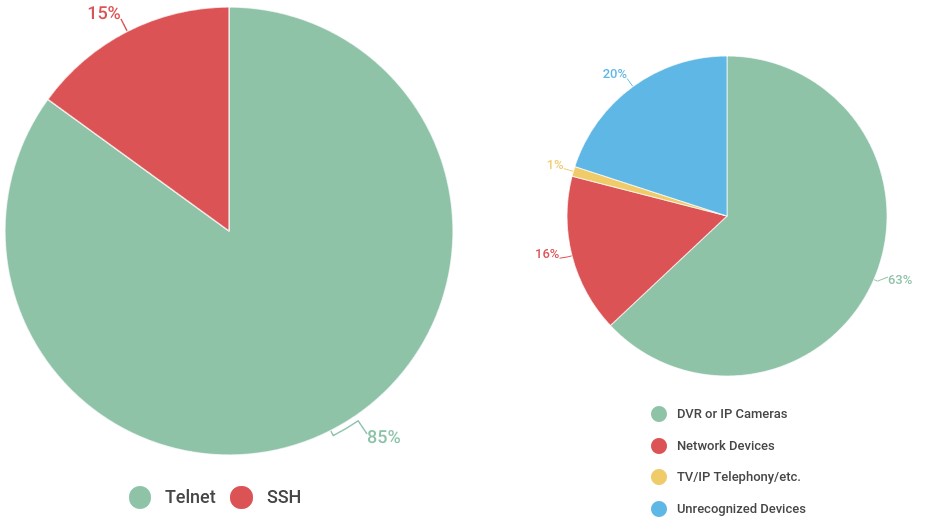
Secondo il report del primo quadrimestre 2018 di Kaspersky, i dispositivi più spesso violati rimangono i router. La restante parte di gadget IoT compromessi include una varietà di tecnologie diverse, come i dispositivi DVR, stampanti ed addirittura le lavatrici.

Le statistiche mostrano che il metodo più popolare di propagazione del malware dell’IoT è ancora l’attacco a Forzatura Bruta delle password, utilizzata nel 93% degli attacchi rilevati. Nella maggior parte dei casi rimanenti, l’accesso a un dispositivo IoT è stato acquisito utilizzando exploit ben noti.

Il compito di questi ultimi viene poi ulteriormente agevolato dal fatto che una significativa parte dei dispositivi “intelligenti” comunica con l’esterno tramite le porte Telnet e/o SSH.

COSA FARE?

Sembrerebbe quindi non esservi una soluzione semplice al problema, ma esaminando più attentamente i fatti ci si rendere conto che delle contromisure sono sempre attuabili.

Di seguito alcune buone pratiche da intraprendere per limitare l’esposizione agli attacchi.

Dovrebbe essere prassi l’acquisto di dispositivi provenienti da produttori che garantiscano un buon periodo di longevità del supporto, in modo da assicurare la costante correzione dei bug che possono verificarsi nel tempo.

Le patch di sicurezza dovrebbero essere preferibilmente installate in maniera manuale, per evitare quanto detto nei paragrafi precedenti, previa verifica sul sito del produttore della bontà del software rilasciato.

Le password pre-configurate vanno immediatamente sostituite appena si installa un nuovo dispositivo. L’utilizzo di password complicate che includano lettere maiuscole, minuscole, numeri e simboli è preferibile.

  • Se il dispositivo è provvisto di una password standard che non può essere modificata, oppure di un account predefinito che non può essere disattivato, disabilitate i servizi di rete in cui vengono utilizzati tali elementi, oppure impedite l’accesso alla rete dall’esterno relativamente ai servizi in causa.
  • I dispositivi non sicuri, inoltre, finiscono su Shodan, un motore di ricerca che aiuta i malintenzionati a cercare gli oggetti dell’Internet of Things senza password.

A meno che non si riveli necessario per l’utilizzo stesso del dispositivo, è consigliabile inibire l’accesso a quest’ultimo da reti esterne (WAN);

Infine, disattivare tutti i servizi di rete non necessari per l’utilizzazione del dispositivo, con particolare attenzione alle porte Telnet, SSH, SAMBA, TR-069, ove non necessario, permette un isolamento migliore della propria rete.

Articolo a cura di Daniele Rigitano

L’articolo Sicurezza dei Sistemi (id)IoT proviene da ICT Security Magazine.

https://www.ictsecuritymagazine.com/articoli/sicurezza-dei-sistemi-idiot/


L’Hardware e la Sicurezza IT – Parte 2: Attacchi Side Channel, Row Hammer ed attacchi alla Cache

La sicurezza dei sistemi IT è principalmente conosciuta in relazione ad attacchi esterni od interni che sfruttano vulnerabilità del codice od abuso di privilegi. Abbiamo tutti sentito parlare di virus, worm e malware di vario tipo che sfruttano vulnerabilità dirette di sistemi e applicazioni. Un’altra grande categoria di attacchi noti a tutti sono quelli che genericamente possiamo indicare con il termine “Phishing”, ovvero truffe e inganni che convincono l’utente di un sistema IT a fornire all’attaccante informazioni riservate od a sottrarre danaro. Inoltre una categoria di attacchi realizzabili con i sistemi IT sono quelli svolti dall’interno (“Insider attack”) ovvero da persone che abusano dei propri privilegi sui sistemi IT per danneggiare l’organizzazione per cui lavorano a proprio favore od a favore di terzi.

Nell’ambito dei sistemi IT vi è però un’altra importante categoria di minacce e attacchi anch’essa di grande rilevanza e lunga storia, sono gli attacchi “Side Channel” (ovvero condotti tramite un canale laterale) e di inferenza. Invece di sfruttare una vulnerabilità esplicita e diretta di un sistema, un attacco Side Channel sfrutta delle caratteristiche indirette del sistema per giungere comunque alla sua compromissione. Gli esempi sono molti, ma è comunque utile ricordarne alcuni dei principali.

Una delle principali famiglie di attacchi Side Channel va ora sotto il nome di TEMPEST e riguarda metodi per spiare, ovvero estrarre informazioni da un sistema IT, sfruttando l’emissione dal sistema di segnali radio, elettrici, termici, di vibrazioni ecc. [1,2]. TEMPEST è un nome in codice dell’NSA (National Security Agency, USA) che si riferisce ad un insieme di misure da implementare, di verifiche da effettuare su strumenti informatici, e relative certificazioni, per prevenire alcune classi di attacchi Side Channel. I primi studi delle minacce di tipo TEMPEST risalgono ai primi anni del 1900 quando si incominciarono a sviluppare metodi alternativi per intercettare messaggi trasmessi via telefono o radio. E’ però principalmente negli anni ’60 e ’70 che TEMPEST fu ideato e sviluppato.[1]

Uno dei principali canali di attacchi Side Channel è quello delle radiazioni elettromagnetiche. Ad esempio è stato mostrato che è possibile ricostruire quanto mostrato su di un monitor non schermato anche a distanza di metri e attraverso muri [3]. Analogamente sfruttando l’emanazione di radiazioni elettromagnetiche è stato possibile intercettare quanto in transito attraverso modem non schermati, ma anche attraverso cavi di connessione. Inoltre smart-card, schede FPGA, CPU, chip crittografici ecc. emettono radiazioni elettromagnetiche che, se non schermate, possono permettere l’intercettazione delle informazioni.

E’ possibile intercettare informazioni anche monitorando l’utilizzo di corrente elettrica da parte dell’hardware ed in alcuni casi monitorando l’emissione di onde sonore o di emissioni termiche.

Recentemente è stato mostrato [4] come la ricostruzione di quanto presente su di un monitor, anche di uno smartphone, è possibile analizzando i rumori acustici di fondo emessi dagli schermi e registrati da comuni microfoni presenti nei nostri dispositivi quotidiani.

Le principali misure di sicurezza TEMPEST sono

  1. La schermatura dei sistemi
  2. La modifica dei processi software o dei componenti hardware in modo da non emettere radiazioni che possano portare o far dedurre informazioni.

Un altro esempio recente [6] riguarda lo studio dei chip dedicati alle comunicazioni Wireless, come WiFi e Bluetooth. Questi chip includono sullo stesso substrato sia una componente ricetrasmittente analogica che una componente digitale utilizzata anche per la cifratura del traffico. E’ stato notato che la presenza sullo stesso substrato di silicone di entrambe le componenti porta in molti chip alla presenza di interferenze fra le due componenti, generate dalla componente digitale e amplificate dalla componente analogica. Ne risulta quindi che studiando il “rumore” della trasmissione radio è possibile identificare i segnali emessi dalla componente digitale del chip durante la cifratura / decifrazione del traffico. In alcuni casi questo fenomeno può portare alla identificazione della chiave segreta di cifratura anche a qualche metro di distanza.

Vi sono anche attacchi Side Channel non direttamente fisici come i precedenti, ma implementati tramite monitoraggio delle applicazioni IT o dell’attività dell’Hardware stesso. Una classe importante di questi attacchi è quella che utilizza la misura dei tempi di elaborazione in particolare quando applicati alla crittografia. Sin a partire da [5] è stato mostrato come conoscendo l’algoritmo di cifratura e misurando i tempi di esecuzione dell’algoritmo crittografico, sia possibile da parte di una terza parte presente sul sistema, risalire alle chiavi di cifratura. Questo può essere evitato se l’algoritmo crittografico esegue le elaborazioni in tempo costante, ovvero in modo indipendente dai dati in ingresso (incluse le chiavi), od in alcuni casi con una modifica dell’algoritmo chiamata “Bliding” che introduce dei dati casuali all’interno dell’elaborazione, poi rimossi, in modo da rendere inintelligibile il risultato dell’attacco tramite misura dei tempi di elaborazione.

Row Hammer

A partire dal 2015 con lo studio di Kim et al. [7] sulla vulnerabilità poi chiamata Row Hammer, cresce grandemente l’interesse sia accademico che dei professionisti di sicurezza informatica, a partire dai componenti del Project Zero di Google, all”interazione tra funzionalità hardware in particolare delle CPU e sue componenti, e le violazioni del modello di sicurezza ad anelli descritto nella prima parte di questo articolo.

L’osservazione alla base dell’effetto Row Hammer è che la miniaturizzazione delle componenti hardware, in particolare delle DRAM, può portare ad errori dovuti a disturbi provenienti da locazioni vicine.

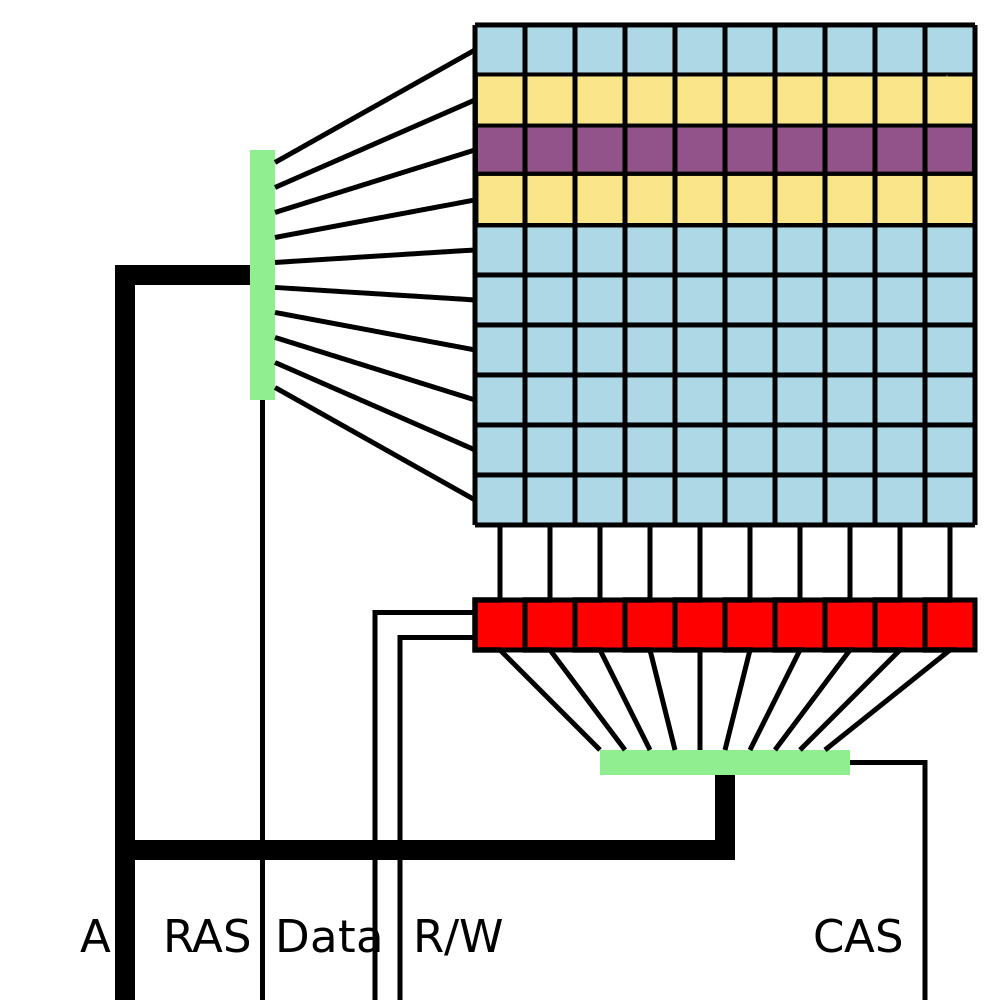
Semplificando il più possibile la descrizione del processo fisico, si può dire che in una cella DRAM il valore 0 o 1 è rappresentato dalla presenza o meno di carica elettrica in un condensatore. Ogni cella che rappresenta 1 bit è composta da un condensatore e da un transistor, e le celle sono organizzate in righe. Le celle di una riga vengono lette / scritte insieme in un’unica operazione (si veda la Figura 1). Le operazioni di lettura in realtà rimuovono fisicamente le cariche dai condensatori che poi devono essere ricaricati, ovvero riscritti, per mantenere il dato. Ma i condensatori, soprattutto quelli così piccoli, si scaricano velocemente, per cui è necessario rinfrescare i dati, ovvero rileggerli/riscriverli, molto frequentemente. Ad esempio DDR3 DRAM hanno un periodo di refresh di 64 millisecondi, mentre sono necessari circa 50 nanosecondi per leggere / scrivere una riga di memoria.

Per ingrandire la capacità delle memorie, e ridurne il costo, è necessario ridurne le dimensioni, ma questo vuol dire avvicinare tra loro le celle. I produttori di DRAM si sono sempre preoccupati[2] di minimizzare i fenomeni in cui effetti elettromagnetici di una cella influiscono sulle celle limitrofe, chiamati anche Errori di Disturbo (“Disturbance Errors”). Questi errori sono stati ridotti sia con misure fisiche di isolamento delle celle, sia con il processo di rinfrescamento dei dati, sia con l’introduzione di memorie con ECC (Error Correction Code), in grado di correggere 1 o 2 errori per riga / parola. Le ECC DRAM sono però più costose e un po’ più lente delle memorie non-ECC e sono utilizzate tipicamente solo in server di alto livello.[3]

I produttori di DRAM hanno sempre considerato errori prodotti casualmente o da fenomeni fisici esterni, ma non hanno però considerato che qualcuno potesse causare volontariamente degli errori di disturbo per violare la sicurezza del sistema. Invece questo è proprio quello che Kim et al. si sono proposti di fare nello studio [7].

Quello che Kim et al. hanno notato è che leggendo un bit[4] alcune celle nelle righe limitrofe perdono carica elettrica ad una velocità leggermente più veloce di quanto succede normalmente. Se il bit viene letto alcune volte nell’arco di un periodo di rinfrescamento, la perdita di carica elettrica nelle righe limitrofe è minima e non produce alcun effetto. Ma se invece si ripete la lettura dello stesso bit o della stessa riga, centinaia di migliaia di volte nell’arco di un periodo di rinfrescamento, allora alcune celle possono scaricarsi completamente, cambiando quindi il loro valore.

Fig. 1 Esempio di attacco Row Hammer: la lettura rapida delle righe gialle può indurre il cambio di valore di alcune celle viola, la riga rossa indica il “row buffer” [Wikipedia]

Per riuscire a leggere migliaia di volte lo stesso bit, od un bit nella stessa riga, nell’arco di un periodo di rinfrescamento è necessario però aggirare le misure di miglioramento delle prestazioni presenti nell’hardware. In particolare all’interno di ogni DRAM sono presenti dei “row buffer” (anche chiamati “sense-amplifier”) che mantengono copia di una riga in modo che letture immediatamente successive siano servite dal quest’ultimo e non direttamente dalla riga. Inoltre, come descritto nella prima parte di questo articolo, una volta letto un dato dalla RAM, questo viene caricato nelle varie Cache presenti nella CPU, in modo che letture immediatamente successive dello stesso dato non accedano per nulla alla RAM ma ad una Cache e siano molto più veloci.

E’ possibile, anche se non facile, scrivere programmi che aggirino le Cache, i “row buffer” ecc. In [8] sono riportati alcuni riferimenti ad articoli che descrivono tecniche per implementare attacchi Row Hammer. Sono stati ideati anche attacchi in javascript all’interno di browser, via network, che utilizzano le GPU, su smartphone ecc.

La difficoltà di implementazione degli attacchi non ha però evitato di trovare modi di renderli molto pericolosi. L’idea principale è quella di modificare un bit in memoria che garantisce la sicurezza del sistema: ad esempio se si riesce a modificare un bit che indica che un settore di memoria è privilegiato, allora qualunque processo può accedere a quei dati riservati. Modificando quindi opportuni bit in memoria è possibile sia accedere a dati riservati al kernel o di altri utenti e processi, ed anche accedere direttamente all’anello 0 (kernel mode) senza passare da System Call e Gate, e così via. Potenzialmente quindi gli attacchi Row Hammer possono completamente aggirare qualunque misura di sicurezza e permettere all’attaccante qualunque azione sul sistema. Le possibili conseguenze di un attacco Row Hammer includono: l’accesso amministrativo al sistema operativo, l’accesso a chiavi crittografiche e dati riservati, l’accesso da una macchina virtuale alle applicazioni e dati di un’altra macchina virtuale sullo stesso Host ecc.

Per implementare un attacco Row Hammer il problema principale quindi è quello di identificare esattamente i bit in memoria fisica[5] DRAM che si vogliono modificare, ed ideare una procedura in grado di modificare solo quelli. La difficoltà di esecuzione di questi attacchi li rende quindi generalmente poco efficaci, ma come è stato dimostrato, sicuramente possibili.

Contromisure per Row Hammer

Bisogna innanzitutto notare che non tutte le memorie DRAM sono vulnerabili ad un attacco Row Hammer, dipende non solo dal modello di memoria ma in alcuni casi anche dalla singola memoria.

In generale la soluzione definitiva per eliminare la vulnerabilità è quella di produrre nuove memorie DRAM che per costruzione non siano suscettibili a Row Hammer. Questo però non è semplice in quanto le richieste del mercato sono di maggiore capacità, minore dimensione e minor costo delle memorie, e non è facile sviluppare nuove memorie che siano al contempo anche non vulnerabili a Row Hammer. Inoltre le memorie ECC, come già indicato, garantiscono di correggere errori ad 1 o 2 bit per parola / riga, mentre gli attacchi Row Hammer tipicamente includono più bit e quindi possono aver successo anche su queste memorie.

Come mitigazione Hardware, in alcune nuove CPU e memorie sono state introdotte istruzioni che permettono di monitorare la frequenza di accesso alle righe di memoria e, se questa supera certe soglie, di forzare l’esecuzione di un rinfrescamento, il che impedisce l’effetto Row Hammer.

Sono anche state proposte ed implementate molteplici altre misure di protezione. Tra le più semplici misure di protezione vi sono le seguenti:

  • il dimezzamento del tempo di refresh, ad esempio ogni 32 millisecondi, riduce l’efficacia di molti tipi di attacchi Row Hammer, potenzialmente a costo di rallentare l’accesso alla memoria;
  • l’introduzione di procedure per verificare se le memorie sono vulnerabili ad attacchi Row Hammer, in modo da implementare misure di protezione solo su queste;
  • visto che l’attacco Row Hammer esegue delle attività molto particolari, l’introduzione di misure di monitoraggio degli accessi alla RAM o dell’utilizzo delle Cache (che devono essere svuotate o aggirate dall’attaccante) o di Buffer di memoria, per identificare e bloccare i processi che eseguono un attacco Row Hammer;
  • analogamente i sistemi operativi possono limitare l’accesso o l’uso di istruzioni utili ad implementare Row Hammer, come le istruzioni clflush e kmalloc heap in linux;
  • infine è possibile che il sistema operativo separi fisicamente nelle memorie i dati con privilegi diversi o di diversi utenti (ad esempio per macchine virtuali) in modo che un attaccante non possa leggere dati in una riga confinante ad una con altri privilegi, anche se questo può introdurre molte complicazioni alla già non semplice gestione della memoria.

Attacchi alla Cache

Come abbiamo visto, i dati sono gestiti non solo nella RAM ma anche in una gerarchia di Cache, tipicamente 3, ciascuna più piccola della precedente ma più veloce. L’ultima cache, usualmente la terza “L3” anche detta Last Level Cache “LLC”, quella più lontana dalla CPU e più vicina alla RAM, è quella di maggior interesse in quanto tipicamente contiene tutti i dati presenti anche nelle Cache inferiori e per tutti i Core presenti sul sistema. Sono stati ideati alcuni tipi di attacchi che sfruttano la caratteristica principale della Cache LLC, ovvero quella di essere più veloce della RAM. I più noti tra questi attacchi sono “Prime + Probe”, “Flush + Reload” e “Flush + Flush” [9]. L’idea di base di questi attacchi è di misurare il tempo di lettura di un dato, se il dato è già presente in Cache il tempo di lettura è molto inferiore al caso in cui il dato non sia presente in Cache ed il sistema operativo debba leggerlo nella RAM e copiarlo nella Cache.

Sono state ideate due classi di attacchi, entrambe violano la riservatezza dei dati ma non permettono la modifica degli stessi e l’aumento di privilegi di un processo. Gli attacchi alla Cache non sono così distruttivi come Row Hammer, ma possono comunque avere conseguenze molto gravi.

Il primo tipo di attacco permette di creare un “Covert Channel”, ovvero un canale di comunicazione non previsto, non facilmente rilevabile e che può violare le politiche di sicurezza del sistema. Un esempio eclatante è la realizzazione di una connessione Secure Shell (SSH) tra due macchine virtuali eseguite sullo stesso Host, macchine virtuali tra le quali non dovrebbe esserci alcuna comunicazione [10]. Questo canale di comunicazione è stabilito tramite un attacco alla Cache dell’Host che ospita le due macchine virtuali.

L’idea di base di questo tipo di attacco assomiglia un poco all’utilizzo del codice Morse, ovvero alla codifica dell’informazione in segnali brevi e lunghi, rispettivamente presenza o assenza di un dato nella Cache LLC.

Si può descrivere brevemente l’attacco come segue: l’attaccante è in grado di installare su entrambe le macchine virtuali il proprio codice (eventualmente diffuso anche tramite malware). L’attaccante deve identificare un’area fisica della Cache da utilizzare per l’attacco. Questo è forse il punto più complesso dell’attività in quanto, come descritto, l’accesso alla Cache è tramite la memoria virtuale, mentre la Cache è organizzata secondo la memoria fisica. Inoltre i due programmi sono eseguiti su due macchine virtuali distinte per cui il mapping tra memoria virtuale e fisica effettuato sia dal sistema operativo che dall’Hypervisor usualmente differisce.[6] Nondimeno da un’analisi dell’hardware e di come sistemi operativi e Hypervisor gestiscono la memoria e le Cache, è possibile in alcuni casi trovare procedure tecniche per identificare le stesse aree della Cache LLC in entrambe le macchine virtuali. Una volta trovata una procedura per scrivere, leggere o rimuovere dati da un’area fisica della LLC, i due programmi eseguono con la stessa periodicità ma in maniera necessariamente asincrona le seguenti azioni:

  • se il programma che invia il messaggio deve inviare un 1, legge/scrive dei dati (casuali) nella LLC un numero concordato di volte in rapida successione
  • altrimenti se il programma che invia il messaggio deve inviare uno 0, non scrive nulla nella LLC per lo stesso periodo di tempo
  • il programma che riceve il messaggio richiede, con la stessa periodicità, la lettura di uno stesso set di dati che ha caricato in memoria (RAM) e misura il tempo di ogni lettura.

Quando il processo che invia il messaggio invia un 1, cancella dalla LLC i dati del processo che riceve il messaggio, quindi quando il processo che riceve il messaggio legge i suoi dati deve attendere che questi siano ri-caricati dalla RAM nelle Cache: il tempo di lettura sarà quindi alto. Invece quanto il processo che invia il messaggio invia uno 0, l’area della LLC non viene sovrascritta, quindi il processo ricevente trova direttamente in Cache i propri dati e la lettura è molto più veloce. I tempi di lettura del processo ricevente sono quindi alti, per un 1, e bassi, per uno 0.

Ovviamente vi sono molte complicazioni nell’esecuzione di questa semplice procedura, ad esempio i programmi sono interrotti nell’esecuzione dal sistema operativo per l’esecuzione di Interrupt, od altri programmi possono utilizzare la stessa area della LLC.[7] Possono quindi venire introdotti molti errori nel canale di trasmissione. La presenza di rumore ed errori in canali di comunicazione è però un argomento ben noto delle reti di comunicazione e si possono adottare protocolli di correzione degli errori che permettono di rimuovere quasi completamente gli errori e realizzare un canale di comunicazione funzionale, a costo di rallentare la velocità di invio dei dati.

Il secondo tipo di attacco permette di leggere dati riservati utilizzati da un altro programma in esecuzione sullo stesso sistema fisico. Tipicamente si considera come attacco esemplare la lettura della chiave segreta di de/cifratura utilizzata da un altro programma in esecuzione anche su di un’altra macchina virtuale, ma sempre sullo stesso Host.

L’esempio più semplice di questo tipo di attacco è quello di due utenti sulla stessa macchina (virtuale o fisica), uno che utilizza una chiave segreta per de/cifrare dei dati ed il secondo utente che intercetta la chiave segreta del primo. L’attacco si basa sull’utilizzo di librerie condivise, ovvero entrambi gli utenti utilizzano la stessa libreria crittografica per de/cifrare i dati. Essendo una libreria condivisa, il sistema operativo mantiene in memoria fisica RAM una sola copia della libreria, e mappa la stessa copia fisica nelle due distinte memorie virtuali dei due processi, quello che esegue la de/cifrazione e quello che esegue l’attacco. Supponiamo inoltre che la libreria implementi l’algoritmo RSA utilizzando la procedura matematica chiamata “Square-and-multiply” (questa procedura non è più utilizzata dalle librerie crittografiche attuali).[8] La caratteristica principale di nostro interesse di questa procedura matematica è che è iterativa sui bit della chiave segreta, ripetuta per ogni blocco di dati da de/cifrare, e che esegue due operazioni distinte nel caso in cui un bit della chiave segreta sia 1 o 0. Utilizzando la stessa libreria crittografica, l’attaccante può agire come segue:

  • per prima cosa l’attaccante rimuove dalla Cache le istruzioni della libreria crittografica, utilizzando l’istruzione clflush o caricandovi altri dati
  • poi l’attaccante attende un tempo sufficiente a che il processo vittima esegua un ciclo della procedura “Square-and-multiply”
  • infine l’attaccante misura il tempo di lettura (o esecuzione) di una delle due operazioni della libreria.

Se il processo vittima ha utilizzato la stessa operazione dell’attaccante, il tempo misurato è breve perché il processo vittima ha già caricato l’operazione in LLC, altrimenti il tempo misurato è notevolmente maggiore perché l’operazione deve essere caricata dal processo attaccante dalla RAM.

Visto che l’utilizzo delle due operazioni è legato alla presenza di un 1 o di uno 0 nella chiave segreta, è possibile, ripetendo molte volte le misure ed a meno di rumori ed errori come nel caso precedente, individuare i bit della chiave segreta anche con precisioni superiori al 70%.

Contromisure per attacchi alla Cache

Le contromisure contro gli attacchi alla Cache sono in parte simili a quelle adottate per limitare gli attacchi Row Hammer. Con le tecnologie di oggi è difficile immaginare architetture fisiche diverse dall’attuale con la gerarchia di Cache tra la RAM e i Core e quindi risulta molto difficile eliminare il fenomeno fisico alla base di questi attacchi, ovvero la differenza di tempi di accesso alla Cache rispetto alla RAM. Quello che invece è possibile fare è limitare o controllare l’accesso dei processi alle istruzioni che misurano con altissima precisione i tempi di esecuzione di blocchi di codice, e l’accesso ad istruzioni, come clflush, che permettono di gestire le Cache od indirizzarne i contenuti. Queste misure possono essere implementate sia in hardware che nei Sistemi Operativi, ad esempio limitando l’esecuzione di alcune istruzioni solo in kernel mode.

Altre misure includono l’eliminazione o forte diminuzione dell’utilizzo della deduplication, e una diversa gestione delle librerie comuni (shared libraries) e delle aree comuni delle memorie. Questo impedirebbe ad esempio a diverse macchine virtuali di utilizzare le stesse aree fisiche della Cache, evitando l’attacco Covert Channel qui sopra descritto, ma al contempo rendendo più complesso e meno efficiente l’utilizzo stesso della Cache.

Infine per quanto riguarda gli algoritmi crittografici, questi devono comunque garantire elevati livelli di sicurezza e devono essere scritti in modo da eseguire il codice in tempo costante indipendentemente dagli ingressi, sia i dati che le chiavi. Le librerie crittografiche più recenti soddisfano questi requisiti, almeno per quanto riguarda gli attacchi noti.

Riferimenti Bibliografici

Note

  • [1] Oggi il termine corretto è EMSEC, ovvero “Emissions Security”, anche se TEMPEST è ancora utilizzato come termine generico.
  • [2] Sin dagli anni ’70, ad esempio già con la DRAM Intel 1130.
  • [3] ECC DRAM furono introdotte principalmente per correggere errori indotti da radiazioni elettromagnetiche esterne e radiazioni di background quali particelle alpha, neutroni ecc. ad esempio emessi dal sole, che possono interferire con una cella e cambiarne il valore.
  • [4] Come indicato, la lettura di un bit induce la lettura / annullamento / riscrittura di una intera riga di memoria.
  • [5] Si ricordi la breve descrizione della gestione della memoria riportata nella prima parte di questo articolo, con la presenza di memoria fisica e virtuale, pagine, segmenti ecc.
  • [6] L’identificazione di una stessa area della Cache può essere semplice nel caso in cui l’Hypervisor utilizzi la “deduplication” (mappa alla stessa memoria fisica di blocchi di memoria uguali), misura utile a ridurre l’utilizzo della memoria.
  • [7] La gestione della LLC è comunque in carico al Sistema Operativo, in questo caso Host, ed i processi non possono utilizzare aree della LLC in maniera esclusiva.
  • [8] Un simile attacco è possibile quando l’algoritmo AES è implementato tramite “T-tables”, anche questa implementazione non è più utilizzata dalle librerie crittografiche attuali.


Articolo a cura di Andrea Pasquinucci

L’articolo L’Hardware e la Sicurezza IT – Parte 2: Attacchi Side Channel, Row Hammer ed attacchi alla Cache proviene da ICT Security Magazine.

https://www.ictsecuritymagazine.com/articoli/lhardware-e-la-sicurezza-it-parte-2-attacchi-side-channel-row-hammer-ed-attacchi-alla-cache/


Macro dinamiche del rischio cyber

Ogni anno, in concomitanza con il ben noto meeting annuale, il World Economic Forum pubblica il Global Risk Report prodotto con la collaborazione di esperti e decision-maker disseminati in tutto il mondo per identificare e analizzare i rischi più rilevanti per la nostra società globalizzata. I rischi di cui si occupa il Global Risk Report riguardano tutti gli aspetti della nostra vita economica, sociale, politica, culturale e tra questi, negli ultimi anni, hanno iniziato a affacciarsi nella classifica e a risalirne la china i rischi che fanno parte di un cluster che possiamo identificare con il nome “rischio cyber”.

La figura seguente mostra il valore di rischio normalizzato su di una scala 5×5 di probabilità e impatto dei rischi facenti parte del cluster cyber.
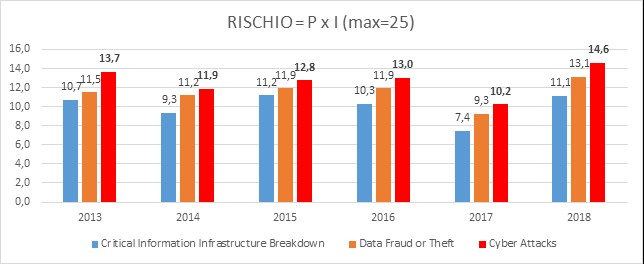
Figura 1 – Rielaborazione su dati WEF

Si tratta di valori di rischio elevati che si accentuano in modo particolare nell’ultima rilevazione. Dobbiamo inoltre considerare che:

  • nel 2016, Data fraud entra nei top 10 risk all’ 8° posto per probabilità di accadimento, ma è fuori dalla top 10 per impatto percepito;
  • nel 2017, Data fraud or theft e Cyberattacks entrano nei top 10 risk al 5°e 6°posto rispettivamente per probabilità di accadimento, ma sono fuori dalla top 10 per impatto percepito;
  • Nel 2018 i due rischi, in ordine invertito, scalano al 3°e 4° posto della classifica per probabilità di accadimento, mentre Cyberattacks che entra al 6° posto della top 10 dei rischi per impatto percepito.

Si tratta, quindi, di una crescita costante dell’importanza di questi rischi nel percepito di una serie di personaggi generalmente fuori dallo stretto mondo degli specialisti che si occupano di questa materia.

Ora, osservando il Global Risk Landscape 2018, si nota che il cluster dei rischi cyber crea una sorta di triangolo posizionato nel quadrante in alto a destra della mappa. In effetti, la cosa che sorprende è che il percepito del panel di contributori al Global Risk Landscape sia che i cyberattack comportino un rischio (probabilità x impatto) più elevato rispetto ai più tradizionali rischi legati ad attacchi terroristici, crisi alimentari e disoccupazione.
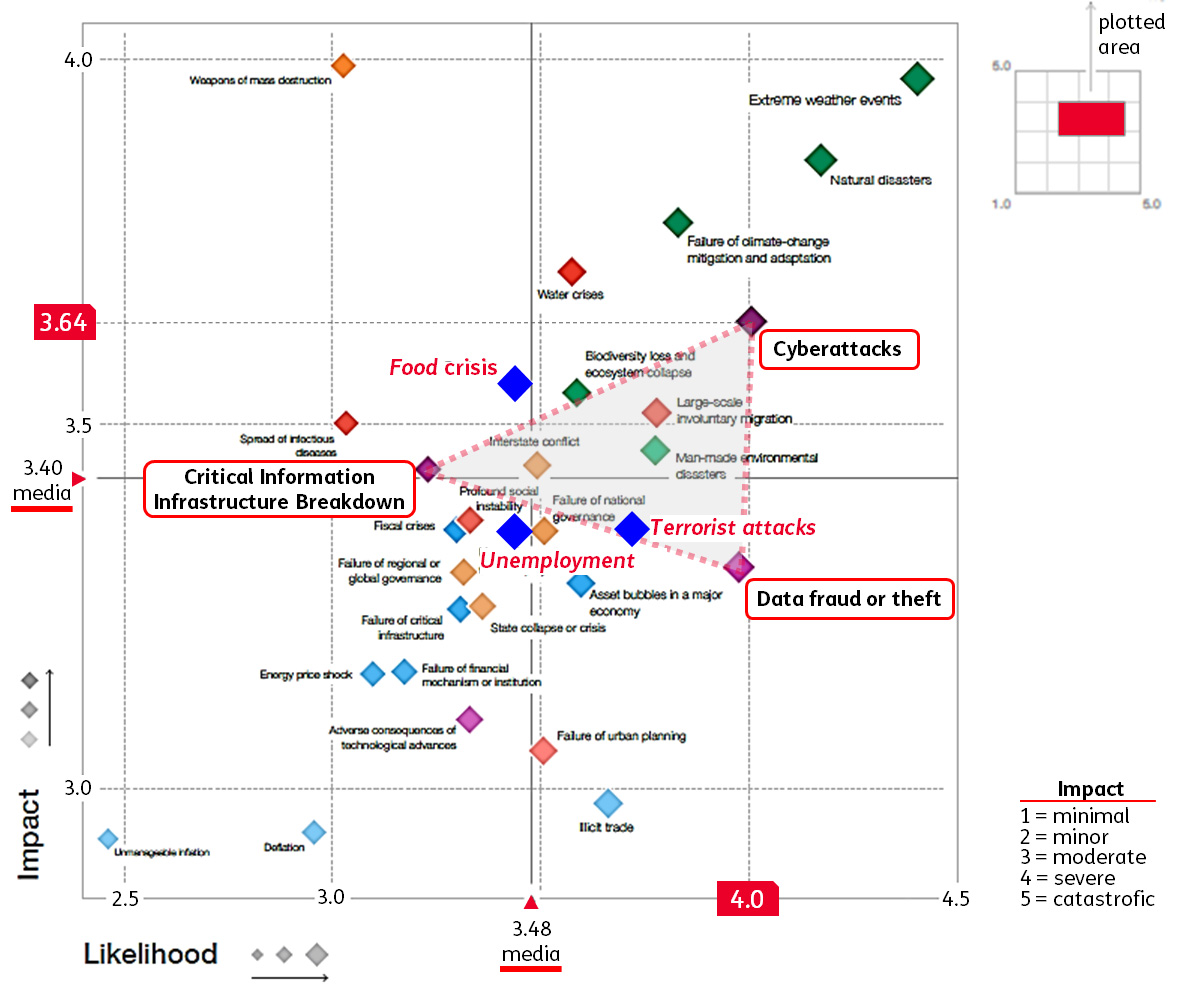
Figura 2 – World Economic Forum: Global Risk Landscape 2018

Questo è un punto certamente interessante che trova, secondo me, risposta nel fatto che il rischio cyber è un rischio particolare, dotato di caratteristiche in grado di amplificarne il potenziale negativo. Il rischio Cyber, infatti, è un rischio di sistema.[1] D’altra parte, è del tutto intuitivo osservare che il funzionamento delle infrastrutture critiche è sempre più basato sulle tecnologie digitali, che l’interdipendenza delle “Critical Information Infrastructure” aumenta costantemente e di conseguenza, aumenta il rischio che un danno prodotto in un nodo del sistema si ripercuota sui nodi circostanti con effetti a catena potenzialmente catastrofici. Ovviamente, non si tratta solo di questo, bisogna considerare almeno altri due fattori che contribuiscono a sostenere una valutazione di rischio così elevata: 1) l’anonimia, ovvero, il fatto che è praticamente impossibile attribuire la responsabilità di un cyberattack ad un individuo o gruppi; 2) l’asimmetria, ovvero, il fatto che un attaccante può concentrarsi su di una singola vulnerabilità ed un ambito anche ristretto, mentre chi difende non può esimersi dal considerare tutto il contesto degli asset dell’istituzione/ente/azienda e tutte le vulnerabilità[2], il che aumenta esponenzialmente la complessità da gestire.

A supporto di questa tesi, possiamo osservare che negli ultimi 3 anni si sono verificati almeno tre eventi che presentano tutte le caratteristiche del rischio sistemico, ovvero, di un evento in grado di produrre gravi effetti indiretti di secondo e anche di terzo livello.
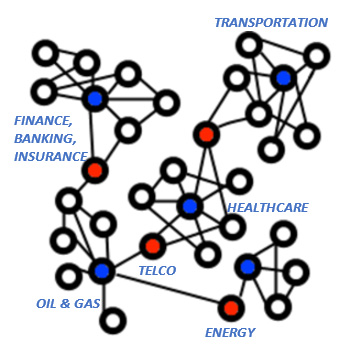
Figura 3 – Reti di infrastrutture critiche

Il 21 Ottobre 2016, un attacco DDoS a DYN (provider di servizi DNS negli USA) ha generato per 6 ore seri impatti sulla disponibilità dei servizi dei principali over-the-top statunitensi. La botnet utilizzata per l’attacco era composta da circa 10 milioni di indirizzi IP, per la maggior parte videoregistratori e videocamere “intelligenti”. Nei fatti, si è trattato del primo significativo black out di Internet negli Stati Uniti.

Il 17 Dicembre 2016, a Kiev, un attacco ai sistemi di distribuzione dell’energia elettrica realizzato utilizzando un malware poi denominato “Industroyer” causa un black out che si è protratto per 75 minuti.

Il 12 maggio 2017, il virus informatico WannaCry ha infettato centinaia di migliaia di sistemi Microsoft Windows in tutto il mondo, mettendo in seria difficoltà più di 105 paesi. Una vera e propria epidemia su vasta scala che ha colpito più di duecentomila computer, paralizzando aziende e organizzazioni, dal Servizio Sanitario Nazionale inglese alla compagnia telefonica spagnola Telco, passando per FedEx, Renault, Deutsche Bahn e il Ministero degli Interni russo. Tra i paesi più colpiti troviamo Spagna, Gb, Usa, Cina, Portogallo, Vietnam, Russia e Ucraina.
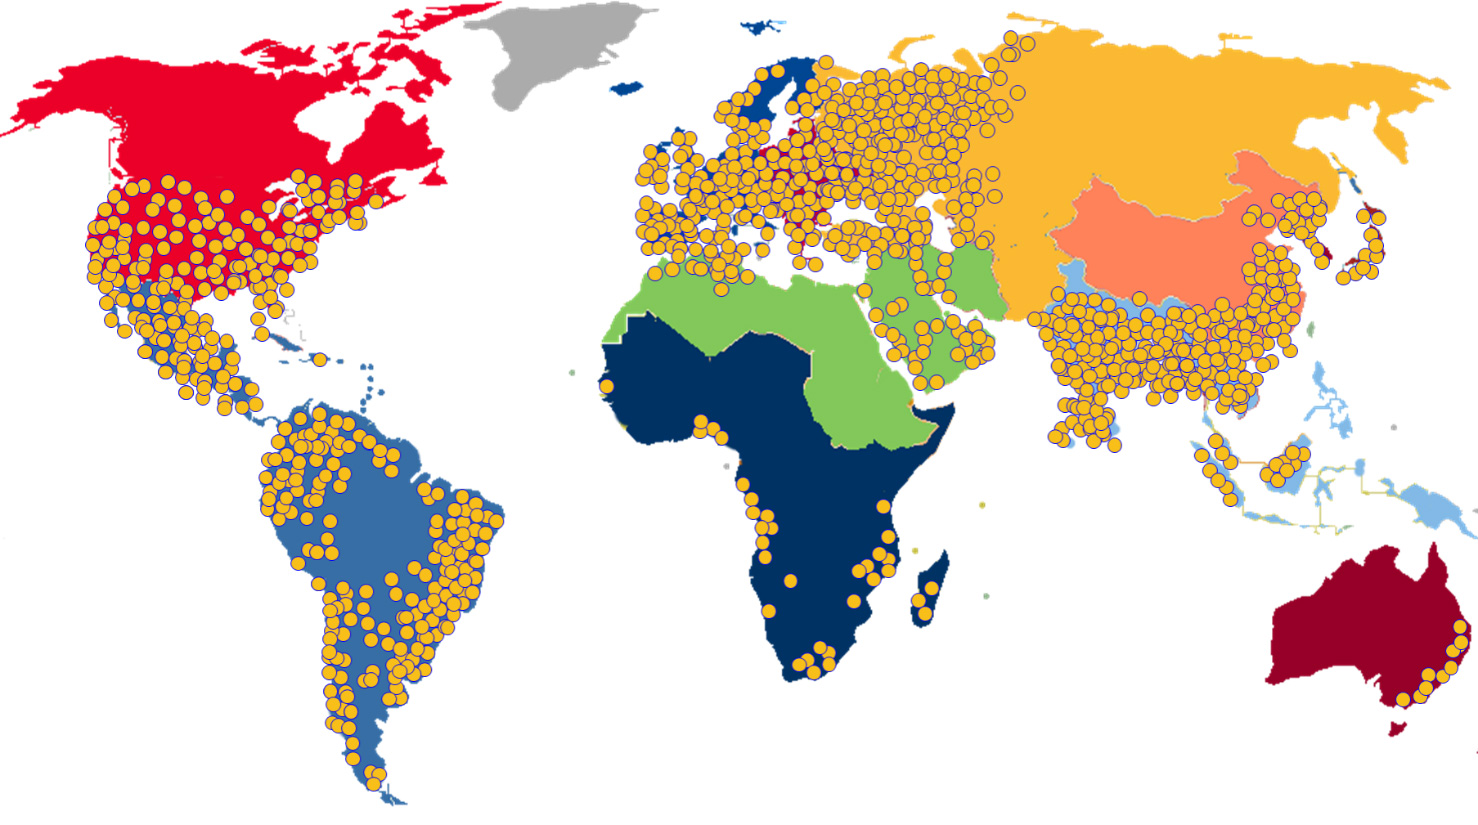
 

Figura 4 – Diffusione Wannacry maggio 2017

Storicamente, il rischio sistemico è stato studiato in relazione al sistema bancario[3] e al mondo della finanza; ora, però, l’incredibile livello di interconnessione raggiunto dal substrato digitale che rende possibile quasi ogni forma di attività umana, si pone esso stesso come elemento sistemico in grado di causare crisi di dimensioni forse non immaginabili e non comparabili con il singolo evento in grado di innescarla.

Energia, comunicazioni e trasporti sono le infrastrutture critiche[4] per eccellenza, in quanto caratterizzate da un alto grado di interdipendenza e – non trattando le prime due beni “immagazzinabili” – sono in grado di provocare effetti istantanei trasmettendo rapidamente a tutti gli altri settori disagi e degrado della qualità della vita[5]. Da questo punto di vista, è chiaro perché il legislatore Europeo si sia a lungo dedicato al tema della resilienza in particolare delle reti di servizi essenziali (Direttiva NIS).

Per comprendere meglio il ruolo del rischio cyber come rischio sistemico è necessario mappare il grado di interconnessione delle singole infrastrutture critiche, il loro grado di vicinanza, il livello di causalità reciproco e l’esposizione al rischio dei singoli punti di interconnessione. Sulla base di questo, poi, bisognerebbe definire delle metriche utili a fissare delle soglie di attenzione. È un tema ancora non sufficientemente presidiato anche se, dal punto di vista regolatorio, recentemente sono stati fatti diversi passi in avanti nel senso di costruire una risposta “di sistema” almeno sul terreno della privacy, della resilienza delle reti e dell’aumento della sensibilità sul tema del cyber Risk.

Insomma, se il rischio cyber è un rischio di sistema e la cyber resilience è un bene pubblico, allora anche la risposta di paesi, istituzioni e imprese deve essere “di sistema”. Anche se GDPR, Direttiva NIS, Regolamento eIDAS e Cybersecurity Act[6], costituiscono un framework di regole che inizia ad assumere una dimensione organica, a livello di implementazione, invece, manca ancora una solida consuetudine a condividere semantiche, metriche, metodi di misurazione e statistiche sul fenomeno cyber, elementi indispensabili se si vuole affrontare questo rischio come rischio di sistema.

Come per molte malattie, il rischio cyber è amplificato, anzi, “si nutre” di altri fattori digitali che sono strettamente correlati tra di loro. Direi che il fattore primigenio può essere fatto risalire alla legge di Moore[7] che fornisce il carburante che ha consentito a tutta l’industria digitale di svilupparsi ad una velocità esponenziale. È, infatti, evidente che la crescita vertiginosa della potenza dei microprocessori e quindi della capacità di calcolo garantita dalla legge di Moore, abbinata all’incredibile livello di miniaturizzazione raggiunto nei processi produttivi delle componenti elettroniche ha permesso l’esplosione dell’era delle reti di telecomunicazioni e dell’informatica che ha aperto all’era di Internet come piattafroma di distribuzione di tutte le innovazioni digitali.

Dal 2017 al 2020, la popolazione globale passerà da 7,7 a 7,8 miliardi di persone crescendo di 100 milioni di unità (+1%), mentre la “popolazione” dei device IOT connessi alla rete passerà da 8,4 miliardi a 20,4 miliardi[8] con un incremento di 12 miliardi di oggetti (+242%) il che, credo, rende chiara la misura dell’enorme velocità a cui viaggia il mondo digitale. La velocità estrema è, quindi, il tratto principale che caratterizza gli ecosistemi digitali e che influisce in modo così significativo sul rischio cyber. Tutto viene consumato in grande fretta e di conseguenza, il ciclo di vita delle tecnologie si riduce drasticamente. Se pensiamo, ad esempio, ad un’industry capital intensive come quella delle tecnologie radiomobili che deve assorbire costi elevati per la concessione delle frequenze e per la stesura delle reti (torri, antenne, accesso radio, core network, etc.), osserviamo che in meno di 40 anni si sono succedute 5 differenti tecnologie: il TACS parte nei primi anni 80, il 2G nel 1991, il 3G dopo 10 anni, il 4G dopo 9 anni e il 5G dopo 8 anni e la velocità di download passa dai 384 kbps del primo 3G, ai 100 Mbps del 4G, ai 10 Gbps del 5G. In questo processo di crescita vorticosa ci sono due date chiave: la disponibilità estesa e a basso costo di capacità di banda sulle reti di telecomunicazioni che è databile all’anno 2000 e la nascita degli OTT che è databile tra 2007 e 2008. Dopo il 2008 abbiamo assistito alla rapida crescita del numero di device costantemente connessi, ad un economia che dipende sempre di più da algoritmi di IA, alla crescita del potere dei social ed al rischio delle fake news, alla crescita dello sfruttamento dei contenuti personali dovuto allo spostamento sempre più avanti del trade-off tra privacy e servizio.

Ma ciò non basta. Le tecnologie digitali stanno cambiando anche le relazioni tra nazioni e blocchi di potere. “… il solo modo di comprendere i cambiamenti geopolitici contemporanei è quello di mettere insieme quello che sta avvenendo nel mondo dell’informatica e ciò che sta avvenendo nel mondo delle telecomunicazioni, con ciò che sta avvenendo in ambito ecologico e ciò che sta avvenendo nella globalizzazione o in ambito demografico. Non c’è altro modo, oggi, per offrire un quadro complessivo della situazione”[9]. La geopolitica di ieri[10] trattava della geografia come elemento fondamentale per la possibilità di movimento degli eserciti e per le necessarie linee di rifornimento, per la possibilità di instaurare traffici commerciali via mare facilmente difendibili in modo semplice e poco costoso. Oggi, la geopolitica nell’era digitale tratta delle reti di telecomunicazione, dei cavi sottomarini, degli hub e dei landing point dove passa il traffico di internet, della manipolabilità degli elettori tramite i social. Si tratta di scenari in grado di spostare il baricentro delle sfere d’influenza e – come è normale che sia – anche di tanto business.

Ora, se guardiamo questo scenario dalla prospettiva del rischio cyber è semplice osservare che i principali effetti del big bang digitale in cui abbiamo vissuto i tempi più recenti sono:

  • Incremento della superficie esposta a chi fosse intenzionato a realizzare cyber-attacchi con conseguente crescita a dismisura delle vulnerabilità potenzialmente sfruttabili e di conseguenza il rischio di impatti rilevanti.
  • Cicli di vita delle tecnologie più corti e, quindi, tecnologie legacy che devono coesistere con quelle più recenti creando due problemi di natura opposta: sui sistemi più vecchi, ormai obsoleti, non è più conveniente investire ed è quindi molto difficile riuscire a sanare le vulnerabilità presenti; su quelli più recenti c’è un problema di maturità della tecnologia che spesso crea molti problemi di sicurezza.
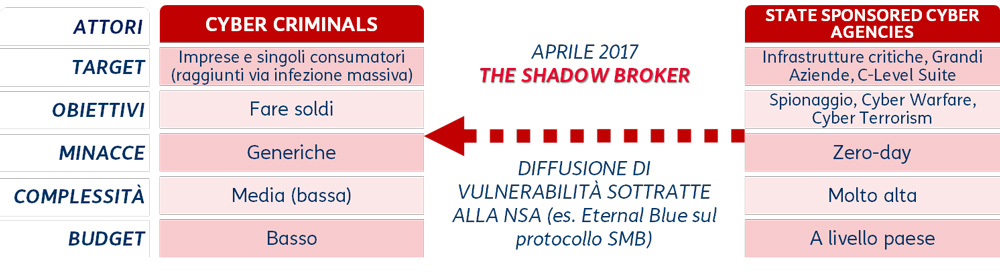
  • Incremento delle complessità delle Le realtà che si muovono nel campo delle minacce, sono con qualche approssimazione classficabili in due macro gruppi: cyber criminalità comune e cyber criminalità organizzata. I primi sono interessati solo al ritorno economico delle operazioni che mettono in campo, usano cyber minacce generiche, di media complessità e bassi costi. I secondi, invece, sono spesso sponsorizzati da nazioni, hanno obiettivi più ambiziosi che non sono semplicemente legati al solo ritorno economico, usano minacce esclusive o costruite ad hoc, di complessità elevata e costi molto elevati. Ora, per molto tempo questi due mondi non si sono toccati ma, nel mese di aprile 2017 per una serie di vicissitudini[11], il gruppo hacker “The shadow broker” ha reso disponibili una serie di vulnerabilità prima sconosciute (0-day) sottratte alla NSA[12] tra le quali quella denominata “Eternal Blue” che sfrutta una debolezza del protocollo SMB di Microsoft. Nel successivo mese di Maggio, questo 0-day è stato utilizzato per realizzare la campagna di attacchi Wannacry di cui abbiamo già parlato. È come se un arsenale di armi nucleari fosse stato reso disponibile alla criminalità comune.
La derivata di tutti gli scenari descritti e di tutti i trend illustrati è un considerevole e costante incremento degli incidenti di sicurezza. Ovviamente, potremmo discutere a lungo su che cosa si intende per incidente di sicurezza, su quali sono i casi in cui è opportuno targare un problema come “incidente di sicurezza” e su come tipizzarlo allo scopo di costruire aggregazioni statistiche significative a livello paese. Rimane, però, il fatto che l’aumento degli incidenti di sicurezza è un elemento intuitivo, che tutti siamo disposti a dare per scontato. Ce ne rendiamo conto ancora poco, ma la rivoluzione digitale ci ha portato in dono una situazione che possiamo definire “la tempesta digitale”, uno scenario caratterizzato da attacchi informatici di differente intensità e gravità che si succedono rapidamente e fanno crescere la probabilità che si verifichi un evento catastrofico come un “Big One” o una “tempesta perfetta”, per restare nella metafora.

Diretta conseguenza di quanto detto fino ad ora è che nessuno e a nessun livello (stato, istituzione, ente o impresa) può esimersi dal valutare il rischio cyber in relazione alla propria attività, ambito di azione o business. Sia che si approcci il tema partendo dalla necessità di difesa delle operation o che si parta, invece, dalla protezione della privacy, il punto di arrivo è sempre lo stesso: analizzare la probabilità che un evento avverso crei un danno significativo e, di conseguenza, adottare le contromisure (azioni di mitigazione) opportune. L’analisi del rischio, che è al centro degli ultimi provvedimenti emanati a livello Europeo, ha come obiettivo principale quello di ridurre la superficie esposta ad un livello tollerabile, ovvero, capace di generare solo impatti trascurabili. Per fare ciò è necessario fotografare l’AS IS ed effettuare una gap analysis confrontandosi con le best practice e, se possibile, con i propri peer magari con l’ausilio di uno dei molti strumenti metodologici e Framework che ci aiutano a seguire tutti i passi correttamente e che addirittura ci suggeriscono le contromisure (anche tecniche) da adottare nelle diverse situazioni.

Ora, quali sono i principali trend che emergono dalla rivoluzione digitale che hanno un impatto significativo sul fenomeno cyber?

Il fattore umano

È certamente uno dei rischi principali ed è anche un paradosso. Da una lato la rivoluzione digitale ha in molti  modi potenziato le nostre capacità: attraverso i social ci ha offerto la possibilità di intrattenere tantissime relazioni contemporaneamente, di dire sempre la nostra anche su temi che solo due decenni fa sarebbero rimasti al più relegati alla cerchia di amici più ristretta; da un altro lato, invece, ci ha regalato aspetti negativi come la polarizzazione delle opinioni, gli haters, i troll, le fake news, un contesto insomma ottimo per “distruggere” consenso ma per niente in grado di “costruirlo”. In questo mondo che viaggia alla velocità della luce (immaginatevi per un momento a bordo dell’Enterprise del capitano Kirk) questi super individui le cui capacità sono potenziate da Internet e dai social, sorprendentemente, si scoprono estremamente vulnerabili al social engineering/phishing che si conferma essere i canali più di frequente utilizzato in fase di innesco di attacchi anche complessi. L’obiettivo dei cyber criminali è sottrarre credenziali per l’accesso ai sistemi e/o indurre i target a scaricare software malevolo. Si tratta di un fatto cruciale: le credenziali sono la chiave che consente di accedere ai dati che sono la risorsa pregiata della digital economy, l’elemento da proteggere e da valorizzare al tempo stesso, il carburante che fa girare tutto.

Secondo il report 2018 dell’osservatorio Clusit[13], l’incremento degli attacchi compiuti con tecniche di Phishing / Social Engineering è enorme, la sanità è stato il settore più colpito (+102%), seguito dalla GDO (+70%) e, “solo” terzo, dal settore Finance / Banche (+64%).

Bisogna, quindi, proteggere i super individui digitali con rimedi che consistono principalmente nell’effettuare campagne di educazione affiancate a test «dal vivo» che sono fondamentali per misurare la bontà dei comportamenti. È utile, inoltre, adottare in modo ampio un secondo fattore di autenticazione ad esempio tramite una OTP (token a scadenza dopo # secondi) generata tramite un app sul proprio smartphone (es. Google Authenticator e MS Authenticator).

La Supply Chain

Sempre di più le aziende, così come le realtà istituzionali, si configurano come entità aperte; come accade in natura, esse sono al centro di una molteplicità di ecosistemi che le aiutano a condurre i propri processi di business e al contempo ad essere più resilienti ed adattarsi meglio ai cambiamenti del mercato. L’ecosistema dei partner è coinvolto in segmenti sempre più importanti dei processi di business: gestisce i dati dei nostri clienti ed ha credenziali di accesso ai nostri sistemi core; è su questo fronte che si gioca una buona parte della sicurezza del business. In quest’ottica, dunque, si capisce facilmente come sia importante includere l’intera filiera dei fornitori/partner all’interno del processo di ICT Risk Management. Per fare un esempio che può sembrare banale, ma in realtà non lo è  affatto, facciamo riferimento ad una filiera particolarmente critica come quella dei device – PC, tablet, smartphone e modem – che sono i possibili punti d’ingresso degli hacker nelle organizzazioni. È indispensabile proteggere questi device in modo adeguato, in primis facendo in modo che il processo di acquisto di questi asset sia rigidamente controllato e strettamente connesso al processo di sicurezza allo scopo di evitare data breach e/o la creazione di gruppi di zombie eventualmente utilizzabili per realizzare attacchi. Continuando con gli esempi, una speciale attenzione va posta nelle filiere manifatturiere dove la componentistica da integrare nel prodotto finale è basata su tecnologia digitale. La stessa attenzione va posta ove ci sia la possibilità di alterare flussi di dati in ingresso ad applicazioni che sfruttano algoritmi di intelligenza artificiale (come ad esempio i sistemi che presiedono al funzionamento dei mercati finanziari) per fare in modo che l’algoritmo di AI prenda delle decisioni sbagliate perché basate su dati non attendibili. È per questi motivi, quindi, che chi in azienda si occupa della gestione della supply chain oltre all’attenzione a ridurre i costi, aumentare le performance, ridurre i rischi operativi, aumentare la flessibilità, si dovrà concentrare anche sulla valutazione e gestione del rischio cyber; visto che il mondo digitale è strettamente interconnesso è indispensabile che tutti gli elementi dell’ecosistema viaggino perfettamente allineati.

Utilizzo non governato del software Open Source
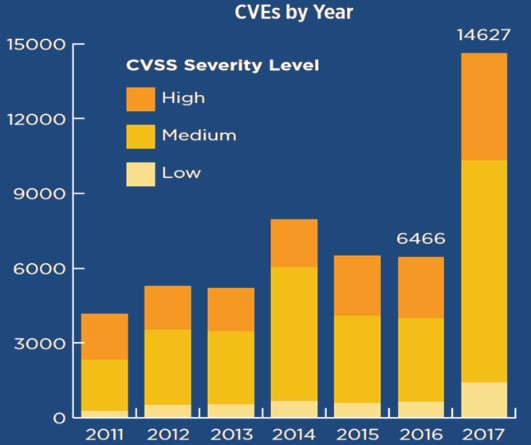
Figura 5 – Criticità delle vulnerabilità rilevate su software Open Source per gravità ed anno

Tre dei dieci prodotti più vulnerabili sono open source.[14] Semplicemente consultando il “National Vulnerability Database” del NIST si vede che la distribuzione dei CVE[15] per gravità (CVSS)[16] si impenna nel 2017 con un considerevole incremento delle fasce medium e high. Da una ricerca della società BlackDuck[17] emerge che il 96% di un campione di applicazioni analizzato ha componenti open source e il 67% di queste ha vulnerabilità spesso note da anni. Il software open source, quindi, è ovunque e, in generale, è molto vulnerabile; molto spesso, poi, i committenti non sono nemmeno consapevoli di avere così tanto open source nei loro software. Il fatto è che spesso l’introduzione del sw open source risponde a logiche di puro saving, tra l’altro, introducendo un nuovo rischio potenziale legato al licensing che è comunque presente per le distribuzioni ufficiali del software open source. Una buona governance delle tecnologie e in particolare dell’utilizzo del software open source è una componente fondamentale di qualsiasi possibile approccio di sicurezza. È ovvio che non è possibile spostare all’indietro le lancette dell’orologio, così come non è possibile far finta di non vedere gli enormi vantaggi che il lavoro delle community ci può dare; rimane però il fatto che non possiamo pensare di continuare a pagare il prezzo di capex continuamente decrescenti con un incremento costante delle vulnerabilità e quindi del rischio. È un modo di procedere che non ci porterà niente di buono ed è un problema serio.

Complessità, obsolescenza, patching

Il costante aggiornamento degli strati del software di sistema sui quali le applicazioni basano il loro funzionamento, è condizione fondamentale per ridurre le vulnerabilità e, di conseguenza, la superficie esposta ad un potenziale attaccante. L’attività di aggiornamento di una release del software di sistema si chiama patching. Molto spesso, sia per l’obsolescenza dell’hw che non supporta le nuove release del software di sistema che per l’obsolescenza dell’applicazione che hanno bisogno di interventi spesso «importanti» per funzionare con le nuove release, l’attività di patching non può essere eseguita. Si generano, quindi, una serie di vincoli che indeboliscono considerevolmente, il sistema nel suo complesso. Se poi, come capita spesso, l’obsolescenza è collegata ad un’elevata complessità del landscape infrastrutturale: molti layer di rete, molti data center, moltissimi server, allora la soluzione del problema diventa esponenzialmente più complessa se non strutturalmente non possibile.

Come si può essere sicuri che le patch vengano applicata prima che la compliance lo richieda o prima che qualcuno tenti di sfruttarle? Un semplice calcolo[18][19] ci porta a scoprire che per essere confidenti al 95% di ciò è necessario che il tempo medio di applicazione delle patch sia 3 volte più veloce rispetto a quanto richiesto. Ad esempio, se il requisito di compliance dice che dovete applicare le patch ogni 12 mesi, allora per essere confidenti al 95% di raggiungere l’obiettivo dovete tarare il vostro processo in modo che sia in grado di concludere un giro completo di patch in media in 4 mesi. Se poi il team che si dedica a questa attività è impegnato al 70% (ipotesi ragionevole), allora la migliore performance del processo di patching deve essere 10 volte inferiore al tempo richiesto dalla compliance, nel caso dell’esempio precedente 1,2 mesi. Se ciò è vero, nel 95% dei casi il processo di patching si concluderà, come richiesto, entro i 12 mesi. Ora, credo sia facile comprendere che se la base installata è composta da qualche decina di migliaia di server, allora il problema del patching è strutturalmente non risolvibile. E quindi, quali soluzioni è possibile ipotizzare? Come prima cosa bisogna darsi degli obiettivi basati sulla priorità calcolata in base al rischio (sensibilità dei dati, esposizione verso internet etc.). Poi, bisogna eseguire il patching ove non ci siano problemi di obsolescenza o di costo/opportunità. Infine, dove non sia possibile o non conveniente applicare correttamente il patching, è  possibile scegliere una strategia di virtual patching creando tramite un agent specializzato un ambiente protetto in cui l’applicazione / sistema può funzionare al sicuro dalle vulnerabilità esposte dallo stack software sottostante.

Transizione al cloud pubblico non governata

Flessibilità, Scalabilità, TCO più basso rispetto alle architetture on premise fanno si che l’84% delle aziende del campione[20] migrerà almeno il 10% delle istanze di server sul public cloud nei prossimi 3 anni o comunque lo raddoppierà. Skill shortage e mancanza di capacità di gestione dello shared responsibility model costituiscono i problemi principali. Cifratura dei tenant su public cloud (con chiavi in esclusivo possesso del cliente) e riconfigurazione dei sistemi IAM costituiscono i controlli di sicurezza da indirizzare in via prioritaria. Il rischio più rilevante, però, è una governance debole del processo di transizione al cloud pubblico.
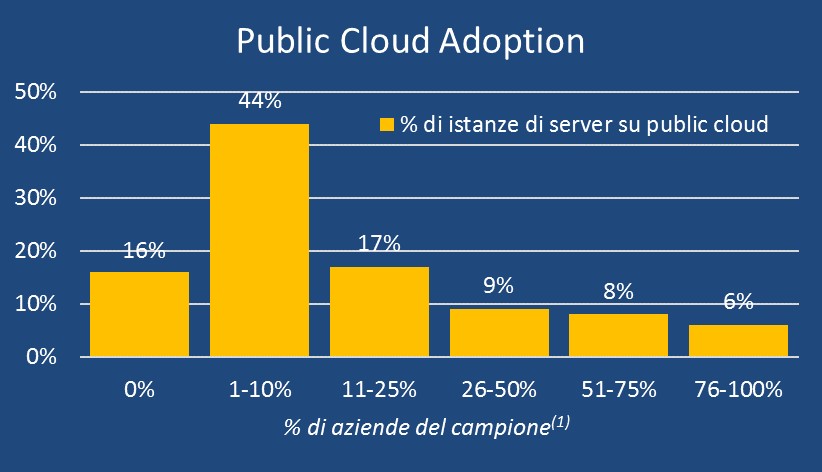
Figura 6 – Indagine McKinsey: % workload VS % aziende del campione

Specialmente nei casi in cui l’obsolescenza e la complessità infrastrutturale costituiscono un ostacolo insormontabile alla realizzazione dei controlli di sicurezza di base (vedi argomento precedente), l’adozione del cloud pubblico in modo ragionato e governato è una delle possibilità da considerare con attenzione, soprattutto riguardo ai controlli di sicurezza da attivare e alla condivisione delle responsabilità sul tema con il/i cloud service provider. È evidente che la migrazione verso il cloud pubblico di un numero di workload rilevanti è un processo che richiede tempo soprattutto per la definizione di rigorose matrici di compatibilità che ci devono garantire di poter sfruttare tutti i vantaggi del cloud eliminando il più possibile le vecchie legacy. Durante il periodo di transizione, quindi, chi si occupa di sicurezza dovrà continuare a mantenere e sviluppare l’infrastruttura di sicurezza convenzionale e al contempo preparare la transizione ad un modello di sicurezza cloud centrico. Un approccio bi-modale, quindi, che garantisca la coesistenza del vecchio con il nuovo per il periodo di tempo necessario.
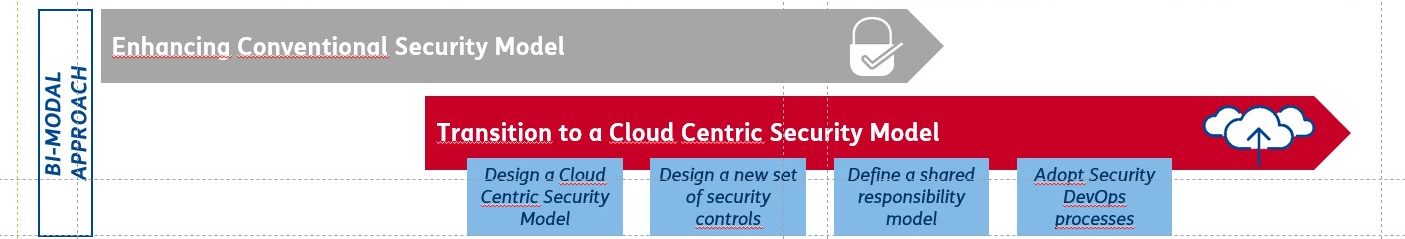
Figura 7 – Cybersecurity model: bi-modal approach

È evidente, però, che il principale razionale del passaggio al cloud non è quello dell’efficienza se pur in ottica security; il tema principale riguarda l’adozione di nuove piattaforme e metodologie di sviluppo (DevOps) in grado di accorciare drasticamente i tempi di delivery garantiti dall’approccio tradizionale (waterfall) al prezzo di una profonda ridefinizione di strumenti, processi e ruoli che pone a chi si occupa di security la sfida di disegnare controlli di sicurezza che siano efficaci anche in questo nuovo scenario.

Conclusioni

Insomma, il contesto è complesso e in molti ambiti ci ritroviamo senza difese. Ci dobbiamo preparare al fatto che una fetta consistente del rischio cyber non possa essere mitigato, ma vada gestito con altre strategie (accettare, eliminare, trasferire). Se l’opzione di mitigazione diventata più difficile da attuare, anche il concetto di tolleranza al rischio va ridefinito. Potremmo essere obbligati a coesistere con un elevato livello di rischio anche se la nostra tolleranza al rischio è relativamente bassa e dunque per obbligo e non per scelta di business. È necessario che i Board siano consapevoli di questa situazione allo scopo di assumere le decisioni più opportune in relazione ai segmenti di business prioritari.

Sappiamo bene che il fatto di essere oggetto di un cyber attack non è questione di “se” ma solo di “quando”. Sappiamo anche che la “sicurezza totale” non è una categoria realizzabile e che i nostri avversari sono sconosciuti e godono di molti vantaggi strategici. Da soli ci possiamo solo muovere alla ceca con poca probabilità di successo. Assieme, però, possiamo recuperare molti punti di svantaggio ed arrivare ad avere la meglio sui nostri avversari.

Quello che serve, quindi, è una solida roadmap europea che sia parte di una “call to action” globale[21] rivolta ad istituzioni, imprese e industria specializzata per un impegno ad accettare la sfida del cyber risk (e vincerla). Non è certamente una sfida semplice da vincere ma, prendendo spunto dalle parole del Presidente JFK[22], una comunità accetta le sfide che ha di fronte proprio perché non sono semplici, perché ci danno l’occasione di mettere a frutto il meglio delle nostre capacità e del nostro impegno.

Note

[1] Il rischio sistemico è il rischio di “guasti in un intero sistema”, contrapposto al rischio di “guasti di singole parti e componenti”. I rischi sistemici sono caratterizzati da: a) eventi avversi che si combinano indirettamente per produrre grandi fallimenti; b) condivisione del rischio o contagio, poiché una evento avverso innesca una catena di altre “isteresi”, ovvero, di sistemi che non sono in grado di recuperare l’equilibrio dopo uno shock.

  • Kaufman, G. G. e K. E. Scott. 2003. “Che cos’è il rischio sistemico e i regolatori di banca ritarda o contribuisce a farlo?” Independent Review 7 (3): 371-391. Vedi citazione a pag. 37.
  • Goldin, I. e M. Mariathasan. The Butterfly Defect: come la globalizzazione crea rischi sistemici e cosa fare al riguardo. Princeton University Press, 2014.

[2] https://www.ictsecuritymagazine.com/articoli/la-cybersecurity-vista-dalla-prospettiva-di-un-telco-operator/

[3] Il rischio sistemico misura la probabilità che una situazione di tensione di una singola banca possa innescare instabilità nell’intero sistema finanziario (e viceversa); l’importanza sistemica fa riferimento all’impatto sul sistema finanziario del possibile fallimento di un intermediario bancario. Banca D’Italia “Working Paper N. 1153 – Un’analisi delle misure di rischio sistemico e di importanza sistemica durante la crisi finanziaria globale”.

[4] Direttiva Europea 104/08/CE: “Infrastruttura Critica è un elemento, un sistema o parte di questo, ubicato negli stati membri ed essenziale al mantenimento delle funzioni vitali della società, della salute, della sicurezza e del benessere economico e sociale dei cittadini, il cui danneggiamento o la cui distruzione avrebbe un impatto significativo.

[5] Aldo Mariani e Luisa Franchina: “Infrastrutture Critiche: interdipendenze e analisi degli effetti domino”

https://www.ictsecuritymagazine.com/articoli/infrastrutture-critiche-interdipendenze-analisi-degli-effetti-domino/

[6] In corso di emanazione.

[7] In elettronica e informatica è indicato come prima legge di Moore il seguente enunciato «La complessità di un microcircuito, misurata ad esempio tramite il numero di transistori per chip, raddoppia ogni 18 mesi (e quadruplica quindi ogni 3 anni)». https://it.wikipedia.org/wiki/Legge_di_Moore

[8] https://www.gartner.com/newsroom/id/3598919

[9] “Grazie per essere arrivato tardi – un ottimista nell’epoca delle accelerazioni”, Thomas L. Friedman – Mondadori, aprile 2017.

[10] “Le 10 mappe che spiegano il mondo”, Tim Marshall – Garzanti, giugno 2017.

[11] https://en.wikipedia.org/wiki/The_Shadow_Brokers

[12] https://it.wikipedia.org/wiki/National_Security_Agency

[13] https://clusit.it/rapporto-clusit/

[14] Skybox Security Vulnerability & Threat – Trend Report 2018

[15] Common Vulnerability & Exposures – https://nvd.nist.gov/vuln-metrics/cvss

[16] Common Vulnerabilities Scoring System – https://cve.mitre.org/

[17] BlackDuck – “2017 open source security & risk analysis”

[18] Thanks to Don TurnBlade, ISACA

Tr: the required time for a patch to be applied
P: the confidence that a patch will be supplied
Tc: Average time taken for patches to be applied: actual processing plus time waiting for a turn to be patched.
P = 1 – exp(-Tr/Tc); Solving for Tc:   Tc = – Tr / ln(1 – P) à Suppose, P = 0.95 or 95% confident, then Tc = Tr / 2.996
U: Utilization or average staff work loading à Suppose U = 70%
Te: Rate of Best speed patching.
Tc = Te /  (1-U); Solving for Te:  Te = Tc *  (1 – U)    ; U = 0.7, Tc = Tr / 2.996  à Te = Tr * (1 – 0.7) / 2.996 = Tr / 9.986

[19] “How to measure anything in cybersecurity risk” – Douglas W. Hubbard & Richard Seiersen – Wiley 2016

[20] McKinsey 2018. “Making a secure transition to the public cloud”.

[21] Gus Hunt, Accenture – https://www.key4biz.it/cybertech-2018-gus-hunt-accenture-contro-il-cybercrime-serve-uno-sforzo-comune/232842/

[22] Discorso alla Rice University sull’impegno spaziale della nazione. Presidente John F. Kennedy Houston, Texas –  12 settembre 1962. “Abbiamo deciso di andare sulla luna in questo decennio e di impegnarci anche in altre imprese, non perché sono semplici, ma perché sono ardite, perché questo obiettivo ci permetterà di organizzare e di mettere alla prova il meglio delle nostre energie e delle nostre capacità, perché accettiamo di buon grado questa sfida, non abbiamo intenzione di rimandarla e siamo determinati a vincerla, insieme a tutte le altre.”


Articolo a cura di Marcello Fausti

L’articolo Macro dinamiche del rischio cyber proviene da ICT Security Magazine.

https://www.ictsecuritymagazine.com/articoli/macro-dinamiche-del-rischio-cyber/
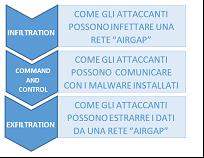


Elementi di sicurezza negli impianti domotici – parte terza

Dopo aver parlato di fattore umano e sicurezza degli impianti in una casa domotica, questo terzo articolo prova a descrivere le implicazioni di sicurezza legate alla connessione di questi impianti a servizi Internet esterni.

Uno dei fattori di successo della diffusione della domotica è la possibilità di accedere all’impianto tramite smartphone quando si è fuori casa per monitorare, intervenire o verificarne lo stato. Inoltre l’impianto stesso può recuperare informazioni importanti usando servizi terzi prima di decidere come comportarsi. Un esempio classico è il caso in cui, prima di avviare l’impianto di irrigazione, il sistema verifichi le condizioni meteo in zona così da avere maggiori informazioni per decidere quando e quanto innaffiare.

Infine, faremo il punto del nostro excursus fatto con i tre articoli scritti proponendo alcuni temi di discussione che saranno da affrontare per portare il giusto livello di consapevolezza all’interno di questo settore.

Connessione dall’esterno agli impianti domotici

Probabilmente i primi sistemi residenziali che hanno dato la possibilità di un controllo remoto sono stati gli impianti di antifurto e videocontrollo: la possibilità di controllare cosa stava succedendo dentro casa dall’esterno era – e lo è tutt’oggi – una funzionalità ritenuta importante. Inizialmente lo si faceva usando la linea telefonica, quindi quella GSM, veicolando le informazioni e l’interazione prima tramite suono e quindi tramite SMS. La successiva e naturale evoluzione è stata quella dell’utilizzo di linee dati veloci (3G/4G, ADSL/Fibra) che ha consentito l’utilizzo crescente dello scambio di dati video e del progressivo passaggio all’interazione in tempo reale. Oggi è del tutto usuale collegarsi alle telecamere presenti nell’abitazione per verificare da remoto lo stato dell’alloggio, rispondere a un videocitofono dall’ufficio o spegnere le luci in tempo reale da qualunque parte del mondo ove sia disponibile una connessione Internet.

Ovviamente possiamo affermare – ed è obiettivamente banale – che ogni casa ed edificio connesso ad una linea dati tramite un operatore telefonico è niente più che un nodo di una rete. Ogni impianto domotico, quindi, è esposto ad ogni forma di attacco pensabile per un nodo di rete qualsiasi ed andrebbe protetto nello stesso modo. Purtroppo, però, questa consapevolezza non è così diffusa: pensare ad un’abitazione come se fosse un semplice terminale connesso è un passaggio culturale che al momento non è del tutto avvenuto nel settore (soprattutto per il residenziale).

Difatti la procedura più comune per permettere una connessione tramite app cellulare dall’esterno agli apparati interni di un impianto domotico è quella di “aprire le porte” ovvero impostare regole di NAT sul modem dell’operatore. Tipicamente le porte aperte sono le porte standard indicate dal produttore e sono reindirizzate direttamente sull’IP dell’apparato senza alcun meccanismo di identificazione intermedia (es. restringendo gli accessi a specifici MAC Address). Se sommiamo questa situazione con la poca abitudine a modificare le credenziali di accesso standard degli apparati (si faccia riferimento ai precedenti articoli) è chiaro quanto possa essere facile accedere allo stream di una telecamera interna usando uno scanner di rete – gli intervalli di indirizzi assegnati ad ogni operatore sono addirittura facilmente riscontrabili online [1] perfino segmentati per città [2] – ed un browser. Come evidenziato negli articoli precedenti, parte della colpa di questa “insicurezza diffusa” va cercata anche nell’inadeguatezza dei prodotti disponibili che spesso non implementano protocolli sufficientemente recenti o mancano del tutto di meccanismi di autenticazione/crittografia o della possibilità di personalizzare i parametri di configurazione delle connessioni.

Non ci stancheremo mai di ricordare come buona parte della sicurezza possa essere raggiunta con una corretta architettura e progettazione, in particolare ricordiamo:

  1. separare nettamente la rete che ospita i device domotici dalla rete utente. L’abbiamo sottolineato più volte precedentemente, la separazione delle reti tramite router e firewall accuratamente configurati è la condizione di minima sicurezza che bisogna iniziare a garantire. Inoltre, questa azione, non ha il minimo impatto sulle modalità di utilizzo dell’impianto da parte dell’utente che non dovrà barattare la sicurezza con un aumento di complessità;
  2. usare connessioni protette per accedere all’interno degli impianti. Sostituire l’accesso remoto tramite NAT con VPN e SSH Tunneling in modo da garantire connessioni cifrate, autenticate e autorizzate. Questa opzione, purtroppo, in molti casi necessita un aumento di complessità delle procedure di connessione che l’utente finale deve effettuare per accedere.

L’aumento di complessità per l’utente finale non è da sottovalutare. Nell’ambito della domotica residenziale c’è una ipersensibilità alla complessità da parte degli utenti che percepiscono un netto calo del livello di comfort a fronte anche di un minimo aumento di complessità delle procedure. Questo può essere un grosso ostacolo alla messa in sicurezza di un impianto: l’utente solitamente preferisce barattare la sicurezza con la semplificazione. Al riguardo, fortunatamente, si può evidenziare un trend da parte dei produttori – in particolare dei prodotti legati alla sicurezza e all’integrazione di sistemi [3] – che dimostrano un’attenzione maggiore al tema. Cresce da parte di questa classe di produttori l’offerta di app e device che si connettono con modalità sicure di accesso basate su VPN del tutto trasparenti all’utente[4].

Connessione degli impianti domotici a servizi esterni

Oltre alla necessità di accesso degli utenti ai propri impianti c’è oggi sempre maggiore necessità da parte degli impianti stessi di collegarsi verso servizi terzi di storage, elaborazione dati e servizi altri.

Ad esempio, il controllo vocale è al momento attuale uno dei trend tecnologici emergenti [5] e tutti i device che permettono questo tipo di controllo si appoggiano a server esterni di elaborazione, acquisizione dati e ricerca. In questo scenario, quindi, se avessimo un sistema domotico controllato da Alexa o Google Home, dovremmo consentire a questi device di comunicare con servizi esterni.

In tali scenari le criticità principali possono derivare da:

  1. protocolli di comunicazione verso servizi terzi non sicuri;
  2. condivisione di dati sensibili con soggetti terzi;
  3. interruzione di connettività.

Fortunatamente casi di protocolli di comunicazione non sicuri stanno progressivamente riducendosi poiché il livello di sicurezza di servizi nati per sopravvivere online è mediamente alto, monitorato e mantenuto. Ovviamente diventa cruciale la scelta del fornitore: sarà necessario selezionare il fornitore di servizi che tenga in conto gli aspetti di sicurezza, che possa vantare una comprovata fiducia del mercato e che non sia stato scelto semplicemente per via del prezzo del device. Una valutazione di qualità del prodotto deve oggi essere fatta sempre considerando la qualità e la sicurezza dei servizi offerti e non solo dell’oggetto in sé.

Il tema della condivisione dei dati sensibili come le credenziali di login, le API KEY e altri dati necessari alla connessione è altro tema da non sottovalutare in ambito domotico. Spesso questi dati sono forniti e condivisi con i servizi terzi con gran facilità senza soppesare bene se effettivamente il servizio attivato porti un beneficio concreto in termini di comfort e qualità della vita quotidiana o ne aumenti inutilmente la complessità. In caso di data breach dei siti dei fornitori di servizi, tutto il nostro impianto viene di conseguenza, esposto ad accessi non autorizzati. Se si usufruisce di servizi online, l’installatore o il manutentore dovrebbe predisporre per le connessioni machine-to-machine una politica per l’utilizzo di password sicure, differenziate e per il loro rinnovo periodico. Sicuramente la nuova normativa europea sul trattamento dei dati personali (GDPR) [6] – con l’obbligo di informare tempestivamente gli utenti in caso di violazione dei dati – dà l’opportunità di ripristinare rapidamente la sicurezza di un impianto domotico sempre che, ovviamente, si sia provveduto a definire una politica di manutenzione continuata e che i manutentori si siano organizzati per ricevere e gestire tali comunicazioni.

L’ultimo punto della nostra lista, ossia la garanzia che il sistema funzioni in assenza di connettività, può sembrare bizzarro. Per un impianto domotico, troppo spesso, la progettazione viene fatta partendo dai device e non dalle esigenze o subisce l’invasione dei prodotti consumer che non sempre hanno certe “malizie”. Un esempio classico è quello delle smart plug che possono essere comandate solo da cellulare. Queste prese appoggiano tutta la loro intelligenza sulla condivisione di dati e statistiche verso server esterni che elaborano e presentano valori di consumo e altre statistiche sul cellulare dell’utente. Inoltre, sempre passando attraverso il server, è possibile verificare lo stato della presa, alimentarla e disalimentarla. Tutta questa comunicazione che avviene attraverso il server del servizio, in caso di mancanza di connettività non consente ovviamente né di acquisire dati né di mandare comandi ai device. Un impianto domotico deve essere sempre autonomo dalla connettività per evitare che, mettendo fuori uso la linea dati, si resti “intrappolati” in casa.

La sicurezza nella domotica: una sfida ancora da vincere

Come abbiamo visto in questo trittico di articoli, la questione della sicurezza nella domotica residenziale è complessa e coinvolge tanti livelli diversi ovvero non solo quello tecnico, ma anche quello culturale e comportamentale dei tanti soggetti coinvolti.

Agli utenti, i proprietari delle case, deve essere oggi molto chiaro che il comfort di una casa in grado di capire e adeguarsi al proprio stile di vita e al proprio modo di interagire con l’ambiente ha un prezzo in termini di rischi di sicurezza. Sicurezza in senso non solo di esposizione ad attacchi malevoli che possono creare disagi o danni diretti, ma anche di esposizione verso soggetti privati terzi dei dati molto privati legati alle abitudini e ai comportamenti che si hanno in casa. Il tema della privacy dei dati raccolti da una casa è poco dibattuto e soprattutto poco percepito: sarà necessario accendere al più presto i riflettori sulla questione.

I progettisti e gli installatori hanno, in termini diretti, responsabilità verso il cliente e anche verso la comunità tutta sul tema della sicurezza. In particolare a loro va, oltre il dovere di dare maggiore priorità al tema nella realizzazione quotidiana del loro lavoro, l’onere di aumentare la consapevolezza sul tema dei loro clienti. Altra missione importante è quella di accrescere la cultura della manutenzione continuativa degli impianti che da troppi operatori del settore è vissuta incredibilmente come un male ineluttabile piuttosto che come un’opportunità. Come abbiamo visto la logica del “tanto chi vuoi che si interessi alla casa del mio cliente” non regge più, anzi è un atteggiamento mentale che facilita i comportamenti criminali online. Anche se “il mio cliente” non subirà un danno diretto questo non affranca il tecnico dalla responsabilità di costruire una società più sicura. La prolificazione di impianti non protetti dagli accessi esterni non è solo un problema per i proprietari dell’impianto, ma diventa un problema di sicurezza più generale se si pensa che ogni impianto domotico può diventare un tramite per effettuare, ad esempio, un attacco. Al riguardo ricordiamo come nel 2016 ci fu un massiccio attacco DDoS che coinvolse alcuni dei maggiori siti web tra cui Amazon e Twitter. L’attacco partì da quasi 100.000 device tra IP Camera e altri dispositivi che erano stati penetrati dal virus Mirai grazie alla debolezza delle password usate [7]. Questo da un lato sottolinea che una cultura della sicurezza dell’abitazione non risponde alla sicurezza solo della vita di un singolo ma anche a quella di milioni di altre persone.

Infine i produttori, sono i soggetti più influenti su questo tema perché possono agire sia sui clienti finali che sui tecnici in modo diretto semplicemente aumentando la sicurezza dei propri prodotti. L’evoluzione e le richieste che vengono dal mercato della smart home e della domotica mettono evidentemente sotto pressione gli imprenditori che si vedono progressivamente costretti a rivoluzionare – anche profondamente – non solo i prodotti che offrono ma spesso la struttura con cui progettano e producono i prodotti stessi. Se volessimo inquadrare questa tendenza in una visione più ampia, legata al mercato della domotica, potremmo sottolineare come anche qui (forse con più resistenza rispetto ad altri mercati) stia progressivamente emergendo la trasformazione dei modelli di business da quelli tradizionali di vendita di semplici prodotti alla vendita di servizi: non ti vendo più il device per rendere la casa domotica ma ti vendo un servizio (che in futuro includerà l’hardware stesso) che renderà la tua casa intelligente e accessibile. Questo cambio di paradigma implica un’assunzione di responsabilità diretta sulla sicurezza degli impianti/servizi offerti. Tuttavia questa sorta di innovazione predestinata non è una condanna destinata ai soli operanti nella domotica ma è un trend generale imposto dai nuovi paradigmi raccolti sotto il termine IoT (Internet of Things) [8] che, come ogni evento epocale, andrà abbracciato e non più combattuto.

Riferimenti


A cura di: Matteo De Simone, Michelangelo De Bonis

L’articolo Elementi di sicurezza negli impianti domotici – parte terza proviene da ICT Security Magazine.

https://www.ictsecuritymagazine.com/articoli/elementi-di-sicurezza-negli-impianti-domotici-parte-terza/


Misure di sicurezza tra NIS e GDPR: brevi appunti ed alcune semplici riflessioni

Il rapporto tra NIS e GDPR

Il recente ingresso nell’ordinamento italiano della direttiva NIS (“Direttiva (UE) 2016/1148 del Parlamento europeo e del Consiglio, del 6 luglio 2016, recante misure per un livello comune elevato di sicurezza delle reti e dei sistemi informativi nell’Unione”) e del GDPR (Regolamento UE 2016/679 del Parlamento europeo e del Consiglio, del 27 aprile 2016, relativo alla protezione delle persone fisiche con riguardo al trattamento dei dati personali, nonché alla libera circolazione di tali dati e che abroga la direttiva 95/46/CE – regolamento generale sulla protezione dei dati) ha prodotto l’effetto di una certa confusione in materia di ambito applicativo delle relative misure di sicurezza da adottare, confusione che questo breve articolo cercherà di risolvere. Entrambe le normative, infatti, definiscono quale debba essere il processo di corretto trattamento di dati, seppur di diversa natura. A tal riguardo vi prego di considerare il “dato” come una registrazione elementare nella memoria di un computer, priva di una dimensione numerica prestabilita che possa farlo ritenere una precisa unità di misurazione (Questa è la definizione di G. Pica, Diritto penale delle nuove tecnologie, UTET, Torino, 1999, recepita in dottrina, inter alia, da P. Perri, Protezione dei dati e nuove tecnologie aspetti nazionali, europei e statunitensi, Giuffrè, Milano, 2007).

GDPR: oggetto di tutela

Occorre chiarire, in primo luogo, quale sia l’oggetto della tutela del GDPR.

Il Regolamento trova infatti applicazione nei casi di trattamento di dati personali, da intendersi, sulla base dell’art. 4, come qualsiasi informazione riguardante una persona fisica (si badi bene: non giuridica!) identificata o identificabile. Si considera identificabile, ai sensi del GDPR, la persona fisica che possa essere identificata, direttamente o indirettamente, con particolare riferimento a un identificativo quale il nome, un numero di identificazione, i dati relativi all’ubicazione, un identificativo online o a uno o più elementi caratteristici della sua identità fisica, fisiologica, genetica, psichica, economica, culturale o sociale. Per stabilire l’identificabilità di una persona, in conformità al considerando 26 del Regolamento, è opportuno considerare tutti i mezzi di cui il titolare del trattamento o un terzo possa ragionevolmente avvalersi per identificare detta persona fisica direttamente o indirettamente. Per accertare la ragionevole probabilità di utilizzo dei mezzi validi per identificare la persona fisica, è necessario prendere in considerazione l’insieme dei fattori obiettivi, tra cui i costi e il tempo necessario per l’identificazione, tenendo conto sia delle tecnologie disponibili al momento del trattamento, sia degli sviluppi tecnologici. Il GDPR, in conseguenza di quanto sopra esposto, non trova applicazione in relazione ad ipotesi di trattamento di dati del tutto anonimi. Il GDPR, è bene precisare, non trova applicazione indistintamente in ogni caso di trattamento di dati personali, non risulta difatti applicabile, in conformità all’art, 2, con riferimento al trattamento di dati:

  1. effettuati per attività che non rientrano nell’ambito di applicazione del diritto dell’Unione Europea;
  2. effettuati dagli Stati membri nell’esercizio di attività che rientrano nell’ambito di applicazione del titolo V, capo 2, TUE;
  3. effettuati da una persona fisica per l’esercizio di attività a carattere esclusivamente personale o domestico (si pensi alla memorizzazione di un numero di telefono di un amico in agenda);
  4. effettuati dalle autorità competenti a fini di prevenzione, indagine, accertamento o perseguimento di reati o esecuzione di sanzioni penali, incluse la salvaguardia contro minacce alla sicurezza pubblica e la prevenzione delle stesse.

Le misure di sicurezza

Il GDPR prevede tra l’altro, in buona sostanza, che chi effettui un trattamento di dati personali – fatte salve le limitazioni sopra descritte – adotti specifiche misure di sicurezza. Ai sensi dell’art. 32, infatti “tenendo conto dello stato dell’arte e dei costi di attuazione, nonché della natura, dell’oggetto, del contesto e delle finalità del trattamento, come anche del rischio di varia probabilità e gravità per i diritti e le libertà delle persone fisiche, il titolare del trattamento e il responsabile del trattamento mettono in atto misure tecniche e organizzative adeguate per garantire un livello di sicurezza adeguato al rischio, che comprendono, tra le altre, se del caso:

  1. la pseudonimizzazione e la cifratura dei dati personali;
  2. la capacità di assicurare su base permanente la riservatezza, l’integrità, la disponibilità e la resilienza dei sistemi e dei servizi di trattamento;
  3. la capacità di ripristinare tempestivamente la disponibilità e l’accesso dei dati personali in caso di incidente fisico o tecnico;
  4. una procedura per testare, verificare e valutare regolarmente l’efficacia delle misure tecniche e organizzative al fine di garantire la sicurezza del trattamento”.

L’oggetto di tutela della direttiva NIS, come attuata dal D. lgs. 65/2018

La Direttiva NIS, come attuata nel nostro ordinamento dal D. lgs. 65/2018, non si prefigge direttamente il compito di assicurare alcuna tutela dei dati personali, ma piuttosto quello di definire obblighi di adozione di specifiche misure di sicurezza volte a conseguire un livello elevato di sicurezza della rete e dei sistemi informativi in ambito nazionale, contribuendo ad incrementare il livello comune di sicurezza nell’Unione Europea. Sono soggetti all’adozione di tali misure, sulla base di quanto definito all’art. 3 del D. lgs., quelli che possono essere considerati “fornitori di servizi critici” e, segnatamente:

  • L’operatore di servizi essenziali, da intendersi quale“soggetto pubblico o privato, della tipologia di cui all’allegato II, che soddisfa i criteri di cui all’articolo 4, comma 2” del D. lgs. L’allegato II, a sua volta, con buona approssimazione, include nei servizi essenziali:
    • fornitura di energia: elettricità, petrolio e gas;
    • trasporto: aereo, ferroviario, marittimo e stradale;
    • settore bancario: istituti di credito;
    • salute: istituti sanitari;
    • infrastrutture proprie dei mercati finanziari: le sedi di negoziazione e le controparti centrali;
    • acqua: fornitura di acqua potabile e la relativa distribuzione;
    • infrastrutture digitali: Internet Exchange point, fornitori di servizi DNS e registri TLD.
  • Il fornitore di servizio digitale, da intendersi quale “qualsiasi persona giuridica che fornisce un servizio digitale” definito come “servizio ai sensi dell’articolo 1, paragrafo 1, lettera b), della direttiva (UE) 2015/1535 del Parlamento europeo e del Consiglio, del 9 settembre 2015, di un tipo elencato nell’allegato III”. L’allegato III a sua volta, ricomprende:
    • il Mercato online;
    • i Motori di ricerca;
    • i Servizi di cloud.

Le misure di sicurezza

Gli operatori di servizi essenziali, in conformità all’art. 12 del D. lgs., devono adottare misure tecniche e organizzative adeguate e proporzionate alla gestione dei rischi posti alla sicurezza della rete e dei sistemi informativi che utilizzano nelle loro operazioni. Tenuto conto delle conoscenze più aggiornate in materia, dette misure devono assicurare un livello di sicurezza delle reti e dei sistemi informativi adeguato al rischio esistente. Gli operatori di servizi essenziali devono altresì adottare misure adeguate per prevenire e minimizzare l’impatto di incidenti a carico della sicurezza della rete e dei sistemi informativi utilizzati per la fornitura dei servizi essenziali, al fine di assicurare la continuità di tali servizi. Nell’adozione delle sopraccitate misure questi devono tenere conto delle linee guida predisposte dal gruppo di cooperazione, composto da rappresentanti degli Stati membri, della Commissione europea e dell’Agenzia dell’Unione europea per la sicurezza delle reti e dell’informazione (ENISA), nonché di specifiche linee guida redatte dalle autorità competenti NIS – le autorità competenti per settore definite all’art. 7 del D. lgs. – in tema di notifica delle violazioni. Queste ultime autorità, possono inoltre, ove necessario, definire specifiche misure di sicurezza, sentiti gli operatori di servizi essenziali.

Per quanto concerne i fornitori di servizi digitali, che non siano micro o piccole imprese, questi – sulla base di quanto definito dall’art. 14 del D. lgs, devono identificare ed adottare misure tecniche e organizzative adeguate e proporzionate alla gestione dei rischi relativi alla sicurezza della rete e dei sistemi informativi che utilizzano. Tenuto conto delle conoscenze più aggiornate in materia, tali misure devono assicurare un livello di sicurezza della rete e dei sistemi informativi adeguato al rischio esistente e tengono conto dei seguenti elementi:

  1. la sicurezza dei sistemi e degli impianti;
  2. trattamento degli incidenti;
  3. gestione della continuità operativa;
  4. monitoraggio, audit e test;
  5. conformità con le norme internazionali.

I fornitori di servizi digitali devono adottare, infine, misure per prevenire e minimizzare l’impatto di incidenti a carico della sicurezza della rete e dei sistemi informativi del fornitore di servizi digitali sui servizi di cui all’allegato III del D. lgs., offerti all’interno dell’Unione europea, al fine di assicurare la continuità di tali servizi. I fornitori di servizi digitali sono infine tenuti ad adottare le disposizioni di attuazione degli atti di esecuzione della Commissione europea che specificano ulteriormente le misure tecnico-organizzative sopraccitate.

Brevi riflessioni finali

GDPR e NIS sono due normative volte a tutelare differenti beni giuridici, ma potrebbero risultare, nella pratica, parzialmente sovrapponibili. Non è possibile escludere, infatti, che attacchi a sistemi “critici” per lo Stato possano comportare, come effetto, un trattamento illecito di dati personali.

Per quanto concerne le misure di sicurezza assistiamo ad un approccio, a livello metodologico, dicotomico. Se da una parte il GDPR pone in essere quella che è stata definita da parte della dottrina una “enfatizzazione del ruolo del titolare”, (S. Bonavita, R. Pardolesi, “GDPR e diritto alla cancellazione in Danno e responsabilità, n. 3/2018, Ipsoa) assegnandogli l’onere e l’onere di definire quali misure di sicurezza debbano essere adottate, il D. lgs. pare consentire, di fatti, all’Autorità di imporre specifiche misure di sicurezza, misure, che in ogni caso, devono essere definite “tenuto conto delle conoscenze più aggiornate in materia”, a differenza di quelle da adottare nel caso di trattamento dei dati personali, da valutarsi “tenendo conto dello stato dell’arte e dei costi di attuazione, nonché della natura, dell’oggetto, del contesto e delle finalità del trattamento, come anche del rischio di varia probabilità e gravità per i diritti e le libertà delle persone fisiche”. Analizzando il dato testuale parrebbe pertanto essere necessario, per i “fornitori di servizi critici”, l’adozione di misure che potrebbero essere più elevate rispetto a quelle previste nel caso di trattamento di dati personali. In questo scenario, inoltre, andrebbe altresì considerata la giurisprudenza dell’Autorità Garante, la quale in passato ha difatti imposto ai titolari l’adozione di misure allorché non espressamente previste dal dettato normativo. Il panorama è destinato ad assumere ulteriori elementi di complessità considerando la Direttiva (UE) 2016/943 del Parlamento europeo e del Consiglio, dell’8 giugno 2016, sulla protezione del know-how riservato e delle informazioni commerciali riservate (segreti commerciali) contro l’acquisizione, l’utilizzo e la divulgazione illeciti, recepita dal Decreto legislativo, 11/05/2018 n. 63, la quale potrebbe spingere soggetti desiderosi di tutelare il loro know-how riservato all’adozione di misure di sicurezza che potrebbero anche essere in contrasto con le normative sopra analizzate.

Uno scenario di questo tipo comporta, concretamente, l’esigenza da parte delle società coinvolte nei sopraccitati trattamenti, di rivedere, a livello di processo, le misure di sicurezza adottate, valutando l’opportunità di declinare la tutela del dato a seconda delle informazioni delle quali questo è portatore.


Articolo a cura di Simone Bonavita 

L’articolo Misure di sicurezza tra NIS e GDPR: brevi appunti ed alcune semplici riflessioni proviene da ICT Security Magazine.

https://www.ictsecuritymagazine.com/articoli/misure-di-sicurezza-tra-nis-e-gdpr-brevi-appunti-ed-alcune-semplici-riflessioni/


Il GDPR e l’avvocato. Protezione dei dati sensibili dei clienti negli studi legali

Il Regolamento UE 2016/679 relativo alla protezione dei dati personali, entrato in vigore il 25 maggio 2018, deve essere applicato anche da coloro che esercitano la libera professione forense, indipendentemente dalla tipologia di studio legale all’interno del quale si svolge l’attività.

Ciascun avvocato, nell’esercizio delle sue funzioni, ha accesso a delle informazioni che, per loro natura, sono particolarmente sensibili e che possono riguardare, ad esempio, la situazione familiare, i dati giudiziari, la salute e l’orientamento politico del singolo individuo.

Il trattamento di ciascuno di questi dati è associato ad una logica specifica e diversa da quella comunemente utilizzata poiché connessa sia al rapporto di fiducia che lega l’assistito al proprio avvocato che al rispetto degli obblighi deontologici.

Il primo obbligo del professionista è quello di garantire, con particolare cura, il segreto professionale, espressione della trasparenza e confidenzialità del rapporto instaurato.

La divulgazione, seppur accidentale, di tali dati potrebbe ledere i diritti e la libertà delle persone coinvolte in modo irreversibile ed esporle a problematiche di non poco conto.

Al fine di evitare pericoli gli avvocati dovranno assicurarsi che:

  • le modalità di trattamento e di trasmissione dei dati siano chiaramente definite;
  • le misure di sicurezza siano precisamente individuate, definite ed attuate;
  • i colleghi o i collaboratori di studio (es. segreteria, praticanti, colleghi, collaboratori a qualsiasi titolo) siano adeguatamente informati e coinvolti nel processo di protezione dei dati personali dei singoli clienti;
  • le norme e la sicurezza siano rispettate anche nell’ipotesi in cui lo studio abbia esternalizzato a terzi alcuni servizi (ad esempio, l’utilizzo di una segreteria virtuale, la conservazione dei dati su cloud) o utilizzi propri mezzi di comunicazione a terzi (sito web, blog, servizi di consultazione on line).

Precisamente, ai sensi dell’art. 4, comma 7, GDPR, il titolare del trattamento dei dati personali è la persona fisica o giuridica, l’autorità pubblica, il servizio o altro organismo che, singolarmente o insieme ad altri, determina le finalità e i mezzi del trattamento di predetti dati. Una simile funzione ben si concilia con il ruolo di carattere gestionale svolto da colui che può determinare finalità e mezzi del trattamento (cd. Data Controller).

L’avvocato, dunque, è titolare del trattamento di tutte le informazioni che vengono fornite dagli assistiti in virtù del mandato ricevuto. Secondo l’art. 26 del GDPR, le stesse funzioni dovranno essere espletate da eventuali contitolari qualora siano stati sottoscritti un mandato ed autorizzazione al trattamento dei dati da parte di più difensori, i quali, in caso di violazioni, risponderanno ciascuno per la propria parte in ragione delle responsabilità e degli obblighi assunti ex art.13 e 14 del GDPR.

Invero, nel caso in cui ogni avvocato riceva mandato per specifiche prestazioni o attività, pur inerenti lo stesso oggetto di controversia, consulenza o problematica, non si ravvisa una collaborazione nelle finalità e, dunque, ciascuno sarà titolare del trattamento elaborandone autonomamente le modalità. È il caso, ad esempio, dell’assistenza specifica di più avvocati – appartenenti allo stesso studio – in ambiti diversi e separati, come l’avvocato cui è affidata la difesa in sede civile e l’avvocato cui è affidata la difesa in sede penale per il medesimo soggetto e per fatti correlati.

Nel caso di società o associazioni è sempre l’ente giuridico – in nome del legale rappresentante pro tempore – ad essere qualificato titolare; ciononostante, in virtù del mandato tra assistito e avvocato (di natura prettamente personale e fiduciaria), si reputa che il titolare non potrà che essere identificato nell’avvocato che riceve (o negli avvocati della società o associazione che ricevono) l’incarico di svolgere la prestazione e non nel legale rappresentante della persona giuridica.

L’avvocato, inoltre, ha l’obbligo di tenere il registro delle attività di trattamento sotto la sua responsabilità anche ove il trattamento stesso sia riferito a particolari categorie di dati o a dati relativi a condanne, reati o sanzioni (ad esempio: gli avvocati che si occupano di diritto penale, quelli che si occupano di famiglia e minori, di diritto della previdenza sociale, di medical malpractice e, in generale, di vertenze in materia di risarcimento danni da lesioni personali). Tale obbligo non vige per le organizzazioni con meno di 250 dipendenti, sempre che il trattamento non includa un rischio non occasionale per i diritti e le libertà delle persone interessate o si riferisca, in particolare, a dati sensibili o relativi a condanne e reati.

In ogni caso la detenzione del registro è sempre consigliabile. Quest’ultimo dovrà includere necessariamente ex art. 30 del GDPR: il nome ed i contatti del titolare, del contitolare, del responsabile e, se del caso, del rappresentante, del responsabile dell’elaborazione e del responsabile della protezione dei dati. Dovrà contenere, inoltre, gli scopi del trattamento; la descrizione delle categorie relative ai dati trattati, nonché delle categorie di persone coinvolte nel trattamento o dei destinatari a cui i dati personali sono stati o saranno comunicati.

Altro aspetto fondamentale è quello che attiene la sfera del rapporto tra professionista e cliente. Infatti, nell’ambito dell’esercizio della professione forense, è bene ricordare che il trattamento dei dati personali è unicamente finalizzato alla formazione del fascicolo dell’assistito ed alla difesa dei suoi interessi.

L’articolo 9, comma 1, GDPR, disciplina il divieto – in linea di principio – del trattamento dei dati sensibili. Il suddetto articolo, tuttavia, contempla l’eccezione di cui al comma 2, lettera f), ai sensi della quale il divieto imposto dal comma 1 può essere derogato per “accertare, esercitare o difendere un diritto in sede giudiziaria o ogniqualvolta le autorità giurisdizionali esercitino le loro funzioni”.

L’avvocato, quindi, per poter espletare il proprio incarico – ad esempio in ambito penalistico – dovrà raccogliere dati sulle condanne penali e sui precedenti del cliente. La natura speciale di questi elementi richiede garanzie di un trattamento specifico che può essere attuato esclusivamente sotto il controllo dell’Autorità pubblica o essere direttamente regolamentato da precise disposizioni previste dalla legge nazionale.

Pertanto, in ossequio al dettato dell’art. 13 del GDPR, gli assistiti di uno studio legale dovranno essere informati:

  • sull’identità e sui dettagli di contatto del titolare del trattamento e dell’eventuale responsabile della protezione dei dati (se previsto);
  • sull’obiettivo perseguito (gestione e monitoraggio dei file dei clienti);
  • sulla base giuridica del trattamento (prestazione contrattuale o precontrattuale su richiesta del cliente);
  • sull’interesse legittimo del titolare, se costituisce la base giuridica del trattamento ex art. 6, comma 1, lettera f), GDPR;
  • sui destinatari dei dati (subappaltatori, ufficiali giudiziari, etc.);
  • sui flussi transfrontalieri;
  • sulla durata di conservazione;
  • sui diritti che possono vantare;
  • sulle condizioni per l’esercizio dei diritti;
  • sul diritto di revocare il consenso;
  • sul diritto di presentare un reclamo all’autorità di controllo;
  • sulle informazioni relative alla natura normativa o contrattuale del trattamento.

Queste informazioni potranno essere incluse nell’accordo con il cliente o essere comunicate via e-mail o in occasione della trasmissione di una nota di onorario.

Altro aspetto da analizzare è quello inerente la conservazione dei dati dei clienti, che dovranno essere custoditi per tutta la durata del mandato professionale fino al raggiungimento dell’obiettivo perseguito e, prima della loro cancellazione definitiva, sino a quando non sia prescritta un’eventuale azione di responsabilità professionale in cui potrebbe incorrere l’avvocato.

Nel caso estremo in cui vi sia una revoca dell’incarico, l’avvocato che ha inizialmente trattato i dati è tenuto a comunicare al suo collega che il cliente ha sottoscritto mandato conforme alle norme di legge e dovrà provvedere alla loro trasmissione in formato strutturato comunemente usato e leggibile da una qualsiasi macchina. Ove il fascicolo fosse tenuto in modalità esclusivamente cartacea, quest’ultimo dovrà essere consegnato al cliente nel minor tempo possibile, con l’eccezione delle lettere riservate che dovranno essere consegnate direttamente al nuovo avvocato.

Da ultimo, i titolari e responsabili del trattamento dei dati sensibili, nel caso in cui violino le norme precauzionali del GDPR create dal legislatore, potranno incorrere in sanzioni amministrative significative.

Precisamente, l’autorità Garante per la protezione dei dati personali potrà: rivolgere avvertimenti; ammonire l’avvocato, l’associazione o la società professionale; limitare temporaneamente o permanentemente un trattamento; sospendere il flusso dei dati; ordinare di soddisfare richieste per l’esercizio dei diritti delle persone; ordinare la rettifica, la limitazione o la cancellazione dei dati; ritirare la certificazione di conformità concessa all’avvocato, allo studio, all’associazione o alla società professionale ovvero ordinarne il ritiro all’autorità di certificazione; comminare una sanzione amministrativa di importo compreso tra i 10 ed i 20 milioni di euro, ovvero, in caso di grandi studi internazionali, di importo compreso tra il 2% ed il 4% del fatturato mondiale.

Bibliografia:

Articolo a cura di Valentina Bartolucci

L’articolo Il GDPR e l’avvocato. Protezione dei dati sensibili dei clienti negli studi legali proviene da ICT Security Magazine.

https://www.ictsecuritymagazine.com/articoli/il-gdpr-e-lavvocato-protezione-dei-dati-sensibili-dei-clienti-negli-studi-legali/


WCrypt: Cosa abbiamo imparato dallo spauracchio degli ultimi anni?

Cifrare i dati di un pc per trarne un profitto economico è la strategia criminale usata in ambito informatico per mezzo dei ransomware, i software del riscatto. Questa tecnica ha trovato la sua massima espansione e clamore negli ultimi anni a causa del malware che ha messo in ginocchio le infrastrutture ICT contaminando migliaia di computer: Wannacry.

Il fatto del 2017

Nel primo pomeriggio di venerdì 12 maggio 2017, i media hanno dato la notizia di un attacco alla sicurezza informatica a livello globale compiuto attraverso un codice maligno, capace di crittografare i dati residenti nei sistemi informativi e chiedere un riscatto in criptovaluta per il loro ripristino.

Anche l’Italia è stata marginalmente interessata dall’attacco e ad occuparsi del caso è stato il CNAIPIC [1], il Centro Operativo anticrimine informatico della Polizia Postale, che ha prontamente diramato un comunicato [2] nel giorno stesso dell’evento, consigliando alcuni interventi utili anche per prevenire ulteriori e possibili propagazioni di varianti.

Il ransomware, come riportato dal bollettino Microsoft [3], una volta trasmesso tramite mail con la metodica del phishing e del social engineering oppure direttamente da rete pubblica sfruttando una falla protocollare dei dispositivi connessi, procedeva:

  1. a criptare i dati dei computer, con le tecniche di crittografia asimmetrica a chiave pubblica RSA [4];
  2. a moltiplicarsi nella rete cui appartenevano i pc infettati, attraverso un codice della NSA [5] denominato EternalBlue, che sfruttava una vulnerabilità del protocollo di condivisione file di rete SMB (Server Message Block) usato dai sistemi Microsoft Windows.

Anatomia del contagio

  1. Il malware veniva installato attraverso un dropper, un programma eseguito aprendo un allegato ad una mail ingannevole, probabilmente un finto file pdf o doc, oppure eseguito direttamente da internet, senza l’interazione di un utente, sfruttando l’exploit descritto nel punto 4.
  2. Il dropper, una volta copiato sul pc tentava la connessione ad un sito e solo se la connessione non andava a buon fine, procedeva all’installazione di due componenti un cryptolocker ed un exploit.
  3. Il cryptolocker aveva il compito di cifrare i dati del sistema colpito;
  4. L’exploit quello di infettare la rete locale della vittima, se non opportunamente aggiornata, tramite la vulnerabilità del protocollo SMB.

Si veda a tal proposito la figura seguente.

Kill Switch

Il codice malevolo si proliferava solo se veniva verificata la mancata raggiungibilità di un sito pubblico che di fatto era inesistente:

hxxp://www[.]iuqerfsodp9ifjaposdfjhgosurijfaewrwergwea[.]com

solo la registrazione di questo dominio ha successivamente creato la condizione, il kill swich, per far cessare l’azione del malware scemandone la divulgazione.

La diffusione di questo ransomware è stato considerato come il peggior attacco informatico degli ultimi anni per velocità di contaminazione e portata mettendo a rischio il funzionamento di uffici pubblici e aziende.

La componente Cryptolocker

Lo schema di cifratura implementato da WannaCry ha utilizzato un meccanismo di crittografia asimmetrica basato su una coppia di chiavi pubblica e privata generata tramite l’utilizzo di due numeri primi [6]. La chiave pubblica è stata usata per crittografare i dati del sistema colpito, mentre quella privata è stata l’oggetto del ricatto.

L’algoritmo di funzionamento, come già accennato, è l’RSA. La sua efficacia si basa sul principio matematico secondo il quale è facile calcolare il prodotto di due numeri primi anche molto grandi, ma è molto più difficile il processo inverso, cioè scomporre il prodotto per trovare quali siano i due numeri primi utilizzati come fattori.

Descriverò i principi con un esercizio di esempio.

I passi fondamentali dell’algoritmo RSA sono i seguenti:

  • Si scelgono a caso due numeri primi, p e q, l’uno indipendentemente dall’altro. Più questi numeri sono grandi, maggiore sarà la sicurezza dell’algoritmo.
  • Si calcola il loro prodotto n=p∙q.
  • Si sceglie poi un numero e (l’esponente pubblico), più piccolo di n e primo (cioè il cui unico divisore comune è 1) con il prodotto (p-1)∙(q-1).
  • Si calcola il numero d (l’esponente privato) tale che valga la condizione

(e∙d) ≡ 1 modulo (p-1)∙(q-1)

ovvero che le divisioni (e∙d)/[(p-1)∙(q-1)] e 1/[(p-1)∙(q-1)] diano lo stesso resto.

  • Una volta determinati gli esponenti e, d ed il prodotto n, le coppie (n, e) e (n, d) definiscono rispettivamente la chiave pubblica e quella privata.
  • Per cifrare un messaggio si utilizza la formula C(M) = Me (modulo n), ovvero il messaggio cifrato C è dato dal resto della divisione Me /n.
  • Per decifrare un messaggio si utilizza la formula M(C) = Cd (modulo n), ovvero il messaggio decifrato M è dato dal resto della divisione Cd/n.

Il punto di forza di questo algoritmo sta nella difficoltà di calcolo dell’esponente privato d.

Per un esempio pratico sostituiamo a p e q due numeri primi piccoli per facilità di calcolo (ricordo che in realtà i numeri usati possono essere dell’ordine delle centinaia) e supponiamo di voler cifrare e decifrare il messaggio M=13:

  1. Scelti due numeri primi p=11 e q=2, calcoliamo il loro prodotto n=11∙2=22.
  2. Eseguiamo il calcolo (p-1)∙(q-1)=(11-1)∙(2-1)=10∙1=10.
  3. Scegliamo come esponente pubblico e=3 che è minore di n=22 e primo con il prodotto (p-1)∙(q-1)=10.
  4. Appuriamo che 3 e 10 sono primi fra loro (hanno come unico comune divisore 1).
  5. Calcoliamo d (intero) in modo che d∙e ≡ 1 modulo (p-1)(q-1) ovvero troviamo un numero tale che d∙e ≡ 1 modulo 10. Questo è possibile se d=7, infatti il prodotto 21=7∙3 ≡ 1 modulo 10 in quanto entrambi le divisioni 21/10 e 1/10 hanno resto pari a 1.
  6. Noti i valori n, d, e secondo le regole dell’algoritmo RSA è possibile definire come chiave pubblica la coppia (n=22, e=3), mentre come chiave privata la coppia (n=22, d=7).
  7. A questo punto per cifrare il messaggio M=13, dalla formula C(M)=Me (modulo n) risulta che C(13)=133(modulo 22)=19 ovvero il resto della divisione 133/22.
  8. Per decifrare C=19 dalla formula M(C)=Cd (modulo n) risulta che M(19)=197(modulo 22)=13 ovvero il resto della divisione 197/22.

Cercare di calcolare d se le dimensioni di n e q sono dell’ordine di 10100, risulta complesso in quanto per trovare il prodotto (p-1)∙(q-1) è necessario scomporre n in fattori.

La componente Exploit

Per la divulgazione del ransomware all’interno della rete della vittima, l’exploit ha sfruttato una falla della versione 1 del protocollo SMB (Server Message Block) utilizzato in alcuni sistemi operativi Microsoft e deputato a fornire accesso condiviso a file, stampanti, porte seriali e comunicazioni varie tra i nodi della rete. In questo modo WCrypt si è diffuso sulle reti colpite secondo il modus operandi tipico di un worm:

  1. La prima fase dell’infezione viene infatti condotta mediante un eseguibile che effettua scansioni della rete sulla porta TCP 445 del protocollo SMB alla ricerca di sistemi Windows vulnerabili.
  2. Nella seconda fase una volta ottenuto l’accesso ad una macchina, il malware crea ed esegue una copia di sé stesso sul sistema.

Questa anomalia del protocollo SMB, catalogata dalla CVE (Common Vulnerabilities and Exposures) con il numero CVE-2017-0144, permette in locale, qualora il sistema operativo in questione non è stato aggiornato con la patch di sicurezza Microsoft MS17-010, l’esecuzione arbitraria di codice da parte di utenti remoti. Il successo dell’attacco è stato ottenuto proprio grazie al mancato aggiornamento preventivo dei sistemi operativi colpiti.

Il riscatto con valuta digitale

Per il pagamento del riscatto, Wannacry imponeva l’uso della valuta bitcoin [7]. La ben nota schermata di blocco del programma @WanaDecryptor@.exe apparsa sugli schermi dei pc contaminati riportava, infatti, un vademecum dettagliato su come eseguire la transazione di pagamento sul conto, individuato da una stringa di 34 caratteri alfanumerici.

Ma perché i creatori di Wannacry hanno scelto per il pagamento del riscatto il bitcoin?

C’è da dire che per questo tipo di transazioni, pur essendo assolutamente trasparenti e tracciabili, risulta praticamente impossibile risalire al titolare di un certo indirizzo di conto, proprio per le peculiarità tipiche della valuta digitale:

  • Anonimato: I conti bitcoin non sono legati ad un particolare nome e indirizzo. Non è quindi facile risalire ad informazioni sul proprietario.
  • Trasparenza: è possibile sapere pubblicamente quanti bitcoin sono presenti su un conto, ma non è possibile sapere a chi fa riferimento il conto stesso. Ogni transazione viene tracciata in un registro chiamato Blockchain.
  • Velocità: Una transazione bitcoin avviene entro pochi minuti.
  • Non ripudiabilità: una transazione emessa non può più essere richiamata così come una transizione ricevuta non può più essere eliminata.

Ecco come sarebbe avvenuto il pagamento del riscatto in modo semplificato e schematizzato:

  1. La vittima cede al ricatto e spedisce una richiesta di transizione bitcoin.
  2. La richiesta raggiunge il database distribuito (Blockchain) sui nodi appartenenti alla rete Bitcoin, i cosiddetti miners.
  3. I miners verificano la transazione e competono tra loro per l’impacchettamento della stessa in un blocco (secondo il processo di mining). Per accodare correttamente il blocco nella Blockchain, i miners risolvono un complesso calcolo computazionale. Questa operazione viene controllata e condivisa tra i miners.
  4. Quando il problema di calcolo viene risolto ed il blocco viene approvato, il miner solutore viene pagato in bitcoin;
  5. La transazione viene aggiunta nella Blockchain ed evasa. L’intestatario del conto in questione, il criminale, riceve così il riscatto in completo anonimato.

Considerazioni finali

Ad appena un anno di distanza [8][9] l’exploit Eternalblue è tornato a far parlare di sé. Gli specialisti di ESET [10], hanno, infatti, identificato una nuova campagna di ransomware che mirava a colpire quei computer sui quali non era ancora stata applicata la patch emessa da Microsoft già nel Marzo 2017.

Cosa dobbiamo imparare da tutto questo?

In generale, per mitigare il rischio di esposizione alle minacce malware e migliorare la sicurezza, sarebbe opportuno, a tutti i livelli, adottare una politica di condotta cautelativa, garantire il patching periodico dei sistemi IT, ma in primis, condividere con tutti ogni information advisory. Questo perché “Ogni verità e scoperta non ha valore alcuno se poi non la si mette a disposizione degli altri” – cit. Alessandro Righini.

Note

[1] https://www.commissariatodips.it/profilo/cnaipic.html

[2] https://www.commissariatodips.it/fileadmin/src/doc/pdf/comunicato.pdf

[3] https://cloudblogs.microsoft.com/microsoftsecure/2017/05/12/wannacrypt-ransomware-worm-targets-out-of-date-systems/

[4] https://it.wikipedia.org/wiki/RSA

[5] https://www.nsa.gov/

[6] http://www.repubblica.it/tecnologia/sicurezza/2017/05/19/news/wanadecrypt_ecco_il_metodo_per_liberare_i_pc_attaccati_da_wannacry_senza_pagare_il_riscatto-165854774/

[7] https://it.wikipedia.org/wiki/Bitcoin

[8] http://www.ilsole24ore.com/art/tecnologie/2018-05-25/vi-ricordate-wannacry-un-anno-ecco-cosa-e-successo-e-cosa-succedera–175739.shtml?uuid=AExRIvuE

[9] https://blog.eset.it/2018/08/wannacry-alla-ribalta-possibili-ritardi-nella-produzione-dei-nuovi-iphone-di-apple/

[10] https://www.eset.com/int/about/

Sitografia


Articolo a cura di Salvatore Lombardo

L’articolo WCrypt: Cosa abbiamo imparato dallo spauracchio degli ultimi anni? proviene da ICT Security Magazine.

https://www.ictsecuritymagazine.com/articoli/wcrypt-cosa-abbiamo-imparato-dallo-spauracchio-degli-ultimi-anni/