Incident Response: dal Processo alle Procedure

Premessa

In un precedente articolo dal titolo “Security Operations Center: il cuore della protezione dell’Informazione[1]”, focalizzato sulle strutture dedicate alla gestione operativa della cyber-security, ho fatto riferimento a processi tipici di un Security Operations Center (SOC). L’assenza di standard di riferimento e di rigide nomenclature promuove una certa libertà di definire i contorni, spesso liquidi e incerti, di entità operative tra loro simili (da cui la frequente interscambiabilità di acronimi quali SOC[2], CERT[3], CSIRT e IRT[4], la cui origine, spesso, non è relativa al contesto ICT[5]): tali entità sono le protagoniste assolute dei processi di Incident Management.

Alcune definizioni

Evento

Un evento è un episodio osservabile in un sistema o in una rete. Gli eventi comprendono un utente che si collega a un file condiviso o che invia un messaggio di posta elettronica, un server che riceve una richiesta per una pagina web, un firewall che impedisce un tentativo di connessione. Eventi avversi hanno una conseguenza negativa, quali ad esempio i crash di sistema, i packet flood[6], l’utilizzo non autorizzato dei privilegi di sistema, l’accesso non autorizzato a dati sensibili e l’esecuzione di codice malevolo finalizzato a distrugge i dati o a prenderli in ostaggio.

Incidente di sicurezza

Un incidente di sicurezza è una violazione o una minaccia imminente di violazione delle politiche di sicurezza e di utilizzo lecito degli strumenti tecnologici. Esempi di incidenti sono:

  • un attaccante comanda a una botnet[7] di inviare un elevato volume di richieste di connessione a un web server, causandone il blocco;
  • gli utenti sono indotti ad aprire un file di report trimestrale inviato tramite posta elettronica che, in realtà, incorpora codice malevolo;
  • un attaccante ottiene dati sensibili e minaccia di renderli pubblici se l’organizzazione non pagherà una certa somma di denaro;
  • un utente fornisce o espone informazioni sensibili verso altri tramite servizi di file sharing [8]peer-to-peer[9].
Incident Management

L’Incident Management è la capacità di gestire in modo efficace eventi avversi inaspettati con l’obiettivo di minimizzarne gli impatti e mantenere o ripristinare le normali operazioni all’interno di limiti temporali definiti. Una capacità sostenibile di Incident Management richiede l’allocazione di risorse umane e materiali a supporto delle operazioni di business per assicurare la continuità del minimo delle operazioni e contenere le violazioni di sicurezza secondo la strategia di gestione del rischio adottata dall’organizzazione. L’Incident Management riguarda tutte le azioni prese prima (inclusi test e pianificazione), durante e dopo il verificarsi di un incidente di sicurezza delle informazioni. Le azioni intraprese dovrebbero essere finalizzate a mitigare l’impatto di un incidente con i seguenti obiettivi:

  • fornire uno strumento efficace per indirizzare la situazione in modo tale che l’impatto dell’incidente sia minimo per l’organizzazione;
  • fornire al management le informazioni sufficienti per decidere un corso di azione appropriato;
  • mantenere o ripristinare la continuità dei servizi dell’organizzazione;
  • fornire una difesa contro gli attacchi;
  • fornire deterrenza tramite l’utilizzo di tecnologia, investigazione e azioni successive.
Incident Response

L’Incident Response è parte del processo di Incident Management e può essere definito come la “capacità operativa dell’Incident Management che identifica, prepara e risponde agli incidenti per controllare e limitare i danni; fornire capacità investigative e mantenere, recuperare e ripristinare le normali operazioni in accordo ai livelli di servizio (SLA) previsti”.

Una capability di Incident Response dovrebbe includere:

  • creazione di una policy e di un piano di Incident Response;
  • sviluppo delle procedure per garantire il trattamento dell’incidente e il reporting;
  • definizione delle linee guida per comunicare con entità esterne all’organizzazione;
  • scelta di una struttura di team e un modello di staffing;
  • stabilire relazioni e linee di comunicazione tra l’Incident Response Team (IRT) e altri gruppi, sia interni (dipartimento legale) sia esterni (ad esempio, forze dell’ordine);
  • determinare quali servizi dovrebbe erogare l’IRT;
  • dedicare appropriate risorse e addestrare il team.

Gli attacchi compromettono frequentemente dati personali e di business e rispondere velocemente ed efficacemente alle violazioni di sicurezza è diventato un fattore critico; il concetto di incidente di sicurezza informatica è ormai ampiamente noto. Avere una capability di Incident Response permette di gestire gli incidenti in modo sistematico in maniera tale che siano prese tempestivamente le decisioni appropriate. Una capability del genere permette anche di migliorarsi nel tempo e di gestire nel migliore dei modi anche le problematiche di natura legale che possono presentarsi durante le fasi di un incidente.

Contesto operativo

Gli incidenti possono verificarsi in molti modi diversi e non è possibile creare istruzioni universalmente valide per trattare in maniera appropriata ogni incidente. Ci sono diverse tipologie di incidenti basate su vettori di attacco comuni, ma si tratta di categorie utili a definire procedure di trattamento specifiche: diversi tipi di incidenti hanno bisogno di diverse strategie di risposta.

I segnali di un incidente ricadono in due categorie: precursori e indicatori. Un precursore è un segnale di un incidente che potrebbe accadere nel futuro, mentre un indicatore è un segnale di un incidente che potrebbe già essere accaduto o potrebbe addirittura essere in corso.

Esempio di precursori sono:

  • log di applicazioni e sistemi che rilevano l’utilizzo di attività di Information Gathering e Vulnerability Scanning;
  • l’annuncio della disponibilità di exploit[10] software per sfruttare vulnerabilità tecnologiche effettivamente esistenti all’interno dell’organizzazione;
  • minacce provenienti dall’esterno, quali, ad esempio, attacchi informatici o azioni dimostrative effettuate da gruppi di Hacktivist come Anonymous in concomitanza con la data del 5 novembre[11].

Esempi di indicatori sono:

  • un sensore IDS o una qualsiasi sonda di sicurezza che rileva attività anomale o attacchi veri e propri generando il relativo allarme;
  • software antivirus e antimalware che rileva endpoint infettati da codice malevolo e produce il relativo allarme;
  • evidenza di manomissioni, tramite analisi del file di log, alle configurazioni di sistemi, applicazioni, database, sistemi di storage o apparati di rete e sicurezza;
  • diversi tentativi di autenticazione falliti da parte di sistemi remoti e sconosciuti;
  • aumento esponenziale del traffico di rete sia sulle direttrici esterne (compromissione massiva di sistemi interni che, facendo parte di una o più botnet e obbedendo alle istruzioni impartite da un Centro di Comando e Controllo remoto, tentano di partecipare ad attacchi DDoS[12] verso indirizzi IP pubblici su Internet) sia su quelle interne (ricezione di un attacco DDoS proveniente dall’esterno).
Policy

La policy che governa la risposta agli incidenti è peculiare per ogni organizzazione, ma molte sono caratterizzate da tratti comuni: oltre alle dichiarazioni di alto livello e all’ambito di applicazione, la policy definisce:

  • concetti e nomenclature delle entità coinvolte;
  • struttura organizzativa, ruoli, responsabilità, livelli di autorizzazione e punti di escalation;
  • requisiti di gestione degli incidenti in termini di comunicazione esterna e Information Sharing;
  • definizione della gravità (severity) degli incidenti;
  • indicatori di performance e tipologia di report.
Piano

Il piano di risposta all’incidente deve fornire gli elementi per implementare la capability richiesta. Ogni organizzazione dovrebbe avere un piano per soddisfare i propri requisiti unici e specifici, correlati alla missione dell’organizzazione stessa, alle sue dimensioni, strutture e funzioni. Il piano dovrebbe comprendere i seguenti elementi:

  • missione, strategie e obiettivi;
  • approccio organizzativo e approvazione da parte del senior management;
  • modalità di comunicazione da parte dell’IRT;
  • metriche di misurazione dell’efficacia della risposta agli incidenti.
Procedure

Le procedure dovrebbero prendere le mosse dalla Policy e dal Piano. Le procedure operative standard delineano specifici processi tecnici, checklist e moduli utilizzati dall’IRT. Le procedure devono fornire il giusto livello di dettaglio recependo al proprio interno le priorità dettate dai requisiti dell’organizzazione. L’utilizzo di procedure standard dovrebbe anche minimizzare gli errori, soprattutto quelli derivanti dalla gestione degli incidenti da parte degli operatori del team in situazioni di forte stress.

Il Processo di Incident Response

Il processo di Incident Response definito dal NIST[13] consta di diverse fasi:

  • Preparation (Preparazione): in questa fase rientra ogni azione propedeutica e continuativa finalizzata a creare le condizioni migliori per gestire l’incidente in maniera appropriata. Ogni elemento utile dovrebbe essere ricondotto a questa fase, sia esso di natura logistica, hardware, software, di comunicazione e di processo (Risk Assessment periodici, gestione delle configurazioni, facility quali War Room);
  • Detection & Analysis (Rilevamento e Analisi): in considerazione dell’eterogeneità e del dinamismo intrinseco dei vettori d’attacco (interni, esterni, tecnologici, di processo, umani) è possibile isolare, per ogni tipologia di attacco, precursori e indicatori. Tali elementi sono di natura tecnologica (log, apparati di sicurezza specializzati, SIEM, flussi di traffico di rete), informativa (reperimento delle notizie di vulnerabilità, Information Sharing con strutture preposte) e umana (segnalazioni provenienti da personale interno o da organizzazioni esterne). Precursori e indicatori determinano la capacità di rilevare potenziali incidenti definendo contestualmente il perimetro di visibilità e il margine operativo effettivo. La componente di analisi, immediatamente successiva, è particolarmente complessa e si scompone in ulteriori attività specializzate (profiling, comprensione dei comportamenti “normali”, definizione di baseline di riferimento, correlazione degli eventi di sicurezza, mantenimento di una base di conoscenza aggiornata e facilmente fruibile, capacità di raccolta e filtraggio di grandi quantità di dati). Il risultato della fase di analisi è costituito dalla documentazione completa dell’incidente, descritto negli attributi fondamentali di categoria di impatto sulle funzioni organizzative (severity alta, media o bassa), sulla dimensione di sicurezza dell’informazione interessata (Privacy Breach, perdita di riservatezza, integrità, disponibilità) e nella stima di risorse necessarie al superamento del problema. In questo modo è possibile assegnare la corretta priorità all’incidente indirizzando, di conseguenza, gli sforzi operativi;
  • Containment Eradication & Recovery (Contenimento, Sradicamento e Ripristino): il contenimento è la fase che fornisce il tempo necessario alla definizione della migliore strategia possibile. Tali strategie sono variabili in funzione di diversi fattori ed è possibile svilupparne diverse in base alla categoria di attacco: contenere un attacco in corso tramite il vettore della posta elettronica è diverso da contenere un attacco DDoS o un’estrazione indebita di dati sensibili. In questa fase è necessario collezionare ogni evidenza possibile dell’incidente tramite opportuni strumenti e tecnologie finalizzate a salvaguardare l’integrità dei dati raccolti, identificando la sorgente dell’attacco e monitorandone l’attività. Dopo che un incidente è stato contenuto è necessario procedere all’eventuale sradicamento di alcune componenti dell’incidente stesso (codice malevolo, account compromessi) e al ripristino delle normali operazioni. Tale ripristino può coinvolgere attività sistemistiche (backup&restore, installazione da zero di sistemi e applicazioni, installazione di patch critiche) e di sicurezza (revisione delle policy dei firewall, modifiche nella produzione di log). Per gli incidenti su larga scala, è bene ricordarlo, la fase di Recovery può durare mesi;
  • Post-Incident Activity (Attività post incidente): questa fase riguarda l’apprendimento e il miglioramento. Ogni incidente gestito rappresenta un’occasione di crescita e dovrebbe essere affrontato collettivamente dal gruppo di lavoro tramite incontri (Lesson Learned) finalizzati ad analizzare, commentare ed eventualmente correggere i comportamenti attuati. Ci sono diversi indicatori significativi a questo proposito: numero di incidenti gestiti in un dato lasso di tempo, tempo speso per risolvere ogni singolo incidente, rivisitazione della documentazione di ogni incidente.
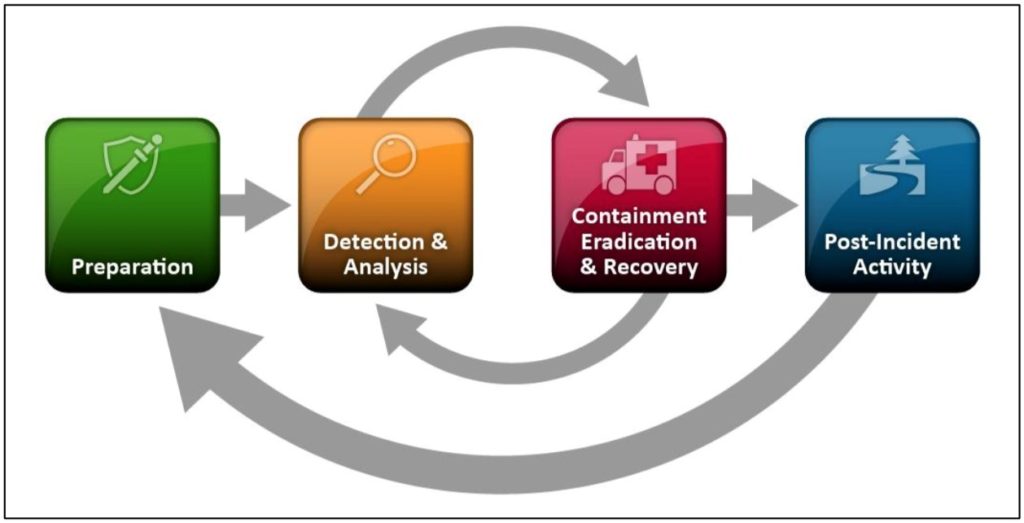
Figura 1 – Ciclo di vita dell’Incident Response – NIST

Incident Report

L’Incident Report dovrebbe incorporare tutte le informazioni salienti relative all’incidente e alle operazioni attuate per la sua gestione. Alcuni elementi fondamentali sono di seguito elencati:

  • Informazioni di contatto relative a chi ha gestito e prodotto il report dell’incidente
  • Nome
  • Ruolo
  • Unità organizzativa
  • Indirizzo e-mail
  • Numero di telefono
  • Ubicazione (indirizzo, numero di stanza)
  • Dettagli dell’incidente
  • Riferimenti temporali: quando è iniziato l’incidente, quando è stato rilevato, quando è stato risolto o chiuso, quando è stato fatto il report
  • Ubicazione fisica (città, stato)
  • Stato corrente dell’incidente (in corso, chiuso)
  • Sorgente/causa dell’incidente (reti, sistemi, applicazioni, dati), inclusi i nomi dei sistemi, gli indirizzi IP e i ruoli
  • Descrizione dell’incidente (come è stato rilevato, cosa è accaduto)
  • Descrizione delle risorse coinvolte (reti, sistemi, applicazioni, dati), inclusi i nomi dei sistemi, gli indirizzi IP e i ruoli
  • Se si tratta di informazioni note, categoria dell’incidente, vettori di attacco associati, indicatori (schemi di traffico anomalo, chiavi di registro Microsoft)
  • Fattori usati per assegnare la priorità (impatto sulle funzionalità, sull’informazione, capacità di recupero)
  • Fattori di mitigazione (ad esempio, furto di un portatile contenente dati sensibili ma equipaggiato con soluzioni di full disk encryption)
  • Azioni di risposta effettuate (spegnimento di un server, disconnessione dalla rete, etc)
  • Altre organizzazioni contattate (ad esempio, il produttore del software)
  • Commenti generali

Raccomandazioni

Le raccomandazioni finali del NIST, applicabili in ogni scenario in cui è necessario gestire in maniera appropriata un incidente di sicurezza, sono di natura generale e quindi adottabili e adattabili all’interno di contesti eterogenei. Tali raccomandazioni, di seguito elencate, sono un utile punto di riferimento:

  • acquisire strumenti e risorse che potrebbero essere utili durante il trattamento dell’incidente;
  • prevenire l’accadimento degli incidenti assicurando che reti, sistemi e applicazioni si trovino in uno stato di sufficiente sicurezza;
  • identificare precursori e indicatori tramite gli allarmi generati dalle varie tipologie di dispositivi e software di sicurezza;
  • stabilire meccanismi per ricevere comunicazione, dall’esterno, di incidenti di sicurezza generati dalla propria organizzazione;
  • richiedere un livello di logging e audit minimo su tutti i sistemi e un livello superiore per tutti i sistemi critici;
  • profilare reti e sistemi per rilevare eventuali discostamenti dalle baseline di riferimento;
  • comprendere il normale comportamento di reti, sistemi e applicazioni;
  • creare una politica di conservazione dei log (log retention);
  • effettuare la correlazione degli eventi;
  • mantenere sincronizzati tutti gli orologi interni dei sistemi;
  • mantenere viva e utilizzare una base di conoscenza condivisa interna al gruppo IRT;
  • iniziare a registrare ogni informazione non appena si presenta un concreto sospetto di incidente;
  • tutelare e proteggere i dati relativi all’incidente;
  • assegnare le giuste priorità al trattamento degli incidenti sulla base di fattori rilevanti;
  • stabilire strategie e procedure per contenere gli incidenti;
  • seguire procedure predefinite per raccogliere e gestire le evidenze;
  • catturare i dati volatili dei sistemi come ulteriori evidenze;
  • ottenere snapshot complete dei sistemi, non solamente backup dei file system;
  • condurre riunioni di Lesson Learned dopo gli incidenti più significativi.

Un esempio di procedura

Partendo dalle fasi del ciclo di vita dell’Incident Response individuate dal NIST, in Tabella 1 è rappresentata sinteticamente una possibile procedura di risposta ad un attacco DDoS:


Fase Azioni
Preparation
  • Definizione della lista dei contatti e delle procedure interne di comunicazione
  • Definizione del supporto specialistico e dell’Internet Service Provider che eroga il servizio di connettività
  • Configurazioni di rete e dell’infrastruttura
Detection & Analysis
  • Rivelamento e allarme
  • Analisi dell’attacco
  • Identificazione delle motivazioni
  • Attivazione delle azioni di mitigazione
Containment, Eradication and Recovery
  • Modifiche alle configurazioni di rete
  • Controllo dell’andamento del traffico legittimo
  • Gestione della banda e della priorità assegnata a specifici protocolli di comunicazione
  • Blocco del traffico malevolo
  • Scrubbing del traffico[14]
  • Sinkholing[15]
  • Verifica del ritorno allo stato di normalità del traffico
  • Ripristino della configurazione standard
Post-Incident Activity
  • Analisi dell’incidente e divulgazione dell’informazione
  • Eventuali contatti con le forze dell’ordine

Tabella 1 – Procedura di Incident Response a un attacco DDoS

Conclusioni

La risposta agli incidenti informatici di sicurezza è storicamente caratterizzata da un approccio reattivo, ma la dinamica evolutiva delle tecnologie di sicurezza di nuova generazione (Machine Learning, Artificial Intelligence, Big Data) permette di prefigurare con notevole accuratezza possibili scenari tramite l’utilizzo di analisi predittive e di altre tecniche statistiche. La crescente automazione in determinate aree tecnologiche di sicurezza (antivirus, firewall, gestione delle patch e dei sistemi di autenticazione) non riesce però a essere del tutto efficace nella risposta agli incidenti perché, come evidenziato da Bruce Schneier[16], questa appartiene ad un dominio caratterizzato da eccessiva incertezza. In questo senso un modello di orchestrazione della sicurezza basato sugli umani – che rappresenti l’unione di persone, processi e tecnologia – può essere incredibilmente potente. Lo sviluppo di un autentico approccio proattivo rappresenta una possibilità nuova e importante per le attività di Incident Response ma, come sempre, le innovazioni dirompenti nel mondo delle macchine devono essere conoscibili, gestibili e governate da esseri umani.

Note

Articolo a cura di Andrea Boggio

L’articolo Incident Response: dal Processo alle Procedure proviene da ICT Security Magazine.

https://www.ictsecuritymagazine.com/articoli/incident-response-dal-processo-alle-procedure/


WPA3: cosa offre il nuovo standard

Presentato a gennaio 2018, il protocollo WPA3 ha fatto il suo debutto ufficiale lo scorso 25 giugno e sembra rappresentare una svolta nel mondo della sicurezza delle reti senza filo. Sarà adottato come standard per le reti wireless verosimilmente a partire dal 2020.

La Wi-Fi Alliance, l’organizzazione non profit proprietaria del marchio Wi-Fi costituita dalle industrie leader del settore banda larga senza fili, ha introdotto diverse migliorie che dovrebbero sopperire alle mancanze del predecessore WPA2.

Ricordiamo che quest’ultimo, ritenuto fino a poco tempo fa relativamente sicuro purché implementato con una password robusta e un SSID personalizzato, si è rivelato vulnerabile nell’ottobre dello scorso anno a KRACK, un particolare tipo di attacco in grado di bypassare l’autenticazione iniziale di un client, compromettendo l’intera sicurezza della comunicazione client/router. Ne abbiamo parlato nel dettaglio in questo articolo.

Tra le novità principali del nuovo modello WPA, troviamo l’introduzione del protocollo SAE (Simultaneous Authentication of Equals) in sostituzione di PSK (Pre-Shared Key) il quale fonda il proprio principio di funzionamento sul meccanismo di handshake a 4 vie: fu proprio questo scambio di messaggi tra client e Access point a rendere possibile il KRACK attack sviluppato dal belga Mathy Vanhoef.

SAE rivede in maniera sostanziale il meccanismo di autenticazione di ciascun device presente all’interno della rete. Ogni dispositivo viene considerato – come suggerisce l’acronimo – uguale agli altri: di conseguenza viene meno la tipica distinzione client/authority (router nella maggioranza dei casi). Il protocollo sembra essere resistente agli attacchi passivi, attivi e dizionario e dovrebbe fornire un elevato grado di sicurezza senza ricorrere, appunto, ad authority centralizzate o all’utilizzo di certificati da installare su ciascun device. Essendo inoltre un protocollo peer-to-peer privo di asimmetria in grado di supportare contemporaneamente più inizializzazioni, ben si presta all’utilizzo nelle rete mesh basate su 802.11. Infine, la password di ogni singola comunicazione device/router viene cambiata ogni volta che si stabilisce una connessione, vanificando di fatto gli sforzi di un potenziale malintenzionato, il quale dovrebbe ripetere l’attacco ad ogni occasione (oltre a trovarsi fisicamente nei pressi del router oggetto di attacco).

Proprio quest’ultimo aspetto ha un ulteriore risvolto: l’attaccante in possesso della password di rete non sarà più in grado di decriptare il traffico dei vari client catturato in precedenza (si parla in questo caso di forward secrecy).

WPA3-ENTERPRISE

Così come i predecessori WPA1 e WPA2, anche la versione 3 viene implementata in versione personal ed enterprise, quest’ultima destinata a realtà aziendali, istituzioni finanziarie e governative, in cui l’esigenza di protezione di dati sensibili è ancora più sentita. In WPA3-enterprise viene innalzato il livello di crittografia a 192 bit, il minimo richiesto dalle organizzazioni (in primis il CNSS – Committee on National Security Systems) per poter operare in sicurezza. In particolare si prevede una crittografia a 256-bit Galois/Counter Mode Protocol per la comunicazione principale, a 384-bit Hashed Message Authentication Mode per la creazione/conferma delle chiavi e un Elliptic Curve Digital Signature Algorithm per l’autenticazione delle chiavi).

WI-FI EASY CONNECT

Altra novità introdotta – e brevettata da Wi-Fi alliance – è Wi-Fi Easy Connect, dedicata ai dispositivi IoT.

Premettiamo a questo proposito che internet è continuamente oggetto di scansioni e per un malintenzionato imbattersi in un dispositivo IoT (e magari vulnerabile) è relativamente facile: è sufficiente provare il tool autosploit per rendersene conto.

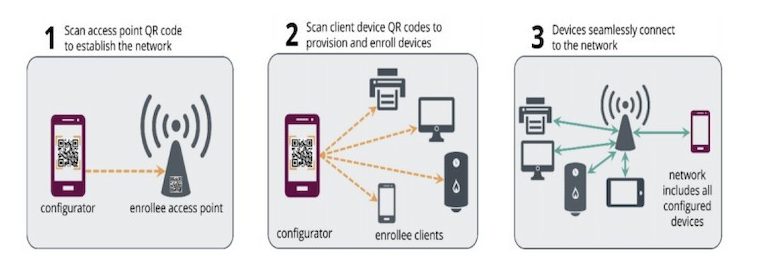
Data l’enorme diffusione di tali apparati per i più svariati utilizzi (termostati, orologi, frigoriferi e così via), è stata sviluppata questa nuova modalità di connessione, che oltre a garantire una maggior sicurezza nello scambio delle chiavi, facilita di molto il collegamento ad internet dei device privi di schermo o interfaccia grafica: anziché dover inserire di volta in volta una password, i device saranno dotati di un unico QR code che funzionerà come una sorta di chiave pubblica: per aggiungere un device alla rete sarà sufficiente scansionare il relativo codice da un dispositivo (smartphone) già collegato alla rete. A scansione avvenuta, la rete e l’apparecchio si scambiano ed autenticano le chiavi per le connessioni seguenti. Da sottolineare che Easy Connect è in realtà un protocollo separato di WPA3: gli apparecchi in grado di supportarlo devono essere certificati WPA2 ma non necessariamente WPA3.

ENHANCED OPEN

Troviamo infine un ulteriore protocollo sviluppato appositamente per le reti pubbliche aperte (tipiche di aeroporti, ristoranti, bar, ecc.), generalmente suscettibili di attacchi di tipo passivo.

Questo standard si avvale del protocollo Opportunistic Wireless Encryption (OWE), definito dall’Internet Engineering Task Force RFC 8110 standard, usato nella protezione dalle intercettazioni e sniffing di dati e in grado di fornire protezione anche da packet injection da parte di un attaccante: in pratica ogni connessione Wi-Fi tra client e Access point viene crittografata singolarmente con una propria chiave, anche se potrebbe non essere necessario – oppure poco pratico per via dell’elevato numero di utenti –  inserire alcuna password per collegarsi alla rete.

Tale modalità di collegamento a Internet è sicuramente interessante in ottica dell’iniziativa WiFi4EU, un progetto istituito dalla Commissione Europea per la promozione di connessioni Wi-Fi in spazi pubblici (piazze, biblioteche, musei, centri sanitari) per il quale sono stati stanziati complessivamente circa 120 milioni di euro; si prevede che entro il 2020 tra le 6.000 e 8.000 comunità locali all’interno del territorio europeo siano munite delle infrastrutture dedicate.

CONCLUSIONI

Sebbene le premesse illustrate da Wi-Fi Alliance possano sembrare promettenti, sorgono alcuni dubbi circa la compatibilità dei precedenti apparati con il nuovo standard: la tecnologia SAE non necessita, nonostante una maggior complessità di calcoli demandati alle CPU, di elevati requisiti hardware ma la decisione di aggiornare i firmware dei vari dispositivi per renderli compatibili con WPA3 spetta unicamente ai produttori, che per ragioni di convenienza potrebbero non effettuare l’upgrade dei loro prodotti.

In questo senso le probabilità di implementare WPA3 sui propri apparecchi sarebbero senz’altro maggiori per i firmware open-source sviluppati dalle community come DD-WRT e Tomato.

Non è tutto.

Lo stesso Mathy Vanhoef è preoccupato di come WiFi Alliance sia stata troppo chiusa nell’affrontare quello che potrebbe rivelarsi un cambiamento generazionale: sembra infatti che esperti e matematici non abbiano avuto occasioni per avanzare commenti o critiche circa potenziali vulnerabilità del protocollo SAE voluto dall’organizzazione.

Sottolinea poi come quest’ultima non abbia esplicitamente dichiarato che tutti i dispositivi attuali possano far parte del nuovo standard e che la questione di compatibilità dei device attuali è ancora da definire. Le critiche interessano anche gli altri protocolli rilasciati assieme a WPA3 – Easy Connect e Enhanced Open – che generano confusione all’utente medio, il quale non viene guidato riguardo la scelta da effettuare in base alle esigenze specifiche.

Per concludere possiamo dire che non è il caso di correre ai ripari riempiendo il carrello di apparecchi WPA3 ma è sicuramente d’obbligo ponderare a fondo la questione in caso di investimenti futuri (soprattutto per realtà aziendali e ambienti esposti al pubblico), così come prestare attenzione a release e nuovi firmware che si spera arrivino dai produttori.

Il nuovo standard è più sicuro e la migrazione rappresenta un ulteriore passo avanti per garantire la sicurezza degli utenti… almeno fino alla prossima vulnerabilità.


Articolo a cura di Milo Caranti

L’articolo WPA3: cosa offre il nuovo standard proviene da ICT Security Magazine.

https://www.ictsecuritymagazine.com/articoli/wpa3-cosa-offre-il-nuovo-standard/


GDPR – Dove siamo arrivati e quali prospettive ci attendono

In molti hanno lavorato a lungo a fianco dei loro clienti e collaboratori, avendo avuto ben chiaro un obiettivo preciso, quello della linea di demarcazione posto dalla data di applicazione della normativa GDPR (EU 679/2016), il 25 Maggio 2018.

Trascorsi ormai diversi mesi da questa data, vediamo, in breve, come le aziende si siano organizzate e quale sia la situazione attuale.

Corporate, grandi aziende e multinazionali

Per quanto riguarda le aziende di grandi dimensioni e quelle che operano in contesti multinazionali, una parte di esse ha già raggiunto un livello di conformità alla normativa che ritiene adeguato, in base agli obiettivi che si è posta.

Molte altre aziende invece, sanno benissimo di non avere raggiunto un livello di compliance sufficiente in ogni area della organizzativa, essendosi concentrate prevalentemente sulle applicazioni ad alto rischio, ed avendo tralasciato il resto.

Queste aziende tipicamente si pongono l’obiettivo di colmare i propri GAPs in termini di compliance, entro la fine di quest’anno, o ai primi del 2019, accettando i rischi residuali riguardanti le proprie mancanze di conformità, ritenendoli sostanzialmente limitati.

Questo atteggiamento, purtroppo, è stato anche parzialmente amplificato dai media, che hanno diffuso spesso e volentieri voci (inconsistenti) sulla “applicazione soft” delle sanzioni nel primo periodo dopo l’entrata in vigore della legge, se non addirittura l’esistenza di un consistente “grace period”, cioè di un periodo senza alcuna sanzione.

Piccole e medie aziende

Per quanto riguarda le aziende piccole e medie, è difficile sostenere che gli adeguamenti alla normativa GDPR siano stati la loro priorità, e molte di esse hanno deciso di rinviare l’attività di adeguamento almeno all’autunno, se non addirittura oltre.

Un po’ perché oberati da impegni e scadenze pressanti, connesse alla natura della loro attività, un po’ per la mancanza di budget e soprattutto nell’incertezza sull’effettività dell’applicazione della legge.

Da notare che in molti si sono lamentati della confusione generata dalle numerose e variegate proposte di adeguamento a GDPR ricevute, spesso a costi diversissimi tra loro.

Comprensibile.   Sarebbe stato difficile per chiunque, e tanto più per aziende senza skills interni adeguati, e senza un supporto specialistico esterno, percepire la differenza tra le varie proposte, alcune magari a prezzo stracciato da consulenti esterni improvvisati, altre da parte di fornitori tradizionali IT e Security (talvolta altrettanto improvvisati) da quelle di società e professionisti specializzati.

Per questo motivo, purtroppo, gli adeguamenti si sono spesso trasformati in una gara al ribasso tra fornitori “GDPR”. La necessità di impiegare meno tempo sul cliente e potere quindi abbassare il prezzo di offerta, ha certamente contribuito a rendere più superficiali e meno efficaci i progetti di adeguamento, ed ad aumentare il livello generale di rischio sulla Privacy.

Dove siamo arrivati

Il clamore di cui ha vissuto la fase implementativa, prima del 25 Maggio, oggi si è oramai molto attenuato, per svariati motivi.

Un po’ perché l’onda emozionale iniziale, spinta da una scadenza chiara e non rimandabile, e sollecitata da forti pressioni dei media e dei venditori di servizi, che hanno pesantemente utilizzato lo spauracchio delle sanzioni per motivare i clienti e spingere le vendite dei propri prodotti di Security e di consulenza GDPR, al momento si è molto attenuata.

Coloro che hanno realizzato seriamente i propri adeguamenti, spesso esausti dall’enorme impegno profuso nella messa in opera degli adeguamenti tecnici, nelle nuove misure si sicurezza e nella rivisitazione di numerosi processi aziendali, tendono per lo più a tirare il fiato, e a dedicarsi ad attività di rifinitura degli obiettivi raggiunti, consci però di non essere giunti alla fine del lavoro sapendo bene che la conformità deve anche essere mantenuta nel tempo.

Altri, quelli che hanno realizzato i propri progetti a livello più formale che sostanziale, e neppure in maniera completa, sembrano essere arrivati alla fine del loro percorso, e si accontentano di poter presentare delle evidenze formali che ritengono sufficienti per convincere le Authority della loro conformità.

Gli ultimi, infine, ancora attendono guardinghi per decidere quale sarà il momento migliore per fare qualcosa di concreto investendo il minimo del budget possibile. In fondo, come spesso si sente ripetere, prima o poi dovranno pure fare qualcosa per poter dichiarare di essere in regola, almeno da un punto di vista formale.

Quali prospettive

Un recente sondaggio di TrustArc (fonte : TrustArc GDPR Compliance Status Report @2018) realizzato intervistando il management delle proprie aziende clienti di ogni fascia ed a livello internazionale, rivela che solo per il 20% la maggior parte dei Manager, ritiene di essere compliant a GDPR, mentre per il 53% ritiene che lo sarà entro fine del 2018, ed il 27% non ha ancora cominciato un percorso di adeguamento a GDPR. Nella sola Europa le percentuali sono un po’ migliori, con il 27% che ritiene di essere compliant, il 74% ritiene che lo sarà entro fine 2018 ed il 93% entro la fine del 2019 .

Si ricorda qui che le aziende intervistate avendo già acquisito soluzioni e servizi orientate alla Privacy, rappresentano un sottoinsieme anche qualificato, ma che non rappresenta l’intera categoria, per cui si ritiene che le percentuali complessive siano inferiori, soprattutto nei segmenti medio bassi, che tradizionalmente meno investono nella protezione della Privacy.

Sempre la stessa fonte, riporta che i maggiori problemi siano dovuti alla complessità della legge ed alla  difficoltà di reperimento di skills adeguati sul mercato.

Inoltre, una parte consistente degli stessi Manager intervistati, avendo implementato progetti legati alla Privacy ha acquisito consapevolezza sulle “best practice” che dovrebbero essere adottate, ritiene evidente che per loro il raggiungimento di un livello, a loro giudizio, soddisfacente, non sarà il punto finale delle attività, ma che il mantenimento della compliance GDPR richiederà ulteriori budget.

Tanto è vero che il 67% degli intervistati, ha dichiarato che manterrà, se non aumenterà, il budget a disposizione per le attività GDPR anche per il 2019.

Per le piccole medie, tranne le più sensibili, e quelle più esposte sul fronte dei consumatori, vale quanto sopra esposto, per lo più rimangono in attesa del momento migliore per eseguire l’adeguamento.

Anche se esiste per loro un forte pressione da parte delle aziende loro clienti, che hanno bisogno di avere fornitori “compliant a GDPR“, molti adottano solo il minimo dei requisiti possibile, e comunque si rivelano disposti a firmare pesanti condizioni capestro con i loro committenti, dichiarando una compliance formale che spesso non sono in grado di dimostrare.

Viene da domandarsi se le aziende committenti, si rendano ben conto del rischio cui si espongono, affidandosi a fornitori che sono conformi a GDPR solo sulla carta.

Nel frattempo, come rilevato dalle varie Authority della Privacy Europee, avviene un diffuso e notevole aumento delle segnalazioni di Data Breach un po’ in tutti i Paesi dell’Eurozona.

Dai dati forniti dalle varie Authority, l’incremento del numero delle segnalazioni rispetto all’anno precedente, in cui non era in vigore la GDPR, è generalizzato e generalmente consta di almeno due cifre, se non addirittura di tre, con incrementi che vanno dal 50% in Francia a punte del 500% in Italia  rispetto all’anno precedente.  (DPA Francese +56% ; DPA UK : +260% ; Garante Privacy : +500%)

Al punto che l’Authority inglese segnala addirittura un “overreporting” con 500 chiamate per segnalazioni di vario genere relative a problematiche sulla Privacy, per ogni settimana.

E’ logico presumere che i nuovi obblighi di segnalazione alle Authority, faranno emergere gradualmente, ma in maniera consistente, una serie di problematiche che precedentemente venivano gestite “in casa” e non comunicate a nessuno, tanto meno agli utenti che ne erano vittime.

In conclusione

Per quanto nei media l’argomento GDPR abbia preso durante l’estate una pausa di riflessione, a partire da Settembre, con la piena ripresa delle attività,  l’argomento sembra nuovamente tornato all’attenzione di tutti. Complice anche la pubblicazione della nuova normativa Italiana per l’armonizzazione della vecchia legge sulla privacy a GDPR, entrata in vigore il 19 Settembre .

Inoltre, man mano che aumenterà la consapevolezza dei cittadini sui propri nuovi diritti, o anche se il richiamo alla GDPR verrà visto come un mezzo per vendicarsi di torti, a loro avviso subìti dalle aziende, aumenteranno ulteriormente e proporzionalmente anche i “claims”, cioè le segnalazioni alle Authority.

In realtà, anche se nessuno lo dice espressamente, molti tra gli addetti ai lavori sono in attesa di vedere le prime applicazioni di sanzioni “pesanti “ da parte delle Authority, con la convinzione che ciò darà un segnale forte, e potrà scatenare una nuova corsa da parte delle aziende alla verifica sulla qualità dei propri adeguamenti.

Esattamente il contrario di quanto una corretta gestione della Privacy dovrebbe fare:
monitorare la qualità dei risultati di adeguamento, indipendentemente da fattori esterni e dalle sanzioni, con l’ottica di avvantaggiarsi rispetto a quelli che sono ancora lontani dalla conformità.

Purtroppo sembrano ancora essere una rarità le aziende che vedono la GDPR come un opportunità ed un vantaggio nei confronti dei propri concorrenti, invece che come un problema.


Articolo a cura di Francesco Falcone

L’articolo GDPR – Dove siamo arrivati e quali prospettive ci attendono proviene da ICT Security Magazine.

https://www.ictsecuritymagazine.com/articoli/gdpr-dove-siamo-arrivati-e-quali-prospettive-ci-attendono/


Nuova versione della ISO 19011 sugli audit

A luglio 2018 è stata pubblicata la nuova versione dello standard internazionale ISO 19011 dal titolo “Guidelines for auditing management systems”. In contemporanea sono state approvate le versioni europea EN ISO 19011 e italiana UNI EN ISO 19011 (“Linee guida per audit di sistemi di gestione”).

Lo standard è dedicato agli audit di prima e seconda parte (audit interni e ai fornitori o ad altre parti esterne interessate), ma è applicabile anche agli audit di certificazione. Come dice il titolo, lo standard riguarda i sistemi di gestione (in particolare quelli descritti da standard quali ISO 9001 e ISO/IEC 27001), però può essere utilizzato come utile riferimento per altri audit, per esempio quelli richiesti dal GDPR.

Questo breve articolo non ha l’intenzione di descrivere completamente la norma, ma solo fornirne alcuni elementi. Se ne consiglia la lettura, in quanto di (relativa) facile lettura.

Le novità

Questa è la terza edizione dello standard (le versioni precedenti erano del 2002 e 2011), resa necessaria dall’approccio basato sul rischio previsto dalle ultime versioni degli standard ISO per i sistemi di gestione.

Nella premessa della versione inglese sono riassunte le novità:

  • aggiunta, tra i principi dell’audit, dell’approccio basato sul rischio;
  • ampliamento della guida sulla gestione del programma di audit, includendo considerazioni sui rischi;
  • ampliamento della guida sulla conduzione degli audit, in particolare sulla loro pianificazione;
  • ampliamento dei requisiti generali per le competenze degli auditor;
  • miglioramento della terminologia per renderla più orientata ai processi;
  • rimozione dei requisiti specifici per le competenze degli auditor (in quanto riportati da altri standard);
  • estensione dell’Appendice A (guida di dettaglio) per inserire i nuovi concetti relativi al contesto, leadership and commitment, audit virtuali, conformità e filiera di fornitura.

I principi degli audit

Sin dalla prima edizione, la norma riporta i principi degli audit. Come sopra indicato, è stato aggiunto l’ultimo della lista che segue:

  • Integrità (onestà e responsabilità): il fondamento della professionalità;
  • Presentazione imparziale: obbligo di riferire in modo veritiero e accurato;
  • Dovuta professionalità: l’applicazione di diligenza e giudizio nel corso dell’attività di audit;
  • Riservatezza: sicurezza delle informazioni;
  • Indipendenza: la base per l’imparzialità dell’audit e l’obiettività delle conclusioni dell’audit;
  • Approccio basato sull’evidenza (o “sulle prove”): il metodo razionale per raggiungere conclusioni dell’audit affidabili e riproducibili in un processo di audit sistematico;
  • Approccio basato sul  rischio  (risk-based approach):  un approccio  all’audit  che considera rischi e opportunità.

Il programma di audit

La norma ruota intorno al concetto di “programma di audit”, definito come “Disposizioni per un insieme di uno o più audit pianificati per un arco di tempo definito e orientati verso uno scopo specifico”.

Il programma di audit è spesso inteso come l’insieme degli audit da condurre in un arco temporale pluriennale (solitamente 3 anni, alcune volte anche 5). Esso include ulteriori informazioni, tra cui: gli obiettivi dell’audit, il campo di applicazione degli audit, la frequenza dei singoli audit, le procedure e i criteri (ossia gli standard di riferimento per condurre le valutazioni) da seguire. Il programma di audit deve essere strutturato considerando il contesto in cui dovranno essere condotti gli audit e i relativi rischi.

I rischi relativi al programma di audit includono: l’errata determinazione dell’estensione, numero, durata, siti e programmazione temporale degli audit; dotazioni o competenze insufficienti del responsabile del programma, degli auditor o del gruppo di audit nel suo complesso; inefficaci canali di comunicazione; mancata considerazione della sicurezza delle informazioni; carenze di disponibilità  e  cooperazione  da  parte  dell’organizzazione  oggetto  dell’audit.

Il programma deve determinare le risorse umane e materiali per condurre gli audit. In particolare le competenze degli auditor e delle persone coinvolte nel programma, incluso lo stesso responsabile del programma.

La norma specifica poi le attività necessarie all’attuazione del programma di audit (per esempio comunicare il programma alle parti interessate, coordinare temporalmente gli audit, fornire le risorse necessarie e selezionare gli auditor, assegnare il ruolo di lead auditor per ogni singolo audit) e, infine, al suo riesame e miglioramento, in quanto anche il programma di audit deve essere soggetto al ciclo PDCA.

Conduzione di un audit

Ogni singolo audit previsto dal programma di audit va realizzato.

Per questo la norma descrive le attività necessarie, tra cui:

  • contatto con l’organizzazione oggetto dell’audit;
  • riesame delle informazioni documentate;
  • pianificazione;
  • assegnazione di ruoli e responsabilità a guide e osservatori;
  • riunione di apertura;
  • comunicazione durante l’audit;
  • raccolta e verifica delle informazioni (con anche esempi pratici);
  • produzione delle risultanze dell’audit (ossia valutazione delle prove raccolte durante l’audit);
  • riunione di chiusura;
  • preparazione e distribuzione del rapporto di audit (in Italia solitamente il rapporto è consegnato nel corso della riunione di chiusura, ma questo non succede in molti altri Paesi);
  • conduzione di eventuali audit straordinari (per esempio in caso di non conformità gravi).

Rischi da considerare relativi alla conduzione di un audit includono: il mancato raggiungimento degli obiettivi di audit a causa di una pianificazione scorretta; la potenziale influenza negativa degli auditor in materia di salute e sicurezza sul lavoro, ambiente e qualità (per esempio, contaminazione di una camera bianca).

Competenze degli auditor

Il capitolo 7 della ISO 19011 è dedicato alle competenze generali degli auditor. La descrizione delle competenze tecniche specifiche sono demandate ad altre norme. Per esempio, per quanto riguarda la ISO/IEC 27001, alla ISO/IEC 27007 per gli audit di prima e seconda parte e alla ISO/IEC 27006 per gli audit degli organismi di certificazione.

Va detto che i requisiti sulle competenze degli audit sono eccessivi e prevedono capacità e competenze impossibili da trovare in un’unica persona.

Importante è il paragrafo intitolato “Acquisizione della competenza di auditor” perché ricorda che la partecipazione ad un corso o ad un programma di formazione non è condizione né necessaria né sufficiente per ottenere le competenze richieste. Purtroppo negli anni, in quanto più facile da richiedere e verificare, si è affermata la prassi di specificare un numero determinato di ore di corso e di giornate di esperienza per poter considerare competente una persona.

Guida di dettaglio

La norma si chiude con un’appendice con maggiori dettagli su alcune attività di audit (per esempio sulla filiera di fornitura).


Articolo a cura di: Cesare Gallotti

L’articolo Nuova versione della ISO 19011 sugli audit proviene da ICT Security Magazine.

https://www.ictsecuritymagazine.com/articoli/nuova-versione-della-iso-19011-sugli-audit/


WPA3: analisi delle nuove reti WiFi

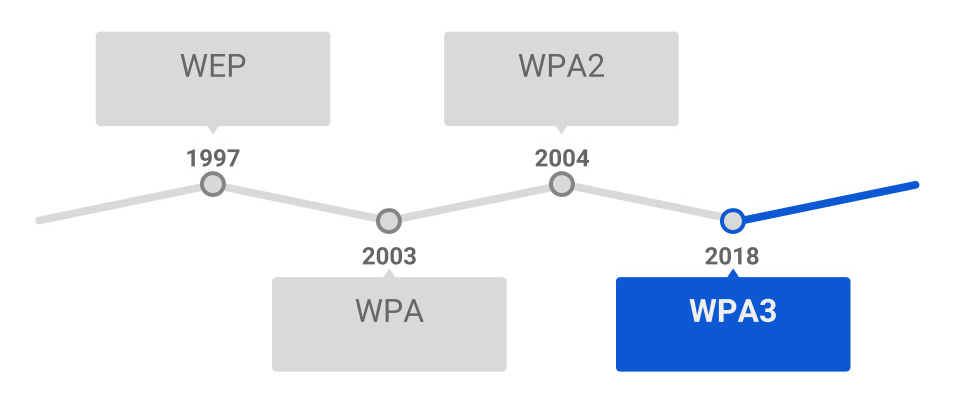
Nel 2003 la Wi-Fi Alliance ha introdotto la famiglia di protocolli Wi-Fi Protected Access (WPA), che si occupa della sicurezza della trasmissione via Wi-Fi. Nel 2004 è stata introdotta una versione più sicura del protocollo: il WPA2. Nel 2018, dopo aver constatato l’inadeguatezza dello standard WPA2 (dal punto di vista della sicurezza), è stata la volta del WPA3 (Figura 1).


Nota: in realtà il WPA3 non è un nuovo standard o protocollo, ma specifica quali standard e protocolli un dispositivo deve seguire per essere certificato WPA3. D’ora in poi useremo il termine “protocollo” nella sua accezione più generica.

Un protocollo che si occupa dello scambio di chiavi, come quelli della famiglia WPA, dovrebbe presentare alcune proprietà di sicurezza; ad esempio, dovrebbe prevenire o quantomeno resistere ai seguenti attacchi:

  • attacchi a dizionario (online e offline)
  • attacchi attivi e passivi
  • attacchi di tipo replay e pre-play
  • attacchi man-in-the-middle

Inoltre

  • dovrebbe impedire le intercettazioni fatte al fine di ricavare informazioni utili
  • dovrebbe implementare la proprietà di forward secrecy

Il WPA3 appena definito implementa solo alcune di esse, vediamo quali. I principali vantaggi, come definiti dalla Wi-Fi Alliance, del WPA3 rispetto al WPA2, sono:

  • Riduzione degli attacchi alle reti: il WPA3 riduce il successo degli attacchi, forzando i protocolli legacy ad usare l’algoritmo Advanced Encryption Standard (AES);
  • Aumento della resilienza della rete (Network Resiliency): l’utilizzo dei Protected Management Frames (PMF), resi obbligatori dal WPA3, aggiunge un livello di sicurezza all’intera infrastruttura, utile soprattutto contro gli attacchi che mirano all’intercettazione delle comunicazioni e alla manomissione dei frame di gestione della connessione. Lo standard 802.11 prevede 3 tipi di frame: frame dati, frame di controllo e frame di gestione. Nel precedente protocollo, solo i frame dati erano protetti da cifratura, poiché quelli di gestione normalmente arrivano prima dell’associazione tra i dispositivi. Il problema è che tra i management frame ci sono anche quelli di gestione della de-autenticazione, della dissociazione e di alcuni parametri necessari al corretto riconoscimento di un dispositivo nella rete. Informazioni che possono essere facilmente utilizzate per ingannare un dispositivo; ad esempio, delle stazioni lecite possono essere estromesse dalla rete a causa di un falso Access Point (AP) che invia falsi messaggi. I PMF, introdotti con la revisione 802.11w, erano opzionali nel WPA2 e sono stati resi obbligatori con l’introduzione del WPA3.

WPA3 personal

L’unica modifica rilevante allo standard WPA3-Personal riguarda il metodo di autenticazione: il Pre-Shared Key (PSK) è stato sostituito con il Simultaneous Authentication of Equals (SAE) (Riquadro 1). Nel WPA3-Personal, la password viene utilizzata solo per l’autenticazione, non per generare le chiavi, usando la conoscenza di questa da parte dei due attori. Il WPA3 garantisce in questo modo maggiore sicurezza, in particolare si ha:

  • una completa resistenza agli attacchi a dizionario;
  • una maggiore resistenza delle chiavi di sessione anche conoscendo la password;
  • una scelta delle password più naturale, essendo il WPA3-Personal resistente agli attacchi a dizionario. In questo modo può essere scelta una password più semplice da ricordare e da digitare;
  • una continuità con le versioni del protocollo precedenti.

Riquadro 1: Simultaneous Authentication of Equals

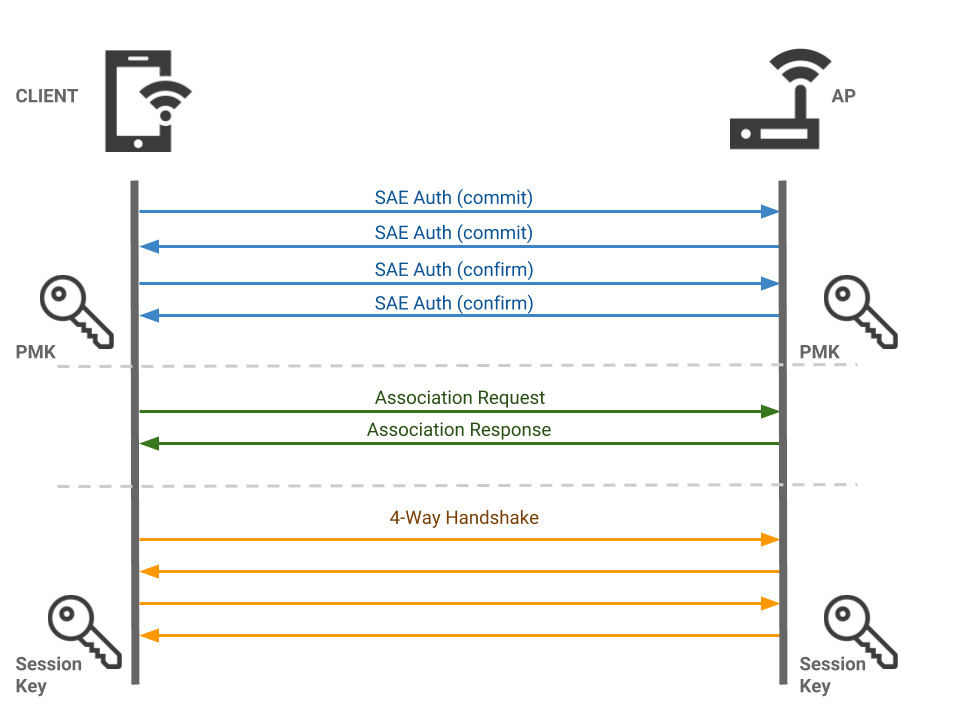
Il protocollo Simultaneous Authentication of Equals (SAE) è una variante di Dragonfly che prevede lo scambio di chiavi basandosi sulla zero-knowledge proof, quindi nessuna password è effettivamente scambiata. Il concetto è lo stesso che sta alla base di ogni protocollo per lo scambio di chiavi: i due attori vengono autenticati usando un segreto condiviso (ad esempio una password) e alla fine si avrà un oggetto segreto che può essere utilizzato nelle comunicazioni tra i due attori (Figura 2).

In dettaglio: il metodo SAE viene usato dai vari client per autenticarsi e creare una chiave di sessione; supporta sia l’FFC (Finite Field Cryptography) sia l’ECC (Elliptic Curve Cryptography), di default viene utilizzato l’ECC. Dopo lo scambio con SAE, viene generata un’unica Pairwise Master Key (PMK) condivisa tra il client e AP. Una volta creata la PMK, il processo di associazione si completa e inizia il 4-Way Handshake per creare una chiave di sessione.

Dal punto di vista della sicurezza, SAE è un protocollo che resiste sia ad attacchi passivi che attivi, ad attacchi a dizionario e ad attacchi di tipo replay. In particolare:

  • gli attacchi passivi, dove l’attaccante semplicemente trasmette il traffico tra due attori leciti, cercando di ricavare informazioni utili (password o chiave condivisa) dai messaggi, non sono fattibili; lo stesso vale per gli attacchi attivi, dove l’attaccante interviene direttamente sui messaggi, modificandoli.
  • gli attacchi a dizionario non sono efficienti perché manca la possibilità, da parte dell’attaccante, di verificare l’ipotesi, ovvero, se la password non è corretta, occorre rieseguire il protocollo utilizzando un’altra ipotesi e così via. Quindi un attaccante non può eseguire un attacco e fare ripetuti tentativi offline finché non trova la password giusta.
  • il protocollo implementa la forward secrecy, ovvero anche la conoscenza della chiave di cifratura a lungo termine non fornisce all’attaccante un vantaggio nella conoscenza delle chiavi di sessione. Chiavi di sessione che si basano anche su dei contributi casuali delle due parti che rimangono sconosciuti all’attaccante.
  • infine, compromettere la chiave intermedia PMK (Denning-Sacco attack) non rappresenta per un attaccante un vantaggio nel determinare una diversa chiave di cifratura di un’altra esecuzione del protocollo.

WPA3-SAE Transition Mode

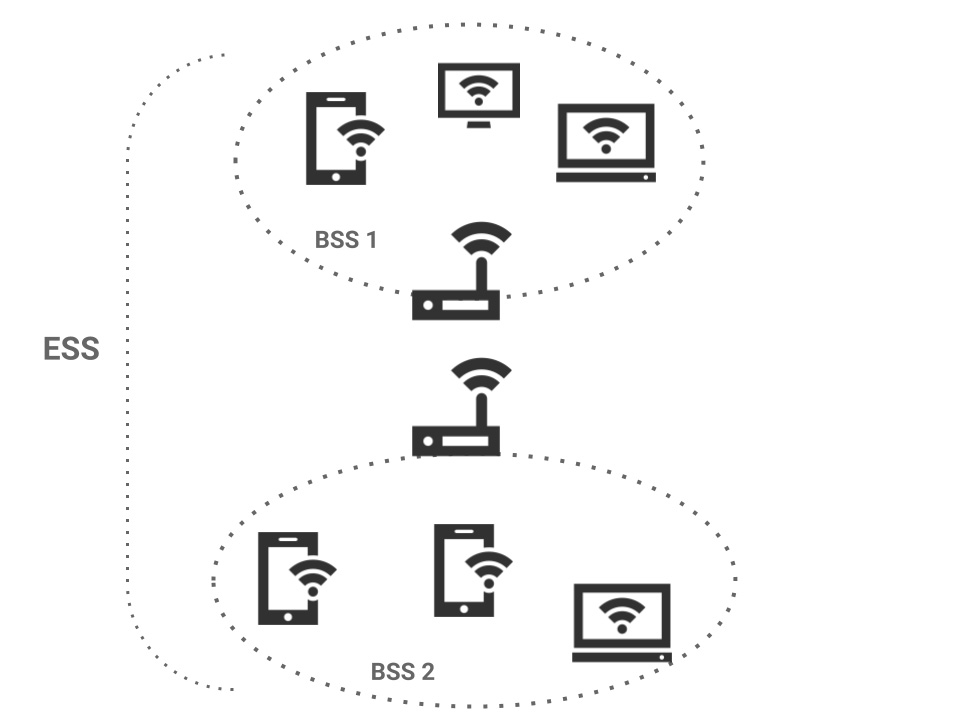
Oltre alla modalità standard è presente anche una modalità di transizione. Quando in un basic service set (BSS) (Figura 3) sono presenti dispositivi che operano sia in WPA2-PSK sia in WPA3-SAE, un AP deve funzionare in modalità WPA3-SAE Transition Mode. In questo modo, è capace di garantire l’accesso alla WLAN ad entrambi i tipi di dispositivo utilizzando la stessa password. Un dispositivo, in modalità WPA3-SAE Transition Mode, non godrà appieno di tutti i vantaggi previsti dall’uso del WPA3, in quanto, per garantire l’interoperabilità e la compatibilità dei due sistemi, è stato necessario sacrificare alcune funzionalità. Ovviamente tale modalità è da intendersi solo per un utilizzo provvisorio della WLAN e si deve passare alla modalità pienamente compatibile con il WPA3 il prima possibile.

WPA3 Enterprise

Per quello che riguarda le reti di livello enterprise, il WPA3 non presenta particolari modifiche rispetto al WPA2. C’è però da evidenziare che, nelle reti dove la sicurezza è un fattore critico, è prevista, seppur opzionalmente, una modalità di sicurezza a 192 bit. Per garantire la coerenza, tale modalità fornisce un livello minimo di sicurezza per le primitive crittografiche di tutti gli elementi delle rete. In dettaglio, la modalità a 192 bit del WPA3-Enterprise prevede:

  • l’utilizzo del protocollo 256-bit Galois/Counter Mode Protocol (GCMP-256) per l’autenticazione e la cifratura;
  • l’utilizzo di 384-bit Hashed Message Authentication Mode (HMAC) con Secure Hash Algorithm (HMAC-SHA384) per la gestione e la verifica della chiave;
  • l’utilizzo degli algoritmi Elliptic Curve Diffie-Hellman (ECDH) e Elliptic Curve Digital Signature Algorithm (ECDSA) per lo scambio e l’autenticazione della chiave.

Quindi ogni aspetto riguardante la gestione delle chiavi utilizzerà, in questa modalità, un sistema di crittografia sufficientemente robusto. In questa modalità non sono permesse configurazioni che abbassano il livello di sicurezza, portandolo ad un grado inferiore a quello stabilito; di conseguenza, ogni client presente nella rete deve operare in modalità 192-bit, pena l’esclusione dalla stessa. Infine, per il WPA3-Enterprise, non c’è bisogno di nessuna modalità di transizione, perché, come detto prima, non c’è stata nessuna modifica sostanziale rispetto al WPA2-Enterprise.

Conclusioni

Mathy Vanhoef (@vanhoefm), il ricercatore che sta dietro al KRACK attacks (https://www.krackattacks.com), definisce il WPA3 come un’occasione mancata. Quello che Vanhoef contesta alla Wi-Fi Alliance è che solo una delle quattro nuove feature, previste a Gennaio 2018, è obbligatoria, mentre le altre misure sono gestite diversamente. È stato reso obbligatorio solo l’utilizzo dell’handshake basato sul protocollo Simultaneous Authentication of Equals; le altre caratteristiche o fanno parte di altre certificazioni (Wi-Fi CERTIFIED Easy Connect e Wi-Fi CERTIFIED Enhanced Open program) o sono opzionali (come l’incremento della dimensione delle chiavi per il WPA3-Personal). In conclusione, il WPA3 rappresenta un passo avanti nella sicurezza, però quanto è stato fatto non è sufficiente visto anche l’utilizzo del Wi-Fi.


Articolo a cura di Gianluigi Spagnuolo


L’articolo WPA3: analisi delle nuove reti WiFi proviene da ICT Security Magazine.

https://www.ictsecuritymagazine.com/articoli/wpa3-analisi-delle-nuove-reti-wifi/


Insider Threat: Tecniche di Exfiltration

In questo articolo verranno trattate alcune tecniche esercitate dagli attaccanti interni per trasferire dati e informazioni al di fuori della rete aziendale. Nella seconda parte dell’articolo verrà approfondito un approccio di monitoraggio e simulazione d’attacco con il fine di prevedere gli eventi avversi più comuni.

Introduzione

E’ credenza comune che la maggior parte delle minacce informatiche siano riconducibili a fattori esogeni, con la visione stereotipata dell’attaccante che cerca di penetrare la rete aziendale da una postazione remota. Questa limitazione porta a trascurare i rischi di natura endogena, alle quali un’azienda è sottoposta quotidianamente.

Contribuiscono inoltre ad alimentare un illusorio senso di sicurezza i vari componenti tecnologici quali firewall e antivirus; la tendenza è quella di fidarsi della propria infrastruttura al punto che nello svolgere le analisi di rischio, le minacce interne vengono spesso associate a probabilità di accadimento basse e trascurabili.

Non esiste una definizione unica di insider: ai fini dell’articolo considereremo “insider threat” un individuo o un programma che sfrutta la sua posizione interna al sistema per commettere azioni malevole. Nello specifico, l’articolo si focalizzerà unicamente su minacce interne di natura colposa.

E’ possibile delineare due principali macro-categorie di insider:

  • Personale dipendente e terze parti che, da un account aziendale, hanno la possibilità di effettuare attacchi informatici alla rete.
  • Malware, un programma informatico usato per condurre attività indesiderate. L’attacco di un software malevolo è solitamente considerato un fattore rischio esogeno, tuttavia in questa sede considereremo il caso in cui il malware si sia già insidiato nell’infrastruttura aziendale.

Il patrimonio aziendale che può rientrare nel mirino degli insider è molto vasto. Nel mondo digitale, il dato è una risorsa strategica fondamentale: le informazioni aziendali riservate, proprietà intellettuale, dati personali di clienti e di dipendenti, potrebbero facilmente costituire un obiettivo di alto valore per qualsiasi attaccante. In termini di asset aziendali, i database ed i file server sono quelli più colpiti, essendo per loro natura una fonte significativa di dati digitali.

Tecniche di Exfiltration

Con il termine “exfiltration”, si fa riferimento all’insieme di tecniche utilizzate al fine di trasferire dati e informazioni da una rete, o più in generale da un elaboratore, verso un’infrastruttura governata dall’attaccante, in modo non autorizzato. L’esportazione può avvenire principalmente in due approcci:

  • Manuale, ad esempio tramite accesso fisico a un elaboratore utilizzando device quali external hard drive, USB drive, o altri dispositivi di memoria rimovibili.
  • Seguendo una procedura semi-automatizzata attraverso l’utilizzo di un programma malevolo. Tale tecnica sfrutta il canale di comunicazione di rete esistente e non richiede alcun accesso fisico. In questo caso, la trasmissione dei dati potrebbe avvenire adoperando connessioni cablate, WiFi, Bluetooth o un altro canale di radiofrequenza.

Approfondiremo di seguito l’approccio più diffuso illustrando le tecniche di exfiltration semi-automatizzate, tramite quindi canali di comunicazione digitali.

Negli ultimi anni, i protocolli di rete sfruttati dagli attori malevoli per trasferire informazioni sono stati: ICMP (Internet Control Message Protocol), UDP (User Datagram Protocol) e TCP (Transmission Control Protocol).

ICMP

Il protocollo ICMP è utilizzato generalmente dagli amministratori di rete per trasmettere informazioni tra gli elaboratori di una rete, come per esempio malfunzionamenti o dati di controllo. Le ragioni per le quali viene abilitato questo protocollo possono essere varie, tra cui manutenzione facilitata della rete.

Questo protocollo potrebbe essere impiegato per veicolare dati all’interno dei singoli pacchetti e trasportare quindi informazioni: abusando della funzionalità echo request1, è possibile iniettare dati in uno spazio di qualche byte riservato al payload. Nel dettaglio, il pacchetto basato su IPv42 è composto da 20 bytes per lo IPv4 header, 8 byter per lo ICMP header e una dimensione di byte arbitraria (fino a raggiungere il massimo valore consentito dalla MTU3 per l’intero pacchetto) per il ICMP payload dove concretamente sono inseriti i dati da exfiltrare.

UDP

I protocolli UDP e TCP non sono protocolli di amministrazione, ma sono designati per trasferire dati tra gli elaboratori tramite le applicazioni software.

Nelle reti aziendali, l’utilizzo più comune del protocollo UDP è per il servizio DNS (Domain Name System): un sistema utilizzato per la risoluzione di nomi dei nodi della rete in indirizzi IP. Tali indirizzi IP sono essenziali per inviare e ricevere i pacchetti di rete, tramite le applicazioni. Infatti, per poter far funzionare un normale browser web, è necessario abilitare questo servizio nel firewall perimetrale e risulta usuale trovare questo canale di comunicazione abilitato nelle reti aziendali.

Anche in questo caso è possibile abusarne per veicolare dati da exfiltrare, utilizzando appunto la risoluzione dei nomi di dominio: anzichè risolvere il hostname, è possibile inserire una sequenza di byte arbitrari, opportunamente codificati per rispettare i caratteri consentiti4, al fine di inviare dati. Mentre per la ricezione di dati, è consigliato utilizzare il campo DNS TXT in quanto può ospitare diversi byte.

Tale canale di comunicazione, come ICMP è molto limitato in termini di quantità di byte che si possono far veicolare in un singolo pacchetto. Questo è uno dei motivi per cui TCP risulta essere più idoneo e che si presta meglio all’invio di dati, considerata inoltre la sua caratteristica di trasferire i pacchetti in modo affidabile.

TCP

Molti software, inclusi i browser di navigazione web, sono basati sul protocollo TCP. Nel dettaglio, il protocollo TCP supporta diverse applicazioni, tra cui appunto i servizi web HTTP (Hypertext Transfer Protocol) e HTTPS (Hyper Text Transfer Protocol Secure), ma anche altre implementazioni tra cui FTP5 (File Transfer Protocol) e Email6.

Il servizio FTP è stato creato per trasferire file, quindi chiaramente un’interessante via per veicolare dati, però é assai probabile che questo utilizzo venga prevenuto, disattivandolo oppure chiudendo la connessione di uscita. Mentre invece il protocollo di posta elettronica risulta generalmente abilitato, specialmente per le reti aziendali. Tale sistema potrebbe essere tranquillamente utilizzato per trasferire dati e informazioni, sotto forma di testo o allegato. In particolar modo se si utilizzano servizi email di terze parti, il monitoraggio delle informazioni passanti per i server di posta risulta molto complicato.

HTTP(S)

Analizzando in dettaglio il servizio HTTP, basato sul protocollo TCP, è possibile capire il motivo per cui è diventato uno dei migliori metodi utilizzato per exfiltrare informazioni. Tale servizio web è difatti adoperato principalmente per la navigazione Internet e quindi abilitato verosimilmente in tutte le reti aziendali. L’attaccante che vorrà trasferire informazioni potrà fare affidamento sicuro a questo canale.

La versione HTTPS aggiunge inoltre un canale di comunicazione cifrato: in questo caso, specialmente per quelle organizzazioni che non intercettano il traffico TLS (Transport Layer Security), è pressoché improbabile decifrare il traffico passante sulla rete analizzando i pacchetti, e quindi venire a conoscenza di quale dato stia lasciando la rete interna.

Negli ultimi anni si sono viste diverse mitigazioni a questa minaccia, tra cui consentire o meno la connessione web ai siti non trusted e con reputazione bassa. Questo meccanismo di prevenzione si potrebbe eludere facilmente utilizzando i servizi cloud di terze parti, i quali hanno guadagnato un’alta reputazione (quindi meno monitorati nelle reti aziendali) e solitamente sono sempre consentiti nelle policy aziendali.

Prevenzione: monitoring e proactive assessment

L’elaborazione di una strategia di sicurezza dei dati efficace e un sistema di controllo interno é essenziale al fine di prevenire attacchi informatici, individuarli e bloccarli.

Un buon approccio per fronteggiare questi tipi di minacce è la defence-in-depth, che utilizza vari livelli e strati di tecnologie, processi e personale per una protezione totale. Al giorno d’oggi dal punto di vista tecnologico, la forma di detection e mitigation più utilizzata nelle medio e grandi organizzazioni sono i sistemi di Data Loss Prevention (DLP), seguite delle soluzioni SIEM (Security Incident Event Management) incaricati di correlare ad analizzare i log. Possono essere poi configurati ulteriori tecnologie quali Identity Access Management (IAM), Intrusion Detection e Prevention Systems (IDS e IPS).

Secondo le best practices e gli standard industriali di settore, quali NCSC7 e CSC8, il monitoraggio degli eventi di sicurezza è un elemento chiave della sicurezza aziendale. Generalmente il monitoraggio e correlazione degli eventi di sicurezza è l’attività principale del SOC (Security Operation Centre), per poi rispondere prontamente agli incidenti informatici.

L’attività successiva alla definizione di un consolidato defence-in-depth, è quella di eseguire delle simulazioni d’attacco quanto piu realistiche per misurare i tempi di risposte ed i tempi di intervento alla minaccia. Considerata la notevole evoluzione degli attacchi reali su ampia scala, le organizzazioni hanno la necessità di evolvere i propri approcci al security testing, con l’ottica di valutare l’effettiva resilienza contro gli attacchi di natura “cyber” e colmare il divario tra security testing dell’infrastruttura e scenari d’attacco reali. Partendo da tale aspetto, le attività di red teaming utilizzano le tattiche, le tecniche e gli strumenti allo stato dell’arte per simulare un attacco reale contro un’organizzazione e verificarne la reale resilienza, valutando inoltre l’efficacia e la capacità di detection delle strutture SOC.

Al fine di testare l’effettiva resilienza e preparazione agli attacchi informatici, e specialmente le minacce insider, la simulazione d’attacco deve prevedere di emulare le tecniche di exfiltration precedentemente descritte, sia in termini di canali sfruttati che di tipologie di dato carpito.

La parte critica di un’ operazione di adversary simulation, è fare in modo che il team attaccante rimanga quanto più invisibile e trasparente al team interno di difesa dell’organizzazione attaccata, evitando pertanto di far scattare gli alert ed essere rilevati da vari meccanismi di sicurezza (Firewall, IDS/IPS e AV).

Infine, uno degli indicatori più importanti di questo esercizio è rappresentato dalla durata del tempo medio da rilevazione MTTD (Mean Time To Detect) e dal tempo medio di recovery MTTR (Mean Time To Recover) per la squadra di difesa, che dovrebbero essere migliorati per ogni attacco eseguito.

Conclusione

Negli ultimi anni sono cresciuti in modo quasi esponenziale nuovi tipi di attacchi informatici, più complessi, comunemente chiamati APT (Advanced Persistence Threat) che sono in grado di creare e personalizzare i vettori di attacco per essere pienamente funzionanti con l’ambiente di destinazione. Le semplici attività di valutazione delle vulnerabilità ed i penetration test non sono più sufficienti a soddisfare e mitigare la minaccia di un attacco informatico, poiché in molti casi l’anello più debole nella catena di sicurezza è il fattore umano e l’uso appropriato delle tecnologie.

In questo contesto, le simulazioni d’attacco focalizzate sulle attività che un’attaccante compie una volta inserito nella rete interna, consentono di ottenere una comprensione della resilienza dell’organizzazione contro tali vettori, il miglioramento delle capacità investigative e di risposta del team di sicurezza della difesa, permettendo infine di valutare il ritorno degli investimenti di un’organizzazione sulla sicurezza delle informazioni.

Riferimenti

Understanding the insider threat & how to mitigate it – NCC Group
https://www.nccgroup.trust/uk/our-research/understanding-the-insider-threat-and-how-to-mitigate-it/

MITRE ATT&CK
https://attack.mitre.org/

Wikipedia, the free encyclopedia
https://wikipedia.org

Insider Threat Report: 2018 – CA Technologies
https://www.ca.com/content/dam/ca/us/files/ebook/insider-threat-report.pdf

Note

  1. Anche conosciuta come “ping”, è una funzionalità del protocollo ICMP con i seguenti parametri: Type 8 eCode 0. Si veda RFC 792 (https://tools.ietf.org/html/rfc792).
  2. Internet Protocol version 4, è la quarta revisione dell’Internet Protocol. Si veda RFC 791 (https://tools.ietf.org/html/rfc791).
  3. Maximum Transmission Unit, rappresenta il datagramma di dimensioni massime che può essere trasmesso attraverso la rete, generalmente 1500 byte.
  4. Ogni sottodomino può avere una dimensione massima di 63 caratteri, e l’intero hostname 253 caratteri. I caratteri accettati possono essere lettere dalla “a” alla “z”, numeri dallo ‘0’ al ‘9’ e il segno meno ‘-‘.
  5. Nelle sue versioni cifrate SCP (Secure Copy Protocol) e SFTP (SSH File Transfer Protocol o Secure File Transfer Protocol).
  6. Con i protocolli SMTP (Simple Mail Transfer Protocol), IMAP (Internet Message Access Protocol) e POP3 (Post Office Protocol 3).
  7. National Cyber Security Centre (https://www.ncsc.gov.uk/guidance/10-steps-cyber-security)
  8. CIS Critical Security Controls (https://learn.cisecurity.org/20-controls-download?f=CSC-MASTER-VER%25206.0%2520CIS%2520Critical%2520Security%2520Controls%2520%252010.15.2015)


Articolo a cura di Mattia Reggiani

L’articolo Insider Threat: Tecniche di Exfiltration proviene da ICT Security Magazine.

https://www.ictsecuritymagazine.com/articoli/insider-threat-tecniche-di-exfiltration/


L’Hardware e la Sicurezza IT – Parte 1: un poco di storia

Il 3 gennaio 2018 sono state divulgate informazioni riguardo due vulnerabilità di sicurezza informatica chiamate “Spectre” e “Meltdown” [1] la cui origine è in alcune funzionalità dei microprocessori. “Spectre” e “Meltdown” sono pertanto vulnerabilità presenti nell’Hardware e risolvibili definitivamente solo con la sostituzione o modifica dell’Hardware stesso, anche se ovviamente sono possibili alcune mitigazioni software.

Per capire come si è arrivati a “Spectre” e “Meltdown”, perché sono così importanti e pericolosi, e apprezzare i principi su cui si basano, è utile partire dalle origini e riassumere velocemente un po’ di storia dell’informatica.

La Nascita dell’Hardware Moderno

È negli anni ’60 che vedono la luce i primi elaboratori la cui struttura di base è la progenitrice di quelli attuali. Sino ad allora gli elaboratori, oltre ad essere estremamente costosi e di enormi dimensioni, avevano quasi esclusivamente tre grandi clienti: i militari, le grandi aziende e le università. Questi elaboratori, che ora chiamiamo genericamente Mainframe, funzionavano secondo l’approccio chiamato “Batch”: i programmatori preparavano un “Job”, ovvero l’esecuzione di un programma od un gruppo di programmi, e caricavano nell’elaboratore[1] il codice da eseguire e tutti i dati necessari all’esecuzione. Nell’elaboratore risiedeva permanentemente un programma, il Sistema Operativo, con i compiti di caricare i Job, lanciarne l’esecuzione e riprendere il controllo dell’elaboratore al termine dell’esecuzione di un Job per avviare il Job successivo.

E’ importante notare che solo un Job è caricato ed eseguito nell’elaboratore in ogni istante: durante l’esecuzione un Job ha a disposizione e controlla tutto l’hardware dell’elaboratore, non vi è condivisione alcuna delle risorse. Non essendoci condivisione di risorse né connessione ad altri elaboratori, non vi sono problematiche o possibili minacce di sicurezza. Gli unici possibili rischi sono dovuti a errori interni ai programmi stessi che possono portare a risultati errati o ad errori tali da far abortire l’esecuzione.

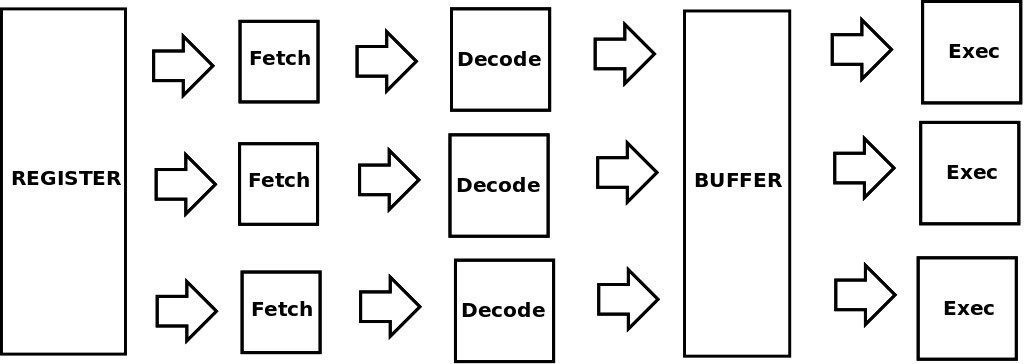
Ma questo approccio all’esecuzione dei programmi non è efficiente: tra un Job e l’altro la CPU, ai tempi la risorsa più costosa, poteva rimanere inutilizzata per molto tempo in attesa del caricamento e scaricamento di dati e istruzioni. Per ovviare a questo si introdussero, in Hardware, “pipeline” di esecuzione e CPU SuperScalari. Le “pipeline” sono componenti Hardware con lo scopo di caricare, preparare per l’esecuzione, e scaricare dati e istruzioni, mentre le CPU SuperScalari hanno molteplici unità di esecuzione, ad esempio una per eseguire calcoli su numeri interi, una su numeri a virgola mobile (floating point), una su numeri booleani ecc., in modo da poter eseguire in parallelo calcoli diversi.

Fig. 1 – Modello di Pipeline [A.Pasquinucci]

Per gestire questi sistemi è necessario che il ruolo del Sistema Operativo aumenti: da puro sistema di carico/scarico di dati e istruzioni diventa il gestore delle code e dell’elaborazione, anche se sempre di un solo Job alla volta.

Si noti anche una caratteristica che diventerà importante per alcuni tipi di vulnerabilità “Spectre” e “Meltdown”: nelle CPU SuperScalari le istruzioni non sono sempre eseguite nell’ordine previsto dal programma, spesso anzi alcuni tipi di istruzioni, ad esempio calcoli su numeri a virgola mobile, sono eseguite in anticipo non appena disponibili i dati necessari. Questo è fatto perché se poi il calcolo risulta necessario, allora si è guadagnato del tempo perché il risultato è già pronto, altrimenti se il calcolo non è utilizzato dal programma, viene eliminato. La gestione dell’esecuzione delle istruzioni fuori dall’ordine del programma è demandata principalmente ai circuiti Hardware che fanno sì che per il Sistema Operativo ed i programmi l’esecuzione risulti sempre nell’ordine dato. La logica adottata in Hardware è che è meglio tenere impegnate le CPU anche con calcoli che nel caso non saranno utili, piuttosto che tenerle ferme: alcune volte ci sarà un grande guadagno di tempo, altre volte il guadagno sarà minimo, ma in ogni caso non si perderà mai tempo.

Modelli di Sicurezza IT

Prima di proseguire con l’evoluzione degli elaboratori, è utile rammentare quale fosse ai tempi l’approccio alla sicurezza informatica. Visto che gli elaboratori erano per lo più mono-processo, mono-utente e non erano connessi tra di loro, le principali esigenze di sicurezza provenivano dai militari. Il principale modello di sicurezza militare è quello formalizzato e dimostrato da Bell – La Padula nel 1973, un modello di sicurezza a multi-livello: rispecchiando la gerarchia militare, il modello richiede che ognuno possa leggere solo i documenti al proprio livello ed ai livelli inferiori, mentre possa inviare nuovi documenti solo al proprio livello ed ai livelli superiori (write-up, read-down). Bell e La Padula dimostrarono che questo modello garantisce la riservatezza delle informazioni. Biba nel 1977 dimostrò che il modello opposto (write-down, read-up) garantisce l’integrità delle informazioni.

Vi sono altri modelli per la sicurezza delle informazioni: ad esempio il controllo di accesso discrezionale (DAC) prevede che ogni utente possa decidere chi può accedere e come alle proprie informazioni, usualmente tramite la configurazione di liste di controllo accesso (ACL). Questo approccio è stato adottato ad esempio dai Sistemi Operativi di tipo Unix.

Più in generale si è giunti a formulare il concetto di sistemi “di fiducia” (“Trusted”) che prevedono che vi sia un insieme di regole di sicurezza (“Trusted Computing Base”, TCB) gestite dal responsabile della sicurezza, e che all’interno del Sistema Operativo vi sia un processo sicuro (“Reference Monitor”) che verifica che l’esecuzione di ogni istruzione soddisfi la TCB. Questi concetti sono anche formulati nei requisiti e certificazioni di sicurezza quali gli Orange Book e i Common Criteria [2, 3].

Più avanti sarà necessario approfondire alcuni aspetti dell’approccio ai sistemi Trusted, TCB e Reference Monitor. Per ora però è importante ricordare l’approccio alla sicurezza come descritto dai sistemi a multi-livello.

Multiprocesso e Multiutente

Ritornando alla nostra breve storia, il passo successivo nell’evoluzione degli elaboratori è l’esecuzione contemporanea di più programmi, ovvero di più Job ognuno di un utente diverso. Questo è il passo cruciale per la nascita degli elaboratori moderni ed il principale attore di questo passo è il Sistema Operativo. L’evoluzione del Sistema Operativo lo porta ad adempiere principalmente a due compiti:

  1. Macchina Estesa (o macchina virtuale): la scrittura di programmi direttamente in linguaggio macchina o in linguaggi appena più evoluti richiede comunque la conoscenza dell’Hardware e del suo funzionamento, questo rende molto complessa la scrittura dei programmi; invece il Sistema Operativo può interporre un’interfaccia applicativa, che semplifica e nasconde le complessità dell’Hardware rendendo più semplice la scrittura dei programmi; non solo, permette anche di eseguire lo stesso programma su Hardware diversi;
  2. Gestore delle Risorse: se si vogliono eseguire più programmi allo stesso tempo, è necessario che il Sistema Operativo, che ha il compito di caricarli e scaricarli dalla CPU, li gestisca durante tutto il tempo della loro esecuzione, non solo all’inizio ed alla fine, ed in maniera molto precisa e dettagliata.

E’ necessario approfondire come il Sistema Operativo svolge il compito di Gestore delle Risorse. Prima di tutto, all’interno di una CPU (e per ora consideriamo solo elaboratori con una CPU ciascuno) viene eseguito un solo programma alla volta. Vengono però caricati in memoria più programmi e la CPU ne alterna l’esecuzione. Il Sistema Operativo decide quale programma deve essere eseguito, per quanto tempo, e verifica che durante l’esecuzione un programma non tocchi i dati degli altri programmi ne utilizzi periferiche Hardware in modo inappropriato. L’alternanza di esecuzione dei programmi permette di rendere molto più efficiente l’utilizzo delle risorse, ad esempio mentre un programma legge o scrive dei dati, un altro viene eseguito nella CPU. Il Sistema Operativo quindi gestisce l’accesso a tutte le risorse Hardware da parte dei programmi in modo che questo sia efficiente e che al contempo l’integrità, riservatezza e disponibilità dei dati siano garantite. Questo deve essere fatto dal Sistema Operativo in modo tale che durante l’esecuzione un programma possa comunque disporre di tutte le risorse Hardware, come se fosse eseguito da solo, in assenza di altri programmi.

Multics

Nel 1965 MIT, AT&T, IBM e GE decisero di sviluppare in comune un sistema operativo ‘sicuro’ chiamato Multics. Questo sistema operativo doveva essere:

  1. Progettato top-down
  2. Capace di supportare almeno 1000 utenti contemporaneamente
  3. ‘Reliable’
  4. ‘With sufficient control of access to allow selective sharing of information’

ed avere molte altre caratteristiche di sicurezza militare. Il progetto non ebbe successo commerciale, uno dei motivi fu che le richieste di sicurezza intrinseca al sistema, garantite da uno sviluppo controllato top-down, portarono ad un’eccessiva complicazione del software rispetto alle piattaforme hardware disponibili in quegli anni. Così nel 1969 AT&T convinse i partner a chiudere lo sviluppo di Multics, anche se Multics venne sviluppato in maniera indipendente ancora per una decina di anni.

Multics fu però un passaggio molto importante nella storia dei Sistemi Operativi, anche per essere il padre di Unix (e la somiglianza dei nomi non è casuale).

Ma come Multics avrebbe potuto soddisfare questi requisiti? Come poteva un Sistema Operativo gestire le risorse, garantire l’isolamento tra programmi ed al contempo permettere che un programma utilizzasse tutte le risorse del sistema?

La soluzione che si adottò allora anche per Multics, e che tuttora è alla base dell’Hardware IT, è simile all’approccio alla sicurezza multi-livello citato precedentemente. In particolare Multics fu progettato con 8 livelli, chiamati Anelli di Protezione (“Protection Rings”) ed implementati in Hardware (vedi Fig. 2). L’anello più interno, convenzionalmente numerato con 0, è l’anello con maggiori privilegi, il livello massimo di sicurezza, mentre l’anello più esterno, il 7, ha il livello minore di privilegi. Ogni programma viene caricato ed eseguito solo ed esclusivamente in un livello, ma può chiamare altri programmi che sono eseguiti in altri livelli (tipicamente superiori). E’ l’Hardware che isola i livelli, e non permette ad un programma eseguito ad un certo livello di accedere direttamente alle risorse di un altro livello. In ogni istante nell’Hardware vi è un indicatore che segna a quale livello sono eseguite le istruzioni. Per accedere a risorse gestite da un altro livello, un programma effettua una richiesta, ovvero una chiamata ad una funzione speciale (System Call) che attiva una chiamata Hardware dedicata (Call Gate). Queste chiamate Hardware permettono di accedere a specifiche routine ad un determinato livello: se i parametri passati con la richiesta sono corretti, allora la richiesta è accettata e viene eseguito il comando al nuovo livello. Ad esempio per leggere e scrivere su disco, un programma in esecuzione ad un livello esterno esegue una System Call al Sistema Operativo a livello 0 chiedendo di leggere/scrivere i dati. E’ quindi il Sistema Operativo stesso che esegue la lettura / scrittura e poi ritorna i dati e l’esecuzione al programma al procedente livello.

Fig. 2 – Anelli di protezione per le CPU Intel x86 [Wikipedia]

In questo modo l’Hardware garantisce che il Sistema Operativo, a livello 0, gestisca direttamente tutte le risorse, sia in grado di fornire un’interfaccia applicativa che virtualizza e semplifica l’accesso alle risorse, garantendo allo stesso tempo l’integrità, riservatezza e disponibilità dei dati. Senza la separazione tra Sistema Operativo e altri programmi fornita dall’Hardware, non sarebbe possibile garantire la sicurezza dell’esecuzione contemporanea di programmi né la separazione tra programmi e dati di utenti diversi.

La maggior parte delle moderne CPU adotta una struttura ad Anelli di Protezione, a partire ad esempio dalle CPU Intel x86 che hanno 4 anelli. In generale però gli attuali Sistemi Operativi non sfruttano tutti gli Anelli, ma ne usano solo due, tipicamente quello più privilegiato e quello meno privilegiato. Si dice che il Sistema Operativo opera in “kernel mode” (ring 0) mentre tutti gli altri programmi sono eseguiti in “user mode”. Ci sono alcuni motivi per cui in pratica si usano solo due anelli tra cui la semplicità di gestione del codice, la portabilità del codice su diversi modelli di CPU, la maggiore facilità nel gestire molti privilegi in software piuttosto che in Hardware.

La ricerca di maggiori prestazioni insieme all’estensione delle capacità di calcolo delle CPU, all’esplosione del numero di periferiche e di utilizzi degli elaboratori, ha portato ad una crescita quasi incontrollata della dimensione dei Sistemi Operativi eseguiti in Kernel Mode. Ovviamente le dimensioni e la complessità sono tra i primi nemici della sicurezza, e questo si riscontra quotidianamente nelle vulnerabilità di sicurezza che si scoprono nei Sistemi Operativi.

La gestione della Memoria Dinamica

La presenza di Gate e System Call non è però sufficiente a raggiungere gli obiettivi del progetto Multics, è anche necessario che durante l’esecuzione ogni programma possa accedere, anche solo virtualmente, a tutto l’Hardware, in particolare a tutta la memoria dinamica. La gestione della memoria (principalmente la RAM, Random Access Memory, e le Cache) è un argomento molto complesso ma per i nostri scopi è necessario farne almeno un accenno di cui avremo assolutamente bisogno per capire il funzionamento di “Spectre” e “Meltdown”.

L’idea di partenza è quella di dare ad ogni programma accesso a tutta la memoria in maniera virtuale. Ogni programma può quindi allocare qualunque indirizzo (virtuale) della memoria, questi indirizzi però non sono reali, vengono tradotti in tempo reale negli indirizzi di memoria realmente utilizzati da una componente Hardware chiamata Unità di Gestione della Memoria (MMU) con l’ausilio di tabelle Hardware di conversione (ad esempio TLB, LTD, GDT ecc.). In questo modo un programma pensa di utilizzare tutta la memoria, ma in realtà solo l’Hardware ed il Sistema Operativo sanno veramente quali locazioni di memoria fisica sono utilizzate dal programma, ed in quale memoria: RAM, Cache (e di quale livello) od anche disco nel caso di swap.

L’approccio di Multics ed anche di molti dei processori moderni quali ad esempio quelli della famiglia Pentium Intel, è quello di utilizzare un processo di gestione della memoria chiamato Segmentazione con Paginazione (“Segmentation with Paging”) che implementa sia il mapping tra indirizzi virtuali e fisici che la gestione della memoria fisica, con lo spostamento delle pagine di memoria da una memoria all’altra a seconda della necessità di uso.

Infatti le memorie fisiche sono organizzate in maniera gerarchica: dallo swap su disco, memoria più lontana dalla CPU e più lenta, alla RAM, ai vari livelli di Cache di cui L1 è quello più vicino alla CPU, più veloce ma tipicamente piccolo (vedi Fig. 3).

Fig. 3 – Gerarchia delle memorie [A.Pasquinucci]

Il Sistema Operativo fa sì che vengano caricati nella Cache L1 le istruzioni ed i dati che servono all’esecuzione del programma. Si definisce “Cache Hit” quando il processore trova nella Cache L1 i dati o le istruzioni di cui ha bisogno. Quando invece il processore non trova nella Cache L1 i dati o le istruzioni di cui ha bisogno per proseguire l’elaborazione, si dice che si verifica un “Cache Miss”.

Nel caso di Cache Miss, il Sistema Operativo deve dapprima liberare sufficiente spazio nella Cache per poter caricare i nuovi dati, e questo richiede trovare spazio nelle Cache inferiori, nella RAM o su disco, ove scrivere i dati. Poi trovare nelle Cache inferiori, nella RAM o su disco i dati da caricare e copiarli nella Cache L1. Dopodiché può essere ridato il controllo al programma che può procedere nell’esecuzione. E’ chiaro che nel caso di Cache Miss i tempi di esecuzione di una istruzione sono molto più lunghi, anche 100 volte, che nel caso di Cache Hit.

Tutto ciò è ulteriormente complicato dal fatto che, come indicato inizialmente, le “pipeline” di esecuzione del codice sono molteplici e non è detto che le istruzioni vengano eseguite nell’ordine previsto dal programma, e questo è fatto per utilizzare al massimo le CPU.

Per “Spectre” e “Meltdown” è necessaria qualche ulteriore informazione tecnica su come è gestita la memoria di un elaboratore. Come già indicato, la memoria è tipicamente organizzata in Pagine e Segmenti. Una Pagina è un’unità di memoria sia fisica che virtuale, spesso di 4KB, che viene gestita dall’Hardware come un blocco unico con un unico indirizzo. Questo semplifica l’indirizzamento della memoria e le attività di copia dei dati tra le diverse Cache e memorie. I Segmenti invece sono spazi di memoria virtuali, gestiti dall’Hardware, che permettono ad un programma di avere a disposizione più di uno spazio di memoria con indirizzi consecutivi che partono da 0. I Segmenti possono avere dimensioni (virtuali) differenti a seconda delle necessità del programma. Un tipico esempio di uso di un Segmento è quello delle librerie condivise (“Shared Libraries”): alcune librerie di sistema, ad esempio quelle grafiche, sono spesso utilizzate da molti programmi contemporaneamente. In assenza di Segmenti, ogni programma deve caricare nel proprio spazio virtuale una copia della libreria, mentre se l’Hardware supporta i Segmenti, il Sistema Operativo può caricare una libreria in un Segmento (read-only) ed includere il Segmento nello spazio virtuale di memoria di tutti i programmi che lo utilizzano, velocizzando le operazioni e riducendo l’utilizzo di memoria. Visto che un Segmento può essere molto grande, in CPU Intel x86 i segmenti sono di 4GB dimensione superiore a quella della Cache L1, è necessario suddividere in Pagine i Segmenti in modo da gestire il caricamento dei dati nelle diverse memorie.

Un ultima osservazione, nelle attuali CPU a 64 bit, l’utilizzo dei Segmenti non è più veramente necessario poiché lo spazio di memoria a 64 bit indirizzabile è veramente enorme e i dati possono essere distribuiti direttamente in blocchi di memoria con indirizzo di base differente. I Segmenti sono comunque utilizzati per la protezione della memoria, ad esempio indicano se un’area di memoria può essere acceduta solo in “kernel mode” od anche in “user mode”.

Sicurezza e Hardware

L’Hardware ha quindi un ruolo fondamentale ed indispensabile nel garantire la sicurezza, intesa come riservatezza, integrità e disponibilità dei dati e delle risorse. In particolare l’Hardware:

  • isola il Sistema Operativo da tutti gli altri programmi;
  • permette solo al Sistema Operativo di accedere all’Hardware ed a tutte le risorse del sistema;
  • obbliga tutti gli altri programmi ad accedere alle risorse tramite il Sistema Operativo che può quindi sia gestire le risorse fisiche (integrità e disponibilità) sia verificare i permessi di accesso alle risorse assumendo il ruolo di Reference Monitor (riservatezza);
  • gestisce, insieme al Sistema Operativo, la concomitanza di esecuzione di più programmi contemporaneamente ed in particolare della memoria dinamica.

Cosa succederebbe se un programma potesse anche solo leggere i dati di un altro programma in esecuzione, senza passare attraverso il Sistema Operativo? Dovremmo sicuramente definire questa una vulnerabilità Hardware.

Note

[1]     I programmi e i dati erano tipicamente caricati per mezzo di schede cartacee perforate lette da opportune unità di input dell’elaboratore.

Riferimenti Bibliografici

[1] Alcuni riferimenti su “Spectre and Meltdown”:

[2] The Orange Book, DoDD 5200.28-STD, pubblicato nel 1983 e aggiornato 1985 dal National Computer Security Center (NCSC), parte della National Security Agency (NSA),  http://csrc.nist.gov/publications/secpubs/rainbow/std001.txt

[3] “Common Criteria for Information Technology Security Evaluation” (anche noto come “Common Criteria” o CC), ISO/IEC 15408,

http://www.iso.org/iso/iso_catalogue/catalogue_tc/catalogue_detail.htm?csnumber=50341

[4] A.S. Tanenbaum, “Modern Operating Systems”, Prentice Hall


A cura di: Andrea Pasquinucci

L’articolo L’Hardware e la Sicurezza IT – Parte 1: un poco di storia proviene da ICT Security Magazine.

https://www.ictsecuritymagazine.com/articoli/lhardware-e-la-sicurezza-it-parte-1-un-poco-di-storia/


La silente guerra degli hacker italiani

C’è una guerra in atto all’interno del panorama internet italiano, una guerra silenziosa di cui i quotidiani praticamente non parlano ma molto importante perché corre sul filo della responsabilità del trattamento dei dati personali. Forse il termine “guerra” potrà sembrare eccessivo ad alcuni di voi, ma permettetemi di snocciolare qualche dato che, sinceramente, dovrebbe far riflettere: a giugno di questo anno sono stati attaccati il sito del Consiglio della Regione Toscana: http://www.consiglio.regione.toscana.it e il sito riguardante il potenziamento delle linee della TAV http://www.e78grossetosiena.it. A luglio sono stati attaccati il Ministero della Salute e il sito che collegava le attività dell’Expo di Milano alle attività commerciali in Basilicata (http://www.daexpoallabasilicata.it). Ad agosto, mentre molti di noi erano sotto l’ombrellone, è stato attaccato il sito della UILM (Unione Italiana Lavoratori Metalmeccanici). Per continuare:

  • 12 agosto: data breach con esposizione pubblica di credenziali utenti appartenenti al MEF;
  • 7 settembre: data breach con esposizione pubblica di oltre 37.500 account di utenti INAS;
  • 11 settembre: data breach con esposizione pubblica di username e password appartenenti al Ministero dell’Ambiente e del Ministero del Tesoro;
  • 16 settembre: data breach con esposizione pubblica di utenze appartenenti all’UNUCI (Unione Nazionale Ufficiali in Congedo d’Italia).

Ne sono previsti altri, entro il cinque novembre per l’esattezza, ma prima di proseguire credo sia giusto chiarire alcuni concetti chiave. Le azioni di cui parliamo si basano, grossomodo, su due tipologie di attacco: il de facing ossia la modifica dell’aspetto grafico di un sito in modo che possa apparire come vuole l’hacker, e il data-breach che prevede l’entrata in possesso di database da cui estrarre i dati. La tipologia di attacco sembra dimostrare che gli hacker hanno una fitta rete di “aiutanti”, pronti a garantire gli accessi ai dati o, quantomeno, in grado di semplificare le varie operazioni di sabotaggio. È un panorama preoccupante che lascia scoperti alcuni interrogativi ed il principale è “come mai le protezioni non funzionano?”.

La protezione non è solo un fattore tecnico, è altresì garantita dalle componenti umane di professionalità, competenza ed etica; questi ultimi spesso dimenticati, sottovalutati o letteralmente ignorati. Dai vari tweet di gruppi hacker come Anonymous Italia o LulzSecITA si scoprono principalmente due aspetti: il primo riguarda le password in uso agli utenti, spesso non in linea con i comuni criteri di sicurezza. Il secondo riguarda le banche dati, popolate da tabelle in cui le credenziali sono “in chiaro”, ossia in cui password dell’utente è leggibile a chiunque ne abbia accesso.

Esistono quindi due facce della stessa medaglia: da un lato c’è l’attaccante che viola la legge con un accesso abusivo al sistema informatico. Dall’altro c’è chi avrebbe dovuto gestire adeguatamente le informazioni e non lo ha fatto. A valle di un attacco c’è sempre un messaggio che lo reclama fornendo dati tecnici interessanti e ci si aspetterebbe provvedimenti legali in entrambe le direzioni, anche per chi non ha protetto adeguatamente tali informazioni. È il caso di Rogue0, l’hacker che ha ripetutamente penetrato la piattaforma utilizzata dal Movimento 5 Stelle e di proprietà della Casaleggio Associati. L’hacker ha garantito che può accedere alla piattaforma ripetutamente e senza troppi problemi e a poco sono valse le raccomandazioni del Garante sulla Privacy: già dopo il primo attacco la piattaforma era stata data per sicura e invece sappiamo come è finita: il 6 settembre su Twitter appaiono i numeri di cellulare di esponenti del Movimento 5 Stelle e dati di tabelle provenienti dalla piattaforma. Come mai nessuno ha controllato che la falla fosse stata chiusa realmente e la piattaforma fosse davvero sicura e in grado di operare?

Diciamo la verità, in Italia abbiamo un brutto vizio: non controlla nessuno fino a quando non accade qualcosa di spiacevole e chi pensa che questi attacchi hacker abbiano finalità politica sbaglia anche se gli obiettivi sembrano suggerirlo. Questi gruppi hacker hanno lo scopo di detronizzare le istituzioni che vantano sicurezza e perfezione quando, in realtà, non sono in grado di fornirle. A valle dell’attacco all’INAS, il gruppo LulzSecITA ha scritto quanto segue: “Ancora una volta, l’Istituzione Italiana si mostra incapace di #proteggere i #dati #sensibili dei propri cittadini, mettendo così in serio pericolo le loro vite, e se vogliamo parlare di numeri, sono ben 37.500.”


Alla base vi è la voglia di sbugiardare la sicurezza che molti soggetti istituzionali sembrano palesare e le tecniche adottate per riuscire in questo obiettivo, sono quelle che fanno più male perché mettono a nudo l’incapacità tecnica di difendersi oltre che la scarsa professionalità nella gestione dei dati. In un’intervista al sito Motherboard.it si leggono due risposte molto interessanti dell’hacker Rogue0:

Domanda di Motherboard.it: Hai anche accesso in scrittura al database?

Risposta dell’hacker: L’accesso è sempre lo stesso quindi sì, in uno dei tweet ho scritto nome e tipo di user e i suoi privilegi, quindi è una cosa pubblica


Domanda di Motherboard.it: Cosa pensi dell’idea della democrazia diretta e del voto elettronico? La tua è anche una battaglia di principi o solo legata al comportamento del partito M5S?

Risposta dell’hacker: Ancora queste domande. 🙂 Questo non è un hack politico, a me del comportamento del partito non frega niente. Se vuoi è una battaglia di principi informatici. Se ti riferisci ai numeri dei ministri è solo perché fanno rumore, a scapito di Davide [Casaleggio, ndr]. Povero Davide. lol
 

Si evince la totale e reiterata incapacità a proteggere la piattaforma su cui sono ospitati i dati degli utenti. A valle del data breach condotto dal gruppo LulzSecITA su INAS, in molti hanno contestato che alcuni dati erano stati ottenuti utilizzando SQL Map, un penetration test tool parecchio conosciuto da chi si occupa di cyber security. Parliamo di uno strumento che è stato immesso sulla rete nel 2006 e la cui ultima edizione (la 1.1) risale a gennaio 2017. SQL Map è noto per la sua semplicità di utilizzo e altro non fa che lanciare una raffica diversificata di attacchi contro una banca dati per saggiarne la resistenza; per questo motivo, ad esempio, viene utilizzato per testare la qualità e la sicurezza di un sito web. Usare SQL Map per un attacco dovrebbe essere inutile, perché reso inefficace tramite il corretto sviluppo del codice sorgente. Portare e concludere con successo un attacco con tale strumentazione rivela la completa inadeguatezza tecnologica dell’attaccato e la totale superficialità con cui viene fatta la manutenzione del codice sorgente e dei database. Torniamo al concetto dei controlli: chi scrive ha profondo rispetto e stima per il Garante ma si rende anche conto che probabilmente la struttura di quest’ultimo è pesantemente sotto-organico rispetto a ciò che servirebbe per fronteggiare eventi di questo tipo. Il ruolo del Garante rischia di essere relegato a quello di semplice ammonitore quando invece la completezza delle sue funzioni sono fondamentali per una gestione corretta delle informazioni.

Il cinque novembre si avvicina: il gruppo hacker LulzSecITA ha già lasciato intendere che ci sarà un altro nuovo e pesante attacco, magari anche con la collaborazione di Anonymous. I due gruppi hanno collaborato spesso insieme e lo hanno fatto dando vita ad AntiSec, un nome che racchiude un concetto fin troppo chiaro (Anti Security). È ragionevole pensare che LulzSecITA sia già in possesso delle informazioni e le stia elaborando per presentarle in maniera massiccia in quella data. Il tweet che hanno pubblicato è abbastanza eloquente e cita un passaggio di “La tempesta” (Shakespeare-Angeli) /Atto primo/Scena seconda. Inoltre, come è stato fatto notare più volte su internet (l’ultima dalla Dott.ssa Claudia Cofini), il 5 novembre è una data rilevante:

“Il 5 novembre rimanda anche alle congiure delle polveri di cui uno dei protagonisti è Guy Fawkes, da cui prende ispirazione la maschera di Anonymous e il film V for Vendetta”

Questa guerra, perché di questo si tratta, è nel pieno svolgimento ed obiettivamente trova fondamento sulla superficialità tecnica e professionale di chi dovrebbe tutelare i dati dei cittadini; citando Sun Tzu: “il generale esperto attacca la strategia del meno esperto. Questa è la prima cosa da fare.” La speranza è che il vento cambi e che vi sia maggiore senso di responsabilità nel trattare queste informazioni, tenendo sempre a mente che il valore di un’azienda è data dalle informazioni in suo possesso e speriamo che il vento cambi in fretta.

Riferimenti utili

Intervista dell’hacker R0gue0 al sito Motherboard.it: https://motherboard.vice.com/it/article/3ke8qj/rousseau-hack-rogue0-intervista-movimento-5-stelle


A cura di: Edoardo Limone

L’articolo La silente guerra degli hacker italiani proviene da ICT Security Magazine.

https://www.ictsecuritymagazine.com/articoli/la-silente-guerra-degli-hacker-italiani/


Il Phishing Assessment per la Sicurezza Aziendale

Il phishing è uno dei metodi di attacco più comune, sfrutta come tecnica principale il Social Engineering e viene utilizzato per compromettere le credenziali e rubare dati sensibili.

Attraverso il phishing, gli aggressori inviano messaggi di posta elettronica che sembrano essere legittimi e possono contenere nomi, indirizzi e-mail e loghi di organizzazioni fidate (es. Banche, negozi al dettaglio, agenzie governative).

La tecnica di contraffazione degli indirizzi di posta e dei nomi è chiamata spoofing e per tutta la mail sono spesso utilizzate parole che esprimono un senso di urgenza, puntando sulle emozioni umane al fine di forzare un errore dell’utente.

Nella totalità delle campagne di phishing c’è necessità di un fattore comune per andare a segno.
Questo fattore comune è l’uomo, infatti l’errore umano è essenziale per la riuscita di un attacco di questo genere.

Altre tipologie di phishing possono essere così classificate:

  • Spear phishing
    Si tratta di un attacco mirato verso un individuo o una compagnia.
  • Clone phishing
    Tipologia di phishing in cui una mail legittima viene modificata e reinoltrata ai medesimi interlocutori, dichiarando di essere una versione aggiornata.
  • Whaling
    Si tratta di attacchi di phishing indirizzati verso alte figure aziendali o di enti.
    Lo scopo è di ottenere delle credenziali di un manager. Il contenuto della mail viene creato su misura per l’obiettivo.

Negli ultimi mesi in Italia abbiamo avuto un’impennata di attacchi di phishing ai danni di aziende e privati.

Secondo le statistiche del mese di Giugno, elaborate dal C.R.A.M. (Centro Ricerche Anti-Malware), hanno fatto da padrone attacchi di tipo “commerciale”, che hanno come obiettivo, quello di ottenere credenziali di accesso a conti bancari, caselle di posta elettronica e altro.

Osservando anche il trend degli ultimi anni, facendo riferimento alla tabella presente in Wikipedia, possiamo notare un massiccio incremento annuale degli attacchi, ciò anche per via della maggiore disponibilità di apparati per la navigazione ormai alla portata di tutti.

https://it.wikipedia.org/wiki/Phishing

L’Italia è stata impattata maggiormente da Trojan di tipo bancario:

  • UrSnif
  • ZeuS Panda
  • GootKit

Le funzioni principali di questi trojan sono:

  • Catturare screenshot
  • Rubare password di varia tipologia
  • Rubare i cookie
  • Rubare certificati
  • Avviare un proxy SOCKS
  • Esfiltrare le informazioni dell’utente
  • Scaricare e installare nuovi malware

L’utente finale, molte volte, non si accorge neanche di cosa accade dopo aver cliccato un link o dopo aver aperto un allegato, il più delle volte ha modo di capirlo solo dopo aver visto svuotarsi il proprio conto in banca o perché non ha più accesso alla propria casella di posta elettronica.

Quindi, dare ai dipendenti che cliccano su un link, la possibilità di avere un immediato riscontro in ambiente controllato, tramite un “alert” che indica che sono appena caduti vittime di un test, permette un apprendimento maggiore sul phishing e su come avrebbero potuto rilevare che si trattava di un attacco.

Le mitigazioni delle campagne di phishing si possono basare su due macro-categorie

  1. Hardware e Software
  2. Formazione dell’utente finale

Nella categoria HARDWARE E SOFTWARE possono essere raggruppati tutti quei dispositivi atti ad applicare determinate regole, signature o IoC (Indicator of Compromise) che bloccano il flusso prima che le email arrivino a destinazione.
Per citarne alcuni: firewall, antispam, feed ecc…

Per la formazione dell’utente finale, occorre pianificare degli attacchi simulati e organizzare piani di formazione continui, tenendo presente che gli attacchi di phishing, basandosi sul Social Engineering, mutano per essere sempre più sofisticati, anche perché per andare a segno, devono far leva sull’ingenuità dell’obiettivo.

Senza una corretta formazione e informazione, si è sempre soggetti a rischio tenendo conto che gli apparati Hardware e Software non sono infallibili.
Tale processo è utile per identificare quei dipendenti che potrebbero richiedere ulteriore formazione e, quindi, renderla partecipe dei rischi cibernetici che possono esserci dietro un semplice click.

Un proverbio della saggezza popolare recita:
“Chi si è scottato con l’acqua calda, ha paura anche di quella fredda”.

Il phishing assessment potrebbe essere quindi una soluzione completa per un’azienda che richieda un piano strategico sulla sicurezza informatica aziendale.

Un’attività di questo tipo si snoda principalmente in 3 fasi:

  1. Analisi degli obiettivi
  2. Campagna di phishing
  3. Analisi dei risultati in base alle attività degli utenti

Nel primo punto, di regola, vengono richiesti gli indirizzi email oggetti di attacco e più informazioni possibili, in modo da poter creare template, URL e allegati in base alle richieste.
Alcune aziende fanno richiesta di una simulazione partendo dalle sole informazioni che si possono reperire in rete, in questo modo, l’attacco simulato sarà molto simile a un vero e proprio attacco mirato.

Nel secondo punto, si settano tutti i parametri prima dell’inizio della campagna, in modo da avere la possibilità di seguire l’evolversi degli eventi in tempo reale. Le mail possono contenere link oppure allegati e che spingono gli utenti ad effettuare delle azioni mentre sono monitorati.

Nel terzo invece, si ha l’analisi dei dati raccolti, la stesura di un rapporto e l’eventuale ingaggio di un formatore che possa istruire i dipendenti al corretto utilizzo della rete e fornire le basi della sicurezza informatica.

Le metriche di valutazione fornite nel rapporto, possono essere anche utilizzate per evidenziare e potenziare i punti deboli nelle policy di gestione e configurazione della posta elettronica aziendale e settare altri apparati hardware e software.

Buona regola sarebbe quella di prevedere più sessioni a distanza di pochi mesi per valutare l’efficacia del programma di formazione.

Sono presenti pochi tool online di tipo Open Source e la documentazione in rete, specialmente in lingua italiana non è proprio copiosa.

Uno strumento Open Source degno di nota è “Gophish Open-Source Phishing Framework “.

Repository ufficiale: https://getgophish.com

Ottimo strumento completamente personalizzabile, offre una dashboard dove osservare l’evolversi della campagna in tempo reale, gestire la lista degli obiettivi in maniera semplice e intuitiva.

Molto flessibile anche a riguardo dei sistemi operativi, poiché è disponibile per Windows, Mac OSX, e Linux.

Riferimenti:

*Statistiche del mese di Giugno elaborate dal C.R.A.M. (Centro Ricerche Anti-Malware),
https://www.tgsoft.it/italy/news_archivio.asp?id=944

URSNIF
https://blog.trendmicro.com/trendlabs-security-intelligence/ursnif-the-multifaceted-malware/

ZeuS Panda
https://en.wikipedia.org/wiki/ZeuS_Panda

Gootkit
https://www.cyber.nj.gov/threat-profiles/trojan-variants/gootkit

Repository ufficiale Gophish:
https://getgophish.com


A cura di: Sergio Caruso

L’articolo Il Phishing Assessment per la Sicurezza Aziendale proviene da ICT Security Magazine.

https://www.ictsecuritymagazine.com/articoli/il-phishing-assessment-per-la-sicurezza-aziendale/


AI & Controlli di Sicurezza

Spesso mi chiedo quali vantaggi concreti possano offrire in ambito di “offensive security” l’utilizzo di tecnologie come il Machine/Deep Learning (o più ampiamente di Artificial Intelligence) e quali possano essere le reali applicazioni per consentirci di raggiungere migliori risultati in termini di controllo utilizzando invece che persone cicli macchina.

Con l’aumento delle superfici di rischio dovuto all’avvento di nuove frontiere tecnologiche come IoT, Cloud, e in generale 3rd platform, molte realtà che oggi si occupano di sicurezza si trovano impreparate e stentano a mantenere il passo con l’incredibile aumento della domanda per poter misurare con efficacia il rischio del proprio cyberspace.

L’avvento dell’intelligenza artificiale, come ogni altra nuova tecnologia per noi addetti alla Sicurezza informatica, rappresenta immediatamente una minaccia. Ma subito dopo risulta evidente che questa minaccia può introdurre enormi benefici nella Cyber Security stessa e che questi potranno essere l’unica strada per garantire un controllo efficace di tutte le direttrici di rischio, sperando anche ad un incremento della percentuale di LMC (livello massimo di confidenza) cosa che in grandi aziende, per motivi di tempo, risorse, costi e complessità dei sistemi sta diminuendo di anno in anno.

Quindi da non addetto ai lavori mi sono chiesto, se si possano automatizzare una serie di attività che svolgiamo ad elevato costo e skill come ad esempio i pentest. Ma prima di andare avanti ad immaginare un nuovo libro di Asimov mi chiedo, cosa è oggi un hacker e concedetemi di farlo con un po’ di poesia.

Cosa è un hacker

Un hacker o (nel nostro caso un “ethical-hacker” nel senso di “cattivo ma buono”) porta con se un ampio bagaglio culturale di anni basato su metodo, tecnica, intuito, genio e creatività. Questo lo porta a superare problemi di natura complessa utilizzando modelli euristici (spesso completamente empirici) oltre ad essere mosso da una folle “curiosità” e “passione” che lo spinge a “smontare” le cose per poi “ricostruirle” avendo cura di capire bene come sono fatte dentro, mettendo in dubbio il certo con l’incerto dove alcune volte, di incerto, non c’è proprio nulla.

Sono artisti del nuovo secolo che non portano con se un pennello e una tavolozza di colori ma tools informatici, grande conoscenza trasversale dei sistemi e la voglia costante di vincere una sfida infinita che non li porterà mai a nessun beneficio tangibile (nel caso di ethical) se non alla sola affermazione di essere capaci di arrivare a vedere oltre, dove gli altri non riescono a farlo.

Persone speciali con le quali può risultare difficile comunicare in un primo momento perché si aspettano altissime competenze e grande professionalità. Non sono le persone che si vedono nei film grasse con gli occhiali, con le maglie unte di grasso e patatine fritte appiccicate sulle t-shirt. Sono persone normali, ma piene di risorse e di capacità nascoste che solo trovando le giuste corde consentono di raggiungere traguardi impossibili sia a livello umano che a livello lavorativo.

AI applicata alla CyberSecurity

Come visto un ethical-hacker è una persona complessa che poco si sposa con un automa. Pensando di automatizzare attraverso un tool l’attività di un hacker con una concreta efficacia mi vengono in mente una serie di possibili problemi data l’attività poco modellizzabile perché fortemente abbinata ad intuito e genialità.

  • Una vista semplice. Un pentest di fatto è testare se sono presenti exploit utilizzabili su un sistema, provarli fino ad arrivare a trovare una breccia, trovare le successive falle concatenandole tra loro fino ad arrivare ad acquisire un accesso amministrativo capace di accedere ai dati e compromettere l’intero sistema. Detta così è automatizzabile, anzi, per questioni di tempo non tutte le vulnerabilità “exploitabili” vengono testate, per un hacker una volta trovato il “buco” è finito il gioco, un automa sicuramente farà sicuramente di meglio.
  • Una vista più complessa: e se l’”exploit” non è pubblico ma è una POC e occorre quindi costruirlo, se invece occorre analizzare il comportamento del sistema e i dati applicativi scambiati per poi scrivere del codice per ingegnerizzare il download dei dati. Se invece occorre capire tra tanti scenari “difficili” quale sia quello più fruttuoso in termini di exploit quando dai risultati di scansione sono presenti tutte vulnerabilità con criticità bassa? Probabilmente le cose si complicano.

Ora proviamo a descrivere un ipotetico modello: per “vulnerability-gate” verranno descritti gli Hop dell’assessment che consentiranno attraverso la loro combinazione di raggiungere il “Gold-gate” ovvero l’impatto finale.

  • Percorso di attacco: modellare un percorso di attacco è semplice, partendo da un tool di scansione si recuperano le vulnerabilità exploitabili in modo da percorrerle fino al prossimo vulnerability gate. Comporta un’infinità di combinazioni che hanno una pre-condizione e una post-condizione che risulta direttamente proporzionale alla pervasività dell’assessment. Inoltre tecnicamente è possibile abbinare più tool di scansione per rilevare vulnerabilità exploitabily dove alcuni scanner falliscono (ad es. Drupal e Joomla-Scan avviato a seguito della rilevazione della porta 80 dall’NMap).
  • Scelta dell’exploit: ogni vulnerabilità rilevata in discovery ha i suoi exploit che devono essere ricercati, scaricati, testati e sfruttati; pertanto è necessario un database degli exploit che si aggiorni costantemente per permettere il recupero e la scelta del miglior exploit presente sulla base delle “pre-condizioni” determinate dalla scansione e dalla potenziale minaccia in modo da guadagnare il prossimo vulnerability-gate.
  • Produzione e utilizzo dell’Exploit: il tester per generare un impatto potrebbe scrivere codice e testarlo all’interno del sistema una volta individuata la vulnerabilità per passare al prossimo vulnerability-gate. Non abbiamo oggi strumenti automatici che scrivono codice sfruttando delle pre-condizioni e delle post-condizioni di contorno, che testino in esercizio tale exploit in maniera silente e non intrusiva. Questo risulta a mio avviso molto difficile da modellare.
  • Genio, intuito e creatività: il tester spesso guadagna un Golden-Gate con eleganza e “singolarità”. Lo fa alcune volte in modo empirico e creativo, riuscendo sulla base della sua esperienza ad identificare rapidamente una soluzione, utilizzando proprio quelle informazioni che prima riportavo come “pre-condizioni” e “post-condizioni” che variano di volta in volta sulla base delle configurazioni dei sistemi e dei vulnerability-gate precedenti. La creatività è un reale problema di modellazione in quanto mette in discussione il certo per l’incerto, cosa che fanno gli esseri umani e non le macchine. Gli algoritmi possono provare una infinità di combinazioni, in forza bruta e con pattern complessi, ma le black-box in apprendimento non supervisionato riusciranno a mettere in discussione l’incerto e le condizioni di contorno come fa un hacker?

Quello che penso è che in questo dominio, arrivare al risultato di un hacker sarà quasi impossibile (ma forse mi sbaglio). Sicuramente avremo dei grandissimi risultati anche in tempi brevi sugli strumenti automatizzati di scansione, che a mio avviso sono molto indietro rispetto ai tempi e alle minacce che ogni giorno affliggono i nostri sistemi. Ad esempio, riallacciando il punto 3, molti software oggi (in particolare i vunerability Scanner Web) consentono di rilevare vulnerabilità exploitabili (se le rilevano) e molto spesso la loro pervasività è direttamente proporzionali ai possibili “deface” che possono essere fatti sui sistemi. Questo un hacker non lo fa perché conosce bene cosa vuol dire preservare il servizio e ha la giusta sensibilità nel farlo.

In un lontano “futuro” probabilmente si riuscirà in tutto questo (e spero anche a breve detto tra noi). Oggi è vero, riusciamo a pitturare bene una foro attraverso un algoritmo di Deep learning che sa come si riproduce un quadro impressionista di Van Gogh, ma riusciamo a creare Van Gogh?

Io credo che il genio umano rimarrà per lungo tempo indisturbato.

A cura di: Massimiliano Brolli

L’articolo AI & Controlli di Sicurezza proviene da ICT Security Magazine.

https://www.ictsecuritymagazine.com/articoli/ai-controlli-di-sicurezza/