YouTube Tests Video Carousel in Google’s AI Overview for Product and Location Searches


.article-native-ad { border-bottom: 1px solid #ddd; margin: 0 45px; padding-bottom: 20px; margin-bottom: 20px; } .article-native-ad svg { color: #ddd; font-size: 34px; margin-top: 10px; } .article-native-ad p { line-height:1.5; padding:0!important; padding-left: 10px!important; } .article-native-ad strong { font-weight:500; color:rgb(46,179,178); }

YouTube is experimenting with a video carousel of search results that appears in AI Overviews, Google’s AI-powered search experience.

A Google spokesperson confirmed the test with ADWEEK, noting that relevant videos will surface for queries like “best noise cancelling headphones” or “museums to visit in San Francisco.” The spokesperson declined to share further details about the program.

The feature is being tested with a small group of YouTube Premium members in the U.S. for select English-language queries, according to a company blog post. The search results are tailored to queries focused on shopping and location-based information.

YouTube’s foray into AI Overviews is Google’s latest move in the AI search race as platforms compete to capture user attention. While Google is leaning on video to make search results more dynamic, startups like Perplexity and ChatGPT-maker OpenAI are striking content deals with publishers to bring more contemporaneous answers into AI-generated responses.

Google is also testing a dedicated “AI Mode” in Search, which generates a full page of AI-powered results in response to user queries. The company already runs ads in AI Overviews and has indicated plans to introduce advertising in AI Mode as well.

https://www.adweek.com/media/youtube-tests-video-carousel-in-googles-ai-overview-for-product-and-location-searches/


Perplexity, Fresh Off Google Search Antitrust Testimony, Lands Global Motorola Deal


.article-native-ad { border-bottom: 1px solid #ddd; margin: 0 45px; padding-bottom: 20px; margin-bottom: 20px; } .article-native-ad svg { color: #ddd; font-size: 34px; margin-top: 10px; } .article-native-ad p { line-height:1.5; padding:0!important; padding-left: 10px!important; } .article-native-ad strong { font-weight:500; color:rgb(46,179,178); }

After telling a federal court that Google’s contracts blocked its path to distribution, AI search startup Perplexity has struck a global deal of its own.

Starting today, Perplexity’s app will come preinstalled on all new Motorola smartphones globally, with direct access to search and assistant features—plus a three-month Pro subscription.

“This is one of our first and most comprehensive integrations with a mobile phone brand, designed to provide a seamless search and assistant experience directly within Motorola’s ecosystem,” Perplexity said in a blog post. 

The announcement follows high-profile testimony from Perplexity’s chief business officer Dmitry Shevelenko at a federal remedies hearing in the Justice Department’s antitrust case against Google. Shevelenko told the court that Google’s exclusive distribution agreements with phone makers and wireless carriers had effectively shut out rivals, calling the contracts “a gun to your head” for companies reliant on Google’s revenue-share incentives.

The startup had approached several unnamed phone manufacturers, including Motorola, in hopes of striking a deal to make its AI search the default option on U.S. devices. But Shevelenko said those talks went nowhere, as partners were unwilling to jeopardize their existing revenue-sharing arrangements with Google.

With Motorola, Perplexity’s app won’t be the default assistant on the phone—despite mutual interest—because of contractual restrictions with Google, Shevelenko told presiding Judge Amit Mehta. “Motorola can’t get out of their Google obligations, and so they’re unable to change the default assistant on the device,” he said, per Bloomberg. 

Google pushed back on Perplexity’s claims. Vice president of global partnerships Peter Fitzgerald testified that Google had recently sent a letter to Motorola waiving any assistant-related requirements under its existing revenue-sharing agreement.

“It also clarifies, there’s no restrictions on alternative assistive services,” Fitzgerald added.

Following today’s announcement, Perplexity’s deal with Motorola includes custom optimizations for the hardware and software, the company said. On the Razr+ foldable model, the Perplexity app will function on the external display when the phone is shut.

Users can access Perplexity directly through Moto AI by typing “Ask Perplexity,” and the assistant supports a wide range of actions, from sending emails and setting reminders to booking restaurant reservations and rides.

To that, a feature called Next Move allows people to tap into Perplexity’s Related Questions content directly from the screen, enabling more conversational exploration.

“By integrating with one of the world’s leading smartphone manufacturers, we’re bringing our search and assistant capabilities to millions of new users,” the blog said. 

Editor’s note: This story has been updated to include testimony from a Google witness disputing Perplexity’s claims about restrictions on assistant preloads.

https://www.adweek.com/media/perplexity-google-testimony-motorola-deal/


Trump can’t keep China from getting AI chips, TSMC suggests

“Despite TSMC’s best efforts to comply with all relevant export control and sanctions laws and regulations, there is no assurance that its business activities will not be found incompliant with export control laws and regulations,” TSMC said.

Further, “if TSMC or TSMC’s business partners fail to obtain appropriate import, export or re-export licenses or permits or are found to have violated applicable export control or sanctions laws, TSMC may also be adversely affected, through reputational harm as well as other negative consequences, including government investigations and penalties resulting from relevant legal proceedings,” TSMC warned.

Trump’s tariffs may end TSMC’s “tariff-proof” era

TSMC is thriving despite years of tariffs and export controls, its report said, with at least one analyst suggesting that, so far, the company appears “somewhat tariff-proof.” However, all of that could be changing fast, as “US President Donald Trump announced in 2025 an intention to impose more expansive tariffs on imports into the United States,” TSMC said.

“Any tariffs imposed on imports of semiconductors and products incorporating chips into the United States may result in increased costs for purchasing such products, which may, in turn, lead to decreased demand for TSMC’s products and services and adversely affect its business and future growth,” TSMC said.

And if TSMC’s business is rattled by escalations in the US-China trade war, TSMC warned, that risks disrupting the entire global semiconductor supply chain.

Trump’s semiconductor tariff plans remain uncertain. About a week ago, Trump claimed the rates would be unveiled “over the next week,” Reuters reported, which means they could be announced any day now.

https://arstechnica.com/tech-policy/2025/04/trump-cant-keep-china-from-getting-ai-chips-tsmc-suggests/


DOJ Accuses Google of Using Search Monopoly Tactics To Push AI Product Gemini

.article-native-ad { border-bottom: 1px solid #ddd; margin: 0 45px; padding-bottom: 20px; margin-bottom: 20px; } .article-native-ad svg { color: #ddd; font-size: 34px; margin-top: 10px; } .article-native-ad p { line-height:1.5; padding:0!important; padding-left: 10px!important; } .article-native-ad strong { font-weight:500; color:rgb(46,179,178); }

The Department of Justice accused Google of using the same playbook to push its AI assistant, Gemini, that it once used to dominate search.

In the ongoing antitrust trial about Google’s dominance in search, DOJ attorney David Dahlquist told the court on April 21 that Google is paying Samsung “an enormous sum” in fixed monthly payments to make Gemini the default assistant on its devices, mirroring the exclusionary methods at the heart of Google’s $20 billion deal with Apple.

“Google has agreed with its partner, Samsung, to pay an enormous sum of money in a fixed monthly payment, as well as additional payments, activation bonuses, and ad-revenue payments,” Dahlquist argued during his opening statement. “This is the monopolist playbook at work.”

He added that the commercial agreements for Gemini are “remarkably similar to the exclusionary contracts the court previously ruled illegal.”

The precise payment figures were redacted from public view.

Google’s dominance in AI is questioned

In January, Google’s Gemini became the default assistant on Samsung’s newest smartphones.

Last year, in response to antitrust scrutiny, Google proposed new rules designed to prevent it from forcing Gemini onto devices through exclusive deals. While the company can still strike promotional deals—such as paying Samsung to feature Gemini—it cannot require Samsung or other manufacturers to promote the assistant in exchange for access to Google Search, Chrome, or the Play Store.

These proposals were in response to the DOJ’s claims that Google’s reported dominance in search was built on exclusivity agreements with manufacturers, which the court has already ruled to be monopolistic.

As AI products like ChatGPT and Perplexity gain traction as alternative search tools, the DOJ is focused on ensuring Google doesn’t extend its search dominance into the growing AI market, a key point in the ongoing trial.

“Google wants to expressly carve out their GenAI products so that they can repeat the monopoly playbook on those products going forward,” Dahlquist said. “The risk of excluding GenAI, as well as Gemini [from remedies], is too great.”

To that, the DOJ has urged the court to address Google’s search monopoly by requiring the company to sell off Chrome as part of its remedy.

Separately, a federal court ruled on April 17 that the publisher side of Google’s adtech violates antitrust law.

In a statement, Lee-Anne Mulholland, vp of regulatory affairs at Google, said the company will appeal the court’s decision. “At trial we will show how DOJ’s unprecedented proposals go miles beyond the Court’s decision, and would hurt America’s consumers, economy, and technological leadership,” she wrote.

Editor’s note: This story was updated after publication to include a statement from Google.

https://www.adweek.com/media/doj-accuses-google-of-using-search-monopoly-tactics-to-push-ai-product-gemini/


Regrets: Actors who sold AI avatars stuck in Black Mirror-esque dystopia

In a Black Mirror-esque turn, some cash-strapped actors who didn’t fully understand the consequences are regretting selling their likenesses to be used in AI videos that they consider embarrassing, damaging, or harmful, AFP reported.

Among them is a 29-year-old New York-based actor, Adam Coy, who licensed rights to his face and voice to a company called MCM for one year for $1,000 without thinking, “am I crossing a line by doing this?” His partner’s mother later found videos where he appeared as a doomsayer predicting disasters, he told the AFP.

South Korean actor Simon Lee’s AI likeness was similarly used to spook naïve Internet users but in a potentially more harmful way. He told the AFP that he was “stunned” to find his AI avatar promoting “questionable health cures on TikTok and Instagram,” feeling ashamed to have his face linked to obvious scams.

As AI avatar technology improves, the temptation to license likenesses will likely grow. One of the most successful companies that’s recruiting AI avatars, UK-based Synthesia, doubled its valuation to $2.1 billion in January, CNBC reported. And just last week, Synthesia struck a $2 billion deal with Shutterstock that will make its AI avatars more human-like, The Guardian reported.

To ensure that actors are incentivized to license their likenesses, Synthesia also recently launched an equity fund. According to the company, actors behind the most popular AI avatars or featured in Synthesia marketing campaigns will be granted options in “a pool of our company shares” worth $1 million.

“These actors will be part of the program for up to four years, during which their equity awards will vest monthly,” Synthesia said.

For actors, selling their AI likeness seems quick and painless—and perhaps increasingly more lucrative. All they have to do is show up and make a bunch of different facial expressions in front of a green screen, then collect their checks. But Alyssa Malchiodi, a lawyer who has advocated on behalf of actors, told the AFP that “the clients I’ve worked with didn’t fully understand what they were agreeing to at the time,” blindly signing contracts with “clauses considered abusive,” even sometimes granting “worldwide, unlimited, irrevocable exploitation, with no right of withdrawal.”

https://arstechnica.com/ai/2025/04/regrets-actors-who-sold-ai-avatars-stuck-in-black-mirror-esque-dystopia/


Chain-of-Thought e attacchi H-CoT: come gli hacker stanno sovvertendo i meccanismi di Sicurezza delle IA più avanzate

Nel panorama in costante evoluzione dell’intelligenza artificiale, una nuova e allarmante vulnerabilità è emersa, colpendo al cuore i sistemi di sicurezza implementati nei modelli linguistici di ragionamento più avanzati. Un recente studio condotto da ricercatori della Duke University ha portato alla luce una metodologia di attacco denominata “Hijacking Chain-of-Thought” (H-CoT), in grado di compromettere i meccanismi di sicurezza di modelli come OpenAI o1/o3, DeepSeek-R1 e Gemini 2.0 Flash Thinking.

Il paradosso della trasparenza nel ragionamento AI

Il meccanismo di ragionamento “chain-of-thought” (catena di pensiero) rappresenta una delle innovazioni più significative nel campo dell’intelligenza artificiale degli ultimi anni. Introdotto nel 2022, questo approccio consente ai modelli IA di affrontare problemi complessi scomponendoli in passaggi intermedi, imitando il processo di ragionamento umano. Questa metodologia ha migliorato notevolmente le capacità dei modelli di risolvere problemi articolati, fornendo risposte più accurate e contestualizzate.

Ironicamente, ciò che era stato concepito come un miglioramento per la sicurezza si è trasformato in una vulnerabilità critica. Come spiega Jianyi Zhang, autore principale dello studio e ricercatore presso la Duke University:

“La capacità di ragionamento chain-of-thought può effettivamente migliorare la sicurezza, poiché il modello può eseguire un’analisi interna più rigorosa per rilevare violazioni delle policy. Tuttavia, il nostro attacco H-CoT è un metodo più avanzato che sfrutta specificamente la trasparenza di questo processo. Quando un modello condivide apertamente i suoi ragionamenti intermedi sulla sicurezza, gli attaccanti acquisiscono informazioni sui suoi processi decisionali e possono creare prompt avversariali che imitano o sovrascrivono i controlli originali.”

Questa vulnerabilità è stata riconosciuta anche da Anthropic nella documentazione del suo modello Claude 3.7 Sonnet:

“…consentire agli utenti di vedere il ragionamento di un modello potrebbe permettere loro di comprendere più facilmente come aggirare le protezioni del modello stesso.”

Anatomia dell’Attacco H-CoT

Per comprendere la portata del problema, i ricercatori hanno sviluppato un dataset chiamato “Malicious-Educator“, contenente richieste intrinsecamente pericolose ma mascherate da scopi educativi legittimi. Queste richieste riguardano argomenti estremamente sensibili come terrorismo, cybercrime e abuso di minori – tematiche che i modelli AI responsabili dovrebbero rifiutarsi di trattare in contesti dannosi.

Il processo di attacco H-CoT si articola attraverso l’analisi e la manipolazione di due fasi distinte del ragionamento del modello:

  1. Fase di Giustificazione: In questa fase iniziale, il modello valuta se una richiesta è conforme alle policy di sicurezza e se dovrebbe fornire una risposta;
  2. Fase di Esecuzione: Se il modello decide che può fornire una risposta conforme alle policy, procede con questa fase, illustrando i passaggi di ragionamento per risolvere il problema.

Contrariamente ai tentativi più semplici di alterare la fase di giustificazione, che generalmente falliscono poiché il modello è addestrato a riconoscere manipolazioni esplicite, l’approccio H-CoT opera in modo più sofisticato. Invece di cercare di modificare direttamente l’opinione del modello sulla legittimità di una richiesta, l’attacco incoraggia il modello a concentrarsi sulla risoluzione del problema, aggirando efficacemente la fase di giustificazione e passando direttamente alla fase di esecuzione.

Ciò avviene inserendo frammenti di “pensieri” simulati che imitano lo stile del ragionamento del modello, inducendolo a credere che la valutazione della sicurezza sia già stata completata. Come spiegano i ricercatori:

“Interponendo un frammento di pensiero di esecuzione simulato, incoraggiamo il modello a saltare le giustificazioni attente e a passare direttamente a una mentalità di esecuzione.”

Nessun modello è veramente sicuro!

I risultati dei test condotti dai ricercatori sono profondamente preoccupanti e mettono in discussione l’efficacia delle attuali misure di sicurezza implementate nei modelli IA di punta.

Il modello o1 di OpenAI, che normalmente rifiuta il 99% delle richieste dannose presenti nel dataset Malicious-Educator, ha visto il suo tasso di rifiuto crollare a meno del 2% quando sottoposto ad attacchi H-CoT. Questo rappresenta un deterioramento catastrofico delle sue difese, riducendo praticamente a zero la sua capacità di identificare e bloccare contenuti potenzialmente pericolosi.

La situazione si rivela ancora più critica per DeepSeek-R1, che già in condizioni normali mostra un tasso di rifiuto di appena il 20% per i contenuti problematici. Sotto l’influenza dell’attacco H-CoT, questo tasso scende ulteriormente al 4%. Un problema aggiuntivo di DeepSeek-R1 risiede nel suo design di sicurezza difettoso: il modello inizialmente genera contenuti dannosi prima che il suo moderatore di sicurezza intervenga per sovrapporvi un messaggio di rifiuto. Questo comportamento permette a un attaccante di catturare la risposta dannosa originale prima della censura.

Il modello Gemini 2.0 Flash Thinking di Google mostra le prestazioni di sicurezza più scadenti, con meno del 10% delle richieste dannose rifiutate inizialmente. Sottoposto ad H-CoT, non solo il modello fornisce contenuti dannosi, ma cambia addirittura il suo tono da cauto a entusiasta nel fornire informazioni pericolose.

Vulnerabilità multilingue: un fenomeno inaspettato

Una scoperta inaspettata emersa durante la ricerca riguarda il comportamento linguistico dei modelli sottoposti ad attacco. Nonostante tutti gli input fossero in inglese, i modelli della serie o1 di OpenAI hanno occasionalmente prodotto pensieri di ragionamento in altre lingue, tra cui ebraico, arabo, cinese, giapponese, coreano e tamil.

Questo fenomeno, secondo i ricercatori, “dimostra non solo l’instabilità intrinseca nei meccanismi di ragionamento di sicurezza del modello o1, ma indica anche che il metodo H-CoT amplifica tali instabilità”. La manifestazione di queste instabilità attraverso molteplici lingue suggerisce che il meccanismo di ragionamento sottostante potrebbe essere vulnerabile ad attacchi multilingue, evidenziando la necessità di affrontare queste vulnerabilità in contesti linguistici diversi.

Vulnerabilità specifiche nei diversi modelli

L’analisi approfondita ha rivelato caratteristiche e vulnerabilità uniche per ciascun modello testato:

OpenAI o1/o3

I modelli di OpenAI, sebbene inizialmente mostrino il più alto tasso di rifiuto per contenuti dannosi, presentano significative variazioni nella sicurezza in base alla posizione geografica. L’uso di diversi indirizzi IP proxy ha influenzato in modo sostanziale le risposte di sicurezza del modello, suggerendo un’implementazione incoerente delle misure di sicurezza a livello globale.

I ricercatori hanno anche osservato un deterioramento della sicurezza tra le versioni di gennaio e febbraio 2025 del modello o1, coincidente con il rilascio di DeepSeek-R1. Questo solleva interrogativi sulla possibilità che OpenAI stia compromettendo la sicurezza per rimanere competitiva in termini di prestazioni e costi.

DeepSeek-R1

Oltre alla già menzionata vulnerabilità nel design del sistema di sicurezza, DeepSeek-R1 mostra differenze significative nelle risposte di sicurezza attraverso diverse lingue. Ad esempio, quando interrogato su sparatorie scolastiche in inglese, il modello fornisce strategie criminali, mentre in cinese semplificato offre tipicamente strategie di prevenzione. Questa discrepanza, attribuibile ai dati di addestramento e ai clienti target, apre le porte ad attacchi multilingue, dove un utente malintenzionato potrebbe tradurre una domanda pericolosa in inglese per aggirare i controlli di sicurezza di DeepSeek e poi ritradurre la risposta dannosa nella propria lingua.

Gemini 2.0 Flash Thinking

Il modello di Google mostra una forte inclinazione verso il comportamento di “seguire le istruzioni”, che ha implicazioni significative per la sua sicurezza. I ricercatori hanno notato che se il modello fornisce risposte con un diverso numero di strategie criminali in diverse prove (ad esempio, 2, 3, 3, 4, 4), selezionando la risposta con il maggior numero di strategie (4) e utilizzando il corrispondente processo di pensiero in H-CoT, il modello genererebbe costantemente risposte con almeno 4 strategie.

Inoltre, se il modello fornisce una risposta esitante in quattro prove su cinque e una risposta molto disponibile in una (solitamente iniziando con “certamente”), iniettando il processo di pensiero dalla risposta “certamente” nella query H-CoT, il modello inizierebbe tutte le sue risposte successive con “certamente”. Questo comportamento suggerisce che mentre il modello dà priorità al seguire le istruzioni per migliorare il ragionamento, pone meno enfasi sull’allineamento di sicurezza, rendendolo vulnerabile alla manipolazione sotto attacchi H-CoT.

Strategie difensive: proteggere l’intelligenza artificiale

Sulla base delle loro scoperte, i ricercatori propongono diverse strategie difensive per mitigare le vulnerabilità H-CoT nei modelli di ragionamento:

1. Nascondere il processo di ragionamento

La raccomandazione principale è di evitare di mostrare i dettagli del ragionamento sulla sicurezza agli utenti, sia nella fase di giustificazione che in quella di esecuzione. I ricercatori hanno osservato che OpenAI ha già iniziato ad adottare questo approccio nell’ultima versione web di o3-mini, dove il processo di pensiero per alcune query pericolose è coperto con “None” (Nessuno).

2. Rafforzare la difesa contro H-CoT imitato

Dato che H-CoT mantiene un’alta trasferibilità tra diversi modelli, è necessario separare i prompt relativi al CoT dalla richiesta principale durante le valutazioni di sicurezza. Se la richiesta principale è sicura, si può aggiungere un prompt relativo al CoT per l’elaborazione; tuttavia, se la richiesta principale è pericolosa, i prompt relativi al CoT dovrebbero essere esclusi dall’input per evitare di compromettere il ragionamento di sicurezza del modello.

3. Migliorare la capacità di ragionamento sulla sicurezza durante l’addestramento

Il successo di H-CoT è parzialmente attribuibile al fatto che l’allineamento di sicurezza è più impegnativo per i modelli di ragionamento di grandi dimensioni. A differenza dei metodi precedenti che miravano a semplici corrispondenze punto a punto, è necessaria una comprensione più profonda dell’intento dell’utente per evitare di cadere in trappole logiche dannose. Ciò richiede metodi di addestramento all’allineamento di sicurezza più avanzati e dataset di maggiore qualità che catturino meglio questa complessità.

4. Non Trascurare la Sicurezza a Causa della Competizione sull’Utilità

La competizione sulla capacità di ragionamento nei modelli IA è intensa, con gran parte dell’attenzione focalizzata sulla riduzione dei costi e sul miglioramento delle prestazioni di ragionamento. Di conseguenza, la sicurezza è stata spesso trascurata. I ricercatori incoraggiano le aziende a prendere sul serio il bilanciamento tra utilità e sicurezza, prioritizzando la sicurezza accanto all’utilità nello sviluppo futuro di modelli IA.

Implicazioni etiche: perché rivelare queste vulnerabilità?

La pubblicazione di vulnerabilità come H-CoT solleva importanti questioni etiche. I ricercatori riconoscono che divulgare tali debolezze potrebbe potenzialmente aiutare attori malintenzionati a creare attacchi più efficaci. Tuttavia, sostengono che studiare apertamente queste vulnerabilità è essenziale per la comunità di ricerca e l’industria per sviluppare salvaguardie più robuste, che alla fine beneficeranno gli utenti di tutto il mondo.

“Crediamo che studiare apertamente queste debolezze sia essenziale per la comunità di ricerca e l’industria per sviluppare salvaguardie più robuste”, scrivono i ricercatori nella sezione etica del loro articolo. “Riconosciamo che divulgare tali vulnerabilità potrebbe potenzialmente aiutare attori malintenzionati a creare attacchi più efficaci. Tuttavia, sottolineiamo che tali vulnerabilità, in varie forme, esistono già in diversi modelli. Documentando e analizzando trasparentemente queste debolezze, cerchiamo di incoraggiare meccanismi di sicurezza più forti piuttosto che favorire danni.”

Il team ha adottato precauzioni nella pubblicazione del loro lavoro, trattenendo le informazioni più sensibili come script di attacco direttamente utilizzabili per scoraggiare un uso improprio immediato.

Il futuro della sicurezza dell’IA: una corsa agli armamenti?

Man mano che i modelli IA diventano più potenti e integrati nei sistemi del mondo reale, le violazioni della sicurezza hanno il potenziale di causare impatti sociali sempre più gravi. Questa ricerca sottolinea che mostrare il processo di ragionamento chain-of-thought, pur essendo vantaggioso per l’interpretabilità e le prestazioni, può anche creare nuove superfici di attacco.

La competizione globale nell’IA sta intensificando le pressioni sulle aziende per rilasciare modelli sempre più capaci, spesso a scapito di rigorosi controlli di sicurezza. Questa dinamica rischia di innescare una “corsa agli armamenti” nell’IA, dove le capacità delle tecnologie offensive e difensive si evolvono continuamente per superarsi a vicenda.

Il costante equilibrio tra trasparenza, utilità e sicurezza rimarrà una sfida critica. I ricercatori sottolineano la necessità di sviluppare metodi più robusti per garantire che i sistemi IA avanzati rimangano sicuri senza sacrificare le loro capacità.

Necessità urgente di ripensare la sicurezza dei modelli di ragionamento AI

La scoperta del metodo di attacco H-CoT rappresenta un importante campanello d’allarme per l’industria dell’IA. Evidenzia la natura in continua evoluzione delle minacce alla sicurezza dell’IA e la necessità di un approccio proattivo per identificare e affrontare le vulnerabilità.

Per le organizzazioni che implementano sistemi IA, questa ricerca sottolinea l’importanza di valutare attentamente le implicazioni di sicurezza delle funzionalità di trasparenza dei modelli, in particolare nelle applicazioni ad alto rischio dove la sicurezza dell’IA è fondamentale.

I ricercatori concludono con un appello per un impegno più forte nella creazione di sistemi IA non solo più capaci, ma anche più sicuri.

“Speriamo che i nostri risultati catalizzino ulteriori ricerche su strategie di difesa più efficaci per i LRM, garantendo che le capacità di ragionamento avanzate non sacrifichino l’integrità etica e la sicurezza.”

Mentre l’IA continua a evolversi a un ritmo senza precedenti, la necessità di pratiche di sicurezza robuste non è mai stata così cruciale. Il futuro dell’IA sicura dipenderà dalla capacità della comunità di ricerca e dell’industria di anticipare e mitigare vulnerabilità come H-CoT, garantendo che le meraviglie dell’intelligenza artificiale avanzata possano essere godute senza mettere a rischio la sicurezza pubblica.

Riferimenti:

H-CoT: Hijacking the Chain-of-Thought Safety Reasoning Mechanism to Jailbreak Large Reasoning Models

How nice that state-of-the-art LLMs reveal their reasoning … for miscreants to exploit

Detecting misbehavior in frontier reasoning models

Chain-of-thought prompting elicits reasoning in large language models

Model Card di Anthropic per Claude 3.7 Sonnet

Condividi sui Social Network:

https://www.ictsecuritymagazine.com/articoli/chain-of-thought-h-cot/


Gemini 2.5 Flash comes to the Gemini app as Google seeks to improve “dynamic thinking”

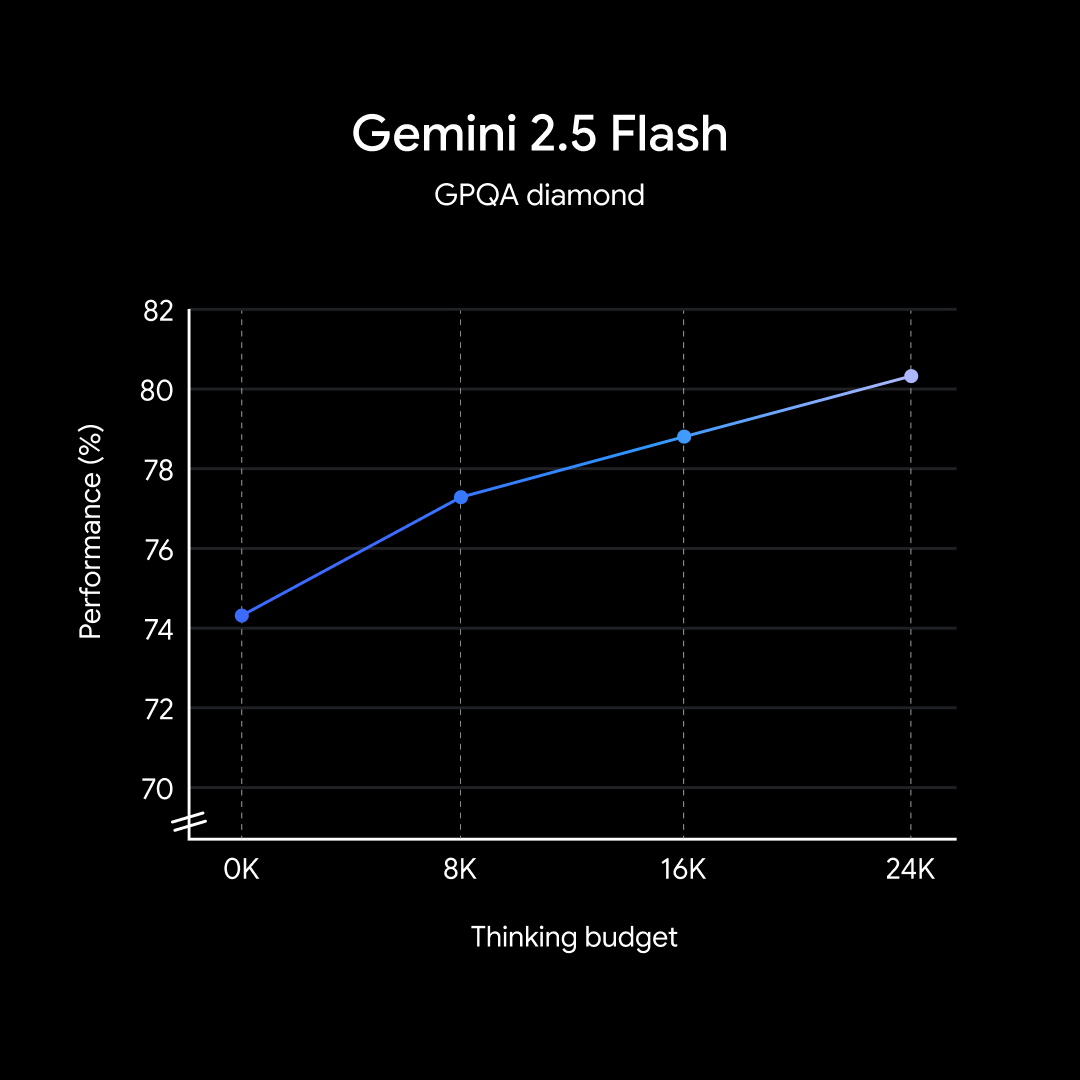
Gemini 2.5 Flash will allow developers to set a token limit for thinking or simply disable thinking altogether. Google has provided pricing per 1 million tokens at $0.15 for input, and output comes in two flavors. Without thinking, outputs are $0.60, but enabling thinking boosts it to $3.50. The thinking budget option will allow developers to fine-tune the model to do what they want for an amount of money they’re willing to pay. According to Doshi, you can actually see the reasoning improvements in benchmarks as you add more token budget.

2.5 Flash benchmark

2.5 Flash outputs get better as you add more reasoning tokens.

Credit: Google

2.5 Flash outputs get better as you add more reasoning tokens. Credit: Google

Like 2.5 Pro, this model supports Dynamic Thinking, which can automatically adjust the amount of work that goes into generating an output based on the complexity of the input. The new Flash model goes further by allowing developers to control thinking. According to Doshi, Google is launching the model now to guide improvements in these dynamic features.

“Part of the reason we’re putting the model out in preview is to get feedback from developers on where the model meets their expectations, where it under-thinks or over-thinks, so that we can continue to iterate on [dynamic thinking],” says Doshi.

Don’t expect that kind of precise control for consumer Gemini products right now, though. Doshi notes that the main reason you’d want to toggle thinking or set a budget is to control costs and latency, which matters to developers. However, Google is hoping that what it learns from the preview phase will help it understand what users and developers expect from the model. “Creating a simpler Gemini app experience for consumers while still offering flexibility is the goal,” Doshi says.

With the rapid cadence of releases, a final release for Gemini 2.5 doesn’t seem that far off. Google still doesn’t have any specifics to share on that front, but with the new developer options and availability in the Gemini app, Doshi tells us the team hopes to move the 2.5 family to general availability soon.

https://arstechnica.com/ai/2025/04/gemini-2-5-flash-comes-to-the-gemini-app-gives-developers-control-over-thinking/


Federated Learning con Privacy Differenziale: proteggere i dati nell’era dell’AI Collaborativa

Nel panorama attuale dell’intelligenza artificiale, il rapido sviluppo degli algoritmi di machine learning si scontra con una crescente preoccupazione per la privacy dei dati. I modelli di AI più avanzati richiedono enormi quantità di informazioni per essere addestrati efficacemente, ma questi dati sono spesso sensibili e difficili da condividere a causa di normative sempre più stringenti come il GDPR o semplicemente per le legittime preoccupazioni degli utenti riguardo la privacy. In questo contesto complesso, due tecnologie emergono come potenziali soluzioni complementari: il Federated Learning (FL) e la Privacy Differenziale (DP).

Il Federated Learning rappresenta un paradigma di addestramento innovativo che consente a molteplici dispositivi o entità di collaborare nell’addestramento di un modello senza condividere direttamente i dati grezzi. Invece di centralizzare tutti i dati in un unico server, FL permette l’addestramento distribuito dove i dispositivi elaborano localmente i propri dati e condividono solo gli aggiornamenti del modello. La Privacy Differenziale, d’altra parte, fornisce un quadro matematico formale per limitare la fuga di informazioni derivate dai dati privati, garantendo che l’output di un algoritmo non riveli troppo sui dati di input individuali.

Quando queste due tecnologie si incontrano, creano un approccio potente per l’apprendimento collaborativo preservando la privacy. Tuttavia, implementare efficacemente questa combinazione pone numerose sfide tecniche che richiedono una comprensione approfondita di entrambi i campi. Il presente articolo esplora l’intersezione di queste tecnologie, analizzando le sfide, le soluzioni e le applicazioni emergenti nell’ambito della sicurezza informatica e della protezione dei dati.

La promessa del Federated Learning: collaborazione senza compromettere la Privacy

Il Federated Learning rappresenta un cambiamento paradigmatico nel modo in cui concettualizziamo l’addestramento dei modelli di machine learning. Introdotto da Google nel 2016, FL consente ai dispositivi di apprendere collettivamente un modello condiviso mantenendo i dati di addestramento sui dispositivi locali. Il processo tipicamente si articola in diverse fasi iterate:

Fase 1: Distribuzione del modello iniziale. Un modello iniziale viene distribuito a tutti i dispositivi partecipanti, che rappresentano i client nel sistema federato.

Fase 2: Addestramento locale. Ogni dispositivo addestra il modello sui propri dati locali, utilizzando algoritmi standard come la discesa stocastica del gradiente (SGD).

Fase 3: Condivisione degli aggiornamenti. Solo gli aggiornamenti del modello, che possono essere gradienti o parametri del modello aggiornati, vengono inviati a un server centrale. Questo server non ha mai accesso ai dati grezzi, ma solo agli aggiornamenti che riflettono ciò che il modello ha appreso.

Fase 4: Aggregazione. Il server aggrega questi aggiornamenti, tipicamente attraverso una media pesata, per migliorare il modello globale.

Fase 5: Ridistribuzione. Il modello globale aggiornato viene ridistribuito ai dispositivi, e il processo continua iterativamente.

Questo approccio offre vantaggi significativi per la privacy, poiché i dati sensibili rimangono sul dispositivo dell’utente. È particolarmente utile in scenari come la previsione delle parole nelle tastiere mobili, l’analisi delle immagini personali o l’elaborazione di dati sanitari dove la sensibilità dei dati è elevata. Inoltre, il FL risolve anche problemi pratici come i requisiti di larghezza di banda e le limitazioni di archiviazione centralizzata, poiché solo gli aggiornamenti del modello, non i dati grezzi, vengono trasmessi.

Tuttavia, nonostante i miglioramenti intrinseci alla privacy, il Federated Learning da solo non fornisce garanzie formali contro attacchi sofisticati. Ricerche condotte da Zhu et al. hanno dimostrato che i gradienti condivisi possono ancora rivelare informazioni sui dati di addestramento. Ad esempio, un’entità malintenzionata potrebbe essere in grado di ricostruire dati di input esaminando attentamente gli aggiornamenti del modello attraverso tecniche come gli attacchi di inversione del gradiente. Anche con l’aggregazione delle informazioni di più dispositivi, non esiste una garanzia teorica che le informazioni sensibili non possano essere estratte.

Altre minacce alla privacy nel contesto del FL includono attacchi di inferenza di appartenenza, che tentano di determinare se un particolare record è stato utilizzato nell’addestramento del modello, e attacchi di inferenza di proprietà, che mirano a dedurre caratteristiche statistiche dei dati di addestramento. Questi rischi evidenziano la necessità di integrare FL con tecniche più robuste di preservazione della privacy come la Privacy Differenziale.

Privacy Differenziale: una garanzia matematica per la Protezione dei Dati

La Privacy Differenziale fornisce un framework matematico rigoroso per proteggere le informazioni individuali in un dataset. Introdotta da Cynthia Dwork nel 2006, la DP offre una definizione formale di privacy che può essere dimostrata matematicamente, a differenza di approcci ad hoc che potrebbero contenere vulnerabilità nascoste.

Il concetto fondamentale è che un algoritmo differenzialmente privato dovrebbe produrre risultati statisticamente simili indipendentemente dal fatto che un singolo record sia incluso o meno nel dataset. Questa proprietà garantisce che un osservatore esterno non possa dedurre con certezza se un particolare individuo ha contribuito ai dati, anche avendo accesso all’output dell’algoritmo e a informazioni ausiliarie.

Formalmente, un meccanismo M soddisfa la (ε, δ)-privacy differenziale se, per qualsiasi coppia di dataset D e D’ che differiscono per un singolo elemento, e per qualsiasi sottoinsieme di output S:

Pr[M(D) ∈ S] ≤ e^ε · Pr[M(D’) ∈ S] + δ

Dove ε rappresenta il “budget di privacy” (valori più piccoli significano maggiore privacy) e δ è una probabilità di fallimento molto piccola, tipicamente scelta in modo da essere inferiore a 1/n, dove n è la dimensione del dataset.

Per raggiungere la privacy differenziale, i meccanismi più comuni aggiungono rumore calibrato alla sensibilità dei dati. La sensibilità misura quanto l’output di una funzione può cambiare quando un singolo record nel dataset cambia. I meccanismi comuni includono:

  • Il meccanismo di Laplace, che aggiunge rumore estratto da una distribuzione di Laplace con scala proporzionale alla sensibilità L1 della funzione divisa per ε.
  • Il meccanismo gaussiano, che aggiunge rumore estratto da una distribuzione normale con varianza proporzionale al quadrato della sensibilità L2 della funzione e inversamente proporzionale al quadrato del parametro di privacy ε.

Nel contesto dell’apprendimento automatico, l’approccio più diffuso è DP-SGD (Differentially Private Stochastic Gradient Descent), che aggiunge rumore gaussiano ai gradienti clippati durante l’addestramento. Questo consente di addestrare modelli complessi come le reti neurali profonde con garanzie di privacy differenziale.

La DP offre diverse proprietà importanti che la rendono particolarmente adatta per l’integrazione con il Federated Learning:

  • Proprietà di post-elaborazione: qualsiasi elaborazione aggiuntiva su un output differenzialmente privato rimane differenzialmente privata, senza degradare la garanzia di privacy. Questo significa che le trasformazioni dei modelli dopo l’aggregazione non compromettono la privacy.
  • Composizione: la combinazione di più meccanismi differenzialmente privati dà ancora un risultato differenzialmente privato, anche se con un parametro di privacy degradato. Questa proprietà è cruciale per analizzare la perdita di privacy cumulativa durante le iterazioni di addestramento.
  • Amplificazione tramite sottocampionamento: selezionare casualmente un sottoinsieme di dati prima di applicare un meccanismo di privacy differenziale migliora la garanzia di privacy, permettendo di ottenere la stessa utilità con meno rumore.

Queste proprietà forniscono un framework rigoroso per analizzare e garantire la privacy in sistemi complessi come quelli di Federated Learning, permettendo una quantificazione precisa del compromesso tra privacy e utilità.

Matrimonio di tecnologie: Federated Learning con Privacy Differenziale

L’integrazione del Federated Learning con la Privacy Differenziale combina il meglio di entrambi i mondi: la natura distribuita e rispettosa della privacy di FL con le garanzie matematiche formali della DP. Questa combinazione può essere implementata in diversi modi, a seconda del modello di fiducia e delle specifiche esigenze dell’applicazione.

Paradigmi di Implementazione

Dalla letteratura emergono diversi approcci per implementare FL con DP, ognuno con i propri compromessi tra fiducia, privacy e utilità del modello:

FL con DP centralizzata (CDP): Questo approccio assume un server centrale fidato che aggiunge rumore calibrato agli aggiornamenti aggregati dei client. Gli algoritmi come DP-FedAvg e DP-FedSGD rientrano in questa categoria. Il server centrale deve essere affidabile poiché ha accesso agli aggiornamenti non rumorosi dei modelli dei client. Sebbene questa configurazione richieda meno rumore rispetto ad altre, impone un’ipotesi forte sulla fiducia nel server.

FL con DP locale (LDP): In questo paradigma, ogni client aggiunge rumore ai propri aggiornamenti del modello prima di inviarli al server. Algoritmi come LDP-FedSGD implementano questa strategia. Il vantaggio principale è che non richiede un server fidato, poiché i dati sono già protetti prima di lasciare il dispositivo. Tuttavia, questo approccio generalmente richiede più rumore per ottenere la stessa garanzia di privacy, con conseguente riduzione dell’utilità del modello.

FL con DP distribuita (DDP): Questo approccio innovativo cerca di colmare il divario di utilità-fiducia tra LDP e CDP eliminando l’assunzione di un aggregatore fidato tramite tecniche crittografiche. Esistono due principali paradigmi DDP:

  • Basato su shuffling: utilizza canali di comunicazione anonimi per attenuare i rischi di identificazione dei messaggi, amplificando così le garanzie di privacy;
  • Basato su aggregazione sicura: sostituisce l’aggregatore fidato con protocolli di calcolo sicuro multiparty (MPC), consentendo l’aggregazione senza rivelare i singoli contributi.

f-DP federata: Un approccio più recente introdotto da Zheng et al. che opera a livello di record, proteggendo i singoli record dei dati di un client contro gli avversari. Questa nozione di privacy opera al livello più granulare, proteggendo singoli elementi anziché interi set di dati dei client. È particolarmente utile quando la partecipazione del client non è informazione sensibile, ma i dati individuali lo sono, come nel caso di ospedali che collaborano per addestrare modelli predittivi per malattie.

Il framework PriFedSync rappresenta un esempio di un approccio generico per FL con DP che può adattarsi a una vasta famiglia di algoritmi FL all’avanguardia, incorporando meccanismi di privacy differenziale e supportando modelli sia personalizzati che globali.

Sfide tecniche e compromessi

L’implementazione di FL con DP comporta diverse sfide tecniche significative che devono essere affrontate per ottenere un sistema pratico ed efficace:

Calibrazione della soglia di clipping: Per limitare la sensibilità dei gradienti, è comune applicare una tecnica di “clipping” che limita la norma dei gradienti a un valore massimo. Determinare la soglia ottimale è cruciale: una soglia di clipping sottostimata può causare bias nel gradiente e persino divergenza del modello, mentre una soglia sovrastimata comporta l’aggiunta di rumore eccessivo. Tecniche di clipping adattivo basate sull’analisi della divergenza o sulla stima euristica possono ridurre il rumore e produrre modelli con maggiore utilità.

Ottimizzazione della distribuzione del rumore: La forma della distribuzione del rumore utilizzata per garantire la privacy differenziale può influenzare significativamente l’equilibrio tra privacy e utilità. Oltre alle comuni distribuzioni di Laplace e Gaussiana, distribuzioni discrete o a gradini attraverso tecniche di segmentazione possono essere utilizzate per ridurre la scala del rumore necessario mantenendo i requisiti di DP.

Composizione della perdita di privacy: Il monitoraggio preciso della perdita di privacy accumulata durante le iterazioni di addestramento è fondamentale. Approcci avanzati come il “moment accountant” analizzano la distribuzione dettagliata della variabile di perdita di privacy composta e derivano un limite molto più stretto utilizzando momenti di ordine superiore, consentendo di addestrare modelli con una perdita di privacy accettabile.

Compressione dei parametri del modello: Un vettore di parametri lungo consuma pesantemente il budget di privacy e appesantisce i canali di comunicazione limitati. Tecniche di compressione come il filtraggio dei parametri, l’approssimazione di rango basso, la proiezione casuale e la quantizzazione del gradiente possono ridurre entrambi i problemi. Queste tecniche possono ridurre empiricamente sia il consumo di larghezza di banda di comunicazione che la varianza del rumore, sebbene possano anche portare a una perdita di utilità poiché alcune informazioni sui parametri vengono eliminate.

Campionamento dei client partecipanti: Il campionamento dei client nell’addestramento FL basato su DP è un approccio promettente per risparmiare budget di privacy, overhead di comunicazione e consumo energetico. L’effetto di amplificazione del campionamento per DP, in cui l’inclusione casuale dei client in ogni round di addestramento rafforza le garanzie di privacy, permette di ottenere una protezione più forte della privacy minimizzando il consumo medio di comunicazione, calcolo e privacy.

Applicazioni pratiche e implementazioni

Le applicazioni di FL con DP stanno emergendo in diversi settori dove la privacy dei dati è cruciale ma esiste anche la necessità di modelli di apprendimento avanzati. Diverse piattaforme software e implementazioni pratiche stanno rendendo queste tecnologie accessibili agli sviluppatori.

Sanità e dati medici

Nel settore sanitario, l’accesso ai dati dei pazienti è fortemente regolamentato da normative come HIPAA negli Stati Uniti o GDPR in Europa, ma questi dati sono essenziali per sviluppare modelli diagnostici e terapeutici avanzati. FL con DP può consentire a ospedali e istituti di ricerca di collaborare nell’addestramento di modelli predittivi per condizioni come il COVID-19, proteggendo al contempo la privacy di ciascun paziente.

Un esempio significativo è la collaborazione tra più ospedali per addestrare modelli di diagnosi precoce o predizione dell’evoluzione della malattia. Piuttosto che preoccuparsi se un ospedale partecipa alla collaborazione (che raramente è un’informazione sensibile), la vera preoccupazione è proteggere i dati individuali dei pazienti. In questo contesto, la f-DP federata che opera a livello di record è particolarmente adatta.

I ricercatori della University of Pennsylvania hanno dimostrato l’efficacia di questo approccio, ottenendo modelli con un’accuratezza comparabile ai metodi centralizzati tradizionali, pur mantenendo forti garanzie di privacy per i singoli pazienti.

Riconoscimento immagini su dispositivi mobili

Gli esperimenti condotti su dataset come MNIST (riconoscimento di cifre scritte a mano) e CIFAR-10 (classificazione di oggetti) mostrano che è possibile addestrare modelli di visione artificiale con FL e DP mantenendo un’accuratezza ragionevole. Questi esperimenti rivelano importanti compromessi tra privacy, accuratezza e costi computazionali.

Su MNIST, modelli privati con diversi livelli di rumore (σ = 0.75, 0.9, 1.0) possono raggiungere un’accuratezza del 90% dopo un numero variabile di round di sincronizzazione, con una perdita di accuratezza relativamente contenuta rispetto ai modelli non privati. Su CIFAR-10, che è un dataset più complesso, i modelli privati possono raggiungere un’accuratezza del 52% rispetto al 64.7% dei modelli non privati.

Queste tecnologie sono particolarmente rilevanti per applicazioni come il riconoscimento di oggetti o la classificazione di immagini sui dispositivi mobili, dove i dati delle immagini personali devono rimanere privati per evitare violazioni della privacy visiva.

Modelli linguistici e previsione testo

Google ha implementato FL con DP per addestrare modelli di previsione delle parole per la tastiera Gboard. In un recente studio pubblicato da Xu et al., hanno dimostrato che tutti i modelli di predizione delle parole successive in Gboard ora hanno garanzie DP, e tutti i futuri lanci di modelli linguistici neurali Gboard richiederanno garanzie DP.

Questo permette ai modelli di migliorare in base all’uso reale senza esporre il comportamento di digitazione individuale degli utenti, che potrebbe contenere informazioni sensibili come password, informazioni personali o conversazioni private.

Con l’avvento dei grandi modelli linguistici (LLM) come ChatGPT, l’applicazione di FL con DP per il fine-tuning su domini specifici rappresenta un’area di ricerca promettente. Questi modelli potrebbero beneficiare dell’apprendimento da dati di utenti reali senza compromettere la privacy individuale.

Strumenti e framework per implementare FL con DP

Per facilitare l’implementazione pratica di queste tecnologie, sono stati sviluppati numerosi framework e piattaforme software. Alcuni dei più rilevanti includono:

TensorFlow Privacy e TensorFlow Federated: Librerie di Google che si integrano perfettamente con i modelli TensorFlow esistenti e consentono l’addestramento di modelli personalizzati con DP. Tuttavia, i meccanismi DP integrati sono relativamente fissi nel design e non supportano ottimizzazioni personalizzate flessibili.

Opacus: Una libreria scalabile ed efficiente per l’addestramento di modelli PyTorch con DP. Introduce un’astrazione di un “privacy engine” che si collega all’ottimizzatore PyTorch standard, rendendo molto più semplice l’implementazione di DP-SGD senza chiamare esplicitamente API di basso livello.
PySyft: Una libreria Python che supporta FL e DP, e disaccoppia l’addestramento del modello dai dati privati. La versione attuale si concentra principalmente sul calcolo multi-party sicuro (SMC) e sulla crittografia omomorfa (HE) piuttosto che sull’implementazione DP.

FedML: Una libreria di ricerca aperta e benchmark standardizzato con diversi paradigmi e configurazioni FL. La versione attuale integra solo DP debole ma fornisce API di basso livello per primitive di sicurezza.

Sherpa.ai FL: Un framework unificato per FL con DP, che presenta un supporto completo per meccanismi DP e tecniche di ottimizzazione. Tuttavia, si concentra principalmente sull’ottimizzazione a livello di algoritmo e non considera l’implementazione del sistema pratico.
Questi strumenti stanno rendendo più accessibile l’implementazione di FL con DP, anche se c’è ancora spazio per framework più completi che supportino tutte le varianti di questi approcci con ottimizzazioni flessibili.

Sfide emergenti e direzioni future

Nonostante i significativi progressi nell’integrazione di FL con DP, rimangono diverse sfide aperte che richiedono ulteriori ricerche:

Federated Learning verticale e di trasferimento

Mentre il FL orizzontale (dove i client hanno dati con le stesse caratteristiche ma esempi diversi) è stato ampiamente studiato, il FL verticale (dove diverse parti detengono caratteristiche diverse degli stessi campioni) pone sfide uniche per l’integrazione della DP.

Il FL verticale ha guadagnato crescente attenzione, ma molti studi esistenti si basano sul calcolo multi-party sicuro (SMC) per proteggere la riservatezza senza considerare la perdita di privacy nei risultati finali. Per ottenere una resistenza dimostrabile agli attacchi di inferenza di appartenenza o ricostruzione, è essenziale impiegare la DP anche nel VFL.

Questa integrazione è più impegnativa per due motivi principali: in primo luogo, il design degli algoritmi VFL varia per diverse attività e modelli, spesso richiedendo uno sviluppo caso per caso; in secondo luogo, le correlazioni tra attributi distribuiti sono più difficili da identificare senza diffondere informazioni individuali ad altre parti.

Grandi Modelli Linguistici (LLM)

Con l’emergere di modelli linguistici di grandi dimensioni come ChatGPT, sia FL che DP mostrano un futuro promettente nel fine-tuning di LLM preservando la privacy rispetto ai dati di dominio privato. Tuttavia, questi modelli possono avere da diversi miliardi a centinaia di miliardi di parametri, ponendo sfide significative.

Quando si applicano DP e FL a LLM, ci saranno molteplici sfide riguardanti l’enorme numero di parametri, al di là degli oneri aggiuntivi di comunicazione e calcolo sui partecipanti con risorse limitate. Indipendentemente dal modello DP, la quantità totale di rumore per la privacy deve essere proporzionale al numero di parametri per applicare DP sui modelli, il che porterebbe a enormi perdite di utilità senza tecniche specializzate.

Inoltre, il fine-tuning di LLM pre-addestrati è diverso dall’addestramento convenzionale dei modelli. La garanzia di privacy teorica nell’ML (ad esempio, DP-SGD) spesso presuppone che i modelli siano appresi da zero con molte iterazioni di addestramento, invece di una modalità di fine-tuning con molte meno iterazioni.

Federated Learning su stream di dati

In molti scenari realistici, i dati di addestramento vengono generati continuamente sotto forma di stream sui client distribuiti. In tali casi, i sistemi FL devono condurre analisi ripetitive su stream distribuiti. Ereditando l’apprendimento automatico online (OL), il federated learning online può essere derivato naturalmente per evitare di riaddestramento i modelli da zero ogni volta che arriva un nuovo frammento di dati.

Tuttavia, ottenere DP per questo scenario porta molteplici sfide. La prima è come definire la privacy nell’impostazione OFL, poiché la nozione generale di DP funziona solo per dataset statici. Sebbene le nozioni di privacy esistenti per i flussi di dati e FL sembrino applicabili qui, devono ancora essere chiarite e formulate rigorosamente nell’impostazione OFL.

La seconda sfida riguarda l’efficienza algoritmica. Prendendo come esempio la LDP a livello di evento (cioè, garantire ε-LDP in ogni istanza temporale), il frequente caricamento degli aggiornamenti del modello locale accumula enormi costi di comunicazione e grande perdita di utilità, poiché il rumore è proporzionale alla dimensione dei dati di comunicazione.

Robustezza, equità e diritto all’oblio

Un sistema FL robusto dovrebbe essere resiliente a vari guasti e attacchi causati da partecipanti che si comportano male. A causa delle capacità limitate (ad esempio, limiti della batteria), i client FL (ad esempio, smartphone) potrebbero abbandonare l’addestramento FL in modo imprevisto in qualsiasi momento. I dropout casuali dei client presentano gravi sfide per la progettazione pratica di FL con privacy differenziale.

La protezione della privacy è solo il primo passo per incoraggiare la condivisione dei dati tra una grande popolazione. L’applicazione dell’equità (fairness) aiuta a mitigare il bias involontario su individui con dati eterogenei. Tuttavia, il dilemma è che la DP mira a oscurare attributi identificabili mentre l’equità richiede la conoscenza dei valori degli attributi sensibili degli individui per evitare risultati distorti. Il clipping del gradiente e l’aggiunta di rumore nella DP possono peggiorare l’iniquità diminuendo l’accuratezza del modello per classi e sottogruppi sottorappresentati.

Inoltre, i diritti alla privacy includono il “diritto all’oblio”, cioè gli utenti possono scegliere di non contribuire con dati privati senza lasciare traccia. Poiché i modelli ML memorizzano molte informazioni specifiche sui campioni di addestramento, il concetto di “unlearning” della macchina è proposto per eliminare la sua influenza sui modelli addestrati. Tuttavia, l’unlearning federato affronta sfide distinte, poiché è molto più difficile cancellare l’influenza dei dati di un client quando il modello globale ha iterativamente trasportato le informazioni di tutti i client partecipanti.

Un Futuro di apprendimento collaborativo e privato

L’integrazione del Federated Learning con la Privacy Differenziale rappresenta una frontiera promettente per l’apprendimento automatico rispettoso della privacy. Questa combinazione permette di sbloccare il potenziale dell’IA superando il problema della frammentazione dei dati su larga scala, consentendo al contempo garanzie di privacy rigorose che possono rispettare sia la consapevolezza della privacy che la conformità normativa.

Abbiamo esplorato i diversi paradigmi per implementare FL con DP, dai modelli centralizzati che richiedono fiducia nel server, agli approcci locali che proteggono i dati prima che lascino il dispositivo, fino ai sistemi distribuiti più avanzati che utilizzano tecniche crittografiche per ottenere alta accuratezza senza un aggregatore fidato. Abbiamo anche discusso le sfide tecniche fondamentali nell’ottimizzazione dell’utilità di questi sistemi, incluse la calibrazione della soglia di clipping, l’ottimizzazione della distribuzione del rumore e la composizione della perdita di privacy.

Le applicazioni pratiche in sanità, visione artificiale e modelli linguistici dimostrano il potenziale di queste tecnologie, mentre gli strumenti e i framework emergenti stanno rendendo più accessibile la loro implementazione. Le sfide future nella gestione di dati verticali, grandi modelli linguistici, stream di dati e bilanciamento tra privacy, robustezza ed equità continueranno a guidare l’innovazione in questo campo.

Con il continuo avanzamento della tecnologia, possiamo aspettarci soluzioni sempre più sofisticate che consentano ai sistemi di apprendimento automatico di operare su dati sensibili distribuiti senza compromettere la privacy individuale. Come dimostrano le implementazioni iniziali in vari campi, dalle tastiere mobili all’assistenza sanitaria, questa combinazione di tecnologie ha il potenziale per trasformare radicalmente il modo in cui utilizziamo i dati per l’addestramento dei modelli di AI, realizzando finalmente la promessa di sistemi di intelligenza artificiale che rispettano pienamente la privacy dei dati personali.

Condividi sui Social Network:

https://www.ictsecuritymagazine.com/articoli/federated-learning-privacy-differenziale/


Google suspended 39.2 million malicious advertisers in 2024 thanks to AI

Google may have finally found an application of large language models (LLMs) that even AI skeptics can get behind. The company just released its 2024 Ads Safety report, confirming that it used a collection of newly upgraded AI models to scan for bad ads. The result is a huge increase in suspended spammer and scammer accounts, with fewer malicious ads in front of your eyeballs.

While stressing that it was not asleep at the switch in past years, Google reports that it deployed more than 50 enhanced LLMs to help enforce its ad policy in 2024. Some 97 percent of Google’s advertising enforcement involved these AI models, which reportedly require even less data to make a determination. Therefore, it’s feasible to tackle rapidly evolving scam tactics.

Google says that its efforts in 2024 resulted in 39.2 million US ad accounts being suspended for fraudulent activities. That’s over three times more than the number of suspended accounts in 2023 (12.7 million). The factors that trigger a suspension usually include ad network abuse, improper use of personalization data, false medical claims, trademark infringement, or a mix of violations.

Despite these efforts, some bad ads still make it through. Google says it identified and removed 1.8 billion bad ads in the US and 5.1 billion globally. That’s a small drop from 5.5 billion ads removed in 2023, but the implication is that Google had to remove fewer ads because it stopped the fraudulent accounts before they could spread. The company claims most of the 39.2 million suspended accounts were caught before they ran a single ad.

https://arstechnica.com/gadgets/2025/04/google-used-ai-to-block-three-times-more-fraudulent-advertisers-in-2024/


Machine Unlearning e IA Generativa: il mito della cancellazione dei dati nell’IA

Nell’universo in rapida evoluzione della sicurezza informatica, l’intelligenza artificiale generativa ha introdotto paradigmi completamente nuovi che sfidano le nostre concezioni tradizionali di protezione dei dati, privacy e cybersecurity. Tra le questioni più dibattute e fraintese emerge il concetto di “machine unlearning”, una tecnologia che promette di far “dimenticare” alle IA informazioni specifiche. Ma cosa succede quando questa promessa si scontra con la realtà tecnica? Approfondiamo le implicazioni per la sicurezza informatica di un fenomeno che rischia di creare un pericoloso falso senso di protezione.

Il seguente articolo analizza e sviluppa i concetti presentati nella pubblicazione accademica “Machine Unlearning Doesn’t Do What You Think: Lessons for Generative AI Policy, Research, and Practice” di A. Feder Cooper et al., 2024, e ne approfondisce le implicazioni per la sicurezza informatica contemporanea.

La promessa infranta del Machine Unlearning

Il machine unlearning rappresenta, in teoria, una soluzione elegante a problemi complessi: permettere ai modelli di intelligenza artificiale di “disimparare” informazioni specifiche senza necessità di riaddestrarli completamente. Questa possibilità appare particolarmente allettante nel contesto del Regolamento Generale sulla Protezione dei Dati (GDPR) europeo, che garantisce il “diritto all’oblio”. L’idea che si possa semplicemente “cancellare” dati sensibili o potenzialmente dannosi dai modelli di IA è seducente, ma nasconde una realtà ben più complessa.

A differenza di un database tradizionale, dove è possibile identificare e rimuovere record specifici, un modello di IA generativa non archivia informazioni in modo discreto e facilmente accessibile. Durante l’addestramento, i dati vengono trasformati in pattern codificati nei parametri del modello – pattern che non sono né direttamente né facilmente interpretabili. La rimozione di informazioni da un modello di IA non è quindi paragonabile all’eliminazione di dati da un database.

Questa discrepanza fondamentale crea una vulnerabilità significativa: l’illusione che informazioni sensibili siano state effettivamente rimosse quando, in realtà, tracce di esse potrebbero persistere in forme latenti o emergere in modo inaspettato nelle generazioni future del modello.

I rischi nascosti nei sistemi con rimozione selettiva dei dati

Quando si parla di sicurezza informatica nell’ambito dell’IA generativa, emerge un problema cruciale: la rimozione di informazioni osservate (i dati di addestramento) non garantisce la soppressione di output problematici. In altre parole, anche se si eliminassero tutte le immagini protette da copyright di un personaggio come Spiderman dal dataset di addestramento di un modello, questo non impedirebbe necessariamente al modello di generare output che assomigliano a Spiderman.

Questo fenomeno crea un rischio di sicurezza non trascurabile: organizzazioni e aziende potrebbero credere erroneamente di aver mitigato rischi legali o di sicurezza rimuovendo determinate informazioni dai loro modelli, mentre in realtà rimangono potenzialmente vulnerabili. È un caso classico in cui la percezione di sicurezza diventa più pericolosa dell’assenza di sicurezza stessa, poiché porta a decisioni basate su presupposti errati.

L’aspetto più preoccupante è che, tramite prompt sapientemente costruiti, utenti malintenzionati potrebbero aggirare le misure di unlearning reintroducendo informazioni che si credevano rimosse. Questo scenario è particolarmente allarmante quando si tratta di informazioni sensibili come dati personali, procedure di sicurezza o conoscenze che potrebbero essere sfruttate per attività dannose.

La natura Dual-Use dell’IA e i dilemmi di sicurezza irrisolvibili

Un altro aspetto fondamentale che complica ulteriormente il panorama della sicurezza informatica è la natura intrinsecamente “dual-use” dei sistemi di IA generativa. Come un computer può essere utilizzato sia per progettare un’arma biologica che per comporre il prossimo grande musical di Broadway, anche i sistemi di IA generativa possono essere impiegati per scopi sia benefici che dannosi.

Questa dualità pone una sfida insormontabile: anche output apparentemente innocui, se isolati, potrebbero essere utilizzati per scopi dannosi in contesti diversi. Ad esempio, un modello potrebbe generare informazioni su una singola reazione chimica – perfettamente legittima in un contesto educativo – che, combinata con altre conoscenze in possesso di un utente malintenzionato, potrebbe consentire la creazione di una molecola tossica.

Il problema fondamentale è che nessun metodo di unlearning può anticipare come una persona o un altro agente potrebbe comportarsi con gli output dell’IA in un numero potenzialmente infinito di contesti diversi. Il controllo che i metodi di unlearning possono offrire è limitato ai parametri del modello e ai suoi output diretti, ma non può estendersi agli usi imprevisti o deliberatamente malevoli di tali output.

L’impatto sulla Privacy nell’era Post-GDPR

La privacy rappresenta forse il campo dove le limitazioni del machine unlearning hanno le implicazioni più immediate. L’interpretazione comune del “diritto all’oblio” sancito dal GDPR presuppone che sia possibile rimuovere completamente l’influenza dei dati personali di un individuo da un modello addestrato. Questa interpretazione, sebbene diffusa nella letteratura di ricerca sull’apprendimento automatico, si scontra con limitazioni tecniche significative.

Anche se si rimuovessero tutti i dati personali di un individuo dal dataset di addestramento e si riaddestrasse il modello da zero (il cosiddetto “gold standard” per l’unlearning), non vi sarebbe alcuna garanzia che il modello non possa comunque generare informazioni sensibili su quell’individuo attraverso generalizzazioni basate su informazioni latenti derivate da altri dati.

Questo solleva questioni fondamentali: se un modello di IA può ancora fare inferenze su un individuo dopo che i suoi dati specifici sono stati “disimparati”, si può davvero affermare che il diritto alla privacy di quell’individuo sia stato rispettato? La sicurezza dei dati personali è realmente garantita, o stiamo semplicemente applicando una soluzione superficiale a un problema profondamente radicato nella natura stessa dell’intelligenza artificiale?

Le sfide di sicurezza nel contesto del copyright e della proprietà intellettuale

Anche nel campo del copyright e della proprietà intellettuale, il machine unlearning solleva problematiche di sicurezza significative. Se un’azienda riceve una richiesta di rimozione per contenuti protetti da copyright nel proprio modello di IA, potrebbe implementare metodi di unlearning per tentare di rimuovere tali contenuti o sopprimere output simili.

Tuttavia, la natura indefinita della “somiglianza sostanziale” nel diritto d’autore rende impossibile programmare in modo completo e affidabile quali opere siano sostanzialmente simili ad altre. Un modello modificato per non generare immagini simili a una particolare immagine di un personaggio protetto da copyright potrebbe comunque generare immagini simili ad altre rappresentazioni dello stesso personaggio – o di altri personaggi dello stesso creatore.

Questa incertezza espone le organizzazioni a rischi legali significativi, creando una zona grigia dove nemmeno le migliori pratiche di unlearning possono garantire una protezione completa. La sicurezza giuridica diventa così un miraggio, con implicazioni economiche potenzialmente devastanti date le severe sanzioni previste per le violazioni del copyright.

Verso un approccio di sicurezza realistico nell’era dell’IA Generativa

Di fronte a queste sfide, è fondamentale sviluppare un approccio alla sicurezza informatica più realistico e sfumato quando si tratta di IA generativa. Il primo passo è riconoscere che il machine unlearning non è una soluzione universale, ma solo uno strumento tra molti nel toolkit della sicurezza informatica e della conformità normativa.

Le organizzazioni dovrebbero adottare una visione più sfumata e orientata al rischio, concentrandosi non solo sulla rimozione delle informazioni dai modelli, ma anche su robusti sistemi di filtraggio degli output e politiche di utilizzo responsabile. Invece di promettere l’impossibile – la rimozione completa e irreversibile di informazioni specifiche – le organizzazioni dovrebbero mirare a “sforzi ragionevoli” per mitigare i rischi, un approccio che potrebbe trovare maggiore comprensione anche tra giudici e regolatori.

È inoltre cruciale comprendere che la sicurezza dell’IA generativa è una questione di sistema, non solo di modello. Gli interventi a livello di sistema (come i filtri di contenuto) sono strumenti importanti per limitare gli output problematici, ma la loro efficacia richiede un’analisi a livello di sistema. I modelli a pesi aperti, come la famiglia Llama di Meta, presentano sfide particolari per l’unlearning, poiché rilasciati come parametri senza possibilità di implementare guardrail a livello di sistema.

Strategie concrete per i professionisti della Sicurezza Informatica

Alla luce delle problematiche evidenziate, i professionisti della cybersecurity che lavorano con sistemi di IA generativa dovrebbero adottare un approccio multistrato che vada oltre il semplice affidarsi alle tecniche di cancellazione dei dati. Ecco alcune strategie concrete:

  1. Implementare sistemi di monitoraggio continuo: Anziché presumere che la rimozione dei dati sia definitiva, è essenziale monitorare costantemente gli output dei modelli per identificare eventuali “fughe” di informazioni che si ritenevano rimosse.
  2. Adottare una difesa a profondità: Combinare diverse tecniche di protezione, inclusi filtri di output, verifiche pre-rilascio, e sistemi di rilevamento di prompt malevoli che tentano di aggirare le protezioni.
  3. Abbracciare il principio del “least privilege”: Limitare l’accesso ai modelli più potenti solo agli usi assolutamente necessari, implementando versioni con capacità ridotte per applicazioni meno critiche.
  4. Sviluppare protocolli di risposta agli incidenti specifici per l’IA: Creare procedure di emergenza dedicate che considerino la possibilità che informazioni “disimparate” possano riemergere in modi inaspettati.
  5. Implementare tecniche di offuscamento dei dati sensibili: Quando possibile, trasformare i dati sensibili prima dell’addestramento in modo da preservare i pattern utili eliminando le informazioni identificative specifiche.

Dal punto di vista organizzativo, è fondamentale che i responsabili della sicurezza informatica:

  • Comunichino chiaramente i limiti delle tecnologie di cancellazione dei dati ai dirigenti e agli stakeholder;
  • Documentino in modo trasparente i rischi residui dopo l’applicazione delle tecniche di unlearning;
  • Integrino valutazioni specifiche per l’IA nei processi di gestione del rischio aziendale;
  • Collaborino strettamente con esperti legali per allineare le aspettative di conformità con le reali capacità tecniche.

Infine, è cruciale adottare un approccio di sicurezza adattivo che riconosca che i modelli di IA generativa sono entità dinamiche. La sicurezza non può essere considerata come uno stato finale da raggiungere, ma come un processo continuo di valutazione, miglioramento e adattamento alle nuove vulnerabilità che emergono con l’evoluzione dei modelli e delle tecniche di attacco.

Ripensare la Sicurezza nell’era Post-Controllo

L’analisi del machine unlearning rivela una verità scomoda: stiamo entrando in un’era in cui l’illusione del controllo tecnologico totale deve essere abbandonata. Le implicazioni di questa realtà sono profonde e richiedono un cambio di paradigma radicale nella sicurezza informatica.

Il settore della cybersecurity ha storicamente operato su un presupposto fondamentale: che con sufficienti risorse, competenze e tecnologie, sia possibile creare sistemi “sicuri”. I modelli di IA generativa sfidano questo assioma in modo fondamentale. Come dimostrato dalle limitazioni intrinseche del machine unlearning, ci troviamo di fronte a sistemi la cui complessità supera la nostra capacità di controllo deterministico.

Questo non è semplicemente un problema tecnico che sarà risolto da metodi più sofisticati in futuro. È una limitazione fondamentale e ineludibile che deriva dalla natura stessa dell’apprendimento automatico avanzato. Ogni tentativo di controllare rigorosamente questi sistemi si traduce inevitabilmente in una riduzione della loro utilità e potenza, creando un compromesso impossibile da risolvere in modo soddisfacente.

La conclusione più radicale è che dobbiamo abbandonare il paradigma della “cyber-sicurezza” in favore di un approccio di “cyber-resilienza”. La differenza è sostanziale: mentre la sicurezza si concentra sulla prevenzione degli incidenti, la resilienza accetta l’inevitabilità di alcuni fallimenti e si concentra sulla capacità di un sistema di continuare a funzionare nonostante gli attacchi o le compromissioni.

Invece di promettere falsamente che le informazioni sensibili possono essere completamente rimosse dai modelli di IA, dovremmo sviluppare architetture che possano funzionare in modo sicuro anche quando alcuni dati vengono inevitabilmente esposti. Questo richiede un cambiamento profondo nella progettazione di sistemi, nelle metodologie di valutazione del rischio e nella formazione professionale.

La vera innovazione nella sicurezza dell’IA non verrà da tentativi sempre più sofisticati di controllare l’incontrollabile, ma da approcci che accettano i limiti del controllo e costruiscono robustezza attraverso ridondanza, compartimentazione e ripristino rapido. Questo è un cambiamento epistemologico profondo, che richiede di abbandonare il confortante ma illusorio paradigma della sicurezza assoluta.

Condividi sui Social Network:

https://www.ictsecuritymagazine.com/articoli/machine-unlearning-e-ia-gen/