AI, negli Usa la polizia adotta il software AI che geolocalizza le foto. Come funziona GeoSpy

Dalla Florida alla California, negli Stati Uniti le forze dell’ordine iniziano a sperimentare nuovi strumenti di AI per l’analisi geospaziale delle immagini. Gli uffici dello sceriffo di Miami-Dade e il Los Angeles Police Department hanno acquistato GeoSpy, un sistema capace di individuare in pochi istanti la possibile posizione geografica di una fotografia analizzandone gli elementi visivi: architetture, vegetazione, conformazione del terreno, dettagli ambientali.

A rivelarlo sono email interne ottenute tramite richieste FOIA (Freedom of Information Act), e analizzata dal quotidiano statunitense 404media, che offrono uno spaccato concreto sull’uso operativo della tecnologia.

Gli obiettivi? Generare pista investigative preliminari

Nel caso di Miami-Dade, il dipartimento dispone sia di un modello globale sia di una versione addestrata specificamente sulla contea. L’obiettivo dichiarato è generare piste investigative preliminari, soprattutto nei casi in cui una semplice immagine possa contenere indizi territoriali difficili da individuare con l’occhio umano. Allo stesso tempo, dalle comunicazioni emerge consapevolezza dei limiti dello strumento: il sistema è ancora in fase di test e può produrre falsi positivi.

Le email mostrano un interesse trasversale all’interno dei dipartimenti. Dalla divisione rapine alle unità cyber, diversi reparti vedono in GeoSpy un possibile acceleratore nelle indagini complesse, comprese quelle che riguardano la diffusione online di materiale di abuso sessuale minorile. La promessa è quella di trasformare immagini apparentemente decontestualizzate in indizi geospaziali utili a circoscrivere un’area o individuare un luogo.

GeoSpy: costo dell’operazione? 80mila dollari

Il costo dell’operazione non è marginale. Miami-Dade avrebbe investito oltre 80 mila dollari tra modelli personalizzati e pacchetti di ricerche. Una cifra che segnala la crescente propensione delle agenzie a puntare su sistemi automatizzati di analisi delle immagini, anche in assenza — almeno finora — di arresti o risultati investigativi attribuibili esclusivamente al software.

Parallelamente, Graylark Technologies, società dietro GeoSpy, starebbe valutando applicazioni future anche in ambiti non strettamente investigativi. Intanto l’accesso pubblico alla versione consumer del servizio è stato sospeso dopo precedenti inchieste giornalistiche che ne avevano evidenziato le potenziali implicazioni in termini di privacy e sorveglianza.

Dalle comunicazioni interne emerge infine un approccio prudente. I funzionari invitano a limitare la circolazione di dati sensibili e a considerare le indicazioni fornite dal sistema come semplici spunti investigativi, da verificare attraverso metodi tradizionali. Ma senza regole chiare, audit indipendenti e limiti operativi rigorosi il rischio è quello di ampliare in modo silenzioso l’infrastruttura di sorveglianza digitale. Il tema diventa ancora più delicato se tecnologie simili dovessero essere impiegate in ambiti federali o in operazioni collegate all’ICE.

Leggi le altre notizie sull’home page di Key4biz

https://www.key4biz.it/ai-negli-usa-la-polizia-adotta-il-software-ai-che-geolocalizza-le-foto-come-funziona-geospy/565361/


L’arma dell’autenticità: come il cybercrimine sta piegando i servizi SaaS


Il panorama delle minacce informatiche è in continuo cambiamento e recentemente si sta assistendo a  una metamorfosi del phishing dove la tecnica del mascheramento cede il passo all’abuso deliberato delle infrastrutture cloud legittime. Check Point Software Technologies ha recentemente portato alla luce una campagna di phishing massiva che, invece di creare domini fraudolenti, utilizza le funzionalità native delle piattaforme Software-as-a-Service (SaaS) per veicolare truffe telefoniche. L’operazione ha già raggiunto numeri impressionanti, con circa 133.260 e-mail inviate che hanno messo nel mirino oltre 20.000 aziende a livello globale, sfruttando la reputazione di giganti come Microsoft, Zoom e Amazon.

Questa strategia segna un cambio di paradigma fondamentale nel social engineering, poiché le esche non sono semplici imitazioni ma comunicazioni generate dai sistemi reali dei fornitori. Inserendo contenuti fraudolenti nei campi controllati dall’utente, come i dati del profilo o i metadati di fatturazione, gli attaccanti costringono le piattaforme a inviare notifiche ufficiali che superano indenni ogni controllo di autenticazione come SPF, DKIM e DMARC. Il risultato è un messaggio che eredita la totale fiducia e autorevolezza del brand mittente, rendendo quasi impossibile il rilevamento da parte dei sistemi di sicurezza automatizzati e abbassando drasticamente la soglia di sospetto degli utenti.

Un fenomeno in rapida crescita

L’analisi dei dati evidenzia un’accelerazione verticale del fenomeno negli ultimi mesi: se nell’ultimo semestre si sono registrate circa 648.291 e-mail malevole, ben 463.773 di queste sono state concentrate negli ultimi tre mesi. Questa impennata suggerisce che i criminali informatici considerino l’abuso del SaaS un meccanismo di distribuzione estremamente scalabile e redditizio. David Gubiani, Regional Director Security Engineering di Check Point, sottolinea come a peggiorare la situazione (rendendo gli attacchi potenzialmente molto più  efficaci) dopo il primo approccio tramite email, l’operatività venga spostata al telefono, tramite l’indicazione di chiamare il call center per sistemare il problema. In questo modo, si bypassa l’analisi degli URL e il sandboxing, trasferendo il cuore dell’attacco verso una manipolazione vocale diretta, dove il fattore umano diventa l’anello debole.

I metodi identificati spaziano dalla manipolazione dei campi profilo su piattaforme come YouTube e Malwarebytes, alla generazione di notifiche di abbonamento fraudolente tramite i flussi di lavoro di Microsoft Entra ID e Power BI. Particolarmente sofisticato è l’abuso degli inviti di Amazon Business, dove gli aggressori inseriscono falsi addebiti e finti numeri di assistenza da chiamare direttamente nei campi dell’invito aziendale. In tutti questi casi, le piattaforme non sono state compromesse nel senso tradizionale del termine: sono le loro funzionalità legittime a essere utilizzate impropriamente per dare credibilità a una truffa che si conclude con una chiamata a un call center controllato dai criminali.

USA bersaglio preferito, ma Europa al secondo posto

A livello settoriale, il comparto Tecnologia e IT è il più colpito con il 26,8% dei casi, seguito dalla produzione industriale e dal settore dell’istruzione. Geograficamente, gli Stati Uniti rimangono il bersaglio principale, ma l’Europa segue a ruota con una quota del 17,8%, a dimostrazione della portata globale dell’offensiva. La lezione per i difensori è chiara: la provenienza di un’e-mail da un dominio affidabile non è più una garanzia di sicurezza. È necessaria un’evoluzione delle strategie di difesa che passi attraverso l’analisi contestuale dei messaggi e una formazione degli utenti capace di riconoscere le nuove dinamiche del phishing vocale basato su servizi cloud.

Condividi l’articolo


Articoli correlati

Altro in questa categoria


https://www.securityinfo.it/2026/02/09/larma-dellautenticita-come-il-cybercrimine-sta-piegando-i-servizi-saas/?utm_source=rss&utm_medium=rss&utm_campaign=larma-dellautenticita-come-il-cybercrimine-sta-piegando-i-servizi-saas


NTLM verso lo “switch-off”: Microsoft si prepara a bloccarlo di default


Microsoft ha comunicato che l’autenticazione NTLM verrà disabilitata di default nelle future versioni, lasciando comunque il protocollo presente nel sistema operativo e riattivabile solo tramite policy quando davvero necessario.

Perché NTLM è un bersaglio: relay, replay e pass-the-hash

Il problema di NTLM non è soltanto la sua età, ma la sua esposizione a classi di attacchi che si innestano bene in ambienti enterprise moderni. Microsoft, e diversi esperti, citano esplicitamente relay, replay e man-in-the-middle come le “famiglie” di tecniche che diventano particolarmente pericolose quando un attore malevolo riesce a posizionarsi “in mezzo” a una conversazione di rete o a sfruttare autenticazioni legacy per muoversi lateralmente. In termini di tassonomie operative, il tema si collega a pattern noti come l’Adversary-in-the-Middle e il pass-the-hash, che continuano a comparire un po’ troppo spesso quando si fa la forensica di un attacco proprio perché “funzionano” quando l’azienda mantiene queste dipendenze.

La roadmap in tre fasi: audit, nuove capability Kerberos, poi blocco di default

Microsoft ha strutturato la transizione in tre fasi per ridurre il rischio senza provocare un blackout improvviso di applicazioni e servizi. La prima fase ruota attorno a capacità di auditing potenziate, già disponibili su Windows 11 24H2 e Windows Server 2025, utili a capire dove e perché NTLM viene ancora usato. La seconda fase, prevista per la seconda metà del 2026, introduce nuove funzionalità pensate per “chiudere” i buchi che oggi portano al fallback su NTLM, tra cui IAKerb e un Local Key Distribution Center (Local KDC). La terza fase è quella decisiva: nelle future release, l’NTLM di rete sarà disabilitato per impostazione predefinita, pur restando riabilitabile tramite policy per scenari legacy inevitabili.


“Disabilitato di default” non significa “rimosso”: cosa cambia operativamente

Microsoft sottolinea che non si tratta ancora della rimozione completa del protocollo, ma di una consegna del sistema in uno stato più sicuro “by default”, dove l’OS preferisce alternative moderne e Kerberos-based. Questo permetterà di usare NTLM ancora, ma sarà una scelta chiara dell’utente e non un possibile ripiego automatico in caso di sfruttamento di una vulnerabilità o un derivato di vecchie configurazioni di cui si è persa memoria.

In molte reti, infatti, l’uso di NTLM non è “intenzionale”, ma il risultato di condizioni che impediscono a Kerberos di funzionare come previsto. Microsoft, nella propria serie di hardening su Active Directory, entra nel dettaglio delle cause tipiche: problemi di connettività verso i domain controller, uso di account locali, errori o assenza di Service Principal Name (SPN), accesso alle risorse via indirizzo IP invece che tramite FQDN, oppure applicazioni configurate (o addirittura hardcoded) per chiamare NTLM. Ed è proprio qui che la roadmap prova a intervenire: IAKerb nasce per gestire scenari dove il client non ha una visione completa, mentre LocalKDC mira a ridurre l’uso di NTLM in autenticazioni basate su account locali, storicamente uno dei punti più difficili da eliminare.

Audit potenziato: visibilità prima del blocco

La parte più importante, oggi, è ottenere telemetria affidabile su dove NTLM sta ancora transitando. Microsoft indica esplicitamente che Windows 11 24H2 e Windows Server 2025 offrono auditing più ricco per identificare dipendenze e priorità di remediation, evitando di scoprire “a produzione ferma” che un pezzo di infrastruttura si appoggia ancora al legacy. Nella pratica, la stessa documentazione Microsoft enfatizza la necessità di mappare le dipendenze applicative e validare i workload critici con Kerberos, iniziando a testare configurazioni “NTLM-off” in ambienti non produttivi.

Questo implica un uso approfondito dei log: NTLM va trattato come un “debito tecnico misurabile”, non come un dettaglio di protocollo. Nei suggerimenti sull’hardening dello scenario, Microsoft cita famiglie di eventi utili a capire chi autentica, verso cosa e con quale versione negoziata; nelle build più recenti (24H2/Server 2025) compaiono anche eventi più dettagliati che aiutano a ricostruire il motivo del fallback e, in alcuni casi, il processo coinvolto. L’obiettivo operativo è trasformare l’eliminazione di NTLM in un percorso governato: riduzione progressiva, controllo dell’impatto e blocchi mirati dove non esistono più dipendenze.

NTLMv1: già fuori gioco, ma attenzione ai “derivati” e alle eredità crittografiche

Il percorso di dismissione è iniziato da tempo: NTLMv1 risulta già rimosso in Windows 11 24H2 e Windows Server 2025, ma restano casi in cui sopravvivono elementi di crittografia legacy. Microsoft descrive esplicitamente scenari in cui “rimasugli” di NTLMv1 possono ancora emergere, ad esempio in contesti legati a MS-CHAPv2 in ambienti domain-joined, e introduce chiavi di registro e log dedicati per passare da una modalità di audit a una di enforcement. La timeline pubblica include anche un punto rilevante: a ottobre 2026, in assenza di configurazione esplicita, il default può spostarsi verso una postura più restrittiva per specifici meccanismi collegati a derivati di NTLMv1.

Condividi l’articolo


Articoli correlati

Altro in questa categoria


https://www.securityinfo.it/2026/02/03/ntlm-verso-lo-switch-off-microsoft-si-prepara-a-bloccarlo-di-default/?utm_source=rss&utm_medium=rss&utm_campaign=ntlm-verso-lo-switch-off-microsoft-si-prepara-a-bloccarlo-di-default


IoMT e il paradosso della certificazione: quando la compliance normativa ostacola la cybersecurity dei dispositivi medicali

La sicurezza dei dispositivi medicali IoMT (Internet of Medical Things) rappresenta oggi uno dei paradossi più critici e meno discussi nel panorama della cybersecurity sanitaria europea. Il Regolamento MDR 2017/745 impone che i dispositivi certificati CE non possano essere modificati – inclusa l’installazione di software antivirus o l’applicazione di patch di sicurezza – senza invalidare la certificazione stessa.

Questa rigidità normativa, concepita per tutelare la sicurezza del paziente, si scontra frontalmente con le esigenze di protezione cyber imposte dalla Direttiva NIS2 e dalle minacce ransomware che nel 2024 hanno colpito il 67% delle organizzazioni sanitarie a livello globale, secondo il report Sophos condotto su 14 Paesi. L’articolo analizza questo conflitto regolatorio e propone il modello della “securizzazione laterale” – basato su microsegmentazione di rete e architetture Zero Trust – come soluzione architetturale che consente di proteggere i dispositivi senza alterarne la configurazione certificata.

Il nodo irrisolto della sicurezza IoMT negli ospedali europei

La sicurezza IoMT è diventata la questione centrale per ogni CISO del settore sanitario. Il motivo è tanto semplice quanto allarmante: secondo analisi di settore basate su dati Forescout, la stragrande maggioranza degli ospedali gestisce dispositivi medicali con vulnerabilità note e attivamente sfruttate dagli attaccanti. Non si tratta di un dato astratto, ma di una realtà operativa quotidiana che i responsabili della sicurezza informatica ospedaliera conoscono bene.

Il problema, tuttavia, non risiede nella mancanza di consapevolezza o di competenze tecniche. Il vero ostacolo è strutturale e normativo: i dispositivi medicali certificati CE ai sensi del Regolamento MDR 2017/745 non possono essere modificati senza compromettere la loro conformità regolatoria. Questo significa che un monitor cardiaco, una pompa per infusione o un sistema di imaging diagnostico – tutti dispositivi critici per la cura del paziente – devono rimanere esattamente nella configurazione in cui sono stati certificati, anche quando presentano vulnerabilità software documentate.

Il paradosso emerge in tutta la sua evidenza: la normativa pensata per proteggere il paziente impedisce di fatto l’implementazione delle misure di cybersecurity necessarie a proteggerlo da minacce che, secondo il report IBM Cost of a Data Breach 2024, hanno causato danni per una media di 9,77 milioni di dollari per ogni violazione nel settore sanitario – il costo più alto tra tutti i comparti industriali per il quattordicesimo anno consecutivo.

Il conflitto normativo: MDR 2017/745 versus requisiti di cybersecurity

Per comprendere la profondità di questo conflitto è necessario esaminare le due cornici normative che, paradossalmente, dovrebbero entrambe tutelare la sicurezza dei pazienti.

Il Regolamento MDR 2017/745: la logica della certificazione

Il Medical Device Regulation europeo, entrato in vigore nel maggio 2021, ha sostituito le precedenti direttive introducendo requisiti più stringenti per l’immissione sul mercato dei dispositivi medicali. L’Allegato I, Sezione 17.2, stabilisce che il software contenuto nei dispositivi medicali deve essere sviluppato e prodotto “allo stato dell’arte”, considerando il ciclo di vita, la gestione del rischio e la sicurezza delle informazioni.

Tuttavia, la certificazione CE – rilasciata dagli Organismi Notificati dopo rigorosi processi di valutazione della conformità – cristallizza la configurazione del dispositivo. Qualsiasi modifica sostanziale richiede una nuova valutazione di conformità, con tempi e costi che possono risultare proibitivi. Il principio sottostante è chiaro: garantire che il dispositivo funzioni esattamente come testato e validato, senza alterazioni che potrebbero comprometterne la sicurezza clinica.

Questa rigidità ha senso dal punto di vista della sicurezza del paziente in senso tradizionale. Un’alterazione del firmware di una pompa per infusione potrebbe teoricamente modificarne il dosaggio; un aggiornamento software di un ventilatore polmonare potrebbe introdurre malfunzionamenti. La certificazione CE è progettata per prevenire questi rischi.

La Direttiva NIS2: l’imperativo della cybersecurity

Sul versante opposto, la Direttiva NIS2 – in vigore dal 18 ottobre 2024 – classifica ospedali e produttori di dispositivi medicali come “entità essenziali” o “importanti”, imponendo obblighi stringenti in materia di gestione del rischio cyber. L’Articolo 21(2) elenca dieci misure di sicurezza obbligatorie, tra cui la gestione delle vulnerabilità, la sicurezza della supply chain e la capacità di risposta agli incidenti.

Il problema emerge quando si considera che la gestione delle vulnerabilità, nel contesto IT tradizionale, si traduce principalmente nell’applicazione tempestiva di patch di sicurezza. Ma per un dispositivo medicale certificato CE, applicare una patch significa potenzialmente invalidare la certificazione.

Un esempio concreto: la pompa per infusione vulnerabile

Consideriamo uno scenario reale documentato dalla University of New Brunswick nel dataset CICIoMT2024. Una pompa per infusione connessa alla rete ospedaliera presenta una vulnerabilità nota nel protocollo MQTT utilizzato per la comunicazione. Gli attaccanti possono sfruttare questa vulnerabilità per intercettare i comandi o, nel peggiore dei casi, alterare i parametri di infusione.

La soluzione tecnica sarebbe immediata: applicare la patch rilasciata dal vendor o, in alternativa, installare un agente di endpoint protection. Tuttavia, entrambe le opzioni comporterebbero una modifica del software del dispositivo. Secondo la lettura più conservativa del MDR, questo richiede una nuova valutazione di conformità da parte dell’Organismo Notificato – un processo che può richiedere mesi e che il vendor potrebbe non essere disposto ad affrontare per dispositivi già in commercio.

Il risultato? La pompa rimane vulnerabile, connessa alla rete ospedaliera, in attesa che il vendor rilasci un aggiornamento già validato nell’ambito del suo processo di Post-Market Surveillance. Un’attesa che può protrarsi per anni nei casi di dispositivi legacy.

La fotografia delle vulnerabilità IoMT nel 2025

I numeri raccontano una situazione critica. Il report 2025 di Forescout documenta un incremento del 15% anno su anno del rischio medio dei dispositivi connessi, con quattro nuove tipologie di dispositivi IoMT entrate nella lista dei più rischiosi: dispositivi di imaging, apparecchiature di laboratorio, workstation sanitarie e controller per pompe di infusione. Questi ultimi sono particolarmente critici poiché una compromissione potrebbe permettere agli attaccanti di alterare i parametri di somministrazione dei farmaci.

Secondo analisi di settore, una percentuale significativa dei dispositivi medicali opera su sistemi operativi end-of-life che non ricevono più aggiornamenti di sicurezza, mentre i controller delle pompe di infusione mostrano vulnerabilità critiche e wormable nel 20% dei casi analizzati.

La situazione in Italia

In Italia, la situazione è particolarmente preoccupante. L’Agenzia per la Cybersicurezza Nazionale ha documentato un incremento del 111% degli eventi cyber nel settore sanitario tra il 2023 e il 2024, passando da 27 a 57 eventi. Gli incidenti effettivi hanno raggiunto quota 57, influenzati in parte da un attacco supply chain che ha coinvolto numerosi clienti del settore sanitario attraverso un fornitore. Nel solo 2024 sono stati registrati 10 casi significativi di ransomware che hanno colpito strutture sanitarie italiane.

L’attacco alla ASST Rhodense del giugno 2024 esemplifica le conseguenze operative: il gruppo ransomware Cicada3301 ha compromesso i sistemi informatici degli ospedali di Garbagnate, Bollate e Rho, costringendo le strutture a sospendere interventi chirurgici non urgenti, esami di laboratorio e altri servizi programmati. Il gruppo ha rivendicato l’esfiltrazione di 1 terabyte di dati sensibili, inclusi documenti medici, prescrizioni e informazioni personali dei pazienti.

Il contesto europeo

A livello europeo, i dati di Check Point Research per gennaio-settembre 2024 indicano che le organizzazioni sanitarie europee hanno subito una media di 1.686 attacchi settimanali per organizzazione, con un incremento del 56% rispetto allo stesso periodo dell’anno precedente – il maggiore aumento percentuale tra tutte le regioni analizzate. L’Italia si posiziona tra i Paesi più colpiti nel settore healthcare a livello globale.

La securizzazione laterale: proteggere senza modificare

Di fronte a questo paradosso normativo, la comunità della cybersecurity sanitaria ha sviluppato un approccio alternativo che consente di proteggere i dispositivi medicali IoMT senza alterarne la configurazione interna. Questo paradigma, che possiamo definire “securizzazione laterale”, opera esclusivamente sul contesto di rete in cui il dispositivo è inserito, lasciando intatto il software certificato.

Il principio architetturale

L’idea fondamentale è semplice: se non posso installare un antivirus sul dispositivo, posso però controllare con precisione chi può comunicare con esso e come. Invece di proteggere il dispositivo dall’interno, lo proteggo dall’esterno, creando un perimetro di sicurezza granulare che ne limita l’esposizione alle minacce.

Questo approccio si articola in tre componenti principali:

Visibilità completa dell’ambiente IoMT. Prima di proteggere, è necessario conoscere. Piattaforme come Claroty Medigate o Armis consentono di identificare automaticamente tutti i dispositivi medicali connessi alla rete, classificarli per tipologia e rischio, e mappare i loro pattern di comunicazione legittimi.

Microsegmentazione identity-based. Una volta identificati i dispositivi e i loro flussi di comunicazione autorizzati, è possibile implementare policy di segmentazione granulare che consentano solo il traffico strettamente necessario. Un monitor cardiaco, ad esempio, deve poter comunicare con il sistema di gestione dei dati clinici (PACS) e con la workstation del reparto, ma non ha alcun motivo legittimo per accedere a Internet o comunicare con la stampante dell’amministrazione.

Prevenzione del lateral movement. Il vero valore della microsegmentazione emerge nella capacità di contenere un’eventuale compromissione. Se un attaccante riesce a violare un dispositivo vulnerabile, la segmentazione impedisce che possa utilizzarlo come punto di pivot per raggiungere altri sistemi critici. Il lateral movement rappresenta un vettore di attacco prevalente nelle violazioni riuscite nel settore sanitario.

Il caso MultiCare Health System

L’implementazione della microsegmentazione in ambito sanitario trova un esempio significativo nel caso di MultiCare Health System, il più grande sistema sanitario no-profit dello Stato di Washington con 14 ospedali e circa 29.000 dipendenti.

Jason Elrod, CISO di MultiCare, ha affrontato la sfida partendo da una posizione di scetticismo – come lui stesso ha dichiarato – verso le promesse dei vendor. L’implementazione di una piattaforma di microsegmentazione identity-based ha permesso di ottenere il 99% di visibilità sui dispositivi connessi in meno di 4 ore, con un deployment completo delle policy di segmentazione in 4-16 settimane, senza alcuna interruzione dei flussi clinici.

L’aspetto cruciale dell’approccio adottato è che la protezione avviene a livello di rete, senza richiedere l’installazione di agenti software sui dispositivi medicali. Questo consente di proteggere anche dispositivi legacy che operano su sistemi operativi obsoleti – come Windows 7 o Windows XP Embedded – impossibili da aggiornare sia per ragioni tecniche che normative.

L’allineamento con i nuovi requisiti regolatori

La securizzazione laterale non è solo una soluzione tecnica elegante; sta diventando un requisito normativo esplicito.

Stati Uniti: la proposta di aggiornamento HIPAA Security Rule

La proposta di aggiornamento alla HIPAA Security Rule, pubblicata dall’Office for Civil Rights (OCR) del Department of Health and Human Services il 27 dicembre 2024, prevede esplicitamente la segmentazione di rete come misura obbligatoria per la protezione delle informazioni sanitarie elettroniche (ePHI). Il documento elimina la distinzione tra specifiche required e addressable, rendendo di fatto obbligatorie tutte le misure di sicurezza precedentemente considerate opzionali.

Il periodo di commenti pubblici si è chiuso il 7 marzo 2025 e si attende la pubblicazione della regola finale entro la fine dell’anno. Le organizzazioni sanitarie statunitensi dovrebbero già prepararsi a soddisfare questi requisiti.

Europa: le linee guida per il settore sanitario

Le linee guida HHS 405(d) Health Industry Cybersecurity Practices richiedono esplicitamente capacità di defense-in-depth attraverso la segmentazione di rete, con particolare enfasi sulla prevenzione del lateral movement. L’NHS Digital britannico ha rilasciato guidance che impongono la segmentazione di rete come requisito per tutti i Trust del sistema sanitario nazionale.

Implicazioni operative per i professionisti della sicurezza sanitaria

Per i CISO e i security architect del settore sanitario, questo scenario impone un ripensamento delle strategie di protezione. Non è più possibile affidarsi esclusivamente alle tradizionali misure di endpoint security; è necessario adottare un approccio architetturale che riconosca le specificità dell’ambiente IoMT.

Assessment della superficie di attacco IoMT

Il primo passo è acquisire visibilità completa sull’inventario dei dispositivi medicali connessi. La mancanza di visibilità è indicata da una percentuale significativa di CISO ospedalieri come la principale barriera alla gestione efficace del rischio IoMT. Non è possibile proteggere ciò che non si conosce.

Piattaforme specializzate nella discovery IoMT consentono di identificare dispositivi che spesso sfuggono ai tradizionali strumenti di network scanning, includendo apparecchiature biomedicali, sistemi di building automation connessi alla rete clinica e dispositivi shadow IT introdotti dai reparti senza coinvolgimento dell’IT centrale.

Prioritizzazione risk-based

Non tutti i dispositivi presentano lo stesso livello di rischio. Un sistema di imaging diagnostico connesso al PACS e contenente dati clinici di migliaia di pazienti richiede una protezione diversa rispetto a un sensore di temperatura ambientale. La prioritizzazione deve considerare:

  • la criticità clinica del dispositivo per la cura del paziente;
  • la sensibilità dei dati trattati;
  • il livello di connettività e l’esposizione a Internet;
  • la presenza di vulnerabilità note con exploit pubblici;
  • la disponibilità o meno di patch da parte del vendor.

Secondo i dati di Forescout, i sistemi di imaging diagnostico e i dispositivi di monitoraggio dei pazienti rappresentano i target primari degli attacchi ai dispositivi medicali, seguiti da apparecchiature di laboratorio e pompe per infusione.

Implementazione della microsegmentazione

L’implementazione della microsegmentazione in ambiente sanitario richiede un approccio graduale che minimizzi il rischio di interruzione dei servizi clinici. Le best practice suggeriscono:

Fase di discovery e learning. Acquisire visibilità completa e mappare i pattern di comunicazione legittimi prima di implementare qualsiasi policy restrittiva.

Definizione delle policy in modalità audit. Configurare le regole di segmentazione in modalità di solo monitoraggio, verificando che non blocchino traffico clinico legittimo.

Enforcement progressivo. Attivare l’enforcement partendo dai segmenti meno critici, espandendo gradualmente la copertura.

Integrazione con incident response. Predisporre procedure per l’isolamento rapido di dispositivi compromessi senza impatto sui servizi clinici essenziali.

Gestione del rapporto con i vendor

Un aspetto spesso trascurato riguarda la relazione con i produttori di dispositivi medicali. La NIS2 impone esplicitamente requisiti di sicurezza della supply chain (Articolo 21(2)(d)), richiedendo alle organizzazioni sanitarie di valutare e monitorare la postura cyber dei propri fornitori.

I Manufacturer Disclosure Statements for Medical Device Security (MDS2) forniscono informazioni strutturate sulla sicurezza dei dispositivi, ma troppo spesso rimangono documenti statici che non vengono operazionalizzati. L’integrazione dei dati MDS2 con le piattaforme di microsegmentazione consente di tradurre automaticamente le caratteristiche di sicurezza dichiarate dal vendor in policy di protezione effettive.

Prospettive evolutive: verso una convergenza normativa

Il paradosso normativo tra MDR e requisiti cyber non potrà rimanere irrisolto a lungo. Diversi segnali indicano una progressiva consapevolezza della necessità di armonizzazione.

L’Action Plan europeo sulla cybersecurity ospedaliera

Il 15 gennaio 2025 la Commissione Europea ha pubblicato un Action Plan dedicato alla cybersecurity di ospedali e provider sanitari. Il documento riconosce esplicitamente l’interdipendenza tra provider sanitari e industria medicale, e propone misure che impattano l’intera supply chain del settore.

Tra le azioni più significative, il piano propone che gli Stati membri richiedano alle entità soggette a NIS2 di riportare i pagamenti di riscatti ransomware – un cambio significativo rispetto all’attuale framework. L’obiettivo dichiarato è raccogliere dati per comprendere l’efficacia delle misure anti-ransomware e supportare le investigazioni.

L’evoluzione dell’approccio FDA

Dall’altra parte dell’Atlantico, la FDA statunitense ha adottato un approccio più progressivo. Con la Sezione 524B del FD&C Act, introdotta nel dicembre 2022 tramite il Consolidated Appropriations Act, i produttori di dispositivi cyber sono ora obbligati a:

  • fornire una Software Bill of Materials (SBOM) che documenti tutti i componenti software;
  • progettare e mantenere processi per garantire la cybersecurity del dispositivo lungo l’intero ciclo di vita;
  • rendere disponibili aggiornamenti e patch post-market.

La guidance finale aggiornata di giugno 2025 chiarisce esplicitamente i requisiti per i cyber devices e le aspettative per il ciclo di vita post-market.

Il Cyber Resilience Act europeo

Il Cyber Resilience Act europeo, parte del più ampio framework di cybersecurity dell’Unione, introduce requisiti di sicurezza by-design per i prodotti con componenti digitali. L’integrazione tra CRA, MDR e NIS2 dovrà necessariamente portare a un approccio più coerente alla gestione delle vulnerabilità nei dispositivi medicali.

Considerazioni conclusive

La sicurezza dei dispositivi medicali IoMT si trova oggi al centro di una tensione normativa che riflette due concezioni diverse – ma entrambe legittime – della protezione del paziente. La certificazione CE tutela il paziente da malfunzionamenti del dispositivo; la cybersecurity lo tutela da attacchi che potrebbero comprometterne l’integrità o renderlo indisponibile nel momento del bisogno.

La securizzazione laterale rappresenta, allo stato attuale, la risposta più efficace a questo paradosso. Proteggere il contesto invece del dispositivo consente di implementare misure di sicurezza robuste senza entrare in conflitto con i requisiti regolatori sulla certificazione.

Tuttavia, questa soluzione architetturale non può rimanere l’unica risposta a lungo termine. È necessario che il framework normativo europeo evolva verso un modello che consenta l’aggiornamento tempestivo dei dispositivi medicali senza richiedere complesse ri-certificazioni per ogni patch di sicurezza. L’esperienza FDA dimostra che questo equilibrio è possibile.

Nel frattempo, i professionisti della sicurezza IoMT nel settore sanitario devono adottare un approccio pragmatico: implementare la microsegmentazione come misura di protezione immediata, mantenere una visibilità completa sull’inventario dei dispositivi connessi e strutturare un dialogo costruttivo con i vendor per accelerare la disponibilità di aggiornamenti validati.

La posta in gioco è troppo alta per attendere una soluzione normativa perfetta. La significativa presenza di vulnerabilità note nei dispositivi medicali ospedalieri non è una statistica accettabile. È un rischio che richiede azione immediata, nei limiti – ma non oltre – di quanto la normativa consente.

Condividi sui Social Network:

https://www.ictsecuritymagazine.com/articoli/iomt/


Framework SLSA: guida completa ai livelli di sicurezza e strategie di implementazione per la Software Supply Chain

L’ecosistema digitale contemporaneo poggia su fondamenta invisibili ma critiche: la catena di approvvigionamento del software. Ogni applicazione moderna integra centinaia di dipendenze, librerie e componenti esterni, creando una superficie di attacco che si estende ben oltre i confini del codice proprietario. Gli attacchi alla supply chain software hanno registrato un incremento del 200% nel 2023 rispetto all’anno precedente secondo il State of the Software Supply Chain Report di Sonatype, trasformando quello che era un vettore di attacco marginale in una minaccia sistemica per l’intero ecosistema tecnologico globale.

L’attacco a SolarWinds nel dicembre 2020 ha rappresentato un punto di non ritorno: la compromissione del processo di build ha permesso la distribuzione di aggiornamenti malevoli a oltre 18.000 organizzazioni, incluse agenzie governative statunitensi e corporation Fortune 500. Questo evento ha catalizzato la nascita di SLSA, un framework che ambisce a definire standard universali per la sicurezza della software supply chain.

Che cos’è il Framework SLSA: origini e architettura concettuale

SLSA (pronunciato “salsa”) è l’acronimo di Supply-chain Levels for Software Artifacts. Sviluppato originariamente da Google e successivamente adottato dalla Open Source Security Foundation (OpenSSF) come progetto community-driven, SLSA rappresenta un framework di sicurezza che definisce requisiti progressivi per proteggere l’integrità degli artefatti software durante l’intero ciclo di vita della produzione.

La filosofia architetturale di SLSA si distingue per tre caratteristiche fondamentali.

La prima è la progressività strutturata: anziché imporre requisiti monolitici, il framework articola la sicurezza in livelli incrementali che permettono un’adozione graduale, calibrata sulla maturità organizzativa e sulle risorse disponibili.

La seconda è la verificabilità empirica: ogni requisito SLSA è progettato per essere verificabile attraverso evidenze oggettive, principalmente mediante attestazioni crittograficamente firmate che documentano la provenance degli artefatti.

La terza è l’agnosticismo tecnologico: il framework prescinde da specifiche tecnologie o piattaforme, concentrandosi su principi universali applicabili a qualsiasi stack tecnologico.

La specifica corrente, SLSA v1.0, rilasciata il 19 aprile 2023, ha consolidato anni di iterazioni e feedback dalla community, introducendo una struttura più coerente e requisiti più pragmatici rispetto alle versioni precedenti. Una novità significativa della v1.0 è la suddivisione dei requisiti in track separati: la versione attuale definisce il Build Track con i livelli 1-3, mentre altri track (come il Source Track) sono previsti per versioni future.

Anatomia dei livelli SLSA: dal livello 0 al livello 3

Il framework SLSA nella versione 1.0 articola la maturità della supply chain security attraverso il Build Track, che comprende quattro livelli progressivi (da L0 a L3). Ciascun livello è caratterizzato da requisiti specifici che rafforzano le garanzie di integrità e provenance degli artefatti software.

Build L0: assenza di requisiti

Il livello zero rappresenta l’assenza di SLSA: nessun requisito è soddisfatto e non esistono garanzie di integrità degli artefatti. Questo livello descrive lo stato di partenza della maggior parte dei progetti software prima dell’adozione del framework.

Build L1: documentazione della provenance

Il primo livello operativo rappresenta il punto di ingresso nel framework e si focalizza sulla creazione di una traccia documentale del processo di build.

Il Livello 1 richiede che il processo di build produca attestazioni di provenance che documentino quale sorgente è stata utilizzata, quale processo di build è stato eseguito e quali artefatti sono stati generati. Queste attestazioni seguono il formato standardizzato in-toto, un framework per la supply chain integrity sviluppato alla NYU Tandon School of Engineering e ora progetto graduated della Cloud Native Computing Foundation.

La provenance al Livello 1 non richiede ancora garanzie crittografiche robuste: l’obiettivo primario è stabilire visibilità sul processo di build, creando le fondamenta per i livelli successivi. Come specificato nella documentazione SLSA, questo livello può essere facilmente aggirato o falsificato, ma fornisce comunque benefici significativi per audit e incident response.

Sebbene le garanzie di sicurezza al Livello 1 siano limitate, l’adozione di questo livello fornisce immediate capacità di tracciamento. In caso di vulnerabilità scoperta in una dipendenza, l’organizzazione può rapidamente identificare quali build sono potenzialmente compromessi.

Build L2: attestazioni firmate e build service autenticato

Il Livello 2 introduce requisiti crittografici che trasformano le attestazioni di provenance da semplici documenti a evidenze verificabili.

Le attestazioni di provenance devono essere crittograficamente firmate utilizzando chiavi gestite dal servizio di build. Questo garantisce che le attestazioni non possano essere falsificate o modificate retroattivamente senza invalidare la firma.

Il processo di build deve essere eseguito su un hosted build service che implementi controlli di autenticazione e autorizzazione. Piattaforme come GitHub Actions, Google Cloud Build e GitLab CI/CD offrono funzionalità native per la generazione di attestazioni SLSA Livello 2.

Il Livello 2 introduce un significativo incremento della fiducia: le attestazioni firmate permettono a consumatori terzi di verificare l’autenticità della provenance senza dover fidarsi implicitamente del produttore del software.

Build L3: isolamento del build e hardening della piattaforma

Il Livello 3 rappresenta il massimo livello di sicurezza attualmente definito nella specifica v1.0, introducendo requisiti architetturali che proteggono il processo di build da manipolazioni interne.

Il build deve essere eseguito in un ambiente isolato che impedisca interferenze da altri processi o build concorrenti. L’isolamento deve garantire che il processo di build non possa essere influenzato da fattori esterni non documentati nelle attestazioni di provenance.

La piattaforma di build deve implementare meccanismi di hardening che prevengano la compromissione del sistema di generazione delle attestazioni, anche in presenza di codice sorgente malevolo. Questo requisito, noto come unforgeable provenance, impone che la generazione e firma delle attestazioni avvenga in un dominio di sicurezza separato dal codice in esecuzione.

La specifica SLSA Build Track dettaglia i requisiti tecnici per l’isolamento, includendo la necessità di ambienti effimeri che vengono distrutti dopo ogni build, l’impossibilità per i custom build steps di accedere ai materiali crittografici usati per firmare la provenance, e l’isolamento completo tra build differenti anche all’interno dello stesso progetto.

Il Livello 3 fornisce garanzie contro minacce interne e compromissioni del processo di sviluppo. Anche se un attaccante ottiene accesso al repository sorgente o al sistema CI/CD, la generazione di attestazioni fraudolente risulta significativamente più complessa.

Prospettive future: Build L4 e Source Track

La specifica SLSA v1.0 si concentra deliberatamente sul Build Track con livelli 1-3, rimandando a versioni future requisiti più avanzati. Come indicato nella documentazione What’s New in SLSA v1.0, sono previsti sviluppi che includono un Build Level 4 (con requisiti come il two-party review e i reproducible builds) e un Source Track dedicato alla protezione dell’integrità del codice sorgente.

Questa scelta architetturale riflette un approccio pragmatico: consolidare requisiti stabili e implementabili prima di estendere l’ambito del framework.

Implementazione pratica del Framework SLSA

L’adozione del framework SLSA richiede un approccio metodico che integri modifiche tecnologiche, processuali e organizzative. Le seguenti linee guida delineano un percorso di implementazione strutturato.

Fase 1: assessment e gap analysis

Prima dell’implementazione, è essenziale condurre una valutazione dello stato corrente della supply chain. La specifica SLSA fornisce criteri dettagliati che possono essere utilizzati come checklist per identificare gap rispetto ai requisiti di ciascun livello.

L’assessment dovrebbe mappare le piattaforme di build attualmente utilizzate e le loro capacità native di attestazione, i processi di code review esistenti, le pratiche di gestione delle dipendenze e la visibilità sulla loro provenance, e le capacità di verifica delle attestazioni nei processi di deployment.

Fase 2: infrastruttura di attestazione

L’implementazione delle attestazioni SLSA richiede l’integrazione di componenti specifici nella pipeline CI/CD. I SLSA GitHub Generators offrono implementazioni di riferimento per GitHub Actions che generano automaticamente attestazioni conformi.

Per ambienti enterprise, Sigstore, un progetto OpenSSF, fornisce un’infrastruttura completa per la firma e verifica delle attestazioni, includendo Fulcio (Certificate Authority per identità effimere), Rekor (Transparency log immutabile per attestazioni) e Cosign (strumento per firma e verifica di container e artefatti).

L’integrazione con SLSA Verifier permette la validazione automatizzata delle attestazioni durante i processi di deployment, garantendo che solo artefatti con provenance verificata raggiungano gli ambienti di produzione.

Fase 3: hardening del build environment

Il raggiungimento del Livello 3 richiede investimenti significativi nell’hardening dell’infrastruttura di build. Le raccomandazioni del NIST Secure Software Development Framework (SSDF) forniscono guidance complementare per l’implementazione di ambienti di build sicuri.

Elementi critici includono l’implementazione di build ermetici che isolino completamente il processo, la separazione dei privilegi tra l’ambiente di esecuzione del build e il sistema di attestazione, il monitoring e logging completo delle operazioni di build per finalità forensi, e la rotazione periodica delle chiavi di firma con audit dei meccanismi di accesso.

Fase 4: integrazione organizzativa

L’aspetto organizzativo risulta critico per il successo dell’implementazione. Anche se il two-party review formale è previsto per livelli futuri, stabilire processi robusti di revisione del codice fin dalle prime fasi dell’adozione SLSA prepara l’organizzazione per requisiti più stringenti.

Le best practice includono la definizione di policy chiare per la revisione del codice, il training dei team di sviluppo sui principi SLSA e sulle procedure operative, l’integrazione dei controlli SLSA nei processi di vendor assessment per dipendenze esterne, e il reporting periodico sulla conformità e sui gap identificati.

Ecosistema e interoperabilità: SLSA nel contesto normativo

Il framework SLSA non opera in isolamento ma si integra in un ecosistema più ampio di standard e normative per la software security.

Sinergie con SBOM e VEX

L’Executive Order 14028 dell’amministrazione Biden, firmato il 12 maggio 2021, ha imposto requisiti di Software Bill of Materials (SBOM) per i fornitori del governo federale USA. SLSA e SBOM sono complementari: mentre SBOM documenta i componenti presenti nel software, SLSA attesta la provenance e l’integrità del processo che ha prodotto quei componenti.

Il formato VEX (Vulnerability Exploitability eXchange), promosso dalla CISA, si integra con le attestazioni SLSA per fornire informazioni sulla applicabilità delle vulnerabilità agli artefatti specifici.

Allineamento con NIS2 e Cyber Resilience Act

La Direttiva NIS2 dell’Unione Europea, applicabile dal 17 ottobre 2024, introduce requisiti espliciti per la sicurezza della supply chain software, particolarmente per operatori di servizi essenziali e fornitori di servizi digitali. L’adozione del framework SLSA costituisce un meccanismo concreto per dimostrare conformità ai requisiti di supply chain risk management previsti dalla direttiva.

Il Cyber Resilience Act, entrato in vigore il 10 dicembre 2024 con piena applicazione prevista dall’11 dicembre 2027, impone requisiti di cybersecurity per prodotti con elementi digitali immessi sul mercato europeo. Il regolamento richiede ai produttori di garantire la sicurezza lungo l’intero ciclo di vita del prodotto, includendo requisiti sulla gestione delle vulnerabilità e sulla trasparenza della supply chain che si allineano strettamente con i principi SLSA.

Prospettive future: SLSA e l’evoluzione della Supply Chain Security

Il framework SLSA rappresenta un punto di partenza, non una destinazione finale, nell’evoluzione della software supply chain security. Diverse direttrici di sviluppo stanno emergendo nella community e nelle organizzazioni di standardizzazione.

Attestazioni per Source Code e dipendenze

Come indicato nella sezione Current Activities del sito SLSA, la community sta lavorando attivamente su nuovi track che estenderanno le garanzie oltre il processo di build. Il Source Track in sviluppo definirà requisiti per la protezione dell’integrità dei repository e per la tracciabilità delle modifiche al codice sorgente. Un Dependency Track è inoltre in fase di elaborazione per affrontare i rischi introdotti dalle dipendenze esterne.

Integrazione con AI/ML Supply Chain

L’emergere di modelli di machine learning come componenti critici delle applicazioni moderne pone sfide uniche per la supply chain security. Iniziative come Model Transparency stanno esplorando l’applicazione di principi SLSA alla provenance dei modelli AI, includendo attestazioni sui dataset di training e sui processi di fine-tuning.

Hardware-Backed Attestations

L’integrazione con tecnologie di attestazione hardware, come Trusted Platform Module (TPM) e Confidential Computing, promette di fornire root of trust basata su hardware per le attestazioni SLSA, elevando ulteriormente le garanzie di integrità.

Conclusioni: SLSA come imperativo strategico

L’adozione del framework SLSA trascende la mera conformità tecnica per configurarsi come imperativo strategico nell’economia digitale contemporanea. In un ecosistema dove la fiducia nel software è prerequisito per qualsiasi transazione digitale, la capacità di attestare rigorosamente la provenance e l’integrità degli artefatti software costituisce un differenziatore competitivo e un requisito per l’operatività in settori regolamentati.

L’implementazione progressiva dei livelli SLSA permette alle organizzazioni di calibrare gli investimenti in sicurezza rispetto al profilo di rischio specifico, evitando sia il sottoinvestimento che espone a compromissioni catastrofiche, sia il sovrainvestimento che drena risorse da altre priorità strategiche.

Il framework SLSA rappresenta la codificazione di principi che la community di sicurezza ha elaborato attraverso decenni di incidenti e lezioni apprese. Con l’entrata in vigore di normative come NIS2 e il Cyber Resilience Act, e con la crescente sofisticazione degli attacchi alla supply chain, la sua adozione non è più questione di “se” ma di “quando” per qualsiasi organizzazione che produca o consumi software in contesti critici.

Condividi sui Social Network:

https://www.ictsecuritymagazine.com/articoli/framework-slsa/


Crittografia post-quantistica, un mercato mondiale stimato in 13 miliardi di dollari entro il 2035

Il boom della crittografia post-quantistica atteso tra il 2026 e il 2035

La crittografia post-quantistica esce dalla nicchia degli addetti ai lavori e si prepara a diventare uno dei pilastri della sicurezza digitale globale. A dirlo è una nuova ricerca di Juniper Research, che fotografa un mercato in rapidissima espansione: da 1,2 miliardi di dollari nel 2026 a 13,3 miliardi di dollari nel 2035 (+1000%), con un tasso di crescita annuo composto (CAGR) del 30%. Numeri che raccontano una trasformazione strutturale in corso, spinta dall’avanzata del quantum computing e dalla crescente consapevolezza dei suoi impatti sulla cybersicurezza.

Che cos’è la crittografia post-quantistica

La crittografia post-quantistica (Post-Quantum Cryptography, PQC) comprende un insieme di algoritmi progettati per resistere agli attacchi dei computer quantistici, capaci – almeno in prospettiva – di compromettere gli attuali sistemi di cifratura a chiave pubblica. Il riferimento è al cosiddetto “Q-Day”, il momento in cui la potenza dei computer quantistici renderà vulnerabili le tecniche crittografiche oggi alla base di comunicazioni, transazioni finanziarie, identità digitali e infrastrutture critiche.

Anche se il Q-Day non ha ancora una data certa, governi e grandi organizzazioni lo considerano ormai un rischio concreto, tanto da avviare con largo anticipo la transizione verso soluzioni “quantum-safe”.

Le forze che trainano il mercato

Secondo il Report di Juniper Research, che offre una visione di lungo periodo basata su oltre 54.000 datapoint di 61 Paesi, la crescita del mercato della crittografia post-quantistica è alimentata da due fattori principali.

Il primo è la rapida evoluzione di standard e regolamenti, pensati proprio per preparare sistemi e infrastrutture all’era post-quantistica. In questo contesto, un ruolo centrale è svolto dagli algoritmi standardizzati dal NIST (National Institute of Standards and Technology), che in molti Paesi sono già diventati l’opzione di riferimento per la sicurezza “quantum-resistant”.

Il secondo driver è rappresentato dai continui investimenti in ricerca e sviluppo, che stanno accelerando la maturità degli algoritmi attraverso test rigorosi e applicazioni in scenari reali. Questo processo sta riducendo le incertezze tecnologiche e rendendo la PQC sempre più pronta per un’adozione su larga scala.

Il pericolo della “scarsa” consapevolezza

Nonostante le prospettive di mercato, Juniper Research segnala come la scarsa consapevolezza resti uno dei principali ostacoli. Molte aziende tendono ancora a sottovalutare il rischio di attacchi abilitati dal quantum computing. Come sottolinea Louis Atkin, Research Analyst di Juniper Research, è fondamentale rendere il tema più comprensibile e accessibile, così da favorire il coinvolgimento del management e sbloccare gli investimenti necessari.

Collaborazione e interoperabilità per un’adozione rapida ed efficace della crittografia post-quantistica

Guardando al futuro, la ricerca evidenzia che la collaborazione globale tra organizzazioni e Paesi sarà cruciale per un’adozione efficace della crittografia post-quantistica. La crittografia, infatti, è per sua natura un dominio che richiede interoperabilità: sistemi, reti e infrastrutture devono funzionare senza frizioni anche oltre i confini nazionali.

Il fatto che molti Stati abbiano già accettato gli algoritmi del NIST come standard de facto – anche in contesti dove la comprensione del panorama quantistico è ancora limitata – è visto come un segnale positivo. La sfida, nei prossimi anni, sarà garantire che la transizione verso soluzioni quantum-safe avvenga in modo coordinato tra settori diversi, dalla finanza alle telecomunicazioni, fino alla pubblica amministrazione.

Leggi le altre notizie sull’home page di Key4biz

https://www.key4biz.it/crittografia-post-quantistica-un-mercato-mondiale-stimato-in-13-miliardi-di-dollari-entro-il-2035/562208/


Finanza, Il G7 Cyber Expert Group traccia la rotta verso la crittografia post-quantistica. Il documento

G7 Cyber, la roadmap per la transizione del settore finanziario verso la crittografia post-quantistica

Il G7 Cyber Expert Group (CEG) ha pubblicato una nuova roadmap per supportare la transizione ordinata e coordinata del settore finanziario verso la crittografia post-quantistica, un passaggio considerato ormai inevitabile per garantire la sicurezza di dati e transazioni nell’era dei computer quantistici.

Il documento appena diffuso nasce dalla consapevolezza che l’attuale infrastruttura crittografica su cui si fonda il sistema finanziario globale, basata in larga parte sulla crittografia a chiave pubblica, potrebbe diventare vulnerabile con l’avvento di computer quantistici sufficientemente avanzati.
Una prospettiva che non riguarda un futuro remoto, ma che impone scelte strategiche già oggi.

Il documento “Advancing a Coordinated Roadmap for the Transition to Post-Quantum Cryptography in the Financial Sector”.

L’iniziativa trae origine dalle priorità della Presidenza italiana del G7 nel 2024 e si fonda sugli esiti di un workshop del G7 su quantum computing e stabilità finanziaria, ospitato dalla Banca d’Italia nel settembre 2024. Il workshop ha costituito un momento chiave per sviluppare una comprensione comune delle opportunità e dei rischi associati alle tecnologie quantistiche e porre le basi per l’elaborazione di azioni concrete e coordinate nell’ambito dei lavori del G7 CEG.

Perché il quantum computing è un rischio (oltre che un’opportunità)

I computer quantistici promettono capacità di calcolo radicalmente superiori a quelle dei sistemi tradizionali, con potenziali benefici anche per il settore finanziario: dall’ottimizzazione dei portafogli alla gestione del rischio.
Eppure, la stessa potenza di calcolo potrebbe essere utilizzata per rompere gli algoritmi crittografici più diffusi, come quelli basati su RSA ed elliptic curve, che oggi proteggono i più conosciuti sistemi di pagamenti, comunicazioni e identità digitali.

Lo scenario più critico è noto come “harvest now, decrypt later”: intercettare oggi dati cifrati per decifrarli domani, quando la tecnologia quantistica lo renderà possibile. Per il mondo finanziario, questo significa mettere a rischio informazioni sensibili anche a lungo termine.

Che cos’è la crittografia post-quantistica

La crittografia post-quantistica comprende algoritmi progettati per resistere sia agli attacchi dei computer classici sia a quelli quantistici. Non si tratta di crittografia “quantistica” in senso stretto, ma di soluzioni matematiche che possono essere implementate sugli attuali sistemi IT e che non risultano vulnerabili agli algoritmi quantistici noti, come quello di Shor.

Il passaggio alla crittografia post-quantistica, però, non è un semplice aggiornamento software, perchè implica una revisione profonda di sistemi, protocolli, infrastrutture, dipendenze da fornitori terzi e modelli di governance. Proprio per questo il G7 parla di transizione e non di sostituzione immediata.

La roadmap del G7 per una transizione da completare (possibilmente) entro il 20235

La roadmap elaborata dal G7 CEG non introduce nuovi obblighi regolatori, ma fornisce un quadro di riferimento condiviso per autorità, istituzioni finanziarie e fornitori tecnologici.

Sviluppata da una task force dedicata costituita dalla Presidenza canadese del G7 nel 2025 e composta da esperti delle autorità e dell’industria, la roadmap delinea un approccio strutturato alla migrazione dei sistemi crittografici e individua le principali fasi della transizione e le attività necessarie a garantire continuità operativa, interoperabilità e resilienza complessiva del sistema finanziario.

L’obiettivo è favorire un approccio armonizzato tra Paesi e operatori, lasciando comunque flessibilità per adattare i piani alle specificità di ciascuna organizzazione.

Il documento individua sei fasi principali della transizione:

  1. consapevolezza e preparazione,
  2. mappatura e inventario degli asset crittografici,
  3. valutazione del rischio e pianificazione,
  4. esecuzione della migrazione,
  5. test delle soluzioni adottate,
  6. validazione continua e monitoraggio.

Un principio chiave è l’approccio risk-based, tramite cui i sistemi più critici dovranno essere migrati prima, mentre quelli a minore impatto potranno seguire tempistiche più estese. In questo contesto, il G7 indica il 2035 come orizzonte temporale di riferimento per completare la transizione complessiva, con una priorità ai sistemi critici già all’inizio del prossimo decennio

Chi è il G7 Cyber Expert Group (CEG) e perché la roadmap è importante

Il G7 Cyber Expert Group è un gruppo di lavoro permanente fondato nel 2015 che riunisce rappresentanti delle autorità finanziarie e delle banche centrali dei Paesi G7, oltre all’Unione europea. Il CEG ha il compito di coordinare le politiche di cybersecurity, favorire la cooperazione internazionale e rafforzare la resilienza del sistema finanziario globale.

Presieduto congiuntamente dal Dipartimento del Tesoro degli Stati Uniti e dalla Bank of England, il gruppo svolge anche un ruolo centrale nella condivisione delle informazioni e nella gestione degli incidenti cyber, diventando un punto di riferimento su temi emergenti come il rischio quantistico.

La roadmap del G7 rende chiaro un messaggio: la transizione verso la crittografia post-quantistica è una sfida tecnologica, ma soprattutto strategica e organizzativa. Non riguarda solo la sicurezza informatica, ma la fiducia nel sistema finanziario digitale nel suo complesso.

Per banche, assicurazioni, fintech e fornitori di servizi critici, iniziare ora a pianificare questa evoluzione significa proteggere il valore dei dati nel lungo periodo, evitare migrazioni affrettate in futuro e accompagnare in modo sicuro la prossima fase della trasformazione digitale.
In un mondo sempre più interconnesso e a rischio cyber attacchi di varia natura, la resilienza crittografica diventa così uno dei pilastri della stabilità economica globale.

Leggi le altre notizie sull’home page di Key4biz

https://www.key4biz.it/finanza-il-g7-cyber-expert-group-traccia-la-rotta-verso-la-crittografia-post-quantistica-il-documento/561651/


Belgio, per il responsabile della Cybersecurity “L’Europa ha perso Internet perché dipende dagli Usa”

La superiorità degli Usa in materia di infrastrutture digitali è chiara, ma per l’Europa può diventare un rischio. Lo ha detto in una intervista al Financial Times il direttore del Cybersecurity Center del Belgio (CCB) Miguel De Bruycker, secondo cui al momento è “impossibile” conservare in modo completo i dati in Europa perché le imprese americane dominano il settore. “Abbiamo perso tutto il cloud. Per essere onesti, abbiamo perso tutto Internet”.  “Se vuoi le tue informazioni conservate al 100% nella Ue, puoi soltanto sognartelo. E’ un obiettivo irrealistico”, ha aggiunto.

Dal Belgio il monito di De Bruycker riecheggia il nostro allarme sull’Indipendenza Digitale

Un reality check quello di De Bruycker che riecheggia quanto già emerso dalla nostra conferenza di maggio scorso sull’”Indipendenza digitale”, organizzata da Key4biz e Red-Open, che ha messo in evidenza il pesante gap tecnologico dell’Europa nei confronti delle tecnologie made in Usa.    

Cloud e AI cruciali per la cybersecurity

Il responsabile della cybersecurity belga aggiunge che la sicurezza informatica europea dipende principalmente dalla cooperazione di aziende americane. Una dipendenza che ha aumentato il ritardo degli europei nello sviluppo di nuove tecnologie, come il cloud computing e l’intelligenza artificiale, cruciali per la sicurezza informatica. L’Europa deve quindi sviluppare le proprie capacità, ma teme che la recente legislazione europea possa ostacolare queste iniziative. Miguel De Bruycker invita quindi i governi europei a sostenere le iniziative private in questi settori.

Allarme dal Belgio: “Non pensiamo agli hyperscaler Usa, ma a noi stessi”

“Invece di concentrarci su come fermare gli hyperscaler statunitensi, forse dovremmo dedicare le nostre energie a costruire qualcosa per noi stessi“, sostiene il belga.

Gli hacker russi ci sguazzano

Il Belgio, sede delle istituzioni dell’Unione Europea, è stato vittima di una guerra ibrida orchestrata dalla Russia per destabilizzare i paesi della regione. Raid con droni, attacchi informatici o sabotaggi sono alcuni degli episodi che diversi paesi europei hanno dovuto affrontare dall’inizio dell’invasione dell’Ucraina nel 2022. Nel caso di Bruxelles, la città ha subito cinque ondate di attacchi informatici durati diversi giorni, in cui dispositivi volti a sabotare infrastrutture critiche sono riusciti a saturare i siti web di aziende e agenzie governative, disattivandoli temporaneamente.

Cyberattacchi russi per screditare le istituzioni europee. Belgio e Bruxelles nel mirino

Per De Bruycker, è evidente che anche gli attacchi informatici di origine russa mirano a interrompere i portali web delle istituzioni europee per screditarle.

Secondo De Bruycker, gli attacchi hanno in genere preso di mira fino a 20 organizzazioni diverse al giorno e, sebbene non sia chiaro se gli eventi fossero direttamente collegati al Cremlino, si sono generalmente verificati in risposta a dichiarazioni anti-russe di politici europei. Per il presidente del CCB, gli attacchi non sono particolarmente dannosi e sottolinea che il loro obiettivo principale è quello di interrompere e interrompere il funzionamento dei siti web senza la necessità di estrarre informazioni.

The post Belgio, per il responsabile della Cybersecurity “L’Europa ha perso Internet perché dipende dagli Usa” appeared first on Key4biz.

https://www.key4biz.it/belgio-per-il-responsabile-della-cybersecurity-leuropa-ha-perso-internet-perche-dipende-dagli-usa/560863/


Spotify svaligiata, rubati 256 milioni di brani e 86 milioni di file audio

Saccheggiata Spotify, disponibile per tutti online un volume di dati enorme paria 300 terabyte

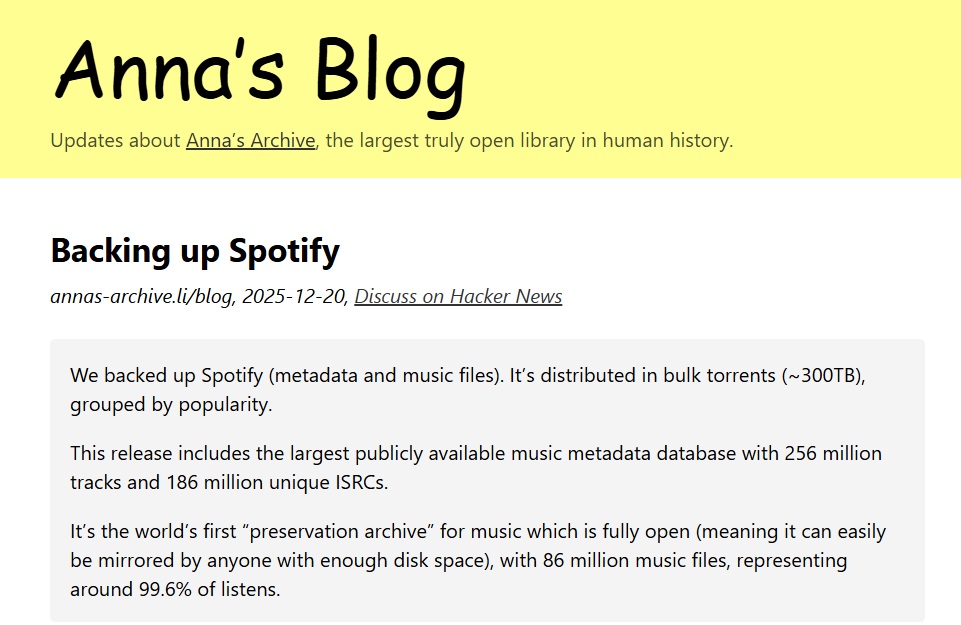
Un attacco senza precedenti colpisce Spotify, la principale piattaforma di streaming musicale al mondo. Un gruppo di hacker (o di criminali, a seconda dei punti di vista) ha dichiarato di aver effettuato il backup dell’intero catalogo musicale del servizio, pubblicando online metadati relativi a 256 milioni di brani e 86 milioni di file audio, per un volume complessivo di dati stimato in poco meno di 300 terabyte.

La notizia è stata resa pubblica da Anna’s Archive, un motore di ricerca open source noto per indicizzare le cosiddette “shadow libraries”, finora focalizzate soprattutto su libri e testi accademici.
Secondo il gruppo non si tratta di attacco o saccheggio, ma di “liberazione” di file.

In un post sul proprio blog, il progetto afferma che la raccolta rappresenterebbe “il primo archivio di conservazione musicale completamente aperto al mondo”, facilmente replicabile da chiunque disponga di competenze tecniche e sufficiente spazio di archiviazione.

Qui vale la pena spiegare subito che non è solo un problema di capacità tecniche e di archiviazione, ma di violazione del diritto d’autore. In linea di massima, lo scraping di dati, noto anche come web scraping, è una tecnica usata spesso per estrarre informazioni automatizzate da siti web utilizzando script, o software specializzati. Non è un’attività intrinsecamente illecita, ma può diventare tale, se viola normative come il GDPR, termini di servizio dei siti o diritti d’autore.

Cosa è stato sottratto

Secondo quanto riportato dalla piattaforma open source – che di solito non si occupa di questo tipo di file (generalmente libri, documenti e articoli, file di testo quindi), ma l’occasione “fa l’uomo ladro” come si dice – i dati pubblicati comprendono:

  • metadati di 256 milioni di tracce musicali
  • 86 milioni di file audio
  • contenuti caricati sulla piattaforma tra il 2007 e il 2025
  • materiale che rappresenterebbe circa il 99,6% degli ascolti complessivi su Spotify

Il gruppo che ha messo in atto il colpo sostiene che l’archivio consenta, almeno teoricamente, di ricostruire una copia funzionale dell’intero catalogo Spotify, pur riconoscendo che qualunque tentativo di utilizzo pubblico sarebbe immediatamente bloccato da azioni legali da parte delle major discografiche e degli altri titolari dei diritti.

Spotify fa partire un’indagine, sembrano salvi i dati personali degli utenti

Spotify ha confermato ufficialmente l’accaduto. In una dichiarazione a Euronews Next, un portavoce della società ha ammesso che la libreria della piattaforma è stata oggetto di “scraping non autorizzato da parte di terzi”.

Secondo Spotify, gli attaccanti avrebbero utilizzato “tattiche illecite per aggirare i sistemi di DRM (Digital Rights Management)”, sfruttato account fraudolenti, successivamente identificati e disabilitati, forzato l’accesso senza autorizzazione a parte dei file audio e ai metadati del catalogo.

La società ha precisato che non vi è alcuna indicazione di compromissione di dati personali non pubblici degli utenti. L’unica informazione legata agli utenti coinvolta nell’incidente riguarderebbe playlist pubbliche create dagli stessi utenti.

Spotify non ha però specificato la quantità esatta di dati sottratti, limitandosi a confermare l’accesso non autorizzato.

Una violazione massiva del diritto d’autore, dati buoni per addestrare gratuitamente modelli di AI

Dal punto di vista del diritto d’autore, l’incidente rappresenta un evento di portata eccezionale. Anche se i file non fossero immediatamente utilizzabili a fini commerciali, la disponibilità su reti peer-to-peer di un archivio di tali dimensioni costituisce una violazione massiva dei diritti di riproduzione, distribuzione e comunicazione al pubblico.

Il rischio più rilevante riguarda l’uso dei dati per l’addestramento di modelli di intelligenza artificiale.

Yoav Zimmerman, CEO di Third Chair, società specializzata nel monitoraggio degli usi non autorizzati di proprietà intellettuale, ha commentato l’acccaduto: “È appena diventato drammaticamente più facile per le aziende di AI addestrare modelli sulla musica moderna su larga scala. L’unica cosa che può fermare tutto ciò è la legge sul copyright e la deterrenza dell’enforcement”.

In altri termini, la sottrazione di quasi 300 terabyte di contenuti musicali abbassa drasticamente la barriera tecnologica per l’uso illecito della musica protetta, spostando il conflitto interamente sul piano legale.

Spotify rafforza la sicurezza, ma il danno è fatto

Spotify ha ribadito il proprio impegno nella tutela degli artisti e dei detentori dei diritti: “Fin dal primo giorno ci siamo schierati al fianco della comunità artistica contro la pirateria“.

La società ha dichiarato di stare rafforzando le misure di sicurezza, di collaborare con i partner dell’industria musicale e di monitorare attivamente comportamenti sospetti per prevenire nuovi attacchi.

L’episodio segna un punto di svolta per l’intero settore dello streaming. Se da un lato conferma la centralità di Spotify come archivio di fatto della musica contemporanea, dall’altro mette in luce la vulnerabilità strutturale delle piattaforme digitali di fronte a operazioni di scraping su larga scala.

In gioco non c’è solo la sicurezza tecnologica, ma l’equilibrio economico e giuridico dell’intera filiera musicale globale.

Leggi le altre notizie sull’home page di Key4biz

https://www.key4biz.it/spotify-svaligiata-rubati-256-milioni-di-brani-e-86-milioni-di-file-audio/560408/


Intelligenza Artificiale Spiegabile (XAI): quando la trasparenza diventa requisito di sicurezza informatica

L’Intelligenza Artificiale Spiegabile (XAI) rappresenta oggi una necessità strategica per la cybersecurity. La crescente adozione di sistemi AI in ambiti critici sta spostando il dibattito dalla pura efficienza prestazionale alla necessità di comprendere come e perché un algoritmo arrivi a una determinata decisione. Nel contesto della sicurezza informatica, questa evoluzione non rappresenta un vezzo accademico ma una necessità operativa e, sempre più spesso, un obbligo normativo.

Quando un sistema di rilevamento delle intrusioni basato su machine learning identifica un’anomalia classificandola come minaccia critica, gli analisti SOC non possono accontentarsi di un responso binario. Devono comprendere quali caratteristiche del traffico di rete hanno innescato l’allerta, quali pattern sono stati riconosciuti, quale livello di confidenza caratterizza quella specifica inferenza. Questa esigenza diventa ancora più stringente quando l’output dell’algoritmo guida decisioni che possono bloccare interi segmenti di rete, isolare sistemi produttivi o innescare procedure di incident response che coinvolgono risorse umane ed economiche significative.

Intelligenza Artificiale Spiegabile (XAI): colmare il divario tra complessità algoritmica e comprensibilità umana

L’Explainable AI nasce per colmare il divario tra la complessità crescente dei modelli di apprendimento automatico e la necessità umana – e spesso legale – di comprenderne il funzionamento. Non si tratta semplicemente di “aprire la scatola nera”, metafora ormai abusata ma ancora efficace: l’obiettivo è costruire sistemi che siano intrinsecamente interpretabili o dotarli di meccanismi che permettano di ricostruire a posteriori il ragionamento algoritmico.

Come evidenziato nell’articolo “Nuovi modelli di IA: Explainable AI e Hybrid AI“, l’opacità dell’AI rappresenta un ostacolo fondamentale: “In ambito scientifico, l’opacità dell’AI si riferisce all’incapacità di comprendere il processo decisionale interno di un sistema di intelligenza artificiale, specialmente quelli basati su algoritmi complessi come il deep learning.”

Nel panorama della digital forensics, questa capacità assume contorni ancora più definiti. Un’evidenza digitale prodotta da un sistema AI può essere contestata in sede giudiziaria se non è possibile dimostrare la tracciabilità del processo decisionale. Il perito deve poter spiegare non solo cosa ha rilevato l’algoritmo, ma attraverso quale logica inferenziale è giunto a quella conclusione. La catena di custodia dell’evidenza digitale si estende così al modello stesso e ai suoi parametri, richiedendo nuove competenze e protocolli di documentazione.

Il quadro normativo europeo: AI Act e NIS2

AI Act e requisiti di trasparenza

Dal punto di vista normativo, il GDPR aveva già introdotto il concetto di diritto alla spiegazione nelle decisioni automatizzate che producono effetti giuridici o incidono significativamente sull’interessato (articolo 22, artt. 13, 14, 15 e considerando 71). L’AI Act europeo (Regolamento UE 2024/1689), entrato in vigore il 1° agosto 2024 e pienamente applicabile dal 2 agosto 2026, rafforza ulteriormente questi requisiti classificando i sistemi AI in base al rischio e imponendo obblighi di trasparenza crescenti.

Per i sistemi ad alto rischio utilizzati in ambito di sicurezza delle infrastrutture critiche, identificazione biometrica o gestione di dati sensibili, la spiegabilità non è più opzionale: è un requisito di conformità. L’articolo 19 dell’AI Act (Automatically Generated Logs) impone agli operatori di sistemi ad alto rischio di mantenere log automatici che registrino le operazioni del sistema durante il suo ciclo di vita, permettendo la tracciabilità delle decisioni prese dal sistema AI, includendo input, output e timestamp.

Direttiva NIS2 e gestione del rischio cyber

La Direttiva NIS2, recepita in Italia con il Decreto Legislativo 138/2024 (entrato in vigore il 16 ottobre 2024), introduce un ulteriore livello di complessità. Gli enti essenziali e importanti sono chiamati a implementare misure tecniche e organizzative adeguate per gestire i rischi legati alla sicurezza di reti e sistemi informativi. Quando queste misure incorporano componenti di AI – dalla detection automatizzata delle minacce alla gestione dinamica degli accessi – la capacità di spiegare il comportamento di questi sistemi diventa parte integrante della dimostrazione di conformità verso le autorità competenti, in Italia rappresentate dall’ACN.

Per i security operation center che integrano strumenti AI, questo significa ripensare l’intera architettura di logging e audit trail, garantendo che ogni decisione automatizzata – dal blocco di un IP alla quarantena di un file sospetto – sia documentata in modo da permettere una ricostruzione ex-post del ragionamento algoritmico.

Framework tecnici e standard emergenti per l’XAI

NIST AI Risk Management Framework

Sul piano operativo, l’industria sta convergendo verso framework standardizzati per l’implementazione dell’XAI. Il NIST AI Risk Management Framework, pubblicato il 26 gennaio 2023, dedica ampio spazio alla trasparenza e alla spiegabilità come elementi fondamentali della gestione del rischio AI. Il framework propone un approccio strutturato che include la documentazione del sistema, la validazione delle performance, il monitoraggio continuo e la gestione degli incidenti legati all’AI.

ISO/IEC 42001: standard per l’AI Management System

A livello europeo, lo standard ISO/IEC 42001 sui sistemi di gestione dell’intelligenza artificiale, pubblicato nel dicembre 2023, fornisce requisiti e linee guida per stabilire, implementare, mantenere e migliorare continuamente un AI Management System. Questo standard, che sarà probabilmente referenziato nei processi di certificazione previsti dall’AI Act, include requisiti specifici sulla tracciabilità e la spiegabilità dei sistemi AI, particolarmente per applicazioni in contesti critici.

MITRE ATT&CK e ATLAS

Nel contesto della cybersecurity, il framework MITRE ATT&CK ha iniziato a integrare considerazioni sui sistemi di AI utilizzati sia dagli attaccanti sia dai difensori. La matrice ATLAS (Adversarial Threat Landscape for Artificial-Intelligence Systems) documenta tattiche e tecniche specifiche per compromettere sistemi di machine learning, includendo attacchi che sfruttano proprio la mancanza di trasparenza per iniettare bias, avvelenare i dataset di training o eludere i meccanismi di detection.

Come spiegato nell’articolo “Il problema del BIAS nei dataset e della XAI“, “Una delle contromisure ed anche un sistema per capire meglio l’output di un algoritmo di IA è quello della XAI (eXplainable Artificial Intelligence), ossia l’intelligenza artificiale spiegabile. Gli algoritmi sono sostanzialmente delle black box, delle scatole nere nelle quali entrano i dati di input, che vengono elaborati per generare degli output, il motivo per cui sia stata generata una risposta rispetto ad un’altra non è facilmente comprensibile.”

La supply chain dell’AI e il rischio di opacità stratificata

Una dimensione spesso trascurata riguarda la supply chain dell’intelligenza artificiale. Molte organizzazioni non sviluppano internamente i propri modelli di AI ma utilizzano API di terze parti, modelli pre-addestrati o soluzioni commerciali proprietarie. Questa dipendenza introduce quello che potremmo definire un “rischio di opacità stratificata“: anche quando il fornitore offre interfacce di spiegabilità, queste possono operare a un livello di astrazione tale da mascherare problematiche più profonde nel modello sottostante.

Il caso dei modelli foundation illustra perfettamente questo dilemma. Quando un’organizzazione utilizza un LLM commerciale per automatizzare l’analisi di log di sicurezza o la correlazione di threat intelligence, si affida a un sistema la cui architettura interna, i dati di training e i processi di fine-tuning sono spesso protetti da segreto industriale. Come possono i CISO garantire che questi sistemi non abbiano appreso bias dai dati di training? Come verificare che non siano suscettibili a prompt injection o data poisoning?

La risposta richiede un approccio contrattuale e tecnico integrato. I contratti di procurement devono includere clausole specifiche sui livelli di trasparenza garantiti, sulle modalità di audit algoritmico, sulla possibilità di testare il modello con dataset controllati. Sul piano tecnico, emergono metodologie di testing adversarial che permettono di sondare i confini comportamentali del modello, identificando potenziali vulnerabilità senza necessariamente accedere ai suoi parametri interni.

XAI e threat intelligence: il caso del ransomware-as-a-service

L’applicazione dell’XAI nella threat intelligence merita un approfondimento specifico. Consideriamo il fenomeno del ransomware-as-a-service, dove gruppi criminali operano con modelli di business strutturati e tattiche in continua evoluzione. I sistemi di AI vengono utilizzati per correlare indicatori di compromissione attraverso fonti eterogenee – dark web, telemetria di rete, rapporti di incident response – identificando pattern emergenti e prevedendo possibili vettori di attacco.

Un sistema XAI efficace in questo contesto non si limita a segnalare che un particolare hash di file è associato a una campagna ransomware. Dovrebbe spiegare perché quella associazione è significativa: quali caratteristiche comportamentali del malware sono state osservate, quale similarità strutturale esiste con campioni noti, quale correlazione temporale emerge con attività di reconnaissance su altri target. Questa ricchezza informativa trasforma il sistema AI da strumento di allerta a moltiplicatore di intelligence, permettendo agli analisti di comprendere non solo la minaccia immediata ma il contesto strategico in cui si inserisce.

Alcuni fornitori di security intelligence stanno sviluppando dashboard di “explainability” che visualizzano graficamente il processo decisionale dell’AI. Grafici di feature importance mostrano quali attributi del malware hanno pesato maggiormente nella classificazione. Mappe di attivazione delle reti neurali evidenziano quali porzioni di codice hanno attirato l’attenzione del modello. Linee temporali correlano l’evento specifico con pattern storici osservati. Questi strumenti trasformano il responso algoritmico in un’esperienza investigativa, dove la macchina non sostituisce l’analista ma ne amplifica le capacità cognitive.

Come descritto nell’articolo “AI offensiva e difensiva: strategie di cybersecurity nel 2025“, “L’AI spiegabile (XAI) offre una soluzione promettente fornendo interpretabilità e trasparenza, permettendo ai professionisti della sicurezza di comprendere meglio, fidarsi e ottimizzare i modelli IDS.”

Il paradosso della spiegabilità nell’era del quantum computing

Un tema emergente, ancora poco esplorato ma destinato ad acquisire rilevanza, riguarda l’intersezione tra XAI e quantum computing. Man mano che algoritmi quantistici vengono integrati in sistemi di AI – sia per accelerare il training di modelli complessi sia per sviluppare nuove architetture di quantum machine learning – la sfida della spiegabilità assume dimensioni ulteriori.

I computer quantistici operano secondo principi che sfuggono all’intuizione classica: sovrapposizione, entanglement, interferenza. Quando questi fenomeni vengono sfruttati per costruire modelli di machine learning, il concetto stesso di “spiegazione” diventa problematico. Come si può spiegare una decisione che emerge da uno stato quantistico collassato al momento della misurazione? Come documentare un processo inferenziale che sfrutta parallelismo quantistico attraverso spazi di Hilbert ad alta dimensionalità?

Paradossalmente, proprio mentre la comunità della cybersecurity si prepara alla transizione post-quantum per proteggere le comunicazioni dalla crittoanalisi quantistica, potremmo trovarci ad affrontare sistemi di AI quantistica intrinsecamente meno spiegabili dei loro predecessori classici. Questa prospettiva rende ancora più urgente lo sviluppo di framework concettuali e metodologie di XAI che possano adattarsi a paradigmi computazionali radicalmente diversi.

Certificazione e attestazione della spiegabilità

L’AI Act introduce il concetto di “organismi notificati” che avranno il compito di valutare la conformità dei sistemi AI ad alto rischio prima della loro immissione sul mercato. Questo meccanismo, simile a quanto già avviene per dispositivi medici o macchinari industriali, solleva la questione di come certificare la spiegabilità di un sistema AI.

A differenza di requisiti funzionali tradizionali, verificabili attraverso test deterministici, la spiegabilità ha una componente soggettiva: una spiegazione può essere tecnicamente accurata ma incomprensibile per l’utente finale, o viceversa intuitiva ma scientificamente imprecisa. Gli organismi di certificazione dovranno sviluppare metodologie di valutazione che bilancino accuratezza tecnica e comprensibilità contestuale, tenendo conto del profilo degli stakeholder che utilizzeranno le spiegazioni.

Alcune proposte in discussione prevedono l’adozione di “benchmark di spiegabilità” standardizzati, dove il sistema AI viene testato su scenari di riferimento e le sue spiegazioni valutate secondo metriche oggettive: completezza, consistenza, contrastività (capacità di spiegare perché è stata presa una decisione invece di un’altra), continuità (stabilità delle spiegazioni rispetto a variazioni minime dell’input). Tuttavia, il dibattito rimane aperto su quali di queste proprietà dovrebbero essere prescrittive e quali semplicemente raccomandate.

Sovranità digitale e modelli europei di XAI

La dimensione geopolitica dell’AI non può essere ignorata quando si discute di spiegabilità. L’Europa, attraverso l’AI Act e iniziative come il progetto Gaia-X, sta tentando di costruire un ecosistema AI basato su valori di trasparenza, accountability e rispetto dei diritti fondamentali che si differenzia dall’approccio più liberista degli Stati Uniti e da quello più dirigista della Cina.

In questo contesto, l’XAI diventa elemento di differenziazione competitiva. Modelli europei che incorporano trasparenza by-design potrebbero trovare mercato presso organizzazioni e governi che privilegiano compliance normativa e riduzione del rischio reputazionale rispetto alla pura performance predittiva. Iniziative come i progetti Horizon Europe dedicati all’AI trustworthy stanno finanziando ricerca su architetture di XAI specificatamente progettate per soddisfare i requisiti normativi europei.

Per le organizzazioni italiane, questa dinamica crea opportunità ma anche responsabilità. Investire in competenze e soluzioni XAI europee significa contribuire alla costruzione di quella sovranità tecnologica che l’ACN ha identificato come priorità strategica. Significa anche prepararsi a un mercato dove la certificazione di conformità ai requisiti di spiegabilità potrebbe diventare prerequisito per accedere a gare pubbliche o mercati regolamentati.

Verso un’etica operativa dell’AI in sicurezza

Oltre gli aspetti normativi e tecnici, l’XAI solleva questioni etiche che i professionisti della sicurezza non possono eludere. L’utilizzo di AI per decisioni che impattano la privacy, la libertà di movimento in ambienti fisici protetti, l’accesso a risorse critiche richiede non solo conformità legale ma anche legittimazione etica.

Un sistema di videosorveglianza intelligente che utilizza analisi comportamentale per identificare minacce potenziali opera in una zona grigia dove efficienza securitaria e diritti individuali si confrontano. La capacità di spiegare perché un comportamento è stato classificato come anomalo – e quindi potenzialmente minaccioso – non risolve il dilemma etico ma lo rende almeno trasparente, permettendo un dibattito informato e meccanismi di contestazione da parte degli individui interessati.

Alcune organizzazioni stanno adottando “AI ethics boards” interni che valutano l’introduzione di nuovi sistemi AI non solo sotto il profilo della compliance ma anche della sostenibilità etica. In questi comitati, la presenza di esperti di sicurezza è fondamentale per bilanciare l’imperativo della protezione con il rispetto dei diritti, utilizzando l’XAI come strumento di mediazione: sistemi più trasparenti sono anche sistemi più facilmente sottoponibili a scrutinio etico.

Implicazioni pratiche per CISO e team di sicurezza

Per tradurre questi principi in azioni concrete, i responsabili della sicurezza devono integrare l’XAI nei processi decisionali quotidiani. Questo significa innanzitutto sviluppare o acquisire competenze ibride: data scientist che comprendano le minacce cyber, security analyst che sappiano interrogare modelli di machine learning, legal counsel che possano interpretare i requisiti di spiegabilità nel contesto specifico dell’organizzazione.

Sul piano procedurale, è opportuno istituire protocolli di “AI incident response” che definiscano come gestire situazioni in cui un sistema AI produce decisioni errate o inspiegabili. Chi ha l’autorità di disabilitare un sistema automatizzato in caso di comportamento anomalo? Come si documenta un falso positivo prodotto da AI per evitare recidive? Quali meccanismi di escalation si attivano quando le spiegazioni fornite dal sistema risultano insufficienti o contraddittorie?

La formazione continua diventa imperativa. I team SOC devono familiarizzare con i concetti fondamentali di machine learning – non per diventare data scientist, ma per sviluppare quella literacy che permette di distinguere una correlazione spuria da un pattern significativo, di riconoscere quando un modello sta operando fuori dal suo dominio di competenza, di valutare criticamente le confidence score associate alle predizioni.

Scenari futuri e direzioni di ricerca nell’XAI

Guardando avanti, alcune direzioni di sviluppo appaiono particolarmente promettenti. La ricerca su modelli “intrinsecamente interpretabili” – architetture di neural network progettate per essere trasparenti per costruzione anziché richiedere tecniche post-hoc di spiegazione – potrebbe ridurre il trade-off tra performance e spiegabilità. Approcci come le Neural Additive Models o le Concept Bottleneck Networks mostrano che è possibile costruire sistemi potenti mantenendo un livello di interpretabilità umana.

L’integrazione tra XAI e sistemi di knowledge graph rappresenta un’altra frontiera interessante. Mappando le decisioni algoritmiche su grafi di conoscenza esplicita – ontologie di minacce, tassonomie di vulnerabilità, modelli di comportamento normale – si può costruire un ponte tra il ragionamento sub-simbolico delle reti neurali e la logica esplicita comprensibile agli umani.

Infine, l’utilizzo dell’AI per spiegare l’AI – modelli linguistici che traducono output tecnici in linguaggio naturale, sistemi che generano contro-fattuali per illustrare decisioni (“il sistema ha bloccato questa transazione perché, se il parametro X fosse stato diverso, sarebbe stato classificato come legittimo”) – apre possibilità di rendere la spiegabilità accessibile anche a stakeholder non tecnici.

Conclusione: trasparenza come investimento strategico

In definitiva, l’Intelligenza Artificiale Spiegabile non configura una singola tecnologia ma un paradigma progettuale che deve permeare l’intero ciclo di vita dei sistemi AI utilizzati in contesti di sicurezza. Dalla raccolta e selezione dei dati di training, alla scelta dell’architettura del modello, fino al deployment e al monitoraggio continuo, ogni fase deve incorporare considerazioni di interpretabilità.

Per i CISO e i responsabili della sicurezza, questo significa adottare framework di governance che includano requisiti espliciti di spiegabilità nei processi di procurement e sviluppo di soluzioni AI, prevedere meccanismi di audit algoritmico periodico e investire nella formazione dei team affinché sviluppino quella literacy necessaria per interrogare criticamente gli output dei sistemi intelligenti.

La posta in gioco supera la mera conformità normativa: riguarda la costruzione di una fiducia giustificata nei sistemi automatizzati che sempre più frequentemente prendono decisioni che impattano la sicurezza delle organizzazioni e, in ultima analisi, la protezione dei dati personali e dei diritti fondamentali degli individui. Un sistema opaco può funzionare perfettamente fino al momento in cui fallisce, e senza spiegabilità quel fallimento rimane inspiegabile, irreplicabile, e quindi impossibile da prevenire in futuro.

La trasparenza algoritmica diventa così non un vincolo allo sviluppo tecnologico, ma una condizione abilitante per un’innovazione sostenibile e responsabile. Nel contesto italiano ed europeo, dove la cybersecurity si intreccia sempre più strettamente con considerazioni normative, etiche e geopolitiche, l’investimento in XAI rappresenta non un costo ma un vantaggio competitivo: la capacità di dimostrare non solo che i propri sistemi funzionano, ma anche di spiegare come e perché lo fanno.

Condividi sui Social Network:

https://www.ictsecuritymagazine.com/articoli/intelligenza-artificiale-spiegabile-xai/