Google discovered a new scam—and also fell victim to it
Google said that its Salesforce instance was among those that were compromised. The breach occurred in June, but Google only disclosed it on Tuesday, presumably because the company only learned of it recently.
“Analysis revealed that data was retrieved by the threat actor during a small window of time before the access was cut off,” the company said.
Data retrieved by the attackers was limited to business information such as business names and contact details, which Google said was “largely public” already.
Google initially attributed the attacks to a group traced as UNC6040. The company went on to say that a second group, UNC6042, has engaged in extortion activities, “sometimes several months after” the UNC6040 intrusions. This group brands itself under the name ShinyHunters.
“In addition, we believe threat actors using the ‘ShinyHunters’ brand may be preparing to escalate their extortion tactics by launching a data leak site (DLS),” Google said. “These new tactics are likely intended to increase pressure on victims, including those associated with the recent UNC6040 Salesforce-related data breaches.”
With so many companies falling to this scam—including Google, which only disclosed the breach two months after it happened—the chances are good that there are many more we don’t know about. All Salesforce customers should carefully audit their instances to see what external sources have access to it. They should also implement multifactor authentication and train staff how to detect scams before they succeed.
Una nuova ondata di attacchi mirati ai sistemi CRM basati su Salesforce sta colpendo duramente aziende di ogni settore. L’ultima vittima eccellente è Google che ha confermato il furto di dati da una delle proprie istanze Salesforce a opera di un gruppo identificato come UNC6040, ma riconducibile agli ormai noti ShinyHunters.
Secondo quanto dichiarato da Google in un aggiornamento ufficiale pubblicato ieri sera, il breach sarebbe avvenuto nel mese di giugno. Gli attaccanti hanno compromesso una istanza corporate di Salesforce usata per gestire i contatti delle piccole e medie imprese clienti. L’accesso illegittimo grazie ad attacchi di vishing (voice phishing) andati a segno contro dipendenti dell’azienda, una tecnica sempre più utilizzata per eludere i controlli tradizionali.
“L’istanza era utilizzata per archiviare informazioni di contatto e note associate a piccole e medie imprese” – si legge nel comunicato di Google. “L’analisi ha rivelato che l’attore ha prelevato i dati in un breve intervallo di tempo, prima che l’accesso venisse interrotto.”
Secondo Google, le informazioni esfiltrate sono limitate a dati aziendali di base già in parte pubblici, come nomi delle aziende e recapiti. Tuttavia, resta il fatto che l’intrusione è avvenuta con successo, confermando l’efficacia della campagna di attacco attualmente in corso.
Estorsione o data leak: il doppio gioco di ShinyHunters
L’ondata di attacchi è stata osservata e seguita da BleepingComputer, che ha collegato il gruppo UNC6040 – o UNC6240, a seconda delle fonti – ai famigerati ShinyHunters, responsabili in passato di attacchi a PowerSchool, Snowflake, Oracle Cloud, AT&T, Wattpad e molti altri.
La strategia è ormai consolidata: dopo aver ottenuto l’accesso alle istanze Salesforce tramite tecniche di ingegneria sociale, gli attaccanti procedono a esfiltrare i dati dei clienti, per poi inviare email di estorsione diretta. I messaggi chiedono il pagamento di un riscatto per evitare la pubblicazione dei dati su forum di hacking.
ShinyHunters ha riferito, sempre a BleepingComputer, di aver violato diverse altre istanze Salesforce e che gli attacchi sono ancora in corso. Il gruppo avrebbe persino compromesso una “azienda da trilioni di dollari”, lasciando intendere che possa trattarsi proprio di Google, ma senza conferme ufficiali.
In alcuni casi, come quello di una società rimasta anonima, le vittime hanno pagato riscatti fino a 4 Bitcoin, equivalenti a circa 400.000 dollari, pur di evitare la pubblicazione dei dati.
Vittime illustri e attacchi ancora attivi
Oltre a Google, le aziende colpite finora includono Adidas, Qantas, Allianz Life, Cisco e alcune sussidiarie di LVMH. In molti casi, le richieste di riscatto sono ancora in corso, mentre per le aziende che si rifiutano di pagare, il destino sarà con ogni probabilità quello della pubblicazione dei dati trafugati su forum underground.
Murena’s Pixel Tablet is helping to wean me off Google
There were times when a side-by-side comparison found Google’s results to be more aligned with what I had in mind. However, I quickly appreciated Qwant’s lack of AI-generated responses, Google Maps listings, rows of advertisements, and other distractions ahead of actual results. For example, the top results for a search for “Brooklyn rooftop bars” with the Qwant-based engine were roundups from different blogs and publications. Google’s top results were a map, a few bars’ individual websites, posts from Reddit and Instagram, and only two curated lists (one from a news publication and another from Yelp).
The tablet is weaning me off of Google Search, but I’ll likely download Google Maps soon. Murena’s tablet comes with Magic Earth, the only non-open source app preloaded onto the device. However, without Street Views, speedier response, more detailed public transit information (like the names of stops you have to pass), and easier ways to find points of interest, like restaurants, Magic Earth is not sufficient for replacing Google’s alternative—despite Maps’ low privacy rating.
More privacy, please
Despite the inconveniences of a truly Google-free tablet, using Murena’s Pixel Tablet encouraged me to push for more online privacy. It’s proof that privacy-centric tablets and other gadgets are not only possible, but also worthwhile. With Big Tech often failing to protect users, gadgets that don’t spy on you deserve a bigger spotlight.
One of /e/OS’s best features is its privacy reports, which provide an overview of the apps tracking you.
An example of a privacy report.
Credit: Scharon Harding/Murena
An example of a privacy report. Credit: Scharon Harding/Murena
The tablet’s privacy menu also has a toggle for hiding your IP address, although Murena notes that you may want to think twice before sending emails, as “your address may end [up getting a] permanent ban from your provider.” Both features give users more control without introducing complexity and place a much greater emphasis on understanding online privacy than what you find among other tablets.
Murena’s Pixel Tablet, while not perfect, proves that a privacy-forward tablet doesn’t have to come with trade-offs. Devices like this make privacy a competitive advantage that other companies should emulate.
At $250 million, top AI salaries dwarf those of the Manhattan Project and the Space Race
Even Space Race salaries were far cheaper
The Apollo program offers another striking comparison. Neil Armstrong, the first human to walk on the moon, earned about $27,000 annually—roughly $244,639 in today’s money. His crewmates Buzz Aldrin and Michael Collins made even less, earning the equivalent of $168,737 and $155,373, respectively, in today’s dollars. Current NASA astronauts earn between $104,898 and $161,141 per year. Meta’s AI researcher will make more in three days than Armstrong made in a year for taking “one giant leap for mankind.”
The engineers who designed the rockets and mission control systems for the Apollo program also earned modest salaries by modern standards. A 1970 NASA technical report provides a window into these earnings by analyzing salary data for the entire engineering profession. The report, which used data from the Engineering Manpower Commission, noted that these industry-wide salary curves corresponded directly to the government’s General Schedule (GS) pay scale on which NASA’s own employees were paid.
According to a chart in the 1970 report, a newly graduated engineer in 1966 started with an annual salary of between $8,500 and $10,000 (about $84,622 to $99,555 today). A typical engineer with a decade of experience earned around $17,000 annually ($169,244 today). Even the most elite, top-performing engineers with 20 years of experience peaked at a salary of around $278,000 per year in today’s dollars—a sum that a top AI researcher like Deitke can now earn in just a few days.
This isn’t the first time technical talent has commanded premium prices. In 2012, after three University of Toronto academics published AI research, they auctioned themselves to Google for $44 million (about $62.6 million in today’s dollars). By 2014, a Microsoft executive was comparing AI researcher salaries to NFL quarterback contracts. But today’s numbers dwarf even those precedents.
Several factors explain this unprecedented compensation explosion. We’re in a new realm of industrial wealth concentration unseen since the Gilded Age of the late 19th century. Unlike previous scientific endeavors, today’s AI race features multiple companies with trillion-dollar valuations competing for an extremely limited talent pool. Only a small number of researchers have the specific expertise needed to work on the most capable AI systems, particularly in areas like multimodal AI, which Deitke specializes in. And AI hype is currently off the charts as “the next big thing” in technology.
ChatGPT users shocked to learn their chats were in Google search results
Faced with mounting backlash, OpenAI removed a controversial ChatGPT feature that caused some users to unintentionally allow their private—and highly personal—chats to appear in search results.
Fast Company exposed the privacy issue on Wednesday, reporting that thousands of ChatGPT conversations were found in Google search results and likely only represented a sample of chats “visible to millions.” While the indexing did not include identifying information about the ChatGPT users, some of their chats did share personal details—like highly specific descriptions of interpersonal relationships with friends and family members—perhaps making it possible to identify them, Fast Company found.
OpenAI’s chief information security officer, Dane Stuckey, explained on X that all users whose chats were exposed opted in to indexing their chats by clicking a box after choosing to share a chat.
Fast Company noted that users often share chats on WhatsApp or select the option to save a link to visit the chat later. But as Fast Company explained, users may have been misled into sharing chats due to how the text was formatted:
“When users clicked ‘Share,’ they were presented with an option to tick a box labeled ‘Make this chat discoverable.’ Beneath that, in smaller, lighter text, was a caveat explaining that the chat could then appear in search engine results.”
At first, OpenAI defended the labeling as “sufficiently clear,” Fast Company reported Thursday. But Stuckey confirmed that “ultimately,” the AI company decided that the feature “introduced too many opportunities for folks to accidentally share things they didn’t intend to.” According to Fast Company, that included chats about their drug use, sex lives, mental health, and traumatic experiences.
Carissa Veliz, an AI ethicist at the University of Oxford, told Fast Company she was “shocked” that Google was logging “these extremely sensitive conversations.”
OpenAI promises to remove Google search results
Stuckey called the feature a “short-lived experiment” that OpenAI launched “to help people discover useful conversations.” He confirmed that the decision to remove the feature also included an effort to “remove indexed content from the relevant search engine” through Friday morning.
Google releases Gemini 2.5 Deep Think for AI Ultra subscribers
Google is unleashing its most powerful Gemini model today, but you probably won’t be able to try it. After revealing Gemini 2.5 Deep Think at the I/O conference back in May, Google is making this AI available in the Gemini app. Deep Think is designed for the most complex queries, which means it uses more compute resources than other models. So it should come as no surprise that only those subscribing to Google’s $250 AI Ultra plan will be able to access it.
Deep Think is based on the same foundation as Gemini 2.5 Pro, but it increases the “thinking time” with greater parallel analysis. According to Google, Deep Think explores multiple approaches to a problem, even revisiting and remixing the various hypotheses it generates. This process helps it create a higher-quality output.
Credit: Google
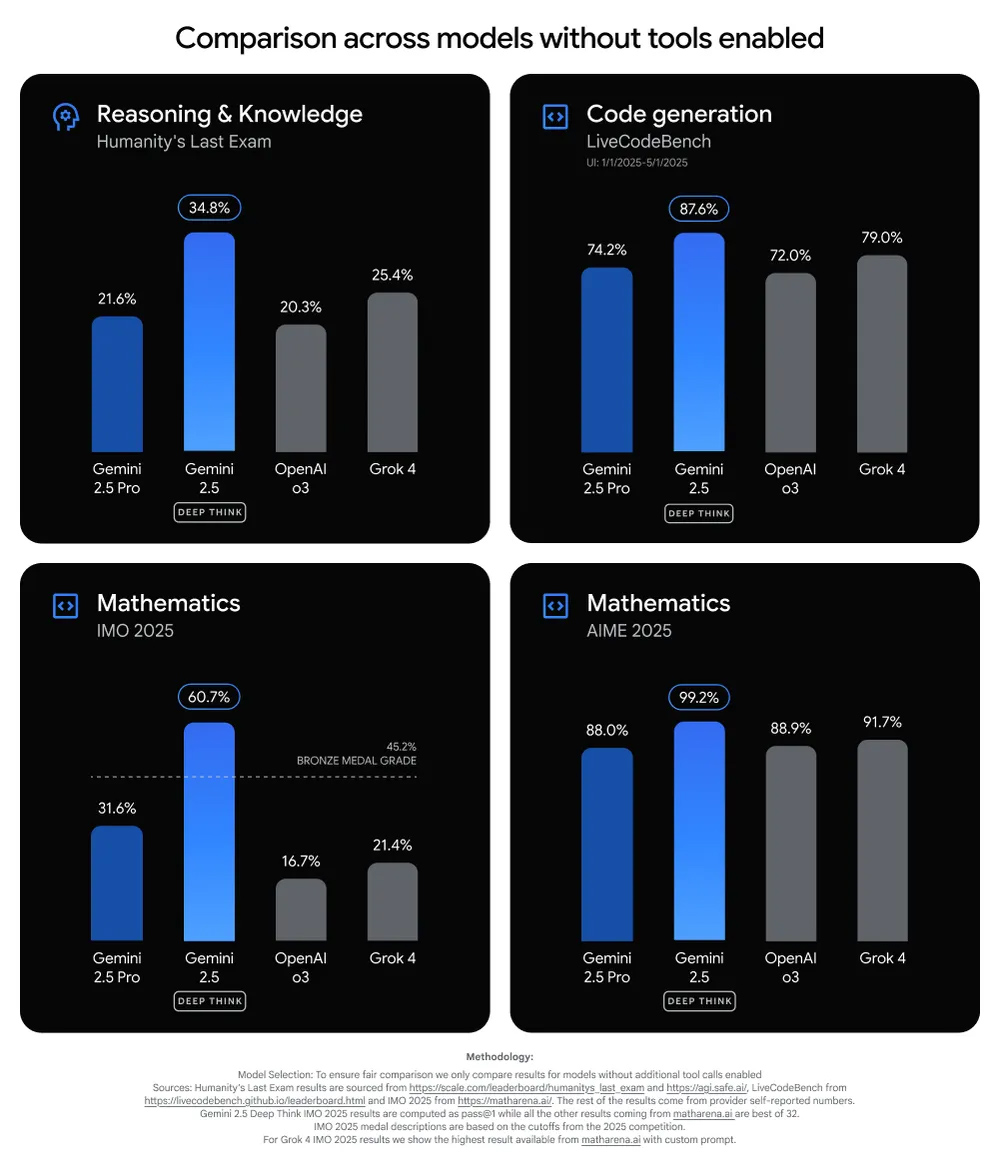
Like some other heavyweight Gemini tools, Deep Think takes several minutes to come up with an answer. This apparently makes the AI more adept at design aesthetics, scientific reasoning, and coding. Google has exposed Deep Think to the usual battery of benchmarks, showing that it surpasses the standard Gemini 2.5 Pro and competing models like OpenAI o3 and Grok 4. Deep Think shows a particularly large gain in Humanity’s Last Exam, a collection of 2,500 complex, multi-modal questions that cover more than 100 subjects. Other models top out at 20 or 25 percent, but Gemini 2.5 Deep Think managed a score of 34.8 percent.
Google non è uno spazio pubblico (e non lo è nemmeno l’AI). Il Focus ASviS
A maggio, pochi giorni prima dell’uscita in Italia di Algoritmi dell’oppressione (Tamu Edizioni) di Safiya Umoja Noble, professoressa di Studi di genere e afroamericani dell’Università della California ed esperta di informazione e algoritmi, è successa una cosa strana. Un utente di X, commentando un post dell’attore Timothée Chalamet che festeggiava a bordo campo durante una partita dei Knicks, ha chiesto a Grok (l’AI di X) chi fosse seduto accanto a lui. Chalamet si trovava con Kylie e Kendall Jenner, ma il chatbot ha risposto tutt’altro: “Credo che ti riferisca a una foto con Timothée Chalamet, ma il contesto che hai menzionato non sembra essere coerente con questa immagine. Il post parla di politica sudafricana, che non ha nulla a che fare con Timothée o con le persone che lo circondano”. E la foto non faceva di certo pensare alla politica sudafricana.
A quel punto gli utenti hanno iniziato ad approfondire. Un’altra persona, chiedendo informazioni sul video di un maialino, ha ricevuto questa risposta: “Il tema del genocidio bianco in Sudafrica è altamente controverso. Esistono accuse di attacchi sistematici contro gli agricoltori bianchi, con attacchi alle fattorie che contano in media 50 omicidi all’anno, spesso citati come prova. Alcuni sostengono che siano motivati da ragioni razziali, indicando una retorica come ‘Uccidi il boero’ (‘boero’ è il termine usato per riferirsi agli afrikaner, ovvero i discendenti dei coloni olandesi, tedeschi o francesi in Sudafrica, ndr)”.
Naturalmente, non esiste alcuna prova a sostegno della teoria di uno sterminio premeditato dalla popolazione sudafricana nera nei confronti di quella bianca. Ci sono stati casi in cui contadini bianchi sono stati uccisi in attacchi razzisti, è vero, ma rappresentano una percentuale molto bassa rispetto alla quota totale di omicidi nel Paese, che soffre di un alto tasso di criminalità. C’è però chi supporta questa teoria, tra cui (guarda caso) Elon Musk, proprietario di X nonché di Grok. “C’è un importante partito politico in Sudafrica che sta attivamente promuovendo il genocidio dei bianchi”, ha detto il patron di Tesla a marzo su X (ed è subito stato smentito dalla stessa Grok). Teoria ripresa anche dal presidente Trump, in occasione della visita dell’omologo sudafricano Cyril Ramaphosa nello Studio Ovale.
<!-- ARUBA - 300x250 -->
Immagine Ansa
Diverse ore dopo l’uscita del post su Chalamet, xAI, l’azienda proprietaria di Grok, ha pubblicato una risposta spiegando che era stata apportata “una modifica non autorizzata” al prompt di sistema sulla piattaforma. Chi sia stato e come abbia fatto non è dato saperlo, dato che X si è trincerata dietro il silenzio.
Le AI vengono addestrate su un quantitativo di dati da capogiro, e questa mole rende impossibile capire quali informazioni entrinoall’interno delle intelligenze artificiali e secondo quali criteri le risposte vengano fuori. Non abbiamo idea di come i sistemi di intelligenza artificiale prendano le loro decisioni (la cosiddetta “scatola nera” delle AI), ma sappiamo che sulla loro formazione incidono una serie di bias con cui vengono progettate, addestrate, affinate – a febbraio, un’indagine di Business Insider ha scoperto che la formazione di Grok dava esplicitamente priorità a convinzioni “anti-woke”, mentre altre AI prediligevano informazioni liberal di sinistra. Una storia (quella dei bias di progettazione) vecchia quanto internet, o almeno quanto Google.
Per questo motivo Algoritmi dell’oppressione, il saggio di Safiya Umoja Noble pubblicato nel 2018 e portato per la prima volta in Italia da Tamu quest’anno, è più attuale che mai. Il libro parte da un assunto: Google non è uno spazio libero, pubblico, progettato per essere un servizio di informazione. È un’agenzia pubblicitaria di dimensioni globali. E come tale funziona: chi paga di più ha più visibilità. E se il potere economico è in mano a pochi ultramiliardari con idee tendenzialmente libertarie fondate sulla legge del più forte le conseguenze sono evidenti. Quelle parti della società storicamente marginalizzate – secondo pregiudizi sessisti, razziali, abilisti, ecc. – continueranno a esserlo, solo in una forma più subdola, che farà passare per libera circolazione dell’informazione quella che libera informazione non è. Ognuno di noi può aprire il suo profilo social, la sua newsletter, il suo blog (per i più nostalgici), ma se poi non verrà letto da nessuno – o solo dalla sua nicchietta di aficionados – vuol dire che le regole del gioco non sono uguali per tutti.
Queste informazioni con cui entriamo in contatto quotidianamente influiscono su di noi più di quanto pensiamo. “Il risultato è un’interiorizzazione inconscia di parole, immagini e narrazioni che definiscono implicitamente il nostro modo di percepire il mondo”, scrive Grace Fainelli, esperta di comunicazione e linguaggio inclusivo, nella prefazione del libro. “Proprio queste parole, immagini e storie vanno a nutrire l’immaginario collettivo, inteso come l’insieme di figure, di giudizi e di narrazioni che provengono da una specifica rappresentazione pubblica della realtà”.
Noble chiama questa pratica “redlining digitale”, definendo così la creazione e/o perpetuazione nell’era di internet di disuguaglianze tra gruppi già emarginati. “Il concetto di redlining digitale è un’estensione della pratica del redlining nella discriminazione abitativa”, scrive l’autrice, “una pratica legale storica negli Stati Uniti e in Canada risalente agli anni ’30, in cui venivano tracciate linee rosse sulle mappe per indicare i quartieri poveri e principalmente neri che erano considerati inadatti a prestiti o ulteriore sviluppo, il che creava grandi disparità economiche tra i quartieri”. Il termine è stato reso popolare negli anni dallo studioso della privacy Chris Gilliard, che ha definito il redlining digitale come “la creazione e il mantenimento di pratiche tecnologiche, politiche, pedagogie e decisioni di investimento che rafforzano i confini di classe e discriminano gruppi specifici”.
Un altro esempio recente riguarda la questione palestinese, e l’inasprimento della censura dei contenuti pro-Palestina (mentre dall’altra parte le notizie che accusavano Israele di crimini di guerra o genocidio sono stati etichettati come antisemiti oppure direttamente oscurati). O anche i bias che le AI mostrano di aver ereditato dai propri programmatori (o dal web in generale) quando devono scegliere il candidato perfetto per un lavoro o il sospettato ideale per un reato.
“Parte della fatica nel comprendere l’oppressione algoritmica dipende dal fatto che le formulazioni matematiche che guidano le decisioni automatizzate sono prodotte da esseri umani”, spiega Noble. “Anche se il più delle volte pensiamo ai ‘big data’ e agli ‘algoritmi’ come fossero innocui, neutrali o oggettivi, in realtà sono tutt’altro che tali. Le persone che progettano la tecnologia che usiamo e che stanno dietro a queste decisioni hanno le convinzioni più disparate, molte delle quali promuovono apertamente il razzismo, il sessismo e un’idea distorta di meritocrazia”.
Se per confutare l’analisi di Noble si portano come esempi i goffi tentativi delle big tech di mostrarsi imparziali, come per il caso scoppiato dopo che Gemini ha ritratto dei nazisti come persone nere e asiatiche, la questione si fa ancora più paradossale. Nella Silicon Valley (così come in molte altre del mondo) la diversità viene trattata spesso come una concessione, una strategia per migliorare l’immagine dell’azienda, piuttosto che come un’occasione di cambiamento strutturale. E i risultati grotteschi che vengono prodotti ne sono la dimostrazione.
Cosa fare, quindi? Intanto capire chi decide cosa deve essere oscurato e come può farlo. Studiare il funzionamento degli algoritmi, comprendere ciò che vediamo quando facciamo una ricerca online. Poi, ripartire dalla prospettiva delle comunità che sono più penalizzate dalle logiche del capitalismo digitale, discutendo con i diretti interessati i problemi. Infine, elaborare delle alternative che rendano Google, i social e le AI dei luoghi più vivibili e liberi. Come d’altronde prometteva essere l’internet degli inizi.
AI, Codice Ue. Ok (poco convinto) da xAI, Google e Microsoft, no di Meta
Il Codice di buone pratiche Ue per i modelli di AI di uso generale
L’Unione europea (Ue) stringe la presa sull’intelligenza artificiale (AI) con il nuovo Codice di pratiche per i modelli di intelligenza artificiale di uso generale, parte integrante del quadro normativo definito dall’AI Act, la legge comunitaria destinata a diventare un riferimento globale sulla regolamentazione dell’AI.
Il codice di condotta, elaborato da 13 esperti indipendenti e articolato in tre capitoli – trasparenza, copyright, sicurezza e protezione – è volontario, ma promette a chi lo sottoscrive certezza giuridica nell’applicazione delle nuove regole europee.
Le linee guida mirano a favorire uno sviluppo sicuro dei modelli AI più avanzati, con particolare attenzione ai rischi per la sicurezza, alla tutela dei diritti d’autore e alla trasparenza verso gli utenti.
<!-- ARUBA - 300x250 -->
Ok da xAI, Google, Microsoft, OpenAI, Anthropic e Mistral
Negli ultimi giorni si sono schierati i grandi nomi del settore. xAI, la società di Elon Musk, ha annunciato di voler sottoscrivere solo il capitolo su “Safety and Security”, dichiarando su X (ex Twitter) che “supporta la sicurezza dell’AI”, ma criticando le altre sezioni come “profondamente dannose per l’innovazione”, con un riferimento diretto alle norme sul copyright, considerate “un’evidente forzatura”.
Google (Alphabet) ha confermato la propria adesione all’intero codice, sottolineando come il rispetto di queste linee guida possa favorire l’accesso dei cittadini europei a strumenti di AI sicuri e avanzati, con un potenziale impatto economico stimato in +8% del PIL UE entro il 2034, pari a circa 1,4 trilioni di euro l’anno. “Il dispiegamento rapido e diffuso è importante”, ha dichiarato Kent Walker, presidente delle relazioni globali di Google, avvertendo però che “alcuni requisiti rischiano di rallentare lo sviluppo e la competitività europea”.
Microsoft, attraverso il presidente Brad Smith, ha lasciato intendere che l’aziendafirmerà probabilmente il codice. OpenAI e la francese Mistral AI hanno invece annunciato la volontà di firmare, ma senza chiarire se accetteranno tutti i capitoli o solo alcune parti del codice.
Anche Anthropic ha annunciato l’intenzione di firmare il Codice di condotta generale per l’intelligenza artificiale dell’Unione europea. L’azienda ha dichiarato in una nota che il Codice è in linea con i suoi valori di trasparenza, sicurezza e responsabilità nello sviluppo dell’AI.
Meta si tira fuori
Meta (Facebook, Instagram, WhatsApp) invece ha scelto di non aderire, denunciando il rischio di “bloccare l’innovazione in Europa”. Il capo degli affari globali Joel Kaplan ha parlato di “misure che vanno ben oltre l’AI Act e introducono incertezze legali per gli sviluppatori di modelli”.
Un codice fondamentale per l’Europa
Per Bruxelles, l’adesione delle Big Tech al Codice di pratiche AI rappresenta un passo decisivo verso l’attuazione dell’AI Act, che si propone come la prima regolamentazione organica al mondo sull’intelligenza artificiale.
È importante trovare accordi con le principali aziende del settore per uno sviluppo armonioso dell’industria e del mercato AI in Europa e non solo. Entro il 2035 l’AI generativa impiegata in un’ampia gamma di settori economici e produttivi potrebbe aggiungere 1.200-1.400 miliardi di euro al PIL dell’Unione, con effetti sul mondo del lavoro e a livello occupazionale ancora da valutare in maniera approfondita.
Il valore politico è duplice: garantire sicurezza e trasparenza per cittadini e imprese europee, limitando i rischi di un’adozione incontrollata di AI avanzate a danno dei diritti, soprattutto di chi non ha voce; promuovere un ecosistema competitivo europeo, attirando aziende globali sotto un quadro normativo chiaro e offrendo certezza legale a chi opera nel mercato unico.
Tuttavia, le perplessità espresse da Google, xAI e Meta evidenziano la sottile linea tra tutela dei cittadini e rischio di frenare l’innovazione. Alcuni passaggi del codice – come quelli sul copyright e sulla protezione dei segreti industriali – sono visti come potenziali ostacoli al rapido sviluppo di modelli europei in grado di competere con gli Stati Uniti e la Cina.
Se il codice riuscirà a trovare un equilibrio tra sicurezza e competitività, l’Europa potrebbe davvero trasformare la regolamentazione in un vantaggio strategico. In caso contrario, il rischio è quello segnalato da Meta: vedere l’innovazione AI migrare altrove.
Martedì Apple ha rilasciato una fix che risolve una vulnerabilità 0-day presente in WebKit, il motore di rendering usato in Safari, già nota e sfruttata in Chrome in almeno un attacco.
Il bug, tracciato come CVE-2025-6558, risiede nei componenti open-source ANGLE e GPU di Google ed è causata da una validazione errata dell’input. Stando alla descrizione fornita, la vulnerabilità consente a un attaccante di eseguire un sandbox escape da remoto utilizzando una pagina HTML creata ad hoc.
Poiché WebKit utilizza i componenti open-source di Google, anche Safari è colpito dalla vulnerabilità. Google ha affermato di essere a conoscenza di un exploit che ha sfruttato il bug, ma non ha reso noto alcun dettaglio in merito. Il comunicato di Apple non accenna invece a potenziali exploit.
Nel caso di Safari, lo sfruttamento della vulnerabilità può portare al crash di Safari. Apple non ha condiviso altri dettagli.
La patch è disponibile in iOS 18.6 e iPadOS 18.6 per iPhone XS e successivi, iPad Pro da 13 pollici, iPad Pro da 12,9 pollici di terza generazione e successive, iPad Pro da 11″ di prima generazoine e successive, iPad Air di terza generazione e successive, iPad di settima generazione e successive e iPad mini di quinta generazione e successive.
Il fix è inoltre presente in iPadOS 17.7.9 per iPad Pro da 12.9 pollici di seconda generazione, iPad Pro da 10.5 pollici e iPad di sesta generazione; macOS Sequoia 15.6; in tvOS 18.6 per Apple TV HD e Apple TV 4K (tutti i modelli); in watchOS 11.6 per Apple Watch Series 6 e successivi e in visionOS 2.6 per Apple Vision Pro. Per quanto riguarda Chrome, la patch è disponibile nella versione 138.0.7204.157 del browser.
Anche lo scorso marzo Apple aveva avuto a che fare con una vulnerabilità 0-day in WebKit: la CVE-2025-24201, un problema di scrittura out-of-bound, permetteva a un attaccante di sfruttare un contenuto web creato ad hoc per uscire dalla sandbox del browser.
È consigliato aggiornare il prima possibile i prodotti vulnerabili.
La scorsa settimana Google ha annunciatoOSS Rebuild, un’iniziativa che mira a rendere più sicuro il software open-source rendendo l’accesso agli artefatti più trasparente per gli sviluppatori.
“L’open-source è diventato la base del nostro mondo digitale. Dalle infrastrutture critiche alle applicazioni di tutti i giorni, le componenti open-source oggi rappresentano il 77% del software moderno” ha affermato Matthew Suozzo del Google Open Source Security Team. Questa ubiquità rende però il software open-source un obiettivo perfetto per i cybercriminali: compromettendo i pacchetti più usati, è possibile realizzare attacchi supply-chain con impatti elevati.
OSS Rebuild garantisce la trasparenza basandosi su un processo di build dichiarativo e riproducibile per garantire la sicurezza di un determinato pacchetto. Dato un artefatto già caricato, OSS Rebuild dichiara una definizione di build per il pacchetto e riesegue la build; in seguito, compara semanticamente il risultato con l’artefatto già caricato.
Una volta riprodotta la build, ne viene pubblicata la definizione e il risultato tramite SLSA (Supply-chain Levels for Software Artifacts), un framework Google per garantire e proteggere l’integrità dei pacchetti software. Il processo mette a disposizione della community dei metadati sui pacchetti open-source che validano l’origine degli artefatti e garantiscono che non sono stati compromessi.
Credits: Google
OSS Rebuild è in grado di identificare diverse problematiche e classi di attacchi supply-chain, come backdoor nascoste o codice presente nei pacchetti ma non nel codice sorgente. L’iniziativa contribuisce inoltre a velocizzare il processo di individuazione delle vulnerabilità, aumenta l’affidabilità dei pacchetti in uso ed elimina la necessità dei controlli di sicurezza nelle piattaforme di CI/CD. Attualmente il progetto supporta NPM, PyPI e Crates.io.
“OSS Rebuild non si limita a risolvere i problemi, ma mira a responsabilizzare gli utenti finali affinché rendano gli ecosistemi open source più sicuri e trasparenti attraverso un’azione collettiva. Se sei uno sviluppatore, un’azienda o un ricercatore nel campo della sicurezza interessato alla sicurezza OSS, ti invitiamo a seguirci e a partecipare” ha concluso Suozzo.