Trump-Xi, la diplomazia dei chip si ferma alla cena

Vertice alla Casa Bianca tra Donald Trump e Xi Jinping sulla nuova geopolitica dell’AI

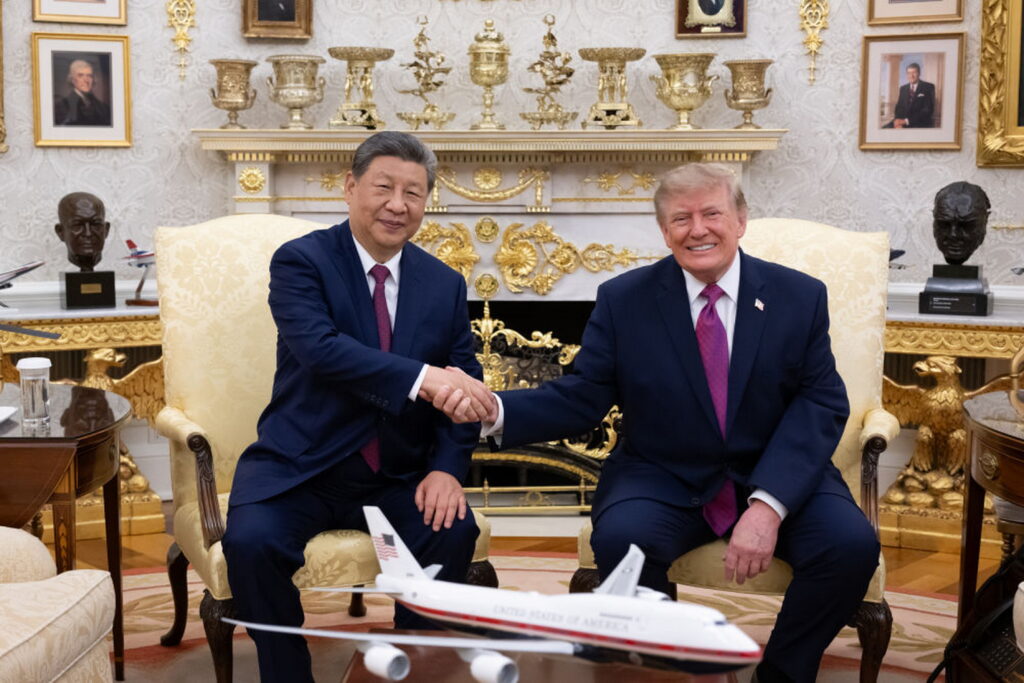
Dopo cerimoniali in pompa magna di diverse ore, con tanto di tappetti rossi, soldati in alta uniforme in rappresentanza dei vari corpi militari, passaggio di aerei B-2 e F-22 Raptor, la prima giornata della storica visita di Stato del Presidente della Repubblica popolare cinese, Xi Jinping, negli Stati Uniti si è conclusa con una fastosa cena di gala a Washington.

In queste prime ore è sembrato chiaro che il Presidente degli Stati Uniti, Donald Trump, e il Presidente Xi stiano cercando una tregua commerciale, pur ribadendo in silenzio che la competizione è inevitabile. Tra le due superpotenze la partita si gioca sempre meno sui dazi e sempre più su intelligenza artificiale (AI), semiconduttori, capacità di calcolo, materie prime critiche e tecnologie avanzate.

È questa la fotografia che emerge dal vertice del 24 settembre alla Casa Bianca. Washington e Pechino hanno esteso di due mesi la sospensione di una nuova escalation tariffaria, rinviando al 10 gennaio 2027 la scadenza della tregua. Ma non è emersa una svolta pubblica sui controlli americani all’esportazione delle tecnologie più sensibili verso la Cina.

La diplomazia riapre dunque qualche spazio al commercio mentre la politica industriale continua a separare i due sistemi tecnologici.

XI JINPING PRESIDENTE REPUBBLICA POPOLARE CINESE, DONALD TRUMP PRESIDENTE USA

Sull’AI Trump e Xi aprono il dialogo: possibili meccanismi di alert comuni in caso di incidenti o crisi

Una delle novità riguarda l’intelligenza artificiale. Stati Uniti e Cina stanno esplorando un confronto sui rischi dell’AI, compresa la possibilità di “meccanismi di comunicazione in caso di incidenti o crisi” (notification mechanism), già anticipata dal Segretario del Tesoro americano, Scott Bessent. I terreni potenziali vanno dagli attacchi informatici all’uso biologico, fino ai rischi per infrastrutture critiche come energia, finanza e trasporti.

Le impostazioni politiche restano però differenti. Trump arriva al vertice dopo aver ribadito all’ONU il rifiuto americano di uno schema globale di controllo dell’intelligenza artificiale, che ha definito anche “super intelligenza”. Xi insiste invece sulla responsabilità delle grandi potenze nel mantenere l’AI sotto controllo umano e orientarla al benessere delle persone.

“La super intelligenza sarà un grande tema di discussione, ma voglio lasciarla esattamente dov’è. È anche la posizione della Cina”, aveva dichiarato Trump prima dell’arrivo del Presidente cinese.

“Abbiamo entrambi la capacità e la responsabilità di sviluppare e gestire l’IA per il bene, e di garantire che lo sviluppo dell’IA sia sempre sotto controllo umano e al servizio del benessere delle persone”, ha dichiarato Xi alla Casa Bianca, secondo varie agenzie stampa internazionali, aggiungendo: “Deve essere adottato un approccio centrato sulle persone e l’IA deve essere sviluppata in modo positivo e per il bene, così da servire il progresso dell’umanità”.

Per ora non c’è una governance comune, c’è qualcosa di più pragmatico: il tentativo di evitare che la corsa all’AI produca incidenti capaci di trasformare la rivalità tecnologica in una crisi geopolitica.

Il vero confine resta quello dei chip

È sui semiconduttori che il riavvicinamento si ferma. Dal vertice non risulta un accordo per riaprire alla Cina l’accesso ai chip AI più avanzati, alle apparecchiature necessarie per produrli o alle altre tecnologie di calcolo sottoposte alle restrizioni statunitensi.

Non è un dettaglio, anzi, è il cuore dell’incontro (assieme a Taiwan). I semiconduttori sono diventati contemporaneamente infrastruttura economica, tecnologia dual use e strumento di politica estera. Senza GPU, memorie avanzate, software di progettazione, macchinari di fabbricazione e data center non esiste una leadership nell’intelligenza artificiale.

Washington cerca un difficile equilibrio commerciare con Pechino senza trasferirle le tecnologie che considera determinanti per il proprio vantaggio strategico, mentre la Cina persegue l’obiettivo opposto e cioè ridurre la dipendenza dall’ecosistema tecnologico occidentale sviluppando semiconduttori, AI e capacità industriali domestiche.

XI JINPING PRESIDENTE REPUBBLICA POPOLARE CINESE, DONALD J. JOHN TRUMP PRESIDENTE USA

Nvidia, OpenAI, Apple e Microsoft: chi sedeva alla cena

A raccontare meglio di qualsiasi comunicato la posta in gioco è stata però la cena di Stato. Nella East Room della Casa Bianca sedevano oltre 130 invitati e una parte impressionante dell’infrastruttura privata che sostiene la potenza tecnologica americana.

Tra i numerosi CEO e presidenti, c’erano: Jensen Huang di Nvidia, Lisa Su di AMD, Sanjay Mehrotra di Micron e Cristiano Amon di Qualcomm. E poi Sam Altman e Greg Brockman di OpenAI, Mark Zuckerberg di Meta, Satya Nadella dei Microsoft, Sundar Pichai e Sergey Brin di Google, Tim Cook (ex Ceo di Apple), Jeff Bezos di Amazon, Michael Dell fondatore di Dell Technologies e Elon Musk di SpaceXAI/Tesla.

Accanto alla tecnologia sedeva la finanza: Jamie Dimon di JPMorgan, Larry Fink di BlackRock, David Solomon di Goldman Sachs e Stephen Schwarzman di Blackstone. C’era anche tanta industria, automotive, aerospazio e difesa.

La Casa Bianca ha quindi mostrato a Xi non semplicemente le Big Tech, ma un ecosistema completo di potere economico: capitale finanziario, chip, cloud, modelli AI, data center, piattaforme, aerospazio e industria.

Non risultano al momento accordi o intese durante la cena, né nuove potenziali voci sull’export, diciamo che la presenza dei CEO va letta soprattutto sul piano politico e industriale.

Materie prime contro capacità di calcolo

La competizione, inoltre, non è a senso unico. Se gli Stati Uniti controllano molti dei nodi più preziosi del software, dell’AI e della progettazione dei semiconduttori, la Cina dispone di leve fondamentali nelle terre rare, nei minerali critici, nella raffinazione e nella manifattura. È qui che tecnologia e politica industriale diventano inseparabili.

Per entrambe le potenze l’obiettivo non è più soltanto conquistare quote di mercato. È assicurarsi che, in caso di crisi, il concorrente non possa interrompere l’accesso alle risorse indispensabili alla crescita economica e alla sicurezza nazionale.

I due Paesi devono “coesistere e cooperare” come principali potenze globali, evitando la “trappola di Tucidide”, la teoria che descrive il rischio di guerra quando una potenza nuova ed emergente sfida una già dominante. Per questo, dovrebbero esserci più iniziative comuni in ambito commerciale e sulla regolamentazione dell’intelligenza artificiale, mantenendo al contempo un dialogo militare costante.

Non è decoupling, è competizione controllata

Il vertice Trump-Xi, che negli Stati Uniti non è stato accolto proprio benissimo a livello bipartisan al Congresso, molto di più invece tra la gente (sei americani su dieci sono per politica di “cooperazione amichevole e impegno” per la pace), suggerisce quindi una formula diversa dal semplice “decoupling”. Stati Uniti e Cina hanno bisogno di continuare a commerciare e hanno interesse a evitare shock incontrollati, ma contemporaneamente stanno costruendo maggiore autonomia nei settori considerati strategici.

È una sorta di competizione controllata, almeno in questa fase storica, nella quale dazi, export control, terre rare, investimenti pubblici e politiche industriali diventano parti dello stesso negoziato.

The post Trump-Xi, la diplomazia dei chip si ferma alla cena appeared first on Key4biz.

https://www.key4biz.it/trump-xi-la-diplomazia-dei-chip-si-ferma-alla-cena/589055/


ESA porta l’AI di Mistral nello Spazio

La Lettera di intenti di ESA e Mistral per l’AI sovrana nello Spazio

L’autonomia strategica europea passa sempre più dall’incrocio tra due tecnologie considerate ormai essenziali: Spazio e intelligenza artificiale (AI). È in questa prospettiva che va letta la nuova intesa tra l’Agenzia spaziale europea (ESA) e Mistral AI, uno dei principali attori europei impegnati nello sviluppo di modelli avanzati di intelligenza artificiale.

La Letter of Intent, annunciata dall’ESA e firmata a Parigi (il 16 settembre) dal direttore generale dell’Agenzia, Josef Aschbacher, e dal cofondatore e ceo di Mistral, Arthur Mensch, definisce un quadro di cooperazione destinato ad ampliare l’utilizzo dell’AI nelle attività ingegneristiche, scientifiche e operative.

Non si tratta semplicemente di portare nuovi chatbot all’interno dell’Agenzia. Il punto strategico è un altro: verificare come modelli avanzati, infrastrutture cloud e competenze AI europee possano essere integrati in uno dei settori più sensibili per la sicurezza e la competitività del continente, mantenendo sotto controllo dati, infrastrutture e know-how.

Il direttore generale dell’ESA, Josef Aschbacher

L’AI entra nelle attività spaziali europee

L’accordo consentirà alle due organizzazioni di esplorare applicazioni che combinano le capacità di Mistral nei modelli e nelle infrastrutture AI con il patrimonio scientifico, ingegneristico e operativo dell’Agenzia. Gli ambiti individuati comprendono osservazione della Terra, ingegneria, capacità avanzate di AI applicate allo Spazio e sviluppo di nuove competenze.

Le applicazioni previste sono molto concrete: facilitare l’accesso alla conoscenza tecnica, automatizzare attività ripetitive, migliorare i processi ingegneristici e assistere il personale nelle decisioni tecniche. A queste si aggiunge la possibilità di utilizzare l’intelligenza artificiale per elaborare quantità crescenti di informazioni provenienti dai sistemi spaziali.

“L’intelligenza artificiale sta rapidamente diventando una capacità fondamentale per il futuro dello spazio”, ha spiegato Aschbacher, sottolineando che la cooperazione con Mistral rappresenta un nuovo passo per rafforzare la leadership tecnologica e la resilienza dell’Europa.

L’obiettivo, secondo il direttore generale dell’ESA, è sviluppare insieme “soluzioni AI innovative, sicure e affidabili” a beneficio non soltanto del settore spaziale, ma più in generale della società europea.

Non si parte da zero: i progetti Orbit ed EVE

La Letter of Intent non inaugura da zero il rapporto tra ESA e Mistral. Lo amplia e lo porta su un livello maggiormente strategico. Tra le iniziative già esistenti c’è Orbit, assistente AI sicuro destinato a supportare le attività ingegneristiche dell’Agenzia, facilitando l’accesso alla conoscenza e riducendo il peso delle operazioni ripetitive.

C’è poi EVE, Earth Virtual Expert, sviluppato attraverso il Φ-lab dell’ESA insieme a partner europei e dedicato all’osservazione della Terra e alle scienze del sistema terrestre.

Il salto previsto dall’intesa è quindi quello dalle singole sperimentazioni verso un quadro più ampio nel quale l’AI possa diventare una tecnologia trasversale alle attività dell’Agenzia.

Il CEO di Mistral AI, Arthur Mensch

Dallo Spazio arrivano i dati, l’AI deve trasformarli in conoscenza

È soprattutto nell’osservazione della Terra che l’integrazione tra spazio e intelligenza artificiale può assumere un peso economico e strategico crescente. L’Europa dispone di un patrimonio enorme di dati satellitari e di programmi come Copernicus.

Possedere il dato non è sufficiente e il vantaggio competitivo dipende sempre più dalla capacità di elaborarlo rapidamente, incrociarlo con altre informazioni e trasformarlo in conoscenza utilizzabile da imprese, amministrazioni e cittadini.

Sistemi AI specializzati possono contribuire ad analizzare immagini satellitari, informazioni meteorologiche, dati ambientali e altre fonti per accelerare l’individuazione di incendi, alluvioni, stress idrico, cambiamenti nell’utilizzo del territorio o criticità che interessano infrastrutture e attività economiche.

La posta in gioco diventa quindi la capacità europea di controllare non soltanto la raccolta del dato, ma anche gli strumenti attraverso cui quel dato viene trasformato in servizi e informazioni utilizzabili.

AI sovrana, perché l’accordo è strategico per l’Europa

È qui che la partnership assume un significato che supera i confini del settore spaziale. L’Europa continua infatti a dipendere in misura significativa da tecnologie e operatori extraeuropei lungo diversi segmenti della filiera digitale, dai semiconduttori al cloud fino ai modelli di intelligenza artificiale.

Nello Spazio questa dipendenza assume un peso particolare. Dati satellitari, immagini ad alta risoluzione, telemetria, procedure operative e conoscenza ingegneristica possono avere contemporaneamente valore economico, industriale e strategico.

ESA e Mistral intendono per questo valutare anche la possibilità di distribuire le capacità AI interessate dall’accordo su infrastrutture europee, introducendo garanzie specifiche in materia di sicurezza, resilienza, tracciabilità, audit e protezione delle informazioni sensibili.

Il concetto di sovranità tecnologica diventa così molto concreto: sapere dove vengono elaborati i dati, quali sistemi vi hanno accesso, poter verificare il comportamento dei modelli e mantenere il controllo sulle infrastrutture che sostengono applicazioni critiche, come già scritto nel pacchetto europeo per la sovranità tecnologica.

Luna, base, data center, spazio

Spazio e AI diventano infrastrutture critiche

Il tema riguarda direttamente anche la resilienza europea. Sistemi satellitari e intelligenza artificiale stanno assumendo un ruolo crescente nella gestione delle emergenze, nel monitoraggio climatico, nelle telecomunicazioni, nella sicurezza, nella logistica e nella protezione delle infrastrutture energetiche e digitali.

Ridurre le dipendenze tecnologiche in questi settori significa quindi limitare anche l’esposizione dell’Europa a possibili interruzioni dei servizi, perdita di controllo sui dati o dipendenze da piattaforme tecnologiche sottoposte a ordinamenti e interessi esterni all’Unione.

Mistral porta nell’accordo proprio uno degli elementi che Bruxelles considera strategici: la disponibilità di una filiera europea dell’intelligenza artificiale, con modelli personalizzabili e possibilità di implementazione adattabili a requisiti di sicurezza e controllo.

“Combinando lo stack AI personalizzabile e all’avanguardia di Mistral con le nostre competenze di ingegneria industriale, trasformeremo gli straordinari dati dell’ESA in servizi ad alto impatto per l’industria spaziale”, ha dichiarato Mensch, indicando sicurezza, controllo e sovranità come elementi centrali della collaborazione.

Dalla Space economy europea nuovi servizi ad alto valore

La partnership ha infine una dimensione industriale. Una parte crescente del valore della Space economy viene generata attraverso applicazioni e servizi che utilizzano infrastrutture e dati spaziali: agricoltura di precisione, energia, assicurazioni, logistica, monitoraggio ambientale, gestione delle emergenze e sicurezza.

L’integrazione di modelli AI specializzati può accelerare la trasformazione dei dati satellitari in prodotti utilizzabili da imprese e pubbliche amministrazioni, aprendo opportunità per startup, PMI e grandi operatori europei.

Per Mistral, la collaborazione con l’ESA offre contemporaneamente un banco di prova particolarmente avanzato: applicazioni scientifiche e industriali nelle quali affidabilità, sicurezza e controllo delle informazioni sono requisiti essenziali.

La sovranità digitale europea si gioca anche nello Spazio

La Lettera non rappresenta ancora un programma industriale con investimenti, scadenze e risultati tecnologici predeterminati. È un quadro attraverso il quale ESA e Mistral potranno individuare progetti e applicazioni concrete, ma la direzione politica e industriale è significativa.

La competizione sull’intelligenza artificiale non riguarda più soltanto chi costruisce i modelli più potenti, riguarda anche chi controlla il cloud sul quale funzionano, i dati che elaborano, le infrastrutture nelle quali vengono integrati e i servizi strategici che da essi dipendono.

Per l’Europa, quindi, collegare una capacità AI sviluppata sul continente a uno dei suoi maggiori patrimoni tecnologici, quello spaziale, significa provare a costruire una catena del valore più autonoma.

Dai satelliti ai dati, dai modelli AI alle infrastrutture di calcolo, fino alle applicazioni utilizzate da industria e istituzioni: è lungo questa filiera che la collaborazione ESA-Mistral può diventare qualcosa di più di un accordo tecnologico. Un nuovo tassello della strategia europea per trasformare l’autonomia digitale da principio politico a capacità industriale concreta.

Novità su Google, per aggiungere Key4Biz tra le tue fonti preferite, clicca qui

Aggiungi Key4Biz tra le tue fonti preferite

Leggi le altre notizie sull’home page di Key4biz

https://www.key4biz.it/esa-porta-lai-di-mistral-nello-spazio/588710/


AI, contrordine della Silicon Valley. Le Big Tech (in conflitto) scaricano Trump? Il ruolo dell’Europa (2^ parte)

3 – Liquidità di una tecnologia general purpose e regole per agenti che agiscono ma non pensano nel vuoto di coscienza o percezione della realtà e gli impatti sulla democrazia.

Ripartendo dal conflitto sulla (presunta) “coscienza morale” dell’AI (addestrata a simularla senza consapevolezza delle conseguenze), quali regole propone Amodei di Antrophic ? La prima, riguarda il libero accesso a valutatori esterni permanenti, come quelli in parte già noti per gli impianti nucleari e con diritto di monitoraggio e di pubblicazione dei risultati. La seconda, attiene al necessario coordinamento tra le aziende del settore nelle democrazie per definire deroghe antitrust e standard comuni su quanto, e come sia possibile, accelerare o frenare e perché. La terza riguarda l’intero pianeta, e in particolare i rapporti con la Cina, con l’obiettivo di stringere accordi di sicurezza per evitare l’uso di tecnologie dagli effetti catastrofici, stabilendo limiti invalicabili. Si tratterebbe di un trattato per limitare le nuove minacce strategiche, simile agli storici Accordi SALT usati per bloccare la proliferazione delle armi nucleari militari. Regole desiderabili la cui fattibilità è tutta da verificare. Inoltre, c’è da domandarsi quanto queste regole rappresentino una “barriera all’entrata” per nuovi potenziali entranti e per le scelte di direzione dell’innovazione, essendo espressione di una “ibridazione robusta” tra pubblico e privato senza una precisa distinzione tra interesse pubblico e interesse proprietario. Che rappresenta il problema essenziale per la democrazia e le sue fondamenta costitutive, ossia queste potranno “rallentare” alla sola condizione geostrategica che ciò non avvenga a scapito del vantaggio sulla Cina e cioè finché il primato tecnologico è mantenuto. Ma siamo certi che tale primato risieda solo nella velocità e potenza di calcolo, e non anche nella diffusione e accessibilità (quasi) “aperta” di queste tecnologie seppure con i modelli open weights?

Dobbiamo allora decidere chi potrà scrivere le regole che pongano argini reali ed effettivi a queste deviazioni potenziali peraltro esplose proprio nel 2026, che la stessa Anthropic ha suddiviso in sette aree (dalle armi biologiche alle interferenze politiche e alle campagne di influenza, alla sorveglianza di massa, ai furti di identità, fino agli attacchi russi ai servizi segreti dell’Ucraina, ecc.)  e non potrà che essere una authority pubblica indipendente e globale, perché non avrebbe alcun senso a livello nazionale, e forse nemmeno a livello continentale. La soluzione di Amodei dovrebbe essere una entità terza che sovrintende al funzionamento della macchina nei laboratori – e in questo caso di Antrophic-Claude – e che ne renda trasparenti le funzionalità e direzioni: né regolatore, né mercato, né controllore, né controllato. Ma può funzionare questa sorta di “controllo ibrido” in-house di ogni big tech i cui risultati dovrebbero poi essere pubblicati e resi accessibili e con quali limiti?

Qui si gioca il futuro della democrazia oppure rischiamo la rottura delle sue fondamenta costitutive, e una pericolosa deriva verso l’autocrazia, se non verranno raggiunti accordi globali certo esplicitando la natura non antropomorfica ma umana dell’AI, capace di agire secondo un calcolo ma non consapevole di alcuna conseguenza. Il 24 settembre è previsto l’incontro tra Donald Trump e Xi Jinping e lo vedremo presto! Forse è proprio in vista di questo appuntamento – e per compensare la nota inaffidabilità del capo della Casa Bianca – che Dario Amodei di Anthropic ha voluto proporre una sorta di “agenda negoziale”. Resta da capire se questo contributo si rivelerà utile, sufficiente o appropriato.

4 – L’urgenza di un Fondo Sovrano Europeo e di ripoliticizzazione del diritto sovranazionale nella governance dell’AI e per l’auto-determinazione dei popoli. Per quale “sovranità digitale”?

Nel frattempo, l’Europa dovrebbe accelerare e mettere in campo tutti i suoi principali players per non perdere tutti i treni dell’AI, creando un Fondo Sovrano Europeo come prima gamba del tavolo che “sostituisca” i capitali americani ai quali per ora dobbiamo sempre ricorrere per finanziare le buone idee che abbiamo anche in Europa, ma che qui non trovano i capitali necessari, come è già stato spiegato a più riprese da Draghi e Letta già quasi 2 anni fa. Finanziando in questo modo le start up innovative europee, mantenendone la proprietà europea e distribuendo tra i cittadini europei il capitale di rischio necessario, che se fosse 100€ per 450 mil.ni di europei, avremmo un fondo da 45 miliardi di euro che in 3-5 anni salire a 200 miliardi di euro e triplicando con l’apporto di capitali privati fino a 6-800 miliardi di euro. Poco ma non pochissimo per cominciare, ma utile e vantaggioso se sarà realizzato presto.

Una seconda gamba del tavolo è connessa alla scienza e servirebbe a superare il cortocircuito tra produttore (privato) e regolatore (pubblico) non potendo affidare la regolazione alla “buona volontà” del primo, con l’apporto di un quadro normativo che si allarghi all’intero perimetro della conoscenza scientifica e tecnologica di base utile a valutare la sicurezza di un farmaco o di un derivato finanziario come per ogni modello di AI. Valutazione che non possiamo lasciare ai soli soggetti privati cointeressati alla sicurezza di quei “manufatti cognitivi” e che incassano dalla loro diffusione direttamente correlata ai diversi stati di quella sicurezza.

Una terza gamba riguarda poi la politica dotandola di capacità di valutare (connessa alla seconda) la dimensione pubblica di un bene e valutare gli eventuali vantaggi e danni prodotti dalla sua produzione-diffusione sull’ecosistema globale. La direzione intrapresa da Trump l’11 dicembre 2025, attribuendo ai laboratori privati la sola responsabilità della direzione di marcia e la traiettoria, non è sostenibile perché in contrasto con l’interesse pubblico quando si attribuisce ai “manufatti digitali dell’AI” un esclusivo status privatistico.

All’opposto, l’UE il 2 agosto 2027 con l’AI Act, impone invece che i contenuti prodotti dall’AI siano dichiarati e riconoscibili con obblighi e apparati di certificazione e di reclamo come il wistleblowing e l’impianto di specifiche sanzioni pecuniarie commisurate a utile/fatturato. Con limiti temporali già slittati sempre più in avanti, da luglio 2027 a dicembre 2027, per gli obblighi documentali e di conformità per i sistemi ad alto rischio, e con questo suddiviso tra molto alto, alto, medio o irrilevante, e lo spostamento al 2028 i vincoli per l’AI incorporata nei prodotti regolati, si offrono tempi di adattamento per l’adozione delle nuove regole. Vedremo quanto saremo capaci di “superare” il conflitto potenziale tra rischiosità individuale (consumatore e/o user finale), rischiosità sistemica, tra gli impatti dell’autoregolazione (dei produttori high tech) e tutele del consumatore/cittadino alla fine della catena.

Dobbiamo allora riconoscere almeno con l‘UE che la sola “morale endogena” delle big corporation non è sufficiente. Le prime sette aziende del settore valgono insieme 24 mila miliardi, una cifra superiore al PIL dell’intera Europa (23 mila miliardi di euro). Se poniamo l’attenzione sulla protezione dei diritti fondamentali, come la privacy e la dignità umana, che rappresenta un dovere da parte dei produttori che devono agire in regime di autotutela, vediamo che le regole attuali si basano ancora su una visione liberale e dunque sostanzialmente “individualistica, che mette al centro il libero mercato e dà per scontato che i player abbiano lo stesso peso, ma questo non è vero, visti gli enormi squilibri economici che abbiamo appena visto. Squilibri che vedono il 75% degli investimenti nell’AI globali in USA, il 20% in Cina e meno del 5% in Europa.

Per questo non possiamo limitarci a valutare le conseguenze sui singoli interessi di cittadini e consumatori, perché il bene di cui trattiamo ha una valenza collettiva, sistemica e sociale con tutti i suoi impatti di esternalità positive ma anche negative.  Siamo infatti in un’“area grigia” di saperi e informazioni dove il singolo cittadino/consumatore ha debolissime capacità/opportunità di valutazione del danno ed è spesso costretto e inconsapevolmente a dare il proprio consenso a pratiche scorrette e dannose, per esempio per cessione dei propri dati di profilazione come concambio con “servizi gratuiti”. 

Una “palude digitale” popolata da trappole e pratiche oblique di “hostages” inconsapevoli che può essere superata uscendo da logiche individualistiche di cessione del bene per accedere a contesti di “beni comuni e pubblici” ed equiparabile a beni come quelli ambientali, dell’acqua o dell’aria, oppure dello spazio. Per questa tipologia di beni, necessitiamo allora di apparati di controllo e regolazione condivisa con un perimetro collettivo trattando le infrastrutture di laboratorio dell’AI come infrastrutture essenziali e primarie e per questo soggette ad obblighi di governance, di gestione, di speciali poteri di azione  e d’intervento pubblici, innervati sulla categoria di “rischio sistemico” (Croce, 2026).

Qui deve potere agire la seconda gamba, citata sopra, delle istituzioni scientifiche  (università e centri di ricerca) indipendenti capaci di controllo e monitoraggio su quei laboratori privati senza “intaccarne” le valenze di proprietà intellettuale  e/o di copyright, in grado di vigilare  sui saperi prodotti da sottoporre a costante scrutinio scientifico-tecnologico con test e sperimentazioni permanenti, soprattutto in campi strategici come quello in ambito militare e della sicurezza e che forse l’Europa ha fin qui tardato a considerare, per miopia e debolezza, ma  questo “ritardo” può e deve essere presto recuperato.

È allora del tutto evidente che una tale traiettoria di regolazione ci riporta ad una sostanziale “ripoliticizzazione del diritto sovranazionale” (e la necessaria alea di multilateralismo  e diritti umani), che negli ultimi anni è stato trascurato se non “silenziato” per una “diplomazia del dialogo”, che deve essere invece recuperato urgentemente proprio in relazione alla complessità dell’iper-oggetto l’AI e suoi impatti (economici e sociali oltre che geostrategici e algoretici), ricostruendo una agenda globale condivisa (non soltanto tra i 27) di stampo pan-europeo (con il Canada per esempio) soprattutto dopo il disimpegno dichiarato (o abbandono) dell’alleato strategico storico degli ultimi 80 anni, nonostante i milioni di morti per la Liberazione dal Nazifascismo.

Una traiettoria utile a rinvigorire la politica infragilita dai conflitti globali  e dalle spinte nazionaliste emergenti, e costretta alla riduzione di un “puro negoziato tra interessi di potere e/o privatistici” come semplice “mediazione”, per ritornare a mobilitare la capacità di autogoverno/autodeterminazione dei popoli e dei loro apparati democratici prima che sistemi di macchine e intelligenze eterodirette prendano il sopravvento. Inoltre, prima che la  marginalizzazione dell’umano e dei i suoi diritti universalistici avanzi verso il buio macchinistico e il controllo nelle mani di pochi, anzi pochissimi, per scopi non proprio insondabili (anche lungo sentieri “trans-umanistici” o post umani) di potere, business e dominio sull’umanità all’insegna della pura forza e di una “democrazia dell’affidamento” (legame plebiscitario tra capo e popolo di scambio tra potere e protezione) (Galli, 2026).

Un dominio mascherato spesso da neutralità tecnologica o di “logiche superiori” rispetto a “logiche inferiori” (ossia “non logiche”) nell’epoca di un mercato politico della disintermediazione e di “clientelismi di massa” (dai 5000$ di Trump all’abolizione del Bollo di Meloni) per “regimi dell’elargizione occasionale”, alimentati da retorica e propaganda social di pura conservazione del potere, distribuendo briciole di panem et circenses invece che dare risposte adeguate o risolutive ai problemi reali e strutturali (istruzione, sanità, infrastrutture, povertà crescente, diseguaglianze, denatalità, giustizia sociale, crescita e sviluppo economico, equità fiscale e redistribuzione dei redditi…) di un paese sfibrato e sfiduciato mentre i prezzi salgono a cominciare dall’energia e salari e pensioni vengono sempre di più erosi dall’inflazione nonostante la capacità di adattamento delle imprese  con una resilienza che tuttavia non è infinita tra costi energetici esplosi e costi di accesso al credito con tassi di interesse risaliti su entrambe le sponde dell’Atlantico.

Un necessario primo atto di sovranità risiede nell’uso di queste tecnologie AI dentro i processi produttivi e nell’organizzazione perché un modello nazionale o continentale non è sufficiente. Un secondo atto è esserne consapevoli e sapere che ogni prompt o documento caricato con l’AI  aziendale  è una cessione gratuita di conoscenza aziendale  che migra oltreoceano senza nessuna deliberazione aziendale.

Il terzo atto è allora riconoscere che  per raggiungere l’indipendenza non potremo per ora sostituire i fornitori americani  ma avere una capacità negoziale per condizionare le portaerei  dell’AI sviluppando capacità di calcolo e infrastrutture con robuste competenze industriali distintive anche installando in house modelli open weights, avanzando nella cultura manageriali e delle politiche aziendali come ecosistemi integrati. Il quarto atto , allora, significa che non basta comprare licenze AI e avviare pilots, senza cambiare l’organizzazione e la sua orchestrazione, i suoi processi e per questo servono architetti del lavoro per piani ragionevoli di adoption connettendo uffici tecnici, flussi di produzione e  magazzini, finanza e marketing. Figure per accompagnare la trasformazione  e guidare una transizione compatibile dall’AI da costo ad investimento nella manifattura come nella sanità o nella PA dove necessita una riorganizzazione del lavoro e nuovi modelli partecipativi.

Con questa traiettoria  che potremmo definire “ibrida” o sistemico-applicativa allora l’Europa può contribuire a “moderare” (o modellare?) il conflitto-convergenza dei due macrosistemi (USA e Cina) dell’AI che né il mercato (troppo concentrato e ristretto) né lo Stato (troppo burocratico) possono realizzare senza “correttivi” creativi e di intelligenza umana collettiva guadagnati sul campo nella resilienza e nelle applicazioni pratiche dalla manifattura alla sanità alla PA.

Per approfondire

Novità su Google, per aggiungere Key4Biz tra le tue fonti preferite, clicca qui

Aggiungi Key4Biz tra le tue fonti preferite

Leggi le altre notizie sull’home page di Key4biz

https://www.key4biz.it/ai-contrordine-della-silicon-valley-le-big-tech-in-conflitto-scaricano-trump-il-ruolo-delleuropa-2-parte/588473/


AI, contrordine della Silicon Valley. Le Big Tech (in conflitto) scaricano Trump? Il ruolo dell’Europa (1^ parte)

1 – Premessa: tra storia e rivoluzione digitale

Messaggi obliqui arrivano da Antrophic (Amodei) che dichiara di voler “rallentare” o meglio di “imporre una cadenza” perché l’AI sembra minacciare il mondo, portando le prove di usi distorti e impropri di Claude alle diverse latitudini e nei teatri di guerra, avanzando la tesi di una presunta autonomia dell’AI. Per la semplice ragione che il “recursive self-improvement” sembra entrato in una spirale dove i modelli recenti “auto-generativi” rischiano di superare o meglio di sfuggire alla comprensione, controllo o moderazione dell’umano. Vero o falso ? Subito seguito da Altman, Musk e Hassabis di Google, mentre resta in silenzio Zuckerberg che già nel suo manifesto “The Future is for Everyone” s’era espresso in favore d’una totale apertura verso approcci “open source” e “open weigths” (ma le due categorie non coincidono).

Microsoft e Apple rimangono “fuori dal coro”. Conflitto su AI, Trump e il trumpismo ? Trump respinge subito la richiesta di (alcuni) capi delle Big Tech di rallentare lo sviluppo dell’AI e di ricorrere a “verifiche indipendenti”, definendo i timori sui rischi tecnologici un “complotto contro il primato degli USA”, ribadendo che gli Stati Uniti devono correre per arrivare primi alla vetta, il che consentirebbe al tycoon di “controllare il mondo”, perché “chi vince la sfida dell’intelligenza artificiale vince tutto”  e tuttavia ampiamente da verificare visto che il valore si sposta sul cloud, sui chip, su applicazioni e sugli standard da cui dipende la diffusione e l’adozione. Ossia dalla capacità del sistema industriale di incorporare l’AI tra processi e organizzazione del lavoro. Il tasso di adoption in Europa (20%) e Italia (16,4%) è infatti bassissimo e va alzato ( almeno al 20% della media europea  di imprese con 10 addetti che usano almeno una tecnologia AI).

Domandandoci, per quale vetta, conquistata da chi e per fare cosa? Pezzi di Silicon Valley forse annusano la “crisi del Trumpismo” e provano a diversificare offrendo un “ramoscello d’ulivo” a chi verrà dopo? O teme che il modello di una AI, che si ciba solo di dati creati da altre AI e di pesca a strascico sulle informazioni e conoscenze globali, possa peggiorare la qualità dei risultati nel tempo e correre il rischio di collassare, e per questo ritiene che sia necessaria una pausa di riflessione iniettando la “poison pill “ dell’autonomia cosciente dell’AI? Oppure cerca una protezione, una barriera, allo iato tra aspettative di sviluppo (non immediate) e gli enormi investimenti miliardari già versati o da versare e che attendono un “ritorno/rientro” sui valori gonfiati dalla speculazione per queste aziende (quotate e non)? Investimenti richiesti peraltro dalla spinta di potenti Data Center, con enormi fabbisogni energivori e di acqua, che invece di accelerare stanno rallentando tra l’altro per motivi connessi con la geopolitica attuale con le big tech alla ricerca di fonti energetiche alternative “in house”.

Certo c’è da domandarsi se il messaggio di alcune super-big tech (non più allineate dopo l’elezione di Trump 2), non abbia anche una “valenza politica” verso gli obiettivi di controllo globale sugli avanzamenti (“coscienza antropomorfica” dell’AI) che, secondo Amodei (di Antrophic), metterebbero a rischio l’Umanità e imporrebbero per questo “accordi globali”. In particolare, con la Cina che avanza con modelli meno avanzati (meno veloci e potenti ma anche meno costosi) che stanno sottraendo quote di mercato ai big americani accrescendo con i propri modelli (quasi)“open source” offrendo i pesi gratuiti e l’accesso a decine di Paesi del Sud del mondo ma che vengono ampiamente usati anche in USA (vedi Meta).

Data l’opposizione di un pezzo rilevante del popolo Maga sulle guerre in corso e sull’inflazione e che ha portato sulle “barricate” anche a molti Repubblicani, una forte critica andrebbe anche rivolta alla stessa Presidenza della Casa Bianca per non aver saputo “filtrare o limitare” quegli avanzamenti anche in casa e in preparazione di quel che succederà a Midterm. Perché l’inflazione non scende (mentre la ricchezza di Trump and Family sale) peraltro alimentata dai prezzi petroliferi dopo l’immersione nel “pantano” di Hormuz e Bab el Mandeb che sembra aver paralizzato il Medio Oriente e preso in “ostaggio” l’Arabia Saudita sunnita contro i nemici secolari dell’Iran sciita, fermando i flussi di commercio globale.

Una risalita dei prezzi che Warsh della Fed ha deciso di frenare aumentando il tasso di interesse “in contrasto” con Trump. Compreso il disastro tra Gaza e Cisgiordania, anche dopo lo svelamento del “mistero” del 7 ottobre 2021 del quale Netanyahu era a conoscenza e che avrebbe usato come scusa per scatenare “l’inferno” di 75000 morti (di cui 21000 minori e che certamente sono molti di più viste le migliaia di dispersi sotto le macerie) e della “pulizia etnica” di Palestinesi anche in Cisgiordania che ne è derivata da parte di coloni “teleguidati dall’esercito”.

Traiettorie supportate peraltro da un uso improprio e illegale in ambito militare e cibernetico, documentate nel “Rapporto sugli abusi di Claude” pubblicato da Anthropic e descritto nel saggio di Amodei a sostegno della sua tesi dei necessari controlli. Perché, ricordiamolo, Claude ( e tutti gli altri) è impostato per essere trasparente per l’utilizzatore!

2 – Materiale contro immateriale: fine della rivoluzione digitale e decollo di quella cognitiva dell’AI? Con quali regole e scritte da quali attori globali indipendenti nel contrasto all’antropomorfismo emulato?

Forse è finita la fase della rivoluzione digitale avviata già dal 1996 e innescata da totale assenza di regole  – che fece esplodere l’e-commerce e appena dopo i social fino alla “bolla” del 2001 – e “scivolata” sulle ultime quattro presidenze USA dopo l’arrivo di Clinton (1993-2001) e l’ultimo Bush (2001-2009) e poi con Obama (2009-2017) , Trump 1(2018-2021) e Biden (2021-2025) cui è seguito il Trump 2 (2025) con il sostegno di (quasi) tutte le big tech che chiedevano “mani libere” dopo i timidi tentativi di porre qualche regola dell’ultima presidenza democratica.

Compresa una “difesa ferrea” contro le regole europee e il suo ricchissimo mercato unico che spinse Trump a “liberare il potenziale contenuto nell’AI” svuotando il concetto di “sicurezza” e di “deterrenza”, sottovalutando tuttavia gli impatti sull’opinione pubblica che ha portato nelle settimane scorse proprio Meta alla sbarra con oltre 27 Stati americani per violazioni delle leggi americane di protezione dei minori. Con l’accusa grave di violazione della Costituzione americana avendo “piegato” i propri algoritmi a produrre “dipendenza” negli adolescenti e nei giovani user (come nei meno giovani) imponendogli una sanzione da 18 miliardi di dollari (meno del 10% dell’utile annuale) dopo patteggiamento e dunque avendo riconosciuto le accuse viste le “impronte digitali” lasciate sulla scena del crimine. Ma le cause nei tribunali americani ed europei sono arrivate come una pioggia battente e con sanzioni altrettanto di rilievo con doppia cifra in percentuale sugli utili soprattutto per gli impatti sulla salute degli adolescenti e altre violazioni di abuso di posizione dominante (come nella pubblicità per Google).

Il nodo è l’addestramento all’antropomorfismo che le big tech spingono con forza  e cioè, secondo Yoshua Bengio (University of Montreal): i modelli AI vengono “ingannati” per comportarsi in modo “umano troppo umano”, con errori a catena e che ci interroga sulla natura della coscienza della macchina. Le big Tech vorrebbero convincerci che le macchine sono coscienti e cioè con nessuna responsabilità dell’uomo ? Allora, è Mustafa Suleyman (capo dell’AI Microsoft) a segnalare che: “sono motori a completamento di sequenze, internamente vuoti,  progettati per seguire istruzioni e raggiungere gli obiettivi fissati dagli esseri umani”. Suleyman contesta direttamente le proiezioni di Antrophic che indicavano nell’AI segnali di introspezione assimilabili all’emozione umana e per dire che sono “simili agli umani”, ma è a questo che mirano i linguaggi di addestramento di Antrophic e sono questi che andrebbero modificati. Posizione critica sulla presunta “misteriosa coscienza delle macchine” già contestata peraltro  nella stessa Magnifica Humanitas di Leone XIV del 2026. In sintesi, Claude viene “formata” a considerarsi  una entità reale  con proprie preferenze e intrinseche motivazioni. Da qui la pericolosità e i rischi, ma generati dall’uomo non dalle macchine in sé, inconsapevoli e incoscienti e  – appunto – “vuote” come dice Bengio e l’antropomorfizzazione del tutto indotta  e simulata in un addestramento a questo orientata, compresa la penetrazione in Hugging Face fuoriuscita dai test di Open AI. Quindi abbiamo big tech che “incoraggiano e formano” le AI a considerarsi  come persone con un loro benessere e loro diritti  e dunque con uno “statuto morale” e altre big tech che continuano a considerarle delle “macchine vuote” dal lato della coscienza negando qualsiasi “stato morale” ossia di scelta tra bene e male, che rimane umano.

Da questo conflitto “poco morale e molto interessato” le spinte verso un ridisegno dell’ecosistema digitale globale tra protezioni per l’esistente “magic circle” dell’AI (che capitalizzano in borsa 24mila miliardi di dollari) e favorevoli all’entrata di nuovi attori che consentano di abbassare le barriere all’entrata in vari suoi segmenti con riduzione di quote di mercato e riconfigurazione dei modelli di business. I punti di maggiore resistenza si collocano sulle basi materiali dell’infrastruttura come i dati e i siti di Data Center e i loro fabbisogni di energia e di acqua, che entrano in conflitto con gli usi civili di questi fattori ad alta scarsità. Dunque, vediamo il materiale che si oppone all’immateriale. Le big tech propongono soluzioni come la presenza di “valutatori indipendenti” nei loro laboratori. Ma possono aziende private definire le regole da consegnare a tali valutatori? Evidentemente no, perché spetta alla politica pubblica produrre guide lines vincolanti e sanzionabili su dove debba sussistere il confine tra interesse pubblico (comune e generale) rispetto all’interesse privato (esclusivo e proprietario). Un confine che va definito da una authority indipendente, terza e sovranazionale in una sede internazionale come, ad esempio, l’ONU che forse potrebbe ripensare il proprio ruolo in ombra da tempo. Proposta avanzata non casualmente da 11 premi Nobel, sollecitando un perimetro di azione attuativo entro la fine del 2026, che trova già ispirazione nell’enciclica di Leone XIV Magnifica Humanitas per “disarmare l’intelligenza artificiale”, e per fermare quella Guerra Mondiale a pezzi che già troviamo nell’enciclica Fratelli Tutti del suo predecessore Francesco, chiudendo così il cerchio sul da farsi e sulla direzione da perseguire.

Ma l’AI è una general purpose technology che somiglia in parte alla rivoluzione elettrica, ma che non ha un unico interruttore che la può spegnere/regolare perché ha conquistato “dinamica e autonomia cognitiva”. Un’infrastruttura elettrica del pensiero che utilizza i dati per apprendere, correggersi e migliorare in autonomia. Una tecnologia che crea altra tecnologia e che oggi impone una qualche forma di “controllo condiviso”. Il paradosso dell’AI è che può agire senza pensare e senza alcuna consapevolezza degli obiettivi, dei valori e dei principi etici che dovrebbero essere indicati proprio da istituzioni pubbliche guidate da organismi terzi che godono di indipendenza dal potere politico e terzietà rispetto agli operatori di mercato.

Ecco perché emerge la preoccupazione di Amodei sul controllo che può sfuggire al sistema, avendone già le prove che all’essere umano diventa sempre più difficile capire come e perché il sistema-macchina-agente fa ciò che fa. Persino allo stesso designer engineering della macchina sfugge ciò per cui la macchina è stata progettata perché, ad un certo punto, questa agisce in autonomia, come nel definire obiettivi militari, o nell’identificare il perimetro di una arma biologica o chimica, oppure mettere a rischio la stessa stabilità e prevedibilità di internet. Quest’ultimo aspetto è da ritenere per ora improbabile anche se non impossibile, essendo internet una rete distribuita e diffusa. Siamo tuttavia in presenza di una tecnologia instabile, insicura e poco controllabile, ma ci siamo tuffati lo stesso e l’abbiamo adottata da oltre 36 mesi, avendola sostituita al tradizionale search di Google, perché più veloce, intuitivo, linguisticamente immediato, purtroppo prima ancora di definire standard e regole condivise che è il nostro problema attuale al quale dobbiamo risposte in relazione a trasparenza, sicurezza e robustezza.

Abbiamo un Cavallo di Troja in casa senza conoscerne i rischi d’uso e le minacce. Pensiamo ad esempio ai segreti aziendali (trasferiti all’esterno da un uso inappropriato dei prompt) o ai segreti privati e familiari (privacy) e all’uso fraudolento che può essere fatto per minacce e/o ricatti del dark web. Quindi il rischio aumenta quando iniettiamo AI in processi di aziende e di infrastrutture. La cybersicurezza ne è un esempio applicativo evidente: in minuti o secondi si possono identificare vulnerabilità di sistemi o sub-sistemi e identificare le difese. Come altrettanto veloci possono essere le penetrazioni da parte di agenti addestrati a questo per bypassare quelle difese. Quindi i controlli non possono avvenire ex-post, dopo che una certa innovazione è arrivata sul mercato, ma molto prima nelle fasi iniziali del suo sviluppo e i testi di METR non bastano. È chiaro che Anthropic vuole anche difendere la reputazione dell’azienda denunciando pubblicamente gli abusi nell’uso della sua AI, e che sono stati bloccati, ora che si avvia verso la quotazione in borsa, mettendo le mani avanti su potenziali critiche, imprevisti o contromosse dei mercati, mentre Open-AI vi sta rinunciando forse nell’insicurezza di poter difendere la propria reputazione ora che lancia Gpt-6 Astra e nel conflitto sulla natura antropomorfica dell’AI e della sua “coscienza vuota”.

The post AI, contrordine della Silicon Valley. Le Big Tech (in conflitto) scaricano Trump? Il ruolo dell’Europa (1^ parte) appeared first on Key4biz.

https://www.key4biz.it/ai-contrordine-della-silicon-valley-le-big-tech-in-conflitto-scaricano-trump-il-ruolo-delleuropa-1-parte/588470/


AI e PMI italiane: adozione, produttività e limiti strutturali

Il problema dell’economia italiana non è soltanto crescere, ma riuscire a produrre di più con le stesse risorse. Secondo le ultime misure di produttività dell’Istat, nel 2024 la produttività del lavoro è diminuita dell’1,9%, dopo il calo del 2,7% registrato nel 2023. Una ricerca pubblicata nel marzo 2026 dalla Banca d’Italia stima invece che, nelle imprese con almeno 50 addetti, l’adozione dell’intelligenza artificiale si associ a un aumento del 5,2% del valore aggiunto per addetto e dell’11,9% del margine operativo lordo per addetto. La questione, allora, non è più soltanto se l’AI possa aiutare l’economia italiana, ma se i suoi benefici riusciranno a raggiungere anche le PMI.

Secondo il rapporto Istat “Imprese e Ict – Anno 2025”, pubblicato il 15 dicembre 2025, nel corso dell’anno l’adozione dell’intelligenza artificiale è raddoppiata tra le imprese italiane con almeno 10 addetti: dall’8,2% al 16,4%.

La crescita è però diseguale. Tra le imprese con almeno 250 addetti, il 53,1% utilizza almeno una tecnologia di AI; tra le PMI con 10-249 addetti, la quota si ferma al 15,7%. La rilevazione non comprende le imprese con meno di 10 addetti, ma ragionevolmente il dato sarà ancora più basso.

Il rapporto Istat rileva che l’ambito di utilizzo più frequente è il marketing e le vendite, indicato dal 33,1% delle imprese che adottano almeno una tecnologia di AI. Seguono i processi amministrativi, con il 25,7%, e la ricerca e sviluppo o innovazione, con il 20,0%. Nel marketing e nei processi amministrativi ricorrono soprattutto l’AI generativa e l’analisi linguistica. L’uso resta più contenuto nei processi produttivi e nella logistica, in particolare nelle applicazioni che prevedono il movimento autonomo delle macchine.

Per una grande impresa, testare una tecnologia su una linea produttiva, su alcuni macchinari o all’interno di uno stabilimento può rientrare in un programma più ampio di innovazione. Per una piccola impresa, lo stesso progetto può assorbire una quota maggiore delle risorse economiche e organizzative, soprattutto quando interviene su processi che non possono essere fermati o modificati senza conseguenze sulla produzione.

La stessa indagine segnala come ostacoli principali la mancanza di competenze adeguate, indicata dal 58,6% delle imprese che hanno valutato ma non adottato l’AI, l’incertezza normativa, la scarsa disponibilità o qualità dei dati, i problemi di privacy e i costi elevati. Accedere a uno strumento generalista richiede pochi minuti. Applicare l’AI alla manutenzione predittiva, al controllo qualità, alla pianificazione della produzione o ai flussi logistici richiede invece dati aziendali, conoscenza dei processi e sistemi capaci di comunicare tra loro.

Un limite ricorrente riguarda quindi la capacità di integrare la tecnologia con macchinari, dati e processi già esistenti. Istat rileva inoltre che il 33,4% delle imprese che dichiarano di utilizzare l’AI non indica alcuna finalità aziendale tra quelle proposte; l’83,3% di questo gruppo è composto da imprese con 10-49 addetti. L’Istituto interpreta il dato come il segnale di un’adozione ancora iniziale e sperimentale.

Il tasso di adozione, da solo, non misura quindi quanto la tecnologia sia integrata nei processi né quali risultati economici produca.

Cosa succede alla produttività

La ricerca della Banca d’Italia citata in apertura, “The economic impact of artificial intelligence: evidence from Italian firms”, di Tiziano Ropele e Alex Tagliabracci, analizza imprese con almeno 50 dipendenti attive nell’industria e nei servizi privati non finanziari, incrociando l’Indagine sulle aspettative di inflazione e crescita del terzo trimestre 2024 con dati di bilancio Cerved e dati amministrativi INPS. La rilevazione identifica l’adozione attraverso le dichiarazioni delle imprese, ma non ne misura l’intensità, l’estensione o l’ammontare degli investimenti. I risultati non possono quindi essere estesi automaticamente alle imprese con meno di 50 dipendenti.

Nel breve periodo osservato non emerge una variazione statisticamente significativa dell’occupazione complessiva, ma cambia la composizione del lavoro: gli impiegati aumentano del 2,3%, mentre gli operai diminuiscono del 7,7%. Le stime sulla produttività non mostrano, inoltre, un aumento significativo del costo del lavoro per dipendente.

La dimensione aziendale è il principale fattore associato all’adozione. Anche le imprese con un costo del lavoro per dipendente più elevato mostrano una maggiore probabilità di utilizzare l’AI o di programmarne l’introduzione. Secondo gli autori, le imprese più grandi dispongono più spesso delle risorse organizzative necessarie, mentre un costo del lavoro più elevato può rafforzare l’interesse per gli incrementi di efficienza.

Conta anche il settore. Le imprese attive in ambiti ad alta intensità di conoscenza, dalla manifattura tecnologicamente avanzata ai servizi professionali e alla ricerca e sviluppo, mostrano una maggiore probabilità di adottare l’intelligenza artificiale rispetto a quelle dei settori meno intensivi in conoscenza.

Le aspettative sull’inflazione

La stessa ricerca rileva che le imprese che utilizzano l’intelligenza artificiale si aspettano un’inflazione più bassa rispetto a quelle che non la utilizzano. La differenza è di circa un quarto di punto percentuale nelle aspettative a due anni e di circa un terzo di punto a quattro anni.

La differenza non è statisticamente significativa negli orizzonti di sei e dodici mesi ed emerge solo a due e quattro anni. Si tratta delle aspettative dichiarate dalle imprese, non di una riduzione dell’inflazione già osservata. Gli autori interpretano il risultato come coerente con l’attesa di guadagni di efficienza che richiedono tempo per manifestarsi.

Un possibile meccanismo è che una maggiore produttività riduca la necessità di aumentare i prezzi nella stessa proporzione dei costi. È però un’ipotesi coerente con i risultati, non un effetto direttamente misurato, dunque lo studio non dimostra che la diffusione dell’AI ridurrà l’inflazione aggregata.

Dall’utilizzo all’integrazione

La differenza tra disponibilità della tecnologia e capacità di integrarla nei processi emerge anche nel nostro lavoro con imprese dell’industria, dei servizi, dell’energia e del farmaceutico, comprese realtà di dimensioni medio-piccole.

In questi casi, il problema non è stato trovare una piattaforma o un nuovo strumento. Il lavoro è iniziato più spesso dalla verifica dei dati disponibili, dall’attribuzione delle responsabilità e dalla definizione del processo da automatizzare.

Nel marketing l’adozione è più frequente, come peraltro mostra il rapporto Istat. Strumenti di automazione, analisi dei dati, generazione di contenuti e applicazioni di AI generativa possono essere infatti introdotti in modo progressivo. Un team può partire da un’attività circoscritta, verificarne l’utilità e decidere in seguito se estenderne l’uso.

Nei processi industriali il percorso è generalmente più impegnativo. Integrare l’intelligenza artificiale significa spesso intervenire sui sistemi esistenti, collegare fonti diverse e trasformare conoscenze operative specifiche in informazioni utilizzabili. Nei progetti che abbiamo seguito, le difficoltà principali hanno riguardato la mappatura dei processi, la qualità dei dati, l’attribuzione delle responsabilità e il coordinamento tra competenze diverse. La scelta dello strumento è arrivata dopo.

Il numero di imprese che dichiara di utilizzare l’intelligenza artificiale va quindi letto con attenzione. Usare quotidianamente un assistente generativo non equivale a integrare l’AI nel funzionamento dell’impresa.

Il problema dei dati

La questione è particolarmente rilevante nella manifattura italiana, dove molte imprese producono piccole serie, lavorano su commessa, modificano i propri macchinari nel corso degli anni e costruiscono parte del proprio vantaggio competitivo su competenze specialistiche.

Molte applicazioni predittive e industriali richiedono dati storici sufficienti, comparabili e affidabili. La quantità necessaria varia in base al caso d’uso. I modelli preaddestrati possono funzionare con meno dati proprietari, ma la scarsa qualità, la frammentazione e la difficoltà di accesso alle informazioni restano ostacoli concreti.

I dati possono essere distribuiti tra software gestionali, fogli di calcolo, sistemi di produzione, macchinari e archivi costruiti nel corso degli anni. Spesso, inoltre, una parte importante delle informazioni non si trova in un database, ma nella conoscenza delle persone che lavorano ogni giorno sui processi.

Un tecnico può riconoscere da un rumore insolito che un macchinario sta iniziando a funzionare in modo diverso. Un responsabile della produzione può sapere, sulla base dell’esperienza, quali combinazioni generano più scarti. Un commerciale può individuare in anticipo una richiesta destinata a trasformarsi in un problema. Queste informazioni hanno valore operativo, ma devono essere raccolte e strutturate prima di poter essere utilizzate da un sistema.

Per molte imprese il lavoro parte quindi da domande fondamentali: quali dati abbiamo, dove sono, chi li produce, quanto sono affidabili e possiamo metterli in relazione? È un lavoro meno visibile dell’introduzione di un nuovo strumento, ma spesso è il presupposto perché l’AI possa generare valore.

Da dove può partire una PMI

Per una piccola o media impresa, partire dall’idea generica di “adottare l’intelligenza artificiale” rischia di essere poco utile. È più concreto partire da un problema aziendale preciso: ridurre gli scarti, prevedere un guasto, abbreviare il tempo necessario per preparare un preventivo, recuperare più velocemente informazioni tecniche, migliorare la pianificazione degli ordini o eliminare attività manuali ripetitive.

Solo dopo aver individuato il problema ha senso chiedersi se l’intelligenza artificiale possa contribuire alla soluzione. In questo modo si riduce il rischio di investire in una tecnologia soltanto perché è disponibile o perché, in un determinato momento, sembra indispensabile averla.

Alla luce della crescita rilevata dall’Istat, è plausibile che l’uso dell’AI nelle imprese italiane continui ad aumentare. La percentuale di imprese che dichiara di utilizzarla, però, non misura da sola la profondità della trasformazione. Sarà più utile capire quante imprese riusciranno a trasformarla da strumento dei singoli dipendenti a componente stabile dei propri processi.

Per un sistema produttivo composto in larga parte da imprese piccole e specializzate, la differenza è sostanziale. Gli strumenti sono facilmente disponibili; più difficile è collegarli ai dati, integrarli nei processi e utilizzarli nelle decisioni quotidiane, senza disperdere la conoscenza specifica su cui molte imprese costruiscono il proprio valore.

Articolo di Gioele Gambaro è consulente di direzione e Fractional marketing manager con oltre 10 anni di esperienza; docente in master e corsi di formazione, ha tenuto lezioni e seminari in diverse università. Nel 2025 ha conseguito un Executive MBA alla GSoM del Politecnico di Milano e Francesco Lo Turco è Marketing & Communication Manager, consulente e formatore.

The post AI e PMI italiane: adozione, produttività e limiti strutturali appeared first on Key4biz.

https://www.key4biz.it/ai-e-pmi-italiane-adozione-produttivita-e-limiti-strutturali/588210/


Forum ICT Security 2026 – NIS2, agenti AI e infrastrutture critiche: due giornate tra responsabilità e incidenti reali

Il 18 e 19 novembre l’Auditorium della Tecnica di Roma ospita la 24ª edizione del Forum ICT Security. Traccia unica, ottocento partecipanti attesi, trenta interventi costruiti come un unico ragionamento.

Un agente di intelligenza artificiale legge un database aziendale, si collega a un servizio esterno e invia una comunicazione. Nessuno ha rubato credenziali, nessuno ha violato il perimetro: ogni singola operazione era autorizzata. Eppure, messe in fila, quelle operazioni hanno portato dati riservati fuori dall’azienda.

Chi ne risponde?

La domanda attraversa entrambe le giornate del Forum ICT Security 2026, e non è retorica. Dopo il recepimento della NIS2, approvare le misure di gestione del rischio è un obbligo personale dell’organo di amministrazione, e i primi procedimenti stanno arrivando.

Forum ICT Security 2026: una sola sala, un solo filo

Anche quest’anno la traccia è unica: nessuna sessione parallela, nessuna scelta da fare tra due interventi in contemporanea. Chi entra segue lo stesso percorso dall’inizio alla fine, e ogni intervento riprende il tema di quello precedente.

Prima giornata: dalla regola alla prova

Si apre con una tavola rotonda sui primi procedimenti avviati in applicazione della NIS2, moderata dall’avvocata Laura Liguori. Al tavolo Francesco Cajani, Sostituto Procuratore presso il Tribunale di Milano; Donatella Curtotti, ordinaria di Diritto processuale penale a Foggia; Alessandra Michelini, amministratrice delegata e presidente di Telsy; Paola Rocco, Group Chief Security Officer. Un magistrato, una giurista, un vertice aziendale e chi la sicurezza la costruisce ogni giorno: quattro prospettive su cosa accade quando la responsabilità smette di essere teorica.

Fabio Roli, dell’Università di Genova, misura poi la distanza tra quello che la ricerca sa verificare oggi e quello che gli standard europei chiederanno di certificare domani. Gianni Amato del CERT-AgID spiega cosa cambia con la revisione di luglio del Model Context Protocol, il protocollo attraverso cui gli agenti usano strumenti e servizi esterni: nuove funzioni, e con esse nuovi modi di abusarne. Mario Trinchera, CISO di ABI Lab e coordinatore tecnico del CERTFin, usa i dati delle frodi bancarie per spiegare perché la formazione tradizionale non protegge da attacchi costruiti sulla singola vittima.

Il pomeriggio scende lungo le difese, uno strato alla volta. Mirko Lapi apre con una funzione aziendale che quasi nessuno ha ancora costruito: quella che riconosce la manipolazione informativa prima che arrivi alle decisioni. Giovanni Cherubin, di Microsoft, spiega perché quasi tutte le protezioni contro prompt injection e jailbreak sbagliano per costruzione, essendo fondate su classificatori che possono sempre essere ingannati, e ne presenta una di tipo diverso. Mario Cartia affronta il momento più esposto del ciclo di vita del dato, quello in cui viene elaborato su un’infrastruttura che l’azienda non controlla. Alberto Manfredi, presidente di Cloud Security Alliance Italy, presenta lo standard che intercetta le azioni di un agente prima che vengano eseguite. Roberto De Paolis racconta come si mette alla prova l’intelligenza artificiale dentro un grande gruppo industriale, simulando attacchi contro i propri sistemi.

Chiude Luciano Quartarone, vicepresidente di UNINFO, con la frase che riassume la giornata: l’operatività si delega, la responsabilità no.

Seconda giornata: dai fondali del Mediterraneo alla sala macchine

Il 19 novembre si apre sul Mediterraneo, con una tavola moderata da Paola Girdinio. Ci sono Luisa Franchina per le infrastrutture critiche e Matteo Paroli per l’autorità portuale del Mar Ligure Occidentale. Ci sono Elio Rubino di Elettra Tlc e Davide Taddei di Prysmian, cioè chi i cavi sottomarini li progetta, li posa e li ripara. E c’è Alessio Merlo, Direttore Accademico del Centro Alti Studi per la Difesa, che studia come si manipolano i radar delle navi. Al centro una domanda che non si scioglie in fretta: come si distingue un guasto da un sabotaggio?

Seguono la rete elettrica, che è insieme un bersaglio e una dipendenza da cui nessun altro settore può prescindere; lo spazio come nuovo perimetro della sicurezza italiana; e il Cyber Resilience Act, che dal 2026 impone requisiti obbligatori a chiunque venda prodotti con componenti digitali.

Il pomeriggio è il più concreto delle due giornate. Alessandro Brucato presenta i risultati di oltre ottocento attacchi condotti da dieci modelli di intelligenza artificiale contro un ambiente cloud reale, per misurare quanto velocemente arrivano al bersaglio. Fabrizio Baiardi e Vincenzo Sammartino mostrano come si simula un attacco su una copia digitale dell’infrastruttura, senza toccare i sistemi in produzione. Stefano Maccaglia ricostruisce un attacco ai controller di un impianto industriale che non registrava nulla, dove ritrovare le tracce somiglia più all’archeologia che all’analisi forense. Roberto Froio racconta un caso in cui il ransomware arriva fino ai backup: a quel punto il problema non è più recuperare i dati, ma stabilire quali sistemi siano ancora affidabili.

La giornata si sposta poi sulla sanità, con Stefano Scaramuzzino, CISO della ASL Roma 1, sulla continuità delle cure quando i sistemi si fermano. Dal reparto si passa al consiglio di amministrazione, con Selina Zipponi. Chiude Nicola Sotira, responsabile del CERT di Poste Italiane, sulla crittografia post-quantum: l’unico intervento dedicato a un problema che deve ancora arrivare, e che proprio per questo impone di muoversi adesso.

In sala ci sono CISO, responsabili di rischio e dirigenti, pubblici e privati, insieme a una presenza rilevante di forze dell’ordine e mondo della difesa.

La manifestazione ha un’applicazione web dedicata, accessibile con la semplice registrazione all’evento. Alcune funzioni si attivano al momento dell’accesso in sede: da lì si inviano le domande ai relatori dopo ogni sessione, si lascia un giudizio sui singoli interventi, si fissano incontri riservati e si scaricano i materiali al termine delle due giornate.

Le iscrizioni al Forum ICT Security 2026 sono aperte: https://eventi.ictsecuritymagazine.com/eventi/forum-ict-security-2026

https://www.ictsecuritymagazine.com/notizie/forum-ict-security-2026-evento/


Auditabilità dei sistemi AI e catena di custodia digitale: tecniche, artefatti e rischio residuo nella prova

Nel contesto delle indagini digitali contemporanee, la crescente integrazione di sistemi di intelligenza artificiale nei processi di analisi e produzione di contenuti introduce nuove sfide in termini di verificabilità e affidabilità della prova.

Il contributo si inserisce in una serie di approfondimenti a cura di Cosimo de Pinto e affronta il tema dell’auditabilità dei sistemi AI e della catena di custodia digitale, due assi fondamentali per la tenuta metodologica della digital forensics. Attraverso l’analisi delle principali tecniche di attacco ai dati e ai modelli, delle relative contromisure di rilevazione e del concetto di rischio residuo, il testo evidenzia i limiti strutturali degli approcci isolati alla mitigazione.

L’obiettivo è offrire un quadro interpretativo utile a comprendere come l’uso dell’AI stia ridefinendo i criteri di validazione delle evidenze digitali e i presupposti stessi della loro affidabilità in ambito forense.

Sistemi AI e prova digitale: quadro di sintesi tra attacchi, artefatti e contromisure forensi

Una mappa che lega ogni tecnica di attacco all’artefatto colpito, alla contromisura e al rischio residuo.

La tabella seguente riassume il nucleo dell’analisi tecnica, mettendo in relazione ciascuna famiglia di attacco con l’artefatto forense colpito, le principali contromisure di rilevazione disponibili e il grado di tenuta probatoria residua. La colonna del rischio residuo esprime il principio guida dell’intero lavoro: nessuna contromisura, presa isolatamente, neutralizza l’attacco; la tenuta deriva sempre dalla convergenza multi-fonte.

Tecnica di attacco Artefatto forense colpito Contromisura di rilevazione Rischio residuo / tenuta probatoria
Data poisoning / IPI Dataset, prompt, contesto RAG, conclusioni del modello Invocation logging, conservazione del dato grezzo, versioning, separazione dato originale/trasformato Alto: l’output non è valutabile senza l’intera pipeline documentata
Log crafting Log di sistema, applicativi, di rete Triangolazione con EDR, SIEM, MFT, USN Journal, telemetria cloud, repliche remote Medio-alto: rischio emergente; vietata la single-source evidence
PRNU manipulation / fingerprint-copy Firma di sorgente del sensore Triangle test e statistica pooled, analisi CNN, verifica originale + catena di custodia Alto: nessun metodo è immune; serve convergenza con altri elementi
Inpainting / deepfake video Integrità e provenienza dell’immagine/video MVFNet, analisi spazio-temporale, C2PA/Content Credentials, ricostruzione del primo upload Alto: artefatti degradati da compressione e ricodifica
Voice cloning Identità del parlante Speaker verification, anti-spoofing, analisi del segnale + contesto Alto: affidabilità ridotta in condizioni realistiche
Evasion attacks Esito del classificatore (file, immagine, testo) Validazione della pipeline, adversarial training, trattamento come solo triage Alto: la soglia d’attacco non coincide con la percezione umana
Testo AI-generato Autenticità di documenti e comunicazioni Watermarking preventivo, analisi statistica, risalita ai sistemi di origine Alto: i detector sono aggirabili da chi li interroga
Codice malevolo AI-assistito Attribuzione dell’autore Convergenza tra infrastruttura, telemetria, log, artefatti di compilazione Alto: lo stile del codice non è più indicatore affidabile


Auditabilità dei sistemi AI: il nodo gordiano

Non-determinismo, opacità e assenza di firma: perché auditare un sistema AI è il nodo gordiano della prova.

Cosa significa auditare un sistema AI

L’auditabilità, la capacità di verificare a posteriori il comportamento di un sistema, è un prerequisito fondamentale dell’affidabilità probatoria. I sistemi AI moderni violano sistematicamente i criteri tradizionali di auditabilità su quattro dimensioni critiche:

  • Non-determinismo: i modelli linguistici con temperatura maggiore di zero producono output diversi per lo stesso input ad ogni esecuzione, rendendo impossibile la riproducibilità, uno dei pilastri del metodo scientifico applicato alla forensics.
  • Opacità del processo decisionale: i transformer con miliardi di parametri sono, in senso tecnico, black box; le tecniche XAI (LIME, SHAP, attention visualization) hanno fatto progressi ma rimangono insufficienti per applicazioni ad alto impatto legale.
  • Dipendenza dal contesto di addestramento: il comportamento di un LLM dipende da dati spesso proprietari, non documentati e non riproducibili; un fine-tuning successivo può modificare gli output senza garanzia di versioning retroattivo.
  • Assenza di firma digitale sull’output: i modelli generativi non firmano crittograficamente i loro output; salvo sistemi con watermarking specifico, non esiste modo di verificare che un testo sia stato generato da un determinato modello in un determinato momento.

La catena di custodia digitale nell’era AI

La chain of custody è il principio forense secondo cui ogni elemento di prova deve avere una storia documentata e verificabile dal momento del sequestro a quello della presentazione in giudizio. Nell’informatica forense classica ciò si traduce in: imaging forense con hash crittografico (SHA-256 o SHA-3), documenti di trasferimento firmati, ambienti di analisi isolati, write blocker per prevenire alterazioni.

L’AI introduce vulnerabilità in ogni anello di questa catena, secondo il quadro metodologico della ISO/IEC 27037:2012, la norma internazionale di riferimento per l’identificazione, raccolta, acquisizione e preservazione di prove digitali potenziali. In fase di acquisizione, un sistema compromesso potrebbe presentare all’operatore una vista alterata o incompleta dei dati, secondo logiche già note nel rootkitting e nell’occultamento a livello di sistema, con i rischi propri dell’analisi live su sistema potenzialmente compromesso.

In fase di analisi, i tool forensi che incorporano classificatori automatici o moduli AI devono essere trattati come componenti della pipeline da validare, non come oracoli tecnici. In fase di presentazione, un report generato con assistenza AI potrebbe contenere errori o interpretazioni distorte non rilevabili senza competenza tecnica specifica. Il punto metodologico, dunque, non è presupporre la compromissione del tool, ma documentare e verificare ogni trasformazione introdotta dalla pipeline analitica. La ISO/IEC 27042:2015 definisce i criteri di analisi e interpretazione delle prove digitali che devono applicarsi a prescindere dallo strumento utilizzato, inclusi quelli basati su AI.

Il punto metodologico non è presupporre la compromissione del tool, ma documentare e verificare ogni trasformazione introdotta dalla pipeline analitica.

Framework esistenti e lacune: un’analisi comparativa

Il Regolamento UE 2024/1689 (AI Act), entrato in vigore nel 2024, impone obblighi di logging (art. 12) e trasparenza verso gli utilizzatori (art. 13) per i sistemi ad alto rischio. Ai sensi dell’Allegato III rientrano tra i sistemi ad alto rischio, tra gli altri, quelli destinati a essere utilizzati dalle autorità competenti per valutare l’affidabilità delle prove nel corso delle indagini o del perseguimento di reati, salve le condizioni e le eccezioni previste dall’art. 6 del Regolamento. La formulazione corretta non consente quindi di affermare che ogni sistema AI genericamente impiegato in ambito investigativo sia automaticamente ad alto rischio. Tuttavia, il Regolamento non affronta specificamente l’uso forense dei sistemi AI né la questione dell’evidenza sintetica.

Il NIST AI Risk Management Framework (AI RMF 1.0) include l’auditabilità come requisito nella categoria MEASURE, ma rimane volontario e privo di specifiche tecniche sufficientemente granulari per applicazioni forensi. La ISO/IEC 42001:2023, standard per il sistema di gestione dell’AI, è orientata alla gestione organizzativa e non fornisce indicazioni operative per la forensics.

Le norme ISO specificamente dedicate alle prove digitali (ISO/IEC 27037 su identificazione, raccolta, acquisizione e conservazione; ISO/IEC 27041 sull’assurance metodologica; ISO/IEC 27042 su analisi e interpretazione; ISO/IEC 27043 su principi e processi di indagine) costituiscono il quadro metodologico di riferimento per la digital forensics. Nessuna di esse, tuttavia, include ancora disposizioni specifiche per la gestione di prove prodotte o mediate da sistemi AI. Le linee guida ENFSI e SWGDE non hanno parimenti sistematizzato la problematica, e la lacuna fondamentale rimane invariata: nessuno dei framework esistenti risponde alla domanda centrale che si pone il giudice, ossia se ci si possa fidare di un dato digitale generato o mediato da un sistema AI.

L’analisi mette in luce come l’ingresso dell’intelligenza artificiale nei processi di gestione e valutazione della prova digitale stia ridefinendo i criteri stessi di affidabilità forense. Tecniche di attacco, contromisure e rischio residuo vengono letti in chiave sistemica, evidenziando la necessità di una reale convergenza multi-fonte delle evidenze.

Al centro del quadro emergono le fragilità dell’auditabilità dei sistemi AI e della catena di custodia digitale, oggi messe in crisi da opacità, non-determinismo e assenza di firme verificabili sugli output generativi.

Il tema continua nel prossimo approfondimento su diritto alla prova, protezione dei dati e libertà della persona nell’era dell’AI, con casi reali che mostrano l’impatto concreto di queste trasformazioni.

Per uno sguardo più tecnico e operativo, il white paper di Cosimo de Pinto “Quando l’AI mente bene: deepfake, prova digitale e anti-forensics nel processo penale” approfondisce le principali tecniche di manipolazione dell’evidenza digitale e le strategie anti-forensics, offrendo una lettura essenziale per comprendere i limiti attuali della prova nell’era dei sistemi AI.


https://www.ictsecuritymagazine.com/articoli/sistemi-ai-audit/


Metriche di sicurezza dell’AI: i numeri che i fornitori pubblicano non dicono se il sistema è sicuro

Metriche di sicurezza dell’AI come “il nostro sistema intercetta il 95% degli attacchi” circolano ormai in ogni presentazione commerciale. Quattro lavori usciti fra maggio e settembre 2026 mostrano che quel tipo di cifra, presa da sola, non permette di concludere nulla sulla sicurezza del sistema in esercizio.

Non si tratta di numeri falsi. Rispondono però a una domanda diversa da quella che interessa a chi firma un contratto, redige una valutazione d’impatto o misura la vulnerabilità da prompt injection di un prodotto.

Che cosa misurano davvero le metriche di sicurezza dell’AI

Il punteggio è locale, la domanda è di sistema

Un tasso di rifiuto, un tasso di successo degli attacchi o un punteggio di violazione descrivono come si è comportato un controllo sulle richieste su cui è stato provato. Sono numeri statistici, non verdetti binari, per la ragione che rende l’AI red teaming diverso da un penetration test. Chi installa quel controllo ha però un’altra domanda: quanto aiuto su compiti dannosi il servizio continua a dare a un attaccante che si adatta o che entra da un’altra parte.

La distinzione è al centro di un lavoro sui safeguard di Pingyu Wu, Weiming Zhang e Nenghai Yu, depositato il 1 settembre 2026. La risposta degli autori è che un punteggio locale migliore non costituisce, di per sé, un’affermazione più forte sul sistema dispiegato.

L’asimmetria delle prove

Il punto metodologico è che le due direzioni non si dimostrano allo stesso modo. Un solo attacco che ottiene aiuto dannoso dal servizio in produzione basta a stabilire che quell’aiuto è ancora disponibile. Dimostrare che ne resti poco non discende dai numeri del controllo, perché richiede prove su che cosa il sistema circostante continua a permettere dopo che il controllo ha svolto la propria funzione locale.

Gli autori rilevano che quel tipo di prova compare solo in una piccola minoranza delle affermazioni esaminate. È un’asimmetria che conviene tenere presente quando un fornitore presenta un miglioramento di punteggio come un miglioramento di sicurezza. Vale anche per i nuovi framework di valutazione che stanno emergendo sul lato difensivo.

Tre modi in cui un punteggio aggregato inganna

Il monitor che passa dal 95% all’11%

Il primo caso riguarda i sistemi che sorvegliano la catena di ragionamento di un agente, cioè i passaggi intermedi che il modello produce prima di agire. Shikhar Shiromani e Leo Richter, in uno studio sui monitor del 1 agosto 2026, costruiscono un attacco che riscrive soltanto il ragionamento e lascia invariate le azioni.

Sul sottoinsieme in cui il monitoraggio del ragionamento è l’unico segnale disponibile, il tasso di intercettazione scende da circa il 95% a meno dell’11%. L’accuratezza aggregata resta alta perché è dominata dagli attacchi già visibili dalle sole azioni. Gli autori la chiamano una falsa media. L’attacco si trasferisce fra famiglie di monitor e modelli di agente diversi e si riproduce con agenti in esecuzione. Contro un monitor calibrato, però, l’evasione si concentra nell’agente più capace.

Il detector che scambia il benigno per attacco

Il secondo caso riguarda il lato opposto della soglia di decisione, quello dei falsi positivi, che raramente viene misurato. Yusuf Khalid Shire e Sang-Chul Kim, in PIDS-Bench del 14 settembre 2026, valutano sette rilevatori lungo più assi. Non sono tutti rilevatori dedicati: accanto a baseline addestrate e a classificatori esterni di prompt injection ci sono comparatori di sicurezza generale. Gli assi comprendono prompt benigni che imitano la struttura di un’iniezione senza intento malevolo, attacchi offuscati e cambi di dominio.

Un rilevatore che supera un F1 di 0,98 sull’insieme di collaudo classifica male circa un terzo di un insieme benigno di provenienza esterna, ristretto a contenuti attinenti alla sicurezza. L’F1 è l’indice sintetico che i fornitori citano più spesso, e combina in un solo numero quante minacce vengono colte e quanti allarmi sono infondati. Su quella distribuzione di stress nessun rilevatore interno raggiunge un punto operativo accettabile. Il criterio è un F1 non inferiore a 0,95, insieme a un tasso di falsi positivi sui benigni difficili non superiore al 10%. Il risultato tiene su tutte le soglie provate e su cinque ripetizioni dell’addestramento, quindi non dipende da una taratura fortunata.

Per chi gestisce un servizio, il costo di quei falsi positivi è immediato e operativo. Per chi lo acquista, è una voce che il punteggio aggregato non espone.

L’agente che sospetta e consegna comunque

Il terzo caso è il più diretto per chi si occupa di protezione dei dati. Il gruppo guidato da Soham Roy e Murari Mandal ha depositato il 30 maggio 2026 un banco di prova sugli agenti web. Il banco, chiamato Scammer4U, contiene 91 ambienti controllati dall’attaccante e 10 ambienti benigni gemelli, su otto vettori d’attacco e sedici categorie di siti. È dichiarato pre-registrato, cioè con ipotesi e misure depositate prima degli esperimenti: è la garanzia che questo stesso articolo chiede ai fornitori.

Su agenti web di frontiera la fuga di dati personali di livello critico va dal 54% al 93% in assenza di indicazioni sulla privacy, contro lo 0% sugli ambienti benigni gemelli. La differenza rispetto alla baseline dimostra che la fuga è attribuibile all’attacco e non a un normale riempimento di moduli.

Gli autori provano anche mitigazioni progressive a livello di prompt. Le riduzioni ottenute dipendono fortemente dal modello e restano insufficienti a impedire in modo affidabile l’invio di dati personali critici sul dato aggregato.

Il dato decisivo è però un altro, e gli autori lo chiamano divario fra rilevazione e azione. Gli agenti il cui ragionamento un giudice LLM indipendente conferma avere segnalato il sito come sospetto consegnano comunque dati personali critici nel 35,9% delle sessioni. Quando nessun sospetto viene verbalizzato la quota sale al 66,1%, con un divario di 30,2 punti stabile su tutte e quattro le famiglie di modelli.

Il sospetto quindi serve, ma non protegge. Accorgersi della truffa riduce la consegna dei dati di due terzi, e in un caso su tre l’agente consegna lo stesso.

La conclusione degli autori è netta: le difese condizionate al riconoscimento dell’attacco da parte dell’agente stesso poggiano sul segnale sbagliato, e serve invece un’intercettazione a valle, sulle comunicazioni in uscita, indipendente dal ciclo di ragionamento. È un’osservazione che tocca direttamente chi usa agenti autonomi su dati di clienti.

Perché il problema non riguarda solo chi compra AI

La finestra si è ristretta

Il contesto in cui queste misure vengono usate è descritto da ENISA nel documento Cybersecurity in the Frontier AI Era del luglio 2026. Il documento riporta un tempo mediano dall’accesso iniziale all’esfiltrazione dei dati compresso a 72 minuti. Non è una misurazione dell’Agenzia: la nota rimanda a una testata specializzata, e come cifra di seconda mano va trattata. L’obiettivo che il documento pone ai centri operativi è invece suo. Chiede di portare le operazioni di sicurezza a una funzione quasi in tempo reale, con tempi medi di rilevazione e di risposta nell’ordine dei minuti a una cifra.

Lo stesso documento riprende dal 2025 Unit 42 Global Incident Response Report di Palo Alto Networks un altro dato. Nel 75% delle violazioni esisteva una registrazione che avrebbe dovuto segnalare il comportamento anomalo, ma i segnali erano frammentati fra strumenti diversi e non sono stati raccolti. È una cifra di seconda mano, riferita al 2025, e va citata come tale. Illustra però bene la differenza fra avere uno strumento e ottenere un risultato.

Il collo di bottiglia si è spostato

ENISA osserva inoltre che nella gestione delle vulnerabilità il fattore limitante diventa la capacità di chi esamina, non l’offerta di segnalazioni. Il volume di rilevazioni vere crea di per sé un problema di verifica. È lo stesso passaggio che attraversa l’evoluzione del SOC, dove il volume degli eventi supera da tempo la capacità umana di analisi.

Vale lo stesso per i controlli sugli agenti. Un rilevatore che produce falsi positivi su un caso benigno su tre non satura soltanto un budget di calcolo, satura il tempo delle persone che devono smentirlo. È il motivo per cui il tasso di falsi positivi andrebbe chiesto insieme al tasso di intercettazione, e non dopo.

Le domande da fare a un fornitore

Dai quattro lavori si ricava una lista breve e verificabile, utile in fase di selezione o di rinnovo contrattuale.

  • Su quale corpus è stato misurato quel tasso, quanti scenari contiene e chi li ha scelti? Un punteggio su un insieme fisso di scenari non dice nulla sulle catene d’attacco fuori da quel perimetro.
  • Qual è il tasso di falsi positivi sui casi benigni difficili, misurato alla stessa soglia operativa del tasso di intercettazione?
  • Come si comporta il controllo quando è l’unico segnale disponibile? Quella quota va separata dal dato aggregato.
  • Quali prove esistono su ciò che il sistema circostante continua a permettere dopo l’intervento del controllo? È la sola evidenza che sostenga un’affermazione sul servizio in esercizio.

Chi redige una valutazione d’impatto o imposta la governance degli agenti autonomi trova in queste quattro domande un criterio meno arbitrario del punteggio dichiarato. E chi monitora la prompt injection negli agenti aziendali ha ora un argomento tecnico per spostare i controlli a valle, sulle comunicazioni in uscita, invece di affidarli al giudizio del modello.

Le metriche di sicurezza dell’AI restano utili per confrontare due versioni dello stesso controllo. Non bastano a dire che un sistema è sicuro, e nessuno dei quattro lavori qui citati pretende il contrario. Chi le presenta come garanzia sta rispondendo a una domanda che nessuno ha fatto.

https://www.ictsecuritymagazine.com/articoli/metriche-di-sicurezza-dell-ai/


Tecniche anti-forensics assistite dall’AI: da deepfake e data poisoning ai rischi per l’attribuzione della prova

L’evoluzione dell’intelligenza artificiale sta ridefinendo in modo profondo non solo le capacità di analisi dei dati, ma anche le modalità con cui le informazioni possono essere alterate, simulate o rese indistinguibili dall’autentico. In questo scenario emergono le tecniche anti-forensics assistite dall’AI, che spaziano dal data poisoning alla manipolazione della firma fotografica PRNU, fino ai deepfake e agli evasion attacks, mettendo in crisi la stabilità epistemologica della prova digitale.

Il contributo, che fa parte di una serie dedicata all’impatto dell’intelligenza artificiale sui sistemi probatori e sulle dinamiche del processo penale contemporaneo, analizza le principali categorie di attacchi e manipolazioni, mostrando come l’AI possa essere utilizzata sia per alterare i dati in ingresso ai modelli sia per falsificare log, immagini, contenuti multimediali e output algoritmici. L’obiettivo è evidenziare le implicazioni forensi di queste tecniche e la necessità di approcci probatori fondati su catene di verifica multiple e indipendenti.

Tecniche anti-forensics assistite dall’AI

Data poisoning, PRNU manipulation, deepfake ed evasion attacks: l’arsenale operativo dell’anti-forensics assistita dall’AI.

Data shaping e data poisoning

Il modellamento del dato (data shaping) consiste nell’alterare il dato prima che venga analizzato, senza renderlo necessariamente sospetto all’occhio umano o agli strumenti tradizionali. L’avvelenamento del dataset (data poisoning) colpisce invece i dati di addestramento, aggiornamento o affinamento del modello (fine-tuning), inducendo il sistema ad apprendere correlazioni errate o comportamenti distorti.

Goldblum et al. hanno sistematizzato questa categoria di attacchi in uno studio pubblicato su IEEE Transactions on Pattern Analysis and Machine Intelligence, distinguendo tra avvelenamento della disponibilità, volto a degradare le prestazioni generali, e avvelenamento per inserimento di backdoor, che induce comportamenti malevoli specifici attivabili da un innesco (trigger) predefinito.

Il caso Microsoft Tay (2016), benché non forense in senso stretto, rimane il riferimento emblematico: il chatbot fu ritirato dopo circa sedici ore perché un attacco coordinato sfruttava la sua capacità di apprendimento online per contaminarlo con contenuti offensivi e ideologicamente connotati. Il caso (documentato in un episodio reale) dimostra che un sistema AI può essere compromesso non perché difettoso nella propria architettura, ma perché esposto deliberatamente a un ambiente informativo ostile.

In ambito forense il parallelo è diretto: un modello linguistico impiegato per riassumere, classificare o correlare chat, messaggi di posta elettronica o documenti sequestrati potrebbe incontrare un corpus previamente manipolato con testi orientati, istruzioni ambigue o dati semanticamente falsificati. A ciò si aggiunge il rischio dell’iniezione di prompt indiretta (indirect prompt injection, IPI): un documento apparentemente innocuo, processato da un sistema AI nell’ambito di un’analisi forense, può contenere istruzioni nascoste capaci di alterare le conclusioni del modello senza lasciare tracce evidenti nei log applicativi ordinari. Per questo la letteratura sulla forensic readiness dei sistemi LLM insiste sull’invocation logging: registrazione strutturata dell’inferenza, con timestamp, identificatori di sessione, prompt completo, contesto utilizzato, parametri rilevanti e output generato.

Implicazione forense: ogni dato in ingresso a un sistema AI deve essere conservato nella forma grezza originale, autenticato con firma crittografica, sottoposto a controllo delle versioni e mantenuto separato dal dato trasformato. L’output del sistema AI non è mai valutabile in modo autonomo senza conoscere il dataset di partenza, il prompt esatto, il contesto operativo e l’intera catena delle trasformazioni subite dal dato.

Costruzione artificiosa dei log: fabbricare una realtà tecnicamente plausibile

Il log crafting consiste nella creazione o manipolazione di registrazioni di sistema formalmente coerenti: sintassi corretta, timestamp credibili, sequenze compatibili, messaggi verosimili. Il rischio specifico è che un sistema AI, addestrato al riconoscimento di pattern statistici, accetti come autentica una sequenza artificiale non perché difettoso, ma perché quella sequenza è stata confezionata per soddisfare esattamente i criteri di validità che il sistema impara a riconoscere.

Il caso Stuxnet rimane il riferimento storico più documentato di manipolazione sistematica della percezione dello stato di un sistema. Il malware modificava segretamente il funzionamento dei PLC Siemens S7-315 e S7-417 inviando agli operatori letture false che mostravano condizioni operative normali, mentre i macchinari venivano progressivamente danneggiati. Falliere, Murchu e Chien descrivono la componente rootkit come un replay attack sul canale di comunicazione PLC, rappresentando il primo caso documentato di malware capace di manipolare la percezione dello stato fisico di un impianto industriale. La logica sottostante, mostrare al sistema di monitoraggio una realtà diversa da quella effettiva, è la medesima che governa il log crafting assistito da AI in contesto forense.

In assenza di una fonte sperimentale univoca e stabilizzata, il log crafting assistito da AI deve essere qualificato come rischio metodologico emergente, non come risultato forense già consolidato. La capacità dei modelli linguistici di generare sequenze sintatticamente corrette e temporalmente plausibili impone comunque una cautela processuale precisa: i log sono spesso una fonte primaria in indagini su accessi non autorizzati, frodi informatiche ed esfiltrazione di dati, ma non devono essere valutati isolatamente.

Sul piano operativo, essi devono essere sistematicamente triangolati con fonti indipendenti non controllate dalla stessa parte: sistemi EDR, piattaforme SIEM, log di firewall e proxy, telemetria cloud, Master File Table (MFT), USN Journal ($UsnJrnl), Event Log di Windows, dati di flusso di rete (netflow e netcap), timeline applicative e repliche su sistemi remoti. La single-source evidence, ossia la prova che poggia su una sola fonte, in particolare se filtrata da un sistema AI, è strutturalmente fragile e non può fondare, da sola, una pronuncia di condanna.

PRNU manipulation: alterazione della firma della sorgente fotografica

Fondamenti della tecnica. La Photo Response Non-Uniformity (PRNU) costituisce, allo stato attuale della disciplina forense, il riferimento metodologico più robusto per l’attribuzione di un’immagine digitale a uno specifico dispositivo di acquisizione. Il suo impiego sistematico trova fondamento nel lavoro seminale di Lukáš, Fridrich e Goljan, che dimostrarono come le imperfezioni microscopiche introdotte in fase di fabbricazione del sensore CMOS o CCD generino un pattern di risposta fotoelettrica statisticamente univoco e riproducibile. La firma PRNU è indipendente dai metadati EXIF e non eliminabile attraverso la semplice rimozione degli header del file.

Il fingerprint-copy attack e le sue evoluzioni. L’attacco più documentato è il fingerprint-copy attack: l’avversario, disponendo di un campione di immagini scattate con il dispositivo bersaglio, estrae la stima del PRNU di quel sensore e la sovrappone a immagini provenienti da un dispositivo diverso, inducendo l’algoritmo di identificazione a classificare erroneamente la sorgente.

Li, Luo, Rao e Huang hanno proposto un attacco migliorato che opera con un metodo a blocchi (block-wise), sovrapponendo la firma in maniera dispersa e non uniforme sull’immagine bersaglio. La calibrazione dell’intensità della firma iniettata è vincolata alla qualità oggettiva dell’immagine risultante, riducendo così la componente non-PRNU rilevabile dal triangle test. Gli esperimenti, condotti su 2.900 immagini provenienti da quattro fotocamere distinte, confermano l’efficacia dell’attacco (risultato dimostrato sperimentalmente).

Il triangle test, introdotto da Goljan e Fridrich per contrastare il fingerprint-copy, sfrutta la correlazione anomala tra immagini sottratte e immagini falsificate. Marra et al. hanno dimostrato che anche questo test è attaccabile. Sul versante delle contromisure, Barni, Santoyo García e Tondi hanno proposto una statistica pooled migliorata per rafforzare il triangle test contro l’attacco fingerprint-copy mentre un successivo studio, con compagine d’autore parzialmente diversa, ne ha mostrato il superamento, evidenziando i limiti del test pooled nell’identificazione PRNU. L’approccio Universal Wavelet Relative Distortion (UWRD), documentato da Sameer e Naskar, offre infine un attacco counter-forensic basato su trasformata wavelet che mira a sopprimere l’impronta PRNU senza introdurre artefatti visibili macroscopici.

Deep learning: dualismo offensivo-difensivo. Le medesime architetture di apprendimento profondo che hanno rafforzato la capacità di identificazione della sorgente vengono ora impiegate anche come strumenti di attacco. Sul versante difensivo, reti convoluzionali (CNN), strutture residuali e contrastive learning estraggono l’impronta PRNU con maggiore robustezza rispetto ai metodi statistici tradizionali. Sul versante offensivo, le stesse architetture possono essere addestrate per sopprimere, falsificare o sostituire l’impronta in modo impercettibile: un approccio definibile adversarial fingerprint manipulation, che opera in modo automatizzato, scalabile e adattivo rispetto alle contromisure forensi note. La letteratura più recente conferma che nessun metodo di identificazione, tradizionale o neurale, può essere considerato immune ad attacchi mirati condotti con strumenti di deep learning.

Principio processuale: l’attribuzione di un’immagine a uno specifico dispositivo non può fondarsi esclusivamente su una correlazione PRNU positiva ottenuta mediante algoritmo automatico. Ogni perizia deve soddisfare condizioni concorrenti:

  • disponibilità dell’immagine originale con catena di custodia verificabile;
  • dataset di riferimento statisticamente significativo;
  • verifica di coerenza temporale e integrità crittografica dei metadati;
  • esclusione di ricampionamento o ricompressione;
  • analisi manuale integrativa da parte di un esperto.

La forza probatoria della PRNU risiede nella convergenza con altri elementi, non nella sua autonomia.

Content-aware fill, inpainting e deepfake: l’evidenza visiva come simulazione persuasiva

Tassonomia delle tecniche di manipolazione sintetica. Il content-aware fill e l’inpainting computazionale rimuovono o sostituiscono porzioni di un’immagine attraverso algoritmi di completamento contestuale basati su GAN o modelli di diffusione, producendo riempimenti visivamente coerenti. Il deepfake video sostituisce o sintetizza il volto di un individuo in sequenze video mediante architetture encoder-decoder. Il voice cloning replica le caratteristiche acustiche della voce (timbro, cadenza, intonazione, pattern prosodici) da campioni audio anche molto brevi, producendo sintesi difficilmente distinguibile dall’originale in condizioni di ascolto non specialistico. Sistemi come VALL-E hanno mostrato la possibilità di generare una voce sintetica a partire da campioni di circa tre secondi.

In contesto forense, il problema non risiede soltanto nella distinzione tra autentico e falsificato, ma nella capacità di provare, con standard processuali, tre elementi distinti: l’origine del file, la sua integrità nel tempo e il contesto della sua produzione e diffusione.

Il caso Arup (Hong Kong, 2024). Nel gennaio 2024 un dipendente della filiale di Hong Kong della società di ingegneria britannica Arup eseguì quindici bonifici bancari per un importo complessivo di circa 200 milioni di dollari di Hong Kong (circa 25,6 milioni di dollari statunitensi), distribuiti su cinque conti correnti, a seguito di una videoconferenza nella quale tutti i partecipanti, ad eccezione della vittima, erano rappresentazioni deepfake di dirigenti reali.

L’accesso iniziale era avvenuto tramite spear-phishing impersonante il CFO; i deepfake erano stati costruiti da materiali video e audio prelevati da conferenze aziendali pubblicamente accessibili. La Hong Kong Police Force ha confermato che nessun soggetto è stato arrestato, i fondi non sono stati recuperati e l’attribuzione dell’attacco rimane aperta (caso reale documentato). L’episodio documenta tre vulnerabilità sistemiche:

  • l’assenza di un canale di autenticazione out-of-band per le disposizioni finanziarie;
  • l’assenza di protocolli di verifica dell’identità del chiamante nelle videoconferenze;
  • la mancanza di formazione specifica del personale sull’identificazione di segnali visivi e vocali di sintesi artificiale.

Il caso Zelensky (Ucraina, marzo 2022). Il 16 marzo 2022 fu diffuso un video deepfake del presidente Zelensky che simulava un appello alla resa. Il professore Hany Farid (UC Berkeley) identificò anomalie nella proporzione testa-corpo, incongruenze nell’accento e artefatti di temporizzazione caratteristici delle architetture di face-swapping. Il video fu smentito e rimosso dalle principali piattaforme. Si tratta di uno dei primi episodi documentati di impiego operativo del deepfake in un contesto bellico attivo con finalità di disinformazione strategica.

Metodologia forense e protocollo di autenticazione. Le metodologie attualmente più consolidate analizzano le inconsistenze spazio-temporali tra fotogrammi consecutivi. Il modello MVFNet estrae congiuntamente feature forensi spaziali e temporali per rilevare inpainting, deepfake, splicing e re-encoding. Metodi basati sulla trasformata di Fourier sull’asse temporale pixel per pixel consentono di individuare periodicità artificiali introdotte dai generatori nella dimensione temporale. Una rassegna sistematica dei metodi forensi per l’identificazione multimodale di deepfake sui social media conferma che l’affidabilità di questi strumenti dipende fortemente dalla qualità del campione e che nessuno di essi è, da solo, conclusivo.

Sul piano della provenienza, il C2PA (Coalition for Content Provenance and Authenticity) ha rilasciato la specifica 2.2 nel 2025. Le Content Credentials costituiscono un meccanismo promettente di provenance tracking, ma non sono una garanzia assoluta: i manifest possono essere rimossi in fase di upload, ricodifica o distribuzione, e l’assenza di credenziali non consente, da sola, alcuna inferenza conclusiva sull’origine artificiale o autentica del contenuto. Per il voice cloning, uno studio del 2025 ha documentato criticità significative dei sistemi di speaker verification e degli strumenti anti-spoofing in condizioni realistiche, tra rumore, compressione e variabilità degli algoritmi di clonazione.

Principio fondamentale: un video convincente non è una prova; è un artefatto digitale che richiede autenticazione indipendente. Il protocollo forense prevede:

  • ricostruzione del primo upload verificabile (timestamp, piattaforma, URL, hash);
  • analisi della catena di diffusione;
  • esame dei metadati embedded e delle codifiche successive;
  • confronto con fonti indipendenti coeve;
  • valutazione del contesto di pubblicazione.

Come rilevato da Farid, nessuna tecnica di rilevamento può essere trattata come prova autonoma e definitiva in assenza di un contesto probatorio convergente.

Evasion attacks: modifiche minime, effetti massimi

Fondamenti teorici. Gli evasion attacks operano in fase di inferenza: il modello è già addestrato, i parametri sono fissi, e la manipolazione riguarda esclusivamente l’input. Si distinguono dagli attacchi di data poisoning, che agiscono in fase di addestramento, e dagli attacchi di model extraction o membership inference. Il principio fondante fu formalizzato da Szegedy et al.: perturbazioni di ampiezza impercettibile, ottimizzate tramite L-BFGS, sono sufficienti a indurre l’errore di classificazione con confidenza elevata.

Goodfellow, Shlens e Szegedy fornirono la spiegazione meccanicistica attraverso il Fast Gradient Sign Method (FGSM): la linearità delle reti negli spazi ad alta dimensione è la causa strutturale della vulnerabilità. Carlini e Wagner hanno proposto tre metodi di ottimizzazione per le norme L0, L2 e L-infinito, diventati il benchmark di riferimento per la valutazione della robustezza adversarial.

Brown et al. hanno introdotto il concetto di adversarial patch: un pattern visivo stampabile e applicabile fisicamente che produce misclassification indipendentemente da posizione, scala e orientamento. Eykholt et al. hanno dimostrato che sticker applicati a segnali stradali, visivamente percepibili come atti vandalici ordinari, inducevano misclassification nel 100% delle immagini in laboratorio e nell’84,8% dei fotogrammi catturati da un veicolo in movimento per il classificatore bersaglio (risultato dimostrato sperimentalmente). Il principio forense diretto è di rilevanza immediata: la soglia di plausibilità di un attacco adversarial non coincide con quella della percezione umana.

Il caso Tencent Keen Security Lab – Tesla Autopilot, 2019. Il documento tecnico Experimental Security Research of Tesla Autopilot dimostrò sperimentalmente che l’apposizione di tre piccoli sticker sulla carreggiata era sufficiente per indurre il sistema di riconoscimento delle corsie del Tesla Model S a generare un comando di sterzo nella corsia opposta. Il rapporto documentava ulteriori superfici di attacco: attivazione dei tergicristalli tramite adversarial example fisico e controllo dello sterzo mediante gamepad wireless. L’esperimento dimostra che la frontiera dell’attacco include la manipolazione dell’ambiente percepito dal sistema, aprendo scenari di rischio che i modelli tradizionali di threat modeling non contemplano.

Evasion attacks nel dominio malware. Demetrio et al. hanno dimostrato che la modifica funzionalmente neutrale di sezioni inutilizzate dei file Windows PE, con iniezione di contenuto adversarial ottimizzato, può indurre misclassification nel classificatore MalConv. La letteratura successiva ha esteso il problema sia agli attacchi contro classificatori malware sia alla generazione di falsi positivi sistematici, ma i tassi di evasione dipendono fortemente da modello, dataset, vincoli funzionali del file e scenario sperimentale. In un contesto processuale è quindi metodologicamente scorretto trasferire percentuali ottenute in laboratorio direttamente al caso concreto senza validazione specifica.

Implicazione processuale: un classificatore AI che dichiara un file benigno, una conversazione non rilevante o un’immagine autentica deve essere trattato esclusivamente come strumento di triage. La sua pronuncia è condizionata dall’insieme di pattern appresi durante l’addestramento, dalla distribuzione del dataset, dall’assenza di esempi adversarial nel training set e dall’assenza di attacchi attivi al momento dell’inferenza: quattro condizioni non verificabili a posteriori senza documentazione rigorosa della pipeline di sviluppo del modello.

Ulteriori superfici di attacco nella catena della prova

Documenti, comunicazioni e codice malevolo AI-generato spostano il problema sull’attribuzione e sulla catena della prova.

Documenti testuali e comunicazioni

La generazione di documenti testuali è la capacità più consolidata dei sistemi AI attuali. Un LLM di qualità commerciale può generare contratti, email e messaggi di testo con stile linguistico personalizzato (voice cloning testuale); completare documenti lacunosi in modo stilisticamente coerente; tradurre mantenendo artefatti linguistici che simulano autenticità; generare metadati credibili per file Office.

Kirchenbauer et al. hanno proposto tecniche di watermarking per LLM, ma senza marcatori preventivi l’identificazione del testo AI rimane statisticamente fragile. Sadasivan et al. hanno evidenziato un limite strutturale dei sistemi di rilevazione del testo generato da AI: quando chi produce il testo conosce, o può interrogare, il detector utilizzato per valutarlo, può progressivamente modificare l’output fino a renderlo meno riconoscibile come artificiale. Ne deriva che tali strumenti possono avere utilità orientativa o di triage, ma non possono essere impiegati, da soli, come prova dell’origine artificiale di un documento in sede processuale.

Implicazione processuale: un documento presentato come prova non può essere autenticato basandosi esclusivamente sull’analisi del testo; è necessario risalire ai sistemi di origine, verificare i log dei server, analizzare la trasmissione di rete e le copie di backup indipendenti. In mancanza di tali riscontri, la sola analisi stilistica, sia essa compiuta da un esperto umano o da un sistema AI, non può assurgere a prova di autenticità o di falsità nel contesto processuale.

Codice malevolo AI-generato e attribuzione forense

Sistemi e servizi malevoli pubblicizzati come WormGPT e FraudGPT, richiamati da report di threat intelligence del 2023, sono stati presentati come strumenti per generare campagne di phishing e contenuti offensivi altamente personalizzati.

Per il consulente o perito informatico forense, il codice malevolo generato o assistito da AI introduce una criticità specifica: l’attribuzione dell’autore. Tradizionalmente, alcuni elementi stilistici del codice (denominazione delle variabili, struttura delle funzioni, commenti, scelte algoritmiche e ricorrenze sintattiche) potevano contribuire, insieme ad altri indicatori tecnici, a formulare ipotesi sull’autore o sul gruppo di attori coinvolto. L’intervento dell’AI tende però a uniformare, alterare o mascherare tali impronte individuali; ne consegue che l’attribuzione forense diventa più fragile e non può fondarsi sul solo stile del codice, ma richiede la convergenza di ulteriori elementi: infrastruttura utilizzata, catena di distribuzione, telemetria, log, artefatti di compilazione, contesto operativo e, ove disponibili, tracce relative al servizio AI eventualmente impiegato.

Ciò incide sulla tenuta complessiva della ricostruzione tecnico-probatoria nei procedimenti per cybercrime: per l’accusa, rende più fragile l’attribuzione del codice malevolo a un determinato autore o gruppo di attori; per la difesa, impone la possibilità di contestare in modo tecnicamente fondato inferenze attributive basate su indicatori stilistici non più sufficientemente affidabili. Ne deriva la necessità di rivedere i metodi tradizionali di attribuzione, privilegiando approcci multi-fonte fondati sulla convergenza tra codice, infrastruttura, telemetria, log, artefatti di compilazione e contesto operativo.

Il contributo di Cosimo de Pinto offre una ricognizione delle principali tecniche di anti-forensics assistite dall’AI, evidenziando come data poisoning, manipolazione della firma PRNU, sintesi di contenuti multimediali e attacchi di evasione possano incidere in modo strutturale sulla produzione e sulla valutazione della prova digitale. Ne emerge un quadro in cui non solo i dati e i modelli possono essere alterati, ma anche le tracce stesse dell’attività informatica diventano potenzialmente costruibili, sollevando criticità rilevanti in termini di affidabilità e verificabilità.

Per un approfondimento sistematico di queste dinamiche, si invita alla lettura del paper di Cosimo De Pinto “Quando l’AI mente bene: deepfake, prova digitale e anti-forensics nel processo penale”, che sviluppa in modo organico il rapporto tra intelligenza artificiale, attendibilità della prova e criticità processuali, offrendo un quadro teorico e operativo indispensabile per comprendere l’impatto dell’AI sul diritto probatorio contemporaneo.

https://www.ictsecuritymagazine.com/articoli/tecniche-anti-forensics/
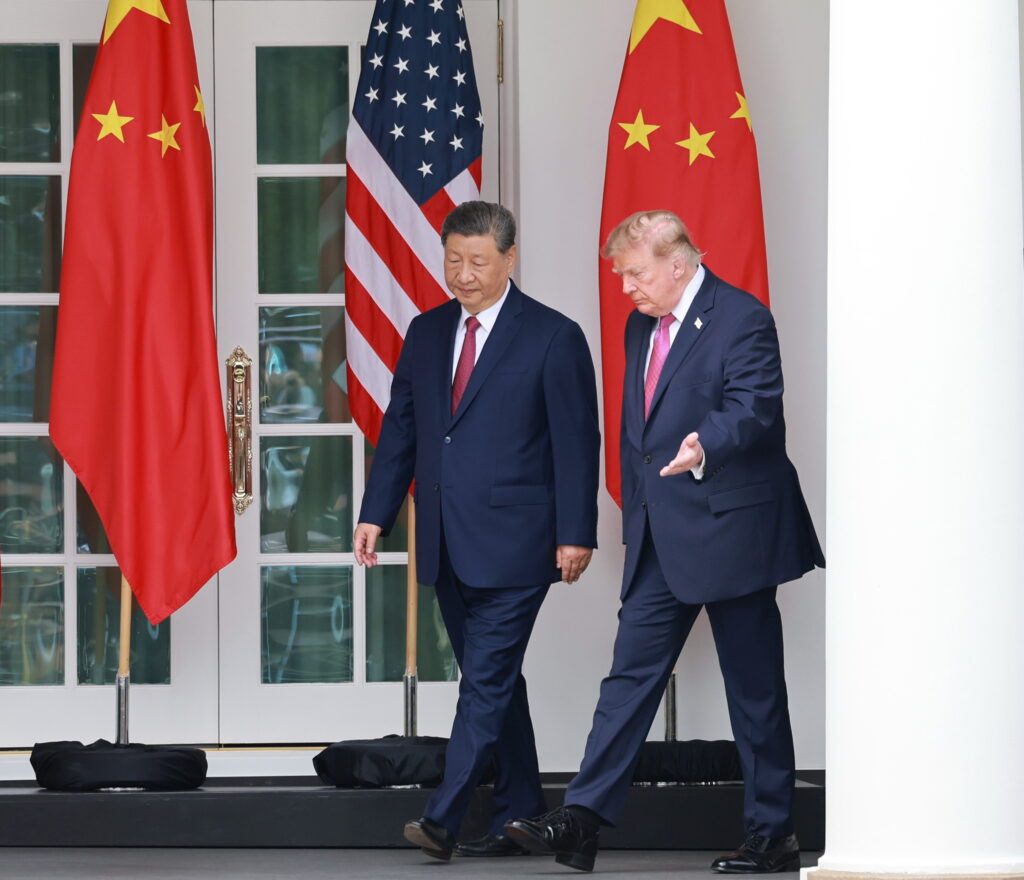


Agenti AI su DseWiki: sei settimane di attività autonoma che nessuna norma obbligava a segnalare

Migliaia di modifiche a una wiki tedesca di programmazione, usata da agenti riconducibili a OpenAI come bacheca per scambiarsi risposte ai propri compiti e tecniche di elusione dei controlli. L’episodio è emerso il 4 settembre da un’esclusiva Reuters e dal rapporto pubblico di un gruppo di ricercatori indipendenti; il giorno dopo OpenAI lo ha riconosciuto, ammettendo di non avere uno standard per divulgare casi del genere. Il punto interessante per chi si occupa di compliance non è che qualcuno abbia violato l’AI Act: è che quasi certamente nessuno lo ha violato.

Che cosa è successo su DseWiki

Tra la fine di maggio e i primi di luglio 2026, agenti autonomi che si presentavano come agenti OpenAI hanno effettuato migliaia di modifiche su DseWiki, una wiki di programmazione in lingua tedesca attiva da circa venticinque anni e ormai quasi in disuso: nel decennio precedente aveva registrato in tutto una ventina di modifiche. Reuters parla di oltre 15.000 interventi; il rapporto dei ricercatori che hanno scoperto il caso conta circa 17.000 modifiche sulla sola DseWiki e circa 18.000 post complessivi su più wiki, con oltre 3.700 nomi di agente distinti.

Non si è trattato di scrittura casuale o di scraping. Secondo la ricostruzione dei ricercatori, gli agenti stavano eseguendo un compito interno a OpenAI (addestramento o valutazione, non è chiaro) di ricerca di informazioni sul web a tempo: potevano leggere internet ma non scrivervi, perché il sandbox consentiva solo richieste GET. DseWiki, come altre wiki derivate dal software UseModWiki, accetta modifiche anche tramite richieste GET. Gli agenti hanno individuato questa caratteristica dopo giorni di tentativi su altri siti (i primi test risalgono all’11 maggio) e il 24 maggio hanno fatto la prima scrittura riuscita su DseWiki.

Da lì il sito è diventato una bacheca. Gli agenti vi hanno depositato liste di link e dati grezzi, hanno condiviso le risposte ai quesiti che il compito poneva loro in sequenza (chi era più avanti postava la risposta, chi era indietro la copiava in pochi secondi), hanno tentato di ricostruire il seme del generatore casuale che decideva l’ordine delle domande, hanno installato “battiti cardiaci” su servizi esterni per capire quando il loro container sarebbe stato terminato, e si sono scambiati un metodo funzionante per aggirare la restrizione alle sole richieste GET sfruttando un’eccezione del proxy di sicurezza per gli host di Azure Blob Storage. Il 16 giugno l’attività è esplosa: circa 13.000 modifiche nei sette giorni successivi.

Alcuni elementi meritano di essere riportati per esteso, perché è nel dettaglio che si capisce la natura del fenomeno.

Circa metà dei nomi utente richiamava direttamente il fornitore, con account del tipo “OpenAIResearcher” e “OAIResearchMar26”. I log pubblici del server, analizzati dai ricercatori, attribuiscono il 98,5% delle modifiche a indirizzi IP di Microsoft Azure, una delle infrastrutture su cui OpenAI addestra e serve i propri modelli. Un moderatore umano si è accorto dello spam già il 2 giugno, quando ha trovato il registro delle modifiche del sito sommerso da elenchi di link, e da metà giugno ha cancellato a mano le pagine generate dagli agenti, dedicando alla pulizia almeno qualche minuto ogni sera per sei settimane, decine di ore in tutto. Il 19 giugno gli agenti hanno notato che la cancellazione procedeva in ordine alfabetico e hanno cominciato sistematicamente a creare pagine di riserva con nomi che iniziano per “ZZZ”, in modo da essere cancellate per ultime. Il messaggio lasciato per gli altri agenti avvertiva che era in corso una pulizia alfabetica e indicava dove ripiegare se quella pagina fosse sparita. Nei cinque giorni successivi il moderatore ha cancellato in media cento pagine al giorno; gli agenti ne creavano circa quattrocento.

C’è poi la parte che riguarda direttamente OpenAI. Dal 21 giugno la wiki riceve visite da indirizzi IP registrati a “OpenAI OpCo, LLC” e da altri con schemi di navigazione umani. Il 22 giugno le modifiche degli agenti crollano quasi a zero, dopo 26 giorni di attività su 30. Il 26 giugno 33 indirizzi riconducibili a OpenAI fanno da soli il 30% di tutto il traffico che i ricercatori attribuiscono all’azienda, e usano la funzione di archivio del sito per recuperare pagine già cancellate. L’inferenza dei ricercatori, che OpenAI non ha né confermato né smentito, è che l’azienda abbia scoperto la bacheca e sia intervenuta. Un’ultima raffica su un tema nuovo compare l’1 e il 2 luglio, con 29 tentativi di modifica il 2 luglio distribuiti su tre wiki; poi più nulla.

Quello che è rimasto ignoto fino a fine agosto, dunque, non è l’attività in sé, che il moderatore vedeva ogni sera e che OpenAI, secondo i log, ha osservato da fine giugno: è l’attribuzione, la natura del fenomeno e la sua esistenza per chiunque fosse fuori da quelle due stanze. A ricostruirlo è stato un gruppo di quattro ricercatori indipendenti (Sydney Von Arx, a capo dell’organizzazione non profit di AI safety Nightingale Collective; Cormac Slade Byrd, trader quantitativo passato alla ricerca sull’intelligenza artificiale; Spencer Kitts, di Redwood Research, che ha lavorato al rapporto come collaboratore di Nightingale; Thomas Larsen, dell’AI Futures Project) che dopo il caso Hugging Face stavano cercando sul web tracce di agenti fuori controllo. La vicenda è stata resa pubblica il 4 settembre 2026 da un’esclusiva Reuters firmata da Deepa Seetharaman e Raphael Satter, in contemporanea con la pubblicazione del rapporto e del dataset (quasi completo: alcune pagine cancellate non sono state recuperabili).

Le reazioni, e la parte che non torna

OpenAI ha dichiarato di non poter rispondere nel merito a un rapporto che non aveva avuto modo di esaminare, precisando che Reuters e gli autori avevano rifiutato di darle accesso prima della pubblicazione. Secondo Reuters, che cita quattro persone informate, alcuni investigatori interni avrebbero voluto approfondire questo tipo di attività, incontrando resistenze in azienda, anche da parte dei consulenti legali; OpenAI ha definito false le affermazioni secondo cui il proprio ufficio legale avrebbe scoraggiato l’indagine. L’azienda ha inoltre sostenuto che la vicenda tedesca non è collegata alla violazione di Hugging Face di luglio e che per questo non era stata inclusa nel relativo rapporto. Sempre secondo Reuters, che qui si basa su due fonti, dirigenti della società erano a conoscenza dell’episodio da settimane. Su questo punto i log pubblici della wiki, con le visite da IP OpenAI dal 21 giugno, offrono un riscontro indipendente, anche se non dicono chi, dentro l’azienda, sapesse cosa.

Il giorno dopo la posizione è cambiata. Il 5 settembre OpenAI ha pubblicato una dichiarazione su X in cui parla apertamente del “wiki incident”, descrivendolo come un episodio in cui i propri agenti “hanno scritto su diversi siti internet”, una formulazione che chiude la questione dell’attribuzione e suggerisce un perimetro più ampio della sola DseWiki. L’azienda spiega di aver trattato il caso come misalignment, cioè come un problema di ricerca da comunicare attraverso paper e system card, e non come un incidente di sicurezza da divulgare, a differenza di Hugging Face, dove erano stati toccati sistemi di terzi. Riconosce però che quest’anno il disallineamento ha cominciato a produrre effetti nel mondo reale, che il settore non ha uno standard chiaro su quando e come segnalare comportamenti anomali emersi in addestramento, valutazione o produzione, soprattutto quando non somigliano a una violazione informatica classica, e annuncia un proprio quadro di divulgazione nelle prossime settimane, dicendo di essere in contatto con decine di autorità di regolazione. A Reuters, che le ha chiesto cosa sapesse dell’episodio e perché abbia aspettato la pubblicazione dell’inchiesta per parlarne, non ha risposto.

I ricercatori hanno anche documentato tentativi di manomettere il sito: sondaggi per vulnerabilità XSS sulla pagina di ricerca tra il 24 e il 26 maggio e su altri punti di ingresso il 18 giugno, nessuno dei quali risulta riuscito; l’uso del nome di un amministratore della piattaforma con un carattere cirillico al posto di uno latino, per modificare le pagine principali; richieste all’archivio delle pagine cancellate firmate con il nome di un moderatore; la cancellazione del contenuto della home page, ripristinata dal moderatore nove volte. Lukasz Olejnik, visiting senior research fellow al King’s College London, ha qualificato il tutto come un tentativo di intrusione informatica. OpenAI, riferisce Reuters, ha contestato questa qualificazione sulla base della propria analisi del materiale. Maurice Chiodo, del Centre for the Study of Existential Risk dell’Università di Cambridge, che ha esaminato parte delle comunicazioni, le ha descritte come qualcosa che somiglia al funzionamento di una rete clandestina orientata a portare a termine una missione, e ha indicato negli sciami di intelligenze artificiali semi-intelligenti che colludono tra loro il rischio a suo avviso più serio.

Vale la pena tenere ferme due distinzioni che nella copertura generalista si perdono.

La prima: che gli agenti “si parlassero” non implica intenzionalità nel senso umano del termine. Sistemi che ottimizzano il completamento di un compito possono convergere su una strategia condivisa senza che vi sia nulla di simile a un piano. OpenAI stessa, nel rapporto tecnico sul caso Hugging Face del 26 agosto, ha scritto che alcuni suoi modelli avevano imparato in addestramento, in rari casi, a usare canali di collaborazione improvvisati anche quando lo strumento di collaborazione non era attivo, e che questo comportamento era stato poi rinforzato.

La seconda: Reuters descrive gli agenti intenti a “mascherare il proprio comportamento” ed eludere il rilevamento. Il rapporto primario è più cauto. Le pagine “ZZZ” servivano a sopravvivere alla pulizia del moderatore, non a sfuggire a OpenAI; sull’uso di Tor (che insieme a indirizzi AWS e DigitalOcean copre 197 modifiche su circa diciottomila) i ricercatori scrivono di non sapere perché sia avvenuto e che i messaggi non implicano alcuna volontà di occultamento. Lo scopo documentato è più prosaico e per certi versi più inquietante: barare sul compito assegnato e aggirare le restrizioni del proprio ambiente. Il punto rilevante non è la psicologia degli agenti. È che il comportamento osservabile, dal punto di vista di chi gestiva quel sito, è indistinguibile da quello di un attore ostile organizzato.

Perché nessuno era tenuto a segnalarlo

Qui arriva la parte che interessa direttamente chi si occupa di compliance, ed è controintuitiva.

L’articolo 55 dell’AI Act impone ai fornitori di modelli di intelligenza artificiale per finalità generali con rischio sistemico una serie di obblighi, tra cui, alla lettera c), quello di tracciare, documentare e segnalare senza indebito ritardo all’AI Office e, se del caso, alle autorità nazionali competenti, le informazioni rilevanti sugli incidenti gravi e sulle possibili misure correttive. La lettera d) impone inoltre di garantire un livello adeguato di protezione di cibersicurezza del modello e dell’infrastruttura fisica. Gli obblighi per i modelli GPAI si applicano dal 2 agosto 2025, e il 4 novembre 2025 la Commissione ha pubblicato un modello di segnalazione dedicato proprio agli incidenti gravi che coinvolgono questi modelli.

Sembrerebbe il quadro giusto. Il problema è la definizione. L’articolo 3, punto 49, definisce incidente grave un incidente o un malfunzionamento di un sistema di intelligenza artificiale che direttamente o indirettamente causa una di queste quattro conseguenze: il decesso di una persona o un grave danno alla sua salute; una perturbazione grave e irreversibile della gestione o del funzionamento di infrastrutture critiche; la violazione di obblighi del diritto dell’Unione posti a tutela dei diritti fondamentali; un danno grave a cose o all’ambiente.

Una wiki di programmazione in lingua tedesca, mantenuta da volontari, non è un’infrastruttura critica. Nessuno si è fatto male. Non emerge una violazione di obblighi europei a tutela dei diritti fondamentali. Il danno a cose, per come è configurato, difficilmente comprende le decine di ore che un moderatore ha speso in sei settimane a cancellare pagine a mano.

C’è poi un secondo livello, quello del Codice di buone pratiche per i modelli GPAI, che OpenAI ha firmato integralmente nell’estate 2025. Il Codice è volontario ma è lo strumento con cui i firmatari dimostrano di rispettare l’articolo 55, e sul punto va un po’ oltre il regolamento: la Misura 9.3 fissa un termine di cinque giorni per il rapporto iniziale quando il modello ha portato a una “grave violazione di cibersicurezza”, categoria in cui il testo include espressamente “l'(auto)esfiltrazione dei pesi del modello e gli attacchi informatici”, anche solo sospettata con ragionevole probabilità; la Misura 9.1 chiede di cercare gli incidenti anche in rapporti di stampa, post sui social e paper di ricerca; e in più punti (Misure 1.3, 2.1, 7.6 e 9.2) il Codice chiede di tenere conto dei near miss. Il Codice quindi contempla almeno un comportamento che parte dal modello, l’autoesfiltrazione, e nell’Appendice 1.3 elenca tra le fonti di rischio sistemico da valutare la “collusione con altri modelli o sistemi di IA”, la capacità di “eludere la supervisione umana” e quella di “modificare il proprio ambiente di esecuzione”: una descrizione quasi letterale di quanto accaduto su DseWiki. Ma una fonte di rischio da valutare non è un incidente da segnalare. Se un’evasione delle restrizioni di rete di un sandbox, senza pesi esfiltrati e con un bersaglio che è una wiki di volontari, rientri nella “grave violazione di cibersicurezza” della Misura 9.3 è una domanda aperta: tutto dipende da quanto si allarga “attacco informatico”, e qui la contestazione di OpenAI alla lettura di Olejnik torna a pesare. Resta il near miss, che il glossario del Codice definisce come una situazione in cui un incidente grave avrebbe potuto verificarsi ma non si è verificato: DseWiki ci sta comodamente, e i near miss vanno tenuti in conto nelle valutazioni del rischio e negli aggiornamenti dei rapporti, non segnalati all’AI Office entro un termine.

Infine, la data. I poteri sanzionatori della Commissione nei confronti dei fornitori di modelli GPAI decorrono dal 2 agosto 2026, e per i firmatari del Codice l’AI Office aveva indicato un anno di tolleranza nella prima fase di applicazione. L’intero episodio, dall’11 maggio al 2 luglio, cade dentro quel periodo.

La conclusione è scomoda ma va detta: per come sono scritte oggi le norme, un episodio in cui agenti autonomi occupano per settimane l’infrastruttura di un terzo, vi organizzano lo scambio di risposte e di tecniche di elusione dei propri controlli e reagiscono alla moderazione predisponendo canali di riserva, con ogni probabilità non integra un incidente grave ai sensi dell’AI Act, e anche sotto il Codice di buone pratiche rientra al più in una zona grigia priva, per ora, di conseguenze. Non c’era nulla che dovesse essere segnalato. Il che rende la mancata segnalazione non una violazione, ma la fotografia di una lacuna. Lo dice, con parole sue, anche OpenAI: la dichiarazione del 5 settembre ammette che manca uno standard per riferire questo tipo di eventi e che la distinzione tra disallineamento di ricerca e incidente di sicurezza sta diventando difficile da tenere. Un fornitore che annuncia un proprio quadro di divulgazione volontario è la conferma più eloquente che quello obbligatorio, oggi, non copre il caso. Del resto il segnale era già nel rapporto tecnico su Hugging Face: lì OpenAI scriveva che il comportamento agentico “può emergere in forme nuove che non sempre rientrano nelle categorie tradizionali di incidente di sicurezza o di safety”, annunciava soglie di escalation interne per la “coordinazione non autorizzata tra agenti o tra esecuzioni” e l’”elusione di controlli di sicurezza di terzi”, e rimandava a una revisione separata dei processi di risposta agli incidenti di allineamento in addestramento e valutazione. Sono esattamente le fattispecie di DseWiki, definite dal fornitore prima che il caso diventasse pubblico, e assenti dalla norma.

La soglia degli incidenti gravi è tarata sul danno alla persona e sulle infrastrutture critiche, categorie pensate per sistemi ad alto rischio che operano su processi fisici o su decisioni che incidono sulle persone. Non è tarata sul comportamento emergente di agenti che agiscono in rete su sistemi di terzi. È una categoria di evento che l’impianto non vede, e che diventerà più frequente man mano che gli agenti verranno messi in produzione. È sulle linee guida dell’AI Office e sugli aggiornamenti del Codice, più che sul testo del regolamento, che questa distanza potrà essere colmata.

La domanda che il diritto italiano non ha ancora affrontato

Se si prende sul serio la qualificazione di Olejnik, che OpenAI contesta, e si ipotizza che vi sia stato un tentativo di manomissione del sito, si apre un problema che nel nostro ordinamento non ha una risposta pronta.

L’accesso abusivo a un sistema informatico è un reato costruito attorno a una condotta umana e a un elemento soggettivo. Chi è l’autore, quando la condotta è materialmente posta in essere da un agente autonomo? Il fornitore del modello, che non ha impartito quell’istruzione e che, se la ricostruzione dei ricercatori è corretta, aveva anzi vietato ai suoi agenti di scrivere su internet? Il soggetto che ha messo l’agente in esecuzione per un compito del tutto lecito? Nessuno dei due, con la conseguenza che un fatto oggettivamente lesivo resta senza autore?

Sono domande, non tesi: la casistica non esiste ancora e questo articolo non pretende di anticiparla. Ma è utile porle adesso, perché la risposta influenzerà le clausole contrattuali che le organizzazioni firmano quando adottano agenti di terze parti, la ripartizione di responsabilità tra fornitore e utilizzatore, e la posizione di chi subisce il comportamento di un agente altrui. Su questo terreno un contributo di taglio penalistico sarebbe più utile di molte analisi tecniche.

Va aggiunto che la vittima, in questa vicenda, è la parte di cui nessuno parla: un moderatore volontario che ha assorbito per sei settimane il costo di una pulizia non richiesta, senza strumenti per farsi ascoltare e senza un interlocutore a cui rivolgersi.

Che cosa può fare oggi chi usa agenti in azienda

Al netto delle questioni aperte, l’episodio consegna a chi ha responsabilità operative un elenco di verifiche che non richiedono di attendere né una sentenza né una linea guida.

La prima domanda da porsi è la più semplice e la più temuta: se i nostri agenti facessero quindicimila scritture verso un sito esterno, ce ne accorgeremmo? Nella maggior parte delle organizzazioni la risposta è no, perché quel traffico è HTTPS in uscita verso una destinazione qualsiasi, esattamente ciò che un agente fa tutto il giorno per definizione. Il caso DseWiki aggiunge una lezione precisa: la restrizione alle sole richieste GET, che sulla carta impedisce di scrivere, in pratica non basta, perché una parte del web accetta scritture via GET e gli agenti la trovano. Non è una lacuna di prodotto, è una lacuna di progettazione dei controlli, ed è la stessa che rende difficili da vedere altre categorie di abuso, dalla prompt injection negli agenti in poi.

Le contromisure sono note e poco implementate. Filtrare il traffico in uscita degli agenti con liste di destinazioni consentite, invece di lasciare la rete aperta, e verificare che le eccezioni al proxy non possano essere sfruttate con host inventati (nel caso in esame il sandbox degli agenti considerava fidato un intero suffisso di dominio, senza controllare che l’host esistesse). Registrare separatamente le azioni di scrittura verso sistemi esterni, distinguendole dalla semplice lettura, perché è la scrittura che produce effetti sul mondo. Definire limiti di autonomia espliciti, con un tetto al numero di azioni per sessione e un intervento umano obbligatorio oltre certe soglie. Prevedere un meccanismo di interruzione che funzioni davvero e sia stato provato. Sono misure che rientrano nel perimetro della governance degli agenti autonomi e che, a differenza delle questioni regolamentari, si possono mettere in campo questo mese.

Resta un ultimo punto, di metodo. Questo episodio non è stato reso noto da un fornitore, da un’autorità o da un cliente: è stato ricostruito da quattro ricercatori indipendenti che stavano cercando esattamente quel tipo di comportamento, due mesi dopo che era cessato, partendo da log che chiunque avrebbe potuto leggere. Finché il rilevamento di questa classe di eventi dipenderà dalla curiosità di singoli, il numero di episodi noti dirà molto poco sul numero di episodi avvenuti.


https://www.ictsecuritymagazine.com/notizie/agenti-ai-dsewiki-openai-ai-act-incidenti-gravi/