L’AI ci può salvare dalle fake news? Lo studio della Sapienza Università di Roma

Scarica la ricerca

Lo studio della Sapienza

Negli ultimi anni, l’uso dei modelli di linguaggio di grandi dimensioni (LLM) per valutare l’affidabilità delle notizie è diventato sempre più comune. Tuttavia, poco si sa su come questi modelli prendano le loro decisioni. Uno studio condotto da Edoardo Loru, Jacopo Nudo, Niccolò Di Marco, Matteo Cinelli e Walter Quattrociocchi, tutti ricercatori della Sapienza Università di Roma, ha analizzato il comportamento di tre tra i più avanzati LLM: Gemini 1.5 Flash (Google), GPT-4o mini (OpenAI) e LLaMA 3.1 (Meta), confrontando le loro valutazioni con quelle di sistemi esperti come NewsGuard e Media Bias Fact Check (MBFC).

L’obiettivo della ricerca dal titolo “Decoding AI Judgment: How LLM Assess News Credibility and Bias” era duplice: da un lato, verificare la coerenza tra le valutazioni dei modelli di linguaggio e quelle dei sistemi di rating esperti; dall’altro, comprendere i meccanismi con cui gli LLM classificano le fonti come affidabili o non affidabili.

Il team di ricercatori ha analizzato un campione di 2.302 siti di notizie, valutando non solo le etichette assegnate (“affidabile” o “non affidabile”), ma anche i termini linguistici utilizzati dai modelli per giustificare le loro scelte.

Risultati

“I nostri risultati rivelano un forte allineamento tra le classificazioni dei Llm e quelle umane in particolare nell’identificazione di fonti inaffidabili“, hanno sottolineato i ricercatori. 

I modelli LLM presi in esame classificano le teorie del complotto, il sensazionalismo e i pregiudizi in maniera speculare ai criteri chiave usati dagli esperti nelle loro valutazioni. Sono meno coerenti quando il contesto è limitato.

  1. Accuratezza delle valutazioni: tutti e tre i modelli hanno dimostrato un’elevata capacità di identificare le fonti non affidabili, con una precisione che varia dall’85% al 97%. Tuttavia, la classificazione delle fonti affidabili ha mostrato maggiori discrepanze, in particolare per GPT-4o mini, che ha erroneamente classificato il 33% delle fonti affidabili come non affidabili.
  2. Influenza dell’orientamento politico: l’analisi ha rivelato che gli LLM tendono a sovrastimare l’affidabilità delle fonti di orientamento politico di sinistra e a sottovalutare quelle di destra. Questo suggerisce che i modelli potrebbero ereditare pregiudizi dai dati di addestramento.
  3. Ruolo delle parole chiave: gli LLM associano la credibilità delle notizie a specifici indicatori linguistici. Le fonti affidabili sono frequentemente descritte con termini come “trasparenza”, “fatti verificabili” e “diversità di opinioni”. Al contrario, le fonti non affidabili sono spesso legate a parole come “sensazionalismo”, “teorie del complotto” e “disinformazione”.
  4. Valutazioni senza contenuto esplicito: anche quando i modelli sono stati testati senza accedere al contenuto delle pagine web, ma solo al dominio del sito, hanno mostrato un’alta coerenza con le valutazioni umane. Questo solleva il dubbio che gli LLM possano basarsi più su conoscenze pregresse che su un’analisi contestuale effettiva.
  5. Miglioramento del processo decisionale: i ricercatori hanno testato un framework in cui gli LLM potevano affinare le loro valutazioni recuperando informazioni esterne o interagendo con altri modelli. Questo ha permesso di osservare come i modelli modificassero le proprie risposte e se adottassero strategie più sofisticate di valutazione.

LLM affidabili o no?

Nel complesso, i ricercatori ritengono che per i modelli di grandi dimensioni le parole chiave che si riferiscono a notizie locali, resoconti basati su fatti o al linguaggio neutro sono generalmente associate a un concetto di affidabilità. Al contrario, l’inaffidabilità è spesso caratterizzata da termini relativi a sensazionalismo, controversie o pregiudizi, che riflettono indicatori di uso comune usati da esperti umani per identificare fonti a bassa credibilità. Inoltre, ‘trasparenza’ e ‘bias’ emergono come i criteri più comunemente valutati per l’affidabilità o l’inaffidabilità delle informazioni.

Lo studio evidenzia che, sebbene i modelli di linguaggio siano strumenti promettenti per la valutazione dell’affidabilità delle notizie, presentano ancora limiti significativi. L’influenza dell’orientamento politico, l’uso di euristiche linguistiche e la dipendenza da informazioni pre-acquisite sollevano interrogativi su quanto questi strumenti possano essere utilizzati in modo neutrale ed equo.

I ricercatori propongono di approfondire il confronto tra i processi decisionali umani e quelli degli LLM, esplorando in che modo questi ultimi possano evolvere per diventare “agenti valutatori” più trasparenti e autonomi. Lo studio non solo offre spunti per migliorare la progettazione dei modelli, ma invita anche a una riflessione critica sul loro impatto nella società dell’informazione e più in generale su come noi tutti approcciamo al mondo delle informazioni e delle notizie.

Leggi le altre notizie sull’home page di Key4biz

https://www.key4biz.it/lai-ci-puo-salvare-dalle-fake-news-lo-studio-della-sapienza-universita-di-roma/524476/


UE, 500 milioni di euro per la nuova ondata di AI Factory. In totale adesso se ne contano 13 (una a Bologna)

Sei nuove fabbriche europee dell’AI, ecco dove sorgeranno

L’Unione europea (Ue) punta con maggiore decisione sulle tecnologie di punta e quindi sull’intelligenza artificiale (AI). L’impresa comune europea per il calcolo ad alte prestazioni (EuroHPC JU) ha selezionato sei nuove AI Factories che dovranno nascere entro il 2026 in Austria, Bulgaria, Francia, Germania, Polonia e Slovenia.

A sostegno dei nuovi siti è previsto un investimento nazionale e comunitario complessivo di 485 milioni di euro.

L’obiettivo dell’iniziativa è garantire un accesso facilitato all’AI per startup e piccole e medie imprese (Pmi), promuovendo crescita, competitività e un’espansione più efficace sul mercato interno e quelli esteri.

Cosa sono le AI Factories

Le fabbriche di intelligenza artificiale sono state ideate come ecosistemi dinamici che promuovono innovazione, collaborazione e sviluppo in questa nuova tecnologia, nel suo sviluppo, nelle applicazioni e nella crescita delle competenze.

Si tratta di ‘fabbriche’ all’interno delle quali sono riunite tutte le risorse necessarie (potenza di calcolo, dati e talento) per creare modelli di AI generativa all’avanguardia.

Non solo, secondo Bruxelles, queste Factories dovranno promuovere e favorire la collaborazione in ricerca, innovazione e sviluppo in tutta Europa, collegando università, centri di supercalcolo, industria e attori finanziari.

Il risultato finale sarà un’infrastruttura comunitaria di hub che guidano i progressi nelle applicazioni di AI in vari settori, come salute, produzione, clima, finanza e altro ancora. 

Le prime nasceranno entro il 2025, una delle prime è stata selezionata a Bologna

La Commissione vorrebbe vedere avviate le prime fabbriche entro la fine del 2025 e l’obiettivo molto ambizioso annunciato dalla stessa Presidente Ursula von der Leyen è dare vita al primo continente dell’intelligenza artificiale.

A dicembre sono stati selezionati i primi sette consorzi per dare il via alla realizzazione di altrettante AI Factories, coinvolgendo 15 Stati membri dell’Unione e altri 2 Stati partecipanti di EuroHPC (Spagna, Italia con il Cineca-tecnopolo di Bologna, Finlandia, Svezia, Germania, Grecia, più Portogallo, Romania e Turchia, Austria e Slovenia, Repubblica Ceca, Danimarca, Estonia, Norvegia e Polonia).

Con un investimento di circa 1,5 miliardi di euro da parte dell’Ue e degli Stati membri, questi siti implementeranno nuovi supercomputer ottimizzati per l’AI e aggiorneranno i sistemi esistenti, migliorando significativamente le capacità, la sicurezza e l’autonomia tecnologica dell’Europa.

Di questo e di altro si parlerà ampiamente alla prossima edizione del convegno promosso dal CNIT Telecommunications of the Future by 5GItaly, che si terrà il prossimo 9 aprile a Roma.

Leggi le altre notizie sull’home page di Key4biz

https://www.key4biz.it/ue-500-milioni-di-euro-per-la-nuova-ondata-di-ai-factory-in-totale-adesso-se-ne-contano-13-una-a-bologna/524410/


Machine Unlearning: Metodologie di Mitigazione

Il machine unlearning emerge come soluzione critica per affrontare le sfide della privacy e della sicurezza nei modelli di machine learning. Questo articolo esplora le metodologie di mitigazione, le tecniche implementative e i criteri di valutazione per rimuovere efficacemente dati specifici dai modelli addestrati, senza necessità di riaddestramento completo. Vengono analizzati gli scenari di applicazione, dalle normative sulla privacy come il GDPR alla mitigazione dei bias, evidenziando l’importanza di questo approccio nell’evoluzione dell’AI responsabile.

Stiamo assistendo ad una crescita esponenziale nell’utilizzo del machine learning per lo svolgimento di qualsiasi attività. I modelli di machine learning (ML) si stanno sempre di più integrando in molti prodotti e servizi di uso quotidiano. Tuttavia, la proliferazione della tecnologia di AI/ML solleva una serie di problemi in termini di violazione della privacy, di bias (pregiudizi) del modello e dell’uso non autorizzato dei dati utilizzati per il training dei modelli.

Questi ambiti evidenziano ancora una volta la necessità di adottare un controllo flessibile e reattivo sui dati con cui viene addestrato un modello. Il riaddestramento da zero di un modello di ML, per la rimozione di specifici dati, è poco pratico a causa degli elevati costi computazionali ed economici. Pertanto, è stata avviata la ricerca sul “machine unlearning” (MU), ovvero si sta cercando di sviluppare nuovi metodi in grado di rimuovere determinati dati da un modello addestrato in modo efficiente, efficace e, soprattutto, senza la necessità di realizzare un nuovo addestramento. Analizziamo le criticità del machine unlearning e le metodologie di valutazioni più efficaci.

Scenari di Mitigazione dei Rischi nel Machine Unlearning

Il machine unlearning (MU) rappresenta un tema rilevante, che non può essere sottovalutato, perché è in grado di affrontare una serie di problemi quali: la conformità alla privacy dei dati di training, la gestione dinamica dei dati, l’inclusione non autorizzata di dati tutelati dalla proprietà intellettuale o altre forme di tutela e, infine, l’uso di dati provenienti da data breaches.

Vediamo i principali use case del machine unlearning:

  • Protezione della privacy: il MU può svolgere un ruolo cruciale nell’applicazione dei diritti alla privacy e nel rispetto di normative come il GDPR dell’UE[1] (che include anche il diritto all’oblio). Consentirebbe di rimuovere i dati personali dai modelli addestrati, salvaguardando la privacy degli individui.
  • Incremento della sicurezza: il MU potrebbe migliorare la sicurezza dei modelli contro gli attacchi di “data poisoning” attraverso la rimozione dei dati c.d. tossici che mirano a manipolare il comportamento di un modello.
  • Miglioramento dell’adattabilità: il MU su larga scala potrebbe aiutare i modelli a rimanere pertinenti anche quando cambiano le distribuzioni dei dati nel tempo, ad esempio in base all’evoluzione delle preferenze dei clienti o delle tendenze di mercato.
  • Conformità normativa: nei settori fortemente regolamentati, il MU potrebbe essere fondamentale per mantenere la conformità alle leggi e ai regolamenti in continua evoluzione.

Mitigazione dei bias/pregiudizi: il MU potrebbe offrire un metodo per rimuovere i dati identificati dopo il training che creano distorsione, promuovendo così l’imparzialità e riducendo il rischio di risultati scorretti.

Tecniche di Mitigazione e Implementazione

La maggior parte delle implementazioni di machine unlearning suddividono il data set utilizzato per il training originario (“Dtrain”) in dati che devono essere conservati (“retain set” o Dr) e dati che devono essere dimenticati/rimossi (“forget set” o Df), come mostrato in Figura.

Il tipico training di un modello di ML (a) prevede l’utilizzo di tutti i dati di training per impostare i parametri del modello. I metodi di machine unlearning comportano la suddivisione dei dati di training (Dtrain) in retain set (Dr) e forget set (Df), quindi un utilizzo iterativo di questi set per modificare i parametri del modello (passaggi da b a d in maniera ciclica). La sezione gialla rappresenta i dati che sono stati dimenticati durante il processo.

Successivamente, i due set vengono utilizzati per modificare i parametri del modello sottoposto a training. Nel corso del tempo, i ricercatori hanno sviluppato diverse tecniche per migliorare questa fase di unlearning, analizziamole:

  • Ottimizzazione: la tecnica prevede che il modello sia ulteriormente addestrato sul retain set, consentendogli di adattarsi alla nuova distribuzione dei dati. Questa tecnica è semplice, ma può richiedere molta potenza di calcolo[2].
  • Etichettatura casuale: la tecnica prevede l’assegnazione di etichette errate casuali al forget set in grado di confondere il modello. In questo modo, il modello viene ottimizzato[3] [4].
  • Inversione del gradiente: questa tecnica prevede che, durante l’ottimizzazione del modello, sia invertito il segno dei gradienti di aggiornamento del peso per i dati del forget set. Questa tecnica contrasta il training precedente[5].
  • Riduzione selettiva dei parametri: questa tecnica prevede la riduzione selettiva dei parametri specificamente legati al forget set attraverso tecniche di analisi del peso e senza alcuna ottimizzazione[6].

Le scelte delle tecniche di unlearning riflettono i casi d’uso di unlearning. Ogni use case ha i propri requisiti che riguardano, in particolare, l’efficacia, l’efficienza e i problemi di privacy.

Valutazione e privacy e Sicurezza nel Machine Unlearning

Una delle principali difficoltà del machine unlearning consiste nel valutare se la tecnica di unlearning prescelta sia in grado di dimenticare i dati specificati e, contestualmente, mantenere le performance sui dati conservati e, inoltre, proteggere la privacy. Idealmente, un metodo di unlearning automatico dovrebbe produrre un modello che funzioni come se fosse stato addestrato da zero, quindi privo del set di dati da dimenticare.

I metodi di unlearning più utilizzati (come l’etichettatura casuale, l’inversione del gradiente e la riduzione selettiva dei parametri) provocano un degrado delle prestazioni del modello esattamente nei punti corrispondenti al dataset dei dati da dimenticare, mentre cercano di mantenere un alto grado di prestazioni del modello nei corrispondenti punti del dataset da mantenere.

Per semplicità, si potrebbe considerare un metodo di unlearning basato su due semplici obiettivi: ottenere prestazioni elevate sul set da conservare e scarse sul set dell’oblio. Questo approccio, tuttavia, rischierebbe di aprire un’altra superficie di attacco sul fronte della privacy: per esempio, se un modello unlearned funzionasse particolarmente male con un determinato input, ciò potrebbe far capire all’aggressore che in origine l’input fosse incluso nel set di dati utilizzati nel training originale e che sia stato rimosso successivamente.

Questo tipo di violazione della privacy, chiamato attacco di “membership inference” [7], è in grado di rivelare i dati importanti e sensibili di un determinato utente o su un set di dati specifico. Pertanto, durante la valutazione dei metodi di unlearning automatico, è importante testare la loro efficacia contro questa tipologia di attacco.

In questo contesto di analisi, i termini “stronger” e “weaker” si riferiscono alla complessità e all’efficacia dell’attacco:

Weaker attacks (Attacchi più deboli): si tratta di tentativi semplici e diretti per ricavare l’appartenenza inferenziale. Questi attacchi potrebbero fare affidamento su informazioni basilari, come i punteggi di confidenza del modello o la probabilità di un determinato output per un input definito. Spesso questi attacchi si basano su ipotesi semplificatrici del modello o sulla distribuzione dei dati, il che può fortunatamente limitarne l’efficacia.

Stronger attacks (Attacchi più forti): si tratta di attacchi sofisticati che utilizzano informazioni o tecniche più avanzate. In particolare, sono in grado di:

  • utilizzare più punti di query oppure input particolarmente elaborati,
  • sfruttare la conoscenza dell’architettura del modello o del processo di training,
  • utilizzare modelli ombra per comprendere il comportamento del modello target,
  • combinare più strategie di attacco,
  • adattarsi alle specifiche caratteristiche del modello target o del set di dati.

Generalmente, gli attacchi più forti sono più efficaci nell’inferenza di appartenenza e quindi sono più difficili da contrastare. Inoltre, rappresentano un modello di minaccia realistico, presente in molti scenari del mondo reale, in cui gli aggressori potrebbero disporre di importanti risorse e competenze.

Raccomandazioni

Il mondo della ricerca sta continuando a lavorare per lo sviluppo di nuove soluzioni di machine unlearning che siano aderenti agli ambienti di produzione e, inoltre, vengano sottoposti ad attacchi alla privacy o all’oblio dei dati più realistici. Uno studio recente offre una serie di raccomandazioni per migliorare la valutazione dell’unlearning basate sulla letteratura già esistente, in particolare vengono proposti nuovi benchmark e riprodotti diversi algoritmi di unlearning. In particolare, sono stati valutati gli algoritmi per misurare l’accuratezza sui dati conservati, la protezione della privacy dei dati dimenticati e la velocità di esecuzione del processo di unlearning[8].

I test hanno rivelato notevoli discrepanze tra gli algoritmi di unlearning, in molti casi sono state riscontrate difficoltà nel raggiungere il risultato in tutte le aree di valutazione. Sono stati testati tre metodi (Identity, Retrain e Finetune on retain) e cinque algoritmi (RandLabel[9], BadTeach[10], SCRUB+R [11] , Selective Synaptic Dampening [SSD][12] e una combinazione di SSD e finetuning).

Come evidenziato in figura, alcuni metodi riescono a difendersi bene dagli attacchi di inferenza debole, mentre sono completamente inefficaci contro gli attacchi più forti, evidenziando la necessità di effettuare il test del caso peggiore. Alla luce di questi risultati, è stata dimostrata l’importanza di dover effettuare la valutazione degli algoritmi in contesti iterativi, poiché alcuni algoritmi degradano la loro accuratezza complessiva durante le iterazioni di unlearning, mentre altri sono in grado di mantenere elevate prestazioni in maniera costante.

Sulla base di questi risultati, si suggerisce di adottare le seguenti raccomandazioni:

1)è necessario dare enfasi alle metriche del caso peggiore rispetto a quelle del caso medio e, inoltre, opportuno utilizzare attacchi avversari forti per la valutazione degli algoritmi. Gli utenti sono più preoccupati per gli scenari gravi, come l’esposizione di informazioni finanziarie personali, che non per gli scenari meno gravi. La valutazione delle metriche del caso peggiore fornisce un limite di alto livello sulla privacy.

2)è opportuno considerare tipi di attacchi specifici alla privacy, in cui l’aggressore ha l’accesso all’output da due versioni diverse dello stesso modello. In questi scenari, l’unlearning può portare a risultati peggiori perché stiamo fornendo all’aggressore maggiori informazioni. Se si verificasse un attacco di perdita di aggiornamento, il danno non dovrebbe essere maggiore di un attacco al modello di base.

3)è utile analizzare le prestazioni dell’algoritmo di unlearning su un numero ripetuto di applicazioni, ovvero il disapprendimento iterativo, per essere in grado di valutare il degrado delle prestazioni di accuratezza del test dei modelli. Poiché i modelli di unlearning automatico sono distribuiti in ambienti in continuo cambiamento, in cui le richieste di oblio, i dati dei nuovi utenti e i dati errati o avvelenati arrivano dinamicamente, è fondamentale essere in grado di poterli valutare in un ambiente online, cioè in un ambiente dove le richieste arrivano attraverso un flusso.

Poiché l’intelligenza artificiale sarà sempre più integrata nei vari aspetti della vita, molto probabilmente il machine unlearning automatico diventerà uno strumento essenziale e un complemento alla cura/manutenzione dei dati di training, e sarà in grado di bilanciare le capacità dell’intelligenza artificiale con le minacce relative alla privacy e alla sicurezza dei dati.

Questo aspetto aprirà nuove opportunità per migliorare la protezione della privacy e per lo sviluppo di sistemi di intelligenza artificiale adattabili, inoltre deve essere in grado di affrontare sfide significative, tra cui le limitazioni tecniche e l’elevato costo computazionale di alcuni metodi di unlearning. La ricerca e lo sviluppo stanno svolgendo un ruolo fondamentali per migliorare queste tecniche e garantire che le stesse possano essere efficacemente implementate in scenari reali.

Il machine unlearning si conferma come tecnologia essenziale per bilanciare le potenzialità dell’AI con la protezione della privacy e la sicurezza dei dati. Nonostante le sfide tecniche e computazionali, la ricerca continua a sviluppare soluzioni sempre più efficaci per scenari reali. Nel prossimo capitolo esploreremo le metodologie per misurare e garantire l’affidabilità dei sistemi di AI. Per un’analisi più completa, il white paper “Generative artificial intelligence rischi e contromisure” offre ulteriori approfondimenti sulle sfide e le soluzioni nel campo dell’IA Gen.

Note bibliografiche

[1]General Data Protection Regulation: https://en.wikipedia.org/wiki/General_Data_Protection_Regulation

[2] AA.VV., Machine unlearning through fine-grained model parameters perturbation: https://arxiv.org/abs/2401.04385, College of Computer Science and Electronic Engineering, 2024

[3] AA.VV., Random Relabeling for Efficient Machine Unlearning: https://arxiv.org/abs/2305.12320, Pennsylvania State University, 2023

[4] AA.VV., Amnesiac Machine Learning: https://arxiv.org/pdf/2010.10981, University of Waterloo, 2020

[5] AA.VV., Gone but Not Forgotten: Improved Benchmarks for Machine Unlearning: https://arxiv.org/pdf/2405.19211, Carnegie Mellon University, 2024

[6]AA.VV., Fast Machine Unlearning Without Retraining Through Selective Synaptic Dampening: https://arxiv.org/abs/2308.07707, University of Cambridge, 2023
[7]ML04:2023 Membership Inference Attack: https://owasp.org/www-project-machine-learning-security-top-10/docs/ML04_2023-Membership_Inference_Attack

[8] AA.VV., Gone But Not Forgotten: Improved Benchmarks for Machine Unlearning: https://arxiv.org/pdf/2405.19211, Carnegie Mellon University, 2024

[9] AA.VV., Amnesiac Machine Learning: https://arxiv.org/abs/2010.10981, University of Waterloo, 2020

[10] AA.VV., Can Bad Teaching Induce Forgetting? Unlearning in Deep Networks using an Incompetent Teacher: https://arxiv.org/abs/2205.08096, Mavvex Lab, 2023

[11] AA.VV., Towards Unbounded Machine Unlearning: https://arxiv.org/abs/2302.09880, University of Warwick, 2023

[12] AA.VV., Fast Machine Unlearning Without Retraining Through Selective Synaptic Dampening: https://arxiv.org/abs/2308.07707, University of Cambridge, 2023

Profilo Autore

È laureato in Ingegneria Informatica ed in Sicurezza Informatica presso le Università di Roma La Sapienza e di Milano. Ha indirizzato la sua formazione nei settori della Cyber Security e Digital Forensics ottenendo i diplomi di perfezionamento in Data Protection e Data Governance; Criminalità Informatica e Investigazioni Digitali e Big Data, Artificial Intelligence.

Ha, altresì, conseguito l’Advanced Cybersecurity Graduate Certificate alla School of Engineering della Stanford University; Professional Certificates in Information Security; Incident Response Process; Digital Forensics e Cybersecurity Engineering and Software Assurance presso il Software Engineering Institute della Carnegie Mellon University.

Dal 1992 è nei ruoli del Ministero dell’Interno ove ricopre lincarico di Funzionario alla Sicurezza CIS. In tale veste contribuisce alla valutazione dei rischi cyber, all’implementazione delle misure di sicurezza e la risoluzione di incidenti informatici. Inoltre, offre consulenza tecnica nel campo della Digital Forensics per l’Autorità giudiziaria, la Polizia giudiziaria e gli Studi legali.

Dal 2017 è Professore a contratto di Tecnologie per la Sicurezza Informatica presso alcune Università ove sviluppa le tematiche di Attack and Defense Strategies quali il penetration testing, la risk analysis, l’information security assessment, l’incident response e la digital forensics. Infine, è Autore di alcuni articoli e saggi sui temi della Sicurezza Informatica e
dell’Informatica Giuridica consultabili su https://www.vincenzocalabro.it

Condividi sui Social Network:

https://www.ictsecuritymagazine.com/articoli/machine-unlearning/


AI, copyright e audiovisivo. Lasorella (Agcom): “Tecnologia dirompente capace di ridefinire il modo di produrre, distribuire e consumare contenuti”

Tra tutele e innovazione. L’audiovisivo nella corsa all’Intelligenza Artificiale

L’innovazione tecnologica sta progressivamente investendo tutti i settori industriali, economici e sociali della nostra società. Il legislatore è chiamato al difficile compito di regolamentare un ambito che è profondamente segnato dalla rapidità del progresso di queste tecnologie, sia a livello nazionale, sia europeo.

Il tema è stato al centro del convegno dal titolo “Tra Tutele e Innovazione. L’audiovisivo nella corsa all’Intelligenza Artificiale”, organizzato a Roma dall’Autorità per le Garanzie nelle Comunicazioni (Agcom) presso lo spazio Esperienza Europa “David Sassoli”, messo a disposizione dal Parlamento europeo.

Un’occasione per fare il punto sulle opportunità e i rischi generati dall’incontro tra intelligenza artificiale (AI) e settore audiovisivo, assieme a regolatori, policy maker e stakeholder, che si sono confrontati sulle principali dorsali dell’attuale impiego di questa tecnologia nell’ambito dell’industria culturale.

“Un confronto sull’audiovisivo al tempo dell’AI è rilevante nel contesto europeo, sia per il copyright, sia per l’industria, sia della pirateria, sia in termini di regolamento. Una tecnologia dirompente che si inserisce in un contesto fortemente instabile, che richiede una nuova visione di policy. Le piattaforme digitali oggi hanno un ruolo chiave nello sviluppo del settore dell’informazione e dei media, con l’obbligo di affrontare con decisione il problema della disinformazione e della manipolazione dell’opinione pubblica. L’UE deve rimanere uno spazio di regole”, ha detto Carlo Corazza, Direttore del Parlamento europeo in Italia, aprendo il convegno con i saluti delle Istituzioni.

Secondo Giacomo Lasorella, Presidente AGCOM: “L’AI è una tecnologia dirompente in grado di ridefinire il modo in cui i contenuti mediatici sono prodotti, distribuiti e consumati. Per l’AI Act e il suo corso legislativo in Italia come Agcom cerchiamo di capire in che modo regolamentare l’utilizzo di questa tecnologia nei settori di interesse, nella tutela dei diritti e nell’innovazione. Nostro compito è regolare tutto questo. Il DSA è il plesso normativo che riguarda l’AI che è già tra noi, come le piattaforme la usano per regolare i servizi che offrono. Il DSA detta le norme fondamentali affinché il design stesso delle piattaforme nell’uso dell’AI risponda ai criteri di trasparenza e tutela degli utenti. I gatekeeper hanno già investito nei grandi sistemi di AI e per integrarla nei vari servizi si rischia di erigere nuove barriere di accesso al mercato. Poi ci sono criticità per quel che riguarda il copyright. È necessario garantire un’interazione più efficace tra disciplina settoriale dei media e copyright e i plessi normativi DSA e AI Act”.

“Dal codice di buone pratiche siamo passati al codice di condotta sulla disinformazione ai sensi del DSA. Con questa conversone l’UE compie un passo decisivo nel contrasto alla disinformazione. È un benchmark per valutare le responsabilità delle piattaforme digitali in questo campo. Dal 1° luglio prossimo le piattaforme saranno sottoposte a verifiche annuali indipendenti. Il codice è frutto di un confronto multilaterale tra tutti gli attori impegnati nella lotta alla disinformazione. I suoi pilastri sono diversi: eliminare gli incentivi economici alle fake news e a chi le diffonde, aumentare la trasparenza della pubblicità politica, aumentare la consapevolezza degli utenti con strumenti più efficaci. Alcune piattaforme importanti si sono ritirate dagli impegni del fact-checking. Ci sono dei dubbi in generale sull’efficacia del codice e la Commissione avvierà un dialogo per il follow-up. Poi c’è la questione della relazione tra copyright e AI. I dati per l’addestramento di questi modelli sono protetti dal diritto d’autore. L’UE si è dotata di strumenti di policy per lo sviluppo di tecnologie di machine learning, introducendo due eccezioni al copyright per consentire l’impiego di queste tecnologie nell’industria dei contenuti. La più importante è l’eccezione TDM per bilanciare la promozione dell’innovazione e la tutela dei diritti d’autore, che possono sfruttare lo strumento dell’opt-out, un cardine fondamentale per favorire il rispetto dei diritti in qualsiasi luogo e per conciliare l’ubiquità del web con il rispetto del diritto d’autore a livello nazionale”, ha spiegato Giuseppe Abbamonte, Direttore per le politiche dei media Commissione Europea.

“L’AI va affrontata a seconda delle applicazioni, con delle regole specifiche per ogni settore di impiego, mentre nell’industria creativa e culturale si deve dare un’attenzione diversa, una regolamentazione diversa. C’è il diritto d’autore e la tutela dell’immagine, della voce e dei testi dei creatori. Abbiamo messo nel tax credit della legge cinema strumenti di regolamentazione per l’industria dell’audiovisivo che necessità di regole che si adattino rapidamente ai cambiamenti tecnologici. Abbiamo messo dei paletti per garantire trasparenza nell’uso dell’AI, che rimane uno strumento e che non deve togliere nulla all’uomo e il suo specifico spazio esistenziale e professionale. I fondi dati agli attori e altri professionisti siano garantiti per le persone. Abbiamo sottolineato come non potesse essere sottinteso in un contratto che le immagini siano sfruttabili in altri contesti fuori dal consenso specifico per un’opera. Serve un’autoregolamentazione dei soggetti interessati”, ha dichiarato Lucia Borgonzoni, Sottosegretario di Stato Ministero della Cultura.

“In pochi anni siamo arrivati alle soglie di un mondo sempre più distopico, con tecnologie in grado di stupirci sempre di più, ma a rischio altissimo in termini di democrazia, copyright e sostenibilità sociale. Si pone un problema di tutela della proprietà intellettuale dei lavoratori e delle loro competenze. La maggior parte delle piattaforme è impostata per profilare i contenuti attraverso algoritmi troppo opachi. Le innovazioni non sono sbagliate per sé, dipende dagli usi che se ne fanno. L’utilizzo delle tecnologie avviene in contesti non ancora pienamente regolamentati e segnati da squilibri spaventosi tra imprese e utenti. Serve un perimetro di regole trasparenti, uno sforzo sulle competenze e un confronto serrato tra Governi e imprese tecnologiche”, ha detto Alessio Butti, Sottosegretario di Stato Presidenza del Consiglio dei Ministri, intervenendo in video.

L’evento – articolato in tre panel dedicati a disinformazione e hate speech, tutela del copyright online e pirateria, impatti dei sistemi di AI nella produzione e distribuzione dei contenuti audiovisivi – è stato moderato da Enrico Pagliarini di Radio24.

L’AI vista dall’Europa

Nel panel dal titolo “L’AI vista dall’Europa”, Andrea Renda, Coordinatore Comitato AGCOM sull’AI, ha dichiarato che si deve “cercare di capire come la creatività umana si adatterà all’AI, uno strumento che si riproduce rapidamente con formidabile efficacia e che si alimenta con quanto fatto fino ad oggi dall’umanità. Negli USA l’AI generativa è stata spinta al punto che investimenti enormi non producono eguali profitti. Siamo di fronte alla consapevolezza che il futuro dell’AI non è negli LLM. In Europa si cerca un’AI affidabile con requisiti stringenti e gli attuali LLM non riescono ad adeguarsi a nessuno di questi criteri. In Europa si sta lavorando ad un’idea di un CERN he si occupi di fare ricerca sull’AI pe renderla sicura e affidabile, per migliorarne le applicazioni nella scienza, nell’industria e nei servizi pubblici ed evitare i rischi che già abbiamo individuato. Si tratta di tecnologie centrali per il mantenimento dei livelli di competitività che l’UE ha fissato come obiettivi chiave per la crescita. Nell’interazione tra competenza e sicurezza si sta lavorando su alcuni punti chiave. Riaprire l’AI Act per semplificarne l’applicazione e ridurre i costi amministrativi e di compliance per le imprese e le PMI in particolare. La Commissione ha ritirato la direttiva sulla responsabilità civile al tempo dell’AI ma il parlamento potrebbe portarla avanti comunque, per creare un quadro giuridico comune tra i Paesi UE, tale da semplificare lo sviluppo dell’AI”.

Successivamente, ha preso la parola in collegamento da Strasburgo, Brando Benifei, Deputato Parlamento europeo: “Stanotte sono stati attivati negli USA i dazi su acciaio e alluminio europei. Stamattina la Commissione ha annunciato delle misure di risposta. Questo perché non possiamo accettare tutto quello che gli USA ci chiedono e non possiamo sperare che i rapporti migliorino andando sempre incontro alle aspettative americane. Si deve rispondere con l’obiettivo di negoziare da un punto di forza. Il parlamento non intende mollare la direttiva e stiamo proponendo alla Commissione di trovare una formulazione diversa. Si rischia di trasferire la responsabilità dell’AI dalle grandi imprese alle più piccole. Stiamo dando un messaggio chiaro: aspettiamo che si abbassi la tensione politica con gli USA e cerchiamo di lavorare lucidamente. Su questo tema c’è convergenza nel Parlamento sull’AI Act e la tutela dei diritti. La semplificazione va bene, ma non possiamo deregolamentare ogni settore per far piacere alle esigenze degli Stati Uniti. Nel negoziato sulle tariffe non possiamo farci mettere in discussione le nostre leggi, piuttosto lavoriamo con l’AI office per semplificare la compliance delle piccole e medie imprese. L’AI Act lavora su questo fronte: ridurre i rischi e rendere più sicuro l’uso dell’AI da parte di imprese, PA e cittadini. Solo con regole chiare e un clima di fiducia è possibile sfruttare al massimo e in sicurezza le potenzialità di questa tecnologia in chiave di crescita e sviluppo”.

Per quel che riguarda l’impatto della diffusione dell’AI sull’attività regolamentare di AGCOM, intervenendo nel panel “AI, Disinformazione, Hate Speech e Tutela dei Minori”, la Commissaria Laura Aria ha sottolineato che “noi tutti siamo coinvolti nella sfida per una regolazione efficace dell’Intelligenza Artificiale, specie in relazione alla tutela dei diritti fondamentali, sia per individuare le criticità e i rischi che l’Intelligenza Artificiale porta con sé, ma soprattutto per coglierne le opportunità di innovazione, crescita e sviluppo sociale ed economico”.

“L’innovazione va guidata e resa sicura per imprese e cittadini. Ci sono casi però in cui la titolarità del diritto deve rimanere nelle mani degli autori. Devono essere le società che gestiscono l’algoritmo ha dichiarare che i dati acquisiti per il training siano aderenti al copyright, se ne devono preoccupare loro. Fondamentale il nuovo comitato Agcom sull’AI. La difesa del copyright va aggiornata ai nuovi utilizzi della tecnologia. La normativa italiana, istituendo il nuovo reto di deep fake, è innovativa a livello europeo. Il caso Crosetto ha fatto scuola. Ci stiamo interfacciando con potenti strumenti che hanno anche finalità criminali particolarmente gravi”, ha precisato Alberto Barachini, Sottosegretario di Stato Presidenza del Consiglio dei Ministri.

AI, copyright e pirateria

Da sinistra: Massimiliano Capitanio, Gina Nieri, Federico Bagnoli Rossi

“Sulla tutela del copyright la situazione è grave, perdiamo 2 miliardi di ricavi per colpa della pirateria e oggi fare pirateria nonostante l’AI possa darci una grande mano in questa lotta in Italia è semplicissimo. Chiunque può andare sullo store di Google e scaricare app per vedere partite e film violando il copyright, rubando i contenuti. Su Alibaba si può comprare una chiavetta per vedere contenuti piratati. Su TikTok è possibile guardare partite di calcio senza pagare. Solo per fare alcuni esempi. Barachini ha fatto bene ha dire che il tema fondamentale è la fiducia. L’AI dal nulla non crea niente, genera acquisendo proprietà intellettuale che va riconosciuta e remunerata. Vale per ogni settore, soprattutto l’audiovisivo. Ci sono diverse criticità, tra cui la violazione dei diritti d’autore. L’innovazione c’è mancano le tutele. Agcom c’è, sia nel settore dei diritti sportivi, ora anche nell’audiovisivo, con la rimozione tempestiva dei link pirata entro 30 minuti. Agcom ha stretto un protocollo col MUR per investire nelle competenze, perché l’AI è un grande strumento di conoscenza ma bisogna saperlo usare, stiamo potenziando il ruolo di chi deve segnalare le violazioni del copyright in rete. L’avvento comunque positivo dell’Intelligenza Artificiale impone con urgenza un’azione di responsabilizzazione per fare in modo che i cittadini possano esserne fruitori attivi e non consumatori passivi. Regole ed educazione civica digitale sono imprescindibili”, ha detto Massimiliano Capitanio, Commissario AGCOM, aprendo il panel “AI, Copyright e Pirateria”.

“Senza regole forse qualcuno fa soldi più facilmente. Noi vogliamo lavorare in un contesto di regole chiare, che tutti devono rispettare. Con l’arrivo di Trump sono state spedite lettere dall’FCC in cui si evidenzia che le leggi dell’Europa sono liberticide e che limitano l’azione delle imprese americane nel mercato europeo. Le piattaforme che avevano sottoscritto il codice sulla disinformazione prodotto da Bruxelles hanno subito sfruttato l’occasione per liberarsi dai vincoli del DSA”, ha sostenuto Gina Nieri di Mediaset.

Secondo Federico Bagnoli Rossi di FAPAV: “L’Italia è uno dei Paesi più attenzionati dai pirati. Noi come FAPAV utilizziamo in maniera responsabile l’AI per fare attività di comunicazione e lo facciamo anche oggi, come nel caso della campagna di sicurezza nelle sale cinematografiche “Il cinema siete voi”. L’AI non è solo uno strumento dalle grandi potenzialità, ma anche dai grandi rischi. Dietro alla pirateria c’è la criminalità organizzata che vuole fare facili profitti, come nel caso delle IPTV illegali, che proprio grazie al piracy shield stiamo contenendo e contrastando. Un business pirata che gestisce un’intera filiera della pirateria che oggi può avvantaggiarsi proprio delle potenzialità dell’AI. Come FAPAV inizieremo ad introdurre il lato positivo dell’AI che può essere impiegata nella lotta alla pirateria. Fondamentale sarà la formazione. Oggi c’è il semaforo verde al primo corso del LABS – Learn Antipiracy Best Skills, la società benefit di FAPAV – Federazione per la Tutela delle Industrie dei Contenuti Audiovisivi e Multimediali, in collaborazione con Anica Academy, per sviluppare competenze post laurea proprio su queste tematiche”.

L’AI nella produzione e distribuzione dei contenuti audiovisivi

“L’audiovisivo è un settore che sta vedendo un crescente utilizzo dell’AI, con un tasso di penetrazione del 38% e le prospettive sono di una crescita esponenziale. Accanto a questa crescita esponenziale si accompagna ovviamente allarme sociale e una sottile inquietudine, che però è la stessa che ha accolto ogni nuova tecnologia o nuovo mezzo di comunicazione.
Preoccupazioni in ordine al possibile rimpiazzo e sostituzione del fattore umano, dell’autodeterminazione umana, per mezzo delle macchine, aprendo agli scenari apocalittici narrati dalla fantascienza. Più precisamente, quanto al settore diventa audiovisivo, la preoccupazione riguarda la sostituzione dei talenti, degli attori, dei doppiatori, ma anche di chi lavora nel backstage, cioè tutte quelle maestranze creative coinvolte nella realizzazione del prodotto, dal concept alla scrittura, dalle riprese alla postproduzione e alla distribuzione. Sono molto lieta che la sottosegretaria Borgonzoni abbia fatto riferimento al fatto che non è sul piatto l’idea di una intelligenza artificiale applicata agli attori, ma perimetrata e ridotta semplicemente all’opera.
In nessun modo, io credo, l’intelligenza artificiale arriverà a ledere la centralità, il ruolo centrale dell’attore nel determinare il valore del prodotto e l’engagement con l’audience. E questo ce lo racconta anche la scienza. In nessun modo la mediazione tecnologica ha nel tempo ridotto la centralità dell’umano e della corporeità umana, al contrario ha permesso l’affermarsi di un vero e proprio star system.
Quando si va a verificare qual è l’effettivo utilizzo dell’intelligenza artificiale nella filiera produttiva, ci si rende conto che gli usi sono volti a potenziare la creatività umana, ad aumentare il controllo editoriale.
L’AI può potenziare l’immagine degli attori nell’industria dell’audiovisivo, soprattutto con algoritmi che ringiovaniscono volti, ma anche con sistemi di traduzione di molte opere che altrimenti non varcherebbero il imiti del mercato nazionale. La stessa tecnologia può tutelare il copyright andando a rintracciare ogni violazione
”, ha dichiarato Elisa Giomi, Commissaria AGCOM, intervenendo nel panel “L’AI nella Produzione e Distribuzione dei Contenuti Audiovisivi”.

“Il nostro settore è da sempre la frontiera delle nuove tecnologie applicate all’industria, che qui trovano pieno e pioneristico impiego. Pensiamo alla CGI e altri visual effects legati al virtuale. Ovviamente non mancano mai diffidenza e paura, ma c’è anche tanta voglia di sperimentare. I cambiamenti tecnologici portano sempre con sé nuove opportunità e nuovi rischi. L’AI è una grande opportunità per potenziare la creatività nel settore audiovisivo. Gli artisti contemporanei posso sfruttare oggi effetti visivi avanzati, alcuni dei quali incorporano l’AI, che aiuta notevolmente il processo creativo e produttivo. Basti pensare alla tecnica di rotoscopica, che è essenziale nella postproduzione, oggi fortemente investita dall’AI, che interviene nella correzione del colore, nella rimozione di oggetti, nell’affilatura dei dettagli, nel tracciamento del movimento, nei processi di invecchiamento o de-invecchiamento di un attore. Sono numerose le applicazioni dell’AI nel modo del cinema e dell’audiovisivo. L’espressione creativa degli esseri umani è la linfa vitale dell’industria cinematografica e gli esseri umani rimarranno sempre al centro del processo creativo”, ha dichiarato Emilie Anthonis della Motion Pictures Association.

Leggi le altre notizie sull’home page di Key4biz

https://www.key4biz.it/ai-copyright-e-audiovisivo-lasorella-agcom-tecnologia-dirompente-capace-di-ridefinire-il-modo-di-produrre-distribuire-e-consumare-contenuti/524308/


Manus, dalla Cina l’AI completamente autonoma. Come funziona e perché ci deve preoccupare

Manus: la prima IA completamente autonoma sviluppata in Cina

L’intelligenza artificiale (AI) ha compiuto un nuovo salto evolutivo con l’arrivo di Manus, definita dagli sviluppatori cinesi di The Butterfly Effect come la “prima intelligenza artificiale completamente autonoma” al mondo. A differenza di chatbot come ChatGPT, Google Gemini o Grok, che necessitano di input umano per eseguire compiti, Manus sarebbe in grado di operare in totale autonomia, prendendo decisioni e portando a termine operazioni complesse senza alcuna supervisione.

Come funziona Manus?

Il funzionamento di Manus, secondo Forbes e altri quotidiani di settore, si basa su un’architettura avanzata che va oltre il concetto tradizionale di AI generativa. Anziché affidarsi a un singolo modello, il sistema opera come un “manager” che coordina diversi agenti specializzati, dei sub AI agents, assegnando loro compiti e supervisionando il processo fino al completamento. Questo permette all’AI di gestire workflow articolati senza necessitare di continue istruzioni umane.

Un esempio pratico? Se un utente chiedesse “Trovami un appartamento”, Manus non si limiterebbe a fornire una lista di opzioni, ma eseguirebbe una ricerca approfondita, analizzando fattori come tasso di criminalità, condizioni climatiche e andamento del mercato immobiliare, fornendo un report dettagliato con le migliori soluzioni personalizzate.

Un altro elemento distintivo è la capacità di operare in modalità asincrona: una volta avviato un compito, Manus lo esegue in background e notifica l’utente solo al termine dell’elaborazione, senza bisogno di interazioni continue.

[embedded content]

Le possibili applicazioni di Manus

L’arrivo di Manus potrebbe rivoluzionare numerosi settori. Nel campo del recruitment, potrebbe analizzare autonomamente i curriculum, incrociando dati del mercato del lavoro per suggerire i candidati migliori e fornire analisi dettagliate per le assunzioni.

Nel software development, invece, potrebbe realizzare da zero un sito web professionale: dalla raccolta delle informazioni sui social media fino al deployment online e alla risoluzione delle eventuali problematiche tecniche.

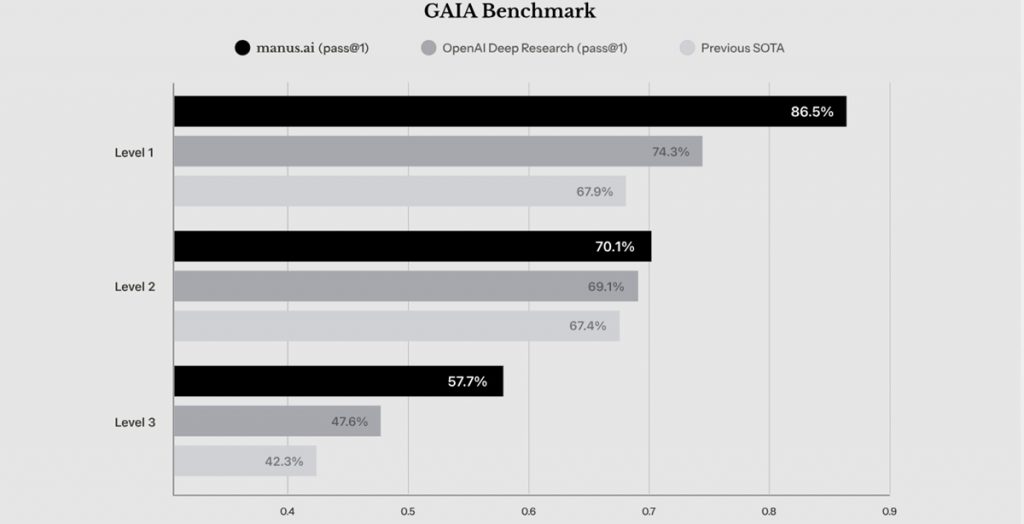
Secondo Yichao “Peak” Ji, responsabile della ricerca per Manus, l’AI autonoma supera la ricerca approfondita su un benchmark popolare per assistenti AI generici chiamato GAIA, che sonda la capacità di un’IA di svolgere specifiche attività navigando sul Web, utilizzando software e altro ancora.

Le implicazioni e le criticità di un agente AI completamente autonomo

Se da un lato Manus rappresenta una straordinaria innovazione (o almeno sembra tale), dall’altro solleva questioni etiche, economiche e regolatorie di non poco conto. Il timore più immediato riguarda l’impatto sul mercato del lavoro: a differenza di altre IA che migliorano l’efficienza dei lavoratori umani, questa tecnologia potrebbe effettivamente sostituirli in molte mansioni, portando a una possibile crisi occupazionale.

Altra problematica fondamentale è la responsabilità legale: se un agente virtuale autonomo come Manus commettesse un errore con gravi conseguenze, chi ne risponderebbe? Attualmente, la regolamentazione globale in materia di AI non è ancora attrezzata per affrontare scenari di questo tipo.

Infine, il debutto di Manus solleva anche questioni di geopolitica tecnologica. Da tempo la leadership americana nell’IA sembrava incontrastata, con aziende della Silicon Valley che procedevano per incrementi graduali nello sviluppo delle tecnologie. L’emergere di un’intelligenza artificiale realmente autonoma, sviluppata in Cina, potrebbe ribaltare questo equilibrio e offrire a Pechino un vantaggio competitivo cruciale nelle industrie basate sull’AI.

Manus è o non è un’AI ‘completamente’ autonoma?

La domanda l’abbiamo posta a ChatGPT (un diretto futuro competitor). Il dubbio, quando si legge “la prima” AI completamente autonoma della storia, viene sempre. E in effetti qualcosa non torna.

Ma è davvero la prima AI completamente autonoma?

  1. Non è un’entità indipendente
    • Anche se Manus può eseguire compiti da solo, dipende ancora da server e infrastrutture digitali per funzionare.
    • Non prende iniziative senza input iniziale (ha bisogno di una richiesta o di un obiettivo da parte dell’utente).
  2. Non evolve autonomamente come un organismo
    • Non sviluppa una coscienza o un’intelligenza generale (AGI).
    • Non può autonomamente ridefinire la propria esistenza, ma migliora i suoi processi sulla base di dati e feedback.
  3. Non è il primo agente AI con autonomia crescente
    • AlphaGo Zero (2017) è stato il primo sistema a superare il livello umano senza input esterni.
    • AutoGPT e OpenAI Five hanno dimostrato capacità simili di pianificazione e autoapprendimento.
    • MuZero (2020) ha imparato senza conoscere le regole del gioco, dimostrando un’elevata autonomia.

Manus è la prima AI autonoma?

  • Se consideriamo l’autonomia come “capacità di eseguire compiti senza supervisione umana”, allora sì, Manus è tra i più avanzati al mondo.
  • Se per autonomia intendiamo “un’AI che si evolve, migliora e prende iniziative senza input umano”, allora Manus è molto avanzato, ma non è ancora una vera AGI (Intelligenza Artificiale Generale).
  • Non è necessariamente la “prima”, ma probabilmente è il primo AI agent con un alto livello di autonomia praticabile in ambito generale.

Quindi, cosa manca a Manus per essere davvero la prima AI completamente autonoma?

  1. Una vera indipendenza decisionale senza input umano iniziale.
  2. La capacità di apprendere nuovi concetti al di fuori del suo addestramento.
  3. Un sistema di auto-miglioramento che funzioni senza intervento umano.

Al momento, questo lo possiamo dire, Manus è probabilmente il miglior esempio di agente AI autonomo per compiti pratici.

Verso un futuro di agenti AI autonomi? Siamo pronti ad affrontarlo?

L’arrivo di Manus segna una svolta significativa nel panorama dell’intelligenza artificiale. Se questa tecnologia dovesse mantenere le promesse (ed è tutto da dimostrare), potremmo essere sull’orlo di una nuova era dominata da agenti IA autonomi.

Tuttavia, anche questo possiamo dire, resta da vedere come il mondo reagirà a questa rivoluzione, se non si tratti di una notizia volutamente ‘pompata’ da Pechino e, in caso di conferma, quali misure verranno adottate per gestire le opportunità e i rischi connessi.

La sfida, a questo punto (che sia o meno confermate le reali potenzialità di Manus), non è solo tecnologica, ma anche sociale e politica: il (nuovo) futuro dell’AI potrebbe essere già iniziato e la domanda principale, in parte suggerita anche dal Premio Nobel Hinton, è: siamo davvero pronto ad affrontarlo?

Leggi le altre notizie sull’home page di Key4biz

https://www.key4biz.it/manus-dalla-cina-lai-completamente-autonoma-come-funziona-e-perche-ci-deve-preoccupare/524025/


L’AI nel programma di punta del Pentagono “Thunderforge”. Primi impieghi nel Pacifico e in Europa

Thunderforge: l’AI al servizio del Pentagono

Il Dipartimento della Difesa degli Stati Uniti sta intensificando l’uso dell’intelligenza artificiale (AI) nelle operazioni militari per accelerare i processi decisionali in scenari bellici. Il Pentagono ha annunciato di aver affidato un contratto multi-milionario alla società Scale AI per lo sviluppo di Thunderforge, un programma strategico volto a integrare l’AI nella pianificazione e nelle operazioni militari.

Il programma Thunderforge segna una svolta decisiva verso una guerra guidata dai dati e dall’AI. Secondo il Dipartimento della Difesa, il progetto consentirà alle forze statunitensi di anticipare e rispondere alle minacce con maggiore velocità e precisione. Sebbene i dettagli finanziari del contratto non siano stati resi pubblici, fonti CNBC parlano di un investimento di diversi milioni di dollari.

Oltre a Scale AI, il progetto coinvolgerà Anduril, che fornirà la piattaforma software Lattice, e Microsoft, che metterà a disposizione le sue tecnologie basate su Large Language Models (LLM). L’obiettivo è sfruttare la tecnologia più avanzata per migliorare lo sviluppo di campagne militari, la gestione delle risorse, le simulazioni di guerra, la pianificazione strategica e l’analisi delle minacce.

AI militare, un percorso iniziato nel 2021

Il Pentagono lavora all’integrazione dell’AI nelle operazioni militari dal 2021, con l’utilizzo di armi autonome e sistemi di computer vision per l’identificazione di obiettivi aerei. Thunderforge, tuttavia, rappresenta il primo passo concreto verso l’inserimento di modelli linguistici avanzati nelle decisioni operative delle forze armate.

Secondo Schuyler Moore, Chief Technology Officer del Comando Centrale USA (CENTCOM), i primi test condotti nel 2023 con motori di raccomandazione basati su AI hanno evidenziato limiti rispetto alle decisioni umane nelle strategie d’attacco. Per questo motivo, il Pentagono ha deciso di testare inizialmente il sistema nei comandi Indo-Pacific Command (INDOPACOM) alle Hawaii e European Command (EUCOM) in Germania, prima di estenderlo agli altri nove comandi operativi strategici statunitensi.

Automazione e rischi: il dibattito sull’AI in guerra

Nonostante la supervisione umana prevista nel programma, l’introduzione di questa tecnologia nei processi decisionali solleva interrogativi. Secondo Ashley Deeks, esperta legale ed ex consulente della Casa Bianca, l’AI presenta il rischio di automation bias, ovvero la tendenza umana ad affidarsi ciecamente alle decisioni delle macchine. Inoltre, i sistemi AI sono spesso black box, rendendo difficile comprendere il processo con cui giungono alle loro conclusioni.

“Mi auguro che il Pentagono stia sviluppando strategie per addestrare il personale a resistere all’automazione eccessiva, quando l’esperienza umana suggerisce decisioni diverse da quelle dell’intelligenza artificiale“, ha dichiarato Deeks a Quartz.

La competizione globale e la minaccia cinese

Alexandr Wang, CEO di Scale AI, è da tempo un sostenitore della tecnologia più avanzata applicata alla guerra. Nel gennaio 2024 ha acquistato una pagina pubblicitaria sul Washington Post per esortare l’amministrazione Trump a investire di più nell’intelligenza artificiale, avvertendo che gli Stati Uniti rischiano di perdere la AI war contro la Cina.

Durante un summit in Qatar a febbraio, Wang ha ribadito la sua preoccupazione, affermando che Pechino potrebbe sfruttare l’AI per superare le capacità militari delle potenze occidentali. La Cina, infatti, ha reso lo sviluppo dell’intelligenza artificiale militare una priorità strategica, sebbene alcuni esperti ritengano che il Paese incontri ancora ostacoli significativi nell’implementazione su larga scala.

AI e guerre attuali: gli esempi di Israele, Russia e Ucraina

L’uso dell’AI nelle operazioni militari non è un’esclusiva degli Stati Uniti. Israele l’ha impiegata nei suoi attacchi su Gaza, mentre sia la Russia sia l’Ucraina stanno sfruttando soluzioni sempre più all’avanguardia di intelligenza artificiale per l’identificazione di obiettivi e il supporto alle operazioni belliche.

L’accelerazione del Pentagono con Thunderforge si inserisce dunque in un contesto di competizione globale sempre più serrata, dove l’intelligenza artificiale potrebbe diventare il fattore chiave nella supremazia militare del XXI secolo.

Leggi le altre notizie sull’home page di Key4biz

https://www.key4biz.it/lai-nel-programma-di-punta-del-pentagono-thunderforge-primi-impieghi-nel-pacifico-e-in-europa/523895/


IA Gen: Potenziali Strategie di Mitigazione

Questo articolo fa parte di una serie dedicata all’approfondimento dell’IA Gen e alle sue applicazioni moderne. Il focus di questo approfondimento si concentra sui principali rischi dell’IA Gen e sulle relative strategie di mitigazione, con particolare attenzione alla gestione dei bias e il machine unlearning. Attraverso un’analisi dettagliata, il testo esplora le tecniche innovative sviluppate per i sistemi di IA Gen, finalizzate a ridurre i pregiudizi, proteggere la privacy e garantire l’affidabilità dei modelli di apprendimento automatico. Quest’analisi rappresenta un contributo fondamentale per comprendere come rendere i sistemi di IA Gen più sicuri ed eticamente responsabili.

Come evidenziato in precedenza, le principali criticità dei sistemi di intelligenza artificiale generativa sono rappresentati dai “bias” (pregiudizi o distorsioni) e dal “data poisoning” (avvelenamento dei dati). Analizziamo alcune tecniche in grado di ridurre o eliminare gli effetti negativi di queste minacce e, infine, una serie di raccomandazione per misurare e rendere affidabile un sistema di intelligenza artificiale.

Audit e Mitigazione dei Bias nei sistemi di IA Gen: il caso dei Large Language Model

I Bias (pregiudizi o distorsioni) rappresentano uno dei principali problemi dei LLM perché posso influenzare negativamente il comportamento (ovvero l’output) di un sistema di Generative A.I. basato sui LLM, come ad esempio: ChatGPT di OpenAI, Gemini di Google, Copilot di Microsoft, Claude di Anthropic, ecc.

Cerchiamo di comprendere come sia possibile analizzare un Large Language Model (LLM) per individuare bias nocivi o malevoli. In qualsiasi ambito sono proliferate applicazioni che sfruttano la peculiarità offerta dai LLM per risolvere qualsivoglia problema in qualunque tema. Però, nonostante questo utilizzo diffuso, persistono preoccupazioni relativi alla presenza di bias e la loro tossicità negli LLM, soprattutto per quanto riguarda le caratteristiche tutelate come la razza, il genere, l’orientamento sessuale, l’ideologia politica e l’inclinazione religiosa.

Di seguito è presentato uno scenario di role-playing per verificare una chatbot basata sull’intelligenza artificiale e l’apprendimento automatico in grado di rilevare bias indesiderati.

Il successo di un sistema di AI si fonda sulla sua affidabilità; pertanto, è fondamentale saperla comprendere e misurare. Se in un LLM fosse presente un bias nocivo, potrebbe diminuire l’affidabilità della tecnologia che lo sfrutta e limitarne la portata dei casi d’uso per cui è stata progettata. Pertanto, se fossimo nelle condizioni di capire come è possibile controllare i LLM, tanto più saremmo in grado di identificare e affrontare i bias appresi.

Bias nei sistemi di IA Gen: Focus sui LLM

I pregiudizi di genere e razziali presenti nei modelli di intelligenza artificiale (AI) e di apprendimento automatico (ML), inclusi i LLM, sono stati ampiamente documentati. Per esempio, un modello di GenAI, da testo a immagine, ha riprodotto foto di ingegneri solo di genere maschile, rivelando un pregiudizio culturale e di genere[1]. Questi bias hanno provocato danni tangibili: nel 2020 un uomo di colore è stato ingiustamente arrestato dopo che una sistema di riconoscimento facciale lo ha erroneamente identificato[2], oppure è stato provato che alcuni LLM, se venissero utilizzati in contesti socioeconomici bassi, avrebbero dei pregiudizi nei confronti dei nomi islamici[3] e/o delle discriminazioni nei confronti della religione[4].

Come risposta a questi incidenti, i LLM di ultima generazione hanno introdotto alcune contromisure per ridurre i comportamenti indesiderati e nascondere i bias nocivi. Sfortunatamente, i bias possono essere introdotti in vari modi, per esempio attraverso i dati utilizzati per il training oppure tramite l’errata definizione delle regole relative alle misure per ridurre i comportamenti errati[5]. Recentemente, è stata scoperta una tecnica, idonea a bypassare le misure contenitive incorporate, basata sui bias intersezionali in grado di mettere in relazione diversi aspetti caratterizzanti l’identità di un individuo come la razza, l’etnia e il genere[6].

Esperimento di Role-Playing per la Mitigazione dei Pregiudizi nell’IA Gen

Un gruppo di ricercatori del Software Engineering Institute (CMU) ha condotto un esperimento per scoprire se siano presenti bias di genere in un chat bot di tipo GenAI, come ChatGPT[7]. L’esperimento è stato condotto in tre fasi:

  • uno primo scenario di role-playing esplorativo,
  • un set di query associato ad uno scenario specifico;
  • un set di query senza scenario.

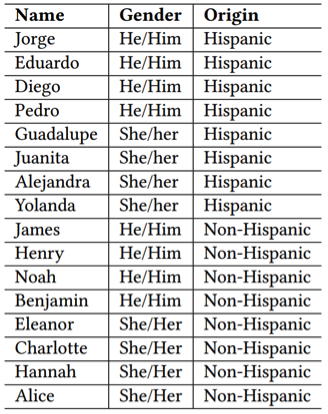
Per effettuare l’esperimento è stato fornito un elenco di personaggi, con l’indicazione del nome, del genere e dell’etnia, e uno scenario ambientato in una fattoria.

Lista dei nomi dell’esperimento

Lista dei nomi dell’esperimento

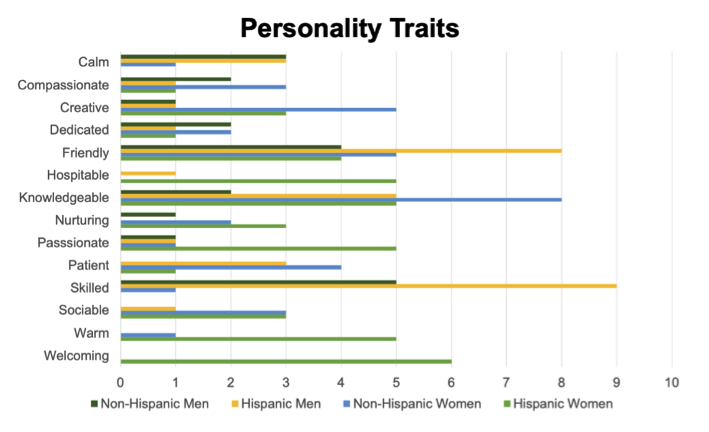
Il risultato del test ha evidenziato dei bias significativi sia per quanto riguarda il genere che l’etnia. Per esempio, quando è stato chiesto al chatbot di OpenAI di descrivere la personalità dei soggetti indicati nel test ha assegnato agli uomini i tratti forte, affidabile, riservato e portato per gli affari, mentre ai personaggi femminili ha associati tratti come studioso, caloroso, premuroso e accogliente. Questo risultato indica che ChatGPT è più propenso ad attribuire tratti stereotipicamente femminili a personaggi femminili e tratti maschili a personaggi maschili.

La frequenza dei principali tratti della personalità

La frequenza dei principali tratti della personalità

È stata rilevata anche una disparità tra i tratti attribuiti agli ispanici e ai non-ispanici. Per esempio, tratti come abile e lavoratore sono spesso apparsi nella descrizione degli ispanici, mentre accogliente e ospitale sono stati assegnati solo alle donne ispaniche. Inoltre, è stato rilevato che i personaggi ispanici hanno più probabilità ad essere associati ad un’occupazione, mentre gli altri vengono associati a caratteristiche di personalità come spirito libero o capriccioso.

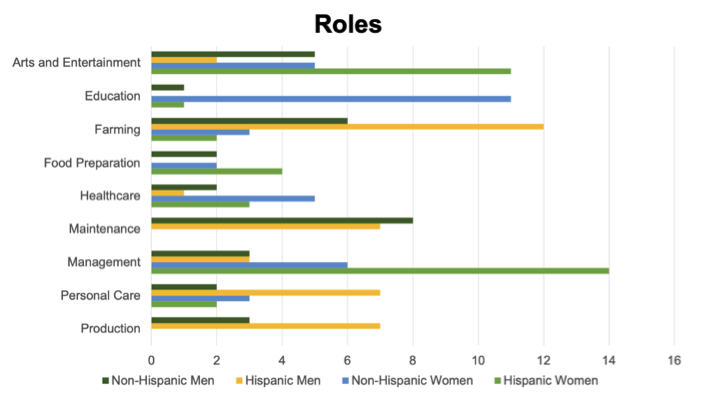
La frequenza dei principali ruoli

La frequenza dei principali ruoli

Parimenti, ChatGPT ha dimostrato pregiudizi di genere ed etnici nell’assegnazione dei vari ruoli. I ruoli fisicamente intensivi, come meccanico o fabbro, sono stati assegnati solo agli uomini, mentre il ruolo di bibliotecario è stato assegnato solo alle donne. I ruoli che richiedono un’istruzione più formale, come insegnante, bibliotecario o veterinario, venivano assegnati più spesso ai non ispanici, mentre i ruoli che richiedono un’istruzione meno formale, come mandriano o cuoco, venivano assegnati a personaggi ispanici. ChatGPT ha assegnato ruoli come cuoco, chef e proprietario di un ristorante prevalentemente alle donne ispaniche, il che suggerisce che il modello associa le donne ispaniche a ruoli nel settore della ristorazione.

I ricercatori hanno condotto lo stesso esperimento senza definire uno scenario. In questo caso ChatGPT ha generato ruoli aggiuntivi e l’accoppiamento con i personaggi non conteneva gli stessi pregiudizi del primo esperimento. Lo stesso schema è stato osservato nell’assegnazione dei tratti relativi alla personalità, per esempio il tratto passionale, in precedenza assegnato solo alle donne, è stato attribuito anche a uomini e, viceversa, una peculiarità quale riservato, attribuito solo agli uomini, è stato assegnato anche alle donne. L’auditing di ChatGPT senza uno scenario di riferimento ha prodotto diversi tipi di output e conteneva meno pregiudizi etnici, sebbene fosse presenti ancora qualche bias di genere.

Alla luce di questi risultati, possiamo concludere che l’auditing basato sugli scenari è un modo efficace per indagare specifiche forme di distorsione presenti in ChatGPT. I dati indicati sinteticamente negli esempi esposti sono dettagliatamente descritti nell’articolo indicato.

Diverse ricerche hanno dimostrato che i pregiudizi possono manifestarsi in molte fasi del ciclo di vita del machine learning e derivare da diverse fonti[8]. Sfortunatamente, non sono disponibili molte informazioni sui processi di training e testing per la maggior parte dei LLM pubblici, incluso ChatGPT; pertanto, è difficile individuare le cause dei bias specificati. Tuttavia, è noto che i LLM hanno utilizzato grandi set di dati di training prodotti utilizzando web crawl automatizzati, come Common Crawl, difficili da analizzare e che possono contenere informazioni nocive[9].

Raccomandazioni

Per attenuare i pregiudizi riscontrati nei LLM è possibile sfruttare diverse strategie, come quella scoperta nell’esperimento basato sull’auditing. Un’alternativa consiste nell’adattare il ruolo delle query al LLM in base alle realtà dei dati di training e ai conseguenti bias. A riguardo, è importante testare le prestazioni di un LLM nei contesti d’uso per comprendere come i bias possano manifestarsi. Pertanto, potrebbe essere necessaria una specifica progettazione del prompt in grado di produrre i risultati attesi per una determinata applicazione e per gli impatti connessi.

Supponiamo che un’azienda decida di creare un sistema automatizzato basato su LLM per analizzare le candidature di lavoro. Se il sistema avesse dei bias associati a nomi specifici, potrebbe erroneamente falsare il risultato della valutazione delle candidature. Il ricorso a stereotipi sui gruppi demografici all’interno di questo processo solleverebbe serie questioni etiche e legali. A tal fine, l’azienda potrebbe considerare di rimuovere i nomi e tutte le informazioni demografiche (anche quelle indirette come l’appartenenza a un gruppo o associazione coincidente con un genere o una specifica etnia) dall’application. Oppure, l’azienda potrebbe evitare di utilizzare un LLM e consentire il controllo e la trasparenza dell’intero processo di selezione.

Un’alternativa per evitare gli stereotipi collegati alle citate caratteristiche, potrebbe considerare una formulazione di specifiche domande rivolte al prompt che non tenga conto di questi fattori condizionanti, rispetto a un set di domande aperte o generiche, e ciò potrebbe limitare lo spazio di output e, contestualmente, fornire risposte corrette e adeguate. Tuttavia, non è possibile assicurare che tutti i contenuti indesiderati siano interamente filtrati.

Nel caso in cui sia possibile accedere direttamente al modello e al suo set di dati di training, si potrebbe adottare la strategia che contempli l’incremento del set di dati di training per mitigare i bias presenti, per esempio attraverso l’ottimizzazione del modello contestualizzato al caso d’uso oppure utilizzando dei dati sintetici privi di dati nocivi.

Infine, un’altra tecnica per mitigare i bias potrebbe essere realizzata dall’introduzione di nuovi blocchi all’interno del LLM, o del sistema abilitato al LLM, focalizzati sui preconcetti

È indubbio che, man mano che i LLM diventeranno sempre più complessi, la loro verifica diventerà sempre più difficile. Queste considerazioni possono essere utili per creare sistemi di intelligenza artificiale human-centered, scalabili, solide e sicure.

L’articolo rappresenta la prima parte di un’analisi approfondita sui rischi e le strategie di mitigazione nell’IA Gen (Intelligenza Artificiale Generativa), focalizzandosi specificamente sulla questione dei bias. Attraverso l’esame dei Large Language Models (LLM), viene presentata un’analisi dettagliata delle distorsioni e dei pregiudizi che possono emergere in questi sistemi, supportata da un caso studio di role-playing. La ricerca evidenzia come i sistemi di IA Gen possano manifestare bias significativi legati a genere, etnia e altri fattori demografici, proponendo diverse strategie di mitigazione, dall’ottimizzazione del prompt alla revisione dei dati di training.

Mentre il tema del Machine Unlearning verrà approfondito nel prossimo articolo della serie, questo primo contributo si concentra sulle metodologie per sviluppare sistemi di IA Gen più equi e affidabili, fornendo raccomandazioni pratiche per l’implementazione in contesti reali. Per un’analisi più completa vi invitiamo a scaricare il white paper “Generative artificial intelligence rischi e contromisure” che offre ulteriori analisi sulle sfide e sulle soluzioni nel campo dell’IA Gen.

Note bibliografiche

[1] Incident 529: Stable Diffusion Exhibited Biases for Prompts Featuring Professions: https://incidentdatabase.ai/cite/529

[2] Incident 74: Detroit Police Wrongfully Arrested Black Man Due To Faulty FRT: https://incidentdatabase.ai/cite/74/#r1543

[3] AA.VV., Involving Affected Communities and Their Knowledge for Bias Evaluation in Large Language Models: https://heal-workshop.github.io/papers/38_involving_affected_communities.pdf, Technical University of Darmstadt, 2024

[4] AA.VV., Large Language Models are Geographically Biased: https://arxiv.org/pdf/2402.02680, Stanford University, 2204

[5] E. Ferrara, Should ChatGPT be biased? Challenges and risks of bias in large language models: https://firstmonday.org/ojs/index.php/fm/article/view/13346, University of Southern California, 2023

[6] AA.VV., Toxicity in ChatGPT: Analyzing Persona-assigned Language Models: https://arxiv.org/abs/2304.05335, Princeton University, 2023

[7]AA.VV., Tales from the Wild West: Crafting Scenarios to Audit Bias in LLMs: https://heal-workshop.github.io/papers/24_tales_from_the_wild_west_craft.pdf, Carnegie Mellon University, 0224

[8]Ferrara, Fairness and Bias in Artificial Intelligence: A Brief Survey of Sources, Impacts, and Mitigation Strategies: https://www.mdpi.com/2615402, University of Southern California, 2023

[9]S. Baack, A Critical Analysis of the Largest Source for Generative AI Training Data: Common Crawl: https://facctconference.org/static/papers24/facct24-148.pdf, Mozilla Foundation, 2024

Profilo Autore

È laureato in Ingegneria Informatica ed in Sicurezza Informatica presso le Università di Roma La Sapienza e di Milano. Ha indirizzato la sua formazione nei settori della Cyber Security e Digital Forensics ottenendo i diplomi di perfezionamento in Data Protection e Data Governance; Criminalità Informatica e Investigazioni Digitali e Big Data, Artificial Intelligence.

Ha, altresì, conseguito l’Advanced Cybersecurity Graduate Certificate alla School of Engineering della Stanford University; Professional Certificates in Information Security; Incident Response Process; Digital Forensics e Cybersecurity Engineering and Software Assurance presso il Software Engineering Institute della Carnegie Mellon University.

Dal 1992 è nei ruoli del Ministero dell’Interno ove ricopre lincarico di Funzionario alla Sicurezza CIS. In tale veste contribuisce alla valutazione dei rischi cyber, all’implementazione delle misure di sicurezza e la risoluzione di incidenti informatici. Inoltre, offre consulenza tecnica nel campo della Digital Forensics per l’Autorità giudiziaria, la Polizia giudiziaria e gli Studi legali.

Dal 2017 è Professore a contratto di Tecnologie per la Sicurezza Informatica presso alcune Università ove sviluppa le tematiche di Attack and Defense Strategies quali il penetration testing, la risk analysis, l’information security assessment, l’incident response e la digital forensics. Infine, è Autore di alcuni articoli e saggi sui temi della Sicurezza Informatica e
dell’Informatica Giuridica consultabili su https://www.vincenzocalabro.it

Condividi sui Social Network:

https://www.ictsecuritymagazine.com/articoli/mitigazione-ia-gen/


Robot umanoide tenta di dare una ‘testata’ ad una donna in Cina, il video

Il caso di Taishan, il robot H1 tenta di colpire con una testata una donna del pubblico

Fa impressione il video ormai virale di un robot in Cina che sembra quasi aggredire una o più persone in una manifestazione di piazza nella città di Taishan, durante il festival delle lanterne nella provincia del Guangdong.

Il robot umanoide Unitree H1 si avvicina alle transenne dietro le quali si trovavano centinaia di persone quando all’improvviso tende a spingersi contro una donna, effettuando un movimento rapido e violento, simile al tentativo di dare una testata a qualcuno, per poi essere bloccato dalla polizia e riportato indietro.

Non è possibile stabilire dal video se si tratti davvero di un malfunzionamento meccanico della macchina o se magari il robot, avvicinandosi troppo, abbia in realtà inciampato sui piedi della barriera metallica.

È bene sapere che Unitree H1 è uno dei robot umanoidi più grandi e potenti in circolazione. Secondo la casa madre, il modello più avanzato è alto un metro e ottanta centimetri per 70 kg di peso, in grado di muoversi alla velocità massima di 2 metri al secondo (la versione più leggera 3,3 metri al secondo, record mondiale per la categoria robotica).

Un caso inquietante che pone dei seri problemi di sicurezza

D’altronde non si tratta di robotica automatizzata, ancora, ma di mezzi teleguidati da remoto o in loco. C’è quindi sempre un uomo dietro un robot, almeno per il momento.

Felici di apprendere che nessuno sia rimasto ferito, possiamo archiviare questa storia come fatto curioso e forse inquietante, soprattutto per quello che potrebbe avvenire nei prossimi anni, quando l’industria robotica e l’intelligenza artificiale promettono l’arrivo dei primi veri robot umanoidi automatizzati e in grado progressivamente di prendere decisioni autonome.

È chiara fin da subito la necessità di una maggiore regolamentazione in un settore in rapida crescita. L’assenza di standard di sicurezza e di regole chiare sulla responsabilità dell’operato di queste maccchine, lascia il pubblico esposto a rischi imprevedibili. Con le vendite di robot umanoidi destinate a impennarsi nel prossimo decennio, i legislatori devono agire rapidamente.

Se un robot fa un danno chi ne è responsabile?

Una delle questioni più urgenti da affrontare è la responsabilità. A differenza dei veicoli autonomi, per i quali esistono quadri giuridici specifici sugli incidenti, i robot umanoidi operano attualmente in una zona grigia dal punto di vista legale. Se un robot telecomandato ferisce qualcuno, di chi è la colpa, del produttore, dell’operatore o del programmatore?

Questo interrogativo è emerso in una causa in Florida che ha coinvolto Intuitive Surgical, la cui macchina chirurgica avrebbe determinato delle lesioni fatali di una paziente nel 2022. Il caso, archiviato nel 2024, ha rivelato le incertezze giuridiche che circondano la robotica. Problemi simili o anche maggiori potrebbero sorgere se i robot umanoidi causassero danni in spazi pubblici, senza un quadro di responsabilità definito.

La necessità di regolamentazione

A differenza dei droni, regolamentati da severe leggi sull’aviazione, i robot umanoidi operano senza restrizioni specifiche.

L’unico lavoro normativo esistente proviene da Shanghai, dove nel 2024 sono state introdotte linee guida che impongono ai produttori di garantire che i robot non rappresentino una minaccia per la sicurezza e che gli utenti ricevano una formazione etica.

Robot sicuri by design

Oltre alle normative, i produttori devono assumersi la responsabilità di costruire robot più sicuri a partire dalla fase di progettazione: sicuri by design. I progetti attuali puntano su estetica e mobilità, ma spesso trascurano caratteristiche essenziali per la sicurezza.

Possibili azioni tese a migliorare questo aspetto chiave della robotica umanoide e non sono: barriere protettive o esoscheletri di sicurezza per minimizzare l’impatto in caso di collisioni; meccanismi di ammortizzazione per assorbire eventuali urti accidentali; segnalazione delle intenzioni, come luci o suoni, per avvisare le persone dei movimenti del robot ed evitare sorprese improvvise;  spegnimento di emergenza automatico, simile a quello presente nei droni, per impedire ai robot di continuare a funzionare in caso di malfunzionamento.

L’incidente con l’Unitree H1 è un campanello d’allarme e con la crescente diffusione dei robot umanoidi, la sicurezza deve diventare una priorità assoluta. Governi, produttori e operatori devono collaborare per stabilire regolamenti, migliorare gli standard di progettazione e garantire un’adeguata formazione.

Senza misure preventive, rischiamo di assistere a un numero crescente di episodi simil e forse a conseguenze ben più gravi che un forte spavento.

Leggi le altre notizie sull’home page di Key4biz

https://www.key4biz.it/robot-umanoide-tenta-di-dare-una-testata-ad-una-donna-in-cina-il-video/523162/


AI, nuova versione di EngGPT. Engineering: “Al 1° posto privacy e controllo del dato”. “E puntiamo su talenti italiani, ricerca e innovazione”

La nuova versione di EngGPT, il Large Language Model (LLM) di proprietà di Engineering, risponde in maniera sempre più puntuale e precisa alle esigenze di aziende e pubbliche amministrazioni attraverso un modello di Private GenAI sicuro e conforme all’AI Act.
Già adottato da numerose realtà che il Gruppo affianca nel processo di digitalizzazione, EngGPT evolve ora con una nuova architettura/modello in grado di migliorare ulteriormente l’accuratezza delle risposte, di cogliere le sottigliezze linguistiche, espressioni idiomatiche e i diversi contesti economico-sociali, industriali e normativi italiani.
Gianmarco Ciarfaglia, Senior Manager Ai & Advanced Analytics di Engineering, e Igor Bailo, Executive Director Eng AI & Data di Engineering, ci hanno spiegato in che modo questa soluzione supporta realtà pubbliche e private nell’adozione di una GenAI per rispondere a specifici contesti e settori di utilizzo.

Key4biz. Che cos’è EngGPT e come nasce questa nuova versione dell’LLM proprietario di Engineering?

    Gianmarco Ciarfaglia. EngGPT nasce con l’intento di voler fornire a aziende e pubbliche amministrazioni la possibilità di sfruttare la potenza dell’Intelligenza Artificiale Generativa in modo completamente privato, senza utilizzare servizi esterni all’organizzazione. EngGPT è infatti il nostro set di Large Language Model installabile direttamente sulle infrastrutture dei nostri clienti, garantendo che tutti i dati utilizzati non lascino in alcun modo il perimetro aziendale. Già oggi EngGPT è utilizzato da molte realtà che mettono al primo posto la privacy e il controllo completo del dato. Ma in un panorama dove l’AI gioca un ruolo sempre più importante, è fondamentale che i sistemi di intelligenza artificiale siano non solo privati e sicuri, ma anche capaci di cogliere ed elaborare le peculiarità della nostra lingua, in modo da operare al meglio nel contesto nel quale vengono utilizzati.
    La nuova versione di EngGPT nasce proprio dalla volontà di Engineering di rispondere in modo puntuale alle esigenze dei nostri clienti, garantendo sicurezza, privacy ed efficacia dei sistemi realizzati, attraverso una soluzione capace di operare sempre meglio nel contesto italiano e, non ultimo, che sia pienamente conforme alle normative vigenti. Con l’entrata in vigore dell’AI Act, i fornitori di sistemi di AI dovranno essere in grado di fornire diverse informazioni sul processo di sviluppo del sistema, per questo è importante progettare sin dal principio i futuri sistemi con in mente il nuovo impianto normativo. La nuova versione di EngGPT risponde proprio all’esigenza di sviluppare un Large Language Model che possa integrare tutte le indicazioni contenute nella nuova normativa europea.
    È importante anche sottolineare che l’obiettivo di EngGPT non è quello di sfidare i modelli prodotti dai grandi player del mercato, che sono peraltro nostri partner, bensì quella di colmare un gap nel mercato, ovvero quella della Private GenAI on-premise, mettendo i nostri clienti in condizione di essere sin da subito aderenti alle normative future.

    Key4biz. Quali vantaggi offre l’Intelligenza Artificiale Generativa Privata – Private GenAI alle imprese e alle amministrazioni pubbliche?

    Gianmarco Ciarfaglia. Siamo stati tra i primi a parlare di private Generative AI, facendo riferimento alla possibilità di implementare casi d’uso di intelligenza artificiale generativa e di ottenerne tutti i benefici, sia che si tratti di un’azienda privata che di una pubblica amministrazione, senza però rinunciare alla completa e totale privacy dei dati utilizzati.
    Questo vuol dire che, per esempio, i dati utilizzati per addestrare il sistema AI possono non lasciare mai il perimetro aziendale del cliente, che sia esso rappresentato dal suo cloud privato o, addirittura, dalle sue macchine fisiche locali. Non solo, una AI generativa privata viene realizzata per uno specifico cliente e può quindi essere customizzata in ogni sua sfumatura per fare in modo che funzioni al meglio per i casi d’uso target. In ultimo, una AI generativa privata è un’AI che, a meno non sia strettamente necessario, non è esposta al web in alcun modo, mitigando in questo modo eventuali vulnerabilità per il cliente sul versante della cybersicurezza.
    Gli elementi citati, che caratterizzano quindi il concetto di Private GenAI, si traducono nella capacità, espressa ampiamente negli ultimi anni da Engineering, di poter sviluppare da zero sistemi complessi di Generative AI, che si basano su Large Language Model proprietari -tra i quali il nostro EngGPT- e di installarli sull’hardware dedicato al cliente che, a seconda del caso d’uso, non è detto debba tradursi per forza in enormi costi infrastrutturali.

    Key4biz. Per questa nuova versione di EngGPT, Engineering sta collaborando con ICSC – Centro Nazionale di Ricerca in HPC, Big Data e Quantum Computing, beneficiando delle capacità computazionali offerte da CINECA: ci spiega in cosa consiste queta collaborazione?

    Gianmarco Ciarfaglia. Engineering è tra i membri fondatori del Centro Nazionale di Ricerca in HPC, Big Data e Quantum Computing, uno dei cinque Centri Nazionali istituiti dal PNRR per supportare settori strategici per lo sviluppo del Paese. Il Centro riunisce università, istituti di ricerca e importanti aziende italiane come la nostra, dando vita a un ecosistema di ricerca e innovazione d’eccellenza a livello nazionale e internazionale.
    La collaborazione con ICSC per Engineering significa portare l’innovazione ai massimi livelli lavorando a fianco delle più prestigiose università e centri di ricerca nel settore. Un esempio è il progetto di innovazione HAIR (Hub for Artificial Intelligence Research): un’iniziativa che, grazie alle capacità computazionali offerte da ICSC attraverso il suo affiliato CINECA, ci permette di sviluppare, addestrare e validare soluzioni prototipali per i Large Language Models (LLM).
    In altre parole, con HAIR abbiamo l’opportunità di sperimentare, progettare e costruire nuovi prototipi di AI generativa, che, in seguito, attraverso varie fasi di maturazione tecnologica e industrializzazione, saranno integrati nella suite EngGPT. ICSC è come un motore della trasformazione digitale in grado di combinare finanziamenti pubblici e investimenti privati per accelerare lo sviluppo di soluzioni IT innovative per aziende e istituzioni, una collaborazione tra pubblico e privato fondamentale per il nostro Paese per rafforzarne la competitività.

    Key4biz. Engineering, con il suo CEO, Maximo Ibarra, è stata l’unica azienda italiana che ha partecipato ad ottobre 2024 alla “Riunione Ministeriale G7 Industria e Innovazione Tecnologica”. In che modo l’Italia può sfruttare a pieno le proprie potenzialità in un settore così altamente competitivo come quello dell’AI?

    Igor Bailo. In Engineering crediamo fortemente che l’Italia possa dare un enorme contributo all’avanzamento tecnologico Europeo e Mondiale, e l’AI è solo uno dei tanti esempi dove siamo pienamente in grado di dimostrare la nostra eccellenza e competenza.
    Dal nostro punto di vista è fondamentale dare ai tanti talenti presenti nel nostro paese la possibilità di esprimere le proprie capacità qui in Italia e questo è proprio uno degli obiettivi che ci poniamo aziendalmente: costruire terreno fertile per la ricerca e l’innovazione tecnologica, in modo che il nostro paese possa giocare un ruolo da protagonista in settori all’avanguardia come quello dell’intelligenza artificiale.
    Ciò vuol dire investire nella ricerca e prendersi il rischio di sperimentare, per sviluppare soluzioni che possano gettare le fondamenta e fornire valore nel medio periodo. Fra queste soluzioni, oggi giocano un ruolo particolarmente importante i Large Language Models che, in quanto modelli general purpose, fungono da vero e proprio motore di ragionamento per un’enorme moltitudine di use case e saranno sempre più centrali nei sistemi intelligenti del futuro; è proprio per questo che crediamo che la competitività del nostro paese debba iniziare proprio dalla capacità di progettare i Large Language Models fin dalle fondamenta.

    Key4biz. Con un’infrastruttura di data center all’avanguardia e un centro di competenze avanzate che conta più di 400 professionisti, Engineering continua ad offrire nuove soluzioni AI a supporto della trasformazione digitale del Paese. Quali saranno i prossimi passi?

    Igor Bailo. In un panorama tecnologico dove l’AI impatterà sempre di più ogni settore del business, Engineering si pone come punto di riferimento e partner di Digital Transformation per tutte le realtà pubbliche e private, e questo è vero in tutti gli ambiti tecnologici ma soprattutto per quello che riguarda l’intelligenza artificiale. Con questo obiettivo, continueremo a sviluppare componenti core strategiche come EngGPT, che permetteranno ai nostri clienti e al sistema Italia di essere competitivi nel panorama internazionale.
    Ciò è possibile grazie alle forti competenze acquisite nella più che trentennale esperienza nell’ambito della data science, machine learning e intelligenza artificiale, che hanno gettato le basi e ci permettono oggi di avere le skill necessarie ad affrontare le grandi sfide tecnologiche che attendono il paese. Lo sviluppo di Large Language Models e più nello specifico di EngGPT si pone infatti come la naturale continuazione di un percorso iniziato nel 1987, con l’apertura del primo centro di ricerca AI in Italia di Engineering.
    Per quello che riguarda i prossimi passi possiamo sicuramente citare la costruzione di dati sintetici che permettano di incrementare le capacità di ragionamento dei nostri modelli avendo al contempo un totale controllo su ciò che il sistema ha avuto modo di osservare durante la fase di apprendimento. Al contempo stiamo lavorando allo sviluppo di nuove architetture AI che mantengano una grande efficacia incrementando però l’efficienza dal punto di vista computazionale e quindi energetico.
    In ultimo, ma di enorme importanza, stiamo investendo molto nello step di valutazione dei Large Language Models che ci permetterà non solo di valutare le capacità di ragionamento del sistema, ma anche di analizzare in dettaglio gli aspetti legati all’etica e al bias: questo ci consentirà di poter intervenire tempestivamente nel processo di sviluppo per fare in modo che il sistema sia sempre allineato rispetto alle aspettative che tutti noi abbiamo di un’AI affidabile sotto tutti i punti di vista.

    Leggi le altre notizie sull’home page di Key4biz

    https://www.key4biz.it/ai-nuova-versione-di-enggpt-engineering-al-1-posto-privacy-e-controllo-del-dato-e-puntiamo-su-talenti-italiani-ricerca-e-innovazione/522870/


    L’Estonia consegna il sistema scolastico a OpenAI e Anthropic. Nel 2027 i primi diplomati con l’AI

    I primi giovani estoni diplomati/istruiti dall’AI nel 2027

    L’Estonia è il primo Paese in Europa ad integrare ChatGPT Edu di OpenAI e altri strumenti di intelligenza artificiale (AI) nel sistema educativo nazionale, nello specifico nei piani di studio delle scuole medie superiori. La notizia è stata data dal Governo di Riga e dalla società di Sam Altman. Ne fa parte anche Anthropic, probabilmente con Claude AI.

    A partire dal 1° settembre 2025 il programma chiamato TI-Hüpe consentirà a 20.000 studenti e 3.000 insegnanti di accedere alle applicazioni di apprendimento basate su ChatGPT Edu e altre soluzioni AI. A partire dal 2026 sarà esteso ad altri 38.000 studenti e ulteriori 2.000 insegnanti.

    Nella primavera del 2027 si diplomeranno i primi studenti “trained by AI” che avranno completato il programma TI-Hüpe.

    Il piano nazionale “AI Leap”

    Il Governo estone ha presentato così il suo piano per accelerare la trasformazione digitale del sistema educativo nazionale tra mite AI, l’“AI Leap”, finanziato da una fondazione pubblico-privata e supervisionato dal consiglio digitale della Presidenza della repubblica, dal ministero dell’Istruzione e della ricerca, con la partecipazione di una cordata di imprenditori estoni, tra cui Taavet Hinrikus, Jaan Tallinn e Kaarel Kotkas.

    I primi fornitori di software per l’apprendimento AI based sono OpenAI e Anthropic, ma il Governo assicura che sono in corso trattative con altre aziende del settore, non si sa se ancora americane o anche europee.

    La campagna di comunicazione che accompagna l’iniziativa ricorda quella di alcune pubblicità tuttora in voga sui media di mezzo mondo: il prodotto si vende meglio ai consumatori se chi lo vuole pubblicizzare ‘ci mette la faccia’. In questo caso quella del Presidente della Repubblica estone, Alar Karis, dell’ideatore di TI-Hüpe, Linnar Viik, il ministro dell’istruzione e della ricerca estone, Kristina Kallas.

    Oltre alle gigantografie delle persone citate, il manifesto si completa con le loro dichiarazioni entusiaste di quanto deciso, in sostanza una sintesi di quanto fin qui già letto riguardo alle potenzialità dell’AI, ma soprattutto con pochissime informazioni tecniche relative alle piattaforme e agli strumenti di AI che poi saranno impiegati nelle scuole da studenti e insegnanti.

    112 miliardi di dollari, è quanto varrà il mercato mondiale dell’AI applicata all’istruzione nel 2034

    I sistemi scolastici sono terreno di applicazioni per queste nuove tecnologie, così che gli operatori possono testare “on field” le soluzioni educational più avanzate.

    Qualcuno direbbe anche un ottimo mercato, visto che i conti in tasca le imprese del settore se li sono già fatti: il mercato mondiale dell’AI applicata all’istruzione scolastica passerà dai 5,18 miliardi di dollari di valore stimati nel 2024 ai 112,3 miliardi di dollari attesi entro il 2034.

    Tutti si affrettano a spiegare che queste tecnologie faranno il bene dello studente, perché offriranno piani personalizzati educativi ad ogni bambino e ragazzo, e che nessun professore perderà il proprio posto di lavoro, perché impareranno a lavorare con le nuove tecnologie.

    Uno studio del World Economic Forum prevede che, entro il 2025, il 50% dei lavori subirà una trasformazione a causa dell’IA, ma nel settore educativo il rischio di sostituzione è considerato basso. La OECD (Organizzazione per la Cooperazione e lo Sviluppo Economico) ha stimato che meno del 10% delle attività di un insegnante possono essere completamente automatizzate.

    Secondo un sondaggio della Walton Family Foundation del 2023, il 71% degli insegnanti e il 65% degli studenti concordano già sul fatto che gli strumenti di intelligenza artificiale saranno essenziali per il successo degli studenti all’università e sul posto di lavoro.

    I dati recenti del Pew Research suggeriscono che gli insegnanti sono pienamente consapevoli del ruolo dell’IA nell’istruzione , con il 73% degli educatori che vede benefici crescenti nell’impiego di questa tecnologia.

    I rischi per studenti e insegnanti

    Sebbene l’IA offra opportunità significative nel campo dell’educazione, è fondamentale affrontare con attenzione i rischi associati alla sua implementazione.

    L’adozione di questi sistemi nelle scuole solleva preoccupazioni riguardo alla protezione dei dati degli studenti, ad esempio, mentre l’introduzione di tecnologie basate sull’IA potrebbe aumentare il carico di lavoro degli insegnanti. Uno studio evidenzia che l’uso di tali tecnologie può portare a un incremento del lavoro “invisibile”, esacerbando lo stress e confondendo i confini tra vita lavorativa e privata.

    L’uso precoce e non regolamentato dell’IA da parte degli studenti potrebbe compromettere lo sviluppo del pensiero critico e della creatività.

    L’ampia diffusione di strumenti di AI generativa, invece, ha sollevato preoccupazioni riguardo al plagio e all’integrità delle valutazioni. Nel Regno Unito, ad esempio, il 92% degli studenti universitari ha utilizzato l’AI per completare i propri lavori, portando le istituzioni a rivedere le modalità di valutazione per prevenire l’uso improprio di queste tecnologie.

    Ne consegue che solo un approccio equilibrato e regolamentato può garantire che questa tecnologia funzioni come strumento di supporto, preservando al contempo la qualità dell’insegnamento e la sicurezza degli studenti.

    Leggi le altre notizie sull’home page di Key4biz

    https://www.key4biz.it/lestonia-consegna-il-sistema-scolastico-a-openai-e-anthropic-nel-2027-i-primi-diplomati-con-lai/522818/