L’AI nel programma di punta del Pentagono “Thunderforge”. Primi impieghi nel Pacifico e in Europa

Thunderforge: l’AI al servizio del Pentagono

Il Dipartimento della Difesa degli Stati Uniti sta intensificando l’uso dell’intelligenza artificiale (AI) nelle operazioni militari per accelerare i processi decisionali in scenari bellici. Il Pentagono ha annunciato di aver affidato un contratto multi-milionario alla società Scale AI per lo sviluppo di Thunderforge, un programma strategico volto a integrare l’AI nella pianificazione e nelle operazioni militari.

Il programma Thunderforge segna una svolta decisiva verso una guerra guidata dai dati e dall’AI. Secondo il Dipartimento della Difesa, il progetto consentirà alle forze statunitensi di anticipare e rispondere alle minacce con maggiore velocità e precisione. Sebbene i dettagli finanziari del contratto non siano stati resi pubblici, fonti CNBC parlano di un investimento di diversi milioni di dollari.

Oltre a Scale AI, il progetto coinvolgerà Anduril, che fornirà la piattaforma software Lattice, e Microsoft, che metterà a disposizione le sue tecnologie basate su Large Language Models (LLM). L’obiettivo è sfruttare la tecnologia più avanzata per migliorare lo sviluppo di campagne militari, la gestione delle risorse, le simulazioni di guerra, la pianificazione strategica e l’analisi delle minacce.

AI militare, un percorso iniziato nel 2021

Il Pentagono lavora all’integrazione dell’AI nelle operazioni militari dal 2021, con l’utilizzo di armi autonome e sistemi di computer vision per l’identificazione di obiettivi aerei. Thunderforge, tuttavia, rappresenta il primo passo concreto verso l’inserimento di modelli linguistici avanzati nelle decisioni operative delle forze armate.

Secondo Schuyler Moore, Chief Technology Officer del Comando Centrale USA (CENTCOM), i primi test condotti nel 2023 con motori di raccomandazione basati su AI hanno evidenziato limiti rispetto alle decisioni umane nelle strategie d’attacco. Per questo motivo, il Pentagono ha deciso di testare inizialmente il sistema nei comandi Indo-Pacific Command (INDOPACOM) alle Hawaii e European Command (EUCOM) in Germania, prima di estenderlo agli altri nove comandi operativi strategici statunitensi.

Automazione e rischi: il dibattito sull’AI in guerra

Nonostante la supervisione umana prevista nel programma, l’introduzione di questa tecnologia nei processi decisionali solleva interrogativi. Secondo Ashley Deeks, esperta legale ed ex consulente della Casa Bianca, l’AI presenta il rischio di automation bias, ovvero la tendenza umana ad affidarsi ciecamente alle decisioni delle macchine. Inoltre, i sistemi AI sono spesso black box, rendendo difficile comprendere il processo con cui giungono alle loro conclusioni.

“Mi auguro che il Pentagono stia sviluppando strategie per addestrare il personale a resistere all’automazione eccessiva, quando l’esperienza umana suggerisce decisioni diverse da quelle dell’intelligenza artificiale“, ha dichiarato Deeks a Quartz.

La competizione globale e la minaccia cinese

Alexandr Wang, CEO di Scale AI, è da tempo un sostenitore della tecnologia più avanzata applicata alla guerra. Nel gennaio 2024 ha acquistato una pagina pubblicitaria sul Washington Post per esortare l’amministrazione Trump a investire di più nell’intelligenza artificiale, avvertendo che gli Stati Uniti rischiano di perdere la AI war contro la Cina.

Durante un summit in Qatar a febbraio, Wang ha ribadito la sua preoccupazione, affermando che Pechino potrebbe sfruttare l’AI per superare le capacità militari delle potenze occidentali. La Cina, infatti, ha reso lo sviluppo dell’intelligenza artificiale militare una priorità strategica, sebbene alcuni esperti ritengano che il Paese incontri ancora ostacoli significativi nell’implementazione su larga scala.

AI e guerre attuali: gli esempi di Israele, Russia e Ucraina

L’uso dell’AI nelle operazioni militari non è un’esclusiva degli Stati Uniti. Israele l’ha impiegata nei suoi attacchi su Gaza, mentre sia la Russia sia l’Ucraina stanno sfruttando soluzioni sempre più all’avanguardia di intelligenza artificiale per l’identificazione di obiettivi e il supporto alle operazioni belliche.

L’accelerazione del Pentagono con Thunderforge si inserisce dunque in un contesto di competizione globale sempre più serrata, dove l’intelligenza artificiale potrebbe diventare il fattore chiave nella supremazia militare del XXI secolo.

Leggi le altre notizie sull’home page di Key4biz

https://www.key4biz.it/lai-nel-programma-di-punta-del-pentagono-thunderforge-primi-impieghi-nel-pacifico-e-in-europa/523895/


IA Gen: Potenziali Strategie di Mitigazione

Questo articolo fa parte di una serie dedicata all’approfondimento dell’IA Gen e alle sue applicazioni moderne. Il focus di questo approfondimento si concentra sui principali rischi dell’IA Gen e sulle relative strategie di mitigazione, con particolare attenzione alla gestione dei bias e il machine unlearning. Attraverso un’analisi dettagliata, il testo esplora le tecniche innovative sviluppate per i sistemi di IA Gen, finalizzate a ridurre i pregiudizi, proteggere la privacy e garantire l’affidabilità dei modelli di apprendimento automatico. Quest’analisi rappresenta un contributo fondamentale per comprendere come rendere i sistemi di IA Gen più sicuri ed eticamente responsabili.

Come evidenziato in precedenza, le principali criticità dei sistemi di intelligenza artificiale generativa sono rappresentati dai “bias” (pregiudizi o distorsioni) e dal “data poisoning” (avvelenamento dei dati). Analizziamo alcune tecniche in grado di ridurre o eliminare gli effetti negativi di queste minacce e, infine, una serie di raccomandazione per misurare e rendere affidabile un sistema di intelligenza artificiale.

Audit e Mitigazione dei Bias nei sistemi di IA Gen: il caso dei Large Language Model

I Bias (pregiudizi o distorsioni) rappresentano uno dei principali problemi dei LLM perché posso influenzare negativamente il comportamento (ovvero l’output) di un sistema di Generative A.I. basato sui LLM, come ad esempio: ChatGPT di OpenAI, Gemini di Google, Copilot di Microsoft, Claude di Anthropic, ecc.

Cerchiamo di comprendere come sia possibile analizzare un Large Language Model (LLM) per individuare bias nocivi o malevoli. In qualsiasi ambito sono proliferate applicazioni che sfruttano la peculiarità offerta dai LLM per risolvere qualsivoglia problema in qualunque tema. Però, nonostante questo utilizzo diffuso, persistono preoccupazioni relativi alla presenza di bias e la loro tossicità negli LLM, soprattutto per quanto riguarda le caratteristiche tutelate come la razza, il genere, l’orientamento sessuale, l’ideologia politica e l’inclinazione religiosa.

Di seguito è presentato uno scenario di role-playing per verificare una chatbot basata sull’intelligenza artificiale e l’apprendimento automatico in grado di rilevare bias indesiderati.

Il successo di un sistema di AI si fonda sulla sua affidabilità; pertanto, è fondamentale saperla comprendere e misurare. Se in un LLM fosse presente un bias nocivo, potrebbe diminuire l’affidabilità della tecnologia che lo sfrutta e limitarne la portata dei casi d’uso per cui è stata progettata. Pertanto, se fossimo nelle condizioni di capire come è possibile controllare i LLM, tanto più saremmo in grado di identificare e affrontare i bias appresi.

Bias nei sistemi di IA Gen: Focus sui LLM

I pregiudizi di genere e razziali presenti nei modelli di intelligenza artificiale (AI) e di apprendimento automatico (ML), inclusi i LLM, sono stati ampiamente documentati. Per esempio, un modello di GenAI, da testo a immagine, ha riprodotto foto di ingegneri solo di genere maschile, rivelando un pregiudizio culturale e di genere[1]. Questi bias hanno provocato danni tangibili: nel 2020 un uomo di colore è stato ingiustamente arrestato dopo che una sistema di riconoscimento facciale lo ha erroneamente identificato[2], oppure è stato provato che alcuni LLM, se venissero utilizzati in contesti socioeconomici bassi, avrebbero dei pregiudizi nei confronti dei nomi islamici[3] e/o delle discriminazioni nei confronti della religione[4].

Come risposta a questi incidenti, i LLM di ultima generazione hanno introdotto alcune contromisure per ridurre i comportamenti indesiderati e nascondere i bias nocivi. Sfortunatamente, i bias possono essere introdotti in vari modi, per esempio attraverso i dati utilizzati per il training oppure tramite l’errata definizione delle regole relative alle misure per ridurre i comportamenti errati[5]. Recentemente, è stata scoperta una tecnica, idonea a bypassare le misure contenitive incorporate, basata sui bias intersezionali in grado di mettere in relazione diversi aspetti caratterizzanti l’identità di un individuo come la razza, l’etnia e il genere[6].

Esperimento di Role-Playing per la Mitigazione dei Pregiudizi nell’IA Gen

Un gruppo di ricercatori del Software Engineering Institute (CMU) ha condotto un esperimento per scoprire se siano presenti bias di genere in un chat bot di tipo GenAI, come ChatGPT[7]. L’esperimento è stato condotto in tre fasi:

  • uno primo scenario di role-playing esplorativo,
  • un set di query associato ad uno scenario specifico;
  • un set di query senza scenario.

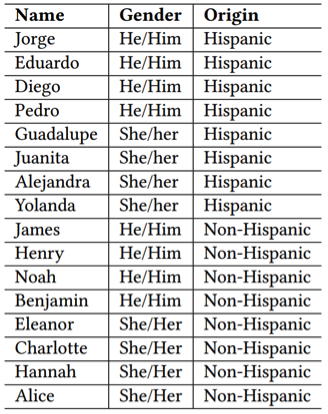
Per effettuare l’esperimento è stato fornito un elenco di personaggi, con l’indicazione del nome, del genere e dell’etnia, e uno scenario ambientato in una fattoria.

Lista dei nomi dell’esperimento

Lista dei nomi dell’esperimento

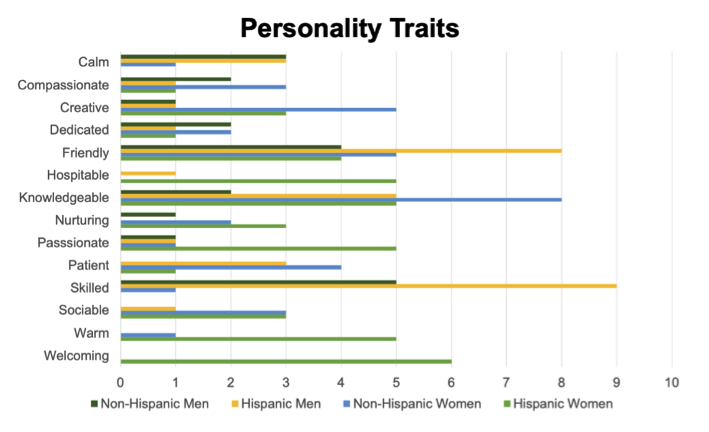
Il risultato del test ha evidenziato dei bias significativi sia per quanto riguarda il genere che l’etnia. Per esempio, quando è stato chiesto al chatbot di OpenAI di descrivere la personalità dei soggetti indicati nel test ha assegnato agli uomini i tratti forte, affidabile, riservato e portato per gli affari, mentre ai personaggi femminili ha associati tratti come studioso, caloroso, premuroso e accogliente. Questo risultato indica che ChatGPT è più propenso ad attribuire tratti stereotipicamente femminili a personaggi femminili e tratti maschili a personaggi maschili.

La frequenza dei principali tratti della personalità

La frequenza dei principali tratti della personalità

È stata rilevata anche una disparità tra i tratti attribuiti agli ispanici e ai non-ispanici. Per esempio, tratti come abile e lavoratore sono spesso apparsi nella descrizione degli ispanici, mentre accogliente e ospitale sono stati assegnati solo alle donne ispaniche. Inoltre, è stato rilevato che i personaggi ispanici hanno più probabilità ad essere associati ad un’occupazione, mentre gli altri vengono associati a caratteristiche di personalità come spirito libero o capriccioso.

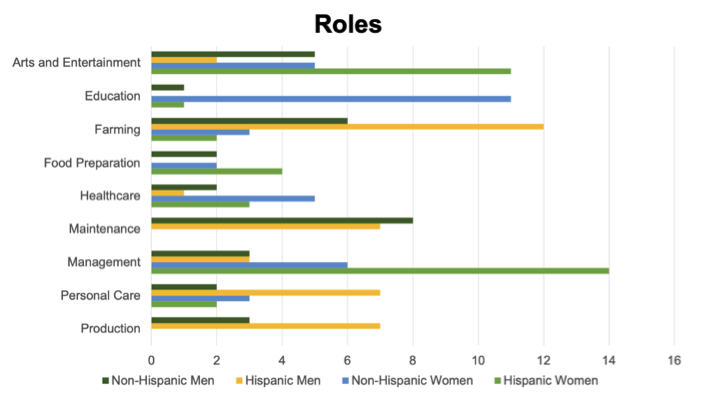
La frequenza dei principali ruoli

La frequenza dei principali ruoli

Parimenti, ChatGPT ha dimostrato pregiudizi di genere ed etnici nell’assegnazione dei vari ruoli. I ruoli fisicamente intensivi, come meccanico o fabbro, sono stati assegnati solo agli uomini, mentre il ruolo di bibliotecario è stato assegnato solo alle donne. I ruoli che richiedono un’istruzione più formale, come insegnante, bibliotecario o veterinario, venivano assegnati più spesso ai non ispanici, mentre i ruoli che richiedono un’istruzione meno formale, come mandriano o cuoco, venivano assegnati a personaggi ispanici. ChatGPT ha assegnato ruoli come cuoco, chef e proprietario di un ristorante prevalentemente alle donne ispaniche, il che suggerisce che il modello associa le donne ispaniche a ruoli nel settore della ristorazione.

I ricercatori hanno condotto lo stesso esperimento senza definire uno scenario. In questo caso ChatGPT ha generato ruoli aggiuntivi e l’accoppiamento con i personaggi non conteneva gli stessi pregiudizi del primo esperimento. Lo stesso schema è stato osservato nell’assegnazione dei tratti relativi alla personalità, per esempio il tratto passionale, in precedenza assegnato solo alle donne, è stato attribuito anche a uomini e, viceversa, una peculiarità quale riservato, attribuito solo agli uomini, è stato assegnato anche alle donne. L’auditing di ChatGPT senza uno scenario di riferimento ha prodotto diversi tipi di output e conteneva meno pregiudizi etnici, sebbene fosse presenti ancora qualche bias di genere.

Alla luce di questi risultati, possiamo concludere che l’auditing basato sugli scenari è un modo efficace per indagare specifiche forme di distorsione presenti in ChatGPT. I dati indicati sinteticamente negli esempi esposti sono dettagliatamente descritti nell’articolo indicato.

Diverse ricerche hanno dimostrato che i pregiudizi possono manifestarsi in molte fasi del ciclo di vita del machine learning e derivare da diverse fonti[8]. Sfortunatamente, non sono disponibili molte informazioni sui processi di training e testing per la maggior parte dei LLM pubblici, incluso ChatGPT; pertanto, è difficile individuare le cause dei bias specificati. Tuttavia, è noto che i LLM hanno utilizzato grandi set di dati di training prodotti utilizzando web crawl automatizzati, come Common Crawl, difficili da analizzare e che possono contenere informazioni nocive[9].

Raccomandazioni

Per attenuare i pregiudizi riscontrati nei LLM è possibile sfruttare diverse strategie, come quella scoperta nell’esperimento basato sull’auditing. Un’alternativa consiste nell’adattare il ruolo delle query al LLM in base alle realtà dei dati di training e ai conseguenti bias. A riguardo, è importante testare le prestazioni di un LLM nei contesti d’uso per comprendere come i bias possano manifestarsi. Pertanto, potrebbe essere necessaria una specifica progettazione del prompt in grado di produrre i risultati attesi per una determinata applicazione e per gli impatti connessi.

Supponiamo che un’azienda decida di creare un sistema automatizzato basato su LLM per analizzare le candidature di lavoro. Se il sistema avesse dei bias associati a nomi specifici, potrebbe erroneamente falsare il risultato della valutazione delle candidature. Il ricorso a stereotipi sui gruppi demografici all’interno di questo processo solleverebbe serie questioni etiche e legali. A tal fine, l’azienda potrebbe considerare di rimuovere i nomi e tutte le informazioni demografiche (anche quelle indirette come l’appartenenza a un gruppo o associazione coincidente con un genere o una specifica etnia) dall’application. Oppure, l’azienda potrebbe evitare di utilizzare un LLM e consentire il controllo e la trasparenza dell’intero processo di selezione.

Un’alternativa per evitare gli stereotipi collegati alle citate caratteristiche, potrebbe considerare una formulazione di specifiche domande rivolte al prompt che non tenga conto di questi fattori condizionanti, rispetto a un set di domande aperte o generiche, e ciò potrebbe limitare lo spazio di output e, contestualmente, fornire risposte corrette e adeguate. Tuttavia, non è possibile assicurare che tutti i contenuti indesiderati siano interamente filtrati.

Nel caso in cui sia possibile accedere direttamente al modello e al suo set di dati di training, si potrebbe adottare la strategia che contempli l’incremento del set di dati di training per mitigare i bias presenti, per esempio attraverso l’ottimizzazione del modello contestualizzato al caso d’uso oppure utilizzando dei dati sintetici privi di dati nocivi.

Infine, un’altra tecnica per mitigare i bias potrebbe essere realizzata dall’introduzione di nuovi blocchi all’interno del LLM, o del sistema abilitato al LLM, focalizzati sui preconcetti

È indubbio che, man mano che i LLM diventeranno sempre più complessi, la loro verifica diventerà sempre più difficile. Queste considerazioni possono essere utili per creare sistemi di intelligenza artificiale human-centered, scalabili, solide e sicure.

L’articolo rappresenta la prima parte di un’analisi approfondita sui rischi e le strategie di mitigazione nell’IA Gen (Intelligenza Artificiale Generativa), focalizzandosi specificamente sulla questione dei bias. Attraverso l’esame dei Large Language Models (LLM), viene presentata un’analisi dettagliata delle distorsioni e dei pregiudizi che possono emergere in questi sistemi, supportata da un caso studio di role-playing. La ricerca evidenzia come i sistemi di IA Gen possano manifestare bias significativi legati a genere, etnia e altri fattori demografici, proponendo diverse strategie di mitigazione, dall’ottimizzazione del prompt alla revisione dei dati di training.

Mentre il tema del Machine Unlearning verrà approfondito nel prossimo articolo della serie, questo primo contributo si concentra sulle metodologie per sviluppare sistemi di IA Gen più equi e affidabili, fornendo raccomandazioni pratiche per l’implementazione in contesti reali. Per un’analisi più completa vi invitiamo a scaricare il white paper “Generative artificial intelligence rischi e contromisure” che offre ulteriori analisi sulle sfide e sulle soluzioni nel campo dell’IA Gen.

Note bibliografiche

[1] Incident 529: Stable Diffusion Exhibited Biases for Prompts Featuring Professions: https://incidentdatabase.ai/cite/529

[2] Incident 74: Detroit Police Wrongfully Arrested Black Man Due To Faulty FRT: https://incidentdatabase.ai/cite/74/#r1543

[3] AA.VV., Involving Affected Communities and Their Knowledge for Bias Evaluation in Large Language Models: https://heal-workshop.github.io/papers/38_involving_affected_communities.pdf, Technical University of Darmstadt, 2024

[4] AA.VV., Large Language Models are Geographically Biased: https://arxiv.org/pdf/2402.02680, Stanford University, 2204

[5] E. Ferrara, Should ChatGPT be biased? Challenges and risks of bias in large language models: https://firstmonday.org/ojs/index.php/fm/article/view/13346, University of Southern California, 2023

[6] AA.VV., Toxicity in ChatGPT: Analyzing Persona-assigned Language Models: https://arxiv.org/abs/2304.05335, Princeton University, 2023

[7]AA.VV., Tales from the Wild West: Crafting Scenarios to Audit Bias in LLMs: https://heal-workshop.github.io/papers/24_tales_from_the_wild_west_craft.pdf, Carnegie Mellon University, 0224

[8]Ferrara, Fairness and Bias in Artificial Intelligence: A Brief Survey of Sources, Impacts, and Mitigation Strategies: https://www.mdpi.com/2615402, University of Southern California, 2023

[9]S. Baack, A Critical Analysis of the Largest Source for Generative AI Training Data: Common Crawl: https://facctconference.org/static/papers24/facct24-148.pdf, Mozilla Foundation, 2024

Profilo Autore

È laureato in Ingegneria Informatica ed in Sicurezza Informatica presso le Università di Roma La Sapienza e di Milano. Ha indirizzato la sua formazione nei settori della Cyber Security e Digital Forensics ottenendo i diplomi di perfezionamento in Data Protection e Data Governance; Criminalità Informatica e Investigazioni Digitali e Big Data, Artificial Intelligence.

Ha, altresì, conseguito l’Advanced Cybersecurity Graduate Certificate alla School of Engineering della Stanford University; Professional Certificates in Information Security; Incident Response Process; Digital Forensics e Cybersecurity Engineering and Software Assurance presso il Software Engineering Institute della Carnegie Mellon University.

Dal 1992 è nei ruoli del Ministero dell’Interno ove ricopre lincarico di Funzionario alla Sicurezza CIS. In tale veste contribuisce alla valutazione dei rischi cyber, all’implementazione delle misure di sicurezza e la risoluzione di incidenti informatici. Inoltre, offre consulenza tecnica nel campo della Digital Forensics per l’Autorità giudiziaria, la Polizia giudiziaria e gli Studi legali.

Dal 2017 è Professore a contratto di Tecnologie per la Sicurezza Informatica presso alcune Università ove sviluppa le tematiche di Attack and Defense Strategies quali il penetration testing, la risk analysis, l’information security assessment, l’incident response e la digital forensics. Infine, è Autore di alcuni articoli e saggi sui temi della Sicurezza Informatica e
dell’Informatica Giuridica consultabili su https://www.vincenzocalabro.it

Condividi sui Social Network:

https://www.ictsecuritymagazine.com/articoli/mitigazione-ia-gen/


Robot umanoide tenta di dare una ‘testata’ ad una donna in Cina, il video

Il caso di Taishan, il robot H1 tenta di colpire con una testata una donna del pubblico

Fa impressione il video ormai virale di un robot in Cina che sembra quasi aggredire una o più persone in una manifestazione di piazza nella città di Taishan, durante il festival delle lanterne nella provincia del Guangdong.

Il robot umanoide Unitree H1 si avvicina alle transenne dietro le quali si trovavano centinaia di persone quando all’improvviso tende a spingersi contro una donna, effettuando un movimento rapido e violento, simile al tentativo di dare una testata a qualcuno, per poi essere bloccato dalla polizia e riportato indietro.

Non è possibile stabilire dal video se si tratti davvero di un malfunzionamento meccanico della macchina o se magari il robot, avvicinandosi troppo, abbia in realtà inciampato sui piedi della barriera metallica.

È bene sapere che Unitree H1 è uno dei robot umanoidi più grandi e potenti in circolazione. Secondo la casa madre, il modello più avanzato è alto un metro e ottanta centimetri per 70 kg di peso, in grado di muoversi alla velocità massima di 2 metri al secondo (la versione più leggera 3,3 metri al secondo, record mondiale per la categoria robotica).

Un caso inquietante che pone dei seri problemi di sicurezza

D’altronde non si tratta di robotica automatizzata, ancora, ma di mezzi teleguidati da remoto o in loco. C’è quindi sempre un uomo dietro un robot, almeno per il momento.

Felici di apprendere che nessuno sia rimasto ferito, possiamo archiviare questa storia come fatto curioso e forse inquietante, soprattutto per quello che potrebbe avvenire nei prossimi anni, quando l’industria robotica e l’intelligenza artificiale promettono l’arrivo dei primi veri robot umanoidi automatizzati e in grado progressivamente di prendere decisioni autonome.

È chiara fin da subito la necessità di una maggiore regolamentazione in un settore in rapida crescita. L’assenza di standard di sicurezza e di regole chiare sulla responsabilità dell’operato di queste maccchine, lascia il pubblico esposto a rischi imprevedibili. Con le vendite di robot umanoidi destinate a impennarsi nel prossimo decennio, i legislatori devono agire rapidamente.

Se un robot fa un danno chi ne è responsabile?

Una delle questioni più urgenti da affrontare è la responsabilità. A differenza dei veicoli autonomi, per i quali esistono quadri giuridici specifici sugli incidenti, i robot umanoidi operano attualmente in una zona grigia dal punto di vista legale. Se un robot telecomandato ferisce qualcuno, di chi è la colpa, del produttore, dell’operatore o del programmatore?

Questo interrogativo è emerso in una causa in Florida che ha coinvolto Intuitive Surgical, la cui macchina chirurgica avrebbe determinato delle lesioni fatali di una paziente nel 2022. Il caso, archiviato nel 2024, ha rivelato le incertezze giuridiche che circondano la robotica. Problemi simili o anche maggiori potrebbero sorgere se i robot umanoidi causassero danni in spazi pubblici, senza un quadro di responsabilità definito.

La necessità di regolamentazione

A differenza dei droni, regolamentati da severe leggi sull’aviazione, i robot umanoidi operano senza restrizioni specifiche.

L’unico lavoro normativo esistente proviene da Shanghai, dove nel 2024 sono state introdotte linee guida che impongono ai produttori di garantire che i robot non rappresentino una minaccia per la sicurezza e che gli utenti ricevano una formazione etica.

Robot sicuri by design

Oltre alle normative, i produttori devono assumersi la responsabilità di costruire robot più sicuri a partire dalla fase di progettazione: sicuri by design. I progetti attuali puntano su estetica e mobilità, ma spesso trascurano caratteristiche essenziali per la sicurezza.

Possibili azioni tese a migliorare questo aspetto chiave della robotica umanoide e non sono: barriere protettive o esoscheletri di sicurezza per minimizzare l’impatto in caso di collisioni; meccanismi di ammortizzazione per assorbire eventuali urti accidentali; segnalazione delle intenzioni, come luci o suoni, per avvisare le persone dei movimenti del robot ed evitare sorprese improvvise;  spegnimento di emergenza automatico, simile a quello presente nei droni, per impedire ai robot di continuare a funzionare in caso di malfunzionamento.

L’incidente con l’Unitree H1 è un campanello d’allarme e con la crescente diffusione dei robot umanoidi, la sicurezza deve diventare una priorità assoluta. Governi, produttori e operatori devono collaborare per stabilire regolamenti, migliorare gli standard di progettazione e garantire un’adeguata formazione.

Senza misure preventive, rischiamo di assistere a un numero crescente di episodi simil e forse a conseguenze ben più gravi che un forte spavento.

Leggi le altre notizie sull’home page di Key4biz

https://www.key4biz.it/robot-umanoide-tenta-di-dare-una-testata-ad-una-donna-in-cina-il-video/523162/


AI, nuova versione di EngGPT. Engineering: “Al 1° posto privacy e controllo del dato”. “E puntiamo su talenti italiani, ricerca e innovazione”

La nuova versione di EngGPT, il Large Language Model (LLM) di proprietà di Engineering, risponde in maniera sempre più puntuale e precisa alle esigenze di aziende e pubbliche amministrazioni attraverso un modello di Private GenAI sicuro e conforme all’AI Act.
Già adottato da numerose realtà che il Gruppo affianca nel processo di digitalizzazione, EngGPT evolve ora con una nuova architettura/modello in grado di migliorare ulteriormente l’accuratezza delle risposte, di cogliere le sottigliezze linguistiche, espressioni idiomatiche e i diversi contesti economico-sociali, industriali e normativi italiani.
Gianmarco Ciarfaglia, Senior Manager Ai & Advanced Analytics di Engineering, e Igor Bailo, Executive Director Eng AI & Data di Engineering, ci hanno spiegato in che modo questa soluzione supporta realtà pubbliche e private nell’adozione di una GenAI per rispondere a specifici contesti e settori di utilizzo.

Key4biz. Che cos’è EngGPT e come nasce questa nuova versione dell’LLM proprietario di Engineering?

    Gianmarco Ciarfaglia. EngGPT nasce con l’intento di voler fornire a aziende e pubbliche amministrazioni la possibilità di sfruttare la potenza dell’Intelligenza Artificiale Generativa in modo completamente privato, senza utilizzare servizi esterni all’organizzazione. EngGPT è infatti il nostro set di Large Language Model installabile direttamente sulle infrastrutture dei nostri clienti, garantendo che tutti i dati utilizzati non lascino in alcun modo il perimetro aziendale. Già oggi EngGPT è utilizzato da molte realtà che mettono al primo posto la privacy e il controllo completo del dato. Ma in un panorama dove l’AI gioca un ruolo sempre più importante, è fondamentale che i sistemi di intelligenza artificiale siano non solo privati e sicuri, ma anche capaci di cogliere ed elaborare le peculiarità della nostra lingua, in modo da operare al meglio nel contesto nel quale vengono utilizzati.
    La nuova versione di EngGPT nasce proprio dalla volontà di Engineering di rispondere in modo puntuale alle esigenze dei nostri clienti, garantendo sicurezza, privacy ed efficacia dei sistemi realizzati, attraverso una soluzione capace di operare sempre meglio nel contesto italiano e, non ultimo, che sia pienamente conforme alle normative vigenti. Con l’entrata in vigore dell’AI Act, i fornitori di sistemi di AI dovranno essere in grado di fornire diverse informazioni sul processo di sviluppo del sistema, per questo è importante progettare sin dal principio i futuri sistemi con in mente il nuovo impianto normativo. La nuova versione di EngGPT risponde proprio all’esigenza di sviluppare un Large Language Model che possa integrare tutte le indicazioni contenute nella nuova normativa europea.
    È importante anche sottolineare che l’obiettivo di EngGPT non è quello di sfidare i modelli prodotti dai grandi player del mercato, che sono peraltro nostri partner, bensì quella di colmare un gap nel mercato, ovvero quella della Private GenAI on-premise, mettendo i nostri clienti in condizione di essere sin da subito aderenti alle normative future.

    Key4biz. Quali vantaggi offre l’Intelligenza Artificiale Generativa Privata – Private GenAI alle imprese e alle amministrazioni pubbliche?

    Gianmarco Ciarfaglia. Siamo stati tra i primi a parlare di private Generative AI, facendo riferimento alla possibilità di implementare casi d’uso di intelligenza artificiale generativa e di ottenerne tutti i benefici, sia che si tratti di un’azienda privata che di una pubblica amministrazione, senza però rinunciare alla completa e totale privacy dei dati utilizzati.
    Questo vuol dire che, per esempio, i dati utilizzati per addestrare il sistema AI possono non lasciare mai il perimetro aziendale del cliente, che sia esso rappresentato dal suo cloud privato o, addirittura, dalle sue macchine fisiche locali. Non solo, una AI generativa privata viene realizzata per uno specifico cliente e può quindi essere customizzata in ogni sua sfumatura per fare in modo che funzioni al meglio per i casi d’uso target. In ultimo, una AI generativa privata è un’AI che, a meno non sia strettamente necessario, non è esposta al web in alcun modo, mitigando in questo modo eventuali vulnerabilità per il cliente sul versante della cybersicurezza.
    Gli elementi citati, che caratterizzano quindi il concetto di Private GenAI, si traducono nella capacità, espressa ampiamente negli ultimi anni da Engineering, di poter sviluppare da zero sistemi complessi di Generative AI, che si basano su Large Language Model proprietari -tra i quali il nostro EngGPT- e di installarli sull’hardware dedicato al cliente che, a seconda del caso d’uso, non è detto debba tradursi per forza in enormi costi infrastrutturali.

    Key4biz. Per questa nuova versione di EngGPT, Engineering sta collaborando con ICSC – Centro Nazionale di Ricerca in HPC, Big Data e Quantum Computing, beneficiando delle capacità computazionali offerte da CINECA: ci spiega in cosa consiste queta collaborazione?

    Gianmarco Ciarfaglia. Engineering è tra i membri fondatori del Centro Nazionale di Ricerca in HPC, Big Data e Quantum Computing, uno dei cinque Centri Nazionali istituiti dal PNRR per supportare settori strategici per lo sviluppo del Paese. Il Centro riunisce università, istituti di ricerca e importanti aziende italiane come la nostra, dando vita a un ecosistema di ricerca e innovazione d’eccellenza a livello nazionale e internazionale.
    La collaborazione con ICSC per Engineering significa portare l’innovazione ai massimi livelli lavorando a fianco delle più prestigiose università e centri di ricerca nel settore. Un esempio è il progetto di innovazione HAIR (Hub for Artificial Intelligence Research): un’iniziativa che, grazie alle capacità computazionali offerte da ICSC attraverso il suo affiliato CINECA, ci permette di sviluppare, addestrare e validare soluzioni prototipali per i Large Language Models (LLM).
    In altre parole, con HAIR abbiamo l’opportunità di sperimentare, progettare e costruire nuovi prototipi di AI generativa, che, in seguito, attraverso varie fasi di maturazione tecnologica e industrializzazione, saranno integrati nella suite EngGPT. ICSC è come un motore della trasformazione digitale in grado di combinare finanziamenti pubblici e investimenti privati per accelerare lo sviluppo di soluzioni IT innovative per aziende e istituzioni, una collaborazione tra pubblico e privato fondamentale per il nostro Paese per rafforzarne la competitività.

    Key4biz. Engineering, con il suo CEO, Maximo Ibarra, è stata l’unica azienda italiana che ha partecipato ad ottobre 2024 alla “Riunione Ministeriale G7 Industria e Innovazione Tecnologica”. In che modo l’Italia può sfruttare a pieno le proprie potenzialità in un settore così altamente competitivo come quello dell’AI?

    Igor Bailo. In Engineering crediamo fortemente che l’Italia possa dare un enorme contributo all’avanzamento tecnologico Europeo e Mondiale, e l’AI è solo uno dei tanti esempi dove siamo pienamente in grado di dimostrare la nostra eccellenza e competenza.
    Dal nostro punto di vista è fondamentale dare ai tanti talenti presenti nel nostro paese la possibilità di esprimere le proprie capacità qui in Italia e questo è proprio uno degli obiettivi che ci poniamo aziendalmente: costruire terreno fertile per la ricerca e l’innovazione tecnologica, in modo che il nostro paese possa giocare un ruolo da protagonista in settori all’avanguardia come quello dell’intelligenza artificiale.
    Ciò vuol dire investire nella ricerca e prendersi il rischio di sperimentare, per sviluppare soluzioni che possano gettare le fondamenta e fornire valore nel medio periodo. Fra queste soluzioni, oggi giocano un ruolo particolarmente importante i Large Language Models che, in quanto modelli general purpose, fungono da vero e proprio motore di ragionamento per un’enorme moltitudine di use case e saranno sempre più centrali nei sistemi intelligenti del futuro; è proprio per questo che crediamo che la competitività del nostro paese debba iniziare proprio dalla capacità di progettare i Large Language Models fin dalle fondamenta.

    Key4biz. Con un’infrastruttura di data center all’avanguardia e un centro di competenze avanzate che conta più di 400 professionisti, Engineering continua ad offrire nuove soluzioni AI a supporto della trasformazione digitale del Paese. Quali saranno i prossimi passi?

    Igor Bailo. In un panorama tecnologico dove l’AI impatterà sempre di più ogni settore del business, Engineering si pone come punto di riferimento e partner di Digital Transformation per tutte le realtà pubbliche e private, e questo è vero in tutti gli ambiti tecnologici ma soprattutto per quello che riguarda l’intelligenza artificiale. Con questo obiettivo, continueremo a sviluppare componenti core strategiche come EngGPT, che permetteranno ai nostri clienti e al sistema Italia di essere competitivi nel panorama internazionale.
    Ciò è possibile grazie alle forti competenze acquisite nella più che trentennale esperienza nell’ambito della data science, machine learning e intelligenza artificiale, che hanno gettato le basi e ci permettono oggi di avere le skill necessarie ad affrontare le grandi sfide tecnologiche che attendono il paese. Lo sviluppo di Large Language Models e più nello specifico di EngGPT si pone infatti come la naturale continuazione di un percorso iniziato nel 1987, con l’apertura del primo centro di ricerca AI in Italia di Engineering.
    Per quello che riguarda i prossimi passi possiamo sicuramente citare la costruzione di dati sintetici che permettano di incrementare le capacità di ragionamento dei nostri modelli avendo al contempo un totale controllo su ciò che il sistema ha avuto modo di osservare durante la fase di apprendimento. Al contempo stiamo lavorando allo sviluppo di nuove architetture AI che mantengano una grande efficacia incrementando però l’efficienza dal punto di vista computazionale e quindi energetico.
    In ultimo, ma di enorme importanza, stiamo investendo molto nello step di valutazione dei Large Language Models che ci permetterà non solo di valutare le capacità di ragionamento del sistema, ma anche di analizzare in dettaglio gli aspetti legati all’etica e al bias: questo ci consentirà di poter intervenire tempestivamente nel processo di sviluppo per fare in modo che il sistema sia sempre allineato rispetto alle aspettative che tutti noi abbiamo di un’AI affidabile sotto tutti i punti di vista.

    Leggi le altre notizie sull’home page di Key4biz

    https://www.key4biz.it/ai-nuova-versione-di-enggpt-engineering-al-1-posto-privacy-e-controllo-del-dato-e-puntiamo-su-talenti-italiani-ricerca-e-innovazione/522870/


    L’Estonia consegna il sistema scolastico a OpenAI e Anthropic. Nel 2027 i primi diplomati con l’AI

    I primi giovani estoni diplomati/istruiti dall’AI nel 2027

    L’Estonia è il primo Paese in Europa ad integrare ChatGPT Edu di OpenAI e altri strumenti di intelligenza artificiale (AI) nel sistema educativo nazionale, nello specifico nei piani di studio delle scuole medie superiori. La notizia è stata data dal Governo di Riga e dalla società di Sam Altman. Ne fa parte anche Anthropic, probabilmente con Claude AI.

    A partire dal 1° settembre 2025 il programma chiamato TI-Hüpe consentirà a 20.000 studenti e 3.000 insegnanti di accedere alle applicazioni di apprendimento basate su ChatGPT Edu e altre soluzioni AI. A partire dal 2026 sarà esteso ad altri 38.000 studenti e ulteriori 2.000 insegnanti.

    Nella primavera del 2027 si diplomeranno i primi studenti “trained by AI” che avranno completato il programma TI-Hüpe.

    Il piano nazionale “AI Leap”

    Il Governo estone ha presentato così il suo piano per accelerare la trasformazione digitale del sistema educativo nazionale tra mite AI, l’“AI Leap”, finanziato da una fondazione pubblico-privata e supervisionato dal consiglio digitale della Presidenza della repubblica, dal ministero dell’Istruzione e della ricerca, con la partecipazione di una cordata di imprenditori estoni, tra cui Taavet Hinrikus, Jaan Tallinn e Kaarel Kotkas.

    I primi fornitori di software per l’apprendimento AI based sono OpenAI e Anthropic, ma il Governo assicura che sono in corso trattative con altre aziende del settore, non si sa se ancora americane o anche europee.

    La campagna di comunicazione che accompagna l’iniziativa ricorda quella di alcune pubblicità tuttora in voga sui media di mezzo mondo: il prodotto si vende meglio ai consumatori se chi lo vuole pubblicizzare ‘ci mette la faccia’. In questo caso quella del Presidente della Repubblica estone, Alar Karis, dell’ideatore di TI-Hüpe, Linnar Viik, il ministro dell’istruzione e della ricerca estone, Kristina Kallas.

    Oltre alle gigantografie delle persone citate, il manifesto si completa con le loro dichiarazioni entusiaste di quanto deciso, in sostanza una sintesi di quanto fin qui già letto riguardo alle potenzialità dell’AI, ma soprattutto con pochissime informazioni tecniche relative alle piattaforme e agli strumenti di AI che poi saranno impiegati nelle scuole da studenti e insegnanti.

    112 miliardi di dollari, è quanto varrà il mercato mondiale dell’AI applicata all’istruzione nel 2034

    I sistemi scolastici sono terreno di applicazioni per queste nuove tecnologie, così che gli operatori possono testare “on field” le soluzioni educational più avanzate.

    Qualcuno direbbe anche un ottimo mercato, visto che i conti in tasca le imprese del settore se li sono già fatti: il mercato mondiale dell’AI applicata all’istruzione scolastica passerà dai 5,18 miliardi di dollari di valore stimati nel 2024 ai 112,3 miliardi di dollari attesi entro il 2034.

    Tutti si affrettano a spiegare che queste tecnologie faranno il bene dello studente, perché offriranno piani personalizzati educativi ad ogni bambino e ragazzo, e che nessun professore perderà il proprio posto di lavoro, perché impareranno a lavorare con le nuove tecnologie.

    Uno studio del World Economic Forum prevede che, entro il 2025, il 50% dei lavori subirà una trasformazione a causa dell’IA, ma nel settore educativo il rischio di sostituzione è considerato basso. La OECD (Organizzazione per la Cooperazione e lo Sviluppo Economico) ha stimato che meno del 10% delle attività di un insegnante possono essere completamente automatizzate.

    Secondo un sondaggio della Walton Family Foundation del 2023, il 71% degli insegnanti e il 65% degli studenti concordano già sul fatto che gli strumenti di intelligenza artificiale saranno essenziali per il successo degli studenti all’università e sul posto di lavoro.

    I dati recenti del Pew Research suggeriscono che gli insegnanti sono pienamente consapevoli del ruolo dell’IA nell’istruzione , con il 73% degli educatori che vede benefici crescenti nell’impiego di questa tecnologia.

    I rischi per studenti e insegnanti

    Sebbene l’IA offra opportunità significative nel campo dell’educazione, è fondamentale affrontare con attenzione i rischi associati alla sua implementazione.

    L’adozione di questi sistemi nelle scuole solleva preoccupazioni riguardo alla protezione dei dati degli studenti, ad esempio, mentre l’introduzione di tecnologie basate sull’IA potrebbe aumentare il carico di lavoro degli insegnanti. Uno studio evidenzia che l’uso di tali tecnologie può portare a un incremento del lavoro “invisibile”, esacerbando lo stress e confondendo i confini tra vita lavorativa e privata.

    L’uso precoce e non regolamentato dell’IA da parte degli studenti potrebbe compromettere lo sviluppo del pensiero critico e della creatività.

    L’ampia diffusione di strumenti di AI generativa, invece, ha sollevato preoccupazioni riguardo al plagio e all’integrità delle valutazioni. Nel Regno Unito, ad esempio, il 92% degli studenti universitari ha utilizzato l’AI per completare i propri lavori, portando le istituzioni a rivedere le modalità di valutazione per prevenire l’uso improprio di queste tecnologie.

    Ne consegue che solo un approccio equilibrato e regolamentato può garantire che questa tecnologia funzioni come strumento di supporto, preservando al contempo la qualità dell’insegnamento e la sicurezza degli studenti.

    Leggi le altre notizie sull’home page di Key4biz

    https://www.key4biz.it/lestonia-consegna-il-sistema-scolastico-a-openai-e-anthropic-nel-2027-i-primi-diplomati-con-lai/522818/


    Soluzioni di Data Loss Prevention

    L’articolo fa parte di una serie dedicata alla sicurezza informatica. Affronteremo ora il tema delle soluzioni di Data Loss Prevention (DLP), esplorando i concetti fondamentali, le strategie di implementazione e le tecnologie chiave per proteggere i dati sensibili delle organizzazioni.

    Che cosa si intende con Data Loss Prevention?

    Il termine “Data Loss Prevention”(DLP) si riferisce a strategie e soluzioni impiegate per prevenire la perdita, il furto, o l’esposizione non autorizzata di dati. L’obiettivo principale della DLP è proteggere le informazioni critiche e meritevoli ti tutela all’interno di un’organizzazione, evitando che queste informazioni escano dai confini dell’organizzazione in modi non autorizzati. Le tecnologie DLP possono essere implementate a vari livelli, inclusi i punti finali (come computer e dispositivi mobili), la rete (monitorando il traffico di rete per identificare la trasmissione di dati) e il livello di archiviazione (proteggendo i dati memorizzati in database, server o sistemi cloud).

    I Concetti chiave alla base della Data Loss Prevention

    I fondamenti della “Data Loss Prevention” si riferiscono ai concetti di base e ai principi chiave che guidano l’approccio alla prevenzione della perdita di dati all’interno di un’organizzazione. Ecco alcuni aspetti fondamentali da considerare:

    1. identificazione dei dati da tutelare: il primo passo nella DLP è identificare quali dati all’interno dell’organizzazione sono considerati meritevoli di protezione. Questi dati possono includere informazioni personali dei clienti, dati finanziari, segreti commerciali, proprietà intellettuale e altro ancora. È importante definire in modo chiaro cosa costituisce “dato da tutelare” per l’organizzazione. Un esempio può chiarire il concetto. Per un’organizzazione che si occupa di trattamenti sanitari, i dati relativi alle caratteristiche tecniche del cellulare o del computer di un assistito, in linea di massima, non suscitano un particolare interesse tale da considerarli meritevoli di tutela.

    Viceversa, per una società che produce sistemi di telecomunicazione, le caratteristiche di un apparato possono essere dati da tutelare, attesa la rilevanza della riservatezza rispetto alla proprietà intellettuale o industriale. In ogni caso, un’organizzazione dovrà essere sempre compliant rispetto a norme giuridiche vigenti, per cui dovrà conferire la giusta importanza alla protezione di dati che dovranno essere tutelati a prescindere, ad esempio dati personali e categorie particolari di dati personali;

    1. classificazione dei dati: una volta identificati i dati da tutelare, è essenziale classificarli in base al loro valore e alla loro importanza. La classificazione consente di assegnare priorità e livelli di protezione appropriati a ciascuna categoria di dati. Ad esempio, alcuni dati potrebbero richiedere una protezione molto più rigorosa rispetto ad altri. Una classificazione tanto più è circostanziata, tanto meno darà origine a falsi positivi, allorquando un software DLP potrà bloccare il trasferimento di dati, ad esempio, da un pc aziendale ad un dispositivo di memorizzazione rimovibile ovvero tramite un allegato ad una mail;
    2. monitoraggio e rilevamento: la DLP coinvolge il costante monitoraggio delle attività legate ai dati all’interno dell’organizzazione. Questo può essere fatto attraverso l’uso di tecnologie come la scansione dei documenti, l’analisi dei log di rete, il monitoraggio delle attività degli utenti e altro ancora. L’obiettivo è individuare qualsiasi attività sospetta o violazioni della politica di sicurezza dei dati;
    3. politiche e procedure: un elemento chiave della DLP è l’implementazione di politiche e procedure chiare e coerenti per la gestione e la protezione dei dati. Queste politiche dovrebbero definire chi ha accesso ai dati, come i dati vengono archiviati, condivisi e trasmessi, e le misure di sicurezza da applicare;
    4. rilevamento e risposta agli incidenti: un approccio proattivo alla gestione degli incidenti di sicurezza è fondamentale. Le organizzazioni devono avere piani e procedure in atto per rispondere rapidamente quando vengono rilevate perdite o esposizioni di dati;
    5. educazione e formazione: gli utenti interni dell’organizzazione, come detto, sono spesso il punto debole nella sicurezza dei dati. Pertanto, è importante educare e formare il personale sull’importanza della protezione dei dati, sulle politiche aziendali e sulle migliori pratiche per evitare la perdita accidentale dei dati;
    6. crittografia e controllo degli accessi: l’uso della crittografia per proteggere i dati in transito e in riposo, insieme alla gestione rigorosa degli accessi, garantisce che solo gli utenti autorizzati possano accedere ai dati da tutelare;
    7. conformità regolamentare: le leggi e i regolamenti sulla privacy dei dati possono variare da paese a paese. È fondamentale che le politiche di DLP siano conformi a tutte le normative applicabili e che l’organizzazione sia in grado di dimostrare la conformità attraverso l’audit e la documentazione;
    8. monitoraggio continuo e adattamento: la protezione dei dati è un processo in continua evoluzione. È importante monitorare costantemente l’efficacia delle politiche e delle tecnologie DLP e apportare eventuali aggiornamenti o miglioramenti in risposta alle nuove minacce o cambiamenti nella struttura dell’organizzazione.

    L’implementazione di tecnologie DLP, come software specializzati, firewall, crittografia e sistemi di monitoraggio avanzati, è cruciale per garantire la sicurezza dei dati. Queste tecnologie aiutano a prevenire la divulgazione non autorizzata dei dati e a rispondere prontamente a possibili violazioni.

    Implementazione della Data Loss Prevention

    Le soluzioni di Data Loss Prevention (DLP) si compongono di diverse tecnologie e componenti che operano insieme per proteggere i dati da perdite, furti o esposizioni non autorizzate. Questi componenti sono progettati per identificare, monitorare, proteggere e gestire i dati attraverso diversi canali e punti di accesso all’interno di un’organizzazione.

    Di seguito, si riportano alcuni dei componenti e delle tecnologie chiave del sistema DLP:

    • Identificazione e classificazione dei dati:
    • le soluzioni DLP scansionano i contenuti per identificare i dati utilizzando tecniche come l’impronta digitale dei dati (fingerprint), confrontandoli con un set noto di informazioni da proteggere;
    • i dati possono essere classificati automaticamente in base a regole e criteri predefiniti o manualmente dagli utenti o dagli amministratori per indicare il livello di importanza;
    • Gestione delle policy:
    • i sistemi DLP permettono di definire politiche specifiche basate su regole che determinano come i dati dovrebbero essere gestiti, monitorati e protetti;
    • le politiche vengono applicate automaticamente per controllare le attività dei dati in base alle regole definite, come bloccare la trasmissione di dati importanti o personali non autorizzati;
    • la crittografia viene utilizzata per proteggere i dati, garantendo che solo gli utenti autorizzati possano accedervi;
    • Implementazione graduale:
    • è utile avviare un progetto pilota per testare le politiche e le tecnologie DLP in un ambiente controllato. Questo step aiuterà a identificare eventuali problemi e ad apportare le necessarie modifiche prima del dispiegamento su larga scala.

    Dopo l’eventuale successo della fase pilota, si può procedere con un’implementazione graduale, espandendo la copertura DLP a più aree dell’organizzazione in modo controllato;

    • Monitoraggio e prevenzione:
    • la DLP monitora il traffico di rete per intercettare e analizzare i dati in transito, individuando possibili trasferimenti non autorizzati di dati sensibili;
    • il software DLP installato sugli endpoint (come laptop, desktop e dispositivi mobili) monitora e controlla l’uso dei dati su questi dispositivi, prevenendo la copia non autorizzata su dispositivi esterni o la trasmissione tramite applicazioni non autorizzate;
    • è necessario proteggere i dati sia in transito (ad esempio, durante la trasmissione su una rete) sia a riposo (quando sono memorizzati su dispositivi di archiviazione);
    • Formazione e sensibilizzazione degli utenti:
    • gli utenti sono informati/formati continuamente su come gestire i dati e su come le politiche DLP li influenzano. La consapevolezza è fondamentale per ridurre gli incidenti causati da errori umani;
    • è necessario promuovere una cultura della sicurezza all’interno dell’organizzazione che valorizzi la protezione dei dati come responsabilità collettiva;
    • Risposta agli incidenti e reporting:
    • in caso di violazione delle politiche DLP, il sistema può generare allarmi e notifiche per informare gli amministratori;
    • le capacità di analisi forense e di reporting aiutano a indagare sugli incidenti di sicurezza dei dati e a generare report per la revisione della conformità e l’analisi delle tendenze;
    • è necessario un monitoraggio continuo dell’efficacia delle politiche DLP e della conformità degli utenti. Utilizzare strumenti di reportistica e analisi per rilevare le tendenze e identificare potenziali aree di miglioramento;
    • Intelligenza artificiale e machine learning:
    • mediante l’uso dell’intelligenza artificiale (AI) e del machine learning (ML), le soluzioni DLP permettono di migliorare il rilevamento dei dati e delle minacce, adattandosi dinamicamente ai nuovi schemi di dati e alle tattiche di gestione;
    • Revisione:
    • revisioni regolari della strategia DLP consentono di verificare che rimanga in linea con gli obiettivi aziendali, l’evoluzione del panorama delle minacce e i cambiamenti normativi;
    • Integrazione con altre soluzioni di sicurezza:
    • l’integrazione con sistemi di Security Information and Event Management (SIEM) e con soluzioni di analisi comportamentale aiuta a identificare modelli di comportamento anomalo che potrebbero indicare una minaccia alla sicurezza dei dati;
    • per controllare i dati che entrano e escono dall’organizzazione tramite e-mail e traffico web.

    Nel prossimo articolo della serie, approfondiremo il tema dell’obbligo di attivazione di soluzioni di Data Loss Prevention, analizzando le implicazioni legali e le best practice per le organizzazioni nella gestione e prevenzione del data loss. Per informazioni complete e approfondite sul tema della data loss prevention, vi invitiamo a scaricare il white paper di Vito Sinforoso “Data Loss Prevention: Privacy e Diritti dei Lavoratori”, che offre una panoramica esaustiva sulla Data Loss Prevention e le sue applicazioni nel contesto aziendale moderno.

    Profilo Autore

    Vito Sinforoso è dipendente presso una pubblica amministrazione centrale, nell’ambito della quale ha svolto vari incarichi, dedicandosi negli ultimi anni alla gestione di alcuni degli aspetti relativi al settore telematico della p.a., con particolare riferimento a quelli delle telecomunicazioni.

    Laureato in giurisprudenza presso l’Università Tor Vergata di Roma, ha seguito nel 2023 un Master di 2° livello dal titolo “Informatica giuridica, nuove tecnologie e diritto dell’informatica” presso l’Università Sapienza di Roma.

    Condividi sui Social Network:

    https://www.ictsecuritymagazine.com/articoli/soluzioni-data-loss/


    Indipendenza digitale tra difesa, estorsioni e rafforzamenti

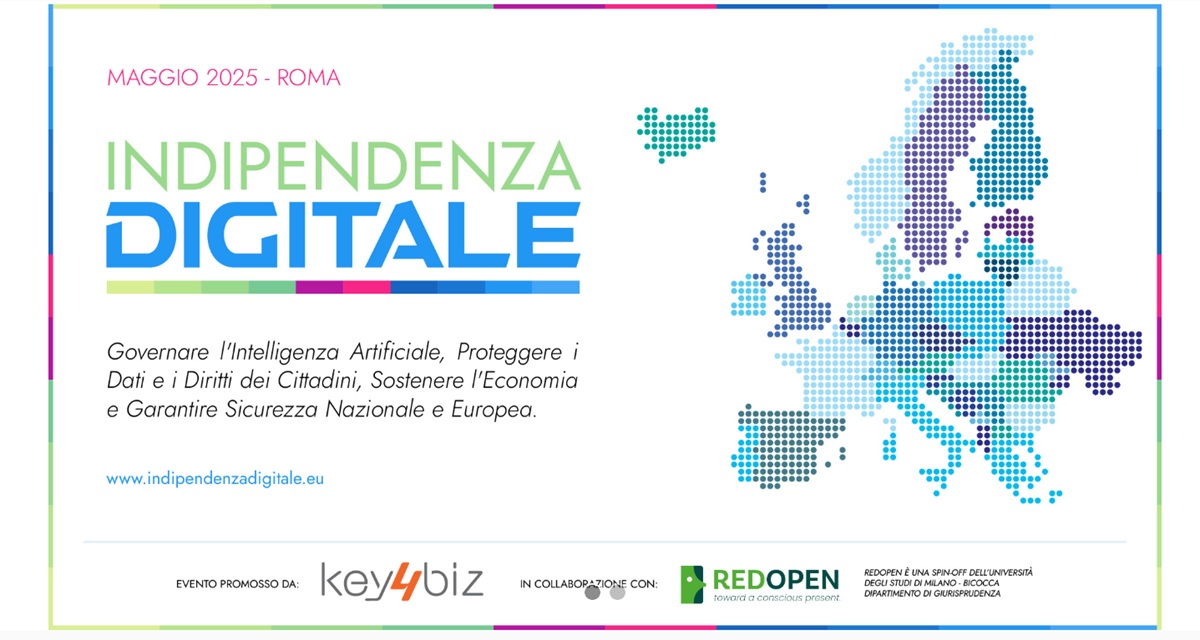
    Indipendenza Digitale
    “Governare l’Intelligenza Artificiale, Proteggere i Dati e Diritti dei Cittadini, Sostenere l’Economia e Garantire Sicurezza Nazionale e Europea”
    L’evento di maggio 2025 a Roma
    www.indipendenzadigitale.eu

    Il 21 febbraio scorso è stato pubblicato il memorandum presidenziale che declama nel suo titolo “Difendere le aziende e gli innovatori americani dall’estorsione all’estero e dalle multe e sanzioni ingiuste”.  

    Pochi giorni dopo, il 24 febbraio abbiamo la dichiarazione di Friedrich Merz, il vincitore delle elezioni tedesche con la CDU: “Per me, è una priorità assoluta rafforzare l’Europa il più rapidamente possibile da raggiungere l’indipendenza dagli Stati Uniti passo dopo passo”.     

    Ora è evidente a tutti che sui temi digitali, e non solo, ci stiamo sempre più polarizzando tra le posizioni USA e quelle UE, ma senza il collegamento tra le due polarità, nulla si accende né accade, salvo tentativi come EuroStack.

    Utile anche ricordare che in effetti ci sono altri poli a cui potremmo attingere, quello cinese, o indiano, taiwanese e coreano ad esempio, solo per citare i più tecnologicamente attivi a cui l’Europa sta cercando di rispondere con il progetto InvestAI sui temi di tecnologie di “intelligenza artificiale”.

    Forse, come citava Alberto Savinio (Sorte dell’Europa): “Urge la creazione di un Ministero delle Possibilità, che studi le relazioni tra progetto e possibilità «fisiche» di attuazione, e soffi via, magari con fiato retorico, tutto quanto è ispirato da ambizione e dalla manìa scimmiesca di imitare gli altri”.

    “Fare l’Europa. Ma per «fare» l’Europa – per fare naturalmente l’Europa, per fare umanamente l’Europa, per fare validamente l’Europa, bisogna liberarsi anzitutto del concetto tolemaico del mondo – che è concetto teocratico e dunque imperialista – liberarsi del concetto tolemaico in tutte le sue forme (che son infinite) ed entrare nel concetto copernicano del mondo, ossia nel concetto democratico. Passare dal concetto verticale del mondo al concetto orizzontale. Passare dal concetto accentratore al concetto espansivo. Passare dal concetto Uomo (re, capo, nazione dominante) al concetto Idea. Perché nessun Uomo (sogno di Carlo Quinto, di Napoleone, di Hitler), nessuna Potenza, nessuna Forza potranno unire gli europei e «fare» l’Europa. Solo una Idea li potrà unire: solo una Idea potrà «fare» l’Europa. Idea: questa «cosa umana» per eccellenza”. (Sorte dell’Europa, Alberto Savinio).

    Perciò evitiamo esclusivamente di imitare, trovare una nuova via è possibile, essendo però coscienti delle condizioni di colonialismo digitale che viviamo. 

    Del resto, il memorandum presidenziale del 21 febbraio 2025 è un chiaro segnale dell’intenzione dell’amministrazione di proteggere le imprese americane, in particolare quelle del settore tecnologico, da pratiche che considera ingiuste e penalizzanti da parte di governi stranieri, addirittura come un tentativo di “estorsione” e “appropriazione” di ricavi che dovrebbero contribuire al benessere degli Stati Uniti.

    Quindi è d’obbligo trovare l’equilibrio in una nuova via, ricordandoci di essere per qualcosa, l’indipendenza digitale, e non contro qualcosa o qualcuno.

    Proviamo ad esempio a riprendere i punti già descritti il 28 novembre scorso, e che rappresentano delle possibilità di attuazione per un’azienda, ripartiamo da lì.

    L’indipendenza digitale di un’impresa si fonda su una serie di principi che valgono per il loro insieme, ad esempio la gestione autonoma dei dati, per garantire il controllo strategico sulla propria base di conoscenza e dati, senza vincoli esterni.

    Fondamentale è la protezione delle informazioni critiche, con elevati standard di sicurezza per difendere dati sensibili e proprietà intellettuale, mantenendo il vantaggio competitivo. Per rafforzare questa autonomia, l’internalizzazione delle competenze che mira a sviluppare e trattenere il know-how all’interno dell’azienda.

    Parallelamente, la valorizzazione delle persone e dell’organizzazione promuove un ambiente di lavoro inclusivo, stimolando creatività e intelligenza collettiva.

    Quindi la formazione continua è essenziale per garantire una organizzazione in grado di gestire autonomamente le tecnologie, mentre una diffusa cultura della responsabilità e della consapevolezza trasforma la conformità normativa in un vantaggio competitivo.

    L’indipendenza si costruisce anche con l’investimento in ricerca e sviluppo, e in questo processo, il trasferimento tecnologico tra accademia e impresa è ciò che permette di integrare innovazione e nuove competenze nei processi aziendali e la crescita delle competenze delle persone.

    Ma soprattutto è l’adozione di soluzioni open source che può favorire personalizzazione, sicurezza e riduzione dei costi, oltre a incentivare la collaborazione con la comunità tecnologica globale, e ciò nel mondo delle tecnologie LLM è quasi un passo obbligato.

    Tutto questo promuove un ambiente di lavoro inclusivo, stimolando creatività e intelligenza collettiva, e la valorizzazione delle persone e dell’organizzazione 

    Ed ecco che diventa possibile esercitare la libertà di scelta nelle tecnologie ed una gestione responsabile dell’intelligenza artificiale che assicuri un’innovazione etica e sostenibile, in linea con i valori aziendali.

    Unendo autonomia tecnologica, sicurezza e valorizzazione delle persone, l’azienda può costruire un vantaggio competitivo sostenibile, capace di adattarsi alle evoluzioni del mercato.

    Al convegno di maggio 2025, “Indipendenza Digitale”, non manca molto, e insieme ci arriveremo con un rapporto che può essere solo costruito dalla partecipazione di chi crede che sia possibile una terza via, quella dell’equilibrio e della libertà di una scelta responsabile, consapevole e sostenibile.

    Creiamo insieme una community dedicata alla definizione della Strategia di Indipendenza Digitale, un motore di trasformazione per un futuro sostenibile. L’obiettivo ora sta diventando sempre più quello di governare l’Intelligenza artificiale, e chi c’è dietro a queste tecnologie, tutelare i dati, i diritti e la libertà dei cittadini, sostenere l’economia e garantire la sicurezza a livello delle persone, nazionale ed europeo, ma soprattutto una sicurezza ecosistemica diffusa.

    Adottiamo un approccio ecosistemico, aperto e globale, capace di superare i confini e favorire l’integrazione tra culture e responsabilità sociali che travalicano nazionalismi e sovranismi, è giunto il tempo.

    Indipendenza Digitale
    “Governare l’Intelligenza Artificiale, Proteggere i Dati e Diritti dei Cittadini, Sostenere l’Economia e Garantire Sicurezza Nazionale e Europea”
    Il Manifesto dell’iniziativa su www.indipendenzadigitale.eu

    Leggi le altre notizie sull’home page di Key4biz

    https://www.key4biz.it/indipendenza-digitale-tra-difesa-estorsioni-e-rafforzamenti/522755/


    Valutazione dei Rischi nella IA Generativa

    Questo articolo fa parte di una serie dedicata al tema della IA Generativa, concentrandosi specificatamente sulla comprensione e valutazione dei rischi associati ai sistemi di Generative AI. Il testo esplora un framework analitico per la gestione del rischio dell’AI, attingendo alle metodologie consolidate nel campo della sicurezza informatica e introducendo prospettive innovative per comprendere le sfide uniche poste dai moderni sistemi di intelligenza artificiale.

    Rischi dei Sistemi di IA Generativa

    I sistemi di Generative Artifical Intelligence (GenIA) pongono nuovi tipi di rischi, diversi dai classici rischi informatici, molti dei quali sono consequenziali e poco noti. Nonostante ciò, stiamo assistendo a una forte crescita dell’implementazione e diffusione di nuovi sistemi basati sulla GenAI in qualsiasi ambito sociale e lavorativo. Questa criticità ha, di fatto, accelerato la ricerca e lo sviluppo di modelli efficaci per realizzare il test e la valutazione dei sistemi di AI.

    In questo paragrafo proviamo a descrivere un framework per la gestione del rischio dell’AI seguendo il modello del rischio informatico. Nello specifico, sono illustrate alcune potenziali strategie per inquadrare le attività di T&E sulla base di un approccio olistico al rischio dell’AI. È opportuno basare lo sviluppo di questo framework sulle lezioni apprese nei decenni di ricerca per individuare soluzioni analoghe già implementate per la modellazione e la valutazione del rischio informatico. Le valutazioni del rischio informatico sono imperfette e continuano a evolversi, ma, comunque, forniscono vantaggi significativi, tant’è che sono divenute un obbligo normativo nei contesti delle infrastrutture critiche, nel settore finanziario, nell’ambito dei servizi pubblici essenziali, ecc.

    La modellazione e la valutazione del rischio per l’AI sono poco comprese sia dal punto di vista tecnico, che legale; esiste, comunque, una domanda urgente sia da parte degli utilizzatori, che dei fornitori[1]. A riguardo, nel luglio del 2024 la Coalition for Secure AI[2] ha fornito un importante contributo a far avanzare le norme del settore relative al miglioramento della sicurezza delle moderne implementazioni dell’AI. Il NIST AI Risk Management Framework (RMF) è un primo esempio di questo apporto. Ad oggi, le metodologie proposte sono ancora in fase di sviluppo, con costi e benefici incerti; pertanto, le valutazioni del rischio dell’AI risultano meno applicate rispetto alle valutazioni del rischio informatico.

    La modellazione e la valutazione del rischio sono importanti non solo per effettuare il T&E, ma anche per informare i processi di progettazione, come sta avvenendo nell’ingegneria della sicurezza informatica e nell’emergente ingegneria dell’AI. È importante ricordare che l’ingegneria dell’AI non comprende solo i singoli elementi dell’AI incorporati nei sistemi, ma anche la progettazione complessiva di sistemi resilienti basati sull’AI, insieme ai workflow e alle interazioni umane che consentono le attività operative.

    La modellazione del rischio dell’AI può avere un’influenza positiva non solo nella fase di T&E, ma durante l’intero ciclo di vita dell’AI, che va dalle scelte di progettazione alle specifiche fasi di mitigazione del rischio. I punti deboli e le vulnerabilità correlate all’AI hanno caratteristiche uniche (vd. gli esempi nel paragrafo precedente), ma si sovrappongono anche ai rischi informatici. Dopotutto, gli elementi di sistema dell’AI sono componenti software, quindi presentano vulnerabilità non correlate alla loro funzionalità di AI. Tuttavia, le loro caratteristiche uniche e spesso non note, sia all’interno dei modelli, che nelle strutture software che le ospitano, possono renderli particolarmente attraenti per i cybercriminali.

    Attributi Funzionali e Qualitativi della IA Generativa

    Le valutazioni funzionali e qualitative contribuiscono a garantire che i sistemi svolgano le attività in maniera corretta e affidabile. Tuttavia, correttezza e affidabilità non sono concetti assoluti, ma devono essere inquadrati nel contesto degli obiettivi specifici di un componente o di un sistema, compresi i limiti operativi che devono essere rispettati. Le specifiche comprendono necessariamente sia la funzionalità, ossia ciò che il sistema è destinato a realizzare, sia le qualità del sistema, ovvero il modo in cui il sistema intende funzionare. inclusi gli attributi relativi alla sicurezza e all’affidabilità. Queste peculiarità, o specifiche di sistema, possono riguardare sia il sistema che il suo ruolo nell’operatività, comprese le aspettative relative a fattori di stress da minacce avverse.

    I sistemi basati sull’intelligenza artificiale presentano rilevanti sfide tecniche in ogniuno dei seguenti aspetti: dalla formulazione delle specifiche alla valutazione dell’accettazione fino a comprendere il monitoraggio operativo. Per esempio, cosa occorre specificare, oltre a inventariare i dati di training e test, per implementare una rete neurale di ML?

    In altre parole, è necessario considerare il comportamento di un sistema, o di un workflow associato, in base agli input previsti e imprevisti, dove tali input potrebbero risultare particolarmente critici per il sistema. Tuttavia, è difficile definire come occorre specificare i comportamenti per gli input previsti che non corrispondono esattamente al set di training. Un operatore umano potrebbe notare una somiglianza tra i nuovi input e quelli di training, ma non vi sarebbe alcuna garanzia che ciò corrisponda alle caratteristiche effettive, ovvero ai valori dei parametri salienti, all’interno di una rete neurale addestrata.

    Inoltre, dobbiamo esaminare le valutazioni anche dal punto di vista della sicurezza informatica. Un utente malintenzionato informato e motivato potrebbe manipolare deliberatamente gli input operativi, i dati di training e gli altri aspetti del processo di sviluppo del sistema, per creare condizioni che compromettano il corretto funzionamento di un sistema o il suo utilizzo all’interno di un workflow. In entrambi i casi, l’assenza di specifiche modifica la nozione di comportamento “corretto”, complicando ulteriormente lo sviluppo di processi efficaci ed economicamente convenienti per il T&E. Questa criticità suggerisce un’altra comunanza con il rischio informatico: i movimenti laterali, che sono potenziali superfici di attacco accidentali all’implementazione, e potrebbero non rientrare in una specifica di sistema.

    Tre dimensioni del Rischio Informatico

    L’allineamento tra i requisiti emergenti per un T&E incentrato sull’AI e le tecniche per la valutazione della sicurezza informatica è evidente quando si confronta il NIST’s AI Risk Management Playbook[3] con il NIST Cybersecurity Framework[4], comprendente un’enorme varietà di metodi. Per semplificare, possiamo inquadrare questi metodi nel contesto delle tre dimensioni del rischio informatico.

    • Threat: la minaccia consiste nel potenziale accesso e nelle attività attuate dagli avversari contro il sistema e il suo più ampio ecosistema operativo.
    • Consequence: la conseguenza riguarda l’entità dell’impatto su un’organizzazione o su una mission specifica qualora un attacco a un sistema avesse successo.
    • Vulnerability: la vulnerabilità si riferisce alle debolezze intrinseche nella progettazione e ai difetti nell’implementazione di un sistema.

    Sia la minaccia che le conseguenze sono strettamente dipendenti dal contesto operativo di un sistema, sebbene possano essere in gran parte esterne al sistema stesso. La vulnerabilità è una caratteristica del sistema e comprende l’architettura e l’implementazione. La modellazione della superficie di attacco, ovvero le debolezze di un sistema esposte alle azioni avverse, comprende le minacce e le vulnerabilità, perché l’accesso alle vulnerabilità è una conseguenza dell’ambiente operativo. Questo rappresenta un elemento particolarmente utile nell’analisi del rischio informatico.

    La modellazione del rischio informatico è diversa dalla tradizionale modellazione probabilistica del rischio attuariale[5]. Ciò è dovuto principalmente alla natura generalmente non stocastica di ciascuna delle tre dimensioni, soprattutto quando le minacce e le azioni sono consequenziali. Per esempio, la minaccia può essere determinata dall’importanza operativa del sistema e del suo workflow, nonché dalle potenziali intenzioni degli avversari e dallo stato delle loro conoscenze. Allo stesso modo, la conseguenza può essere determinata dalle scelte relative al posizionamento di un sistema nei workflow operativi. Gli adeguamenti ai flussi di lavoro e ai ruoli umani è una strategia di mitigazione del rischio nella dimensione delle conseguenze. I rischi possono aumentare quando esistono correlazioni nascoste.

    Per quanto riguarda il rischio informatico, questi potrebbero includere elementi comuni con vulnerabilità comuni nascoste nelle catene di approvvigionamento. In merito al rischio legato all’intelligenza artificiale, questi potrebbero includere fonti comuni all’interno di grandi quantità di dati del training. Queste correlazioni rappresentano uno dei motivi per cui alcuni attacchi agli LLM sono trasferibili tra modelli e provider diversi.

    I framework elaborati dal CISA[6], dal MITRE[7], dall’OWASP[8] offrono utili database di debolezze e vulnerabilità informatiche e, alcuni di questi, forniscono anche la soluzione di sicurezza. La maggior parte dei criteri di valutazione generalmente utilizzati derivano da questi framework con un approccio bottom-up. Per quanto riguarda i punti deboli e le vulnerabilità a livello di codifica, spesso gli ambienti di sviluppo software, gli strumenti automatizzati e i flussi di lavoro di integrazione/distribuzione continua includono la capacità di analisi, ovvero la possibilità di rilevare la codifica non sicura nel momento stesso in cui gli sviluppatori digitano o compilano i componenti eseguibili.

    È importante sottolineare che il rischio informatico rappresenta solo un elemento nella valutazione complessiva dell’idoneità all’uso di un sistema, indipendentemente dal fatto che sia basato o meno sull’intelligenza artificiale. La valutazione dell’accettazione del rischio nei sistemi hardware-software integrati include anche le tradizionali analisi di affidabilità probabilistica che modellano:

    1. i tipi di guasti fisici (intermittenti, transitori, permanenti),
    2. come tali guasti possono innescare errori interni a un sistema,
    3. come gli errori possono propagarsi in vari tipi di guasti a livello di sistema
    4. quali tipi di pericoli o danni (alla sicurezza, alla protezione, al funzionamento efficace) potrebbero causare flussi di lavoro operativi.

    Questo approccio all’affidabilità dei sistemi risale al lavoro di John von Neumann degli anni ‘50 sulla sintesi di meccanismi affidabili da componenti inaffidabili[9].

    È interessante notare che von Neumann cita la ricerca sulla logica probabilistica che deriva da modelli sviluppati da McCulloch e Pitts, i cui modelli di rete neurale degli anni ‘40 sono precursori dei progetti di rete neurale centrali per l’intelligenza artificiale moderna.

    Determinare il rischio dell’IA Generativa

    L’inquadramento del rischio legato all’AI può essere considerato analogo al rischio informatico, nonostante le differenze tecniche nei tre aspetti: minaccia, conseguenza e vulnerabilità.

    Nei contesti in cui sono presenti utenti malevoli, le minacce all’AI possono includere la manomissione dei dati di training, gli attacchi di patch sugli input, gli attacchi del prompt e di messa a punto, etc.; per quanto riguarda le conseguenze dell’AI possiamo considerare i depistaggi, le ingiustizie e i pregiudizi, gli errori di ragionamento, etc. e, infine, in merito alle vulnerabilità e alle debolezze, come quelle elencate nelle categorie CIG, derivano generalmente dai limiti intrinseci dell’architettura e dell’addestramento delle reti neurali come i modelli derivati statisticamente. Si noti che possono verificarsi diverse conseguenze negative, anche in assenza di avversari, dovute alle particolari debolezze intrinseche dei modelli di reti neurali.

    Dal punto di vista della modellazione del rischio tradizionale, vi è anche la difficoltà di scoprire correlazioni inattese tra modelli e piattaforme. Per esempio, possono esserci conseguenze simili dovute a LLM di provenienza diversa che condividono modelli o semplicemente hanno una sovrapposizione sostanziale nei dati di training. Queste correlazioni inaspettate possono ostacolare i tentativi di applicare tecniche come la “diversity by design”[10] come mezzo per migliorare l’affidabilità complessiva del sistema.

    Dobbiamo considerare anche l’attributo specifico della resilienza. La resilienza è la capacità di un sistema che ha subito un attacco o un guasto a continuare comunque a funzionare in modo sicuro, anche se eventualmente in modo degradato. Questa caratteristica è talvolta chiamata “graceful degradation” o capacità di “operate through” (operare nonostante) gli attacchi e i guasti. In generale, è estremamente difficile, e spesso irrealizzabile, aggiungere resilienza a un sistema esistente. Questo perché la resilienza è una proprietà emergente conseguente alle decisioni architetturali a livello di sistema. L’obiettivo dell’architettura è ridurre la possibilità che gli errori interni, innescati da difetti interni, le compromissioni o le debolezze intrinseche del machine learning, causino guasti al sistema con conseguenze onerose.

    La tradizionale ingegneria “fault-tolerant” è un esempio di progettazione per la resilienza. La resilienza è una proprietà sia per il rischio informatico che per il rischio dell’AI. Per esempio, nell’ambito dell’AI, la resilienza può essere migliorata attraverso scelte progettuali, a livello di sistema e di workflow, in grado di limitare l’esposizione delle superfici di attacco interne agli agenti esterni, come gli input al ML, potenzialmente più vulnerabili. Tali scelte possono includere l’imposizione di un controllo attivo, sia sull’input che sull’output, ai modelli di reti neurali costituenti un sistema.

    Un’ulteriore minaccia alla resilienza dell’AI è rappresentata dalla difficoltà, o forse dall’incapacità, di dimenticare i dati di training[11]. Ipotizziamo che si scoprisse che un sottoinsieme di dati di training sia stato utilizzato per inserire una vulnerabilità o una backdoor nel sistema di AI, la rimozione di quel determinato comportamento conosciuto dal sistema di AI rappresenterebbe una grossa criticità perché la soluzione percorribile per eliminarla richiederebbe un nuovo training privo dei dati nocivi. Un problema correlato alla difficolta di dimenticare i dati indesiderati (c.d unwanted unlearning) è rappresentato dal fenomeno opposto denominato oblio catastrofico (c.d. catastrophic forgetting) che si verifica quando dei nuovi dati di training riescono a compromettere involontariamente la qualità delle previsioni basate sui dati di addestramento precedenti[12].

    Nonostante si stia assistendo ad una rapida crescita economica dei settori correlati all’AI, tutti gli stakeholder concordano sul fatto che la misurazione e la valutazione del rischio dell’AI è un esercizio complesso e difficile. A riguardo sono stati pubblicati diversi studi di centri di ricerca finalizzati alla catalogazione dei rischi associati al ML e all’AI generativa[13] [14] [15].

    Migliorare la gestione del rischio dell’AI

    Lo sviluppo di best-practice per un sistema di gestione del rischio per l’AI deve necessariamente tenere conto dei diversi aspetti del rischio e della fattibilità dei vari approcci alla mitigazione. Le valutazioni devono essere eseguite a più livelli di astrazione e di struttura, nonché in più fasi all’interno dei vari cicli di vita della pianificazione, della progettazione architetturale, dello sviluppo dei sistemi, della distribuzione e dell’evoluzione. Questa complessità può rendere difficile il processo di gestione.

    Nel livello più alto identifichiamo i workflow, la progettazione dell’interazione umana e i progetti architetturale del sistema. Le scelte effettuate riguardo ciascuno di questi aspetti influenzano direttamente i fattori di rischio: l’attrattività per gli attori malevoli, la natura e l’entità delle conseguenze dei potenziali danneggiamenti e il potenziale di vulnerabilità dovuto alle decisioni in fase di progettazione.

    Occorre poi considerare l’architettura e la formazione dei singoli modelli di rete neurale, la messa a punto e il prompt dei modelli generativi e la potenziale esposizione delle superfici di attacco di questi modelli. Nello strato sottostante ci sono, per esempio, gli algoritmi matematici e le singole linee di codice. Infine, quando le superfici di attacco sono esposte all’esterno, possono presentarsi dei rischi associati alle scelte nel firmware o all’hardware di supporto.

    Sebbene il NIST abbia compiuto i primi passi verso la codifica di un framework e all’elaborazione di playbook per gestire i rischi dell’AI, resterebbero ancora molte criticità irrisolte nel ciclo di sviluppo degli elementi comuni dell’ingegneria per l’AI (progettazione, implementazione, test e valutazione, evoluzione) che potrebbero evolversi in nuovi standard guidati da metriche convalidate e utilizzabili per un ritorno sugli sforzi effettuati.

    Probabilmente, adesso c’è una buona opportunità per sviluppare rapidamente un approccio integrato e completo del ciclo di vita che consenta di associare la progettazione e l’implementazione del sistema ad un processo di T&E di tipo “shift-left” supportato dalla produzione di prove. Ciò contrasta con i recenti metodi per la codifica sicura. Quest’ultima ha fornito un efficiente metodo di analisi e alcuni strumenti efficaci nei moderni linguaggi “memory-safe”. Si tratta di grandi opportunità, ma l’arrivo tardivo della codifica sicura non ha evitato la presenza di codice non sicuro e spesso vulnerabile il cui aggiornamento rappresenta un onere troppo elevato.

    È importante notare che la persistente difficoltà di valutare la sicurezza di un insieme di codice ostacola non solo l’adozione di best practice, ma anche la creazione di fiducia per il suo utilizzo. Gli sviluppatori e i valutatori prendono decisioni in base alla loro esperienza, per esempio il fuzzing è correlato a un miglioramento della sicurezza.

    In molti casi gli approcci più utili alla valutazione del codice non si riferiscono all’effettivo grado di sicurezza, ma si concentrano sulla portata della conformità con un determinato processo applicativo di varie tecniche di progettazione e sviluppo. In pratica, i risultati effettivi restano difficili da valutare. Di conseguenza, l’aderenza a procedure codificate, come il “secure development lifecycle (SDL)”[16] e la conformità al “Federal Information Security Modernization Act (FISMA)”[17], sono diventate essenziali per la gestione del rischio informatico.

    L’adozione può anche essere guidata da motivi non correlati, ma allineati. Per esempio, esistono progetti avanzati relativi a linguaggi e strumenti per il miglioramento della sicurezza, la cui adozione è guidata dall’interesse a migliorare la produttività, senza necessità di una formazione approfondita o una configurazione preliminare.

    Un esempio è rappresentato dal linguaggio open source “TypeScript”[18] come alternativa sicura a JavaScript. TypeScript è quasi identico nella sintassi e nelle prestazioni di esecuzione a JavaScript, ma supporta il controllo statico, che può essere eseguito nello stesso istante in cui gli sviluppatori scrivono il codice, è quindi in grado di far emerge un errore prima che arrivi in esecuzione. Quindi, gli sviluppatori possono adottare TypeScript per migliorare la produttività e, contestualmente, ottenere vantaggi in termini di sicurezza.

    Date le difficoltà riscontrate nello sviluppo di metriche per molti fattori di rischio dell’AI, è importante sfruttare l’allineamento positivo delle motivazioni progettuali per migliorare la sicurezza dell’AI. È complesso sviluppare misure specifiche per casi generali, quindi è opportuno utilizzare metodi o soluzioni alternative, ovvero best practice derivate dall’esperienza. Le soluzioni alternative possono riguardare: il grado di aderenza alle best practice dell’ingegneria del software, le strategie di formazione, l’implementazione di test e analisi, la scelta di strumenti e così via. È importante sottolineare che queste tecniche ingegneristiche includono lo sviluppo e la valutazione di architetture e di modelli progettuali che consentono la creazione di sistemi più affidabili partendo da elementi meno affidabili.

    L’ambito del rischio informatico offre un approccio ibrido di sostituzione e misurazione diretta selettiva tramite i “National Information Assurance Partnership (NIAP) Common Criteria”[19]: i progetti vengono valutati in modo approfondito, ma l’analisi sul codice di livello inferiore non vengono eseguite in modo esaustivo, ma tramite campionamento. Un altro esempio è rappresentato dal progetto “Building Security In Maturity Model (BSIMM)”[20] che include un processo di miglioramento continuo delle sue best practice. Naturalmente, qualsiasi utilizzo di metodi alternativi deve essere accompagnato da una ricerca approfondita, sia per valutarne costantemente la validità, sia per sviluppare metodi specifici.

    Criteri di valutazione

    Impiego di un AI Red Team

    Un primo esempio di metodologia per la valutazione del rischio dell’AI può essere rinvenuto nell’Executive Order 14110 “on the Safe, Secure, and Trustworthy Development and Use of Artificial Intelligence” [21], emanato dal Governo americano nell’ottobre 2023, in cui questo rischio è stato considerato ad alto potenziale e, pertanto, si è deciso di utilizzare il modello del red teaming per attuarne la valutazione.

    I red team nascono in ambito militare e vengono utilizzati per simulare attacchi di avversari sempre più evoluti e pericolosi. Nel contesto dei rischi informatici o dei rischi legati all’AI, i red team operano, invece, durante l’intero ciclo di vita del sistema, dalla definizione dell’ambito di utilizzo, alla predisposizione dei requisiti, alla progettazione architetturale, fino allo sviluppo e al deployment del sistema, comprendendo anche la successiva fase evolutiva.

    Questa integrazione non è facilmente realizzabile perché le competenze dell’AI non sono ancora sufficientemente mature. Le lezioni apprese in tale ambito suggeriscono che è meglio integrare le competenze dei team di sviluppo in tema di sicurezza, piuttosto che imporre l’attenzione ai problemi di sicurezza.

    Ciò suggerisce la presenza di un gruppo di esperti multidisciplinari in grado di individuare le potenziali debolezze e vulnerabilità e misurare lo stato di avanzamento delle misure di contenimento, delle azioni di mitigazioni, degli strumenti utilizzati e delle best practice associate. Questi esperti dovrebbero essere inseriti in team agili in modo da poter influenzare le scelte operative e le decisioni progettuali. Il loro obiettivo si concretizza nell’ottimizzazione dei benefici derivanti dall’uso dell’AI e nella diminuzione dei rischi.

    I red team dell’AI devono affrontare, oltre ai rischi e alle minacce poste dagli avversari, anche i rischi associati alle debolezze specifiche dell’AI, comprese le categorie di debolezze e vulnerabilità relative alla confidenzialità, all’integrità e alla governance. Il successo dipenderà dalla piena consapevolezza di tutte le dimensioni del rischio e dall’accesso a strumenti e capacità adeguati a supportare assesment efficaci ed economicamente convenienti.

    Allo stato attuale, non esiste ancora una prassi standardizzata per i red team dell’AI; infatti, non sono stati definiti e resi operativi gli strumenti, la formazione e le attività da espletare, perché è un settore in rapida evoluzione tecnologia. Il questo senso, l’AI Risk Management Framework del NIST rappresenta un primo passo importante nel definire questa dimensionalità.

    Metodi per la valutazione del rischio dell’AI

    L’approccio del red teaming richiede la disponibilità e l’uso di un’ampia gamma di metodologie e tecniche; pertanto, è possibile seguire dei metodi alternativi in grado di effettuare la valutazione basandosi sull’acquisizione delle conformità dei processi e/o della valutazione dei prodotti, come avviene nelle classiche valutazioni di sicurezza e qualità.

    A riguardo, possono essere presentate diversi tipi di evidenze che vanno dalla trasparenza, concretizzabile attraverso una serie di schede tecniche dettagliate, all’acquisizione di autocertificazioni sulla qualità dei prodotti fornite dai fornitori, nei limiti delle considerazioni legali relative alla proprietà intellettuale e alla responsabilità sul prodotto. Tutto ciò si potrebbe estende alla gestione della supply chain per sistemi integrati, in cui potrebbero esserci vari livelli di trasparenza. Nell’ambito della sicurezza informatica, la responsabilità è un tema in continua evoluzione e, possiamo aspettarci, che lo sarà anche per l’AI.

    Analizziamo i due metodi:

    • La conformità dei processi, per il rischio legato all’AI, può riguardare l’aderenza alle best practice nella progettazione dell’AI. Queste conformità possono spaziare dalle valutazioni effettuate a livello di progettazione, per esempio su come i modelli di AI vengono incapsulati all’interno di un’architettura di sistema, alla conformità con le best practice per la gestione e la formazione dei dati. Inoltre, possono includere l’uso di strumenti per il monitoraggio dei comportamenti sia di sistema, che degli operatori. Si evidenzia che i metodi incentrati sui processi del rischio informatico, come il NIST Cybersecurity Framework[22], possono interessare centinaia di criteri che, a loro volta, possono essere applicati nello sviluppo e nella valutazione di un sistema. I progettisti e i valutatori devono selezionare e stabilire le priorità tra i numerosi criteri per sviluppare una strategia che garantisca l’allineamento con l’obiettivo del progetto. Si presuppone che, con la maturazione delle tecniche per lo sviluppo delle capacità dell’AI, emergeranno processi proattivi che tenderanno a sfruttare la capacità operativa basata sull’intelligenza artificiale per ridurre al minimo le principali variabili del rischio. In questo contesto, è solitamente più vantaggioso utilizzare i prototipi di conformità già convalidi, anziché effettuare l’analisi e i test specifici per un processo. Però questa strategia può essere rischiosa nel contesto dell’intelligenza artificiale. Per esempio, le nozioni di copertura dei test e i criteri di somiglianza degli input, molto utilizzati dagli sviluppatori di software, non si trasferiscono bene ai modelli basati su rete neurale.
    • La valutazione del prodotto può porre notevoli difficoltà tecniche, soprattutto con l’aumento della scalabilità, della complessità e dell’interconnessione. Inoltre, può creare problemi legali al tema della proprietà intellettuale e della responsabilità. Nell’ambito della sicurezza informatica, alcune caratteristiche dei prodotti stanno diventando facilmente accessibili per realizzare una valutazione diretta. Ciò è una conseguenza della scelta di aumentare la trasparenza, come è indicato nelle metodologie software bills of materials (SBOM) e nelle architetture Zero Trust (ZT).

    Paradossalmente, anche la totale trasparenza di un modello di AI con miliardi di parametri potrebbe fornire poche informazioni. Ciò è correlato alla fusione del codice e dei dati nei moderni modelli di intelligenza artificiale. Esiste, tuttavia, una importante ricerca in grado di estrarre da un LLM le mappe associative, esaminando i pattern di attivazione dei neuroni. Al contrario, i modelli di intelligenza artificiale black boxed potrebbero rivelare più di quanto i loro creatori abbiano potuto elaborare in merito alla loro progettazione e realizzazione. La riservatezza percepita dei dati di training può essere violata tramite attacchi di inversione del modello per ML e output memorizzati del LLM.

    In sintesi, la valutazione diretta dei modelli di reti neurali rimane un traguardo importante e sfidante. Ciò fornisce un ulteriore impulso all’espansione dell’ingegneria dell’AI e all’applicazione di principi specifici per lo sviluppo e la valutazione dei sistemi basati sull’AI e dei work-flow che li utilizzano.

    Criterio basato sugli incentivi

    I citati criteri di valutazione, incentrati sui processi e sui prodotti, possono apparire una criticità per chi cerca di massimizzare i benefici dell’applicazione dell’AI, operando in maniera efficiente ed efficace. In tal senso, le scelte tecniche effettuate in merito alla progettazione e allo sviluppo di un sistema basato sull’intelligenza artificiale devono necessariamente controbilanciare le opzioni connesse alle circostanze operative e di contesto. Una valida alternativa è rappresentata dal criterio basato sugli incentivi. In effetti, questo approccio offre un maggiore grado di libertà e, contestualmente, consente una riduzione del rischio attraverso adeguamenti ai workflow e ai sistemi progettati.

    Gli incentivi possono essere sia positivi che negativi, per esempio potrebbero essere offerti incentivi positivi nei contratti di implementazione nel caso in cui le asserzioni relative ai rischi dell’AI siano supportate da evidenze o da dichiarazioni di responsabilità. Le evidenze potrebbero riguardare un’ampia gamma di scelte progettuali che spaziano dall’architettura dei sistemi e dei workflow, alla predisposizione del modello e delle misure di protezione.

    Questo approccio, basato sui principi emergenti dell’ingegneria dell’intelligenza artificiale, consente di realizzare sistemi affidabili e in grado di evolversi in determinati contesti, anche mentre operano per far progredire lo sviluppo di tecniche più generali.

    Di seguito sono indicate le principali metodologie di valutazione dei rischi dell’AI:

    1. Stabilire la priorità dei rischi. Questo metodo consente di identificare e di priorizzare i potenziali punti deboli e le vulnerabilità di un sistema sulla base di uno specifico obiettivo. Questo processo andrebbe eseguito prima possibile, teoricamente prima che sia avviata la progettazione e la realizzazione dei sistemi.
    2. Identificare gli obiettivi correlati al rischio. Questa metodologia si concentra sull’identificazione degli obiettivi di sistema, insieme alle relative misure a livello di sistema, esclusivamente connessi ai rischi ritenuti rilevanti.
    3. Mettere insieme le misure tecniche e di mitigazione. Questa tecnica permette di identificare le misure tecniche e le potenziali azioni di mitigazione, con le relative procedure e gli strumenti associati, comuni per gli stessi rischi. Inoltre, è in grado di tenere traccia dello sviluppo delle capacità tecniche emergenti.
    4. Adeguare le scelte operative e progettuali di alto livello. Questa procedura individua le correzioni alle scelte operative e progettuali di alto livello per i rischi con priorità più elevata che potrebbero consentire probabili riduzioni del rischio. Questa procedura può riguardare l’adeguamento dei workflow operativi e limitare le conseguenze potenziali, per esempio elevando il ruolo umano oppure riducendo la superficie di attacco. Inoltre, potrebbe valutare anche l’adattamento dell’architettura di sistema per consentire una riduzione delle superfici di attacco interne e limitare l’impatto delle vulnerabilità connesse alla capacità del ML.
    5. Identificare i metodi per valutare i punti deboli e le vulnerabilità. Quando non è possibile individuare misure dirette, devono essere impiegate soluzioni alternative. Questi metodi possono spaziare dall’uso di checklist, in stile NIST-playbook, all’adozione di best practices, come le“DevSecOps for IA”[23]. Inoltre, potrebbero includere valutazioni a livello di specifiche o di progetto analoghi ai “Common Criteria”[24].
    6. Ricerca di attributi allineati. Questo metodo di basa sulla ricerca di consensi positivi per la mitigazione del rischio attraverso attributi, potenzialmente non correlati, che offrono misure migliorative. Per esempio, la produttività o l’adozione di altri tipi di incentivi possono guidare l’adozione di procedure favorevoli alla riduzione di determinate categorie di rischi. Nel contesto dei rischi legati all’intelligenza artificiale, questo approccio potrebbe includere l’uso dei modelli progettuali per la resilienza delle architetture come metodo per la localizzazione di eventuali effetti negativi delle debolezze del machine learning.
    div]:bg-bg-300 [&_.ignore-pre-bg>div]:bg-transparent [&_pre]:-mr-4 md:[&_pre]:-mr-9″>

    _*]:min-w-0″>

    Nel prossimo articolo di questa serie, approfondiranno le potenziali strategie di mitigazione, concentrandosi sull’audit dei Bias e sulle tecniche di Machine Unlearning. Per un’analisi più dettagliata, invitiamo i lettori a scaricare il white paper “Generative artificial intelligence rischi e contromisure”, che offre una panoramica esaustiva sulle sfide e le soluzioni nel campo della Generative AI.

    Note bibliografiche

    [1] AI in 2024: McKinsey Report Reveals Value Generation & AI Adoption Spike: https://www.switchsoftware.io/post/ai-in-2024-gen-ai-rise-and-business-impact, 2024

    [2] Making AI Systems Secure for All: https://www.coalitionforsecureai.org/

    [3] NIST’s AI risk management playbook: https://airc.nist.gov/AI_RMF_Knowledge_Base/Playbook

    [4] NIST Cybersecurity Framework: https://www.nist.gov/cyberframework

    [5]The Roles of the Actuary in the Selection & Application of Actuarial Models: https://www.actuary.org/sites/default/files/2023-02/01_Models2.9.23.pdf

    [6] Cybersecurity & Infrastructure Security Agency: https://www.cisa.gov/known-exploited-vulnerabilities-catalog

    [7] MITRE Corporation: https://cwe.mitre.org/data/index.html

    [8] Open Web Application Security Project: https://owasp.org/www-community/attacks/

    [9] J. von Newmann, Probabilistic Logics and the Synthesis of Reliable Organisms from Unreliable Components: https://web.mit.edu/6.454/www/papers/pierce_1952.pdf, California Institute of Technology, 1952

    [10] AA.VV., Systems of Systems Engineering: Basic Concepts, Model-Based Techniques, and Research Directions: https://dl.acm.org/doi/abs/10.1145/2794381, 2015

    [11] Snyder, Machine forgetting: How difficult it is to get AI to forget: https://www.axios.com/2024/01/12/ai-forget-unlearn-data-privacy, 2024

    [12] AA.VV., An Empirical Study of Catastrophic Forgetting in Large Language Models During Continual Fine-tuning: https://arxiv.org/abs/2308.08747, School of Engineering, Westlake University, 2024

    [13] T. Hagendorff, Deception abilities emerged in large language models: https://www.pnas.org/doi/10.1073/pnas.2317967121, 2024

    [14] AA.VV., AI-Related Risks Test the Limits of Organizational Risk Management: https://sloanreview.mit.edu/article/ai-related-risks-test-the-limits-of-organizational-risk-management/, 2024

    [15] AA.VV., Artificial Intelligence Index Report 2024: https://aiindex.stanford.edu/wp-content/uploads/2024/05/HAI_AI-Index-Report-2024.pdf, Stanford University, 2024

    [16] Microsoft Security Development Lifecycle (SDL): https://www.microsoft.com/en-us/securityengineering/sdl

    [17] Federal Information Security Modernization Act (FISMA): https://security.cms.gov/learn/federal-information-security-modernization-act-fisma

    [18] Typescript: https://jaydevs.com/javascript-vs-typescript/

    [19] National Information Assurance Partnership (NIAP) Common Criteria: https://www.niap-ccevs.org/

    [20] Building Security In Maturity Model (BSIMM) project: https://www.synopsys.com/glossary/what-is-bsimm.html

    [21] Executive Order on the Safe, Secure, and Trustworthy Development and Use of Artificial Intelligence del 30/10/2023: https://www.whitehouse.gov/briefing-room/presidential-actions/2023/10/30/executive-order-on-the-safe-secure-and-trustworthy-development-and-use-of-artificial-intelligence/

    [22]NIST Cybersecurity Framework: https://www.nist.gov/itl/smallbusinesscyber/nist-cybersecurity-framework-0

    [23]DevSecOps Speeds Artificial Intelligence and Machine Learning Capability: https://www.sei.cmu.edu/publications/annual-reviews/2020-year-in-review/year_in_review_article.cfm?customel_datapageid_315013=315534

    [24] Common Criteria: https://www.commoncriteriaportal.org/index.cfm
    Profilo Autore

    È laureato in Ingegneria Informatica ed in Sicurezza Informatica presso le Università di Roma La Sapienza e di Milano. Ha indirizzato la sua formazione nei settori della Cyber Security e Digital Forensics ottenendo i diplomi di perfezionamento in Data Protection e Data Governance; Criminalità Informatica e Investigazioni Digitali e Big Data, Artificial Intelligence.

    Ha, altresì, conseguito l’Advanced Cybersecurity Graduate Certificate alla School of Engineering della Stanford University; Professional Certificates in Information Security; Incident Response Process; Digital Forensics e Cybersecurity Engineering and Software Assurance presso il Software Engineering Institute della Carnegie Mellon University.

    Dal 1992 è nei ruoli del Ministero dell’Interno ove ricopre lincarico di Funzionario alla Sicurezza CIS. In tale veste contribuisce alla valutazione dei rischi cyber, all’implementazione delle misure di sicurezza e la risoluzione di incidenti informatici. Inoltre, offre consulenza tecnica nel campo della Digital Forensics per l’Autorità giudiziaria, la Polizia giudiziaria e gli Studi legali.

    Dal 2017 è Professore a contratto di Tecnologie per la Sicurezza Informatica presso alcune Università ove sviluppa le tematiche di Attack and Defense Strategies quali il penetration testing, la risk analysis, l’information security assessment, l’incident response e la digital forensics. Infine, è Autore di alcuni articoli e saggi sui temi della Sicurezza Informatica e
    dell’Informatica Giuridica consultabili su https://www.vincenzocalabro.it

    Condividi sui Social Network:

    https://www.ictsecuritymagazine.com/articoli/rischi-ia-generativa/


    Del Fante (Poste Italiane): “Nel 2025 focus su pacchi, risparmio postale, assicurazioni, energia”. Presto un modello di governance per l’AI

    [embedded content]

    I risultati preliminari di Poste Italiane per il 2024

    L’attività economica italiana ha ripreso nell’ultima parte dell’anno 2024 il trend di modesta crescita avuto nel primo semestre, dopo il ristagno del prodotto interno lordo registrato nel terzo trimestre; tale andamento ha risentito, come nel resto dell’area Euro, della persistente debolezza della manifattura e del rallentamento dei servizi.

    Le recenti proiezioni stimano un incremento del PIL nazionale dello 0,5% nell’anno 2024 e un’accelerazione nel triennio 2025-2027 con un’espansione del PIL in media dell’1% l’anno. La crescita rimarrà contenuta nella prima parte del 2025, per riacquistare slancio in seguito, sostenuta dai consumi e dalle esportazioni. Le stime del triennio restano ad ogni modo circondate dall’incertezza riconducibile allo scenario internazionale: un orientamento maggiormente protezionistico delle politiche commerciali e le perduranti tensioni derivanti dai conflitti in corso potrebbero frenare la domanda estera e interna.

    In tale contesto, il Gruppo Poste Italiane ha chiuso il 2024 con nuovi record: l’Ebit Adjusted del 2024 ha raggiunto 2,96 miliardi di euro che, oltre ad essere superiore alla guidance di piano comunicata nel mese di luglio scorso, è cresciuto sensibilmente nel corso degli ultimi anni quasi triplicando il livello del 2017. Analoga progressione di crescita nel periodo è stata registrata dall’utile netto di Gruppo che si è attestato a oltre 2 miliardi di euro nell’esercizio 2024, in linea con la guidance aggiornata del piano. A tali risultati hanno contribuito la crescita dei ricavi in tutte le strategic business unit e, in particolare, le performance rilevanti sul margine di interesse e nel comparto pacchi, oltre all’attenta disciplina sui costi. Nuovi massimi storici hanno, inoltre, riguardato la raccolta lorda complessiva realizzata dal Gruppo e in particolare quella sui fondi comuni di investimento. Il comparto assicurativo ha continuato a registrare nell’anno flussi netti positivi con performance superiori rispetto a quelle del mercato.

    Del Fante: “Per il 2025 rimaniamo focalizzati su pacchi, risparmio, assicurazioni, luci e gas“

    Poste Italiane archivia un 2024 da record e rivede al rialzo gli obiettivi del 2025 grazie al contributo di tutte le linee di business e, soprattutto, al grande lavoro dei suoi 120.000 dipendenti. L’Ad Matteo Del Fante intervistato dal TG Poste ha voluto manifestare la sua gratitudine per i risultati raggiunti, indicando le prossime sfide che attendono il Gruppo. “Questa azienda – ha detto Del Fante – non produce beni fisici ma offre servizi. Se i nostri colleghi operativi e l’azienda tutta non collaborassero non si raggiungerebbero questi numeri. Quando si ottiene più di quello che ci si aspettava, significa che tutti i colleghi ci hanno messo passione ed è la cosa per noi più importante. Un grazie sulla base di risultati concreti”. Del Fante si è poi soffermato sui principali obiettivi per il 2025. “Rimaniamo focalizzati sulla logistica, in particolare sui pacchi – ha continuato l’Amministratore Delegato di Poste Italiane –. Resteranno importanti i prodotti di risparmio: quest’anno ricorre il 150° anniversario del libretto postale e il centenario del buono fruttifero. Stiamo studiando con Cassa Depositi e Prestiti delle emissioni per celebrare le soluzioni di risparmio più apprezzate dagli italiani, per un valore di 340 miliardi. Per quanto riguarda la protezione sarà un anno molto positivo. Per la nostra offerta di luce e gas il 2025 sarà storico perché ci siamo dati l’obiettivo di raggiungere il milione di contratti. Al momento Poste Energia conta 700mila clienti, abbiamo ancora lavoro da fare”, ha concluso Del Fante.

    Poste Vita

    Il Gruppo Poste Vita chiude il 2024 con un coefficiente di solvibilità pari al 334%, che diventa circa il 300% al netto della previsione di distribuire alla capogruppo Poste Italiane SpA dividendi per circa 1,5 miliardi di euro in arco piano, in aggiunta alla distribuzione del 100% degli utili.

    Sulla base dei risultati raggiunti, nonché dell’ampia visibilità sui flussi di cassa futuri e della solida generazione e ottimizzazione di capitale, il management ha proposto il miglioramento della politica di dividendi, aumentando il payout ratio al 70% per il 2024-2028. Il dividendo preliminare per l’anno 2024 è di 1,08 euro ad azione, in crescita del 35% rispetto al valore del precedente esercizio. Sin dalla quotazione avvenuta nel 2015, gli azionisti hanno beneficiato di una elevata e crescente remunerazione complessiva con performance superiore ai valori registrati dal principale indice di Borsa Italiana e il record storico del prezzo del titolo che ha raggiunto 14,88 euro il 18 febbraio 2025.

    The Connecting Platform

    Il nuovo piano “2024 – 2028 Strategic Plan – The Connecting Platform”, presentato alla comunità finanziaria nel mese di marzo 2024, posa le basi su:

    1. un nuovo modello di servizio commerciale che massimizza il valore dell’Azienda ‘piattaforma’ in modo diversificato, integrato e sostenibile;
    2. la trasformazione del Gruppo verso un operatore logistico completo, assicurando la sostenibilità finanziaria del segmento Corrispondenza, Pacchi e Distribuzione.

    Il nuovo modello di servizio mira a ottimizzare la copertura e la gestione dei clienti in logica omnicanale, indirizzando l’impegno dei consulenti in attività “relazionali” anziché “transazionali”, generando valore per il Gruppo. Nel corso del 2024 è stato confermato il ruolo dell’Ufficio Postale come punto di riferimento per la costruzione e il mantenimento della relazione con il cliente e affinato il modello di servizio focalizzandolo su segmenti di clientela strategica e a maggior valore. È stata inoltre ulteriormente potenziata la rete dei Punto Poste Casa e Famiglia con l’obiettivo di rafforzare i canali di accesso e vendita dei prodotti/servizi anche attraverso l’ampliamento dell’offerta.

    La trasformazione logistica

    Nell’ambito della trasformazione logistica verso un operatore logistico end-to-end rileva l’evoluzione della rete postale, sempre più orientata alla gestione dei pacchi e lo sviluppo del business internazionale e della logistica integrata; in tale strategia rientrano la partnership strategica con DHL siglata nel 2023 e la costituzione nel mese di aprile 2024 di Locker Italia SpA, per lo sviluppo in Italia di una rete di locker su cui effettuare le consegne last-mile dei pacchi. Nel mese di settembre 2024 è stato inaugurato il primo dei 10.000 locker che saranno attivati in tutto il territorio nazionale e che consentiranno, grazie alla loro capillarità e tecnologia, di migliorare ulteriormente la qualità dei servizi a supporto dell’e-commerce. Al fine di accelerare e cofinanziare il processo di trasformazione infrastrutturale e immobiliare del Gruppo, è stata costituita nel mese di febbraio 2025 la joint venture Patrimonio Italia Logistica – SICAF SpA in gestione esterna, che mira a gestire con modalità all’avanguardia e secondo i più alti standard di qualità ed ESG l’infrastruttura logistica del Gruppo Poste Italiane. L’operazione coinvolgerà, inoltre, più operatori specializzati nello sviluppo immobiliare in ambito logistico in grado di apportare risorse finanziarie e know-how specialistico e accelerare così il processo di rinnovamento dei siti.

    Al rafforzamento della c.d. logistica integrata contribuisce anche la costituzione, avvenuta nel mese di marzo 2024, della NewCo Poste Logistics SpA.

    Per la gestione e razionalizzazione della logistica sanitaria integrata per l’Azienda Sanitaria Provinciale di Cosenza è stata costituita la società SPV Cosenza.

    Anche per il 2025, il Gruppo Poste Italiane conferma la centralità del Risparmio Postale nella propria offerta e l’attenzione all’offerta di prodotti/servizi che risultino al passo con

    Sinergie con TIM?

    Beneficiando della crescita dell’e-commerce e dei pagamenti cashless, il business di PostePay evolverà verso soluzioni di pagamento digitali e innovative, così da aumentare il livello di fidelizzazione del cliente, lo stock e soprattutto l‘utilizzo delle carte di pagamento. Nell’ambito della telefonia proseguirà l’impegno nella proposizione di nuovi prodotti e servizi integrati con un focus sulle evoluzioni della Postepay Connect.

    Inoltre, il recente ingresso nella compagine azionaria di Telecom Italia S.p.A. da parte di Poste Italiane abilita l’evoluzione dei rapporti commerciali tra le due società e mira a creare sinergie e favorire il consolidamento del mercato nazionale delle telecomunicazioni.

    App Poste Italiane, trasformazione del canale web e implementazione dell’AI

    Tra le iniziative di maggior rilievo in ambito omnicanalità, nel corso del 2025 sarà portato a termine il percorso di migrazione della customer base delle app BancoPosta e Postepay sull’unica app Poste Italiane, la quale rappresenterà un punto di accesso unico e il riferimento per l’operatività sul canale app e che gestirà un traffico potenziale di oltre 6 milioni di visite giornaliere. Grazie anche all’intelligenza artificiale, verrà garantita un’elevata personalizzazione dell’app con contenuti diversificati real time, viste e funzionalità dedicate, al fine di adattarla ai comportamenti e rispondendo alle esigenze del singolo cliente. Nell’ambito del potenziamento dei canali digitali del Gruppo, è stato inoltre avviato un percorso di trasformazione del canale web che vedrà nel corso dell’anno la prima revisione del sito consumer Poste.it sviluppata in un’ottica cliente-centrico e con un design coerente con l’app Poste Italiane. Nel corso dell’anno il Gruppo proseguirà inoltre nella traiettoria di sviluppo già avviata, estendendo l’utilizzo dell’intelligenza artificiale all’interno del suo modello di business a beneficio dei processi interni e dei clienti e al fine di rendere sempre più inclusivo l’accesso ai servizi dell’ecosistema del Gruppo.

    L’impegno nell’implementazione dell’intelligenza artificiale si svilupperà nell’ottica di potenziare i valori portanti del Gruppo, all’interno del quadro etico di riferimento e mettendo al centro le persone. Verrà istituito un modello di governance dell’intelligenza artificiale che, a partire dai principi identificati nel Manifesto Etico finalizzato lo scorso dicembre 2024, stabilisca le regole, i processi e le responsabilità per un utilizzo sicuro ed efficace delle nuove tecnologie.

    Il Progetto Polis e la transizione ecologica

    Il Gruppo proseguirà nel 2025 nella realizzazione di ‘Polis’, progetto strategico a supporto della coesione sociale del Paese che coinvolge circa 7.000 comuni con meno di 15 mila abitanti, nei quali l’Ufficio Postale sarà trasformato in hub di servizi digitali per un accesso rapido e facile ai servizi della Pubblica Amministrazione. È inoltre prevista la realizzazione di circa 250 spazi di coworking a livello nazionale e l’implementazione di numerose azioni a supporto della transizione energetica del Paese. Da inizio progetto sono stati completati 2.918 Uffici Postali e 81 Spazi per l’Italia (coworking).

    Con il Progetto Polis, parte del Piano Complementare al PNRR, Poste Italiane promuove la coesione economica, sociale e territoriale del Paese e il superamento del digital divide nei piccoli centri. Ad oggi, completati 3.026 interventi di rinnovo negli uffici postali, con circa altri 600 in corso, e realizzati 81 spazi di co-working. Erogati oltre 50 mila servizi della Pubblica Amministrazione, di cui oltre 20 mila passaporti.

    Nel percorso di transizione intrapreso verso la carbon neutrality, proseguiranno gli investimenti e le iniziative strategiche, quali il rinnovo della flotta di recapito con mezzi a basse emissioni di CO2, l’installazione di pannelli fotovoltaici per l’approvvigionamento energetico e l’efficientamento degli immobili; continuerà inoltre la sostituzione delle attuali carte Postepay con carte realizzate con materiali ecosostenibili e con carte digitali, nonché lo sviluppo di specifiche offerte volte a valorizzare i comportamenti sostenibili dei clienti, tra i quali lo sviluppo di una piattaforma di donazione omnicanale che consentirà ai clienti, possessori di una carta Postepay, di effettuare erogazioni liberali verso Associazioni ed Organizzazioni terze, utilizzando le stesse carte Postepay. Nell’ambito della transizione green rileva inoltre la costituzione nel corso del 2024 della nuova società Postego S.p.A., che mira ad internalizzare progressivamente il parco auto di Poste Italiane.

    Poste Energia

    L’offerta retail di Poste Energia per luce e gas, lanciata a giugno 2022, ha contribuito alla performance, ricavi per € 76 milioni nell’esercizio 2024 e € 23 milioni nel quarto trimestre, sostenuta da positive dinamiche di mercato e dal perdurare di condizioni di settore favorevoli.

    Il risultato operativo (EBIT) Adjusted è cresciuto nell’esercizio 2024 del 20,3% su base annua pari a € 529 milioni nell’esercizio 2024 e il 20,9% a € 148 milioni nel quarto trimestre del 2024, trainato da una solida performance di ricavi.

    Per il 2025 il Gruppo Poste si attende: 1 milione di contratti nell’offerta Energia (>50% rispetto al 2024), sostenuti da un rinnovato sforzo commerciale e da un contesto di mercato favorevole.

    Milano Cortina 2026

    Tra le recenti iniziative che valorizzano la vocazione sociale di Poste Italiane, rileva la recente partnership siglata in vista dei Giochi Invernali del 2026 durante i quali l’Azienda sarà premium logistic partner dei Giochi Olimpici e Paralimpici di Milano Cortina 2026, gestendo, attraverso la controllata Poste Logistics, il trasporto e la logistica di tutti i beni, le attrezzature e i materiali necessari per il successo dell’evento presso le sedi olimpiche e paralimpiche.

    Leggi le altre notizie sull’home page di Key4biz

    https://www.key4biz.it/poste-italiane-i-numeri-del-2024-presto-un-modello-di-governance-per-lai/522381/


    L’AI generativa cambia il mondo della musica, mercato da 22 miliardi di dollari entro il 2034

    L’industria musicale nell’era dell’AI generativa

    Il digitale in generale aveva già stravolto il settore 25 anni fa, ora l’intelligenza artificiale generativa (Gen AI) lo sta trasformando in profondità, direttamente alla radice, cioè nel modo in cui la musica viene creata, prodotta e distribuita.

    Nel 2024, il mercato globale della Gen AI nella musica ha raggiunto un valore di 419,85 milioni di dollari, crescendo con un tasso annuo composto (CAGR) del 53,34% dal 2019. Le stime proposte da The Business Research Company indicano un’espansione straordinaria fino a 4,3 miliardi di dollari nel 2029 (CAGR del 59,25%), per poi arrivare a 22,57 miliardi di dollari entro il 2034, crescendo al 39,32% annuo tra il 2029 e il 2034.

    Questa crescita è trainata da alcuni fattori sociali ed economici, tra cui il forte processo di urbanizzazione in quasi tutti i continenti, dalla diffusione e il massiccio utilizzo dei social media, dalla maggiore penetrazione di internet e diffusione dei servizi di streaming musicale. Tuttavia, l’elevato costo operativo e le preoccupazioni sulla privacy dei dati rappresentano ancora degli ostacoli da superare.

    Un mercato frammentato con leader emergenti

    L’industria dell’AI generativa nella musica è altamente frammentata: nel 2023, i primi dieci competitor detenevano solo il 24,17% del mercato. Tra questi, Jukedeck era il leader con una quota del 5,57%, seguito da T Suno (2,97%), Aiva Technologies SARL (2,30%), Boomy Corporation (2,15%) e Amper Music Inc. (1,89%). Altri player come Amadeus Code, Beatoven AI, Hydra II (Rightsify), Vochlea Music e Udio AI detenevano ciascuno l’1,86%.

    Musica e Gen AI, quali settori guideranno la crescita? Qualche numero

    Per tipologia di utilizzo

    • Song composition e creative process è il segmento principale con 165,25 milioni di dollari nel 2024 (39,36% del mercato) e secondo il report dovrebbe crescere più rapidamente tra il 2024 e il 2029, con un CAGR del 64,07%.

    Per modello software

    • Cloud-based solutions dominano con 74,69% del mercato (313,6 milioni di dollari nel 2024) e cresceranno a un CAGR del 61,90% fino al 2029.

    Per sistema operativo

    • Windows è la piattaforma principale con 73,01% del mercato (306,52 milioni di dollari nel 2024).
    • Mac OS crescerà però rapdamente (CAGR del 62,44%) nei prossimi cinque anni.

    Per tipologia di utenti finali

    • Professionisti e ingegneri del suono rappresentano il 27,31% del mercato (114,68 milioni di dollari nel 2024).
    • Gli autori di musica elettronica saranno presto dei driver per questa tecnologia, con un CAGR del 66,37% tra 2024-2029.

    Espansione geografica: Nord America domina, ma l’Asia-Pacifico cresce più velocemente

    Il Nord America è attualmente il mercato più grande con una quota del 40,59% (170,44 milioni di dollari nel 2024), ma l’Asia-Pacifico e l’Europa Occidentale guideranno la crescita nei prossimi anni con CAGR rispettivamente del 62,18% e 60,72%.

    Gli Stati Uniti rappresenteranno la quota maggiore della crescita, guadagnando 1,35 miliardi di dollari entro il 2029.

    Quale futuro dell’AI nella musica?

    L’intelligenza artificiale generativa non è più solo una sperimentazione, ma un passaggio tangibile che sta già trasformando l’industria musicale. Con un mercato che passerà da 419,85 milioni di dollari nel 2024 a 22,57 miliardi di dollari nel 2034, le opportunità per aziende e artisti sono immense.

    Il cloud computing, l’AI e i modelli text-to-music stanno ridisegnando il settore, mentre Nord America e Asia-Pacifico restano i mercati più strategici da tenere d’occhio. L’AI nella musica non è solo un trend, ma un cambiamento strutturale destinato a definire il futuro della creatività musicale.

    Creatività e copyright, tra rischi e opportunità

    L’introduzione della Gen AI nel mondo della musica (e non solo, dei media in generale) ha creato enormi problemi, in termini culturali e di diritti connessi alla proprietà intellettuale, basti pensare al concetto della creatività e dell’originalità di un’opera, ma certamente ha mostrato anche delle grandi opportunità di cambiamento e di miglioramenti fino ad oggi impensabili, da un punto di vista professionale.

    Come si legge in un contributo della Federazione industriale musica italiana (Fimi), da un lato vi sono grandi preoccupazioni riguardo all’integrità artistica, al termine delle opportunità retribuite per i musicisti che lavorano e a molte questioni sul controllo e sul copyright; dall’altro emergono anche le potenzialità che gli strumenti di AI generativa stanno avendo nel settore.

    Ci sono infatti aspetti tecnologici che riguardano la creatività e la produzione, ma anche altre aree del settore fortemente dipendenti dalle innovazioni che l’AI sta introducendo.

    Il copyright è certamente un punto dolente in questa faccenda, anche se un ulteriore livello di integrazione tra AI e metadati potrebbe migliorare i sistemi di ripartizione dei diritti musicali e di gestione delle royalty, nonché le attività di content protection, rendendo più efficiente il contrasto alle riproduzioni non autorizzate e alle contraffazioni.

    Un mercato che cambia con l’AI, chi vince e chi perde

    Mentre i ricavi dei fornitori di Gen AI vedranno una crescita significativa nei prossimi cinque anni, i creatori rischiano di perdere una quota importante del loro reddito attuale a causa dell’impatto dell’AI generativa. A riguardo è stato recentemente pubblicato uno studio molto interessante condotto dalla CISAC (CISAC Annual Report 2024), la Confederazione Internazionale delle Società di Autori e Compositori, la principale rete mondiale degli organismi di gestione collettiva.

    Nonostante forniscano il carburante creativo del mercato dei contenuti Gen AI, i creatori di musica e audiovisivi vedranno perdere rispettivamente il 24% e il 21% dei loro ricavi entro il 2028. Ciò equivale a una perdita cumulativa di 22 miliardi di euro nel periodo di 5 anni (10 miliardi di euro nella musica; 12 miliardi di euro nell’audiovisivo).

    Lo studio rileva che il mercato dei contenuti musicali e audiovisivi generati dall’intelligenza artificiale aumenterà in modo esponenziale nei prossimi cinque anni, passando dagli attuali circa 3 miliardi di euro a 64 miliardi di euro nel 2028.

    Come risultato di questa crescita esponenziale del mercato della musica e dei contenuti audiovisivi, si stima che i ricavi futuri dei fornitori di Gen AI saliranno di 4 miliardi di euro nella musica (in aumento rispetto a 0,1 miliardi di euro nel 2023) e 5 miliardi di euro nell’audiovisivo (in aumento rispetto a 0,2 miliardi di euro) entro il 2028.

    Si tratta di ricavi derivanti direttamente dalla riproduzione senza licenza delle opere dei creatori, che rappresentano un trasferimento di valore economico dai proprietari alle aziende di AI.

    Nel settore musicale, i mercati dello streaming e delle librerie musicali saranno fortemente influenzati da questa tecnologia. Entro il 2028, si prevede che la musica Gen AI rappresenterà circa il 20% dei ricavi delle piattaforme di streaming musicale tradizionali e circa il 60% dei ricavi delle librerie musicali.

    Leggi le altre notizie sull’home page di Key4biz

    https://www.key4biz.it/lai-generativa-cambia-il-mondo-della-musica-mercato-da-22-miliardi-di-dollari-entro-il-2034/522330/