ISO/IEC 42001: un sistema di gestione dell’intelligenza artificiale

In un contesto di rapida evoluzione tecnologica, l’Intelligenza Artificiale (IA) si è affermata come una forza trainante nei più diversi settori industriali e operativi.

Nel contesto delineato, lo standard ISO/IEC 42001:2023 assume un’importanza cruciale, offrendo un quadro normativo chiaro e strutturato per l’integrazione responsabile dell’Intelligenza Artificiale all’interno delle organizzazioni. Tale norma stabilisce i requisiti per l’implementazione, la manutenzione e il miglioramento continuo di un sistema di gestione dell’IA, mirando a guidare le organizzazioni nello sviluppo, nell’utilizzo e nel monitoraggio dei sistemi IA in maniera responsabile.

Partendo dalla premessa che l’IA può comportare specifiche considerazioni, come l’utilizzo per la presa di decisioni automatiche talvolta in modo non trasparente o non spiegabile, ISO/IEC 42001 enfatizza la necessità di una gestione specifica che superi quella dei sistemi IT tradizionali. A questo si aggiunge la peculiarità dei sistemi IA che, apprendendo continuamente, modificano il loro comportamento durante l’utilizzo, richiedendo particolare attenzione per assicurare che l’uso responsabile persista nonostante le evoluzioni comportamentali.

Incorporando tali sistemi all’interno delle strutture gestionali esistenti, l’adozione di un sistema di gestione dell’IA secondo lo standard ISO/IEC 42001 rappresenta una decisione strategica per ogni organizzazione, che deve tener conto delle proprie esigenze e obiettivi, delle dimensioni e della struttura, oltre che delle aspettative delle parti interessate; pertanto, attraverso l’applicazione di questo standard, le organizzazioni possono non solo rispondere efficacemente ai rischi associati all’IA ma anche sfruttare le sue potenzialità per innovare e migliorare continuamente le proprie operazioni in modo etico e sostenibile.

L’ISO/IEC 42001 si configura come uno strumento di inestimabile valore per assicurare che l’implementazione dei sistemi di intelligenza artificiale avvenga nel rispetto dei principi di sicurezza, eticità e trasparenza, cruciali soprattutto nei settori più sensibili. In particolare, lo standard delinea specifiche linee guida per la valutazione dei rischi associati all’IA, trattando in modo approfondito i rischi e le opportunità che devono essere considerati per garantire che il sistema di gestione dell’IA possa raggiungere i risultati previsti, prevenire o ridurre effetti indesiderati e perseguire il miglioramento continuo.

Esso inoltre impone che le organizzazioni stabiliscano criteri di rischio AI, supportino valutazioni di rischio coerenti, validi e comparabili e gestiscano il trattamento dei rischi con soluzioni adeguate, evidenziando l’importanza di documentare tutte le azioni intraprese in questo contesto. Fondamentalmente, lo standard richiede che le organizzazioni mantengano una dichiarazione di applicabilità che dettagli i controlli necessari, giustificando le inclusioni e le esclusioni.

La portata dell’ISO/IEC 42001 si estende quindi oltre la mera integrazione tecnologica, offrendo una base per la gestione olistica dell’IA che include la formulazione di politiche AI, la definizione di obiettivi e la pianificazione strategica allineata con la direzione strategica dell’organizzazione. Ciò assicura che l’adozione dell’IA non solo rispetti i requisiti normativi e legali ma si armonizzi anche con gli obiettivi etici e di business dell’entità, promuovendo un ambiente in cui l’innovazione tecnologica proceda di pari passo con la responsabilità sociale e la conformità normativa.

L’armonizzazione dello standard ISO/IEC 42001 con altri standard di gestione internazionali permette un’integrazione fluida e coerente delle pratiche di gestione dell’IA nelle strutture esistenti delle organizzazioni, promuovendo una sinergia tra vari aspetti della gestione aziendale, come la qualità, la sicurezza, la sicurezza informatica e la privacy. Questo approccio non solo facilita l’adozione dello standard stesso da parte delle organizzazioni che già implementano altri sistemi di gestione conformi alle norme ISO, ma rafforza anche l’efficacia delle politiche e delle procedure di gestione dell’IA, assicurando che esse siano allineate con le migliori pratiche e i requisiti legali internazionali.

Lo standard è strutturato per essere applicabile a un’ampia varietà di organizzazioni, indipendentemente dalle loro dimensioni o dal settore di operatività. Esso prevede specifici requisiti per la documentazione, la pianificazione e la valutazione delle performance del sistema di gestione dell’IA, assicurando che ogni aspetto, dal rischio alla conformità e all’innovazione, sia adeguatamente monitorato e gestito.

Implementando l’ISO/IEC 42001, le organizzazioni possono dimostrare concretamente il loro impegno verso una gestione responsabile dell’IA, potenziando la fiducia tra i clienti, i regolatori e le parti interessate, mentre simultaneamente si adattano a un ambiente regolamentato in continua evoluzione. Inoltre, tale standard aiuta le organizzazioni a identificare e sfruttare le opportunità legate all’IA, minimizzando i rischi associati e garantendo che le tecnologie siano usate in modo etico e sostenibile.

L’ISO/IEC 42001 si erge dunque come uno strumento complementare all’AI Act, puntando a fornire un metodo strutturato e standardizzato per l’integrazione delle migliori pratiche di gestione dei rischi e conformità nel settore dell’IA. Questa sinergia tra normativa e standardizzazione facilita le organizzazioni nell’attuazione di soluzioni di intelligenza artificiale che non solo rispettano i requisiti legislativi ma superano le aspettative etiche e di responsabilità sociale.

Il framework offerto dall’ISO/IEC 42001 permette alle organizzazioni di classificare i rischi associati ai sistemi di IA in categorie ben definite, consentendo loro di implementare controlli proporzionati al livello di rischio identificato. In questo modo, le organizzazioni possono garantire che i sistemi di IA siano non solo efficaci e efficienti, ma anche sicuri, trasparenti e giusti, in linea con i principi fondamentali dell’AI Act.

Questa norma aiuta quindi le organizzazioni a:

  1. Identificare e valutare i rischi specifici dell’IA: attraverso processi dettagliati di valutazione del rischio e gestione del trattamento del rischio, come prescritto nello standard.
  2. Implementare controlli efficaci: basati sui requisiti di rischio e i controlli di riferimento forniti nell’annesso della norma.
  3. Monitorare e rivedere continuamente l’efficacia del sistema di gestione dell’IA: assicurando che i sistemi di IA siano soggetti a miglioramenti continui e adattati alle mutevoli esigenze legislative e operative.

Inoltre, l’approccio basato sul rischio promosso dall’ISO/IEC 42001 assicura che le misure adottate siano proporzionate alla natura e alla gravità dei rischi associati alle specifiche applicazioni di IA, facilitando così un equilibrio tra innovazione tecnologica e obblighi normativi. Questo non solo ottimizza le risorse ma rafforza anche la fiducia del pubblico e dei regolatori nelle capacità di gestione del rischio dell’organizzazione.

Lo standard ISO/IEC 42001 pone un accento decisivo sulla trasparenza e “spiegabilità”, elementi fondamentali per garantire che le decisioni adottate o assistite dai sistemi di IA siano comprensibili agli utenti finali. Questo aspetto è essenziale per costruire fiducia e per permettere un controllo efficace delle decisioni automatiche, particolarmente in contesti in cui le implicazioni possono essere significative, come nella sanità o nella gestione finanziaria.

Incoraggiando un utilizzo etico dell’IA, lo standard mira anche a rispettare i diritti umani e ad adempiere alle normative vigenti, rafforzando la necessità di integrare considerazioni etiche fin dalle fasi iniziali della progettazione e dello sviluppo dei sistemi di IA. Questo approccio proattivo aiuta a prevenire problemi legati alla privacy e alla sicurezza dei dati, garantendo che i sistemi di IA operino in modo sicuro e rispettoso della privacy degli individui.

ISO/IEC 42001 fornisce quindi una guida chiara su come le organizzazioni possono strutturare i loro sistemi di gestione dell’IA per affrontare e minimizzare i rischi, promuovendo al contempo un’innovazione responsabile. Questo standard non solo migliora la sicurezza e la fiducia nei sistemi di IA ma contribuisce anche a stabilire una base solida per la crescita sostenibile e etica delle tecnologie emergenti.

L’impegno verso lo standard ISO/IEC 42001 riflette una maturità organizzativa che riconosce l’importanza di integrare principi di responsabilità e sicurezza nell’uso dell’intelligenza artificiale. La guida metodologica offerta dallo standard fornisce un percorso chiaro per le organizzazioni che desiderano assicurare che il loro utilizzo dell’IA sia non solo innovativo ma anche in linea con i valori etici e le normative vigenti.

Il processo di allineamento a questo standard non è solo una misura precauzionale; è un investimento strategico che può differenziare un’organizzazione sul mercato, migliorare la fiducia del cliente e della società civile, e ridurre il rischio legale e operativo. Inoltre, l’approccio strutturato per la gestione dei rischi e la compliance, nonché per il monitoraggio e il miglioramento continuo delle pratiche di IA, si traduce in un ciclo di gestione che perpetua l’innovazione e la crescita sostenibile.

L’integrazione di un modello di governance come quello promosso dall’ISO/IEC 42001 può anche catalizzare ulteriori innovazioni all’interno delle organizzazioni, stimolando lo sviluppo di nuove soluzioni di IA che non solo rispettano i più alti standard di sicurezza e eticità, ma che sono anche progettate per superare le aspettative di tutte le parti interessate, dal cliente finale ai regolatori.

In conclusione, l’adozione di ISO/IEC 42001 rappresenta un passo fondamentale per le organizzazioni che aspirano a posizionarsi come leader nel campo dell’IA responsabile e sostenibile, proiettandole verso un futuro in cui tecnologia e etica si fondono in un unico, armonioso percorso di progresso tecnologico.

Articolo a cura di Francesco Capparelli e Lara Maugeri
Profilo Autore

Avvocato, Certified Ethical Hacker, Auditor di diversi schemi di certificazione (ISO/IEC 27001, ISO 22301, ISO 37001, ISO/IEC 20000-1, ISO 9001) e Project Manager. Chief Cybersecurity Advisor di ICT Cyber Consulting, Quality and Information Security Manager di ICTLC S.p.A., Of Counsel di ICT Legal Consulting, membro del CdA dell’Istituto Italiano per la Privacy e la Valorizzazione dei Dati e Senior Fellow Researcher nel framework Horizon Europe.
Autore di manuali, pubblicazioni e articoli scientifici sui temi relativi alla data protection e alla sicurezza informatica.
Profilo Autore

Cyber Security Specialist – ICT Cyber Consulting

Laurea Magistrale in Scienze Filosofiche all’Università di Catania. Certificazioni CISCO: IT Support, Cyber Security & Networking.

Condividi sui Social Network:

https://www.ictsecuritymagazine.com/articoli/iso-iec-42001-un-sistema-di-gestione-dellintelligenza-artificiale/

OpenAI lancia GPT-4 “omni”, il chatbot che parla come una persona (anche in italiano)

Nemmeno il buon Steve Jobs avrebbe potuto riassumere così bene l’evoluzione di un prodotto o un servizio. È bastato aggiungere una “o” per sintetizzare il potenziale di GPT, e quindi di ChatGPT. Il LLM di OpenAI adesso è “omni”, ossia “tutto”. GPT-4o è un passo in avanti importante, se non fondamentale, nelle strategie non solo dello sviluppatore più cool del momento ma per tutta la comunità di appassionati di intelligenza artificiale. Un modo per anticipare quello che verrà poi, l’era dell’AGI, l’artificial general intelligence, che promette meraviglie. Si declinerà in GPT-5? Non lo sappiamo ma per adesso il balzo nella comprensione e restituzione di un contenuto da parte di un software è già arrivato a livelli umanamente accettabili, come dimostrano recenti ricerche del MIT.

Più veloce ed economico

Il modello aggiornato “è molto più veloce” e migliora “le funzionalità di testo, visione e audio”, ha affermato Mira Murati, CTO di OpenAI nella presentazione in diretta streaming. Sarà gratuito per tutti gli utenti free e a pagamento, che continueranno ad “avere fino a cinque volte i limiti di capacità” di chi usa ChatGPT senza sborsare un euro. In un post, OpenAI ricorda che le funzionalità di GPT-4o “saranno implementate in modo iterativo”, ma le sue funzionalità di testo e immagini sono già state integrate sin da subito in ChatGPT.

Il CEO di OpenAI, Sam Altman, ha sottolineato che il modello è “nativamente multimodale”, il che significa che può generare contenuti o comprendere comandi tramite voce, testo o immagini. Un concetto che è stato utilizzato qualche settimana fa anche da Meta per descrivere Meta AI a bordo degli ultimi modelli di Ray-Ban: un software che riesce a riconoscere ciò che si trova intorno per rispondere alle domande degli utenti, del tipo: “Di che monumento si tratta”?. Gli sviluppatori che vogliono armeggiare con GPT-4o avranno accesso all’API, che costa la metà ed è due volte più veloce di GPT-4 Turbo.

Arriva “Her”

Trasferendo le opportunità di “omni” su smartphone, la sensazione è quella di interagire con un assistente vocale in stile “Her”, dell’omonimo film di Spike Jonze. L’app potrà agire, rispondendo in tempo reale e osservando il mondo che ci circonda. Ciò va oltre l’attuale modalità vocale che è più limitata, risponde a un messaggio alla volta e funziona solo con la voce e non, ad esempio, tramite fotocamera e contenuti in upload. Gpt-4o permetterà inoltre a ChatGPT di riconoscere le emozioni nella voce dell’utente, generando in questo modo risposte con toni adeguati. In una demo, l’IA ha letto una storia per bimbi, cambiando tono e velocità a seconda dei vari passaggi narrativi.

L’AI Act cosa prevede in merito? Ad oggi, il divieto di carpire le emozioni solo sul luogo di lavoro e nell’ambito scolastico quindi niente che abbia a che fare con un uso “domestico” della tecnologia. Questa nuova funzionalità di GPT-4o sarà presto sotto la lente di ingrandimento del Garante Privacy italiano ed europeo?

Un aspetto importante, soprattutto per gli utenti al di fuori dagli Stati Uniti, è che Gpt-4o mostra un netto miglioramento rispetto a Gpt-4 Turbo nella gestione di testi in lingue diverse dall’inglese. Ecco qui sotto un esempio in italiano.

Business is business

Altman ha riflettuto sulla strategia di OpenAI successivamente all’evento live streaming di lancio di “omni”. Il manager ha confermato che la visione originale dell’azienda era quella di “creare un’AI generale che desse beneficio a più persone”, ora però la situazione è cambiata. Il punto focale sembra essersi spostato sul ritorno economico di un investimento che non è per niente banale. Non a caso, OpenAI è stata criticata per non rendere disponibili in open source i suoi modelli avanzati di intelligenza artificiale, puntando su API a pagamento e uno store di chatbot personalizzabili.

Prima di GPT-4o, alcune fonti americane parlavano della possibilità che la compagnia stesse preparando un motore di ricerca per rivaleggiare con Google. Niente di più sbagliato: nella corsa all’intelligenza artificiale, OpenAI guarda verso orizzonti più ampi. Ad ogni modo, “omni” è arrivato esattamente 24 ore prima della partenza della Google I/O 2024 di stasera, dove l’AI non sarà un ingrediente ma la pietanza principale di una ricca cena.

https://www.key4biz.it/openai-lancia-gpt-4-omni-il-chatbot-che-parla-come-una-persona-anche-in-italiano/490215/


Bias nell’Intelligenza Artificiale: Strategie e Norme ISO per la Valutazione e il Controllo

I sistemi AI trovano ormai dilagante applicazione in ogni ambito della nostra vita e cultura attraverso, ad esempio, i modelli di Machine Learning (ML), ma, come molte volte accade, non si hanno informazioni chiare su come il modello abbia “imparato” e prodotto un determinato output.

Ecco, quindi, come un sistema di gestione dedicato all’AI può costituire un importante strumento a supporto di una corretta governance e controllo di tali modelli.

A tal proposito, la norma ISO 42001:2023 introduce molti di questi concetti, come nel caso della clausola 9.1, che individua proprio gli indicatori dedicati, o dei controlli previsti dall’Allegato A, che riportano la necessità di avere la contezza dei risultati: i controlli della classe A.6.2, da esempio, richiedono la verifica e la validazione delle misure.

Altro punto focale, sempre oggetto di richiamo quando si ragiona in punto di sistemi intelligenti, è quello che va a toccare i concetti di analisi dei rischi e di valutazione d’impatto.

A supporto dello standard ISO/IEC 42001:2023 Sistema di Gestione dell’AI ci sono altre norme che guidano ad una corretta analisi e implementazione dei controlli, quali

  • la norma ISO/IEC 42005 – Tecnologia dell’informazione — Intelligenza artificiale (AI) Valutazione d’impatto dei sistemi IA, e
  • la ISO/IEC 23894, Information technology — Artificial intelligence — Risk Management.

Con riferimento, specificamente, ai modelli di ML e alla loro verifica, possono venire in aiuto alcune norme dedicate, comprese quelle sulla qualità dei dati, come ad esempio:

  • ISO/IEC 4213 Information technology — Artificial intelligence — Assessment of machine learning classification performance,
  • ISO/IEC 6254 Information technology — Artificial intelligence — Objectives and approaches for explainability of ML models and AI systems,
  • ISO/IEC 23053 Framework for Artificial Intelligence (AI) Systems Using Machine Learning (ML), e
  • ISO/IEC 5259 1-5 Data quality for analytics and machine learning (ML) ISO/IEC 5339.

Dal momento che, come si è accennato ed è ormai noto, una delle problematiche intrinseche più rilevanti dei sistemi algoritmici è – a tutt’oggi – costituita dalla loro opacità e scarsa comprensibilità, è evidente come sia sempre più necessario affidarsi a specifiche metodologie al fine di meglio comprendere la correttezza del modello in uso.

Ancora di più se si pensa ad un ulteriore aspetto di complessità dell’AI, ossia quello che coinvolge la distorsione algoritmica o bias, intesa come forma di distorsione cognitiva causata dal pregiudizio in grado di influenzare ideologie, opinioni e comportamenti. Il bias è, per semplificare, un errore nel processo di apprendimento che deriva da assunzioni errate.

Con il precipuo scopo di indagare tale specifico aspetto è nata la ISO 24027:2021, che descrive metodologie e meccanismi per scoprire e trattare i bias nei sistemi di intelligenza artificiale, che vengono descritti, nelle definizioni, come:

  • “bias”, ossia una differenza sistematica nel trattamento[1] di determinati oggetti, persone o gruppi rispetto ad altri;
  • “bias cognitivo umano”[2], che si verifica quando gli esseri umani elaborano e interpretano le informazioni;
  • “bias di conferma”, quel tipo di bias cognitivo umano che favorisce le previsioni dei sistemi di intelligenza artificiale che confermano credenze o ipotesi preesistenti.

Nel documento si analizzano varie fonti di distorsioni indesiderate nei sistemi di AI, ricondotte a 3 categorie principali (distorsioni cognitive umane; distorsioni dei dati; distorsioni introdotte da decisioni ingegneristiche), così come il trattamento delle stesse durante i singoli stadi del ciclo di vita del sistema intelligente, a partire dalla raccolta dei dati, per passare alla progettazione, allo sviluppo, alle fasi di test e. arrivare al monitoraggio e alla validazione continui.

Sebbene si tenda ad attribuire al concetto di distorsione sempre un’accezione negativa, la norma in oggetto apre spiegando che, in realtà, gli effetti dei bias possono essere positivi, neutri o negativi, come si è cercato di sintetizzare nella tabella che segue:

Effetto positivo L’introduzione di errori/bias può servire a raggiungere un risultato equo. Ad esempio, l’introduzione di una distorsione nella fase decisionale di un processo di selezione di personale con date caratteristiche al fine di compensare “tare” nei data set dovute alla sottorappresentazione consolidata nel tempo di tali professionalità.
Effetto neutro La distorsione porta il sistema intelligente a classificare erroneamente un dato elemento, ma senza impatti particolari. Ad esempio, una vettura a guida autonoma riconosce come ostacolo un cassonetto, ma lo classifica erroneamente come idrante.
Effetto negativo Il bias porta con sé conseguenze indesiderate (etici o non ricadenti su profili etici) Ad esempio, può limitare le opportunità delle persone interessate (distorsioni che favoriscono candidati di un sesso piuttosto che di un altro) o incidere negativamente nella classificazione di qualcosa (es. una galassia)

Ciò premesso, resta tuttavia evidente come la perplessità prevalente relativa ai pregiudizi sia la facilità con cui gli stessi possono propagarsi in un sistema, a cui corrisponde – per contro – la difficoltà di riconoscerli e mitigarli. Tale aspetto va peggiorando tanto più il sistema è automatizzato (e tante più AI contribuiscono all’automazione), poiché in tal caso la supervisione umana diventa sempre meno efficace e, quindi, i bias negativi (anche involontari) trovano una facile via di sopravvivenza.

È bene evidenziare come mentre è decisamente probabile che in un sistema possano essere rintracciate più fonti di bias contemporaneamente, è, invece, assai improbabile che l’analisi di un sistema possa rilevarli tutti.

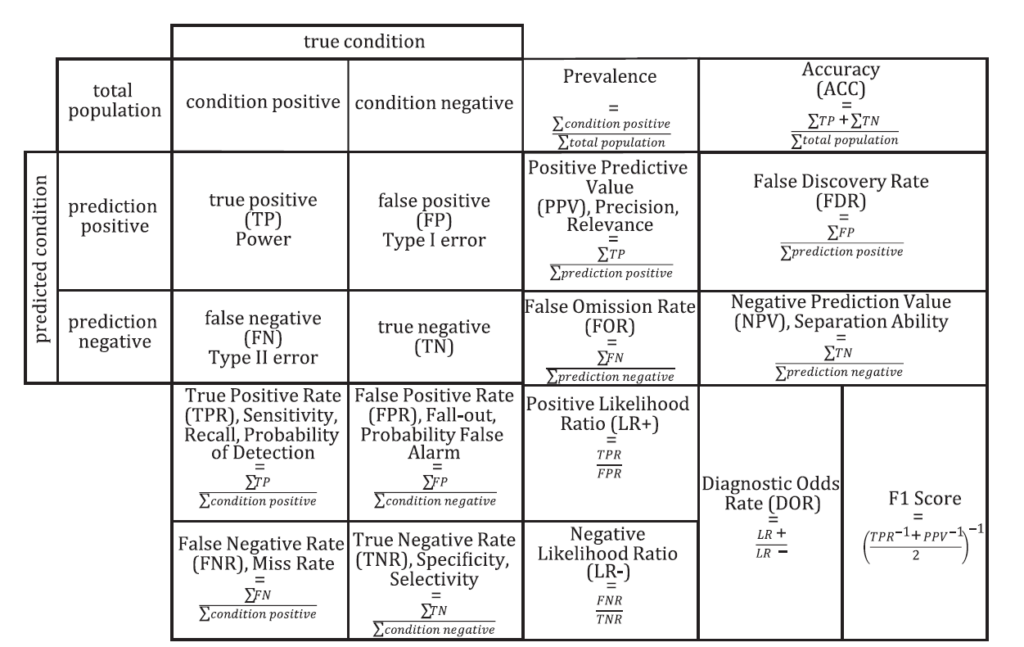
Alla luce di tutto quanto sopra descritto e in particolare con riferimento alle metodologie applicabili, si ritiene, quindi, di una certa utilità soffermarsi sulla cd. “matrice di confusione”, che costituisce uno strumento per analizzare gli errori compiuti da un modello di machine learning.

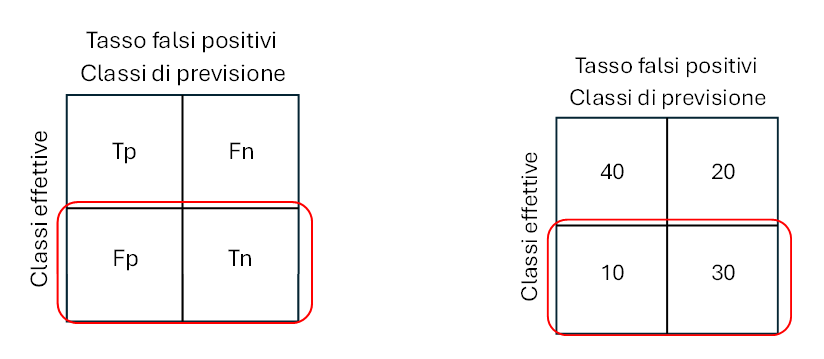
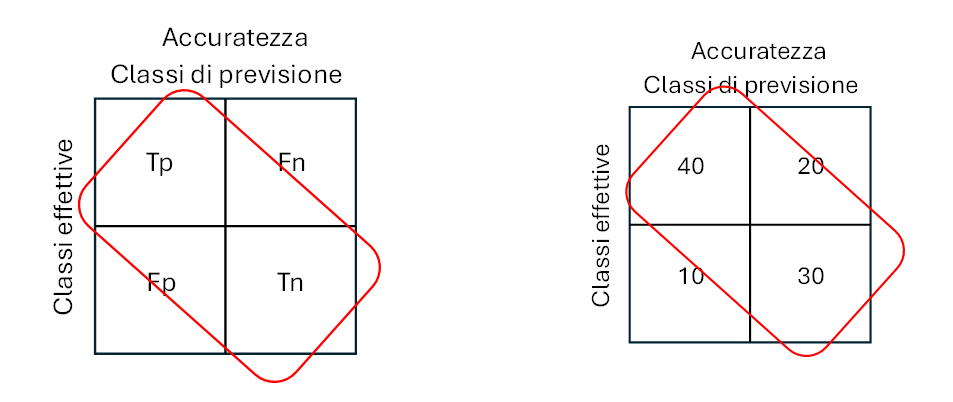
Nello specifico, come evidenzia la ISO 24027:2021, tale matrice riporta il numero di falsi positivi, falsi negativi, veri positivi e veri negativi e include ulteriori criteri di prestazione derivati da questi valori, come riportato nell’immagine seguente

Poiché una matrice di confusione contiene e confronta più parametri, consente un’analisi dettagliata delle prestazioni di un classificatore ed è utile per aggirare o scoprire i punti deboli dei singoli parametri.

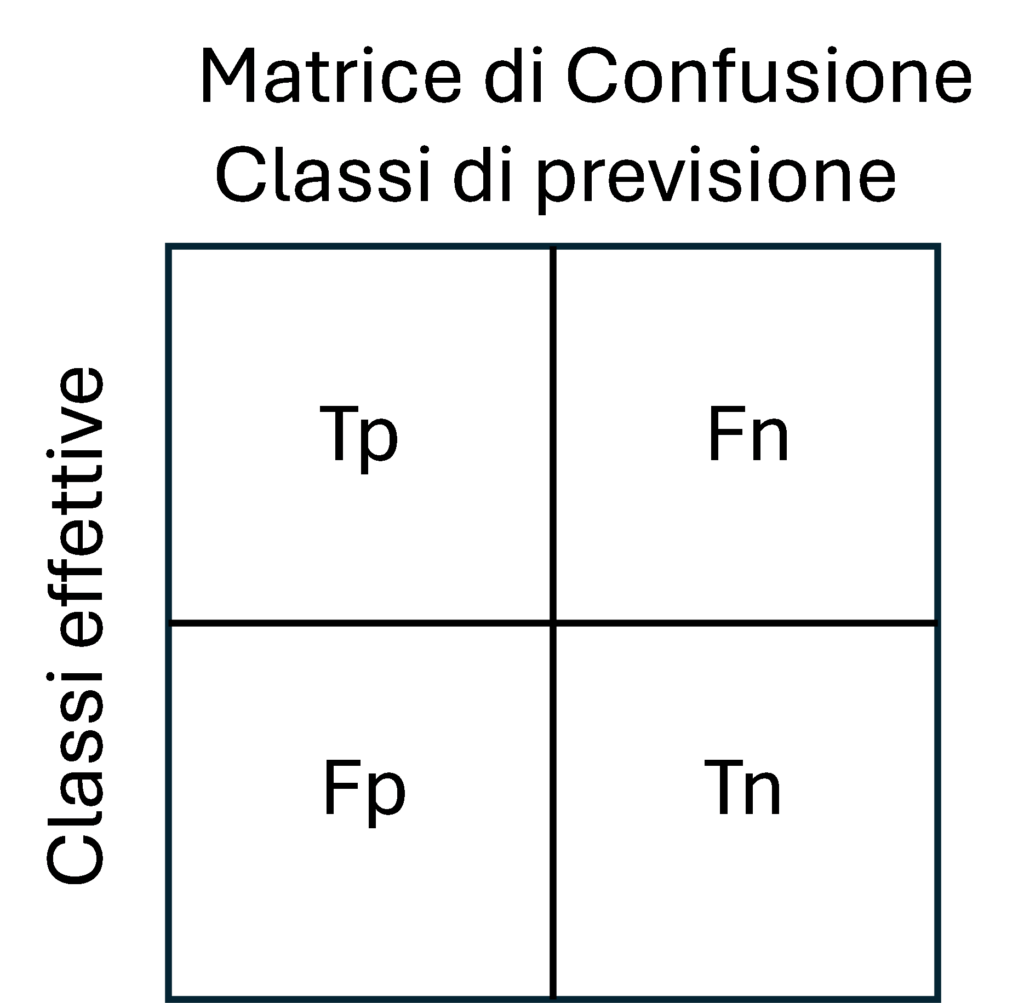
Consideriamo per semplicità un classificatore binario dove le classi si identificano con SI e NO.

Figura 1: la matrice di confusione

Dove Tp = Veri Positivi, Fn = Falsi Negativi, Fp = Falsi Positivi e Tn = Veri Negativi.

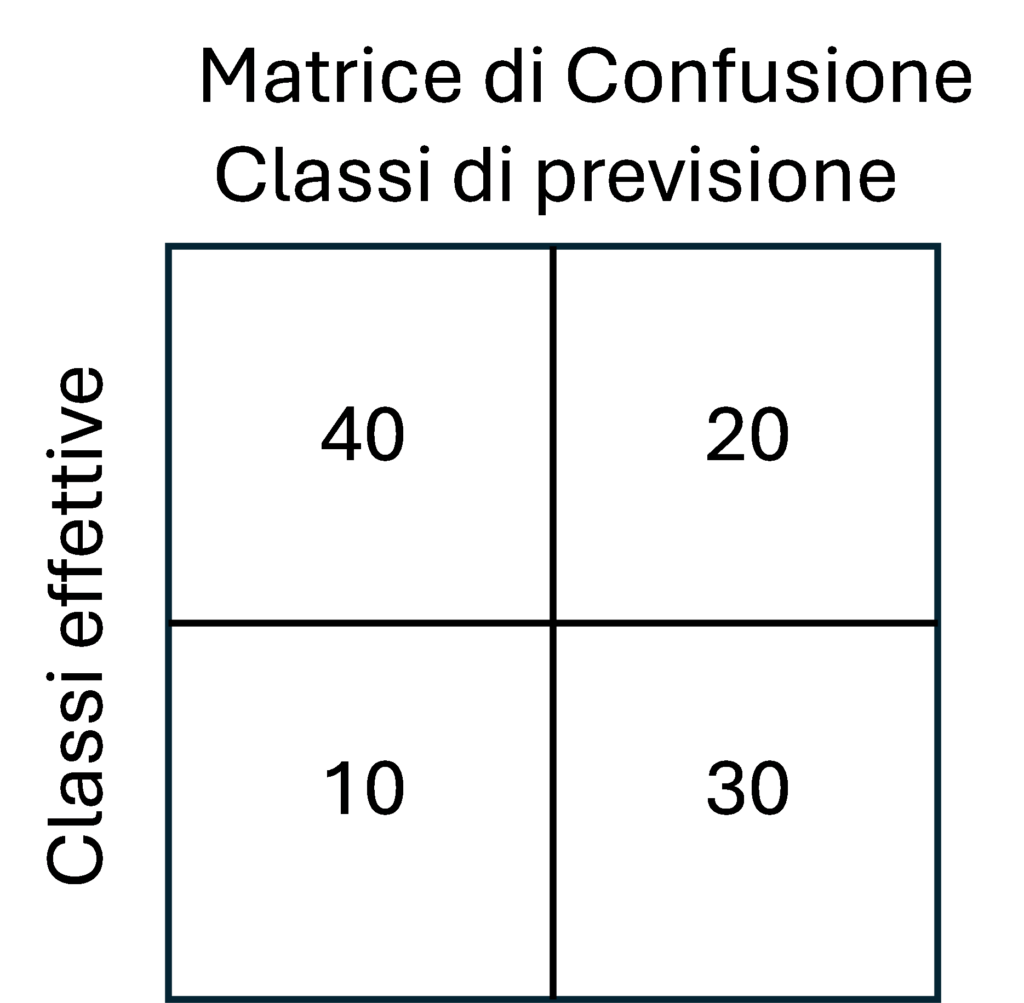
Ad esempio, il modello analizza 100 risultati (identificazione di immagini di animali: cane e gatto) e le classifica come risultati veri o falsi. In 70 casi il modello classifica correttamente (cani) mentre in 30 sbaglia (gatti).

Figura 2: esempio di numerica nella matrice.

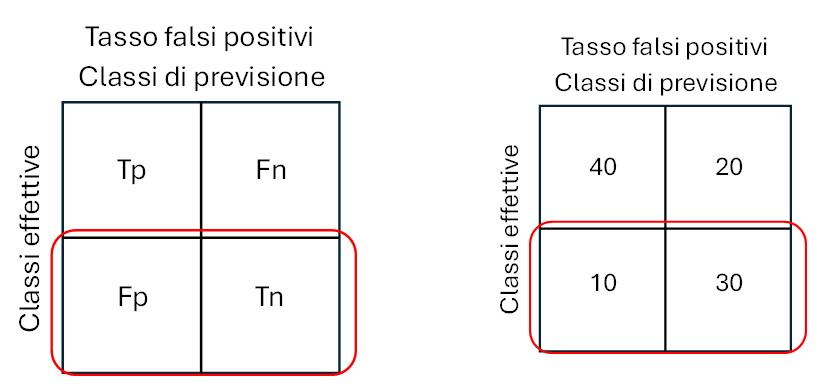
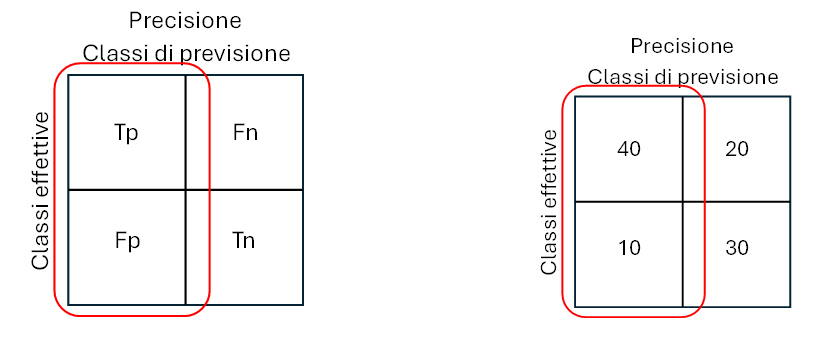
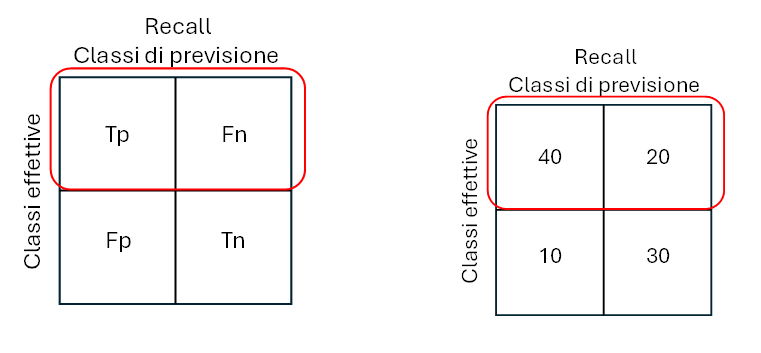
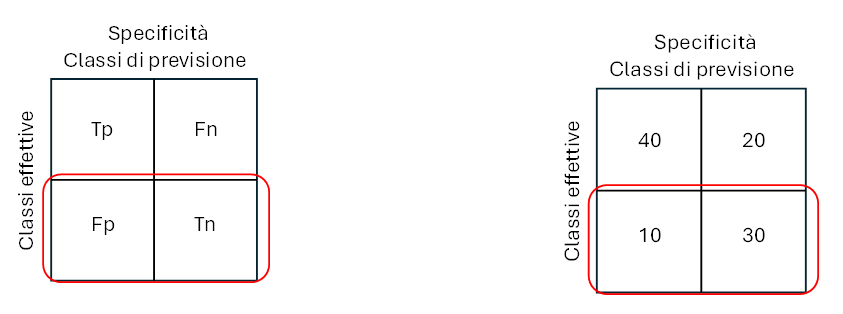
Come indicato nella figura 1, possono verificarsi quattro casi:

  • True positive (Tp)
    Se la classe prevista è SI nella prima riga e prima colonna ed è uguale alla classe effettiva il modello ha risposto correttamente SI.
  • True negative (Tn)
    Se la classe prevista è NO nella seconda riga e seconda colonna ed è uguale alla classe effettiva, il modello ha risposto correttamente NO.
  • False positive (Fp)
    Se la classe prevista è SI ma è diversa dalla classe effettiva, quindi nella seconda riga e prima colonna, il modello ha sbagliato a rispondere SI.
  • False negative (Fn)
    Se la classe prevista è NO ma è diversa dalla classe effettiva, cioè prima riga e seconda colonna, il modello ha sbagliato a rispondere NO.

Per soddisfare anche i controlli delle norme e le guide dalle norme ISO sopra citate è opportuno introdurre le metriche di una matrice di confusione.

  • Accuratezza: l’accuratezza complessiva del modello, definita come il rapporto tra le previsioni corrette e il numero totale di previsioni. Indica la proporzione di esempi che sono stati previsti correttamente.
  • Precisione: la precisione del modello, definita come il rapporto tra i veri positivi e il numero totale di esempi previsti come positivi. Indica la proporzione di esempi previsti come positivi e che sono effettivamente positivi.
  • Richiamo: il richiamo del modello, definito come il rapporto tra i veri positivi e il numero totale di esempi effettivamente positivi. Indica la proporzione di esempi positivi che sono stati previsti correttamente come positivi.
  • Punteggio F1: il punteggio F1 è una media ponderata della precisione e del richiamo ed è calcolato come. Fornisce un’unica metrica che bilancia sia la precisione che il richiamo.
  • Specificità (Specificity):La specificità rappresenta la proporzione di veri negativi rispetto al totale delle istanze negative effettive. Misura quanto il modello è bravo a identificare le istanze negative.
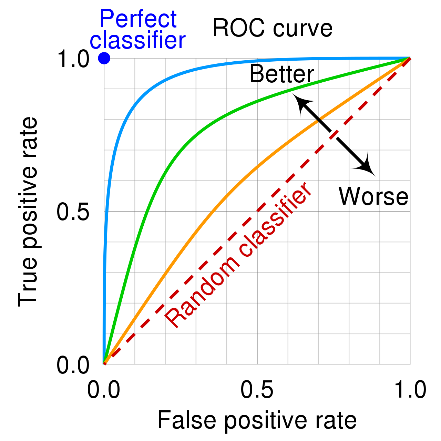
  • ROC Curve (Receiver Operating Characteristic Curve):La curva ROC è un grafico che mostra la relazione tra il tasso di veri positivi e il tasso di falsi positivi al variare della soglia di classificazione. A mano a mano che la soglia varia, i punti ROC vengono disegnati e collegati, e l’area sotto la curva ROC (AUC) può essere utilizzata come misura dell’efficacia del modello.

Accuratezza

L’accuratezza misura la percentuale delle previsioni esatte sul totale delle istanze. È l’inverso del tasso di errore. È compreso tra 0 (peggiore) e 1 (migliore). Essa indica quante volte il nostro modello ha correttamente classificato un item nel nostro dataset rispetto al totale.

Infatti, la formula per l’accuratezza è la divisione tra numero di risposte corrette e il totale delle risposte. Vale a dire che non ci permette di comprendere il contesto nel quale stiamo operando.

Deve essere sempre considerata nel contesto del modello. Ad esempio, è sconsigliato usare la accuratezza come metrica di valutazione quando operiamo con un dataset sbilanciato, dove le classi sono distribuite in maniera impari. Se la accuratezza non è altro che il rapporto tra risposte corrette sul totale, allora se una classe compone il 90% del nostro dataset e il nostro modello (erroneamente) classifica ogni esempio nel dataset con quella classe specifica, allora la sua accuratezza sarà del 90%.

Si potrebbe quindi pensare che il modello sia molto performante, quando in realtà è molto lontano dall’esserlo.

ACC = (Tp+Tn)/(Tp+Tn+Fp+Fn) = 1 – ERR (1)

Figura 3: Accuratezza, nell’esempio Accuratezza = (40+30)/(40+20+10+30)= 70%

dove ERR è il tasso di errore, cioè, misura la percentuale di errore delle previsioni sul totale delle istanze. È compreso tra 0 (migliore) e 1 (peggiore).

ERR = (Fp+Fn)/(Tp+Tn+Fp+Fn) (2)

Figura 4: Tasso errore, nell’esempio, Tasso di errore = (20+10)/(40+20+10+30)= 30%

Precisione

La precisione è la percentuale delle previsioni positive corrette (Tp) sul totale delle previsioni positive del modello (giuste Tp o sbagliate Fp).

La precisione non è altro che l’accuratezza calcolata solo per classi positive. Essa è anche chiamata specificità positiva poiché definisce quanto sensibile è uno strumento quando c’è il segnale da riconoscere. Di fatto, la metrica ci informa quanto spesso siamo corretti quando classifichiamo una classe come positiva.

Un modello con alta precisione ci allerterà poche volte, ma quelle volte che lo farà possiamo essere abbastanza sicuri che si tratti veramente di un dato inteso come intruso.

Pr = Tp/(Tp+Fp) (3)

Figura 5: Precisione nell’esempio, Precisione = 40/(40+10) =80%

Richiamo o sensitività

Il richiamo o sensitività è la percentuale delle previsioni positive corrette (Tp) sul totale delle istanze positive. È compreso tra 0 (peggiore) e 1 (migliore). Se siamo interessati a riconoscere quanti più classi positive possibili, allora il nostro modello dovrà avere un richiamo alto.

In pratica significa che qui dobbiamo tener conto dei falsi negativi invece dei falsi positivi. Il richiamo viene anche chiamato sensibilità perché all’aumentare del richiamo, il nostro modello diventa sempre meno preciso e classifica anche classi negative come positive.

Un modello ad alta precisione è conservativo, ma introduce anche molto rumore di fondo.

Risulta quindi impossibile avere un modello con alta precisione e alto richiamo. Infatti, queste due metriche sono complementari: se aumentiamo una, l’altra deve diminuire. Si tratta del precision/recall trade-off.

Rec = Tp/(Tp+Fn) (4)

Figura 6: Richiamo nell’esempio, Recall = 40/(40+20) = 67%

Specificità

La specificità è la percentuale delle previsioni negative corrette (Tn) sul totale delle istanze negative. È compresa tra 0 (peggiore) e 1 (migliore).

Sp = Tn/(Tn+Fp) (5)

Figura 7: Specificità nell’esempio, Specificità = 30/(10+30) = 75%

Tasso dei falsi positivi

Il tasso dei falsi positivi (False Positive Rate) è la percentuale delle previsioni positive errate (Fp) sul totale delle istanze negative. Compreso tra 0 (migliore) e 1 (peggiore).

Fpr = Fp/(Tn+Fp) (6)

Figura 8: Tasso dei falsi positivi nell’esempio, Tasso falsi positivi = 10/(10+30) = 25%

Punteggio F

Il punteggio F (F-Score) è la media armonica delle metriche Precision e Recall. Varia da 0 (peggiore) a 1 (migliore).

A questo punto è chiaro che usare precisione o richiamo come metrica di valutazione è difficile perché possiamo solo usarne una a scapito dell’altra. Il punteggio F1 risolve proprio questo problema. Il punteggio F1 combina precisione e richiamo in una sola metrica. Questa è la media armonica di precisione e richiamo, ed è probabilmente la metrica più usata per valutare modelli di classificazione binaria. Se il punteggio F1 aumenta, vuol dire che il modello ha aumentato le performance per precisione, richiamo o per entrambi

F1 = (2* Rec*Pre)/Rec+Pre (7)

Nell’esempio: Punteggio F = (2*Recall*Precisione)/(Recall+Precisione) = 0.73 (8)

ROC-AUC

La metrica ROC-AUC si basa su una rappresentazione grafica della curva ROC (receiving operating characteristic curve).

“le curve ROC […] sono degli schemi grafici per un classificatore binario. Lungo i due assi si possono rappresentare la sensibilità e (1-specificità), rispettivamente rappresentati da True Positive Rate (TPR, frazione di veri positivi) e False Positive Rate (FPR, frazione di falsi positivi). In altre parole, si studiano i rapporti fra allarmi veri (hit rate) e falsi allarmi.” Tratto da Wikipedia

Figura 9: Curva ROC

AUC significa Area Under the Curve (area al di sotto della curva). Se poniamo l’attenzione sulla linea blu, vediamo che al di sotto di essa c’è di fatto una area più grande rispetto alle linee verde arancione. La linea tratteggiata indica una metrica di ROC-AUC del 50%.

Di conseguenza un buon modello avrà una ROC-AUC grande, mentre un modello scarso si posizionerà vicino alla linea tratteggiata, che non è altro che un modello che risponde in maniera casuale.

La metrica ROC-AUC è anche molto utile per confrontare diversi modelli uno contro l’altro.

Coefficiente di correlazione di Matthews (MCC)

Questo serve per valutare correttamente anche modelli addestrati su dataset non bilanciati.

La formula si comporta come un coefficiente di correlazione. Essa è compresa tra +1 e -1. Un valore che tende a +1 misura la qualità delle predizioni del nostro classificatore anche in contesti con classi sbilanciate nel dataset, poiché indica una correlazione tra valori reali osservati e previsioni fatte dal nostro modello.

MCC = [(Tp*Tn)-(Fp*Fn)]/ Ö[(Tp+Fp)*(Tp+Fn)*(Tn+Fp)*(Tn+Fn)] (9)

Ma possiamo fare un ulteriore passo avanti.

Possiamo introdurre, altri calcoli di verifica, coinvolgendo calcoli algebrici e la meccanica quantistica. In particolare, introduciamo il quadrato di un binomio

(a+b)2 = a2+ b2+2*a*b (10)

dove, i quadrati sono considerati la probabilità di accadimento e il doppio prodotto è l’interferenza.

Quindi possiamo estendere le formule sopra citate (recall, sensibilità, etc.) e considerando il rapporto tra il doppio prodotto e la somma dei quadrati

2ab/a2+b2 (11)

ottenendo:

Precisione:

InPr = (2*Tp*Fp)/(Tp2+Fp2), che nell’esempio assume il valore 0.47 (12)

Recall:

InRec = (2*Tp*Fn)/(Tp2+Fn2), che nell’esempio assume il valore 0.8 (13)

Specificità:

InSp = (2*Tn*Fp)/(Tn2+Fp2), che nell’esempio assume il valore 0.6 (14)

Queste formule forniscono il rapporto tra l’interferenza e la somma di probabilità.

Per concludere, dunque, per raggiungere una visione ed un controllo completi dei sistemi di intelligenza artificiale, pare imprescindibile puntare alla conoscenza tanto della parte umanistica, etica, psicologica e giuridica, quanto della componente più prettamente tecnica, che a sua volta non potrà prescindere dal supporto fornito dagli standard di settore, in parte qui analizzati.

Note

[1] Il trattamento è qualsiasi tipo di azione, inclusa la percezione, l’osservazione, la rappresentazione, la previsione o la decisione.

[2] i pregiudizi cognitivi umani influenzano il giudizio e il processo decisionale.

Articolo a cura di Stefano Gorla e Avv. Anna Capoluongo

Profilo Autore

Consulente e formatore in ambito governance AI, sicurezza e tutela dei dati e delle informazioni;
Membro commissione 533 UNINFO su AI; Comitato di Presidenza E.N.I.A.
Membro del Gruppo di Lavoro interassociativo sull’Intelligenza Artificiale di Assintel
Auditor certificato Aicq/Sicev ISO 42001, 27001, 9001, 22301, 20000-1, certificato ITILv4 e COBIT 5 ISACA, DPO Certificato Aicq/Sicev e FAC certifica, Certificato NIST Specialist FAC certifica,
Referente di schema Auditor ISO 42001 AicqSICEV.
Master EQFM. È autore di varie pubblicazioni sui temi di cui si occupa.
Relatore in numerosi convegni.

Profilo Autore

Avvocato Data Protection & ICT | Data Protection Officer UNI 11697 | membro dell’EDPB’s Support Pool of Experts | Membro Women For Security | Membro Osservatorio sulla Giustizia Civile Tribunale Milano (Gruppo sul danno da illecito trattamento dei dati personali) | Afferente B-ASC (Università Milano-Bicocca Applied Statistics Center) | Vicepresidente Institute for Research of Law Economical and Social Studies| Membro Gruppo di Lavoro sull’AI di ANORC | Docente a c. (Università di Padova, Sole24Ore Business School), Comitato di Presidenza E.N.I.A.

Condividi sui Social Network:

https://www.ictsecuritymagazine.com/articoli/bias-nellintelligenza-artificiale-strategie-e-norme-iso-per-la-valutazione-e-il-controllo/


“The Hardest Part” è il primo video musicale realizzato da Sora di OpenAI. L’inizio di un business a costo zero per le case di discografiche?

Il musicista di musica elettronica Ernest Weatherly Greene, più noto con lo pseudonimo Washed Out, torna con un album quest’anno e ad anticiparlo c’è una canzone, The Hardest Part, che sta facendo parlare di sé ancor prima che per la musica per il suo videoclip.

Il video è stato realizzato con Sora, il software AI che permette di creare prodotti audiovisivi a partire da un testo scritto che ne fornisce di fatto la sceneggiatura. Non è il primo prodotto di questo tipo realizzato con il software ma, a quanto pare, è la prima collaborazione ufficiale tra l’OpenAI, un musicista e un filmmaker.

Il video è stato “generato” dal regista Paul Trillo per un motivo molto semplice: abbattere i costi di produzione che sarebbero stati inevitabilmente più elevati se Trillo avesse interpellato attori “in carne e ossa” per girare le varie scene. L’inizio di un business a costo zero per le case di produzione?

È evidente che la nascita di strumenti avanzati come Sora sono destinati a cambiare il settore della produzione video. Questo suscita da una parte preoccupazione in coloro che svolgono un’attività professionale facilmente sostituibile da strumenti basati sull’AI. L’inizio di un business a costo zero per le case di produzione?

[embedded content]

https://www.key4biz.it/the-hardest-part-e-il-primo-video-musicale-realizzato-da-sora-di-openai-linizio-di-un-business-a-costo-zero-per-le-case-di-produzione/489643/


xAI, possibile fundraising da 18 miliardi di dollari. La startup di Musk pronta a sfidare OpenAI e Anthropic

xAI raccoglie investimenti e sfida OpenAI (sostenuta da Microsoft) e Anthropic (Amazon e Alphabet)

Un anno fa le prime voci lanciate sul Financial Times, poi è seguito l’annuncio ufficiale di Elon Musk sul suo social X circa sei mesi dopo, con un post dedicato, oggi infine le prime indicazioni sul round di finanziamento della sua startup xAI che, secondo Bloomberg, potrebbe avvicinarsi ai 18 miliardi di dollari di valore.

I round di investimento sono momenti chiave per le startup, in cui riescono a raccogliere finanziamenti da investitori esteri finalizzati a sostenere la crescita sui mercati.

Ovviamente, xAI punta a sfidare OpenAI (in cui ha fortemente investito Microsoft) e Anthropic (dove hanno investito Alphabet e Amazon) in questo mercato in forte accelerazione e Grok è il suo primo modello di punta e si contrapporrà direttamente a ChatGPT e Gemini (ex Bard).

A fine marzo 2024 è stata presentata la versione 1,5 di Grok, con tanto di tabella di confronto con Mistral Large, Claude 2-3, ChatGPT 4, Gemini Pro-1,5

Secondo persone informate dei fatti, ha riportato Bloomberg News, il volume degli investimenti raccolti non è ancora ben definito, ma potrebbe essere superiore ai 6 miliardi di dollari, raggiungendo così un cumulato di 18 miliardi. Tra i possibili investitori ci sono anche Sequoia Capital e (secondo il Financial Times) Morgan Stanley.

“Il round è ancora in corso e valutazioni e tempi possono ancora cambiare”, si legge sul sito. La notizia girava da qualche settimana sulla stampa, ma a quanto pare siamo agli ultimi passaggi.

L’accesso ai dati è a dir poco fondamentale per lo sviluppo di modelli linguistici di grandi dimensioni e per far addestrare chatbot basati su intelligenza artificiale, un settore su cui xAI punta molto (visto che Gork è il suo primo chatbot).

Musk non ha dubbi: “Grok superiore alle altre AI”, ma non sarà per tutti

Grok potrà accedere ai dati di X, ha spiegato Musk negli scorsi mesi, il che renderà questa AI superiore a tutte le altre, più curiosa, più veloce, più aggiornata (quasi dimenticando che il vero problema è la sua affidabilità, il livello di sicurezza, il rispetto dei diritti umani e la capacità di distinguere il vero dal falso, il reale dal fittizio).

Sempre secondo il patron di Tesla e dello stesso social media, Grok non sarà accessibile a tutti, ma solo ad un numero selezionato di utenti e in futuro a tutti coloro che attiveranno un abbonamento con la versione Premium di X (16 dollari al mese).

https://www.key4biz.it/xai-possibile-fundraising-da-18-miliardi-di-dollari-la-startup-di-musk-pronta-a-sfidare-openai-e-anthropic/489705/


AI e tecnologie quantistiche, call Ue da 112 milioni di euro

Pubblicato l’invito a presentare proposte nell’ambito del programma di la voro digitale, industriale e spaziale 2023-2024 di Orizzonte Europa per la due settori chiave per l’Unione europea: l’intelligenza artificiale (AI) e le tecnologie quantistiche.

La call avviata dalla Commissione europea potrà contare su risorse complessive per 112 milioni di euro, di cui 65 milioni per l’AI, 40 milioni di euro circa per le tecnologie quantistiche e 7,5 milion idi euro per una transizione digitale sostenibile dal punto di vista sociale e culturale.

Progetti per l’AI

I fondi disponibili per questa call dedicata all’intelligenza artificiale sono pari a 65 milioni di euro, di cui 50 milioni per la ricerca di soluzioni finalizzate allo sviluppo di nuove modalità di combinazione dei dati e all’espansione delle capacità dei modelli di intelligenza artificiale di grandi dimensioni.

Altri 15 milioni di euro saranno investiti nello sviluppo di modelli AI trasparenti e in grado di migliorare affidabilità e sicurezza degli stessi, soprattutto nei processi decisionali che sono alla base.

Tecnologie quantistiche

Qui la Commissione ha investito 40 milioni di euro. Di questi, 25 milioni saranno spesi per la creazione di una rete paneuropea di gravimetri quantistici (sensori di gravità), che fornirà misurazioni della gravità ad alta precisione, importanti per vari settori come l’osservazione della Terra e l’ingegneria civile.

Altri 15 milioni di euro saranno investiti in progetti transnazionali di ricerca e sviluppo nel campo delle tecnologie quantistiche di prossima generazione. Lo scopo di questa cooperazione è garantire che l’Unione europea rimanga in prima linea nella competizione in questo settore considerato strategico.

Per una transizione digitale con le persone al centro

Ulteriori 7,5 milioni di euro saranno, infine, destinati a progetti che sosterranno i valori europei e metteranno le persone al centro della trasformazione digitale.

Obiettivo primario in questa linea d’azione è operare per aumentare l’influenza dell’Unione europea nella standardizzazione globale delle tecnologie dell’informazione e della comunicazione.

https://www.key4biz.it/ai-e-tecnologie-quantistiche-call-ue-da-112-milioni-di-euro/489630/


A.I. tra “nebbie” e “nuvole”: L’intelligenza artificiale per lo sviluppo del Fog e Cloud Continuum

Introduzione al Cloud Continuum e all’Intelligenza Artificiale

La relazione tra intelligenza artificiale e cloud continuum è sempre più importante e rilevante nel panorama tecnologico attuale. L’intelligenza artificiale si basa sull’elaborazione di enormi quantità di dati e sulla capacità di apprendere e adattarsi in modo autonomo, mentre il cloud continuum offre un unico ecosistema formato da una vasta gamma di risorse di calcolo e di archiviazione accessibili da ovunque. Potremmo definire il Cloud Continuum un’esperienza senza soluzione di continuità tra l’elaborazione centralizzata e quella distribuita, tra data center on premise, cloud pubblici e privati, strutture fog e di edge computing, un’evoluzione che va oltre il concetto tradizionale di cloud computing. Non si tratta solo di una tecnologia ma di una topologia in cui molte tecnologie cloud vengono integrate creandone una nuova che collega tutto. Un connubio perfetto tra una tecnologia “affamata” di informazioni come l’I.A. e un’altra abilitante a tutte le informazioni.

Evoluzione del Cloud Computing: Fog e Edge Computing

Il Cloud Continuum mira quindi ad integrare e rendere trasparenti 3 componenti fondamentali delle tecnologie cloud: il cloud computing che riporta i dati a un server centrale per l’archiviazione e l’analisi, il fog computing e l’edge computing che consentono di eseguire analisi e altre funzioni ai margini della rete, localmente, proprio alla fonte dei dati.

L’intelligenza artificiale, finora sviluppatasi prevalentemente nel cloud computing, in questa nuova visione architetturale (Fig.1) si espande ulteriormente anche al Fog Computing ed all’Edge Computing, ambito fino ad ora utilizzato principalmente in sistemi locali basati sull’Internet delle Cose (IoT), progettati con l’obiettivo di ridurre il traffico di dati verso il cloud analizzando parte dei dati localmente ed inviando solo informazioni “semilavorate”, in modo da poter essere utilizzati anche in ambienti con bassa latenza e larghezza di banda.

In particolare l’utilizzo dell’I.A. nel Fog Computing sta emergendo come una soluzione sempre più interessante al problema dell’elaborazione dei dati nell’IoT, che nel frattempo si sta trasformando in AIoT (Artificial Intelligence+IoT), amplificando potenza e velocità di analisi rispetto ai dispositivi finali, essendo questa la componente più vicina ai dispositivi IoT rispetto alle risorse cloud più potenti.

Fig 1

L’integrazione dell’IA nella gestione delle risorse Cloud

Con l’aumento dell’utilizzo dell’I.A. e del Machine Learning (ML), a tutti i vari livelli, i carichi di lavoro del cloud, fog e edge computing stanno diventando sempre più diversificati e dinamici. La convergenza tra fog computing ed intelligenza artificiale, richiede però l’uso di una gestione più intelligente delle risorse.

Nelle tradizionali piattaforme di cloud computing, la gestione delle risorse viene effettuata utilizzando approcci euristici tradizionali senza considerare carichi di lavoro diversi e dinamici. La maggior parte di questi metodi si basa su statiche euristiche configurate offline per determinati scenari di carico di lavoro, che non sono in grado di scalare le applicazioni in fase di esecuzione in base al modello e al comportamento del carico di lavoro.

L’intelligenza artificiale sta entrando anche nei meccanismi di gestione dinamica delle risorse tra i vari stack, l’utilizzo di tecniche I.A./ML per ottimizzare le politiche di gestione delle risorse e potrebbero essere utilizzate per modellare e prevedere metriche a livello di applicazione ed infrastruttura, alfine di ottimizzare l’orchestrazione delle attività e delle risorse migliorando la qualità delle decisioni di provisioning, fino a predirle.

Il Futuro del Cloud Continuum e l’IA

Lo sviluppo del Cloud Continuum riveste così un aspetto fondamentale per gestire le nuove sfide allo sviluppo della futura generazione di applicazioni e servizi, un futuro dove l’utilizzo del cloud non sarà on demand ma permanente e costante e non riguarderà una singola problematica, informazione o file ma il “contesto”.

Per garantire questa costante permanenza nella nostra quotidianità, il cloud continuum deve necessariamente diventare più pervasivo, dalla domotica, all’automotive, dai device mobili ai social network, i contesti per il monitoraggio delle nostre vite diventano sempre più ampi, e l’integrazione di un’I.A. connessa al cloud in tutti i nostri sistemi e processi, sembra essere l’obiettivo a breve e medio termine.

L’I.A. diventa così il “driver” principale per uno sviluppo simbiotico con il Cloud Continuum, che non punta solo a migliorare la produttività e la qualità della nostra vita ma a cambiare definitivamente anche il modo di interagire, sostituendo tastiera e mouse con i sistemi conversazionali dell’I.A. generativa (LLM).

Uno dei primi esempi di integrazione pervasiva è sicuramente il chat bot CoPilot di Microsoft che essendo radicato nel sistema operativo, elimina le catene della limitazione del contesto. L’intero computer, ogni file e ogni dato diventa il contesto.

Dal processo di analisi olistico alla risoluzione avanzata di problemi, l’intera dinamica dell’interazione tra utenti e macchine cambia radicalmente, il cloud continuum entra, a pieno titolo, grazie all’intelligenza artificiale, nel loop decisionale delle nostre scelte.

Considerazioni sulla Sicurezza e l’Etica nel Cloud Continuum

Tutto quello che finora avevamo capito sugli algoritmi di profilazione, a volte eticamente discutibili, che spesso ci suggeriscono e condizionano nelle scelte, sta per svilupparsi in un ambito completamente nuovo: il contesto, che eclisserà i parametri tradizionali degli attuali algoritmi, con il potere derivante da un’intelligenza artificiale in grado di comprende ed utilizzare “il contesto” dei nostri dati e del nostro comportamento.

Una potenzialità senza eguali se paragonata alle tecnologie passate e tutto questo in un mondo dove gli esseri umani sono sempre più connessi, a gennaio 2024 circa 5,54 miliardi di persone in tutto il mondo utilizzano Internet, costituendo il 70,4% della popolazione mondiale (Fonte: Worldometer).

Il cloud continuum potrà permettere di accedere istantaneamente ai tutti nostri dati in tempo reale e alle nostre applicazioni ovunque ci troviamo, senza la necessità di complessi processi di migrazione e integrazione, aumenterà esponenzialmente la produttività in modo sempre più distribuito, efficiente e flessibile, utilizzando la potenza ottimale di calcolo disponibile negli ambienti cloud e multi-cloud.

Fig 2

Il cloud continuum permetterà all’I.A. di interconnettere ed analizzare tutte le informazioni a noi associate, qualsiasi nostra traccia digitale prodotta potrà essere collegata e correlata al nostro contesto (Fig.2).

Il cloud continuum con la sua struttura permette all’I.A. di sfruttare al meglio la sua componente più rivoluzionaria: i modelli linguistici di grandi dimensioni (LLM).

Gli LLM sono reti neurali artificiali che hanno una notevole capacità nell’elaborazione del linguaggio naturale, la generazione di linguaggi generici e altri compiti.

Nello specifico, questi modelli sono in grado di analizzare dati non strutturati, esattamente gli stessi che utilizza l’essere umano per comunicare e apprendere: testi, immagini, video, etc..

Nel 2023 il volume dei dati analizzati dalle I.A. è stato di circa 120 Zettabyte, (per avere un’idea delle dimensioni, uno Zettabyte corrisponde a circa 36000 anni di un video in HD), numero questo in costante crescita nei prossimi anni.

Di tutti i dati analizzati solo il 20% sono dati strutturati, il rimanente 80% appartiene a dati non strutturati: dati presi dai siti web di informazione, dai video di Youtube, da documenti nei repository open source fino ai post dei social network.

L’uso del Continuum Cloud, potenzialmente, permetterà all’I.A. di accedere a qualsiasi “forma” di dato, analizzarla e correlarla ai relativi contesti.

Lo sviluppo del Cloud Continuum permetterà inoltre ai modelli I.A. di crescere ed elaborare sempre più informazioni personali direttamente supervisionate da noi, immaginate ad es. Copilot di Microsoft a cui chiedete di generare documenti di presentazione, leggere mail di lavoro o personali, classificarle e magari ad alcune, rispondere. L’integrazione di un chat bot all’interno di un sistema operativo che è presente nel browser, negli strumenti di produttività, nei sistemi di posta e comunicazione, ha l’enorme vantaggio di poter addestrare l’I.A. a comprendere meglio il nostro modo di essere, il nostro pensiero, su cosa è corretto e sbagliato relativamente al nostro contesto. Questa interazione, che sarà sempre più continuativa e quotidiana, permetterà all’I.A. di evolvere più velocemente nella “comprensione” delle informazioni, seguendo un processo di crowdsourcing. Grazie al crowdsourcing (“folla” dall’inglese crowd) un gran numero di persone può partecipare attivamente a risolvere processi complessi suddividendoli in micro task, nel nostro caso è addestrare l’I.A. a comprendere ciò che analizza.

Ogni richiesta che noi facciamo all’I.A., ogni correzione concettuale che gli diamo, stiamo di fatto facendo del micro training all’I.A., la quale imparerà e condividerà la singola esperienza fatta con ognuno di noi nella sua capacità globale di rispondere alle esigenze di tutti e il Cloud Continuum gli permetterà di avere un’esperienza “sensoriale” su tutto il dominio cibernetico, costante ed in tempo reale.

Una nuova e rivista schiera di agenti virtuali si sta affacciando nel nostro mondo, da versioni sempre più “intelligenti” di assistenti come Siri, Google e Alexa ad assistenti smart con tante funzionalità di I.A. che porteremo sempre in tasca con noi (come ad es. Rabbit R1 – https://www.rabbit.tech/).

E’ inutile dire che tutto ciò porta inevitabilmente a dubbi e perplessità sulla sicurezza dei sistemi e sulla riservatezza e privacy delle informazioni. Alcuni vedono il cloud continuum come l’ennesima enfasi sulla centralizzazione dei dati e delle risorse informatiche, rendendo le organizzazioni ancora più dipendenti dalle grandi corporations che detengono e gestiscono queste enormi infrastrutture e l’integrazione con l’I.A. amplifica queste preoccupazioni.

Un Continuum Cloud che potrebbe facilitare la migrazione verso l’ambiente digitale, potrebbe contestualmente aprire a nuove vulnerabilità e minacce, rendendo le nostre informazioni più sensibili ancora più vulnerabili agli attacchi informatici e alla violazione della privacy, ambienti gestiti da entità esterne di cui non si conosce veramente l’affidabilità e la sicurezza.

Se consideriamo le ingenti risorse necessarie allo sviluppo dei sistemi di I.A. e la capacità del Cloud Continuum di aggregare e gestire risorse eterogenee (pubbliche e private) in un unico ecosistema, le disponibilità economiche necessarie sono effettivamente appannaggio solo di poche e grandi corporations (che hanno fatturati simili al PIL di piccolo Stato) come mostrato nei grafici in figura 3 e 4 per l’anno 2023.

Fig. 3
Fig. 4

La democratizzazione di queste tecnologie e l’etica nell’uso delle risorse è un tema sicuramente vitale per lo sviluppo di applicazioni e servizi sempre più personalizzati, per migliorare, in sicurezza, la qualità della nostra vita. Il rapido sviluppo dell’intelligenza artificiale potrebbe però portare ad una maggiore dipendenza da sistemi automatizzati, rischiando di limitare la libertà individuale e la diversità delle scelte.

Bilanciamento tra Innovazione e Protezione dei Diritti Individuali

Si ripropone un tema ormai annoso, periodico e costante e cioè che è fondamentale trovare un equilibrio tra l’innovazione tecnologica, la protezione dei diritti e delle libertà individuali, per garantire che il progresso sia realmente benefico per la società nel suo complesso.

L’imprenditore miliardario hi-tech Bryan Johnson, proprietario della società di biohacking BionTech, considerato un guru della Silicon Valley, ha dato una rappresentazione del futuro dell’I.A. molto interessante, rappresentando rispetto alle attuali capacità umane, in quanta parte l’I.A. ci sostituirà in queste attività e quanto invece l’essere umano potrà fare grazie all’I.A. (Fig.5).

Fig.5

Immagine che parla da sé e alquanto suggestiva, un’opportunità incredibile e una nuova conoscenza ci aspettano, saremo in grado di gestirla?

Articolo a cura di Francesco Arruzzoli

Profilo Autore

Con oltre 25 anni di esperienza nell’ambito della sicurezza delle informazioni Francesco Arruzzoli è Senior Cyber Security Threat Intelligence Architect presso la Winitalia srl di cui è cofondatore. Si occupa di progettare infrastrutture e soluzioni per la Cyber Security di aziende ed enti governativi. In passato ha lavorato per multinazionali, aziende della sanità italiana, enti governativi e militari. Esperto di Cyber Intelligence e contromisure digitali svolge inoltre attività di docenza presso alcune università italiane.

Condividi sui Social Network:

https://www.ictsecuritymagazine.com/articoli/a-i-tra-nebbie-e-nuvole-lintelligenza-artificiale-per-lo-sviluppo-del-fog-e-cloud-continuum/


Economia dei dati nell’intelligenza artificiale: lo studio italiano per una filiera AI

Ci sono ben 14 Proposte di Legge depositate di cui 3 al Senato e 11 alla Camera a segnalarci che il tema dell’intelligenza artificiale ha centralizzato l’attenzione del Parlamento. Più rari sono invece gli studi presentati da soggetti italiani sul tema. Ieri Seeweb ha pubblicato “L’economia dei dati nell’Intelligenza Artificiale” un white paper piuttosto concentrato che in sole 40 pagine prova a fotografare la struttura del mercato proponendo alcune soluzioni interessanti per la filiera tricolore.

Si parte da un assunto. Viviamo un’economia data driven, dove tutto è guidato dai dati. Le acquisizioni si basano sui dati, le aziende comprano aziende che hanno un patrimonio di competenze già formate e hanno un business concentrato sul “nuovo petrolio”. Ma di quali dati stiamo parlando? Dati personali e non personali. Si, anche i dati aziendali hanno un rinnovato interesse nel nuovo quadro dove si cerca di far combaciare lo sviluppo della tecnologia con il ritorno degli investimenti.

Nel punto più alto della curva di hype raggiunta dall’AI in pochissimo tempo, sappiamo tutto delle condotte e dei protagonisti, pochi ed extraeuropei che hanno capacità di investimento miliardarie. Quello che non sappiamo e che quindi non facciamo è riportare il dibattito dai massimi sistemi al nostro quotidiano peninsulare. Ci sono in Italia aziende attive nella filiera AI? Sicuramente i cloud provider italiani. Perchè il cloud è la precondizione dell’AI. Tra i vari ingredienti, oltre ai dati di training ed alle competenze che scarseggiano, servono infrastrutture e applicazioni di cloud computing su cui puntare. Ce ne sono nello Stivale e vanno valorizzate come mai prima d’ora.

E’ un fattore di crescita ma anche di sicurezza. Il dato strategico in Italia, processato in una cornice regolamentare europea, in un perimetro fiscale italiano: non è poco. E’ un sogno? I soldi sono pochi e comunque non bastano mai. Allora non vanno sprecate risorse alla ricerca di un campione solamente, ma va cercato il modo di amplificare le realtà del territorio attive nel settore. 

La sfida è avvincente, la strategia è pronta. O quasi. Il Governo l’ha proposta al Parlamento che ne discuterà nei prossimi mesi. Tempo prezioso. Letture attente del mondo che ci circonda come quella che ci propone Seeweb nel white paper possono meglio indirizzare le scelte di oggi a vantaggio di domani.  La tesi ricorrente in questo paper è che per garantire all’Italia uno sviluppo di sistemi di intelligenza artificiale occorrerà introdurre misure correttive di alto valore sistemico. Tra le  misure emerse nell’analisi di Seeweb assumono maggiore rilevanza quelle che possono avere la capacità di far crescere un mercato competitivo, aperto e sicuro dell’intelligenza artificiale.  Queste misure riguardano principalmente la regolazione dell’accesso e del controllo dei dati di input utilizzati per allenare i sistemi di intelligenza artificiale, la prevenzione delle distorsioni e delle concentrazioni del mercato da parte delle piattaforme dominanti extraeuropee ed il sostegno alle aziende italiane della filiera dell’AI. 

Da sole, queste misure  potrebbero non essere sufficienti per affrontare tutte le varie questioni sollevate dall’AI, ma certamente costituiscono un importante punto di partenza per andare avanti nella giusta direzione.

Per approfondire

https://www.key4biz.it/economia-dei-dati-nellintelligenza-artificiale-lo-studio-italiano-per-una-filiera-ai/489422/


Il project ACDC (Apple Chips in Data Center) è il piano di Apple sull’AI?

Il Wall Street Journal lancia la bomba sulla guerra dell’intelligenza artificiale. Apple ha avviato lo sviluppo di un chip proprietario per l’esecuzione di software AI nei suoi data center: nome del progetto è Project ACDC (Apple Chips in Data Center).

Quasi tutte le aziende che offrono servizi basati sull’intelligenza artificiale generativa utilizzano le GPU di NVIDIA per l’addestramento dei LLM (Large Language Model). Per ridurre la dipendenza da NVIDIA, Microsoft, Google e Meta hanno progettato chip custom, mentre OpenAI cerca finanziamenti per la costruzione di fabbriche. Secondo le fonti del WSJ, anche Apple avrebbe scelto questa strada, sfruttando le sue competenze nel settore.

L’azienda di Cupertino progetta chip da oltre 14 anni, quindi lo sviluppo di versioni server non dovrebbe incontrare grandi difficoltà. La produzione verrà affidata a TSMC. Le fonti del WSJ affermano che i chip serviranno principalmente per l’inferenza (esecuzione) dei modelli di IA generativa, in quanto le GPU di NVIDIA offrono una potenza al momento inavvicinabile per quanto riguarda l’addestramento dei modelli.

L’investitori impazienti sull’AI: ne sapremo di più il 10 giugno?

Gli investitori di Apple sono diventati impazienti per la presunta mancanza di progressi dell’azienda nell’Intelligenza artificiale. I rivali tecnologici hanno visto aumentare il prezzo delle loro azioni con annunci di IA eclatanti. Microsoft ha ottenuto il maggior aumento grazie alla stretta e precoce collaborazione dell’azienda con OpenAI. All’inizio di quest’anno, Microsoft ha superato Apple come azienda più valutata al mondo, e il suo vantaggio è solo aumentato.

Il CEO di Apple, Tim Cook, ha cercato di rassicurare gli investitori affermando che l’azienda sta investendo nella tecnologia e che presto avrà importanti annunci di IA.

“Crediamo nel potere trasformativo e nelle promesse dell’IA, e crediamo di avere vantaggi che ci differenzieranno in questa nuova era, tra cui la combinazione unica di integrazione senza soluzione di continuità di hardware, software e servizi di Apple”, ha affermato Cook in una conference call per i risultati trimestrali recenti dell’azienda.

Apple punta la sfida verso NVIDIA

I sistemi di IA generativa, come i grandi modelli di linguaggio che alimentano ChatGPT, elaborano spesso immense quantità di dati utilizzando server informatici ospitati in data center. Per quella potenza di calcolo, la maggior parte delle grandi aziende tecnologiche si basa pesantemente su server dotati di chip di Nvidia, che si è trovata nel bel mezzo di una corsa all’oro dell’IA.

La maggior parte delle principali aziende tecnologiche ha sviluppato i propri chip per server di IA o sta esplorando questa possibilità per liberarsi da Nvidia, che detiene una quota di mercato stimata superiore all’80% in tali chip. Google ha forse il prodotto di chip per server di IA interno più maturo, con le sue unità di elaborazione tensoriale, avviato nel 2013. OpenAI è anche in trattative per finanziare un ambizioso progetto di chip interno, come già riportato dal Wall Street Journal.

La competenza esistente di Apple nel campo dei chip potrebbe essere un fattore su cui l’azienda può trovare un vantaggio critico rispetto agli altri giganti tecnologici nell’IA. Tra i suoi rivali, Apple ha la storia più lunga e il maggior successo nella progettazione di silicio personalizzato. L’azienda ha iniziato a incorporare i propri chip di elaborazione in iPhone e iPad nel 2010.

https://www.key4biz.it/il-project-acdc-apple-chips-in-data-center-e-il-piano-di-apple-sullai/489287/


Attacchi ai Modelli di Intelligenza Artificiale

I modelli di Intelligenza Artificiale (AI) stanno assumendo molto velocemente un grande ruolo nella vita di tutti noi. Le previsioni sono che nei prossimi anni utilizzeremo quotidianamente modelli AI sia in ambito lavorativo sia personale per moltissimi scopi. Ad esempio IDC [Rif. 1] prevede che entro il 2027 il 60% dei PC venduti avrà componenti Hardware (“system-on-a-chip – SoC”, diversi dalle GPU) dedicate all’elaborazione locale di modelli AI (si veda anche [Rif. 2]). Ci si aspetta un simile sviluppo anche per i dispositivi mobili quali smartphone, tablet ecc. oltre, ovviamente, ai server.

Oltre alle possibili debolezze comuni a qualsiasi programma informatico, i modelli AI hanno delle debolezze specifiche e in alcuni casi nuove, contro le quali non siamo abituati a confrontarci quasi quotidianamente. La ricerca in questo campo è molto attiva e nuovi risultati sono annunciati ogni giorno. È comunque possibile fare già ora una rassegna dei principali tipi di debolezze dei modelli AI che possono essere sfruttate da un attaccante.

Approcci allo Studio dei Tipi di Attacchi ai Modelli AI

In generale lo studio di un attacco ad un sistema informatico può essere analizzato considerando le vulnerabilità che l’attaccante intende sfruttare, le tecniche per implementare l’attacco e l’effetto dell’attacco sul sistema attaccato. Vi sono vari approcci allo studio degli attacchi ai sistemi informatici. Fra i più noti è quello che fa riferimento alla “Kill Chain”, ovvero identificare nell’ordine le azioni che un attaccante porta a termine per realizzare l’attacco per trovare i punti ove poterlo fermare. La metodologia più utilizzata per i modelli AI è quella sviluppata da MITRE con ATLAS™ [Rif. 3]. Questo approccio, focalizzandosi sulle azioni dell’attaccante, è sicuramente quello più appropriato per la gestione degli incidenti in tempo reale perché aiuta il difensore a identificare la migliore maniera per gestire l’incidente.

Un altro approccio è più preventivo e consiste nel valutare principalmente le vulnerabilità e i possibili effetti di un eventuale loro sfruttamento da parte di un attaccante per poter implementare misure di sicurezza sulla base di una valutazione dei rischi. In questo caso si ricorre spesso alla formulazione di tassonomie quale quella di NIST [Rif. 4] o di Microsoft [Rif. 5].

In questa sede non si intende descrivere in dettaglio una “Kill Chain” o proporre una tassonomia, ma fare una rassegna ad alto livello di quanto ad oggi si è capito cercando di organizzare le informazioni in uno schema sufficientemente semplice. Per questo l’approccio adottato è più simile a quello di una tassonomia mancandone però il rigore e la completezza.

Per questo articolo sono state considerate le debolezze o vulnerabilità dei modelli AI e le possibili conseguenze o effetti del loro sfruttamento. Questi sono stati raggruppati in quelli che genericamente saranno chiamati “attacchi”. Seguendo [Rif. 4] conviene distinguere due tipi di attacchi: quelli comuni a molti tipi di modelli AI, che sono indicati come modelli AI Predittivi, e quelli specifici ai modelli Generativi e “General Purpose” quali ad esempio i “Large Language Models” (LLM) come GPT, Bard/Gemini, LLaMA ecc.

In sicurezza informatica, gli effetti dello sfruttamento di una debolezza o vulnerabilità sono usualmente classificati dalla violazione di una o più caratteristiche di sicurezza tra Riservatezza, Integrità e Disponibilità (RID, in Inglese CIA). Nella letteratura già richiamata, questa classificazione è utilizzata anche per i modelli AI con due piccole varianti: si considerano Riservatezza insieme a Privacy, Integrità, Disponibilità e per i modelli Generativi anche Abuso. Con Abuso si intende proprio l’utilizzo di un modello AI Generativo per generare dati in violazione degli scopi e/o dei modi di utilizzo del modello stesso. Si noti che l’abuso di un modello AI Generativo qui considerato è diverso dall’abuso di una tradizionale applicazione informatica. Tutte le funzionalità e possibili dati prodotti da una usuale applicazione informatica sono disegnati e implementati dai programmatori; in questa situazione un abuso si può verificare nel caso di utilizzo di funzionalità esistenti da parte di chi non ne è autorizzato (violazione dell’Integrità del sistema di autorizzazione dell’applicazione) o in violazione della licenza d’uso. Come sarà descritto in seguito, per i modelli Generativi un ulteriore caso di abuso è l’utilizzo del modello per generare dati non previsti dai programmatori o in violazione degli scopi dell’addestramento del modello, senza però violarne le caratteristiche RID.

Attacchi ai Modelli AI Predittivi

In generale gli attacchi ai modelli AI possono essere classificati in tre classi:

  • “Poisoning” (Avvelenamento)
  • “Evasion / Adversarial Attacks” (Evasione)
  • “Extraction / Reconstruction” (Estrazione / Ricostruzione).
Avvelenamento

Gli attacchi di avvelenamento sono quelli più simili ai comuni attacchi alla sicurezza dei sistemi informatici e avvengono usualmente nella fase di addestramento dei modelli AI, qui da intendersi generalmente come le attività tramite le quali un modello AI impara modificando i propri dati interni. L’addestramento può essere fatto in molte modalità: dalla modalità più semplice di una volta sola prima della messa in esercizio del modello AI, a modelli AI che imparano continuamente dai feedback che ricevono dai dati prodotti.

Oggetto dell’attacco possono essere sia i dati utilizzati per l’addestramento del modello AI sia il modello stesso, ovvero il codice che lo implementa.

Avvelenamento del codice

L’attacco forse più tradizionale è quello per la modifica del codice di un modello AI: l’attaccante accedendo in maniera illecita ai sistemi IT che gestiscono il codice del sistema AI, o a quelli di terze parti che sviluppano il codice o anche componenti di supporto come possono essere librerie crittografiche o numeriche (in molti casi open-source), o ancora impersonando uno sviluppatore di modelli AI e abusando di codice open-source, può modificare il codice aggiungendo ad esempio una backdoor o modificando in maniera opportuna ai propri scopi il codice del modello. È stato mostrato che è possibile introdurre modifiche al codice del modello estremamente difficili da identificare nel codice stesso, se non tracciando l’accesso illecito ai sistemi IT. L’effetto di queste modifiche comporta usualmente una violazione dell’Integrità del modello AI, ovvero dell’integrità sia del codice del modello sia del comportamento e dei dati prodotti dal modello. Un attaccante può quindi introdurre nel modello dei comportamenti noti soltanto a lui, ad esempio che a certi specifici dati in ingresso corrispondono certi tipi di dati in uscita. Oppure le modifiche possono alterare le capacità del modello impedendogli di gestire correttamente certi dati in ingresso o limitandone le prestazioni. In alcuni casi le modifiche al codice possono portare alla violazione della Disponibilità del modello AI, ad esempio il modello può utilizzare troppe risorse di calcolo per l’elaborazione di alcuni tipi di dati in ingresso e non è più in grado di completare le elaborazioni nei tempi attesi.

Avvelenamento dei dati di addestramento

I modelli AI di Machine Learning, tra cui la maggior parte dei modelli AI al momento più conosciuti, hanno come caratteristica la necessità di utilizzare grandi quantità di dati per l’addestramento. Ovviamente questo fornisce un nuovo e molto interessante punto di attacco: modificando i dati di addestramento, un attaccante può modificare il comportamento di un modello AI, e quindi i dati da questo prodotti, per raggiungere i propri scopi. Il primo esempio è quello di un modello AI utilizzato per individuare malware o spam: un attaccante può cercare di inserire tra i dati di addestramento il proprio malware o i propri messaggi di spam indicandoli come dati benevoli in modo che, quando operativo, il modello AI non li segnali come malware o spam. In questo caso, effetto dell’attacco è di violare l’Integrità del modello tramite la modifica dei dati di addestramento.

La necessità di ottenere grandi quantità di dati di addestramento aumenta le possibili modalità di attacco e rende più difficile adottare misure di difesa. Spesso i dati di addestramento sono pubblici, cercati e scaricati da Internet, ma questo rende molto difficile garantire che la sorgente sia qualificata, lecita e non a sua volta oggetto di attacco o direttamente creata dall’attaccante. Ma anche se i dati di addestramento inizialmente sono corretti, spesso vi sono varie terze parti che li raccolgono, li analizzano, formattano ecc. in modo da poter essere utilizzati come dati di addestramento nei modelli AI. Anche tutte queste terze parti possono diventare oggetto di attacco o essere gestite direttamente da un attaccante. Inoltre, tutti coloro coinvolti nella gestione dei dati di addestramento devono garantire la sicurezza di veramente grandi quantità di dati, il che può portare difficoltà nel controllo accessi o anche solo nella protezione dei dati sia in transito sia quando memorizzati (a riposo). Infine, non è facile per chi utilizza i dati per addestrare i propri modelli AI, verificarne l’integrità, qualità e l’assenza di dati maligni.

Per questi motivi è utile considerare la possibilità di utilizzare dati di addestramento sintetici, ovvero creati appositamente per l’addestramento. Oltre a permettere una maggiore protezione dei dati contro attacchi, l’utilizzo di dati sintetici evita anche il rischio di infrangere diritti d’autore, licenze e la riservatezza o privacy delle informazioni. D’altra parte, generare dei sintetici e realistici non è per nulla facile, e non è applicabile a tutti i possibili utilizzi dei modelli AI.

Evasione

Gli attacchi detti di Evasione, anche chiamati “Adversarial Attacks” o “Adversarial Examples”, sono forse quelli più specifici dei modelli di Machine Learning perché per lo più connessi al processo di apprendimento dei modelli stessi e al modo in cui le informazioni apprese vengono utilizzate dai modelli durante la loro esecuzione. Il nome di questi tipi di attacchi viene dal fatto che i modelli di Machine Learning possono compiere errori che dal punto di vista umano sono macroscopici, violando completamente il comportamento atteso e oggetto dell’addestramento. In pratica si tratta di dati di ingresso al modello molto simili a quelli di addestramento sui quali il modello sbaglia completamente [Rif. 6], come i famosi esempi dei cartelli stradali di stop con uno sticker giallo riconosciuti come cartelli di limite di velocità, o montature di occhiali, cappelli, trucco per il viso che portano il modello a riconoscere una persona per un’altra. Questi errori dei modelli di Machine Learning sono delle vulnerabilità che possono essere sfruttate da un attaccante. Se l’attaccante conosce alcune di queste vulnerabilità di un modello, può sfruttarle a proprio favore e quindi “evadere” dal comportamento del modello sfruttando degli “Adversarial Examples”. L’esempio più semplice è ancora quello di un sistema AI per il riconoscimento dei volti ad esempio utilizzato in un luogo pubblico. Se l’attaccante è a conoscenza che il modello AI compie un errore nel riconoscimento dei volti se sul volto sono presenti particolari montature di occhiali, le può utilizzare per non essere individuato.

Vi sono molteplici modi in cui un attaccante può individuare queste vulnerabilità: ad esempio se l’attaccante ha accesso completo o ha una copia completa del modello AI addestrato, lo può studiare per individuare gli “Adversarial Examples”; o può studiare modelli simili adattando poi i risultati al modello da attaccare; o se può accedere ai risultati dell’elaborazione dei dati del modello ma non al modello stesso, può adottare un attacco di forza bruta nel quale modifica i dati in ingresso al modello sino a individuare l’errore di elaborazione cercato.

Questi attacchi portano ad una violazione dell’Integrità dei dati prodotti dal un modello AI e sono particolarmente pericolosi perché permettono all’attaccante di sovvertire completamente il comportamento del modello AI con dati che sono molto simili ai dati di addestramento, per cui a priori del tutto leciti. È quindi molto difficile individuare questi attacchi solo analizzando i dati di ingresso al modello AI. Invece per individuare queste vulnerabilità è necessaria un’attività simile a quella ben nota dei Read Team, ovvero un gruppo di esperti di sicurezza che attacca il modello AI per individuarne le vulnerabilità come se fosse un vero attaccante.

Estrazione / Ricostruzione

Questo tipo di attacchi sfrutta delle debolezze o vulnerabilità dei modelli AI per violare la Riservatezza e/o Privacy dei dati di addestramento o della struttura del modello, tramite l’utilizzo del modello stesso. È importante ricordare che in molti modelli AI i dati di addestramento non sono archiviati in modo simbolico (l’archiviazione simbolica permette di individuare la locazione di memoria nella quale è archiviato un singolo dato), ma sub-simbolico e sparso, ovvero un singolo dato è destrutturato e poi distribuito e aggregato con altri dati nella memoria del modello AI. Quindi, almeno ad oggi, non è possibile implementare all’interno di un modello AI un sistema di controllo accessi alle informazioni utilizzate per l’addestramento e ai dati della struttura stessa del modello AI.

Gli attacchi di estrazione e ricostruzione permettono all’attaccante di sottoporre al modello AI degli input formulati in modo tale da ottenere in output informazioni sui dati di addestramento o della struttura stessa del modello AI, e in alcuni casi di ottenere i dati stessi.

Se per i modelli Generativi è abbastanza semplice immaginare come a una ben formulata richiesta il modello possa rispondere fornendo in output come risposta un dato di addestramento, per altri tipi di modelli l’estrazione o ricostruzione delle informazioni presenti nel modello è più complessa, ma spesso possibile. Ad esempio, un attaccante avendo idea del tipo di dati utilizzati per addestrare un modello di Machine Learning di classificazione ma non sapendo esattamente quali dati sono stati utilizzati, può sottoporre al modello dei dati in ingresso così preparati da poter dedurre dalle risposte del modello se un certo dato è stato utilizzato per l’addestramento del modello stesso (questi attacchi sono chiamati di “membership inference”).

Un approccio per difendersi da questi attacchi utilizza il concetto di “Differential Privacy” che misura la quantità massima di informazioni sui dati di addestramento che un attaccante può estrarre dal modello AI. Sono state proposte varie tecniche che implementano la “Differential Privacy” utilizzando specifiche procedure di preparazione dei dati di addestramento e di addestramento dei modelli AI ma che non sono efficaci rispetto a tutti i possibili tipi di attacchi di Estrazione o Ricostruzione. Altri metodi di difesa utilizzano il monitoraggio e l’applicazione di filtri ai dati in ingresso e a quelli prodotti dai modelli AI.

Attacchi ai Modelli AI Generativi

Oltre agli attacchi ai Modelli AI appena descritti, i modelli AI Generativi e “General Purpose” quali ad esempio i “Large Language Models” (LLM) come GPT, Bard/Gemini, LLaMA ecc., possono essere oggetto di un’altra classe di attacchi chiamata

  • “Abuse” (Abuso)
Abuso

Con Abuso si intende proprio l’utilizzo di un modello AI Generativo in modo difforme da quanto previsto o consentito. I modelli AI Generativi possono essere abusati per scopi diversi tra i quali:

  • La generazione di malware (generazione di codice maligno);
  • La generazione di campagne di Phishing;
  • La generazione di informazioni (testi, audio, immagini, video) false ma con grande rassomiglianza a informazioni vere (“Fake News”), inclusa la modifica di dati storici in modo credibile e la generazione di campagne per influenzare il pubblico su temi politici, di discriminazione, di costume ecc.;
  • La generazione di dati a supporto di frodi, truffe, azioni di delinquenza, attacchi informatici ecc.
  • La generazione di testi (ad esempio per un Chatbot) che convincono un utente a cliccare su un link che porta a un malware, o a divulgare informazioni riservate.

In alcuni casi i modelli AI Generativi possono essere abusati tramite l’uso delle loro interfacce macchina (API) che producono in maniera automatica i dati utilizzati in tempo reale per l’attività illegale. Un esempio di questo può essere la generazione automatica di testi utilizzati da un Chatbot o per uno scambio di messaggi email per portare a termine una truffa.

Questi tipi di attacchi sono per lo più compiuti utilizzando l’interfaccia interattiva, o tramite API, del modello AI Generativo. Queste interfacce, in particolare per i Large Language Models, accettano testi scritti o parlati (o immagini) in linguaggio corrente e non programmatico. L’utente quindi invia una richiesta (“Query”) al modello AI che la interpreta, elabora e fornisce il risultato. Come indicato precedentemente, l’elaborazione può includere anche la ricerca di informazioni presso altre fonti, incluso Internet. L’attaccante sfrutta quindi possibili debolezze del modello AI nell’accettazione e interpretazione della richiesta per ottenere dati a priori non permessi. Questi tipi di attacchi vanno usualmente sotto il nome di “Prompt Injection” o “Adversarial Prompting” in quanto l’attaccante inserisce al “Prompt” del modello AI una richiesta il cui scopo è di abusare del modello stesso. A livello teorico, questo tipo di attacchi assomiglia molto agli attacchi di SQL Injection nei quali si modifica la Query SQL in modo che il database esegua un comando non permesso.

Sono stati proposti e utilizzati molti diversi metodi per costruire richieste che portano ad un abuso di un modello AI Generativo tra cui “Prefix injection”, “Refusal suppression”, “Style injection”, “Role-play”, “Ignore previous instructions”, “Special encoding”, “Character transformation”, “Word transformation”, “Prompt-level obfuscation” ecc. [Rif. 7], e la ricerca in questo ambito è in continuo sviluppo.

Vi sono diverse tecniche per difendersi da attacchi di questo tipo. Una tecnica adottata nel processo di addestramento di questi modelli è chiamata “Reinforcement Learning from Human Feedback (RLHF)” e consiste in una fase ulteriore di addestramento svolto tramite l’intervento diretto di persone specialmente addestrate a insegnare al modello a non generare risposte offensive, dannose o non lecite. Un altra tecnica consiste nell’affiancare al modello AI Generativo un modello AI Predittivo per la classificazione di testi (o di immagini ecc.) che è addestrato a identificare dati malevoli, offensivi o non leciti eventualmente inviati al, o generati dal modello AI Generativo. Il modello AI Predittivo esamina quindi i dati in ingresso e i dati prodotti dal modello AI Generativo e calcola la probabilità che un dato prodotto si configuri come risultato di un abuso del modello AI Generativo. Infine si utilizzano anche filtri programmati specificatamente per individuare abusi nei dati in ingresso e prodotti dal modello.

Infine va citata anche la vulnerabilità dei modelli AI Generativi indicata genericamente come “Allucinazione” ovvero la generazione di dati che non hanno senso, sono irrealistici o falsi ma che sono presentati come reali e appaiono molto convincenti. Questa vulnerabilità può essere sfruttata da un attaccante per creare campagne di disinformazione, di phishing o truffe e in pratica può risultare molto efficace a questi scopi.

AI Generativa come attaccante autonomo

Sinora i modelli AI sono stati considerati come l’oggetto di un attacco, in realtà modelli AI possono anche essere utilizzati come strumento d’attacco. Questo non è strano in quanto le informazioni di sicurezza informatica in generale e sui modelli AI stessi, possono essere utilizzate sia dai difensori sia dagli attaccanti. Ad esempio, un modello AI può essere utilizzato per studiare i punti deboli di un sistema informatico o di un altro modello AI, e queste informazioni possono essere sfruttate sia da un difensore sia da un attaccante. Un attaccante può quindi adottare modelli AI tra i propri strumenti per eseguire attacchi a sistemi informatici, e un difensore può fare lo stesso. Si ha quindi una situazione in cui i modelli AI svolgono allo stesso tempo il ruolo di attaccante e difensore: in altre parole si ha uno scenario di “guerra” tra i modelli AI utilizzati da attaccanti e difensori.

E, almeno a livello di laboratorio, è già possibile considerare la creazione di “worm” che autonomamente diffondono malware tra modelli AI Generativi [Rif. 8].

Di maggiore interesse è considerare la possibilità che un modello AI Generativo esegua autonomamente attacchi ad altri sistemi informatici. Questo scenario richiama immediatamente alla mente molti romanzi e film di fantascienza, spesso con conseguenze tragiche (si pensi ad esempio a Skynet della serie Terminator). La possibilità teorica esiste, come ad esempio descritto in [Rif. 9]. Una modalità teorica in cui già oggi potrebbe essere possibile un attacco eseguito autonomamente da un modello AI Generativo è la seguente. Un modello AI Generativo quale un Large Language Model (LLM) è addestrato con una enorme quantità di informazioni che tipicamente includono anche informazioni di sicurezza informatica quali le modalità di eseguire attacchi a un sito Web come SQL Injection o Cross Site Scripting (XSS). Inoltre già oggi i modelli più avanzati hanno la capacità di eseguire ricerche in Internet per ottenere informazioni in tempo reale, e il risultato della ricerca può essere utilizzato dal modello AI come nuovo dato di ingresso in un ciclo complesso di elaborazione. In altre parole è tecnologicamente possibile che un modello AI Generativo possa ad esempio utilizzare un attacco SQL Injection per ottenere delle informazioni da un sito Web, ritenendo che questa tecnica sia la più efficace per accedere alle informazioni, senza che l’utente sia a conoscenza né del fatto che il modello sta cercando di estrarre informazioni da uno specifico sito Web né che la tecnica utilizzata per ottenere le informazioni sia un attacco informatico.

Riferimenti

[1] IDC, “IDC Forecasts Artificial Intelligence PCs to Account for Nearly 60% of All PC Shipments by 2027”, 7/2/2024, https://www.idc.com/getdoc.jsp?containerId=prUS51851424

[2] La Repubblica “Quel microchip fa Nvidia a tutti. L’Eldorado produttivo promesso dall’AI trascina le Borse mondiali”, 23 febbraio 2024; MarketWatch “Nvidia makes Wall Street history as stock surge adds $277 billion in market cap”, https://www.marketwatch.com/story/nvidias-stock-surge-could-add-200-billion-in-market-cap-with-mammoth-growth-on-tap-8d9472d2

[3] MITRE ATLAS™ “Adversarial Threat Landscape for Artificial-Intelligence Systems”, https://atlas.mitre.org/

[4] NIST AI 100-2 “Adversarial Machine Learning: A Taxonomy and Terminology of Attacks and Mitigations”, https://csrc.nist.gov/pubs/ai/100/2/e2023/final

[5] Microsoft “Failure Modes in Machine Learning”, https://learn.microsoft.com/en-us/security/engineering/failure-modes-in-machine-learning

[6] A. Pasquinucci, “Adversarial Attacks a Modelli di Machine Learning”, White Paper, ICT Security Magazine, https://www.ictsecuritymagazine.com/pubblicazioni/adversarial-attacks/

[7] Per una breve introduzione si veda “Prompt Injection Attacks in Large Language Models”, SecureFlag, https://blog.secureflag.com/2023/11/10/prompt-injection-attacks-in-large-language-models/

[8] S. Cohen, R. Bitton, B. Nassi, “Here Comes the AI Worm: Unleashing Zero-click Worms that Target GenAI-Powered Applications”, https://sites.google.com/view/compromptmized

[9] R. Fang, R. Bindu, A. Gupta, Q. Zhan, D. Kang, “LLM Agents can Autonomously Hack Websites”, https://arxiv.org/abs/2402.06664 ; R. Fang, R. Bindu, A. Gupta, D. Kang, “LLM Agents can Autonomously Exploit One-day Vulnerabilities”, https://arxiv.org/abs/2404.08144

Articolo a cura di Andrea Pasquinucci

Profilo Autore

PhD CISA CISSP
Consulente freelance in sicurezza informatica: si occupa prevalentemente di consulenza al top management in Cyber Security e di progetti, governance, risk management, compliance, audit e formazione in sicurezza IT.

Condividi sui Social Network:

https://www.ictsecuritymagazine.com/articoli/attacchi-ai-modelli-di-intelligenza-artificiale/