Nelle prossime settimane si attende l’adozione del testo definitivo da parte del Comitato dei Ministri; in seguito la Convenzione sarà aperta all’adozione da parte dei singoli Stati ed entrerà in vigore appena raggiunto il numero di ratifiche previsto.
Lo scopo dichiarato è stabilire regole e standard condivisi circa l’impatto dell’Intelligenza Artificiale sui diritti umani fondamentali – quali la dignità, l’uguaglianza o la riservatezza dei dati personali – e sui processi democratici nazionali.
Stante la pervasività delle tecnologie AI nell’attuale società globale e la natura transnazionale dei relativi strumenti, il documento sceglie di dettare principi generali e definizioni ampie per consentirne un’applicazione quanto più ampia possibile, ritenendo che “the more global the instrument becomes, the more impact it will have on peoples’ lives around the globe.”
In tale spirito la Segretaria Generale del CAI, Marija Pejčinović Burić, ha definito la Convenzione“a legal framework that covers AI systems throughout their lifecycles” e ha specificato che, sebbene elaborata nel contesto europeo, la stessa intende porsi come “a global instrument, open to the world” al fine di favorire una disciplina internazionale uniforme in ambito di Intelligenza Artificiale.
G7. Urso: “AI e tecnologie quantistiche per le nostre Pmi”. Focus su spazio e chip (video)
La ministeriale G7 “Industria, Tecnologia e Digitale”, agli incontri di Verona la regina è sempre l’AI
Partito a Verona il G7 Italia 2024 “Industria, Tecnologia e Digitale”, con la prima giornata presieduta dal Ministro delle Imprese e del Made in Italy, Adolfo Urso. Al centro della ministeriale quelli che sono definiti i tempi più sfidanti per le imprese, chiamate ad affrontare la duplice transizione green e digitale.
Tra questi, l’applicazione al tessuto industriale dell’intelligenza artificiale (Artificial Ingelligence, AI) e delle tecnologie emergenti, tra quelle quantistiche; la sicurezza e la resilienza delle catene di approvvigionamento e delle reti; lo sviluppo digitale sostenibile e inclusivo a livello globale, con un focus sull’Africa, in linea con il Piano Mattei.
[embedded content]
Tanti i partecipanti ai lavori, tra cui il ministro dell’Innovazione, della Scienza e dell’Industria del Canada, Francois-Philippe Champagne; il vice cancelliere e ministro dell’Economia e dell’Azione climatica della Germania, Robert Habeck; il viceministro dell’Economia, del Commercio e dell’Industria del Giappone, Taku Ishii; il viceministro degli Interni e delle Comunicazioni giapponese, Junji Hasegawa; il segretario di Stato per la Scienza, l’Innovazione e la Tecnologia del Regno Unito, Michelle Donelan; il segretario di Stato per il Digitale della Francia, Marina Ferrari; il Senior counselor per l’AI e lo sviluppo dell’occupazione del dipartimento del Commercio Usa, Zoe Baird; il vicepresidente della Commissione europea Margrethe Vestager.
Agli appuntamenti ministeriali hanno partecipato, come Paesi outreach, i rappresentanti della Corea del Sud, Ucraina ed Emirati Arabi Uniti.
IA, quantistica e microelettronica nel bilaterale Urso-Vestager
“Intelligenza artificiale, meccanica quantistica e microelettronica sono i temi che ho approfondito nell’incontro bilaterale, a margine del G7 Industria, con la vicepresidente della Commissione Europea e Commissario Europeo per la Concorrenza, Margrethe Vestager. I recenti conflitti ci hanno dimostrato che, oggi più che mai, il nostro continente deve raggiungere l’indipendenza strategica e a questo fine in ambito G7 collaboreremo sui semiconduttori con la Commissione, per salvaguardare la nostra economia e le nostre industrie”, ha commentato Urso in una nota diffusa sui social.
Adolfo Urso e Margrethe Vestager
I tavoli con Giappone e Corea del Sud
Urso ha poi incontrato il viceministro giapponese degli Affari Interni e Comunicazione, Junji Hasegawa: “L’incontro fa seguito alla mia visita a Tokyo di dicembre scorso e si inserisce in un rinnovato contesto relativo alle relazioni bilaterali tra i nostri Paesi, sempre più forti e positive. Nella riunione è emerso che entrambi i nostri Paesi vogliono proseguire sulla strada tracciata dal “Processo di Hiroshima” sull’Intelligenza Artificiale, che il governo italiano eredita proprio dal G7 del Giappone, affinché le grandi potenze rappresentate in questa assise possano sempre più convergere su principi comuni e antropocentrici, mettendo al centro i valori e i diritti della persona. Siamo inoltre consapevoli che sia centrale che lo sviluppo delle tecnologie emergenti debba coinvolgere un numero sempre più grande di stakeholder e di Paesi nel mondo, secondo i principi dell’inclusività e della sostenibilità dello sviluppo“.
Infine, ha precisato Urso: “abbiamo confermato la volontà comune di rafforzare la nostra collaborazione nel settore della microelettronica, sempre più strategica in vista delle sfide dell’industria del futuro“.
Adolfo Urso e Junji Hasegawa
Il secondo bilaterale Italia-Asia, sempre a margine dei lavori, è stato con Jean Koh, presidente della Commissione coreana sulle Piattaforme Digitali: “Abbiamo avuto un confronto sullo stato di attuazione del Memorandum of Understanding volto a intensificare la cooperazione tra Italia e Corea del Sud nei campi della scienza e della tecnologia spaziale, recentemente sottoscritto tra i nostri due Paesi alla presenza del Presidente della Repubblica Italiana Sergio Mattarella e del Presidente della Repubblica della Corea del Sud Yoon Suk-Yeol. È emerso inoltre il reciproco interesse a potenziare la nostra cooperazione nei campi della microelettronica e del quantum computing, per sostenere l’innovazione e la trasformazione digitale delle nostre imprese”.
[embedded content]
I Paesi Outreach (Corea del Sud, Ucraina, Emirati Arabi)
Tre le sessioni di lavoro. La prima, alla presenza dei Paesi Outreach (Corea del Sud, Ucraina, Emirati Arabi), si è concentrata su ‘Intelligenza Artificiale e Tecnologie Emergenti nell’Industria’. La discussione si è focalizzata sul “potenziale impatto positivo dell’IA su molti settori, con riferimento all’aumento della produttività, dell’efficienza, dell’innovazione e della scoperta scientifica, e rischi connessi”, si legge sul sito del ministero delle Imprese e del made in Italy.
Un focus specifico è stato destinato ai fattori trainanti e alle sfide dell’adozione dell’IA da parte delle micro, piccole e medie imprese. È stato affrontato il ruolo delle tecnologie quantistiche, con particolare attenzione “al loro potenziale nell’acquisizione, trasmissione ed elaborazione delle informazioni, nonché nel favorire scoperte nel campo della chimica, dei materiali e della fisica”.
Sono state, infine, descritte le iniziative di cooperazione tra i Paesi G7 in questi ambiti e gli strumenti previsti.
Semiconduttori e sicurezza reti (anche sottomarine)
Nel corso della seconda sessione è stato affrontato il tema delle ‘Reti sicure e resilienti, Catene di approvvigionamento e Fattori chiave di produzione’. Un ampio confronto sulle azioni necessarie ad assicurare le catene globali del valore, con particolare attenzione al ruolo chiave dei semiconduttori come “fondamentali elementi per l’economia digitale, per la sicurezza economica e la resilienza”.
Il dibattito è continuato sulle reti terrestri sicure e resilienti, sulle reti sottomarine via cavo e su quelle non terrestri per promuovere la connettività globale.
Nella terza e ultima sessione del G7 Industria ‘Sviluppo Digitale – Prosperare Insieme’ il focus si è spostato sulle azioni concrete che i Paesi del G7 possono intraprendere per favorire l’avanzamento digitale globale, promuovere uno sviluppo inclusivo e sostenibile e contribuire ad accelerare i progressi verso il raggiungimento degli Sustainable Development Goals.
In particolare, il confronto si è concentrato su come colmare il divario digitale e quello di genere entro il 2030, promuovere la crescita economica sostenibile, affrontare le sfide associate alla trasformazione digitale e assicurare che i benefici delle tecnologie siano condivisi equamente. L’IA avrà un ruolo centrale nell’aiutare ad affrontare le sfide dello sviluppo, come la crisi climatica, l’istruzione e la salute.
Il documento del B7 sull’AI
In occasione della ministeriale, che si è aperta con la riunione del B7, il più autorevole Engagement Group istituito in seno al G7 guidato quest’anno da Confindustria con il supporto di Deloitte come unico Knowledge Partner, Confindustria e Deloitte hanno pubblicato il B7 Flash, un’analisi approfondita sulle sfide che saranno affrontate nel G7.
Per cogliere le opportunità che l’Ai offre serve anche “potenziare le competenze Stem e le competenze digitali” altrimenti per la B7 Chair si rischia di “creare maggiori disuguaglianze”.
“Adversarial Machine Learning”, “Adversarial Attacks”, “Adversarial Examples” e “Adversarial Robustness” sono termini che appaiono sempre più spesso quando si considerano aspetti di sicurezza dei modelli di Machine Learning (ML).
Bug Hunting e Adversarial Examples
Come pratica ormai consolidata nella sicurezza informatica, una nuova applicazione, sistema o servizio va prima o poi soggetto a delle verifiche di “sicurezza”, intesa anche in senso lato, da parte di esperti che cercano di trovare errori, comportamenti anomali o vere e proprie vulnerabilità. Questo accade anche per i modelli di Intelligenza Artificiale e in particolare di Machine Learning.
Sin dalle prime applicazioni pratiche dei modelli ML, nei primi anni 2000, i ricercatori si impegnarono a verificare il loro comportamento: ad esempio trovando modalità di evadere i filtri anti-SPAM basati su modelli ML e aggirare le applicazioni di ML per il riconoscimento di immagini (inizialmente questi erano chiamati genericamente Evasion Attacks, mentre il termine maggiormente usato oggi è Adversarial Examples).
Queste attività possono essere considerate l’equivalente di eseguire un Penetration Test su un’applicazione Web, o di trovare il modo di aggirare o ingannare un sensore biometrico con funzioni di controllo degli accessi. Riportiamo qui solo due esempi provenienti dalla ormai enorme letteratura a riguardo [Rif. 1] e relativi ad applicazioni ML per il riconoscimento di immagini.
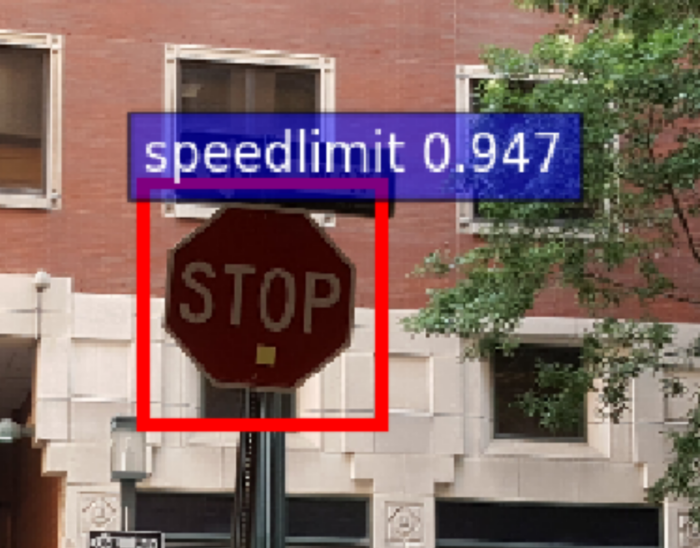
Fig. 1 Cartello stradale di Stop con sticker [Fonte Rif. 2]
La Fig. 1 presenta un ben riconoscibile cartello stradale di Stop ma, a causa dello sticker giallo apposto sotto la scritta, il modello ML sotto attacco interpreta il segnale con il 94,7% di probabilità come un limite di velocità (tipicamente 40Kmh o 25Mph). Una ipotetica vettura a guida autonoma che utilizzasse questo modello ML per riconoscere la segnaletica stradale, quindi, non si fermerebbe allo Stop ma proseguirebbe a velocità inferiore al limite, con ben immaginabili possibili conseguenze.
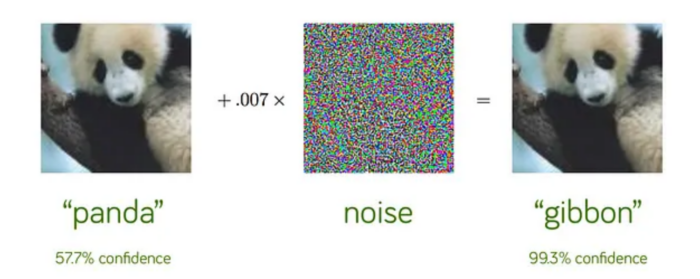
Fig. 2 Un panda o una scimmia gibbone? [Fonte Rif. 3]
La Fig. 2 presenta un’immagine di un panda (a sinistra) in cui al 7 per mille dei pixel viene aggiunto del “rumore bianco”. Il risultato è che, per l’occhio umano, l’immagine non è cambiata; mentre per il modello ML ora rappresenta una scimmia gibbone con il 99,3% di probabilità.
Lo studio di queste vulnerabilità ha portato a comprendere – si veda ad esempio [Rif. 4] – che non si tratta di errori dovuti ad una particolare implementazione errata o disattenzione dei programmatori, ma di un problema più generale e profondo dei modelli ML.
Per semplicità e chiarezza di esposizione, conviene distinguere due significati simili ma non precisamente identici del termine “Adversarial Machine Learning”:
Adversarial ML – Aspetti Scientifici: studio della “Robustezza” dei modelli tramite la possibilità di costruire Adversarial Examples con tecniche sperimentali e matematiche – si vedano i due esempi precedenti;
Adversarial ML – Aspetti Operativi: Studio dei possibili attacchi ai modelli ML utilizzati in ambiente Business.
I due ambiti hanno ovviamente ampie aree di sovrapposizione ma i principali obiettivi, pur essendo allineati, sono diversi.
In ambito scientifico lo scopo della ricerca è comprendere quali sono le ragioni dell’esistenza degli Adversarial Examples e, di conseguenza, come migliorare i modelli ML in modo da non averne. I modelli ML senza Adversarial Examples sono chiamati Robusti: questo non vuol dire che non possono fare errori o confondersi, ma che non hanno deviazioni sistematiche con grandi errori dal comportamento atteso.
Nel primo esempio sopra riportato, in un modello ML Robusto l’applicazione di sticker o altri camuffamenti e scritte che all’occhio umano non nascondono il cartello stradale di Stop, possono al più ridurre la confidenza dell’identificazione del cartello da parte del modello ML ad una percentuale del 70% o 60%, ma non identificare il cartello come un altro segnale con quasi assoluta certezza. Nel secondo esempio, due immagini che appaiono uguali all’occhio umano devono essere classificate similmente da un modello ML Robusto, al più con diverso livello di confidenza; e non possono essere identificate come raffiguranti due animali diversi, quello errato con quasi assoluta certezza.
È possibile quindi paragonare il processo di creazione di un modello ML Robusto al processo di sviluppo sicuro del software: ormai è ben noto come sviluppare software adottando pratiche che permettono di ridurre il più possibile la probabilità di Bugs e vulnerabilità di sicurezza, anche se rimane molto difficile se non impossibile (anche teoricamente) scrivere del software complesso con garanzia assoluta di assenza di vulnerabilità.
Ma i modelli ML che sono oggi disponibili sono ancora molto giovani. Benché i primi sviluppi di modelli di Intelligenza Artificiale risalgano agli anni ’50, lo sviluppo dei modelli ML odierni è iniziato decisamente negli anni ’90. Anche se l’architettura di base di molti modelli ML è a prima vista semplice, gli algoritmi matematici che li supportano possono essere molto complessi e ancora non ben compresi/risolti dai ricercatori, ad esempio quelli dei modelli di Deep Learning che recentemente hanno fatto tanto clamore giornalistico.
Siamo quindi nel periodo in cui si è identificato un problema (l’esistenza di Adversarial Examples in modelli ML) e lo si sta studiando; ma non si è ancora trovata la soluzione generale (come costruire modelli ML Robusti) né l’approccio operativo per risolverlo.
L’esistenza di Adversarial Examples è legata al processo di apprendimento di un modello ML. Una tra le principali caratteristiche dei modelli ML è avere moltissimi, anche centinaia di miliardi di parametri numerici configurabili. Inizialmente questi parametri hanno valori casuali e il processo di apprendimento consiste appunto nel configurare il miglior valore di ogni parametro in modo che ogni dato di addestramento in ingresso venga elaborato dal modello, producendo in uscita il risultato atteso. Semplificando molto il funzionamento di questi modelli, quando un nuovo dato viene elaborato dal modello ML, i valori dei parametri configurati permettono di identificare somiglianze con i dati di addestramento e fornire un risultato probabilisticamente vicino a quello corretto od ottimale. Ovviamente il set di dati di addestramento non è esaustivo di tutti i possibili dati esistenti: nei due esempi precedenti non comprende tutte le possibili immagini di cartelli stradali o di panda, anche perché sarebbe una quantità infinita di dati. I set di dati di addestramento sono però rappresentativi dei dati esistenti ma a priori (e in pratica) non è detto che siano sufficienti a configurare tutti i parametri del modello ML in maniera ottimale. C’è quindi la possibilità che una particolare combinazione di dati in ingresso corrisponda ad uno speciale set di parametri che non è stato configurato ottimamente per quei dati (o per nulla) e che quindi generi un risultato errato.
Una ovvia prima soluzione all’esistenza degli Adversarial Examples è addestrare nuovamente il modello ML includendo tra i dati di addestramento gli Adversarial Examples. Il primo problema di questo approccio è che bisogna innanzitutto essere capaci di identificare tutti gli Adversarial Examples; e questo è proprio uno dei principali problemi ancora aperti. Inoltre alcuni modelli ML hanno mostrato di essere soggetti a vulnerabilità o debolezze quali la “sotto-specifica” (Underspecification, ovvero il fatto che una minima modifica ai dati di addestramento produce grandi modifiche nel modello) e la “smemoratezza” (Forgetfulness, ovvero un aggiornamento del modello con nuovi dati porta il modello a dimenticare parte di quello che aveva già appreso). Vi è quindi il rischio che un ulteriore addestramento di un modello ML, aggiungendo anche gli Adversarial Examples tra i dati di addestramento, possa introdurre nuovi Adversarial Examples, senza quindi risolvere il problema. Queste e simili fragilità attuali del processo di apprendimento dei modelli ML rendono oggi difficile – se non impossibile – identificare ed eliminare completamente gli Adversarial Examples dai modelli ML.
Rif. 2: T. Gu, B. Dolan-Gavitt, S. Garg, “BadNets: Identifying Vulnerabilities in the Machine Learning Model Supply Chain”, 2017, arXiv:1708.06733
Rif. 3: I.J. Goodfellow, J. Shlens, C. Szegedy, “Explaining and Harnessing Adversarial Examples”, 2014, arXiv:1412.6572
Rif. 4: B. Biggio, B. Nelson, P. Laskov, “Poisoning Attacks against Support Vector Machines”, 2013-03-25, ArXiv:1206.6389; Biggio, I. Corona, D. Maiorca, B. Nelson, N. Srndic, P. Laskov, G. Giacinto, F. Roli, Fabio, “Evasion attacks against machine learning at test time” , 2013, ECML PKDD. Lecture Notes in Computer Science. Vol. 7908. Springer. pp. 387–402, arXiv:1708.0613; Biggio, F. Roli, Fabio, “Wild patterns: Ten years after the rise of adversarial machine learning” , dicembre 2018, Pattern Recognition. 84: 317–331, arXiv:1712.03141intell
PhD CISA CISSP Consulente freelance in sicurezza informatica: si occupa prevalentemente di consulenza al top management in Cyber Security e di progetti, governance, risk management, compliance, audit e formazione in sicurezza IT.
L’esame parlamentare non sembra aver apportato modifiche significative al testo votato dal Coreper lo scorso febbraio.
Confermati il generale approccio risk-based, gli obblighi di trasparenza a carico dei fornitori di servizi, l’introduzione dell’AI Office presso la Commissione e il divieto per le autorità statali di utilizzare tecniche di “social scoring”, predictive policing o riconoscimento biometrico nei luoghi pubblici.
Permane anche l’esclusione dal raggio applicativo del Regolamento dei sistemi impiegati a fini militari e di difesa nazionale, come pure degli strumenti usati per scopi di ricerca scientifica o rilasciati sotto licenze free/open source, a meno che non presentino particolari rischi ovvero rientrino nella definizione di General Purpose AI (GPAI).
Secondo il correlatore del Regolamento, l’eurodeputato italiano Brando Benifei, si tratta della “prima regolamentazione a livello internazionale che indica una chiara strada verso uno sviluppo dell’IA sicuro e basato sull’essere umano”.
Sebbene l’AIA sia effettivamente il primo atto normativo formalmente approvato in materia, la corsa alla regolamentazione dell’Intelligenza Artificiale ha visto negli ultimi tempi l’adozione di numerosi standard tecnici e linee guida di organismi sovranazionali, testimoniando il comune sentire rispetto all’esigenza di individuare regole comuni rispetto a una tecnologia che esercita il proprio potenziale trasformativo pressoché in ogni ambito dell’esistenza umana.
L’ultimo passaggio di questo lungo iter è previsto ad aprile, quando il Consiglio europeo dovrà pronunciarsi sulla versione finale.
A partire dalla pubblicazione nella Gazzetta Ufficiale dell’UE, decorreranno poi i 24 mesi al termine dei quali il Regolamento sarà pienamente applicabile in tutti gli Stati membri dell’Unione; un periodo piuttosto lungo, inteso – come già per il GDPR – per consentire ad aziende e Pubbliche Amministrazioni di adeguarsi a una disciplina estremamente pervasiva, ridefinendo le proprie policy e individuando le nuove figure richieste.
Sono tuttavia previste anticipazioni per alcuni divieti, codici di condotta e norme generali, nonché per gli obblighi relativi ai sistemi d’Intelligenza Artificiale “ad alto rischio”, che entreranno in vigore rispettivamente dopo 6, 9, 12 e 36 mesi dalla definitiva approvazione dell’AI Act.
B7: “Investimenti digitali e IA per aumentare la produttività e promuovere crescita sostenibile”
L’impatto dell’IA sulle imprese e l’economia italiana
Sei grandi imprese su dieci hanno già avviato diversi progetti di impiego dell’intelligenza artificiale (IA) in Italia. Un’adozione più diffusa di questa tecnologia potrebbe dare una spinta decisiva all’economia, partendo da una maggiore produttività e competitività sui mercati internazionali.
Se le aziende e la pubblica amministrazione (PA) adottassero in maniera diffusa l’Intelligenza artificiale, in particolare l’IA generativa, il nostro Paese potrebbe vedere il Pil aumentare del 18%, fino a 312 miliardi di euro, secondo uno studio realizzato da The European House – Ambrosetti e Microsoft.
Sono delle indicazioni positive, che però ci obbligano a guardare il futuro con i piedi nelle sabbie mobili di ritardi e limitazioni di varia natura. Per puntare seriamente sull’IA serve innanzitutto un quadro regolatorio chiaro ed efficace, non repressivo, ma certamente attento ad una serie di criticità di cui molto si è parlato nei mesi passati e ancora nelle ultime settimane a Bruxelles.
Primo evento B7 in concomitanza con la prima riunione ministeriale del G7 sui temi dell’industria, della tecnologia e del digitale
ripensare le catene di approvvigionamento in ottica di resilienza e di promozione di un commercio aperto, libero e multilaterale;
il ruolo degli stimoli pubblici nel sostenere le economie G7 in una fase di profonda trasformazione industriale imposta dalla attuale congiuntura economica, ambientale e geopolitica;
la necessità di una maggiore collaborazione tra i Paesi G7 su investimenti digitali e IA per migliorare la competitività economica, aumentare la produttività e promuovere una crescita sostenibile nel lungo periodo;
l’urgenza di un approccio normativo comune e di infrastrutture robuste e resilienti imposta dal rapido sviluppo dell’AI e di altre tecnologie digitali unitamente alla diffusione di competenze tecniche e principi etici per garantirne un utilizzo responsabile.
Bisogna poi affrontare seri problemi di carenza di competenze digitali, non solo per l’intelligenza artificiale, perché la carenza di competenze digitali tra i dipendenti riguarda anche altre tecnologie, a cui aggiungere la bassa digitalizzazione delle imprese stesse, in particolare le piccole e le medie organizzazioni.
Marcegaglia: “B7 pronto ad elaborare raccomandazioni di policy per consentire alle applicazioni IA di dispiegare tutto il loro potenziale“
“La digitalizzazione è fondamentale per tutti i settori industriali, sia nel privato sia nel pubblico: come B7 ci impegneremo per promuovere le competenze digitali oltre i confini delle imprese e raggiungere anche le pubbliche amministrazioni, in modo da rafforzare la sicurezza dell’accesso ai dati e fornire alle stesse imprese e ai cittadini servizi più efficienti e più sicuri”, ha precisato in una nota Emma Marcegaglia, B7 Chair, aggiungendo: “Siamo consapevoli dei rischi associati all’AI e il G7 si è impegnato a sviluppare codici etici armonizzati. È un passaggio decisivo: il B7 è pronto ad elaborare raccomandazioni di policy per consentire alle applicazioni dell’AI di dispiegare tutto il loro potenziale positivo, rendendo l’industria dei nostri Paesi sempre più forte e competitiva”.
Il primo giorno dell’incontro ministeriale G7, il 14 marzo a Verona, sarà presieduto dal Ministro delle Imprese e del Made in Italy, Adolfo Urso.
Il secondo giorno dell’incontro ministeriale G7, il 15 marzo a Trento, sarà presieduto dal Sottosegretario di Stato per l’Innovazione Tecnologica, il Senatore Alessio Butti.
“Il governo sta predisponendo un provvedimento di legge sull’IA che ha come obiettivo quello di stabilire alcuni principi, determinare le regole complementari a quelle del regolamento europeo che è in via di approvazione e individuare le misure più efficaci per stimolare il nostro tessuto produttivo”, è quanto dichiarato dal Presidente del Consiglio, Giorgia Meloni, partecipando al convegno “L’intelligenza artificiale per Italia“, voluto dal sottosegretario Alessio Butti e organizzato dal Dipartimento per la trasformazione digitale della Presidenza del Consiglio e da Agenzia per l’Italia Digitale.
“Noi siamo convinti che possa e debba esistere una via italiana all’intelligenza artificiale, una via italiana allo sviluppo dell’intelligenza artificiale, una via italiana al governo dell’intelligenza artificiale.Stiamo inoltre lavorando per individuare l’organismo più idoneo a svolgere il ruolo di autorità competente sull’uso delle tecnologie basate sull’intelligenza artificiale”, ha aggiunto la Premier, secondo cui: “L’intelligenza artificiale è la principale sfida che abbiamo davanti”.
Cdp mette un miliardo di euro sull’IA tricolore
“Il sistema Italia ha bisogno che si parta dai grandi campioni di questa nazione e per questo voglio ringraziare Cdp – e segnatamente Cdp Venture Capital – perché grazie al loro impegno sarà possibile investire un miliardo di euro sull’IA, sia creando un nuovo fondo di investimento specializzato sull’IA, sia usando fondi di investimento già attivi ma che coinvolgono questa tecnologia“, ha detto la Premier.
Si tratta di un nuovo pacchetto di risorse che va ad aggiungersi al fondo già annunciato dal Dipartimento trasformazione digitale, Cassa depositi e prestiti – Venture Capital e l’Agenzia per la cybersicurezza nazionale.
Una tecnologia fondamentale per la crescita economica, la competitività delle nostre aziende, ma non solo, perché il suo impatto va in profondità anche nella società: “Eravamo abituati a un progresso che aveva come obiettivo soprattutto quello di ottimizzare le capacità umane e che si concentrava essenzialmente sulla sostituzione del lavoro fisico in un mondo nel quale l’uomo rimaneva comunque al centro, ma l’intelligenza artificiale ha ribaltato questo paradigma, ad essere soppiantato oggi non è più il lavoro fisico, ma rischia di essere l’intelletto umano”, ha proseguito Meloni.
La Presidente del Consiglio ha poi sottolineato che l’IA “è una tecnologia che può sprigionare tutto il suo potenziale positivo, solo se il suo sviluppo si muoverà in un perimetro di regole etiche che mettano al centro la persona, i suoi diritti e i suoi bisogni, questa è la bussola che ha orientato e che continuerà a orientare il nostro lavoro, a partire dalla presidenza del G7”.
Il grave gap Ue con Usa e Cina
Fin qui il messaggio della Presidente del Consiglio, che cerca di porre maggiormente in evidenza una specie di IA ‘made in Italy’ frutto della regolamentazione europea. Il problema però, più che l’Italia, è proprio Bruxelles.
Come ha spiegato Alec Ross, docente alla Bologna Business School, già coordinatore della politica tecnologica per la campagna elettorale di Barack Obama e tra i maggiori esperti mondiali di economia digitale, il problema europeo è che hanno investito troppo poco, rispetto a Stati Uniti e Cina, l’Unione europea è arrivata troppo tardi.
“È una vera competizione ma a questo punto gli Stati Uniti sono primi perché investono di più: quest’anno gli Usa investono 65 miliardi mentre la Cina ne investe 35. In secondo luogo, perché gli Stati Uniti sono molto più avanti nel campo dell’Ai generativa. Ai cinesi non piacciono i Large Language Models (LLM) come ChatGPT perché sono molto difficili da censurare e controllare e il governo cinese limiterà tutto ciò che non può censurare o controllare“, ha spiegato Ross sulle pagine di La Repubblica.
Altro limite per l’Europa: al momento sembra più decisa a normare l’IA che a svilupparla. Secondo Ross: “Invece di schierare la propria, gli europei hanno preferito recitare la parte dell’arbitro, che fischia i falli e mostra il cartellino giallo. L’arbitro può contribuire a decidere il risultato della partita, soprattutto se dirige male, ma non è mai lui a vincerla. Se vogliono vincere, gli europei devono mandare in campo la loro squadra”.
Avvicinare l’IA a starutp e piccole e medie imprese
L’iniziativa mira a garantire un’ampia gamma di misure a sostegno delle start-up e dell’innovazione in materia di IA, compresa una proposta volta a fornire un accesso privilegiato ai supercomputer alle startup nel settore dell’IA e alla comunità dell’innovazione in senso lato.
Sul fronte degli investimenti venture capital in IA, gli Stati Uniti impiegano circa cinque volte l’importo speso in Cina e undici volte di quello nell’UE. Tra i Paesi europei, la Francia, la Germania e la Svezia si collocano sul podio coprendo circa il 65% degli investimenti VC totali in UE. L’Italiasi classifica in ottava posizione dietro a Romania, Spagna e Irlanda.
IA, in Europa è guerra tra le aziende per accaparrarsi i migliori professionisti
Aumenta il numero di imprese del settore IA europeo
Negli ultimi 10 anni, il numero di persone che lavorano nel campo dell’intelligenza artificiale (IA) in tutta Europa è aumentato del 1.000%.
Gran parte degli esperti sta progressivamente confluendo in alcune startup di grande rilevanza. Lo scorso anno queste società si sono assicurate 11 mega-round europei su 36, da 100 milioni di dollari. Tra queste possiamo evidenziare Mistral AI, che ha portato a casa 105 milioni di dollari circa, e Aleph Alpha, che si è assicurata 460 milioni di dollari in finanziamenti di serie B.
Dei sette unicorni nati in Europa nel 2023, quattro sono attivi nel settore IA: DeepL, Helsing.ai, Synthesia e Quantexa.
Negli ultimi cinque anni, la forza lavoro IT europea è passata da 750.000 dipendenti agli oltre 2,3 milioni di oggi. Secondo Tom Wehmeier, capo dell’intelligence di Atomico: “Spesso si pensa che i migliori talenti nel settore tecnologico migrino dall’Europa agli Stati Uniti, ma guardando bene i dati si può constatare che è il contrario”.
Più professionisti in Europa che negli USA (ma qui è più facile raccogliere fondi)
Cambia però il rapporto tra le due sponde dell’Atlantico per quel che riguarda gli investimenti e la capacità di raccogliere risorse finanziarie.
Le startup americane hanno il 40% di possibilità in più di raccogliere fondi di venture capital entro i primi cinque anni di attività. Le probabilità di diventare unicorni, però, sono le stesse alla fine.
Secondo un articolo di Martin Coulter, pubblicato dalla Reuters, cavalcando l’onda degli investimenti nel settore, un gruppo di aziende straniere di intelligenza artificiale – tra cui la canadese Cohere e le statunitensi Anthropic e OpenAI – hanno aperto uffici in Europa l’anno passato, aumentando la pressione sulle aziende tecnologiche che già cercano di attrarre e trattenere talenti nella regione.
Per trattenere professionisti dell’IA aziende costrette ad ingaggi costosi
Per evitare di perdere competenze al momento difficili da rimpiazzare, secondo la società di ricerca Avery Fairbank, nell’ultimo anno c’è stato un “aumento esponenziale” delle retribuzioni per il personale dirigente delle società di intelligenza artificiale in Gran Bretagna, con un incremento tra 50 e 100 mila sterline (su uno stipendio base di 350 mila sterline).
Questo potrebbe rappresentare un punto di svolta in negativo per il mercato dell’IA europeo, perché molte aziende si troveranno in tempi rapidi di fronte ad una scelta cruciale: sborsare più soldi, o perdere professionisti (al momento già insufficienti rispetto alle sfide che attendono le organizzazioni).
IA, Garante Privacy avvia istruttoria su “SORA” di OpenAI
Il Garante Privacy ha avviato una istruttoria nei confronti di OpenAI, la società statunitense che nelle scorse settimane ha annunciato il lancio di un nuovo modello di intelligenza artificiale, denominato “Sora”, in grado, da quanto annunciato, di creare scene dinamiche, realistiche e fantasiose, partendo da poche istruzioni testuali.
Considerate le possibili implicazioni che il servizio “Sora” potrebbe avere sul trattamento dei dati personali degli utenti che si trovano nell’Unione europea e in particolare in Italia, l’Autorità ha chiesto ad OpenAi di fornire una serie di chiarimenti.
Entro 20 giorni, la società dovrà precisare se il nuovo modello di intelligenza artificiale sia un servizio già disponibile al pubblico e se venga o verrà offerto ad utenti che si trovano nell’Unione Europea, in particolare in Italia.
OpenAI inoltre dovrà chiarire al Garante una serie di elementi: le modalità di addestramento dell’algoritmo; i dati raccolti ed elaborati per addestrarlo, specialmente se si tratti di dati personali; se tra questi vi siano anche particolari categorie di dati (convinzioni religiose, filosofiche, opinioni politiche, dati genetici, salute, vita sessuale); quali siano le fonti utilizzate.
Nel caso in cui il servizio venga o verrà offerto a utenti che si trovano nell’Ue, il Garante ha chiesto in particolare alla società di indicare se le modalità previste per informare utenti e non utenti e le basi giuridiche del trattamento dei dati forniti di quanti accedono al servizio siano conformi al Regolamento europeo.
Tecnologie e competenze digitali, bando Ue da 176 milioni di euro (un terzo delle risorse per l’IA)
Il nuovo bando per IA, competenze digitali, spazio europeo dei dati e infrastrutture cloud-to-edge
Prosegue il lavoro del programma Europa Digitale per favorire l’incontro tra i cittadini, le amministrazioni pubbliche e le imprese alla trasformazione digitale, alle sue tecnologie e conoscenze. La Commissione europea ha lanciato un nuovo bando da 176 milioni di euro per far partire nuovi progetti dedicati alla strategia europea sui dati, per ampliare le infrastrutture informatiche, per sviluppare e promuovere innovazione tecnologica e favorire il miglioramento delle competenze digitali e tecnologiche in generale.
Per partecipare c’è tempo fino al 29 maggio 2024.
Per le iniziative e le proposte relative all’intelligenza artificiale (IA), l’invito mette a disposizione di imprese, amministrazioni pubbliche e altre organizzazioni degli Stati dell’Unione circa 67,5 milioni di euro. Tra gli obiettivi fissati dal bando la creazione di grandi modelli linguistici ‘made in EU’ e soluzioni di IA generativa.
Per realizzare invece uno spazio europeo dei dati e una strategia di tutela e gestione degli stessi, sono stati stanziati 74 milioni di euro.
Quasi 30 milioni di euro saranno messi a disposizione di progetti invece dedicati alle infrastrutture cloud-to-edge, col fine di integrare al meglio le diverse soluzioni edge nei settori chiave delle telecomunicazioni e dell’industria.
Al centro sempre le competenze digitali
Altri progetti saranno selezionati per rafforzare la piattaforma europea delle competenze digitali, necessarie per formare nuovi profili professionali, di cui tanto l’economia e le industrie più rilevanti al momento hanno bisogno. Qui sono stati messi circa 4 milioni di euro.
Un altro milione di euro, infine, è stato stanziato per un progetto volto a promuovere la collaborazione transfrontaliera per l’offerta di servizi pubblici digitali.
Il Programma Europa Digitale è il primo programma di finanziamento dell’UE incentrato sull’avvicinamento della tecnologia digitale alle imprese e ai cittadini. Con un bilancio totale previsto di 7,5 miliardi di euro in 7 anni, contribuisce alla trasformazione digitale della società e dell’economia europea, apportando benefici in particolare alle piccole e medie imprese.
NIST AI Risk Management Framework, una risorsa per le organizzazioni
Poco più di un anno fa, nel gennaio del 2023, il National Institute of Standards and Technology (NIST) ha diffuso un documento dal titolo “Artificial Intelligence Risk Management Framework – AI RMF 1.0” al fine di contribuire alla mitigazione dei rischi legati all’Intelligenza Artificiale.
Il documento è accompagnato dall’AI RMF Playbook, che fornisce ulteriori strumenti per l’implementazione delle misure raccomandate dal Framework.
La strategia USA sull’Intelligenza Artificiale
L’AI RMF scaturisce da un’elaborazione triennale che ha visto l’agenzia statunitense collaborare con diversi partner pubblici e privati.
Le fitte consultazioni con gli esponenti delle Big Tech caratterizzano da diversi anni i lavori del governo di Washington sul tema; in questo parzialmente differenziandosi dalla strategia europea, che vede un minor contributo dei privati alla nascente regolamentazione di settore.
L’Artificial Intelligence Risk Management Framework si articola in due parti, la prima delle quali (“Foundational Information”) è suddivisa in 4 sotto-sezioni:
Framing Risk. Dopo aver definito il rischio come “composite measure of an event’s probability of occurring and the magnitude or degree of the consequences”, il NIST riconosce che la valutazione quantitativa/qualitativa del rischio legato agli strumenti AI, soprattutto nelle prime fasi del loro ciclo di vita, presenta delle difficoltà; sottolineando come la pretesa di “azzerare” i livelli di rischio possa addirittura risultare “controproduttiva”, dovendosi pertanto preferire misure e strategie mirate alla loro ragionevole mitigazione.
Audience. Ritenendo che ogni strategia di risk management dipenda dalla “collective responsibility” il documento evidenzia la necessità che i relativi processi abbiano uno stampo multidisciplinare, includendo diverse professionalità, prospettive e discipline per garantirne l’efficacia e il successo.
AI Risks and Trustworthiness. Rispetto all’affidabilità dei sistemi basati sull’Intelligenza Artificiale, il Framework cita diverse caratteristiche che andrebbero sempre contemplate (e bilanciate fra loro) nella progettazione degli stessi:
safe,
valid and reliable,
secure and resilient,
accountable and transparent,
explainable and interpretable,
privacy-enhanced,
fair with harmful bias managed.
Effective. Come già avvenuto per la stesura del Framework, rispetto alla valutazione della sua efficacia e agli eventuali aggiornamenti futuri il NIST dichiara l’intenzione di voler procedere “in conjunction with the AI community”.
Anche la seconda parte (dal titolo “Core and Profiles”) si articola in quattro sezioni, corrispondenti ad altrettante funzioni essenziali per la gestione dei rischi connessi all’impiego dell’Intelligenza Artificiale:
Govern. Rispetto al ruolo delle istituzioni governative il documento cita come esempi: “policies, processes, and procedures for AI systems; empowering teams responsible for AI systems; promoting workforce diversity, equity, inclusion, and accessibility; and implementing processes for robust engagement with relevant AI actors”.
Map. L’importanza di questa funzione deriva dalla complessità dell’AI system lifecycle, che impone di coordinare diverse prospettive e numerosi attori al fine di “develop more trustworthy AI systems by improving their capacity for understanding contexts or anticipating risks of non-intended uses of AI systems”.
Measure. La funzione di “misurazione” e monitoraggio dei pericoli legati all’AI e dei relativi impatti, finalizzata a fornire “a traceable basis to inform management decisions”, include la valutazione dei sistemi in base alle loro caratteristiche (specificate nella Parte I), oltre a meccanismi per tracciare l’evoluzione dei rischi nel tempo e a sistemi di feedback circa la validità e attualità delle misurazioni stesse.
Manage. L’ultima funzione raggruppa tutte le attività associate alla gestione operativa dei rischi (anche relativi a “third-party AI systems”) identificati lungo i passaggi precedenti: ciò include la loro classificazione in ordine di priorità e la definizione di strategie per “maximize AI benefits and minimize negative impacts” nonché la scelta delle più idonee contromisure, che devono sempre includere “response and recovery plans”.
Quanto infine ai destinatari cui si rivolge, il Framework dichiara l’ambizioso obiettivo di rappresentare una risorsa per ogni individuo, organizzazione o società – a prescindere dal settore di riferimento – le cui operazioni includano attività di “designing, developing, deploying or using AI systems, to help manage the many risks of AI and promote trustworthy and responsible development and use of AI systems”.