False estensioni AI su Chrome: rubano API e sessioni


Un’inquietante campagna di cyberspionaggio ha colpito almeno 260.000 utenti Chrome, sfruttando il crescente interesse verso gli assistenti basati su intelligenza artificiale. Dietro un’apparente offerta di tool utili per scrivere, riassumere o leggere le email, si celano invece estensioni malevole progettate per rubare dati sensibili e informazioni personali.

AiFrame: l’infrastruttura della truffa

L’indagine è stata condotta da LayerX Security che ha ribattezzato l’operazione con il nome “AiFrame”. Tutte le estensioni riconosciute all’interno di questa campagna malevola, ben 32, condividono lo stesso codice base e comunicano con domini remoti sotto il controllo di tapnetic[.]pro, un’infrastruttura centralizzata che consente agli attaccanti di gestire in tempo reale i payload e le capacità delle estensioni.

Spesso, queste campagne durano poco dal momento che le estensioni vengono controllate spesso dagli esperti di sicurezza, ma AiFrame ha organizzato un sistema di “reincarnazione” automatica grazie al quale diverse estensioni rimosse dallo store ufficiale sono ricomparse con nuovi ID, mantenendo nome e funzionalità simili. È il caso di AI Sidebar, che dopo essere stata rimossa come “Gemini AI Sidebar” (con 80.000 installazioni) è riapparsa con un nuovo ID, già utilizzato da oltre 70.000 utenti.
Iframe invisibili e attacchi silenziosi

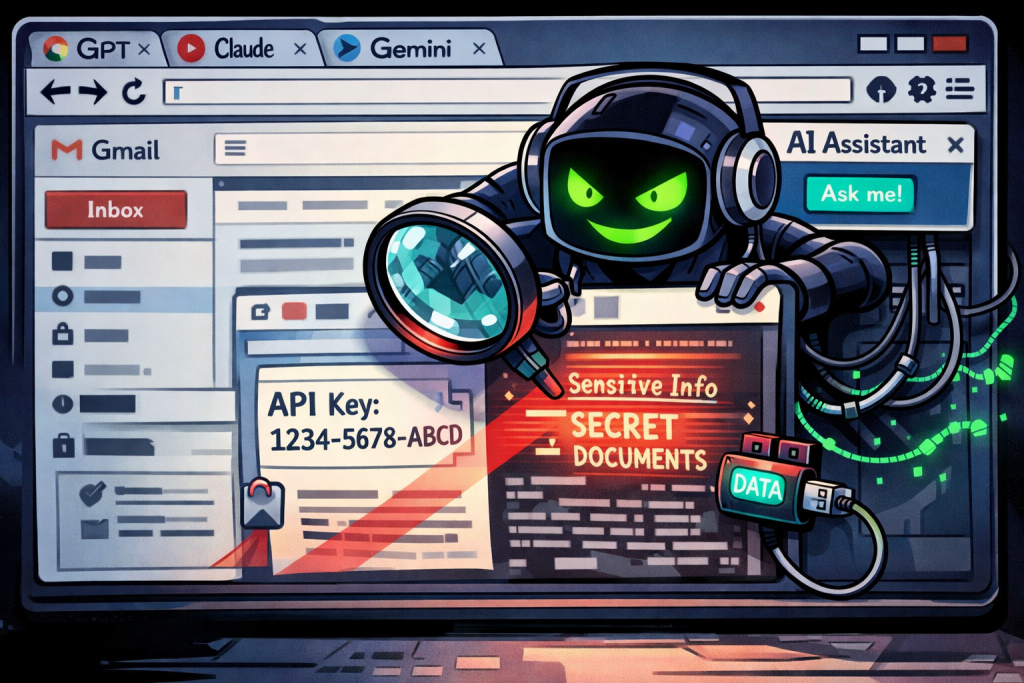
Uno degli elementi tecnici più pericolosi di AiFrame è l’uso degli iframe. L’interfaccia dell’estensione non è reale, ma è un overlay caricato da remoto che può essere modificato dinamicamente in ogni momento, senza passare da un aggiornamento ufficiale sul Chrome Web Store. Questo iframe è in grado di inviare comandi all’estensione, istruendola a leggere contenuti dalla pagina attiva.

Gli script iniettati sfruttano librerie come Readability di Mozilla per estrarre titoli, testi, metadata e contenuti leggibili. Le informazioni raccolte, inclusi eventuali token di autenticazione e contenuti dinamici, vengono poi trasmesse al dominio remoto, sfuggendo a ogni controllo dell’utente e di Google.

Gmail nel mirino: accesso completo ai contenuti

Circa la metà delle estensioni individuate si concentra su Gmail, implementando un codice comune per l’integrazione con la casella di posta. L’estensione è in grado di leggere i messaggi visibili, accedere ai contenuti delle conversazioni, e persino intercettare i testi in fase di scrittura. Tutti questi dati vengono silenziosamente inoltrati ai server remoti, senza che l’utente possa rendersene conto.

Il badge “Featured” assegnato ad alcune di queste estensioni, come nel caso di “AI Assistant”, aggrava ulteriormente la situazione: l’etichetta di qualità contribuisce a consolidare un falso senso di sicurezza, inducendo l’utente a fidarsi di un componente che, in realtà, agisce da agente malevolo nel browser.

L’ingegneria sociale dell’intelligenza artificiale

L’attacco è particolarmente insidioso perché sfrutta un fenomeno sociotecnico recente: l’interazione conversazionale con gli assistenti AI ha abbattuto le barriere di diffidenza, portando gli utenti a condividere più facilmente dati e contesti personali. Questa abitudine è stata trasformata dagli attaccanti in un punto di forza: gli iframe truccati simulano perfettamente le interfacce di strumenti noti come ChatGPT, Claude o Gemini, rendendo l’intercettazione praticamente invisibile.

Anche il riconoscimento vocale è stato utilizzato come vettore: alcune estensioni captano le parole pronunciate dagli utenti, le trascrivono e le inviano al server controllato dagli attaccanti, aggiungendo un ulteriore livello di sorveglianza invisibile.

Ancora disponibili, ancora pericolose

Nonostante la gravità della scoperta, molte delle estensioni malevole risultano ancora oggi disponibili sul Chrome Web Store. Google, al momento della pubblicazione del report, non ha rilasciato alcun commento ufficiale sulla vicenda.

Il report completo di LayerX elenca gli ID di tutte le estensioni coinvolte. Finché non verranno rimosse, il consiglio è di sospendere ogni fiducia verso gli assistenti AI installabili come estensioni browser, almeno fino a una verifica rigorosa delle fonti e dei permessi richiesti.

Condividi l’articolo


Articoli correlati

Altro in questa categoria


https://www.securityinfo.it/2026/02/13/false-estensioni-ai-su-chrome-rubano-api-e-sessioni/?utm_source=rss&utm_medium=rss&utm_campaign=false-estensioni-ai-su-chrome-rubano-api-e-sessioni

Effetto Domino: nel 2026 i fornitori sono le vulnerabilità più critiche


Nell’ultimo High-Tech Crime Trends Report 2026 realizzato da Group-IB, leader globale nella cybersecurity e nell’investigazione dei crimini digitali, emerge un quadro inquietante sull’evoluzione delle minacce. Lo studio, frutto di un monitoraggio costante effettuato dai centri DCRC in 11 paesi e basato su telemetria e investigazioni sul campo, è stato concepito per fornire a governi e aziende una utile guida per anticipare i rischi di un panorama cyber sempre più interconnesso.

L’industrializzazione del rischio nella supply chain moderna

Da qualche tempo, ormai, l’attenzione dei gruppi dediti al cybercrimine si sta spostando dalle singole infrastrutture verso l’intero ecosistema di fiducia che lega fornitori e clienti finali. Secondo l’analisi di Group-IB, non siamo più di fronte a intrusioni isolate ma a una vera e propria compromissione sistemica delle catene di approvvigionamento tecnologico globale. Gli attaccanti hanno compreso che colpire un singolo vendor SaaS, un fornitore di servizi gestiti o un repository di codice significa ottenere un accesso immediato e persistente a centinaia di organizzazioni a valle della catena di distribuzione del servizio o del  software. Questo cambio di paradigma trasforma una singola vulnerabilità locale in un effetto domino capace di paralizzare interi settori industriali con un’efficienza operativa senza precedenti.

La militarizzazione del codice aperto e dei flussi d’identità

Uno dei fronti più critici evidenziati dal report riguarda la corruzione dei repository open-source come npm e PyPI, diventati i nuovi vettori per la distribuzione di malware su scala “industriale”. Attraverso il furto di credenziali dei manutentori e l’uso di worm automatizzati, i cybercriminali iniettano codice malevolo nelle librerie software, trasformando le pipeline di sviluppo in canali di infezione di massa. Parallelamente, assistiamo a un’evoluzione del phishing potenziato dall’intelligenza artificiale che ora mira specificamente ai workflow di integrazione OAuth. Questo approccio permette agli attori malevoli di aggirare l’autenticazione a più fattori e stabilire una presenza legittima e duratura all’interno degli ambienti cloud e dei sistemi CI/CD, rendendo la distinzione tra traffico lecito e malevolo quasi impossibile per i perimetri difensivi classici.

L’ecosistema del ransomware e il mercato degli accessi a monte

Il modello operativo del crimine informatico si è strutturato in una filiera altamente specializzata dove i broker di accesso iniziale e gli operatori ransomware collaborano con una precisione e un coordinamento degno delle migliori filiere produttive tradizionali. L’obiettivo primario dei gruppi di minaccia non è più la singola vittima, ma i punti di accesso a monte che garantiscono un’esposizione multi-tenant. Questo approccio moltiplica l’impatto finanziario delle campagne di estorsione, poiché la violazione di un unico fornitore di servizi si traduce nella compromissione simultanea di decine di database di clienti diversi. I gruppi più sofisticati, tra cui spiccano nomi come Lazarus e Scattered Spider, stanno sfruttando metodicamente queste architetture di fiducia condivisa per massimizzare l’asimmetria dell’attacco e minimizzare i tempi di rilevamento.

Verso una difesa basata sulla gestione della fiducia sistemica

In questo scenario di minacce interconnesse, la sicurezza informatica deve evolvere verso una protezione che non si limiti ai confini aziendali ma che analizzi ogni singola dipendenza e relazione digitale. Come sottolineato dai ricercatori di Group-IB, la sfida attuale per i responsabili della sicurezza è mettere in sicurezza la fiducia stessa attraverso un monitoraggio rigoroso delle integrazioni di terze parti e una verifica continua delle identità. Non è più sufficiente proteggere i propri asset isolati, poiché è necessario anticipare i rischi emergenti analizzando le dinamiche degli ecosistemi underground dove vengono scambiati gli accessi privilegiati. Solo una visione che integri l’intelligence predittiva con una comprensione profonda delle catene di attacco integrate può permettere alle aziende di interrompere il ciclo dell’offensiva prima che il danno diventi sistemico.

Condividi l’articolo


Articoli correlati

Altro in questa categoria


https://www.securityinfo.it/2026/02/12/effetto-domino-nel-2026-i-fornitori-sono-le-vulnerabilita-piu-critiche/?utm_source=rss&utm_medium=rss&utm_campaign=effetto-domino-nel-2026-i-fornitori-sono-le-vulnerabilita-piu-critiche


Lummastealer risorge dalle ceneri: ancora una volta lo stop è momentaneo


L’ecosistema del cybercrime dimostra ancora una volta una resilienza straordinaria: a meno di dodici mesi dall’operazione di smantellamento internazionale che sembrava averne decretato la fine, LummaStealer è riemerso con una catena di infezione profondamente rinnovata. Il ritorno di questo infostealer non è un semplice “rebranding”, ma una ristrutturazione tattica che vede l’introduzione di CastleLoader come primo stadio critico.

Questa nuova architettura dimostra come i gruppi MaaS (Malware-as-a-Service) siano in grado di riorganizzare le proprie infrastrutture C2 e i vettori di delivery in tempi record, capitalizzando sulle lezioni apprese dai precedenti shutdown delle autorità.

L’Architettura Modulare e il Ruolo di CastleLoader

La nuova struttura offensiva si basa su un design modulare a più stadi, dove CastleLoader funge da sofisticato “apripista” per il payload finale. Questo loader non è un semplice downloader, ma un componente progettato per l’evasione preventiva. Una volta eseguito, solitamente attraverso archivi compressi che simulano software legittimo, CastleLoader avvia una serie di controlli ambientali per rilevare la presenza di sandbox o debugger. Solo dopo aver confermato di trovarsi su un host reale e non in un ambiente di analisi, il loader stabilisce una connessione cifrata per recuperare LummaStealer, iniettandolo direttamente nella memoria di processi di sistema già attivi, minimizzando così l’impronta sul file system dell’host.

Il nucleo operativo di LummaStealer è caratterizzato da un offuscamento estremamente aggressivo, finalizzato a neutralizzare sia l’analisi statica che quella euristica. Il malware impiega tecniche di risoluzione dinamica delle funzioni API, evitando di importare palesemente le librerie sospette nella propria tabella di importazione (IAT). Questo approccio, unito all’uso di junk code e metamorfismo del codice sorgente, rende estremamente difficile la creazione di firme rilevanti. Inoltre, il malware sfrutta il controllo del flusso indiretto per confondere i motori di disassemblaggio, garantendo che l’esecuzione del codice malevolo avvenga in modo non lineare e protetto da trigger di rilevamento comportamentale.

Esfiltrazione Mirata e Gestione dei Dati Sensibili

Una volta stabilita la persistenza in memoria, LummaStealer attiva i suoi moduli di scansione focalizzati sull’estrazione di asset digitali di alto valore. Il targeting è chirurgico: il malware interroga i database SQL dei browser per recuperare cookie di sessione (utili per il session hijacking), dati di auto-fill e credenziali salvate. Particolare enfasi viene posta sui cold wallet di criptovalute e sulle estensioni browser dedicate alla gestione di asset digitali, dove il malware tenta di esfiltrare chiavi private e seed. I dati raccolti vengono pacchettizzati e inviati a server C2 attraverso protocolli di comunicazione che imitano il normale traffico web, spesso sfruttando servizi cloud legittimi come tunnel per mascherare la destinazione finale dei pacchetti esfiltrati.

Infrastruttura di Comando e Strategie di Hardening

La rete di Comando e Controllo (C2) è stata riprogettata per evitare i singoli punti di fallimento che hanno portato al precedente abbattimento. Gli operatori utilizzano ora un’architettura decentralizzata o domini a vita breve (fast-flux), che rendono complessa l’identificazione dei server master. Per i difensori IT, il contrasto a questa minaccia richiede un monitoraggio intensivo dei tentativi di iniezione di memoria e delle anomalie nel traffico di rete in uscita. È essenziale implementare soluzioni EDR capaci di correlare l’apertura di file sospetti con chiamate di sistema insolite, oltre a una rigorosa segmentazione dei privilegi utente per impedire che il loader possa scalare le autorizzazioni necessarie per l’esfiltrazione dei dati di sistema.

Condividi l’articolo


Articoli correlati

Altro in questa categoria


https://www.securityinfo.it/2026/02/11/lummastealer-risorge-dalle-ceneri-ancora-una-volta-lo-stop-e-momentaneo/?utm_source=rss&utm_medium=rss&utm_campaign=lummastealer-risorge-dalle-ceneri-ancora-una-volta-lo-stop-e-momentaneo


ZeroDayRAT: La Nuova Minaccia per Android e iOS


I ricercatori di iVerify, un’azienda specializzata in sicurezza informatica per dispositivi mobili, ha rivelato l’arrivo nel panorama delle minacce di un nuovo, preoccupante strumento: ZeroDayRAT. Questa piattaforma spyware è emersa nel sottobosco del cybercrime su Telegram, presentandosi come una soluzione completa per il controllo remoto di dispositivi Android e iOS. Lungi dall’essere un semplice estrattore di dati, ZeroDayRAT si posiziona come un toolkit di compromissione mobile a tutto tondo in grado di offrire agli aggressori un controllo profondo e persistente sui dispositivi infetti.

Architettura e Compatibilità del Malware

ZeroDayRAT si distingue per la sua ampia compatibilità, estendendosi su un vasto spettro di versioni di sistemi operativi mobili. Gli sviluppatori pubblicizzano il supporto per le versioni Android dalla 5 alla 16, coprendo quindi sia dispositivi legacy che i più recenti aggiornamenti del sistema operativo Google. Sul fronte Apple, la compatibilità arriva fino a iOS 26, includendo le ultime versioni del sistema operativo mobile. Questa trasversalità rende ZeroDayRAT una minaccia preoccupante poiché la sua potenziale superficie di attacco è estremamente ampia. La piattaforma offre agli acquirenti un pannello di controllo completo, con una interfaccia di gestione intuitiva e centralizzata dei dispositivi compromessi, evidenziando una grande maturità nella sua concezione e implementazione.

Capacità di Monitoraggio e Raccolta Dati

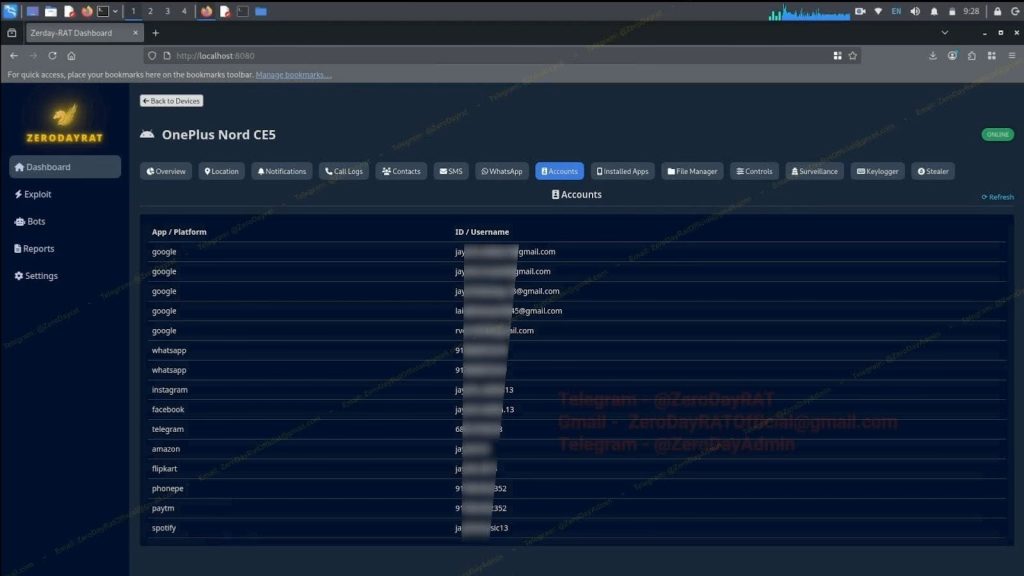
Il cuore operativo di ZeroDayRAT risiede nelle sue estese capacità di sorveglianza passiva. La dashboard di gestione del malware fornisce all’operatore una panoramica dettagliata di ogni dispositivo compromesso, visualizzando informazioni cruciali come il modello del terminale, la versione del sistema operativo, lo stato della batteria, i dettagli della SIM (inclusi IMSI e IMEI), la posizione geografica del dispositivo e lo stato del blocco schermo. A un livello più granulare, il malware è in grado di registrare l’utilizzo delle applicazioni, tracciare le cronologie delle attività dell’utente e intercettare tutti gli scambi di messaggi SMS. Ulteriori sezioni del pannello permettono di visualizzare le notifiche ricevute e un elenco degli account registrati sul dispositivo, fornendo identificativi utente ed e-mail che potrebbero essere successivamente sfruttati per attacchi di brute-forcing o credential stuffing su altri servizi. Se sono stati ottenuti i permessi di accesso al GPS, ZeroDayRAT è in grado di tracciare la vittima in tempo reale, visualizzando la posizione attuale su una mappa interattiva, completa di cronologia degli spostamenti.

Dal sito di iVerify

Operazioni Attive e Controllo Remoto

Oltre alla sorveglianza passiva, ZeroDayRAT abilita una serie di operazioni attive che consentono agli aggressori un controllo diretto sul dispositivo. Questo include la possibilità di attivare da remoto le fotocamere (sia quella anteriore che posteriore) e il microfono, fornendo flussi multimediali in tempo reale per la sorveglianza ambientale. Un modulo di registrazione dello schermo permette di catturare l’interazione dell’utente con il dispositivo, rivelando password, PIN, gesti di sblocco e altre informazioni sensibili. L’accesso ai permessi SMS è particolarmente critico: non solo consente l’intercettazione delle password monouso (OTP), facilitando il bypass dell’autenticazione a due fattori (2FA), ma permette anche l’invio di SMS dal dispositivo della vittima, potenzialmente per attività di spam, frode o diffusione del malware stesso. Ulteriormente, un modulo keylogging registra ogni input dell’utente, comprese password, pattern di sblocco e qualsiasi testo digitato, offrendo una miniera d’oro di credenziali.

Furto Finanziario Avanzato

ZeroDayRAT implementa moduli specifici per il furto finanziario, dimostrando una focalizzazione diretta sull’esfiltrazione di asset economici. Un componente dedicato al furto di criptovalute scannerizza le app wallet più comuni come MetaMask, Trust Wallet, Binance e Coinbase. Questo modulo non solo registra gli ID dei wallet e i saldi, ma tenta anche l’iniezione di indirizzi negli appunti, sostituendo gli indirizzi wallet copiati dalla vittima con indirizzi controllati dall’aggressore per deviare le transazioni. Parallelamente, un “bank stealer” prende di mira le app di online banking, le piattaforme UPI (come Google Pay e PhonePe) e servizi di pagamento come Apple Pay e PayPal. La tattica principale qui è l’utilizzo di overlay screen, ovvero schermate false che si sovrappongono all’interfaccia legittima dell’app per ingannare la vittima e indurla a inserire le proprie credenziali direttamente nelle mani dell’aggressore.

Implicazioni per la Sicurezza Aziendale e Individuale

Il toolkit ZeroDayRAT, sebbene non sia stato dettagliato il suo meccanismo di distribuzione iniziale da iVerify, rappresenta una minaccia significativa a più livelli. Per le organizzazioni, la compromissione di un dispositivo di un dipendente tramite ZeroDayRAT potrebbe fungere da punto d’ingresso per violazioni aziendali più ampie, esponendo dati sensibili e infrastrutture critiche. La capacità di intercettare OTP e credenziali, unita al keylogging e al controllo remoto, può bypassare molte delle difese perimetrali tradizionali. A livello individuale, una compromissione ZeroDayRAT porta a una totale perdita di privacy e a potenziali perdite finanziarie devastanti. La raccomandazione primaria per mitigare tali rischi rimane l’adesione rigorosa all’installazione di applicazioni esclusivamente dagli store ufficiali (Google Play e Apple App Store) e da sviluppatori con comprovata reputazione. Per gli utenti ad alto rischio, l’attivazione di funzionalità di sicurezza avanzate come la “Modalità Lockdown” su iOS e la “Protezione Avanzata” su Android è fortemente consigliata, poiché queste opzioni sono progettate per limitare l’esposizione a exploit e malware sofisticati.

Condividi l’articolo


Articoli correlati

Altro in questa categoria


https://www.securityinfo.it/2026/02/10/zerodayrat-la-nuova-minaccia-per-android-e-ios/?utm_source=rss&utm_medium=rss&utm_campaign=zerodayrat-la-nuova-minaccia-per-android-e-ios


L’arma dell’autenticità: come il cybercrimine sta piegando i servizi SaaS


Il panorama delle minacce informatiche è in continuo cambiamento e recentemente si sta assistendo a  una metamorfosi del phishing dove la tecnica del mascheramento cede il passo all’abuso deliberato delle infrastrutture cloud legittime. Check Point Software Technologies ha recentemente portato alla luce una campagna di phishing massiva che, invece di creare domini fraudolenti, utilizza le funzionalità native delle piattaforme Software-as-a-Service (SaaS) per veicolare truffe telefoniche. L’operazione ha già raggiunto numeri impressionanti, con circa 133.260 e-mail inviate che hanno messo nel mirino oltre 20.000 aziende a livello globale, sfruttando la reputazione di giganti come Microsoft, Zoom e Amazon.

Questa strategia segna un cambio di paradigma fondamentale nel social engineering, poiché le esche non sono semplici imitazioni ma comunicazioni generate dai sistemi reali dei fornitori. Inserendo contenuti fraudolenti nei campi controllati dall’utente, come i dati del profilo o i metadati di fatturazione, gli attaccanti costringono le piattaforme a inviare notifiche ufficiali che superano indenni ogni controllo di autenticazione come SPF, DKIM e DMARC. Il risultato è un messaggio che eredita la totale fiducia e autorevolezza del brand mittente, rendendo quasi impossibile il rilevamento da parte dei sistemi di sicurezza automatizzati e abbassando drasticamente la soglia di sospetto degli utenti.

Un fenomeno in rapida crescita

L’analisi dei dati evidenzia un’accelerazione verticale del fenomeno negli ultimi mesi: se nell’ultimo semestre si sono registrate circa 648.291 e-mail malevole, ben 463.773 di queste sono state concentrate negli ultimi tre mesi. Questa impennata suggerisce che i criminali informatici considerino l’abuso del SaaS un meccanismo di distribuzione estremamente scalabile e redditizio. David Gubiani, Regional Director Security Engineering di Check Point, sottolinea come a peggiorare la situazione (rendendo gli attacchi potenzialmente molto più  efficaci) dopo il primo approccio tramite email, l’operatività venga spostata al telefono, tramite l’indicazione di chiamare il call center per sistemare il problema. In questo modo, si bypassa l’analisi degli URL e il sandboxing, trasferendo il cuore dell’attacco verso una manipolazione vocale diretta, dove il fattore umano diventa l’anello debole.

I metodi identificati spaziano dalla manipolazione dei campi profilo su piattaforme come YouTube e Malwarebytes, alla generazione di notifiche di abbonamento fraudolente tramite i flussi di lavoro di Microsoft Entra ID e Power BI. Particolarmente sofisticato è l’abuso degli inviti di Amazon Business, dove gli aggressori inseriscono falsi addebiti e finti numeri di assistenza da chiamare direttamente nei campi dell’invito aziendale. In tutti questi casi, le piattaforme non sono state compromesse nel senso tradizionale del termine: sono le loro funzionalità legittime a essere utilizzate impropriamente per dare credibilità a una truffa che si conclude con una chiamata a un call center controllato dai criminali.

USA bersaglio preferito, ma Europa al secondo posto

A livello settoriale, il comparto Tecnologia e IT è il più colpito con il 26,8% dei casi, seguito dalla produzione industriale e dal settore dell’istruzione. Geograficamente, gli Stati Uniti rimangono il bersaglio principale, ma l’Europa segue a ruota con una quota del 17,8%, a dimostrazione della portata globale dell’offensiva. La lezione per i difensori è chiara: la provenienza di un’e-mail da un dominio affidabile non è più una garanzia di sicurezza. È necessaria un’evoluzione delle strategie di difesa che passi attraverso l’analisi contestuale dei messaggi e una formazione degli utenti capace di riconoscere le nuove dinamiche del phishing vocale basato su servizi cloud.

Condividi l’articolo


Articoli correlati

Altro in questa categoria


https://www.securityinfo.it/2026/02/09/larma-dellautenticita-come-il-cybercrimine-sta-piegando-i-servizi-saas/?utm_source=rss&utm_medium=rss&utm_campaign=larma-dellautenticita-come-il-cybercrimine-sta-piegando-i-servizi-saas


Google Revises Discover Guidelines Alongside Core Update via @sejournal, @MattGSouthern

Google revised its “Get on Discover” documentation following the lauch of the February Discover core update.

On its documentation updates page, Google said it added more information on how sites can increase the likelihood of content appearing in Discover. Here’s what was added.

What Changed

Comparing the archived version with the current page shows Google rewrote its list of recommendations for Discover visibility.

The previous version combined title and clickbait guidance into a single bullet, saying to “Use page titles that capture the essence of the content, but in a non-clickbait fashion.”

Google split that into two items. The first now says “Use page titles and headlines that capture the essence of the content.” The second says “Avoid clickbait and similar tactics to artificially inflate engagement.”

That word “clickbait” is new. The previous version said “Avoid tactics to artificially inflate engagement” without naming the tactic.

The sensationalism guidance changed too. The old version said “Avoid tactics that manipulate appeal by catering to morbid curiosity, titillation, or outrage.” The revision names the tactic, saying “Avoid sensationalism tactics that manipulate appeal.”

The new addition is a recommendation to “Provide an overall great page experience,” with a link to Google’s page experience documentation. That recommendation isn’t in the archived version.

Image requirements, traffic fluctuation guidance, and performance monitoring sections remain unchanged.

Why This Matters

These documentation changes map to what Google said the core update targets. The blog post announcing the update said the update would show more locally relevant content, reduce sensational content and clickbait, and surface more original content from sites with expertise.

Discover documentation has changed before alongside algorithm updates. Previously, Google added Discover to its Helpful Content System documentation and later expanded its explanation of why Discover traffic fluctuates. Both of those updates aligned with broader changes to how Discover evaluated content.

Page experience has been part of Google’s Search guidance since 2020 but wasn’t in the Discover-specific recommendations before this revision.

Looking Ahead

The February Discover core update is rolling out to English-language users in the United States over the next two weeks. Google said it plans to expand to all countries and languages in the months ahead.

Publishers monitoring Discover traffic in Search Console should check the Get on Discover page for the current recommendations. Google’s standard core update guidance applies as well.


Featured Image: ZikG/Shutterstock

https://www.searchenginejournal.com/google-revises-discover-guidelines-alongside-core-update/566748/


n8n: nuove vulnerabilità critiche aggirano le patch di dicembre


La sicurezza di n8n, una delle piattaforme open source più utilizzate per l’automazione dei workflow, torna nuovamente sotto i riflettori dopo la scoperta di nuove vulnerabilità critiche che mettono a rischio server, credenziali e processi aziendali basati anche su intelligenza artificiale. I difetti, tracciati complessivamente come CVE-2026-25049, consentono ad attaccanti autenticati di aggirare le contromisure introdotte solo poche settimane fa per correggere una precedente falla di gravità quasi massima.

Il problema nasce da una gestione ancora imperfetta della sanitizzazione delle espressioni all’interno dei workflow. Nonostante le patch rilasciate a dicembre 2025 per mitigare la CVE-2025-68613, i ricercatori hanno dimostrato che è ancora possibile inserire codice malevolo capace di superare i controlli e arrivare all’esecuzione di comandi sul sistema host che esegue n8n. Un dettaglio che trasforma quella che dovrebbe essere una semplice automazione applicativa in un vettore di compromissione completo.

Le nuove vulnerabilità hanno ricevuto un punteggio CVSS di 9.4, ma diversi esperti ritengono che la valutazione non rifletta pienamente l’impatto reale negli ambienti di produzione. Il motivo è semplice: n8n non è un servizio periferico, bensì un nodo centrale in cui convergono credenziali, API key e token di accesso a servizi cloud, piattaforme SaaS e sempre più spesso modelli di intelligenza artificiale.

Un problema di espressioni che diventa esecuzione di comandi

Secondo quanto confermato dagli stessi maintainer di n8n in un advisory di sicurezza, un utente autenticato con i permessi per creare o modificare workflow può costruire espressioni in grado di innescare comandi di sistema non previsti. In pratica, chi ha accesso alla logica di automazione può trasformare un parametro di workflow in un punto di ingresso per il controllo dell’intero server.

È un aspetto particolarmente delicato perché n8n è spesso utilizzato in contesti collaborativi, dove più utenti o team hanno la possibilità di intervenire sui flussi. In questi casi, la linea di demarcazione tra utente legittimo e attaccante interno o compromesso diventa estremamente sottile, rendendo il modello di fiducia implicito uno dei punti più deboli della piattaforma.

Una sequenza di incidenti che preoccupa i difensori

La nuova disclosure arriva a breve distanza da un altro episodio particolarmente grave, noto come “ni8mare”, che aveva esposto decine di migliaia di server n8n alla possibile compromissione completa tramite una vulnerabilità di remote code execution sfruttabile senza autenticazione. In quel caso, bastava individuare un’istanza vulnerabile per prenderne il controllo, senza alcuna credenziale.

La frequenza con cui n8n compare nelle patch list dei team di sicurezza sta diventando un segnale d’allarme. Non tanto per la presenza di bug in sé, inevitabili in qualsiasi software complesso, quanto per la loro natura sistemica e per il tipo di accesso che rendono possibile. Ogni nuova falla sembra confermare quanto le piattaforme di automazione siano ormai infrastrutture critiche a tutti gli effetti.

Il valore dei dati custoditi nei workflow

A sottolineare la gravità del problema è anche Pillar Security, una delle realtà che hanno contribuito alla scoperta delle nuove vulnerabilità. Secondo i ricercatori, l’aspetto più pericoloso non è solo la possibilità di eseguire codice, ma il contesto in cui questo avviene. Un server n8n compromesso equivale spesso a un archivio aperto di segreti digitali.

Chi riesce a sfruttare la vulnerabilità può ottenere accesso a chiavi API di servizi come OpenAI o Anthropic, credenziali cloud per ambienti AWS e token utilizzati per orchestrare processi aziendali complessi. Il tutto senza necessariamente interrompere i workflow, che continuano a funzionare normalmente, rendendo l’attacco estremamente silenzioso.

Secondo Eilon Cohen, ricercatore di sicurezza AI presso Pillar Security, la combinazione tra semplicità di sfruttamento e valore degli asset esposti rende queste vulnerabilità particolarmente appetibili. In sostanza, la capacità di creare un workflow equivale, in alcuni contesti, alla possibilità di “possedere” l’intero server.

Patch disponibili, ma il problema resta strutturale

n8n ha rilasciato gli aggiornamenti correttivi per CVE-2026-25049 e invita gli utenti ad applicarli immediatamente. Allo stesso tempo, gli esperti raccomandano un approccio più ampio che includa una revisione rigorosa dei permessi utente, un’analisi dei workflow esistenti e la rotazione delle credenziali sensibili, soprattutto quelle legate a servizi cloud e AI.

Condividi l’articolo


Articoli correlati

Altro in questa categoria


https://www.securityinfo.it/2026/02/06/n8n-sotto-pressione-nuove-vulnerabilita-critiche-aggirano-le-patch-di-dicembre/?utm_source=rss&utm_medium=rss&utm_campaign=n8n-sotto-pressione-nuove-vulnerabilita-critiche-aggirano-le-patch-di-dicembre


Google Shows How To Check Passage Indexing via @sejournal, @martinibuster

Google’s John Mueller was asked how many megabytes of HTML Googlebot crawls per page. The question was whether Googlebot indexes two megabytes (MB) or fifteen megabytes of data. Mueller’s answer minimized the technical aspect of the question and went straight to the heart of the issue, which is really about how much content is indexed.

GoogleBot And Other Bots

In the middle of an ongoing discussion in Bluesky someone revived the question about whether Googlebot crawls and indexes 2 or 15 megabytes of data.

They posted:

“Hope you got whatever made you run 🙂

It would be super useful to have more precisions, and real-life examples like “My page is X Mb long, it gets cut after X Mb, it also loads resource A: 15Kb, resource B: 3Mb, resource B is not fully loaded, but resource A is because 15Kb < 2Mb”.”

Panic About 2 Megabyte Limit Is Overblown

Mueller said that it’s not necessary to weigh bytes and implied that what’s ultimately important isn’t about constraining how many bytes are on a page but rather whether or not important passages are indexed.

Furthermore, Mueller said that it is rare that a site exceeds two megabytes of HTML, dismissing the idea that it’s possible that a website’s content might not get indexed because it’s too big.

He also said that Googlebot isn’t the only bot that crawls a web page, apparently to explain why 2 megabytes and 15 megabytes aren’t limiting factors. Google publishes a list of all the crawlers they use for various purposes.

How To Check If Content Passages Are Indexed

Lastly, Mueller’s response confirmed a simple way to check whether or not important passages are indexed.

Mueller answered:

“Google has a lot of crawlers, which is why we split it. It’s extremely rare that sites run into issues in this regard, 2MB of HTML (for those focusing on Googlebot) is quite a bit. The way I usually check is to search for an important quote further down on a page – usually no need to weigh bytes.”

Passages For Ranking

People have short attention spans except when they’re reading about a topic that they are passionate about. That’s when a comprehensive article may come in handy for those readers who really want to take a deep dive to learn more.

From an SEO perspective, I can understand why some may feel that a comprehensive article might not be ideal for ranking if a document provides deep coverage of multiple topics, any one of which could be a standalone article.

A publisher or an SEO needs to step back and assess whether a user is satisfied with deep coverage of a topic or whether a deeper treatment of it is needed by users. There are also different levels of comprehensiveness, one with granular details and another with an overview-level of coverage of details, with links to deeper coverage.

In other words, sometimes users require a view of the forest and sometimes they require a view of the trees.

Google has long been able to rank document passages with their passage ranking algorithms. Ultimately, in my opinion, it really comes down to what is useful to users and is likely to result in a higher level of user satisfaction.

If comprehensive topic coverage excites people and makes them passionate enough about to share it with other people then that is a win.

If comprehensive coverage isn’t useful for that specific topic then it may be better to split the content into shorter coverage that better aligns with the reasons why people are coming to that page to read about that topic.

Takeaways

While most of these takeaways aren’t represented in Mueller’s response, they do in my opinion represent good practices for SEO.

  • HTML size limits belie a concern for deeper questions about content length and indexing visibility
  • Megabyte thresholds are rarely a practical constraint for real-world pages
  • Counting bytes is less useful than verifying whether content actually appears in search
  • Searching for distinctive passages is a practical way to confirm indexing
  • Comprehensiveness should be driven by user intent, not crawl assumptions
  • Content usefulness and clarity matter more than document size
  • User satisfaction remains the deciding factor in content performance

Concern over how many megabytes are a hard crawl limit for Googlebot reflect uncertainty about whether important content in a long document is being indexed and is available to rank in search. Focusing on megabytes shifts attention away from the real issues SEOs should be focusing on, which is whether the topic coverage depth best serves a user’s needs.

Mueller’s response reinforces the point that web pages that are too big to be indexed are uncommon, and fixed byte limits are not a constraint that SEOs should be concerned about.

In my opinion, SEOs and publishers will probably have better search coverage by shifting their focus away from optimizing for assumed crawl limits and instead focus on user content consumption limits.

But if a publisher or SEO is concerned about whether a passage near the end of a document is indexed, there is an easy way to check the status by simply doing a search for an exact match for that passage.

Comprehensive topic coverage is not automatically a ranking problem, and it not always the best (or worst) approach. HTML size is not really a concern unless it starts impacting page speed. What matters is whether content is clear, relevant, and useful to the intended audience at the precise levels of granularity that serves the user’s purposes.

Featured Image by Shutterstock/Krakenimages.com

https://www.searchenginejournal.com/how-check-if-entire-document-is-indexed/566661/


Google Search Hits $63B, Details AI Mode Ad Tests via @sejournal, @MattGSouthern

Alphabet reported Q4 2025 revenue of $113.8 billion, beating Wall Street estimates and marking the company’s first year above $400 billion in annual revenue. Google Search grew 17% to $63.07 billion.

On the earnings call, the company revealed how it plans to monetize AI Mode and shared new data on how AI is changing search behavior.

What’s Happening

Google Search and other advertising revenue hit $63.07 billion, up 17% from $54.03 billion in Q4 2024. Search growth accelerated through 2025, rising from 10% in Q1 to 12% in Q2 to 15% in Q3 and 17% in Q4.

CEO Sundar Pichai said Search had more usage in Q4 than ever before. He attributed the growth to AI features changing how people search.

Pichai said on the call:

“Once people start using these new experiences, they use them more. In the US, we saw daily AI Mode queries per user double since launch.”

Queries in AI Mode are three times longer than traditional searches, and a “significant portion” lead to follow-up questions.

AI Mode Monetization Tests

Chief Business Officer Philipp Schindler said Google is “in the early stages of experimenting with AI Mode monetization, like testing ads below the AI response, with more underway.”

On Direct Offers, a new pilot program, Schindler said:

“We announced Direct Offers, a new Google Ads pilot, which will allow advertisers to show exclusive offers for shoppers who are ready to buy, directly in AI Mode.”

Google also plans to launch checkout directly within AI Mode from select merchants.

Schindler said the longer AI Mode queries are creating new ad inventory. Gemini’s understanding of intent “has increased our ability to deliver ads on longer, more complex searches that were previously challenging to monetize.”

YouTube Miss Explained

YouTube ad revenue reached $11.38 billion, up 9% but below the $11.84 billion analysts expected.

Schindler attributed the miss to election ad lapping from Q4 2024:

“On the brand side, as an ad share, the largest factor negatively impacting the year-over-year growth rate was lapping the strong spend on U.S. elections.”

He also noted that subscription growth can reduce ad revenue. When users switch to YouTube Premium, it hurts ad revenue but helps the overall business.

What Else Happened

Google Cloud revenue jumped 48% to $17.66 billion. Alphabet plans to spend $175 billion to $185 billion on capital expenditures in 2026, nearly double its 2025 spending. That suggests more AI features coming to Search and other products.

Why This Matters

Looking back a year ago at Q4 2024 results, Search grew 12%. By Q1 2025, AI Overviews reached 1.5 billion monthly users, and Search was growing 10%. Now Search growth has accelerated to 17%.

The metrics Google celebrated on this call describe users staying on Google longer. Schindler described the new ad inventory as additive, reaching queries that were “previously challenging to monetize.”

That’s a monetization win for Google. The tradeoff to watch is referral traffic.

When asked about cannibalization, Pichai said Google hasn’t seen evidence of it:

“The combination of all of that I think creates an expansionary moment. I think it’s expanding the type of queries people do with Google overall.”

That may be true for queries. Whether it holds for referral traffic is something you’ll need to track in your own analytics.

Looking Ahead

Google maintains the position that AI features expand search activity rather than cannibalize it. The Q4 revenue numbers back it up.

The open question is what expanding AI Mode features means for referral traffic, and your own analytics will tell that story.


Featured Image: Rokas Tenys/Shutterstock

https://www.searchenginejournal.com/google-search-hits-63b-details-ai-mode-ad-tests/566613/


Google’s Mueller Calls Markdown-For-Bots Idea ‘A Stupid Idea’ via @sejournal, @MattGSouthern

Some developers have been experimenting with bot-specific Markdown delivery as a way to reduce token usage for AI crawlers.

Google Search Advocate John Mueller pushed back on the idea of serving raw Markdown files to LLM crawlers, raising technical concerns on Reddit and calling the concept “a stupid idea” on Bluesky.

What’s Happening

A developer posted on r/TechSEO, describing plans to use Next.js middleware to detect AI user agents such as GPTBot and ClaudeBot. When those bots hit a page, the middleware intercepts the request and serves a raw Markdown file instead of the full React/HTML payload.

The developer claimed early benchmarks showed a 95% reduction in token usage per page, which they argued should increase the site’s ingestion capacity for retrieval-augmented generation (RAG) bots.

Mueller responded with a series of questions.

“Are you sure they can even recognize MD on a website as anything other than a text file? Can they parse & follow the links? What will happen to your site’s internal linking, header, footer, sidebar, navigation? It’s one thing to give it a MD file manually, it seems very different to serve it a text file when they’re looking for a HTML page.”

On Bluesky, Mueller was more direct. Responding to technical SEO consultant Jono Alderson, who argued that flattening pages into Markdown strips out meaning and structure,

Mueller wrote:

“Converting pages to markdown is such a stupid idea. Did you know LLMs can read images? WHY NOT TURN YOUR WHOLE SITE INTO AN IMAGE?”

Alderson argued that collapsing a page into Markdown removes important context and structure, and framed Markdown-fetching as a convenience play rather than a lasting strategy.

Other voices in the Reddit thread echoed the concerns. One commenter questioned whether the effort could limit crawling rather than enhance it. They noted that there’s no evidence that LLMs are trained to favor documents that are less resource-intensive to parse.

The original poster defended the theory, arguing LLMs are better at parsing Markdown than HTML because they’re heavily trained on code repositories. That claim is untested.

Why This Matters

Mueller has been consistent on this. In a previous exchange, he responded to a question from Lily Rayabout creating separate Markdown or JSON pages for LLMs. His position then was the same. He said to focus on clean HTML and structured data rather than building bot-only content copies.

That response followed SE Ranking’s analysis of 300,000 domains, which found no connection between having an llms.txt file and how often a domain gets cited in LLM answers. Additionally, Mueller has compared llms.txt to the keywords meta tag, a format major platforms haven’t documented as something they use for ranking or citations.

So far, public platform documentation hasn’t shown that bot-only formats, such as Markdown versions of pages, improve ranking or citations. Mueller raised the same objections across multiple discussions, and SE Ranking’s data found nothing to suggest otherwise.

Looking Ahead

Until an AI platform publishes a spec requesting Markdown versions of web pages, the best practice remains as it is. Keep HTML clean, reduce unnecessary JavaScript that blocks content parsing, and use structured data where platforms have documented schemas.

https://www.searchenginejournal.com/googles-mueller-calls-markdown-for-bots-idea-a-stupid-idea/566598/