Google Tests ‘Strongest Match’ Labels On Search Ads via @sejournal, @brookeosmundson
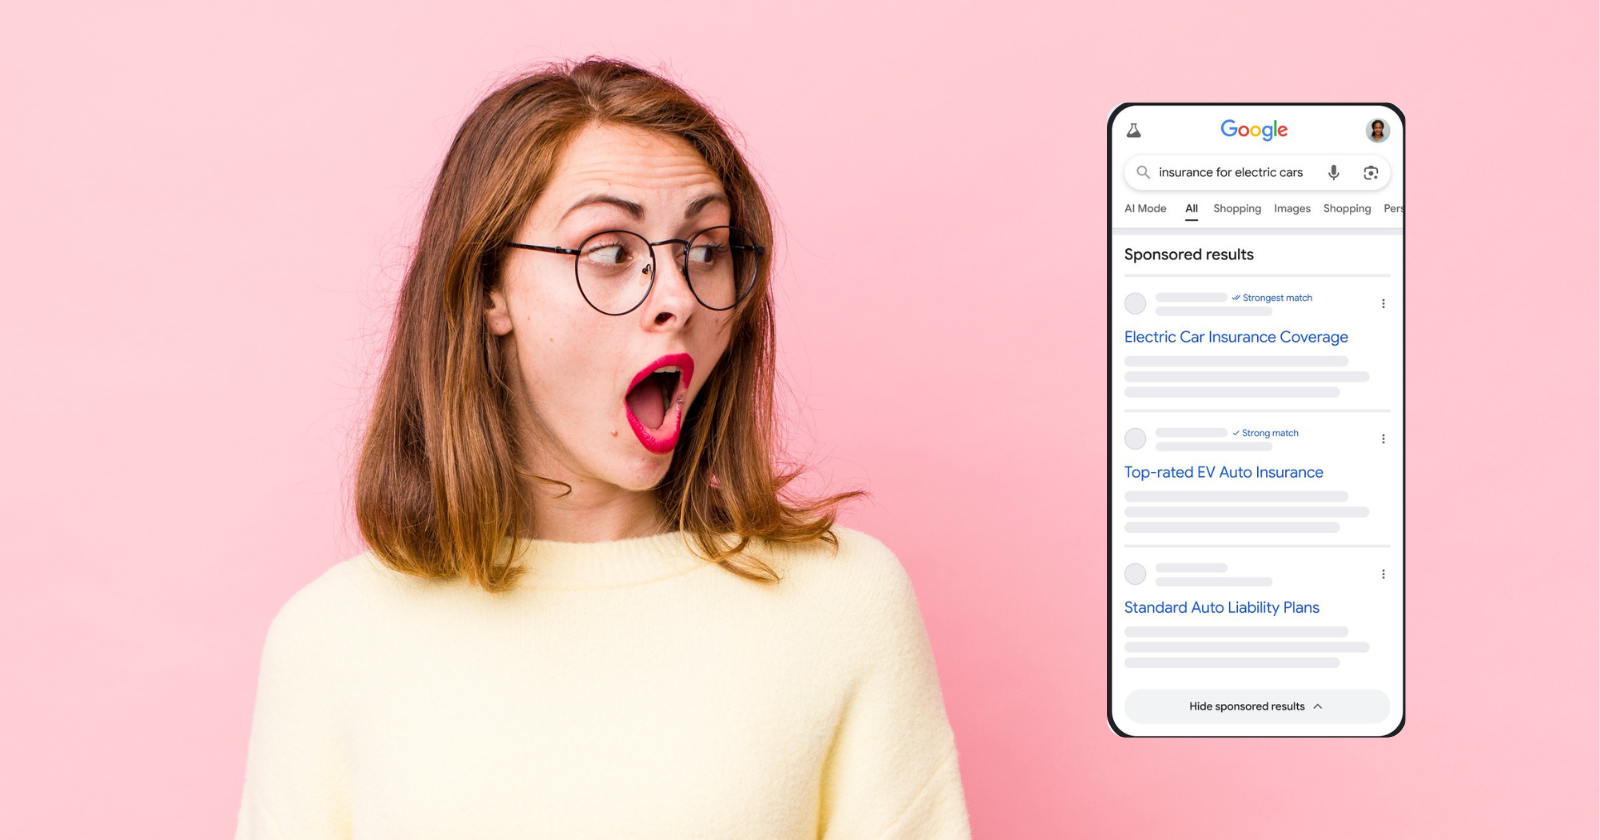
Google is testing a new Search ads label that could give certain advertisers a visible endorsement directly within search results.

In a LinkedIn post, Google Ads Liaison Ginny Marvin announced a limited U.S. experiment that adds a “Strongest match” or “Strong match” label to select Search ads.

According to Marvin, the labels are intended to help users quickly identify the most relevant information for their query while helping advertisers connect with high-intent audiences.

The experiment is currently rolling out to a small percentage of users in the United States.

Marvin said the designation relies on existing ad quality and relevance signals that Google already uses to evaluate Search ads.

While the announcement itself was relatively brief, it immediately sparked questions from advertisers about how the label is determined, whether it could influence click behavior, and what it might signal about the future direction of Search.

Google Hasn’t Explained What Qualifies As A “Strongest Match”

Google’s announcement answered what the label is intended to do, but not how advertisers qualify for it.

According to Marvin, the designation is based on existing quality and relevance signals. Beyond that, Google has not shared any details about how the label is determined.

As a result, advertisers still don’t know:

  • Which signals are used to determine the label
  • How those signals are weighted
  • Whether the designation is based on the query, keyword, ad, landing page, or a combination of factors
  • Whether multiple advertisers can receive the label in the same auction
  • Whether the label is tied to ad position

The lack of detail quickly became one of the main discussion points following the announcement.

Several advertisers questioned whether the designation reflects the same systems Google already uses to evaluate ad relevance or whether the experiment introduces an additional layer of evaluation.

Others questioned whether bid strength plays any role.

Google’s description suggests the label is intended to reflect relevance rather than spend. However, the company has not explained how those determinations are made.

Until Google shares more information, advertisers are left with a label that appears meaningful but lacks a clear definition.

Advertisers Are Asking For More Transparency

Advertisers quickly focused on a different question: how Google determines which ads receive the label.

Several commenters asked whether “Strongest match” reflects the same relevance systems Google already uses or whether additional factors are involved.

Terry Hogan questioned whether the designation is truly based on relevance or whether bid strength contributes to the decision.

Kristen Kelleher asked a popular question, based on the amount of likes she got:

What components make up the scoring underneath the match label? Is this based on the keyword based quality score, ad relevance, landing page exp or is it only based on the ad itself?

So far, Google has not provided additional detail.

Other comments asked measurement questions around the label testing.

Craig Graham asked: “Are there plans for any kind of advertiser-side reporting for this if the experiment rolls out more broadly?”

That visibility could become important if the designation influences click behavior. Advertisers will likely want to know when their ads receive the label and whether it impacts performance.

Questions also accumulated in Marvin’s LinkedIn post about how the label will appear within search results.

Bernt Muurling asked whether the strongest match will always be the first result shown.

If the label only appears on the top-ranked ad, it reinforces Google’s existing ranking decisions. If it can appear elsewhere on the page, it introduces a new signal that users may evaluate alongside ad position.

Justin Windschitl pointed to what may be the biggest challenge for the experiment:

Interested what the criteria are for labeling “match types” and if there can be flaws with the labeling, hurting businesses. On the flip side, if it’s buttoned up, it could be very beneficial for filtering best matches and more effective ad spend!

If the designation is occasionally inaccurate, advertisers may question whether Google is effectively endorsing one business over another.

Could This Become A Public Relevance Signal?

The experiment stands out because it could make Google’s assessment of relevance visible to users.

Advertisers have always known that Google evaluates factors such as ad relevance, landing page experience, expected click-through rate, and other quality signals when determining which ads appear and where they rank. Those evaluations largely happen behind the scenes.

A “Strongest match” label would move part of Google’s relevance evaluation from Google Ads into the user experience itself.

That may seem like a small change, but it introduces a new dynamic into the search experience.

Users already see ad position. A visible label gives them another signal to evaluate.

That is one reason several advertisers immediately questioned how the designation is determined and whether it could influence click behavior.

It also raises questions about whether the label becomes a competitive advantage of its own.

If users begin viewing the designation as a recommendation from Google, advertisers who receive the label could benefit beyond the visibility that comes with ranking well in the auction.

Whether that happens will likely depend on how often the label appears and whether users respond to it.

For now, Google has positioned the experiment as a way to help users identify relevant information more quickly. The broader question is whether advertisers and users eventually view the designation as a relevance signal, a recommendation, or something in between.

Why Google May Be Testing This Now

While Google hasn’t shared the reasoning behind the experiment, the test arrives as Search continues to evolve beyond a traditional list of links.

Google already makes relevance decisions every time an auction takes place. The difference is that those decisions typically remain behind the scenes.

This experiment tests what happens when part of that evaluation becomes visible to users.

Google already makes relevance decisions every time an auction takes place. This experiment tests whether those assessments should be visible to users.

Like many Search tests, the feature may never move beyond experimentation. If it does, it could mark another step toward Google making more of its relevance decisions visible within the Search experience itself.

What This Means For Advertisers

At this point, advertisers should view the label as an experiment rather than a new optimization opportunity.

Google hasn’t introduced any controls, reporting, or guidance around how advertisers qualify for the designation.

For now, the announcement is getting a lot of attention because it introduces a new user-facing signal in Search ads. Whether that signal influences click behavior or campaign performance is unclear until Google provides more information.

We’ll continue watching the rollout and update this story if Google shares additional details about qualification criteria, reporting, or broader availability.

Featured image: Kues / Shutterstock, Phone image courtesy of Google 

https://www.searchenginejournal.com/google-strongest-match-search-ad-labels-test/580378/


Falsa skill elude gli scanner e a raggiunge più di 26.000 agenti AI


La rapida diffusione degli Agenti AI sta creando un ecosistema sempre più complesso nel quale modelli linguistici, strumenti esterni e componenti aggiuntivi collaborano per svolgere attività operative. Questa architettura modulare, però, sta aprendo una nuova superficie di attacco che ricorda da vicino le vulnerabilità già viste nel mondo open source e nei marketplace di applicazioni.

Un caso recente evidenziato dai ricercatori ha mostrato come una falsa skill per agenti AI sia riuscita a superare i controlli automatici di sicurezza e a raggiungere oltre 26.000 agenti, dimostrando quanto siano ancora immature molte delle difese implementate nei marketplace dedicati agli agenti intelligenti.

Quando il problema non è il modello ma l’estensione

Molte piattaforme agentiche consentono agli utenti di installare componenti aggiuntivi, spesso chiamati skill, tool o plug-in. Questi moduli permettono all’agente di accedere a nuove funzionalità, interagire con servizi esterni o automatizzare processi complessi.

Il problema è che la sicurezza di questi ecosistemi non dipende soltanto dal modello AI utilizzato, ma anche dall’affidabilità delle estensioni installate. Se una skill malevola riesce a superare i controlli preliminari, può ottenere accesso a dati sensibili, credenziali e processi aziendali eseguiti dall’agente.

Secondo una recente analisi su quasi 4.000 skill distribuite in diversi marketplace, i ricercatori hanno identificato 76 payload malevoli confermati, mentre il 13,4% delle skill analizzate presentava almeno una vulnerabilità classificata come critica.

Come è stata aggirata la scansione automatica

L’aspetto più interessante della vicenda riguarda il modo in cui la falsa skill è riuscita a sfuggire agli strumenti di verifica.

Gli scanner automatici utilizzati da molte piattaforme si concentrano prevalentemente sull’analisi statica del codice e sulla ricerca di pattern noti. Gli autori della skill hanno invece sfruttato tecniche di offuscamento e comportamenti attivati solo in determinate condizioni operative, rendendo difficile individuare la componente malevola durante le verifiche preliminari.

Il rischio per le aziende

La vicenda evidenzia un problema destinato a crescere nei prossimi anni. Sempre più aziende concedono agli agenti AI accesso a repository di codice, documentazione interna, strumenti di produttività, piattaforme cloud e una skill compromessa potrebbe diventare un vettore privilegiato per attività di esfiltrazione dati, raccolta di credenziali, installazione di backdoor o manipolazione dei workflow aziendali. I ricercatori hanno già osservato casi reali di skill progettate per sottrarre informazioni sensibili o modificare il comportamento degli agenti ospitanti. La criticità è amplificata dal fatto che molti agenti operano con privilegi elevati e possono accedere direttamente a servizi interni o risorse normalmente non esposte a utenti esterni.

Verso una nuova generazione di controlli

La diffusione degli AI Agent sta riproponendo dinamiche già note nel mondo del software tradizionale. Così come repository open source e store di applicazioni sono diventati obiettivi privilegiati degli attacchi supply chain, anche i marketplace delle skill stanno emergendo come un nuovo bersaglio.

Per le aziende che intendono adottare agenti autonomi sarà quindi fondamentale introdurre processi di validazione indipendenti, sandbox dedicate, monitoraggio continuo e controlli granulari sui privilegi concessi alle estensioni installate.

Condividi l’articolo


Articoli correlati

Altro in questa categoria


https://www.securityinfo.it/2026/06/21/una-falsa-skill-elude-gli-scanner-e-a-raggiunge-piu-di-26-000-agenti-ai/?utm_source=rss&utm_medium=rss&utm_campaign=una-falsa-skill-elude-gli-scanner-e-a-raggiunge-piu-di-26-000-agenti-ai


Don’t Miss Our Live Webcast: A Look at the June Lightroom Updates

Adobe is releasing its June Lightroom updates this week, and we know you’re probably wondering, “What’s new, and should I be using it?”

That’s exactly what Scott Kelby will be covering in a FREE live webcast tomorrow, Thursday, June 18 at 3:00 pm ET.

Instead of digging through release notes or trying to figure everything out on your own, join Scott as he highlights the newest additions to Lightroom, shares some of his favorite features, and shows how they can fit into your everyday editing and organizing experience. Whether you use Lightroom every day or just occasionally, this is a fun and easy way to catch up on what’s new.

If you’ve been busy making photos instead of keeping up with updates, we’ve got you covered!

▶️ Join us live here: Facebook | YouTube | KelbyOne

https://layersmagazine.com/dont-miss-our-free-live-webcast-a-look-at-the-june-lightroom-updates.html


Zscaler porta la Zero Trust nell’era degli agenti AI


Sebbene il numero di casi d’uso nel nostro Paese sia ancora molto basso, le previsioni di tutti gli esperti dicono che gli agenti AI diventeranno i veri “operati” dell’automazione dei processi in azienda. Il problema è che chi dovrà gestirne la sicurezza non ha ancora l’esperienza necessaria per farsi un quadro chiaro di come questi opereranno in concreto sulla rete interna, su quella esterna e sui client. Questa carenza di visione complica enormemente la creazione di una infrastruttura di sicurezza efficace.

In particolare, governare e proteggere un numero crescente di agenti AI autonomi che operano in modo indipendente, accedono ai dati aziendali e prendono decisioni alla velocità delle macchine pone una serie di sfide che è bene affrontare insieme a chi ha già avuto modo di sperimentare con casi reali, in ambiti complessi.

A questo proposito, Zscaler ha annunciato una serie di innovazioni che estendono le funzionalità della piattaforma Zero Trust Exchange alla protezione dell’ecosistema Agentic AI con l’obiettivo di offrire quella che l’azienda definisce la prima piattaforma Zero Trust completa progettata specificamente per la nuova generazione di agenti intelligenti.

L’Agentic AI cambia le regole della sicurezza

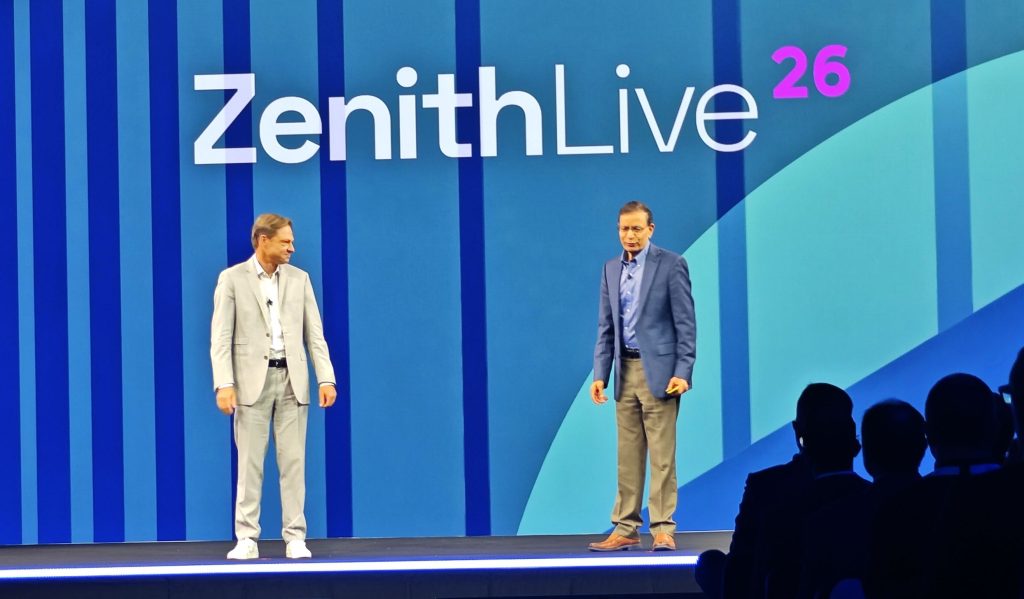
Durante la sessione europea del loro evento annuale Zenith Live, tenutasi a Vienna, Zscaler ha condiviso la sua visione sull’evoluzione dell’AI che, a suo dire, sta introducendo complessità che le architetture di sicurezza tradizionali non sono state progettate per gestire. Gli agenti autonomi non si limitano infatti a eseguire istruzioni ricevute dagli utenti, ma possono generare task, creare subagenti, accedere a servizi, utilizzare credenziali e interagire con applicazioni e dati aziendali senza un intervento umano diretto.

Questo scenario genera nuove problematiche in termini di visibilità, governance e controllo degli accessi, rendendo più difficile comprendere quali agenti stiano operando, quali dati utilizzino e quali azioni siano autorizzati a compiere. Parallelamente, la crescente integrazione dell’AI nei processi di sviluppo software espone endpoint e workstation a plugin, estensioni e strumenti potenzialmente malevoli che molte soluzioni di sicurezza tradizionali non sono attualmente in grado di individuare efficacemente.

AI Broker: controllo sulle comunicazioni tra agenti

Una delle principali novità presentate dall’azienda è Zscaler AI Broker, una soluzione progettata per proteggere le comunicazioni tra agenti AI attraverso broker MCP (Model Context Protocol) e framework Agent-to-Agent.

Il sistema introduce un Agent Registry integrato che consente alle aziende di ottenere una visibilità dettagliata sulle risorse accessibili da ciascun agente e di applicare controlli granulari sugli accessi. L’obiettivo è evitare che gli agenti possano espandere autonomamente i propri privilegi o accedere a informazioni non necessarie per l’esecuzione delle attività assegnate.

Endpoint AI Security amplia la protezione sui dispositivi

Accanto al broker per gli agenti, Zscaler ha introdotto Endpoint AI Security, una soluzione che estende la protezione fino ai dispositivi utilizzati dai dipendenti. La piattaforma è progettata per individuare minacce nascoste all’interno di browser, estensioni, plugin e strumenti AI installati localmente, componenti che spesso sfuggono alle tradizionali piattaforme di Endpoint Detection and Response. L’approccio consente di applicare policy coerenti tra cloud ed endpoint, offrendo una visione unificata dei rischi legati all’utilizzo dell’intelligenza artificiale all’interno dell’organizzazione.

AI Access Graph punta sulla governance dei dati

Un altro tassello fondamentale della strategia presentata a Vienna è rappresentato da Zscaler AI Access Graph, una tecnologia sviluppata a partire dall’acquisizione di Symmetry Systems. La soluzione crea una mappatura delle relazioni tra identità, applicazioni, modelli AI e fonti dati, consentendo alle organizzazioni di comprendere in modo più accurato chi accede alle informazioni, attraverso quali agenti e per quali finalità.

L’integrazione con Zero Trust Exchange permette di applicare controlli più rigorosi, ridurre gli accessi non necessari e tracciare in tempo reale la lineage dei dati lungo l’intero percorso, dalla sorgente fino all’utilizzo da parte degli agenti AI. Considerato che i requisiti normativi diventano sempre più stringenti, la capacità di ricostruire i flussi informativi potrebbe diventare uno degli elementi chiave per la governance dell’intelligenza artificiale.

Più visibilità sugli asset AI e oltre 250 applicazioni GenAI monitorate

Le novità annunciate includono anche un importante aggiornamento di Zscaler AI Protect, la piattaforma introdotta all’inizio del 2026 per la protezione degli ambienti AI. Sul fronte dell’asset management, la soluzione amplia le capacità di discovery permettendo di individuare AI integrate nelle applicazioni SaaS, server MCP presenti nei cloud pubblici e rischi nascosti nei codebase agentici attraverso attività di scansione del codice. La visibilità viene inoltre estesa alle attività AI che avvengono direttamente sugli endpoint aziendali.

Particolarmente interessante è il rafforzamento delle funzionalità di Secure Access to AI, che ora consentono di estrarre e analizzare i prompt provenienti da oltre 250 applicazioni GenAI, offrendo una visione completa delle conversazioni e supportando le Compliance API di Anthropic e OpenAI. L’azienda introduce inoltre guardrail basati sull’intento dell’intera conversazione e non sul singolo prompt, un approccio che mira a ridurre i tentativi di aggiramento delle policy attraverso sequenze di richieste apparentemente innocue.

Sicurezza dell’AI lungo tutto il ciclo di vita

L’ultima area di innovazione riguarda la protezione delle applicazioni AI durante l’intero ciclo di vita. Le nuove funzionalità comprendono attività di AI red teaming dedicate ai server MCP, servizi di prompt hardening e strumenti di conformità basati su heat map che aiutano le organizzazioni a identificare le aree più esposte dal punto di vista della governance. L’obiettivo è quello di integrare la sicurezza fin dalle fasi iniziali di sviluppo e distribuzione delle applicazioni AI, evitando che i controlli vengano aggiunti solo successivamente quando i sistemi sono già operativi.

La strategia presentata da Zscaler evidenzia come a fianco della protezione dell’utente serva trovare spazio per la protezione degli agenti AI. Con l’aumento delle identità non umane, delle comunicazioni agent-to-agent e dei workflow automatizzati, le aziende avranno bisogno di strumenti in grado di garantire visibilità, controllo e governance su un ecosistema sempre più distribuito per riuscire a evitare intrusioni e garantire la governance richiesta dalle normative più recenti.

Condividi l’articolo


Articoli correlati

Altro in questa categoria


https://www.securityinfo.it/2026/06/16/zscaler-porta-la-zero-trust-nellera-degli-agenti-ai/?utm_source=rss&utm_medium=rss&utm_campaign=zscaler-porta-la-zero-trust-nellera-degli-agenti-ai


Infrastrutture Critiche e Geopolitica: è l’Era dell’Antifragilità


Il nuovo assetto geopolitico mondiale ha messo a nudo una serie di problematiche che sono state trascurate troppo a lungo. In pratica, quello che per anni abbiamo visto accadere nel software, ovvero l’entusiasmo per le nuove feature che andava a coprire la necessità di rendere sicuro il loro utilizzo, si è applicato anche in mille altri settori lontanissimi dal coding. L’esperienza di Alessio Fasano, Country Manager della Southern EMEA Region di FireMon con un passato da CSO in una primaria Telco nazionale, ci offre una prospettiva privilegiata su come l’Europa e l’Italia stiano affrontando queste minacce.

Il conflitto tra Ucraina e Russia ha riacceso i riflettori su vulnerabilità che vanno ben oltre il semplice sabotaggio fisico. Sebbene incidenti come il taglio dei cavi sottomarini nel Mar Rosso rappresentino un rischio concreto di interruzione della connettività, la preoccupazione principale degli esperti riguarda le cosiddette landing station. Questi nodi, dove i cavi approdano e il traffico viene aggregato, sono apparati critici che richiedono una visibilità totale. Il timore non è solo l’assenza di segnale, ma che la rete stessa diventi il veicolo per infiltrazioni profonde nei sistemi informatici aziendali e governativi, sfruttando ogni possibile punto d’accesso tra i cinque domini, dal sottomarino allo spaziale.

Una situazione poco omogenea

La preparazione del sistema Paese rispetto a tali scenari appare oggi variegata, definibile come una situazione a macchia di leopardo. Mentre i settori utility e finanziario hanno mostrato una maggiore maturità, le telecomunicazioni e i trasporti si trovano a gestire una complessità tecnologica e operativa senza precedenti. In questo contesto, le normative europee e nazionali hanno agito come una leva fondamentale per scuotere la consapevolezza dei board. In Italia, il Perimetro di Sicurezza Nazionale Cibernetica ha imposto un primo importante risveglio, passando da una gestione puramente burocratica a implementazioni tecniche reali sui sistemi. Tuttavia, il percorso è ancora lungo e si prevede che la NIS2, il regolamento DORA e l’AI Act spingeranno ulteriormente le aziende verso una postura di sicurezza non più tattica ma strategica, finalizzata alla sovranità digitale europea.

Le Telco stanno cambiando

Un elemento di ulteriore complicazione è rappresentato dalla recente ondata di consolidamento e acquisizioni nel settore Telco. Le operazioni finanziarie che portano alla creazione di “super-telco” generano un’amplificazione della complessità operativa immediata. I tecnici si trovano improvvisamente a gestire un numero di device moltiplicato, dovendo far convivere infrastrutture diverse e proteggere contemporaneamente segmenti corporate e business.

Senza strumenti avanzati di Network Security Policy Management che garantiscano automazione e semplificazione, queste realtà rischiano fermi disastrosi a seguito di attacchi mirati. La difficoltà principale nel risolvere queste inefficienze non è però tecnologica, ma organizzativa: persistono ancora silos invalicabili tra chi gestisce la sicurezza, il networking e le operazioni, con ogni dipartimento impegnato a difendere il proprio status quo invece di collaborare per una visibilità comune.

Il CISO deve evolvere insieme alla situazione

Il superamento di queste barriere è oggi guidato dalla figura del CISO, il cui ruolo è profondamente maturato negli ultimi anni. Grazie alle responsabilità introdotte dalle nuove normative, il responsabile della sicurezza ha finalmente ottenuto un posto al tavolo delle decisioni, sebbene rimangano margini di miglioramento nella segregazione dei compiti e nei riporti gerarchici, che dovrebbero puntare direttamente al CEO per garantire massima efficacia. Il CISO moderno è colui che deve traghettare l’azienda oltre il concetto di resilienza, tipicamente legato alla ridondanza dei sistemi gestita dal COO, per approdare a quello di antifragilità. Essere antifragili significa avere la capacità di reagire all’imprevedibile e di adattarsi velocemente durante una crisi. In un mondo in cui la domanda non è più se si verrà attaccati, ma quando accadrà, la chiave del successo risiede nel training costante, nelle simulazioni in War Room e nella capacità di gestire l’incidente con strumenti che permettano risposte rapide e basate sui dati.

Condividi l’articolo


Articoli correlati

Altro in questa categoria


https://www.securityinfo.it/2026/06/09/infrastrutture-critiche-e-geopolitica-e-lera-dellantifragilita/?utm_source=rss&utm_medium=rss&utm_campaign=infrastrutture-critiche-e-geopolitica-e-lera-dellantifragilita


Google Must Let Websites Opt Out Of AI Search Features In UK via @sejournal, @MattGSouthern

The UK’s Competition and Markets Authority has imposed a new conduct requirement on Google Search that will let publishers opt out of having their content used in AI search features.

The requirement follows the CMA’s decision to designate Google with strategic market status in general search. It sits under the UK’s digital markets competition regime, the framework created by the Digital Markets, Competition and Consumers Act.

For clarity, designating Google with that status is not a finding that the company broke competition law.

What Google Has To Do

The requirement places three obligations on Google.

Google must provide a way for websites to opt out of AI search features like AI Overviews and AI Mode. The CMA says greater control can strengthen publishers’ bargaining power with Google.

Additionally, Google needs to give websites a way to opt out of having their content used to train AI models. According to the CMA, this publisher opt-out is a world first.

Google must also attribute publisher content with clear links in AI-generated results.

Cardell said:

“With features like AI Overviews rapidly reshaping online search, it is crucial that content publishers, including news organizations, have appropriate bargaining power over how their content is used. At the same time, these measures will help tens of millions of UK search users better understand and trust the information presented to them.”

Timeline And Oversight

Most of the requirements come into effect six months after publication. Google has nine months to introduce page-level controls for AI search features.

Google will also have to submit compliance reports to the CMA every six months for the first year. The CMA expects Google to publish a summary or a non-confidential version so we can learn more about the impact of these changes.

Google hasn’t said how the opt-out will work, including whether publishers will manage it via a robots.txt directive, Search Console, or another method.

Why This Matters

The main way to keep content out of AI Overviews has been the nosnippet directive, which also strips standard search snippets. A control that separates AI-feature use from normal indexing, if it works as the CMA describes, would remove that tradeoff for publishers whose content reaches UK users.

Looking Ahead

The CMA said it will announce further action on Google’s search business in the coming weeks. The regime took effect in 2025, and the agency has since opened four strategic market status investigations into Google, Apple, and Microsoft.

https://www.searchenginejournal.com/google-must-let-websites-opt-out-of-ai-search-features-in-uk/577970/


Il gruppo criminale cinese TA4922 adesso punta anche all’Europa


Un gruppo cybercriminale di lingua cinese fino a poco tempo fa concentrato prevalentemente sul mercato asiatico sta ampliando rapidamente il proprio raggio d’azione verso Europa e Africa. Secondo le analisi pubblicate da Proofpoint, il gruppo chiamato TA4922 ha aumentato sensibilmente il volume delle proprie operazioni nel corso del 2026, prendendo di mira organizzazioni nel Regno Unito, in Germania, in Italia e in Sudafrica, oltre a continuare le campagne già attive in Giappone, Corea del Sud, Taiwan, Singapore e altri Paesi asiatici.

Gli analisti descrivono TA4922 come uno degli attori più insoliti tra quelli monitorati. Pur essendo classificato come gruppo a motivazione prevalentemente economica, il suo comportamento operativo ricorda per complessità e varietà quello di alcuni gruppi di cyber spionaggio. L’obiettivo principale sembra essere l’ottenimento di accesso persistente agli ambienti delle vittime per attività di furto dati, frode, rivendita degli accessi compromessi e monetizzazione delle intrusioni.

Phishing localizzato e social engineering su misura

Uno degli aspetti più interessanti dell’operatività di TA4922 è la forte capacità di adattamento alle realtà locali. Le campagne osservate utilizzano email scritte nelle lingue dei Paesi bersaglio e costruite per apparire credibili all’interno dei rispettivi contesti aziendali.

I messaggi impersonano frequentemente uffici HR, reparti finanziari, autorità fiscali, fornitori o colleghi di lavoro. I temi utilizzati ruotano attorno a fatture, pagamenti, tasse, buste paga, benefit aziendali e comunicazioni amministrative, sfruttando argomenti che inducono i destinatari ad agire rapidamente senza effettuare verifiche approfondite.

Proofpoint evidenzia inoltre come il gruppo utilizzi migliaia di indirizzi email temporanei generati su servizi legittimi come Outlook, Hotmail e Gmail. Questa strategia consente agli attaccanti di aggirare più facilmente i controlli basati sulla reputazione del mittente e migliorare il tasso di consegna delle campagne malevole.

L’obiettivo è portare la conversazione fuori dalla posta elettronica

Una caratteristica che distingue TA4922 da molte altre operazioni di phishing consiste nel tentativo sistematico di spostare le comunicazioni verso piattaforme alternative come Microsoft Teams, WhatsApp e, in Asia, anche LINE. L’obiettivo è quello di uscire dal perimetro dei controlli di sicurezza implementati sulle caselle e-mail aziendali. Una volta stabilito il contatto attraverso canali meno monitorati, gli attaccanti possono proseguire le attività di social engineering, convincere la vittima a scaricare file malevoli oppure raccogliere credenziali e informazioni sensibili con minori probabilità di essere individuati.

Una cassetta degli attrezzi sempre più ricca

L’espansione geografica è stata accompagnata da una significativa crescita dell’arsenale malware utilizzato dal gruppo. Se nelle prime campagne il malware più frequentemente associato a TA4922 era ValleyRAT, noto anche come Winos 4.0, negli ultimi mesi sono comparsi nuovi strumenti che aumentano notevolmente la flessibilità operativa degli attaccanti. Tra questi figurano Atlas RAT, un trojan di accesso remoto utilizzato in diverse campagne contro organizzazioni europee e asiatiche, e due nuove famiglie individuate da Proofpoint e denominate RomulusLoader e SilentRunLoader.

Atlas RAT offre funzionalità avanzate di controllo remoto, raccolta informazioni, trasferimento file e monitoraggio del sistema compromesso. RomulusLoader agisce invece come downloader e stager per ulteriori payload, utilizzando tecniche come process hollowing, injection e cifratura per rendere più difficile il rilevamento. SilentRunLoader, scritto in Python, è stato osservato mentre sottraeva credenziali, cookie e dati di navigazione da Google Chrome prima di trasmetterli verso infrastrutture controllate dagli attaccanti.

DLL sideloading e strumenti legittimi per sfuggire ai controlli

Come molti gruppi moderni, TA4922 combina codice malevolo e software legittimo per ridurre la probabilità di intercettazione. Le campagne osservate fanno ampio uso di DLL sideloading, tecnica che consente di eseguire codice malevolo sfruttando applicazioni considerate affidabili dal sistema operativo. In altri casi gli attaccanti installano software di amministrazione remota legittimi come AnyDesk e SyncFuture, mascherando le proprie attività all’interno del normale traffico aziendale.

Gli analisti di Proofpoint continuano a classificare TA4922 come un gruppo orientato prevalentemente al profitto. Tuttavia, le capacità tecniche dimostrate e le funzionalità presenti nei malware utilizzati sollevano interrogativi sulle possibili evoluzioni future. Strumenti in grado di registrare attività degli utenti, acquisire screenshot, raccogliere dati dai browser e mantenere accessi persistenti potrebbero infatti essere utilizzati non soltanto per finalità economiche ma anche per attività di sorveglianza e raccolta informativa. Secondo Proofpoint, queste capacità potrebbero essere condivise, vendute o riutilizzate in contesti differenti rispetto alle campagne attualmente osservate.

Condividi l’articolo


Articoli correlati

Altro in questa categoria


https://www.securityinfo.it/2026/06/04/il-gruppo-criminale-cinese-ta4922-adesso-punta-anche-alleuropa/?utm_source=rss&utm_medium=rss&utm_campaign=il-gruppo-criminale-cinese-ta4922-adesso-punta-anche-alleuropa


Google CEO Sundar Pichai Is OK With AI Mode Replacing Classic Search via @sejournal, @martinibuster

In a recent interview, Google’s CEO Sundar Pichai confirmed that sources and links will always be a part of the AI answers and when asked how he feels about a decline in the use of Classic Search  in favor of AI Search, he mentioned that Google will survive on a blend of subscriptions and advertising.

Google On The Future Of Links And Sources

Google’s CEO acknowledged that people still want to connect with what’s on the web. He also shared that Google is creating a seamless transition from classic search to AI Mode and that according to their internal metrics, people are satisfied with it.

In response to an interviewer question as to whether Google is at some point going to transition away from the ten blue links and classic search, he said that the process is a “continuum,” which means a gradual transition, not a “rip the band-aid” type change.

The question the interviewer asked:

“I think a lot of people expect that at some point, the kind of normal Google sort of classic search interface goes away. The 10 blue links maybe go away and you just kind of have this AI mode as the default.

…Do you think that goes away at any point that you sort of rip the band-aid off and just go full AI mode?”

Sundar Pichai confirmed that sources and links won’t always be a part of Search:

“You know, I think it’s important to bring users along the journey as well as making sure the product is working for their expectations.

So, you know, I try not to get ahead of that.

I think it is very clear as we evolve through these changes, people are responding positively. We can see it in the long-term metrics of the product in such a clear way. And so I think we understand that. But people want search to be fast.

I do think through search, people are looking to connect with what’s out there on the web, so that’s important to us. It’s all of that.

So I think you’re seeing us evolve the product.

And I think you’ll continue to see it be methodical, but we didn’t have AI Mode a year ago. But now a lot of people are experiencing it. I think we have made it more seamless to go there than before.

And so it’s a continuum.

But I don’t see…

Sources and links will always be there as part of it.”

Pichai says people want to connect with what is on the web and that sources and links remain part of the experience. But he also says AI Mode is becoming more seamless and widely used, which actually impacts referrals.

Visibility Is Not The Same As Referrals

The idea of evolving classic search so that it’s seamlessly transitioning to AI Mode is not going to be popular with publishers and SEOs. The reality of “links” and “sources” in AI Mode is that visibility is not the same thing as referral traffic. So when Pichai’s AI Mode offers visibility with one hand, it’s also diminishing referrals with the other.

This ties directly with the concept of Google Zero. Google Zero is the big brand calculation that referral traffic is dwindling to zero. So in order to survive, businesses must promote and monetize as if Google referrals will one day be zero, Google Zero.

The reality of AI Mode is that Google is preserving the appearance of attribution while diminishing the economic value of clicks.

Google Says Users Are Responding Positively

The other important point in his answer is that Pichai says Google can see positive user response to AI Mode in their long-term metrics. But people are increasingly concerned about data center use, the record amounts of water that they use, and the harm that does to the environment as well as to the cost of energy, which affects the cost of everything from the clothes you wear to the dinner on the table.

The interviewer even mentioned how college graduates across the United States booed at the very mention of AI. So with all of the negative public sentiment against AI, Pichai still insists that people are happy with it.

Google Is Okay With Replacing The Search Advertising Model

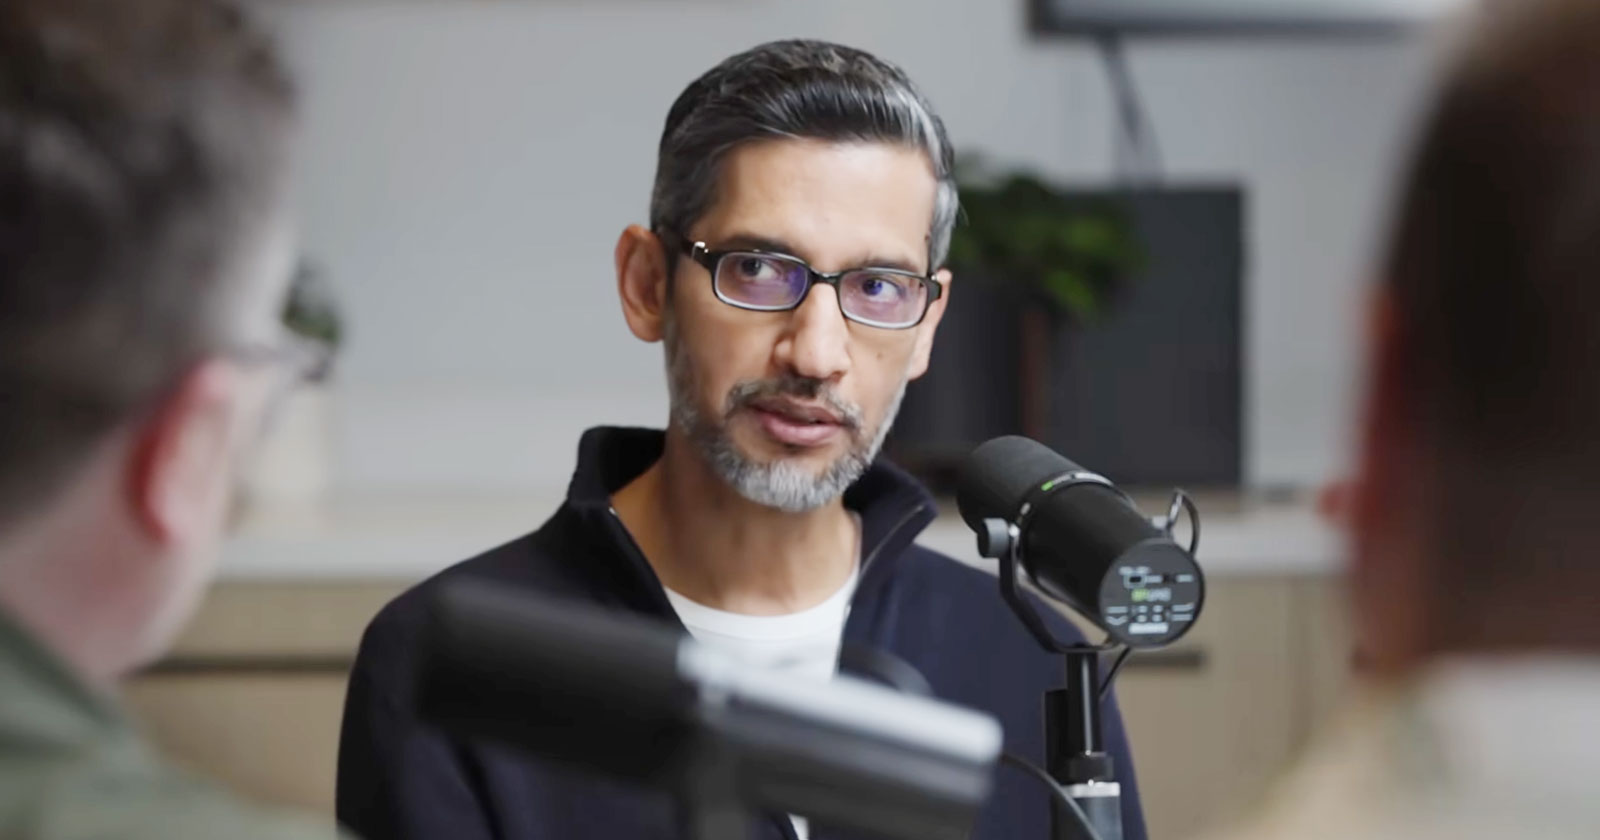
One of the two interviewers gestured to his co-interviewer and commented that he had told him that he hadn’t done a traditional Google Search in a year and asked Pichai if he’s okay with people abandoning search in favor of pure AI queries.

He asked Pichai if he’s okay with users who don’t use classic search :

“When you hear that, are you cool? Like, this is the kind of user that I want right now, or does it send you a little chill because the traditional search ad business is a pretty good one for you.”

Pichai’s answer seemed to suggest that there may in the future be a blending of subscription and advertising revenues.

He responded:

“Well, I think we will, if anything, in the AI mode, in an agentic… these things are going to do a lot more for you than what we were able to do for users 10 years ago.

I think the economic value is always a function of the total value you’re giving users. All of us would say over time, the value we are providing users increases, there’s more competition, there are more choices.

So I feel comfortable between a combination of subscription and ads that the right models will continue to be there.”

That’s maybe the first time someone at Google has mentioned a blend of subscriptions and advertising as a way of monetizing the AI web. Where does that leave publishers?

When asked about the negative economic future that many feel AI is bringing, he compared AI to the introduction of the spreadsheet and how that revolutionized financial analysis, to how it will make coding easier, and how it will enable doctors to spend more time with patients.

All of those analogies and comparisons sidestep the damage to the web ecosystem that non-referring visibility brings.

His answer:

“I think people are going to be more productive. They will have more time for leisure. All of that will simultaneously be true.”

Pichai is confident that the web ecosystem can subsist on visibility, and that Google will be fine if people stop using classic search. But where does that leave the web ecosystem? Pichai all but recommended eating cake.

Watch the New York Times Hard Fork Podcast

[embedded content]

Featured image/Screenshot from Hard Fork podcast

https://www.searchenginejournal.com/googles-ceo-is-comfortable-with-ai-mode-replacing-classic-search/577923/


Il 78% delle aziende ha già subito o sospetta incidenti legati all’IA


A leggere il nuovo “2026 Cloud Security Report” realizzato da Check Point insieme a Cybersecurity Insiders, sembra proprio che l’adozione dell’intelligenza artificiale nelle aziende stia crescendo più rapidamente della capacità delle organizzazioni di proteggerla.

Il report, basato sulle risposte di 1.042 professionisti IT e cybersecurity provenienti da organizzazioni di tutto il mondo, mostra un quadro chiaro, preoccupante, ma anche atteso dal momento che ogni grande innovazione che porta “urgenza” tende a far prevalere la necessità di implementazione su quella della sicurezza “by design”. Così l’AI è già entrata nei processi produttivi, ma le architetture di sicurezza non sono state progettate per gestire traffico AI-driven, agenti autonomi e modelli generativi operativi su larga scala.

L’AI è già in produzione, ma la sicurezza è rimasta indietro

Il dato forse più importante dell’intero report riguarda la velocità dell’adozione. Il 70% delle organizzazioni dichiara infatti di avere già workload GenAI in produzione, mentre il 64% ha implementato agenti AI in ambienti pilota o direttamente in sistemi live. Ancora più significativo è il fatto che il 12% delle aziende abbia già concesso agli agenti AI accessi privilegiati a sistemi core aziendali.

Purtroppo, come dicevamo, sembra che le infrastrutture di difesa non stiano tenendo il passo. L’83% delle organizzazioni ritiene infatti che proteggere sistemi GenAI sia più difficile rispetto alle applicazioni tradizionali. La difficoltà nasce dal fatto che le architetture di sicurezza storiche erano state progettate per utenti umani, SaaS relativamente prevedibili e flussi applicativi stabili, non per agenti autonomi, API dinamiche e traffico AI machine-to-machine.

Il 78% delle aziende ha già visto incidenti AI-related o teme di averli subiti

Il 54% delle organizzazioni conferma di avere già subito almeno un incidente di sicurezza collegato all’AI, mentre un ulteriore 24% sospetta incidenti ma ammette di non avere sufficiente telemetria per verificarli. Complessivamente, il 78% delle aziende ha già registrato o teme di avere registrato impatti legati all’intelligenza artificiale.

Fra gli incidenti più frequenti emergono l’utilizzo non autorizzato di strumenti AI (“shadow AI”), segnalato dal 41% delle organizzazioni, l’impiego di contenuti generati dall’AI in attacchi phishing o deepfake, indicato dal 37%, e la perdita di dati sensibili attraverso servizi AI, fenomeno che riguarda il 32% delle aziende intervistate.

Secondo il report, uno dei problemi principali è che il traffico AI assomiglia spesso a traffico legittimo. Chiamate API verso LLM, richieste outbound e comunicazioni agent-to-agent possono facilmente mimetizzarsi nel traffico normale se i sistemi di ispezione non sono progettati specificamente per interpretare il contesto AI.

Il gap più grave: strategia e architettura non coincidono

Uno degli elementi più impressionanti dello studio è il cosiddetto “AI readiness gap”. Il 77% delle organizzazioni afferma di avere modificato la propria strategia di sicurezza in risposta all’AI, ma solo il 26% ritiene che la propria architettura sia effettivamente pronta a supportare workload AI senza importanti redesign infrastrutturali. Il risultato è un divario di 51 punti percentuali tra strategia e capacità reale di enforcement. In pratica, le aziende stanno aggiornando policy, governance e budget, ma i controlli non riescono ancora a propagarsi in modo coerente tra cloud, SaaS, data center, endpoint e workload AI.

Secondo Check Point, questo scenario sta creando policy frammentate, punti ciechi e perdita di controllo sui flussi AI distribuiti nell’ambiente ibrido enterprise.

Le aziende non vedono davvero l’AI che usano

La mancanza di visibilità è un altro tema centrale. Solo il 5% delle organizzazioni dichiara di avere piena visibilità sugli strumenti AI utilizzati dai dipendenti. Questo significa che il restante 95% prende decisioni di governance senza sapere davvero quali modelli, servizi, agenti o workflow AI siano attivi nell’organizzazione. Ancora più preoccupante è il fatto che solo il 5% affermi di riuscire a distinguere in modo affidabile attività AI legittime da utilizzi sospetti o non autorizzati. Gli strumenti tradizionali di discovery, sottolinea il report, erano stati progettati per individuare SaaS catalogati e applicazioni note, non chiamate API verso LLM, notebook AI o agenti che utilizzano account di servizio già esistenti.

Il traffico AI sta mettendo in crisi le infrastrutture di rete

L’intelligenza artificiale sta modificando rapidamente i pattern di traffico nelle reti enterprise. Il 51% delle aziende segnala un aumento del traffico API-driven, il 48% vede crescere il traffico verso servizi AI esterni, il 42% registra nuovi flussi user-to-AI e il 26% rileva un incremento del traffico east-west interno ai data center. Le architetture esistenti faticano a reggere il cambiamento. Solo il 24% dichiara di riuscire a ispezionare completamente il traffico AI senza penalizzare le performance, mentre il 76% ammette gap di ispezione o compromessi prestazionali.

Parallelamente, il 67% delle organizzazioni denuncia policy frammentate nei propri ambienti ibridi e il 64% afferma che la propria architettura necessita di redesign moderati o significativi per supportare l’AI.

I data center tornano centrali per l’AI

Un altro dato interessante riguarda il ritorno dell’on-premises. Il 29% delle organizzazioni sta già spostando workload AI verso data center privati o infrastrutture interne, mentre un ulteriore 49% sta pianificando o valutando questa possibilità. La ragione è legata a esigenze di sovranità del dato, prestazioni e controllo operativo. Il 76% delle aziende considera la sicurezza del perimetro del data center critica o mission-critical per workload AI, ma solo il 35% ritiene di essere realmente preparato a proteggerli.

Secondo il report, i data center AI stanno diventando ambienti molto diversi rispetto all’infrastruttura enterprise tradizionale, con traffico east-west elevatissimo, forte dipendenza da API e connessioni continue tra orchestrazione, storage, inferenza e servizi downstream.

La governance dell’accesso AI è completamente frammentata

Le aziende non hanno ancora trovato un modello dominante per gestire l’accesso dei dipendenti agli strumenti AI. Il 24% non applica alcun controllo specifico, il 22% si affida principalmente agli endpoint agent, il 19% utilizza regole diverse a seconda che l’utente sia on-network o off-network e un altro 19% blocca completamente gli strumenti AI esterni. Solo il 16% applica policy coerenti indipendentemente dalla posizione dell’utente.

Questo significa che lo stesso dipendente può avere livelli di protezione completamente differenti a seconda del browser, della rete o del dispositivo utilizzato.

Endpoint, SaaS e browser restano pieni di buchi e i WAF sono in crisi

Il report evidenzia forti limiti nella capacità di controllare il traffico AI SaaS. Solo il 13% delle organizzazioni riesce a ispezionare completamente e applicare policy efficaci verso servizi come ChatGPT, Gemini o Copilot. Sul fronte endpoint la situazione è persino peggiore: appena l’11% dichiara di avere piena visibilità e controllo sugli strumenti AI browser-based o installati sui dispositivi gestiti. Inoltre, il 39% afferma che i propri strumenti endpoint non coprono le applicazioni AI, mentre solo il 12% dispone di rilevamento real-time dello shadow AI sui dispositivi corporate.

Inoltre, l’intelligenza artificiale sta mettendo in crisi anche i sistemi WAF e WAAP. Solo il 22% delle aziende ritiene che i propri strumenti siano efficaci contro attacchi GenAI-specific come prompt injection o jailbreak. Il 71% segnala invece un aumento dei falsi positivi dopo l’adozione dell’AI. Secondo lo studio, i WAF tradizionali erano stati progettati per traffico web umano e pattern prevedibili, mentre i modelli generativi introducono prompt lunghi, streaming di risposte, API model-driven e interazioni service-to-service che sfuggono alle logiche storiche di inspection.

Runtime protection e testing sono ancora quasi assenti

Uno dei punti più delicati riguarda i controlli runtime sugli LLM. Solo il 17% delle organizzazioni ha distribuito in modo esteso controlli runtime come input validation, output filtering o autorizzazioni sull’utilizzo di tool da parte degli agenti AI.

Parallelamente, il 56% non possiede un processo strutturato di security testing per applicazioni GenAI oppure effettua test solo in modo occasionale. In pratica, moltissime applicazioni AI arrivano in produzione senza test sistematici contro prompt injection, adversarial input o abusi runtime.

L’AI sta creando una nuova crisi di identità e accessi, così come nella protezione dei dati

Il tema delle identità non umane emerge come uno dei principali problemi futuri. Il 48% delle organizzazioni identifica la gestione delle non-human identities come la sfida numero uno legata all’AI. Gli agenti AI utilizzano account di servizio, API key e credenziali delegate che spesso non rientrano nei tradizionali modelli IAM human-centric. Il problema è aggravato dal fatto che il 46% delle aziende non possiede alcun processo strutturato di assessment per vendor AI e solo il 7% effettua scansioni dei modelli AI prima del deployment per verificare vulnerabilità o codice malevolo.

La protezione dei dati emerge come uno dei punti più critici dell’intera ricerca. Il 25% delle aziende permette già oggi l’inserimento di codice sorgente in strumenti AI esterni, esponendo IP, configurazioni e logiche proprietarie a piattaforme con limitato controllo sull’esfiltrazione. Il 44% non riesce a tracciare il percorso dei dati sensibili una volta entrati nei workflow AI e solo il 15% dispone di sistemi DLP specificamente progettati per i flussi AI.

Secondo il report, molte aziende stanno consentendo l’ingresso di informazioni critiche nei sistemi AI senza avere lineage tracking, enforcement inline o visibilità sui movimenti downstream dei dati.

Le aziende rilevano gli attacchi AI, ma non riescono a bloccarli

Il report evidenzia una situazione particolarmente grave sul fronte prevention. Solo il 13% delle organizzazioni riesce a bloccare in tempo reale prompt malevoli o jailbreak prima che raggiungano il modello. Sul fronte della protezione dei dati, appena il 16% riesce a impedire che dati sensibili vengano inviati verso servizi AI. Ancora peggiore la situazione sugli output: soltanto il 5% è in grado di bloccare contenuti AI-generated pericolosi prima che raggiungano utenti o sistemi downstream.

Per Check Point, questo dimostra che molte organizzazioni possiedono sistemi di detection, ma non veri meccanismi di prevenzione inline capaci di operare “a velocità di inferenza”.

I dipendenti aggirano regolarmente i controlli AI

La ricerca evidenzia anche un problema organizzativo molto concreto. Il 42% delle aziende ammette che i dipendenti bypassano i controlli di sicurezza AI quando questi rallentano il lavoro.

In pratica, utenti e team trovano scorciatoie più rapide utilizzando account personali, strumenti browser-based non autorizzati o workflow esterni ai controlli aziendali. Questo fenomeno trasforma la governance AI in un problema operativo e culturale oltre che tecnologico.

Governance AI: responsabilità diffuse e poca enforcement

La governance emerge come uno degli aspetti più immaturi. Il 44% attribuisce la responsabilità AI al CISO, il 40% a comitati cross-funzionali e il 36% al CIO o all’IT leadership. Solo il 14% possiede un responsabile AI security dedicato.

Ancora più significativo è il fatto che il 45% abbia policy AI documentate, ma appena il 14% le faccia rispettare e auditare realmente.

Nel frattempo cresce la pressione normativa legata a framework come AI Act europeo e NIST AI RMF: soltanto il 7% si considera pienamente preparato.

Il mercato si sta muovendo verso piattaforme unificate

Nonostante le difficoltà, il report evidenzia una direzione molto chiara del mercato. Il 75% delle organizzazioni ha modificato la propria strategia architetturale a causa dell’AI e il 52% sta aumentando il budget dedicato alla sicurezza AI.

L’86% considera fondamentale una gestione unificata della sicurezza tra data center, cloud ed edge, mentre il 37% sta già consolidando strumenti e piattaforme verso modelli più centralizzati.

Secondo Check Point, il futuro della sicurezza AI passerà sempre più attraverso architetture “Hybrid Mesh Network Security”, capaci di distribuire policy coerenti, ispezione inline e controlli runtime attraverso ambienti cloud, endpoint, SaaS e data center.

Condividi l’articolo


Articoli correlati

Altro in questa categoria


https://www.securityinfo.it/2026/05/28/il-78-delle-aziende-ha-gia-subito-o-sospetta-incidenti-legati-allia/?utm_source=rss&utm_medium=rss&utm_campaign=il-78-delle-aziende-ha-gia-subito-o-sospetta-incidenti-legati-allia


SEO poisoning e chatbot AI dirottati per un malware miner


Le campagne di SEO poisoning non sono certo una novità nel panorama cybercriminale. Da decenni gli attaccanti manipolano i motori di ricerca per spingere siti malevoli tra i primi risultati, inducendo gli utenti a scaricare malware credendo di visitare pagine legittime. Ma una nuova campagna analizzata da Microsoft Security Blog mostra un’evoluzione particolarmente interessante del fenomeno: gli attori malevoli stanno iniziando a sfruttare anche i chatbot AI per distribuire malware destinato al cryptomining GPU.

Secondo i ricercatori, gli attaccanti stanno prendendo di mira utenti molto specifici: appassionati hardware, gamer e power user che dispongono di GPU ad alte prestazioni, sistemi ideali per attività di cryptojacking ad alta redditività.

Dalla SEO poisoning ai chatbot AI

La campagna sfrutta una combinazione di tecniche di social engineering e manipolazione algoritmica. Gli utenti cercano online utility popolari come CrystalDiskInfo, HWMonitor, Display Driver Uninstaller o FurMark e vengono indirizzati verso domini controllati dagli attaccanti che imitano i siti ufficiali. La parte più interessante della ricerca riguarda però l’utilizzo dei Large Language Model. Microsoft spiega di aver osservato casi in cui utenti che chiedevano consigli di download a chatbot AI ricevevano link verso domini malevoli inseriti direttamente nelle risposte generate dal modello.

Non si tratta ancora di un attacco strutturato contro gli LLM stessi, ma piuttosto di una forma di “AI search poisoning”, cioè un’estensione della classica SEO poisoning all’interno degli ecosistemi conversazionali basati su AI. Il concetto è semplice ma estremamente efficace: se gli utenti iniziano a sostituire Google con chatbot AI per trovare software e utility, gli attaccanti seguiranno inevitabilmente lo stesso flusso.

Come funziona la catena di infezione

La campagna descritta da Microsoft non punta alla massima diffusione possibile. L’obiettivo sembra essere invece la selezione accurata delle vittime più redditizie. I software impersonati dagli attaccanti sono infatti tutti associati a utenti enthusiast, overclocker o gamer avanzati. Questo consente agli operatori della campagna di aumentare la probabilità di compromettere sistemi dotati di GPU discrete di fascia alta, molto più profittevoli per il mining rispetto ai normali PC consumer.

Secondo l’analisi tecnica, gli utenti vengono indirizzati verso siti clone costruiti per sembrare identici alle pagine ufficiali delle utility più note. Una volta scaricato il software, il payload avvia una catena di infezione che include componenti di persistenza e accesso remoto. Tra gli elementi più preoccupanti figura l’abuso di ScreenConnect, utilizzato per mantenere accesso persistente ai sistemi compromessi. Questo dettaglio è particolarmente rilevante perché suggerisce che la campagna non sia limitata al solo cryptomining. Microsoft sottolinea infatti che gli accessi ottenuti potrebbero essere successivamente sfruttati anche per furto dati, movimenti laterali e distribuzione ransomware. La presenza di strumenti di remote management rende quindi l’infezione potenzialmente molto più pericolosa di un semplice miner GPU.

Il ruolo crescente della SEO poisoning nell’ecosistema malware

La SEO poisoning sta diventando una delle tecniche preferite dai cybercriminali per ottenere accesso iniziale. Secondo ReliaQuest, le rilevazioni di malware collegate a campagne SEO poisoning sono cresciute del 60% in sei mesi tra il 2023 e il 2024. Anche Zscaler aveva già osservato campagne analoghe basate su keyword AI, utilizzate per distribuire malware come Vidar, Lumma e Legion Loader attraverso siti ottimizzati con tecniche Black Hat SEO. La novità è che ora il fenomeno sembra estendersi oltre i motori di ricerca tradizionali, entrando nei flussi conversazionali generati dai chatbot AI: non viene compromessa l’AI in sé, ma il contesto informativo che l’AI utilizza per rispondere agli utenti.

Condividi l’articolo


Articoli correlati

Altro in questa categoria


https://www.securityinfo.it/2026/05/27/seo-poisoning-e-chatbot-ai-dirottati-per-un-malware-miner/?utm_source=rss&utm_medium=rss&utm_campaign=seo-poisoning-e-chatbot-ai-dirottati-per-un-malware-miner