Self-Sovereign Identity e Distributed Ledger Technology: una Rivoluzione nell’Identità Digitale

Al 22° Forum ICT Security, Igor Serraino – Independent ICT Advisor – ha trattato argomenti avanzati come l’innovazione tecnologica della blockchain, la gestione dell’identità digitale attraverso Self-Sovereign Identity (SSI) e l’applicazione della Zero Knowledge Proof (ZKP) nel suo intervento “Self-Sovereign Identity and Distributed Ledger Technology: Innovations in Digital Identity Management for Users and Machines”.

Il relatore ha esaminato i benefici della SSI, tra cui spiccano il controllo decentralizzato e autonomo sui dati personali dell’utente, nonché la maggiore sicurezza derivante dall’uso di registri distribuiti, citando, come spunti di approfondimento, varie tecnologie correlate.

È stata, in particolare, approfondita l’importante metodologia Zero Knowledge Proof, che grazie all’uso di protocolli crittografici consente di verificare la correttezza di un’informazione senza divulgare dati sensibili, esemplificandone alcuni casi d’uso in ambiti ove sia essenziale tutelare la privacy degli utenti pur potendo verificare la veridicità di una affermazione.

Self-Sovereign Identity: la gestione delle identità nel mondo digitale

Nel contesto tecnologico contemporaneo, la Self-Sovereign Identity (SSI) rappresenta una delle innovazioni più rilevanti nel panorama dell’identità digitale.

Il modello di identità digitale SSI – che sfugge a una precisa traduzione in italiano – è emblematico di una trasformazione radicale nella gestione delle identità nel mondo informatizzato, con profonde implicazioni per la privacy, la sicurezza e la capacità dell’utente di disporre e gestire ogni tipo di informazione che lo caratterizza.

Serraino ha infatti sottolineato come l’adozione della SSI non modifichi soltanto l’interazione tra individui e organizzazioni ma ridefinisca la struttura stessa delle relazioni digitali, fondandosi sui princìpi di decentralizzazione e sovranità dei dati.

Fondamenti della Self-Sovereign Identity

Per analizzare pienamente la portata della SSI, il relatore è partito dalle basi concettuali che la definiscono.

La SSI spesso è erroneamente ricondotta a modelli a database relazionali o di archiviazione strutturata secondo tipica logica CRUD: si tratta invece di un framework complesso, distribuito e rigorosamente decentralizzato, implementato tramite paradigma BlockChain, pensato per garantire l’autenticazione e la validazione dell’identità attraverso meccanismi che, ad oggi, presentano ancora un alto grado di innovazione rispetto allo stato dell’arte.

SSI impone di conferire al titolare dei dati il totale controllo sugli stessi, cruciale in un’epoca in cui la protezione delle informazioni personali è diventata una priorità a livello globale.

L’idea della centralità del controllo – con l’individuo come unico depositario dei propri dati – distingue profondamente la SSI dai tradizionali modelli di gestione delle identità.

Self-Sovereign Identity (SSI) basics

La struttura della SSI poggia su tre pilastri essenziali:

  1. Controllo e Accesso

Il primo pilastro riguarda la capacità dell’individuo di decidere autonomamente a quali informazioni condividere e con chi, nonché in quale contesto. Questo modello di gestione granulare dei dati può essere assimilato a una “cassaforte digitale” in cui l’utente ha compartimenti separati per ogni aspetto della propria identità.

  1. Sicurezza e Integrità

Il secondo pilastro si riferisce all’adozione dei principi fondamentali della sicurezza informatica: confidenzialità, integrità e disponibilità (nota anche come CIA triad). L’utilizzo del paradigma BlockChain garantisce che le informazioni restino inalterate, riducendo al minimo il rischio di compromissioni.

  1. Portabilità e Sovranità dei Dati

Il terzo pilastro riguarda la portabilità dei dati: nel modello SSI l’utente non è vincolato a un singolo fornitore di servizi ma può muovere le proprie credenziali tra diverse piattaforme, mantenendo comunque la sovranità e il pieno controllo sulle proprie informazioni.

Evoluzione dell’Identità Digitale

Ripercorrendo l’evoluzione che ha portato alla SSI, Serraino ha ricordato che ad oggi un’alta percentuale dei sistemi di identità digitale, soprattutto nella Pubblica Amministrazione, sono centralizzati e basati su modelli in cui un’unica autorità detiene il controllo sui dati personali degli utenti; un’architettura che presenta evidenti limiti, tra cui la vulnerabilità a violazioni di sicurezza (unico entry point) e la limitata autonomia degli utenti, nonché frammentazione informativa e complessità nell’applicazione di policies di IR e DR.

Self-Sovereign Identity (SSI)

In risposta a queste criticità si è quindi sviluppato il modello federato, che consente di utilizzare le stesse credenziali per accedere a più servizi: rappresenta senza dubbio un miglioramento rispetto al modello centralizzato, ma la dipendenza da entità terze rimane un problema irrisolto. Si pensi ad esempio alla revoca da parte del fornitore di servizi, per cui l’utente vada a perdere il privilegio di accesso anche ad altre piattaforme che si basano sull’identità federata non più disponibile.

Il modello user-centric, prevedendo un maggiore controllo degli utenti sui propri dati, ha rappresentato un ulteriore passo avanti; ma non è riuscito a eliminare completamente la necessità di provider centralizzati, le identità digitali sono comunque mantenute e controllate dalle entità che forniscono i servizi di identità digitale.

La Self-Sovereign Identity idealmente risolve le varie problematiche insite negli altri modelli, introducendo decisamente il pattern della decentralizzazione, in cui il titolare dell’identità risulta l’unico responsabile e controllore delle proprie informazioni. Si realizza insomma un “contenitore di identità” i cui dati sono sotto il pieno controllo del proprietario, che può aggiornarli, eliminarli, gestirli, in base alla propria volontà.

Il Triangolo della Fiducia

Un elemento fondamentale della SSI è il cosiddetto “Triangle of Trust” (ToT), o “Triangolo della Fiducia” – controllo, sicurezza e integrità, portabilità e sovranità – che coinvolge tre attori principali: il titolare dell’identità, l’entità emittente e l’entità verificante via VC (Verifiable Credentials).

Self-Sovereign Identity (SSI) - SSI triangle of trust (ToT)

Serraino ha evidenziato come in questo schema il titolare dell’identità possa essere un individuo, un’organizzazione o persino un dispositivo IoT, caratteristica funzionale – negli ultimi anni – anche ad esempio al contesto di Impresa 4.0 e le relative realtà operazionali delle Organizzazioni coinvolte.

In qualunque caso, l’entità emittente sarà responsabile della creazione e registrazione delle credenziali, mentre all’entità verificante spetterà validare l’informazione attraverso logiche a paradigma BlockChain.

Questo approccio garantisce un ecosistema di fiducia distribuita, eliminando la necessità di una singola autorità che autentichi e certifichi le identità a livello centralizzato, ove a supporto si trovano tecnologie algoritmiche come ZKP (Zero Knowledge Proofs) o DID (Decentralized Identifier)

Il Ruolo della Blockchain nella Self-Sovereign Identity

Nel paradigma SSI un ruolo cardine è rivestito dalla BlockChain: come ha ricordato Serraino, questa non va idealizzata come una sorta di database distribuito, ma piuttosto fondata su un registro immutabile (DLT) che garantisce la sicurezza e la tracciabilità delle transazioni, riducendo drasticamente la necessità di intermediari e promuovendo la fiducia tra le parti.
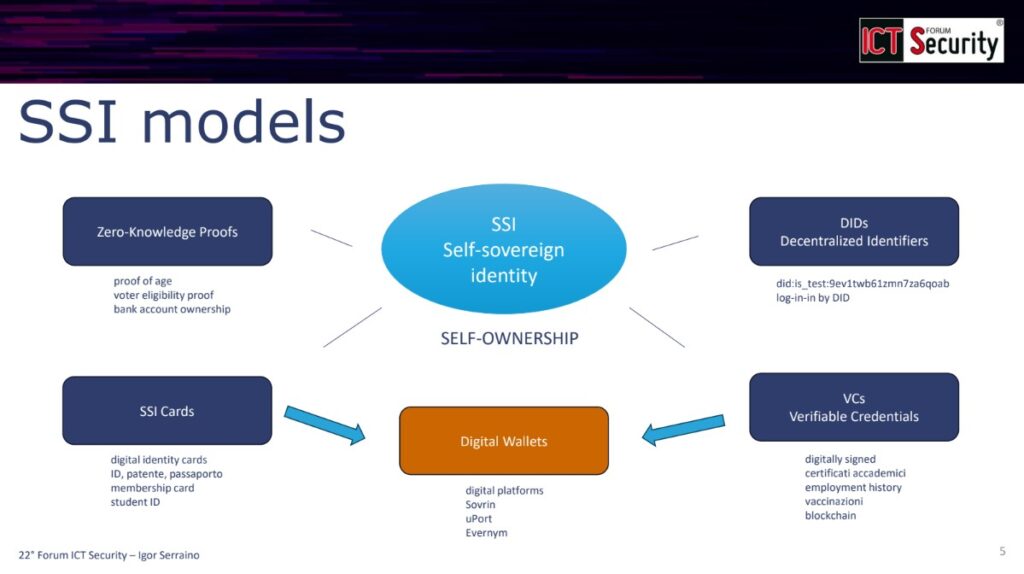
Self-Sovereign Identity (SSI) - SSI models

In tale contesto i digital wallets fungono da interfaccia utente, consentendo la gestione degli identificatori decentralizzati (DID) e delle VC credenziali verificabili; mentre le SSI cards, equivalenti digitali di documenti fisici come passaporti o patenti, sono uno strumento chiave per l’identificazione in contesti sia digitali che fisici. Si è ricordato il contesto della Pubblica Amministrazione, ove la sperimentazione della documentazione digitale, patenti e passaporti, sia già partita tramite piattaforme applicative ad hoc.

Zero Knowledge Proof: un’Innovazione Chiave

Un ulteriore avanzamento tecnologico nel contesto della SSI è rappresentato dalla Zero Knowledge Proof (ZKP). Si tratta di una famiglia di tecnologie crittografiche che permettono di dimostrare la veridicità di un’affermazione senza dover rivelare le informazioni che la riguardano. Per esempio, con le ZKP è possibile dimostrare a qualcuno di conoscere la soluzione di un complesso schema di sudoku, senza svelare nulla della soluzione stessa.

Ulteriori esempi applicativi di questa tecnologia crittografica alla base della SSI, sono nell’ambito dell’attestazione la veridicità delle informazioni senza rivelare i dettagli sottostanti: nell’esempio illustrato dal relatore, si ricava come sia possibile dimostrare di essere maggiorenni senza dover fornire la propria data di nascita. Da una prospettiva più tecnica, Serraino ha anticipato che la ZKP si sta affermando anche come strumento per ottimizzare l’efficienza computazionale rispetto ai tradizionali metodi di mining della BlockChain, rappresentando una soluzione più sostenibile e scalabile.

Applicazioni e Implicazioni della Self-Sovereign Identity

L’implementazione pratica della SSI trova nella BlockChain uno strumento fondamentale, applicando un modello informativo distribuito a supporto della validazione dell’identità in contesti complessi costituiti da più attori; in merito, il relatore ha ribadito come l’ambito di applicazione non sia solo per singoli individui ma anche per organizzazioni e dispositivi IoT ove gli aspetti di sicurezza informatica spesso passano in secondo piano, rispetto ad esigenze operative correlate al dover realizzare in tempo breve sistemi tecnologicamente innovativi e per cui le competenze sul campo sono difficili da reperire.

La BlockChain offre infatti la possibilità di fornire una prova univoca e incontrovertibile delle identità, lasciando al titolare la scelta – revocabile in qualsiasi momento – di concedere l’accesso a terze parti.

Oltre ad aumentare il controllo sui dati, questo sistema decentralizzato riduce il rischio di attacchi informatici, poiché non esiste un singolo punto di fallimento che possa essere compromesso.

Con la SSI ogni individuo diventa il vero titolare dei propri dati, eliminando la necessità di intermediari e garantendo piena sovranità sulle proprie informazioni personali.

Contesto Europeo: il Framework EBSI

Passando ad alcuni esempi concreti di applicazioni della SSI, il relatore ha citato il framework EBSI (European Blockchain Services Infrastructure), che testimonia l’impegno dell’Unione Europea nel promuovere l’adozione della SSI.

Self-Sovereign Identity (SSI) - Verifiable Credentials Framework

EBSI intende fornisce servizi come la notarizzazione digitale, gli audit trail e la conformità agli standard internazionali, contribuendo a rendere l’interazione tra cittadini e istituzioni più trasparente e sicura.

La SSI è infatti progettata per supportare una vasta gamma di casi d’uso, dalla gestione delle identità alla tracciabilità delle transazioni: nel contesto europeo i settori interessati includono la certificazione delle credenziali accademiche, l’implementazione dell’identità digitale europea e la condivisione attendibile dei dati nelle Pubbliche Amministrazioni.

Protocolli di Comunicazione e Sicurezza

I protocolli di comunicazione implementati nella SSI rappresentano un notevole progresso rispetto ai sistemi tradizionali, in particolare per quanto riguarda la sicurezza e la protezione dei dati.

L’autenticazione reciproca basata di identificatori decentralizzati (DID) – in cui si verifica l’identità sia del mittente che del destinatario – offre un livello di sicurezza che supera di gran lunga i protocolli standard, citando ad esempio il caso PEC di ampia diffusione, o ancora le casistiche di truffe di phishing estremamente diffuse.

La protezione dei metadati è un altro aspetto fondamentale, poiché permette di evitare che informazioni sensibili, come timestamp o indirizzi IP, possano essere utilizzate per scopi malevoli.

Il paradigma BlockChain realizza concettualmente e tecnologicamente le caratteristiche dei protocolli di sicurezza, assicurando l’integrità dei messaggi e la reale identità di entrambe le parti, garantendo che le comunicazioni non possano essere alterate durante la loro trasmissione.

Prospettive future

Le prospettive per la futura diffusione del paradigma SSI appaiono estremamente promettenti, grazie alla standardizzazione dei protocolli e all’interoperabilità tra sistemi diversi.

I più rilevanti casi d’uso citati nella presentazione hanno incluso:

  • ambito pubblico – la SSI potrebbe risolvere il problema della frammentazione dei dati, consentendo una gestione più sicura delle identità e una migliore condivisione delle informazioni tra le varie entità della Pubblica Amministrazione;
  • ambito sanitario – la SSI permetterebbe ai pazienti di mantenere il controllo completo dei propri dati medici, decidendo chi può accedervi e in quali circostanze, così migliorando la privacy e la qualità delle cure;
  • ambito educativo – la SSI consente l’uso di credenziali verificabili per attestare titoli di studio e qualifiche accademiche, riducendo il rischio di frodi nonché semplificando il processo di verifica da parte di datori di lavoro e istituzioni.

Conclusioni

In conclusione dell’intervento il relatore ha ribadito che la Self-Sovereign Identity rappresenta un vero e proprio cambio di paradigma nella gestione delle identità digitali.

Non si tratta, infatti, soltanto di un’innovazione tecnologica ma di una trasformazione che mette l’utente al centro del proprio ecosistema digitale, garantendo sicurezza, privacy e controllo.

L’implementazione su larga scala della SSI potrebbe rivoluzionare il modo in cui interagiamo con istituzioni, aziende e altre persone, creando un futuro digitale più equo e rispettoso dei diritti individuali: la collaborazione tra governi, industria e sviluppatori sarà fondamentale per costruire un ecosistema interoperabile e sicuro entro cui realizzare appieno le potenzialità della SSI, ponendo le basi per una nuova era di sovranità digitale.
Profilo Autore

Igor Serraino è professionista IT.
Opera come analista infrastrutturale e di Open Innovation nel contesto di Impresa 4.0 fin dal 2017, in qualità di Technology Expert per una importante società di settore attiva in ambiti aziendali eterogenei e sfidanti.
Il suo portfolio professionale senior-level si consolida attraverso una decennale esperienza da analista e sviluppatore hard-skills in ambienti Java-based, con particolare riferimento alla coprogettazione e sviluppo di applicativi per la gestione finanziaria commercializzati nel mondo della Pubblica Amministrazione.
Ha all’attivo numerose attività di formazione aziendale, workshops e pubblicazioni nei contesti di Cyber Security (GDPR e ISO27001), Legal-Tech, BlockChain Architect.

Condividi sui Social Network:

https://www.ictsecuritymagazine.com/articoli/self-sovereign-identity/


In Cina fiorisce il mercato nero dei dati personali


In Cina scoppia il mercato nero dei dati sensibili: oltre a costringere le aziende a raccogliere informazioni sui propri utenti, il governo cinese sta puntando anche sui dipendenti delle imprese e degli organi statali, portandoli a ottenere dati privati e rivenderli a criminali.

Oltre quindi alla raccolta centralizzata di dati operata dalle aziende tecnologiche, esiste un mercato nero parallelo che incentiva dipendenti e funzionari pubblici a vendere informazioni sensibili a cybercriminali e aziende, generando guadagni che possono raggiungere i 70.000 yuan al giorno (più di 9.000 euro).

Cina dati personali

In un approfondimento sul tema, Jessica Lyons di  The Register spiega che questi “lavoratori in nero” non raccolgono solo i dati degli utenti normali, ma anche di alti funzionari del Partito Comunista Cinese e hacker ricercati dall’FBI, per scopi di monitoraggio e spionaggio.

“Mentre la ricerca occidentale sul crimine informatico si concentra in modo particolare sui criminali del mondo anglofono e russo, esiste anche un’ampia comunità di criminali informatici di lingua cinese che si dedicano a truffe, crimini informatici di basso livello e con motivazioni finanziarie” ha affermato Kyla Cardona, ricercatrice di sicurezza di SpyCloud.

Dietro questa operazione massiva ci sono dei broker di dati che agiscono come intermediari, reclutando persone con annunci espliciti. Alcuni di questi broker affermano di avere “contratti ufficiali” con le principali aziende di telecomunicazioni cinesi per accedere alle abitudini di navigazione degli utenti e rivenderle. A comprare queste informazioni non sono solo i cybercriminali, ma anche business legittimi che li sfruttano per aumentare le vendite.

La Cina pullula di database di dati personali

I dati raccolti finiscono nei cosiddetti “database di ingegneria sociale” o SGK (Shegong Ku). Questi database contengono nomi, indirizzi di residenza, date di nascite, numeri di telefono, email, informazioni bancarie e sanitarie, dettagli sulle proprietà dell’utente e anche foto e scansioni per il riconoscimento visivo.

Tutte queste informazioni vengono pubblicizzate e vendute, o in alcuni casi addirittura fornite gratuitamente. È possibile inoltre effettuare ricerche generiche per pochi dollari (da 1 a 5 per ricerca), oppure sottoscrivere un abbonamento premium per accedere a informazioni dettagliate su un’azienda, spesso pubblicate da un insider.

Lyons riporta che uno dei database più grandi, ora non più accessibile, conteneva informazioni di più di 3 milioni di utenti. Attualmente il database più grande ancora attivo ha 317.000 abbonati, molto superiore alla media di 90.000 per mese. “Se non riesci a trovare qualcosa su uno di questi, probabilmente lo trovi in un altro o in un canale cinese di leak. È una parte importante dell’intero ecosistema del cybercrime che in Occidente non è presente” ha affermato Cardona.

Digital padlock on data screen – Web and data security

In occasione della Cyberwarcon, Cardona e Aurora Johnson, un’altra ricercatrice di SpyCloud, hanno mostrato quanto è semplice accedere alle informazioni contenute nei database e soprattutto quanti dettagli si possono ottenere. Le due hanno ottenuto accesso ai dati di membri di alto livello del Partito e informazioni quali l’ID WeChat personale, gli hobby, lo stato civile, lo stipendio e il codice IMEI che identifica univocamente un dispositivo mobile.

Accedere a tutte queste informazioni significa però anche riuscire a tracciare le attività dei cybercriminali e individuarli più facilmente. Cardona e Johnson hanno presentato come caso di studio quello relativo a Fu Qiand (alias StandNY), hacker accusato di attacchi informatici a livello globale. Accedendo ai dati contenuti negli SGK, i ricercatori hanno ottenuto numerosi dettagli personali dell’hacker, inclusi account violati, indirizzi IP e numeri di telefono.

Il mercato nero dei dati personali in Cina è una minaccia non indifferente: sfruttando i meccanismi di sorveglianza di stato per fini illeciti, è un pericolo per tutti, dai cittadini comuni ai funzionari di alto rango. Questo fenomeno non ha conseguenze solo all’interno del Paese, ma alimenta un sistema cybercriminale che ha implicazioni globali. Se per i ricercatori occidentali queste dinamiche offrono nuove opportunità per tracciare le attività criminali, sollevano anche preoccupazioni crescenti sulla sicurezza dei dati e la privacy.

Condividi l’articolo


Articoli correlati

Altro in questa categoria


https://www.securityinfo.it/2024/12/10/in-cina-fiorisce-il-mercato-nero-dei-dati-personali/?utm_source=rss&utm_medium=rss&utm_campaign=in-cina-fiorisce-il-mercato-nero-dei-dati-personali


Cybersecurity trends 2026: il futuro della Sicurezza Digitale nell’Era dell’IA

Cybersecurity trends 2026, quale futuro ci aspetta? La cybersecurity sta vivendo una trasformazione senza precedenti, trainata dall’intelligenza artificiale (IA) e dalla crescente complessità delle minacce digitali. Questa evoluzione richiede un approccio sempre più integrato alle tecnologie emergenti, come l’Internet of Things (IoT), il quantum computing e l’architettura Zero Trust. Il presente studio analizza le dinamiche tecnologiche, le sfide normative e le opportunità strategiche che definiranno il panorama della sicurezza informatica nel 2026.

Impatto dell’IA: Verso un’Automazione Intelligente

Tra i Cybersecurity Trends 2026, l’IA si conferma un pilastro della sicurezza informatica moderna, grazie a:

  • Rilevamento avanzato di minacce: Gli algoritmi di machine learning (ML) identificano pattern di attacco complessi e inediti.
  • Automazione delle risposte: La gestione automatizzata degli incidenti riduce drasticamente i tempi di intervento.
  • Analisi predittiva: Modelli di IA prevedono vulnerabilità future, rafforzando la prevenzione.

Tuttavia, l’uso dell’IA da parte di attori malevoli rappresenta una sfida critica. Per mitigare i rischi, è essenziale adottare misure di sicurezza multilivello e sviluppare algoritmi spiegabili per garantire trasparenza nelle decisioni. Questo rende l’IA un elemento chiave dei Cybersecurity Trends 2026, poiché le sue applicazioni continuano a espandersi e a evolversi.

Quantum Computing: Opportunità e Rischi

Il quantum computing è una delle maggiori sfide per i sistemi crittografici tradizionali, ma offre anche opportunità innovative per la sicurezza dei dati:

  • Crittografia quantum-safe: Algoritmi progettati per resistere alle capacità computazionali dei futuri computer quantistici.
  • Randomizzazione quantistica: Generazione di chiavi crittografiche con elevata entropia per una sicurezza senza precedenti.

Le organizzazioni devono prepararsi investendo in ricerca collaborativa e implementando infrastrutture post-quantum, garantendo la resilienza delle loro risorse digitali. Il quantum computing, come parte dei Cybersecurity Trends 2026, rappresenta una sfida ma anche una promessa per il futuro della sicurezza.

Architettura Zero Trust: Un Nuovo Paradigma

Il modello Zero Trust ridefinisce le strategie di sicurezza aziendale, basandosi sul principio “never trust, always verify”. I suoi elementi chiave includono:

  • Autenticazione continua: Validazione dinamica di utenti e dispositivi.
  • Micro-segmentazione: Isolamento delle risorse per limitare il rischio di compromissione laterale.
  • Orchestrazione intelligente: Integrazione di IA per la gestione di ambienti multi-cloud e distribuiti.

L’implementazione del modello richiede non solo innovazioni tecnologiche, ma anche un cambiamento culturale con policy adattative e strumenti di monitoraggio avanzati. L’architettura Zero Trust si inserisce tra i Cybersecurity Trends 2026 come approccio indispensabile per affrontare minacce sempre più sofisticate.

Sicurezza IoT: Protezione di Ecosistemi Complessi

La rapida diffusione dell’IoT introduce nuove vulnerabilità, rendendo necessarie strategie di sicurezza specifiche:

  • Standard globali: Protocollo unificato per garantire interoperabilità e sicurezza.
  • Gestione delle patch automatizzata: Sistemi intelligenti che rilevano e correggono vulnerabilità in tempo reale.
  • Protezione edge computing: Soluzioni di sicurezza localizzate nei nodi periferici per migliorare la resilienza delle reti.

L’integrazione tra IoT e IA consentirà un controllo distribuito più efficiente, ottimizzando i costi operativi e rafforzando la risposta alle minacce. Nei Cybersecurity Trends 2026, l’IoT si conferma un settore cruciale, dove la sicurezza deve essere considerata una priorità strategica.

Privacy e Conformità Normativa: Una Priorità Strategica

L’inasprimento delle normative globali impone alle aziende di adottare strategie proattive per la gestione etica dei dati:

  • Privacy by design: Protezione dei dati integrata fin dalle prime fasi di progettazione.
  • Automazione normativa: Strumenti per garantire conformità in tempo reale e ridurre i rischi legali.
  • Governance trasparente: Rafforzamento della fiducia degli stakeholder attraverso politiche di gestione responsabile.

Investire in tecnologie avanzate di compliance diventerà essenziale per mantenere la competitività in un contesto normativo sempre più stringente. Questi aspetti rappresentano un pilastro nei Cybersecurity Trends 2026, sottolineando l’importanza di bilanciare innovazione e responsabilità.

Conclusioni

Il 2026 rappresenta un punto di svolta per la cybersecurity, con l’emergere di tecnologie avanzate e approcci trasformativi. L’IA, il quantum computing, l’architettura Zero Trust e l’IoT ridefiniranno le modalità di protezione delle risorse digitali. I Cybersecurity Trends 2026 evidenziano come solo le organizzazioni che abbracceranno l’innovazione con una visione strategica e proattiva potranno garantire un ecosistema digitale resiliente e sicuro. In un panorama in continua evoluzione, la preparazione e la capacità di adattamento saranno fondamentali per affrontare con successo le sfide del futuro.

Condividi sui Social Network:

https://www.ictsecuritymagazine.com/notizie/cybersecurity-trends-2026/


Booking.com says typos giving strangers access to private trip info is not a bug

For Booking.com, it’s essential that users can book travel for other users by adding their email addresses to a booking because that’s how people frequently book trips together. And if it happens that the email address added to a booking is also linked to an existing Booking.com user, the trip is automatically added to that person’s account. After that, there’s no way for Booking.com to remove the trip from the stranger’s account, even if there’s a typo in the email or if auto-complete adds the wrong email domain and the user booking the trip doesn’t notice.

According to Booking.com, there is nothing to fix because this is not a “system glitch,” and there was no “security breach.” What Alfie encountered is simply the way the platform works, which, like any app where users input information, has the potential for human error.

In the end, Booking.com declined to remove the trip from Alfie’s account, saying that would have violated the privacy of the user booking the trip. The only resolution was for Alfie to remove the trip from his account and pretend it never happened.

Alfie remains concerned, telling Ars, “I can’t help thinking this can’t be the only occurrence of this issue.” But Jacob Hoffman-Andrews, a senior staff technologist for the digital rights group the Electronic Frontier Foundation, told Ars that after talking to other developers, his “gut reaction” is that Booking.com didn’t have a ton of options to prevent typos during bookings.

“There’s only so much they can do to protect people from their own typos,” Hoffman-Andrews said.

One step Booking.com could take to protect privacy

Perhaps the bigger concern exposed by Alfie’s experience beyond typos is Booking.com’s practice of automatically adding bookings to accounts linked to emails that users they don’t know input. Once the trip is added to someone’s account, that person can seemingly access sensitive information about the users booking the trip that Booking.com otherwise would not share.

While engaging with the Booking.com support team member, Alfie told Ars that he “probed for as much information as possible” to find out who was behind the strange booking on his account. And seemingly because the booking was added to Alfie’s account, the support team member had no problem sharing sensitive information that went beyond the full name and last four digits of the credit card used for the booking, which were listed in the trip information by default.

https://arstechnica.com/tech-policy/2024/12/booking-com-says-typos-giving-strangers-access-to-private-trip-info-is-not-a-bug/


Sovranità Digitale: Controllo, Sfide e Prospettive Future

La relazione “Sovranità Digitale e Intelligence”, presentata durante il 22° Forum ICT Security da Francesco Arruzzoli, Responsabile del Centro Studi Cerbeyra, ha evidenziato l’importanza cruciale del controllo delle informazioni e delle risorse tecnologiche.

L’intervento ha esplorato l’impatto degli hyperscaler – come Amazon e Google – sulla sovranità digitale, evidenziando le soluzioni adottate da queste aziende, tra cui la costruzione di data center sul territorio europeo.

Sono stati altresì discussi i rischi legati alla sovranità digitale e l’importanza di normative per la protezione dei dati: in particolare, la presentazione ha sottolineato anche la necessità di piani di emergenza per contrastare efficacemente cyber attacchi di ampia portata.

Concetti fondamentali della Sovranità Digitale

Il relatore ha introdotto il tema trattato con una citazione significativa: “La libertà è partecipare al governo della propria vita”.

Così scriveva, oltre 2000 anni fa, Marco Tullio Cicerone in un trattato sulla libertà e la sovranità: Arruzzoli ha sottolineato la sorprendente attualità di queste parole, che dopo due millenni continuano a fornire degli insegnamenti essenziali.

La sovranità di cui parlava Cicerone, infatti, è un concetto che oggi si estende al mondo digitale. Non più esclusiva del mondo fisico, la sovranità ha infatti assunto una dimensione virtuale: la sovranità digitale rappresenta il diritto di ogni individuo, organizzazione, azienda, ente pubblico o nazione di controllare le proprie informazioni, risorse tecnologiche e identità online.

Senza questo controllo si rischia di essere influenzati da poteri invisibili, perdendo la propria autodeterminazione in un mondo sempre più iperconnesso.

Pilastri della Sovranità Digitale

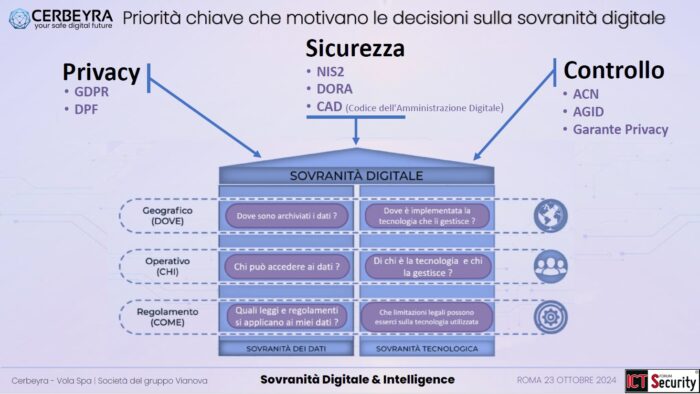
Tale sovranità digitale si fonda su due pilastri fondamentali: la sovranità dei dati e la sovranità tecnologica.

Per misurare il livello di controllo su tali domini, è utile rispondere a tre domande: dove, chi e come?

  • Dove: la localizzazione geografica dei dati e delle infrastrutture che li gestiscono.
  • Chi: chi ha accesso ai dati, nonché chi possiede e controlla la tecnologia che li amministra.
  • Come: i regolamenti applicabili, ossia quali leggi si applicano ai dati e quali limitazioni legali esistono nell’uso della tecnologia.

Priorità chiave che motivano le decisioni sulla sovranita digitale_cerbeyra

Rispondere a queste domande fornisce un metro di giudizio per valutare il livello di controllo sulla propria sovranità digitale.

Quadro normativo per la Sovranità Digitale

Questi aspetti sono già disciplinati da diverse normative. Tra queste il GDPR, che tutela della privacy dei dati; il Data Protection Framework (DPF), che regolamenta le trasmissioni digitali dei dati personali tra Stati Uniti ed Europa; infine la direttiva NIS 2, che detta norme per la sicurezza delle reti e dei sistemi informativi, insieme al DORA, la sua versione specificamente dedicata ai servizi finanziari, che entrerà in vigore nel gennaio 2025.

Inoltre, per l’Italia, il Codice dell’Amministrazione Digitale (CAD) fornisce indicazioni su come la Pubblica Amministrazione debba gestire dati e informazioni. Anche diversi organi di controllo, quali l’Agenzia per la Cybersicurezza Nazionale, l’AGID e il Garante per la Privacy, sono impegnati nella gestione di queste complesse questioni.

L’Unione Europea sta sviluppando ulteriori progetti in materia. Ne sono esempi il Cloud Service Scheme (EUCS) dell’ENISA, che mira a creare livelli di certificazione in base alla sensibilità dei dati gestiti dai fornitori di servizi cloud; o iniziative come Gaia-X, mirato alla creazione di una federazione di cloud provider che garantiscano regole di trasparenza e sicurezza.

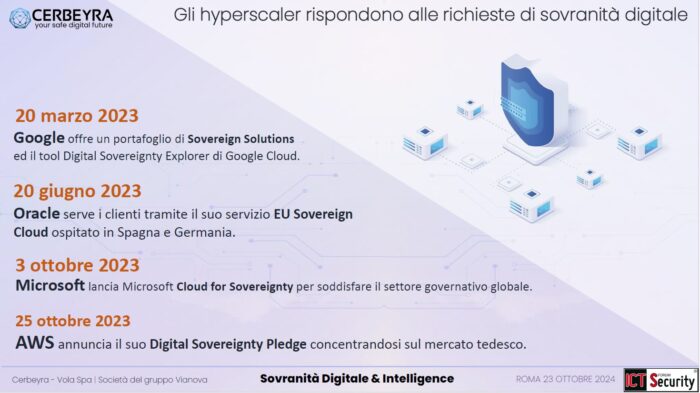
sovranita digitale cerbeyra: Gli hyperscaler rispondono alle richieste di sovranità digitale secondo Cerbeyra

Tuttavia – secondo Arruzzoli – queste iniziative rischiano di essere compromesse, poiché uno dei principi di base è che i fornitori dei servizi siano esclusivamente europei. Ciò ha inevitabilmente suscitato la reazione delle big tech come Amazon, Google e Microsoft che, in quanto hyperscaler capaci di erogare servizi a miliardi di utenti, hanno interessi economici e politici che spesso si situano in “zone grigie” rispetto alla sovranità digitale.

Rischi e sfide della Sovranità Digitale

In risposta all’elaborazione delle normative europee per la certificazione dei fornitori di servizi cloud, queste grandi aziende hanno definito rapidamente le proprie soluzioni di sovranità digitale, costruendo data center nel territorio europeo nonché utilizzando il loro potere di lobbying per evitare di essere escluse dalla gestione della sovranità digitale dell’Unione.

Al riguardo hanno sostenuto che, se fossero escluse, il divario tecnologico tra l’Europa e il resto del mondo aumenterebbe, con conseguenze economiche negative per le imprese e le nazioni del Vecchio Continente.

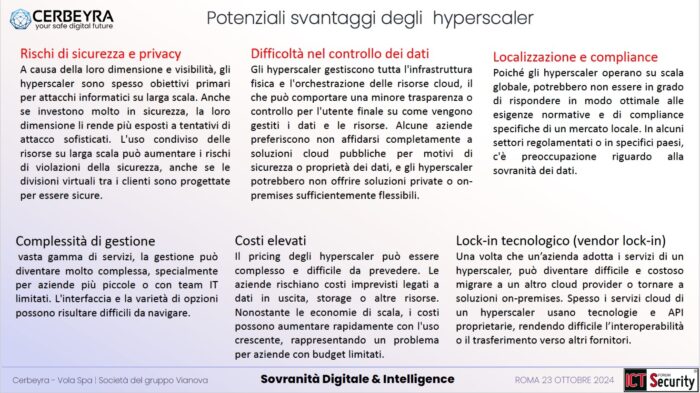
Tuttavia, il relatore ha portato l’attenzione sui principali rischi per la sovranità digitale che deriverebbero dall’affidarsi agli hyperscaler.

sovranita digitale cerbeyra: Potenziali svantaggi degli hyperscaler nella sovanita digitale secondo cerbeyra

Il primo è relativo agli attacchi informatici: entità globali che gestiscono miliardi di utenti rappresentano, infatti, bersagli estremamente attraenti per il cybercrime e un attacco nei loro confronti potrebbe colpire simultaneamente governi e cittadini in diverse parti del mondo, rendendo estremamente difficile la gestione delle conseguenze.

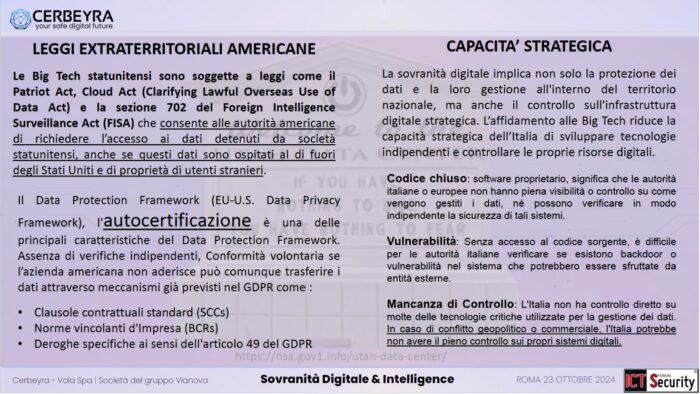
Un ulteriore rischio è legato alla compliance e alla localizzazione dei dati: chi gestisce i dati e chi ne detiene il controllo effettivo sono aspetti non sempre trasparenti. Normative come il Cloud Act, il Patriot Act e la sezione 702 del Foreign Intelligence Surveillance Act (FISA) consentono infatti alle agenzie governative USA di accedere alle infrastrutture tecnologiche delle big tech in qualsiasi Paese si trovino, anche se i dati appartengono a cittadini stranieri, potendo così aggirare qualsiasi regolamento europeo in materia.

sovranita digitale cerbeyra: sovranità digitale e normativa la visione di cerbeyra

Nonostante l’Europa abbia tentato di affrontare queste sfide con il Data Protection Framework, il relatore ha ricordato come la sua efficacia sia limitata dal fatto che si basa sull’adesione volontaria delle big tech.

Ciò solleva importanti dubbi strategici sulla sicurezza delle informazioni e sul controllo effettivo della tecnologia; soprattutto guardando al futuro sviluppo dei computer quantistici, che porteranno ad un enorme aumento della capacità di elaborare e correlare i nostri dati personali.

Sovranità Digitale: controllo e soluzioni nazionali

Per offrire un esempio concreto di mancanza di controllo sui propri dati, Arruzzoli ha citato un’applicazione utilizzata per registrare videoconferenze e analizzare i sentimenti dei partecipanti. Questa funzione viola infatti l’art. 5 dell’Artificial Intelligence Act, che vieta espressamente la deduzione delle emozioni sul posto di lavoro.

Il relatore ha pertanto evidenziato come, nonostante le leggi vigenti, esistano numerose falle nella regolamentazione e il rischio di un’estrazione illecita di dati – di cui spesso non siamo neppure consapevoli – resti elevato.

È quindi cruciale creare ecosistemi digitali nazionali in cui cittadini, aziende ed enti governativi possano avere un pieno controllo sulle proprie informazioni.

Un esempio virtuoso citato nell’intervento è rappresentato dal gruppo Vianova, operatore integrato che offre telefonia fissa, mobile e servizi avanzati di telecomunicazione impegnandosi a gestire i dati degli utenti in modo da garantire l’affidabilità e la sicurezza dei relativi processi.

Il Modello Vianova: un approccio alla Sovranità Digitale

Il gruppo Vianova gestisce una propria rete, infrastruttura e data center – tutti situati in territorio italiano – per offrire un elevato livello di controllo e sicurezza ai clienti, che sono esclusivamente aziende ed enti governativi.

La connettività è progettata per evitare compromissioni anche in caso di congestionamento della rete; in tal modo nel 2023 è stato possibile prevenire quasi il 70% dei disservizi ancor prima che fossero segnalati dagli utenti. I data center di Pisa e Massarosa sono conformi al livello Tier 4 e garantiscono, tanto sui servizi di hosting quanto in caso di co-location, la massima sicurezza ai dati del cliente.

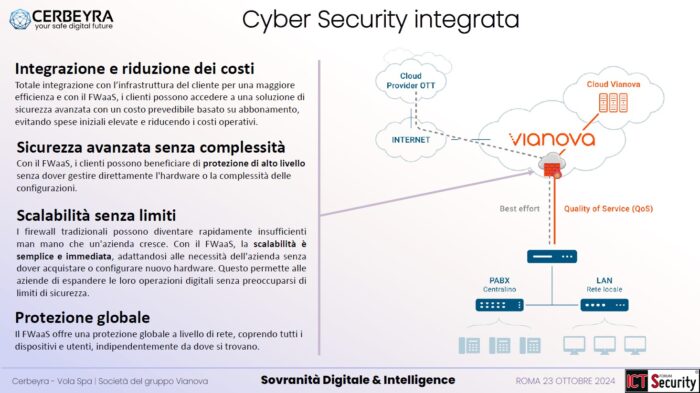
La sicurezza è integrata by design in tutte le comunicazioni, includendo servizi quali il “firewall as a service” o le connessioni private per la telefonia mobile.

sovranita digitale di vianova cerbeyra: sovranità digitale_Cyber Security integrata di cerbeyra e vianova

Infine, l’intelligenza artificiale è implementata tramite una piattaforma di Cyber Threat Intelligence che monitora costantemente la rete e i sistemi dei clienti, rilevando vulnerabilità o anomalie per attivare immediatamente le operazioni di risposta.

Un esempio concreto citato da Arruzzoli ha riguardato l’analisi di un’attività di phishing. Nel caso esposto, la piattaforma Vianova aveva rilevato come la sandbox di Microsoft Defender non si fosse limitata a esaminare il contenuto di un’email ricevuta dal cliente ma avesse avuto accesso, durante il processo, a numerose informazioni aggiuntive.

Sebbene simili attività siano formalmente legali, il relatore ha evidenziato come si pongano – anche alla luce delle esaminate differenze normative tra Europa e Stati Uniti – seri interrogativi in merito a quale utilizzo venga fatto di tali dati, nonché all’effettivo controllo sugli stessi.

Verso una Sovranità Digitale sostenibile

In conclusione Arruzzoli ha ribadito come la sovranità digitale rappresenti la chiave per proteggere il futuro delle nazioni, dei cittadini e delle imprese.

Oggi, infatti, chi controlla i dati controlla il destino collettivo. È quindi essenziale lavorare per garantire un futuro in cui il controllo rimanga nelle mani di chi genera quei dati: un’efficace strategia di sovranità digitale deve basarsi su normative solide, infrastrutture robuste e consapevolezza diffusa, affinché il controllo delle informazioni resti in ambito locale e venga gestito in modo democratico e sicuro.

Profilo Autore

Con oltre 25 anni di esperienza nell’ambito della sicurezza delle informazioni Francesco Arruzzoli è Senior Cyber Security Threat Intelligence Architect presso la Winitalia srl di cui è cofondatore. Si occupa di progettare infrastrutture e soluzioni per la Cyber Security di aziende ed enti governativi. In passato ha lavorato per multinazionali, aziende della sanità italiana, enti governativi e militari. Esperto di Cyber Intelligence e contromisure digitali svolge inoltre attività di docenza presso alcune università italiane.

Condividi sui Social Network:

https://www.ictsecuritymagazine.com/articoli/sovranita-digitale-ict/


Guida Completa al Registro delle Attività di Trattamento: Elementi Minimi per Titolari e Responsabili

Il contenuto che segue fa parte di una serie di articoli dedicati al Registro dei trattamenti. In questo focus, approfondiamo gli elementi minimi richiesti nel Registro delle Attività di Trattamento, evidenziando le informazioni essenziali che ogni Titolare e Responsabile del trattamento devono includere.

Informazioni presenti nel Registro delle Attività di Trattamento

Ogni Titolare del trattamento e, ove applicabile, il suo rappresentante tengono un registro delle attività di trattamento svolte sotto la propria responsabilità. Tale registro contiene tutte le seguenti informazioni:

  • Il nome e i dati di contatto del titolare del trattamento e, ove applicabile, del contitolare del trattamento, del rappresentante del titolare del trattamento e del responsabile della protezione dei dati.
  • Le finalità del trattamento.
  • Una descrizione delle categorie di interessati e delle categorie di dati personali.
  • Le categorie di destinatari a cui i dati personali sono stati o saranno comunicati, compresi i destinatari di paesi terzi od organizzazioni internazionali.
  • Ove applicabile, i trasferimenti di dati personali verso un paese terzo o un’organizzazione internazionale, compresa l’identificazione del paese terzo o dell’organizzazione internazionale e, per i trasferimenti di cui al secondo comma dell’articolo 49, la documentazione delle garanzie adeguate.
  • Ove possibile, i termini ultimi previsti per la cancellazione delle diverse categorie di dati.
  • Ove possibile, una descrizione generale delle misure di sicurezza tecniche e organizzative di cui all’articolo 32, paragrafo 1.

Il contenuto del Registro rappresenta una sintesi delle attività di trattamento attivate dal Titolare o dal Responsabile anche mediante i loro rappresentanti e, quindi, da qui la necessità di predisporre una più specifica policy privacy interna da cui estrarre le informazioni utili sia per la compilazione del Registro che dell’informativa ex artt. 13 e 14 del GDPR.

Il Ruolo dei Soggetti Autorizzati al Trattamento

In tale contesto è, quindi, utile richiamare sin da ora l’attenzione circa l’importanza che rivestono i soggetti autorizzati al trattamento. Essi rappresentano coloro che, durante l’esecuzione di un trattamento dei dati, per primi conoscono la qualità del dato trattato (comune, particolare e giudiziario unitamente alle loro sottocategorie) oltre ad ogni informazione utile così da poter supportare il Titolare nel costante aggiornamento della policy privacy interna e di conseguenza del Registro.

Ai fini della compilazione del Registro dei trattamenti ed a titolo esemplificativo corre precisare che l’operazione di anonimizzazione oltre che misura di sicurezza è essa stessa un trattamento e come tale deve essere censita nel Registro dei trattamenti nonché indicato tra le informazioni presenti nell’informativa resa all’interessato.

Elementi Minimi del Registro del Responsabile

Prima di illustrare gli elementi minimi del Registro del Responsabile è utile evidenziare come tra gli obblighi del titolare all’atto della nomina di un responsabile del trattamento ex art. 28 del GDPR riscontriamo la verifica dei requisiti di cui al par. 1 dello stesso, e più in particolare essi rilevano, ai fini del principio di accountability, e anche in questo caso, per quanto attiene l’obbligo di collaborazione con l’Autorità.

Il Titolare, quindi, sarà tenuto a verificare sia la corretta applicazione del GDPR da parte del Responsabile che la corretta tenuta del Registro, anche al fine di non incorrere nelle sanzioni previste dal GDPR per la mancata o incompleta tenuta del Registro stesso.

Ciò premesso, ogni responsabile del trattamento e, ove applicabile, il suo rappresentante tengono un registro di tutte le categorie di attività relative al trattamento svolte per conto di un titolare del trattamento, contenente:

  • Il nome e i dati di contatto del responsabile o dei responsabili del trattamento, di ogni titolare del trattamento per conto del quale agisce il responsabile del trattamento, del rappresentante del titolare del trattamento o del responsabile del trattamento e, ove applicabile, del responsabile della protezione dei dati.
  • Le categorie dei trattamenti effettuati per conto di ogni titolare del trattamento.
  • Ove applicabile, i trasferimenti di dati personali verso un paese terzo o un’organizzazione internazionale, compresa l’identificazione del paese terzo o dell’organizzazione internazionale e, per i trasferimenti di cui al secondo comma dell’articolo 49, la documentazione delle garanzie adeguate.
  • Ove possibile, una descrizione generale delle misure di sicurezza tecniche e organizzative di cui all’articolo 32, paragrafo 1.

Importanza della Documentazione nel GDPR

La figura del responsabile del trattamento è contenuta nell’art. 28 GDPR che al paragrafo 1 enunciati i presupposti e le garanzie che il titolare deve verificare mentre al paragrafo 2 enunciata la procedura di nomina.

  1. Qualora un trattamento debba essere effettuato per conto del titolare del trattamento, quest’ultimo ricorre unicamente a responsabili del trattamento che presentino garanzie sufficienti per mettere in atto misure tecniche e organizzative adeguate in modo tale che il trattamento soddisfi i requisiti del presente regolamento e garantisca la tutela dei diritti dell’interessato.
  2. Il responsabile del trattamento non ricorre a un altro responsabile senza previa autorizzazione scritta, specifica o generale, del titolare del trattamento. Nel caso di autorizzazione scritta generale, il responsabile del trattamento informa il titolare del trattamento di eventuali modifiche previste riguardanti l’aggiunta o la sostituzione di altri responsabili del trattamento, dando così al titolare del trattamento l’opportunità di opporsi a tali modifiche.

In un rapporto tra un titolare e un responsabile, il titolare è sempre tenuto a comprovare l’adozione delle misure adeguate al caso di specie. In particolare, la mera nomina di un responsabile non è sufficiente a tenerlo indenne da eventuali responsabilità derivanti da violazioni del GDPR. Il titolare è dunque tenuto anche ad adottare tutte le misure adeguate necessarie e ivi inclusa la scelta del responsabile al fine di soddisfare i requisiti del GDPR e garantire la tutela dei diritti dell’interessato così da non incorrere nella culpa in eligendo e nella culpa in vigilando.

L’articolo si è focalizzato sull’analisi degli elementi minimi del Registro delle Attività di Trattamento, sottolineando l’importanza della documentazione e della corretta tenuta dei registri per garantire la conformità al GDPR. Nel prossimo articolo, affronteremo la compilazione del registro del Titolare e del Responsabile, fornendo linee guida utili per una corretta applicazione del regolamento. Invitiamo i lettori a scaricare il white paper dal titolo “La compilazione del Registro dei trattamenti nel nuovo quadro normativo del Reg. UE 679/2016“ per approfondire ulteriormente questi temi.

Profilo Autore

Tecnologo presso l’UAIG del CNR.
Abilitato all’esercizio della professione forense.

Condividi sui Social Network:

https://www.ictsecuritymagazine.com/articoli/registro-trattamento/


Intelligenza Artificiale Privacy Preserving: un Futuro per la Protezione dei Dati Sensibili

Durante il 22° Forum ICT Security, Manuel Roveri – Professore Ordinario presso il Politecnico di Milano e Co-founder di Dhiria s.r.l. – ha esplorato le prospettive future dell’Intelligenza Artificiale Privacy Preserving, con particolare enfasi sulle tecnologie emergenti per la tutela delle informazioni personali e aziendali.

Nella relazione “Machine Learning e Homomorphic Encryption: Il Futuro dell’Intelligenza Artificiale Privacy Preserving”, il prof. Roveri ha delineato le principali sfide connesse all’implementazione dei servizi AI e al necessario bilanciamento con la tutela della privacy: ha poi illustrato tecniche di privacy-preserving computation, tra cui l’anonimizzazione e l’homomorphic encryption, fornendo esempi concreti di applicazioni ai dati genomici e satellitari.

Tra i temi affrontati anche le sfide del deep learning su dati criptati e relative potenzialità di addestramento, nonché l’importanza cruciale della privacy in tutti i servizi AI; l’obiettivo principale resta infatti garantire la riservatezza delle informazioni, tramite tecniche sofisticate di elaborazione sicura su dati criptati.

L’intervento ha evidenziato come le tecnologie emergenti possano consentire risultati avanzati senza compromettere la riservatezza delle informazioni sensibili, aprendo la strada a un futuro in cui l’intelligenza artificiale rispetti integralmente la privacy degli utenti.

Contesto dell’Intelligenza Artificiale Privacy Preserving

Negli ultimi tempi l’intelligenza artificiale ha subito un’evoluzione sostanziale, segnata dal cambiamento radicale avvenuto all’inizio dello scorso anno.

Tale evoluzione è stata agevolata dalla disponibilità di modelli di linguaggio di grandi dimensioni: come GPT-3, sviluppato già nel 2017 e utilizzato nel 2020 per la redazione di un articolo pubblicato dal quotidiano britannico Guardian.

La svolta avvenuta nel 2023 ha riguardato il modo in cui l’AI è diventata accessibile a un pubblico molto più ampio. Se infatti nel passato l’implementazione di questi algoritmi richiedeva un team di esperti di AI, dataset su larga scala e infrastrutture di calcolo avanzate, oggi le stesse capacità sono disponibili per chiunque grazie alla diffusione dell’Artificial Intelligence-as-a-Service (AIaaS).

Analogamente ad altri servizi digitali – come quelli di posta elettronica, archiviazione, CRM – l’AIaaS non esige che l’utente comprenda l’algoritmo sottostante o l’infrastruttura su cui opera: per ottenere i risultati è sufficiente collegarsi al servizio tramite dispositivi mobili o browser e fornire i dati richiesti.

Tuttavia il relatore ha ricordato che l’uso di questi servizi, per quanto spesso gratuiti, comporta dei costi impliciti poiché implica il rilascio di dati in chiaro, imponendo un compromesso tra la comodità dei servizi e la protezione della privacy.

Pertanto, il prof. Roveri ha posto una domanda fondamentale: come progettare servizi di intelligenza artificiale che preservino la privacy dei dati?

Tecniche fondamentali per l’Intelligenza Artificiale Privacy Preserving

La Privacy Preserving Computation affronta questo problema mediante diverse tecniche che garantiscono la riservatezza dei dati durante il processo di elaborazione.

Tra tali tecniche, il relatore ha sintetizzato le principali:

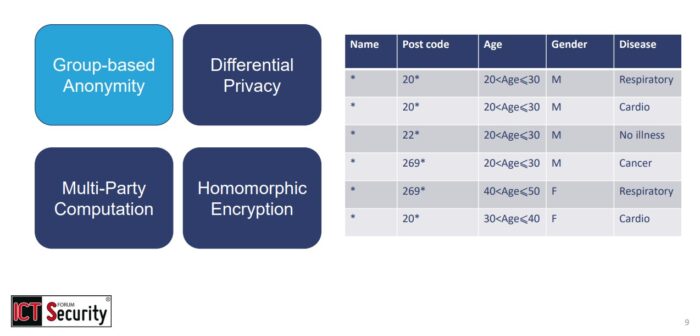
    1. Anonimizzazione dei dati – consiste nella rimozione di tutte le informazioni sensibili presenti in un database, come nomi o identificatori di localizzazione, per impedire che i datiencryptionencryption siano associabili a specifici individui;
      Slide dell'intervento “Machine Learning e Homomorphic Encryption: Il Futuro dell'Intelligenza Artificiale Privacy-Preserving”. Prof. Manuel Roveri al Forum ICT Security 2024: Anonimizzazione dei dati
      Slide dell’intervento “Machine Learning e Homomorphic Encryption: Il Futuro dell’Intelligenza Artificiale Privacy-Preserving”. Prof. Manuel Roveri al Forum ICT Security 2024
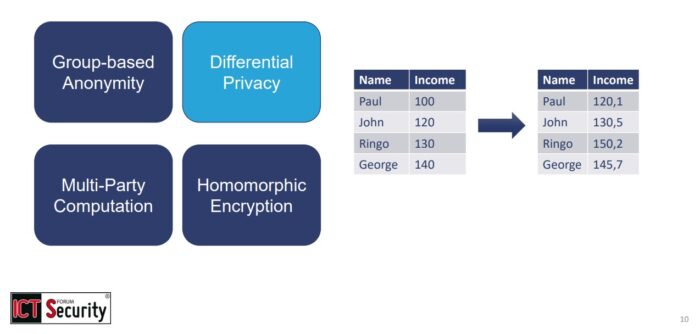
    2. Differential Privacy – complementare al precedente, prevede l’aggiunta di “rumore statistico” al fine di perturbare i dati per consentirne l’analisi aggregata senza divulgare informazioni dettagliate sui singoli individui, preservando così la privacy;
      Slide dell'intervento del prof. Manuel Roveri “Machine Learning e Homomorphic Encryption: Il Futuro dell'Intelligenza Artificiale Privacy-Preserving” al Forum ICT Security 2024: Differential Privacy
      Slide dell’intervento “Machine Learning e Homomorphic Encryption: Il Futuro dell’Intelligenza Artificiale Privacy-Preserving”. Prof. Manuel Roveri al Forum ICT Security 2024
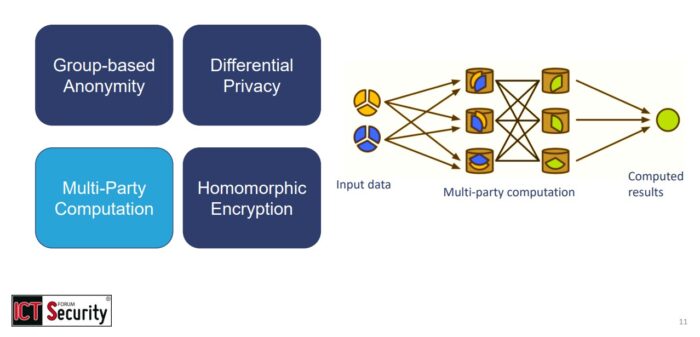
    3. Multi-Party Computation (MPC) – i dati vengono distribuiti “a pezzi”, in modo che nessuno abbia accesso completo alla totalità dei dati originali ma tutti possano collaborare per ottenere in sicurezza il risultato finale;
Slide dell'intervento “Machine Learning e Homomorphic Encryption: Il Futuro dell'Intelligenza Artificiale Privacy-Preserving”: Multi-Party Computation (MPC), Prof. Manuel Roveri al Forum ICT Security 2024
Slide dell’intervento “Machine Learning e Homomorphic Encryption: Il Futuro dell’Intelligenza Artificiale Privacy-Preserving”. Prof. Manuel Roveri al Forum ICT Security 2024
  1. Homomorphic Encryption (HE) – consente di elaborare i dati in forma criptata ma, a differenza di altri schemi crittografici, permette di eseguire operazioni sui dati criptati fornendo un risultato che, una volta decriptato, equivale sostanzialmente a quello delle operazioni svolte sui dati in chiaro.
    Slide dell'intervento “Machine Learning e Homomorphic Encryption: Il Futuro dell'Intelligenza Artificiale Privacy-Preserving”: Homomorphic Encryption (HE), Prof. Manuel Roveri al Forum ICT Security 2024
    Slide dell’intervento “Machine Learning e Homomorphic Encryption: Il Futuro dell’Intelligenza Artificiale Privacy-Preserving”. Prof. Manuel Roveri al Forum ICT Security 2024

Tipologie di Homomorphic Encryption nell’Intelligenza Artificiale Privacy Preserving

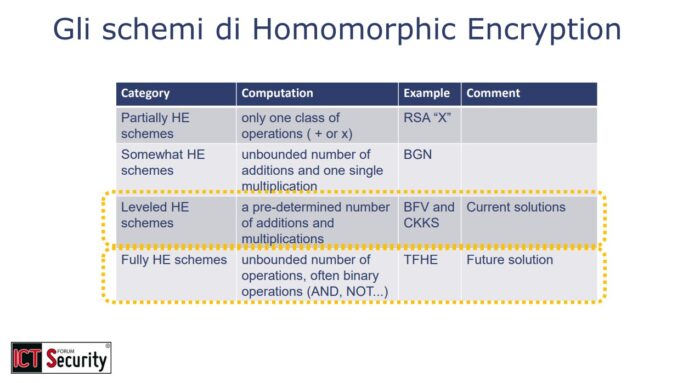
A loro volta gli schemi di homomorphic encryption si suddividono in diverse categorie, distinte in base alle loro capacità di elaborazione dei dati criptati.

  • Partial Homomorphic Encryption: consente l’esecuzione di una singola operazione, come la somma o il prodotto, limitando significativamente la complessità delle operazioni.
  • Somewhat Homomorphic Encryption: consente un numero illimitato di somme ma una sola moltiplicazione.
  • Leveled Homomorphic Encryption: attualmente il più utilizzato, consente un numero predeterminato di somme e moltiplicazioni che lo rendono adatto a scenari di elaborazione specifici.
  • Full Homomorphic Encryption (FHE): grazie al processo di bootstrapping, questo schema permette un numero illimitato di operazioni ed è considerato lo schema che in futuro potrà rivelarsi resistente agli attacchi da parte di computer quantistici.
Slide dell'intervento “Machine Learning e Homomorphic Encryption: Il Futuro dell'Intelligenza Artificiale Privacy-Preserving”: Partial Homomorphic Encryption, Somewhat Homomorphic Encryption, Leveled Homomorphic Encryption, Full Homomorphic Encryption (FHE): Prof. Manuel Roveri al Forum ICT Security 2024
Slide dell’intervento “Machine Learning e Homomorphic Encryption: Il Futuro dell’Intelligenza Artificiale Privacy-Preserving”. Prof. Manuel Roveri al Forum ICT Security 2024

Sfide tecniche e soluzioni per l’Intelligenza Artificiale Privacy Preserving

Come ricordato da Roveri, sebbene offrano possibilità avanzate, le tecniche di homomorphic encryption presentano anche diverse sfide.

Tra queste spiccano la necessità di trasformare le operazioni non lineari in operazioni lineari (o polinomiali) e la limitazione nella lunghezza della pipeline di elaborazione, oltre a un’elevata richiesta di memoria e potenza di calcolo. Questi sono aspetti particolarmente critici per le reti di deep learning, caratterizzate proprio da operazioni non lineari, profondità di elaborazione elevata e da un’enorme richiesta di risorse computazionali.

Simili criticità sono alla base della seconda domanda posta nel corso dell’intervento: è possibile progettare reti neurali capaci di operare su dati criptati?

Per rispondere positivamente è stato citato il caso, già oggetto di una pubblicazione scientifica, della rete di elaborazione immagini AlexNet, dove le operazioni non lineari sono state sostituite con operazioni polinomiali per poter applicare l’homomorphic encryption preservando comunque un’accuratezza comparabile all’originale. Ad esempio la versione approssimata della rete, operando su immagini criptate, raggiunge un’accuratezza del 98,1% sul dataset MNIST (rispetto al 98,7% della versione originale).

I costi in termini di occupazione di memoria sono considerevoli, passando da 7.5 MB a 780 MB; anche i tempi aumentano sensibilmente, dai pochi millisecondi della rete originale ai diversi minuti richiesti dalla rete criptata.

Tuttavia il relatore ha argomentato che tali costi – oltre a essere giustificati dalla necessità di proteggere i dati lungo l’intero processo – possono essere mitigati sfruttando macchine ad alta computazione in modalità as-a-Service, tipicamente tramite il ricorso al Cloud.

Applicazioni pratiche dell’Intelligenza Artificiale Privacy Preserving

L’applicazione delle tecniche privacy preserving, quindi, consente di sviluppare una pipeline di elaborazione dati completamente criptata, in cui i dati vengono cifrati con una chiave pubblica ed elaborati in forma criptata nel cloud.

In seguito, i risultati potranno essere decodificati esclusivamente dal proprietario dei dati.

Passando agli scenari in cui tale approccio sia già stato applicato con successo, il prof. Roveri ha presentato diversi esempi:

  1. Elaborazione di dati satellitari criptati – utilizzata, in collaborazione con e-GEOS, per il rilevamento e la classificazione di oggetti nell’ambito di un progetto dell’Agenzia Spaziale Europea; in questo caso la crittografia garantisce la riservatezza dei dati sensibili provenienti da satelliti di osservazione, permettendone comunque l’elaborazione.
  2. Elaborazione di dati genomici criptati, a cui si fa ricorso per consentire la classificazione e localizzazione primaria dei tumori senza compromettere le informazioni genomiche dei pazienti; questo approccio consente di utilizzare dati sensibili per la ricerca medica, salvaguardando la privacy dei soggetti coinvolti.
  3. Manutenzione predittiva su dati criptati, applicata a macchinari industriali in impianti di produzione critici; ciò consente l’elaborazione dei dati per ottimizzare la manutenzione dei sistemi, senza necessità di esporre informazioni critiche.

Prospettive future per l’Intelligenza Artificiale Privacy Preserving

Il futuro dell’Intelligenza Artificiale Privacy Preserving – che in realtà, secondo il prof. Roveri, è già presente – non si limita alla fase di inferenza, estendendosi anche alla fase di addestramento sui dati criptati.

Volendo costruire un modello di elaborazione ad hoc senza divulgare informazioni sensibili, è stato illustrato come sia possibile utilizzare un training set criptato in base al quale definire un modello che preservi la privacy durante tutto il processo di apprendimento: questa evoluzione apre la strada alla possibilità di fornire sia inferenza sia addestramento personalizzati, garantendo al contempo la riservatezza delle informazioni.

In conclusione, il relatore ha quindi ribadito come l’Intelligenza Artificiale rappresenti un’area di ricerca e sviluppo cruciale per garantire un equilibrio sostenibile tra innovazione tecnologica, tutela della privacy e sicurezza dei dati.

Condividi sui Social Network:

https://www.ictsecuritymagazine.com/articoli/intelligenza-artificiale-privacy-preserving/


Strategia Digitale Europea 2024: Strategia dei Dati, Intelligenza Artificiale e Sicurezza

Nel contesto della rapida evoluzione tecnologica globale, l’Unione Europea ha intrapreso una trasformazione digitale ambiziosa e innovativa, riassunta nella Strategia Digitale Europea. Questa iniziativa non rappresenta una risposta superficiale alle sfide tecnologiche contemporanee, ma una visione strategica complessa e lungimirante volta a posizionare l’Europa come leader globale dell’economia digitale. L’obiettivo fondamentale della Strategia Digitale Europea è creare una base solida per lo sviluppo tecnologico sostenibile, favorendo la crescita di un ecosistema capace di stimolare l’innovazione, la cooperazione intersettoriale e la resilienza economica.

Questa strategia è stata concepita per affrontare le sfide tecnologiche emergenti e presenti, riconoscendo la natura pervasiva della tecnologia nella vita quotidiana, nell’economia e nella governance. In questo contesto, l’Unione Europea intende stabilire nuovi standard globali per una digitalizzazione responsabile, con particolare attenzione ai diritti fondamentali, alla sicurezza e alla sostenibilità — elementi centrali della visione europea per un futuro digitale inclusivo ed eticamente orientato.

La Visione Strategica Europea

La Strategia Digitale Europea si distingue per un approccio che potremmo definire dialettico. Da un lato, promuove attivamente l’apertura e la condivisione dei dati, riconoscendone il ruolo di catalizzatore per l’innovazione tecnologica e il progresso economico. Dall’altro, stabilisce un solido quadro normativo per la protezione dei diritti fondamentali e la tutela degli investimenti in innovazione. Questa dualità, lungi dall’essere una contraddizione, riflette la sofisticata comprensione della complessità del panorama digitale contemporaneo e l’intenzione di trovare un equilibrio dinamico tra apertura e sicurezza.

L’approccio duale mira a garantire che l’innovazione tecnologica avvenga all’interno di un contesto regolamentato, in cui i diritti dei cittadini siano preservati e gli investimenti privati possano prosperare. L’obiettivo è creare un ecosistema in cui i dati siano accessibili e utilizzabili, senza compromettere la privacy o la sicurezza. Questo equilibrio è essenziale per favorire la fiducia dei cittadini e degli stakeholder nel sistema digitale, evitando che l’apertura indiscriminata dei dati conduca a vulnerabilità sistemiche.

Il Nuovo Paradigma dei Dati nella Strategia Digitale Europea

Un aspetto rivoluzionario della Strategia Digitale Europea è il suo approccio innovativo alla gestione dei dati. Per la prima volta, viene formalmente riconosciuto il duplice valore dei dati: sia come asset economico che come bene pubblico. Questa concettualizzazione si traduce in un quadro normativo che consente sia la monetizzazione dei dati che il loro utilizzo per scopi altruistici e di interesse pubblico.

La normativa introduce il concetto di “spazi dati europei”, ecosistemi digitali progettati per consentire il libero flusso di dati in maniera sicura e controllata. Questi spazi non sono semplici repository di informazioni, ma rappresentano veri e propri mercati digitali in cui i dati possono essere scambiati, analizzati e valorizzati secondo regole chiare e condivise. L’obiettivo della Strategia Digitale Europea è costruire un’infrastruttura digitale interoperabile, capace di favorire un ambiente di innovazione collaborativa e inclusiva per tutti gli attori, dalle PMI alle istituzioni pubbliche e ai grandi player di mercato.

Gli spazi dati europei sono progettati per garantire interoperabilità e standardizzazione, fattori fondamentali per consentire la comunicazione efficace tra diverse piattaforme e sistemi. Tale interoperabilità è cruciale per costruire un ecosistema di innovazione che sia trasversale e inclusivo, in cui attori diversi possano collaborare in maniera efficace. L’idea alla base della Strategia Digitale Europea è quella di promuovere la democratizzazione dell’accesso ai dati, abbattendo le barriere geografiche e dimensionali e assicurando pari opportunità di partecipazione all’economia dei dati.

L’Intelligenza Artificiale nel Contesto della Strategia Digitale Europea

La Strategia Digitale Europea adotta un approccio distintivo nei confronti dell’intelligenza artificiale, caratterizzato da un forte accento su responsabilità e trasparenza. L’AI Act introduce un sistema di classificazione basato sul rischio, che va oltre la semplice regolamentazione tecnica, ponendo un’enfasi significativa sugli impatti etici e sociali. Questo approccio riflette la consapevolezza che l’intelligenza artificiale non è solo una tecnologia, ma uno strumento che ha profonde implicazioni per la società.

Il regolamento europeo vieta pratiche considerate incompatibili con i valori dell’Unione, come il social scoring, e impone requisiti stringenti per i sistemi ad alto rischio. Di particolare rilevanza è l’obbligo per i fornitori di documentare dettagliatamente i dati utilizzati per l’addestramento dei modelli e di rispettare i diritti d’autore, indipendentemente dalla giurisdizione di origine. Questo approccio non solo promuove la trasparenza, ma contribuisce a costruire un clima di fiducia tra utenti e sviluppatori di tecnologia, cruciale per una diffusione responsabile e sostenibile dell’IA.

L’AI Act prevede anche misure per garantire che i sistemi di IA siano equi e privi di bias, richiedendo verifiche rigorose e valutazioni di impatto sociale. L’obiettivo è prevenire discriminazioni e assicurare che l’IA sia sviluppata e utilizzata in maniera etica, in conformità con i valori europei di dignità e rispetto per i diritti umani. La Strategia Digitale Europea intende così stabilire un nuovo standard globale per l’intelligenza artificiale, orientato non solo all’efficienza tecnologica, ma anche alla tutela degli interessi collettivi e individuali.

Implicazioni della Strategia Digitale Europea per il Mondo Aziendale

La trasformazione normativa introdotta dalla Strategia Digitale Europea ha un impatto significativo sul mondo aziendale, richiedendo alle imprese di ripensare profondamente i processi operativi e la propria struttura organizzativa. Emerge la figura del “Data Board Member”, un membro del consiglio di amministrazione con competenze specifiche sui dati, riflettendo il riconoscimento dell’importanza strategica della gestione dei dati come questione di governance aziendale di primo livello.

Le imprese devono affrontare nuove sfide legate alla conformità normativa e alla responsabilità etica nell’uso delle tecnologie digitali. Non è più sufficiente implementare sistemi di IA o gestire dati; è essenziale comprendere il funzionamento di queste tecnologie, monitorarne l’utilizzo e saper identificare e mitigare eventuali problematiche. Questo tipo di responsabilità richiede investimenti consistenti in formazione e sviluppo delle competenze a tutti i livelli dell’organizzazione.

La trasformazione digitale promossa dalla Strategia Digitale Europea richiede anche un approccio collaborativo più intenso, sia all’interno delle organizzazioni sia con l’esterno. Le aziende sono chiamate a sviluppare partnership strategiche con altri attori del mercato, con istituzioni pubbliche e con enti di ricerca per sfruttare appieno il potenziale dei dati e dell’IA. Questo approccio collaborativo è parte integrante di una governance aziendale più inclusiva, che integra la sostenibilità e la responsabilità sociale come elementi chiave della strategia aziendale.

La Proprietà dei Dati nella Strategia Digitale Europea: Un Nuovo Modello

Un aspetto particolarmente innovativo della Strategia Digitale Europea è l’approccio alla proprietà dei dati. Il Data Act introduce un modello di proprietà condivisa che riconosce i diritti di una molteplicità di stakeholder: l’utente, il produttore del software e il produttore del dispositivo. Questo modello riflette la natura interconnessa dell’economia digitale, in cui il valore è generato dalla collaborazione e dall’interazione tra diversi attori.

Il modello di proprietà condivisa consente nuove opportunità per l’innovazione, promuovendo un accesso più equo e democratico ai dati. Questo approccio favorisce la condivisione e l’uso dei dati tra diversi settori economici, contribuendo alla crescita e all’efficienza complessiva del sistema economico. Le organizzazioni sono incoraggiate a considerare i dati non solo come un asset esclusivo, ma come una risorsa da valorizzare collettivamente per il bene comune, con benefici potenziali per tutta la società.

Inoltre, il Data Act stabilisce meccanismi per risolvere eventuali controversie tra le parti interessate, assicurando che i diritti di tutti gli stakeholder siano rispettati e che il valore generato dai dati sia equamente distribuito. Questo approccio mira a creare un ambiente di fiducia e cooperazione, essenziale per il successo dell’economia digitale delineata dalla Strategia Digitale Europea.

Verso un Futuro Digitale Europeo

La Strategia Digitale Europea per i dati e l’IA rappresenta un tentativo ambizioso di definire un nuovo paradigma di digitalizzazione che bilanci innovazione, protezione dei diritti, competitività e valori fondamentali. Il successo di questa strategia dipenderà dalla capacità delle organizzazioni di adattarsi e innovare all’interno di questo nuovo quadro normativo, nonché dalla capacità delle istituzioni di mantenere un equilibrio tra regolamentazione e flessibilità.

L’Europa mira a costruire un ecosistema digitale competitivo, inclusivo e sostenibile. Questo richiede un impegno costante delle istituzioni per mantenere aggiornate le normative e rispondere in maniera adeguata ai rapidi sviluppi tecnologici. La cooperazione tra settore pubblico e privato sarà fondamentale per raggiungere questi obiettivi, così come sarà cruciale il coinvolgimento attivo dei cittadini, che devono essere informati e partecipare consapevolmente al processo di trasformazione digitale.

In conclusione, la Strategia Digitale Europea sta delineando un percorso originale verso la digitalizzazione, che ha il potenziale di diventare un modello di riferimento globale per una trasformazione digitale etica e sostenibile. La sfida consisterà nel mantenere un equilibrio delicato tra innovazione e protezione, tra apertura e sicurezza, in un panorama tecnologico in costante evoluzione. Questo percorso richiederà sforzi concertati, investimenti strategici e una visione condivisa del futuro digitale, ma le opportunità per creare un ecosistema digitale equo, sicuro e propulsore di innovazione sono immense.

Fonti:

https://commission.europa.eu/strategy-and-policy/priorities-2019-2024/europe-fit-digital-age/europes-digital-decade-digital-targets-2030_it

https://www.europarl.europa.eu/factsheets/it/sheet/64/un-agenda-digitale-europea

https://www.europarl.europa.eu/factsheets/it/sheet/64/un-agenda-digitale-europea

https://commission.europa.eu/strategy-and-policy/priorities-2019-2024/europe-fit-digital-age_it

https://digital-strategy.ec.europa.eu/it/policies/2024-state-digital-decade-package

https://eur-lex.europa.eu/IT/legal-content/summary/2030-digital-decade-policy-programme.html

Condividi sui Social Network:

https://www.ictsecuritymagazine.com/notizie/strategia-digitale-europea/


Redbox easily reverse-engineered to reveal customers’ names, zip codes, rentals

Thousands of Redboxes getting dumped

It’s worth noting that the amount of data expected to be stored on Redboxes is small compared to Redbox’s overall business. Since Redbox once rented out millions of DVDs weekly, the data retrieved only represents a small portion of Redbox’s overall business and, likely, of business conducted on that specific kiosk.  That might not be much comfort to those whose data is left vulnerable, though.

The problem is more alarming when considering how many Redboxes are still out in the wild with uncertain futures. High demand for Redbox removals has resulted in all sorts of people, like Turing, gaining access to kiosk hardware and/or data. For example, The Wall Street Journal reported last week about a “former Redbox employee who convinced a 7-Eleven franchisee” to give him a Redbox, a 19-year-old who persuaded a contractor hauling a kiosk away from a drugstore to give it to him instead, as well as a Redbox landing in an Illinois dumpster.

Consumer privacy concerns

Chicken Soup’s actions may violate consumer privacy regulations, including the Video Privacy Protection Act outlawing “wrongful disclosure of video tape rental or sale records.” However, Chicken Soup’s bankruptcy (most of its assets are in a holding pattern, Lowpass reported) makes customer remediation more complicated and less likely.

Mario Trujillo, staff attorney for the Electronic Frontier Foundation, told Ars that this incident “highlights the importance of security research in uncovering flaws that can leave customers unprotected.”

“While it may be hard to hold a bankrupt company accountable, uncovering the flaw is the first step,” he added.

Turing, which reverses engineers a lot of tech, said that the privacy problems she encountered with Redbox storage “isn’t terribly uncommon.”

Overall, the situation underscores the need for stricter controls around consumer data, whether it comes internally from companies or, as some would argue, through government regulation.

“This security flaw is a reminder that all companies should be obligated to minimize the amount of data they collect and retain in the first place,” Trujillo said. “We need strong data privacy laws to do that.”

https://arstechnica.com/gadgets/2024/10/redbox-hard-drive-hacked-to-reveal-customer-information-from-2471-rentals/


Nintendo’s new clock tracks your movement in bed

The motion detectors reportedly work with various bed sizes, from twin to king. As users shift position, the clock’s display responds by moving on-screen characters from left to right and playing sound effects from Nintendo video games based on different selectable themes.

A photo of Nintendo Sound Clock Alarmo.

A photo of Nintendo Sound Clock Alarmo.

A photo of Nintendo Sound Clock Alarmo. Credit: Nintendo

The Verge’s Chris Welch examined the new device at Nintendo’s New York City store shortly after its announcement, noting that setting up Alarmo involves a lengthy process of configuring its motion-detection features. The setup cannot be skipped and might prove challenging for younger users. The clock prompts users to input the date, time, and bed-related information to calibrate its sensors properly. Even so, Welch described “small, thoughtful Nintendo touches throughout the experience.”

Themes and sounds

Beyond motion tracking, the clock has a few other tricks up its sleeve. Its screen brightness adjusts automatically based on ambient light levels, and users can control Alarmo through buttons on top, including a large dial for navigation and selection.

The device’s full-color rectangular display shows the time and 35 different scenes that feature animated Nintendo characters from games like the aforementioned Super Mario Odyssey, The Legend of Zelda: Breath of the Wild, and Splatoon 3, as well as Pikmin 4 and Ring Fit Adventure.

Alarmo also offers sleep sounds to help users doze off. Nintendo plans to release additional downloadable sounds and themes for the device in the future using its built-in Wi-Fi capabilities, which are accessible after linking a Nintendo account. The Nintendo website mentions upcoming themes for Mario Kart 8 Deluxe and Animal Crossing: New Horizons in particular.

As of today, Nintendo Online members can order an Alarmo online, and as mentioned above, Nintendo says the clock will be available through other retailers in January 2025.

https://arstechnica.com/gaming/2024/10/nintendos-new-clock-tracks-your-movement-in-bed/