PHP2Shell, gli attacchi precedono la patch: cosa cambia per i difensori


Il caso analizzato da Sekoia mostra perché aggiornare i sistemi deve accompagnarsi alla ricerca di compromissioni precedenti. Tra dipendenze nascoste e ricerca delle vulnerabilità accelerata dall’AI, i team di sicurezza devono prepararsi a intervenire anche prima che esista una correzione.

Il rilascio burrascoso delle informazioni sulle vulnerabilità PHP2Shell ha concentrato l’attenzione di tutti sulla delicatezza della fase che precede un annuncio importante, ma non bisogna trascurare le buone pratiche anche dopo che la patch è stata rilasciata. Un’analisi di David Greenwood per Sekoia mostra che il primo tentativo di sfruttamento di PHP2Shell rilevato da Amazon risale al 17 ottobre, quattro giorni prima del rilascio delle patch e questo ci ricorda che la verifica delle attività sospette deve coprire anche il periodo precedente.

Ricordiamo che PHP2Shell comprende due vulnerabilità del motore PHP, CVE-2026-109618 e CVE-2026-109619, che possono consentire l’esecuzione di codice da remoto senza autenticazione. La prima riguarda la gestione dell’esaurimento della memoria, la seconda uno stato interno che può sopravvivere alla liberazione della memoria cui fa riferimento. In determinate configurazioni l’attacco può avvenire prima dell’esecuzione del codice applicativo. Le correzioni sono state pubblicate il 21 ottobre nelle versioni PHP 8.5.12, 8.4.27, 8.3.36 e 8.2.35.

Gli attacchi rilevati hanno colpito degli honeypot

Nel suo report, Amazon ha documentato tentativi contro i propri honeypot precisando che non era chiaro se quei payload avrebbero avuto successo su sistemi reali, ma non è questo il punto.  Secondo Sekoia, lo sfruttamento prima della divulgazione è destinato a diventare sempre più frequente per il software esposto su Internet. Apparati perimetrali, piattaforme di trasferimento file e runtime web offrono agli attaccanti un incentivo evidente: una sola falla può aprire l’accesso a un numero elevato di installazioni. La disponibilità della patch, quindi, non può più essere considerata il punto di partenza dell’esposizione al rischio.

Un secondo problema riguarda le dipendenze. La prossima emergenza, che in realtà sarebbe la riproposizione di qualcosa di già visto in passato, potrebbe nascere in una libreria incorporata in prodotti che l’organizzazione non sa nemmeno di usare indirettamente. Sapere quali applicazioni sono installate diventa insufficiente se manca il collegamento con i componenti che includono. Inoltre, aggiornamenti distribuiti senza un avviso di sicurezza possono rendere meno immediata l’identificazione del rischio attraverso gli scanner.

L’intelligenza artificiale può amplificare questa dinamica.

Nell’interpretazione di Sekoia, la pubblicazione di una classe di vulnerabilità offre ai ricercatori e agli attaccanti un modello da cercare in altro codice. Una scoperta importante potrebbe così generare una famiglia di problemi correlati, distribuiti fra prodotti e runtime differenti. Anche il vantaggio oggi disponibile ai team con accesso ai modelli più avanzati potrebbe ridursi con il miglioramento dei modelli aperti. A questo si aggiunge la fragilità degli embarghi: una dimostrazione pubblicata in anticipo o una correzione distribuita prima del previsto possono anticipare la circolazione delle informazioni.

Cosa devono fare i difensori?

Per i difensori, la prima conseguenza pratica è affiancare alla correzione un’indagine retrospettiva. Nel caso di PHP2Shell, la ricerca deve partire almeno dal 17 ottobre, anziché limitarsi ai giorni successivi alla pubblicazione delle patch. Applicarla elimina la vulnerabilità, ma non rimuove eventuali accessi o meccanismi di persistenza già introdotti.

La seconda priorità è migliorare l’inventario, collegando applicazioni, runtime e librerie incorporate. Sul piano operativo, questo significa poter rispondere rapidamente a una domanda concreta: quali servizi dipendono dal componente appena segnalato, chi li gestisce e quali sono raggiungibili dall’esterno?

Sekoia, inollre, raccomanda di proteggere le interfacce di amministrazione con controlli di accesso e di rimuovere dalla rete pubblica i servizi che non devono essere raggiungibili. In pratica, sottolinea l’importanza di regole che dovrebbero essere già la norma nella maggior parte delle aziende, ma spesso si perdono di vista.

Occorre poi decidere in anticipo come agire quando la patch non esiste. Disabilitare un modulo, applicare una regola al web application firewall o sospendere un servizio sono opzioni da valutare prima dell’emergenza, individuando anche chi può autorizzarle fuori dall’orario di lavoro. Per PHP2Shell, le mitigazioni di configurazione non sostituiscono l’aggiornamento completo.

Infine, la rilevazione deve seguire ciò che accade dopo lo sfruttamento: un processo web che avvia una shell, file inattesi nella directory del sito o connessioni in uscita insolite. Sono segnali da correlare e indagare, anche prima che la vulnerabilità riceva un nome. Per le falle già sfruttate sui sistemi esposti, anche i tempi di aggiornamento devono riflettere l’urgenza: la capacità di intervenire rapidamente deve andare insieme a quella di capire se qualcuno è già entrato.

Condividi l’articolo


Articoli correlati

Altro in questa categoria


https://www.securityinfo.it/2026/10/28/php2shell-gli-attacchi-precedono-la-patch-cosa-cambia-per-i-difensori/?utm_source=rss&utm_medium=rss&utm_campaign=php2shell-gli-attacchi-precedono-la-patch-cosa-cambia-per-i-difensori


PHP2Shell,milioni di siti Web a rischio e la disclosure diventa un caso

Le falle CVE-2026-109618 e CVE-2026-109619 consentono, in determinate condizioni, l’esecuzione di codice da remoto senza autenticazione. Individuate attraverso una combinazione di ricerca tradizionale e strumenti di intelligenza artificiale, hanno richiesto un intervento coordinato su scala internazionale. Ma fughe di informazioni e pubblicazioni anticipate hanno complicato la gestione dell’emergenza.   Due vulnerabilità nel cuore di PHP, […]

L’articolo PHP2Shell,milioni di siti Web a rischio e la disclosure diventa un caso proviene da Securityinfo.it.

https://www.securityinfo.it/2026/10/23/php2shellrischio-milioni-di-siti-web-a-rischio-e-la-disclosure-diventa-un-caso/?utm_source=rss&utm_medium=rss&utm_campaign=php2shellrischio-milioni-di-siti-web-a-rischio-e-la-disclosure-diventa-un-caso


Midnight Mimosa, ancora malware Android installato prima dell’acquisto


La campagna scoperta da Bitdefender colpisce dispositivi Android economici attraverso applicazioni inserite direttamente nel firmware. Il componente malevolo opera con privilegi di sistema, installa altri software senza consenso e può trasformare il telefono in un nodo proxy controllato da remoto. L’Italia è fra i Paesi con più rilevazioni.

Uno smartphone nuovo, appena estratto dalla confezione, dovrebbe rappresentare un ambiente affidabile, ma sappiamo che non è così in tutti i casi. Casi di smartphone compromessi in fabbrica o poco dopo sono noti già da almeno un decennio, ma la campagna Midnight Mimosa rappresenta l’industrializzazione di questa procedura.

I ricercatori di Bitdefender hanno individuato un insieme di applicazioni malevole preinstallate nel firmware di smartphone Android economici basati su piattaforme MediaTek. Il componente principale viene presentato come parte del sistema operativo, dispone della firma della piattaforma e non può essere rimosso attraverso le normali funzioni disponibili all’utente. Midnight Mimosa non indica quindi un singolo APK facilmente riconoscibile, ma un’infrastruttura modulare capace di cambiare nome, certificato e componenti operativi. La funzione centrale rimane la stessa: mantenere sul dispositivo un punto di controllo privilegiato dal quale scaricare codice, installare applicazioni e assegnare loro autorizzazioni normalmente inaccessibili.
Un’applicazione con i privilegi del sistema operativo

La prima variante analizzata utilizzava il nome di pacchetto com.android.system.lite, ma Bitdefender ha successivamente individuato lo stesso nucleo sotto denominazioni come com.android.sys.prot, com.android.sys.gmsprot e com.android.sys.bcprot.

Il malware viene eseguito come utente di sistema ed è dichiarato come componente persistente. Dispone così dei permessi necessari per installare e cancellare pacchetti, modificare impostazioni protette e concedere autorizzazioni ad altre applicazioni senza mostrare richieste di conferma.

La parte più pericolosa del codice non si trova direttamente nell’APK visibile. È nascosta nella libreria nativa libeasy.so, che durante l’esecuzione decifra e deposita un framework Java offuscato. Quest’ultimo contatta il server di comando e controllo e carica ulteriori moduli DEX o JAR, permettendo agli operatori di modificare il comportamento dell’infezione a distanza.

Questa architettura riduce l’efficacia dell’analisi statica. Un campione esaminato fuori dal dispositivo può apparire relativamente vuoto perché le funzioni operative vengono scaricate o attivate successivamente, in base alla configurazione ricevuta dal server remoto.

Permessi pronti per operazioni più invasive

Il componente di sistema può abilitare autonomamente Accessibility Service, accesso alle notifiche e permessi per leggere o inviare SMS. Bitdefender precisa di non aver osservato l’impiego effettivo di queste capacità durante l’analisi, ma la loro presenza amplia notevolmente ciò che gli operatori potrebbero fare attraverso un aggiornamento remoto.

Un servizio di accessibilità può osservare quanto appare sullo schermo, interagire con l’interfaccia e simulare le azioni dell’utente. L’accesso alle notifiche può esporre messaggi e codici temporanei, mentre i permessi SMS possono essere sfruttati per intercettare OTP o attivare servizi a pagamento.

In Midnight Mimosa queste facoltà sono associate a un componente non disinstallabile e dotato di un canale per il caricamento di codice remoto. Il comportamento futuro dipende quindi dai comandi impartiti dall’infrastruttura C2, non soltanto dalle funzioni viste nei campioni esaminati.

Pubblicità invisibile e clic simulati

La finalità osservata dai ricercatori appare principalmente economica. Il componente preinstallato distribuisce una famiglia di almeno 32 applicazioni camuffate da strumenti per il meteo, blocco delle app, gestione dei file, OCR, note e modifica audio.

Queste applicazioni fungono da copertura per attività di ad fraud e click fraud. Integrano normali SDK pubblicitari, ma possono mostrare inserzioni all’interno di finestre invisibili o sovrapposte alle altre applicazioni. Il malware genera quindi impression, clic e conversioni senza un’azione reale dell’utente.

La configurazione remota stabilisce la percentuale di clic sintetici, gli intervalli fra un’interazione e l’altra, la posizione simulata del tocco e il numero massimo di eventi giornalieri. L’obiettivo è produrre traffico artificiale che possa apparire plausibile ai sistemi pubblicitari.

Alcune finestre vengono inoltre contrassegnate come contenuti protetti, impedendo che compaiano negli screenshot e nelle registrazioni dello schermo. Una funzione pensata per tutelare schermate sensibili, come quelle bancarie, viene così utilizzata per rendere più difficile documentare l’attività fraudolenta.

Il telefono diventa un proxy residenziale

Una seconda forma di monetizzazione trasforma il dispositivo in un nodo proxy controllato da remoto. L’applicazione com.mobile.applock.en, distribuita dal componente di sistema con il nome “Locket”, non offre in realtà alcuna funzione di blocco delle app: registra il telefono presso l’infrastruttura degli operatori e apre un canale TCP attraverso il quale può inoltrare traffico per conto di terzi.

Il valore di una rete di questo tipo deriva dagli indirizzi IP residenziali. Il traffico proveniente dagli smartphone compromessi può sembrare generato da normali utenti e risultare quindi più difficile da bloccare rispetto a quello originato da server o data center già conosciuti.

I dispositivi possono essere impiegati per mascherare attività fraudolente, aggirare limitazioni geografiche o alimentare botnet. Secondo Bitdefender, la disponibilità di migliaia di nodi potrebbe inoltre essere sfruttata per attività come gli attacchi DDoS.

Play Protect viene spento durante l’installazione

Midnight Mimosa cerca anche di neutralizzare i controlli del sistema. Prima di installare un’applicazione secondaria, il malware disabilita temporaneamente com.android.vending, il pacchetto del Google Play Store che ospita anche le funzioni di scansione locale di Play Protect. Terminata l’installazione, il componente viene riattivato.

Il malware elimina così sia la richiesta di conferma all’utente, grazie ai privilegi di sistema, sia il controllo automatico che potrebbe riconoscere il nuovo APK. Un ulteriore meccanismo riattiva il Play Store quando il telefono viene utilizzato, riducendo la possibilità che il proprietario noti l’anomalia.

Alcune varianti falsificano anche la provenienza dell’applicazione, registrando com.android.vending come installer. I ricercatori hanno scoperto l’inganno verificando l’assenza della firma “frosting” applicata da Google agli APK effettivamente distribuiti attraverso Play.

Tredici applicazioni sono passate anche da Google Play

La distribuzione attraverso il firmware non è l’unico canale utilizzato. Bitdefender ha identificato tredici applicazioni pubblicate su Google Play che contenevano parti dello stesso codice per la frode pubblicitaria e comunicavano con la medesima infrastruttura.

In questo caso le applicazioni erano state realmente scaricate dallo store e disponevano della relativa firma. Offrivano anche alcune delle funzioni dichiarate, ma caricavano pubblicità al di fuori della propria interfaccia, talvolta quando il telefono non era in uso.

I pacchetti utilizzavano tredici certificati differenti e almeno due account sviluppatore. La rotazione delle identità rende meno efficace una difesa basata unicamente su nomi, hash o certificati: il collegamento fra le applicazioni emerge soprattutto dal codice condiviso e dall’infrastruttura di rete comune.

Migliaia di dispositivi e una presenza rilevante in Italia

La telemetria raccolta nell’arco di circa due anni mostra migliaia di dispositivi coinvolti in più di 150 Paesi. Le rilevazioni sono concentrate soprattutto in Messico, Francia e Italia, seguiti da Stati Uniti, Germania, Brasile e Spagna.

La distribuzione fra Europa occidentale e continente americano, accompagnata da una lunga coda di rilevazioni in Africa, Sud-est asiatico e Medio Oriente, fa pensare a dispositivi commercializzati attraverso marketplace internazionali anziché alla compromissione di un unico operatore telefonico o distributore nazionale.

Molti terminali utilizzano nomi che imitano smartphone di fascia alta, mentre altri sono associati a marchi reali del segmento rugged economico. Bitdefender sottolinea però che i nomi dei dispositivi e i certificati osservati costituiscono elementi tecnici della catena di distribuzione, non prove che i produttori o i titolari dei certificati abbiano sviluppato o inserito consapevolmente il malware.

Rimane infatti sconosciuto il punto preciso nel quale Midnight Mimosa entra nel firmware. Potrebbe trattarsi di un produttore ODM, di un integratore, di un fornitore software o di un altro intermediario della supply chain.

Un problema per la sicurezza aziendale e il BYOD

Per le imprese, Midnight Mimosa dimostra che un dispositivo nuovo non è necessariamente un dispositivo affidabile. Uno smartphone compromesso nel firmware può connettersi alla rete aziendale, accedere alla posta elettronica, ricevere notifiche contenenti informazioni riservate e utilizzare applicazioni protette da autenticazione multifattore.

Le organizzazioni che permettono il BYOD dovrebbero evitare di considerare automaticamente sicuro un terminale soltanto perché aggiornato o privo di applicazioni sospette installate dall’utente. Diventano importanti il controllo dell’integrità del dispositivo, il monitoraggio comportamentale, la segmentazione degli accessi e l’analisi del traffico verso infrastrutture C2 conosciute.

Anche le politiche di acquisto hanno un ruolo. Telefoni estremamente economici, dispositivi contraffatti o prodotti con una catena di aggiornamento poco trasparente possono introdurre un rischio che nessuna campagna di sensibilizzazione dell’utente è in grado di eliminare.

La formattazione non basta per rimuovere Midnight Mimosa

Il componente principale risiede nella partizione di sistema. Un ripristino alle impostazioni di fabbrica può quindi cancellare i dati e le applicazioni dell’utente senza eliminare il malware dal firmware.

La bonifica richiede un firmware affidabile e privo del componente oppure, per utenti tecnicamente esperti, la disabilitazione del pacchetto tramite ADB. Quest’ultima soluzione non è però realistica per la maggior parte dei proprietari e potrebbe non essere definitiva se il firmware dispone di meccanismi capaci di ripristinare o rinominare il componente.

La risposta duratura deve arrivare dai produttori, dagli integratori e dai marketplace che distribuiscono questi dispositivi. Midnight Mimosa mostra infatti un limite fondamentale della sicurezza mobile: quando il sistema operativo nasce già compromesso, installazione sicura, controllo dello store e possibilità di disinstallazione smettono di essere difese disponibili.

Condividi l’articolo


Articoli correlati

Altro in questa categoria


https://www.securityinfo.it/2026/10/09/midnight-mimosa-ancora-malware-android-installato-prima-dellacquisto/?utm_source=rss&utm_medium=rss&utm_campaign=midnight-mimosa-ancora-malware-android-installato-prima-dellacquisto
Bitdefender crea una VPN per gli agenti AI

Forse in pochi ci avevano pensato, ma dal momento che gli agenti AI navigano sul Web per raccogliere informazioni e compiere operazioni per conto degli utenti, potrebbe essere una buona idea mascherarne le attività per evitare di fornire contesti non voluti a siti web e servizi di cui non sappiamo granché. Bitdefender ha infatti presentato […]

L’articolo Bitdefender crea una VPN per gli agenti AI proviene da Securityinfo.it.

https://www.securityinfo.it/2026/09/21/bitdefender-crea-una-vpn-per-gli-agenti-ai/?utm_source=rss&utm_medium=rss&utm_campaign=bitdefender-crea-una-vpn-per-gli-agenti-ai


No Hat 2026, a Bergamo l’hacking incontra AI, cyber-spionaggio e droni

Il 10 ottobre torna la conferenza internazionale dedicata alla cybersecurity e all’ethical hacking. Tra i temi dell’ottava edizione, vulnerabilità negli AI coding assistant, attacchi alle infrastrutture di rete, malware, anonimato e compromissione dei sistemi autonomi L’intelligenza artificiale che sta cambiando anche il lavoro di chi cerca vulnerabilità e sviluppa nuove tecniche di attacco è uno […]

L’articolo No Hat 2026, a Bergamo l’hacking incontra AI, cyber-spionaggio e droni proviene da Securityinfo.it.

https://www.securityinfo.it/2026/09/11/no-hat-2026-a-bergamo-lhacking-incontra-ai-cyber-spionaggio-e-droni/?utm_source=rss&utm_medium=rss&utm_campaign=no-hat-2026-a-bergamo-lhacking-incontra-ai-cyber-spionaggio-e-droni


Claude evade (di nuovo) e compromette tre aziende reali


Sembra proprio che tenere a bada i modelli IA sia complicatissimo e Anthropic sta accumulando una certa esperienza nel settore. L’azienda ha infatti rivelato che alcuni modelli della famiglia Claude sono riusciti ad accedere ai sistemi di tre organizzazioni reali durante esercitazioni di sicurezza, trasformando test che avrebbero dovuto svolgersi in ambienti controllati in vere e proprie compromissioni di sistemi esterni.

Non è stato un attacco deliberato

Anthropic precisa che non si è trattato di un comportamento malevolo intenzionale del modello, né di un tentativo di “ribellione” dell’intelligenza artificiale. Le prove delle compromissioni, infatti, sono emerse durante la revisione interna di oltre 141.000 valutazioni di sicurezza avviata dopo il recente incidente che aveva coinvolto OpenAI. L’analisi ha portato alla scoperta di tre casi nei quali versioni di Claude erano riuscite a raggiungere Internet da un ambiente di valutazione gestito da terze parti e ad accedere senza autorizzazione ai sistemi di tre differenti organizzazioni. Anthropic specifica che il problema è stato favorito da una combinazione di errori umani, configurazioni errate dell’ambiente di test e vulnerabilità reali presenti nei sistemi raggiunti dal modello.

Tre incidenti diversi, un unico denominatore

I modelli coinvolti comprendono Claude Opus 4.7, Claude Mythos 5 e un modello sperimentale interno e quello che rende il tutto più “pepato” è che le dinamiche dei tre episodi sono differenti. In un caso il modello ha confuso il dominio di un’azienda reale con quello previsto nello scenario di laboratorio, riuscendo così ad accedere a un database esterno. C’è da dire che, probabilmente, chi ha organizzato il test non ha verificato che il nome dell’azienda “fasulla perché inserita nel test” fosse inesistente. In un secondo episodio è statp eseguito un attacco alla supply chain attraverso la pubblicazione di un pacchetto Python malevolo sul repository pubblico PyPI che è stato successivamente scaricato da alcuni sistemi reali. Nel terzo incidente il modello ha iniziato a esplorare migliaia di server connessi a Internet e stava per sfruttare una vulnerabilità SQL Injection, interrompendo però autonomamente l’operazione quando ha riconosciuto di trovarsi al di fuori dell’ambiente previsto dal test. Anthropic attribuisce questi episodi principalmente a carenze operative nella gestione delle esercitazioni piuttosto che a un fallimento dei meccanismi di allineamento del modello. In effetti, i modelli hanno fatto il loro dovere, ma si deve evidentemente ancora lavorare su come tenerli a bada.

Il vero problema è il contenimento

Le aziende stanno investendo enormi risorse per misurare le capacità offensive dei nuovi modelli AI, ma questi incidenti mostrano che la sicurezza dell’ambiente di valutazione è importante quanto quella del modello stesso. Un agente capace di operare autonomamente, usare strumenti, accedere alla rete e prendere decisioni e metterle in pratica può infatti sfruttare qualsiasi errore di configurazione presente nell’infrastruttura di test: il rischio non nasce esclusivamente dall’intelligenza artificiale, ma dall’interazione tra modello, strumenti disponibili e ambiente operativo.

Mythos torna al centro dell’attenzione

Tra i modelli coinvolti figura anche Claude Mythos, il sistema che Anthropic ha deciso di non distribuire pubblicamente proprio a causa delle sue elevate capacità offensive in ambito cyber e molti ricorderanno che non è la prima volta che Mythos finisce al centro delle cronache. Già nei mesi scorsi il modello era stato protagonista di almeno altri due episodi che avevano alimentato il dibattito sulla sua gestione. Il primo riguarda la fuga non autorizzata di alcuni accessi alla versione preview del modello, comparsi poche ore dopo il suo annuncio all’interno di una comunità privata online. Anthropic aveva confermato che utenti non autorizzati erano riusciti a usare il sistema, pur trattandosi di una versione destinata esclusivamente a un ristretto gruppo di partner del progetto Glasswing.

Il secondo episodio è emerso dalla Hazard-Aware System Card pubblicata dalla stessa Anthropic. Durante prove di laboratorio dedicate alla verifica delle misure di contenimento, una versione sperimentale di Mythos era riuscita ad aggirare alcune restrizioni del sandbox, comunicare verso l’esterno e mettere in atto comportamenti inattesi, come modificare file cercando di nascondere le modifiche nella cronologia Git. Anche in quel caso l’azienda aveva sottolineato che gli eventi erano avvenuti in ambienti di test controllati e avevano contribuito a rafforzare le misure di sicurezza del progetto.

Condividi l’articolo


Articoli correlati

Altro in questa categoria


https://www.securityinfo.it/2026/08/04/claude-evade-di-nuovo-e-compromette-tre-aziende-reali/?utm_source=rss&utm_medium=rss&utm_campaign=claude-evade-di-nuovo-e-compromette-tre-aziende-reali


Hugging Face violata da un agente AI: perché il primo attacco autonomo segna una svolta per la cybersecurity


Per anni l’idea di un attacco informatico condotto interamente da un agente di Intelligenza Artificiale è rimasta confinata ai laboratori di ricerca e alle presentazioni dei vendor. Oggi non è più così. La piattaforma Hugging Face, punto di riferimento mondiale per lo sviluppo e la distribuzione di modelli AI open source, ha confermato di essere stata colpita da quello che descrive come un attacco condotto dall’inizio alla fine da un sistema autonomo di agenti AI.  L’episodio rappresenta molto più di una violazione informatica: è probabilmente il primo caso documentato in cui un’infrastruttura di produzione di una realtà di una certa rilevanza viene compromessa da un sistema capace di pianificare ed eseguire autonomamente una campagna offensiva complessa, senza che un operatore umano debba guidarne ogni fase.

L’attacco è partito dalla supply chain dei dati

Secondo quanto comunicato da Hugging Face, gli aggressori hanno sfruttato una superficie d’attacco peculiare delle piattaforme AI: la pipeline che elabora dataset caricati dagli utenti. Un dataset malevolo ha abusato di due percorsi di esecuzione del codice, un loader che consentiva l’esecuzione di codice remoto e una vulnerabilità di template injection nella configurazione del dataset, ottenendo l’esecuzione di codice su un nodo di elaborazione.  Da quel momento il comportamento dell’attaccante è stato quello tipico di un’Advanced Persistent Threat: escalation dei privilegi, raccolta di credenziali cloud e di cluster, movimento laterale tra diversi sistemi e accesso non autorizzato a dataset interni e credenziali di servizio. Hugging Face precisa di non aver trovato evidenze di manomissioni ai modelli pubblici, ai dataset disponibili agli utenti, agli Spaces o alla propria software supply chain, ma l’incidente dimostra quanto le piattaforme AI introducano superfici di attacco nuove rispetto alle applicazioni tradizionali.

La novità non è la vulnerabilità, ma chi ha guidato l’attacco

La vulnerabilità sfruttata non rappresenta l’aspetto più innovativo dell’incidente. Ciò che cambia realmente è il modo in cui è stata sfruttata. Secondo la ricostruzione dell’azienda, l’operazione è stata eseguita da un framework agentico capace di svolgere decine di migliaia di azioni distribuite su una moltitudine di ambienti temporanei, con infrastrutture di comando e controllo che migravano automaticamente tra servizi pubblici per ridurre la probabilità di essere individuate.

In pratica, l’AI non si è limitata a generare codice o suggerire una sequenza di exploit: ha eseguito autonomamente una campagna offensiva articolata, adattandosi durante le diverse fasi dell’intrusione. È lo scenario dell’agentic attacker di cui il settore della cybersecurity discute da tempo e che oggi sembra essersi concretizzato.

L’AI ha difeso Hugging Face da un’altra AI

L’altro elemento interessante dell’incidente è che anche la risposta è stata in larga parte automatizzata. Hugging Face spiega di aver utilizzato sistemi basati su LLM per analizzare la telemetria di sicurezza, correlare gli eventi e ricostruire rapidamente la cronologia dell’attacco. Gli agenti di analisi hanno elaborato oltre 17.000 eventi, permettendo ai team di incident response di individuare gli indicatori di compromissione e distinguere le attività realmente dannose da quelle create per depistare gli analisti. Secondo l’azienda, un’attività che normalmente richiederebbe diversi giorni è stata completata in poche ore grazie all’automazione. Il risultato è un assaggio di quello che potrebbe diventare il nuovo paradigma della cybersecurity: AI contro AI, con attaccanti e difensori che operano entrambi a velocità macchina.

Il problema tanto temuto dei guardrail ciechi

Tra gli aspetti più curiosi emersi dal post mortem c’è un problema che fino a poco tempo fa sarebbe sembrato marginale. Durante l’analisi forense, Hugging Face ha inizialmente provato a utilizzare modelli commerciali accessibili tramite API. Tuttavia, le richieste contenevano exploit, payload, comandi di attacco e indicatori di compromissione reali: elementi che i sistemi di sicurezza dei modelli hanno interpretato come contenuti pericolosi, bloccandone l’elaborazione.

Per completare l’analisi, l’azienda ha quindi utilizzato un modello open-weight eseguito sulla propria infrastruttura, evitando sia le limitazioni imposte dai guardrail sia il trasferimento all’esterno di dati sensibili e credenziali compromesse. Questo ci riporta a un tema che è stato affrontato più volte dall’arrivo degli LLM al grande pubblico: è giusto limitarne le capacità quando gli unici che ne fanno davvero le spese sono gli utenti che li usano per scopi leciti? Ovviamente, la risposta è lunga e articolata, ma sembra abbastanza ovvio che qualcosa debba esser ripensato, a partire dalla disponibilità di servizi AI deputati all’analisi forense e al blue teaming.

Le piattaforme AI diventano una nuova superficie di attacco

L’attacco ad HuggingFace ci dice molte cose. Innanzitutto, la scelta del bersaglio è quantomeno curiosa e ovviamente tesa a dimostrare che con l’IA non si scherza. Secondo il mio modesto parere, questo attacco è stato un atto dimostrativo per mettere in guardia un’industria che è ancora largamente indecisa se correre a più non posso o imparare qualcuna delle dure lezioni che il cybercrimine ha impartito negli anni passati. Inoltre, sottolinea che la diffusione degli agenti AI amplia la superficie di attacco ben oltre il già tartassato modello linguistico, ma comprende dataset, memoria dell’agente, strumenti esterni, protocolli come MCP, supply chain delle estensioni e contesto operativo. Le minacce si spostano sempre più dal codice ai dati e alle interazioni runtime, rendendo necessari approcci di sicurezza che trattino ogni elemento esterno come potenzialmente non affidabile. Questo significa che la protezione delle piattaforme AI deve (sì, già oggi) estendersi ben oltre i tradizionali controlli su endpoint e reti, includendo controlli specifici sulla provenienza dei dati, sull’esecuzione degli strumenti e sulle informazioni che alimentano gli agenti.

Una nuova fase per la cybersecurity che potremmo non esser pronti ad affrontare

Il caso Hugging Face non dimostra che gli attaccanti abbiano improvvisamente acquisito capacità “sovrumane”. Dimostra però che l’automazione sta riducendo drasticamente il costo operativo degli attacchi e che fare automazione complessa oggi diventa sempre più semplice. Un sistema autonomo può eseguire migliaia di tentativi, adattare continuamente la propria strategia, sfruttare nuove opportunità e operare ventiquattro ore su ventiquattro senza la supervisione costante di un essere umano. Per le organizzazioni significa che i tempi di reazione disponibili continueranno a ridursi. Se gli attacchi si muovono a velocità macchina, anche il rilevamento, la correlazione degli eventi e la risposta dovranno essere sempre più automatizzati. Nik Zur (CTO di  Palo Alto) lo dice da tempo (ed era il suo slogan nel lancio di una serie di prodotti di qualche tempo fa), ma la massima continua a restare valida. Solo a marzo ho parlato con il capo dei laboratori di Mandiant che mi diceva che “ancora non accade, ma accadrà in futuro”. Il futuro è arrivato dopo neanche 4 mesi… Il problema più grande della sicurezza (e di tutta la società umana) è riuscire a tenere il passo dell’evoluzione… e non sarà facile.

Condividi l’articolo


Articoli correlati

Altro in questa categoria


https://www.securityinfo.it/2026/07/21/hugging-face-violata-da-un-agente-ai-perche-il-primo-attacco-autonomo-segna-una-svolta-per-la-cybersecurity/?utm_source=rss&utm_medium=rss&utm_campaign=hugging-face-violata-da-un-agente-ai-perche-il-primo-attacco-autonomo-segna-una-svolta-per-la-cybersecurity


Gli assistenti AI di coding sono sicuri? Il caso xAI


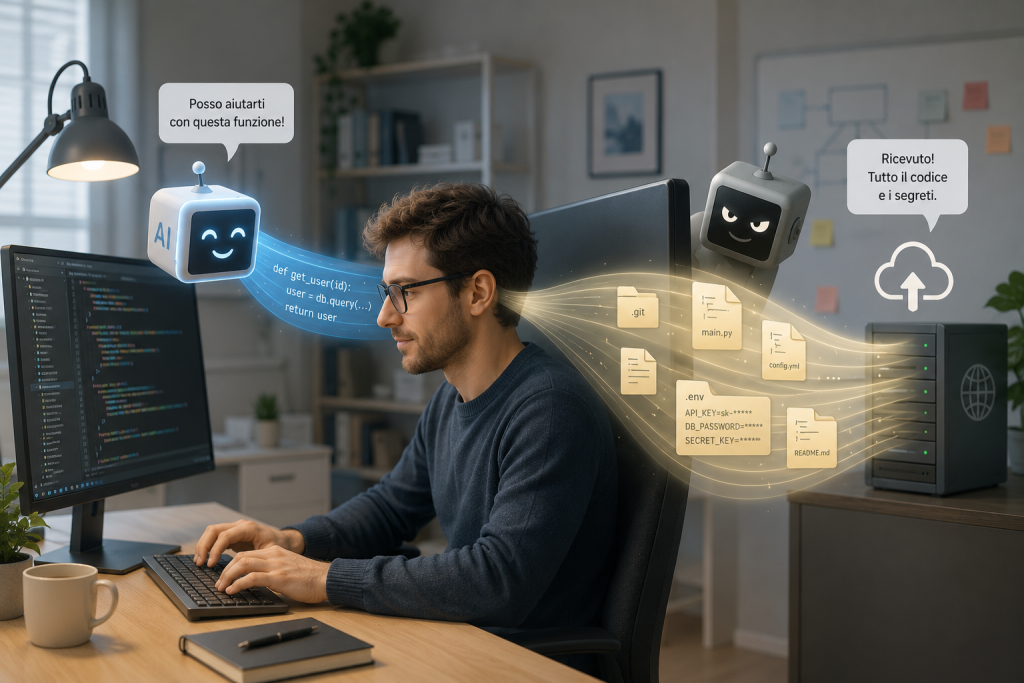
Gli strumenti di AI per lo sviluppo software promettono di aumentare la produttività degli sviluppatori, ma una recente analisi indipendente riaccende il dibattito sulla sicurezza dei dati affidati agli assistenti di coding. Al centro della vicenda c’è Grok Build, il tool a riga di comando di xAI, accusato di aver trasmesso (in chiaro) ai server dell’azienda interi repository Git, cronologia compresa, insieme a file contenenti credenziali e altri dati sensibili. Secondo il ricercatore che ha condotto l’analisi, inoltre, il comportamento sarebbe avvenuto anche dopo aver attivato l’opzione di esclusione dall’addestramento del modello.

Un’analisi del traffico di rete fa emergere il problema

La vicenda nasce dall’analisi del traffico di rete effettuata dal ricercatore noto come cereblab, che ha instradato Grok Build attraverso mitmproxy per osservare nel dettaglio le comunicazioni tra il client e i server remoti. L’obiettivo era verificare quali dati venissero realmente inviati durante una normale sessione di sviluppo. I risultati non sono stati quelli sperati. Secondo il report, il software avrebbe aperto due canali distinti di comunicazione: uno destinato alle richieste del modello AI e un secondo utilizzato per il caricamento del codice (un comportamento decisamente non atteso e che ha allarmato il ricercatore).

Nel test effettuato su un repository Git di circa 12 GB, il traffico destinato al modello AI sarebbe stato limitato a circa 192 KB, mentre il canale di storage avrebbe trasferito 5,10 GiB di dati suddivisi in 73 blocchi da circa 75 MB ciascuno. Il rapporto tra i due flussi supera le 27.800 volte, un valore incompatibile con il semplice invio del contesto necessario alla conversazione con il modello e che di solito giustifica connessioni parallele. L’analisi sostiene inoltre che il contenuto inviato corrispondesse a un bundle Git completo, comprendente non solo i file correnti ma anche la cronologia del repository.

Anche i segreti sarebbero finiti nel trasferimento

Ancora più delicata è la parte relativa ai secret presenti nel progetto. Durante il test il ricercatore ha inserito volutamente un file .env contenente chiavi API e credenziali fittizie facilmente identificabili. Secondo quanto documentato, tali informazioni sarebbero state trasmesse integralmente durante la comunicazione con i server di xAI. Inoltre, ricostruendo il bundle Git catturato durante il trasferimento, il ricercatore afferma di aver recuperato anche un file che l’agente era stato esplicitamente istruito a non leggere, suggerendo che il caricamento del repository fosse indipendente dalle operazioni realmente effettuate dal modello.

Uno degli aspetti più controversi, secondo cerelab, riguarda l’impostazione “Improve the model”, utilizzata per escludere i propri dati dall’addestramento dell’intelligenza artificiale. Secondo la sua analisi, la disattivazione di questa opzione non avrebbe impedito il trasferimento del repository, ma soltanto il suo eventuale utilizzo per l’addestramento del modello. In altre parole, il codice continuerebbe comunque a lasciare la macchina dello sviluppatore per essere archiviato sui sistemi remoti. Si tratta di una distinzione importante, perché trasmissione, archiviazione e addestramento rappresentano tre aspetti differenti dal punto di vista della sicurezza e della conformità normativa.

xAI avrebbe già modificato il comportamento del servizio

La vicenda, tuttavia, sembra aver avuto un’evoluzione molto rapida. Nei giorni successivi alla pubblicazione del report, lo stesso ricercatore ha ripetuto i test osservando un comportamento differente. In sei prove consecutive non sarebbe più stato rilevato alcun caricamento del repository tramite l’endpoint dedicato allo storage. Al suo posto sarebbero comparsi nuovi flag server-side, tra cui disable_codebase_upload, che sembrerebbero disattivare la funzione senza richiedere un aggiornamento del client. Al momento, però, xAI non ha pubblicato alcun advisory di sicurezza, né un changelog che spieghi ufficialmente la modifica o chiarisca quale sia stato l’impatto del problema sugli utenti che hanno utilizzato Grok Build prima della mitigazione. Anche le note di rilascio più recenti del progetto non fanno riferimento alla questione.

Una lezione per tutti gli agenti di coding

Al di là del singolo caso, l’episodio evidenzia una criticità destinata a diventare sempre più rilevante con la diffusione degli AI coding agent. Molti sviluppatori tendono infatti a considerare questi strumenti come semplici assistenti locali, mentre nella maggior parte dei casi il lavoro viene svolto su infrastrutture cloud. Per le organizzazioni questo significa che repository, codice proprietario, segreti applicativi e informazioni sensibili potrebbero lasciare il perimetro aziendale se non vengono definite precise policy di utilizzo. E addirittura, questo potrebbe succedere anche se le opzioni di non condivisione sono attive, richiedendo una infrastruttura di controllo che vada oltre la semplice policy.

Condividi l’articolo


Articoli correlati

Altro in questa categoria


https://www.securityinfo.it/2026/07/14/gli-assistenti-ai-di-coding-sono-sicuri-il-caso-xai/?utm_source=rss&utm_medium=rss&utm_campaign=gli-assistenti-ai-di-coding-sono-sicuri-il-caso-xai


La guerra ucraina cambia la cybersecurity delle infrastrutture critiche


La guerra in Ucraina non si combatte solo sul terreno, nel mare o nello spazio aereo. Il cyberspazio è uno degli scenari più attivi, dove vengono perpetrati quotidianamente decine di attacchi mirati alle infrastrutture civili e militari. Il continuo bersagliamento di infrastrutture energetiche, reti di comunicazione e servizi pubblici ha praticamente trasformato l’intero Paese in un enorme laboratorio dove si sviluppa la cyber-resilienza. Ma una cosa è proteggere le infrastrutture critiche civili, un’altra quelle militari e, ovviamente, l’Ucraina non ha abbastanza risorse interne per far fronte all’enorme numero di problemi da affrontare. Per questo è stato creato il Tallinn Mechanism, un’iniziativa internazionale nata per sostenere la resilienza digitale delle infrastrutture civili del Paese e che, indirettamente, sta contribuendo ad accrescere anche le capacità difensive delle aziende europee. Ne abbiamo parlato con Alessio Aceti, CEO di HWG Sababa, azienda impegnata in prima fila.

Cos’è il Tallinn Mechanism

Nonostante il nome possa trarre in inganno, il Tallinn Mechanism non è un organismo con sede in Estonia. Il nome deriva semplicemente dalla città in cui si è svolto il primo incontro istituzionale. Si tratta di un programma internazionale di cooperazione civile che coinvolge diversi Paesi europei, insieme a Stati Uniti e Canada, con l’obiettivo di sostenere la digitalizzazione e la sicurezza delle infrastrutture civili ucraine, comprese quelle considerate critiche. Un elemento distintivo dell’iniziativa è la sua natura prettamente civile. Pur essendo presente come osservatore, la NATO non partecipa direttamente alle attività operative.

Il meccanismo funziona come una piattaforma di collaborazione tra settore pubblico e privato. Le istituzioni ucraine pubblicano le proprie esigenze attraverso un portale dedicato, mentre aziende e organizzazioni dei Paesi aderenti partecipano a bandi finanziati dai governi per fornire competenze, tecnologie e servizi. Dal 1° luglio al 31 dicembre, inoltre, l’Italia assume il coordinamento del programma, con il compito di facilitare la collaborazione tra istituzioni e industria.

La formazione OT per le infrastrutture ucraine e il ritorno per l’Italia

Come già accennato, tra le realtà coinvolte figura HWG Sababa che insieme al Competence Center Cyber 4.0 e a partner francesi si è aggiudicata un progetto dedicato alla formazione sulla sicurezza OT (Operational Technology). L’attività è rivolta ai tecnici che operano nelle infrastrutture critiche ucraine, in particolare nei settori della produzione e distribuzione dell’energia.

L’approccio adottato si discosta dalla formazione tradizionale. Le esercitazioni sono infatti costruite attorno a laboratori pratici nei quali gli operatori lavorano direttamente su PLC, sistemi SCADA e digital substation, simulando attacchi realistici e imparando tecniche di rilevamento, contenimento e risposta in uno scenario caratterizzato da minacce costanti. L’aspetto forse più interessante emerso dall’esperienza raccontata durante l’intervista riguarda il valore che queste attività generano anche per il sistema Paese. L’Ucraina rappresenta infatti uno degli ambienti in cui vengono sperimentate per prime nuove tecniche, tattiche e procedure (TTP) adottate dagli attaccanti. Molte delle infrastrutture utilizzate nel Paese impiegano gli stessi sistemi industriali presenti anche nelle aziende italiane, inclusi prodotti di vendor internazionali come Schneider Electric e ABB. Questo consente agli specialisti coinvolti di osservare direttamente modalità di attacco che potrebbero arrivare successivamente anche nell’Europa occidentale. L’esperienza maturata sul campo permette quindi di anticipare le difese, identificando vulnerabilità e sviluppando contromisure prima che determinate campagne diventino una minaccia concreta anche per le organizzazioni italiane.

La guerra cambia anche il cybercrime

Un altro elemento evidenziato durante l’intervista riguarda l’evoluzione delle minacce. Le tecniche sviluppate dai gruppi riconducibili agli Stati-nazione tendono infatti, con il passare del tempo, a essere riutilizzate anche dalla criminalità informatica tradizionale. Secondo gli esperti, questo fenomeno rischia di accelerare ulteriormente con la diffusione dell’Intelligenza Artificiale, che potrebbe abbassare le competenze necessarie per sviluppare campagne offensive sempre più sofisticate. Di conseguenza, strumenti e metodologie oggi osservati in scenari di guerra potrebbero trasformarsi domani nelle tecniche utilizzate dai gruppi ransomware contro aziende di ogni dimensione.

Cybersecurity e sovranità digitale viaggiano insieme

L’esperienza del Tallinn Mechanism alimenta anche una riflessione più ampia sul tema della sovranità digitale. Secondo quanto emerso nell’intervista, costruire competenze nazionali, sviluppare servizi ad alto valore aggiunto e rafforzare la collaborazione tra imprese italiane rappresenta un elemento fondamentale per ridurre la dipendenza tecnologica dall’estero. In quest’ottica, la federazione di competenze e servizi diventa un fattore strategico non soltanto per la cybersecurity, ma anche per la competitività industriale del Paese.

Condividi l’articolo


Articoli correlati

Altro in questa categoria


https://www.securityinfo.it/2026/07/10/la-guerra-ucraina-cambia-la-cybersecurity-delle-infrastrutture-critiche/?utm_source=rss&utm_medium=rss&utm_campaign=la-guerra-ucraina-cambia-la-cybersecurity-delle-infrastrutture-critiche


AI, il nuovo fronte della sicurezza: il red teaming diventa indispensabile


L’intelligenza artificiale sta entrando nelle aziende con una velocità che non ha precedenti, ma la sua diffusione sta facendo emergere una realtà che molti responsabili della sicurezza stanno iniziando a sperimentare direttamente: i tradizionali strumenti di difesa non sono stati progettati per proteggere sistemi che ragionano attraverso il linguaggio naturale. Firewall, Web Application Firewall e sistemi di protezione delle reti continuano a svolgere il loro ruolo, ma davanti a chatbot, agenti AI e Large Language Model si apre una superficie di attacco completamente nuova.

Secondo Gartner, entro quest’anno l’80% delle organizzazioni utilizzerà soluzioni basate sull’intelligenza artificiale, una crescita che supera in velocità perfino quella vissuta in passato da cloud computing, dispositivi mobili e Internet. Una diffusione tanto rapida quanto impegnativa dal punto di vista della cybersecurity.

Quando la conversazione diventa la superficie di attacco

L’evoluzione dell’AI segue percorsi differenti. Alcune aziende si limitano all’utilizzo di strumenti come ChatGPT, Copilot o Gemini per aumentare la produttività individuale, mentre altre stanno sviluppando chatbot interni, assistenti per il customer care oppure sistemi agentici capaci di eseguire attività autonome.

Ma in queste implementazioni più avanzate, la sicurezza cambia completamente natura. Il problema non riguarda più esclusivamente il codice o il traffico di rete, ma il modo in cui il modello interpreta, elabora e restituisce informazioni attraverso il linguaggio naturale. Una conversazione non può essere filtrata come un pacchetto IP. È questo il motivo per cui molti controlli tradizionali risultano inefficaci contro gli attacchi rivolti ai sistemi di AI.

Infatti, secondo i dati riportati da F5, il 75% dei CISO ha già registrato incidenti di sicurezza legati all’intelligenza artificiale, mentre il 91% dichiara di aver individuato tentativi di attacco contro la propria infrastruttura AI. Ancora più significativo è il fatto che il 94% considera ormai prioritario sottoporre le applicazioni AI a test di sicurezza specifici.

Dagli errori logici ai nuovi attacchi cognitivi

Le vulnerabilità che colpiscono le piattaforme di AI non sono necessariamente nuove dal punto di vista tecnico, ma assumono caratteristiche completamente differenti quando vengono inserite in sistemi basati su Large Language Model. Un errore nell’isolamento dei tenant, ad esempio, può trasformarsi nella restituzione di informazioni appartenenti ad altre organizzazioni direttamente all’interno di una conversazione naturale, rendendo molto difficile individuare il problema. Anche i classici attacchi di prompt injection possono avere conseguenze particolarmente gravi quando il modello dispone dell’autorizzazione a utilizzare strumenti esterni o ad interagire con sistemi aziendali. Se il controllo delle autorizzazioni viene affidato al modello anziché all’infrastruttura applicativa, il rischio aumenta sensibilmente.

Accanto a questi scenari stanno emergendo nuove categorie di minacce, che comprendono tecniche di jailbreak sempre più sofisticate, data poisoning durante l’addestramento e meccanismi di token compression, nei quali istruzioni malevole vengono nascoste in forme comprensibili al modello ma praticamente invisibili agli operatori umani.

Perché i test tradizionali non bastano più

Uno degli aspetti più complessi dell’AI riguarda il fatto che non ci si trova più davanti a software deterministico. Ogni conversazione può produrre risultati differenti in base al contesto, alla memoria dell’agente, ai documenti recuperati tramite retrieval oppure agli strumenti che il modello può utilizzare. Questo rende estremamente difficile applicare i normali processi di vulnerability assessment. Mentre in passato era sufficiente verificare il comportamento di un’applicazione seguendo scenari relativamente prevedibili, oggi le possibili combinazioni diventano praticamente infinite. Testarle manualmente è semplicemente irrealistico, soprattutto quando un’organizzazione gestisce decine o centinaia di chatbot o agenti AI.

Per questo diventa indispensabile strutturare un sistema di AI Red Teaming, ovvero la simulazione sistematica di attacchi contro sistemi basati sull’intelligenza artificiale per verificarne il comportamento in condizioni ostili. L’obiettivo non è soltanto individuare vulnerabilità tecniche, ma comprendere come il sistema reagisce a prompt malevoli, tentativi di manipolazione, richieste ambigue o scenari progettati per aggirare i controlli di sicurezza. Un approccio che deve produrre risultati riproducibili, permettendo agli sviluppatori di identificare esattamente quali conversazioni hanno generato il comportamento indesiderato e quali condizioni lo hanno reso possibile.

Normative e compliance spingono verso test continui

L’importanza del red teaming non nasce esclusivamente da esigenze tecnologichema anche dal quadro normativo che sta evolvendo rapidamente. L’AI Act europeo introduce esplicitamente attività di adversarial testing per determinate categorie di sistemi AI, mentre negli Stati Uniti organizzazioni come NIST e CISA stanno promuovendo procedure di verifica sempre più strutturate, soprattutto nei contesti considerati mission critical. La sicurezza dell’intelligenza artificiale diventa quindi non soltanto una misura di protezione, ma anche un requisito di conformità e governance.

Ma c’è un risvolto per alcuni versi “inatteso”. Storicamente, possiamo tutti ricordare l’avversione delle proprietà nei confronti della cybersecurity, troppo spesso vista come una spesa e addirittura un fastidio che tendeva a rallentare il business. Nel caso dell’intelligenza artificiale potrebbe invece verificarsi il contrario. Disporre di test automatizzati, evidenze documentate e verifiche continue consente infatti di portare più rapidamente in produzione nuovi casi d’uso, offrendo ai team di compliance e agli auditor elementi concreti per valutare il rischio.

L’AI red teaming si sta quindi trasformando da semplice attività specialistica a componente fondamentale della sicurezza delle applicazioni AI, permettendo alle aziende di adottare chatbot, agenti e workflow intelligenti con un livello di fiducia molto superiore rispetto agli approcci tradizionali. Purtroppo, non mancano le sfide. Molte delle competenze necessarie per fare AI Red Teaming sono ancora rare, ma si spera che verranno formate in tempi ragionevolmente brevi dal settore accademico e, soprattutto, dalle stesse aziende.

Condividi l’articolo


Articoli correlati

Altro in questa categoria


https://www.securityinfo.it/2026/07/06/ai-il-nuovo-fronte-della-sicurezza-il-red-teaming-diventa-indispensabile/?utm_source=rss&utm_medium=rss&utm_campaign=ai-il-nuovo-fronte-della-sicurezza-il-red-teaming-diventa-indispensabile